

Firma Comino przesłała nam niedawno do recenzji najnowszą wersję platformy Comino Grando, wyposażoną w osiem kart NVIDIA RTX PRO 6000 Blackwell, każda z 96 GB pamięci VRAM, co daje łącznie 768 GB pamięci GPU. Testowaliśmy platformę Comino w 2024 roku, wyposażoną w sześć kart RTX 4090 , oferujących łącznie 144 GB pamięci GPU, a także wersję z kartami NVIDIA H100 . Ta najnowsza aktualizacja oznacza znaczący skok generacyjny zarówno pod względem pojemności pamięci, jak i zakresu obciążeń obsługiwanych przez platformę.
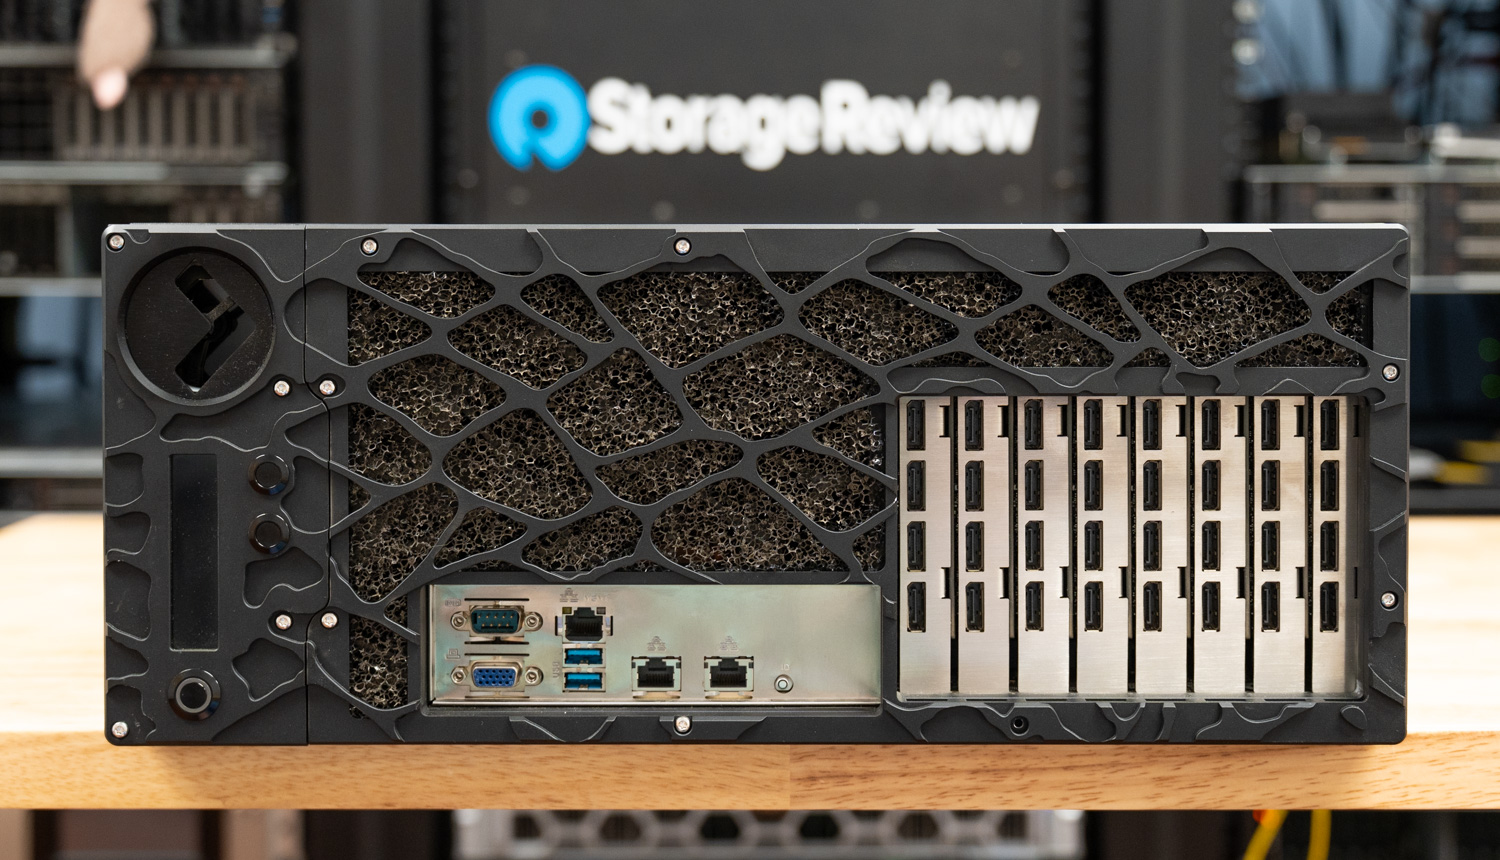
Grando to platforma 4U zaprojektowana specjalnie po to, by rozwiązać krytyczny konflikt między mocą obliczeniową GPU o wysokiej gęstości a zarządzaniem temperaturą. Podczas gdy standardowe obudowy chłodzone powietrzem nie radzą sobie z ciągłym zapotrzebowaniem na TDP 600 W+, jakie stawiają nowoczesne karty profesjonalne, Grando prezentuje zupełnie inne podejście, zbudowane od podstaw w oparciu o architekturę chłodzoną cieczą, zdolną do ciągłego rozpraszania ogromnej ilości ciepła o mocy 6.5 kW. Nie jest to modernizacja ani dodatek; cała obudowa, od odwróconego układu płyty głównej po system kolektorów z szybkozłączkami oznaczonymi kolorami, została zaprojektowana wokół pętli chłodzenia.
Rezultatem jest platforma, która może obsłużyć osiem profesjonalnych procesorów graficznych o pełnym TDP w jednej obudowie 4U, pracując 24/7 w temperaturach otoczenia od 3 do 38°C, bez dławienia termicznego, bez obciążenia akustycznego związanego z chłodzeniem powietrzem o wysokiej prędkości obrotowej i bez uszczerbku dla łatwości serwisowania. Dla organizacji wdrażających wnioskowanie AI, szkolenia z zakresu uczenia maszynowego lub wysokowydajne symulacje na dużą skalę, Grando oferuje coś naprawdę wyjątkowego: serwer, który nie wymaga wyboru między gęstością, temperaturą i niezawodnością.
Specyfikacja Comino Grando
Poniższa tabela przedstawia specyfikacje fizyczne i obsługiwane konfiguracje sprzętowe platformy Comino Grando.
| Specyfikacja / Funkcja | Comino Grando |
|---|---|
| Serwer Comino Grando i stacja robocza do montażu w szafie | |
| Wydajność chłodnicza | 6.5 kW (maksymalnie 6 500 W przy temperaturze powietrza wlotowego 20°C) |
| Płyty główne | Do EATX i EBB |
| Procesory graficzne (serwer) | Do 8; NVIDIA: RTX A6000, RTX 6000 ADA, RTX PRO 6000, A40, L40, L40S, A100, H100, H200 |
| Procesory graficzne (stacje robocze do montażu w szafie) | Do 6; NVIDIA: 3090, 4090, 5080, 5090, RTX A6000, RTX 6000 ADA, RTX PRO 6000, A40, L40, L40S, A100, H100, H200; AMD: W7800, W7900 |
| procesory | Do 2; Jednogniazdowe: Intel Xeon W-2400/2500 i 3400/3500, Intel Xeon Scalable 4. generacji, 5. generacji, XEON 6, AMD Threadripper PRO 5000WX, 7000WX, 9000WX, AMD EPYC 9004/9005 Podwójne gniazdo: Intel Xeon Scalable 4. i 5. generacji, XEON 6, AMD EPYC 9004/9005 |
| RAM | Do 2TB |
| Napędy M2 | Do 8x NVME |
| Dyski | Klatki hot swap na tylnym panelu: do 4 dysków SSD hot swap (4 x 7 mm lub 2 x 15 mm) i do 4 dodatkowych (4 x 7 mm lub 2 x 15 mm) zamiast 4. zasilacza; Klatka wewnętrzna 3.5″ do 4x 3.5″ lub 4x 2.5″ 15mm lub 12x 2.5″ 7mm; Wewnętrzne gniazda 2.5″: do 4 dysków SSD 2.5″ 7 mm |
| Zasilanie i napięcie robocze | Do 4x 2000 W CRPS z funkcją Hot Swap przy napięciu 180–264 V Do 4x 1000 W CRPS z funkcją Hot Swap przy napięciu 90–140 V Tryby redundancji: 4+0, 3+1, 2+2 |
| Poziom hałasu | 39dB-70dB |
| Lan | Do 2x 10 Gbit/s na płycie głównej i do 400 Gbit/s na złączu PCIe |
| OS | Ubuntu / Windows 11 (Pro/Home) / Windows Server |
| Specyfikacje fizyczne i chłodzenia | |
| Chłodzenie cieczy | Procesor z VRM i GPU z GDDR i VRM |
| Zbiornik | Comino custom 450ml ze zintegrowanymi pompkami |
| Fani | 3x Ultra High Flow 6200RPM (wysoki poziom hałasu) lub 3x High Flow 3000RPM (niski poziom hałasu) |
| instalacja sprzętu | Możliwość montażu w szafie rack 19″ lub jako samodzielna stacja robocza |
| Wymagana przestrzeń w szafie | 4U |
| Rozmiar | 439 x 681 x 177 mm (bez uchwytów i wystających części) |
| Waga | 4 procesorów graficznych: 49 kg (netto), 67 kg (brutto) 6 procesorów graficznych: 52 kg (netto), 70 kg (brutto) 8 procesorów graficznych: 55 kg (netto), 72 kg (brutto) |
| Zakres temperatur pracy i przechowywania | Przechowywanie: -5..50°C / 23..122°F Temperatura pracy: 3..38°C / 38..100°F |
| System monitorowania Comino (CMS) | |
| Przegląd | Płyta sterownicza z czujnikami i oprogramowaniem do monitorowania w czasie rzeczywistym |
| Kluczowe zalety | Monitorowanie systemu chłodzenia i procesora/procesora graficznego, interfejs sieciowy, rejestr systemu chłodzenia, scentralizowane monitorowanie grup roboczych |
| Czujniki i urządzenia podłączone | Temperatura (powietrza i chłodziwa), % wilgotności, napięcie, przepływ chłodziwa, poziom chłodziwa w zbiorniku, wentylatory, pompy, płyta główna, wyświetlacz i przyciski |
| Możliwości integracji | Ustanów monitorowanie za pomocą interfejsu API REST i przesyłaj dane z czujników do oprogramowania monitorującego (np. Zabbix, Grafana) lub baz danych (np. InfluxDB). |
| Wymagania techniczne CMS | |
| OS | Windows 11 / 10 Ubuntu 22.04/20.4 (Zależność dla Ubuntu: w systemie docelowym muszą być zainstalowane narzędzia nvidia-smi i sensor) |
| Przeglądarki internetowe | Mozilla Firefox, Google Chrome, Chromium, Apple Safari, Microsoft Edge (Uwaga: Internet Explorer 11 nie jest obsługiwany) |
| Dysk twardy | 300MB |
| Wersja oprogramowania układowego kontrolera | 1.0.6 lub nowszy |
| Wersja PCB kontrolera | 2.xx.xx |
Projekt, budowa i gęstość GPU
Układ i rozmieszczenie podwozia
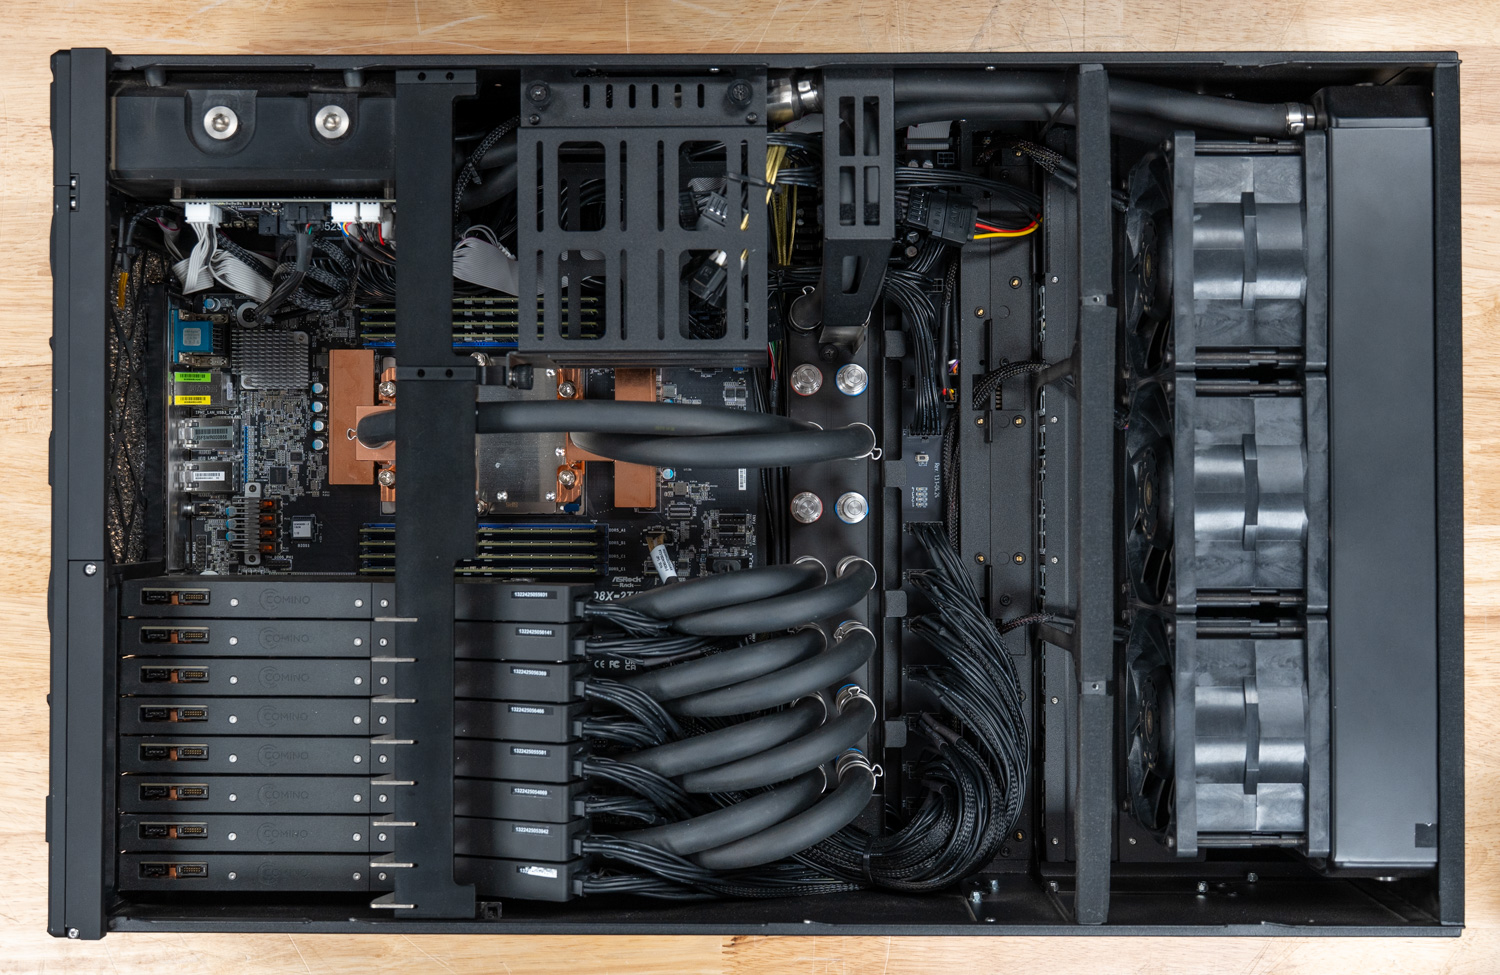
Serwer Grando to majstersztyk w optymalizacji przestrzeni, o wymiarach 17.3 x 26.8 x 6.97 cala (4U). W przeciwieństwie do tradycyjnych serwerów, tylna część płyty głównej znajduje się z przodu obudowy, odwracając konwencjonalny układ wewnętrzny. Dzięki temu komponenty chłodzone powietrzem, takie jak moduły pamięci RAM i moduły VRM, otrzymują najzimniejsze możliwe powietrze, zanim dotrze ono do radiatora chłodzenia cieczą z tyłu.
Sama obudowa została zbudowana według tych samych rygorystycznych standardów, charakteryzując się solidną stalową konstrukcją z matowym, czarnym lakierem proszkowym nałożonym wewnątrz i na zewnątrz. Ten świadomy wybór dotyczy również rurek, kabli, radiatora i maski lutowniczej PCB, odzwierciedlając wyraźny zamiar uzyskania czystej, profesjonalnej estetyki. Co więcej, system zapewnia wszechstronność zastosowań, działając bezproblemowo jako jednostka montowana w 19-calowej szafie rack lub jako samodzielny komputer stacjonarny. W zależności od konfiguracji, waży od 65 do 70 kg (148–159 funtów).
Płyty chłodzące GPU i bloki wodne
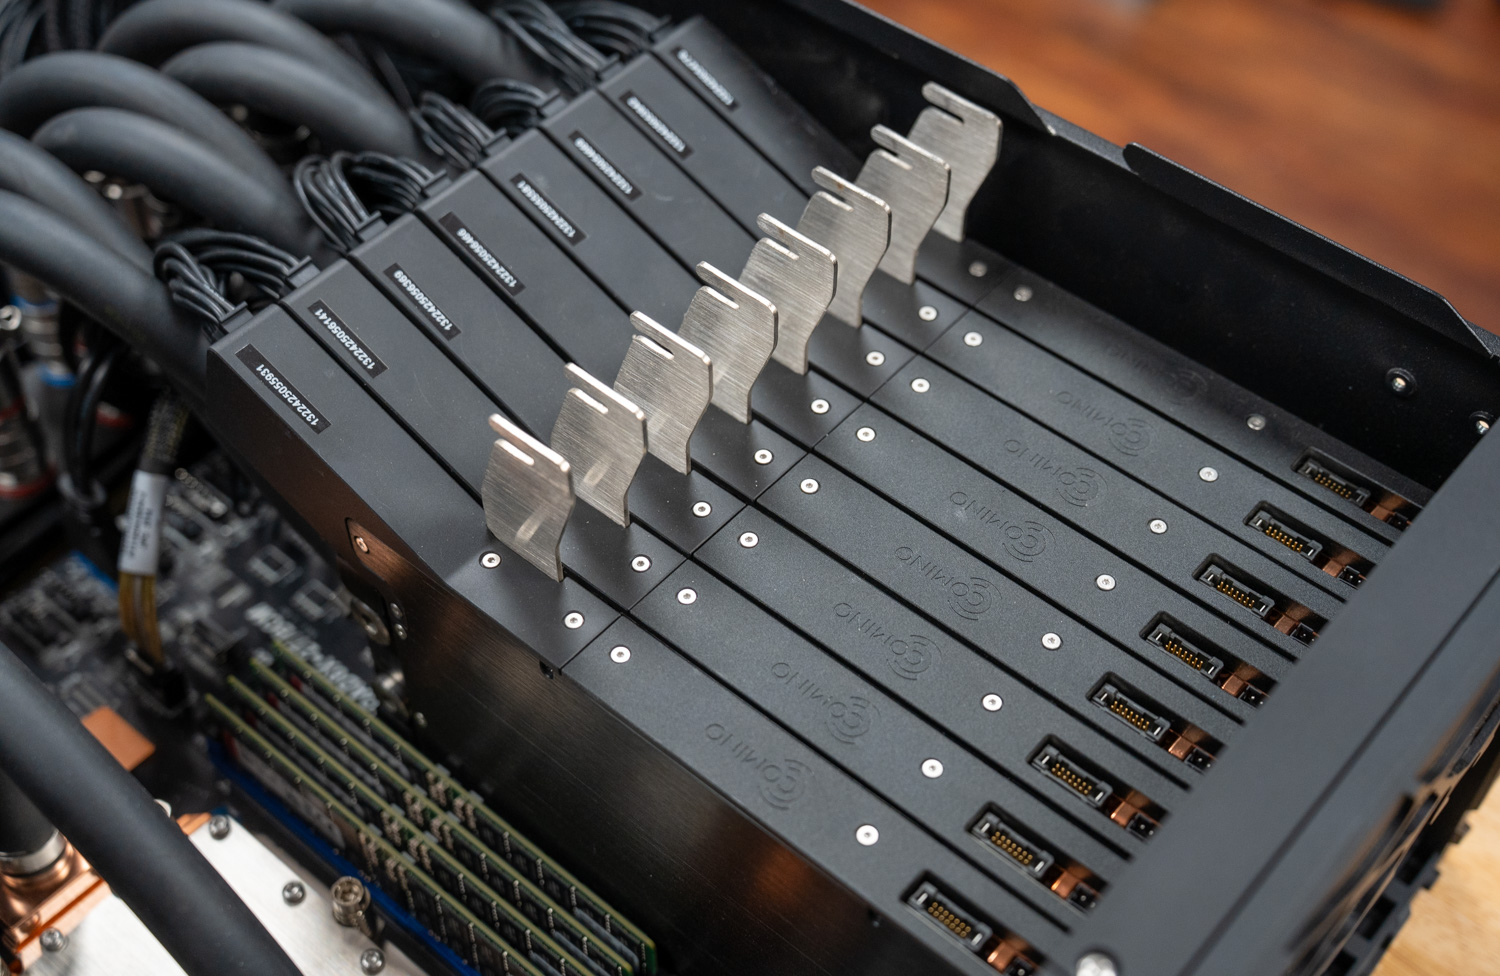
Opatentowane miedziane bloki wodne stanowią rdzeń obudowy Grando, chłodząc nie tylko rdzeń GPU, ale także inne komponenty, takie jak pamięć i regulatory napięcia. Każdy GPU jest dostarczany jako karta standardowa, na której Comino montuje dedykowany układ chłodzenia. W praktyce ta cienka konstrukcja redukuje rozmiar każdej karty do jednego gniazda, umożliwiając umieszczenie sześciu, a nawet ośmiu profesjonalnych GPU obok siebie w jednej obudowie 4U. Nasz egzemplarz testowy został dostarczony z ośmioma kartami NVIDIA RTX PRO 6000 Blackwell, każda o TDP 600 W, co daje całkowite zapotrzebowanie na chłodzenie 4,800 W przy pełnym obciążeniu.
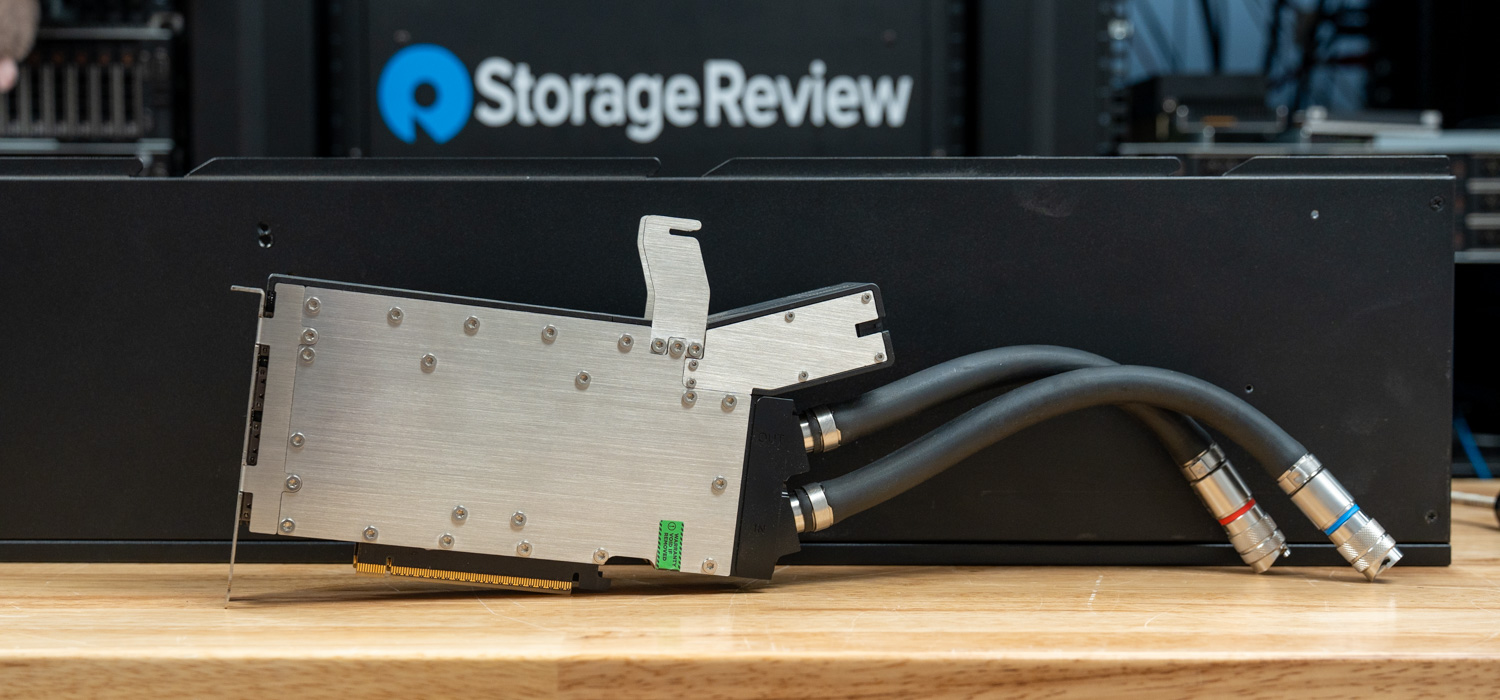
Osiągnięcie gęstości 8 jednoslotowych procesorów graficznych w Comino byłoby praktycznie niemożliwe przy chłodzeniu powietrzem, ponieważ standardowe karty NVIDIA RTX PRO 6000 zajmują po dwa sloty i wymagają znacznego przepływu powietrza. Dla porównania, te chłodzone na zamówienie karty zajmują tylko jeden slot. Płyty chłodzące są solidnie zbudowane, co zauważalnie zwiększa wagę każdej karty, ale waga ta odzwierciedla jakość i wydajność chłodzenia wymagane na tym poziomie.
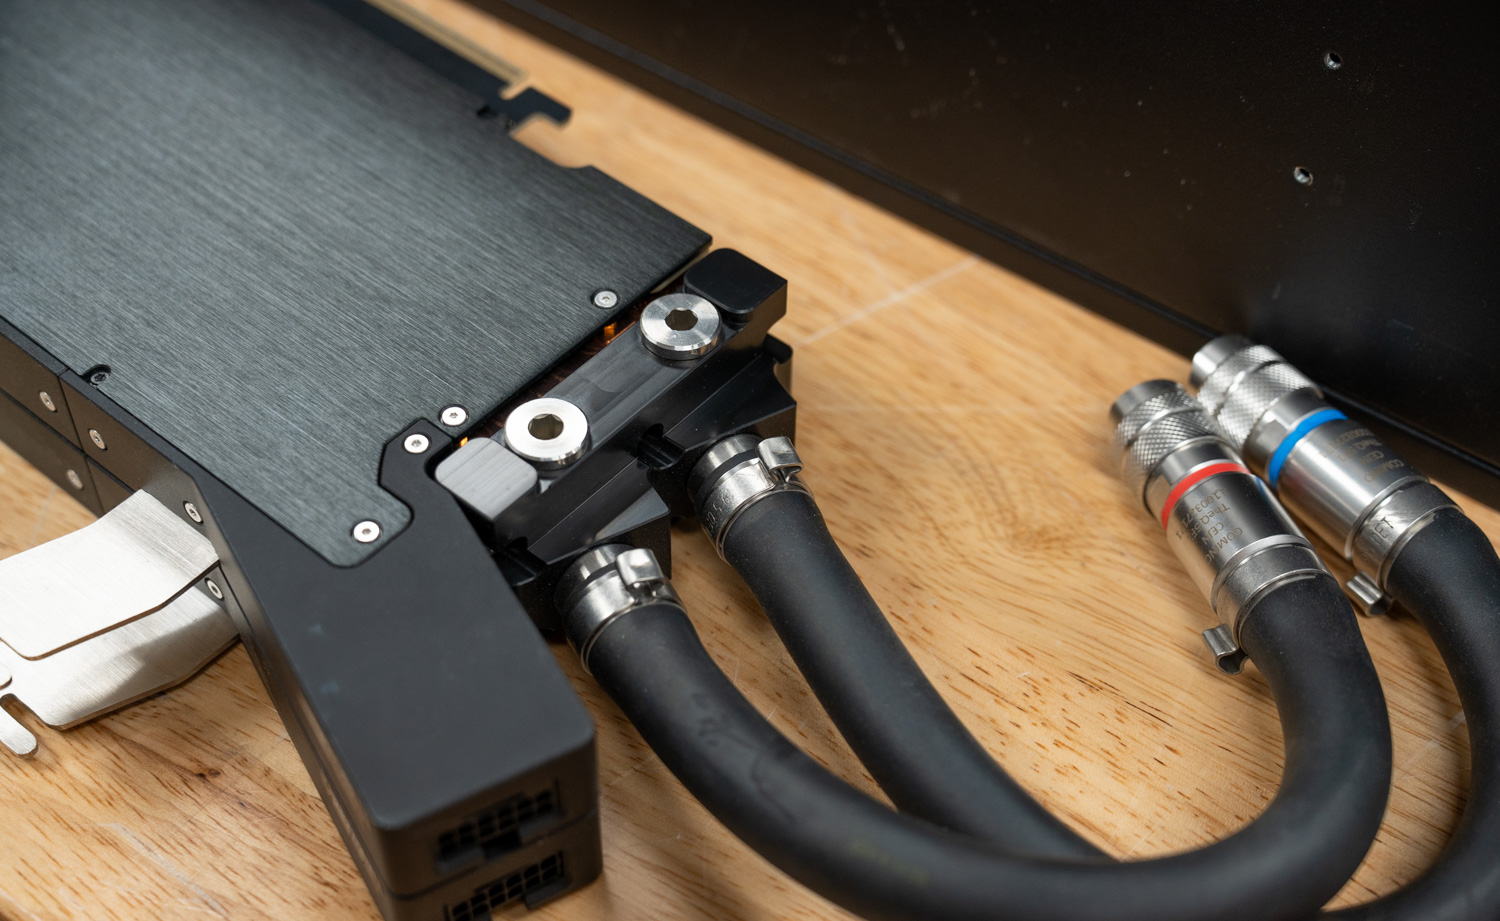
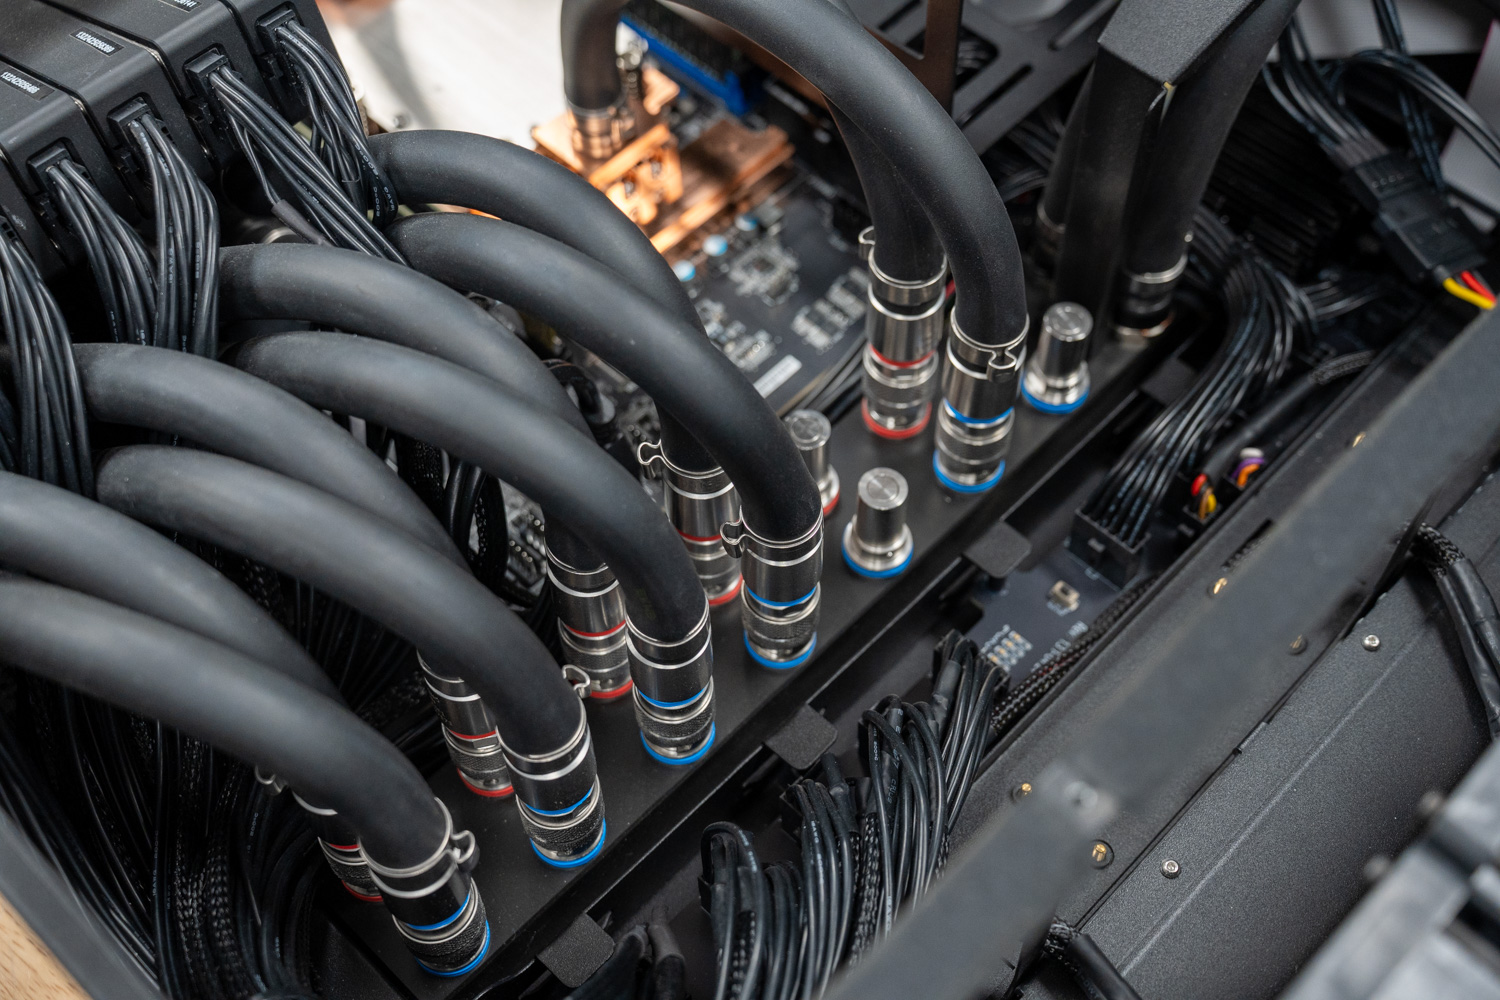
Każda para kart graficznych jest podłączona do dedykowanego podrozdzielacza, który łączy obie karty w jedno połączenie wlotowe i wylotowe z głównym kolektorem chłodziwa. Takie sparowane podejście upraszcza ogólną architekturę pętli, zmniejsza liczbę połączeń w głównym kolektorze i pozwala technikowi odłączyć jedną parę szybkozłączy, aby wyjąć dwie karty jednocześnie, co dodatkowo usprawnia konserwację.
Dystrybucja wody i rozdzielacz
W centrum systemu znajduje się duży kolektor dystrybucji wody, który dostarcza schłodzoną ciecz do każdej płyty chłodzącej procesora graficznego i procesora oraz zapewnia drogę powrotu do radiatora. Wszystkie połączenia między kolektorem a procesorem graficznym i procesorem wykorzystują szybkozłączki „TheQ” firmy Comino. Te niekapiące złączki ze stali nierdzewnej są oznaczone kolorami czerwonymi i niebieskimi pierścieniami, co pozwala na łatwą identyfikację strony ciepłej i zimnej obiegu, eliminując wszelkie wątpliwości podczas instalacji i serwisowania.
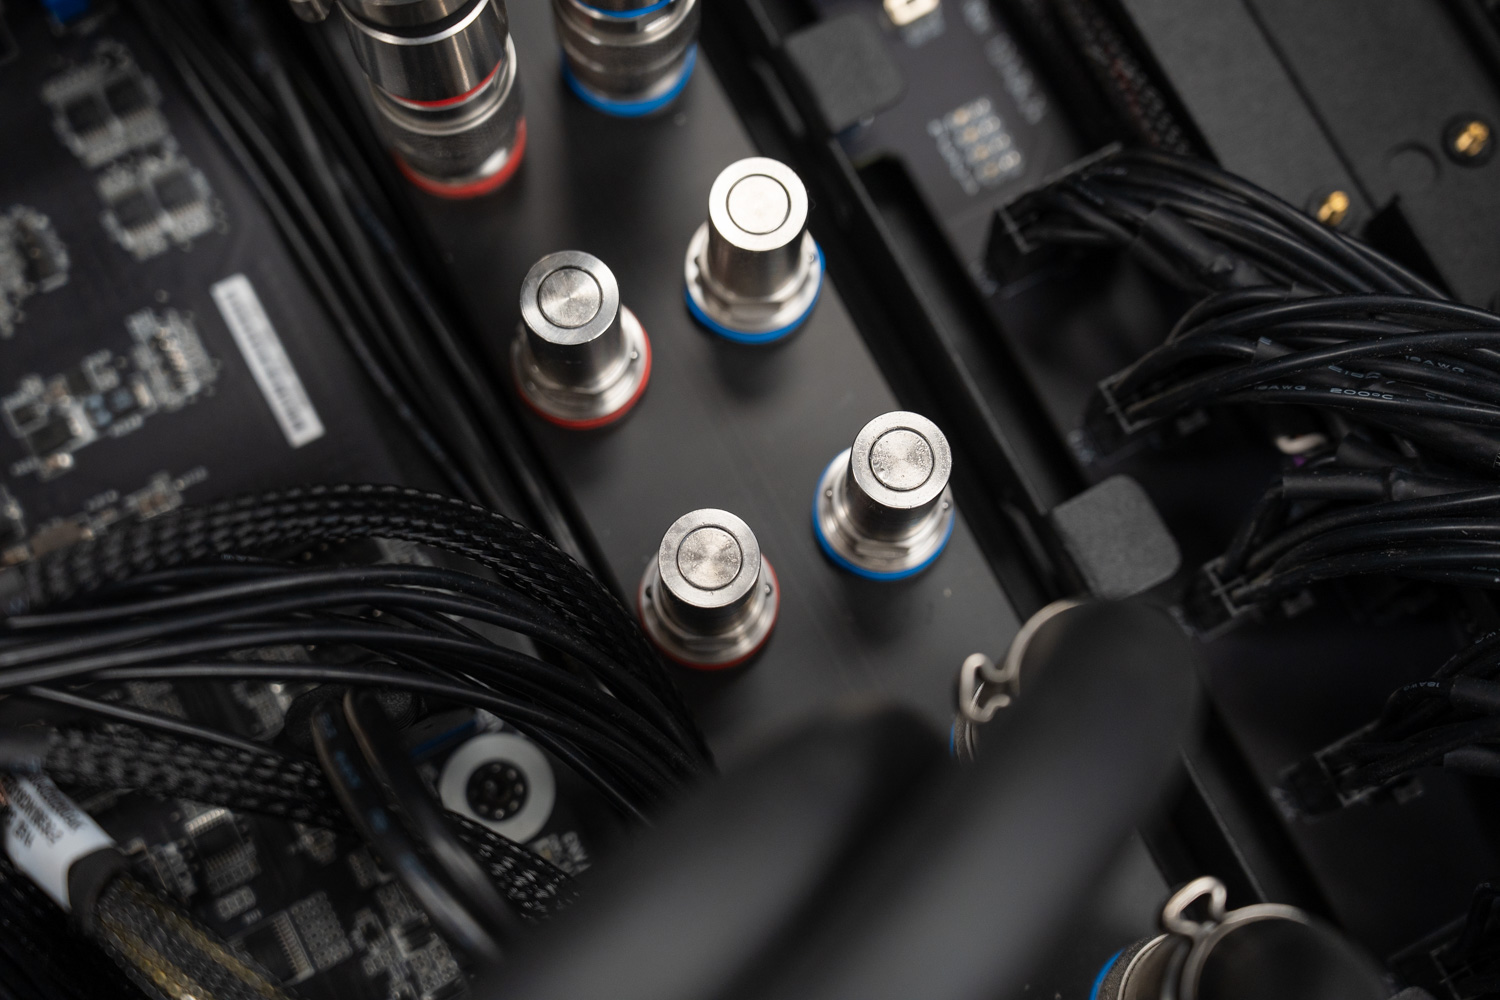
Po odłączeniu pozostawiają minimalne pozostałości na powierzchni styku, umożliwiając technikom demontaż lub wymianę poszczególnych układów GPU lub procesora bez opróżniania zbiornika o pojemności 450 ml i reszty układu. W ten sposób Grando łączy prostotę konserwacji systemów chłodzonych powietrzem z wydajną platformą chłodzoną cieczą.
Chłodzenie procesora i pamięć
Procesor i jego regulatory napięcia korzystają również z dedykowanej płyty chłodzącej podłączonej bezpośrednio do obiegu chłodzenia, co zapobiega powstawaniu wąskiego gardła podczas intensywnych obciążeń wieloprocesorowych. Nasz egzemplarz testowy został dostarczony z płytą główną AMD Turin/Genoa z pojedynczym 48-rdzeniowym procesorem AMD EPYC 9474F. Płyta chłodząca odzwierciedla jakość płyt chłodzących kart, wykonanych z litej miedzi i zabezpieczonych elementami ze stali nierdzewnej.
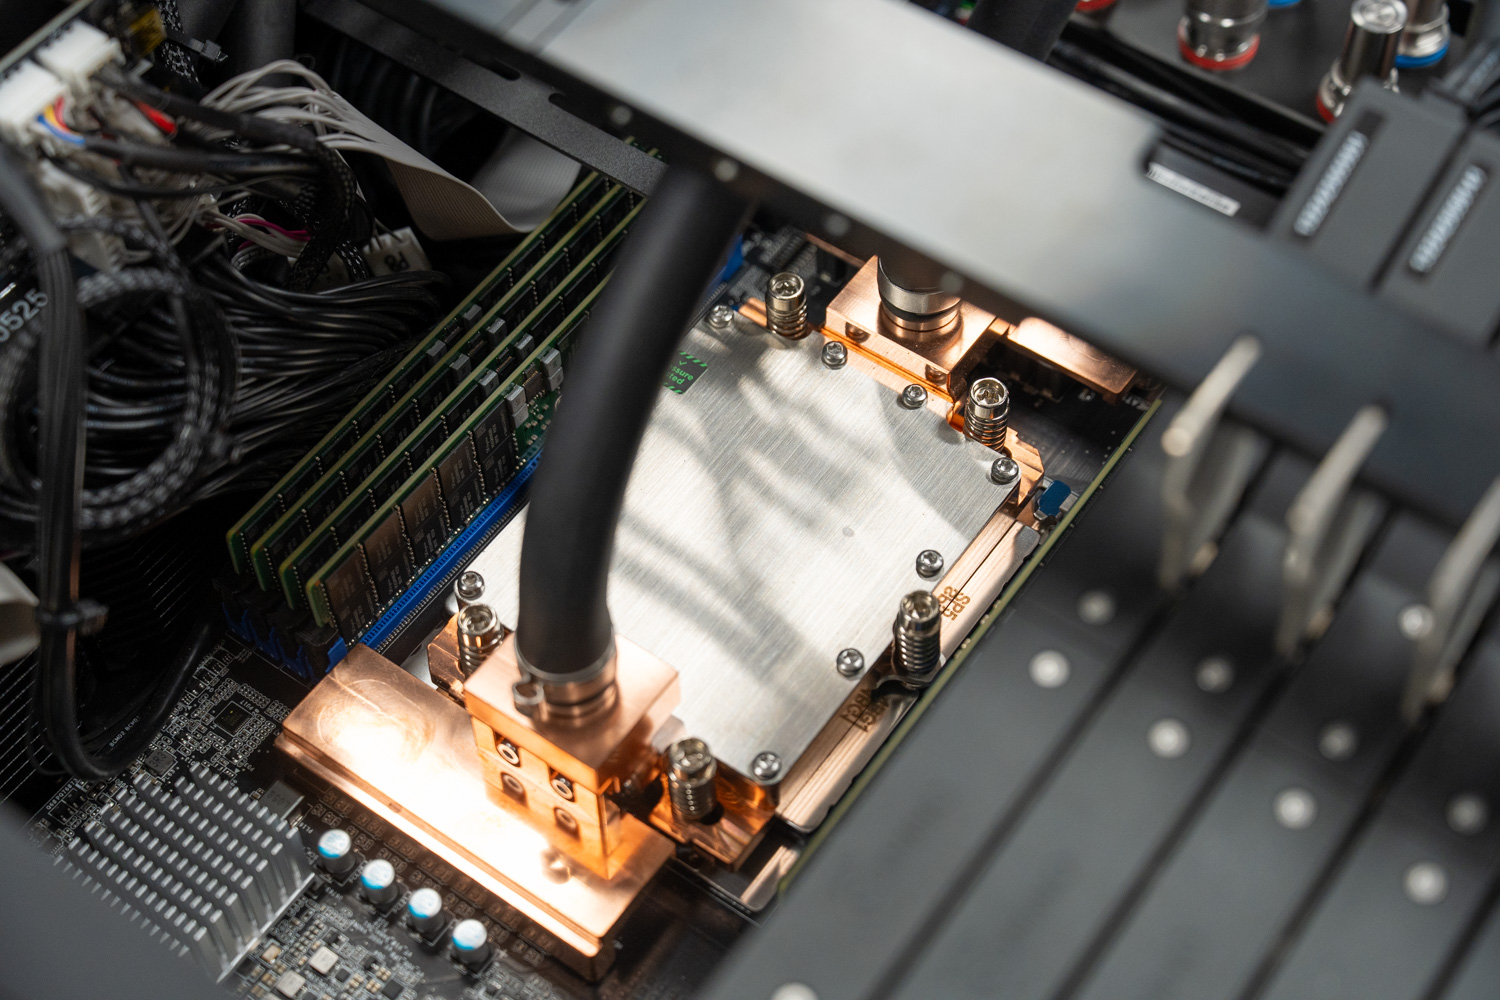
Po bokach procesora znajduje się osiem w pełni zapełnionych gniazd DRAM, które obsługują konfiguracje do 2 TB pamięci RAM. Nasz egzemplarz testowy został wyposażony w 512 GB pamięci RAM DDR5. Belka podtrzymująca rozciąga się nad obszarem procesora graficznego i procesora obudowy, prostopadle do nich, zabezpieczając wrażliwe komponenty, takie jak procesor graficzny, i zapewniając sztywność obudowy podczas transportu.
Grzejnik i wentylatory
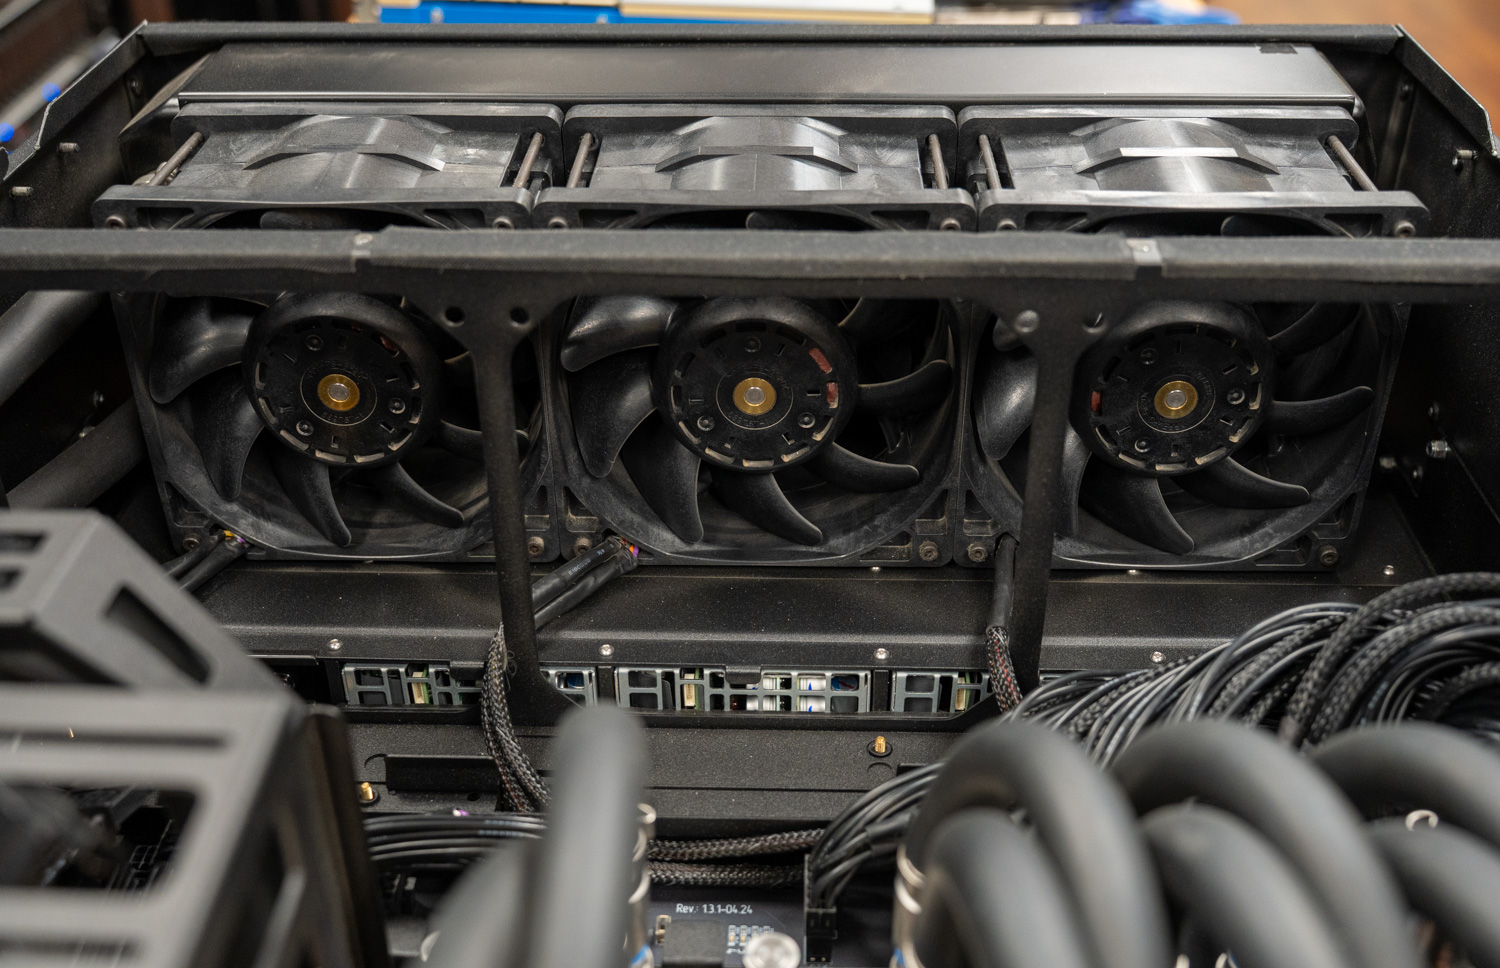
Za chłodzenie odpowiada duża, potrójna chłodnica 140 mm, zamontowana z tyłu obudowy, w połączeniu z trzema szybkimi wentylatorami 140 mm, które osiągają prędkość 6,200 obr./min i zapewniają przepływ powietrza do 1,000 m³/h. Gęsty układ żeber, jaki zapewnia gruba chłodnica, podkreśla przestrzeń termiczną zaprojektowaną w platformie, która w naszej konfiguracji jest w stanie rozproszyć do 6.5 kW ciepła.
Być może najbardziej zaskakujące jest to, że pomimo takiego obciążenia i prędkości wentylatora, urządzeniu udaje się utrzymać akceptowalny poziom hałasu, przekraczający 70 dB przy pełnej mocy. To głośno jak na stację roboczą, ale wyjątkowo oszczędnie jak na system rozpraszający ciepło małego pieca elektrycznego, co świadczy o tym, jak skutecznie pętla cieczowa Comino odprowadza ciepło od podzespołów.
Panel przedni i wyświetlacz telemetryczny
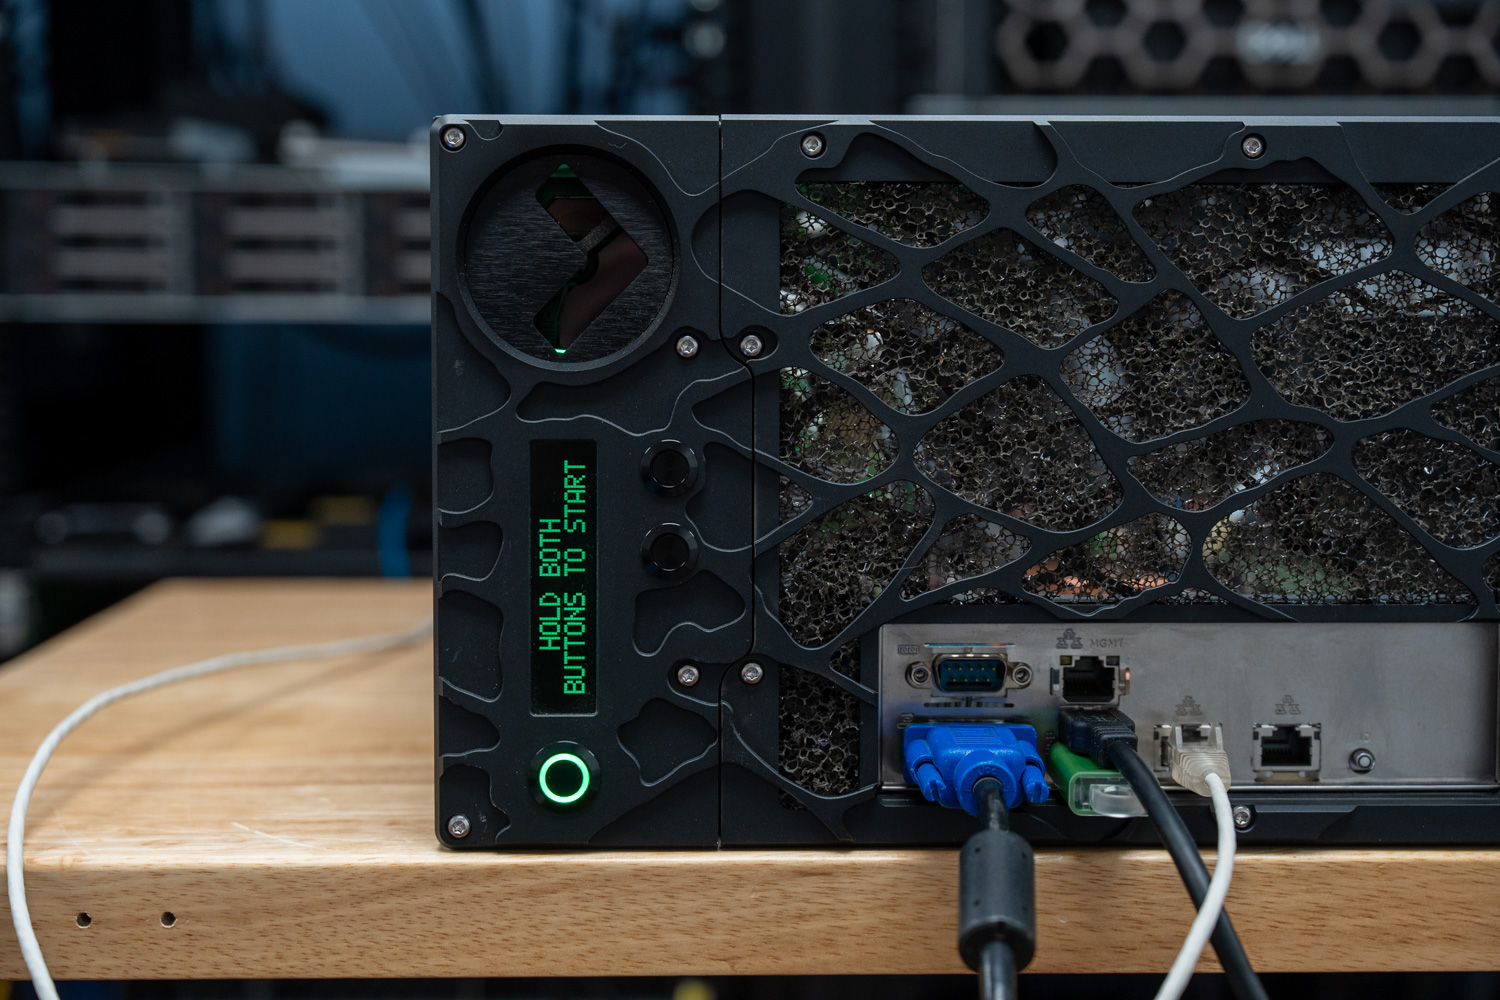
Na przednim panelu znajduje się wyświetlacz LED, który umożliwia odczyt na żywo kluczowych danych telemetrycznych, takich jak stan pompy, temperatura powietrza otoczenia, temperatura płynu chłodzącego i prędkość wentylatora. Użytkownicy poruszają się po menu za pomocą podświetlanych przycisków na module chłodzącym, a krótkie naciśnięcia umożliwiają przewijanie dostępnych danych. Długie naciśnięcie przycisku PB2 otwiera dodatkowe gałęzie menu, w tym Polecenia, Ustawienia serwisowe i Rejestr zdarzeń. Dodatkowo, przedni panel I/O zawiera port VGA do wyświetlania obrazu, port szeregowy, kilka portów USB oraz złącza sieciowe do podłączania urządzeń peryferyjnych i innych.
Architektura zasilania i magazynowania
Dostarczanie mocy i redundancja
Obsługa tego poziomu mocy obliczeniowej wymaga równie solidnego zasilania. Grando obsługuje do czterech modułów CRPS o mocy 1000 W lub 2000 W z możliwością wymiany podczas pracy (hot-swap) w konfiguracji redundantnej, dostarczając do 8.0 kW przy napięciu 180–264 V. Dzięki obsłudze trybów redundancji 4+0, 3+1 i 2+2, system jest odporny na awarie zasilacza, zapewniając jednocześnie ciągłą pracę w trybie 24/7 dla obciążeń AI i HPC.
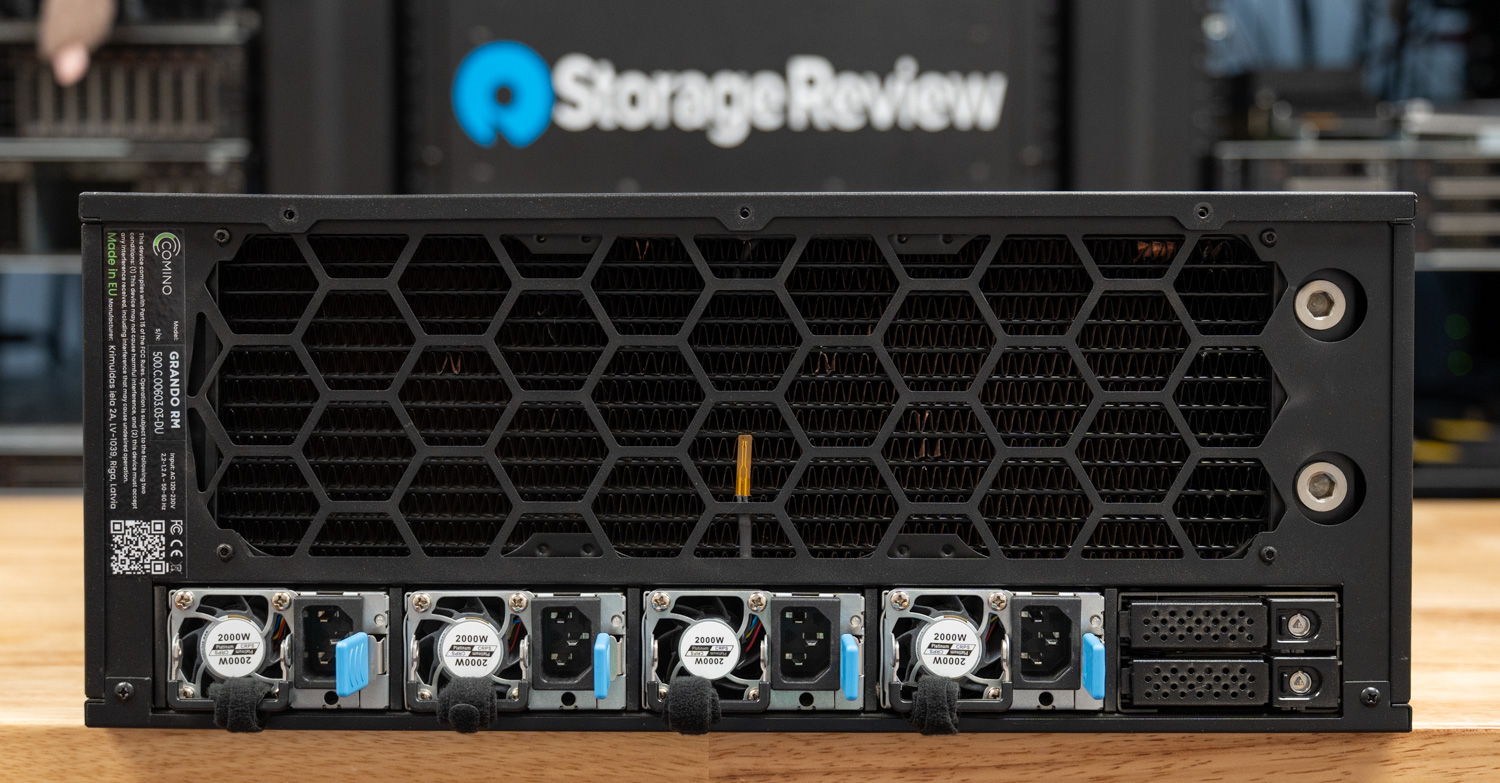
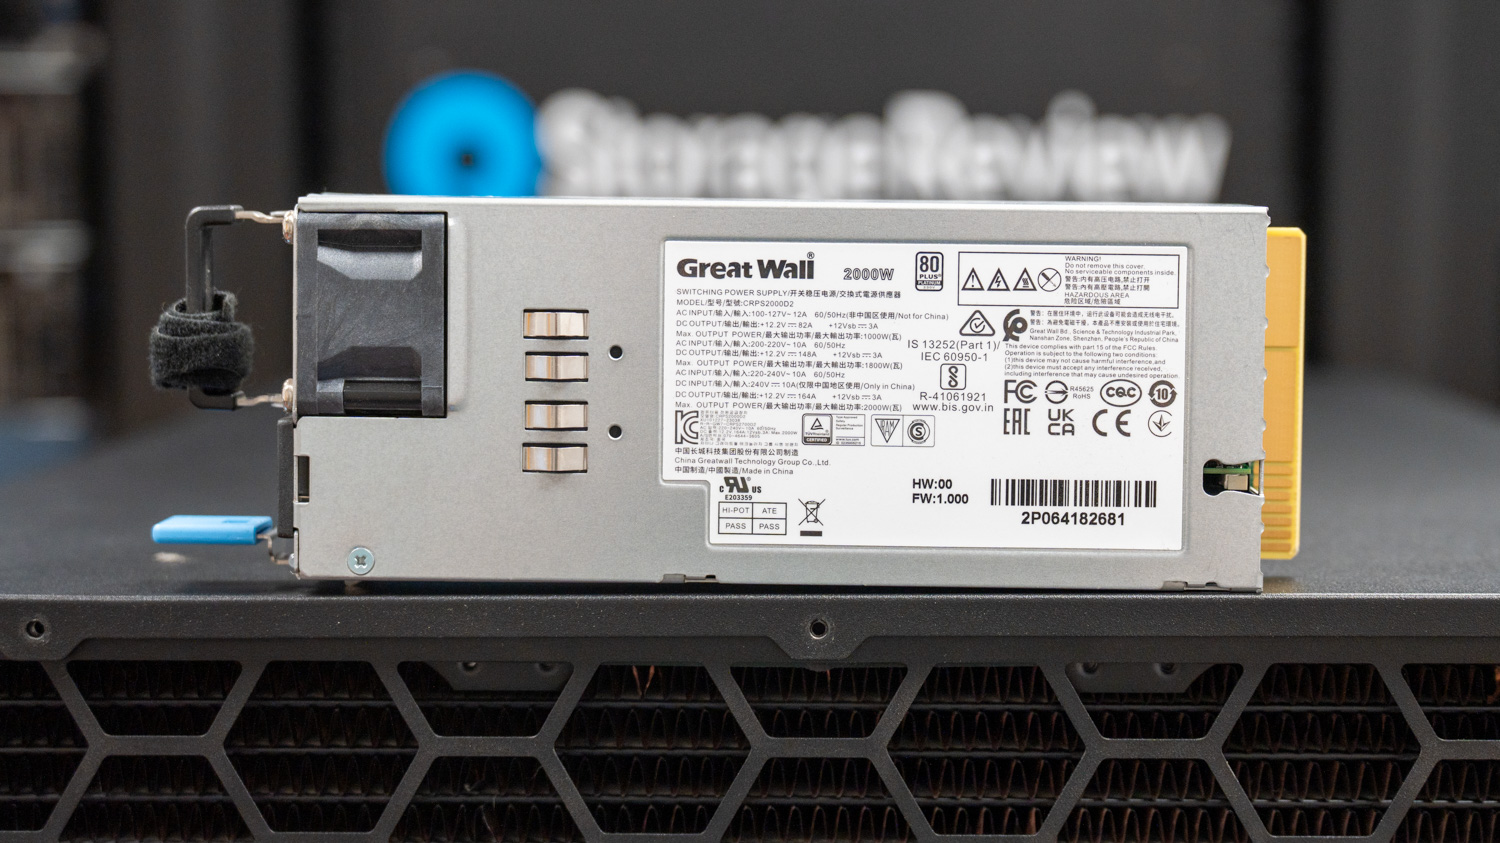
Nasz egzemplarz testowy został dostarczony z czterema zasilaczami Great Wall 2000W 80 Plus Platinum z funkcją hot-swap, co stanowiło pełną konfigurację o mocy 8.0 kW.
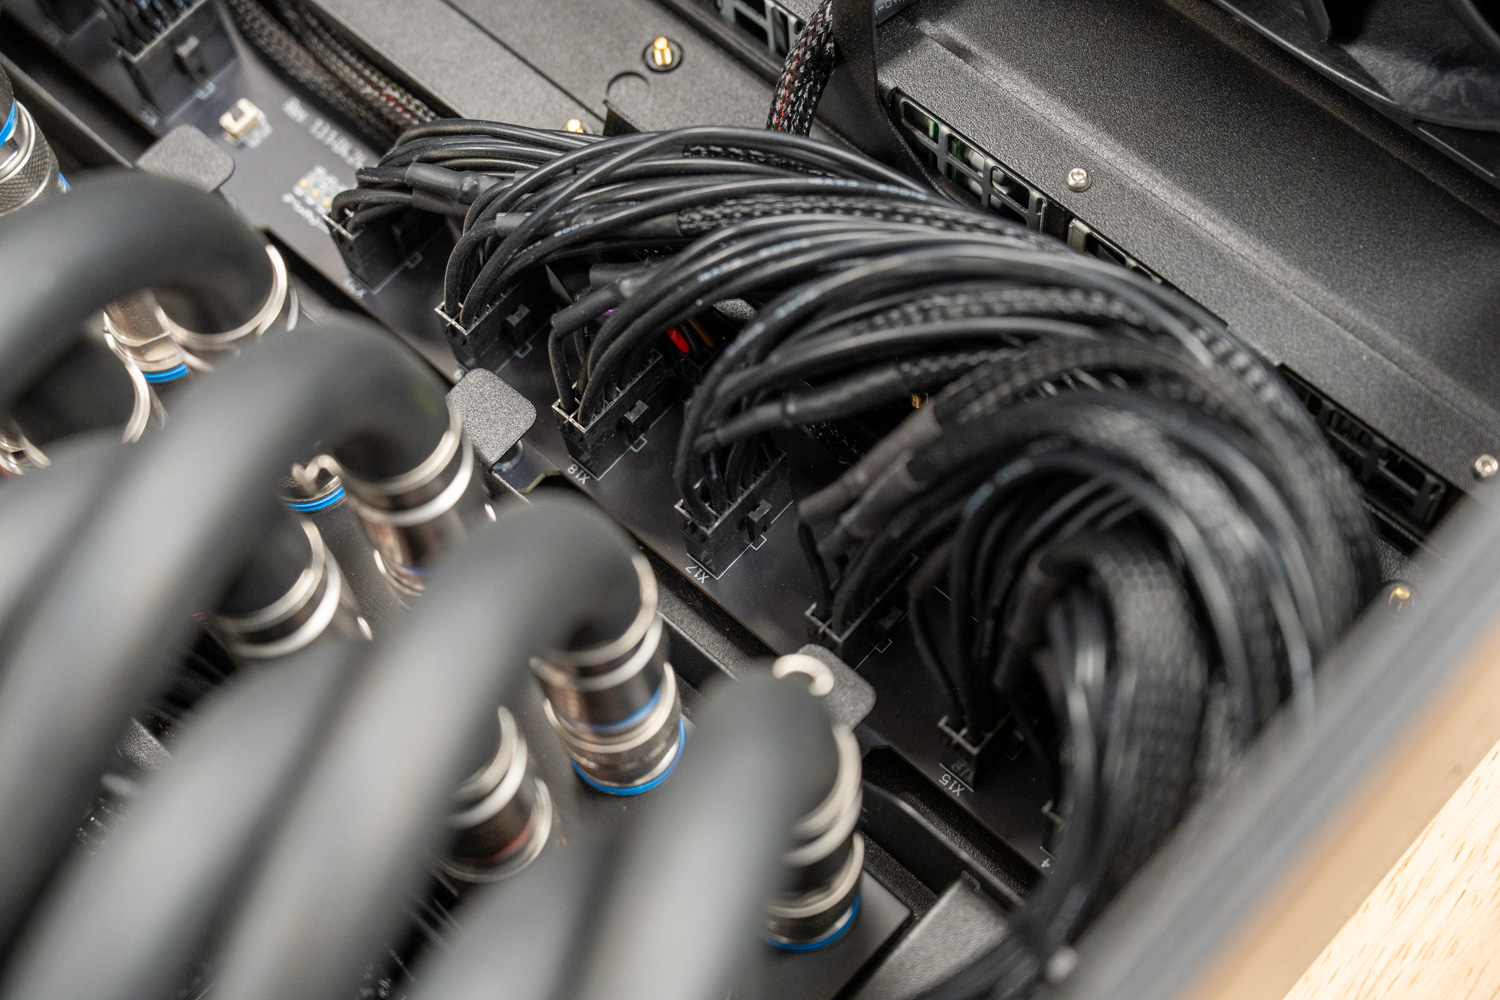
Zasilanie każdego procesora graficznego (GPU) odbywa się za pośrednictwem scentralizowanej, 12-pinowej płytki rozdzielczej zasilania, zamontowanej między układem GPU a głównym okablowaniem. Grando wykorzystuje tę płytkę rozdzielczą do konsolidacji przychodzących źródeł zasilania, a następnie rozgałęzia je do każdego procesora graficznego w uporządkowany i oszczędzający miejsce sposób.
PCIe, pamięć masowa i sieć
Grando wygodnie obsługuje sześć procesorów graficznych bez kompromisów w zakresie przepustowości slotów, a obudowa skaluje się do pełnej konfiguracji ośmiu kart, zapewniając maksymalną gęstość. Płyta główna ASRock Rack GENOAD8X-2T/BCM firmy Comino oferuje siedem gniazd PCIe Gen 5 x16 i jedno x8, co oznacza, że siedem z ośmiu procesorów graficznych działa z pełną przepustowością x16, a ósma karta z x8. Jest to kompromis między liczbą linii PCIe obsługiwanych przez procesor jednogniazdowy a niechęcią firmy Comino do zwiększania rozmiaru, kosztu i złożoności płytki przełącznika PCIe. Przejście na płytę główną z dwoma gniazdami zapewniłoby więcej linii PCIe, ale jednocześnie oferowałoby jeszcze mniej gniazd, ponieważ drugie gniazdo zajmowałoby przestrzeń, którą w przypadku ograniczonej przestrzeni zajmowałyby gniazda PCIe.
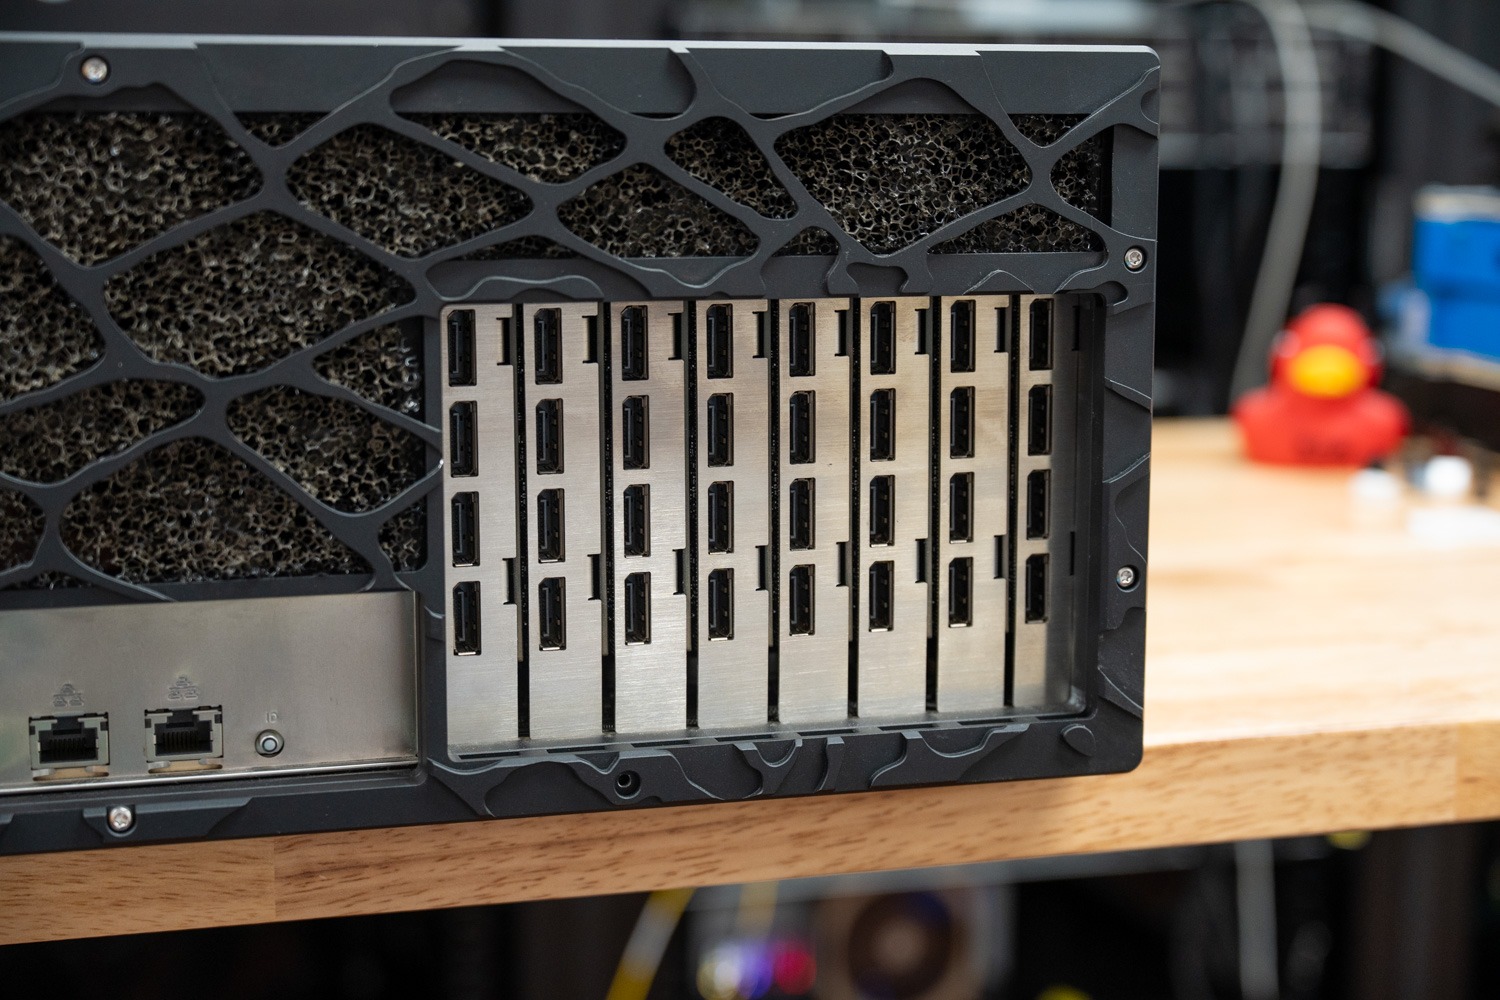
Uruchamianie ośmiu procesorów graficznych w systemie jednoprocesorowym zużywa lwią część dostępnych linii PCIe, co wiąże się z pewnymi kompromisami. Nasz egzemplarz testowy, oparty na procesorze AMD Genoa, ma łącznie 128 linii PCIe Gen 5. Osiem procesorów graficznych zajmuje 120 z nich, a pozostałe 8 linii jest rozdzielonych x4 na każde gniazdo SSD M.2. Oznacza to, że nie jest możliwe jednoczesne uruchomienie ośmiu procesorów graficznych i pełnego zestawu dysków NVMe z tyłu obudowy, podłączonych za pomocą dwóch złączy MCIO. W naszej pełnej konfiguracji z 8 procesorami graficznymi, tylko 2 gniazda M.2 były dostępne na pamięć masową. Administratorzy, którzy potrzebują dodatkowej pojemności NVMe oprócz maksymalnej gęstości GPU, powinni pamiętać, że dodanie tylnej pamięci masowej NVMe typu hot-swap za pośrednictwem klatek na tylnym panelu pochłonie dodatkowe linie PCIe i wyłączy część pojemności GPU w ich systemie.
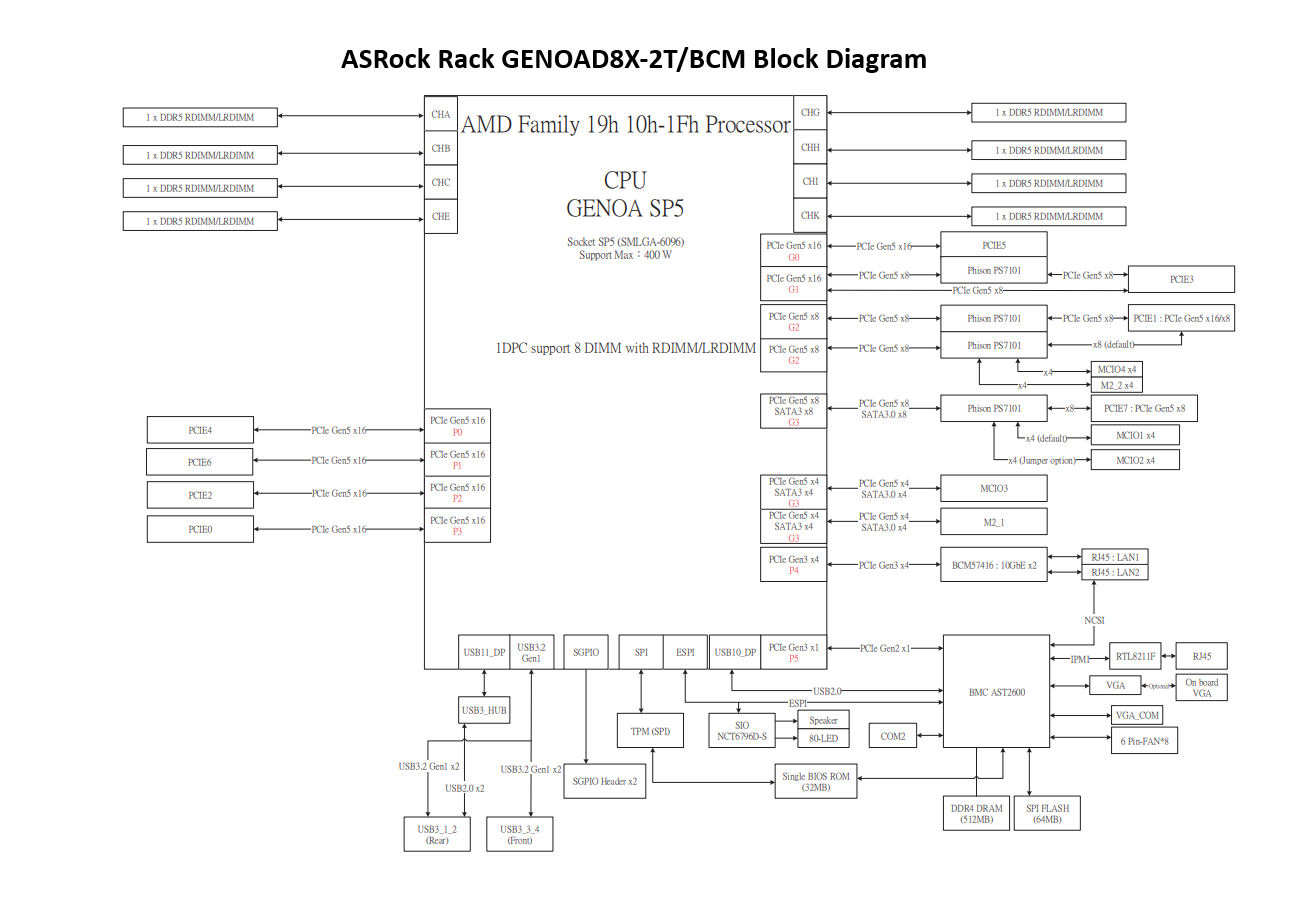
Schemat blokowy płyty głównej ASRock Rack GENOAD8X-2T/BCM przedstawiający procesor, gniazda PCIe Gen 5, kanały DIMM, gniazda M.2, BMC, USB, SATA i połączenia sieciowe.
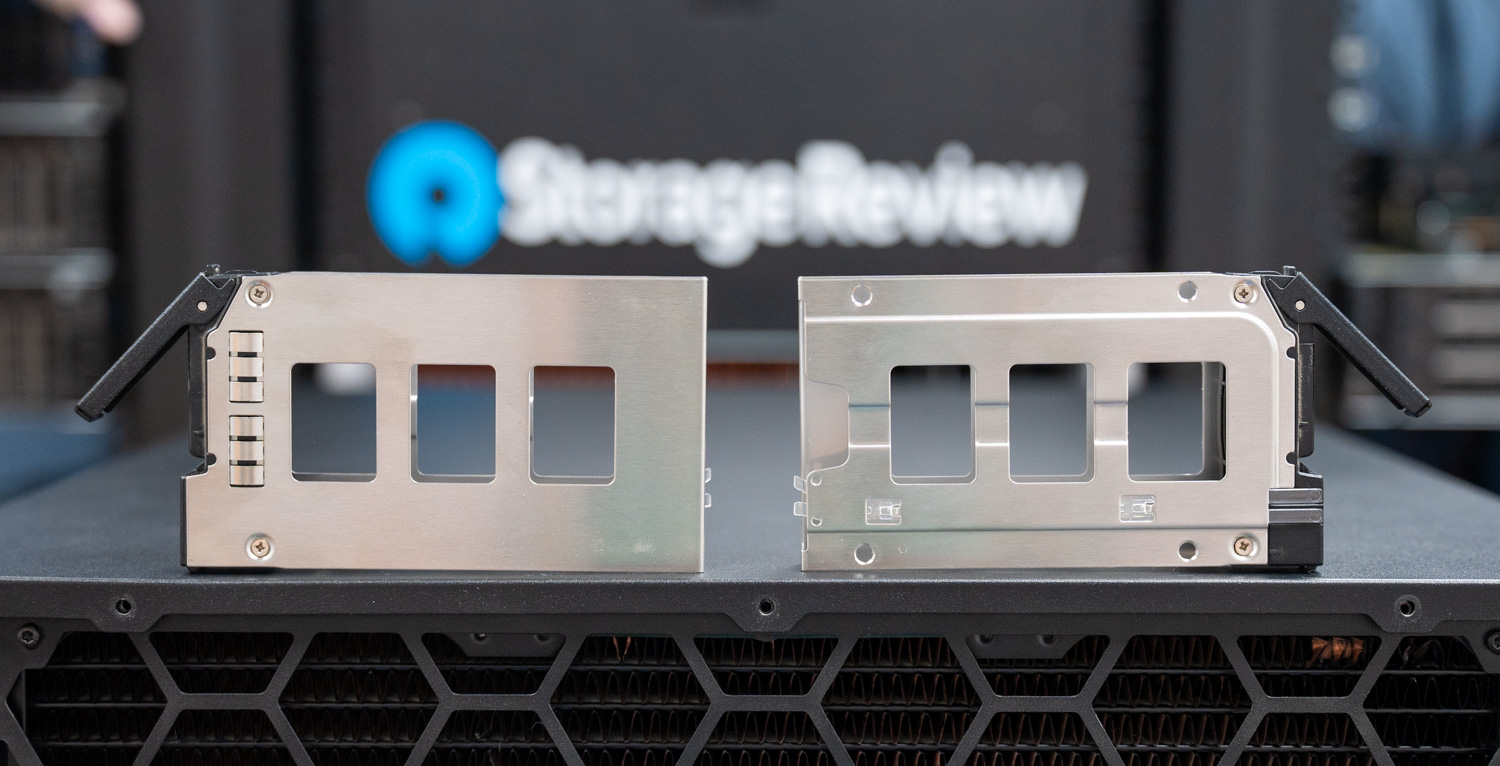
Mimo to, pamięć masowa jest równie modułowa i rozbudowana, choć konfiguracja wpływa na budżet linii PCIe dla GPU, co warto uwzględnić w planowaniu pod kątem zamierzonego zastosowania. Tylny panel naszego egzemplarza testowego zawiera klatkę na dyski 2.5″, która obsługuje do czterech 2.5-calowych dysków SSD w konfiguracjach 4x 7 mm lub 2x 15 mm, z opcjonalnym drugim zestawem do czterech dysków dostępnym zamiast czwartego gniazda zasilacza. Ponieważ nasz egzemplarz testowy wymagał wszystkich czterech zatok zasilania do obsługi pełnej konfiguracji z 8 GPU, mieliśmy dostęp tylko do pierwszej z dwóch zatok hot-swap. Wewnątrz obudowa może pomieścić klatkę 3.5″, która pomieści do czterech dysków 3.5″, cztery dyski 2.5″ 15 mm lub do dwunastu dysków 2.5″ 7 mm, plus cztery dodatkowe wewnętrzne gniazda na dyski SSD 2.5″ 7 mm, jeśli są skonfigurowane.
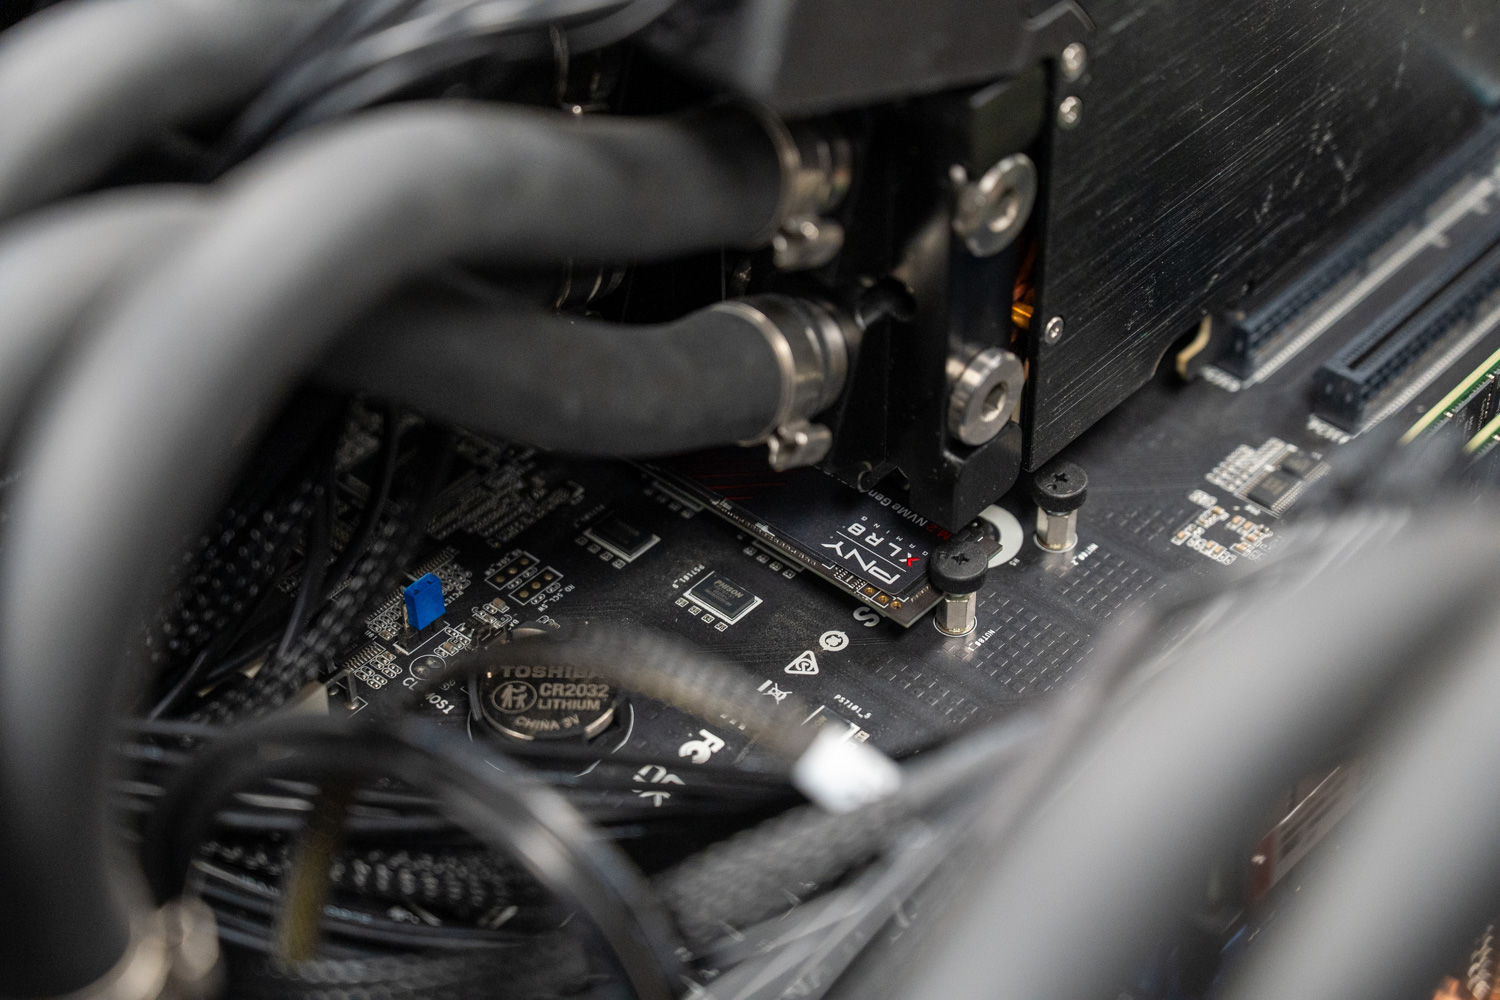
Do obsługi sieci, płyta główna standardowo wyposażona jest w dwa wbudowane porty RJ45 10 Gb/s, obsługiwane przez układ Broadcom BCM57416, a także dedykowany port zarządzania Gigabit Ethernet IPMI. Administratorzy mogą dodatkowo zwiększyć przepustowość, instalując karty sieciowe PCIe obsługujące do 400 Gb/s, co zapewnia łączność o wysokiej przepustowości. Należy jednak pamiętać, że dodatkowe karty sieciowe PCIe zajmują gniazda GPU, zmniejszając maksymalną liczbę GPU, jaką system może obsłużyć.
Zdalne zarządzanie i inteligencja systemu
Aby zabezpieczyć sprzęt i zoptymalizować wydajność, system zawiera system Comino Monitoring System (CMS). Oddzielna, autonomiczna płyta sterująca CMS-em pełni funkcję „mózgu” serwera, niezależnie od głównego systemu operacyjnego. W praktyce kontroler ten odczytuje dane z szerokiej gamy czujników, które śledzą temperaturę powietrza i chłodziwa, poziom wilgotności, natężenie przepływu chłodziwa oraz poziom w zbiorniku w czasie rzeczywistym. Co najważniejsze, ta autonomiczna konstrukcja umożliwia systemowi CMS przeprowadzanie autodiagnostyki i awaryjne wyłączanie systemu w przypadku wykrycia wycieku lub awarii pompy, chroniąc kosztowny sprzęt wewnętrzny przed uszkodzeniem.
Internetowy interfejs graficzny (GUI) obsługuje codzienne zarządzanie, zapewniając administratorom przejrzysty wgląd w wydajność chłodzenia, czas sprawności oraz bieżące zużycie energii przez procesory CPU i GPU. W przypadku wdrożeń na skalę korporacyjną, CMS łączy się również ze scentralizowanymi narzędziami monitorującymi za pośrednictwem interfejsów API REST, takimi jak Zabbix, Grafana i InfluxDB. Łącznie te funkcje pomagają administratorom utrzymać 3-letni okres międzyserwisowy i zapewnić maksymalną wydajność serwera bez ograniczania przepustowości, nawet w środowiskach o wysokiej temperaturze otoczenia.
Poza sztuczną inteligencją: zastosowania kreatywne i inżynieryjne
Chociaż nasze testy koncentrowały się na obciążeniach związanych z wnioskowaniem AI, Grando spełnia równie praktyczną rolę dla kreatywnych profesjonalistów i inżynierów, którzy potrzebują znacznych lokalnych mocy obliczeniowych GPU. Łączna pamięć VRAM 768 GB w ośmiu kartach RTX PRO 6000 otwiera możliwości, z którymi nie mogą się równać konwencjonalne konfiguracje stacji roboczych.
Artyści efektów specjalnych i profesjonaliści zajmujący się grafiką ruchową mogą renderować złożone sceny z ogromnymi zestawami tekstur w całości w pamięci VRAM, eliminując wąskie gardła związane z wymianą dysków, które są zmorą produkcji wykorzystujących materiały 8K lub środowiska o wysokiej liczbie wielokątów. Inżynierowie CAD, wykorzystujący obliczeniową mechanikę płynów lub symulacje strukturalne, mogą pracować nad zespołami o niespotykanej dotąd złożoności bez dzielenia modeli na wiele przebiegów. Montażyści wideo pracujący z wielostrumieniowymi osiami czasu w formacie RAW 8K, koloryści stosujący redukcję szumów opartą na uczeniu maszynowym (ML) w pełnej rozdzielczości oraz artyści 3D renderujący finalne wersje pathtracingu lokalnie, zamiast czekać na dostępność farmy chmurowej – wszyscy oni korzystają z tej gęstości pamięci GPU i mocy obliczeniowej.
Grando nie wymaga pełnej konfiguracji z ośmioma GPU. Comino oferuje platformę w konfiguracjach z czterema, sześcioma i ośmioma GPU, a wszystkie warianty są dostępne od ręki. Mniejsze studia, niezależni twórcy i zespoły inżynierskie mogą dostosować swoją inwestycję do aktualnych potrzeb, zachowując jednocześnie przejrzystą ścieżkę modernizacji w miarę wzrostu obciążeń.
Kompromisy platform: gęstość kontra rozszerzalność
Kompaktowa konstrukcja Grando zapewnia wyjątkową gęstość procesora graficznego i zarządzanie temperaturą w standardowej obudowie 4U, ale gęstość ta wiąże się z kompromisami architektonicznymi, które warto zrozumieć przed wdrożeniem.
Obudowa pomieści płyty główne w formatach EATX i EEB, ale nie obsługuje rozszerzonych płyt serwerowych, które można znaleźć w tradycyjnych platformach dwugniazdowych. Ogranicza to całkowitą liczbę linii PCIe dostępnych dla urządzeń peryferyjnych poza macierzą GPU. W naszej konfiguracji z ośmioma GPU, 128 linii PCIe Gen 5 procesora AMD EPYC jest prawie w całości zajętych przez GPU, pozostawiając niewiele przepustowości dla dodatkowej pamięci masowej NVMe lub szybkich sieci poza wbudowanymi portami 10 GbE.
Kontrastuje to z platformami z ośmioma procesorami graficznymi, które testowaliśmy, firm Dell, HPE i Supermicro. Systemy te wykorzystują większe obudowy, konfiguracje dwugniazdowe i topologie przełączników PCIe, aby obsługiwać znacznie więcej połączeń peryferyjnych. Zazwyczaj mieszczą od czterech do ośmiu dodatkowych kart sieciowych lub jednostek DPU oprócz pełnego zestawu procesorów graficznych, a także osiem lub więcej zatok NVMe z funkcją hot-swap, co czyni je idealnymi do rozproszonych obciążeń wnioskowania, które wymagają połączeń o dużej przepustowości.
Jednak te rozszerzone możliwości wiążą się ze znacznymi kosztami. Pobór mocy przekracza 8 kW. Obciążenia termiczne wymagają dedykowanej infrastruktury chłodzenia centrów danych. Poziom hałasu uniemożliwia wdrożenie poza specjalnie zaprojektowanymi maszynowniami. Czas realizacji zamówienia często wydłuża się do sześciu do osiemnastu miesięcy ze względu na ciągłe ograniczenia dostaw na korporacyjnych platformach GPU.
Grando zajmuje inną pozycję. Dla organizacji, które priorytetyzują szybkie wdrożenie, łatwe w zarządzaniu środowiska operacyjne oraz wnioskowanie lub kreatywne obciążenia nad rozproszonym szkoleniem na dużą skalę, kompromisy często okazują się korzystne. Zespoły, które potrzebują sprzętu już teraz, w środowisku, w którym mogą faktycznie pracować, mogą uznać podejście Grando do gęstości za bardziej praktyczne niż czekanie w kolejce na platformę, której nie będą w stanie realistycznie wdrożyć po jej otrzymaniu.
Wyniki testów wydajności Comino Grando
Konfiguracja systemu
- Podwozie: Comino Grando
- płyta główna: ASRock Rack GENOAD8X-2T/BCM
- PROCESOR: AMD EPYC 9474F 48C
- Pamięć: 512 GB pamięci DDR5
- GPU: 8 x NVIDIA RTX PRO 6000
- Przechowywanie: M.2 SSD
Claude Code Serving – MiniMax M2.5
Poza tradycyjnymi, surowymi testami wnioskowania LLM, chcieliśmy ocenić, jak dobrze ten sprzęt sprawdza się w procesie kodowania agentowego, a konkretnie poprzez obsługę wielu równoczesnych sesji Claude Code z wykorzystaniem modelu hostowanego lokalnie. Ten przypadek użycia ma bezpośrednie przełożenie na produktywność zespołu programistów: ilu inżynierów może jednocześnie korzystać z asystenta kodowania AI obsługiwanego z jednego węzła, zanim jakość pracy ulegnie pogorszeniu?
Aby to przetestować, zbudowaliśmy zestaw testowy, który generuje zbiór danych o umiarkowanie trudnych problemach kodowania (takich jak implementacja pamięci podręcznej LRU, budowanie aplikacji CLI z listą zadań do wykonania, pisanie konwertera Markdown i konstruowanie interfejsu API REST) i uruchamia każdą sesję Claude Code w oddzielnym kontenerze Dockera na lokalnym serwerze vLLM. Pomiędzy sesjami a punktem końcowym wnioskowania znajduje się transparentny serwer proxy, który rejestruje metryki dla każdego żądania dla każdej instancji Claude Code. Użytym modelem był MiniMax M2.5, obsługiwany przez vLLM na ośmiu kartach graficznych NVIDIA RTX PRO 6000 w systemie. Chociaż nie jest to najlepszy model kodowania w publicznych rankingach, M2.5 to wydajny model, który wielu użytkowników, w tym nasi programiści, uruchamia lokalnie.
Jako punkt odniesienia użyliśmy średniej przepustowości wyjściowej Claude Opus 4.6 firmy Anthropic, uzyskanej za pośrednictwem OpenRouter.ai, jednej z najpopularniejszych usług routingu dla dostępu do API produkcyjnego. Ta wartość bazowa wynosi około 37 tokenów na sekundę na żądanie API.
Zmierzyliśmy dwa kluczowe wskaźniki: średnią liczbę tokenów wyjściowych na sekundę na sesję Claude Code (to, co zauważa każdy programista) oraz łączną liczbę tokenów wyjściowych na sekundę we wszystkich sesjach (całkowitą pracę generowaną przez serwer).
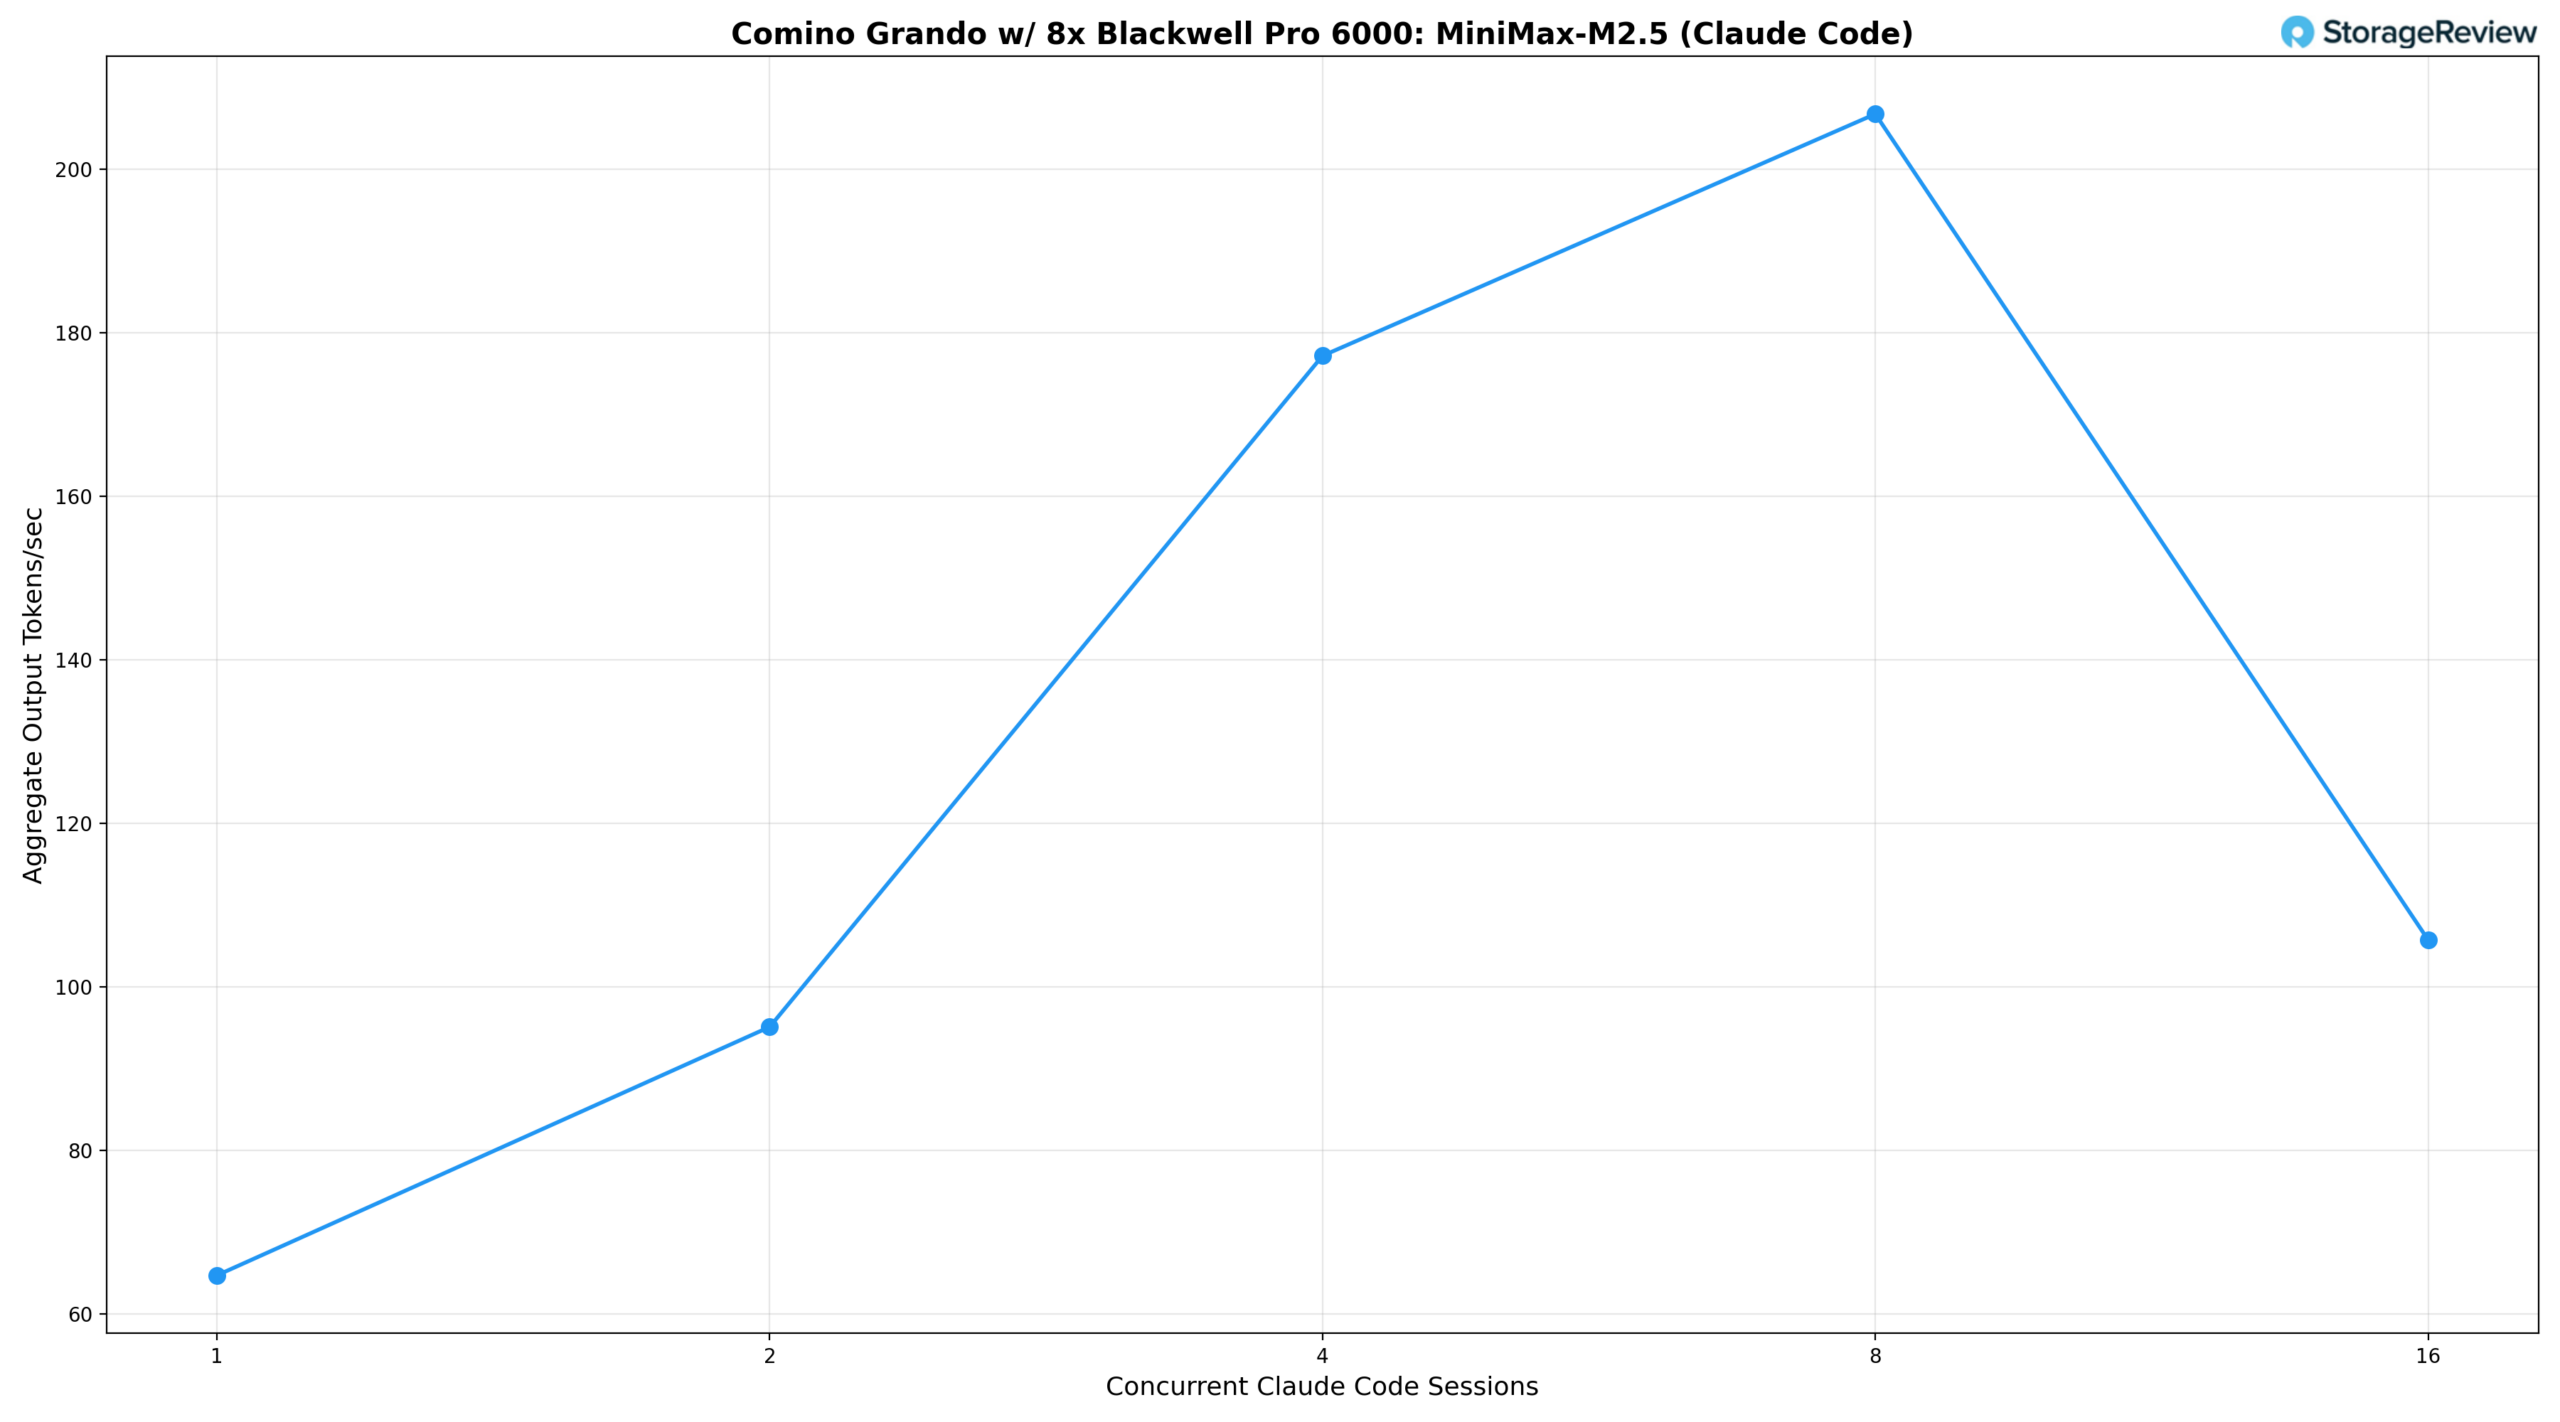
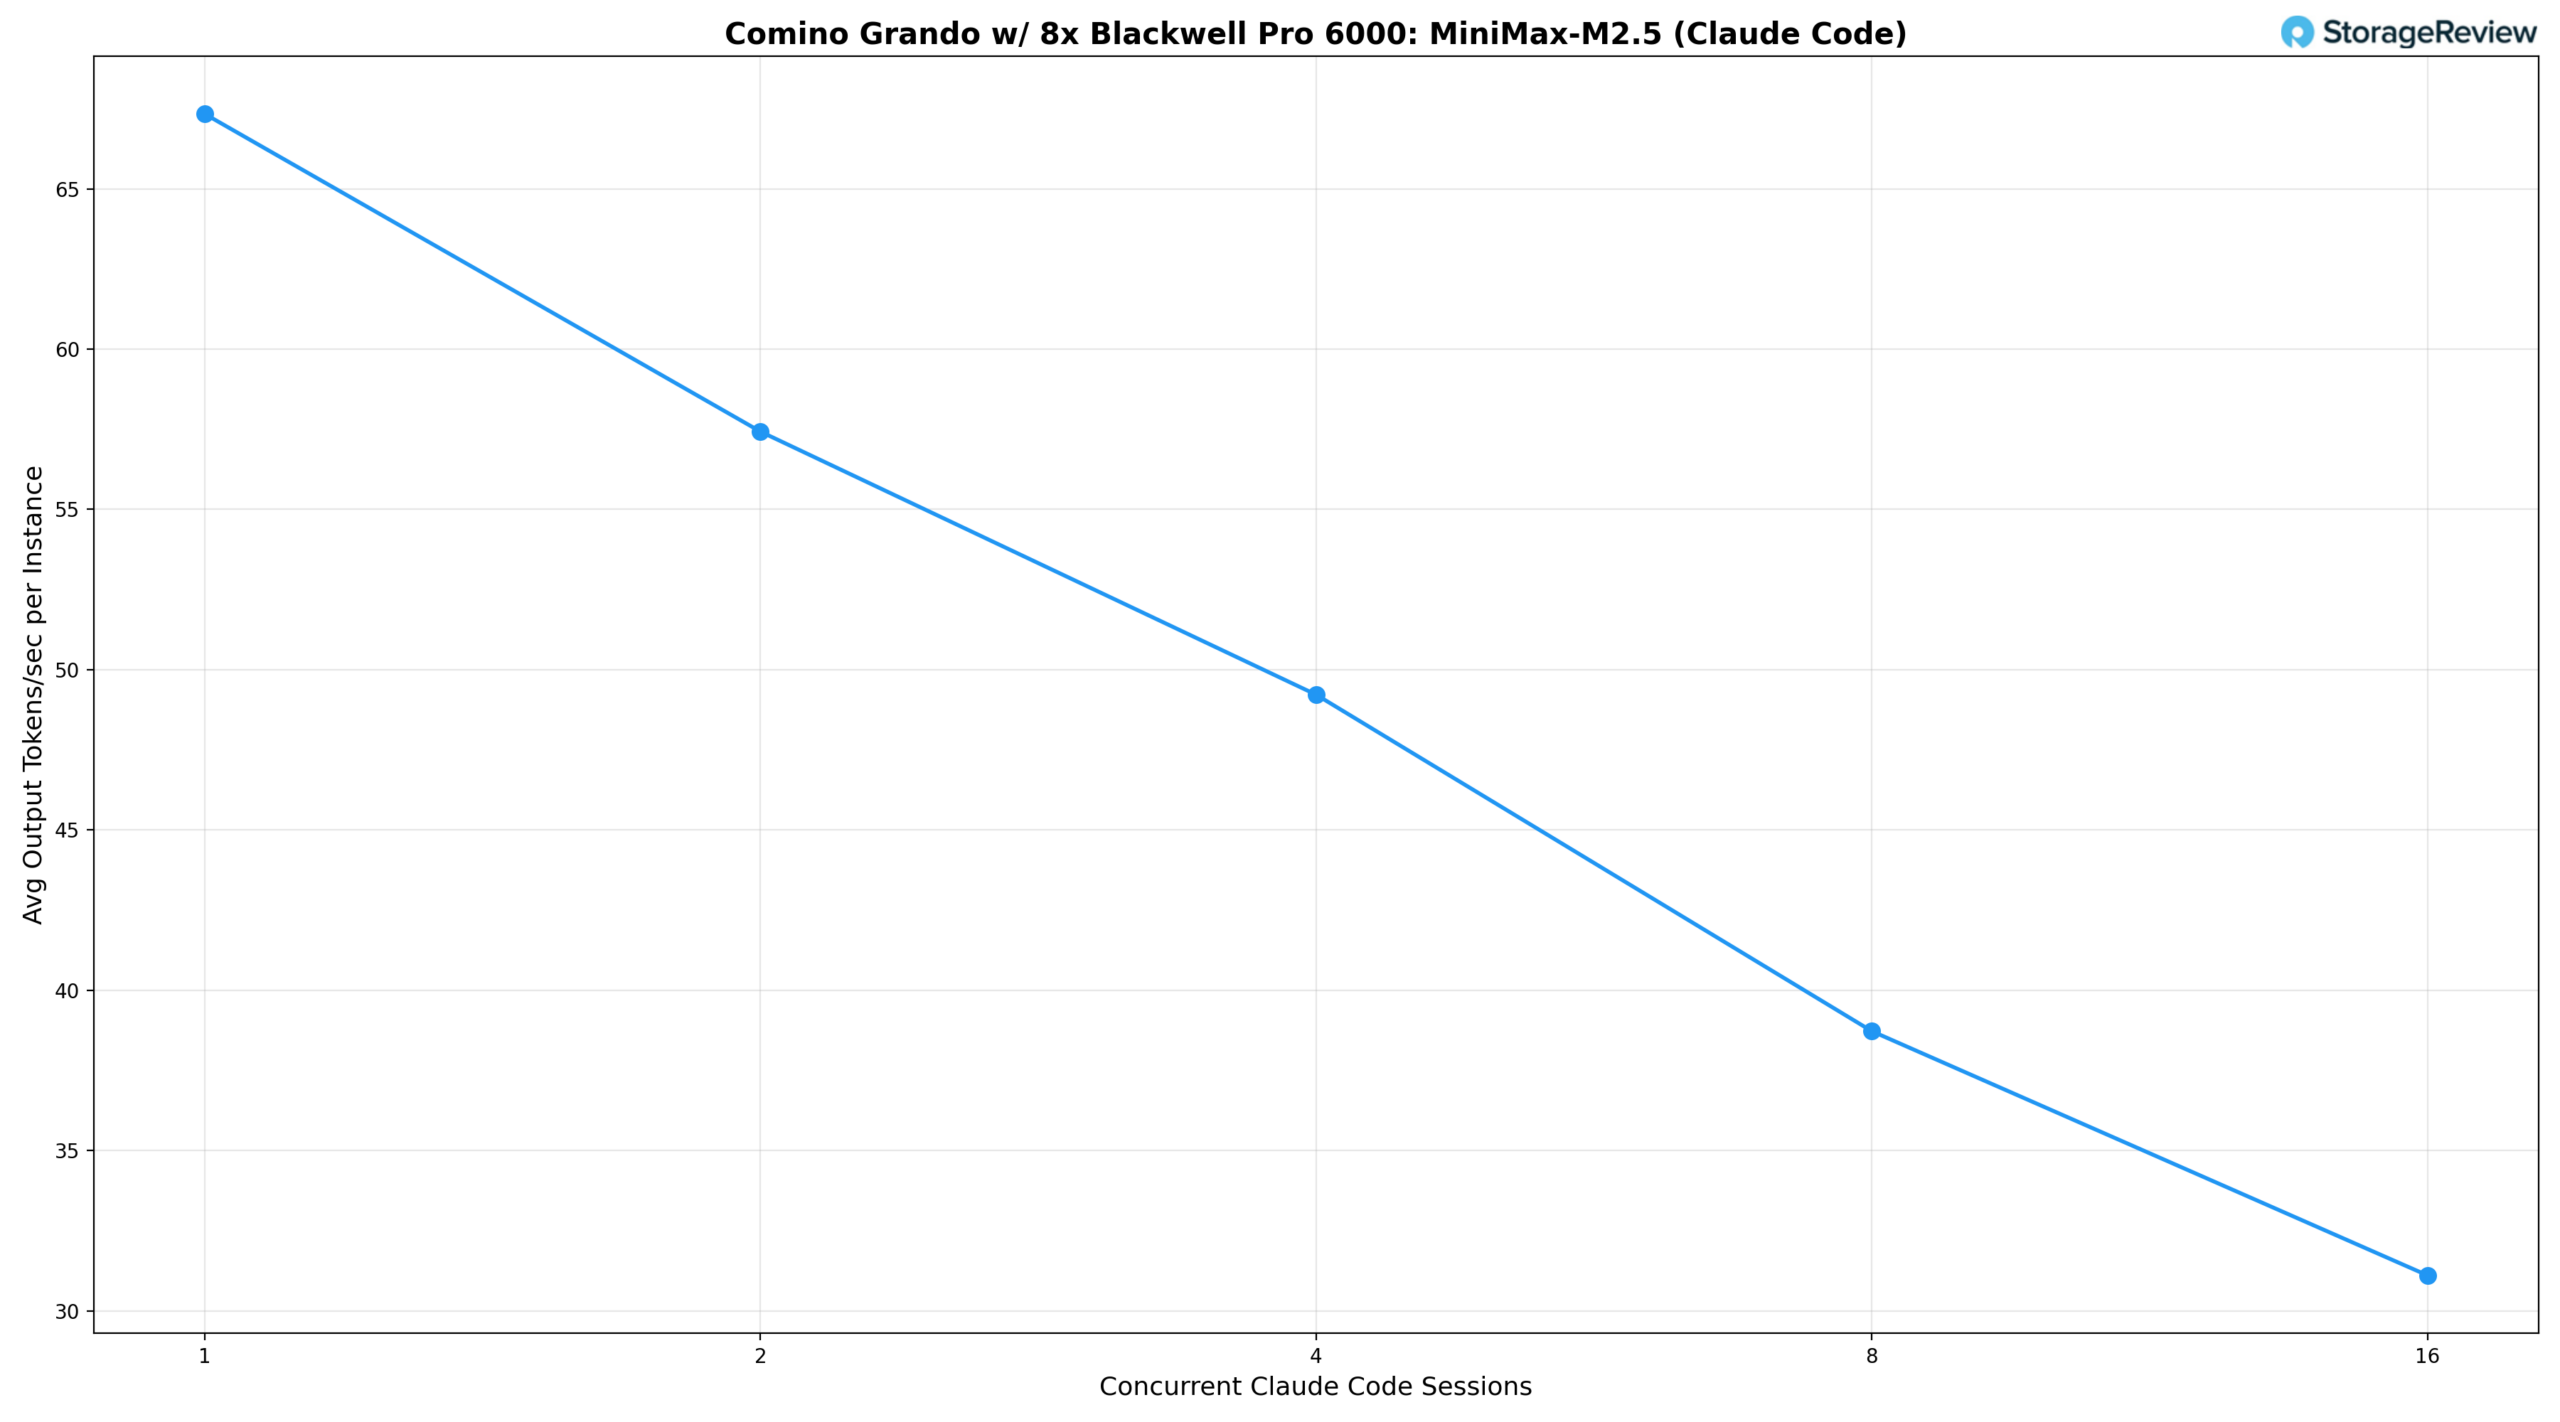
Na podstawie wyników, pojedyncza, jednoczesna sesja Claude Code generuje 67.3 tok/s na użytkownika i łączną wydajność na poziomie 64.7 tok/s. Przy dwóch sesjach przepustowość na instancję nieznacznie spada do 57.4 tok/s, podczas gdy łączna wydajność wzrasta do 95.1 tok/s, ponieważ przetwarzanie wsadowe w vLLM zaczyna amortyzować narzut. Cztery równoczesne sesje utrzymują 49.2 tok/s na użytkownika, co nadal zapewnia wysoką responsywność dla interaktywnych przepływów pracy kodowania, a łączna przepustowość osiąga 177.2 tok/s. Osiem sesji reprezentuje optymalny poziom łącznej wydajności, osiągając szczyt na poziomie 206.7 tok/s, podczas gdy przepustowość na instancję stabilizuje się na poziomie 38.7 tok/s, co pozostaje komfortowym poziomem dla generowania kodu w czasie rzeczywistym i iteracji.
Przy 16 sesjach równoczesnych system wykazuje klasyczny kompromis w przetwarzaniu wsadowym: przepustowość na instancję spada do 31.1 tok/s, a łączna wydajność spada do 105.8 tok/s. Sugeruje to, że przy tym poziomie współbieżności model 230B MiniMax M2.5 przekracza granice możliwości ośmiu procesorów GPU bez wprowadzania znaczących opóźnień dla każdego użytkownika. Spadek łącznej przepustowości z 8 do 16 sesji odzwierciedla zapotrzebowanie na pamięć i przepustowość dużej architektury MoE przy dużym obciążeniu dekodowania jednoczesnego, a nie nieefektywność harmonogramowania.
Dla organizacji rozważających infrastrukturę AI hostowaną we własnym hostingu dla narzędzi programistycznych, Grando stanowi mocny argument. Działając na bazie pionierskiego modelu 230B, może komfortowo obsłużyć do ośmiu jednoczesnych sesji Claude Code przy przepustowości zapewniającej autentyczną interaktywność, z prędkością na użytkownika przekraczającą 38 tok/s przy szczytowej łącznej wydajności. Zespoły składające się z czterech do ośmiu inżynierów mogą pracować z niemal optymalną przepustowością bez zauważalnego spadku responsywności.
Architektura chłodzona cieczą sprawia, że ten poziom mocy obliczeniowej jest praktyczny w środowiskach, w których tradycyjne serwery GPU nie mogą działać. System pracuje na tyle cicho, że zmieści się w biurze startupu, małej maszynowni lub wydzielonym kąciku otwartej przestrzeni roboczej. Systemy chłodzone powietrzem o podobnej gęstości GPU zazwyczaj osiągają poziom hałasu 90 dB lub wyższy, co jest na tyle głośne, że wymaga wydzielonej przestrzeni w centrum danych lub, co najmniej, zamkniętej serwerowni z solidną izolacją akustyczną. Grando może współistnieć z zespołem, który go używa. W połączeniu z pełną lokalizacją danych, brakiem kosztów API per token i pełną kontrolą nad wyborem modelu, oferuje on ścieżkę samodzielnego hostingu, która skaluje się wraz z rosnącym zespołem programistów, bez konieczności rozbudowy infrastruktury centrum danych ani stopniowego wzrostu kosztów.
vLLM Online Serving – wydajność wnioskowania LLM
vLLM to jeden z najpopularniejszych wysokoprzepustowych silników wnioskowania i obsługi dla systemów LLM. Test porównawczy obsługi online vLLM ocenia rzeczywistą wydajność obsługi tego silnika wnioskowania przy współbieżnych żądaniach. Symuluje obciążenia produkcyjne poprzez wysyłanie żądań do działającego serwera vLLM, z konfigurowalnymi parametrami, takimi jak częstotliwość żądań, długość wejścia i wyjścia oraz liczba współbieżnych klientów. Test mierzy kluczowe wskaźniki, takie jak przepustowość (liczba tokenów na sekundę), czas do pierwszego tokena i czas na token wyjściowy (TPOT), pomagając użytkownikom zrozumieć, jak vLLM działa w różnych warunkach obciążenia.
Przetestowaliśmy wydajność wnioskowania w ramach kompleksowego zestawu modeli obejmujących różne architektury, skale parametrów i strategie kwantyzacji, aby ocenić przepustowość przy różnych profilach współbieżności.
Podsumowanie wyników
| Model | Precyzja | Równy (256/256) | Wstępne wypełnienie – mocne (8 tys./1 tys.) | Dekodowanie ciężkie (1k/8k) |
|---|---|---|---|---|
| Comino Grando w/ 8× RTX PRO 6000 Blackwell — vLLM Inference Results (tok/s, peak at BS=256) | ||||
| GPT-OSS 20B | ep_dp1 | 17,280 | 32,061 | 11,187 |
| GPT-OSS 120B | ep_dp1 | 11,726 | 21,636 | 7,570 |
| Lama 3.1 8B Instruktaż | FP8 | 12,109 | 20,137 | 7,353 |
| Lama 3.1 8B Instruktaż | FP4 | 11,954 | 20,206 | 7,239 |
| Lama 3.1 8B Instruktaż | BF16 | 11,752 | 17,346 | 6,155 |
| Koder Qwen3 30B A3B | FP8 | 10,985 | 16,659 | 4,907 |
| Koder Qwen3 30B A3B | BF16 | 10,588 | 16,680 | 4,829 |
| Mistral Small 3.1 24V | BF16 | 8,925 | 11,846 | 4,975 |
| MiniMax M2.5 (230B) | ep_dp1 | 5,753 | 7,357 * | 2,555 |
| Wszystkie wartości podano w tok/s, szczytowa przepustowość przy BS=256. *W przypadku MiniMax M2.5 z intensywnym wstępnym napełnianiem szczyt wyniósł BS=128 (7,357 tok/s); BS=256 wyniosło 7,141 tok/s. | ||||
GPT-OSS 120B i 20B
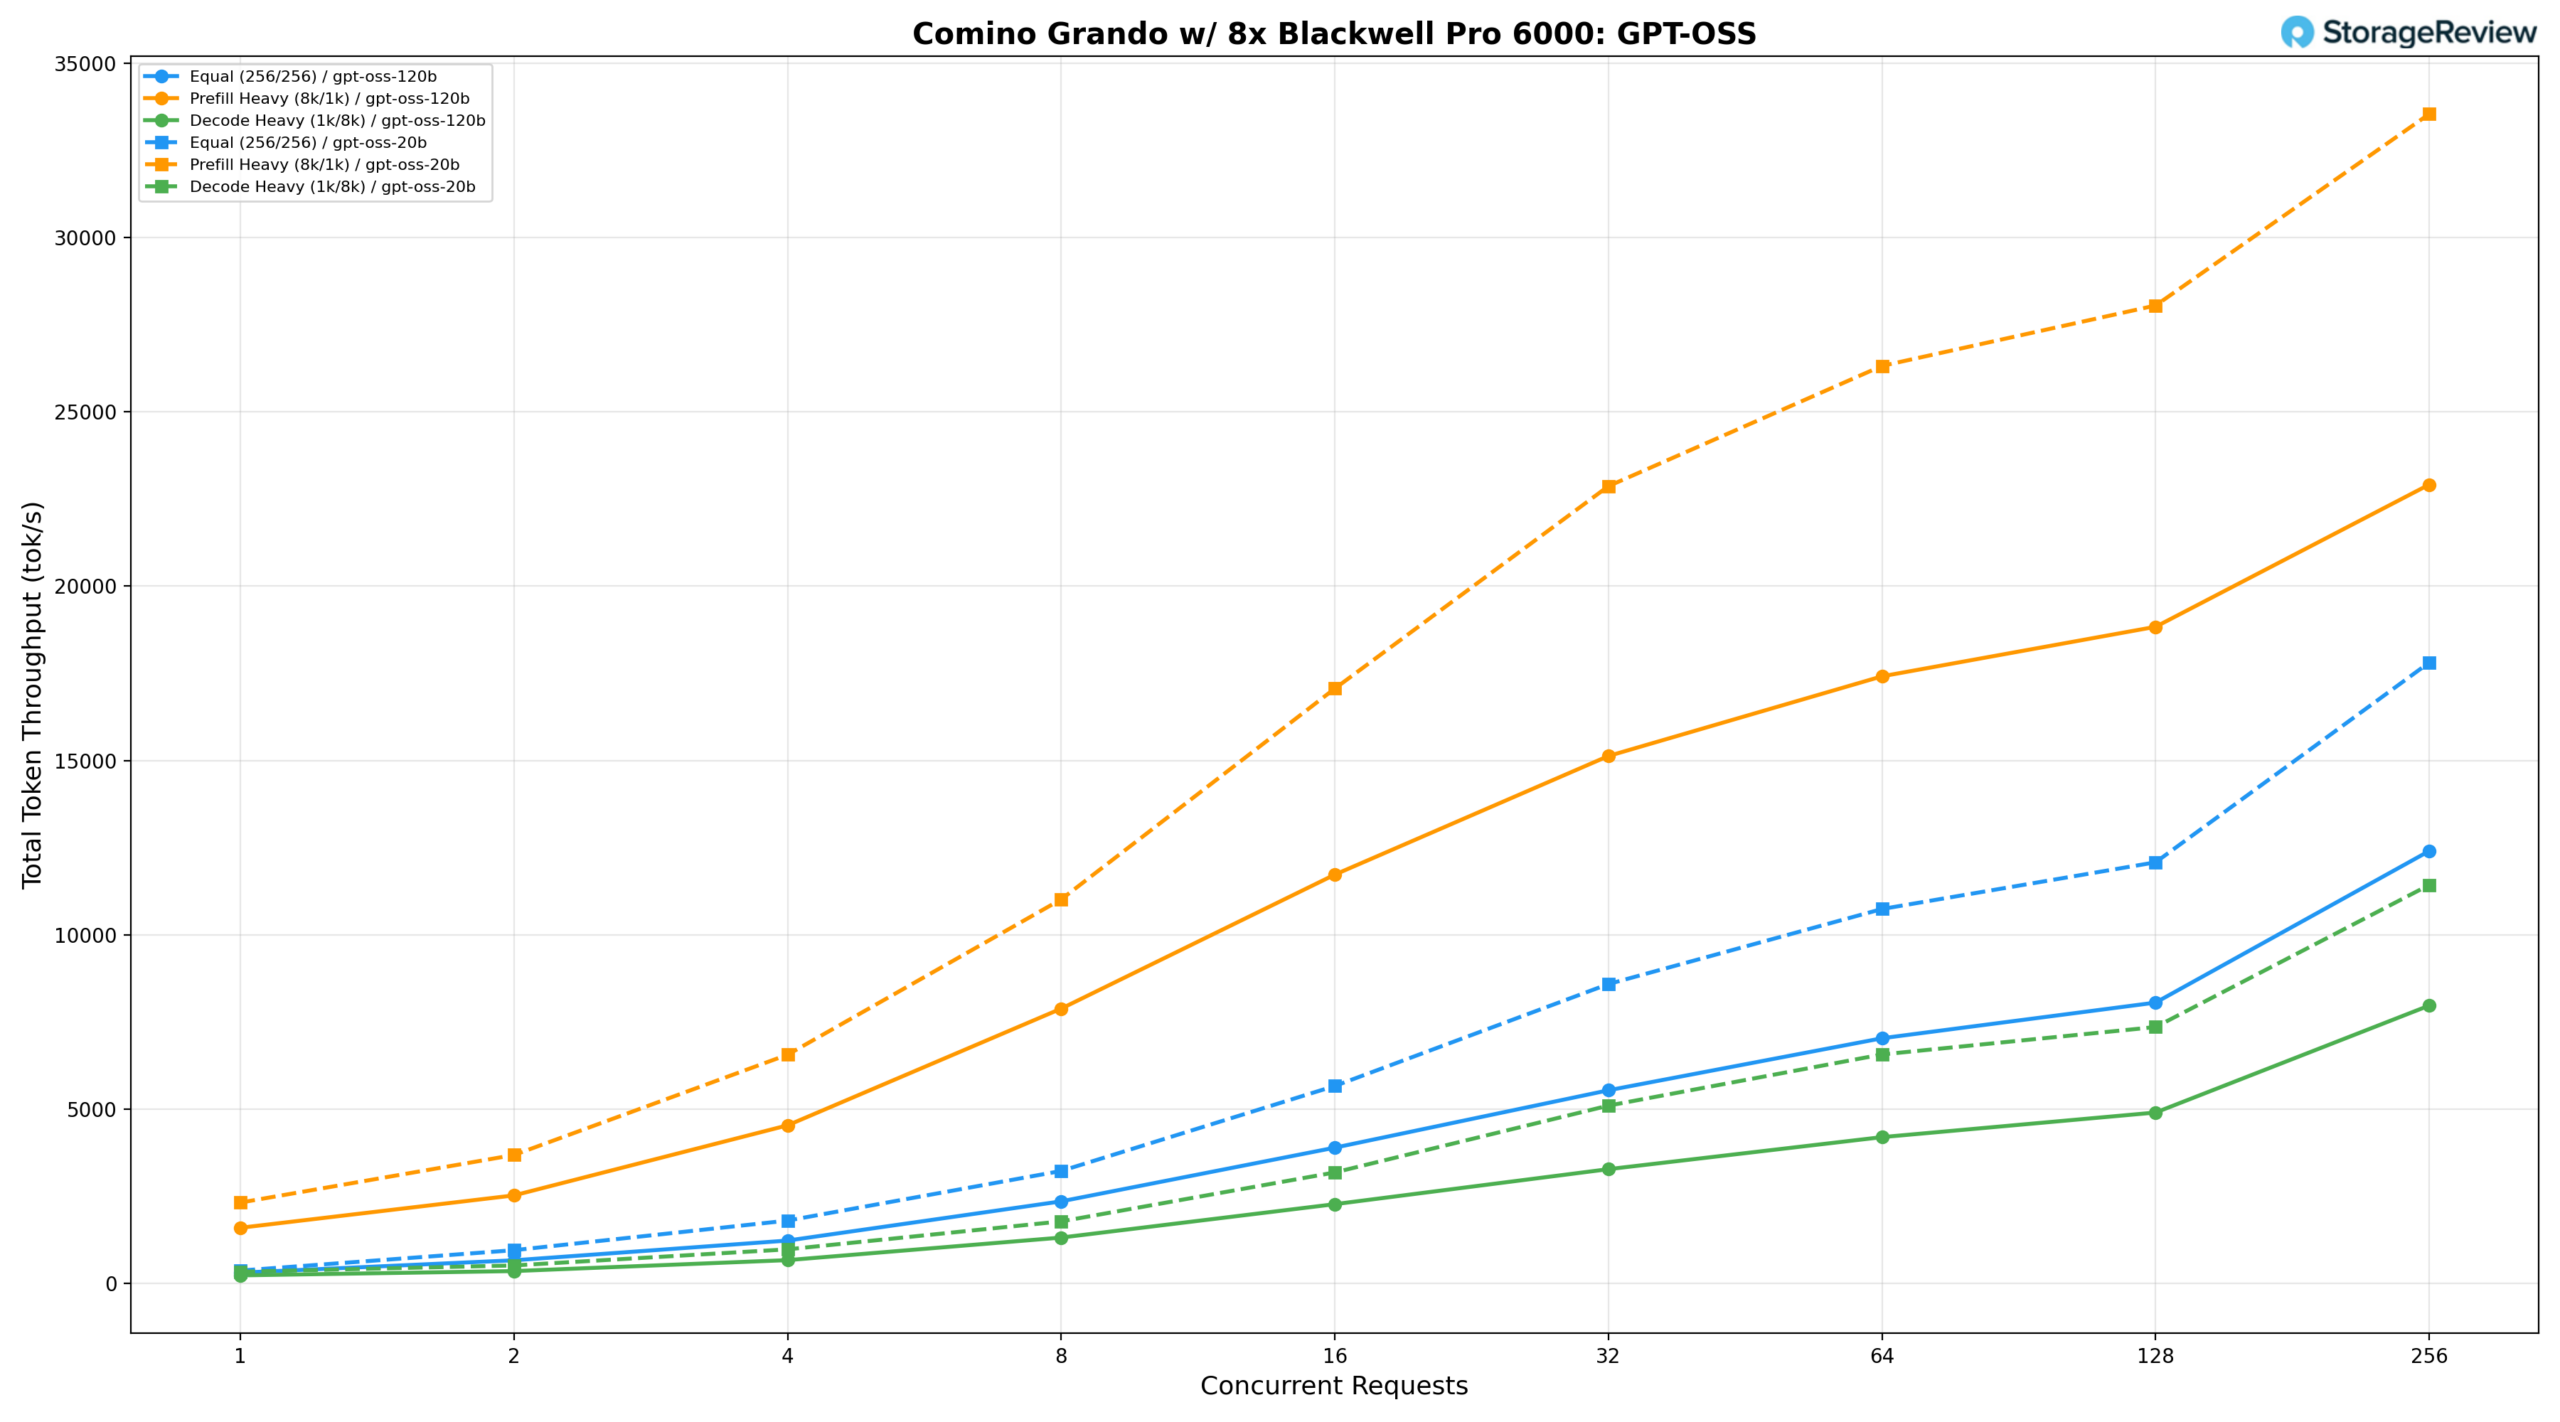
Rodzinę modeli GPT-OSS testowano w konfiguracjach 120B i 20B na Comino Grando.
GPT-OSS 120B
Przy równym obciążeniu (256/256), model 120B zapewnia 268.85 tok/s przy BS=1, osiąga 6,666.23 tok/s przy BS=64 i osiąga szczyt na poziomie 11 726,04 tok/s przy BS=256. Model z dużym obciążeniem wstępnym (8k/1k) rozpoczyna się od 1,375.69 tok/s, wzrasta do 16 374,19 tok/s przy BS=64 i 17 944,55 tok/s przy BS=128 i osiąga szczyt na poziomie 21 636,41 tok/s przy BS=256. Prędkość dekodowania (1k/8k) wzrasta z 196.28 tok/s przy BS=1 do 7,569.97 tok/s przy BS=256, przy czym opóźnienie jest dobrze kontrolowane przy niższych poziomach współbieżności.
GPT-OSS 20B
Model 20B zapewnia 334.80 tok/s przy BS=1 i równym obciążeniu, osiąga 10 303,56 tok/s przy BS=64 i osiąga szczyt na poziomie 17 280,12 tok/s przy BS=256. Model z dużym obciążeniem wstępnym rozpoczyna się od 2,007.90 tok/s, wzrasta do 24 990,46 tok/s przy BS=64 i 26 866,25 tok/s przy BS=128, osiągając szczyt na poziomie 32 060,72 tok/s przy BS=256 – jest to najwyższa bezwzględna przepustowość wstępna odnotowana dla obu rozmiarów modelu. Prędkość dekodowania wzrasta z 286.08 tok/s przy BS=1 do 11 187,36 tok/s przy BS=256, zapewniając w przybliżeniu 1.5-krotność przepustowości dekodowania 120B przy szczytowej współbieżności, przy jednoczesnym zachowaniu mniejszych opóźnień.
Instrukcja Qwen3 Coder 30B A3B i instrukcja FP8
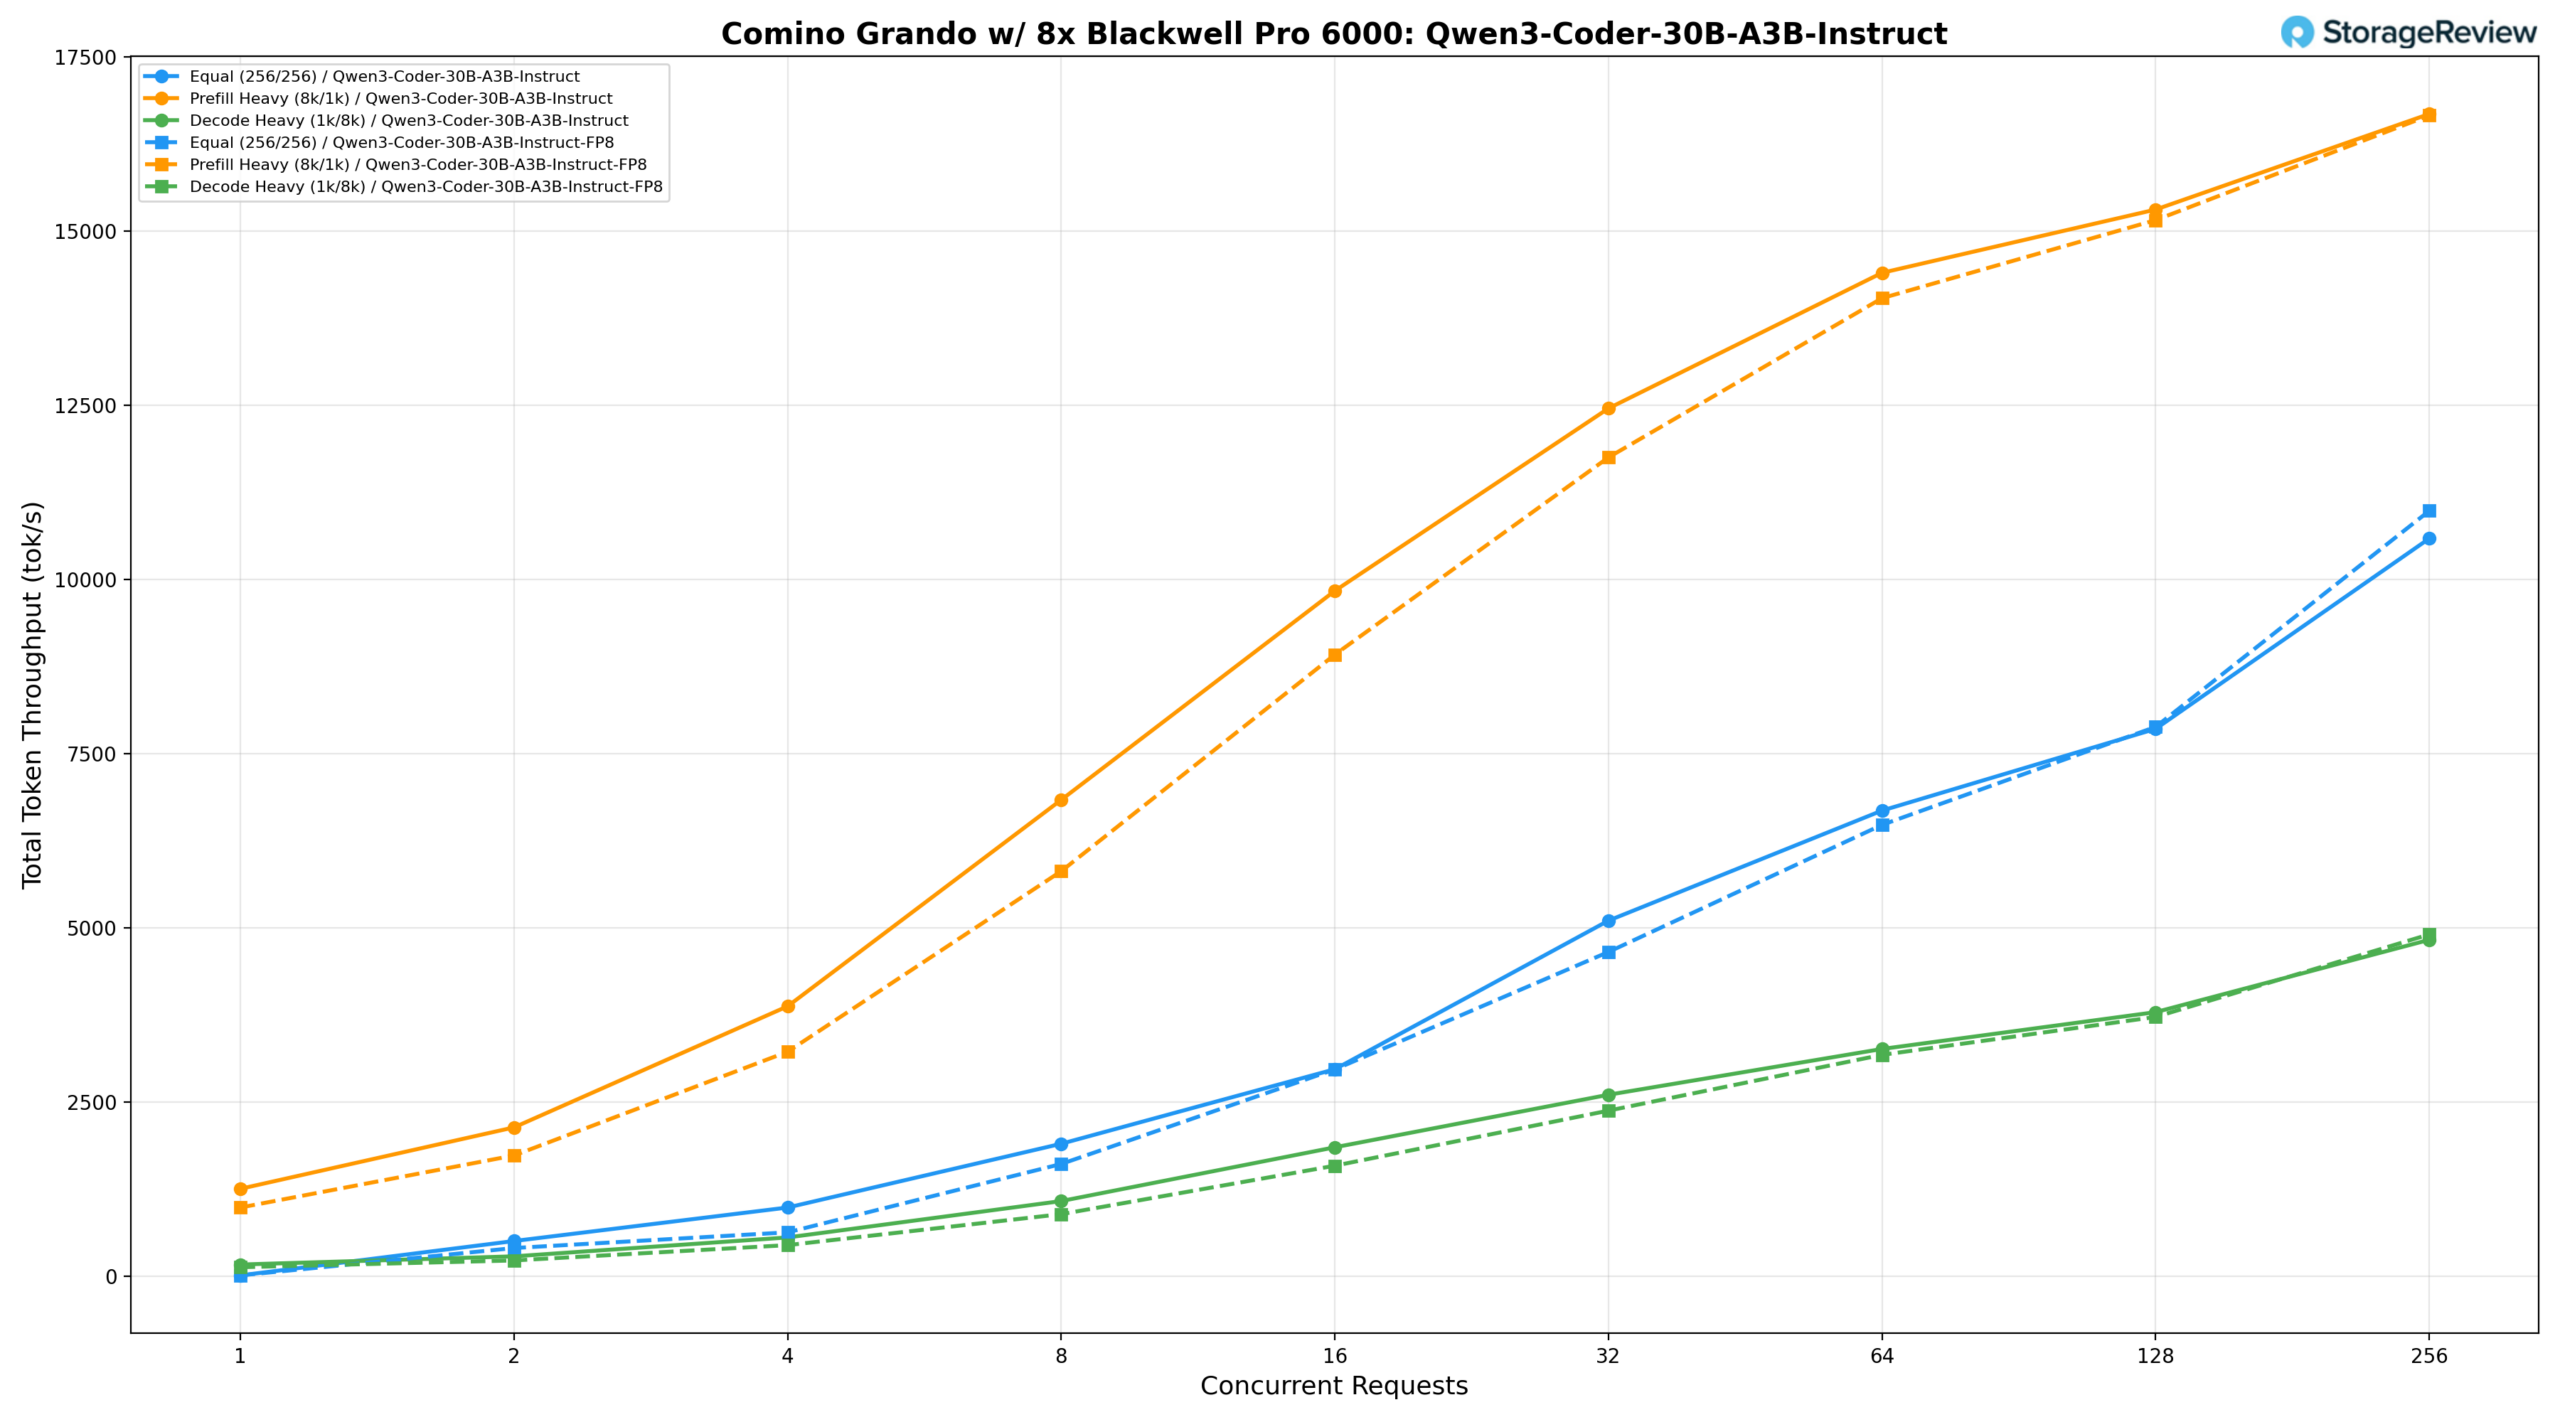
Model Qwen3-Coder-30B-A3B-Instruct został przetestowany z dokładnością BF16 i FP8.
Qwen3-Coder-30B-A3B-Instruct (BF16)
Przy równym obciążeniu (256/256) model BF16 zapewnia 1,902.32 tok/s przy BS=8, osiąga 6,683.58 tok/s przy BS=64 i osiąga szczyt na poziomie 10 587,56 tok/s przy BS=256. Model z dużym obciążeniem wstępnym (8 tys./1 tys.) rozpoczyna się od 1,256.03 tok/s przy BS=1, wzrasta do 14 400,57 tok/s przy BS=64 i 15 308,35 tok/s przy BS=128 i osiąga szczyt na poziomie 16 679,52 tok/s przy BS=256. Prędkość dekodowania (1k/8k) wzrasta ze 169.19 tok/s przy BS=1 do 4,828.82 tok/s przy BS=256, przy czym opóźnienie jest dobrze kontrolowane przy niższych poziomach współbieżności.
Qwen3-Coder-30B-A3B-Instruct (FP8)
Model FP8 zapewnia przepustowość porównywalną z BF16 w większości scenariuszy, przy równym obciążeniu sięgającym 6,478.54 tok/s przy BS=64 i osiągającym szczyt na poziomie 10 984,61 tok/s przy BS=256, co stanowi niewielką poprawę w porównaniu z BF16 przy szczytowej współbieżności. Model z dużym obciążeniem wstępnym rozpoczyna się od 987.48 tok/s przy BS=1, wzrasta do 14 036,46 tok/s przy BS=64 i 15 156,69 tok/s przy BS=128, a osiąga szczyt na poziomie 16 658,98 tok/s przy BS=256. Prędkość dekodowania wzrasta ze 130.70 tok/s przy BS=1 do 4,906.51 tok/s przy BS=256, nieznacznie przewyższając BF16 przy szczytowej współbieżności, podczas gdy obie konfiguracje pozostają ściśle dopasowane w całym zakresie współbieżności.
Mistral Small 3.1 24B Instrukcja 2503
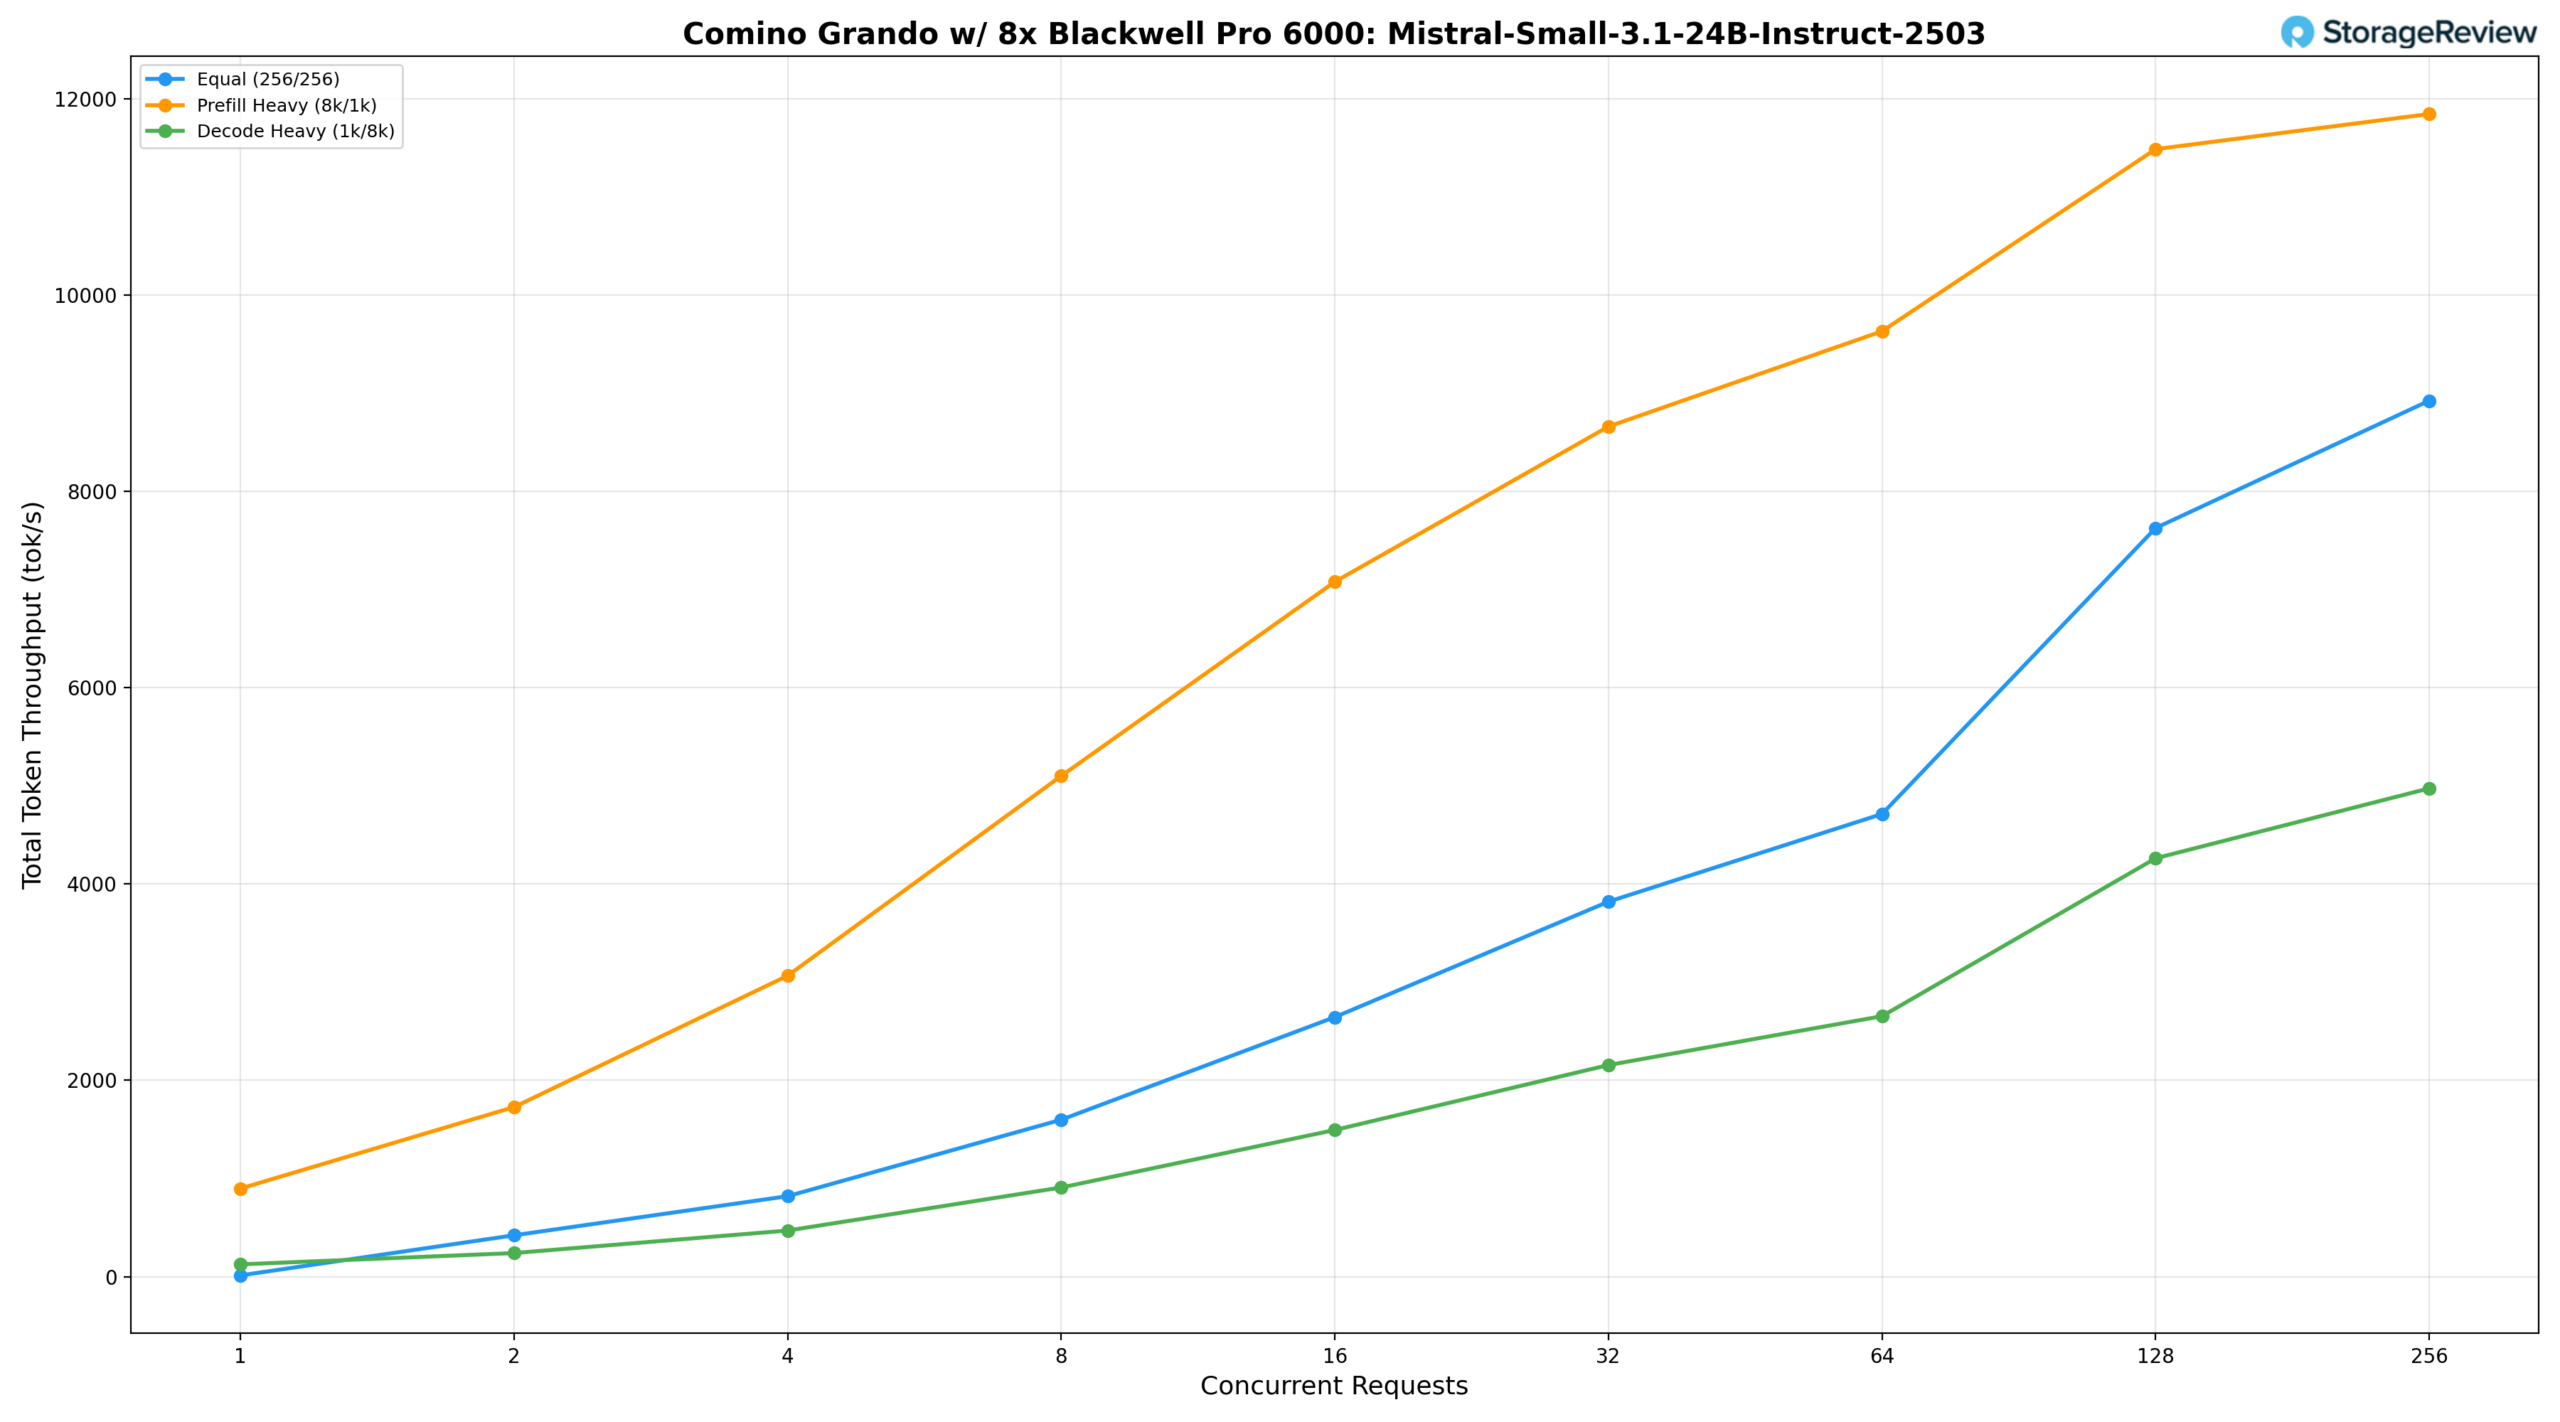
Przy równym obciążeniu (256/256) model zapewnia 1,598.79 tok/s przy BS=8, osiąga 4,713.84 tok/s przy BS=64 i silnie skaluje się do 8,925.12 tok/s przy BS=256. Model z dużym obciążeniem wstępnym (8 tys./1 tys.) zaczyna się od 897.84 tok/s przy BS=1, wzrasta do 9,632.58 tok/s przy BS=64 i 11 488,13 tok/s przy BS=128, osiągając szczyt na poziomie 11 846,15 tok/s przy BS=256. Obciążenie dekodowaniem (1k/8k) wzrasta ze 124.98 tok/s przy BS=1 do 2,653.82 tok/s przy BS=64, a następnie zauważalnie przyspiesza przy wyższych poziomach współbieżności, osiągając 4,262.53 tok/s przy BS=128 i osiągając szczyt na poziomie 4,975.06 tok/s przy BS=256, co odzwierciedla zdolność modelu do utrzymania dużej przepustowości dekodowania w miarę skalowania współbieżności.
Lama 3.1 8B Instruktaż
Model Llama-3.1-8B-Instruct został przetestowany w trzech konfiguracjach precyzji na komputerze Comino, co pozwoliło uzyskać wyraźny obraz wpływu kwantyzacji na przepustowość dla modelu o tej wielkości.
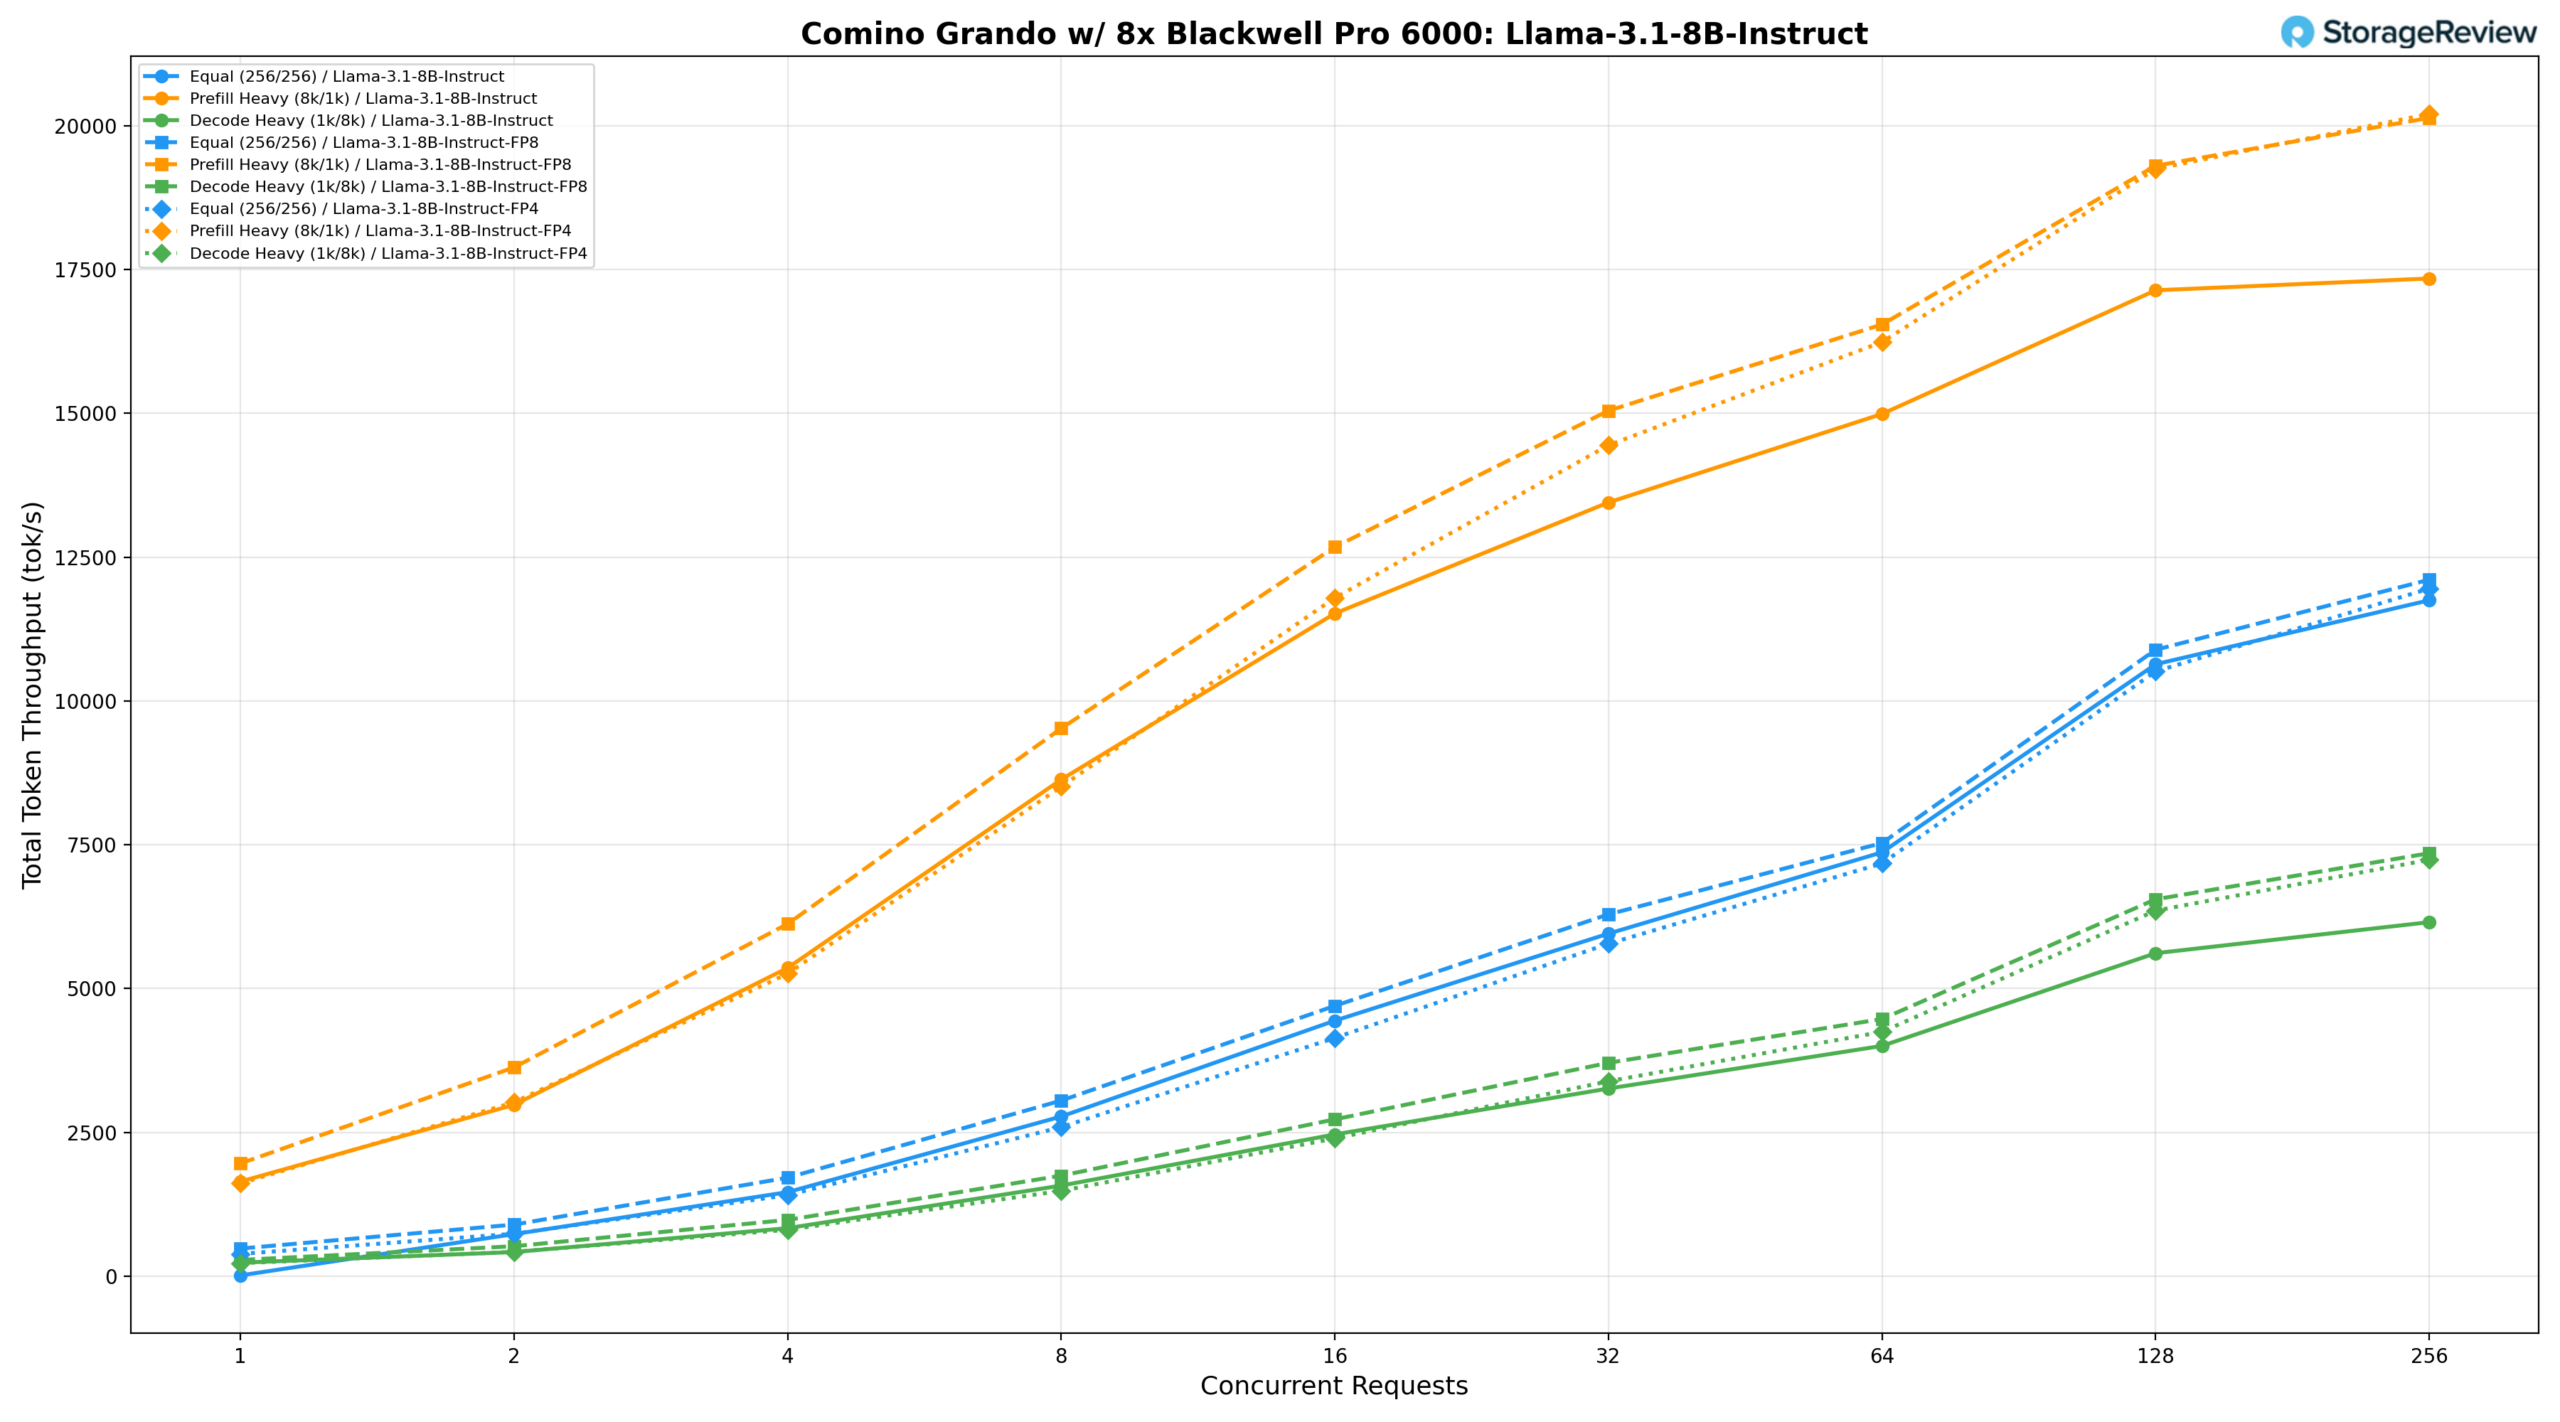
Llama 3.1 8B Instrukcja BF16
Przy takim samym obciążeniu (256/256) model BF16 zapewnia 2,776.42 tok/s przy BS=8, osiąga 7,369.01 tok/s przy BS=64 i osiąga szczyt na poziomie 11 751,56 tok/s przy BS=256. Model z dużym obciążeniem wstępnym (8 tys./1 tys.) rozpoczyna się od 1,645.29 tok/s przy BS=1, wzrasta do 14 990,47 tok/s przy BS=64 i 17 140,71 tok/s przy BS=128 i osiąga szczyt na poziomie 17 345,80 tok/s przy BS=256. Prędkość dekodowania (1k/8k) wzrasta z 234.78 tok/s przy BS=1 do 6,154.73 tok/s przy BS=256.
Llama 3.1 8B Instrukcja FP8
Kwantyzacja FP8 zapewnia znaczący wzrost we wszystkich scenariuszach. Równe obciążenie osiąga 7,530.39 tok/s przy BS=64 i osiąga szczyt na poziomie 12 108,98 tok/s przy BS=256. Obciążenie prefill wzrasta do 16 546,53 tok/s przy BS=64 i 19 306,49 tok/s przy BS=128, osiągając szczyt na poziomie 20 137,35 tok/s przy BS=256, co stanowi wzrost o około 16% w porównaniu z BF16 przy szczytowej współbieżności. Obciążenie dekodowaniem osiąga szczyt na poziomie 7,353.40 tok/s przy BS=256, co stanowi wzrost o około 19% w porównaniu z BF16.
Llama 3.1 8B Instrukcja FP4
FP4 oferuje przepustowość zbliżoną do FP8 przy wyższych poziomach współbieżności, choć nieznacznie ustępuje przy niższych rozmiarach partii. Równe obciążenie osiąga szczyt na poziomie 11 954,40 tok/s przy BS=256, a obciążenie prefill-heavy osiąga najwyższy punkt na poziomie 20 205,57 tok/s przy BS=256, nieznacznie wyprzedzając FP8 przy szczytowej współbieżności. Obciążenie dekodujące osiąga szczyt na poziomie 7,239.29 tok/s przy BS=256, utrzymując się w granicach kilku procent od FP8, co czyni FP4 atrakcyjną opcją, gdy priorytetem jest wydajność pamięci bez znaczącego obniżenia przepustowości.
MiniMax M2.5
MiniMax-M2.5 230B, testowany na Comino Grando, był największym i najbardziej wymagającym modelem, jakiego użyliśmy.
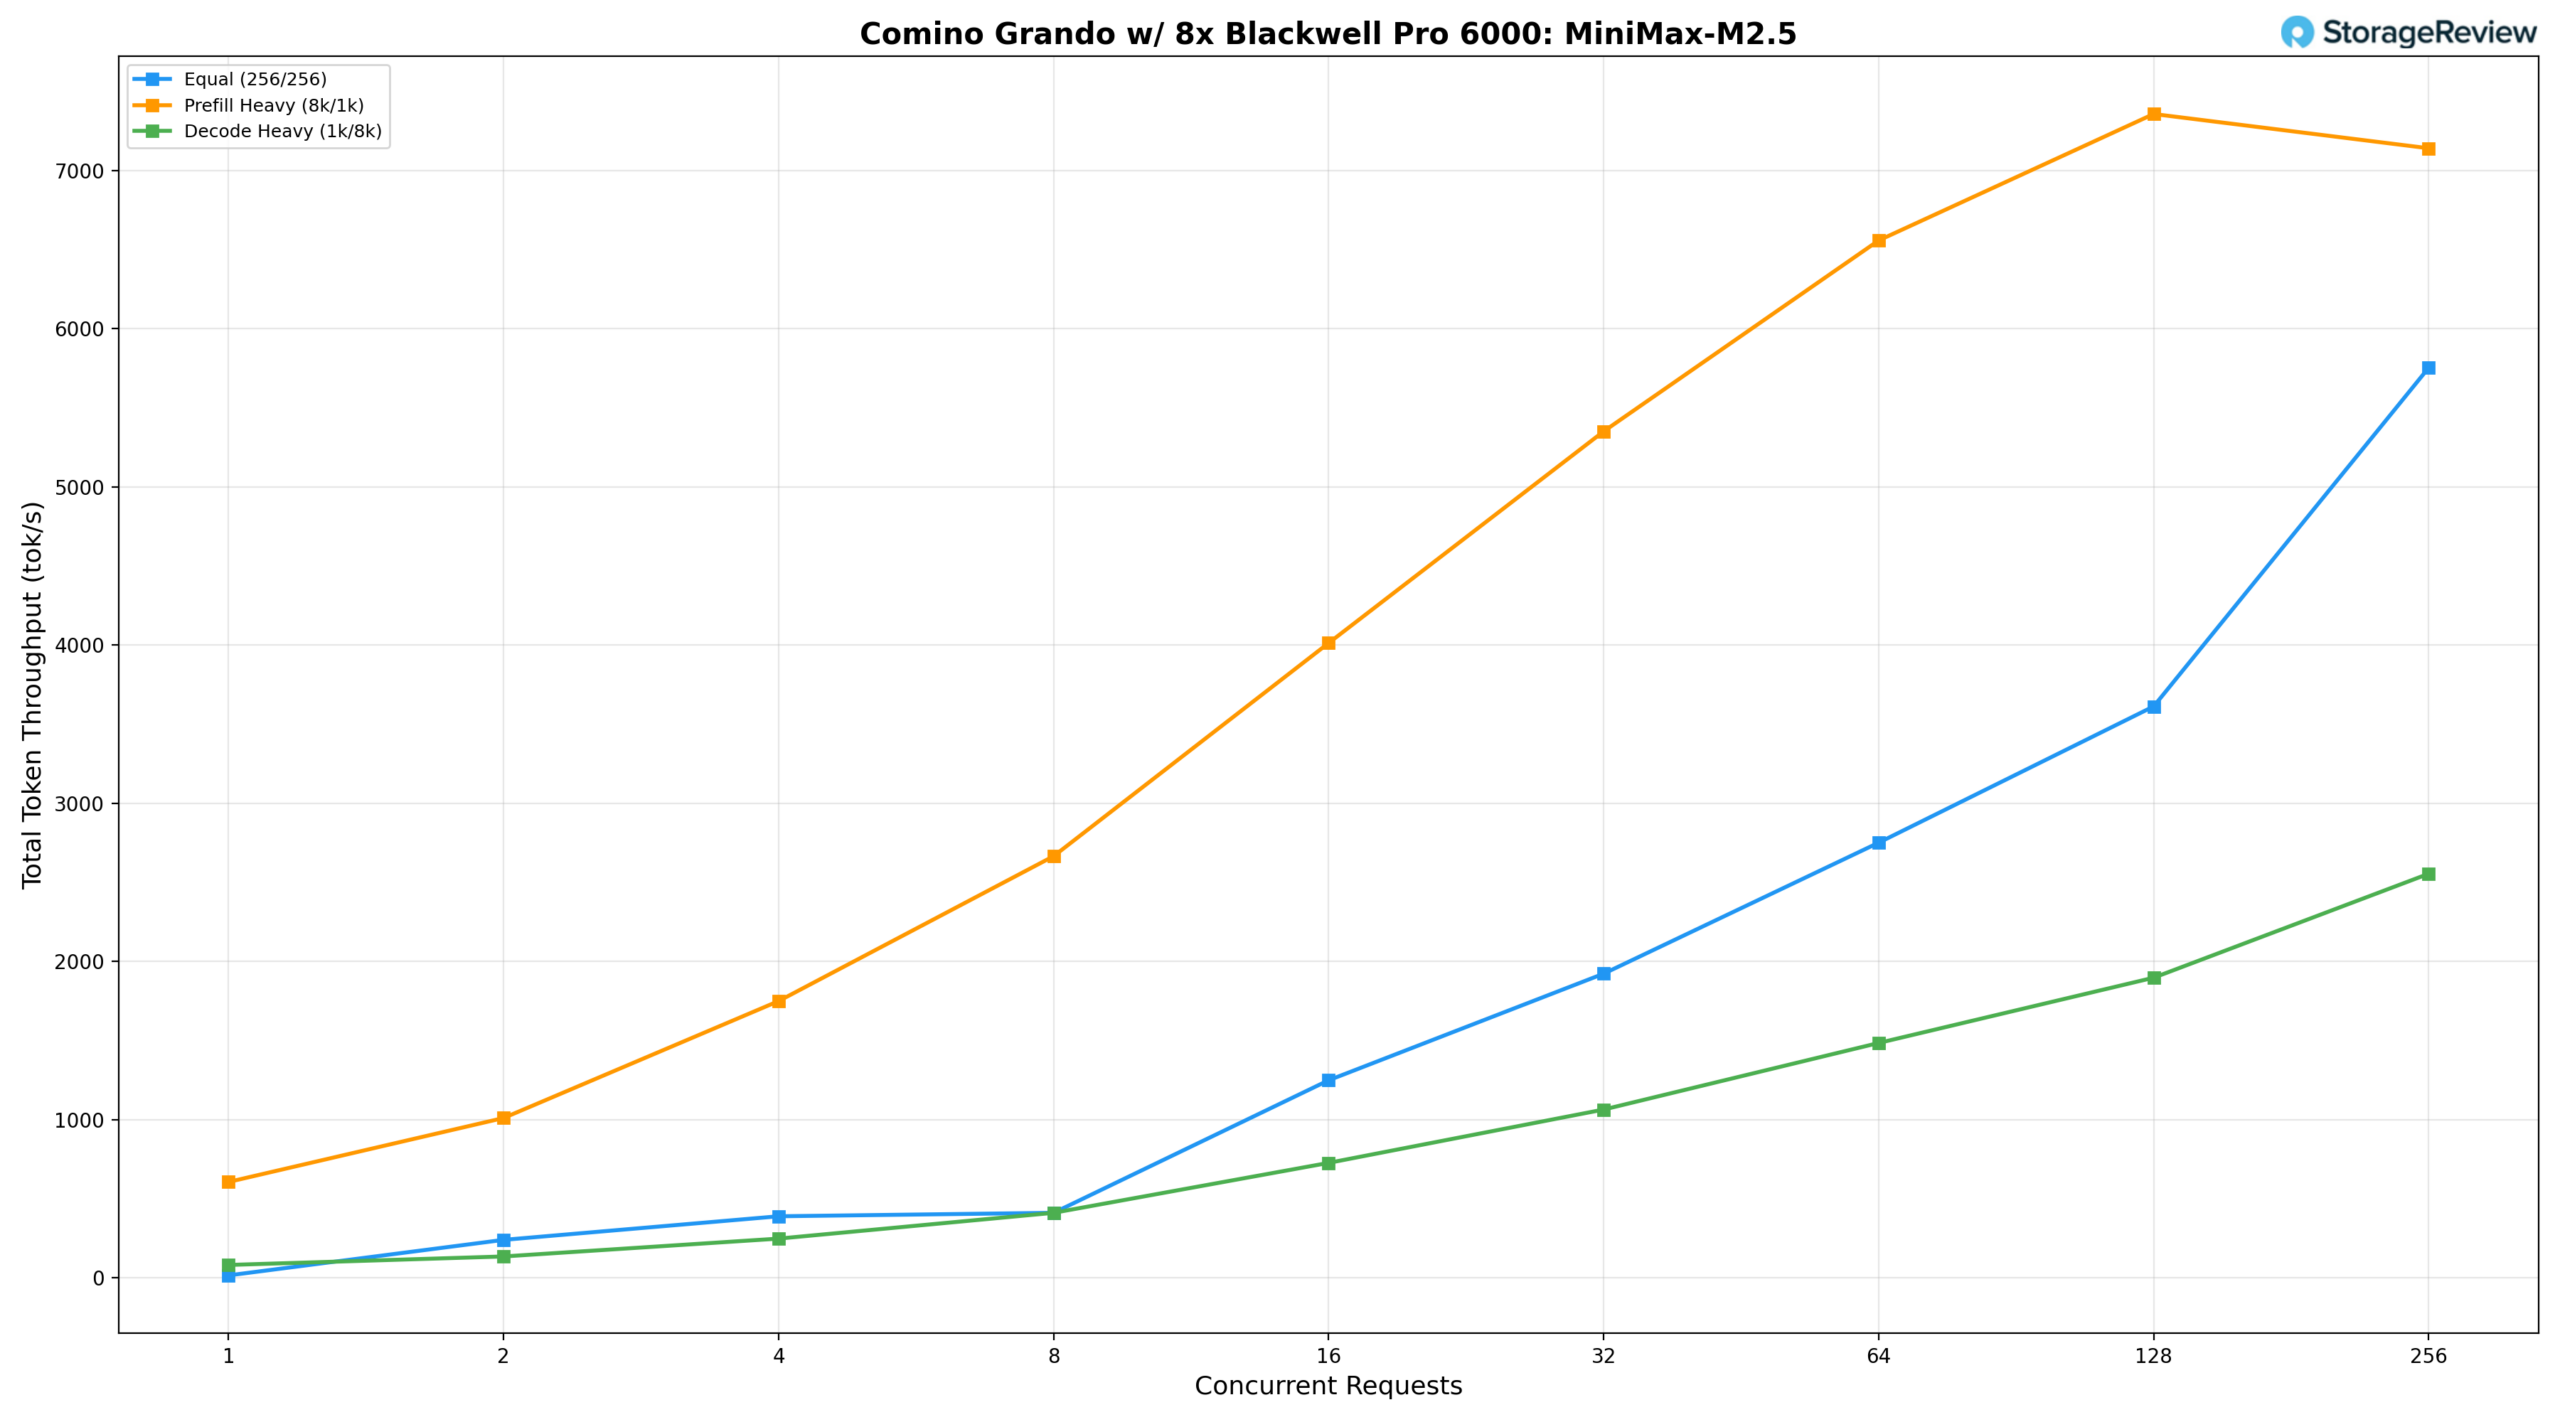
Przy równym obciążeniu (256/256) model zaczyna się od 16.35 tok/s przy BS=1, osiąga 2,751.25 tok/s przy BS=64 i silnie skaluje się przy wyższej współbieżności, osiągając szczyt na poziomie 5,753.24 tok/s przy BS=256. Model z dużym obciążeniem wstępnym (8 tys./1 tys.) zaczyna się od 606.97 tok/s przy BS=1, stopniowo wzrasta do 5,351.02 tok/s przy BS=32 i 6,557.92 tok/s przy BS=64, osiągając szczyt na poziomie 7,357.26 tok/s przy BS=128, zanim nieznacznie zmniejszy się do 7,140.74 tok/s przy BS=256, co sugeruje, że model zbliża się do nasycenia przepustowości wstępnego wypełniania powyżej BS=128. Obciążenie dekodowaniem (1k/8k) stale rośnie z 82.21 tok/s przy BS=1 do 1,485.28 tok/s przy BS=64, osiągając szczyt na poziomie 2,554.87 tok/s przy BS=256, co odzwierciedla oczekiwane zapotrzebowanie na przepustowość pamięci architektury MoE 230B przy stałych obciążeniach dekodowania.
Wniosek
Comino Grando najlepiej rozumieć jako system zaprojektowany specjalnie po to, aby w pełni wykorzystać potencjał ośmiu procesorów graficznych NVIDIA RTX PRO 6000. Każda istotna decyzja projektowa, od odwróconego układu płyty głównej, przez pętlę chłodzenia, po zintegrowany stos monitorujący, ma na celu zapewnienie ciągłej pracy tych procesorów graficznych z pełnym TDP 600 W bez ograniczeń termicznych i energetycznych.
To, co czyni Grando tak atrakcyjnym, to nie pojedyncza funkcja, ale sposób, w jaki cały system jest spójny. Chłodzenie cieczą nie jest dodatkiem, ale architekturą. Zasilanie jest redundantne, z możliwością wymiany w trakcie pracy i skalowalne do obciążenia 4,800 W ośmiu kart 600 W, z zapasem mocy. System monitorowania wykracza poza raportowanie temperatur; autonomicznie chroni sprzęt, gdy coś pójdzie nie tak. Nic nie wydaje się tu dodane na siłę.
Dane dotyczące wydajności potwierdzają tę spójność. W zróżnicowanym zestawie modeli, od Llama 3.1 8B do 230B MiniMax M2.5, Grando zapewnił dane dotyczące przepustowości, które dobrze sprawdzają się na platformie hostowanej samodzielnie. Testy współbieżności Claude Code uwypukliły praktyczną wartość tego rozwiązania: ośmiu inżynierów może jednocześnie uruchamiać sesje kodowania agentowego na lokalnie hostowanym modelu 230B z interaktywnymi prędkościami, a przepustowość na użytkownika przekracza 38 tok/s przy szczytowej łącznej wydajności. Zespoły od czterech do ośmiu osób mogą pracować z niemal optymalną przepustowością bez zauważalnego spadku wydajności.
Wartość tej konfiguracji wykracza poza wnioskowanie AI. Dzięki 96 GB pamięci VRAM na GPU i możliwości skalowania wieloprocesorowego, platforma doskonale nadaje się do zaawansowanych zadań kreatywnych i inżynieryjnych, w tym renderowania efektów wizualnych, symulacji na dużą skalę i złożonych procesów CAD. System skaluje się do konfiguracji z czterema i dwoma GPU, dzięki czemu ten poziom wydajności jest dostępny dla mniejszych studiów i zespołów, które nadal wymagają gęstości na poziomie stacji roboczej.
Grando najbardziej różni się od testowanych przez nas platform korporacyjnych z ośmioma procesorami graficznymi pod względem praktyczności wdrożenia. Systemy te oferują większy zapas mocy na liniach PCIe, więcej gniazd sieciowych i głębszą łączność z pamięcią masową, ale wymagają również dedykowanej infrastruktury centrum danych, pobierają znacznie ponad 8 kW i mają czas realizacji zamówienia, który może wynieść ponad rok. Grando oferuje część możliwości rozbudowy urządzeń peryferyjnych, oferując system, który pracuje wystarczająco cicho, aby dzielić pomieszczenie z użytkownikami, emituje mniej ciepła do otoczenia i jest dostępny od ręki. Dla organizacji, które priorytetowo traktują szybkie wdrożenie i łatwe w zarządzaniu środowiska operacyjne, a nie maksymalną łączność w ramach struktury, ten kompromis jest korzystny.
Strona produktu – Comino Grando
Konfigurator Comino – Strona
Ranking: Comino Grando RTX PRO 6000 zajmuje miejsce Extreme Pick w naszym rankingu najlepszych komputerów stacjonarnych do lokalnej sztucznej inteligencji . Znajdujący się w nim RTX PRO 6000 zajmuje pierwsze miejsce w kategorii najlepszego procesora graficznego do wnioskowania w przedsiębiorstwie w naszym rankingu najlepszych procesorów graficznych dla przedsiębiorstw.


 Amazon