

Karta NVIDIA GeForce RTX 5070 Founders Edition dołącza do nowej serii 50, debiutując po high-endowym modelu 5080 i prezentując architekturę Blackwell firmy NVIDIA w obudowie ze średniej półki. Chociaż wiele spekulowano na temat jej energooszczędności, wydajności AI i ulepszeń w ray tracingu, przekonamy się o tym osobiście podczas testów w warunkach rzeczywistych. Po przeprowadzeniu różnych testów porównawczych – od generowania tekstu przez AI po zaawansowane renderowanie 3D – możemy dokładnie określić jej miejsce w ofercie układów NVIDIA nowej generacji.
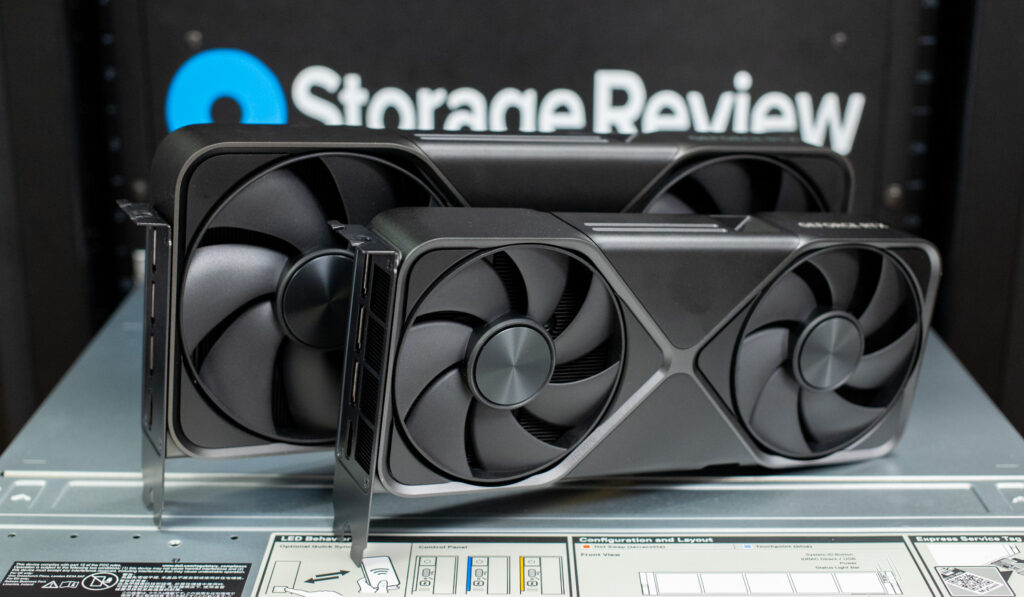
Gracze i entuzjaści sprzętu z niecierpliwością czekają na to, czy RTX 5070 w końcu zaoferuje tak dobry stosunek ceny do wydajności, jaki zawsze obiecywały karty średniej klasy. W ciągu ostatnich kilku lat wiele generacji RTX zmagało się z ograniczeniami podaży, zawyżonymi cenami i rozczarowującymi przeskokami generacyjnymi, co sprawiło, że konsumenci oczekują bardziej znaczących ulepszeń.
Na papierze RTX 5070 obiecuje spory skok w porównaniu z RTX 4070, oferując technologię Multi Frame Generation DLSS 4, wyższą przepustowość pamięci i dodatkową moc obliczeniową – wszystko to w celu zapewnienia płynniejszej rozgrywki i szybszej pracy. Przyjrzyjmy się zatem jej funkcjom, specyfikacji i szczegółom, a następnie przeanalizujmy, jak te udoskonalenia wypadają w porównaniu z poprzednią generacją, oddzielając szum medialny od rzeczywistego wzrostu wydajności.
Architektura NVIDIA GeForce RTX 5070 Founders Edition
Wykorzystując interfejs PCIe Gen5, karta RTX 5070 oferuje 6,144 rdzenie CUDA, taktowane z częstotliwością bazową 2.16 GHz i taktowane do 2.51 GHz. Zapewnia to 31 TFLOPS mocy obliczeniowej FP32, co stanowi wyraźną poprawę w porównaniu z 29 TFLOPSami karty 4070. Rdzenie śledzące promienie czwartej generacji zapewniają 94 TFLOPS mocy RT, oferując lepsze odbicia w czasie rzeczywistym, oświetlenie globalne i obsługę śledzenia ścieżek. Rdzenie Tensor piątej generacji generują 988 TFLOPS mocy obliczeniowej AI TOPS, co znacząco poprawia skalowanie w górę wspomagane przez sztuczną inteligencję, generowanie klatek i obciążenia obliczeniowe.
W porównaniu z kartą RTX 4070 FE, NVIDIA wskazuje, że karta 5070 FE oferuje nawet 1.9-krotną poprawę renderowania 3D przy użyciu technologii DLSS 4 z generacją wielu klatek oraz o 20% wyższą wydajność rasteryzacji. Różnica jest jeszcze bardziej spektakularna dla użytkowników nadal korzystających z karty RTX 3070: ponad 3-krotnie wyższa wydajność z technologią DLSS 4 i o 65% lepsza wydajność tradycyjnego rastrowania.
Jednym z najistotniejszych ulepszeń sprzętowych jest przejście na pamięć GDDR7. Karta RTX 5070 zachowuje 12 GB pamięci VRAM, ale została rozszerzona z GDDR6X do GDDR7 na magistrali 192-bitowej, zwiększając przepustowość pamięci do 675 GB/s – o 33% w porównaniu z 504 GB/s w karcie 4070. Oznacza to szybsze ładowanie tekstur, lepszą wydajność 4K i lepszą obsługę dużych zbiorów danych w aplikacjach kreatywnych.
DLSS 4 i funkcje oparte na sztucznej inteligencji
Obsługa DLSS 4 to jedna z największych zalet serii RTX 50. Wprowadza ona technologię Multi Frame Generation, nową technikę opartą na sztucznej inteligencji, która generuje wiele klatek na sekundę na renderowaną klatkę, znacząco zwiększając liczbę klatek na sekundę (FPS) w obsługiwanych grach. DLSS 4 usprawnia rekonstrukcję promieni (Ray Reconstruction) i superrozdzielczość (Super Resolution), poprawiając klarowność i stabilność obrazu.
W momencie premiery ponad 75 gier obsługuje już DLSS 4, w tym nowsze tytuły, takie jak Avowed i Kingdom Come Deliverance II, oraz starsze tytuły, takie jak niezwykle popularne Red Dead Redemption II i Microsoft Flight Simulator. Dzięki nowym rdzeniom RT i technikom odszumiania wspomaganym przez sztuczną inteligencję, gry wykorzystujące ray tracing i path tracing prawdopodobnie odnotują zauważalny wzrost wydajności.
Dla graczy rywalizujących w turniejach NVIDIA Reflex 2 oferuje funkcję Frame Warp, nową metodę redukcji opóźnień systemowych poprzez dynamiczną regulację taktowania klatek na podstawie ruchu myszy w czasie rzeczywistym. Może to przynieść korzyści w dynamicznych strzelankach, takich jak Overwatch, tryb wieloosobowy Call of Duty, Marvel's Rivals i innych tytułach e-sportowych.
Ulepszenia dotyczące tworzenia treści i profesjonalnych obciążeń roboczych
Poza grami, RTX 5070 doskonale sprawdzi się również w pracy twórców. Jednym z głównych ulepszeń jest dedykowane, akcelerowane sprzętowo kodowanie wideo 4:2:2, które pozwala na eksportowanie wideo w jakości profesjonalnej nawet 6 razy szybciej niż w przypadku RTX 4070. Sterowniki NVIDIA Studio zapewniają zoptymalizowaną wydajność podczas edycji wideo, renderowania 3D i strumieniowania na żywo, a narzędzia oparte na sztucznej inteligencji są zintegrowane z ponad 130 aplikacjami kreatywnymi.
W przypadku przepływów pracy opartych na sztucznej inteligencji (AI), karta 5070 oferuje trzykrotnie większą wydajność GenAI niż RTX 4070, dzięki akceleracji FP4 i najnowszym rdzeniom tensorowym Blackwell. Choć z pewnością nie oferuje takiej samej mocy jak wyższe modele z serii 50, to i tak stanowi doskonały wybór do uczenia maszynowego, przetwarzania obrazu opartego na sztucznej inteligencji (AI) i fotografii obliczeniowej – pomagając użytkownikom szybciej trenować modele, ulepszać obrazy za pomocą AI i przekraczać granice kreatywnej automatyzacji.
NVIDIA GeForce RTX 5070 Founders Edition Wydajność i chłodzenie
Pomimo zwiększonego TGP wynoszącego 250 W (w porównaniu z 200 W w modelu 4070), RTX 5070 pozostaje zaskakująco wydajny, biorąc pod uwagę znaczny wzrost wydajności. NVIDIA dobrze zrównoważyła pobór mocy i moc obliczeniową, zapewniając użytkownikom znaczny wzrost wydajności bez nieproporcjonalnego wzrostu zużycia energii. Chociaż wyższe TGP może budzić zdziwienie, poprawa wydajności i chłodzenia sprawia, że jest to rozsądny kompromis dla tych, którzy potrzebują stałego zasilania bez nadmiernych strat energii.
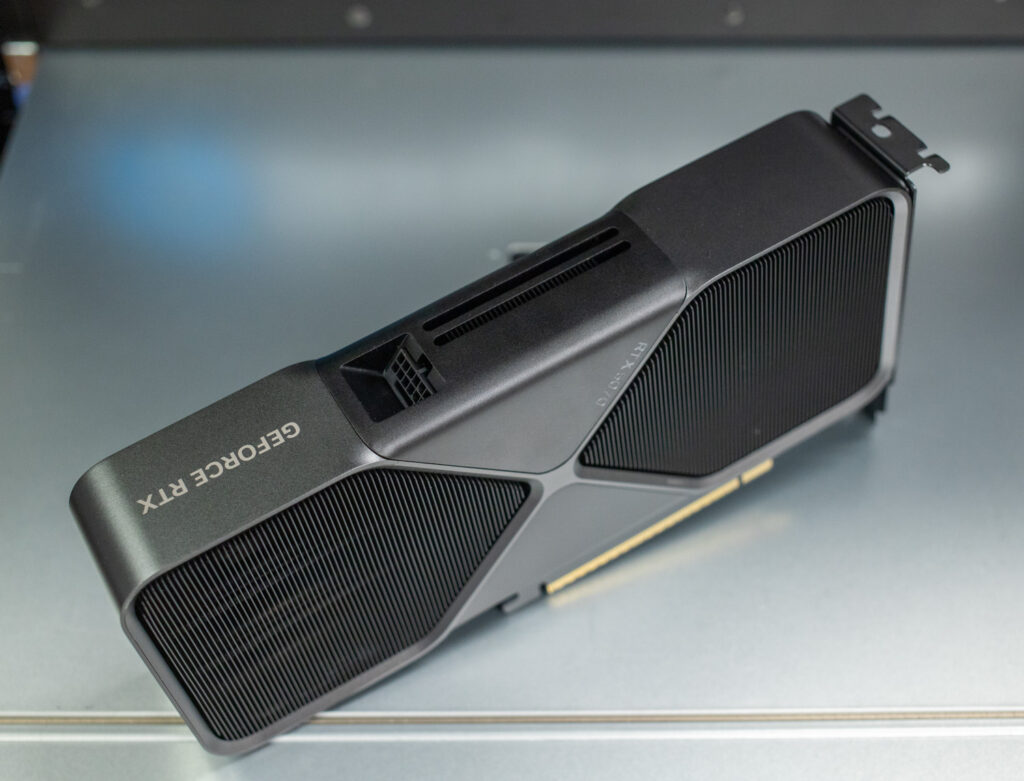
Co więcej, karta NVIDIA RTX 5070 Founders Edition charakteryzuje się zoptymalizowaną konfiguracją dwóch wentylatorów, która efektywnie zarządza przepływem powietrza i odprowadzaniem ciepła. Dzięki większym radiatorom i ulepszonej komorze parowej wyraźnie widać, że NVIDIA priorytetowo potraktowała stabilność termiczną. Oznacza to, że użytkownicy mogą obciążać kartę 5070 podczas długich sesji treningowych AI, renderowania w wysokiej rozdzielczości i innych intensywnych obciążeń, nie martwiąc się o spadki wydajności spowodowane dławieniem termicznym.
Dla użytkowników, którym zależy na niezawodnej wydajności bez obaw o przegrzewanie, konstrukcja karty 5070 wydaje się bardziej przemyślanym ulepszeniem niż zwykłym zwiększeniem mocy.
Wyświetlacz i łączność
Zgodnie z oczekiwaniami, karta RTX 5070 została stworzona z myślą o grach o wysokiej częstotliwości odświeżania i profesjonalnych konfiguracjach monitorów. Obsługuje rozdzielczość 4K z częstotliwością odświeżania 480 Hz i 8K z częstotliwością odświeżania 120 Hz dzięki trzem portom DisplayPort 2.1b i jednemu portowi HDMI 2.1b. To sprawia, że jest to doskonały wybór do monitorów e-sportowych o ekstremalnych częstotliwościach odświeżania, wysokiej klasy wyświetlaczy do gier 4K oraz profesjonalnych monitorów 8K do produkcji wideo, renderowania 3D i tworzenia treści HDR.
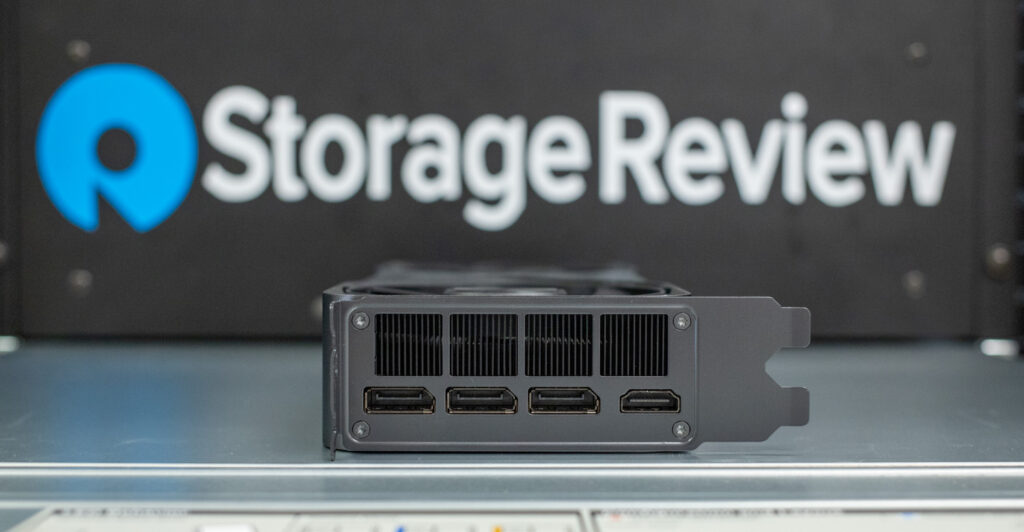
Warto jednak zauważyć, że HDMI Forum ogłosiło HDMI 2.2 na targach CES 2025, które znacząco zwiększa przepustowość do 96 Gb/s, umożliwiając rozdzielczość 10K i częstotliwość odświeżania do 240 Hz. Jeśli chcesz zapewnić sobie taki poziom wydajności w przyszłości, prawdopodobnie będziesz musiał poczekać na nową generację kart RTX, aby w pełni wykorzystać tę technologię.
Przyjrzyjmy się teraz wynikom wydajności i sprawdźmy, co oferuje RTX 5070. Dla posiadaczy RTX 4070 — lub nawet tych, którzy wciąż trzymają się GPU z serii 30 lub 20 — najważniejszym pytaniem jest, czy ulepszenia w zakresie grafiki opartej na sztucznej inteligencji, śledzenia promieni i szybkości pamięci sprawiają, że modernizacja jest opłacalna.
Specyfikacja NVIDIA GeForce RTX 5070 Founders Edition
| Porównanie GPU | NVIDIA RTX4070 | NVIDIA RTX5070 | ASUS Prime NVIDIA RTX 5070 Ti | NVIDIA RTX5080 |
| Nazwa GPU | AD104 | GB205 | GB203 | GB203 |
| Architektura | Ada Lovelace | Blackwella 2.0 | Blackwella 2.0 | Blackwella 2.0 |
| Rozmiar procesu | 5 nm | 5 nm | 5 nm | 5 nm |
| Tranzystory | 35,800 milionów | 31,000 milionów | 45,600 milionów | 45,600 milionów |
| Gęstość | 121.8 mln / mm² | 117.9 mln / mm² | 120.6 mln / mm² | 120.6 mln / mm² |
| Rozmiar matrycy | 294 mm² | 263 mm² | 378 mm² | 378 mm² |
| Szerokość gniazda | Podwójne gniazdo | Podwójne gniazdo | 2.5 Slot | Podwójne gniazdo |
| Wymiary | 240 mm x 110 mm x 40 mm | 242 mm x 112 mm | 304 x 126 x 50 mm | 304 mm x 137 mm x 48 mm |
| TDP | W 200 | W 250 | W 300 | W 360 |
| Połączenia wideo | 1x HDMI 2.1, 3x DisplayPort 1.4a | 1x HDMI 2.1b, 3x DisplayPort 2.1a | 1x HDMI 2.1b, 3x DisplayPort 2.1b | 1x HDMI 2.1b, 3x DisplayPort 2.1b |
| Złącza zasilania | 1x 16-pin | 1x 16-pin | 1x 16-pin | 1x 16-pin |
| Interfejs autobusowy | PCIe 4.0 x16 | PCIe 5.0 x16 | PCIe 5.0 x16 | PCIe 5.0 x16 |
| Zegar bazowy | 1920 MHz | 2165 MHz | 2300 MHz | 2295 MHz |
| Zwiększ zegar | 2475 MHz | 2510 MHz | Tryb OC: 2482MHz Tryb domyślny: 2452 MHz (taktowanie Boost) |
2617 MHz |
| Taktowanie pamięci | 1313 MHz (efektywne 21 Gb / s) | 2209 MHz (efektywne 28 Gb / s) | 1750 MHz (28 efektywnych) Gbps |
2366 MHz (efektywne 30 Gb / s) |
| Rozmiar pamięci | 12 GB | 12 GB | 16 GB | 16 GB |
| Typ pamięci | GDDR6X | GDDR7 | GDDR7 | GDDR7 |
| Magistrala pamięci | Bit 192 | Bit 192 | Bit 256 | Bit 256 |
| Przepustowość pamięci | 504.2 Gb / s | 672.2 Gb / s | 896.0 Gb / s | 960.0 Gb / s |
| Rdzenie CUDA | 5888 | 6,144 | 8960 | 10,752 |
| TMU | 184 | 192 | 280 | 336 |
| ROP | 64 | 64 | 128 | 128 |
| Liczba SM | 46 | 48 | 70 | 84 |
| Rdzenie tensora | 184 | 192 | 280 | 336 |
| Rdzenie RT | 46 | 48 | 70 | 84 |
| L1 Cache | 128 KB (na SM) | 128 KB (na SM) | 128 KB (na SM) | 128 KB (na SM) |
| L2 Cache | 36 MB | 40 MB | 64 MB | 64 MB |
| Szybkość pikseli | 158.4 GPixel / s | 160.6 GPixel / s | 313.9 Gpikseli/s | 335.0 GPixel / s |
| Szybkość tekstury | 455.4 GTeksela/s | 481.9 GTeksela/s | 686.6 GTeksela/s | 879.3 GTeksela/s |
| FP16 (połowa) | 29.15 TFLOPS (1:1) | 30.84 TFLOPS (1:1) | 43.94 TFLOPS (1:1) | 56.28 TFLOPS (1:1) |
| FP32 (zmiennoprzecinkowy) | X TFTPS | X TFTPS | X TFTPS | X TFTPS |
| FP64 (podwójny) | 455.4 GFLOPS (1:64) | 481.9 GFLOPS (1:64) | 686.6 GFLOPS (1:64) | 879.3 GFLOPS (1:64) |
| Cena początkowa (USD) | $599 | $549 | $749 | $999 |
Platforma testowa StorageReview AMD Threadripper
Oto platforma testowa, której będziemy używać do testowania RTX 5070 FE:
- płyta główna: ASUS Pro WS TRX50-SAGE WIFI
- PROCESOR: AMD Ryzen Threadripper 7980X 64-rdzeniowy
- RAM: 128 GB DDR5 4800MT/s
- Przechowywanie: 2 TB Samsunga 980 Pro
- OS: Windows 11 Pro dla stacji roboczych
- Kierowca: Sterownik NVIDIA 571.86 GameReady
Sercem naszego systemu testowego jest procesor AMD Ryzen Threadripper 7980X, wyposażony w 64 rdzenie i rozbudowane możliwości wielowątkowości. Dzięki temu ograniczenia procesora nie kolidują z testami wydajnościowymi zorientowanymi na GPU, zwłaszcza w przypadku przetwarzania AI, ray tracingu i renderowania w wysokiej rozdzielczości, gdzie obciążenia są w dużym stopniu przenoszone na GPU.
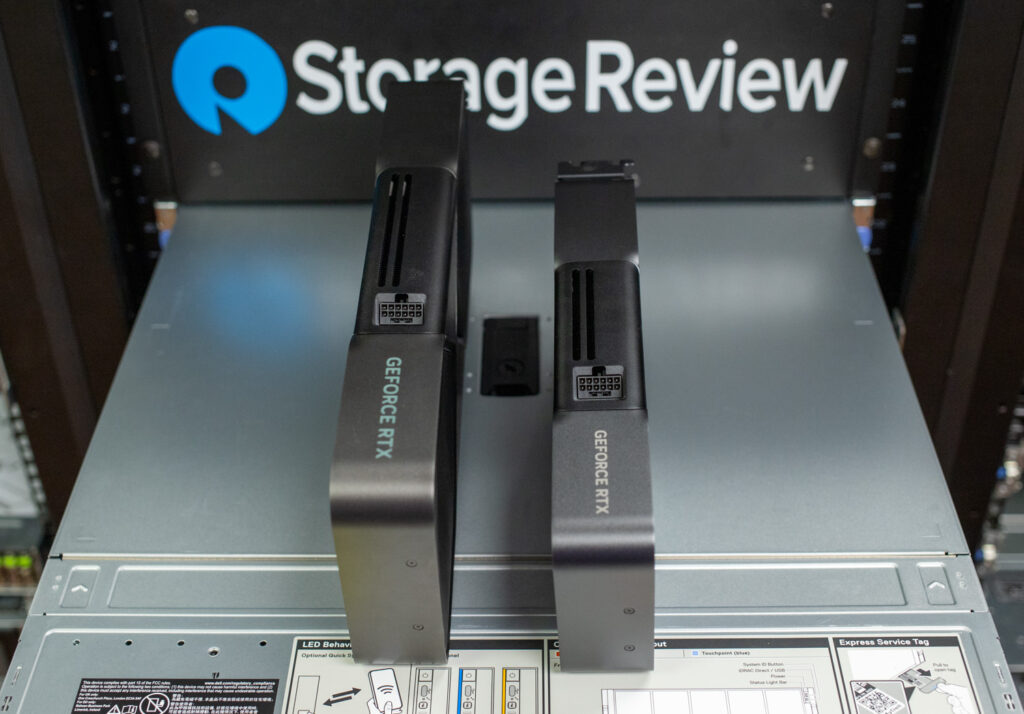
Połączyliśmy kartę 7980X z płytą główną ASUS Pro WS TRX50-SAGE WIFI, aby zapewnić wystarczającą przepustowość PCIe, dzięki czemu GPU może osiągnąć pełnię swojego potencjału bez wąskich gardeł. Nasz system zawiera również 128 GB pamięci DDR5 o przepustowości 4800 MT/s, co zapewnia wystarczającą rezerwę mocy obliczeniowej do płynnej pracy podczas obsługi dużych zbiorów danych. Chociaż Samsung 980 Pro to nieco starszy dysk SSD Gen4, nadal zapewnia wysokie prędkości odczytu/zapisu, minimalizując czas ładowania i zapobiegając utrudnieniom w realizacji zadań wymagających dużej ilości danych, takich jak wnioskowanie modeli AI czy strumieniowanie tekstur, spowodowanym przez wydajność pamięci masowej.
Taka konfiguracja powinna umożliwić nam wyizolowanie i dokładne zmierzenie rzeczywistej wydajności karty GeForce RTX 5070, zatem przystąpmy do konkretów.
Porównamy kartę RTX 5070 FE z następującymi procesorami graficznymi:
- NVIDIA RTX5080 (16 GB GDDR7)
- ASUS Prime NVIDIA RTX 5070 Ti (16 GB GDDR7)
- NVIDIA RTX 4070 (12 GB GDDR6X)
UL Procyon: generowanie tekstu AI
Pierwszym testem w naszym zestawie jest Procyon AI Text Generation Benchmark . Ten benchmark upraszcza testowanie wydajności LLM AI, oferując zwartą i spójną metodę oceny, umożliwiając wielokrotne testowanie wielu modeli LLM, jednocześnie minimalizując złożoność dużych rozmiarów modeli i zmiennych czynników. Opracowany we współpracy z liderami w dziedzinie sprzętu AI, ten benchmark optymalizuje wykorzystanie lokalnych akceleratorów AI, zapewniając bardziej niezawodne i wydajne oceny wydajności. Poniższe wyniki zostały przetestowane przy użyciu TensorRT.
W tym teście karta RTX 5070 Founders Edition przewyższa poprzednią generację 4070 w każdym teście. Niezależnie od tego, czy chodzi o wyniki ogólne, czas wygenerowania pierwszego tokena, czy liczbę tokenów na sekundę, karta 5070 FE wykazuje wzrost wydajności – zazwyczaj rzędu 10–15%. Ten wzrost przekłada się na szybsze wyniki AI, krótsze czasy oczekiwania i płynniejsze wnioskowanie w modelu. Na przykład, w teście Phi, wynik karty 4070 z 3,191 punktów wzrósł do 3,453 punktów w przypadku karty 5070 FE, a liczba tokenów na sekundę wzrosła ze 141.575 do 150.435. Choć nie jest to przełomowa różnica, to wystarczy, aby zauważyć zauważalną poprawę w obciążeniach syntetycznych i rzeczywistym wykorzystaniu.
W porównaniu z mocniejszym modelem 5070 Ti, 5070 FE wypada prawdopodobnie gorzej o około 15–25%, w zależności od konkretnego testu. Na przykład, w tym samym benchmarku Phi, wersja Ti osiąga 4,179 punktów w ogólnym wyniku – znaczny wzrost w porównaniu z 3,453 punktami FE. Ta różnica w wydajności utrzymuje się w testach serii Mistral i Llama, co pokazuje, że Ti oferuje większą przewagę użytkownikom potrzebującym większej przepustowości AI. Tymczasem flagowy model 5080 znajduje się na szczycie tabeli liderów, wyprzedzając 5070 Ti o dodatkowe 5–10%. Jego przewaga jest najbardziej widoczna w szybkości generowania tokenów i czasie do wygenerowania pierwszego tokena, gdzie skrócenie ułamka sekundy może mieć duże znaczenie w przypadku obciążeń o dużej objętości.
Chociaż procesor 5070 FE nie jest gorszy w zadaniach wnioskowania AI, zaawansowani użytkownicy, którzy oczekują jeszcze szybszych czasów generowania — lub ci, którzy przetwarzają ogromne zbiory danych — mogą stwierdzić, że procesory 5070 Ti lub 5080 lepiej spełniają ich potrzeby w tym zakresie wydajności.
| UL Procyon: generowanie tekstu AI | NVIDIA RTX4070 | NVIDIA RTX5070 | ASUS Prime NVIDIA RTX 5070 Ti | NVIDIA RTX5080 |
| Wynik ogólny Phi | 3,191 | 3,453 | 4,179 | 4,400 |
| Czas wyjścia Phi do pierwszego tokena | 0.356 s | 0.323 s | 0.290 s | 0.277 s |
| Tokeny wyjściowe Phi na sekundę | 141.575 tokenów/sek. | 150.435 tokenów/sek. | 192.487 tokenów/sek. | 209.459 tokenów/sek. |
| Całkowity czas trwania Phi | 21.743 s | 20.302 s | 15.771 s | 14.908 s |
| Wynik ogólny Mistral | 2,987 | 3,562 | 4,412 | 4,635 |
| Czas wyjścia Mistral do pierwszego tokena | 0.508 s | 0.433 s | 0.374 s | 0.347 s |
| Żetony wyjściowe Mistral na sekundę | 99.590 tokenów/sek. | 120.507 tokenów/sek. | 160.167 tokenów/sek. | 163.598 tokenów/sek. |
| Całkowity czas trwania Mistrala | 30.651 s | 25.496 s | 19.480 s | 18.933 s |
| Ocena ogólna Llama3 | 2,810 | 3,125 | 4,187 | 4,424 |
| Czas wyjścia Llama3 do pierwszego tokena | 0.423 s | 0.379 s | 0.306 s | 0.283 s |
| Tokeny wyjściowe Llama3 na sekundę | 82.130 tokenów/sek. | 100.388 tokenów/sek. | 131.853 tokenów/sek. | 136.177 tokenów/sek. |
| Całkowity czas trwania Llama3 | 36.147 s | 29.720 s | 22.786 s | 21.985 s |
| Ocena ogólna Llama2 | 2,658 | 3,125 | 4,284 | 4,790 |
| Czas wyjścia Llama2 do pierwszego tokena | 0.947 s | 0.785 s | 0.560 s | 0.493 s |
| Tokeny wyjściowe Llama2 na sekundę | 49.487 tokenów/sek. | 56.647 tokenów/s | 75.905 tokenów/sek. | 83.653 tokenów/sek. |
| Całkowity czas trwania Llama2 | 61.300 s | 53.234 s | 39.545 s | 35.703 s |
UL Procyon: Generowanie obrazu AI
Test Procyon AI Image Generation Benchmark konsekwentnie i dokładnie mierzy wydajność wnioskowania AI na różnym sprzęcie, od energooszczędnych NPU po zaawansowane procesory graficzne (GPU). Obejmuje on trzy testy: Stable Diffusion XL (FP16) dla zaawansowanych procesorów graficznych, Stable Diffusion 1.5 (FP16) dla procesorów graficznych o umiarkowanej mocy oraz Stable Diffusion 1.5 (INT8) dla urządzeń o niskim poborze mocy. Test wykorzystuje optymalny silnik wnioskowania dla każdego systemu, zapewniając uczciwe i porównywalne wyniki.
Karta RTX 5070 FE przewyższa kartę 4070 w każdym teście generowania obrazu – szczególnie zauważalnie w teście Stable Diffusion 1.5 (FP16), gdzie jej ogólny wynik skacze z 2,400 punktów w modelu 4070 do 2,937 punktów w modelu 5070 FE. Ta różnica przekłada się na szybsze generowanie obrazu i krótsze czasy wnioskowania w testach FP16 i INT8, co czyni kartę 5070 FE mocną kandydatką dla użytkowników koncentrujących się na obciążeniach graficznych opartych na sztucznej inteligencji. W porównaniu z modelami 5070 Ti i 5080, 5070 FE wypada gorzej o około 20–25% w większości testów, co może uzasadniać wyższą cenę modelu Ti dla użytkowników o wyjątkowo wysokich wymaganiach w zakresie generowania obrazu z wykorzystaniem sztucznej inteligencji. Tymczasem 5080 idzie o krok dalej, przewyższając Ti o kolejne 15–20%.
Z praktycznego punktu widzenia, RTX 5070 FE oferuje wyraźną przewagę nad 4070, co przekłada się na zauważalnie krótszy czas wnioskowania i płynniejszy proces tworzenia treści. Jeśli jednak regularnie obsługujesz złożone lub wielkoskalowe zadania związane z generowaniem obrazów, dodatkowy wzrost wydajności o 20–25% oferowany przez 5070 Ti – lub o 15–20% w przypadku 5080 – może być wart inwestycji.
| UL Procyon: Generowanie obrazu za pomocą sztucznej inteligencji (wynik ogólny: im wyższy, tym lepiej) | NVIDIA RTX4070 | NVIDIA RTX5070 | ASUS Prime NVIDIA RTX 5070 Ti | NVIDIA RTX5080 |
| Stabilna dyfuzja 1.5 (FP16) — wynik ogólny | 2,400 | 2,937 | 3,755 | 4,650 |
| Stabilna dyfuzja 1.5 (FP16) — czas całkowity | 41.661 s | 34.038 s | 26.625 s | 21.503 s |
| Stabilna dyfuzja 1.5 (FP16) — prędkość generowania obrazu | 2.604 s/obraz | 2.127 s/obraz | 1.664 s/obraz | 1.344 s/obraz |
| Stabilna dyfuzja 1.5 (INT8) — wynik ogólny | 31,048 | 36,320 | 46,744 | 55,683 |
| Stabilna dyfuzja 1.5 (INT8) — czas całkowity | 8.052 s | 6.883 s | 5.348 s | 4.490 s |
| Stabilna dyfuzja 1.5 (INT8) — prędkość generowania obrazu | 1.006 s/obraz | 0.860 s/obraz | 0.669 s/obraz | 0.561 s/obraz |
| Stabilna dyfuzja XL (FP16) — ocena ogólna | 1,940 | 2,473 | 3,352 | 4,257 |
| Stabilna dyfuzja XL (FP16) — czas całkowity | 309.269s | 242.606s | 178.946 s | 140.928s |
| Stabilna dyfuzja XL (FP16) — prędkość generowania obrazu | 19.329 s/obraz | 15.163 s/obraz | 11.184 s/obraz | 8.808 s/obraz |
Luxmark
Luxmark to test wydajności GPU, który wykorzystuje LuxRender, open-source'owy moduł renderujący oparty na ray tracingu, do oceny wydajności systemu w obsłudze bardzo szczegółowych scen 3D. Ten test jest istotny dla oceny możliwości renderowania graficznego serwerów i stacji roboczych, szczególnie w aplikacjach do efektów wizualnych i wizualizacji architektonicznej, gdzie precyzyjna symulacja oświetlenia ma kluczowe znaczenie.
W teście Luxmark, który ocenia wydajność zaawansowanego śledzenia promieni, RTX 5070 FE zapewnia około 20% wzrost w porównaniu z 4070 w teście sceny „Jedzenie” (7,535 vs. 9,061) i około 10% w teście sceny „Hall” (20 003 vs. 22 062). W porównaniu z 5070 Ti, traci on około 33% w teście „Jedzenie” (9,061 vs. 12 073) i 30% w teście „Hall” (22 062 vs. 28 635) – ta zauważalna różnica może uzasadniać wyższą cenę Ti dla użytkowników zajmujących się renderowaniem 3D na dużą skalę lub projektami VFX. Model 5080 jeszcze bardziej zwiększa te marże, przewyższając model 5070 FE o ponad 50% w kategorii żywności (9,061 w porównaniu do 13 637) i o około 40% w kategorii hali (22 062 w porównaniu do 30 815).
| Luxmark (im wyższy tym lepszy) | NVIDIA RTX4070 | NVIDIA RTX5070 | ASUS Prime NVIDIA RTX 5070 Ti | NVIDIA RTX5080 |
| Ocena żywności | 7,535 | 9,061 | 12,073 | 13,637 |
| Wynik Halla | 20,003 | 22,062 | 28,635 | 30,815 |
W powiązanych procesach — takich jak wizualizacja architektoniczna czy produkcja efektów wizualnych — model 5070 FE nadal stanowi znaczący postęp w porównaniu z modelem 4070.
Geekbench 6
Geekbench 6 to wieloplatformowy benchmark mierzący ogólną wydajność systemu. Przeglądarka Geekbench pozwala porównać z nim dowolny system.
W poniższej tabeli wyników, RTX 5070 FE uzyskał 188 892 punkty, co stanowi znaczną poprawę w porównaniu z 174 725 punktami uzyskanymi przez 4070. 8-procentowy wzrost wyniku GPU OpenCL w Geekbench 6 – ze 174 725 do 188 892 – może na pierwszy rzut oka nie wydawać się ogromny. Mimo to, może on zapewnić niewielką poprawę w przypadku zadań wymagających dużej ilości zasobów, takich jak edycja wideo w wysokiej rozdzielczości, złożone renderowanie 3D czy wnioskowanie oparte na uczeniu maszynowym. Chociaż nie wpłynie to znacząco na prostsze procesy, dodatkowy zapas mocy obliczeniowej może być bardziej odczuwalny, jeśli często wykorzystujesz GPU do granic możliwości.
| Geekbench (im wyższy wynik, tym lepiej) | NVIDIA RTX4070 | NVIDIA RTX5070 | ASUS Prime NVIDIA RTX 5070 Ti | NVIDIA RTX5080 |
| Wynik OpenCL GPU | 174,725 | 188,892 | 246,875 | 265,397 |
Przepaść ta, jak można się spodziewać, powiększa się w porównaniu z droższymi modelami z serii 50. Model 5070 Ti zdobywa 246 875 punktów, czyli o około 30% więcej mocy. Na szczycie tabeli wyników plasuje się model 5080, który zdobywa jeszcze więcej, osiągając wynik 265 397, co jest atrakcyjne zarówno dla profesjonalistów, jak i entuzjastów stacji roboczych. Mimo to, model 5070 FE to idealny wybór dla użytkowników, którzy oczekują zauważalnej poprawy w zadaniach wymagających użycia GPU, bez konieczności inwestowania w droższe rozwiązania.
V-Ray
V -Ray Benchmark mierzy wydajność renderowania dla procesorów CPU, GPU NVIDIA lub obu, wykorzystując zaawansowane silniki V-Ray 6. Wykorzystuje szybkie testy i prosty system punktacji, aby umożliwić użytkownikom ocenę i porównanie możliwości renderowania ich systemów. To niezbędne narzędzie dla profesjonalistów poszukujących efektywnych analiz wydajności.
W tym przypadku RTX 5070 FE uzyskał wynik 6,553, co stanowi znaczący wzrost o 47% w porównaniu z wynikiem 4,469 uzyskanym przez RTX 4070. Ten wzrost prawdopodobnie przełoży się na znacznie płynniejsze działanie w przypadku obciążeń intensywnie renderujących, takich jak sceny z ray tracingiem, wizualizacje architektoniczne czy zaawansowane CGI. W przypadku profesjonalistów lub entuzjastów, którzy przesiadają się z 4070 na 5070, czas renderowania może ulec zauważalnemu skróceniu, w zależności od pozostałych elementów konfiguracji systemu.
| V-Ray (im wyżej tym lepiej) | NVIDIA RTX4070 | NVIDIA RTX5070 | ASUS Prime NVIDIA RTX 5070 Ti | NVIDIA RTX5080 |
| ścieżki wirtualne | 4,469 | 6,553 | 8,018 | 9,311 |
Porównując RTX 5070 z modelami z wyższej półki, 5070 Ti osiąga wynik vpath na poziomie 8,018, przewyższając 5070 FE o około 22%. 5080 z kolei osiąga wynik 9,311, oferując o 42% wyższą wydajność niż 5070 FE. Chociaż Ti i 5080 lepiej nadają się do intensywnego renderowania, 5070 FE nadal stanowi znaczący krok naprzód w porównaniu z poprzednią generacją, co czyni go solidną opcją ze średniej półki.
Mark 3D
3DMark Port Royal, Speed Way i Steel Nomad to testy wydajności GPU w różnych scenariuszach. Port Royal koncentruje się na ray tracingu, Speed Way ocenia wydajność w symulacjach wyścigowych, a Steel Nomad testuje GPU za pomocą intensywnej, realistycznej grafiki. Oceniają one możliwości GPU w zakresie renderowania, oświetlenia i dynamicznych scen.
| Test 3DMark (im wyższy wynik, tym lepiej) | NVIDIA GeForce RTX 4070 | NVIDIA RTX5070 | ASUS PRIME NVIDIA RTX 5070 Ti |
| Port Royal | 11,074 | 14,026 | 19,290 |
| Żużel | 4,477 | 5,869 | 7,709 |
| Stalowy Nomad | 3,748 | 5,019 | 6,458 |
Karta NVIDIA RTX 5070 oferuje nawet o 31% wyższą wydajność niż RTX 4070 w testach 3DMark, co stanowi znaczącą poprawę w stosunku do swojej ceny. ASUS PRIME RTX 5070 Ti oferuje jeszcze wyższą wydajność, osiągając średnio o 41% wyższą niż RTX 4070.
Wyniki dotyczące efektywności energetycznej kart założycielskich NVIDIA GeForce RTX 5070
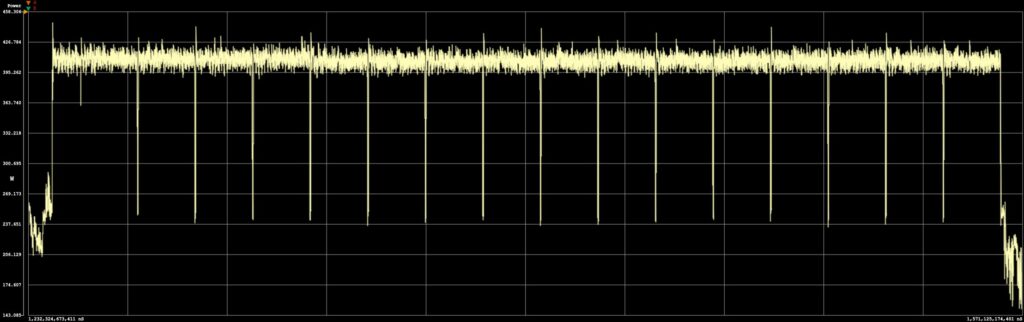
Użyliśmy testu Procyon AI Image jako punktu odniesienia do pomiaru zużycia energii wszystkich nowych procesorów graficznych NVIDIA z serii 50. Uruchomiając test Stable Diffusion XL FP16, bierzemy pod uwagę interwał od przedostatniego generowanego obrazu. Mierzymy czas od początku do końca tego interwału, szczytowe zużycie energii, średni pobór mocy w stanie wysokim oraz pobór mocy w stanie spoczynku po zakończeniu testu. Nasze testy wykazały średnie zużycie energii na poziomie 409 W przy stałym obciążeniu, ze szczytowym poborem 429 W i poborem mocy w stanie spoczynku na poziomie 184 W. Przy nominalnej mocy znamionowej karty NVIDIA GeForce RTX 5070 wynoszącej 250 W, pobór mocy wynosił około 225 W, a szczytowy 245 W. Karta ukończyła nasz 19.2-sekundowy cykl testowy z całkowitym zużyciem energii na poziomie 2.46 Wh. Jest to zauważalny wzrost w porównaniu z modelem 5070Ti i ponad dwukrotnie więcej niż zmierzyliśmy w przypadku karty GeForce RTX 5090.
| Stabilna moc obrazu FP16 (im niższa, tym lepiej) | NVIDIA RTX5070 | ASUS Prime NVIDIA RTX 5070 Ti | NVIDIA RTX5080 | NVIDIA RTX5090 |
| Zużycie energii | 2.46Wh | 1.66Wh | 1.39Wh | 1.16Wh |
| Czas trwania testu | 19.2 s | 11.1 s | 8.7 s | 5.1 s |
Wniosek
Karta NVIDIA RTX 5070 FE osiąga kluczową cenę 549 dolarów, oferując połączenie wydajności i funkcji nowej generacji bez popadania w pułapkę cenową z najwyższej półki. Dla użytkowników kart graficznych z serii 30 lub 20 karta ta stanowi wyraźną poprawę – wyższa liczba klatek na sekundę, lepsza przepustowość pamięci i funkcje oparte na sztucznej inteligencji, takie jak generowanie wielu klatek DLSS 4, przyczyniają się do płynniejszego i bardziej responsywnego działania. Jeśli korzystasz z karty graficznej z serii 40, karta 5070 nadal oferuje znaczące ulepszenia, szczególnie w zakresie renderowania i zadań związanych ze sztuczną inteligencją.
W naszych testach karta RTX 5070 konsekwentnie przewyższała kartę 4070 o 10–15% w aplikacjach opartych na sztucznej inteligencji, a jeszcze większe skoki odnotowano w renderowaniu i zadaniach wymagających dużej mocy obliczeniowej. Na przykład, V-Ray odnotował wzrost wydajności o ponad 40%, znacząco skracając czas renderowania złożonych scen z ray tracingiem. Te korzyści podkreślają postępy firmy NVIDIA w technologii Blackwell, w tym ulepszone rdzenie tensorowe i RT oraz przejście na pamięć GDDR7, która pozwala na lepszą obsługę tekstur o wysokiej rozdzielczości i wymagających zadań kreatywnych. Chociaż 12 GB pamięci VRAM pozostawia wiele do życzenia, to w zupełności wystarcza do wielu zadań związanych z grami i sztuczną inteligencją, zwłaszcza w przypadku mniejszych modeli lokalnych.
Podsumowując, RTX 5070 FE wydaje się być zrównoważoną opcją, która zapewnia dostęp do funkcji nowej generacji w rozsądnej cenie. NVIDIA pozostawiła miejsce dla tych, którzy potrzebują większej mocy, oferując karty 5070 Ti i 5080, ale dla większości użytkowników 5070 oferuje doskonały balans między ceną a wydajnością. Prawdziwym wyzwaniem będzie jednak dostępność. Jeśli NVIDIA utrzyma stabilny poziom zapasów, może to być wreszcie karta średniej klasy, która oferuje zarówno wydajność, jak i dostępność, bez problemów z dostawami, charakterystycznych dla poprzednich generacji.


 Amazon