

Wersja Ollama 0.40.11 oferuje użytkownikom systemu Windows aplikację do czatu na pulpicie oraz lokalne środowisko uruchomieniowe dla innych programów. Ollama rozszerzyła również swój pierwotny interfejs wiersza poleceń, dodając wyszukiwalny selektor modeli, załączniki graficzne oraz linki do narzędzi programistycznych. Niektóre elementy sterujące, których potrzebowaliśmy do testów, nadal są dostępne w plikach konfiguracyjnych programu PowerShell i modelu.
Zainstalowaliśmy Ollamę na naszym komputerze HP Z4 Rack G5 z systemem Windows 11 Pro for Workstations, 128 GB pamięci RAM i kartą graficzną NVIDIA RTX 5000 Ada Generation. Korzystając z istniejących modeli Jan V3.5 4B i Jan V2 VL High GGUF, przetestowaliśmy szybkość generacji, czat, obrazy, wyszukiwanie online i lokalne API. Ollama dobrze obsługiwała nasze modele lokalne, chociaż importowanie modeli GGUF i zbieranie danych o wydajności wyłączyło czat na pulpicie. Jest to trzecia aplikacja w naszej lokalnej serii LLM, po Jan i Open WebUI , a wyniki trafiają na naszą stronę Best Local LLM Tools.
System testowania
| Składnik | Konfiguracja |
|---|---|
| System operacyjny | Windows 11 Pro dla stacji roboczych |
| CPU | Intel Xeon w5-2465X, 16 rdzeni |
| Pamięć | 128GB |
| GPU | Generacja NVIDIA RTX 5000 Ada |
| VRAM | 32 GB (zgłoszono 32 760 MiB) |
| Sterownik NVIDIA | 597.06 |
| Zgodność z CUDA | 13.2 (zgłoszone przez nvidia-smi) |
| Ollama | 0.40.11 |
| Środowisko wykonawcze wnioskowania | Ollama llama.cpp runner (numer kompilacji nie został zarejestrowany) |
Instalowanie Ollama i rozpoczęcie pracy
Instalacja Ollama na naszym komputerze z systemem Windows była miłą odmianą po problemach z konfiguracją, z którymi borykaliśmy się w przypadku innych aplikacji z tej serii. Pobraliśmy standardowy instalator systemu Windows, uruchomiliśmy aplikację i nie musieliśmy instalować osobnego środowiska wykonawczego inferencji ani szukać pakietów CUDA. Szybkie sprawdzenie w programie PowerShell potwierdziło, że Ollama 0.40.11 działa, a jej usługa lokalna odpowiada już pod adresem http://127.0.0.1:11434.
Ekran powitalny Ollama przedstawia lokalne funkcje sztucznej inteligencji i połączenia z narzędziami programistycznymi przed otwarciem głównego interfejsu.
Po przejściu przez ekran powitalny, Ollama otworzył znajomy interfejs czatu z ostatnimi rozmowami, aplikacjami i ustawieniami na lewym pasku bocznym. Pole wiadomości zawiera przycisk załącznika, wyszukiwarkę internetową i selektor modeli. Mogliśmy rozpocząć czatowanie z naszymi zaimportowanymi modelami lokalnymi bez zakładania konta, chociaż Ollama poprosił nas o zalogowanie, gdy później próbowaliśmy włączyć wyszukiwarkę internetową podczas testów.
Przeglądanie i dodawanie modeli
Ollama zapewnia dość prosty wybór modeli, dzięki rozwijanej liście, która pokazuje zarówno zainstalowane modele, jak i inne dostępne do pobrania. Widzieliśmy nasze zaimportowane modele Jan i Qwen3-VL obok kilku opcji w chmurze, które były oznaczone małą ikoną chmury. Dostępne jest również pole wyszukiwania, pozwalające znaleźć inne modele, choć chcielibyśmy zobaczyć tu więcej informacji, takich jak rozmiary modeli, kwantyzacja i wymagania sprzętowe. Jan udostępnia te dane za pośrednictwem centrum modeli, podczas gdy Ollama przechowuje większość tych informacji poza głównym interfejsem czatu.
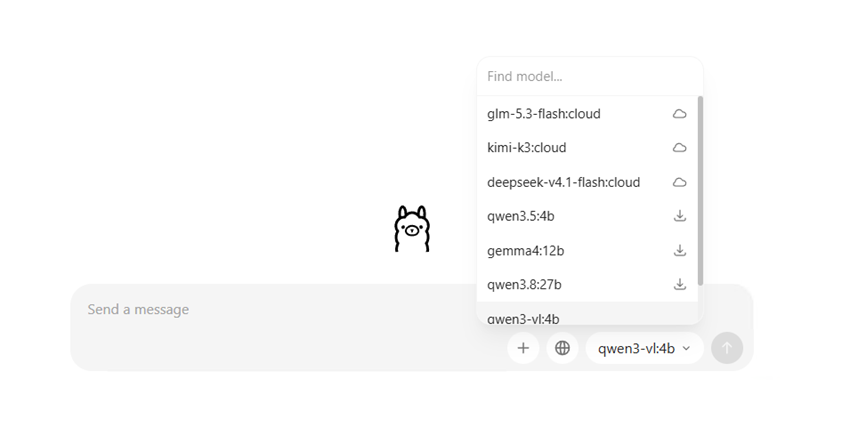
Selektor modeli łączy modele do pobrania i modele w chmurze z zainstalowanymi modelami lokalnymi.
Wprowadzenie naszych dwóch modeli testowych do Ollama wymagało więcej pracy, ponieważ chcieliśmy użyć dokładnie tych samych plików GGUF, które wykorzystaliśmy w naszych poprzednich recenzjach, aby testy wydajności były jak najbardziej porównywalne. Chociaż Ollama umożliwia pobieranie modeli bezpośrednio przez interfejs pulpitu, nie mogliśmy znaleźć opcji importowania plików GGUF już zapisanych na stacji roboczej. Musieliśmy zamiast tego użyć programu PowerShell, tworząc plik modelu dla każdego modelu, który wskazywał na istniejący plik GGUF i zawierał parametry próbkowania użyte we wcześniejszych testach. Następnie użyliśmy ollama create polecenie dodania ich do biblioteki modeli Ollama.
Oba importy przebiegły bez żadnych problemów, a Jan V3.5 pojawił się jako jan-v35-sr i Jan V2 VL High jako jan-v2-srPobraliśmy również Qwen3-VL 4B bezpośrednio przez Ollamę w celu przeprowadzenia oddzielnego testu analizy obrazu.
Po zaimportowaniu modeli sprawdziliśmy, jak Ollama je zidentyfikowała i czy ich ustawienia zostały poprawnie przeniesione. Model Jan V2 VL High został rozpoznany jako model Qwen3-VL o 8.2 miliarda parametrów, wykorzystujący kwantyzację Q4_K_M, co odpowiadało naszemu oryginalnemu plikowi. Wyjątkiem był Jan V3.5, ponieważ zaimportowany przez nas plik GGUF nosił nazwę Jan-v3.5-4B-Q4_K_XL.gguf, ale Ollama zgłosił kwantyzację jako Q4_K_M. Oryginalny plik pozostawiliśmy bez zmian; prawdopodobnym powodem jest to, że Q4_K_XL to dynamiczna kwantyzacja Unslotha, zbudowana głównie z warstw Q4_K_M, a metadane pliku rejestrują ten typ bazowy.
Ustawienia modelu i użycie GPU
Strona ustawień Ollama obejmuje dostęp do chmury, automatyczne aktualizacje, dostęp do sieci, ścieżkę do magazynu modeli oraz suwak długości kontekstu, który podczas naszej pierwszej inspekcji wskazywał 32 tys. tokenów. Nasze testy wydajności wyraźnie zażądały 8,192 tokenów przez API, więc poniższe wyniki testów porównawczych wykorzystywały ten kontekst, a nie domyślny dla pulpitu.
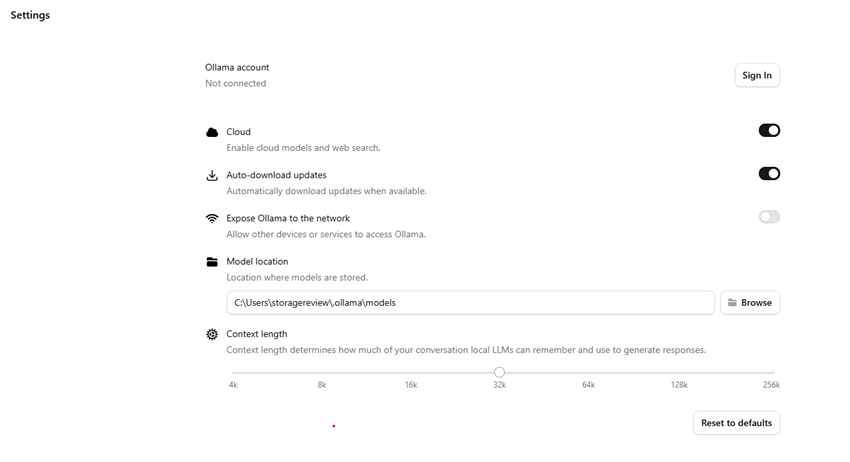
Strona Ustawienia oferuje opcje chmury, aktualizacji, sieci, pamięci masowej modelu i długości kontekstu. Początkowe ustawienie kontekstu pokazane tutaj wynosiło 32 KB.
Ponieważ Ollama nie oferuje takiego samego poziomu konfiguracji modelu za pośrednictwem interfejsu pulpitu jak Jan, większość zmian wprowadziliśmy za pomocą plików modeli i żądań API. Aby zachować porównywalność naszych testów, zastosowaliśmy te same ustawienia, co w poprzednich testach: temperatura 0.8, Top K 40, Top P 0.95, Min P 0.05 oraz karę za powtórzenie 1.0. Zażądaliśmy również rozmiaru partii 2,048, chociaż nie mogliśmy niezależnie zweryfikować, czy Ollama zastosowała go podczas generowania.
Konfiguracja GPU również była inna, ponieważ nie było ustawienia pulpitu odpowiadającego 100 warstwom GPU, których używaliśmy w styczniu. Ollama automatycznie obsługiwał odciążanie GPU, a szybkie sprawdzenie za pomocą ollama ps potwierdzono, że oba importowane modele działały wyłącznie w oparciu o kartę graficzną RTX 5000 Ada.
Zweryfikowaliśmy ten raport z odczytami firmy NVIDIA. Wersja 3.5 ze stycznia zwiększyła alokację pamięci VRAM o kilka gigabajtów po załadowaniu, a odczyt na żywo wykazał 93% wykorzystania GPU podczas generacji. Wersja 2 ze stycznia również raportowała pełną rezydentność GPU i wykazała 96% wykorzystania w naszym przebiegu diagnostycznym. Przynajmniej na tej stacji roboczej nie musieliśmy korzystać z oddzielnej konfiguracji CUDA ani warstwy GPU, aby uzyskać przyspieszoną generację.
Wydajność lokalnej generacji
Do testów generacji wykorzystaliśmy ten sam temat z naszego opublikowanego w styczniu szkolenia praktycznego : „Wyjaśnij RAID 5 i RAID 6 komuś budującemu swój pierwszy serwer NAS. Uwzględnij główne zalety i wady każdego z nich w około 400 słowach”. Wyłączyliśmy wyszukiwanie w sieci, ustawiliśmy kontekst na 8,192 tokeny i uwzględniliśmy tylko ten jeden komunikat użytkownika w każdym żądaniu API. Odrzuciliśmy jedną odpowiedź rozgrzewkową dla każdego modelu, a następnie zebraliśmy trzy zmierzone przebiegi.
Oba modele ukończyły wszystkie trzy przebiegi pomiarowe bez awarii generacji, a wykorzystanie GPU utrzymywało się na wysokim poziomie przez cały czas testów. Ollama nie wymagała dodatkowej konfiguracji CUDA ani ręcznych regulacji warstwy GPU, aby oba modele działały z pełną akceleracją GPU, co nie miało miejsca w Open WebUI, gdzie ręcznie dodawaliśmy biblioteki DLL środowiska wykonawczego CUDA.
| Model | Kwantyzacja | Tokeny wyjściowe | Prędkość dekodowania | Pamięć GPU |
|---|---|---|---|---|
| Styczeń V3.5 4B | Plik Q4_K_XL* | 529 | 145.48 tok/s | 5,082 MiB |
| Jan V2 VL High | Q4_K_M | 1,696 | 92.87 tok/s | 7,124 MiB |
Uwaga: Liczba tokenów wyjściowych, prędkość dekodowania i dane dotyczące pamięci GPU to mediany z trzech zmierzonych przebiegów po odrzuceniu jednego przebiegu rozgrzewkowego. Pamięć GPU to mediana szczytowego wykorzystania pamięci przez cały GPU zarejestrowanego podczas każdego zmierzonego przebiegu.
*Nazwa pliku GGUF w wersji 3.5 ze stycznia identyfikuje Q4_K_XL, podczas gdy informacje o modelu Ollama zgłaszają Q4_K_M; patrz uwagi dotyczące importowania powyżej.
Wersja 3.5 stycznia zarejestrowała 145.48, 145.73 i 145.44 tokenów/s w zmierzonych przebiegach, podczas gdy wersja 2 stycznia zarejestrowała 92.87, 92.22 i 92.97 tokenów/s. Oba zestawy utrzymywały się na podobnym poziomie w kolejnych przebiegach, a zmierzone szczyty pamięci GPU pozostały niezmienione w każdym zestawie. Wersja 2 stycznia wygenerowała znacznie więcej zgłoszonych tokenów wyjściowych, najwyraźniej uwzględniając aktywność wnioskowania, więc te sumy nie stanowią bezpośredniego porównania widocznej długości odpowiedzi.
Na tych samych stacjach roboczych i plikach modelu są to jak dotąd najszybsze wyniki w tej serii. Wersja 3.5 stycznia dekodowała o 18 procent szybciej niż w samym styczniu (123 tokeny/s) i o 26 procent szybciej niż w Open WebUI Desktop (115.32), a wersja 2 stycznia wyprzedziła o 13 procent styczeń (82) i o 24 procent Open WebUI (75.06). Każda aplikacja uruchamia własną kompilację llama.cpp i zarządza odciążaniem GPU na swój własny sposób, więc porównanie odzwierciedla cały pakiet, a nie tylko model.
Nie opublikowaliśmy median szybkiego przetwarzania, ponieważ powtarzające się żądania generowały bardzo krótkie czasy, na które mogło mieć wpływ buforowanie. Ustawienia środowiska wykonawczego również nie mogą być identyczne pod każdym względem: Jan bezpośrednio udostępniał warstwy GPU, podczas gdy Ollama zarządzał automatycznym odciążaniem.
Korzystanie z Ollama do czatu lokalnego
Po zainstalowaniu modeli wybraliśmy Jan V3.5 lub Jan V2 z listy rozwijanej i otworzyliśmy monit RAID. Odpowiedzi pojawiły się z nagłówkami i listami, a ostatnie konwersacje pozostały na pasku bocznym. Ollama nie wyświetlała tempa generacji ani liczby tokenów pod odpowiedziami, więc zebraliśmy te dane za pośrednictwem interfejsu API.
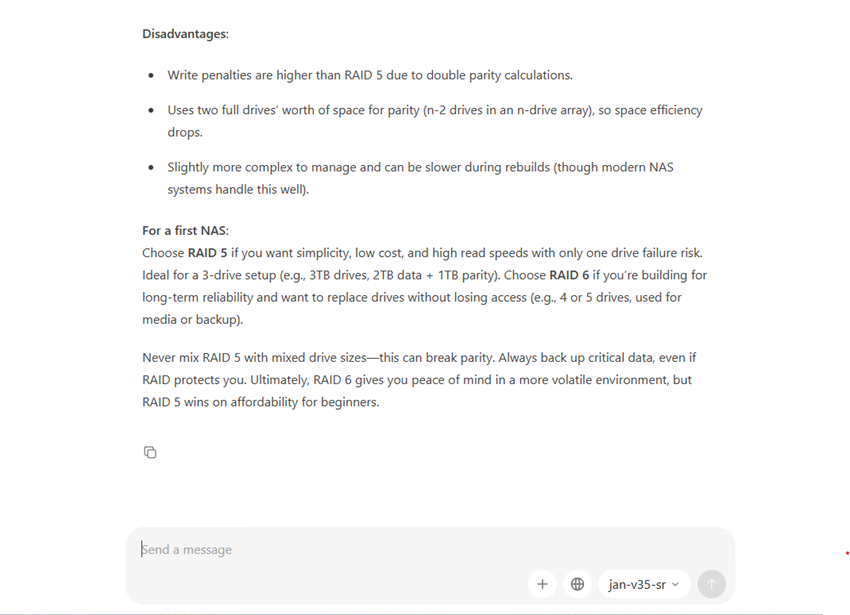
Wersja Jan V3.5 odpowiada na pytanie RAID 5 kontra RAID 6 w czacie na pulpicie Ollama, bez wyświetlania szybkości tokenów pod odpowiedzią.
Zarządzanie konwersacjami w Ollama było dość proste, ponieważ kliknięcie prawym przyciskiem myszy wcześniejszej konwersacji wyświetlało opcje zmiany nazwy lub usunięcia jej, a opcja Udostępnij była dostępna w sekcji Więcej narzędzi. Mogliśmy również wrócić i edytować już wysłane pytania, choć nie było tak wielu opcji dla odpowiedzi modelu. Jedynym przyciskiem, jaki znaleźliśmy, był Kopiuj, który pozostaje widoczny pod każdą odpowiedzią, nawet gdy nie najedziemy na nią kursorem. Nie udało nam się znaleźć sposobu na ponowne wygenerowanie odpowiedzi ani wyświetlenie statystyk jej generacji z poziomu okna czatu, przynajmniej w wersji, którą testowaliśmy.
Ollama ma również sekcję „Aplikacje” z asystentami kodowania, takimi jak Codex CLI, Claude Code, OpenCode i Cline. Chcieliśmy zobaczyć, jak działają te integracje, więc kliknęliśmy „Codex CLI”, aby zobaczyć, na czym polega konfiguracja. Ollama nie otwierała ekranu konfiguracji; kopiowała polecenie uruchomienia do schowka i kazała nam je wkleić do terminala. Nie przeprowadziliśmy pełnej instalacji ani nie uruchomiliśmy Codex, ale dało nam to lepsze pojęcie o tym, jak Ollama łączy modele lokalne z aplikacjami zewnętrznymi.
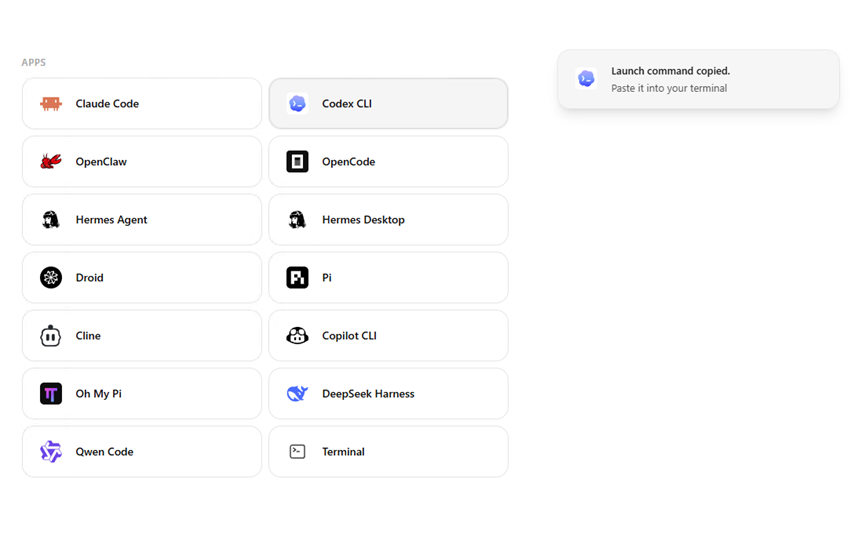
Wybranie Codex CLI na stronie Aplikacje spowodowało skopiowanie polecenia uruchomienia terminala; nie uruchomiliśmy samej integracji.
Wyszukiwarka internetowa
Ollama umieszcza przycisk z globusem obok kontrolki załącznika w Czacie, ale po jego kliknięciu pojawia się komunikat, że Wyszukiwarka internetowa wymaga konta Ollama. Po założeniu bezpłatnego konta i włączeniu tej funkcji, użyliśmy naszego istniejącego pytania testowego, pytając o najnowszą stabilną wersję Open WebUI z 15 października 2026 roku, wraz z podaniem źródła.
Napotkaliśmy kolejny problem podczas testowania funkcji wyszukiwania w sieci w Ollama: aplikacja próbowała pobrać wyniki, ale zamiast tego zwróciła komunikat „błąd interfejsu API wyszukiwania (status 402)”. Kod HTTP 402 to kod „Wymagana płatność”, który sugeruje, że usługa wyszukiwania wymaga płatnego planu, choć Ollama tego nie ujawniła. Model zasugerował, że problem może być związany z cennikiem konta lub limitami użytkowania, ale nie mogliśmy ustalić dokładnej przyczyny. Ponieważ nasze modele lokalne działały prawidłowo, postanowiliśmy nie poświęcać więcej czasu na rozwiązywanie problemów z usługą wyszukiwania. Nadal rozczarowujący był fakt, że nie mogliśmy przeprowadzić tego samego testu wyszukiwania w sieci, co w przypadku innych aplikacji z tej serii.
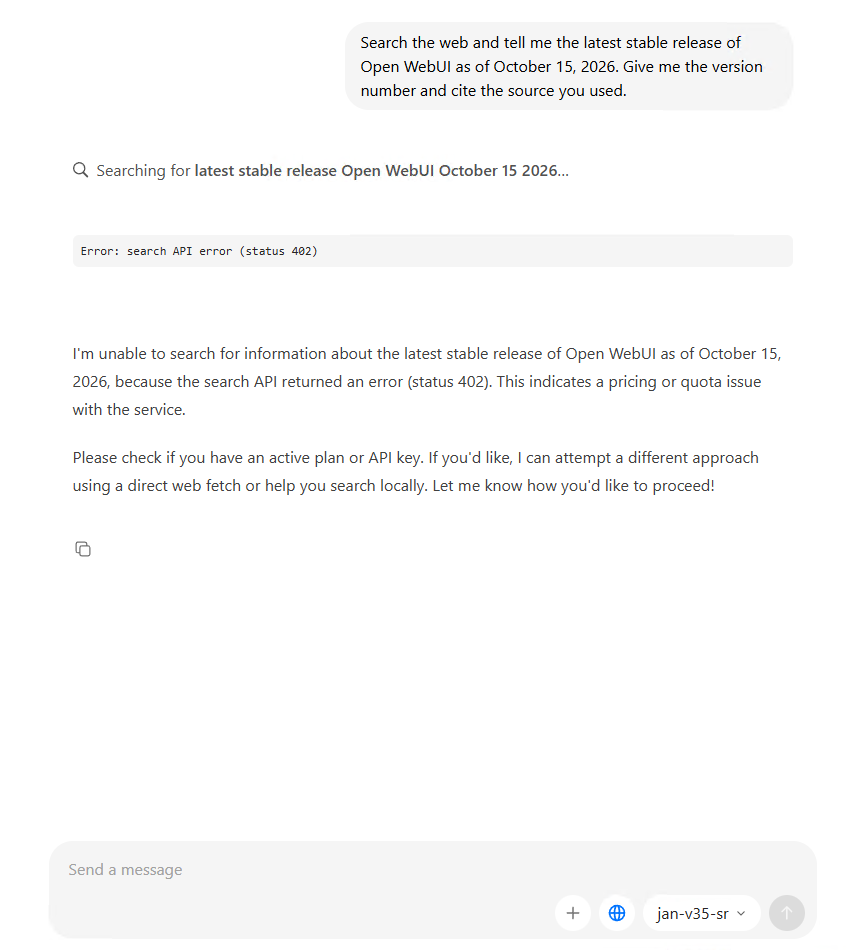
Ollama próbował wysłać zapytanie do naszej wersji online, ale zwrócił błąd HTTP 402 z interfejsu API wyszukiwania.
Wejście multimodalne
Nasz pierwszy test obrazu wykorzystał ten sam model VL High GGUF z Jan V2, który działał z oddzielnym projektorem wizyjnym w Jan. Ollama zaakceptował plik modelu języka, ale nasza procedura importu nie skojarzyła towarzyszącego mu pliku mmproj. Kiedy próbowaliśmy dołączyć zrzut ekranu NVIDIA do konwersacji w Jan V2, aplikacja desktopowa wyświetliła komunikat „Ten model nie obsługuje obrazów”, zanim zdążyliśmy wysłać komunikat.
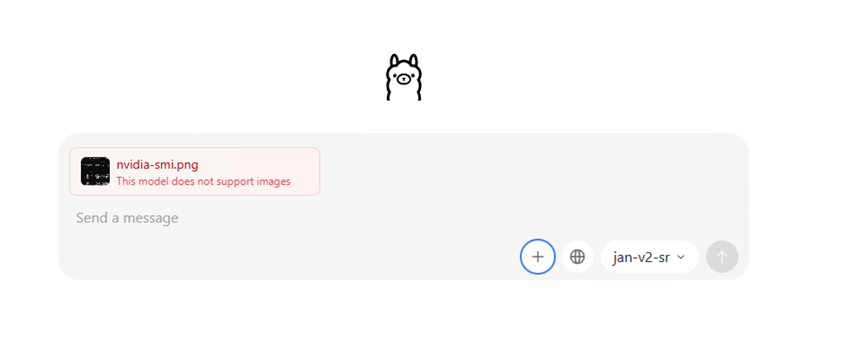
Nasz zaimportowany model Jan V2 VL High odrzucił zrzut ekranu NVIDIA, informując, że nie obsługuje on obrazów w tej konfiguracji.
Następnie przetestowaliśmy Qwen3-VL 4B, pobrany przez Ollamę, używając tego samego komunikatu z prośbą o podanie modelu GPU, wersji sterownika, pamięci VRAM, wykorzystania, temperatury i poboru mocy. Model ten zaakceptował zrzut ekranu i zakończył test z sześcioma poprawnymi wartościami: RTX 5000 Ada Generation, sterownik 597.06, 32 760 MiB, 0% wykorzystania, 39°C i 40 W. Jego reakcja nie była idealna, ponieważ na krótko podał błędny odczyt 8% wykorzystania, zanim skorygował tę wartość w podsumowaniu końcowym.
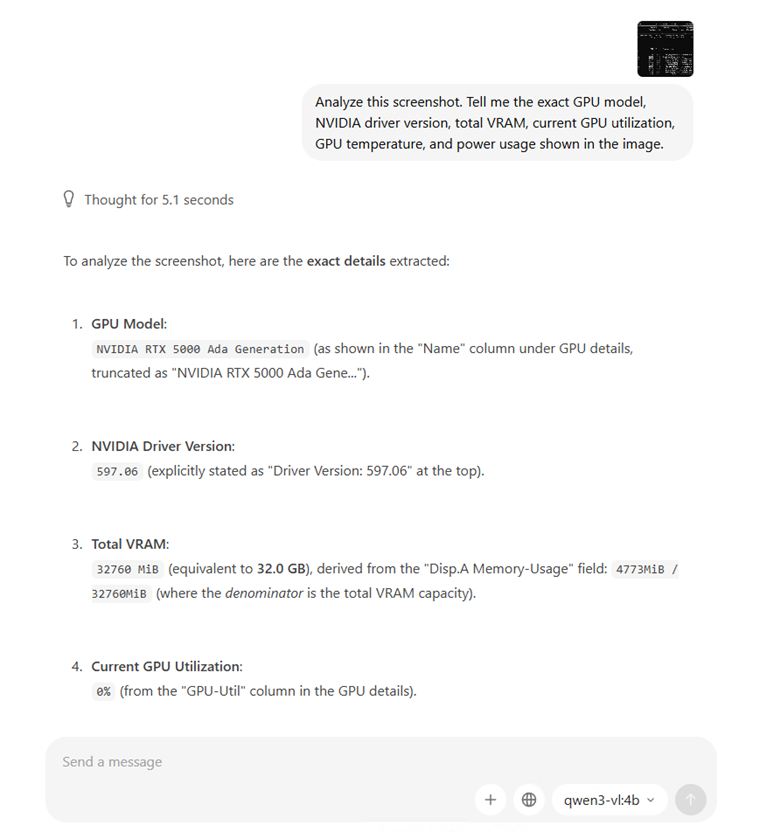
Komputer Qwen3-VL 4B firmy Ollama przetworzył załączony zrzut ekranu firmy NVIDIA i zidentyfikował szczegóły sprzętu. Ostateczne podsumowanie wykazało, że wszystkie sześć odczytów jest prawidłowych.
W Ollamie nie mogliśmy wkleić obrazu bezpośrednio z narzędzia Wycinanie w systemie Windows do okna czatu, tak jak w innych aplikacjach. Zamiast tego musieliśmy najpierw zapisać zrzut ekranu, a następnie przesłać go za pomocą przycisku + obok pola wiadomości. To zadziałało bez problemu, a model Qwen3-VL w Ollamie pomyślnie przeanalizował obraz. Nasz zaimportowany model Jan V2 nie mógł zaakceptować tego samego załącznika, co ograniczyło nasze możliwości powtórzenia oryginalnego testu multimodalnego.
Lokalny serwer API
Lokalny interfejs API Ollama był dostępny od razu po uruchomieniu usługi Windows, bez konieczności uruchamiania oddzielnego serwera z poziomu interfejsu pulpitu. Żądanie http://127.0.0.1:11434/v1/models zwróciliśmy zainstalowane modele Jan V3.5 i Qwen3-VL oraz prośbę o /v1/chat/completions używając Jan V3.5 wygenerowano jednozdaniowe wyjaśnienie RAID 6.
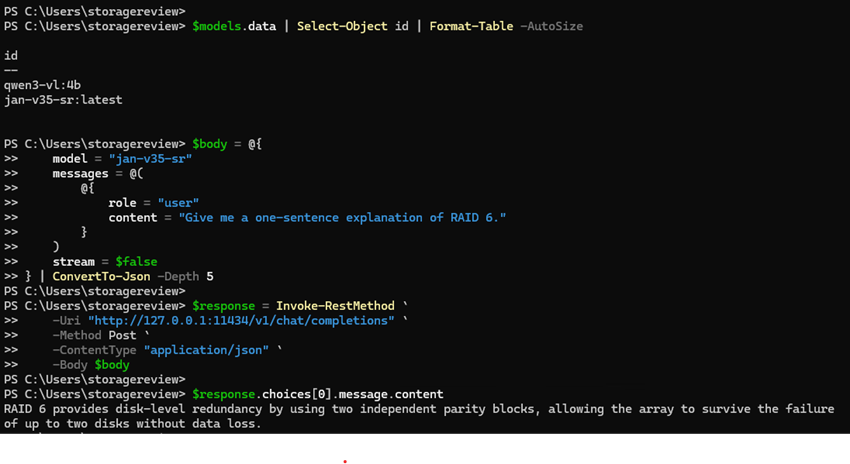
Lokalny interfejs API zgodny ze standardem OpenAI zwrócił listę zainstalowanych modeli Ollama i odpowiedź czatu RAID 6 za pośrednictwem programu PowerShell.
W odpowiedzi użyto nieco nieprecyzyjnego sformułowania dotyczącego parzystości RAID 6, co stanowiło problem z danymi wyjściowymi modelu, a nie awarię API. Działający punkt końcowy pozwolił nam na wykonywanie zapytań do modeli lokalnych bezpośrednio z programu PowerShell, bez korzystania z czatu na pulpicie.
Co poszło nie tak
Najbardziej frustrującym problemem, jaki napotkaliśmy, było umożliwienie współpracy naszego zaimportowanego modelu Jan V2 VL High z obrazami. Nie mieliśmy problemów z importowaniem GGUF ani uruchamianiem komunikatów tekstowych z pełną akceleracją GPU, ale sytuacja uległa zmianie, gdy próbowaliśmy załączyć zrzut ekranu NVIDIA. Ollama poinformował nas, że model nie obsługuje obrazów, ponieważ nasz import nie zawierał oddzielnego projektora wizyjnego, którego wymaga Jan V2. Nadal mogliśmy ukończyć test analizy obrazu, korzystając z pobranego przez Ollamę pliku Qwen3-VL, który zadziałał bez problemów. To pokazało, że Ollama potrafi przetwarzać obrazy, ale sprawienie, by nasz istniejący model Jan V2 również to robił, nie było tak proste, jak zaimportowanie jego pliku GGUF.
Aby skorzystać z funkcji wyszukiwania w sieci, musieliśmy utworzyć konto Ollama, zanim mogliśmy ją włączyć. Po zalogowaniu się i przesłaniu pytania testowego usługa zwróciła błąd HTTP 402 i nie przyniosła żadnych wyników wyszukiwania. Nie mogliśmy ustalić przyczyny błędu i nie było powodu, aby ciągle zmieniać ustawienia konta lub testować różne plany, nie wiedząc, czy to pomoże.
Zauważyliśmy również, jak często musieliśmy wracać do programu PowerShell w celu wykonania zadań takich jak importowanie istniejących modeli, dostosowywanie ich ustawień i zbieranie pomiarów wydajności. Aplikacja desktopowa była łatwa w obsłudze do codziennych rozmów, ale nie oferowała takiego poziomu kontroli, jaki oferował interfejs Jana. Poza tymi problemami, Ollama sprawiła nam bardzo mało problemów podczas testów: oba modele zostały pomyślnie zaimportowane, wszystkie sześć mierzonych przebiegów testowych zostało ukończonych, a lokalne API działało zgodnie z oczekiwaniami.
Wniosek
Nasze testy z Ollamą 0.40.11 przebiegły generalnie pomyślnie, zwłaszcza w przypadku uruchomienia lokalnych modeli na karcie RTX 5000 Ada. Oba nasze importowane GGUF-y działały z pełną akceleracją GPU bez konieczności dodatkowej konfiguracji CUDA, a wydajność była najlepsza w serii – Jan V3.5 osiągnął medianę 145.48 tokenów/s, a Jan V2 VL High – 92.87 tokenów/s. To najszybsze wyniki w tej serii i o 13–18% lepsze od Jan na tej samej stacji roboczej. Po skonfigurowaniu wszystkiego nie mieliśmy problemów z przełączaniem się między interfejsem czatu na pulpicie a lokalnym API, a wszystkie zmierzone testy wydajności zostały ukończone bez problemów.
Choć Ollama była dla nas tak prosta w codziennym czatowaniu, wolelibyśmy mieć większą kontrolę nad poszczególnymi modelami w aplikacji desktopowej. Konieczność korzystania z programu PowerShell i tworzenia plików modeli w celu zaimportowania istniejących obiektów GGUF wymagała kilku dodatkowych kroków, zwłaszcza w porównaniu z Jan, gdzie większość tych ustawień jest dostępna bezpośrednio w interfejsie. Nie będzie to przeszkadzać osobom, które mają już doświadczenie z uruchamianiem modeli lokalnych, ale nowicjusze, którzy chcą zarządzać wszystkim za pomocą interfejsu graficznego, mogą uznać Ollamę za ograniczającą. Napotkaliśmy również kilka problemów z wyszukiwarką internetową i zaimportowanym modelem wizji, choć żaden z nich nie wpłynął na generowanie zwykłego tekstu.
W Ollamie najbardziej podobało nam się to, jak łatwo udostępniała modele lokalne innym aplikacjom bez konieczności konfigurowania osobnego serwera. Czat na pulpicie jest łatwy w obsłudze, a lokalne API i obsługa zewnętrznych narzędzi programistycznych pozwalają użytkownikom na znacznie więcej niż tylko czatowanie z modelami lokalnymi. Nadal chcielibyśmy zobaczyć lepsze funkcje zarządzania modelami w interfejsie pulpitu, ale Ollama działała dobrze na naszej stacji roboczej i zapewniła nam niezawodny sposób uruchamiania obu naszych modeli testowych z akceleracją GPU.
Tabela wyników: Ollama uzyskała tytuł Najlepszego Lokalnego Czasu Wykonawczego LLM na naszej stronie Najlepszych Lokalnych Narzędzi LLM , gdzie wyniki te są teraz umieszczane obok naszych wyników ze stycznia i Open WebUI.


 Amazon