

Wraz z rozwojem infrastruktury AI, potoki danych stają się szybsze, bardziej rozbudowane i coraz bardziej złożone. Od trenowania dużych modeli po wnioskowanie w czasie rzeczywistym na dużą skalę, podsystem pamięci masowej jest niezbędny do zapewnienia ciągłego dostępu procesorów graficznych do niezbędnych danych. Ponieważ pamięć masowa staje się coraz ważniejsza w klastrach AI, organizacje zastanawiają się nad tym, jak zapewnić wysoką przepustowość, przewidywalną wydajność i odporność, szczególnie w środowiskach, w których utrata danych lub przestoje są po prostu niedopuszczalne.
Wyzwanie staje się jeszcze poważniejsze, ponieważ modele sztucznej inteligencji (AI) rosną wykładniczo. Nowoczesne modele językowe i modele bazowe wymagają częstego tworzenia punktów kontrolnych, aby zachować postępy w szkoleniu. Wraz ze wzrostem rozmiarów modeli z miliardów do bilionów parametrów, wymagania dotyczące pamięci masowej dla tych punktów kontrolnych rosną proporcjonalnie. Stwarza to pilną potrzebę dużych, zunifikowanych przestrzeni nazw pamięci masowej, które mogłyby obsługiwać ogromne pliki punktów kontrolnych, jednocześnie zachowując niezwykle wysoką wydajność zapisu i odczytu. Tradycyjne architektury pamięci masowej mają trudności z zapewnieniem zarówno pojemności, jak i szybkości wymaganej dla tych wymagających obciążeń.
Obecne podejścia do zarządzania punktami kontrolnymi, takie jak asynchroniczne tworzenie punktów kontrolnych, które zrzucają wagi modeli do pamięci procesora, aby umożliwić procesorom graficznym kontynuowanie trenowania, napotykają na poważne ograniczenia wraz ze wzrostem modeli. Tymczasowe przechowywanie tych punktów kontrolnych w pamięci systemowej staje się coraz bardziej nieefektywne i kosztowne, wymagając ogromnych ilości pamięci RAM, co zwiększa koszty systemu i zużycie energii. Co ważniejsze, wraz ze wzrostem rozmiarów modeli, to podejście może stać się całkowicie niepraktyczne ze względu na ogromną ilość danych, które musiałyby być tymczasowo przechowywane w pamięci.
Firma Graid Technology wprowadziła nowe podejście, specjalnie dostosowane do tych wyzwań. Opierając się na modelu definiowanym programowo, znanym z wcześniejszych rozwiązań, takich jak SupremeRAID SR1010 , nowy SupremeRAID AE (AI Edition) firmy Graid, wprowadza funkcjonalność RAID klasy korporacyjnej do obciążeń AI przy minimalnych zmianach w infrastrukturze. Zamiast dedykowanej karty RAID sprzętowej lub niestandardowego urządzenia, AE jest dostarczane w formie licencji programowej i wykorzystuje jedynie niewielką część istniejącego procesora graficznego NVIDIA. Oznacza to, że organizacje mogą osiągnąć wydajność i niezawodność pamięci masowej klasy korporacyjnej bez 1) zajmowania dodatkowych gniazd PCIe, 2) wprowadzania zmian w infrastrukturze lub 3) znaczącego wpływu na wydajność procesora graficznego w przypadku obciążeń szkoleniowych i wnioskowania.
Na wynos
- Wysoka wydajność na dużą skalę: SupremeRAID AE osiąga przepustowość odczytu do 183.60 GB/s i przepustowość zapisu do 54.23 GB/s, spełniając tym samym wysokie wymagania sztucznej inteligencji.
- Minimalne obciążenie GPU: Wprowadza minimalne obciążenie (~4%) podczas wnioskowania intensywnie wykorzystującego procesor GPU, zapewniając wysoką ogólną wydajność systemu.
- Ogromna ujednolicona przestrzeń nazw pamięci masowej: Obsługuje do 32 dysków SSD NVMe na macierz, zapewniając prawie 1 PB pamięci masowej w jednej zunifikowanej przestrzeni nazw.
- Zaawansowane możliwości integracji: Pełna integracja z NVIDIA GPUDirect Storage i wiodącymi systemami plików skoncentrowanymi na sztucznej inteligencji (BeeGFS, Lustre, Ceph).
- Uproszczona infrastruktura: Eliminuje dedykowany sprzęt RAID, znacząco redukując złożoność, koszty i obciążenie operacyjne.
Zoptymalizowane przechowywanie i odporność na zaawansowane obciążenia AI
SupremeRAID AE obsługuje do 32 dysków SSD NVMe w jednej macierzy, agregując je w ujednoliconą przestrzeń nazw. Taka struktura umożliwia obciążeniem AI efektywny dostęp do dużych zbiorów danych przy jednoczesnym zachowaniu odporności, co jest szczególnie ważne w środowiskach, w których realizowane są długotrwałe zadania szkoleniowe. W przypadku awarii dysku macierz pozostaje dostępna, a postęp w punktach kontrolnych jest zachowany. Ta ochrona minimalizuje ryzyko utraty danych lub czasochłonnych restartów, co stanowi istotną zaletę dla zespołów zarządzających dużymi modelami lub potokami wnioskowania o dużej objętości.
Inteligentne funkcje zarządzania zasobami SupremeRAID AE oferują dodatkowe możliwości optymalizacji obciążeń AI. Chociaż nasze testy wykazują minimalne obciążenie podczas operacji współbieżnych, wpływ ten można dodatkowo ograniczyć dzięki inteligentnemu harmonogramowaniu. Operacje na punktach kontrolnych zazwyczaj nie są uruchamiane jednocześnie z aktywnym trenowaniem na tym samym węźle; zazwyczaj występuje chwilowa przerwa w trenowaniu podczas faz tworzenia punktów kontrolnych. W tych odstępach czasu SupremeRAID AE może wykorzystać dodatkowe, niewykorzystane zasoby GPU, aby przyspieszyć ukończenie punktów kontrolnych.
SupremeRAID AE obsługuje również technologię NVIDIA GPUDirect Storage. Umożliwia to bezpośrednie połączenia między pamięcią masową a pamięcią GPU, co przekłada się na mniejsze opóźnienia i lepszą wydajność wejścia/wyjścia. Rozwiązanie integruje się z systemami plików zorientowanymi na sztuczną inteligencję, takimi jak BeeGFS, Lustre i Ceph, i oferuje inteligentne odciążanie danych oraz gotowe do orkiestracji interfejsy API do automatyzacji. Podsumowując, SupremeRAID AE oferuje uproszczony, a zarazem wydajny sposób na wykorzystanie zalet RAID w nowoczesnych procesach pracy z wykorzystaniem sztucznej inteligencji.
Oprócz obciążeń szkoleniowych, SupremeRAID AE spełnia krytyczne wymagania nowoczesnych scenariuszy wnioskowania AI. Wraz ze skalowaniem operacji wnioskowania, organizacje coraz częściej polegają na zaawansowanych strategiach, takich jak trwałe zarządzanie pamięcią podręczną KV, optymalizacja dekodowania wstępnego i wstępnego wypełniania oraz wielowarstwowe architektury pamięci. Techniki te często wymagają odciążenia pamięci podręcznej KV i przeniesienia jej do pamięci masowej, gdy przekracza ona pojemność pamięci VRAM. Rozwiązania takie jak NVIDIA Dynamo, Red Hat LLM-D i stos produkcyjny vLLM zawierają integracje wielowarstwowego buforowania KV, które wymagają szybkiej pamięci masowej o dużej pojemności. W takich scenariuszach posiadanie dużych, wydajnych pul pamięci masowej staje się niezbędne do utrzymania wnioskowania z niskimi opóźnieniami, a zdolność SupremeRAID AE do zapewnienia zarówno ogromnej pojemności, jak i wyjątkowej szybkości sprawia, że stanowi on idealną podstawę dla tych zaawansowanych architektur wnioskowania.
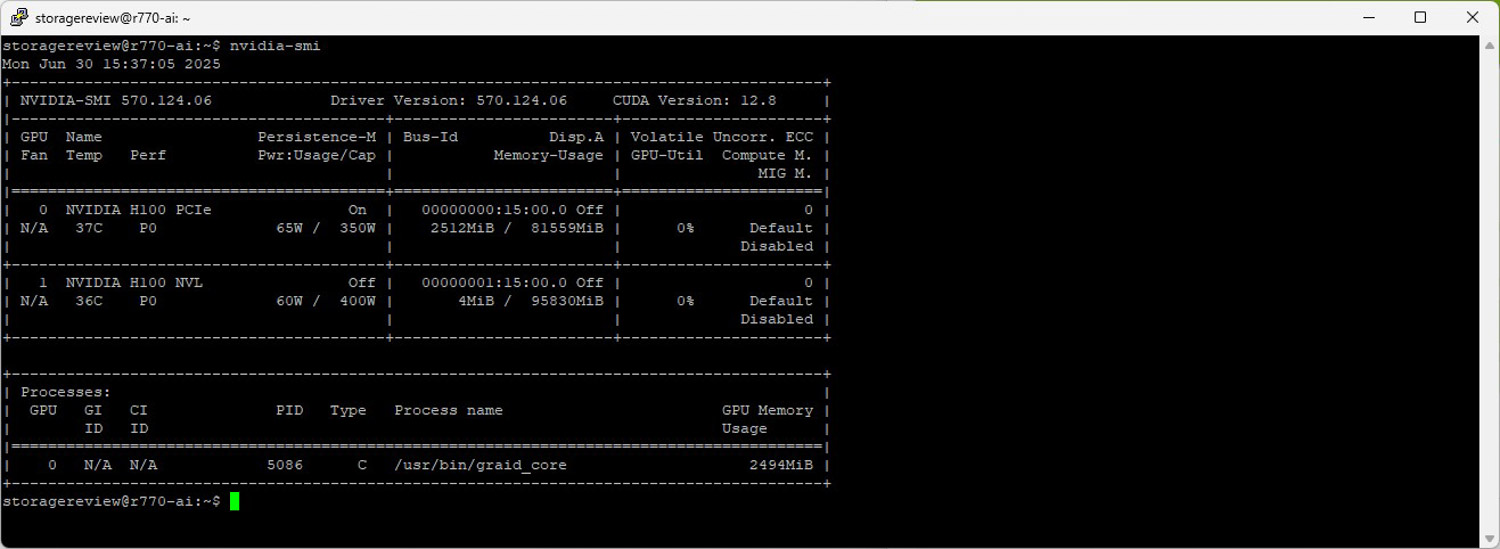
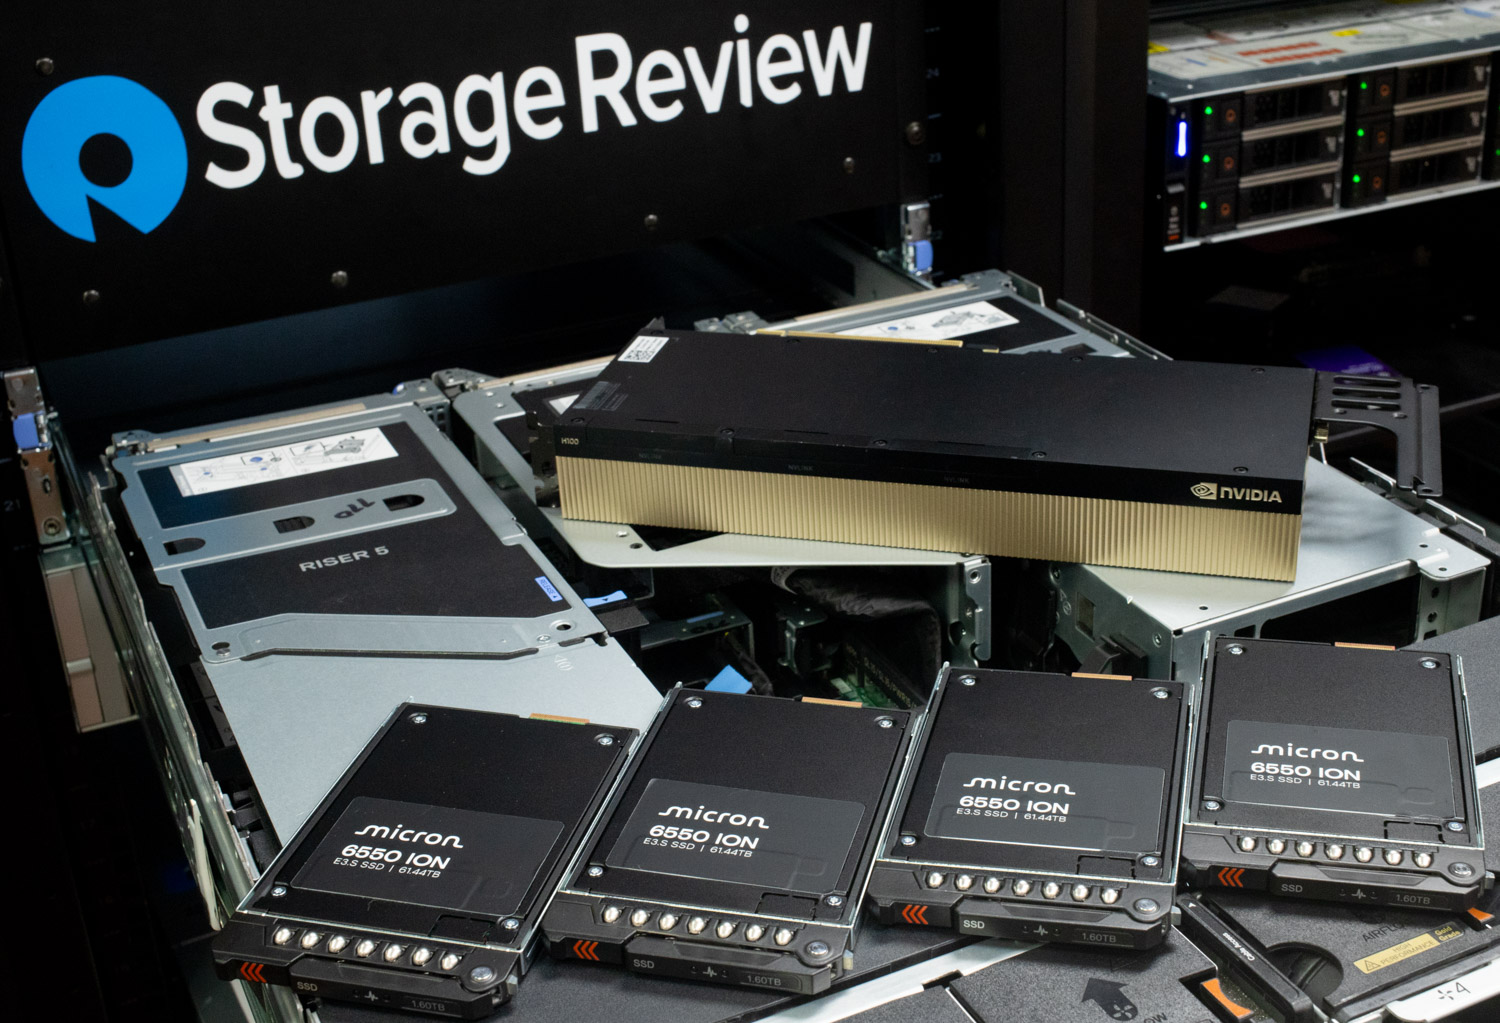
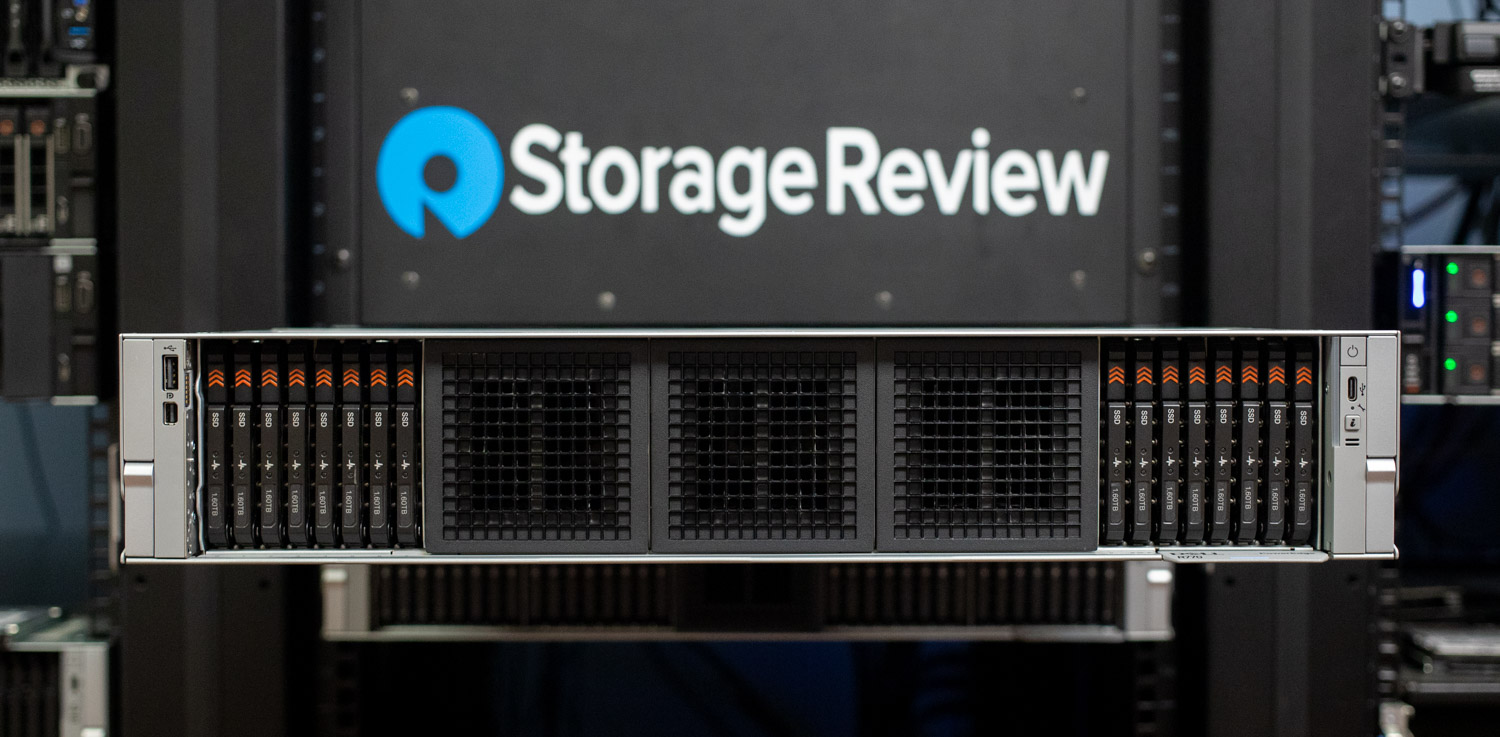
W tej analizie oceniamy rozwiązanie SupremeRAID AE działające na naszej platformie Dell PowerEdge R770, która zawiera dwa procesory graficzne NVIDIA H100 i dyski SSD 16 Micron 6550 Gen5 NVMe o pojemności 61.44 TB. Badamy wydajność w konfiguracji RAID 5 za pomocą narzędzi GDSIO i FIO oraz analizujemy, jak Graid AE wpływa na zachowanie procesora graficznego podczas obciążenia wnioskowania LLM w czasie rzeczywistym. Celem jest zrozumienie, jak to rozwiązanie integruje się ze środowiskami AI klasy korporacyjnej, w których wydajność, pojemność, odporność i prostota muszą być skalowalne.
Liczby w liczbach: dogłębna analiza wydajności SupremeRAID AE
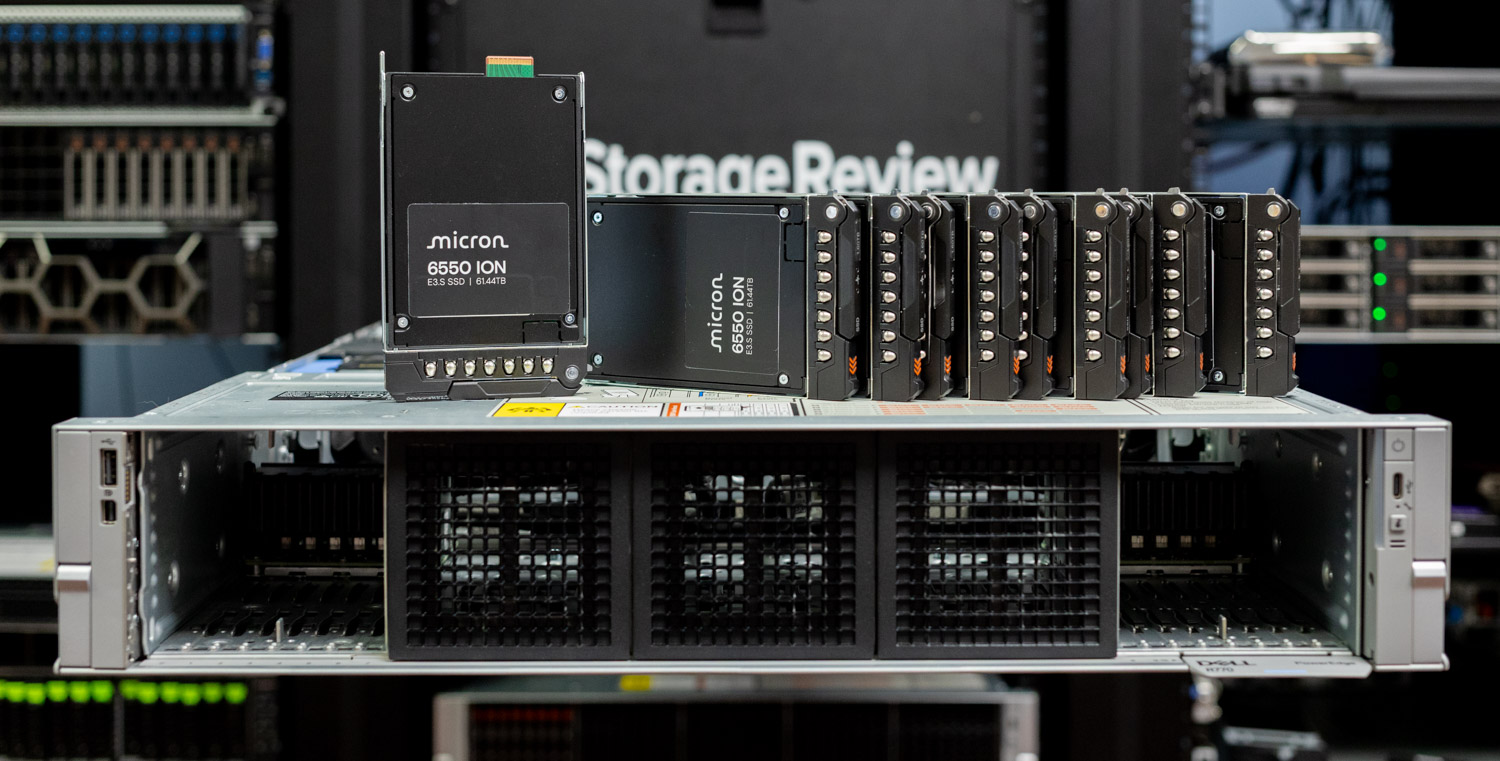
Aby przetestować wydajność Graid SupremeRAID AE, skonfigurowaliśmy serwer Dell PowerEdge R770 z dwoma kartami graficznymi NVIDIA H100 i 16 zatokami E3.S z przodu. System, zbudowany na najnowszej platformie Intel Xeon 6, został wyposażony w dwa procesory Intel Xeon 6787P, z których każdy oferuje 86 rdzeni, co pozwala na obsługę wysoce równoległych obciążeń w środowiskach AI, HPC i o dużej ilości danych.
Serwer R770 został skonfigurowany z 16 zatokami E3.S, a pamięć masową w całości wypełniono dyskami SSD Micron 6550 ION o pojemności 61.44 TB Gen5 NVMe TLC, zaprojektowanymi z myślą o zapewnieniu stabilnej wydajności w szerokim zakresie obciążeń. Dyski SSD Micron zapewniają idealną równowagę między wyjątkową wydajnością a ogromną pojemnością, umożliwiając obciążeniem AI utrzymanie wysokiej przepustowości przy jednoczesnym radykalnym uproszczeniu infrastruktury AI. Dzięki petabajtowi pamięci masowej na zaledwie 16 dyskach, organizacje mogą efektywnie zarządzać rozległymi zbiorami danych i punktami kontrolnymi modeli na dużą skalę w ramach jednego serwera, znacznie redukując złożoność i obciążenie infrastruktury.
Specyfikacje systemu testowego
- Platforma: Dell PowerEdge R770
- PROCESOR: 2x Intel Xeon 6787P (86 rdzeni każdy)
- Pamięć: 32x Micron 64 GB Dual-Rank DDR5 6400 MT/s Całkowita pamięć: 2 TB
- Sieć: Karta sieciowa DELL BRCM 4P 25G SFP 57504S OCP
- GPU 1: NVIDIA H100 (pamięć VRAM 80 GB)
- GPU 2: NVIDIA H100NVL (pamięć VRAM 96 GB)
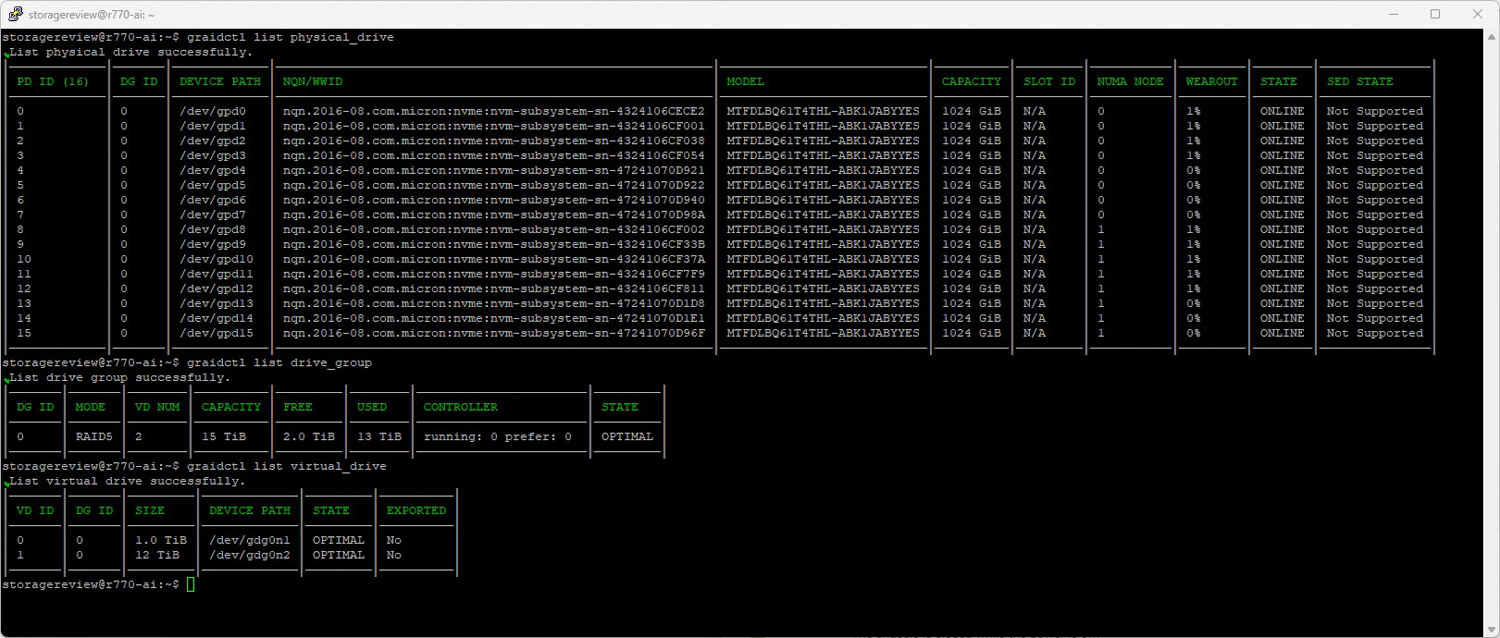
- Przechowywanie: 16 x 61TB Micron ION 6550 Dyski SSD (pula RAID 5 915 TB)
W ramach testów wydajności dyski SSD Micron skonfigurowano w pojedynczej puli RAID 5 z wykorzystaniem SupremeRAID AE. Ten układ wybrano, aby ocenić, jak dobrze SupremeRAID AE równoważy wydajność i odporność na błędy w środowisku opartym na sztucznej inteligencji, wymagającym dużej pojemności pamięci masowej. RAID 5 rozdziela parzystość na wszystkie dyski, co chroni przed awarią pojedynczego dysku, jednocześnie zachowując użyteczną pojemność pamięci masowej.
Przed przystąpieniem do testów wydajności, ważne jest, aby zwrócić uwagę na różnice między GDSIO i FIO podczas pomiaru wydajności pamięci masowej za pomocą Graid. W naszych poprzednich ocenach wydajności Graid, kluczową obserwacją było to, że nie ma wąskich gardeł (takich jak sprzętowa karta RAID), które ograniczałyby szczytową przepustowość. Sprzętowe karty RAID zarządzają podłączonymi do nich urządzeniami pamięci masowej, a gniazdo PCIe może stać się wąskim gardłem w tym procesie. Graid wykorzystuje procesor graficzny (GDSIO) do operacji RAID, ale nie wszystkie dane muszą przez niego przechodzić. W rezultacie procesor graficzny nie ogranicza przepustowości.
Test FIO mierzy wydajność pamięci masowej, wykorzystując procesor do dostępu do niej i jest ograniczony jedynie przez rozwiązanie pamięci masowej. GDSIO z kolei mierzy wydajność pamięci masowej GPU Direct Storage, gdzie to właśnie GPU może być czynnikiem ograniczającym. Na przykład karta NVIDIA H100 ma interfejs PCIe Gen5 x16 i oferuje przepustowość około 63 GB/s na wejściu i wyjściu. Omawiając wąskie gardła wydajności GPU w tym kontekście, problem dotyczy przepustowości, jaką GPU może obsługiwać z funkcją GPU Direct Storage, a nie wąskiego gardła Graid.
Bezpośrednie przechowywanie danych przez GPU NVIDIA
Jednym z testów, jakie przeprowadziliśmy na tym stanowisku testowym, był test Magnum IO GPU Direct Storage (GDS). GDS to funkcja opracowana przez firmę NVIDIA, która pozwala procesorom graficznym ominąć procesor główny (CPU) podczas uzyskiwania dostępu do danych przechowywanych na dyskach NVMe lub innych szybkich urządzeniach pamięci masowej. Zamiast kierować dane przez procesor i pamięć systemową, GDS umożliwia bezpośrednią komunikację między procesorem graficznym a urządzeniem pamięci masowej, znacznie redukując opóźnienia i poprawiając przepustowość danych.
Jak działa bezpośrednie przechowywanie danych GPU
Tradycyjnie, gdy procesor graficzny (GPU) przetwarza dane przechowywane na dysku NVMe, dane muszą najpierw przejść przez procesor (CPU) i pamięć systemową, zanim dotrą do procesora graficznego (GPU). Proces ten wprowadza wąskie gardła, ponieważ procesor (CPU) staje się pośrednikiem, zwiększając opóźnienia i zużywając cenne zasoby systemowe. Technologia GPU Direct Storage eliminuje ten problem, umożliwiając procesorowi graficznemu bezpośredni dostęp do danych z urządzenia pamięci masowej za pośrednictwem magistrali PCIe. Ta bezpośrednia ścieżka zmniejsza obciążenie związane z przesyłaniem danych, umożliwiając szybsze i bardziej wydajne przesyłanie danych.
Obciążenia sztucznej inteligencji, zwłaszcza te wykorzystujące uczenie głębokie, charakteryzują się wysoką intensywnością przetwarzania danych. Trenowanie dużych sieci neuronowych wymaga przetwarzania terabajtów danych, a każde opóźnienie w transferze danych może prowadzić do niewykorzystania procesorów graficznych (GPU) i wydłużenia czasu trenowania. Technologia GPU Direct Storage rozwiązuje ten problem, zapewniając jak najszybsze dostarczanie danych do procesora graficznego (GPU), minimalizując czas przestoju i maksymalizując wydajność obliczeniową.
Ponadto GDS jest szczególnie przydatny w przypadku obciążeń wymagających strumieniowego przesyłania dużych zbiorów danych, takich jak przetwarzanie wideo, przetwarzanie języka naturalnego czy wnioskowanie w czasie rzeczywistym. Zmniejszając zależność od procesora, GDS przyspiesza przesyłanie danych i uwalnia zasoby procesora do innych zadań, co dodatkowo zwiększa ogólną wydajność systemu.
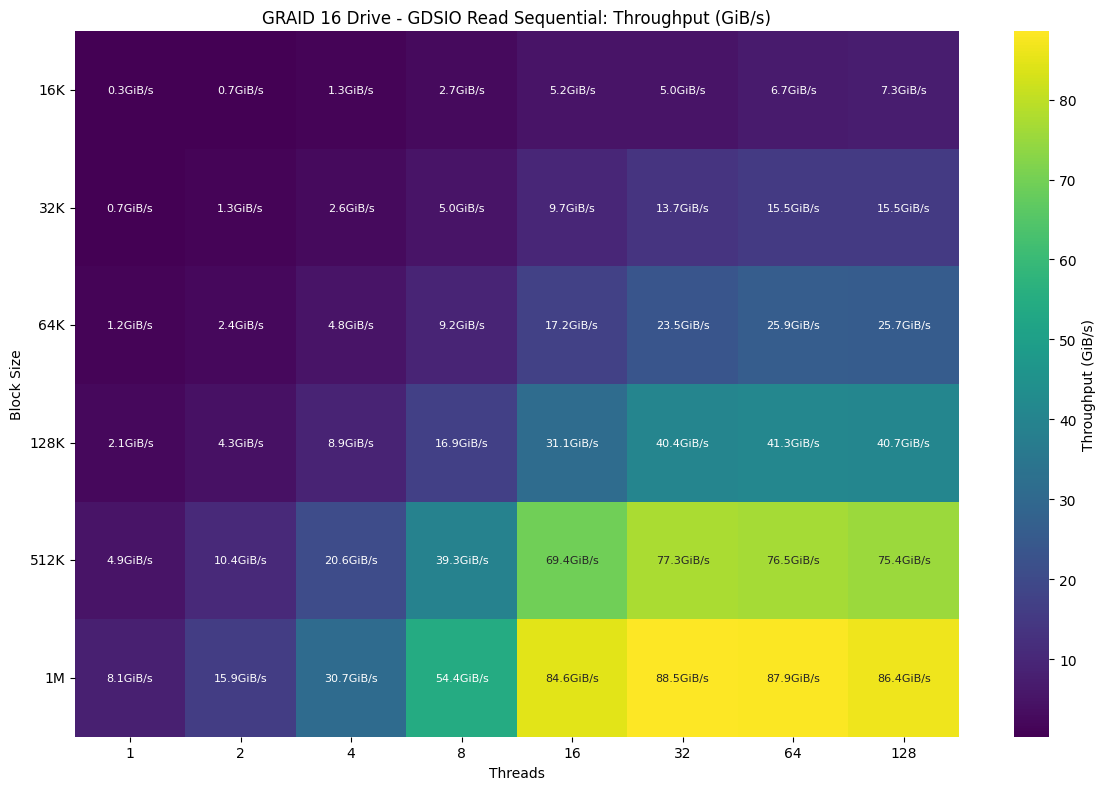
Przepustowość losowego odczytu napędu GDSIO 16
Zanim przejdziemy do danych dotyczących wydajności, należy zauważyć, że czynnikiem ograniczającym wydajność odczytu i zapisu w przypadku GDSIO jest karta graficzna (GPU). Test ma na celu zmierzenie maksymalnej wydajności pamięci masowej, jaką można uzyskać z karty graficznej (GPU). W końcu napotkasz wąskie gardło w gnieździe PCIe, które w przypadku PCIe Gen5 x16 wynosi około 63 GB/s.
Jeśli chodzi o losową przepustowość odczytu GDSIO, macierz osiągnęła najlepsze wyniki przy większych rozmiarach bloków i większej liczbie wątków, jednocześnie mając problemy z efektywnym skalowaniem w dolnym zakresie. Przy 16 tys. / 128 wątkach sytuacja zaczęła się zauważalnie poprawiać, osiągając 7.3 Gb/s, ale prawdziwe przyspieszenie przepustowości nastąpiło dopiero przy 32 tys. i więcej, gdzie macierz osiągnęła 15.5 Gb/s przy 64 wątkach. Znaczny wzrost zaobserwowano przy 64 tys., gdzie przepustowość wzrosła do 25.9 Gb/s, a wydajność wzrosła od 128 tys., gdzie osiągnęła 41.3 Gb/s przy 64 wątkach i utrzymywała się powyżej 40 Gb/s przy 128 wątkach. Maksymalna przepustowość została osiągnięta przy rozmiarze bloku 1 mln i 32 wątkach, gdzie macierz osiągnęła 88.5 Gb/s i utrzymała ten poziom przy największej liczbie wątków.
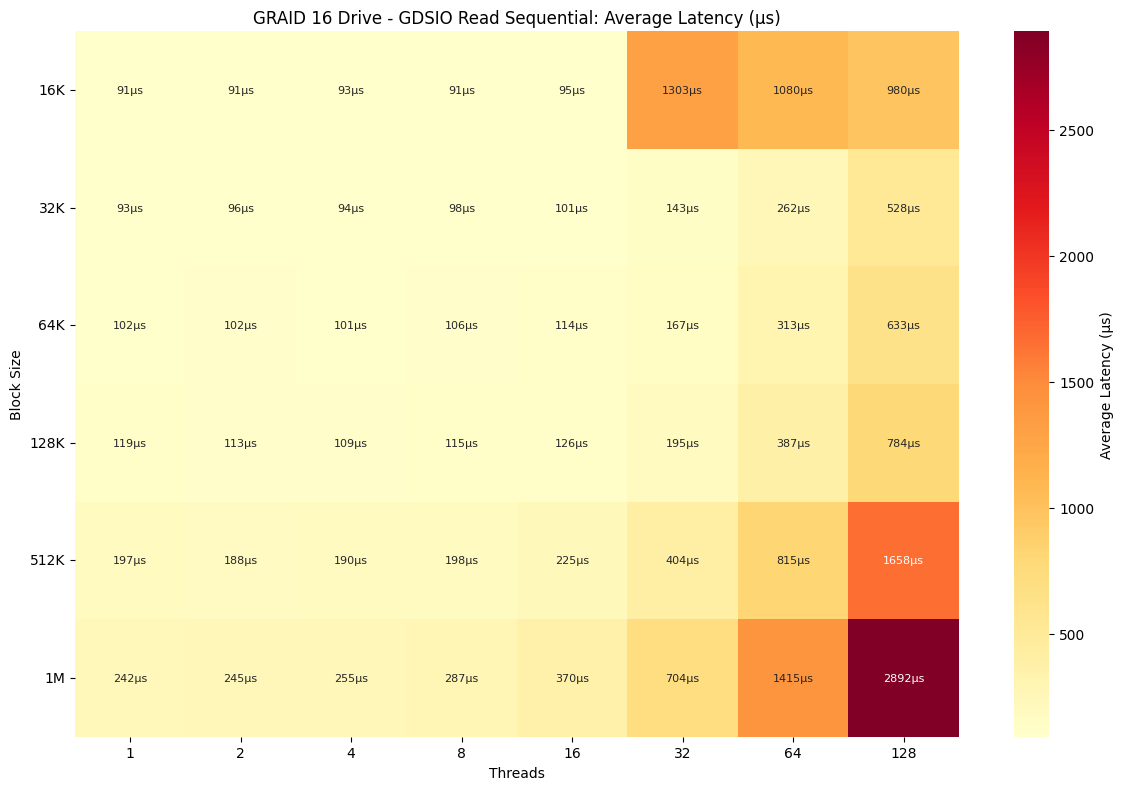
Opóźnienie losowego odczytu dysku GDSIO 16
Kontynuując wyniki przepustowości, losowy profil opóźnienia odczytu tablicy odzwierciedlał zaobserwowane wcześniej zachowanie skalowania. Opóźnienie pozostało wyjątkowo niskie dla wszystkich rozmiarów bloków i liczby wątków do 16 wątków, przy wartościach poniżej 0.1 ms dla wszystkiego do 128 KB. Nawet większe bloki, takie jak 128 KB, utrzymywały się w granicach od 0.13 ms do 0.20 ms. Powyżej 16 wątków opóźnienie jednak zauważalnie wzrosło. Przy 16 000 / 32 wątkach opóźnienie nadal rosło, osiągając ostatecznie 0,980 ms przy 128 wątkach. Podobnie, odczyty 1M, które miały najwyższą przepustowość, wzrosły z 0.242 ms przy jednym wątku do 2.892 ms przy 128 wątkach. Tendencja była spójna dla wszystkich rozmiarów, ponieważ opóźnienie pozostało płaskie przy umiarkowanej współbieżności, ale gwałtownie wzrosło, gdy liczba wątków wzrosła powyżej 32, szczególnie przy większych rozmiarach bloków.
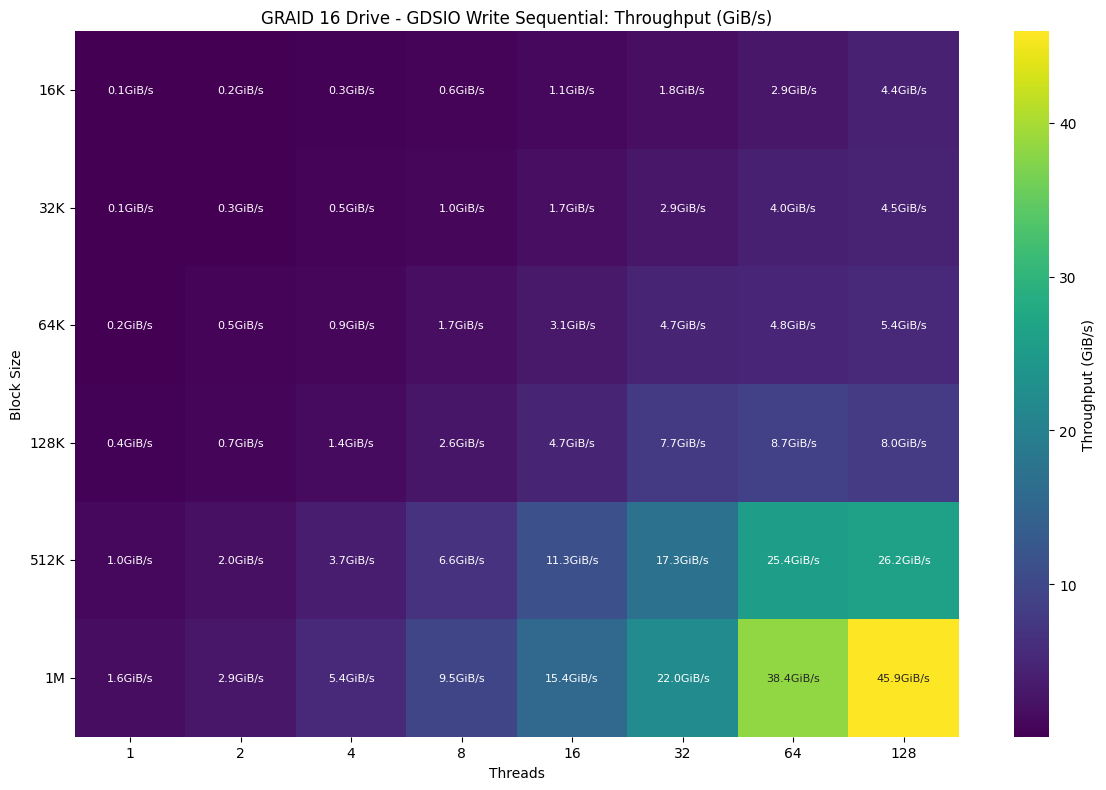
Przepustowość losowego zapisu dysku GDSIO 16
Przechodząc do przepustowości zapisu GDSIO, macierz ponownie wykazała się wysoką wydajnością przy większych rozmiarach bloków, jednocześnie skalując się bardziej stopniowo w porównaniu z odczytami. Wydajność zaczęła się wyraźnie poprawiać począwszy od 32 KB, gdzie przepustowość przekroczyła 5.9 GiB/s, a szczególnie przy 64 wątkach i więcej, gdzie bloki 512 KB i 1 MB zapewniały stały wzrost nawet przy dużej liczbie wątków. Przy 64 wątkach i więcej, zapis 512 KB osiągnął 25.4 GiB/s, a 1 MB osiągnął szczyt 38.4 GiB/s, podczas gdy przy 128 wątkach, zapis 1 MB nadal skalował się do maksymalnej wartości szczytowej 45.9 GiB/s. Rozmiary bloków 512 KB i 128 KB również pozostały spójne przy wysokiej współbieżności, stabilizując się odpowiednio na poziomie około 26.2 GiB/s i 8.0 GiB/s.
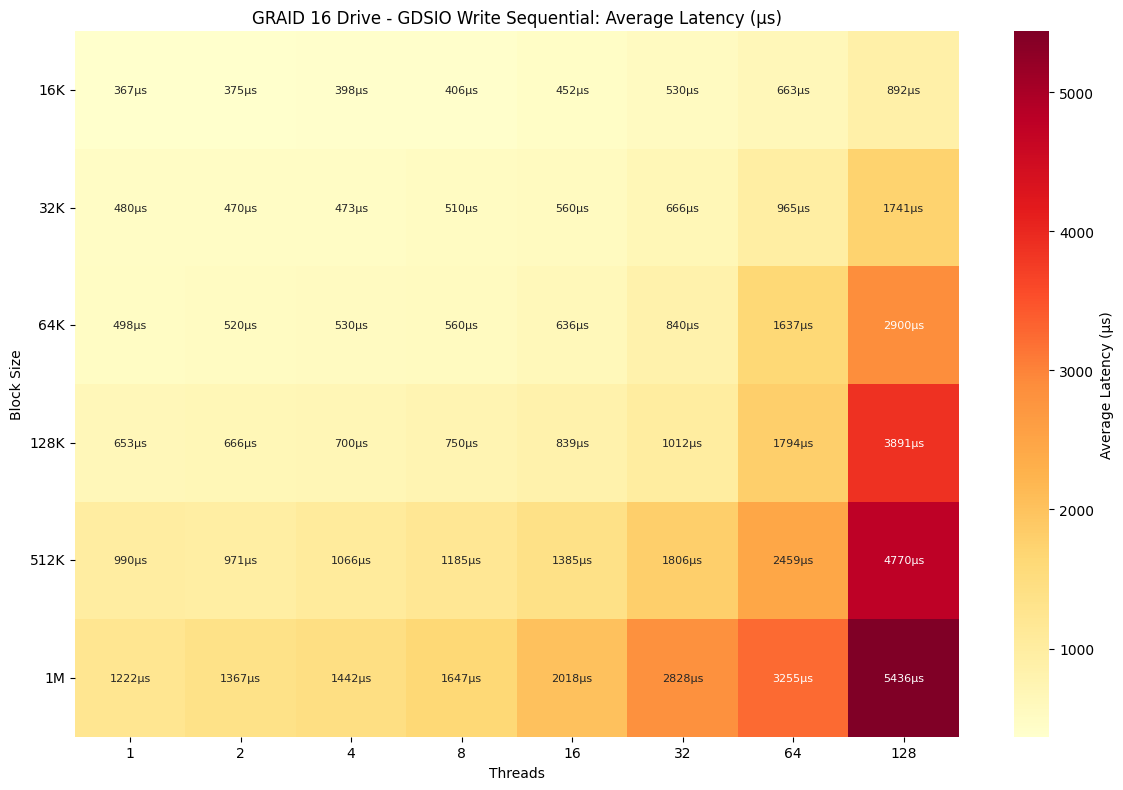
Opóźnienie losowego zapisu dysku GDSIO 16
Po znacznym zwiększeniu przepustowości zapisu, profil opóźnień dla losowych zapisów w macierzy wykazywał stały wzrost wraz ze wzrostem rozmiaru bloku i liczby wątków. Nawet przy niskiej liczbie wątków, opóźnienie zapisu początkowo było zauważalnie wyższe niż odczytu, zaczynając od 0.367 ms i rosnąc wraz z każdym blokiem, aż do 1.222 ms przy 1M. Wraz ze wzrostem współbieżności, opóźnienie stopniowo rosło do 16 wątków, a następnie przyspieszało bardziej agresywnie. Przy 64 wątkach, zapis osiągnął 0.663 ms, podczas gdy zapis 1M wzrósł do 3.255 ms. Przy 128 i 256 wątkach opóźnienie znacznie wzrosło, szczególnie przy dużych rozmiarach bloków. Na przykład, zapis 512K osiągnął 4.770 ms przy 128 wątkach, a 512K i 1M przekroczyły granicę 5 ms, osiągając szczyt 5.436 ms przy 1M.
FIO Test wydajności
Następnie przechodzimy do pomiaru wydajności FIO w pojedynczej puli RAID5. Chociaż GDSIO ostatecznie zależy od wydajności procesorów graficznych zainstalowanych w systemie i ich przepustowości PCIe, FIO może być wyższe w zależności od wydajności dysków SSD, a także samego rozwiązania RAID.
Cała macierz przechodzi spójny proces testowania, rozpoczynający się od fazy wstępnego kondycjonowania, składającej się z dwóch pełnych wypełnień woluminów przy użyciu sekwencyjnego obciążenia zapisem, a następnie sekwencyjnego i losowego obciążenia. Gwarantuje to, że dyski osiągną stan ustalony przed rozpoczęciem pomiaru wydajności.
Dla każdego nowego typu obciążenia ponownie inicjowaliśmy wstępne kondycjonowanie, używając odpowiedniego rozmiaru transferu, aby zachować dokładność i spójność wyników.
W tej sekcji przedstawiono następujące testy porównawcze losowego zapisu/odczytu FIO zastosowane do macierzy dysków SSD Graid 16 RAID 5:
- 1M losowego zapisu/odczytu
- Losowy zapis/odczyt 64K
- Losowy zapis/odczyt 16K
- Losowy zapis/odczyt 4K
1M losowa przepustowość odczytu/zapisu
Przechodząc do losowych operacji 1M, przepustowość odczytu była najszybsza, osiągając szczyt na poziomie 183.60 GB/s przy głębokości wejścia/wyjścia 16 i 172 zadaniach, co stanowiło najbardziej agresywną testowaną konfigurację. Podobne wyniki przy wysokiej przepustowości odnotowano przy 8/172 i 4/172, oba przekraczając 182 GB/s, co podkreśla zdolność macierzy do skalowania wraz ze wzrostem liczby i głębokości zadań. Nawet konfiguracje średniej klasy, takie jak 4/86 i 16/43, utrzymały wysoką wydajność, utrzymując ponad 147 GB/s i wykazując spójną wydajność odczytu na różnych poziomach współbieżności. Przechodząc do zapisów, losowa przepustowość 1M osiągnęła szczyt na poziomie 54.233 GB/s przy 8/172, a niemal identyczny wynik 53.77 GB/s przy 2/86, co potwierdza efektywne skalowanie zapisu przy obciążeniach równoległych. Wydajność płynnie spadała w kombinacjach z mniejszą liczbą wątków, takich jak 1/43 i 2/43, co dawało odpowiednio 24.88 GB/s i 42.48 GB/s, co nadal odzwierciedlało silną krzywą nasycenia nawet przy umiarkowanych poziomach współbieżności.
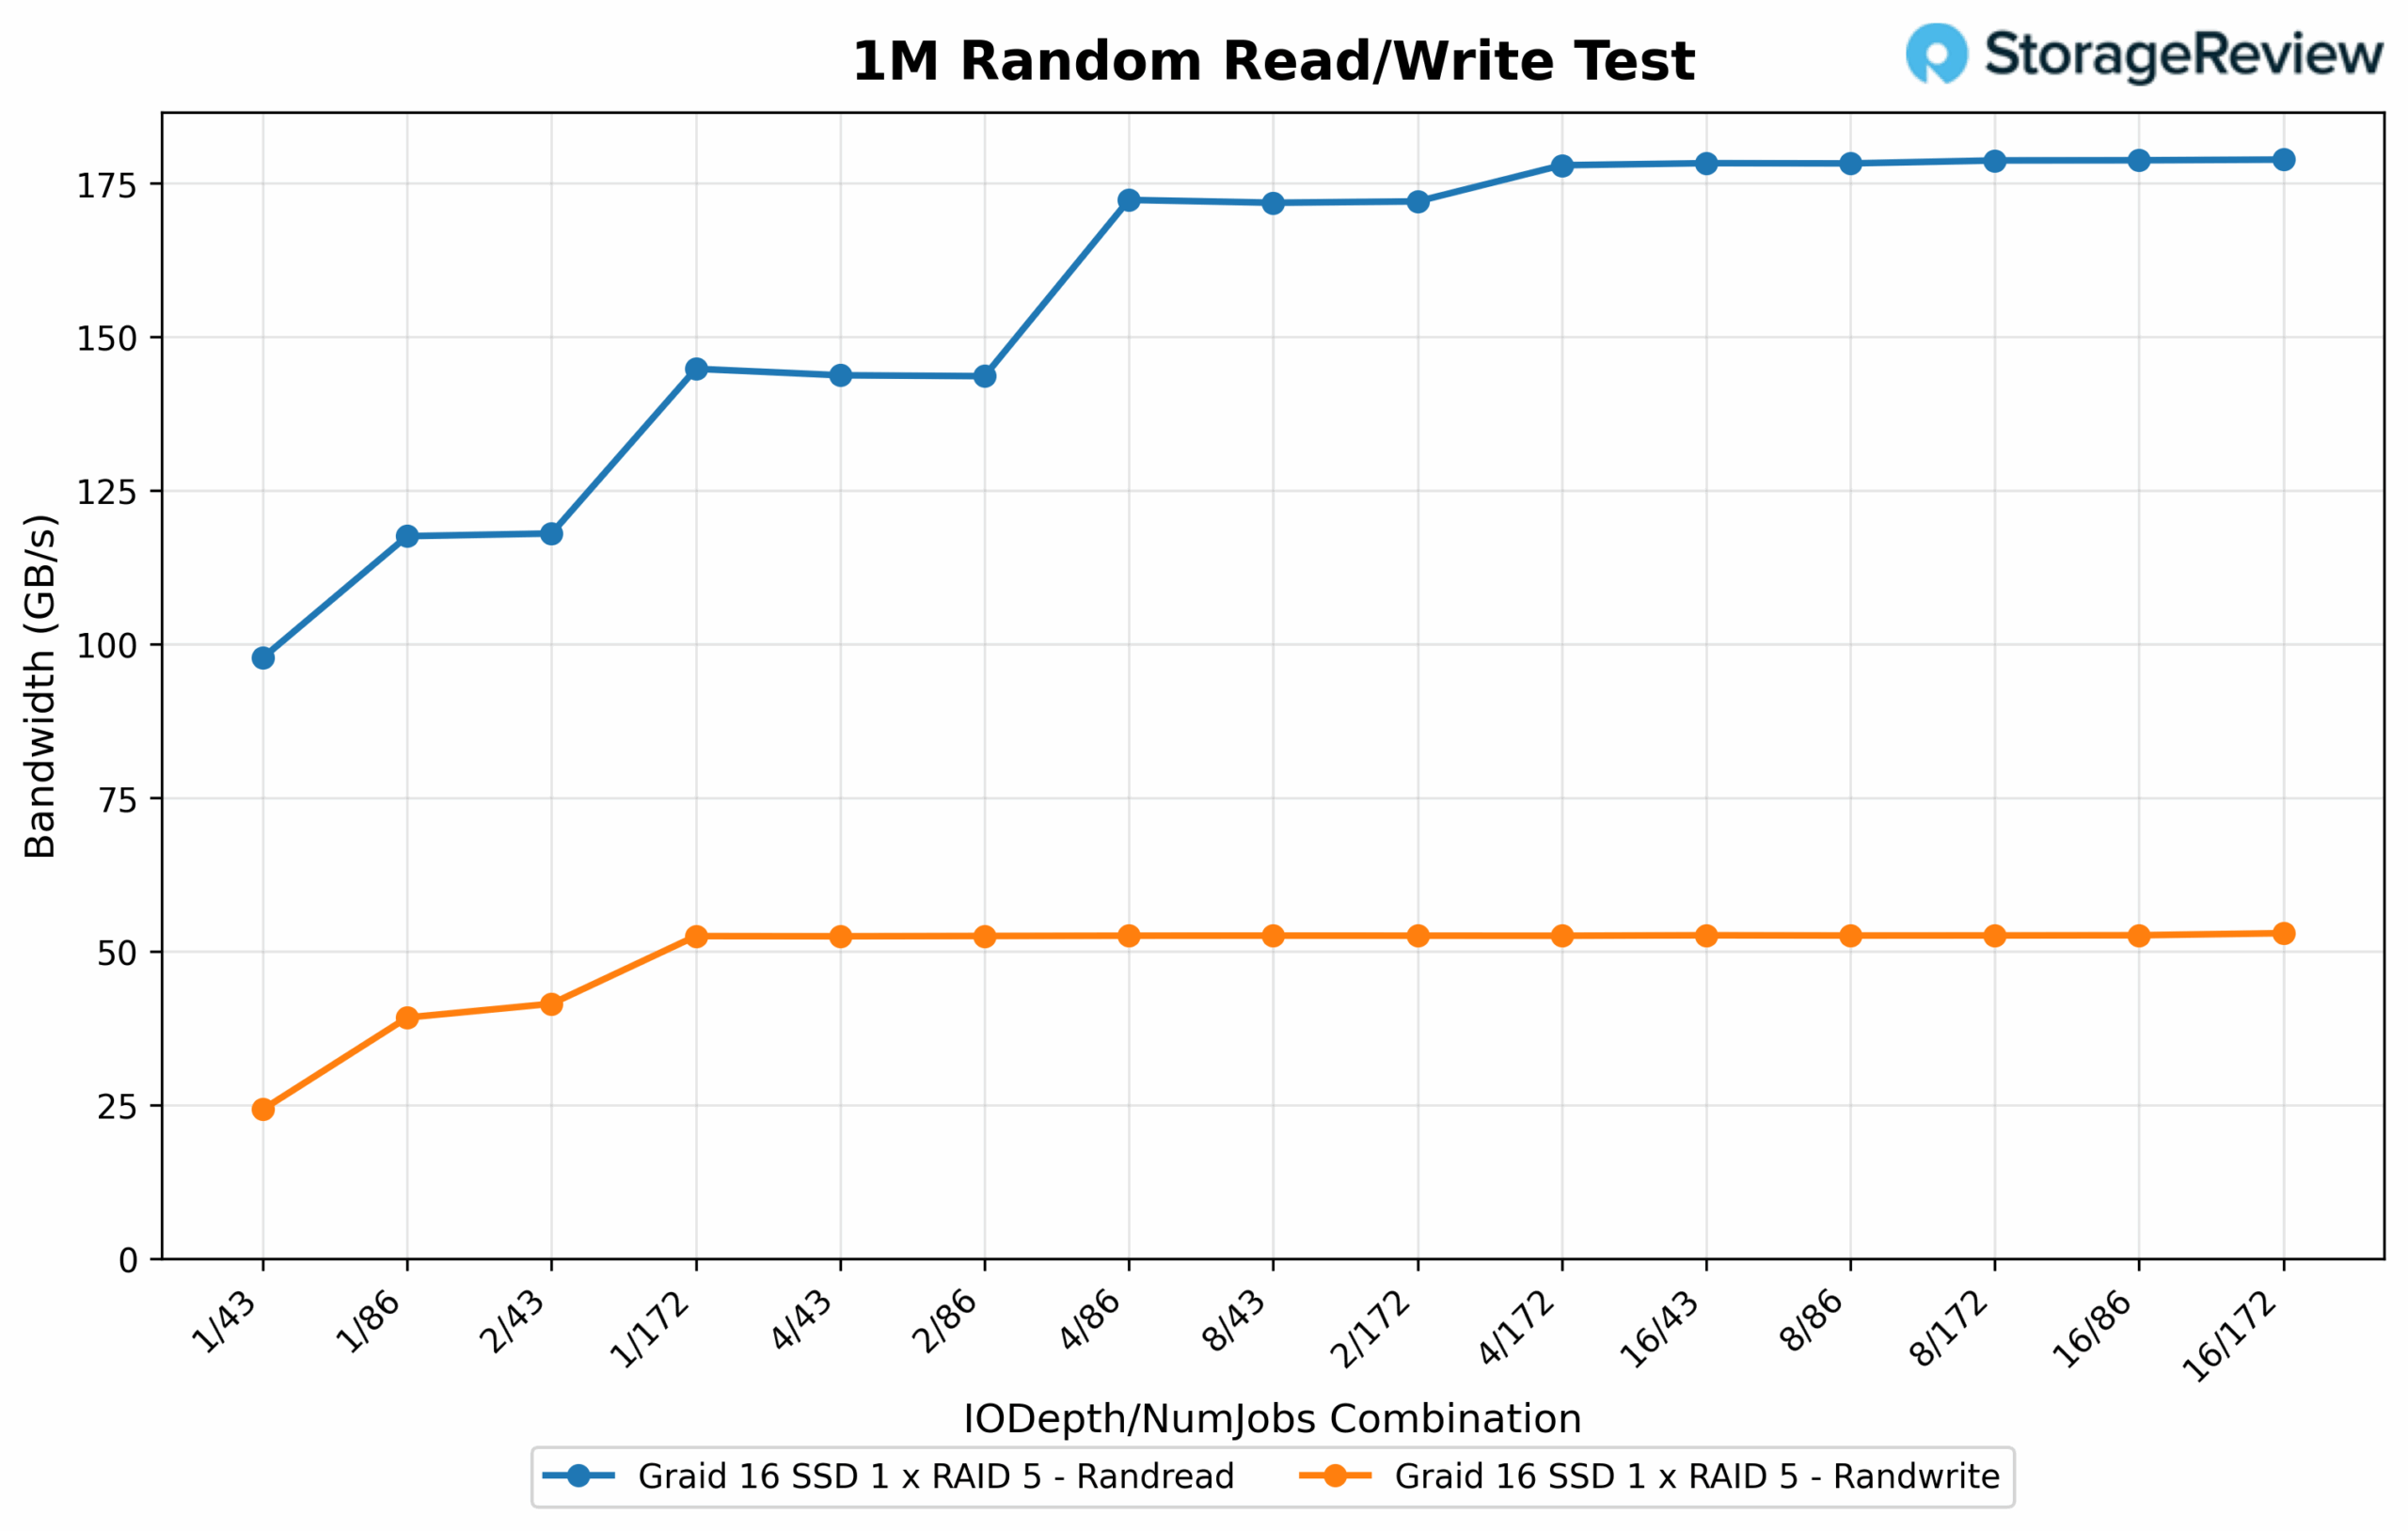
1M losowego opóźnienia odczytu/zapisu
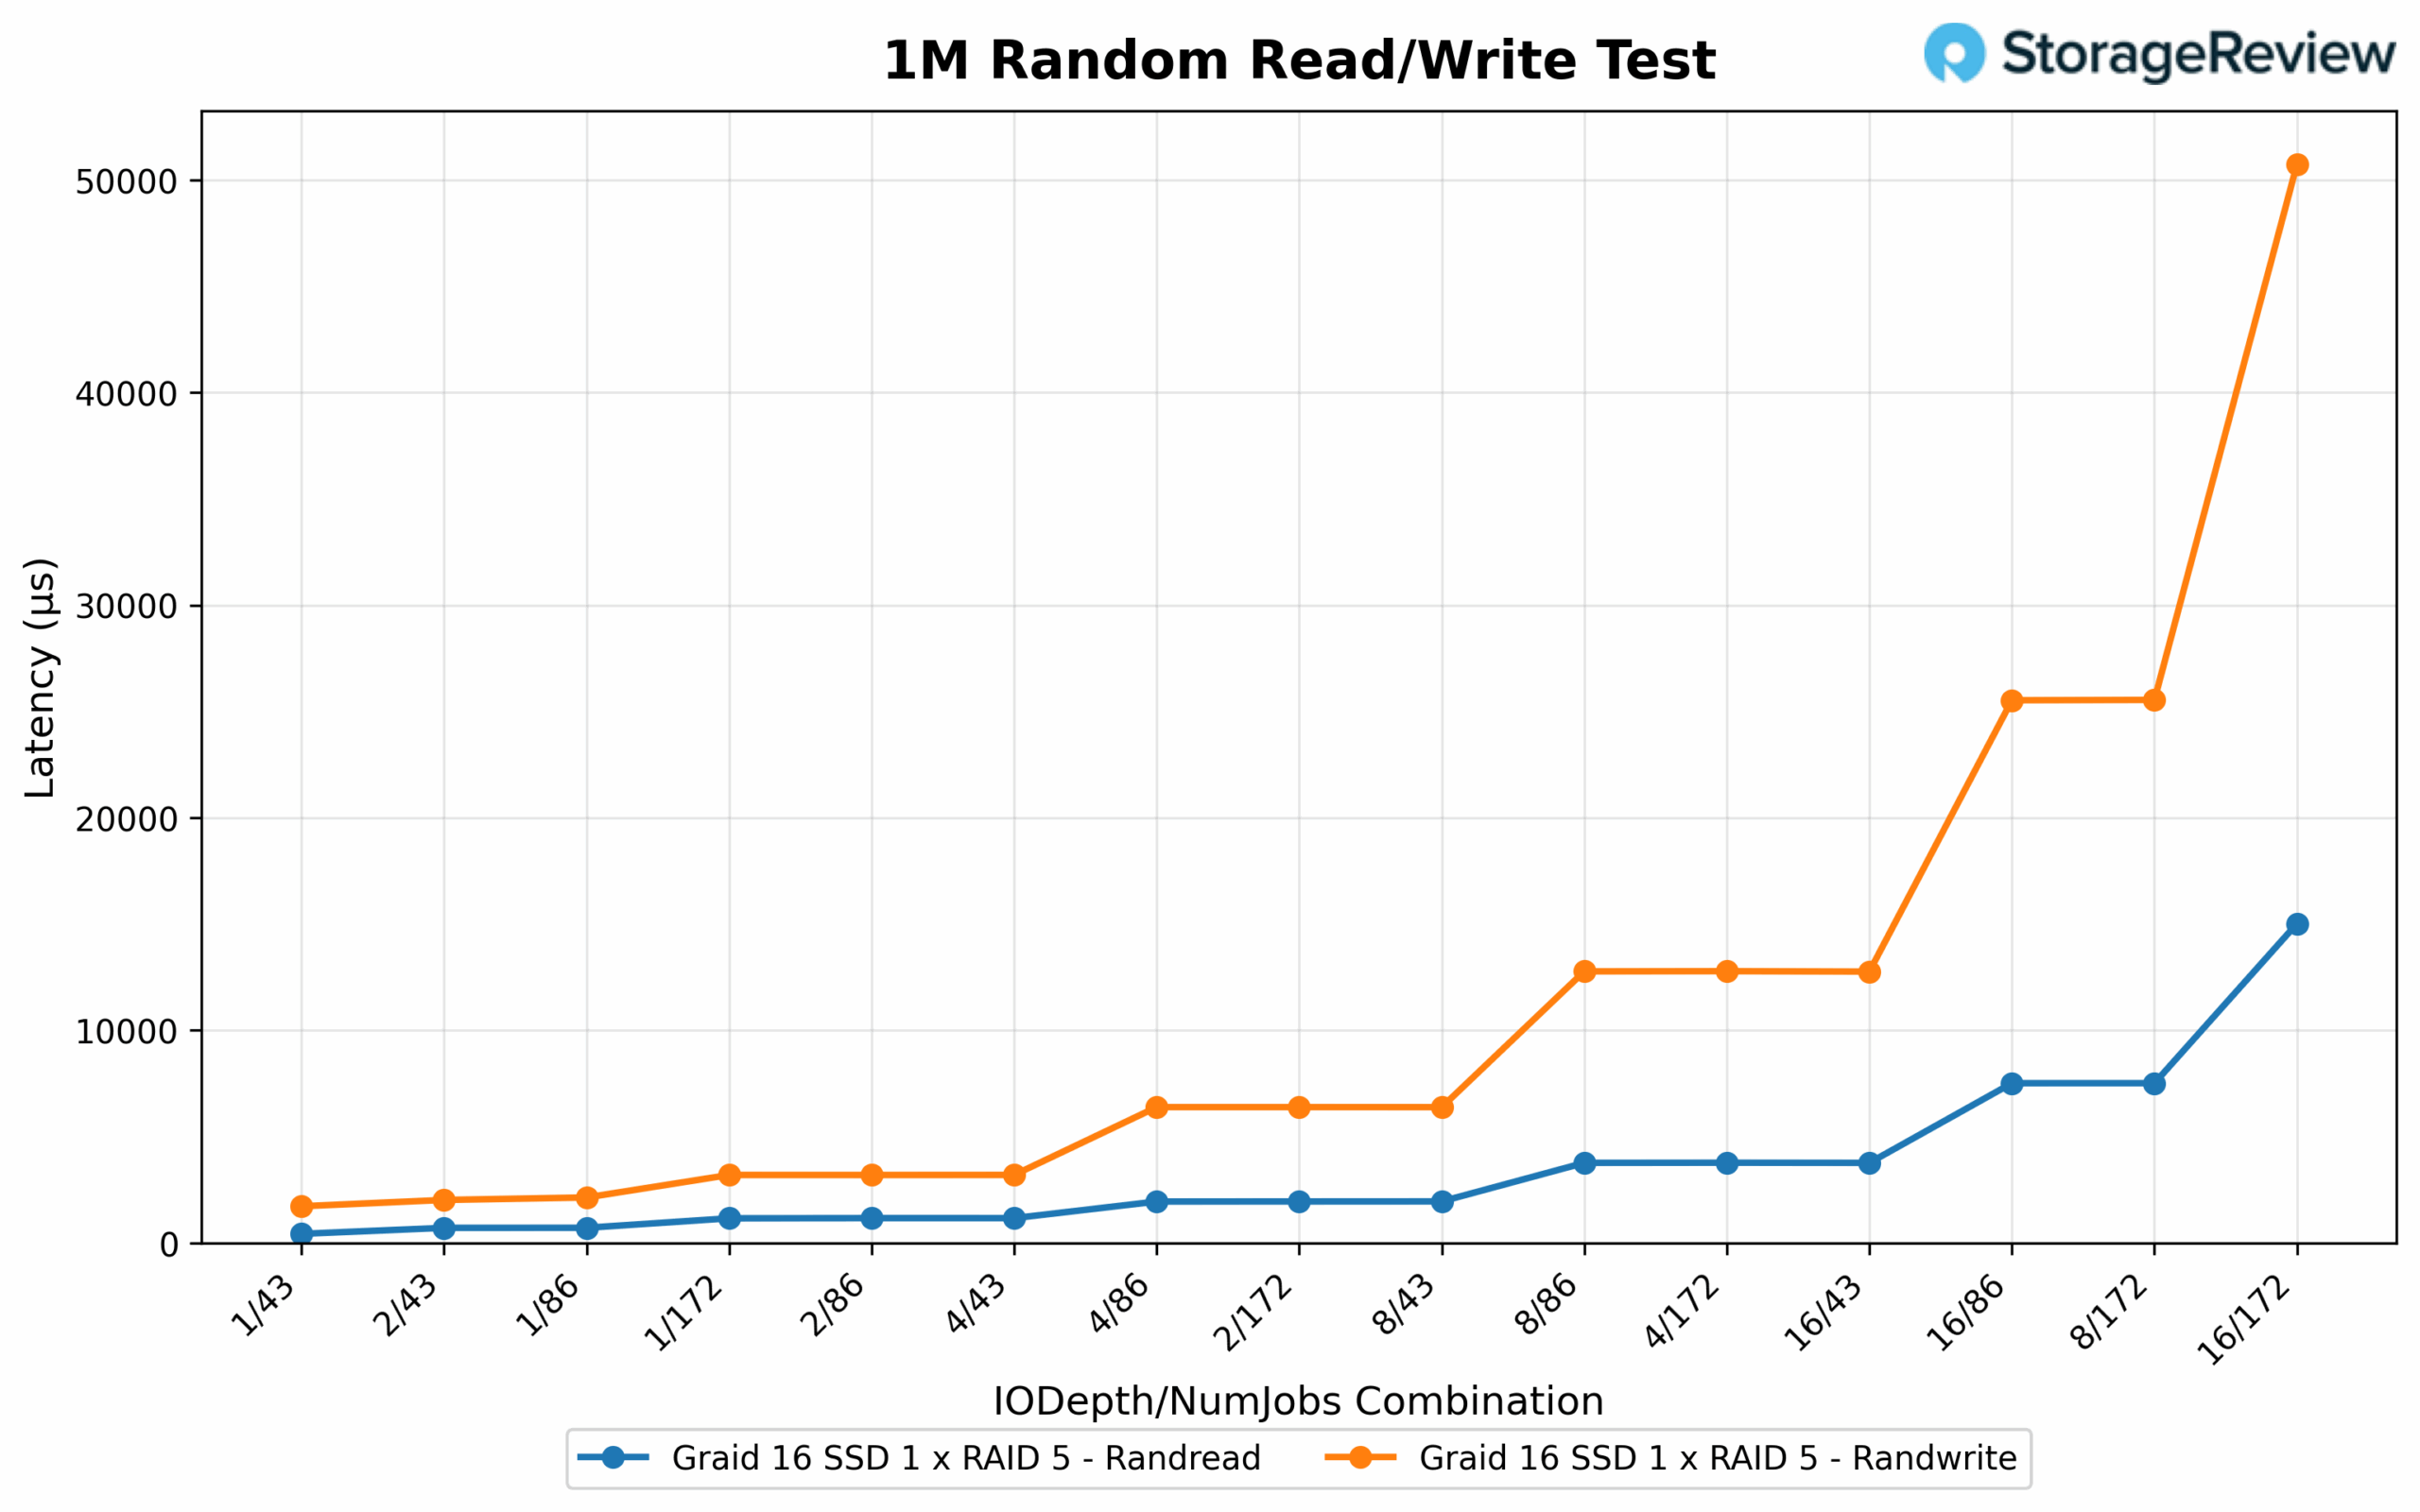
Opóźnienie pozostawało pod kontrolą dla odczytów w całym zakresie testowym. Najniższe zaobserwowane opóźnienie wyniosło 0.714 ms zarówno przy 2/86, jak i 4/86, podczas gdy obciążenia o większej głębokości, takie jak 8/172 i 4/172, utrzymywały się poniżej 2 ms. Konfiguracja, która zapewniła najwyższą przepustowość odczytu, 16/172, charakteryzowała się najwyższym opóźnieniem wynoszącym 7.516 ms – co stanowiło wyraźny kompromis, ponieważ głębsze kolejki wydłużały czas reakcji. Po stronie zapisu opóźnienie kształtowało się podobnie. Najniższe opóźnienie zapisu zmierzono na poziomie 1.727 ms przy 1/43. Silną równowagę między przepustowością a opóźnieniem osiągnięto przy 2/86 i 3.197 ms. Opcje o wyższej współbieżności, takie jak 8/43, odnotowały opóźnienie 6.389 ms, a konfiguracja 16/172, zapewniając szczytową wydajność zapisu, odnotowała najwyższe opóźnienie na poziomie 50.741 ms, co podkreśla znaną odwrotną zależność między przepustowością a reakcją na ekstremalnych głębokościach.
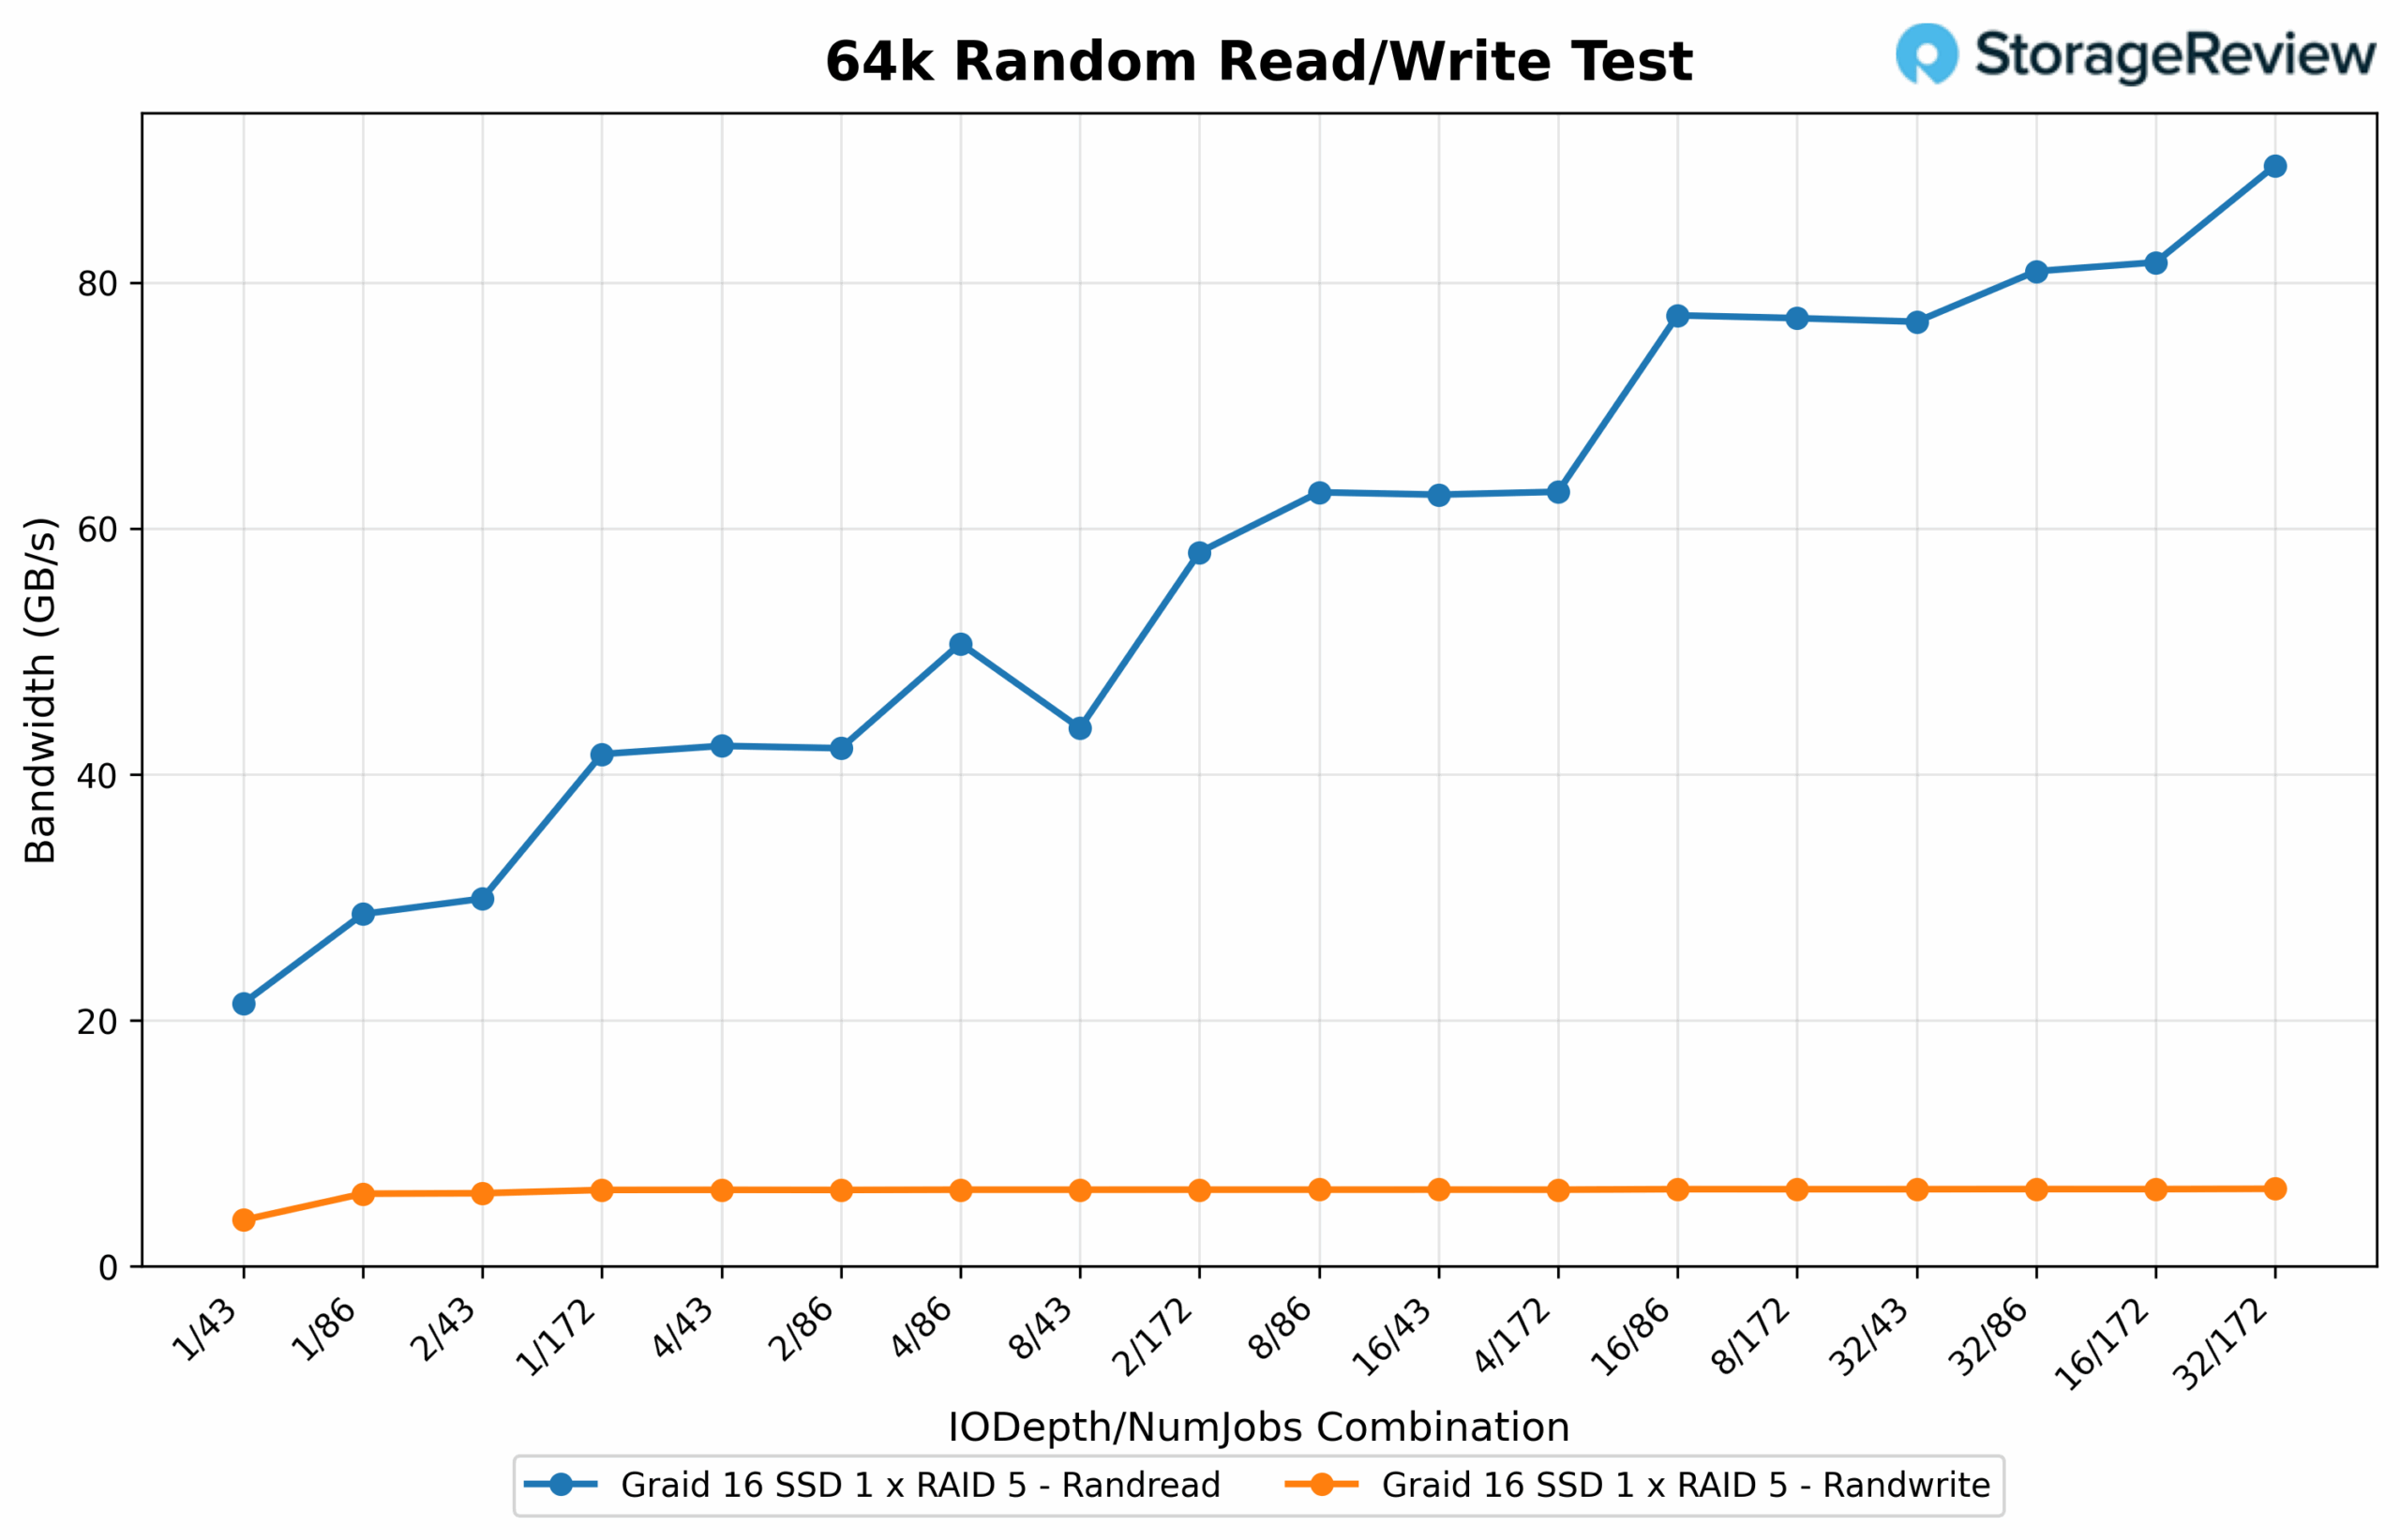
64K losowej przepustowości odczytu/zapisu
Przejście na losowe operacje 64K znacząco poprawiło przepustowość odczytu wraz ze wzrostem głębokości kolejki i liczby zadań, osiągając szczyt 91.65 GB/s przy głębokości 32 IO i 172 zadaniach. Kilka innych konfiguracji pojawiło się tuż za nimi, w tym 16/172 z przepustowością 83.59 GB/s i 32/86 z przepustowością 82.85 GB/s, co wskazuje na stały wzrost wydajności wraz ze skalowaniem obciążenia. Konfiguracje średniej klasy, takie jak 8/172 i 16/86, utrzymywały dobre wyniki między 78 GB/s a 79 GB/s. Natomiast kombinacje o niższej współbieżności, takie jak 1/43 i 1/172, generowały obniżone poziomy przepustowości, wahające się od 21.89 GB/s do 42.63 GB/s, co ilustruje zależność macierzy od paralelizmu w celu uzyskania szczytowej wydajności. Po stronie zapisu losowa przepustowość 64K osiągnęła szczyt na poziomie 6.44 GB/s przy 32/86. Inne konfiguracje o najwyższej wydajności, w tym 32/172 i 16/86, były zbliżone, rejestrując odpowiednio 6.41 GB/s i 6.36 GB/s. Większość punktów testowych mieściła się w przedziale 6.3 GB/s i 6.4 GB/s, wykazując stabilną spójność przy różnych głębokościach kolejek. Konfiguracje o niskiej wydajności, takie jak 1/43, wykazały najniższą wydajność zapisu, wynoszącą 3.83 GB/s, co nadal potwierdza trend progresywnego wzrostu przy większych obciążeniach.
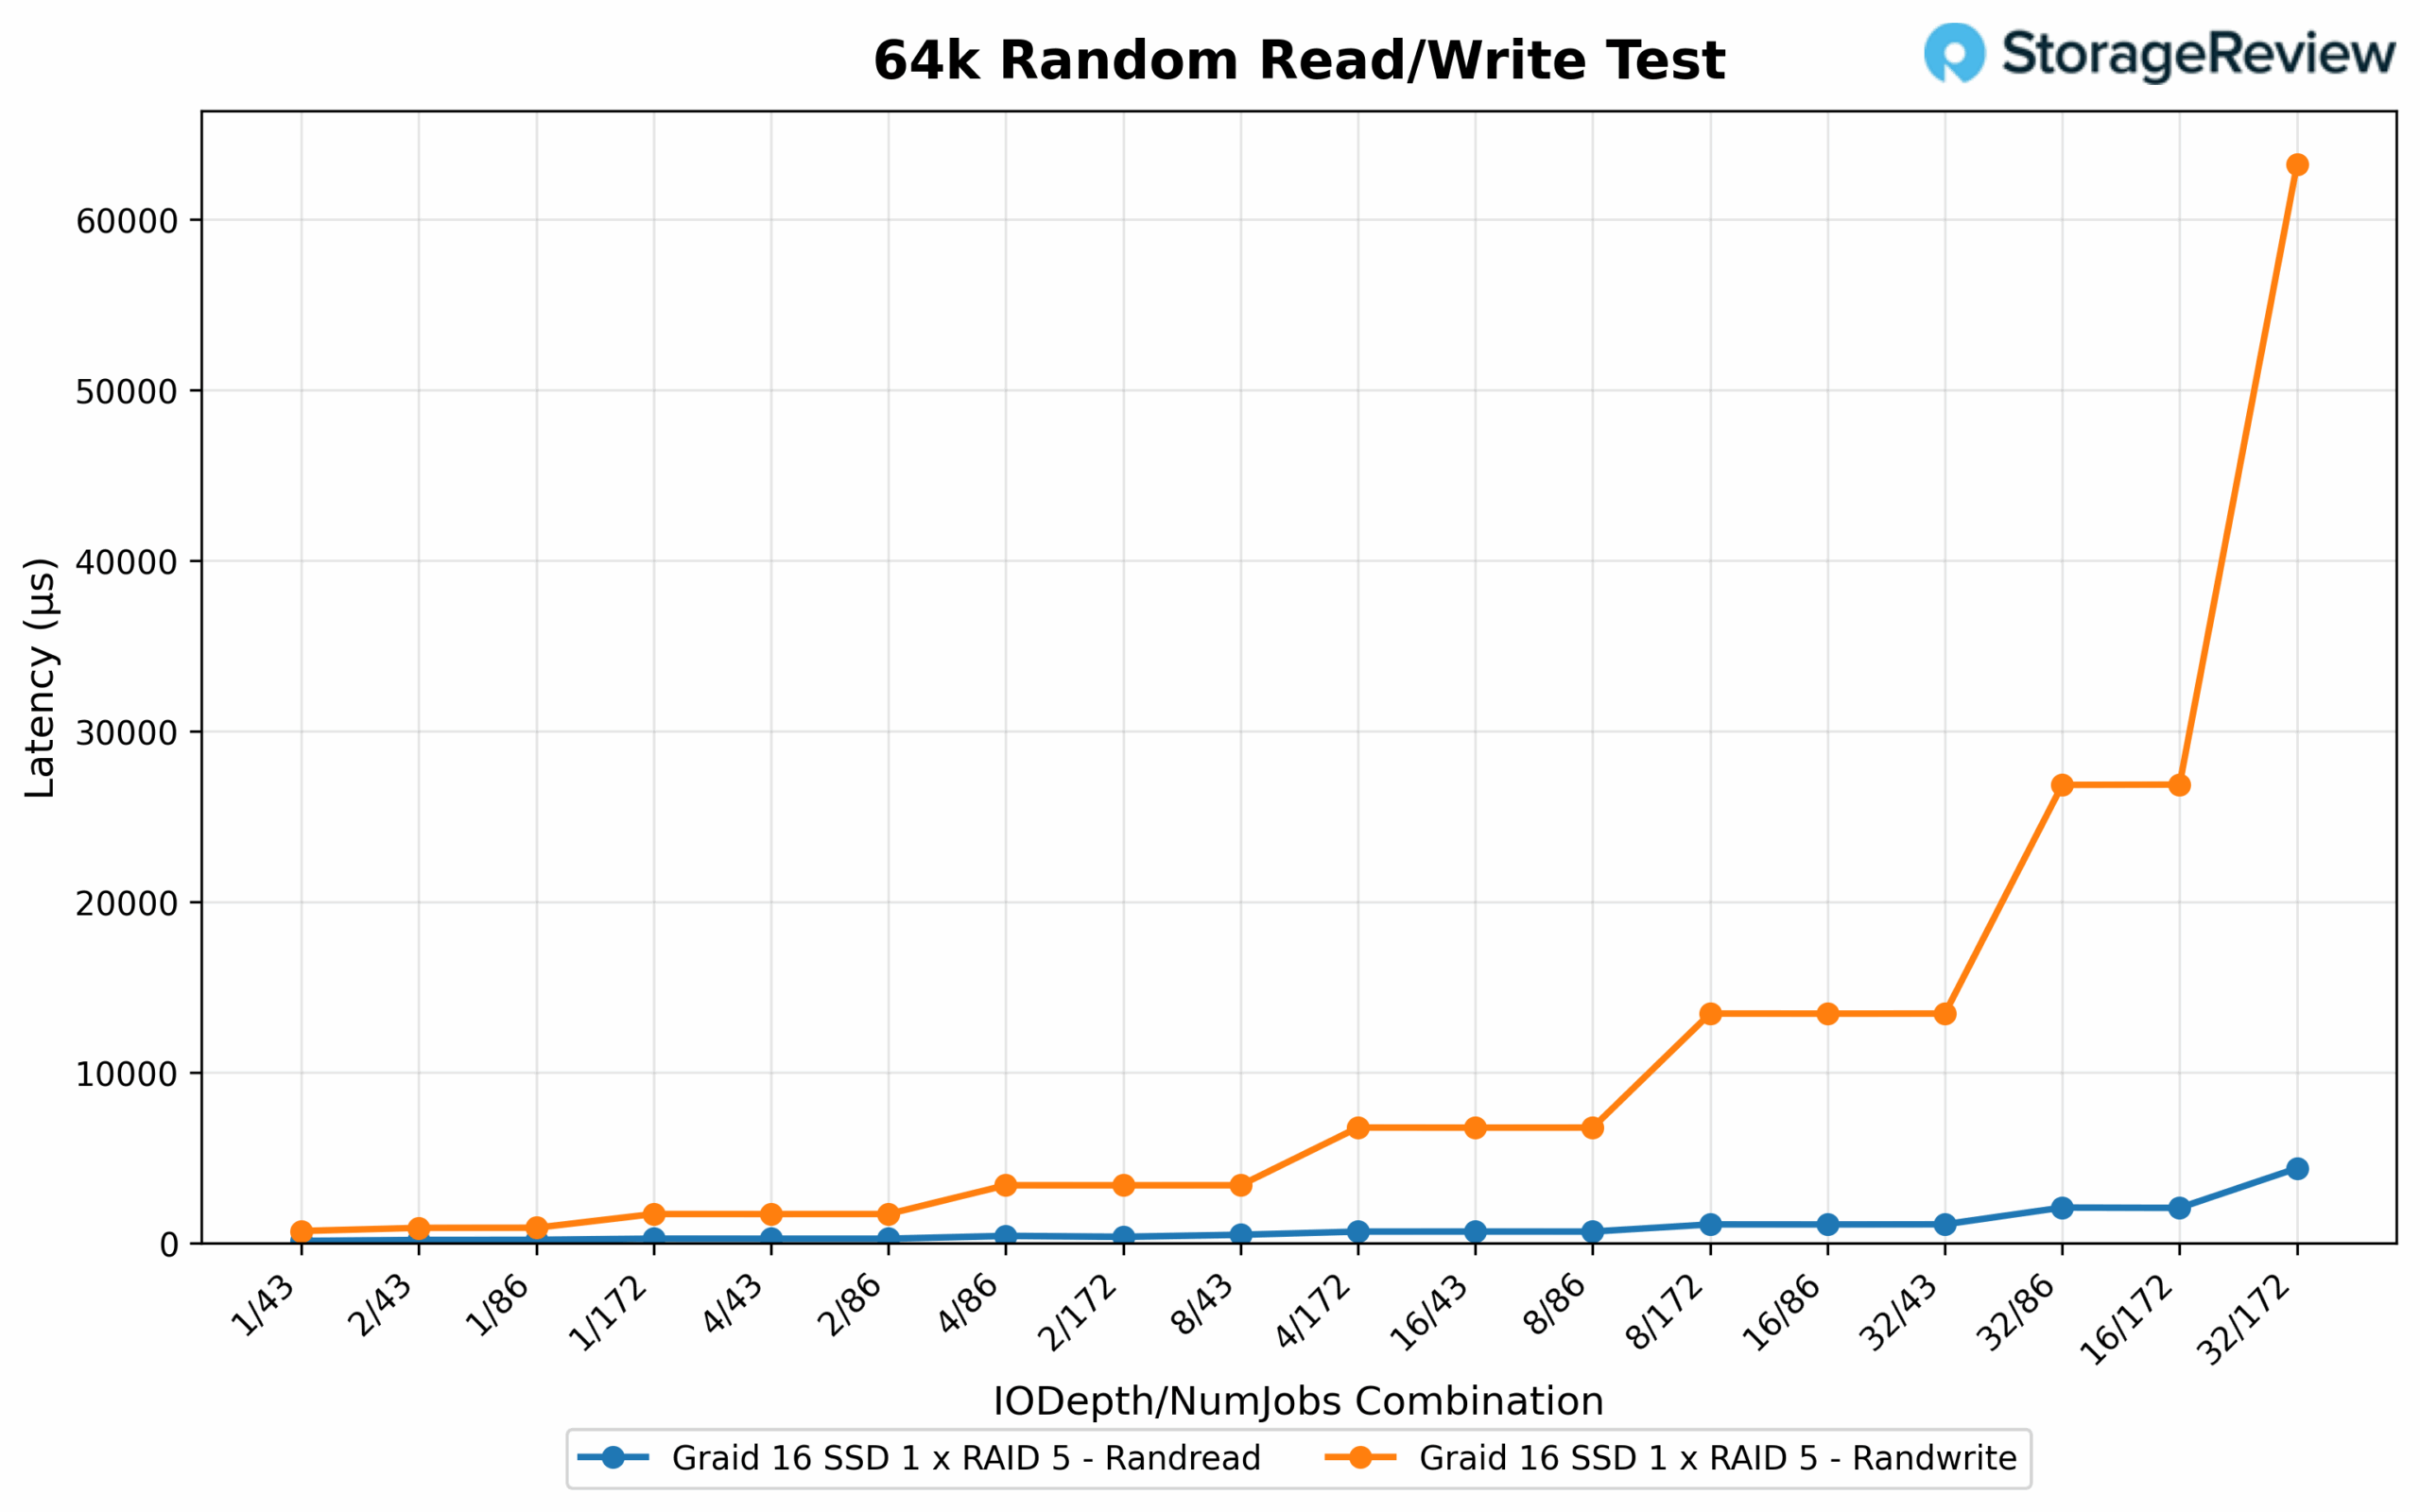
Opóźnienie losowego odczytu/zapisu 64K
Opóźnienie losowego odczytu 64 KB pozostawało stale niskie w większości przypadków testowych. Najniższe opóźnienie wyniosło 0.123 ms przy 1/43, a następnie 0.175 ms przy 1/86. Wraz ze wzrostem przepustowości, opóźnienie utrzymywało się w kontrolowanym zakresie: 4/172 odnotowało 0.666 ms, a 16/172 osiągnęło 2.057 ms. Nawet przy większym obciążeniu, responsywność pozostała wysoka, a 32/86 odnotowało 2.076 ms, pomimo jednego z najwyższych wyników przepustowości. Po stronie zapisu opóźnienie rosło bardziej dynamicznie wraz z głębokością i liczbą zadań. Najniższe opóźnienie odnotowano dla 2/43 i 0.887 ms, a dla 4/43 i 2/86 nieznacznie niższe, odpowiednio 1.694 ms i 1.697 ms. W przypadku cięższych konfiguracji wyraźnie widać było kompromis w zakresie czasu reakcji: w przypadku 8/172 odnotowano 13.445 ms, w przypadku 16/172 — 26.862 ms, a w przypadku 32/172 — 63.201 ms. Świadczy to o zwiększonym obciążeniu kolejek w miarę nasilania się obciążeń.
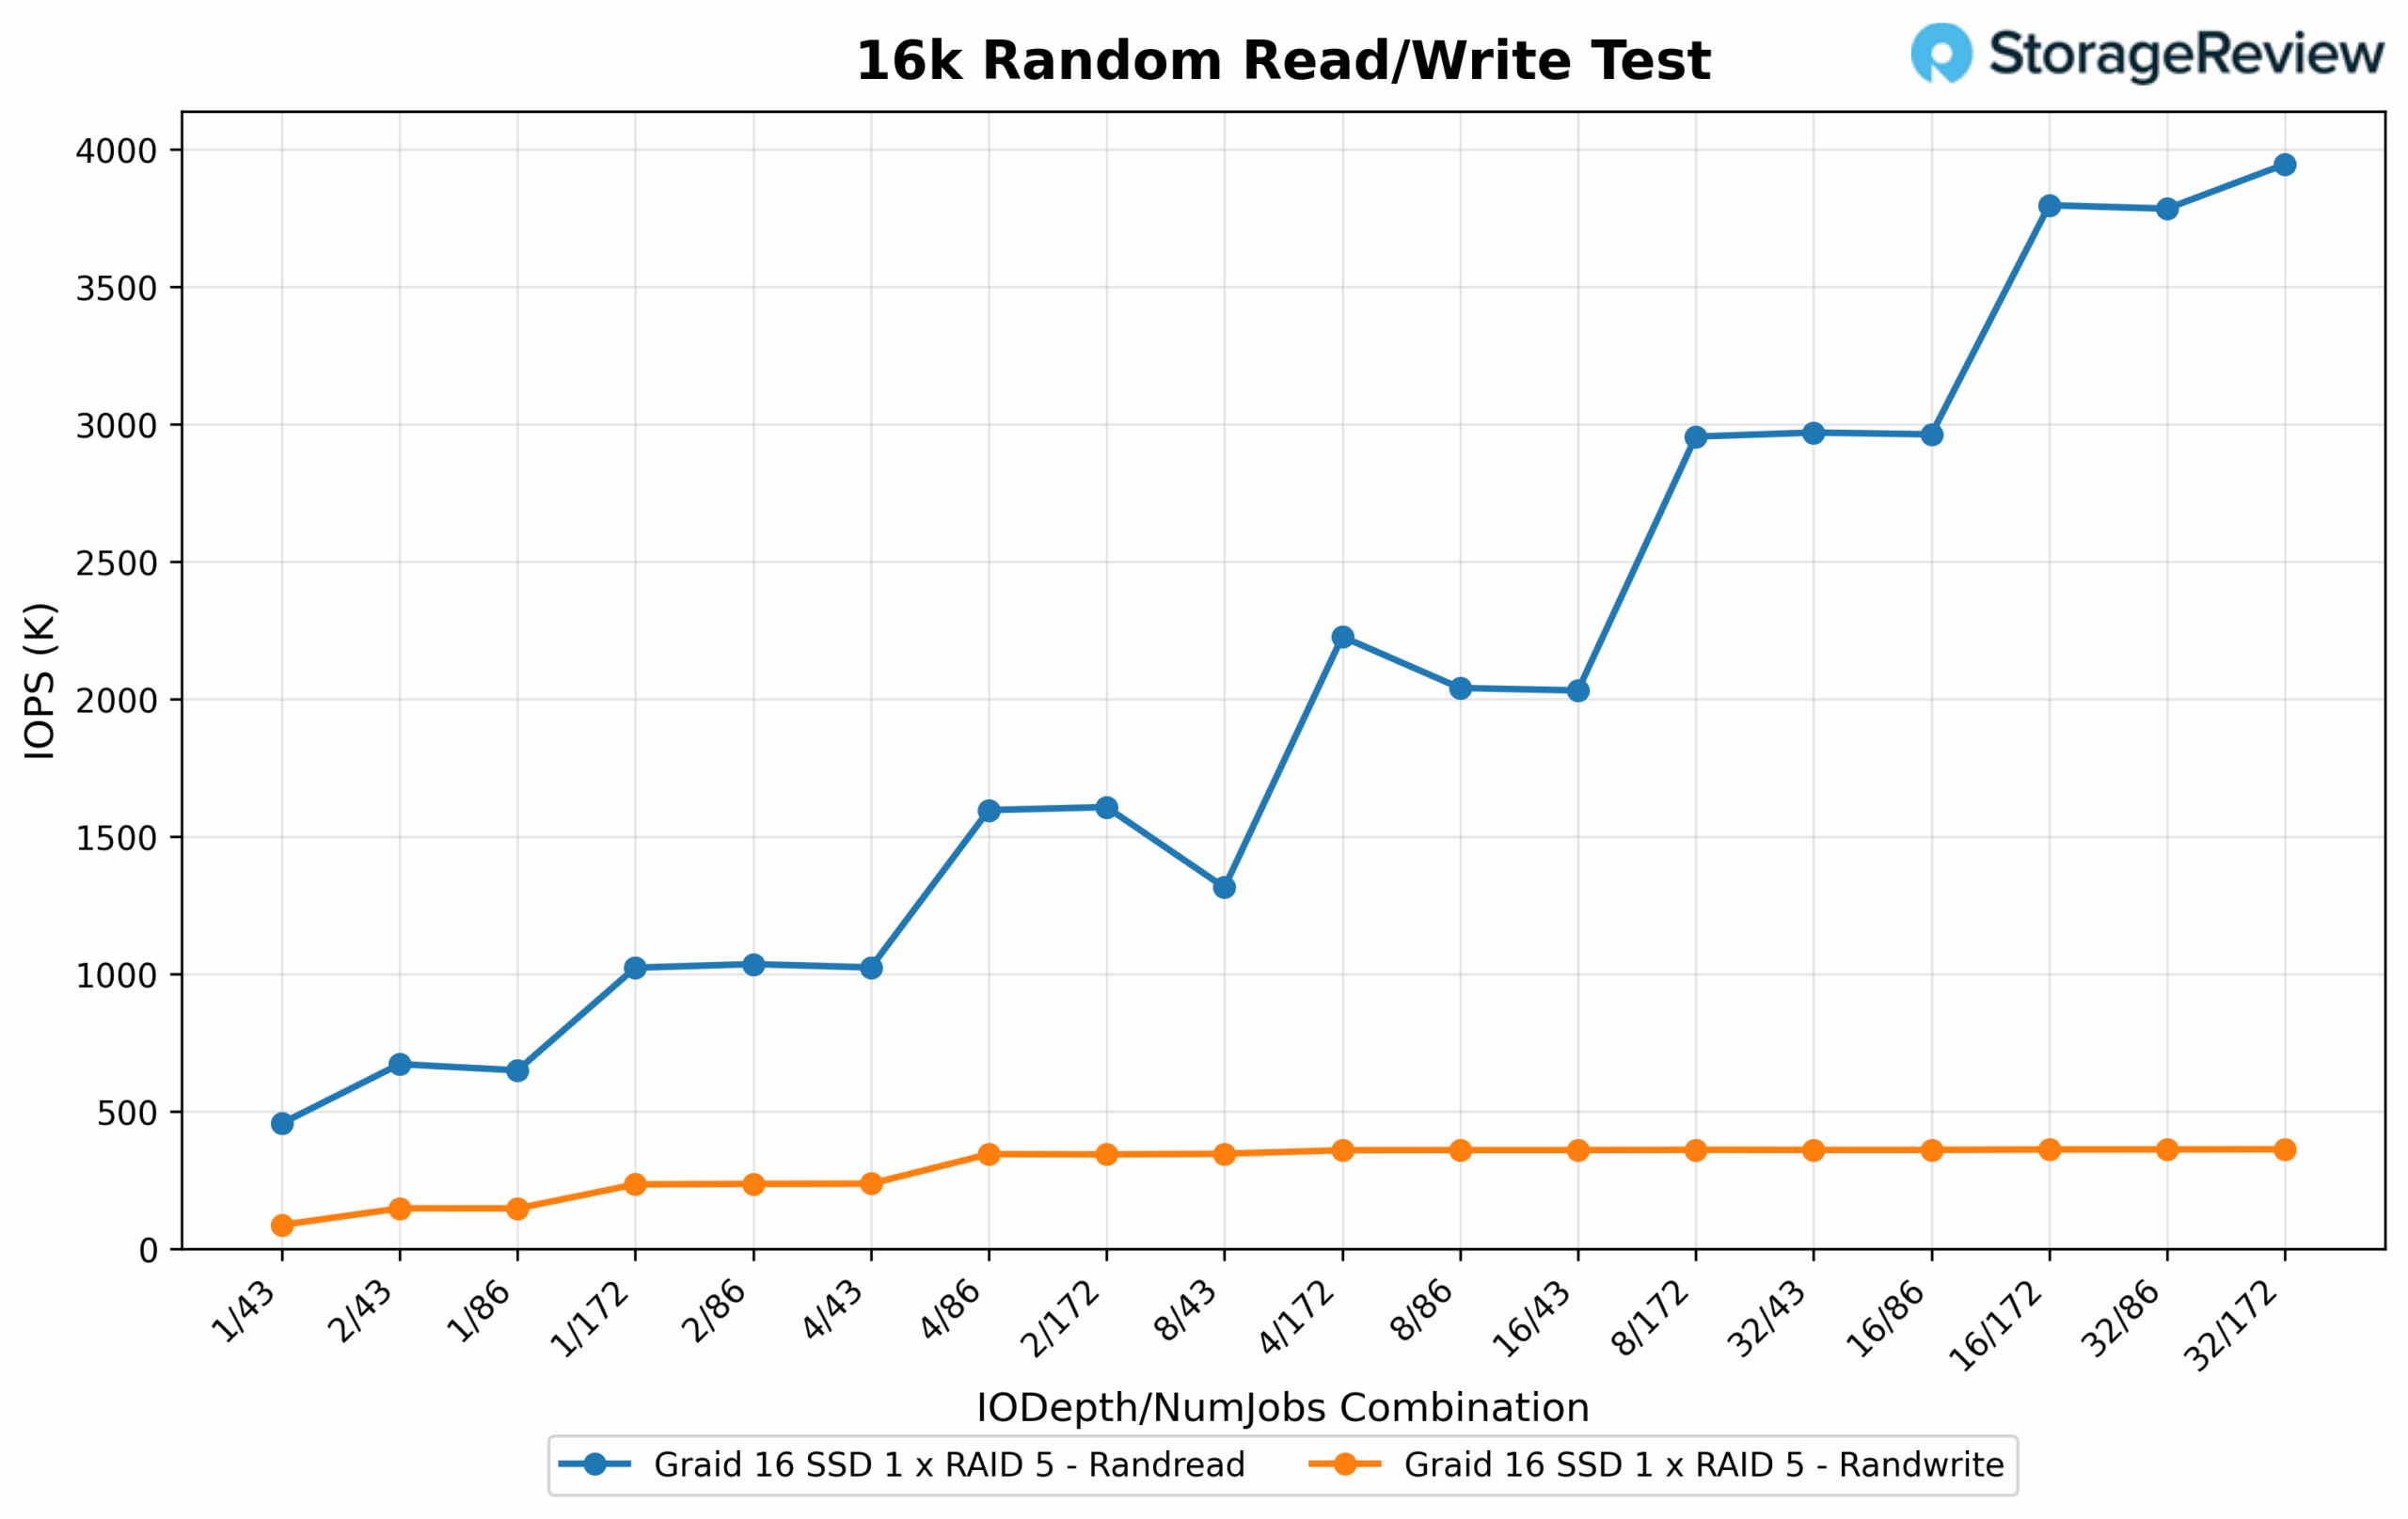
16K losowych operacji odczytu/zapisu IOPS
Opóźnienie losowego odczytu 16 KB pozostało niskie nawet przy szczytowym IOPS. Najlepszą responsywność zaobserwowano w lżejszych konfiguracjach, gdzie 1/43 osiągnął zaledwie 0.087 ms, a 1/86 – 0.114 ms. Kombinacje o wyższej współbieżności, takie jak 4/86 i 8/86, zmierzyły odpowiednio 0.236 ms i 0.420 ms. Nawet konfiguracje o najwyższej wydajności utrzymywały rozsądne opóźnienie, gdzie 16/172 odnotowało 1.143 ms, a 32/172 – 2.372 ms, co świadczy o efektywnym skalowaniu i kontrolowanym wpływie na czas reakcji. W przypadku losowego zapisu 16 KB najniższe opóźnienie odnotowano przy 2/43 i 0.848 ms, następnie 1.253 ms przy 4/43 i 1.415 ms przy 1/43. W miarę zwiększania głębokości i liczby zadań opóźnienie stopniowo rosło: 8/172 osiągnęło 5.574 ms, podczas gdy 16/172 i 32/172 wzrosły odpowiednio do 10.455 ms i 22.958 ms, co uwydatniło oczekiwany kompromis w miarę wzrostu nasycenia kolejki.
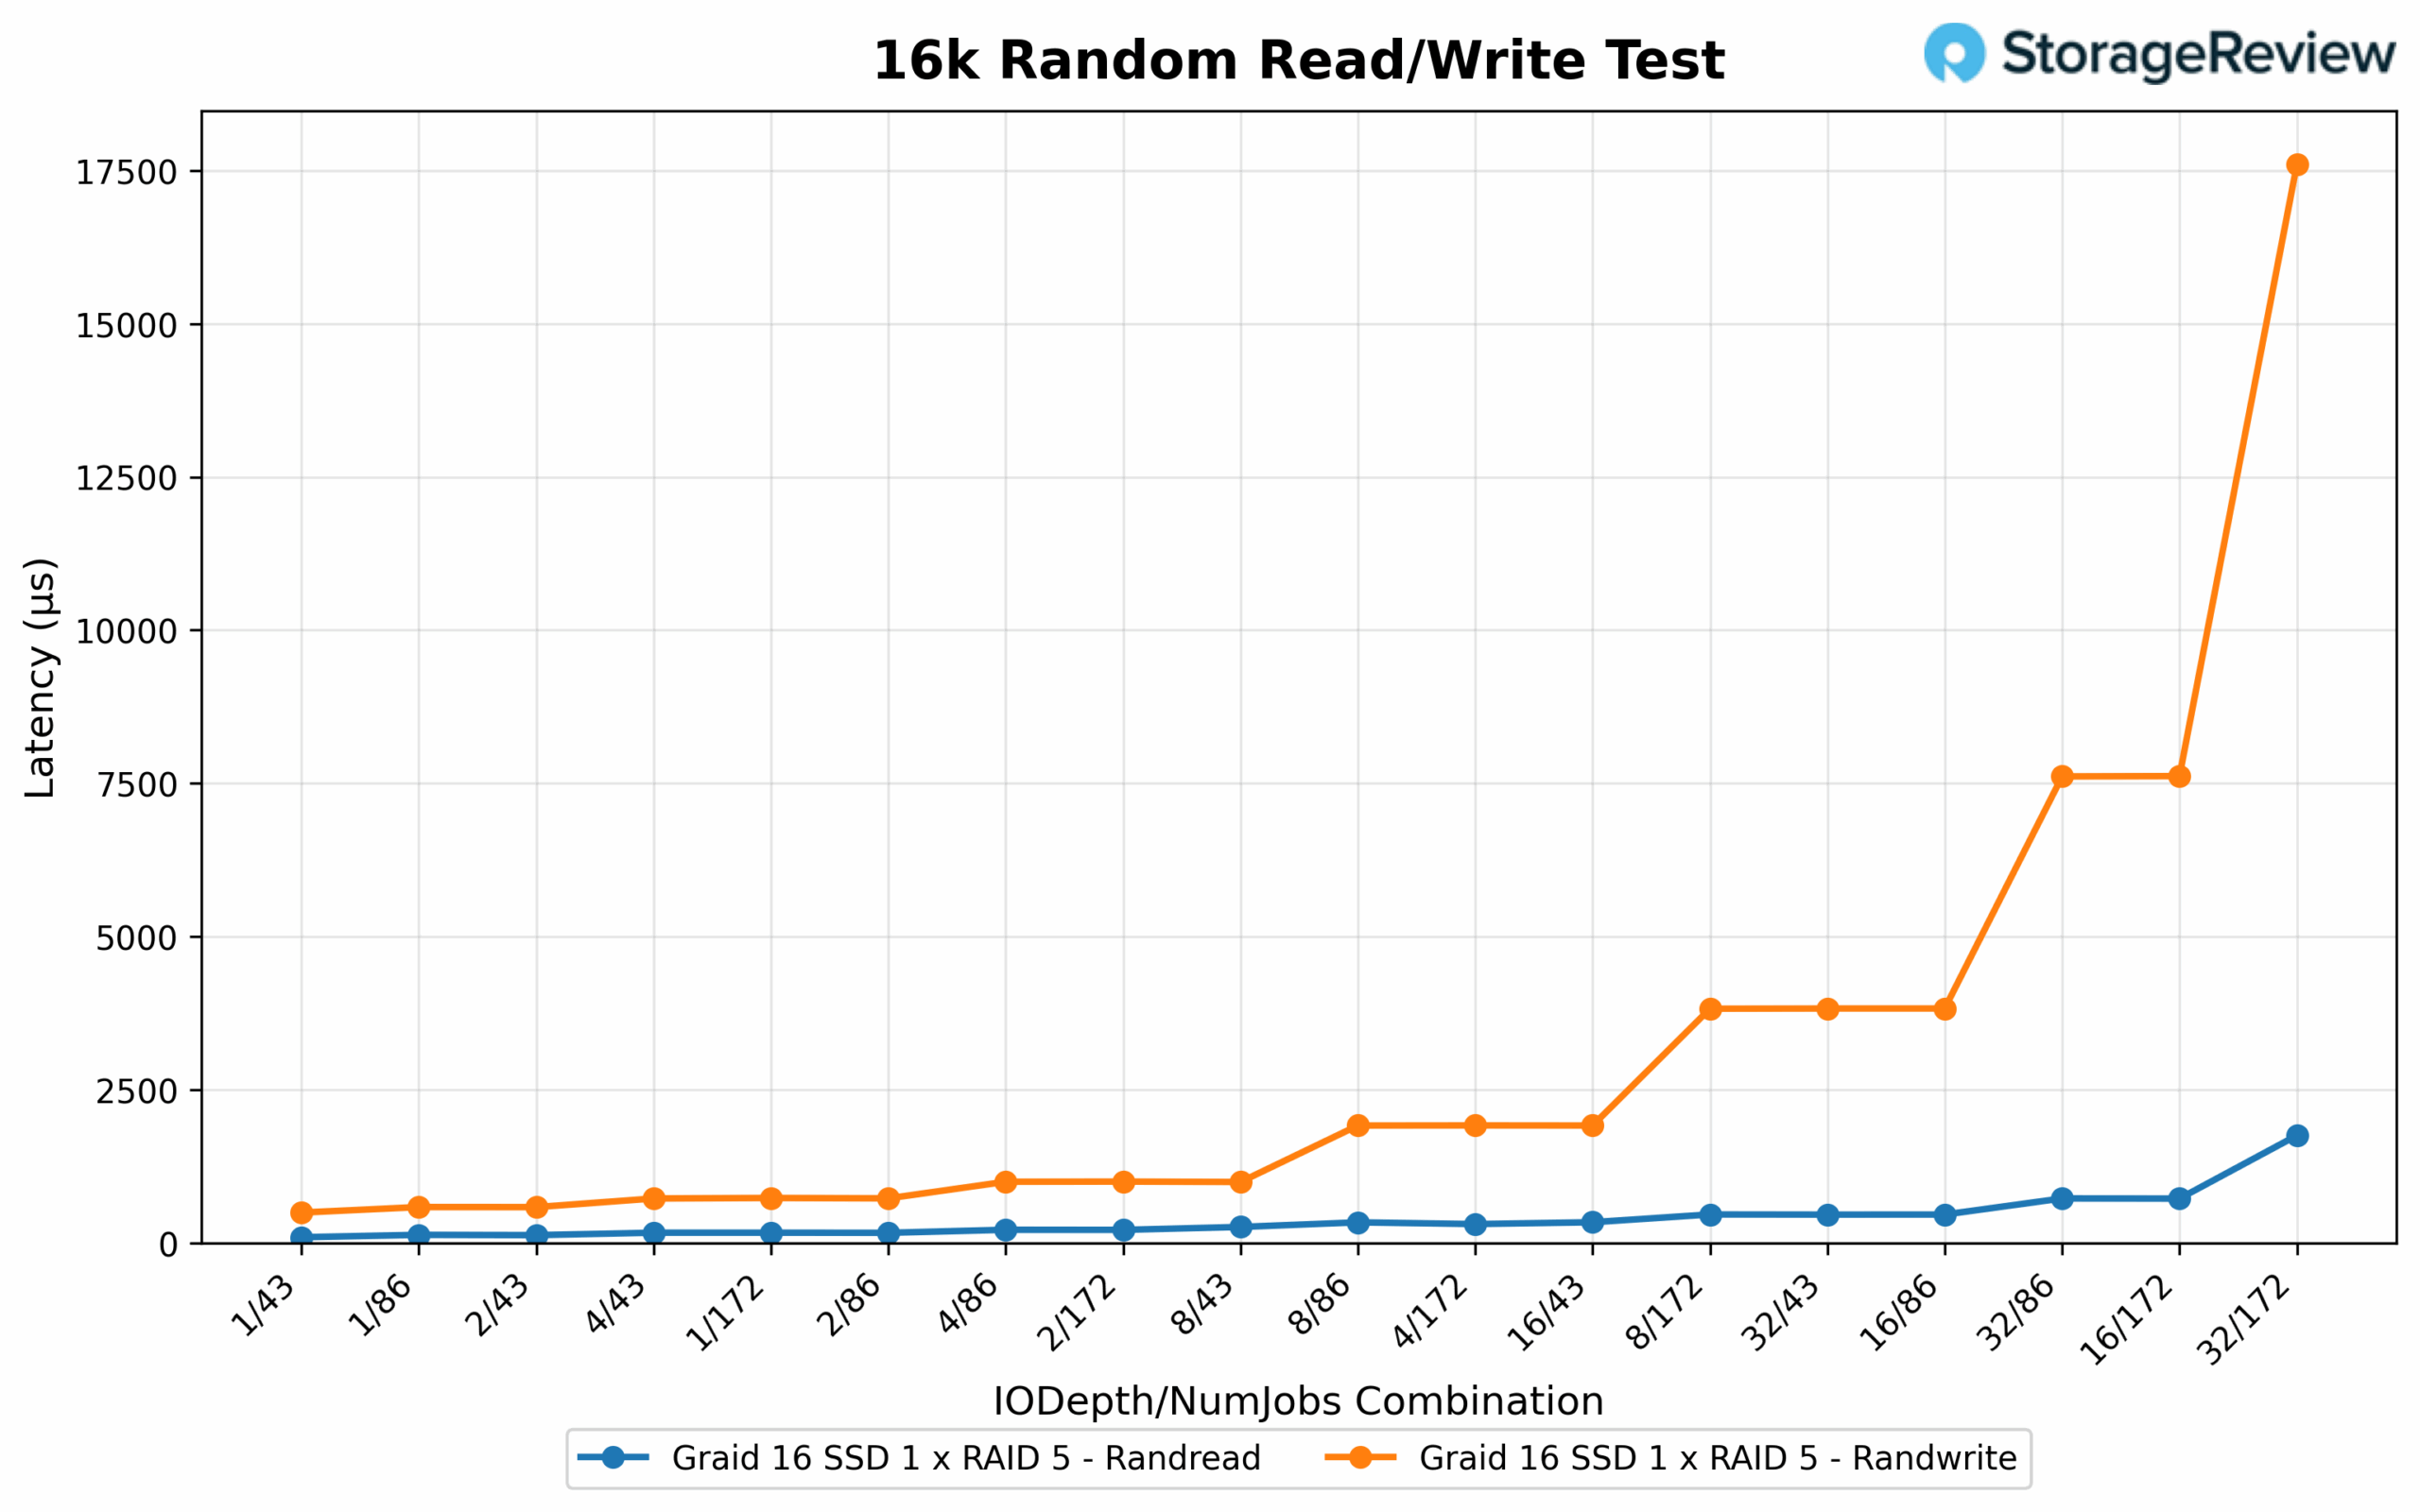
Opóźnienie losowego odczytu/zapisu 16K
Opóźnienie losowego odczytu 16 KB pozostawało stale niskie w całym zakresie. Konfiguracja o największej responsywności wyniosła 1/43 ms przy 0.123 ms, a tuż za nią 1/86 ms przy 0.175 ms. Nawet przy maksymalnym obciążeniu, konfiguracje takie jak 32/172 i 16/172 utrzymywały opóźnienie poniżej 2.1 ms, co pokazuje, że macierz utrzymywała szybkie czasy reakcji przy jednoczesnym zwiększeniu liczby operacji wejścia/wyjścia na sekundę (IOPS). Natomiast opóźnienie losowego zapisu 16 KB wykazywało większą zmienność. Najniższe opóźnienie wyniosło 0.496 ms przy 1/43 ms, a kolejne wydajne przebiegi, takie jak 2/86 i 4/43, utrzymywały się poniżej 1 ms. W miarę zwiększania się współbieżności i głębokości odpowiednio rosło opóźnienie: 16/172 odnotowało 7.017 ms, a 32/172 osiągnęło 17.246 ms, co potwierdza oczekiwany kompromis między szczytową przepustowością a reakcją przy maksymalnym nasyceniu.
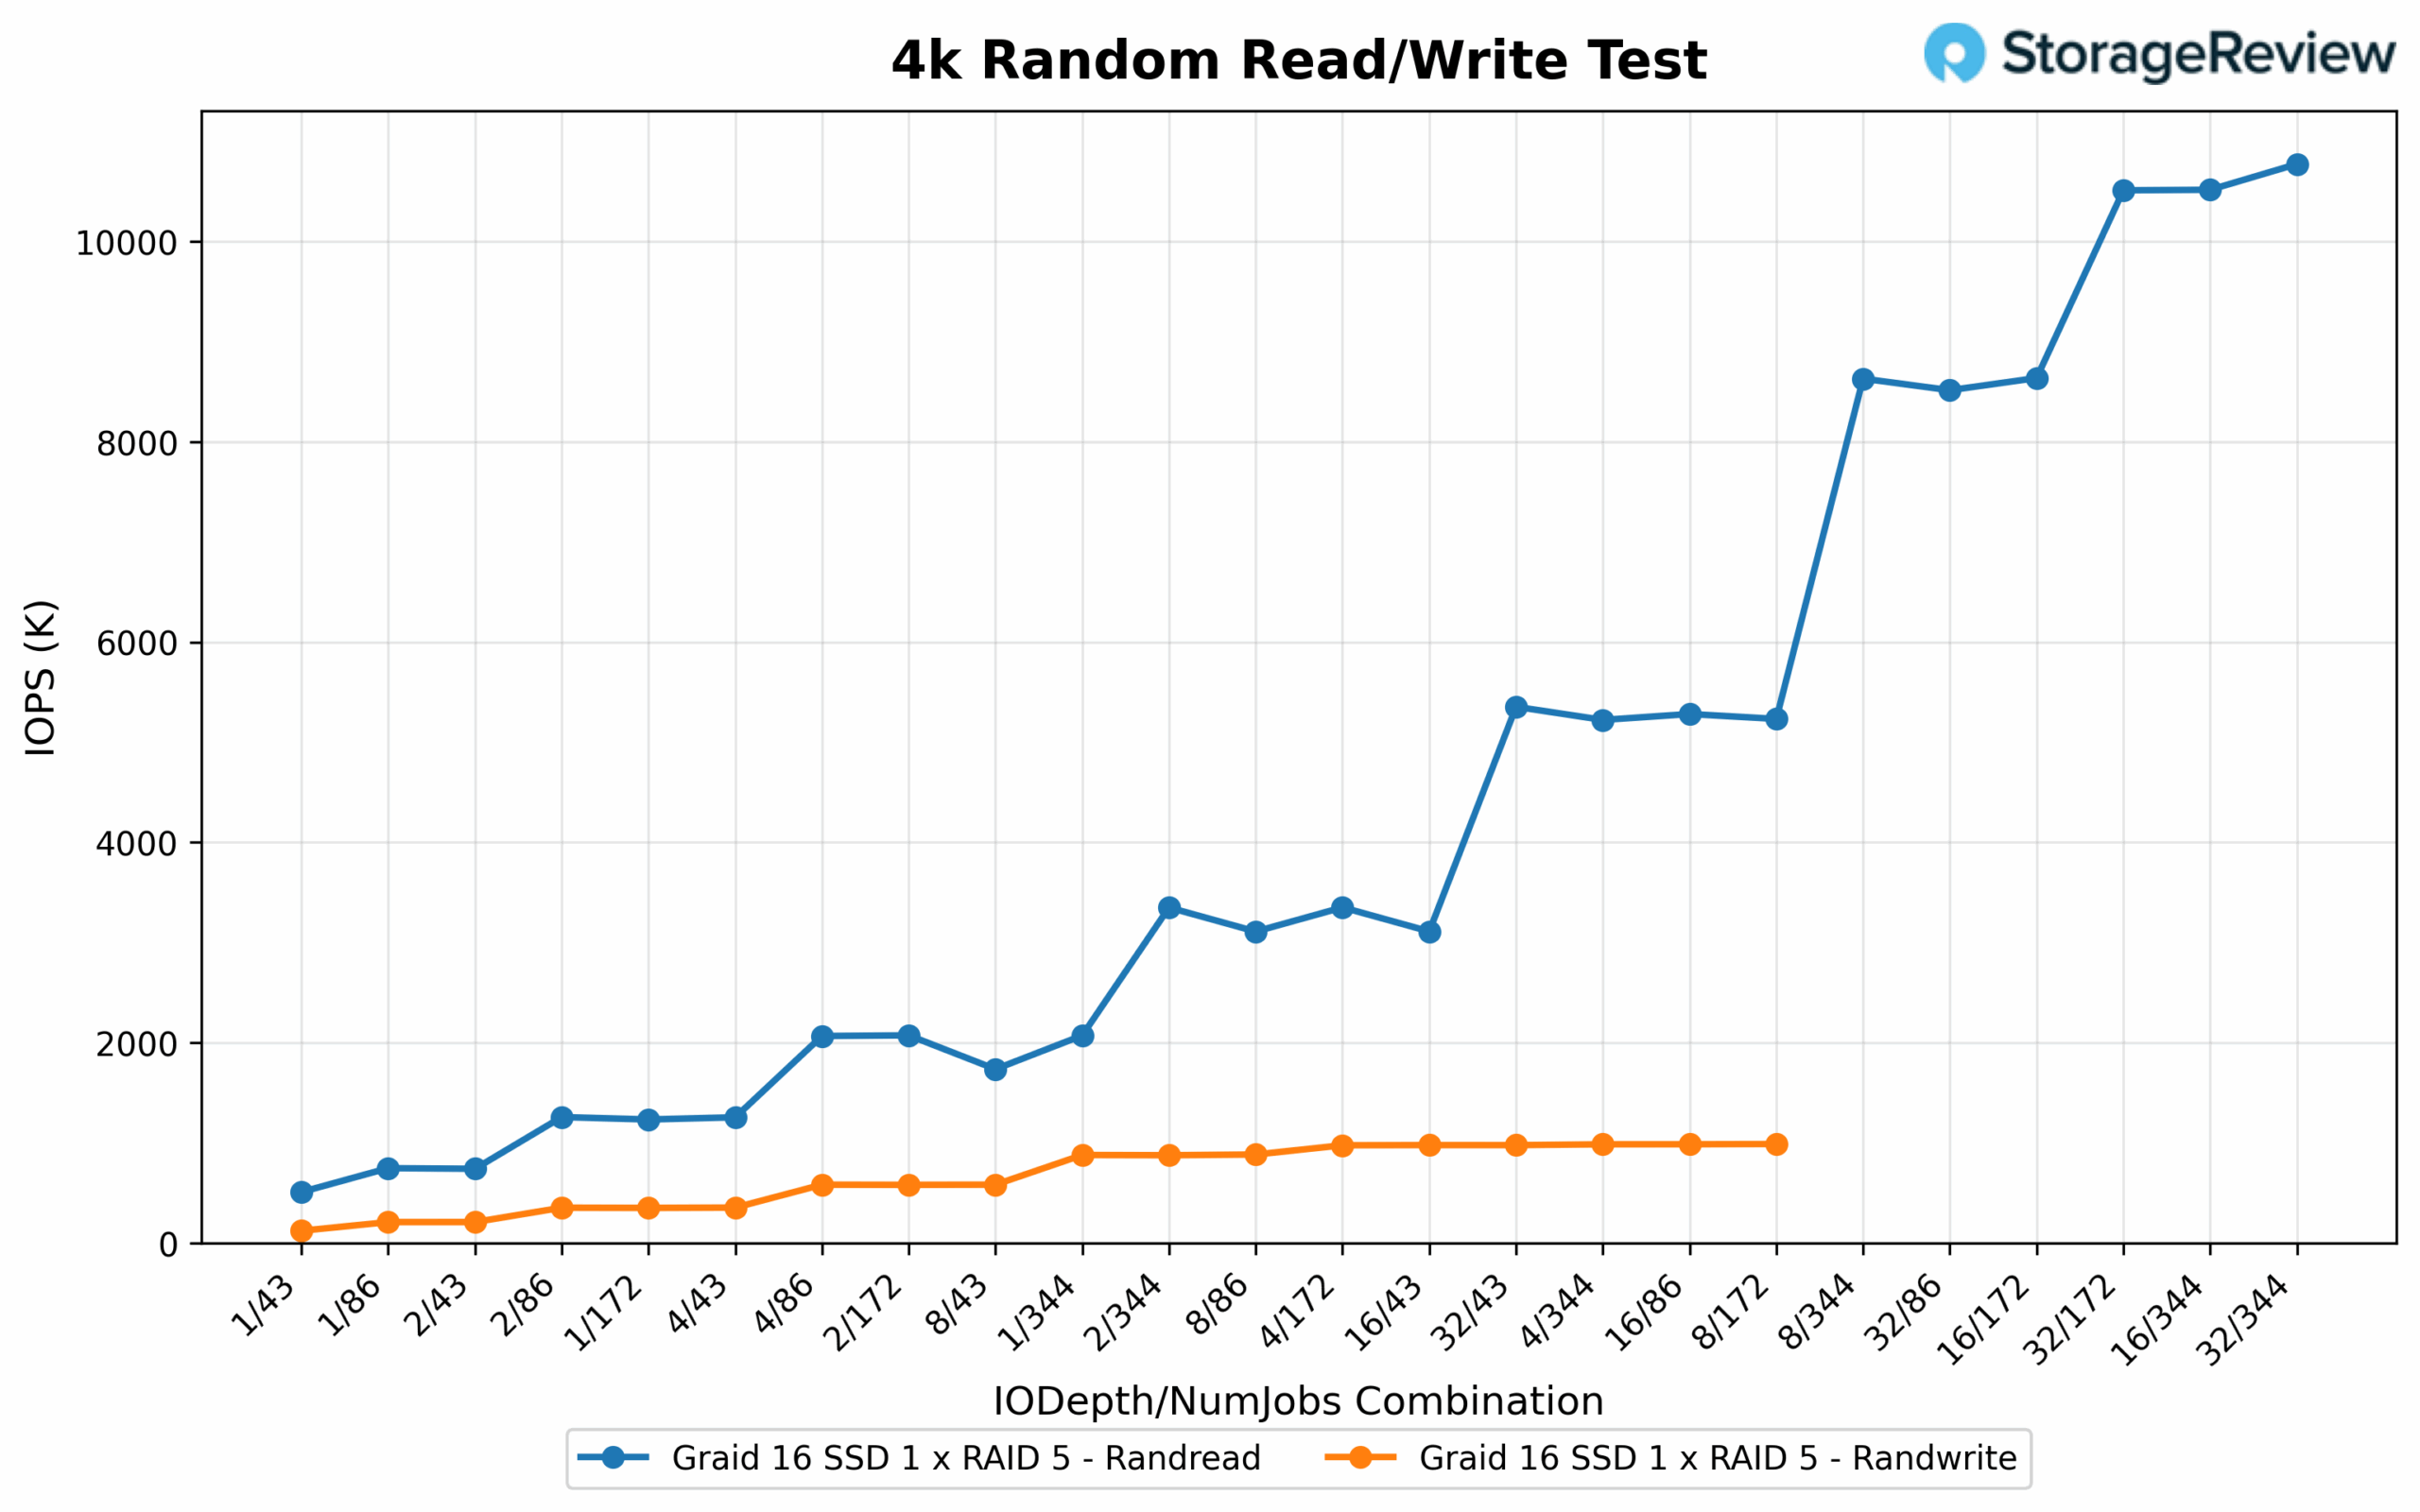
4K losowych operacji odczytu/zapisu IOPS
Przy większym obciążeniu współbieżnym, losowe IOPS dla odczytu 4K osiągnęło imponujący szczyt 10.77 mln przy głębokości IO 32 i 344 zadaniach. Inne konfiguracje podążały tuż za nimi, w tym 16/344 przy 10.52 mln, 4/344 przy 10.51 mln i 8/344 przy 10.42 mln, wszystkie wykazując wyjątkową skalowalność dzięki agresywnym kombinacjom kolejek i głębokości zadań. Nawet opcje o zmniejszonej głębokości, takie jak 8/172 i 16/172, utrzymywały wysoką przepustowość między 5.23 mln a 5.35 mln IOPS, co dodatkowo podkreśla zdolność macierzy do obsługi wymagających obciążeń równoległych. Po stronie zapisu, IOPS dla odczytu 4K osiągnął szczyt na poziomie 987.9 mln przy 32/172. Podobne konfiguracje o wysokiej wydajności obejmowały 32/86 przy 985.1 KB, 16/172 przy 985.6 KB i 8/172 przy 976.9 KB. Dodatkowe kombinacje od 8/86 do 16/86 utrzymywały wydajność w zakresie od 875 KB do 977 KB, wzmacniając spójność i niezawodność macierzy po pełnym nasyceniu współbieżnymi operacjami zapisu.
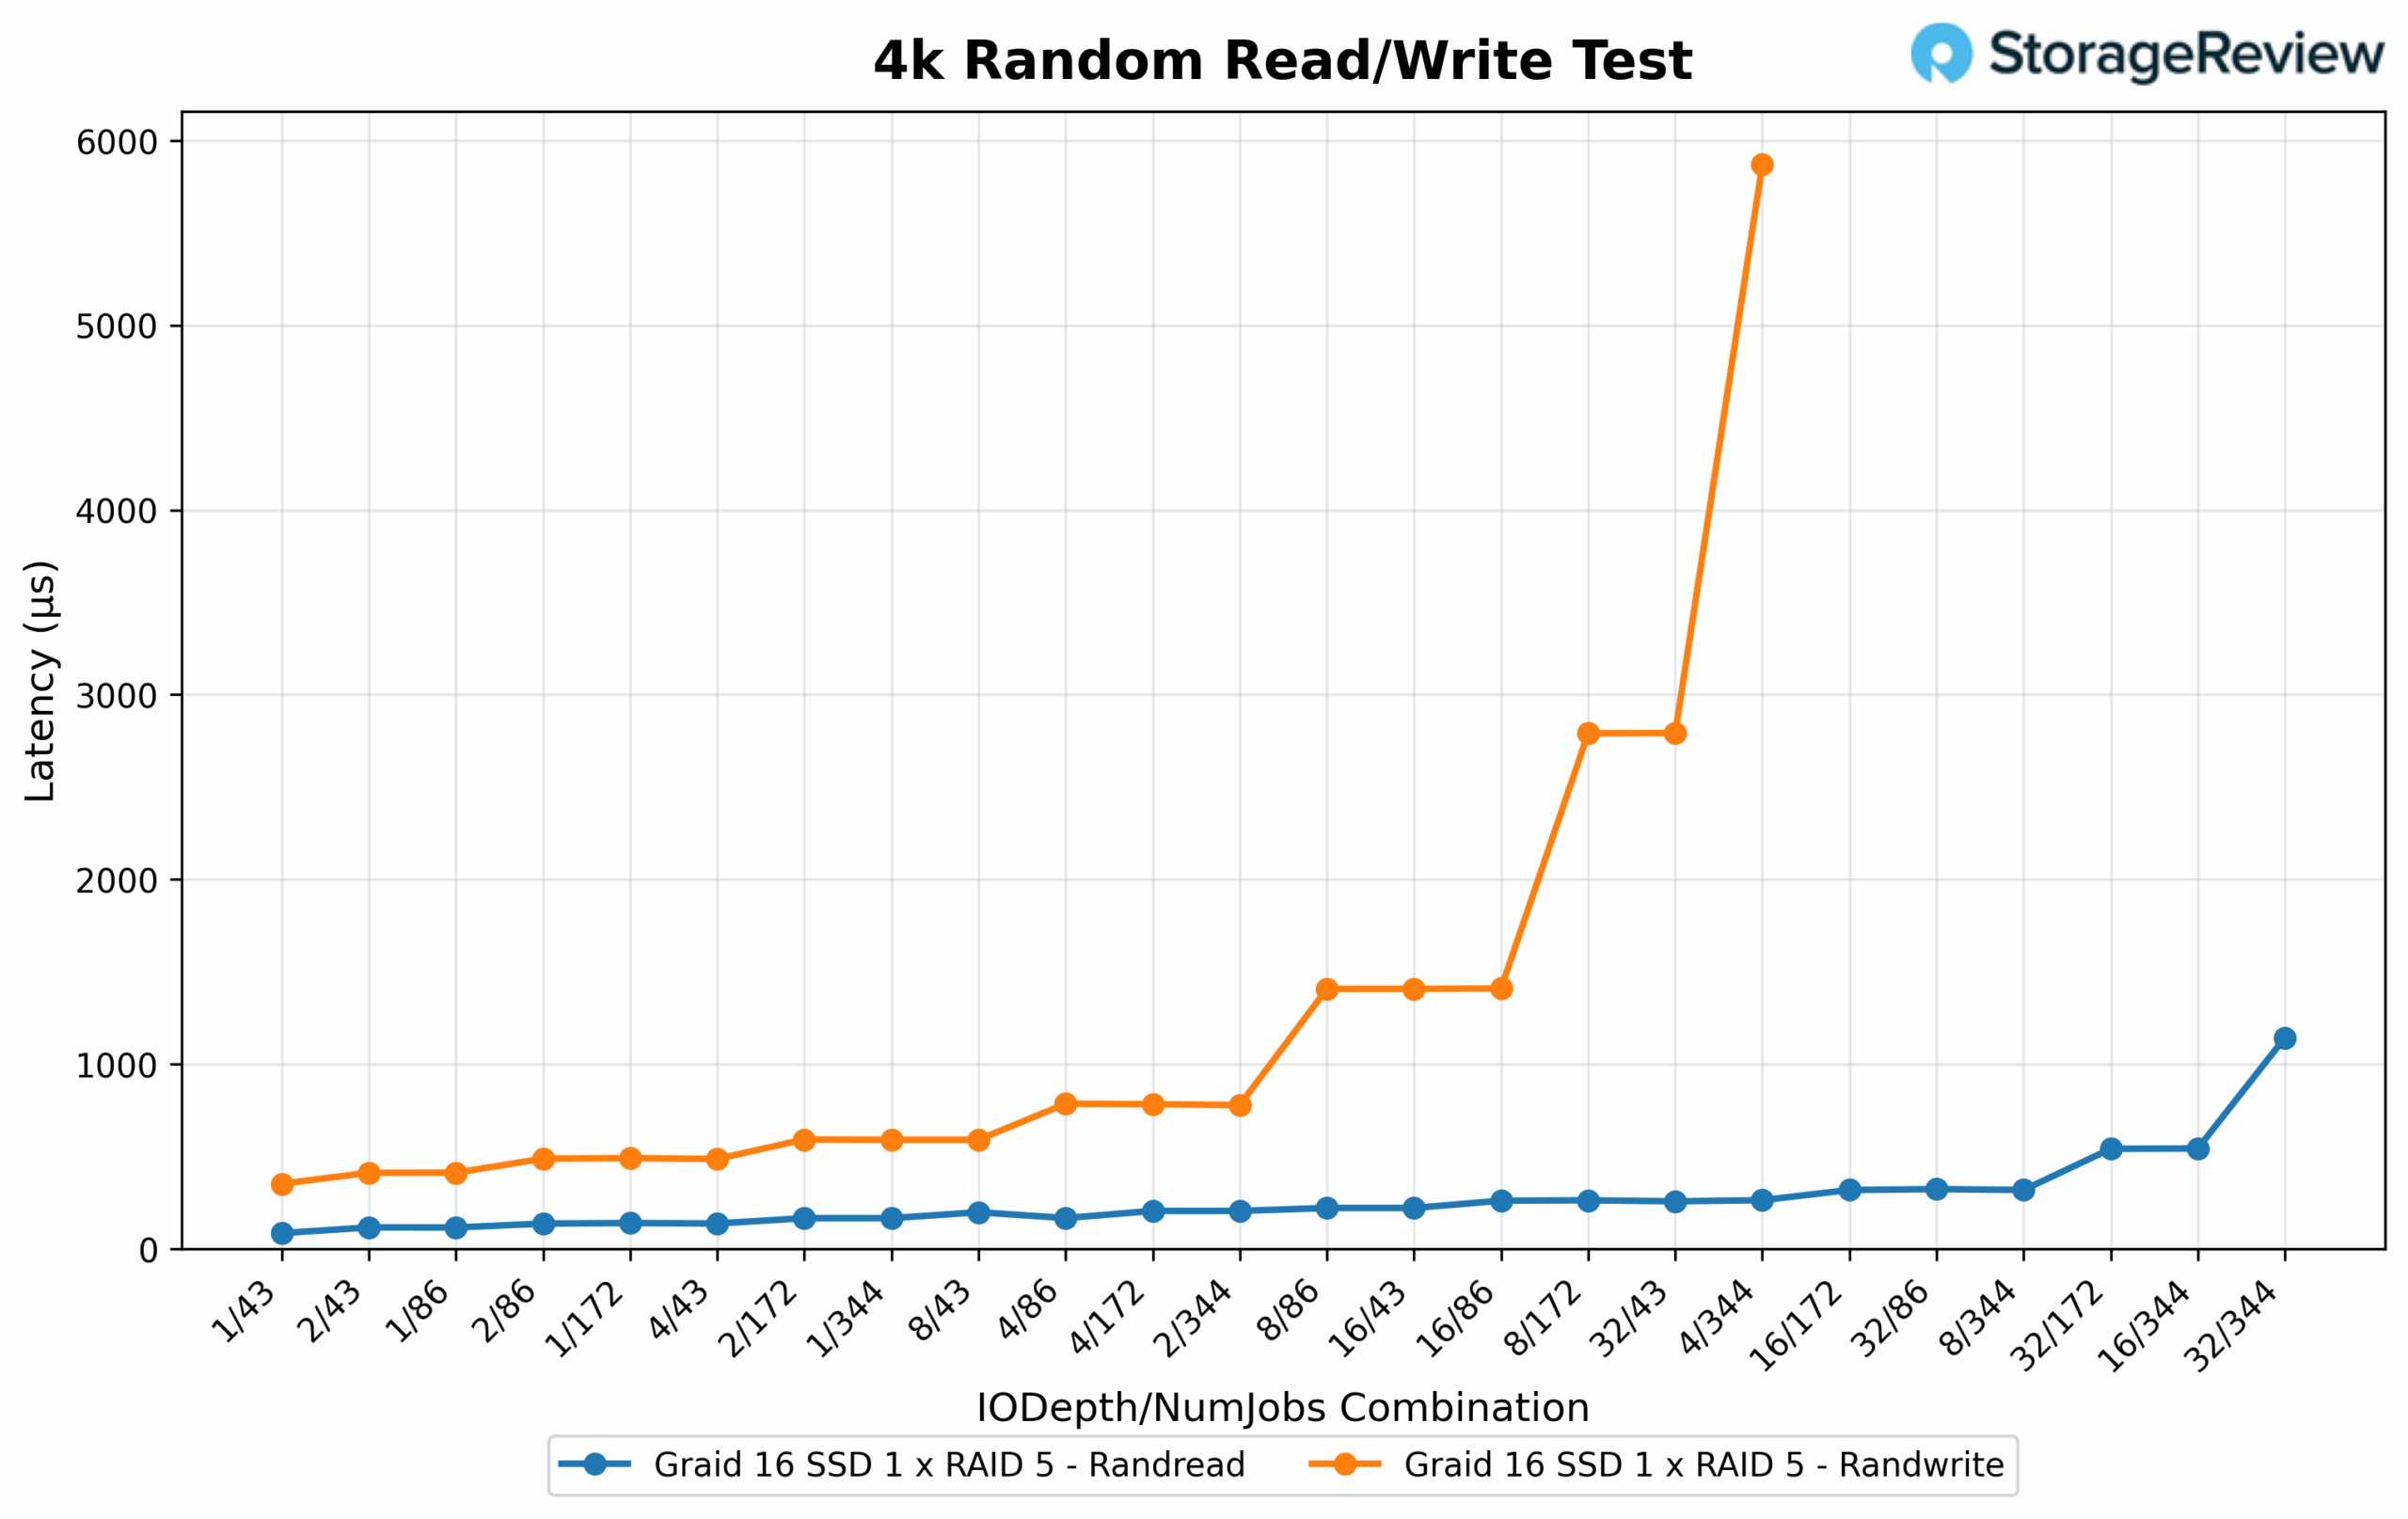
Opóźnienie losowego odczytu/zapisu 4K
Opóźnienie losowego odczytu 4K pozostało wyjątkowo niskie w całym zakresie. Najszybszy czas reakcji wyniósł 0.084 ms przy 1/86, podczas gdy w kilku innych konfiguracjach – w tym 1/43, 2/43 i 4/43 – wszystkie spadły poniżej 0.12 ms. Nawet przy szczytowej liczbie operacji wejścia/wyjścia na sekundę (IOPS) opóźnienie było dobrze kontrolowane, a w najwydajniejszej konfiguracji 32/344 wynosiło zaledwie 1.142 ms. Świadczy to o doskonałej responsywności, nawet przy maksymalnym wykorzystaniu potencjału przepustowości macierzy. Po stronie zapisu, losowe opóźnienie 4K również było dobrze kontrolowane. Najniższa zarejestrowana wartość wyniosła 0.352 ms przy 1/43, podczas gdy w innych wysoce wydajnych konfiguracjach, takich jak 1/86, 2/43 i 4/43, wszystkie utrzymywały się poniżej 0.6 ms. W przypadku konfiguracji o dużej przepustowości, takich jak 32/172 i 32/86, opóźnienie wzrosło nieznacznie do wartości od 2.79 ms do 5.87 ms, mieszcząc się w akceptowalnym zakresie, biorąc pod uwagę utrzymujące się poziomy nasycenia zapisu.
Pomiar obciążenia karty graficznej Graid SupremeRAID AE
Analizując wskaźniki wydajności pamięci masowej Graid SupremeRAID AE, istotne jest rozważenie, jak SupremeRAID, który współdzieli zasoby GPU, może wpływać na obciążenia, które również wykorzystują te same GPU. W poprzednich wdrożeniach SupremeRAID, GPU w systemie było dedykowane dla Graid. W tym rozwiązaniu wdraża się je na platformie zawierającej już GPU, z których Graid może korzystać i współdzielić zasoby. Aby zmierzyć wpływ narzutu, opracowaliśmy scenariusz wnioskowania LLM za pomocą vLLM. Zmierzyliśmy bazową wydajność obciążenia przy bezczynności Graid, a następnie ponownie przy odczycie 172 GB danych z puli RAID 5. Symuluje to obciążenie wnioskowania, wstępnie przydzielając kolejne obciążenie podczas działania poprzedniego. Ponieważ vLLM obciąża GPU do 100%, każda operacja Graid będzie miała wpływ na szybkość tokenów i opóźnienie.
W przypadku obciążenia AI przeprowadziliśmy inferencję za pomocą vLLM, wykorzystując model Llama 3.3 70B z pełną precyzją (BF16) i rozmiarem pamięci podręcznej 16 KB kV. To niemal całkowicie wykorzystało pamięć VRAM na obu kartach (78 GB na karcie 80 GB i 86 GB na karcie 94 GB). Następnie uruchomiliśmy skrypt testowy vLLM z maksymalną długością wyjściową 256 tokenów. Każdy test obejmował 256 zapytań z maksymalną współbieżnością 32 żądań, wykorzystując ciągłe przetwarzanie wsadowe do symulacji realistycznego wzorca żądań. Zebrane metryki to tok/s, czas do pierwszego tokena (TTFT), czas na token wyjściowy (TPOT) i opóźnienie między tokenami (ITL). Obciążenie FIO zainicjowane podczas testu inferencji składało się ze 172 losowych zadań odczytu 16 KB, z których każde odczytywało 1 GB.
Przepustowość odnotowała niewielki spadek we wszystkich obszarach. Przepustowość żądań spadła z 1.86 do 1.78 żądań na sekundę, co stanowi spadek o 4.3%. Przepustowość tokenów wyjściowych spadła z 225.44 do 215.94 tokenów na sekundę, co stanowi spadek o 4.2%. Całkowita przepustowość tokenów spadła z 2029.77 do 1944.30 tokenów na sekundę, co stanowi podobny spadek o 4.2%. Sugeruje to, że transfer wprowadził pewne obciążenie, które nieznacznie wpłynęło na wydajność.
Metryki opóźnień dały mieszane wyniki. Średni czas TTFT wzrósł o 3.6%, z 6,704 ms do 6,945 ms, a mediana czasu TTFT wzrosła o 1.5%. Co ciekawe, czas TTFT w P99 poprawił się, spadając o 2.8% z 14,199 ms do 13,803 ms, co wskazuje na lepszą wydajność w końcowej fazie testu. W przypadku TPOT średnia wzrosła o 5.3%, podczas gdy mediana pozostała względnie płaska, ze wzrostem o 0.65%. Jednak TPOT w P99 wzrósł gwałtownie o 24.6%, z 127.69 ms do 159.15 ms, co wskazuje na znaczący spadek czasu generowania tokenów w najgorszym przypadku. Podobne trendy zaobserwowano w przypadku opóźnienia między tokenami (ITL) – średnia wzrosła o 5.1%, mediana pozostała zasadniczo niezmieniona, a P99 wzrosło o 2.2%.
Rozwiązanie Graid SupremeRAID AE, działające równolegle z naszym obciążeniem vLLM, spowodowało niewielki, ale stały spadek przepustowości (około 4%), a także umiarkowany wzrost średniego opóźnienia i zauważalną degradację wydajności P99 podczas generowania tokenów. Pomimo tych zmian system pozostał w pełni stabilny i responsywny, co dowodzi, że wnioskowanie o wysokiej współbieżności z dużymi modelami, takimi jak Llama 3.3 70B, nadal może działać niezawodnie z rozwiązaniem Graid SupremeRAID AE.
| Metryka (krótszy czas trwania / wyższa liczba toków jest lepsza) | Baseline | Z 172 GB operacji odczytu FIO |
| Pomyślne prośby | 256 | 256 |
| Czas trwania punktu odniesienia (s) | 137.68 | 143.73 |
| Łączna liczba tokenów wejściowych | 248,414 | 248,414 |
| Łączna liczba wygenerowanych tokenów | 31,037 | 31,037 |
| Przepustowość żądań (req/s) | 1.86 | 1.78 |
| Przepustowość tokenów wyjściowych (tok/s) | 225.44 | 215.94 |
| Całkowita przepustowość tokenów (tok/s) | 2029.77 | 1944.30 |
| Czas do pierwszego tokena (TTFT) (im niższe opóźnienie, tym lepiej) | ||
| Średni TTFT (ms) | 6,704.43 | 6,945.72 |
| Mediana TTFT (ms) | 6,469.88 | 6,569.80 |
| P99 TTFT (ms) | 14,199.21 | 13,803.62 |
| Czas na token wyjściowy (TPOT, z wyłączeniem pierwszego tokena) (im niższe opóźnienie, tym lepiej) | ||
| Średnia TPOT (ms) | 81.44 | 85.72 |
| Mediana TPOT (ms) | 80.38 | 80.90 |
| P99 TPOT (ms) | 127.69 | 159.15 |
| Opóźnienie między tokenami (ITL) (im niższe opóźnienie, tym lepiej) | ||
| Średnia ITL (ms) | 79.94 | 83.99 |
| Mediana ITL (ms) | 49.75 | 49.78 |
| P99 ITL (ms) | 539.07 | 550.73 |
Myśli końcowe
Graid SupremeRAID AE to praktyczne i skuteczne rozwiązanie dla organizacji budujących lub skalujących infrastrukturę AI. Zastępując tradycyjny sprzętowy RAID podejściem definiowanym programowo, opartym na GPU, SupremeRAID AE upraszcza wdrożenie, eliminując jednocześnie typowe wąskie gardła, które hamują nowoczesne procesy AI.
Nasze testy wykazały możliwość ujednolicenia do 32 dysków SSD NVMe w jedną, odporną przestrzeń nazw, zapewniając prawie 1 PB pojemności na jednym serwerze i wyjątkową wydajność. Maksymalne wyniki przepustowości odczytu 183 GB/s i zapisu 54 GB/s, w połączeniu z minimalnym obciążeniem GPU podczas wnioskowania na żywo, potwierdzają zdolność serwera do spełnienia podwójnych wymagań: obsługi punktów kontrolnych modeli masowych i wnioskowania z niskim opóźnieniem w dużej skali.
Eliminując koszty i złożoność dedykowanego sprzętu RAID, a jednocześnie płynnie integrując się z technologiami takimi jak NVIDIA GPUDirect Storage i systemami plików zorientowanymi na sztuczną inteligencję, SupremeRAID AE tworzy przyszłościową bazę pamięci masowej. Dla organizacji, którym zależy na usprawnieniu wnioskowania i redukcji ryzyka operacyjnego, SupremeRAID AE zapewnia wydajność, prostotę i odporność niezbędne w produkcyjnych środowiskach AI.
Tabela wyników: Karty H100 NVL w tym teście znajdują się w naszej tabeli najlepszych procesorów graficznych klasy Enterprise , z wynikami testów vLLM dla pojedynczych kart.


 Amazon