

NVIDIA och Microsoft öppnade idag förbeställningar för RTX Spark Windows-bärbara datorer, med tillgänglighet planerad till den 16 oktober, kompakta stationära datorer i november och en förhandsvisning av DGX Station för Windows som NVIDIA kommer att släppa under fjärde kvartalet. Tillkännagivandena kom vid Microsofts Windows AI- och Surface-evenemang i San Francisco, där Jensen Huang gick med Satya Nadella på scenen, och Microsoft deklarerade att deras agentinneslutningslager, Microsoft Execution Containers, är allmänt tillgängligt på Windows 11.
Vi behandlade det första av dessa system tidigare under dagen i vår artikel om Dell XPS 16 Creator Edition , och själva plattformen på Computex i juni. Den här artikeln handlar om vad de två företagen publicerade kring evenemanget som inte var känt tidigare: strömförbrukning för N1X-superchippet, hur Windows delar upp den enhetliga minnespoolen, uppmätt dataflöde för en kodningsmodell med 137 miljarder parametrar på en bärbar dator, mekaniken för de sandbox-agenter som kommer att köras och en fullständig specifikationstabell för Windows DGX Station.
RTX Spark N1X: Två kretsar, tre effektkuvert
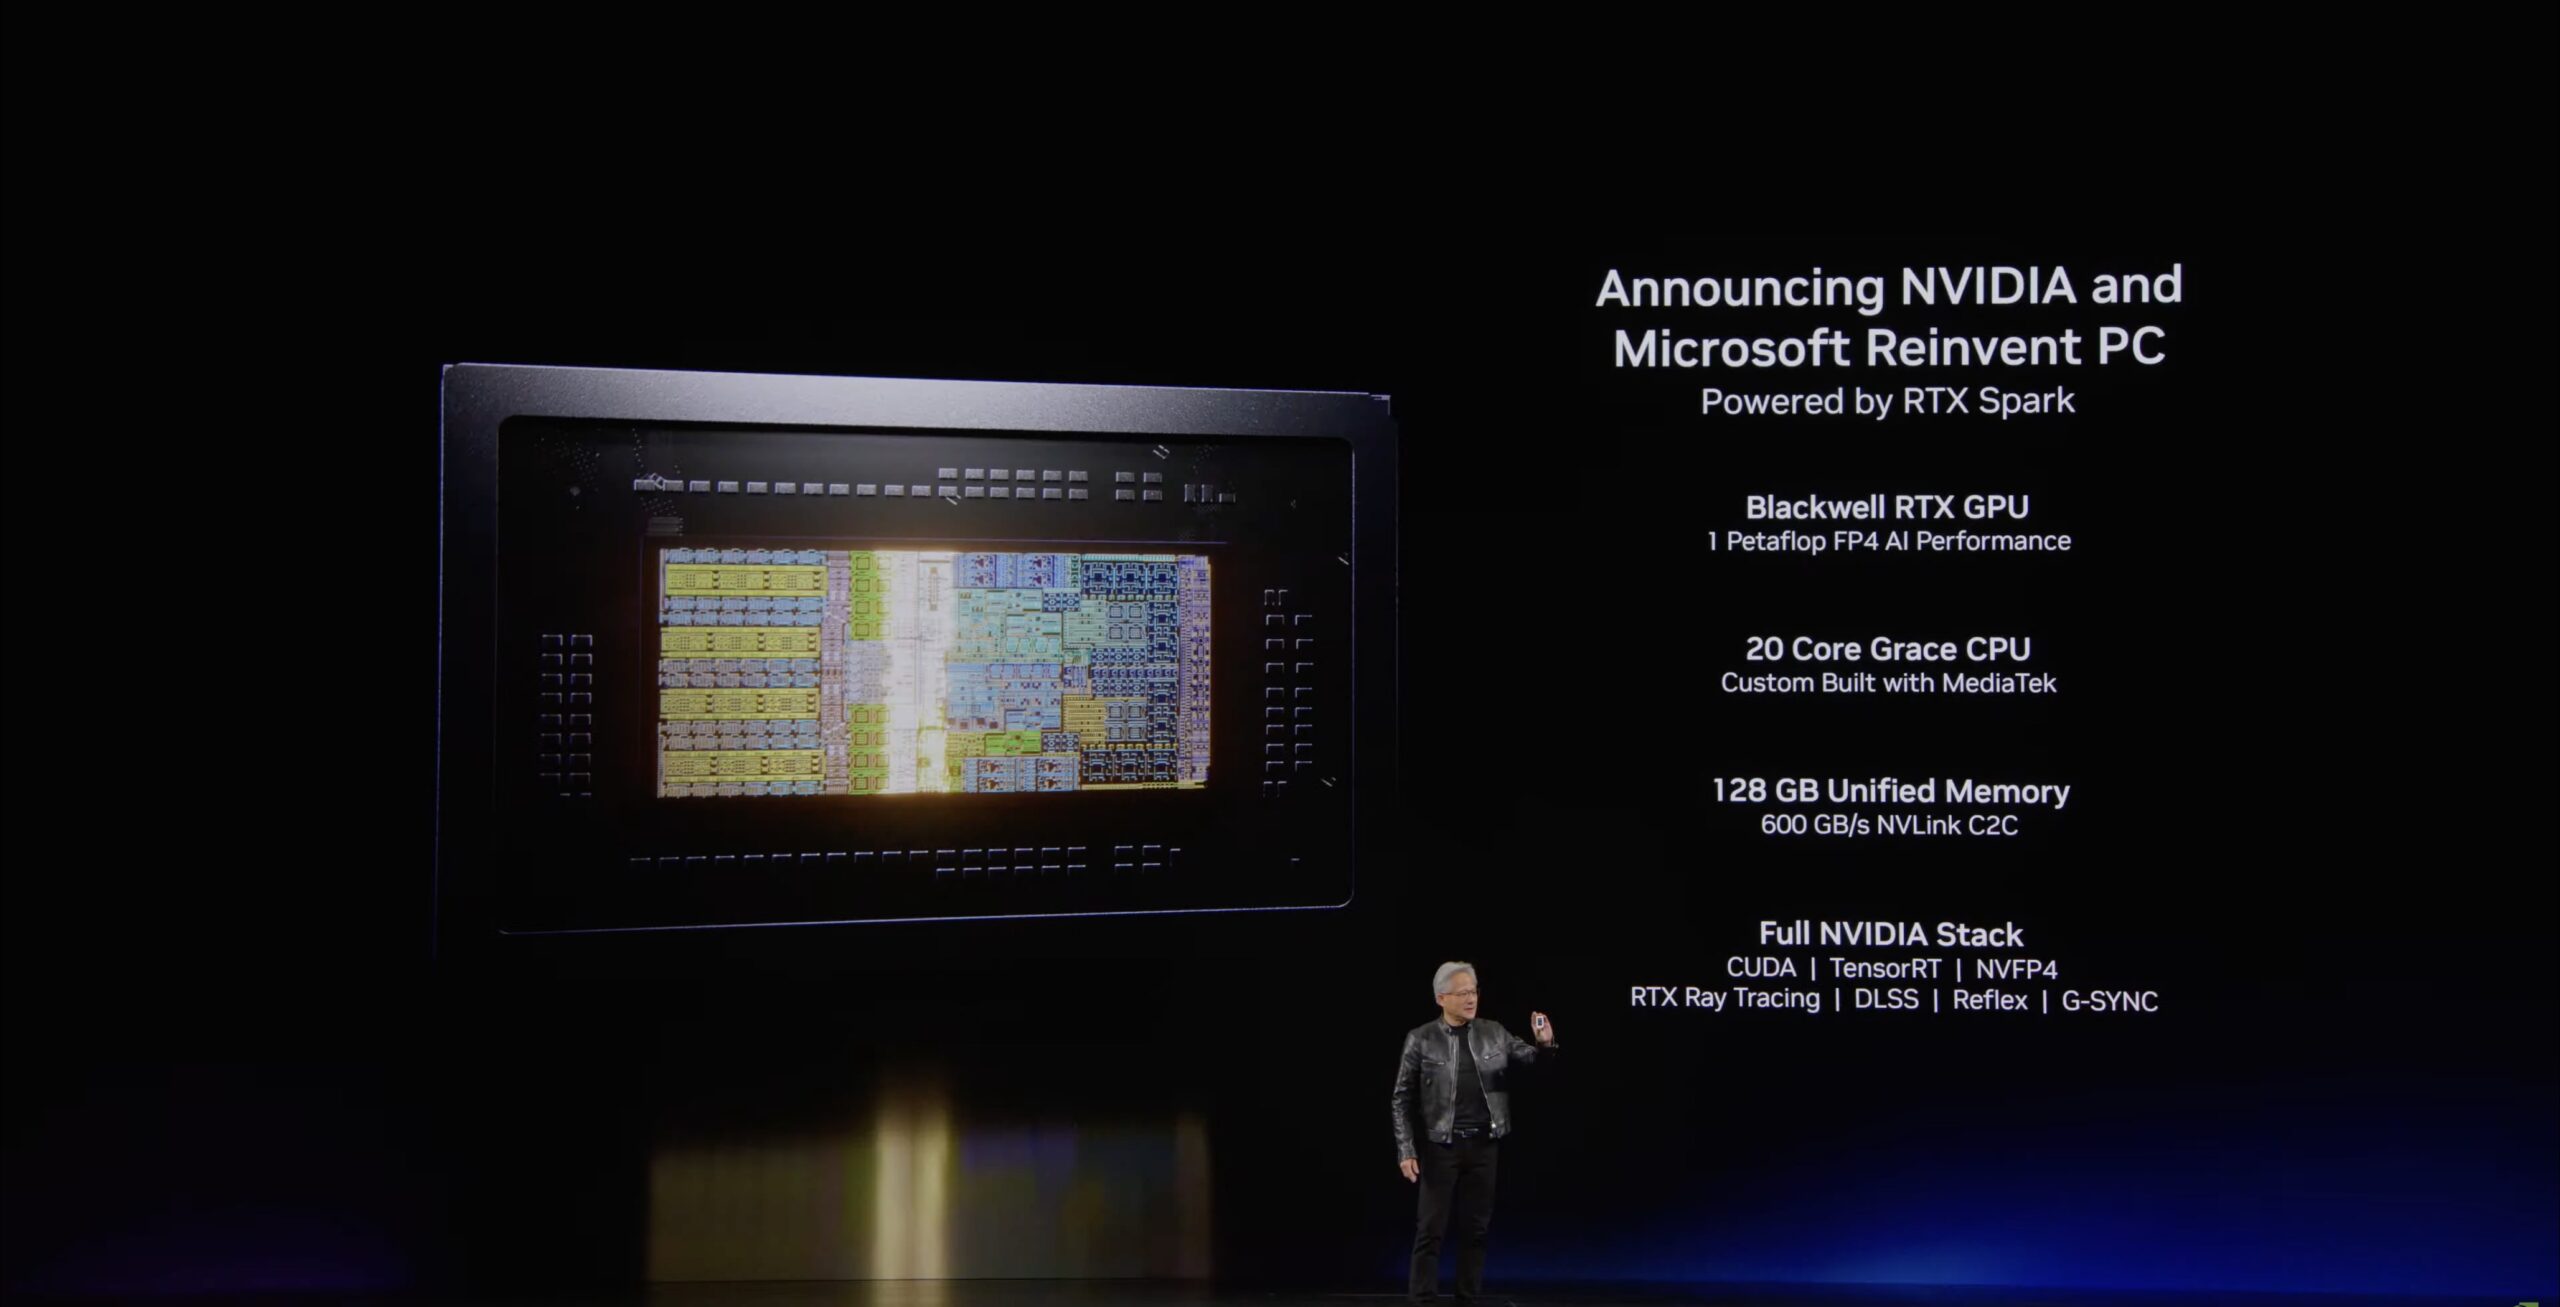
NVIDIAs RTX Spark-specifikationstabell skiljer nu bärbara datorer från stationära datorer, och uppdelningen är mer informativ än siffrorna. Bärbara datorer får två N1X-varianter: en 6 144-kärnig Blackwell RTX-grafikprocessor med en 20-kärnig Grace-processor och upp till 128 GB enhetlig LPDDR5X, och en 5 120-kärnig grafikprocessor med en 18-kärnig processor som når upp till 64 GB; båda har en TDP på 45 till 80 W. Stationära datorer får endast 6 144-kärnig, 20-kärnig del med upp till 128 GB, och NVIDIA listar den till 140 W.
Den siffran på 140 W är samma TDP som NVIDIA publicerar för GB10 i DGX Spark, vilket täcker både CPU och GPU, vilket stämmer överens med vad NVIDIA sa i juni om att de två chipen är samma system som är anpassat för olika plattformar. Det betyder också att en bärbar N1X-dator körs med 32 % till 57 % av den effekt som stationära datorn är klassad för, medan alla system i familjen säljs med samma "upp till 1 petaflop" FP4. Microsofts Surface-fotnoter beskriver den siffran som teoretisk FP4-prestanda med sparsity.
| Specifikation | RTX Spark N1X (Laptop) | RTX Spark N1X (Laptop) | RTX Spark N1X (stationär dator) | GB10 (DGX Spark) |
|---|---|---|---|---|
| GPU | 6 144-kärnig Blackwell RTX | 6 144-kärnig Blackwell RTX | 6 144-kärnig Blackwell RTX | Blackwell, 5:e generationens Tensor-kärnor, 4:e generationens RT-kärnor |
| CPU | 20-kärnig Grace | 18-kärnig Grace | 20-kärnig Grace | 20 Arm-kärnor (10 Cortex-X925, 10 Cortex-A725) |
| TDP | 45 till 80W | 45 till 80W | 140W | 140W (240W nätaggregat) |
| Enat minne | Upp till 128 GB LPDDR5X | Upp till 64 GB LPDDR5X | Upp till 128 GB LPDDR5X | 64 GB eller 128 GB LPDDR5X, 273 GB/s |
| Mediemotorer | 1x 9:e generationens NVENC, 1x 6:e generationens NVDEC | 1x 9:e generationens NVENC, 1x 6:e generationens NVDEC | 1x 9:e generationens NVENC, 1x 6:e generationens NVDEC | 1x NVENC, 1x NVDEC |
| Skärm och I/O | PCIe Gen5, HDMI 2.1b, DisplayPort 2.1b | PCIe Gen5, HDMI 2.1b, DisplayPort 2.1b | PCIe Gen5, HDMI 2.1b, DisplayPort 2.1b | HDMI 2.1a, ConnectX-7 200 Gb/s, 10 GbE |
| Operativsystem | Windows 11 | Windows 11 | Windows 11 | NVIDIA DGX OS |
NVIDIA publicerar inte en tät FP4-siffra för N1X; på GB300, där de publicerar båda, är den täta siffran 75 % av den glesa. Vi förväntar oss att OEM:s termiska design kommer att separera dessa bärbara datorer på ett sätt som den aldrig separerade DGX Spark-enheter, och en spridning på 35 W inom bärbara datorers TDP-intervall, före någon leverantörsjustering, är det första konkreta beviset för det.
Microsoft lägger till en liten nyans på stationära datorer. Deras sida om Surface RTX Spark Dev Box anger ett 100W termiskt hölje inuti ett aluminiumchassi med 1 000 luftventiler, vilket är 40W under NVIDIAs TDP-listor för stationära N1X. De två företagen kan mäta olika saker, en chipklassificering i det ena fallet och en chassidesignpunkt i det andra, men en köpare som jämför kompakta stationära datorer i november bör fråga varje leverantör vilken uthållig kraft deras låda har.
Minneshastighet är den andra plattformsskillnaden från GB10. Dells XPS-specifikationsblad listar LPDDR5X vid 9 400 MT/s, vilket på ett 256-bitarsgränssnitt som GB10:s motsvarar 300.8 GB/s, vilket matchar de 300 GB/s som NVIDIA citerade i juni och cirka 10 % över DGX Sparks 273 GB/s. CPU- och GPU-halvorna ansluts via NVLink-C2C vid 600 GB/s. Resten av tabellen är gemensam för alla tre delarna: femte generationens Tensor-kärnor, fjärde generationens RT-kärnor, DLSS 5, Reflex 2 med Frame Warp och HDMI 2.1b upp till 4K 480Hz eller 8K 120Hz med DSC.
NVIDIAs marknadsplats listar 17 bärbara datorkonfigurationer för förbeställning, och de visar hur stor del av sortimentet som ligger under rubriken. Av de 15 vi läste igenom använder sju 5 120-kärnig processor, och minnet är 24 GB, 32 GB, 48 GB och 128 GB, med lagringsutrymme uppdelat mellan PCIe Gen4- och Gen5-hårddiskar.
Hur Windows delar upp 128 GB enhetligt minne
Minnet delas dynamiskt mellan CPU och GPU, och det maximala som GPU:n kan hantera beror på konfigurationen. En skärmdump av Aktivitetshanteraren i Microsofts och GitHubs tekniska inlägg visar hur det ser ut på en Surface Laptop Ultra med 6 144-kärnig N1X. Windows rapporterar 74.9 GB dedikerat GPU-minne, 35.5 GB delat GPU-minne, 110 GB totalt GPU-minne och 51.5 GB systemminne.
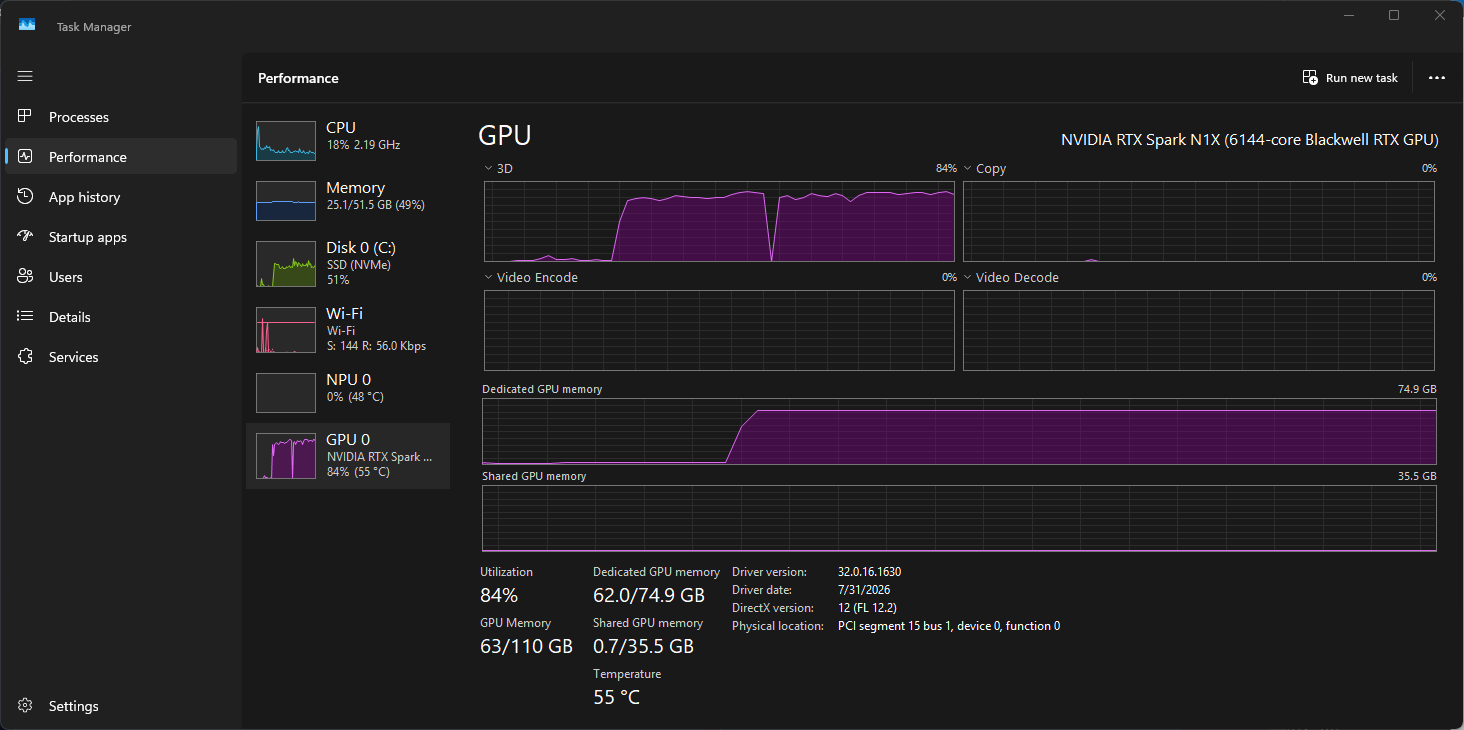
Summan av dedikerade och systemdata blir 126.4 GB, så Windows presenterar den enhetliga poolen på samma sätt som ett separat kort: en fast dedikerad allokering, där GPU:n kan låna från systemminnet upp till en viss gräns. På den enheten är GPU:ns tak 110 GB, eller 86 % av de installerade 128 GB, och vikter, nyckel-värde-cache och runtime-overhead måste alla rymmas under den. Samma skärmdump visar drivrutin 32.0.16.1630, daterad 31 juli, och en NPU listad som en separat enhet från GPU:n.
Inlägget är tydligt med att modellvikter bara är en del av minnesbudgeten; operativsystemet, applikationerna, inferenskörningen och KV-cachen som håller uppmärksamhetstillståndet för en agents växande kontext hämtar alla från samma pool. För 24 GB- och 32 GB-konfigurationerna som utgör en stor del av förbeställningslistan, lämnar det utrymme för modeller i 27B-klassen på 4 bitar och inte mycket mer. Påståendena om stora modeller i lanseringsmaterialet förutsätter alla 128 GB SKU.
Vad som passar: Parameterantal och bitar per vikt
Parametertaken som anges för samma chip verkar lite feljusterade. NVIDIAs produktsida säger modeller upp till 120 miljarder parametrar med en kontext på 1 miljon tokens, och deras blogg citerar Qwen 3.8 Flash Next som ett exempel på 125 miljarder. Microsoft säger modeller som överstiger 120 miljarder, och nämner sedan MAI Code 1.1 Flash till 137 miljarder och DeepSeek V4 Flash till 284 miljarder som modeller som kommer till RTX Spark, och Dell anger 200 miljarder. Spridningen beror på hur många bitar varje vikt får.
| Modell | Driftparametrar | Precision | Fotavtryck | Källa |
|---|---|---|---|---|
| MAI-kod 1.1 Flash | 137 miljarder totalt, 6.8 miljarder aktiva (blandning av experter) | Blandad precision, cirka 3.3 bitar per vikt | 53 GB vikt; 75.5 GB som max vid 256 K kontext | Microsoft, GitHub |
| NVIDIA Nemotron (kommande) | Över 70 miljarder | 2-bitars | Drygt 20 GB | Microsoft |
| DeepSeek V4 Flash | 284B | Ej angivet | Ej angivet | Microsoft |
| Qwen 3.8 Flash Nästa | 125B | Ej angivet | Ej angivet | NVIDIA |
| Qwen3.5 27B | 27B | Q4_K_M | Ej angivet | Fotnot om Microsofts riktmärke |
Microsofts siffror för MAI Code 1.1 Flash är de mest kompletta. Molnmodellen i BF16 skulle vara 274 GB; den enhetliga versionen är 53 GB, vilket Microsoft kallar en 80 % minskning, ungefär 3.3 bitar per vikt med kvantisering med blandad precision. Nemotrons siffra ser ut på samma sätt, eftersom 2 bitar över 70 miljarder vikter är 17.5 GB före overhead. DeepSeek V4 Flash med 284 miljarder parametrar behöver cirka 3.1 till 3.3 bitar per vikt eller färre för att få plats under ett GPU-tak på 110 GB, innan någon kontext laddas.
Det är kvalitetsdatan som gör 3-bitarspåståendet värt att uppmärksamma. Microsoft rapporterar att den kvantiserade enhetens modell ligger på 70.8 % på SWE-Bench, verifierad mot 72.6 % för BF16-molnversionen, och 66.29 % på Terminal-Bench 2.1 mot 62.9 %. Det andra resultatet har den kvantiserade modellen före, vilket på en uppsättning med 89 uppgifter är en skillnad på tre uppgifter och läses för oss som brus. Unsloths GPT-OSS-120B GGUF, jämförelsepunkten, fick 32.0 % och 23.6 % på samma två tester.
Dataflödet kommer från en Surface Laptop Ultra på en Windows Arm64-version av llama.cpp med CUDA-backend och vad Microsoft kallar DFlash2 glidande fönster spekulativ avkodning, testat med en syntetisk kodgenereringsarbetsbelastning. Microsofts diagram innehåller inga dataetiketter, så dessa är våra uppskattningar: cirka 63 tokens per sekund vid en 2K-prompt, 61 vid 8K, 57 vid 32K, 52 vid 64K, 55 vid 120K och 39 vid 256K. Maximalt minne vid 256K-kontext är 75.5 GB, vilket landar precis på den dedikerade GPU-siffran i Aktivitetshanterarens inspelning.

Promptbearbetning är det tal som agentarbete ska låsas på. Microsoft ger 923.5 tokens per sekund vid 64K kontext och 769.8 vid 128K. En kall 64K-prompt tar cirka 71 sekunder att bearbeta, och en kall 128K-prompt tar cirka 170 sekunder innan den första utdatatoken visas. Blogginlägget påpekar att det inte garanterar konstant svarstid att hålla en modell laddad, och att Copilot väger cachestatus när den dirigerar arbete, vilket är anledningen till att förfyllning är den siffra vi först mäter på granskningshårdvara.
MacBook-jämförelsen och dess fotnoter
Microsofts jämförelse ställer RTX Spark-datorer mot en 16-tums MacBook Pro med M5 Pro och 64 GB: upp till 2.1 gånger snabbare tid till första token, 4.3 gånger snabbare bildgenerering och 6.2 gånger snabbare videogenerering. Den första kommer från Microsoft-beställda tester i llama.cpp med Qwen3.5 27B vid Q4_K_M och en fast prompt med 8 192 tokens. De andra två är NVIDIAs tester i ComfyUI, med FLUX.2 Klein 4B vid fyra steg och 1024 x 1024, och LTX 2.3 22B vid 121 bildrutor, åtta steg och 1280 x 720.
Fotnoterna innehåller flera förtydliganden, med början i hårdvaran: alla tester kördes i september på förproduktions-RTX Spark-system med 64 GB, och Apple-systemet är M5 Pro, utan M5 Max i jämförelsen. Båda ComfyUI-testerna använde modellerna med NVFP4-precision, och fotnoterna beskriver inte Macens programkonfiguration. Språkmodellresultatet är en förifyllningsmätning vid en promptlängd; inget av företagen publicerade en jämförelse av avkodningstokens per sekund, vilket är det tal som de flesta lokala LLM-användare anger.
När det gäller spel säger NVIDIA att RTX Spark kör AAA-titlar i 1440p över 100 bilder per sekund med DLSS 5, Reflex och G-SYNC, utan att namnge titlar eller inställningar. Microsofts bidrag är Gears of War: E-Day med DirectX-strålspårning, variabel skuggningshastighet, DirectStorage och Advanced Shader Delivery, vilket Microsoft säger minskar shaderkompileringen vid första lanseringen från minuter till sekunder, plus ett åtagande att Call of Duty kommer till RTX Spark 2027. Prism- och anti-fuskdetaljer finns i vår Dell-bevakning.
Microsoft Execution Containers: Så fungerar agentsandlådan
MXC är den del av tillkännagivandet med längst räckvidd, eftersom det gäller alla Windows 11-datorer och levereras som ett bibliotek med öppen källkod och ett flerspråkigt SDK med backends för macOS och Linux. En utvecklare deklarerar vad en arbetsbelastning behöver i en JSON-policy: de filer den kan ändra, de filer den bara kan läsa, inkommande och utgående nätverksåtkomst och om den kan vidröra skrivbordet. MXC mappar den policyn till en isolerad backend och tillämpar den vid körning, och policyn sitter utanför arbetsbelastningen, så genererad kod kan inte ge sig själv mer åtkomst.
| MXC-backend | Plattformar | Mekanism | Avsedd användning |
|---|---|---|---|
| Processbehållare | Windows 11, macOS, Linux | AppContainer på Windows, Seatbelt på macOS, Bubblewrap på Linux | Låg latensinneslutning för modellgenererad kod och verktygskörning |
| Sessionsbehållare | Endast Windows 11 | Separat Windows-konto och session med eget skrivbord, urklipp, användargränssnitt och inmatning | Långvariga agenter och automatisering som behöver en stationär dator |
| WSL-behållare (WSLc) | Endast Windows 11 | Linux-körningsmiljö via WSL | Linux-första agentverktygskedjor |
| MikroVM | Windows 11 och Linux (experimentellt) | Hårdvaruförstärkt virtualiserad gräns | Högriskarbetsbelastningar och opålitlig kod |
Tre driftslägen täcker policyutvecklingscykeln: Verkställighet blockerar allt utanför policyn, och Inlärning blockerar det och registrerar det i en JSON-aktivitetsrapport. Permissiv tillåter åtgärden och registrerar det som skulle ha nekats, så att ett team kan köra en agent genom verkligt arbete och bygga en policy med minsta behörighet utifrån bevisen. Aktivitetsrapporten är endast tillgänglig för processbehållare i Windows. Organisationer kan lägga till sina egna begränsningar över en utvecklares policy via hanteringsverktyg, och Microsoft säger att Intune-hantering av MXC-processbehållare kommer snart.
Det är värt att vara tydlig med vad som är generellt tillgängligt, och inneslutning är vad som levererades den 7 oktober. Agentidentitet, där Microsoft Entra skiljer en agents handlingar från den inloggade användarens, beskrivs som snart tillgänglig, liksom att utöka Agent 365-kontroller till lokala agenter. Tills dessa anländer begränsar en MXC-container vad en agent kan nå, men säkerhetsverktyg ser fortfarande sin aktivitet under användarens identitet, och den styrning på flottnivå som Microsoft beskriver är ännu inte på plats; deras egen fotnot tillägger att styrning i stor skala kan kräva ytterligare tjänster.
GitHubs beskrivning av sin egen integration visar var gränsen går. Copilot använder basnivån för processcontainern i Windows, och shell-kommandon, tillsammans med lokala Model Context Protocol-servrar och språkservrar som standard, körs inuti den. Copilots inbyggda filverktyg körs i agentens harness, där förfrågningar kontrolleras mot policy men inte isoleras av operativsystemet, och fjärr-MCP-servrar befinner sig helt utanför den lokala sandlådan. Lokal inferens ändrar inget av detta, eftersom ett shell-kommando ärver samma åtkomst oavsett vilken modell som begär det.
Agenter som stöder MXC idag inkluderar GitHub Copilot, OpenAI Codex, OpenClaw, Replit, LM Studio och Unsloth AI, med Claude Code, Perplexity, Manus och Hermes Agent bland de som listas som kommande. NVIDIA har integrerat OpenShell i MXC, vilket enligt Microsoft lägger till policykontroller för agentåtkomst till filer och inferenstjänster, avancerade nätverkskontroller, hantering av autentiseringsuppgifter och OCSF-granskning för företag.
Huang lade tyngden av tillkännagivandet på containerlagret: ”Precis som Windows och DirectX revolutionerade hur applikationer byggdes, kommer MXC att revolutionera hur agenter byggs och distribueras.” Vår syn är snävare: policymodellen är sund, och SDK:et för flera plattformar sänker kostnaden för att implementera den, men den enda integrationen som hittills beskrivits i detalj använder den lättaste backend, och den isolering en agent får är bara så stark som den backend som utvecklaren valde.
Hybrid routing: HydraFusion, Windows ML och llama.cpp
De lokala modellerna når utvecklare via GitHub Copilot. HydraFusion, som GitHub lanserade tidigare i år för att dirigera varje uppgift till rätt molnmodell, utökas till modeller på enheten, med en experimentell förhandsvisning i Copilot-appen, Copilot CLI och Visual Studio Code senare i oktober. Utvecklare kan lämna placeringen på Auto eller välja en lokal modell explicit, antingen MAI Code 1.1 Flash via Windows ML-leverantören eller någon modell bakom en OpenAI-kompatibel lokal slutpunkt.
Microsoft lade också till stöd för llama.cpp till Windows ML, vilket är den runtime som MAI-kodnumren ovan producerades på, och det ger det öppna ekosystemet en stödd väg till plattformen; vår sida om de bästa lokala LLM-verktygen spårar runtimes och frontends som byggts på den. Microsofts egen dimensionering av påståendet är dock blygsam. Dess Dev Box-sida säger att intelligent routing kan avlasta upp till 20 % av Copilot-arbetsbelastningar till lokala modeller, vilket framställer lokal inferens som ett sätt att tänja på en tokenbudget, där molnet fortfarande gör det mesta av arbetet.
System, priser och datum
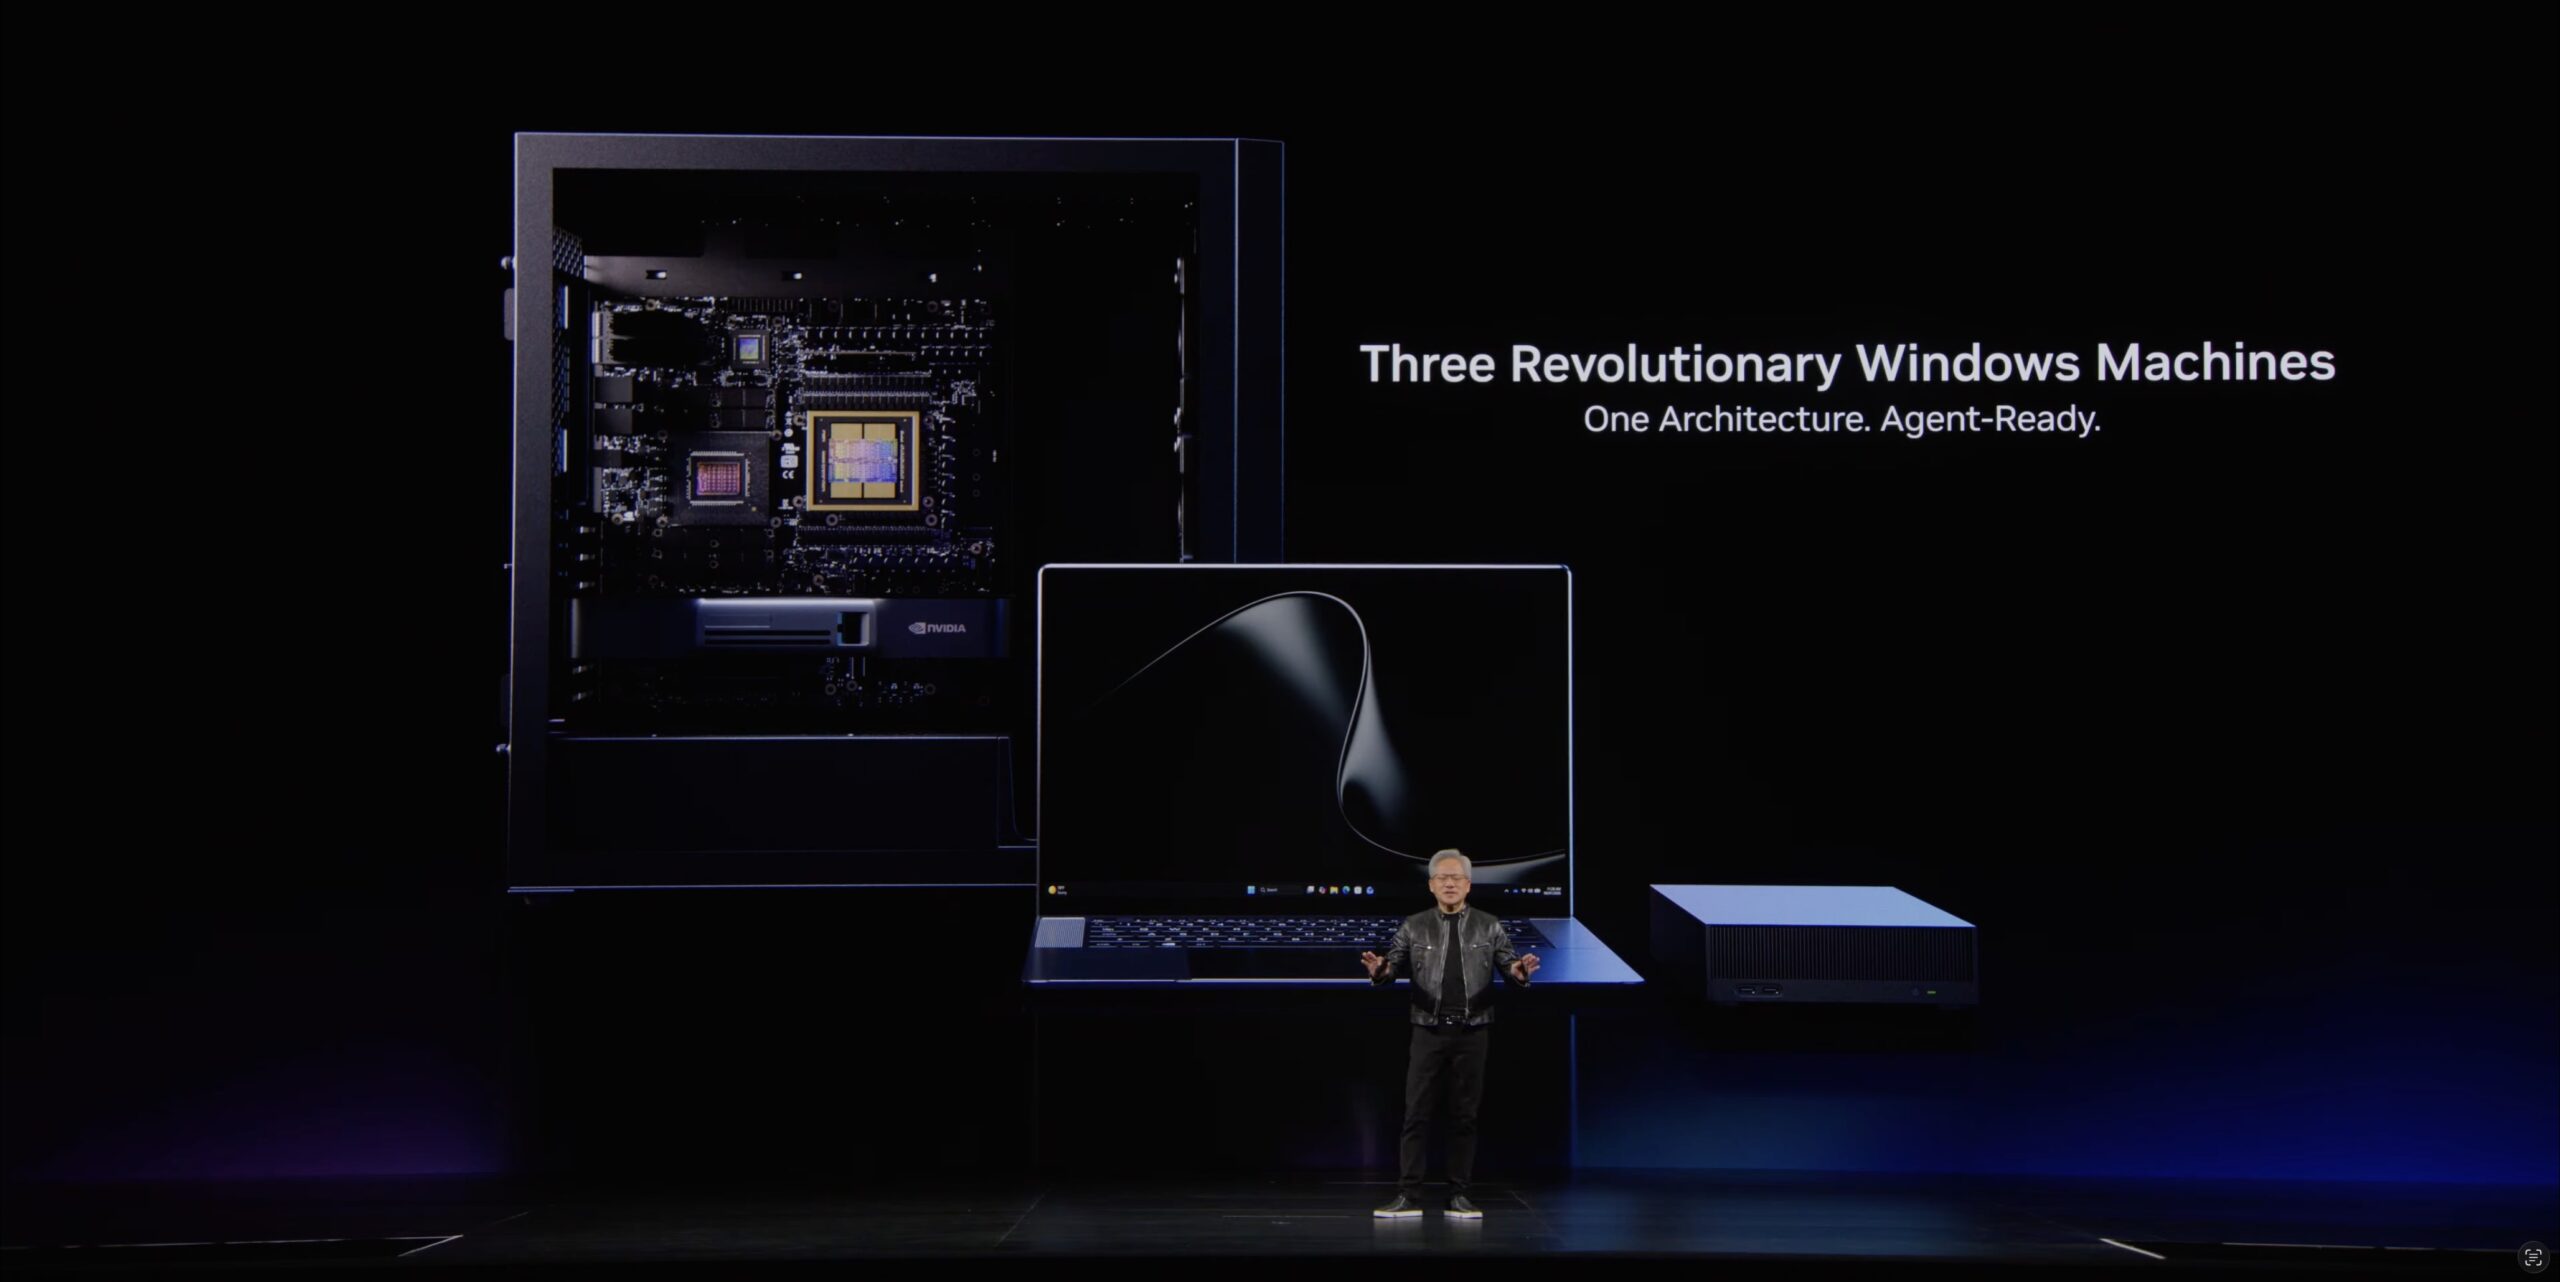
Sex OEM-tillverkare har förbeställt bärbara datorer till den 16 oktober: ASUS ProArt P16 och P14, Dell XPS 16 Creator Edition , HP OmniBook Ultra 16, Lenovo Yoga 9n 2-in-1, MSI Prestige N16 Flip AI+ och Microsofts Surface Laptop Ultra. NVIDIAs marknadsplats listar också en HP OmniBook X 14. MSIs maskin har en 16-tums UHD+ tandem OLED-skärm och ett 99.9 Wh-batteri. NVIDIA nämner dessutom Acer och Gigabyte bland de leverantörer som levererar RTX Spark-system.
Surface Laptop Ultra börjar på 2 599 dollar, det lägsta RTX Spark-priset vi sett, i ett chassi som Microsoft har under 18 mm och en vikt på 2,2 kg. Microsoft hävdar att den har 2.5 gånger högre värmekapacitet än sina nuvarande Surface Laptops, en 15-tums 120Hz pekskärm med 3270 x 2180 pixlar och 2 000 nits maximal HDR-ljusstyrka mätt över ett 10%-fönster, borttagbar lagring och en magnetisk USB-C-laddningsport som fortfarande kan hantera video och data. En 140W nätadapter levereras med utvalda konfigurationer. Den lägsta konfigurationen på NVIDIAs marknadsplats kombinerar 5 120-kärnig chip med 24 GB och en 512 GB Gen4 SSD.
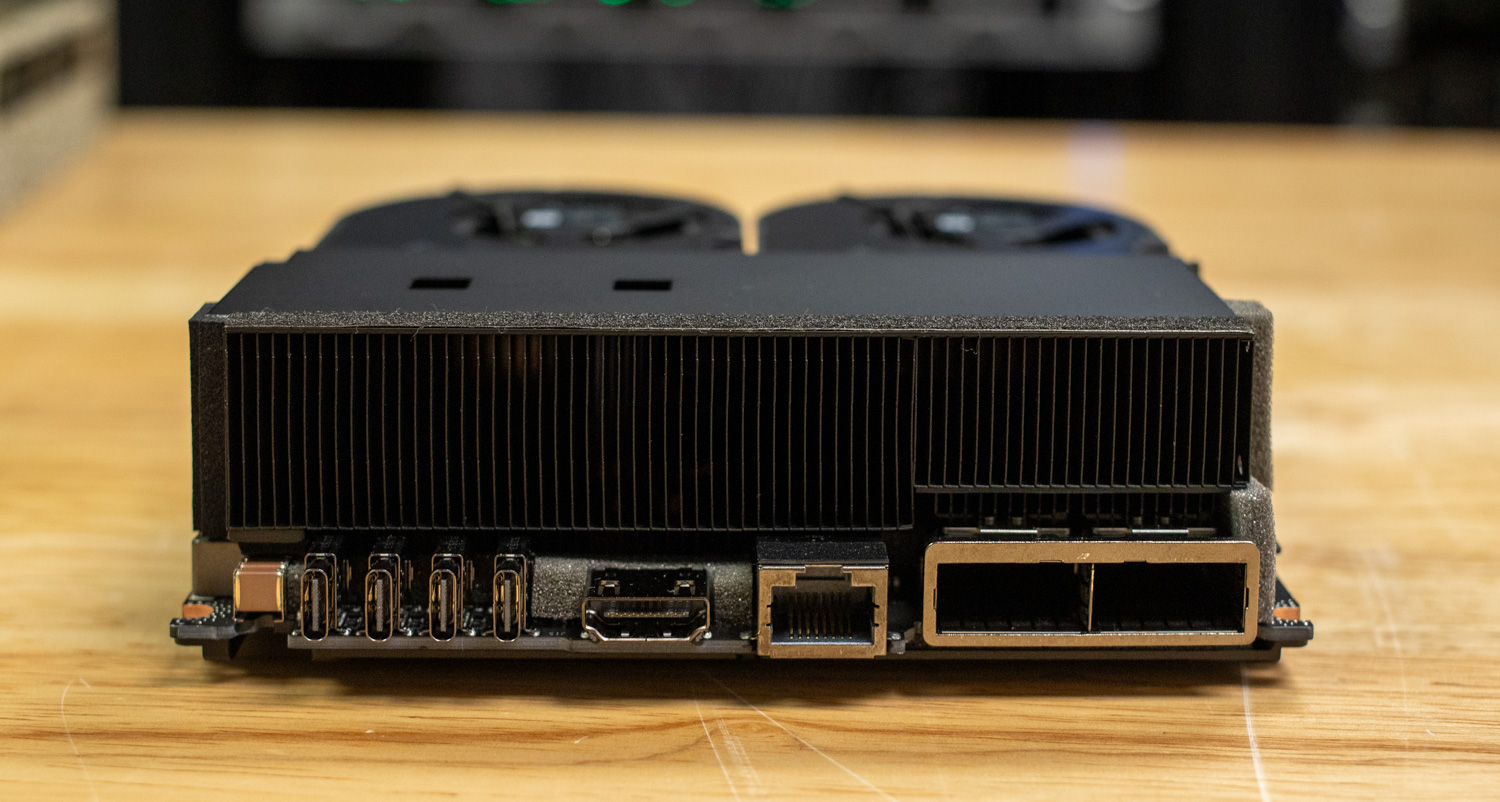
Surface RTX Spark Dev Box är den första kompakta stationära datorn med ett pris på 5 999 dollar och 128 GB minne. Den säljs endast via Microsoft.com i USA och levereras i november, med Visual Studio Code, Git, GitHub Copilot, WSL, Python och Node förinstallerade. Det är 1 000 dollar mer än DGX Spark med 64 GB minne för 4 999 dollar , med dubbelt så mycket minne. Microsoft listar två USB-C-portar, USB-A, HDMI, Ethernet och ett hörlursuttag, och nämner inget om ConnectX-7-portarna som låter DGX Sparks klustra, vilket är ett svar på frågan om nätverk för stationära datorer som vi tog upp i juni.
DGX Station för Windows: Fjärde kvartalet, med den fullständiga specifikationstabellen
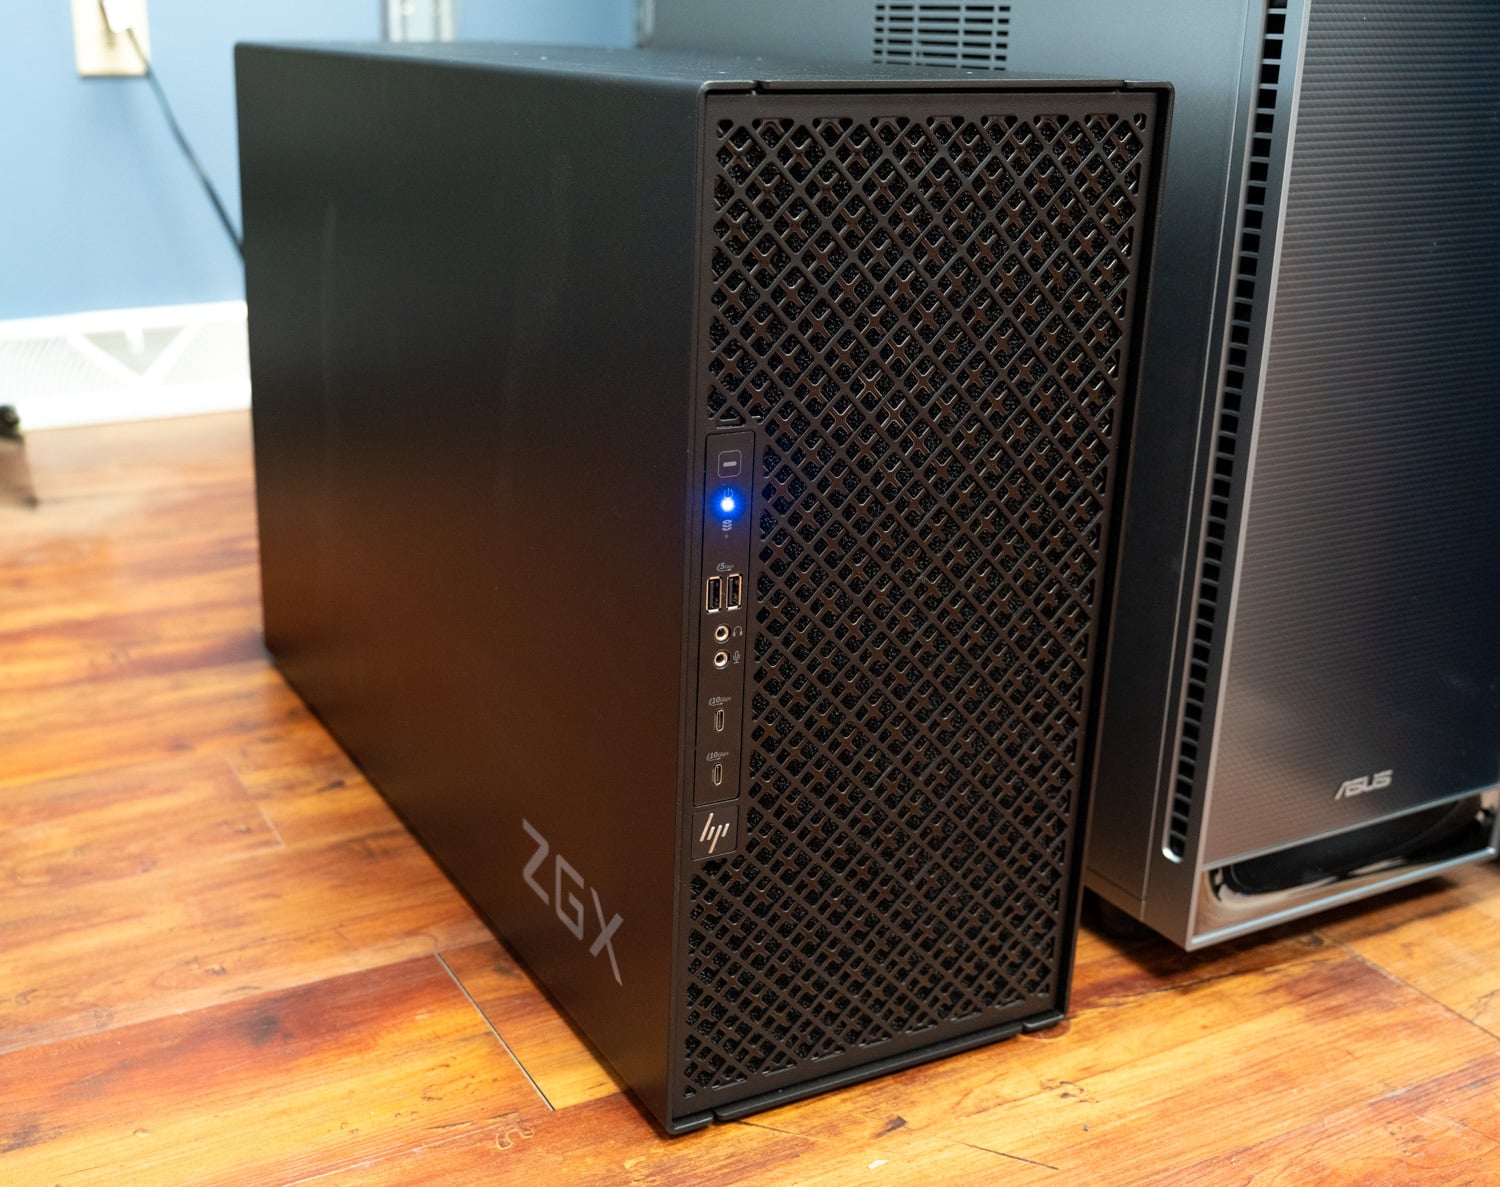
NVIDIAs sida för DGX Station för Windows lyder nu "Kommer under fjärde kvartalet", och Microsoft säger att systemen anländer senare i år, med Dell Pro Precision med GB300 och HP ZGX Fury AI Station först. NVIDIAs partnerlista lägger till ASUS, Gigabyte, MSI och Supermicro. Hårdvaran är GB300 Grace Blackwell Ultra Desktop Superchip som vi har testat på Ubuntu i MSI XpertStation WS300 , ASUS ExpertCenter Pro ET900N G3 och ett kluster med två torn.
| Specifikation | NVIDIA DGX Station för Windows |
|---|---|
| GPU | 1x NVIDIA Blackwell Ultra, 252 GB HBM3e vid 7.1 TB/s |
| CPU | 1x Grace, 72 Neoverse V2-kärnor, 496 GB LPDDR5X vid 396 GB/s |
| Koherent minne | Upp till 748 GB; NVLink-C2C vid 900 GB/s |
| FP4 Tensor Core | 20 PFLOPS med gleshet; 15 PFLOPS utan |
| FP8 och FP6 Tensorkärna | 10 PFLOPS |
| FP16 och BF16 Tensorkärna | 5 PFLOPS |
| TF32 Tensor Core | 2.5 PFLOPS |
| FP32 / FP64 | 80 TFLOPS / 1.3 TFLOPS |
| nätverk | ConnectX-8 SuperNIC, upp till 800 Gb/s: 2x QSFP112 vid 400 Gb/s per port 1x 10GbE RJ-45, 1x 1GbE RJ-45 (BMC) |
| lagring | 4x M.2 PCIe Gen5-platser |
| PCIe-kortplatser | 1x PCIe Gen5 x16; 2x PCIe Gen5 x16 (x8 elektrisk) |
| Stödda RTX PRO GPU:er | RTX PRO 6000 Workstation Edition, RTX PRO 6000 Blackwell Max-Q Workstation Edition, RTX PRO 4000 Blackwell SFF Edition, RTX PRO 2000 Blackwell (stödet kan variera beroende på system) |
| dekodrar | 7 NVDEC, 7 nvJPEG |
| Systemkraft | 1 600 W; 20 A-krets krävs |
| Operativsystem | Microsoft Windows; Linux-verktygskedjor via WSL |
Microsoft beskriver två användningsområden för Windows DGX Station. Den ena är en personlig AI-superdator för ingenjörs- och forskningsarbete, som kör modeller som de listar som Llama 4 Maverick, Kimi K2.6 och DeepSeek V4 Pro, och som enligt fotnoten stöder modeller upp till 1 biljon parametrar på hårdvara. Den andra är vad de kallar en Windows-tokenfabrik, ett delat system som stöder 32 eller fler samtidiga agenter för ett team för att minska molntokenförbrukningen. Microsoft säger att IT kan hantera dessa system med samma verktyg som de använder i hela sin Windows-flotta.
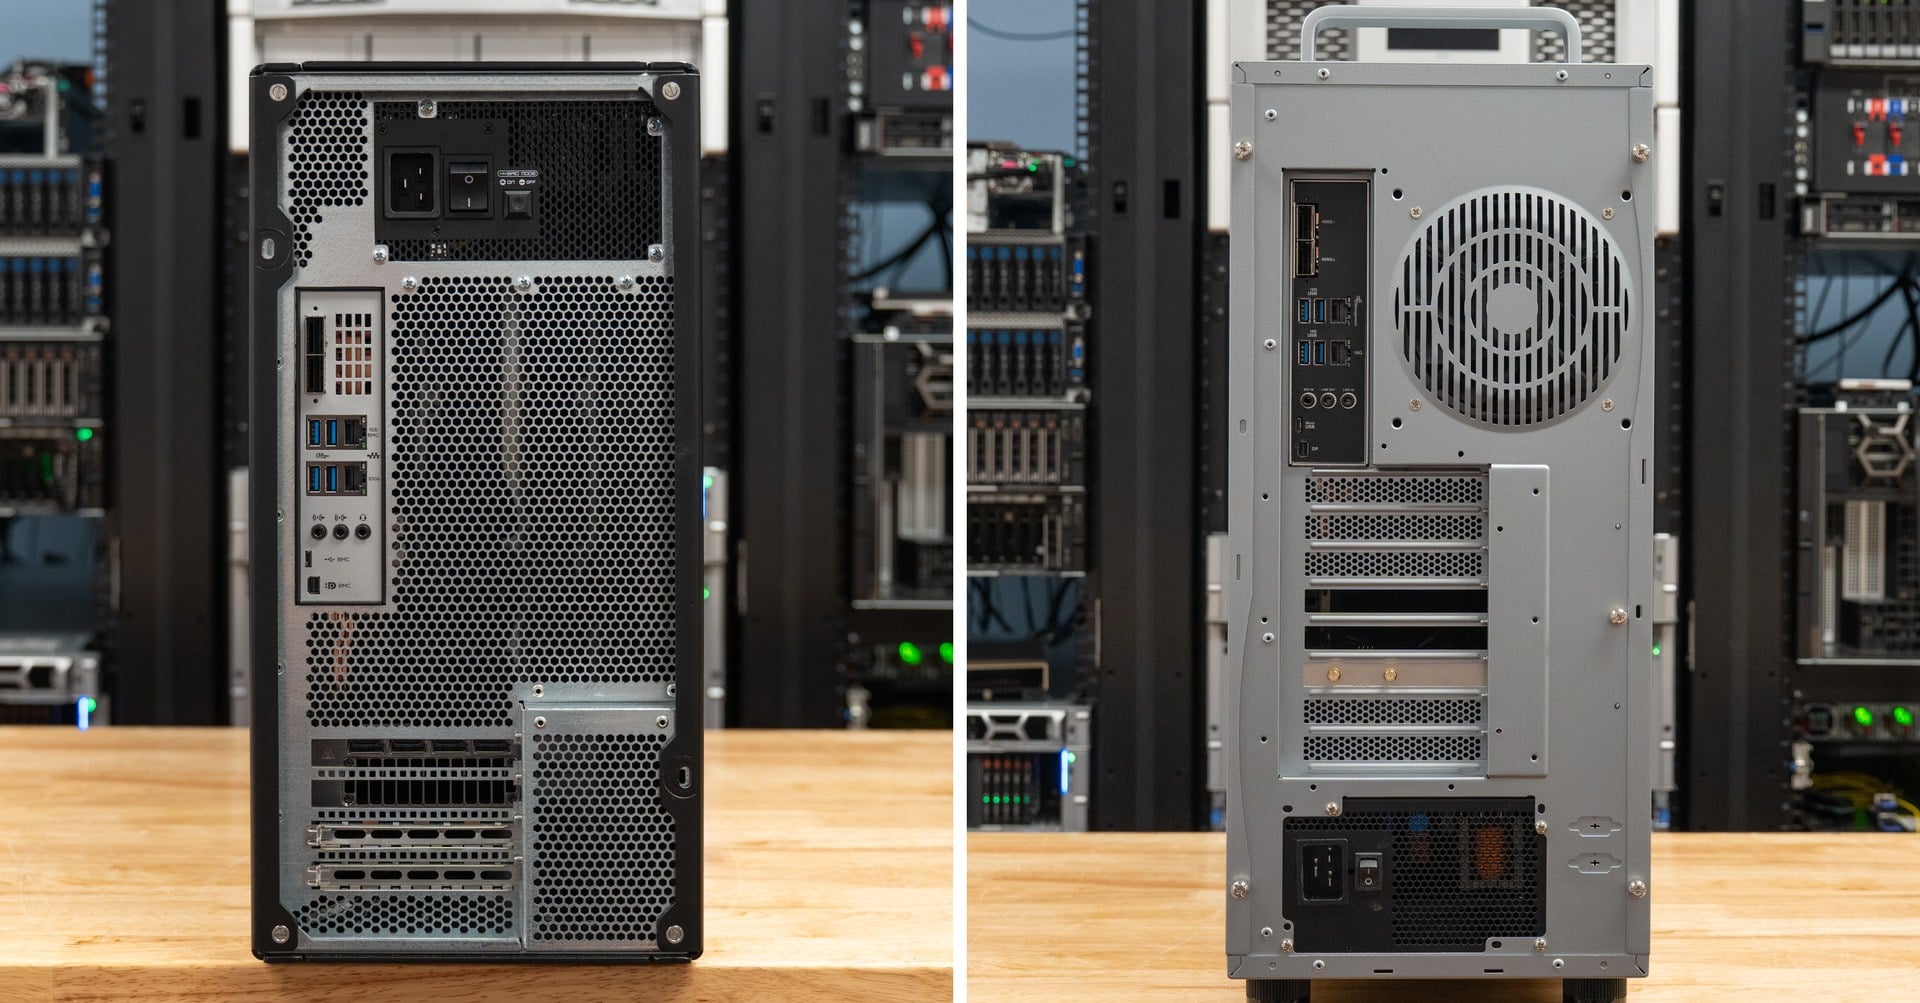
Det valfria RTX PRO-kortet är viktigare på Windows än på Linux. Som vi noterade på Computex har Blackwell Ultra GPU i GB300 inga RT-kärnor, så strålspårad visualisering i Windows design- och teknikapplikationer körs på tilläggskortet, med superchippet som hanterar AI. NVIDIA listar fyra RTX PRO Blackwell-kort som stöds, från RTX PRO 2000 till 6000, och antyder att stödet kan variera beroende på system.
Den öppna frågan från juni är fortfarande öppen. Vårt GB300-arbete har allt varit på Ubuntu med vLLM och NVIDIAs containerstack, och inget av företagen har sagt vilka serverstackar som körs direkt på Windows på denna hårdvara och vilka som körs under WSL, eller vad WSL kostar i dataflöde på en 72-kärnig Grace-värd med två 400 Gb/s-portar. Det är de första sakerna vi kommer att testa när en Windows-enhet når labbet.
Vad det lägger till
Lanseringsmaterialet besvarar flera av de frågor vi lämnade öppna på Computex. Bärbara datorer kör chipet med 45 till 80 W och stationära datorer med 140 W; 128 GB-alternativet är kopplat till det större av två chips; Windows begränsar GPU-adresserbart minne till under den installerade totala strömförbrukningen; och Microsofts första kompakta stationära dator listar inga höghastighetsnätverk. Svaret från Pavan Davuluri, Microsofts vice vd för Windows och enheter, att "du kan köra modeller på den här bärbara datorn som helt enkelt inte får plats på en traditionell maskin" gäller för 128 GB-konfigurationerna, och Microsofts 137B-kodningsmodell med cirka 60 tokens per sekund är en demonstration av det.
Det som fortfarande saknas är allt som är beroende av ett specifikt chassi: ihållande kraft under en lång agentsession, avkodningshastighet mot Apples M5 Max och AMDs Strix Halo-system, batteritid under inferens och prissättning för de flesta 128 GB-bärbara datorer. Vi vet inte heller när Windows når den GB10-baserade DGX Spark, som fick ett Windows-startcertifikat i firmware förra månaden. Recensionsenheterna kommer att gå igenom samma svit bakom våra topplistor för Bästa Bärbara Datorer för Lokal AI och Bästa Stationära Datorer för Lokal AI.



 Amazon