

NVIDIA正式发布了NVIDIA Groq 3 LPX,这是一款专为 Vera Rubin NVL72 平台打造的交互式推理加速器。随着企业级 AI 工作负载从原始模型预训练转向实时推理和自主代理编排,基础设施需求也在发生变化。代理工作流需要迭代式的多步骤执行,其中令牌生成过程中的延迟会累积到自动化推理路径、外部工具查询和多代理通信中。
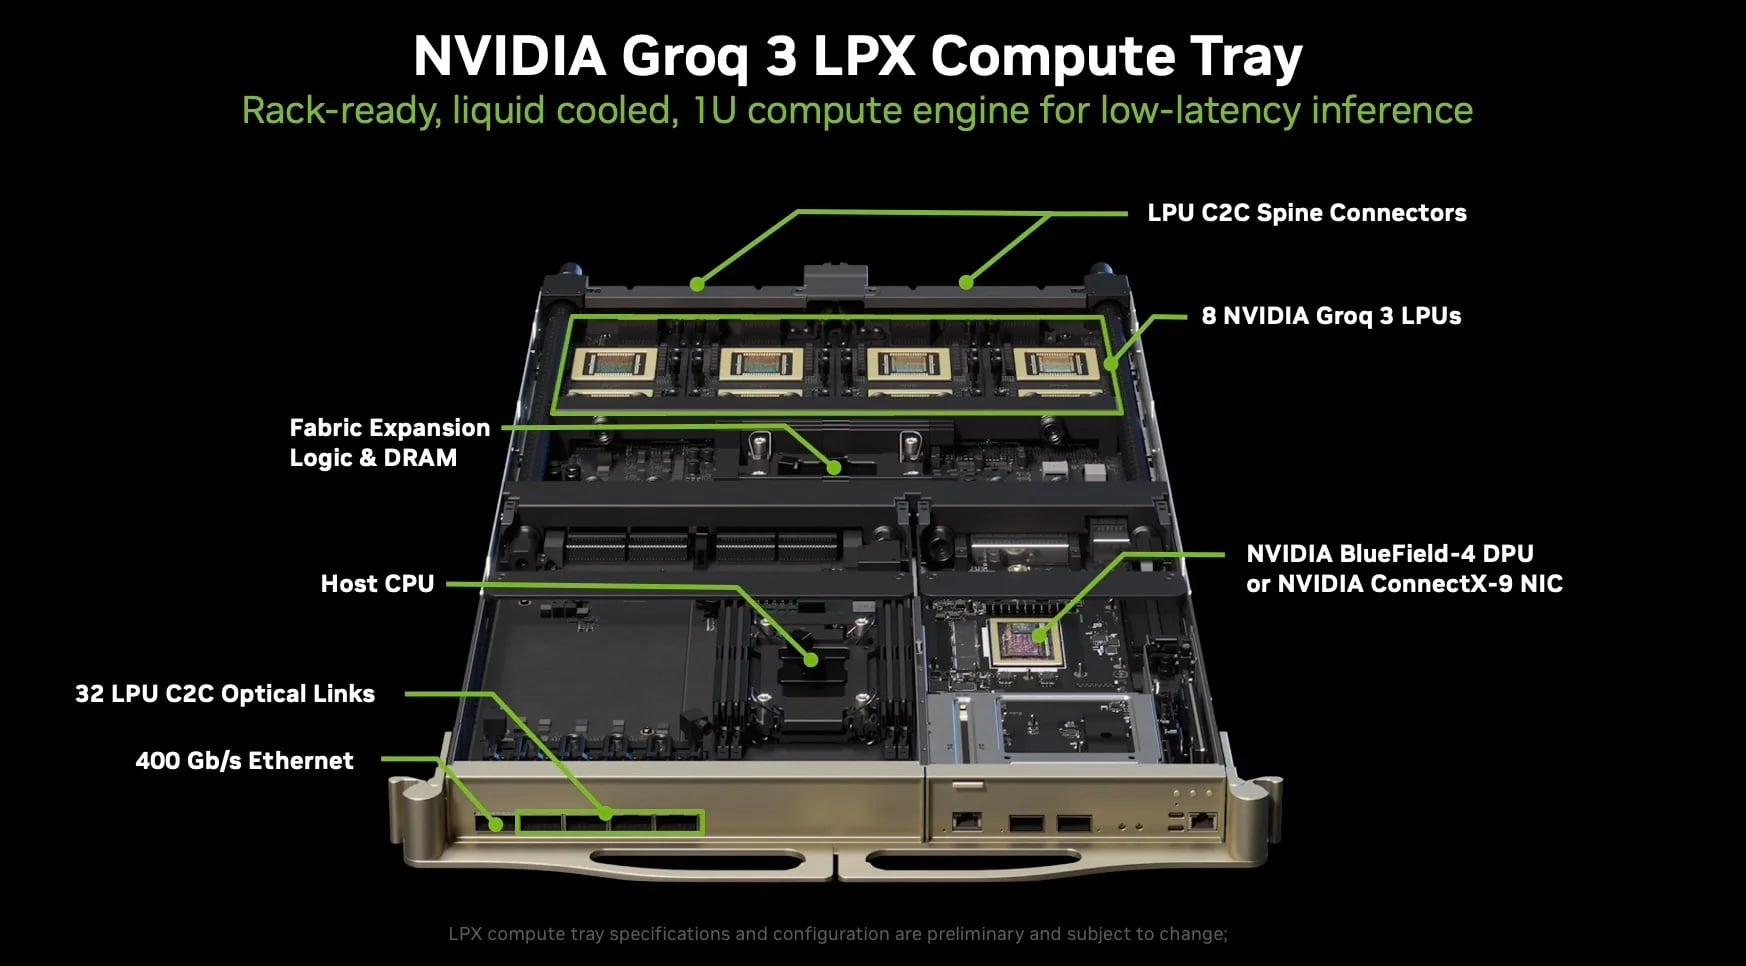
Groq 3 LPX 架构尤其擅长解码阶段。每个 2U 液冷计算托架都搭载 16 个 Groq 3 LPU,以及主机 CPU、扩展逻辑和 DRAM,并配备 BlueField-4 DPU 或 ConnectX-9 网卡,正面设有 32 个 LPU 芯片间光链路和 400Gb/s 以太网接口。在与 Vera Rubin NVL72 系统协同部署的异构环境中,NVIDIA Rubin GPU 负责处理海量输入数据集的上下文信息采集和预填充计算,而 Groq 3 LPX 单元则负责处理对延迟敏感的令牌输出生成。
架构和基准性能
在运行开源 Gemma 4 31B 模型并启用 10 万个令牌的活动上下文窗口后,Groq 3 LPX 的标准 Artificial Analysis 性能评估达到了每秒 3,400 个令牌的输出速率。NVIDIA 指出,这一吞吐量比在相同长上下文参数下性能最接近的替代平台快 4 倍,Artificial Analysis 也将其记录为该模型测得的最快结果。值得注意的是,NVIDIA 的数据来自 8 月 21 日在私有预发布端点上测得的结果,而其他数据则来自实际的无服务器生产端点。对于需要持续解析庞大代码库、复杂 API 模式和密集技术文档的企业代理架构而言,在 10 万个令牌的窗口内保持极高的生成速度至关重要。
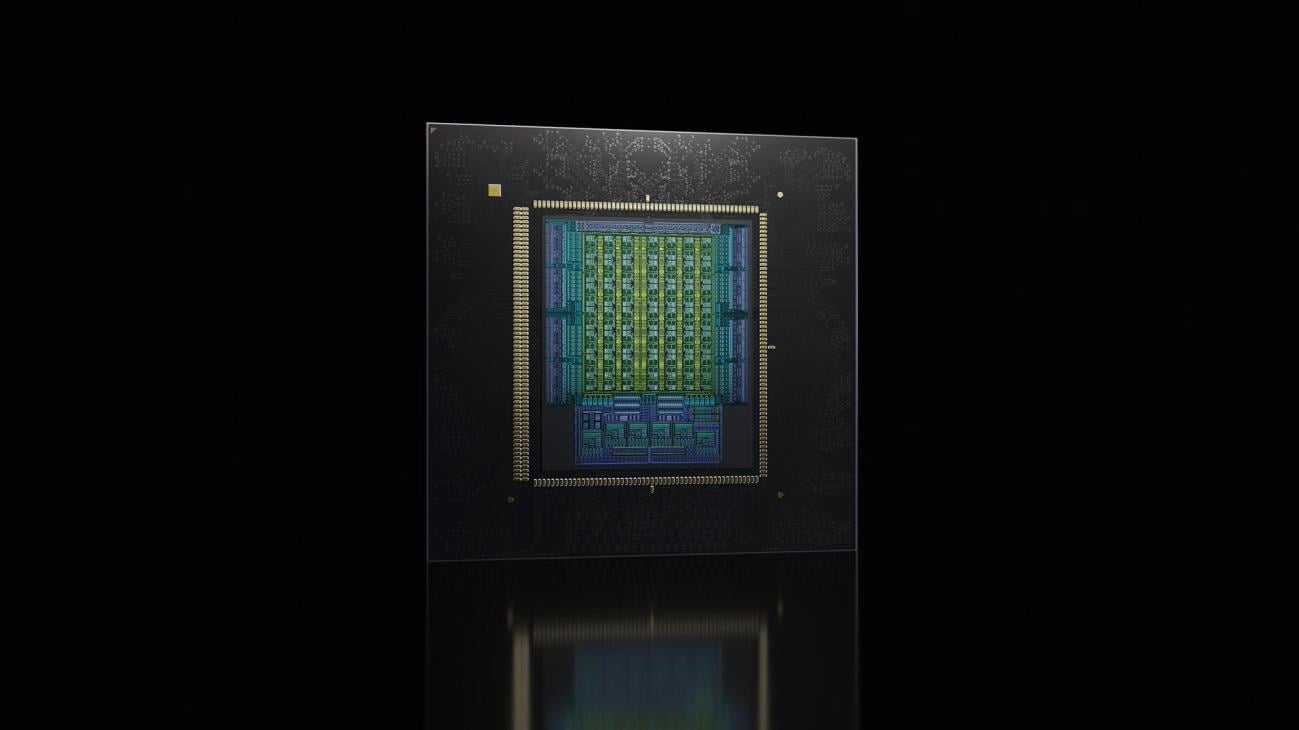

从物理系统架构的角度来看,机架级 Groq 3 LPX 部署包含多达 256 个 LP30 加速器,这些加速器通过高速、直接的芯片间互连连接。
云部署和系统生态系统
目前,专业云服务提供商已开始早期商业化采用该技术。Nebius 已被指定为首家部署 Groq 3 LPX 的 AI 云合作伙伴,并计划将该硬件集成到其 Nebius Token Factory 生产推理服务中。该架构旨在让开发人员能够通过现有的 API 接口访问实时推理加速功能,而无需将代码库迁移到新的框架抽象层。推理服务提供商 Groq 预计将成为该平台的首批采用者之一。


NVIDIA 为此次发布会同时更新了其所搭载机架的平台性能数据,声称在 140,000 万个令牌的智能体编码工作负载下,Vera Rubin NVL72 的每兆瓦令牌吞吐量比 GB300 NVL72 高达 30 倍,并且随着用户交互目标的提高,这一优势还会进一步扩大。该硬件实现方案与 NVIDIA 的全栈 Rubin AI 工厂基础设施完美契合,该基础设施包含七款独立芯片,并采用五种专用机架配置。
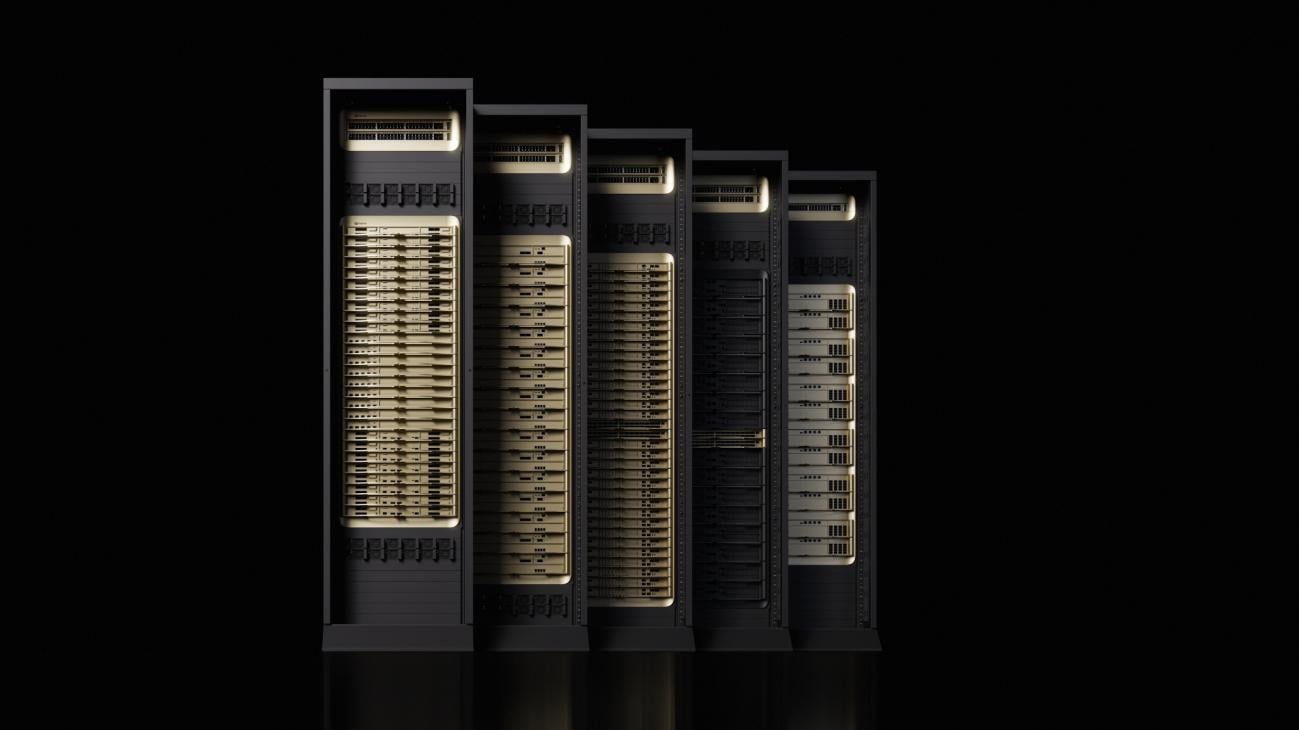
与 Rubin 和 LPX 计算集群一起运行的系统元素包括 NVIDIA Vera CPU 机架、Vera BlueField-4 STX 存储阵列和 NVIDIA Spectrum-6 SPX 网络架构。
NVIDIA 和 Nebius 的说法
“推理是人工智能的增长引擎。NVIDIA 的 Grace Blackwell 和 NVL72 以前所未有的性能和效率飞跃,彻底革新了大型语言模型推理,”NVIDIA 创始人兼首席执行官黄仁勋表示。“Vera Rubin 进一步拓展了这一愿景,推出了专为智能体人工智能时代设计的、针对工作负载优化的 AI 工厂配置,并通过 LPX 技术实现了超快速的令牌生成,从而进一步提升了性能。”
Nebius 从用户实际体验的角度阐述了延迟的价值。“生成阶段决定了 AI 系统的响应速度,而 NVIDIA Groq 3 LPX 正是为此而生,旨在加速这一阶段,”Nebius 首席技术官 Danila Shtan 表示。“作为首个通过 Nebius Token Factory 将其投入生产环境的 AI 云平台,我们确保代理循环中的每一步都流畅无阻,而且开发者无需迁移到新的技术栈,即可使用他们已经在使用的同一 API。”
Spectrum-X 多平面和可扩展基础设施
为了满足这些推理工厂的海量网络需求,NVIDIA重点展示了其Spectrum-X多平面以太网架构。传统的集群扩展若要突破现代密度限制,通常需要增加第三层交换,这会带来延迟增加、光缆成本上升以及功耗开销。Spectrum-X多平面架构通过将主机网络接口拆分为多个独立的平面来规避这些问题,每个平面运行一个扁平的双层网络,可扩展至512,000个GPU。

NVIDIA ConnectX-9 SuperNIC 芯片负责处理流量管理和故障缓解,当与 102.4 Tb/s Spectrum-6 以太网 ASIC 配合使用时,每个 GPU 的网络速度最高可达 1,600 Gb/s。Spectrum-XGS 以太网在不同设施间扩展了相同的协同设计,NVIDIA 表示,这可将多站点 NCCL 集群的运行速度提升 1.9 倍。在八平面拓扑结构中,硬件故障转移可立即绕过故障路径重新路由流量,从而保持约 90% 的聚合网络带宽。NVIDIA 表示,硬件恢复速度比基于软件的多平面负载均衡快 11 倍,这意味着 AI 工厂的产出可提高 1.6 倍。

与此同时,NVIDIA 推出了 Scale-In 网络架构,将 BlueField-4 数据处理单元与DOCA 软件栈相结合。Scale-In 的目标是南北向基础设施架构,将多租户隔离、线速芯片内加密、遥测和高性能存储数据路径从主机处理器卸载。
用于定制硅集成的 NVLink Fusion
NVIDIA 还推出了面向需要混合架构的超大规模运营商的 NVLink Fusion。该框架允许第三方定制 XPU 和 CPU 直接与 NVIDIA 第六代 NVLink 和 NVLink-C2C 横向扩展网络架构集成。通过利用模块化的 NVIDIA MGX 机箱蓝图和管理软件,数据中心运营商可以标准化共享电源、散热和网络机架设计,并根据工作负载的变化调整 GPU、LPU 和定制芯片的具体比例。
NVIDIA 在 Hot Chips 大会上宣布了第二个 Vera Rubin 的消息:SpaceXAI 正在为 Grok 背后的代理工作负载采用 Vera CPU,并计划将优化的 Vera Rubin NVL72 送入轨道,搭载在其第一代 Starmind 卫星上。


 Amazon