

本周在圣何塞举行的OCP全球峰会上,三星展示了一款与AMD合作验证的CXL内存池。该内存池基于三星的CMM-D CXL内存模块构建,旨在支持智能AI推理。两家公司合作验证了CXL内存作为一种能够随着CPU核心数量的增加而扩展内存容量和带宽的方法。其前提是,智能工作负载会导致CPU利用率急剧上升,而内存容量却无法跟上核心数量的增长。三星的内存池演示表明,与静态分配相比,首次令牌获取时间最多可缩短38%,吞吐量最多可提高3.3倍。
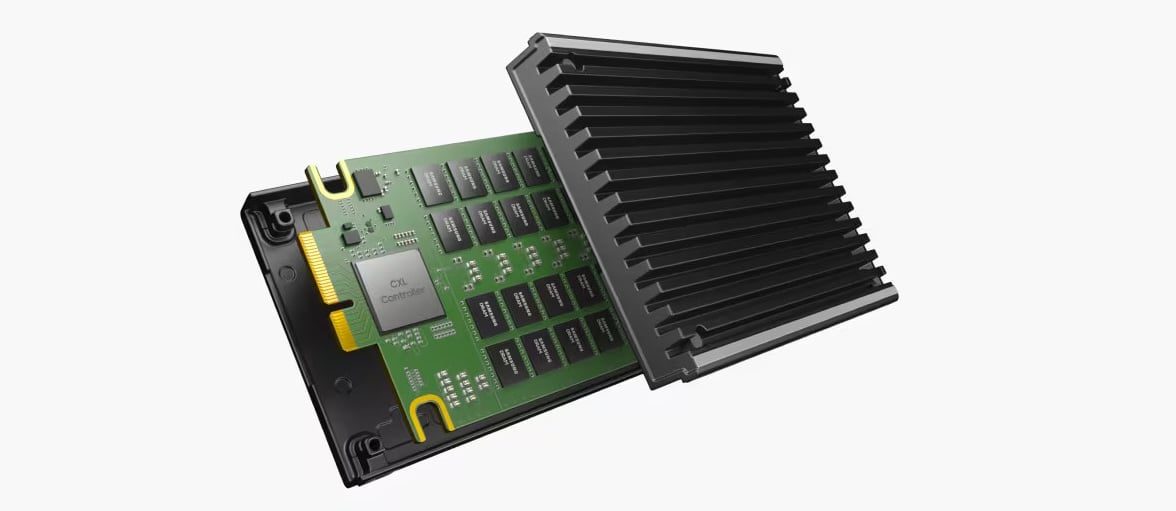
三星在展厅C41展位上展示了其内存和存储产品线,分为令牌化解决方案和KV缓存解决方案两部分。令牌化解决方案涵盖HBM4E和LPDDR5X-PIM,而KV缓存解决方案则涵盖CMM-D MD310 CXL模块、SOCAMM2 LPDDR服务器模块、PM1763 PCIe Gen6 SSD以及BM1773——三星称其为首款256TB E3.S QLC SSD。这种产品线划分遵循LLM流水线的两个阶段:预填充和令牌生成阶段运行在高带宽内存中,而上下文信息则需要在模型生成过程中保存。
CXL内存池架构和多节点共享
该池化演示在 GPU 服务器上运行 AI 代理工作负载,使用基于动态容量设备 (DCD) 语义构建的 CXL 内存池。DCD 语义是 CXL 的一种机制,允许池将内存提供给主机并在运行时收回。多个 LLM 实例通过弹性分配从池中获取内存,因此,当实例遇到上下文或参数峰值时,它会借用容量,并在作业完成后归还,而不是像通常那样,每个节点都根据其峰值容量分配容量,剩余容量则闲置。
三星的演示数据显示,与静态分配相比,TTFT 降低了 38%,吞吐量提高了 3.3 倍;这些是厂商提供的结果,我们没有运行或审核这些结果。
与 AMD 的合作验证了 AMD 计算平台上的相同方法,该平台面临的问题是,随着智能体工作负载的扩展,CPU 会出现性能瓶颈,而内存容量和带宽却无法随核心数量的增加而增长。三星表示,CMM-D 通过使 CPU 和内存容量都随 CPU 扩展,最大限度地提高了并发智能体 AI 用户数量。两家公司均未公布联合部署的服务器配置、CXL 交换机拓扑结构或互连延迟和带宽数据,而该架构的多主机共享部分将在 10 月 15 日与 XCENA 举办的关于动态池化、共享和近内存处理卸载的会议上进行详细讨论。
三星还拥有该存储池所创建层级的生产数据点。其搭载 CMM-D 的 AI 内存节点运行于三星半导体美国园区,为内部 AI 编码代理和其他应用程序提供服务。三星表示,添加所谓的 L3.5 可组合内存层级后,KV 缓存利用率提高了 5 到 7 倍。这项工作由三星内存解决方案实验室、其 AI 平台集成团队以及 SGLang 共同完成。
人工智能基础设施扩展
三星存储业务应用工程团队负责人兼企业副总裁沈浩俊 (Hojun Shim) 于 10 月 12 日发表了题为“面向人工智能时代的创新扩展:利用高度可扩展的内存保持计算全速运行”的高管演讲。正如三星在展位上所阐述的那样,其论点是,仅靠原始内存速度无法在模型规模扩大时保证计算资源的持续运行,而解决方案在于构建一个层级结构:高带宽内存用于活跃计算,CXL 架构可按需扩展容量,而 SSD 支持的层级则用于 KV 缓存和模型持久化。
10月13日,三星内存业务的Jinin So和Youngha Choi进行了第二场演讲,他们用一个标题概括了这种内存分层结构:“代理内存分层:从CXL池化到SSD支持的KV缓存卸载”。这与我们之前在KV缓存卸载到闪存的工作中测试的分层结构相同。三星的相关演示涵盖了灵活的数据放置、LMCache中更大的NVMe最大数据传输容量(用于KV缓存存储)以及将距离计算转移到SSD的向量数据库概念验证。
符号化
在令牌化方面,三星展示了HBM4E(该公司于5月开始提供样品,并在8月的FMS展会上与HBM5一同展出)和LPDDR5X-PIM(将内存处理单元集成到每个DRAM存储体中)。三星声称,PIM部分的有效带宽是标准LPDDR5X的8倍,在其边缘AI加速器上的令牌处理速度是标准LPDDR5X的3倍(基于三星在Llama 3.1 8B上运行的评估结果)。其理念是在DRAM封装内部执行推理过程中内存密集型的部分,从而减少通过互连的数据量,进而降低功耗和时间。
硬件和架构
展厅里展示的所有产品要么是演示产品,要么是现有产品:三星尚未公布AMD产品的CXL内存池控制器SKU、上市日期或功耗等级,而HBM4E和LPDDR5X-PIM的展示也未透露除已公布的HBM4E样品之外的任何产品上市时间信息。CMM-D MD310、PM1763和BM1773是已上市的芯片。
| 名称 | 三星亮相2026年OCP全球峰会 |
|---|---|
| CXL演示 | |
| AMD 合作 | CXL 内存已通过 AMD 验证,可根据 CPU 核心数量扩展内存容量和带宽,并减少智能体 AI 中的 CPU 阻塞。 |
| CMM-D 池化演示 | 基于 DCD 的 CXL 内存池,可在 GPU 服务器上的多个 LLM 实例之间进行弹性分配 与静态分配相比,TTFT 最多可降低 38%,吞吐量最多可提高 3.3 倍(三星数据)。 |
| 带 CMM-D 的 AI 存储节点 | 在三星半导体美国园区进行生产部署 L3.5 可组合内存层,KV 缓存利用率提高 5 到 7 倍(三星数据) |
| 代币化解决方案 | |
| HBM4E | 自五月起开始发货的12层样品 |
| LPDDR5X-PIM | 每家银行的PIM单元 与 LPDDR5X 相比,有效带宽最高可达 8 倍;在三星边缘 AI 加速器 Llama 3.1 8B 上,TPS 最高可达 3 倍(三星数据)。 |
| KV-Cache 解决方案 | |
| CMM-D MD310 | CXL 内存扩展模块 |
| SOCAMM2 | 基于LPDDR的服务器内存模块 |
| PM1763 | PCIe Gen6 SSD,顺序读取速度高达 28.4GB/s,图中所示为液冷散热方案。 |
| BM1773 | 256TB E3.S QLC SSD |
| 其他演示 | AiSIO 加速器直接存储(100M IOPS,冷启动模型加载速度提升高达 10 倍,数据来自三星) LMCache 中的 FDP 和更大的 NVMe MDTS SSD中的NCVS向量距离计算 支持实时迁移的可组合存储,基于标准 NVMe |
| 可用性 | |
| CXL Pooling with AMD | 技术演示;未公布产品型号、日期或功率等级。 |


 Amazon