

AMD Instinct MI350P 是 AMD 继 2022 年的 MI210 之后,四年来推出的首款全新 PCIe Instinct GPU。它将 AMD 的 CDNA 4 架构应用于传统的独立显卡,拥有高达 4.6 PFLOPS 的 MXFP4 性能、144GB 的 HBM3E 显存以及 4TB/s 的显存带宽。所有这些性能都集成在一张双槽、600W 风冷显卡中,为用户提供了一种无需升级到更大的 8 GPU OAM MI350/5X 平台即可部署 Instinct GPU 的新途径。
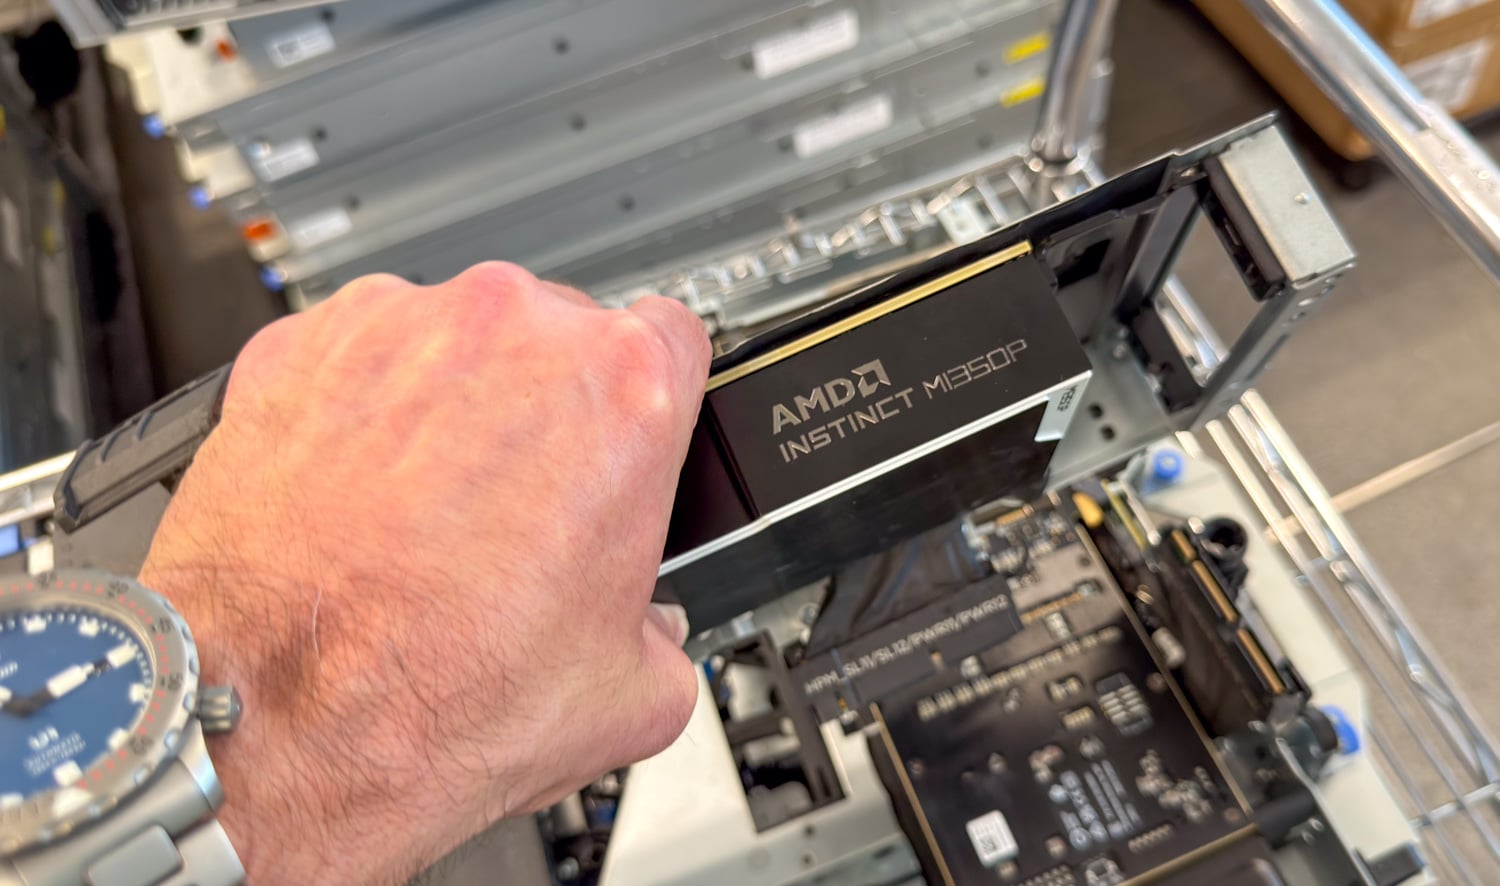
关键精华
- 最引人注目的是:144GB 内存安装在 PCIe 插槽中。 MI350P 是目前 PCIe 加速卡中内存容量最大的,比 H200 NVL 多 3GB,比 RTX PRO 6000 Blackwell 多 48GB,其后方配备了 4TB/s 的 HBM3E 显存,本次评测中的 14 种型号和精度组合中有 10 种可以在一张卡上运行。
- 测量结果显示,两张NVIDIA显卡之间的计算能力相差甚远。 在 450W 功耗下,MAMF 在 BF16 中达到了 580 TFLOPS,在 FP8 中达到了 1,120 TFLOPS,在分块缩放的 FP4 中达到了 2,228 TFLOPS,在所有精度下都比 600W 的 RTX PRO 6000 高出 36% 到 38%,但在 BF16 和 FP8 中落后于没有 FP4 路径的 H200 NVL。
- GPT-OSS 是 MI350P 的最强表现。 在 AMDGPU 31.60、ROCm 10.1.0 和 vLLM 0.32.0 下,GPT-OSS-120B 在聊天工作负载下,128 个流时达到每秒 5,057 个输出标记,比 RTX PRO 6000 快 65%,比 H200 NVL 快 50%,并且在两种提示形状下,曲线在 128 个流时持续攀升。
- 对于聊天大小的提示,MI350P 表现更佳;对于较长的提示,则表现不一。 在 512 个令牌的提示中,该显卡在所有 FP8、BF16 和 GPT-OSS 模型上,在 128 个流时,性能比 RTX PRO 6000 高出 35% 到 65%;在 FP4 与 NVFP4 的两场对决中,性能差距分别为 5% 和 21%;而在 8,192 个令牌的提示中,该显卡在 GPT-OSS 和 Mistral Small 上领先,但在 Llama、Qwen FP8 和 MiniMax-M2.7 上落后,其性能曲线在早期就趋于平缓。
- 双卡结果在 ROCm 7.2.3 中。 DeepSeek-V4-Flash、MiniMax-M3、GLM-5.2 和 GLM-5.3 Flash 报告来自该堆栈的运行,因为这些型号上的 ROCm 10.1 通过了 CPU 专家卸载,而 DeepSeek 使用的是 NVIDIA 运行所没有的推测性解码器。
- 600W 仍然是个悬而未决的问题。 戴尔官方文档显示,PowerEdge XE7745 服务器中配备了 8 个 600W 的 MI350P 处理器,并计划进行后续的全功率测试。
AMD在2026年IFA展会上也展示了搭载MI350P的Threadripper Halo Station原型机,该原型机采用了液冷散热。这款工作站概念机最多可搭载四颗MI350P,并配备一颗96核Threadripper PRO处理器,单机即可提供576GB的HBM3E显存;AMD的产品页面在10月份更新后,将该系统列为2027年上市产品。由此,我们可以从两个角度来看待MI350P:一是作为服务器的PCIe加速器,二是作为构建大型桌面AI系统的基础模块,与GB300 DGX Station等产品展开竞争。
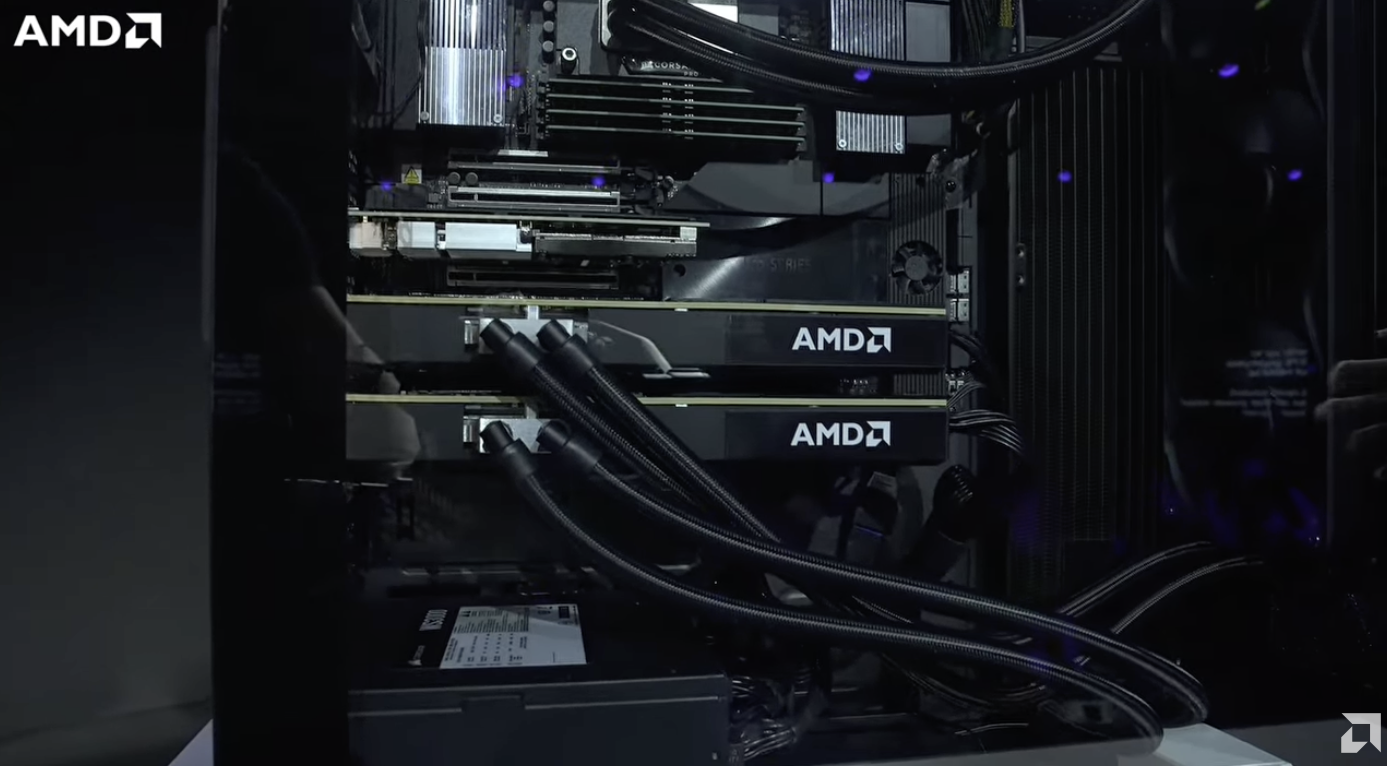
本次评测主要从服务器角度出发,因此对于指定 PCIe 加速卡的买家来说,最重要的对比对象是 NVIDIA RTX PRO 6000 Blackwell,这款显卡与 H200 NVL 处于同一功耗等级,使用相同的插槽。在图表中,H200 NVL 被列为性能最强的 NVIDIA 独立显卡,尤其适用于那些内存带宽决定性能的工作负载。桌面端的评测则以一台 GB300 DGX Station 为例;它属于不同级别的机器,价格也不同,其目的是为了展示完整的 Blackwell Ultra GPU 性能远超任何 PCIe 显卡。
AMD Instinct MI350P 规格
AMD公布的数据表明,MI350P的优势在于低精度浮点运算:MXFP4和MXFP6下为4.6 PFLOPS,FP8下为2.3 PFLOPS,FP16或BF16下为1.15 PFLOPS,这些都是高密度浮点运算数据。显存系统是显卡的另一半:144GB HBM3E显存,4,096位位宽,读写速度4TB/s,并配备128MB Infinity Cache缓存,下文的单流测试结果即基于此。显卡功耗为600W,并可选配450W模式;我们评测的样机运行在450W模式下。
MI350P 采用与更大、更高性能的 MI350/5X GPU 相同的 CDNA 4 架构。MI350P 可以看作是 MI350X 的一半。要理解这一点,了解一下更大 GPU 的组装方式会有所帮助。
MI350X 采用 3D 堆叠式芯片设计,基于台积电的 CoWoS(芯片封装于晶圆之上,又封装于基板之上)封装技术,没有单一的单芯片。八个加速器复合体芯片(XCD)位于两个 I/O 芯片上方,每个 I/O 芯片上包含四个 XCD。AMD 的 Infinity Fabric 互连技术连接各个芯片,而八个 HBM3E 芯片组则为 GPU 提供显存。CoWoS 指的是封装级集成;计算叠加于 I/O 之上的架构是该设计的垂直 3D 堆叠组件。

MI350P 采用了该架构的一半:四个 XCD、一个 I/O 芯片和四个 HBM3E 内存堆栈。每个 XCD 拥有 32 个活跃计算单元,使该卡拥有 128 个计算单元,而 MI350X 则拥有 256 个。内存资源也减半:HBM3E 内存容量从 288GB 减少到 144GB,带宽从 8TB/s 减少到 4TB/s,Infinity Cache 缓存容量从 256MB 减少到 128MB。

| 规格 | AMD Instinct MI350P |
|---|---|
| 平台概述 | |
| 卓越 | cDNA 4 |
| 计算单位 | 128 |
| 流处理器 | 8,192 |
| 矩阵核心 | 512 |
| 工艺应用 | 台积电3nm和6nm工艺 |
| 晶体管 | 73十亿 |
| 峰值引擎时钟 | 2,200MHz |
| 内存 | |
| 容量 | 144GB HBM3E |
| 接口 | 4,096 bit |
| 带宽 | 4TB/秒 |
| 末级缓存 | 128MB |
| ECC | 全芯片 |
| 峰值性能(AMD 官方数据) | |
| MXFP4 | 4.6 浮点数 |
| MXFP6 | 4.6 浮点数 |
| MXFP8 | 2.3 浮点数 |
| OCP FP8 | 2.3 PFLOPS;具有结构化稀疏性的 4.6 PFLOPS |
| FP16 | 1.15 PFLOPS;2.3 PFLOPS(带稀疏性) |
| BF16 | 1.15 PFLOPS;2.3 PFLOPS(带稀疏性) |
| FP32 | 72 TFLOPS |
| FP64 | 36 TFLOPS |
| 功率、散热和外形尺寸 | |
| 典型电路板功耗 | 最大功率 600W;可配置功率 450W |
| 电源连接器 | 12V-2×6 |
| 散热器 | 被动 |
| 外形 | PCIe 扩展卡,全高,双槽 |
| 板长 | 10.5英寸(267毫米) |
| 主机接口 | PCIe 5.0 x16 |
| 产品特性 | |
| 车联网 | 是 |
| 无限缓存 | 是 |
| RAS | 是 |
| 页面退休和避免 | 是 |
600W 是最大功耗,AMD 允许将显卡功耗配置至 450W,而这正是它在我们 2U 主机中的运行功耗。H200 NVL 在 R770 中也达到了 450W,与 RTX PRO 6000 的功耗相同,但 RTX PRO 6000 在 XE7740 中以 600W 的满功率运行,因此在所有对比测试中,NVIDIA 显卡都比 RTX PRO 6000 多出 150W 的功耗。要获得完整的满功率测试结果,还需要一个能够为 600W 被动散热显卡提供足够散热的机箱,而戴尔的 XE7745 技术指南中列出了八颗 600W 的 MI350P 散热器。
另一点需要注意的是:它采用单个 12V-2×6 连接器和 10.5 英寸双槽主板,这使得该显卡可以安装到目前 RTX PRO 6000 或 H200 NVL 所用的相同转接卡中。

下表将 MI350P 与我们图表中的三个 NVIDIA 系统并列比较:RTX PRO 6000 Blackwell Server Edition,它与 MI350P 共享插槽、功率范围和 PCIe 5.0 x16 主机链路;H200 NVL,Hopper 卡,具有与之匹配的内存带宽;以及 GB300 DGX Station,单个 Blackwell Ultra GPU 与 Grace CPU 通过 NVLink-C2C 配对。
首先要看的是内存容量,其中 MI350P 的 144GB 是三款 PCIe 显卡中最大的,比 H200 NVL 多 3GB,比 RTX PRO 6000 多 48GB;内存带宽,其 4TB/s 介于两者之间;以及 FP4 线,AMD 给出的是密集型数值,而 NVIDIA 给出的是稀疏型数值。
| 规格 | AMD Instinct MI350P | NVIDIA RTX PRO 6000 Blackwell 服务器版 | NVIDIA H200 NVL PCIe | NVIDIA GB300 DGX Station |
|---|---|---|---|---|
| GPU架构 | cDNA 4 | 布莱克威尔 | 料斗 | 布莱克韦尔超级 |
| 外形尺寸 | PCIe 加速器 | PCIe 加速器 | PCIe 加速器 | 一块 Blackwell Ultra GPU 搭配一颗 72 核 Grace CPU |
| 显存 | 144GB HBM3E | 96GB GDDR7 纠错码 | 141GB HBM3E | 252GB HBM3E |
| GPU 内存带宽 | 4TB/秒 | 1.6TB/秒 | 4.8TB/秒 | 7.1TB/秒 |
| FP4 | 4.6 PFLOPS MXFP4(密集型) | 4 PFLOPS NVFP4(稀疏) | 没有原生FP4 | 20 PFLOPS NVFP4(稀疏) |
| FP8 | 2.3 PFLOPS(密集型) | 2 PFLOPS(稀疏) | 3.3 PFLOPS(稀疏) | 10 PFLOPS(稀疏) |
| BF16 | 1.15 PFLOPS(密集型) | 1 PFLOPS(稀疏) | 1.6 PFLOPS(稀疏) | 5 PFLOPS(稀疏) |
| FP32 | 72 TFLOPS(密集型) | 120 TFLOPS(稀疏) | 60 TFLOPS(稀疏) | 80 TFLOPS(稀疏) |
| 主机连接 | PCIe 5.0 x16 | PCIe 5.0 x16 | PCIe 5.0 x16 | Grace 与 GPU 之间采用 NVLink-C2C 协议,传输速度为 900GB/s(双向)。 |
| 多GPU连接 | 基于 PCIe 的 | 基于 PCIe 的 | 支持双向或四向 NVLink,每个 GPU 最高可达 900GB/s(双向) | 站点间采用 800Gb/s ConnectX-8 网络连接 |
| 电力 | 可配置功率:450 至 600 瓦 | 可配置功率:300 至 600 瓦 | 可配置功率:450 至 600 瓦 | 最高支持 1200W GPU,并伴有电力晃动 |
与 RTX PRO 6000 相比,MI350P 最显著的区别在于其内存子系统。它的 GPU 显存容量增加了 50%,显存带宽也提升了约 2.5 倍。对于一款容量略大于 96GB 的显卡来说,额外的显存容量可能决定它是使用单 GPU 运行,还是需要分配到多个 GPU 上运行。
然而,RTX PRO 6000 能够胜任更广泛的工作负载,它不仅具备强大的 AI 功能,还拥有用于图形处理、光线追踪和视频制作的硬件。选择显卡不仅仅取决于两个峰值计算参数,还取决于系统还需要完成哪些其他任务。
在高显存 PCIe 加速器中,H200 NVL 是 MI350P 更直接的竞争对手;而更大的 Blackwell 数据中心 GPU 则属于另一个级别。两者的显存容量几乎相同,均为 144GB,而 H200 为 141GB,均采用 HBM3E 显存,但 H200 的显存带宽更高,达到 4.8TB/s,比 MI350P 高出 20%。两者的扩展方式也不同:三张 PCIe 卡均通过 PCIe 连接到主机,但 H200 NVL 还通过 NVLink 桥接器提供专用的 GPU 间连接,最多可连接四张 GPU。
尺寸更大的 MI350X 和 MI355X 的设计初衷是为了与 Blackwell 竞争,而 MI350P 则将硬件配置缩减了一半。这使得它在内存特性和整体定位上更接近 H200 NVL。MI350P 的一个独特之处在于它原生支持 MXFP4 和 MXFP6,这在推理精度逐渐降低的过程中显得尤为重要。
较小的内存子系统是另一项妥协,因为AMD并未用速度更快的HBM3E来弥补HBM堆栈的减少,导致MI350P的带宽仅为4TB/s,在该指标上落后于H200 NVL。正如评测后文的内存带宽和长提示推理结果所示,无论可用计算能力如何,这都可能限制内存带宽密集型工作负载的性能。
DGX Station 的对比则恰恰相反,因为 GB300 Station 搭载了一颗完整的 B300 GPU,只是禁用了其中一个 HBM 显存堆栈。这颗数据中心级芯片的功耗也符合数据中心标准,而 MI350P 只是半颗数据中心级芯片,却被塞进了 600W 的 PCIe 扩展卡中。AMD 需要两到四块 MI350P 才能达到单块 GPU 的性能,理论上两块 MI350P 就能做到:288GB 的内存容量和 8TB/s 的读写速度,而 DGX Station 的内存容量和读写速度分别为 252GB 和 7.1TB/s。然而,这些资源分布在两块卡上,而跨两块卡的工作负载是通过 PCIe 点对点传输数据的,这限制了第二块卡所能带来的性能提升。
性能
测试平台
本次评测的 MI350P 服务器是一台戴尔 PowerEdge R7725,配备两颗 AMD EPYC 9555 处理器(每颗 64 核)、1.5TB DDR5-6400 内存(分布在 24 个 DIMM 插槽中)以及两块 MI350P 显卡,总功率设置为 450W,这是 2U 服务器的功率上限。RTX PRO 6000 Blackwell Server Edition 显卡(600W)运行在我们之前评测的戴尔PowerEdge XE7740 服务器上(该服务器搭载了四块显卡);一块 H200 NVL 显卡(450W)运行在我们评测过的戴尔 PowerEdge R770服务器上;GB300 的数据则来自我们九月份评测的华硕 ExpertCenter Pro ET900N G3 DGX Station 服务器。

下方的 iDRAC 清单显示了这两张卡的安装位置。它们分别位于 PCIe 插槽 2 和 7,均为 Gen5 x16 插槽,且均显示运行状况良好。设备密钥分别为 0-139-0 和 1-199-0,表明每张卡分别位于一个 EPYC 插槽之后。因此,两张 MI350P 卡之间的张量并行流量会在根复合体之间通过插槽链路传输。这是 2U 服务器中双卡部署的默认布局,这一点在后续的双卡测试结果中值得注意。

内存视图显示了主机的其余部分:24 条 64GB DDR5-6400 双列内存条,总容量 1,536GB(服务器最大容量为 6TB),全部支持多位 ECC 纠错。对于 GLM-5.2 运行来说,内存余量至关重要,因为 MXFP4 检查点无法放入两张 288GB 的存储卡中,而 vLLM 会将部分专家权重卸载到主机内存中。

最大可实现 Matmul FLOPS (MAMF)
为了更好地理解 MI350P 的计算性能,我们对这四个系统进行了 MAMF 测试。MAMF(最大可达矩阵乘法 FLOPS)是一种实用的性能指标,旨在衡量加速器在矩阵乘法运算中实际达到的峰值浮点运算速度,比规格表中的理论峰值 FLOPS 更具参考价值。我们分别在 BF16、FP8 和块级 FP4 算法下对每个系统进行测试,并报告每种精度下最佳的持续密集计算结果;图中阴影条形图表示每张 PCIe 卡的计算结果乘以用于大型模型服务运行的卡数,这些结果仅供参考,没有实际测量数据。

在 450W 的功耗下,一块 MI350P 在 BF16 中达到 580 TFLOPS,FP8 达到 1,120 TFLOPS,FP4 达到 2,228 TFLOPS。RTX PRO 6000 Blackwell 紧随其后,分别为 419 TFLOPS、820 TFLOPS 和 1,634 TFLOPS。因此,MI350P 在所有精度下都比 NVIDIA 显卡领先 36% 到 38%,而功耗却低了 150W,其中在 BF16 中的差距最大,达到 38.4%。
H200 NVL 在 BF16 模式下的浮点运算性能为 652 TFLOPS,在 FP8 模式下为 1,205 TFLOPS,两项指标均优于 MI350P,且它没有 FP4 通道。GB300 DGX Station 的性能则高于这三款 PCIe 显卡,其 BF16、FP8 和 FP4 性能分别为 1,924、3,802 和 6,024 TFLOPS,约为 MI350P 的 3.3 倍和 2.7 倍;两块 MI350P 的纸面性能分别接近 1,160 和 4,456 TFLOPS,仍低于 Station 的单 GPU 性能。本评测中的 NVIDIA MAMF 数据来自我们对每张显卡的最新测试,并取代了之前的测试结果。
GPU内存带宽
只有当加速器能够持续为其执行单元提供数据时,原始计算吞吐量才有意义。这一点对于推理任务尤为重要,因为在解码阶段,令牌生成更多地受限于内存带宽,而非可用浮点运算次数(FLOPS)。带宽测试通过计算内核和复制引擎读取、写入和复制GPU内存,从而显示每个GPU内部的可用带宽与其额定带宽的对比情况。

一张 MI350P 的 HBM3E 读取速度为 3,291GB/s,写入速度为 3,204GB/s,约为 4TB/s 额定速度的 80%,复制速度为 1,276 至 1,283GB/s;复制操作会消耗两次带宽,一次用于读取源数据,一次用于写入目标数据。RTX PRO 6000 的 GDDR7 读取速度为 1,540GB/s,写入速度为 1,483GB/s,因此 MI350P 的单卡可用带宽约为其 2.1 倍。
H200 NVL 的读取速度为 4,472GB/s,写入速度为 4,156GB/s,分别比 MI350P 高出 36% 和 30%,与其 4.8TB/s 的额定速度(MI350P 为 4TB/s)相符。GB300 DGX Station 的读取速度可达 6,869GB/s。两块 MI350P 并联测量的读取速度为 6,529GB/s,接近 Station 的水平,但该带宽占用两个 PCIe 插槽,因此跨两个插槽的型号需要为每次 PCIe 数据传输付费。
推理
完成底层测试后,我们转向 LLM 推理。我们的 vLLM 在线服务测试驱动一个与 OpenAI 兼容的端点,该端点具有固定数量的并发流,并记录运行期间每秒的输出 token 数。我们报告了两种曲线:一种是输入 512 个 token,输出 512 个 token,这种规模的测试环境适合聊天,解码操作较多;另一种是输入 8,192 个 token,输出 1,024 个 token,这种规模的测试环境适合 RAG 和文档,并且依赖于预填充。并发流数量从单个流开始翻倍,每个曲线图都止于该流中所有卡片均完成的最高并发流数量。每个点代表每个流的两次请求,因此单流数据基于两次请求,并且比高并发流的运行间波动更大。
每个模型都使用最少数量的显卡运行:GPT-OSS-120B 及以下版本和 MiniMax-M2.7 版本使用一张 MI350P 显卡,DeepSeek-V4-Flash、MiniMax-M3、GLM-5.2 和 GLM-5.3 Flash 版本使用两张 MI350P 显卡。RTX PRO 6000 系列也遵循同样的规则,MiniMax-M2.7 版本使用两张 RTX 显卡搭配一张 MI350P 显卡,MiniMax-M3 和 GLM-5.2 版本使用四张 RTX 显卡搭配两张 MI350P 显卡。低精度版本因厂商而异:AMD 的版本使用 MXFP4 至 Quark 架构,NVIDIA 的版本使用 NVFP4 架构,所有 FP4 架构的组合均以此命名。GPT-OSS 版本使用 MXFP4 架构,并且在所有显卡上运行相同的权重。H200 NVFP4 版本不包含在内。
| 型号 | MI350P | RTX PRO 6000 布莱克韦尔 | H200 NVL | GB300 DGX 站 |
|---|---|---|---|---|
| GLM-5.3 闪光灯 | 2 张卡,MXFP4 | 未运行 | 未运行 | NVFP4 |
| GLM-5.2 | 2 张卡,MXFP4(卸载到主机内存) | 4 张卡片,NVFP4 | 未运行 | NVFP4(Grace 内存中约 215GB 的专家数据) |
| MiniMax-M3 | 2 张卡,MXFP4 | 4 张卡片,NVFP4 | 未运行 | NVFP4(格蕾丝记忆中的专家片段) |
| DeepSeek-V4-闪存 | 2张卡,FP8 | 2张卡,FP8 | 未运行 | FP8 |
| MiniMax-M2.7 | 1 张卡,MXFP4 | 2 张卡片,NVFP4 | 未运行 | NVFP4 |
| GPT-OSS-120B | 1 张卡,MXFP4 | 1 张卡,MXFP4 | 1 张卡,MXFP4 | MXFP4 |
| GPT-OSS-20B | 1 张卡,MXFP4 | 1 张卡,MXFP4 | 1 张卡,MXFP4 | MXFP4 |
| Qwen3-编码器-30B-A3B | 1张卡,FP8和BF16 | 1张卡,FP8和BF16 | 1张卡,FP8和BF16 | FP8 和 BF16 |
| 米斯特拉尔小号 3.1 24B | 1张卡,FP8和BF16 | 1张卡,FP8和BF16 | 1张卡,FP8和BF16 | FP8 和 BF16 |
| 羊驼 3.1 8B | 1 张卡,MXFP4、FP8 和 BF16 | 1 张卡,NVFP4、FP8 和 BF16 | 1张卡,FP8和BF16 | NVFP4、FP8 和 BF16 |
向下阅读 MI350P 列,首先映入眼帘的是 144GB 内存带来的显卡数量。十款机型中有六款仅需一块 MI350P 即可运行,而 RTX PRO 6000 的 96GB 内存则需要第二块显卡来运行 MiniMax-M2.7 处理器。另外两款 MXFP4 检查点(MiniMax-M3 和 GLM-5.2)则需要四块 RTX PRO 6000 显卡,它们都运行在两块 MI350P 上。GLM-5.2 的内存容量甚至超过了 288GB,因此 vLLM 会将部分专家权重转移到 R7725 的主机内存中进行运行;GB300 也采用了类似的策略,将大约 215GB 的专家权重存储在 Grace 内存中。
单卡型号的 MI350P 性能测试数据于 10 月 27 日在 AMDGPU 31.60、ROCm 10.1.0 和 vLLM 0.32.0 环境下运行。戴尔官方验证的组合是 vLLM 0.27、ROCm 10.0 和 AMDGPU 31.5,而我们在此基础上更进一步,使用了 10 月 5 日发布的 ROCm 10.1 版本。NVIDIA 显卡则全程运行在 CUDA 13.4.1 和 vLLM 26.08 容器上。下表列出了每次测试所依据的版本。
| 型号 | vLLM图像 |
|---|---|
| AMD Instinct MI350P | |
| DeepSeek-V4-Flash-0731 | vllm/vllm-openai-rocm@sha256:a78d3e91404e7875aa650a61dea580a9e26d72553bee9ae5b93dbdef7107594d (ROCm 7.2.3) |
| GLM-5.2 MXFP4 | vllm/vllm-openai-rocm:v0.27.1 (ROCm 7.2.3) |
| GLM-5.3 闪存 MXFP4 | vllm/vllm-openai-rocm@sha256:a78d3e91404e7875aa650a61dea580a9e26d72553bee9ae5b93dbdef7107594d (ROCm 7.2.3) |
| GPT-OSS-120B MXFP4 | vLLM 0.32.0 on ROCm 10.1.0, AMDGPU 31.60 (10月27日) |
| GPT-OSS-20B MXFP4 | vLLM 0.32.0 on ROCm 10.1.0, AMDGPU 31.60 (10月27日) |
| 羊驼 3.1 8B BF16 | vLLM 0.32.0 on ROCm 10.1.0, AMDGPU 31.60 (10月27日) |
| Llama 3.1 8B FP8 | vLLM 0.32.0 on ROCm 10.1.0, AMDGPU 31.60 (10月27日) |
| Llama 3.1 8B MXFP4 | vLLM 0.32.0 on ROCm 10.1.0, AMDGPU 31.60 (10月27日) |
| MiniMax-M2.7 MXFP4 | vLLM 0.32.0 on ROCm 10.1.0, AMDGPU 31.60 (10月27日) |
| MiniMax-M3 MXFP4 | vllm/vllm-openai-rocm:nightly-2a02f6efe319c885e3ccbcecde402e0028f9ec1e (ROCm 7.2.3) |
| 密斯特拉尔小型 3.1 24B BF16 | vLLM 0.32.0 on ROCm 10.1.0, AMDGPU 31.60 (10月27日) |
| 密斯特拉尔小型 3.1 24B FP8 | vLLM 0.32.0 on ROCm 10.1.0, AMDGPU 31.60 (10月27日) |
| Qwen3-Coder-30B BF16 | vLLM 0.32.0 on ROCm 10.1.0, AMDGPU 31.60 (10月27日) |
| Qwen3-Coder-30B FP8 | vLLM 0.32.0 on ROCm 10.1.0, AMDGPU 31.60 (10月27日) |
| NVIDIA RTX PRO 6000 Blackwell 服务器版(CUDA 13.4.1.012) | |
| DeepSeek-V4-Flash-0731 | nvcr.io/nvidia/vllm:26.08-py3 |
| GLM-5.2 NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| GPT-OSS-120B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| GPT-OSS-20B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| 羊驼 3.1 8B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Llama 3.1 8B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| Llama 3.1 8B NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| MiniMax-M2.7 NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| MiniMax-M3 NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| 密斯特拉尔小型 3.1 24B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| 密斯特拉尔小型 3.1 24B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| NVIDIA H200 NVL (CUDA 13.4.1.012) | |
| GPT-OSS-120B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| GPT-OSS-20B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| 羊驼 3.1 8B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Llama 3.1 8B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| 密斯特拉尔小型 3.1 24B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| 密斯特拉尔小型 3.1 24B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
报告显示,在 ROCm 7.2.3 上运行的四款双卡型号分别为 DeepSeek-V4-Flash、MiniMax-M3、GLM-5.2 和 GLM-5.3 Flash。我们在 ROCm 10.1 上对这些型号的测试全程使用了 CPU 专家卸载技术,而 DeepSeek-V4-Flash 还使用了 NVIDIA 版本未使用的推测性解码器,这使得它们成为不同的测试,因此我们保留它们,以便在当前版本上进行一次干净的测试。表格中每行 MI350P 数据都标注了其对应的版本。
AMD 为这些型号推荐的方案是使用其 AIM 容器;10 月 9 日发布的 Enterprise AI Suite 2.5 已在 ROCm 10 上验证,并包含 GPT-OSS-120B、Llama 3.3 70B 和 Gemma 3 27B 的 AIM,但 AMD 的加速器列表中目前仅列出了针对 Wan2.2 的优化 MI350P 配置。因此,MI350P 用户目前仍然选择使用默认的 vLLM,这也是我们测试时所采用的方案。
推理结果概览
下方共有 28 个图表,这里用两个表格简要概括:每个型号在最高并发情况下每秒输出令牌数,每张卡均完成此操作,首先展示的是聊天规模的 512 输入/512 输出工作负载。除非另有说明,MI350P 的数据均为单张 450W 卡的数据,每行数据均对应一个堆栈列;GB300 DGX Station 的数据为单张 B300 卡的数据。
| 型号 | 显卡(MI350P / RTX PRO 6000) | MI350P堆栈 | 流 | MI350P | RTX PRO 6000 | H200 NVL | GB300 DGX 站 |
|---|---|---|---|---|---|---|---|
| GLM-5.3 闪光灯(MXFP4 与 NVFP4) | 2 / 无 | ROC 7.2.3 | 32 | 1,462 | 未运行 | 未运行 | 828 |
| GLM-5.2(MXFP4 与 NVFP4) | 2 / 4 | ROC 7.2.3 | 32 | 59 | 40 | 未运行 | 139 |
| MiniMax-M3(MXFP4 对比 NVFP4) | 2 / 4 | ROC 7.2.3 | 32 | 1,509 | 759 | 未运行 | 1,041 |
| DeepSeek-V4-闪存 | 2 / 2 | ROC 7.2.3 | 32 | 1,081 | 829 | 未运行 | 1,766 |
| MiniMax-M2.7(MXFP4 对比 NVFP4) | 1 / 2 | ROC 10.1 | 128 | 1,524 | 1,932 | 未运行 | 4,793 |
| GPT-OSS-120B MXFP4 | 1 / 1 | ROC 10.1 | 128 | 5,057 | 3,064 | 3,376 | 9,280 |
| GPT-OSS-20B MXFP4 | 1 / 1 | ROC 10.1 | 128 | 10,726 | 7,937 | 6,022 | 22,041 |
| Qwen3-Coder-30B FP8 | 1 / 1 | ROC 10.1 | 128 | 6,451 | 3,995 | 7,459 | 12,439 |
| Qwen3-Coder-30B BF16 | 1 / 1 | ROC 10.1 | 128 | 4,696 | 2,881 | 5,240 | 10,000 |
| 密斯特拉尔小型 24B FP8 | 1 / 1 | ROC 10.1 | 128 | 4,458 | 3,242 | 4,624 | 11,075 |
| 密斯特拉尔小型 24B BF16 | 1 / 1 | ROC 10.1 | 128 | 3,065 | 2,026 | 3,373 | 7,861 |
| Llama 3.1 8B (MXFP4 vs NVFP4) | 1 / 1 | ROC 10.1 | 128 | 8,383 | 8,869 | 未运行 | 28,400 |
| Llama 3.1 8B FP8 | 1 / 1 | ROC 10.1 | 128 | 11,045 | 8,073 | 11,054 | 25,602 |
| 羊驼 3.1 8B BF16 | 1 / 1 | ROC 10.1 | 128 | 6,819 | 4,740 | 8,069 | 17,074 |
聊天表中有两个结果尤为突出:在所有 FP8、BF16 和 GPT-OSS 模型上,MI350P 在 128 个流时比 RTX PRO 6000 高出 35% 到 65%;仅在 Llama 和 MiniMax-M2.7 曲线的顶端落后于 NVIDIA 的 NVFP4 版本;在 Llama 3.1 8B 和 Mistral Small 24B 的单流下,其性能大约是 NVIDIA 显卡的两倍,其中 4TB/s 的 HBM3E 发挥了作用。
H200 NVL 的带宽提高了 20%,在 128 流的密集型 FP8 和 BF16 模型上保持 4% 到 18% 的领先优势,在 Llama 3.1 8B FP8 上则与 MI350P 持平;在两个 GPT-OSS 模型上,顺序发生了逆转,MI350P 分别领先 50% 和 78%。
第二张表重复了 8,192 个令牌提示的练习,其中预填充在运行中占主导地位,计算和内存带宽之间的平衡向 NVIDIA 显卡转移。
| 型号 | 显卡(MI350P / RTX PRO 6000) | MI350P堆栈 | 流 | MI350P | RTX PRO 6000 | H200 NVL | GB300 DGX 站 |
|---|---|---|---|---|---|---|---|
| GLM-5.3 闪光灯(MXFP4 与 NVFP4) | 2 / 无 | ROC 7.2.3 | 32 | 760 | 未运行 | 未运行 | 1,219 |
| GLM-5.2(MXFP4 与 NVFP4) | 2 / 4 | ROC 7.2.3 | 16 | 6 | 9 | 未运行 | 87 |
| MiniMax-M3(MXFP4 对比 NVFP4) | 2 / 4 | ROC 7.2.3 | 8 | 524 | 444 | 未运行 | 103 |
| DeepSeek-V4-闪存 | 2 / 2 | ROC 7.2.3 | 32 | 621 | 345 | 未运行 | 954 |
| MiniMax-M2.7(MXFP4 对比 NVFP4) | 1 / 2 | ROC 10.1 | 64 | 331 | 501 | 未运行 | 1,744 |
| GPT-OSS-120B MXFP4 | 1 / 1 | ROC 10.1 | 128 | 2,101 | 1,169 | 1,825 | 5,023 |
| GPT-OSS-20B MXFP4 | 1 / 1 | ROC 10.1 | 128 | 3,603 | 2,482 | 3,419 | 9,555 |
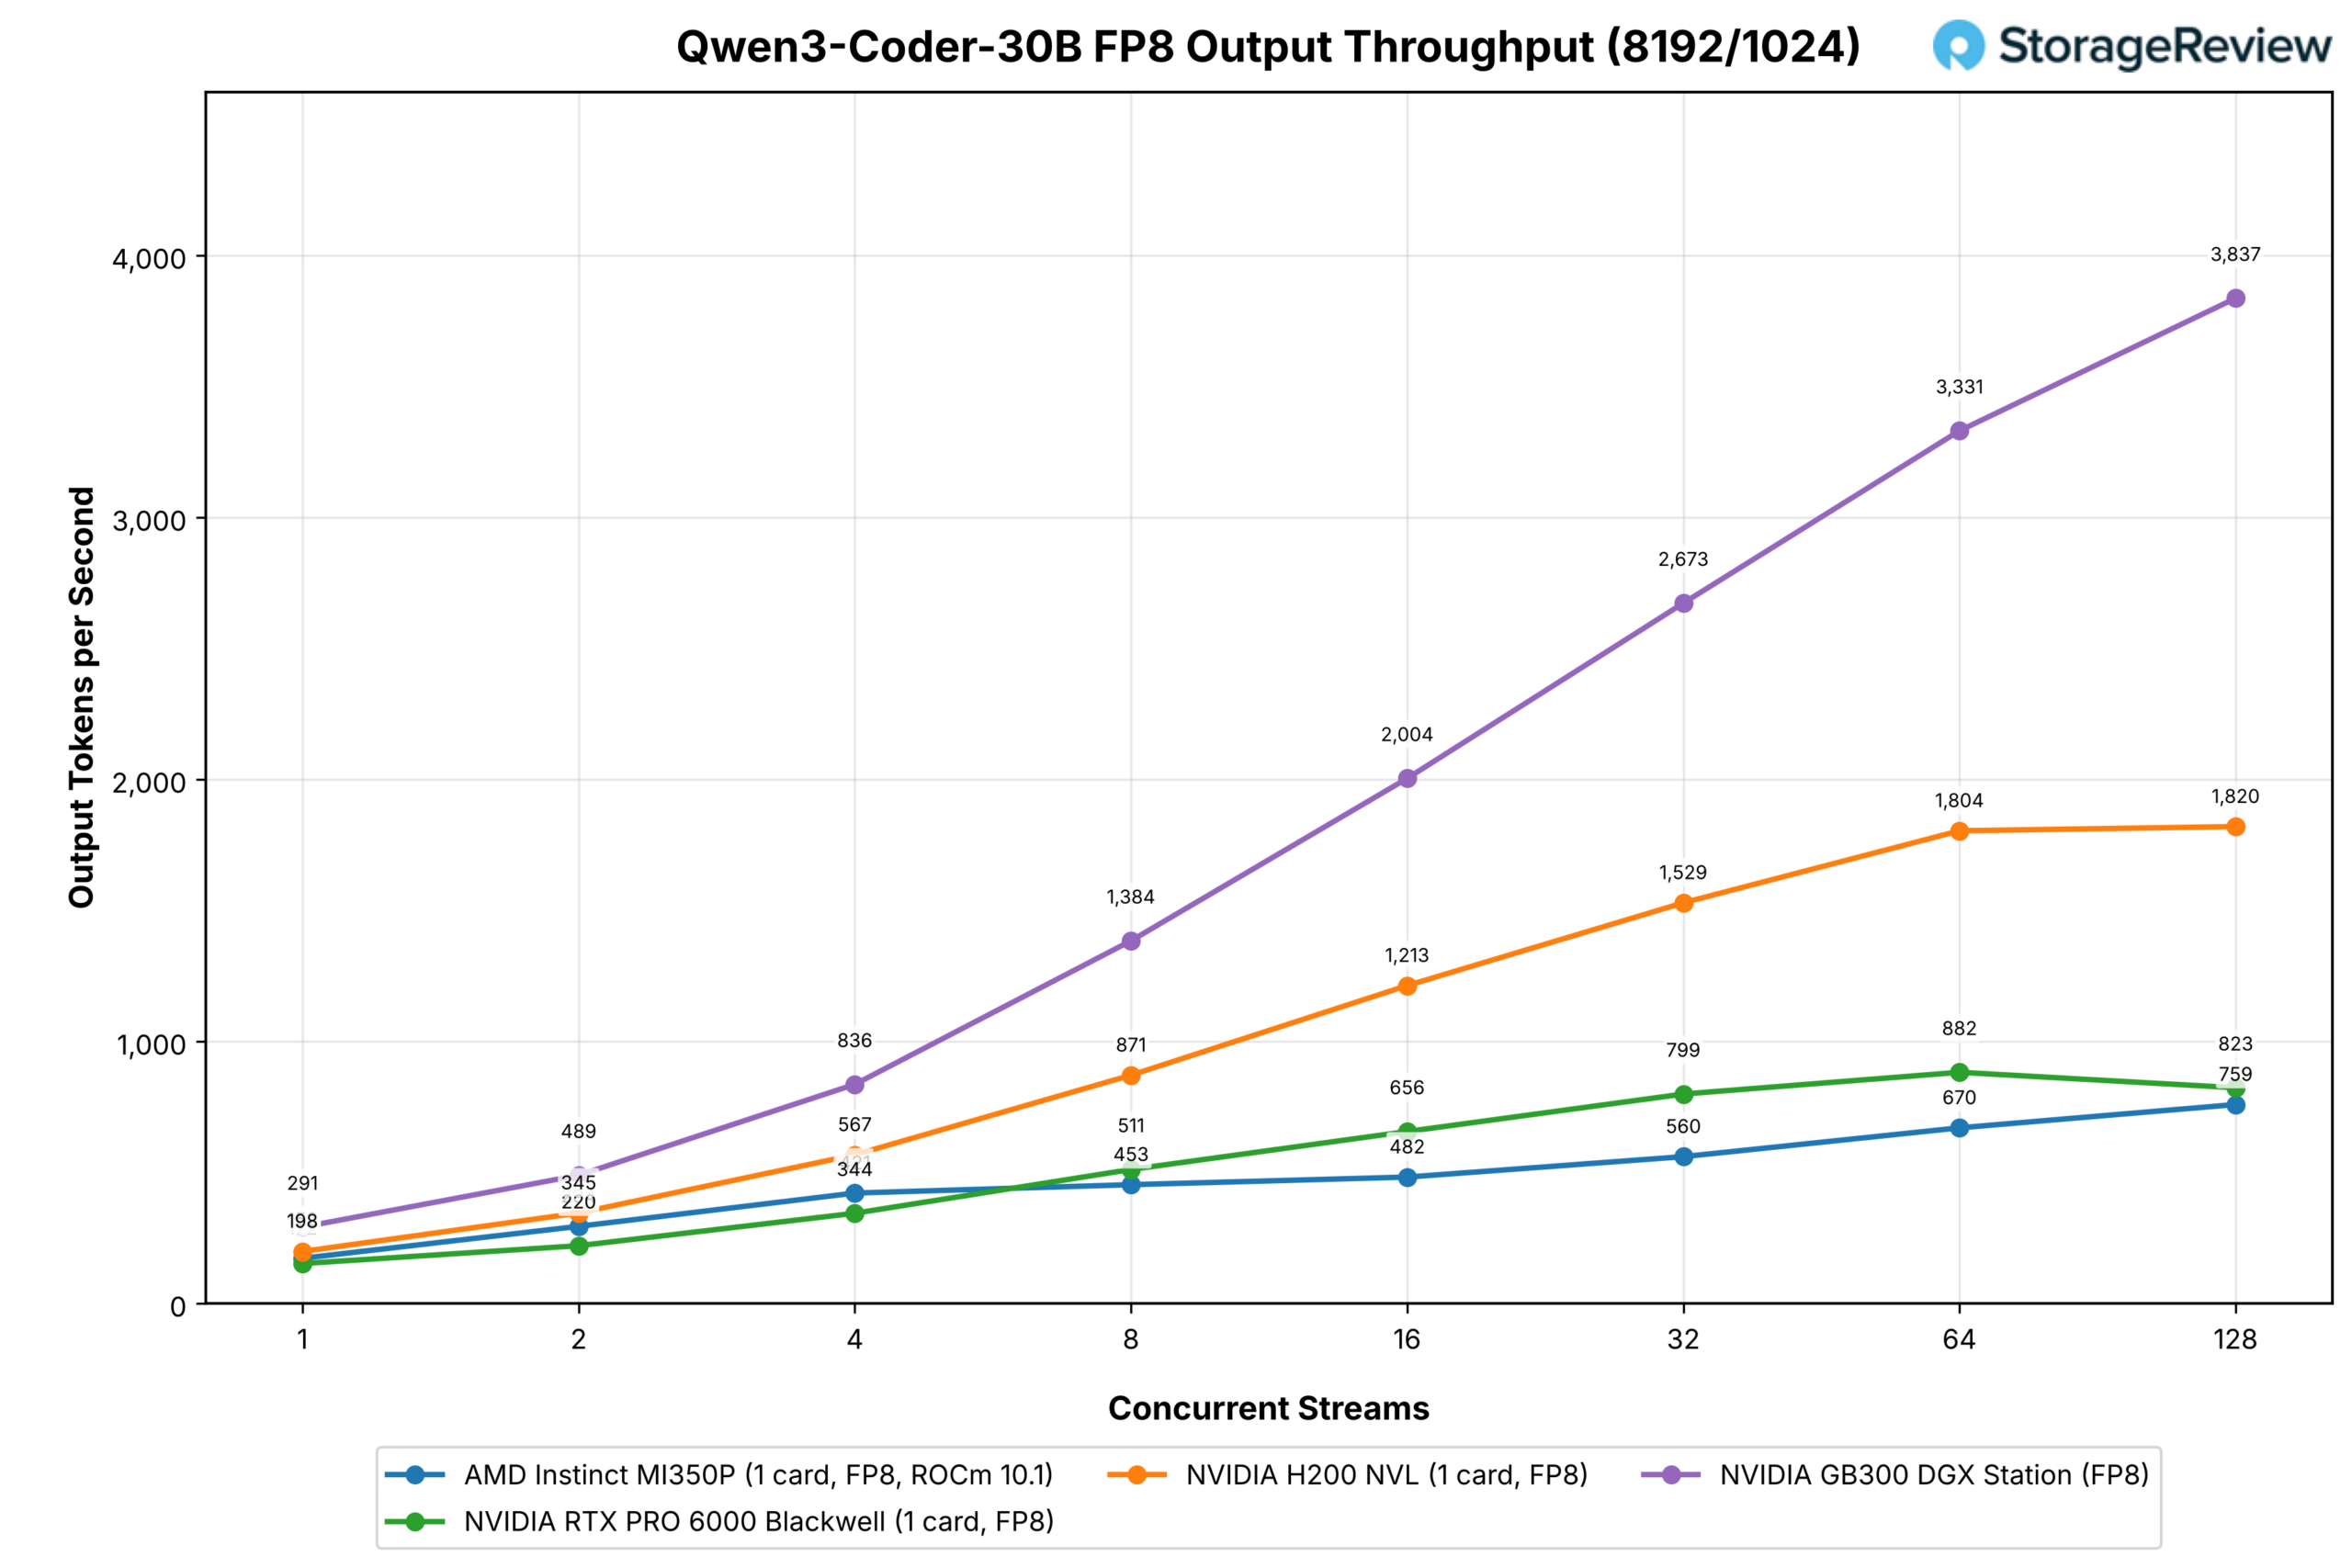
| Qwen3-Coder-30B FP8 | 1 / 1 | ROC 10.1 | 128 | 759 | 823 | 1,820 | 3,837 |
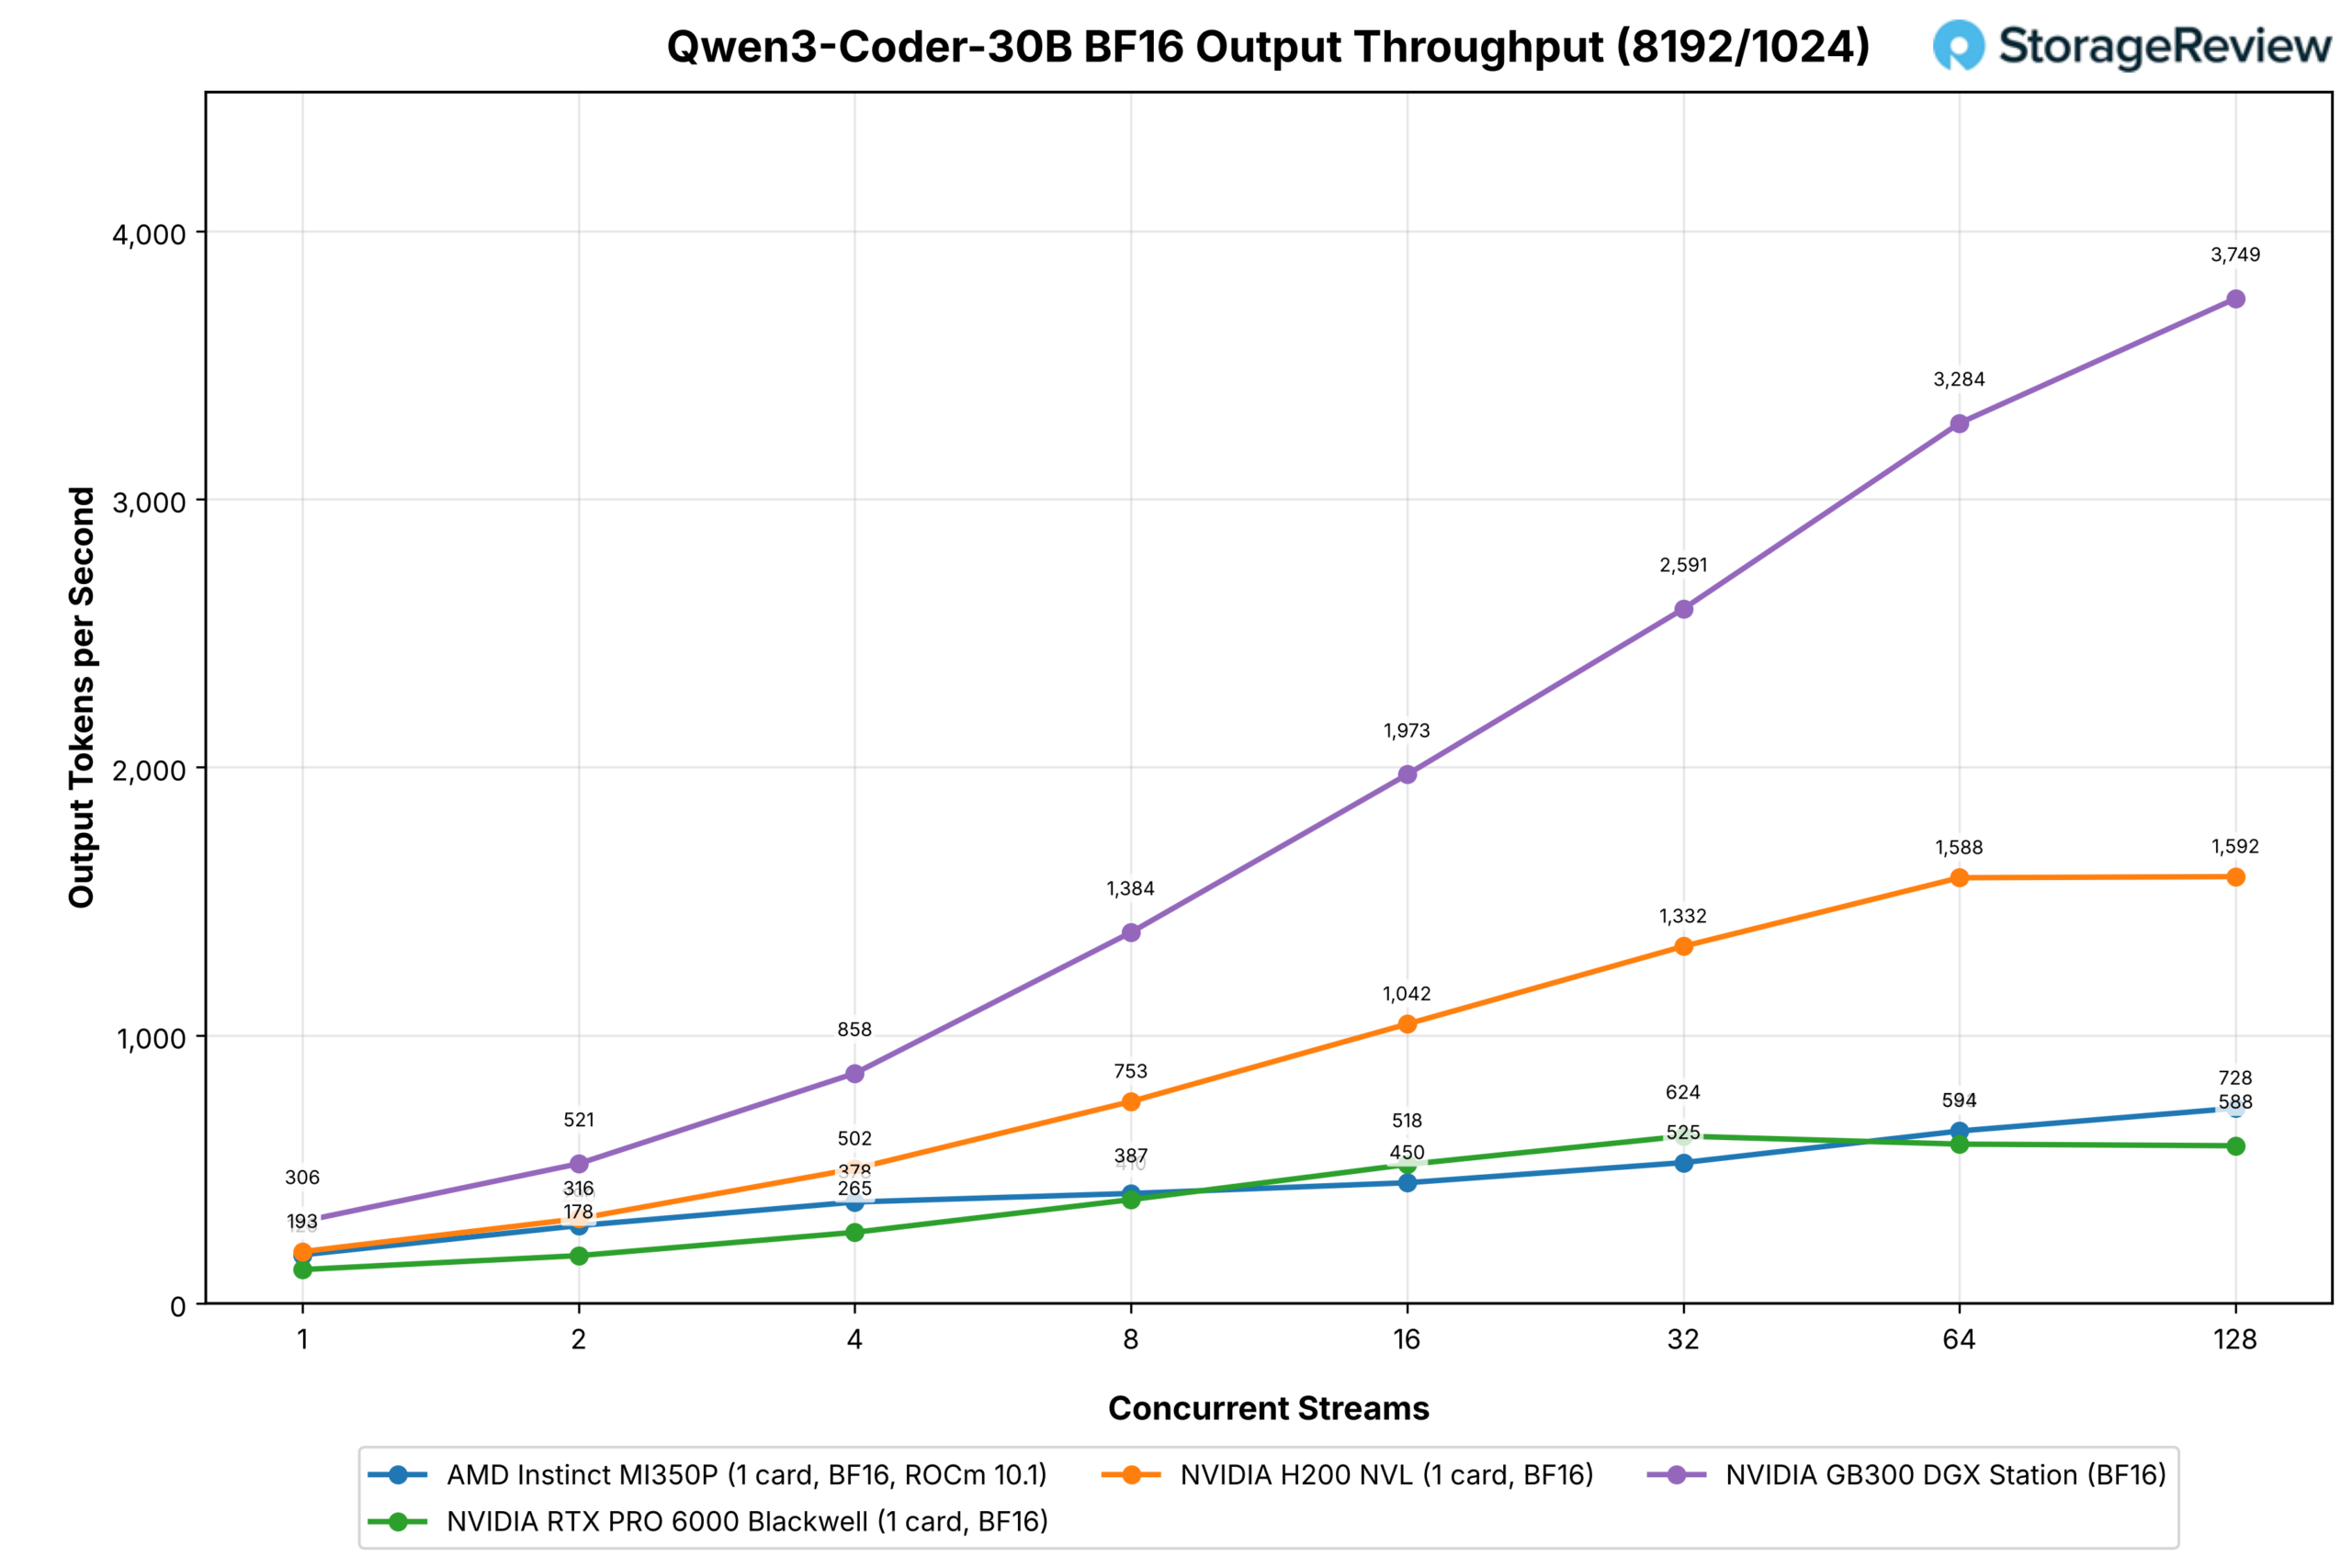
| Qwen3-Coder-30B BF16 | 1 / 1 | ROC 10.1 | 128 | 728 | 588 | 1,592 | 3,749 |
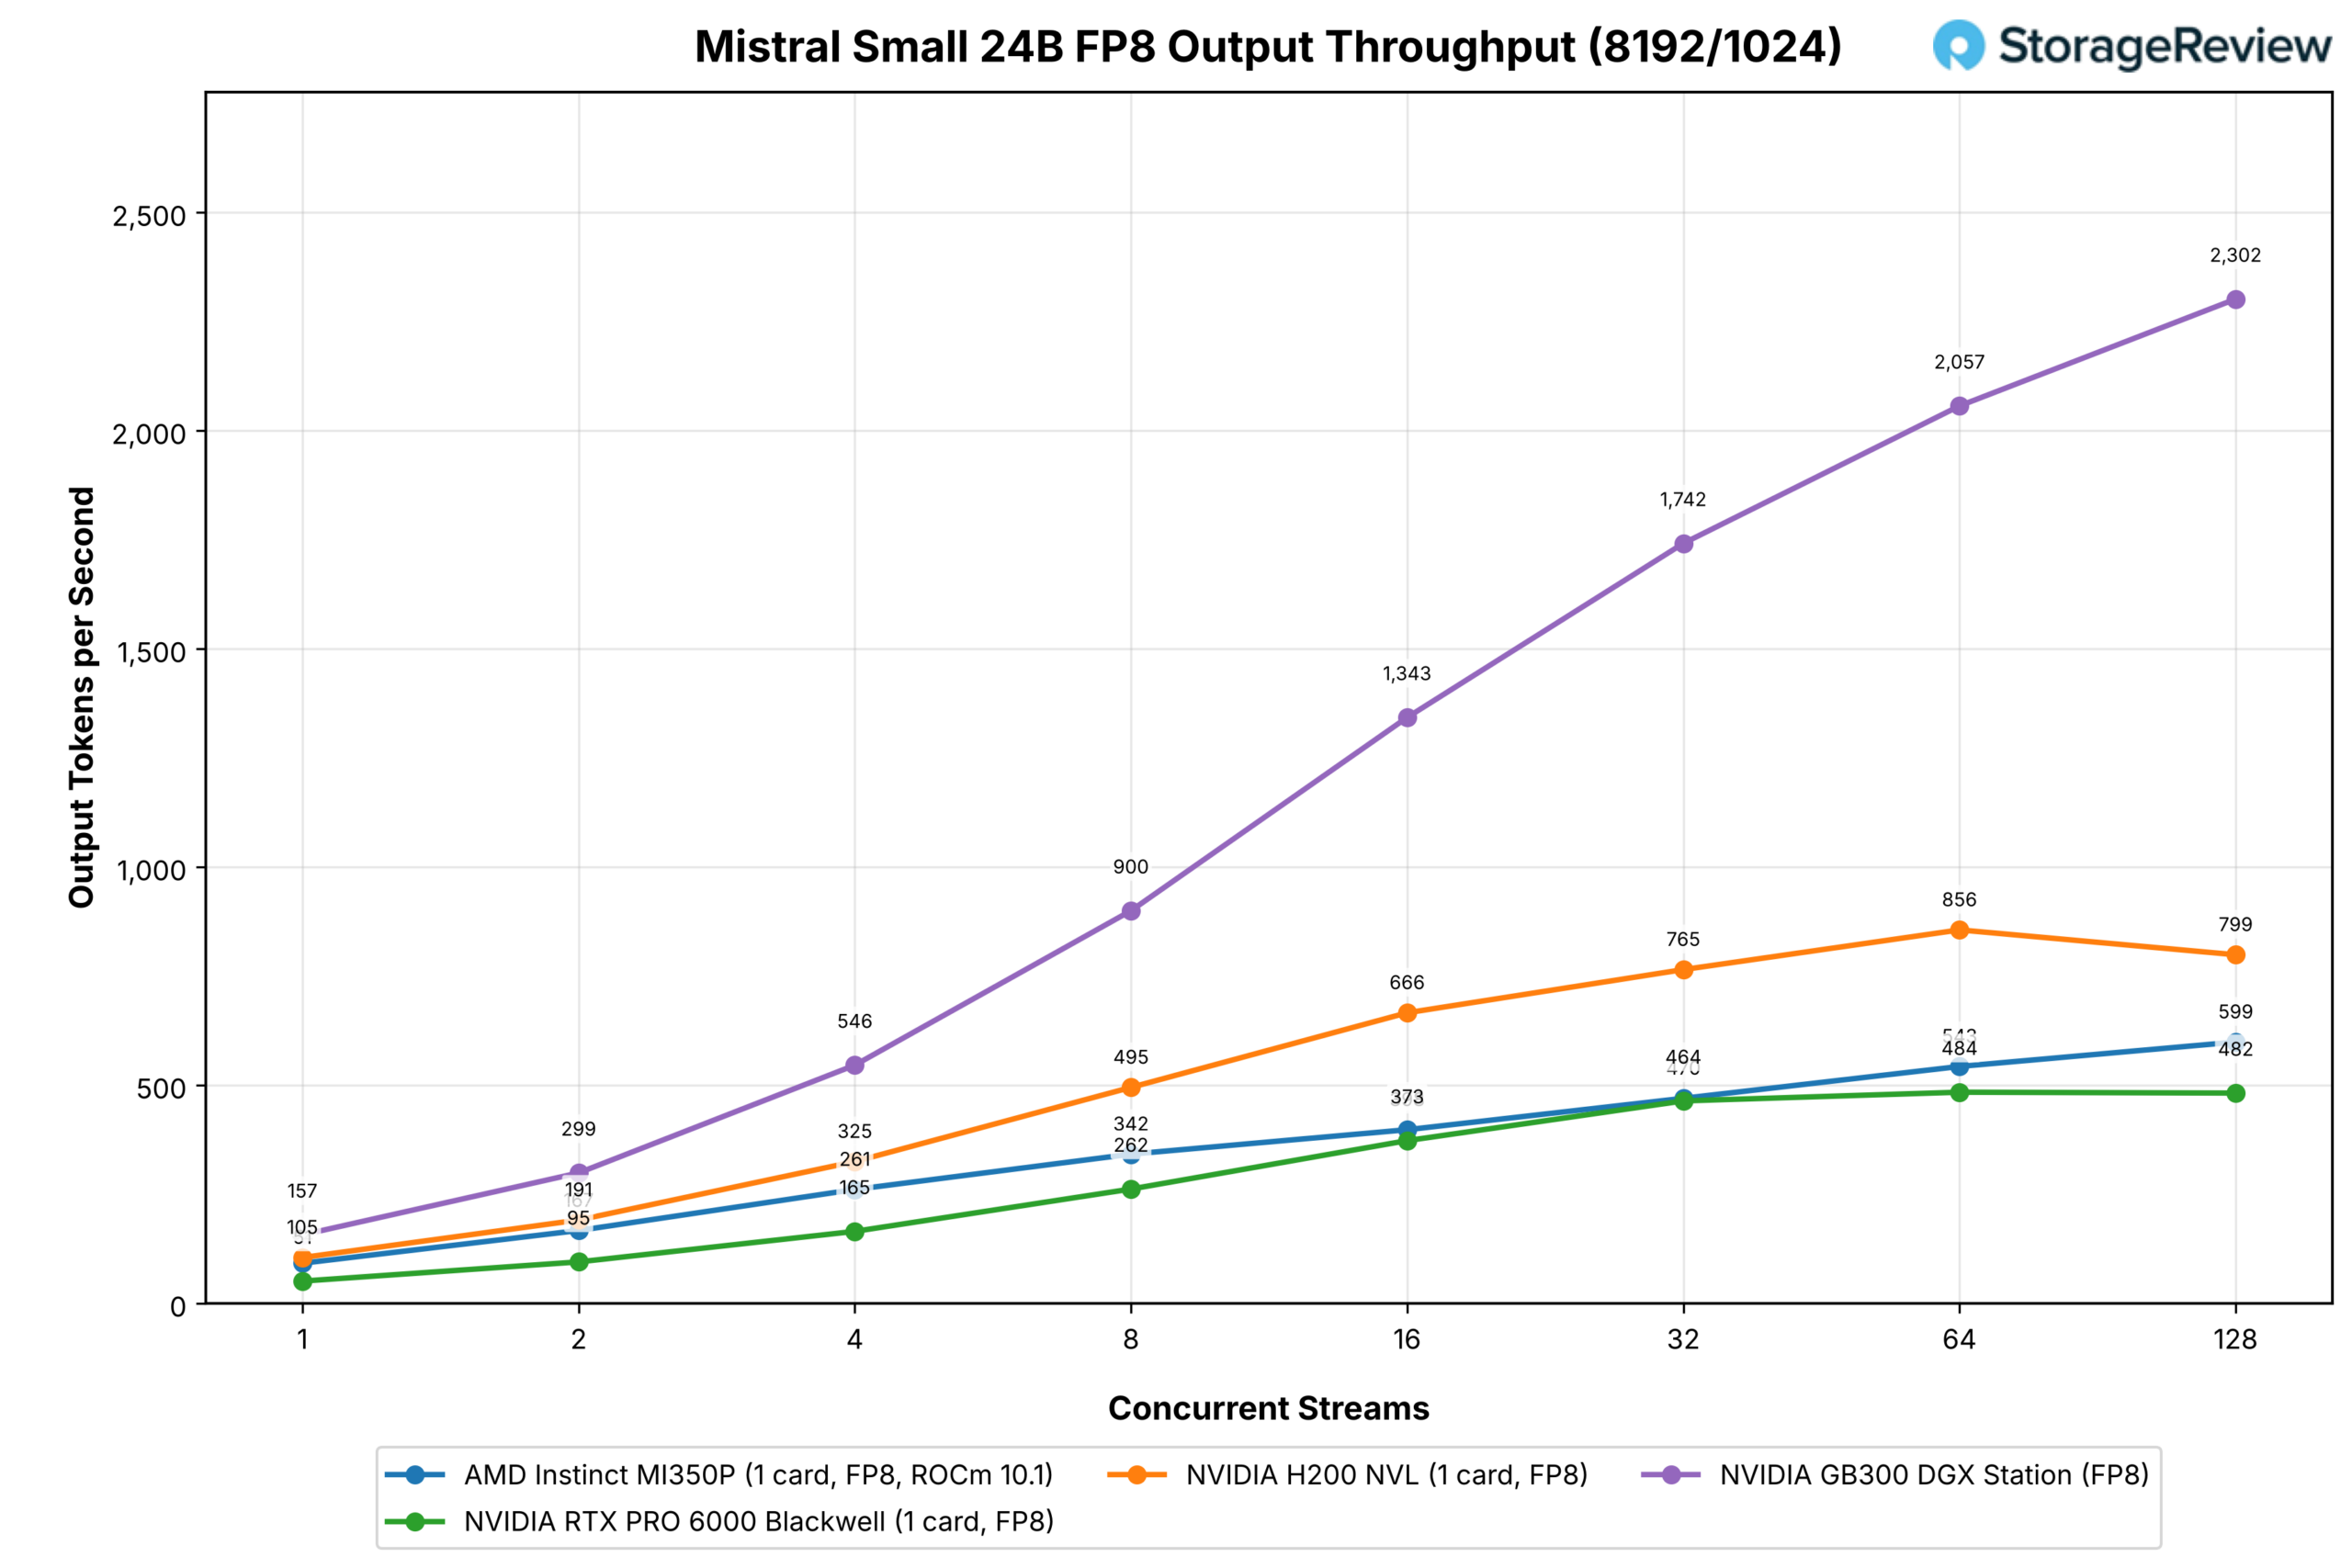
| 密斯特拉尔小型 24B FP8 | 1 / 1 | ROC 10.1 | 128 | 599 | 482 | 799 | 2,302 |
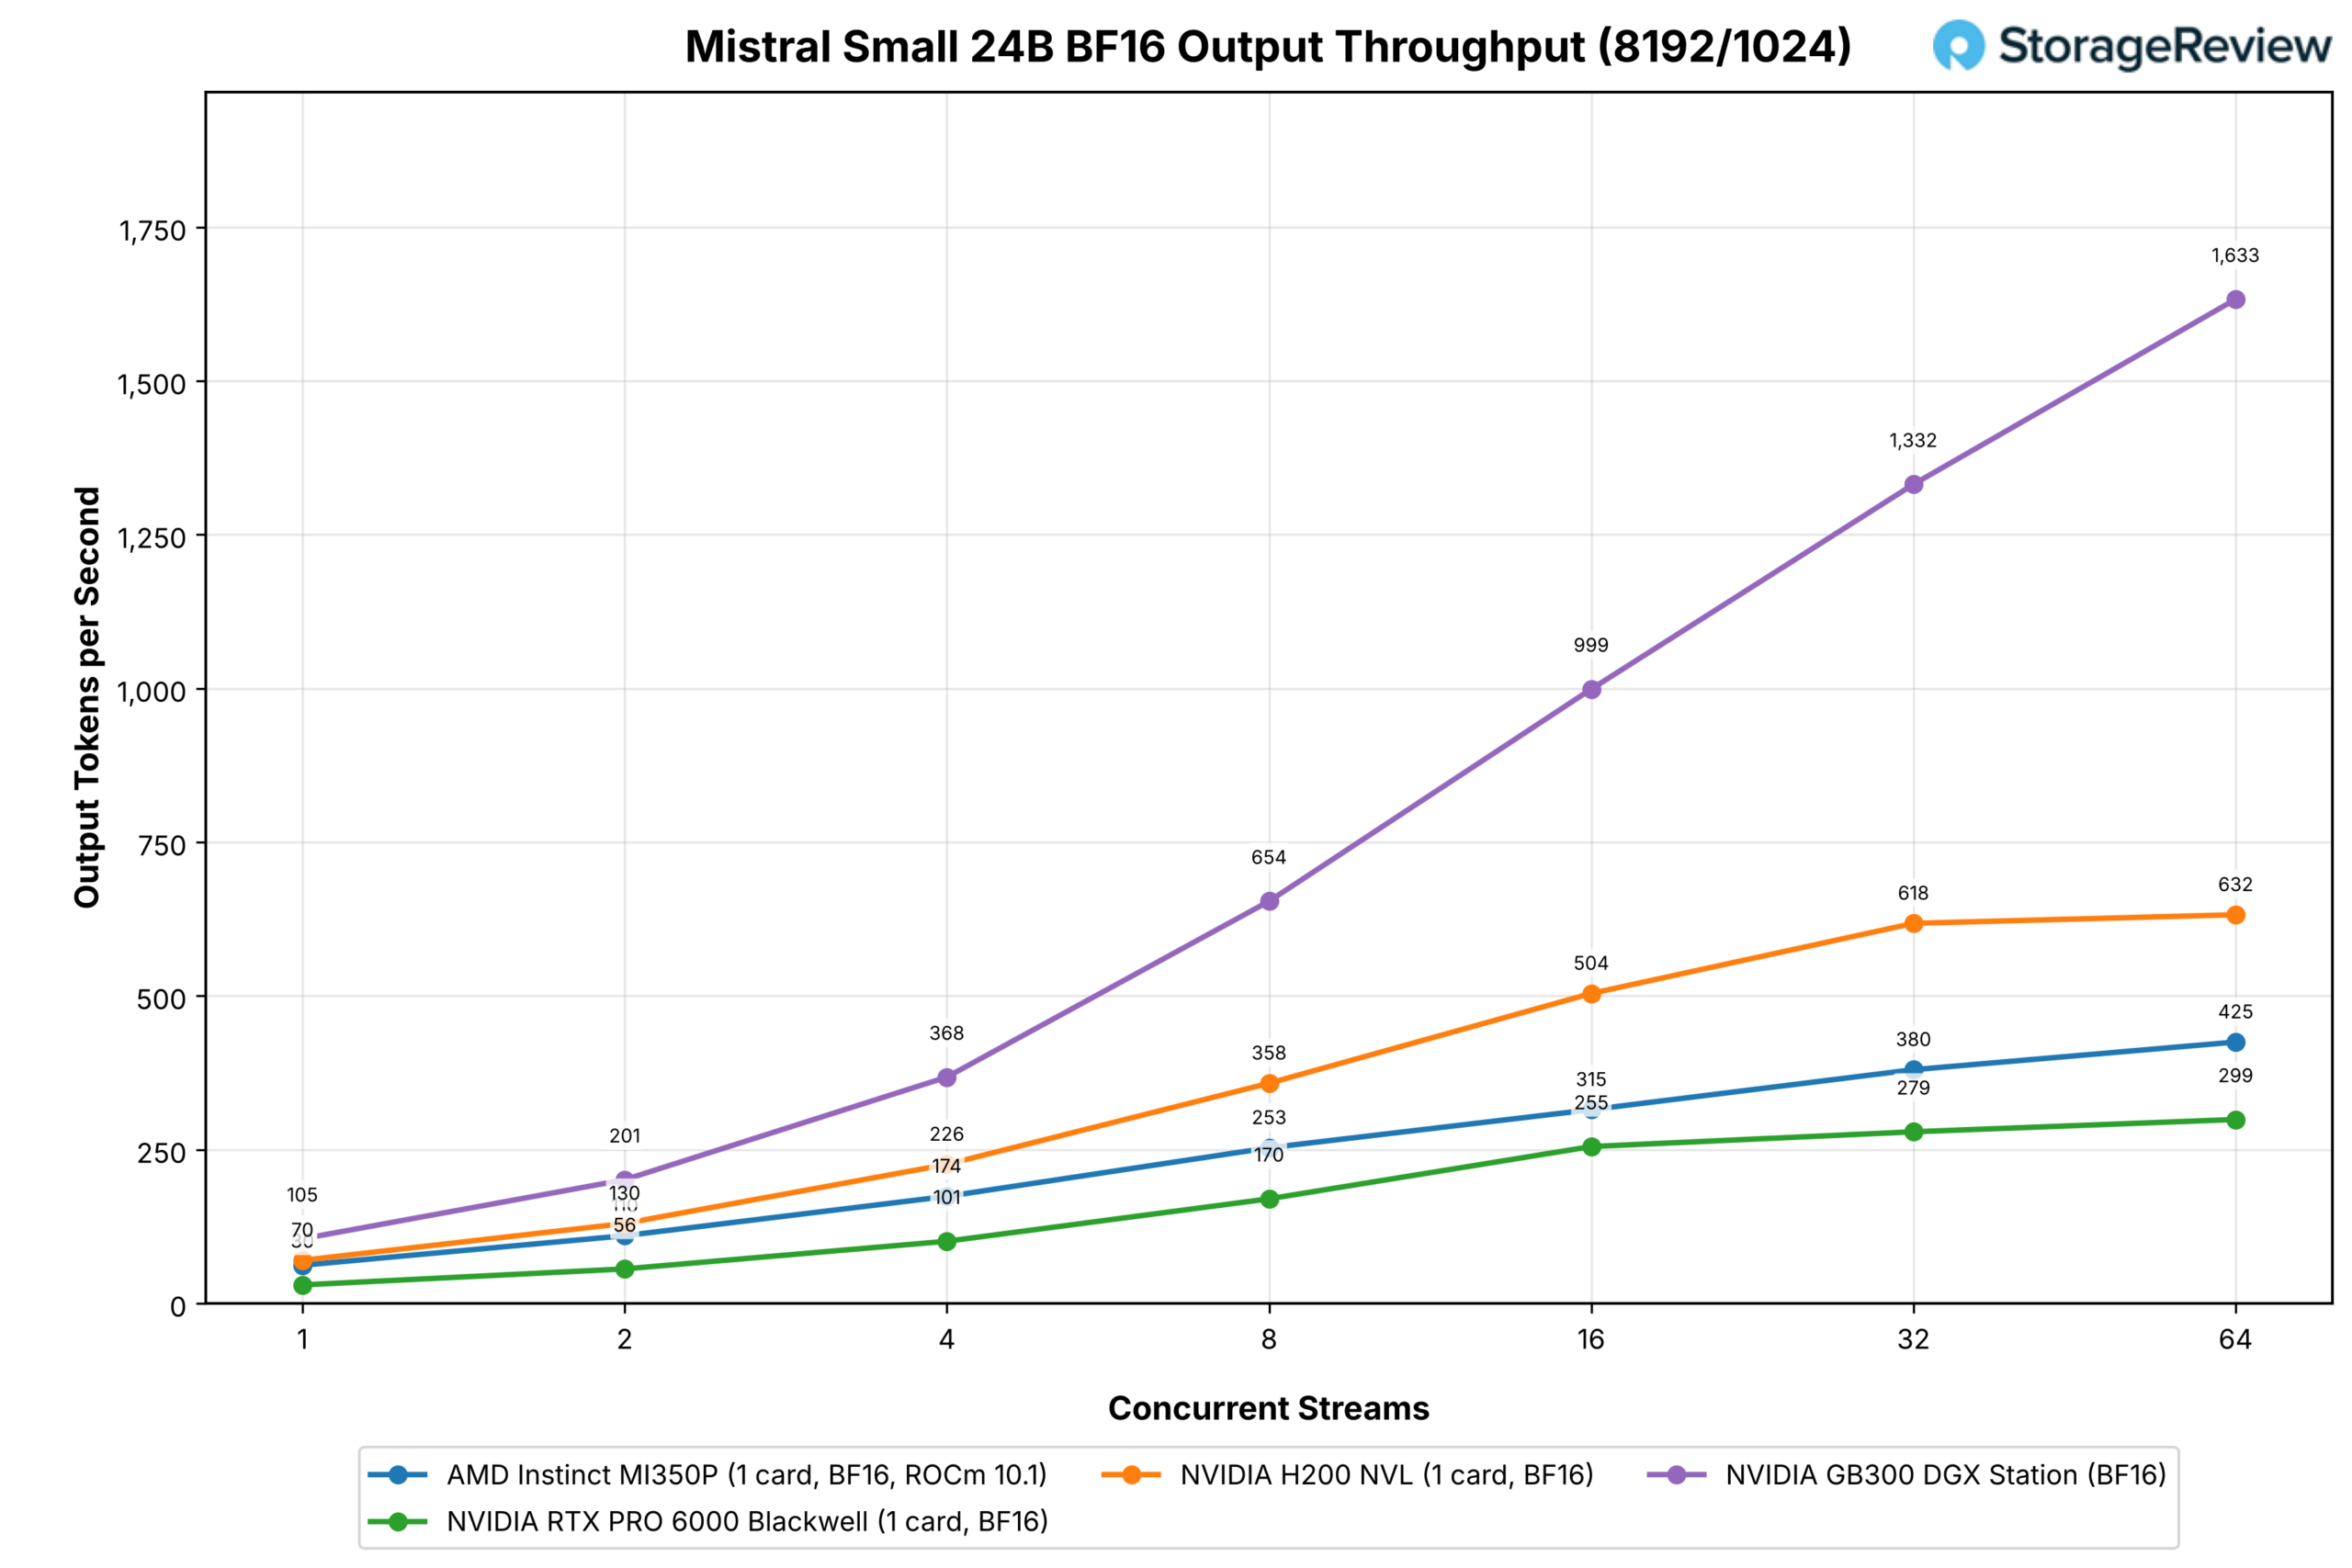
| 密斯特拉尔小型 24B BF16 | 1 / 1 | ROC 10.1 | 64 | 425 | 299 | 632 | 1,633 |
| Llama 3.1 8B (MXFP4 vs NVFP4) | 1 / 1 | ROC 10.1 | 128 | 964 | 1,644 | 未运行 | 6,737 |
| Llama 3.1 8B FP8 | 1 / 1 | ROC 10.1 | 128 | 1,211 | 1,481 | 2,045 | 6,164 |
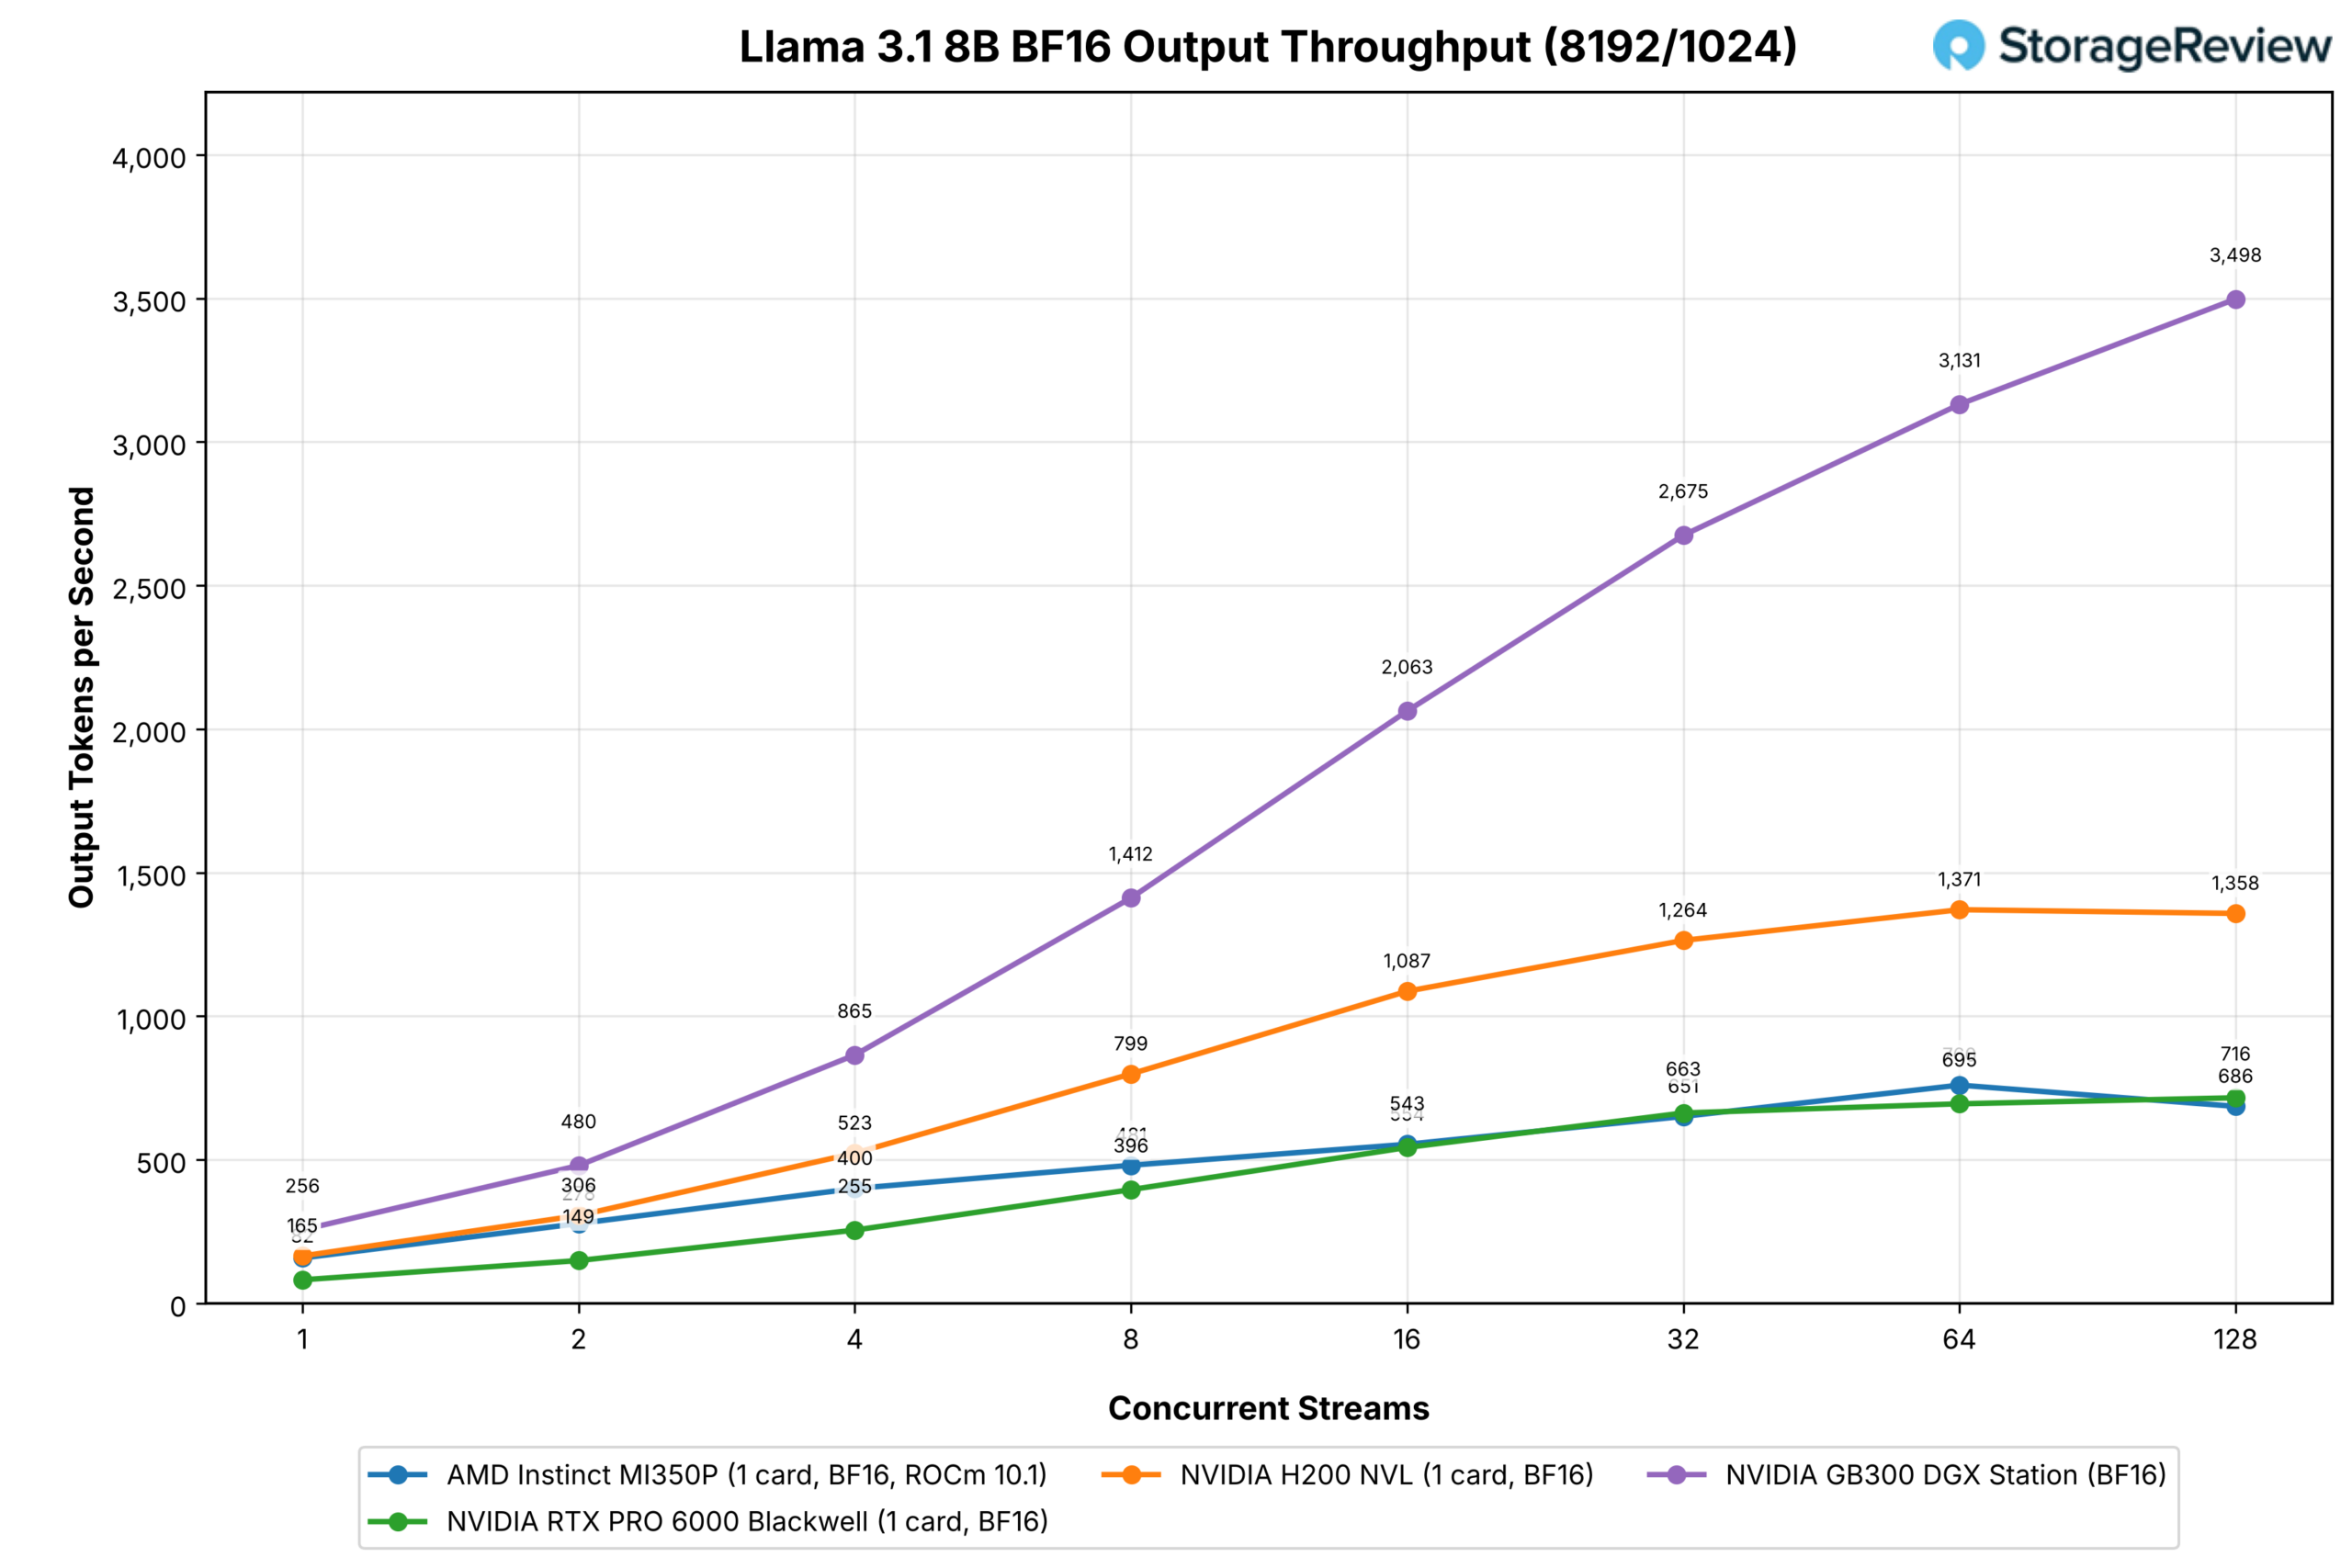
| 羊驼 3.1 8B BF16 | 1 / 1 | ROC 10.1 | 128 | 686 | 716 | 1,358 | 3,498 |
在预填充较多的提示符上,情况喜忧参半:在所有流数下,MI350P 在两种 GPT-OSS 模型以及 Mistral Small 测试中均领先于 RTX PRO 6000;在 128 流测试中与 Qwen3-Coder 性能持平(在 BF16 上领先 24%,在 FP8 上落后 8%);在 Llama 和 MiniMax-M2.7 测试中,MI350P 落后于 NVIDIA 显卡,落后 16 流。与 H200 相比,MI350P 在 120B 流的 GPT-OSS 测试中领先 15%,在 20B 流的 128 流测试中领先 5%;但在高密度模型上,其性能落后 H200 25% 至 58%。
在最大尺寸的机型上,两块 MI350P 显卡对阵四块 RTX PRO 6000 显卡,在聊天工作负载测试中,NVIDIA 显卡组凭借 384GB GDDR7 显存领先于配备 288GB HBM3E 显存的 MI350P 显卡组,在 16 路流测试中表现更佳。而在 MiniMax-M3 机型上,三种配置在 8 路流测试中性能差距均在 10% 以内,之后 RTX 四核显卡组在 16 路流测试中脱颖而出。单块 GB300 显卡在所有 PCIe 配置下,只要其容量达到 252GB,都能以绝对优势胜出。
GLM-5.3 闪光灯
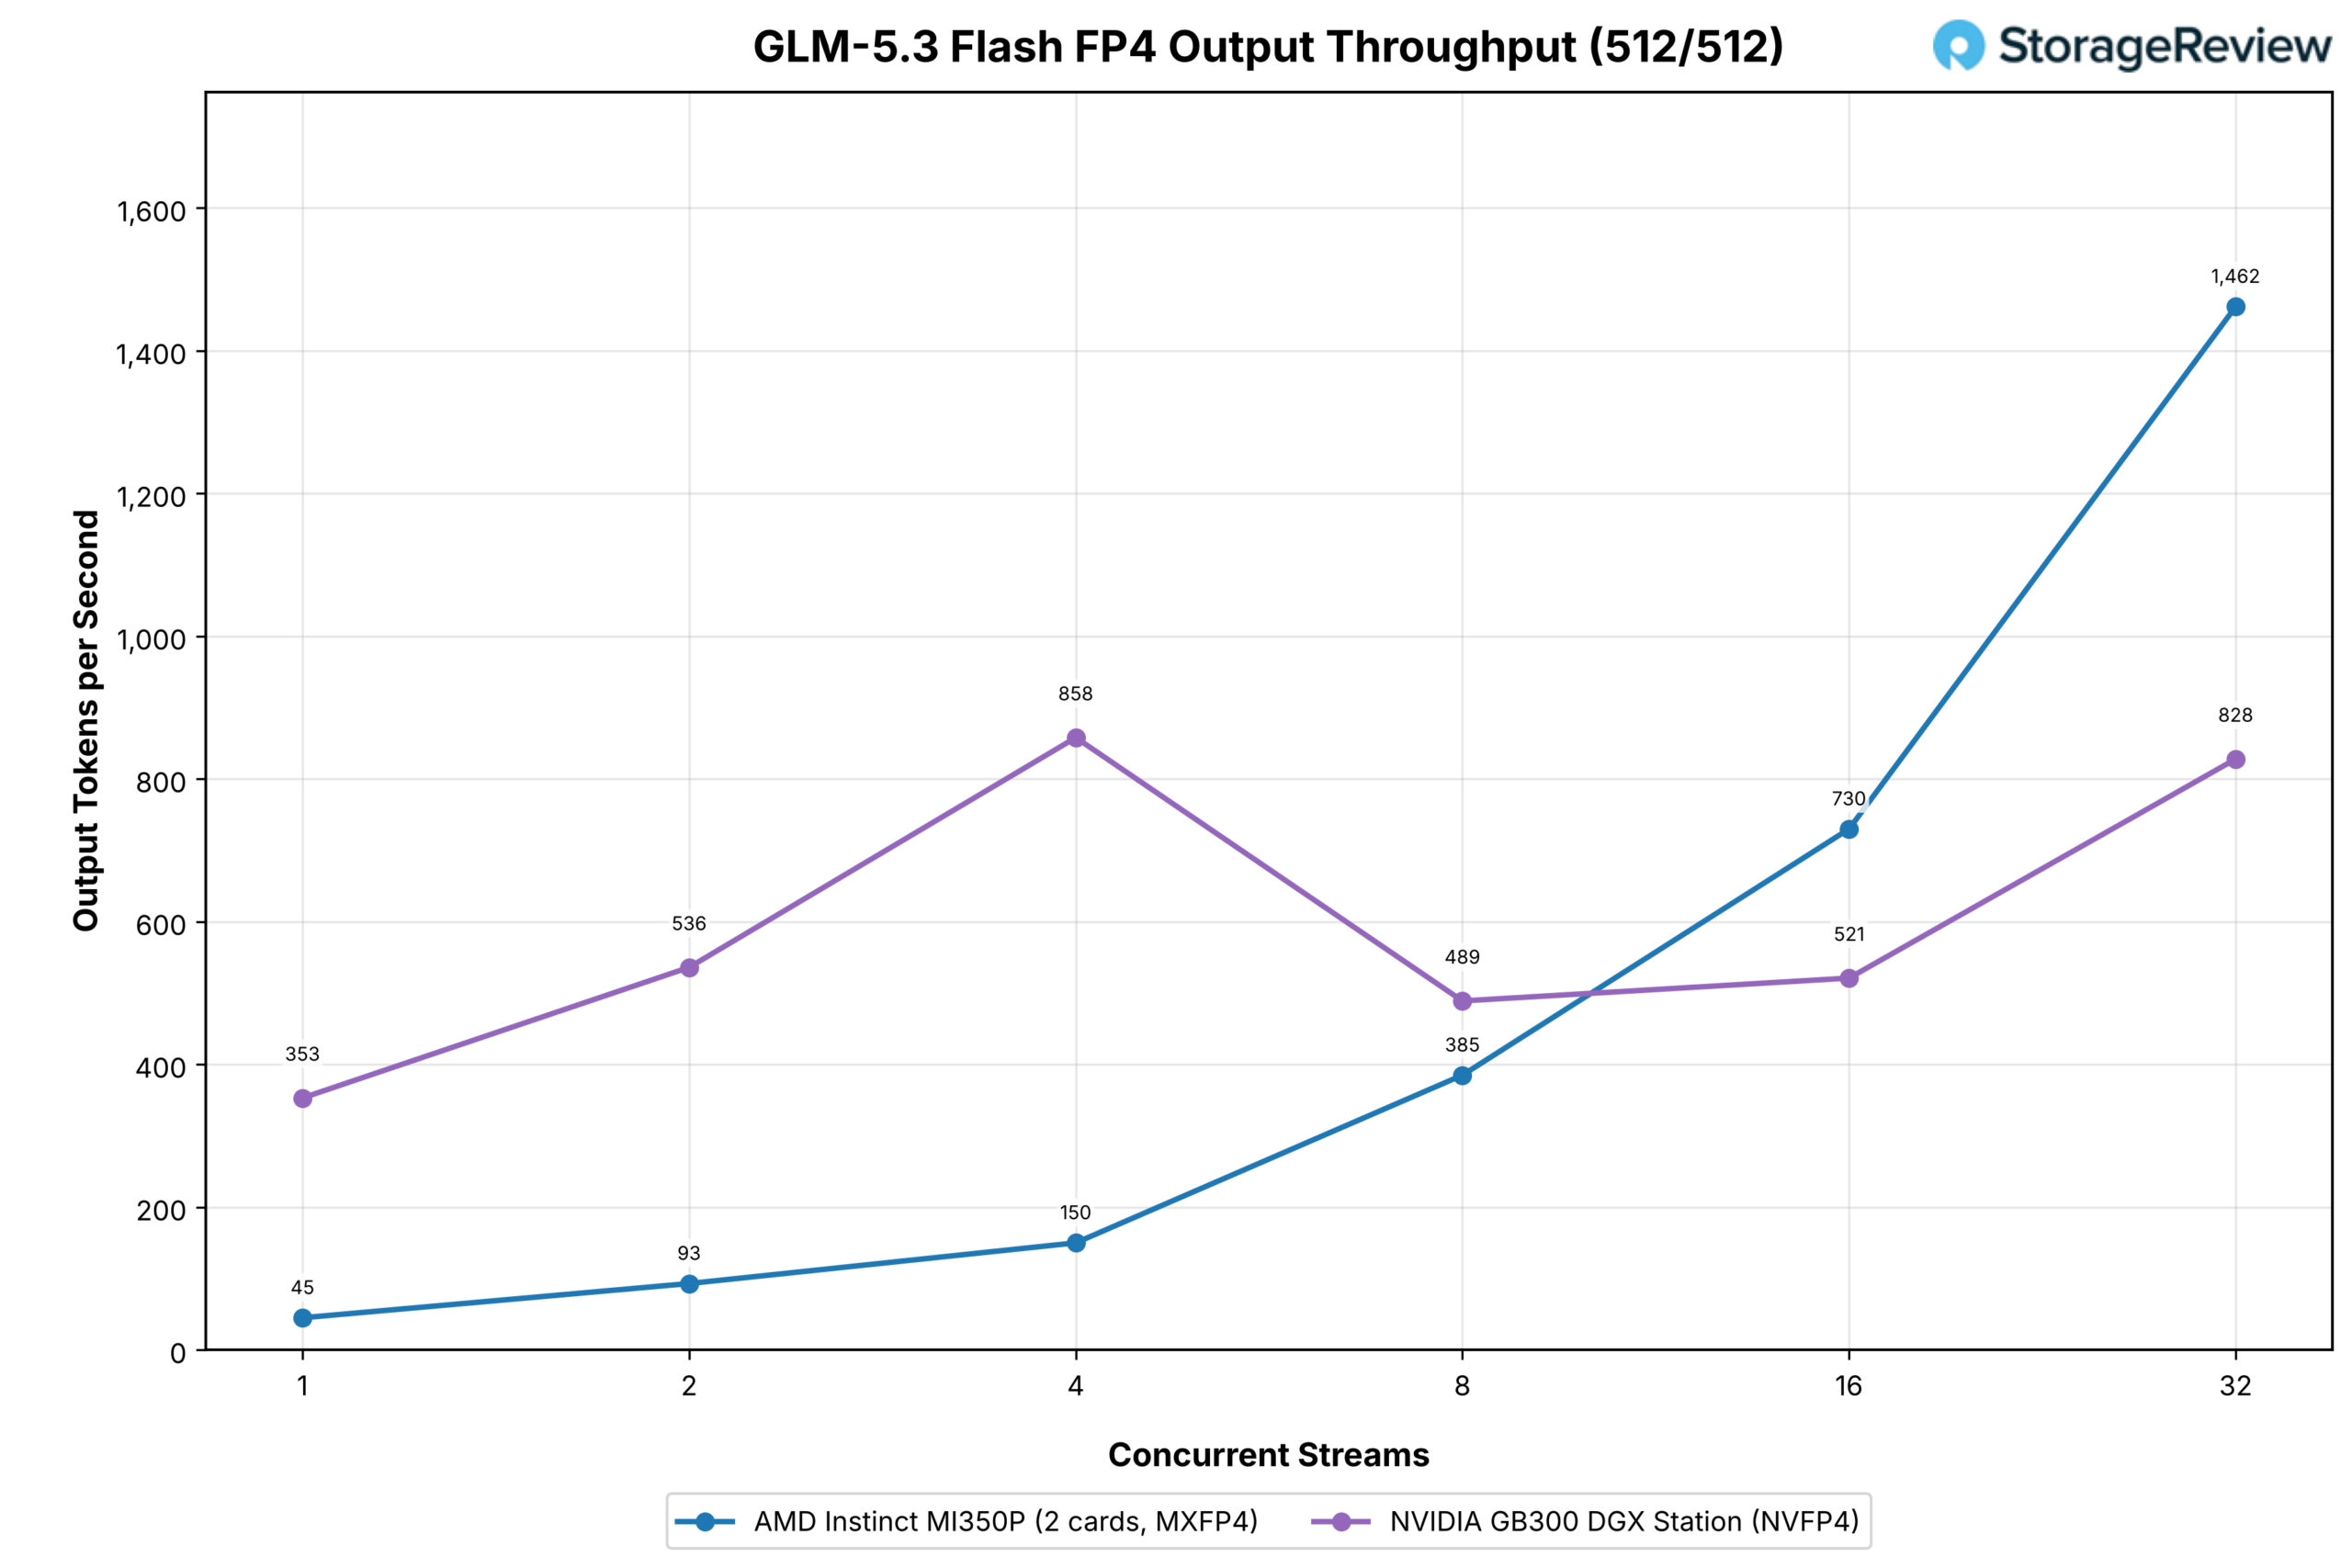
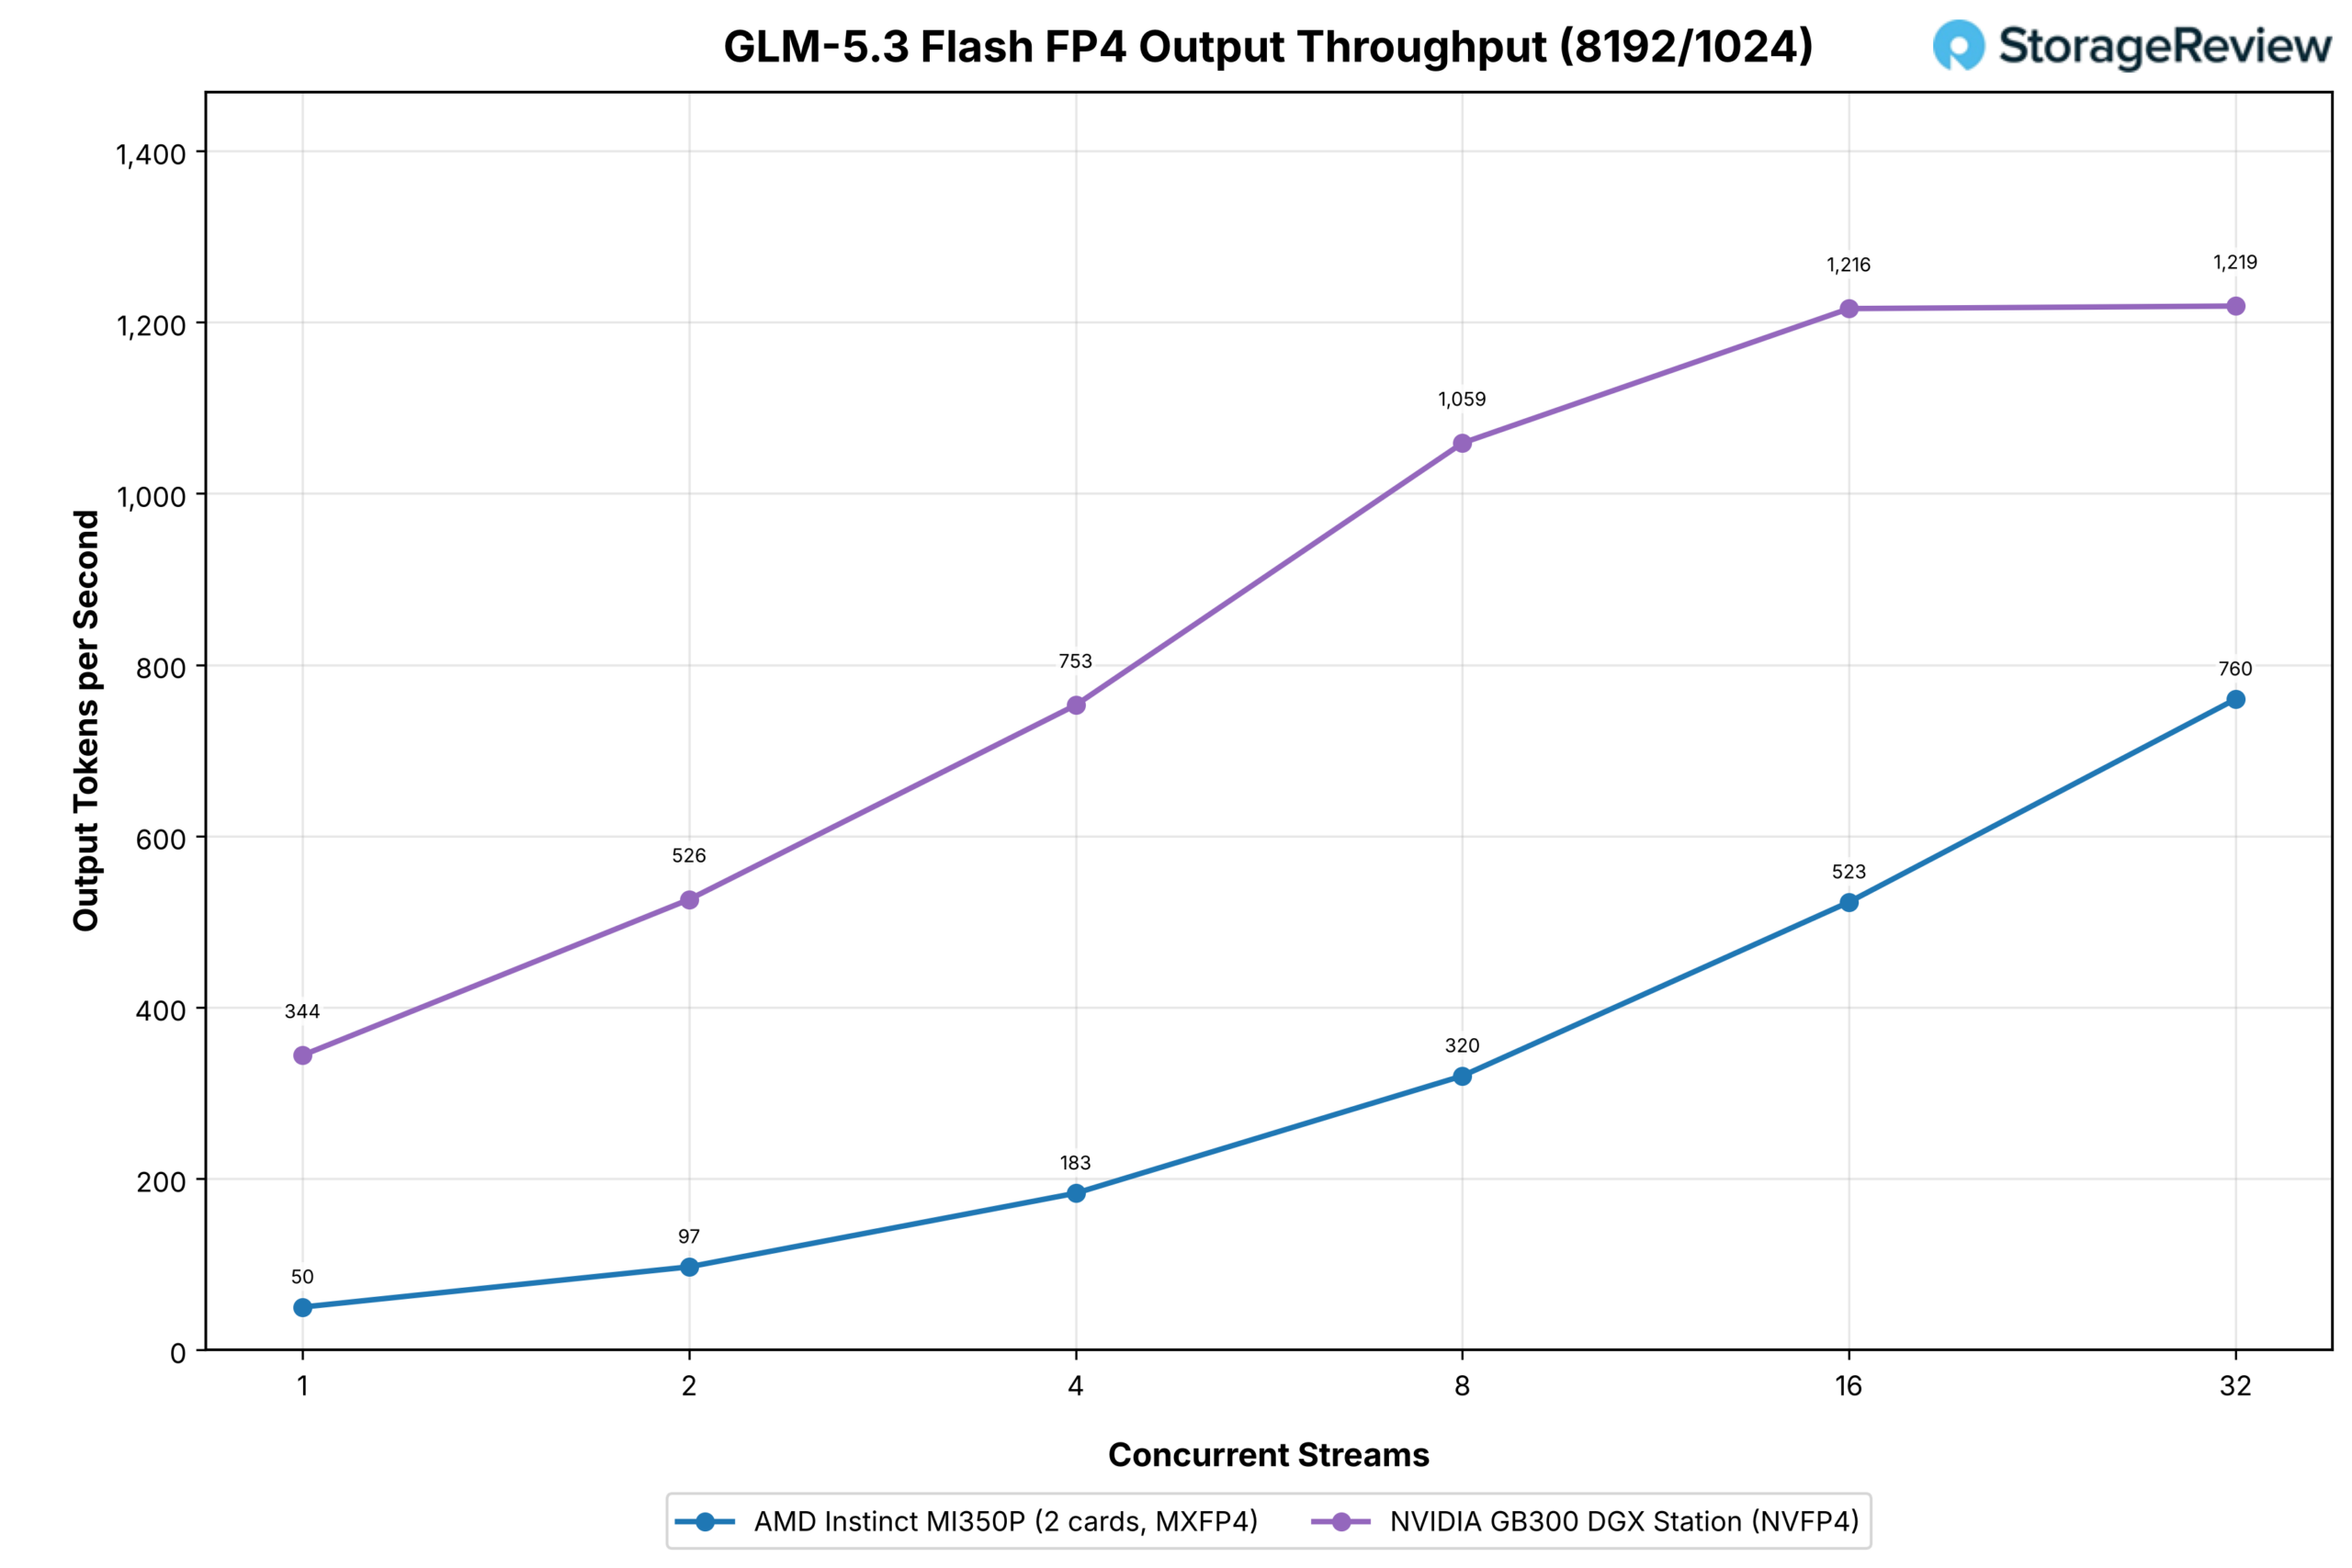
由于 RTX PRO 6000 未运行 GLM-5.3 Flash,因此本次对比测试采用两张 MI350P 显卡与单张 GB300 Station 显卡,测试流数为 32。在聊天工作负载方面,MI350P 显卡组合起初落后,单流输出每秒 45 个令牌,而 Station 显卡为 353 个令牌;但在八流输出时,MI350P 显卡组合超越 Station 显卡,在 32 流输出时达到 1,462 个令牌,而 Station 显卡为 828 个令牌。在预填充密集型工作负载方面,Station 显卡始终领先,在 32 流输出时达到 1,219 个令牌,而 MI350P 显卡组合为 760 个令牌。这是因为 MI350P 显卡组合的预填充数据需要在两张显卡之间通过 PCIe 传输,而 GB300 显卡则使用单块 HBM 内存即可完成所有操作。
GLM-5.2
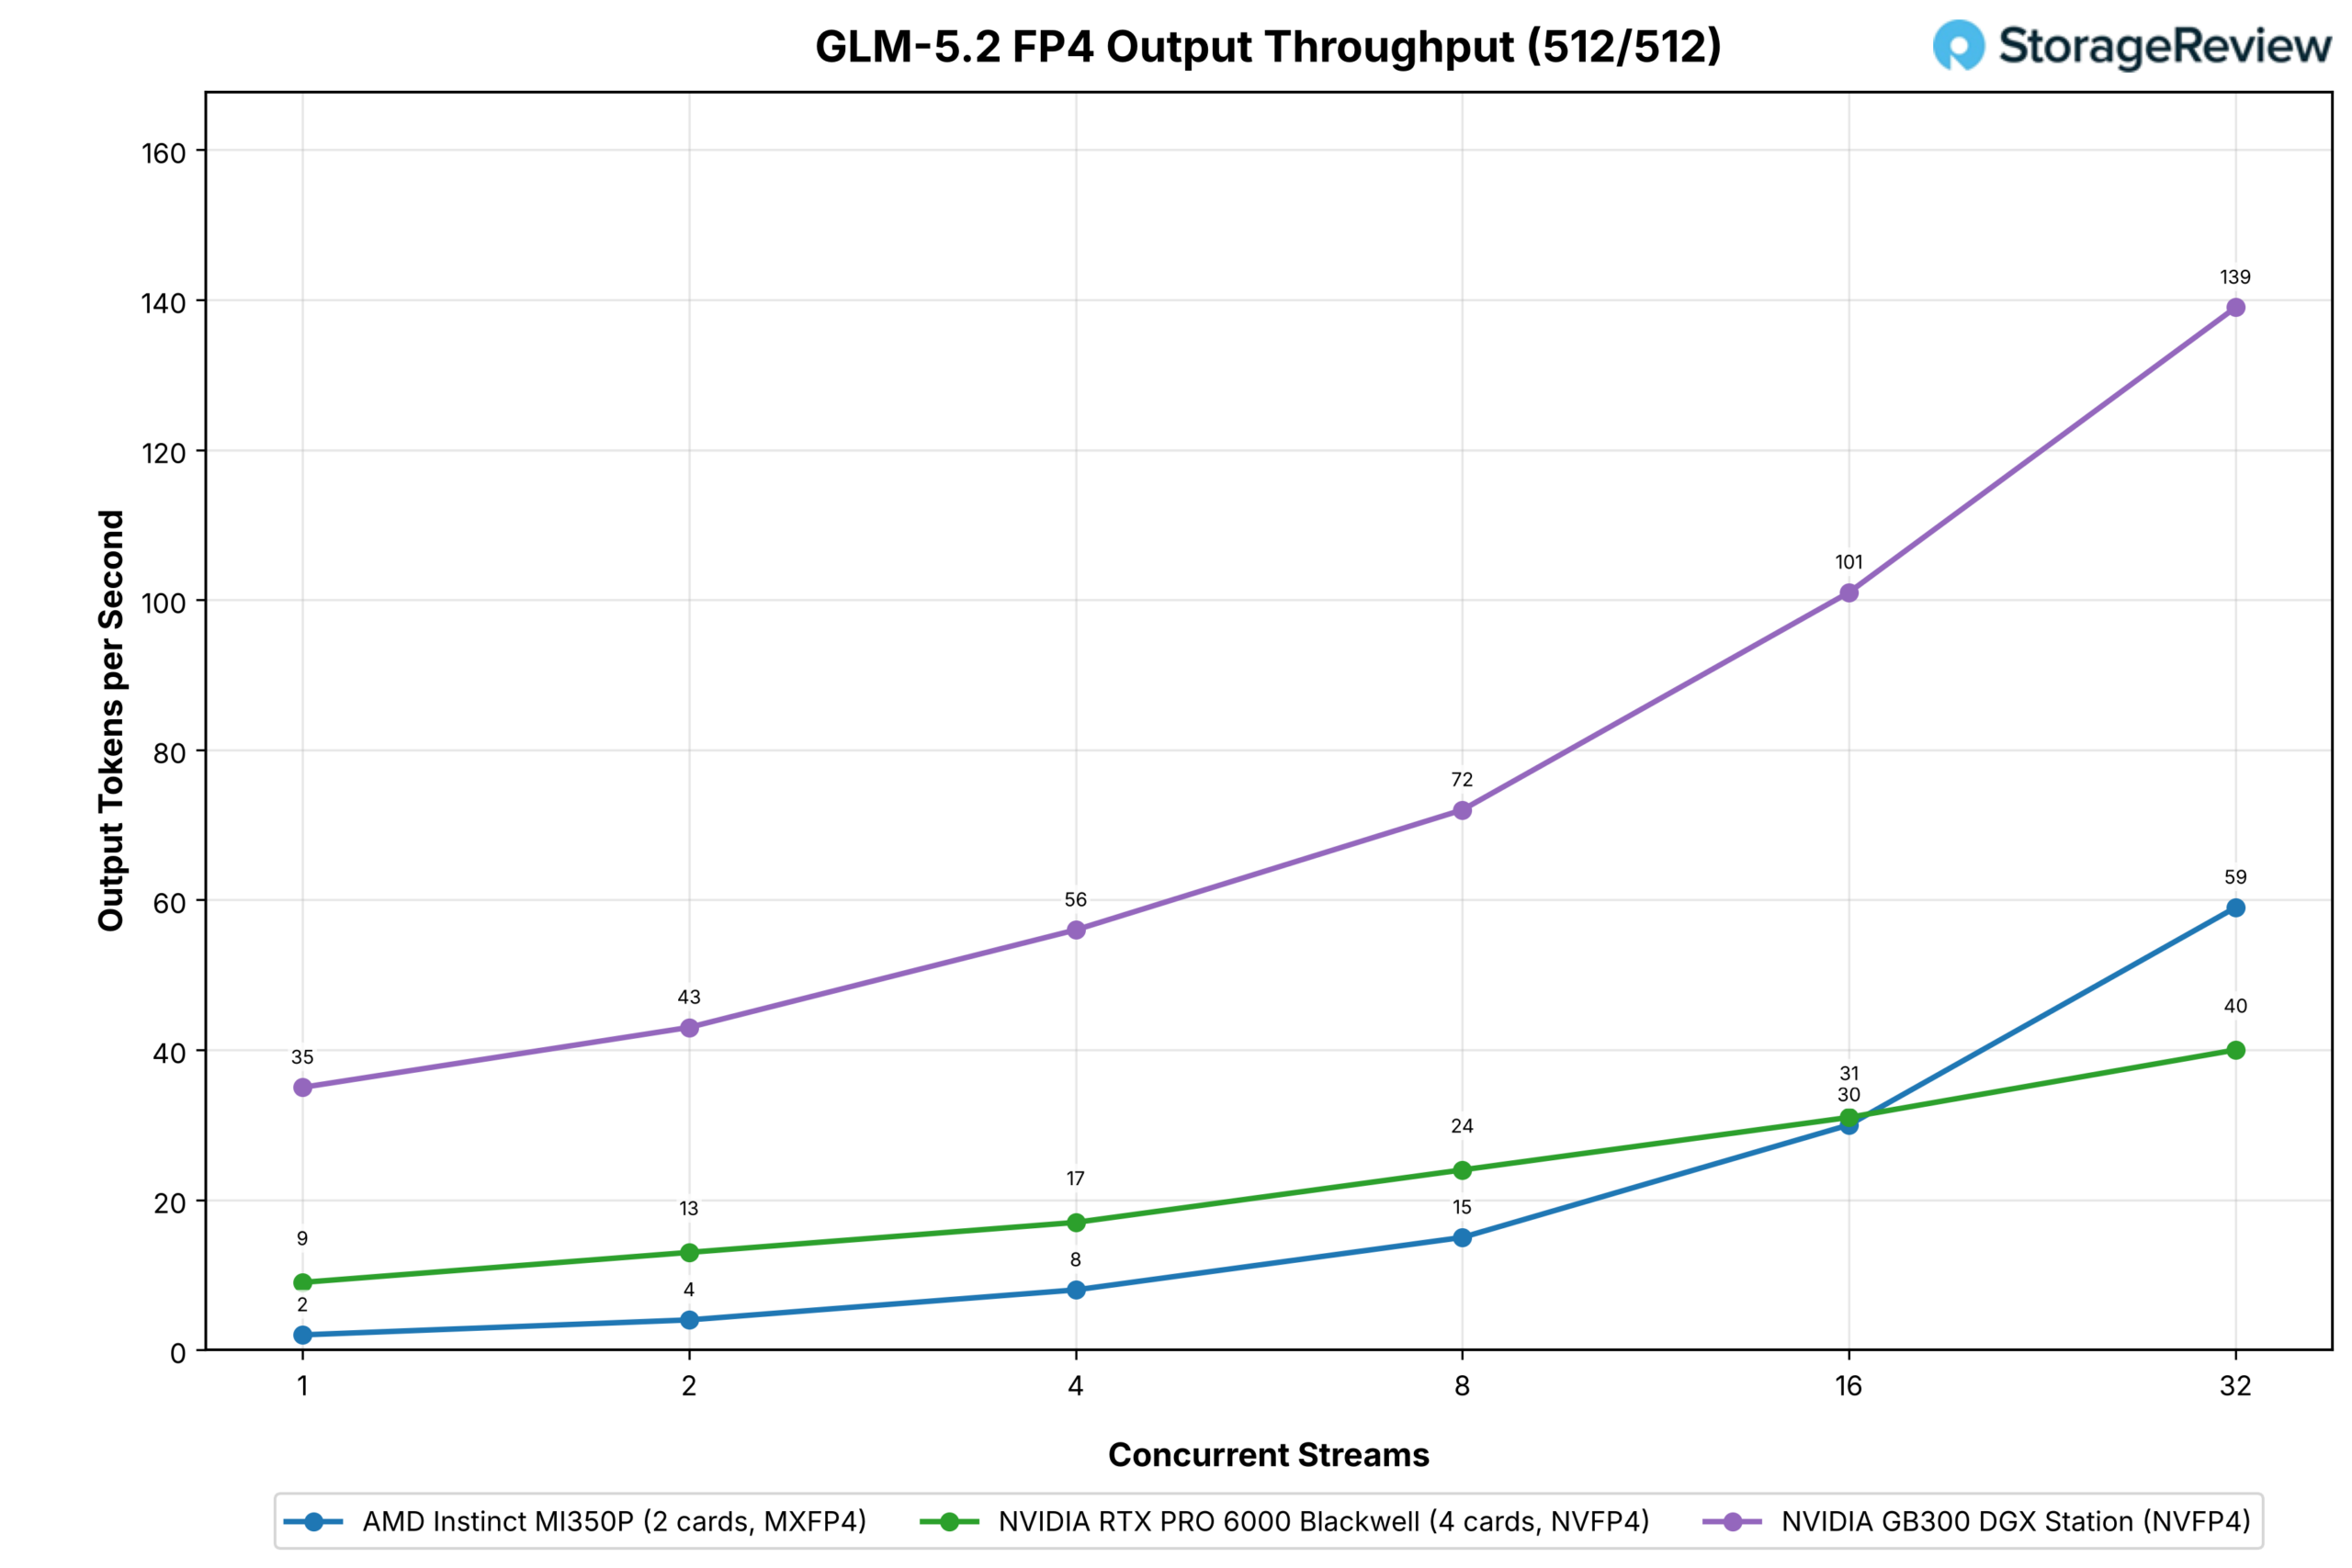
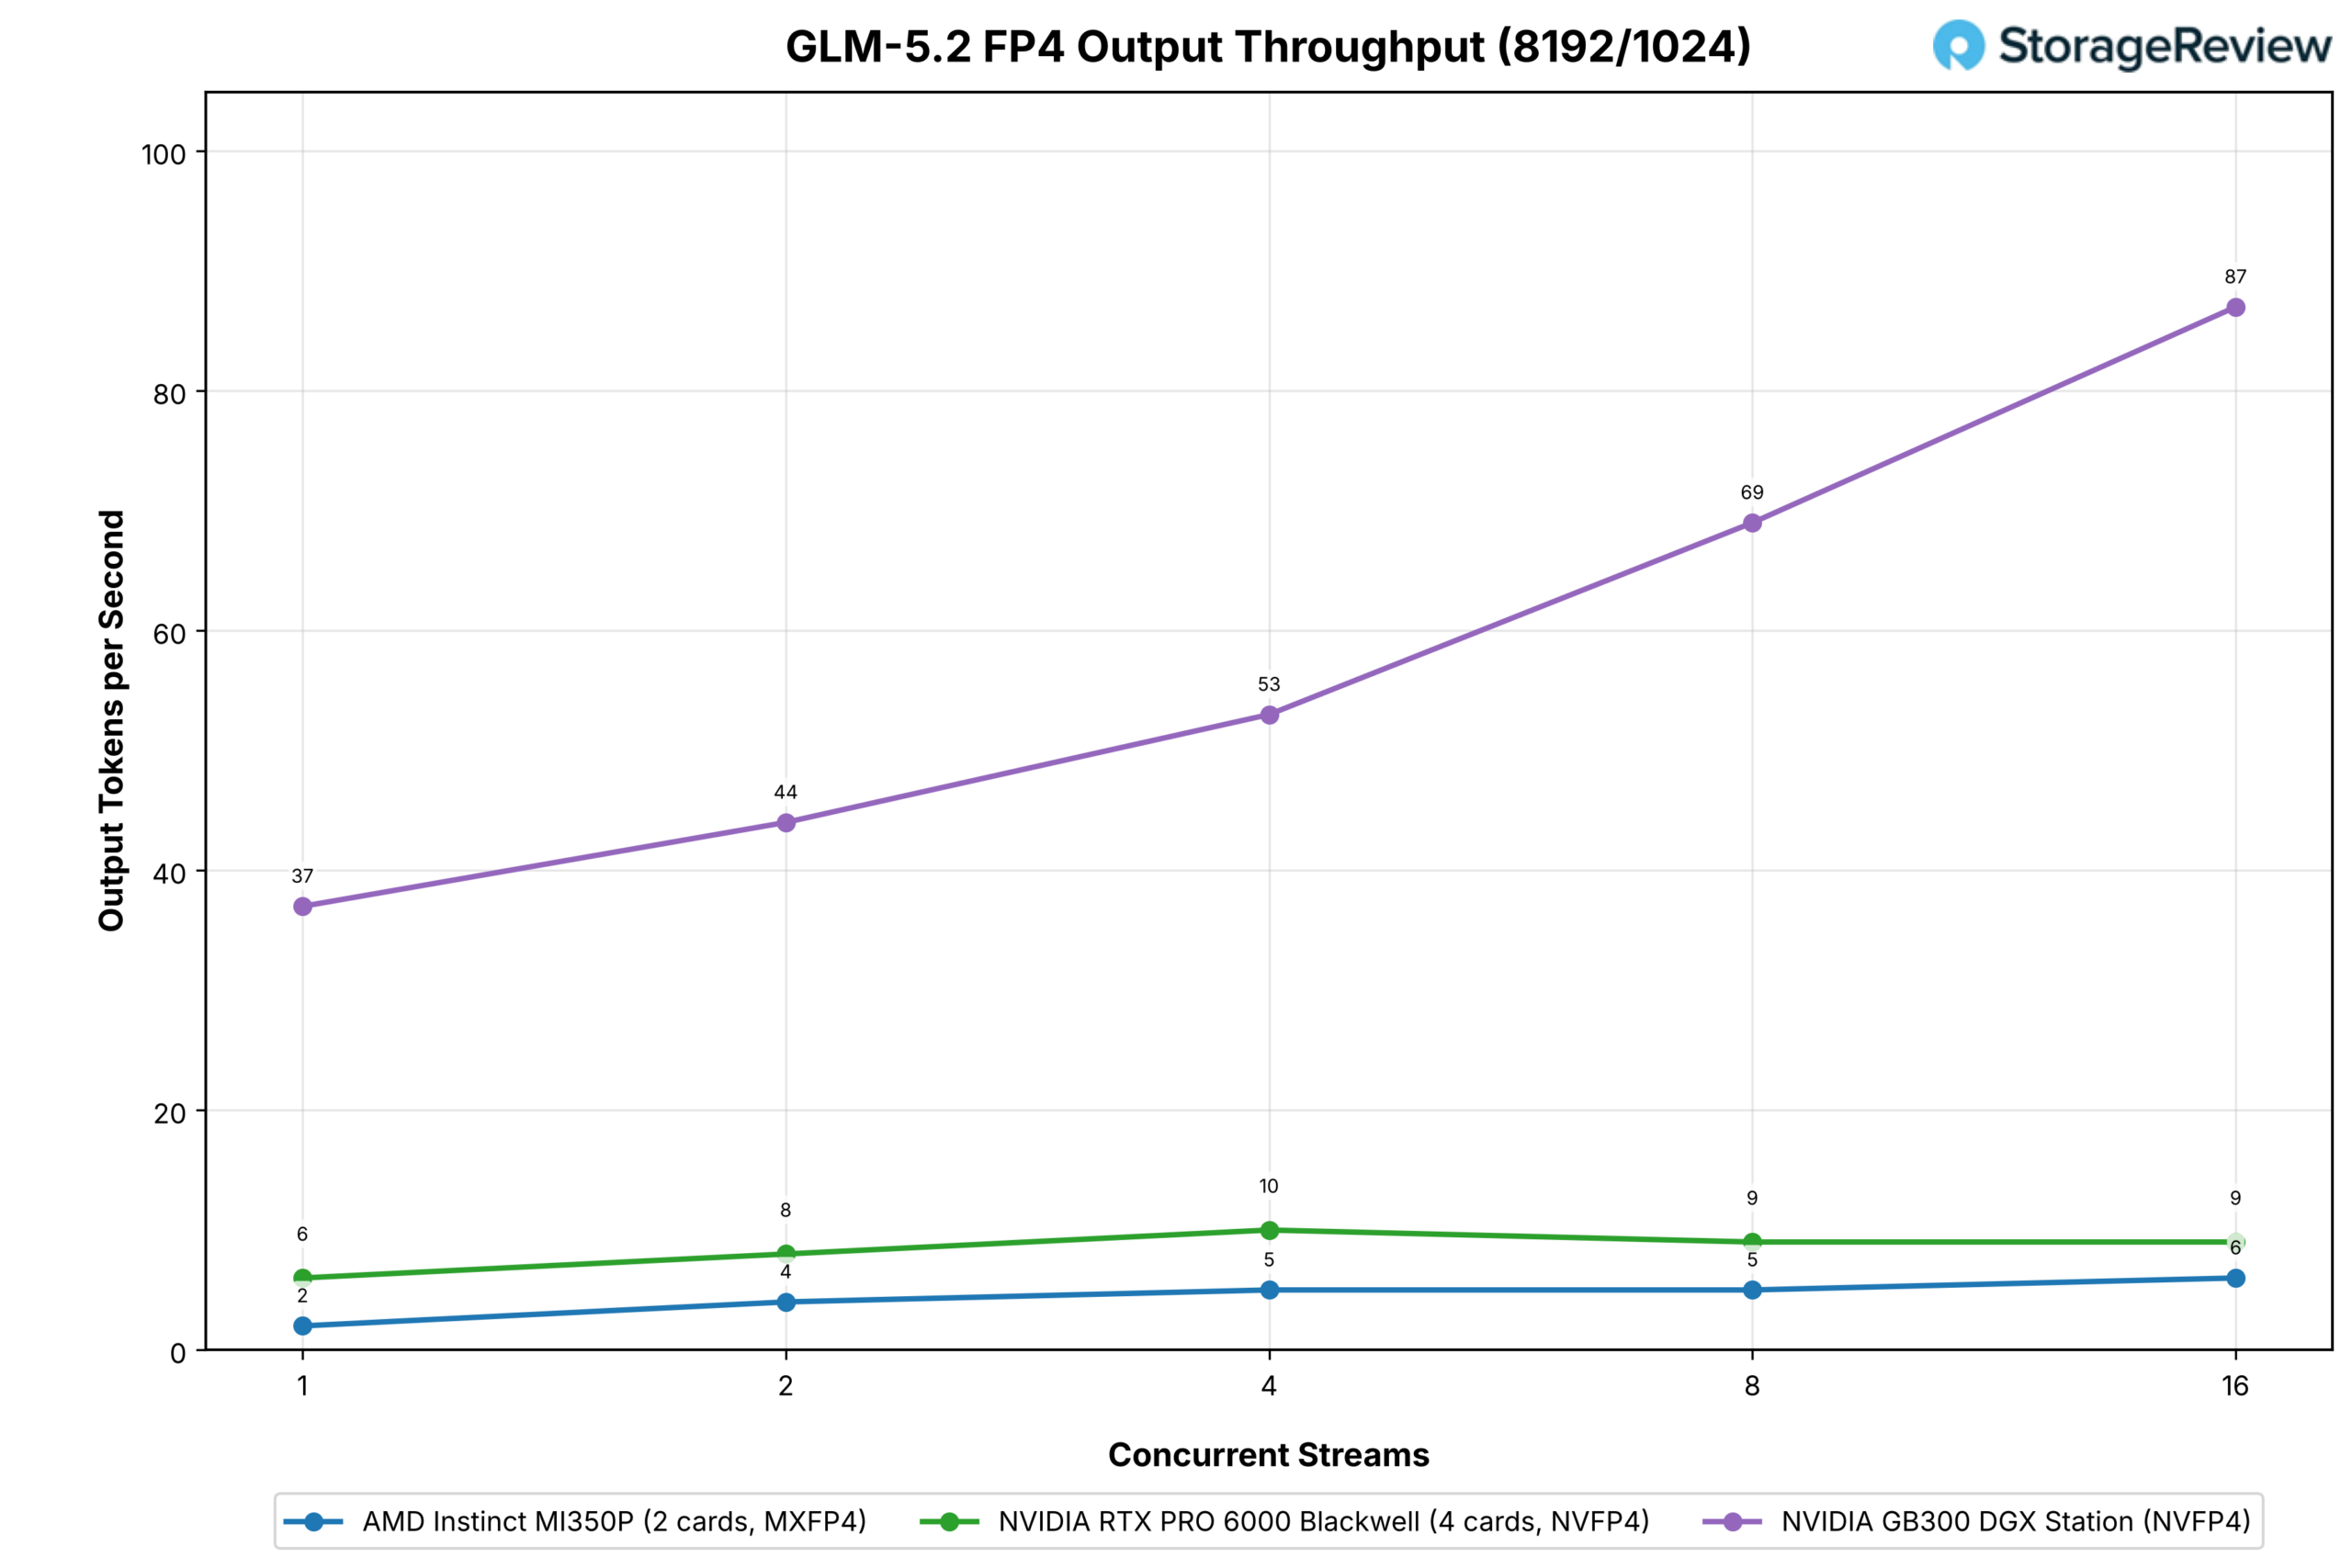
GLM-5.2 是本测试组中内存性能的关键所在。MXFP4 检查点溢出到两张 MI350P 显卡的 288GB 内存中,进入主机内存,因此,这对显卡的单流吞吐量为每秒 2 个输出令牌,而四张配备 384GB GDDR7 显存的 RTX PRO 6000 显卡(内置 NVFP4)的吞吐量为每秒 9 个,Station 的吞吐量为每秒 35 个(Station 将约 215GB 的专家权重卸载到 Grace 内存中)。在聊天工作负载下,RTX 四显卡在 16 个流下表现最佳;在 32 个流下,MI350P 显卡达到 59 个,而 STation 达到 139 个。在预填充密集型提示符下,两种 PCIe 配置在 16 个流下均无法达到个位数,而 STation 的吞吐量为 87 个。
MiniMax-M3
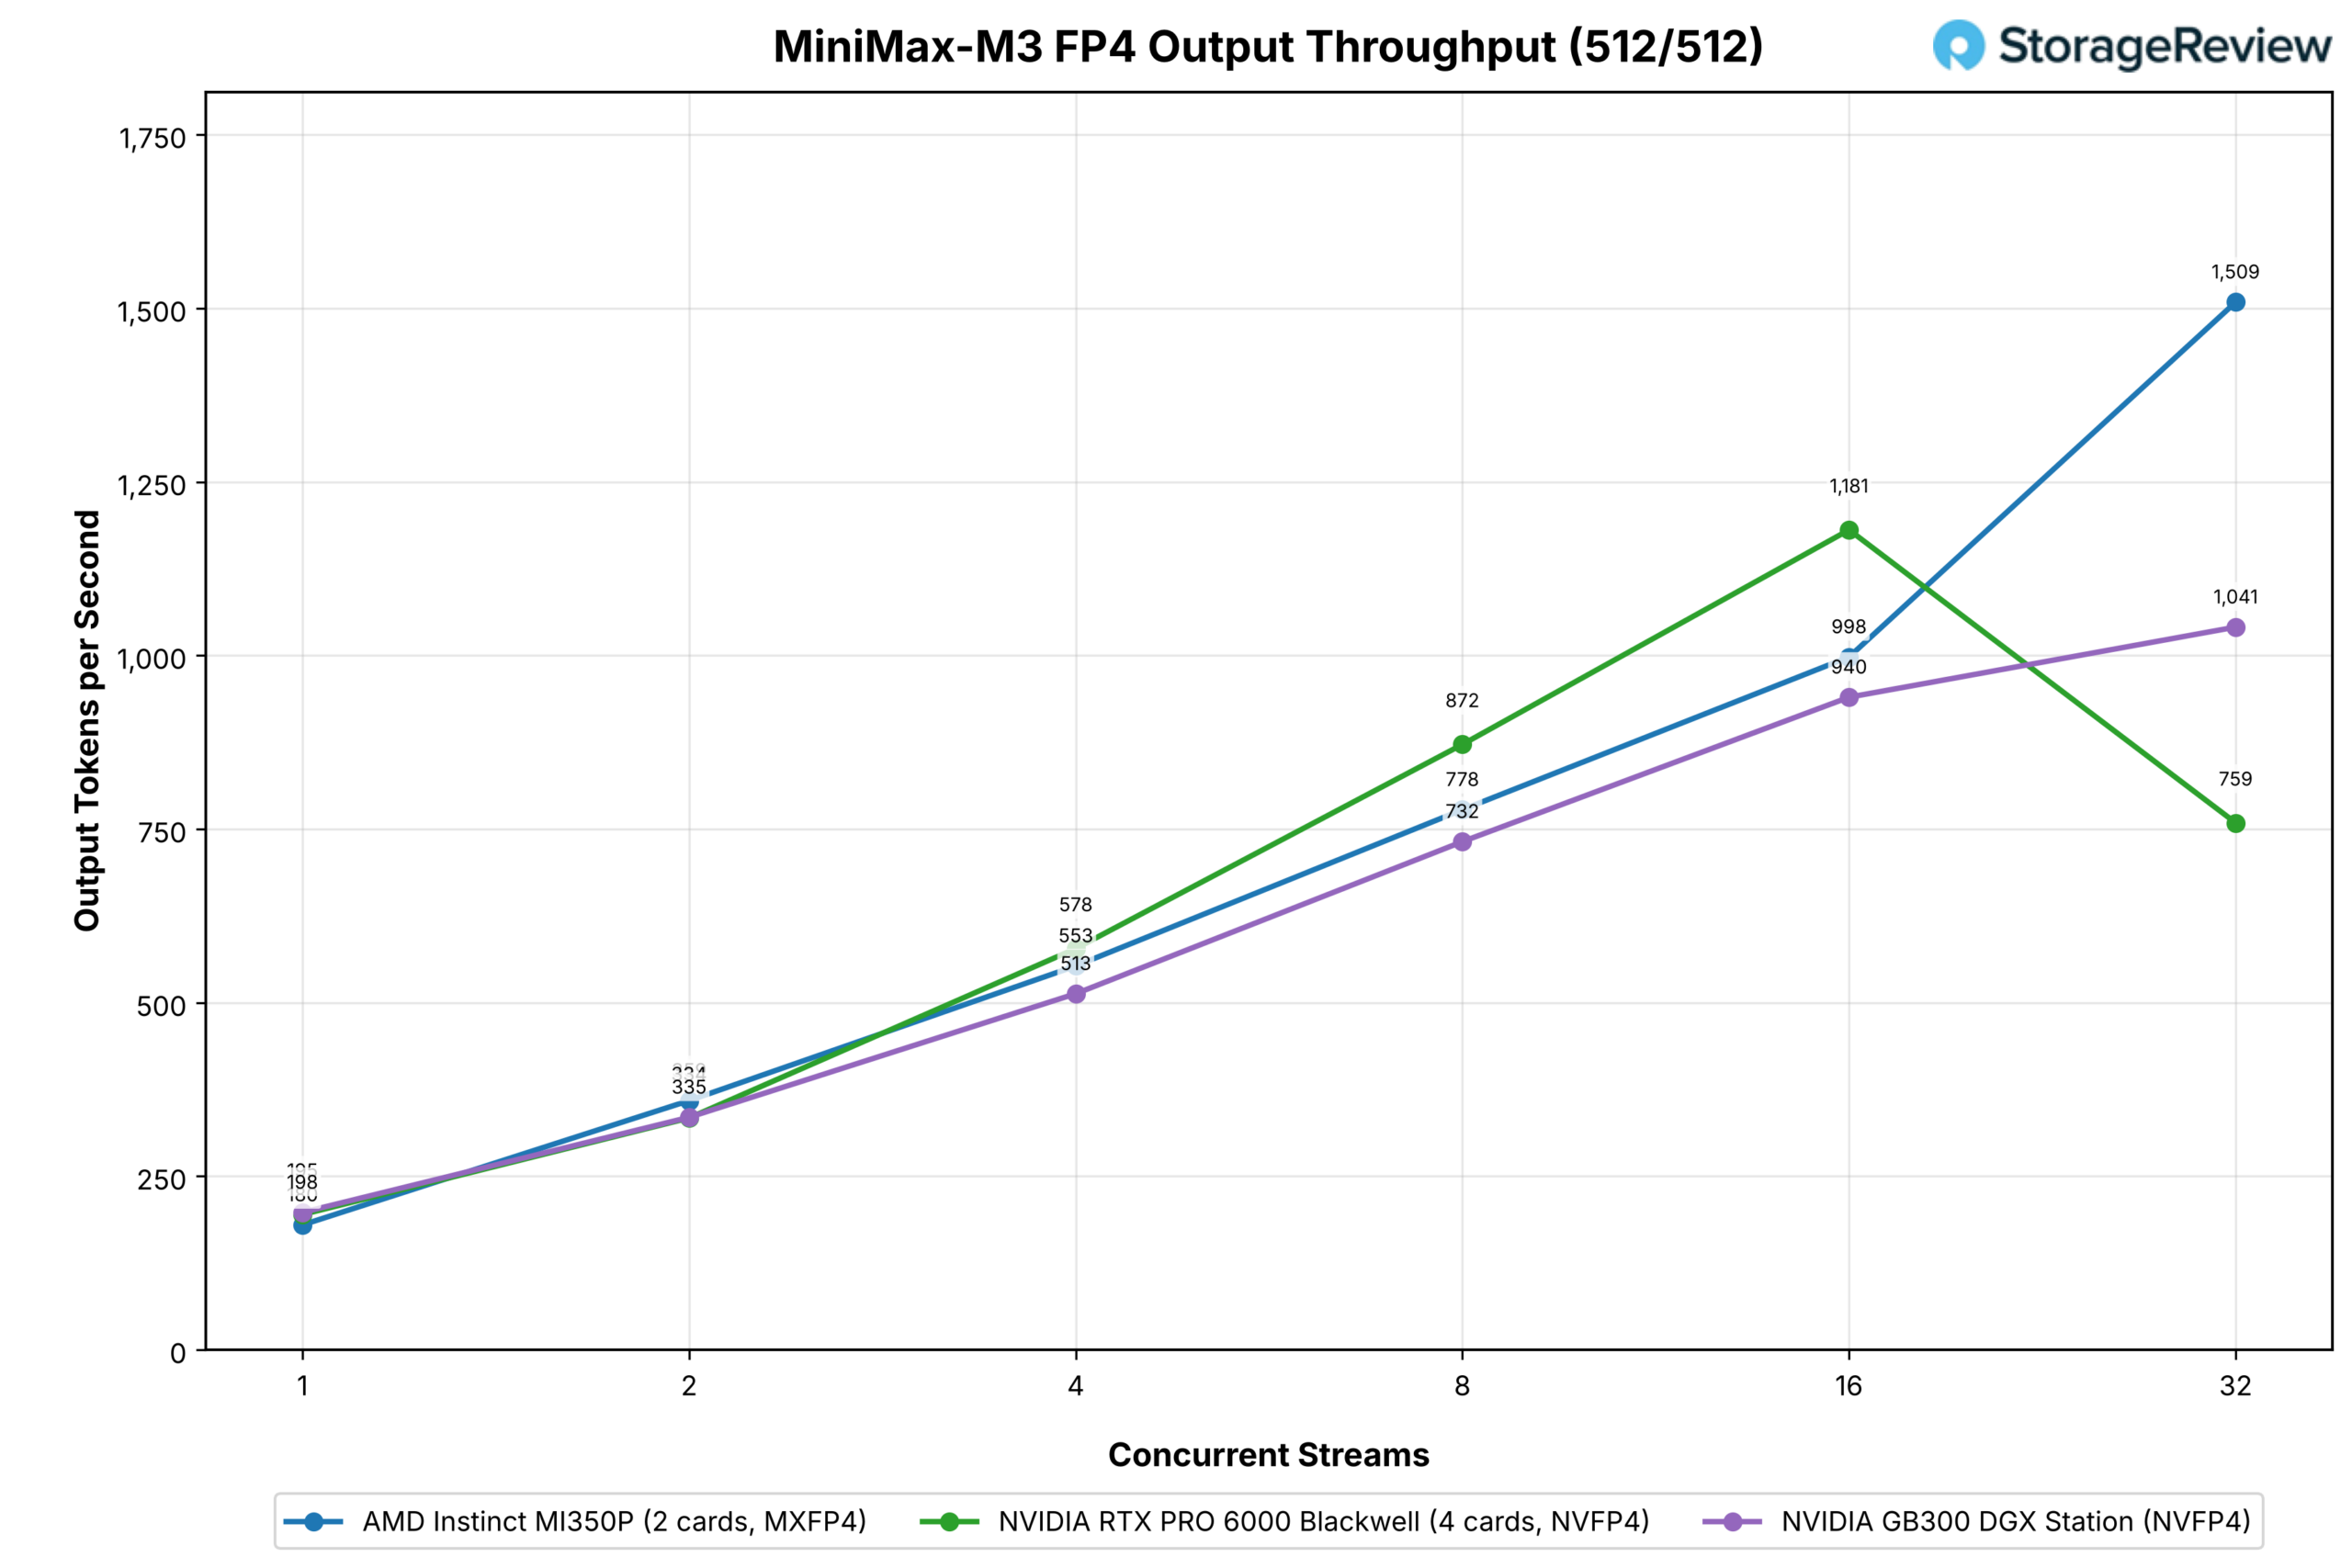
两块 MI350P 存储了 288GB 的 MiniMax-M3 MXFP4 版本;NVIDIA 方面则需要四张 RTX PRO 6000 显卡。在聊天工作负载下,三种配置在八个数据流中的表现相差不到 10%;RTX 四显卡在 16 个数据流时领先(1,181 分,而 MI350P 双卡组为 998 分,Station 为 940 分),在 32 个数据流时,MI350P 双卡组的得分为 1,509 分,而四显卡组为 759 分,Station 为 1,041 分。
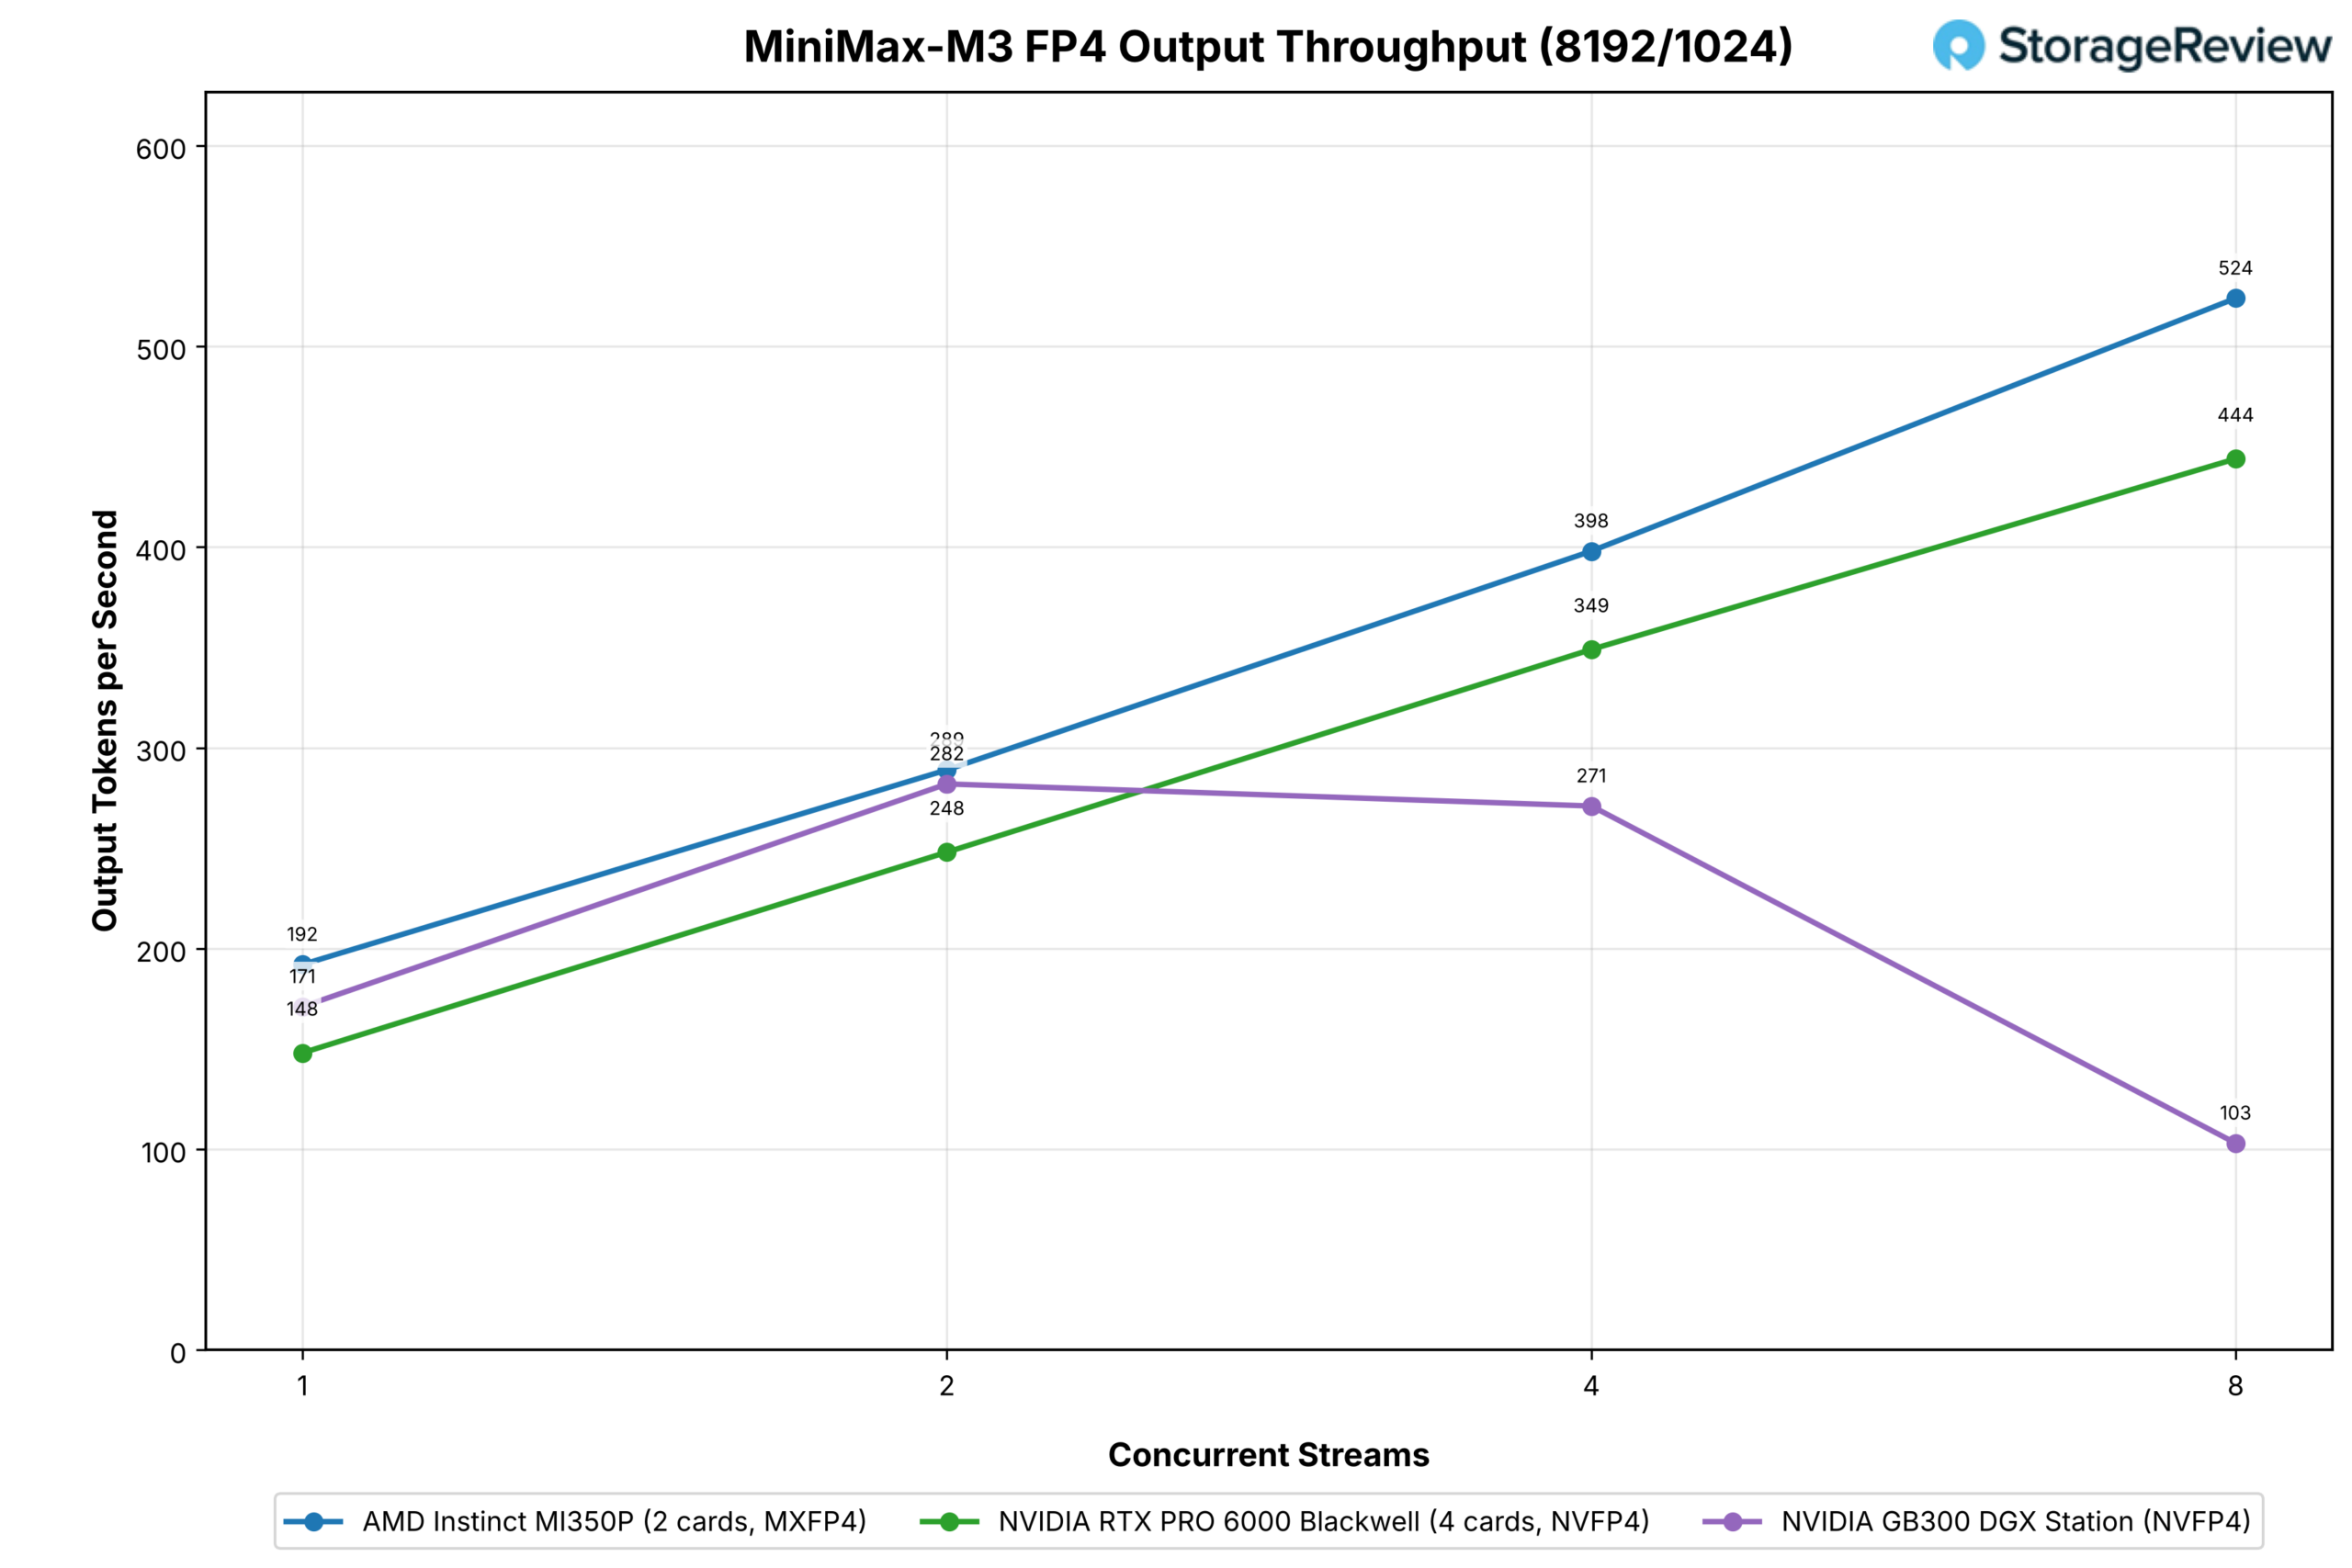
在预填充较多的提示符下,MI350P 组合在八个流的每个点上都领先,达到 524,而四路组合则为 444,而 Station 将此型号专家的一部分保留在 Grace 内存中,下降到 103。
DeepSeek-V4-闪存
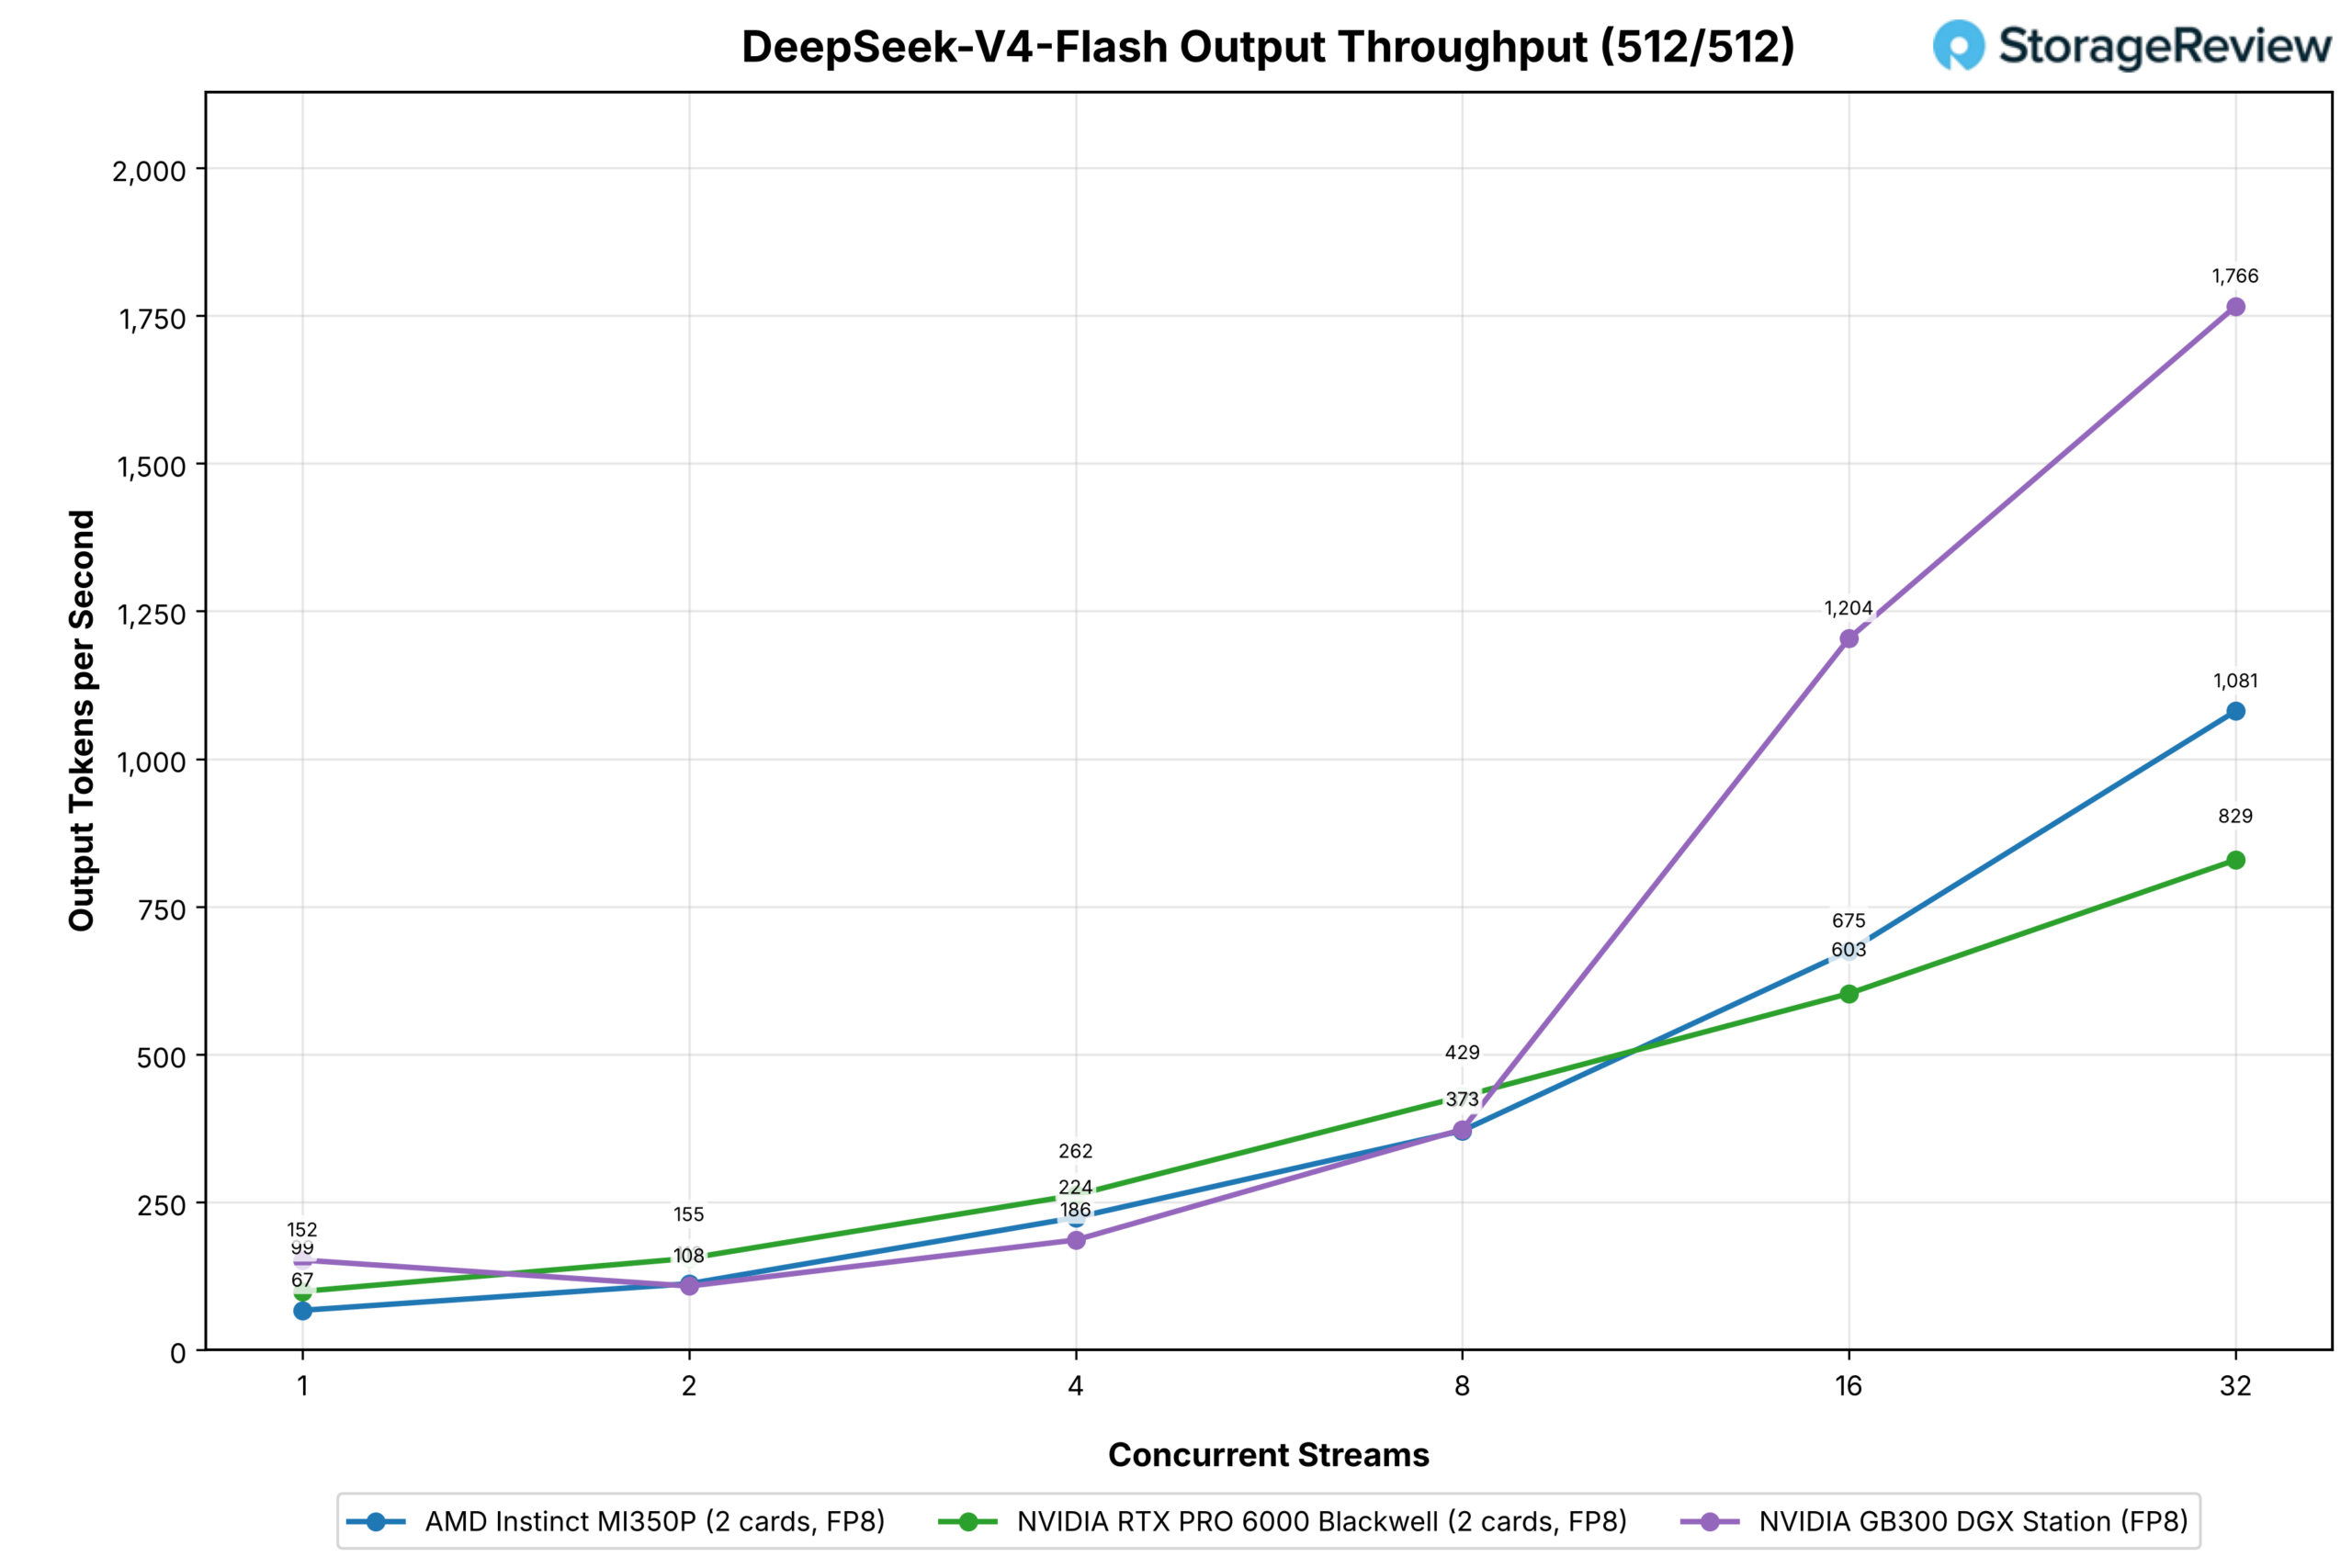
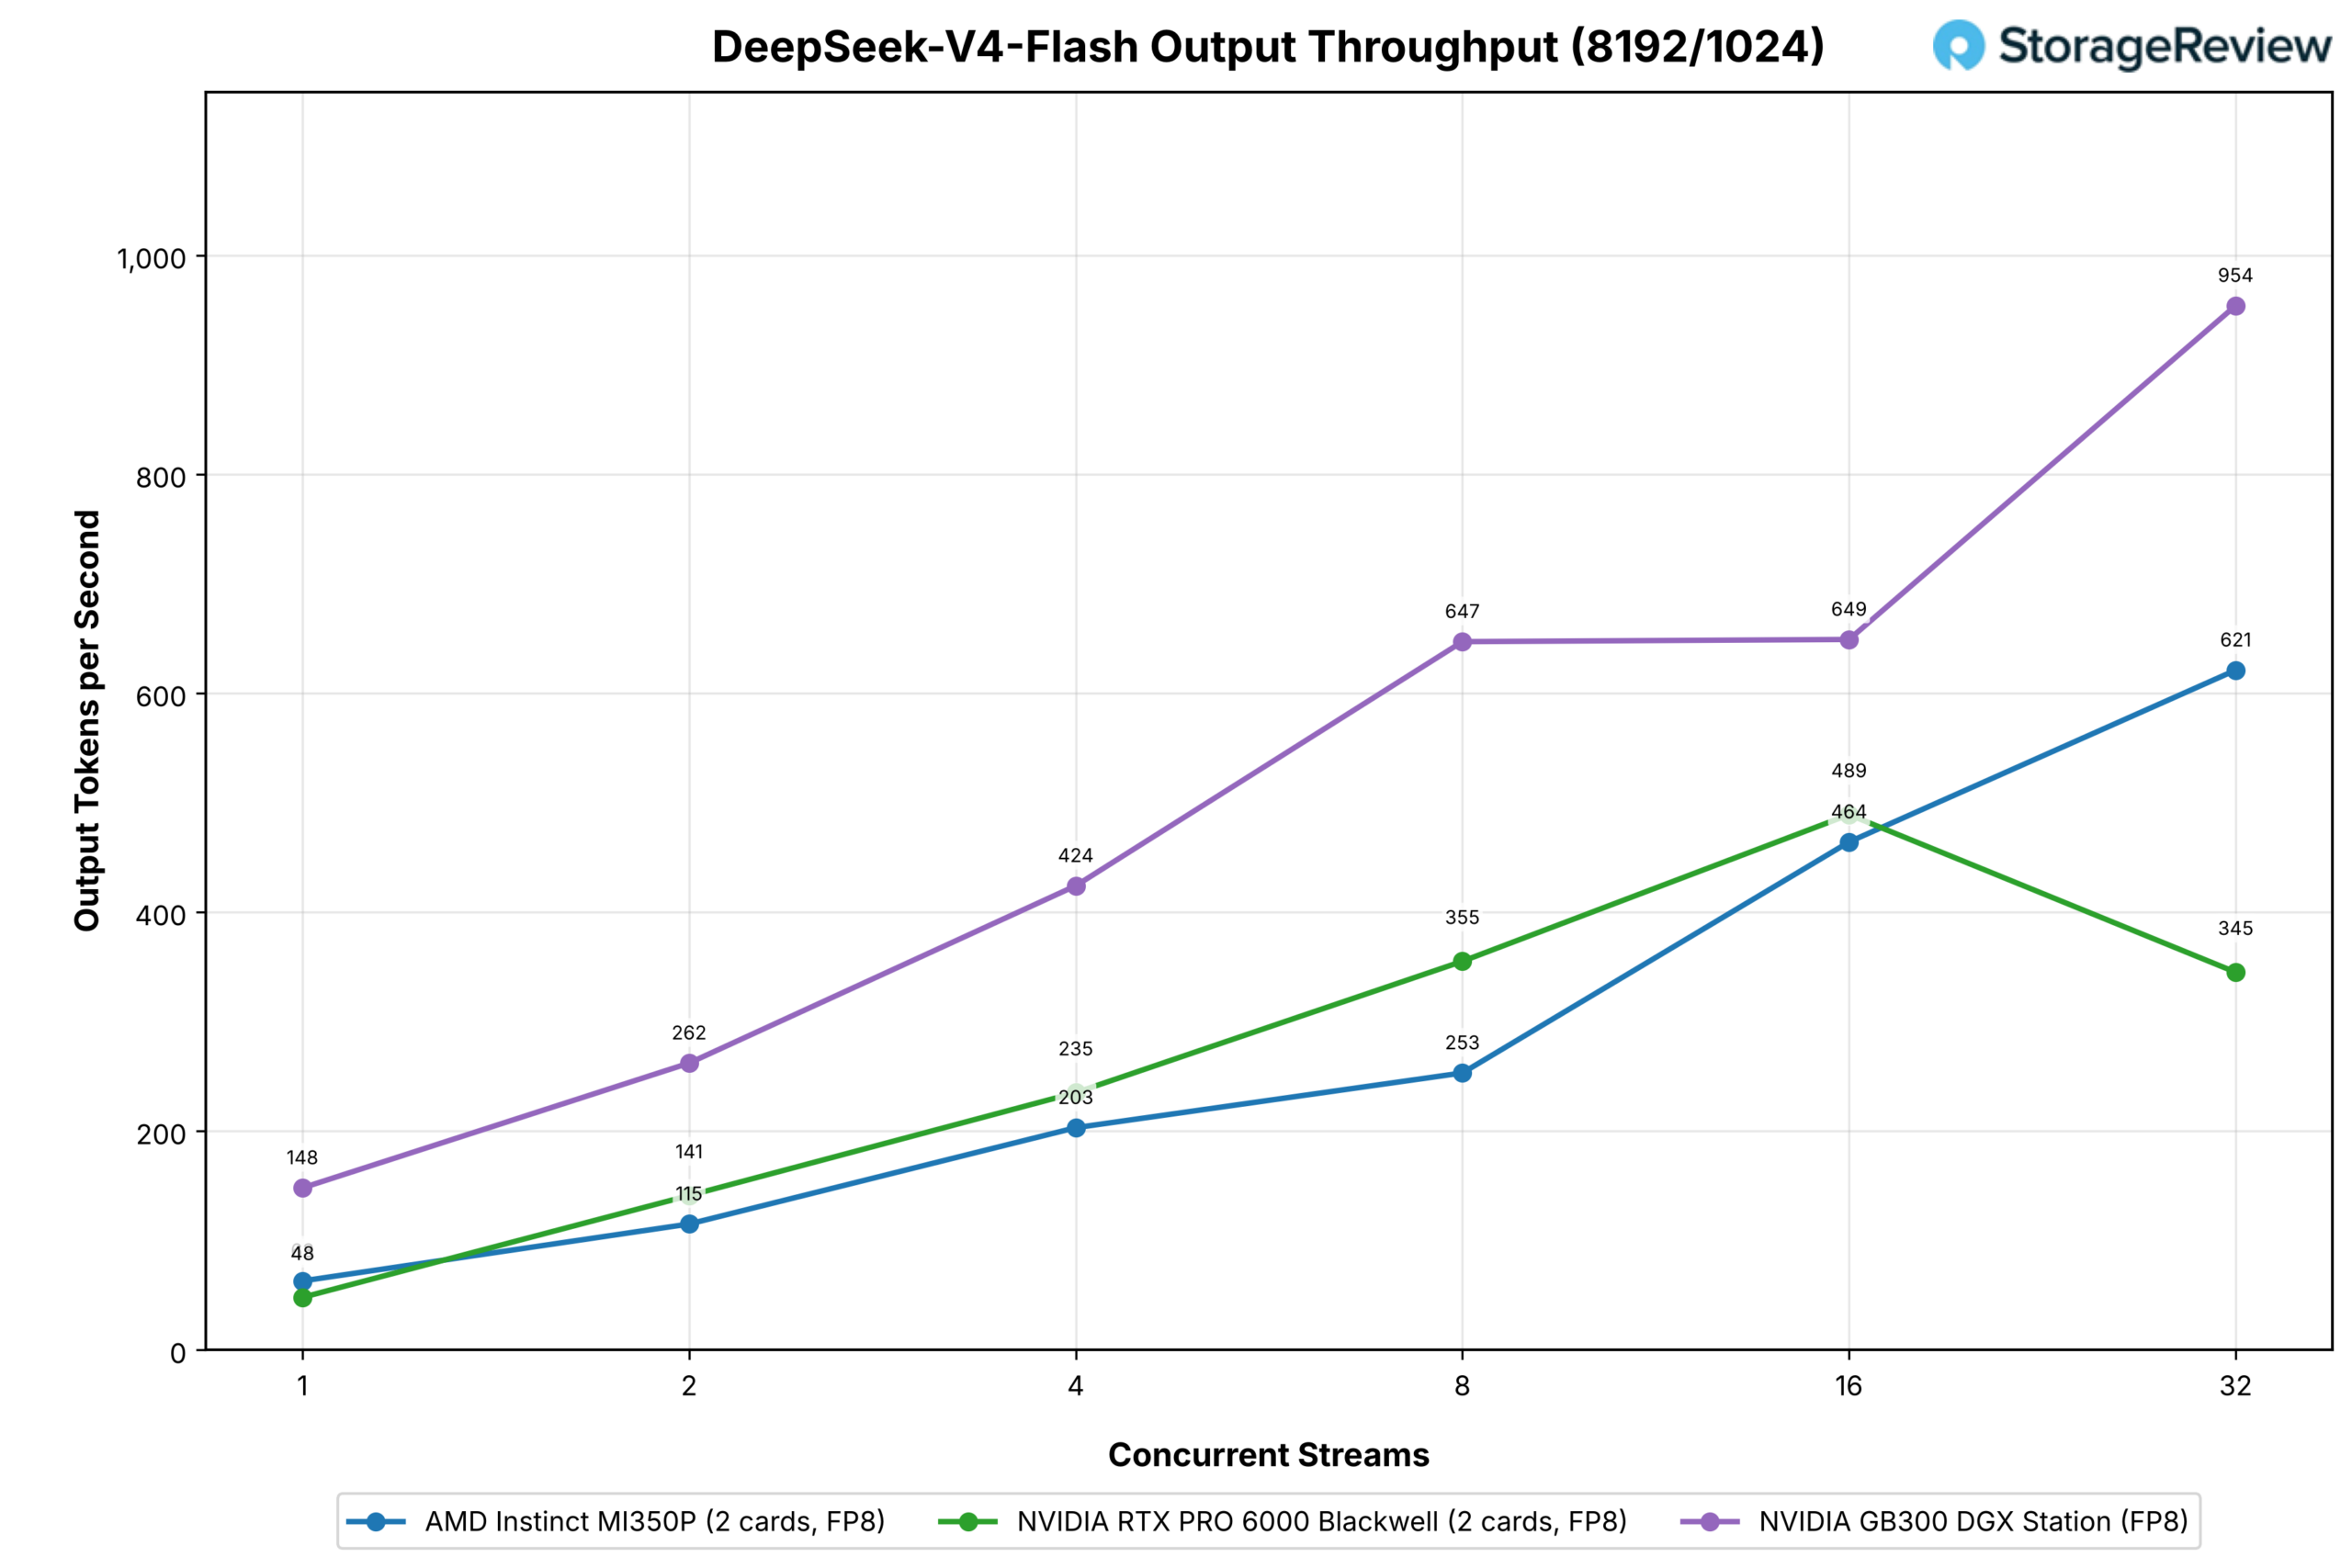
每侧配备两张显卡,并采用原生 FP8 检查点,RTX PRO 6000 双卡组在聊天工作负载下以 8 个流领先,而 MI350P 双卡组则从 16 个流开始超越,最终在 32 个流下达到 1,081 分,而 RTX 双卡组为 829 分;单台 Station 在同一点达到 1,766 分。预填充密集型测试的结果也类似,MI350P 双卡组在 32 个流下达到 621 分,RTX 双卡组为 345 分,Station 为 954 分。
MiniMax-M2.7
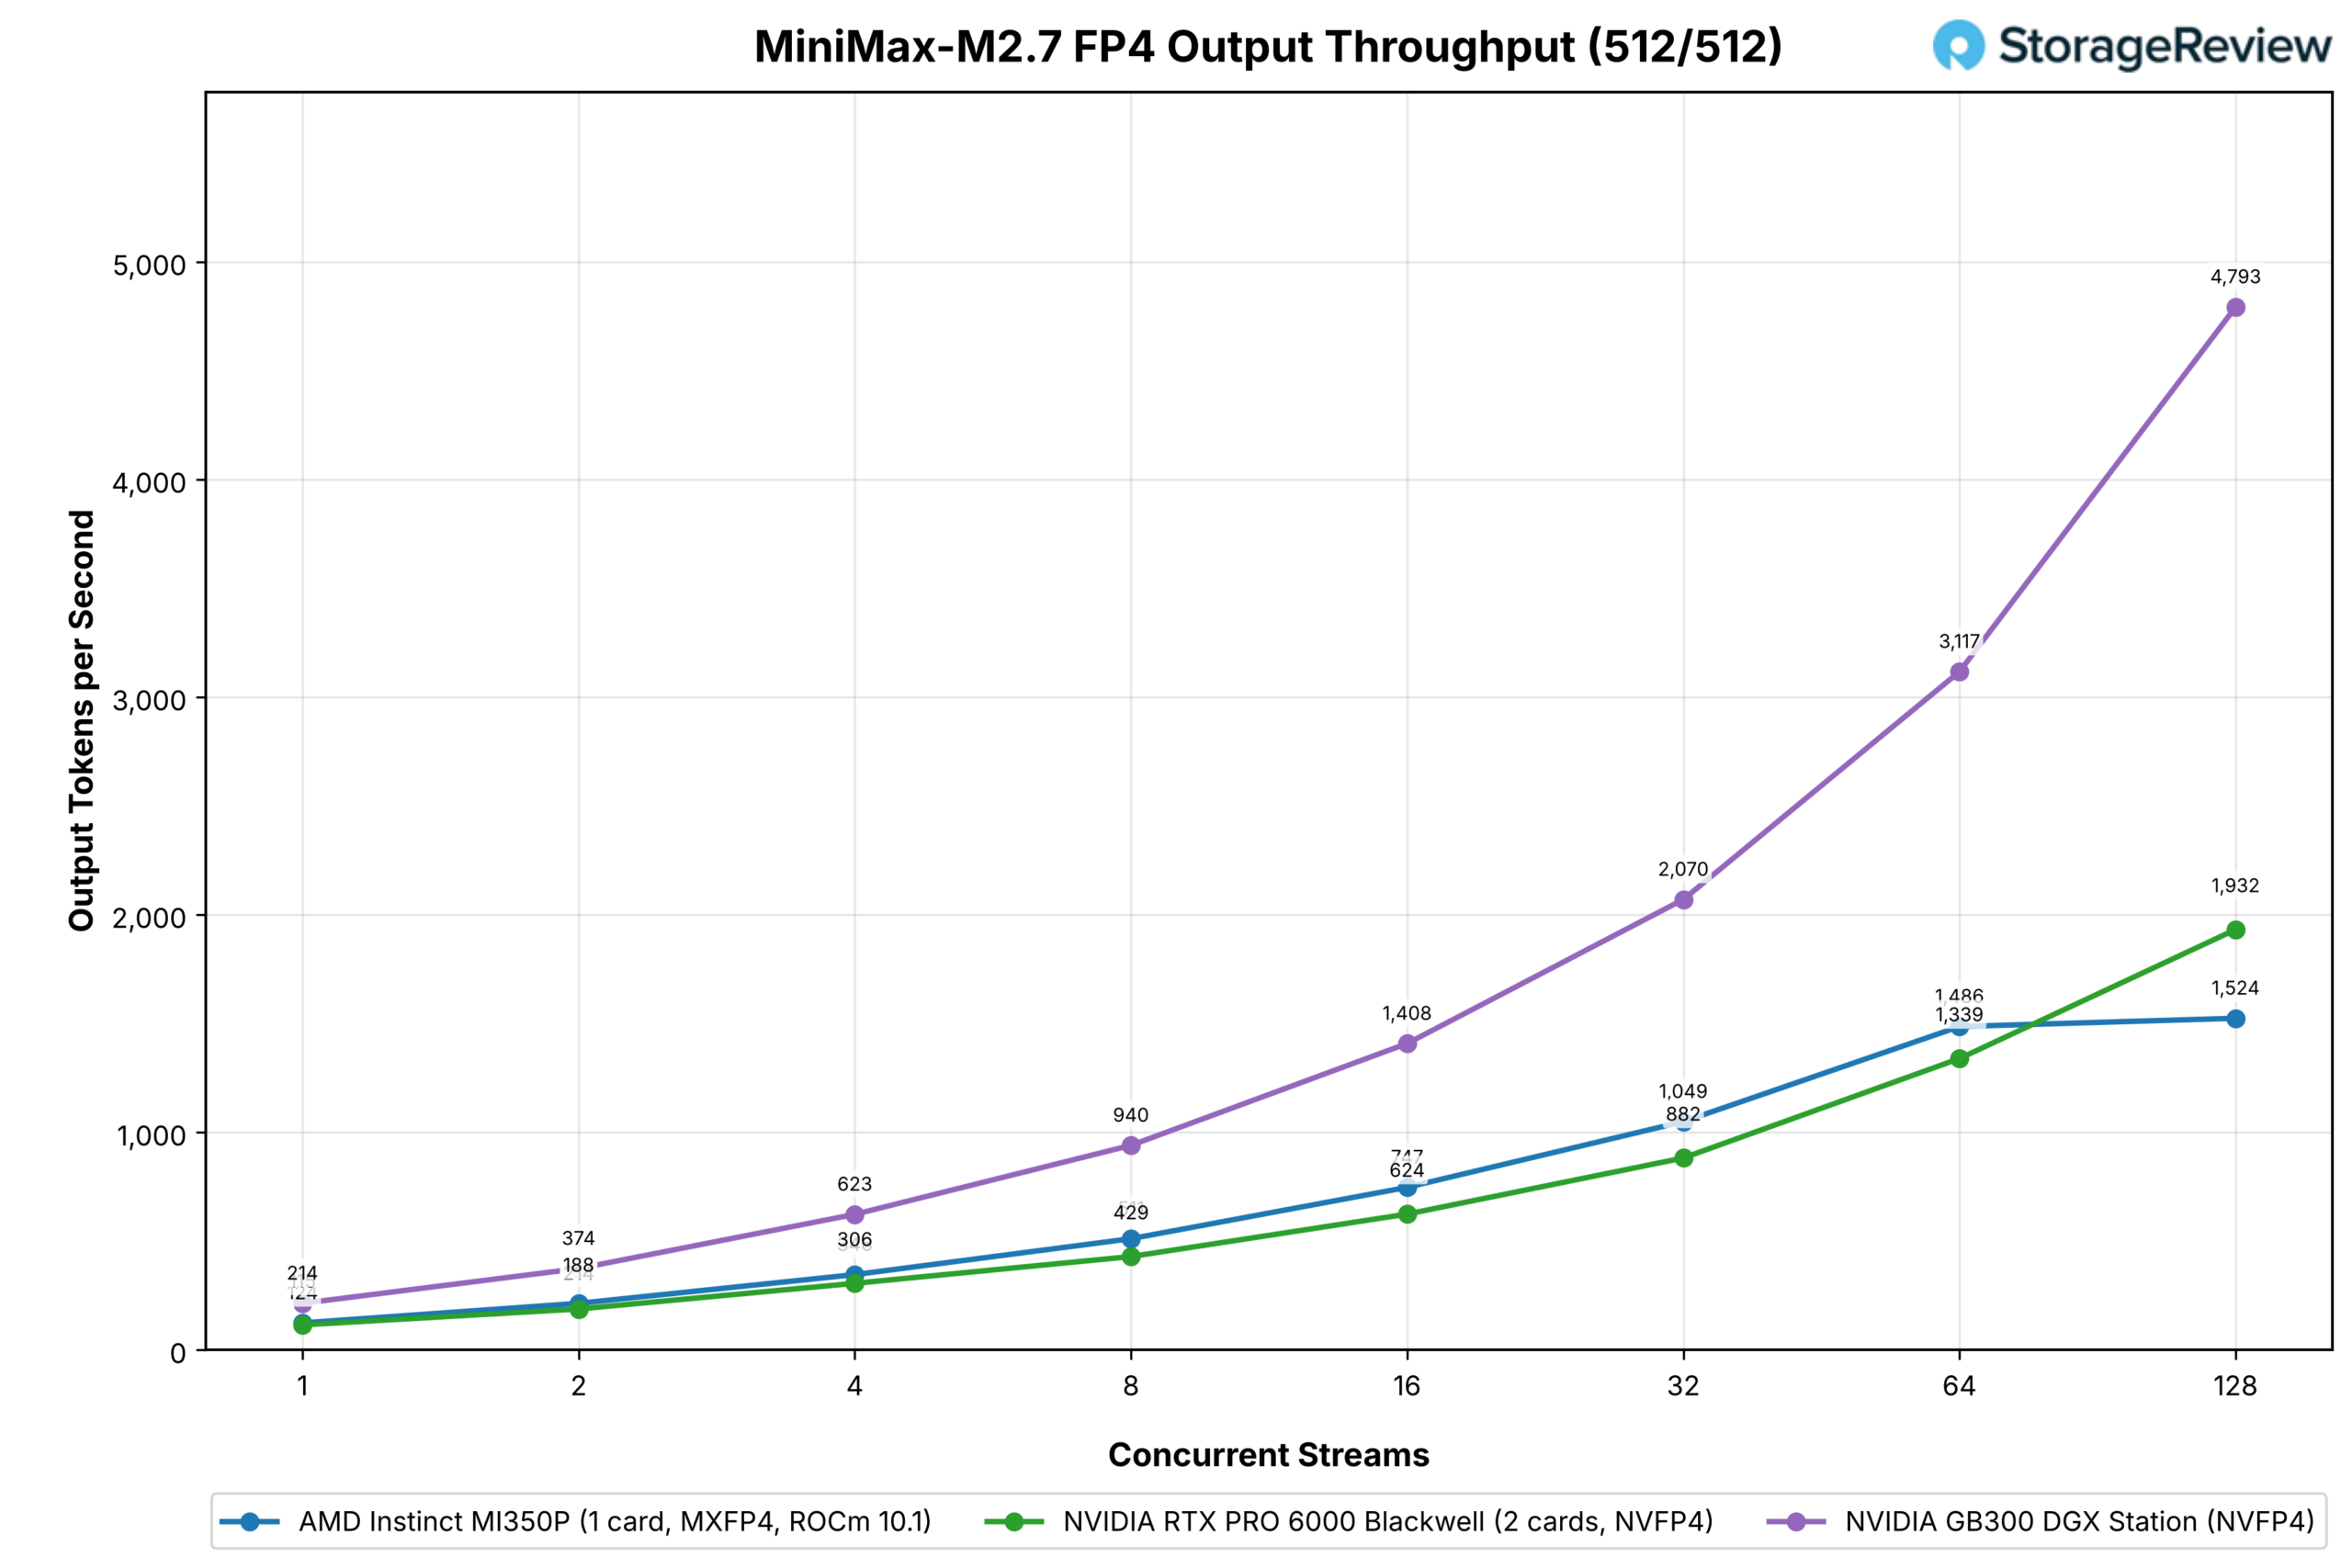
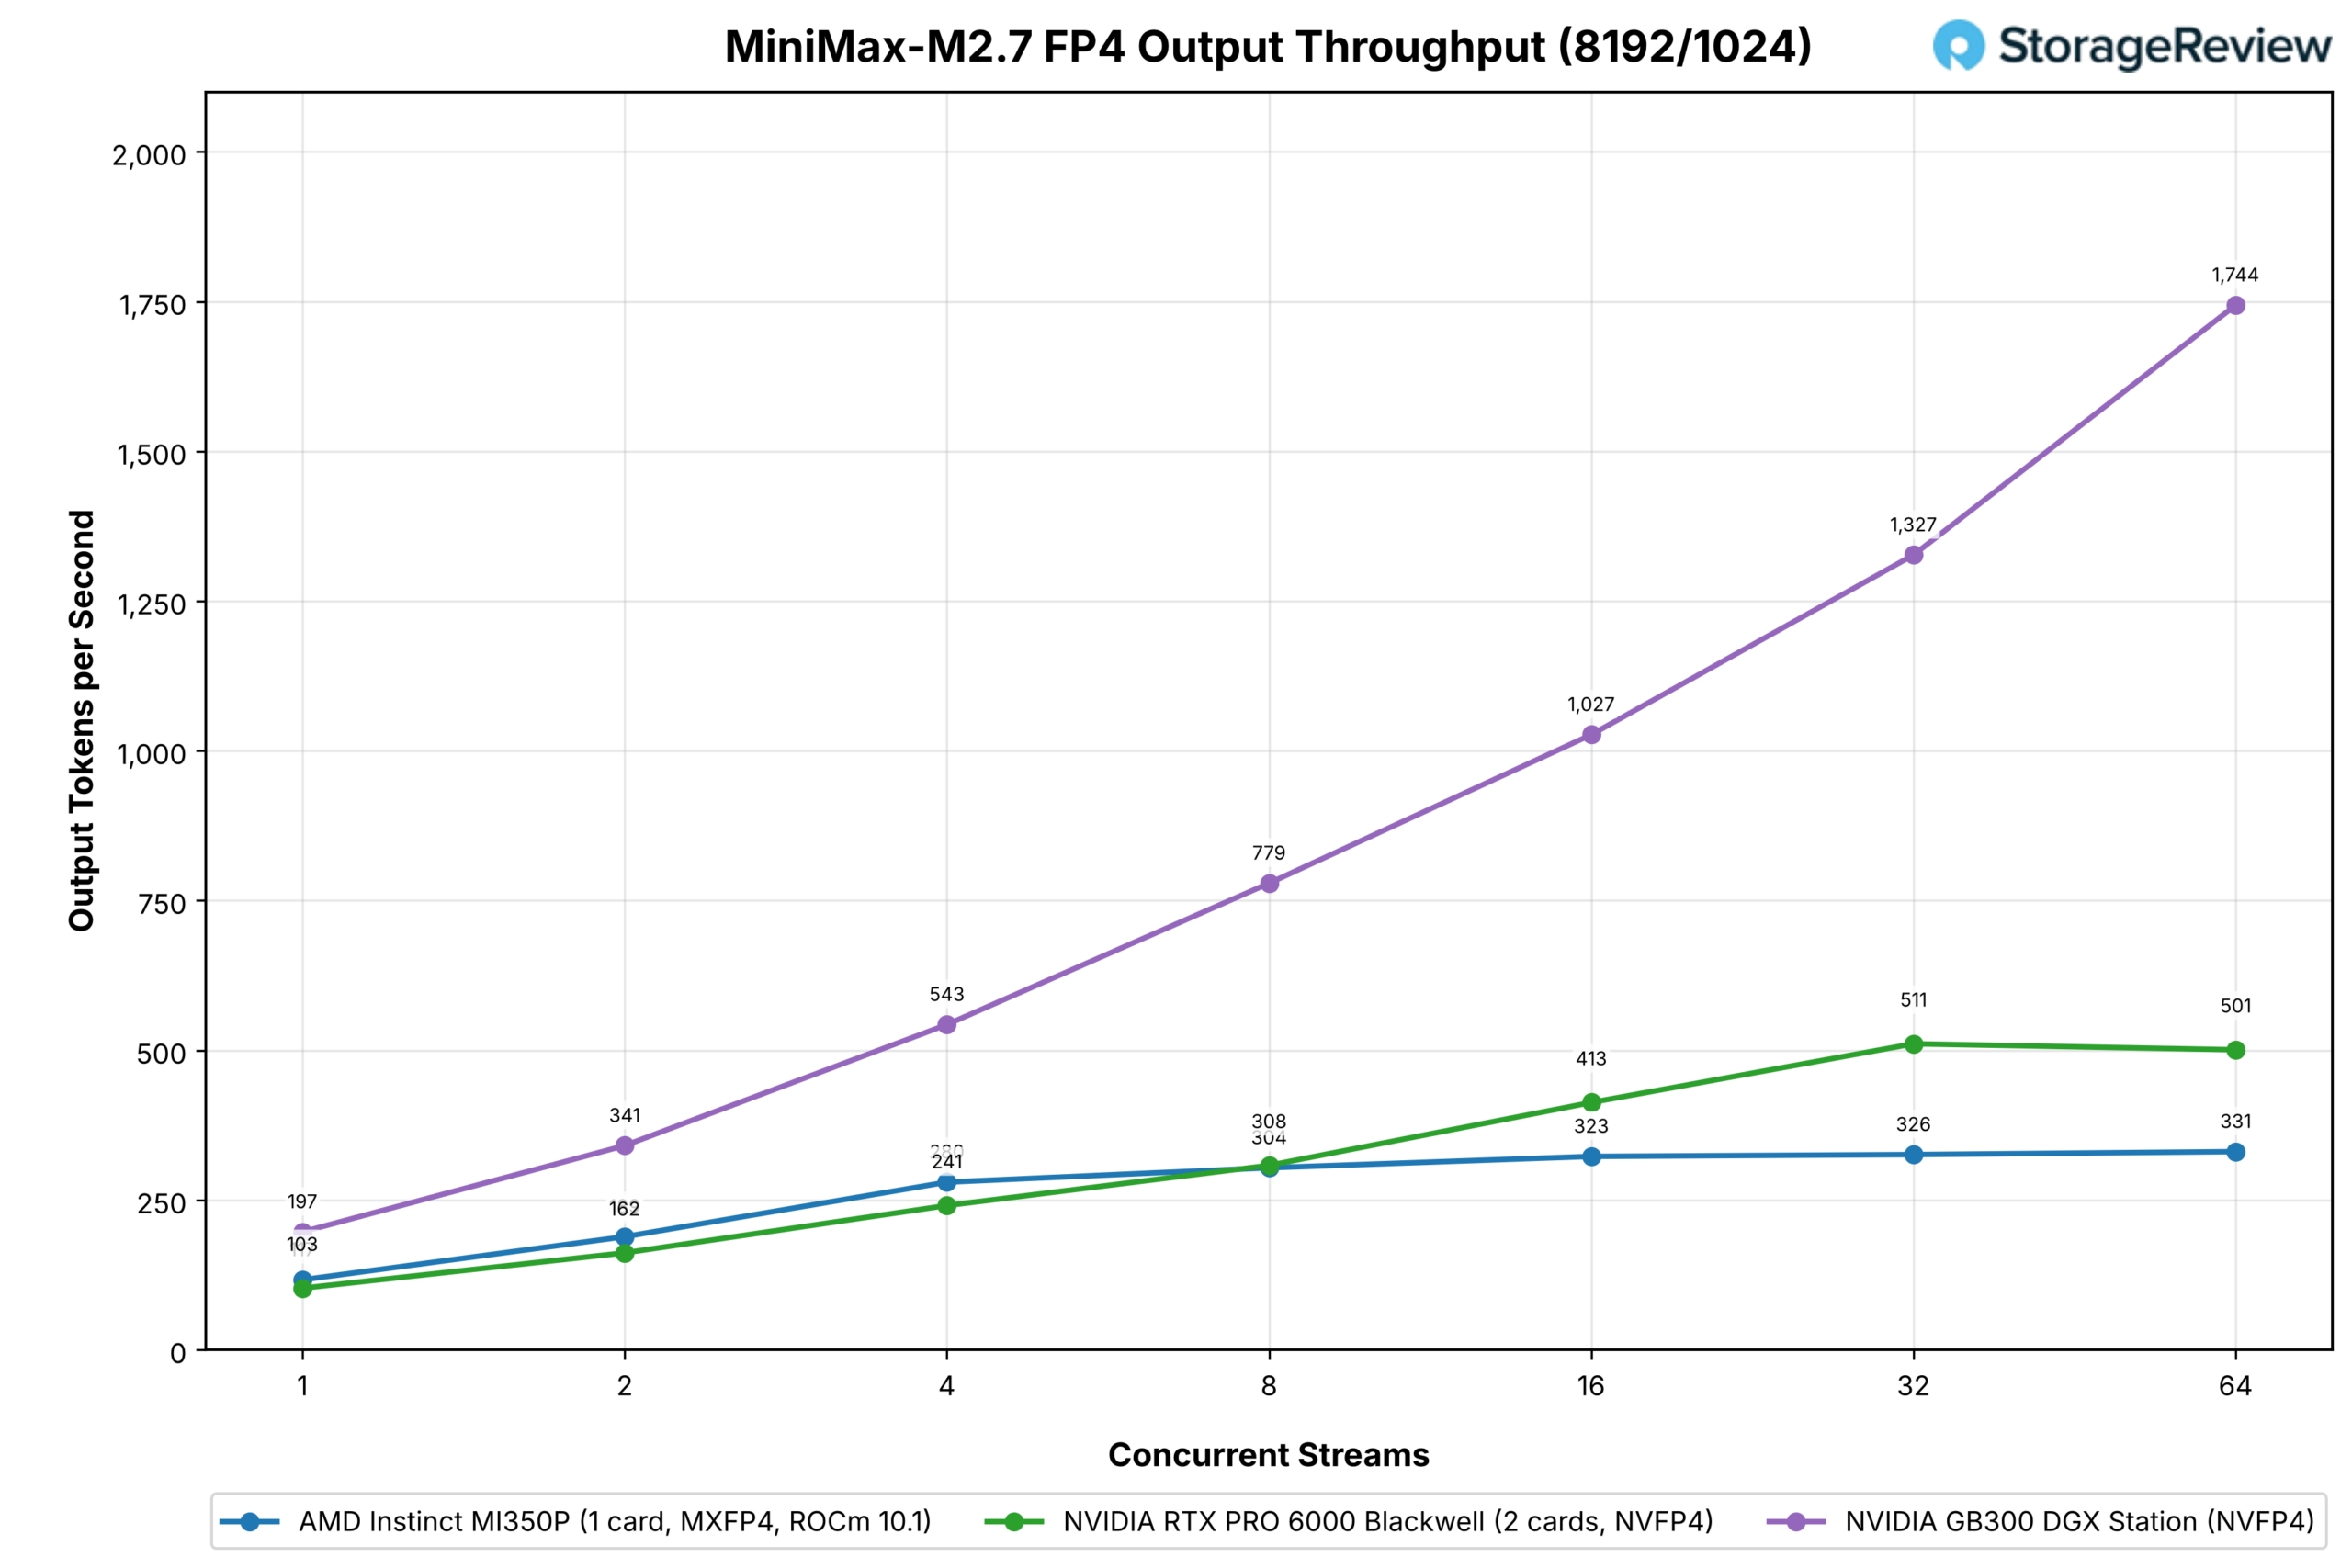
一台搭载 MXFP4 架构 MiniMax-M2.7 芯片的 MI350P 显卡与两张搭载 NVFP4 架构的 RTX PRO 6000 显卡展开较量。单路 MI350P 在单路测试中领先(124 对 115),在 64 路测试中保持 8% 到 20% 的领先优势(1,486 对 1,339),随后在 128 路测试中稳定在 1,524,在 256 路测试中稳定在 1,557,而 RTX 显卡则继续提升至 1,932 和 2,842;而 MI350P 的单路测试成绩则达到 4,793。
在预填充密集型工作负载下,MI350P 每秒可从 8 个流到 64 个流输出 304 到 331 个令牌,而 RTX 对为 501,Station 为 1,744。
GPT-OSS-120B
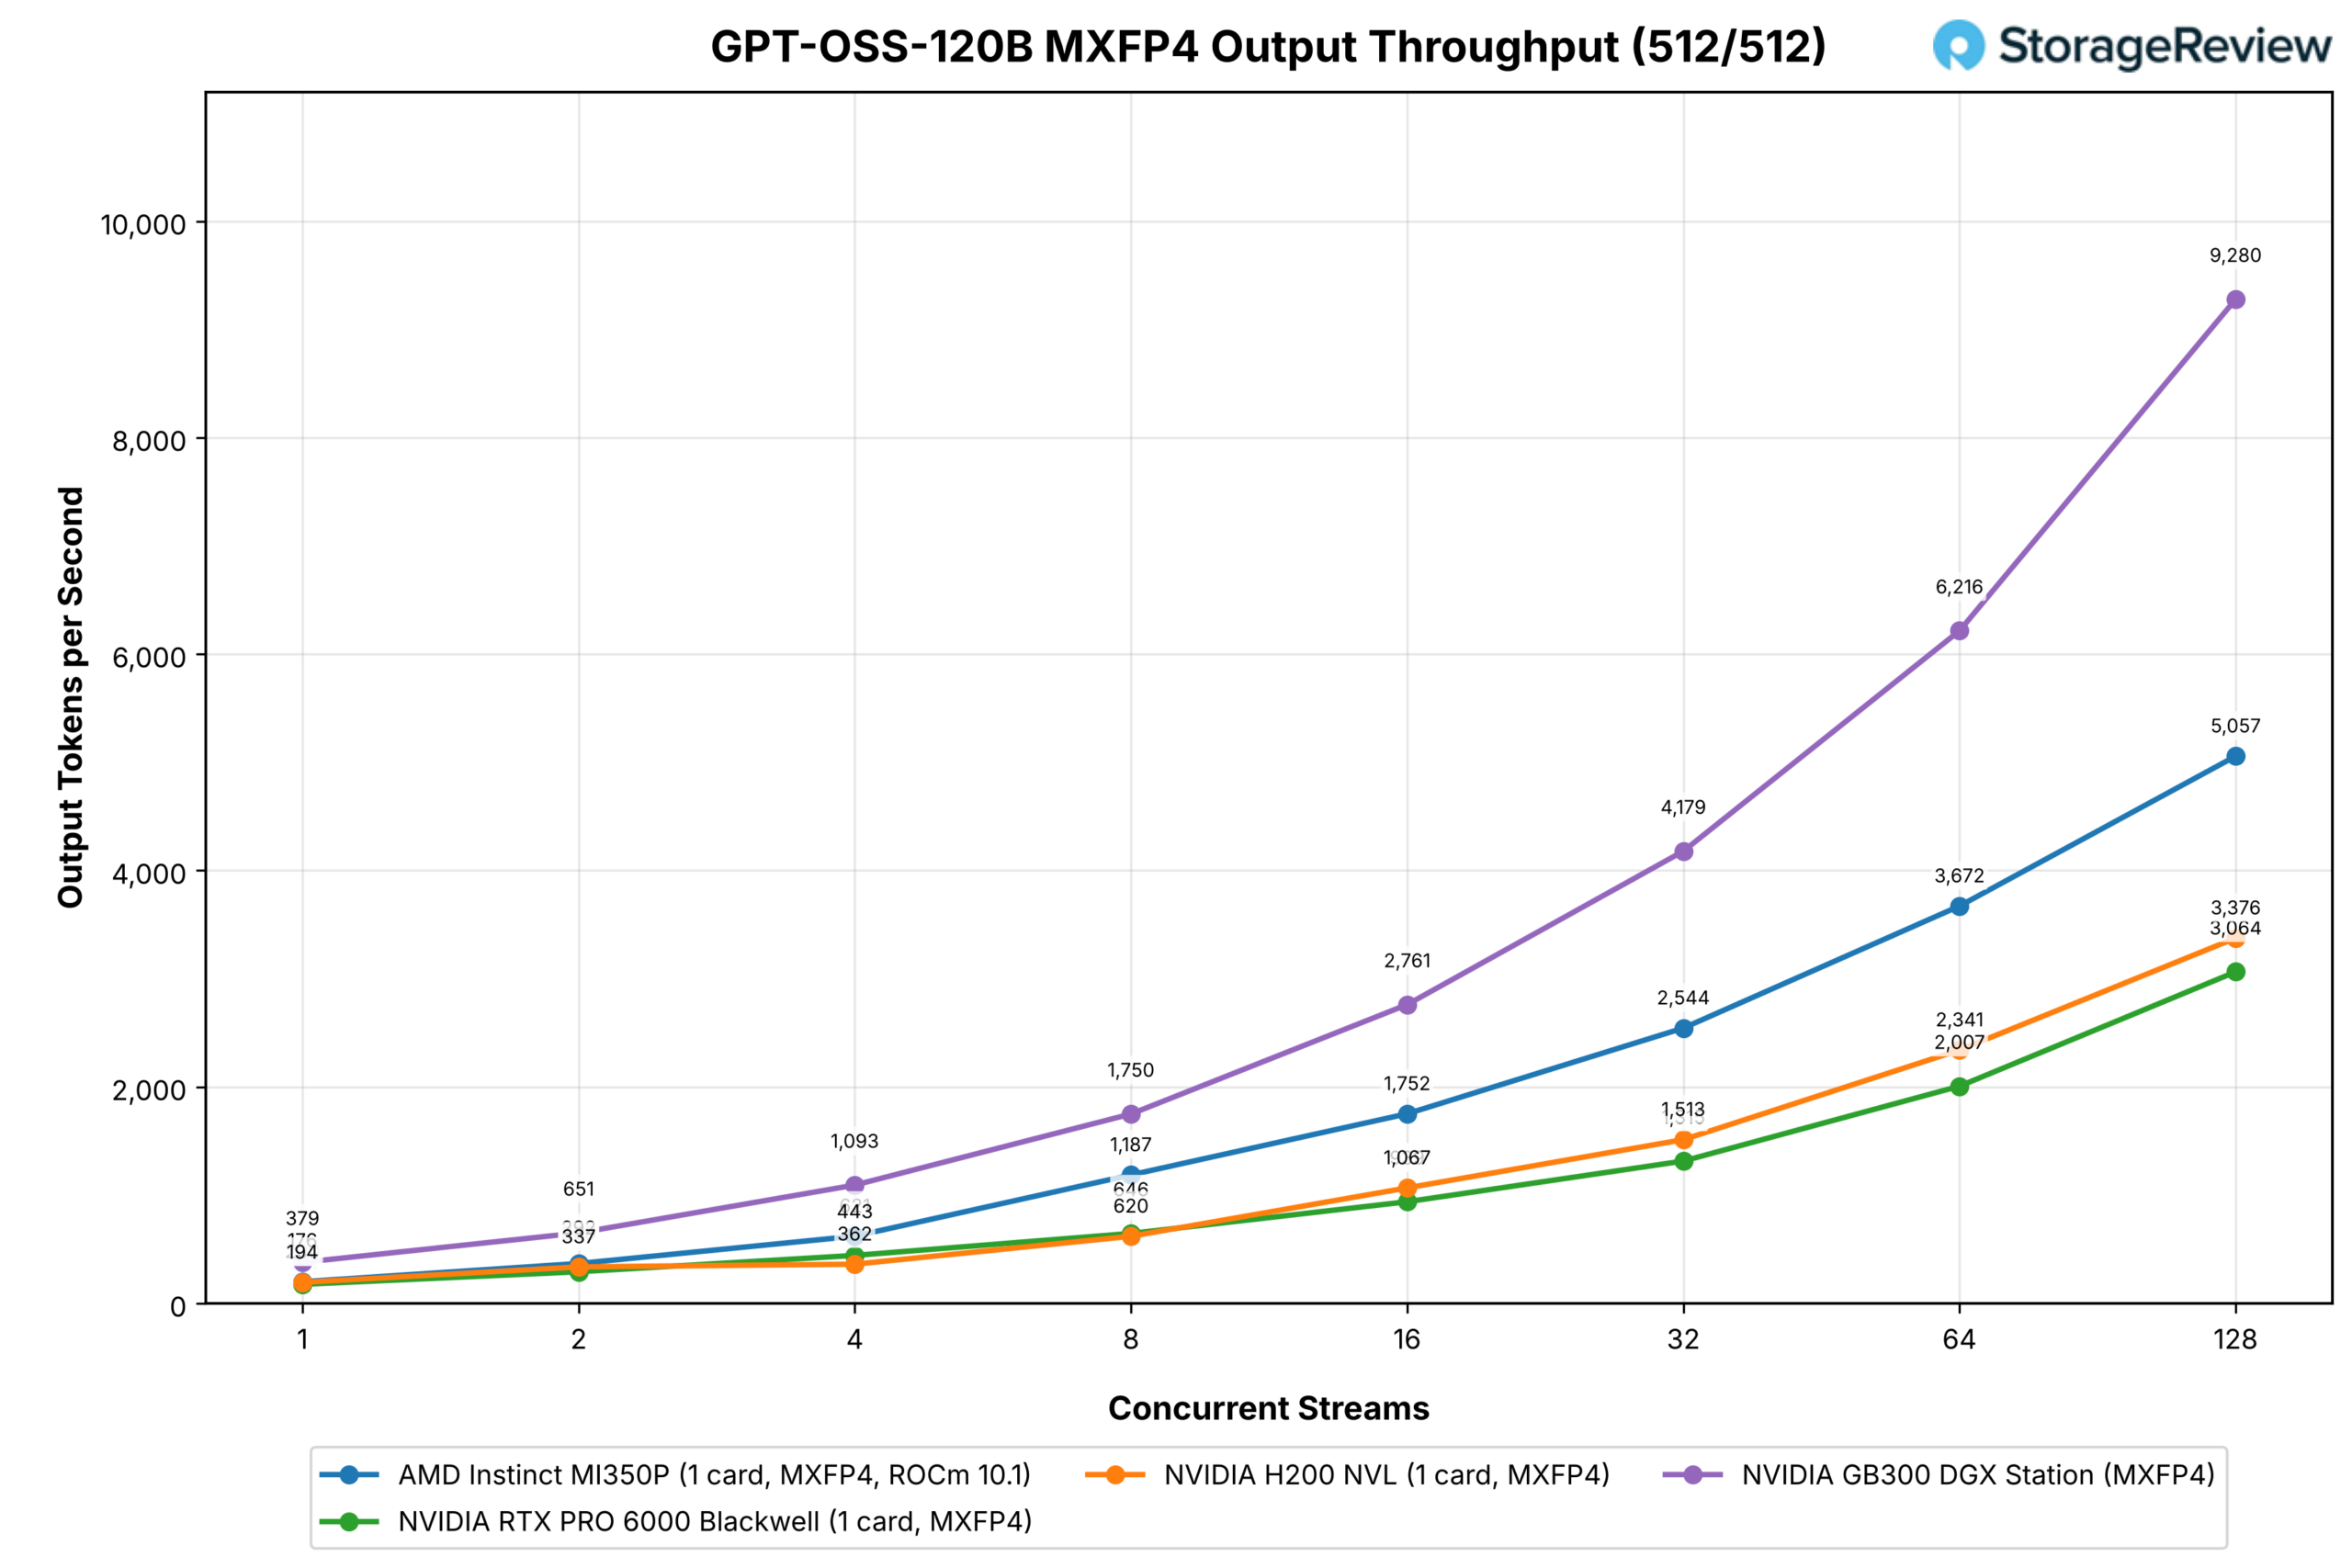
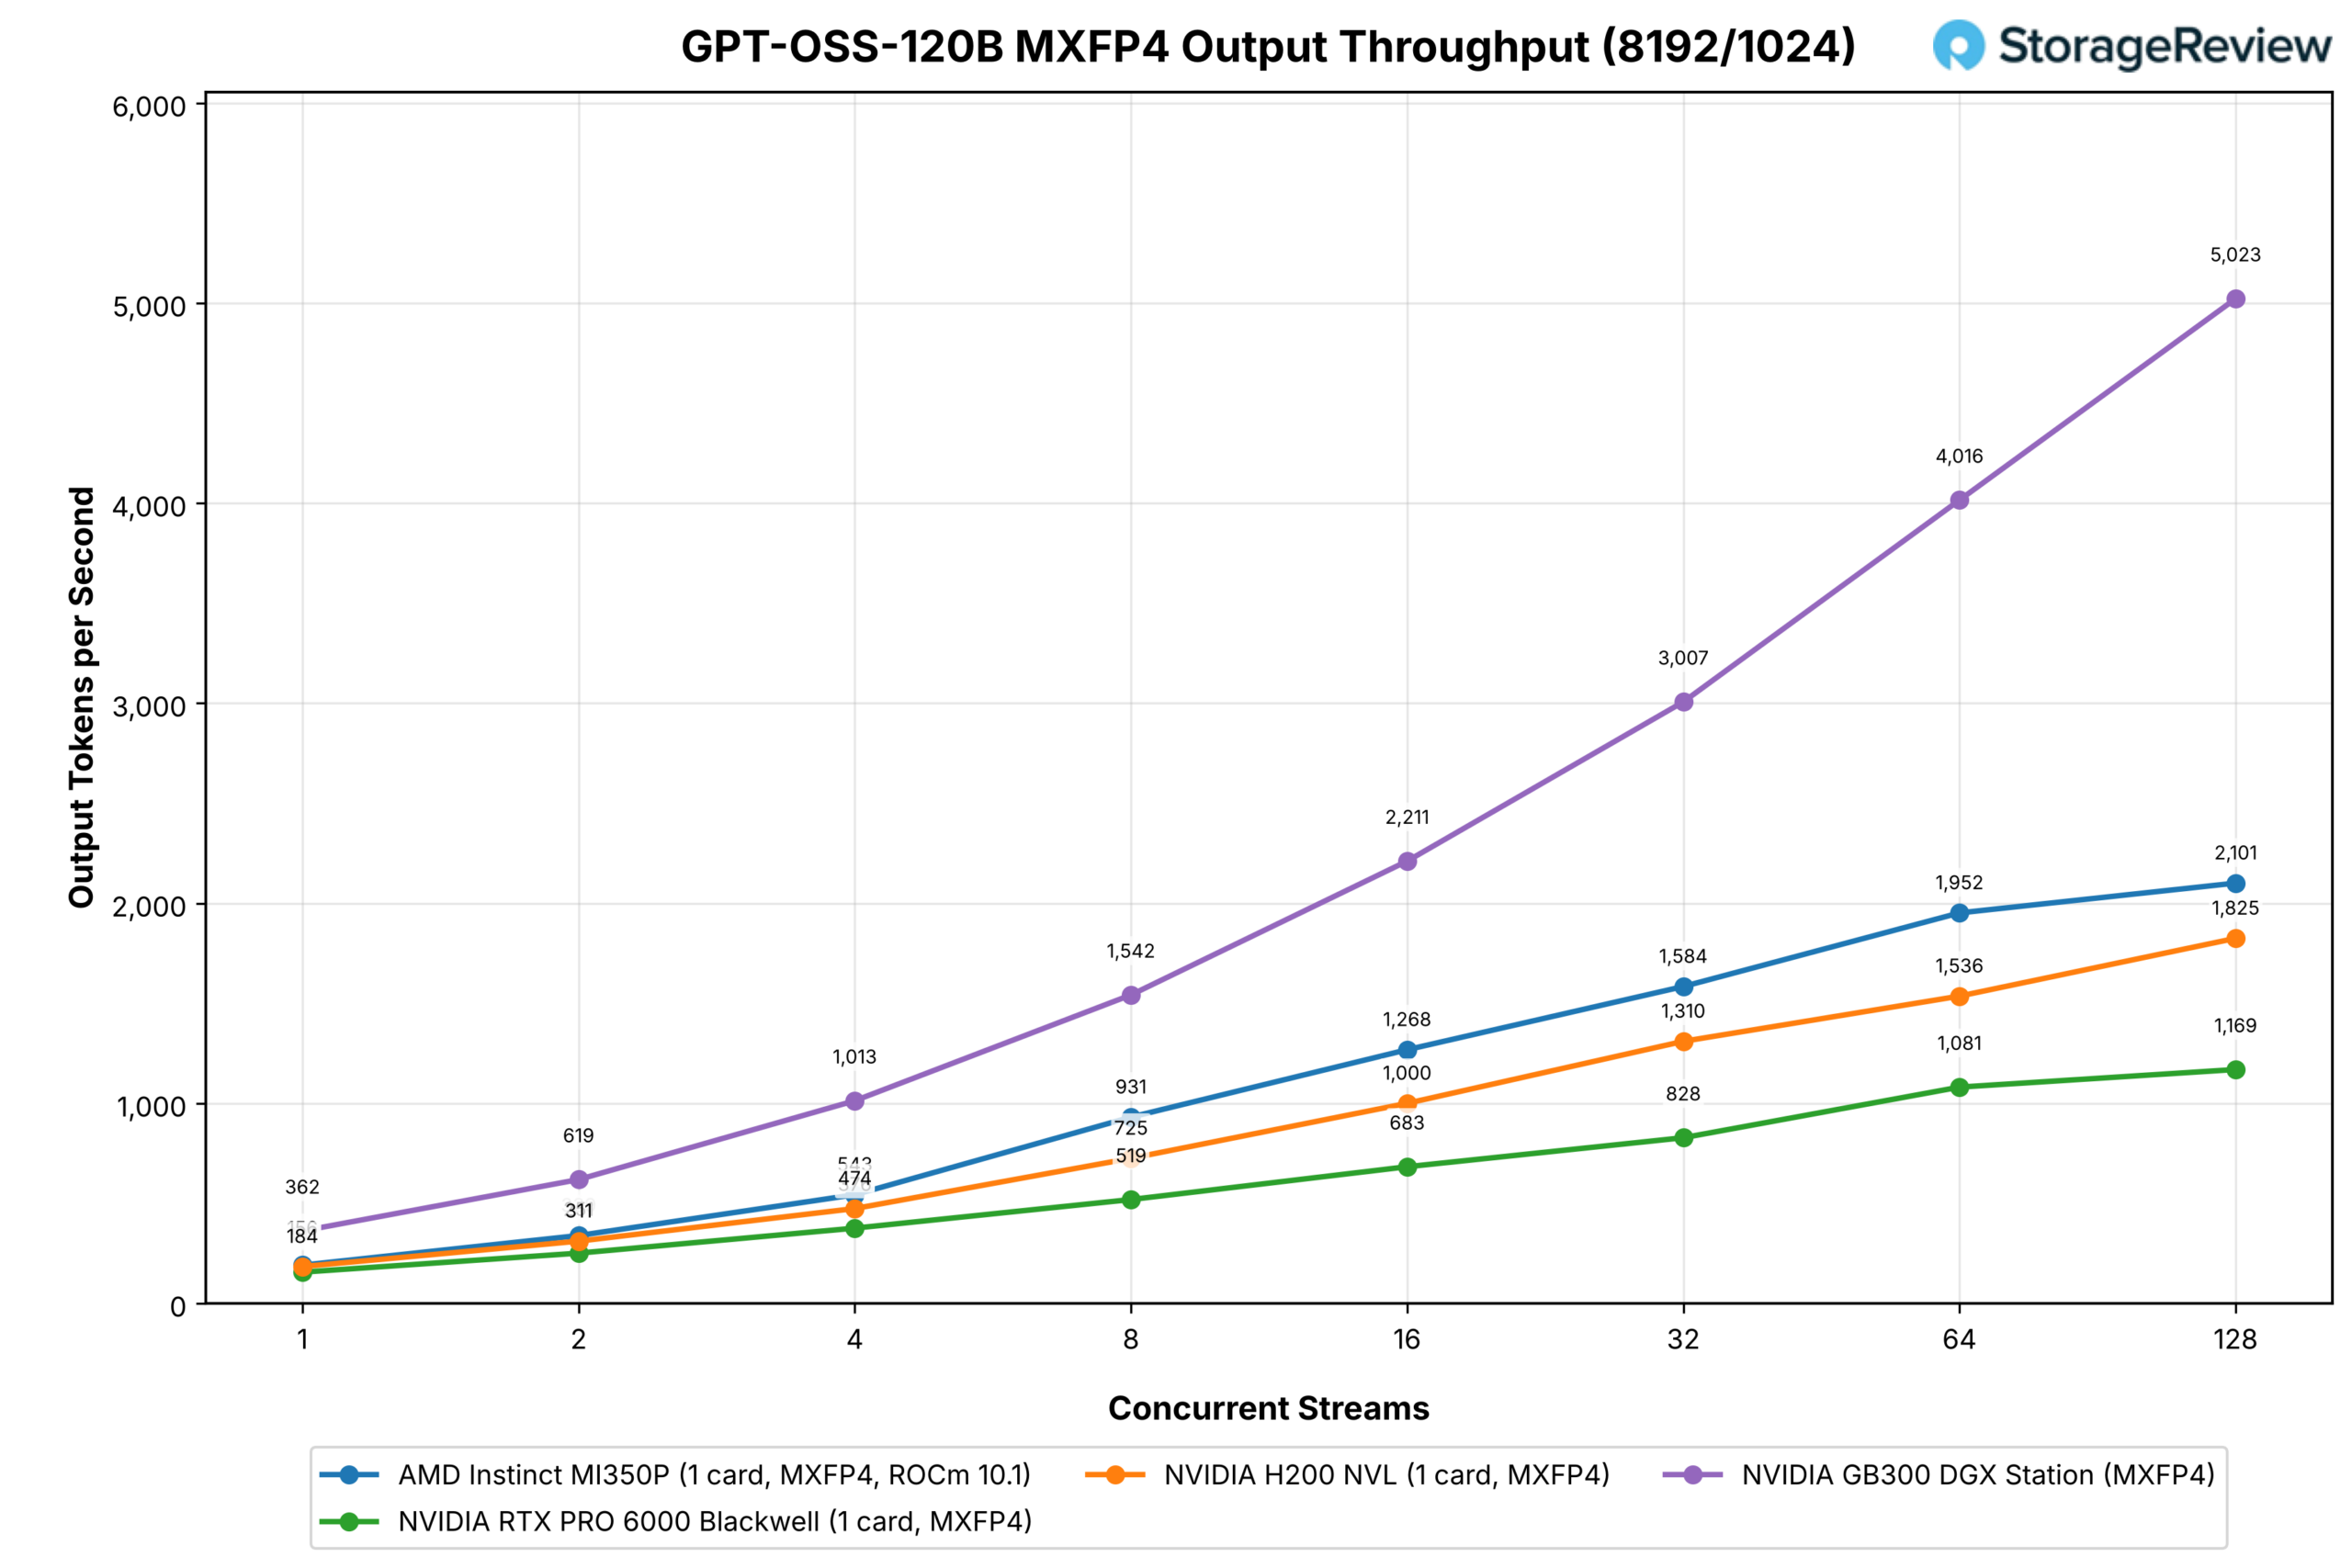
GPT-OSS 采用 MXFP4 编码,因此每张显卡的权重相同。在两种工作负载下,无论流数多少,一张 MI350P 的性能都领先于一张 RTX PRO 6000,从四个流开始,性能提升 40% 到 93%。在聊天工作负载下,MI350P 的输出令牌速度为每秒 5,057 个;在 128 个流的预填充提示符工作负载下,其输出令牌速度为每秒 2,101 个,而 RTX PRO 6000 和 H200 NVL 的相应数值分别为每秒 3,064 个和 1,169 个;Station 的相应数值分别为每秒 3,376 个和 1,825 个;Station 的相应数值分别为每秒 9,280 个和 5,023 个。
AMD 和戴尔于 9 月 16 日提交的 MLPerf Inference v6.1 测试结果为同一模型设定了性能上限:在经过优化的测试环境中,PowerEdge XE7745 服务器上的八颗 MI350P 显卡在离线模式下每秒可生成 48,971 个 token,在服务器场景下每秒可生成 40,868 个 token(GPT-OSS-120B 算法),相当于每颗 GPU 每秒可生成 6,121 个 token 和 5,108 个 token。虽然该测试环境与我们使用的测试环境并不完全相同,但我们在默认 vLLM 算法下,使用 128 个流进行测试时测得的 5,057 个 token 处于该范围的下限。
GPT-OSS-20B
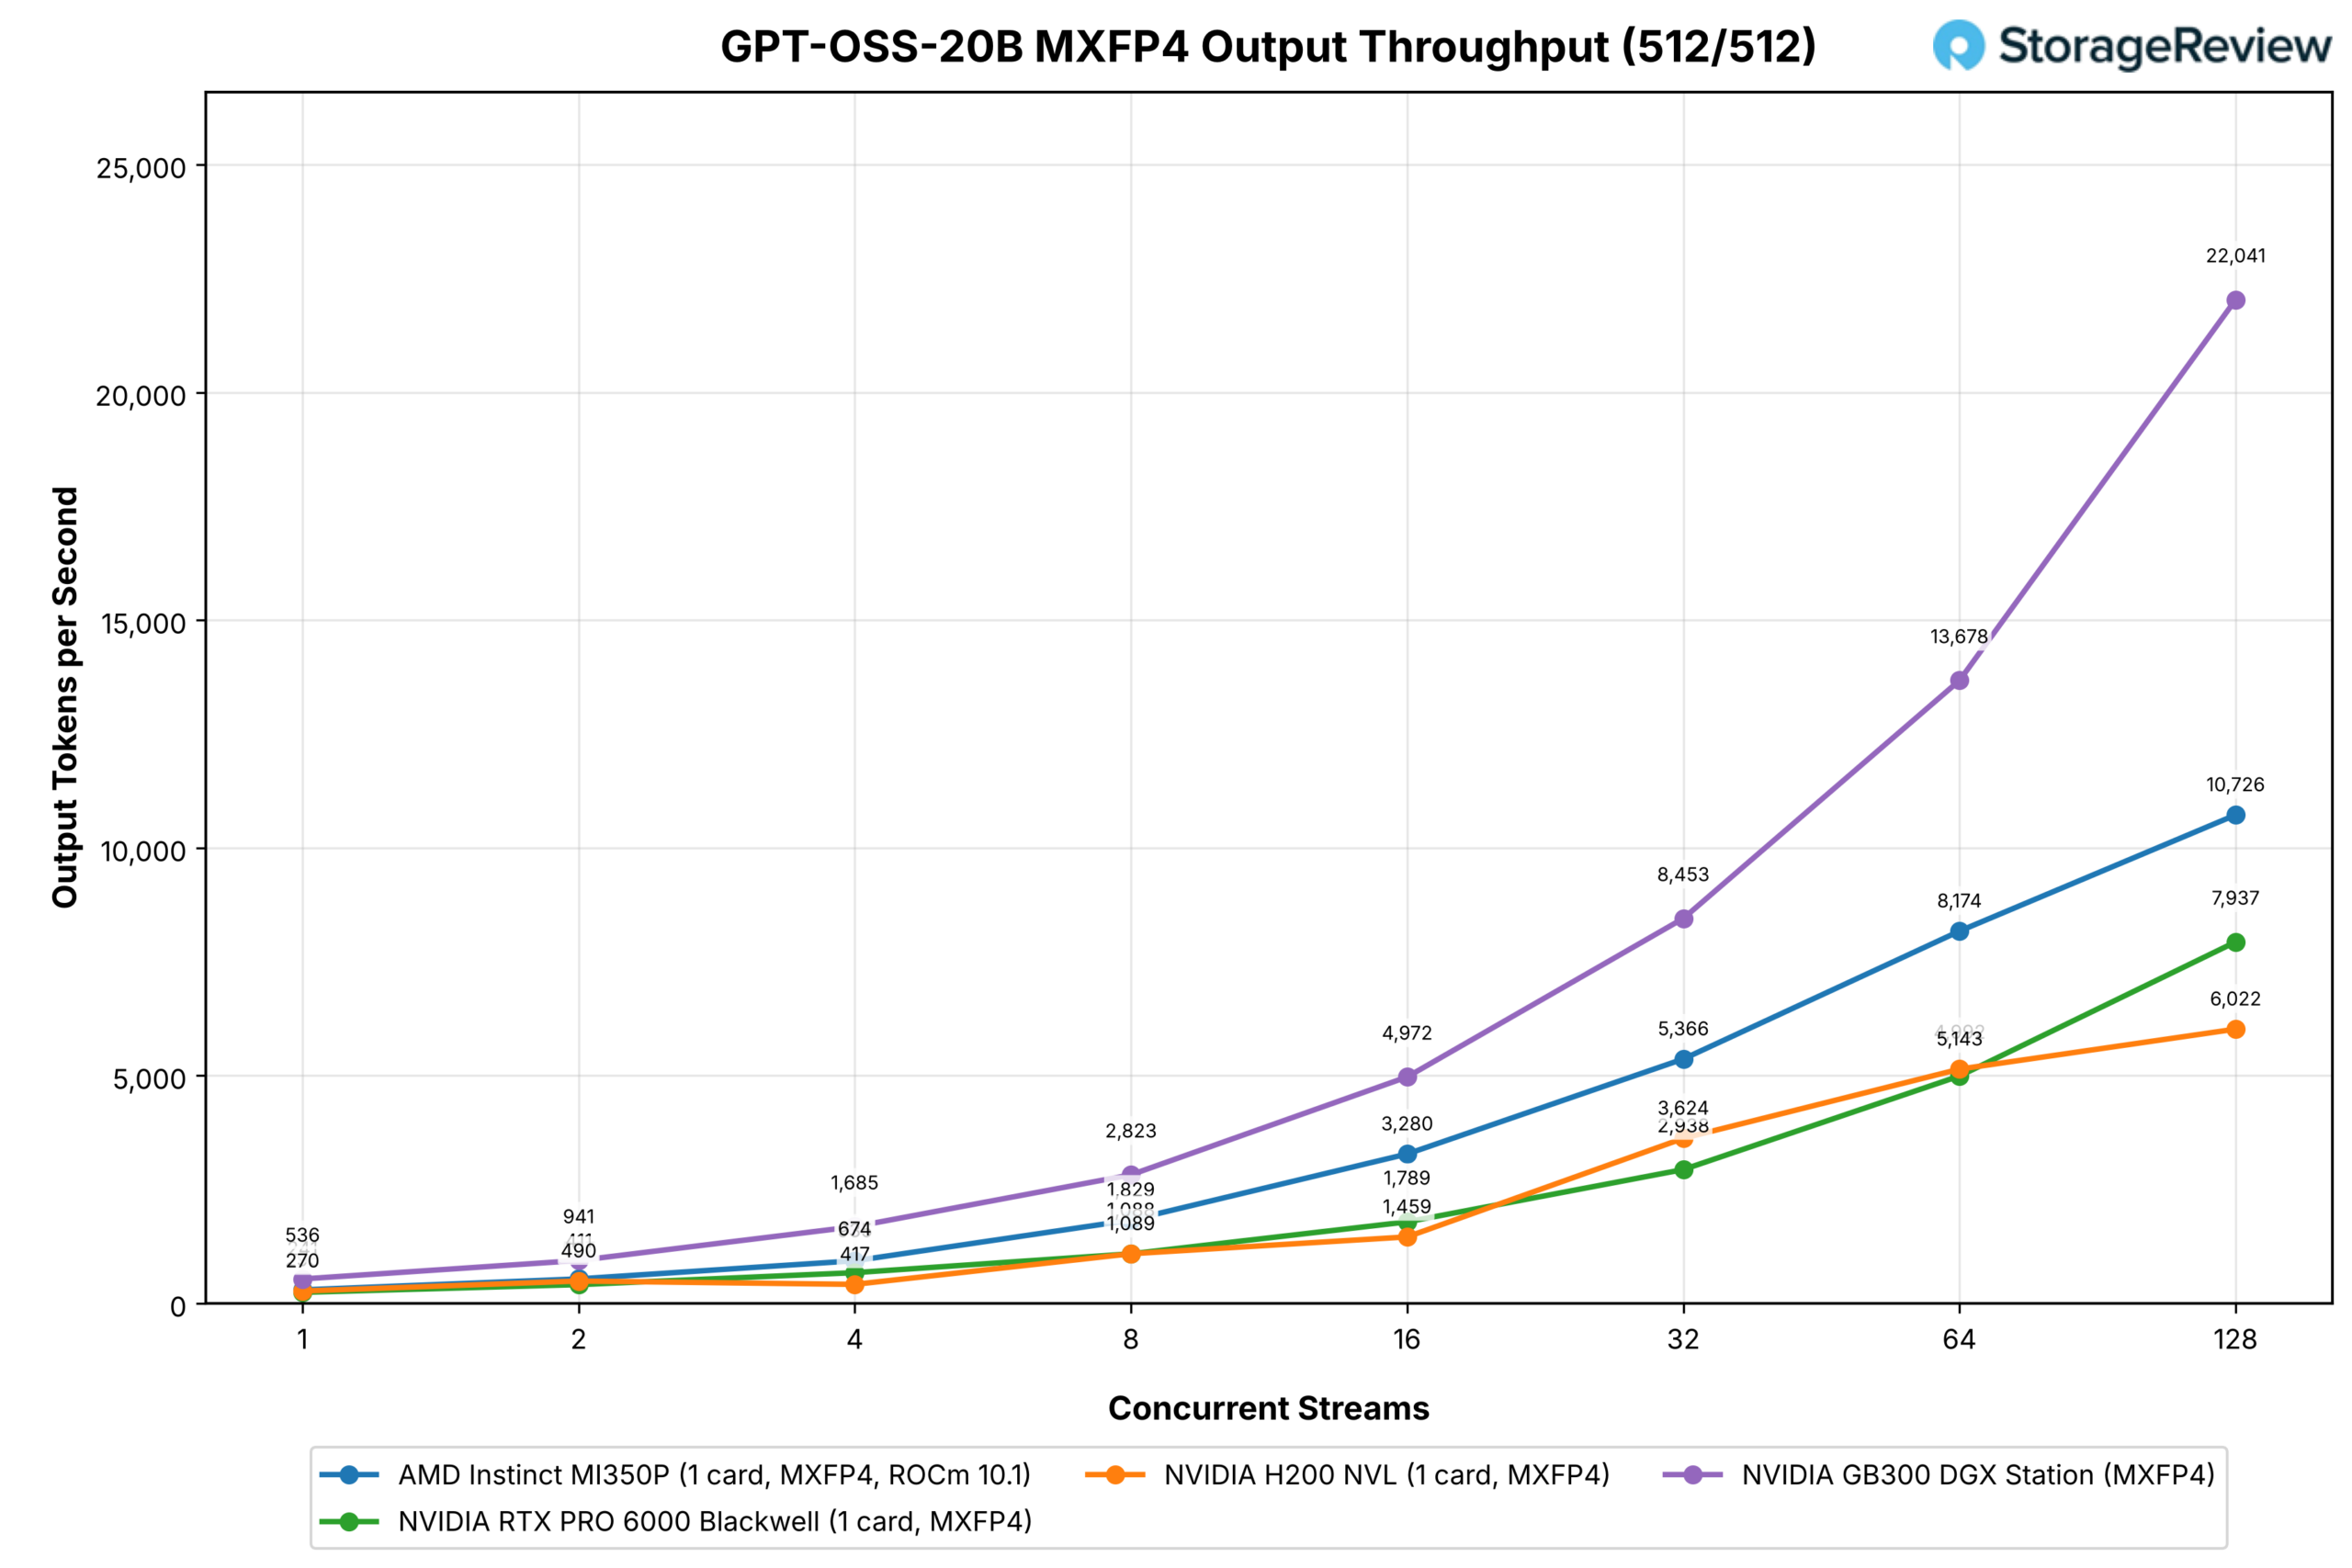
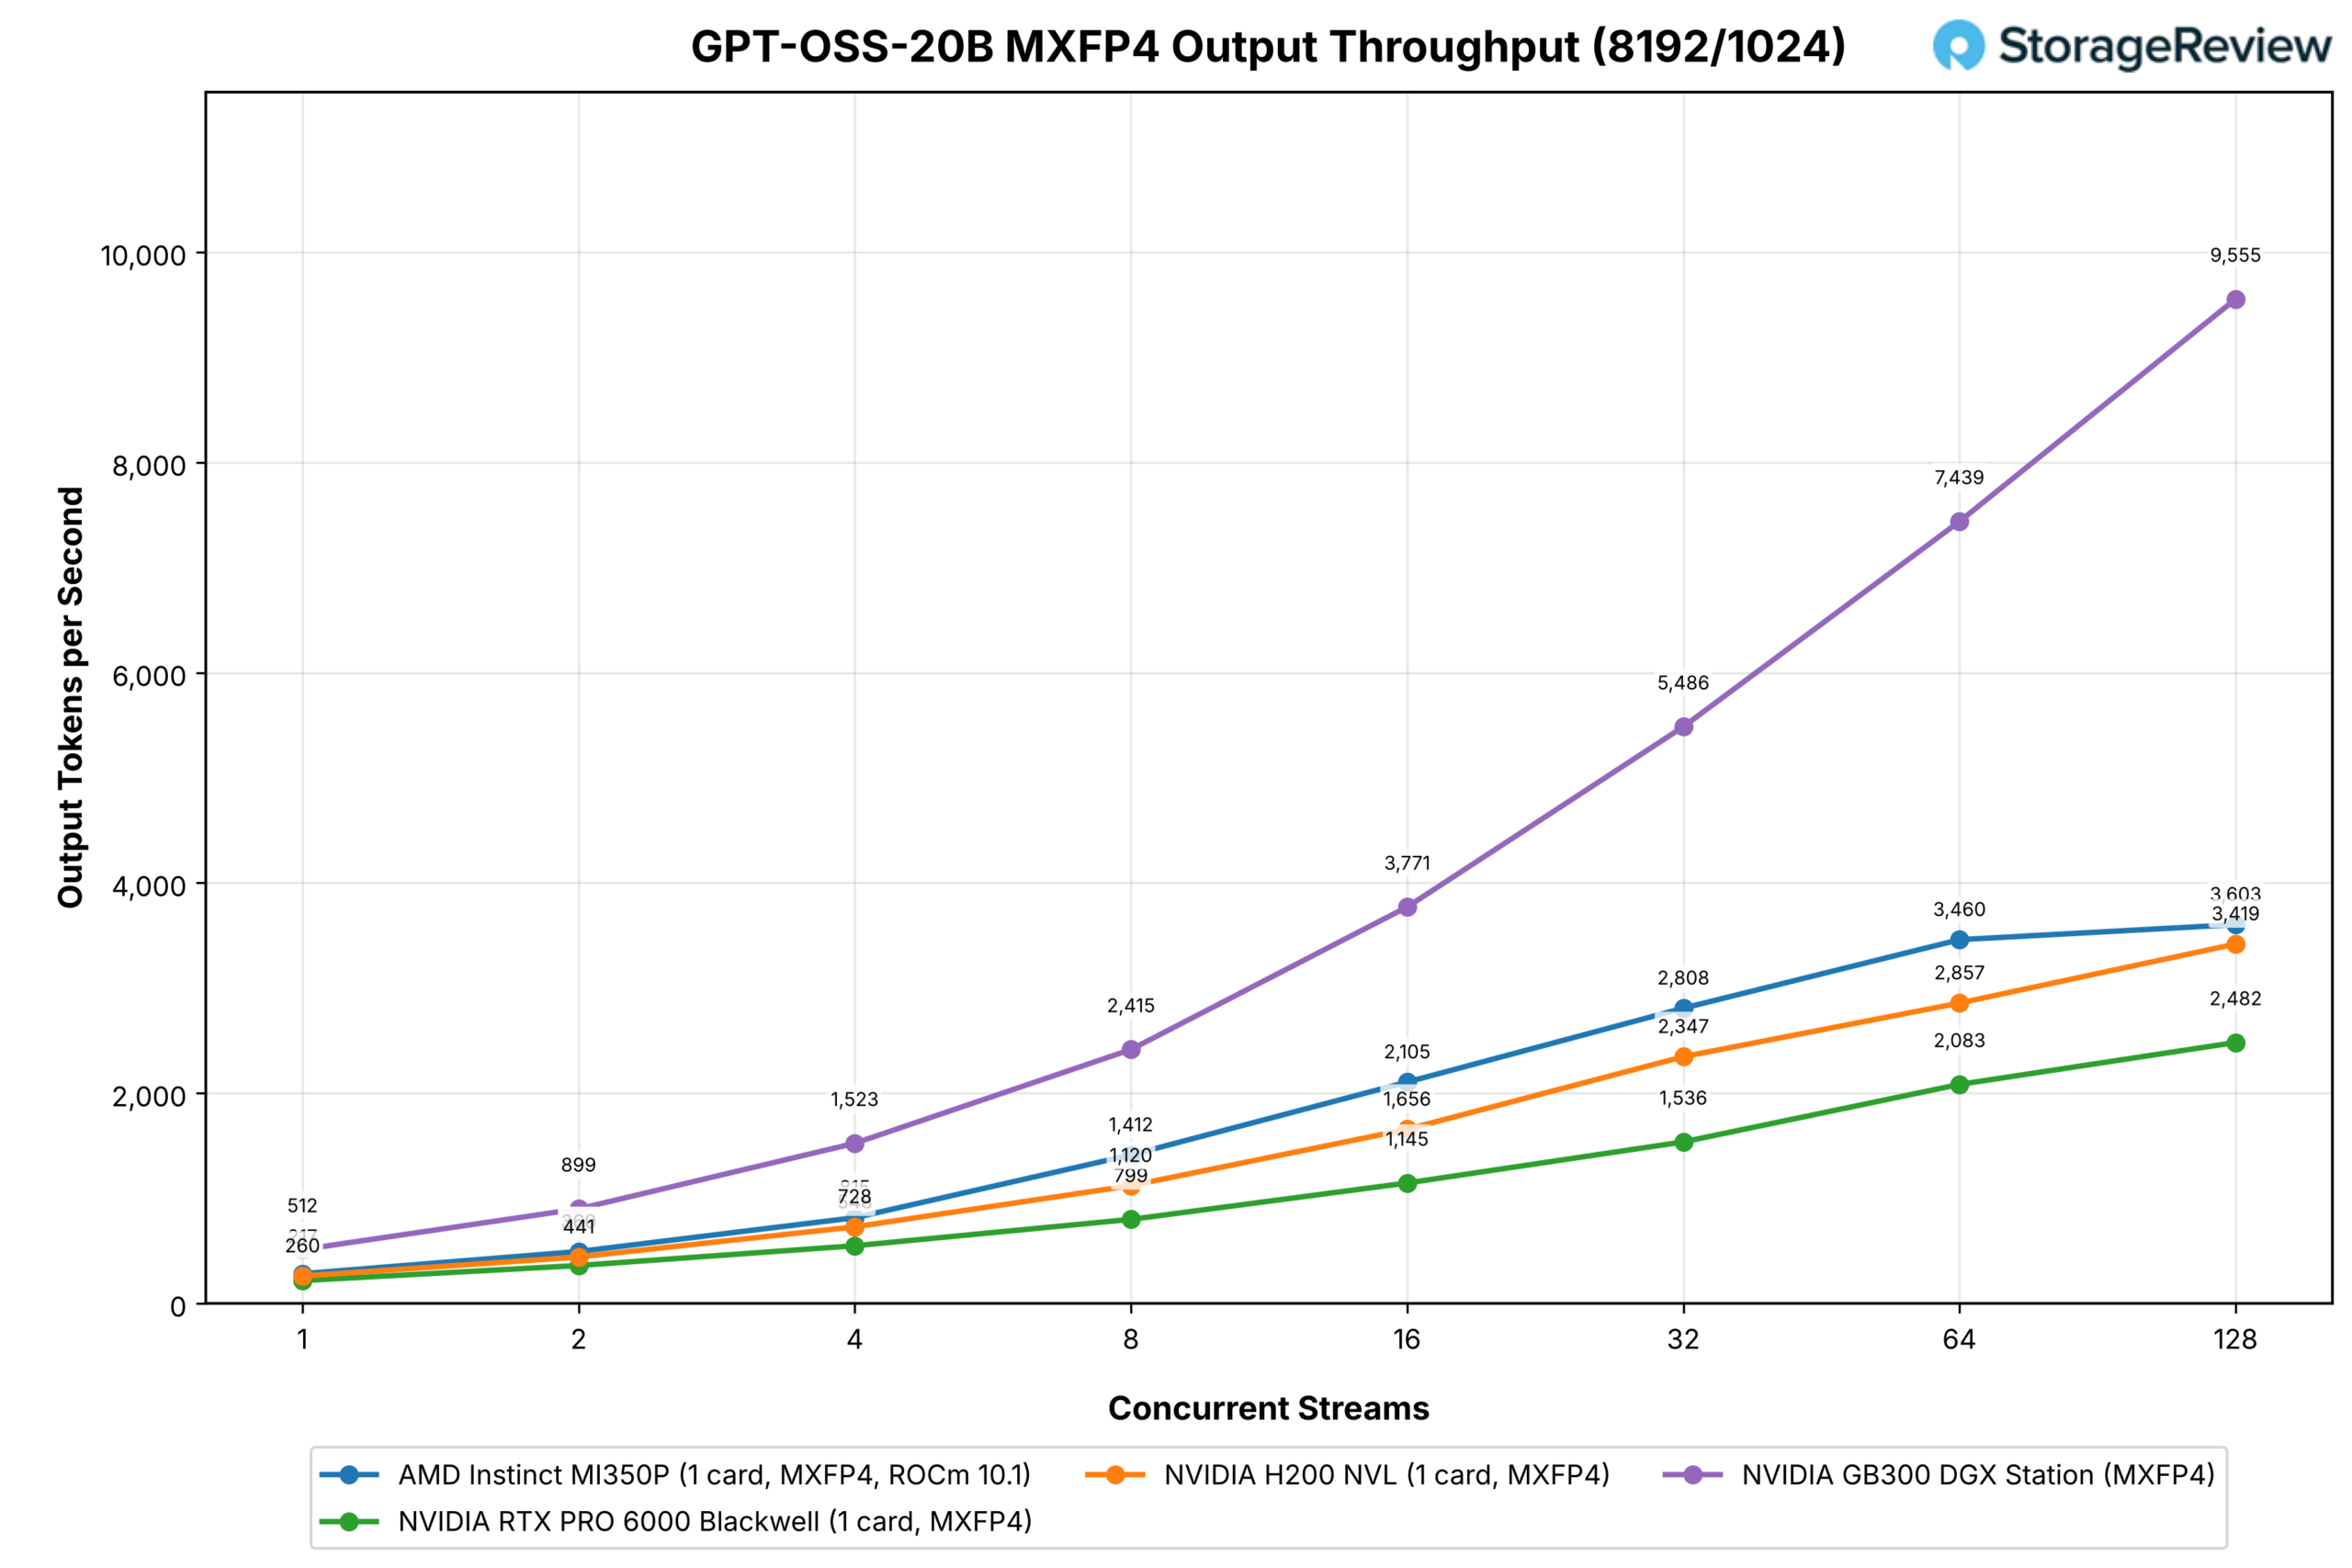
较小的 OpenAI 模型也遵循同样的曲线。在所有测试点上,MI350P 的性能都优于 RTX PRO 6000:在 64 路流测试中,MI350P 的得分为 8,174,而 RTX PRO 6000 为 4,992;在 128 路流测试中,MI350P 的得分为 10,726,而 RTX PRO 6000 为 7,937;在预填充提示测试中,MI350P 的得分为 3,460,而 RTX PRO 6000 为 2,083;在 256 路流测试中,MI350P 的得分为 16,406,而 RTX PRO 6000 的得分为 11,077。H200 NVL 在两种测试条件下的性能均落后于 MI350P,在 128 路流测试中,MI350P 的得分分别为 6,022 和 3,419;而 Station 的得分分别为 22,041 和 9,555。
Qwen3-编码器-30B-A3B
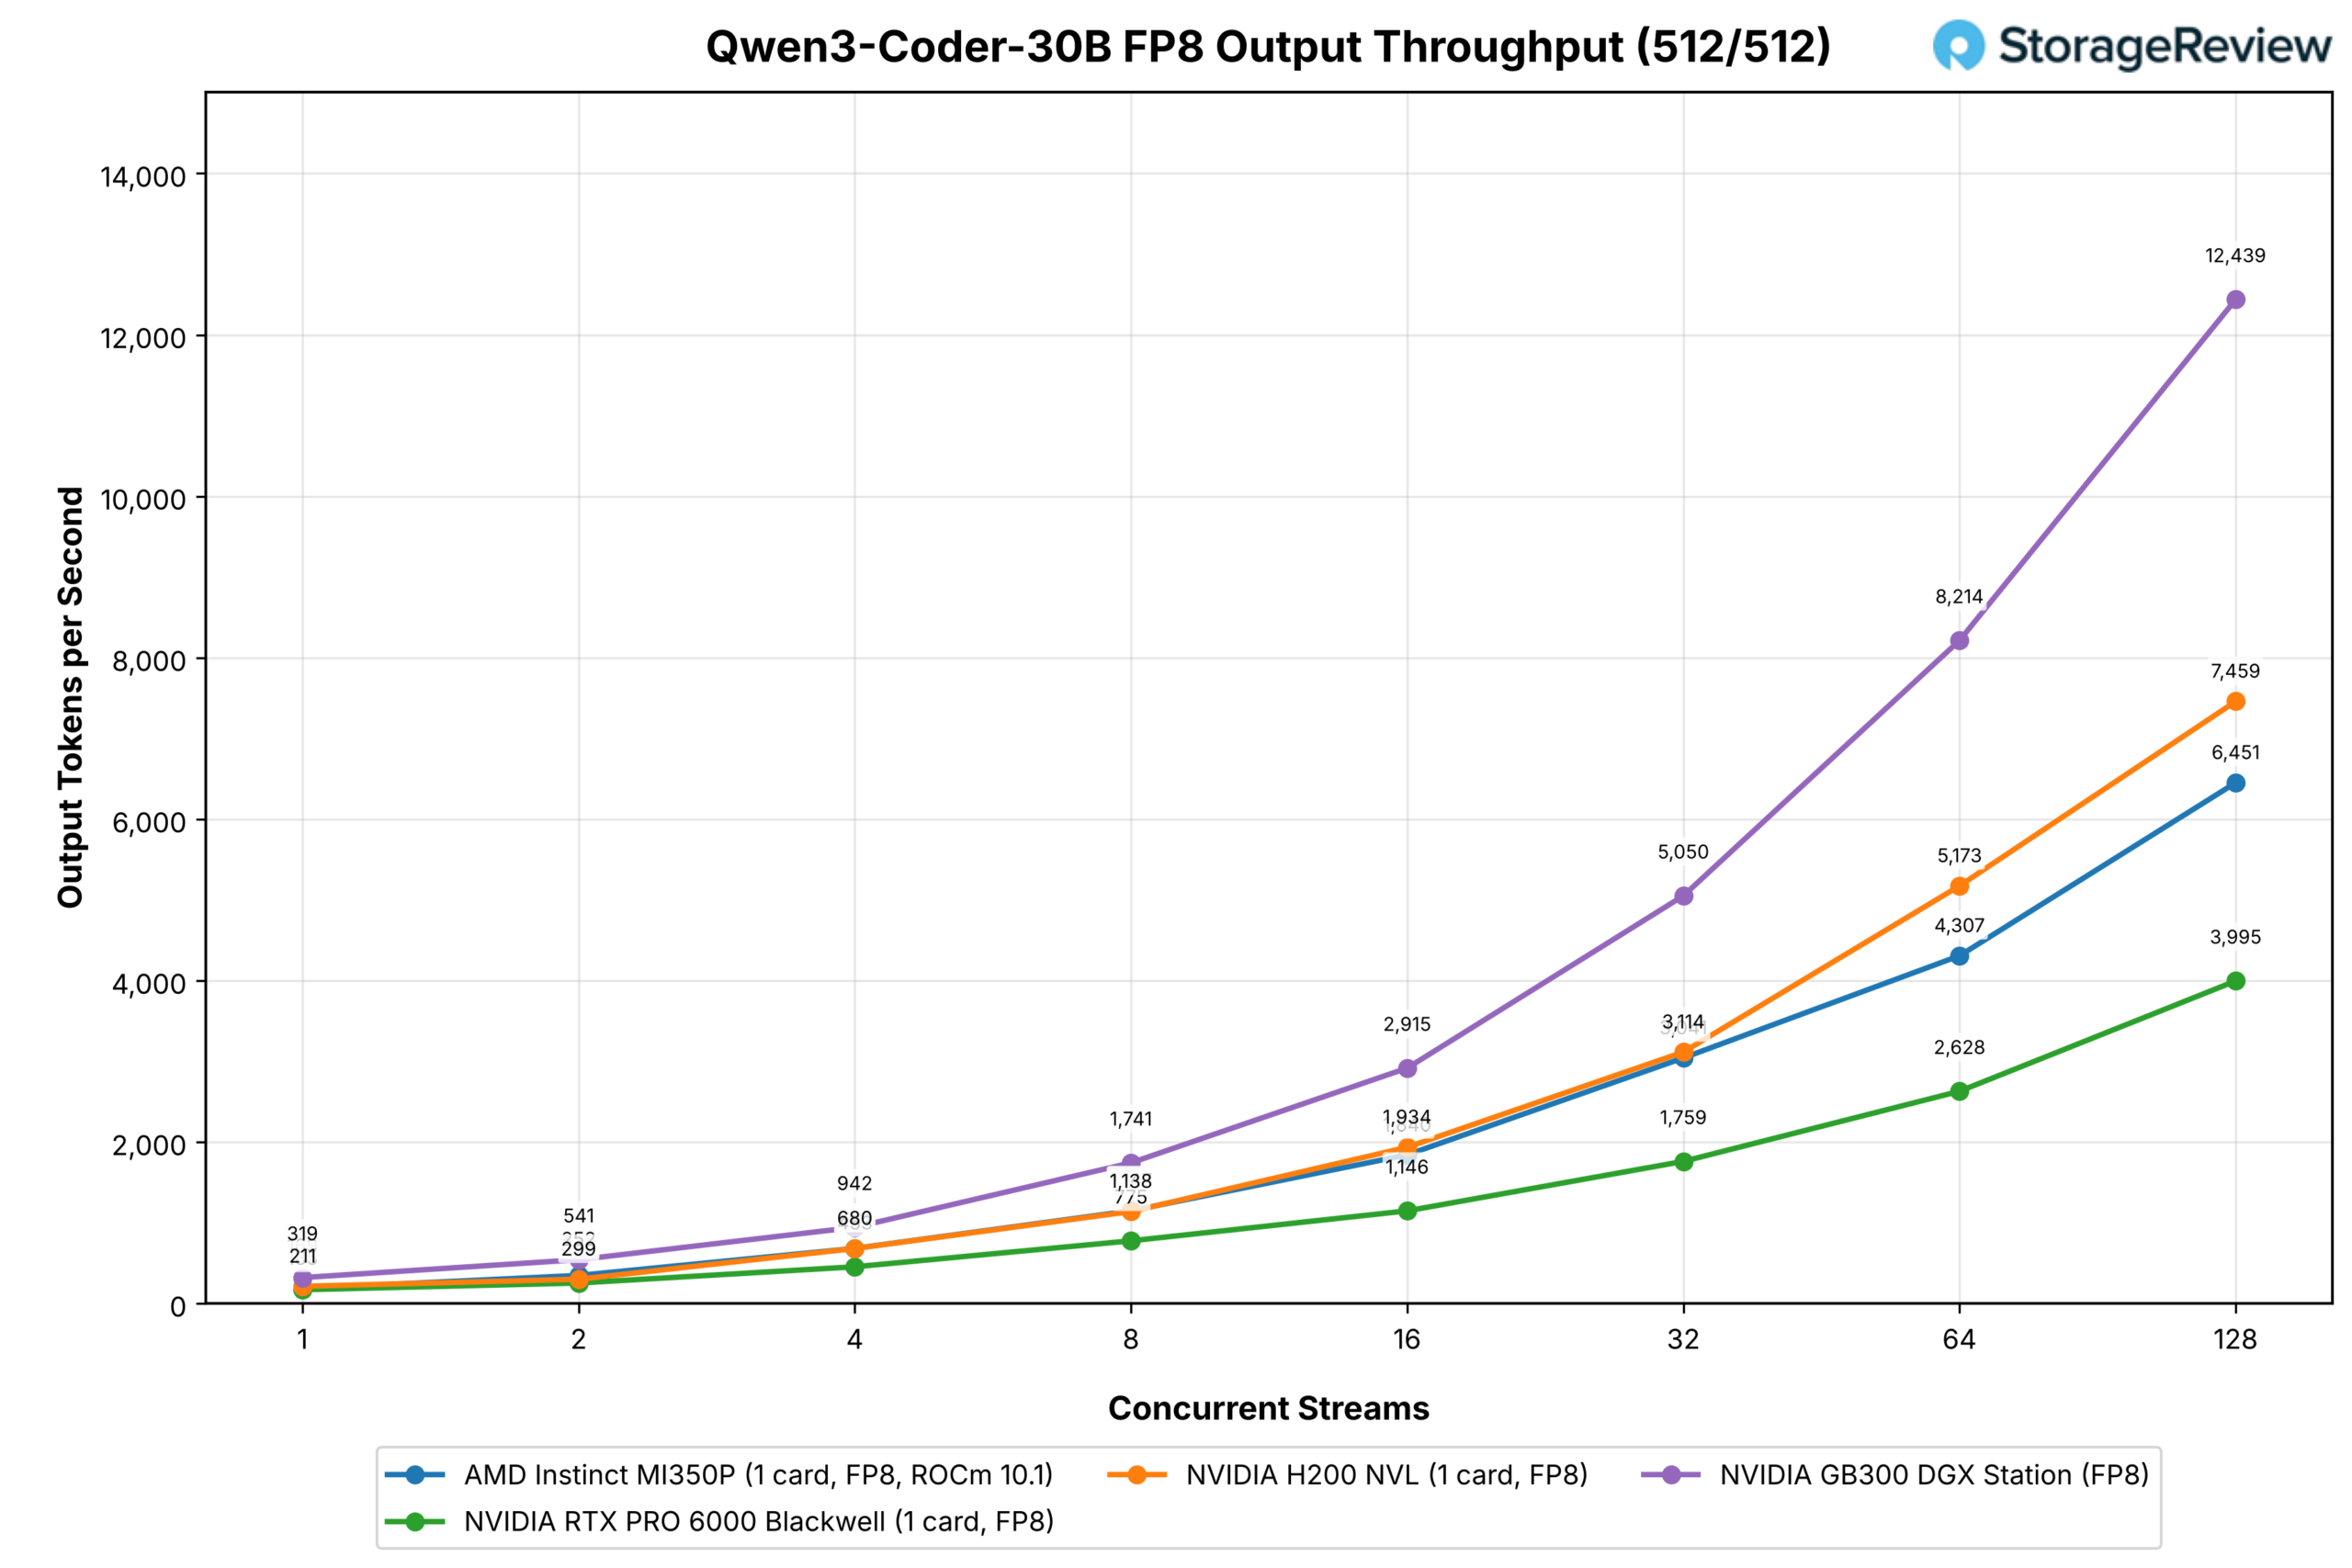
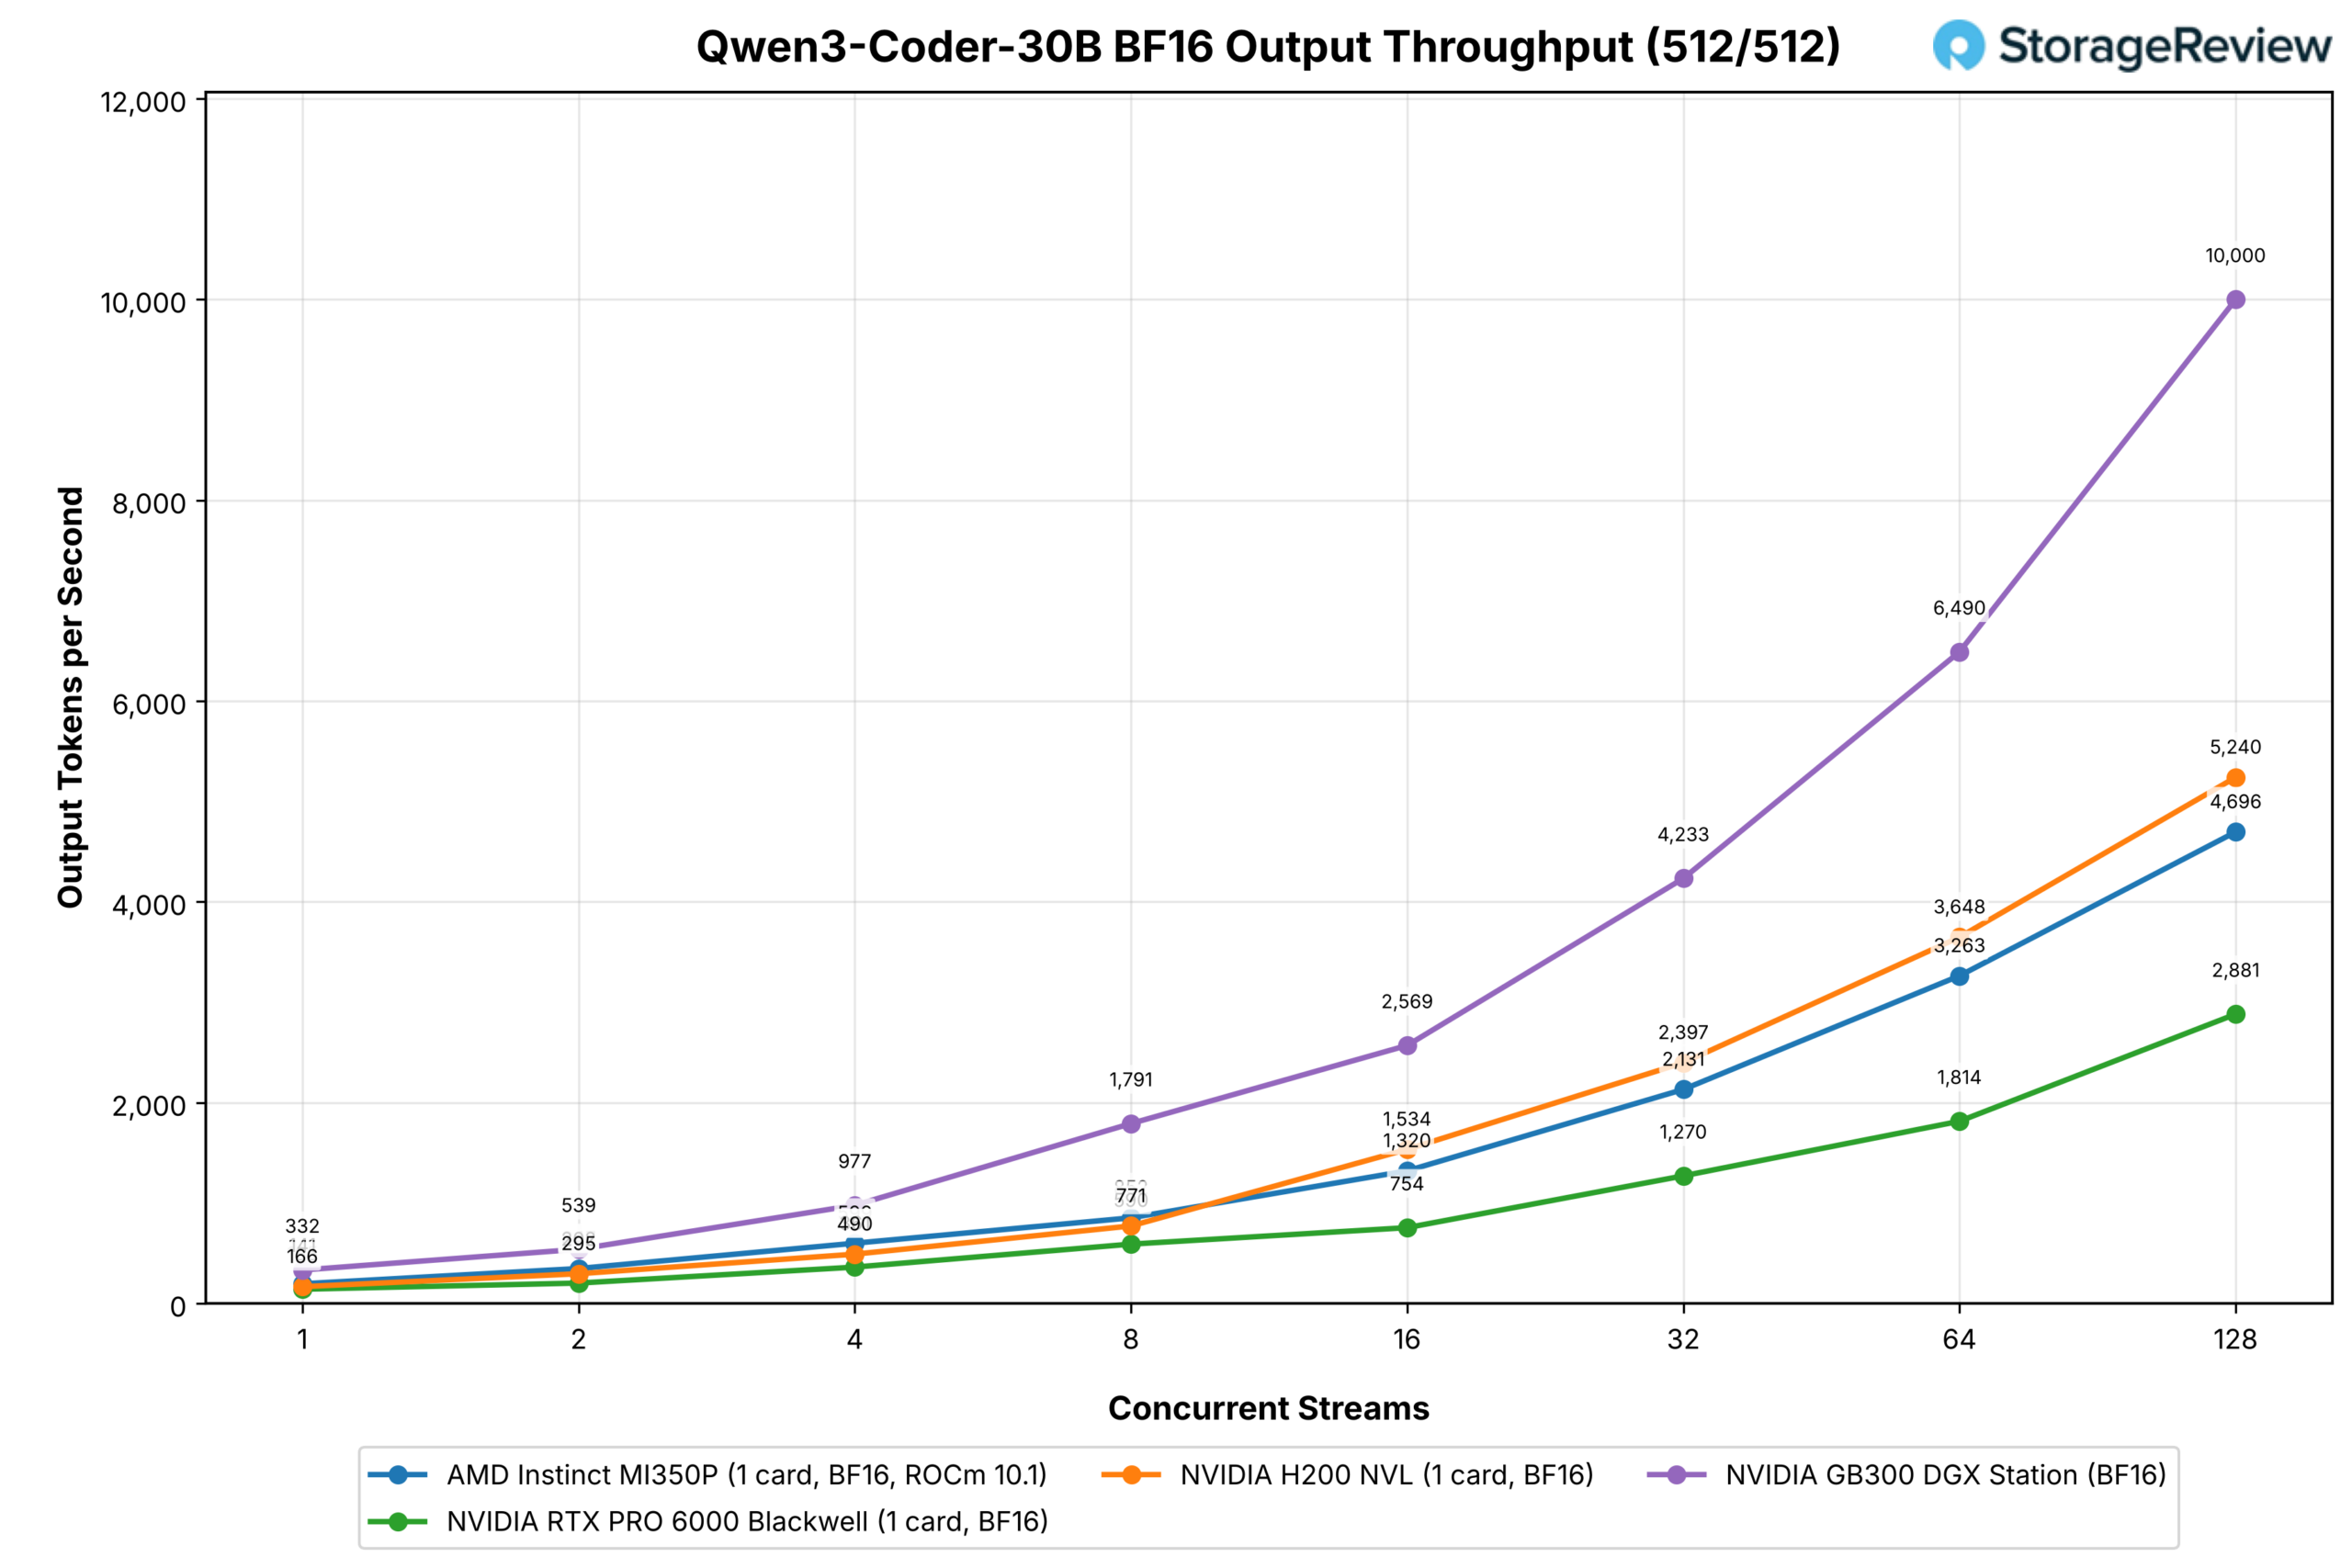
30B MoE 和 3B 活动参数使 MI350P 在聊天工作负载的每个并发数上都领先于 RTX PRO 6000,在 FP8 上达到 6,451 对 3,995,在 128 个流的 BF16 上达到 4,696 对 2,881,而 H200 分别为 7,459 和 5,240。
在预填充较多的提示中,FP8 运行仅在前四个流中领先,然后从第八个流到第 128 个流落后于 RTX PRO 6000,最高分为 759 分,而 RTX PRO 6000 的最高分为 823 分,H200 的最高分为 1,820 分;BF16 运行在 128 个流时达到 728 分,而 RTX PRO 6000 的最高分为 588 分和 1,592 分。
米斯特拉尔小号 3.1 24B
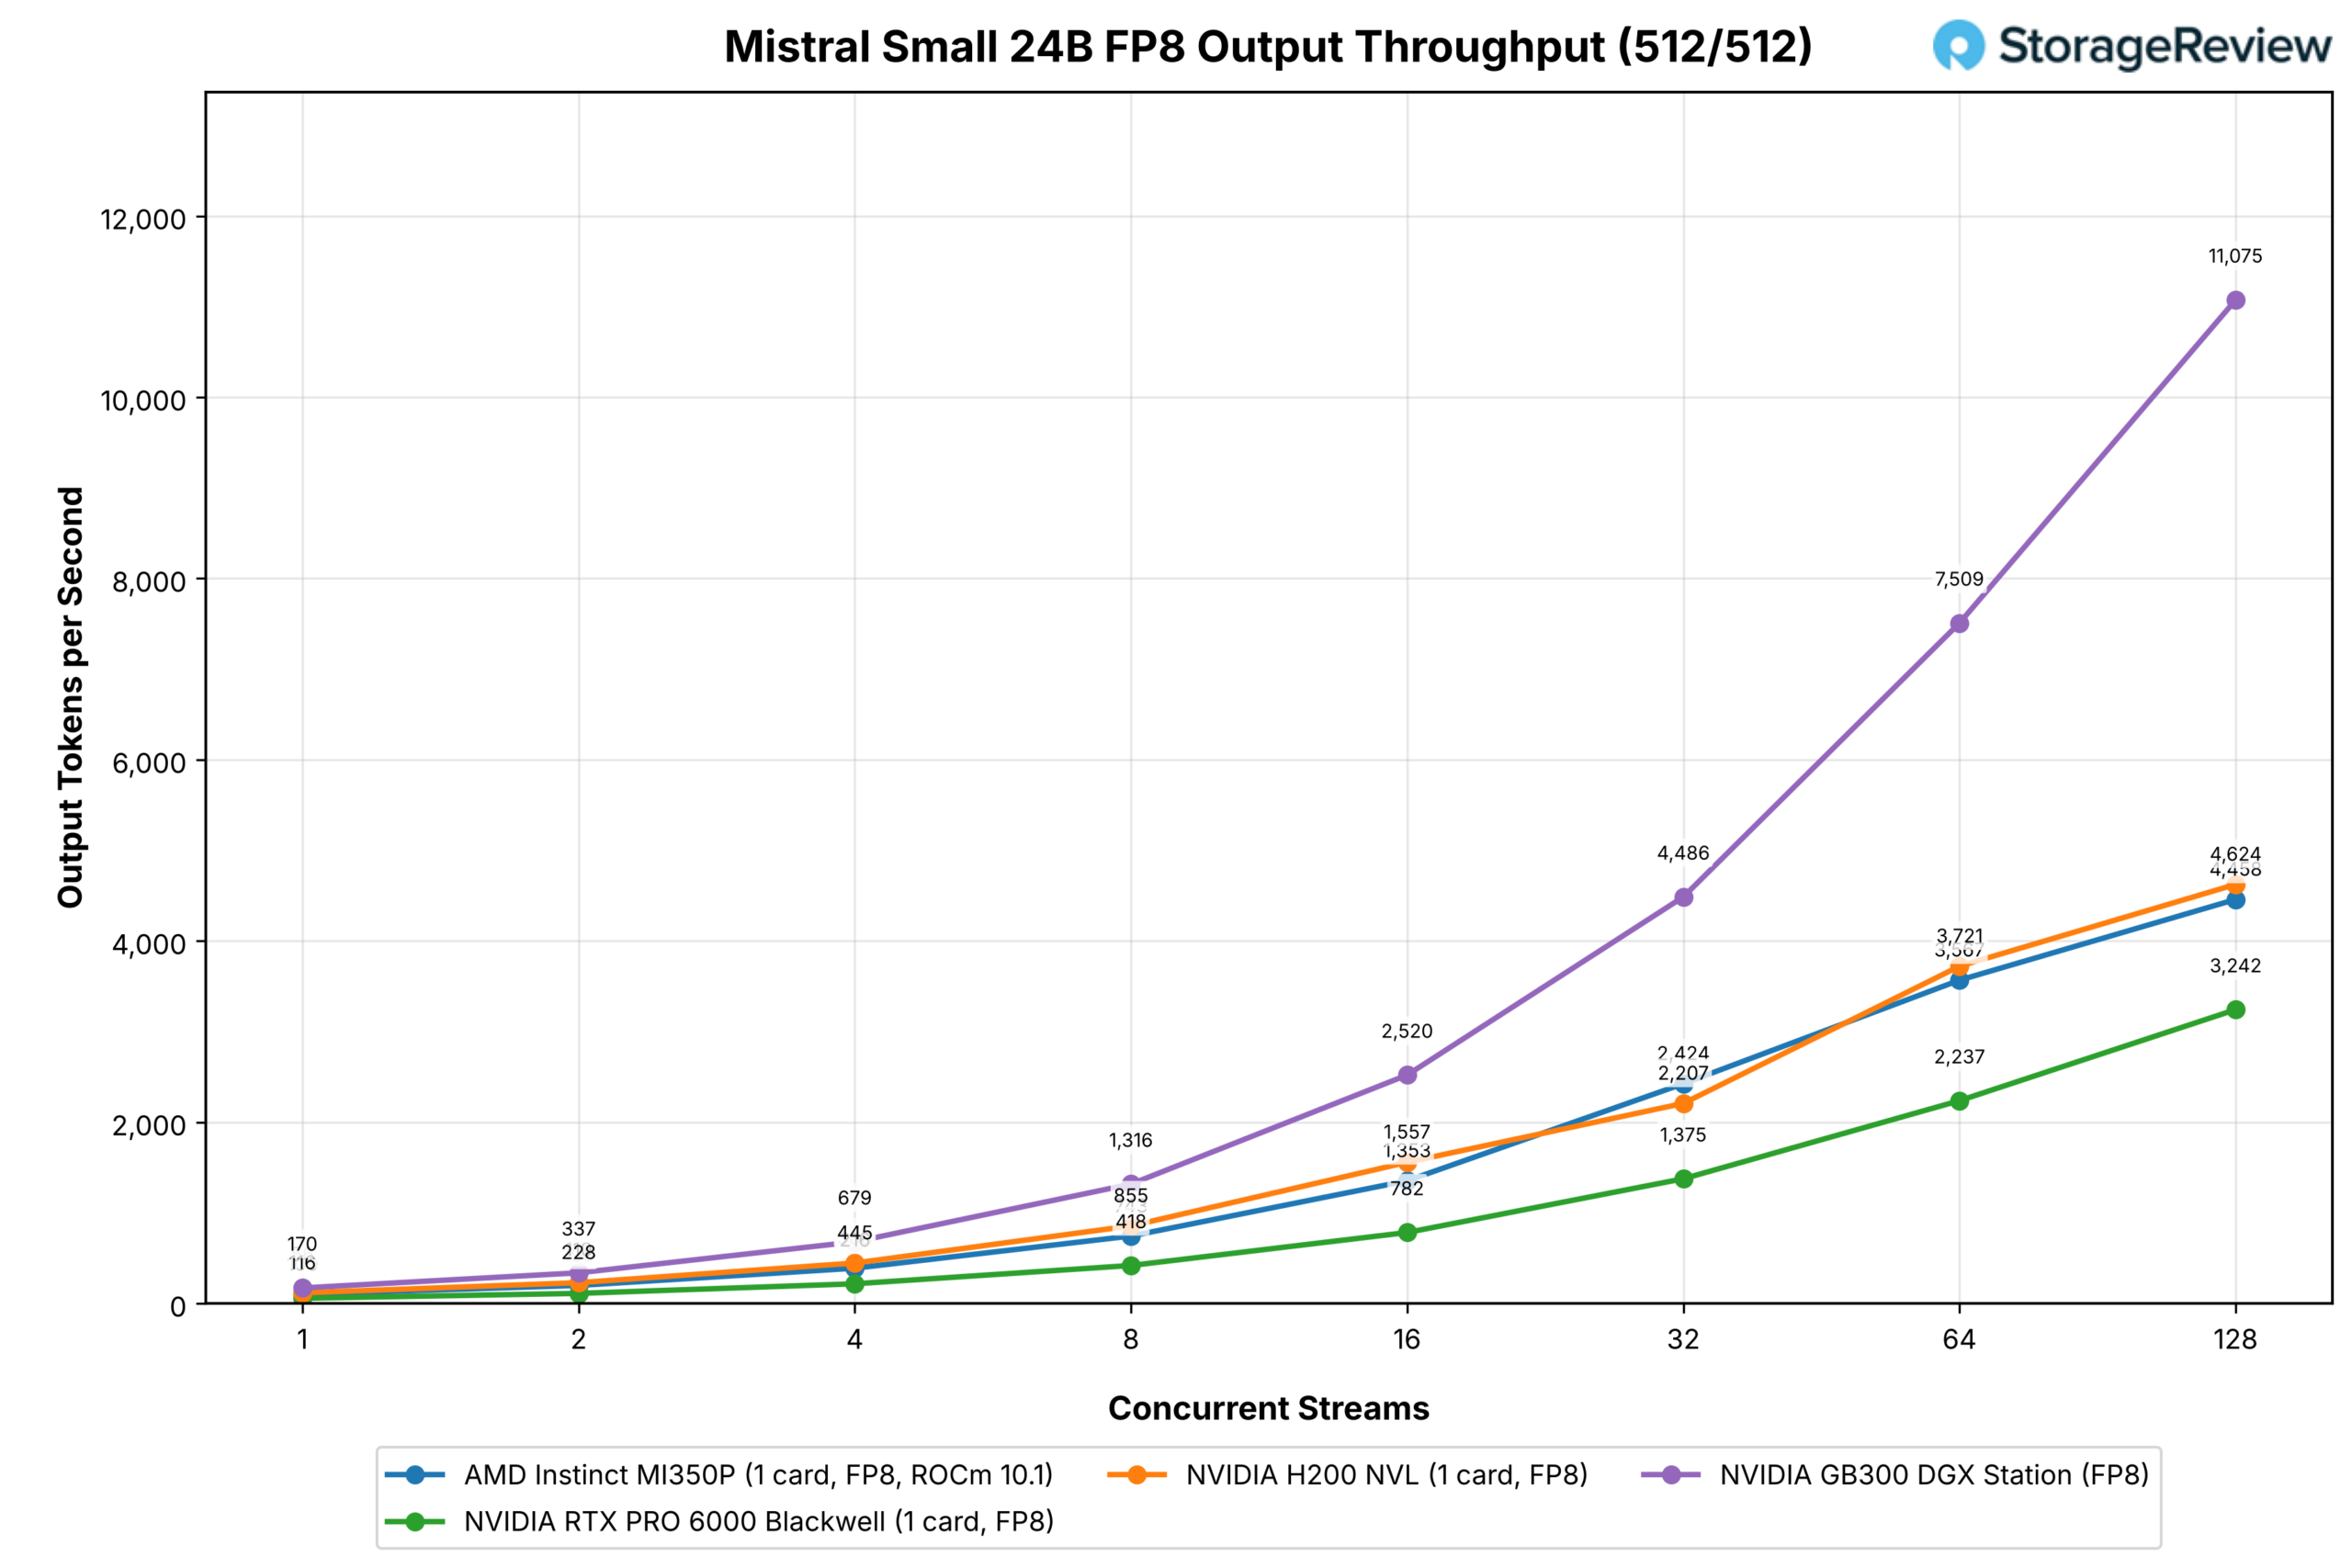
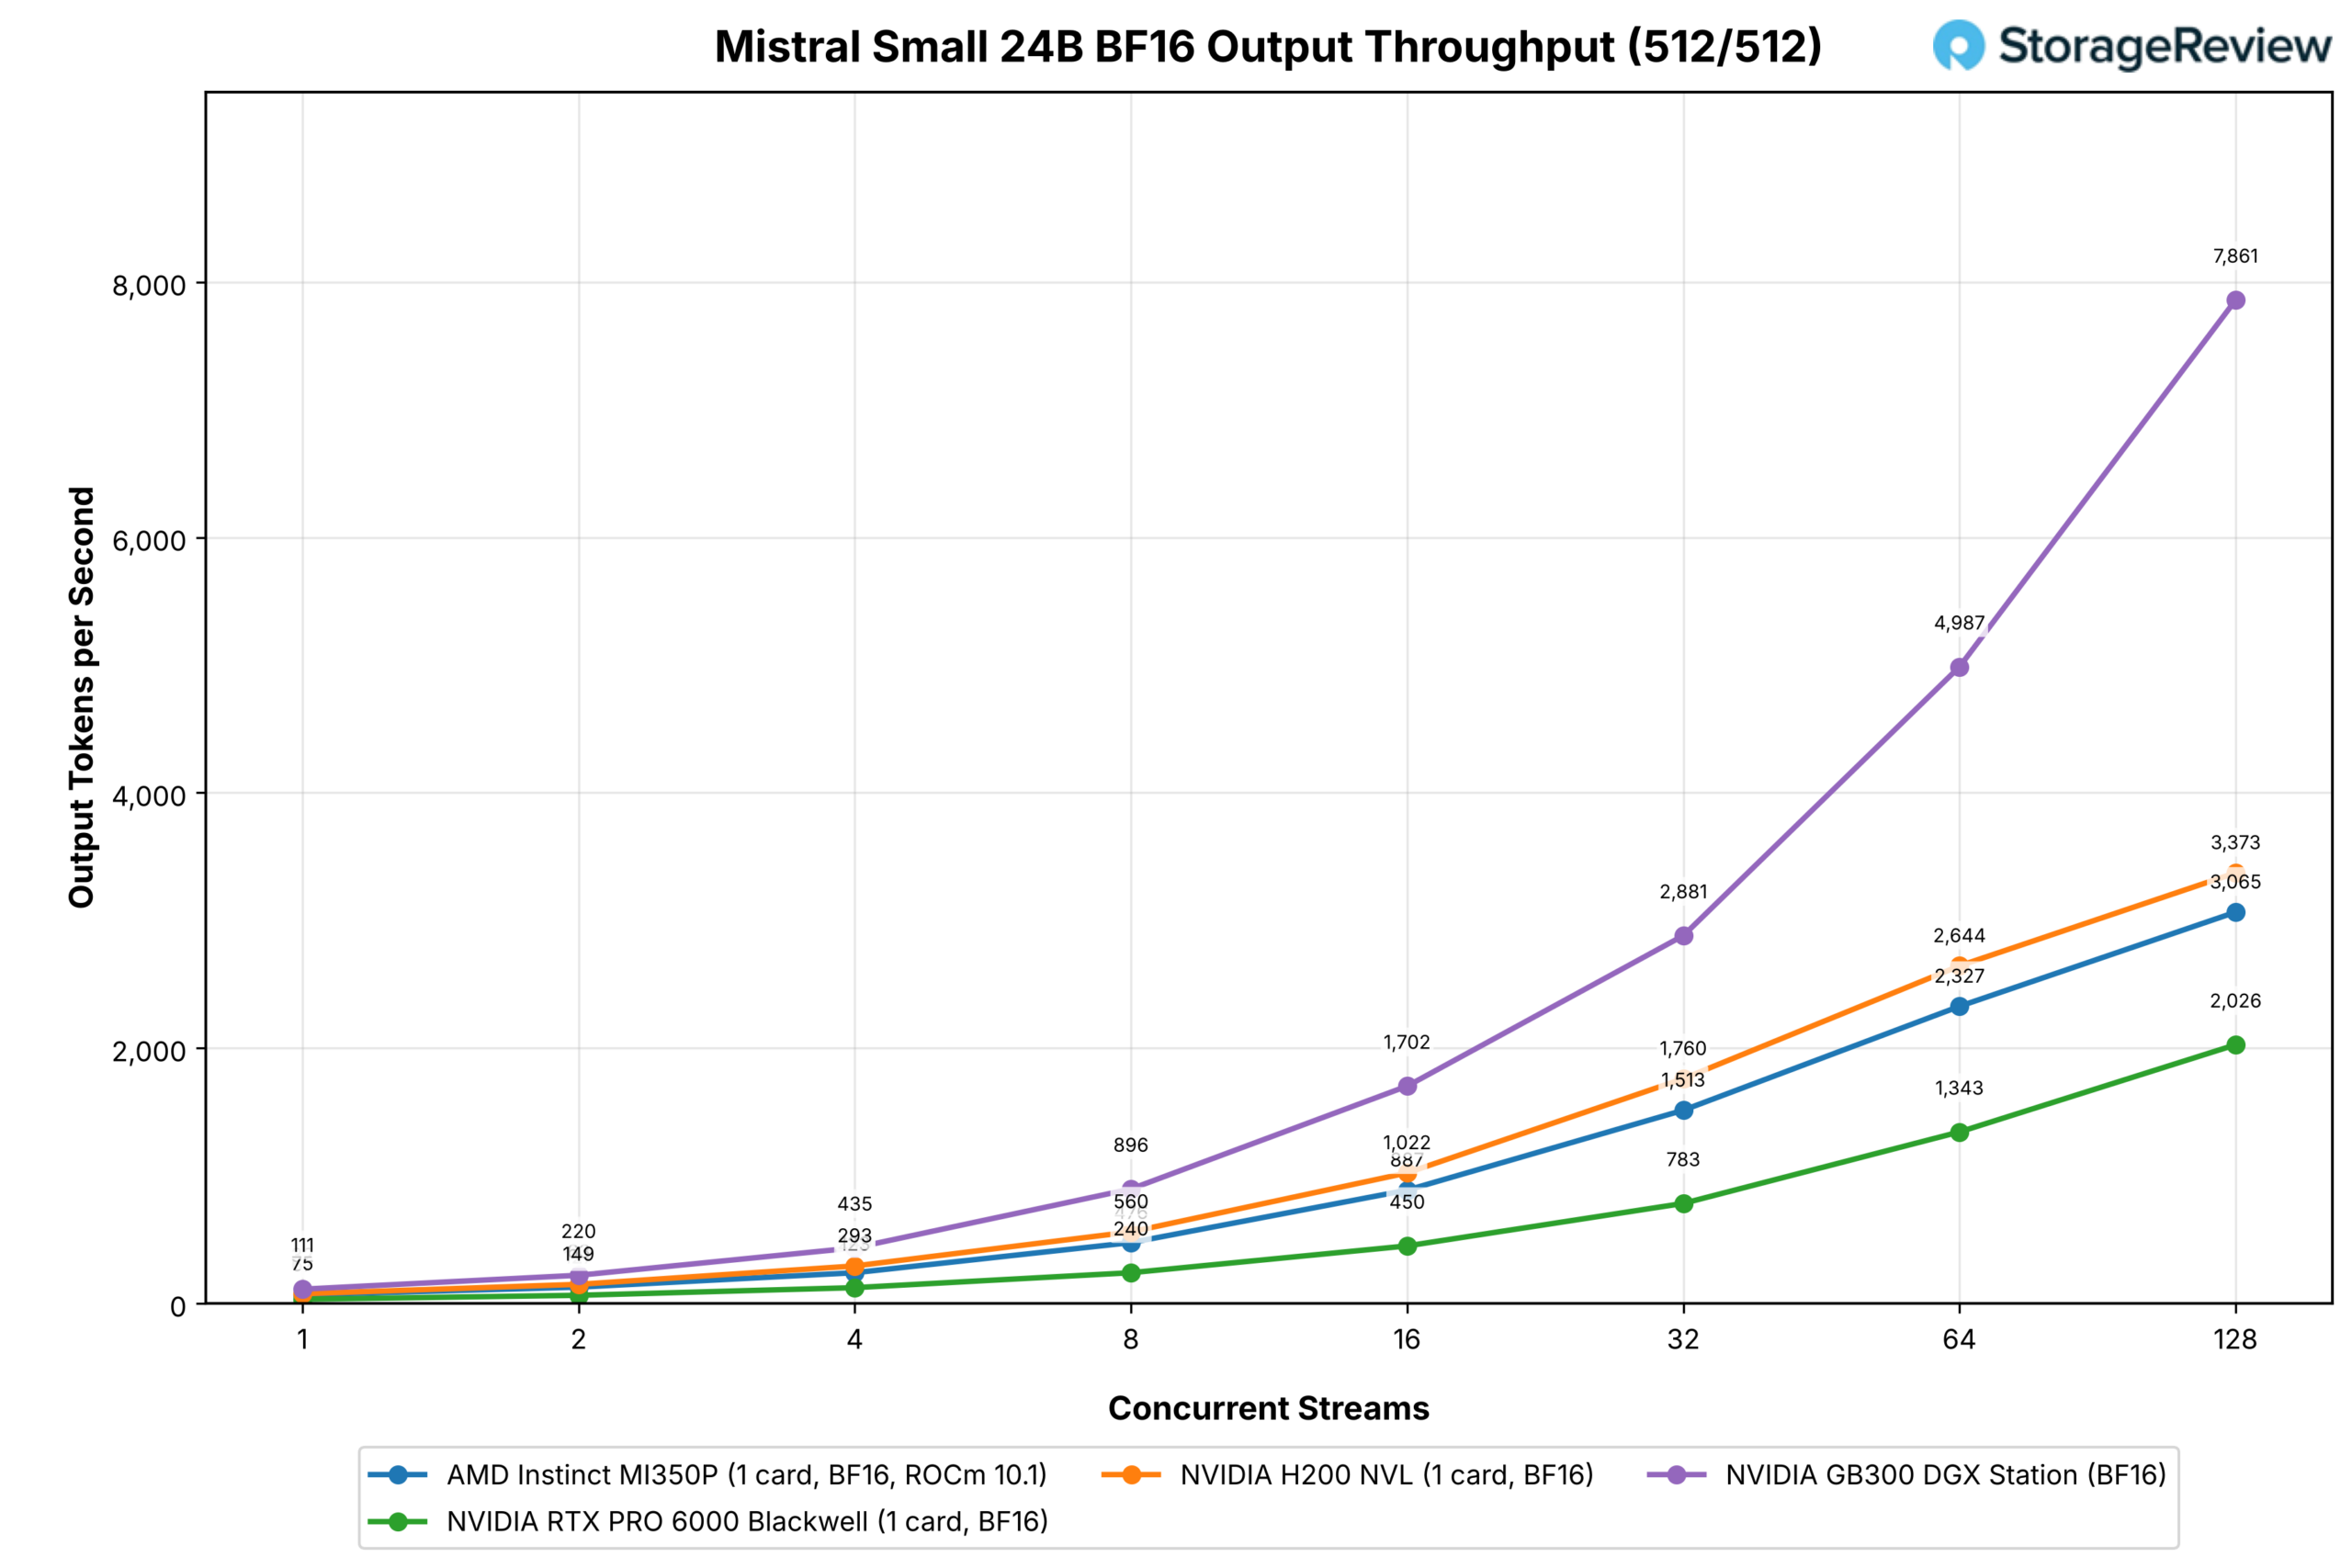
Mistral Small 是 MI350P 相对于 RTX PRO 6000 的最强密集测试结果:在 FP8 测试中,MI350P 的帧率为 4,458,RTX PRO 6000 的帧率为 3,242;在 BF16 测试中,MI350P 的帧率为 3,065,RTX PRO 6000 的帧率为 2,026(在 128 个流的聊天工作负载下);在单流测试中,MI350P 的帧率大约是 NVIDIA 显卡的两倍(在 FP8 测试中为 100,RTX PRO 6000 的帧率为 56;在 BF16 测试中为 67,RTX PRO 6000 的帧率为 32)。
在预填充较多的提示符上,MI350P 也领先于其他型号,在 128 个流的 FP8 上达到 599 分,而其他型号为 482 分;在 64 个流的 BF16 上达到 425 分,而其他型号为 299 分;尽管 H200 在相同情况下分别达到了 799 分和 632 分。
羊驼 3.1 8B
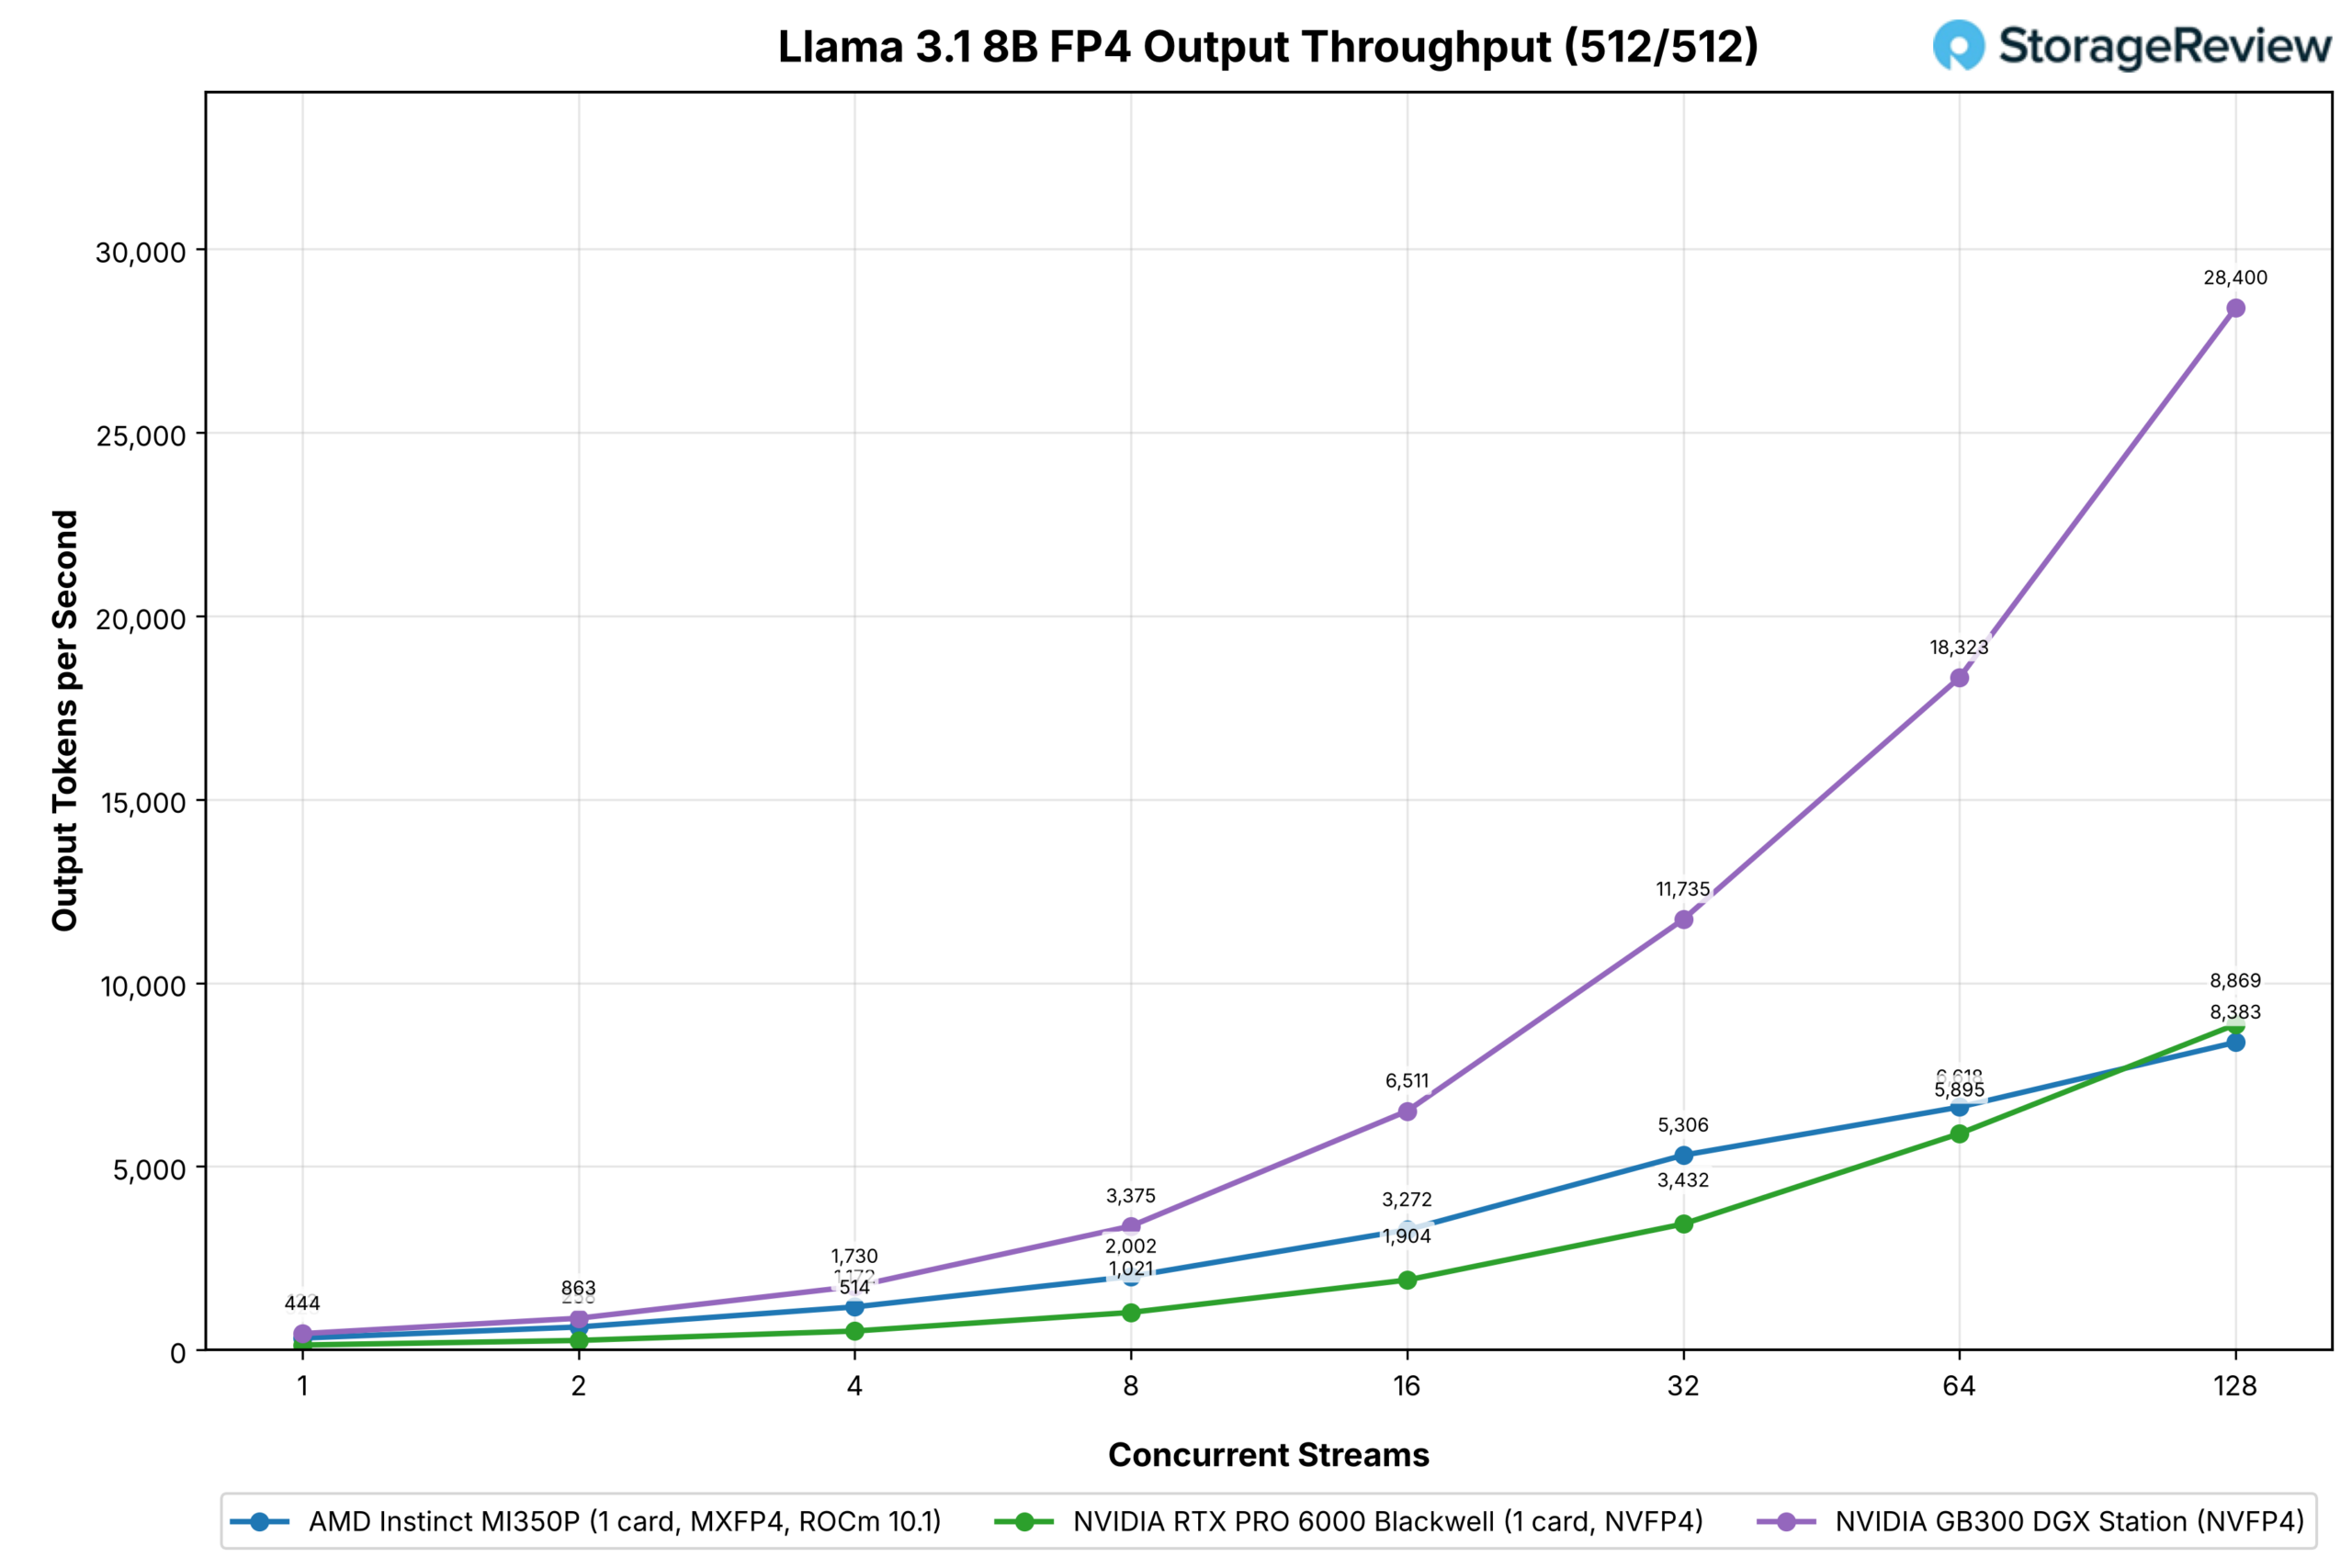
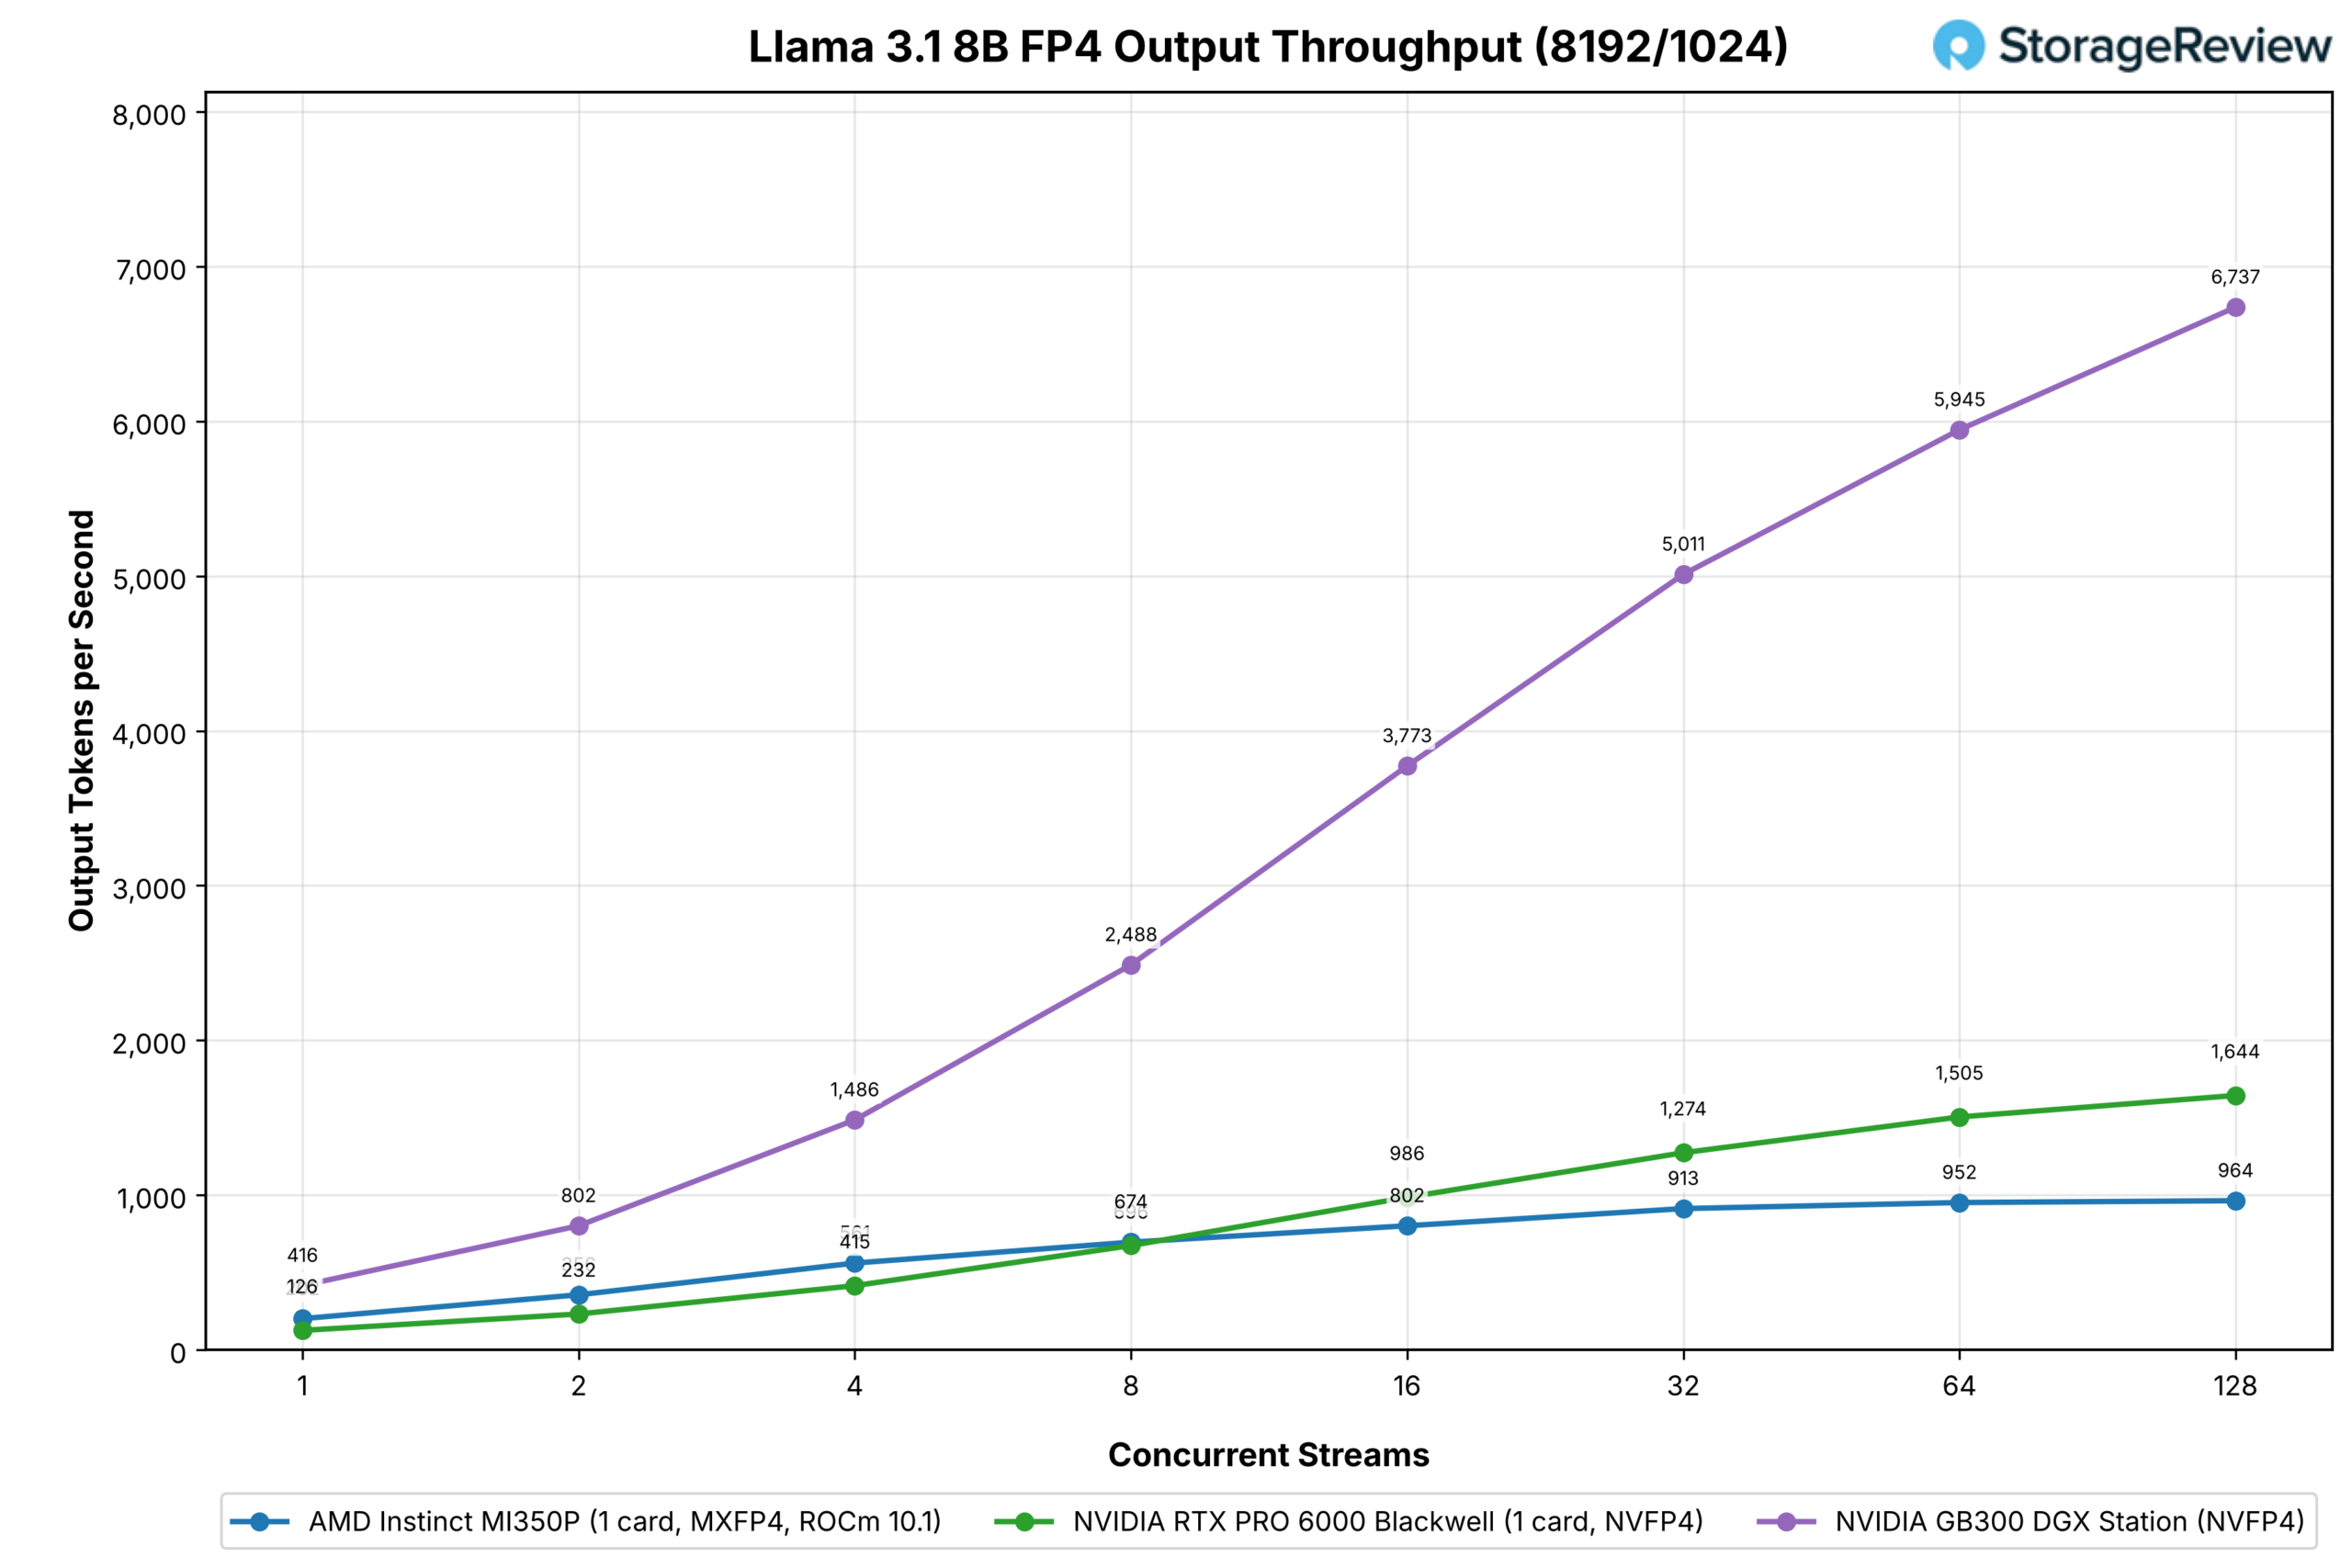
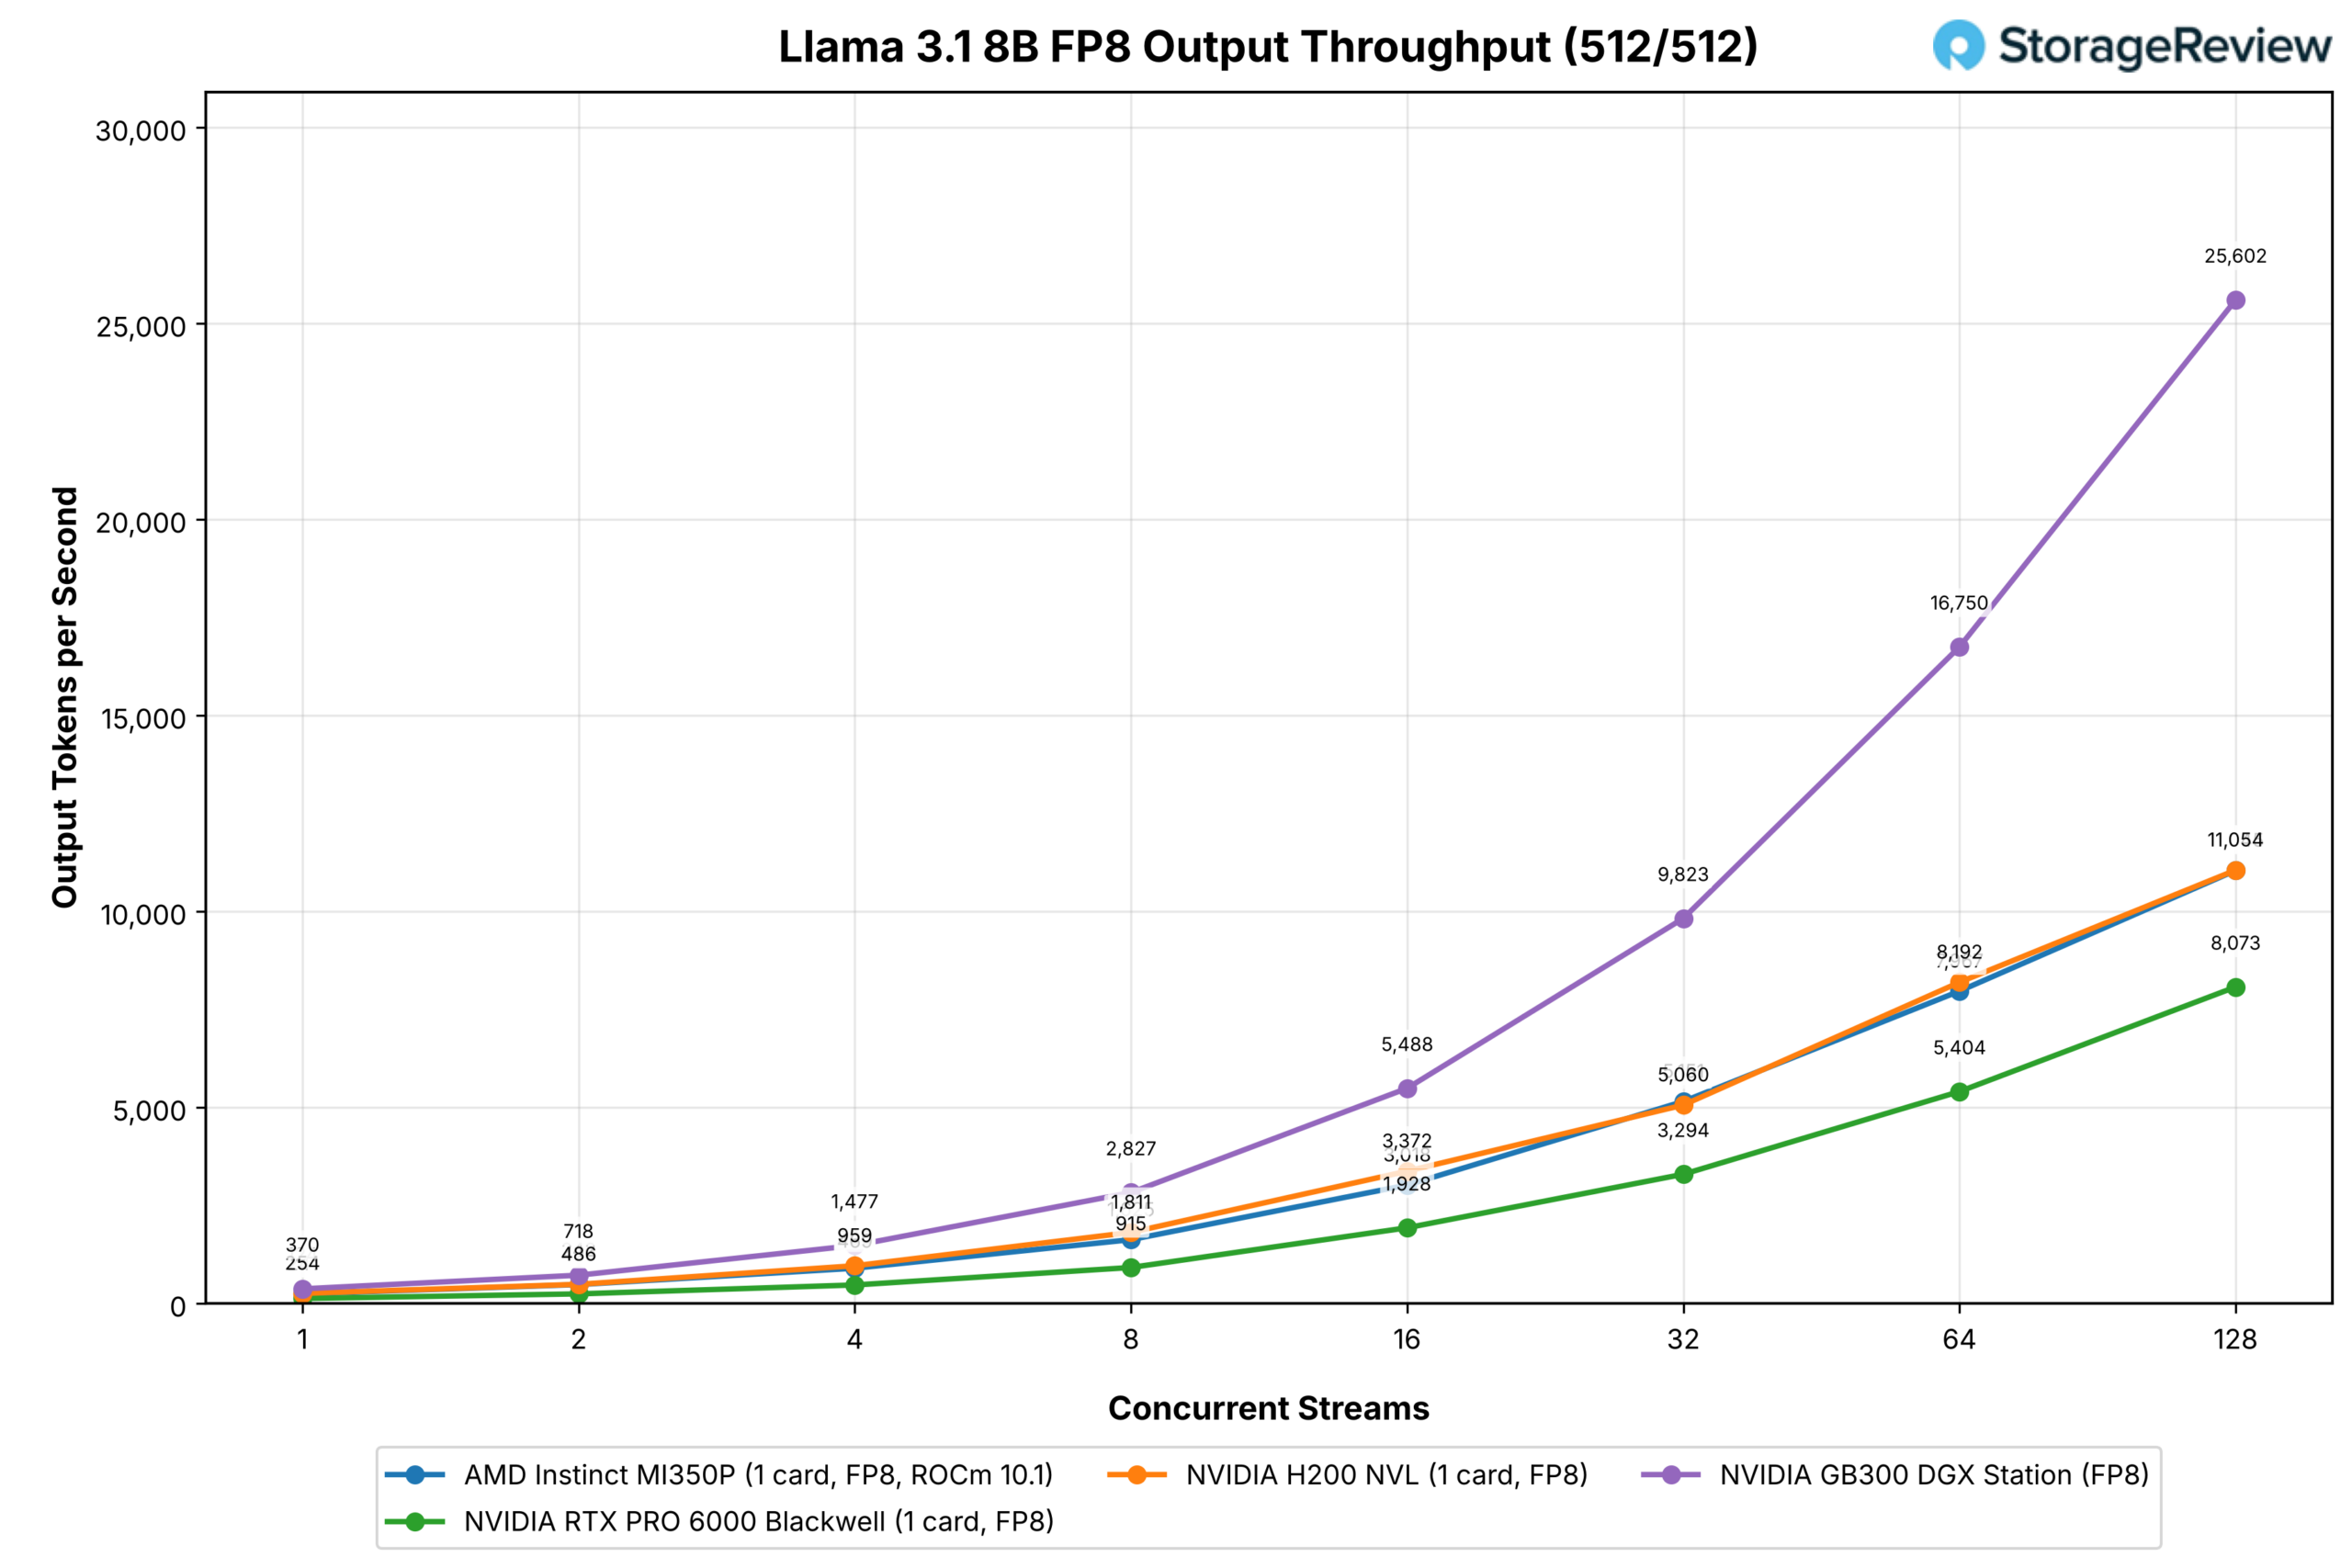
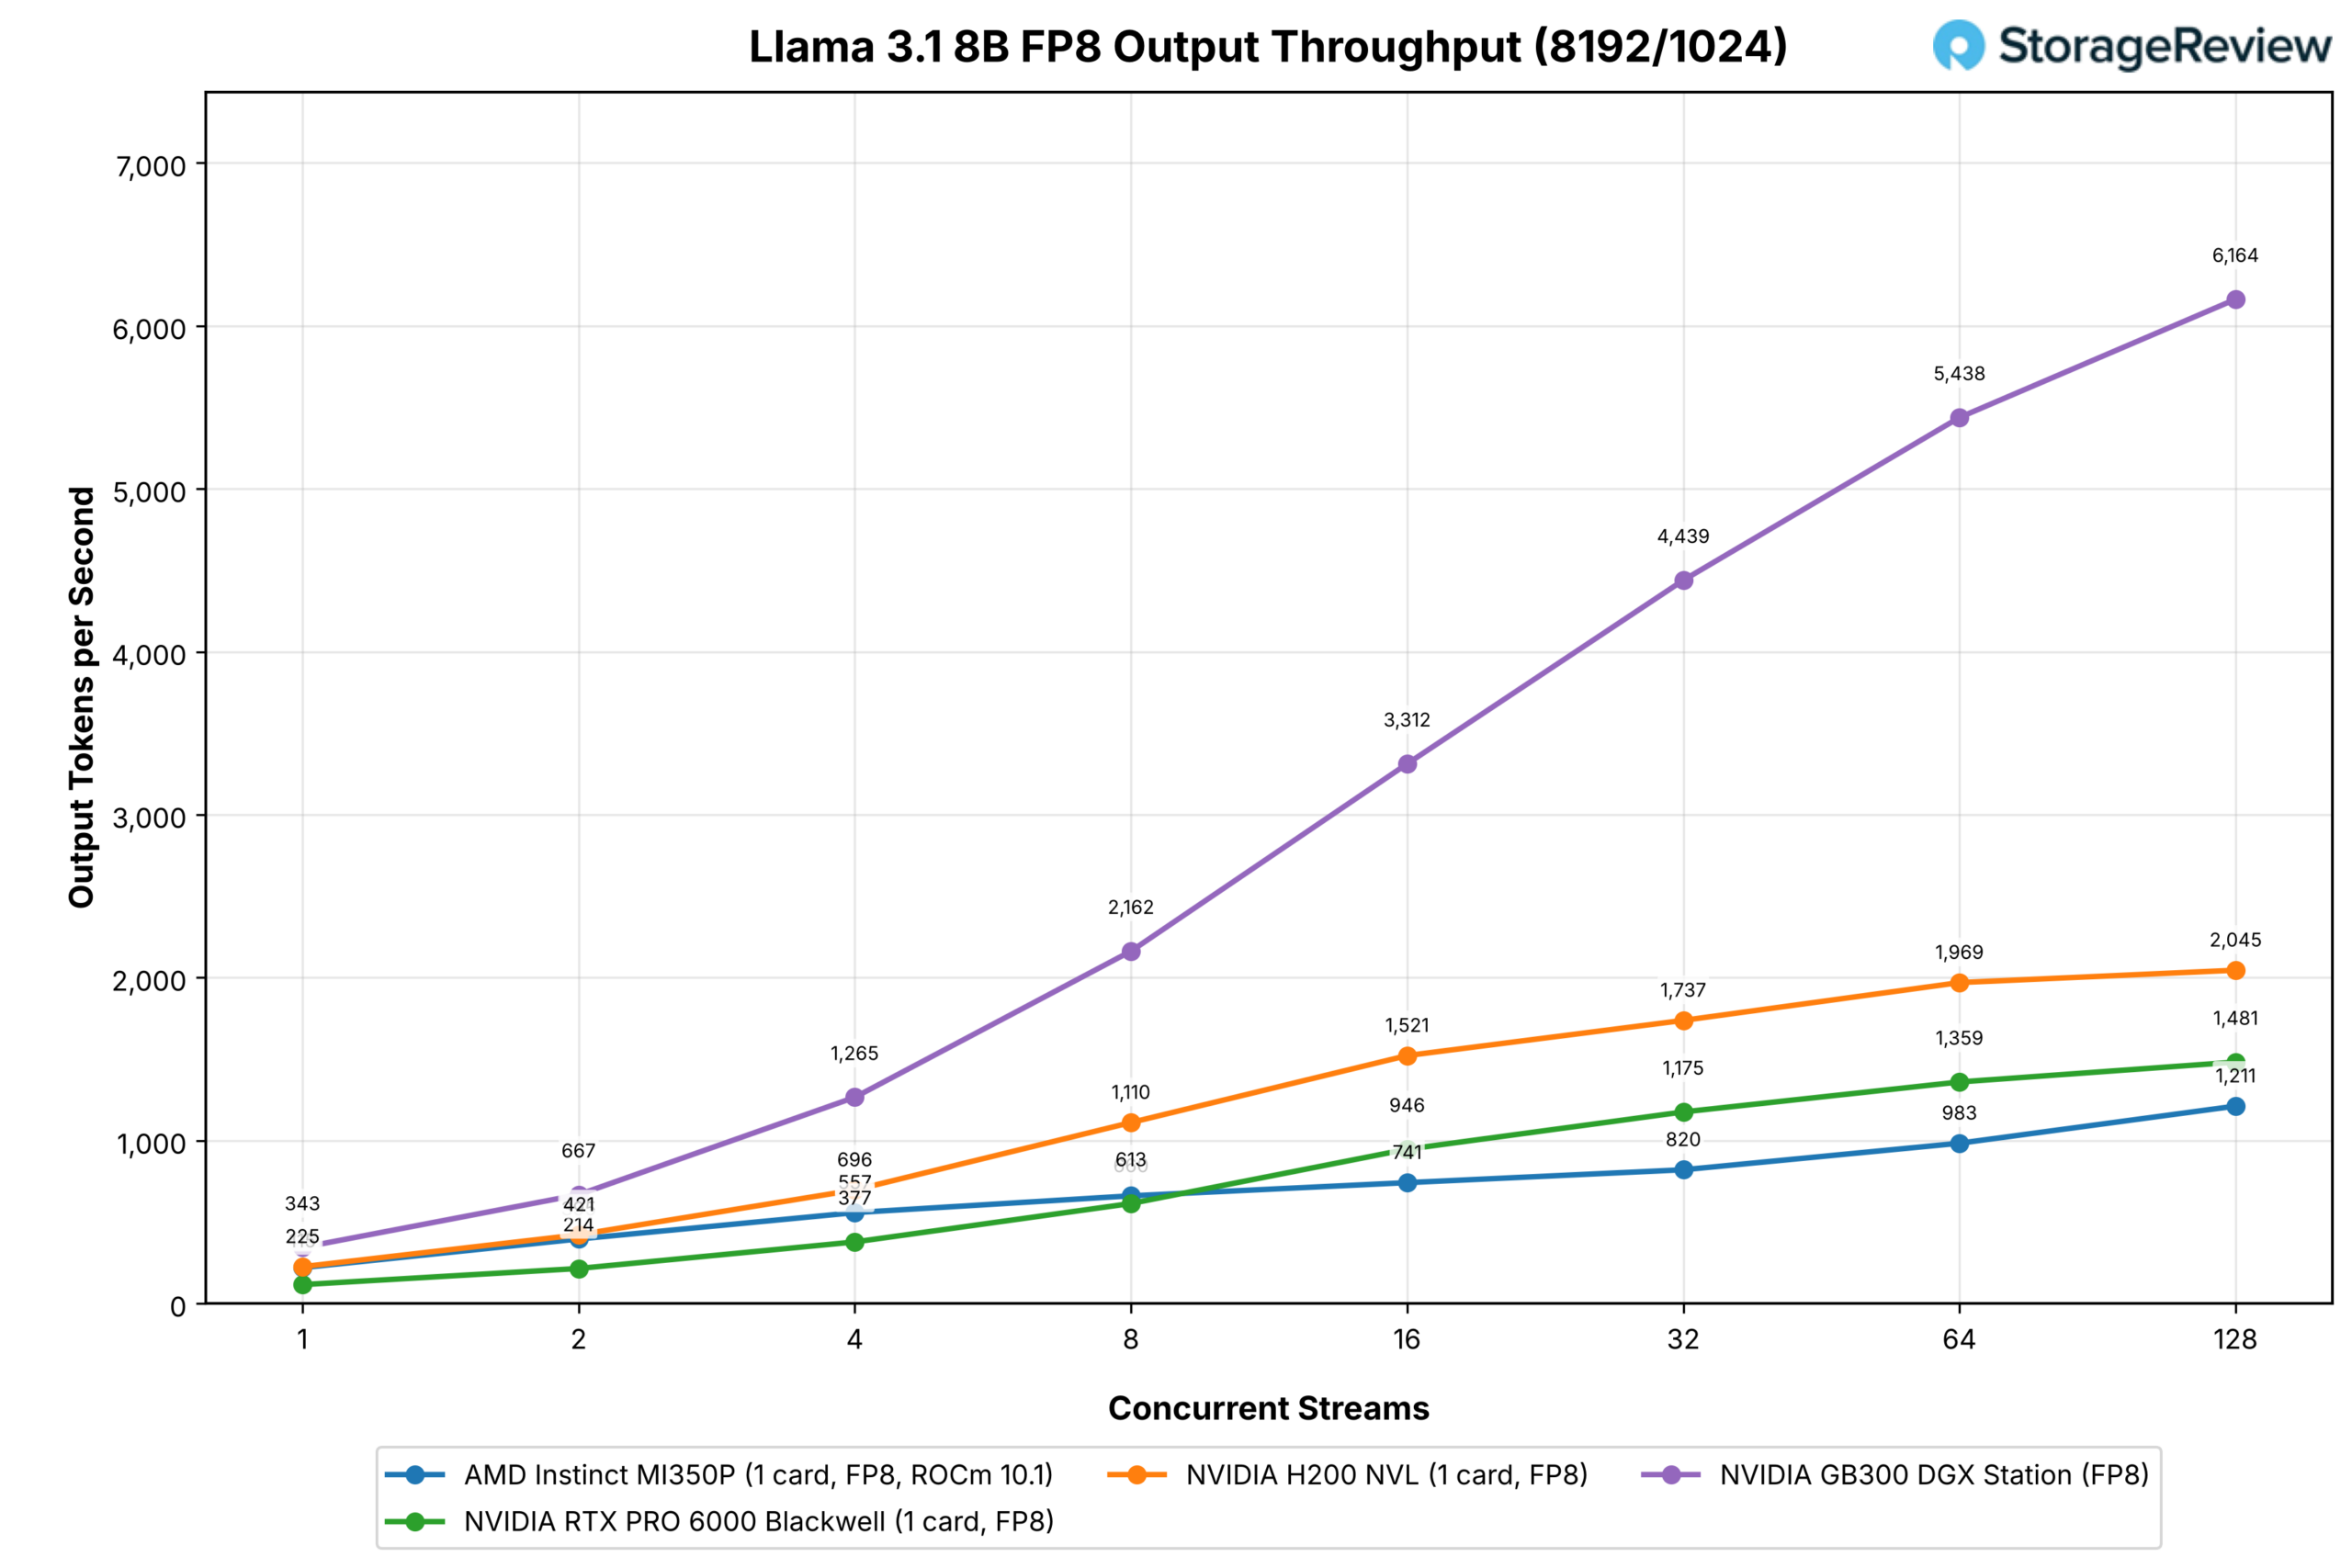
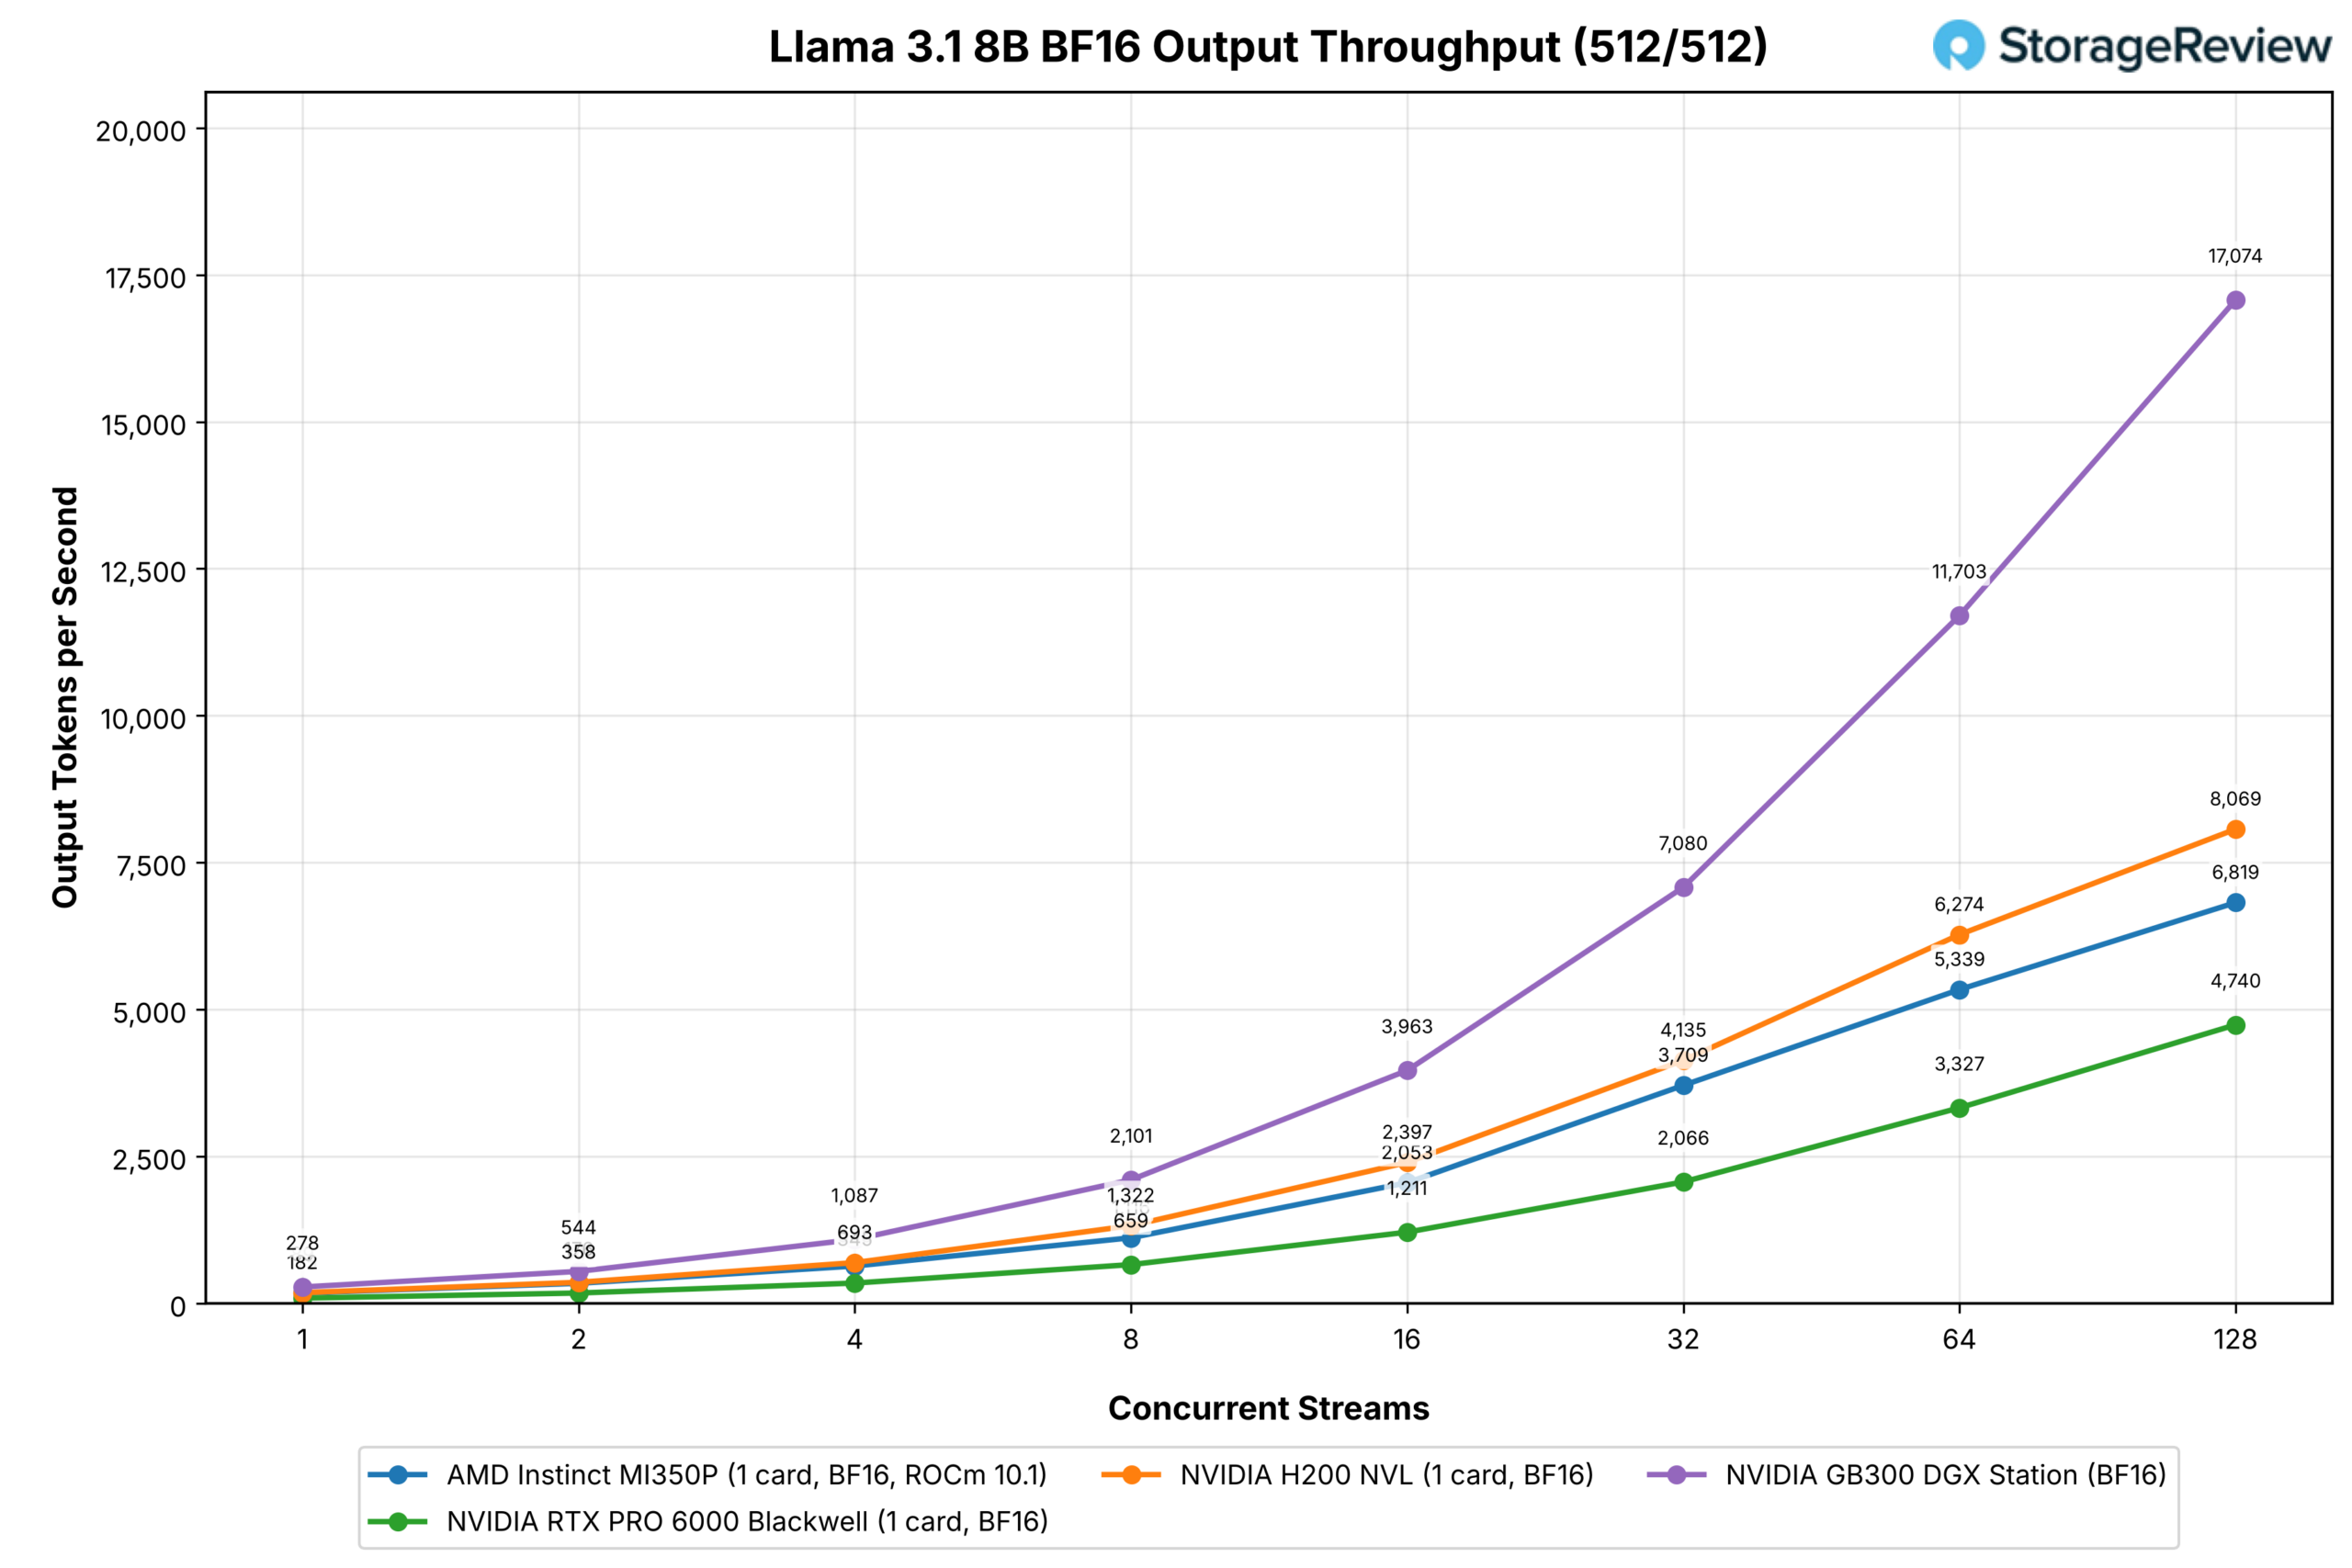
为了延续我们之前的GPU评测,Llama 3.1 8B版本已经发布。在聊天工作负载下,128路流的测试中,MI350P的FP8输出令牌速度为每秒11,045个,而RTX PRO 6000为8,073个,H200为11,054个,与Hopper显卡持平;在BF16测试中,MI350P的FP8输出令牌速度为每秒6,819个,RTX PRO 6000为4,740个,H200为8,069个。AMD的MXFP4版本在128路流下达到了每秒8,383个,比NVIDIA的NVFP4版本(RTX PRO 6000为每秒8,869个)低5%,但在流数较少的情况下,AMD的MXFP4版本领先NVFP4版本12%到143%;在单路流测试中,MXFP4的FP8输出令牌速度为每秒323个,而NVFP4版本为每秒133个。
预填充较多的运行结果则相反:MI350P FP8 比 RTX PRO 6000 和 H200 分别少了 16 个流,最终成绩为 1,211,而 RTX PRO 6000 为 1,481,H200 为 2,045,尽管 MI350P 一开始就比 RTX PRO 6000 领先 90%(仅一个流),而 MXFP4 版本在 128 个流时比 NVFP4 落后 41%。
结语
MI350P 是四年来第一款可直接安装到标准服务器中的 Instinct 显卡,它采用 2U 机箱,功耗为 450W,作为 PCIe 加速器表现出色:144GB HBM3E 显存,读写速度为 4TB/s,在 MAMF 模式下,FP8 浮点运算性能为 1,120 TFLOPS,块级 FP4 浮点运算性能为 2,228 TFLOPS,而 RTX PRO 6000 Blackwell 的相应性能分别为 820 TFLOPS 和 1,634 TFLOPS,并且其可用内存带宽约为 NVIDIA 显卡的 2.1 倍。

与 RTX PRO 6000 相比,MI350P 在所有 FP8、BF16 和 GPT-OSS 模型上处理聊天大小的提示时速度都更快,在 128 个流时快 35% 到 65%,此时 HBM3E 的带宽和容量超过了 96GB GDDR7 显卡,并且在两种 GPT-OSS 模型上,无论流数多少,两种提示形状都领先。
在密集型 FP8 和 BF16 测试中,H200 NVL 仍然胜过对手,在 128 个流的聊天提示测试中领先 4% 到 18%,在长提示测试中领先幅度更大,带宽高出 20%,且没有 FP4 路径;在 GPT-OSS 测试中,MI350P 分别领先 Hopper 显卡 50% 和 78%。更大尺寸的显卡表现则不太稳定,因为四块 RTX PRO 6000 显卡在 GLM-5.2 测试中,在 16 个流的测试中领先于 MI350P 显卡组合,其 384GB 的显存容量对 288GB,并且拥有更高的总带宽和计算能力。
MiniMax-M3 测试结果更为接近:三种配置在八路聊天提示测试中性能差距均在 10% 以内,RTX 四核显卡在 16 路测试中略胜一筹,而 MI350P 双卡配置在八路长提示测试中领先。单卡 MI350P 的 FP4 实测速率比 RTX PRO 6000 高出 36%,因此优势在于卡数。这些双卡测试结果基于 ROCm 7.2.3 版本,并将与 600W 电源测试一同在 ROCm 10.1 版本上再次运行。
在对 MI350P 进行 600W 满功率测试之前,我们目前还无法对其性能做出最终评价。我们计划在一台 PowerEdge XE7745 服务器上进行测试;戴尔在该机箱中支持八块 600W 的 MI350P。据我们了解,AMD 估计额外 150W 的功耗可以带来约 10% 的性能提升。
AMD取得了长足的进步,MI350/5X系列处理器充分展现了其架构的强大性能。我们在实验室中使用MI300X平台进行开发,软件堆栈的运行速度之快,体现在大部分测试套件都能在默认vLLM配置下流畅运行。
从我们在此配置中看到的来看,MI350P 是为那些因交货时间、价格或避免依赖单一制造商而寻求 NVIDIA GPU 替代方案的买家准备的,而戴尔在 PowerEdge 产品线中对它的支持,使得主流服务器能够满足这种硅芯片多样性的需求。
平心而论,我们的工作远未结束。虽然许多买家可能会将这些显卡安装在 2U 服务器中,但如果将它们安装在专为 600W 显卡设计的大型机箱中,则可以发挥更大的性能。无论最终如何部署,这都是 AMD 重返服务器独立显卡市场的绝佳开端。随着软件栈的不断完善,MI350P 以及后续产品都拥有光明的前景。目前,对于内存容量在 96GB 到 144GB 范围内的用户而言,MI350P 是仅有的两款能够让用户使用单 GPU 的 PCIe 显卡之一,也是唯一一款容量超过 141GB 的显卡。
排行榜: AMD Instinct MI350P 出现在我们最佳企业级 GPU排行榜的“其他测试产品”部分,其双卡测试结果在“横向扩展配置”部分。



 Amazon