

我们已经评测过几款GB300 DGX工作站,最近还同时在实验室里测试了两台:华硕ExpertCenter Pro ET900N G3和惠普ZGX Fury AI工作站。这两台主机并排摆放,我们想将它们连接起来,看看第二块GB300能为单台机器带来多大的性能提升,从而更好地协同处理桌面AI工作负载。
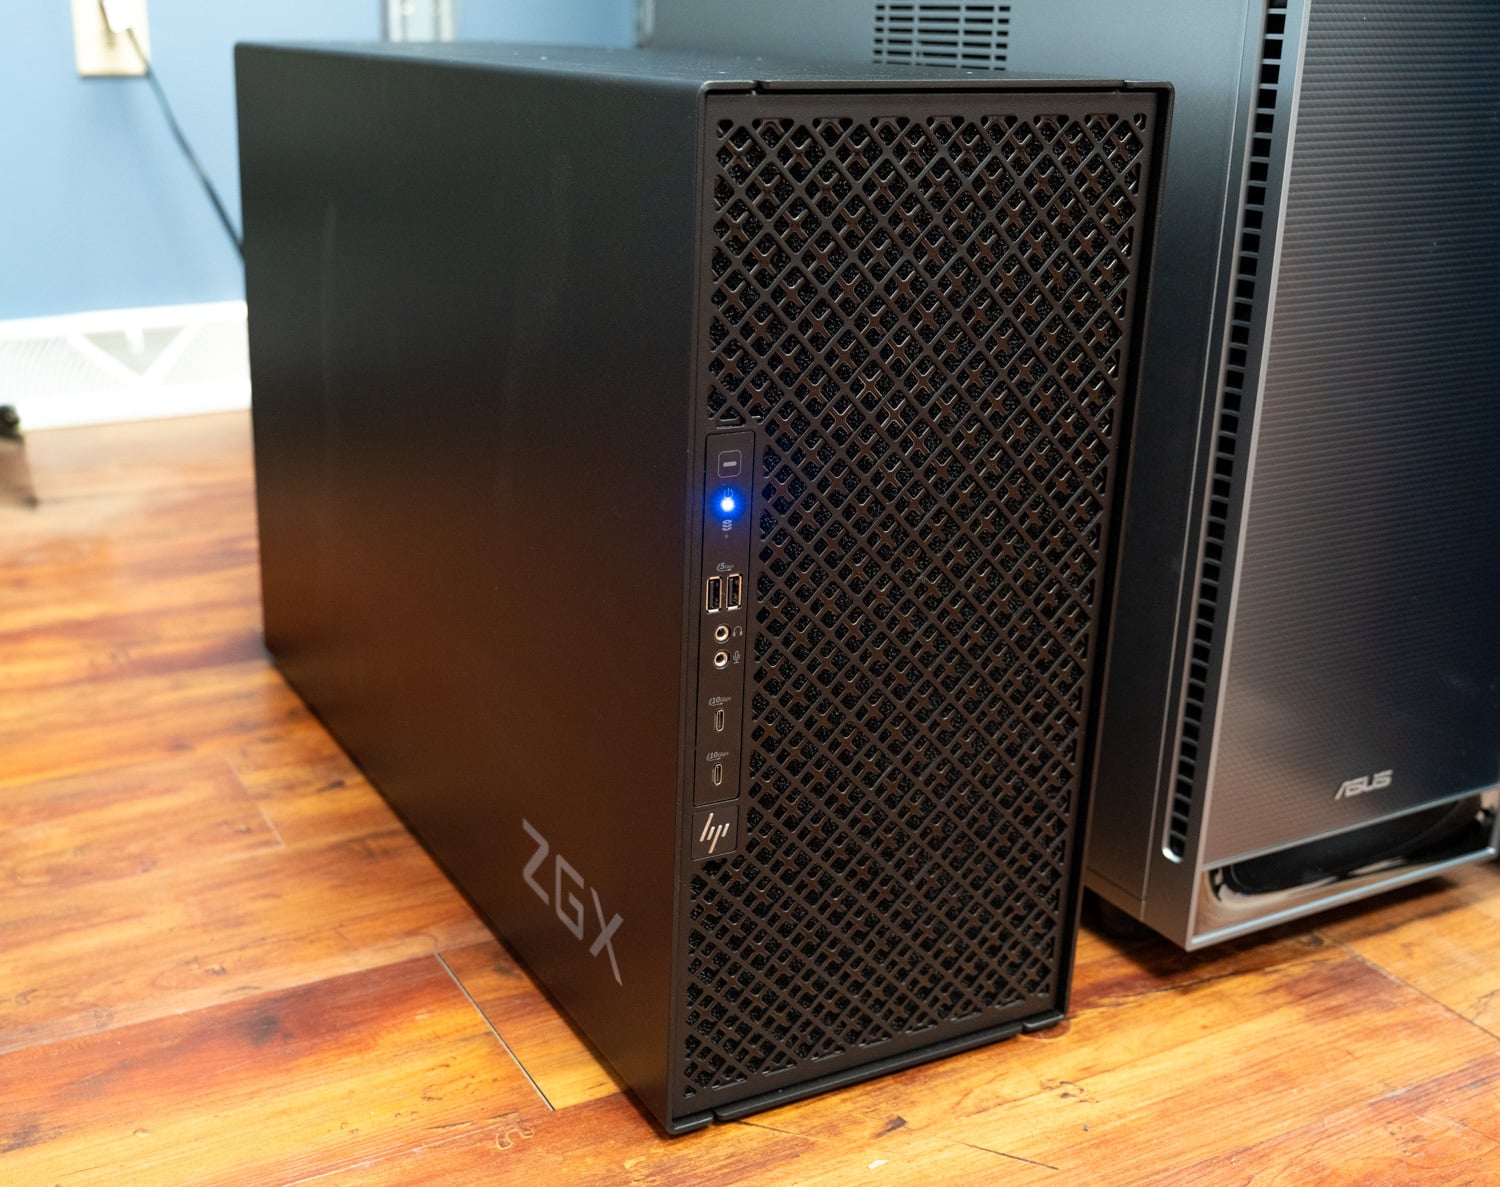
逐步扩展桌面配置并非新概念;NVIDIA 在 GB10 平台上就明确提出了这一理念。DGX Spark 的独特之处在于,它允许用户从一台设备开始,随着工作负载的增长逐步连接更多设备。GB300 的初始性能要强得多,但运行更大型的模型或服务更多用户,即使是我们测试过的速度最快的台式机之一也会面临挑战。这正是我们在最初的 MSI 评测中所要表达的观点:如果你的工作负载需要一台这样的工作站,那么很容易理解为什么最终需要多台。
对许多买家来说,成本将决定何时进行扩展才切实可行。了解两台工作站目前的协同工作情况,可以让从一台工作站起步的用户更清楚地了解日后扩展能带来哪些好处。
关键精华
- 两条电缆,线路速率的 98%: 华硕 ET900N G3 和惠普 ZGX Fury 的 ConnectX-8 端口之间连接了两个 400G DAC,NCCL 在广播、缩减和发送/接收方面实现了 98GB/s 的传输速度,而该组合的理论传输速度为 100GB/s。GPUDirect RDMA 在每条传输轨上都达到了 392Gb/s 的速度,8 字节 RDMA 写入的平均时间为 1.46 µs。NVIDIA 的测试方案完成了整个配置过程。
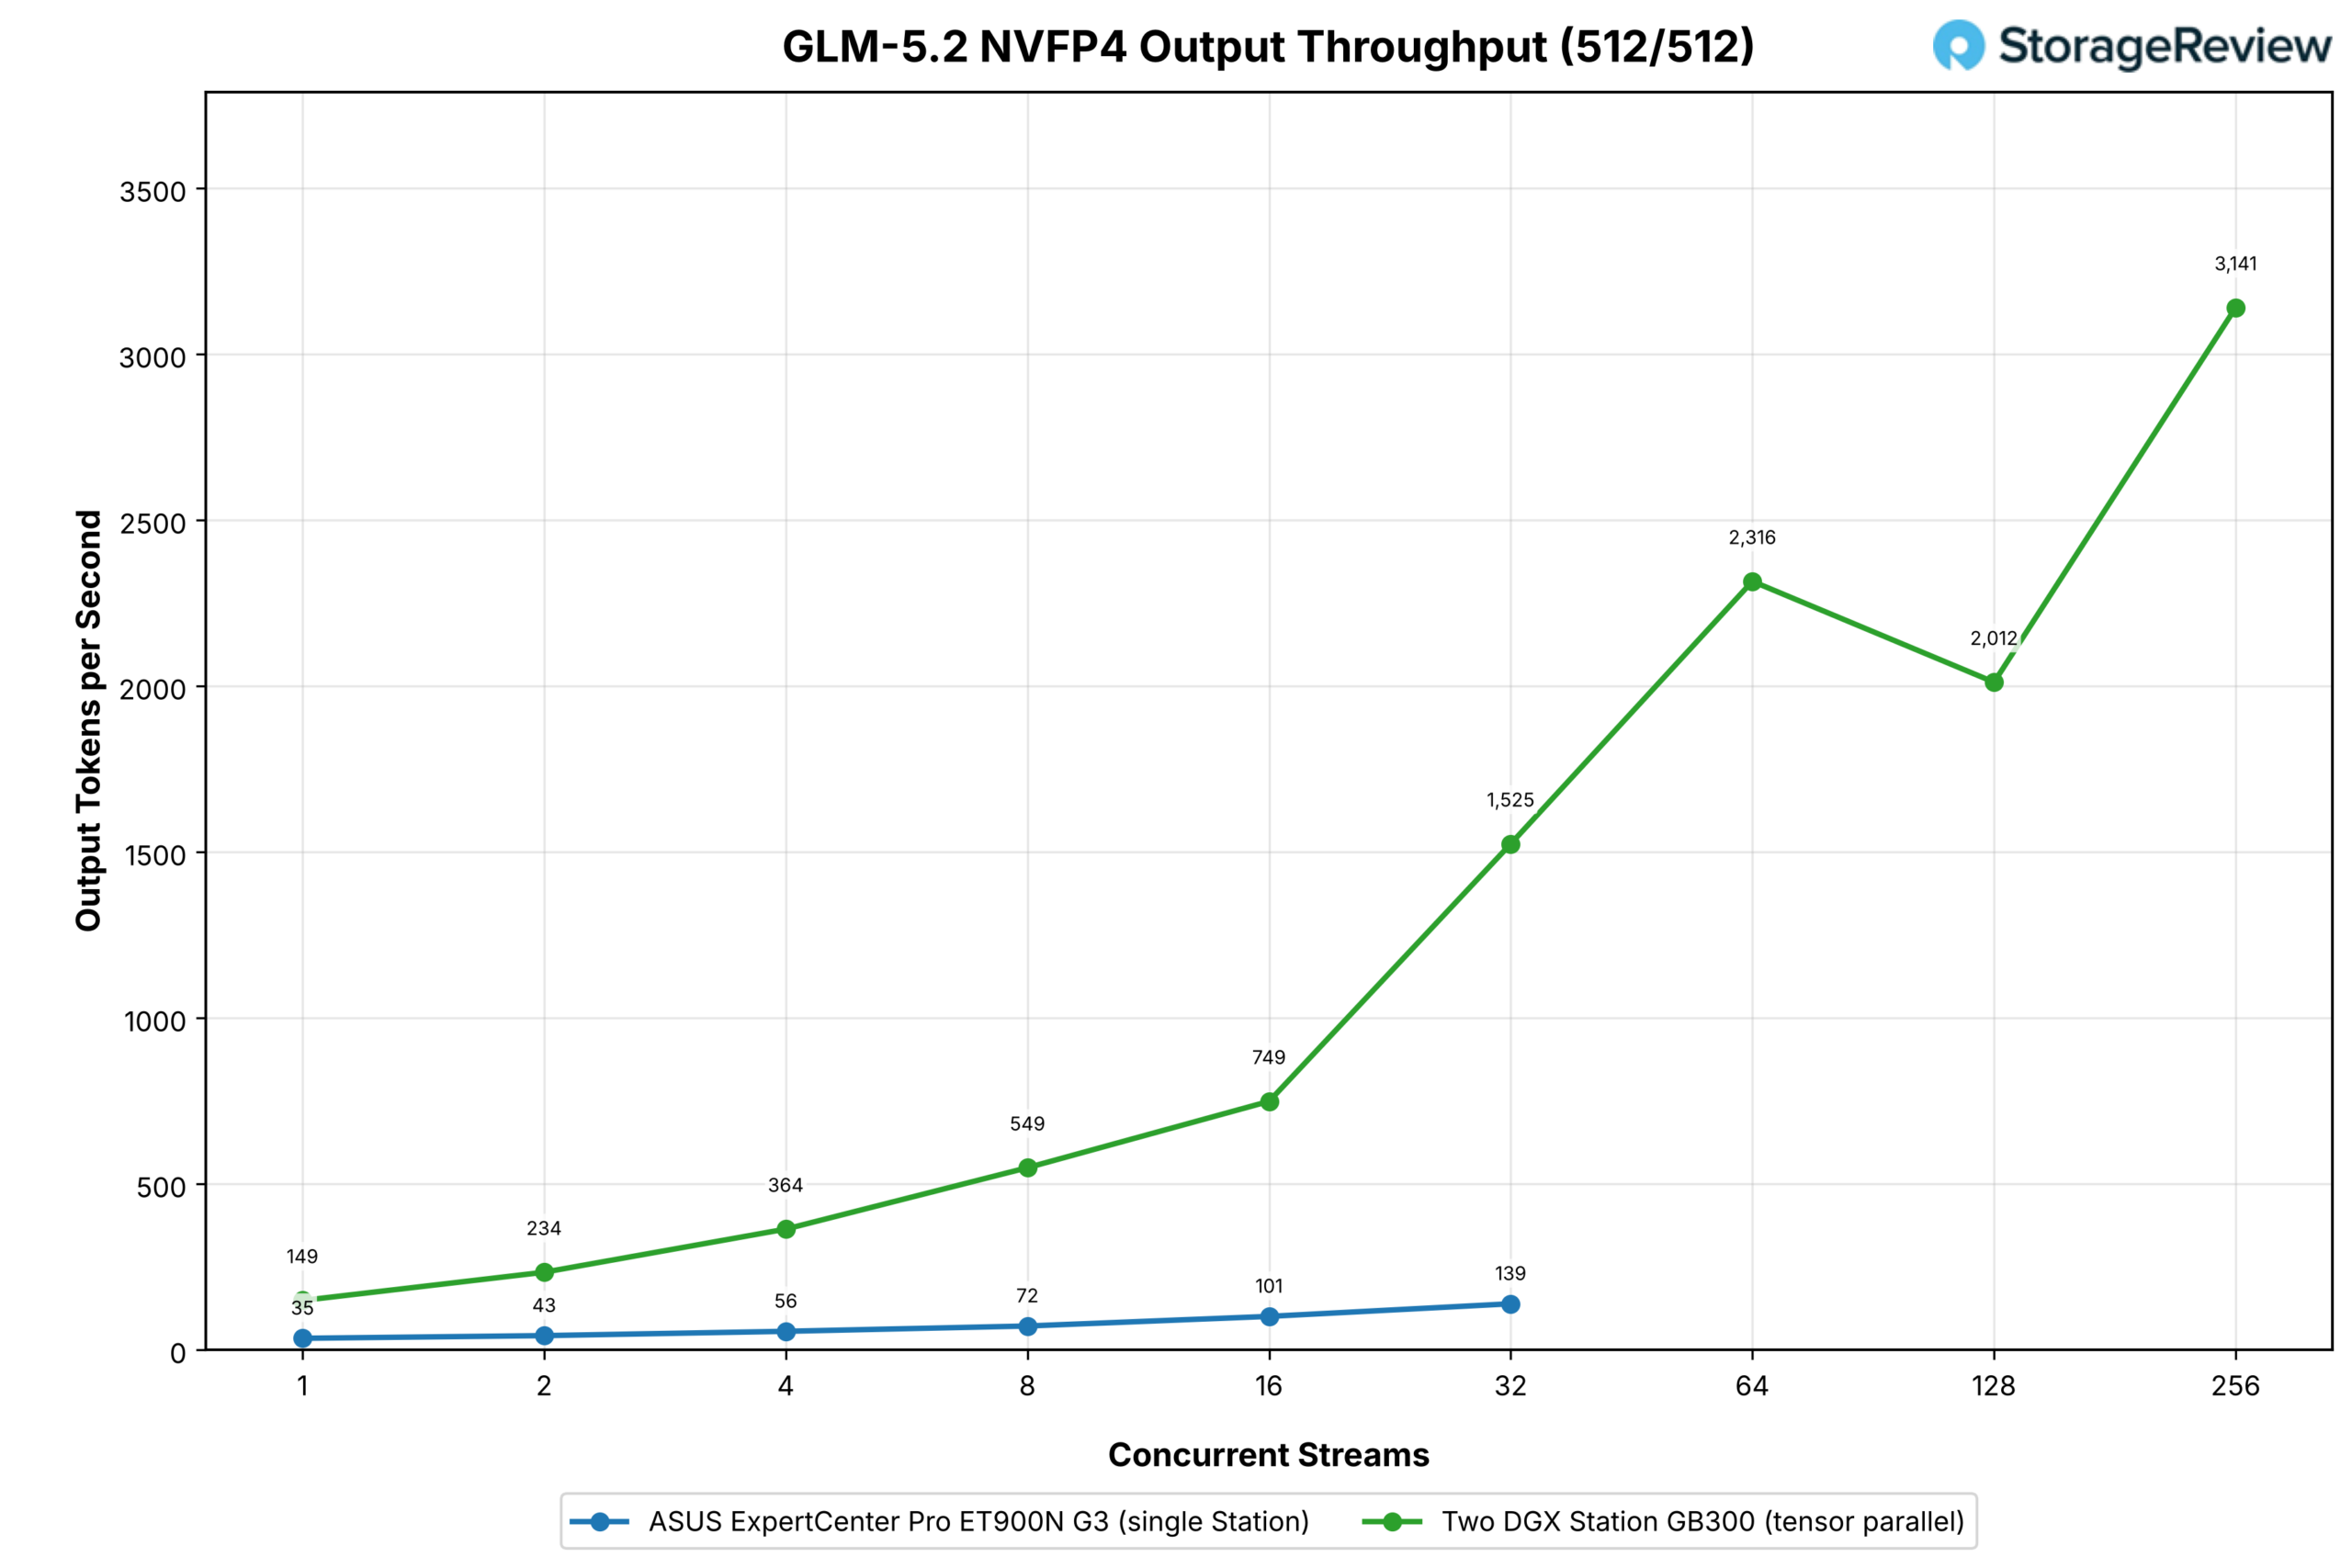
- GLM-5.2 在并发性能相同的情况下性能提升了 11 倍: 433GB 的 NVFP4 检查点将大约 215GB 的专家权重溢出到一台 Station 上的 Grace 内存中,该 Station 在 32 个流上每秒处理 139 个输出标记;在张量并行模式下,通过两台 B300 进行处理,在 32 个流上达到每秒 1,525 个,在 256 个流上达到每秒 3,141 个。
- GLM-5.3 每秒处理令牌数从 188 个增加到 5,018 个: 该组中增益最大的是 27 倍,来自另一个拥有 252GB HBM3e 的型号,该型号在相同的工作负载下仍能以 256 个流的速度攀升,并且在 8,192 个代币的提示下每秒能保持近 600 个输出代币,大约是单个塔的五倍。
- MiniMax-M3 长提示音在一个工作站上最多只能处理八个数据流: 当 KV 缓存耗尽时,单个塔在 8 个流下每秒输出令牌数降至 103 个;此时,一对塔每秒输出令牌数为 736 个,速度提升了 7.1 倍,并在 256 个流下继续提升至每秒 1,801 个。
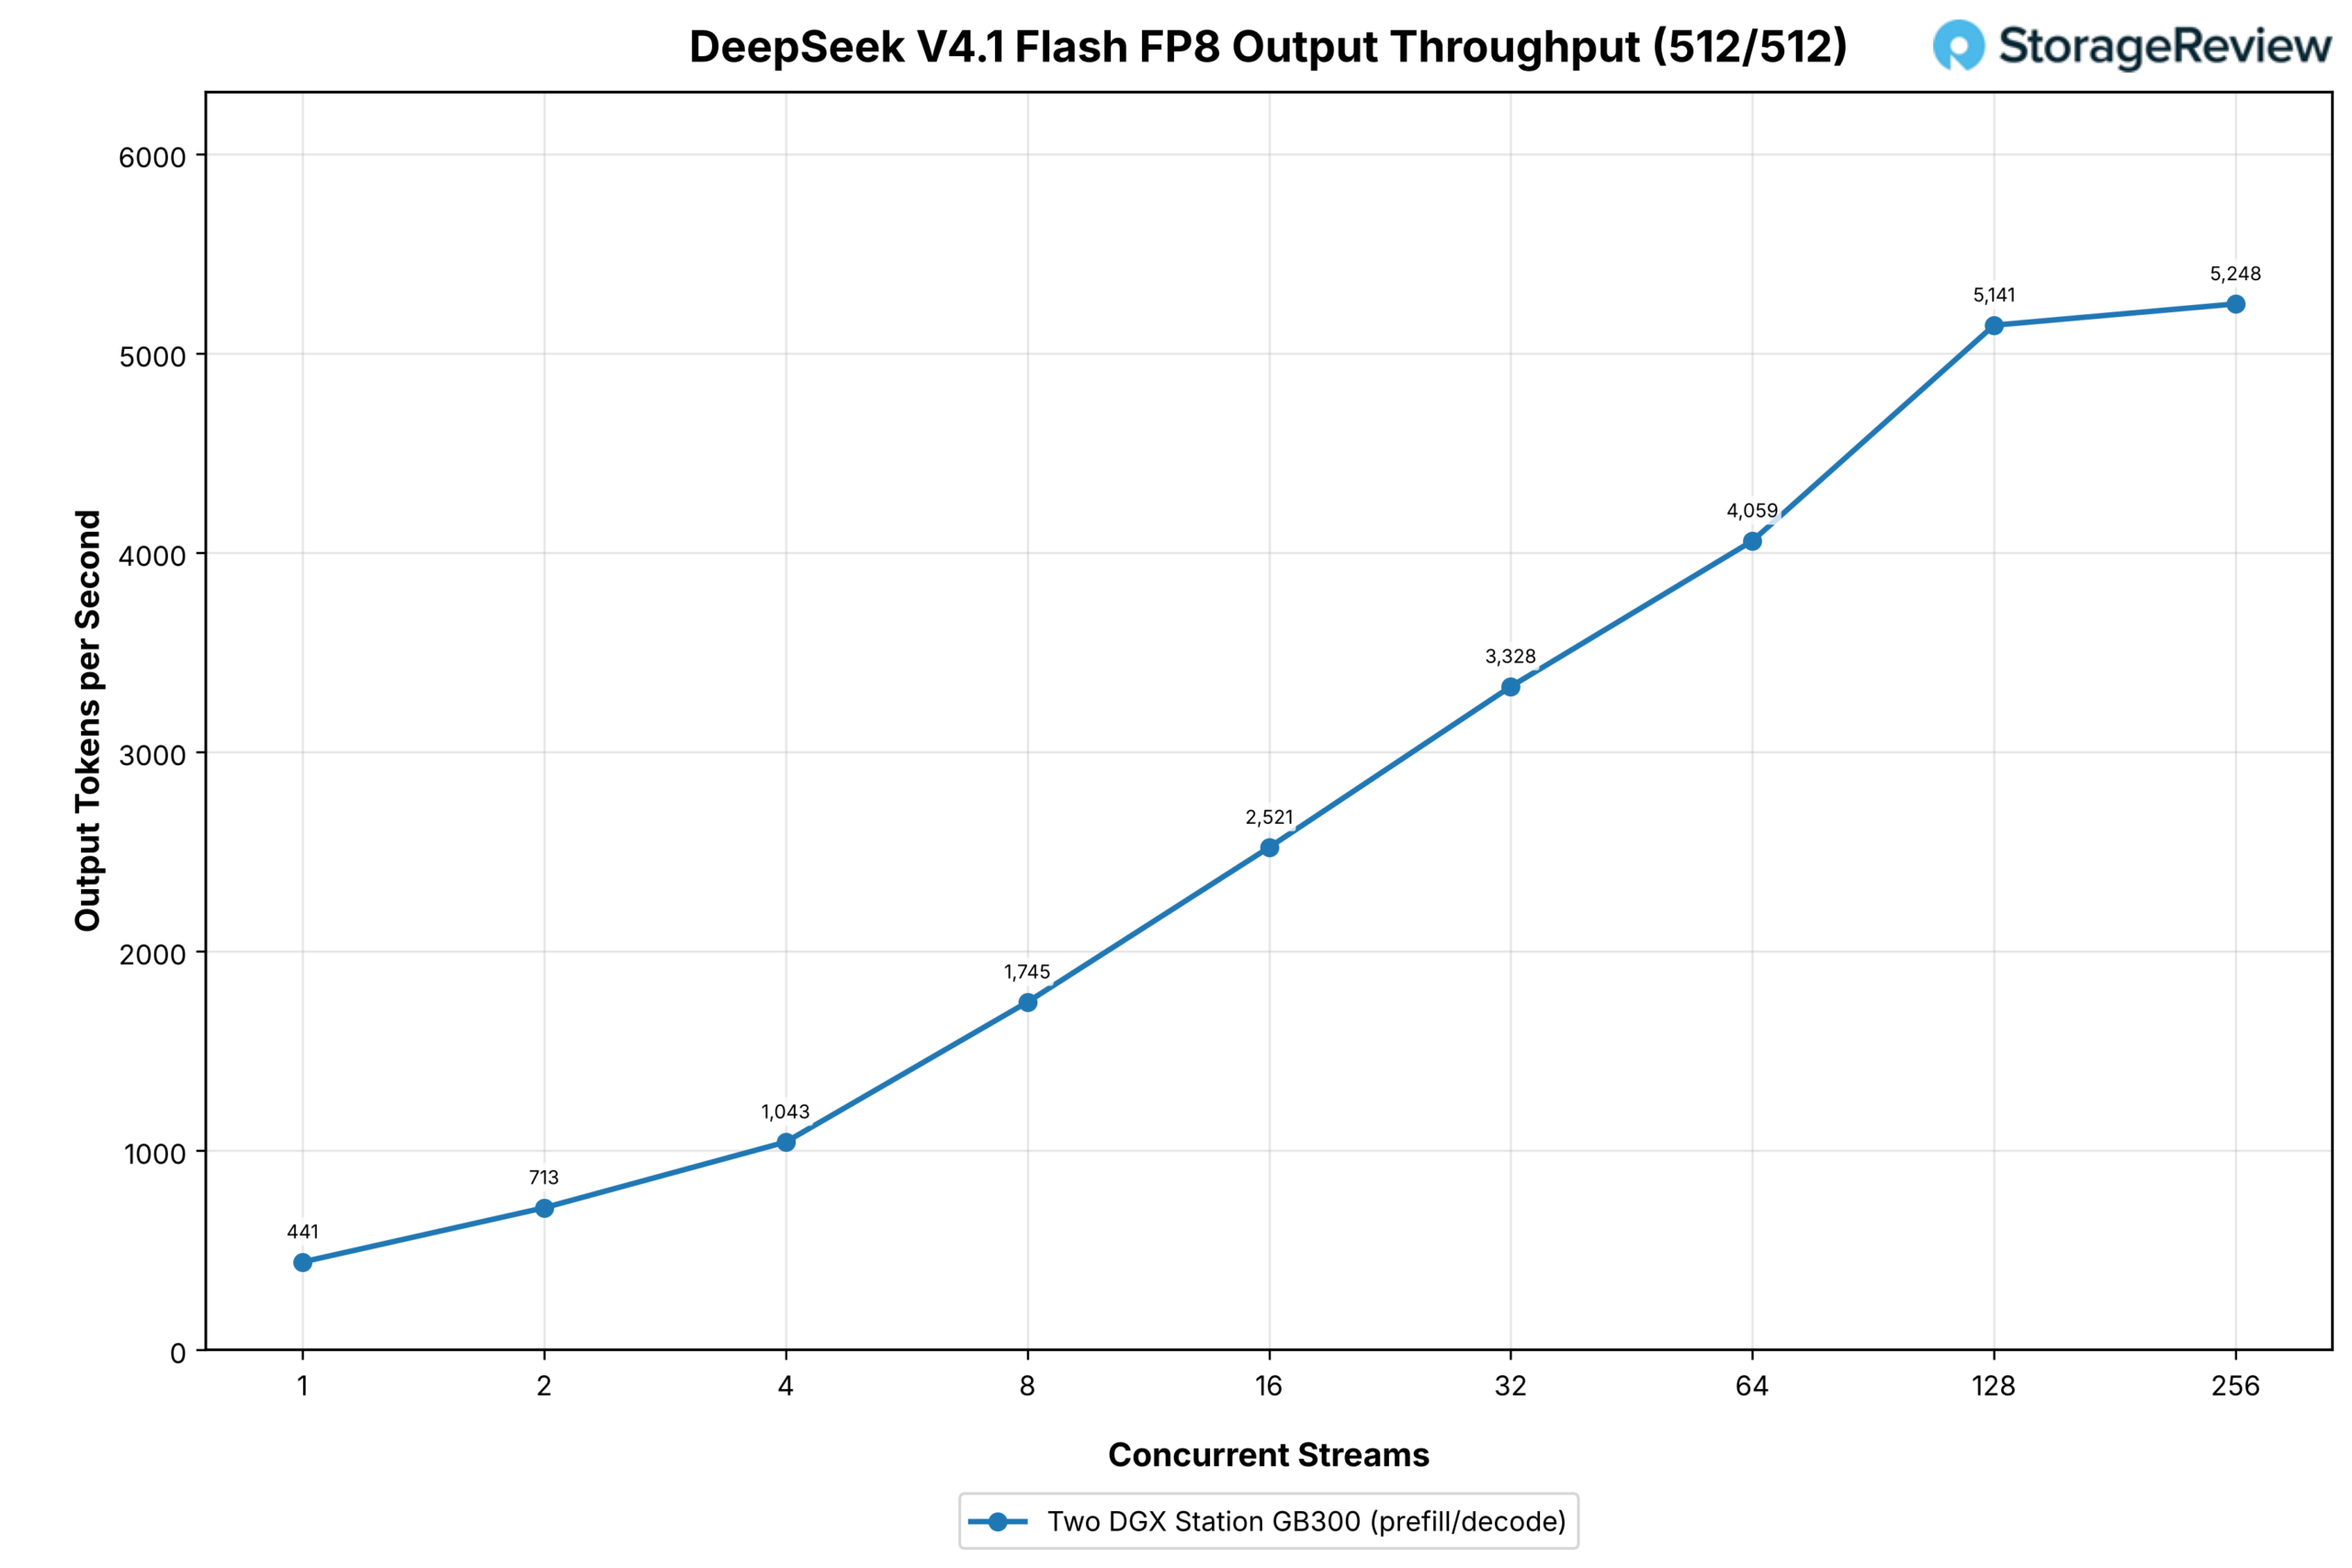
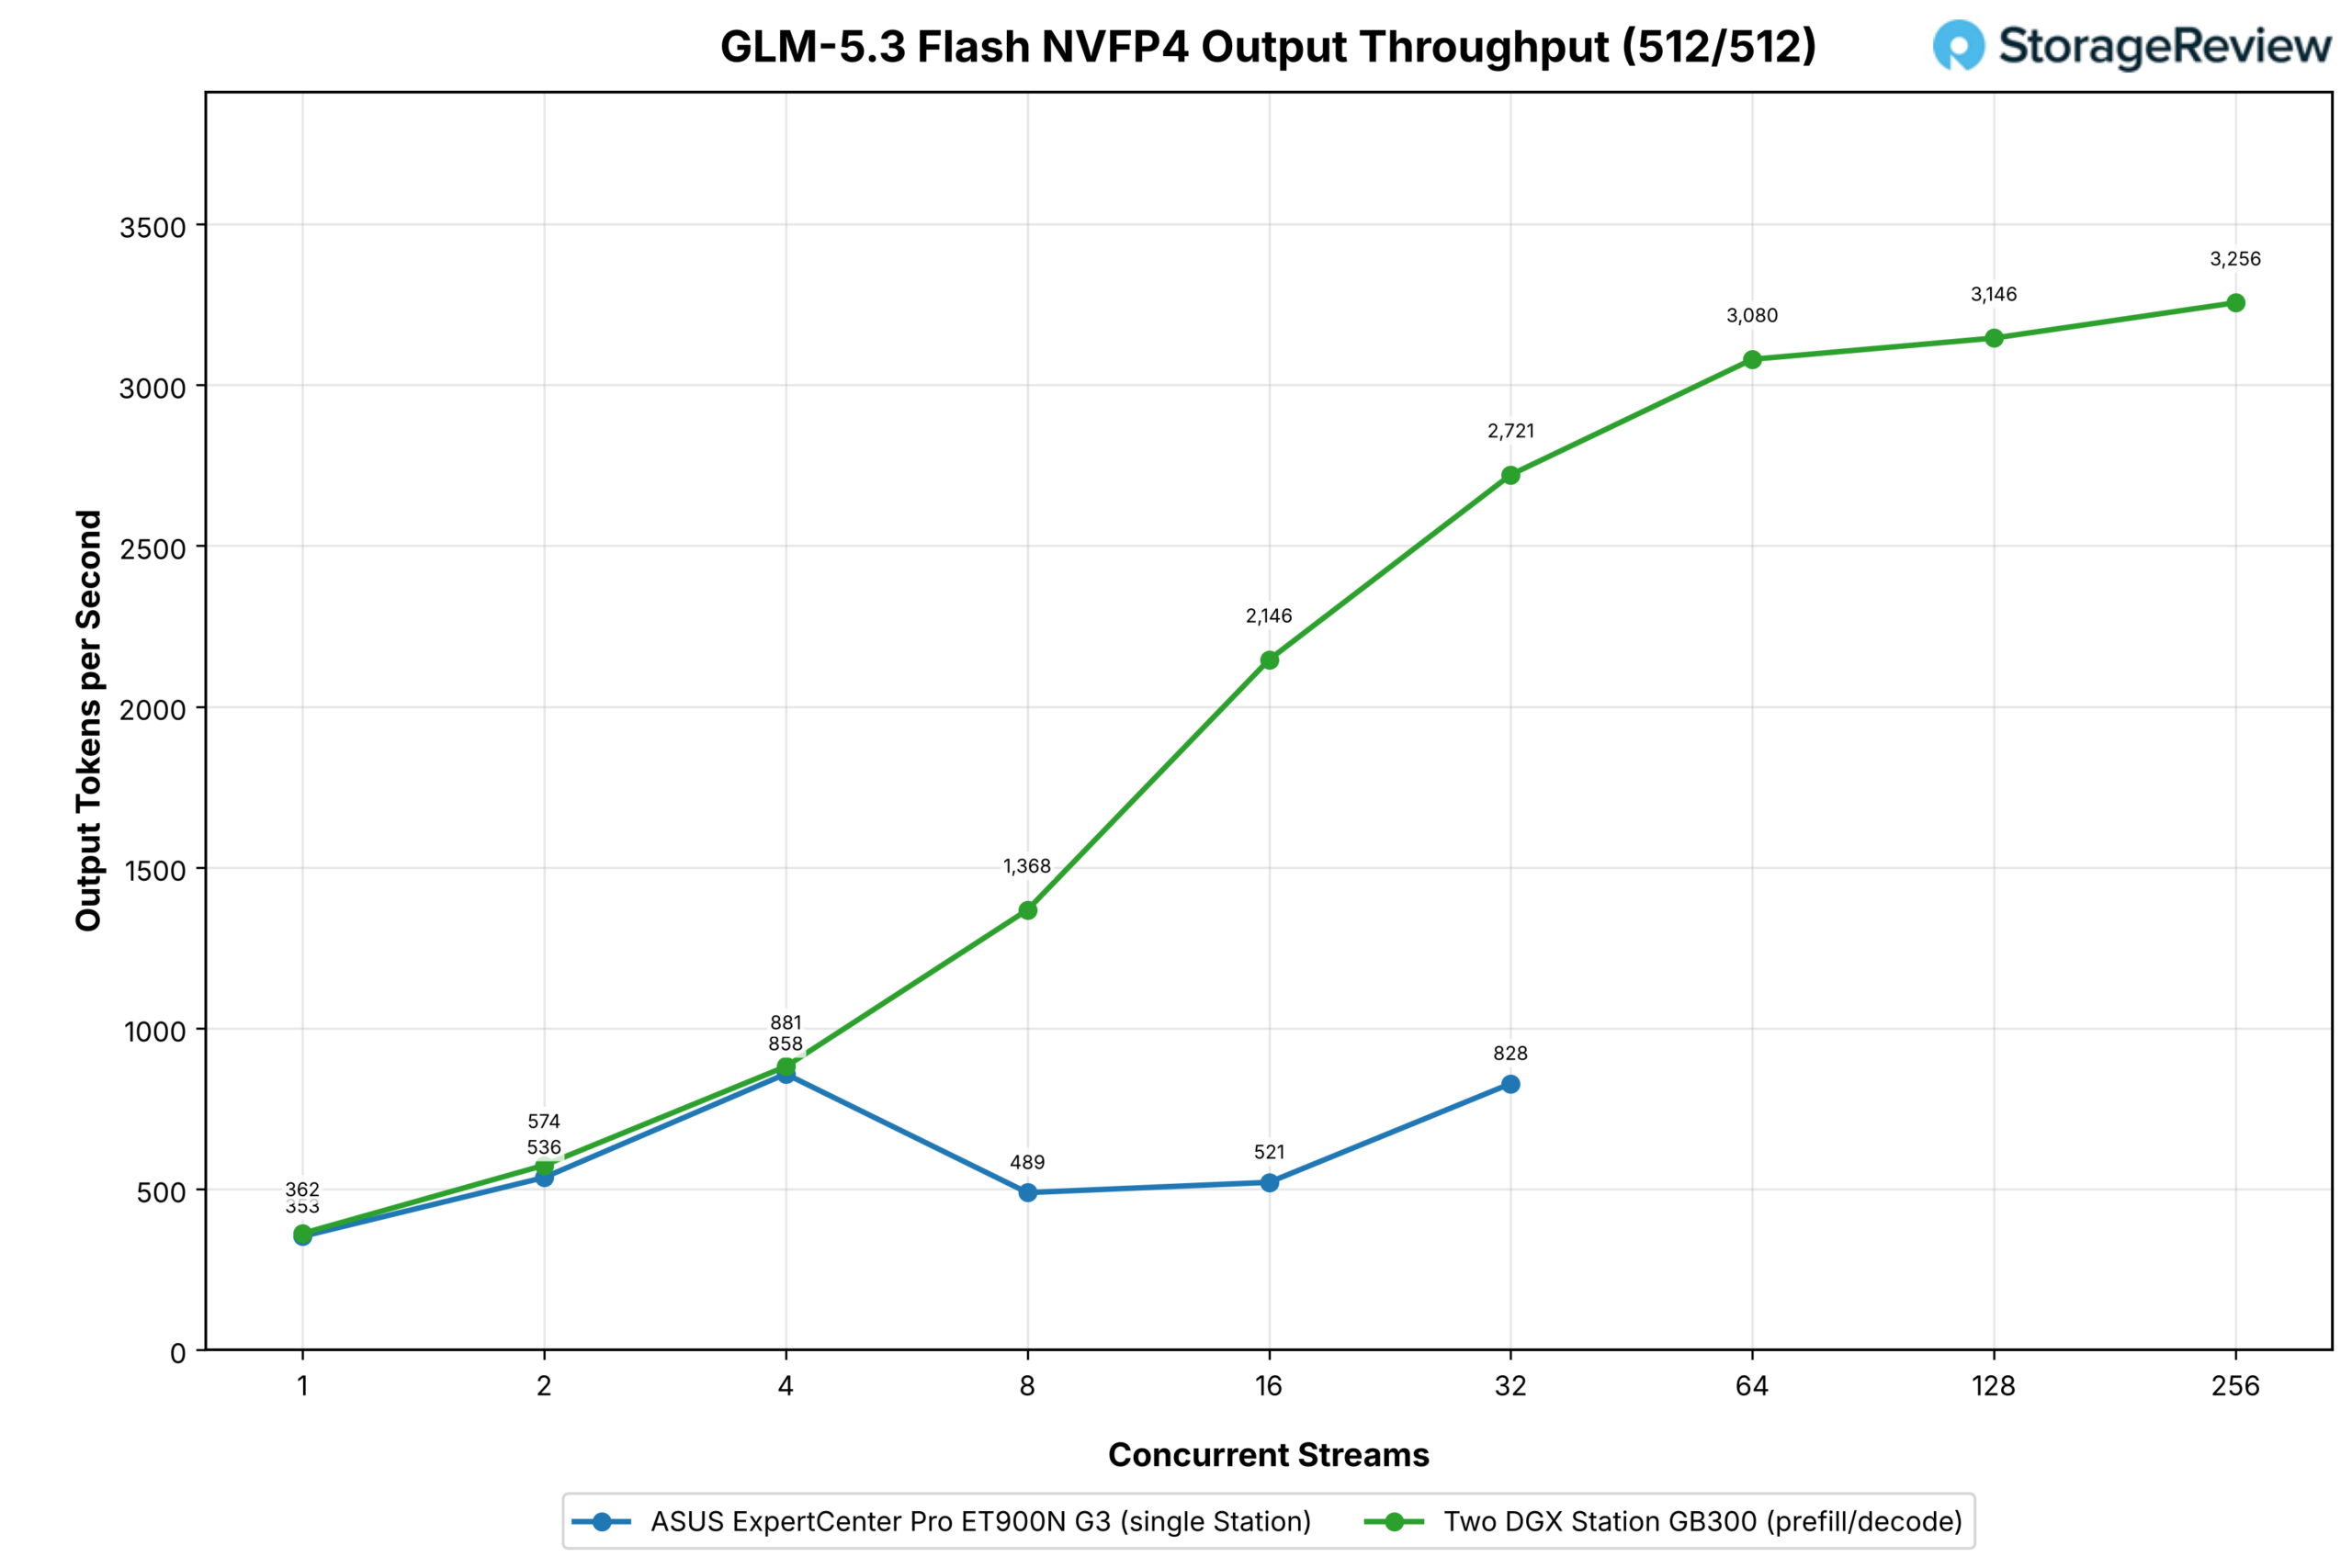
- 符合条件的模型会获得第二个副本,并进行预填充/解码拆分: 当一个工作站进行预填充,另一个工作站进行解码时,GLM-5.3 Flash 在 32 个流下将短提示吞吐量提高了三倍(从 828 提高到 2,721),并将长提示吞吐量提高了一倍(从 1,219 提高到 2,448),而 DeepSeek V4.1 Flash 在所有测试型号中实现了最高的输出吞吐量,在 256 个流下每秒 5,248 个令牌。
DGX 站上的网络连接
在深入了解集群之前,让我们先回顾一下我们在 MSI 评测中提到的网络功能。ConnectX-8 SuperNIC 的功能远不止提供网络连接。它集成的 PCIe 交换机还负责处理工作站的部分内部 I/O,连接到 Grace 以及两个 PCIe Gen 6 x4 存储插槽。
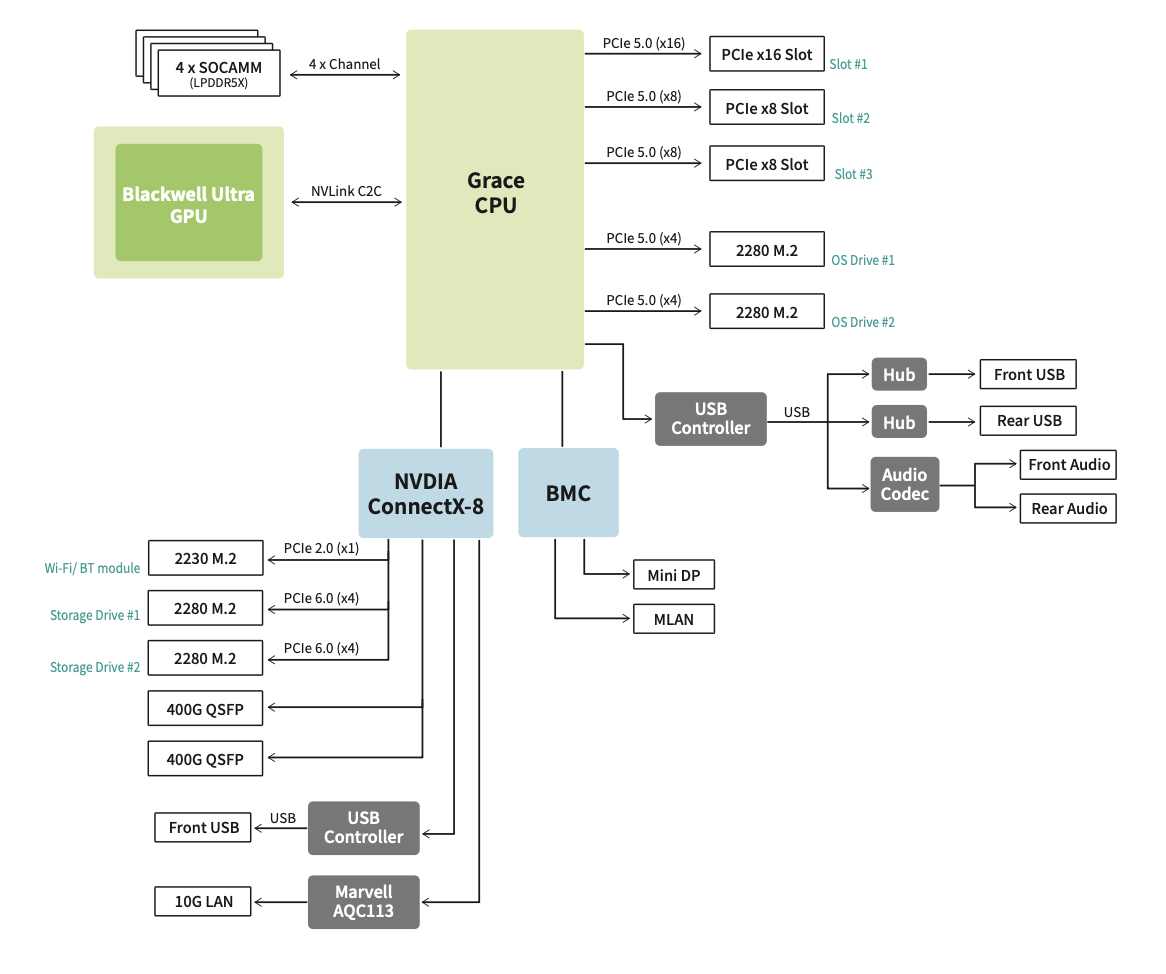
对于实际联网,该系统提供两个 QSFP112 端口,每个端口的额定带宽为 400Gb/s,总带宽为 800Gb/s,可将站点连接在一起或将其连接到更大的网络。
与我们之前在 DGX Spark 评测中介绍的 DGX Spark 的实现方式相比,Spark 的 400Gb/s 级 ConnectX-7 的性能远超 GB10 的 PCIe 连接能力。该控制器位于两条独立的 PCIe 5.0 x4 链路之后,限制了实际可用的网络总吞吐量约为 200Gb/s。在 Linux 系统中,它的两个物理端口也显示为四个逻辑以太网接口。要获得全部带宽,需要将这些接口映射回连接的机箱,配置其后的两个逻辑接口,并确保 RDMA 流量可以使用两条 PCIe 路径。
该工作站为我们提供了一种更简单的配置,它有两个 400Gb/s 端口,每个端口都可以作为独立的网络线路。
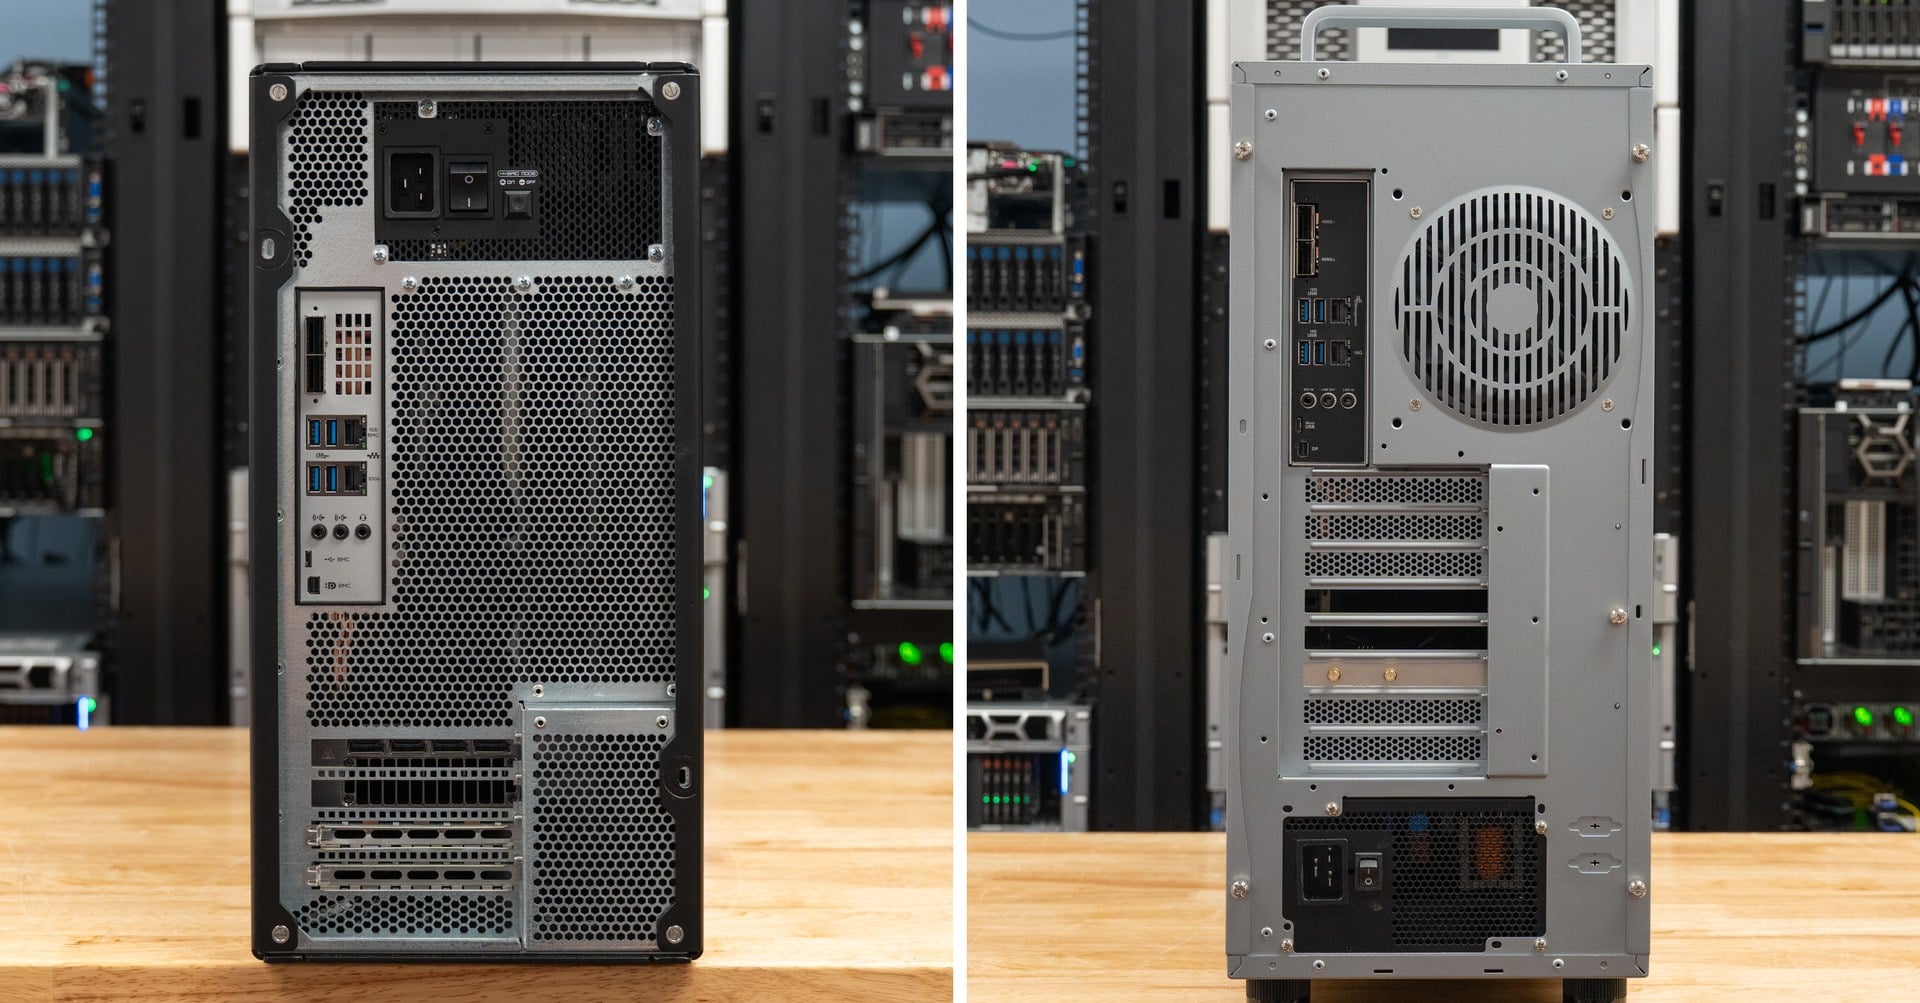
通过两个 QSFP 插槽传输四倍于 Spark 可用带宽的数据,无疑会增加散热负荷。在我们的测试中,所有设备都能轻松应对。ConnectX-8 本身采用液冷散热,一些厂商(例如 MSI)会将这种散热方式延伸到 QSFP 插槽,而其他厂商则像我们在 ASUS 评测中看到的那样,在插槽上方使用散热片和专用风扇。这种散热方式对于光模块尤其有效,因为光模块产生的热量比被动式 DAC 更高。两种散热方案在我们的测试中都表现良好,我们没有遇到任何网络散热问题。
连接两个车站
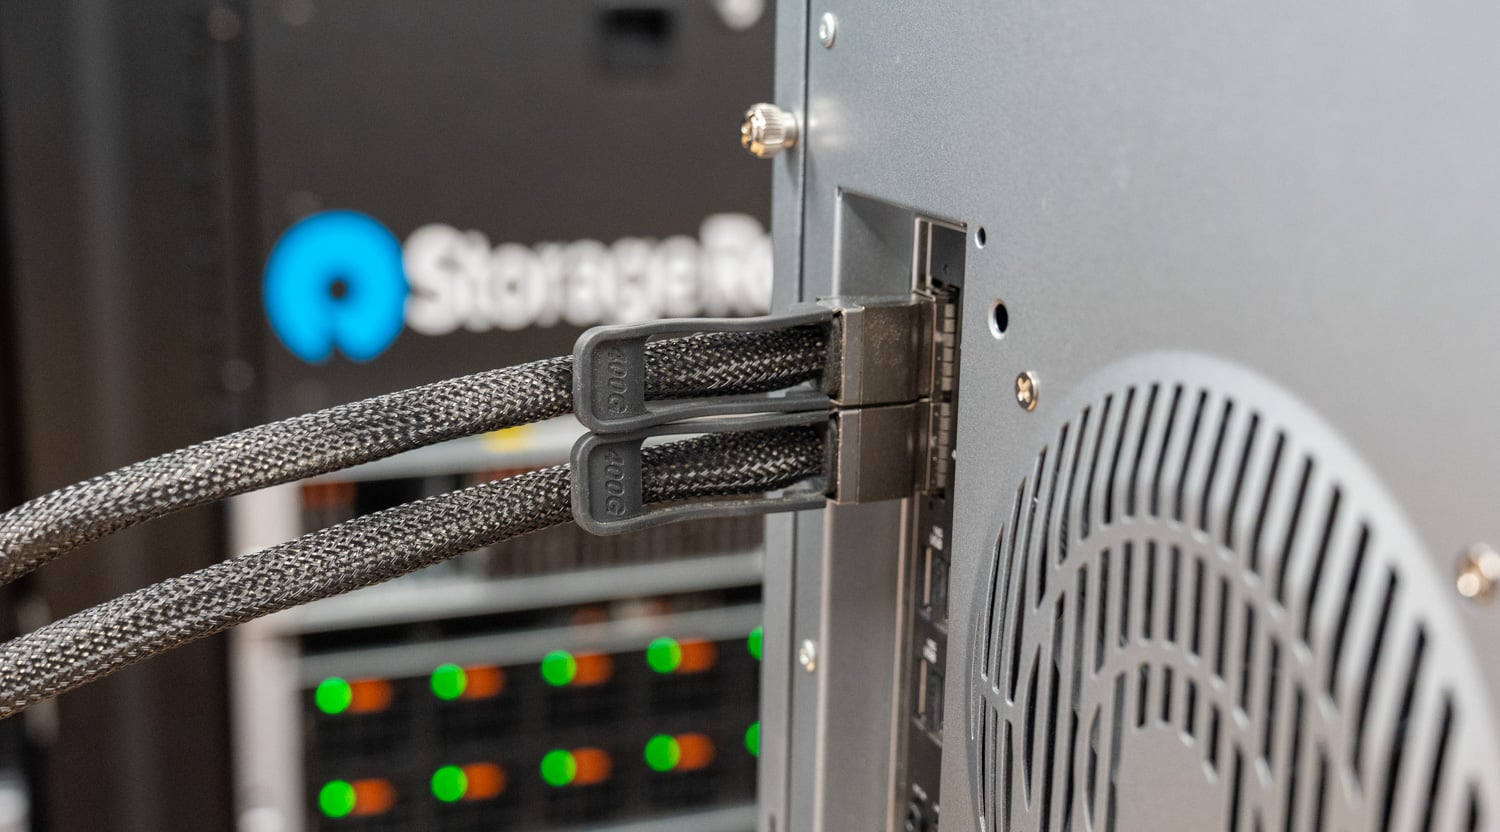
将两台 DGX 工作站集群化很简单:我们使用两根 400G 直连铜缆 (DAC) 连接 ASUS 和 HP 的匹配 QSFP112 端口,从而获得两个独立的 400Gb/s 连接。
软件方面,NVIDIA 提供了系统集群的分步指南,说明非常清晰,我们只需将链接提供给 Claude Code,它就能自动完成设置。它配置了两个站点之间的网络,运行了 NCCL 带宽测试,并生成了测试结果报告。
该指南是一个编号的脚本,由第三台机器运行,通过 SSH 连接到两个工作站。端口连接方式为匹配的链路,QSFP0 连接 QSFP0,QSFP1 连接 QSFP1,每个链路都成为独立的点对点 RoCEv2 链路:脚本以 9,000 字节的 MTU 启动两个 ConnectX-8 接口,为每个链路分配一个私有的 /24 子网,并应用 RoCE 和 GPUDirect 运行时设置。
验证过程随后确认两条链路均已训练至 400G,巨型帧 ping 包能够分别通过两条链路传输,并且两个 RDMA 设备 mlx5_0 和 mlx5_1 均处于活动状态。此外,在每条链路上运行 ib_write_bw 命令,证明该交换矩阵能够传输 RDMA 流量,而不仅仅是 ping 包。之后,将 NCCL 指向这两条链路(NCCL_IB_HCA=mlx5_0,mlx5_1),然后像其他双节点运行一样启动作业。以下结果即来自上述步骤。
第一张表来自 nccl-tests,它记录了在两台 B300 服务器上运行的分布式推理或训练作业问题,两台服务器均使用两条总线。每台工作站配备一个 GPU,因此每次作业都涉及两个 GPU 通过两条 400G 链路交换数据,所以总线带宽列直接对应两条电缆提供的 100GB/s(800Gb/s)带宽。峰值是不同消息大小下的最佳结果;16 GiB 列代表测试过的最大消息大小,此时带宽已趋于稳定。
| 操作 | 峰值大小 | 峰值总线带宽 | 总线带宽为 16 GiB |
|---|---|---|---|
| 全部减少 | 1 GiB | 92.242 GB /秒 | 91.346 GB /秒 |
| 全体集合 | 16 GiB | 87.893 GB /秒 | 87.893 GB /秒 |
| 减少散射 | 2 GiB | 93.930 GB /秒 | 92.905 GB /秒 |
| 广播 Broadcast | 16 GiB | 97.975 GB /秒 | 97.975 GB /秒 |
| 减少 | 16 GiB | 97.978 GB /秒 | 97.978 GB /秒 |
| 总而言之 | 8 GiB | 80.522 GB /秒 | 80.512 GB /秒 |
| 发送/接收,单向 | 16 GiB | 97.953 GB /秒 | 97.953 GB /秒 |
| 发送/接收,双向 | 16 GiB | 每方向 83.748 GB/s | 总计 167.496 GB/s |
广播、降维和单向发送/接收的传输速率均达到 98GB/s,占两条线缆承载能力的 98%。双向同时传输的速率则有所下降,单向降维为 92GB/s,双向传输为 80GB/s。双向发送/接收的测试结果作为参考:在两个 GPU 同时发送数据的情况下,每个方向的速率稳定在 84GB/s,链路总速率为 167GB/s。
第二张表将 NCCL 降级到原始 RDMA 路径,每次使用 ib_write_bw 函数写入一条内存通道。GPUDirect 行记录了从一块 B300 的 HBM 向另一块 B300 的 HBM 进行 1 MiB 数据传输的过程,网卡直接读写 GPU 内存;两条内存通道的读写速度均达到 392Gb/s,占线路速率的 98%。主机内存行是该指南的基本冒烟测试,使用一对来自 Grace 内存的队列,NVIDIA 的测试手册显示,在 400G 内存通道上,Grace 内存的读写速度为 220 至 230Gb/s;我们测得的速度为 228Gb/s。延迟行记录的是 8 字节的写入操作:平均延迟为 1.46 微秒。
| 《测试》(Test) | 带宽 | 链路利用率 |
|---|---|---|
| GPUDirect RDMA、GPU 内存、ib_write_bw、1 MiB 传输 | ||
| 铁路0 | 392.15 Gb / s的 | 98.04% |
| 铁路1 | 392.15 Gb / s的 | 98.04% |
| 主机内存 RDMA,两条轨道 | ||
| RDMA 写入,单向 | 228.15 Gb / s的 | |
| RDMA读取,单向 | 228.23 Gb / s的 | |
| RDMA 发送,单向 | 228.16 Gb / s的 | |
| RDMA 写入,双向 | 447.10 Gb/s 总吞吐量 | |
| RDMA 写入延迟,8 字节 | 平均速度为 1.46 微秒;第 99 百分位数为 1.63 和 1.66 微秒(铁路运输)。 | |
我们如何测试集群
由于与这对模型的合作时间有限,我们专注于推理,这是目前最流行的AI工作负载。我们计划将这项工作扩展到更大的集群。在本文中,我们着重研究了大型模型,并使用张量并行(TP)和预填充/解码(PD)分解技术,比较了单个Station和两个Station的性能。
张量并行将模型中的权重张量和计算任务分配到多个GPU上。在我们的双站配置(TP2)中,每个B300 GPU都承载着模型的一部分,并且两个GPU同时处理每个请求。这为我们提供了更多的高带宽内存(HBM)来存放权重,以及更多的计算资源来运行这些权重。此外,它还要求GPU在整个推理过程中通过NCCL交换中间结果并进行同步,因此通信开销也成为运行模型成本的一部分。
解耦推理将请求的预填充和解码阶段分配给不同的工作进程。预填充处理输入提示并构建键值 (KV) 缓存,该缓存是模型在生成过程中重用的注意力状态。解码则使用该状态逐个生成输出标记。这两个阶段的处理需求不同:预填充计算量大,而解码则内存带宽密集。在规模较大的系统中,这种解耦推理方式允许运维人员根据需求独立扩展这些工作进程,正如我们在KV 缓存卸载论文中所展示的那样。
在单节点架构中,当两个阶段共享一个工作节点时,vLLM 可以将对传入提示的预填充工作与正在进行的请求的解码工作交错进行。这种提示处理可能会增加输出标记之间的间隔时间。在我们的 PD 架构中,一个工作站负责预填充并将请求的键值缓存传输到另一个工作站,后者负责解码。每个工作节点都可以访问其自身的模型副本,包括存储在 Grace 内存中的任何数据。解码工作节点不再需要在生成标记的同时安排新的提示处理,从而提高了推理吞吐量。
在我们的测试中,模型的内存需求决定了我们采用的方法。对于最大的检查点,单个 Station 需要将大量模型权重卸载到 Grace 内存,此时 TP 方案性能最佳。将权重分散到两个 GPU 上,可以让更多模型数据保留在 HBM 内存中,从而降低卸载性能损失。对于那些能够很好地适应单个 Station 的模型(无论是完全运行在 HBM 内存中,还是仅少量卸载到 Grace 内存),我们使用了 PD 解耦方案。该方案包括使用 DeepSeek V4.1 Flash,其 Engram 查找表位于 Grace DRAM 内存中。
为了与之前的测试结果保持一致,我们沿用了之前的方法,即固定输入序列长度 (ISL) 和输出序列长度 (OSL)。相同工作负载的测试使用 512 个输入令牌和 512 个输出令牌,而预填充密集型工作负载则使用 8,192 个输入令牌和 1,024 个输出令牌。我们在保持序列长度不变的情况下,改变并发请求的数量。
每张图表中的单站基准线是我们评测过的 ASUS ET900N G3,扫描至 32 个流;双站运行至 256 个流。每个点都是一次运行,因此在某个并发级别上的下降会被报告为已收集。
推理配置
| 型号 | 集群模式 | 软件 | 推测解码 | 格蕾丝的记忆 |
|---|---|---|---|---|
| DeepSeek V4.1 闪光灯 (FP8) | 预填充/解码分解,每个站点完整副本 | vllm/vllm-openai:deepseekv41-flash-0909 | 模型自带绘图器,固定5个标记 | 每个工作站上,Grace 内存中固定了两张 FP8 记忆图(188.84GiB),并卸载了 131.97GB 的专家权重。 |
| GLM-5.3 NVFP4 | 张量并行(TP2) | NVIDIA vLLM 26.08 NGC 容器 (vLLM 0.27.1) | MTP,固定5代币草案 | 集群上没有;215GB 的专家权重已卸载到单个 Station 上。 |
| GLM-5.3 Flash NVFP4 | 预填充/解码分解,华硕预填充,惠普解码 | vLLM 0.28.1 RC1 | MTP,固定5代币草案 | 没有 |
| GLM-5.2 NVFP4 | 张量并行(TP2) | NVIDIA vLLM 26.08 NGC 容器 (vLLM 0.27.1) | MTP,固定3代币草案 | 集群上没有;约 215GB 的专家权重已卸载到单个 Station 上。 |
| MiniMax-M3 NVFP4 | 张量并行(TP2) | NVIDIA vLLM 26.08 NGC 容器 (vLLM 0.27.1) | EAGLE3,固定3代币轮抽 | 集群上没有;一部分专家被卸载到单个工作站上。 |
推理性能
DeepSeek V4.1 闪存
DeepSeek V4.1 Flash 采用分离式运行,一个工作站负责预填充,另一个负责解码,每个工作站都保存着模型的完整副本:两个 FP8 Engram 表,总计 188.84GiB,存储在 Grace 内存中,另有 131.97GB 的专家权重卸载到 Grace 内存中。这使得它成为该系列中唯一两台机器都使用 Grace 内存的配置。同时,它也是这里唯一没有单工作站配置的型号,因为华硕的评测使用的是早期的 V4 Flash 检查点,两者不具有直接可比性。
在双Station集群上,原生FP8型号在单流模式下每秒输出441个令牌,在32流模式下达到每秒3,328个令牌,在128流模式下达到每秒5,141个令牌,在256流模式下达到每秒5,248个令牌,是该系列所有型号中输出吞吐量最高的,曲线仅在峰值处略有趋于平缓。作为参考,在我们之前的评测中,单台华硕Station在32流模式下处理V4 Flash时,每秒输出令牌数为1,766个。
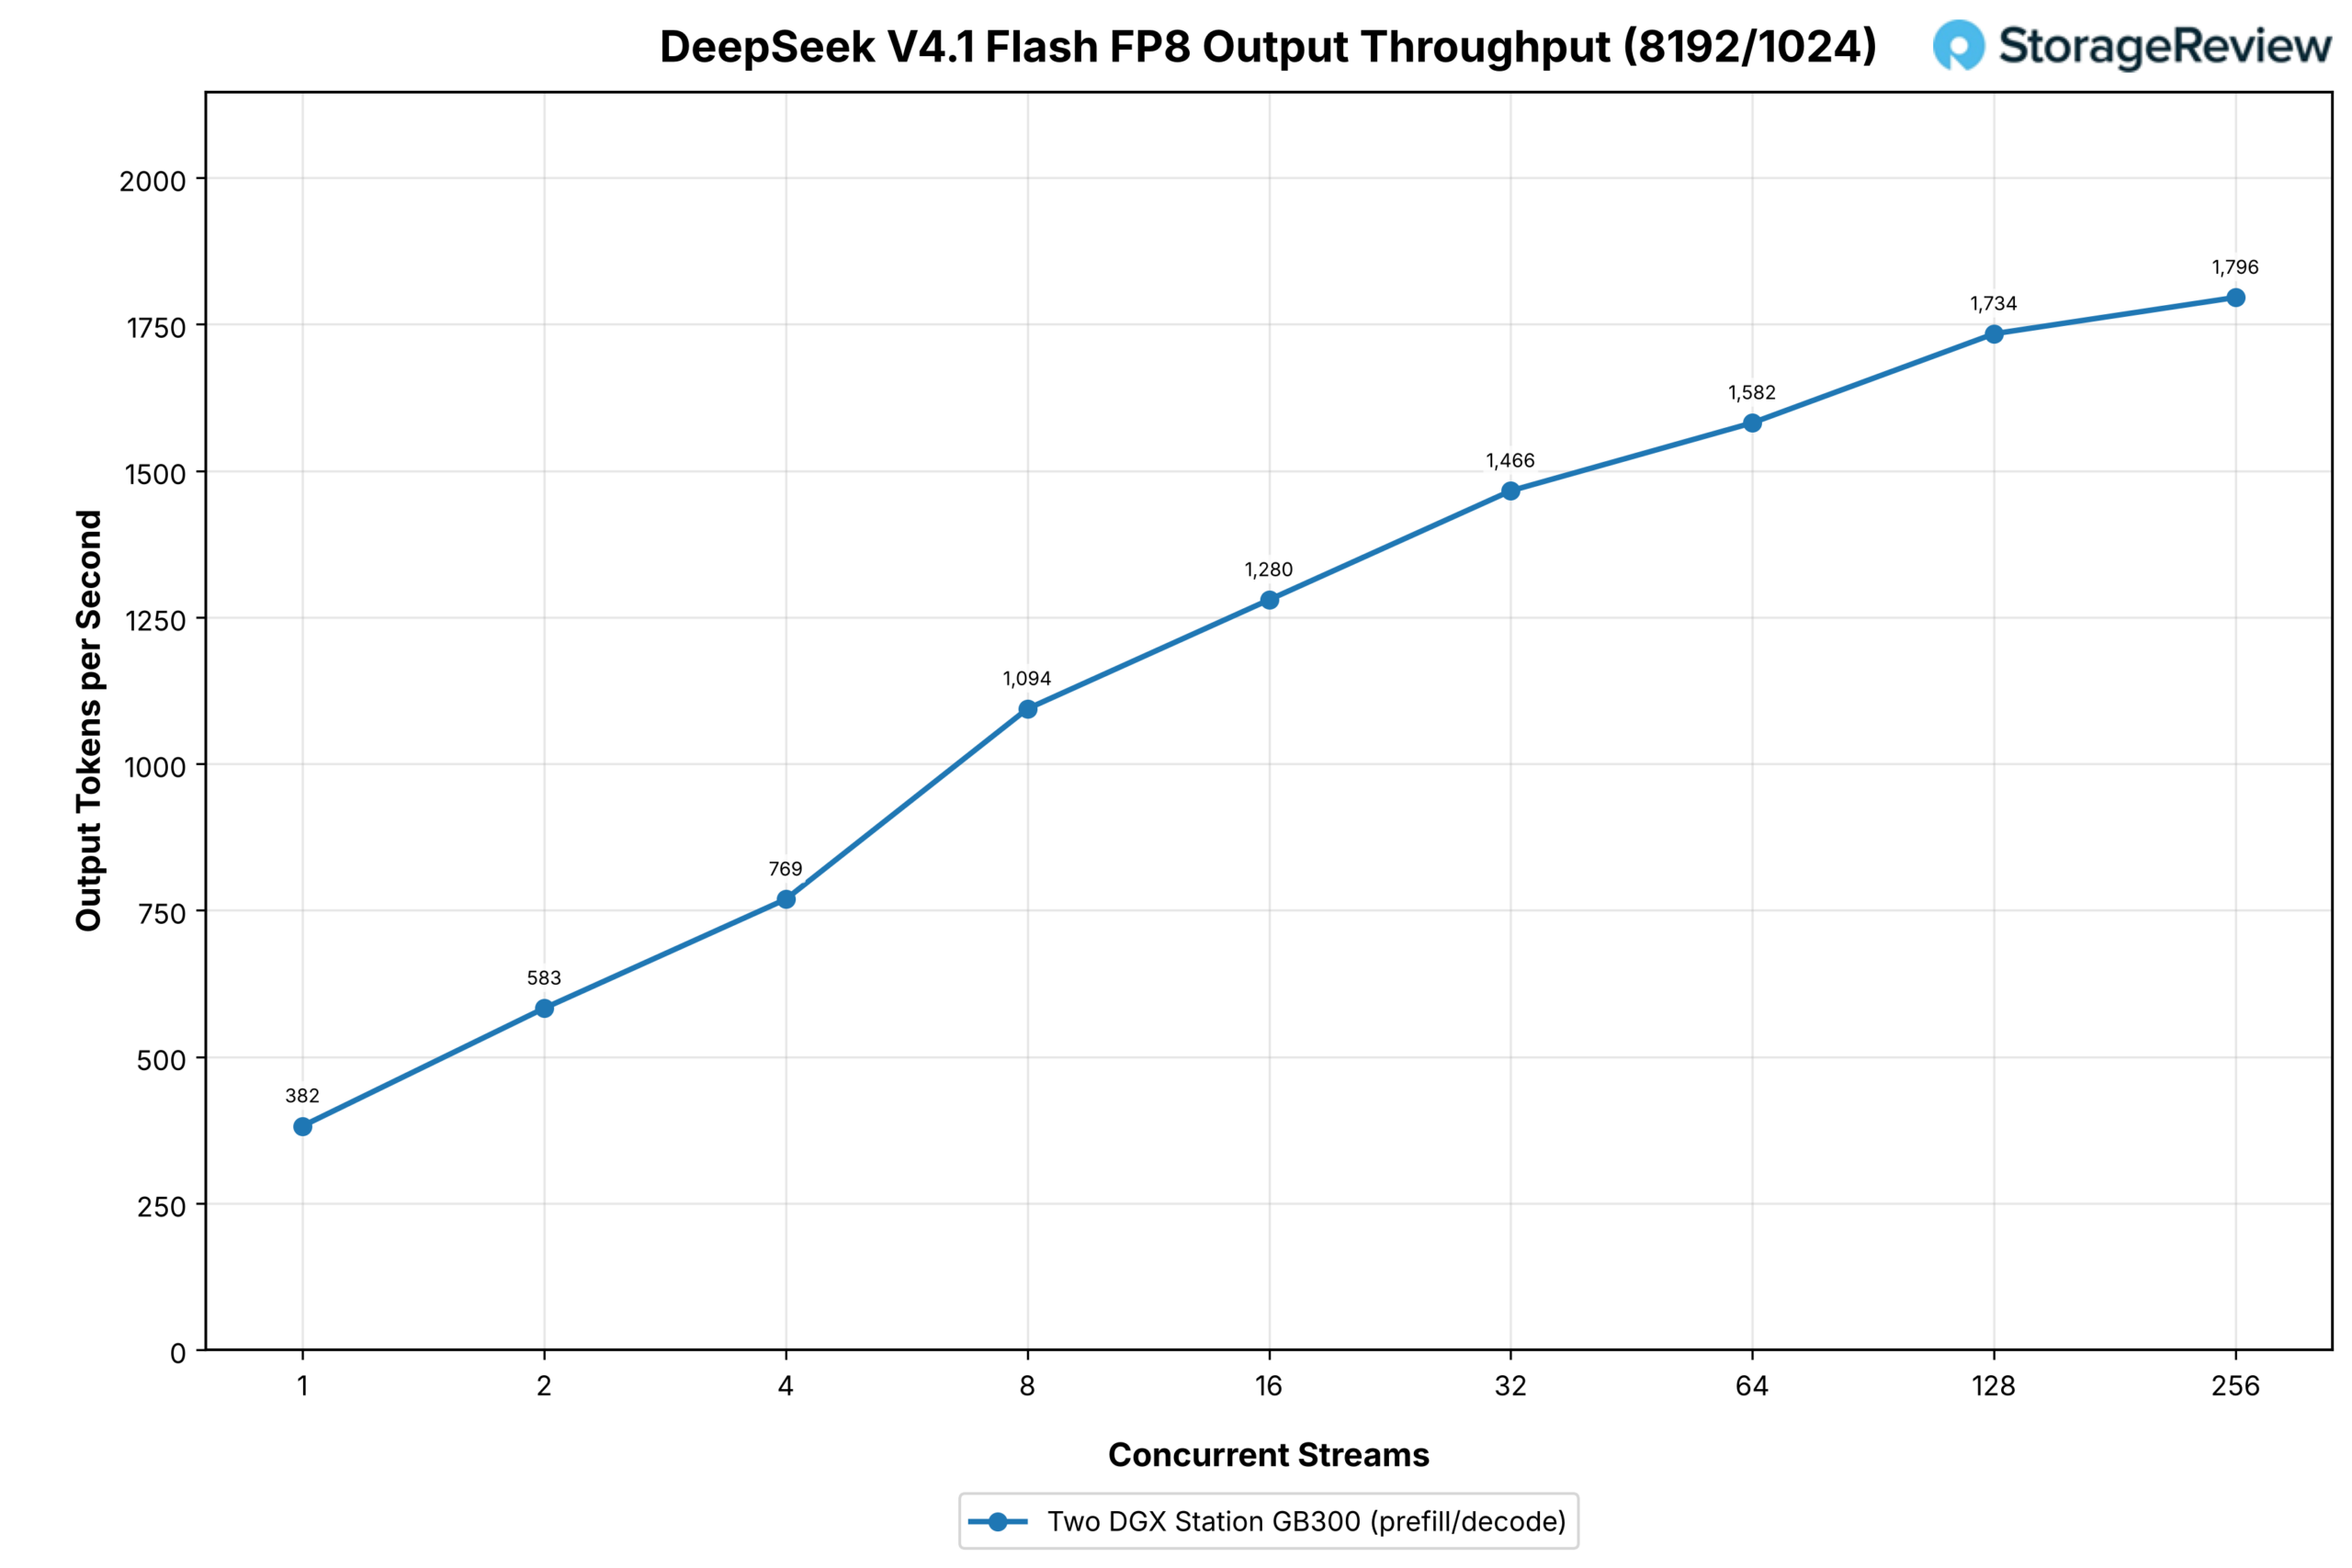
在预填充较多的场景下,集群单流输出速度从每秒 382 个输出标记提升至每秒 1,466 个(32 个流),以及每秒 1,796 个(256 个流)。由于每个请求携带 8,192 个输入标记,因此在测试高峰期,总吞吐量达到了每秒 16,163 个标记。由于每个 Station 的 Grace 内存中都存储着 Engram 表和 131.97GB 的专家权重,因此无论采用何种配置,曲线在整个测试过程中都保持平滑。
GLM-5.3
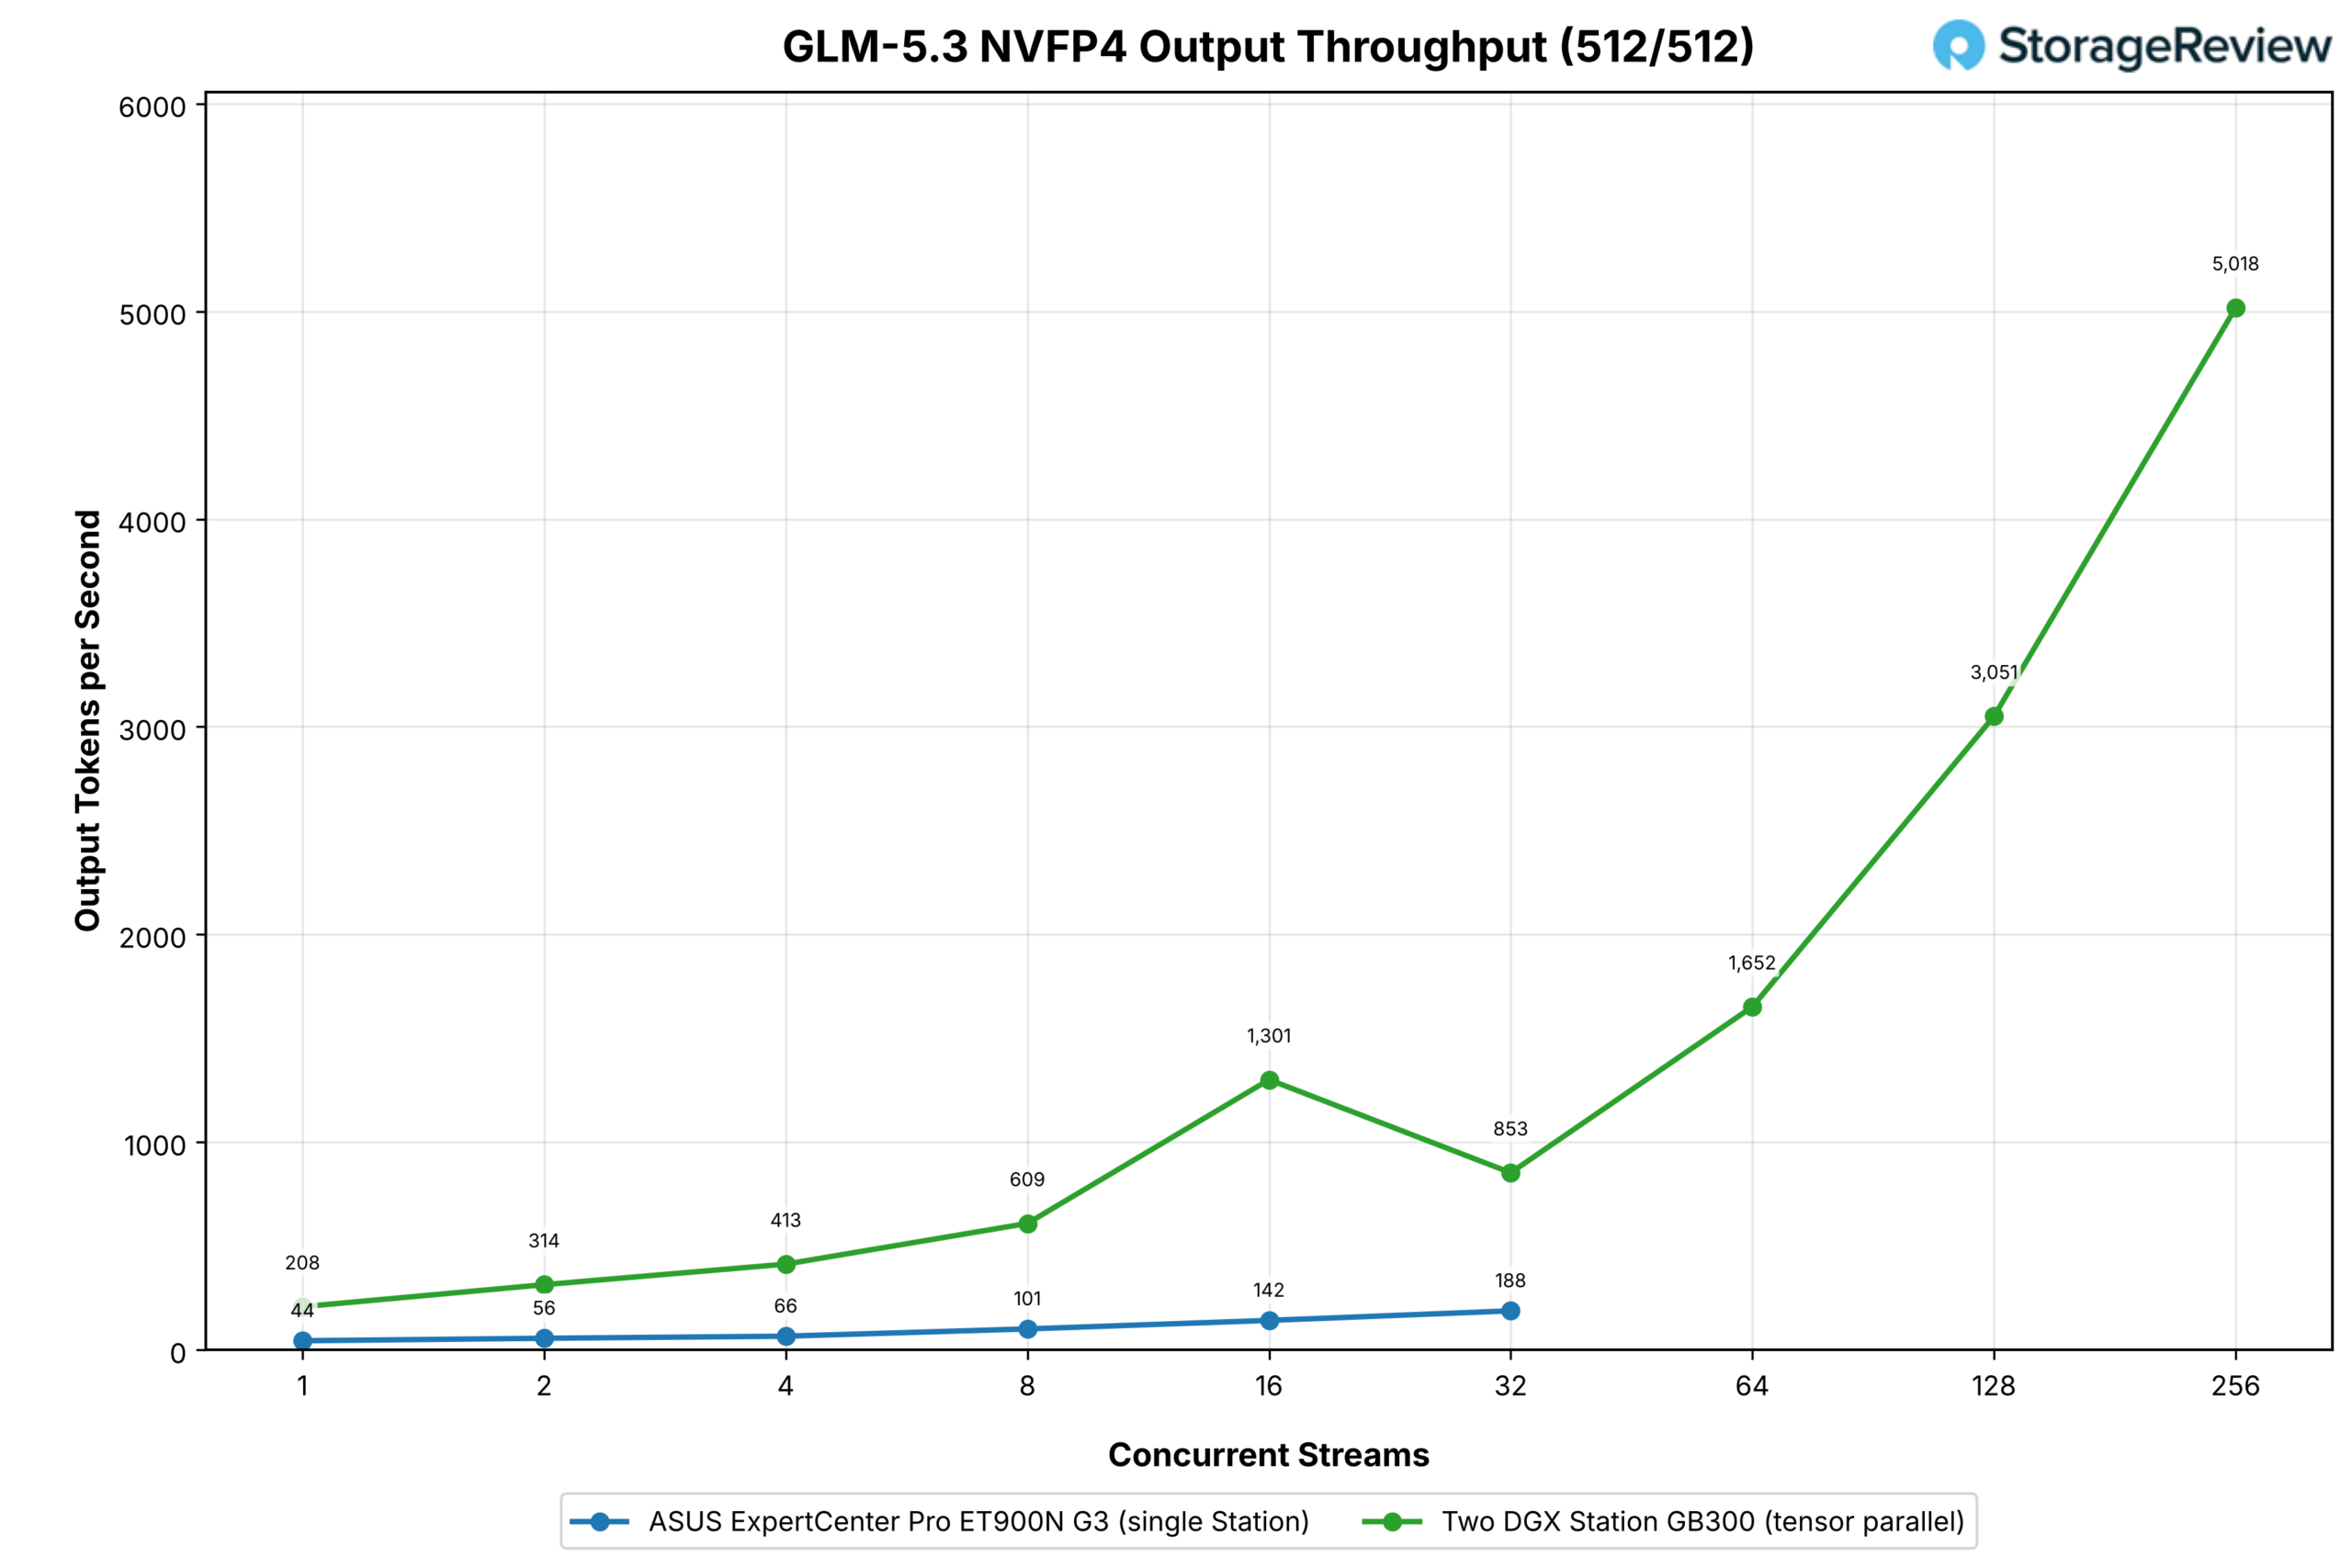
GLM-5.3 在 TP2 中运行,未启用 Grace 卸载。在单个工作站上,它将 215GB 的专家权重卸载到 Grace 内存中,集群结果在大部分扫描过程中与 GLM-5.2 的结果一致,之后开始出现不平衡。单个工作站的运行速度从单流每秒 44 个输出标记提升到相同工作负载下每流 32 个输出标记每秒 188 个。
双站点集群在单流处理时处理量为 208,在 16 流处理时达到 1,301,是单站点集群的 4.7 倍到 9.2 倍,在 32 流处理时下降到 853,然后开始回升,在 64 流处理时达到 1,652,在 128 流处理时达到 3,051,在 256 流处理时达到 5,018。32 流处理时的数据点是收集到的数据;随着并发量的增加,批处理决策和内核选择都会发生变化,而且张量并行部署会在每一层添加一个集体处理,该处理必须在下一步之前完成,因此曲线并非直线,但 256 流处理时的峰值是单站点集群在 32 流处理时达到的 27 倍。
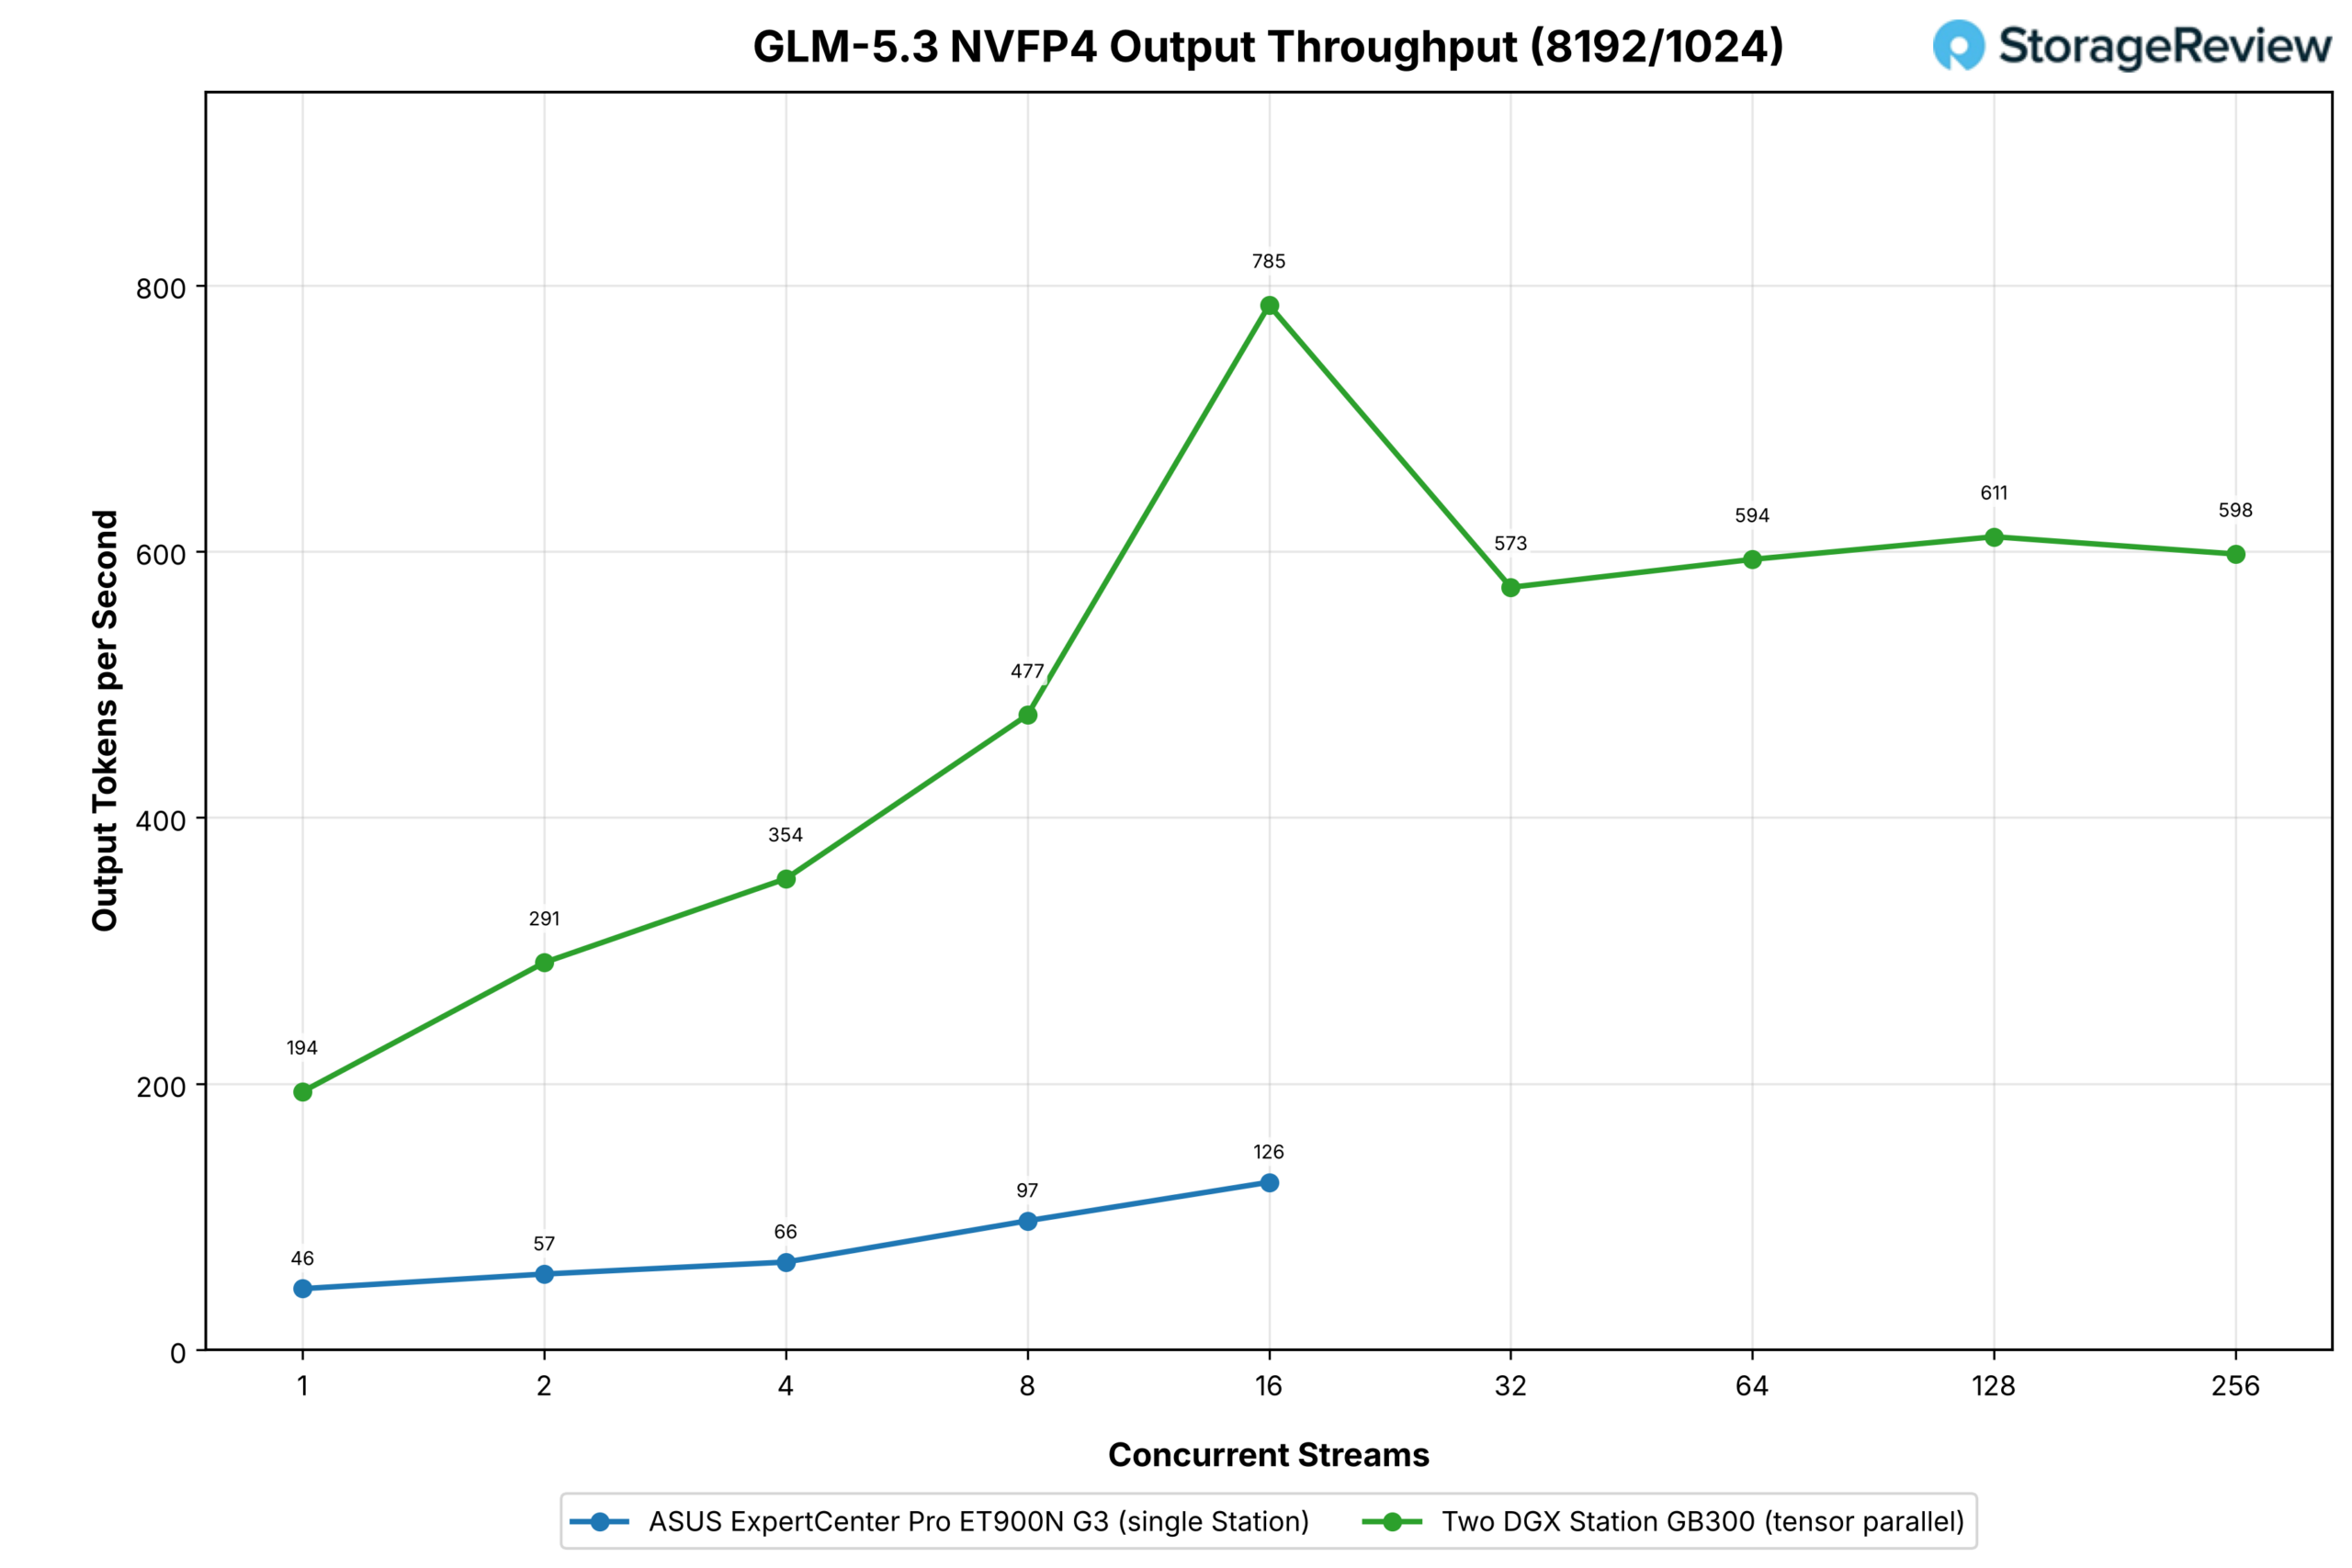
在预填充密集型场景下,单个 Station 的并发流数量被设定为 16 个:卸载模型的性能会很快趋于平缓,进一步提升并发量意义不大。其输出令牌数从单个流时的每秒 46 个提升到 16 个流时的每秒 126 个。集群在同一范围内从每秒 194 个令牌提升到每秒 785 个令牌,最高时提升了 6.2 倍,然后在 32 个流到 256 个流的范围内稳定在每秒 573 个令牌到 611 个令牌之间,长提示符下的输出令牌数上限接近每秒 600 个令牌,仍然是单个 Station 最佳性能的五倍左右。
GLM-5.3 闪光灯
GLM-5.3 Flash 的容量足够小,每个工作站都能存储完整副本,因此采用分离式运行方式,由华硕工作站负责预填充,惠普工作站负责解码。Flash 的活动参数数量较少,因此在单个工作站上运行速度已经很快:单流模式下每秒输出 353 个令牌,32 流模式下每秒输出 828 个令牌,中间部分输出不均匀(四流模式下每秒输出 858 个令牌,八流模式下每秒输出 489 个令牌),我们已将这部分数据记录为已收集的数据。
在分离的对中,相同的工作负载从单流每秒 362 个输出令牌增加到 32 个流每秒 2,721 个输出令牌,是单塔的 3.3 倍,再到 256 个流每秒 3,256 个输出令牌。
在单流和双流情况下,这对组合几乎完全匹配单个站点,这是解码站点单独执行相同工作时所预期的结果;一旦有足够的请求在进行中,预填充站点就会保持忙碌,解码站点也会受益于无需暂停进行预填充,从而获得增益。
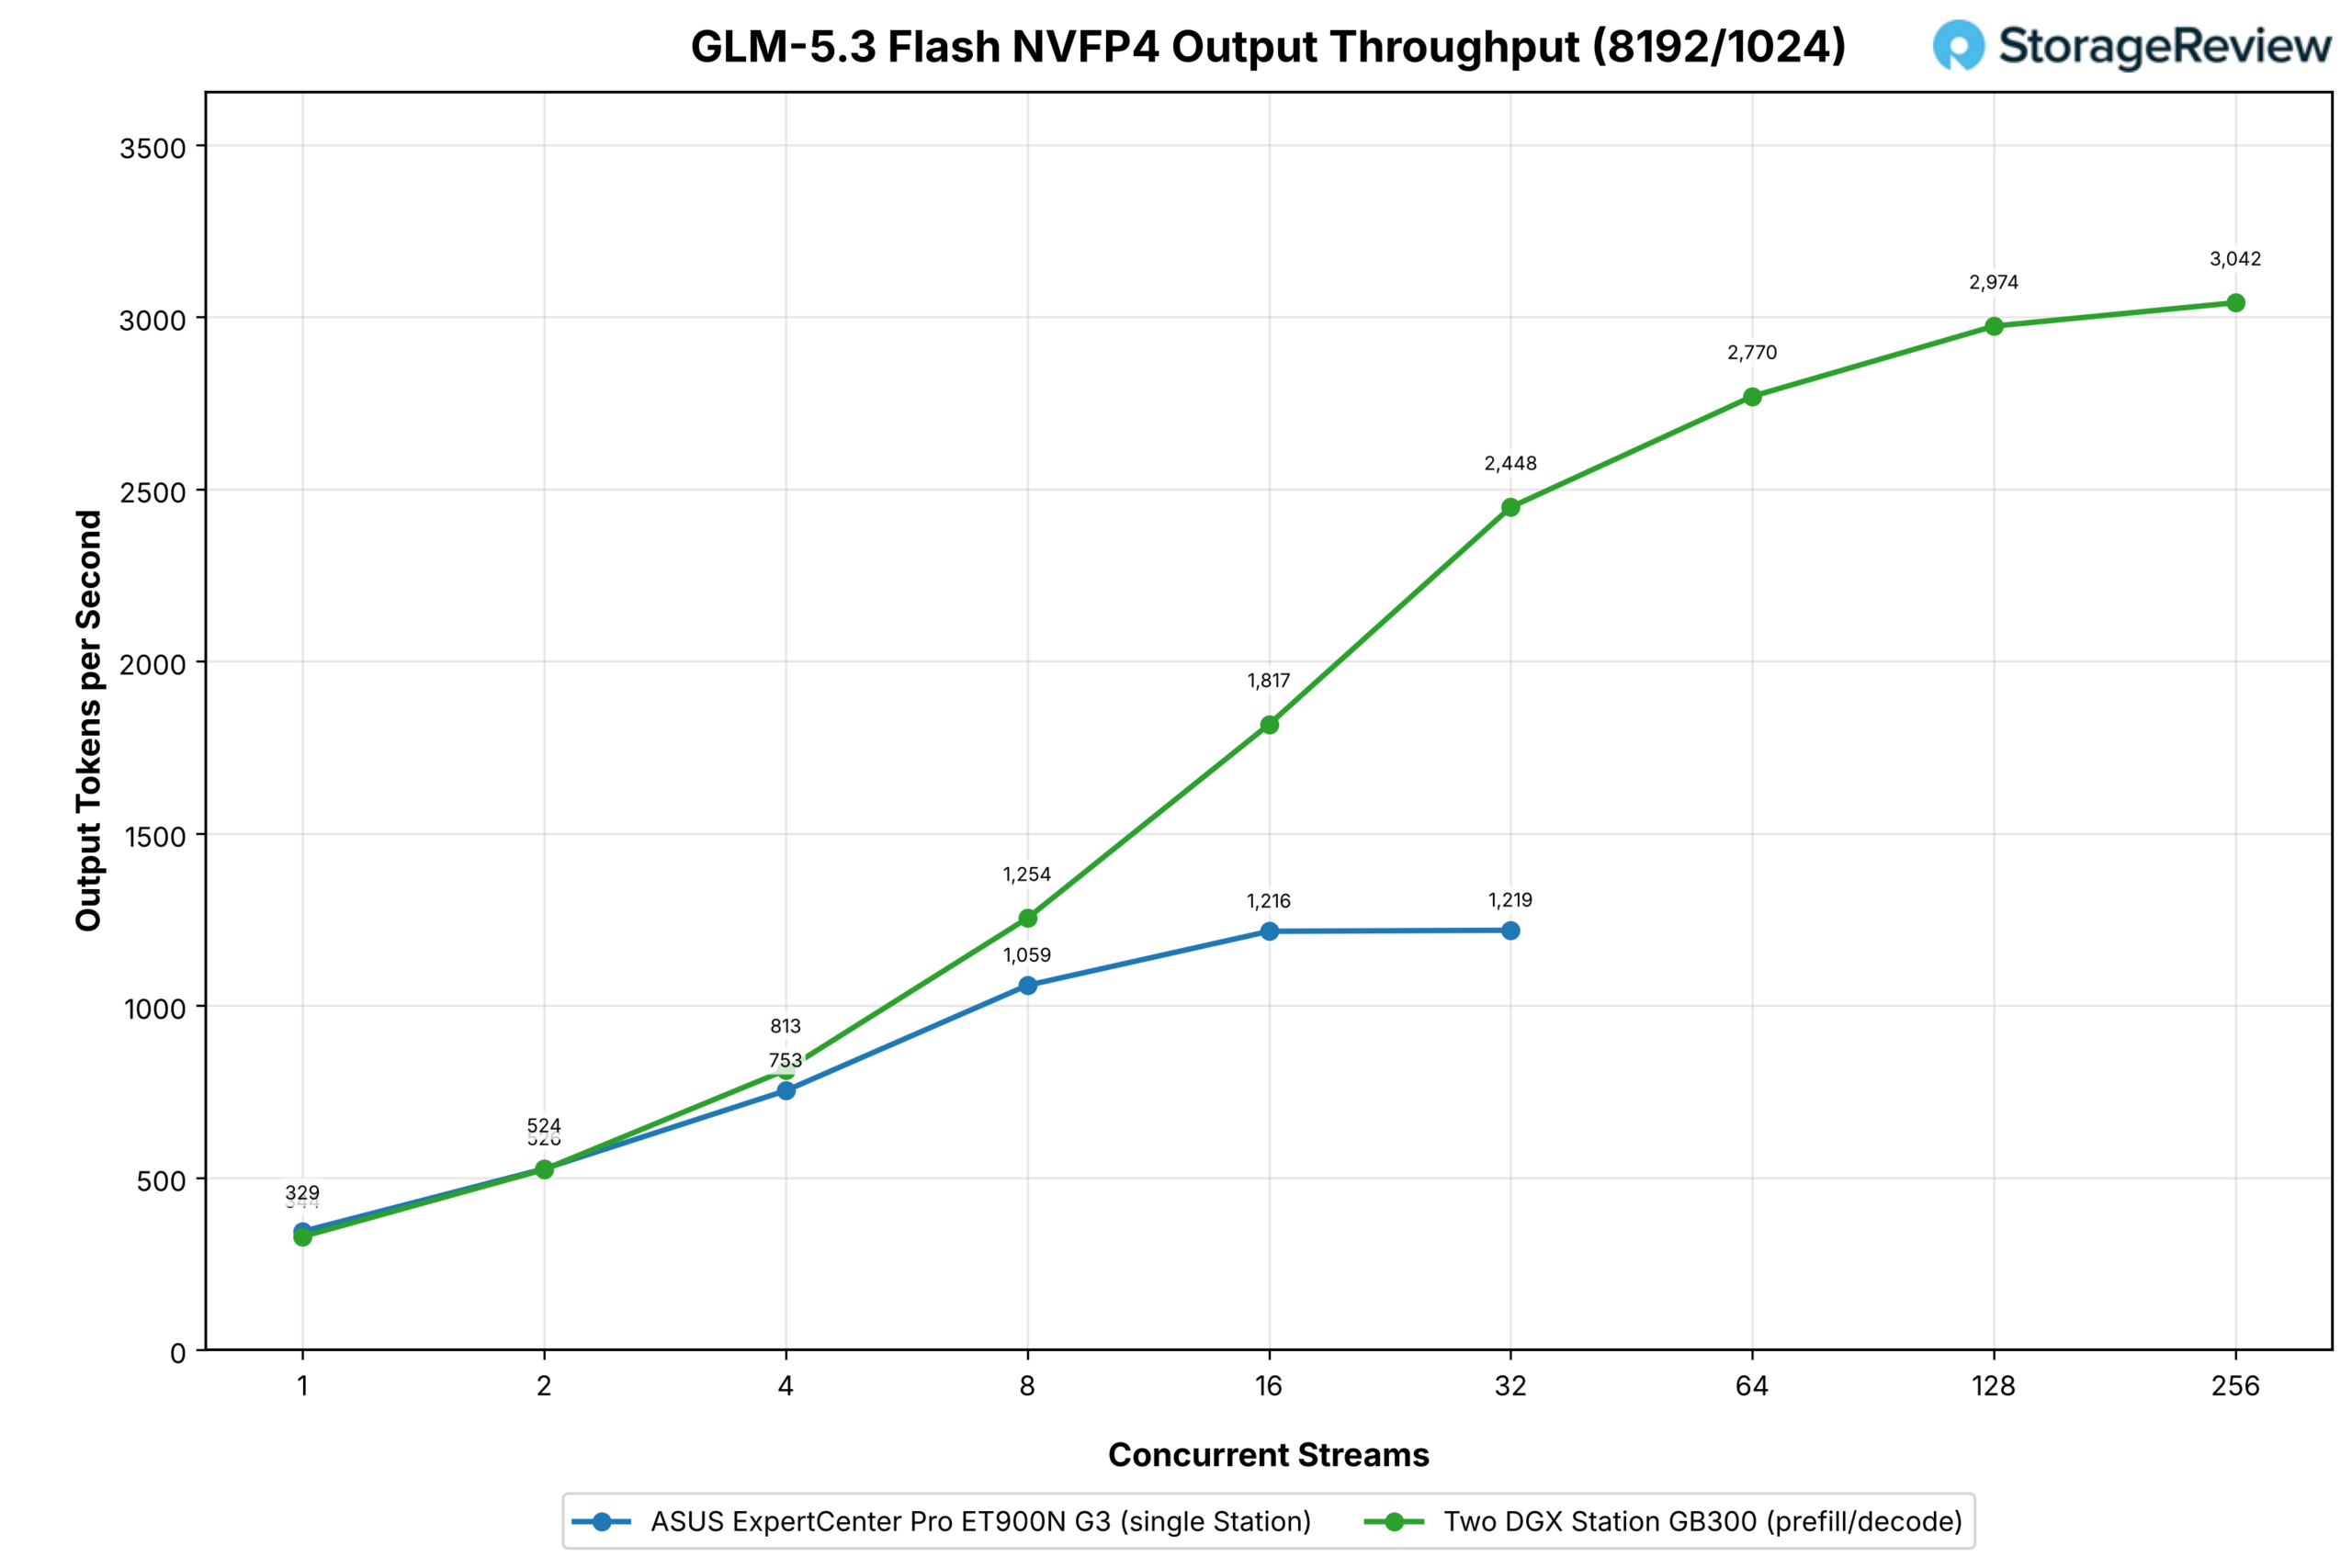
在预填充密集型场景下,单个工作站的输出令牌处理量从单流时的每秒 344 个提升到 16 流时的每秒 1,216 个,并在 32 流时保持在每秒 1,219 个,之后从 16 流开始趋于稳定。预填充/解码组合的输出处理量持续攀升,从单流时的每秒 329 个提升到 32 流时的每秒 2,448 个,是单个工作站输出处理量稳定时的两倍,并在 256 流时达到每秒 3,042 个。这种分离式架构正是为了应对长提示符的情况而设计的,因为预填充工作站可以处理长达 8,192 个令牌的提示符,而解码工作站的键值缓存和计算则保持生成状态。
GLM-5.2
GLM-5.2 在 TP2 模式下运行,集群未启用 Grace 卸载,它是最能证明需要第二个 Station 的模型。NVFP4 检查点大小约为 433GB,因此在单个 GB300 上,大约 215GB 的专家权重存储在 Grace 内存中,并且每个涉及这些权重的解码步骤都会通过 NVLink-C2C 以 396GB/s 的速度传输到 LPDDR5X 内存。模型分布在两个 Station 上,每个 B300 大约可以存储一半的 HBM3e 内存。
在相同的工作负载下,单台 ET900N G3 在单流模式下每秒输出 35 个令牌,在 32 流模式下每秒输出 139 个令牌。双站集群在单流模式下初始输出速度为每秒 149 个令牌,是单塔的 4.3 倍;在 32 流模式下达到每秒 1,525 个令牌,是单塔的 11 倍;之后性能持续攀升,在 64 流模式下达到每秒 2,316 个令牌,在 256 流模式下达到每秒 3,141 个令牌,均超过了单站的性能,但在 128 流模式下略有下降,为每秒 2,012 个令牌。单台工作站能够以对话速度服务于少数用户的模式,在双站集群下可以服务于一个部门。
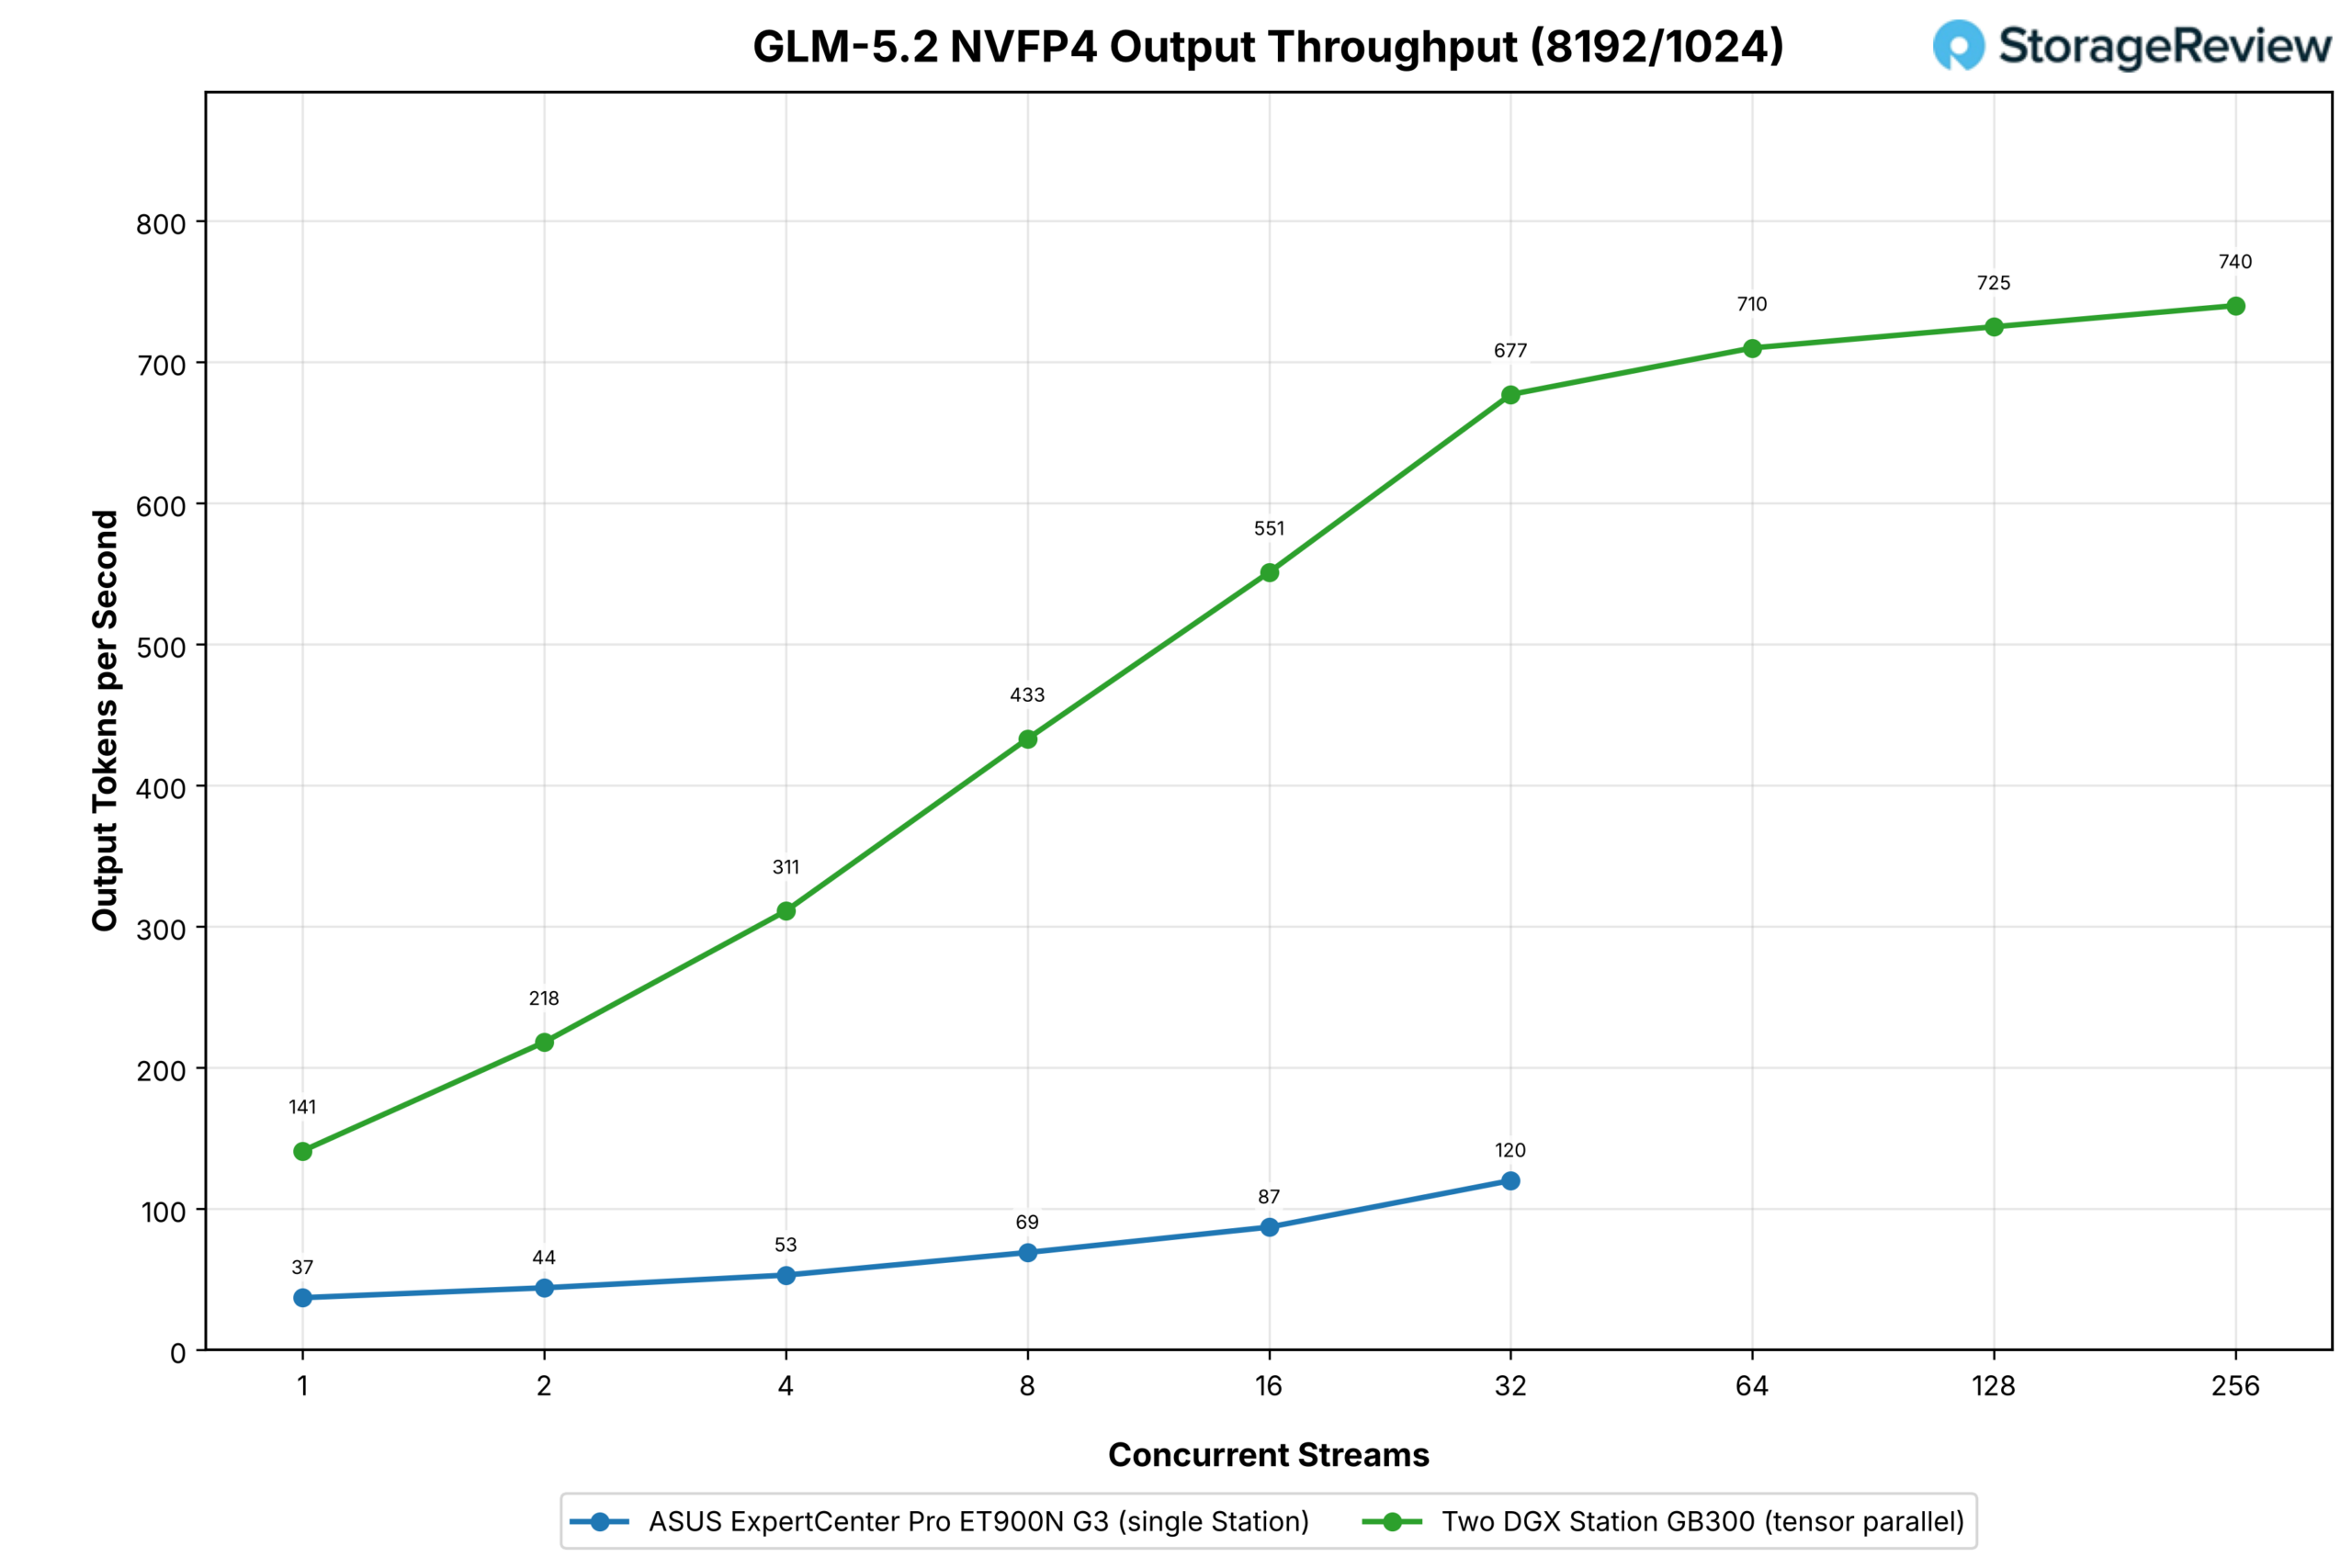
预填充较多的配置文件在较低的高度上也讲述了同样的故事,一个站点从单流每秒 37 个输出令牌增加到 32 流每秒 120 个,集群在同一范围内从 141 个增加到 677 个,在扫描底部是 3.8 倍,顶部是 5.6 倍,然后在 256 流中分别在 710、725 和 740 个趋于平稳。
较长的提示符会将更多工作放在预填充阶段,而这两种配置都属于计算密集型,因此第二个工作站所消除的卸载开销在总开销中所占的比例小于短提示符的情况。两种配置的性能提升都远超 2 倍,因为第二个工作站将 433GB 的 LPDDR5X 内存全部替换为 HBM 内存,而这比第二个 B300 的计算能力更为重要。
MiniMax-M3
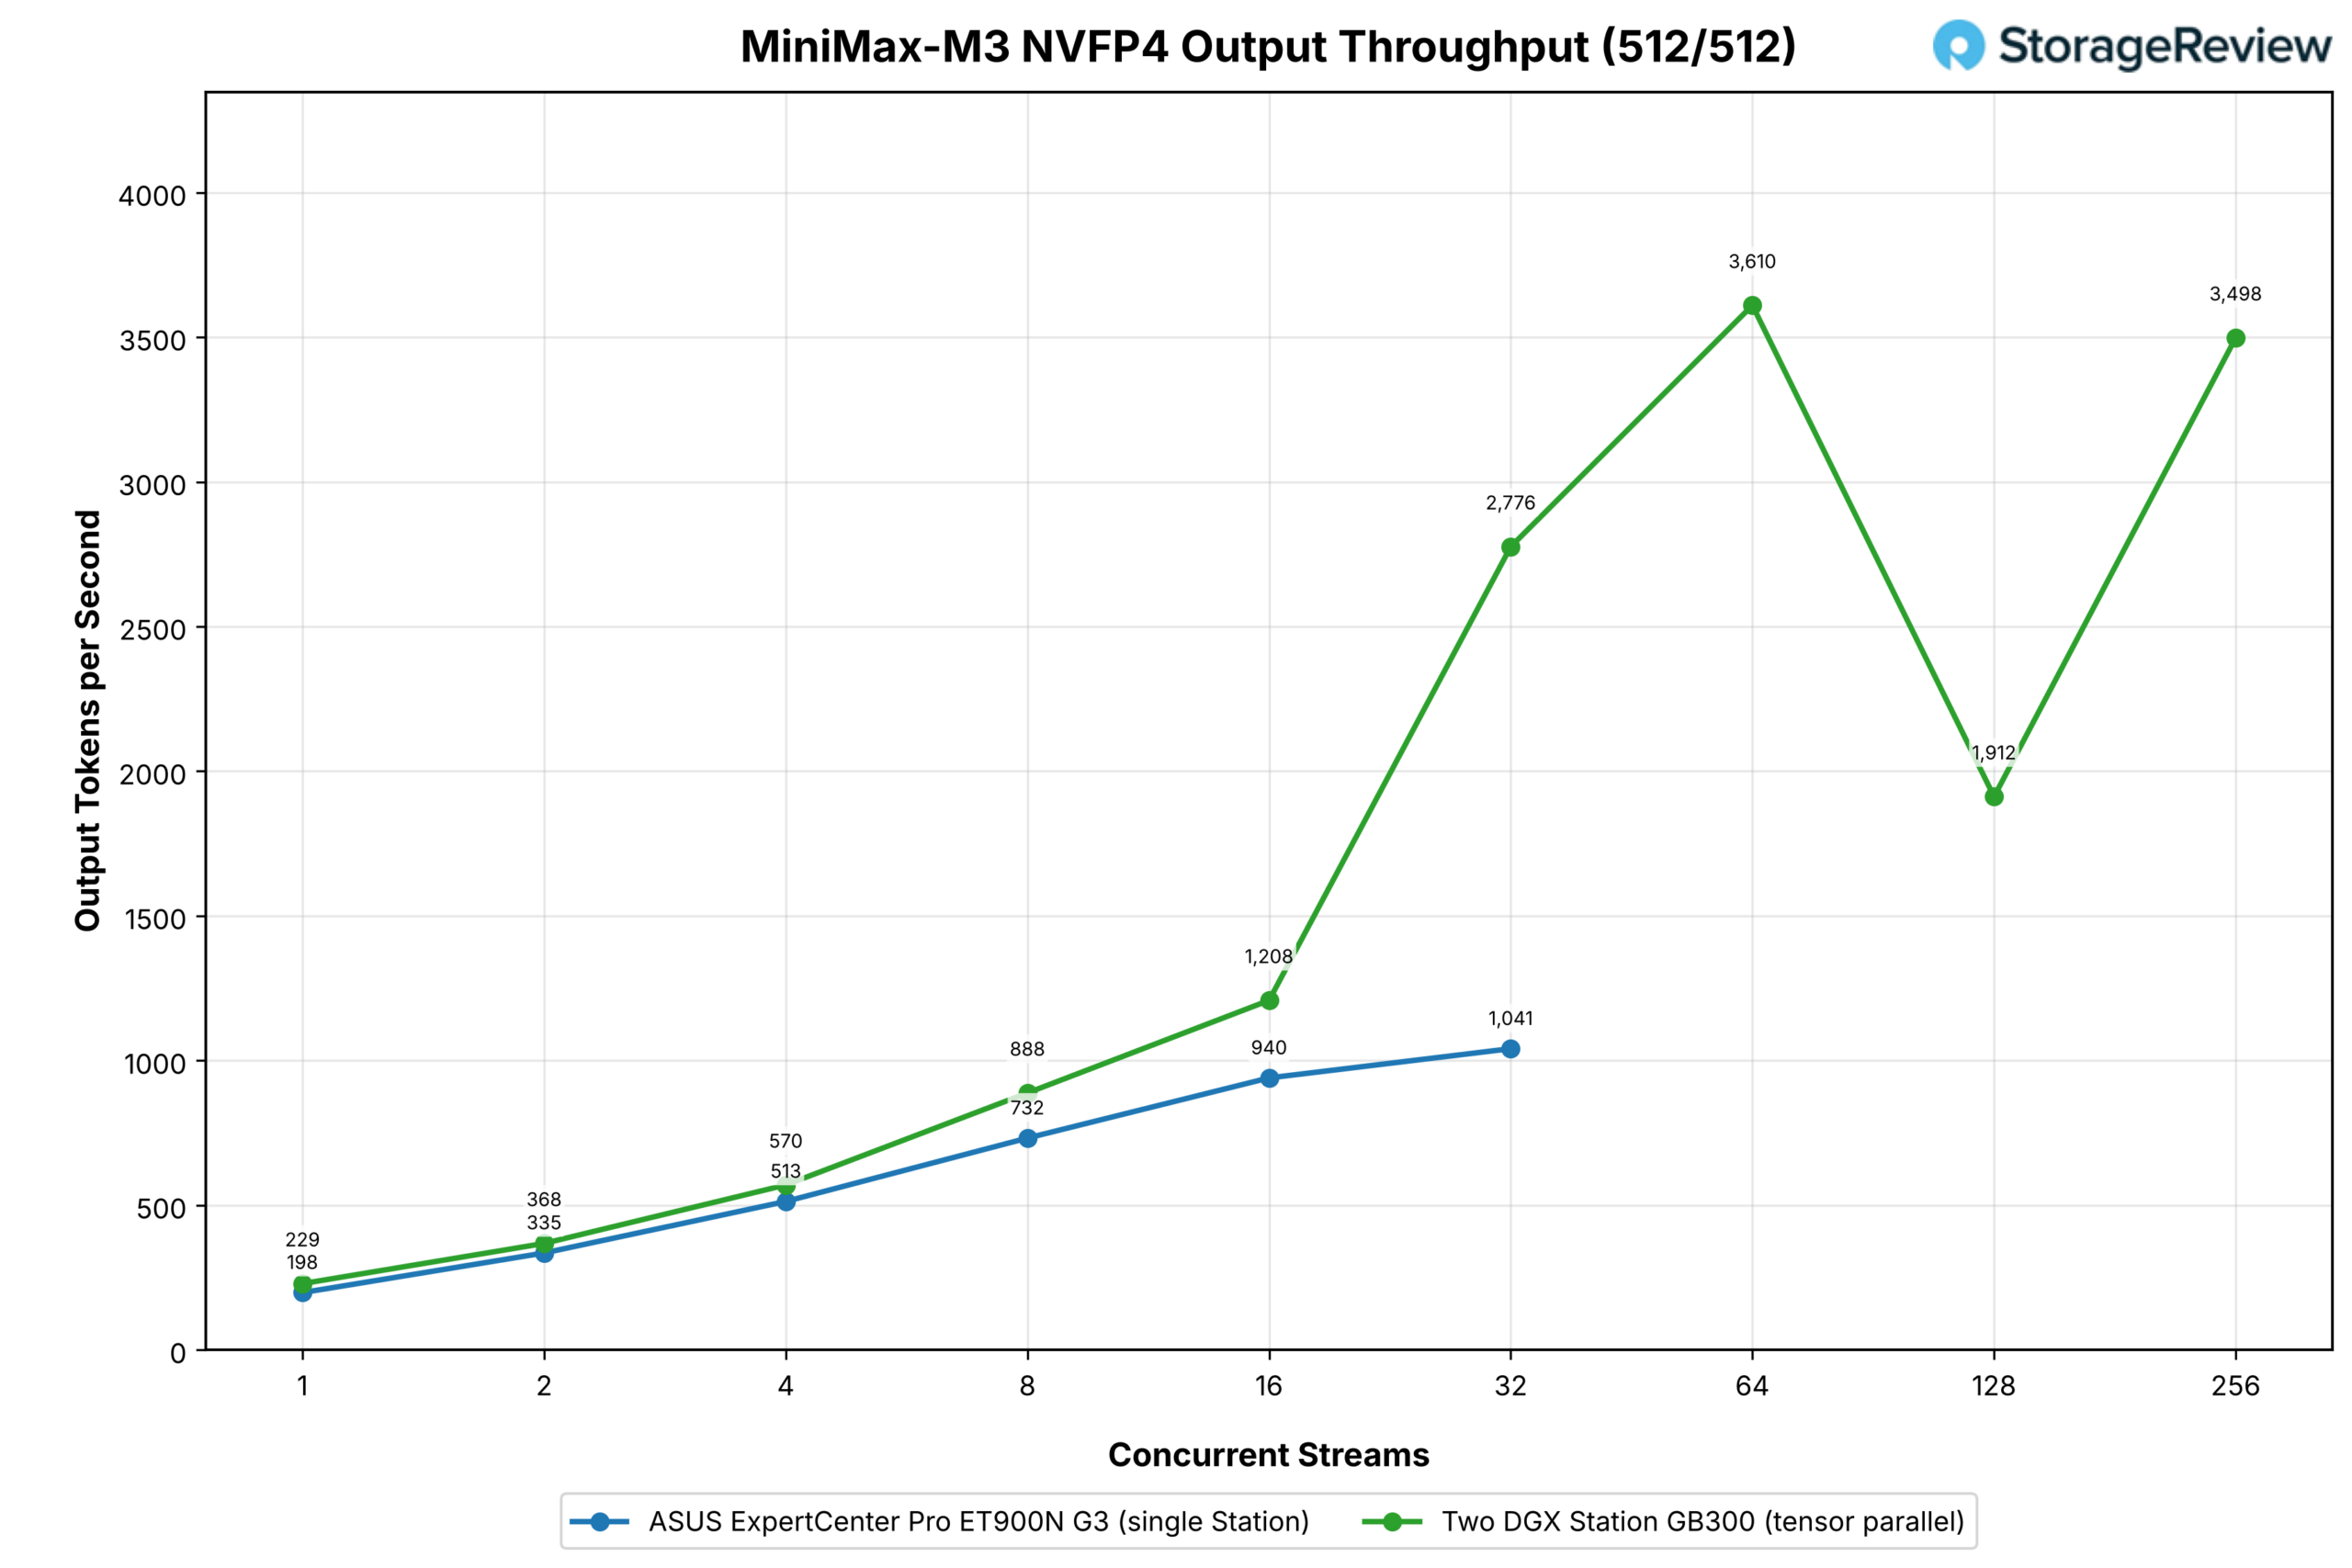
MiniMax-M3 在 TP2 模式下运行,未启用 Grace 卸载。在一台工作站上,它的性能刚好达到 HBM 内存的边界,部分性能由 Grace 内存提供。在华硕的评测中,它在与 EAGLE3 相同的负载下,以 32 个流进行运算时,达到了每秒 1,041 个输出令牌。
集群在 16 个流中与单个 Station 的性能非常接近(1,208 对 940),之后逐渐拉开差距:在 32 个流时达到 2,776,是单个 Station 的 2.7 倍;在 64 个流时达到 3,610;在 128 个流时略微下降至 1,912;在 256 个流时达到 3,498。两个 Station 在这里的贡献比在 GLM-5.2 中要小,因为一个 Station 已经将该模型的大部分运算都保存在 HBM 中,所以第二个 GPU 的贡献更接近于纯粹的计算扩展,再加上 KV 缓存的余量。
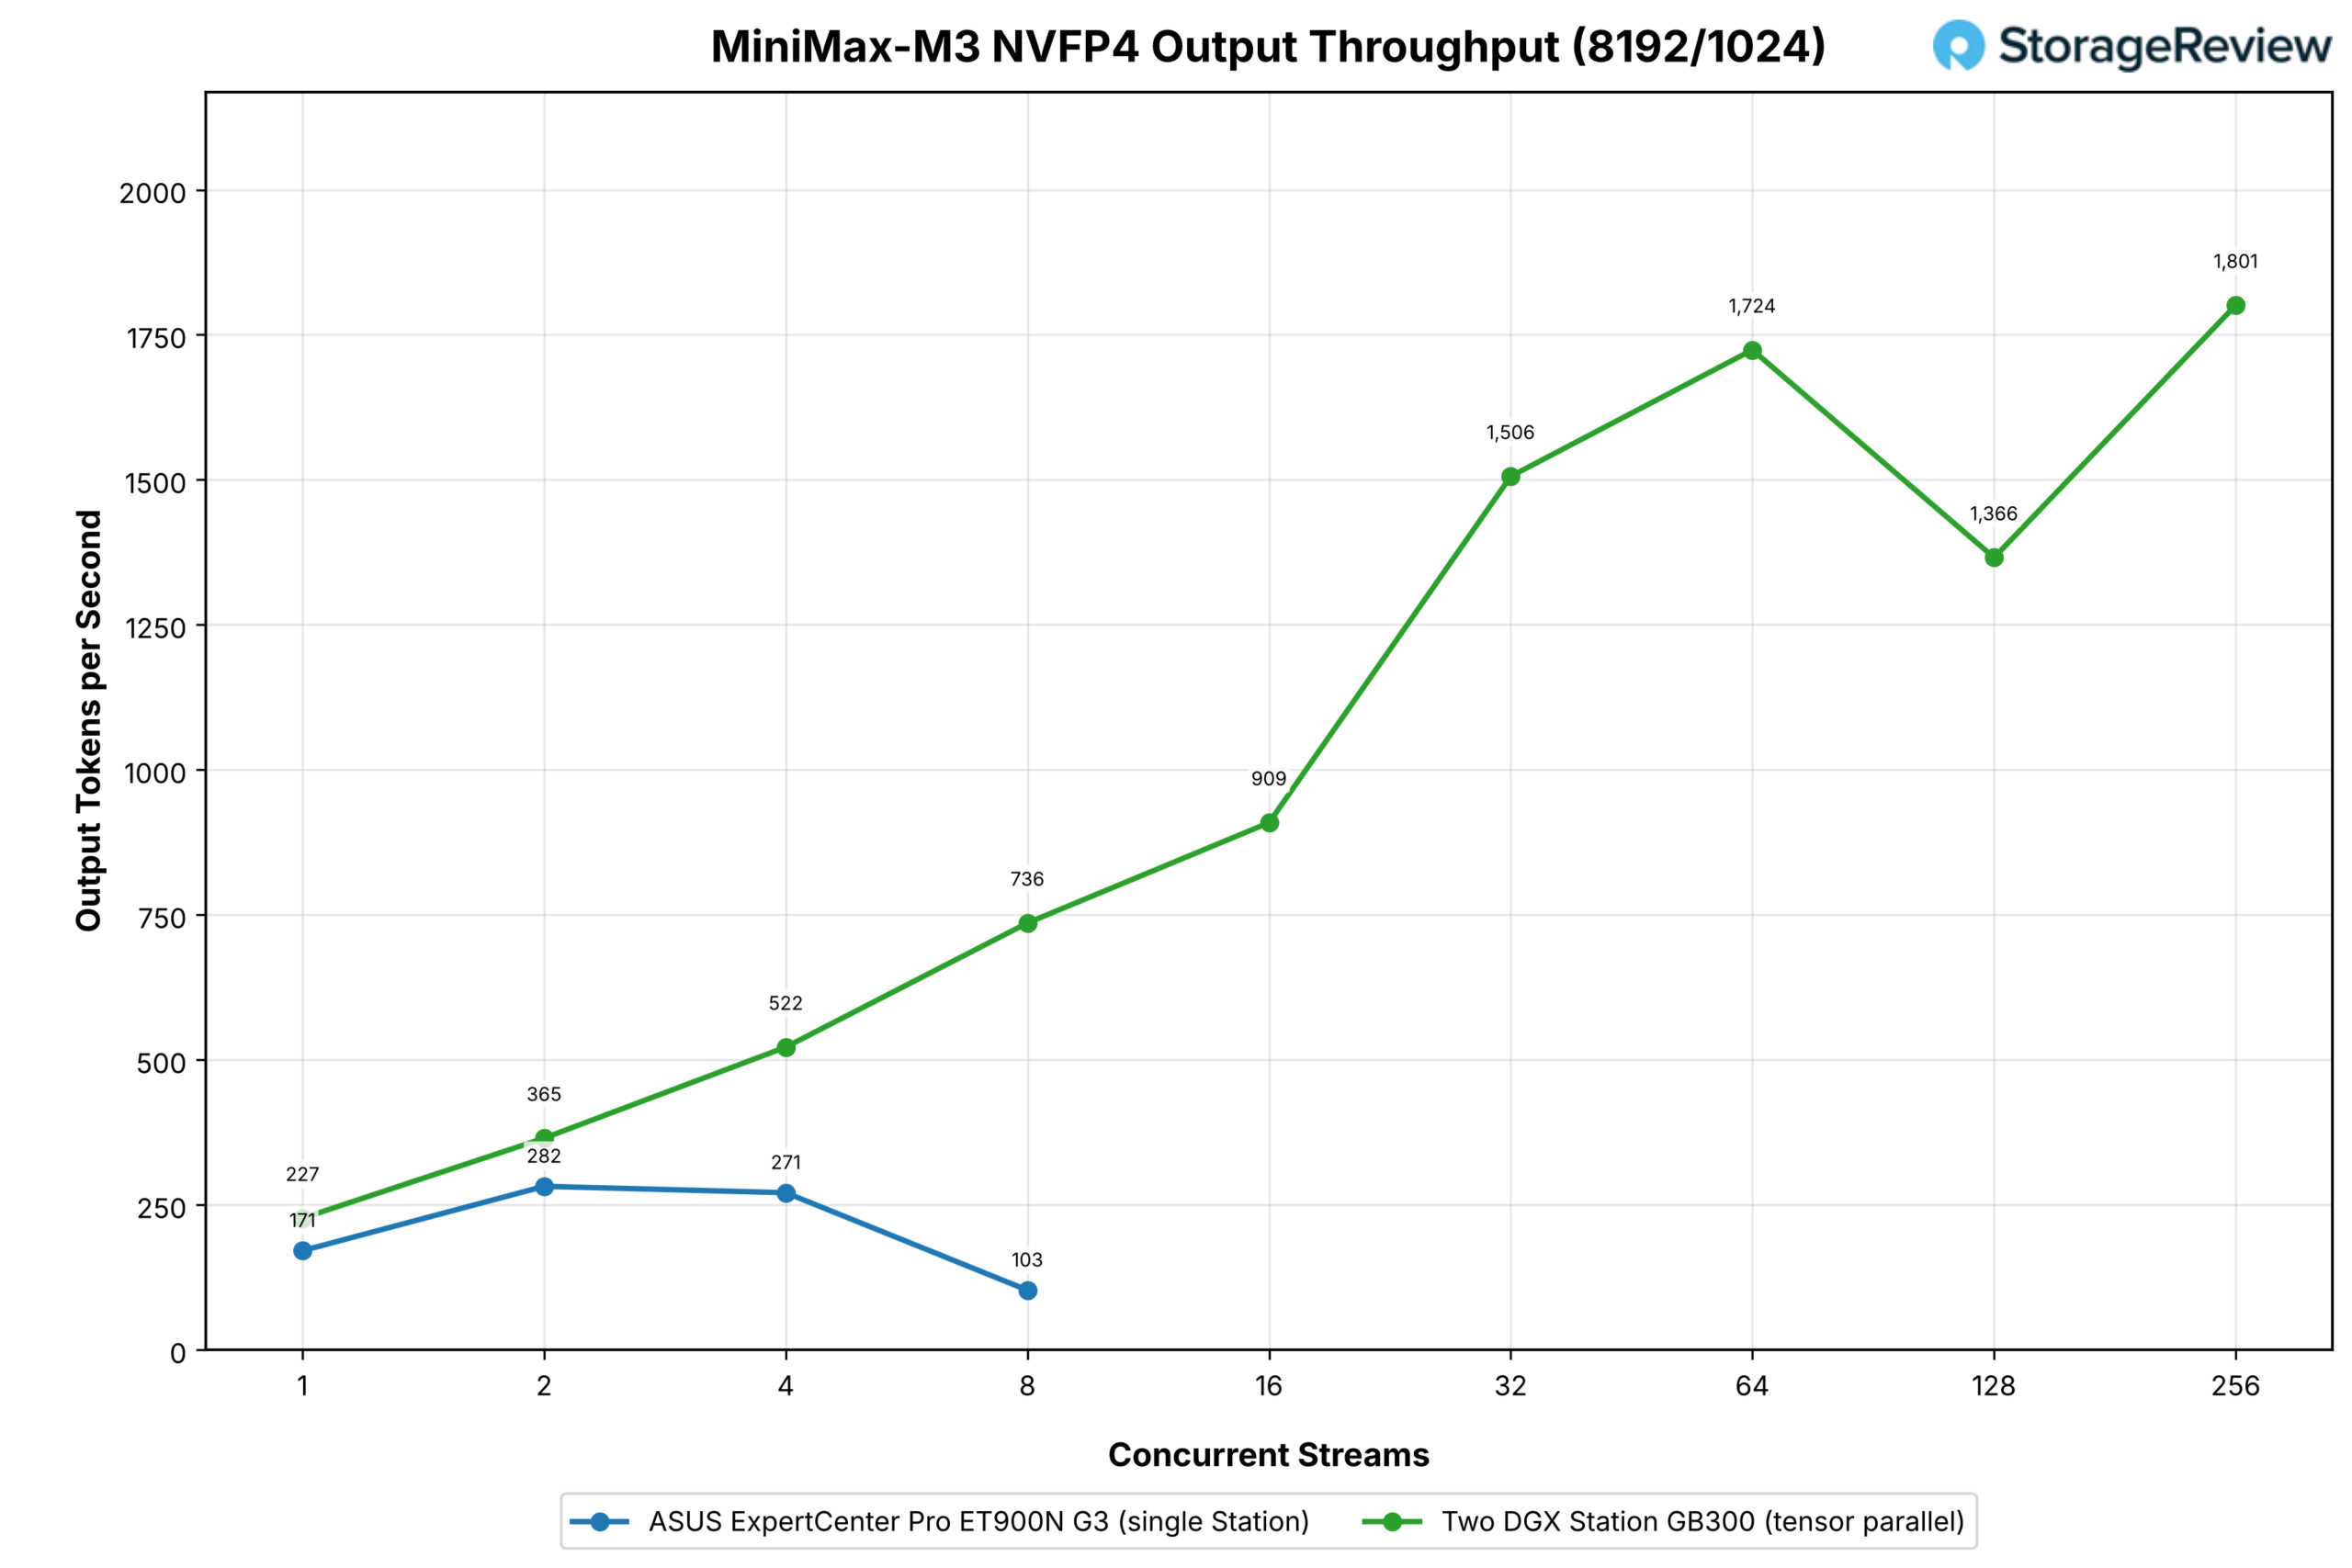
在预填充量较大的场景下,MiniMax-M3 在一个工作站上的空间就用完了:8,192 个令牌的提示符很快消耗掉了剩余的 KV 缓存,因此单个塔在两个流时输出令牌的峰值为每秒 282 个,在四个流时保持在每秒 271 个,在八个流时下降到每秒 103 个,扫描到此结束,因为没有什么可以测量了。
将模型分布在两个 Station 上后,相同的数据点分别达到 365、522 和 736,在两个数据流的情况下,两种配置的缓存均有剩余,性能提升了 30%;在八个数据流的情况下,性能提升了 7.1 倍,其中一个数据流已耗尽。集群随后在 16 个数据流的情况下达到 909,在 32 个数据流的情况下达到 1,506,在 64 个数据流的情况下达到 1,724,在 128 个数据流的情况下达到 1,366,在 256 个数据流的情况下达到 1,801,而单个 Station 在此配置下根本无法达到如此高的性能水平。
结语
两台 GB300 DGX 工作站通过各自的 ConnectX-8 端口连接在一起,正如 NVIDIA 文档中所述,它们可以正常工作;设置过程非常简单,这是我们首次看到双系统配置的吞吐量数据。
第二个工作站对于超过 252GB HBM3e 的型号来说物有所值:GLM-5.2 在单个工作站上 32 个流时每秒输出 139 个令牌,在两个工作站上达到 1,525 个,在 256 个流时达到 3,141 个,因为拆分后,433GB 型号不再使用 LPDDR5X;GLM-5.3 在 256 个流时达到 5,018 个,而单个工作站的上限为 188 个;MiniMax-M3 在长提示符下,从 8 个流时速度开始下降的塔式处理器,到 256 个流时仍在攀升的双塔式处理器。
对于可以装入一个工作站的两款型号,GLM-5.3 Flash 和 DeepSeek V4.1 Flash,使用第二个盒子的更好方法是给每个工作站一个完整的副本,将预填充与解码分开,并让解码工作进程不停地生成;对于 GLM-5.3 Flash,这在 32 个流的情况下使长提示吞吐量翻了一番,短提示吞吐量翻了三倍,而 DeepSeek V4.1 Flash 在该组中实现了最高的输出吞吐量,达到每秒 5,248 个令牌。
自MSI XpertStation WS300 评测以来,我们对该产品的看法没有改变:这是一款针对特定市场的有趣机器,如果您发现自己需要一台,您可能还会发现自己需要更多。
运行这些系统的最佳方式是采用可互换的基础设施:一个团队可以安排工作并根据项目变化重新配置的资源池,而 NVIDIA 拥有实现这一目标所需的全部组件。它收购了 Run:ai 用于调度,Brev 用于开发者环境,以及 Lepton 用于计算市场。如果您能够使用这三者中的任何一个,并搭配一机架的 Station,都会使产品更具吸引力。
双机配置扩展性良好;我们测得的最佳性能提升体现在 GLM-5.3 模型上,单台 Station 每秒输出 188 个令牌,而双机配置下则达到每秒 5,018 个令牌(提升 27 倍),在相同的并发量下,GLM-5.2 模型在 32 个流时性能提升了 11 倍。这两个模型都只能通过将权重溢出到 Grace 内存中才能由单台 Station 处理。这相当于在两台 400G 服务器上实现了 GB300 的性能提升,这让我们不禁好奇,当 NVIDIA 推出搭载下一代 HBM 和 NVLink-C2C 技术的 Vera Rubin Station 时,它的性能将会如何。
这种方案的适用范围并未改变:两台工作站只需放置在桌面上,无需机架或数据中心,即可运行过去需要GPU服务器及其配套设施才能运行的模型。因此,对于那些无法获得数据中心机位或不想等待机位的团队来说,他们现在也能在身边轻松实现前沿的推理能力。撇开价格不谈,NVIDIA已经为这一领域树立了标杆。GB300系列产品在我们“最佳本地AI桌面”排行榜上名列前茅,而此次集群数据也进一步印证了这一选择。



 Amazon