

许多企业在未来一年内最重要的AI基础设施决策并非GPU投资,而是数据库升级。Oracle AI Database 26ai是Oracle正引导其19c用户群升级的长期支持版本。26ai将向量搜索与事务处理集成在同一个引擎中。当向量索引位于数据库中时,块阵列及其背后的SAN架构就成为了AI基础设施,除了处理事务之外,还承载着检索流量。
人工智能底层数据库发生了变化。
Oracle 基于此理念构建了 26ai:原生 VECTOR 数据类型、SQL 向量搜索函数、通过 ONNX 实现的数据库内模型执行,以及用于自然语言查询的 SELECT AI,所有这些都集成在一个 LTS 版本中,该公司列举了超过 300 项新功能。实际上,DBA 可以生成嵌入向量,将其存储在与其描述的行旁边,并在同一事务范围内运行与订单查找相同的相似性搜索。无需运行单独的向量存储,无需维护同步管道,也无需在审计跟踪之外保留受监管数据的第二个副本。
IBM援引IDC的数据指出这一趋势:“集成向量数据库显然是存储和查询向量嵌入的首选平台,因为企业更倾向于为智能体人工智能构建统一、可控的环境。” IBM和博通的客户希望在构建新数据库之前,先扩展他们已有的、值得信赖的数据库。
Oracle并非孤军奋战。DB-Engines 2026年10月发布的流行度排名列出了排名前四的关系型和多模型数据库引擎:Oracle、MySQL、Microsoft SQL Server和PostgreSQL,这四家都已原生或通过pgvector等扩展程序添加了向量类型或向量搜索功能。IBM之所以选择Oracle作为其验证工作的起点,主要是因为Oracle的市场领导地位,不过本文中提到的存储优势也适用于其他数据库引擎。

即使引入人工智能,将块存储保留在本地的理由依然不变:使人工智能部署发挥作用的数据,例如患者记录、索赔、订单和交易记录,都不能外传。将其复制到专用人工智能平台意味着要支付两次存储费用,同时还要接受副本与生产集群数据不一致的风险,并失去使原始数据具有法律效力的治理控制。将检索操作保留在数据库内部可以避免这三点。如今,用于执行亚毫秒级行查找的数组,还能同时为临床医生提供向量相似性扫描服务,并作为备份流使用。
IBM 存储和博通光纤通道 (FC) 团队着手验证这种混合工作负载场景,并围绕 IBM FlashSystem 上的 Oracle AI Database 26ai、博通Brocade Gen 8 SAN 光纤通道网络和Emulex 64G SecureHBA构建了一个环境。然后,他们着手解决基础架构团队提出的问题:当一个向量工作负载在其旁边启动时,事务延迟会受到什么影响?光纤通道网络速度对向量搜索吞吐量的影响是什么?嵌入式数据会消耗多少容量?针对 RMAN 备份卷的勒索软件检测的有效性如何?以及在没有分区票据的情况下向 SAN 添加主机需要满足哪些要求?
数据已经存储在块存储中,现在人工智能开始使用它了。
这并不意味着所有 AI 工作负载都应该使用块存储。企业仍然会将文件和对象数组用于存储非结构化数据:文档、图像、视频、训练集和模型检查点,这些数据从未存储在数据库中,而且可能永远也不会。在接下来的医疗保健演示中,IBM 将原始 X 光图像保存在对象存储中,而仅将嵌入和病例元数据存储在 Oracle 中。改变的是数组的负载,现在该数组可以同时承载多个具有截然不同 I/O 特性的工作负载。
关系型存储层是最为人熟知的:每秒数百万次随机的 4KB 到 16KB I/O 操作,行查找和提交需要在微秒级完成,重做、撤销和检查点流量带来的高并发写入,以及由于面向用户的应用程序正在等待,因此尾延迟保持可预测性。Oracle 的备份实用程序 RMAN 则恰恰相反:它是一个顺序流,需要预留足够的时间才能在窗口期内完成,而不会干扰之前的工作负载。两者都已被充分理解,IBM 的阵列也针对它们进行了优化。
向量层更难描述,因为庞大的向量嵌入表会让向量搜索看起来像是一项带宽密集型工作负载:一次大规模的顺序扫描。IBM 对 Oracle 26ai 向量路径的描述更接近于 OLTP。索引中的每次跳转都是一次大约 4KB 的随机读取;查询路径受 IOPS 限制且对延迟敏感,并且读取操作占主导地位,因为写入操作位于单独的数据摄取和索引构建阶段。
带宽在突发性操作中至关重要,例如构建索引或重新嵌入语料库时,而这些突发性操作往往规模相当大。这种划分是混合 I/O 问题的核心:在查询路径上,向量工作负载与事务争夺相同的队列,使得隔离成为服务质量的关键问题。正如本文后面 32G 与 64G 的对比结果所示,突发性阶段正是网络带宽达到极限的时候。
已验证的架构
IBM 和博通在博通位于科罗拉多州的 AI 实验室搭建了一个用于验证的环境。存储系统采用 IBM FlashSystem 9000 系列阵列,运行 IBM Storage Virtualize 9.1.3,配备 24 个 FlashCore 模块,并通过 64G 光纤通道端口连接到两台博科 Gen 8 G820 SAN 交换机。数据库主机是一台双路 Intel Xeon 6767P 服务器,配备两个 2 端口 Emulex LPe38102 64G SecureHBA 卡,运行基于 ASM 的 Oracle AI Database 26ai,存储路径中未使用 GPU;IBM Storage Insights 系统监控该阵列。

我们仅在该主机上运行了结构和容量测试结果、32G 与 64G 向量搜索对比以及使用 VectorDBBench 对 BioASQ 1M 数据集进行的空间占用测量。该配置也支持应用程序工作负载。一台配备两颗 Xeon Platinum 8470 处理器和八块 NVIDIA H100 80GB GPU 的 Supermicro 821GE-TNHR 服务器运行着医疗保健应用程序及其语言模型。软件栈包括 Oracle 的数据库内 ONNX 嵌入、Ollama Serving Llama 3 和 NVIDIA cuVS。两台服务器之间通过 Broadcom Tomahawk 5 交换机和 Thor 2 400GbE 网卡连接。I/O QoS、多租户、勒索软件检测和医疗保健演示均在此环境中运行。

据 IBM 称,FlashSystem 系列(5300和 5600、7300 和 7600 以及 9500 和 9600)运行相同的 Storage Virtualize 软件,并且本文演示的功能,包括 I/O 节流、自动分区、勒索软件检测、基于策略的高可用性 (HA) 和存储分区迁移,在 Oracle AI Database 26ai 上以相同的方式运行于这些阵列中的任何一个,代码级别也相同。性能和密度会因型号和 FlashCore 模块的代数而异,因此本文中的每个数据都属于其所测试的系统。
通过 I/O QoS 确保最佳 OLTP 和矢量工作负载性能
IBM 和 Broadcom 首先要解答的问题,也是所有 DBA 在生产阵列上部署向量工作负载时都会问到的问题:核心事务会发生什么变化?IBM 在 FlashSystem 9000 系列阵列上进行了两次演示,采用了卷级 I/O 节流技术,即 IBM 所谓的 I/O QoS 机制。数据库分布在 30 个卷上:15 个卷用于 OLTP 表空间(ORCL16 到 ORCL30),使用 Swingbench Order Entry 工具,支持 192 个用户;另外 15 个卷用于向量表(ORCL31 到 ORCL45),使用 200 个线程的合成生成器运行前 k 个 500 个相似度查询,并使用 Storage Insights 对每个卷组进行图表分析。
单独运行 OLTP 时,每个 OLTP 卷的运算速度稳定在 20,500 次/秒。向量生成器启动后,向量卷的运算速度在一分钟内攀升至约 73,000 次/秒,而 OLTP 卷的运算速度则下降至约 13,000 次/秒,降幅达 37%,而事务处理方面没有任何变化。向量搜索路径采用与事务相同的块大小进行 4KB 的随机读取,因此它会访问相同的队列,并读取数组中提供的任何数据。

每个向量卷的 IOPS 上限为 45,000,一行 mkthrottle 在命令行界面 (CLI) 中,将向量卷的性能限制提升到极限,并将 OLTP 性能恢复到约 17,000 次操作/秒。取消限制后,性能恢复正常,向量运行结束后,OLTP 性能回升至 20,500 次操作/秒。仪表板也显示了相同的总体情况:1.28 万 IOPS 未受限制,比限制值低约 950,000 万,这与每个卷的速率乘以 30 个卷的速率相差无几。

第二个演示是 IBM 预期在生产环境中部署的配置:首先设置上限,每个向量卷 45,000 IOPS,每个 OLTP 卷 20,000 IOPS,然后同时启动两个工作负载。向量卷以上限运行,OLTP 卷稳定在约 12,200 ops/s 并在整个运行过程中保持稳定,阵列在 25% CPU 使用率下,以 377 微秒的延迟和 6.9GB/s 的吞吐量实现了 870,000 IOPS(800,000 读取,70,000 写入)。OLTP 的上限高于工作负载的需求,因此从未启用;设置上限是为了防止任何一方的负载过高而导致另一方负载不足。
在测试过程中,Swingbench 的 192 位用户每分钟大约进行 1.19 万笔交易,即约 19,500 TPS。生成器经过调优以达到饱和交易量,因此其单次查询延迟并非应用程序基准。在 30 分钟的运行中,它完成了 35,672 次查询,平均每秒执行 19.8 次,中位延迟约为 10 秒,p99 为 14.3 秒(应用程序超时时间为 15 秒);共有 99 次查询(0.28%)超时,但交易并未受到影响。


FlashSystem 节流是指无论主机或路径如何,都会在阵列层面强制执行的卷上限,除了 IOPS 限制外,还可以选择限制带宽;它会限制相邻卷的资源,而不会预留任何资源。此上限用于容量规划:15 个 45,000 IOPS 的矢量卷,总共有 675,000 IOPS 的矢量资源余量,这足以满足该阵列中 OLTP 卷的需求。不同的阵列或组合可能会略有不同。将矢量上限设置为事务延迟较低的水平,矢量工作负载将获得超出上限的所有资源。
对实时 Oracle 卷进行勒索软件检测
Sophos 2024 年对 2,974 家遭受勒索软件攻击的组织进行的调查发现,94% 的组织发现攻击者攻击了其备份,攻击成功率达 57%,且成功后的恢复成本中位数是未攻击时的八倍。IBM 基于同样的假设构建了测试,优先攻击备份,其次攻击生产环境,并将攻击目标锁定在 RMAN 备份上,而未触及数据库卷。RMAN 将其备份集写入 FlashSystem 卷,然后对这些卷运行勒索软件模拟器,并让阵列自行检测攻击,过程中未部署任何主机代理。
检测在驱动器内部进行:FCM4 和 FCM5 FlashCore 模块在每次写入操作落地时计算熵和压缩率,以及块大小、地址和重写模式,并每两秒将每个卷的摘要信息传递给 Storage Virtualize(版本 8.6.3 或更高版本,FCM 固件版本 4.1 或更高版本)内部的推理引擎。该模型会在 FlashSystem GUI 和 IBM Storage Insights Pro 中发出警报,并将警报转发到 Storage Defender 或 SIEM,并且该模型本身即可进行修补,因此重新训练的模型可以作为小型安全更新发布,无需固件升级。
由于分析是在模块上运行的,即使主机遭到入侵,它也能继续工作。加密输出具有高熵值,并且会停止压缩,无论攻击者是更改文件扩展名、仅加密每隔一个数据块,还是降低加密速率以躲避终端代理,统计信息都会反映出这一点。
在验证过程中,RMAN 通过 16 个并行通道写入备份,每个备份集的大小上限为 150GB。数据库位于每个 ASM 磁盘组的 15 个 200GB 磁盘上,分别用于存储 OLTP 和矢量数据。IBM 对该备份目标执行了攻击,警报在 60 秒内到达 Storage Insights,这符合 IBM 为该功能发布的检测窗口。Storage Insights 标记了卷组中的所有 31 个卷,因为一个卷的警报会将整个卷组标记为威胁。
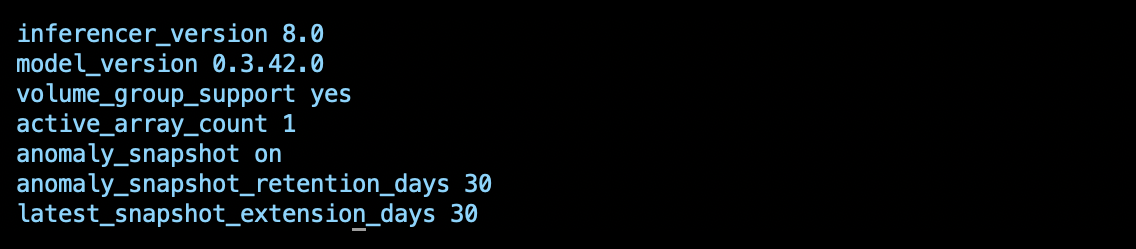
响应是安全副本,阵列无需操作符即可处理:FlashSystem 在威胁出现时立即对受影响的卷组创建了一个不可变快照,并同时延长了上次已知良好快照的保留时间。 lsanomalydetection 数组输出显示了其背后的配置:推理引擎 8.0,模型 0.3.42.0,启用异常快照,新快照保留 30 天,并在上一个正常快照的基础上增加了 30 天。存储虚拟化还会标记可疑快照,以防止任何人从中恢复数据,从而保留加密开始之前的干净恢复点。
该光纤通道网络还具备安全层。博通在博科第八代产品中内置了后量子加密技术,Emulex SecureHBA 可对主机和光纤通道网络之间传输的数据进行加密,而FCIA 的新 FC-SP-3 标准则为整个光纤通道网络设定了量子就绪的安全基线。
无需分区许可即可实现 SAN 扩展:使用 Broadcom 目标驱动分区的 IBM FlashSystem 自动分区
将主机添加到光纤通道 SAN 通常需要提交工单并由两个团队协作:服务器管理员收集 HBA 的 WWPN,SAN 管理员手动在两个光纤通道网络上创建区域,存储管理员将主机映射到正确的目标端口。一个错误的 WWPN 会导致新创建的 Oracle RAC 节点缺少路径。而自动区域划分功能则将这项工作转移到了阵列端:FlashSystem 直接与光纤通道网络通信,识别发起方的 WWPN,选择目标端口,并自动创建区域,无需任何人登录交换机。

该功能基于博科目标驱动分区 (TDZ) 技术,并已在 FlashSystem 软件 9.1.2 版本中推出。它需要运行 Fabric OS 9.1.1 或更高版本的博科交换机,并且交换机管理员需要在面向 FlashSystem 目标端口的交换机端口上启用 TDZ。启用 TDZ 是 SAN 团队唯一需要执行的步骤,在此之前,自动分区功能不会对端口执行任何操作。之后,FlashSystem 会构建对等区域,允许主机发起程序访问目标端口,但彼此之间无法访问,并使用可预测的 IBM_SV_ 名称来标记这些区域为阵列管理区域。
设置从光纤通道端口视图开始,该视图现在显示每个端口连接的交换机、端口是否支持 AutoZone 功能以及其连接是否对称(即每个节点上相同的端口 ID 都连接到同一光纤通道网络)。拓扑视图以颜色映射这些信息,只有绿色的端口(表示已激活、支持 AutoZone 且连接对称)才支持 AutoZone。即使端口支持 AutoZone,非对称端口也不会显示,因为 GUI 会警告这可能会影响冗余和故障转移。

主机创建从“未配置主机”列表开始,该列表通过 FDMI 填充,FDMI 会将每个 HBA 的主机名、操作系统和端口报告给交换矩阵。在 IBM 的演练中,“添加主机”对话框打开,其中已包含服务器名称、操作系统以及尚未分配任何区域的主机的两个 HBA 端口;管理员选择了一个启用 AutoZone 的端口集(该端口集定义了主机可以访问的目标端口),然后单击“添加”。FlashSystem 将目标端口与主机启动器配对,将区域推送到两个交换机,主机随即上线,并在两个交换矩阵上建立了四条路径。

对于 Oracle 而言,IBM 将 AutoZoning 定位为用于添加 RAC 节点和更换 HBA 的功能,因为该功能会跟踪主机或存储连接的变化并调整区域定义以与之匹配,因此更换 HBA 后无需手动重新划分区域。当主机需要访问第二个阵列以进行存储分区迁移或基于策略的高可用性 (PBHA) 时,同样的自动化功能也适用。SAN 团队仍然控制哪些目标端口参与其中,因为在启用 TDZ 之前,端口上不会发生任何操作。因此,添加主机不再需要等待区域更改。
运营范围:PBHA、电网迁移、多租户和部署
基于策略的高可用性 (PBHA) 可在城域范围内同步复制两个 FlashSystem 阵列之间的存储分区,并在两个站点启用双活主机访问。IBM 表示,该功能旨在实现零恢复点目标 (RPO),并确保正确集群化的 Oracle 部署能够顺利度过存储故障转移,避免数据丢失。当故障站点恢复后,数据将重新同步,工作负载将自动迁移,不会造成任何中断。
FlashSystem Grid 功能可将多达 32 个 FlashSystem 阵列联合到一个管理视图下,存储分区迁移功能可将分区及其卷、卷组和主机从一个阵列迁移到另一个阵列,而无需应用程序停机。对于 Oracle 数据库,IBM 建议进行硬件更新,在固件更新前清空系统,并在嵌入集增长时将矢量分区迁移到容量更大的系统。系统每次通过光纤通道或高速以太网迁移一个分区;主机可以通过光纤通道、iSCSI 或 NVMe/TCP 连接,已配置为 PBHA 的分区不符合迁移条件。
Storage Insights 部署顾问负责同一网格的规划。它会根据工作负载的容量、增长率、I/O 特性和延迟目标,对网格中的每个系统进行评分,并在配置任何资源之前确定最合适的方案,并在发现 CPU 或 IOPS 不平衡时推荐迁移方案。迁移和部署均使用 Storage Insights Pro,每个网格系统都注册到同一个 Storage Insights 租户。

多租户架构允许数据库管理员团队和人工智能团队共享同一网格,而无需共享管理权限。在 IBM 的演示中,管理员在同一阵列上创建了两个租户(Tenant_Scale 和 Tenant_oracle_ai),并分别分配了一个系统、一个具有租户角色的用户组和一个初始用户。然后,他们为每个租户创建了一个存储分区,每个分区都包含独立的卷组、卷和主机映射。图形用户界面 (GUI) 会在新分区创建后立即提示配置复制。以 Tenant_Scale 用户身份登录后,GUI 仅显示该租户的分区和资源,不显示 Tenant_oracle_ai 的任何内容;从 Tenant_oracle_ai 端进行相同的检查也得到了相同的结果。
光纤通道网络优势:矢量搜索下的 32G 与 64G 光纤通道对比
IBM 和 Broadcom 在本次测试中特意改变的唯一变量是光纤通道网络。他们使用相同的阵列、主机和 Emulex LPe38102 SecureHBA,针对 BioASQ 1M 数据集(来自生物医学问答语料库的一百万个 1,024 维向量)运行了两次 VectorDBBench 测试:一次使用两个 HBA 端口的 32G 带宽,另一次使用 64G 带宽,并通过相同的 Brocade G820 交换机进行测试。其他所有组件,从 16 个 ASM 卷到 4GB SGA,均保持不变,因此两次测试的区别仅在于光纤通道的生成方式。

此基准测试的搜索阶段为只读扫描:Oracle 的 IVF_FLAT 索引会将每个查询路由到一组分区并进行完整读取,对于 1,024 维的 FLOAT32 向量,这是一个带宽密集型工作负载。在两个 32G 端口上,主机端读取速度稳定在 6.3GB/s,与该端口的线速持平,搜索曲线在 20 个线程下达到每秒 43.7 次查询。在两个 64G 端口上,同一主机读取速度为 12.5GB/s,并在 80 个线程下持续扩展至每秒 85.0 次查询,在相同存储条件下吞吐量提升了 95%。

延迟揭示了 64G 架构的另一面:在单线程情况下,两个光纤通道的延迟相差不到 8%,分别为 0.107 秒和 0.099 秒,因为单个查询不会填满任何一个管道。然而,从五个线程开始,32G 架构的延迟就开始出现排队现象:平均延迟每增加一个线程就翻一番,而当线程数达到 80 个时,p99 值达到 4.08 秒,而 64G 架构仅为 1.14 秒。饱和的光纤通道架构不会发生故障;它会将每个查询排队,而这种等待表现为尾延迟。

加载阶段也发生了变化;在 32G 交换机上导入一百万个向量耗时 94.1 秒,在 64G 交换机上耗时 84.5 秒;IVF_FLAT 索引构建耗时 139.6 秒,而 64G 交换机上耗时 108.4 秒,在速度较慢的交换机上耗时延长了 28.8%;总加载时间从 193.0 秒延长至 233.7 秒。两次运行的召回率和 NDCG 值相差不到 0.1%(32G 交换机上分别为 83.81% 和 84.42%,64G 交换机上分别为 83.95% 和 84.56%),因此交换机架构的升级确实影响了响应速度。对于自部署以来一直使用 32G 交换机的数据库而言,HBA 和交换机的升级显然是提升性能的绝佳机会。
规划矢量容量增长
向量搜索在改变性能之前,会先改变容量计算方式。嵌入是源数据块的固定宽度数值副本,对于文本而言,该副本通常比它所描述的数据块更大:一段 1,000 字节的文本在数据库添加一行来存储之前,会变成一个 1,024 维的 FLOAT32 向量,大小为 4,096 字节。研究团队将这种现象称为向量存储放大,并在与织物比较相同的 BioASQ 1M 数据集上进行了测量。
这百万个向量背后的原始文本大小为 0.90GB。在 Oracle 26ai 中,它变成了一个 7.67GB 的向量表,其中包括约 0.3GB 的行开销。IVF_FLAT 索引在此基础上又增加了 8.57GB,因为它保留了每个向量的第二个集群副本以及大约 4MB 的质心数据。在 SAN 上,持久化占用空间为 16.24GB,是原始文本大小的 18 倍。这还不包括 Oracle 需要的运行空间:索引构建期间的 15 到 23GB 临时空间,以及数据摄取期间的 4 到 8GB 撤销空间和约 15GB 重做空间。

倍增系数随嵌入模型而变化:博通公司采用相同的方法进行外推,得出 768 维 Cohere v3 模型(也经过测量)的倍增系数为源模型的 4.8 倍,384 维 MiniLM 模型为 9.6 倍,4,096 维 Mistral 模型为 32.5 倍。块大小与宽度同样重要,因为在长段落上使用宽向量的放大倍数小于在短段落上使用相同向量的放大倍数,而且量化索引会缩小索引份额。
这些并非FlashSystem或Oracle特有的。数据放大发生在数据库内部,在阵列接收到任何字节之前。每个平台上的每个向量索引都包含向量的副本,因此,在向量项目获得批准之日,它就应该与GPU一起纳入容量预算。阵列决定的是它可以容纳多少增长:IBM第五代FlashCore模块的单模块容量高达105.6TB,在最大的FlashSystem型号上,2U机箱内可提供3.3PB的原始容量,根据IBM的数据,有效容量为11.8PB。因此,向量层可以原地扩展数年,而无需移动分区。
IBM针对医疗保健应用的容量规划模型与图像的处理方式相反:100GB的X光片在数据库中大约只占用2GB的空间,因为数据库中只存储嵌入和病例元数据。文本的处理则更为耗费空间:100GB的临床文本分块后占用860GB到1.2TB的空间,其中大部分是HNSW索引。容量规划的输入是分块数量和模型宽度;源语料库的大小并不具有参考价值。根据IBM的经验,嵌入的压缩率也低于行数据,嵌入的压缩率仅为1.2倍到2倍,而关系型数据的压缩率则为2倍到4倍,因此FlashCore模块的数据缩减只能减少增长,而且每次重新嵌入都需要再次使用临时空间。
IBM 的实用原则是先测量后决定。使用生产环境中的嵌入模型和分块设置,加载 1% 到 5% 的真实语料库,测量每个向量的实际字节数,然后线性扩展,并在模型、维度数量或分块策略发生变化时重复此过程。
端到端人工智能推理:医疗保健应用
IBM 为此次验证开发了一款名为 RAD-AI 的放射学和胃肠病学辅助应用程序。这是一个具有生产级需求的示例应用程序,本文演示了它在与之前章节测量相同的阵列和架构上的完整推理流程。临床医生输入患者的年龄、性别和主诉,上传胸部 X 光片或内窥镜图像,即可收到一份根据存档中最相似的既往病例生成的结构化报告。
该存档包含来自 NIH ChestX-ray14 数据集的 112,120 张胸部 X 光片,以及来自 HyperKvasir 的超过 10,000 张胃肠道内窥镜图像,其中包括 367 个完整内窥镜视频的逐帧向量,涵盖超过 172,000 个预嵌入病例。每张图像都通过运行在 Oracle AI Database 26ai 内部的 ONNX 运行时环境中的 CLIP ViT-L/14 模型,生成一个 768 维向量,因此嵌入操作与包含该向量的行数据位于同一事务中。原始图像存储在对象存储中;向量和病例元数据则存储在 Oracle 数据库中。

在查询时,Oracle 会在整个存档中运行基于余弦距离的近似最近邻搜索,并返回最接近的病例及其原始发现、诊断和结果。检索到的数据集作为 Llama 3 的上下文,由运行在 Supermicro 服务器上的 H100 GPU 之一上的 Ollama 提供服务,用于生成报告:包括临床优先级、发现摘要、分级鉴别诊断和建议措施,并在其下方列出匹配的病例。内镜检查遵循相同的流程,并添加临床注释;对于视频,该流程会逐帧嵌入,以便跟踪病变在胃肠道中的位置。
该应用程序针对同一 FlashSystem 卷运行两种工作负载。事务性工作负载涵盖登录、报告存储、审计日志记录和会话;向量工作负载对嵌入表和病例元数据执行高扇出随机读取,与 I/O QoS 演示中的生成器配置文件相匹配。IBM 的部署设置了前面所述的卷限流,因此批量重新嵌入作业不会减慢临床医生输入病例的速度,并且上面显示的勒索软件检测和分区迁移也适用于这些卷,无需任何更改。

资源消耗最大的步骤是构建归档文件。IBM 通过使用相同的模型和相同的 VECTOR(768, FLOAT32) 目标,对包含 112,120 张胸部 X 光片的完整数据集进行了两次嵌入,以此来衡量其性能。当 ONNX 模型运行在主机 CPU 上的数据库内时,该流程能够以每秒 3.41 张图像的速度进行嵌入,每次嵌入耗时 0.272 秒,处理完整数据集耗时 9.1 小时。将模型迁移到第二台服务器上的 Oracle 私有 AI 服务容器后,吞吐量提升至每秒 8.55 张图像(每次嵌入耗时 0.097 秒),相同的数据摄取过程仅需 3.6 小时即可完成。

两次运行的预处理时间(每张图像约 0.019 秒)和 Oracle 插入时间(不到 1 毫秒)完全相同,因此 2.5 倍的性能提升完全来自于模型的执行位置。私有 AI 服务嵌入服务运行在 CPU ONNX 运行时上,因此该服务器上的 H100 显卡没有参与此次测试;性能提升来自于将模型从数据库主机上移除,而 GPU 在流水线中的份额则体现在接下来要介绍的索引构建部分。
IBM 在科罗拉多州的实验室测量了这些数据;我们并未运行或审核该测试。实际结论是,首次嵌入归档文件以及每次模型更改后的重新嵌入都是耗时数小时的批处理作业,而后续的检索操作则是一个耗时数毫秒的 CPU 和存储作业。
同一个容器也负责索引构建。Oracle 26ai 可以将 HNSW 构建发送到容器的矢量索引服务,该服务使用 GPU 上的 NVIDIA cuVS 构建邻居图,然后将完成的索引返回给数据库。之后,搜索操作无需 GPU 参与即可运行。在 IBM 的记录中,基准 HNSW 构建(32 个邻居,efConstruction 200)在数据库中耗时 8.47 秒,卸载后仅需 2.26 秒,耗时缩短了 3.7 倍。该运行使用了一个小型演示表,因此证实了该路径在此配置下有效;我们仍需测量临床规模下的数据。
该应用演示了本文核心的分工理念。GPU 服务器托管语言模型,并在归档构建或重建期间提供嵌入和索引服务。数据库存储向量及其所描述的记录,而数组和 Fabric 则处理检索读取和事务。检索路径中的任何步骤均不使用外部 API,患者数据也从未离开数据中心。
IBM 选择医疗保健行业作为验证这一概念的垂直领域,但该模式并非仅限于此。将 X 光片存档替换为理赔记录、维护记录或产品目录,三个相同的要素依然适用:向量存储在与其描述的记录旁边,在 GPU 服务器上生成数据,以及在同一个数组上进行检索和事务处理。任何对已有数据进行推理的行业都将采用相同的架构。
接下来是什么
验证工作在相同的硬件上继续进行:第二阶段将推理引擎的键值缓存从GPU内存迁移到同一光纤通道架构上的FlashSystem,从而使长上下文模型能够访问更多的工作集;本系列的下一篇文章将详细介绍这项工作。IBM还在构建内容感知刷新管道,利用IBM Storage Scale AFM和Kafka将新文档实时导入数据库内的ONNX向量化流程,使向量索引能够跟踪其来源,而无需批量重新嵌入。IBM还计划将相同的存储验证扩展到其他已添加向量搜索功能的多模型数据库。
第二阶段也让安全层对新数据发挥作用。当键值缓存迁移到闪存系统时,医疗保健模型的工作上下文(包括患者病史)与向量索引和事务记录一样,都通过相同的光纤通道链路传输。Emulex SecureHBA 在主机和光纤通道网络之间传输数据时对其进行加密,而 Brocade Gen 8 的后量子加密技术则覆盖交换机端。每个阶段都会增加光纤通道网络的工作负载,但不会增加数据以明文形式传输的路径。
排行榜: IBM 在我们最佳存储阵列页面上的简介现在涵盖了 FlashSystem 块存储以及 Storage Scale。
本报告由 Broadcom 赞助。本报告中表达的所有观点和意见均基于我们对所考虑产品的客观看法。



 Amazon