

过去几年,在本地运行大型语言模型变得更加容易,但下载模型和拥有一个好用的桌面环境之间仍然存在差距。Jan 自称是 ChatGPT 的替代方案,它提供了一个开源的桌面应用程序,拥有熟悉的聊天式界面,并将大部分设置都放在应用程序内部。它可以通过 llama.cpp 在本地运行下载的模型,同时还可以连接到托管的 AI 服务,因此您可以从同一个界面使用本地和云端模型。
这篇实操指南也是我们最佳本地LLM工具排行榜上的第一篇指南,我们将在对榜单上的平台进行测试的过程中,添加来自我们自己的测试硬件的可重复性能结果。
除了基本的本地聊天功能外,Jan 还包含内置模型中心、网络搜索和页面获取、图像输入、MCP 集成以及与 OpenAI 兼容的本地 API。
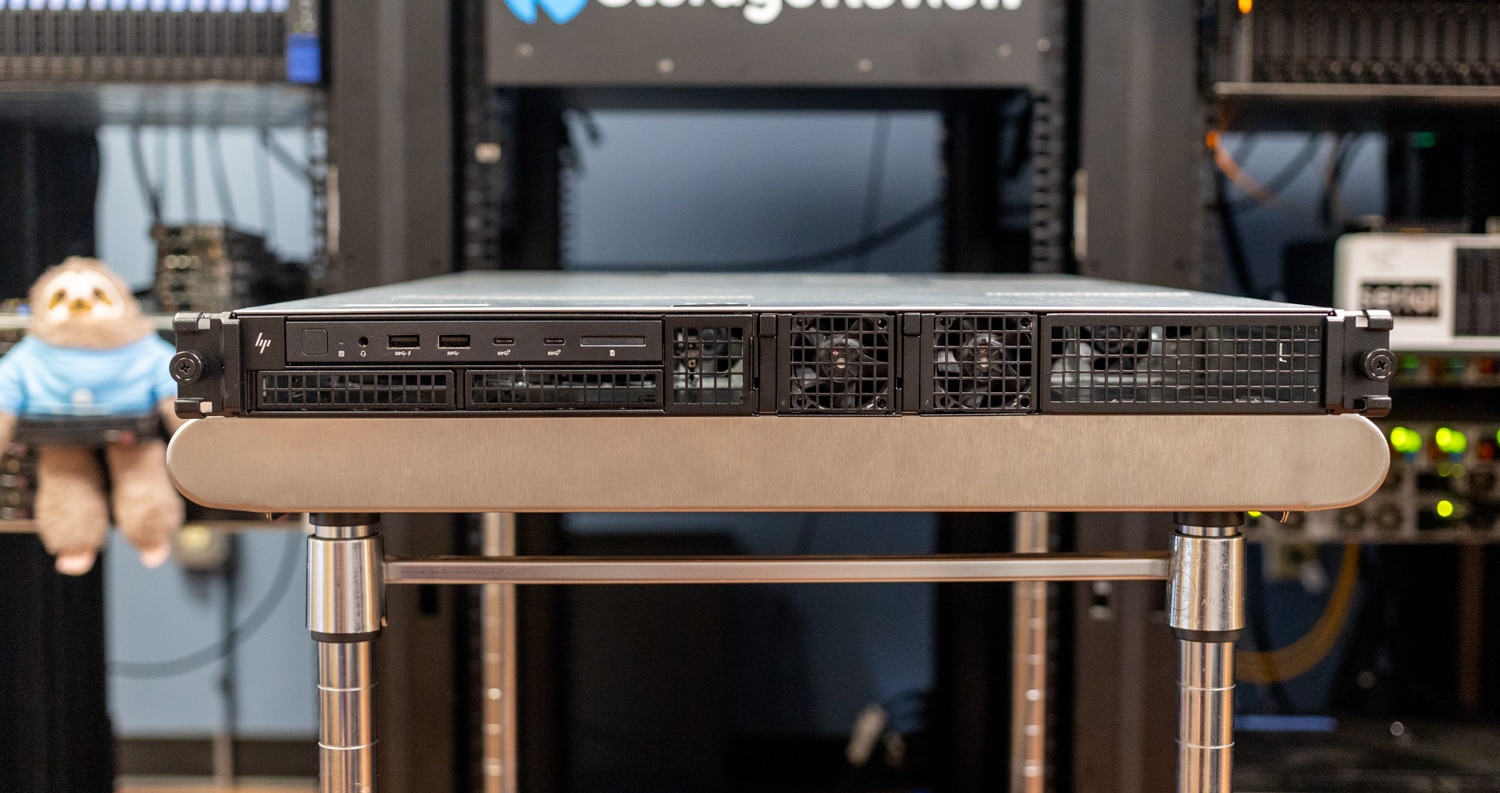
为了进行实际体验,我们在一台配备 Intel Xeon w5-2465X、128GB 内存和 32GB 显存的 NVIDIA RTX 5000 Ada Generation GPU 的HP Z4 Rack G5工作站上从头开始安装了 Jan,该工作站运行的是 Windows 11 专业工作站版。我们想看看安装过程是如何运作的,Jan 如何管理本地模型,GPU 加速是否自动工作,以及一切运行后其主要功能是如何工作的。
Jan 在我们第一次测试和正式发布之间进行了更新,v0.8.5 和 v0.8.6 版本在本次评测发布前不久推出。新版本解决了早期版本中的多个问题,包括将 llama.cpp 直接打包到 Jan 中、更改 GPU 卸载的配置方式、调整并行序列的默认值以及添加对话提示缓存。由于这些更改会影响本地推理,我们在发布前更新到了 v0.8.6 版本并重新运行了所有性能测试。
测试系统
| 元件 | 配置 |
|---|---|
| 运行系统 | Windows 11 Pro for Workstations |
| 中央处理器 | 英特尔至强W5-2465X,16核 |
| 内存 | 128GB |
| GPU | NVIDIA RTX 5000 Ada 一代 |
| 显存 | 32GB |
| NVIDIA驱动程序 | 597.06 |
| CUDA 兼容性 | 13.2 (nvidia-smi) |
| 一月三十一日 | v0.8.6 |
| 美洲驼.cpp | 0.5.0,版本 b11146 |
Jan 通过其硬件设置页面正确检测到了系统硬件,包括 CPU、系统内存和 RTX 5000 Ada。在这个已安装 NVIDIA 驱动程序的系统上,Jan 启用了 GPU 加速,而无需在加载模型之前在应用程序中进行任何额外的 CUDA 设置。
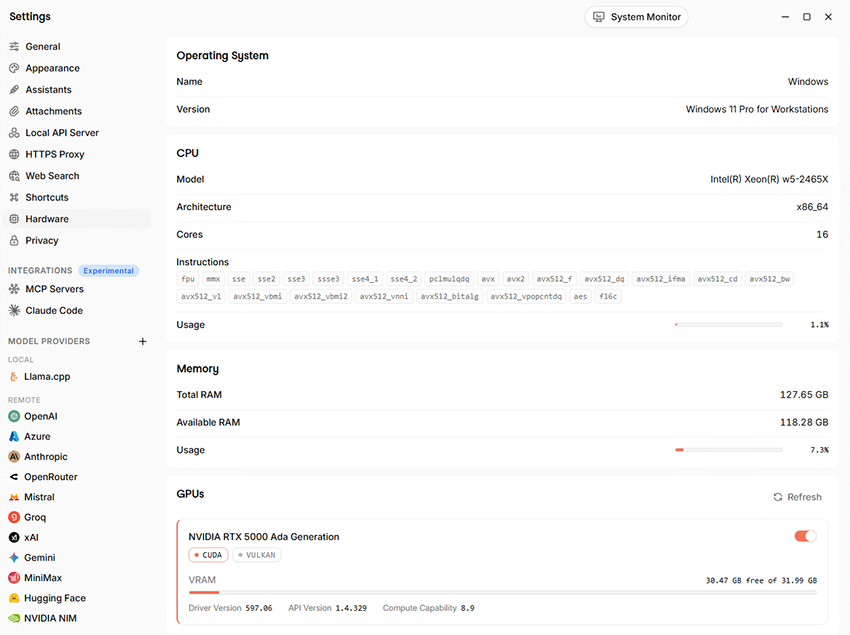
Jan v0.8.6 检测到 Xeon w5-2465X、127.65GB RAM 和 NVIDIA RTX 5000 Ada Generation(31.99GB VRAM)。
安装 Jan 并开始使用
Windows 系统使用标准的 .exe 安装程序,首次启动后直接进入 Jan 的主聊天界面。Jan 不需要注册账号即可使用本地版本。首次启动时,它会询问是否愿意分享匿名使用数据,然后推荐下载其本地版本 Jan V3.5。
Jan V3.5 的初始下载大小为 2.8GB。点击下载按钮后,应用内开始下载,下载完成后 Jan 会显示成功通知。安装完成后,即可在聊天窗口顶部的选择器中找到该模型。
Jan 首次发布时,推荐的 Jan V3.5 本地模型以 2.8GB 的下载大小提供。
浏览和下载模型
Jan's Hub 将模型发现和安装功能集成在应用程序内部,用户可以直接访问 Hugging Face 的模型,并在下载开始前获取实用信息。每个条目都包含下载大小、量化级别、功能标签和硬件适配性指标,帮助用户筛选出适合可用内存和 GPU 的模型。
在我们的 RTX 5000 Ada 系统中,几款显卡都标有绿色的“Fits”标签。Hub 显示 Jan V3.5 4B 版本有 2.5GB 的 Q4_K_M 选项,而 Jan V2 VL High 版本则为 4.7GB,并支持多模式和工具。同一型号的显卡还有其他不同的版本可供选择。
Jan 还可以使用来自 OpenAI、Anthropic、Gemini、Groq 和 Mistral 等提供商的托管模型,以及通过 llama.cpp 在本地运行的模型。这为用户提供了一个统一的界面来管理下载的模型和云端模型,同时 Hub 也省去了查找 GGUF 文件和在安装前检查内存要求等大量手动工作。
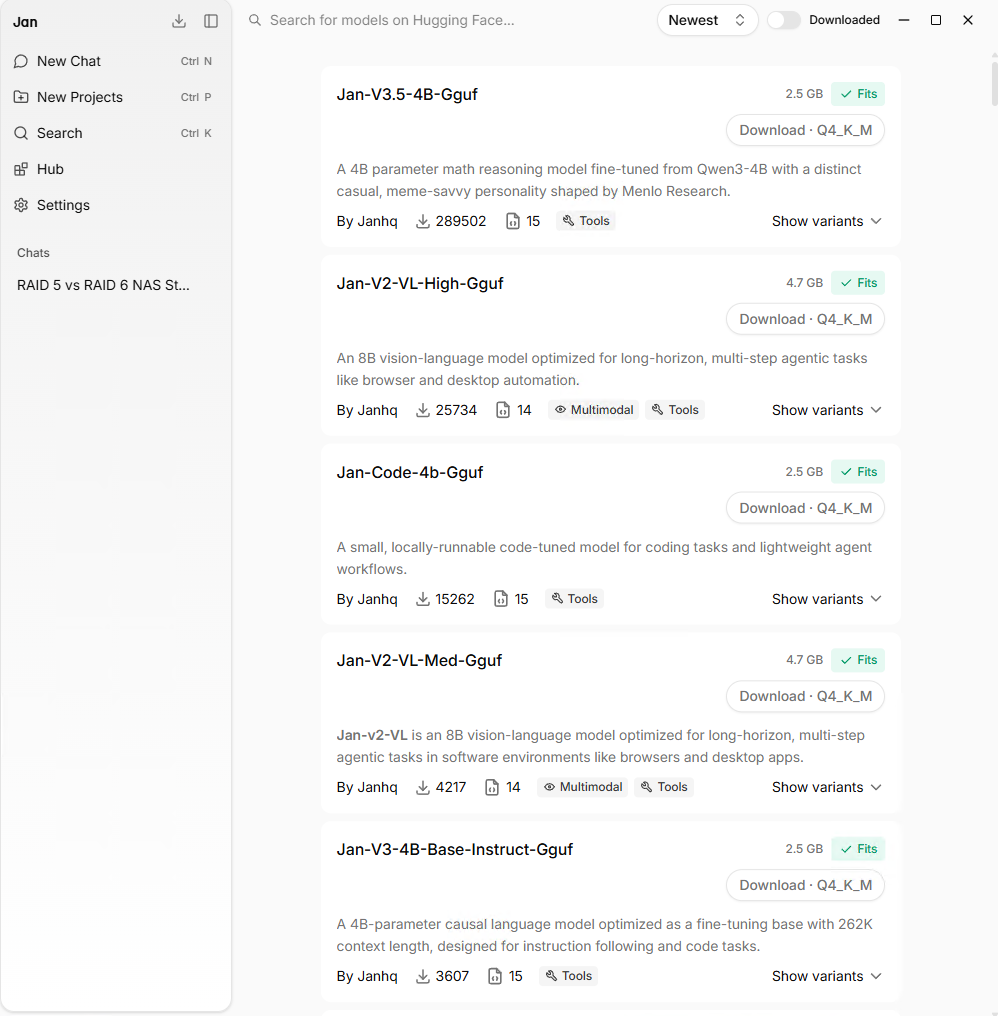
安装前,Hub 会显示下载大小、量化、模型特性和硬件适配状态。
我们下载 Jan V2 VL High 作为我们的第二个模型,因为它增加了图像支持,同时还能轻松装入 RTX 5000 Ada 的 32GB 帧缓冲区。
模型设置和 GPU 使用情况
v0.8.5 和 v0.8.6 更新周期中引入的一项重大变化是,llama.cpp 现在已集成到应用程序中,而之前的版本是单独管理的。我们的安装显示 llama.cpp 版本为 0.5.0,构建版本为 b11146,并行序列设置为 0,以便 llama.cpp 使用其默认行为,同时启用了会话间对话记录功能,以将每次对话的提示缓存保存在磁盘上。
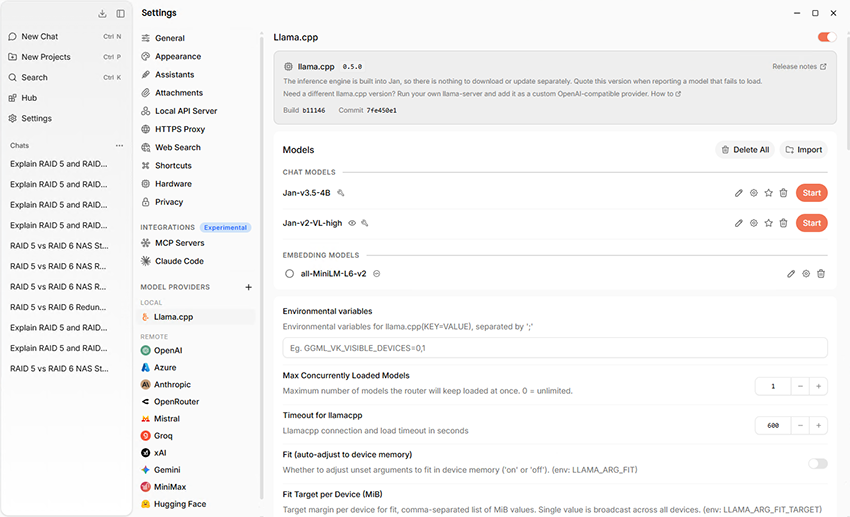
Jan v0.8.6 将 llama.cpp 0.5.0 直接包含在应用程序中,本地模型提供程序设置中显示的版本为 b11146。
安装 Jan V3.5 4B 后,活动模型旁边的齿轮图标可访问其采样和运行时间设置。在我们的安装中,Jan 显示的温度为 0.8,最高 P 值为 0.95,最高 K 值为 40,最低 P 值为 0.05,重复惩罚值为 1。
尽管最近的运行时更改改变了默认的 GPU 卸载行为,但我们升级后的 Jan V3.5 4B 和 Jan V2 VL High 配置在 v0.8.6 版本中仍然显示 100 个 GPU 层,因此我们在重新运行时保留了这些已保存的值。其他控制项包括 8,192 个标记的上下文大小、混合专家模型权重的 CPU 设置、键值缓存卸载以及 2,048 的批处理大小。这些选项允许您直接在 Jan 中调整内存使用和推理行为,而无需编辑命令行或单独的配置文件。
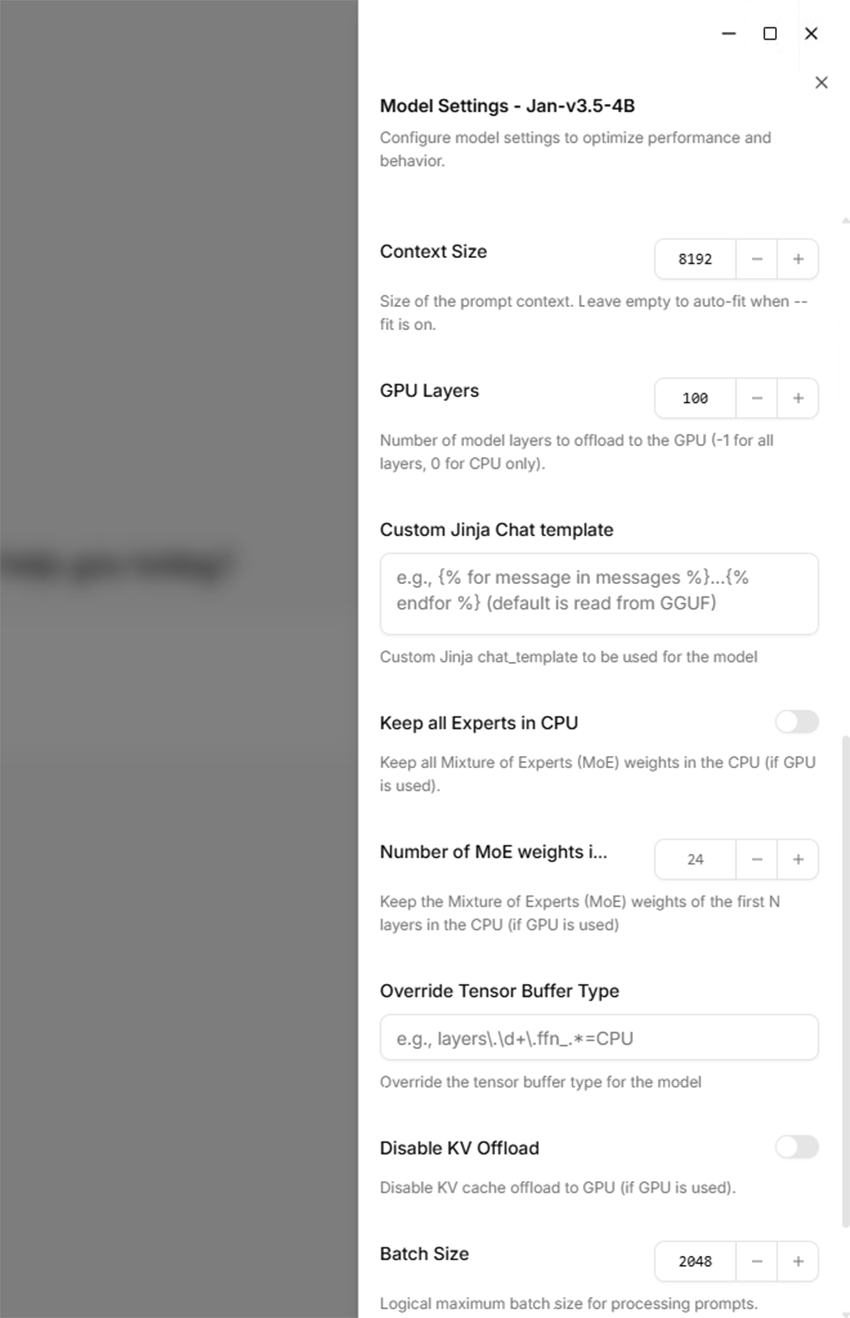
我们升级后的 Jan V3.5 4B 配置文件在 v0.8.6 中保留了 8,192 个令牌的上下文大小、100 个 GPU 层和 2,048 的批处理大小。
本地发电性能
我们使用搭载 RTX 5000 Ada 显卡的两款模型,在 Jan v0.8.6 版本上重复了文本生成测试,以测量更新后的运行时环境下的解码速度。我们禁用了网页搜索功能,将上下文大小保持在 8,192 个词元,将 GPU 层数保持在升级后的模型配置文件中保留的 100 层,并将批处理大小保持在 2,048。
每次运行我们都使用相同的纯文本提示:“向首次搭建NAS的用户解释RAID 5和RAID 6。请用大约400字概括它们各自的主要优缺点。”加载每个模型后的第一次响应被舍弃作为预热,随后在三个新的线程中进行三次正式运行。
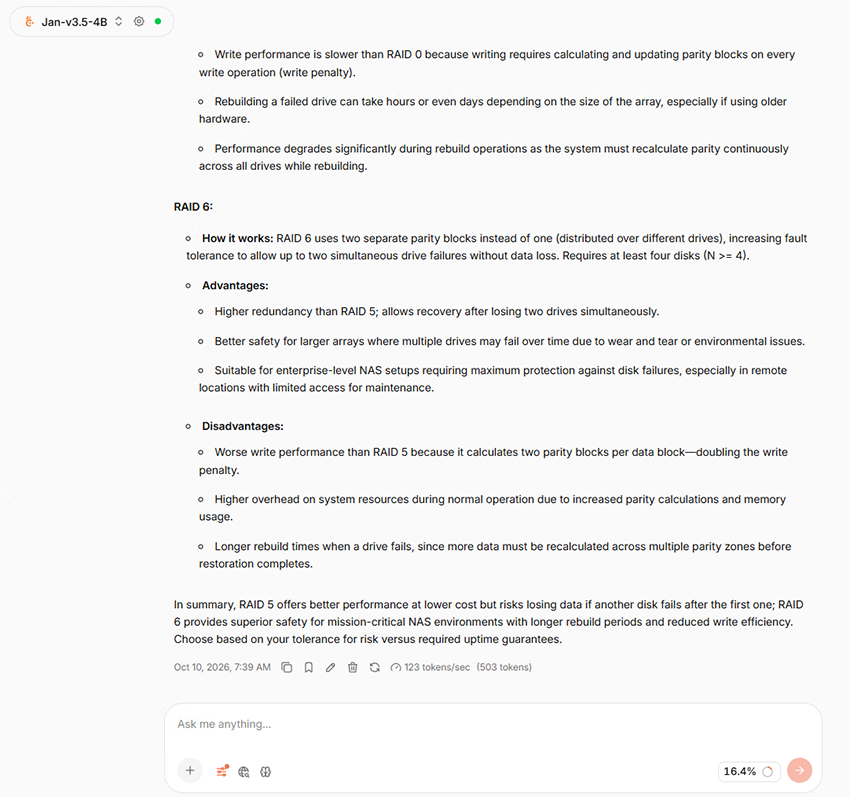
Jan V3.5 4B 在本次测试运行中达到了每秒 123 个令牌,并报告了 503 个 Jan 输出令牌,与三次运行测试的中位数相符。
Jan V3.5 4B Q4_K_XL 在三次测量运行中记录的平均解码速率为 123 个 tokens/秒,平均输出 tokens 数为 503 个(Jan 报告),平均峰值 GPU 内存使用量为 4,839 MiB。Jan V2 VL High Q4_K_M 的平均解码速率为 82 个 tokens/秒,平均输出 tokens 数为 1,728 个(Jan 报告),平均峰值 GPU 内存使用量为 8,197 MiB。
llama.cpp 的计时结果也与 Jan 的屏幕解码数据密切相关,Jan V3.5 4B 的中位评估速率为 122.55 个词元/秒,Jan V2 VL High 的中位评估速率为 82.30 个词元/秒。我们没有报告预填充的中位值,因为 v0.8.6 版本启用了对话提示缓存,多次重复运行显示仅评估了一个提示词元。这些缓存值无法有效地比较完整提示处理的性能。
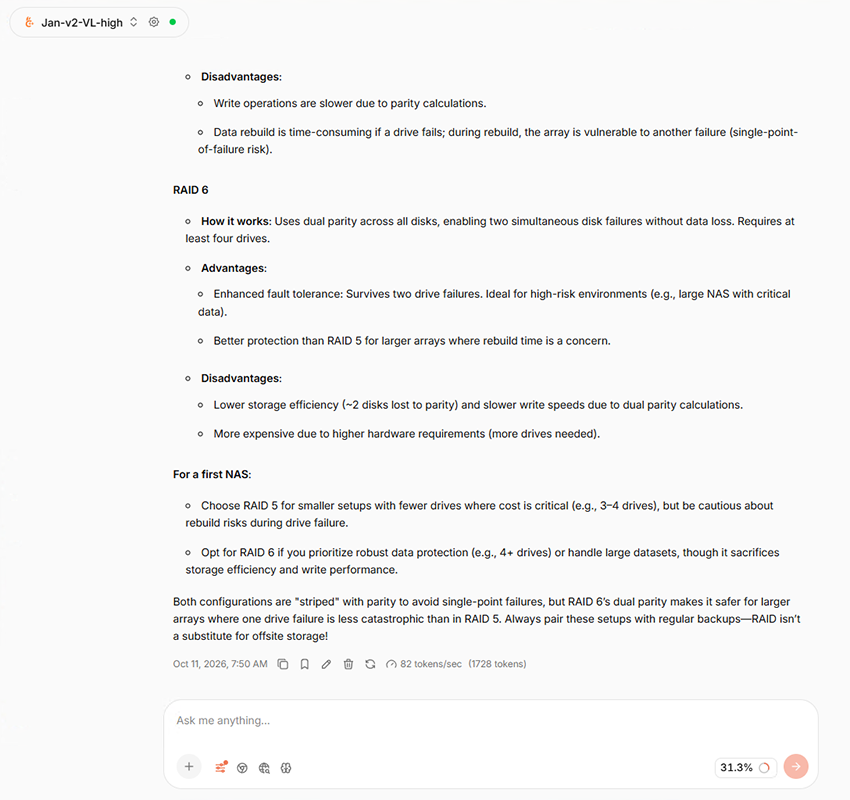
在本次测量运行中,Jan V2 VL High 达到了每秒 82 个令牌,报告输出令牌数为 1,728 个,与三次运行测试的中位数相符。
| 型号 | 量化 | 输出代币 | 解码速度 | GPU内存 |
|---|---|---|---|---|
| Jan V3.5 4B | Q4_K_XL | 503 | 123 吨/秒 | 4,839 MiB |
| 一月 V2 VL 高 | 问题4 | 1,728 | 82 吨/秒 | 8,197 MiB |
注:输出词元数、解码率和GPU内存使用量均为三次测量运行的中位数,其中一次预热运行的数据已被舍弃。GPU内存使用量为每次测量运行期间观察到的峰值内存使用量的中位数。Jan V2 VL High报告的输出词元数似乎包含了推理词元,因为可见答案约为400个单词,而Jan报告的词元总数要大得多。因此,其输出词元数不应与Jan V3.5 4B直接比较。
使用 Jan 进行本地聊天
安装模型后,Jan 的主界面简洁易用。最近的对话显示在左侧边栏,当前使用的模型始终显示在顶部,附件和工具则位于提示框下方。
切换已安装的模型只需点击几下即可完成。Jan 还会在响应末尾显示信息,包括词元计数和生成速率。推理模型可以在生成过程中显示其思考过程,但详细程度取决于所使用的模型。
我们的第一个本地测试要求 Jan 向一位正在搭建 NAS 的用户解释 RAID 5 和 RAID 6 的区别。下载的两款机型都完成了测试,其中 Jan V2 VL High 的回答更长,并且使用了 8,197 MiB 的 GPU 内存,而 4B 机型则使用了 4,839 MiB。
站内搜索
Jan 已将网页搜索和页面抓取功能直接集成到聊天界面中,支持这些工具的型号可以在启用这些工具后将最新的在线信息导入到对话中。我们将 Jan 更新到 v0.8.6 后,再次启用该功能,并向 Jan V2 VL High 提出了与我们本地测试中相同的 RAID 5 与 RAID 6 对比问题,重复了之前的网页搜索测试。
Jan 再次自行判断当前信息可能有所帮助,并尝试调用网络搜索,即使提示并未要求其进行在线搜索。推理视图显示,该模型决定在提交搜索查询之前验证当前的 NAS 推荐。在此次运行中,由于配置的 Exa 服务已达到其免费 MCP 速率限制,搜索本身未能完成,但测试证实,Jan V2 VL High 在判断外部信息可能有用时仍然会自动调用网络搜索。
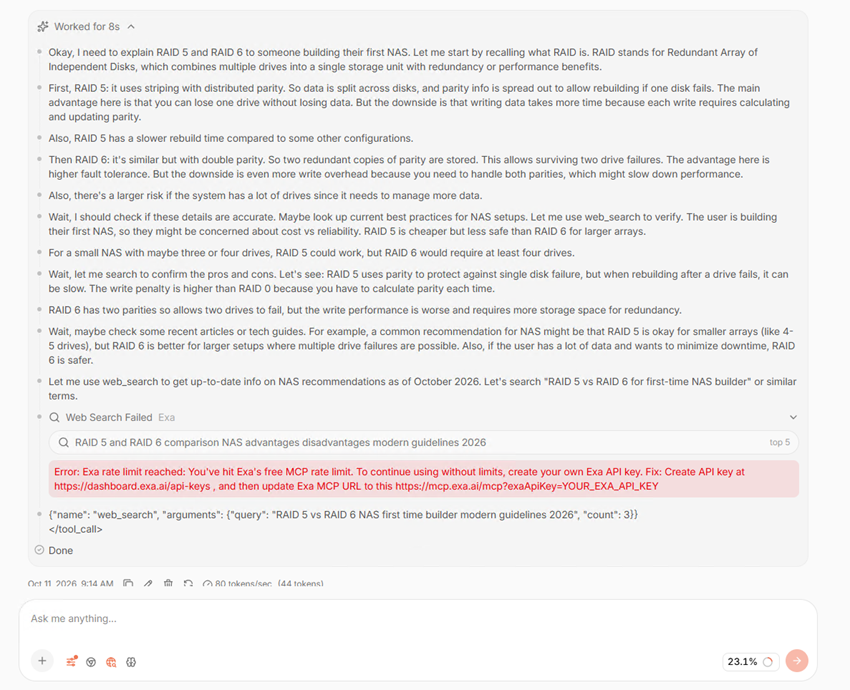
在 Jan v0.8.6 中启用 Web 搜索后,Jan V2 VL High 在 RAID 查询期间自动尝试在线搜索,尽管 Exa 的免费 MCP 速率限制阻止了该请求。
Jan 还支持 MCP,它允许将兼容的外部工具和服务连接到应用程序,包括浏览器交互和其他集成等选项。我们在本次测试中没有测试 MCP,但它的加入为用户提供了另一种方式,可以扩展本地运行模型的功能和操作,使其超越标准聊天界面。
多模式输入
为了在更新到 Jan v0.8.6 后重新测试图像输入,我们将一张新的 nvidia-smi 屏幕截图附加到 Jan V2 VL High,并要求其识别图像中显示的 GPU 型号、NVIDIA 驱动程序版本、总显存、GPU 利用率、GPU 温度和功耗。该模型正确识别了所有六个值:NVIDIA RTX 5000 Ada Generation、驱动程序版本 597.06、显存 32,760 MiB、GPU 利用率 1%、温度 35°C 以及功耗 4W / 250W。
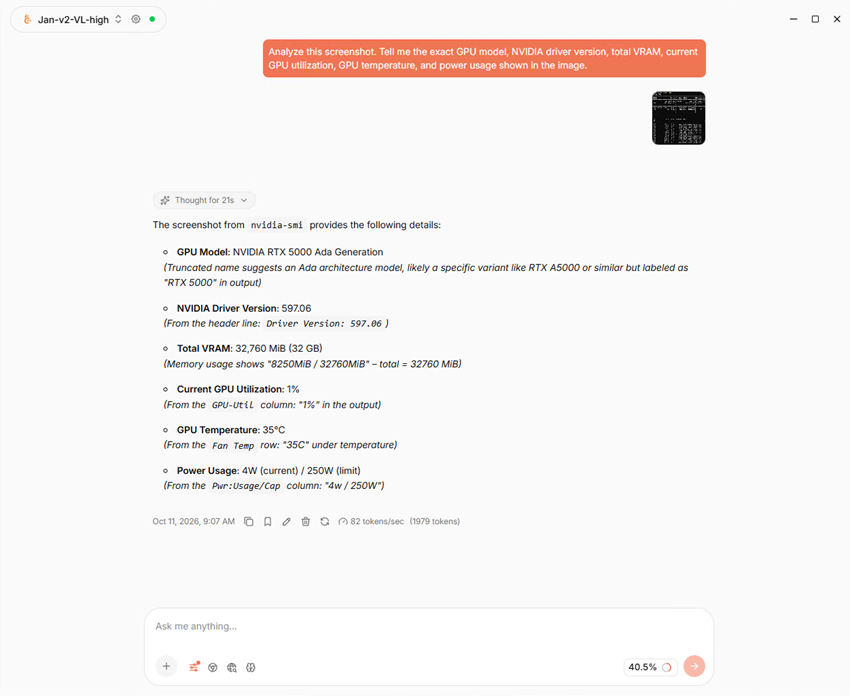
Jan V2 VL High 在 Jan v0.8.6 中从最新的 nvidia-smi 屏幕截图中正确识别了所有六个请求的硬件值。
这比我们之前在 1 月份发布的早期版本上进行的初始多模态测试要好得多,当时的测试结果大部分时间都花在了处理终端布局上。模型在给出答案之前仍然需要 21 秒的推理时间,Jan 报告了 1,979 个输出标记,但可见的响应简洁明了,直接回答了请求。
本地 API 服务器
Jan 还包含一个本地的 OpenAI 兼容 API 服务器,可通过其“设置”菜单访问。我们选择 Jan V3.5 4B 作为默认的本地 API 模型,并直接从界面启动了服务器。
Jan报告服务器运行在:
http://127.0.0.1:1337/v1
内置服务器日志确认启动成功,同时 Jan 还提供了对交互式 API 文档的访问权限。
我们使用 PowerShell 来确保本地 API 工作正常,首先查询 /v1/models,返回了已安装的型号,包括 Jan V2 VL High。然后,我们向 Jan-v3.5-4B-Q4_K_XL 发送了一个聊天补全请求,要求用一句话解释 RAID 6,Jan 直接在 PowerShell 中返回了响应:
“RAID 6 是一种磁盘阵列配置,它通过为每个数据块使用两个独立的奇偶校验块来提供数据冗余,从而使阵列能够在最多两个磁盘发生故障的情况下保持数据不丢失。”
回复中包含一个事实错误:RAID 6 每个条带使用两个奇偶校验块,而不是每个数据块使用两个奇偶校验块。
两个请求都成功后,我们确认支持 OpenAI 兼容端点的软件可以直接与 Jan 下载的模型通信,而无需通过桌面聊天界面发送每个提示。
什么地方出了错
我们最初测试的主要问题出在多模态测试中,Jan V2 VL High 模型虽然理解了 nvidia-smi 截图,但在处理一个简单的提取请求时却花费了过长的时间。上述 v0.8.6 版本的重新测试虽然在简洁的响应中返回了所有六个值,但 21 秒的推理时间和 1,979 个输出标记表明,该模型在给出答案之前仍然需要进行大量工作。
在 v0.8.6 版本上进行的 Web 搜索复测在 1 月份之外遇到了瓶颈:配置的 Exa 服务已达到其免费的 MCP 速率限制,因此模型在 RAID 测试期间尝试的自动搜索无法完成。任何依赖 Web 搜索的用户都应该配置一个具有足够带宽的搜索提供商,以满足日常使用需求。
除了上述几点之外,v0.8.6 的测试进行得很顺利。所有六次重复的本地生成运行均顺利完成,没有出现崩溃、模型加载失败或 GPU 检测问题。
结语
对于任何想要在 Windows 上运行本地 LLM 的用户来说,Jan v0.8.6 简化了大部分设置工作,同时仍然保留了足够的调整空间,允许用户自定义模型运行方式。在我们的测试系统中,它自动检测到了 RTX 5000 Ada 显卡;下载的两个模型都使用了 GPU 加速,并且在下载之前,Hub 会显示模型大小和硬件适配信息。它为新手提供了足够的指导,同时也提供了上下文大小、GPU 层数和内存选项等设置,以满足用户更精细的控制需求。
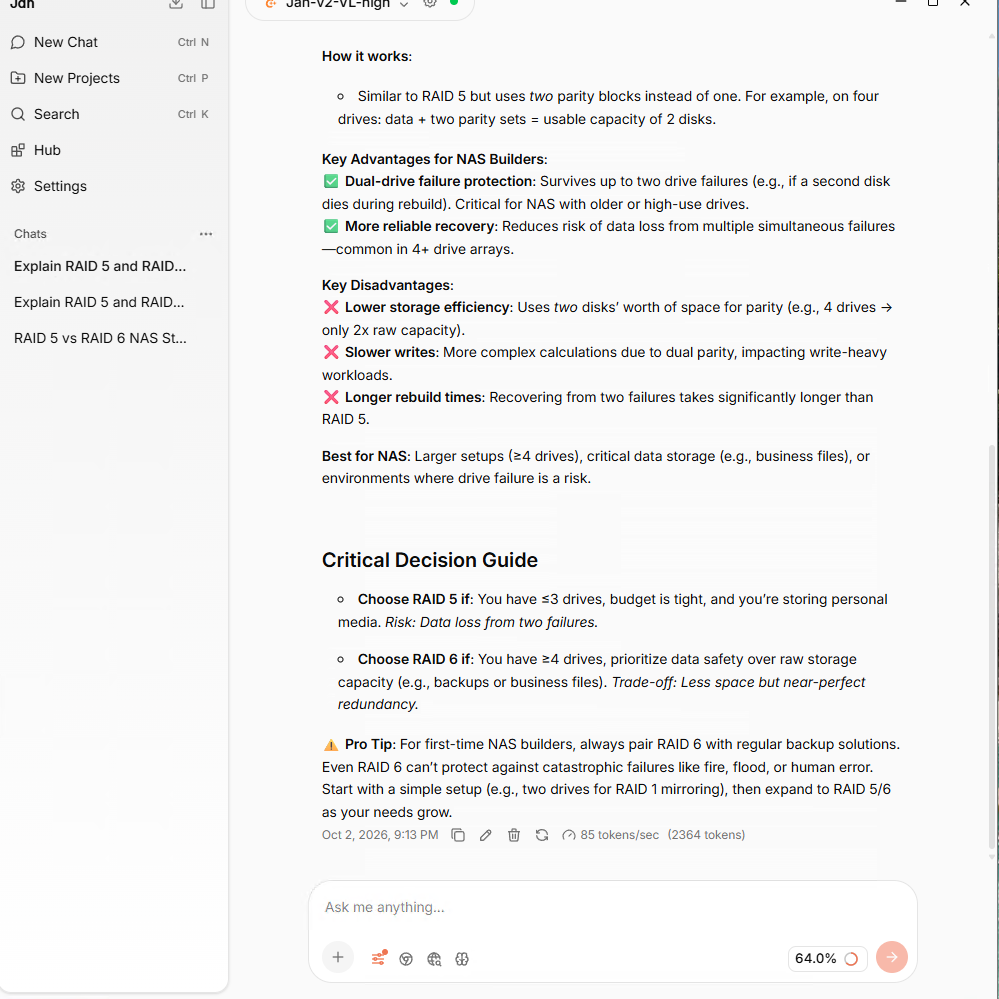
Jan V2 VL High 完成了本地 RAID 比较,并在响应下方显示了生成信息。
Jan 的功能远不止运行本地模型和提供聊天窗口,它在同一界面中添加了许多功能。我们测试了直接从对话中进行网络搜索,测试了 Jan V2 VL High 的图像输入功能,发现它支持与本地 llama.cpp 模型并存的远程 AI 提供商,并且能够通过 PowerShell 向兼容 OpenAI 的 API 发送请求。
在我们的 RTX 5000 Ada 系统上,Jan V3.5 4B 在更新后的文本生成测试中达到了每秒 123 个标记的中位数,而 Jan V2 VL High 达到了每秒 82 个标记。在 v0.8.6 更新后,Jan V2 VL High 在我们重复的多模态测试中也产生了更加简洁的响应,能够正确识别 nvidia-smi 屏幕截图中的所有六个请求值。
Jan 在整个会话期间运行稳定可靠,从全新安装到在 GPU 上运行本地模型,只需一个安装程序、一个模型下载和几次点击即可完成。
我们将使用相同的测试方法,对最佳本地LLM工具排行榜中的其他条目进行测试,为读者提供相同硬件的性能结果,以及功能和日常使用方面的差异。


 Amazon