

NVIDIA RTX PRO 4500 Blackwell 服务器版是 NVIDIA 专为大多数企业现有服务器打造的显卡。它是一款单槽被动散热的 165W 显卡,配备 32GB GDDR7 显存,并拥有完整的 Blackwell 架构特性:第五代 Tensor Core(支持 FP4)、第四代 RT Core、三个编码器和三个解码器,以及多实例 GPU 支持,可将显存分割成两个独立的 16GB 分区。它取代了 L4,成为 NVIDIA RTX PRO 服务器产品线的入门级产品,并且可以轻松安装在 2U PowerEdge、ProLiant 或 ThinkSystem 服务器中,无需担心电源或散热问题。

NVIDIA 对这款显卡的定位是“适配型”:大多数企业并非在构建人工智能工厂;他们运营的是风冷式、老旧数据中心,机架功率有严格限制,他们需要的是一个无需全新服务器级别的加速计算方案。或者,他们从事边缘计算,RTX PRO 4500 更适合边缘计算,能够更好地满足通常决定部署方案的工作负载和功率限制。
RTX PRO 6000 Blackwell占据了该市场的顶端,拥有 96GB 显存和高达 600W 的功耗。4500 系列沿用了相同的架构,但其他各项性能都缩减了近一半,因此,对于那些使用较小配置、任务量较小或预算有限(例如每瓦特成本较高)的用户来说,他们可以选择 Blackwell,而无需为他们用不到的性能空间付费。
此类GPU的工作负载已得到充分理解:小型语言模型推理、视觉AI和视频分析、向量搜索和嵌入生成、转码以及vGPU 20下的虚拟工作站。它声称在小型和中型模型推理方面性能是L4缓存的5倍以上,在Nemotron模型上性能最高可达10倍。其首发合作伙伴包括NTT DATA(边缘视频)、Pacific Biosciences(测序)和诺基亚(AI-RAN基站)。AWS基于此构建了新的G7实例,以替代G6实例。
我们在之前的RTX PRO 4500 Edge 评测中,已经将这款显卡与 HPE ProLiant DL145 Gen11 服务器内部的 L4 缓存进行了对比测试,结果显示其吞吐量是 L4 的 2.7 倍。本次评测将着重分析它与 350W 双槽 L40S(两年来一直是主流集成电路卡的标配)的性能差距,以及更高端的 RTX PRO 6000 在显存和功耗方面有哪些提升。
为了找出答案,我们将 4500 放入戴尔 PowerEdge R770服务器中,与 L40S 和 L4 进行对比,并添加了来自戴尔 Pro Max Tower T2的 RTX PRO 6000 Blackwell 数据,分别测试了其 600W 的默认功耗和 450W 的上限功耗(与 R770 的 GPU 插槽允许的功耗相匹配),并在两种上下文长度下,在四种型号上运行了 vLLM 在线服务。
简单预览一下,在典型的聊天和代理上下文长度下,4500 在 FP8 和 BF16 型号上与 L40S 保持同步,而功耗却不到后者的一半;在 8K 输入下,32GB 帧缓冲区显示出其局限性;而 NVIDIA 在其 Blackwell 产品宣传中主打的 NVFP4 精度,在此 vLLM 版本上的表现与其他产品线保持一致。
关键精华
- L40S 单槽吞吐量 165W: 在 512 个令牌的输入和输出下,4500 在我们运行的每个 FP8 和 BF16 模型上都与 L40S 持平或略胜一筹,在 Ministral 3 14B FP8 上为 1,107 对 995 个令牌/秒,在 Ministral 3 3B 上为 2,006 对 1,988,而这张卡的额定功率只有 L40S 的 47%,插槽数量只有 L40S 的一半。
- 大约是它所取代的 L4 的 3 倍: 在短时间内,L4 的输出吞吐量是 L4 的 2.8 倍至 3.6 倍,而 L4 的板载功耗是 L4 的 2.3 倍。
- 32GB 是有上限的: 在 8K 输入时,4500 的性能比 L40S 低 17% 到 33%,并且其曲线在并发数为 8 时趋于平缓,而 L40S 的性能则持续攀升至 16。曲线趋于平缓是因为 KV 缓存耗尽,而 32GB 是该缓存的极限。
- NVFP4 是一款软件产品,每张卡上都有它的身影: 在 Qwen3.8-27B NVFP4 测试中,4500 在并发数为 32 时每秒可生成 320 个令牌,L40S 在完全没有 FP4 硬件的情况下每秒可生成 480 个令牌,RTX PRO 6000 每秒可生成 621 个令牌。在此 vLLM 构建中,NVFP4 路径在所有这些显卡上都无法随内存带宽的增加而扩展,而 MAMF 测试结果显示,4500 的 FP4 硬件性能达到了 568.6 TFLOPS,而 FP8 硬件的性能仅为 280.1 TFLOPS。
- 更贵的卡能买到什么: 由于戴尔 R770 GPU 插槽的功耗上限为 450W,RTX PRO 6000 在短时运行时的性能约为 4500 的两倍,在 8K 分辨率下约为 2.5 倍至 3.2 倍。其 600W 的额定功耗在此基础上,短时运行时的性能提升了 1% 至 2%,长时间运行时的性能提升了 4% 至 9%,因此 6000 相较于 4500 的大部分性能提升都来自于显存。
NVIDIA RTX PRO 4500 Blackwell 服务器版规格
两款显卡都名为 RTX PRO 4500 Blackwell,它们虽然相似,但并非完全相同的产品。工作站版于 2025 年 GTC 大会上发布,是一款 200W、双槽、主动散热的显卡,配备四个 DisplayPort 输出接口和 896GB/s 的显存带宽。我们此次评测的服务器版则于 2026 年 GTC 大会上亮相,是一款 165W、单槽、被动散热、无显卡头的显卡,显存带宽为 800GB/s。它牺牲了显示输出接口和部分时钟频率,换取了数据中心级的功能:MIG、机密计算、第三个 NVENC 和 NVDEC 编码器,以及 vGPU 20 支持。两款显卡的核心配置相同,均采用 10,496 核 GPU 和 32GB GDDR7 ECC 显存。
NVIDIA 的数据显示,该显卡采用台积电 4nm 定制硅片,面积为 378 平方毫米,包含 45.6 亿个晶体管,配备 82 个第四代 RT 核心,相当于 82 个 SM 单元和 328 个 Tensor 核心。这些数据来自 GB203 芯片,与 RTX 5080 属于同一芯片系列,只是尺寸略有不同。下方的 Tensor 核心数据是 NVIDIA 官方给出的稀疏模式下的峰值性能;密集模式下的性能减半,NVIDIA 自家的 peakTOPS 二进制文件也证实了这一点,该显卡的 FP8 性能为 805 TFLOPS,FP16 性能为 403 TFLOPS。
| 规格 | RTX PRO 4500 Blackwell SE | L4 | L40S | RTX PRO 6000 Blackwell SE |
|---|---|---|---|---|
| 平台概述 | ||||
| 卓越 | 英伟达布莱克威尔 | 英伟达阿达洛夫莱斯 | 英伟达阿达洛夫莱斯 | 英伟达布莱克威尔 |
| CUDA核心 | 10,496 | 7,424 | 18,176 | 24,064 |
| RT核心 | 82(第四代) | 58(第三代) | 142(第三代) | 188(第四代) |
| GPU内存 | 32GB GDDR7 带 ECC | 24GB GDDR6 | 48GB GDDR6 带 ECC | 96GB GDDR7 带 ECC |
| 存储器接口 | 256 bit | 192 bit | 384 bit | 512 bit |
| 内存带宽 | 800GB /秒 | 300GB /秒 | 864GB /秒 | 1,597GB /秒 |
| 性能(NVIDIA峰值数据,稀疏性下的Tensor速率) | ||||
| FP32 | 51 TFLOPS | 30.3 TFLOPS | 91.6 TFLOPS | 120 TFLOPS |
| FP16 / BF16 张量 | 406 TFLOPS | 242 TFLOPS | 733 TFLOPS | 1 浮点数 |
| FP8张量 | 811 TFLOPS | 485 TFLOPS | 1,466 TFLOPS | 2 浮点数 |
| FP4张量 | 1.6 浮点数 | 不支持 | 不支持 | 4 浮点数 |
| RT核心性能 | 154 TFLOPS | 不在名单中 | 209 TFLOPS | 355 TFLOPS |
| 功率和外形尺寸 | ||||
| 最大电路板功率 | 165W | 72W | 350W | 高达 600W(可配置) |
| 外形 | 单槽位,FHFL 4.4“x 10.5” |
单槽位,HHHL | 双槽,FHFL 4.4“x 10.5” |
双槽,FHFL(空气) 单槽,FHXL(液体) |
| Thermal——热 | 被动 | 被动 | 被动 | 被动式(空气)或液体 |
| 电源连接器 | 1 个 PCIe CEM5 16 针 | 插槽动力 | 1x 16针 | 1 个 PCIe CEM5 16 针 |
| 互联 | PCIe 5.0 x16 | PCIe 4.0 x16 | PCIe 4.0 x16 | PCIe 5.0 x16 |
| 重量 | 1,055克 | 不在名单中 | 不在名单中 | 不在名单中 |
| 产品特性 | ||||
| 多实例GPU | 最多 2 个 16GB | 没有 | 没有 | 最多 4 个 24GB |
| NVENC/NVDEC | 3 倍 / 3 倍 | 2 倍 / 4 倍 | 3 倍 / 3 倍 | 4 倍 / 4 倍 |
| 机密计算 | 支持 | 没有 | 没有 | 支持 |
| vGPU 支持 | 是的(vGPU 20) | 是 | 是 | 是 |
设计与建造
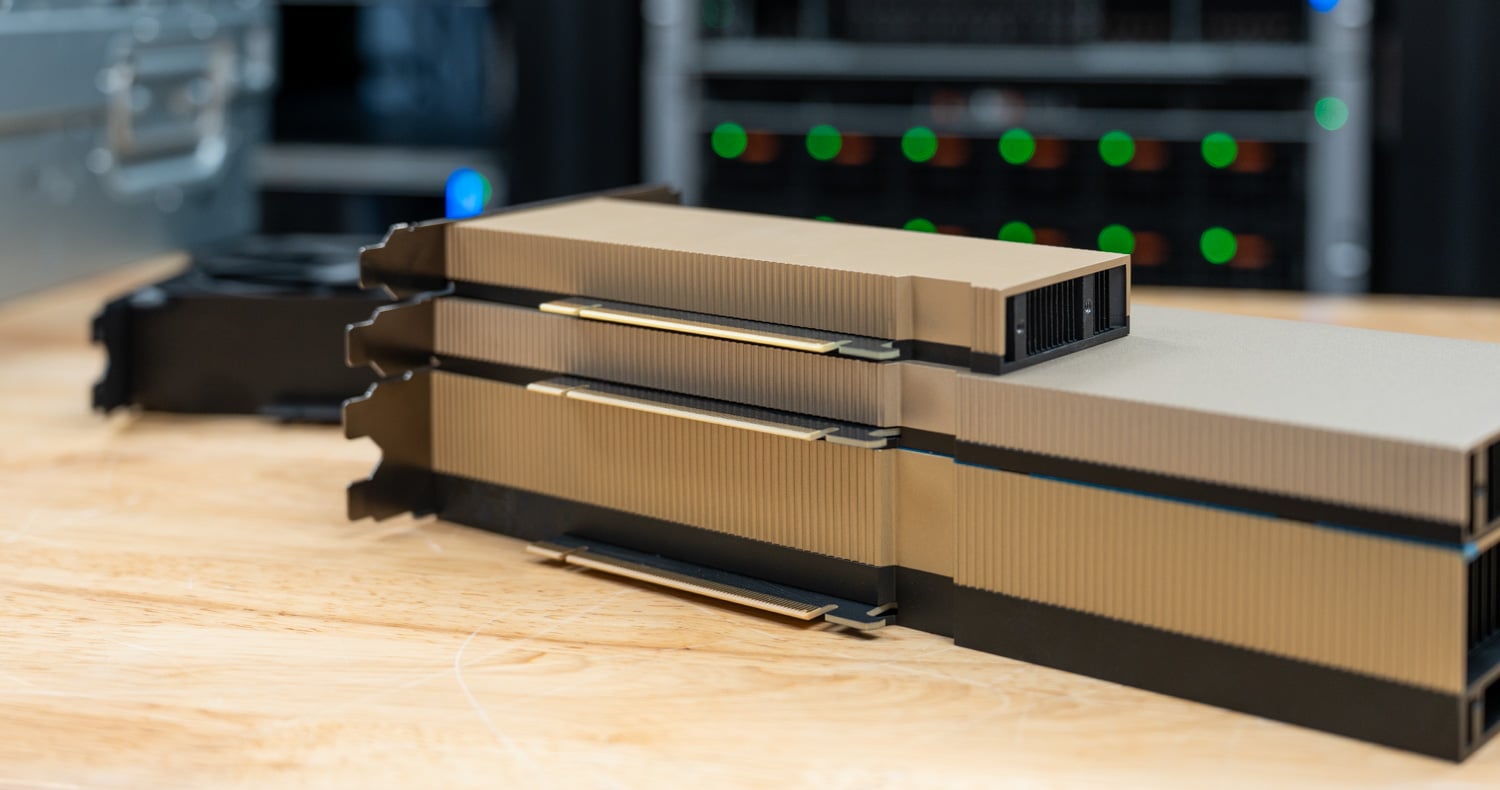
4500 服务器版是一款全高全长主板,高 4.4 英寸,长 10.5 英寸,占用一个插槽位。这与 L4 的半高半长设计截然不同。虽然 L4 仍然是其性能基准测试的对比对象,但 4500 服务器版采用了全高半长 (FHFL) 的外形尺寸,以便为内存、16 针电源输入接口以及仅靠机箱风道即可散热 165W 的散热片腾出空间。

这种外形尺寸是它与 L4 最大的区别。L4 可以适配任何 HHHL 插槽,并从插槽获取 72W 的功率,因此主要用于 1U 服务器和小型边缘服务器。而 4500 是全高全长的,需要 16 针电源线。我们使用的主流 1U 服务器(包括戴尔目前的 1U PowerEdge 系列)如果没有这种接口,最多只能支持 HHHL 或 FHHL 扩展卡。
实际上,这是一张 2U 卡,或者说是为少数围绕 FHFL 插槽构建的 1U 白盒机箱设计的卡,因此购买了 1U 或边缘盒 L4 的商店无法直接替换。
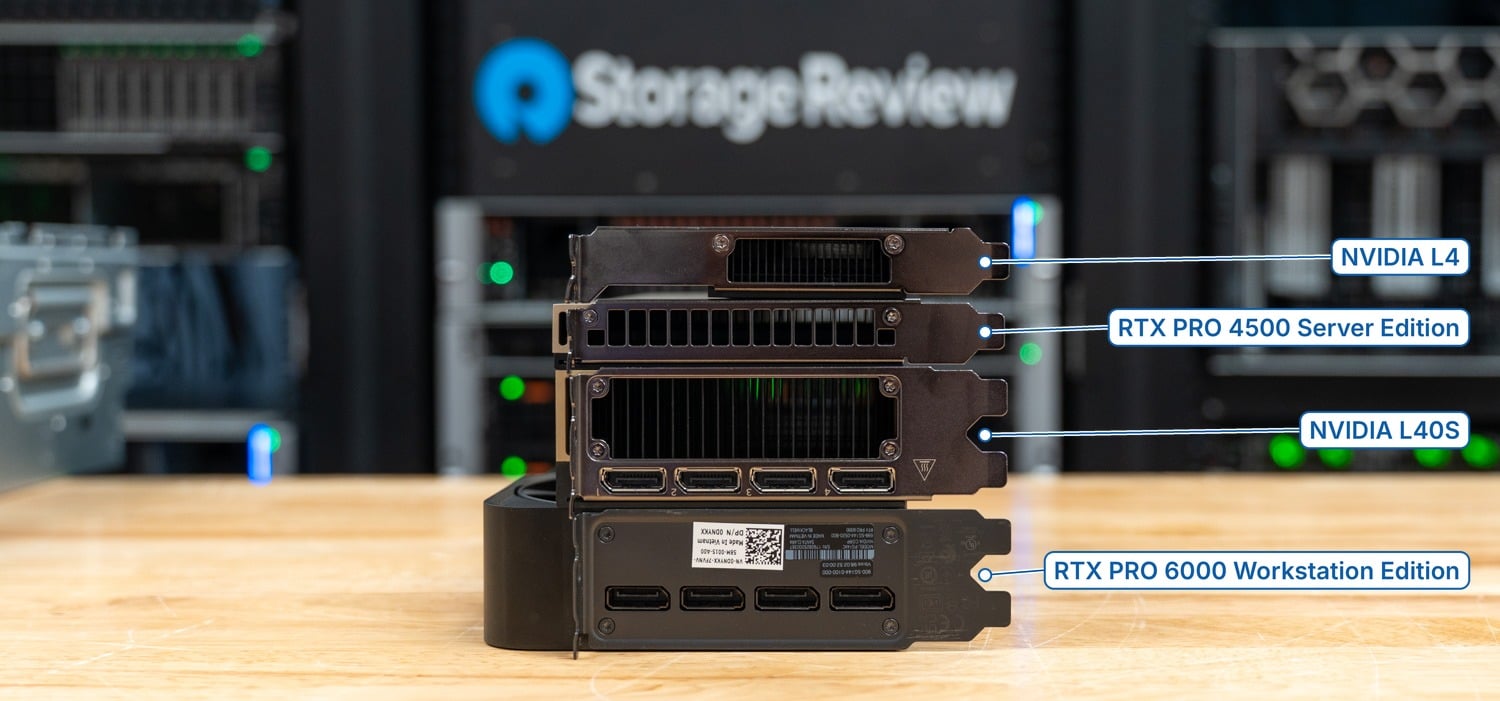
4500 显卡与 L4 显卡并排堆叠,上方是 L4 显卡,下方是 L40S 显卡,4500 显卡需要一个插槽,而 L40S 显卡需要两个插槽,这就是为什么一个 2U 服务器可以安装四个双宽卡,而八个这样的显卡,以及 AWS 的 G7 实例如何在每个主机上运行多达八个这样的显卡。
电源通过一个 PCIe CEM5 16 针接口提供,与 RTX PRO 6000 使用的接口相同,没有辅助的 8 针接口。散热完全被动,因此显卡依赖于服务器风扇,如果机箱内空气流通不畅,显卡会降频运行,这对于同类显卡来说是正常的,所有其他 GPU 也都有相同的要求。
该显卡没有显示输出接口,因此图形处理工作(无论是 vGPU 虚拟工作站还是渲染)都通过网络传输,挡板上设有通风孔。三个第九代 NVENC 和三个第六代 NVDEC 引擎在 L4 的基础上增加了 4:2:2 H.264 和 HEVC 的编码和解码功能,NVIDIA 声称每个 NVDEC 引擎的 H.264 解码吞吐量是 L4 的两倍。下面的挡板照片清晰地展示了这种差异:L4 和 4500 只有通风孔,而 L40S 和 RTX PRO 6000 工作站版则各有四个 DisplayPort 输出接口。
RTX PRO 4500 Blackwell 服务器版适用于哪些场景
NVIDIA 的宣传重点是这款显卡的“核心价值在于将 AI、计算、图形和视频加速功能集成于 165W 的被动式单槽设计中”,专为“机架密度、功耗和散热是主要部署限制因素”的服务器而设计。它位于 NVIDIA 所谓的 RTX PRO 服务器产品组合的主流数据中心和边缘计算领域,定位低于 RTX PRO 6000 Blackwell 服务器版,但又不高于任何高端产品;它是 Blackwell 服务器产品线的入门级产品。
与 L4 缓存相比,NVIDIA 声称其 Nemotron Nano 模型在小型模型推理方面性能提升高达 10 倍(4500 上的 NVFP4 模型对比 L4 上的 FP8 模型),在 Cosmos Reason 2 的视频摘要方面性能提升高达 4 倍,在 4K 分辨率下 SPECviewperf 15 测试中性能提升 1.9 倍,流媒体密度提升 1.8 倍。与 CPU 相比,NVIDIA 声称其在 Milvus 中使用 cuVS CAGRA 进行向量数据库运算时性能提升高达 50 倍,在视觉 AI 方面性能提升高达 100 倍,这两项测试均在配备八张显卡的 4500 服务器上进行,而双路 EPYC 9654 系统则进行了对比。
戴尔服务器团队告诉我们,他们认为4500系列显卡在主流机架中很受欢迎,因为三张32GB的4500显卡价格与一张96GB的6000系列显卡相近,在这种情况下,容量更大的显卡通常会更胜一筹。这款显卡适用于原本没有独立显卡或L4缓存的服务器,对于设计之初就打算配备一张或多张6000系列显卡的服务器来说,它并非最佳选择。
测试设置
我们在戴尔 PowerEdge R770 服务器上安装了 4500、L40S 和 L4 三款显卡。该服务器配置了两颗英特尔至强 6787P 处理器(每颗 86 核)和 2TB DDR5-6400 内存(32 个 DIMM 插槽),并运行 NVIDIA 驱动程序 595.71.05。测试运行使用了 NGC vLLM 26.08-py3 容器,该容器运行基于 CUDA 13.4.1 的 vLLM 0.27.1 版本,因此所有显卡的软件栈完全相同。每张显卡均在其默认功耗限制下进行单独测试,R770 服务器能够为每张显卡提供其额定功率:戴尔官方数据显示,在该机箱中,L4 的功耗为 72W,4500 为 165W,L40S 为 350W。
我们戴尔Pro Max Tower T2工作站中使用的是RTX PRO 6000 Blackwell显卡,它与服务器版RTX PRO 6000 Blackwell采用相同的封装和驱动程序。NVIDIA将工作站版和服务器版RTX PRO 6000 Blackwell的功耗标为600W,并且在我们的测试中它们的性能表现也相同,因此我们将其作为服务器版显卡进行测试。顺便一提,我们之前也评测过搭载RTX PRO 6000服务器版显卡的XE7740服务器,如果您想深入了解这些显卡的性能扩展性,可以参考我们的评测文章。
我们对 6000 显卡进行了两次测试:一次是默认的 600W 功耗,另一次是通过 nvidia-smi 工具验证后设置的 450W 功耗上限。这是因为 450W 是 R770 主板在 GPU 插槽中为 6000 显卡提供的最大功率,也是典型的 2U 服务器用户在 4500 和 6000 显卡之间进行选择时应该参考的功率值。虽然 6000 显卡的宿主机平台有所不同,但在这种 GPU 密集型负载下,CPU 和 PCIe 拓扑结构对测试结果的影响远小于功耗上限的影响。
我们使用 vLLM 的在线服务基准测试,并发级别分别为 1、2、4、8、16 和 32,并采用两种请求形式:512 个输入令牌和 512 个输出令牌,模拟聊天和短代理轮次;以及 8,192 个输入令牌和 1,024 个输出令牌,模拟 RAG 和文档工作,其中预填充占主导地位,键值缓存填充。我们尽可能选择与组中最小的存储卡兼容的模型,因此 L4 的 24GB 容量设定了最低配置:Ministral 3 3B Reasoning 和 Ministral 3 8B Reasoning(BF16 编码)、Ministral 3 14B Instruct(FP8 编码)以及 Qwen3.8-27B(NVFP4 编码),后者适用于 32GB 及以上容量的存储卡,但不包括 L4。
我们报告每个并发级别的输出令牌吞吐量,并引用总吞吐量(包括预填充令牌),因为预填充令牌会改变情况。
这里没有包含:只有 48GB 及以上容量的卡才能容纳的更大型号、MIG 分区、vGPU、视频转码、计量电源、双卡 4500 配置以及高于此级别的数据中心卡。
最大可实现 Matmul FLOPS (MAMF)
MAMF 是一项持续密集的 GEMM 测试,它会报告显卡在每个精度下达到的最佳矩阵乘法吞吐量,因此它是检查 FP4 硬件在服务堆栈排除后是否正常工作的最简便方法。4500 在 BF16 下达到了 135.9 TFLOPS,在 FP8 下达到了 280.1 TFLOPS,在 NVFP4 下达到了 568.6 TFLOPS,精度每降低一级,吞吐量就几乎翻倍。与 NVIDIA 官方公布的 202、406 和 811 TFLOPS 的密集峰值相比,这相当于每个精度下峰值的 67% 到 70%,并且与 NVIDIA 官方 cuBLAS 测试中该显卡的 133、275 和 534 TFLOPS 的数据相符。
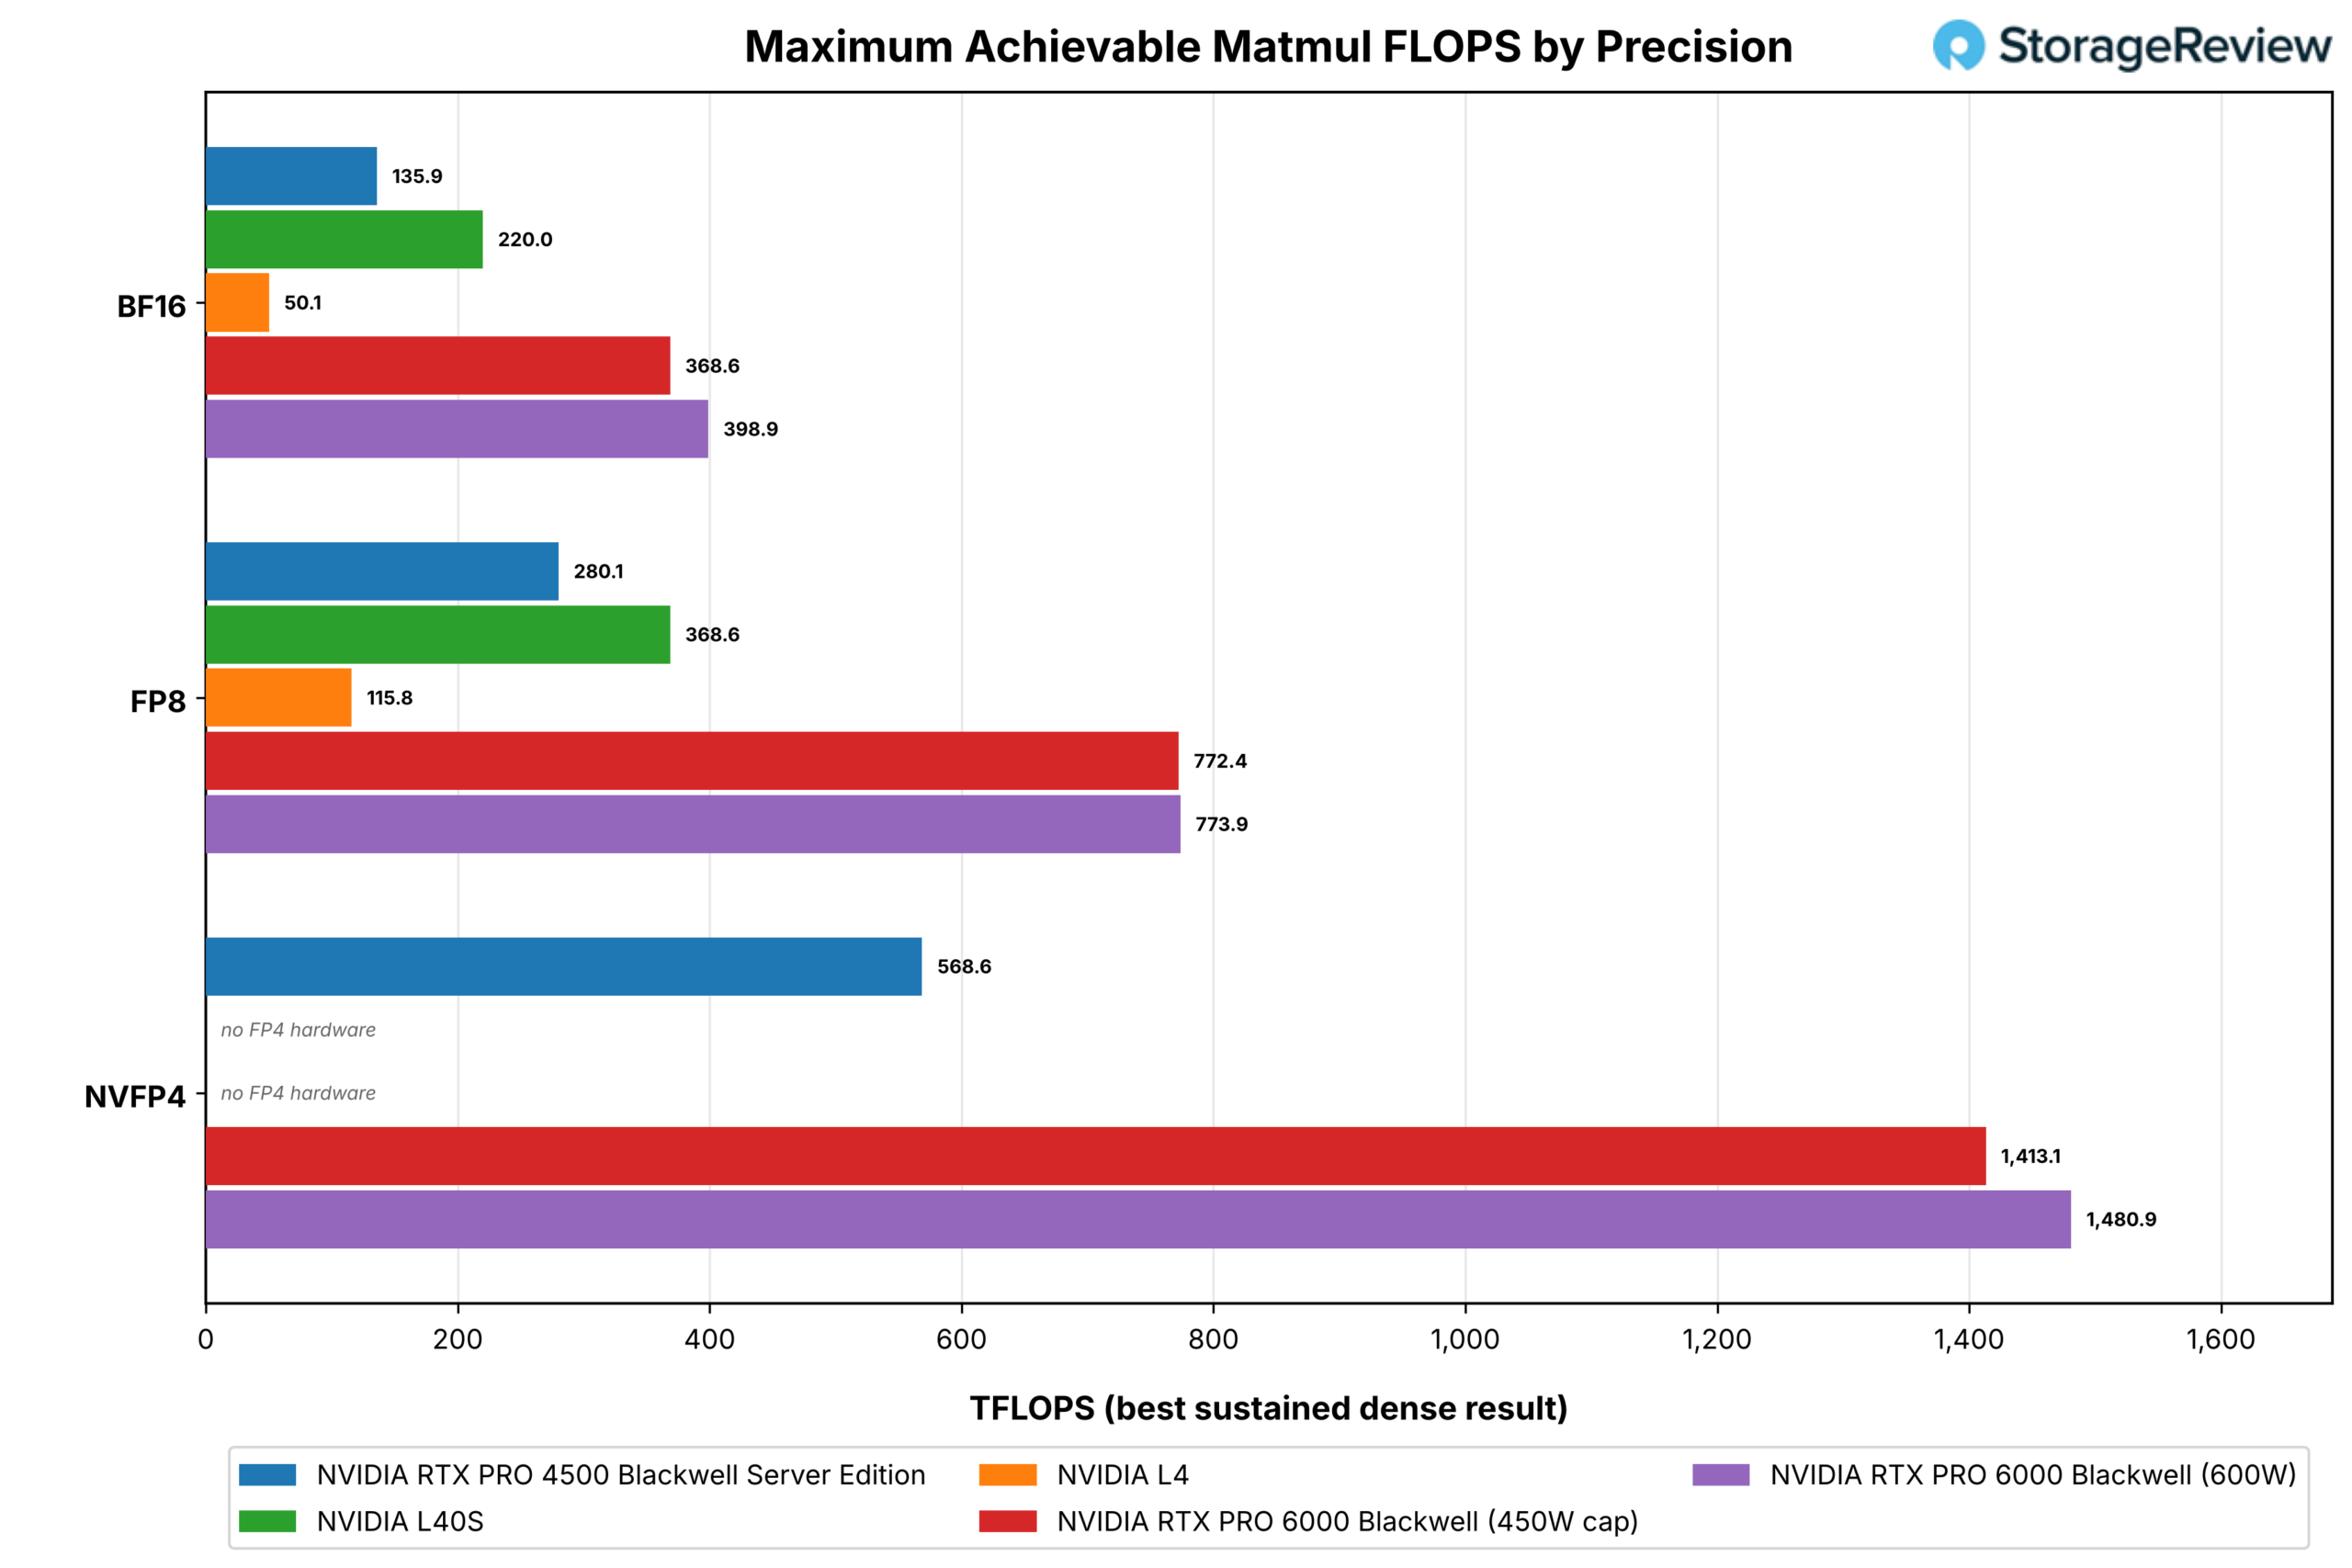
RTX PRO 6000 的性能提升与此类似,在 600W 功耗下分别达到 398.9、773.9 和 1,480.9 TFLOPS,是 4500 在三个精度下的 2.6 到 2.9 倍,这与芯片尺寸和功耗预算的预测相符。在 450W 功耗上限下,其性能分别达到 368.6、772.4 和 1,413.1 TFLOPS:FP8 性能没有变化,BF16 性能下降了 8%,NVFP4 性能下降了 5%,这表明在此测试中,6000 的 FP8 张量路径功耗低于 450W,而其他两个精度仅接近上限。L40S 在 BF16 和 FP8 下分别达到 220.0 和 368.6 TFLOPS,L4 则分别达到 50.1 和 115.8 TFLOPS。两张 Ada 卡都没有 FP4 张量硬件。
一个有用的对比是4500的NVFP4性能与其他所有处理器的FP8性能:568.6 TFLOPS是L40S FP8性能上限的1.5倍,也是6000系列处理器性能上限的74%,而这还是在165W功耗下实现的。这就是FP4的优势,而且这种优势体现在GEMM层面。接下来的vLLM服务测试结果表明,在当前版本中,FP4的性能尚未覆盖整个服务堆栈,而MAMF测试结果表明,随着NVFP4内核的逐步完善,服务性能将会持续提升。
vLLM 在线服务:简短背景 (512/512)
4500 的优势体现在以下几个方面:在三款 FP8 和 BF16 型号的处理器上,并发数为 32 时,其在 Ministral 3 14B 上的吞吐量为 1,107 tokens/s,而 L40S 为 995 tokens/s;在 Ministral 3 8B 上为 1,017 tokens/s,而 L40S 为 1,005 tokens/s;在 Ministral 3 3B 上为 2,006 tokens/s,而 L40S 为 1,988 tokens/s。所有这些测试中,功耗均为 165W 的 Blackwell 显卡都达到了或超过了功耗为 350W 的 Ada 显卡的性能水平。此外,从并发数 1 到 32,各款显卡的性能曲线几乎完全重合,因此这并非峰值性能的体现。L4 在相同型号处理器上的吞吐量分别为 364 tokens/s、279 tokens/s 和 704 tokens/s,这意味着 4500 的性能是其前代产品的 2.8 倍到 3.6 倍。

RTX PRO 6000 的性能展现了 Blackwell 平台其他显卡的实力。在 450W 的功耗限制下,它在三个相同的型号上分别达到了 2,161、2,042 和 4,069 个令牌/秒的吞吐量,分别是 4500 的 1.95 倍到 2.03 倍;在 600W 的满功率下,则分别达到了 2,283、2,139 和 4,155 个令牌/秒,分别是 4500 的 2.06 倍到 2.1 倍。在所有型号上,两款 6000 的性能曲线在并发数 16 之前几乎完全重合,在并发数 32 时也仅有 2% 到 5% 的差距,因此从短期来看,最后增加的 150W 功耗带来的提升微乎其微。与 4500 相比,这款显卡拥有三倍的显存,并且在 R770 插槽中,其功耗更是达到了 2.7 倍,吞吐量却达到了 4500 的两倍。

总吞吐量(包括每个请求的 512 个预填充令牌)也遵循相同的顺序:14B 型号的 4500 为 2,215 个令牌/秒,L40S 为 1,990 个令牌/秒,L4 为 727 个令牌/秒,而 6000 的吞吐量上限为 4,323 个令牌/秒,600W 功耗下为 4,566 个令牌/秒。与 L4 的差距在 8B 型号上最大,为 3.6 倍,在 3B 型号上最小,为 2.8 倍,而与 L40S 的差距从未超过 12%。

vLLM 在线服务:长上下文(8K/1K)
当输入令牌数达到 8,192 个时,情况发生了变化,原因可以从曲线形状中看出。在 Ministral 3 14B FP8 架构上,4500 处理器在并发数为 8 时与 L40S 处理器基本持平,之后速度稳定在 180 个令牌/秒左右,而 L40S 处理器在并发数为 16 时速度继续提升至 230 个令牌/秒并保持稳定。8B 架构也呈现出相同的趋势:4500 处理器在并发数为 32 时速度为 185 个令牌/秒,而 L40S 处理器则为 277 个令牌/秒,4500 处理器在并发数为 8 时速度趋于稳定,L40S 处理器则在并发数为 16 时速度趋于稳定。在 3B 架构上,两款处理器的速度都在并发数为 16 时趋于稳定,分别为 384 个令牌/秒和 475 个令牌/秒。

原因在于键值缓存容量:每个并发的 8K 请求都需要将其上下文驻留在卡上,而一旦权重加载完毕,32GB 的帧缓冲区所能容纳的权重数量就比 48GB 的帧缓冲区少。当 vLLM 的键值空间耗尽时,它就无法再增加有效的并发,吞吐量曲线也随之趋于平缓。仅此原因,在这些模型上,4500 在并发数为 32 时,性能就比 L40S 低 17% 到 33%;正如短上下文测试结果所示,计算能力并非瓶颈所在。L4 缓存容量为 24GB,吞吐量为 300GB/s,在所有模型上,从并发数为 4 开始,吞吐量就趋于平缓,介于 34 到 130 个 token/s 之间。

在这项测试中,6000 的 96GB 内存始终充足,其性能曲线在所有型号上都持续攀升至 32。在 450W 的功耗限制下,其性能分别达到 552、589 和 973 个 tokens/s,是 4500 的 2.5 倍到 3.2 倍;在 600W 的功耗限制下,其性能分别达到 608、639 和 1,033 个 tokens/s,是 4500 的 2.7 倍到 3.5 倍。功耗限制的影响在这里显现出来:长上下文预填充使 6000 的计算密集型性能持续时间更长,因此在并发数为 16 和 32 时,受限于功耗限制的显卡性能损失为 4% 到 9%,而在短上下文预填充时,性能损失仅为 2% 到 5%。无论如何,与 4500 的性能差距从 2 倍扩大到大约 3 倍,而内存而非功耗才是造成这一差距的主要原因。

如果您的工作负载是文档问答、长时间上下文的红黄绿灯(RAG)处理,或者代理需要处理大量工具输出,那么内存是主要规格,4500 的 32GB 内存会成为并发瓶颈。但如果是聊天、分类或代理轮次较短的情况,则不会。在 8K/1K 测试条件下,总吞吐量主要取决于预填充,并且排名顺序相同:4500 在 14B 型号上的速度为 1,713 个令牌/秒,L40S 为 2,070 个令牌/秒,L4 为 381 个令牌/秒,而 6000 的吞吐量上限为 4,971 个令牌/秒,在 600W 功耗下可达 5,474 个令牌/秒。
NVFP4:软件设定上限
Qwen3.8-27B(NVFP4)是该组显卡中唯一一款采用Blackwell主导的FP4 Tensor硬件的型号,其性能曲线最为平缓。在短上下文测试中,并发数为32时,4500的输出值为320 tokens/s;L40S、480和RTX PRO 6000的输出值分别达到621 tokens/s(上限)和616 tokens/s(600W功耗下)。在并发数为1时,所有显卡在27B架构下的输出值都在17到22 tokens/s之间,包括配备1.6TB/s GDDR7显存的6000,而同一款显卡在14B FP8架构下单流输出可达99 tokens/s。

L40S 没有 FP4 张量硬件,因此 vLLM 通过反量化权重并以更高精度进行计算来运行 NVFP4 检查点,这是一条受限于内存带宽的路径,其性能比 4500 高出 1.5 倍。6000 与 4500 拥有相同的 FP4 硬件,带宽是其两倍,其性能在其他所有方面也比 4500 高出约 2 倍,并且其 450W 和 600W 版本在所有并发情况下的功耗差异均在 1% 以内,因此内核也不受功耗限制。
所有四个系列的模式都表明,单流吞吐量不会随内存带宽变化,并且无论底层 GPU 是什么,并发 32 上限都只有 480 到 621,这表明此 vLLM 版本中的 NVFP4 内核路径是每张卡的极限。

在 8K/1K 的帧速率下,4500 在并发数 32 时达到了 153 个令牌/秒,而 L40S 为 190 个令牌/秒,6000 在限制和未限制帧速率下分别为 402 个令牌/秒和 425 个令牌/秒。这些性能曲线与 FP8 和 BF16 型号所展现的受限于键值缓存的性能曲线相同,6000 的 96GB 缓存再次成为其性能持续提升而其他型号性能趋于平缓的原因。
NVIDIA 在这张显卡上实现了 FP4 性能,在 Llama 3.1 8B 测试平台下,2K/256 分辨率时达到 1,221 tokens/s,在 Nemotron 3 Nano 30B A3B 测试平台下,TensorRT-LLM 模式下达到 905 tokens/s。因此,该硬件在 NVIDIA 的技术栈下能够胜任。然而,目前的数据显示,这张显卡的 NVFP4 性能与我们测试过的所有 GPU 的 vLLM 软件性能基本一致。因此,依赖 FP4 吞吐量的用户应该在决定是否依赖该性能之前,先测试一下他们的服务器架构。
每额定功率的吞吐量
本轮测试我们没有测量功耗,因此本次效率计算是基于每张显卡的测试功耗上限。在Ministral 3 14B FP8测试平台,并发数为32时,RTX 4500的每瓦输出令牌数为6.7个/秒,而L40S为2.8个/秒,L4为5.1个/秒,RTX PRO 6000在450W功耗上限下为4.8个/秒,RTX 6000在600W功耗下为3.8个/秒。在3B测试平台上,上述比例保持不变:RTX 4500为12.2个/秒,L40S为5.7个/秒,L4为9.8个/秒,RTX 6000在450W功耗上限下为9.0个/秒,RTX 6000在600W功耗下为6.9个/秒。
就短时性能而言,4500 是该组中效率最高的显卡,只有功耗上限为 6000 的显卡能与之媲美。将 6000 的功耗降至 450W 会使其吞吐量损失 2% 到 5%,但能节省 25% 的功耗预算,因此其效率提升了四分之一。L4 显卡在这项指标上仍然具有竞争力,因为 72W 的分母非常小,但它需要三倍于 4500 的插槽和服务器数量才能达到相同的吞吐量,而 4500 的设计初衷正是为了解决这一问题。
在 8K/1K 的情况下,顺序发生了变化:4500 在 14B 型号上每额定瓦特的吞吐量为 1.2 个令牌/秒,6000 的吞吐量为 1.2 个令牌/秒,600W 的 6000 为 1.0 个令牌/秒,而 L40S 为 0.7 个令牌/秒。一旦 4500 的 KV 缓存耗尽,其吞吐量将停止增长,而其额定功率不会增加,因此从长远来看,450W 的 6000 在效率上与其相当,并且每个插槽的工作负载是其 2.9 倍。
结语
RTX PRO 4500 Blackwell 服务器版正如 NVIDIA 所言:它将 Blackwell 架构集成到了一个插槽、相同的功耗预算和机箱级别中,而此前 Blackwell 架构的显卡最高只能达到 L4 级别。在大多数主流服务器运行的机型(包括小型和中型指令集以及聊天长度上下文的推理模型)上,这款单槽显卡能够以不到 L40S 一半的功耗,提供 L40S 级别的吞吐量,并且性能是 L4 的三倍。
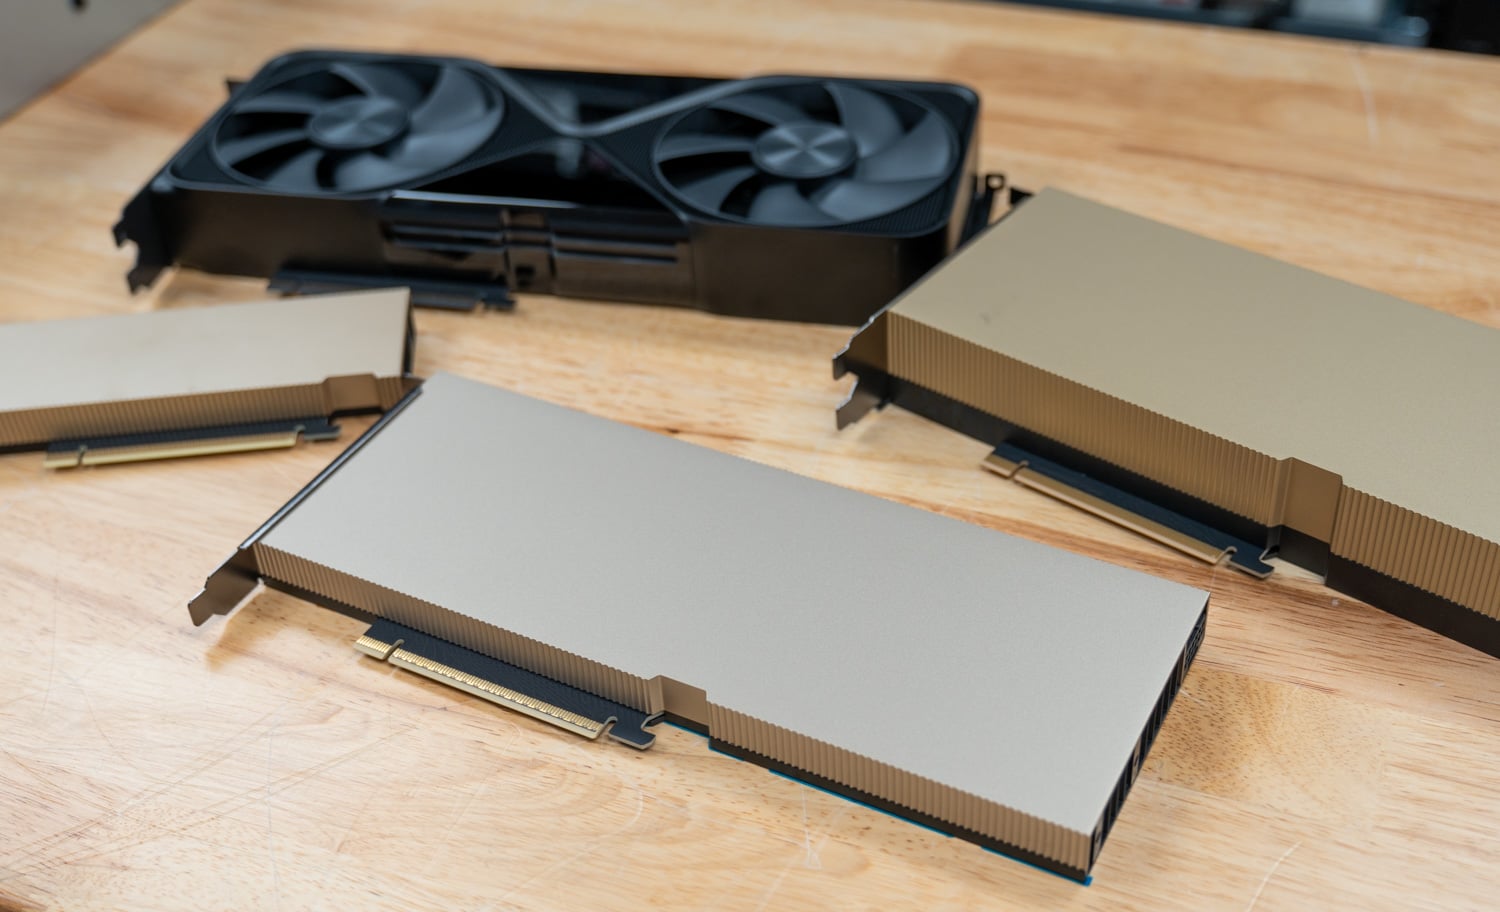
当然,凡事皆有限制。首先是内存:32GB 的内存容量对于这款显卡的目标型号来说足够,但它限制了长时间并发处理的能力,而 L40S 的 48GB 内存,尤其是 6000 的 96GB 内存,则远胜于它。即使在服务器性能限制在允许范围内的情况下,6000 在相同的请求模式下,性能也大约是 4500 的三倍。
NVFP4 是 Blackwell 的旗舰级精密芯片,在这个 vLLM 版本中,它的性能与没有 FP4 硬件的显卡相当。尽管 MAMF 扫描显示,在 GEMM 级别,FP4 硬件提供的速率是显卡 FP8 速率的两倍,但 FP4 的优势需要在您自己的堆栈上进行验证。不过,显然通过软件可以获得更大的提升。
对于拥有 2U 服务器或支持 FHFL 卡的 1U 机箱,且需要在不改动电源或散热的情况下增加推理、视觉 AI、转码或虚拟工作站容量的用户来说,RTX PRO 4500 是一个绝佳的选择。此外,对于那些仍在使用 L4 缓存且 24GB 显存已无法满足需求的用户来说,RTX PRO 4500 也值得考虑。而对于那些工作负载具有长期上下文关联性或需要多租户部署,且每张显卡需要 48GB 或以上显存的组织而言,RTX PRO 6000 则是更佳选择。
NVIDIA 为这些显卡划分了两条清晰的泳道,做得很好,4500 填补了 L4 和 6000 之间的边缘 AI 空白,同时功耗仅为 165W。
排行榜: RTX PRO 4500 Blackwell 服务器版在我们最佳企业级 GPU排行榜上荣获最佳单槽 GPU称号,本次评测中的 L40S 和 RTX PRO 6000 数据也出现在该排行榜上。



 Amazon