

联想Pro 9n 15是一款面向内容创作者的15.3英寸NVIDIA RTX Spark翻盖笔记本电脑,配备165Hz刷新率的2.5K OLED显示屏、支持手写笔的触觉反馈触控板以及厚度仅为0.66英寸的铝合金机身。我们评测的这款机型搭载了入门级处理器:18核N1X处理器,集成5,120核心的Blackwell GPU,配备32GB LPDDR5X内存、1TB第四代固态硬盘以及Windows 11专业版操作系统。联想官方公布的Pro 9n 4起售价为2,999.99美元,该配置包含18核处理器、32GB内存和512GB固态硬盘。在我们评测这款配备1TB固态硬盘和Windows 11专业版操作系统的机型时,其售价尚未公布。
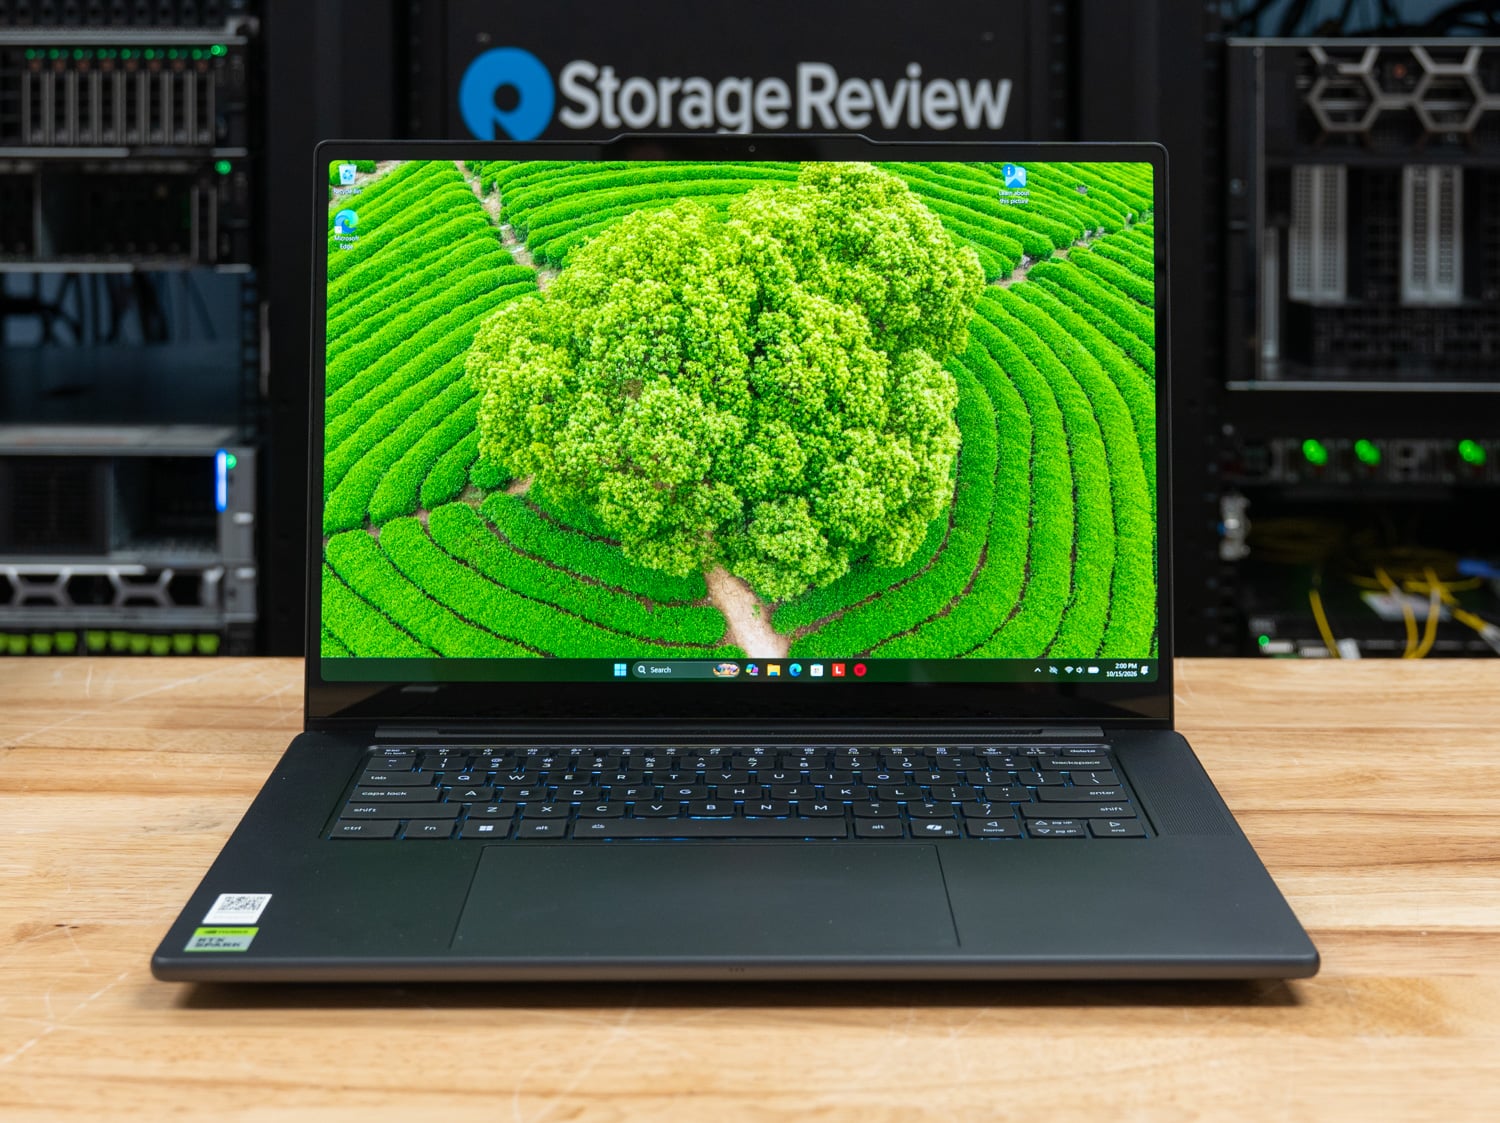
本次评测涵盖了 Pro 9n 的做工和设计,以及它在本地 AI、CPU、内存、游戏性能、散热和存储方面的测试结果。我们将它与以下产品进行比较:配备 32GB 内存的HP OmniBook Ultra 16(同样搭载 20 核处理器和 12GB 显存);配备 20 核处理器和 64GB 内存的联想 Yoga 9n 二合一笔记本电脑;以及 Razer Blade 16(其 RTX 5090 显卡在我们Surface Laptop Ultra 评测中表现最为强劲的 x64 笔记本电脑)。电池续航测试仍在进行中,完成后将另行发布。
在相同频率下,Pro 9n 的 N1X 处理器运行温度比 20 核 OmniBook 更低。联想官方标称其功耗最高为 80W,在所有 CPU 测试中,其全核频率与 32GB OmniBook 的相差不超过 1%,最高温度为 93 摄氏度。这意味着在大多数多线程任务中,Pro 9n 的 18 核性能比 20 核 OmniBook 低 8% 到 11%,但在 Stockfish 和 N=20000 OpenBLAS 求解任务中与 OmniBook 性能持平。较小的 GPU 在 LLM 令牌生成方面性能损失了 2% 到 5%。
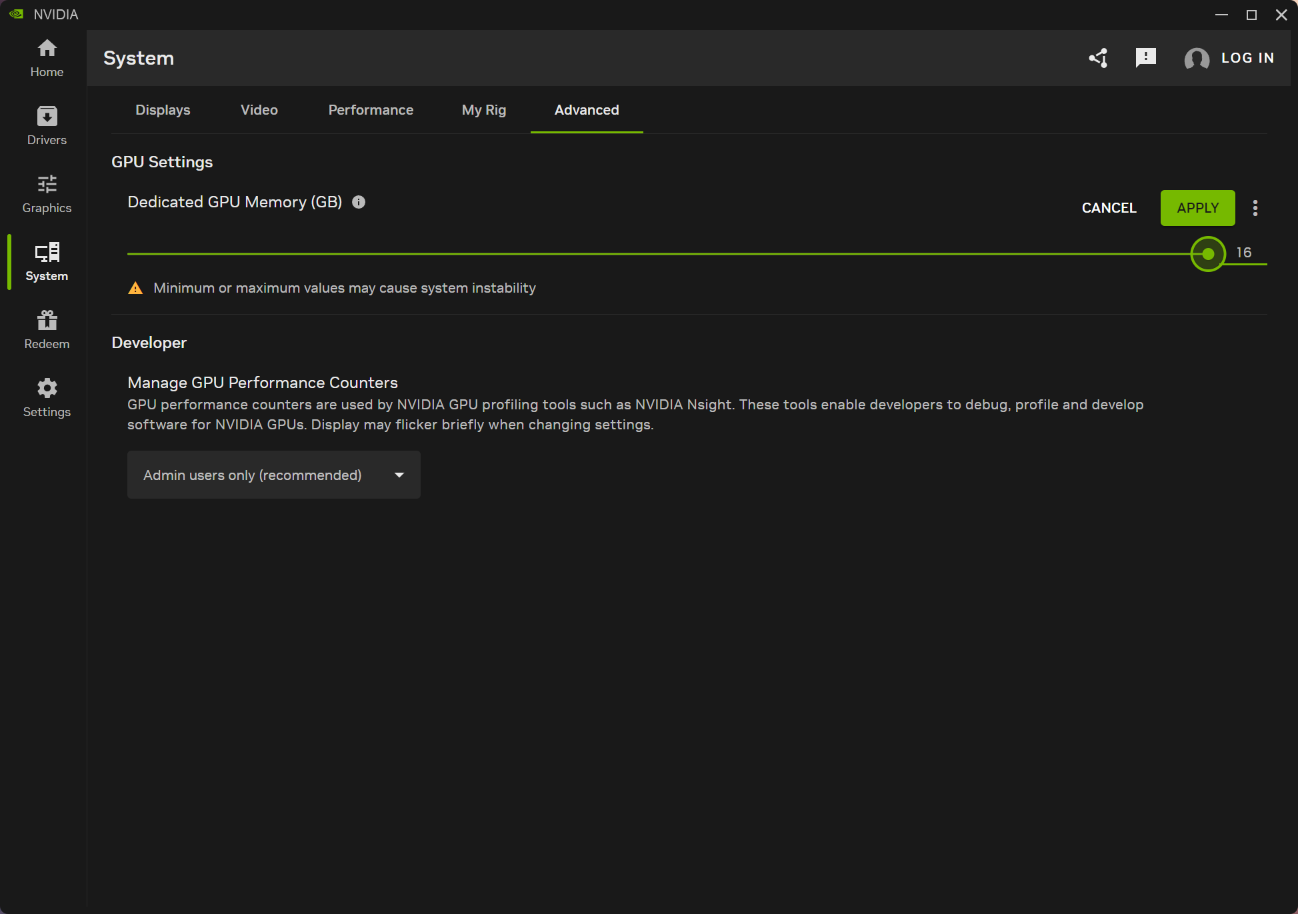
对于所有系统而言,内存都是瓶颈,购买时应以此为依据决定显卡容量。例如,它无法加载 12.8GB 的 gpt-oss:20b 显卡模型。虽然用户可能选择强制加载,但 NVIDIA 应用程序会迅速指出,最小和最大内存分配可能会导致问题。此外,加载占用所有显存的显卡模型也会造成实际问题,因为这样会导致 KV 缓存没有可用空间。
内存分配固定是 Windows 的限制,而非 NVIDIA 的限制。Windows 目前还不支持像 DGX Spark 上的 Linux 系统那样跨 CPU 和 GPU 统一内存分配,因此必须预先设置内存分配;我们了解到 NVIDIA 和微软正在共同努力解决这个问题。
关键精华
- 小模型人工智能全速运行: MLPerf Llama 3.1 8B 在拥有 5,120 个核心的 GPU 上运行速度为每秒 55.1 个 token,比 20 核的 OmniBook 慢 2%,RAG 测试的响应时间为 0.252 秒。由于 GPU 内存分配仅为 12GB,因此它无法参与我们的模型加载和编码代理测试。
- 更少的核心,更高的时钟频率: 在 92 摄氏度的峰值温度下,Pro 9n 在 30 分钟的持续循环测试中保持了 3,288MHz 的频率,并在 Cinebench 2026 多核测试中获得了 6,394 分,比 OmniBook 低 8%,比 Razer Blade 16 高 23%。
- Stockfish 和 OpenBLAS 中 20 核处理器的水平: 在 N=20000 的情况下,全核 OpenBLAS LU 求解达到了 318.1 GFLOPS,而 OmniBook 达到了 322.4 GFLOPS;Stockfish 搜索了 15.20 Mnps,而 OmniBook 为 15.12 Mnps。
- 专为彩色工作而设计的显示器和输入设备: 15.3 英寸 OLED 显示屏最高支持 165Hz 刷新率,Delta E 低于 0.5,95 x 150 毫米的触觉压力板可兼作 Yoga Pen Gen 2 的绘图表面,机身采用 0.66 英寸铝制外壳,内置 92.5Wh 电池。
- 第四代存储,预留第五代存储空间: 三星第四代固态硬盘的读取速度为 7,024MB/s,运行温度最高,为 78 摄氏度;联想第五代产品则支持第二个 M.2 2242 硬盘。
建筑与设计
Pro 9n 是一款传统的翻盖式笔记本电脑,采用铝合金顶盖和底盖,联想称之为“雷霆灰”。它最薄处尺寸为 13.66 x 9.53 x 0.66 英寸,起始重量为 3.64 磅,是本次对比中最轻的笔记本电脑。联想表示,该笔记本电脑通过了 MIL-STD-810H 军规测试,拥有碳中和认证,并且底盖使用了 50% 的再生铝材。
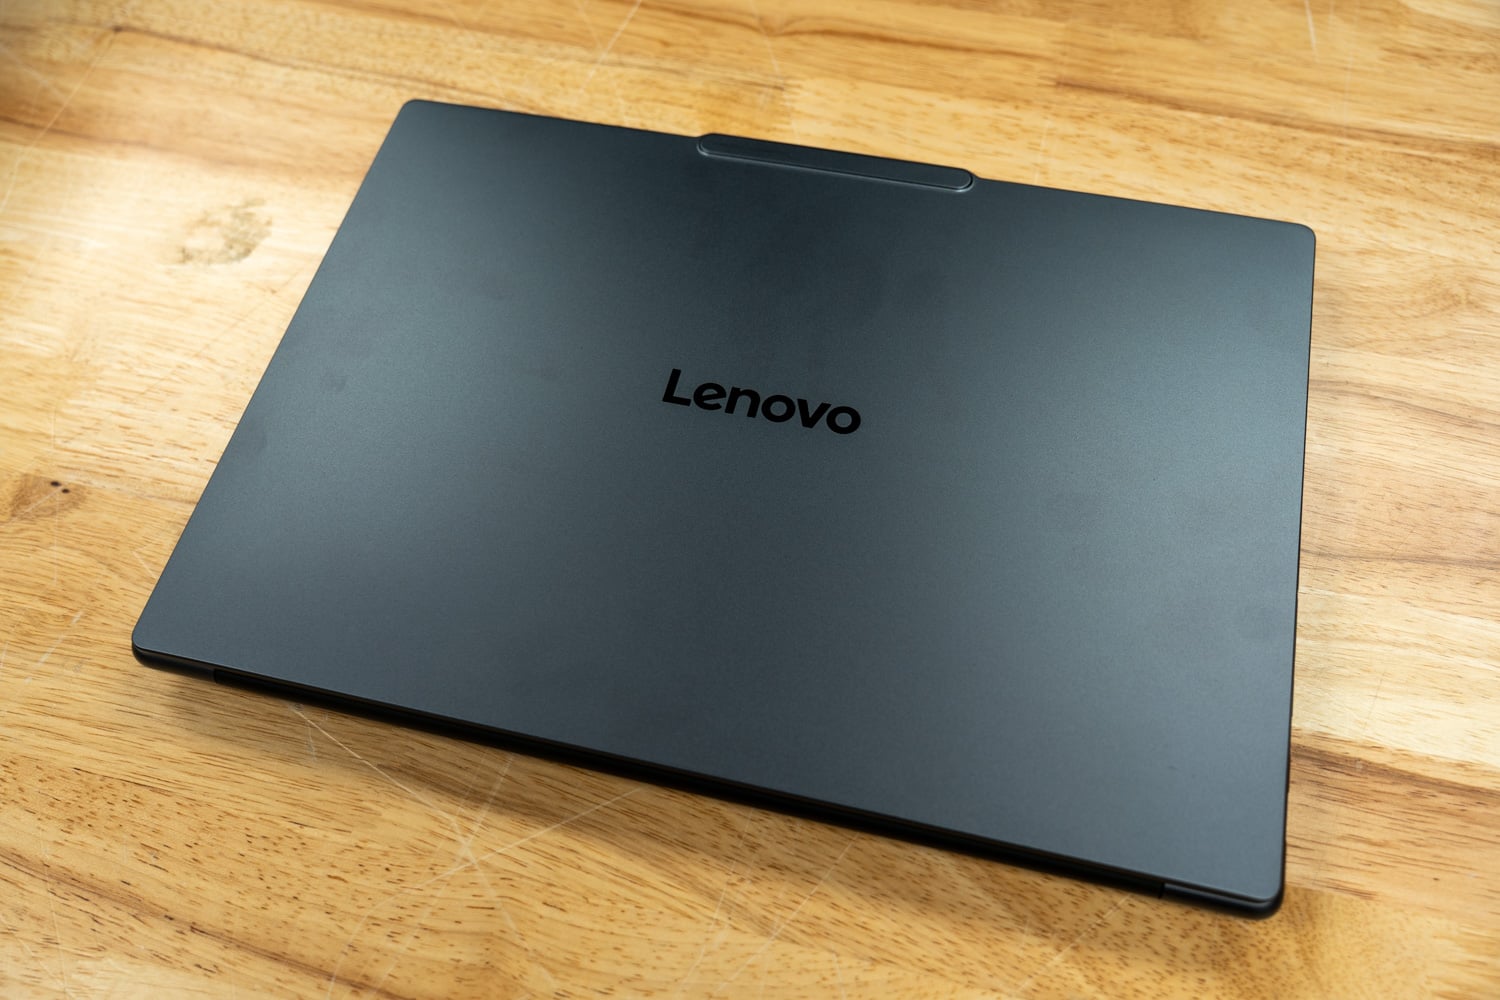
Pro 9n 拿在手里,圆润的边角、接口布局和整体做工都与 Yoga 9n 二合一笔记本电脑相似,并且采用磁吸式顶盖。键盘比 Yoga 的更窄,没有数字小键盘,两侧的空间则被扬声器占据;键盘手感扎实,并带有背光。玻璃材质的 Force Pad 触控板光滑且尺寸足够大,几乎可以双手同时操作。机身比联想推出的 16 英寸变形本 Yoga 略窄。
联想重新设计了N1X的内部结构,采用了全新的散热系统、更大的通风口,以及底部凸起的散热凸起,据称这使得Pro 9n的运行功率最高可达80W。底部后半部分可以看到一个大型进气格栅。

拆下机箱盖后,可以看到散热片两侧各有一个风扇,散热片中央有多根热管,电池则占据了机箱前部。我们的测试结果印证了联想的散热性能声明:正如散热部分所述,Pro 9n 在更高频率下运行温度低于 OmniBook。与其他 NVIDIA 移动平台相比,联想的一个独特设计决策(至少目前如此)是采用了双 2242 M.2 固态硬盘位。其他厂商通常只配备一个 2280 固态硬盘位。因此,联想提供了第二个硬盘位,但 2242 固态硬盘容量较小,性能也往往不如 2280 固态硬盘。

这款笔记本电脑配备一块 15.3 英寸 PureSight Pro OLED 触控屏,分辨率为 2560 x 1600,刷新率可在 48Hz 至 165Hz 之间调节。联想使用 X-Rite Pantone 对其进行校准,Delta E 值低于 0.5,HDR 峰值亮度为 1,100 尼特,sRGB 和 P3 色域覆盖率均为 100%,并通过了 Dolby Vision 和 VESA DisplayHDR True Black 1000 认证。键盘两侧配备四个扬声器,包括两个 2W 低音单元和两个 2W 高音单元,并经过 Dolby Atmos 调校。

键盘键程为 1.5 毫米,带有背光和 Copilot 辅助按键。键盘下方是尺寸为 95 x 150 毫米的触觉反馈力度感应板,可与第二代 Yoga Pen 配合使用,支持 8,192 级压力感应,并通过 AES 3.0 协议进行编码。920 万像素红外摄像头配备电子快门,机身侧面设有物理开关;此外,三个降噪麦克风用于语音通话。
机身右侧配备相机快门按钮、电源按钮、UHS-II SD 读卡器、一个 USB-C 接口和一个始终开启的 10Gbps USB-A 接口;机身左侧配备 HDMI 2.1 接口、第二个 USB-A 接口、第二个 USB-C 接口和一个耳机插孔。两个 USB-C 接口均支持 40Gbps 传输速度,并支持 Power Delivery 和 DisplayPort 2.1,联想将其同时列为 Thunderbolt 4 和 USB 4。无线连接方面,支持 Wi-Fi 7 和蓝牙 5.4,92.5Wh 电池支持快速充电;待新的测试平台完成后,我们将发布电池续航测试结果。


RTX Spark N1X 平台
RTX Spark 是 NVIDIA 为基于 N1X 超级芯片的 Windows PC 系列产品命名的名称,其笔记本电脑版本DGX Spark与 GB10 类似,我们的Surface Laptop Ultra 评测对该平台进行了深入介绍。我们实验室的 Pro 9n 搭载的是第二批处理器,它配备了一颗 18 核 Grace CPU(9 个高速核心和 9 个能效核心,不支持 SMT)以及一颗 5,120 核的 Blackwell RTX GPU。联想官方标称高速核心最高频率为 3.9GHz,能效核心最高频率为 2.8GHz,并且在其他配置中也提供 20 核、6,144 核 GPU 的版本。
N1X 的 LPDDR5X 内存由 CPU 和 GPU 共享,NVIDIA 应用程序中的一项设置决定了 Windows 分配给 GPU 的内存大小;这是 Windows 端的设置,而非 BIOS 选项。我们将 32GB 的 Pro 9n 设置为 12GB GPU 和 20GB CPU,与 32GB 的 OmniBook 的内存分配相同,以便两者直接比较。12GB 的内存分配都无法满足我们最小的本地 AI 模型层级的要求,该层级需要 16GB 的 GPU 可用内存,而更大的分配量则会占用 Windows 可用的内存。Windows 11 26H1 运行在 Arm64 架构上;x64 应用程序通过 Prism 进行模拟,而我们的测试套件则使用所有开源工作负载的原生 Arm64 版本。
联想Pro 9n 15规格
| 规格 | 联想 Pro 9n 15 (83SS0003US) |
|---|---|
| 平台概述 | |
| 处理器 | NVIDIA RTX Spark N1X,18 核 CPU 搭配 5,120 核 Blackwell RTX GPU(测试机型) NVIDIA RTX Spark N1X,20 核 CPU 搭配 6,144 核 Blackwell RTX GPU |
| 内存 | 32GB 板载 LPDDR5X-9400,256 位(经测试);最高可达 128GB 12GB GPU / 20GB 系统内存分配(经测试) |
| 存放 | 最多可支持两个 M.2 2242 固态硬盘(一个 PCIe Gen4,一个 PCIe Gen5) 三星 MZAL81T0HFLB 1TB,Gen4 x4(经测试) |
| 运行系统 | Windows 11 家庭版或专业版(Arm64);测试版本为 Windows 11 专业版。 |
| 显示和 I/O | |
| 展示 | 15.3英寸2.5K (2560 x 1600) PureSight Pro OLED触控屏,48-165Hz VRR,16:10 峰值亮度 1,100 尼特(HDR),100% sRGB 和 P3 色域,Delta E <0.5,经 X-Rite Pantone 校准 杜比视界、VESA DisplayHDR True Black 1000、玻璃 |
| 端口 | 2 个 USB-C 40Gbps 接口(Thunderbolt 4 / USB4,支持 USB PD 和 DisplayPort 2.1) 2 个 USB-A 10Gbps 接口(其中一个始终开启) 1 个 HDMI 2.1 接口(最高支持 8K/60Hz) 1 个 SD 卡读卡器(UHS-II) 1 个耳机/麦克风组合插孔 |
| 无线耳机 | Wi-Fi 7 (802.11be 2×2)、蓝牙 5.4 |
| 相机 | 9.2万像素+红外,带电子快门和开关 |
| 音频 | 四个扬声器:2 个 2W 低音单元,2 个 2W 高音单元;支持杜比全景声 (Dolby Atmos)。 3 个麦克风 |
| 输入 | 背光键盘,1.5毫米键程,Copilot键 95 x 150 毫米触觉力反馈触控板,支持触控笔 Yoga Pen Gen 2(AES 3.0,8,192级压力感应) |
| 力量和体能 | |
| 电池 | 92.5Wh,快速充电快充 |
| 热设计 | 更大的通风口和散热凸起;最高可达 80W TDP(联想标称值) |
| 尺寸 | 13.66 x 9.53 x 0.66 英寸(347 x 242 x 16.7 毫米) |
| 重量 | 起始重量 3.64 磅(1.65 千克) |
| 颜色和材质 | 雷霆灰,铝合金顶盖和底盖;通过 MIL-STD-810H 测试 |
| 定价 | |
| 价格(Lenovo.com) | 起价 2,999.99 美元(18 核处理器,32GB 内存,512GB 硬盘);测试配置未列出 |
测试设置和方法
我们的 Pro 9n 15 搭载 RTX Spark N1X 显卡,配备 18 核 CPU 和 5,120 核 Blackwell GPU,32GB LPDDR5X-9400 内存(12GB GPU 内存和 20GB 系统内存),以及一块 1TB 三星 Gen4 SSD 固态硬盘,运行 Windows 11 专业版 26H1 (Arm64) 操作系统。基准测试在联想性能模式下进行。电池续航测试结果将在完成后添加。
本次对比测试中,所有系统均运行了我们编写的 Windows 客户端基准测试套件 sr-client 1.2,并分别以完整运行模式和峰值模式进行测试,使用出厂预装的 Windows 系统镜像以及 OEM 提供的驱动程序和实用程序。该套件在所有系统上均采用相同的实验室设置:Windows 电源模式设置为“最佳性能”,已连接电源,显示器亮度设置为 50%,所有睡眠和显示器关闭定时器均已禁用,Windows 防火墙和 UAC 提示也已关闭。每个测试结果均为多次运行的中位数,如果测试结果的波动超过 2%,则该套件会重新运行测试才会接受该结果。
| 系统 | 中央处理器 | 内存 | GPU 用于 GPU 和 AI 测试 | SSD | 操作系统和性能模式 |
|---|---|---|---|---|---|
| 联想Pro 9n 15 | NVIDIA RTX Spark N1X,18核/18线程 | 32GB LPDDR5X-9400(12GB GPU / 20GB 系统内存) | 5,120 核心 Blackwell RTX(集成显卡,可用显存 12GB) | 三星 MZAL81T0HFLB 1TB,Gen4 x4 | Windows 11 专业版 26H1 (Arm64),联想性能模式 |
| HP OmniBook Ultra 16 (32GB) | NVIDIA RTX Spark N1X,20核/20线程 | 32GB LPDDR5X-9400(12GB GPU / 20GB 系统内存) | 6,144 核心 Blackwell RTX(集成显卡,可用显存 12GB) | KIOXIA KBG80ZNV 1TB,第五代 x4 | Windows 11 家庭版 26H1 (Arm64),HP 性能 |
| 联想 Yoga 9n 二合一笔记本电脑 16 | NVIDIA RTX Spark N1X,20核/20线程 | 64GB LPDDR5X-9400(32GB GPU / 32GB 系统内存) | 6,144 核心 Blackwell RTX(集成显卡,可用显存 32GB) | 闪迪 PC SN5100S 1TB,Gen4 x4 | Windows 11 家庭版 26H1 (Arm64),联想性能模式 |
| 雷蛇刃16 | AMD Ryzen AI 9 HX 370,12核/24线程 | 32GB LPDDR5X-8000 | NVIDIA GeForce RTX 5090 笔记本电脑显卡,24GB | 三星 MZVL22T0 2TB,Gen4 x4 | Windows 11 家庭版 25H2 (x64),Razer Synapse 性能 |
表格中反复出现两个标签,第一个标签对人工智能部分最为重要。“未运行”表示测试套件拒绝启动测试,因为硬件不符合要求:Pro 9n 和 32GB 的 OmniBook(可用 GPU 内存为 12GB)低于我们设定的两个型号级别,而 Yoga 的 32GB 内存和 Blade 16 的 24GB 内存则低于 M 级。该标签还标记了 OpenBLAS N=40000 的测试大小,该大小需要 11.9GB 内存,如果超过 Windows 系统可用内存的一半,则会跳过测试。
N/A 表示该测试不适用于该硬件,例如在不支持 SMT 的芯片上测试 SMT 单核,或者在运行原生版本的 x64 系统上测试模拟行。如果 RTX Spark 系统通过 Prism 运行 x64 软件,则该行会注明。
本地人工智能性能
Pro 9n 的本地 AI 功能表现平平,因为其 12GB 的 GPU 内存分配限制了它的性能。对于适配的模型,5,120 核 GPU 的性能与 6,144 核 GPU 的性能相差无几,因为这种规模的令牌生成更多地受限于内存带宽而非 GPU 核心数。对于不适配的模型,它根本无法运行,因此模型加载和编码代理测试只能交给 Yoga 和 Blade 16 来完成。
MLPerf 客户端 v2.0
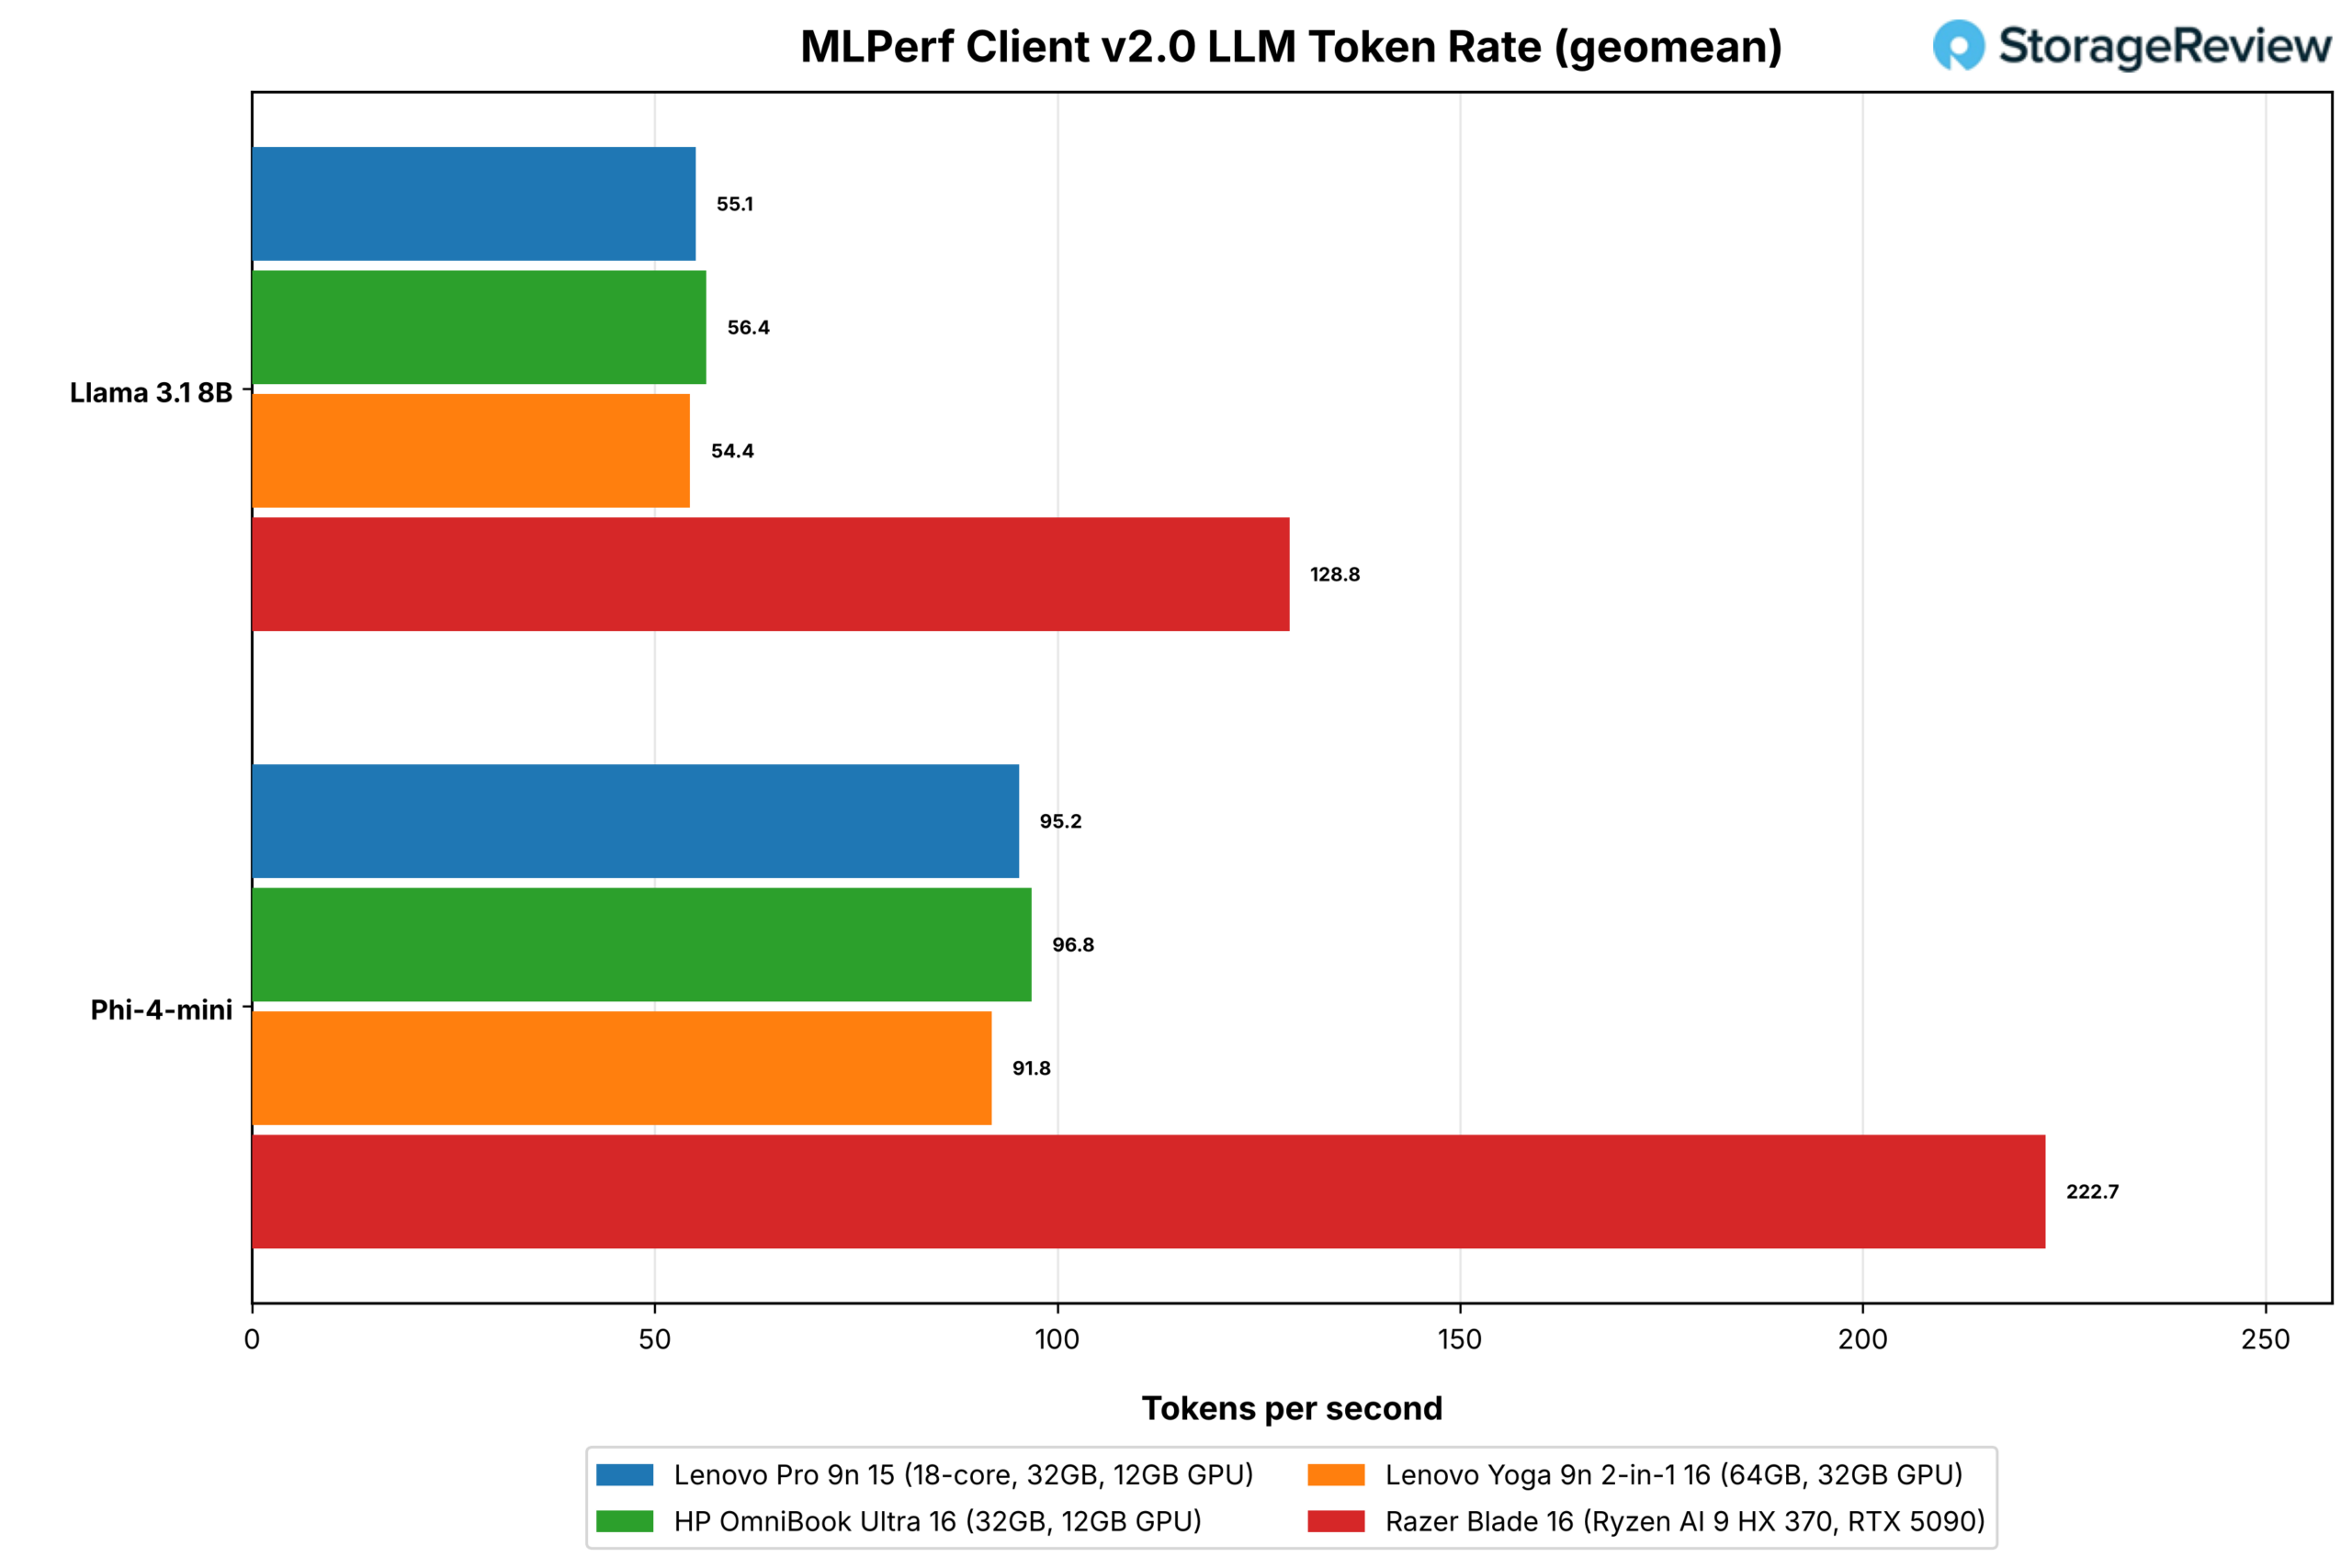
MLPerf 客户端运行 Llama 3.1 8B 和 Phi-4-mini,涵盖五种提示类别,并报告首次令牌到达时间和之后的令牌生成率(以几何平均值表示)。此处所有系统均使用 llama.cpp 和 CUDA,因此各行数据比较的是硬件性能。代理场景中,Llama 3.1 8B 分别作为软件工程代理和数据分析代理运行,并在多个回合中调用工具。
| MLPerf 客户端 v2.0 | Pro 9n 15 | OmniBook Ultra 16 (32GB) | Yoga 9n 二合一 16 | 雷蛇刃16 |
|---|---|---|---|---|
| Llama 3.1 8B,首次到达令牌的时间,几何平均值(秒,越低越好) | 0.303 | 0.275 | 0.353 | 0.149 |
| Llama 3.1 8B,令牌速率,几何平均值(令牌/秒) | 55.1 | 56.4 | 54.4 | 128.8 |
| Phi-4-mini,首次令牌到达时间,几何平均值(秒,越低越好) | 0.135 | 0.123 | 0.158 | 0.074 |
| Phi-4-mini,令牌率,几何平均值(令牌/秒) | 95.2 | 96.8 | 91.8 | 222.7 |
| 数据分析代理,端到端(s,数值越低越好) | 56.2 | 52.4 | 59.7 | 27.8 |
| 数据分析代理,代币速率(tok/s) | 46.9 | 49.0 | 45.3 | 108.3 |
| SWE Agent,端到端(s,数值越低越好) | 48.0 | 46.2 | 51.6 | 24.6 |
| SWE 代理,代币速率(tok/s) | 44.5 | 46.6 | 43.0 | 102.5 |
Pro 9n 在 Llama 3.1 8B 测试中每秒生成 55.1 个令牌,在 Phi-4-mini 测试中每秒生成 95.2 个令牌,尽管 GPU 核心数量少了 17%,但两项测试结果都比 32GB 的 OmniBook 慢了约 2%。更依赖计算能力的首次令牌生成时间差距更大,约为 10%,而两种智能体场景的测试时间分别慢了 7% 和 4%。Pro 9n 在 MLPerf 测试的每一项都胜过 Yoga,因为 Yoga 较低的功耗预算比 Pro 9n 缺少的核心数量造成的性能损失更大。
模型加载和编码代理
我们的模型加载和编码代理测试至少需要 16GB 的 GPU 可用内存,即使是最小的模型 gpt-oss:20b 也需要 12.8GB 的内存。因此,Pro 9n 的 12GB 显存分配使其无法通过这两项测试,所以我们在本次评测中省略了相关图表。我们的Yoga 9n 二合一笔记本电脑评测展示了在同一平台上 32GB GPU 显存分配带来的性能提升,而配置更大内存的 Pro 9n 也符合相同的测试要求。
检索增强生成
我们的 RAG 测试使用 nomic-embed-text 嵌入了 20,963 段 SQuAD v1.1 文章,针对 2,000 个问题分别检索出前五段文章,并使用 Phi-4-mini 对其中 400 道题进行解答,评分标准为完全匹配和 F1 值。两款机型都配备 12GB 存储空间,因此 Pro 9n 可以运行完整测试。

| 鲁尔 | Pro 9n 15 | OmniBook Ultra 16 (32GB) | Yoga 9n 二合一 16 | 雷蛇刃16 |
|---|---|---|---|---|
| 摄入墙壁时间,20,963 次(秒,越低越好) | 191.8 | 195.2 | 188.8 | 131.0 |
| 检索查询时间,p50(毫秒,数值越低越好) | 24.2 | 22.5 | 22.6 | 20.9 |
| 答案,Phi-4-mini 首次令牌到达时间,p50(秒,越低越好) | 0.171 | 0.156 | 0.181 | 0.109 |
| 回答,快速处理(tok/s) | 6,268 | 7,139 | 5,837 | 11,560 |
| 答案,生成速率(tok/s) | 96.6 | 102.0 | 91.1 | 209.2 |
| 问题回答,p50(s,越低越好) | 0.252 | 0.231 | 0.262 | 0.159 |
| 答案 F1 (%) | 74.27 | 73.97 | 73.97 | 74.47 |
Pro 9n 导入语料库耗时 191.8 秒,比 32GB OmniBook 的 195.2 秒更快;其答案生成速度为每秒 96.6 个词元,略低于 HP 的 102.0 个词元。从查询到回答,一个典型问题的耗时为 0.252 秒,介于 HP 的 0.231 秒和 Yoga 的 0.262 秒之间,而 Blade 16 的回答时间为 0.159 秒。F1 在所有系统中的得分均相差不到 0.5 分。
中央处理器性能
Pro 9n 的核心数比 20 核少两个,但实际性能却比其核心数所显示的要低,因为在全核负载下,它的时钟频率高于 20 核系统。在渲染、压缩和编译方面,它比 32GB 的 OmniBook 落后 8% 到 11%,在 Stockfish 和 N=20000 OpenBLAS 求解测试中与 OmniBook 持平,与 20 核 Yoga 互有胜负,在 Cinebench、Stockfish、primesieve 和 OpenBLAS 测试中领先。在单线程测试中,它在 Cinebench 测试中比 20 核机型落后约 8%,在其他测试中落后 2% 到 6%。与 Razer Blade 16 相比,Pro 9n 在渲染、压缩和编译方面胜出,但在 GROMACS、Stockfish、全核 OpenBLAS、SVT-AV1 和大多数单线程测试中落败。
Cinebench 2026 和持续负载
Cinebench 2026 使用 Maxon 的 Redshift 引擎在 CPU 上渲染场景,并分别测试单核、SMT 单核(一个物理核心上运行两个线程)和多核的吞吐量。随后,我们进行一个持续循环测试,重复多核运行约 30 分钟,并将稳定状态与第一次运行进行比较。

| Cinebench 2026(分数越高越好) | Pro 9n 15 | OmniBook Ultra 16 (32GB) | Yoga 9n 二合一 16 | 雷蛇刃16 |
|---|---|---|---|---|
| 单核 | 518.2 | 564.7 | 557.0 | 480.0 |
| SMT单核 | 无 | 无 | 无 | 661.3 |
| 多核心 | 6,394 | 6,934 | 6,292 | 5,179 |
| 持续循环,第一次 | 6,346 | 6,943 | 6,248 | 5,162 |
| 持续循环,稳态 | 6,416 | 6,929 | 6,256 | 5,206 |
| 稳态/首次通过 | 1.011 | 0.998 | 1.001 | 1.009 |
Pro 9n 的多核跑分为 6,394 分,比 32GB 版 OmniBook 的 6,934 分低 8%,比 Yoga 高 2%,比 Blade 16 高 23%。其单核跑分为 518.2 分,比 20 核系统低约 7% 到 8%。持续循环测试持续半小时,最终得分达到 6,416 分,是第一次测试的 101.1%,CPU 最高温度为 92 摄氏度,频率为 3,288MHz。
7-Zip、Blender、HandBrake 和 LLVM
7-Zip 的内置基准测试报告了每个线程和单个核心上的 LZMA 压缩和解压缩吞吐量。Blender 4.5 使用 Cycles 渲染器在 CPU 上渲染 Monster、Junkshop 和 Classroom 场景。HandBrake 使用 x265 和 SVT-AV1 对 60 秒的 4K60 视频片段进行软件编码。LLVM 测试使用 Clang 和 Ninja 编译完整的 LLVM 21.1.4 代码树。

| 7-Zip,单线程(GIPS,数值越高越好) | Pro 9n 15 | OmniBook Ultra 16 (32GB) | Yoga 9n 二合一 16 | 雷蛇刃16 |
|---|---|---|---|---|
| 合计 | 8.93 | 9.10 | 9.12 | 9.24 |
| 压缩 | 7.26 | 7.33 | 7.35 | 7.28 |
| 解压缩 | 10.59 | 10.87 | 10.88 | 11.20 |


这些测试充分体现了核心数量的优势。Pro 9n 在 7-Zip 全线程测试中达到了 138.1 GIPS,比 OmniBook 慢 10%,比 Blade 16 快 10%;在 Blender 的 Monster 场景中比 HP 慢 9%,在 Classroom 场景中慢 8%。LLVM 构建耗时 229.8 秒,而 HP 和 Blade 分别耗时 211.1 秒和 327.0 秒;x265 编码帧率为 37.7 fps,比 OmniBook 慢 11%。
SVT-AV1 在每个 RTX Spark 系统上的运行帧率约为 15 fps,而在 Blade 16 上则为 77.3 fps,这表明 SVT-AV1 的 Arm64 代码路径是导致结果的原因,因为所有四个 N1X 配置都在彼此的一帧内完成,而且在我们测试的软件套件中,这是导致结果的最清晰的例子。
Stockfish、primesieve、Python 和浏览器
Stockfish 报告的国际象棋搜索速度以每秒百万个节点为单位。primesieve 统计所有线程上小于 10^12 的素数,以及单个线程上小于 10^11 的素数。PyPerformance 运行三个 CPython 基准测试程序,每个程序都绑定到一个高性能核心上。Speedometer 3.1 测量 Microsoft Edge 浏览器中 Web 应用程序的响应速度。最后两行运行的是 Prism 模拟器下的 7-Zip x64 版本。
| 《测试》(Test) | Pro 9n 15 | OmniBook Ultra 16 (32GB) | Yoga 9n 二合一 16 | 雷蛇刃16 |
|---|---|---|---|---|
| Stockfish 基准测试,所有线程(Mnps,数值越高越好) | 15.20 | 15.12 | 13.42 | 17.96 |
| Stockfish 工作台,单线程(Mnps,数值越高越好) | 1.70 | 1.73 | 1.72 | 2.04 |
| primesieve 1e12,所有线程(s,越低越好) | 10.56 | 9.54 | 10.77 | 10.60 |
| primesieve 1e11,单线程(s,越低越好) | 12.34 | 12.02 | 12.01 | 6.67 |
| PyPerformance 的值为(毫秒,数值越低越好) | 114.1 | 111.2 | 110.6 | 75.2 |
| PyPerformance nbody(毫秒,数值越低越好) | 82.5 | 80.6 | 80.5 | 60.8 |
| PyPerformance 正则表达式编译(毫秒,数值越低越好) | 86.7 | 84.5 | 84.3 | 69.7 |
| Speedometer 3.1,Edge(评分,越高越好) | 33.9 | 35.4 | 36.1 | 38.4 |
| x64 7-Zip 在模拟器下运行,所有线程 (GIPS) | 117.6 | 127.8 | 124.3 | 不适用(原生 x64) |
| x64 7-Zip 在模拟器下运行,单线程 (GIPS) | 7.94 | 8.36 | 8.25 | 不适用(原生 x64) |
Stockfish 测试充分发挥了 Pro 9n 高频率的优势。在所有 18 个核心上,它的搜索速度达到了 15.20 Mnps,略高于 20 核 OmniBook 的 15.12 Mnps,比 Yoga 高出 13%,运行频率为 3,292MHz,这是我们测试过的所有 RTX Spark 系统中 Stockfish 频率最高的。PrimeSieve 全线程测试耗时 10.56 秒,而 HP 的耗时为 9.54 秒。
单线程测试中,Pro 9n 的性能略逊于 20 核机型,PyPerformance 测试结果为 114.1 毫秒,而 20 核机型为 111.2 毫秒;Speedometer 得分为 33.9,是本次测试中最低的。除了 Cinebench 单核测试外,Blade 16 在所有测试中都领先,Pro 9n 的 Cinebench 单核得分为 518.2,高于 Blade 16 的 480.0。在模拟器下,x64 版本的 7-Zip 运行速度为 117.6 GIPS,达到原生性能的 85%。
GROMACS、OpenBLAS 和内存
GROMACS 在 16 个核心上运行 benchMEM 分子动力学算例,并报告最佳布局下每天的模拟时间(以纳秒为单位)。我们的 OpenBLAS 测试在所有核心和最高核心等级上运行 HPL 风格的双精度 LU 分解求解(三种问题规模)以及 DGEMM 矩阵乘法运算,它是该测试套件中持续浮点运算负载最高的。STREAM 测量持续内存带宽,延迟行测量单次内存访问和核心间延迟。
| 测试(分数越高越好) | Pro 9n 15 | OmniBook Ultra 16 (32GB) | Yoga 9n 二合一 16 | 雷蛇刃16 |
|---|---|---|---|---|
| GROMACS benchMEM,最佳布局(ns/天) | 16.88 | 17.43 | 17.15 | 26.41 |
| OpenBLAS LU N=10000,所有内核 (GFLOPS) | 303.4 | 326.9 | 281.3 | 400.9 |
| OpenBLAS LU N=20000,所有内核 (GFLOPS) | 318.1 | 322.4 | 298.6 | 454.4 |
| OpenBLAS LU N=40000,所有内核 (GFLOPS) | 未运行(需要 11.9GB) | 未运行(需要 11.9GB) | 282.5 | 498.5 |
| OpenBLAS LU N=20000,顶级核心级别(GFLOPS) | 403.8 | 432.2 | 273.2 | 240.4 |
| OpenBLAS DGEMM M=8000,所有核心(GFLOPS) | 357.6 | 368.9 | 312.7 | 455.4 |
| OpenBLAS DGEMM M=8000,顶级核心级别(GFLOPS) | 448.3 | 488.7 | 346.7 | 252.4 |
OpenBLAS 测试中,Pro 9n 与 32GB OmniBook 之间的差距微乎其微。在 N=20000 的 LU 求解测试中,Pro 9n 的全核性能为 318.1 GFLOPS,而 OmniBook 为 322.4 GFLOPS;在 DGEMM 求解测试中,Pro 9n 的全核性能为 357.6 GFLOPS,而 OmniBook 为 368.9 GFLOPS;仅使用其九个高速核心,Pro 9n 的 N=20000 求解性能就达到了 403.8 GFLOPS,这一成绩超越了其自身的全核性能,与 HP 的成绩相同。在 OpenBLAS 测试中,Pro 9n 在所有运行的测试行中都领先于 Yoga,而 Blade 16 在所有核心测试中都领先于其他所有机型。GROMACS 测试结果显示,Pro 9n 的每日计算速度为 16.88 ns,比 HP 慢 3%,而 Blade 16 的每日计算速度为 26.41 ns。

| 《测试》(Test) | Pro 9n 15 | OmniBook Ultra 16 (32GB) | Yoga 9n 二合一 16 | 雷蛇刃16 |
|---|---|---|---|---|
| 流式复制(MB/s,速度越高越好) | 127,682 | 128,814 | 118,738 | 43,731 |
| STREAM Triad(MB/s,越高越好) | 120,272 | 121,662 | 112,067 | 48,298 |
| 内存延迟,1GiB 缓冲区,4KiB 页(纳秒,越低越好) | 143.4 | 143.5 | 141.8 | 129.6 |
| 核心间延迟,所有核心对的平均值(ns,数值越低越好) | 160.6 | 160.9 | 162.8 | 57.0 |
内存性能与 20 核系统平台的结果相同。STREAM Triad 测试速度达到 120,272MB/s,与 OmniBook 的差距约为 1%,是 Blade 16 的 2.5 倍,内存延迟为 143.4 ns,核心间延迟为 160.6 ns,均与 HP 的性能相当。
游戏和GPU编码
SuperTuxKart 1.5 内置基准测试程序在 1080p 全屏模式下,以最高预设设置关闭垂直同步运行,分别使用游戏原生 Arm64 版本和模拟器运行的 x64 版本进行测试。FFmpeg 使用 NVENC HEVC 编码(码率为 8Mbps)和 Media Foundation HEVC 编码器(如有)对同一段 4K60 视频进行编码。

| 测试(分数越高越好) | Pro 9n 15 | OmniBook Ultra 16 (32GB) | Yoga 9n 二合一 16 | 雷蛇刃16 |
|---|---|---|---|---|
| SuperTuxKart 1080p 超高画质,原生画质,平均帧率 (fps) | 218.4 | 236.1 | 216.4 | 200.0 |
| SuperTuxKart 1080p 超高清,原生,稳定(帧率) | 140 | 147 | 131 | 115 |
| SuperTuxKart 1080p 超高画质,x64 模拟器运行,平均帧率 (fps) | 248.6 | 265.4 | 186.8 | 不适用(原生 x64) |
| SuperTuxKart 1080p 超高画质,x64 模拟器运行,帧率稳定 (fps) | 94 | 143 | 93 | 不适用(原生 x64) |
| FFmpeg NVENC HEVC,4K60,8Mbps(帧率) | 139 | 137 | 139 | 132 |
| FFmpeg 媒体基金会 HEVC (fps) | 55 | 55 | 65 | 无 |
Pro 9n 在原生系统下平均帧率为 218.4 fps,比 32GB 版 OmniBook 低 7%,与 Yoga 持平,高于 Blade 16 的 200.0 fps,这表明 RTX 5090 并非 1080p 分辨率下游戏性能的瓶颈。在模拟器下运行的 x64 版本平均帧率为 248.6 fps,高于原生系统,但其 94 fps 的稳定帧率表现欠佳。NVENC 编码器为固定功能编码器,Pro 9n 在 HEVC 编码下达到的 139 fps 与 20 核系统相当。
暖流
Pro 9n 的散热测试结果最有力地证明了联想的系统设计。在 HandBrake 测试中,其最高温度达到 93 摄氏度;在 Cinebench 和持续循环测试中,最高温度达到 92 摄氏度,这是其温度最高的测试项目;在其他 CPU 测试项目中,温度则在 83 至 92 摄氏度之间。相比之下,32GB 版 OmniBook 在所有 CPU 测试中的最高温度都达到了 97 至 98 摄氏度。Pro 9n 在持续循环测试中的平均温度为 87 摄氏度,而惠普 OmniBook 的平均温度为 98 摄氏度。RTX Spark 系统仅通过 Windows 系统的温度分区报告 CPU 温度,而 Pro 9n 的温度分区在空闲频率下会短暂出现 100 至 130 摄氏度的错误读数,这些读数已被排除。
| CPU温度,最高/平均(摄氏度) | Pro 9n 15 | OmniBook Ultra 16 (32GB) | Yoga 9n 二合一 16 | 雷蛇刃16 |
|---|---|---|---|---|
| Cinebench 2026 | 92 / 70 | 98 / 83 | 72 / 65 | 96 / 78 |
| 7-ZIP | 83 / 63 | 98 / 77 | 76 / 62 | 99 / 84 |
| 鳕鱼干 | 88 / 83 | 98 / 96 | 71 / 69 | 92 / 90 |
| 混合器 | 91 / 80 | 98 / 97 | 80 / 75 | 95 / 87 |
| 手刹 | 93 / 74 | 98 / 87 | 86 / 71 | 92 / 86 |
| LLVM 构建 | 87 / 79 | 98 / 92 | 81 / 75 | 98 / 93 |
| GROMACS | 89 / 85 | 98 / 96 | 84 / 81 | 97 / 94 |
| 开放式BLAS | 92 / 83 | 97 / 93 | 85 / 74 | 91 / 87 |
| 流 | 78 / 66 | 95 / 89 | 64 / 59 | 75 / 71 |
| 超级卡丁车 | 74 / 68 | 94 / 86 | 68 / 62 | 89 / 82 |
| MLPerf 客户端 | 76 / 66 | 93 / 85 | 72 / 60 | 97 / 76 |
| 编码代理 | 未运行 | 未运行 | 71 / 67 | 91 / 84 |
| 鲁尔 | 76 / 71 | 94 / 90 | 84 / 75 | 88 / 83 |
| 持续循环 | 92 / 87 | 98 / 98 | 72 / 70 | 94 / 90 |
更低的运行温度并没有降低 Pro 9n 的时钟频率:在所有核心负载下,其频率在所有 CPU 测试中都与 OmniBook 的频率相差不到 1%,并且在 Stockfish、GROMACS、OpenBLAS 和持续循环测试中甚至更高,例如在持续循环测试中,Pro 9n 的频率达到了 3,288MHz,而 HP 为 3,232MHz,Yoga 为 3,015MHz。联想官方标称 Pro 9n 的功耗最高为 80W,Yoga 为 70W,由于 Pro 9n 少了两个核心共享功耗,因此每个核心都能以更低的温度运行得更快。与我们测试过的所有 RTX Spark 系统一样,Pro 9n 在整个循环测试中都保持了稳定的时钟频率。
| 平均CPU时钟频率(MHz) | Pro 9n 15 | OmniBook Ultra 16 (32GB) | Yoga 9n 二合一 16 | 雷蛇刃16 |
|---|---|---|---|---|
| Cinebench 2026 | 2,951 | 2,964 | 2,799 | 4,158 |
| 7-ZIP | 2,849 | 2,862 | 2,722 | 4,014 |
| 鳕鱼干 | 3,292 | 3,269 | 3,057 | 3,645 |
| 混合器 | 3,216 | 3,241 | 3,111 | 3,729 |
| 手刹 | 2,834 | 2,865 | 2,687 | 3,814 |
| LLVM 构建 | 3,197 | 3,193 | 3,083 | 3,697 |
| GROMACS | 3,367 | 3,315 | 3,226 | 3,874 |
| 开放式BLAS | 3,192 | 3,057 | 2,890 | 4,274 |
| 流 | 3,101 | 3,251 | 3,077 | 3,684 |
| 超级卡丁车 | 2,017 | 2,008 | 2,002 | 4,349 |
| MLPerf 客户端 | 2,027 | 2,241 | 1,935 | 3,593 |
| 编码代理 | 未运行 | 未运行 | 1,945 | 3,789 |
| 鲁尔 | 2,760 | 2,724 | 2,707 | 3,764 |
| 持续循环 | 3,288 | 3,232 | 3,015 | 3,726 |
固态硬盘是唯一发热的组件,在存储测试期间,三星硬盘的最高温度达到 78 摄氏度,是本次对比测试中所有系统中温度最高的,比 32GB OmniBook 的 Gen5 KIOXIA 高出 14 摄氏度。
储存效能
我们的存储测试使用 fio 的四个角分别对启动盘进行 5GB 和 25GB 的读写测试,测试内容包括文件系统读写和裸盘读写,此处报告的是 25GB 测试的结果。裸盘读写数据绕过了 NTFS 和 BitLocker,因此两者之间的差距显示了硬盘在 Windows I/O 路径下的性能极限。Pro 9n 和 Yoga 的 BitLocker 保护已关闭,而 OmniBook 的 BitLocker 保护已开启。


| fio,25GB 占用空间,QD32 | Pro 9n 15 | OmniBook Ultra 16 (32GB) | Yoga 9n 二合一 16 | 雷蛇刃16 |
|---|---|---|---|---|
| 顺序读取 128K,文件系统 (MB/s) | 7,024 | 10,509 | 6,874 | 7,125 |
| 顺序读取 128K,原始设备 (MB/s) | 7,165 | 10,047 | 6,975 | 7,134 |
| 顺序写入 128K (MB/s) | 5,699 | 9,464 | 5,905 | 5,250 |
| 随机读取 4K,文件系统,峰值(IOPS) | 338,936 | 289,024 | 394,468 | 694,597 |
| 随机读取 4K,原始设备,峰值(IOPS) | 973,106 | 1,412,982 | 765,766 | 993,050 |
| 随机写入 4K,峰值(IOPS) | 192,000 | 226,661 | 68,923 | 648,446 |
| 原始/文件系统随机读取 | 2.87x | 4.89x | 1.94x | 1.43x |
| 随机读取 4K,4 个任务,p99 延迟(微秒,越低越好) | 578 | 494 | 522 | 444 |
| 随机写入 4K,4 个任务,p99 延迟(微秒,越低越好) | 758 | 602 | 12,255 | 371 |
| 驱动器温度,最高(摄氏度) | 78 | 64 | 67 | 60 |
Pro 9n 的 1TB 三星第四代硬盘顺序读取速度为 7,024MB/s,顺序写入速度为 5,699MB/s,与 Yoga 和 Blade 16 中的第四代硬盘性能相当,约为 OmniBook 第五代 KIOXIA 硬盘的三分之二。随机读取文件系统的 IOPS 达到 338.9K,高于 HP 的 289.0K(原始设备 IOPS 上限为 973.1K)。这一 2.9 倍的差距小于 OmniBook 的 4.9 倍,这与 BitLocker 软件加密导致 HP 性能增加的预期相符。
随机写入性能达到 192.0K IOPS,低于 HP 的 226.7K,但几乎是 Yoga QLC 固态硬盘的三倍。Pro 9n 的六项 fio 配置在重新测试后差异超过了我们设定的 2% 上限,因此被标记为部分结果,这些结果分布在随机读取、随机写入以及 5GB 容量的顺序读取测试中。联想表示,Gen5 版本预留了第二个 M.2 2242 固态硬盘的安装空间,对于想要体验 20 核系统顺序读写速度的用户来说,这将是一个升级方案。
结语
联想Pro 9n 15搭载的18核RTX Spark芯片表现出色。联想的散热设计和80W的额定功率使其在92摄氏度的峰值温度下,全核频率高于20核的翻盖笔记本电脑,因此在渲染性能上仅比32GB的OmniBook Ultra 16低8%到11%,并且在Stockfish和OpenBLAS的编译测试中也能与之匹敌。其较小的GPU在LLM令牌生成方面仅损失2%到5%的成本,而且它是本次评测中最轻薄的系统,重量仅为3.64磅(约1.6公斤),配备Delta E值低于0.5的165Hz OLED屏幕和支持手写笔的力反馈触控板。

内存是此配置的唯一瓶颈,因为 32GB 内存中分配的 12GB GPU 无法容纳 12.8GB 的 gpt-oss:20b 磁盘,所以 Pro 9n 无法参与我们的模型加载和编码代理测试。此外,其第四代 SSD 的顺序读取速度约为 OmniBook 第五代 SSD 的三分之二,不过联想也提供了第二块硬盘的选项。平台方面的限制也同样存在:Windows on Arm I/O 路径、Arm64 移植版本(例如 SVT-AV1)的性能落后于 x64 版本,以及单线程性能方面 Razer Blade 16 更胜一筹。一如既往,我们预计随着这些产品的上市,软件生态系统将迅速发展。
对于那些想要在同类产品中最轻薄的机身中搭载 RTX Spark CPU 和色彩校准 OLED 显示屏,并且本地 AI 工作只需运行小型模型的创作者和开发者来说,Pro 9n 15 的性能与 20 核系统相比毫不逊色,而且运行温度更低。如果想要在本地运行 20 亿或更大的模型,则需要配置更大的内存,或者选择 64GB 或 128GB 的版本。
排行榜:联想 Pro 9n 15 出现在我们“最佳本地 AI 笔记本电脑”排行榜的 RTX Spark 部分,与我们在新客户端套件上测试过的其他 N1X 系统一起。



 Amazon