

微软 Surface Laptop Ultra for Business 是首款采用 NVIDIA 芯片的 Surface 笔记本电脑,也是我们评测的首款搭载 RTX Spark 处理器的系统。我们评测的这款机型配备了完整的芯片:一颗 20 核 Grace Arm CPU、一颗 6,144 核 Blackwell RTX GPU 以及 128GB LPDDR5X 统一内存,用户最多可将 96GB 内存分配给 GPU。微软面向消费者的商店列出的配置价格从 2,599.99 美元(18 核 CPU、24GB 内存、512GB SSD)到 5,899.99 美元(20 核 CPU、128GB 内存、1TB SSD)不等。我们评测的这款商用配置的价格在撰写本文时尚未公布。
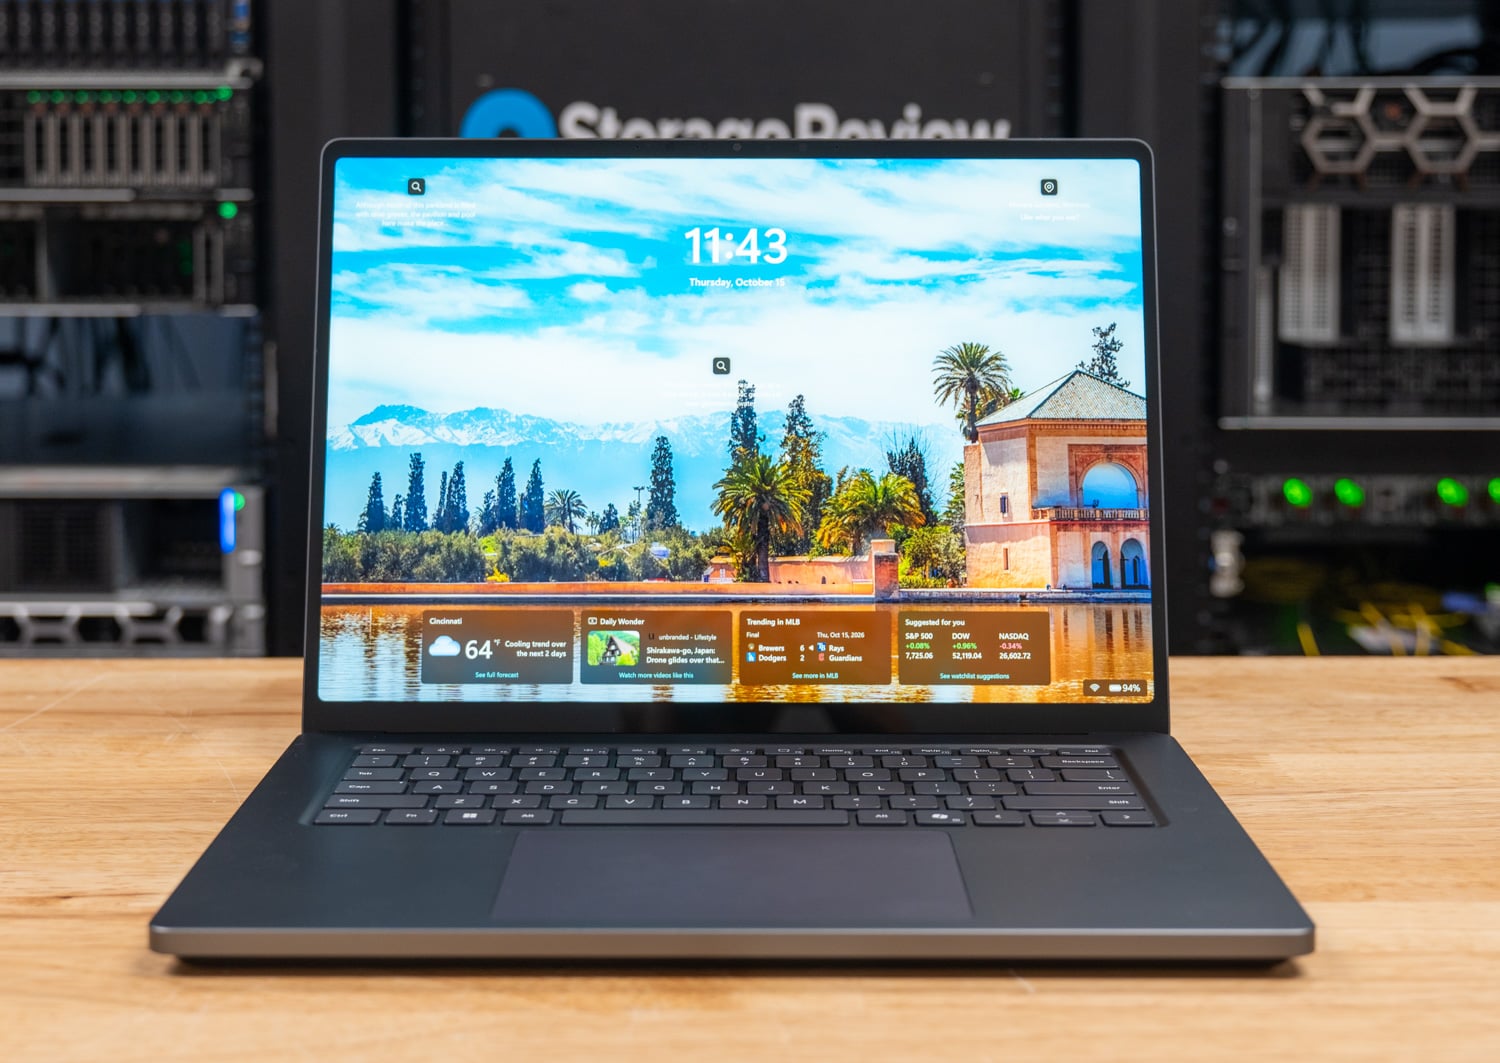
本次评测涵盖了N1X在基准测试中的表现:包括本地AI、CPU、内存、游戏性能、散热和存储,并与四款目前在售的x64笔记本电脑进行对比,这些笔记本电脑分别搭载了英特尔Panther Lake和Arrow Lake H处理器、AMD Strix Point处理器以及NVIDIA RTX 5090和RTX PRO 2000系列笔记本电脑显卡。设计、显示屏、键盘、电池续航以及其他硬件方面的体验将在实验室完成机箱测试后进行后续评测,因此本文主要介绍平台和测试数据。
这款20核N1X处理器几乎赢得了所有多线程CPU测试,通常领先30%甚至更多。它还允许用户为NVIDIA GPU分配64GB显存,比以往任何一款NVIDIA笔记本电脑GPU都多,这使得它能够以可用速度运行一个35亿参数的模型。尽管如此,持续的全核双精度计算在一个晚上就导致这台笔记本电脑的功耗下降了三次,此前的一台评测样机也出现了同样的问题,不得不更换。因此,散热系统比以往更加关键。
关键精华
- 64GB 的 GPU 显存(可扩展至 96GB)会影响运行的程序: gpt-oss:20b 和 Qwen3.6-35B-A3B 的加载和生成速度均为每秒 58 至 89 个令牌;Blade 16 的 RTX 5090 在任何能装下 24GB 内存的程序上速度都比它快 2.3 倍,但对于更大的型号则不适用。
- 该组中速度最快的多核CPU: 在 Cinebench 2026 多核测试中,其得分为 6,963,比 Razer Blade 16 高出 34%,比 Dell Pro Precision 5 16S 高出 47%,LLVM 编译时间为 206 秒,而速度第二快的系统则需要 327 秒。
- 122GB/s 的内存带宽,但会带来延迟: STREAM Triad 达到了 122,114MB/s,比 Precision 5 16S 高出 48%,而 251 ns 的内存延迟和 172 ns 的核心间延迟是该组中最差的,并且在单线程工作中表现出来。
- 一项工作负载会导致断电: 10 月 14 日,在 N=20000 的情况下进行全核 OpenBLAS LU 求解时,设备温度达到 95°C 时断电三次。此前,在其他测试中,该芯片曾在 98°C 下保持 31 分钟。目前已有两台 Surface Laptop Ultra 出现相同故障;日志显示问题出在电源供应或固件保护机制上,而非过热。
- Windows on Arm 支持随机 I/O: 第五代 SK 海力士硬盘的顺序读取速度为 14.1GB/s,原始设备读取速度为 1.67M IOPS,但通过 NTFS 和 BitLocker 加密后,4K 随机 I/O 速度接近 300K IOPS,低于 x64 系统的一半。
RTX Spark N1X 平台
RTX Spark 是 NVIDIA 为基于 N1X 超级芯片的 Windows PC 系列显卡命名的名称,它是DGX Spark中 GB10 的笔记本电脑和紧凑型台式机版本。我们在六月份的台北电脑展上报道了该系列显卡,并在上周的预售活动中公布了其发布详情,因此本节将重点介绍有助于理解测试结果的关键信息。

NVIDIA 提供两款笔记本电脑版 N1X 处理器;顶级配置搭载 20 核 Grace CPU、6,144 核 Blackwell RTX GPU 以及最高 128GB LPDDR5X 内存;次顶级配置则搭载 18 核 CPU 和 5,120 核 GPU,最高内存为 64GB。两款处理器的 TDP 均为 45 至 80W(CPU 和 GPU 的总功耗),而桌面版 N1X 和 GB10 的 TDP 则高达 140W。我们评测的 Surface 搭载的是 20 核 CPU,Windows 系统显示其由 10 个高速核心和 10 个能效核心组成,不支持 SMT(同步多线程)。
内存是这款平台区别于本次评测中所有 x64 笔记本电脑的关键所在:一块 128GB 的 LPDDR5-9400 内存池通过 NVLink-C2C 技术为芯片的两部分供电,在 256 位接口下,9,400 MT/s 的读写速度相当于约 300GB/s 的理论带宽。Windows 系统将其识别为独立显卡,具有固定的专用内存分配和共享内存池。
在我们的测试机上,我们将显存分配设置为 64/64:测试套件测得 GPU 可用显存为 62.5GB,这符合我们本地 AI 模型测试的两个层级的要求。LPDDR5X 内存容量可通过 NVIDIA 应用程序进行用户调整,但显然受限于购买系统时选择的总容量。因此,如果您无法将相同容量的 AI 模型加载到内存中,那么 32GB 或 48GB 的 Surface 在 AI 基准测试中将无法获得相同的结果。
该GPU采用Blackwell架构,配备第五代Tensor Core和第四代RT Core,一个第九代NVENC编码器和一个第六代NVDEC编码器,以及NVIDIA惯用的“高达1 petaflop”的FP4计算能力。微软的脚注将其描述为考虑稀疏性情况下的理论FP4 TOPS。本次评测中所有NVIDIA端的测试均使用原生Arm64架构的llama.cpp和Ollama程序,并运行在CUDA环境下,驱动程序版本为32.0.16.1742。
Windows 是该平台的另一重要组成部分。Surface 运行的是基于 Arm64 架构的 Windows 11 专业版 26H1,因此 x64 应用程序通过 Prism 模拟器运行。我们使用原生 Arm64 二进制文件构建了整个客户端套件,这样 CPU 测试结果就能直接比较芯片本身的性能,而不是转换层的性能。如果原生 Arm64 移植版本尚不成熟,或者 x64 构建是唯一选择,我们会在结果中加以说明,因为这些情况会影响以下几行的测试结果。
微软 Surface Laptop Ultra 商用版规格

| 规格 | 微软 Surface Laptop Ultra 商用版 |
|---|---|
| 平台概述 | |
| 处理器 | NVIDIA RTX Spark N1X,20 核 Grace CPU 搭配 6,144 核 Blackwell RTX GPU(测试机型) NVIDIA RTX Spark N1X,18 核 Grace CPU 搭配 5,120 核 Blackwell RTX GPU |
| NPU | NVIDIA NPU |
| 内存 | 24GB、32GB、48GB、64GB 或 128GB LPDDR5X 统一内存 128GB LPDDR5-9400,64/64GB 固件分割(经测试) |
| 存放 | 可拆卸固态硬盘:512GB(PCIe Gen4)、1TB 或 2TB(PCIe Gen5) 1TB SK 海力士 HFS001TFM9X189N,第五代 x4(经测试) |
| 运行系统 | Windows 11 专业版 (Arm64);24GB 配置下为 Windows 11 家庭版 |
| 显示和 I/O | |
| 展示 | 15 英寸 PixelSense Ultra 触控屏,分辨率 3270 x 2180,最高 120Hz 刷新率,100% DCI-P3 色域,支持 Dolby Vision IQ 1,000 尼特 SDR(典型值),2,000 尼特 HDR 峰值(微软数据) |
| 端口 | 2 个 USB-C / USB4 接口 1 个带磁吸连接的 USB-C / USB4 接口 1x HDMI 2.1b 1个USB-A 3.1 SD卡读卡器 3.5mm耳机插孔 |
| 无线耳机 | Wi-Fi 7(联发科 MT7925)、蓝牙 |
| 相机 | 1080p全高清 |
| 力量和体能 | |
| 电池续航时间(微软官方数据) | 最多可播放 15 小时本地视频 最多 12 小时活跃网络使用时间 (预生产版 20 核、64GB、1TB,亮度 150 尼特) |
| 充电 | USB-C;支持115W或更高功率的Surface或USB-C PD电源快速充电 |
| 重量 | 4.41lb(2.0千克) |
| 颜色 | 白金,夜幕降临 |
| 安全与定价 | |
| 安保防护 | 安全核心 PC、Windows Hello、设备加密(我们的设备采用 BitLocker XTS-AES-128) |
| 价格(微软消费者商店) | 价格从 2,599.99 美元(18 核、24GB、512GB)到 5,899.99 美元(20 核、128GB、1TB,测试机型) |


测试设置和方法
我们的评测样机搭载了 RTX Spark N1X 显卡,配备 6,144 核 Blackwell GPU、128GB LPDDR5-9400 内存(系统和 GPU 各占 64% 内存)、1TB SK 海力士 Gen5 SSD 固态硬盘,运行 Windows 11 专业版 26H1 (Arm64) 操作系统。基准测试在最佳性能电源模式下进行,并连接电源。电池续航测试结果将在后续硬件评测中一同发布。

本次对比测试中,所有系统均运行了我们编写的 Windows 客户端基准测试套件 sr-client 1.2 的完整运行模式和峰值模式。每台系统均使用出厂 Windows 镜像,并安装了 OEM 提供的驱动程序和实用程序,设置为厂商的最佳性能模式,且已连接电源。该测试套件采用相同的实验室设置:Windows 电源模式设置为“最佳性能”,显示器亮度设置为 50%,所有睡眠和显示器关闭定时器均已禁用,Windows 防火墙和 UAC 提示也已关闭。测试过程全程无人值守;每个结果均为多次运行的中位数,如果测试结果的偏差超过 2%,则该套件会重新运行测试才会接受该结果。
该套件使用原生 Arm64 和 x64 二进制文件编写,支持所有开源工作负载,以便 Surface 能够在芯片上与其他产品竞争。
| 系统 | 中央处理器 | 内存 | GPU 用于 GPU 和 AI 测试 | SSD | 操作系统和性能模式 |
|---|---|---|---|---|---|
| 微软 Surface Laptop Ultra | NVIDIA RTX Spark N1X,20核/20线程 | 128GB LPDDR5-9400(64/64 分割) | 6,144 核心 Blackwell RTX(集成显卡,可用显存 62.5GB) | SK海力士HFS001TFM9X 1TB,第五代 x4 | Windows 11 专业版 26H1 (Arm64),最佳性能 |
| 戴尔专业版 Precision 5 16S | 英特尔酷睿Ultra X9 388H,16核/16线程 | 64GB LPDDR5-8533 | 英特尔 Arc Pro B390(集成) | SK海力士PCB01 1TB,第五代 x4 | Windows 11 专业版 25H2 (x64),戴尔优化器 Ultra Performance |
| 戴尔 Pro 7 14 | AMD Ryzen AI 9 HX PRO 470,12核/24线程 | 64GB LPDDR5-8000 | AMD Radeon 890M(集成显卡,32GB VGM) | 三星 BM9C1a 1TB,第四代 x4 | Windows 11 专业版 25H2 (x64),戴尔散热配置文件性能 |
| 雷蛇刃16 | AMD Ryzen AI 9 HX 370,12核/24线程 | 32GB LPDDR5-8000 | NVIDIA GeForce RTX 5090 笔记本电脑显卡,24GB | 三星 MZVL22T0 2TB,Gen4 x4 | Windows 11 家庭版 25H2 (x64),Razer Synapse 性能 |
| 戴尔 Pro Max 14 Premium | 英特尔酷睿Ultra 9 285H,16核/16线程 | 64GB LPDDR5-8400 | NVIDIA RTX PRO 2000 Blackwell 笔记本电脑显卡,8GB | SK海力士PC811 2TB | Windows 11 专业版 25H2 (x64),戴尔优化器 Ultra Performance |
表格中反复出现三个标签,前两个标签之间的区别对于理解人工智能部分至关重要。DNF 表示测试在该系统上启动但未完成,或因失败而被跳过,在本评测中,这适用于 Surface 的 OpenBLAS 运行和 Dell Pro 7 14 的代理 MLPerf 场景。
“未运行”表示测试套件拒绝启动测试,因为硬件不符合要求,最常见的原因是模型超过了系统可提供的GPU内存;戴尔Pro Max 14 Premium的可用GPU内存仅为7.7GB,因此无法参加所有模型负载和代理测试,而Blade 16的24GB内存也使其低于我们的M级机型。“不适用”表示该测试不适用,例如在不支持SMT的芯片上进行SMT单核测试。
本地人工智能性能
这些笔记本电脑上的本地AI性能归根结底取决于两个问题:GPU运行模型的速度,以及模型是否适合其内存。Blade 16的RTX 5090在第一个问题上表现最佳,其24GB内存容量下所有适配的模型,生成令牌的速度约为Surface的2.3倍。Surface则在第二个问题上表现出色,因为它将64GB的统一内存分配给了GPU,是唯一能够以可用速度运行我们测试的M级模型的系统。
Pro Max 14 的 8GB RTX PRO 2000 显卡在小型 Surface 机型上可以跟上 Surface 的运行速度,但对于大型机型来说就太小了,而两个集成 GPU 的 x64 系统虽然运行速度较慢,但可以运行所有程序。
MLPerf 客户端 v2.0
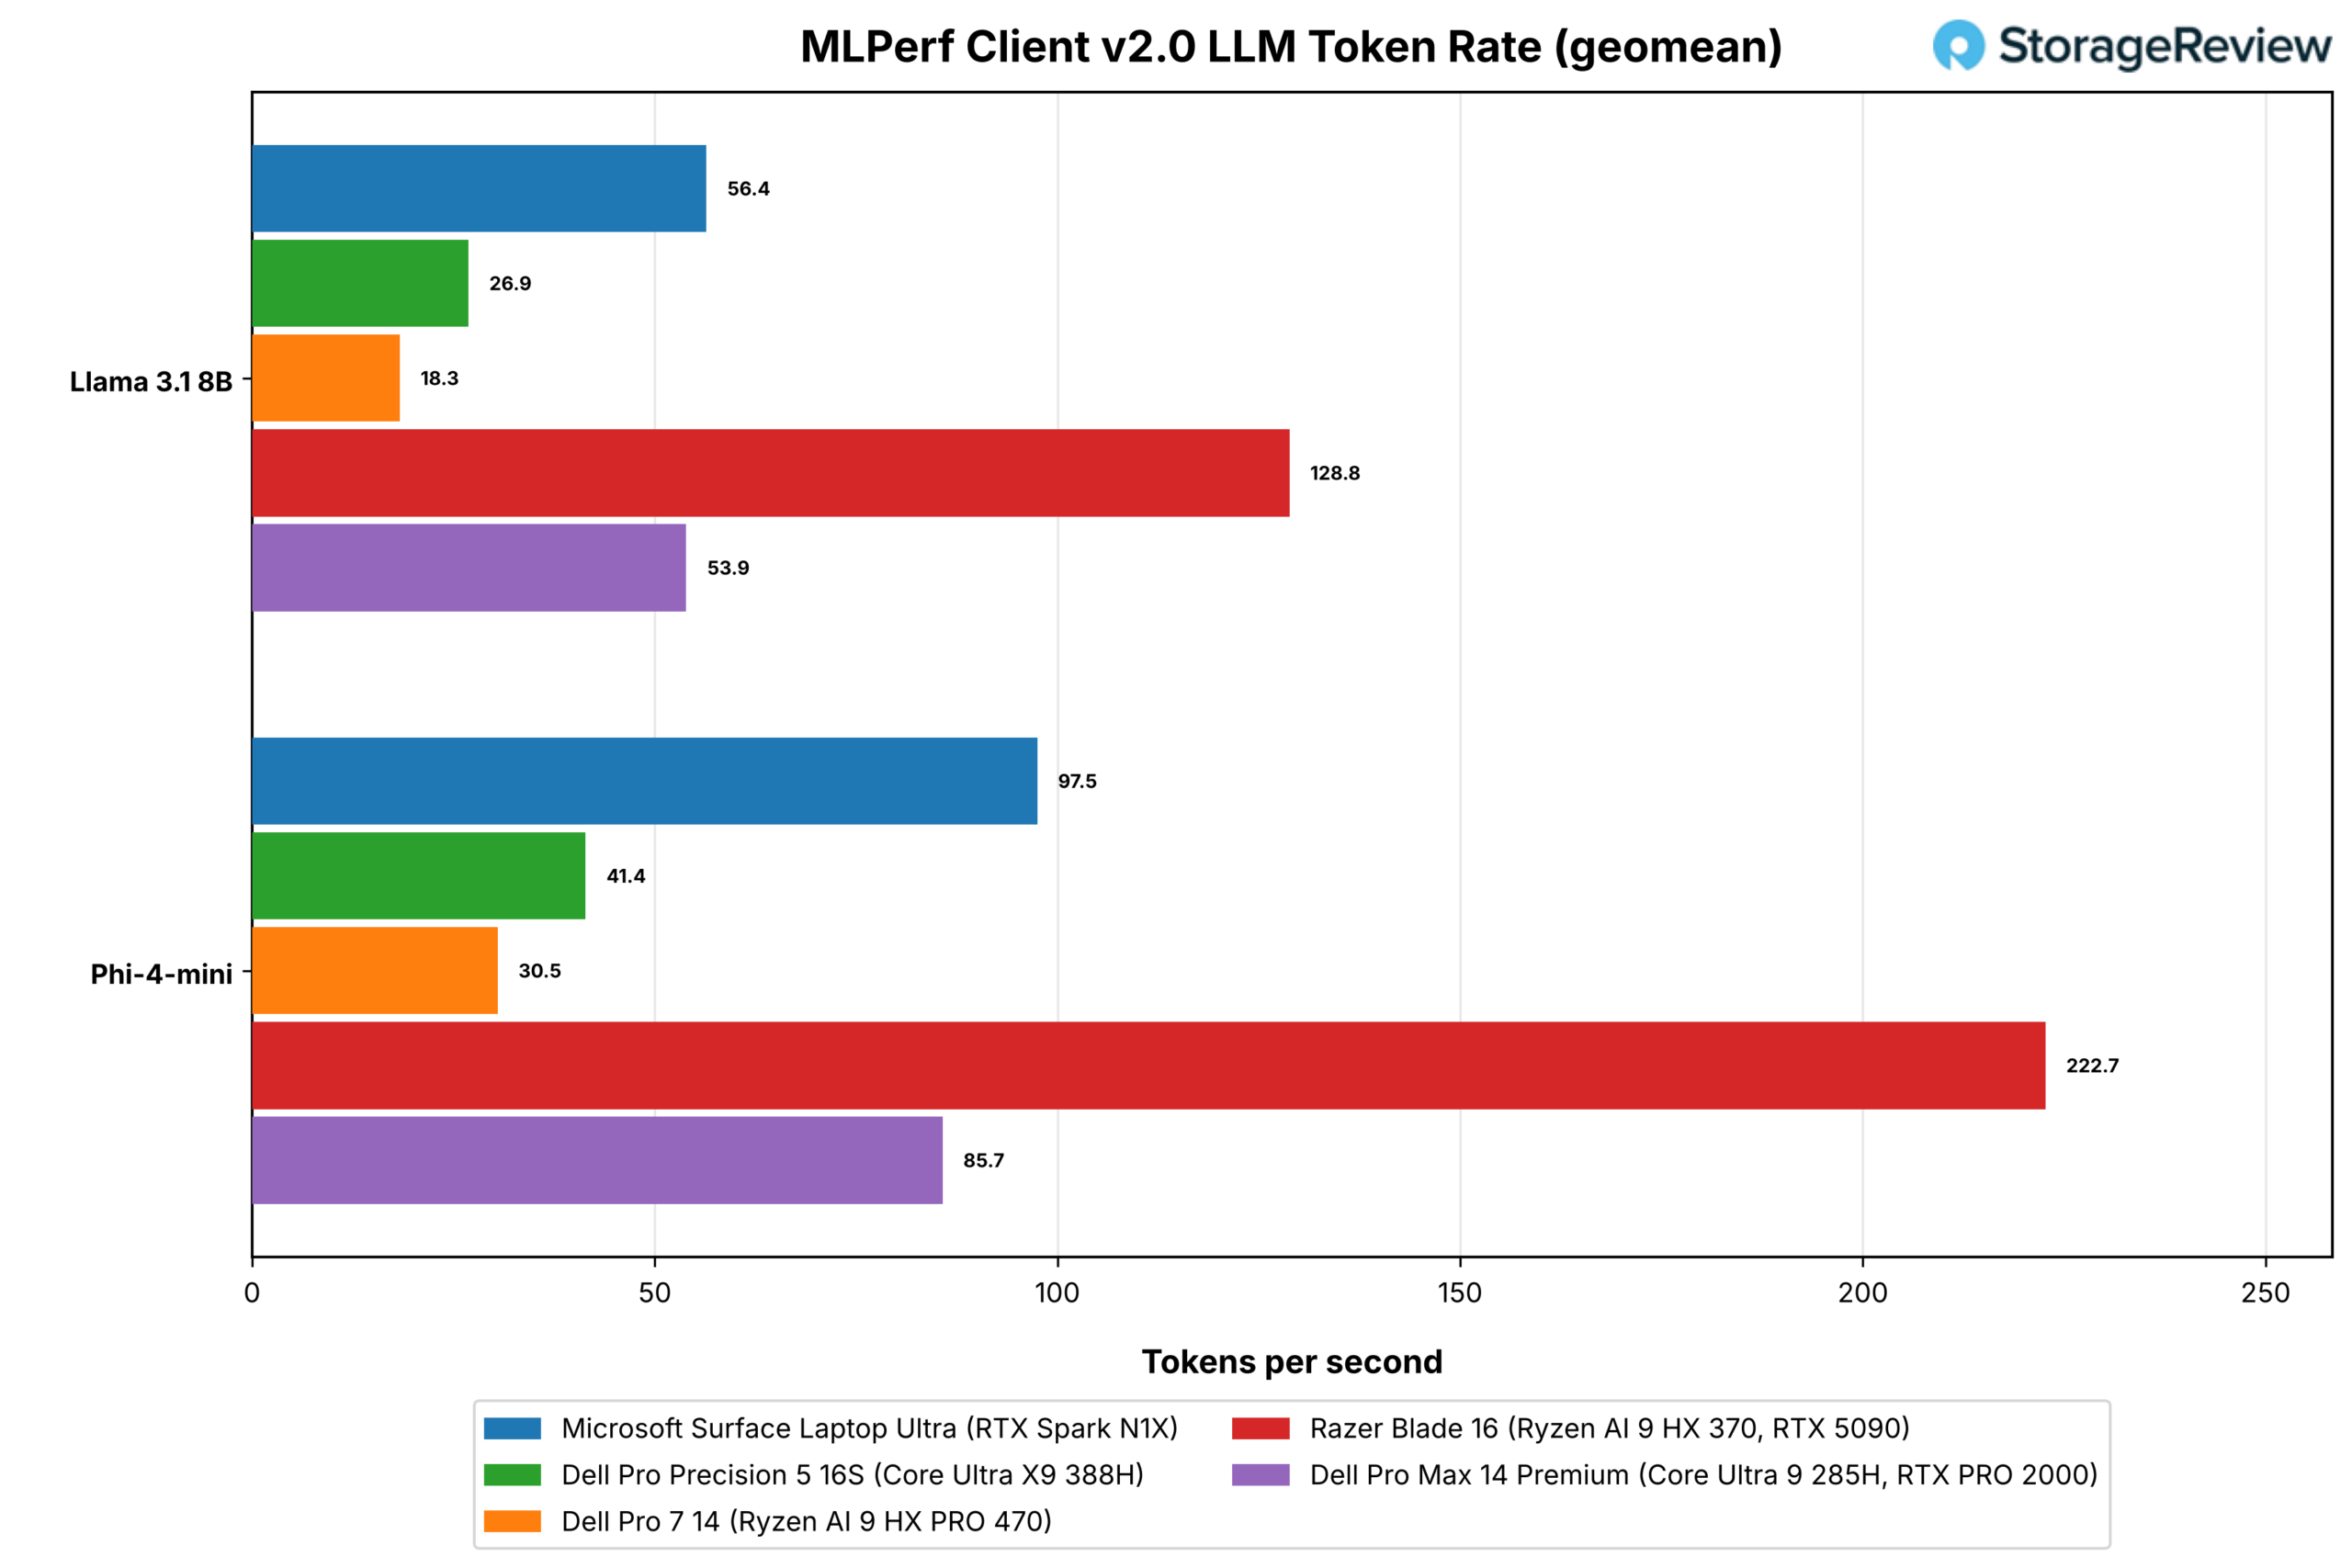
MLPerf 客户端运行 Llama 3.1 8B 和 Phi-4-mini 引擎,测试五种提示类别(内容生成、创意写作、摘要、结构化文本和代码分析),并报告首次词元出现时间和首次词元出现后的词元出现率(以几何平均值表示)。每个系统使用其厂商提供的 GPU 路径:Precision 5 16S 使用 Intel OpenVINO,Pro 7 14 使用 AMD 的 Windows ML 和 DirectML,而三个 NVIDIA 系统则使用 llama.cpp 和 CUDA。因此,引擎各不相同,各行数据比较的是各平台出厂时的性能。
| MLPerf 客户端 v2.0 | Surface Laptop Ultra | 戴尔专业版 Precision 5 16S | 戴尔 Pro 7 14 | 雷蛇刃16 | 戴尔 Pro Max 14 Premium |
|---|---|---|---|---|---|
| Llama 3.1 8B,首次到达令牌的时间,几何平均值(秒,越低越好) | 0.284 | 0.214 | 3.140 | 0.149 | 0.439 |
| Phi-4-mini,首次令牌到达时间,几何平均值(秒,越低越好) | 0.127 | 0.181 | 1.954 | 0.074 | 0.212 |
| 数据分析代理,端到端(s,数值越低越好) | 52.6 | 84.7 | 地下城与勇士 | 27.8 | 61.8 |
| 数据分析代理,代币速率(tok/s) | 48.9 | 25.6 | 地下城与勇士 | 108.3 | 45.4 |
| SWE Agent,端到端(s,数值越低越好) | 46.0 | 65.6 | 地下城与勇士 | 24.6 | 52.6 |
| SWE 代理,代币速率(tok/s) | 46.4 | 25.0 | 地下城与勇士 | 102.5 | 42.8 |
Blade 16 在 Llama 3.1 8B 测试中速度达到 128.8 tok/s,在 Phi-4-mini 测试中速度达到 222.7 tok/s,分别是 Surface 的 56.4 tok/s 和 97.5 tok/s 的 2.3 倍。Pro Max 14 的 RTX PRO 2000 显卡带宽远不及 5090,但在 Llama 3.1 测试中速度仍与 Surface 相差不到 5%,在 Phi-4-mini 测试中差距也小于 12%,这表明 N1X 集成显卡的性能表现与同尺寸机型的小型独立显卡相当。
在集成的 x64 GPU 中,Precision 5 16S 的 Arc Pro B390 在 Llama 3.1 上生成第一个令牌的速度很快,但令牌生成速度只有 Surface 的一半,而 Pro 7 14 的 DirectML 路径速度最慢,第一个令牌的生成耗时 3.1 秒。
MLPerf 的代理场景分别运行 Llama 3.1 8B 作为软件工程代理和数据分析代理,每个代理都会在多个回合中调用工具。Blade 16 在 28 秒内完成了这两个场景,耗时仅为 Surface 的一半,Precision 5 16S 的三分之一。Pro 7 14 未能完成这两个场景:即使为 GPU 预留了 32GB 内存,DirectML 在执行代理提示时仍然耗尽了内存,因此运行失败,并被标记为 DNF(未完成)。
模型加载
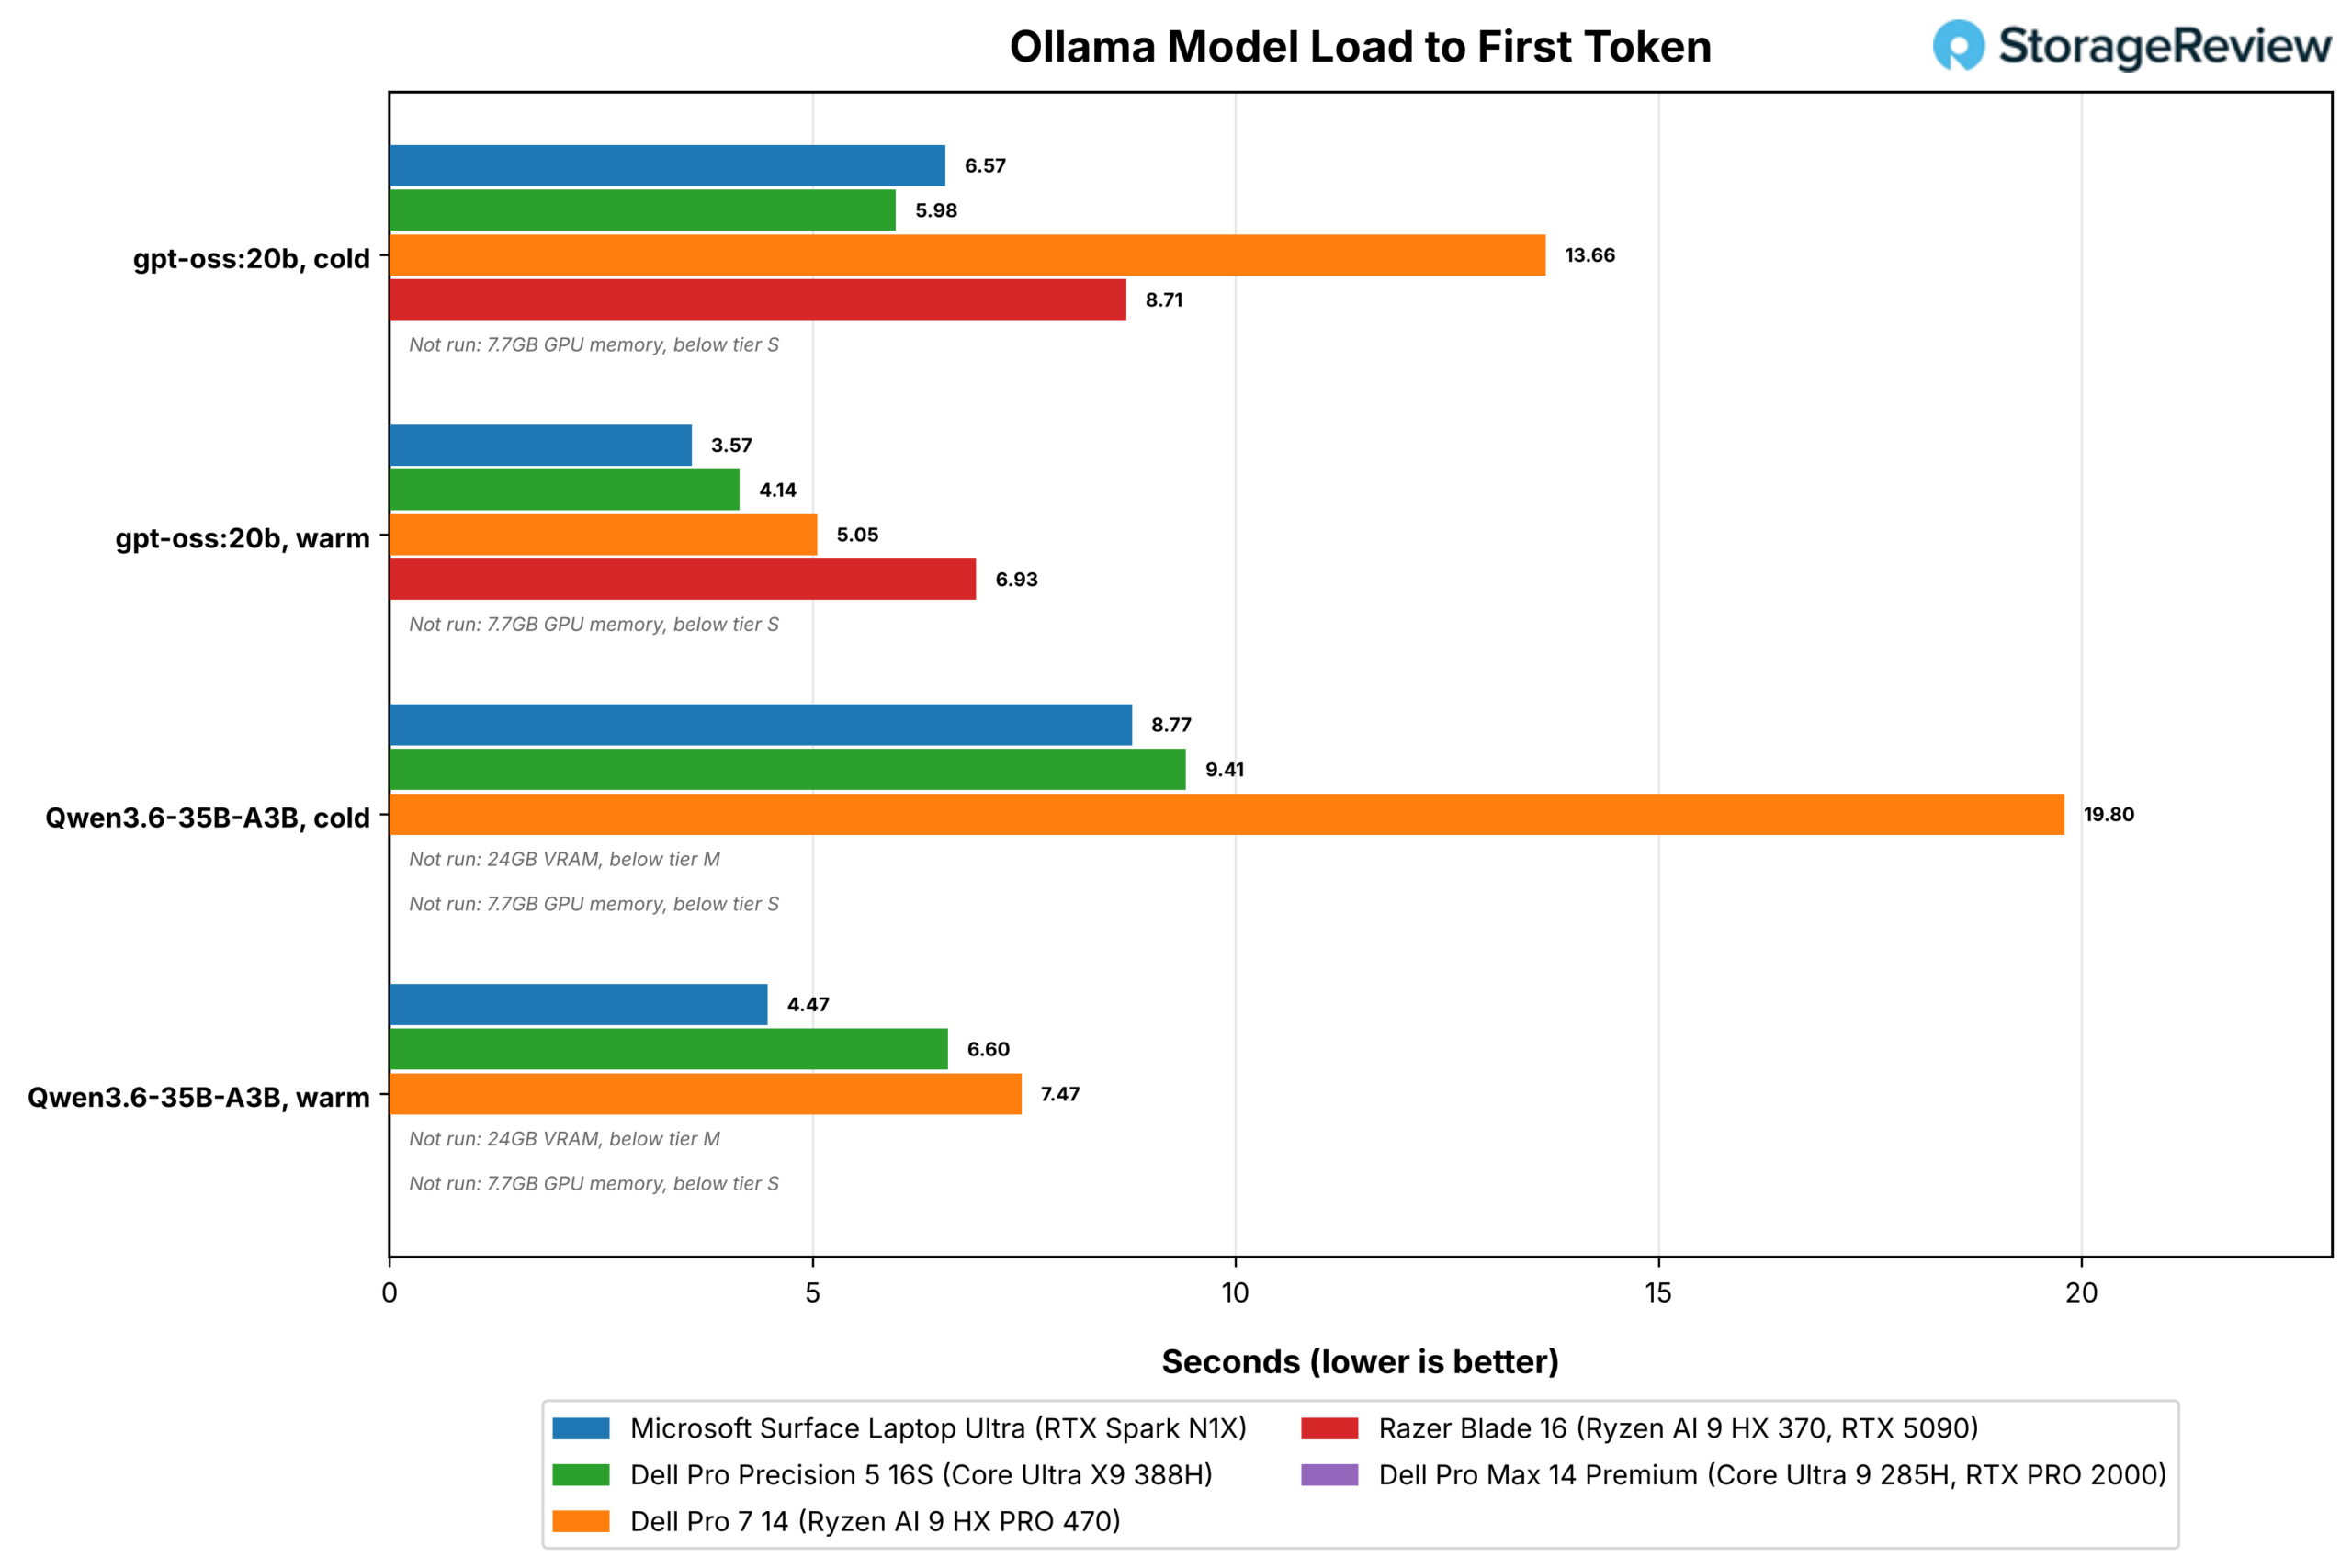
此测试记录本地模型从 SSD 读取到在 Ollama 中生成第一个令牌所需的时间,分别在冷启动(文件缓存已清空)和热启动(文件已在内存中)两种情况下进行,并报告读取过程中 SSD 的速度。S 级测试在至少拥有 16GB GPU 可用内存的系统上使用 gpt-oss:20b 分区表(12.8GB);M 级测试在拥有约 40GB 或更多 GPU 可用内存的系统上添加了 Qwen3.6-35B-A3B 分区表(21.1GB)。交换分区测试加载 Qwen3.6 分区表,切换到 gpt-oss 分区表,并记录返回 Qwen3.6 分区表所需的时间。
| 模型加载(内存映射开启) | Surface Laptop Ultra | 戴尔专业版 Precision 5 16S | 戴尔 Pro 7 14 | 雷蛇刃16 | 戴尔 Pro Max 14 Premium |
|---|---|---|---|---|---|
| gpt-oss:20b,冷加载期间的读取吞吐量(MB/s) | 3,080 | 3,251 | 1,246 | 3,874 | 未运行(7.7GB GPU 显存) |
| Qwen3.6-35B-A3B,模型切换后重新加载(s,数值越低越好) | 5.01 | 13.38 | 22.38 | 未运行(24GB 显存,低于 M 级) | 未运行(7.7GB GPU 显存) |
冷加载测试是对存储性能的考验,两款第五代系统均表现优异:Precision 5 16S 仅用 5.98 秒就完成了 gpt-oss:20b 的第一个令牌加载,而 Surface 则用了 6.57 秒。Surface 在所有热加载和 Tier M 测试中都胜出,并且在交换后仅需 5.0 秒即可恢复到 Qwen3.6 版本,而 Precision 则需要 13.4 秒,这得益于 Surface 将两个模型都驻留在 64GB 的 GPU 内存中。Blade 16 读取模型文件的速度最快,达到 3.9GB/s,但完成第一个令牌加载的时间较晚,这是因为权重需要通过 PCIe 传输到显存,而统一内存系统则可以在读取后立即将其加载到位。
Blade 16 和 Pro Max 14 缺失的几行数据与内存有关。Blade 16 的显存只有 24GB,不符合 M 级内存的要求;而 Pro Max 14 的可用显存仅为 7.7GB,根本达不到任何内存等级,因此测试套件没有对它们进行相关测试。Pro Max 14 的固态硬盘(其写入问题已在存储部分讨论过)的读取速度仅为 1.2GB/s,冷启动耗时 13.7 秒。
编码代理
Codex CLI 通过一个固定代码库中的编码任务驱动由 Ollama 提供的本地模型;当代码库中的 11 个测试全部通过时,运行即告成功。我们报告三次运行的平均耗时、成功运行次数以及生成速率。用户旁智能体测试同时运行智能体和 Speedometer,并报告与单独运行相比,它们各自的速度下降了多少。如果智能体在您工作时运行,那么速度下降的程度就至关重要。

| Codex CLI 编码代理 | Surface Laptop Ultra | 戴尔专业版 Precision 5 16S | 戴尔 Pro 7 14 | 雷蛇刃16 | 戴尔 Pro Max 14 Premium |
|---|---|---|---|---|---|
| S级,gpt-oss:20b 64K:运行时间(秒,数值越低越好) | 191.8 | 584.2 | 376.0 | 64.4 | 未运行(7.7GB GPU 显存) |
| S级:成功(3次) | 3 | 3 | 2 | 2 | 未运行 |
| Tier M,gpt-oss:20b 128K:运行时间(秒,数值越低越好) | 87.5 | 276.1 | 585.4 | 未运行(M级以下) | 未运行 |
| Tier M,gpt-oss:20b 128K:成功(共 3 次) | 2 | 2 | 3 | 未运行 | 未运行 |
| M级,Qwen3.6-35B-A3B 64K:墙内时间(秒,越低越好) | 88.6 | 351.7 | 678.2 | 未运行(M级以下) | 未运行 |
| M级,Qwen3.6-35B-A3B 64K:成功(共3次) | 3 | 3 | 3 | 未运行 | 未运行 |
| 代理人旁边的速度表(分数) | 18.1 | 26.6 | 19.2 | 36.3 | 未运行 |
| 速度表在代理旁边减速(x,数值越低越好) | 1.92 | 1.61 | 1.92 | 1.06 | 未运行 |
| 速度表旁边的代理减速(x,数值越低越好) | 1.10 | 1.00 | 1.11 | 1.05 | 未运行 |
Blade 16 以 137.9 tok/s 的速度在 64 秒内完成了 S 级任务,比 Surface 快三倍,比 Precision 5 16S 快九倍,尽管它在三次测试中只赢了两次,而 Surface 和 Precision 都赢了三次。在 M 级任务中,Surface 在 90 秒内完成了两项任务,比 Precision 5 16S 快三到四倍,比 Pro 7 14 快七到八倍,后者每项任务需要 10 到 11 分钟。实际运行时间还取决于模型调用工具的次数,因此生成速率是更准确的硬件数据。
并发测试充分展现了独立显卡的优势。在运行代理程序的情况下,Blade 16 的浏览器得分下降了 6%,因为该模型运行在 RTX 5090 显卡上,无需占用 CPU 资源。而在 Surface 上,由于代理程序与其他组件共享集成显卡和内存总线,Speedometer 得分几乎减半,从 34.7 降至 18.1,Pro 7 14 的得分也下降了相同的幅度。代理程序本身在任何系统上对浏览器的占用都微乎其微。
检索增强生成
我们的 RAG 测试使用 nomic-embed-text 嵌入了 20,963 段 SQuAD v1.1 文章,针对 2,000 个问题分别提取出前五段文章,并使用 Phi-4-mini 模型进行解答,根据答案与参考答案的完全匹配度和 F1 值进行评分。所有系统都运行相同的小型模型,因此这是一项纯粹的速度比较。

| 鲁尔 | Surface Laptop Ultra | 戴尔专业版 Precision 5 16S | 戴尔 Pro 7 14 | 雷蛇刃16 | 戴尔 Pro Max 14 Premium |
|---|---|---|---|---|---|
| 摄入墙壁时间,20,963 次(秒,越低越好) | 189.8 | 271.7 | 425.9 | 131.0 | 153.9 |
| 检索查询时间,p50(毫秒,数值越低越好) | 23.4 | 22.2 | 31.3 | 20.9 | 21.6 |
| 答案,Phi-4-mini 首次令牌到达时间,p50(秒,越低越好) | 0.161 | 0.855 | 1.527 | 0.109 | 0.260 |
| 回答,快速处理(tok/s) | 6,955 | 2,151 | 863 | 11,560 | 4,031 |
| 问题回答,p50(s,越低越好) | 0.235 | 0.997 | 1.688 | 0.159 | 0.341 |
| 答案 F1 (%) | 73.97 | 74.24 | 74.36 | 74.47 | 74.40 |
Blade 16 导入语料库耗时 131 秒,回答典型问题仅需 0.16 秒,比 Precision 5 16S 快六倍。Pro Max 14 导入语料库耗时 154 秒,排名第二,领先于 Surface 的 190 秒,因为 8GB 内存对于嵌入式机型和 Phi-4-mini 来说已经足够。所有系统的准确率均在 F1 的 0.5 个百分点以内,这与相同型号在 0 温度下的预期结果一致,因此这些笔记本电脑在 RAG 测试中的唯一区别在于等待时间。
中央处理器性能
两大平台决定了CPU的测试结果:Surface的20核N1X处理器几乎在所有多线程测试中都拔得头筹,通常领先30%甚至更多;而戴尔Pro Precision 5 16S搭载的Core Ultra X9 388H处理器则是单线程速度最快的x64 CPU,并在Python、浏览器和OpenBLAS测试中表现领先。相比之下,雷蛇Blade 16的Ryzen AI 9 HX 370处理器在Stockfish和GROMACS测试中胜出,并在大多数渲染和构建测试中位列第二;戴尔Pro 7 14和戴尔Pro Max 14 Premium则在全核性能测试中落后。
Cinebench 2026 和持续负载
Cinebench 2026 使用 Maxon 的 Redshift 引擎在 CPU 上渲染场景,并分别测试单核、SMT 单核(一个物理核心上运行两个线程)和多核的吞吐量。随后,我们进行一个持续循环测试,重复多核运行约 30 分钟,并将稳定状态下的得分与第一次运行的得分进行比较,以此来展示笔记本电脑在过热后性能下降的程度。

Surface 的多核跑分达到 6,963 分,比 Blade 16 高出 34%,比 Precision 5 16S 高出 47%。单核跑分方面,Surface 以 558.5 分略胜 Precision 5 16S 一筹,后者为 534.8 分。两款 AMD 芯片在单线程跑分方面表现落后,Blade 16 为 480.0 分,Pro 7 14 为 464.4 分,分别比 Surface 低 16% 和 20%。SMT 单核技术仅适用于这两款产品,其中 Pro 7 14 的第二个线程分别提升了 33% 和 38% 的性能。
持续循环测试比原始分数更能体现各款笔记本电脑之间的差距。Surface 完成十轮测试后得分 7,016 分,比初始得分高出 1%,CPU 温度始终保持在 98 摄氏度,频率为 3.28GHz;Blade 16 的表现也十分稳定。Pro 7 14 和 Pro Max 14 的得分下降了约 2%,而 Precision 5 16S 在大约 10 分钟后得分下降了 6.2%,并保持在这个水平。
| Cinebench 2026(分数越高越好) | Surface Laptop Ultra | 戴尔专业版 Precision 5 16S | 戴尔 Pro 7 14 | 雷蛇刃16 | 戴尔 Pro Max 14 Premium |
|---|---|---|---|---|---|
| 单核 | 558.5 | 534.8 | 464.4 | 480.0 | 482.6 |
| SMT单核 | 无 | 无 | 617.1 | 661.3 | 无 |
| 多核心 | 6,963 | 4,739 | 4,028 | 5,179 | 4,160 |
| 持续循环,第一次 | 6,938 | 4,765 | 4,040 | 5,162 | 4,314 |
| 持续循环,稳态 | 7,016 | 4,468 | 3,976 | 5,206 | 4,228 |
| 稳态/首次通过 | 1.011 | 0.938 | 0.984 | 1.009 | 0.980 |
7-ZIP
7-Zip 的内置基准测试报告了 LZMA 压缩和解压缩吞吐量(以每秒千兆指令数为单位),分别在每个线程上测试一次,以及在单个核心上测试一次。

Surface 在所有线程测试中以 151.0 GIPS 的成绩领先,比 Blade 16 高出 20%;其压缩性能更是高达 156.9 GIPS,比排名第二的系统高出 35%。Precision 5 16S 在单线程测试中以 9.8 GIPS 的成绩领先。
Surface 的 7.16 GIPS 单线程性能数据需要特别说明。在这台机器上,一个核心在高负载下运行几分钟后,性能会下降到初始速度的 20% 左右,并保持这种状态直到负载结束;7-Zip 的单线程测试运行时间足够长,足以触发这种现象(温度在 47 到 67 摄氏度之间),因此过热并非原因。同样的情况也会延续到后续的 PyPerformance 和 Stockfish 单线程测试中。
| 7-Zip,单线程(GIPS,数值越高越好) | Surface Laptop Ultra | 戴尔专业版 Precision 5 16S | 戴尔 Pro 7 14 | 雷蛇刃16 | 戴尔 Pro Max 14 Premium |
|---|---|---|---|---|---|
| 合计 | 7.16 | 9.80 | 9.01 | 9.24 | 8.84 |
| 压缩 | 4.62 | 8.71 | 6.72 | 7.28 | 7.02 |
| 解压缩 | 9.70 | 10.88 | 11.31 | 11.20 | 10.73 |
混合器
Blender 4.5 使用 CPU 上的 Cycles 渲染器渲染三个标准基准场景(怪物、垃圾店和教室),并报告每分钟的采样数。

在所有三个场景中,排名顺序保持不变:Surface、Blade 16,最后是Precision 5 16S。在Monster场景中,Surface以207.6采样/分钟的采样率领先Blade 16 47%,而在负载最高的Classroom场景中,这一差距缩小至18%,采样率达到93.2。Pro 7 14和Pro Max 14互换了最后两个名次。
手刹
HandBrake 使用 x265(HEVC,中等预设,质量 22)和 SVT-AV1(预设 8,质量 30)对 4K60 Big Buck Bunny 片段的 60 秒进行软件编码,并报告每秒帧数。

两种编码器对Surface的性能表现截然不同。其x265编码的帧率达到41.7 fps,领先其他组别25%,但其原生Arm64 SVT-AV1编码的帧率仅为15.4 fps,约为x64系统帧率的五分之一。芯片上不可能出现x265编码性能领先者的内核速度相差五倍的情况,因此差距在于SVT-AV1的Arm64代码路径,这也是我们测试的软件中,性能决定最终结果的最明显例子。在x64系统中,Precision 5 16S的SVT-AV1编码帧率最高,达到80.8 fps,Pro Max 14和Blade 16的帧率差距在5%以内。
LLVM 构建
此测试使用 Clang 和 Ninja 编译器,以默认作业数编译完整的 LLVM 21.1.4 代码树。它是测试套件中耗时最长的全核工作负载,对内存、存储和 CPU 的要求都非常高。

Surface 编译 LLVM 耗时 206.4 秒,比 Blade 16 的 327.0 秒快了 37%。Precision 5 16S 的 340.1 秒数据是在关闭智能应用控制功能后重新测试得到的,因为该功能在第一次测试中阻止了工具的运行。Pro 7 14 的编译速度最慢,耗时 410.5 秒。
Stockfish、primesieve、Python 和浏览器
Stockfish 内置的基准测试工具以每秒百万个节点为单位报告国际象棋搜索速度。primesieve 统计所有线程上小于 10^12 的素数,以及单个线程上小于 10^11 的素数,并以秒为单位记录时间。PyPerformance 运行三个 CPython 基准测试(go、nbody 和 regex_compile),每个测试都绑定到一个核心上,并报告每次迭代的平均时间。Speedometer 3.1 则用于测量 Microsoft Edge 浏览器中 Web 应用程序的响应速度。
| 《测试》(Test) | Surface Laptop Ultra | 戴尔专业版 Precision 5 16S | 戴尔 Pro 7 14 | 雷蛇刃16 | 戴尔 Pro Max 14 Premium |
|---|---|---|---|---|---|
| Stockfish 基准测试,所有线程(Mnps,数值越高越好) | 15.51 | 14.81 | 14.71 | 17.96 | 12.01 |
| Stockfish 工作台,单线程(Mnps,数值越高越好) | 1.33 | 1.86 | 1.94 | 2.04 | 1.70 |
| primesieve 1e12,所有线程(s,越低越好) | 9.82 | 11.31 | 14.80 | 10.60 | 14.30 |
| primesieve 1e11,单线程(s,越低越好) | 12.03 | 9.56 | 6.66 | 6.67 | 9.82 |
| PyPerformance 的值为(毫秒,数值越低越好) | 123.9 | 69.2 | 75.9 | 75.2 | 74.1 |
| PyPerformance nbody(毫秒,数值越低越好) | 89.8 | 53.2 | 62.3 | 60.8 | 61.3 |
| PyPerformance 正则表达式编译(毫秒,数值越低越好) | 94.1 | 65.1 | 71.1 | 69.7 | 69.8 |
| Speedometer 3.1,Edge(评分,越高越好) | 34.7 | 42.7 | 36.8 | 38.4 | 42.0 |
Stockfish 是 Surface 少数几项未能获胜的全核测试之一;Blade 16 在两次测试中都领先,在所有线程上领先 16%,而 Surface 的单线程成绩则受到了 7-Zip 慢核测试的影响。primesieve 的结果则相反,Surface 在所有线程上以 9.82 秒的成绩最快,而两款 AMD CPU 在单线程上的速度比 Intel 系统快约 30%。
Precision 5 16S 在 Python 和浏览器测试中拔得头筹,Pro Max 14 在 Speedometer 测试中与其差距不到 2%。Surface 在所有四项测试中均垫底。它的 PyPerformance 测试与 7-Zip 在同一核心上运行,因此也继承了核心性能低下的状态;而 Speedometer 测试则是将 Edge 的 Arm64 版本与其他设备的 x64 版本进行对比,因此这些测试结果不仅反映了 Surface 的核心性能,也反映了其固件和软件的性能。即使不考虑核心性能低下的问题,该平台的单线程测试结果也比 x64 平台落后 15% 到 30%,下文的内存延迟数据可以解释部分原因。
GROMACS 和 OpenBLAS
GROMACS 在四种不同的线程布局下,使用所有核心运行 benchMEM 分子动力学算例,并报告每天的模拟时间(以纳秒为单位);其中,最佳布局最为突出。我们的 OpenBLAS 测试在所有核心上运行 HPL 风格的双精度 LU 分解求解(三种问题规模)以及 DGEMM 矩阵乘法运算,并在最高核心类别上再次运行。这是该测试套件中持续浮点运算量最大的任务。
| 《测试》(Test) | Surface Laptop Ultra | 戴尔专业版 Precision 5 16S | 戴尔 Pro 7 14 | 雷蛇刃16 | 戴尔 Pro Max 14 Premium |
|---|---|---|---|---|---|
| GROMACS benchMEM,最佳布局(ns/天,数值越高越好) | 17.29 | 24.87 | 21.58 | 26.41 | 22.74 |
| GROMACS,每个等级每天 1 个线程(ns/天) | 17.21 | 25.01 | 21.58 | 26.59 | 0.84 |
| GROMACS,每个等级 2 个线程(ns/天) | 16.80 | 24.02 | 21.22 | 24.83 | 22.88 |
| OpenBLAS DGEMM M=8000,所有核心(GFLOPS,数值越高越好) | 地下城与勇士 | 527.4 | 358.6 | 455.4 | 367.5 |
| OpenBLAS DGEMM M=8000,顶级核心级别(GFLOPS) | 地下城与勇士 | 262.1 | 228.0 | 252.4 | 266.0 |
| OpenBLAS LU N=10000,所有内核 (GFLOPS) | 地下城与勇士 | 435.3 | 384.3 | 400.9 | 194.2 |
| OpenBLAS LU N=20000,所有内核 (GFLOPS) | 地下城与勇士 | 503.8 | 375.6 | 454.4 | 327.5 |
| OpenBLAS LU N=40000,所有内核 (GFLOPS) | 地下城与勇士 | 459.6 | 397.6 | 498.5 | 394.1 |
| OpenBLAS LU N=40000,顶级核心级别(GFLOPS) | 地下城与勇士 | 255.2 | 221.9 | 250.9 | 271.6 |
Blade 16 在所有 GROMACS 布局中均以 26.4 ns/day 的速度领先,Precision 5 16S 落后 6%。Surface 在其他方面表现出色,但在 GROMACS 的 Arm64 版本中速度最慢,仅为 17.3 ns/day,这是因为 GROMACS 的 Arm64 版本缺少 x64 系统使用的 AVX2 内核。Pro Max 14 在单线程/线程布局下的 0.84 ns/day 速度是一个极端案例,因为它几乎所有时间都耗费在线程间通信上;其最佳布局下的 22.7 ns/day 速度才是可供比较的参考值。
Surface 没有 OpenBLAS 测试结果。全核 N=20000 LU 求解将系统功耗降低了三倍,并且在两台笔记本电脑上都出现了这种情况,因此我们在最后一次运行中跳过了该步骤,让其他 29 台笔记本电脑完成测试;散热部分对此问题进行了说明。在 x64 系统中,Precision 5 16S 在全核 DGEMM 测试中以 527 GFLOPS 的成绩领先,并在两个较小的 LU 求解测试中也取得了不错的成绩;Blade 16 获得了最大求解结果,而 Pro Max 14 仅使用其最高核心数时速度最快,但加上其能效核心后,其 N=10000 的成绩降至 194 GFLOPS。
内存带宽和延迟
STREAM 测量持续内存带宽。内存延迟使用 4KiB 页上的 1GB 缓冲区,而核心间延迟测量每对核心之间的往返延迟。

| 延迟(纳秒,越低越好) | Surface Laptop Ultra | 戴尔专业版 Precision 5 16S | 戴尔 Pro 7 14 | 雷蛇刃16 | 戴尔 Pro Max 14 Premium |
|---|---|---|---|---|---|
| 内存延迟,4KiB 页 | 251.1 | 115.5 | 146.7 | 129.6 | 170.7 |
| 核心到核心的平均值 | 171.6 | 88.2 | 49.7 | 57.0 | 58.3 |
| 核心间最大 | 362.6 | 129.4 | 74.6 | 95.9 | 153.1 |
Surface 的 LPDDR5-9400 内存,在 STREAM Triad 测试中实现了 122,114MB/s 的读写速度,在 Copy 测试中实现了 130,516MB/s 的读写速度,比 Precision 5 16S 高出 48%,约为两款 AMD 系统的 2.6 倍。如此高的带宽是 N1X 处理器在渲染和编译测试中胜出的重要原因之一。然而,代价是延迟:内存延迟为 251 ns,核心间平均延迟为 172 ns,这两项指标均远低于其他测试机型,这也是其单线程和对延迟敏感的测试结果主要受此影响的原因。Precision 5 16S 的内存延迟最低,仅为 116 ns,而 Pro 7 14 的核心间延迟最低,仅为 50 ns。
游戏和GPU编码
SuperTuxKart 是本次测试套件中唯一的一款游戏,在 1080p 分辨率下,它的运行对 CPU 和驱动程序的占用并不高,因此测试结果更多地反映了 CPU 和驱动程序的性能,而非 GPU 的性能。该游戏内置的基准测试程序在 1920×1080 分辨率下以全屏模式运行,所有设置均设置为最高,并关闭垂直同步。测试程序会将游戏画面锁定在独立显卡上(如有),并报告平均帧率以及游戏本身典型的、基本稳定的帧率数据,这些数据反映了帧时间分布中逐渐降低的帧率点。在 Surface 设备上,我们使用 Prism 模拟器运行了 x64 版本。

Surface 原生运行平均帧率为 235.9 fps,在模拟器下运行 x64 版本平均帧率为 264.6 fps,高于 Blade 16 的 200 fps。在这样的帧率下,RTX 5090 的性能远未达到极限;Blade 16 的性能则受限于其 CPU 和 OpenGL 驱动程序,并且它采用混合模式运行,显示器连接到 Radeon 890M 显卡,这会导致每帧增加一份图像副本。
更有说服力的结果来自戴尔的机型,Precision 5 16S 集成的 Arc Pro B390 显卡平均帧率为 166.8 fps,而 Pro Max 14 的独立 RTX PRO 2000 显卡平均帧率为 150.8 fps,Pro Max 14 的稳定帧率在所有机型中最低,仅为 53 fps。如果运行更大型的游戏,5090 的性能将会远超其他所有机型。
FFmpeg 使用各厂商的硬件编码器(Intel QSV、AMD AMF 或 NVIDIA NVENC)将同一个 4K60 视频片段以 8Mb/s 的码率编码为 HEVC,并通过 Windows Media Foundation 单独进行编码。
| 硬件 HEVC 编码(帧率越高越好) | Surface Laptop Ultra | 戴尔专业版 Precision 5 16S | 戴尔 Pro 7 14 | 雷蛇刃16 | 戴尔 Pro Max 14 Premium |
|---|---|---|---|---|---|
| GPU厂商编码器,HEVC 8Mb/s | 135 (NVENC) | 128 (QSV) | 137(AMF) | 132 (NVENC) | 不适用(驱动程序版本低于 FFmpeg 构建所需版本) |
| 媒体基金会编码器,HEVC 8Mb/s | 55 | 不适用(未找到 HEVC MF 编码器) | 110 | 不适用(混合图形) | 不适用(混合图形) |
在这个比特率下,固定功能编码器的性能几乎可以互换,QSV、AMF 和 NVENC 的帧率范围为 128 到 137 fps,其中 Surface 搭载的第九代 NVENC 单核处理器帧率可达 135 fps。Pro Max 14 没有测试结果,因为其驱动程序版本 597.16 无法启动 NVENC,该版本比其他两台 NVIDIA 系统上的驱动程序版本 617.42 更旧。Media Foundation 仅对 Pro 7 14 和 Surface 进行了测试;在 Precision 5 16S 上未发现 HEVC 编码器,而我们跳过了两台混合显卡系统,因为它们会选择自己的适配器,无法与独立 GPU 的性能挂钩。
温度和 OpenBLAS 关机
在最长的工作负载下,Surface 的平均温度为 92 至 97 摄氏度,完成 30 分钟持续循环测试的速度比开始时快了 1%;Blade 16 的最高温度为 98 至 99 摄氏度,结果相同。唯一一款会降温的系统是 Precision 5 16S,但它的降温是定时进行的。尽管 Surface 周围环境温度较高,但它的 OpenBLAS DNF 降温过程并不平顺:在测试套件中最繁重的浮点运算负载下,系统直接断电。

我们可以监测什么
sr-client 通过 LibreHardwareMonitor 和 Windows 性能计数器每隔几秒对传感器进行采样,并汇总每次测试的数据,但不同平台上的覆盖率差异比我们预期的要大。两台 Intel 系统均未向 LibreHardwareMonitor 报告 CPU 温度,导致测试套件在两次测试之间以固定的时间间隔暂停。
CPU温度和时钟频率随工作负载变化
| 工作负载(CPU 最大负载/平均负载,C) | Surface Laptop Ultra | 戴尔专业版 Precision 5 16S | 戴尔 Pro 7 14 | 雷蛇刃16 | 戴尔 Pro Max 14 Premium |
|---|---|---|---|---|---|
| Cinebench 2026 | 98 / 88 | 无传感器 | 83 / 74 | 96 / 78 | 无传感器 |
| 7-ZIP | 98 / 65 | 无传感器 | 75 / 70 | 99 / 84 | 无传感器 |
| 鳕鱼干 | 98 / 96 | 无传感器 | 69 / 68 | 92 / 90 | 无传感器 |
| 混合器 | 98 / 93 | 无传感器 | 76 / 70 | 95 / 87 | 无传感器 |
| 手刹 | 98 / 84 | 无传感器 | 82 / 72 | 92 / 86 | 无传感器 |
| LLVM 构建 | 98 / 92 | 无传感器 | 74 / 68 | 98 / 93 | 无传感器 |
| GROMACS | 98 / 96 | 无传感器 | 71 / 70 | 97 / 94 | 无传感器 |
| 开放式BLAS | 地下城与勇士 | 无传感器 | 83 / 78 | 91 / 87 | 无传感器 |
| 流 | 98 / 92 | 无传感器 | 69 / 66 | 75 / 71 | 无传感器 |
| 超级卡丁车 | 90 / 80 | 无传感器 | 69 / 64 | 89 / 83 | 无传感器 |
| MLPerf 客户端 | 93 / 77 | 无传感器 | 71 / 67 | 97 / 76 | 无传感器 |
| 编码代理 | 86 / 78 | 无传感器 | 78 / 68 | 91 / 84 | 无传感器 |
Surface 在所有高负载全核测试中温度都达到了 97 到 98 摄氏度,在 Stockfish、GROMACS 和 Blender 测试中的平均温度也始终高于 93 摄氏度,这表明它在大部分测试中都处于满负荷运行状态。即使是内存测试 STREAM,温度也达到了 98 摄氏度。Blade 16 的温度也几乎一样高,在 7-Zip 和 LLVM 构建测试中峰值温度达到了 98 到 99 摄氏度,但在大多数测试中,它的平均温度要低 5 到 10 摄氏度。Pro 7 14 的温度最低,全程最高温度仅为 89 摄氏度,这与其较低的时钟频率和较低的全核跑分相符。
| 工作负载(平均 CPU 时钟频率,MHz) | Surface Laptop Ultra | 戴尔专业版 Precision 5 16S | 戴尔 Pro 7 14 | 雷蛇刃16 | 戴尔 Pro Max 14 Premium |
|---|---|---|---|---|---|
| Cinebench 2026 | 2,952 | 3,792 | 3,879 | 4,158 | 3,734 |
| 7-ZIP | 2,405 | 3,936 | 3,767 | 4,014 | 3,710 |
| 混合器 | 3,174 | 3,665 | 3,086 | 3,729 | 3,469 |
| LLVM 构建 | 3,160 | 3,631 | 3,043 | 3,697 | 3,379 |
| GROMACS | 3,325 | 3,525 | 3,023 | 3,874 | 3,458 |
| 流 | 3,255 | 4,014 | 3,590 | 3,684 | 4,057 |
| MLPerf 客户端 | 2,165 | 2,632 | 3,036 | 3,593 | 3,861 |
| 持续循环,稳态 | 3,276 | 3,294 | 2,914 | 3,742 | 3,393 |
在不同的架构上,时钟频率的含义各不相同,因此请继续阅读下文,了解芯片时钟频率如何随任务从轻负载到重负载而变化。Surface 的全核频率稳定在 3.2 至 3.3GHz,这是它在 98 摄氏度下能够保持的频率,而且其 20 个核心在这个频率下仍然优于 12 核或 16 核 x64 处理器在更高频率下的性能。Blade 16 在几乎所有测试中都保持了最高的时钟频率,即使在温度最高的测试中也保持在 3.6GHz 以上,因此它在与 Pro 7 14 相同的芯片系列下,在 Stockfish 和 GROMACS 测试中都领先,而 Pro 7 14 在持续全核负载下频率会降至 2.8 至 3.1GHz。
持续循环测试最能清晰地展现各固件的运行策略。Surface 在所有十次测试中温度均保持在 98°C,最终温度比第一次高出 1%;Blade 16 也达到了同样的温度,但最终温度为 94°C。此时两款机型的散热储备都已耗尽,但它们也无需保留散热储备,因为它们的固件能够将时钟频率稳定在极限状态。
Precision 5 16S 是唯一一款性能下降的系统,而且每次下降的方式都相同:10 到 14 分钟后,得分下降约 6% 并保持不变,第二次完整测试中,得分下降幅度精确到小数点后三位(0.938 对 0.939)。两次测试中得分都在同一分钟下降,这看起来像是戴尔固件中存在长时间功率限制,而不是散热系统性能下降。
Surface并非我们实验室唯一一台运行温度过高的RTX Spark笔记本电脑。其他搭载N1X处理器的笔记本电脑在全核负载下温度也达到了90多度,但到目前为止,它们都没有出现故障。我们目前的推测(虽然无法证实)是,NVIDIA将N1X笔记本电脑的功耗和散热目标设定得非常接近极限,因此能否达标取决于各OEM厂商的散热设计和固件,而这正是Surface与其他笔记本电脑的不同之处。散热性能是我们后续评测中需要重点关注的方面,因为散热设计将成为区分不同平台性能的关键因素。

运行过热和 OpenBLAS 关机
我们的 Surface Laptop Ultra 三次断电,每次都是在全核 OpenBLAS LU 求解器运行到 20 线程 N=20000 问题时发生的。为了让其他 29 项测试顺利完成,我们在最后一次运行中跳过了 OpenBLAS,因此 CPU 部分显示“DNF”(未完成)。这是第二台出现类似故障的设备:第一台评测机在相同的工作负载下出现死机,送修后发现 OLED 显示屏在排气口边缘存在缺陷,并且 CPU 故障可以复现,最终被更换。
| 创建 | 运行中 | 损失前的最后一次阅读 | 之后 |
|---|---|---|---|
| 大约 20:06 | 完整运行,26-openblas:两次 N=10000 LU 的测试集均已完成(分别为 319.7 和 368.1 GFLOPS),然后在 20 个线程上进行 N=20000 的测试。 | CPU 温度 95.7°C,主频 3.2GHz(启动时温度 53°C) | 关机状态,于21:11开机。 |
| 大约 21:30 | 复现步骤,第一轮:12 次 N=10000 次求解通过,N=20000 在 20 个线程上启动,时间为 21:30:13 | 最高温度区 95.2 摄氏度,3.1GHz | 于 21:31 自动重启 |
| 大约 21:35 | 复现步骤 1:相同序列,N=20000,20 个线程,启动时间 21:35:10 | 最高温度区 95.5 摄氏度,3.2GHz | 22:05 回来 |
我们最初的想法是笔记本电脑运行温度达到 98 摄氏度后过热损坏;但实际情况似乎并非如此。Surface 在持续循环测试中保持 98 摄氏度 31 分钟后,温度从 95.2 摄氏度降至 95.7 摄氏度,并在 Cinebench 测试中保持 12 分钟,期间未出现任何故障。Windows 检测到的是强制断电,而非正常关机:每次重启都会记录 Kernel-Power 41 错误代码(错误检查代码为 0),且没有电源按钮按下记录,也没有崩溃转储文件、致命硬件错误记录或过热关机事件(通常过热关机都会留下这些记录)。
时间精确到秒:两个复现程序在第一次运行中都失去了电源,在加载开始后 42 到 46 秒,在 N=20000 求解开始后 14 到 16 秒,并且在丢失电源之前,每次求解都通过了 HPL 残差检查,因此硬件在切割之前一直都在正确计算。
平台计数器两次都达到了相同的峰值:PSYS 热区并非温度值,而是在负载下稳步上升,空闲时约为 1,000 至 1,200,两次故障重现时读数分别为 4,419 和 4,406。第一台 Surface 的 PSYS 读数仅为 2,808,远低于此值,因此这对于平台固件的维护者来说是一个线索,而非阈值。
故障原因也不确定,因为在第一次重启后,完整运行的重试步骤成功通过了所有八种配置(N=40000 及以下),在 20 个线程上,N=20000 和 N=40000 的求解结果分别为 336 GFLOPS 和 370 GFLOPS,也就是说,这台机器四次尝试中有三次断电。两台机器都使用交流电源;这台机器的电池在断电前后电量均为 100%。
两台 Surface Laptop Ultra 出现完全相同的故障,内存配置不同(第一台为 96/32,第二台为 64/64),这表明问题出在该型号的电源管理、散热设计或固件在持续全核 FP64 负载下的保护机制上,而非单个机器本身存在缺陷。我们已报告此问题,如有修复方案,我们将更新此评测。
重现关机过程
我们的复现步骤是在 20 个线程上运行 6 次 N=10000 LU 分解,在 10 个线程上运行 6 次,然后在 20 个线程上运行 N=20000 LU 分解。OpenBLAS 提供了一个 LINPACK 基准测试程序(benchmark/linpack.c),它执行相同的操作:它填充一个随机的 N x N 矩阵,使用 dgetrf 对其进行分解,使用 dgetrs 进行求解,并报告每个矩阵的 MFlops 值,因此任何人都可以重复此过程而无需使用我们的测试套件。
在 Windows on Arm 平台上,有两个细节需要注意,首先是线程数:官方发布的 Windows on Arm OpenBLAS 版本最多只能使用 12 个线程,因此无法充分利用全部 20 个核心;必须使用 0.3.34 版本的源代码构建该库,并提高线程数限制。此外,基准测试的 Windows 计时器只能在 MinGW 风格的工具链下编译,因此需要在 MSYS2 的 CLANGARM64 shell 中构建。以下是解压后的 OpenBLAS 0.3.34 源代码:
pacman -S --needed mingw-w64-clang-aarch64-clang mingw-w64-clang-aarch64-cmake mingw-w64-clang-aarch64-ninja cmake -S . -B build -G Ninja -DCMAKE_BUILD_TYPE=Release -DTARGET=NEOVERSEN1 -DNUM_THREADS=256 -DNOFORTRAN=1 -DC_LAPACK=1 -DBUILD_BENCHMARKS=ON -DBUILD_TESTING=OFF cmake --build build --target benchmark_linpack_DOUBLE
然后,在将 Windows 系统设置为“最佳性能”并连接电源的情况下,该程序会重复每次断电前的运行过程。在我们的 Surface 设备上,断电发生在最后一次 N=20000 求解过程中。
cd build OPENBLAS_LOOPS=6 OPENBLAS_NUM_THREADS=20 ./benchmark_linpack_DOUBLE.exe 10000 10000 1 OPENBLAS_LOOPS=6 OPENBLAS_NUM_THREADS=10 ./benchmark_linpack_DOUBLE.exe 10000 10000 1 OPENBLAS_NUM_THREADS=20 ./benchmark_linpack_DOUBLE.exe 20000 20000 1
两次 OPENBLAS_LOOPS=6 运行通过十二次 N=10000 求解来预热系统,与我们的复现结果相符,最后一个命令在所有 20 个核心上启动 N=20000 求解,我们的 Surface 在 14 到 16 秒后失去电源。
储存效能
存储测试结果将五款固态硬盘分为三组。Surface 的第五代 SK 海力士固态硬盘以 14.1GB/s 的顺序读取速度和 11.5GB/s 的顺序写入速度创下纪录;Precision 5 16S、Pro Max 14 和 Blade 16 通过文件系统实现了 65 万到 78 万 IOPS 的 4K 随机 I/O;而 Pro 7 14 的三星 BM9C1a 固态硬盘的读取速度与普通的第四代固态硬盘相当,但写入速度仅为 120MB/s 左右,这与该硬盘采用的是 QLC 闪存有关。
fio 四角
我们的客户端存储测试使用 fio 对启动卷上的文件进行读写操作,并通过 NTFS 和 BitLocker 加密,完全按照系统出厂时的设置进行,因此结果包含了操作系统和加密带来的开销。测试分别在 QD32 下进行 128K 次顺序读写,以及在 QD32 下进行 4K 次随机读写,并分别运行 4 个、8 个和 16 个作业,取其中最佳结果。每个测试角都使用 5GB 和 25GB 的数据进行测试,以检验当工作集超过驱动器的最快缓存时,测试结果是否仍然有效;25GB 的数据行才是最终的比较对象。


| fio,5GB 占用空间 | Surface Laptop Ultra | 戴尔专业版 Precision 5 16S | 戴尔 Pro 7 14 | 雷蛇刃16 | 戴尔 Pro Max 14 Premium |
|---|---|---|---|---|---|
| 顺序读取 128K QD32 (MB/s) | 14,175 | 10,275 | 3,747 | 7,099 | 7,025 |
| 顺序写入 128K QD32 (MB/s) | 11,475 | 8,909 | 123 | 5,248 | 6,645 |
| 随机读取 4K QD32,峰值(IOPS) | 307,738 | 778,080 | 363,988 | 700,883 | 756,704 |
| 随机写入 4K QD32,峰值(IOPS) | 284,680 | 676,963 | 25,465 | 651,651 | 697,110 |
两块第五代硬盘占据了连续的读写行。Surface 在 25GB 的读写速度分别达到了 14,134MB/s 和 11,461MB/s,Precision 5 16S 紧随其后,读写速度分别为 9,216MB/s 和 9,009MB/s,而三台第四代系统的读取速度则集中在 7.0 至 7.1GB/s 之间。随机 I/O 测试的结果则有所不同:Precision 5 16S、Pro Max 14 和 Blade 16 的读写速度均在 648K 至 780K IOPS 之间,而 Surface 的读写速度则停滞在 300K IOPS 左右,尽管配备了速度更快的硬盘,但其性能仍低于其他 x64 系统的一半。
原始设备数据行显示了性能上限的来源:直接对物理磁盘重复执行 4K 随机读取操作,绕过 NTFS 和 BitLocker,Surface 的 SSD 实现了 1,670,736 IOPS,是文件系统下结果的 5.6 倍,因此 300K 的上限是由 Windows on Arm 存储路径决定的,而不是由硬盘本身决定的。最可能的开销来自 BitLocker 的 XTS-AES-128 软件,该软件启用了内存完整性,导致在执行这 4 个任务时 CPU 使用率达到了 57%。
x64 系统的性能损失较小,但仍然损失了一些 IOPS:Pro Max 14 损失了 1.94 倍,Precision 5 16S 损失了 1.57 倍,Blade 16 损失了 1.43 倍。只有 Pro 7 14 没有变化。
存储延迟和模型负载上限
fio 在 25GB 空间上的完成延迟(以微秒为单位),以及 AI 模型负载测试用作上限的驱动器容量上限:DiskSpd 1MB 顺序读取模型文件。
| 《测试》(Test) | Surface Laptop Ultra | 戴尔专业版 Precision 5 16S | 戴尔 Pro 7 14 | 雷蛇刃16 | 戴尔 Pro Max 14 Premium |
|---|---|---|---|---|---|
| 连续读取 128K,p99(µs,越低越好) | 391 | 971 | 2,179 | 1,384 | 873 |
| 顺序写入 128K,p99(微秒,数值越低越好) | 766 | 3,490 | 120,062 | 889 | 1,036 |
| 随机读取 4K,16 个任务,平均值(微秒,数值越低越好) | 1,839 | 368 | 1,410 | 472 | 635 |
| 随机写入 4K,16 个任务,平均值(微秒,数值越低越好) | 1,984 | 444 | 23,703 | 470 | 636 |
| 原始随机读取 4K QD32,峰值,25GB (IOPS) | 1,670,736 | 1,224,270 | 361,344 | 993,050 | 1,472,021 |
| 模型负载驱动器上限,DiskSpd 1M 顺序读取 (MB/s) | 10,588 | 11,402 | 1,689 | 6,246 | 未运行(模型负载测试未通过) |
Surface 的顺序延迟尾部最为集中,而 Precision 5 16S 的 4K 双向平均延迟最低。Surface 的 16 个作业随机数据集还存在我们在 x64 系统上未曾见过的延迟尾部:p99.99 读取延迟为 4.8 秒,写入延迟为 5.6 秒,而平均值分别为 1.8 毫秒和 2.3 毫秒,这意味着通过 Windows on Arm 路径,大约每 10,000 次 I/O 操作中就有一次延迟达到数秒。我们没有将 Surface 的 4K p99 值列入表格,因为它们低于自身的平均值,这显然是不正确的,我们需要在打印之前确认 fio 在 Arm64 平台上如何报告百分位数。
结语
Surface Laptop Ultra for Business 搭载的 RTX Spark N1X 是我们迄今为止在笔记本电脑中见过的最强大的多线程 CPU,它配备了 122GB/s 的内存带宽和 64GB 的 GPU 显存(可扩展至 96GB),这比以往任何笔记本电脑都为 NVIDIA GPU 配备了更大的显存。它在 Cinebench、7-Zip、Blender、x265 和 LLVM 构建测试中均遥遥领先,顺序读取速度达到 14.1GB/s,顺序写入速度达到 11.5GB/s,创下新的存储记录。此外,它是唯一能够以可用速度运行我们 350 亿参数 M 级模型的系统,在 90 秒内即可完成编码代理的 M 级任务,而 x64 集成系统则需要 5 到 11 分钟。

这些限制仅适用于目前发布的平台。Windows on Arm 的存储路径将随机 I/O 限制在硬盘容量的五分之一,内存延迟是 x64 系统的两倍。单线程性能落后于 x64 平台,一些 Arm64 移植版本(例如 SVT-AV1 和 GROMACS)的性能远逊于其 x64 版本。此外,集成 GPU 还与其他系统组件共享内存总线,因此在运行代理程序时,桌面速度会降低一半。
对于一款配备 24GB 内存的机型来说,Razer Blade 16 的 RTX 5090 生成令牌的速度是 Surface 的 2.3 倍,并且在生成令牌的同时还能保持响应速度;Surface 的最佳使用场景是那些无法安装在较小平台上的机型。
除了上述注意事项外,两台 Surface Laptop Ultra 在相同的全核双精度负载下,均出现了与温度无关的自动断电现象,日志显示为硬断电而非过热保护。大多数用户可能永远不会在 20 个线程上运行 HPL 类型的求解器,而且这款笔记本电脑在其他所有持续测试中温度都保持在 98 摄氏度,并未因此扣分。但工作站级别的笔记本电脑应该能够承受最繁重的正常工作负载,在微软或英伟达解释断电原因之前,这台机器的过热保护机制仍是一个悬而未决的问题。
对于想要在本地运行 20 亿到 35 亿个模型、编译大型树状图或在笔记本电脑的 CPU 上进行渲染的开发人员或分析师来说,这款 Surface 中的 N1X 处理器能够做到本次对比中任何 x64 笔记本电脑都无法做到的事情,而 128GB 配置更是完美地实现了这一目标。
对于那些工作内容仅限于单线程、浏览器密集型应用或使用配备 24GB 内存的独立显卡的用户来说,x64 架构的笔记本电脑可能是更好的选择,而 Precision 5 16S 和 Blade 16 正好满足了这一需求。实验室完成机箱评测后,我们将带来硬件体验和电池续航时间的评测;同时,一旦收到厂商关于关机问题的回复,我们也会尽快发布评测结果。
排行榜: Surface Laptop Ultra for Business 在我们的“最佳本地 AI 笔记本电脑”排行榜的 RTX Spark 部分中进行了测试,与我们在新客户端套件中测试过的其他 N1X 系统一起,并且在我们的“最佳商务笔记本电脑”排行榜的“其他测试产品”部分中也进行了测试。


 Amazon