

HP OmniBook Ultra 16 是惠普推出的 16 英寸 NVIDIA RTX Spark 笔记本电脑,机身厚度仅为 0.62 英寸,搭载 NVIDIA N1X 超级芯片和 3K OLED 显示屏。我们并排测试了两台机器:一台配备完整的 20 核 N1X 芯片、128GB LPDDR5X 内存和 2TB Gen5 固态硬盘;另一台则配备相同的芯片、32GB 内存和 1TB Gen5 固态硬盘。我们测试的 32GB 内存 + 1TB 固态硬盘版本在百思买的售价为 3,199.99 美元,这也是惠普的起售价;64GB 内存 + 2TB 固态硬盘版本在惠普官网的售价为 4,999.99 美元;而我们测试的 128GB 内存 + 2TB 固态硬盘版本只能通过惠普官网的配置器进行配置,截至 10 月 14 日,惠普在该配置器上的售价为 6,229.99 美元。
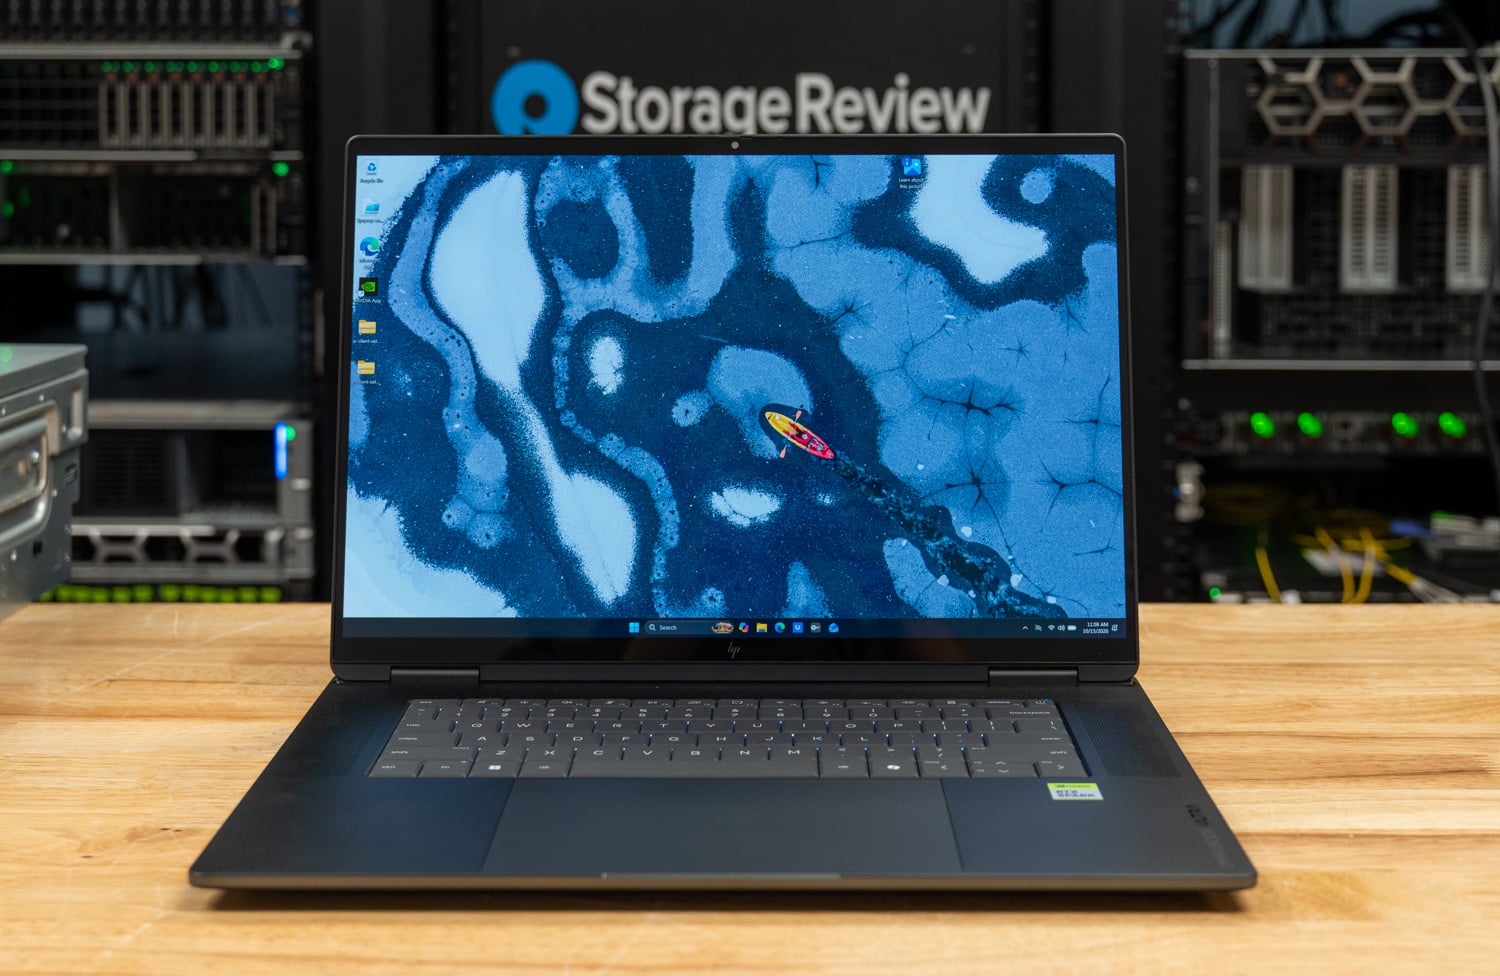
除了这两款惠普笔记本电脑之外,我们还对比了微软 Surface Laptop Ultra(我们测试过的另一款配备 128GB 内存和 RTX Spark 显卡的笔记本电脑)、联想 Pro 9n 15(它与配备 32GB 内存的惠普笔记本电脑共享 12GB 显存)以及雷蛇 Blade 16(其 RTX 5090 显卡使其成为本次对比中最强大的 x64 笔记本电脑)。待新的测试平台搭建完成后,我们将发布电池续航测试结果。
不过,我们先来说说这一点:128GB 的 OmniBook 是我们测试过的最全面的 RTX Spark 系统。它在本组测试中取得了最高的 Cinebench 2026 多核得分,达到 7,004 分;完成 M 级 Qwen3.6 编码任务的速度也超过了其他所有系统;并且能够以 98 摄氏度的温度完整运行需要两台 Surface 设备才能完成的全核 OpenBLAS 求解任务。32GB 版本在 CPU、MLPerf 和 RAG 测试中的表现与它相差不到 2%。对于所有这些系统而言,内存都是瓶颈,因此在购买时应该考虑内存容量:较小的 GPU 内存分配会限制哪些型号的显卡能够兼容并流畅运行。
关键精华
- 128GB 版本可以运行我们测试的所有本地 AI 版本: 在配备 62.5GB GPU 可用显存的情况下,gpt-oss:20b 和 Qwen3.6-35B-A3B 分别以每秒 58.0 和 89.5 个 token 的速度生成数据。Qwen3.6 编码任务三次运行全部通过,耗时 72.0 秒,是所有测试机型中最快的。配备 24GB 显存的 Blade 16 机型,其 RTX 5090 显卡的性能是 RTX 5090 的 2.3 倍。
- 32GB版本保持了速度,但容量有所减少: MLPerf Llama 3.1 8B 的运行速度为每秒 56.4 个令牌,而 128GB 单元的运行速度为每秒 56.5 个令牌,但由于其 12GB GPU 的分配,它无法参与任何模型加载和编码代理测试。
- 该组中最快的多核测试结果: 在 Cinebench 2026 多核测试中,其得分为 7,004,比 Razer Blade 16 高出 35%;LLVM 构建耗时 206.6 秒,而 Blade 则耗时 327.0 秒。
- 高温且在极限状态下稳定: 两台 HP 笔记本电脑在所有全核测试中温度均保持在 98 摄氏度,性能没有下降,并且都完成了全核 OpenBLAS 求解测试,该测试导致两台 Surface Laptop Ultra 设备断电。
- 第五代存储设备位于 Windows on Arm 天花板后面: 128GB 的 Sandisk SN8050S 固态硬盘的顺序读取速度为 13,833MB/s,原始设备读取速度为 1.89M IOPS,但通过 NTFS 和 BitLocker 进行的 4K 随机读取速度最高仅为 437.8K IOPS。
建筑与设计
惠普 OmniBook Ultra 16 采用三片式铝合金机身,经 CNC 精密加工而成,边缘圆润,侧面凹陷,并以惠普称之为“日蚀灰”的深色涂装呈现。其尺寸为 14.01 x 10.1 英寸,厚度从后部的 15.7 毫米逐渐收窄至前部的 11.6 毫米,重量为 4.89 磅;惠普称其为迄今为止最薄的 RTX Spark PC。机身盖采用 50% 的再生金属,键盘部件采用 85% 的消费后再生塑料,扬声器外壳则使用了海洋回收塑料。我们评测的两台机器均采用相同的机身,因此本节内容适用于两种配置。
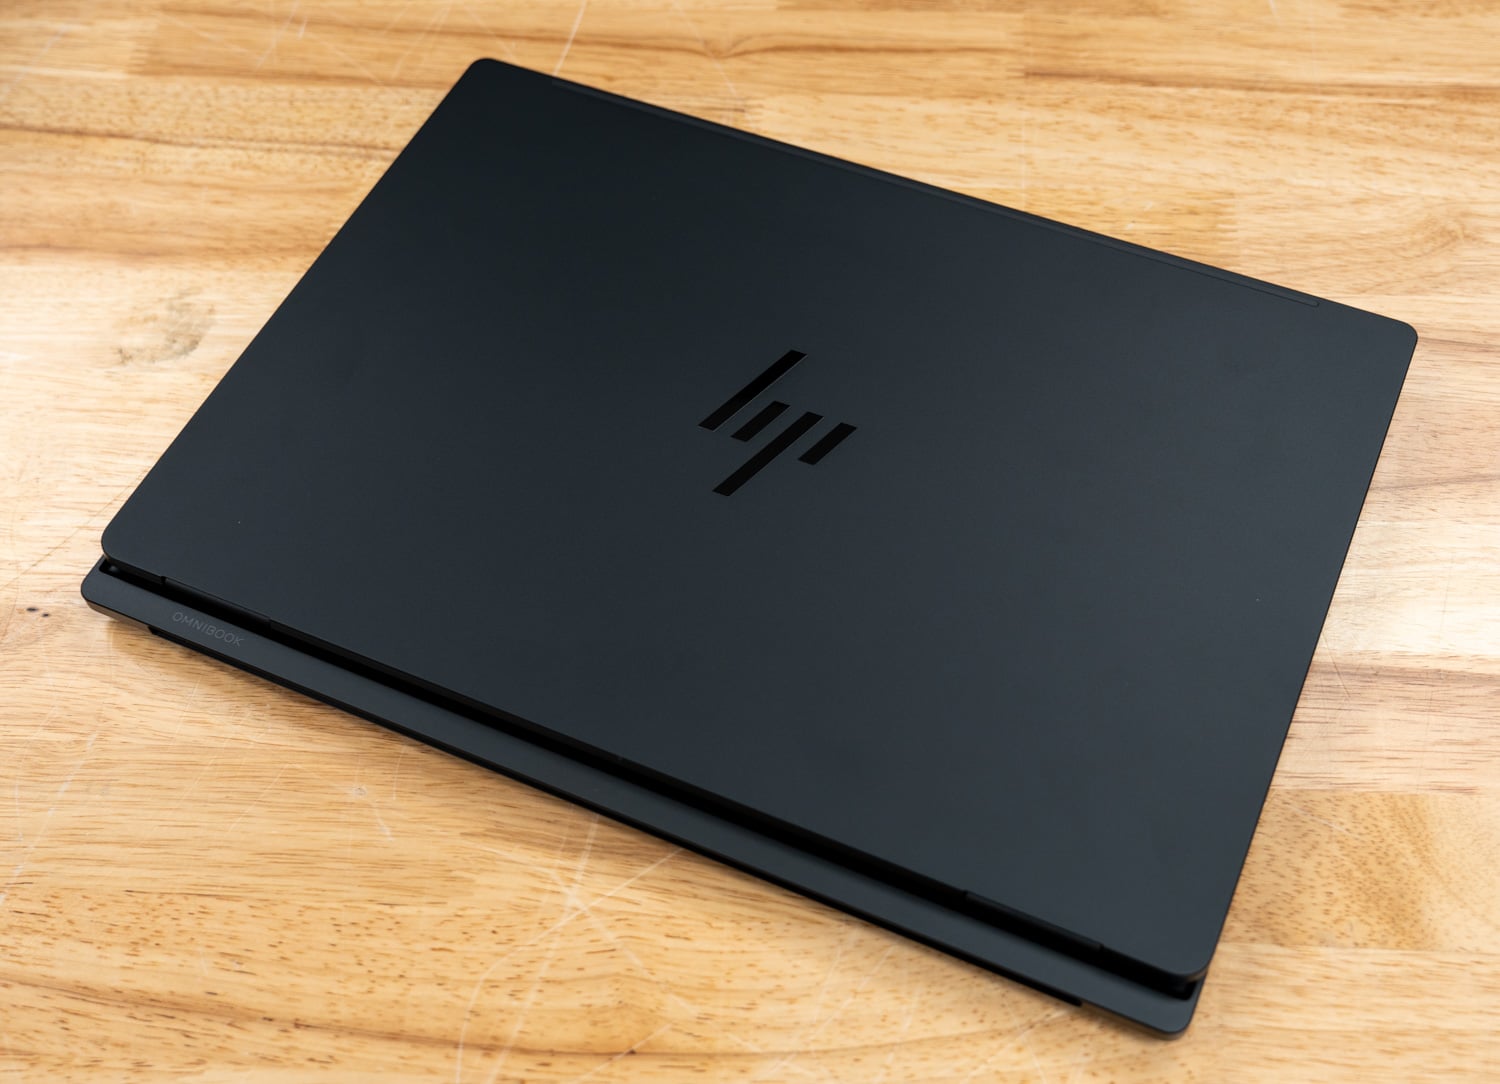
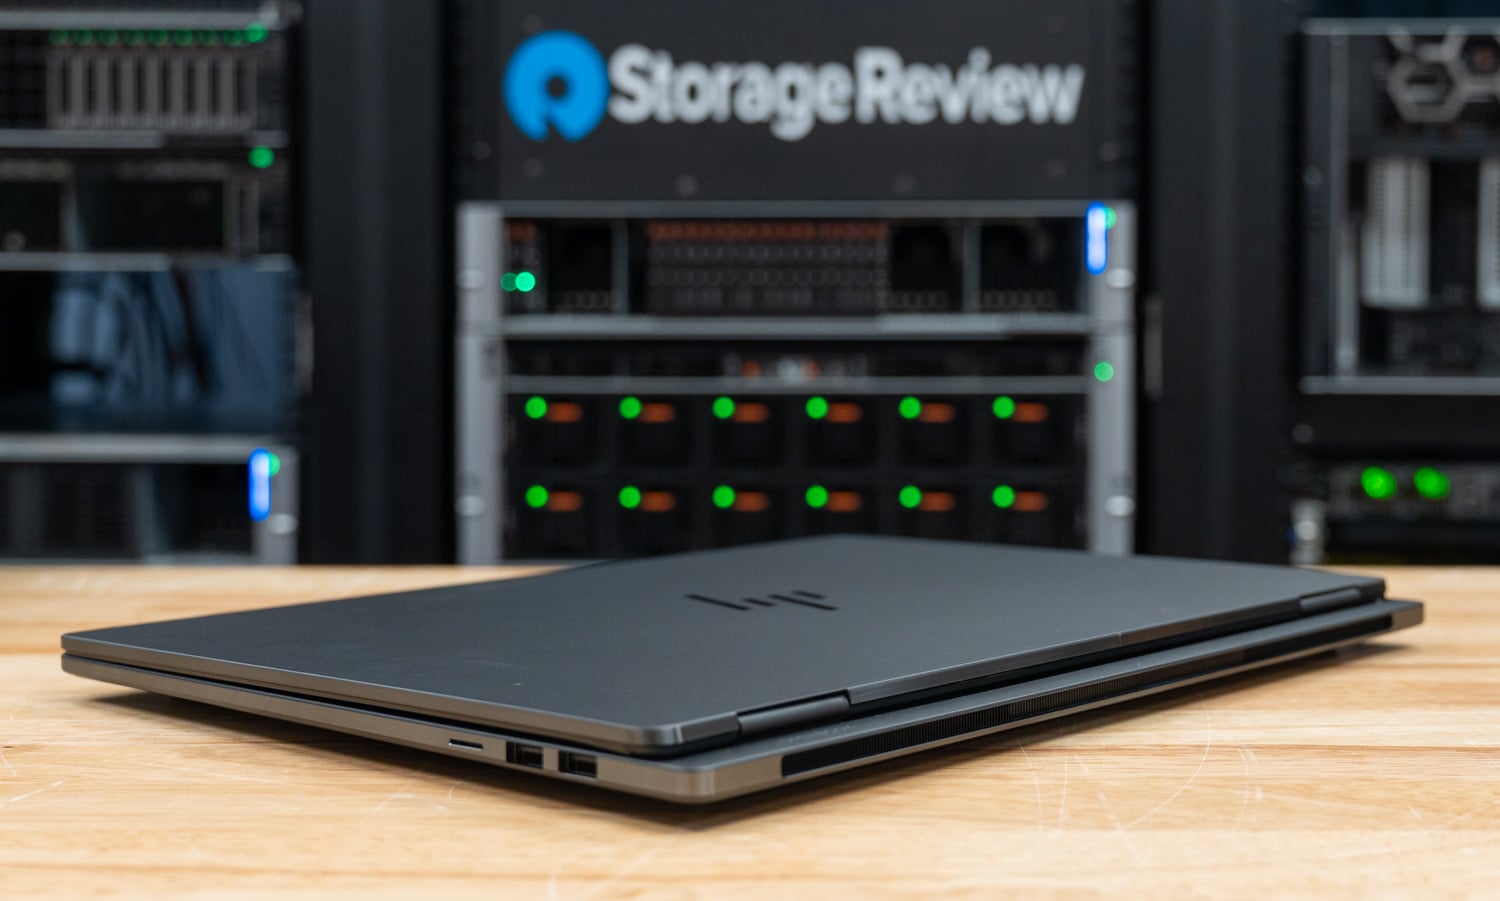
在我们首批评测的RTX Spark笔记本电脑中,OmniBook的手感最佳。其纹理金属表面和纤薄的机身赋予它一种高级而扎实的质感,完全不像它本身那么薄,而且机身完全没有同尺寸笔记本电脑常见的弯曲变形(感觉更像是一台真正的ZBook)。底座后缘延伸至屏幕铰链之后,这在笔记本电脑中并不常见,也改变了散热方式:无论屏幕打开还是关闭,热气都会直接从机身后部排出,而不会吹到铰链或屏幕底部。
惠普将这种延伸设计称为其塔式铰链和机身背部设计,这在惠普消费级笔记本电脑中尚属首次。在传统的翻盖式笔记本电脑中,显示屏和铰链会占据底座后部的大部分空间,因此惠普将机身延伸到铰链后方,使空气能够顺畅地从后方排出。惠普表示,OmniBook 在性能模式下的功耗最高可达 70W。
惠普声称该设计的优势在于持续的性能和更低的表面温度,而我们的测试也证实了前半部分的说法:N1X 在长达 30 分钟的持续循环测试中始终保持稳定运行。然而,在所有 CPU 测试中,它的温度都达到了 98 摄氏度的上限,高于惠普 Pro 9n 和联想 Yoga 9n 二合一 16。因此,后备箱的设计虽然能够排出废气,但并没有降低 CPU 本身的温度。本次评测中,我们并未测量 CPU 的表面温度。
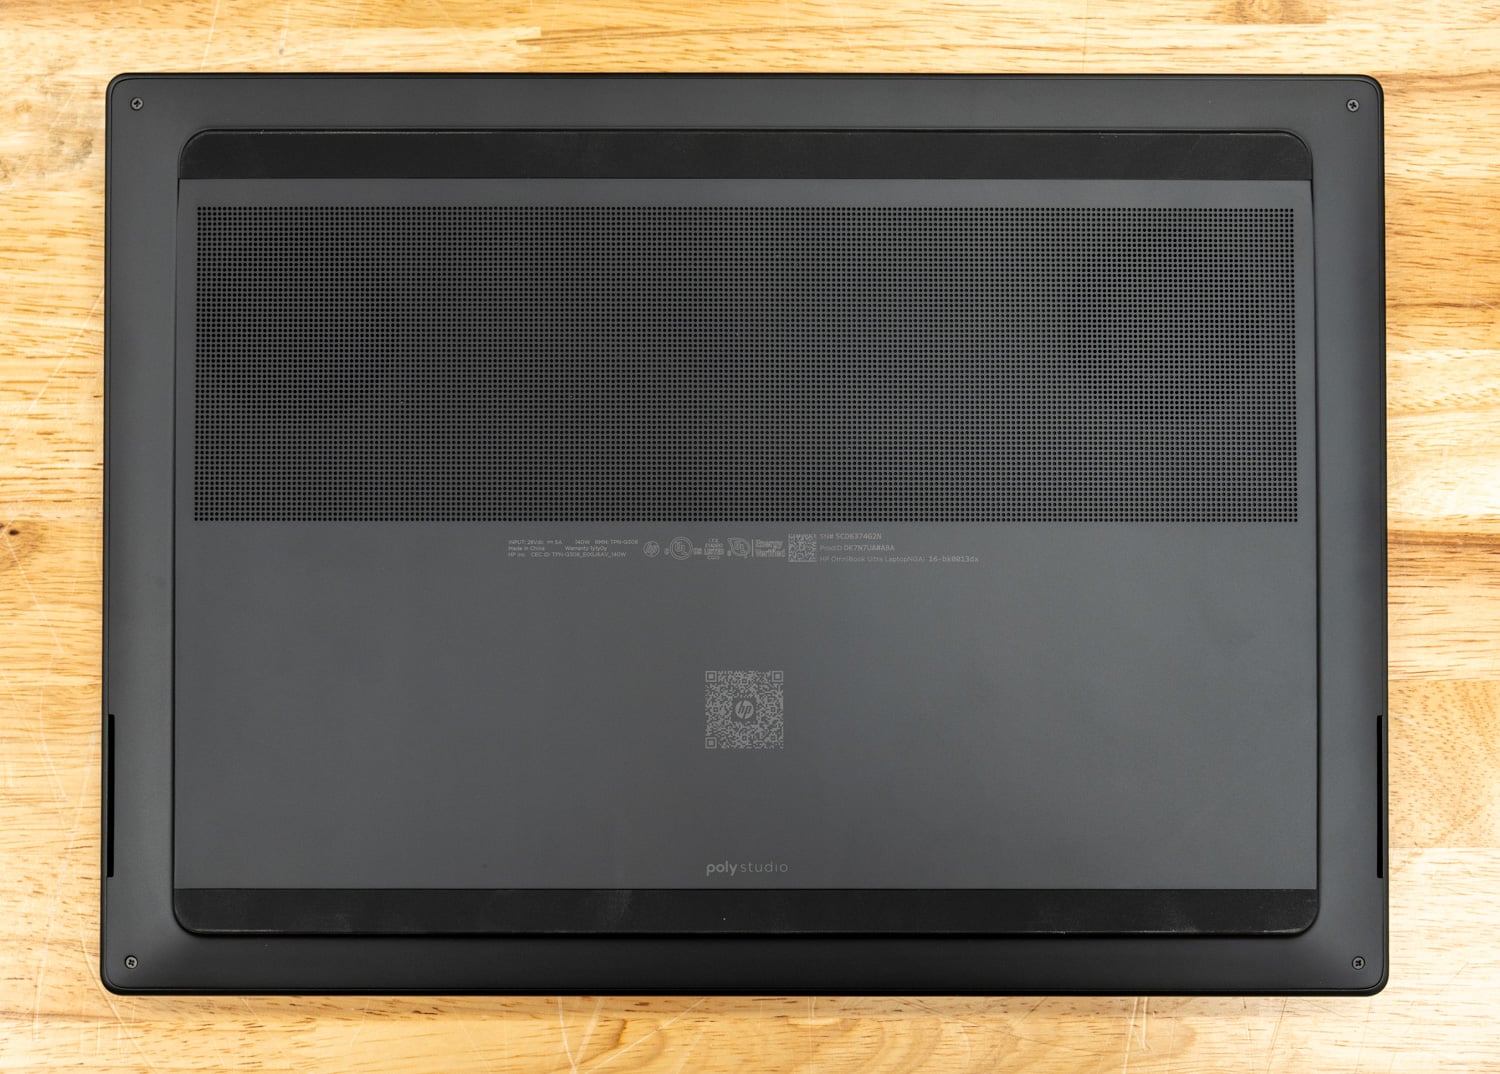
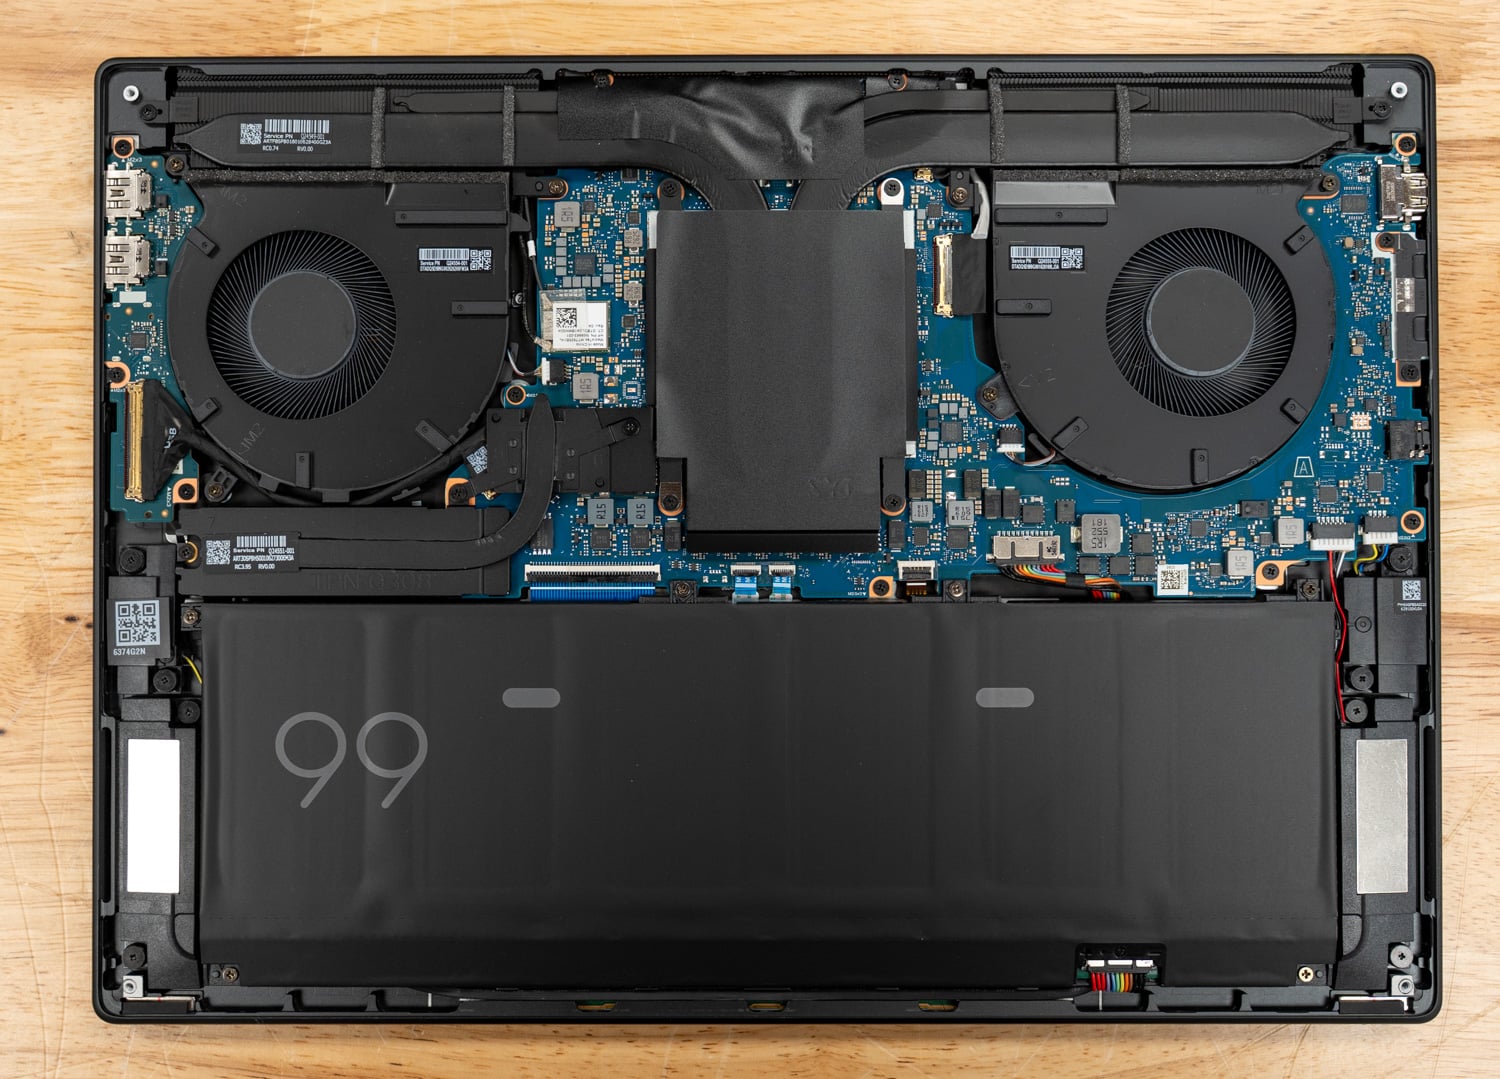
底部面板后半部分大部分被一个大型进气格栅覆盖。取下面板后,可以看到两个风扇位于中央屏蔽罩两侧的后角,热管连接着风扇和99Wh电池,电池占据了机箱的前半部分。惠普表示,每个风扇有79个厚度为0.15毫米的扇叶;两根粗热管覆盖处理器,第三根热管覆盖固态硬盘,热管厚度为1至1.8毫米;此外,热敏电阻用于监测内部温度,红外传感器则用于监测表面温度。
内存采用板载 LPDDR5X,因此您购买的配置就是您将保留的配置,这在 RTX Spark 系统上比在大多数笔记本电脑上更重要,因为内存容量也决定了 GPU 可以使用多少内存。
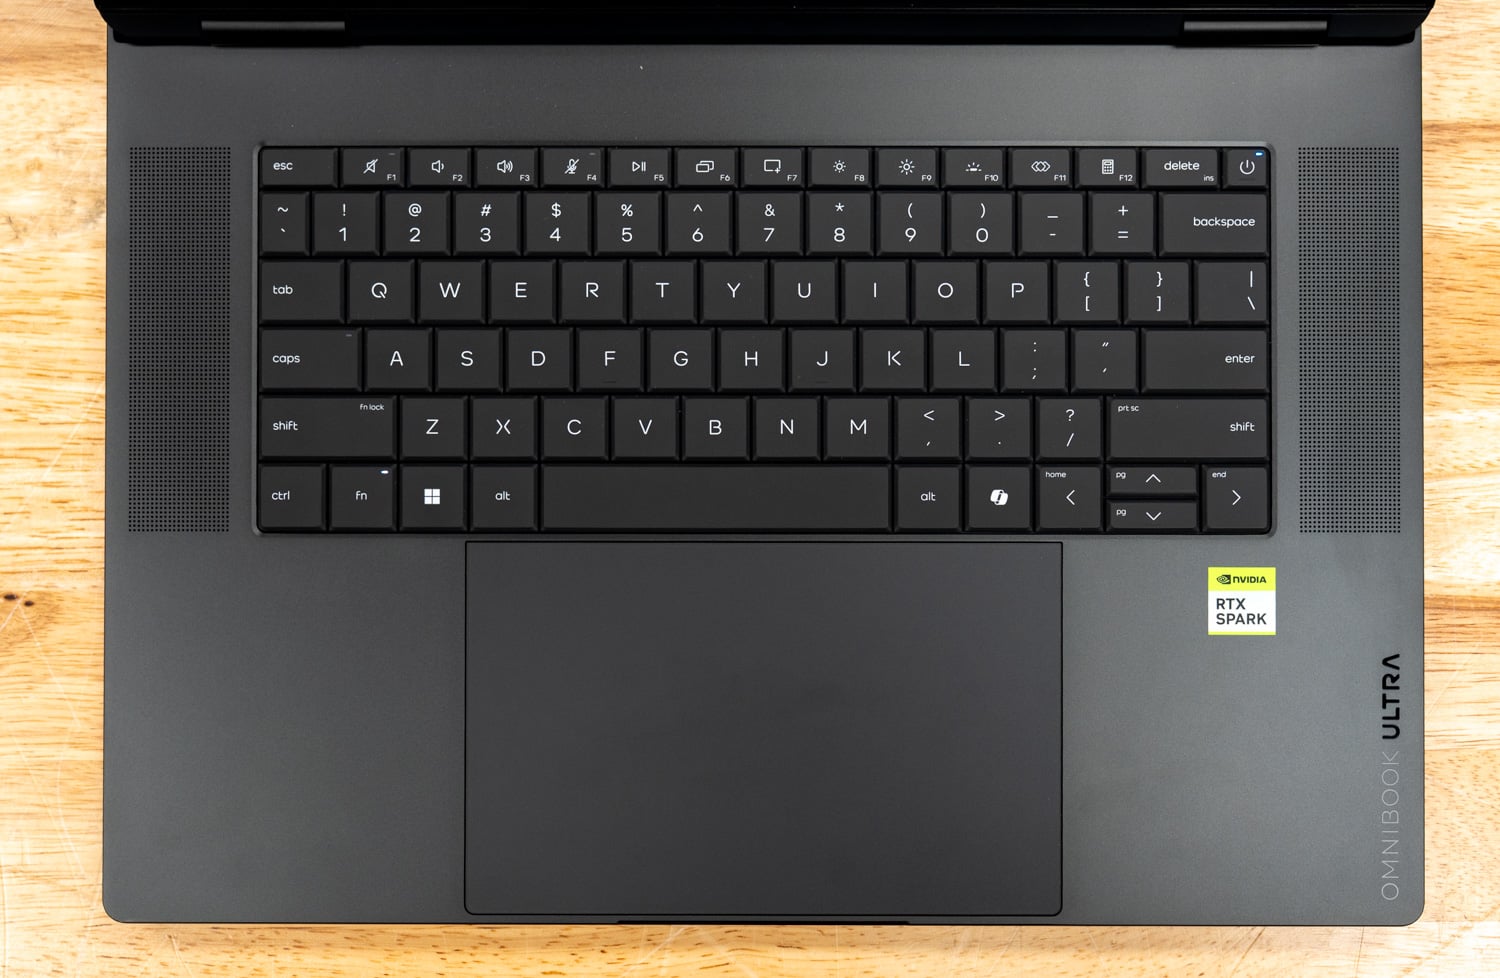
这款键盘采用惠普第二代无网格布局,全尺寸背光键盘,按键间距为3毫米,键帽比第一代更深。键盘两侧是四扬声器格栅,包括两个主驱动单元和两个高音单元,分别安装在独立的智能放大器上,支持DTS空间音频和Poly Studio调音。键盘下方是一块160 x 100毫米的超大触控板,支持任意位置点击,并可调节点击力度,还具备静音点击模式,以及音量和亮度调节手势。5万像素红外摄像头配备物理隐私快门,并可通过专用按键静音麦克风。
这款笔记本电脑配备了一块16英寸3K (2880 x 1800) OLED触控屏,采用康宁第三代大猩猩玻璃,刷新率最高可达120Hz,支持可变刷新率,响应时间为0.2毫秒。惠普官方标称其在SDR模式下亮度为500尼特,在HDR模式下亮度为1,100尼特,拥有100% DCI-P3色域覆盖、VESA DisplayHDR True Black 1000认证,以及低于1的Delta E色差;屏幕占据了机身91%的面积。
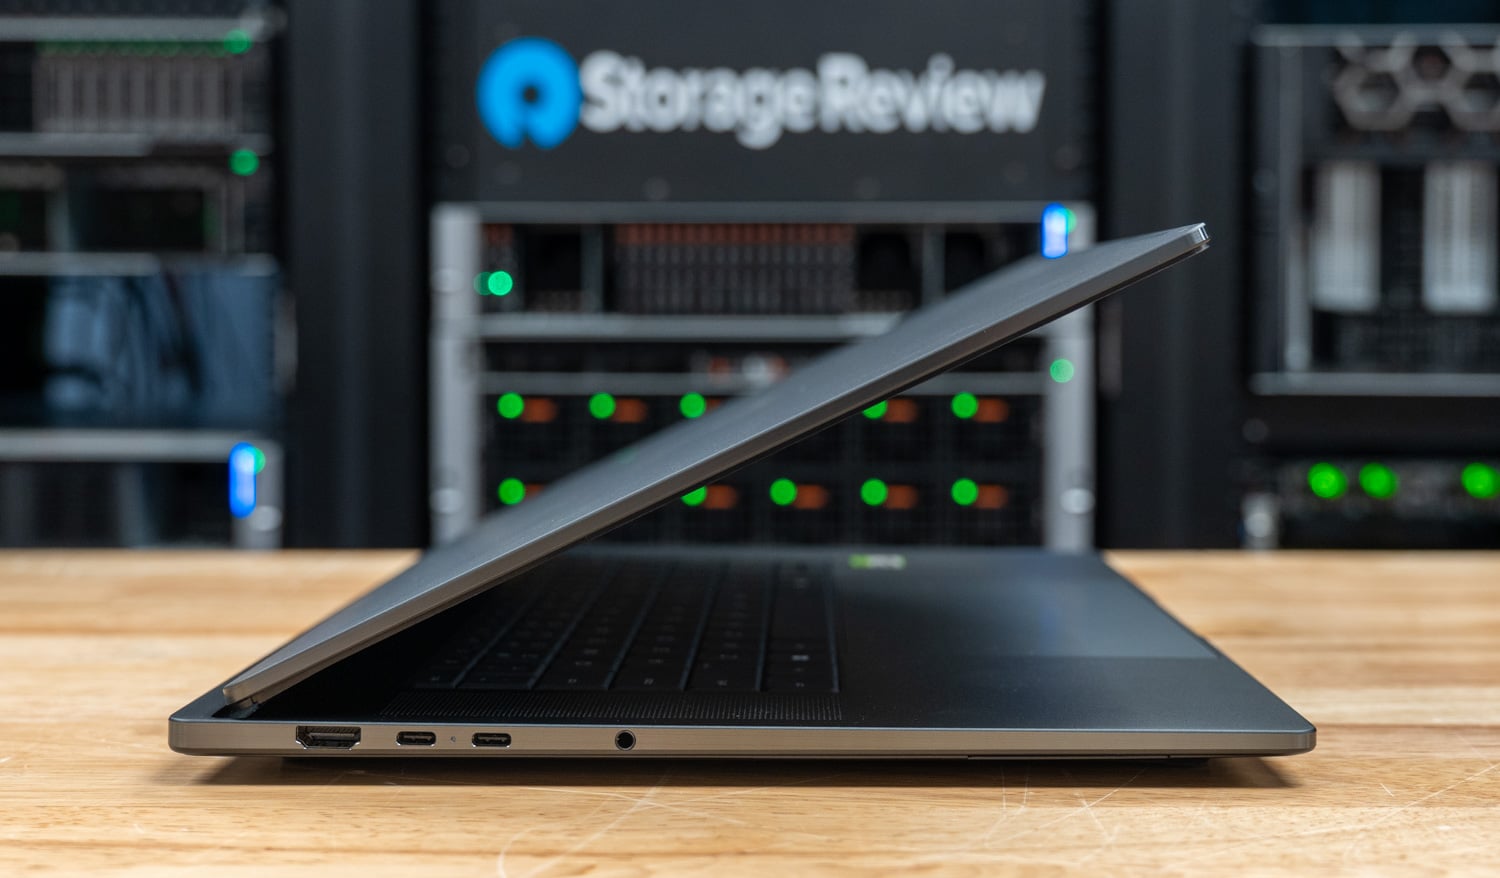
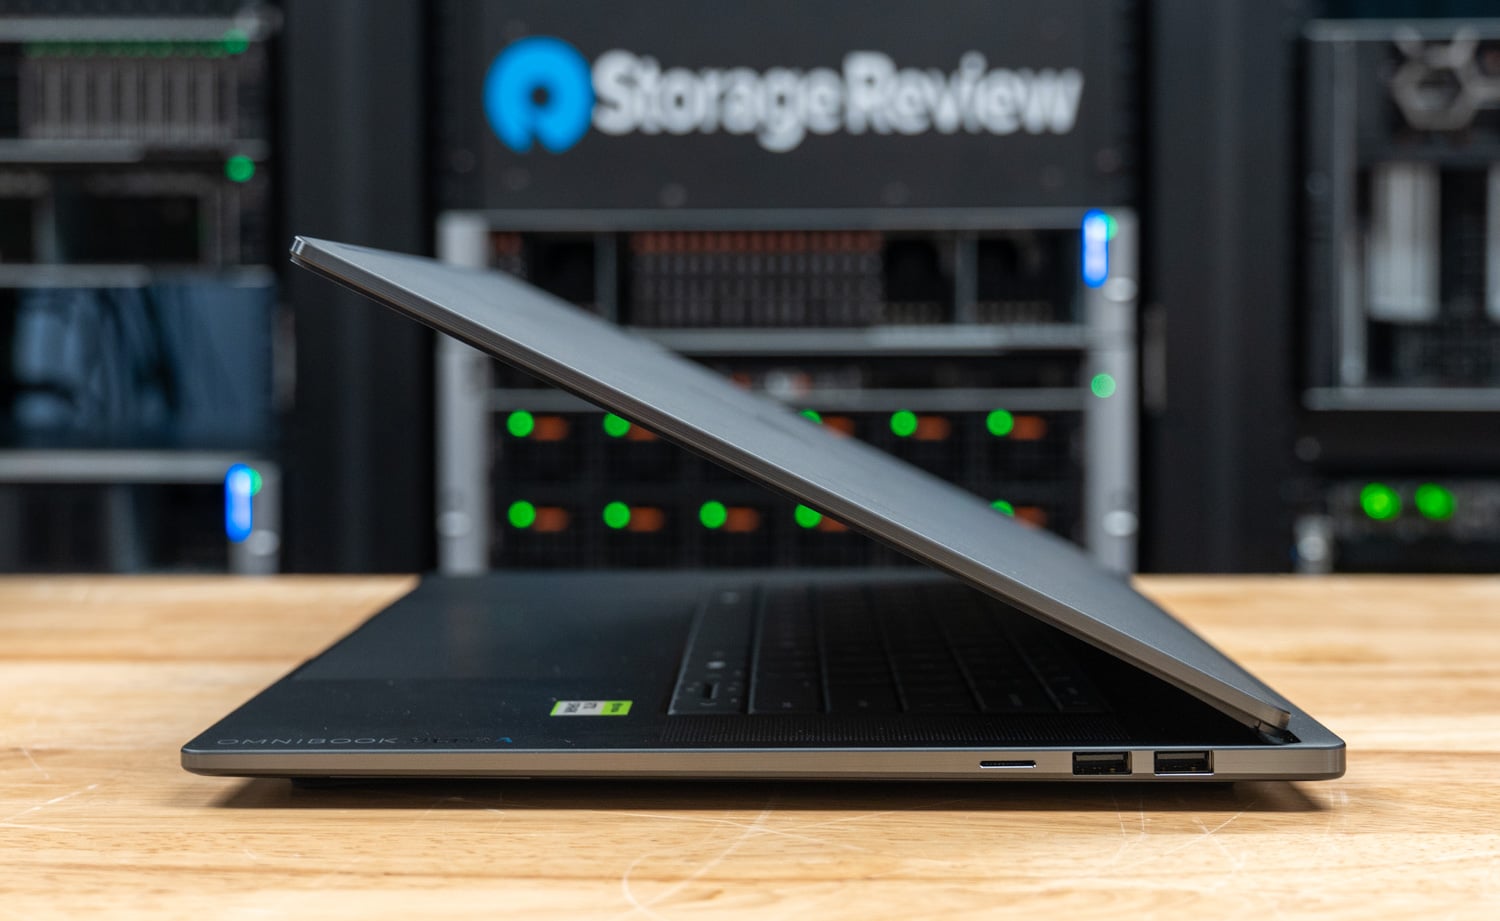
左侧配备 HDMI 2.1 接口、两个支持 USB Power Delivery 和 DisplayPort 2.1 的 40Gbps USB-C 接口以及耳机插孔;右侧配备 microSD 读卡器和两个 10Gbps USB-A 接口。无线网卡采用联发科 MT7925,支持 Wi-Fi 7 和蓝牙 6.0。惠普官方宣称 99Wh 电池续航时间长达 17 小时,并随附一个 140W USB-C GaN 适配器,该适配器采用折叠式插头和可拆卸的 2 米线缆。惠普表示,这款适配器比上一代 140W 适配器体积缩小 43%,重量减轻 28%,充电 30 分钟即可充至 50% 左右。
RTX Spark N1X 平台
RTX Spark 是基于 N1X 超级芯片的 Windows PC 系列,其笔记本电脑版本DGX Spark与 GB10 类似。我们在Surface Laptop Ultra 的评测中已经详细介绍过该平台,因此本节将重点介绍与 OmniBook 测试结果相关的关键信息。我们评测的两款 HP 笔记本电脑均搭载了顶级配置,即 20 核 Grace CPU(10 个高速核心和 10 个能效核心,不支持 SMT)搭配 6,144 核 Blackwell RTX GPU。HP 还提供 18 核 5,120 核 GPU 的版本,与本次对比中的 Lenovo Pro 9n 采用相同的配置。
N1X 的 LPDDR5X 内存以 9,400 MT/s 的速率运行在 256 位接口上,并由 CPU 和 GPU 共享。NVIDIA 应用程序中的一个设置决定了 Windows 分配给 GPU 的专用显存大小。这是 Windows 系统中的设置,而非 BIOS 选项,因此可以轻松地重新调整内存分配。
我们的128GB版本配置为GPU和CPU各64GB,实测GPU可用内存为62.5GB,符合我们本地AI模型测试的两个层级。我们将32GB版本配置为GPU 12GB和CPU 20GB,与联想Pro 9n相同,因此两款32GB系统可以直接比较;12GB配置下,两款系统均不符合模型层级测试的要求。
内存分配固定是 Windows 的限制,而非 NVIDIA 的限制。Windows 目前还不支持像 DGX Spark 上的 Linux 系统那样跨 CPU 和 GPU 统一内存分配,因此必须预先设置内存分配;我们了解到 NVIDIA 和微软正在共同努力解决这个问题。
OmniBook 运行的是基于 Arm64 架构的 Windows 11 26H1 系统,因此 x64 应用程序需要通过 Prism 进行模拟。我们的测试套件使用所有开源工作负载的原生 Arm64 版本,以确保 CPU 性能数据基于硅芯片。如果 Arm64 移植版本尚不成熟,或者唯一的选择是 x64 版本,我们会特别说明,因为下面的几行测试结果依赖于这些移植版本。
HP OmniBook Ultra 16 规格
| 规格 | HP OmniBook Ultra 16 (16-bk0xxx) |
|---|---|
| 平台概述 | |
| 处理器 | NVIDIA RTX Spark N1X,20 核 CPU 搭配 6,144 核 Blackwell RTX GPU(测试机型均为此配置) NVIDIA RTX Spark N1X,18 核 CPU 搭配 5,120 核 Blackwell RTX GPU |
| 内存 | 32GB、64GB 或 128GB LPDDR5X-9400(板载) 128GB内存,64GB GPU内存/64GB系统内存(测试机型为1) 32GB内存,12GB GPU内存/20GB系统内存(测试机型为2) |
| 存放 | 1TB PCIe Gen5 NVMe M.2 SSD 或 2TB PCIe Gen5 NVMe 高性能 M.2 SSD 2TB Sandisk PC SN8050S(测试样机为1台) 1TB KIOXIA KBG80ZNV(测试机型为2) |
| 运行系统 | Windows 11 家庭版或 Windows 11 专业版 (Arm64) 测试系统:Windows 11 专业版(单元 1)、Windows 11 家庭版(单元 2) |
| 显示和 I/O | |
| 展示 | 16英寸3K (2880 x 1800) OLED触控屏,最高支持120Hz刷新率、VRR可变刷新率,响应时间0.2毫秒 500 尼特 SDR、1,100 尼特 HDR、100% DCI-P3、Delta E <1 VESA DisplayHDR True Black 1000,康宁第三代大猩猩玻璃 |
| 端口 | 2 个 USB-C 40Gbps 接口(支持 USB 电源传输和 DisplayPort 2.1) 2个USB-A 10Gbps 1个HDMI 2.1 1 个 microSD 卡读卡器 1 个耳机/麦克风组合插孔 |
| 无线耳机 | 联发科 Wi-Fi 7 MT7925 (2×2),蓝牙 6.0 |
| 相机 | 5万像素红外摄像头,带隐私快门 |
| 音频 | 四扬声器(2个主扬声器,2个高音扬声器),配备独立智能功放;DTS空间音频,Poly Studio调音 |
| 输入 | 第二代无网格背光键盘 160 x 100 毫米触觉触控板,带手势控制功能 |
| 力量和体能 | |
| 电池 | 6芯99Wh锂离子聚合物电池;续航时间长达17小时(惠普官方数据) |
| 充电 | 140W USB-C GaN 适配器;30 分钟可充电约 50%(惠普官方数据) |
| 热设计 | 塔式铰链和机箱;两个风扇、三根热管、热敏电阻和红外传感器;最高 70W TDP(HP 额定值) |
| 尺寸 | 14.01 x 10.1 x 0.62 英寸(后部 15.7 毫米,前部 11.6 毫米) |
| 重量 | 4.89磅 |
| 颜色 | 日蚀灰 |
| 安全与定价 | |
| 安保防护 | 麦克风静音键、摄像头隐私快门、TPM;两台设备均支持 BitLocker XTS-AES-128 加密 |
| 价格筛选 | 3,199.99 美元(32GB,1TB,百思买和惠普官网,测试产品);4,999.99 美元(64GB,2TB,惠普官网) 6,229.99 美元(128GB、2TB,HP.com 配置器测试配置;HP 定价截至 2026 年 10 月 14 日) |
测试设置和方法
我们测试的两台 OmniBook Ultra 16 均搭载了 RTX Spark N1X 显卡,配备 6,144 核 Blackwell GPU:一台配备 128GB LPDDR5X-9400 内存(64/64 内存比例)和一块 2TB Sandisk SN8050S Gen5 固态硬盘,运行 Windows 11 专业版 26H1 系统;另一台配备 32GB 内存(12/20 内存比例)和一块 1TB KIOXIA Gen5 固态硬盘,运行 Windows 11 家庭版 26H1 系统,两台均采用 Arm64 架构。基准测试在 HP 的性能模式下运行,Windows 设置为“最佳性能”,并连接电源。
所有系统均运行了 sr-client 1.2,这是我们编写的 Windows 客户端基准测试套件。该套件在所有系统上应用相同的实验室设置:Windows 电源模式设置为“最佳性能”,显示器亮度设置为 50%,所有睡眠和显示器关闭定时器均已禁用,并且 Windows 防火墙和 UAC 提示均已关闭。每个结果均为多次运行的中位数,如果测试结果的波动超过 2%,则该套件会重新运行测试才会接受该结果。
| 系统 | 中央处理器 | 内存 | GPU 用于 GPU 和 AI 测试 | SSD | 操作系统和性能模式 |
|---|---|---|---|---|---|
| HP OmniBook Ultra 16 (128GB) | NVIDIA RTX Spark N1X,20核/20线程 | 128GB LPDDR5X-9400(64GB GPU / 64GB 系统内存) | 6,144 核心 Blackwell RTX(集成显卡,可用显存 62.5GB) | 闪迪 PC SN8050S 2TB,Gen5 x4 | Windows 11 专业版 26H1 (Arm64),HP 性能 |
| HP OmniBook Ultra 16 (32GB) | NVIDIA RTX Spark N1X,20核/20线程 | 32GB LPDDR5X-9400(12GB GPU / 20GB 系统内存) | 6,144 核心 Blackwell RTX(集成显卡,可用显存 12GB) | KIOXIA KBG80ZNV 1TB,第五代 x4 | Windows 11 家庭版 26H1 (Arm64),HP 性能 |
| 微软 Surface Laptop Ultra | NVIDIA RTX Spark N1X,20核/20线程 | 128GB LPDDR5X-9400(64GB GPU / 64GB 系统内存) | 6,144 核心 Blackwell RTX(集成显卡,可用显存 62.5GB) | SK海力士HFS001TFM9X 1TB,第五代 x4 | Windows 11 专业版 26H1 (Arm64),最佳性能 |
| 联想Pro 9n 15 | NVIDIA RTX Spark N1X,18核/18线程 | 32GB LPDDR5X-9400(12GB GPU / 20GB 系统内存) | 5,120 核心 Blackwell RTX(集成显卡,可用显存 12GB) | 三星 MZAL81T0HFLB 1TB,Gen4 x4 | Windows 11 专业版 26H1 (Arm64),联想性能模式 |
| 雷蛇刃16 | AMD Ryzen AI 9 HX 370,12核/24线程 | 32GB LPDDR5X-8000 | NVIDIA GeForce RTX 5090 笔记本电脑显卡,24GB | 三星 MZVL22T0 2TB,Gen4 x4 | Windows 11 家庭版 25H2 (x64),Razer Synapse 性能 |
查看以下数据,除了已完成的测试数量之外,还有两个重要的术语需要理解。DNF 表示测试已开始但未完成,或因失败而被跳过;此处仅适用于 Surface 的 OpenBLAS 测试,该测试因笔记本电脑断电而被跳过。Not run 表示测试套件拒绝启动测试,因为硬件不符合要求,最常见的原因是某个型号的 GPU 内存超过了可用内存:32GB 的 OmniBook 和 12GB 可用 GPU 内存的 Pro 9n 均低于我们最低的型号级别,而 Blade 16 的 24GB 内存则使其低于 M 级。
N/A 表示该测试不适用于该硬件,例如在不支持 SMT 的芯片上测试 SMT 单核,或者在运行原生版本的 x64 系统上测试模拟行。如果 RTX Spark 系统通过 Prism 运行 x64 软件,则该行会注明。
本地人工智能性能
这些笔记本电脑的本地AI性能取决于GPU运行模型的速度以及模型是否适用。128GB的OmniBook和Surface满足了容量方面的需求,因为它们拥有62.5GB的GPU可用内存,足以运行我们推荐的M级模型;而32GB的OmniBook和Pro 9n则只能在小容量机型上达到相同的运行速度,仅此而已。
MLPerf 客户端 v2.0
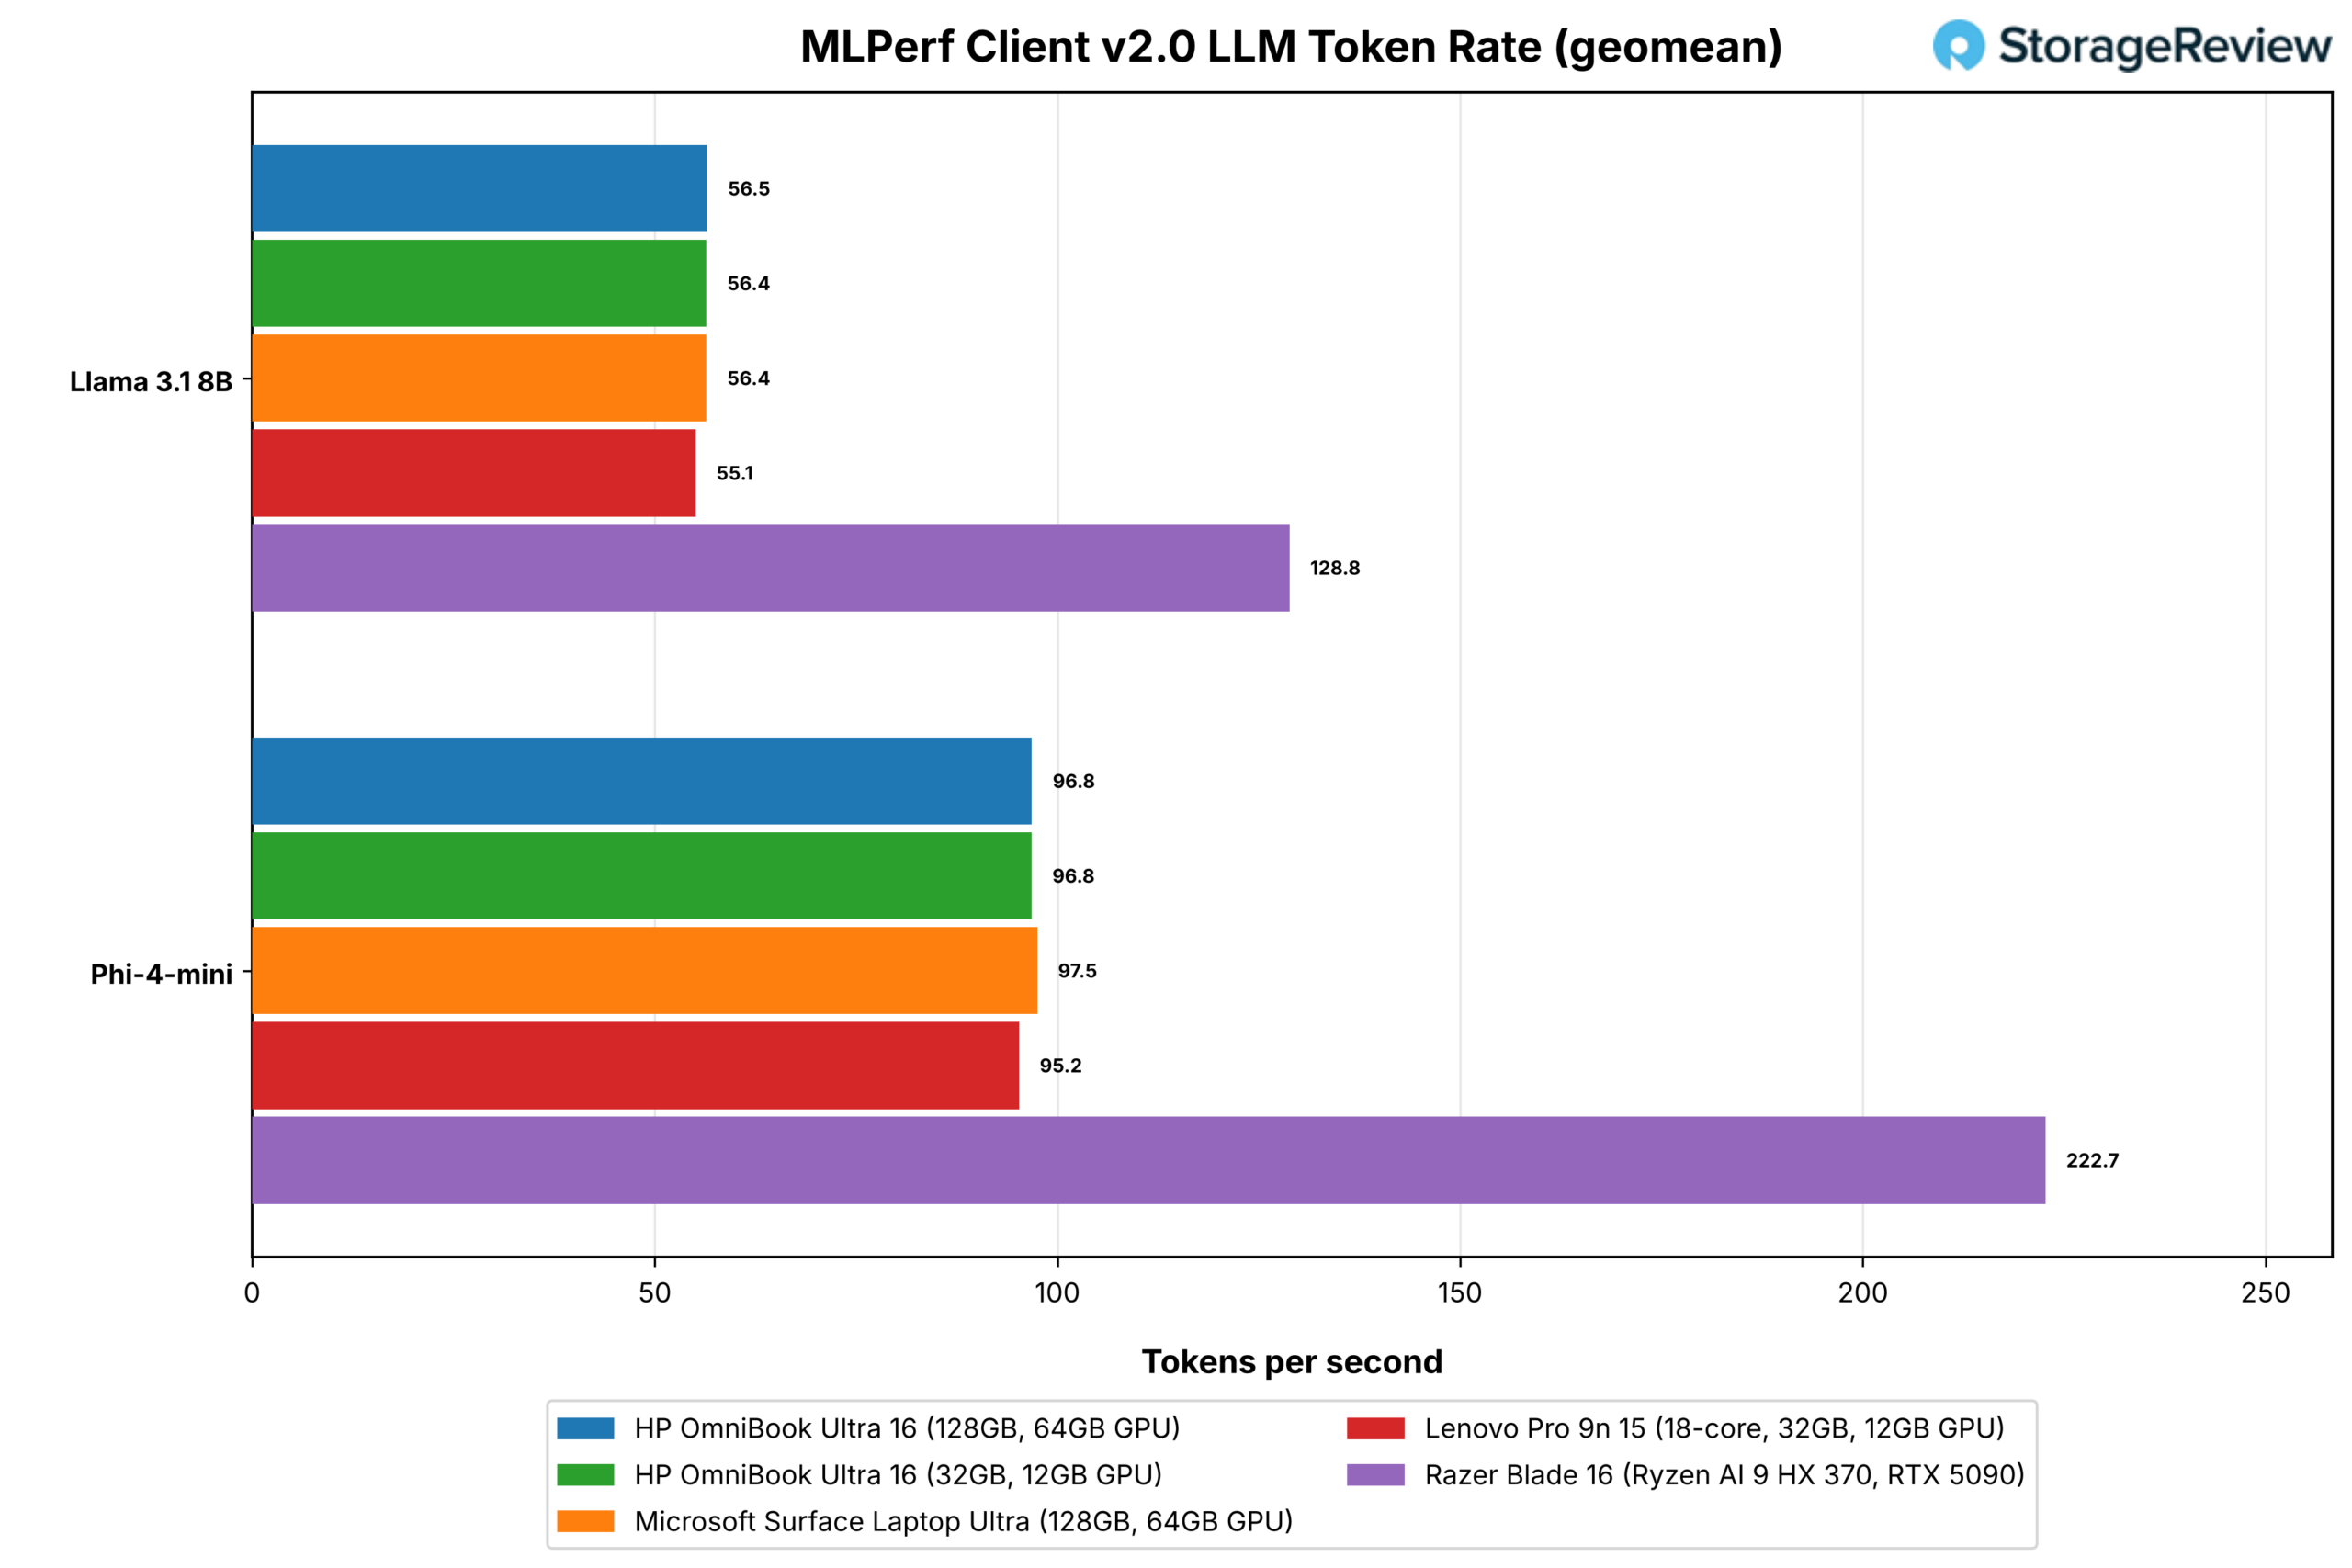
MLPerf 客户端运行 Llama 3.1 8B 和 Phi-4-mini,涵盖五种提示类别,并报告首次令牌到达时间和之后的令牌生成率(以各类别几何平均值表示)。本次评测中的所有系统均使用 llama.cpp 和 CUDA,因此引擎相同,各行数据比较的是硬件。代理场景中,Llama 3.1 8B 分别作为软件工程代理和数据分析代理运行,并在多个回合中调用工具。
| MLPerf 客户端 v2.0 | OmniBook Ultra 16 (128GB) | OmniBook Ultra 16 (32GB) | Surface Laptop Ultra | Pro 9n 15 | 雷蛇刃16 |
|---|---|---|---|---|---|
| Llama 3.1 8B,首次到达令牌的时间,几何平均值(秒,越低越好) | 0.274 | 0.275 | 0.284 | 0.303 | 0.149 |
| Llama 3.1 8B,令牌速率,几何平均值(令牌/秒) | 56.5 | 56.4 | 56.4 | 55.1 | 128.8 |
| Phi-4-mini,首次令牌到达时间,几何平均值(秒,越低越好) | 0.130 | 0.123 | 0.127 | 0.135 | 0.074 |
| Phi-4-mini,令牌率,几何平均值(令牌/秒) | 96.8 | 96.8 | 97.5 | 95.2 | 222.7 |
| 数据分析代理,端到端(s,数值越低越好) | 53.0 | 52.4 | 52.6 | 56.2 | 27.8 |
| 数据分析代理,代币速率(tok/s) | 48.5 | 49.0 | 48.9 | 46.9 | 108.3 |
| SWE Agent,端到端(s,数值越低越好) | 45.3 | 46.2 | 46.0 | 48.0 | 24.6 |
| SWE 代理,代币速率(tok/s) | 46.6 | 46.6 | 46.4 | 44.5 | 102.5 |
两台 OmniBook 运行 Llama 3.1 8B 测试,每秒生成 56.5 和 56.4 个令牌;运行 Phi-4-mini 测试,每秒生成 96.8 和 96.8 个令牌,两者的性能基本相同,也与 Surface 的性能相同,这证实了在合适的型号上,内存容量不会影响 N1X GPU 的速度。Pro 9n 的 5,120 核 GPU 在两台机型上的性能差距均在 3% 以内,因为这种规模的令牌生成更多地受限于内存带宽,而非 GPU 核心数。Blade 16 的性能最佳,每秒生成 128.8 和 222.7 个令牌。
代理场景遵循相同的模式,每个 RTX Spark 系统完成数据分析师场景需要 52.4 到 56.2 秒,完成软件工程师场景需要 45.3 到 48.0 秒,而 Blade 16 在这两个场景中花费的时间大约只有它的一半。
模型加载
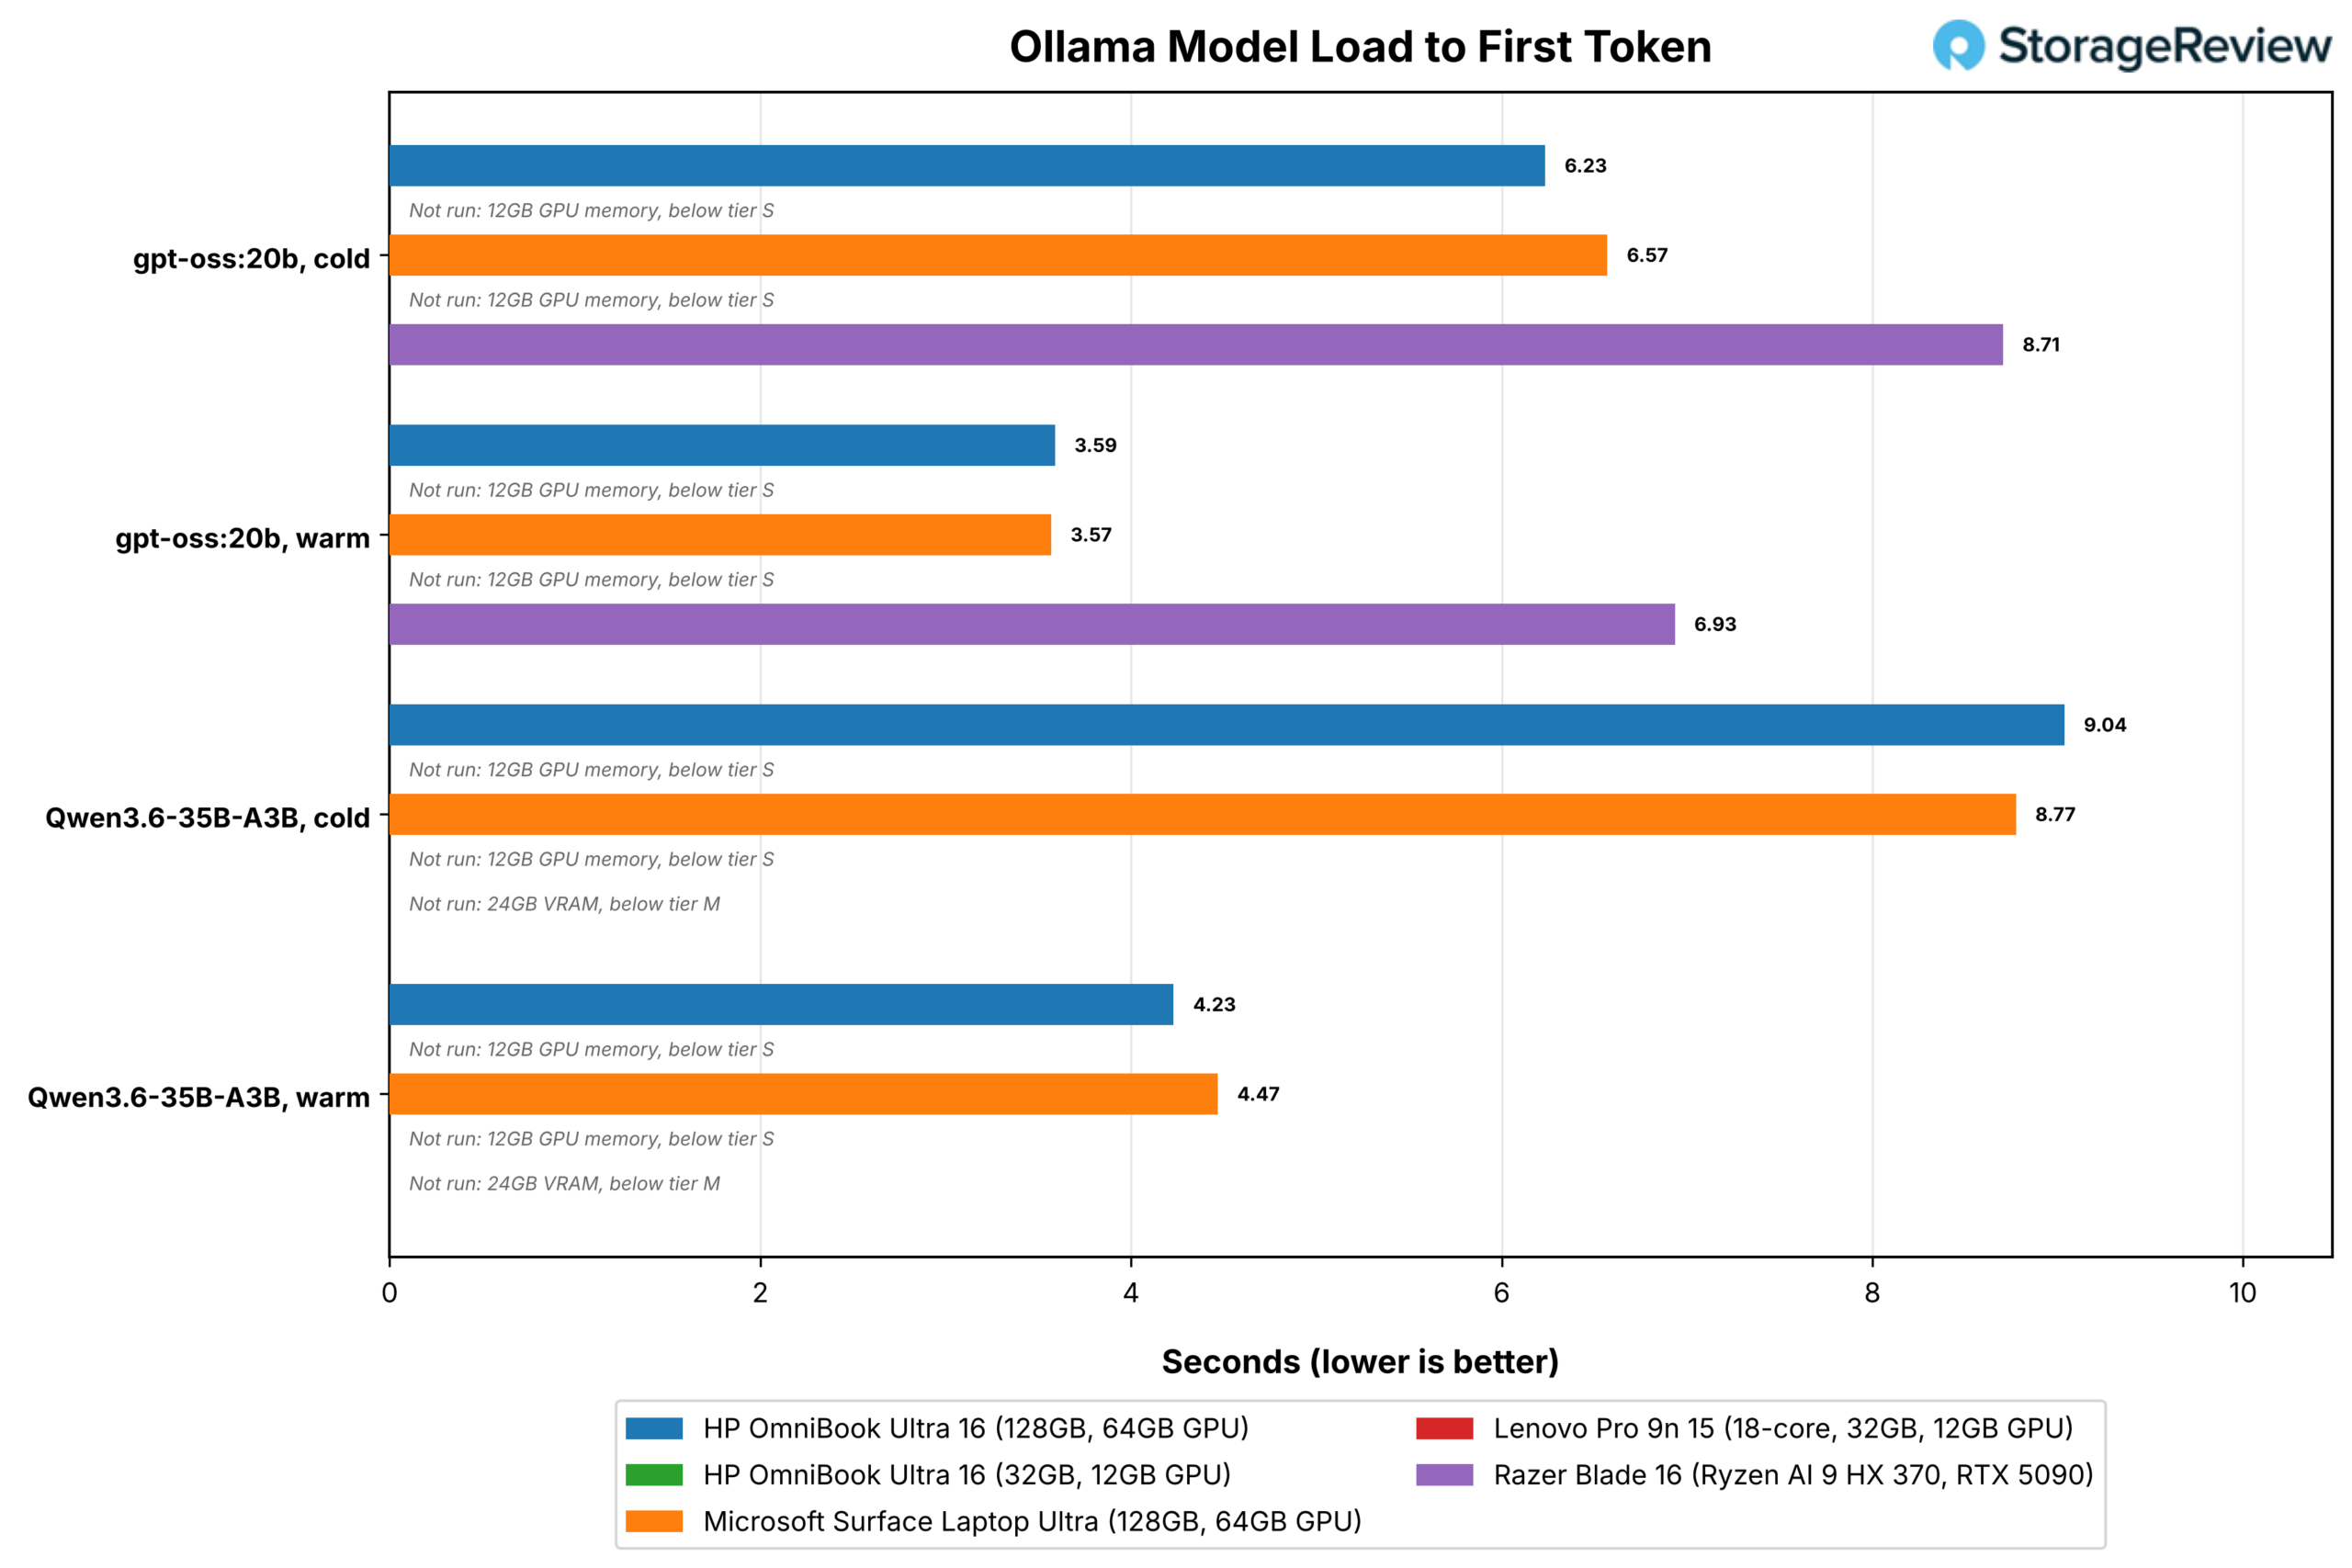
此测试在 Ollama 中对本地模型进行计时,从 SSD 读取到生成第一个令牌,分别在冷态(文件缓存已清空)和热态(文件已在内存中)两种情况下进行,并报告冷态负载下 SSD 的读取速度。S 级测试在至少拥有 16GB GPU 可用内存的系统上使用 gpt-oss:20b (12.8GB) 镜像;M 级测试在拥有约 40GB 或更多 GPU 可用内存的系统上添加了 Qwen3.6-35B-A3B (21.1GB) 镜像。
| 模型加载(内存映射开启) | OmniBook Ultra 16 (128GB) | OmniBook Ultra 16 (32GB) | Surface Laptop Ultra | Pro 9n 15 | 雷蛇刃16 |
|---|---|---|---|---|---|
| gpt-oss:20b,冷加载到第一个标记(s,数值越小越好) | 6.23 | 未运行(12GB GPU 显存) | 6.57 | 未运行(12GB GPU 显存) | 8.71 |
| gpt-oss:20b,热加载到第一个标记(s,数值越小越好) | 3.59 | 未运行(12GB GPU 显存) | 3.57 | 未运行(12GB GPU 显存) | 6.93 |
| gpt-oss:20b,冷加载期间的读取吞吐量(MB/s) | 3,044 | 未运行(12GB GPU 显存) | 3,080 | 未运行(12GB GPU 显存) | 3,874 |
| Qwen3.6-35B-A3B,冷加载到第一个令牌(s,数值越小越好) | 9.04 | 未运行(12GB GPU 显存) | 8.77 | 未运行(12GB GPU 显存) | 未运行(24GB 显存,低于 M 级) |
| Qwen3.6-35B-A3B,热加载到第一个令牌(s,数值越小越好) | 4.23 | 未运行(12GB GPU 显存) | 4.47 | 未运行(12GB GPU 显存) | 未运行(24GB 显存,低于 M 级) |
128GB OmniBook 在冷启动时仅用 6.23 秒就读取了 gpt-oss:20b 文件的第一个标记,速度在所有测试机型中最快,Surface 为 6.57 秒,Blade 16 为 8.71 秒;热启动时仅需 3.59 秒。Blade 读取文件的速度最快,达到 3,874MB/s,但读取第一个标记的速度最慢,因为它的权重数据还需要通过 PCIe 传输到显存 (VRAM),而统一内存则在读取完成后就已生效。惠普的硬盘并非瓶颈所在:其在负载下的读取速度为 3,044MB/s,远低于测试中 DiskSpd 工具以 1MB 块读取相同模型文件时测得的 12,866MB/s 的速度。
在M级测试中,OmniBook和Surface的成绩相差无几,冷启动分别为9.04秒和8.77秒,热启动分别为4.23秒和4.47秒,差距仅为0.3秒。32GB版本的OmniBook和Pro 9n由于可用GPU内存仅为12GB,因此不符合任何级别的测试标准;而配备24GB显存的Blade 16则被排除在M级之外。
编码代理
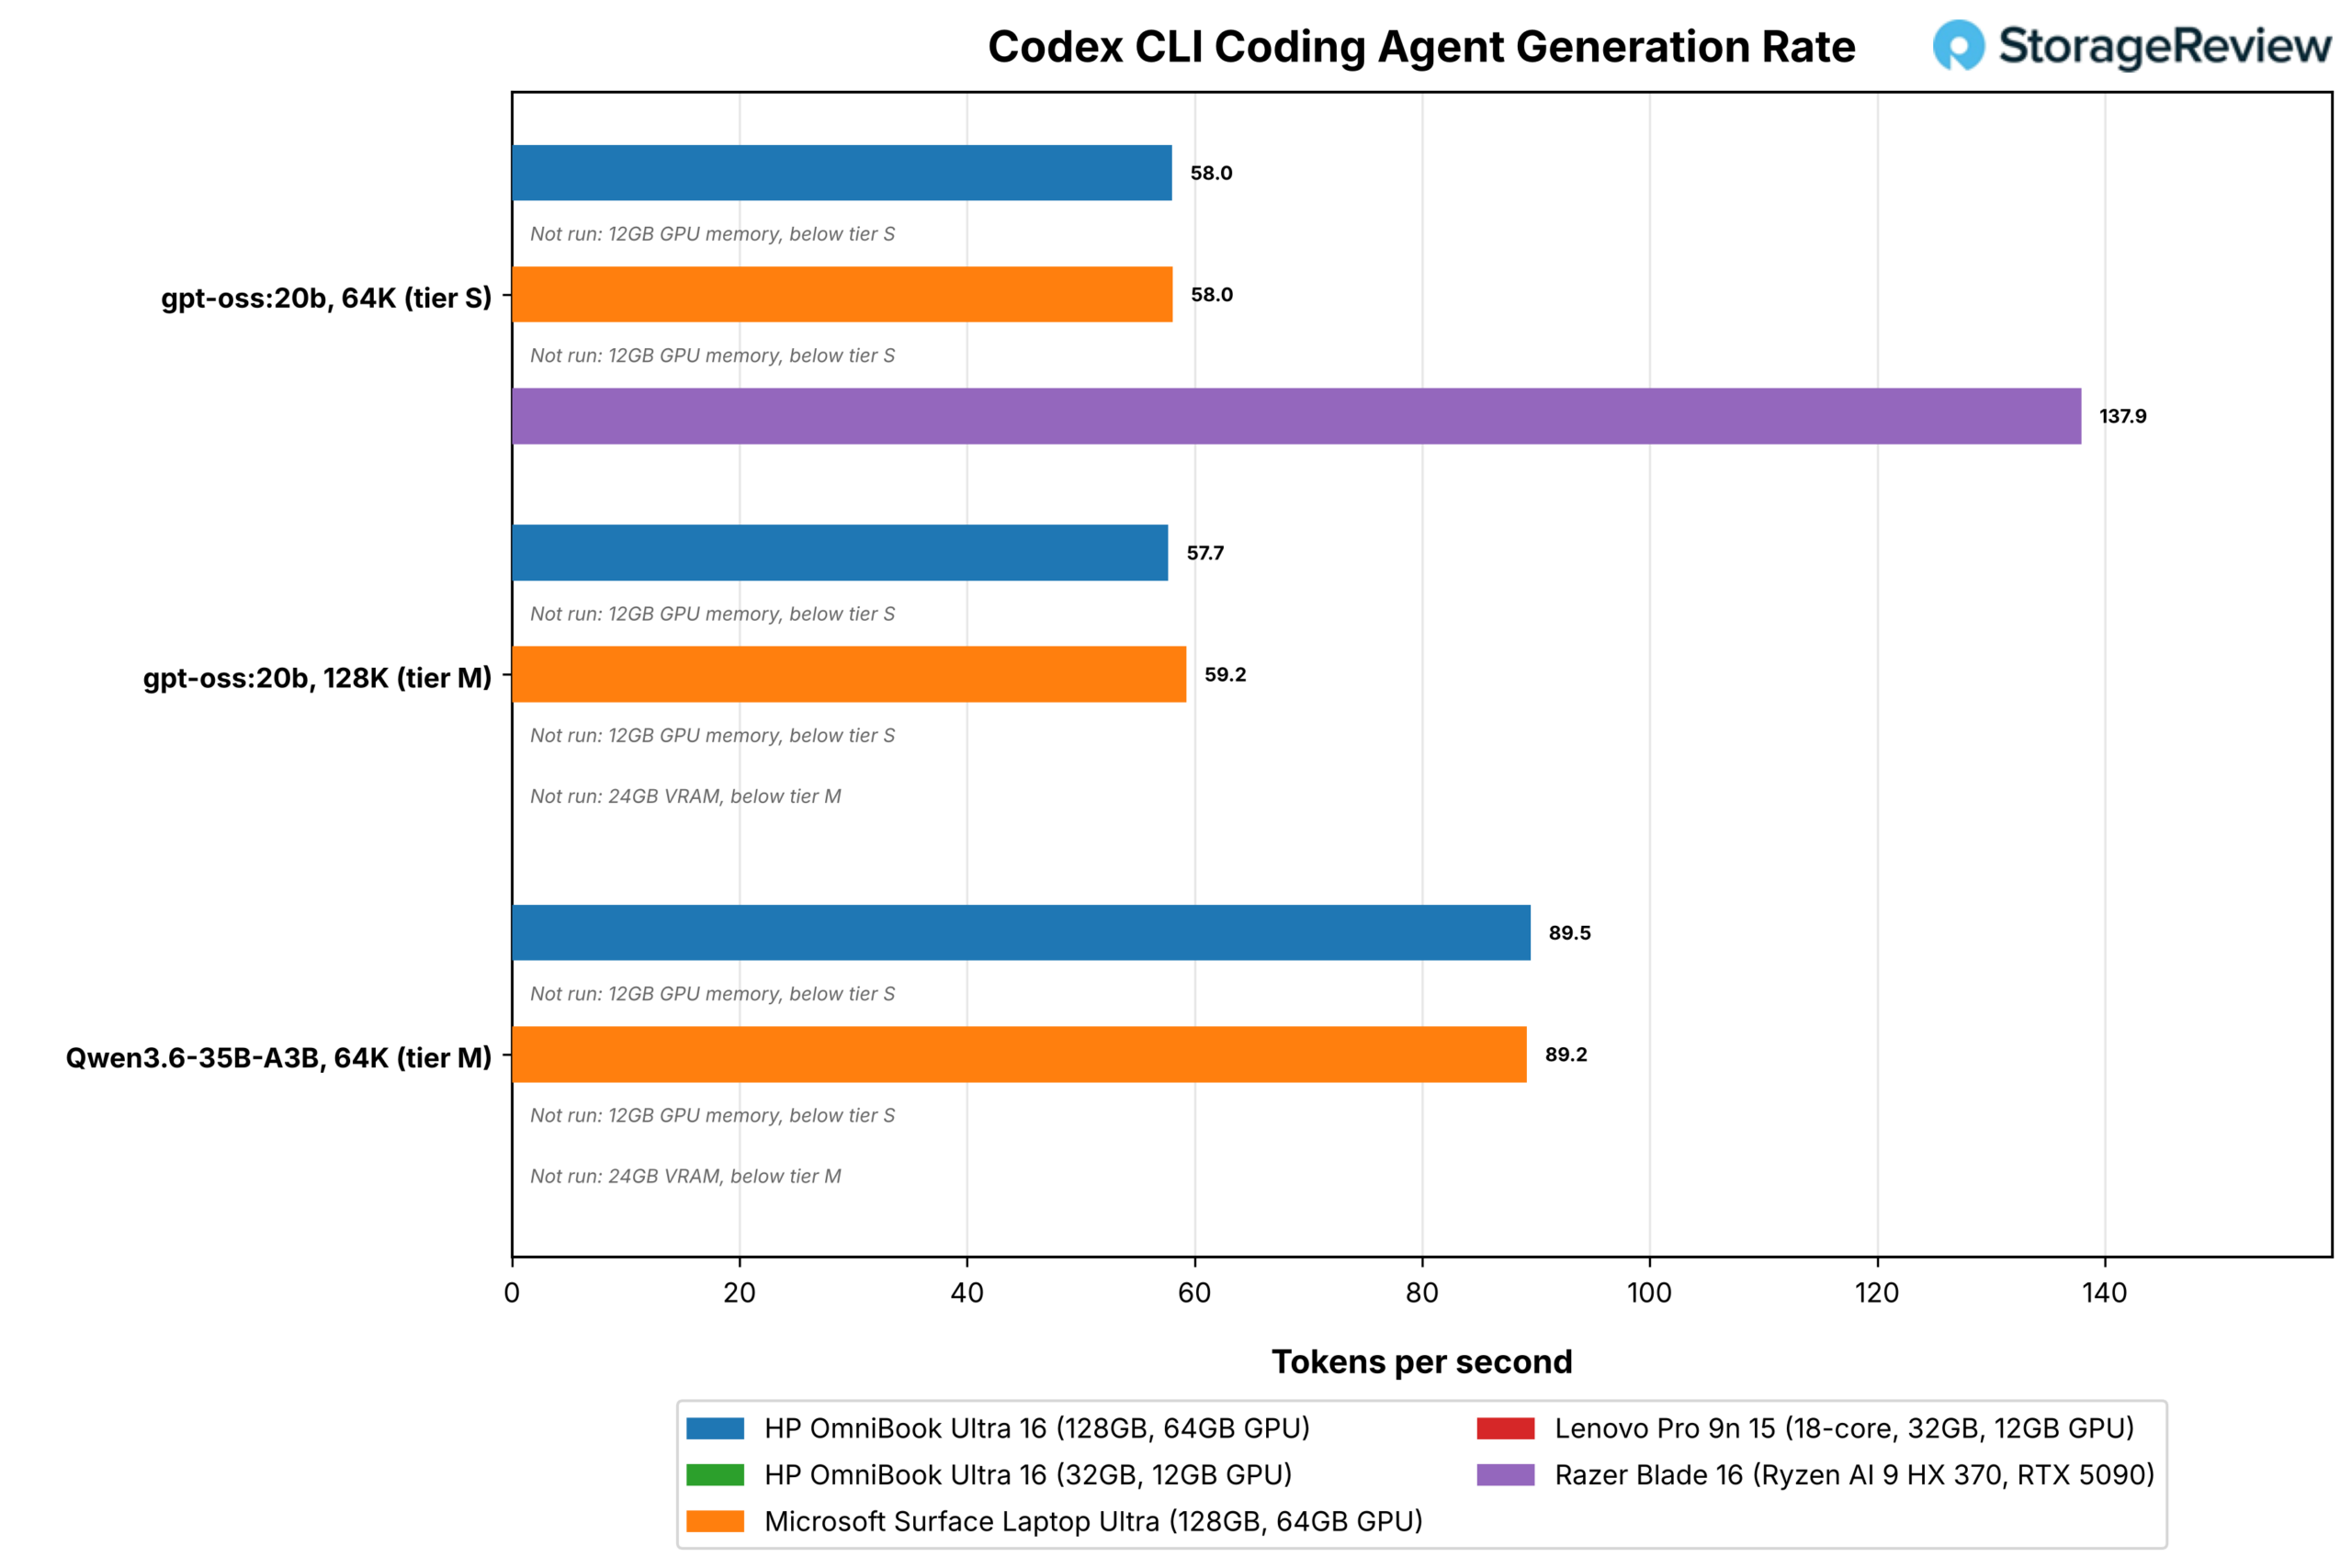
Codex CLI 通过一个固定代码库中的固定编码任务驱动由 Ollama 提供的本地模型;当代码库中的 11 个测试全部通过时,运行即告成功。我们报告了三次运行的中位运行时间、成功运行的次数以及生成速率。用户旁代理测试同时运行代理和 Speedometer,并报告与单独运行相比,每个组件的运行速度分别下降了多少。
| Codex CLI 编码代理 | OmniBook Ultra 16 (128GB) | OmniBook Ultra 16 (32GB) | Surface Laptop Ultra | Pro 9n 15 | 雷蛇刃16 |
|---|---|---|---|---|---|
| S级,gpt-oss:20b 64K:运行时间(秒,数值越低越好) | 115.3 | 未运行(12GB GPU 显存) | 191.8 | 未运行(12GB GPU 显存) | 64.4 |
| S级:成功(3次) | 3 | 未运行(12GB GPU 显存) | 3 | 未运行(12GB GPU 显存) | 2 |
| S级:生成速率(tok/s) | 58.0 | 未运行(12GB GPU 显存) | 58.0 | 未运行(12GB GPU 显存) | 137.9 |
| Tier M,gpt-oss:20b 128K:运行时间(秒,数值越低越好) | 152.1 | 未运行(12GB GPU 显存) | 87.5 | 未运行(12GB GPU 显存) | 未运行(24GB 显存,低于 M 级) |
| Tier M,gpt-oss:20b 128K:成功(共 3 次) | 3 | 未运行(12GB GPU 显存) | 2 | 未运行(12GB GPU 显存) | 未运行(24GB 显存,低于 M 级) |
| M级,Qwen3.6-35B-A3B 64K:墙内时间(秒,越低越好) | 72.0 | 未运行(12GB GPU 显存) | 88.6 | 未运行(12GB GPU 显存) | 未运行(24GB 显存,低于 M 级) |
| M级,Qwen3.6-35B-A3B 64K:成功(共3次) | 3 | 未运行(12GB GPU 显存) | 3 | 未运行(12GB GPU 显存) | 未运行(24GB 显存,低于 M 级) |
| Tier M,Qwen3.6-35B-A3B 64K:生成速率(tok/s) | 89.5 | 未运行(12GB GPU 显存) | 89.2 | 未运行(12GB GPU 显存) | 未运行(24GB 显存,低于 M 级) |
| 代理人旁边的速度表(分数) | 21.2 | 未运行(12GB GPU 显存) | 18.1 | 未运行(12GB GPU 显存) | 36.3 |
| 速度表在代理旁边减速(x,数值越低越好) | 1.73 | 未运行(12GB GPU 显存) | 1.92 | 未运行(12GB GPU 显存) | 1.06 |
| 速度表旁边的代理减速(x,数值越低越好) | 1.04 | 未运行(12GB GPU 显存) | 1.10 | 未运行(12GB GPU 显存) | 1.05 |
128GB 的 OmniBook 顺利通过了全部九项编码测试。它以每秒 89.5 个令牌的速度,用时 72.0 秒完成了 Qwen3.6-35B-A3B 任务,比 Surface 的 88.6 秒(速度相同)更快;在 S 级任务中,它以 115.3 秒的成绩完成了任务,而 Surface 则用时 191.8 秒。在 M 级 gpt-oss:20b 任务中,它的运行时间比 Surface 更长,为 152.1 秒,而 Surface 为 87.5 秒。这是因为该模型在 HP 上调用了更多工具并生成了更多令牌;令牌生成速度分别为每秒 57.7 个令牌和 59.2 个令牌,这才是更直接的硬件比较。
Blade 16 以每秒 137.9 个令牌的速度,耗时 64.4 秒完成了 S 级任务,三次测试通过了两次。并发测试充分体现了独立显卡的优势:Blade 的浏览器得分在运行代理程序后下降了 5%,因为该模型运行在 RTX 5090 显卡上。而在 OmniBook 上,由于代理程序与其他组件共享集成显卡和内存总线,速度计得分从 36.7 降至 21.2,速度下降了 1.73 倍,但仍比 Surface 的 1.92 倍要低。
检索增强生成
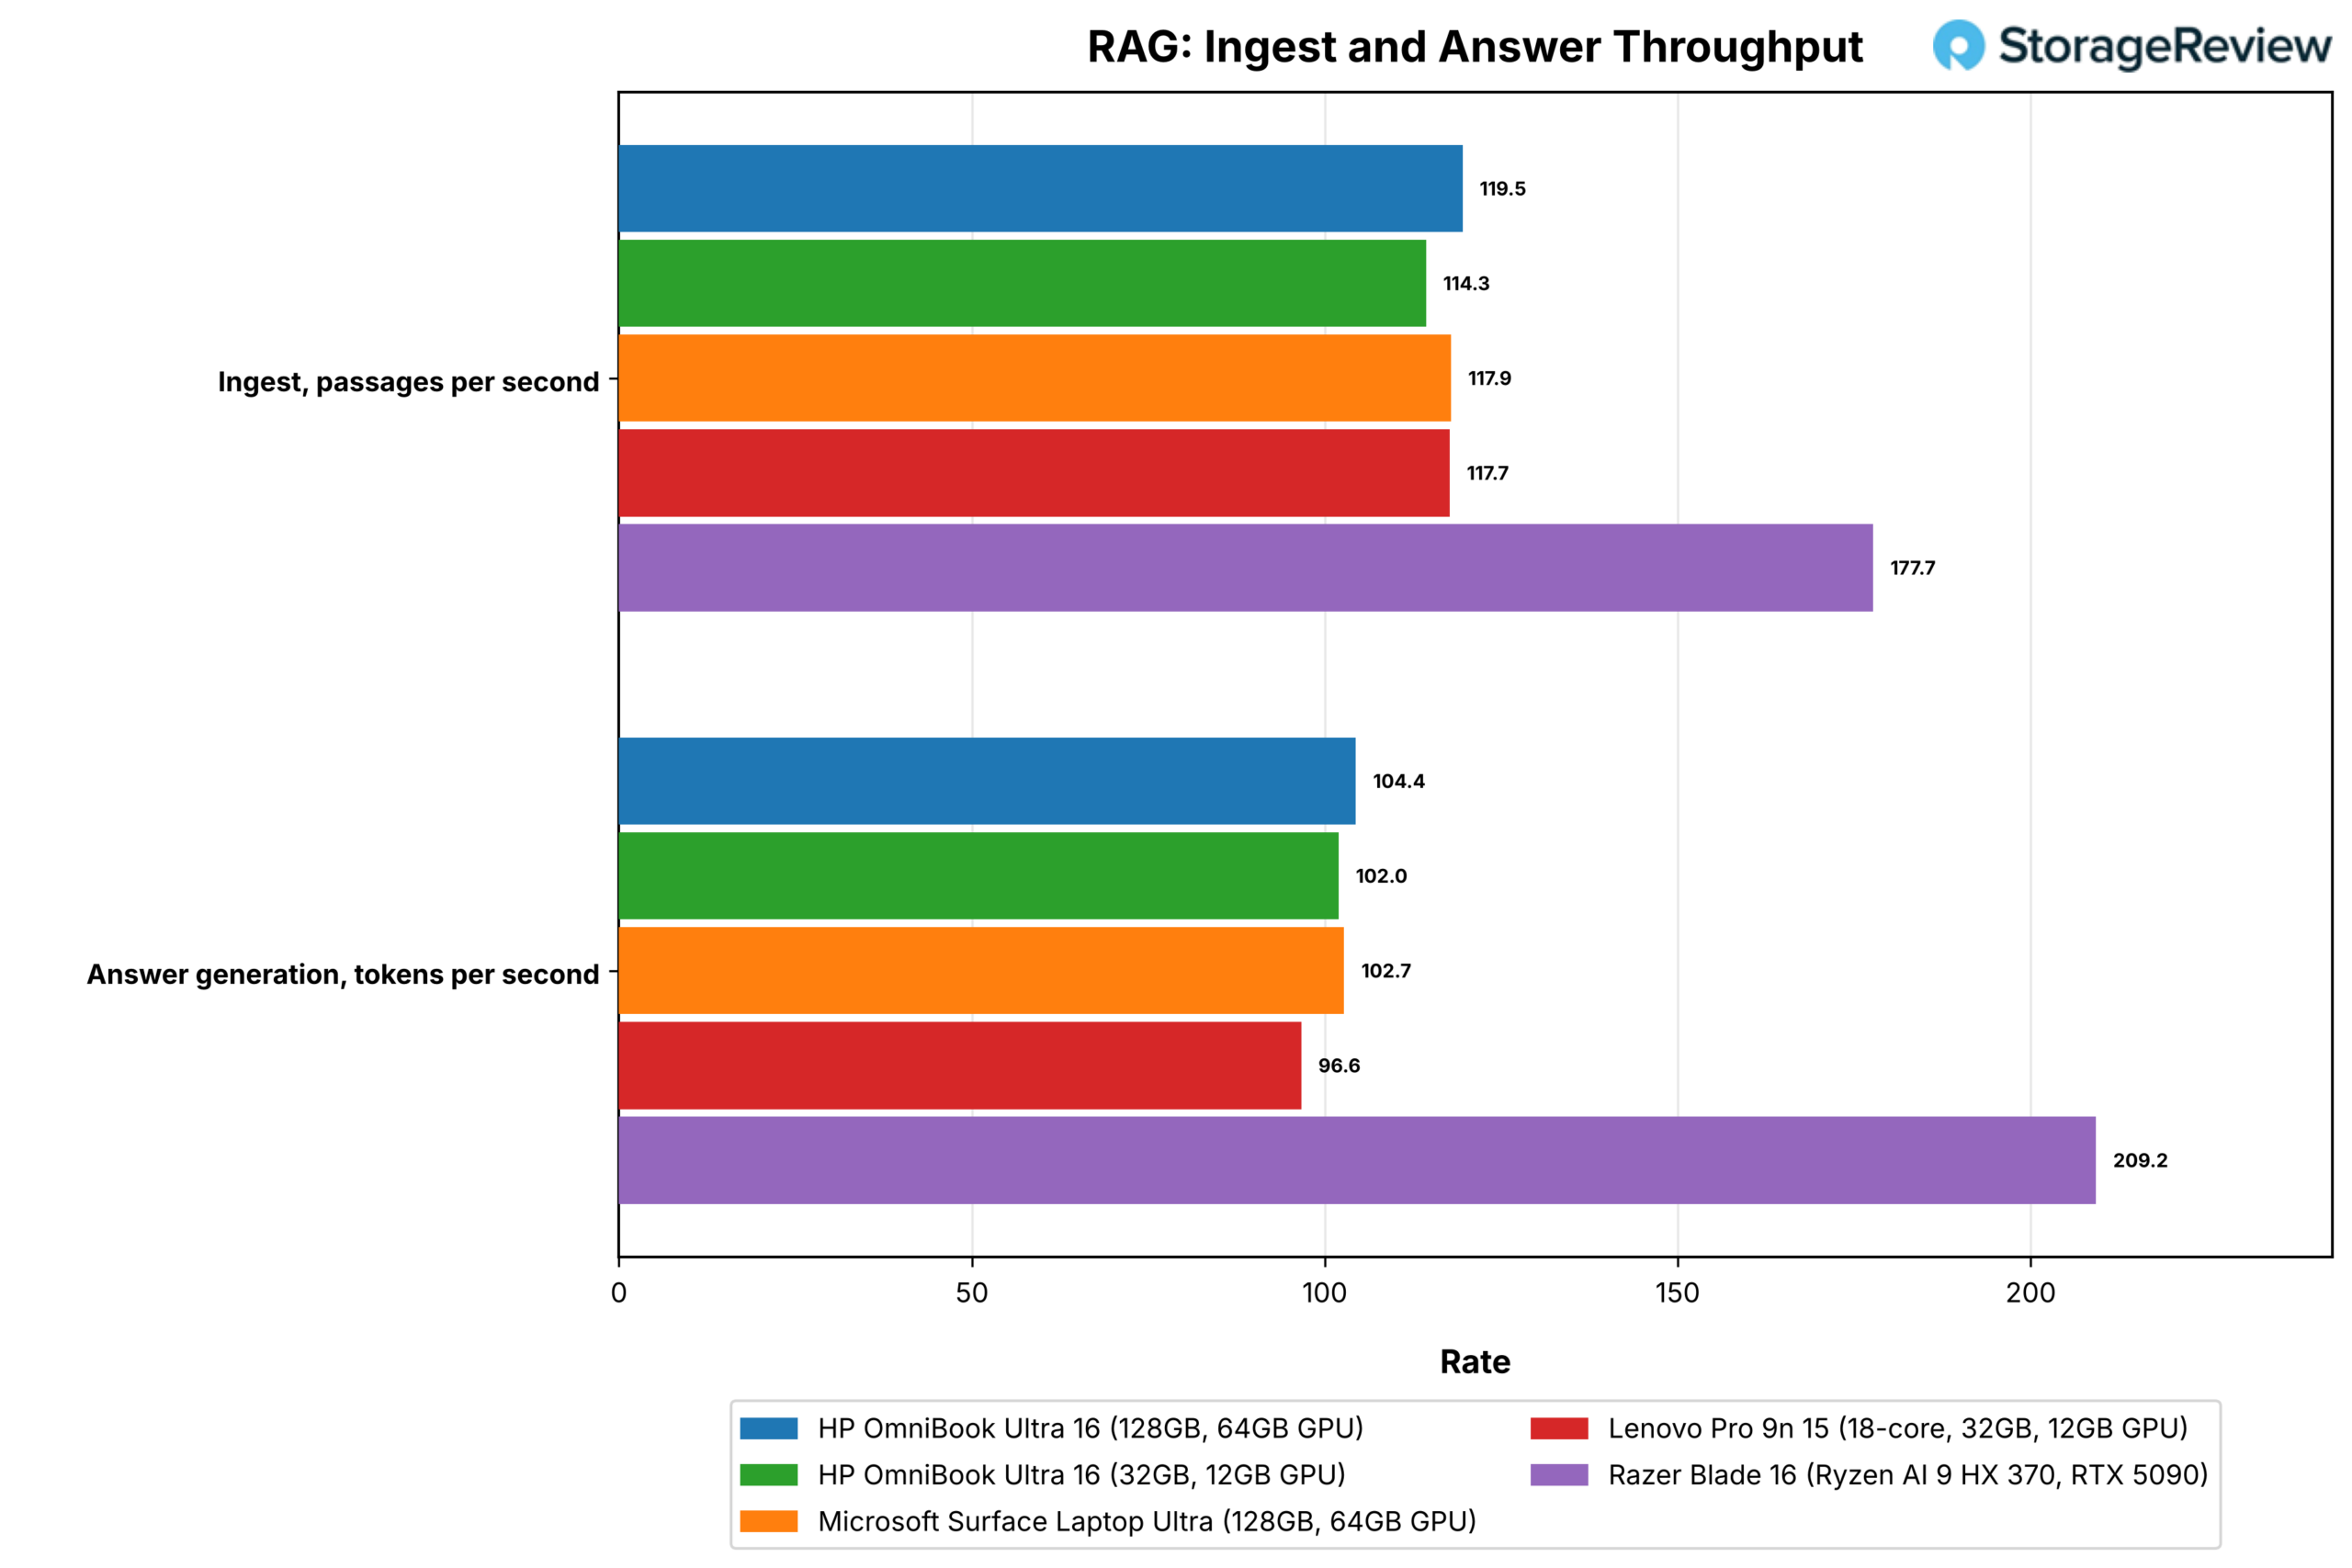
我们的 RAG 测试使用 nomic-embed-text 嵌入了 20,963 段 SQuAD v1.1 文章,针对 2,000 个问题分别提取出前五段文章,并使用 Phi-4-mini 对其中 400 道题进行解答,计算其与参考答案的完全匹配度和 F1 值。由于模型体积小巧,可以在任何系统上运行,因此本次测试主要考察的是速度。
| 鲁尔 | OmniBook Ultra 16 (128GB) | OmniBook Ultra 16 (32GB) | Surface Laptop Ultra | Pro 9n 15 | 雷蛇刃16 |
|---|---|---|---|---|---|
| 摄入墙壁时间,20,963 次(秒,越低越好) | 187.0 | 195.2 | 189.8 | 191.8 | 131.0 |
| 检索查询时间,p50(毫秒,数值越低越好) | 23.3 | 22.5 | 23.4 | 24.2 | 20.9 |
| 答案,Phi-4-mini 首次令牌到达时间,p50(秒,越低越好) | 0.155 | 0.156 | 0.161 | 0.171 | 0.109 |
| 回答,快速处理(tok/s) | 7,142 | 7,139 | 6,955 | 6,268 | 11,560 |
| 答案,生成速率(tok/s) | 104.4 | 102.0 | 102.7 | 96.6 | 209.2 |
| 问题回答,p50(s,越低越好) | 0.227 | 0.231 | 0.235 | 0.252 | 0.159 |
| 答案 F1 (%) | 73.97 | 73.97 | 73.97 | 74.27 | 74.47 |
四台搭载 RTX Spark 显卡的系统在 8 秒内完成了语料库导入,其中 128GB 的 OmniBook 速度最快,耗时 187.0 秒,它们回答典型问题的时间为 0.227 至 0.252 秒。Blade 16 完成语料库导入耗时 131.0 秒,生成答案的速度为每秒 209.2 个词元,是 OmniBook(104.4 个词元)的两倍。三台 20 核系统的准确率完全相同,Pro 9n 和 Blade 的准确率与 F1 值相差不到 0.5 个百分点,这与相同型号在 0 摄氏度下的预期表现一致。
中央处理器性能
三款搭载20核RTX Spark显卡的笔记本电脑在CPU性能方面表现相近,两款OmniBook和Surface在大多数多线程测试中成绩相差仅1%到2%,而18核的Pro 9n则落后它们约7%到11%。与Razer Blade 16的Ryzen AI 9 HX 370相比,N1X在渲染、压缩和编译方面领先约18%到50%,但在GROMACS、OpenBLAS、单线程Python和primesieve测试中则略逊一筹。在这些测试中,Zen 5的单核速度或x64软件的成熟度决定了最终结果。
Cinebench 2026 和持续负载
Cinebench 2026 使用 Maxon 的 Redshift 引擎在 CPU 上渲染场景,并分别测试单核、SMT 单核(一个物理核心上运行两个线程)和多核的吞吐量。随后,我们进行一个持续循环测试,重复多核运行约 30 分钟,并将稳定状态与第一次运行进行比较,以显示笔记本电脑在过热后性能下降的程度。
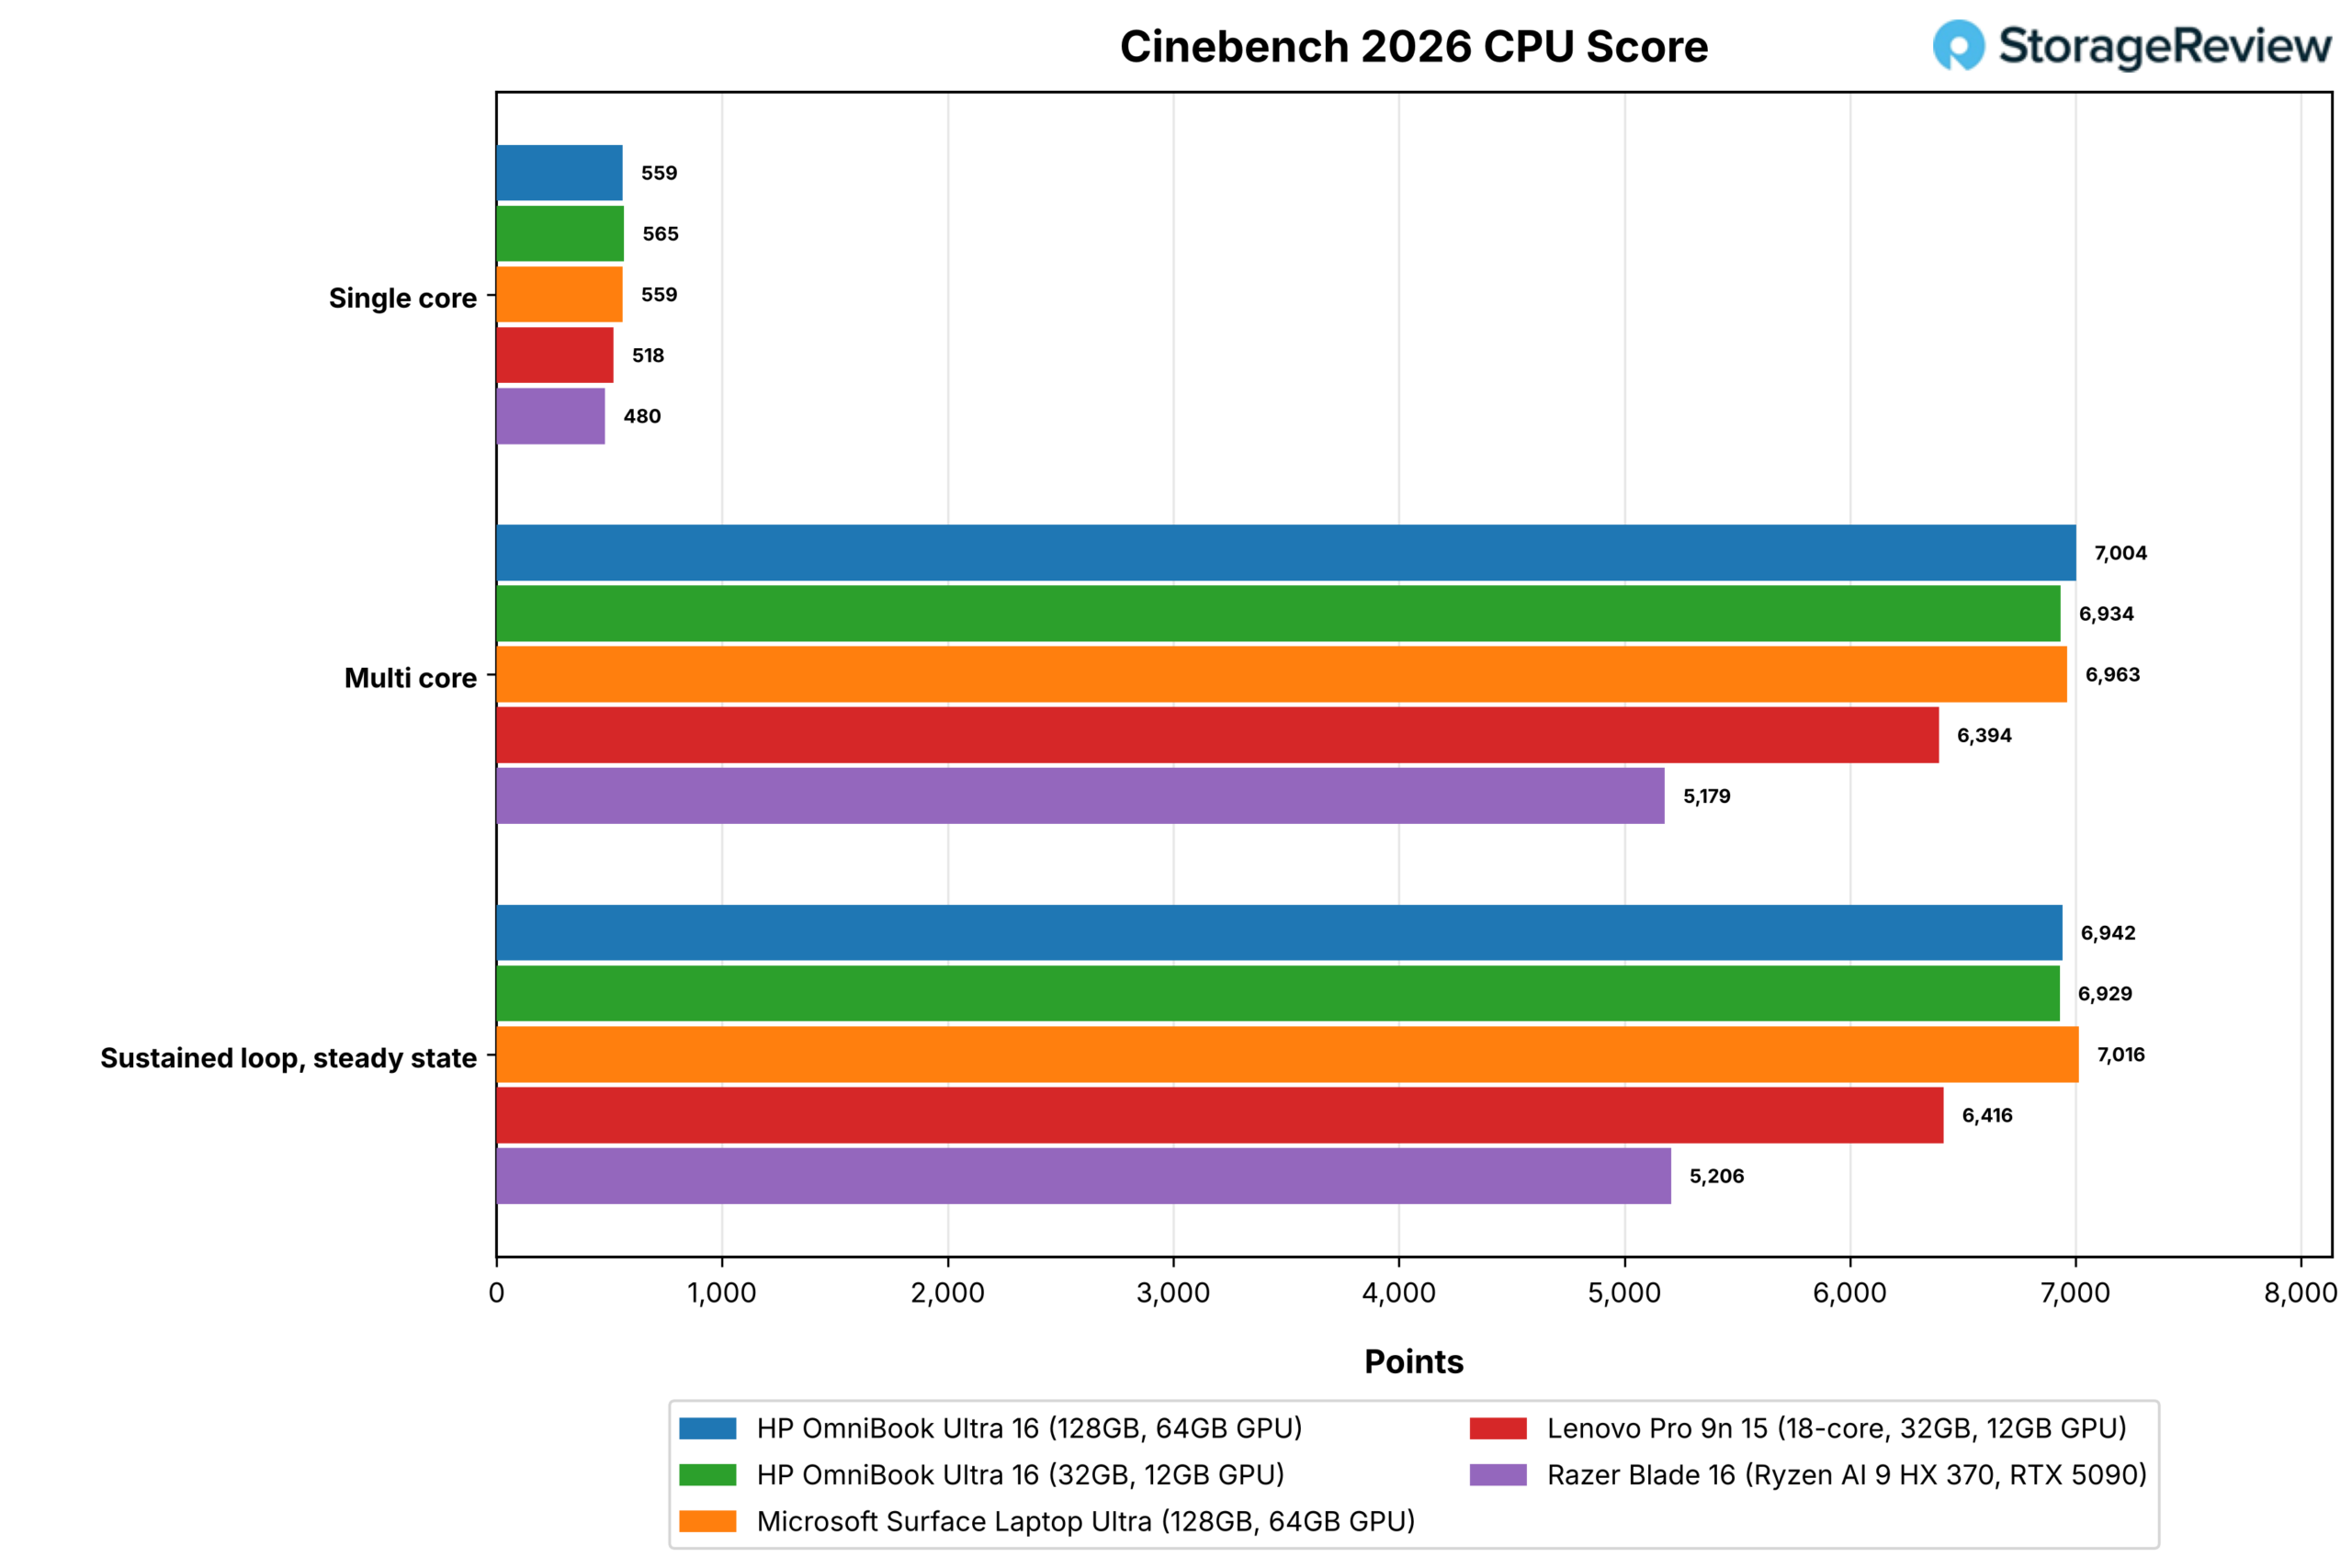
| Cinebench 2026(分数越高越好) | OmniBook Ultra 16 (128GB) | OmniBook Ultra 16 (32GB) | Surface Laptop Ultra | Pro 9n 15 | 雷蛇刃16 |
|---|---|---|---|---|---|
| 单核 | 558.6 | 564.7 | 558.5 | 518.2 | 480.0 |
| SMT单核 | 无 | 无 | 无 | 无 | 661.3 |
| 多核心 | 7,004 | 6,934 | 6,963 | 6,394 | 5,179 |
| 持续循环,第一次 | 6,954 | 6,943 | 6,938 | 6,346 | 5,162 |
| 持续循环,稳态 | 6,942 | 6,929 | 7,016 | 6,416 | 5,206 |
| 稳态/首次通过 | 0.998 | 0.998 | 1.011 | 1.011 | 1.009 |
128GB 版 OmniBook 的多核跑分达到 7,004 分,位列榜首,比 Blade 16 高出 35%,32GB 版 OmniBook 的得分为 6,934 分,Surface 的得分为 6,963 分。32GB 版 OmniBook 的单核跑分也最高,达到 564.7 分。两款惠普笔记本电脑在持续循环测试中均保持了较高的分数,在 CPU 温度为 98 摄氏度、频率约为 3.23GHz 时,首轮测试成绩达到 99.8%;Surface 和 Pro 9n 在相同的半小时内,分数提升了约 1%。
7-ZIP
7-Zip 内置的基准测试报告 LZMA 压缩和解压缩的吞吐量,单位为每秒千兆指令数 (GSI/s),分别在每个线程上运行一次,以及在单个核心上运行一次。LZMA 算法依赖于整数吞吐量、分支预测以及缓存和内存延迟,因此它更倾向于使用数量较多的核心和较快的内存路径,而不是向量宽度。
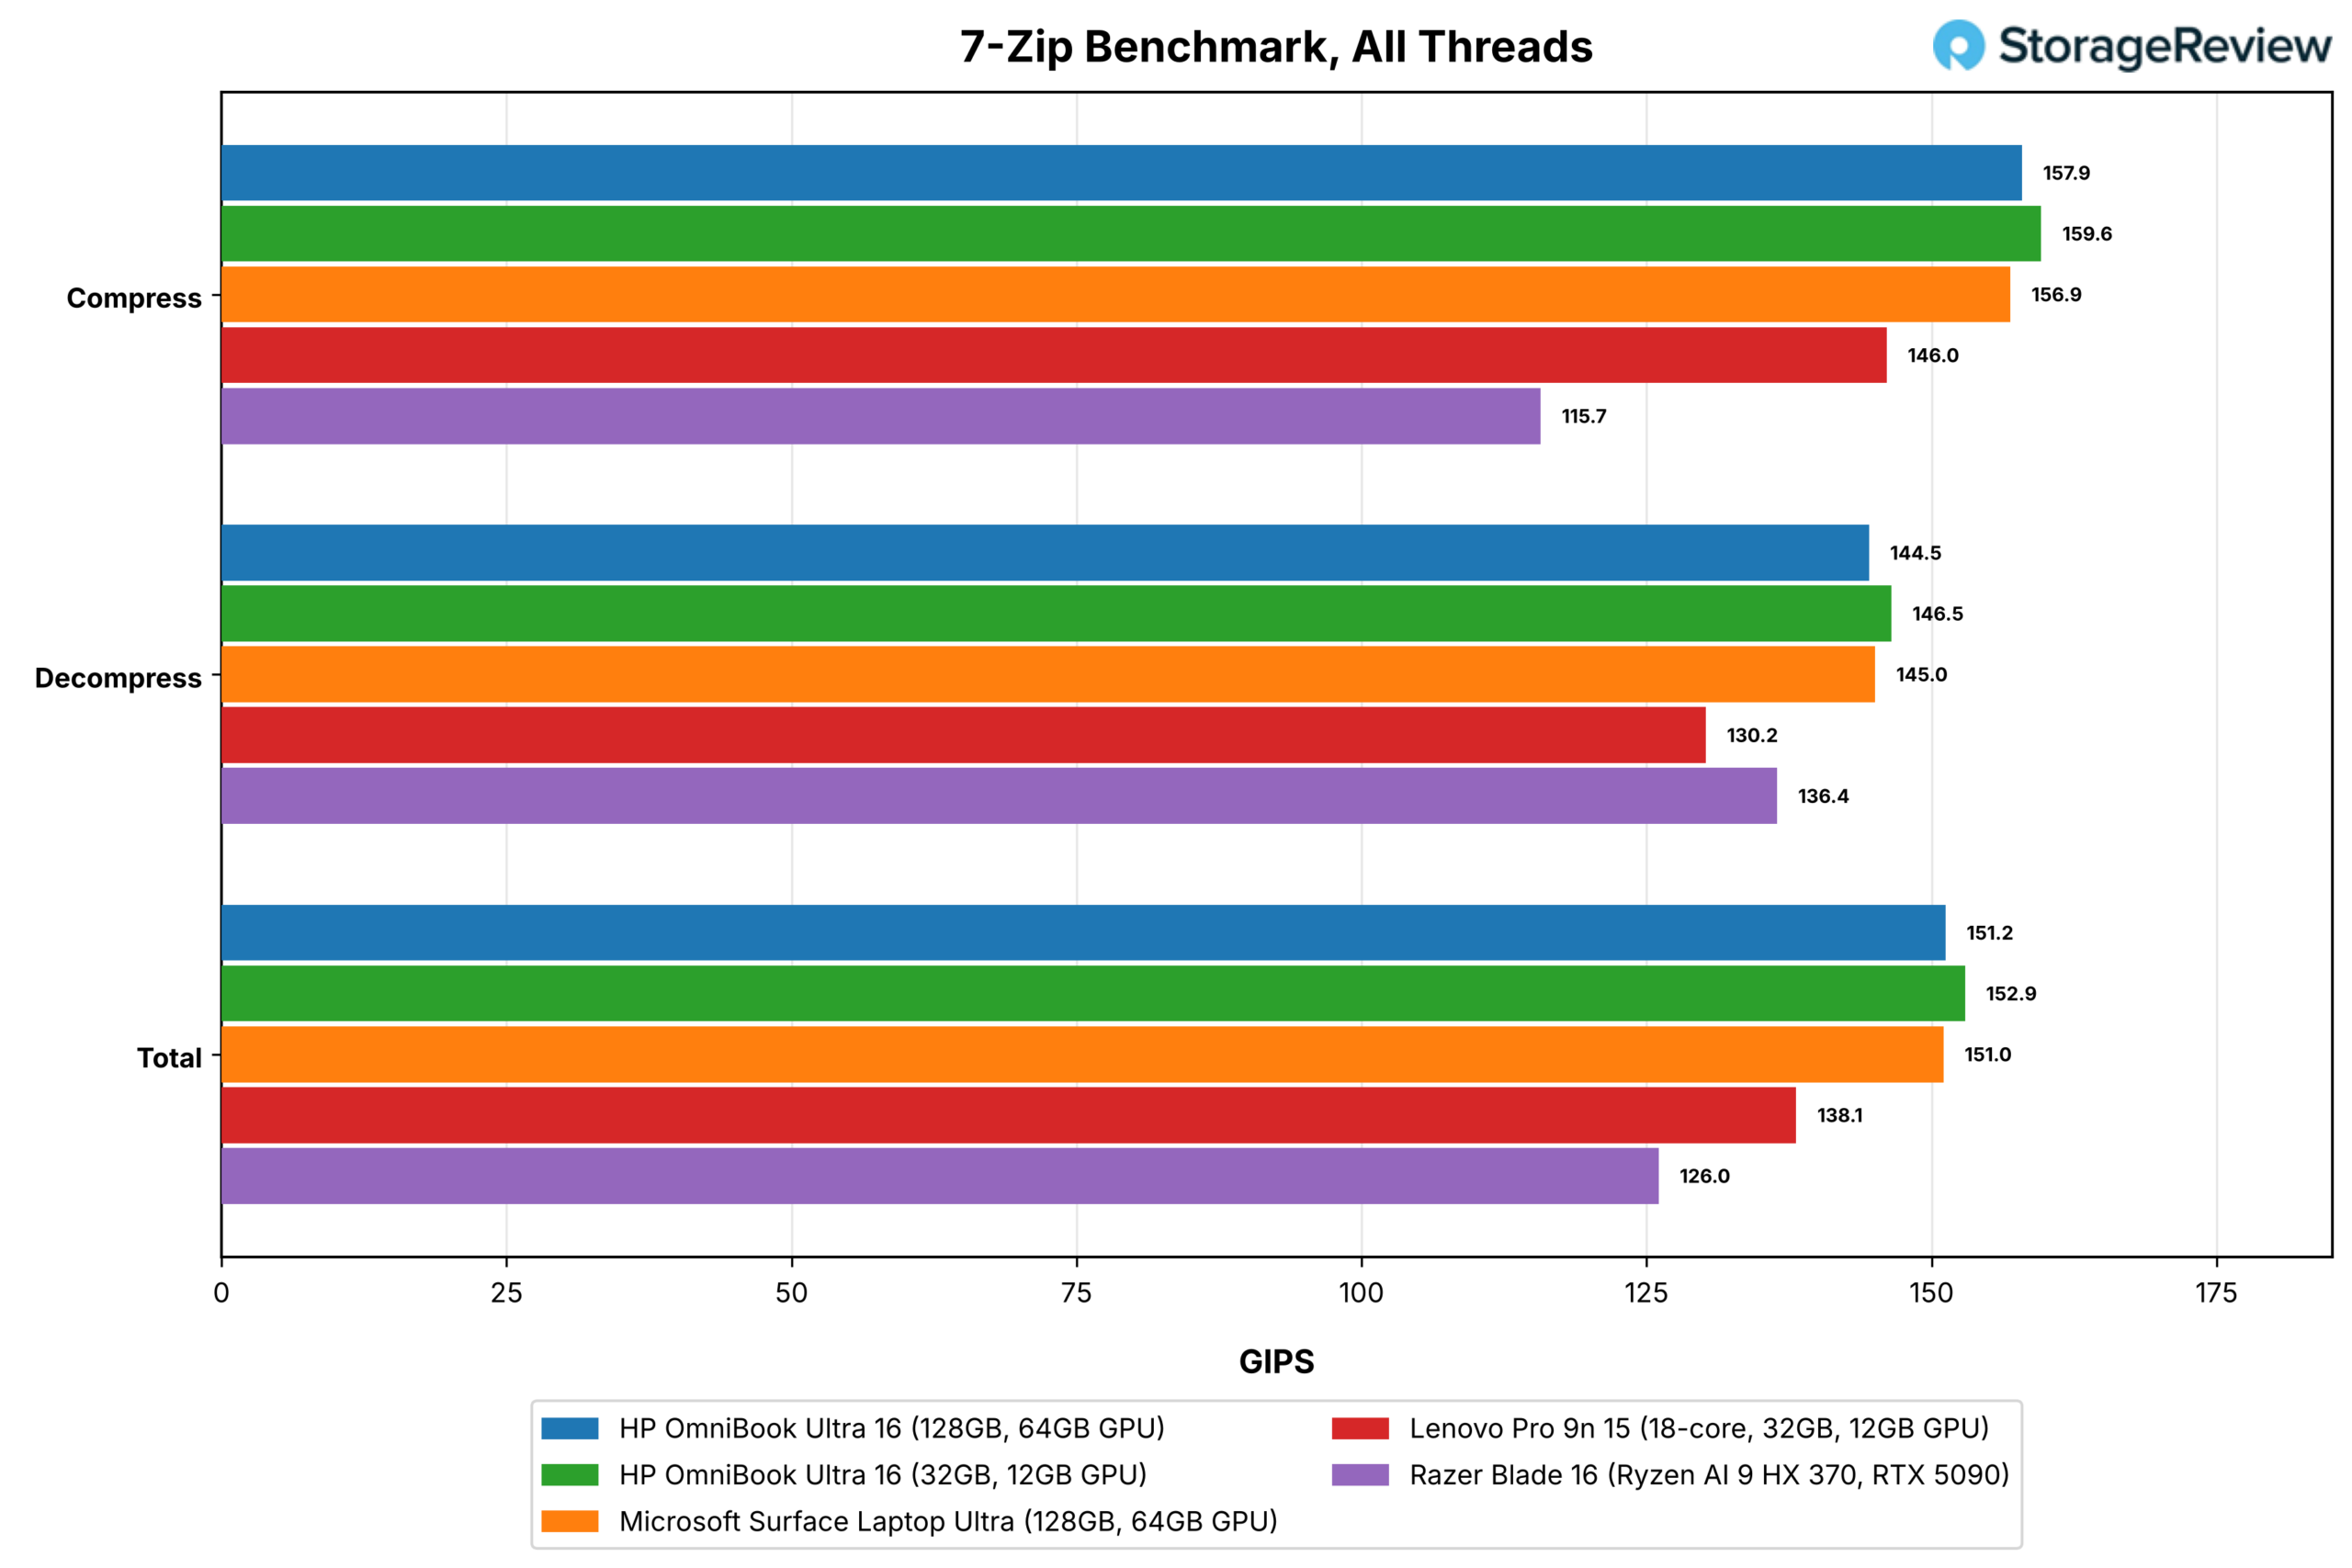
32GB 和 128GB 版本的 OmniBook 在全线程测试中分别以 152.9 和 151.2 GIPS 的成绩领先,比 Blade 16 高出 20%,压缩率也比 Blade 高出约 37%。在单线程测试中,Blade 以 9.24 GIPS 的成绩领先,惠普 OmniBook 紧随其后,分别为 9.09 和 9.10 GIPS。OmniBook 不会像 Surface 那样在单线程测试中出现低核心状态(Surface 单线程性能仅为 7.16 GIPS),因此此处的单线程测试结果反映的是 N1X 本身的性能。
| 7-Zip,单线程(GIPS,数值越高越好) | OmniBook Ultra 16 (128GB) | OmniBook Ultra 16 (32GB) | Surface Laptop Ultra | Pro 9n 15 | 雷蛇刃16 |
|---|---|---|---|---|---|
| 合计 | 9.09 | 9.10 | 7.16 | 8.93 | 9.24 |
| 压缩 | 7.31 | 7.33 | 4.62 | 7.26 | 7.28 |
| 解压缩 | 10.87 | 10.87 | 9.70 | 10.59 | 11.20 |
Blender、HandBrake 和 LLVM
Blender 4.5 使用 Cycles 渲染器在 CPU 上渲染 Monster、Junkshop 和 Classroom 场景。HandBrake 使用 x265(HEVC,中等预设,质量 22)和 SVT-AV1(预设 8,质量 30)对 60 秒的 4K60 视频片段进行软件编码。LLVM 测试使用 Clang 和 Ninja 编译完整的 LLVM 21.1.4 代码树,这是测试套件中最耗时的全核工作负载。
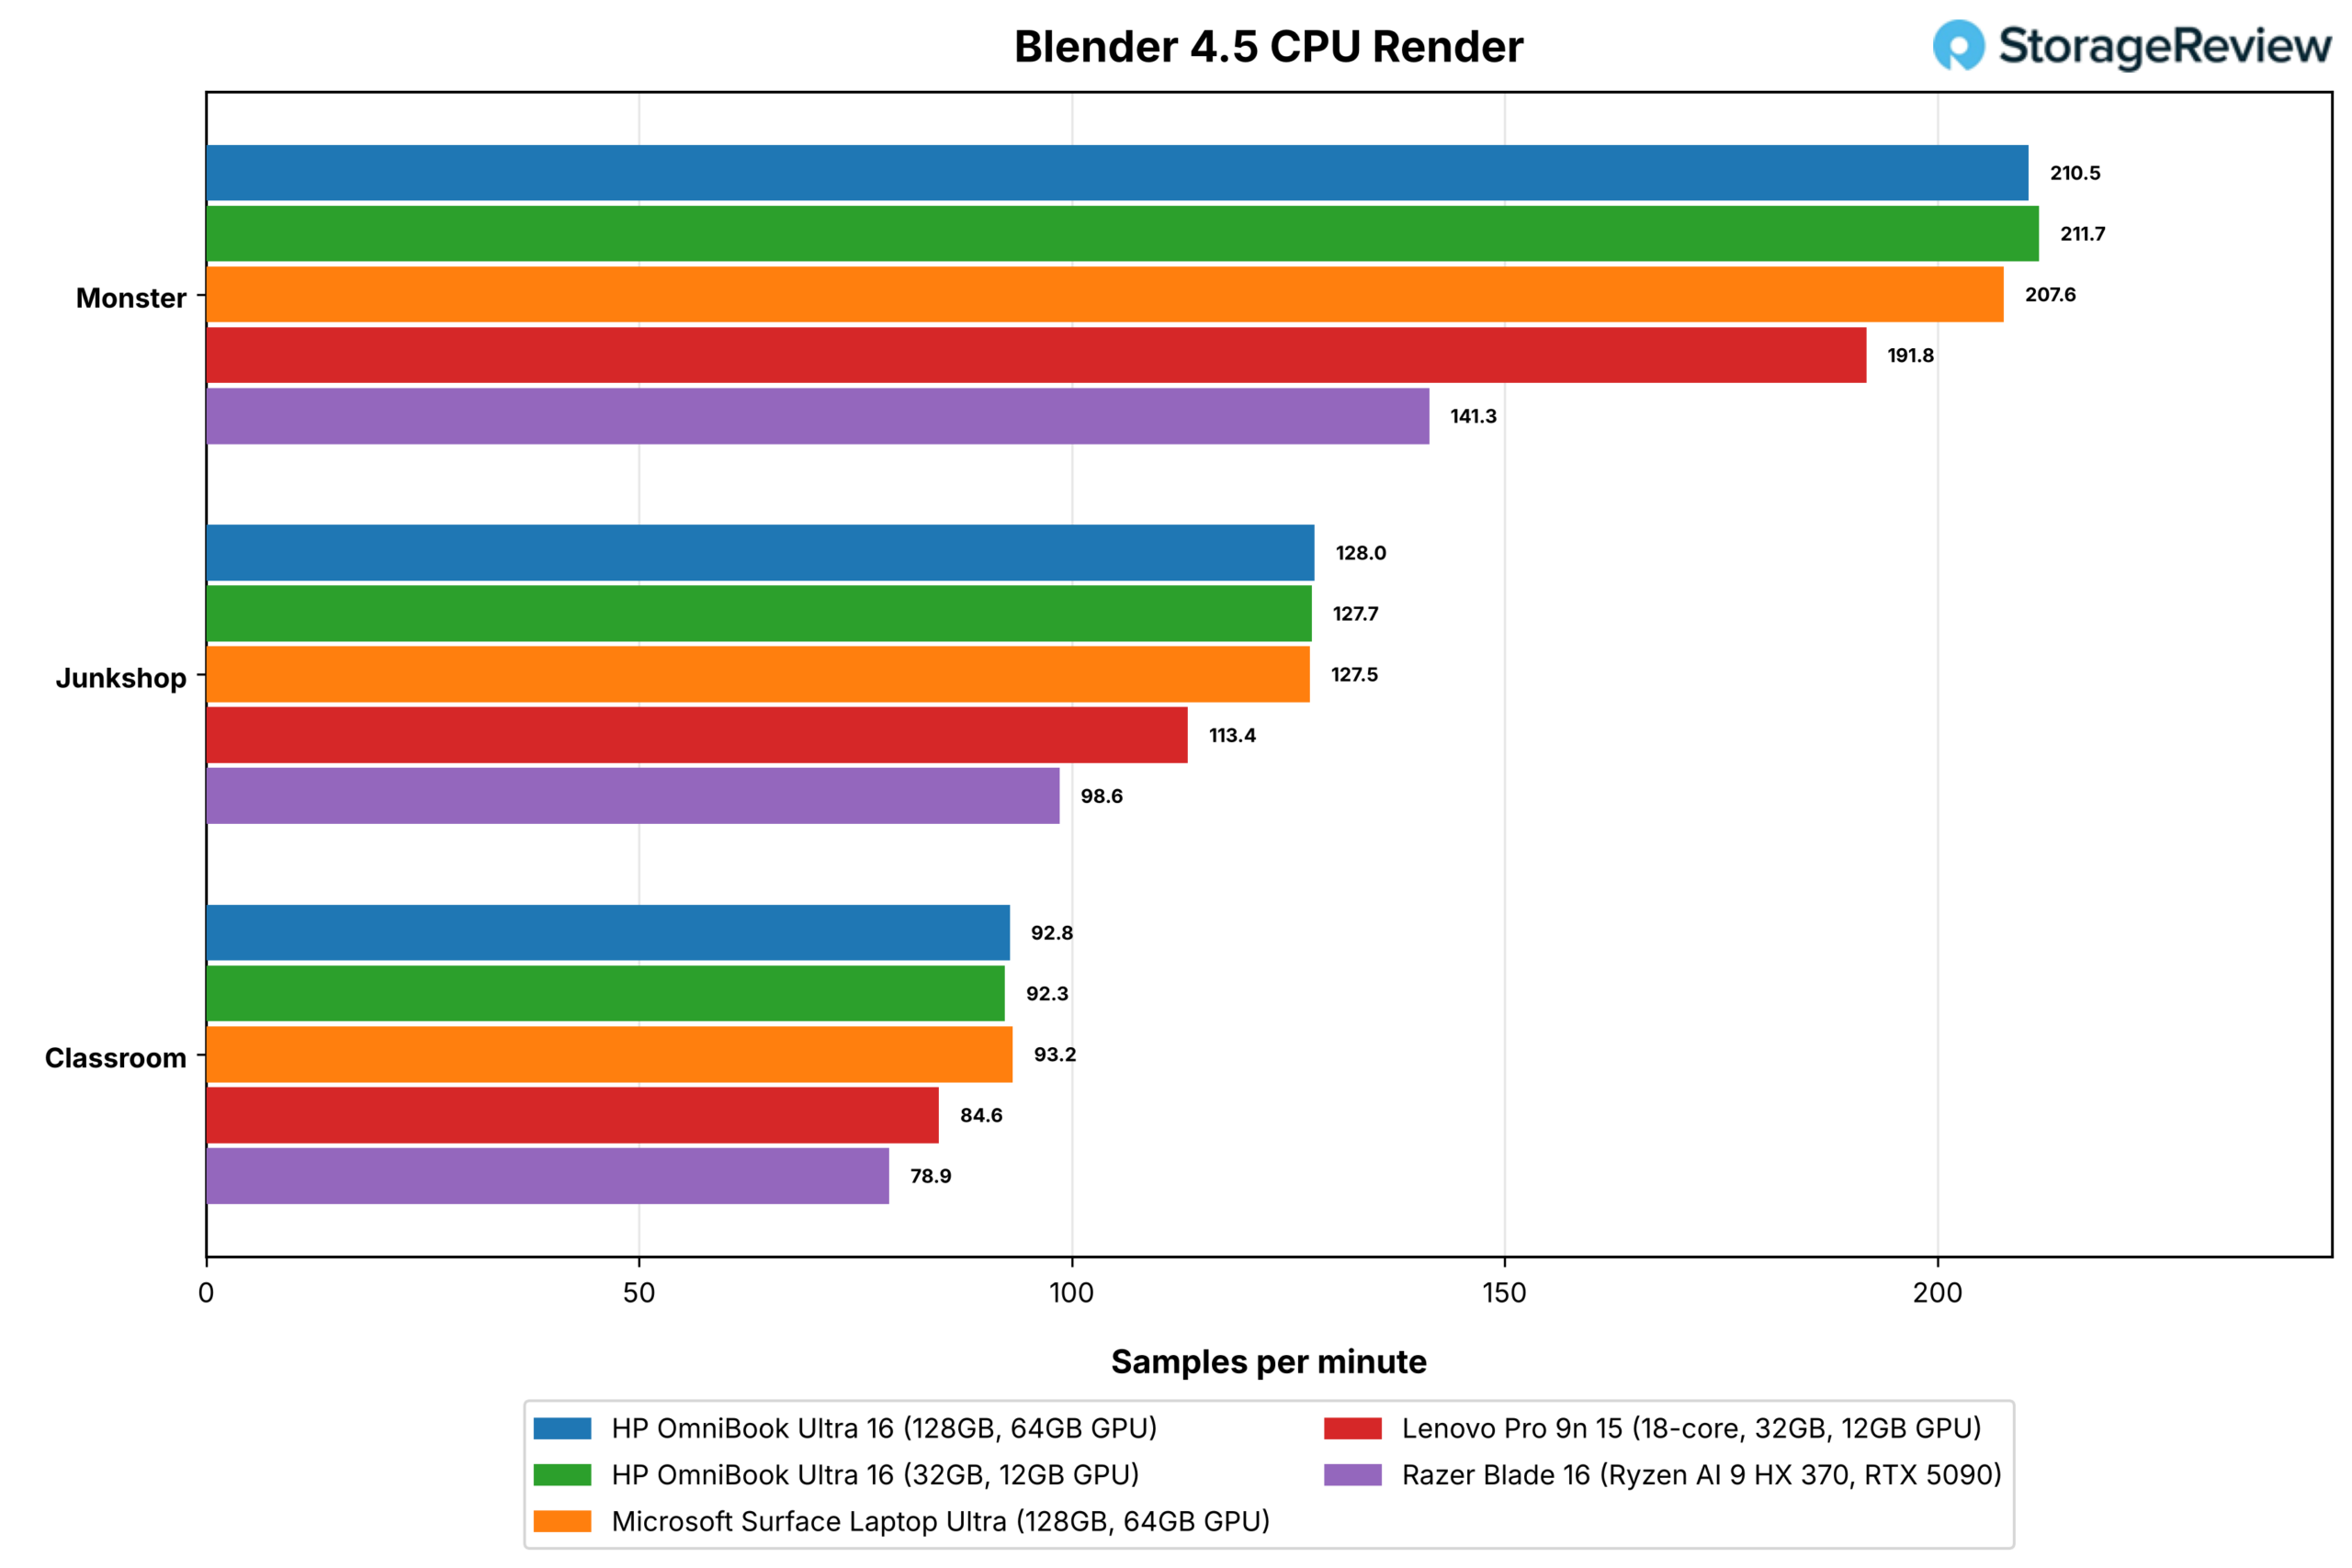
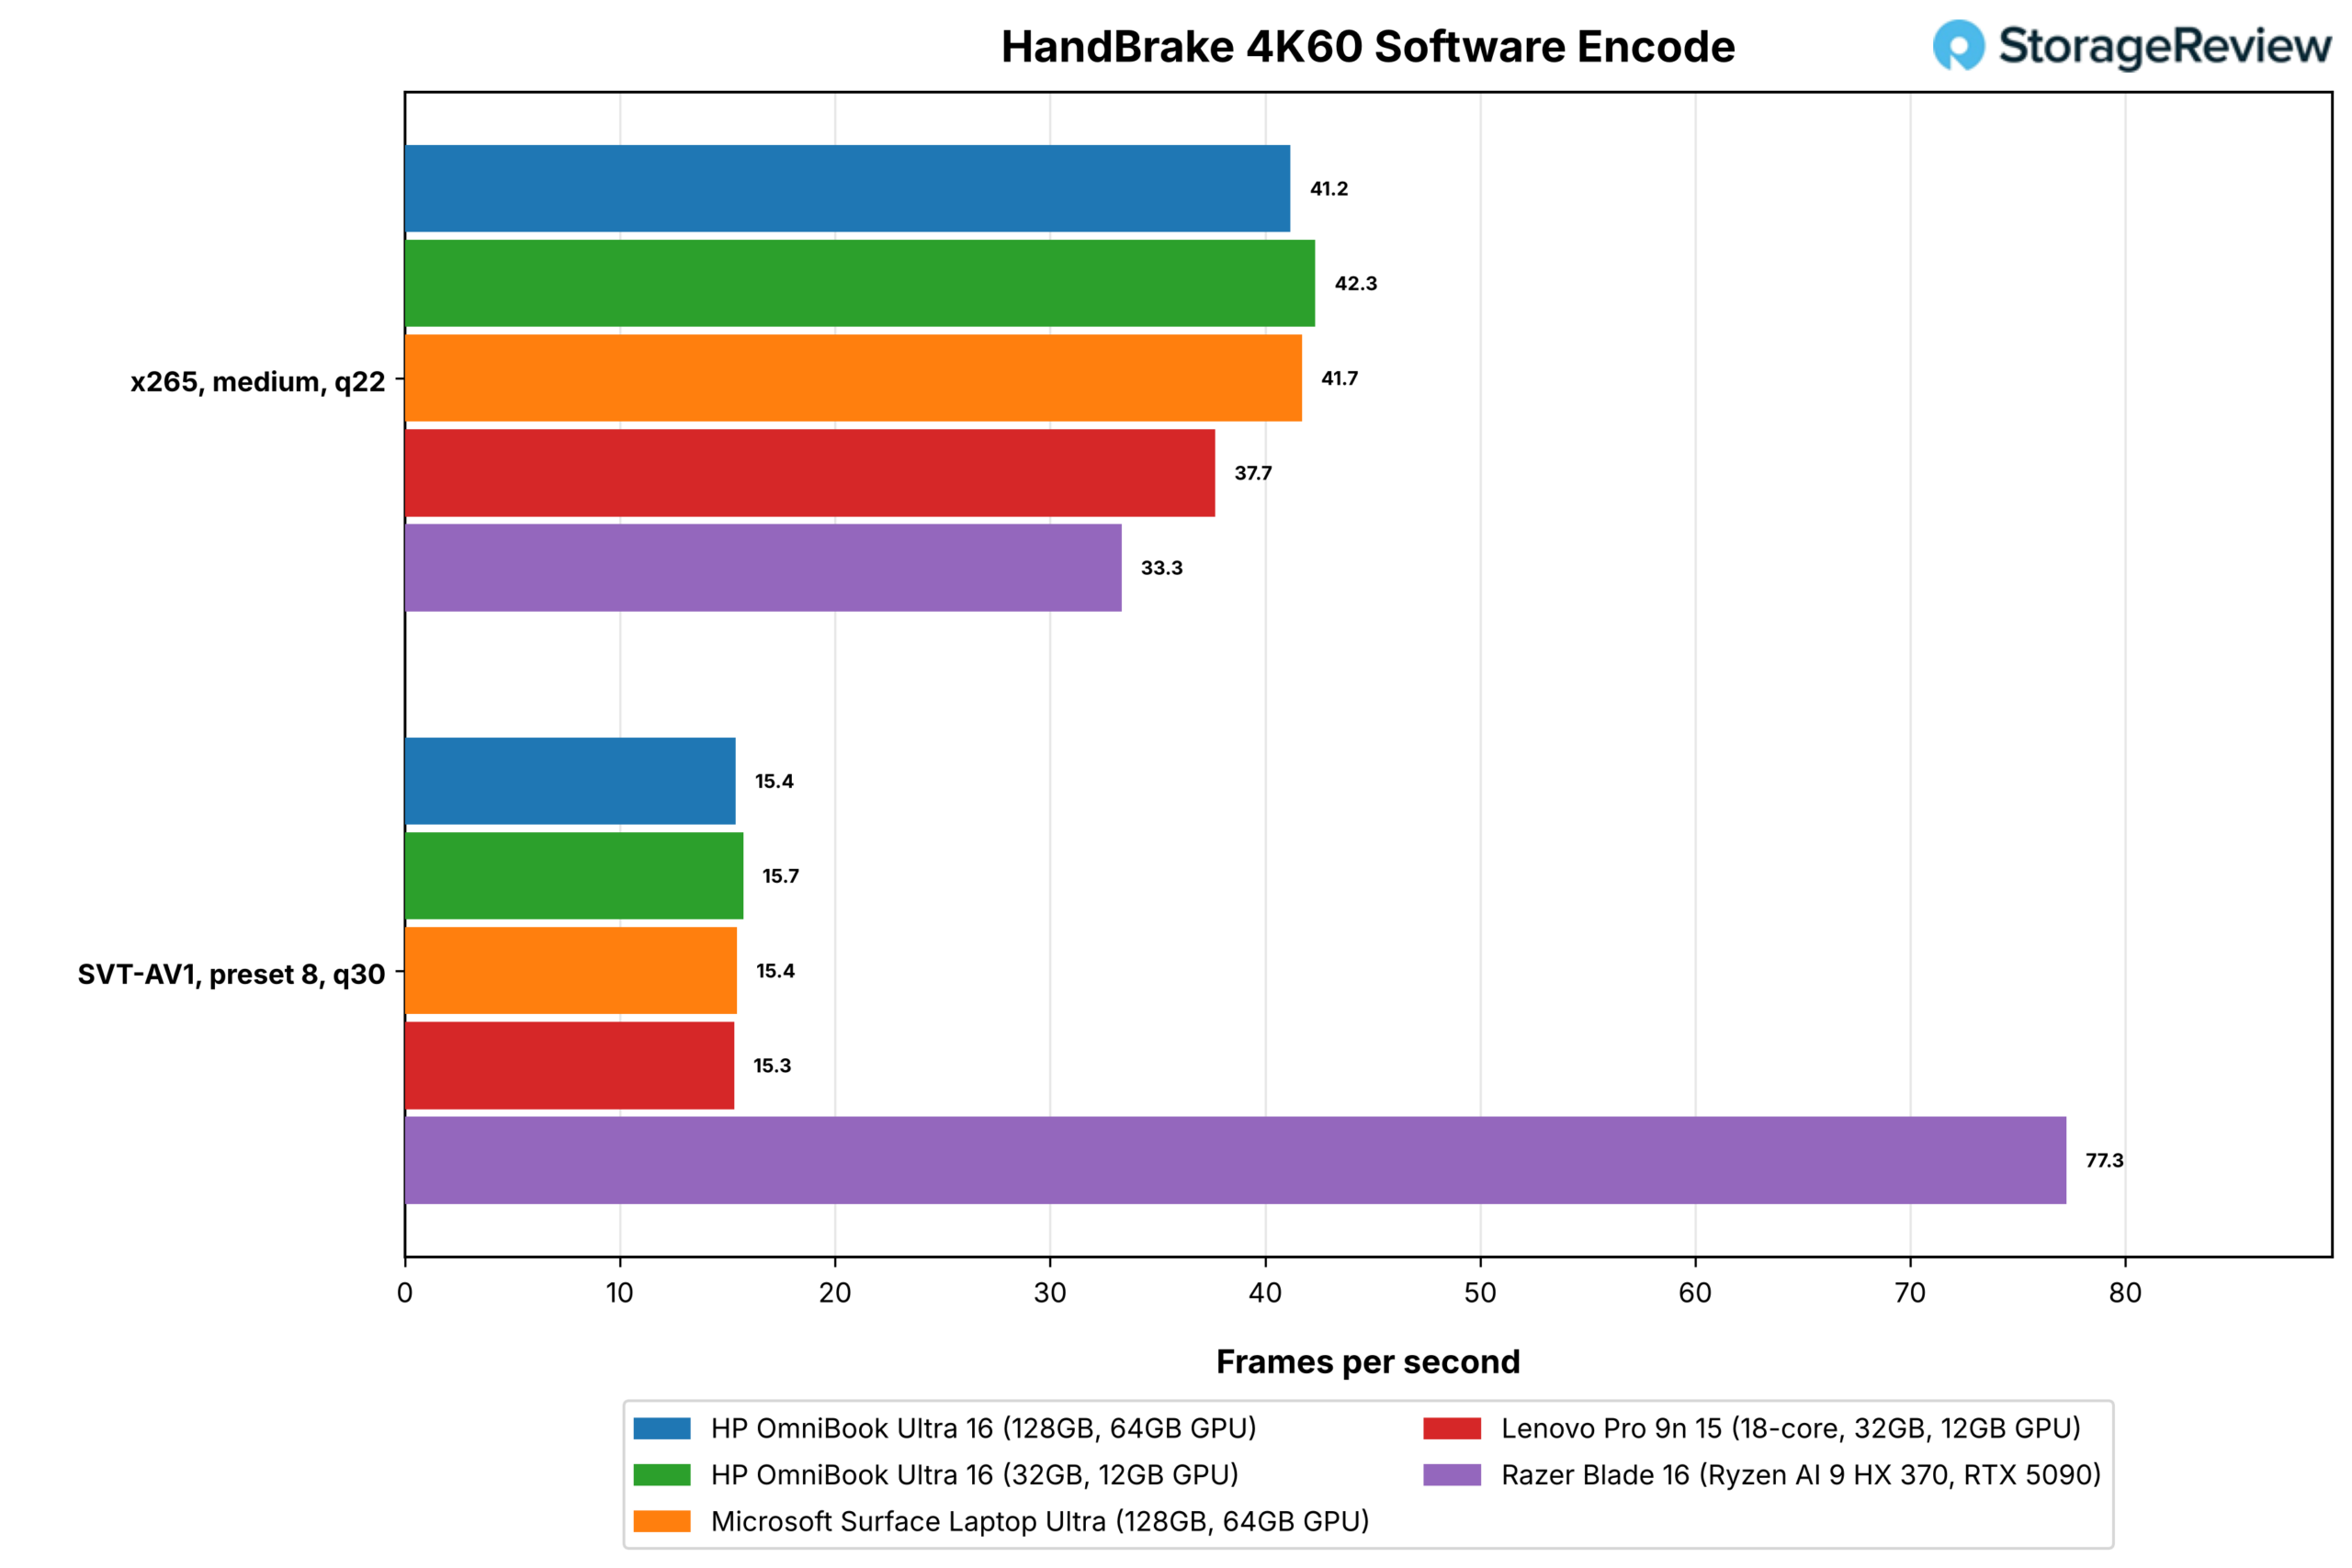
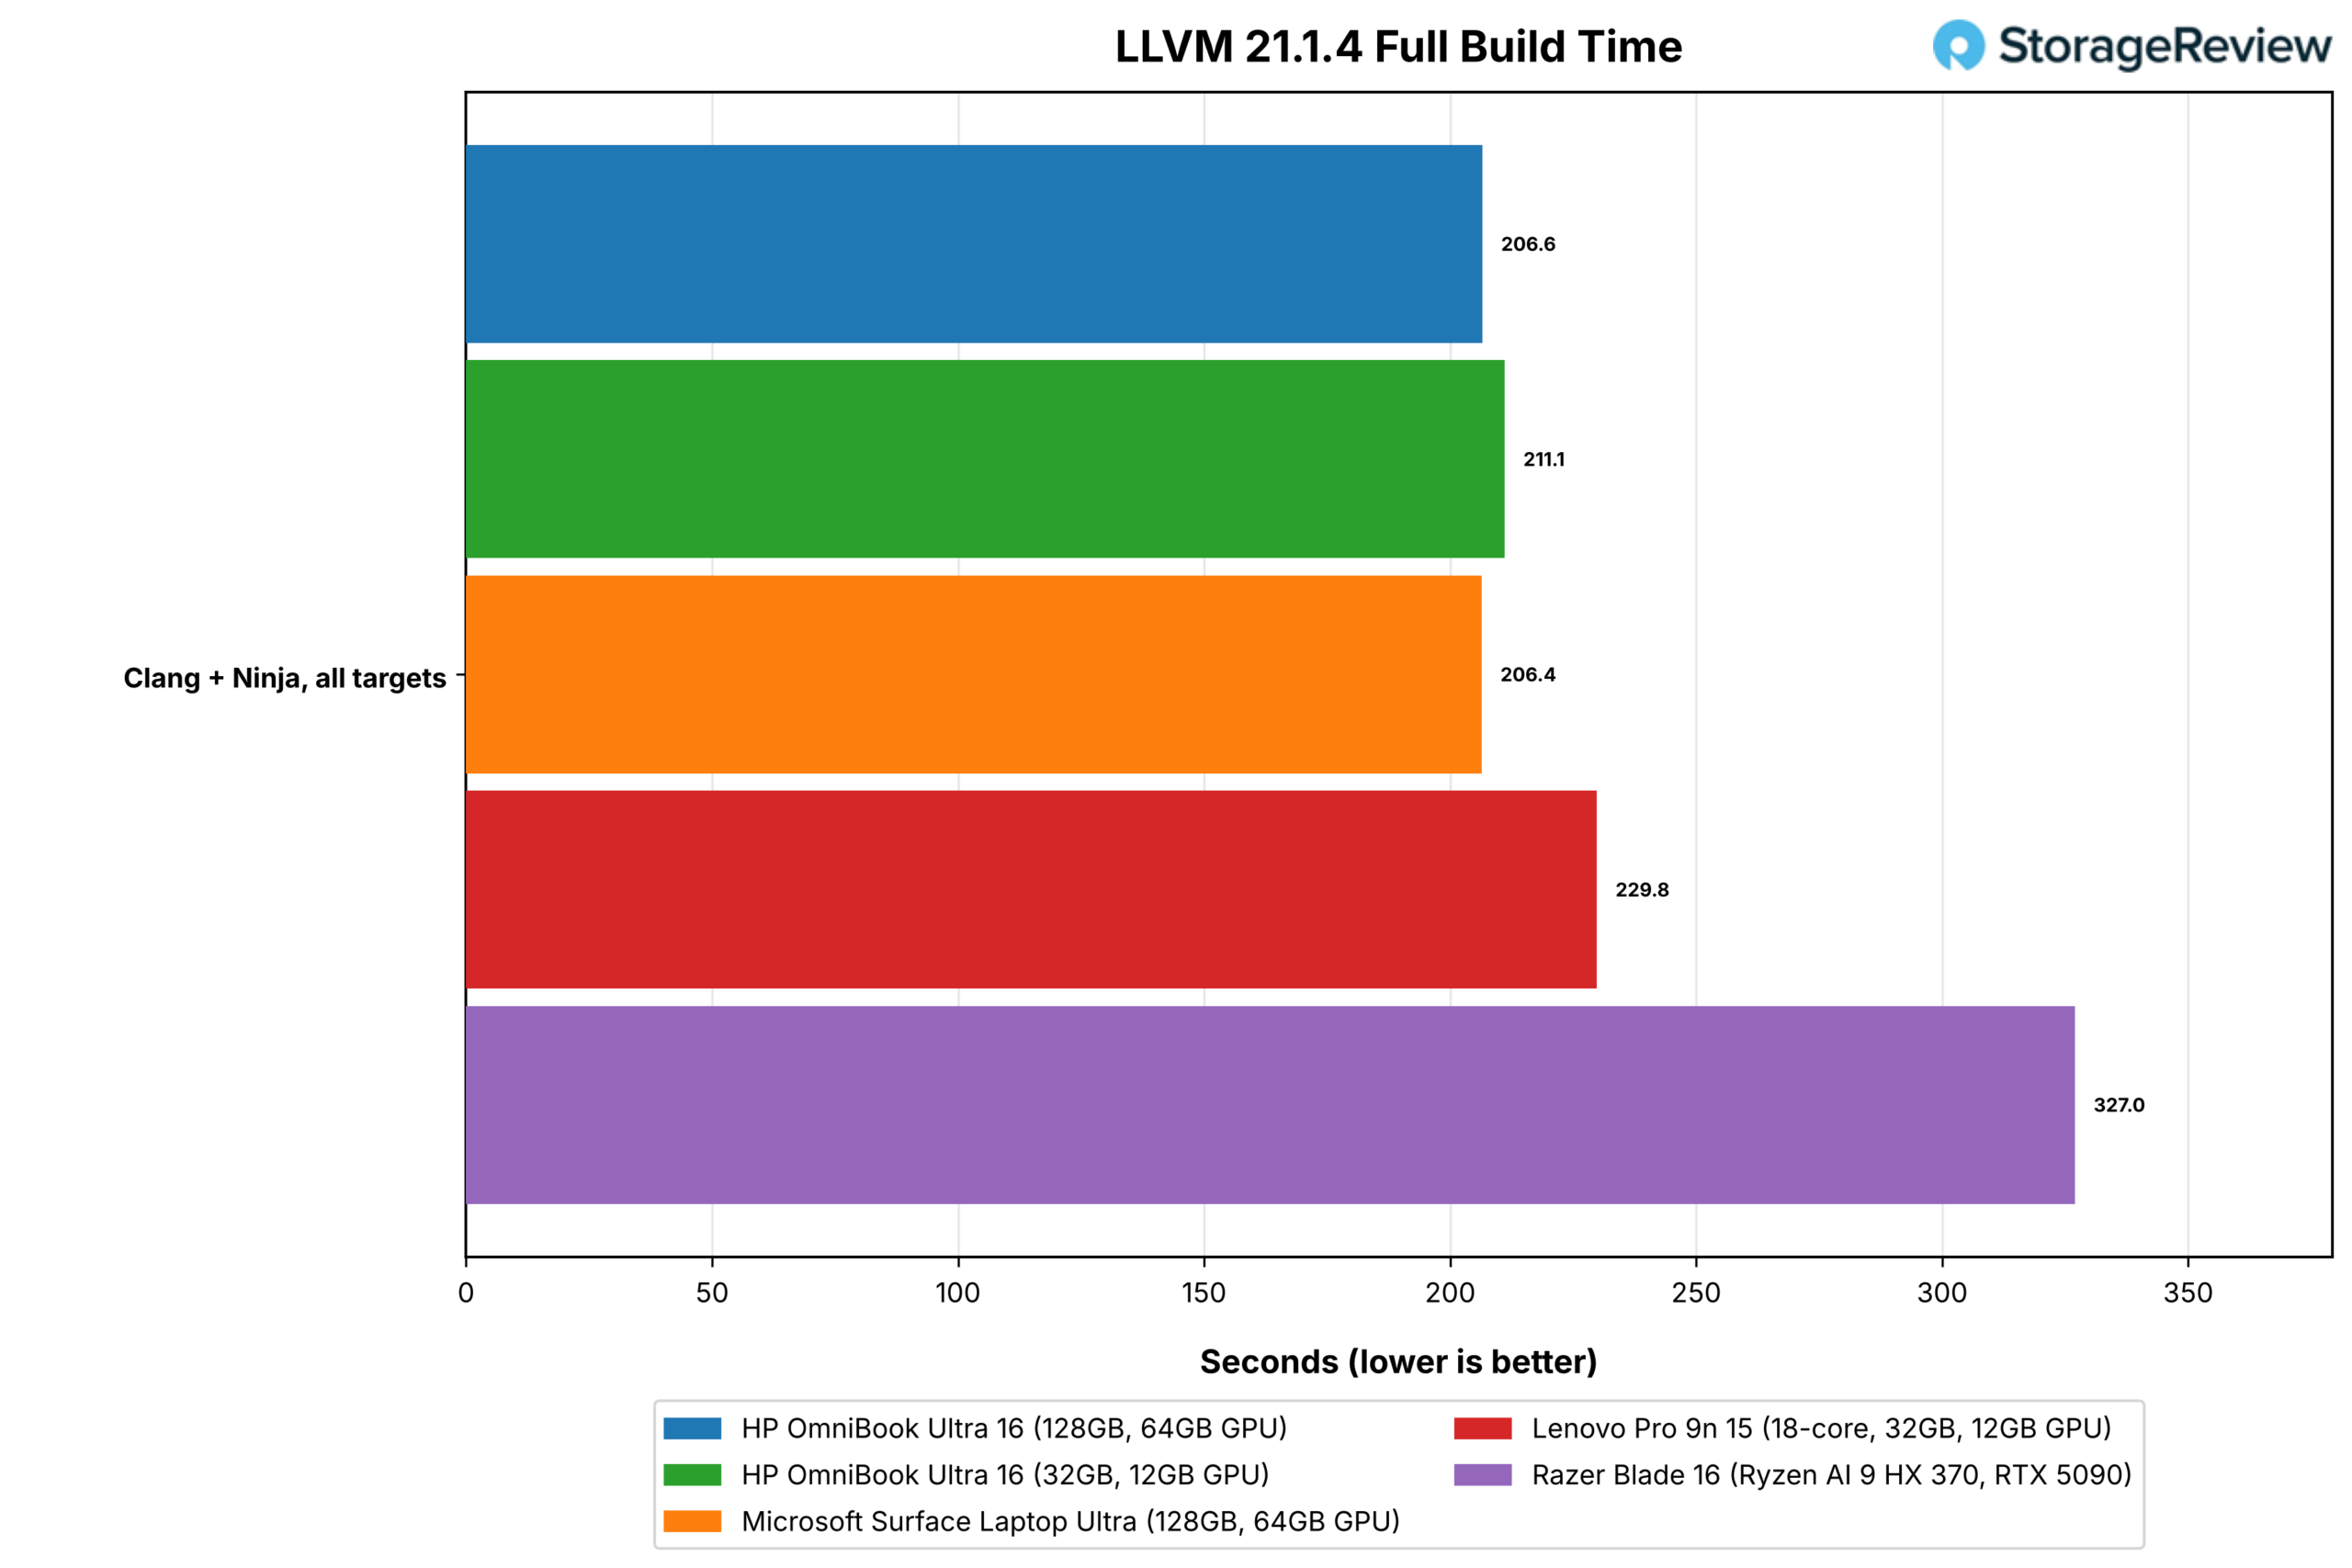
三款20核笔记本电脑在Blender的三个场景测试中成绩相差不到2%,其中32GB OmniBook在Monster场景中以每分钟211.7个采样领先,Surface在Classroom场景中以每分钟93.2个采样领先。128GB OmniBook在Monster场景中领先Blade 16 49%,在Classroom场景中领先18%。128GB OmniBook的LLVM构建耗时206.6秒,与Surface持平,比Blade 16的327.0秒快了37%。
HandBrake 测试结果在软件层面上存在差异,32GB 的 OmniBook 在 x265 编码下以 42.3 fps 的帧率领先,比 Blade 16 高出 27%,而所有 N1X 系统在 SVT-AV1 编码下仅达到约 15 fps,远低于 Blade 的 77.3 fps。在芯片层面上,x265 编码性能领先的核心速度不可能慢五倍,因此差距在于 SVT-AV1 的 Arm64 代码路径。
Stockfish、primesieve、Python 和浏览器
Stockfish 内置的基准测试工具以每秒百万个节点为单位报告国际象棋搜索速度。primesieve 统计所有线程上小于 10^12 的素数,以及单个线程上小于 10^11 的素数。PyPerformance 在单个高性能核心上运行三个 CPython 基准测试(go、nbody 和 regex_compile),而 Speedometer 3.1 则测量 Microsoft Edge 中 Web 应用程序的响应速度。最后两行数据是在 Prism 模拟器下运行 7-Zip 的 x64 版本,显示了仅支持 x64 架构的应用程序在这些系统上的运行成本。
| 《测试》(Test) | OmniBook Ultra 16 (128GB) | OmniBook Ultra 16 (32GB) | Surface Laptop Ultra | Pro 9n 15 | 雷蛇刃16 |
|---|---|---|---|---|---|
| Stockfish 基准测试,所有线程(Mnps,数值越高越好) | 16.28 | 15.12 | 15.51 | 15.20 | 17.96 |
| Stockfish 工作台,单线程(Mnps,数值越高越好) | 1.73 | 1.73 | 1.33 | 1.70 | 2.04 |
| primesieve 1e12,所有线程(s,越低越好) | 9.57 | 9.54 | 9.82 | 10.56 | 10.60 |
| primesieve 1e11,单线程(s,越低越好) | 12.03 | 12.02 | 12.03 | 12.34 | 6.67 |
| PyPerformance 的值为(毫秒,数值越低越好) | 111.2 | 111.2 | 123.9 | 114.1 | 75.2 |
| PyPerformance nbody(毫秒,数值越低越好) | 80.4 | 80.6 | 89.8 | 82.5 | 60.8 |
| PyPerformance 正则表达式编译(毫秒,数值越低越好) | 84.6 | 84.5 | 94.1 | 86.7 | 69.7 |
| Speedometer 3.1,Edge(评分,越高越好) | 36.7 | 35.4 | 34.7 | 33.9 | 38.4 |
| x64 7-Zip 在模拟器下运行,所有线程 (GIPS) | 127.0 | 127.8 | 127.2 | 117.6 | 不适用(原生 x64) |
| x64 7-Zip 在模拟器下运行,单线程 (GIPS) | 8.26 | 8.36 | 8.27 | 7.94 | 不适用(原生 x64) |
Blade 16 在所有线程的 Stockfish 测试中均以 17.96 Mnps 的成绩领先,比 128GB 版 OmniBook 高出 10%。在所有单线程测试中,Blade 16 也遥遥领先:primesieve 单线程测试仅需 6.67 秒,而 N1X 系统则需要约 12 秒;PyPerformance go 测试仅需 75.2 毫秒,而 HP 系统则需要 111.2 毫秒。OmniBook 在所有线程的 primesieve 测试中速度最快,分别为 9.54 秒和 9.57 秒。128GB 版 OmniBook 的 Speedometer 得分为 36.7,与 Blade 的 38.4 分仅相差 5%。
在这个平台上,模拟运行的成本比以前降低了。在128GB OmniBook上,7-Zip的x64版本在所有线程上的运行速度为127.0 GIPS,达到原生Arm64版本的84%,并且略高于运行其原生x64版本的Blade 16。在我们测试过的所有N1X系统上,Cinebench 2026的x64版本在模拟运行下均崩溃,因此相关数据被排除在外。
GROMACS、OpenBLAS 和内存
GROMACS 在 16 个核心上运行 benchMEM 分子动力学算例,采用四种不同的线程布局,并报告最佳布局下每天的模拟时间(以纳秒为单位)。我们的 OpenBLAS 测试在所有核心上运行 HPL 风格的双精度 LU 分解求解(三种问题规模)以及 DGEMM 矩阵乘法运算,并在最佳核心类别上再次运行。这是该测试套件中最繁重的持续浮点运算负载。STREAM 测量持续内存带宽,延迟行则测量单次内存访问和核心间延迟。
| 测试(分数越高越好) | OmniBook Ultra 16 (128GB) | OmniBook Ultra 16 (32GB) | Surface Laptop Ultra | Pro 9n 15 | 雷蛇刃16 |
|---|---|---|---|---|---|
| GROMACS benchMEM,最佳布局(ns/天) | 17.47 | 17.43 | 17.29 | 16.88 | 26.41 |
| OpenBLAS LU N=10000,所有内核 (GFLOPS) | 324.0 | 326.9 | 地下城与勇士 | 303.4 | 400.9 |
| OpenBLAS LU N=20000,所有内核 (GFLOPS) | 329.6 | 322.4 | 地下城与勇士 | 318.1 | 454.4 |
| OpenBLAS LU N=40000,所有内核 (GFLOPS) | 348.8 | 未运行(需要 11.9GB) | 地下城与勇士 | 未运行(需要 11.9GB) | 498.5 |
| OpenBLAS LU N=20000,顶级核心级别(GFLOPS) | 380.5 | 432.2 | 地下城与勇士 | 403.8 | 240.4 |
| OpenBLAS DGEMM M=8000,所有核心(GFLOPS) | 398.5 | 368.9 | 地下城与勇士 | 357.6 | 455.4 |
| OpenBLAS DGEMM M=8000,顶级核心级别(GFLOPS) | 488.7 | 488.7 | 地下城与勇士 | 448.3 | 252.4 |
Blade 16 在 GROMACS 测试中以 26.41 ns/天的成绩领先于 OmniBooks 的约 17.4 ns/天,并且在全核 OpenBLAS 测试中领先约 14% 至 43%,与 Surface 的情况类似。更重要的是,两台 OmniBooks 都完成了 OpenBLAS 测试。128GB 版本运行了所有规模的测试,包括 N=40000,性能达到 348.8 GFLOPS;32GB 版本运行了除 N=40000 以外的所有规模测试,N=40000 需要 11.9GB 内存,如果系统内存超过 Windows 系统内存的一半,则会跳过该测试。Surface 在 N=20000 的求解过程中断电三次;两台 HP 笔记本电脑均在 98°C 的温度下完成了测试。
在 OpenBLAS 测试中,N1X 的顶级核心单独运行性能优于全部 20 个核心同时运行:32GB 版 OmniBook 的 10 个高性能核心在 N=20000 的计算中达到了 432.2 GFLOPS,而全部 20 个核心同时运行的计算结果为 322.4 GFLOPS;128GB 版的 10 个高性能核心(DGEMM)达到了 488.7 GFLOPS。这表明,在此测试中,高性能核心对共享工作负载的拖慢作用大于其带来的性能提升。
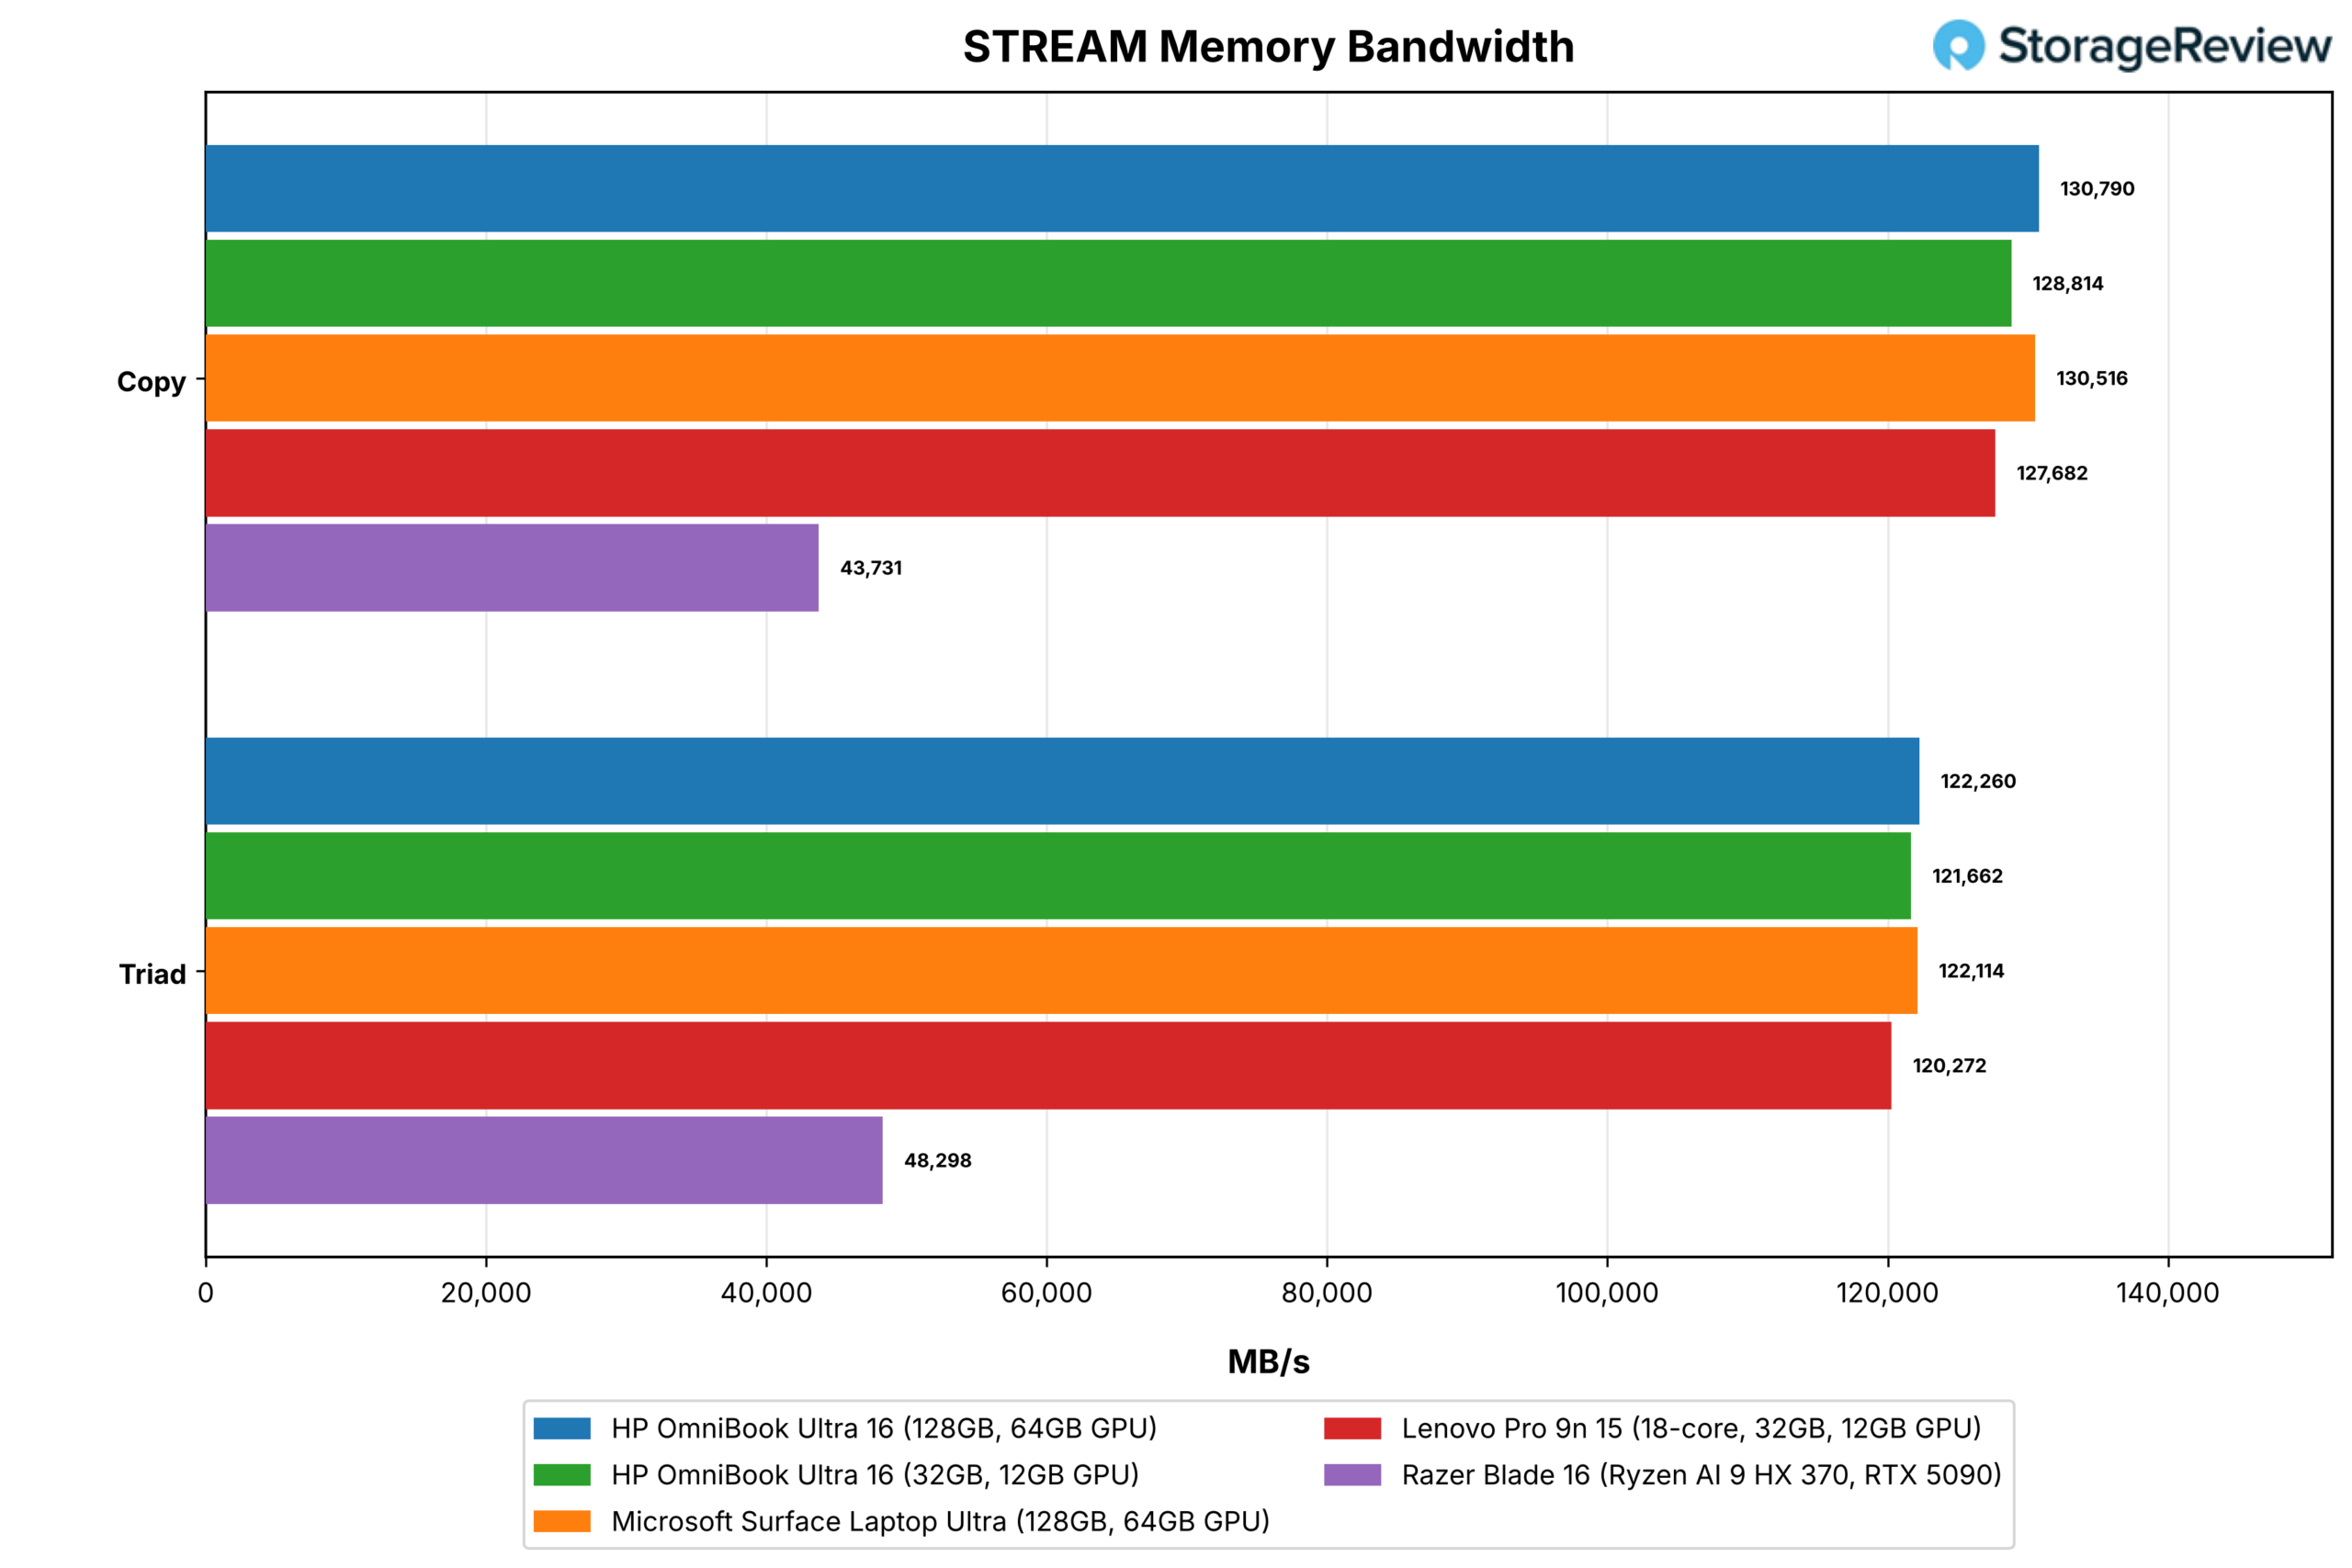
| 《测试》(Test) | OmniBook Ultra 16 (128GB) | OmniBook Ultra 16 (32GB) | Surface Laptop Ultra | Pro 9n 15 | 雷蛇刃16 |
|---|---|---|---|---|---|
| 流式复制(MB/s,速度越高越好) | 130,790 | 128,814 | 130,516 | 127,682 | 43,731 |
| STREAM Triad(MB/s,越高越好) | 122,260 | 121,662 | 122,114 | 120,272 | 48,298 |
| 内存延迟,1GiB 缓冲区,4KiB 页(纳秒,越低越好) | 143.1 | 143.5 | 251.1 | 143.4 | 129.6 |
| 核心间延迟,所有核心对的平均值(ns,数值越低越好) | 156.8 | 160.9 | 171.6 | 160.6 | 57.0 |
内存带宽是RTX Spark平台最明显的硬件优势。所有N1X系统在STREAM Triad测试中读取速度均达到120至122GB/s,是Blade 16(48,298MB/s)的2.5倍。OmniBook的内存延迟约为143纳秒,对于该平台而言也属于正常水平,远低于Surface的251.1纳秒,但仍比Blade的129.6纳秒慢。其核心间延迟为156.8至160.9纳秒,约为Blade(57.0纳秒)的三倍,这也解释了为什么N1X在单线程任务中落后于x64架构。
游戏和GPU编码
SuperTuxKart 1.5 内置基准测试程序在 1080p 全屏模式下,使用最高预设设置并关闭垂直同步,分别使用游戏原生 Arm64 版本和模拟器运行的 x64 版本进行测试。我们记录平均帧率和稳定帧率。FFmpeg 使用 NVENC HEVC 编码相同的 4K60 视频片段,在 NVIDIA 系统上编码码率为 8Mbps,在可用系统上则使用 Media Foundation HEVC 编码器进行编码。
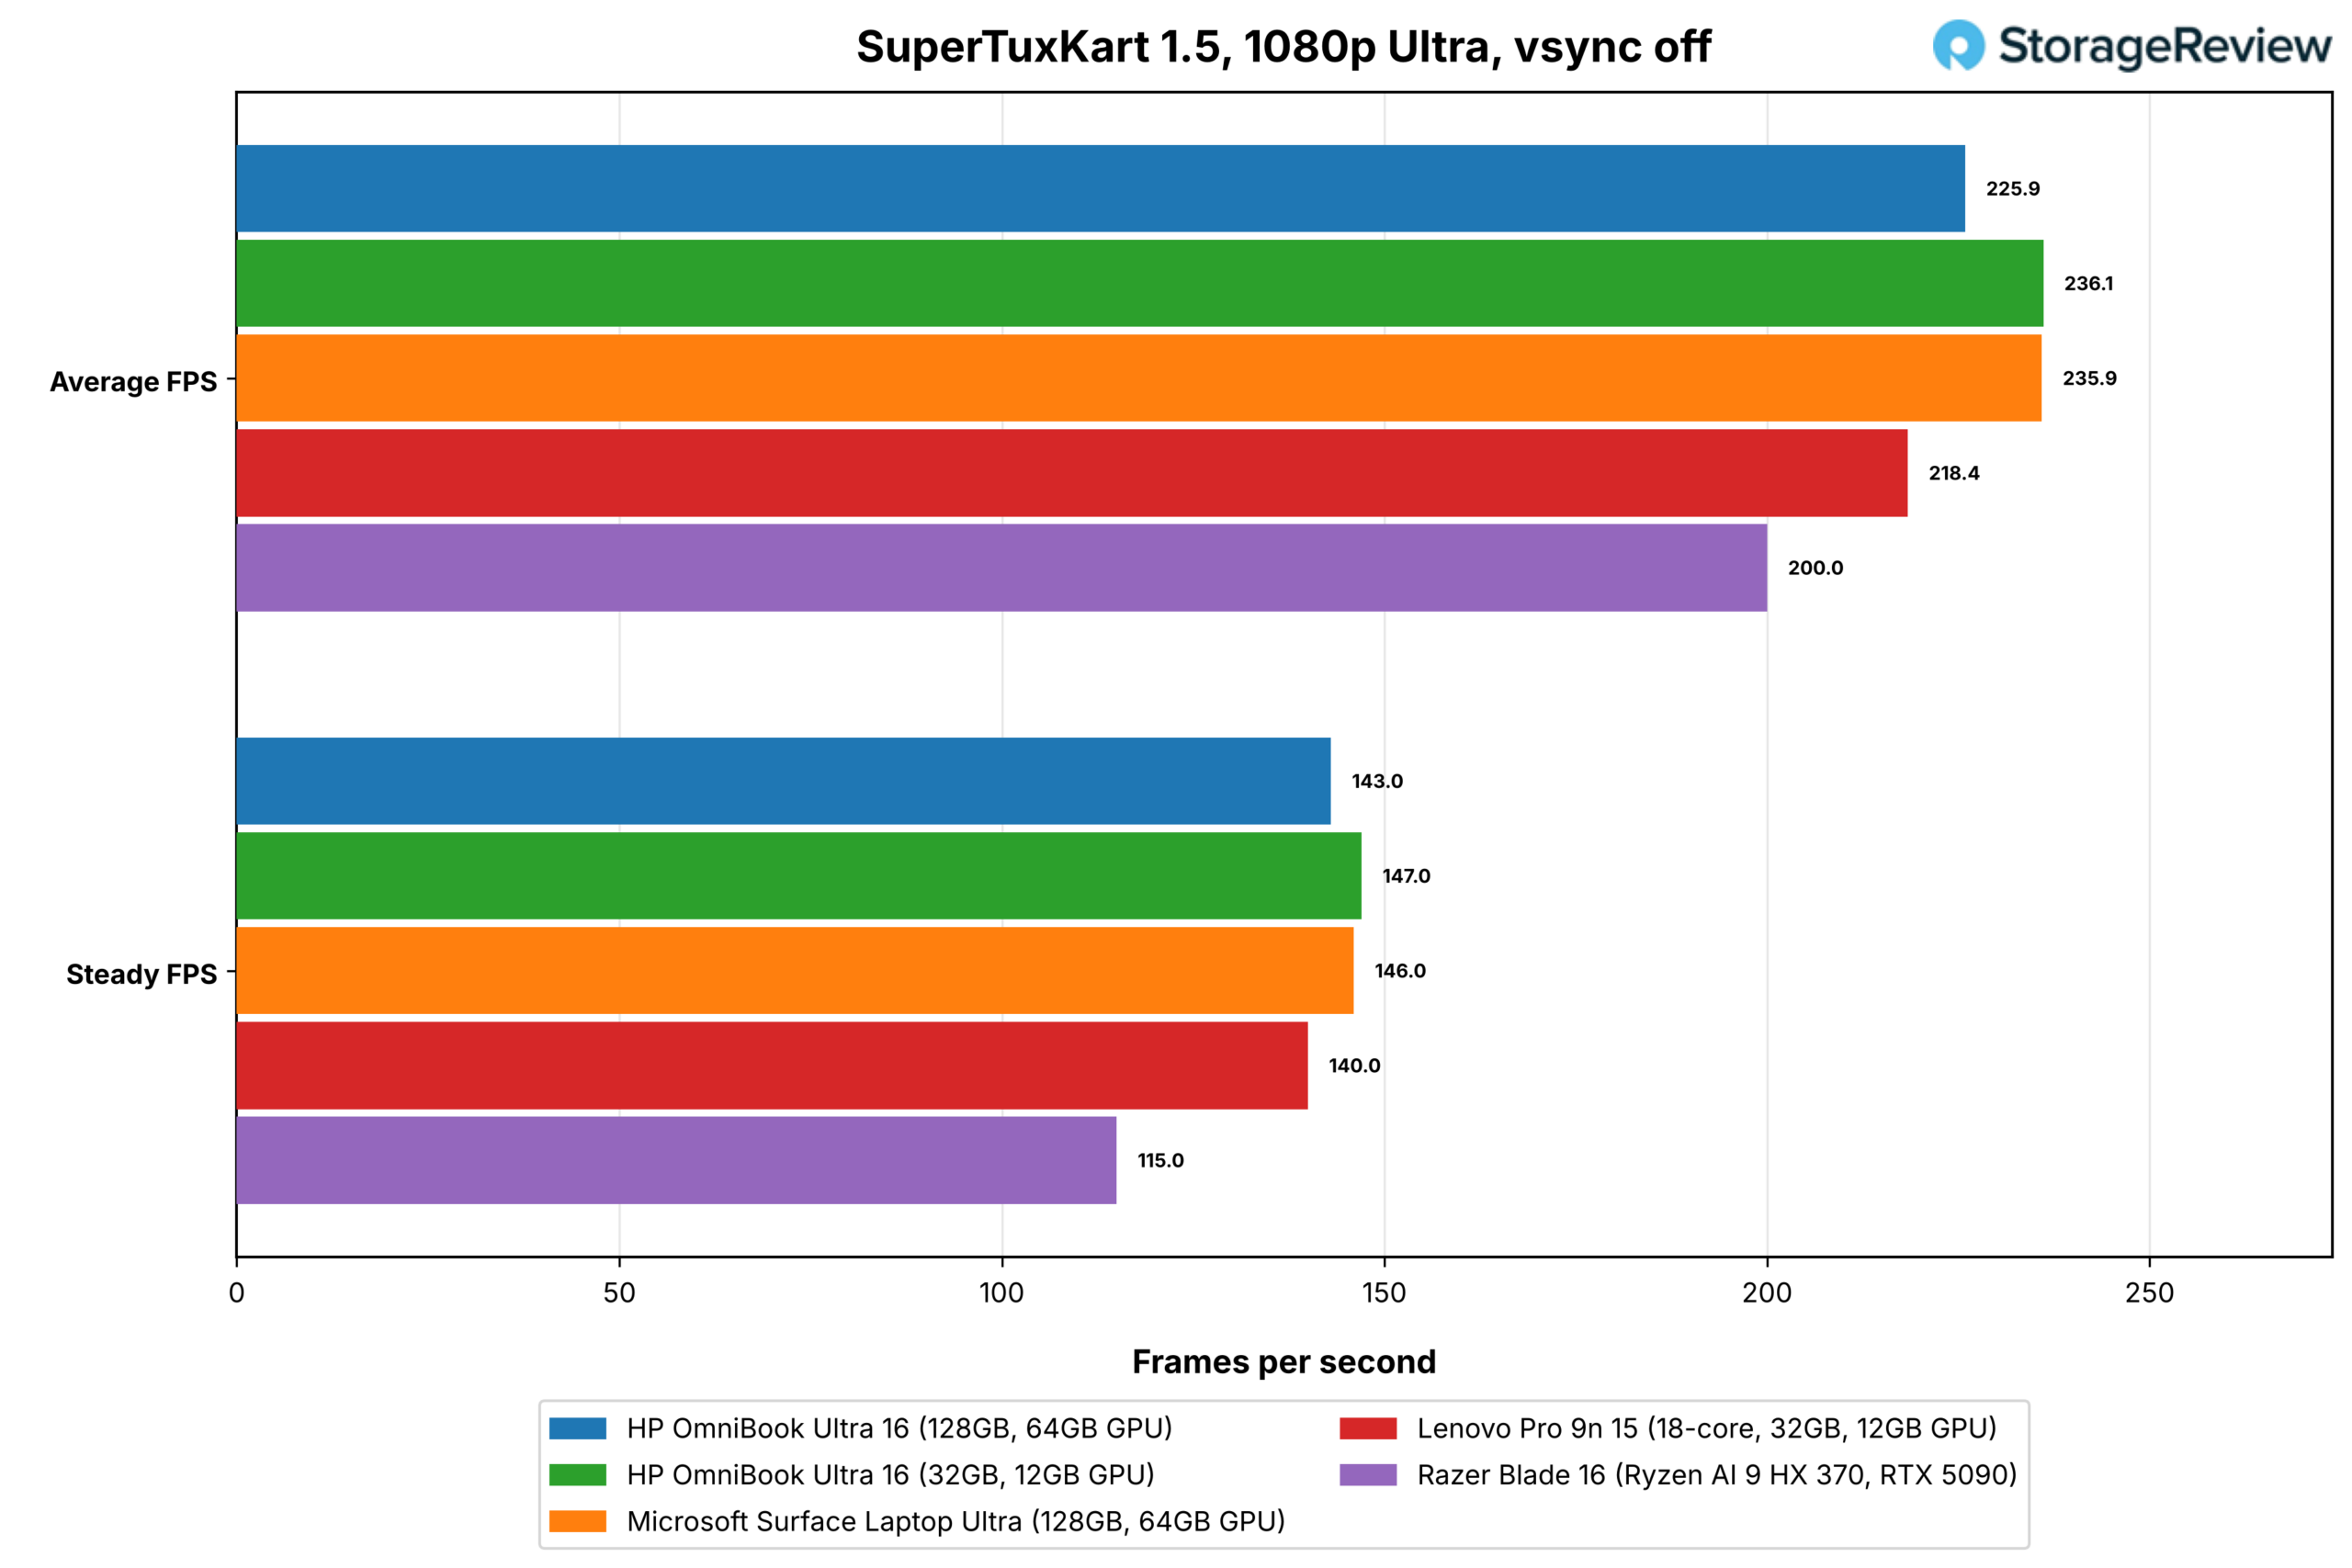
| 测试(分数越高越好) | OmniBook Ultra 16 (128GB) | OmniBook Ultra 16 (32GB) | Surface Laptop Ultra | Pro 9n 15 | 雷蛇刃16 |
|---|---|---|---|---|---|
| SuperTuxKart 1080p 超高画质,原生画质,平均帧率 (fps) | 225.9 | 236.1 | 235.9 | 218.4 | 200.0 |
| SuperTuxKart 1080p 超高清,原生,稳定(帧率) | 143 | 147 | 146 | 140 | 115 |
| SuperTuxKart 1080p 超高画质,x64 模拟器运行,平均帧率 (fps) | 266.5 | 265.4 | 264.6 | 248.6 | 不适用(原生 x64) |
| SuperTuxKart 1080p 超高画质,x64 模拟器运行,帧率稳定 (fps) | 141 | 143 | 129 | 94 | 不适用(原生 x64) |
| FFmpeg NVENC HEVC,4K60,8Mbps(帧率) | 138 | 137 | 135 | 139 | 132 |
| FFmpeg 媒体基金会 HEVC (fps) | 66 | 55 | 55 | 55 | 无 |
32GB 的 OmniBook 和 Surface 并列原生帧率第一,约为 236 fps;128GB 的 OmniBook 帧率为 225.9 fps,而 Blade 16 则达到了 200.0 fps。在这个分辨率下,帧率由 CPU 决定,而 RTX 5090 的性能还有提升空间,因此测试结果更多地反映了各系统核心的性能,而非 GPU 的性能。在模拟器下运行的 x64 版本在两款惠普笔记本电脑上的平均帧率约为 266 fps,高于原生 Arm64 版本,这表明游戏的 Windows on Arm 移植版本速度较慢。
由于 NVENC 是固定功能的,因此硬件编码在各款产品中几乎完全相同。OmniBook 的 HEVC 编码帧率分别为 138 和 137 fps,而 Blade 16 的编码帧率则为 132 fps,128GB 版本的 Media Foundation 编码器帧率则为 66 fps。
暖流
两款 OmniBook 均按照设计使 N1X 处理器发挥到极限性能。在所有全核工作负载下,它们的温度都保持在 98 摄氏度,在 Stockfish、Blender、GROMACS 和 30 分钟持续循环测试中,平均温度在 96 到 98 摄氏度之间,但性能并未因此下降。两台机器在几乎所有测试中温度都相差不到一度,这正是相同机箱应有的表现。RTX Spark 系统仅通过 Windows 温度分区报告 CPU 温度,不显示 GPU 温度,因此下表仅包含 CPU 温度数据。
| CPU温度,最高/平均(摄氏度) | OmniBook Ultra 16 (128GB) | OmniBook Ultra 16 (32GB) | Surface Laptop Ultra | Pro 9n 15 | 雷蛇刃16 |
|---|---|---|---|---|---|
| Cinebench 2026 | 98 / 83 | 98 / 83 | 98 / 88 | 92 / 70 | 96 / 78 |
| 7-ZIP | 98 / 78 | 98 / 77 | 98 / 65 | 83 / 63 | 99 / 84 |
| 鳕鱼干 | 98 / 97 | 98 / 96 | 98 / 96 | 88 / 83 | 92 / 90 |
| 混合器 | 98 / 96 | 98 / 97 | 98 / 93 | 91 / 80 | 95 / 87 |
| 手刹 | 98 / 86 | 98 / 87 | 98 / 84 | 93 / 74 | 92 / 86 |
| LLVM 构建 | 98 / 92 | 98 / 92 | 98 / 92 | 87 / 79 | 98 / 93 |
| GROMACS | 98 / 96 | 98 / 96 | 98 / 96 | 89 / 85 | 97 / 94 |
| 开放式BLAS | 98 / 95 | 97 / 93 | 地下城与勇士 | 92 / 83 | 91 / 87 |
| 流 | 98 / 96 | 95 / 89 | 98 / 92 | 78 / 66 | 75 / 71 |
| 超级卡丁车 | 95 / 82 | 94 / 86 | 90 / 80 | 74 / 68 | 89 / 82 |
| MLPerf 客户端 | 93 / 84 | 93 / 85 | 93 / 77 | 76 / 66 | 97 / 76 |
| 编码代理 | 90 / 79 | 未运行 | 86 / 78 | 未运行 | 91 / 84 |
| 鲁尔 | 94 / 90 | 94 / 90 | 94 / 86 | 76 / 71 | 88 / 83 |
| 持续循环 | 98 / 98 | 98 / 98 | 98 / 97 | 92 / 87 | 94 / 90 |
Surface Laptop Ultra 的散热表现与 HP 笔记本电脑相同,在持续循环测试中温度保持在 98°C 且无明显下降,这也是其 OpenBLAS 关机性能如此突出的原因。OmniBook 系列笔记本电脑在相同的 OpenBLAS 测试序列中最高温度达到 98°C,平均温度分别为 95°C 和 93°C,频率约为 3.0GHz,均未出现故障。在 CPU 测试中,Pro 9n 的最高温度比 HP 笔记本电脑低 5 到 18°C,频率与 HP 笔记本电脑的相差不到 1%。Blade 16 的 Zen 5 核心在 7-Zip 和 LLVM 构建过程中温度达到 98 到 99°C。
| 平均CPU时钟频率(MHz) | OmniBook Ultra 16 (128GB) | OmniBook Ultra 16 (32GB) | Surface Laptop Ultra | Pro 9n 15 | 雷蛇刃16 |
|---|---|---|---|---|---|
| Cinebench 2026 | 2,962 | 2,964 | 2,952 | 2,951 | 4,158 |
| 7-ZIP | 2,838 | 2,862 | 2,405 | 2,849 | 4,014 |
| 鳕鱼干 | 3,269 | 3,269 | 3,263 | 3,292 | 3,645 |
| 混合器 | 3,123 | 3,241 | 3,174 | 3,216 | 3,729 |
| 手刹 | 2,756 | 2,865 | 2,739 | 2,834 | 3,814 |
| LLVM 构建 | 3,151 | 3,193 | 3,160 | 3,197 | 3,697 |
| GROMACS | 3,308 | 3,315 | 3,325 | 3,367 | 3,874 |
| 开放式BLAS | 3,024 | 3,057 | 地下城与勇士 | 3,192 | 4,274 |
| 流 | 3,258 | 3,251 | 3,255 | 3,101 | 3,684 |
| 超级卡丁车 | 1,957 | 2,008 | 2,049 | 2,017 | 4,349 |
| MLPerf 客户端 | 2,114 | 2,241 | 2,165 | 2,027 | 3,593 |
| 编码代理 | 2,078 | 未运行 | 2,242 | 未运行 | 3,789 |
| 鲁尔 | 2,749 | 2,724 | 2,751 | 2,760 | 3,764 |
| 持续循环 | 3,239 | 3,232 | 3,270 | 3,288 | 3,726 |
在全核负载下,OmniBook、Surface 和 Pro 9n 的频率稳定在 3.1 至 3.4GHz,这是 N1X 在这些机箱中的极限频率。而 HP 的两款机型在持续循环测试中分别保持在 3,239MHz 和 3,232MHz,得分稳定。固件能够将频率稳定在极限值,不会出现波动,因此得分较为平稳。固态硬盘在负载下也表现出良好的散热性能,128GB 的 Sandisk 固态硬盘在 80 次 fio 测试后最高温度为 52℃,32GB 的 KIOXIA 固态硬盘最高温度为 64℃。
储存效能
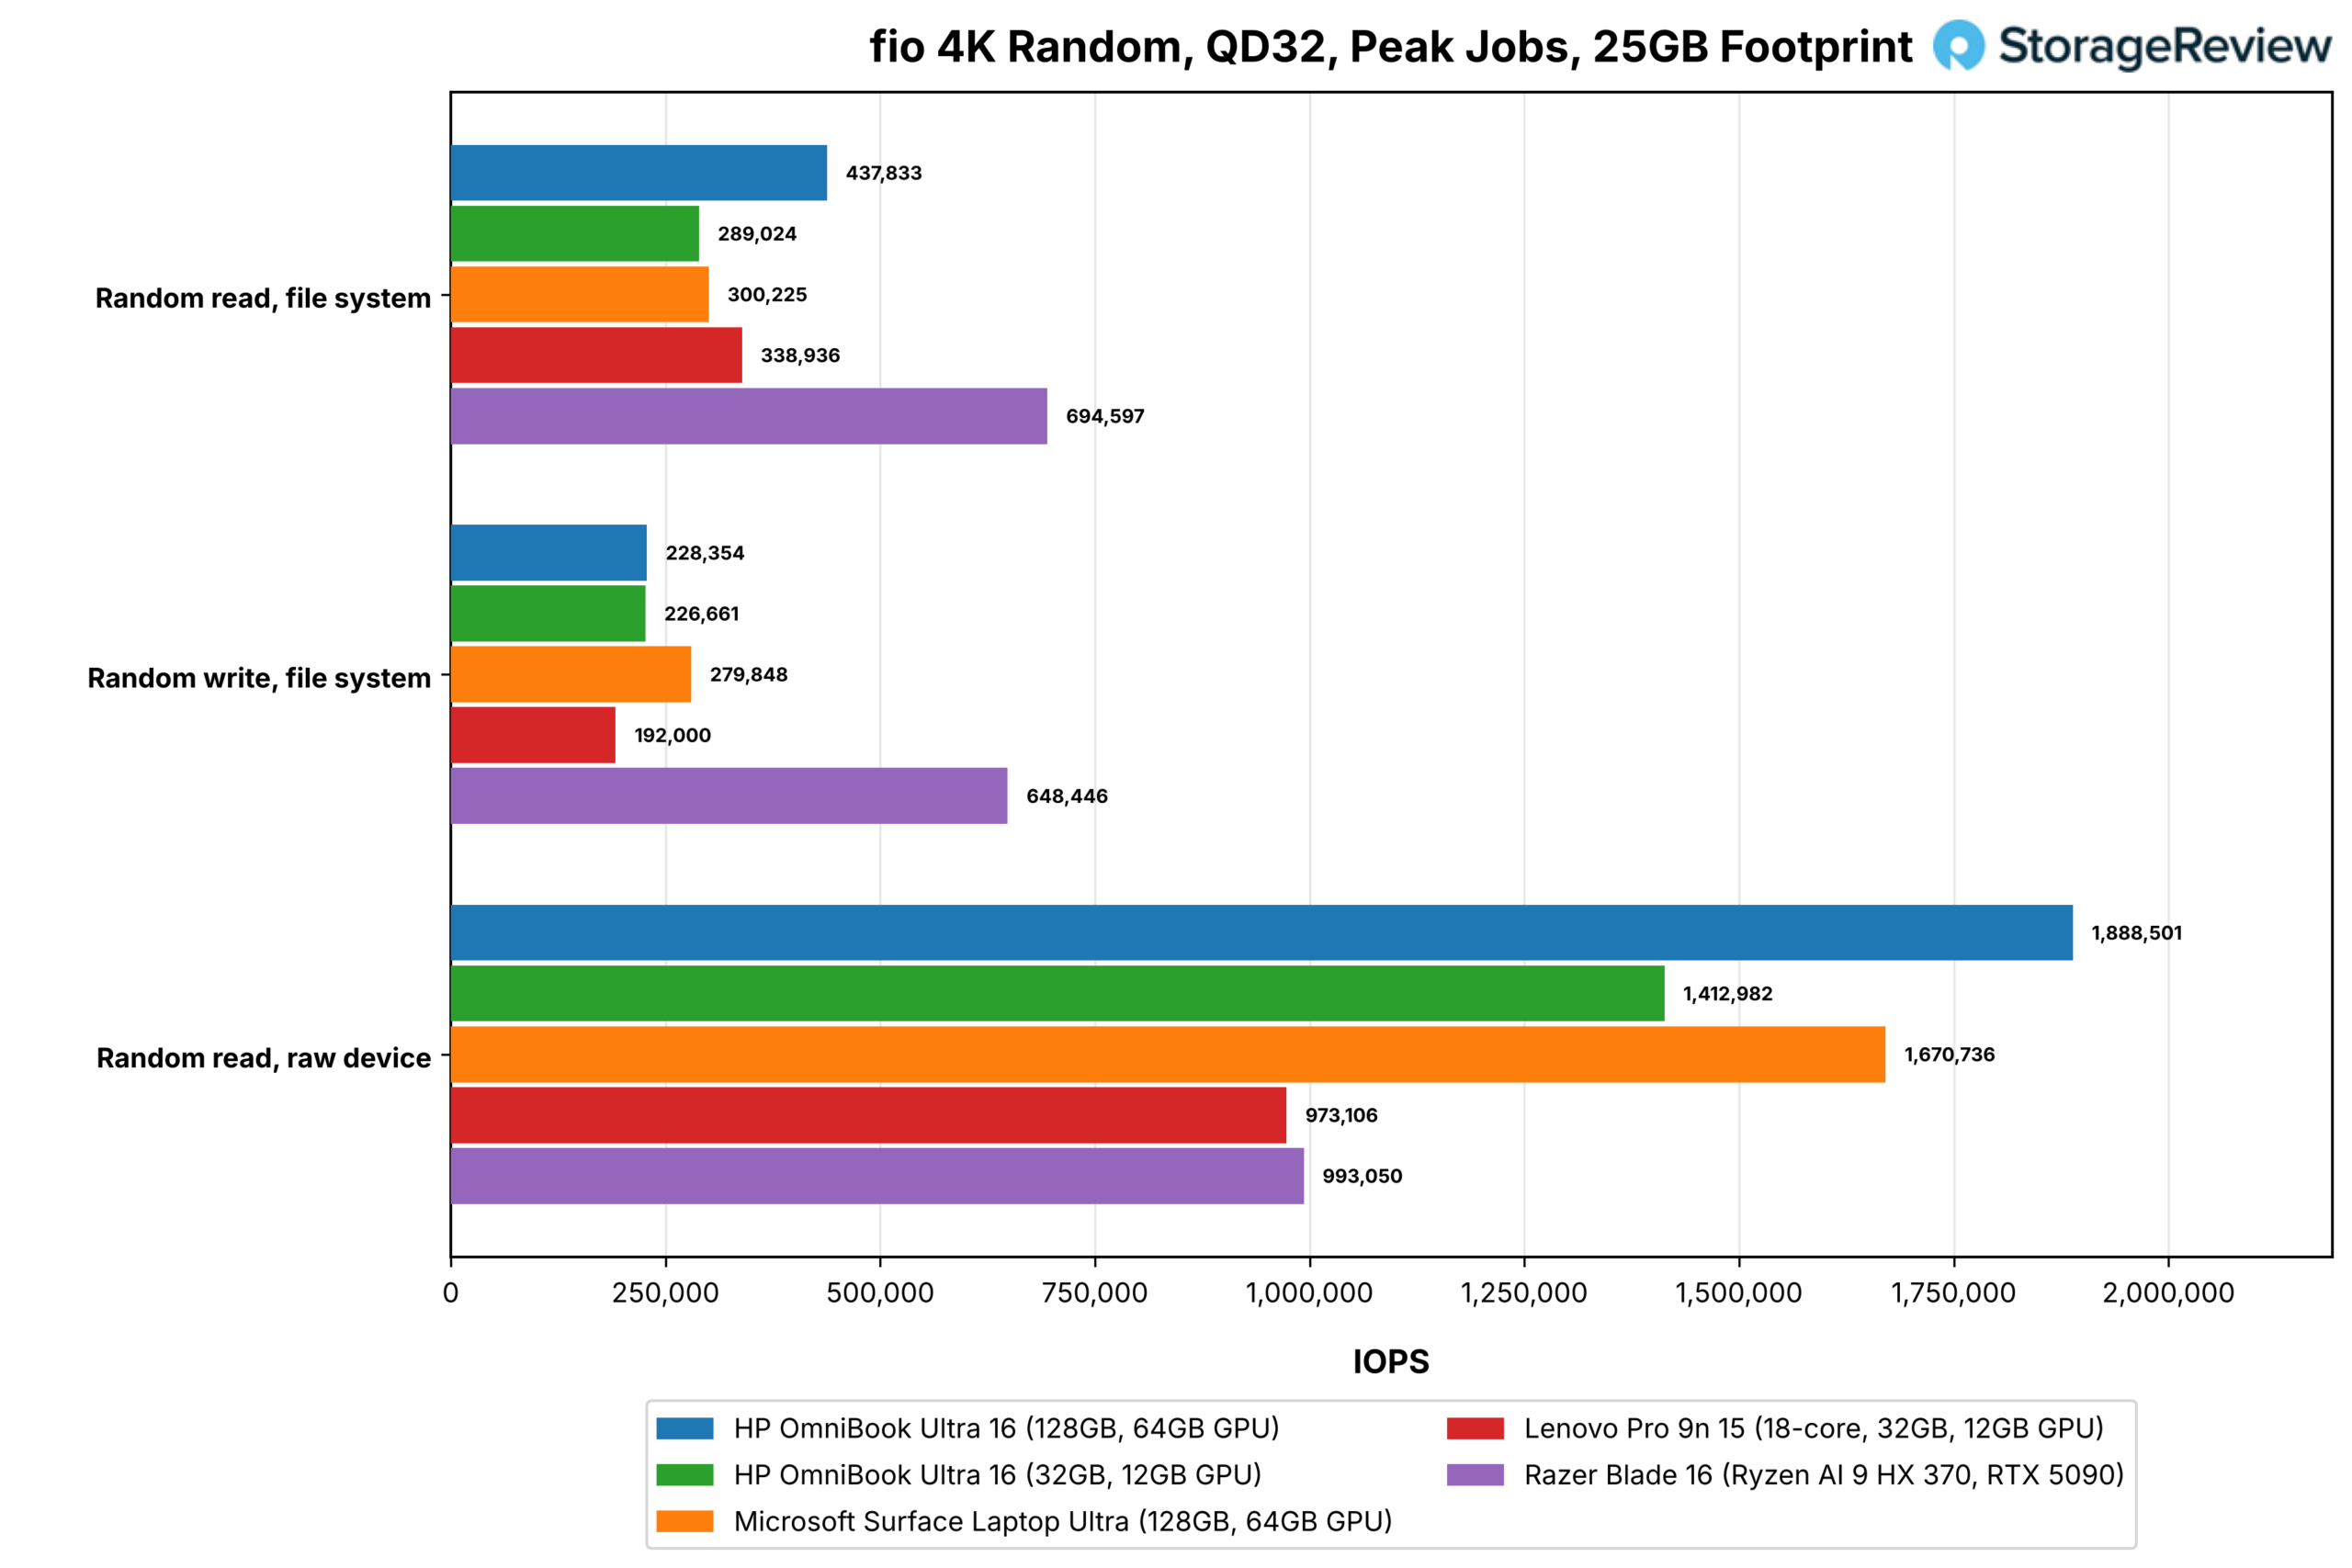
我们的存储测试使用 fio 的四个角分别对启动盘进行 5GB 和 25GB 的读写测试,测试内容包括文件系统读写以及对原始设备读写,此处报告的是 25GB 的测试结果。原始设备读写的数据绕过了 NTFS 和 BitLocker,因此两者之间的差距显示了硬盘在 Windows I/O 路径下的性能极限。所有四台 N1X 系统都运行 Windows on Arm 并启用了 BitLocker 设备加密;两台 HP 电脑的 BitLocker 保护已启用,而 Pro 9n 的 BitLocker 保护则已关闭。
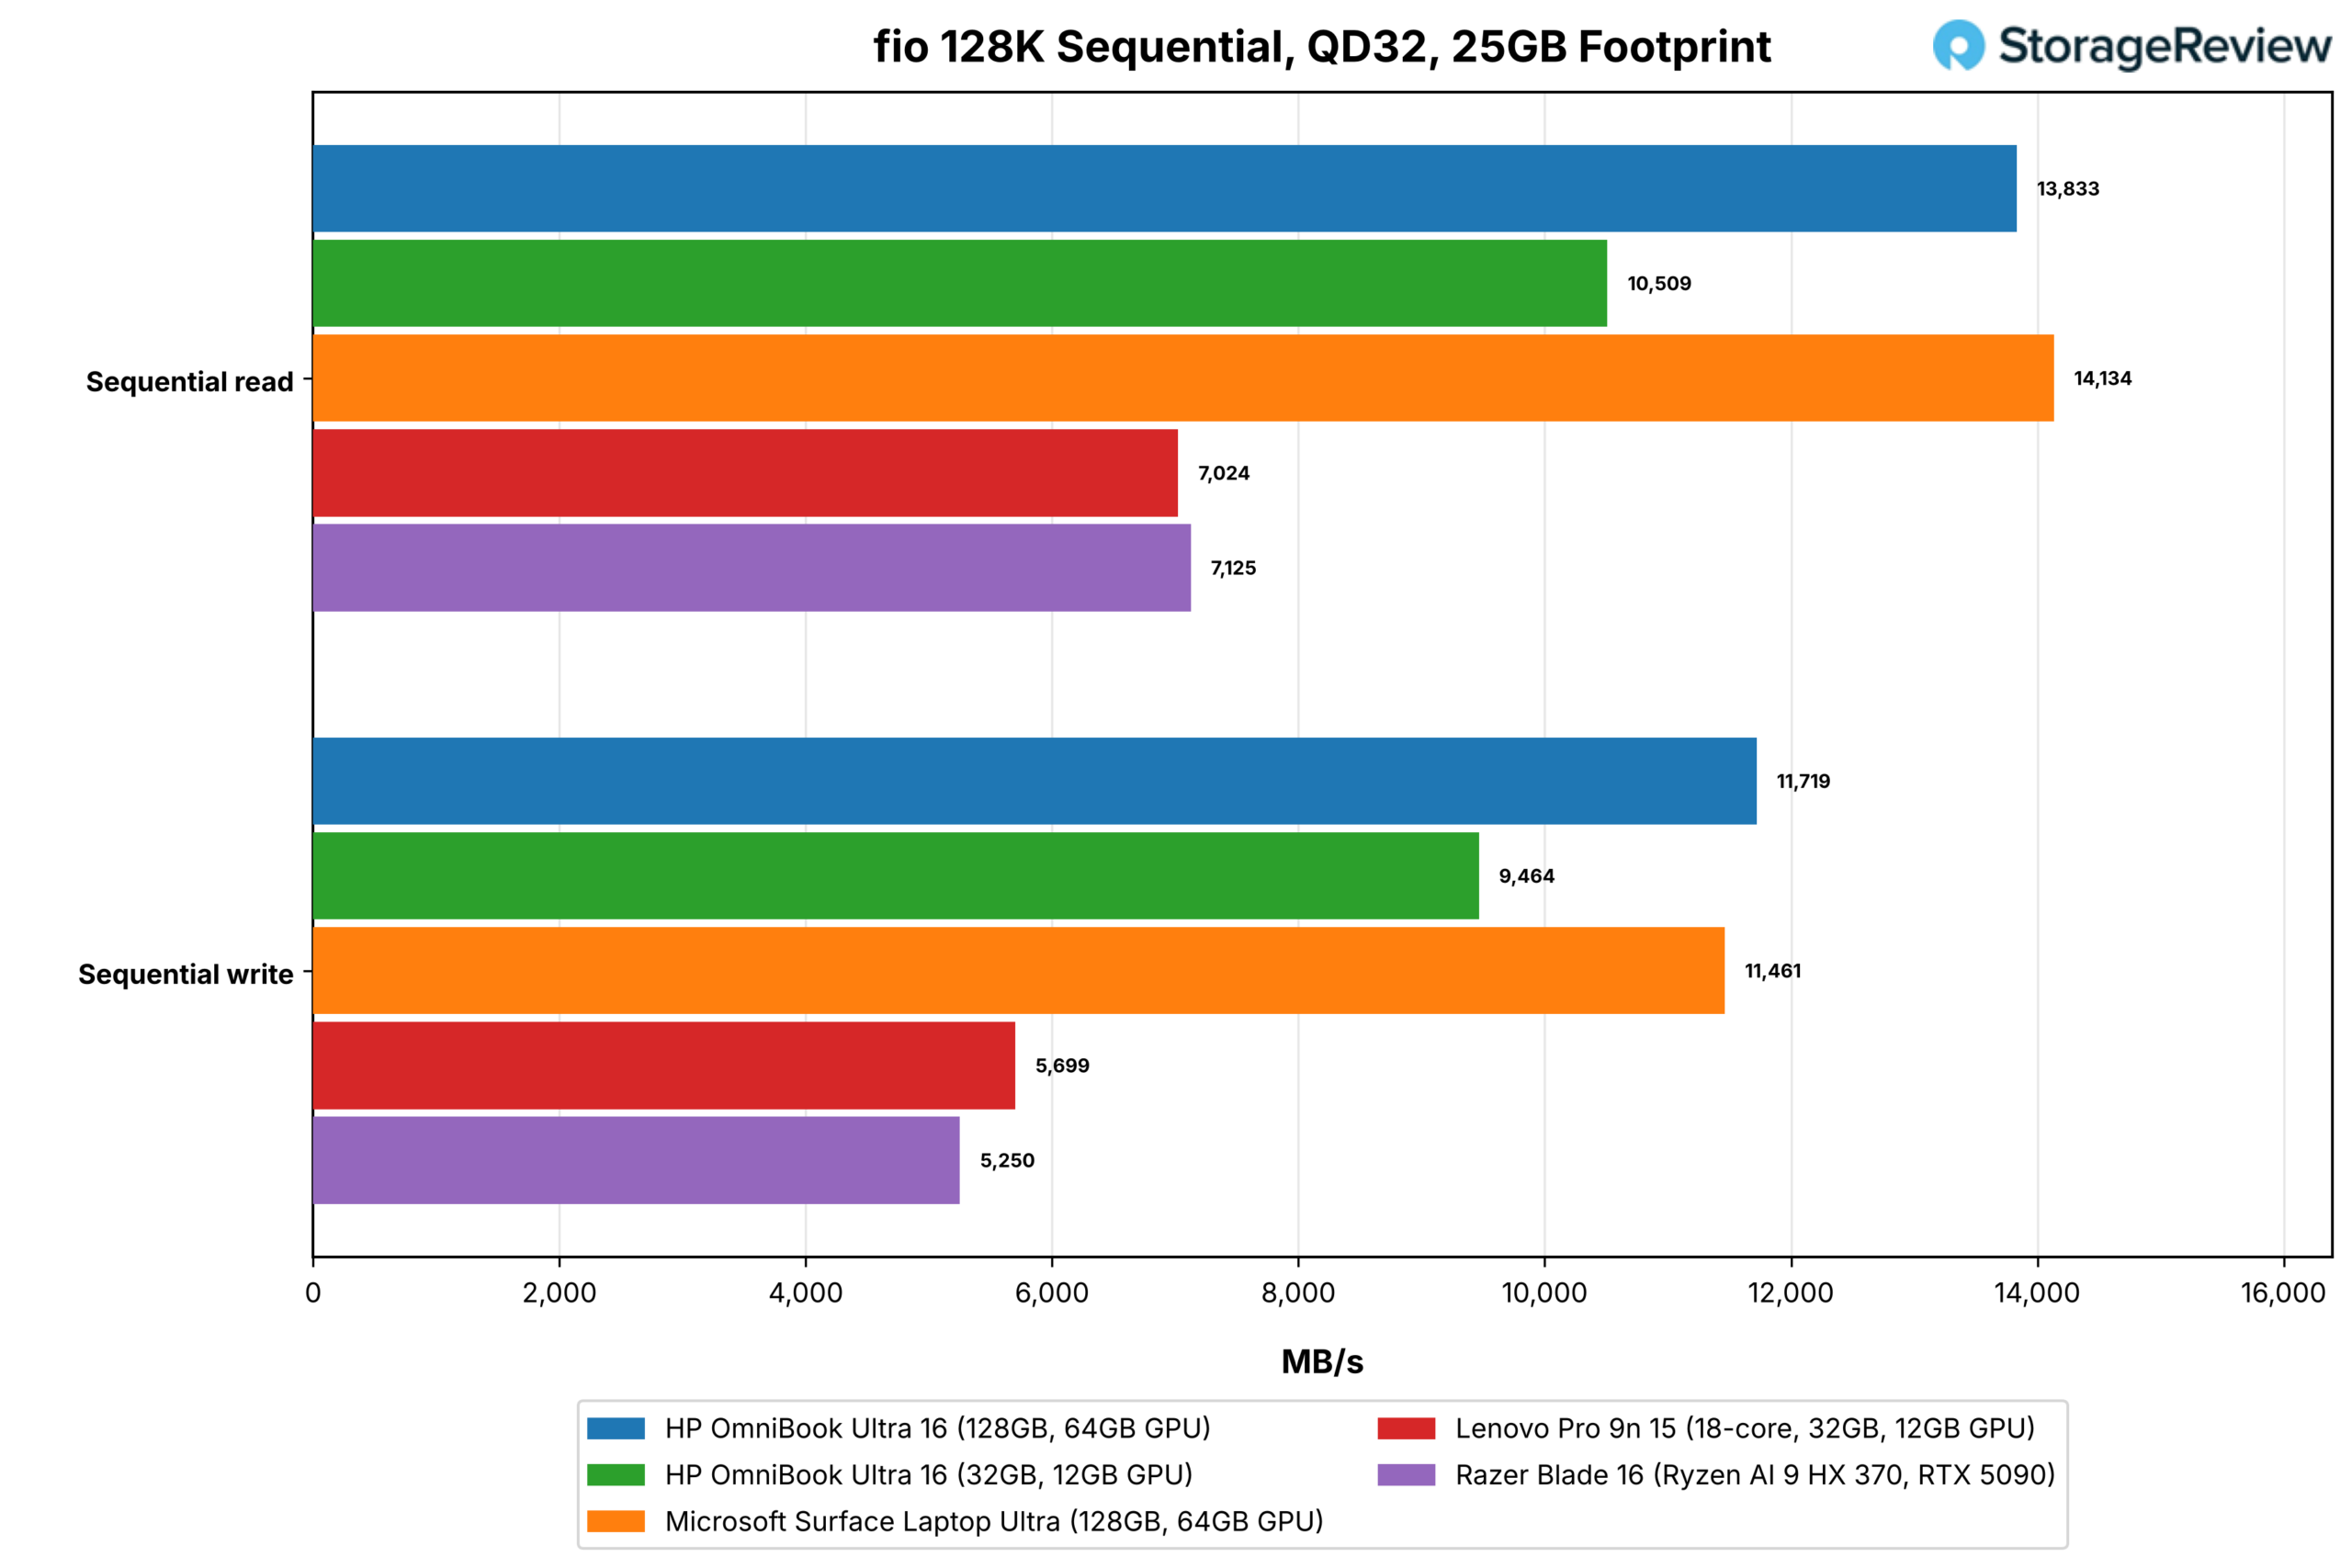
| fio,25GB 占用空间,QD32 | OmniBook Ultra 16 (128GB) | OmniBook Ultra 16 (32GB) | Surface Laptop Ultra | Pro 9n 15 | 雷蛇刃16 |
|---|---|---|---|---|---|
| 顺序读取 128K,文件系统 (MB/s) | 13,833 | 10,509 | 14,134 | 7,024 | 7,125 |
| 顺序读取 128K,原始设备 (MB/s) | 12,479 | 10,047 | 13,815 | 7,165 | 7,134 |
| 顺序写入 128K (MB/s) | 11,719 | 9,464 | 11,461 | 5,699 | 5,250 |
| 随机读取 4K,文件系统,峰值(IOPS) | 437,833 | 289,024 | 300,225 | 338,936 | 694,597 |
| 随机读取 4K,原始设备,峰值(IOPS) | 1,888,501 | 1,412,982 | 1,670,736 | 973,106 | 993,050 |
| 随机写入 4K,峰值(IOPS) | 228,354 | 226,661 | 279,848 | 192,000 | 648,446 |
| 原始/文件系统随机读取 | 4.31x | 4.89x | 5.56x | 2.87x | 1.43x |
| 随机读取 4K,4 个任务,p99 延迟(微秒,越低越好) | 643 | 494 | 477 | 578 | 444 |
| 随机写入 4K,4 个任务,p99 延迟(微秒,越低越好) | 586 | 602 | 449 | 758 | 371 |
| 驱动器温度,最高(摄氏度) | 52 | 64 | 56 | 78 | 60 |
128GB OmniBook 搭载的 2TB Sandisk SN8050S 固态硬盘,顺序读取速度为 13,833MB/s,顺序写入速度为 11,719MB/s,是该组产品中写入速度最快的,读取速度仅次于 Surface 的 SK 海力士固态硬盘。32GB 版本搭载的 1TB KIOXIA Gen5 固态硬盘,顺序读取速度和顺序写入速度分别达到了 10,509MB/s 和 9,464MB/s。Pro 9n 和 Blade 16 中的两块 Gen4 固态硬盘的读取速度则接近 7GB/s。
随机 I/O 性能体现了 Windows on Arm 存储路径的差异。SN8050S 从原始设备读取 4K 随机数据时,IOPS 为 1.89 万,但通过文件系统读取时仅为 437.8 万,差距高达 4.3 倍;KIOXIA 的差距更是达到了 4.9 倍。Blade 16 的 x64 路径性能损失则小得多,从原始读取 993.0 万的硬盘中,通过文件系统读取 IOPS 为 694.6 万。最可能的原因是启用了 VBS 和内存完整性功能的 BitLocker 软件加密,而关闭 BitLocker 保护的 Pro 9n 的性能差距则缩小至 2.9 倍。惠普在配置这些评测系统时启用了 BitLocker。
文件系统路径也出现了长时间的卡顿。在 16 个作业的情况下,最慢的 0.01% 随机读取操作在 128GB 的 OmniBook 上耗时 3.2 秒,在 32GB 的设备上耗时 6.2 秒,而 Blade 16 仅需 14 毫秒。在重新运行后,一个 128GB 的数据集在相同作业数量下仍然超过了我们 2% 的偏差限制,因此被标记为部分结果;峰值和原始设备结果不受影响。
结语
配备 128GB 存储的 HP OmniBook Ultra 16 笔记本电脑表现出色,堪称我们此次 RTX Spark 平台发布测试中最全面的笔记本电脑。它在 CPU、AI 和游戏性能方面与 Surface Laptop Ultra 的差距仅在几个百分点之内,能够以 62.5GB 的 GPU 可用内存流畅运行我们本地的两套 AI 测试,Qwen3.6 编码任务的完成速度也优于其他所有测试系统,并且能够稳定运行全核 OpenBLAS 求解任务(该任务需要两台 Surface 设备在 98°C 的高温下运行),而不会出现任何故障。
HP的塔式铰链和机箱散热设计使N1X在负载持续期间始终保持极限性能,30分钟内性能无明显下降。更重要的是,HP系统在所有测试中均顺利完成。
32GB 版 OmniBook 证明了 N1X 的 CPU 和 GPU 性能并不依赖于内存容量:在 CPU、MLPerf 和 RAG 测试中,其性能与 128GB 版本相差不到 2%,并且在 Cinebench 单核测试和 SuperTuxKart 测试中均名列前茅。它牺牲的是本地模型处理能力,因为 12GB 的 GPU 内存分配使其无法参与所有模型加载和编码代理测试。对于那些看重 N1X CPU 性能的用户来说,32GB 版本损失不大;而对于那些希望使用本地 AI 的用户来说,则应该考虑 64GB 或 128GB 版本。
Windows on Arm 存储路径的 4K 随机读取性能仅为硬盘性能的四分之一不到;一些 Arm64 移植版本(例如 SVT-AV1 和 GROMACS)的性能远逊于其 x64 版本;单线程 Python 的运行速度比 Blade 16 慢 20% 到 50%,单线程 PrimeSieve 的运行速度则慢了约 80%。此外,集成 GPU 还与系统其他部分共享内存总线,因此在运行编码代理时,浏览器速度降低了 1.73 倍。这些都是平台/软件问题,并非惠普的问题,我们期待通过新的补丁和版本更新,生态系统能够不断改进。
对于想要一款性能卓越的移动平台来在本地运行 20 亿到 35 亿个模型、编译大型树木或在 16 英寸轻薄笔记本电脑的 CPU 上进行渲染的开发者和创作者来说,128GB 的 OmniBook Ultra 16 比本次对比中的任何其他笔记本电脑都更胜一筹。
排行榜: 128GB 的 HP OmniBook Ultra 16 在我们的“最佳本地 AI 笔记本电脑”排行榜上名列最佳 RTX Spark 笔记本电脑。



 Amazon