

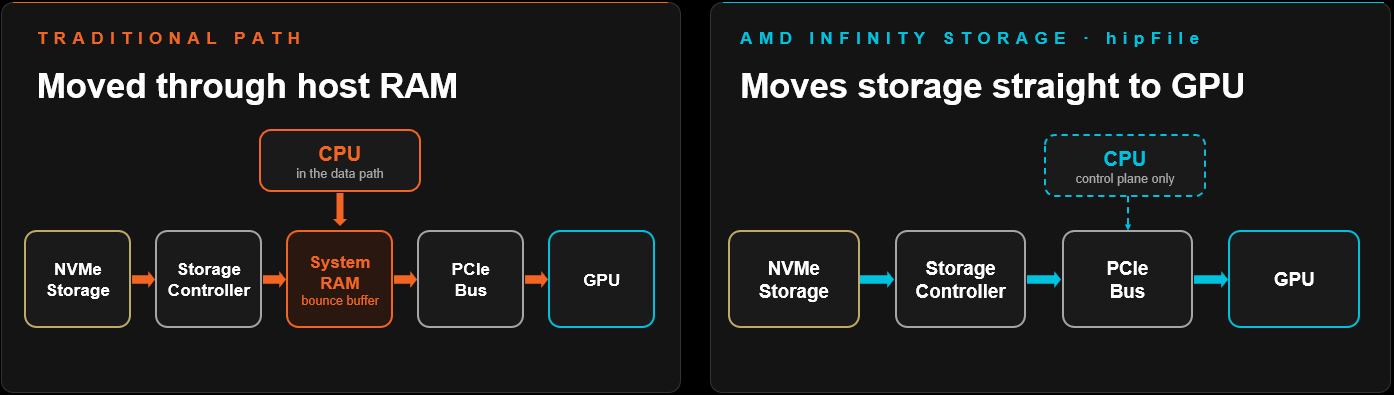
AMD ROCm 10.1, sorti le 5 octobre, optimise le chemin entre le stockage et le GPU. Les fichiers de points de contrôle, les caches clé-valeur et les poids des modèles dépassent désormais régulièrement la capacité de la mémoire de l'accélérateur. Dans ce cas, le temps de transfert des données devient un facteur déterminant du temps d'itération, au détriment des calculs eux-mêmes. Cette version enrichit AMD Infinity Storage, la pile de stockage direct introduite dans ROCm 7.14, en intégrant l'accès au stockage dans l'environnement d'exécution HIP et en ajoutant la prise en charge de la mémoire hôte NUMA. Ainsi, les données atteignent le GPU sans passer par la mémoire du CPU.
Pipelines de stockage GPU direct et mémoire compatible NUMA
La bibliothèque hipFILE d'AMD Infinity Storage bénéficie désormais d'un backend asynchrone optimisé. Les requêtes de lecture et d'écriture s'exécutent directement sur un flux HIP, évitant ainsi l'étape de transit en mémoire hôte requise par le chemin traditionnel. AMD annonce une latence réduite pour les moteurs de points de contrôle et le déchargement du cache KV, tout en maintenant une bande passante stable. Les notes de version précisent que les appels hipFileReadAsync() et hipFileWriteAsync() prennent désormais en charge ce chemin rapide.
Une API d'E/S par lots soumet plusieurs requêtes de fichiers simultanément et les répartit sur un pool interne de threads de travail, ce qui maintient les files d'attente de stockage pleines lorsqu'une tâche d'entraînement traite un grand ensemble de données. La télémétrie s'enrichit en conséquence : hipFileGetStatsL1, L2 et L3 renvoient des statistiques d'E/S de plus en plus détaillées, et ces compteurs alimentent les profileurs ROCm afin qu'un opérateur puisse déterminer si un pipeline est limité par le calcul, la mémoire ou la transmission des données.
Sur les hôtes à deux sockets, une allocation mémoire sur un socket incorrect entraîne une pénalité inter-socket à chaque transfert. ROCm 10.1 étend les API de gestion de la mémoire virtuelle HIP avec les types `hipMemLocationTypeHostNuma` et `hipMemLocationTypeHostNumaCurrent`, permettant ainsi de placer la mémoire hôte sur un nœud NUMA spécifique tout au long de son cycle de vie complet : création, réservation, mappage et suppression. Des bibliothèques telles que RCCL peuvent ensuite créer des tampons de communication NUMA locaux et sans copie, évitant ainsi que le trafic hôte-périphérique n'utilise l'interconnexion des sockets.
Interface de ligne de commande ROCm v1.0.0 et flux de travail des agents d'IA
L'interface de ligne de commande ROCm (ROCm CLI) atteint la version 1.0.0 sous la forme d'un binaire unique pour Linux, Windows et WSL2. Elle permet d'installer, de configurer et d'exécuter des charges de travail d'IA locales sur des GPU AMD. Elle détecte les modules flash-attn et amd-aiter nécessaires à vLLM, prend en charge la nouvelle structure de paquets ROCm 10 et propose une option pour les installations entièrement non interactives dans les environnements scriptés ou d'intégration continue. Un tableau de bord TUI plein écran affiche la télémétrie GPU en temps réel, ainsi que le déploiement du modèle et une fenêtre de chat locale permettant de vérifier la disponibilité des points de terminaison.
AMD Skills, les intégrations packagées pour les agents de codage tels que Claude Code et Codex, en acquiert deux nouvelles. quark-install configure AMD Quark avec une version PyTorch correspondante, et quark-torch-llm-ptq exécute la quantification post-entraînement sur les LLM PyTorch et Hugging Face avec des schémas tels que FP8 et INT4.
Modernisation du profilage et de la télémétrie
Le kit de développement logiciel (SDK) ROCprofiler intègre la relecture du noyau (en version bêta). Le matériel GPU expose un nombre limité de compteurs de performance par exécution ; auparavant, pour obtenir un ensemble complet de compteurs, il fallait relancer l'application entière une fois par groupe de compteurs. La relecture du noyau réexécute chaque exécution sur place, en réinitialisant la mémoire GPU entre chaque itération, et collecte l'ensemble complet en une seule exécution. Le SDK permet également de démarrer et d'arrêter le profilage à tout moment pour PyTorch Kineto et Triton Proton, et inclut une compétence d'agent d'échantillonnage PC qui guide l'assistant de programmation à travers l'échantillonnage PC de rocprofv3 afin de détecter les blocages de calcul.
Le rapport de performance global de ROCm Compute Profiler est désormais une page HTML interactive, permettant à un ingénieur d'isoler un noyau et de faire varier l'axe d'intensité arithmétique selon les niveaux de cache. Des rapports d'échantillonnage PC sont disponibles pour chaque noyau, avec un niveau de détail des échantillons et des blocages sur chaque instruction. Un nouveau guide est consacré au profilage vLLM. ROCm Systems Profiler intègre le traçage Linux pour les APU Gorgon Point 1, 2 et 3 (gfx1150, gfx1152 et gfx1153). Enfin, ROCm Optiq visualise les profils rocprofv3 en parallèle des traces de Systems Profiler et des analyses de Compute Profiler.
AMD SMI (amd-smi) remplace ROCm SMI, qui est retiré de la version standard dans cette version. Il prend en charge les GPU, CPU et APU AMD sous Linux et Windows, sur serveurs physiques et virtualisés, avec une interface en ligne de commande (CLI), une bibliothèque C (amd_smi_lib) et des liaisons pour Python, Go et Rust. La compatibilité avec les conteneurs est étendue à containerd, CRI-O, Podman, LXC et LXD, y compris les pods Kubernetes, permettant ainsi à un administrateur de cluster d'adapter les processus et l'utilisation du GPU au conteneur qui les exécute.
Mises à jour du compilateur principal, des bibliothèques et du support d'exécution
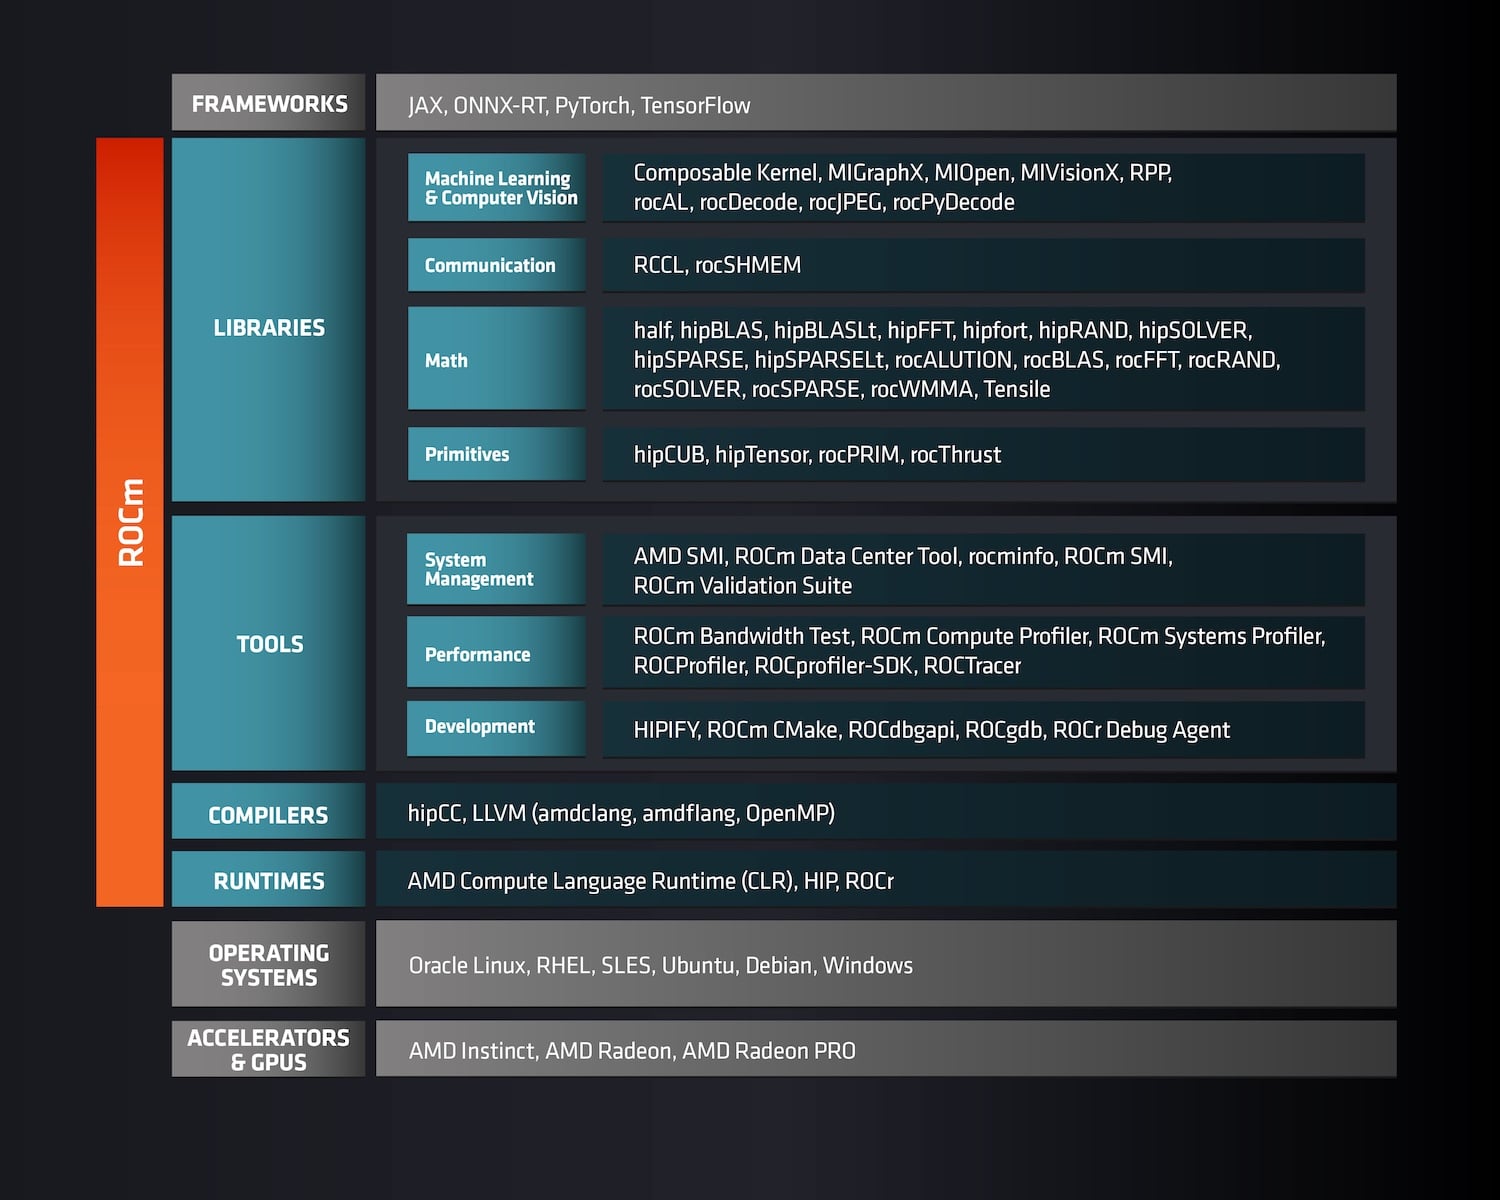
La chaîne d'outils passe de LLVM 23 à LLVM 24, et la macro `clang_major` indique désormais 24. Il est donc conseillé à toute personne fixant des versions de compilateur ou effectuant une liaison avec `libLLVM` de vérifier ce point avant la mise à niveau. Les compilations incrémentales sont plus rapides grâce à la mise en cache des partitions créées par l'optimisation de liaison du code périphérique ; ainsi, les partitions inchangées sont réutilisées lors de la compilation suivante.
Le noyau composable accélère le traitement de l'attention sur les GPU Radeon et ajoute davantage de types de multiplication matricielle quantifiée à son répartiteur. MIGraphX remplace son compilateur backend rocMLIR par rocMLIRTriton, ce qui, selon AMD, améliore les performances d'inférence et réduit souvent les temps de compilation des modèles, tout en assurant la compatibilité du compilateur avec Triton. rocSPARSE effectue des résolutions triangulaires directement sur les matrices stockées au format ELLPACK (ELL), sans conversion préalable.
hipThreads, une nouveauté des bibliothèques de gestion des threads du SDK ROCm Core, transpose les concepts de threading C++ standard sur les GPU AMD sous Linux et Windows. L'objectif est d'accélérer le code existant exécuté sur le GPU sans avoir à le réécrire entièrement en noyaux HIP et en primitives de synchronisation.
Le sous-système Windows pour Linux 2 (WSL2) est désormais disponible en préversion technique. Les paquets Linux standard s'installent dans la machine virtuelle invitée, tandis que la paravirtualisation du GPU prend en charge le pilote hôte Windows. Cette préversion couvre les paquets .deb et les roues Python, mais pas les RPM. De plus, les outils de profilage, de débogage et les outils dépendants de KFD ne sont pas encore fonctionnels dans WSL2. Côté virtualisation, KVM SR-IOV est désormais pris en charge par Ubuntu 26.04 LTS, aussi bien en tant qu'hôte qu'invité, avec la version 9.3.0.K du pilote de virtualisation GIM d'AMD.
La liste du matériel pris en charge ajoute la Radeon AI PRO R9600 aux côtés des Instinct MI355X, MI350X et MI350P, des séries MI300 et MI200, du reste de la famille Radeon AI PRO R9700 et des processeurs Ryzen AI.


 Amazon