

Lors du sommet RAISE à Paris, DDN a mis en avant sa collaboration avec Nebul, fournisseur européen de cloud hybride souverain, visant à améliorer l'efficacité des déploiements d'inférence IA à grande échelle. Annoncée la semaine dernière, cette initiative combine la plateforme d'inférence de Nebul, l'architecture d'intelligence des données Infinia de DDN et le calcul accéléré de NVIDIA pour répondre à une contrainte croissante de l'IA en production : l'impact des déplacements de données pendant l'inférence sur les coûts et les performances.
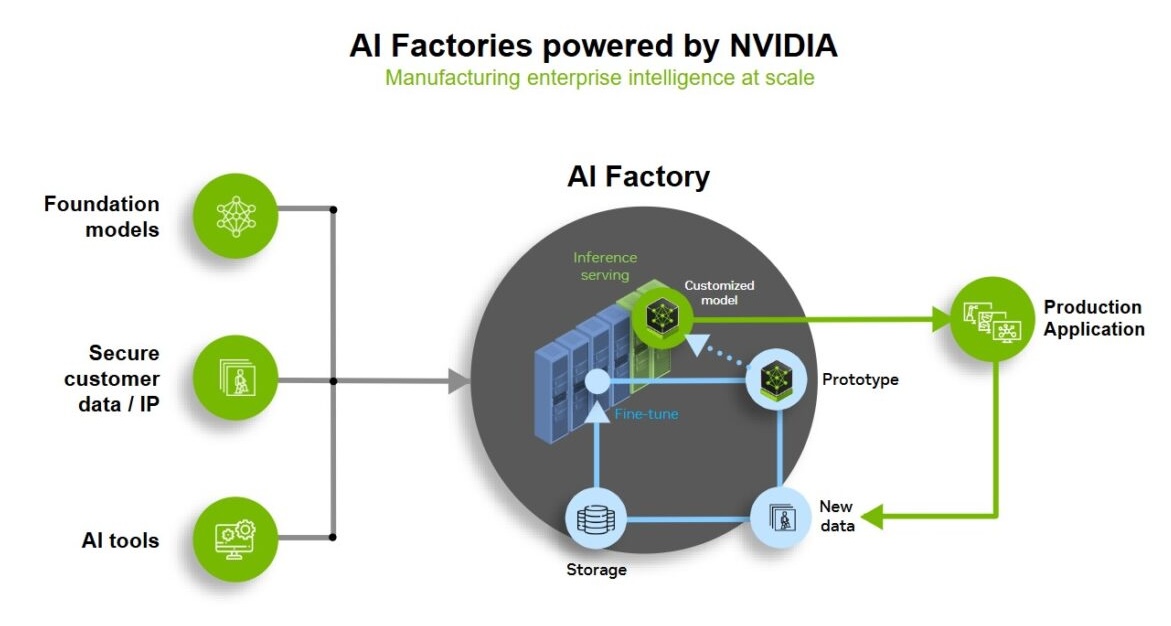
DDN axe son travail sur des indicateurs clés de production, tels que l'utilisation du GPU, le débit de jetons, le coût par jeton et la latence. Le principe est que l'entraînement du modèle détermine la valeur d'une ressource d'IA, tandis que l'inférence en détermine le retour sur investissement opérationnel et commercial. À mesure que l'IA agentielle, la génération augmentée par la recherche et l'inférence à haute concurrence se généralisent, l'infrastructure de stockage et de données peut impacter directement l'utilisation des accélérateurs et le temps de réponse.
Ce projet, qui constitue une preuve de concept en cours, présente jusqu'à présent des résultats préliminaires prometteurs selon DDN. Les entreprises font état d'améliorations mesurables du temps d'obtention du premier jeton grâce à l'activation du cache KV et ont finalisé la validation de l'infrastructure basée sur RoCE. Les tests de performance se poursuivent sur des séquences d'inférence plus longues afin d'identifier de nouvelles opportunités d'optimisation au sein de la plateforme Infinia. Le projet s'est également étendu à une collaboration avec NVIDIA concernant les méthodologies de test de performance, la validation de la scalabilité et les futures publications techniques.
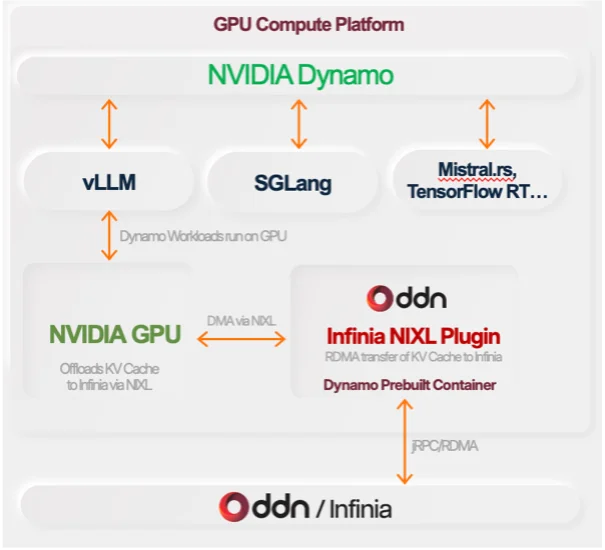
La plateforme utilise des services de cache KV distribués, le déplacement de données natif du GPU, l'orchestration des données et des architectures de stockage haute performance. L'accélération du cache KV est particulièrement pertinente pour l'inférence car elle préserve et récupère rapidement l'état d'attention précédemment calculé, réduisant ainsi les calculs répétitifs et limitant les délais de livraison des données susceptibles de rendre les GPU inactifs.
Les dirigeants de DDN, Nebul et NVIDIA ont annoncé un changement fondamental dans le secteur, passant de l'acquisition de GPU à l'efficacité opérationnelle, avec pour objectif principal de maximiser la valeur des accélérateurs déployés. Alex Bouzari, PDG de DDN, et Arnold Juffer, PDG de Nebul, ont tous deux souligné que si la taille des modèles était historiquement la priorité, le défi actuel réside dans la rentabilité de l'inférence et la viabilité commerciale de l'IA en production grâce à la réduction des coûts des jetons. Rod Evans, vice-président de l'infrastructure cloud chez NVIDIA, a ajouté que, face à l'adoption de charges de travail multi-agents à grande échelle, le succès de l'infrastructure se mesure de plus en plus à l'utilisation et à la latence des GPU plutôt qu'à la simple capacité de calcul brute.
DDN affirme que l'infrastructure d'IA doit évoluer au-delà des opérations de stockage classiques et devenir un acteur clé de l'exécution des IA. L'entreprise indique que ses plateformes prennent en charge plus d'un million de GPU à travers le monde, utilisés par des hyperscalers, des fournisseurs de cloud, des entreprises, des gouvernements et des instituts de recherche.
Pour les équipes d'infrastructure, les indicateurs de production pertinents incluent de plus en plus :
- Utilisation du processeur graphique, mesurant l'efficacité avec laquelle les accélérateurs coûteux restent actifs pendant l'inférence.
- Coût par jeton, reliant l'efficacité des infrastructures au coût de production du modèle.
- Jetons par watt, mesurant le rendement de production par rapport à la consommation d'énergie.
- Temps d'attente avant le premier jetonce qui influe sur la réactivité perçue des applications d'IA interactives.
- Le délai de mise en production reflète l'effort opérationnel nécessaire pour faire passer les services d'IA de la phase de test à la production. Déploiement évolutif.
À mesure que l'inférence devient la charge de travail dominante des systèmes d'IA, la capacité à fournir des données contextuelles et d'entreprise mises en cache aux GPU avec une latence faible et prévisible sera de plus en plus importante pour maintenir leur utilisation et maîtriser les coûts.


 Amazon