

Everpure a annoncé un ensemble de fonctionnalités de plateforme visant à déployer l'IA d'entreprise en production, de la phase pilote jusqu'à la phase de production. Toutes ces fonctionnalités seront disponibles en octobre. La principale nouveauté est PureKVA (Key-Value Accelerator) pour FlashBlade, qui pré-charge le contexte d'inférence directement dans la mémoire GPU et, selon Everpure, permet d'obtenir le premier jeton (TTF) jusqu'à 20 fois plus rapidement. S'y ajoutent une version toujours active du moteur de compression DeepReduce pour les systèmes FlashBlade, la prise en charge native du protocole MCP (Model Context Protocol) dans Everpure Data Intelligence permettant aux agents d'interroger les catalogues de données en temps réel en langage naturel, un outil de partage de fichiers et une architecture de référence basée sur des modèles à pondération ouverte. Everpure présente cet ensemble comme une extension de sa vision de la primauté des données, selon laquelle les données, et non les applications, doivent guider l'architecture d'entreprise à l'ère de l'IA.
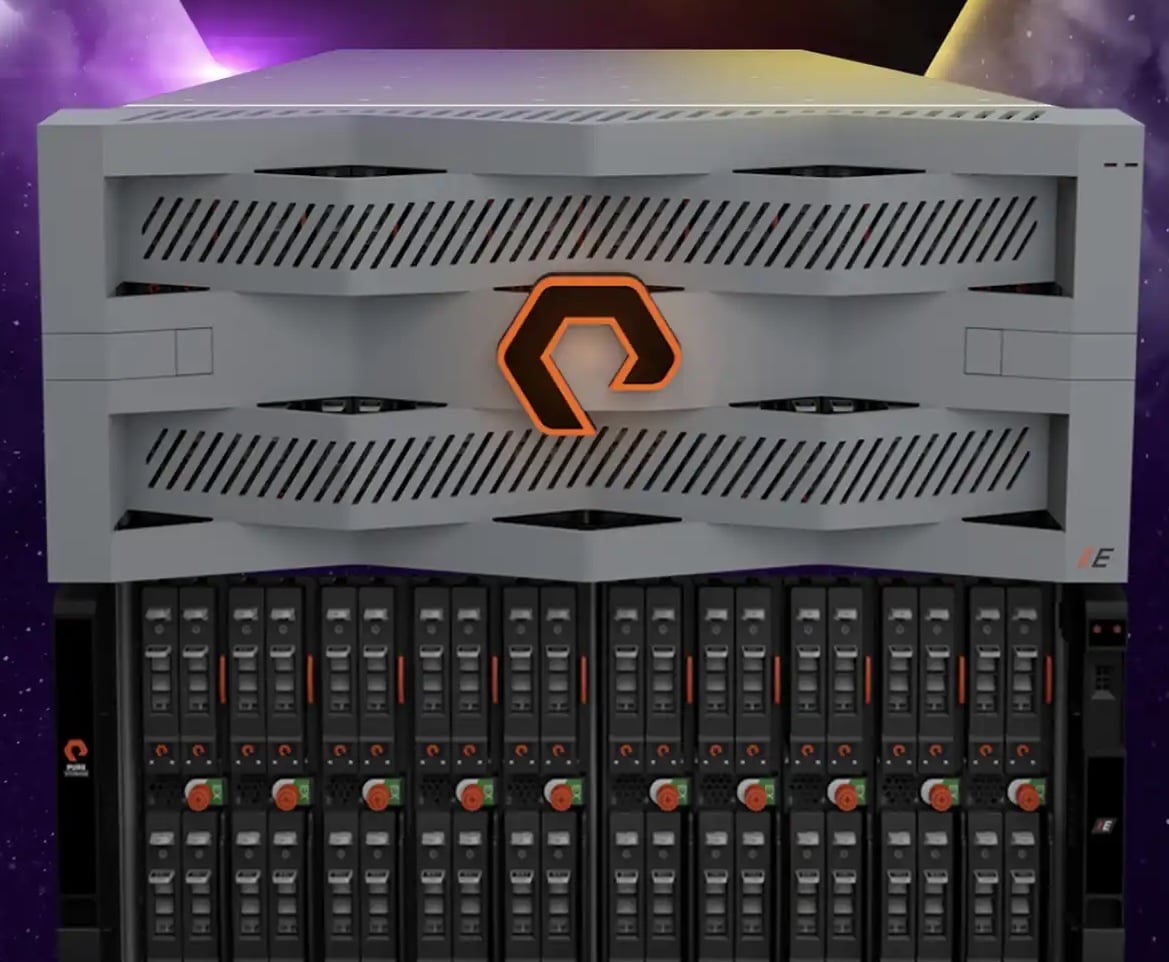
PureKVA et DeepReduce toujours activé sur FlashBlade
PureKVA s'attaque au même problème que celui abordé dans notre article sur le déchargement du cache KV vers la mémoire flash : l'inférence à contexte long consomme du temps GPU pour reconstruire un contexte déjà calculé. L'approche d'Everpure consiste à placer ce contexte directement dans la mémoire GPU avec FlashBlade, sans déplacement des données hors du stockage principal. Selon l'entreprise, cela élimine les temps d'inactivité du GPU, augmente le débit de jetons et réduit la latence de réponse pour les applications temps réel, tout en prenant en charge les environnements mutualisés d'entreprise. Le gain TTFT jusqu'à 20x est une affirmation d'Everpure, sans configuration de test publiée ; il convient donc de le considérer comme une valeur maximale tant que l'entreprise n'aura pas partagé sa configuration.
DeepReduce n'est pas une nouveauté en soi ; Everpure a lancé Purity DeepReduce sur FlashBlade en février, une réduction basée sur la similarité qui s'exécute hors du chemin d'écriture, avec un taux de compression médian d'environ 2:1 sur des données déjà compressées. La nouveauté réside dans le mode permanent : le moteur analyse désormais en continu les blocs de stockage sur les systèmes FlashBlade afin de détecter les similarités de sous-blocs que la déduplication classique ne repère pas, y compris au sein du contenu pré-compressé. La capacité utilisable augmente ainsi automatiquement, sans planification manuelle et, selon Everpure, sans impact sur les performances d'écriture.
MCP, intelligence des fichiers et une architecture de référence ouverte
Everpure Data Intelligence , la couche de classification issue de l'acquisition de 1touch, intègre désormais MCP. Les agents d'IA et les outils de sécurité peuvent ainsi interroger ses catalogues de données en temps réel en langage naturel, trouver les données pertinentes et consulter leur niveau de sensibilité avant de les utiliser comme entrée pour l'IA, les flux de travail des agents ou l'analyse. Le catalogue couvre la plateforme Everpure, les clouds publics, les applications SaaS et le stockage tiers. Le déploiement s'effectue via la console Pure1 existante, sans serveur de gestion supplémentaire et, selon Everpure, sans intervention de services professionnels.
L'outil Privacy-First File Intelligence indique qui peut accéder à chaque partage de fichiers et son niveau de confidentialité sans en lire le contenu. Les équipes peuvent ainsi limiter les risques et récupérer de l'espace avant d'ouvrir les partages aux agents. Everpure associe ce travail de classification à la cyber-résilience : savoir quelles données sont sensibles et qui y accède détermine leur niveau de protection et l'ordre de restauration. L'ensemble comprend également une architecture de référence pour l'optimisation intelligente des jetons, qui utilise des modèles à pondération ouverte pour offrir aux entreprises un meilleur contrôle de leurs données et une meilleure prévisibilité de leurs dépenses en IA en réduisant la consommation de jetons API provenant de fournisseurs externes. Everpure n'a pas précisé les modèles ni les GPU utilisés dans cette architecture de référence.
« L’IA d’entreprise se heurte à un obstacle, non pas par manque de modèles, mais parce que les données ne sont pas prêtes pour des agents autonomes en temps réel. Nous levons cet obstacle. En assurant une gouvernance continue, une automatisation et un accès instantané aux données d’entreprise, nous offrons aux organisations les bases nécessaires pour déployer l’IA en production en toute confiance », a déclaré Prakash Darji, directeur général des données et de l’expérience numérique chez Everpure.
Les fonctionnalités annoncées aujourd'hui seront disponibles en octobre. Elles font suite au lancement de Data Stream en juin et interviennent un mois après qu'Everpure se soit de nouveau hissé en tête des deux axes du Magic Quadrant de Gartner pour le stockage d'entreprise.


 Amazon