

Google a ajouté deux systèmes à sa gamme TPU de huitième génération : le TPU 8tx, un système de calcul confidentiel basé sur la puce TPU 8t, et le TPU 8i Max, qui intègre deux puces TPU 8i dans un seul boîtier pour l’inférence à contexte long. Ils rejoignent la puce d’entraînement TPU 8t et la puce d’inférence TPU 8i présentées par Google lors de la conférence Cloud Next en avril. Google affirme qu’il s’agit de la première fois qu’elle lance quatre systèmes TPU en une seule année.
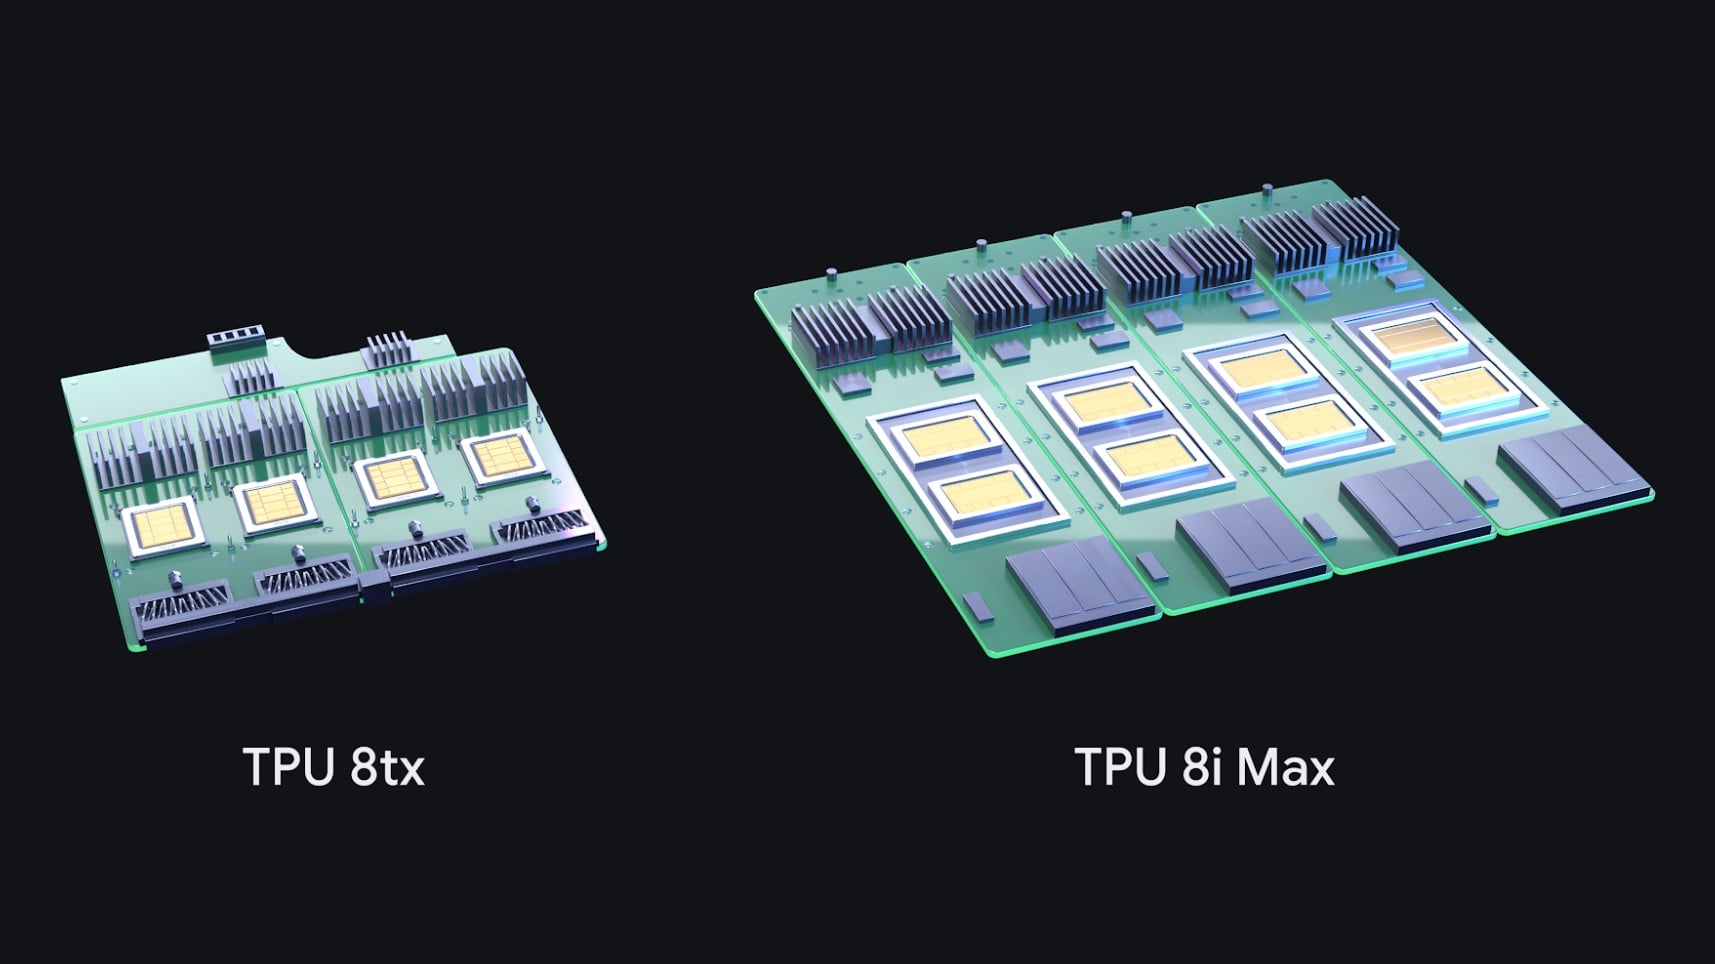
Google décrit ces deux nouveautés comme des systèmes construits autour de puces existantes, dont le conditionnement, la mémoire haute vitesse, le réseau et la sécurité sont adaptés à chaque charge de travail. L'entreprise attribue à cette approche modulaire la possibilité de proposer des configurations spécialisées en quelques mois. Selon Google, les TPU comptent désormais près de 100 clients, parmi lesquels des laboratoires de recherche de pointe, des sociétés de trading, des détaillants et des universités. Certains clients peuvent même déployer les TPU directement dans leurs centres de données.
TPU 8tx : Informatique confidentielle sur silicone TPU 8t
Le TPU 8tx utilise la même puce que le TPU 8t, l'associe à des processeurs hôtes AMD EPYC de 5e génération et intègre des mécanismes de calcul confidentiels au niveau matériel afin de garantir la protection et l'isolation des données et des poids des modèles pendant leur utilisation. Google cite le chiffrement des liaisons PCIe, l'attestation cryptographique et les enclaves de mémoire sécurisées parmi ses fonctionnalités de sécurité. Ce système est destiné aux entreprises et aux gouvernements soumis à des réglementations strictes qui exécutent des modèles et des agents propriétaires ou innovants en même temps que des données sensibles.

Le TPU 8tx intègre également le réseau Boardfly à faible latence conçu par Google pour le TPU 8i. Selon Google, il offre une latence jusqu'à deux fois inférieure à celle du TPU 8t, sans perte de performance notable. Google le positionne comme une solution idéale pour l'inférence sécurisée et l'entraînement à petite échelle. Ainsi, une équipe peut affiner ses modèles sur des données privées, réduire la taille d'un modèle complexe et entraîner des agents par apprentissage par renforcement sans avoir à déplacer de données sensibles entre différents clusters.
TPU 8i Max : Deux puces d'inférence par paquet
Le TPU 8i Max cible la bande passante mémoire pour les charges de travail exigeantes, comme l'exécution simultanée de dizaines d'agents sur l'ensemble d'une base de code ou le traitement de plusieurs heures de vidéo. Google a intégré deux puces TPU 8i dans un seul boîtier, doublant ainsi la puissance de calcul, la mémoire SRAM embarquée et la bande passante HBM par rapport au TPU 8i. Google annonçait 384 Mo de SRAM pour le TPU 8i lors de son lancement ; le doublement de cette capacité correspond donc à 768 Mo par boîtier 8i Max. Google n'a cependant pas communiqué la capacité HBM de ce boîtier. Grâce à sa capacité deux fois supérieure, le 8i Max offre, selon Google, une puissance de calcul et une efficacité énergétique accrues, car il intègre deux fois plus de silicium dans un format rack standard.

Google associe désormais les quatre systèmes de huitième génération aux différentes étapes du travail des agents : TPU 8t pour l’entraînement à grande échelle, TPU 8i pour le raisonnement à faible latence, TPU 8tx pour le calcul confidentiel et TPU 8i Max pour les fenêtres de contexte massives et la densité de calcul la plus élevée par rack. Google n’a pas encore communiqué de date de disponibilité pour les clients Google Cloud des TPU 8tx et TPU 8i Max, ni leurs tarifs.

Synchronisation TPU, Cloud Pathways et découpage dynamique GKE
Google a également publié en open source TPU Sync, une bibliothèque C++ qui considère la mémoire HBM de la puce, la DRAM de l'hôte, le stockage partagé et le réseau du centre de données comme une hiérarchie de mémoire unique. Elle hiérarchise les caches clé-valeur hors puce, transmet le contexte des nœuds de préremplissage aux nœuds de décodage et synchronise les poids d'apprentissage par renforcement des entraîneurs aux échantillonneurs. Google affirme que TPU Sync réduit la latence de transfert clé-valeur de plus de 90 % et le temps d'obtention du premier jeton de 90 % en moyenne sur les modèles de type « mix of experts » à poids ouverts, comportant de 235 à 480 milliards de paramètres.
Cloud Pathways, l'environnement d'exécution de Google DeepMind sur lequel repose Gemini, est désormais disponible sur Google Kubernetes Engine. Il utilise un contrôleur unique pour orchestrer les systèmes TPU sur plusieurs tranches pour le pré-entraînement, l'apprentissage par renforcement et l'inférence multi-hôtes, et assure la continuité des tâches de longue durée malgré les interruptions matérielles grâce au remplacement à chaud des tranches en moins d'une minute et au repartitionnement élastique.
Le découpage dynamique GKE, désormais disponible pour tous, utilise la commutation de circuits optiques pour assembler des cubes TPU en topologies plus vastes ou les diviser en charges de travail isolées plus petites, sans recréer les pools de nœuds. Google affirme que cela réduit les temps de démarrage des tâches jusqu'à cinq fois et accélère la récupération après panne jusqu'à 4.5 fois. Une suite d'agents TPU en préversion s'intègre à des outils de programmation tels que Claude Code, Cursor et Google Antigravity pour intégrer les charges de travail, diagnostiquer les goulots d'étranglement et optimiser automatiquement les noyaux. Par ailleurs, un nouveau moteur de service open source XLA Serving Engine permet de déployer des modèles entraînés en Python depuis un environnement d'exécution C++ sur les TPU, les GPU et les CPU.



 Amazon