

Intel a présenté ses plans en matière de calcul haute performance lors de la conférence SC26, articulés autour de Diamond Rapids, son architecture serveur Xeon de nouvelle génération. Intel annonce que la plateforme pourra gérer jusqu'à 256 cœurs hautes performances, avec une bande passante mémoire allant jusqu'à 1.6 To/s et jusqu'à 1.28 Go de cache de dernier niveau. Ces informations ont été communiquées par Jeff McVeigh, vice-président et directeur général des programmes stratégiques pour centres de données, et couvrent également les GPU Intel série D, les logiciels HPC, la photonique sur silicium et le développement quantique. Intel n'a pas encore communiqué de date de lancement pour Diamond Rapids.
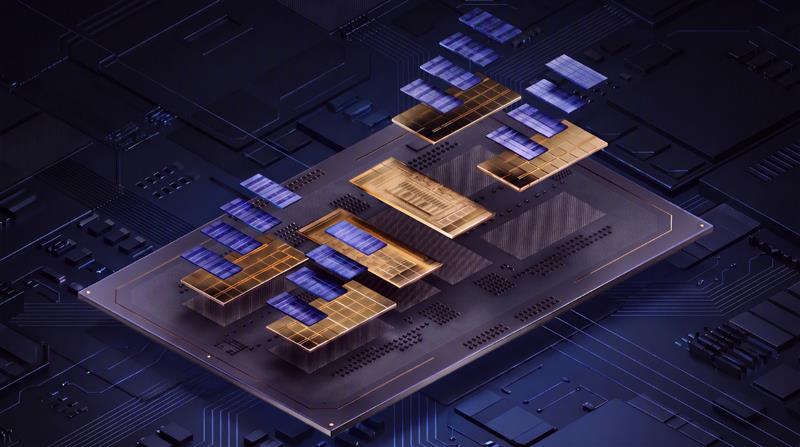
Architecture du processeur Diamond Rapids
Intel décrit Diamond Rapids , une architecture 18A-P présentée en détail lors de la conférence Hot Chips, comme combinant une densité de calcul plus élevée, une bande passante mémoire accrue, des caches plus importants et une accélération CPU étendue. Les extensions de performances avancées Intel (APX) optimisent les performances par cœur, et c'est l'architecture mémoire unifiée d'Intel qui permet d'atteindre le débit de 1.6 To/s. Intel n'a pas précisé le nombre de canaux mémoire ni la vitesse de la mémoire sous-jacente à ce chiffre, ni si celui-ci s'applique à l'ensemble du socket.
L'architecture prend également en charge Intel AVX 10.2 et les extensions matricielles avancées Intel (Intel AMX) améliorées. Intel présente le Xeon de nouvelle génération comme le seul processeur serveur x86 doté d'une capacité de calcul matriciel intégrée pour les charges de travail HPC et d'IA. À titre de comparaison, les processeurs AMD EPYC Venice haut de gamme que nous avons testés disposent de 256 cœurs Zen 6c par socket.
McVeigh a défini la feuille de route autour de systèmes mixtes dans lesquels les processeurs orchestrent les flux de travail et exécutent des bibliothèques de communication parallèles tandis que les accélérateurs prennent en charge le travail d'IA, écrivant que l'avenir du HPC est « ouvert, hétérogène et équilibré ».
Logiciels pour GPU Intel série D et HPC
La série D des GPU Intel associe l'accélération IA au calcul double précision (FP64) sur une carte PCIe refroidie par air, prenant en charge les types de données de FP4 et MXFP4 à FP64. Le GPU Intel D270 embarque 160 Go de mémoire LPDDR5X avec une bande passante de 1.5 To/s, et des configurations partenaires peuvent atteindre 480 Go. Pour les centres de recherche, Intel met l'accent sur la capacité mémoire : stocker des ensembles de données de travail plus importants sur la carte réduit le partitionnement et les transferts entre l'hôte et l'accélérateur, qui ralentissent les flux de travail scientifiques. Intel présente également cette carte pour les agents d'IA toujours actifs qui génèrent du code et lancent des tâches de calcul.
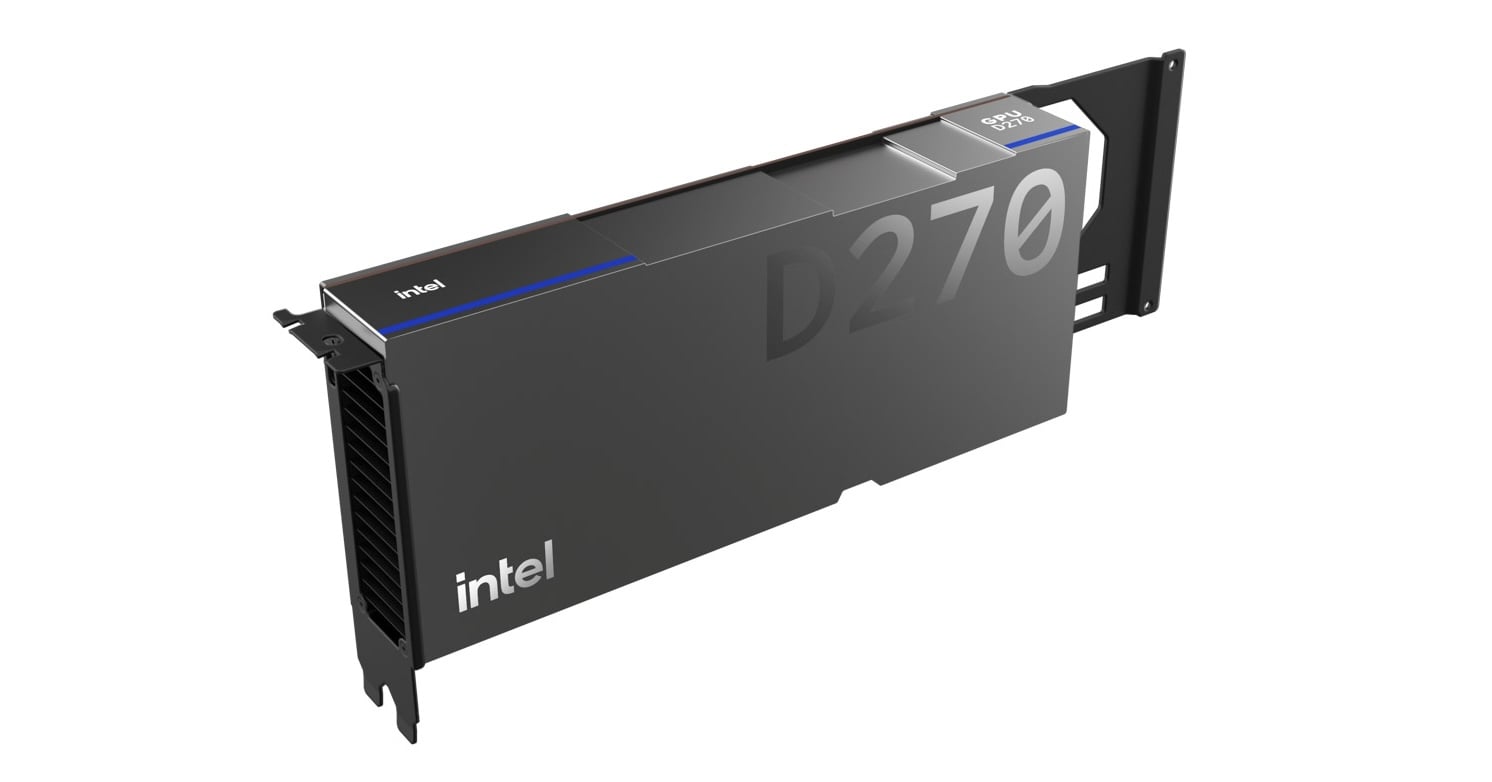
Intel présente deux démonstrations en direct de son GPU D270, la carte de la série D anciennement connue sous le nom de code Crescent Island, sur son stand au salon SC26. La première est une mini-application d'imagerie sismique de Veridien, portée de HIP et CUDA vers SYCL en moins d'un mois. Intel affirme que 90 % de ses noyaux ont fonctionné correctement sans optimisation spécifique. La seconde démonstration répartit un pipeline d'inférence entre des cartes D270 qui gèrent le préremplissage et des unités SambaNova SN50 qui gèrent le décodage, le tout étant orchestré par des processeurs Xeon 6 et Xeon 6+.
Intel a également publié des comparatifs avec la RTX PRO 6000 Blackwell Server Edition de NVIDIA. Sur les charges de travail financières FP64, Intel revendique un débit jusqu'à 5.9 fois supérieur sur le modèle Monte Carlo européen, 5.6 fois supérieur sur le modèle Black-Scholes européen, 4.6 fois supérieur sur le modèle binomial et 1.92 fois supérieur sur le modèle Black-Scholes américain, avec une consommation de 350 W pour la D270 et de 600 W pour la carte NVIDIA. Pour l'inférence, Intel annonce une latence jusqu'à 29 % inférieure sur Drex v2.0 et un débit de jetons de sortie 1.12 fois supérieur sur Qwen3-30B-A3B en FP8.
Il s'agit de résultats fournis par le fournisseur sur des puces de préproduction ; nous ne les avons ni exécutés ni audités. La configuration de test financier d'Intel compare huit cartes NVIDIA à une seule D270, sans préciser si les résultats sont normalisés par carte. De plus, les tests d'inférence NVIDIA ont été effectués sur une machine virtuelle AWS.
Côté logiciel, Intel affirme qu'elle continuera d'investir dans Intel MPI, Fortran, les optimisations du compilateur et oneAPI afin que les bases de code parallèles existantes continuent de fonctionner correctement sur les systèmes mixtes CPU/GPU. L'entreprise travaille également à l'intégration en amont avec les frameworks d'IA, les environnements d'exécution d'inférence et les environnements de déploiement. L'objectif affiché est que les modèles et outils standard fonctionnent sur les nouveaux matériels tels que la série D dès leur déploiement.
Connectivité optique et développement quantique
Intel a également mis en avant ses travaux sur la photonique sur silicium, qui utilise la lumière pour transmettre des données sur de longues distances avec une consommation d'énergie, selon l'entreprise, bien inférieure à celle des liaisons en cuivre. Intel n'a fourni ni chiffres ni calendrier de commercialisation à l'appui de cette affirmation.
Concernant l'informatique quantique, Intel a réaffirmé son projet d'acquisition de Classiq , qui permettrait d'associer la plateforme de synthèse automatisée d'algorithmes quantiques de Classiq à la technologie des qubits de spin sur silicium et à la fabrication de puces d'Intel. Intel prévoit que la transaction sera finalisée au premier semestre 2027, sous réserve de l'approbation des autorités réglementaires.


 Amazon