

NVIDIA et Cisco ont annoncé aujourd'hui leur projet de module optique USFP (Ultra-Dense Small Form Factor Pluggable), conçu pour l'Ethernet 400 Gbit/s par voie dans les infrastructures d'IA. Les premiers émetteurs-récepteurs prévus offrent 16 voies full-duplex dans un format similaire à celui d'un module OSFP, soit une capacité de 6.4 Tbit/s par module. Le connecteur est conçu pour évoluer jusqu'à 32 voies et 12.8 Tbit/s. NVIDIA et Cisco affirment que l'USFP offre une bande passante et une densité de composants en façade quatre fois supérieures à celles des modules enfichables 200 Gbit/s par voie, tout en consommant environ 1.3 fois moins d'énergie.
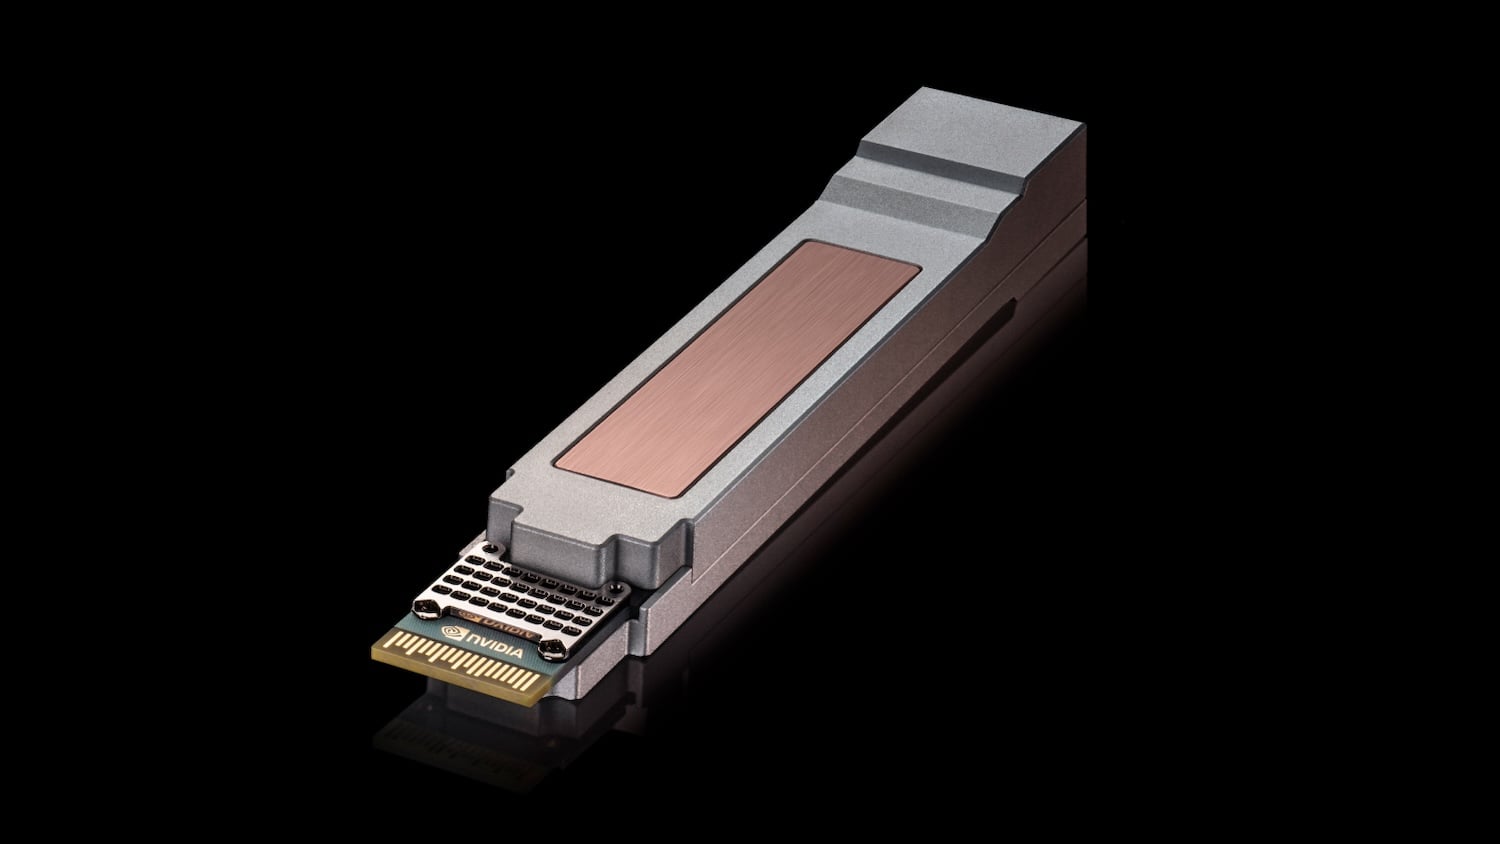
USFP est un projet sans calendrier d'échantillonnage ni date de disponibilité. NVIDIA et Cisco prévoient d'en faire une spécification industrielle ouverte grâce à un accord multisource piloté par la communauté. Il s'agit d'une contribution parmi d'autres présentées par NVIDIA au Sommet mondial OCP, qui incluent également les conceptions de racks Vera Rubin, le logiciel DSX AI Factory, les spécifications des installations et des réseaux électriques, l'alimentation 800 V CC et les travaux sur l'Ethernet menés avec Meta et Google.
USFP augmente le nombre de voies et la densité de bande passante du panneau avant
L'interface USFP double le nombre de voies et le débit par voie des modules actuels, ce qui, selon NVIDIA et Cisco, permet à un commutateur de connecter davantage de terminaux 1.6 Tbit/s sans ajouter de couche réseau. Ces modules sont compatibles avec les commutateurs et les SuperNIC. Les entreprises considèrent la densité du panneau avant comme le facteur limitant la croissance des infrastructures IA : lorsqu'un commutateur atteint sa limite de ports, l'étape suivante consiste à ajouter une couche de commutation avec davantage d'optiques, ce qui augmente la latence, la consommation d'énergie et le coût. L'interface USFP conserve le modèle enfichable, garantissant ainsi la possibilité de remplacer et de réparer les modules sur site.
« La construction des plus grandes usines d'IA au monde commence par une refonte des connexions les plus infimes », a déclaré Gilad Shainer, vice-président senior chez NVIDIA. Bill Gartner, vice-président senior et directeur général des systèmes optiques et de l'optique chez Cisco, a affirmé que le passage à 400 Gb/s par voie pour les modules optiques enfichables nécessitait bien plus qu'une simple extension des modules actuels.
Un nouveau connecteur prend en charge la signalisation à 400 Gb/s
Le connecteur est un réseau de contacts bidimensionnel à insertion en deux étapes : les contacts haute vitesse ne s’activent qu’une fois le module en place. NVIDIA et Cisco affirment que cela réduit l’usure des contacts, améliore l’intégrité du signal et rend la force d’insertion plus prévisible. Ce connecteur est conçu pour 400 Gbit/s par voie et, selon les entreprises, améliore également les performances à 200 Gbit/s par voie.
Un module USFP peut dissiper jusqu'à 100 W sans circuit de refroidissement dédié à l'intérieur de l'émetteur-récepteur, ce qui, selon les fabricants, simplifie la conception des commutateurs et améliore la fiabilité. Chaque configuration USFP prend en charge des conceptions optiques qui simplifient le traitement du signal afin de réduire la latence et la consommation d'énergie. Ce format est compatible avec un large éventail de technologies optiques et de classes de portée. NVIDIA et Cisco collaborent avec TE Connectivity et Amphenol sur les cages, les connecteurs et les modules, et d'autres partenaires devraient rejoindre le projet, s'appuyant sur leur travail d'interopérabilité existant entre NVIDIA Spectrum-X et les réseaux Ethernet basés sur Cisco Silicon One.
MGX 1.2 étend l'infrastructure de rack Vera Rubin
NVIDIA a contribué à l'OCP avec ses conceptions de racks et de plateaux de calcul Vera Rubin via son architecture ouverte MGX, dans le cadre de la conception de référence MGX de troisième génération de l'initiative Open DC de l'OCP, aux côtés des conceptions de refroidissement liquide ouvertes MQD et MQDB. La spécification MGX 1.2 ajoute un refroidissement liquide à connexion directe à l'échelle du rack, une infrastructure d'interconnexion interopérable à l'échelle du rack et une barre omnibus de 5 000 A refroidie par liquide, avec une prise en charge native des équipements 19 pouces et des déploiements en rack jusqu'à 250 kW.
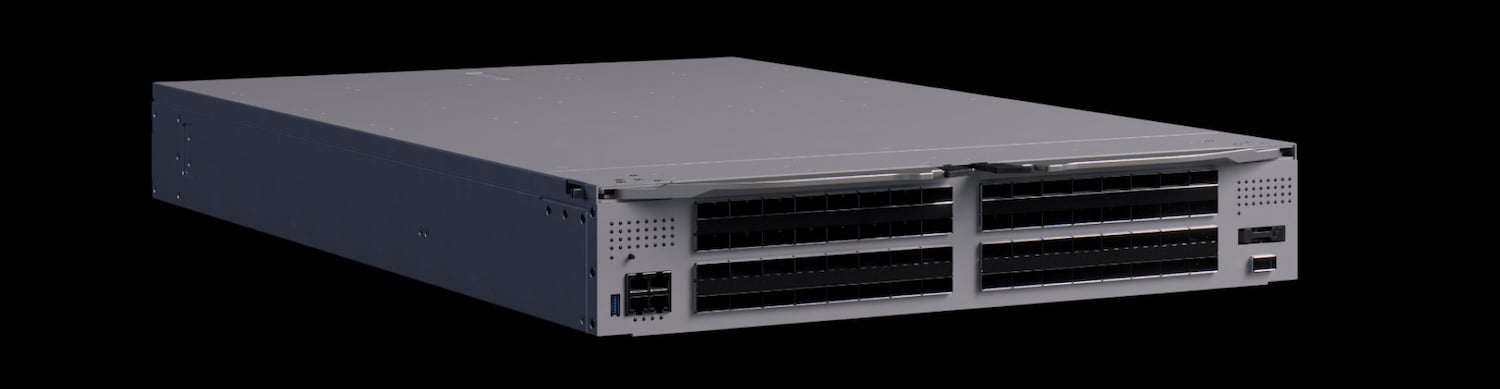
Des baies d'E/S configurables, des plateaux de calcul sans ventilateur à refroidissement liquide et des interfaces d'alimentation et de refroidissement standardisées complètent la spécification. NVIDIA affirme que ces interfaces communes réduisent les temps d'assemblage, de test et de maintenance pour ses partenaires. Une spécification distincte pour la conception des racks CPU Vera étend la technologie MGX au-delà du calcul accéléré. NVIDIA positionne Vera Rubin NVL72 comme la plateforme idéale pour l'entraînement et l'inférence à grande échelle, et le rack CPU Vera pour l'appel d'outils, l'orchestration et l'exécution en environnement isolé qu'offrent les charges de travail automatisées.
DSX OS ajoute des composants de gestion de réseau, de rack et de cluster
NVIDIA a enrichi DSX OS, la couche d'exploitation ouverte de sa plateforme DSX AI Factory, avec quatre composants open source. NVIDIA Config Manager automatise la configuration, la validation et la maintenance des commutateurs sur l'ensemble des infrastructures d'IA. NVIDIA Cluster Readiness Engine soumet les clusters GPU à des tests de charge avant le début de l'entraînement, ce qui, selon NVIDIA, permet de détecter les problèmes matériels susceptibles d'entraîner l'échec des tâches.

Le service de gestion de racks NVIDIA considère le rack comme l'unité opérationnelle, avec une abstraction matérielle et une gestion du firmware à ce niveau. Le fournisseur d'API de cluster pour le contrôleur d'infrastructure NVIDIA gère le déploiement bare-metal et l'intégration des clients. NVIDIA affirme ainsi transformer du matériel brut en clusters prêts pour la production en quelques heures. Ces composants sont issus de l'expérience de NVIDIA avec DGX Cloud et permettent aux fournisseurs de cloud et aux partenaires logiciels d'intégrer les opérations d'IA dans des plateformes mutualisées.
Les spécifications ouvertes couvrent la conception des installations et la récupération du réseau
NVIDIA, AMD, Google et Meta ont publié la spécification Open Data Center Specification v0.7, un modèle partagé d'infrastructure de centre de données couvrant l'architecture électrique, le refroidissement et l'agencement physique, que les fabricants d'équipements, les fournisseurs de colocation et les opérateurs peuvent utiliser comme référence. Google, Meta, Microsoft et NVIDIA ont également publié la spécification OCP Grid Resilience Specification, qui définit comment les grands centres de données d'IA doivent gérer les perturbations du réseau électrique : maintenir la connectivité, réagir automatiquement et retrouver une charge quasi maximale en moins de deux secondes. NVIDIA indique que ces deux spécifications sont conformes à sa conception de référence DSX.
Visionbay a présenté son projet K-1, une plateforme dédiée à l'IA qui associe l'architecture de référence 800 VDC de NVIDIA aux équipements d'alimentation et de refroidissement Vertiv pour les futurs déploiements Vera Rubin. K-1 centralise la conversion AC/DC dans des centres d'alimentation au niveau du cluster et distribue le 800 VDC au plus près des unités de calcul. L'adoption du 800 VDC, du refroidissement liquide et l'extension modulaire seront déployés progressivement. Visionbay n'a pas encore communiqué de date de déploiement.
Meta adopte le Spectrum-6 et le réseau multiplan
Meta adoptera l'Ethernet NVIDIA Spectrum-6 102.4 Tb/s pour ses usines d'IA Vera Rubin. NVIDIA affirme que le Spectrum-6 double la capacité de commutation et la bande passante par voie du Spectrum-4, atteignant 200 Gb/s par voie avec une isolation des performances entre les tâches. Le commutateur N-IceCube de Meta, basé sur le Spectrum-6, est intégré à son rack IcePack 100T à refroidissement liquide et exécute FBOSS, le logiciel de commutation ouvert de Meta, qui utilise l'interface OCP (Switch Abstraction Interface) pour un contrôle matériel indépendant du fournisseur.
Spectrum-X Multiplane associe des commutateurs Spectrum-6 à des SuperNIC ConnectX-9 et répartit le trafic GPU au niveau matériel sur jusqu'à huit plans réseau indépendants. NVIDIA affirme que cette architecture permet de gérer plus de 100 000 GPU avec un nombre réduit de niveaux de commutation. En cas de défaillance d'un composant, le trafic est automatiquement redirigé vers les plans restants, assurant ainsi la continuité des opérations avec une bande passante réduite. Meta et NVIDIA indiquent avoir validé les gains de résilience sur site et dans le cloud, sans toutefois publier de chiffres.
Google Falcon Transport cible le futur matériel réseau NVIDIA
NVIDIA et Google ont annoncé la prise en charge du protocole Falcon Transport pour les futures cartes réseau NVIDIA ConnectX-10 SuperNIC et les DPU BlueField. Falcon assure la fiabilité des données sur Ethernet grâce à l'équilibrage de charge multipath, au contrôle de congestion programmable, à la récupération matérielle des pertes et à la sécurité par connexion. NVIDIA l'implémente avec l'accélération matérielle et le logiciel DOCA, permettant ainsi aux cartes réseau NVIDIA et Google d'utiliser un protocole de transport commun tandis que les applications conservent les interfaces RDMA standard. Les entreprises affirment que cela améliore l'utilisation de la bande passante et la prévisibilité des performances pour le trafic d'IA et de stockage à mesure que les infrastructures Ethernet évoluent.
Cisco livre des systèmes Silicon One G300 et ajoute un composant de haut de rack de 51.2 tonnes
Cisco a profité de l'annonce OCP pour mettre à jour sa gamme de puces. La Silicon One G300 de 102.4 Tb/s est désormais disponible en échantillons et les premiers systèmes basés sur la G300 sont livrés aux clients. Cisco a également ajouté la G302, un ASIC de commutation de 51.2 Tb/s avec SerDes 200G, conçu pour les systèmes haut de gamme (Top-of-Rack), doté d'une optique 1.6T et d'un refroidissement liquide direct sur puce. Sa livraison est prévue avant fin 2026. Cisco indique par ailleurs que sa puce de routage à mémoire tampon profonde P200 de 51.2 Tb/s est désormais en production chez les hyperscalers : Microsoft a déployé des systèmes P200 en production et Alibaba Cloud a déployé son routeur Quantum Cat interne sur P200 via son réseau dorsal eCORE, exécutant SONiC.
Le reste de la liste Cisco est opérationnel. Le Cisco 8001 est un commutateur de gestion basé sur le Silicon One A100, disponible en versions 10G et 1G, qui déploie SONiC sur le réseau hors bande. Les opérateurs peuvent ainsi exécuter un ensemble unique d'API et d'automatisation, de l'infrastructure jusqu'aux baies. SONiC, validé par Cisco, est fourni avec l'architecture Nexus One. Une option Live Protect, qui corrige les vulnérabilités divulguées en temps réel avant la correction définitive, est prévue pour mi-2027. Cisco est membre d'ESUN et travaille actuellement sur la spécification 1.0 pour la mise à l'échelle des réseaux.


 Amazon