

CoreWeave a profité de sa conférence Fully Connected 2026 à San Francisco pour déployer la carte NVIDIA Vera Rubin NVL72 en production. Cognition est le premier client à l'utiliser en conditions réelles. Les ingénieurs de Cognition annoncent un débit total de jetons par GPU jusqu'à 4.8 fois supérieur à celui d'une carte GB200 NVL72 de référence pour l'inférence SWE-2 à interactivité équivalente, et un débit de jetons de sortie par GPU 3.8 fois supérieur pour l'apprentissage par renforcement. Ces résultats proviennent de benchmarks internes de Cognition sur CoreWeave Cloud, exécutés avec des charges de travail d'agents similaires à celles utilisées en production, sans que la taille des modèles, la longueur des contextes ou les paramètres de traitement par lots ne soient divulgués.
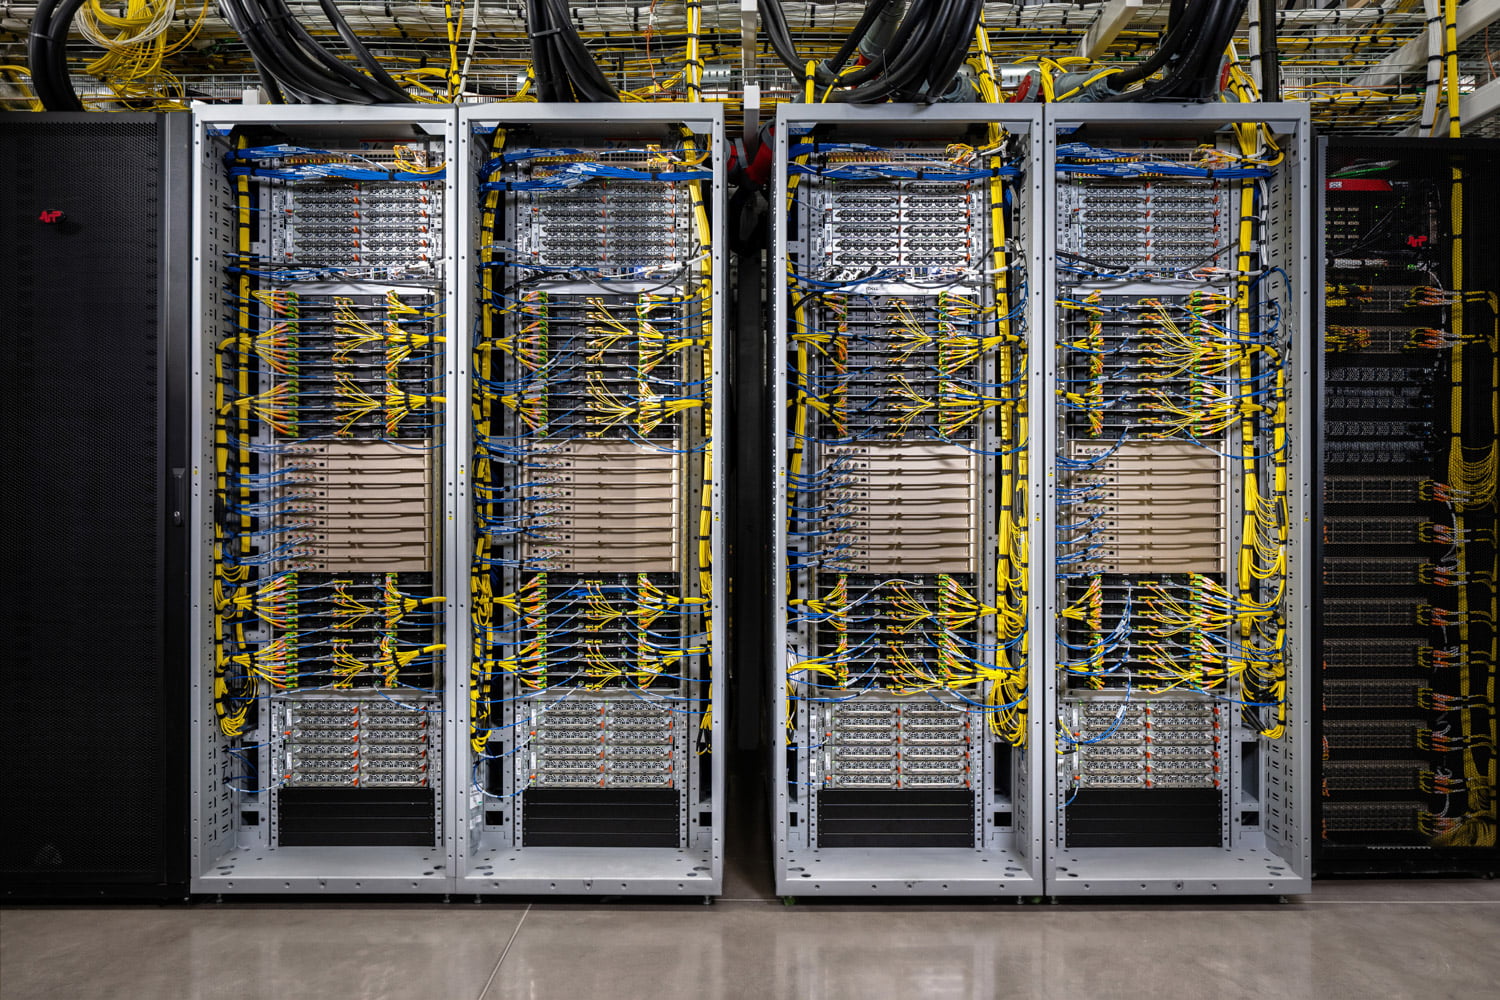
Vera Rubin NVL72 entre en production chez CoreWeave
Cognition exécute l'entraînement, l'apprentissage par renforcement et l'inférence de production pour Devin sur CoreWeave. CoreWeave indique avoir déployé le cluster Vera Rubin NVL72 début septembre et avoir rendu opérationnelles les charges de travail de Cognition quelques jours seulement après la livraison des racks. L'entreprise qualifie cette exécution de premier benchmark d'inférence Vera Rubin réalisé par un client. Selon Cognition, le résultat SWE-2 se traduit par un plus grand nombre de sessions Devin simultanées par GPU et des temps de traitement de la recherche plus rapides.
Le communiqué de presse de CoreWeave indique que Vera Rubin NVL72 est désormais disponible ; son article de blog sur le déploiement Cognition parle d'une disponibilité limitée, il faut donc s'attendre à ce que l'attribution soit soumise à des restrictions pour le moment. Les clients l'utilisent avec le même logiciel et le même modèle d'exploitation que les flottes GB200 NVL72 et GB300 NVL72 de CoreWeave : CoreWeave Kubernetes Service, SUNK, Mission Control, Sandboxes et inférence sans serveur.
Nous avons présenté en septembre, lors de la mise en service de plusieurs baies , les baies elles-mêmes, les NVL72 fabriquées par Dell avec deux SuperNIC ConnectX-9 par GPU, et les validations progressives effectuées par CoreWeave avant la mise en production de chaque baie . La nouveauté réside dans la présence d'un client payant.
Le processeur NVIDIA Vera cible la densité du bac à sable des agents
CoreWeave intégrera également le processeur NVIDIA Vera à son offre en tant que couche de calcul autonome pour les tâches d'agents : exécution en environnement isolé, environnements d'apprentissage par renforcement, appels d'outils, exécution de code et traitement des données liées à l'entraînement et au raisonnement sur GPU. Aucune date précise n'a été communiquée, si ce n'est « prochainement ».
Un nœud Vera sur CoreWeave associe deux processeurs Vera à 88 cœurs, 1.5 To de RAM, 15.36 To de stockage NVMe local et un DPU BlueField-4 à 800 Gbit/s. Un rack complet comprend 128 processeurs et 11 264 cœurs, avec des DPU BlueField-4 et une commutation Ethernet Spectrum-X. CoreWeave affirme que cette configuration prend en charge plus de 11 000 environnements isolés simultanés. Lors de ses propres tests, CoreWeave a constaté un démarrage des sandbox d'agents plus de trois fois plus rapide sur Vera que sur un processeur x86 non spécifié. Vera fonctionnera en mode bare metal, avec la même plateforme et les mêmes modèles de consommation que la flotte de GPU, y compris la capacité spot.
CoreWeave Forge connecte le développement et la production
CoreWeave Forge, lancé lors de l'événement, intègre Weights & Biases Models, les fonctionnalités post-entraînement d'OpenPipe et le projet open source marimo notebook au sein d'une couche de développement unique pour les modèles et les agents. Cette plateforme couvre le suivi des expériences, les évaluations, les traces d'agents, les points de contrôle, l'exécution en environnement isolé, le post-entraînement et le déploiement des inférences. CoreWeave affirme qu'elle est compatible avec différents modèles, frameworks et autres clouds. MasterClass et Canva l'utilisent déjà.
Forge est disponible en versions gratuite, Pro et Entreprise. La version Pro est proposée à partir de 60 $ par mois avec un essai gratuit de 30 jours. Sont disponibles dès aujourd'hui : ARIA, les environnements de test (Sandboxes), les modèles de pondération et de biais, l'apprentissage par renforcement sans serveur (Serverless SFT), l'apprentissage par renforcement sans serveur (Serverless RL), le registre, les notebooks, ainsi que l'inférence sans serveur et dédiée. En avant-première : Agent Lens, la distillation de modèles et les déploiements d'apprentissage par renforcement (RL Rollouts), qui permettent de charger un point de contrôle dans un déploiement en production pendant que la boucle d'entraînement continue de s'exécuter.
Selon le communiqué de CoreWeave, Agent Lens détecte 20 % de défaillances critiques supplémentaires et corrige les problèmes à un dixième du coût, par rapport à un LLM généraliste de pointe non spécifié ; l’article de blog de l’entreprise annonce un coût deux fois moindre, il convient donc d’interpréter ce chiffre avec prudence. Serverless RL promet un entraînement 1.4 fois plus rapide et 40 % moins cher qu’une configuration autogérée. Aucune information n’a été fournie concernant la charge de travail, le modèle, le matériel et la méthodologie.
Réseau de partenaires et déploiement de l'inférence clinique
Le réseau de partenaires CoreWeave, disponible dès aujourd'hui, regroupe les intégrations que CoreWeave affirme avoir testées en conditions de production et validées à la demande des clients, couvrant l'infrastructure, les services de données, les éditeurs de logiciels indépendants (ISV), la sécurité, ainsi que les modèles et l'inférence. Parmi les partenaires figurent CrowdStrike, VAST Data, Reflection, ClickHouse, LanceDB, Inferact, RadixArk, IBM et Red Hat. Exa, Parallel Web Systems et You.com rejoignent le réseau via une intégration de recherche partagée pour les agents hébergés sur CoreWeave, qui sera déployée dans les semaines suivant l'annonce. L'argument principal est que les clients conservent leurs couches de service, leurs outils d'observabilité, leurs procédures opérationnelles et leurs outils de sécurité existants lors de la migration de leurs charges de travail vers le cloud.
Ennoble Care, qui fournit des soins primaires, palliatifs et de fin de vie à domicile à environ 50 000 patients par an dans 15 États, a choisi CoreWeave Cloud pour l'inférence d'IA clinique. Le déploiement s'exécute sur des nœuds NVIDIA RTX PRO 6000 Blackwell Server Edition réservés via CoreWeave Kubernetes Service, avec une isolation matérielle renforcée et des contrôles de confiance zéro pour les données cliniques, ainsi qu'un support technique direct. CoreWeave affirme que CKS déploie des conteneurs 8 à 10 fois plus rapidement qu'une solution cloud classique, sans préciser la plateforme, la charge de travail ni la configuration de test.


 Amazon