

Supermicro a annoncé aujourd'hui, en collaboration avec IBM et NVIDIA, une solution de stockage cache KV qui déplace l'état clé-valeur sous-jacent à l'inférence de contexte long du GPU vers un niveau de stockage 100 % flash partagé. Cette solution combine des serveurs de stockage Supermicro Petascale équipés de processeurs AMD EPYC 9005, IBM Storage Scale, NVIDIA Dynamo et NVIDIA Spectrum-X Ethernet. Les entreprises s'appuient sur une architecture de référence validée, publiée par IBM dans un Redbook. Le principal avantage réside dans une réduction de 56 fois du temps d'obtention du premier jeton sur des requêtes de 130 000 jetons, par rapport à un GPU qui recalcule le contexte intégralement.
Pourquoi KV Cache a besoin d'une couche de stockage
L'inférence se déroule en deux phases : le préremplissage transforme l'invite en jetons et les traite à travers le modèle pour produire les états intermédiaires clé-valeur ; le décodage génère la réponse jeton par jeton à partir de ces états. La conservation de l'état clé-valeur dans un cache persistant permet au système de le réutiliser pour le prochain tour, la prochaine étape de l'agent ou la prochaine requête partageant le même contexte, évitant ainsi un nouveau calcul.
Les flux de travail agents, les assistants de codage, les RAG à contexte long et les applications multi-tours génèrent suffisamment de cet état pour saturer rapidement la mémoire GPU et CPU, c'est pourquoi Supermicro, IBM et NVIDIA développent une couche de stockage réseau.
Dans cette architecture, NVIDIA Dynamo gère la hiérarchie du cache et déplace les blocs via NIXL ; IBM Storage Scale Erasure Code Edition fournit la couche de fichiers partagés ; et les serveurs pétaflopiques fournissent la mémoire flash et les lignes PCIe Gen5 sous-jacentes. Supermicro indique que les trois entreprises ont testé l'architecture au niveau du cluster, en conditions de forte concurrence et avec un trafic réseau important, et présente le résultat comme une solution clé en main avec intégration en rack en usine et déploiement sur site, réduisant ainsi le délai de déploiement de plusieurs semaines à quelques jours.
La configuration testée
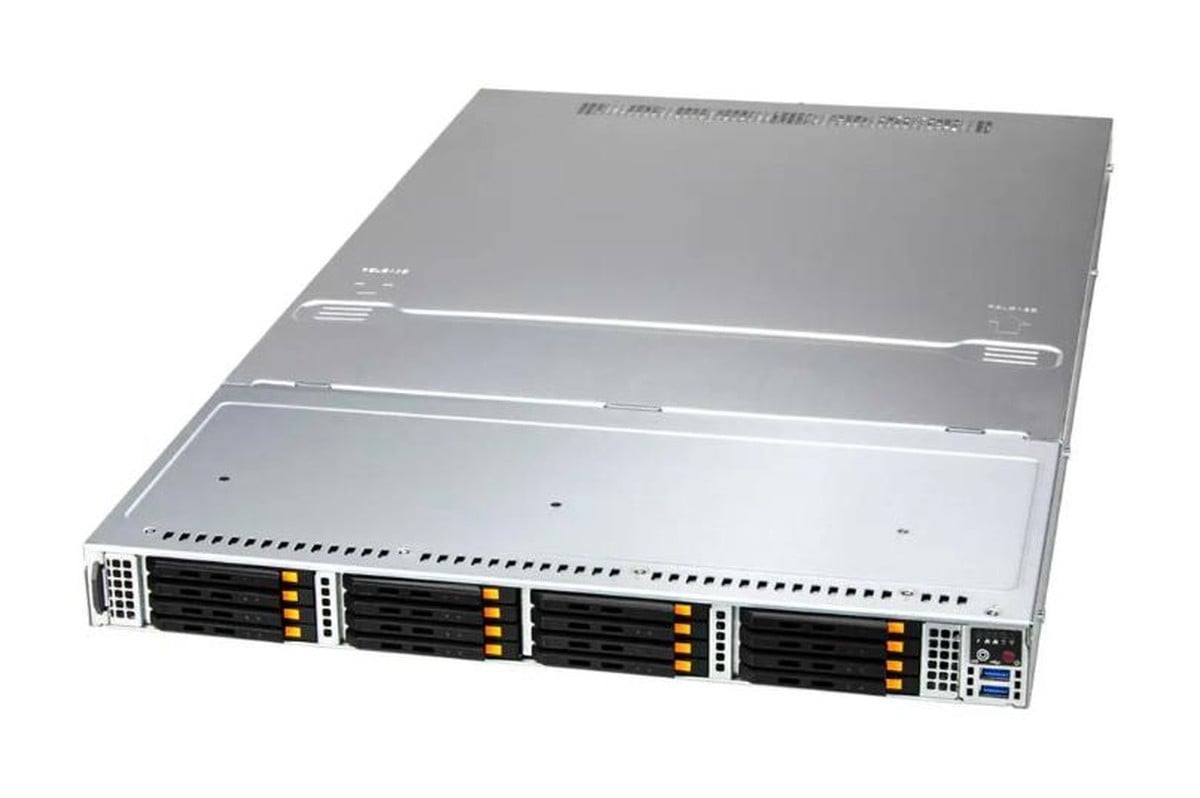
L'architecture de référence utilise huit nœuds pétaflopiques Supermicro ASG-1115S-NE316R, chacun étant un système 1U équipé d'un processeur AMD EPYC 9535 et de 16 disques NVMe Micron E3.S de 7.68 To. Chaque nœud offre ainsi une capacité de stockage flash brute de 122.88 To, soit environ 983 To au total pour les huit nœuds. Chaque nœud est doté d'une interface client NVIDIA BlueField-3 B3220 à deux ports de 200 Gb/s et d'une interface ConnectX-7 de 400 Gb/s pour le stockage. L'architecture comprend trois commutateurs Spectrum-X SN5600 disposés en spine-leaf et des liaisons montantes de 800 Gb/s.
Les nœuds de stockage exécutent RHEL 9.6 et IBM Storage Scale ECE 6.0.0.1 dans une configuration de code d'effacement 8+2P, et IBM estime le débit de lecture de ce niveau à huit nœuds à 315 Go/s d'après des tests antérieurs.
| Composant | Architecture de référence du cache KV (telle que testée) |
|---|---|
| Niveau de stockage | |
| Nœuds de stockage | 8x Supermicro ASG-1115S-NE316R (1U, socket unique) |
| CPU par nœud | AMD EPYC 9535, 128 lignes PCIe Gen5 (64 vers NVMe, 64 vers le réseau) |
| Flash par nœud | 16 disques SSD Micron E3.S NVMe de 7.68 To (122.88 To bruts) |
| Réseau par nœud | NVIDIA BlueField-3 B3220, double port 200 Gb (côté client) NVIDIA ConnectX-7 400 Go (mémoire de stockage) |
| Commutation | 3 cartes NVIDIA Spectrum-X SN5600, architecture spine and leaf, liaisons montantes 800 Gb/s |
| Logiciel de stockage | IBM Storage Scale Erasure Code Edition 6.0.0.1, 8+2P RHEL 9.6 |
| Client d'inférence | |
| Système | Supermicro SYS-212GB-FNR (NVIDIA MGX), Ubuntu 24.04 |
| GPU utilisé pour les tests de performance | 1x NVIDIA RTX PRO 6000 Blackwell, 19.6 Gio restants pour le cache KV après les pondérations et les graphes CUDA |
| Réseautage client | 2 cartes NVIDIA BlueField-3 B3140H 400 Gbit/s, bande passante côté client jusqu'à 80 Gbit/s |
| Modèle et logiciel | openai/gpt-oss-120b (MXFP4) vLLM 0.14.1 NVIDIA Dynamo 0.9.0 avec NIXL Client de test NVIDIA AIPerf |
| Hiérarchisation du cache | Niveaux hôte et local définis à zéro ; les 1.4 million de jetons mis en cache sont servis depuis le niveau de mise à l'échelle du stockage. |
Le client de référence est un système Supermicro SYS-212GB-FNR MGX unique, et les résultats proviennent d'un GPU NVIDIA RTX PRO 6000 Blackwell dans cette machine exécutant le modèle openai/gpt-oss-120b en MXFP4 sous vLLM 0.14.1 et Dynamo 0.9.0.
Après le calcul des poids et des graphiques CUDA, 19.6 Gio de mémoire GPU étaient disponibles pour le cache KV, soit suffisamment pour environ 1.14 million de jetons sur le GPU. Pour les tests, la mémoire hôte et les niveaux locaux ont été initialisés à zéro afin que chaque bloc mis en cache soit renvoyé par Storage Scale. Les résultats mesurent donc le chemin de stockage seul, sans l'aide d'une hiérarchie mixte.
Délai d'obtention du premier jeton multiplié par 56, débit multiplié par 22
Sans cache, le temps d'accès au premier jeton (TTFT) pour le modèle 120B est passé de 0.572 seconde à 10 000 jetons d'entrée à 32.14 secondes à 130 000 jetons, le GPU recalculant l'intégralité du contexte. Avec le cache KV sur Storage Scale, le TTFT est resté compris entre 0.193 et 0.57 seconde sur la même plage, soit un facteur 56 à 130 000 jetons et l'écart de 0.377 seconde mentionné par Supermicro dans son annonce. Ces tests ont été réalisés par IBM, Supermicro et NVIDIA ; nous n'avons ni exécuté ni vérifié les résultats.
Le test de débit a envoyé 200 requêtes via 28 connexions simultanées, issues de 100 invites uniques totalisant 24 millions de jetons et 825 Go de données de cache KV, ce dernier étant initialement vide. Le test de référence avec recalcul a atteint 0.19 requête par seconde en 1 048 secondes ; le niveau Storage Scale a quant à lui atteint 4.26 requêtes par seconde en 46.94 secondes, soit un gain de 22 fois, incluant le temps de démarrage à froid nécessaire au remplissage du cache.
Un troisième test, avec l'ajout de quatre clients générant 200 Go/s de trafic réseau non lié sur la même infrastructure, a permis de traiter 3.6 requêtes par seconde et 200 requêtes en 55.56 secondes, soit environ neuf secondes de plus que lors du test initial et toujours 18 fois plus rapide. IBM attribue cette légère perte de performance à l'isolation du trafic du cache par l'infrastructure Spectrum-X, qui le distingue du trafic d'arrière-plan.
« L’IA agentielle et les applications à contexte long dépendent de la réutilisation efficace du contexte à travers de nombreuses étapes, et NVIDIA Dynamo contribue à orchestrer l’inférence distribuée afin que les entreprises puissent optimiser le débit utilisable de chaque GPU », a déclaré Shruti Koparkar, responsable produit Inférence IA chez NVIDIA. « En associant NVIDIA Dynamo et Spectrum-X Ethernet aux serveurs de stockage pétaflopiques Supermicro et à IBM Storage Scale, cette solution de cache KV crée un niveau de stockage partagé haute performance qui permet de réduire les calculs redondants, d’améliorer le temps d’obtention du premier jeton et d’aider les clients à déployer des services d’inférence IA résilients et à grande échelle. »
Dimensionnement et ce qui n'est pas dans les chiffres
Le guide de dimensionnement d'IBM préconise une architecture à quatre nœuds (4+2P) avec 67 % de capacité utilisable pour les modèles de 7 à 34 milliards de disques et jusqu'à 64 GPU ; une architecture à huit nœuds (8+2P) testée, avec 80 % de capacité utilisable, pour les modèles de 70 à 120 milliards de disques et 100 à 256 GPU nécessitant une bande passante de lecture de 100 à 300 Go/s ; et une architecture à 16 nœuds ou plus (16+3P), avec 84 % de capacité utilisable, pour les modèles plus importants et 300 GPU ou plus, à partir de 300 Go/s. La solution Storage Scale ECE est évolutive et peut gérer de trois à 256 serveurs de stockage.
Le principal inconvénient réside dans la configuration de test mono-GPU. L'architecture de référence est dimensionnée pour des centaines de GPU, mais tous les résultats présentés dans l'article proviennent d'une seule RTX PRO 6000 face à un système de stockage flash de 983 To composé de huit nœuds, dont la capacité est estimée à 315 Go/s par IBM. Le stockage était donc loin d'être saturé, et les tests ne permettent pas d'évaluer le comportement du TTFT lorsqu'un cluster complet de GPU utilise simultanément le cache.
Supermicro n'a pas communiqué le prix ni la date de disponibilité de cette solution, et l'annonce ne fournit aucune donnée sur l'utilisation du GPU. Cette approche se situe sur le même segment que l'accélération du cache KV intégrée à Dynamo de DDN sur l'AI400X3M , à la différence que cette solution s'exécute sur des serveurs Supermicro standard et un réseau Ethernet sous le système de fichiers IBM.
« À mesure que les charges de travail d'IA s'étendent de l'entraînement à l'inférence, les entreprises et les néoclouds déployant des charges de travail d'inférence à haut débit, caractéristiques de l'IA agentique et de l'IA générative multi-tours à contexte long, doivent éliminer les goulots d'étranglement pour améliorer l'efficacité des GPU », a déclaré Charles Liang, président et PDG de Supermicro. « Notre solution avec IBM et NVIDIA démontre clairement ces gains de performance. »



 Amazon