

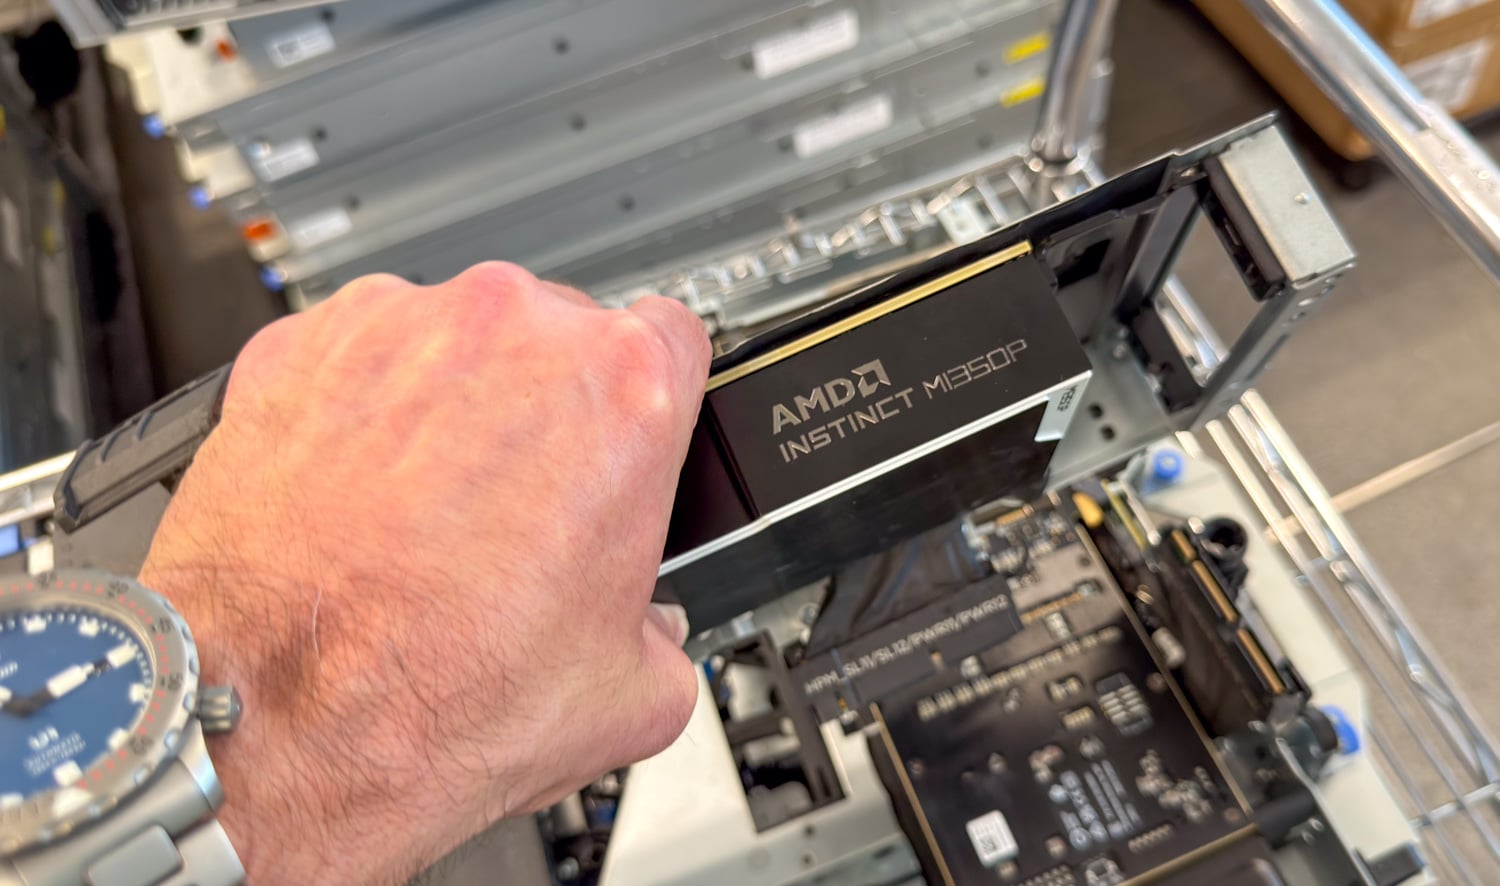
L'AMD Instinct MI350P est le premier GPU PCIe Instinct d'AMD depuis quatre ans, après le MI210 en 2022. Il intègre l'architecture CDNA 4 d'AMD dans une carte d'extension classique, offrant jusqu'à 4.6 PFLOPS de performances MXFP4, 144 Go de mémoire HBM3E et une bande passante mémoire de 4 To/s. Le tout tient dans une carte double slot de 600 W refroidie par air, offrant ainsi aux clients une alternative pour déployer des GPU Instinct sans passer par la plateforme OAM MI350/5X à 8 GPU.
Points clés à retenir
- 144 Go dans un emplacement PCIe, c'est l'information principale. La MI350P embarque la plus grande quantité de mémoire de tous les accélérateurs PCIe actuels, 3 Go de plus que la H200 NVL et 48 Go de plus que la RTX PRO 6000 Blackwell, avec 4 To/s de HBM3E derrière elle, et dix des quatorze combinaisons de modèles et de précisions de ce test ont fonctionné sur une seule carte.
- Les performances de calcul mesurées se situent entre les deux cartes NVIDIA. À 450 W, le MAMF a atteint 580 TFLOPS en BF16, 1 120 en FP8 et 2 228 en FP4 à échelle de blocs, soit 36 à 38 % de plus qu'une RTX PRO 6000 de 600 W à chaque précision et derrière le H200 NVL en BF16 et FP8, qui ne dispose pas de chemin FP4.
- GPT-OSS est le meilleur résultat obtenu par le MI350P. Sur AMDGPU 31.60, ROCm 10.1.0 et vLLM 0.32.0, GPT-OSS-120B a atteint 5 057 jetons de sortie par seconde à 128 flux sur la charge de travail de chat, soit 65 % de plus que la RTX PRO 6000 et 50 % de plus que la H200 NVL, et la courbe continue de grimper à travers 128 flux sur les deux formes d'invite.
- Les messages courts sont plus adaptés au MI350P ; les messages longs donnent des résultats mitigés. Sur les requêtes de 512 jetons, la carte surpasse la RTX PRO 6000 sur tous les modèles FP8, BF16 et GPT-OSS de 35 à 65 % à 128 flux, et les deux confrontations FP4 contre NVFP4 sont à moins de 5 et 21 %, tandis que sur les requêtes de 8 192 jetons, elle est en tête sur GPT-OSS et Mistral Small et à la traîne sur Llama, Qwen FP8 et MiniMax-M2.7, où sa courbe s'aplatit rapidement.
- Les résultats à deux cartes sont sur ROCm 7.2.3. Les résultats des tests DeepSeek-V4-Flash, MiniMax-M3, GLM-5.2 et GLM-5.3 Flash sur cette pile sont rapportés car les passes ROCm 10.1 sur ces modèles ont utilisé le déchargement expert du processeur et, sur DeepSeek, un décodeur spéculatif que les tests NVIDIA n'ont pas utilisé.
- La question des 600 W reste ouverte. Dell documente huit MI350P à 600 W dans le PowerEdge XE7745, et un suivi à pleine puissance est prévu.
AMD a également présenté le MI350P à l'IFA 2026 dans son prototype Threadripper Halo Station, où les mêmes accélérateurs étaient refroidis par liquide. Ce concept de station de travail prend en charge jusqu'à quatre MI350P associés à un processeur Threadripper PRO à 96 cœurs, offrant une capacité totale de 576 Go de mémoire HBM3E dans une seule machine. La page produit d'AMD, mise à jour en octobre, annonce désormais une sortie en 2027. On peut donc envisager le MI350P de deux manières : comme un accélérateur PCIe pour serveurs, et comme la base d'un système d'IA de bureau plus important, concurrent de machines telles que la GB300 DGX Station.
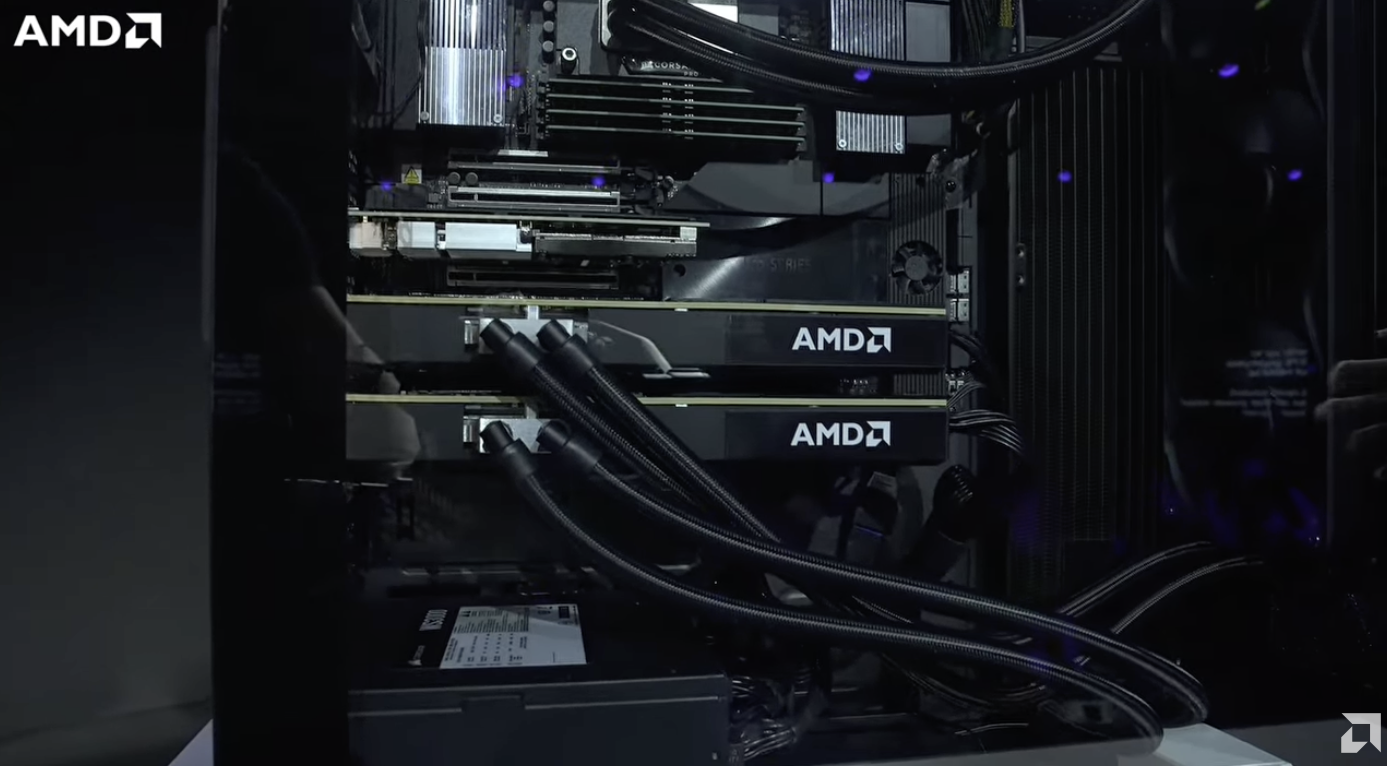
Ce premier aperçu se concentre sur les serveurs. La comparaison pertinente pour un acheteur recherchant un accélérateur PCIe est donc la NVIDIA RTX PRO 6000 Blackwell, carte de même puissance et occupant les mêmes emplacements. La H200 NVL figure dans les graphiques comme la carte d'extension NVIDIA la plus performante pour les charges de travail où la bande passante mémoire est déterminante. Une station GB300 DGX, représentant une configuration de bureau, sert de point de comparaison. Il s'agit d'une machine d'une autre catégorie et à un prix différent, permettant de démontrer la supériorité d'un GPU Blackwell Ultra sur les cartes PCIe.
Spécifications de l'AMD Instinct MI350P
Les chiffres publiés par AMD indiquent que la MI350P privilégie les faibles précisions : 4.6 PFLOPS en MXFP4 et MXFP6, 2.3 PFLOPS en FP8 et 1.15 PFLOPS en FP16 ou BF16, des performances remarquables. L'autre atout de la carte réside dans sa mémoire : 144 Go de HBM3E sur une interface 4 096 bits à 4 To/s, derrière un cache Infinity de 128 Mo, sur lequel reposent les résultats en flux unique présentés ci-dessous. La carte consomme 600 W, avec un mode configurable à 450 W ; notre modèle de test fonctionnait à 450 W.
Le MI350P utilise la même architecture CDNA 4 que les GPU MI350/5X, plus grands et plus puissants. On peut considérer le MI350P comme la moitié d'un MI350X. Pour comprendre pourquoi, il est utile d'examiner comment le GPU plus grand est assemblé.
Le MI350X est un processeur graphique à chiplets empilés en 3D, basé sur la technologie CoWoS (Chip-on-Wafer-on-Substrate) de TSMC, sans puce monolithique. Huit puces d'accélération (XCD) sont disposées au-dessus de deux puces d'E/S, chaque puce d'E/S intégrant quatre XCD. L'architecture Infinity Fabric d'AMD assure la connexion entre les chiplets, tandis que huit modules HBM3E constituent la mémoire du GPU. Le terme CoWoS désigne l'intégration au niveau du boîtier ; l'organisation du calcul au-dessus des E/S correspond à la composante verticale empilée en 3D de la conception.

La MI350P reprend la moitié de cette architecture : quatre XCD, une puce d'E/S et quatre modules HBM3E. Chaque XCD dispose de 32 unités de calcul actives, ce qui porte le total à 128 unités de calcul, contre 256 pour la MI350X. Les ressources mémoire sont également réduites de moitié : 144 Go de HBM3E contre 288 Go, une bande passante de 4 To/s contre 8 To/s et 128 Mo de cache Infinity contre 256 Mo.

| Spécifications | AMD Instinct MI350P |
|---|---|
| En savoir plus sur la plateforme | |
| Architecture | ADNc 4 |
| Unités de calcul | 128 |
| Processeurs de flux | 8,192 |
| Noyaux de matrice | 512 |
| Processus | TSMC 3 nm et 6 nm |
| Transistors | 73 milliards |
| Horloge du moteur de pointe | 2,200MHz |
| Mémoire | |
| Capacités | 144 Go HBM3E |
| Interface | 4,096-bits |
| Bande passante | 4 To / s |
| Cache de dernier niveau | 128MB |
| ECC | Puce complète |
| Performances optimales (selon AMD) | |
| MXFP4 | 4.6hXNUMX FPLOPS |
| MXFP6 | 4.6hXNUMX FPLOPS |
| MXFP8 | 2.3hXNUMX FPLOPS |
| OCP FP8 | 2.3 PFLOPS ; 4.6 PFLOPS avec parcimonie structurée |
| FP16 | 1.15 PFLOPS ; 2.3 PFLOPS avec parcimonie |
| BF16 | 1.15 PFLOPS ; 2.3 PFLOPS avec parcimonie |
| FP32 | 72 TFLOPS |
| FP64 | 36 TFLOPS |
| Puissance, refroidissement et facteur de forme | |
| Puissance de carte typique | Puissance maximale de 600 W ; puissance configurable de 450 W. |
| Câble d'alimentation | 12V-2×6 |
| Refroidissement | Revenu |
| Facteur de forme | Carte d'extension PCIe, pleine hauteur, double emplacement |
| Longueur de planche | 10.5 pouces (267 mm) |
| Interface hôte | PCIe 5.0 x16 |
| Fonctionnalité | |
| SR-IOV | Oui |
| Cache infini | Oui |
| RAS | Oui |
| Retraite et évitement des pages | Oui |
La puissance de 600 W est maximale, et AMD permet de configurer la carte jusqu'à 450 W, ce qui correspond à sa consommation dans notre serveur 2U. Le H200 NVL a atteint la même consommation de 450 W avec la R770, mais la RTX PRO 6000 a fonctionné à pleine puissance (600 W) avec le XE7740. La carte NVIDIA disposait donc de 150 W supplémentaires lors de chaque test comparatif. Les résultats à pleine puissance seront disponibles uniquement avec un boîtier capable de refroidir une carte passive de 600 W. Le guide technique du Dell XE7745 mentionne huit MI350P à 600 W.
Autre point à noter : le connecteur unique 12V-2×6 et la carte mère double emplacement de 10.5 pouces permettent à cette dernière d’être installée dans les mêmes supports qui accueillent aujourd’hui une RTX PRO 6000 ou une H200 NVL.

Le tableau ci-dessous place le MI350P aux côtés des trois systèmes NVIDIA de nos graphiques : la RTX PRO 6000 Blackwell Server Edition, qui partage son emplacement, sa plage de puissance et sa liaison hôte PCIe 5.0 x16 ; la H200 NVL, la carte Hopper avec la bande passante mémoire correspondante ; et la GB300 DGX Station, un seul GPU Blackwell Ultra associé à un processeur Grace via NVLink-C2C.
Les lignes à lire en premier sont la capacité de mémoire, où les 144 Go de la MI350P sont les plus importants des trois cartes PCIe, 3 Go de plus que la H200 NVL et 48 Go de plus que la RTX PRO 6000 ; la bande passante mémoire, où ses 4 To/s se situent entre les deux ; et la ligne FP4, où AMD cite un chiffre dense et NVIDIA un chiffre clairsemé.
| Spécifications | AMD Instinct MI350P | NVIDIA RTX PRO 6000 Blackwell Server Edition | NVIDIA H200 NVL PCIe | Station NVIDIA GB300 DGX |
|---|---|---|---|---|
| Architecture GPU | ADNc 4 | Blackwell | Hopper | Blackwell Ultra |
| Facteur de forme | accélérateur PCIe | accélérateur PCIe | accélérateur PCIe | Un GPU Blackwell Ultra associé à un processeur Grace à 72 cœurs |
| Mémoire GPU | 144 Go HBM3E | 96 Go GDDR7 ECC | 141 Go HBM3E | 252 Go HBM3E |
| Bande passante de la mémoire GPU | 4 To / s | 1.6 To / s | 4.8 To / s | 7.1 To / s |
| FP4 | 4.6 PFLOPS MXFP4 (Dense) | 4 PFLOPS NVFP4 (Sparse) | Pas de FP4 natif | 20 PFLOPS NVFP4 (Sparse) |
| FP8 | 2.3 PFLOPS (Dense) | 2 PFLOPS (Sparse) | 3.3 PFLOPS (Sparse) | 10 PFLOPS (Sparse) |
| BF16 | 1.15 PFLOPS (Dense) | 1 PFLOPS (Sparse) | 1.6 PFLOPS (Sparse) | 5 PFLOPS (Sparse) |
| FP32 | 72 TFLOPS (Dense) | 120 TFLOPS (épars) | 60 TFLOPS (épars) | 80 TFLOPS (épars) |
| Connexion à l'hôte | PCIe 5.0 x16 | PCIe 5.0 x16 | PCIe 5.0 x16 | NVLink-C2C entre Grace et le GPU, 900 Go/s (BiDi) |
| Connectivité multi-GPU | basé sur PCIe | basé sur PCIe | NVLink à deux ou quatre voies, jusqu'à 900 Go/s par GPU (BiDi) | Réseau ConnectX-8 800 Gb/s entre les stations |
| Tuning Moteur | Puissance configurable de 450 à 600 W | Puissance configurable de 300 à 600 W | Puissance configurable de 450 à 600 W | GPU jusqu'à 1200 W avec balancement électrique |
Comparativement à la RTX PRO 6000, le sous-système mémoire de la MI350P constitue la différence la plus flagrante. Elle offre 50 % de mémoire GPU en plus et une bande passante mémoire environ 2.5 fois supérieure. Pour un modèle dont la mémoire dépasse largement 96 Go, cette capacité supplémentaire pourrait déterminer s'il doit fonctionner sur un seul GPU ou être réparti entre plusieurs.
La RTX PRO 6000, quant à elle, couvre un plus large éventail de charges de travail, grâce à son matériel dédié aux graphismes, au ray tracing et à la vidéo, en plus de ses capacités d'IA. Le choix ne se limite pas à deux chiffres de puissance de calcul maximale ; il dépend également des autres tâches que le système doit effectuer.
Parmi les accélérateurs PCIe haute capacité, le H200 NVL est l'équivalent le plus direct du MI350P ; les GPU Blackwell pour centres de données, plus imposants, appartiennent à une catégorie différente. La capacité mémoire est quasiment identique (144 Go pour le H200 contre 141 Go pour le MI350P), les deux utilisant la mémoire HBM3E. Le H200 offre cependant une bande passante mémoire supérieure de 20 %, à 4.8 To/s. Leur évolutivité diffère également : si les trois cartes PCIe se connectent à l'hôte via PCIe, le H200 NVL ajoute une connectivité GPU-à-GPU dédiée grâce à des ponts NVLink, permettant de connecter jusqu'à quatre GPU.
Les modèles MI350X et MI355X, plus imposants, ont été conçus pour concurrencer Blackwell, mais le MI350P réduit de moitié leur configuration matérielle. De ce fait, il se rapproche du H200 NVL en termes de mémoire et de positionnement global. Le MI350P se distingue toutefois par sa prise en charge native des modules MXFP4 et MXFP6, un atout de plus en plus important à mesure que l'inférence tend vers une précision moindre.
Le sous-système mémoire plus petit constitue un autre compromis, car AMD n'a pas compensé la réduction du nombre de puces HBM par une HBM3E plus rapide. De ce fait, la MI350P affiche une bande passante de 4 To/s, inférieure à celle de la H200 NVL sur ce point. Cela peut limiter les performances dans les charges de travail gourmandes en bande passante mémoire, quelle que soit la puissance de calcul disponible, comme le montrent les résultats relatifs à la bande passante mémoire et à l'inférence à long temps d'exécution présentés plus loin dans ce test.
La comparaison avec la DGX Station est inversée : la GB300 Station embarque un GPU B300 complet avec une pile HBM désactivée, une puce de classe centre de données avec une consommation énergétique adaptée, tandis que la MI350P est une demi-puce de classe centre de données intégrée dans l'enveloppe de 600 W d'une carte d'extension PCIe. AMD a besoin de deux ou quatre MI350P pour égaler les performances de ce GPU unique, et théoriquement, deux suffisent : 288 Go et 8 To/s contre 252 Go et 7.1 To/s pour la Station. Cependant, ces ressources sont réparties sur deux cartes, et une charge de travail s'étendant sur les deux échange des données via PCIe peer-to-peer, ce qui limite l'apport de la seconde carte.
Performances
Plateforme de test
L'unité de test MI350P est un serveur Dell PowerEdge R7725 équipé de deux processeurs AMD EPYC 9555 (64 cœurs chacun), de 1.5 To de mémoire DDR5-6400 répartis sur 24 barrettes DIMM et de deux cartes MI350P configurées à 450 W, la limite pour un serveur 2U. Les cartes RTX PRO 6000 Blackwell Server Edition (600 W) ont été testées dans le serveur Dell PowerEdge XE7740 qui héberge notre configuration d'inférence à quatre cartes. Une seule carte H200 NVL (450 W) a été testée dans le serveur Dell PowerEdge R770 de notre test, et les chiffres relatifs à la GB300 proviennent de la station ASUS ExpertCenter Pro ET900N G3 DGX que nous avons testée en septembre.

L'inventaire iDRAC ci-dessous indique la configuration des deux cartes. Elles occupent les emplacements PCIe 2 et 7, tous deux de type Gen5 x16 et en parfait état de fonctionnement. Les clés de périphérique, 0-139-0 et 1-199-0, correspondent à une carte derrière chaque socket EPYC. Ainsi, le trafic parallèle Tensor entre les deux MI350P emprunte la liaison socket pour transiter entre les complexes racine. Il s'agit de la configuration par défaut pour un déploiement à deux cartes dans un serveur 2U ; il est important d'en tenir compte pour l'analyse des résultats ultérieurs.

La vue mémoire affiche le reste de l'hôte : 24 barrettes DIMM de 64 Go DDR5-6400, double rang, pour un total de 1 536 Go dans un serveur pouvant atteindre 6 To, toutes dotées de la correction d'erreurs multibits (ECC). Cette marge est cruciale pour l'exécution de GLM-5.2, car le point de contrôle MXFP4 ne tient pas sur les 288 Go de deux cartes et vLLM décharge une partie des calculs d'experts sur la mémoire hôte.

FLOPS Matmul maximum atteignables (MAMF)
Pour situer les performances de calcul du MI350P dans leur contexte, nous avons exécuté le test MAMF sur les quatre systèmes. Le MAMF (Maximum Achievable Matmul FLOPS) est une mesure pratique des performances, conçue pour évaluer le nombre maximal d'opérations en virgule flottante par seconde (FLOPS) qu'un accélérateur atteint lors de la multiplication matricielle. Il s'agit d'un indicateur plus pertinent que le nombre maximal théorique de FLOPS indiqué dans la fiche technique. Nous avons testé chaque système en BF16, FP8 et FP4 (à l'échelle des blocs) et affichons le meilleur résultat dense et soutenu pour chaque précision. Les barres hachurées représentent le résultat de chaque carte PCIe multiplié par le nombre de cartes utilisées lors des tests de rendu de modèles complexes et sont calculées sans mesure préalable.

Avec une consommation de 450 W, une carte MI350P atteint 580 TFLOPS sous BF16, 1 120 en FP8 et 2 228 en FP4. La RTX PRO 6000 Blackwell suit avec respectivement 419, 820 et 1 634 TFLOPS. La MI350P affiche donc une avance de 36 à 38 % sur la carte NVIDIA à chaque précision, tout en consommant 150 W de moins. L’écart le plus important, de 38.4 %, est observé sous BF16.
Avec 652 TFLOPS en BF16 et 1 205 en FP8, le H200 NVL surpasse le MI350P dans les deux cas, et ne dispose pas de chemin FP4. La station GB300 DGX domine les trois cartes PCIe avec des performances respectives de 1 924, 3 802 et 6 024 TFLOPS, soit environ 3.3 fois le MI350P en BF16 et 2.7 fois en FP4. Deux MI350P affichent théoriquement des performances proches de 1 160 et 4 456 TFLOPS, toujours inférieures à celles du GPU unique de la station. Les valeurs NVIDIA MAMF présentées dans ce test proviennent de nos derniers essais sur chaque carte et remplacent les résultats de nos tests précédents.
Bande passante mémoire GPU
La puissance de calcul brute n'est utile que si l'accélérateur peut alimenter ses unités d'exécution en données. Ceci est particulièrement important pour l'inférence, où la génération de jetons lors de la phase de décodage est davantage limitée par la bande passante mémoire que par les FLOPS disponibles. Le test de bande passante effectue des opérations de lecture, d'écriture et de copie dans la mémoire du GPU via les noyaux de calcul et le moteur de copie, comparant ainsi la bande passante disponible au sein de chaque GPU à sa valeur nominale.

Une carte MI350P atteint une vitesse de lecture de 3 291 Go/s et une vitesse d'écriture de 3 204 Go/s sur sa mémoire HBM3E, soit environ 80 % de sa capacité nominale de 4 To/s. Les copies de données atteignent une vitesse de 1 276 à 1 283 Go/s. Une copie consomme de la bande passante deux fois : une fois pour lire la source et une autre fois pour écrire sur la destination. La mémoire GDDR7 de la RTX PRO 6000 atteint 1 540 Go/s en lecture et 1 483 Go/s en écriture. La MI350P offre donc une bande passante utilisable environ 2.1 fois supérieure.
Les débits de lecture (4 472 Go/s) et d'écriture (4 156 Go/s) du H200 NVL sont respectivement supérieurs de 36 % et 30 % à ceux du MI350P, conformément à sa capacité nominale de 4.8 To/s contre 4 To/s. La station GB300 DGX atteint quant à elle 6 869 Go/s. Deux MI350P testés simultanément atteignent 6 529 Go/s en lecture, un débit proche de celui de la station, mais cette bande passante est limitée à deux emplacements PCIe, et un modèle occupant les deux emplacements engendre un coût pour chaque échange de données via PCIe.
Inférence
Les tests de bas niveau étant terminés, nous passons à l'inférence LLM. Notre test de serveur en ligne vLLM exploite un point de terminaison compatible OpenAI avec un nombre fixe de flux simultanés et enregistre le nombre de jetons de sortie par seconde pendant toute la durée de l'exécution. Nous présentons deux configurations : 512 jetons en entrée et 512 en sortie, correspondant à la taille d'une conversation et nécessitant un décodage important, et 8 192 jetons en entrée et 1 024 en sortie, correspondant à la taille d'un RAG et d'un document et s'appuyant sur le préremplissage. La concurrence double à partir d'un seul flux, et chaque graphique s'arrête à la concurrence maximale à laquelle toutes les cartes qu'il contient ont été traitées. Chaque point correspond à deux requêtes par flux ; les résultats pour un seul flux reposent donc sur deux requêtes et présentent une variance d'exécution plus importante que les points correspondant à une concurrence plus élevée.
Chaque modèle fonctionnait avec le nombre minimal de cartes compatibles : une MI350P pour tous les systèmes jusqu'à GPT-OSS-120B et MiniMax-M2.7, et deux pour DeepSeek-V4-Flash, MiniMax-M3, GLM-5.2 et GLM-5.3 Flash. Les tests de la RTX PRO 6000 suivent la même règle : deux cartes RTX contre une MI350P sur MiniMax-M2.7 et quatre contre deux sur MiniMax-M3 et GLM-5.2. Les configurations basse précision diffèrent selon le fabricant : AMD utilise MXFP4 jusqu'à Quark, NVIDIA utilise NVFP4, et les paires FP4 sont identifiées ainsi. GPT-OSS est livré en MXFP4 et utilise les mêmes pondérations sur chaque carte. Les configurations NVFP4 H200 ne sont pas incluses.
| Modèle | MI350P | RTX PRO 6000 Blackwell | NVL H200 | Station GB300 DGX |
|---|---|---|---|---|
| Flash GLM-5.3 | 2 cartes, MXFP4 | Ne pas exécuter | Ne pas exécuter | NVFP4 |
| GLM-5.2 | 2 cartes, MXFP4 (déchargement sur la mémoire hôte) | 4 cartes, NVFP4 | Ne pas exécuter | NVFP4 (environ 215 Go de mémoire Grace) |
| MiniMax-M3 | 2 cartes, MXFP4 | 4 cartes, NVFP4 | Ne pas exécuter | NVFP4 (un groupe d'experts en mémoire de Grace) |
| DeepSeek-V4-Flash | 2 cartes, FP8 | 2 cartes, FP8 | Ne pas exécuter | FP8 |
| MiniMax-M2.7 | 1 carte, MXFP4 | 2 cartes, NVFP4 | Ne pas exécuter | NVFP4 |
| GPT-OSS-120B | 1 carte, MXFP4 | 1 carte, MXFP4 | 1 carte, MXFP4 | MXFP4 |
| GPT-OSS-20B | 1 carte, MXFP4 | 1 carte, MXFP4 | 1 carte, MXFP4 | MXFP4 |
| Qwen3-Coder-30B-A3B | 1 carte, FP8 et BF16 | 1 carte, FP8 et BF16 | 1 carte, FP8 et BF16 | FP8 et BF16 |
| Mistral Small 3.1 24B | 1 carte, FP8 et BF16 | 1 carte, FP8 et BF16 | 1 carte, FP8 et BF16 | FP8 et BF16 |
| Lama 3.1 8B | 1 carte, MXFP4, FP8 et BF16 | 1 carte, NVFP4, FP8 et BF16 | 1 carte, FP8 et BF16 | NVFP4, FP8 et BF16 |
Consultez la colonne MI350P : le nombre de cartes est la première chose que vous obtenez avec 144 Go. Six des dix modèles fonctionnent avec une seule carte MI350P, tandis que les 96 Go de la RTX PRO 6000 nécessitent une deuxième carte pour le MiniMax-M2.7. Les deux points de contrôle MXFP4, MiniMax-M3 et GLM-5.2, qui restent sur deux MI350P, requièrent quatre RTX PRO 6000. Le GLM-5.2 est celui qui dépasse même 288 Go ; vLLM décharge alors une partie de ses calculs experts sur la mémoire hôte du R7725. Le GB300 fait de même avec environ 215 Go de calculs experts dans la mémoire Grace.
Les performances des modèles MI350P à carte unique ont été mesurées le 27 octobre avec AMDGPU 31.60, ROCm 10.1.0 et vLLM 0.32.0. La configuration validée par Dell est vLLM 0.27 avec ROCm 10.0 et AMDGPU 31.5 ; nous avons testé la version ROCm 10.1 du 5 octobre. Les cartes NVIDIA ont utilisé le conteneur vLLM 26.08 avec CUDA 13.4.1. Le tableau indique la version utilisée pour chaque test.
| Modèle | Image vLLM |
|---|---|
| AMD Instinct MI350P | |
| DeepSeek-V4-Flash-0731 | vllm/vllm-openai-rocm@sha256:a78d3e91404e7875aa650a61dea580a9e26d72553bee9ae5b93dbdef7107594d (ROCm 7.2.3) |
| GLM-5.2 MXFP4 | vllm/vllm-openai-rocm:v0.27.1 (ROCm 7.2.3) |
| Flash GLM-5.3 MXFP4 | vllm/vllm-openai-rocm@sha256:a78d3e91404e7875aa650a61dea580a9e26d72553bee9ae5b93dbdef7107594d (ROCm 7.2.3) |
| GPT-OSS-120B MXFP4 | vLLM 0.32.0 sur ROCm 10.1.0, AMDGPU 31.60 (27 octobre) |
| GPT-OSS-20B MXFP4 | vLLM 0.32.0 sur ROCm 10.1.0, AMDGPU 31.60 (27 octobre) |
| Lama 3.1 8B BF16 | vLLM 0.32.0 sur ROCm 10.1.0, AMDGPU 31.60 (27 octobre) |
| Llama 3.1 8B FP8 | vLLM 0.32.0 sur ROCm 10.1.0, AMDGPU 31.60 (27 octobre) |
| Llama 3.1 8B MXFP4 | vLLM 0.32.0 sur ROCm 10.1.0, AMDGPU 31.60 (27 octobre) |
| MiniMax-M2.7 MXFP4 | vLLM 0.32.0 sur ROCm 10.1.0, AMDGPU 31.60 (27 octobre) |
| MiniMax-M3 MXFP4 | vllm/vllm-openai-rocm:nightly-2a02f6efe319c885e3ccbcecde402e0028f9ec1e (ROCm 7.2.3) |
| Mistral Small 3.1 24B BF16 | vLLM 0.32.0 sur ROCm 10.1.0, AMDGPU 31.60 (27 octobre) |
| Mistral Small 3.1 24B FP8 | vLLM 0.32.0 sur ROCm 10.1.0, AMDGPU 31.60 (27 octobre) |
| Qwen3-Coder-30B BF16 | vLLM 0.32.0 sur ROCm 10.1.0, AMDGPU 31.60 (27 octobre) |
| Qwen3-Coder-30B FP8 | vLLM 0.32.0 sur ROCm 10.1.0, AMDGPU 31.60 (27 octobre) |
| NVIDIA RTX PRO 6000 Blackwell Server Edition (CUDA 13.4.1.012) | |
| DeepSeek-V4-Flash-0731 | nvcr.io/nvidia/vllm:26.08-py3 |
| GLM-5.2 NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| GPT-OSS-120B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| GPT-OSS-20B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| Lama 3.1 8B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Llama 3.1 8B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| Llama 3.1 8B NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| MiniMax-M2.7 NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| MiniMax-M3 NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| Mistral Small 3.1 24B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Mistral Small 3.1 24B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| NVIDIA H200 NVL (CUDA 13.4.1.012) | |
| GPT-OSS-120B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| GPT-OSS-20B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| Lama 3.1 8B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Llama 3.1 8B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| Mistral Small 3.1 24B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Mistral Small 3.1 24B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
Les quatre modèles à deux cartes, DeepSeek-V4-Flash, MiniMax-M3, GLM-5.2 et GLM-5.3 Flash, sont issus d'exécutions sur ROCm 7.2.3. Nos passages sur ROCm 10.1 pour ces modèles ont utilisé le déchargement CPU expert de manière systématique et, sur DeepSeek-V4-Flash, un décodeur spéculatif que les exécutions NVIDIA n'ont pas utilisé, ce qui en fait un test différent. Ils sont donc mis de côté pour un passage complet sur la pile actuelle, et les tableaux indiquent la pile correspondante pour chaque ligne MI350P.
Pour ces modèles, AMD privilégie l'utilisation de ses conteneurs AIM. La suite Enterprise AI Suite 2.5, sortie le 9 octobre, est validée sur ROCm 10 et inclut des AIM pour GPT-OSS-120B, Llama 3.3 70B et Gemma 3 27B. Cependant, le tableau des accélérateurs d'AMD ne mentionne pour l'instant qu'un profil MI350P optimisé pour WAN 2.2. Par conséquent, l'utilisation de vLLM standard reste la solution privilégiée par les acheteurs de MI350P et correspond à celle que nous avons testée.
Aperçu des résultats d'inférence
Vous trouverez ci-dessous 28 graphiques ; voici donc une version abrégée en deux tableaux : nombre de jetons produits par seconde pour chaque modèle à la concurrence maximale, chaque carte étant exécutée avec succès, en commençant par la charge de travail de 512 entrées et 512 sorties (taille d'une conversation). Les valeurs pour le MI350P correspondent à une carte de 450 W, sauf indication contraire sur la ligne. Une colonne indique la pile à laquelle chaque ligne appartient ; la station GB300 DGX est composée d'une seule carte B300.
| Modèle | Cartes (MI350P / RTX PRO 6000) | Pile MI350P | Streams | MI350P | RTX PRO 6000 | NVL H200 | Station GB300 DGX |
|---|---|---|---|---|---|---|---|
| Flash GLM-5.3 (MXFP4 vs NVFP4) | 2 / aucun | ROCm 7.2.3 | 32 | 1,462 | Ne pas exécuter | Ne pas exécuter | 828 |
| GLM-5.2 (MXFP4 vs NVFP4) | 2/4 | ROCm 7.2.3 | 32 | 59 | 40 | Ne pas exécuter | 139 |
| MiniMax-M3 (MXFP4 vs NVFP4) | 2/4 | ROCm 7.2.3 | 32 | 1,509 | 759 | Ne pas exécuter | 1,041 |
| DeepSeek-V4-Flash | 2/2 | ROCm 7.2.3 | 32 | 1,081 | 829 | Ne pas exécuter | 1,766 |
| MiniMax-M2.7 (MXFP4 vs NVFP4) | 1/2 | ROCm 10.1 | 128 | 1,524 | 1,932 | Ne pas exécuter | 4,793 |
| GPT-OSS-120B MXFP4 | 1/1 | ROCm 10.1 | 128 | 5,057 | 3,064 | 3,376 | 9,280 |
| GPT-OSS-20B MXFP4 | 1/1 | ROCm 10.1 | 128 | 10,726 | 7,937 | 6,022 | 22,041 |
| Qwen3-Coder-30B FP8 | 1/1 | ROCm 10.1 | 128 | 6,451 | 3,995 | 7,459 | 12,439 |
| Qwen3-Coder-30B BF16 | 1/1 | ROCm 10.1 | 128 | 4,696 | 2,881 | 5,240 | 10,000 |
| Mistral Small 24B FP8 | 1/1 | ROCm 10.1 | 128 | 4,458 | 3,242 | 4,624 | 11,075 |
| Mistral Petit 24B BF16 | 1/1 | ROCm 10.1 | 128 | 3,065 | 2,026 | 3,373 | 7,861 |
| Llama 3.1 8B (MXFP4 vs NVFP4) | 1/1 | ROCm 10.1 | 128 | 8,383 | 8,869 | Ne pas exécuter | 28,400 |
| Llama 3.1 8B FP8 | 1/1 | ROCm 10.1 | 128 | 11,045 | 8,073 | 11,054 | 25,602 |
| Lama 3.1 8B BF16 | 1/1 | ROCm 10.1 | 128 | 6,819 | 4,740 | 8,069 | 17,074 |
Deux résultats ressortent du tableau de discussion : la MI350P surpasse la RTX PRO 6000 sur tous les modèles FP8, BF16 et GPT-OSS, de 35 à 65 % à 128 flux, n’est devancée par les versions NVFP4 de NVIDIA qu’en haut des courbes Llama et MiniMax-M2.7, et double approximativement les performances de la carte NVIDIA sur un seul flux sur Llama 3.1 8B et Mistral Small 24B, où 4 To/s de HBM3E font le travail.
Le H200 NVL, avec 20 % de bande passante en plus, reste de 4 à 18 % en tête sur les modèles denses FP8 et BF16 à 128 flux et est à égalité sur Llama 3.1 8B FP8 ; sur les deux modèles GPT-OSS, l'ordre s'inverse et le MI350P termine avec 50 et 78 % d'avance.
Le deuxième tableau répète l'exercice sur les invites de 8 192 jetons, où le préremplissage domine l'exécution et l'équilibre entre la bande passante de calcul et de mémoire se déplace vers les cartes NVIDIA.
| Modèle | Cartes (MI350P / RTX PRO 6000) | Pile MI350P | Streams | MI350P | RTX PRO 6000 | NVL H200 | Station GB300 DGX |
|---|---|---|---|---|---|---|---|
| Flash GLM-5.3 (MXFP4 vs NVFP4) | 2 / aucun | ROCm 7.2.3 | 32 | 760 | Ne pas exécuter | Ne pas exécuter | 1,219 |
| GLM-5.2 (MXFP4 vs NVFP4) | 2/4 | ROCm 7.2.3 | 16 | 6 | 9 | Ne pas exécuter | 87 |
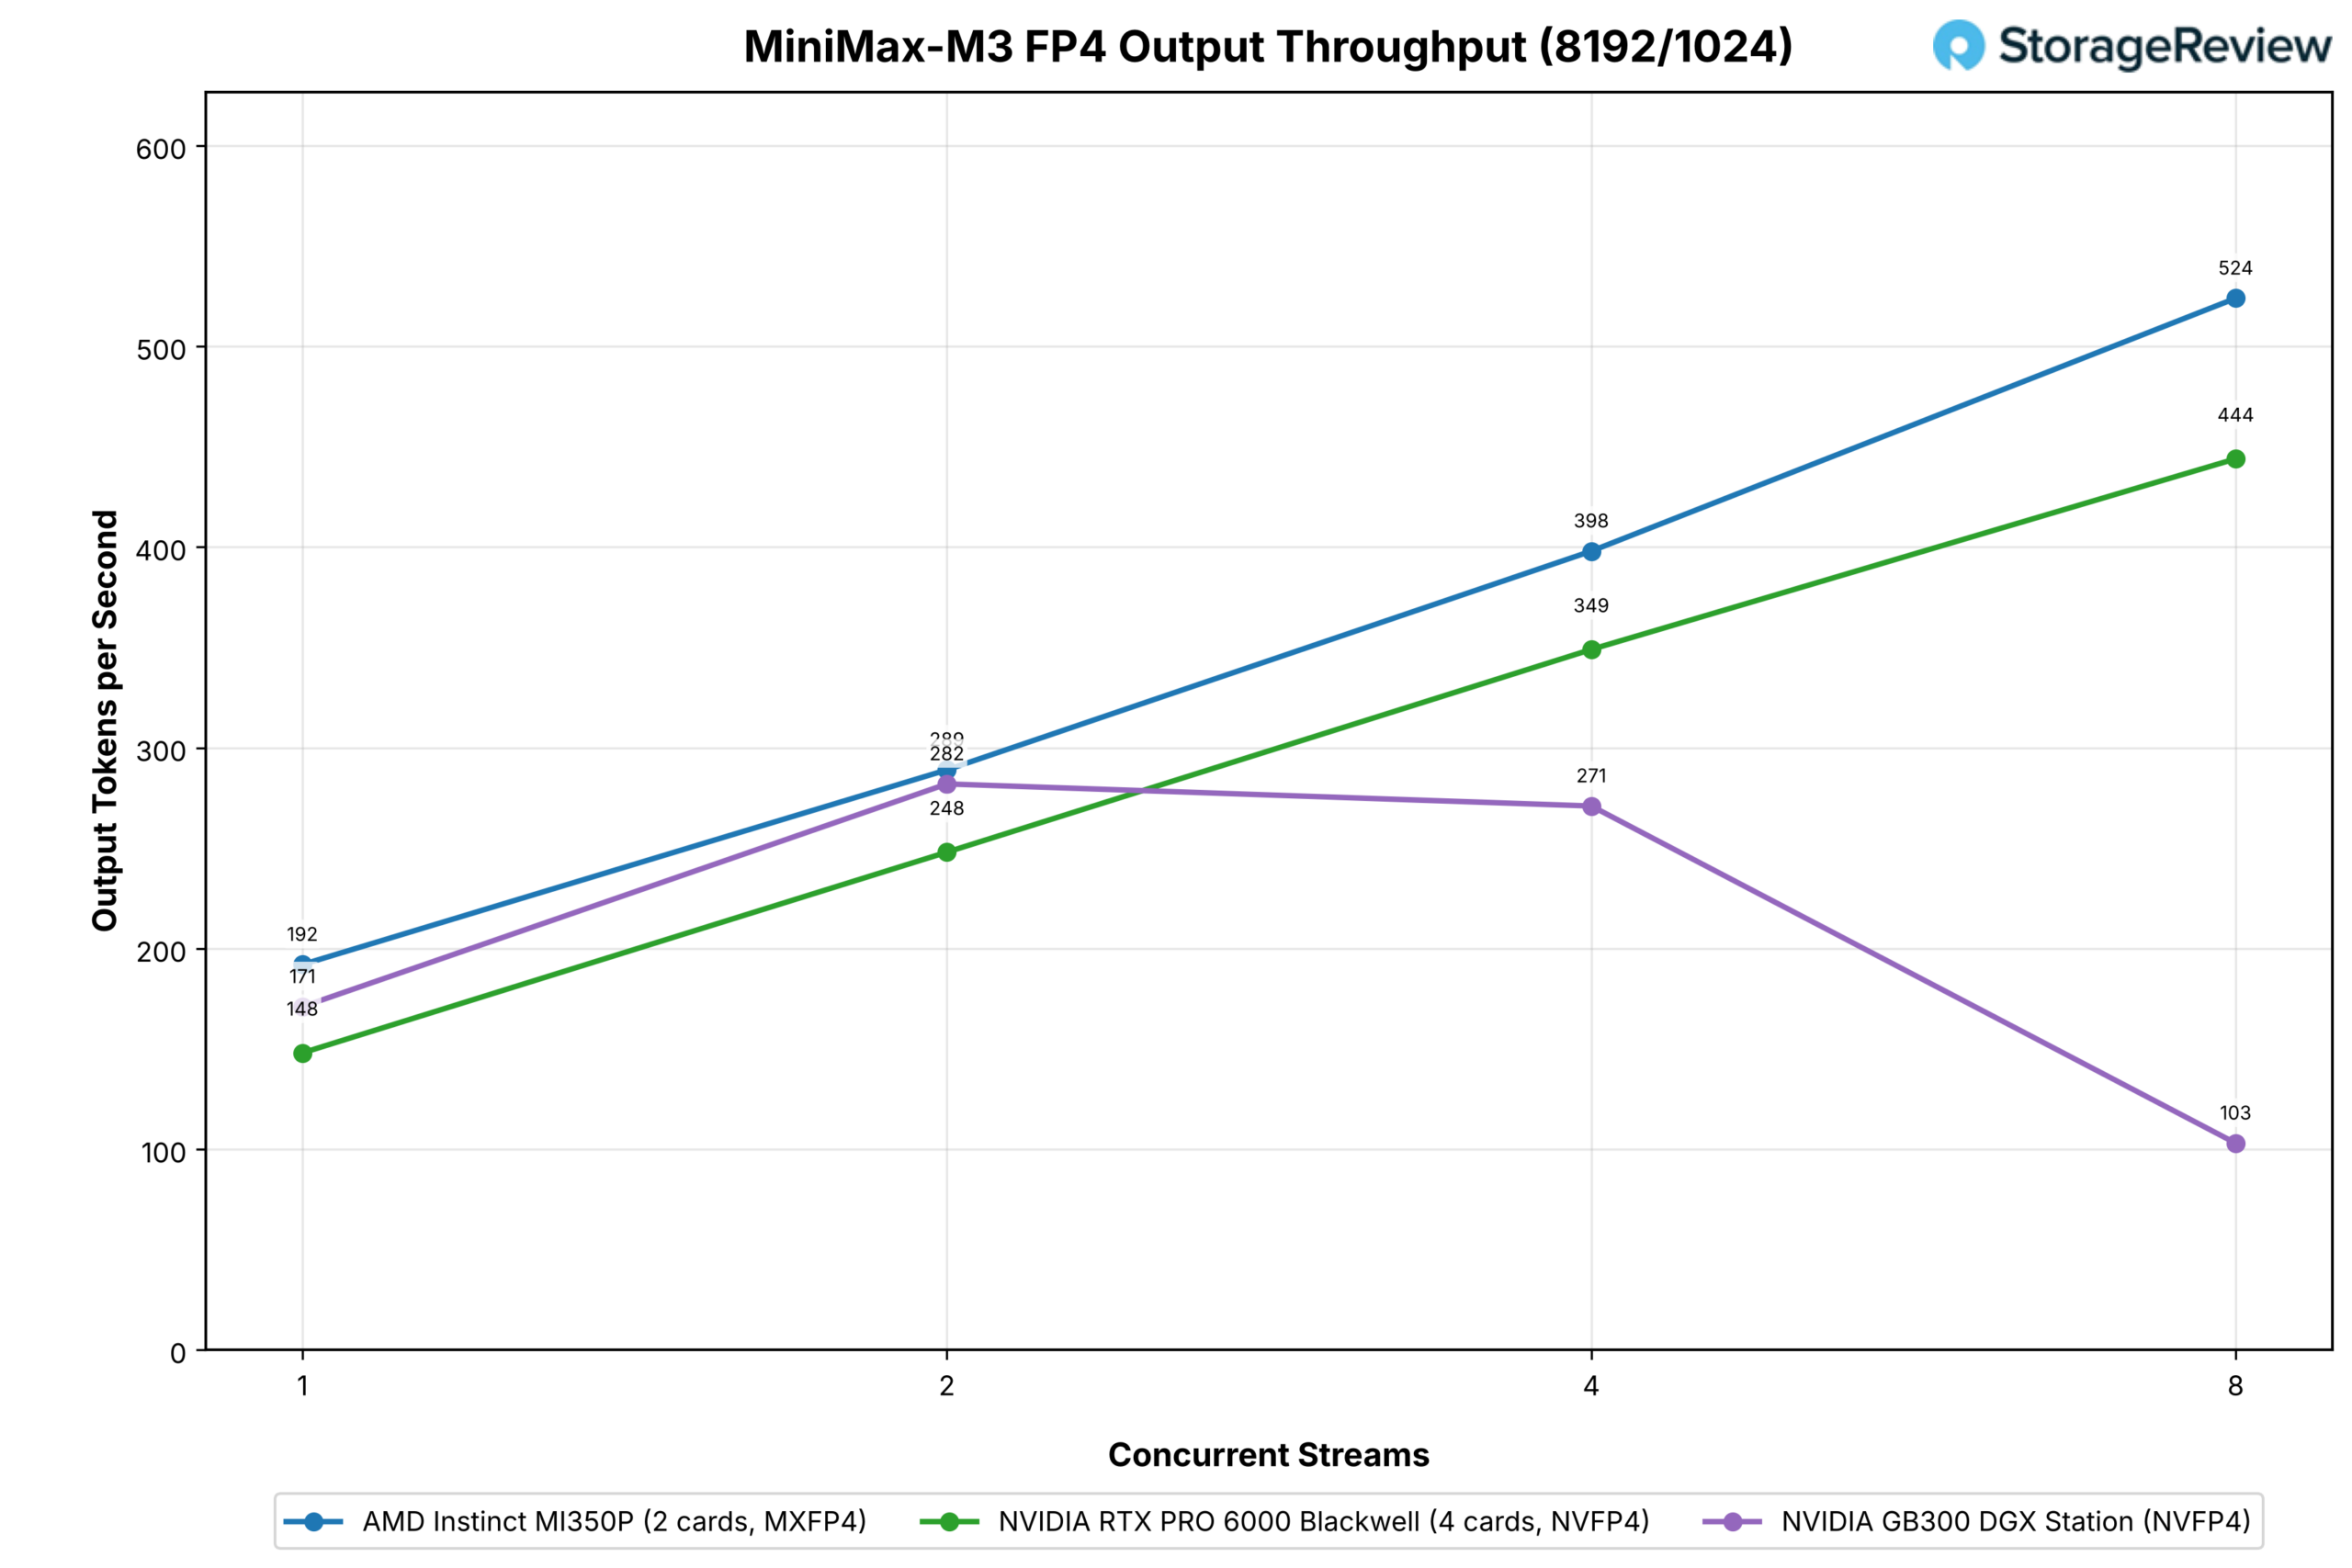
| MiniMax-M3 (MXFP4 vs NVFP4) | 2/4 | ROCm 7.2.3 | 8 | 524 | 444 | Ne pas exécuter | 103 |
| DeepSeek-V4-Flash | 2/2 | ROCm 7.2.3 | 32 | 621 | 345 | Ne pas exécuter | 954 |
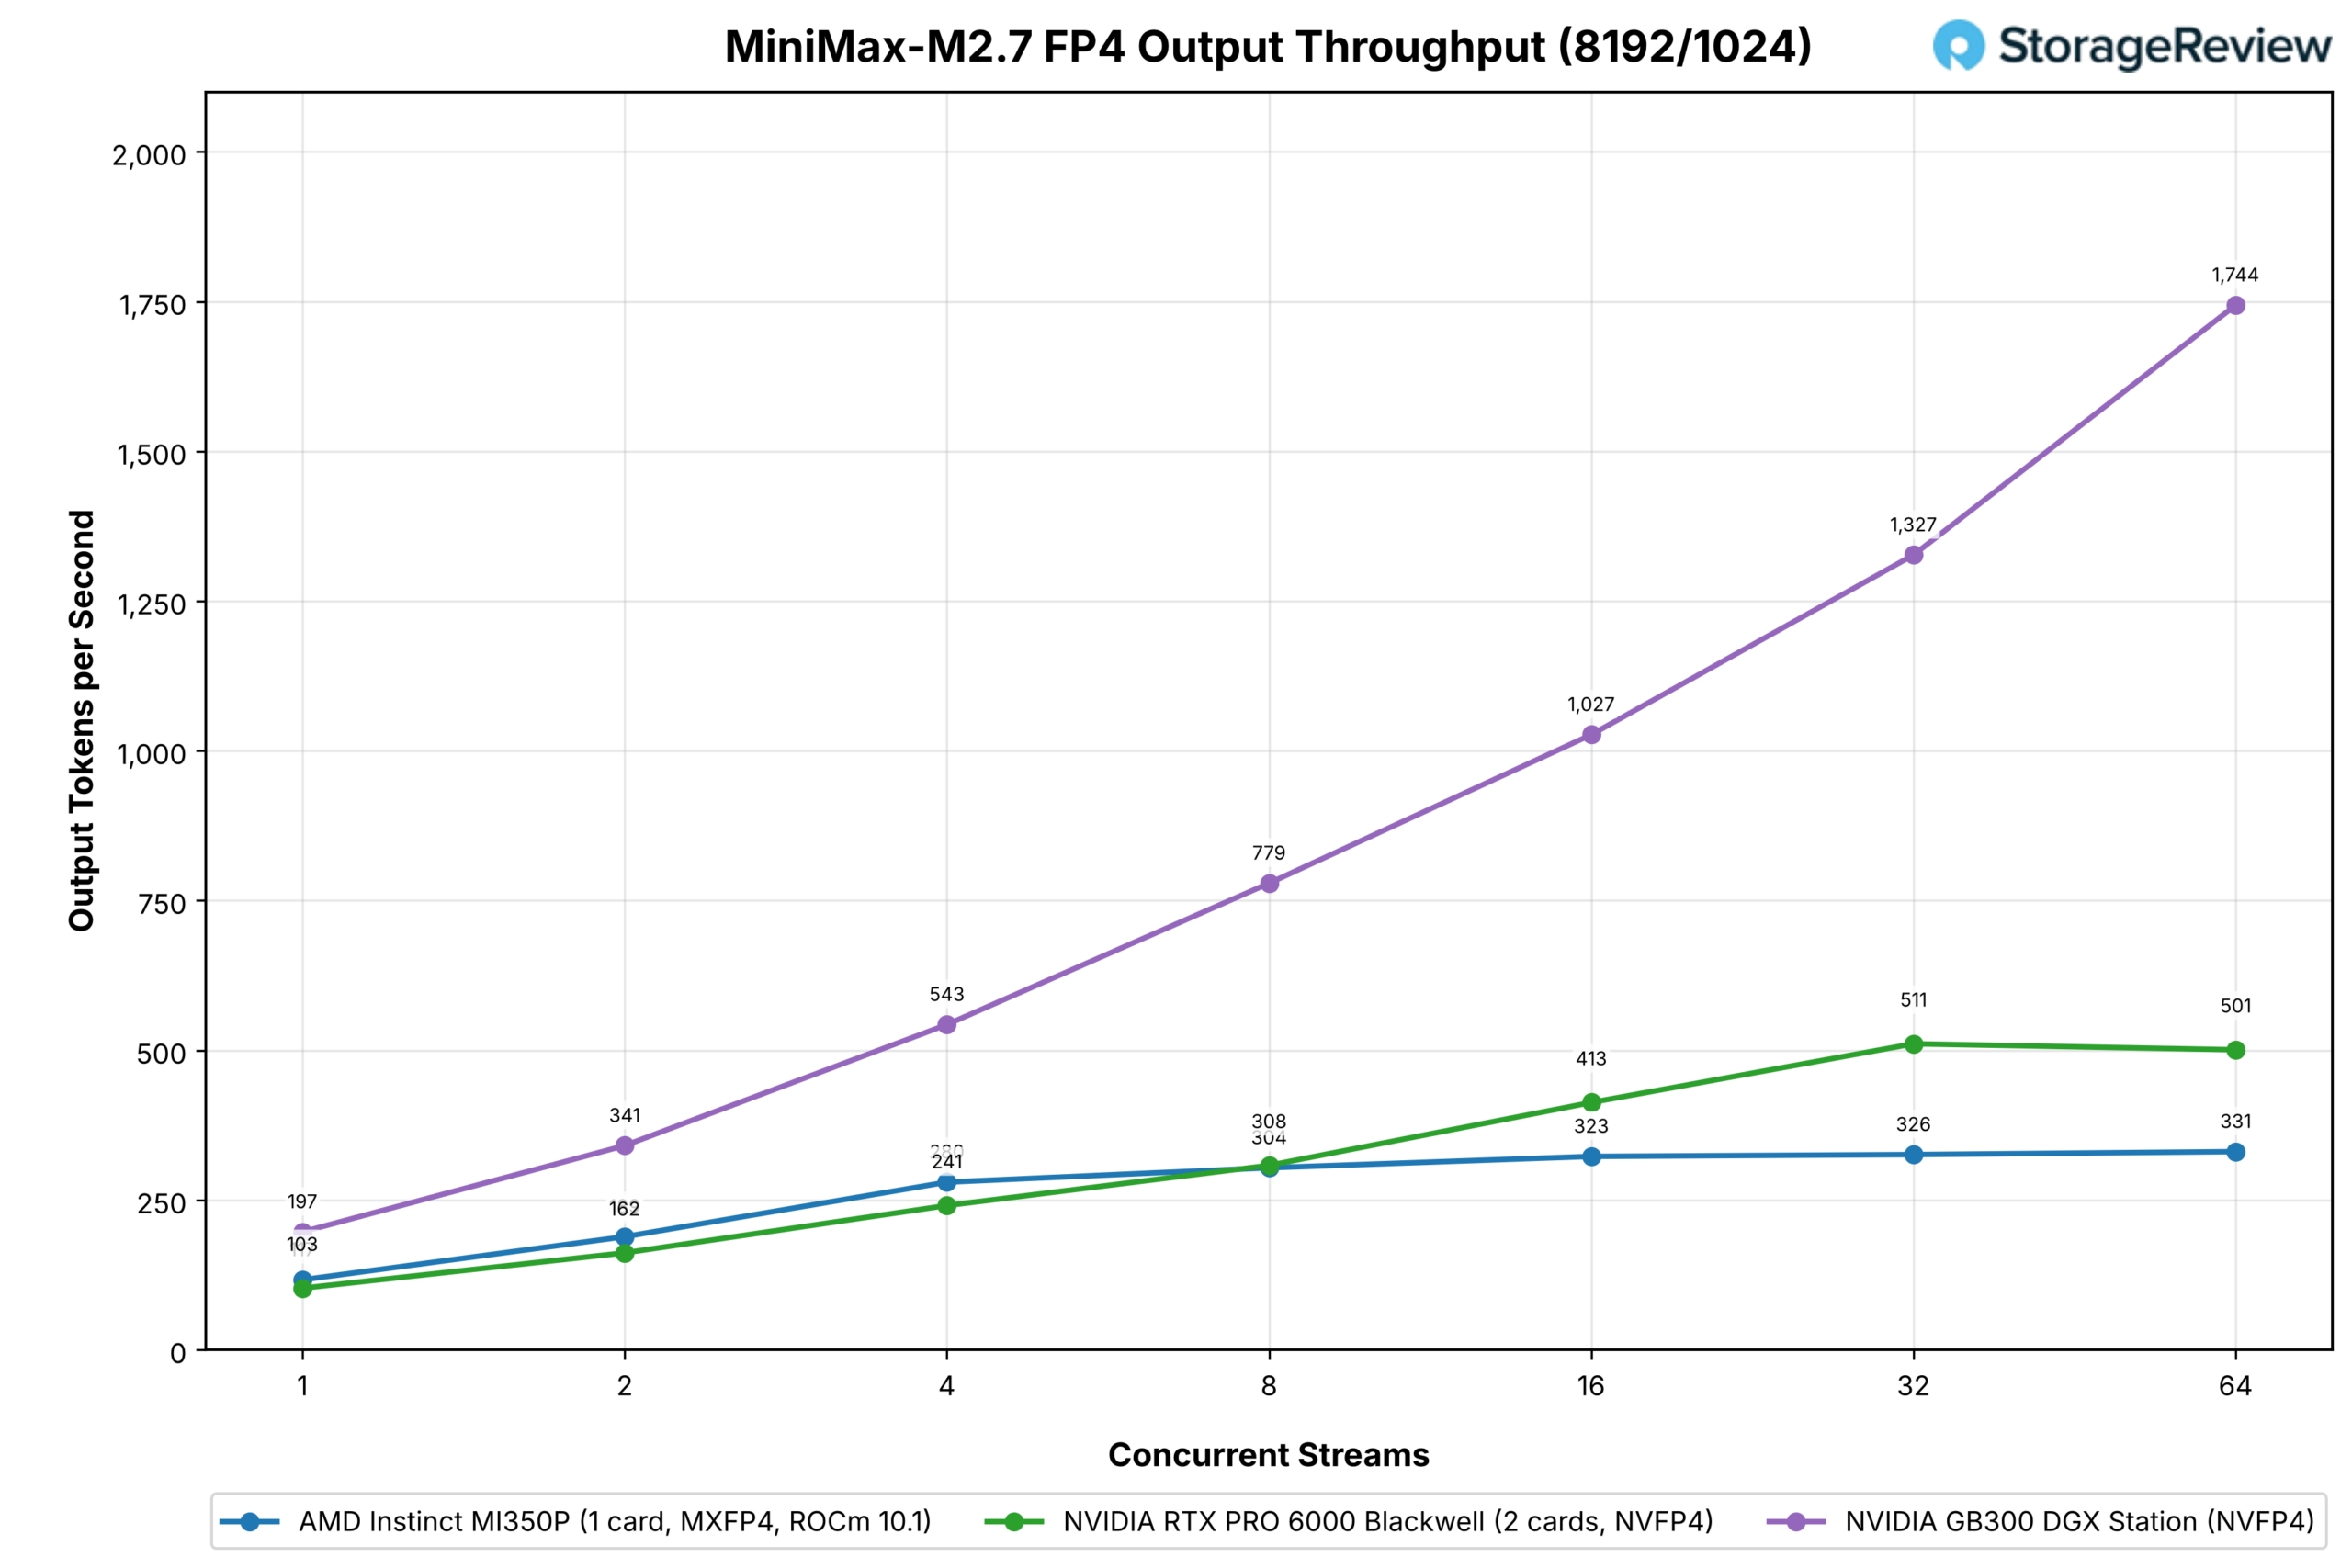
| MiniMax-M2.7 (MXFP4 vs NVFP4) | 1/2 | ROCm 10.1 | 64 | 331 | 501 | Ne pas exécuter | 1,744 |
| GPT-OSS-120B MXFP4 | 1/1 | ROCm 10.1 | 128 | 2,101 | 1,169 | 1,825 | 5,023 |
| GPT-OSS-20B MXFP4 | 1/1 | ROCm 10.1 | 128 | 3,603 | 2,482 | 3,419 | 9,555 |
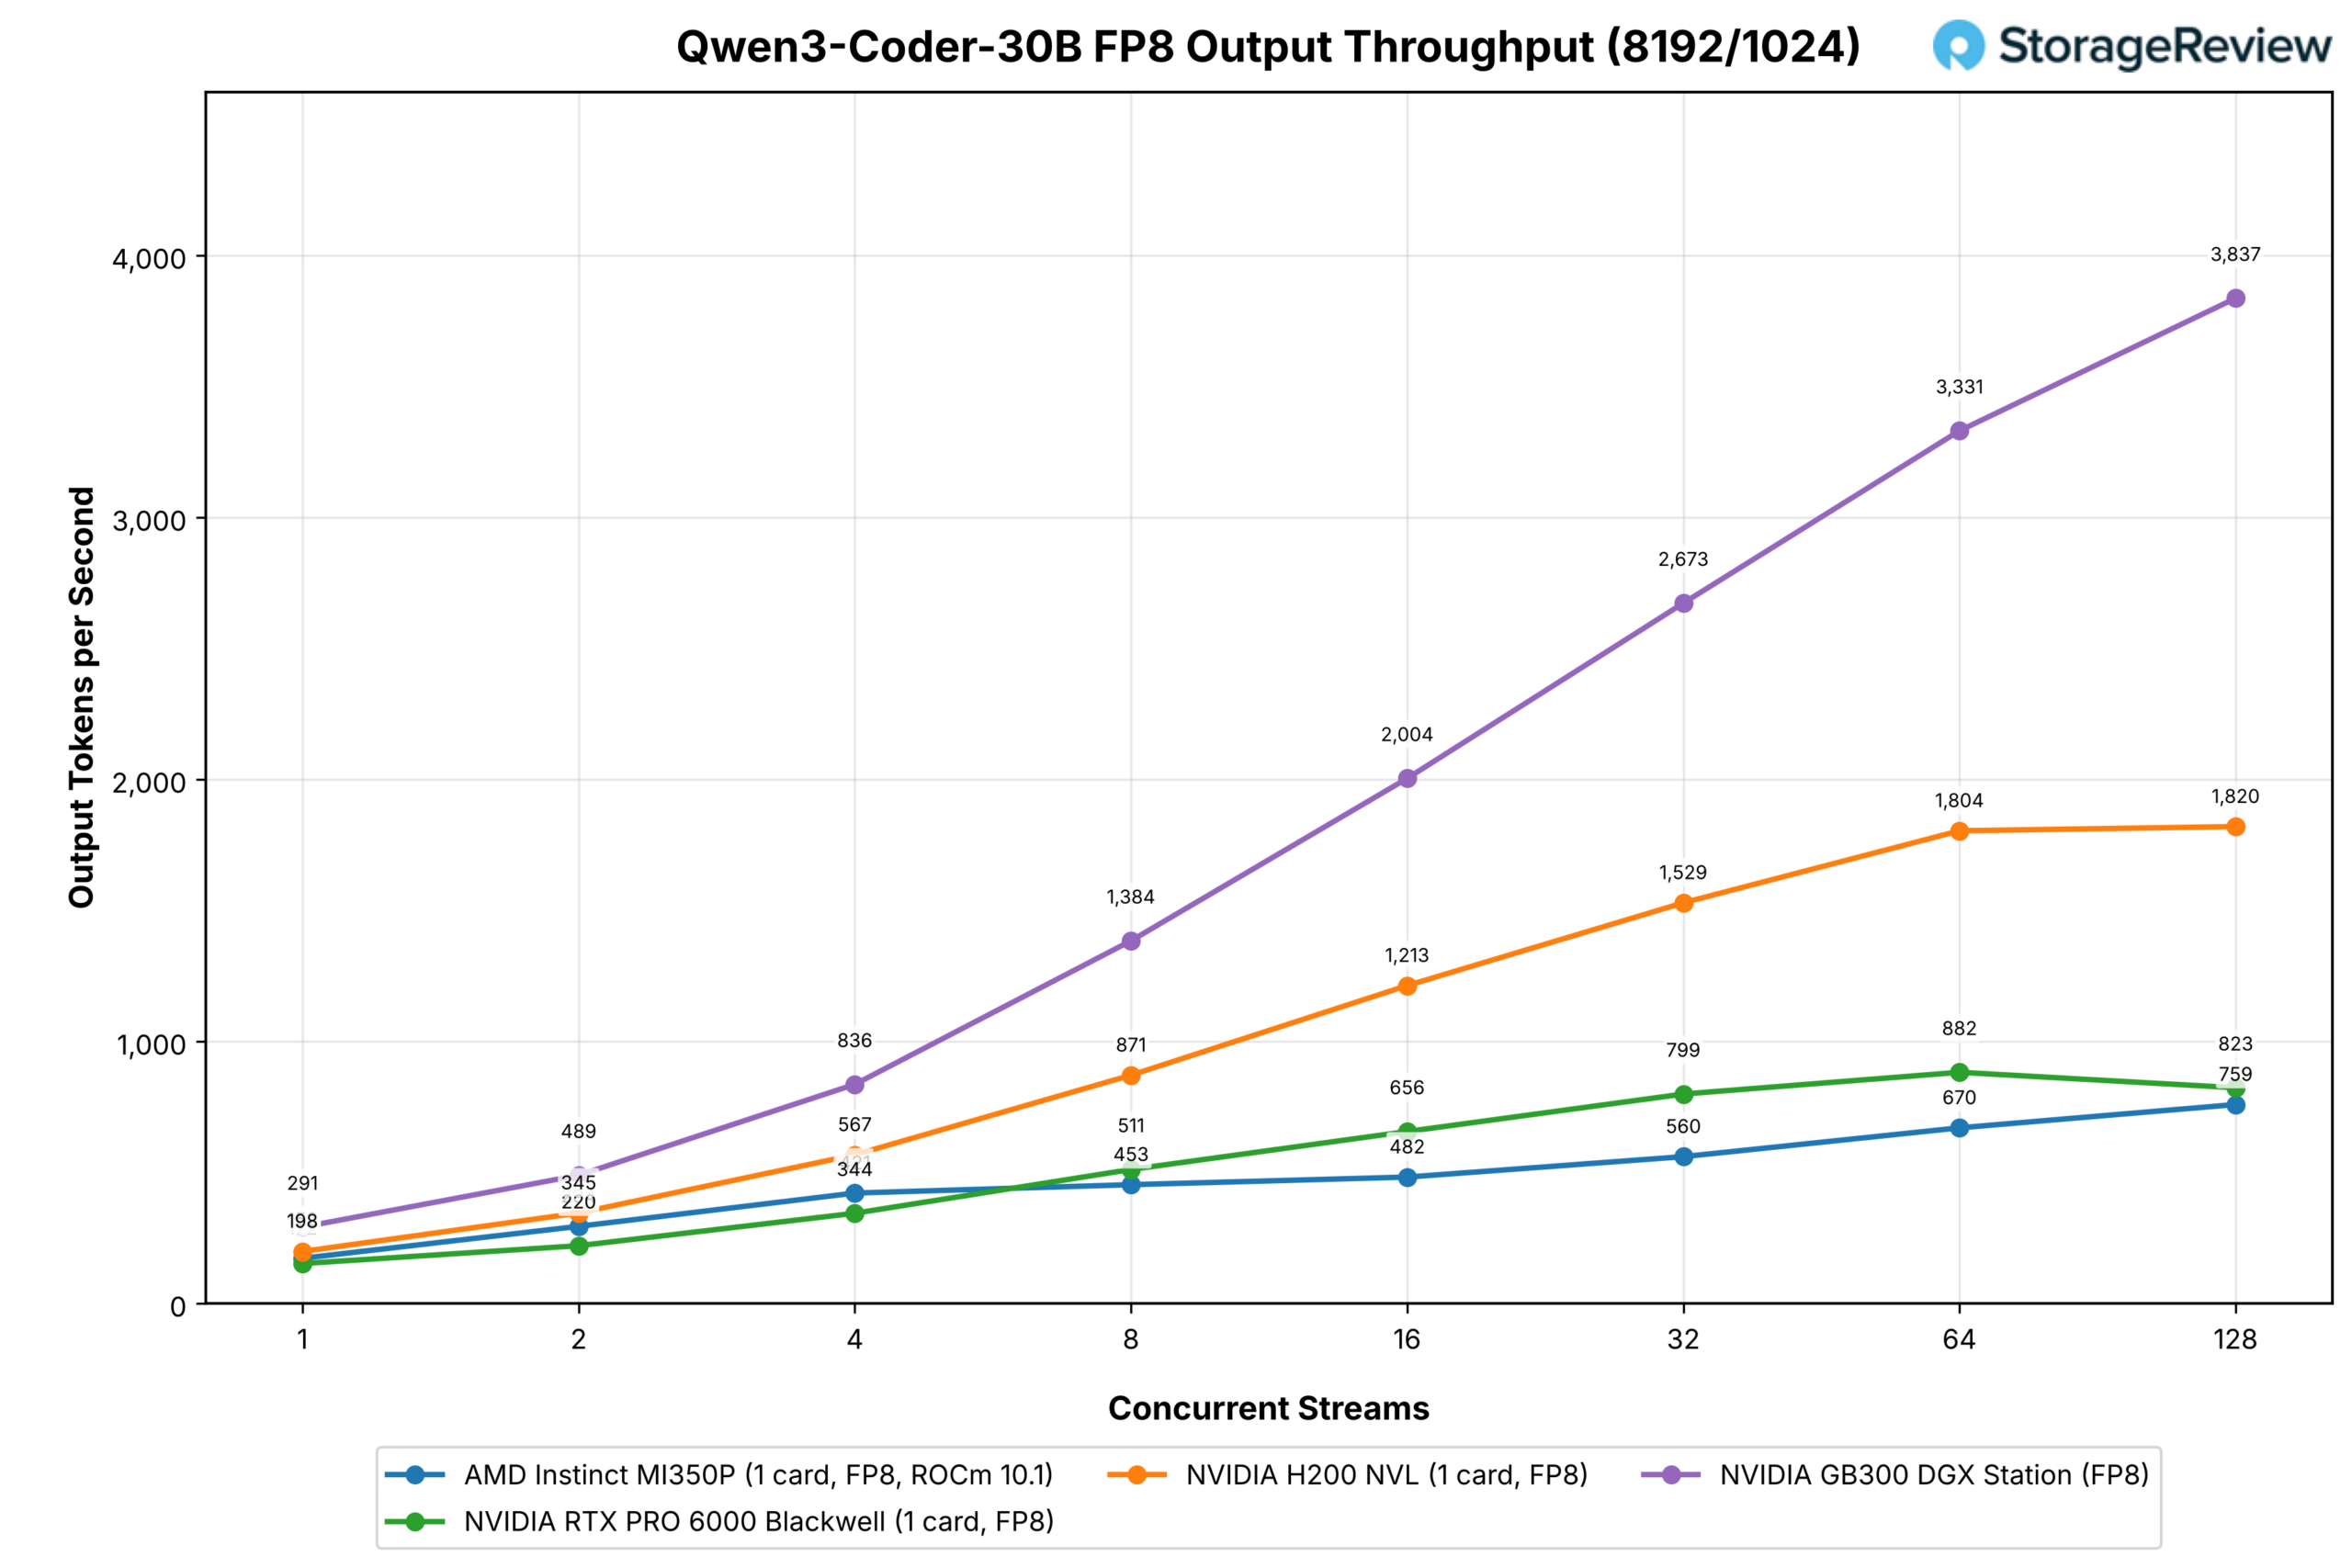
| Qwen3-Coder-30B FP8 | 1/1 | ROCm 10.1 | 128 | 759 | 823 | 1,820 | 3,837 |
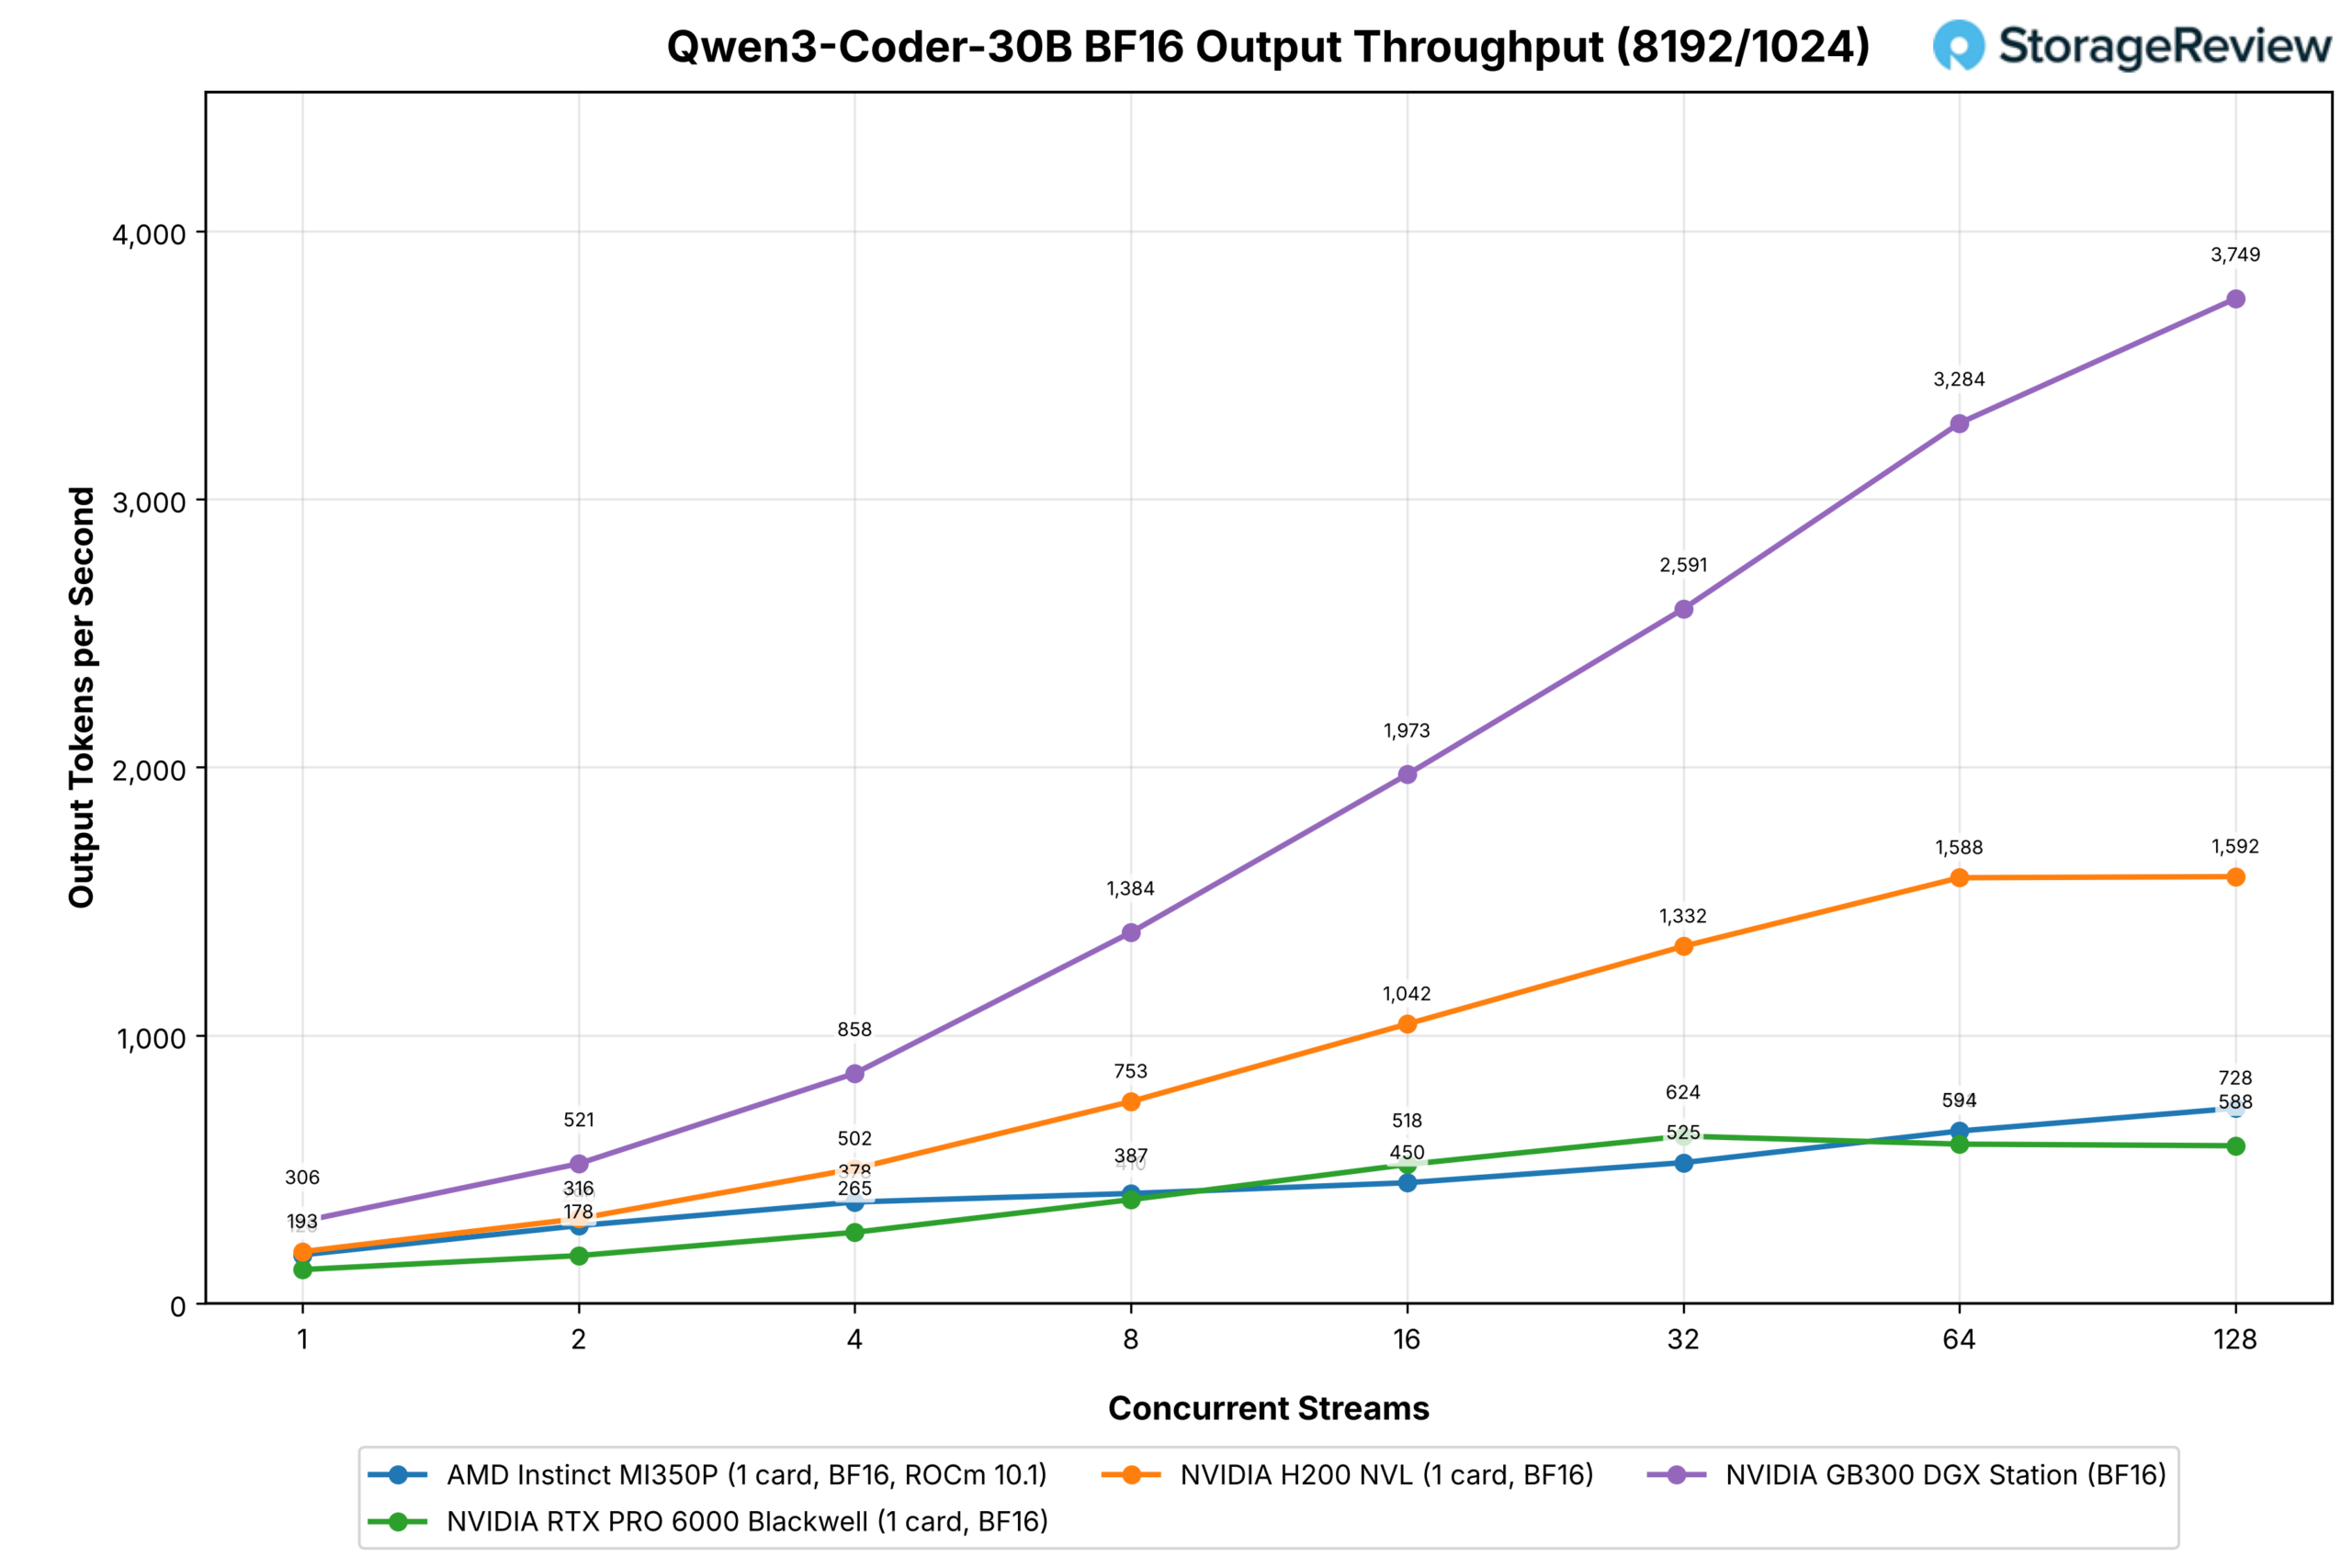
| Qwen3-Coder-30B BF16 | 1/1 | ROCm 10.1 | 128 | 728 | 588 | 1,592 | 3,749 |
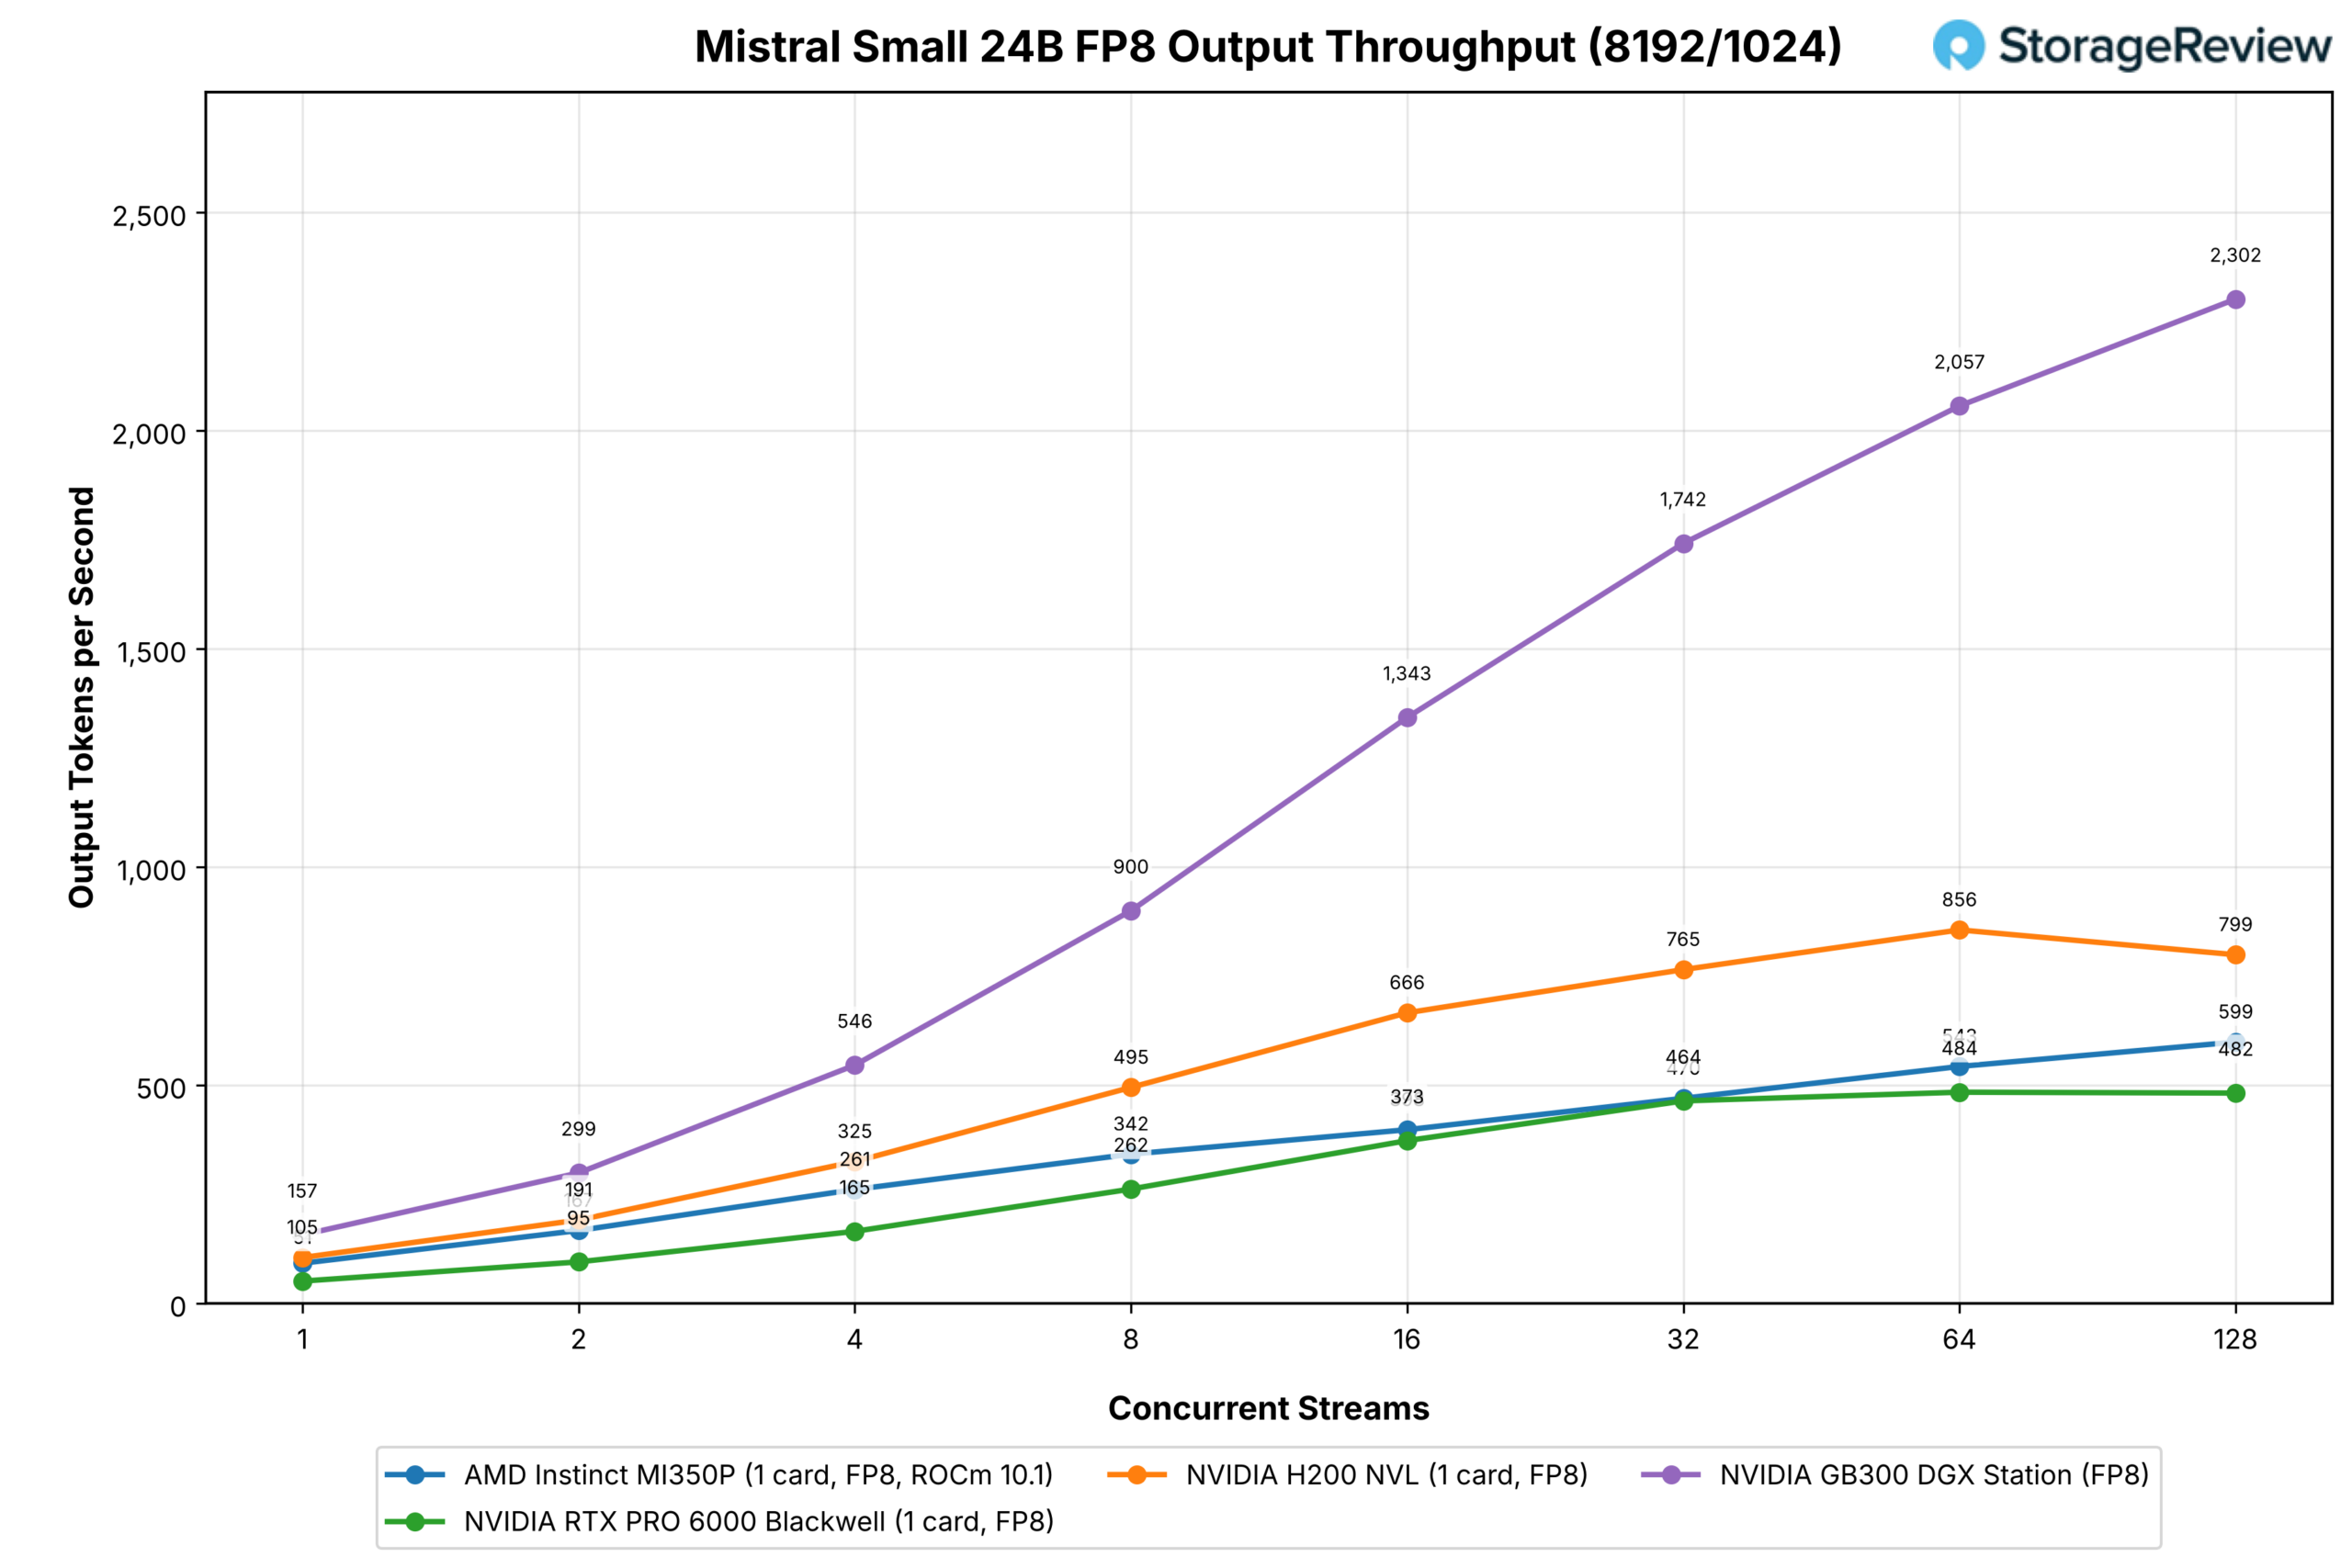
| Mistral Small 24B FP8 | 1/1 | ROCm 10.1 | 128 | 599 | 482 | 799 | 2,302 |
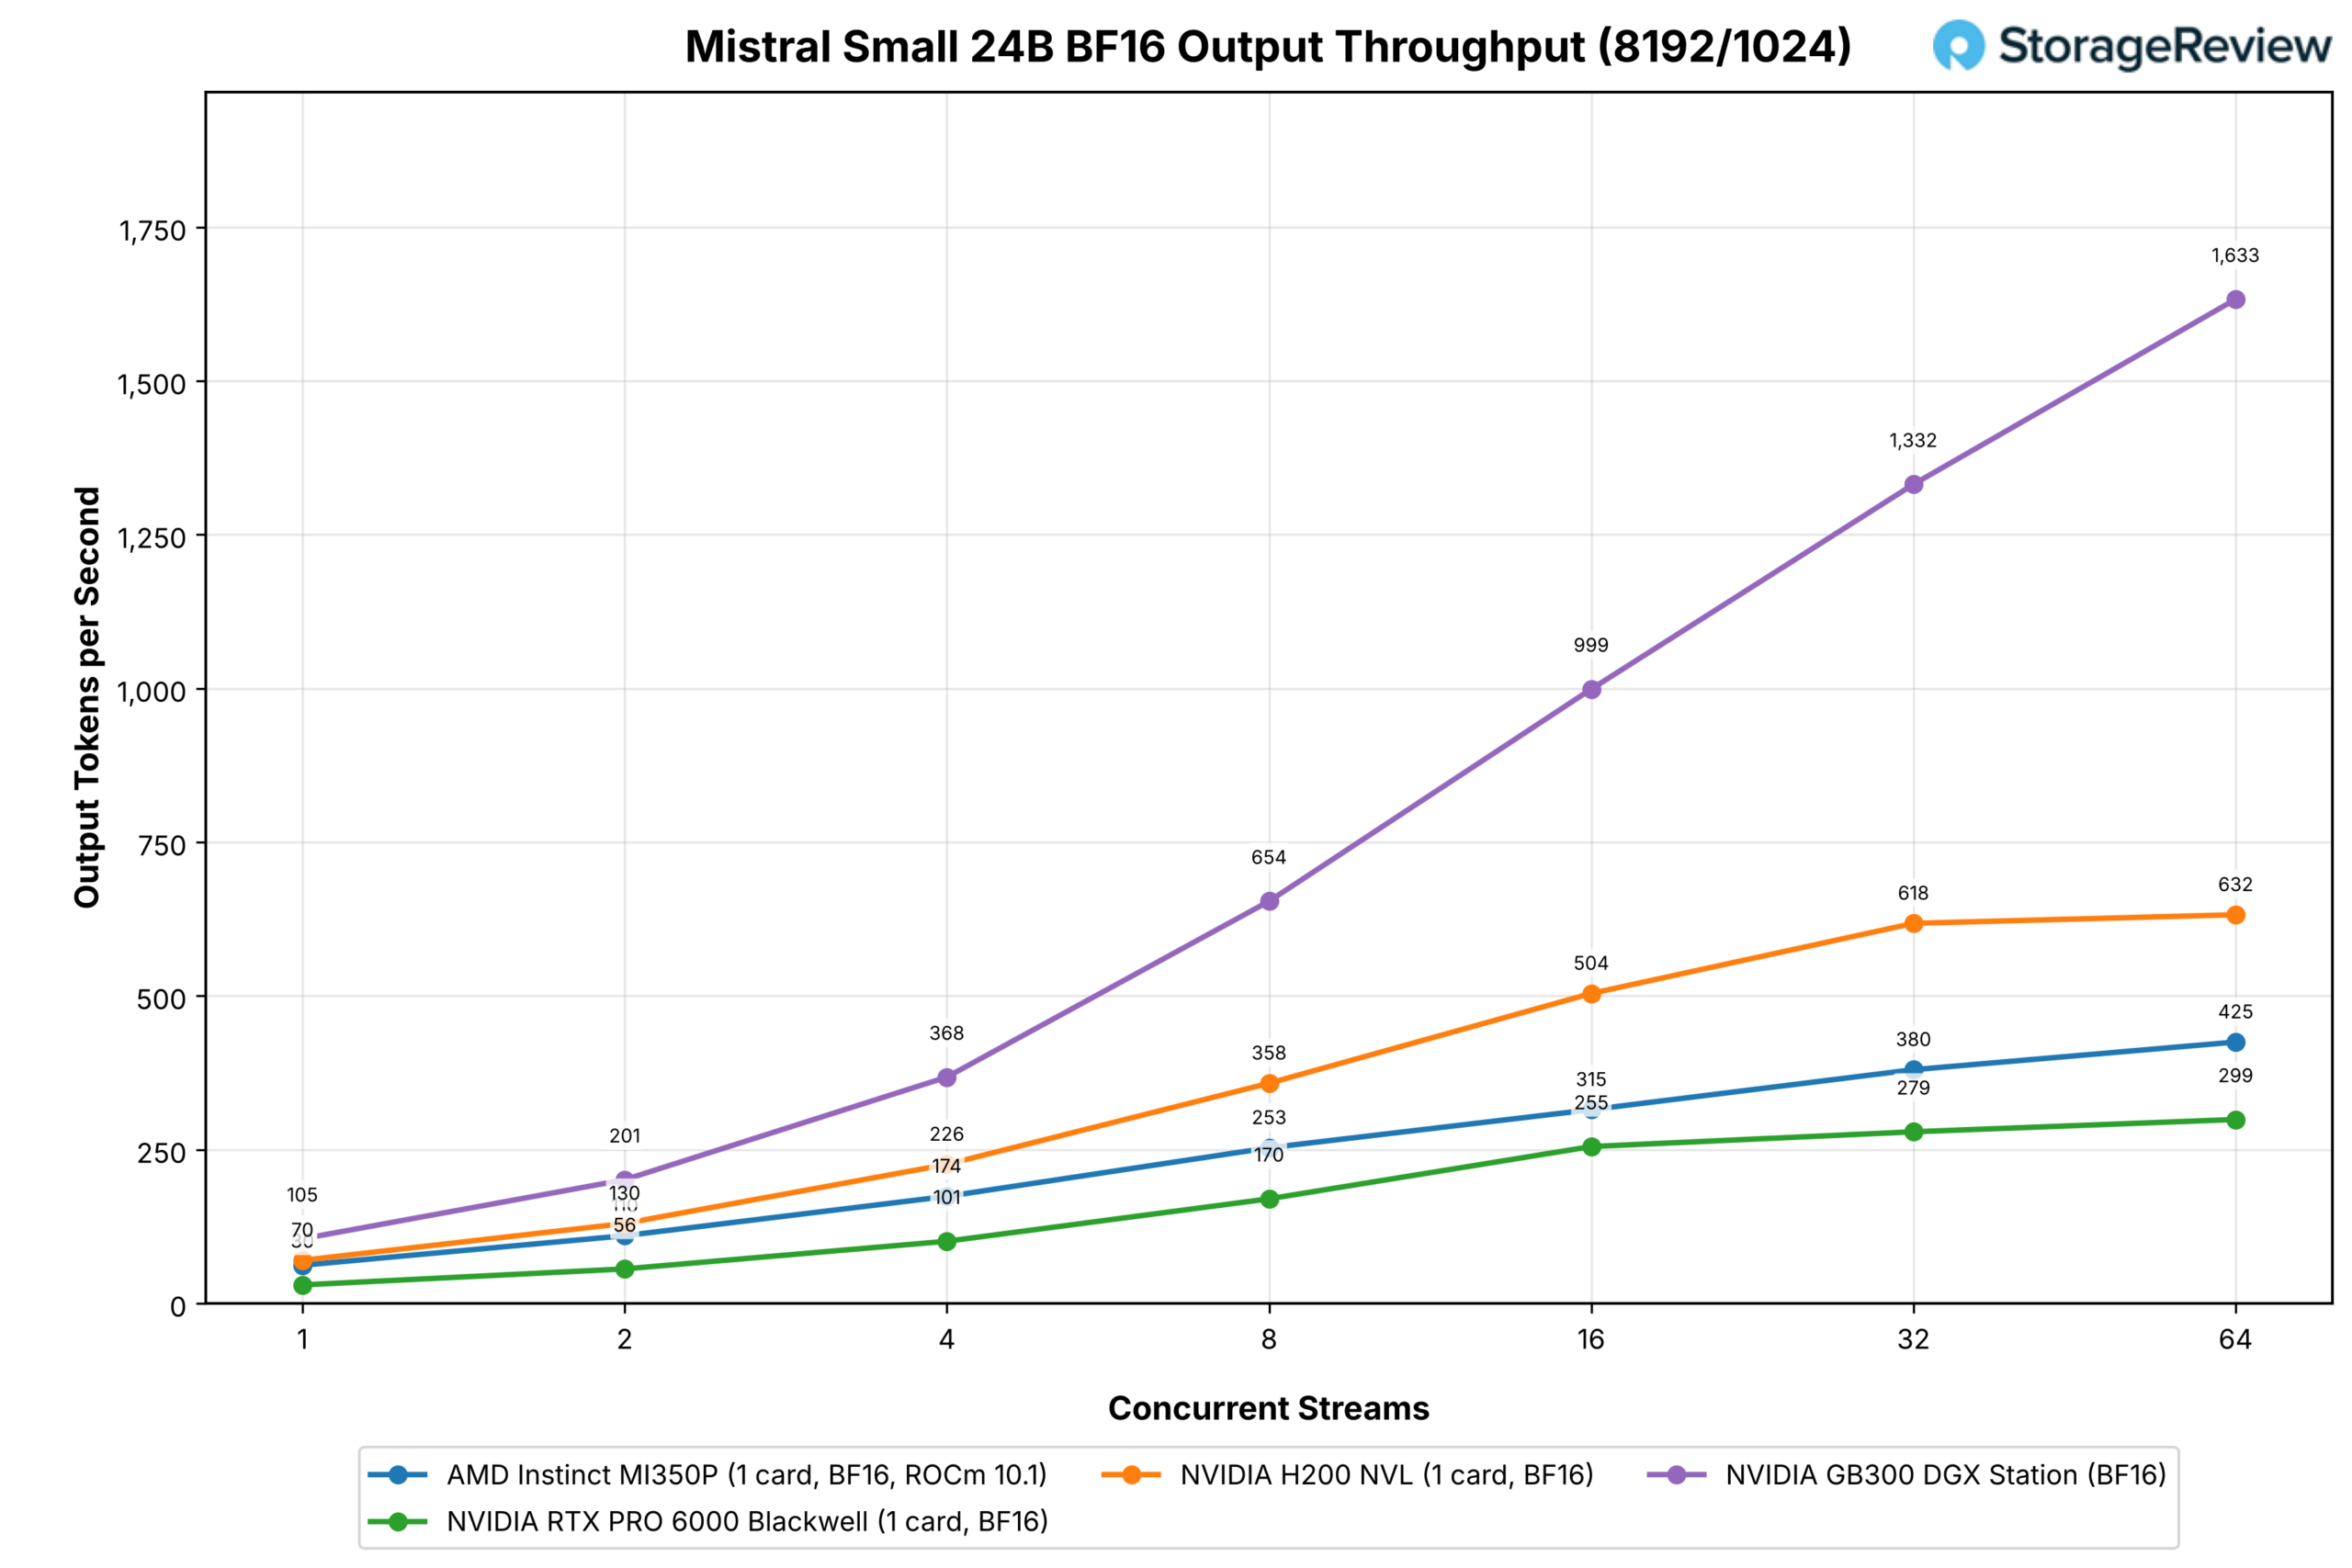
| Mistral Petit 24B BF16 | 1/1 | ROCm 10.1 | 64 | 425 | 299 | 632 | 1,633 |
| Llama 3.1 8B (MXFP4 vs NVFP4) | 1/1 | ROCm 10.1 | 128 | 964 | 1,644 | Ne pas exécuter | 6,737 |
| Llama 3.1 8B FP8 | 1/1 | ROCm 10.1 | 128 | 1,211 | 1,481 | 2,045 | 6,164 |
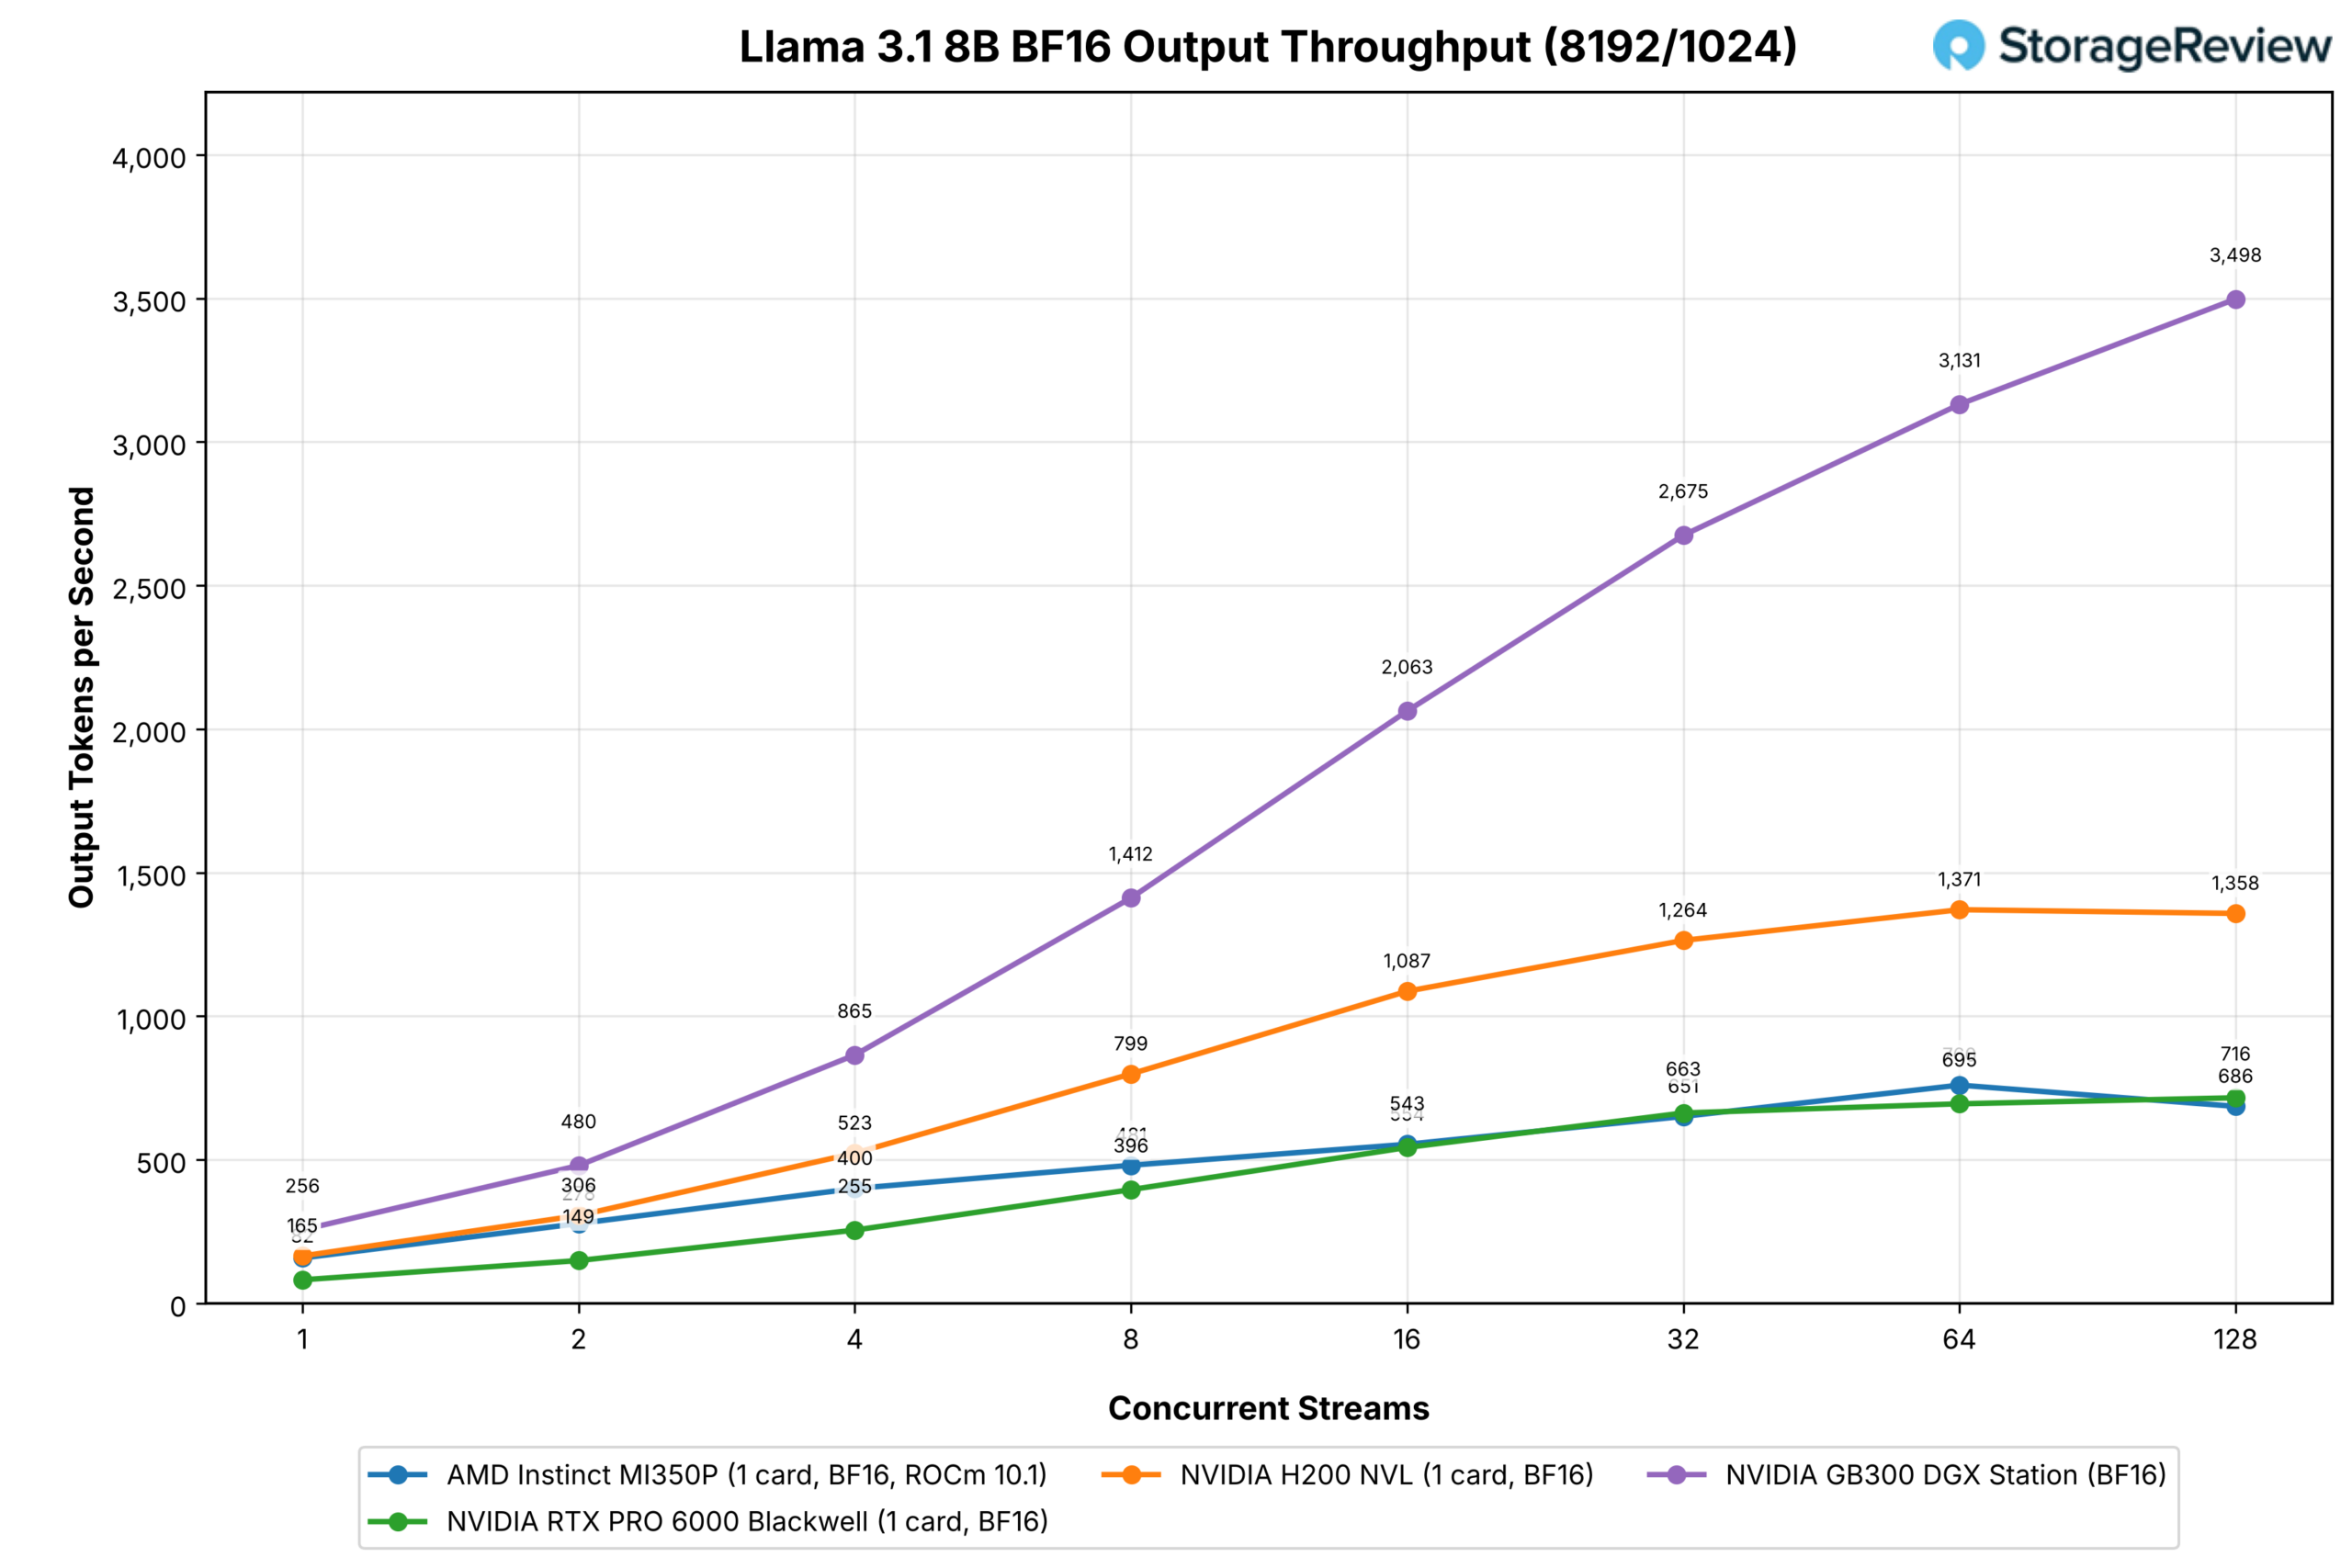
| Lama 3.1 8B BF16 | 1/1 | ROCm 10.1 | 128 | 686 | 716 | 1,358 | 3,498 |
Sur les requêtes nécessitant un préremplissage important, les résultats sont mitigés : la MI350P surpasse la RTX PRO 6000 sur les deux modèles GPT-OSS, quel que soit le nombre de flux, ainsi que sur Mistral Small. Elle se situe entre les deux sur Qwen3-Coder à 128 flux (24 % d'avance sur BF16, 8 % de retard sur FP8), et son avance se stabilise à 16 flux sur Llama et MiniMax-M2.7, où elle se retrouve derrière la carte NVIDIA. Face à la H200, elle la devance de 15 % sur le modèle 120 octets et de 5 % sur le modèle 20 octets à 128 flux, mais accuse un retard de 25 à 58 % sur les modèles plus denses.
Sur les modèles les plus performants, où deux MI350P affrontent quatre RTX PRO 6000, la configuration NVIDIA domine GLM-5.2 sur 16 flux simultanés (charge de travail de chat) grâce à ses 384 Go de GDDR7 contre 288 Go de HBM3E. Sur MiniMax-M3, les trois configurations restent à moins de 10 % d'écart sur huit flux avant que le quadruple RTX ne prenne l'avantage à 16. La GB300 unique surpasse largement toutes les configurations PCIe pour tout ce qui tient dans sa mémoire de 252 Go.
Flash GLM-5.3
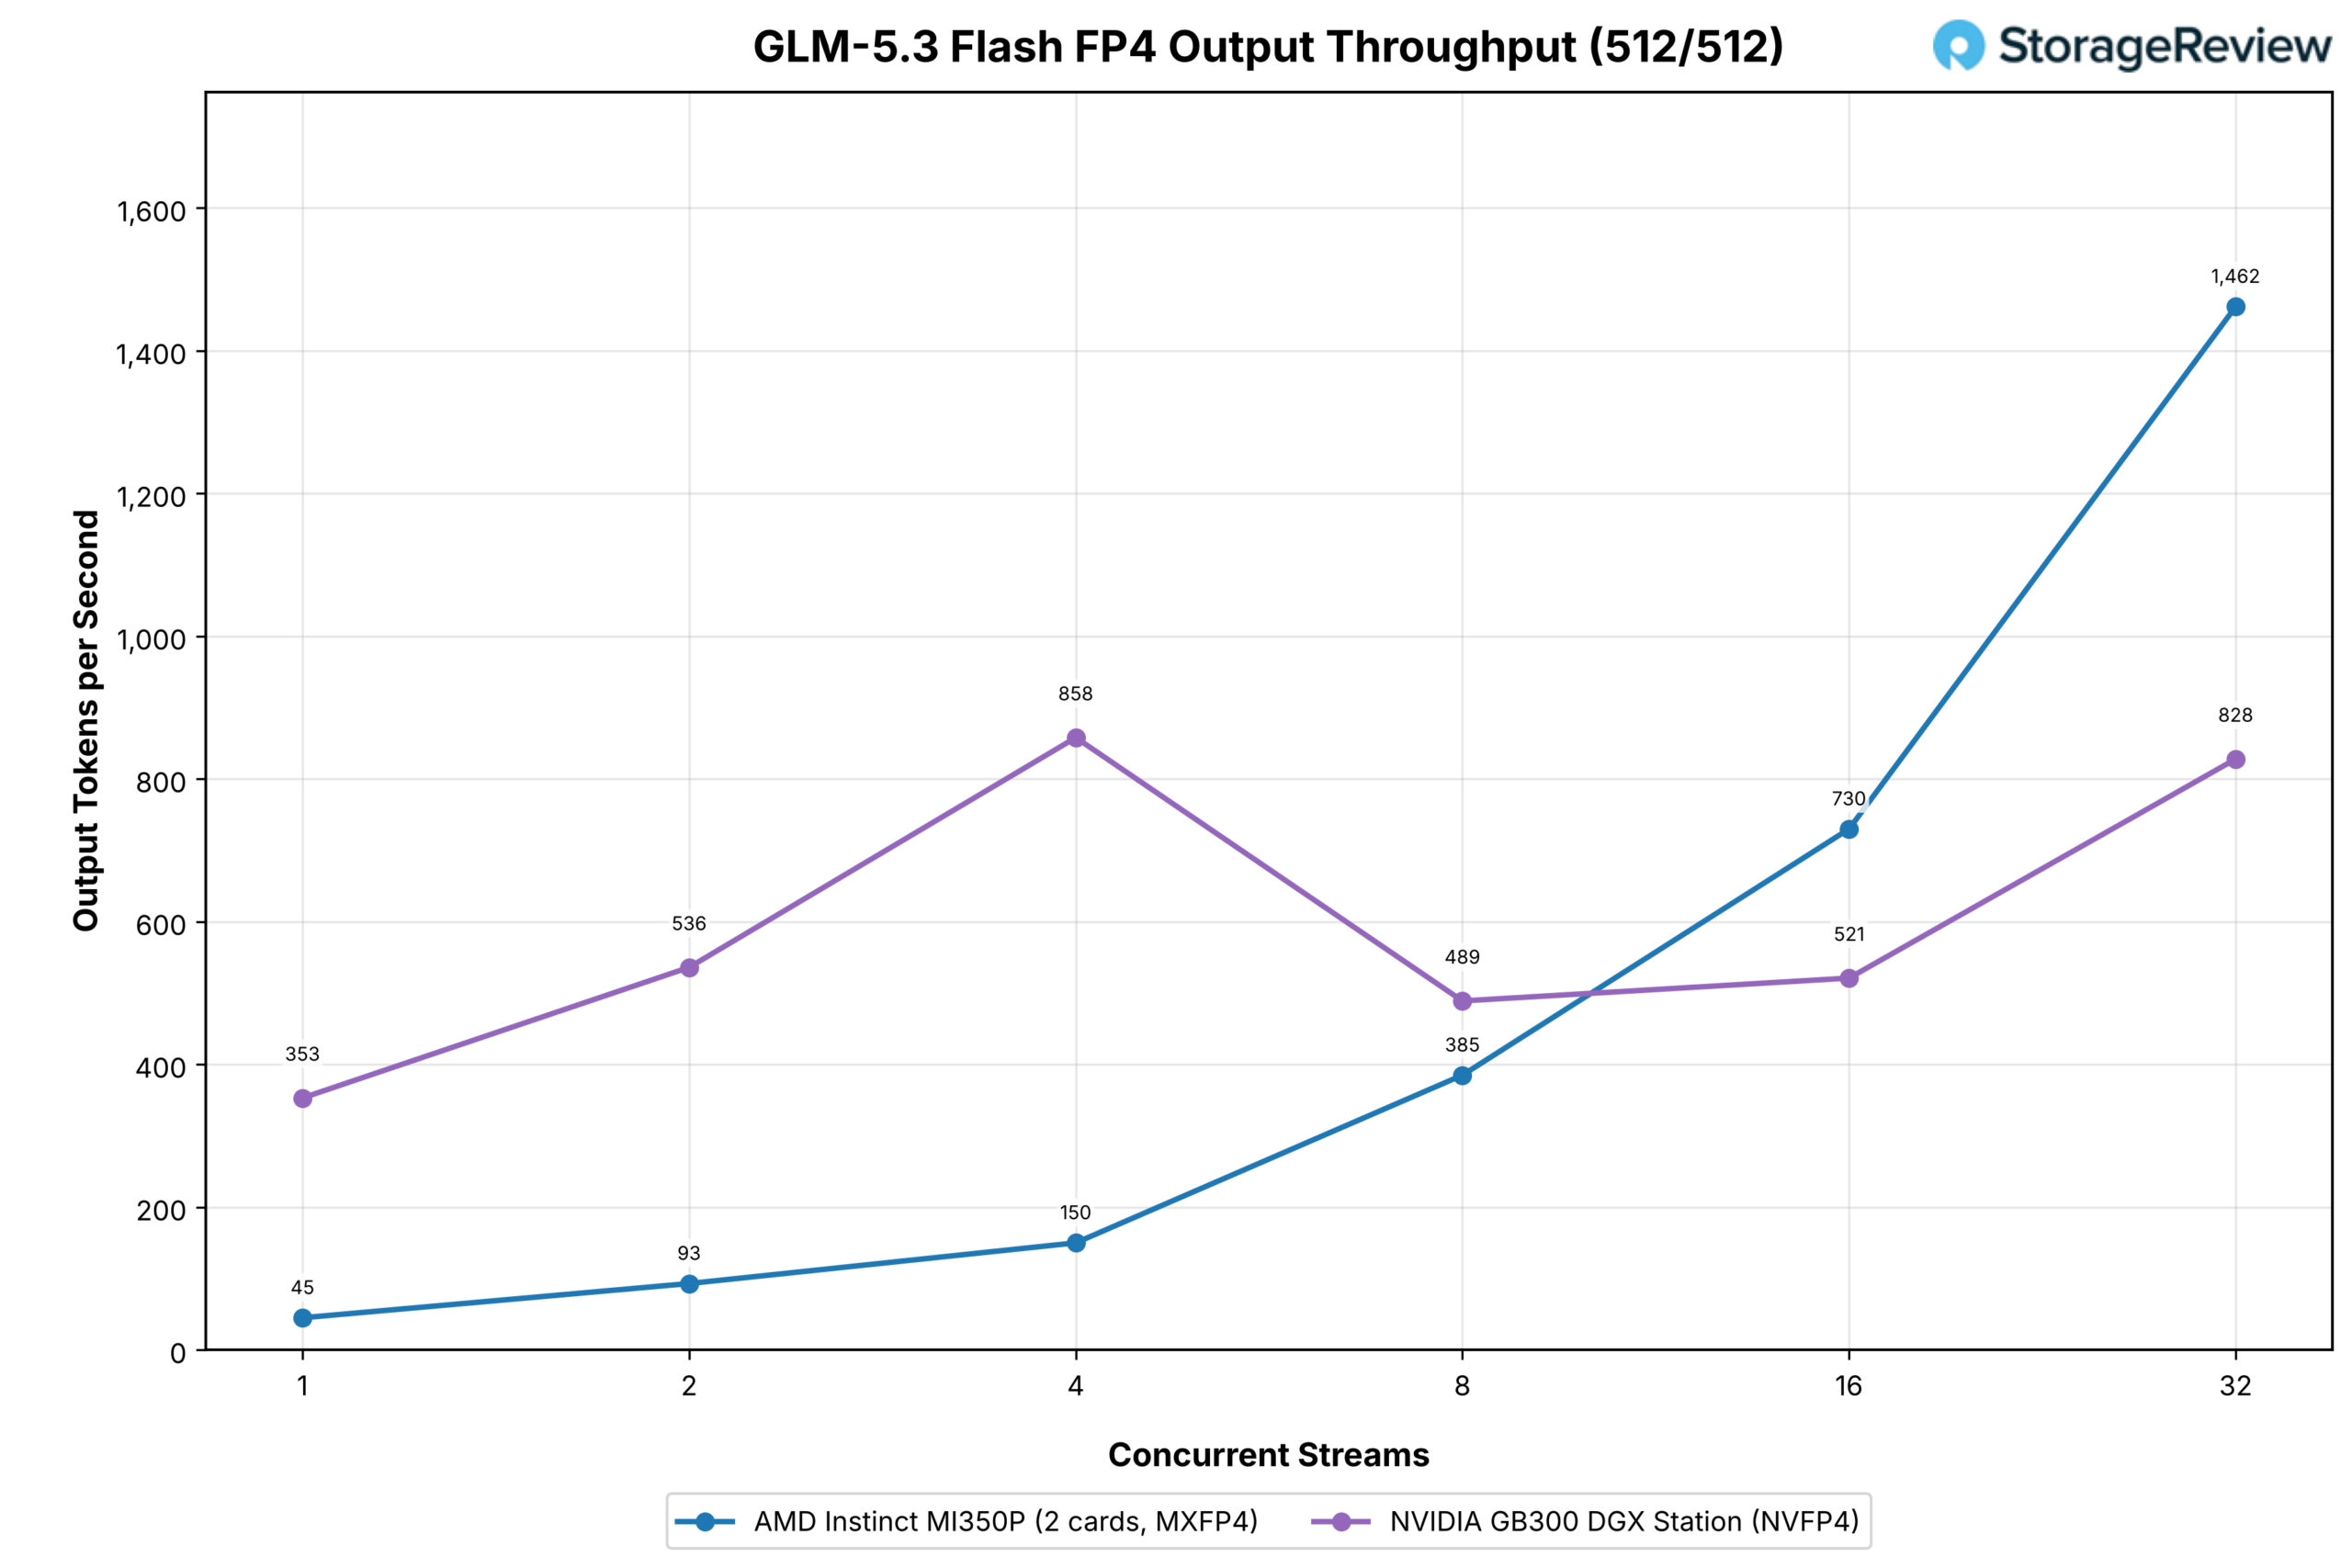
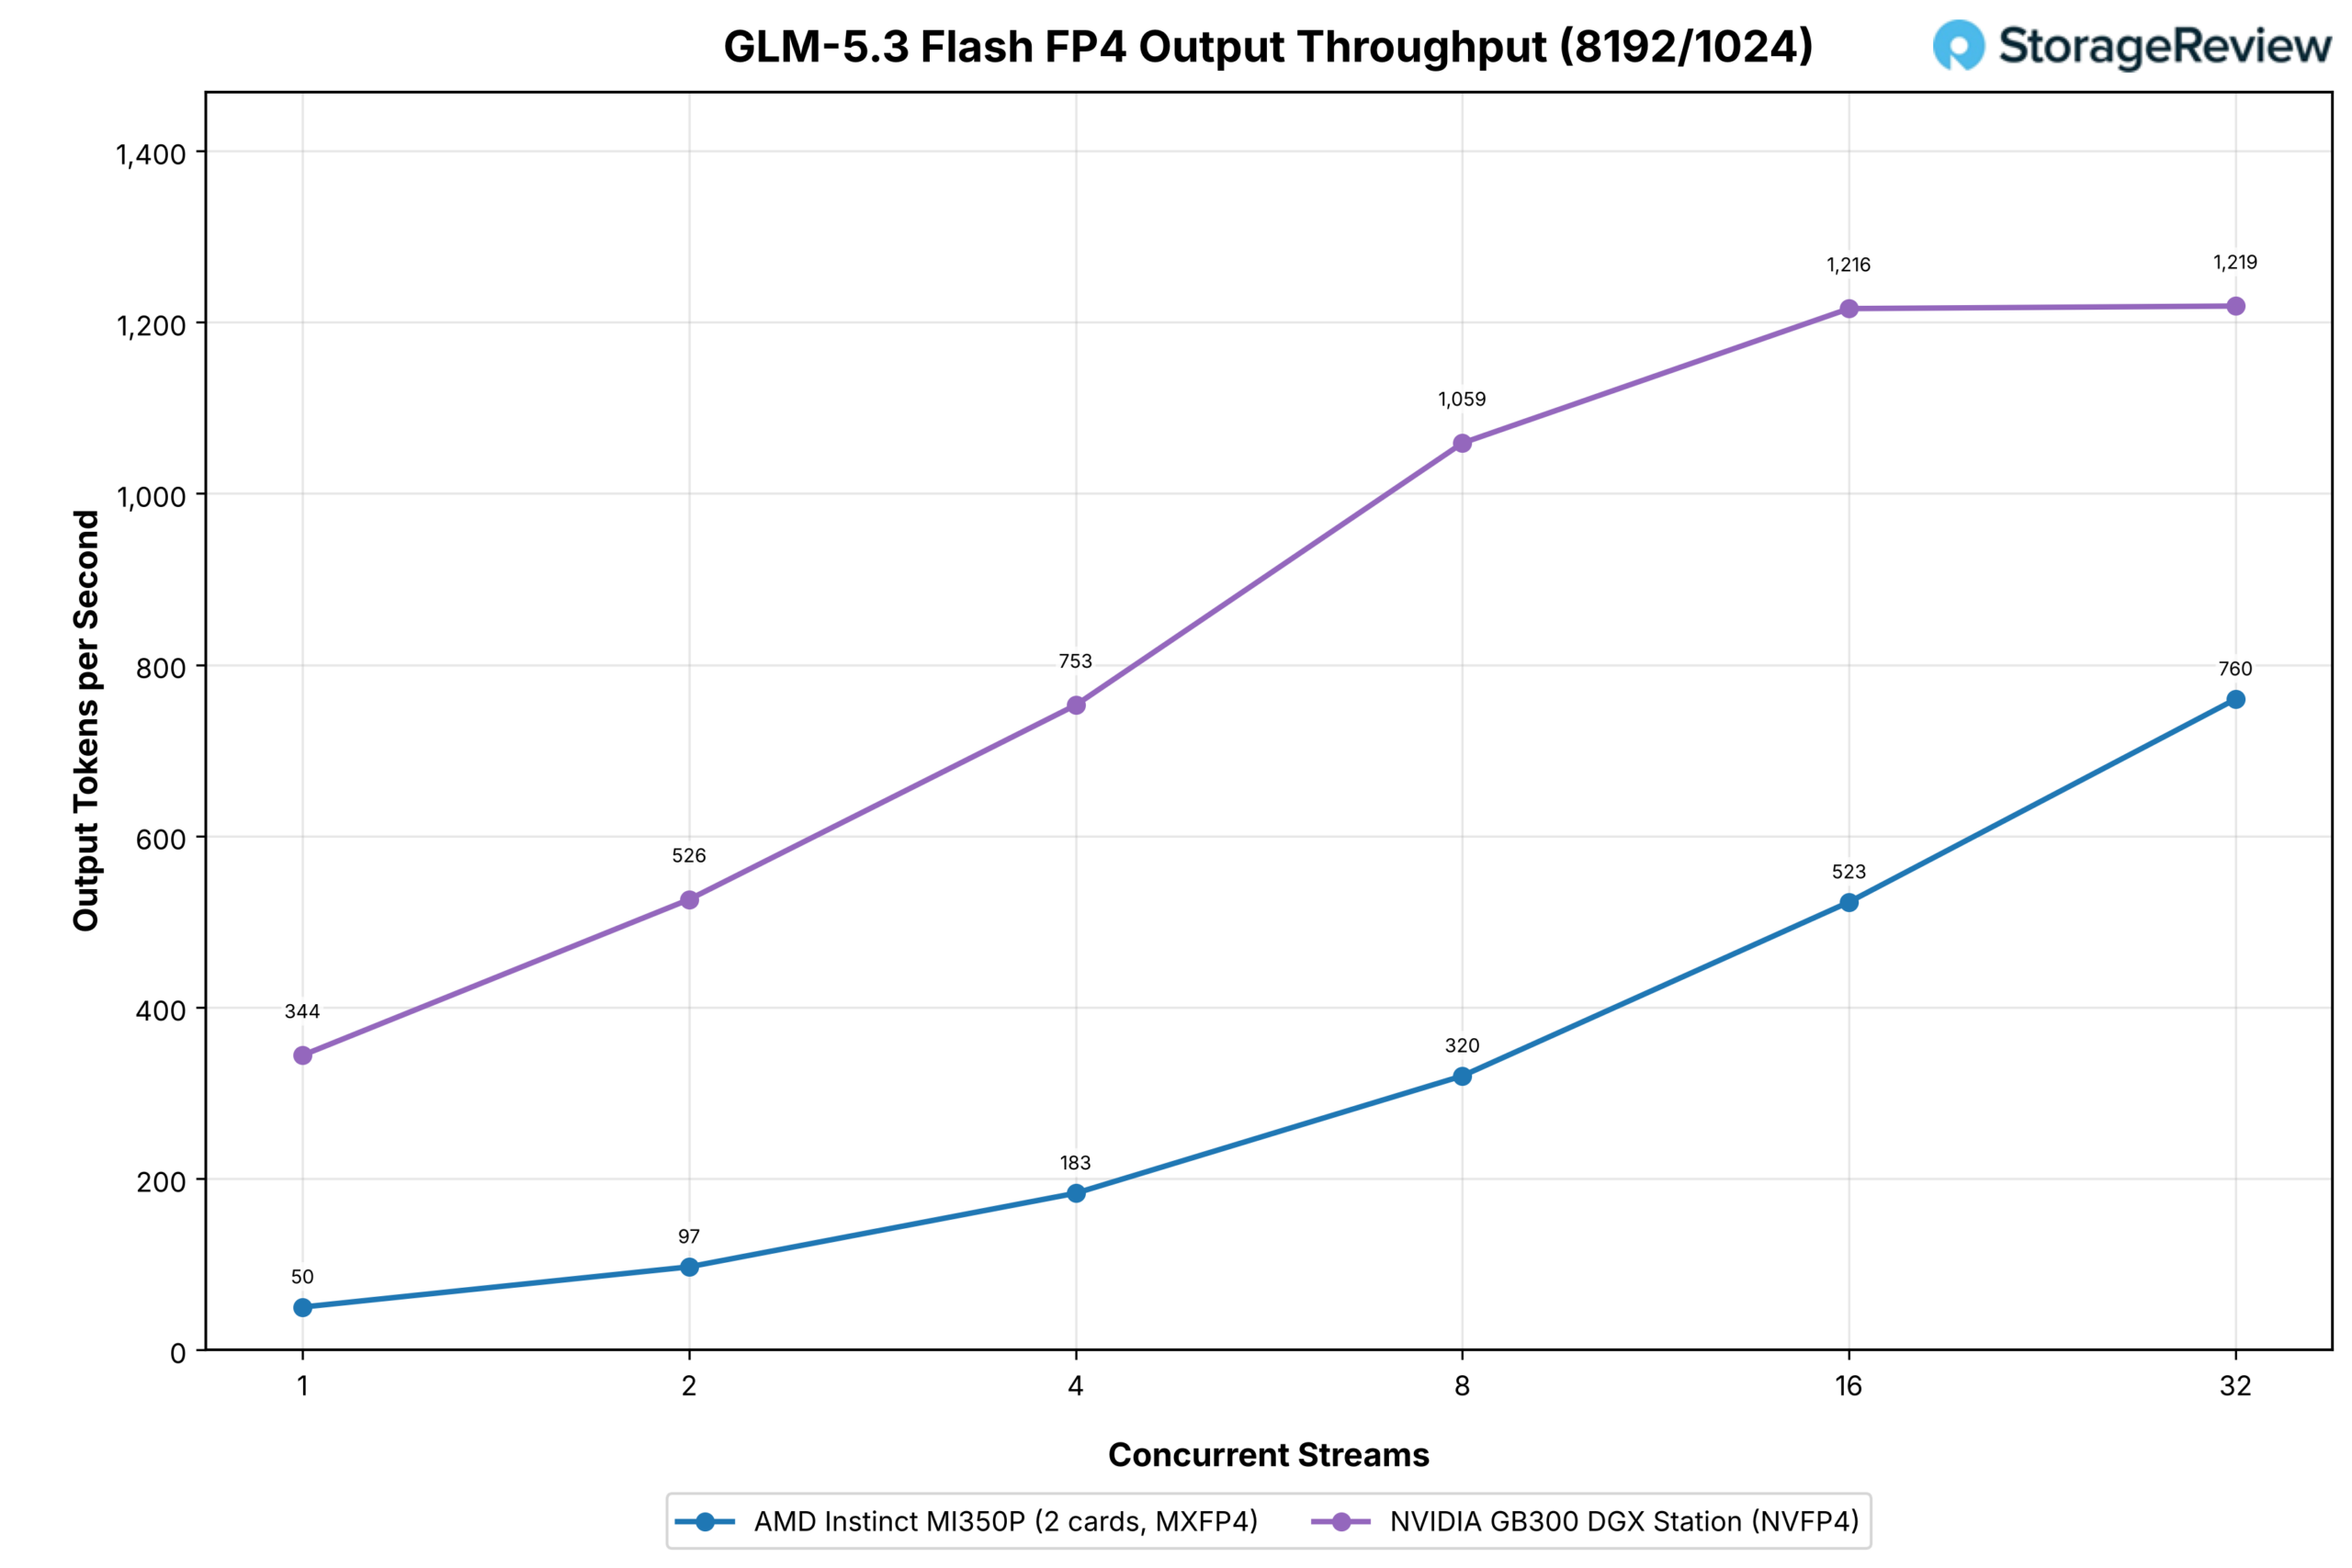
Le test GLM-5.3 Flash n'ayant pas été réalisé sur la RTX PRO 6000, la comparaison porte sur deux cartes MI350P face à une seule GB300 Station, avec 32 flux simultanés. Lors d'une session de chat, les MI350P sont initialement en retrait (45 jetons de sortie par seconde contre 353 pour la Station sur un seul flux), mais dépassent cette dernière à partir de huit flux pour atteindre 1 462 jetons par seconde sur 32 flux (contre 828 pour la Station). En revanche, lors d'une session nécessitant un préremplissage important, la Station domine de bout en bout (1 219 jetons par seconde contre 760 sur 32 flux). Dans ce cas, le préremplissage des MI350P doit transiter par le PCIe entre les deux cartes, tandis que la GB300 gère l'intégralité du processus avec une seule unité de mémoire HBM.
GLM-5.2
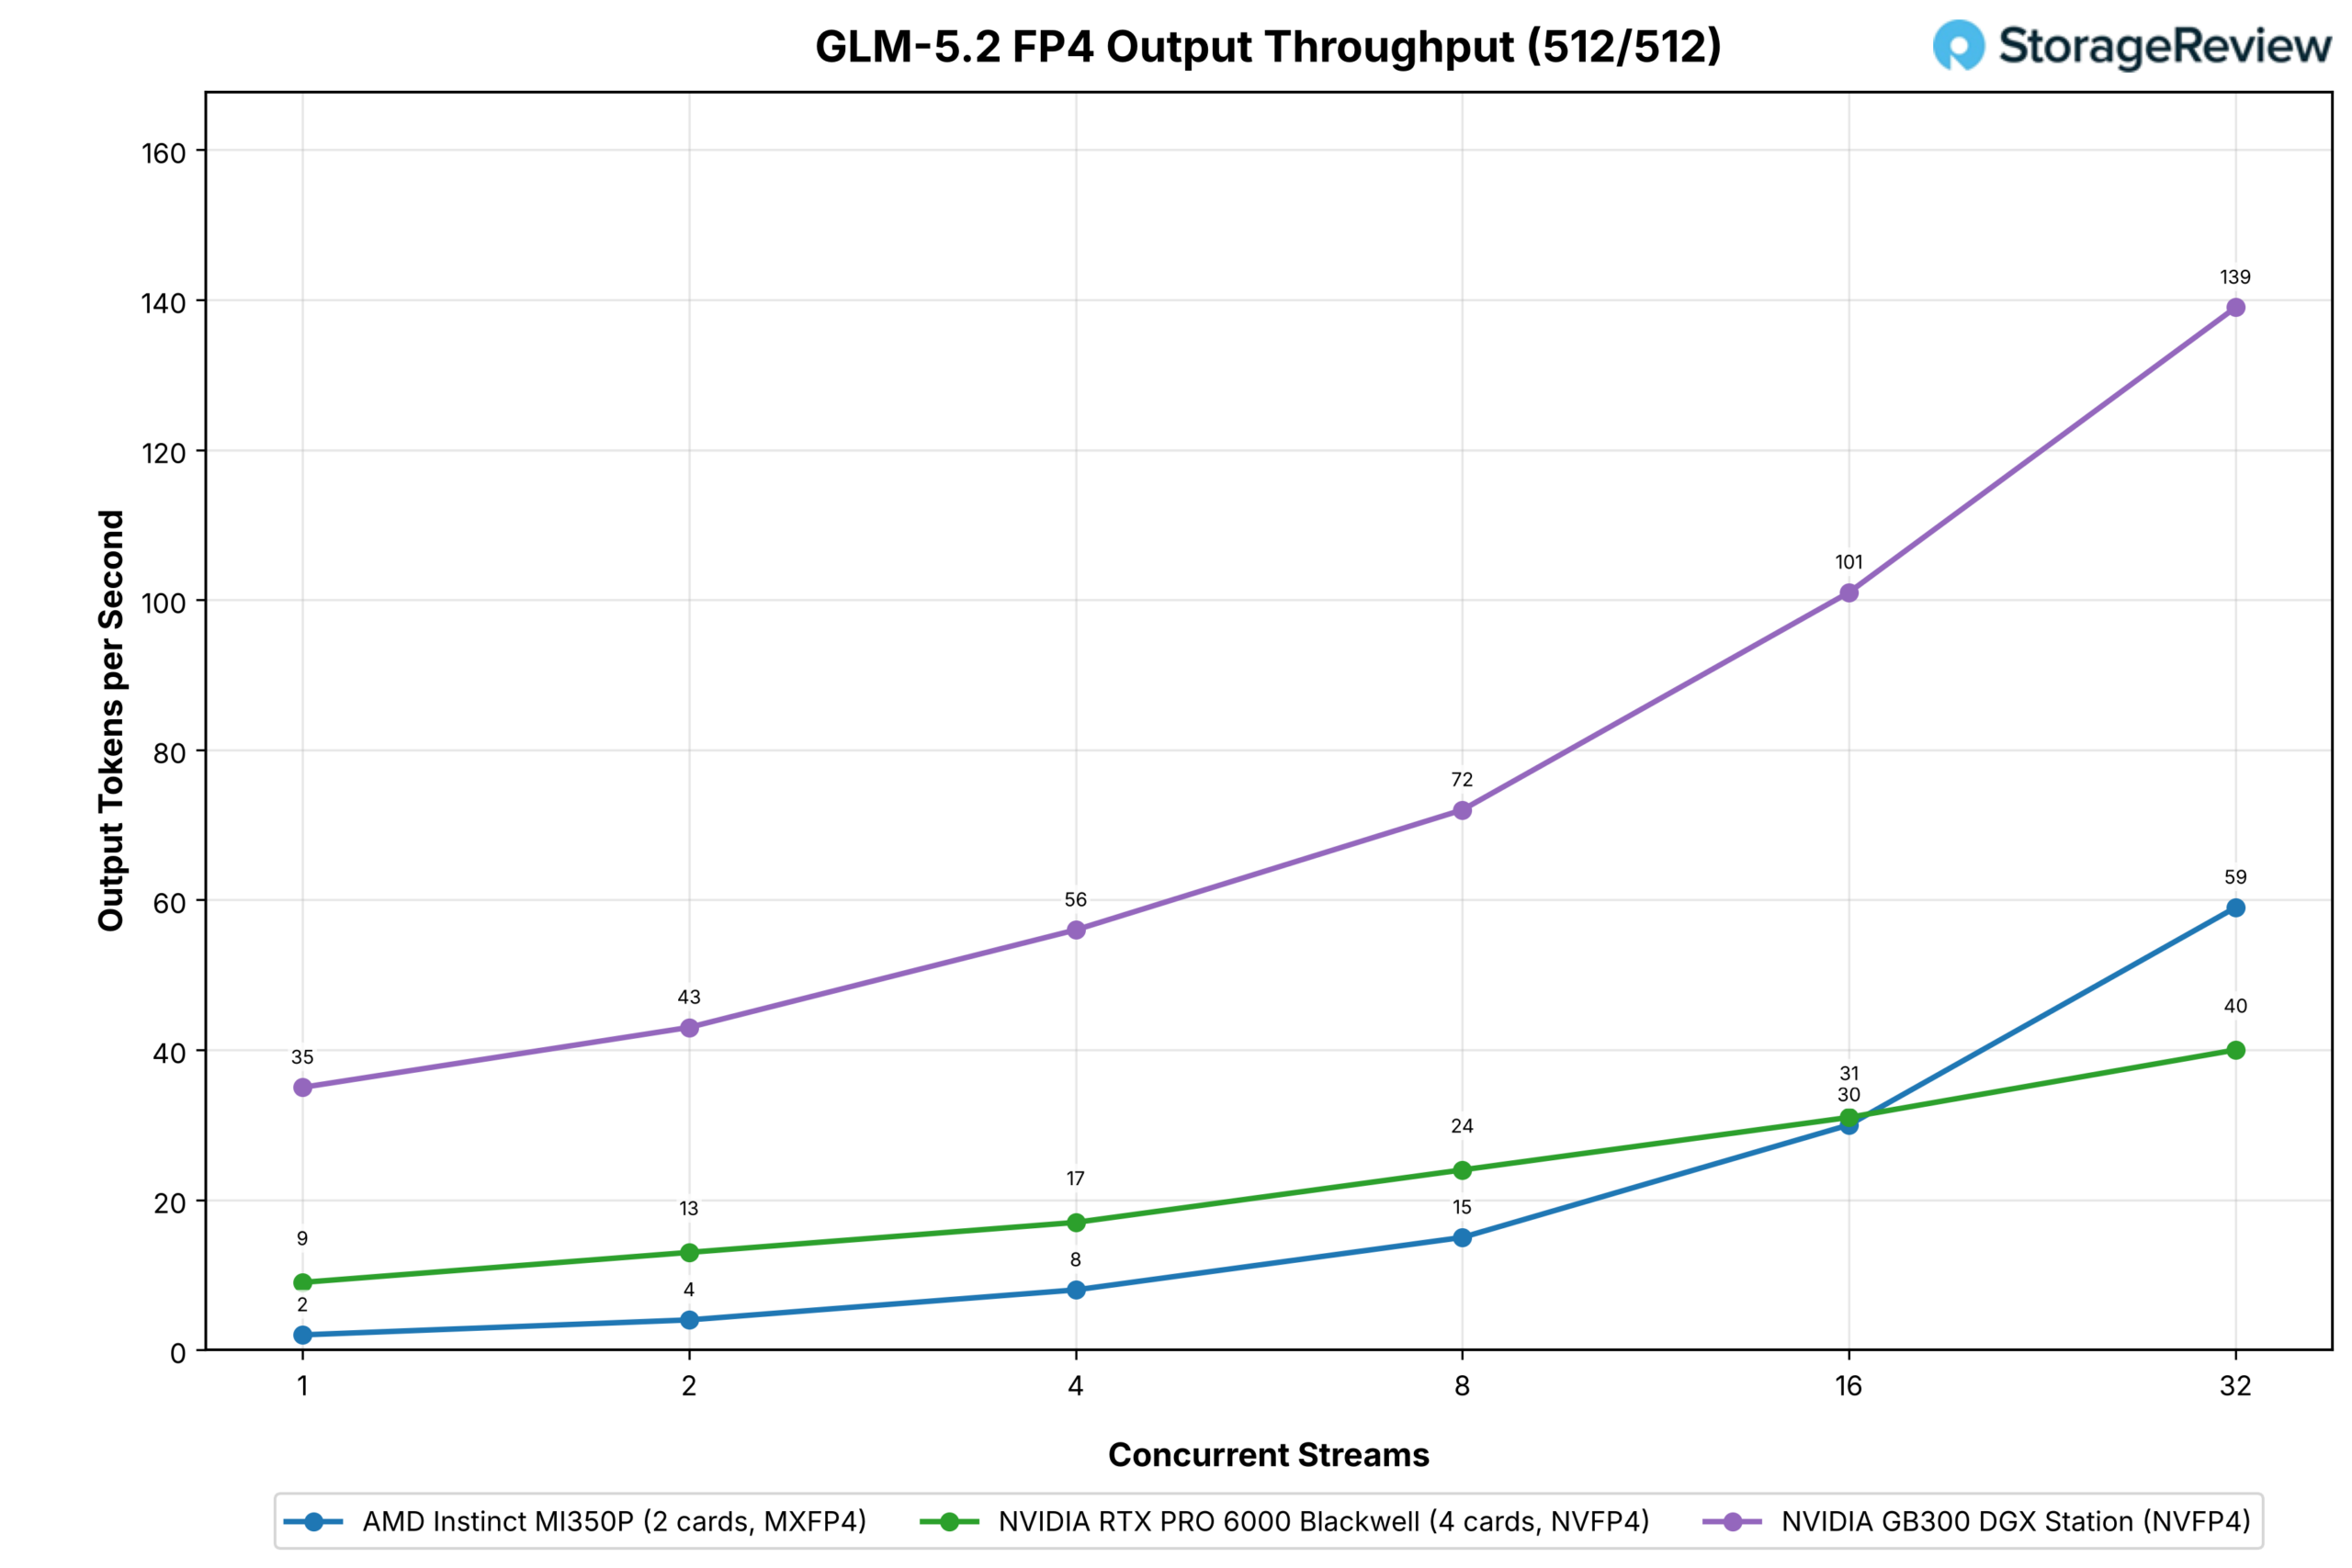
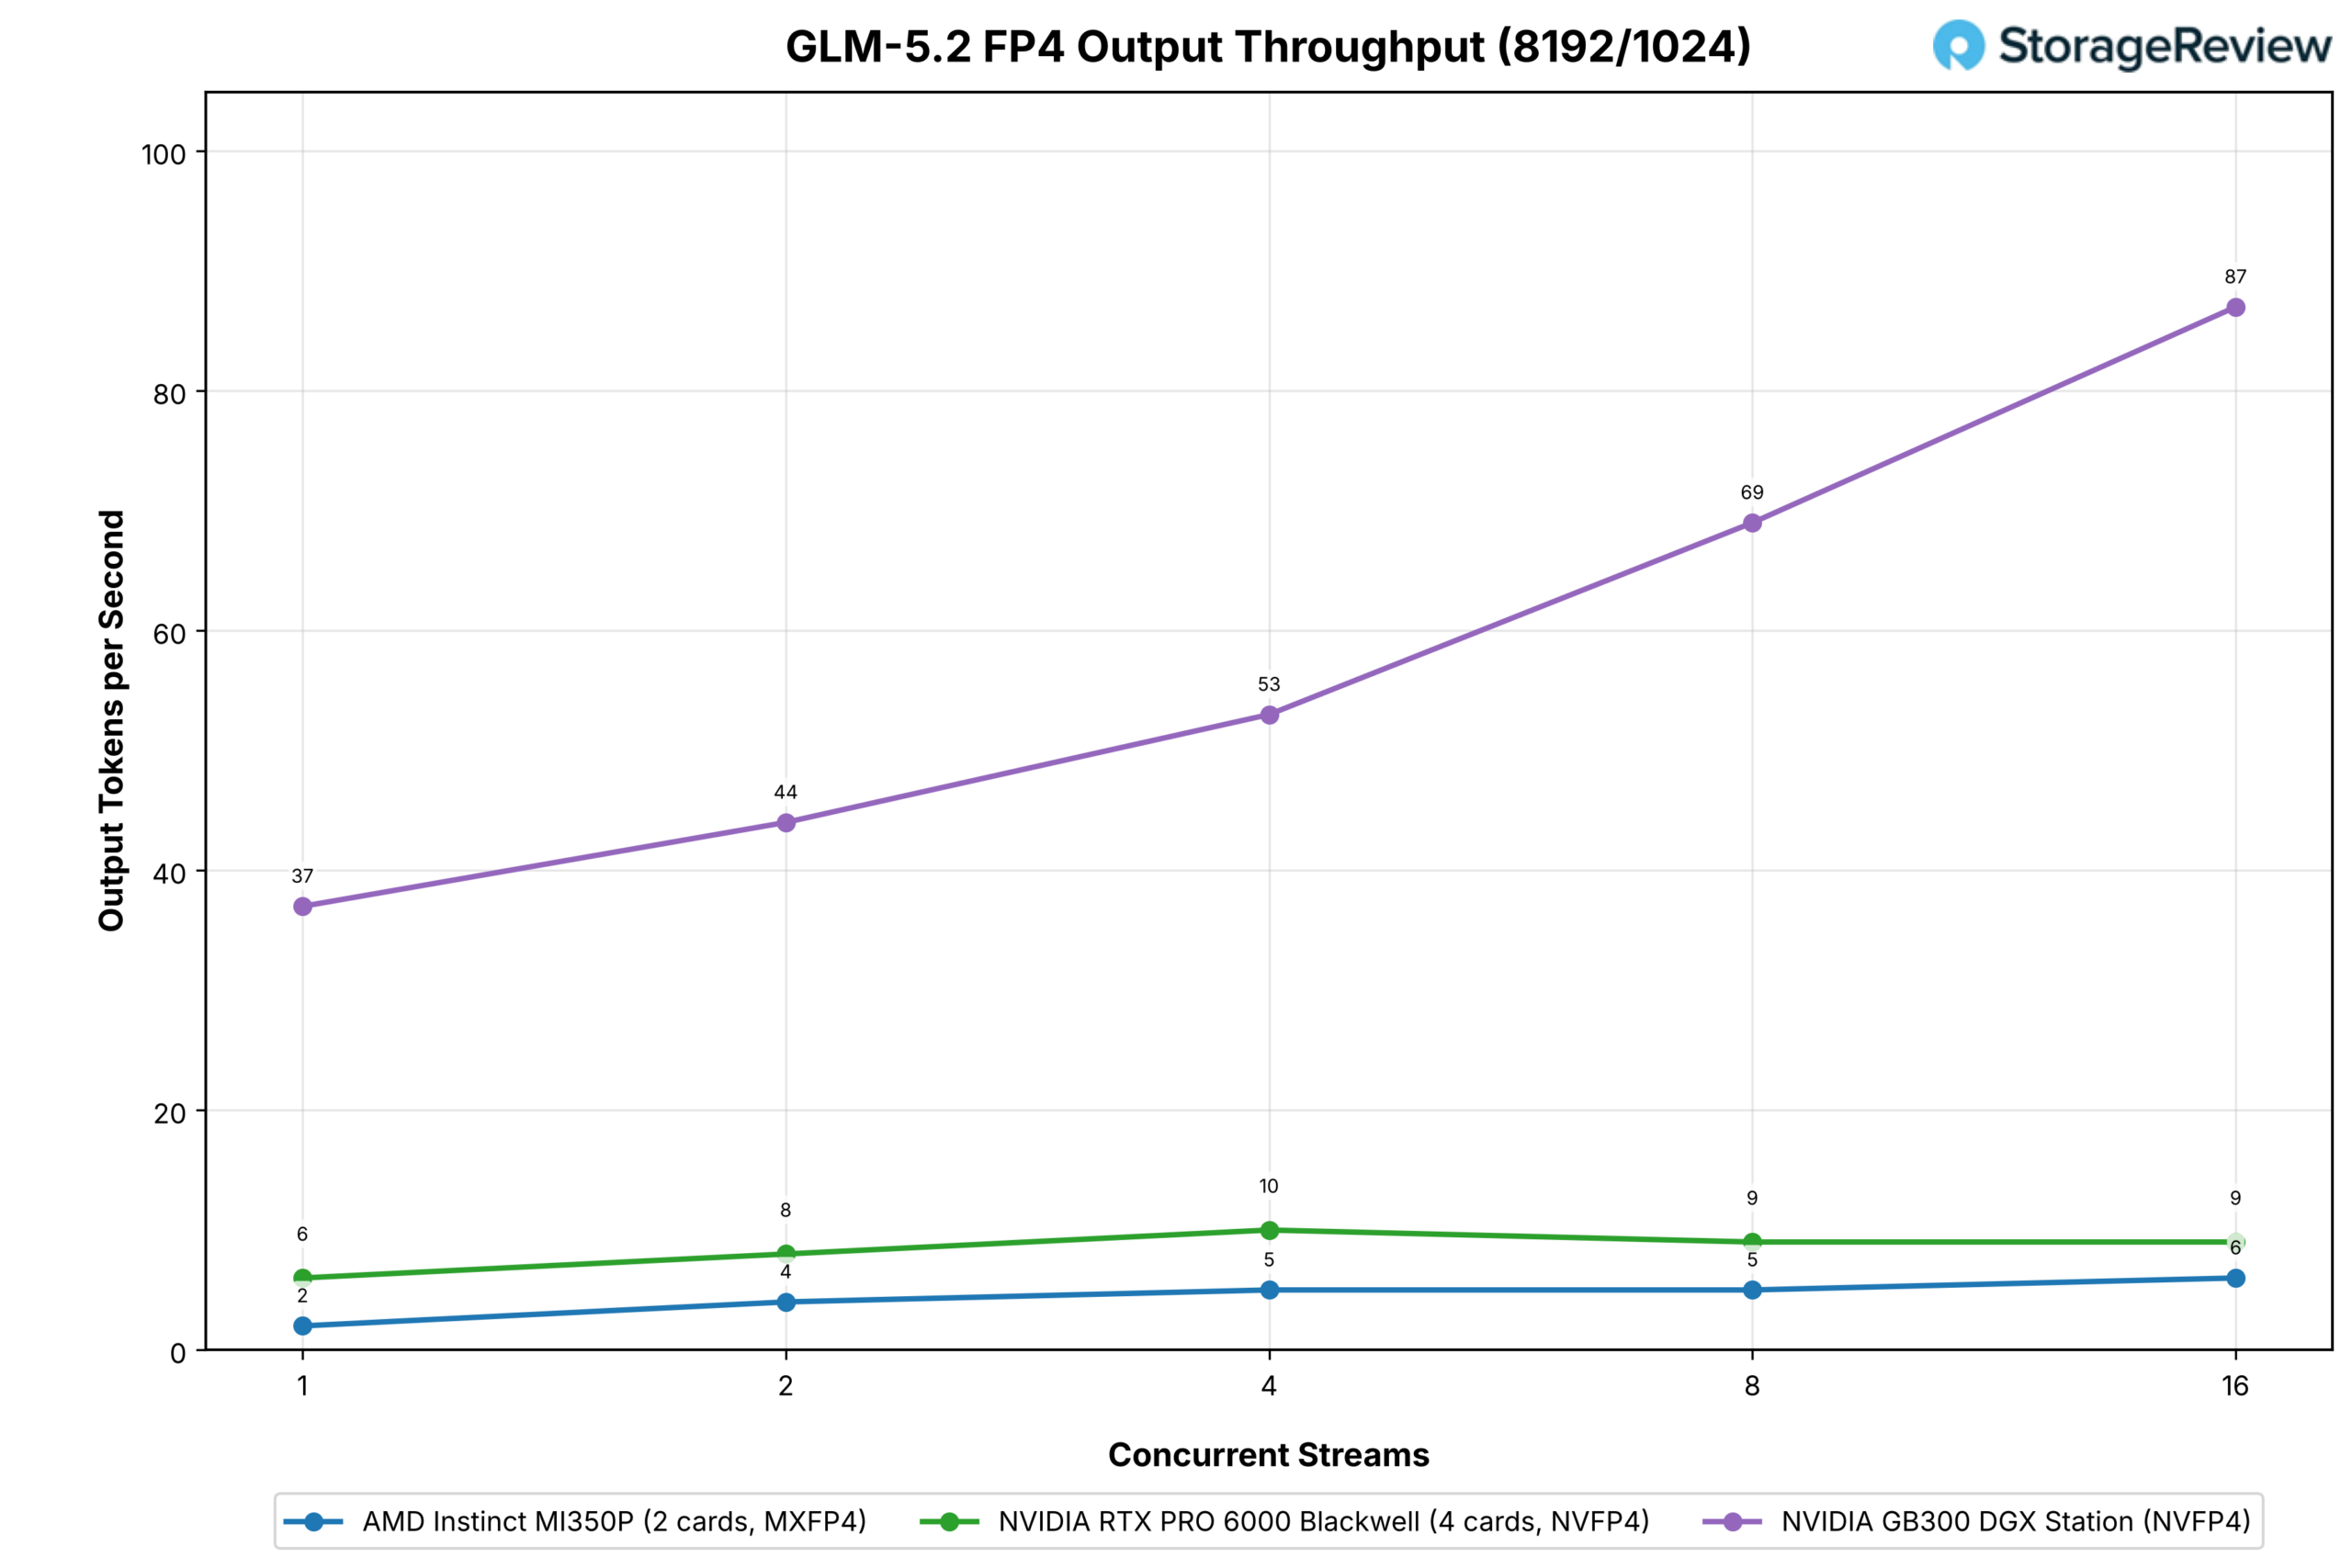
GLM-5.2 est le principal facteur de mémoire dans cette configuration. Le point de contrôle MXFP4 déborde des 288 Go des deux cartes MI350P vers la mémoire hôte. Le débit mono-flux est donc de 2 jetons de sortie par seconde pour la paire, contre 9 pour quatre cartes RTX PRO 6000 avec NVFP4 intégré dans 384 Go de GDDR7 et 35 pour la Station, qui décharge environ 215 Go de poids experts sur la mémoire Grace. Le quadruple RTX domine avec 16 flux sur la charge de travail de chat ; à 32 flux, la paire MI350P atteint 59 contre 40, et la Station atteint 139. Sur les invites nécessitant un pré-remplissage important, aucune des deux configurations PCIe ne dépasse les 10 flux avec 16 flux, contre 87 pour la Station.
MiniMax-M3
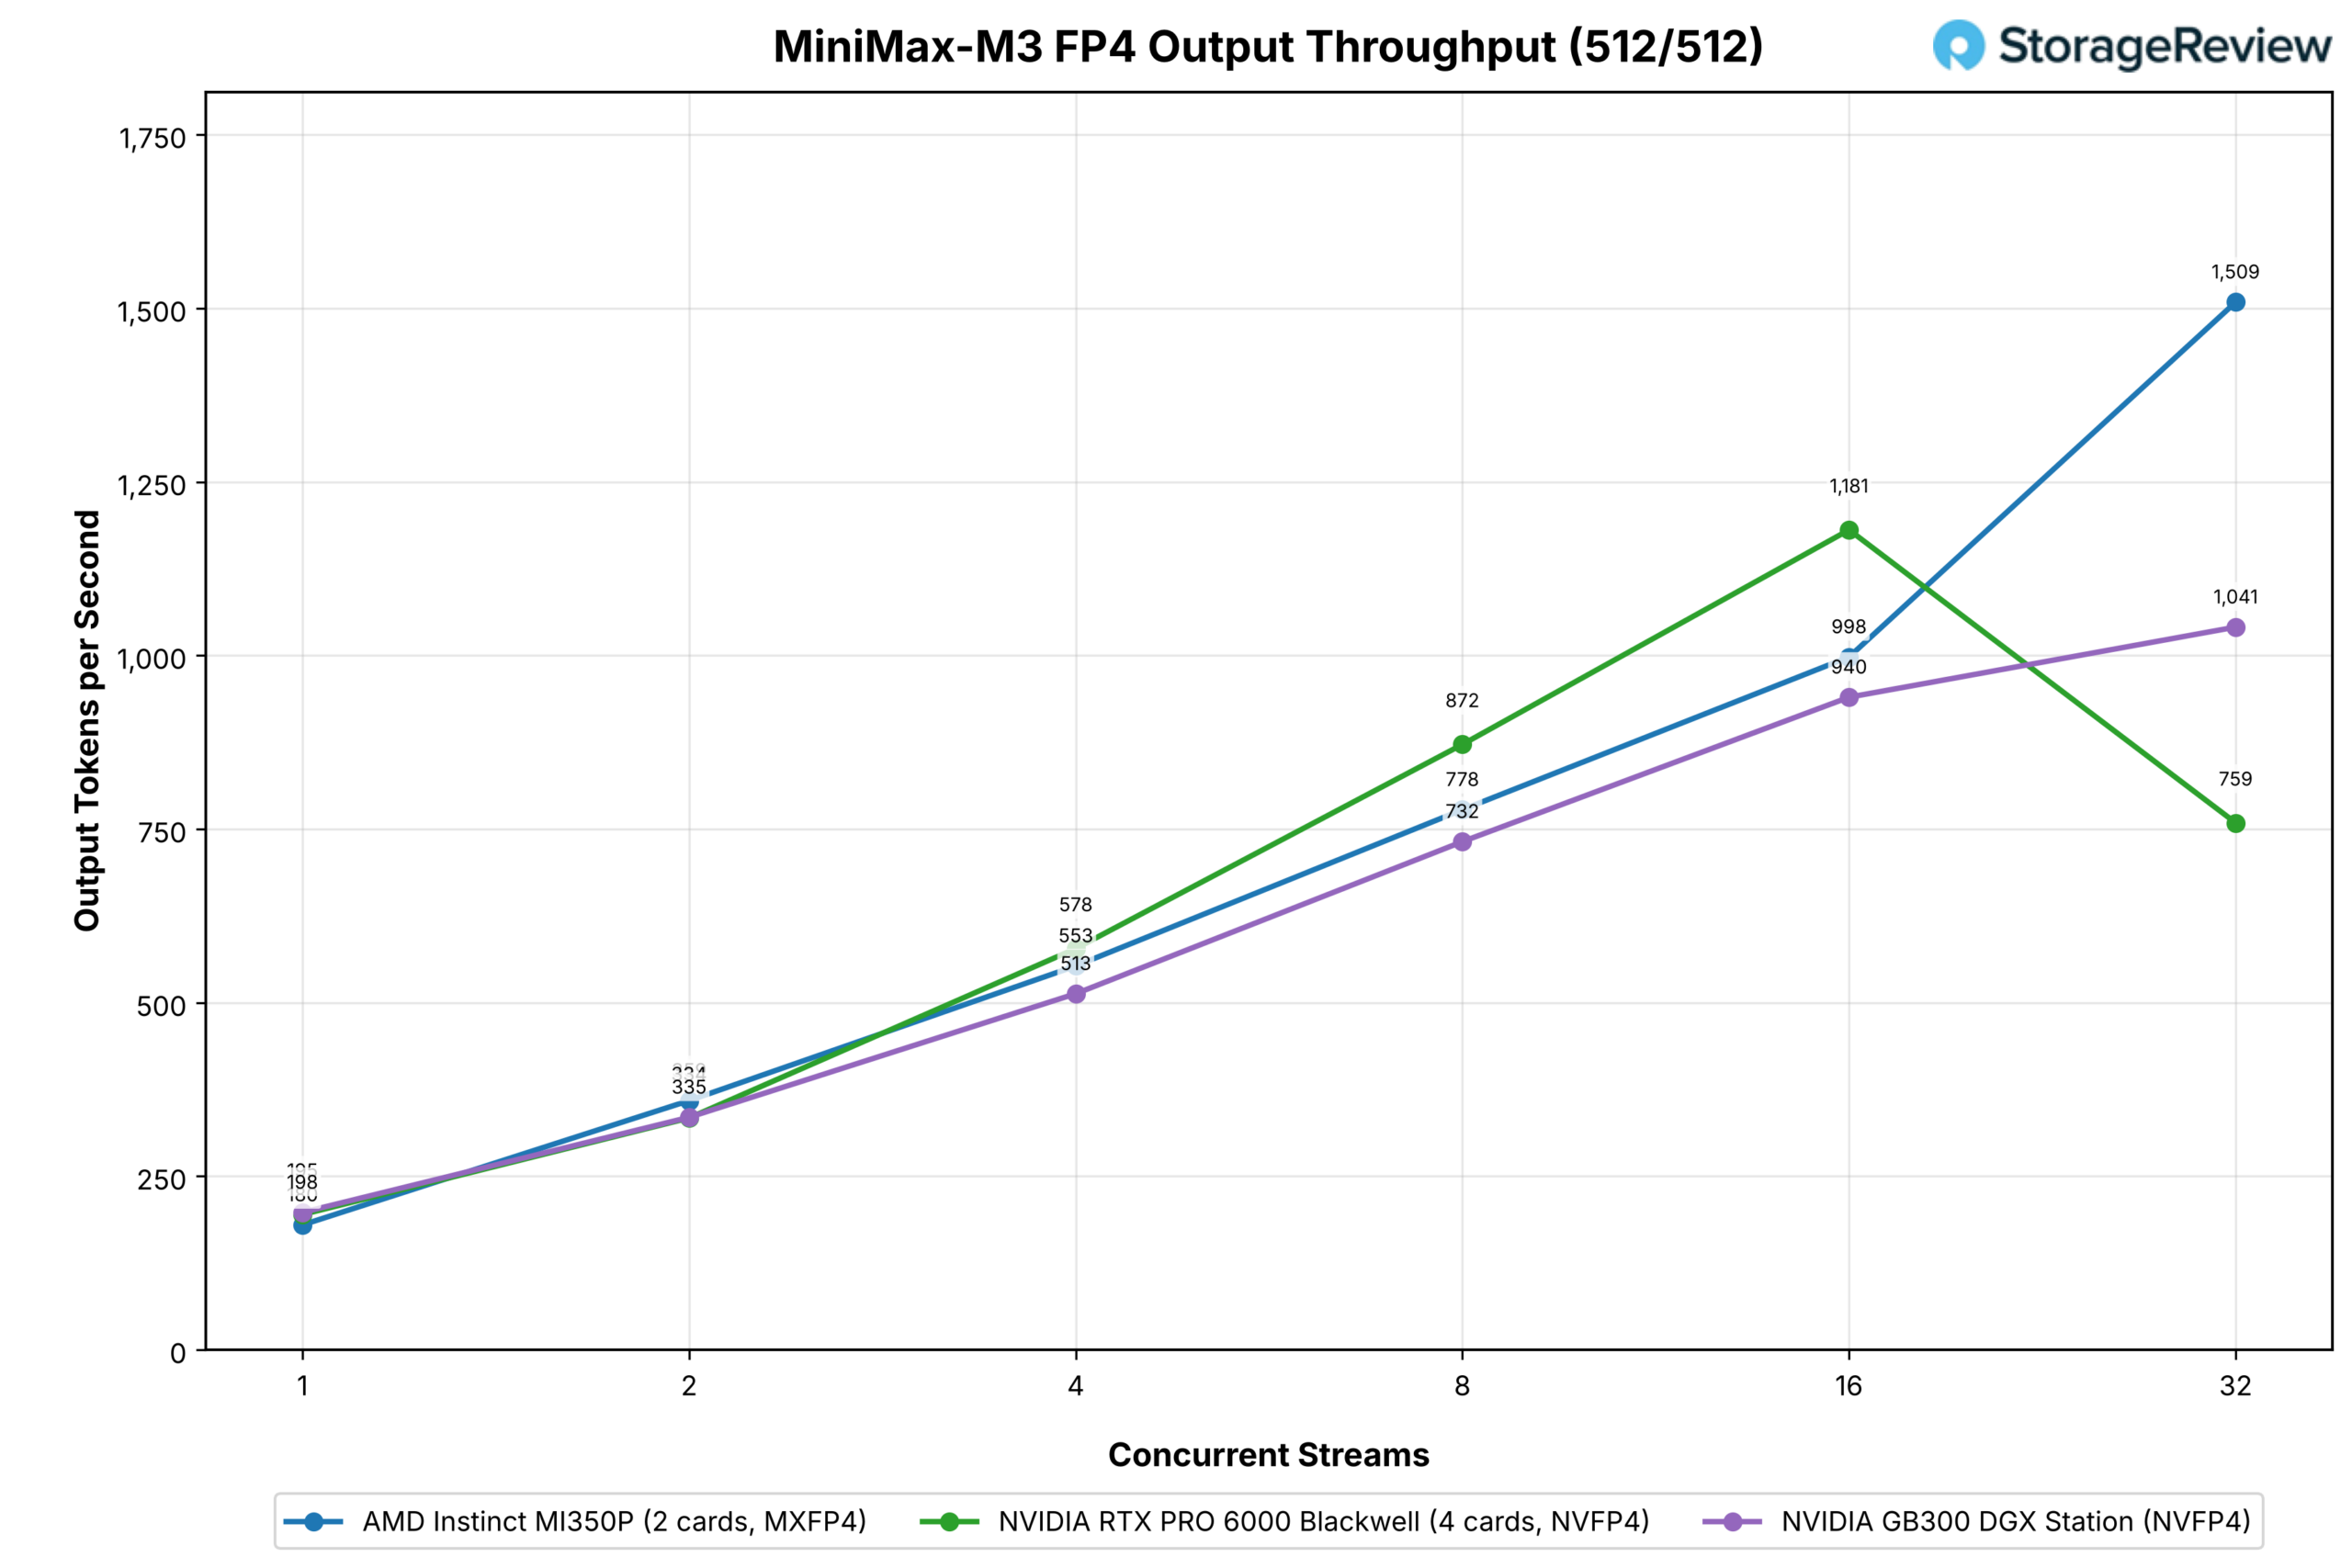
Deux MI350P accueillent la version MXFP4 du MiniMax-M3 de 288 Go ; la partie NVIDIA nécessite quatre cartes RTX PRO 6000. Les performances des trois configurations sont similaires (à 10 % près) sur huit flux de travail de chat ; la configuration quadruple RTX prend l'avantage à 16 (1 181 contre 998 pour la paire et 940 pour la station), et à 32, la paire de MI350P atteint 1 509 contre 759 pour la configuration quadruple et 1 041 pour la station.
Sur les invites à préremplissage important, la paire MI350P mène à chaque point sur huit flux, 524 contre 444 pour le quad, tandis que la Station, qui conserve une partie des experts de ce modèle dans la mémoire de Grace, tombe à 103.
DeepSeek-V4-Flash
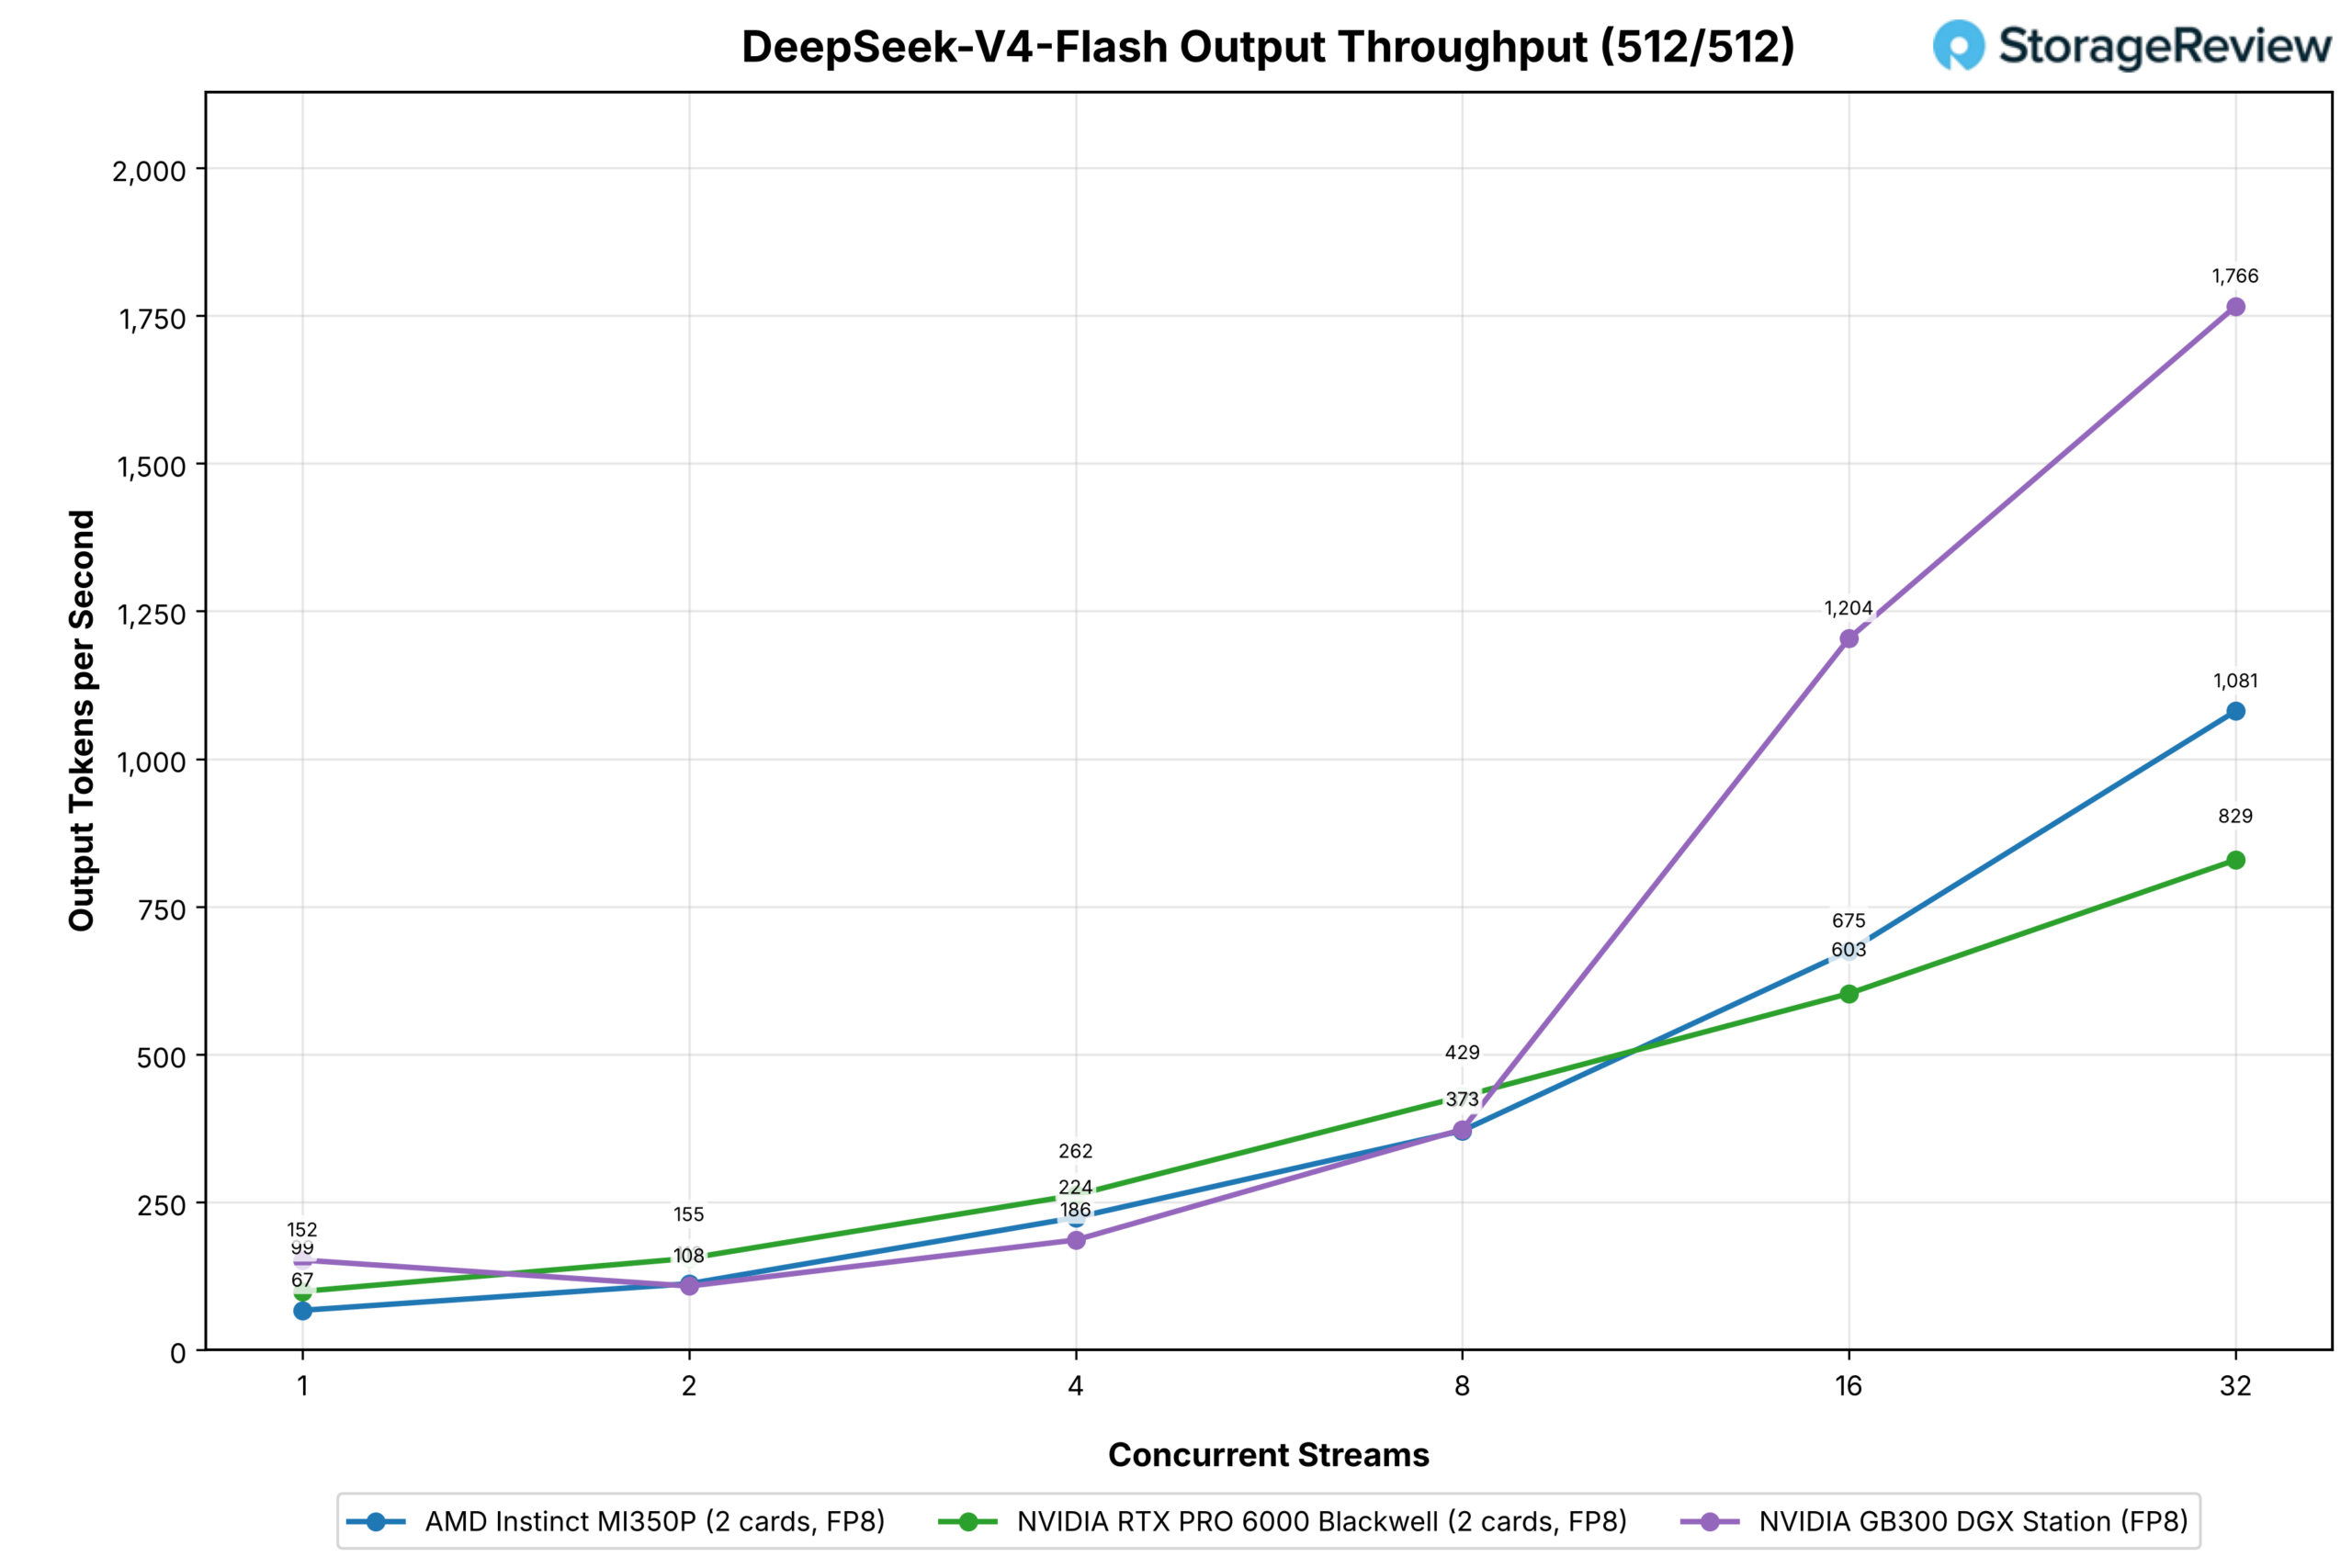
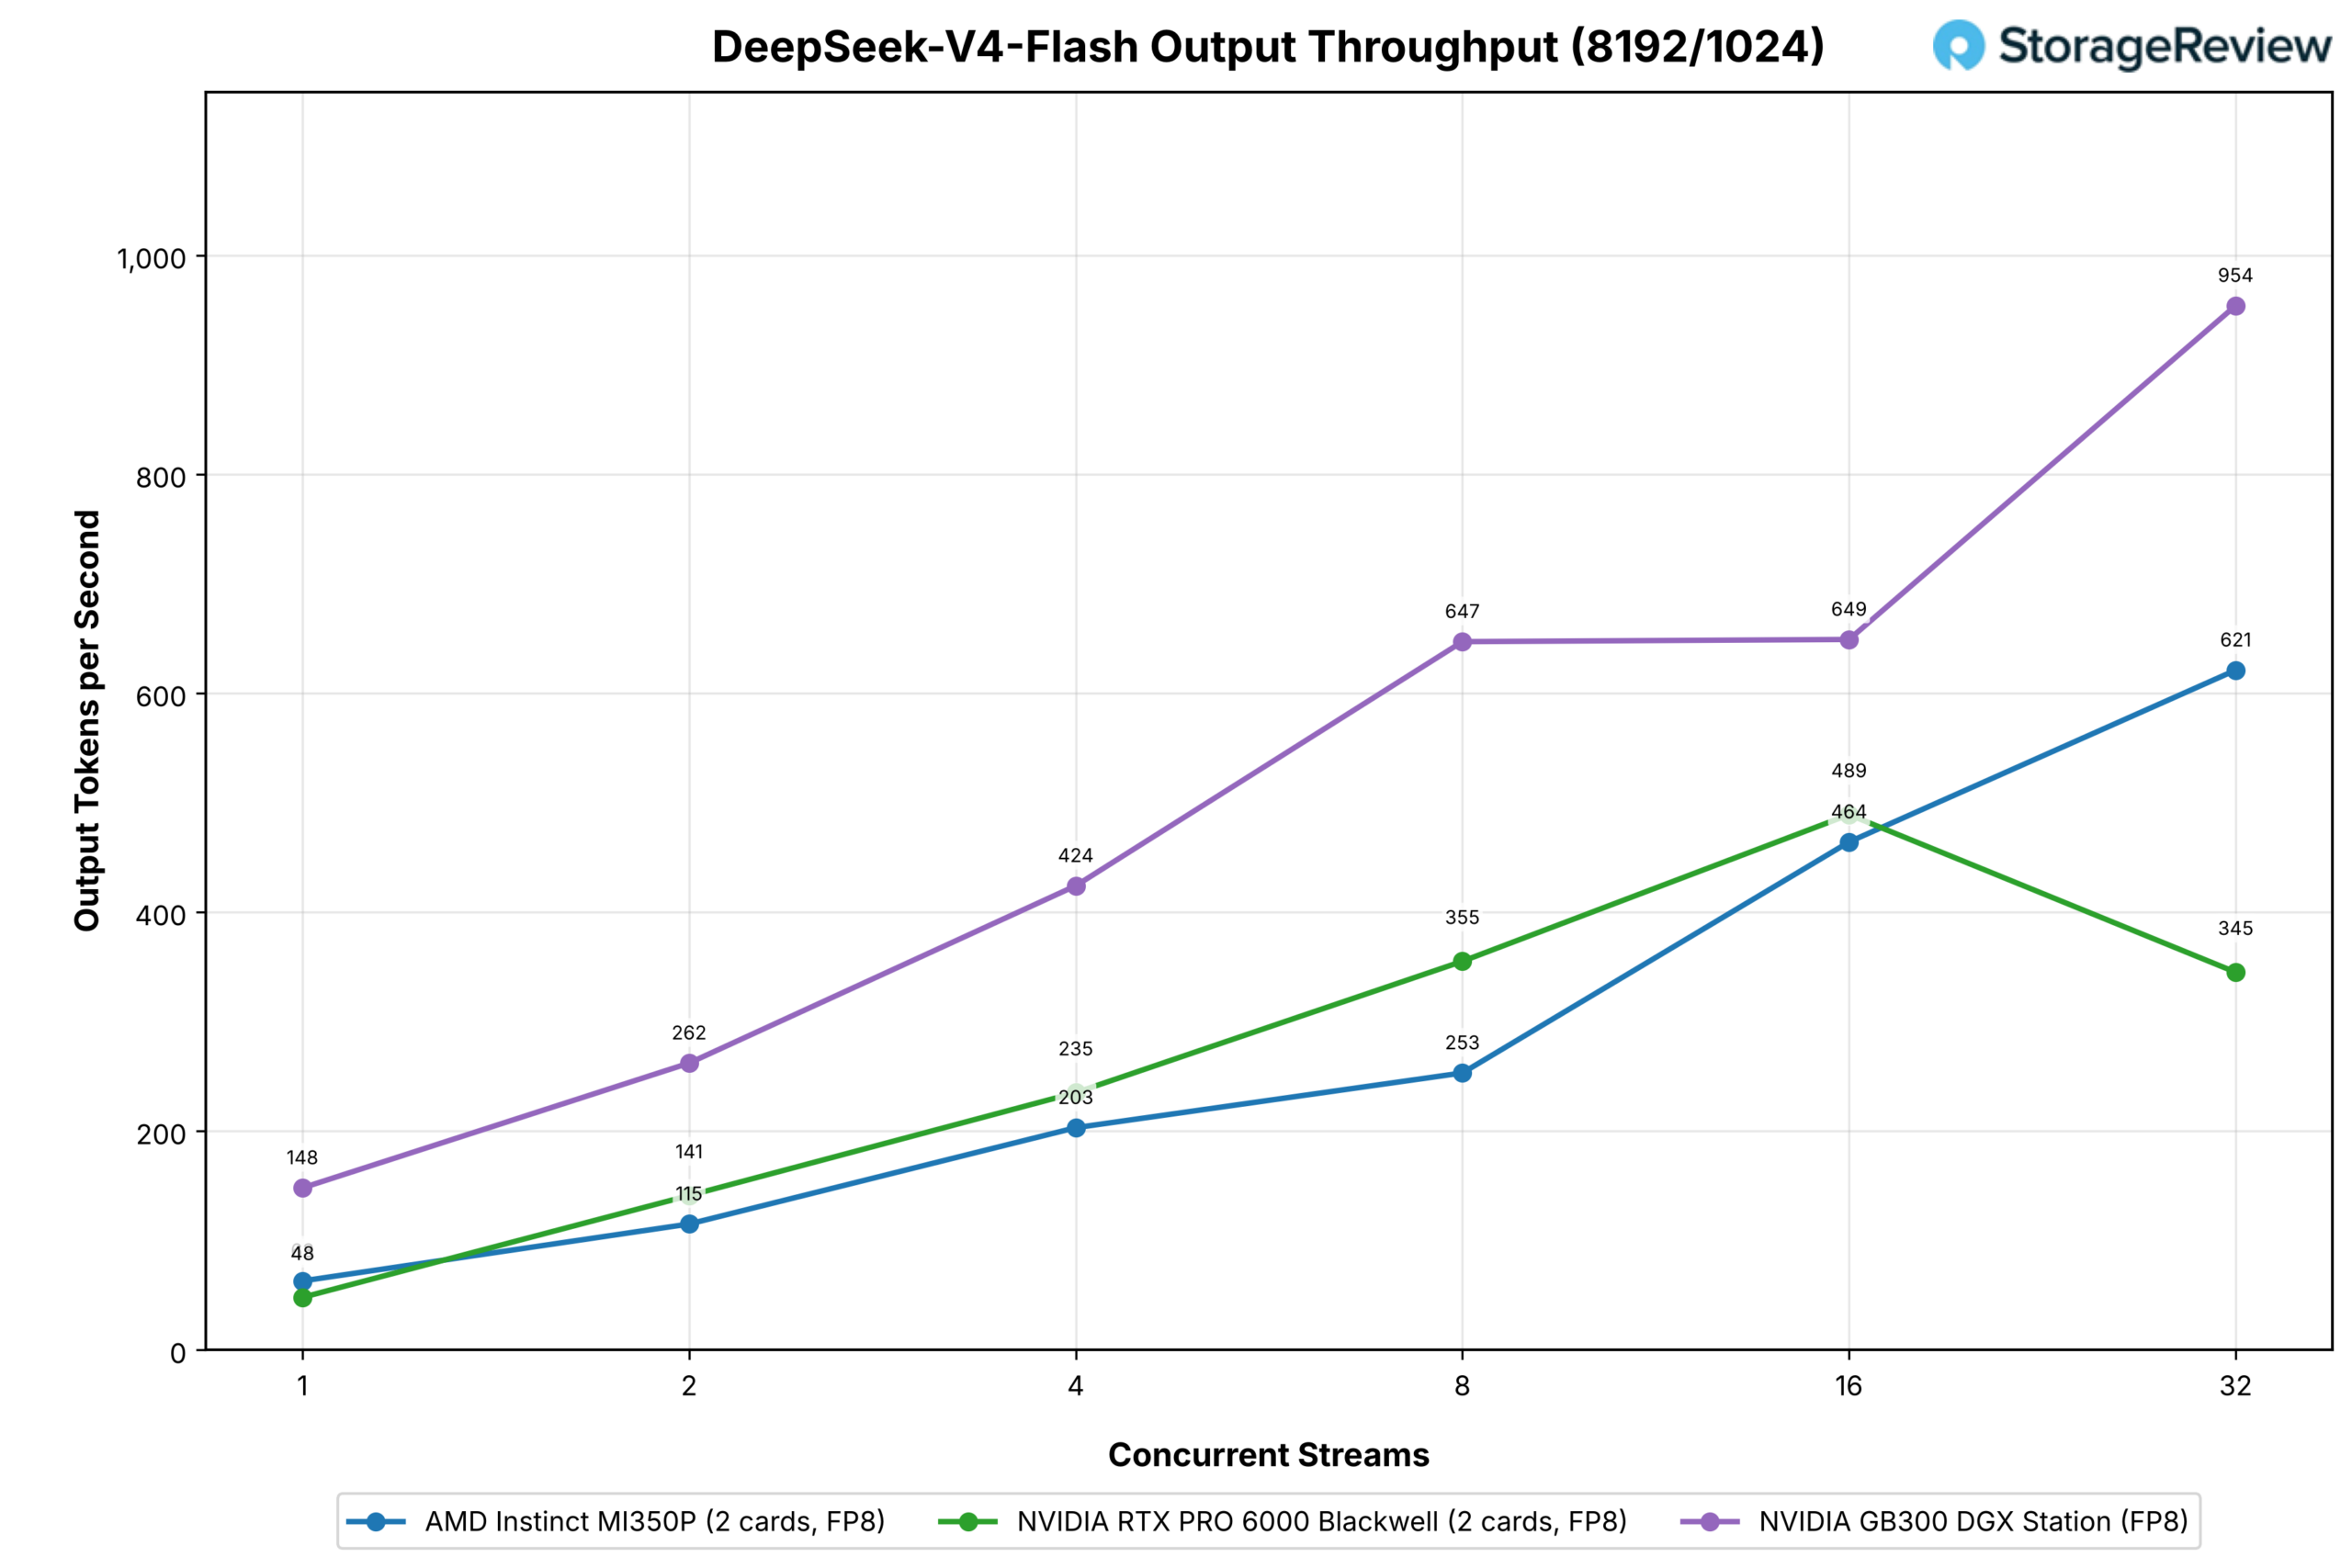
Avec deux cartes de chaque côté et le point de contrôle FP8 natif, la paire RTX PRO 6000 domine les performances sur huit flux de chat, puis la paire MI350P prend le relais à partir du 16e flux, terminant à 1 081 contre 829 sur 32 flux ; la Station seule atteint 1 766 au même point. Le test avec préremplissage important suit la même tendance : la paire MI350P obtient 621 contre 345 pour la paire RTX sur 32 flux et 954 pour la Station.
MiniMax-M2.7
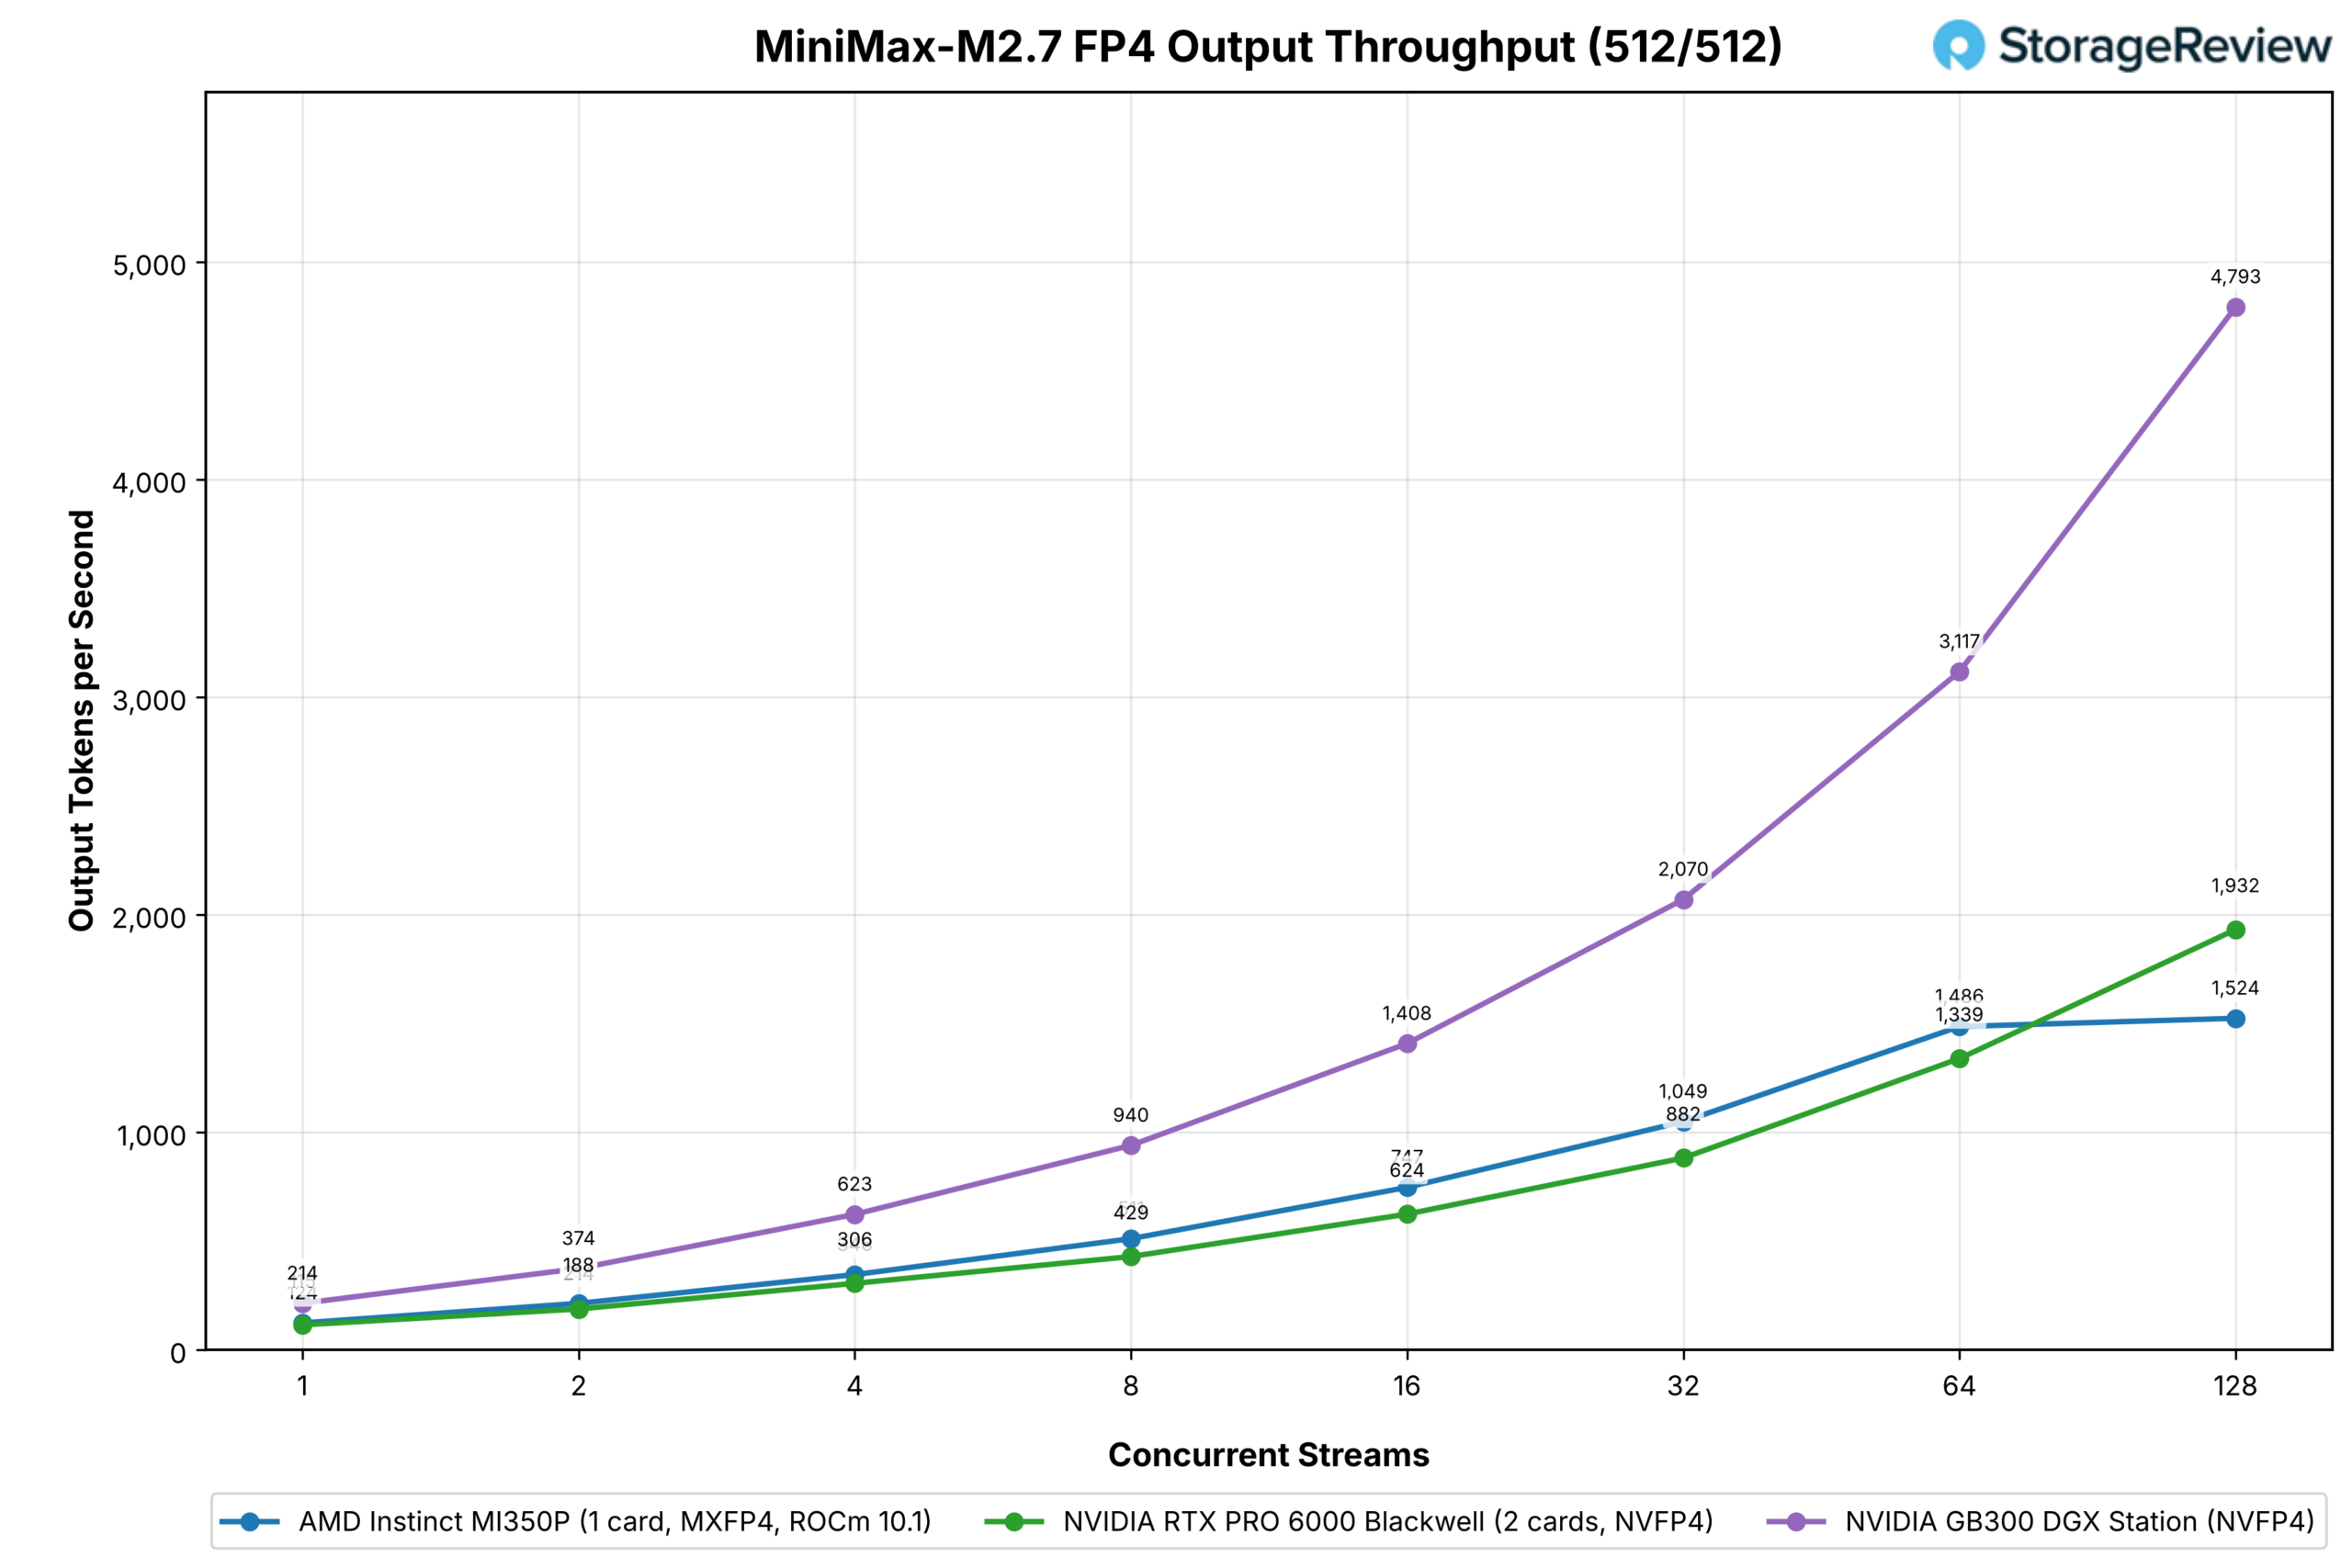
Un MI350P équipé d'une carte MiniMax-M2.7 (MXFP4) est comparé à deux cartes RTX PRO 6000 (NVFP4). Le MI350P domine les deux cartes avec un flux unique (124 contre 115), conserve une avance de 8 à 20 % jusqu'à 64 flux (1 486 contre 1 339), puis se stabilise à 1 524 à 128 flux et à 1 557 à 256 flux. Les deux cartes RTX atteignent quant à elles 1 932 et 2 842 flux ; la Station atteint 4 793 flux.
Sur la charge de travail nécessitant un préremplissage important, le MI350P se maintient à 304 à 331 jetons de sortie par seconde à partir de huit flux à 64, contre 501 pour la paire RTX et 1 744 pour la Station.
GPT-OSS-120B
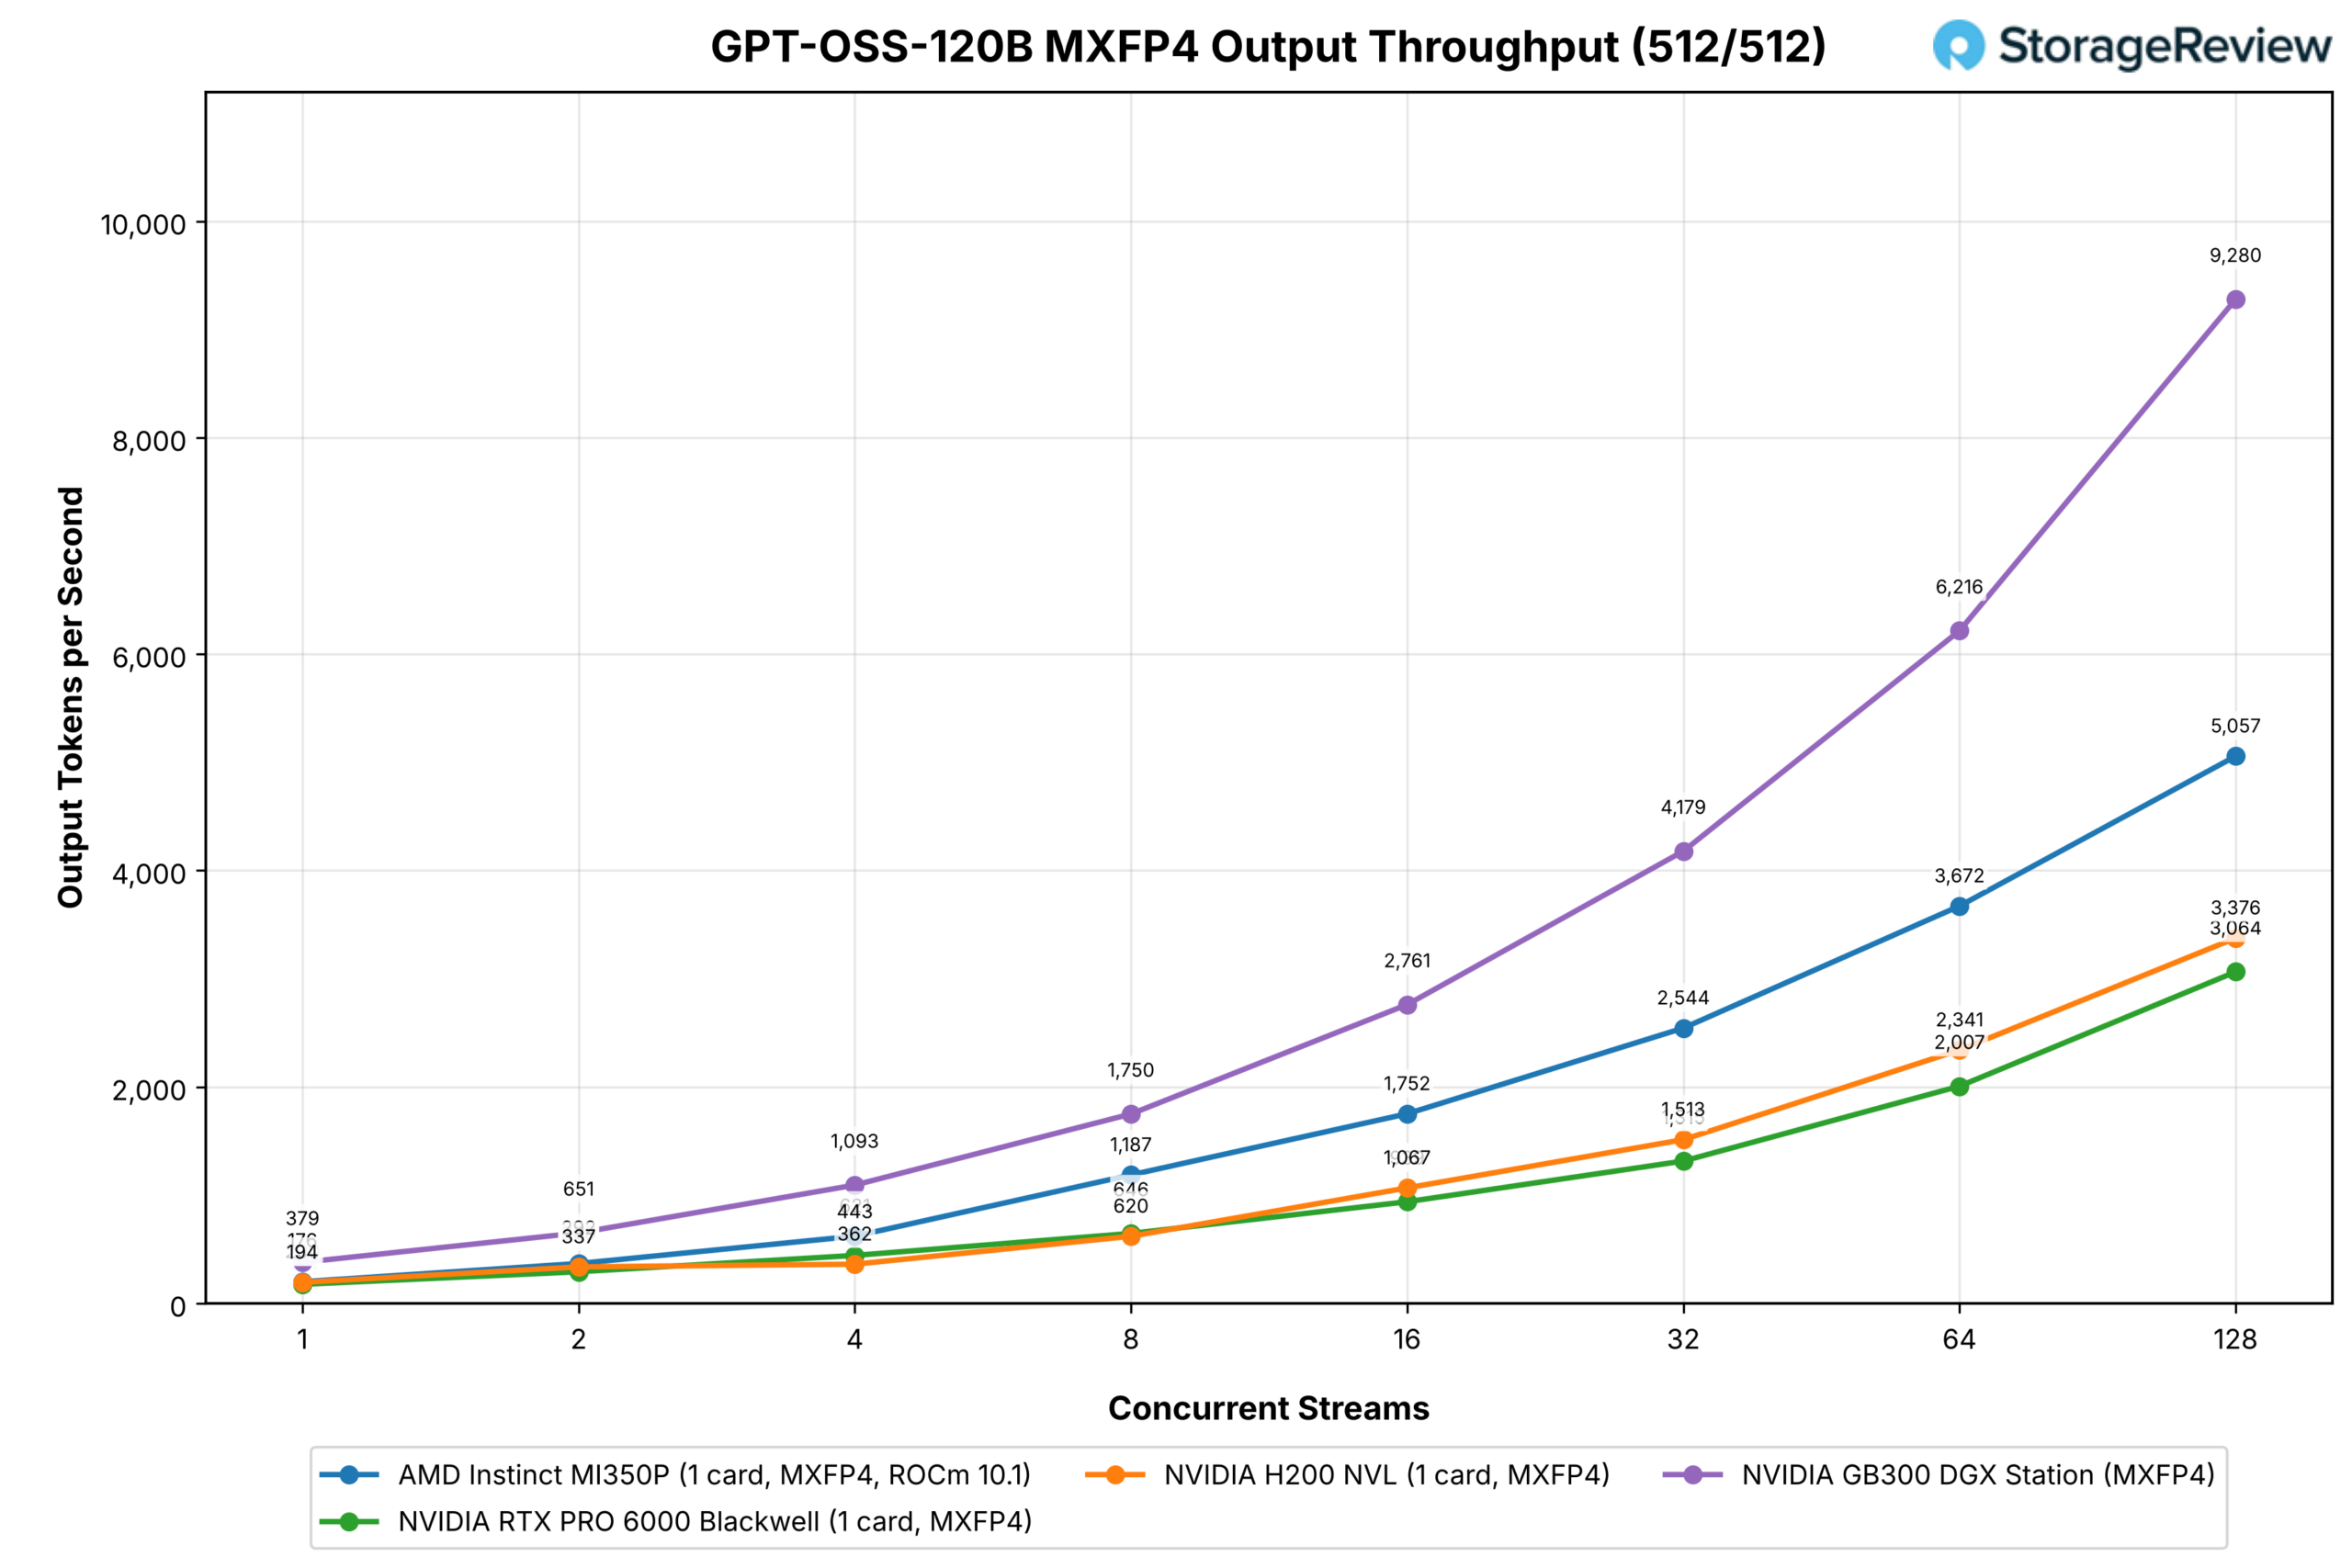
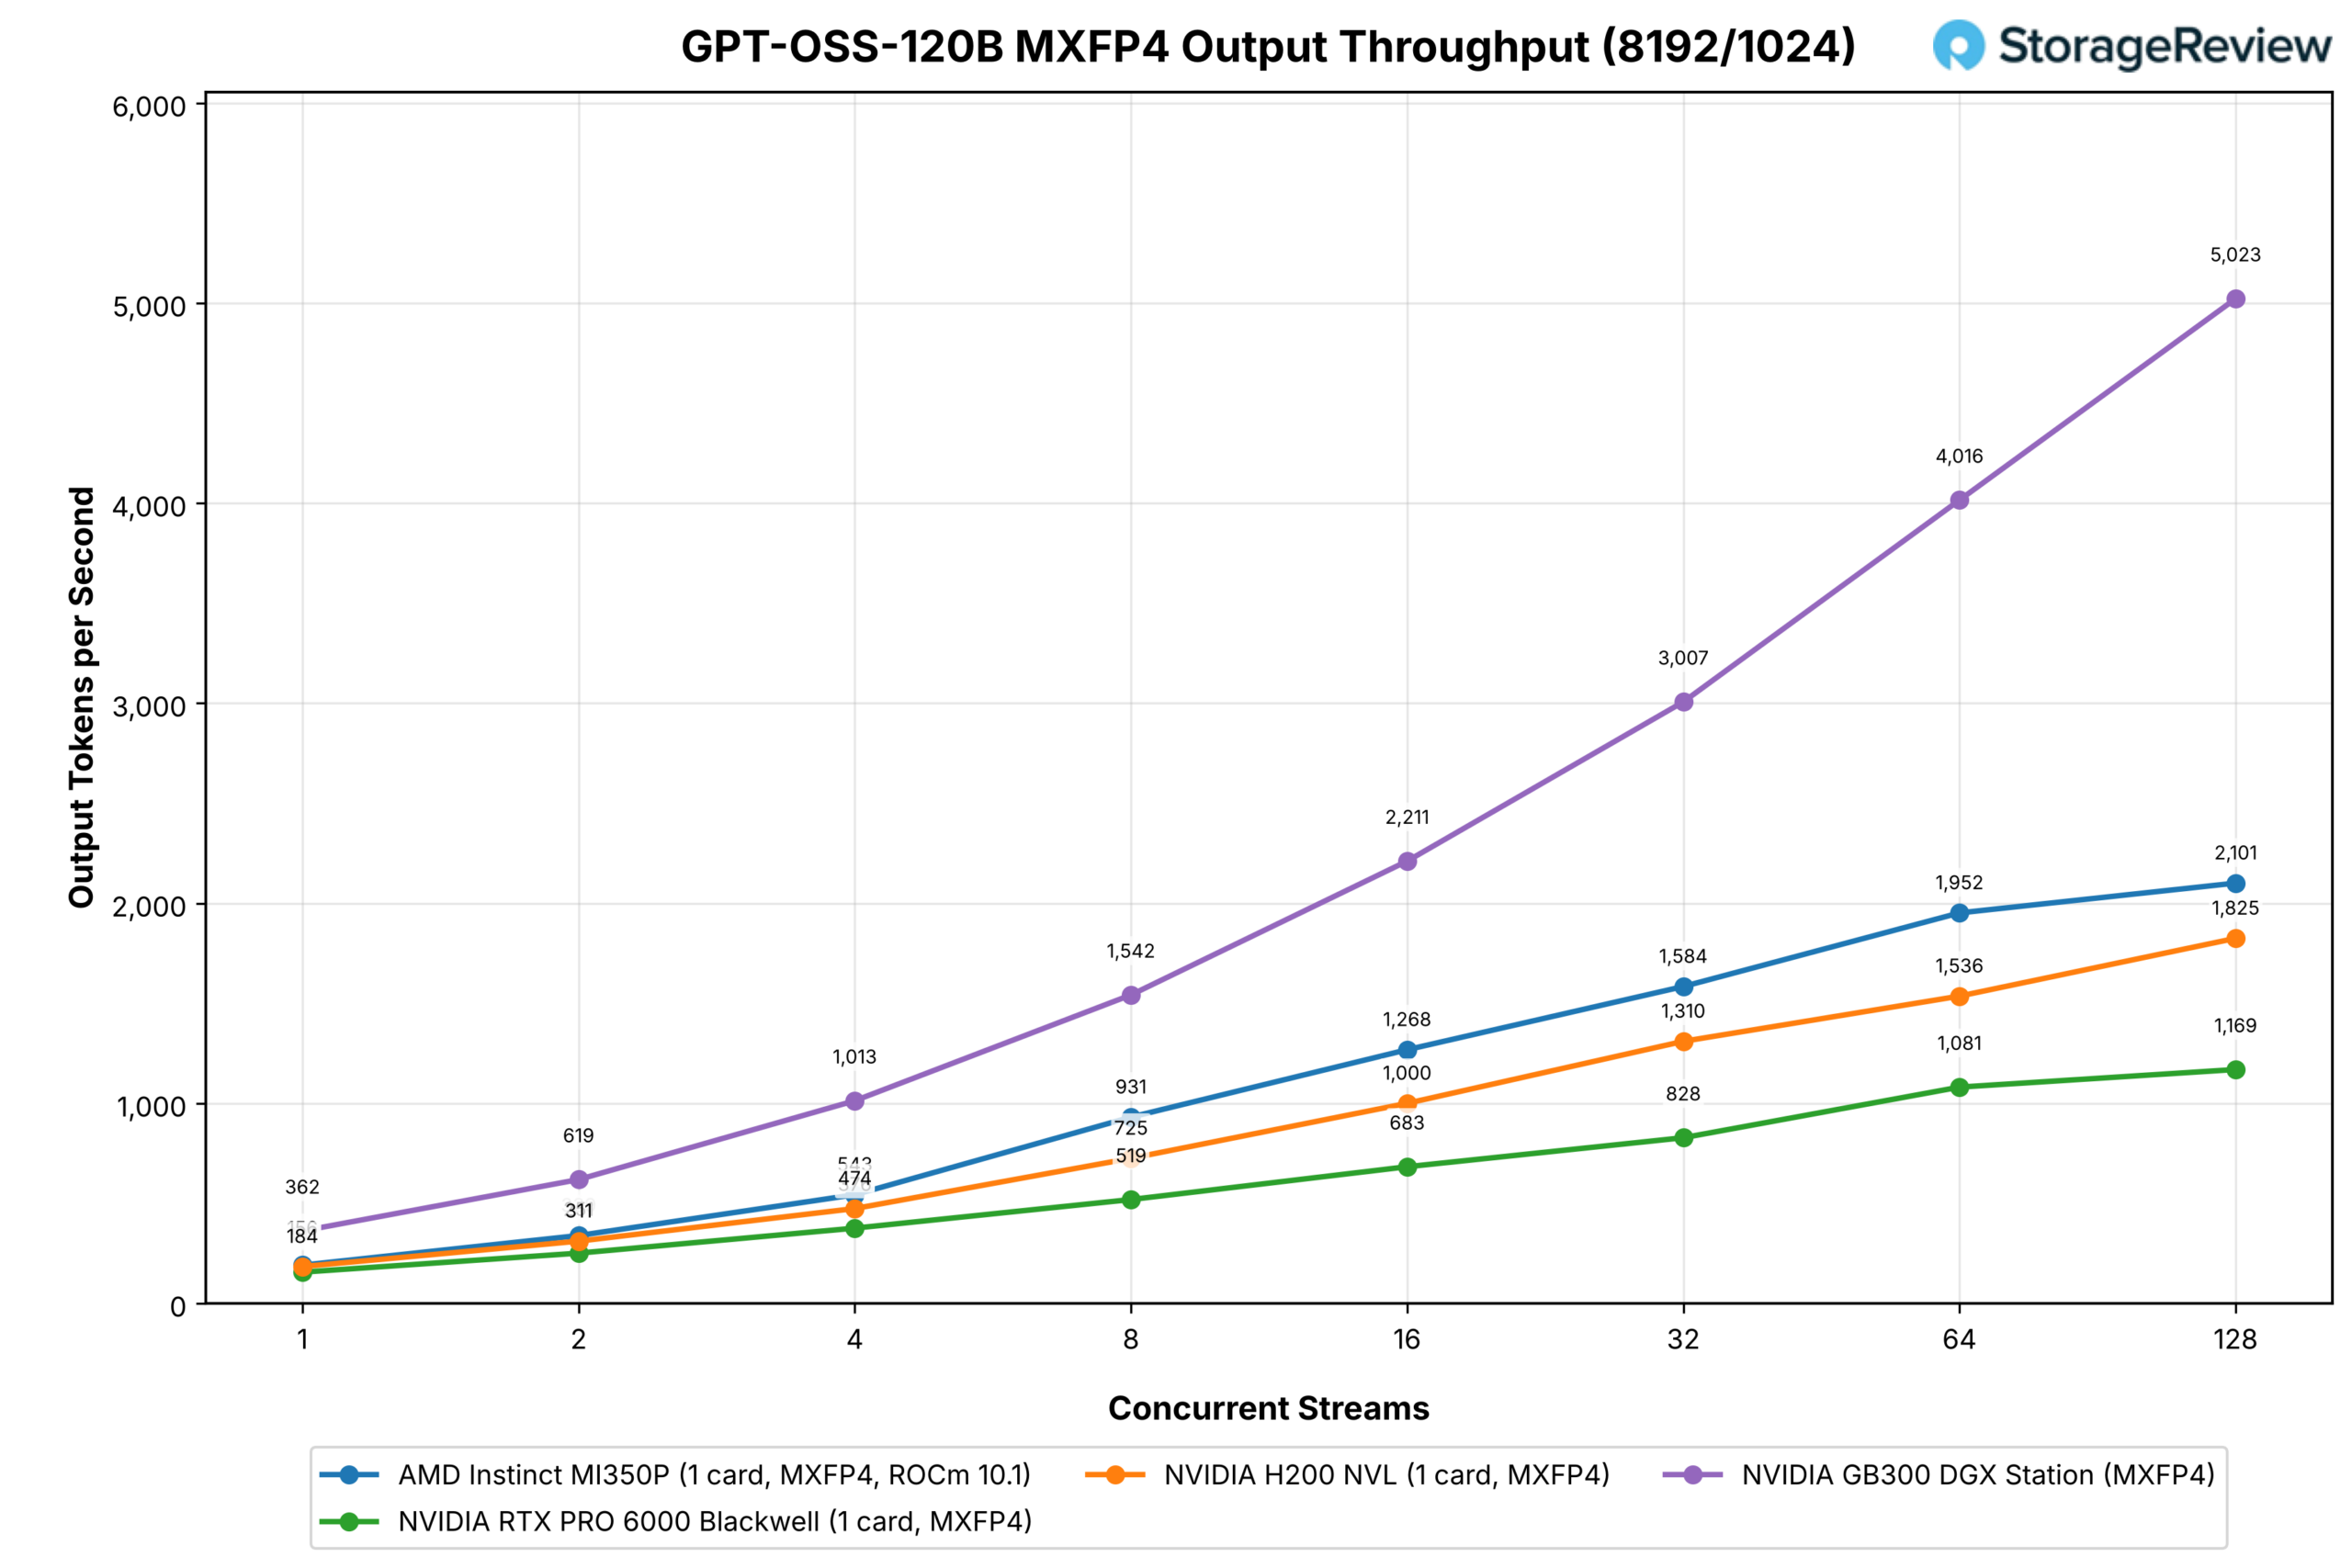
GPT-OSS est livré au format MXFP4, garantissant ainsi des performances identiques pour toutes les cartes. Une MI350P surpasse une RTX PRO 6000 à tous les niveaux de flux, pour les deux charges de travail, avec un gain de 40 à 93 % à partir de quatre flux. Elle atteint 5 057 jetons de sortie par seconde pour la conversation et 2 101 pour les invites avec pré-remplissage à 128 flux, contre respectivement 3 064 et 1 169 pour la RTX PRO 6000 et 3 376 et 1 825 pour la H200 NVL ; la Station atteint quant à elle 9 280 et 5 023.
Le test MLPerf Inference v6.1 d'AMD et Dell, soumis le 16 septembre, fixe une limite aux performances de ce même modèle : huit MI350P dans un PowerEdge XE7745 ont produit 48 971 jetons par seconde hors ligne et 40 868 en configuration serveur avec GPT-OSS-120B, soit respectivement 6 121 et 5 108 jetons par GPU, sur une configuration optimisée. Bien que nos tests ne soient pas parfaitement comparables, les 5 057 jetons que nous avons mesurés avec 128 flux et la configuration vLLM par défaut se situent dans la partie inférieure de cette plage.
GPT-OSS-20B
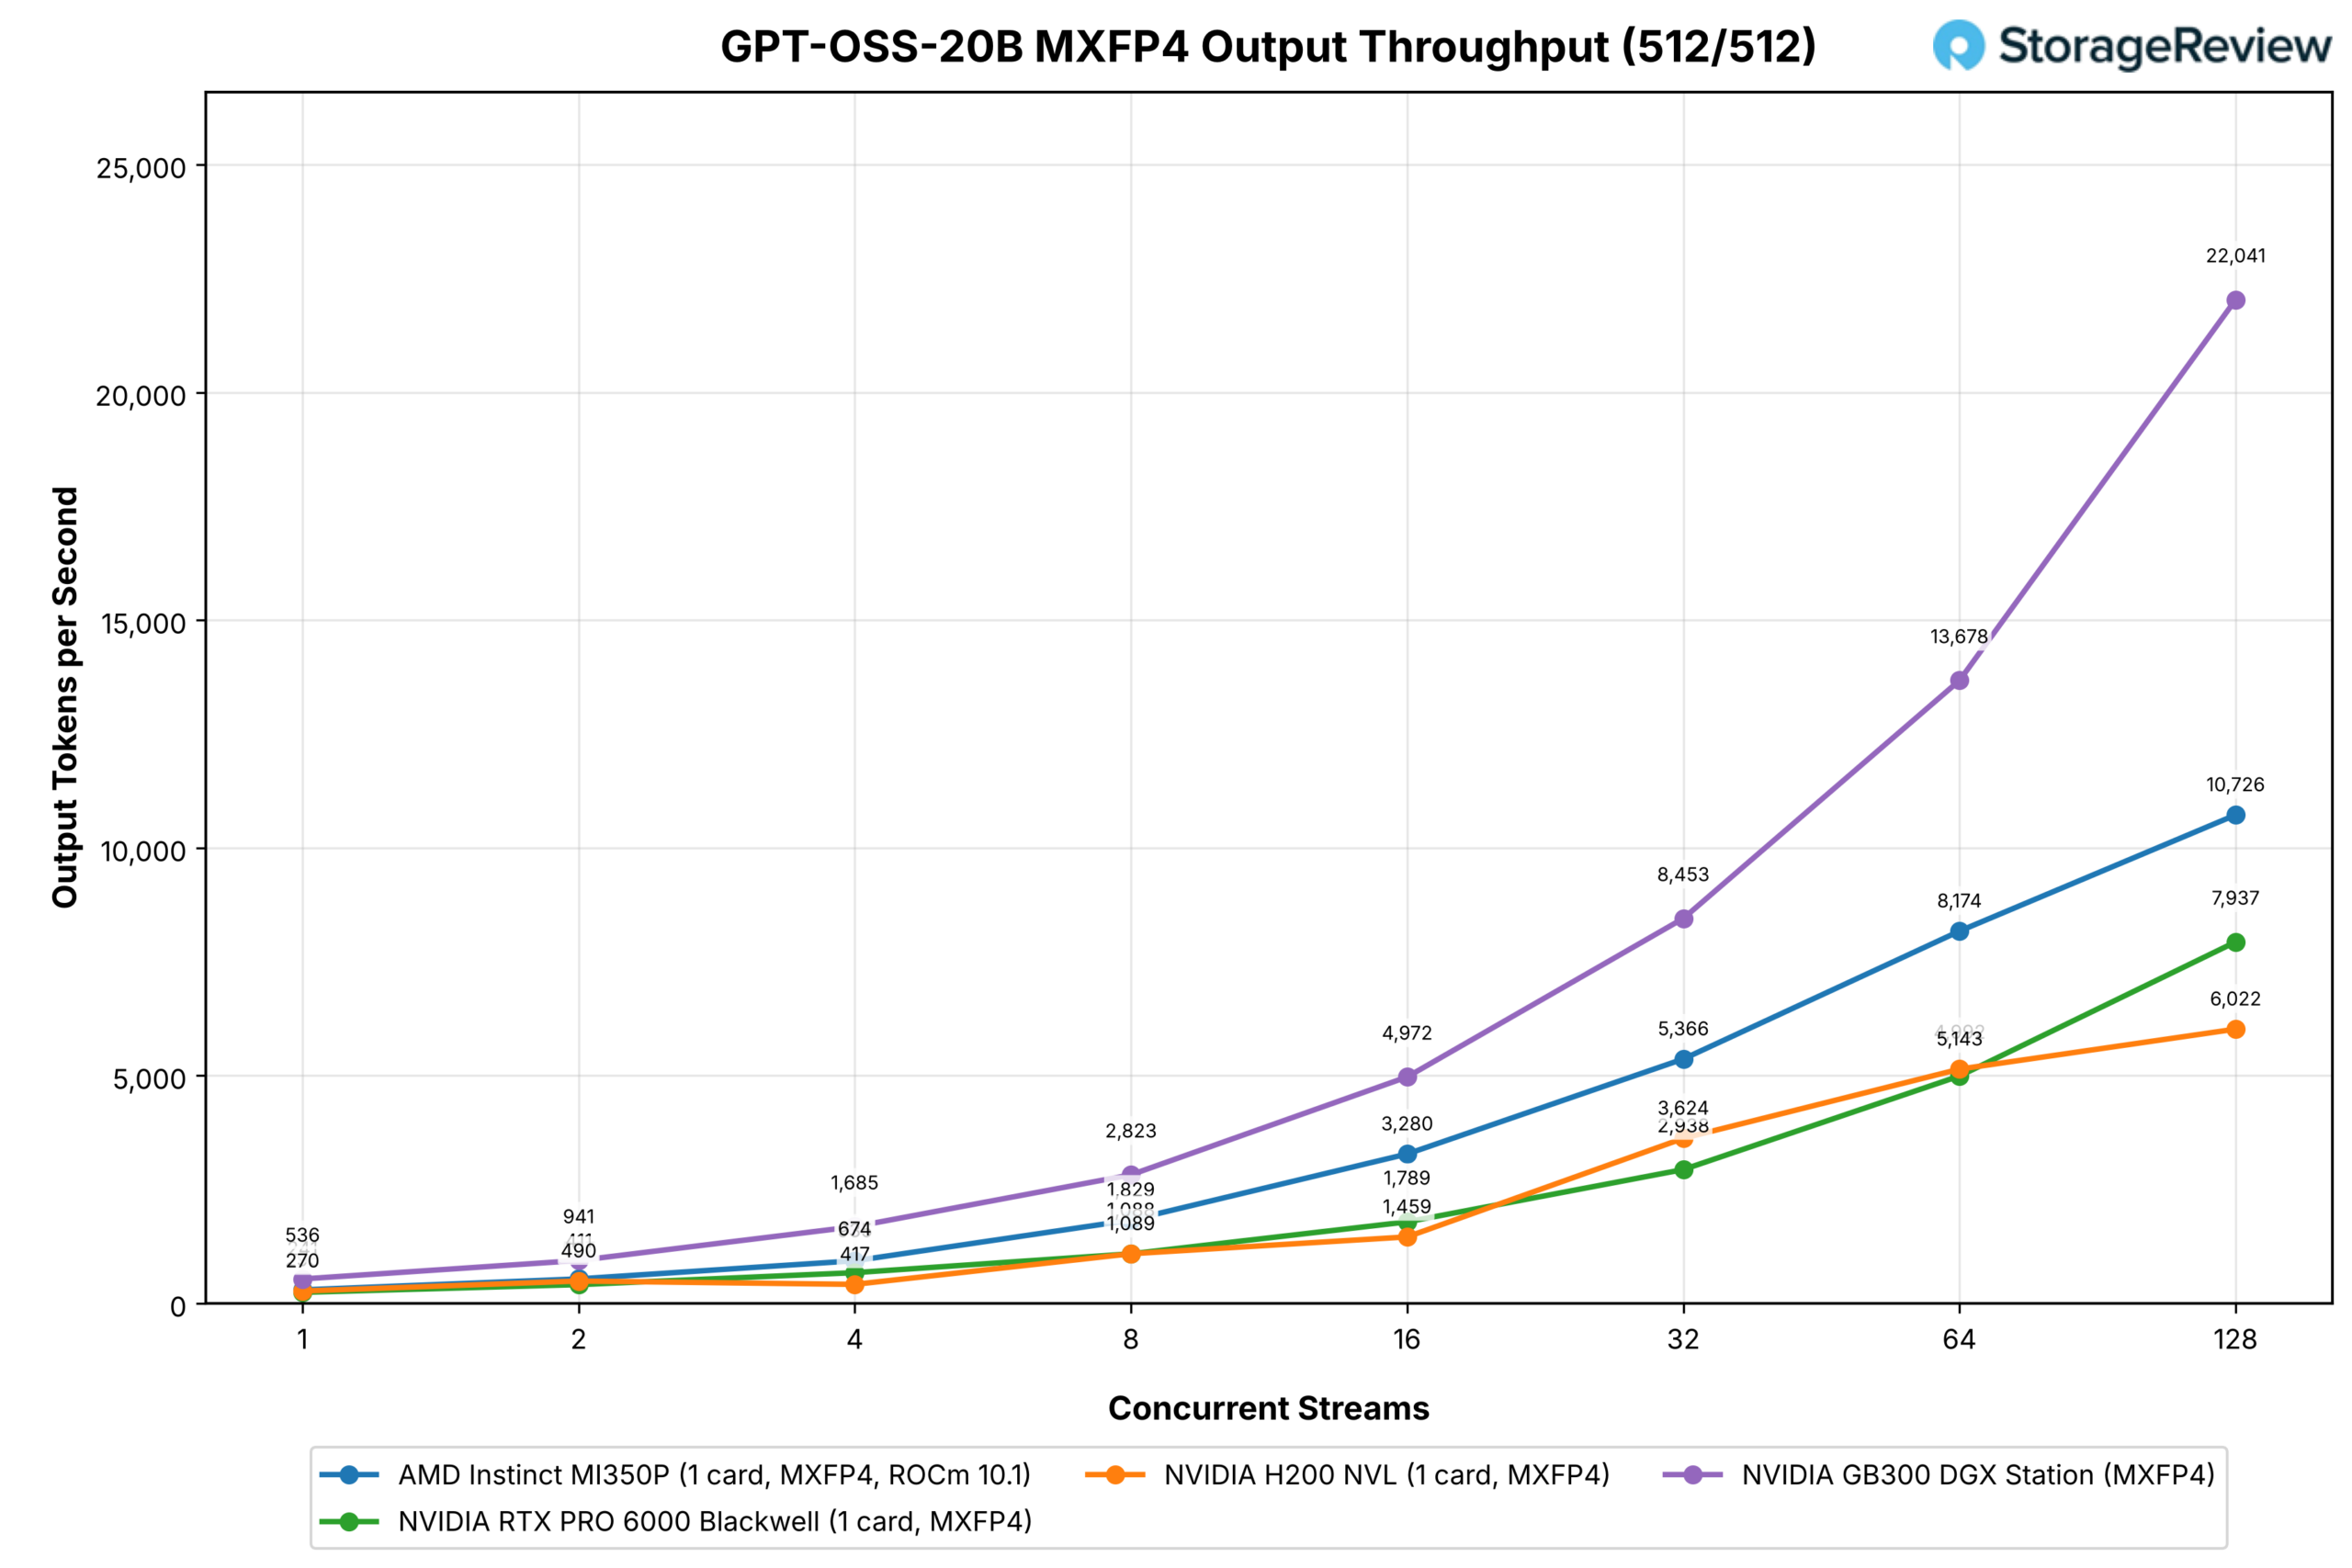
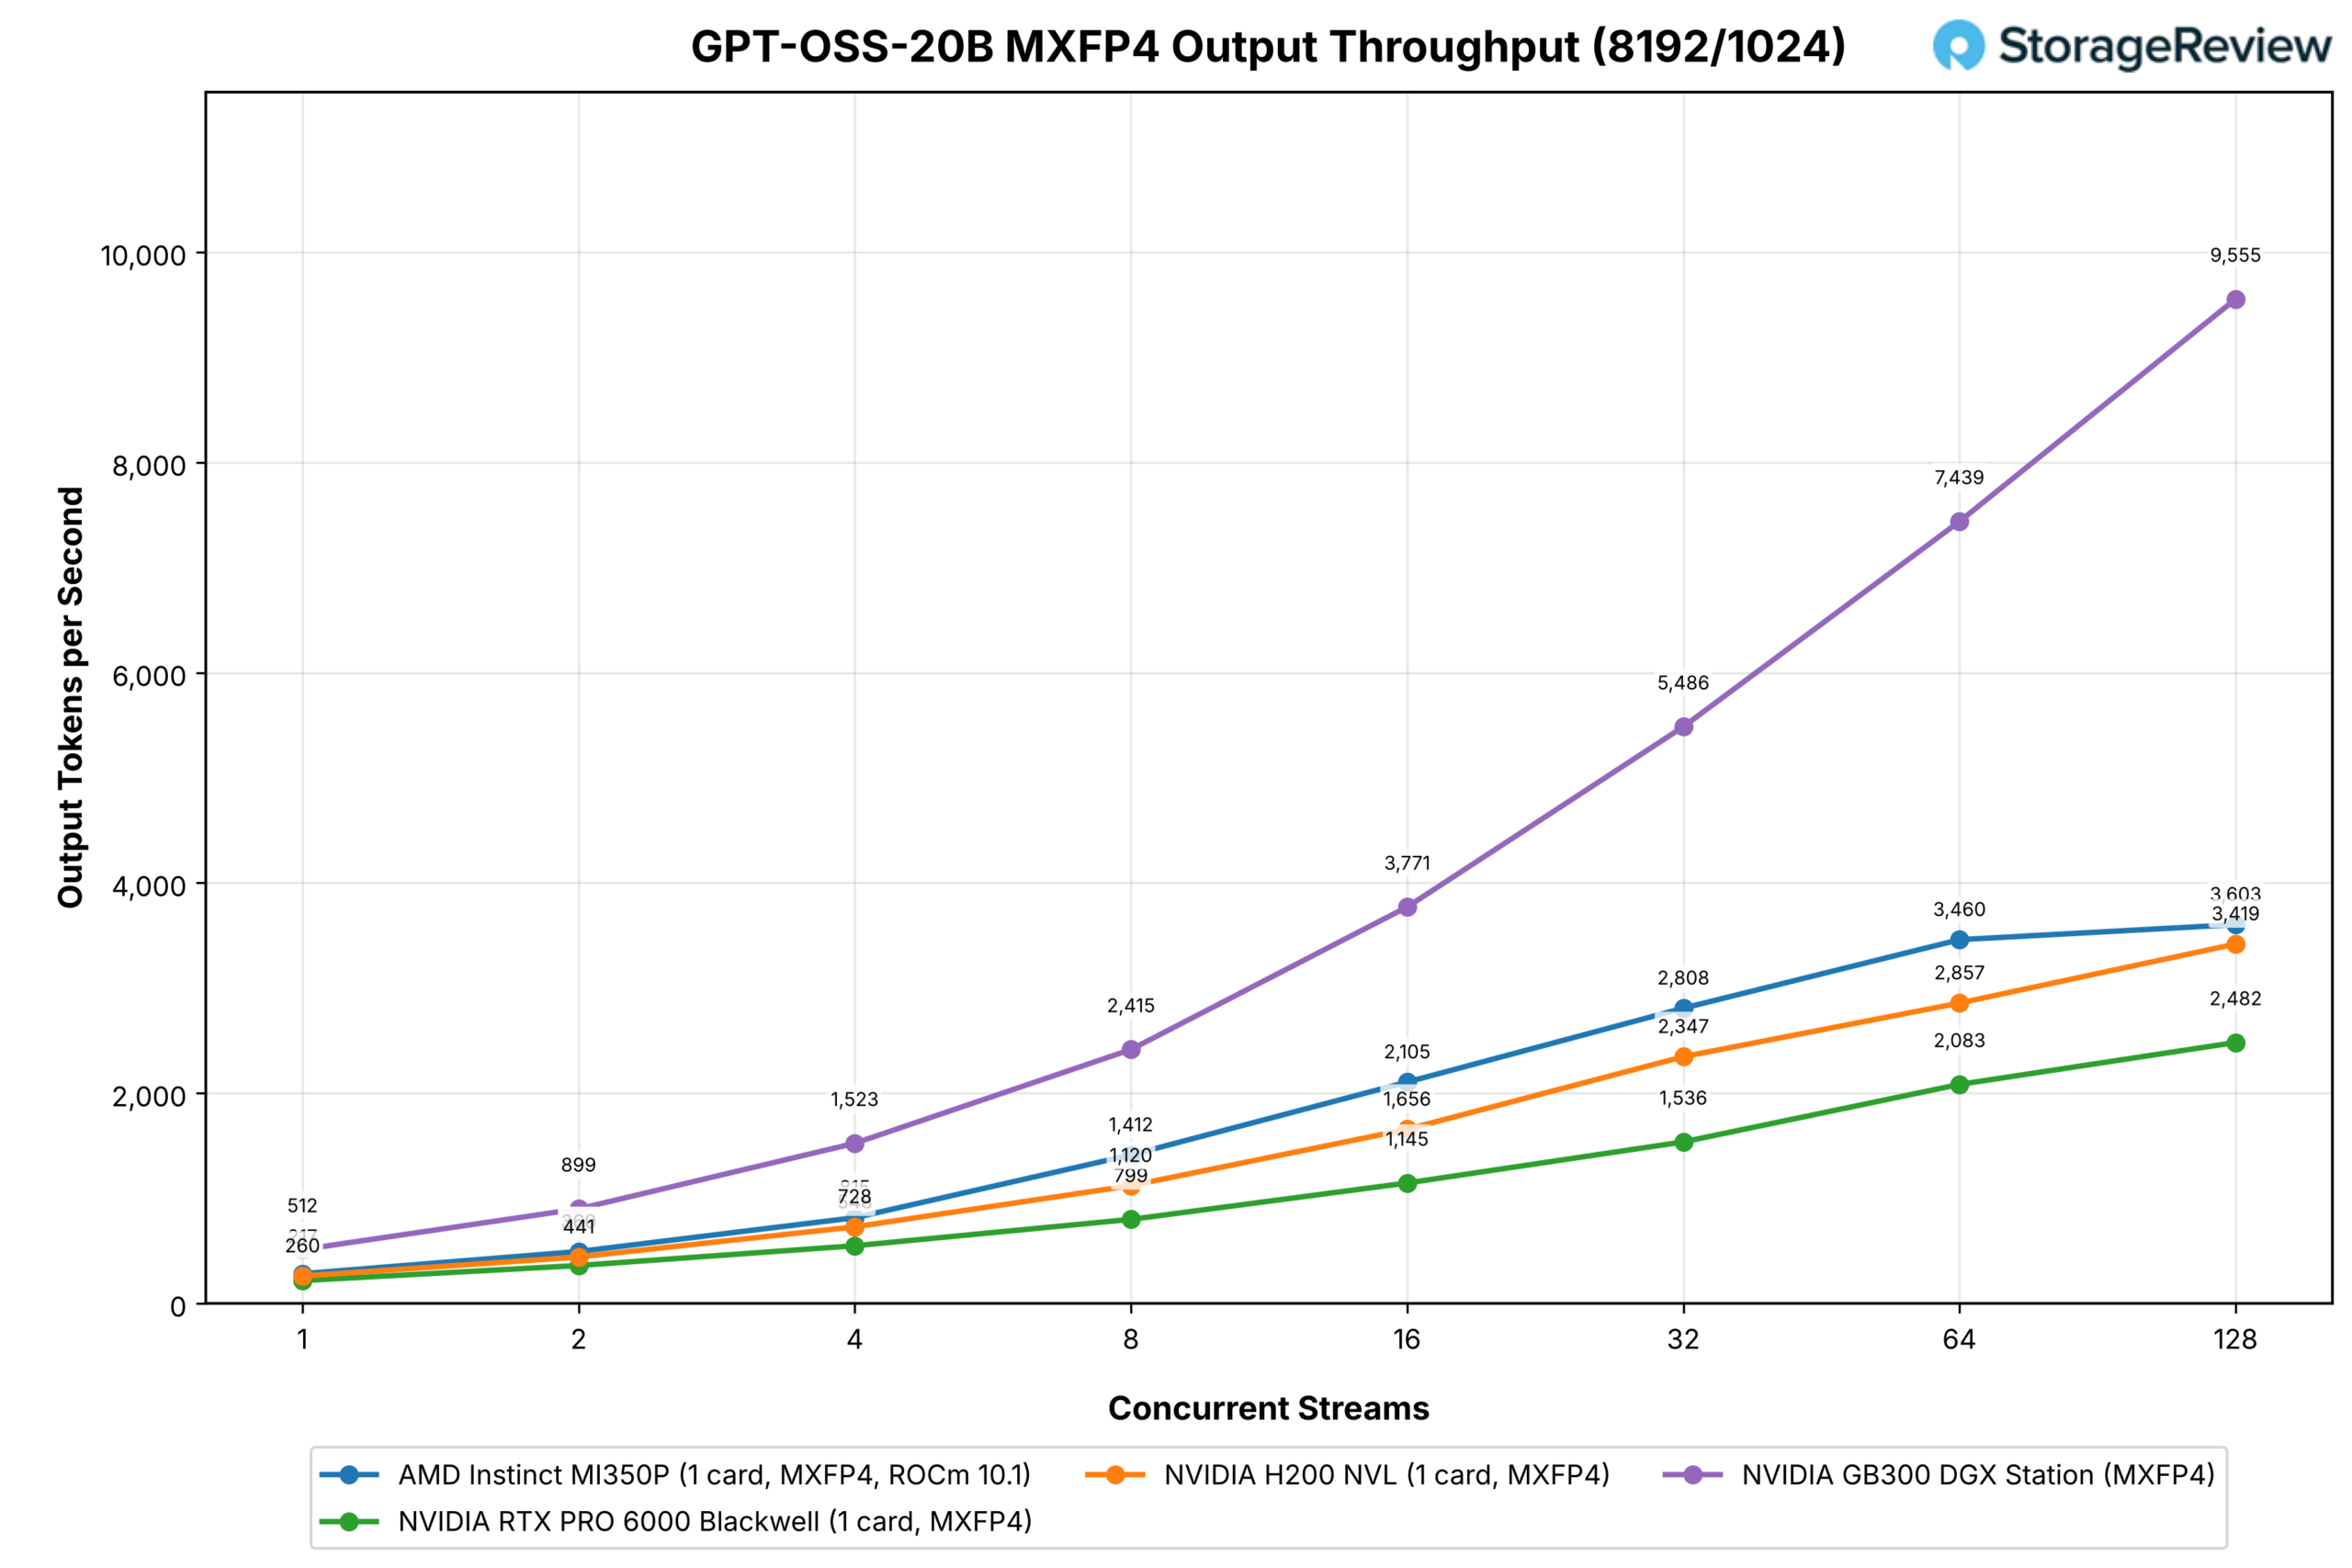
Le modèle OpenAI plus petit suit la même courbe. Le MI350P surpasse le RTX PRO 6000 sur tous les points : 8 174 contre 4 992 à 64 flux et 10 726 contre 7 937 à 128 flux pour la charge de travail de chat ; 3 460 contre 2 083 et 3 603 contre 2 482 pour les invites nécessitant un pré-remplissage important ; et il atteint 16 406 à 256 flux, contre 11 077 pour le RTX PRO 6000. Le H200 NVL est en retrait par rapport au MI350P sur les deux configurations, avec 6 022 et 3 419 à 128 flux, tandis que la Station se situe à 22 041 et 9 555.
Qwen3-Coder-30B-A3B
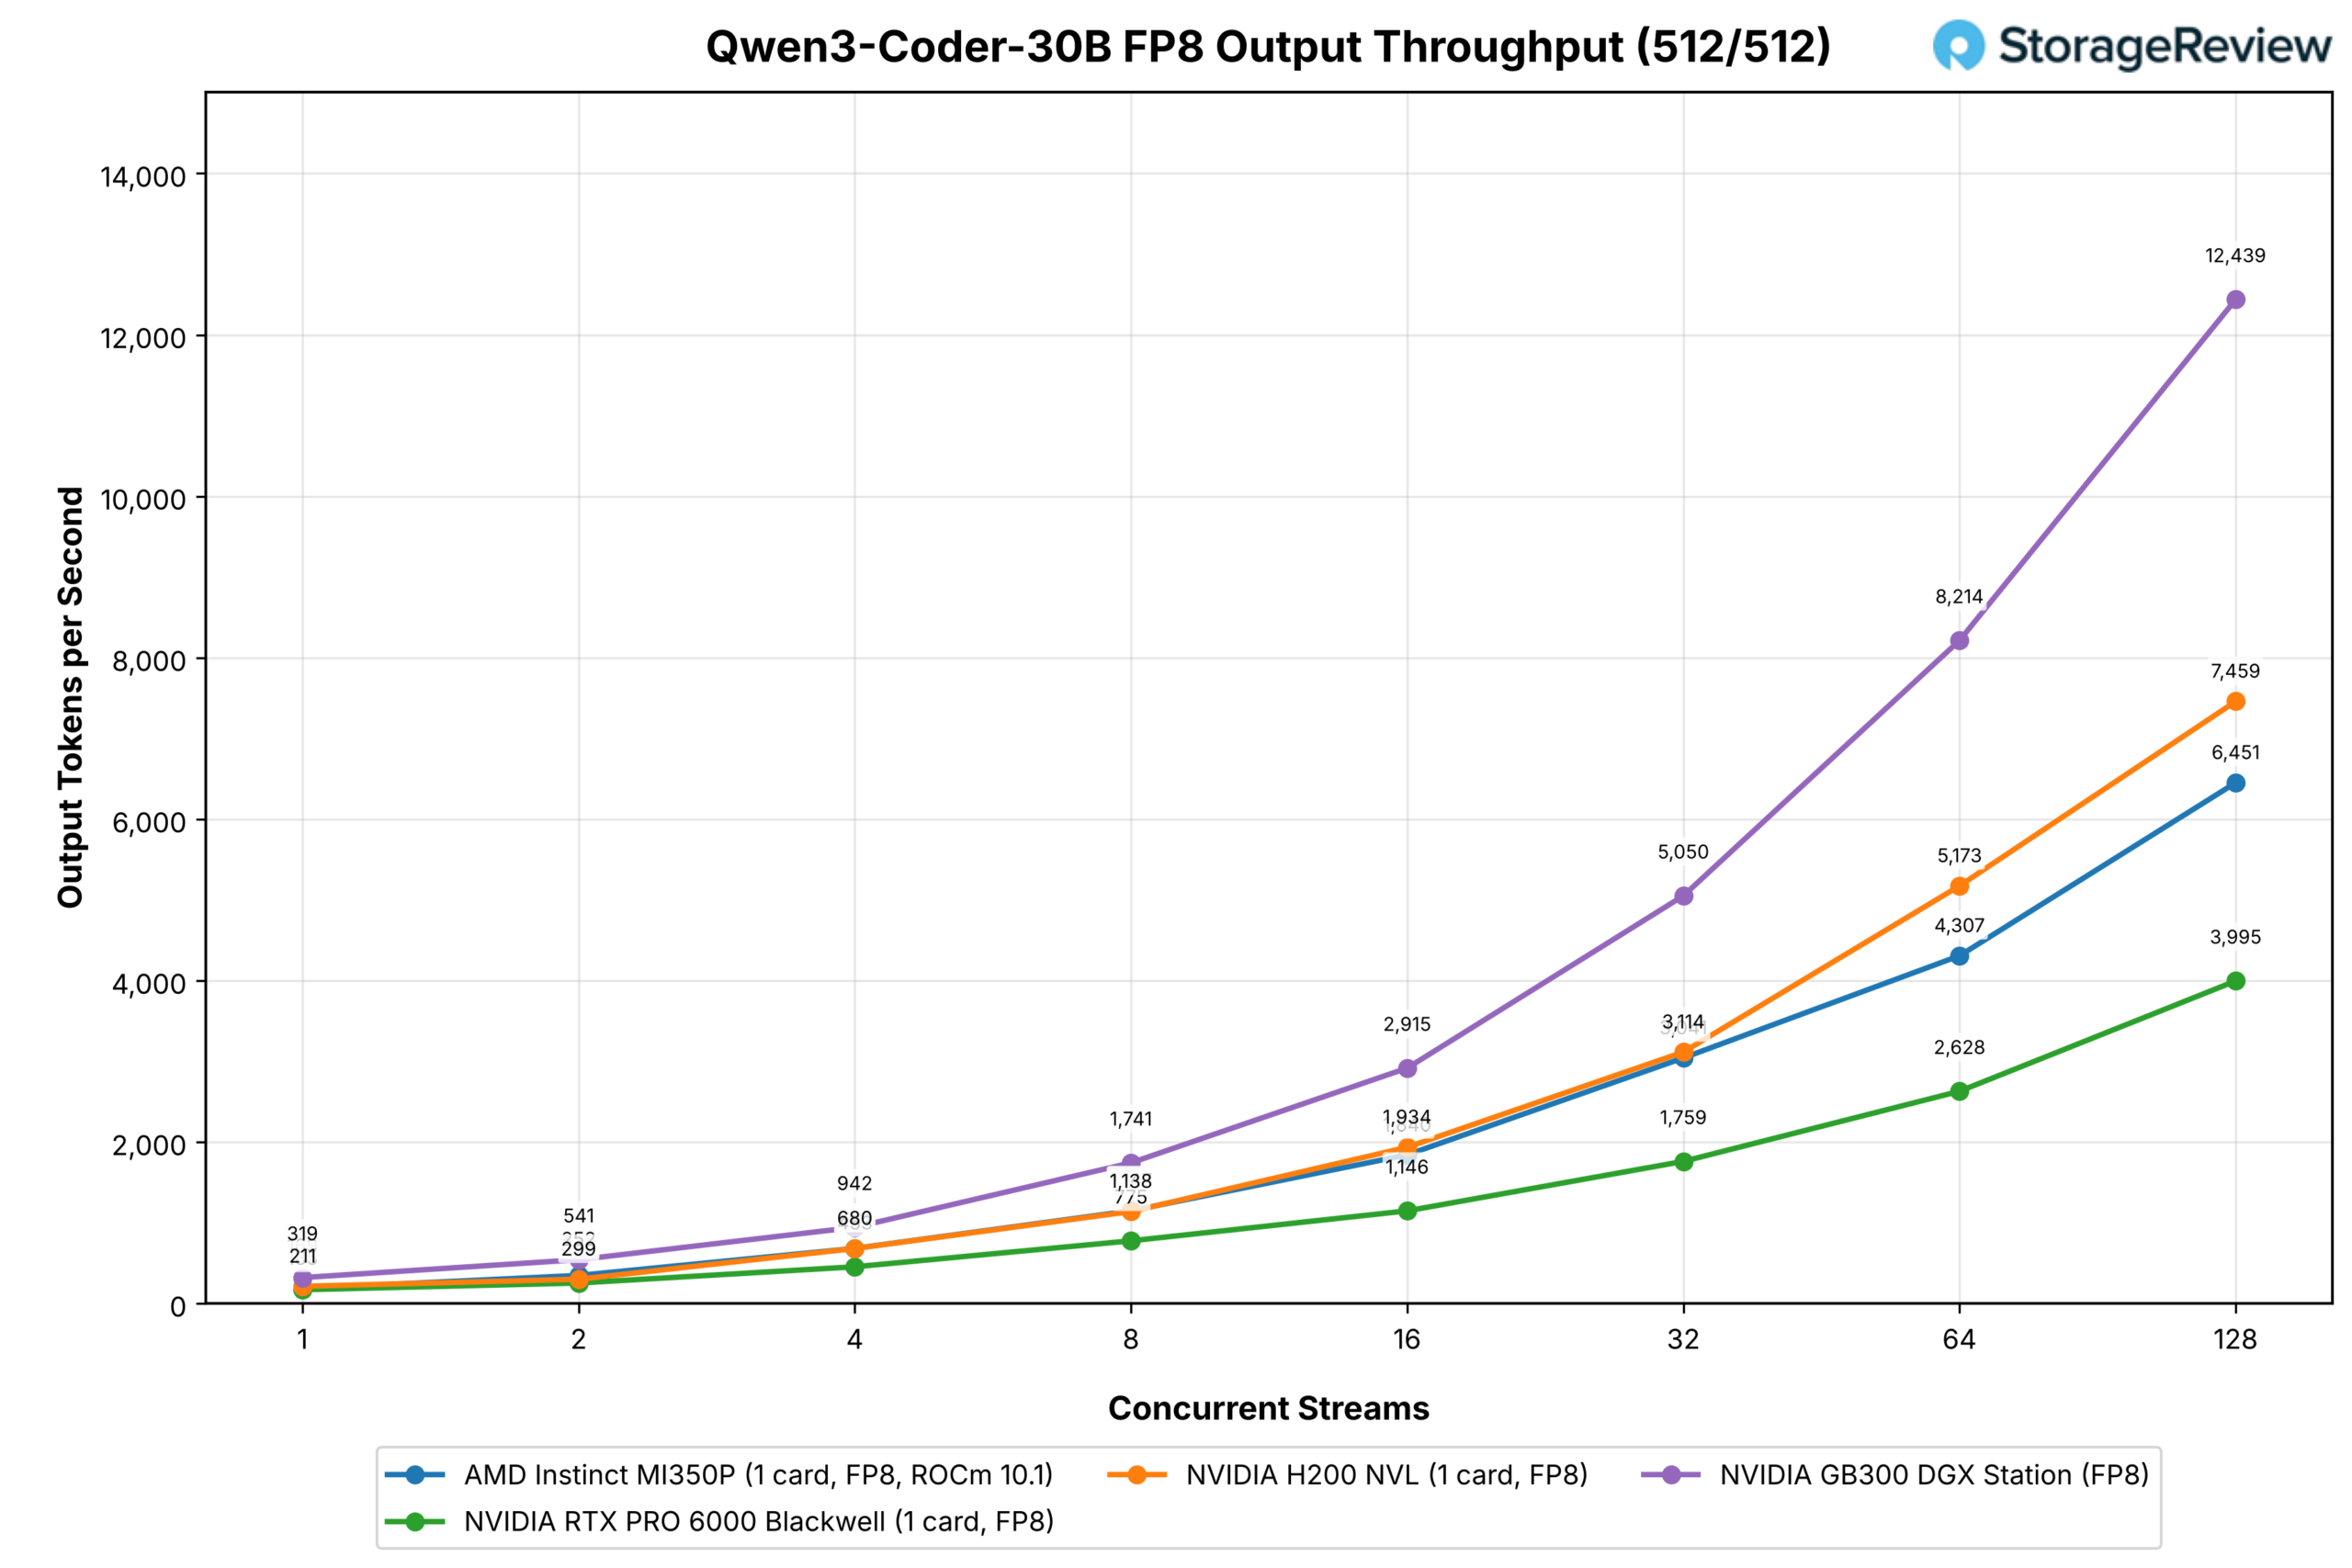
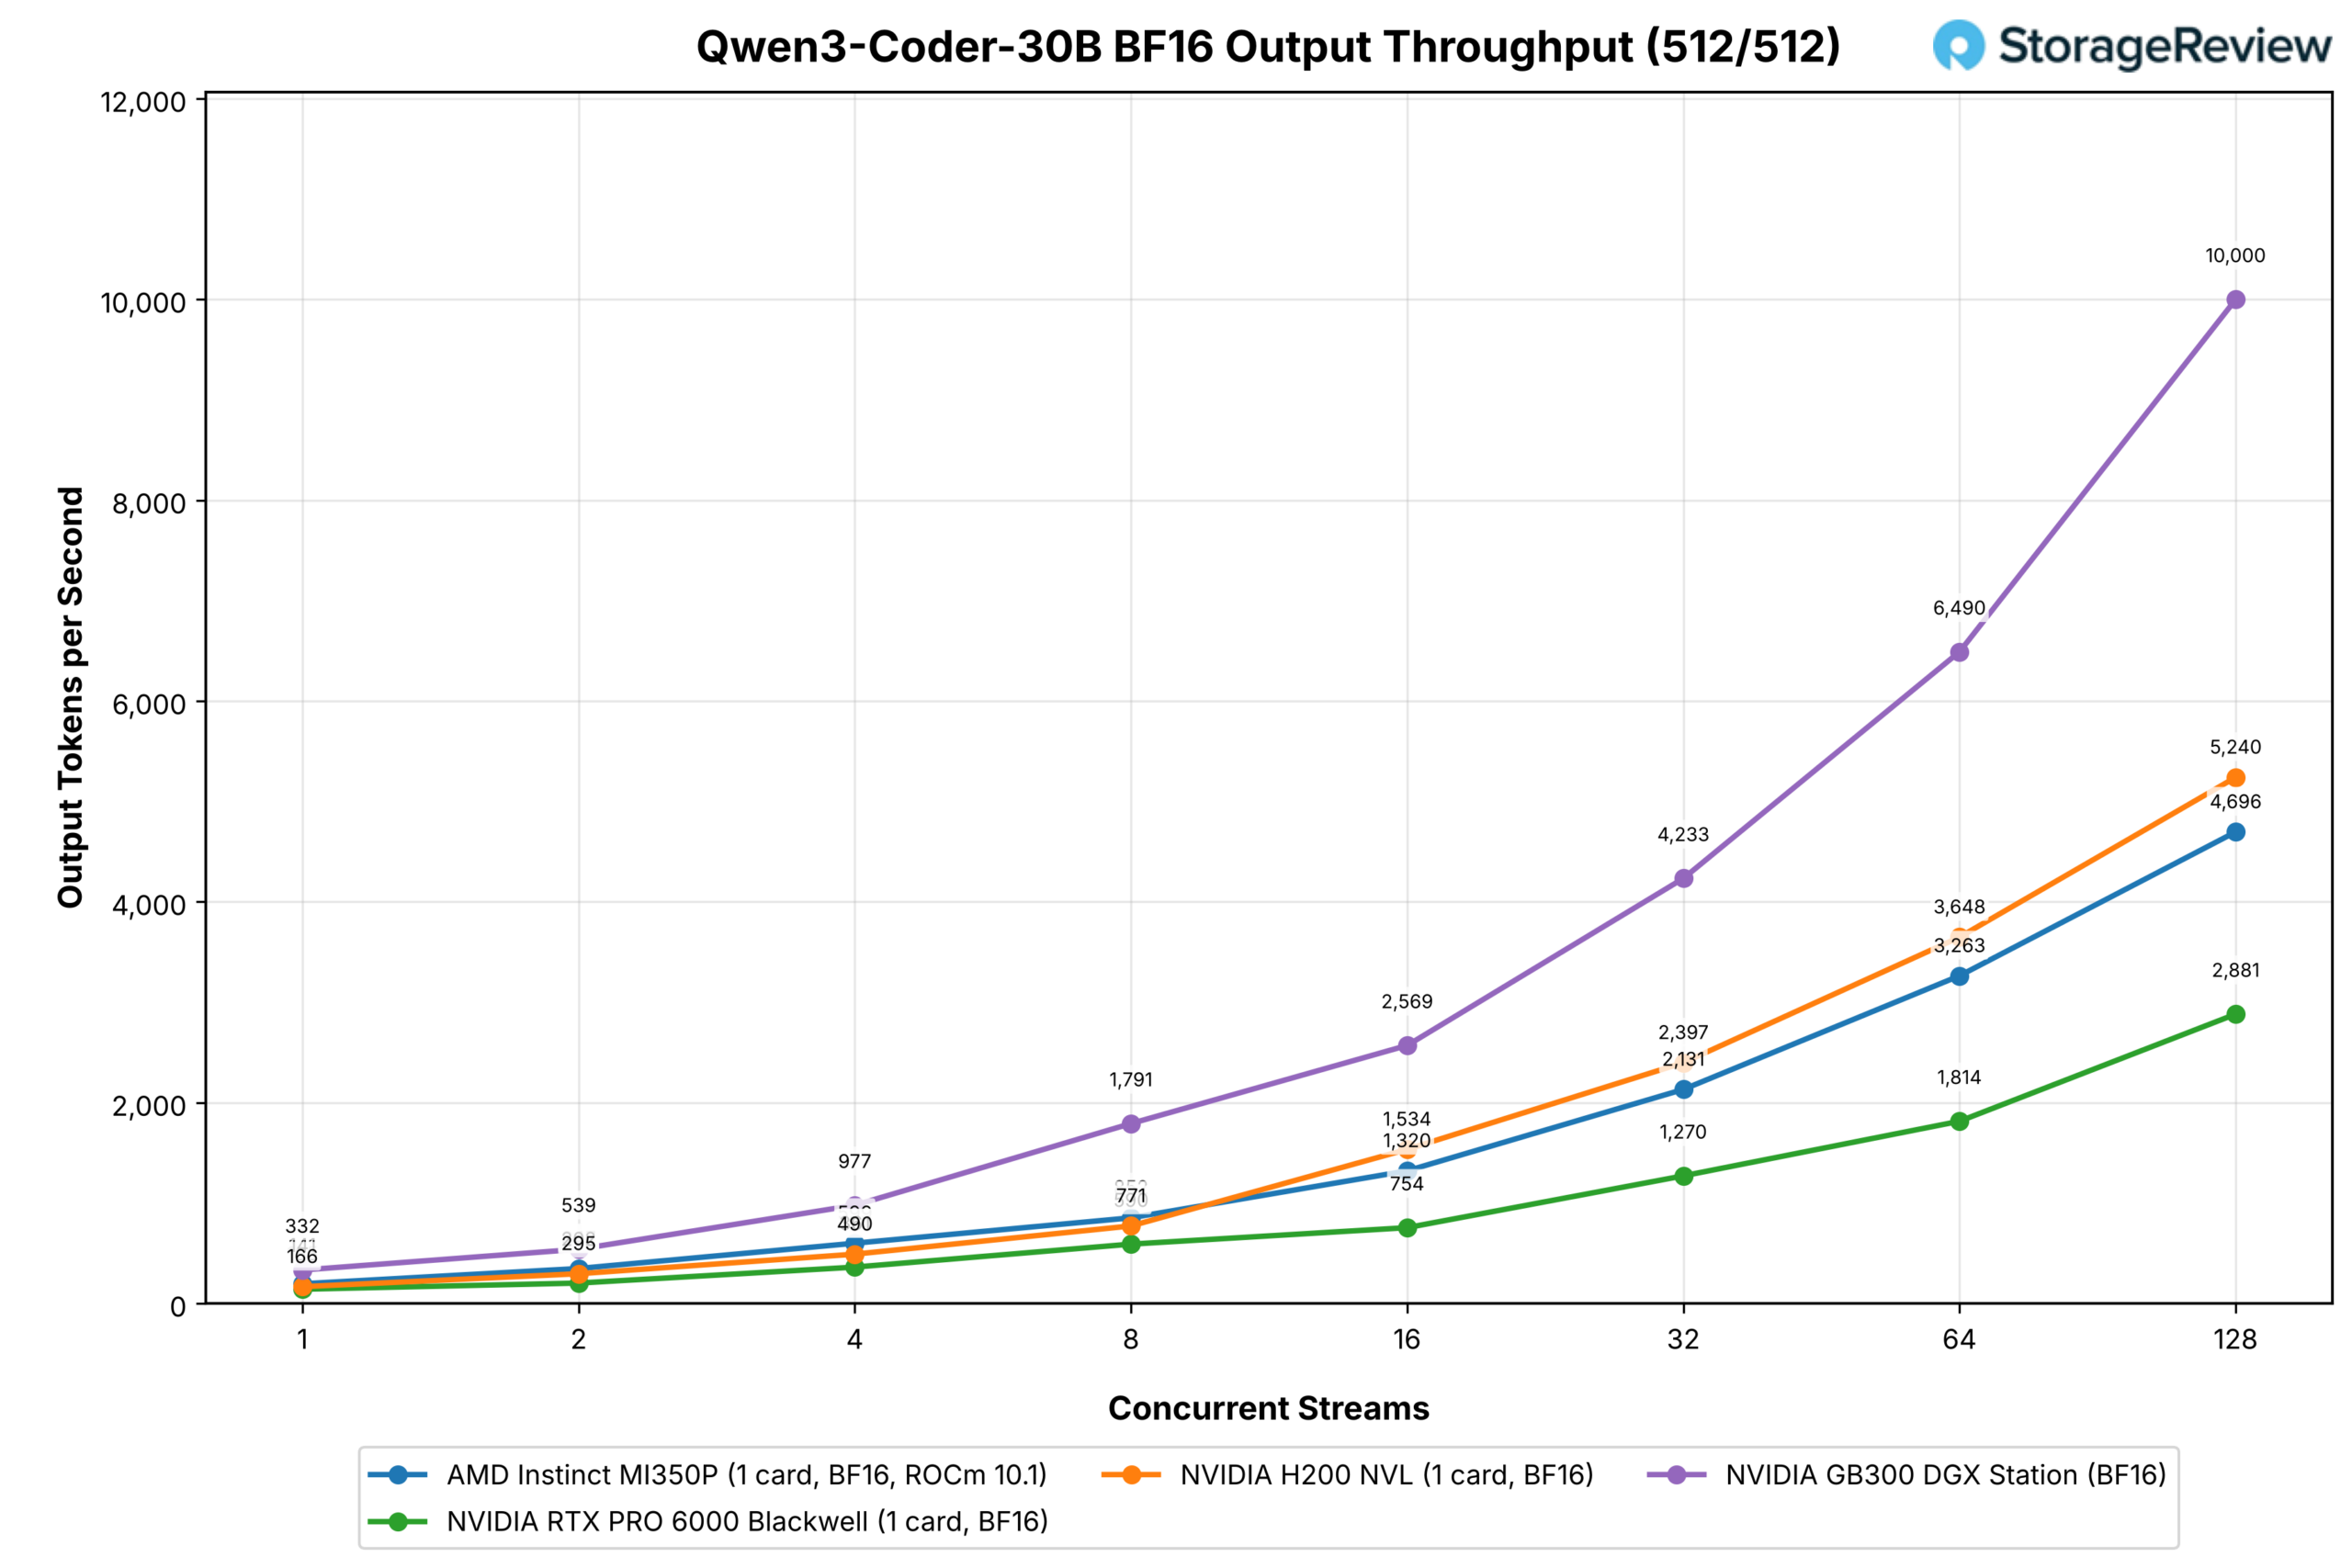
Le 30B MoE avec 3B paramètres actifs donne au MI350P une avance sur le RTX PRO 6000 à chaque simultanéité sur la charge de travail de chat, terminant à 6 451 contre 3 995 sur FP8 et 4 696 contre 2 881 sur BF16 à 128 flux, avec le H200 à 7 459 et 5 240.
Sur les invites nécessitant un préremplissage important, le test FP8 ne mène que sur quatre flux, puis est devancé par le RTX PRO 6000 de huit à 128, 759 contre 823 au sommet, avec le H200 à 1 820 ; le test BF16 grimpe à 728 à 128 flux contre 588 et 1 592.
Mistral Small 3.1 24B
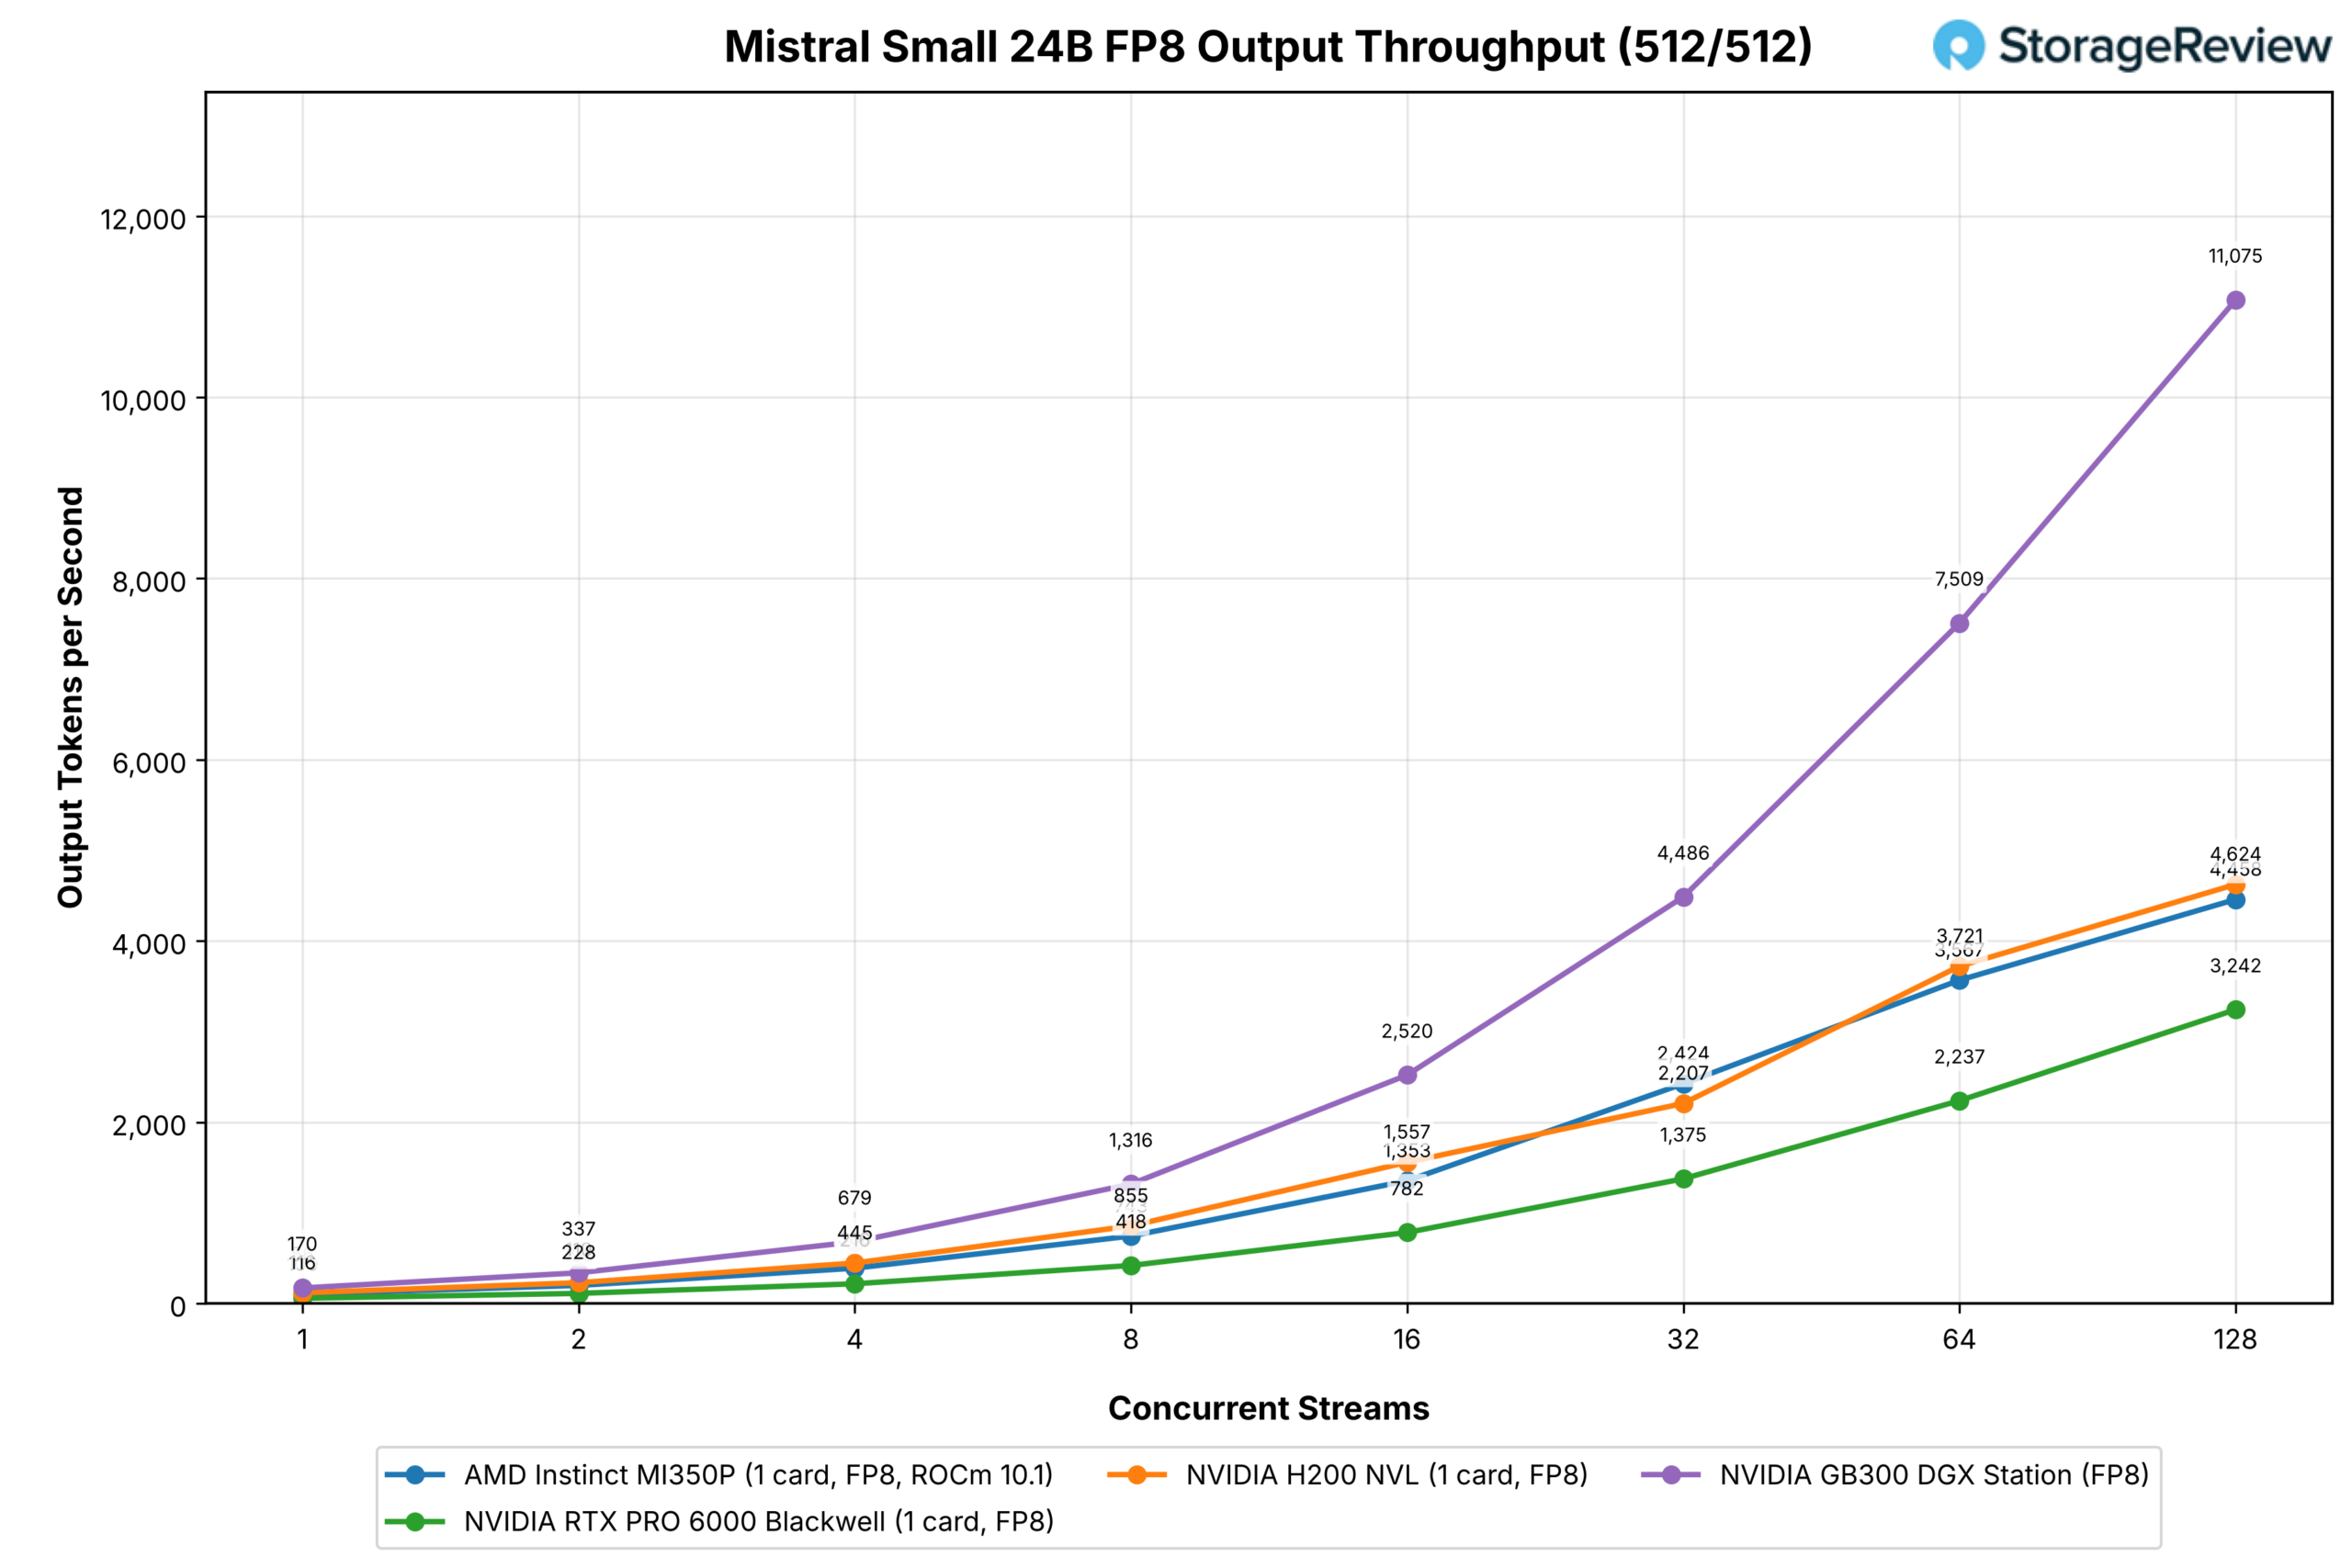
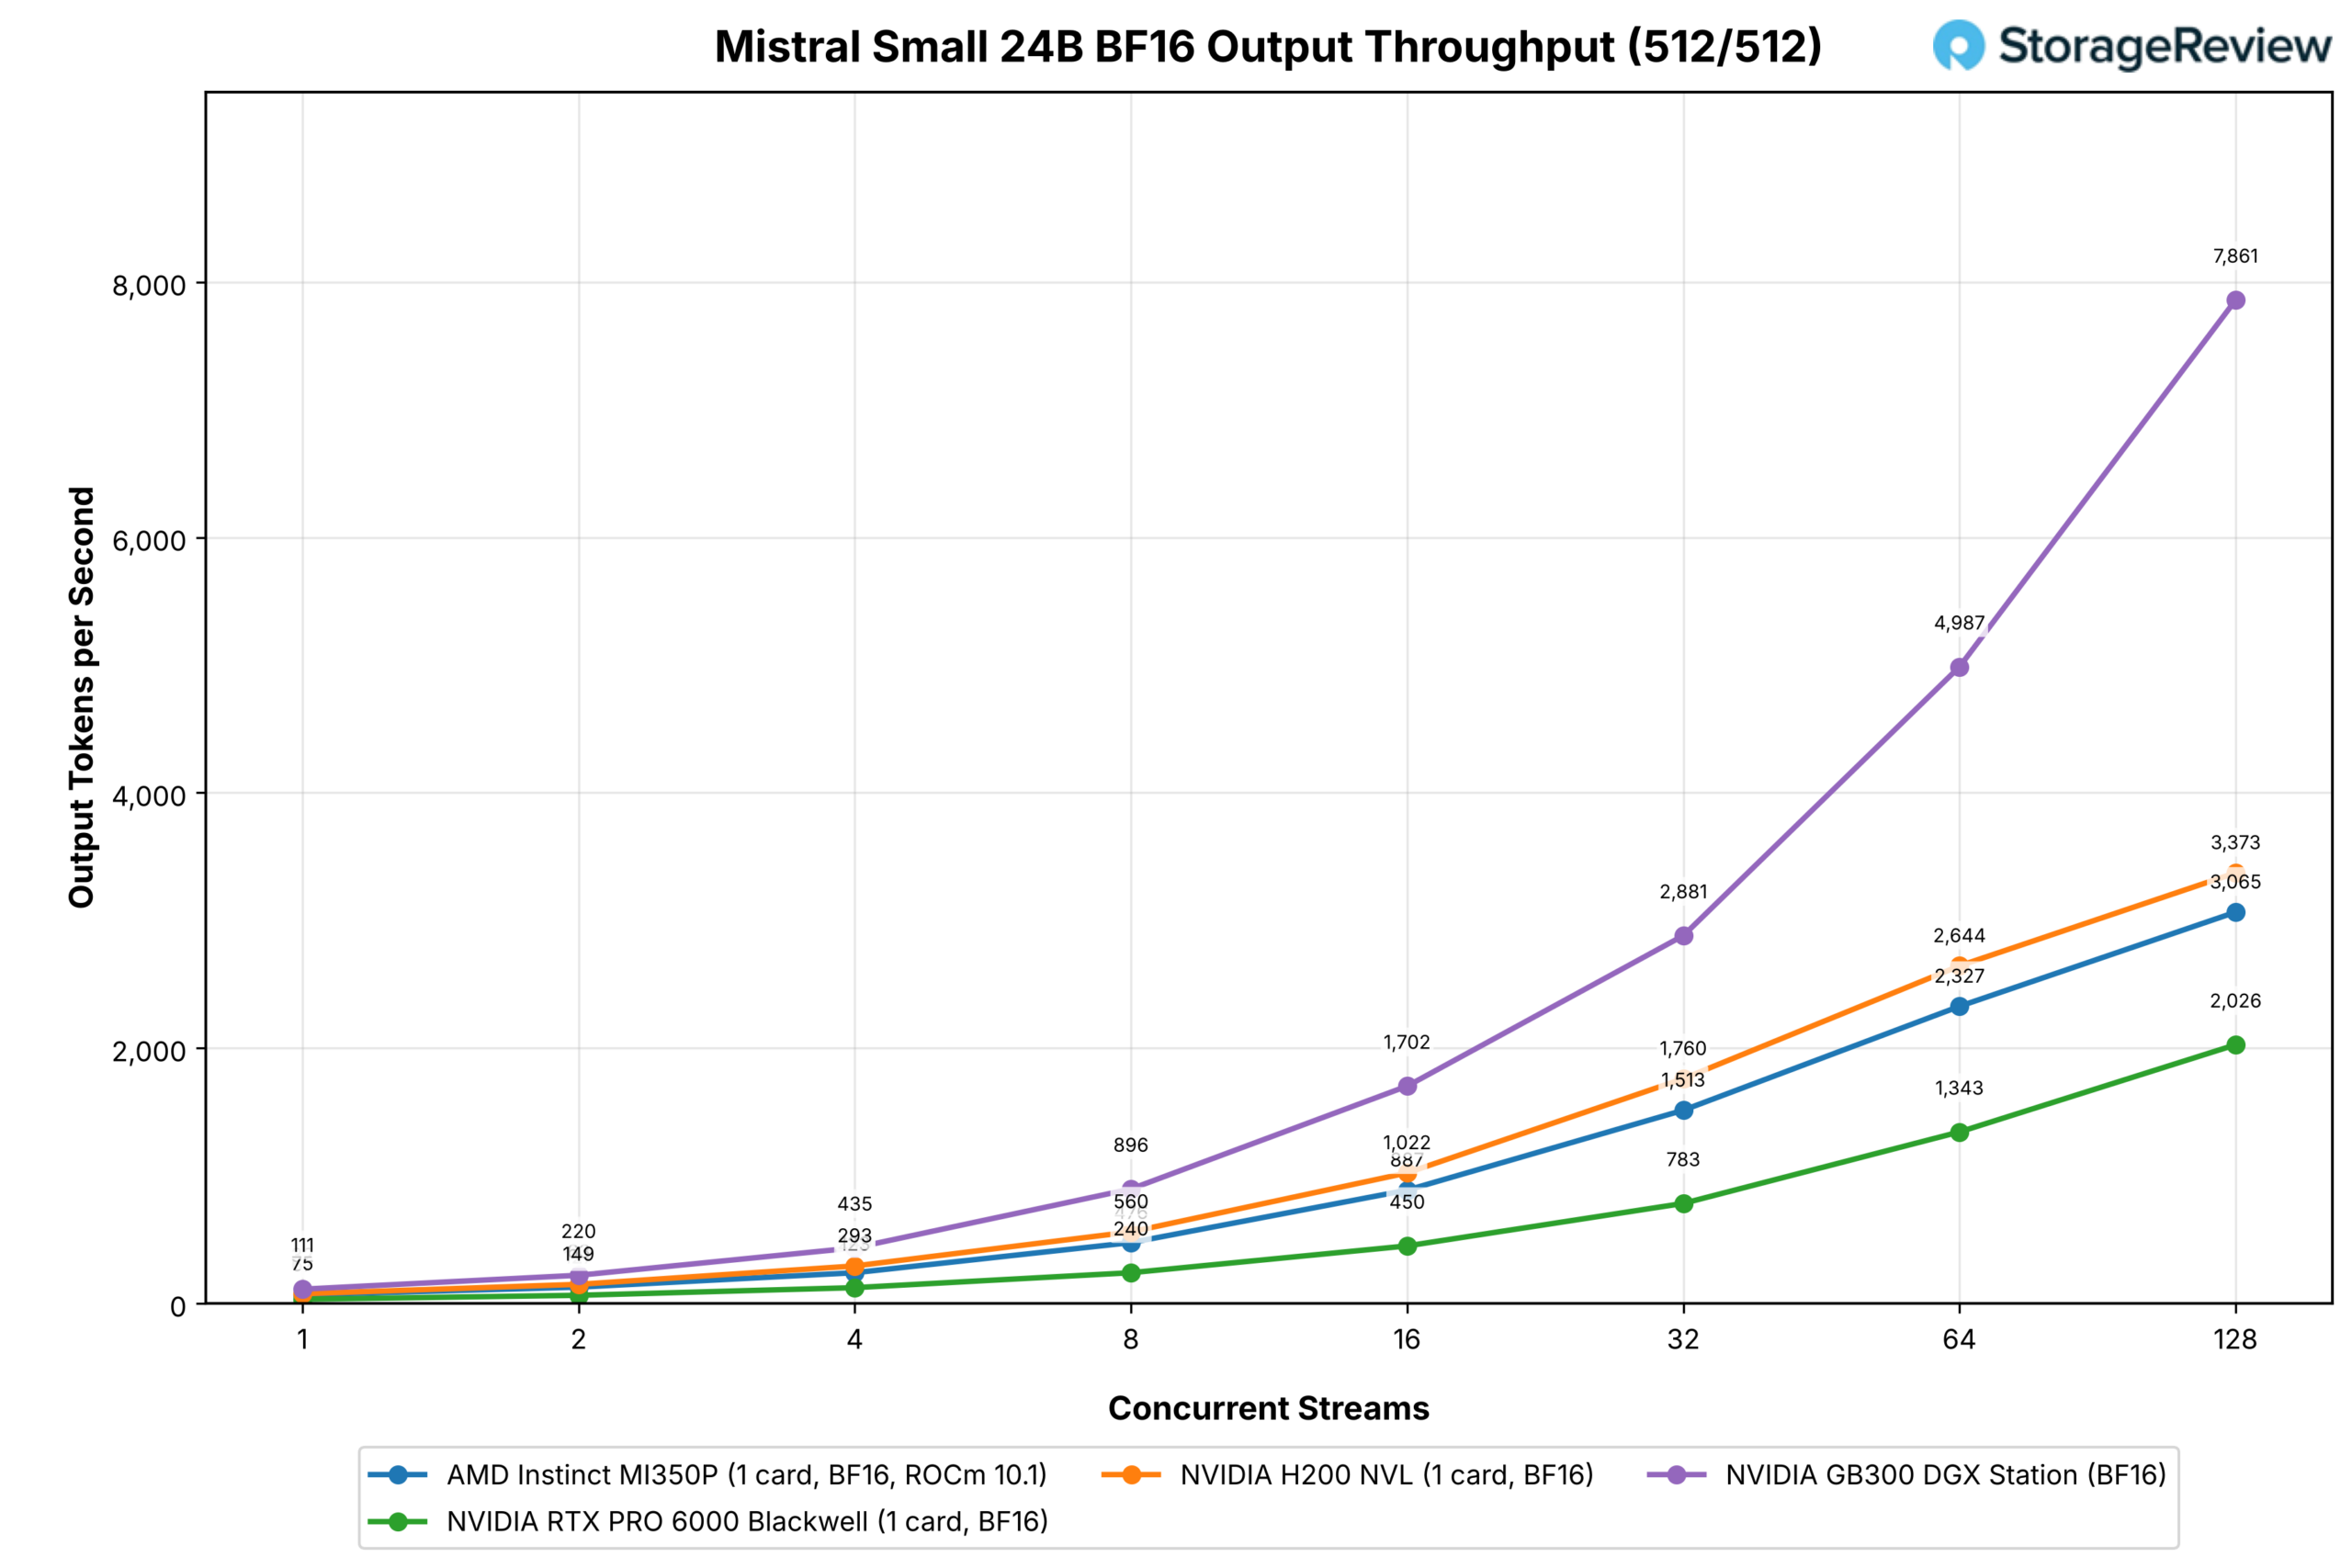
Mistral Small est le résultat le plus dense du MI350P face à la RTX PRO 6000 : 4 458 contre 3 242 sur FP8 et 3 065 contre 2 026 sur BF16 à 128 flux sur la charge de travail de chat, et à un seul flux, le MI350P double approximativement la carte NVIDIA (100 contre 56 sur FP8, 67 contre 32 sur BF16).
C'est également le modèle dense où le MI350P mène sur les invites à préremplissage important, 599 contre 482 sur FP8 à 128 flux et 425 contre 299 sur BF16 à 64, bien que le H200 atteigne 799 et 632 aux mêmes points.
Lama 3.1 8B
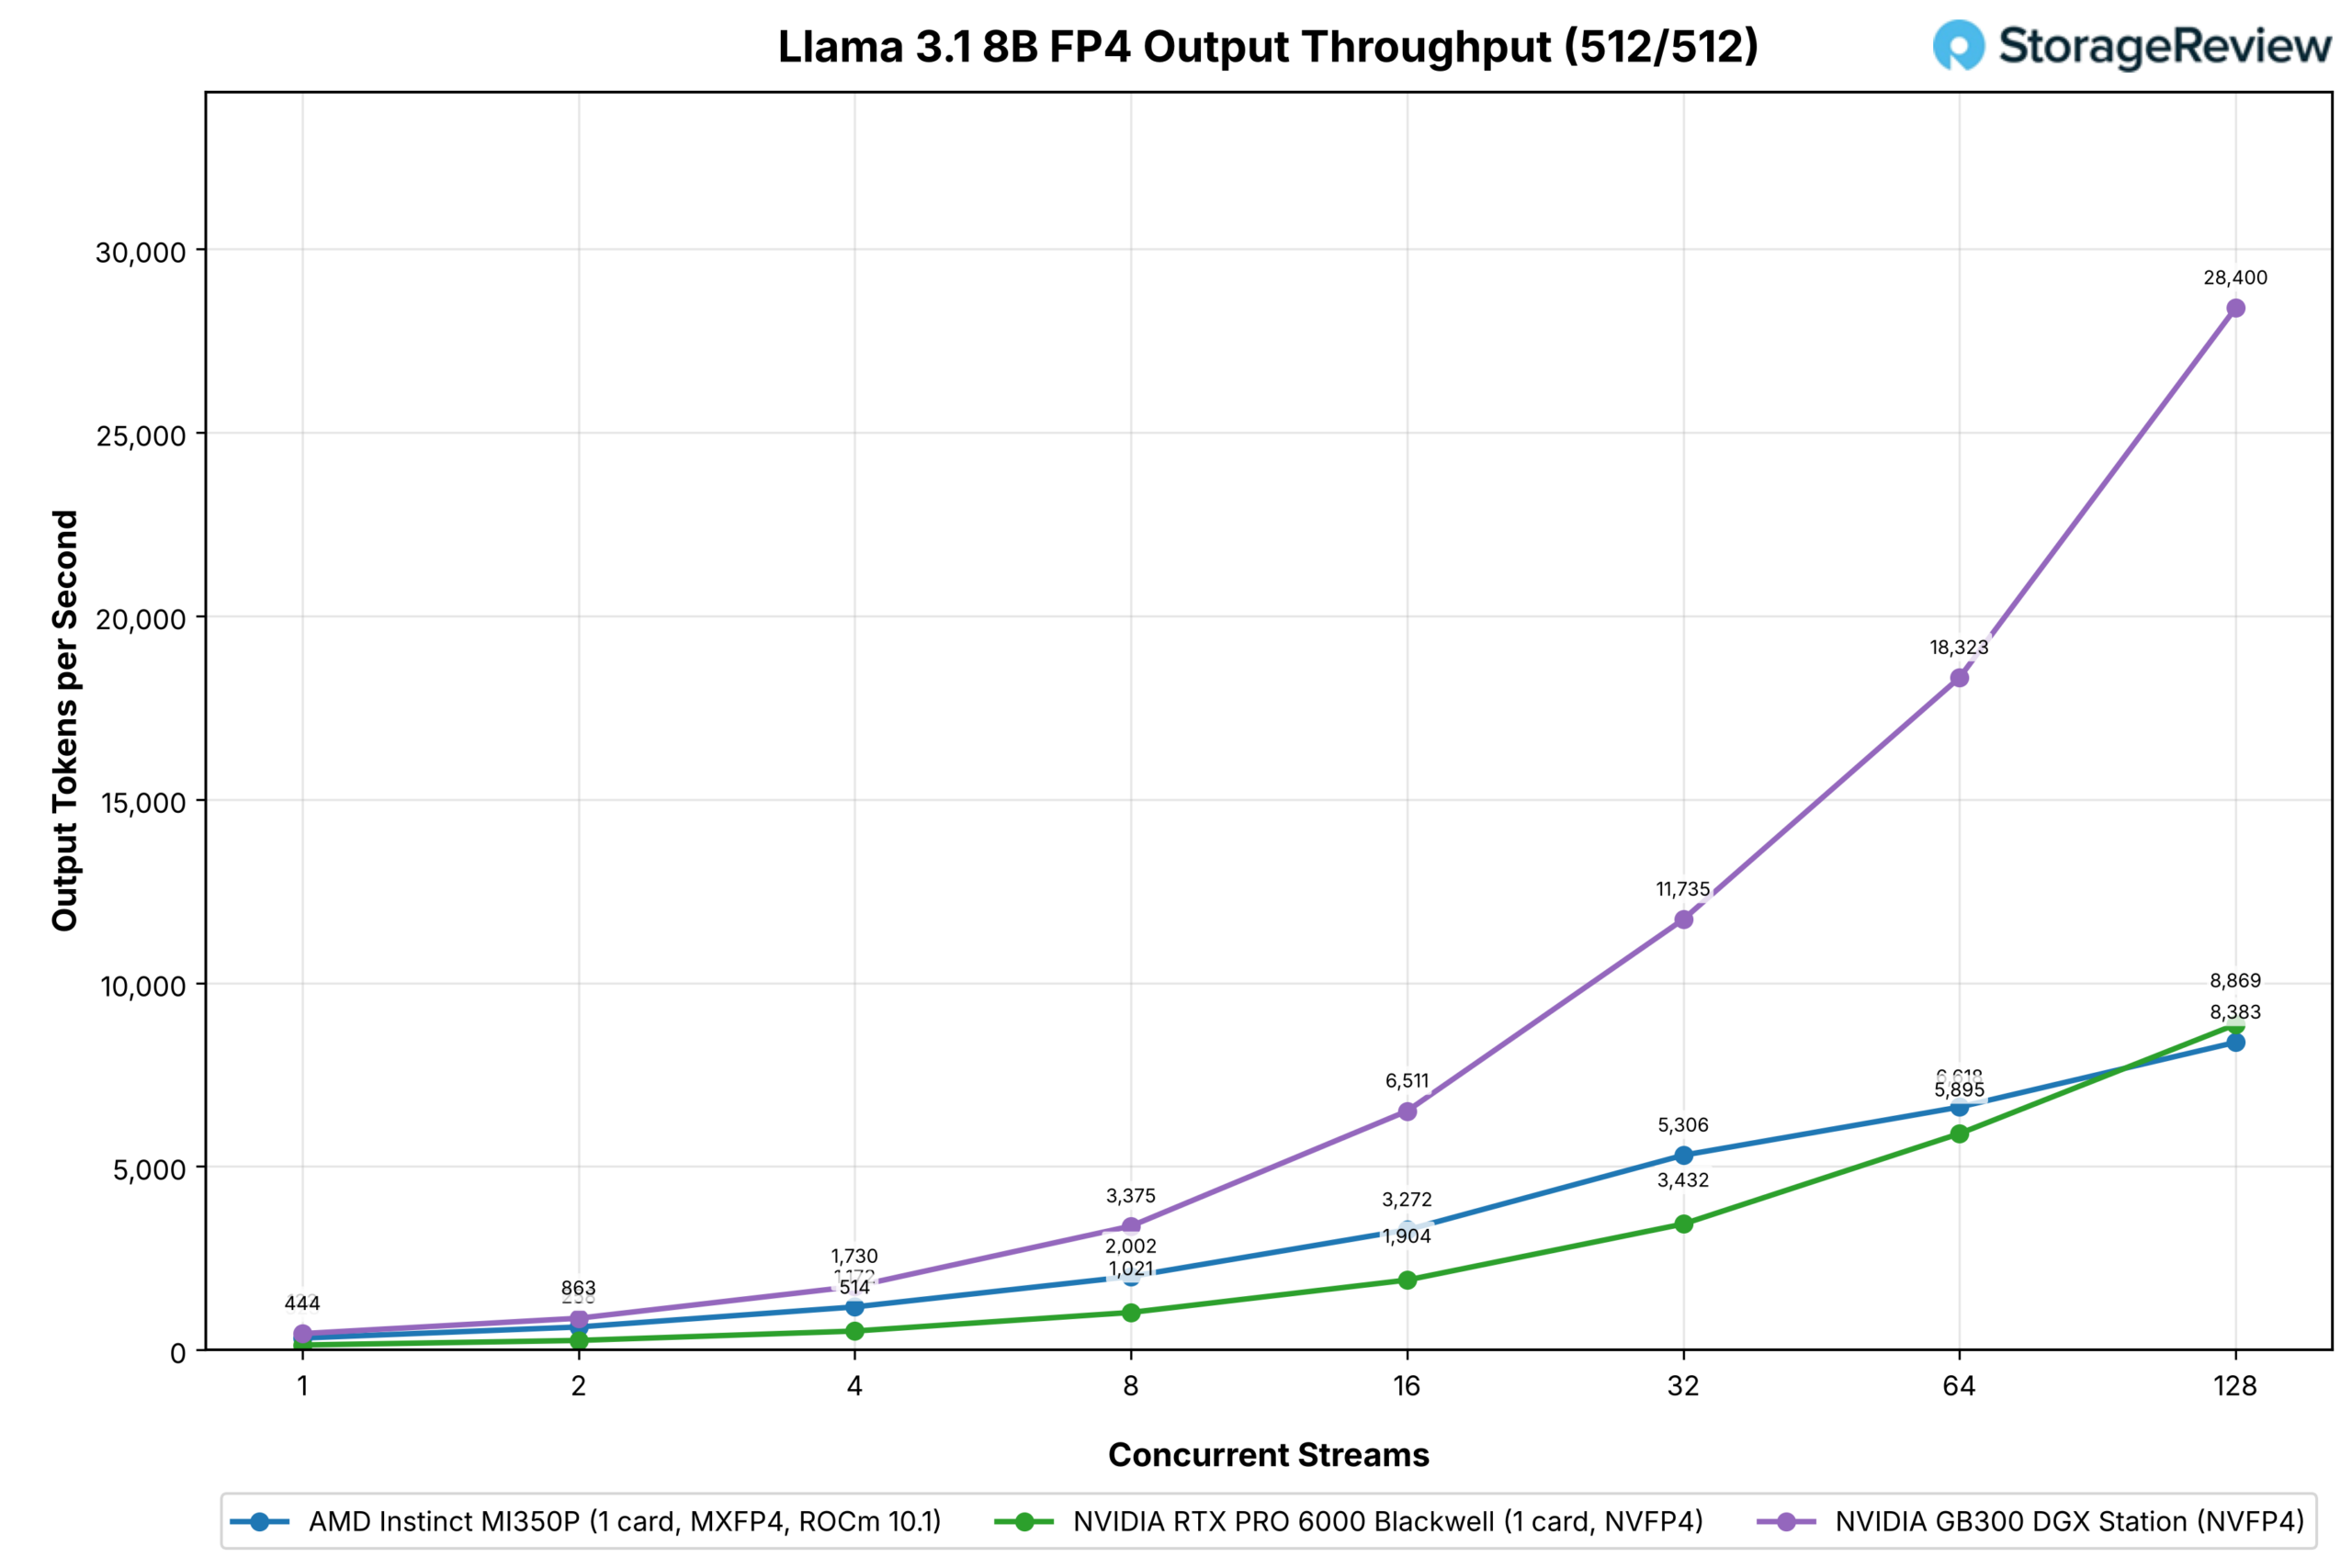
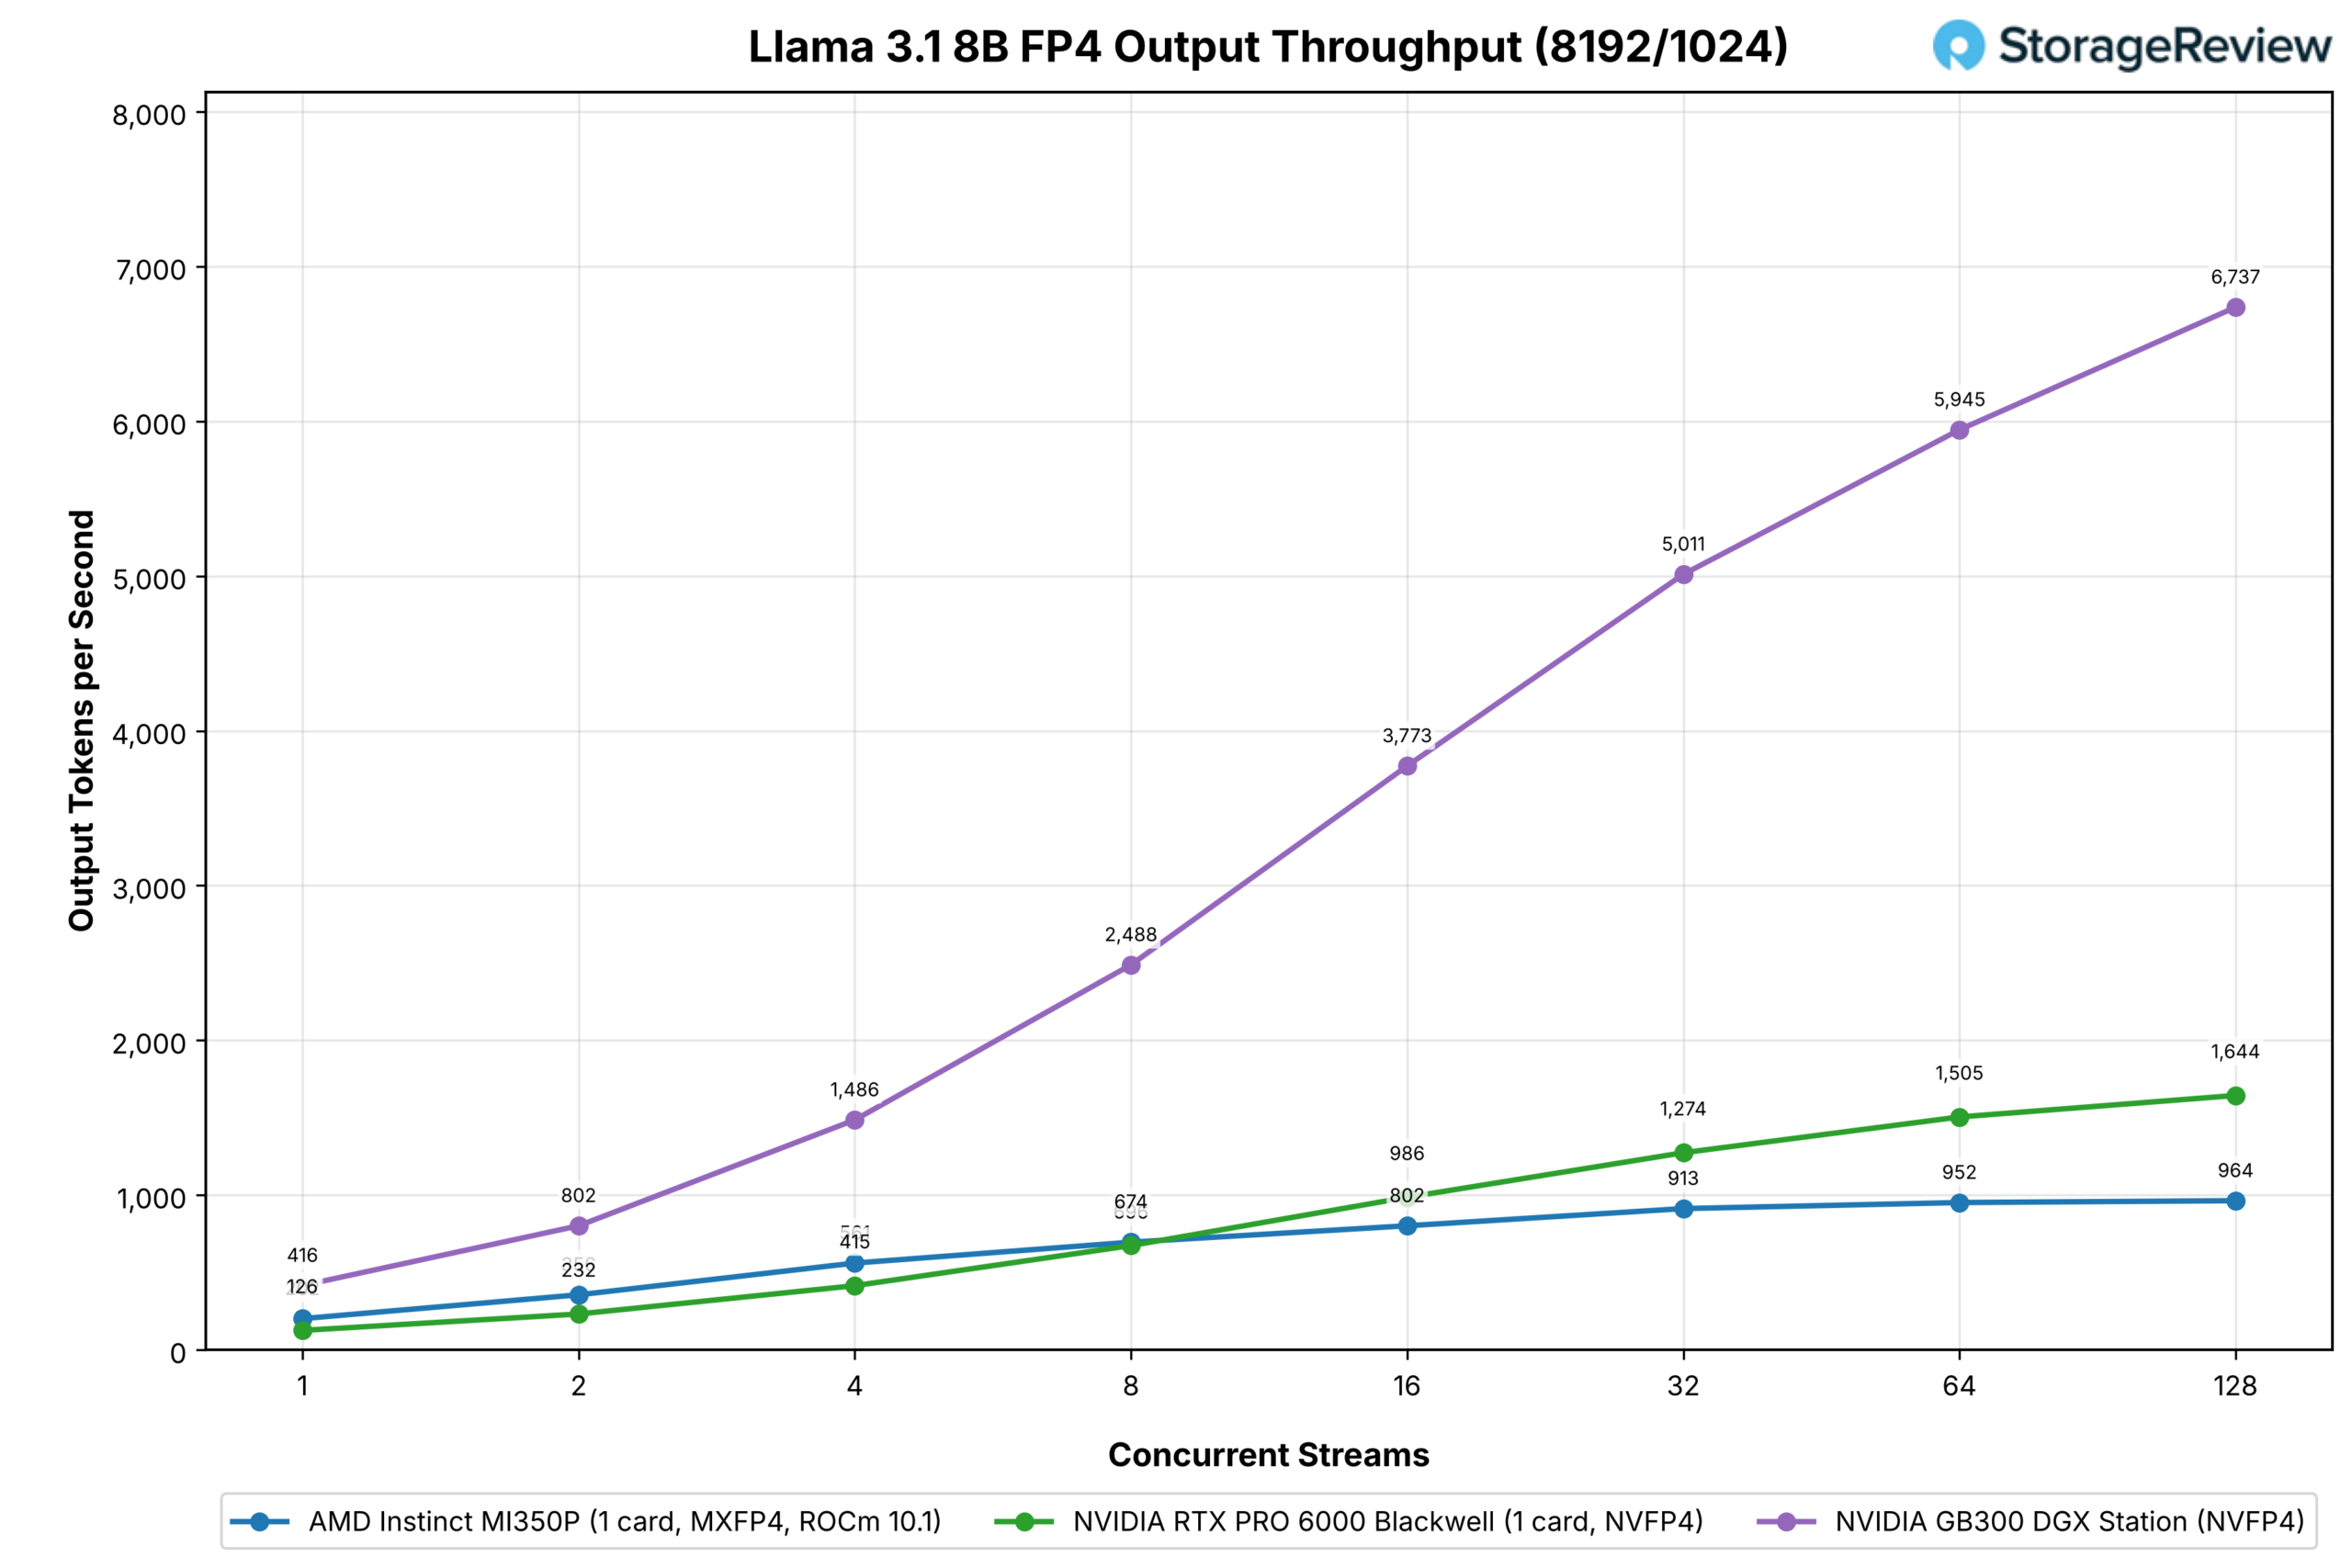
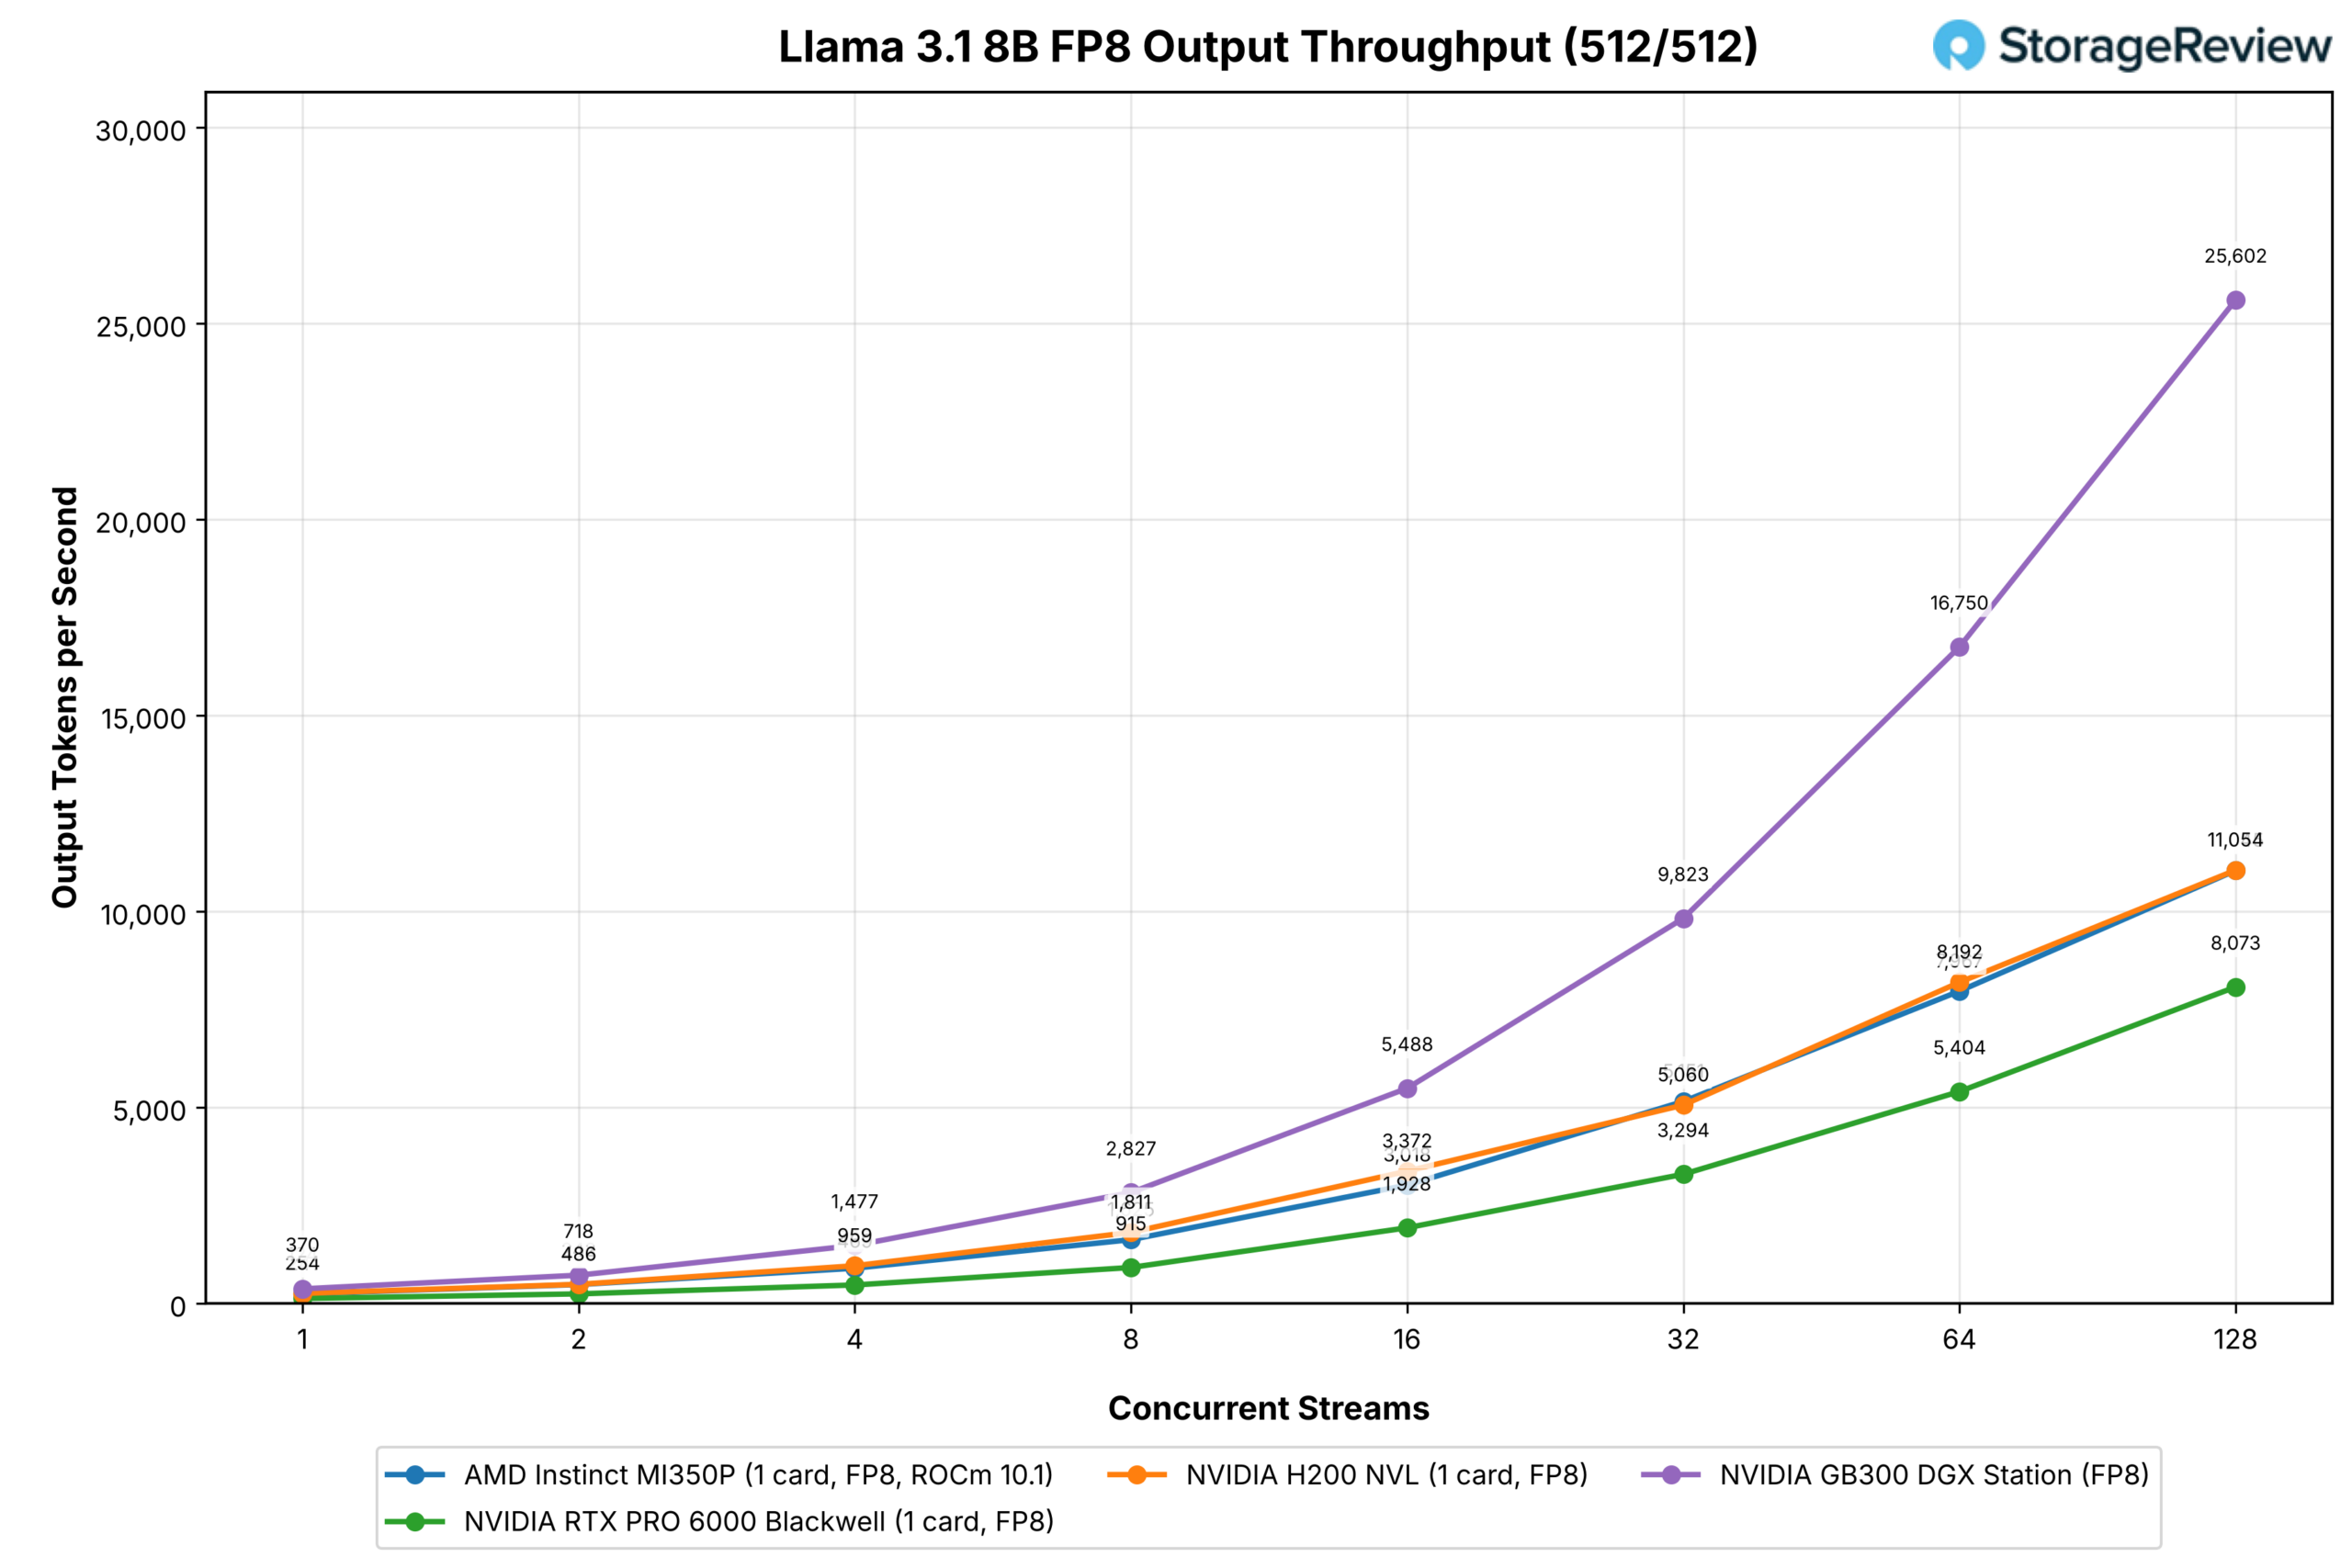
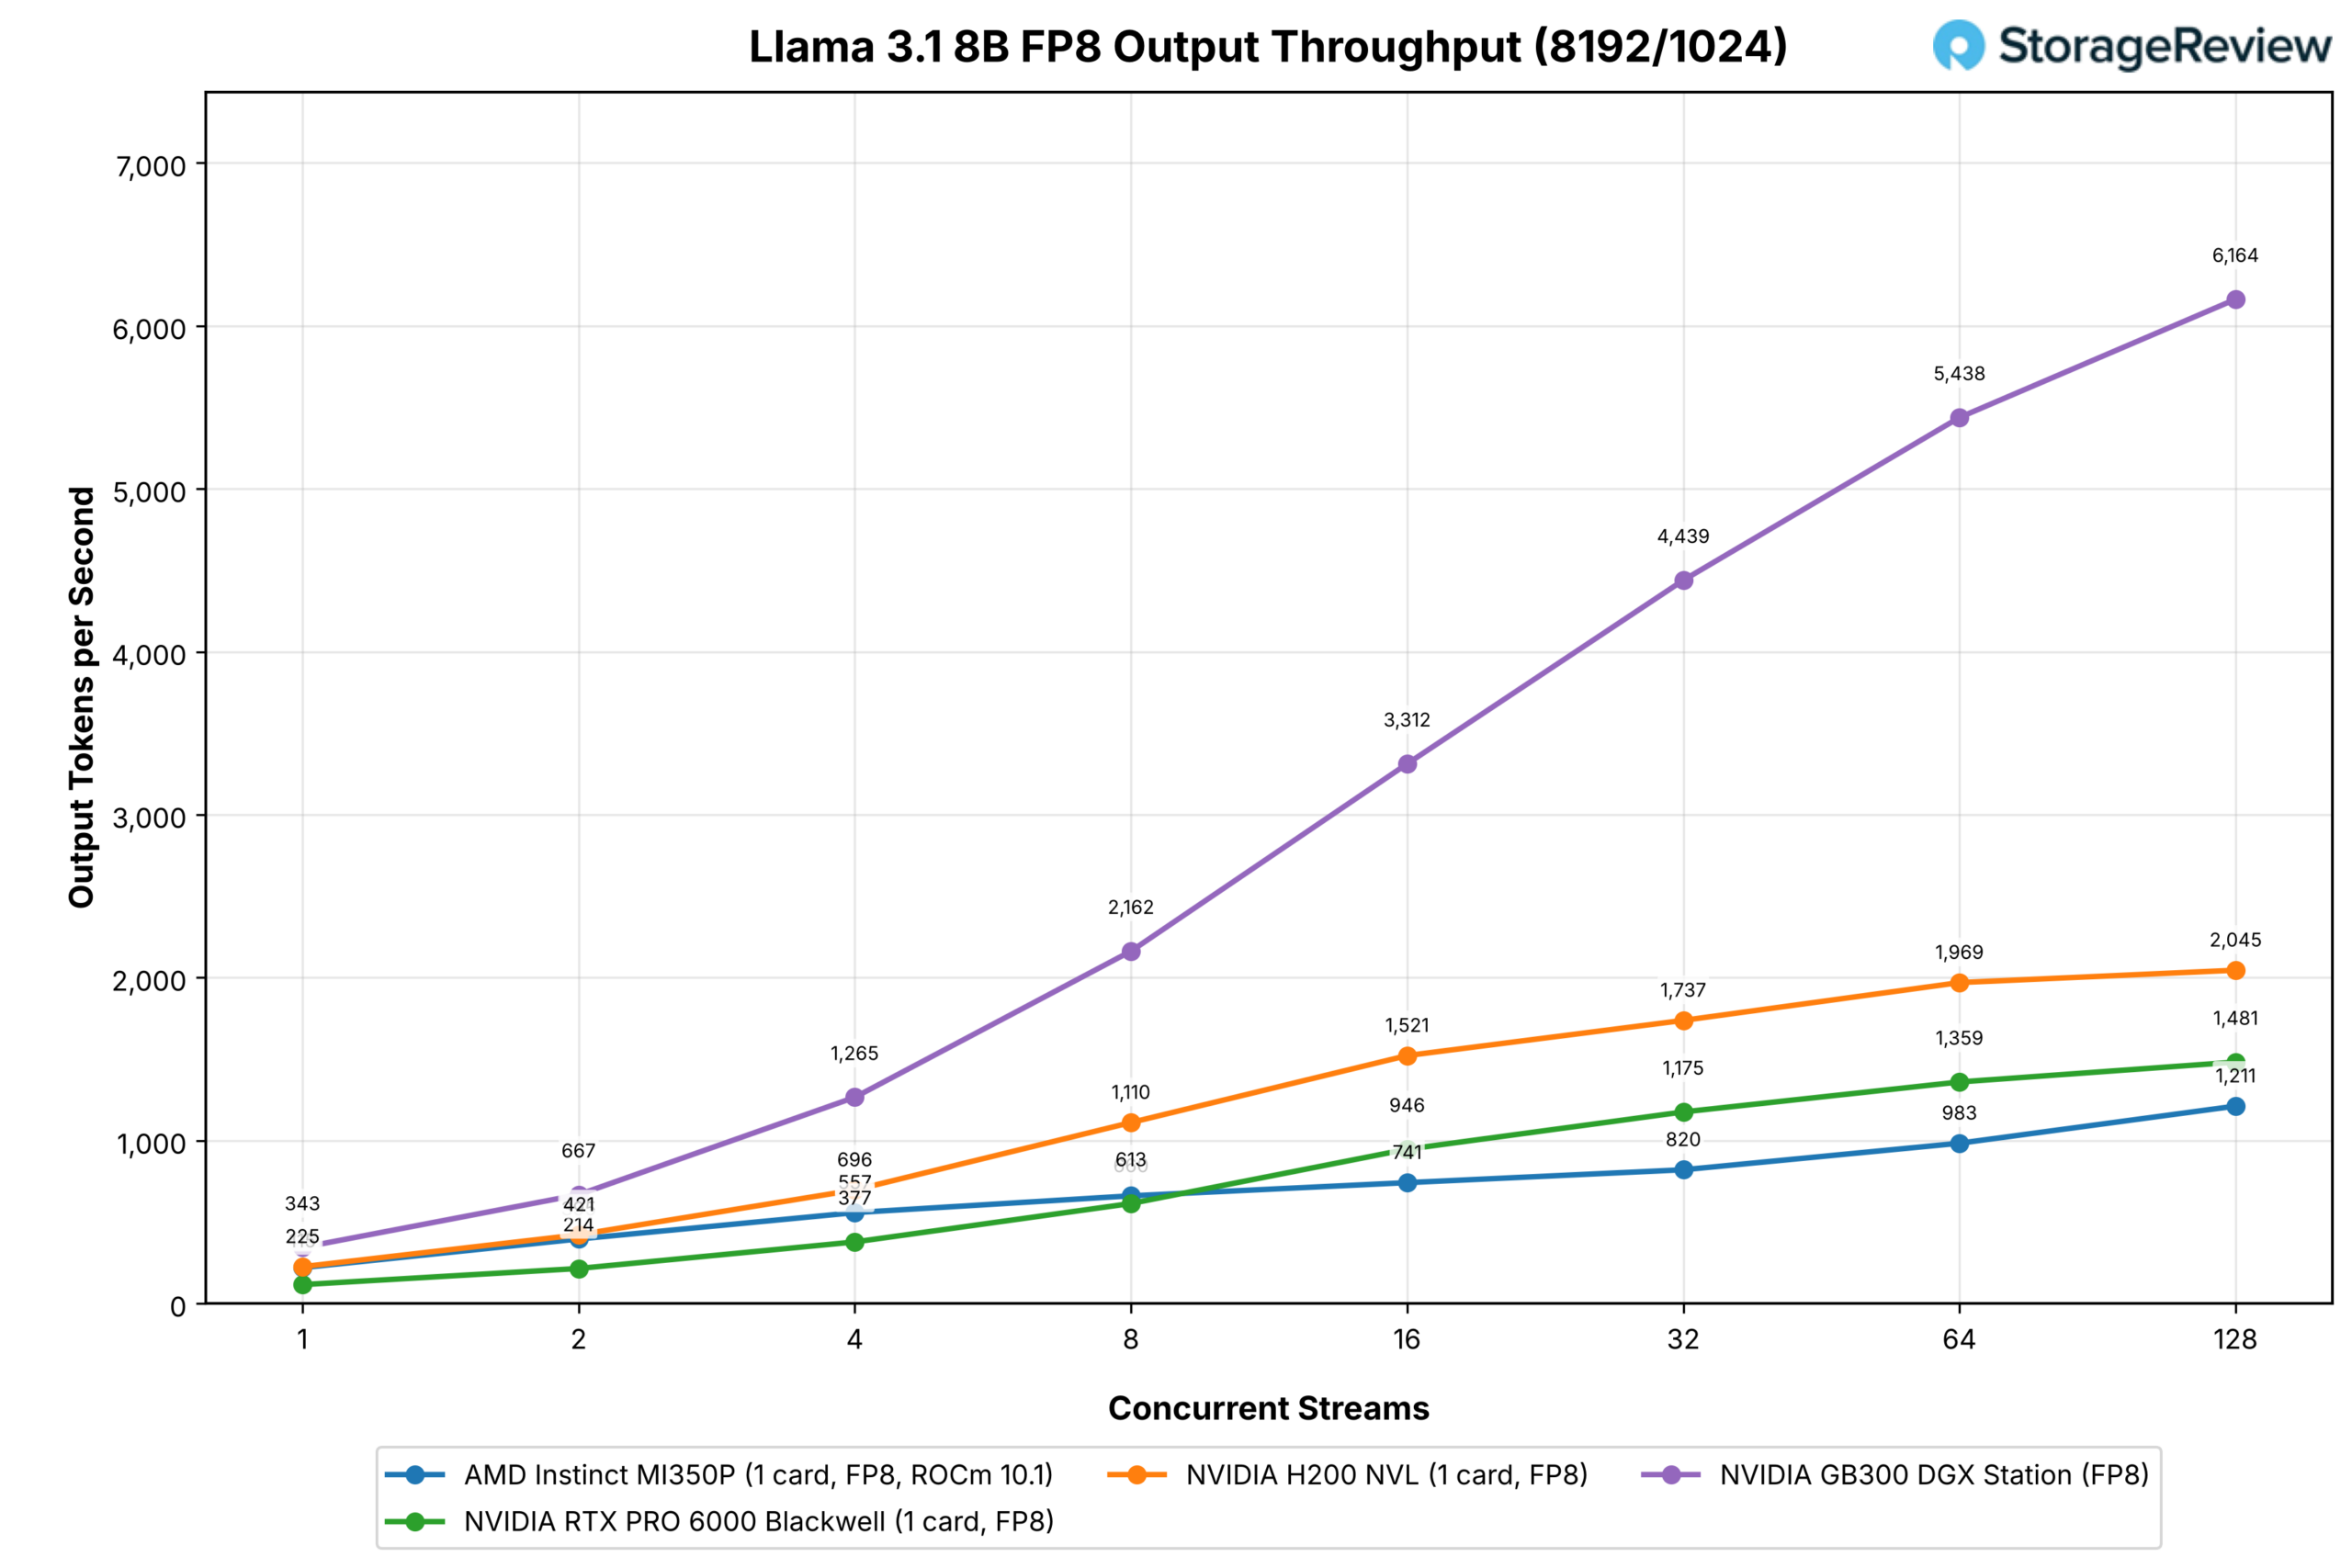
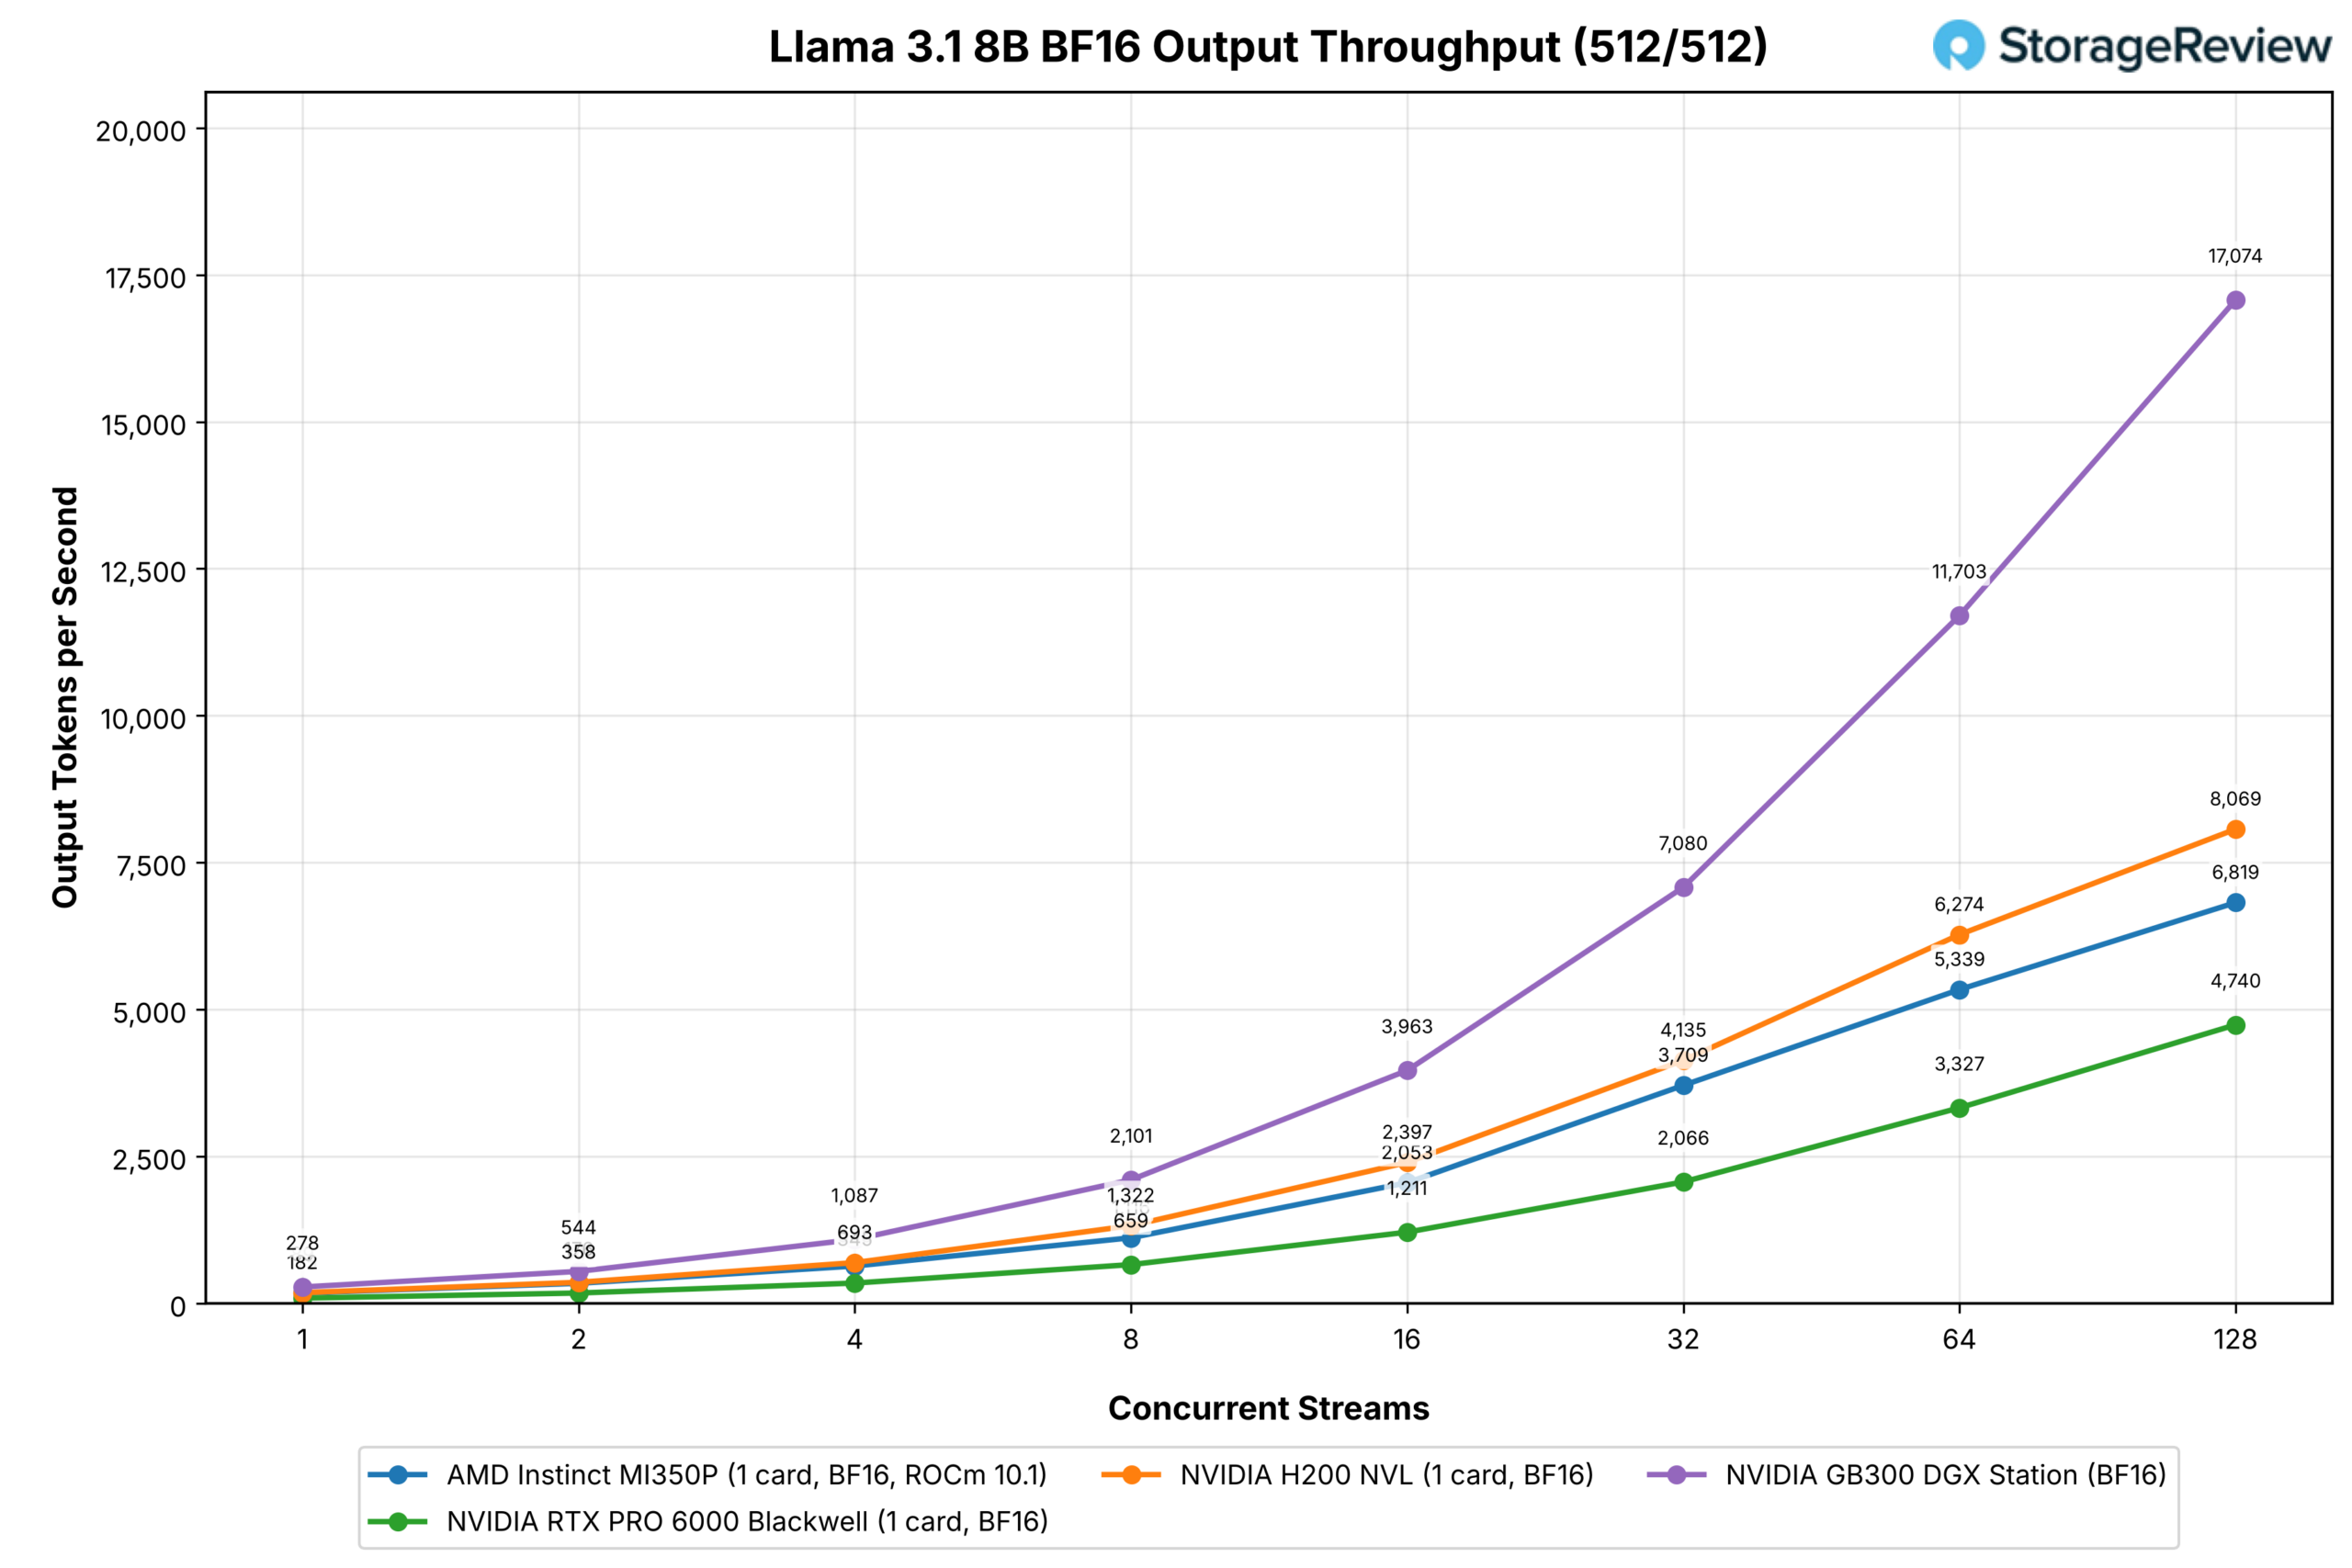
Llama 3.1 8B est disponible pour assurer la continuité de notre couverture GPU précédente. Avec 128 flux simultanés sur la charge de travail de chat, la MI350P atteint 11 045 jetons de sortie par seconde en FP8, contre 8 073 pour la RTX PRO 6000 et 11 054 pour la H200 (à égalité avec la carte Hopper). Sur BF16, elle atteint 6 819 jetons par seconde, contre 4 740 et 8 069. La version MXFP4 d'AMD atteint 8 383 jetons par seconde avec 128 flux, soit 5 % de moins que la version NVFP4 de NVIDIA sur la RTX PRO 6000 (8 869), après l'avoir devancée de 12 à 143 % pour tous les nombres de flux inférieurs. Avec un seul flux, le test MXFP4 affiche 323 jetons par seconde, contre 133 pour la version NVFP4.
Les tests avec un pré-remplissage important inversent le résultat : le MI350P FP8 s’aplatit de 16 flux et termine à 1 211 contre 1 481 pour le RTX PRO 6000 et 2 045 pour le H200, même si le MI350P commence avec 90 % d’avance sur le RTX PRO 6000 à un flux, et la version MXFP4 est en retard de 41 % sur le NVFP4 à 128 flux.
Conclusion
La MI350P est la première carte Instinct en quatre ans à s'intégrer dans un serveur standard, et avec une consommation de 450 W dans un boîtier 2U, elle se comporte comme un accélérateur PCIe : 144 Go de HBM3E à 4 To/s, 1 120 TFLOPS de FP8 et 2 228 TFLOPS de FP4 à l'échelle bloc en MAMF contre 820 et 1 634 pour la RTX PRO 6000 Blackwell, et environ 2.1 fois la bande passante mémoire utilisable de la carte NVIDIA.

Face à la RTX PRO 6000, la MI350P était plus rapide sur les invites de la taille d'un chat sur tous les modèles FP8, BF16 et GPT-OSS, de 35 à 65 % à 128 flux, où la bande passante et la capacité de la HBM3E surpassaient une carte GDDR7 de 96 Go, et elle devançait les deux modèles GPT-OSS à chaque nombre de flux sur les deux formes d'invite.
La H200 NVL la surpasse toujours sur les tests FP8 et BF16 denses, avec des performances supérieures de 4 à 18 % à 128 flux pour les invites de chat, et encore plus importantes pour les invites longues, grâce à une bande passante supérieure de 20 % et à l'absence de chemin FP4. Sur GPT-OSS, la MI350P affiche des performances supérieures de 50 % et 78 % à celles de la carte Hopper. La situation est moins tranchée pour les modèles plus performants : quatre RTX PRO 6000 devancent la paire MI350P sur GLM-5.2 à 16 flux, avec 384 Go contre 288 Go et une bande passante et une puissance de calcul agrégées supérieures.
MiniMax-M3 se rapproche : les trois configurations restent à moins de 10 % d'écart sur huit flux de messages de chat. La configuration quad RTX prend l'avantage à 16 messages, et la paire MI350P domine sur les messages longs sur huit flux. Par carte, le taux FP4 mesuré de la MI350P est 36 % supérieur à celui de la RTX PRO 6000 ; l'avantage réside donc dans le nombre de cartes. Ces résultats à deux cartes ont été obtenus avec la plateforme ROCm 7.2.3 et seront reproduits avec ROCm 10.1, parallèlement aux tests à 600 W.
Il nous est impossible pour l'instant de nous prononcer définitivement sur le MI350P sans l'avoir testé à pleine puissance (600 W), ce que nous prévoyons de faire sur un serveur PowerEdge XE7745 ; Dell prend en charge huit MI350P à 600 W dans ce châssis. Selon nos informations, AMD estime que les 150 W supplémentaires se traduisent par un gain de performances d'environ 10 %.
AMD a fait d'énormes progrès, et la gamme MI350/5X illustre parfaitement les capacités de son architecture. Nous utilisons un serveur MI300X dans notre laboratoire de développement, et la rapidité d'exécution de la suite logicielle s'est révélée remarquable, la plupart des composants fonctionnant sans problème avec la version standard de vLLM.
Avec ce que nous avons constaté dans cette configuration, le MI350P s'adresse aux acheteurs recherchant une alternative aux GPU NVIDIA, que ce soit en raison des délais de livraison, du prix ou pour éviter de dépendre d'un seul fabricant, et la prise en charge par Dell de cette carte dans la gamme PowerEdge offre aux serveurs grand public cette diversité de puces pour répondre à ce besoin.
Il faut bien le dire, notre travail est loin d'être terminé. Si de nombreux acheteurs envisagent d'installer ces cartes dans des serveurs 2U, leurs performances sont optimales dans un châssis plus grand, conçu pour des cartes de 600 W. Quel que soit leur déploiement, il s'agit d'un excellent premier aperçu du retour d'AMD sur le marché des cartes d'extension pour serveurs. Avec la maturation continue de la suite logicielle, la MI350P, et les modèles à venir, ont un avenir prometteur. Actuellement, pour un utilisateur dont les modèles se situent entre 96 Go et 144 Go, la MI350P est l'une des deux seules cartes PCIe permettant de conserver un seul GPU, et la seule à dépasser 141 Go.
Classement : La carte AMD Instinct MI350P apparaît dans la section « Également testée » de notre classement des meilleurs GPU d’entreprise , avec ses résultats à deux cartes dans la section « Configurations Scale-Out ».



 Amazon