

Pendant la majeure partie de son existence dans les centres de données, NVIDIA a considéré le processeur comme un simple composant alimentant le GPU. Grace, son premier processeur serveur, s'inscrivait dans cette logique. Il utilisait des cœurs Neoverse V2 d'Arm disponibles dans le commerce et était principalement commercialisé comme la partie CPU des superpuces Grace Hopper et Grace Blackwell. Ces superpuces ont néanmoins introduit un élément durable de la plateforme : NVLink-C2C, une interface permettant au processeur et au GPU d'accéder de manière cohérente à la mémoire de l'autre avec une bande passante bien supérieure à celle du PCIe.
Its successor, Vera, is far more ambitious. It is a clean-sheet design built around Olympus, NVIDIA’s custom Arm core. Olympus implements Armv9.2, and each Vera CPU features 88 cores and 176 threads. Alongside the new cores, the memory subsystem is the other highlight. Each CPU supports up to 1.5TB of LPDDR5X on SOCAMM modules, with an advertised peak bandwidth of 1.2TB/s per socket, which gives Vera the power efficiency of mobile-class DRAM while keeping the memory field-replaceable. Across the two sockets in our test server, that rating comes to 2.4TB/s, and we measured 2,073GB/s on STREAM Triad.
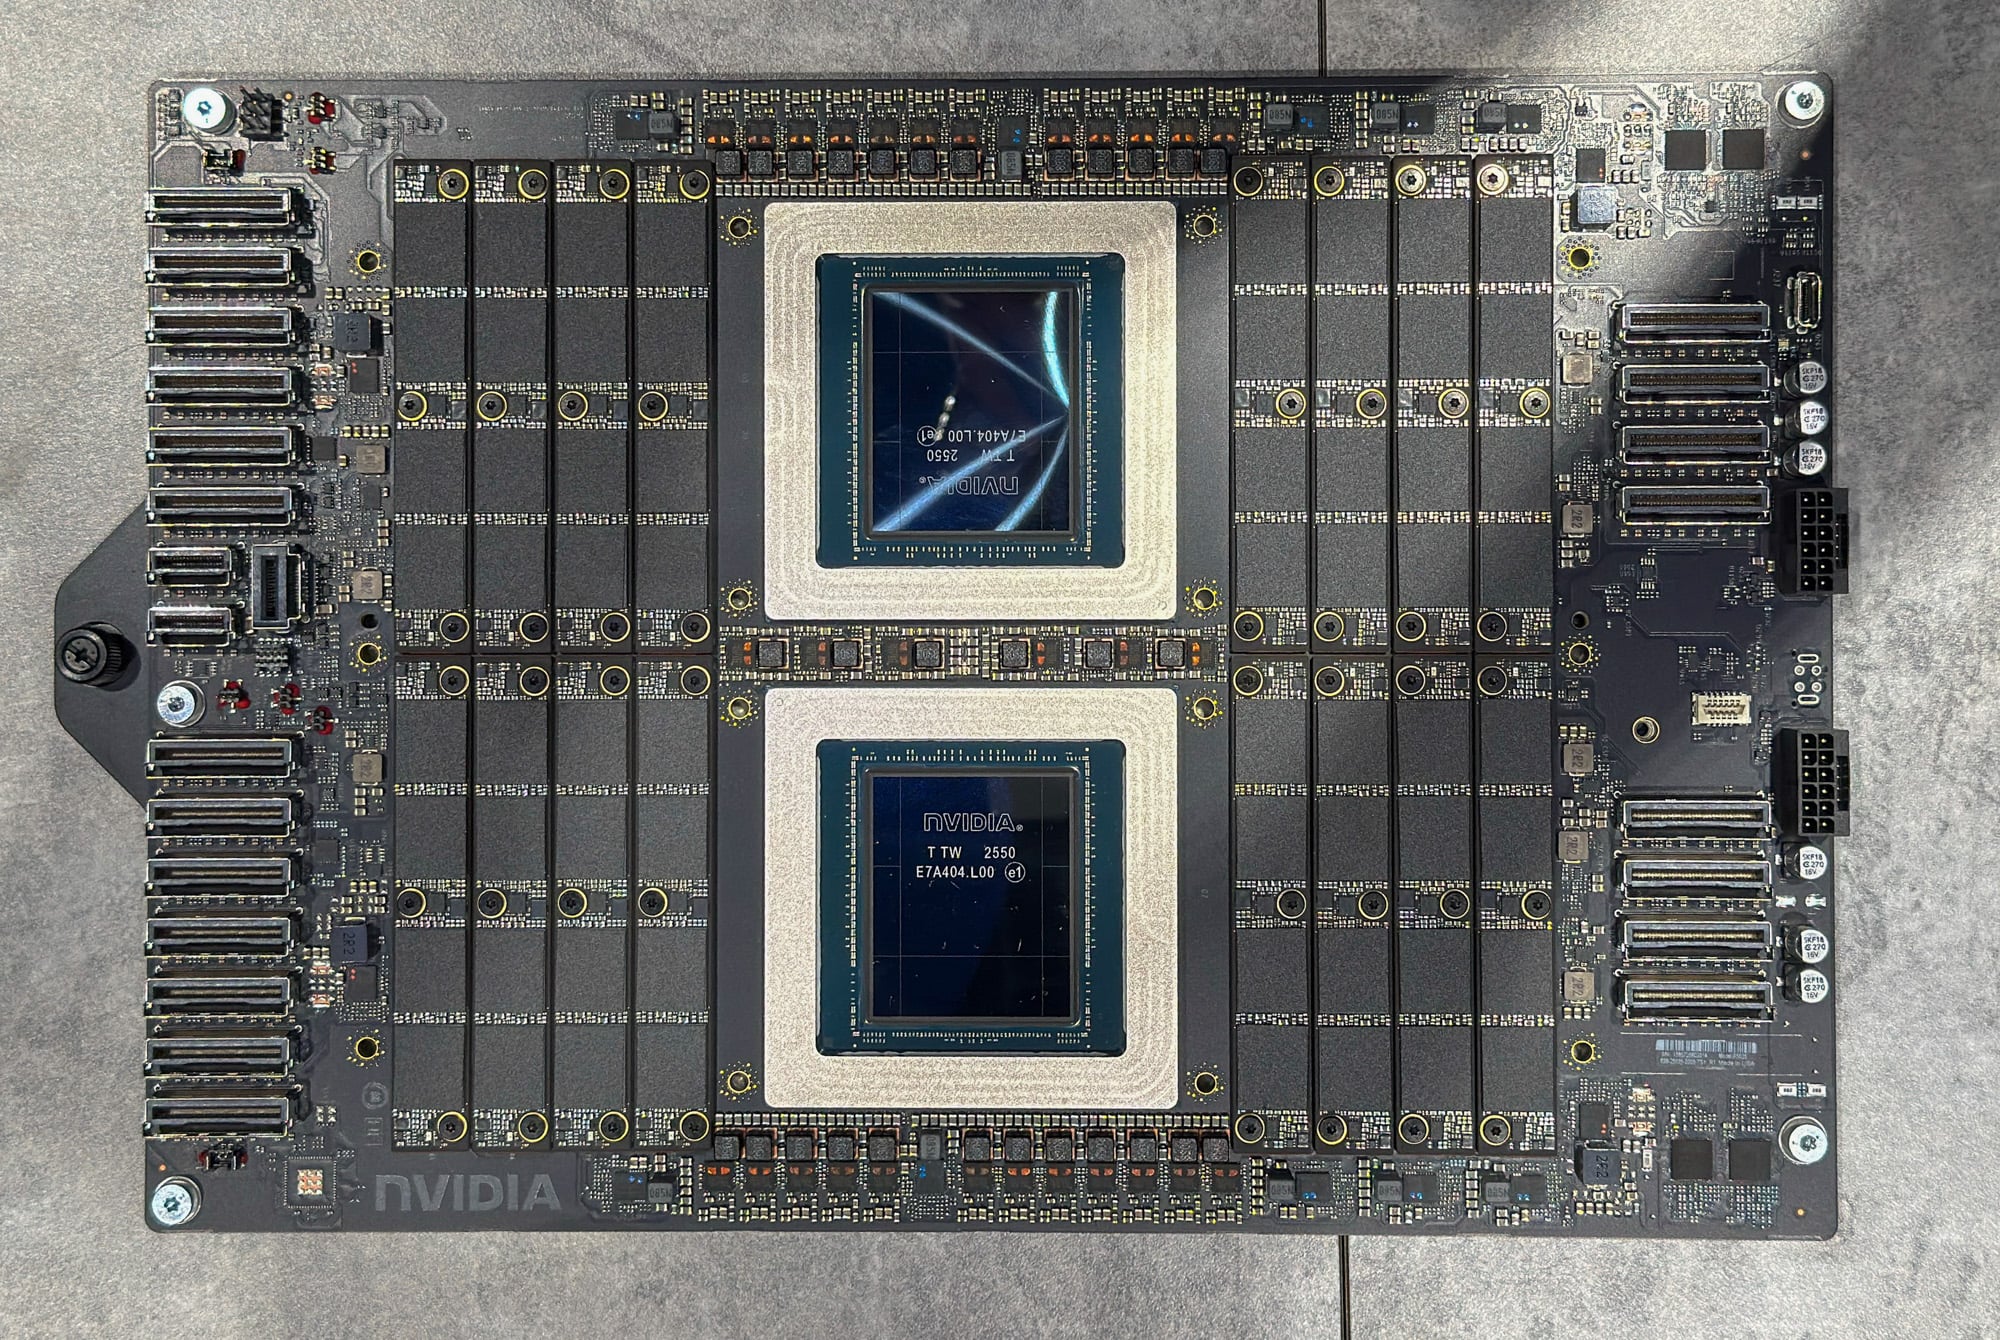
Cette ambition se reflète dans le déploiement de Vera. Toujours intégrée à la superpuce des systèmes Vera Rubin, elle est désormais disponible chez NVIDIA sur sa plateforme de stockage BlueField-4 STX et sur des serveurs CPU autonomes pour environnements sandbox avec agents. Vera bénéficie également d'un large soutien de la part des OEM, des hyperscalers et des fournisseurs de services réseau : Dell, HPE et Supermicro ont intégré des serveurs Vera à leurs gammes, et les hyperscalers et les fournisseurs de services réseau s'apprêtent à en faire une offre grand public. Cette large disponibilité est essentielle car, comme le démontreront nos résultats, Vera est un concurrent sérieux face aux processeurs x86 et offre aux entreprises un troisième fournisseur de processeurs pour diversifier leurs chaînes d'approvisionnement.
Points clés à retenir
- La bande passante mémoire fait plus que doubler par rapport à tous les systèmes x86. Deux sockets Vera ont maintenu un débit supérieur à 2 To/s sur STREAM Triad, soit 2.3 fois les performances du meilleur serveur DDR5 que nous avons testé. Même en lisant la mémoire de l'autre socket via NVLink-C2C, les cœurs Vera ont consommé plus de bande passante que n'importe quel socket x86 en mémoire locale, et la latence locale avec les pages mémoire de grande taille était inférieure de 13 % à celle de l'EPYC 9175F.
- Une puce bien équilibrée pour le large segment moyen du marché. Un cœur Olympus cadencé à 3.4 GHz a compressé 7-Zip 12 % plus rapidement que l'EPYC 9175F à 5.0 GHz et a remporté deux des trois tests Python mono-thread qui l'ont opposé. À pleine charge, Vera a atteint 63 % à 72 % du débit 7-Zip de l'EPYC 9965 avec moins de la moitié de ses cœurs, se maintenant ainsi au niveau du processeur AMD spécialisé en performances par cœur sur un thread et de celui spécialisé en débit sur l'ensemble du système.
- Le fonctionnement vectoriel et cryptographique constitue clairement le point faible. Six pipelines SVE2 128 bits ne peuvent rivaliser avec l'AVX-512 512 bits sur du code conçu pour cette architecture. Sur une configuration à 16 cœurs identiques, Vera a exécuté le test GROMACS benchMEM à la moitié des performances de l'EPYC 9175F et aux deux tiers de celles de l'EPYC 9965, et le chiffrement AES-256-GCM sur un seul cœur à environ un tiers de la vitesse du 9175F. Sur l'ensemble du système, l'EPYC 9965 à 384 cœurs a affiché des performances environ trois fois supérieures sur les tests GROMACS benchPEP et AES.
- Le calcul haute performance limité par la mémoire transforme la bande passante en vitesse. Sur le grand maillage OpenFOAM, Vera s'est avéré 1.44 fois plus rapide que l'EPYC 9965 à 384 cœurs et 1.20 fois plus rapide que le Xeon 6978P à 240 cœurs. Sur le maillage plus petit, où les caches L3 x86 plus volumineux contribuent davantage au problème, Vera est arrivé deuxième, à seulement 12 % du 9965.
- Les bases de données et l'analyse de données sont déjà des domaines concurrentiels. Sur HammerDB TPROC-C avec un seul socket, un système Vera à 88 cœurs a surpassé un processeur EPYC 9965 à 192 cœurs de 26 % sur PostgreSQL et de 8 % sur MariaDB, tout en accusant un retard de 19 % sur MySQL et de 15 % sur VillageSQL ; le Xeon 6787P s'est avéré moins performant que Vera sur les cinq moteurs. Vera a également réalisé le test ClickBench en 23 % de temps en moins que l'EPYC 9965 et a traité 34 % de requêtes supplémentaires sur un ensemble de travail Valkey de 256 Go.
Spécifications techniques
| Spécifications | Processeur NVIDIA Vera |
|---|---|
| Calcul et puissance | |
| Core | NVIDIA Olympus, Armv9.2 avec SVE2 et FP8 |
| Cœurs et threads par socket | 88 cœurs, 176 threads (NVIDIA Spatial Multithreading) |
| Fréquence d'horloge (mesurée) | 3.41GHz |
| TDP | Puissance configurable de 250 W à 450 W |
| Refroidissement | Air ou liquide |
| Cache | |
| instruction L1 | 64 Ko par cœur |
| Données L1 | 96 Ko par cœur, 6 voies |
| L2 | 2 Mo par cœur, privé |
| Cache système (L3) | 164 Mo par socket, partitionnement Arm MPAM |
| Tissu | Structure de cohérence évolutive de 2e génération, bisection de 3.4 To/s |
| Mémoire | |
| Type | LPDDR5X sur 8 modules SOCAMM2 par socket |
| surchargés | 8 x 128 bits (1 024 bits agrégés) |
| Speed | Jusqu'à 9,600MT / s |
| Bande passante | Jusqu'à 1.2 To/s par socket (selon les spécifications du fabricant) |
| Capacités | De 256 Go à 1.5 To par emplacement |
| I / O | |
| PCIe | 6e génération, 88 voies par socket (plateforme CPU uniquement) bifurcation x16, x8, x4, x2 |
| CXL | 3.1, Extension et mise en commun de la mémoire de type 3 |
| NVLink-C2C | Chiffrement de 2e génération, bidirectionnel, cohérent et authentifié à 1.8 To/s |
| Sécurité | |
| Informatique confidentielle | Domaines Arm CCA, RME-DA et RME-CDA, TDISP, clés par VM |
Pourquoi NVIDIA s'intéresse au marché des processeurs
Pour comprendre l'importance de Vera pour NVIDIA, il faut examiner la croissance de l'entreprise. NVIDIA a bâti sa position sur les centres de données autour du GPU, puis s'est étendue à l'infrastructure nécessaire à leur fonctionnement. Côté matériel, l'acquisition de Mellanox en 2020 a apporté la technologie réseau qui connecte les serveurs et assure le transfert des données entre eux. Côté logiciel, CUDA, DOCA et l'ensemble de la pile logicielle ont permis à NVIDIA d'influencer la programmation et l'exploitation de ce matériel. Ensemble, ces éléments ont donné à l'entreprise le contrôle d'une grande partie de la plateforme de calcul accéléré.
Mais la plateforme nécessitait toujours un processeur généraliste. Il fallait un composant pour exécuter le système d'exploitation, préparer les données, gérer les applications et coordonner le travail envoyé aux accélérateurs. Pendant une grande partie de l'expansion de NVIDIA, Intel et AMD ont assumé ce rôle. Cela plaçait NVIDIA dans une position délicate : elle pouvait fournir les GPU, le réseau et une grande partie des logiciels, tout en restant dépendante du processeur d'une autre entreprise au cœur du serveur.
Grace a constitué une première étape majeure vers ce changement. Basé sur des cœurs Arm Neoverse V2, il offrait à NVIDIA un processeur pour centres de données et une solution pour une connexion plus étroite avec ses GPU via NVLink-C2C. Grace présentait néanmoins un écart de performances à combler. Si sa bande passante et son efficacité mémoire le rendaient compétitif comme processeur hôte pour l'IA, les processeurs x86 de pointe conservaient des avantages considérables pour la plupart des autres charges de travail. Ces performances inégales limitaient l'intérêt de choisir Grace comme solution de remplacement polyvalente pour un serveur EPYC ou Xeon.
Vera comble en grande partie cet écart en remplaçant les cœurs Neoverse V2 de Grace par l'architecture Olympus personnalisée de NVIDIA et en augmentant considérablement la bande passante et la capacité de la mémoire. En proposant un processeur performant en complément de ses GPU, DPU et solutions réseau, NVIDIA capte une part plus importante des dépenses liées à chaque serveur. L'entreprise bénéficie ainsi d'un meilleur contrôle sur son écosystème et sur l'interaction de ses composants : les cœurs du processeur, le sous-système mémoire, l'interconnexion et le GPU peuvent être conçus selon les mêmes exigences. La liaison cohérente entre le processeur et le GPU de Vera, désormais capable d'atteindre 1.8 To/s, illustre parfaitement cette intégration.
Capturer une plus grande part des dépenses de chaque système ne représente qu'une partie de la solution. L'apprentissage par renforcement (RL) et l'IA agentielle offrent à NVIDIA une raison supplémentaire de proposer un système CPU autonome. Un agent ne se contente pas de générer une réponse. Il fait appel à des outils, récupère des informations, exécute du code et vérifie les résultats avant de décider de la suite des opérations. Une grande partie de cette exécution se déroule sur les CPU, et lorsque l'étape suivante du modèle dépend du résultat d'une tâche CPU, une exécution lente retarde toute la séquence. Les performances par cœur, la latence mémoire et un comportement prévisible sous charge deviennent donc essentiels à la réactivité de l'agent.
Le noyau Olympus
Ces exigences correspondent parfaitement à la conception des 88 cœurs Olympus de Vera, qui reposent sur une priorité claire : des performances élevées pour chaque cœur, maintenues même lorsque le socket est fortement sollicité. Olympus est l’implémentation par NVIDIA du jeu d’instructions Armv9.2, remplaçant les cœurs Neoverse V2 utilisés dans Grace. Cette distinction est importante : Arm définit les instructions exécutées par le processeur, tandis que NVIDIA conçoit le mécanisme qui les récupère, les planifie et les exécute. Ce contrôle permet à NVIDIA d’optimiser le cœur pour son objectif : achever rapidement les tâches individuelles tout en en exécutant plusieurs simultanément.
La première étape de cet objectif concerne les instructions par cycle (IPC) : le nombre d'instructions exécutées en moyenne par un cœur à chaque cycle d'horloge. La fréquence d'horloge détermine la fréquence de ces cycles ; la microarchitecture détermine la quantité de travail utile pouvant y être effectuée. NVIDIA annonce une amélioration de l'IPC de 1.5x par rapport à la génération précédente. La fréquence d'horloge maximale observée était de 3.41 GHz, mais l'architecture de Vera privilégie l'optimisation du rendement par cycle et le maintien de ce rendement sous charge. Cet aspect est crucial car, pour un compilateur, un interpréteur ou une opération de base de données comportant une longue séquence d'étapes dépendantes, l'ajout de cœurs ne suffit pas à accélérer l'exécution de cette séquence.
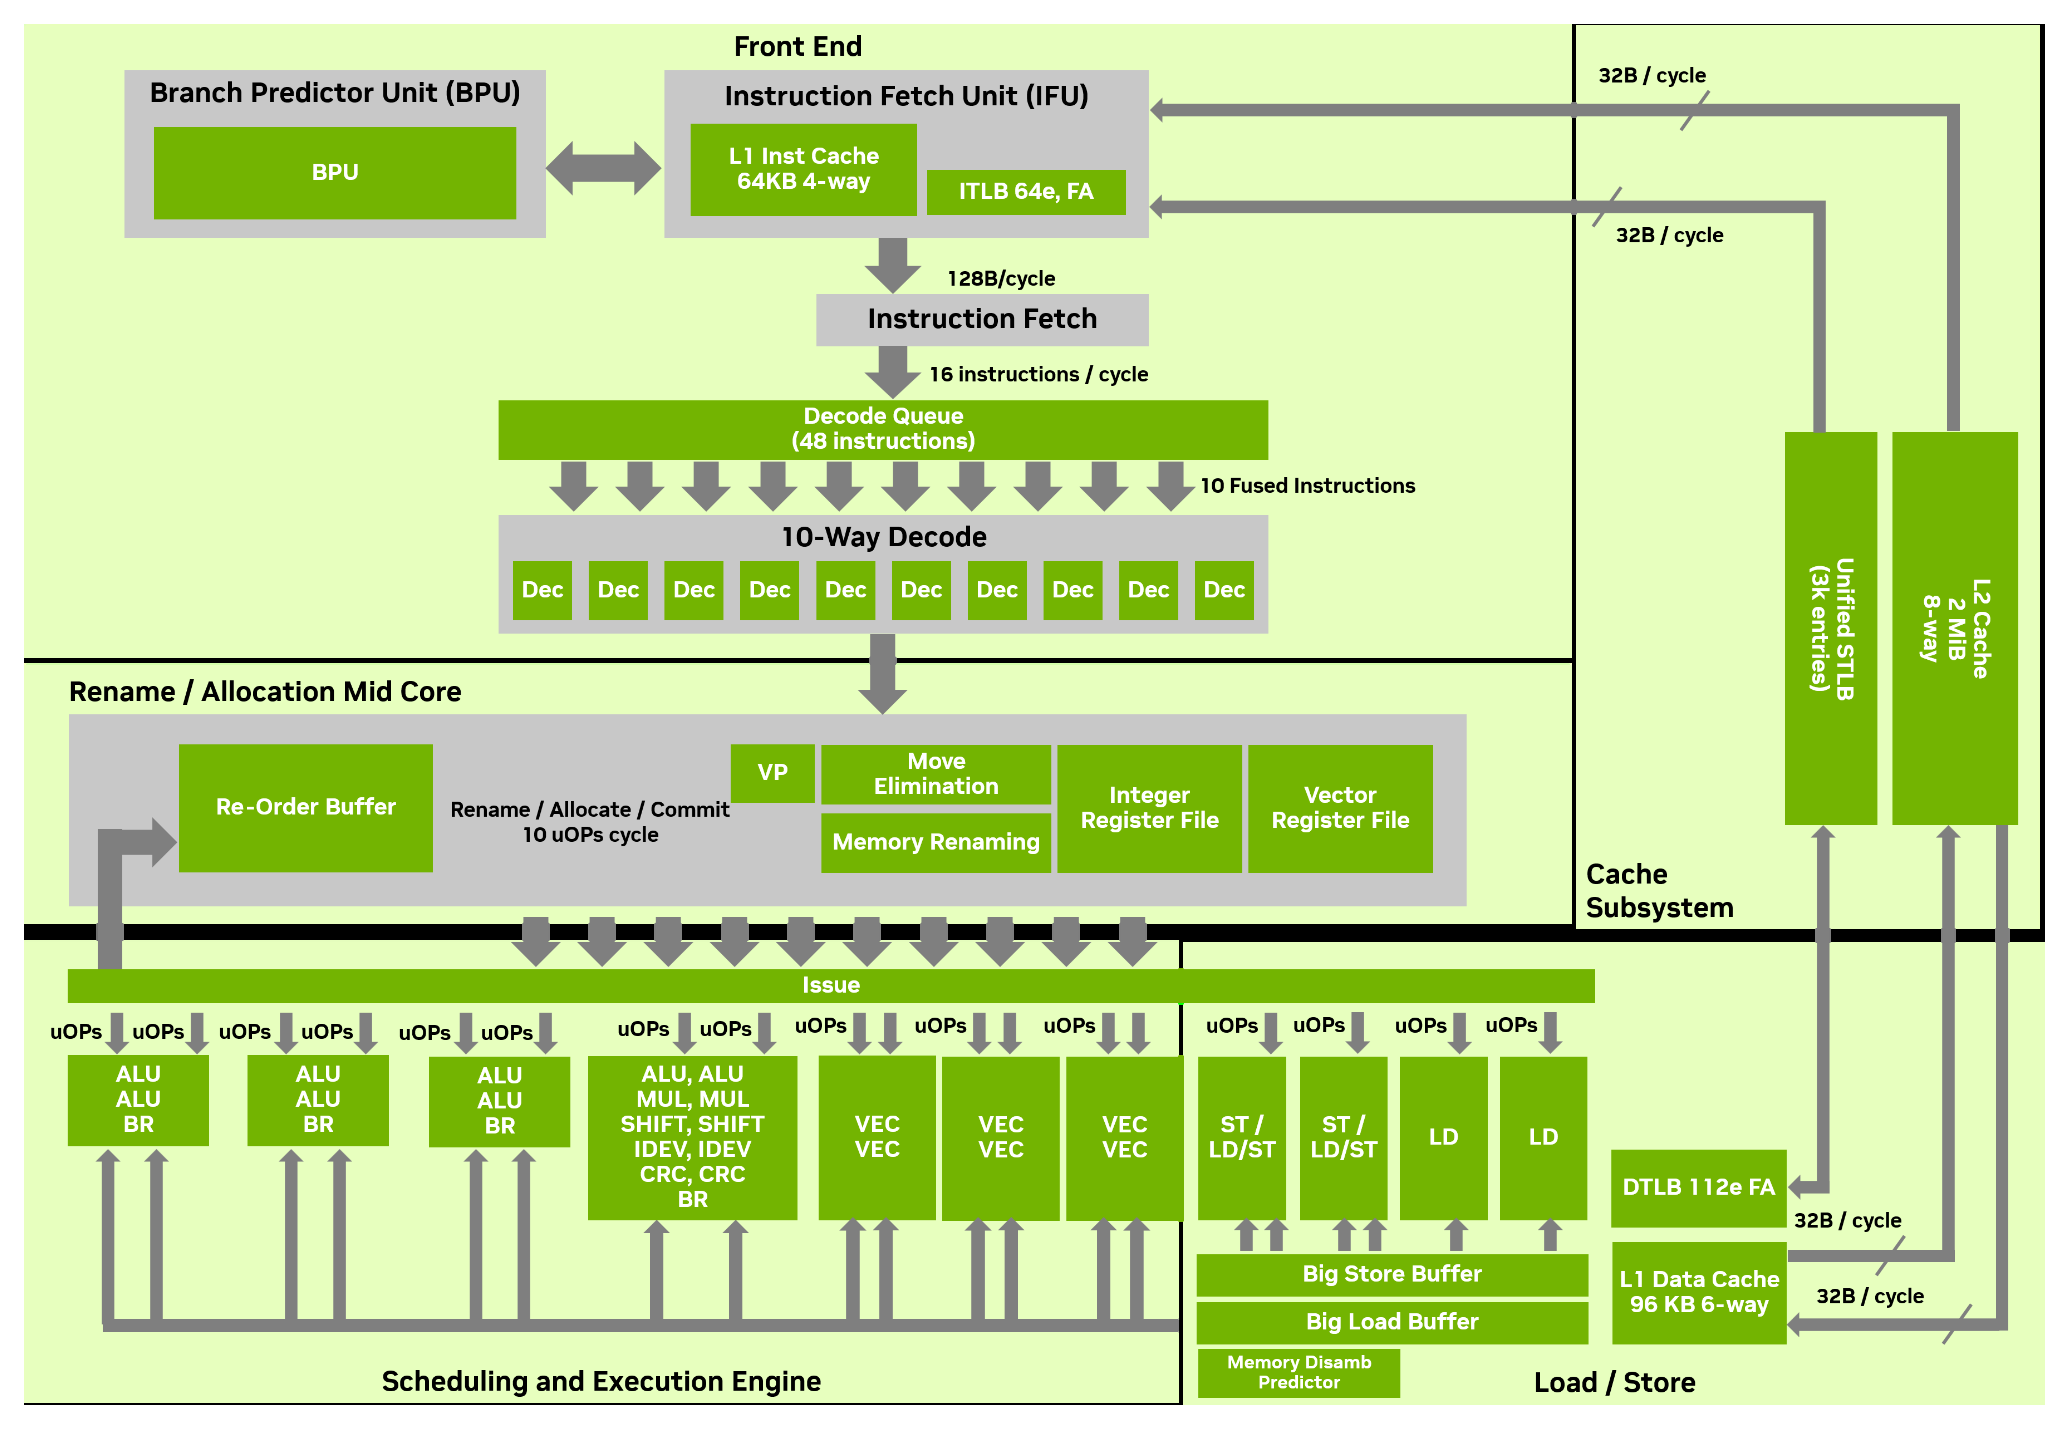
L'obtention d'une communication interprocessus (IPC) optimale repose sur un approvisionnement constant en instructions utiles. Le front-end d'Olympus, la partie du cœur qui récupère et décode les instructions du programme, peut décoder jusqu'à dix instructions par cycle. Cette capacité n'est pertinente que si le front-end est alimenté en continu, ce qui devient complexe lorsque le logiciel effectue fréquemment des branchements entre différents chemins d'exécution. Olympus combine donc un prédicteur de branchement neuronal avec d'autres prédicteurs spécialisés et prend en charge jusqu'à deux branchements par cycle. Une meilleure prédiction permet au cœur de récupérer les instructions nécessaires, réduisant ainsi le temps passé à exécuter le mauvais chemin et à redémarrer après une erreur.
Une fois ces instructions récupérées et décodées, Olympus utilise l'exécution hors séquence pour trouver des tâches pouvant être effectuées pendant que les instructions précédentes sont en attente. Par exemple, si une opération attend de la mémoire, un calcul indépendant peut être exécuté avant elle. Une fenêtre d'instructions étendue offre au processeur davantage d'opportunités de trouver ces tâches indépendantes.
Néanmoins, certaines séquences, comme les chaînes dépendantes décrites précédemment, résistent à cette approche car chaque étape nécessite le résultat de la précédente. Pour ces séquences, Olympus utilise également la prédiction de valeurs afin de permettre aux opérations dépendantes de démarrer avec une valeur prédite, puis vérifie cette valeur lorsque le résultat réel est disponible. Des prédictions correctes peuvent réduire le temps d'attente effectif le long de ces chaînes de dépendance ; des prédictions incorrectes nécessitent la correction et le recalcul du travail spéculatif.
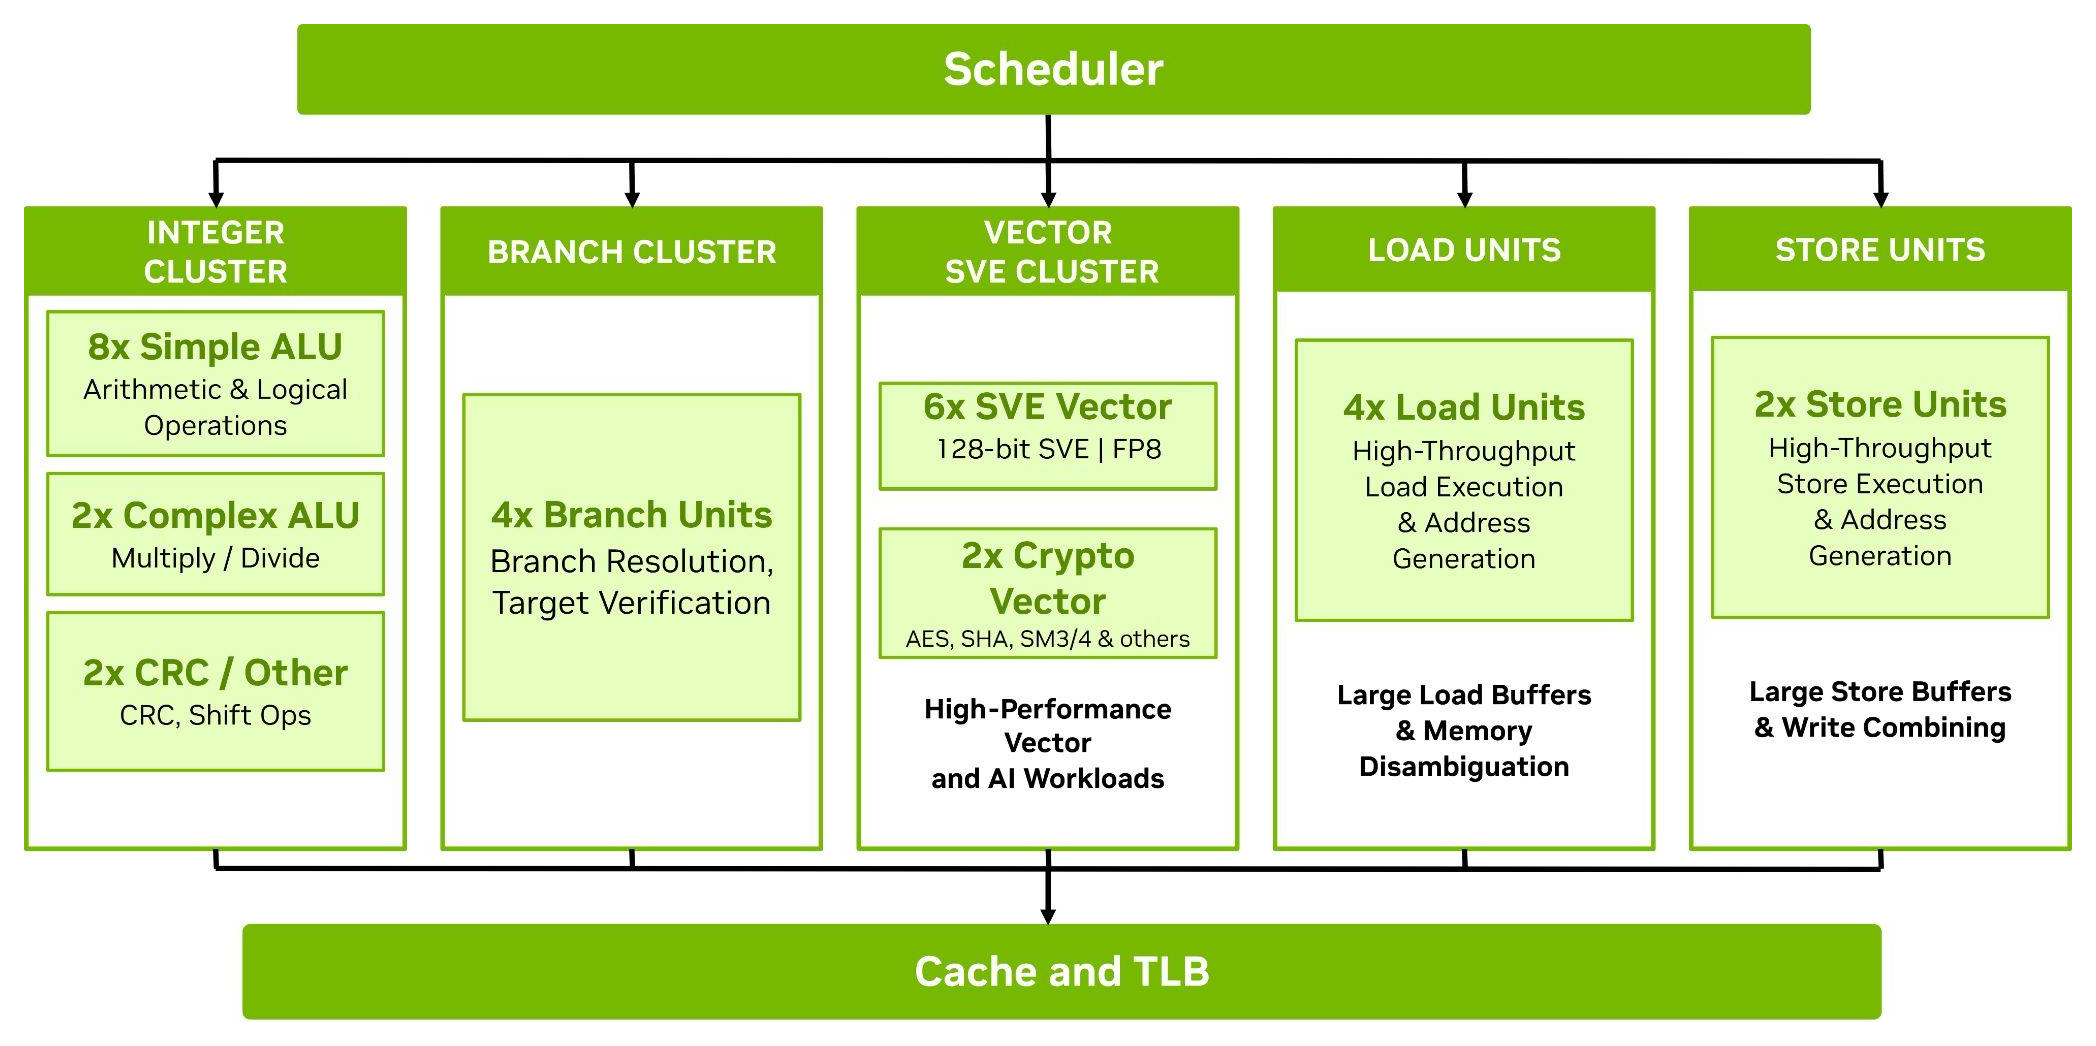
Le moteur d'exécution doit ensuite avoir une capacité suffisante pour transformer ces instructions en tâches complètes. Olympus combine des ressources d'exécution entière étendues avec des unités de branchement dédiées, quatre pipelines de chargement et deux pipelines de stockage. Ces ressources répondent à différents besoins : les unités d'exécution entière gèrent l'arithmétique, les comparaisons et la logique ; les unités de branchement assurent le flux de contrôle ; et les pipelines de chargement/stockage déplacent les données entre le cœur et ses caches. Cet équilibre est crucial, car un décodeur plus large serait peu utile si les instructions s'accumulaient simplement derrière un goulot d'étranglement au niveau de l'exécution ou de la mémoire.
Outre ces ressources scalaires, Olympus dispose de six pipelines vectoriels 128 bits compatibles SVE2, avec prise en charge du FP8 et des capacités cryptographiques dans deux pipelines. Les instructions vectorielles appliquent une opération à plusieurs éléments de données, ce qui les rend utiles pour les calculs numériques, la compression et le traitement des données.
C'est un domaine où Olympus fait un compromis évident : sa largeur de vecteur de 128 bits est inférieure à la largeur de 512 bits disponible via AVX-512 sur les processeurs x86 concurrents. Cette différence est importante pour les noyaux numériques optimisés et même les analyseurs lexicaux, bien que les performances des applications dépendent également du débit des instructions concernées, du code généré et de la quantité de données disponibles. Les applications scientifiques telles que GROMACS constituent donc un test spécifique des points forts de cette architecture.
Chacune de ces ressources d'exécution, scalaire ou vectorielle, dépend de la réception des données en temps voulu ; il est donc tout aussi important de conserver les données fréquemment utilisées à proximité du moteur d'exécution. Chaque cœur dispose d'un cache d'instructions de 64 Ko, d'un cache de données de 96 Ko et d'un cache L2 privé de 2 Mo. Les petits caches de premier niveau offrent un accès rapide aux instructions et aux données les plus immédiatement utiles ; le cache L2, plus volumineux, conserve une plus grande partie de l'ensemble de travail du cœur avant qu'un accès ne doive parcourir une plus grande partie du processeur. L'attribution à chaque cœur d'un cache L2 privé conséquent poursuit le même objectif par cœur : traiter davantage de tâches localement, réduisant ainsi la pression sur le cache partagé et la mémoire principale.
La prélecture complète ces caches en chargeant les données avant même qu'une instruction ne les demande. Outre les préchargeurs pour les accès classiques, Olympus intègre un préchargeur de graphes pour les accès indirects, comme A[B[i]], où une recherche fournit l'index d'une autre. Une fois cette relation établie, le matériel peut commencer à charger la seconde donnée avant même que le programme ne la demande. Ceci permet de résoudre un problème courant dans le traitement de graphes et d'autres charges de travail irrégulières : le processeur dispose d'une capacité d'exécution suffisante, mais la progression dépend de la recherche de la donnée suivante.
La dernière composante d'Olympus répond à l'autre moitié de son objectif : l'exécution simultanée de nombreuses tâches. Chaque cœur prend en charge deux threads matériels, offrant ainsi à Vera 176 threads par socket. NVIDIA nomme ce système « multithreading spatial ». Le cœur peut allouer ses ressources à un seul thread actif ou les répartir entre deux, permettant ainsi de choisir entre concentrer la capacité d'exécution sur un flux d'instructions et prendre en charge un plus grand nombre de tâches simultanées.
L'objectif déclaré de NVIDIA est de réduire les interférences entre les deux threads, afin d'améliorer la prévisibilité des performances lorsqu'ils sont tous deux sollicités. Cette même prévisibilité est essentielle pour les charges de travail applicatives. Les deux threads partagent toujours un cœur physique et le système de mémoire, ce qui signifie que le partitionnement des ressources ne garantit pas une latence applicative fixe.
Tissu, mémoire et E/S
Au-delà de chaque cœur individuel, maintenir la productivité de 88 cœurs nécessite bien plus qu'une connexion rapide à la DRAM. Les cœurs doivent également échanger des données, accéder au cache partagé et communiquer avec les périphériques connectés. Vera connecte ces ressources grâce à la deuxième génération de la Scalable Coherency Fabric de NVIDIA, un maillage interne qui assure également la cohérence des copies mises en cache des données partagées. Les cœurs, le maillage et le cache système de 164 Mo sont intégrés sur une seule puce de calcul, tandis que les contrôleurs mémoire et les E/S sont situés sur des chiplets adjacents. NVIDIA annonce une bande passante de 3.4 To/s pour le maillage, une mesure de la capacité de trafic à travers celui-ci, distincte de la bande passante de la mémoire principale.
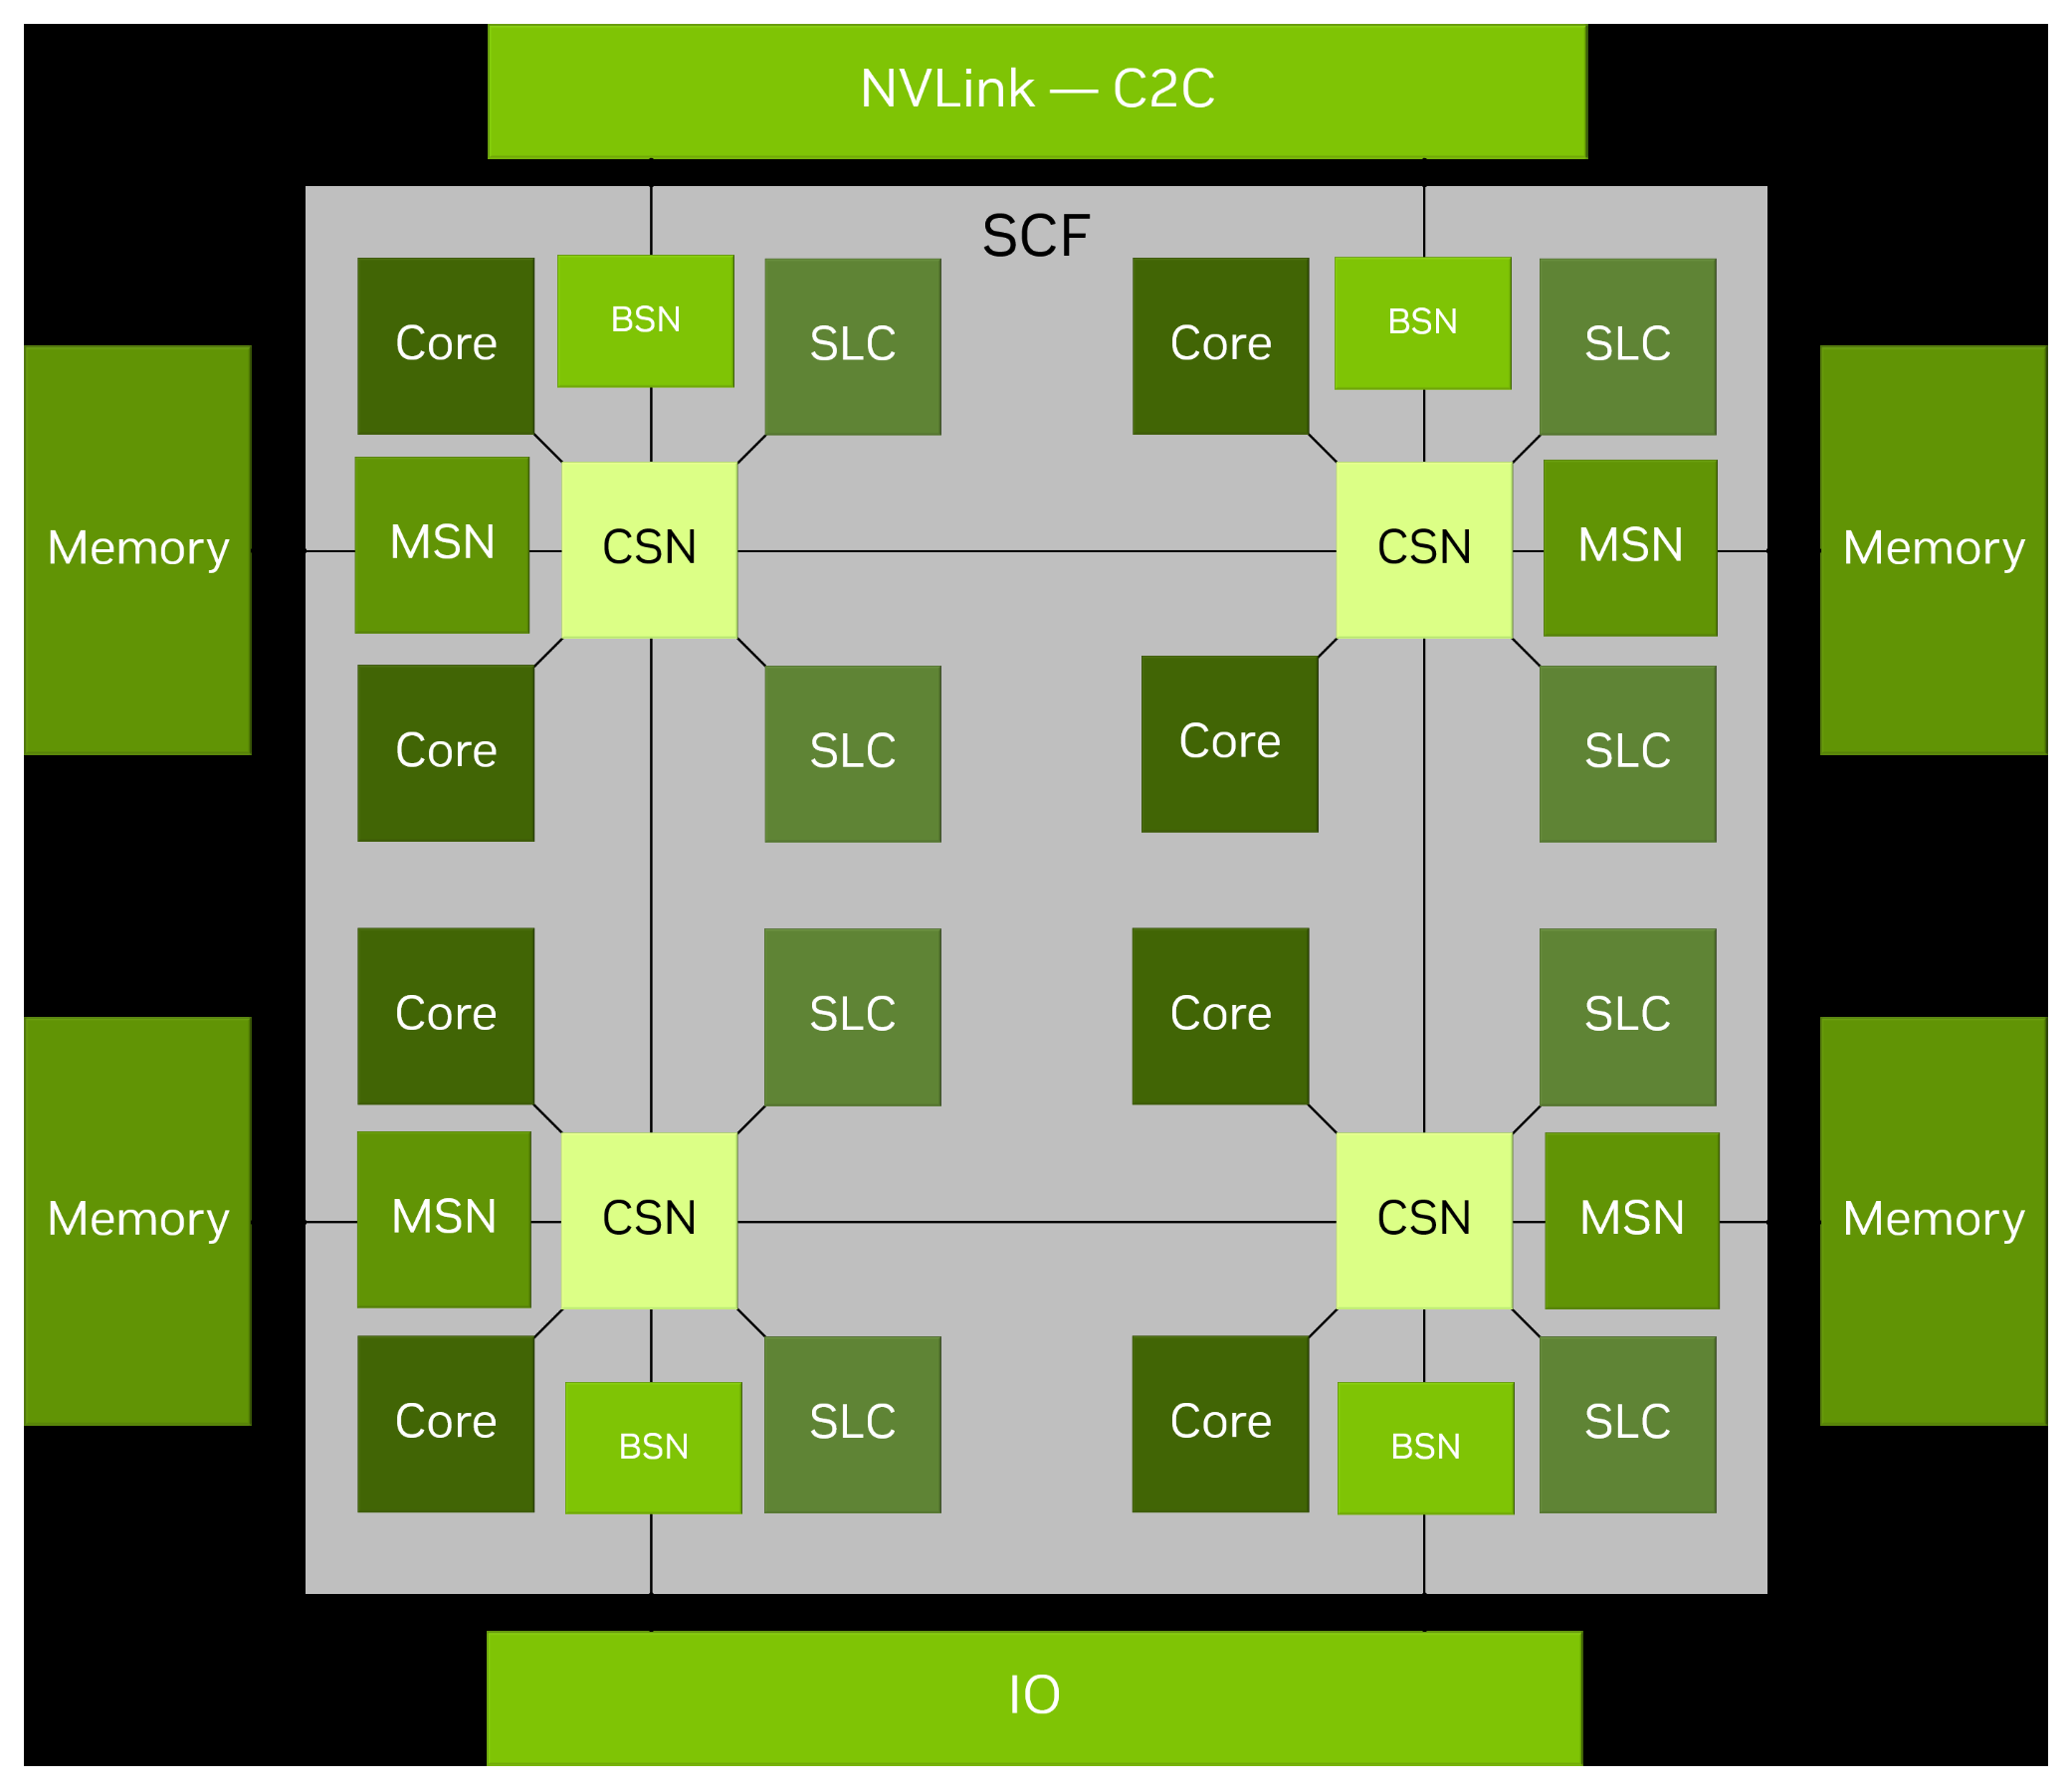
Cette architecture monopuce évite les transferts entre les puces de calcul distinctes lorsque les cœurs communiquent ou accèdent au cache partagé. Côté logiciel, Vera présente également un nœud NUMA par socket : le système d'exploitation considère chaque socket comme un groupe de cœurs et de mémoire locale. Cela simplifie le placement au sein du socket, même si la latence peut varier d'un chemin à l'autre dans le maillage. Un serveur à deux sockets possède toujours deux nœuds NUMA, et l'accès à la mémoire de l'autre socket reste différent de l'accès à la mémoire locale.
Dans chaque socket, le cache système partagé, ou cache L3, se situe un niveau au-dessus des caches L2 privés décrits précédemment. Il offre aux cœurs une nouvelle possibilité de réutiliser les données sans avoir à accéder à la DRAM et fournit une capacité partagée accessible via le socket. Ses 164 Mo sont conséquents, mais certains processeurs concurrents proposent un cache L3 bien plus important. Cela s'avère crucial lorsqu'un ensemble de travail fréquemment accédé est trop volumineux pour le cache L2 d'un cœur, mais tient dans un cache partagé plus grand. Une bande passante DRAM élevée est utile lorsque les données doivent être extraites de la mémoire ; elle ne supprime cependant pas l'avantage d'éviter cet accès dès le départ.
Du fait du partage de cette capacité, Vera prend également en charge Arm MPAM, permettant ainsi au logiciel système de partitionner la capacité du cache partagé et de gérer les allocations de bande passante mémoire entre les charges de travail.
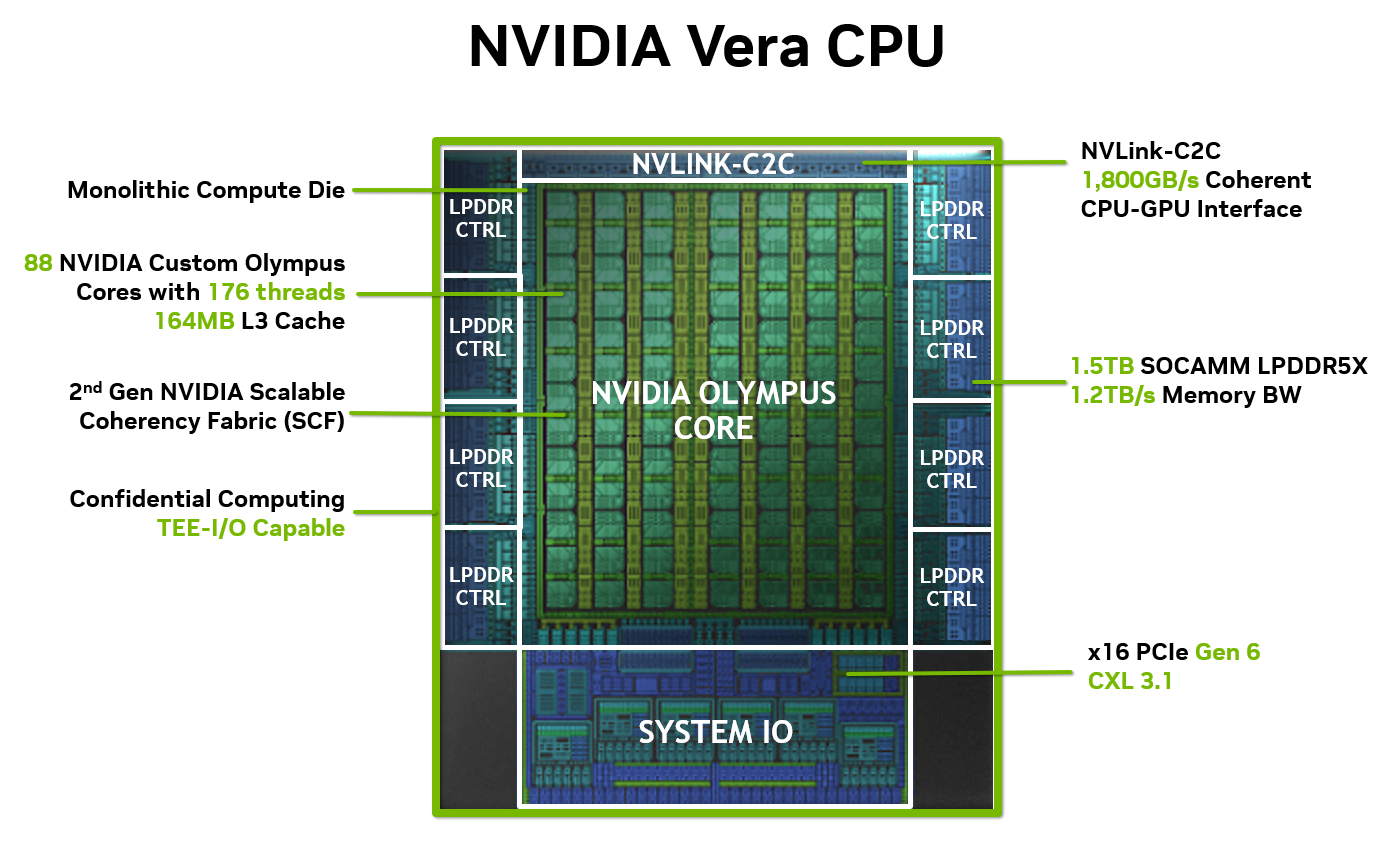
Lorsque les accès atteignent la mémoire principale, Vera dispose d'une bande passante considérable. Huit contrôleurs LPDDR5X 128 bits offrent une interface agrégée de 1 024 bits, avec une mémoire fonctionnant jusqu'à 9 600 MT/s pour une capacité nominale de 1.2 To/s par socket. La mémoire est répartie sur huit modules SOCAMM2 amovibles, combinant LPDDR5X et modules remplaçables sur site. Vera bénéficie ainsi d'une interface mémoire large et rapide sans nécessiter de mémoire soudée.
La bande passante brute ne représente qu'une partie du problème. Le rapport le plus pertinent est celui entre cette bande passante et le nombre de cœurs qui la partagent. En divisant la bande passante nominale de 1.2 To/s par 88 cœurs, on obtient environ 13.6 Go/s par cœur physique. Il s'agit d'une représentation de l'équilibre du processeur, et non d'une allocation dédiée ou d'une garantie de la bande passante reçue par chaque thread. Augmenter le nombre de cœurs sans augmenter proportionnellement la bande passante mémoire réduirait ce rapport.
En divisant la bande passante STREAM mesurée par le nombre de cœurs physiques, on obtient 11.8 Go/s par cœur sur Vera, contre 3.8 Go/s sur le système Xeon 6978P à 240 cœurs. Ceci illustre concrètement le débit mémoire important offert par Vera compte tenu de ses ressources de calcul.
L'efficacité énergétique fait partie intégrante de ce choix de conception. NVIDIA estime la consommation d'un sous-système mémoire LPDDR5X entièrement équipé entre 30 et 40 W environ, selon sa capacité. L'intérêt de la LPDDR5X réside dans sa capacité à fournir cette bande passante tout en limitant la contribution de la mémoire à la consommation totale du serveur, libérant ainsi une plus grande partie des ressources énergétiques et de refroidissement du système pour le calcul.
La bande passante et l'efficacité ne donnent aucune indication sur la quantité de données pouvant être transférées, et la capacité reste un facteur distinct. NVIDIA spécifie jusqu'à 1.5 To de mémoire LPDDR5X directement connectée par socket, ou 3 To sur deux sockets. Pour les charges de travail nécessitant un stockage en mémoire, des débits de transfert plus élevés ne peuvent compenser une capacité insuffisante.
Lorsque la capacité directement connectée s'avère insuffisante, les E/S de Vera offrent une extension possible, ainsi que des connexions pour les périphériques. La plateforme CPU autonome fournit 88 lignes PCIe Gen6 par socket pour le réseau, le stockage et les accélérateurs, tandis que la configuration Vera Rubin en expose 96. Côté mémoire, la prise en charge de CXL 3.1 inclut les périphériques mémoire de type 3 et le regroupement de mémoire, permettant d'étendre la capacité au-delà des modules SOCAMM2. Cette mémoire étendue utilise un chemin d'accès différent de celui de la LPDDR5X directement connectée ; ses performances doivent donc être évaluées séparément.
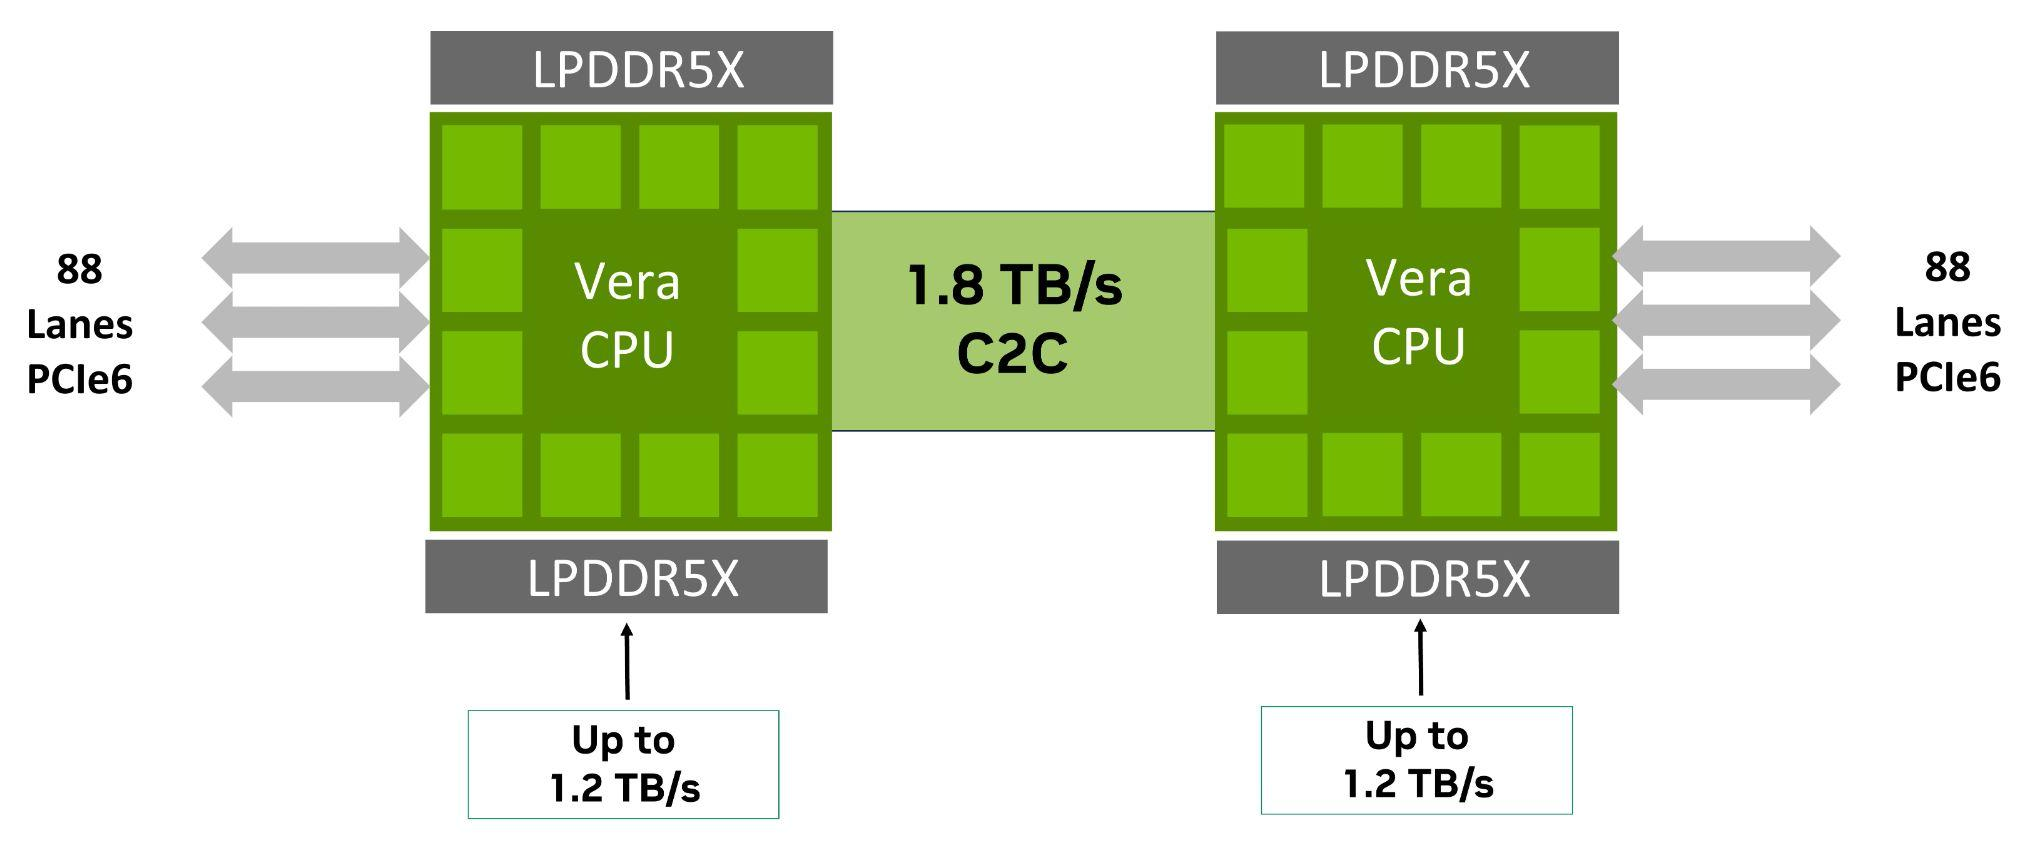
Enfin, pour la communication entre processeurs, Vera utilise la technologie NVLink-C2C de deuxième génération, successeur de la liaison introduite avec les superpuces Grace. Elle permet de connecter deux processeurs Vera dans un serveur biprocesseur ou de relier Vera à des GPU Rubin au sein d'une superpuce. Cette liaison offre une bande passante bidirectionnelle agrégée allant jusqu'à 1.8 To/s, soit 900 Go/s dans chaque sens, et reflète la même intégration étroite CPU-GPU qui motive l'entrée de NVIDIA sur le marché des processeurs.
À l'intérieur du serveur de référence MGX Vera C2
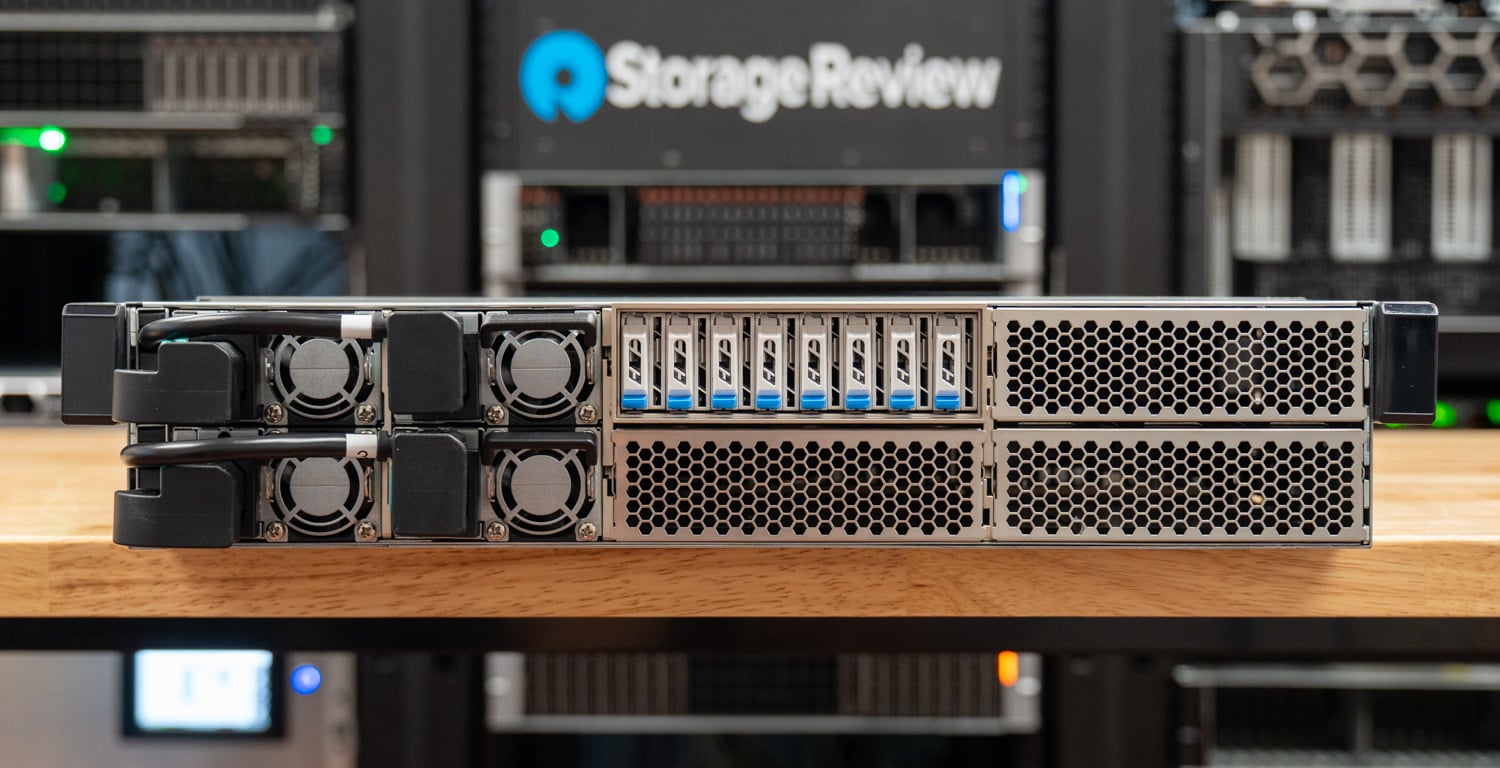
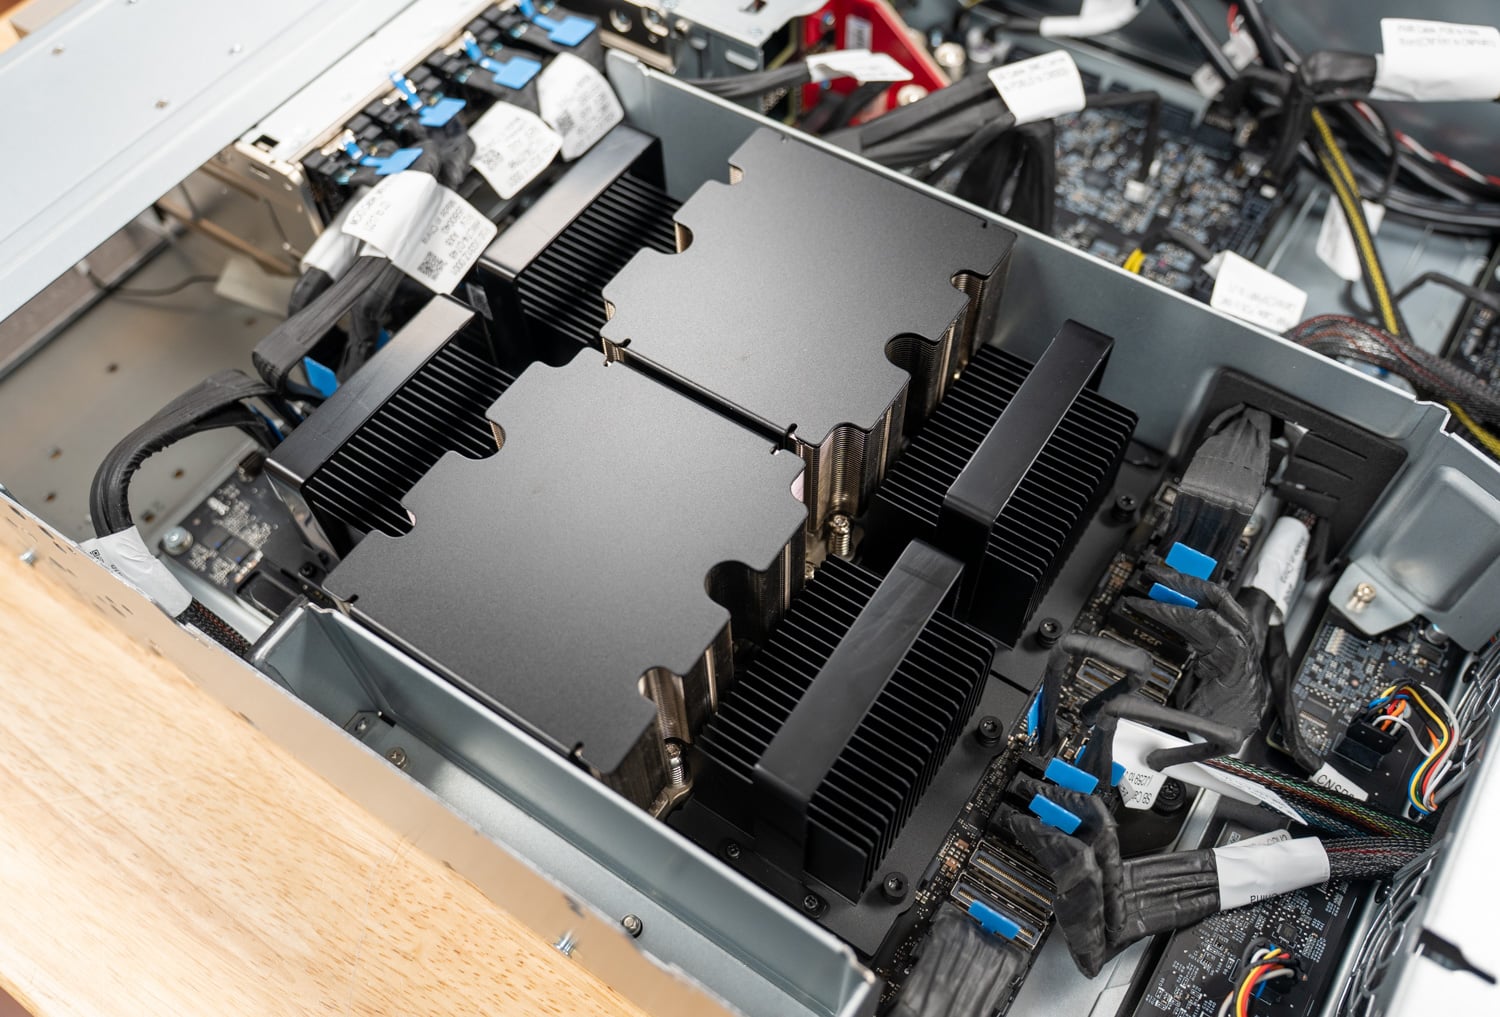
Notre serveur de test est le MGX Vera C2 de NVIDIA, un serveur de référence 2U à double socket et refroidissement par air, utilisé par les partenaires de NVIDIA comme base pour leurs premiers systèmes Vera. Huit baies E1.S sont disposées en haut du panneau avant, à côté de quatre alimentations Delta remplaçables à chaud. Le reste de la face avant est occupé par des grilles d'aération en nid d'abeille. Grâce à l'installation des alimentations en façade, l'arrière reste dégagé pour le câblage d'E/S dans un rack et est dédié aux cartes d'extension PCIe et aux E/S de gestion.
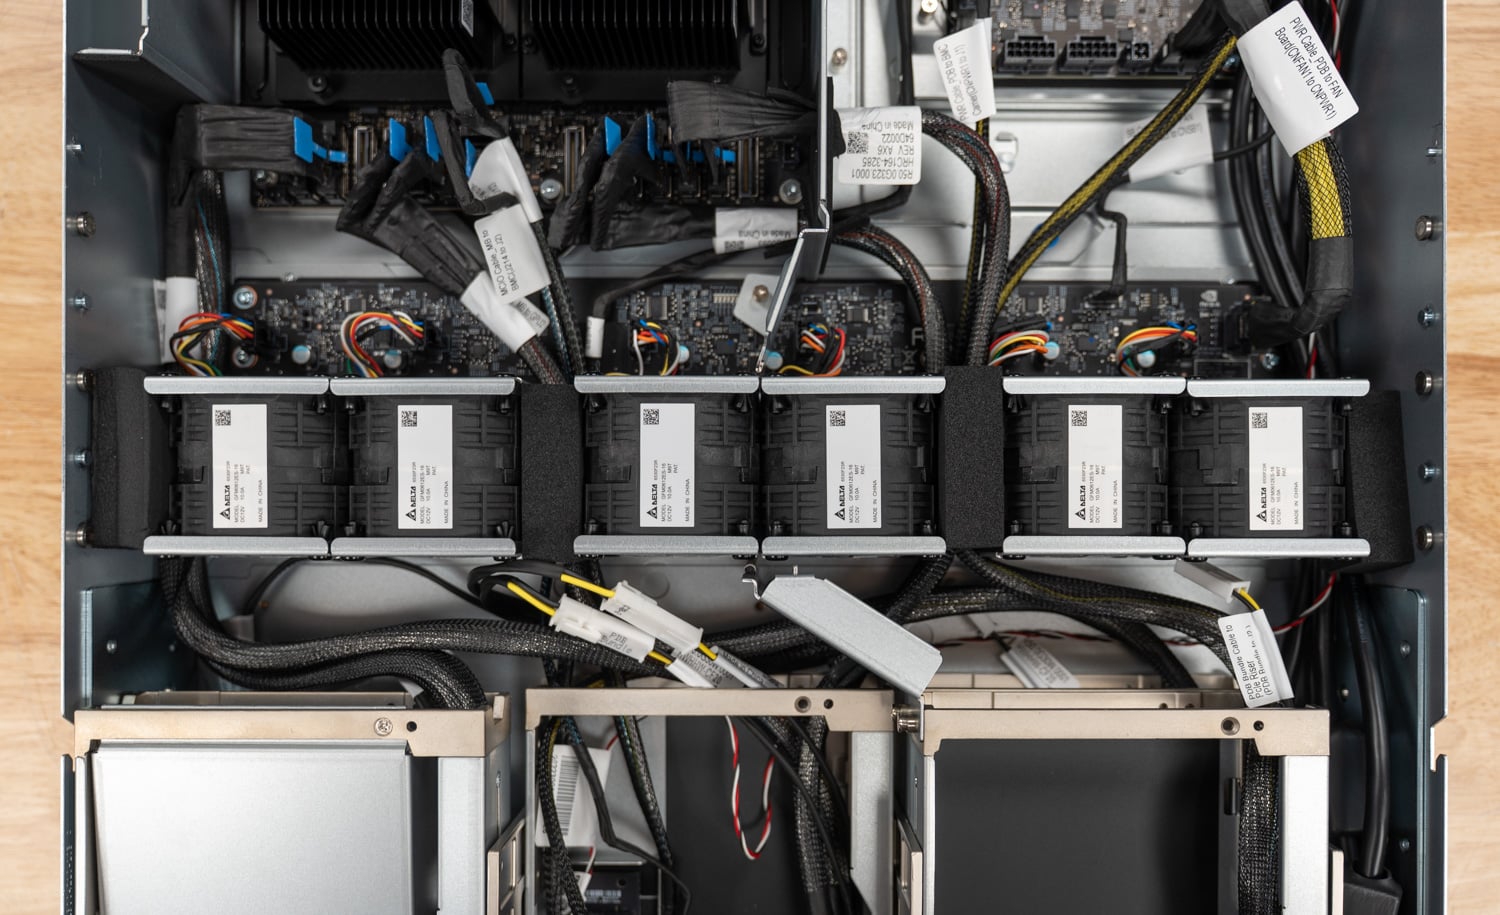
À l'intérieur, les deux processeurs Vera sont côte à côte sous des dissipateurs thermiques passifs, flanqués de modules SOCAMM2. Un mur de six ventilateurs au centre du châssis, juste derrière les baies de disques, aspire l'air au niveau des deux sockets, et des blocs de mousse placés entre chaque paire de ventilateurs orientent le flux d'air. Du point de vue du refroidissement, l'agencement est bien pensé.
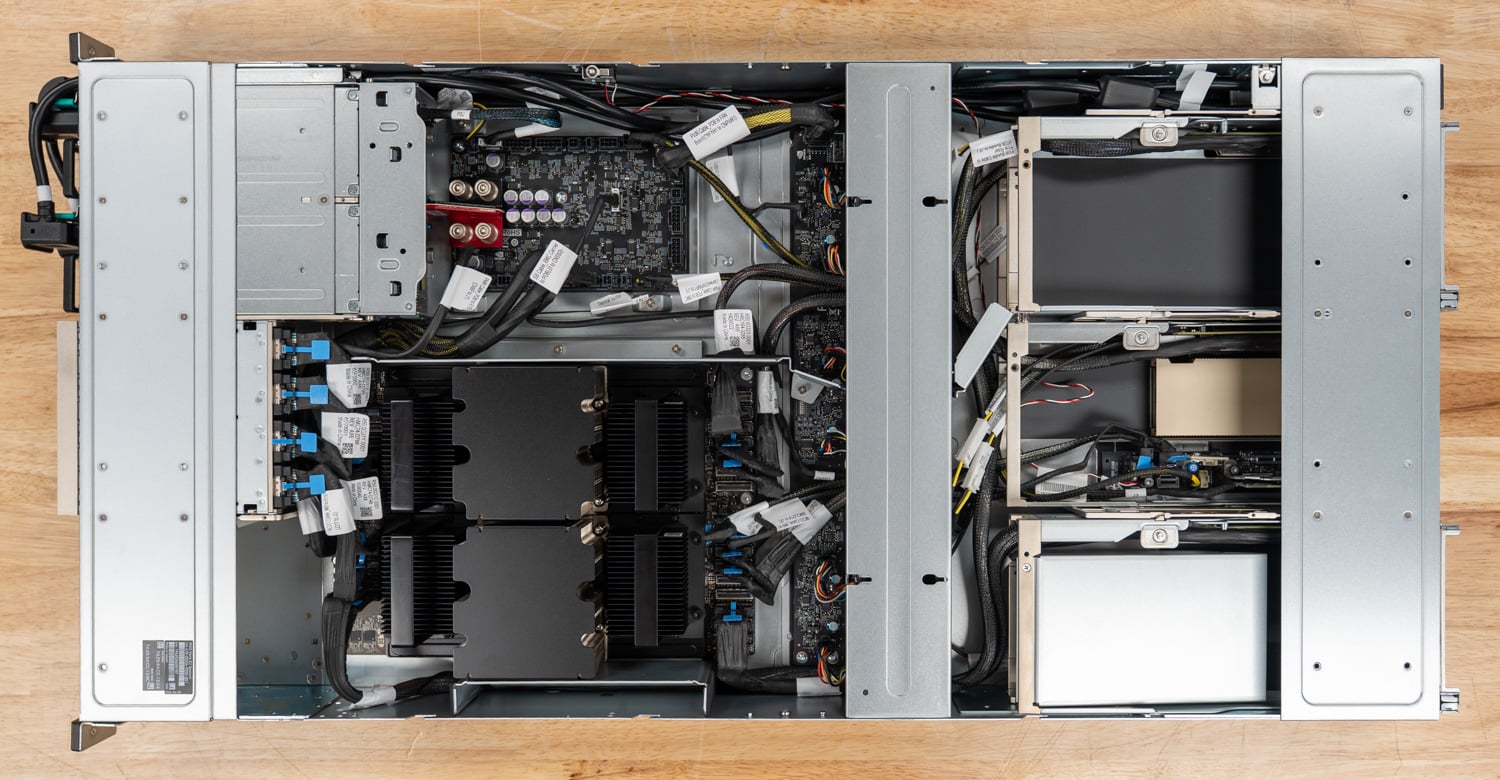
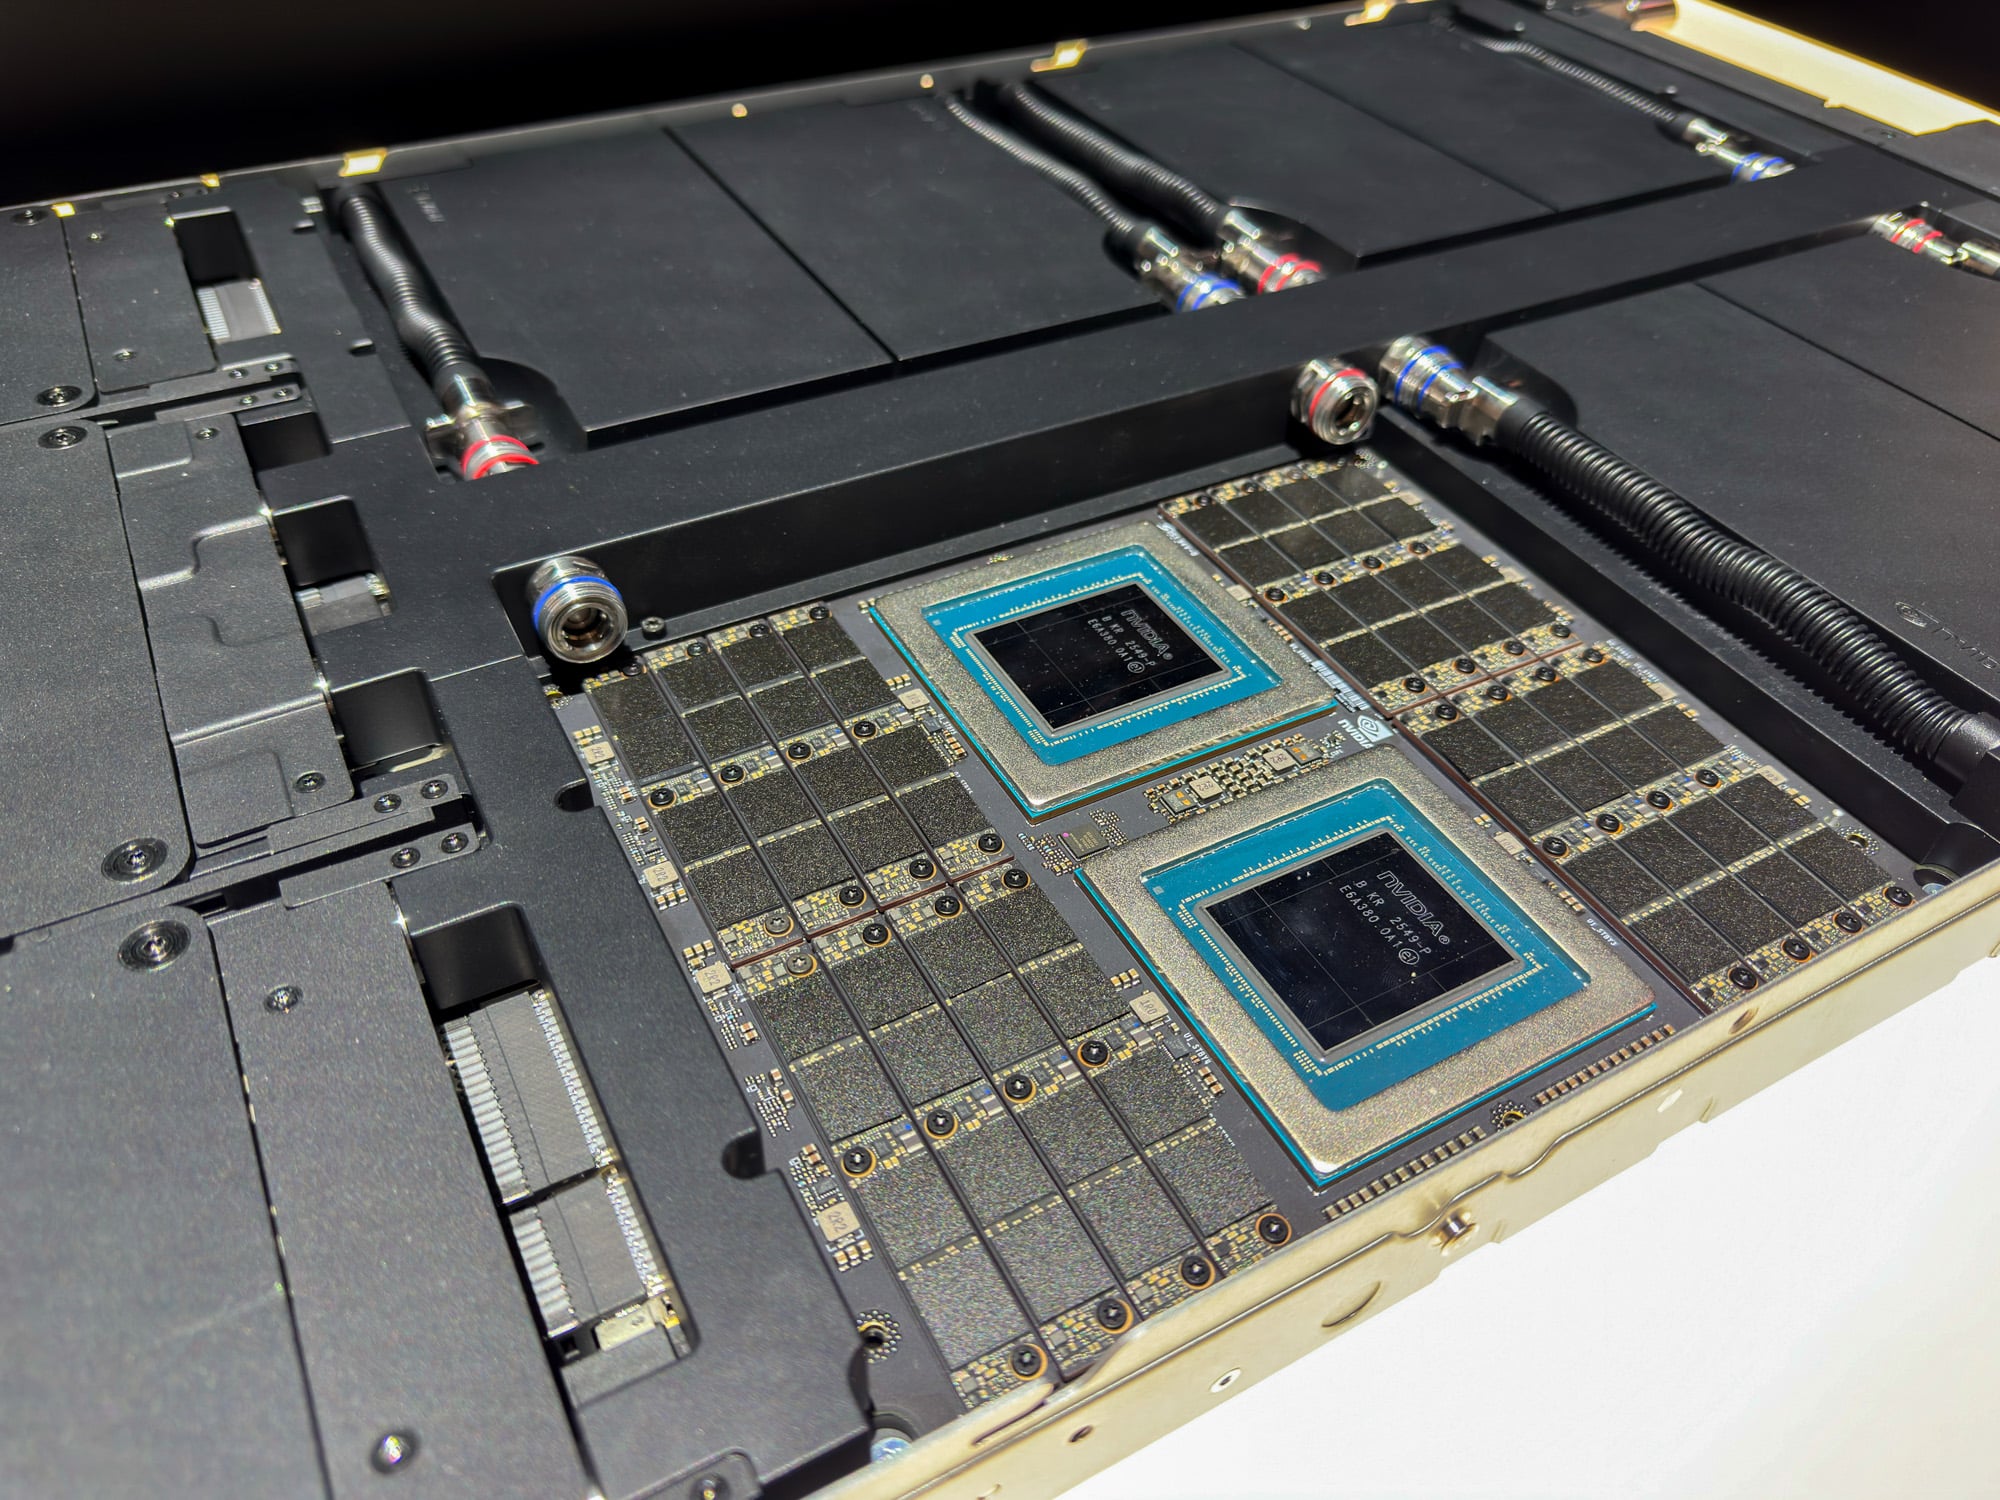
Les deux processeurs sont montés directement sur le circuit imprimé, sans support, à l'instar des puces Vera de NVIDIA. Les 16 emplacements SOCAMM2 entourent les deux modules, permettant ainsi le remplacement de la mémoire sur site, contrairement aux processeurs ; le remplacement d'un processeur nécessite le remplacement de la carte mère. Cet été, nous avons également testé la version à refroidissement liquide de cette même carte, qui utilise des raccords rapides pour acheminer le liquide de refroidissement vers les plaques froides des processeurs, tandis que les modules SOCAMM2 restent refroidis par air.
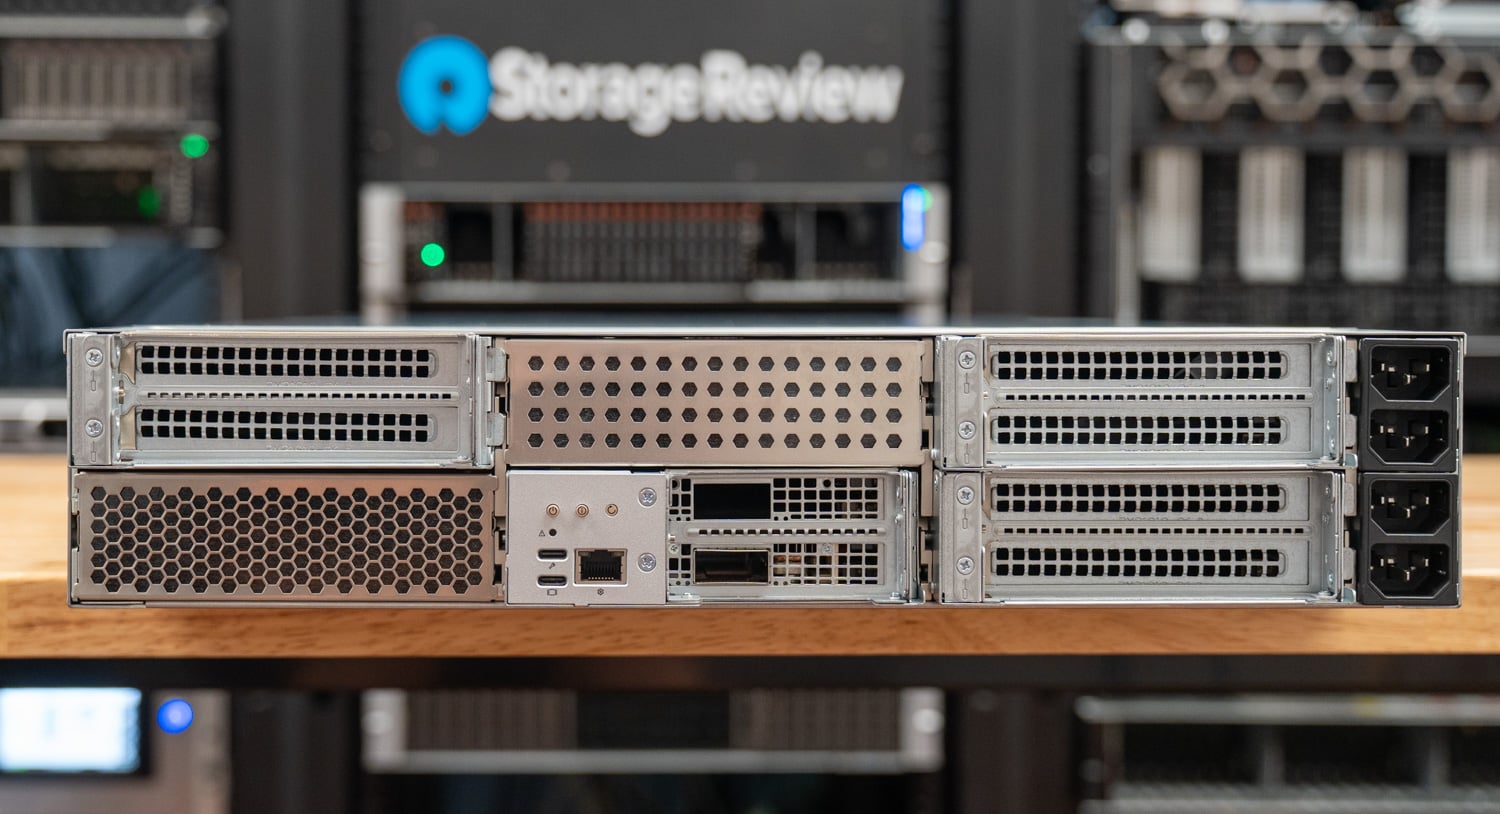
La partie centrale de la carte mère intègre un adaptateur NVIDIA ConnectX-8 pour une connectivité réseau jusqu'à 800G, tandis que le panneau arrière comporte des ports USB, DisplayPort et un port réseau dédié pour la gestion hors bande.
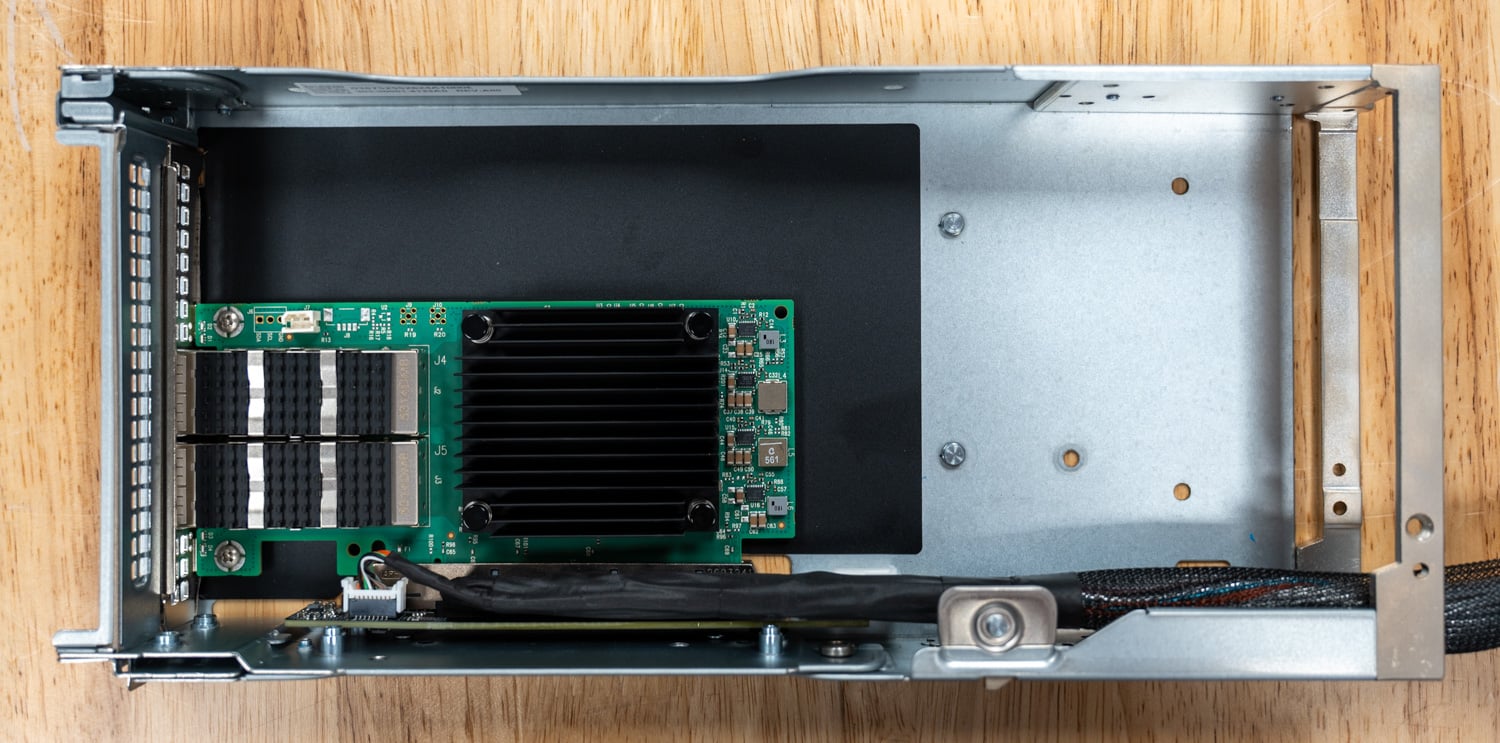
La plateforme est hautement modulaire et prend en charge diverses configurations de stockage et de PCIe arrière, mais cette flexibilité a un coût : le temps de maintenance. Ses trois cartes d'extension PCIe FHFL semblent faciles d'accès au premier abord. Dans un serveur classique, le remplacement d'une carte consiste à libérer la carte d'extension, à déplier une languette de support ou à retirer une vis, puis à faire glisser la carte pour l'extraire.
Sur le serveur Vera, il faut d'abord retirer le cache du ventilateur, puis enlever un ou plusieurs blocs de mousse, et débrancher et extraire les câbles d'alimentation et PCIe de la carte d'extension. Ce n'est qu'ensuite que l'ensemble de la carte d'extension peut être extrait par l'arrière du châssis. Une fois le support dégagé, il faut le démonter pour accéder à la carte, puis le remonter après son remplacement. Une opération qui prend quelques secondes sur un serveur classique nécessite ici entre 5 et 10 minutes par support.
En pratique, la maintenance à l'intérieur du rack est impossible à moins d'être prêt à faire des allers-retours constants ; la plupart des remplacements de composants nécessitent donc de déplacer le serveur sur un établi pour effectuer la maintenance.
Performances et repères
Les tests d'évaluation examinent comment la conception de Vera se traduit en performances, des threads individuels aux charges de travail utilisant l'ensemble du système. Nos tests couvrent la bande passante et la latence de la mémoire, le calcul scientifique, les logiciels d'usage général et les bases de données, démontrant comment le processeur gère les différentes exigences imposées à ses cœurs et à son système de mémoire.
Systèmes de test
| Système | NVIDIA MGX Vera C2 | Dell PowerEdge R7725 | Dell PowerEdge R7725 | Dell PowerEdge R770AP | Dell PowerEdge R770 | Dell PowerEdge R760 |
|---|---|---|---|---|---|---|
| Processeurs | ||||||
| Processeur | NVIDIA Vera | AMD EPYC 9965 | AMD EPYC9175F | Intel Xeon 6978P | Intel Xeon 6787P | Intel Xeon Platine 8592+ |
| sockets | 2 | |||||
| Cœurs / Threads par processeur | 88/176 | 192/384 | 16/32 | 120/240 | 86/172 | 64/128 |
| Horloge de base | 3.4 GHz | 2.25 GHz | 4.2 GHz | 2.1 GHz | 2.0 GHz | 1.9 GHz |
| Horloge maximale | 3.4 GHz | 3.7 GHz | 5.0 GHz | 3.9 GHz | 3.8 GHz | 3.9 GHz |
| Mémoire | ||||||
| Configuration | 16 x 96 Go Micron SOCAMM2 | 24x 128GB | 24x 64GB | 32x 64GB | 16x 64GB | |
| Type / Vitesse | LPDDR5X-9600 | DDR5-6400 | DDR5-5200 | DDR5-4800 | ||
| Capacité totale | 1.5TB | 3TB | 1.5TB | 2TB | 1TB | |
| Stockage | ||||||
| SSD | Solidigm D7-PS1010 7.68 To | Solidigm D7-PS1030 12.8 To | Micron 9550 PRO 7.68 To | Solidigm D7-PS1010 7.68 To | Samsung PM1745 6.4 To | Solidigme D7-P5520 3.84 To |
| Lien SSD | PCIe Gen5x4 | PCIe Gen5x2 | PCIe Gen5x4 | PCIe Gen4x4 | ||
| Microcode | ||||||
| BIOS système | NV_SBIOS 06.07.01.06 | 1.5.3 | 1.2.1 | 1.8.5 | 2.8.2 | |
| Profil BIOS | Réglage par défaut | Performances | ||||
| Pile logicielle | ||||||
| OS | Ubuntu LTS 26.04.1 | Ubuntu LTS 24.04.5 | ||||
| Noyau | 7.0.0-2022-nvidia-bos | 6.8.0-142 / 6.8.0-146 | 6.8.0-147 | 6.8.0-138 | 6.8.0-142 / 6.8.0-146 | 6.8.0-142 / 6.8.0-146 |
| GCC | 15.2.0 | 13.3.0 | ||||
| glibc | 2.43 | 2.39 | ||||
| MPI ouvert | 5.0.10 | 4.1.6 | ||||
| OpenJDK | 11.0.32 | |||||
Nous avons comparé Vera à cinq configurations Dell PowerEdge avec une configuration de mémoire idéale et les avons testées avec la même suite de tests, couvrant les composants EPYC d'AMD avec le plus grand nombre de cœurs et une fréquence optimisée, ainsi que les Xeon de génération actuelle et précédente.
Comme la prise en charge d'Olympus est apparue pour la première fois avec GCC 15, Vera utilisait une pile logicielle plus récente que les systèmes x86, comme indiqué ci-dessus. Les versions des benchmarks, les entrées et les options de compilation étaient par ailleurs identiques sur tous les systèmes.
Bande passante mémoire
C'est au niveau de la mémoire que Vera se distingue le plus de l'architecture x86 ; nous avons donc commencé nos tests par là. Nous avons testé STREAM Triad, exécuté avec un thread OpenMP par cœur physique sur des baies de 16 Gio. Le test principal utilise tous les cœurs du système, les données de chaque thread étant placées sur le même socket. Nous avons ensuite répété l'opération en faisant lire d'abord la mémoire locale des cœurs du socket 0, puis la mémoire du socket distant, chaque cœur lisant les pages de manière entrelacée sur les deux sockets. Le graphique ci-dessous présente les résultats de Triad sur l'ensemble du système pour chaque serveur, avec SMT désactivé.
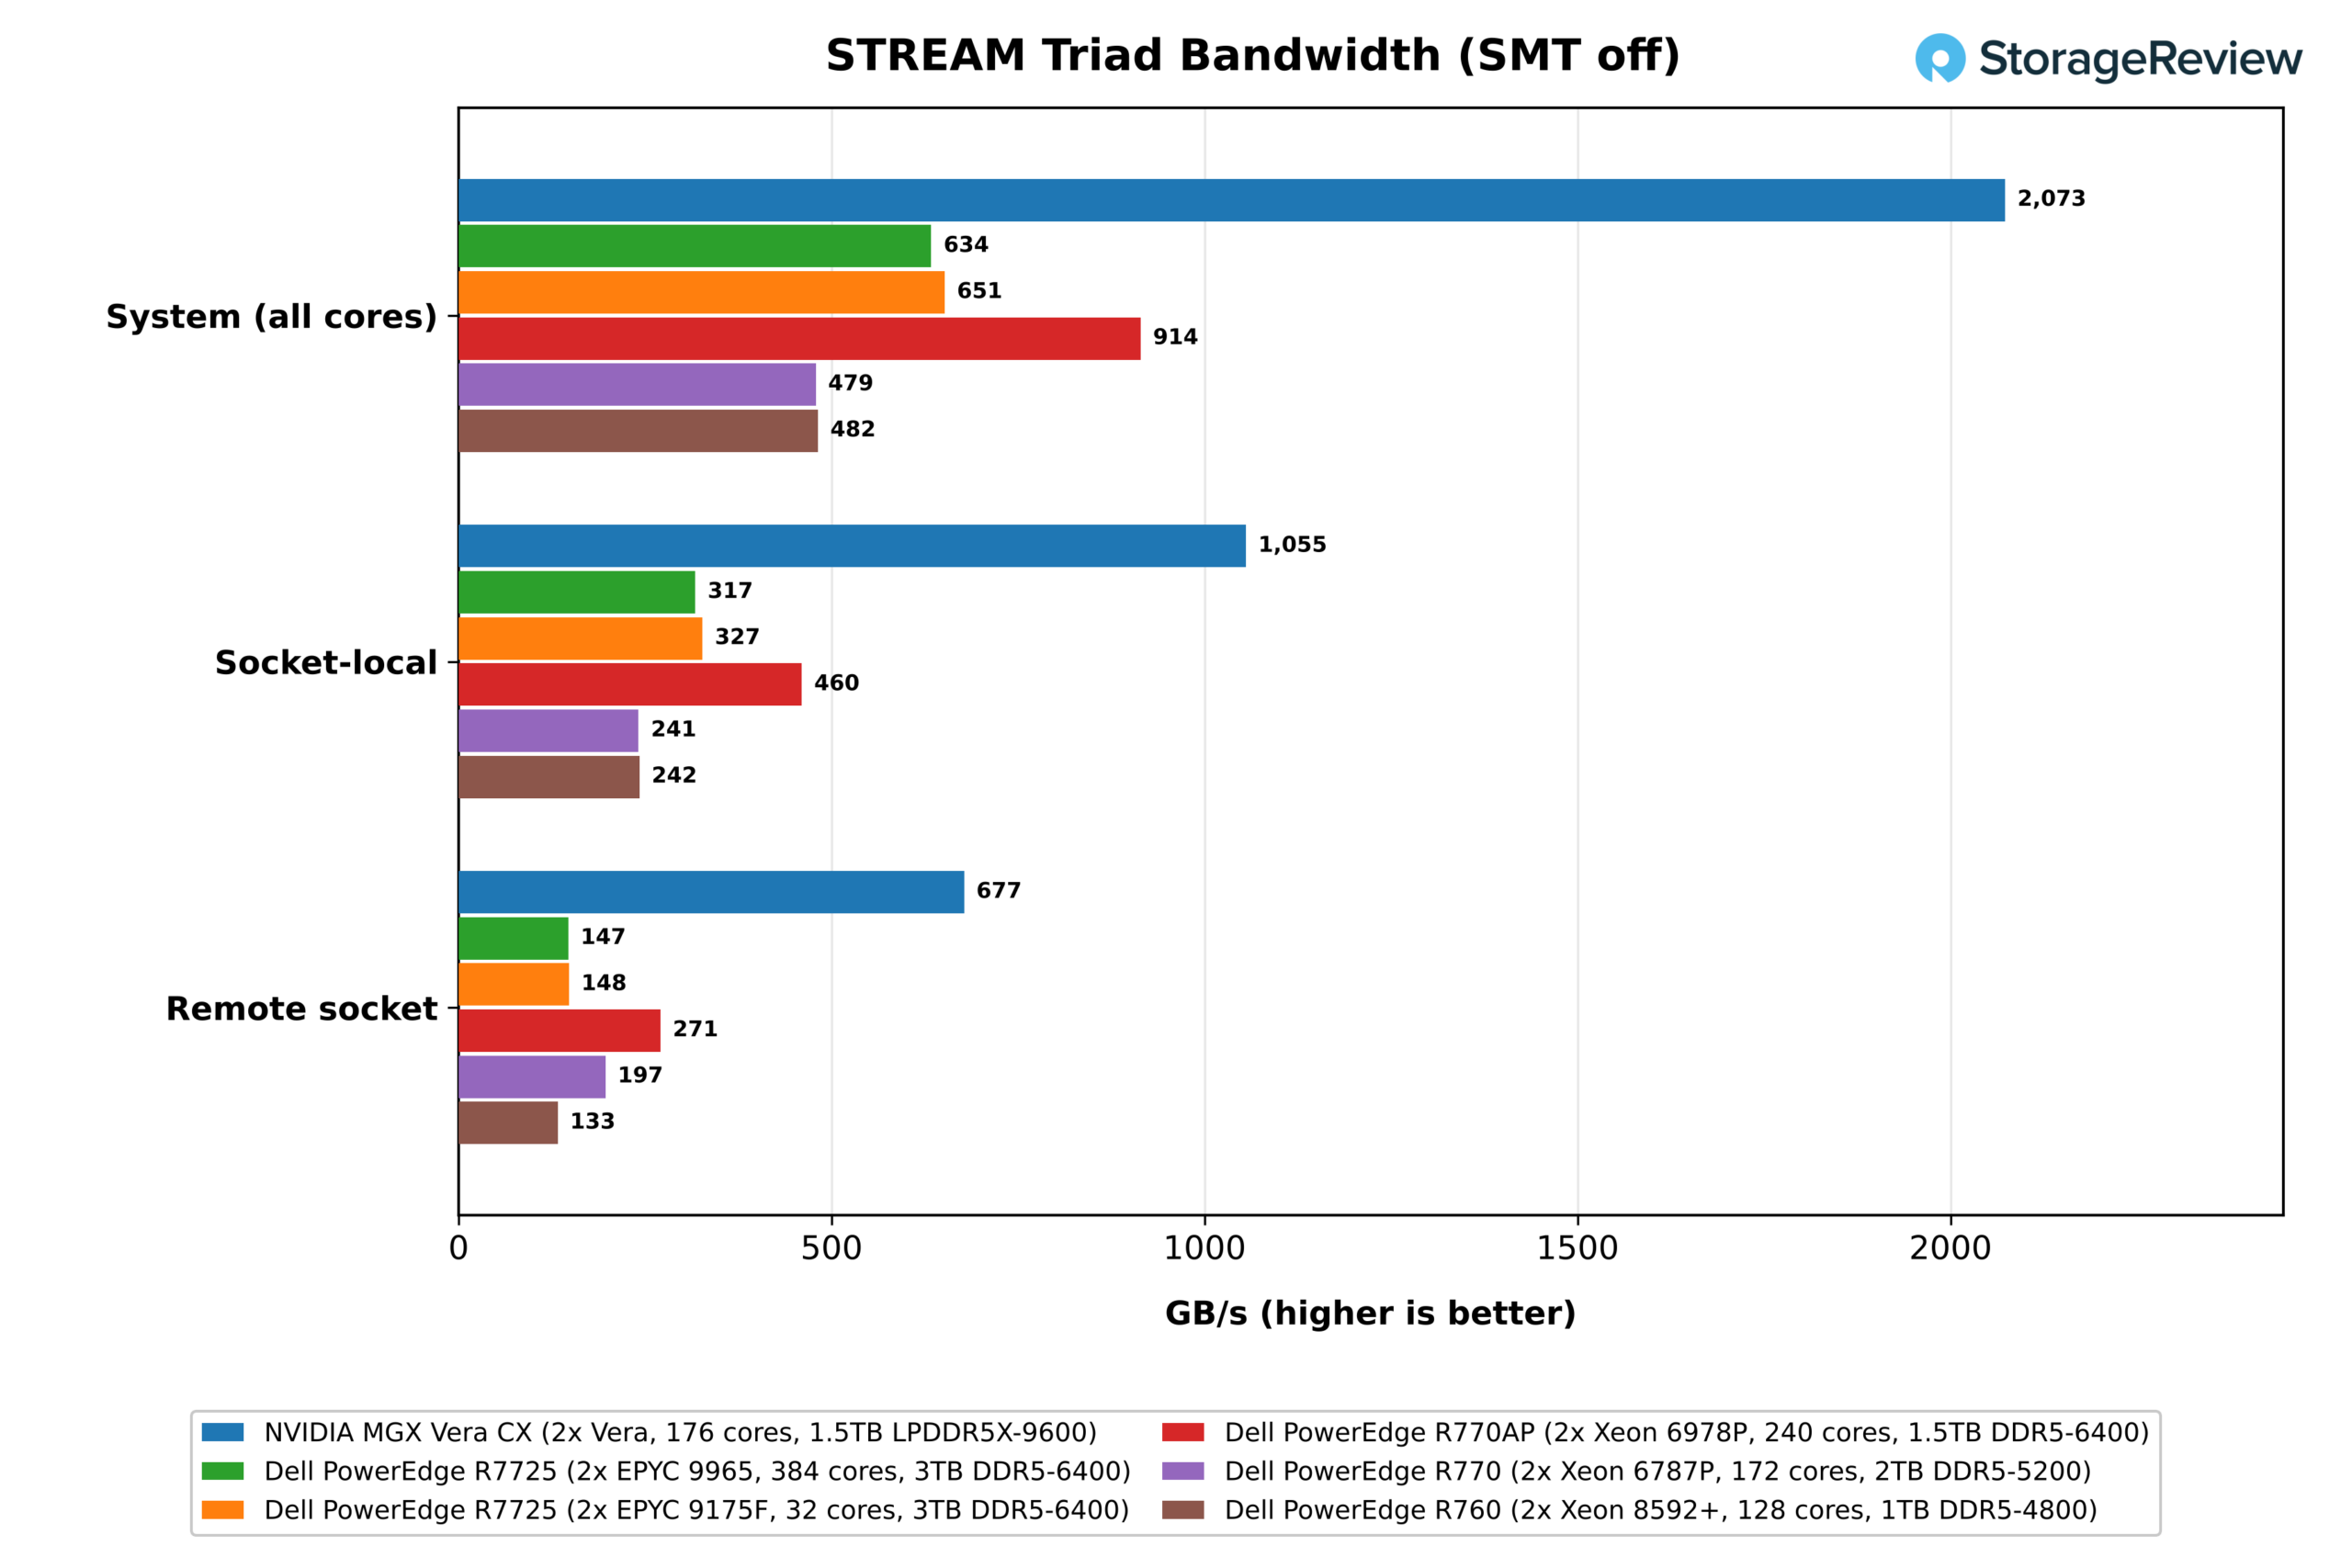
Vera a maintenu un débit de 2 073 Go/s, soit 86 % de sa capacité théorique de 2.4 To/s pour une configuration biprocesseur. Le système x86 le plus proche était le Xeon 6978P, dont les 24 canaux de DDR5-6400 ont atteint 914 Go/s, soit 74 % de sa capacité maximale théorique de 1 229 Go/s, ce qui représente un avantage de 2.3 fois pour Vera. Les deux systèmes EPYC utilisent également 24 canaux de DDR5-6400, mais leurs performances sont nettement inférieures : 651 Go/s pour le 9175F à 32 cœurs et 634 Go/s pour le 9965 à 384 cœurs, soit seulement 52 % de la capacité maximale et un avantage de 3.3 fois pour Vera. Enfin, les Xeon 6787P et 8592+ ferment la marche lorsqu'ils fonctionnent avec des mémoires DDR5-5200 et DDR5-4800 plus lentes, atteignant respectivement 479 Go/s et 482 Go/s.
Une partie du déficit de performances d'EPYC provient de la façon dont STREAM comptabilise le trafic. La suite utilise GCC standard, qui n'émet pas d'écritures en flux continu. Par conséquent, une écriture qui ne trouve pas de cache commence par lire sa ligne de destination en mémoire. STREAM ne comptabilise pas cette lecture, ce qui signifie que Triad sous-estime le trafic transféré d'un quart, quel que soit l'endroit où elle se produit. Les cœurs Zen d'AMD, quant à eux, la comptabilisent pour chaque écriture. Les cœurs ARM, comme les anciens Grace de NVIDIA, détectent les écritures de lignes complètes et ignorent la lecture, tandis que les récents Xeon d'Intel peuvent en ignorer la majeure partie lorsque la mémoire est fortement sollicitée.
La version de test STREAM réalisée séparément avec Phoronix Test Suite confirme cette tendance. Sans SMT, son débit de copie a atteint 832 Go/s sur le 9965 et 873 Go/s sur le 9175F, soit environ 1.5 fois les 551 Go/s et 570 Go/s obtenus avec la suite de tests. Ce résultat correspond au gain attendu pour la copie une fois la lecture supplémentaire éliminée. Sur les processeurs Xeon, les deux versions ont donné des résultats similaires, à 9 % près.
Après correction des lectures non comptabilisées, le 9965 a atteint environ 845 Go/s, soit environ 69 % de sa vitesse maximale, et l'avance de Vera en termes de débit se réduit à environ 2.5 fois. Le 6978P nécessite une correction bien moindre, ce qui fait de son écart de 2.3 la comparaison la plus prudente de cet ensemble.
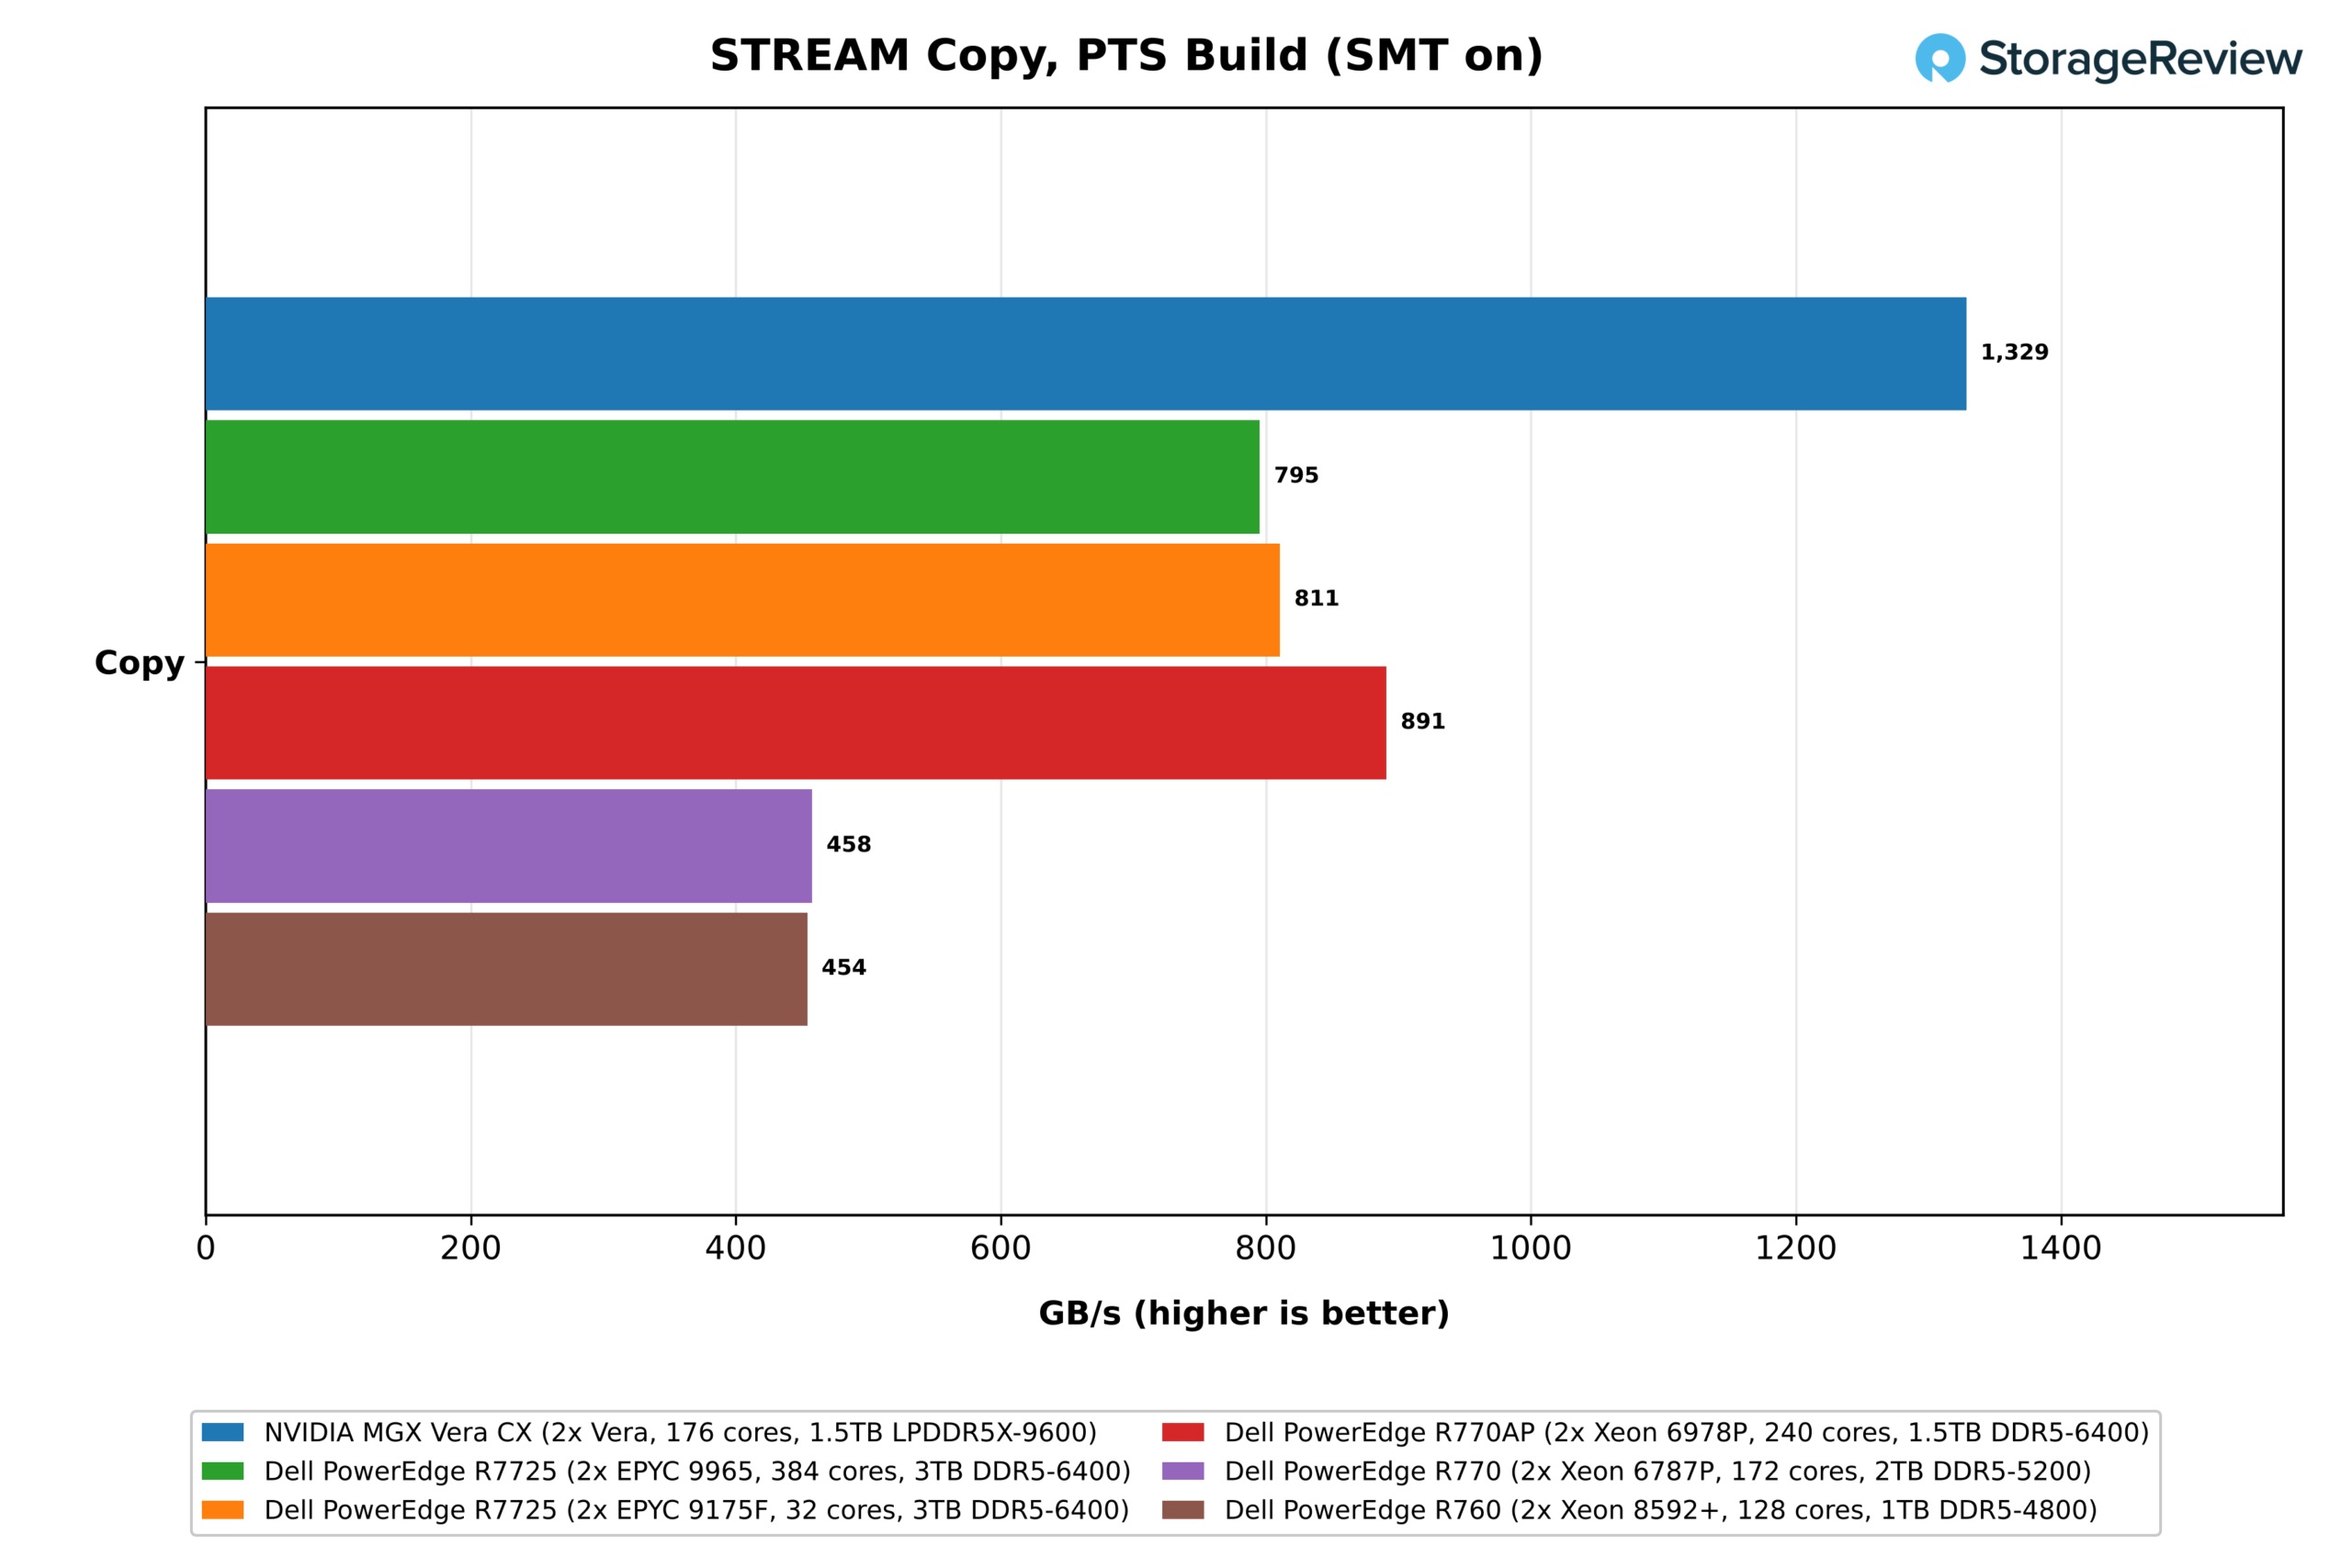
La répartition du test par socket révèle comment l'architecture gère les données non locales aux cœurs. Les cœurs du socket 0, lisant la mémoire locale, ont atteint 1 055 Go/s, soit 88 % de la capacité nominale de 1.2 To/s par socket, et un débit supérieur à celui de n'importe quel serveur x86 complet du test. En lisant la mémoire de l'autre socket via NVLink-C2C, ces mêmes cœurs ont maintenu 677 Go/s, soit 64 % du débit local, contre 59 % pour le Xeon 6978P et 45 % pour l'EPYC 9175F (148 Go/s en lecture distante contre 327 Go/s en lecture locale). Ainsi, même une charge de travail exécutée sur le mauvais socket bénéficie d'une bande passante supérieure à celle de n'importe quel socket x86 lisant la mémoire locale, dont le débit maximal est de 460 Go/s pour le 6978P.
Pour un test final de Vera, nous avons effectué un test avec des pages entrelacées STREAM Triad sur les deux sockets, le cas que rencontre une application non compatible NUMA, ce qui a donné à Vera 1 372 Go/s, soit 1.5 fois le résultat global du 6978P.
Latence
La bande passante ne représente que la moitié du problème de la mémoire. La latence détermine le temps d'attente d'un cœur à chaque échec d'accès au cache, et elle est cruciale pour le code qui effectue des accès mémoire via des pointeurs. Nous la mesurons avec tinymembench, qui chronomètre les lectures aléatoires sur un tampon de 1 Gio depuis un seul thread sur le socket 0. L'EPYC 9175F est le seul système x86 de notre ensemble pour lequel nous disposons de résultats à ce test ; il sert donc de référence.
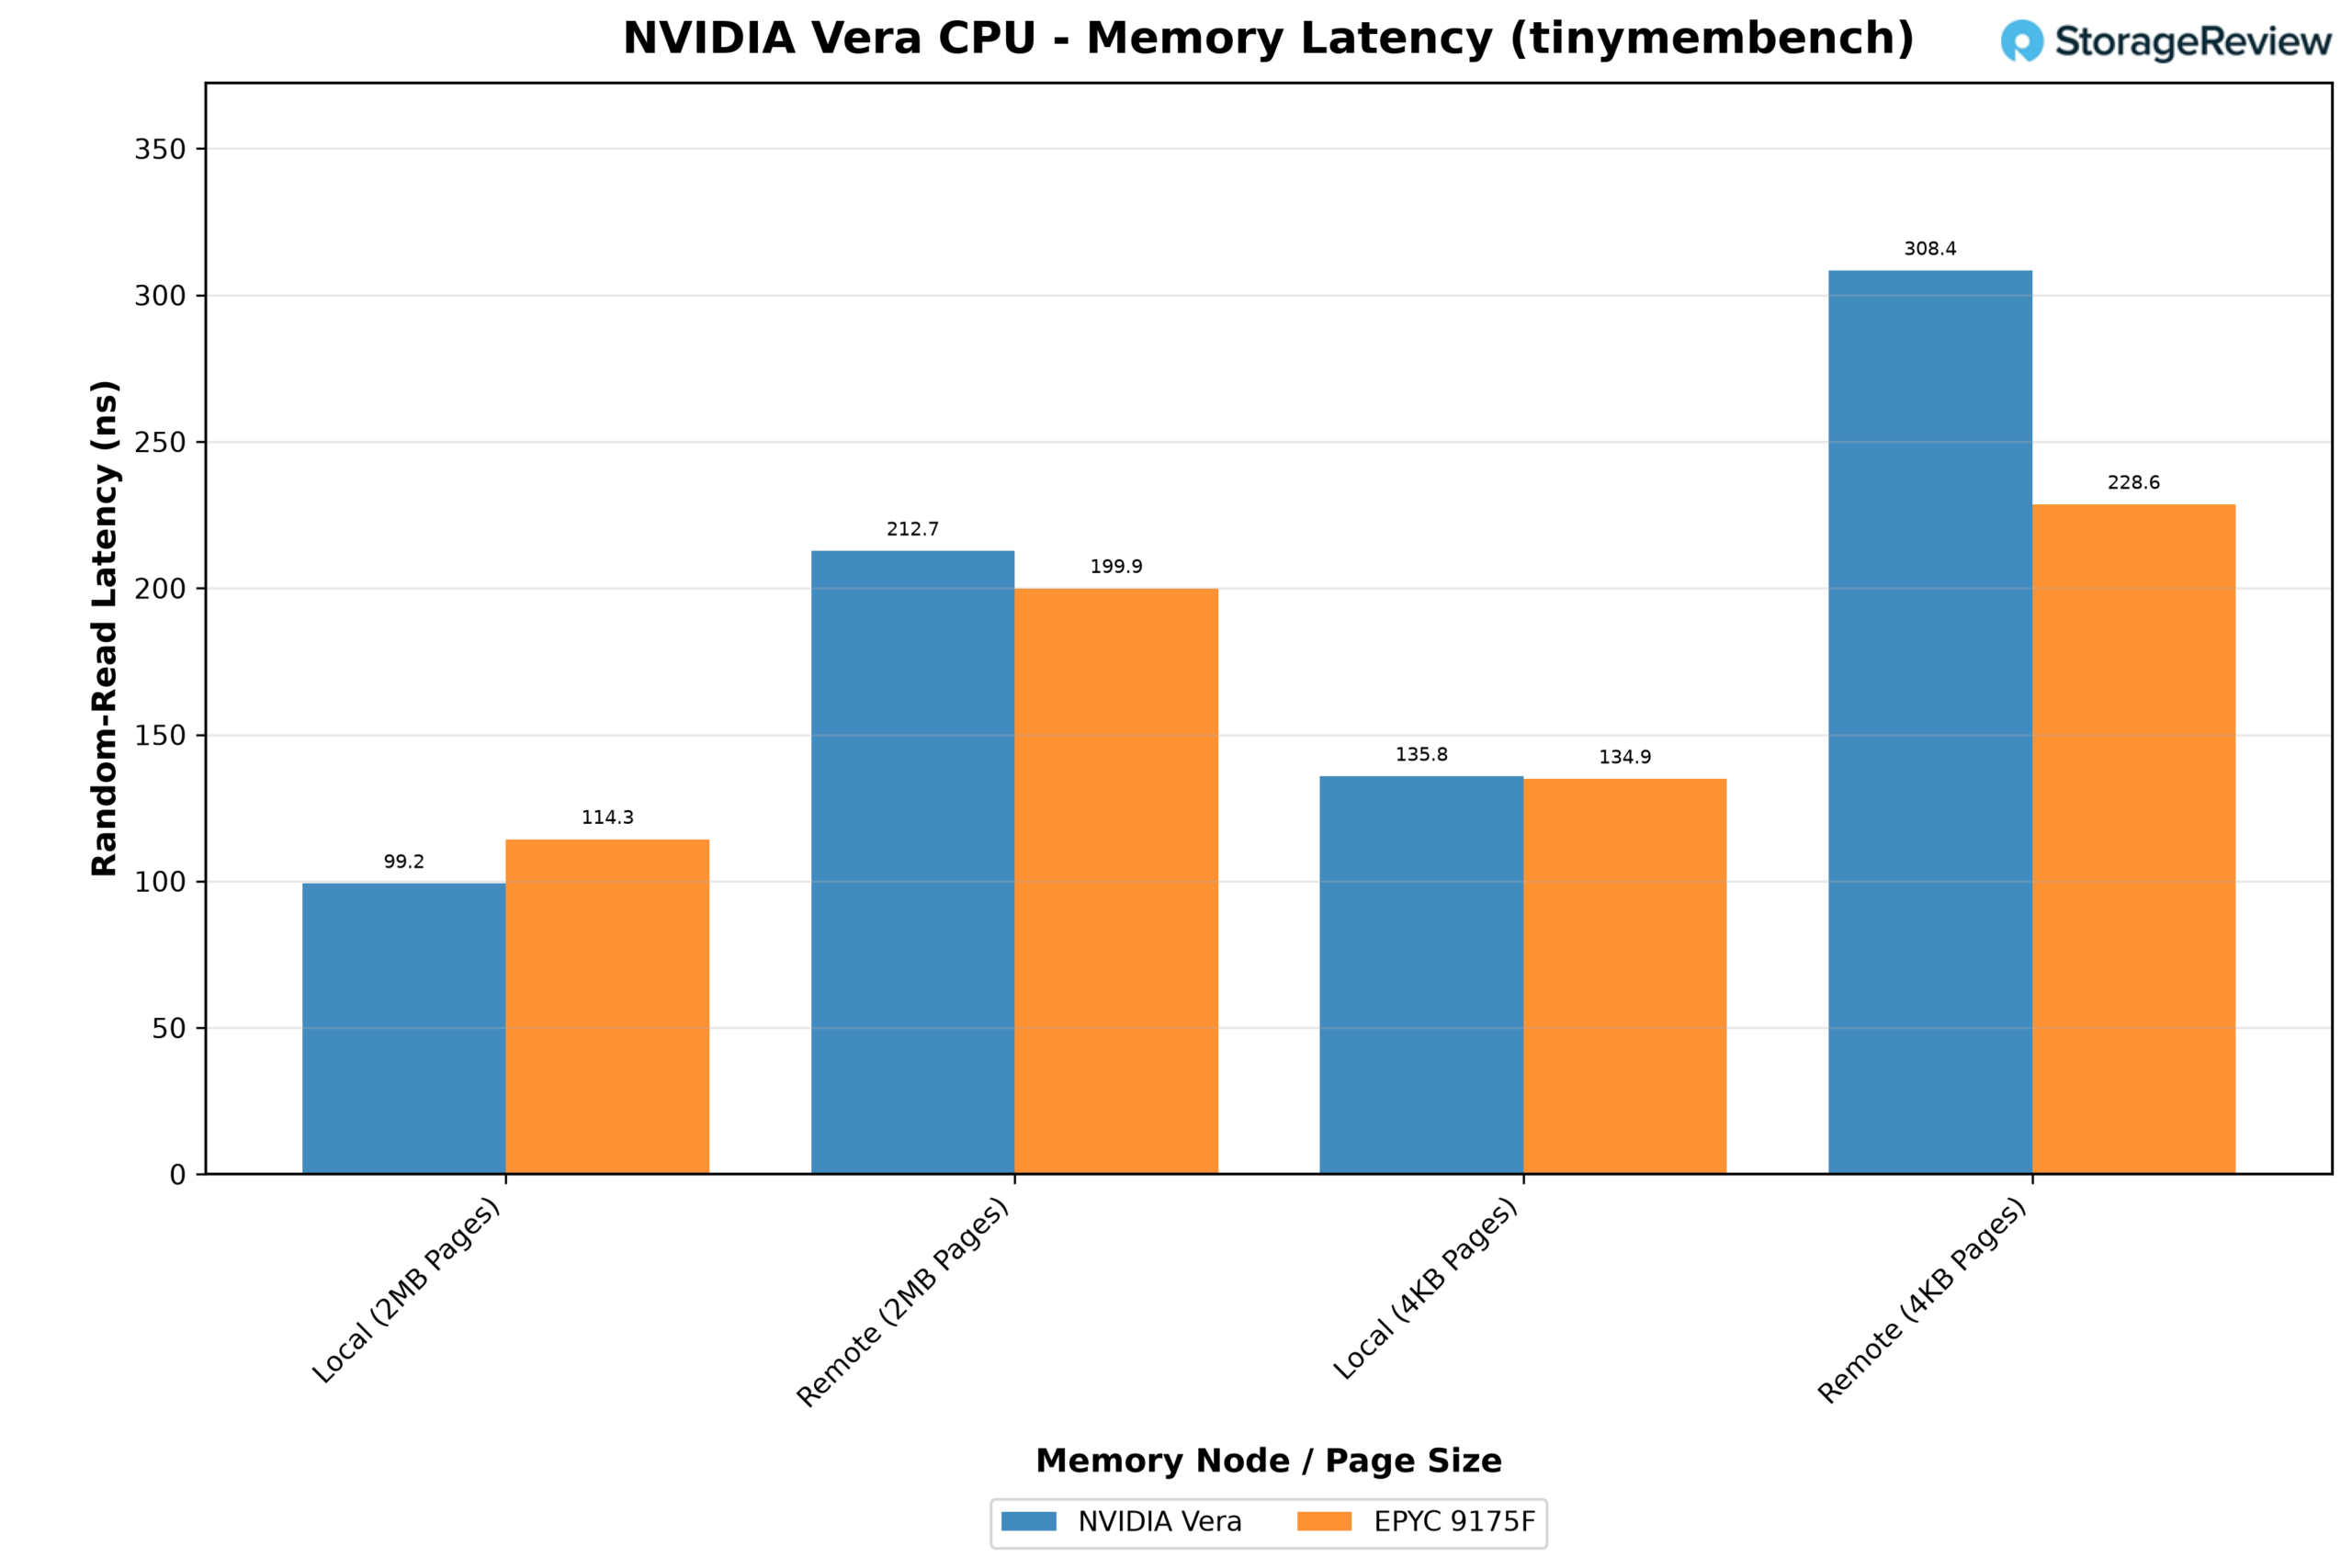
Lors de la lecture de la mémoire locale, Vera est plus rapide que l'EPYC. Avec des pages énormes de 2 Mo, une lecture locale a pris 99.2 ns sur Vera contre 114.3 ns sur le 9175F, soit 13 % plus rapide ; avec des pages standard de 4 Ko, les deux processeurs ont affiché un temps d'accès similaire d'environ 135 ns. C'est lors de l'accès à l'autre socket que la technologie NVLink-C2C révèle son coût. Une lecture distante a pris 212.7 ns sur Vera, soit environ 2.1 fois le temps local, tandis que les 199.9 ns de l'EPYC ne représentaient que 1.75 fois son temps local.
Vera est également plus sensible à la taille des pages. Avec des pages de 4 Ko, où les traductions d'adresses manquées s'ajoutent à chaque lecture, sa latence locale a augmenté de 37 % et sa latence distante a atteint 308.4 ns, contre une augmentation de 18 % et 228.6 ns sur EPYC. Sur Vera, nous utiliserions des pages de grande taille.
HPC
La bande passante et la latence décrivent le système de mémoire pris isolément. Les applications scientifiques montrent ce qui se passe lorsque ce système de mémoire et les cœurs doivent fonctionner de concert, et nos deux tests HPC s'appuient sur des aspects très différents de la conception du processeur.
GROMACS, un code de dynamique moléculaire, effectue la majeure partie de son exécution en calcul vectoriel, avec des boucles critiques écrites manuellement pour chaque largeur SIMD. Cela en fait le test le plus direct du compromis décrit dans la section Olympus : six pipelines SVE2 128 bits contre les unités AVX-512 512 bits sur les architectures x86. OpenFOAM, un solveur de dynamique des fluides numérique, traite de grandes matrices creuses et passe une grande partie de son temps à attendre la mémoire ; il permet ainsi de vérifier si la bande passante mesurée précédemment se confirme dans une application réelle.
GROMACS
Nous avons testé GROMACS 2025.3 avec benchPEP, un cas de 12 millions d'atomes exécuté sur tous les cœurs physiques du serveur. La compilation utilisait ARM_SVE sur Vera et AVX-512 sur tous les systèmes x86. Grâce aux entrées fixes et à la désactivation du réglage PME, chaque plateforme a exécuté le même travail.
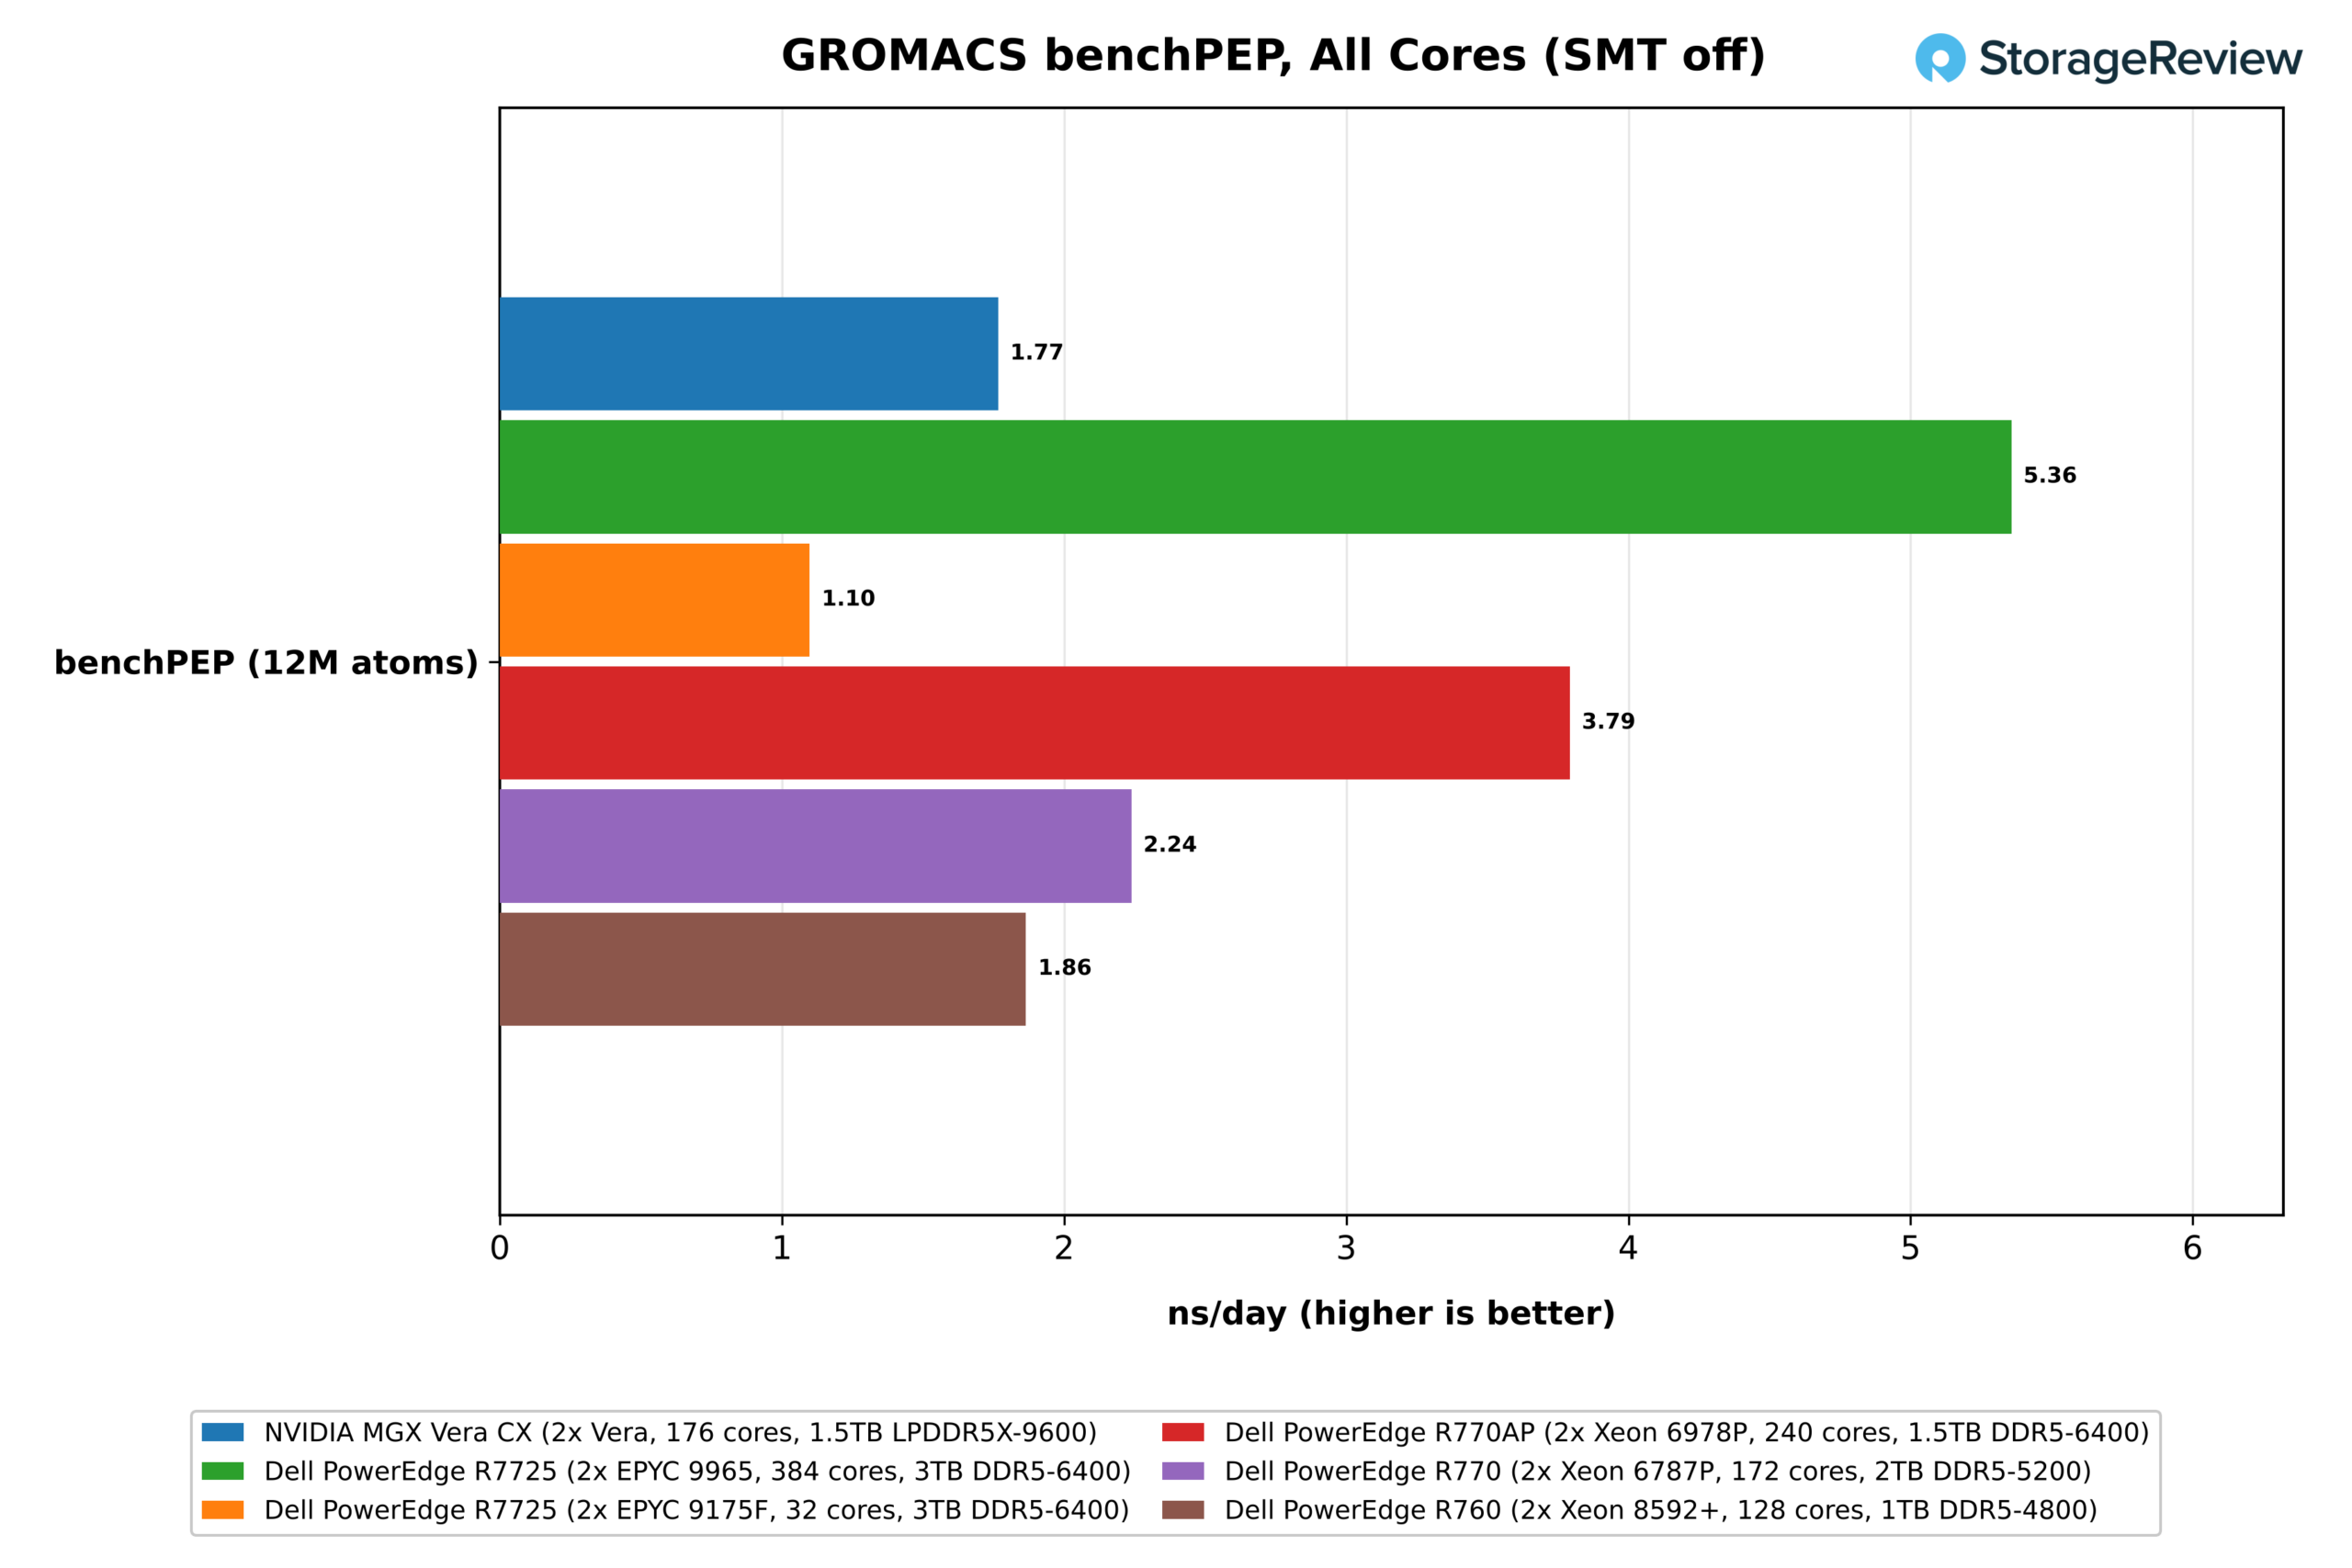
Avec le SMT désactivé, Vera a terminé le test benchPEP à 1.77 ns/jour. L'EPYC 9965 à 384 cœurs a affiché le meilleur score avec 5.36 ns/jour, soit 3.0 fois plus que Vera, suivi du Xeon 6978P à 240 cœurs à 3.79 ns/jour (2.1 fois plus) et du Xeon 6787P à 172 cœurs à 2.24 ns/jour (1.27 fois plus). Le Xeon 8592+ à 128 cœurs a également devancé Vera avec 1.87 ns/jour, ne laissant que l'EPYC 9175F à 32 cœurs, à 1.10 ns/jour, derrière Vera. La normalisation par nombre de cœurs permet de déterminer la part de cet écart imputable à l'architecture. Vera affiche un débit de 0.0100 ns/jour par cœur, contre 0.0130 sur le 6787P, 0.0140 sur le 9965, 0.0146 sur le 8592+ et 0.0158 sur le 6978P. Le déficit par rapport aux gros processeurs x86 s'explique donc en partie par le nombre de cœurs et en partie par le débit par cœur.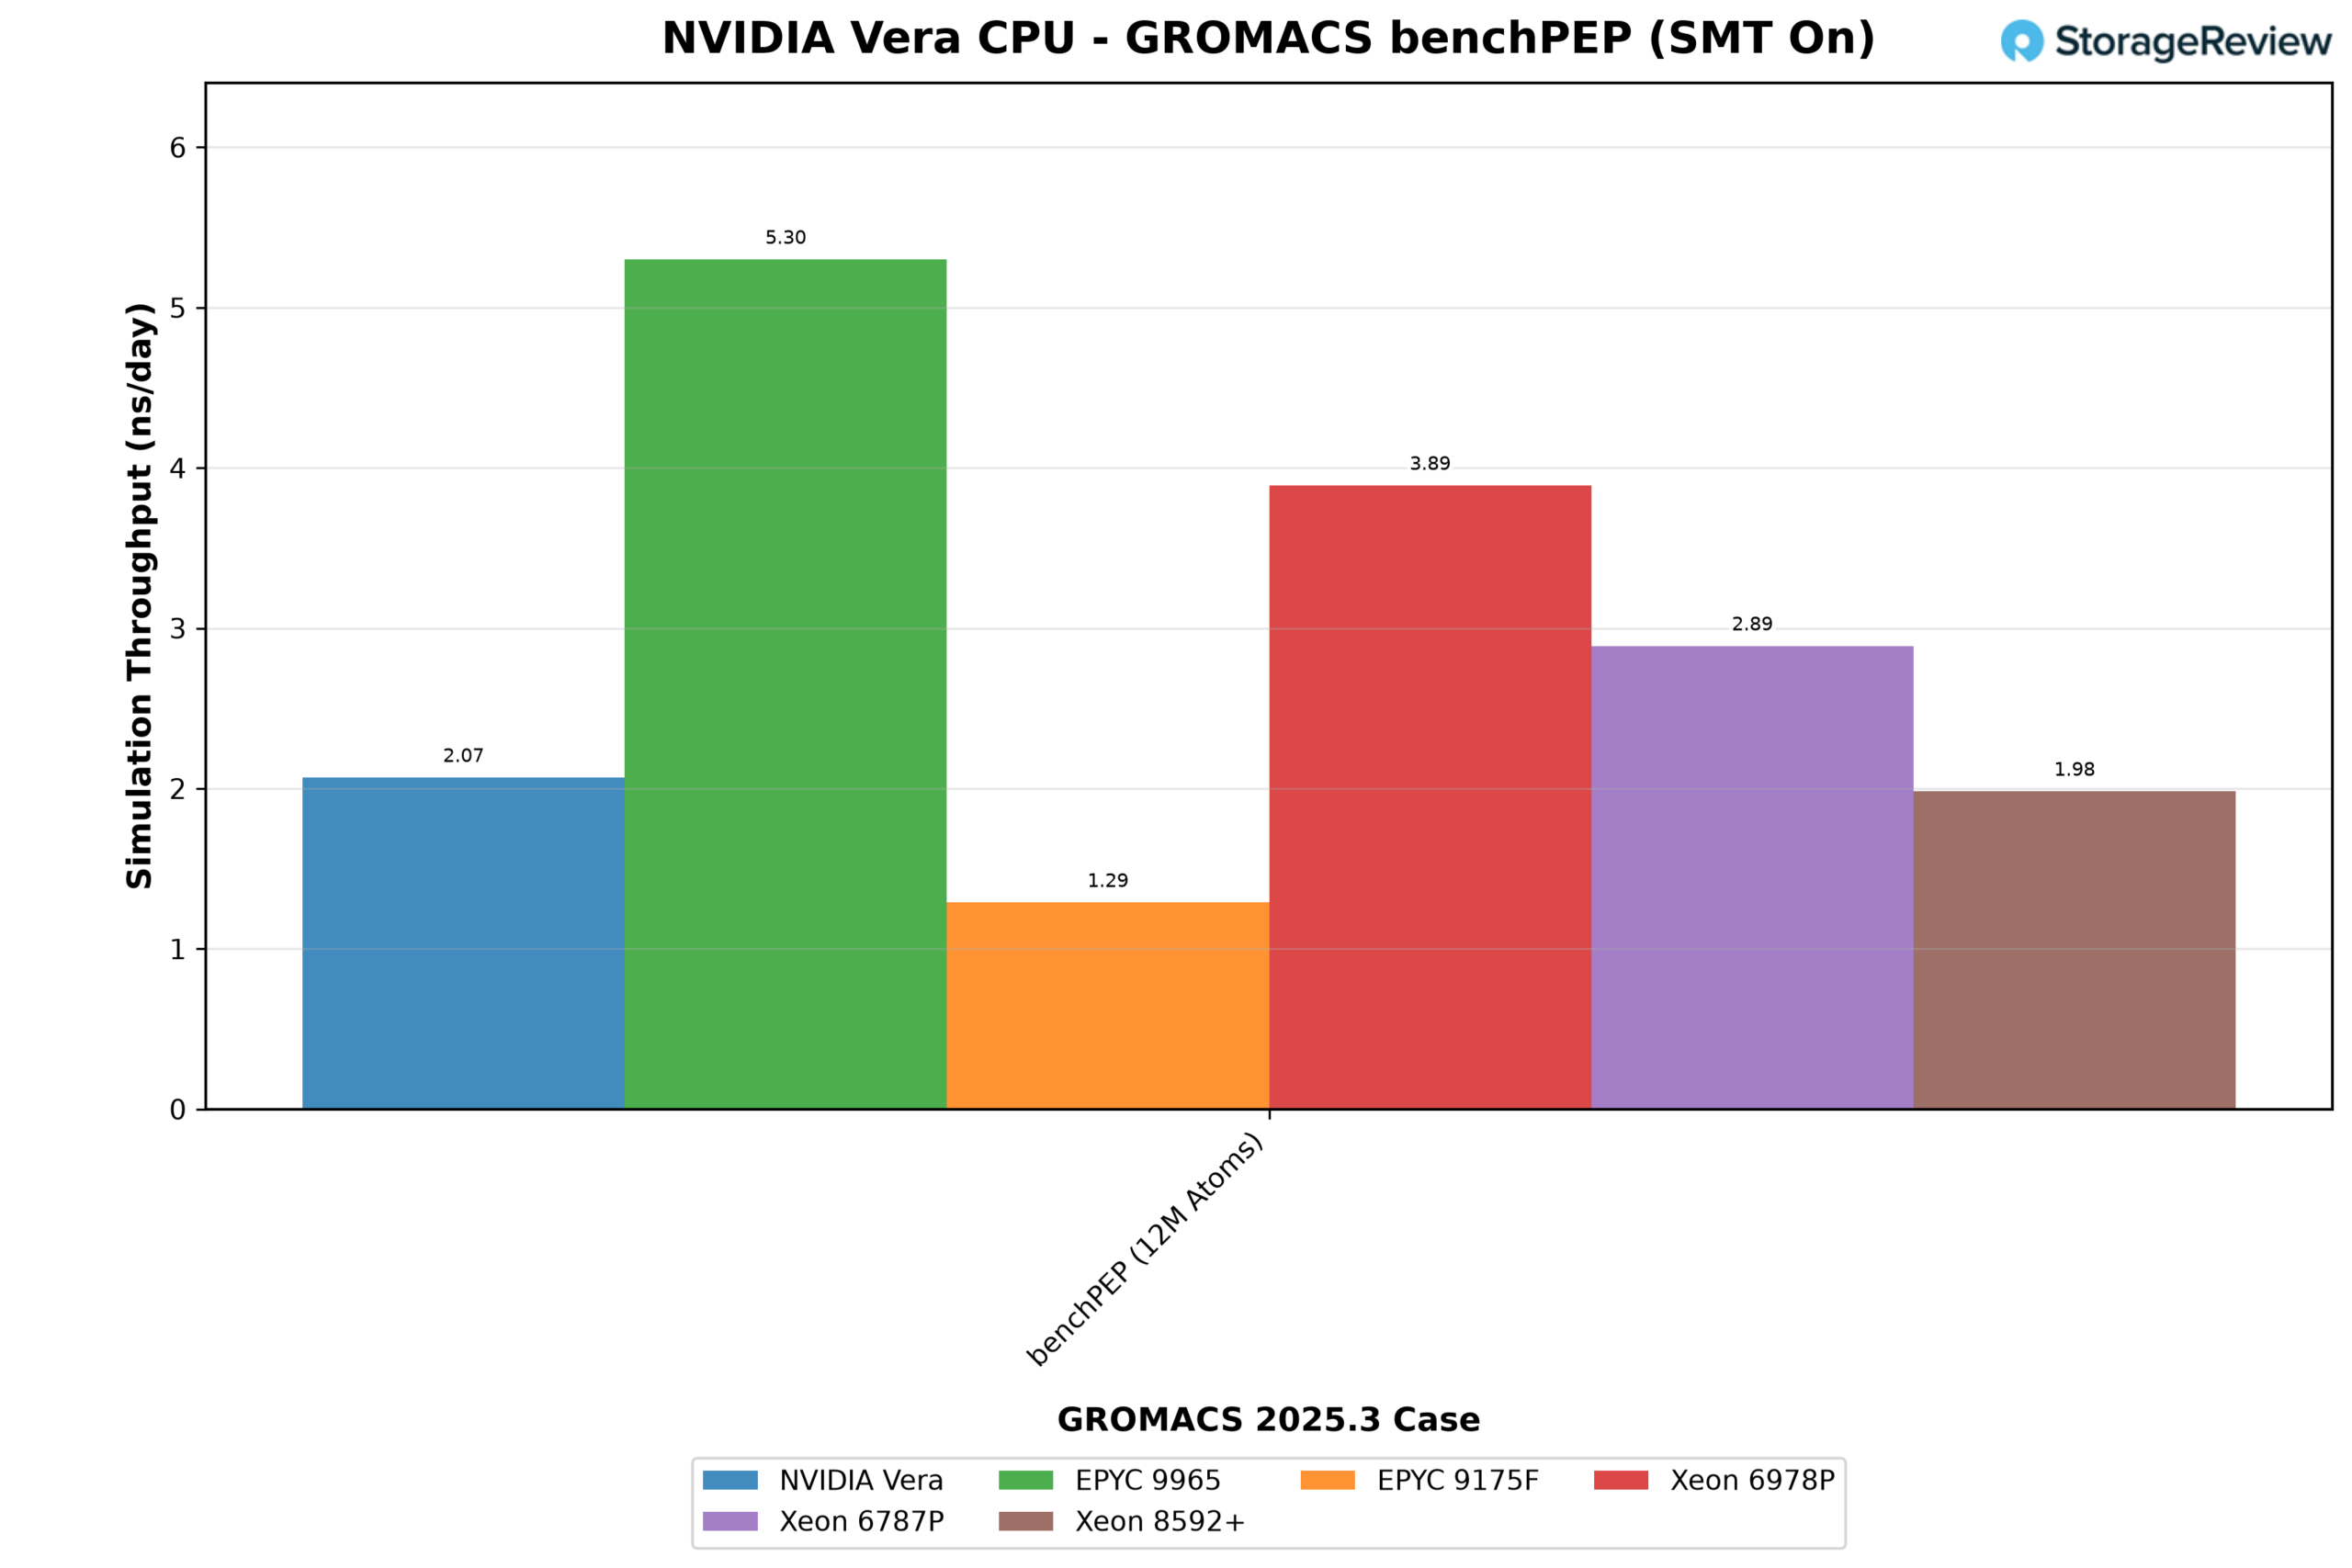
Le multithreading spatial (SMT) permet de regagner une partie du terrain perdu : son activation a amélioré les performances de Vera de 17 %, atteignant 2.07 ns/jour, la meilleure configuration exploitant les 352 cœurs matériels en tant que processus MPI multithread. Ce gain est supérieur à celui obtenu avec le SMT sur le Xeon 6978P (3 %) ou le 8592+ (11 %) lors de nos tests précédents, tandis que l’EPYC 9965 a perdu 3.5 % avec cette fonctionnalité activée. Grâce au partage des ressources entre les deux threads, chaque processus MPI bénéficie d’une portion du cœur, et le fonctionnement du solveur, combinant calculs vectoriels et accès mémoire, semble mieux exploiter ces portions qu’un processus MPI unique.
Le cas benchMEM isole l'écart par cœur en exécutant le système de 82 000 atomes sur 16 cœurs physiques du socket 0 sur chaque plateforme, de sorte que le nombre de cœurs est hors de l'équation, et le résultat reflète le débit vectoriel, le cache et la mémoire locale.
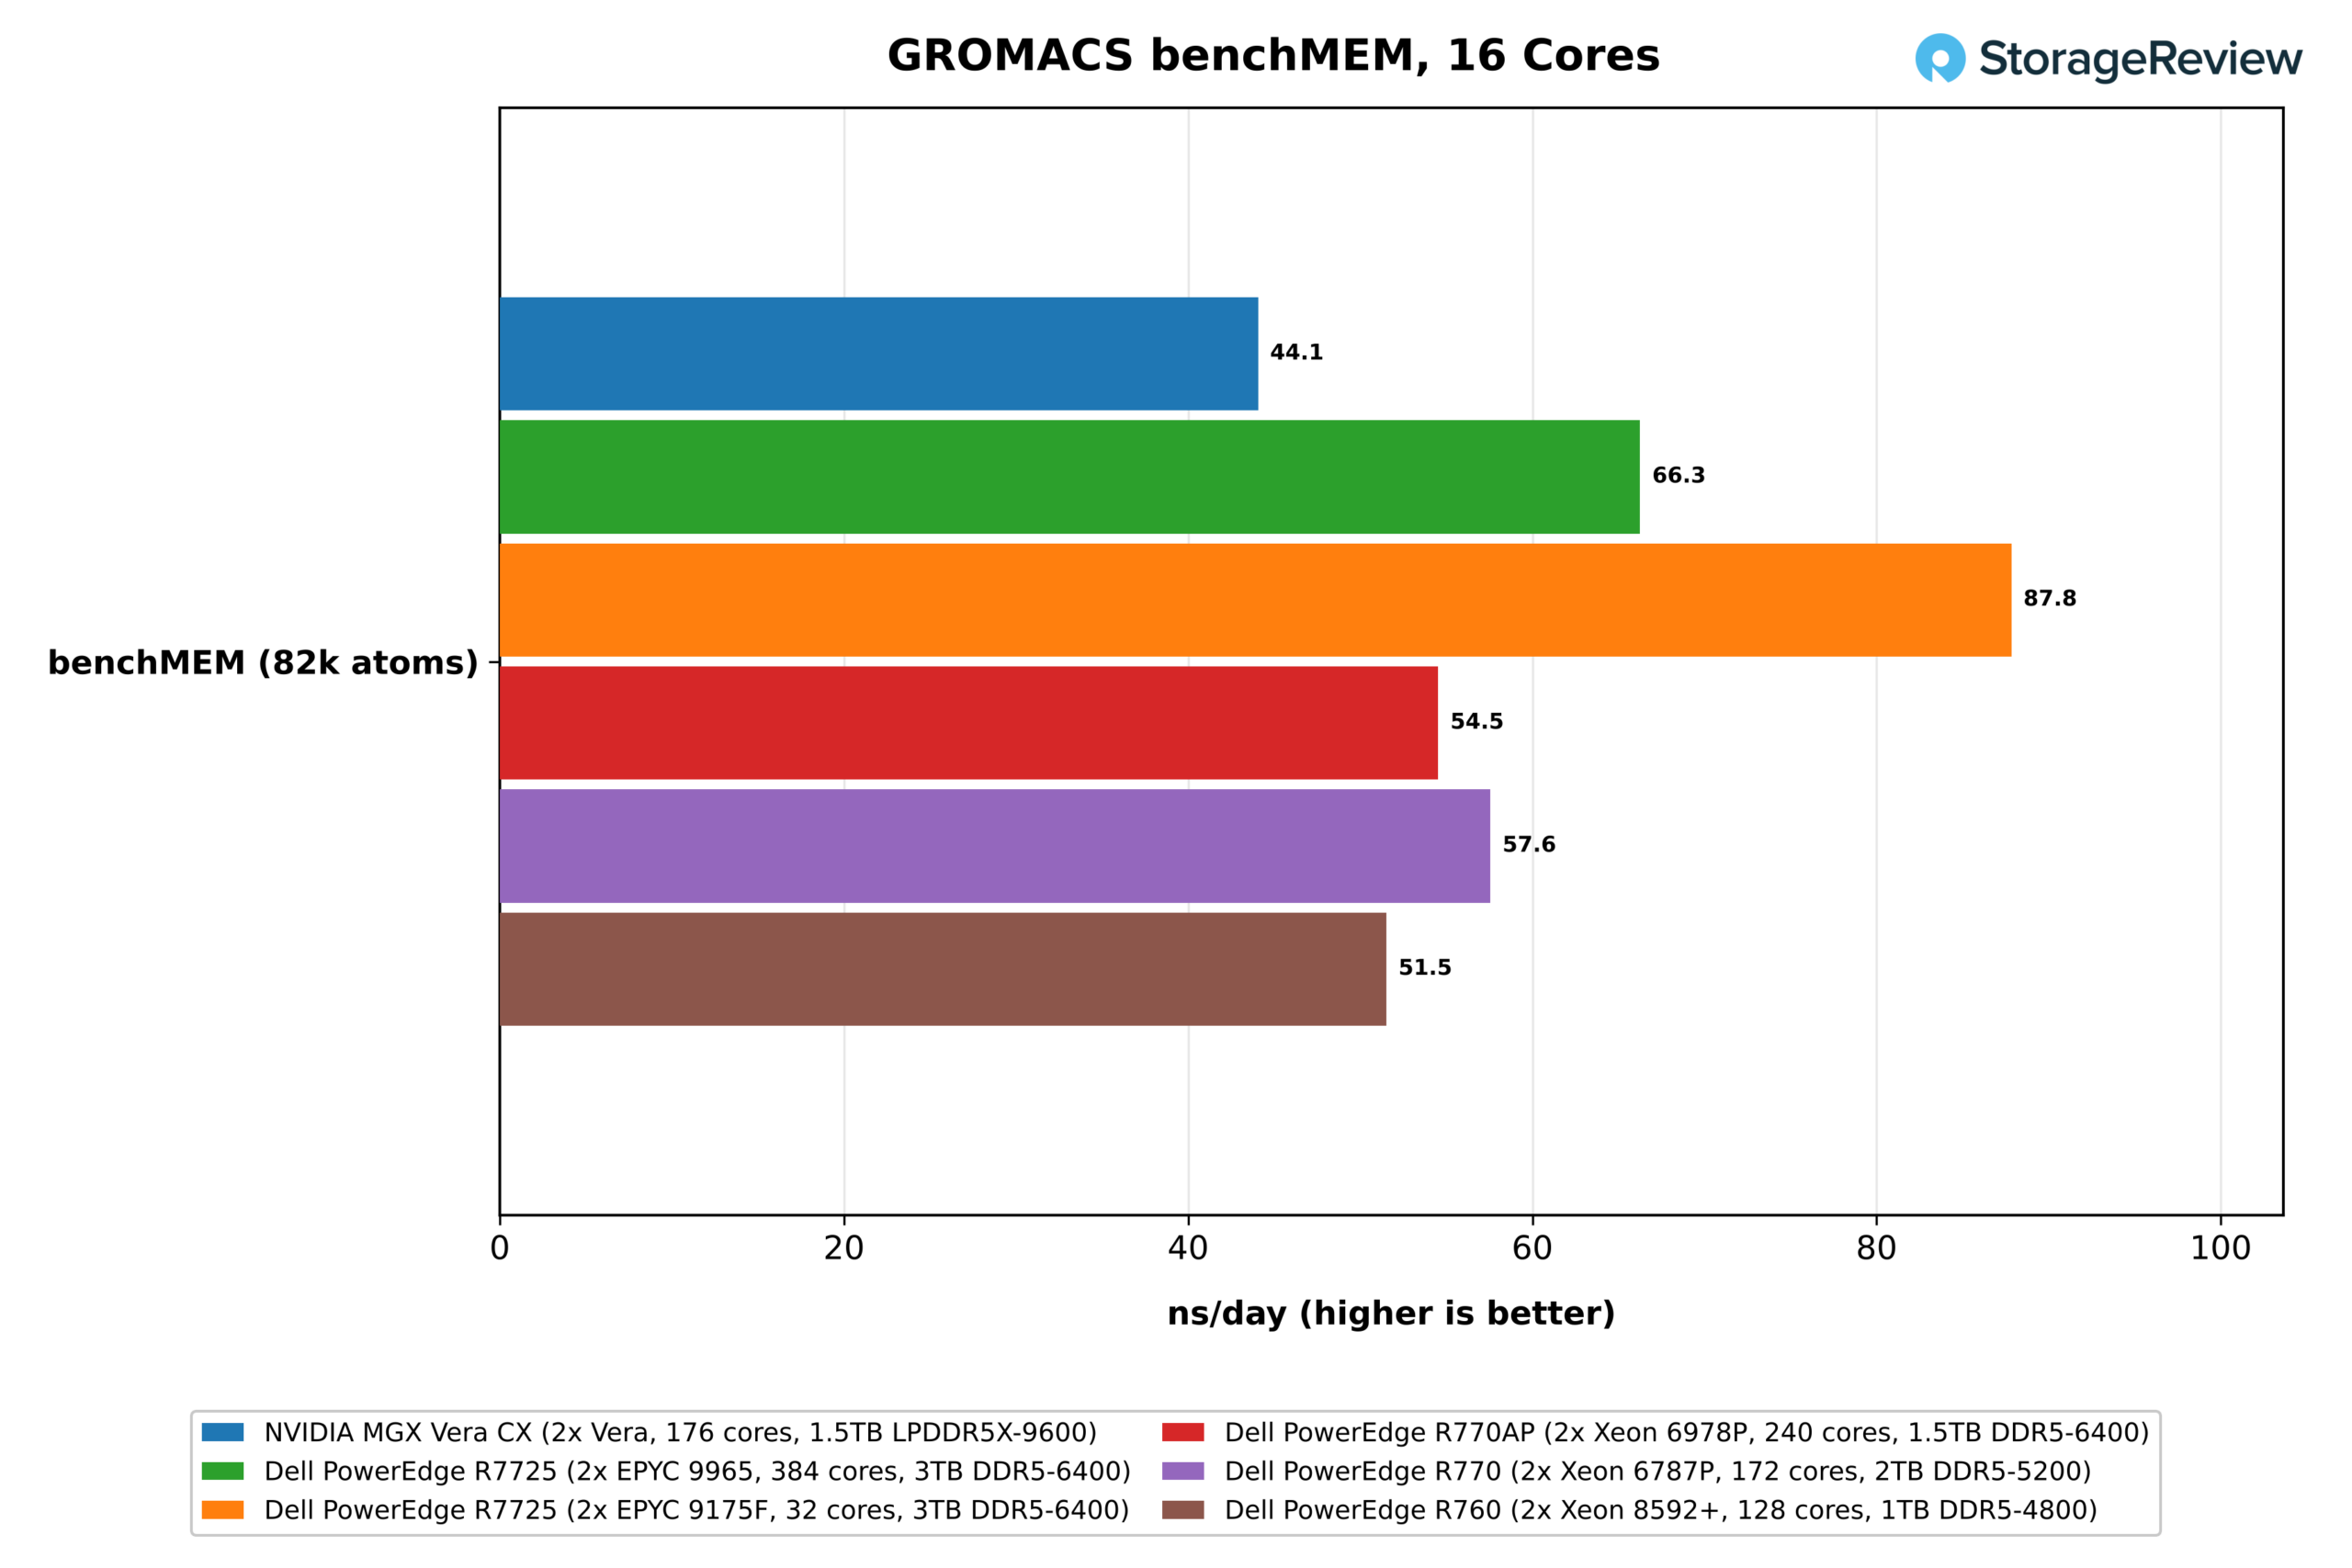
Ici, Vera a enregistré 44.1 ns/jour. L'EPYC 9175F à 5.0 GHz a doublé ce chiffre à 87.8, et l'EPYC 9965 a atteint 66.3, soit 1.5 fois plus que Vera, devançant le Xeon 6787P à 57.6, le 6978P à 54.5 et le 8592+ à 51.5.
Une architecture Vera à 16 cœurs effectue donc environ les deux tiers du travail d'une architecture Zen 5c à 16 cœurs, bien que ces 16 cœurs Zen 5c partagent un seul cache L3 de 32 Mo, tandis que celui de Vera peut exploiter ses 164 Mo de cache système. Cela constitue la mesure la plus précise dont nous disposons pour évaluer le coût des vecteurs 128 bits par rapport à un code écrit pour des vecteurs 512 bits. L'avance supplémentaire du 9175F sur le 9965 est globalement proportionnelle à sa fréquence d'horloge supérieure : 5.0 GHz contre 3.7 GHz.
OpenFOAM
OpenFOAM transfère la pression des unités vectorielles vers le système de mémoire. Nous utilisons OpenFOAM 13 sur le cas d'aérodynamique automobile driverFastback, avec un nœud MPI par cœur physique, pour deux tailles de maillage : un maillage moyen de 2.98 millions de cellules et un maillage élevé de 22.6 millions de cellules.
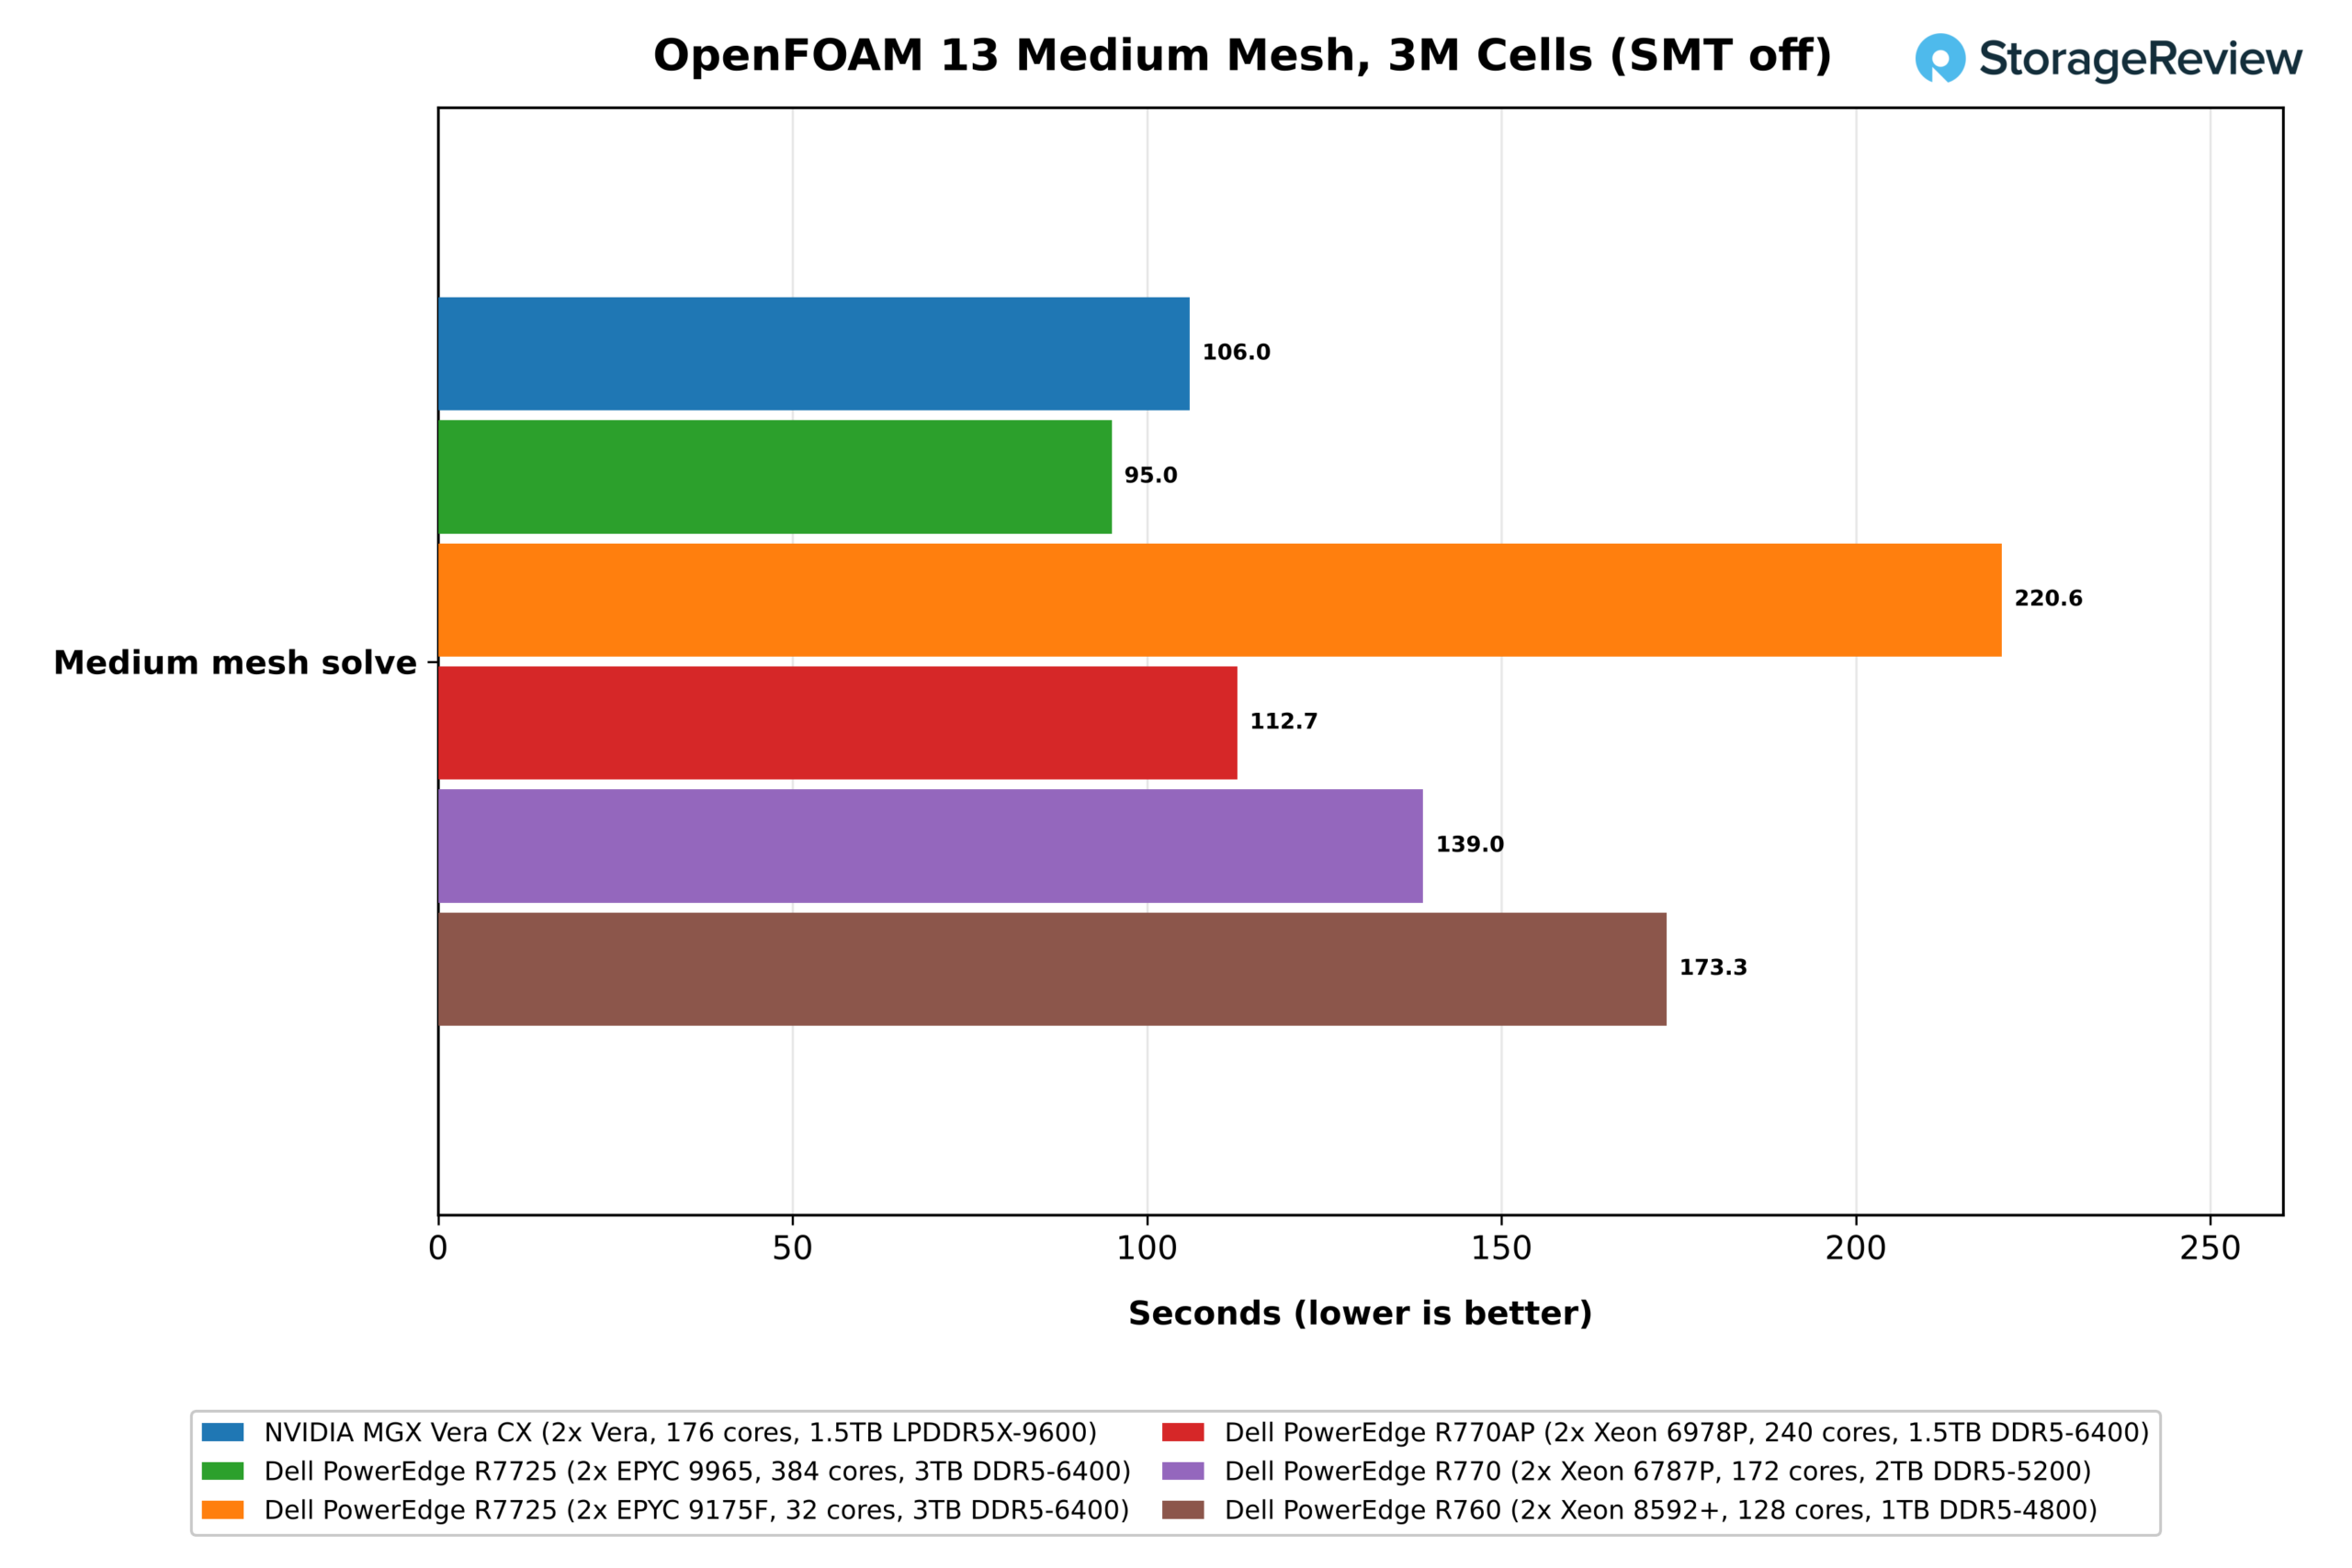
Le maillage moyen a été résolu en 106.0 secondes sur Vera, contre 95.0 secondes sur l'EPYC 9965, 112.7 secondes sur le Xeon 6978P, 139.0 secondes sur le 6787P, 173.3 secondes sur le 8592+ et 220.6 secondes sur le 9175F à 32 cœurs. À cette taille, les 384 cœurs du 9965 l'emportent, et Vera, bien que 12 % plus lent, termine deuxième, 6 % devant le Xeon à 240 cœurs. Avec seulement 3 millions de cellules, les caches L3 plus importants des processeurs x86 traitent probablement une plus grande partie du problème, ce qui confirme l'importance du nombre de cœurs.
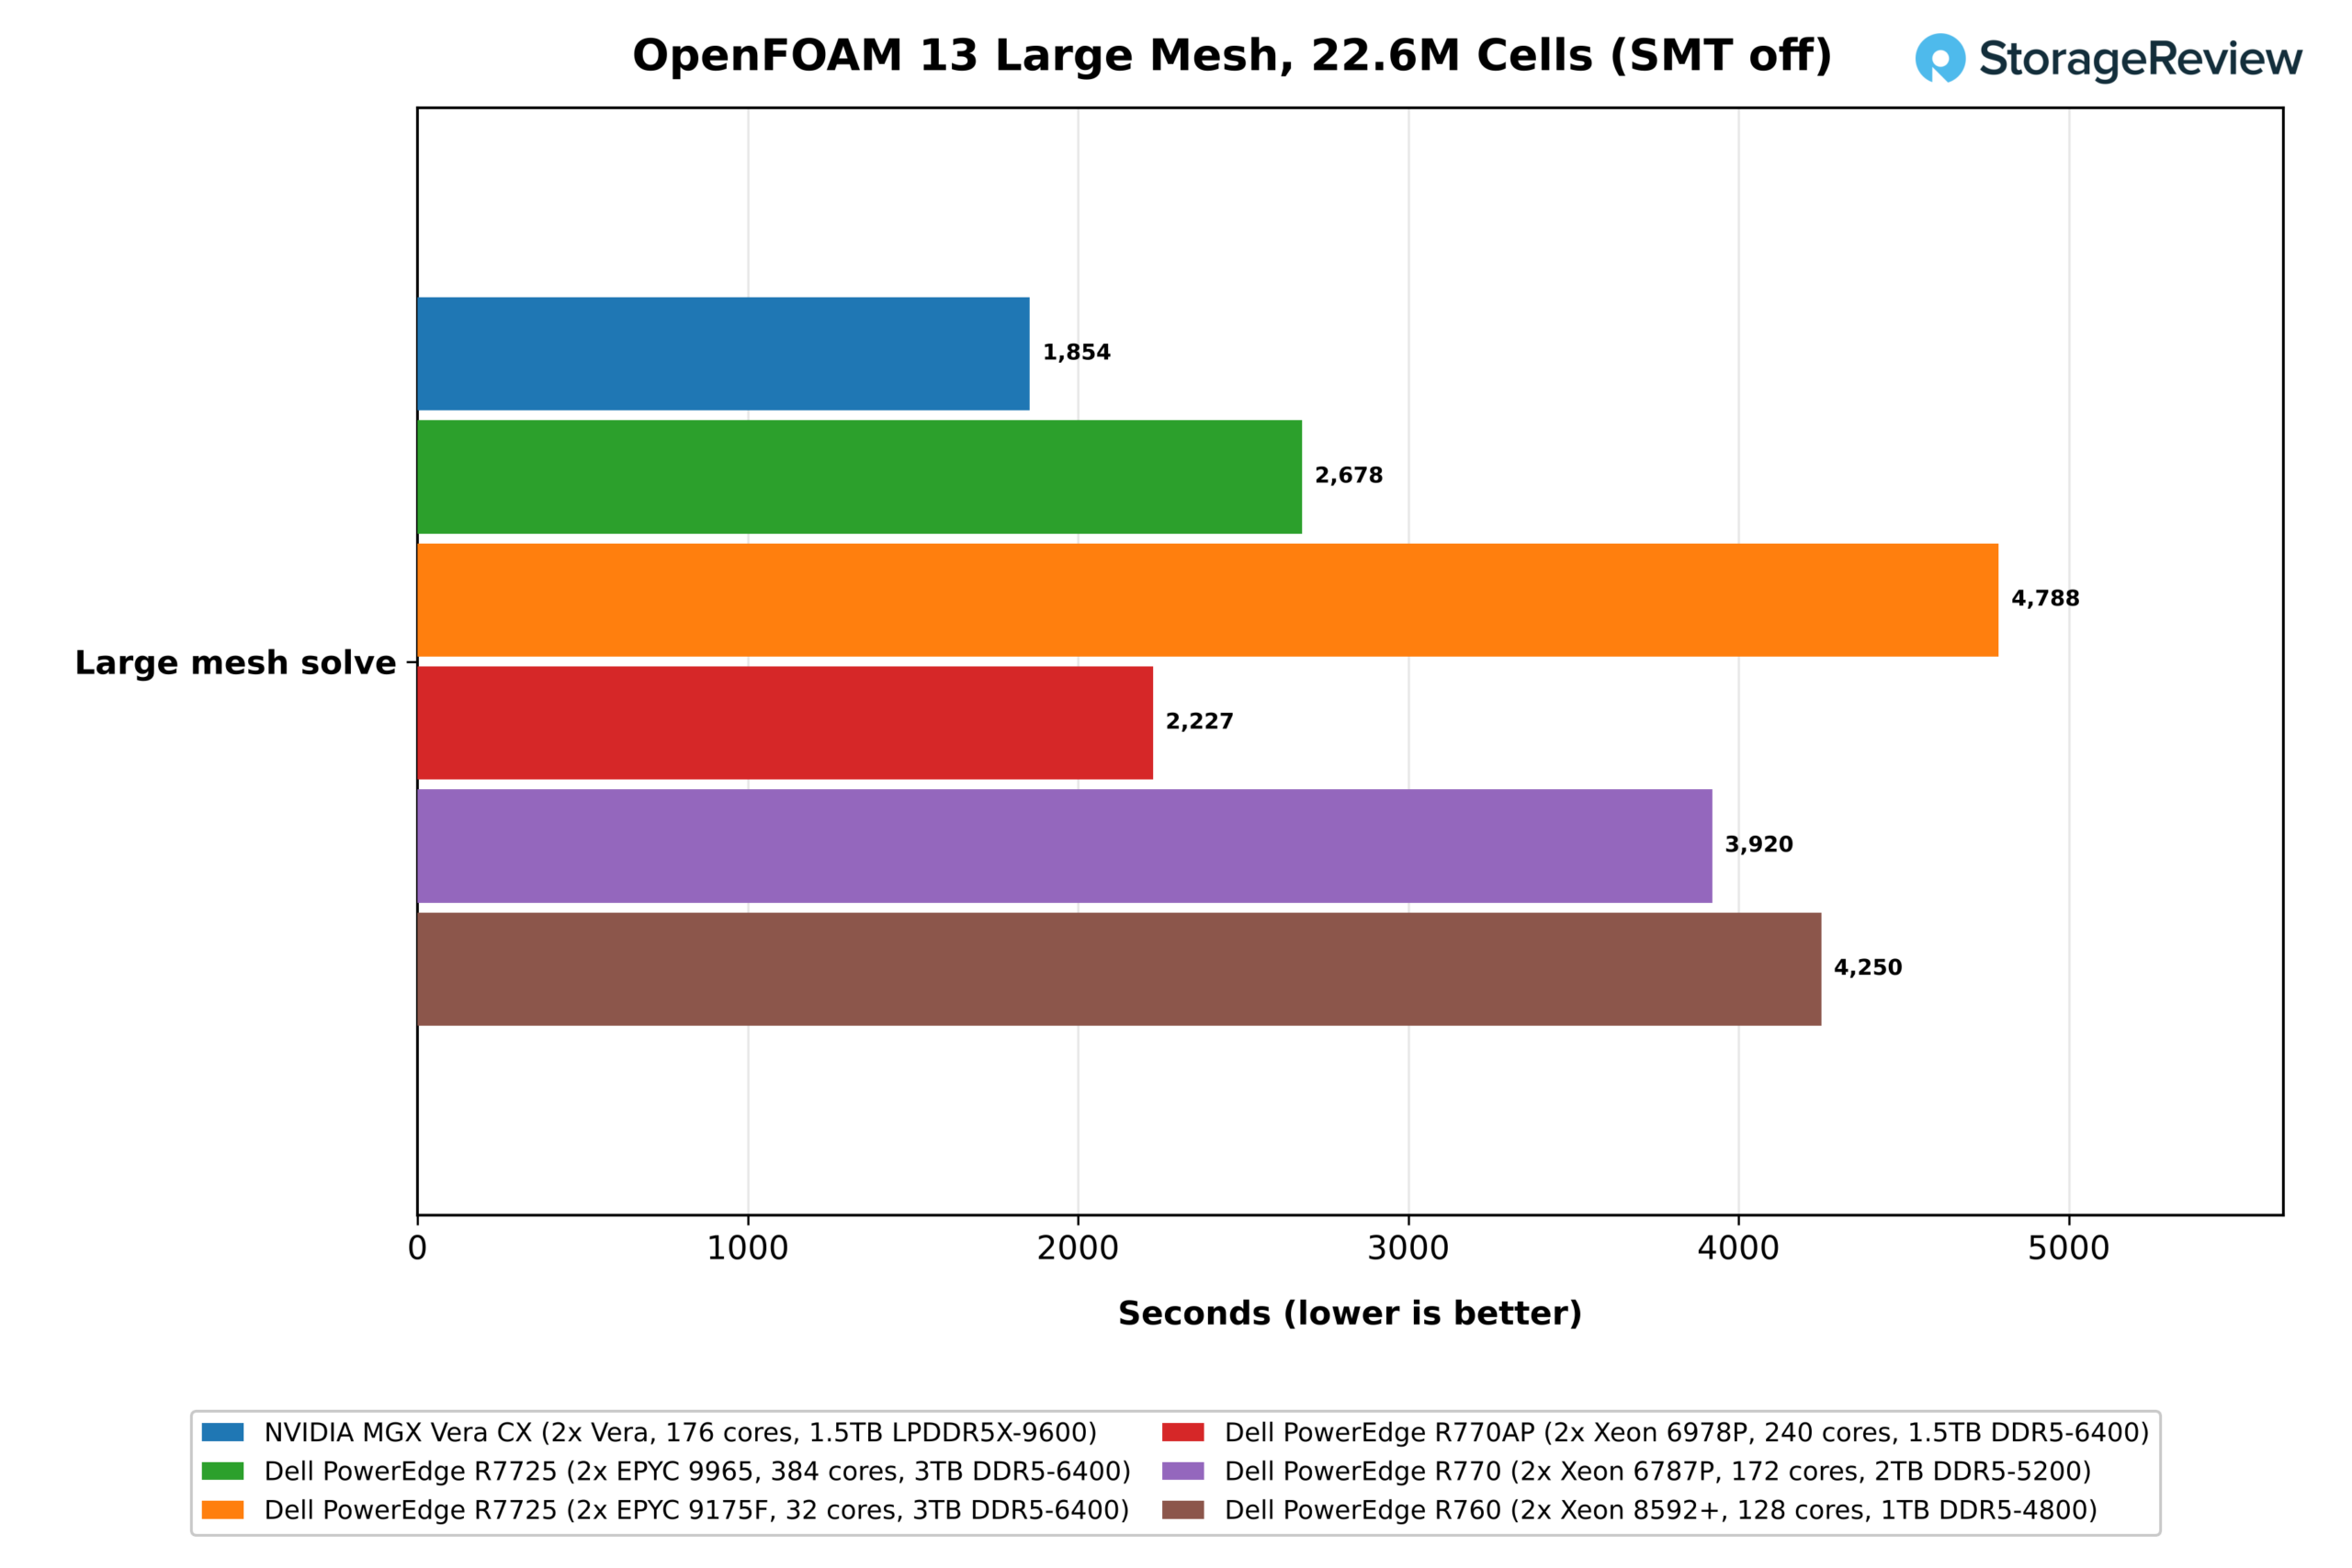
Le calcul maillé étendu inverse l'ordre : Vera le résout en 1 854 secondes, contre 2 227 secondes pour le Xeon 6978P, 2 678 secondes pour l'EPYC 9965, 3 920 secondes pour le 6787P, 4 250 secondes pour le 8592+ et 4 788 secondes pour le 9175F. Il est ainsi 1.44 fois plus rapide que le serveur AMD à 384 cœurs et 1.20 fois plus rapide que le serveur Intel à 240 cœurs. Vera respecte également la limite de consommation maximale de 450 W par socket, contre 500 W pour le 9965.
Analyse et données en mémoire
Les résultats du calcul haute performance (HPC) ont démontré l'impact de la bande passante de Vera sur un solveur scientifique. Les services de données sollicitent différemment le même système de mémoire, et nos deux tests le mettent à l'épreuve de manière opposée. ClickBench exécute des requêtes analytiques qui parcourent et agrègent de grandes colonnes de données, répartissant chaque requête sur tous les cœurs. Il favorise donc un système qui associe de nombreux cœurs à la bande passante nécessaire pour les alimenter. Valkey, un magasin de clés-valeurs en mémoire, traite des millions de petites requêtes, chacune lisant ou écrivant une seule valeur. Ses performances dépendent donc davantage de la rapidité avec laquelle un cœur individuel traite une requête et, une fois que les données dépassent la capacité du cache, de la latence mémoire et de la bande passante.
ClickBench
Nous avons testé ClickBench avec 43 requêtes sur une table d'analyse web de 100 millions de lignes sous ClickHouse 26.8. Son test « hot sum », où chaque requête utilise le cache de page, mesure le nombre de cœurs qu'un système peut mobiliser pour les analyses et agrégations par colonnes, ainsi que la capacité de sa mémoire à les alimenter. Le test « cold sum » inclut un redémarrage du serveur et des lectures sur SSD avant la première exécution de chaque requête.
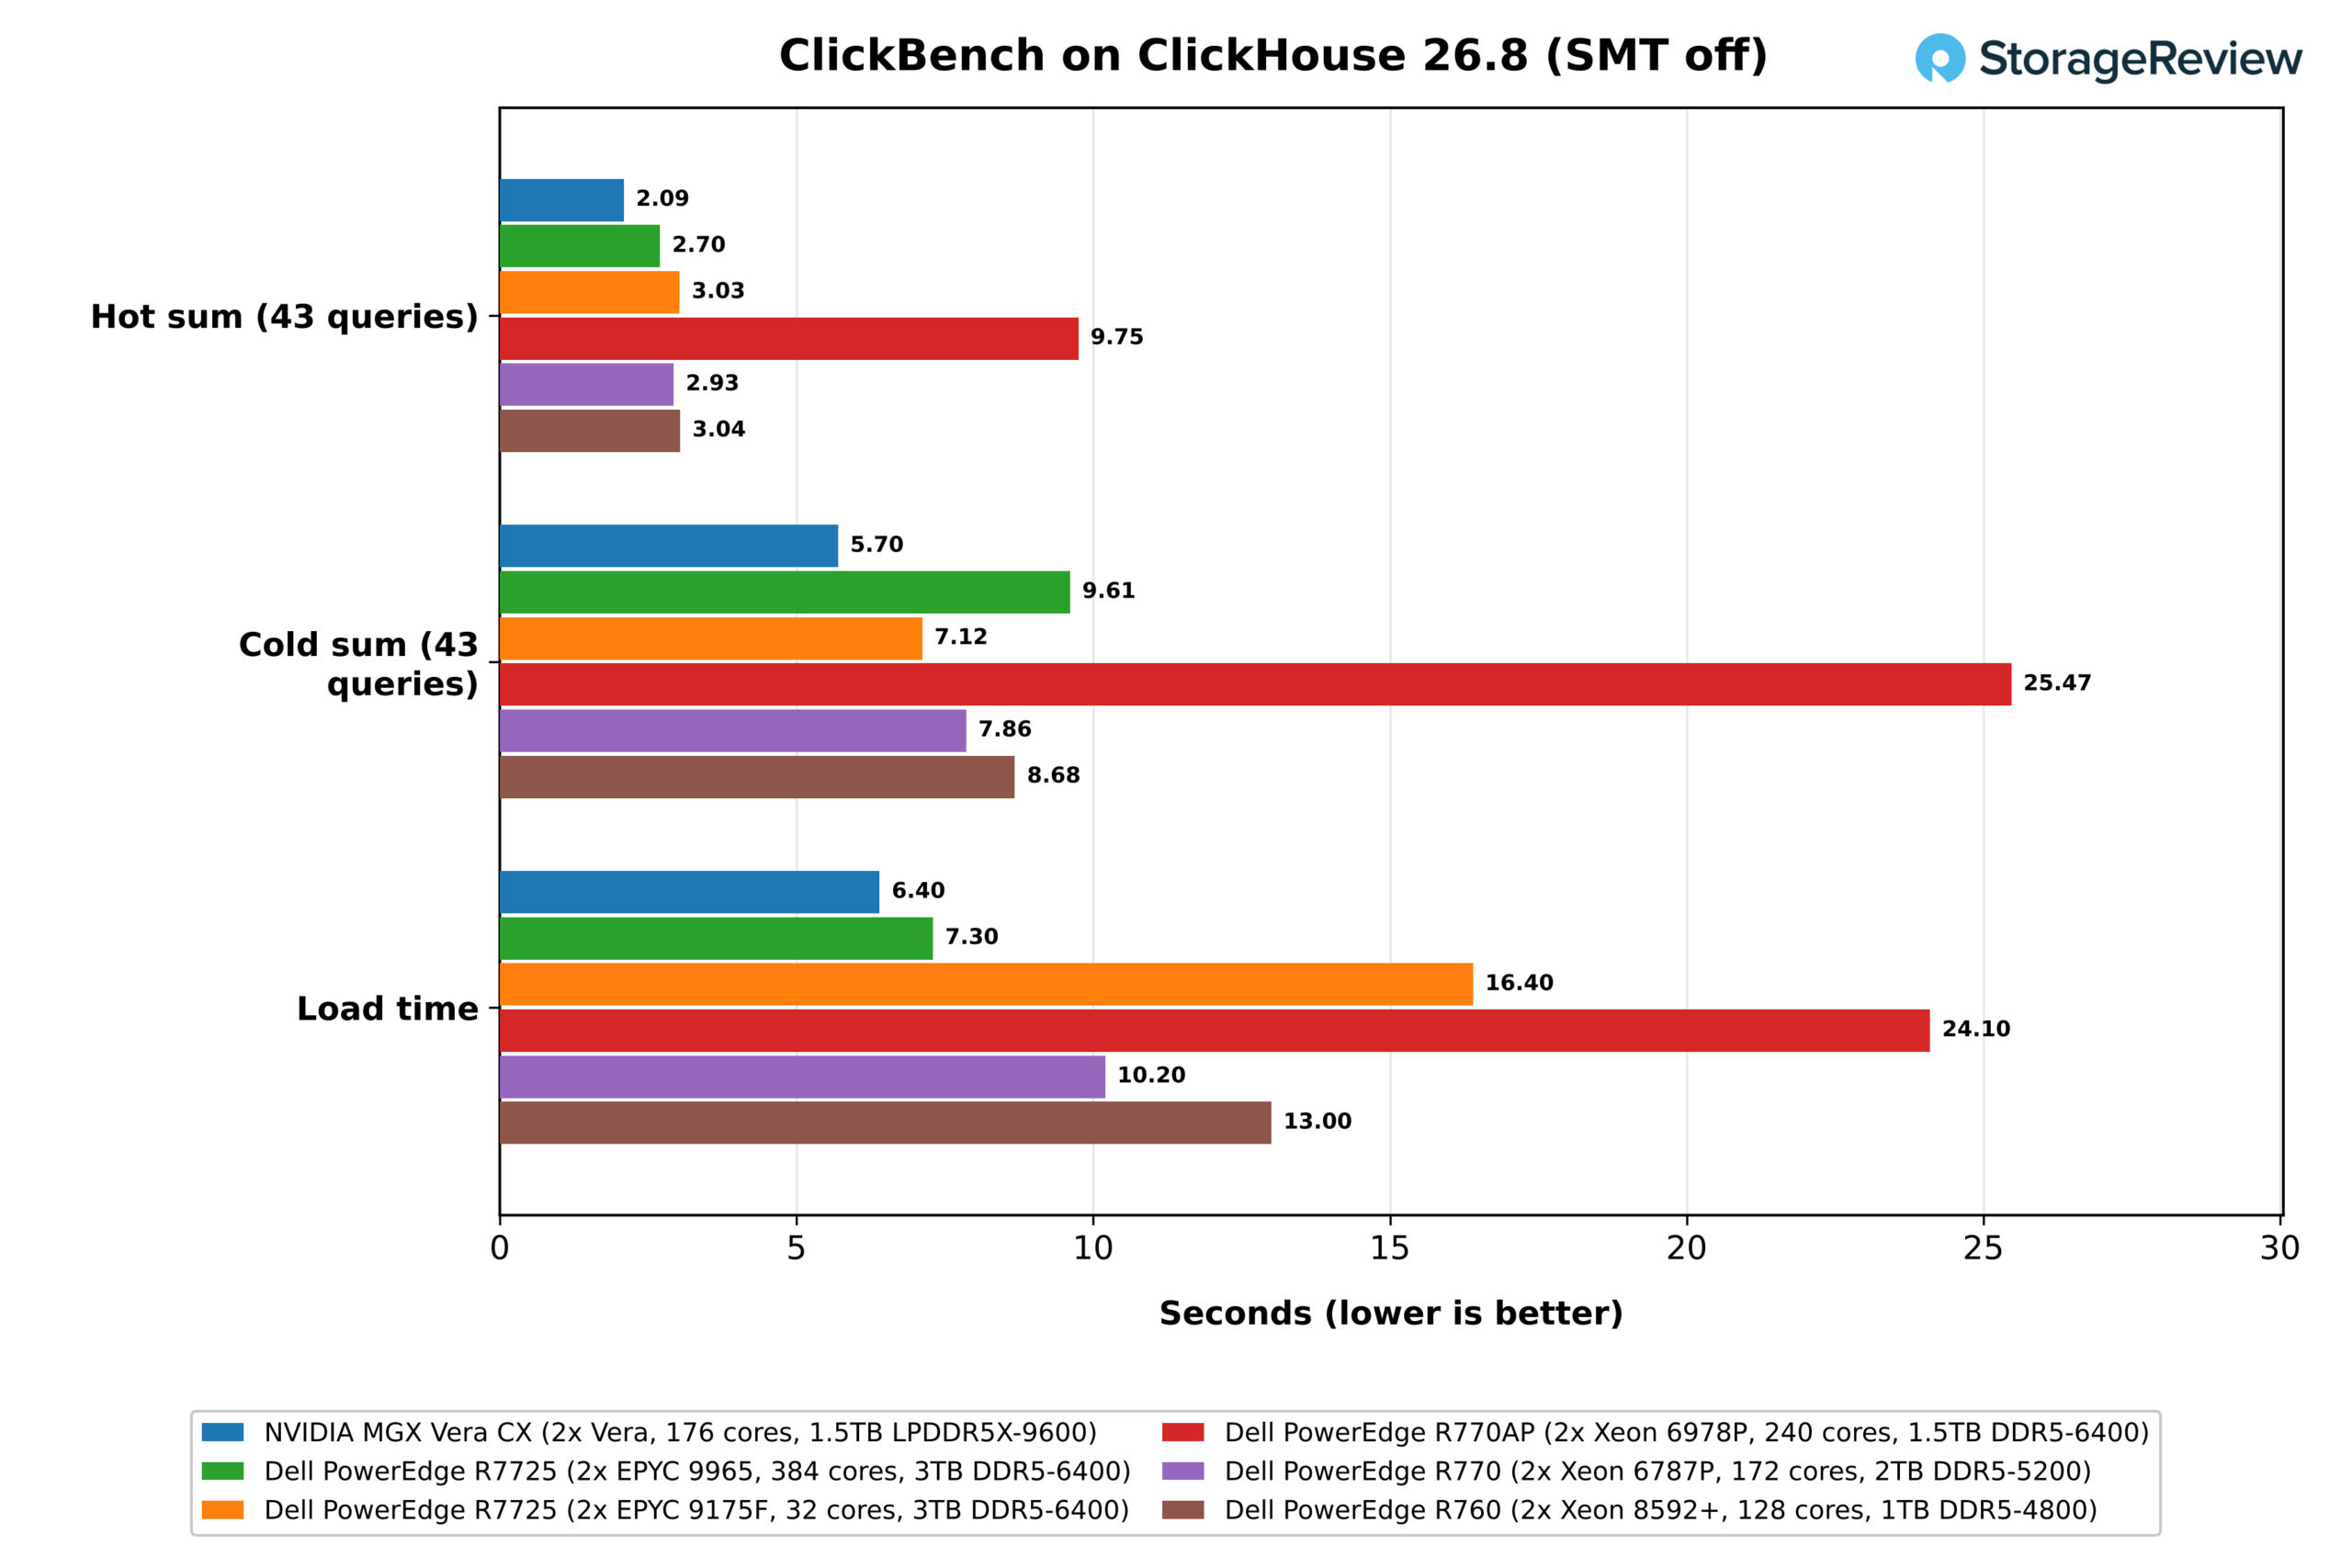
Avec la technologie SMT désactivée, Vera a réalisé le test à chaud en 2.09 secondes, le meilleur résultat de notre série. L'EPYC 9965 arrive ensuite en 2.70 secondes, soit 1.29 fois plus long, tandis que les Xeon 6787P, EPYC 9175F et Xeon 8592+ affichent des performances similaires, comprises entre 2.93 et 3.04 secondes. Cet écart reflète le compromis entre le nombre de cœurs et la bande passante. Le 9965, avec ses 384 cœurs, dispose d'un grand nombre de cœurs mais d'une faible bande passante par cœur ; le 9175F, avec ses 32 cœurs, présente le cas inverse ; et Vera combine 176 cœurs avec une bande passante plus de trois fois supérieure à celle des deux autres.
Vera a également réalisé le meilleur temps de démarrage à froid avec 5.70 secondes, devançant le 9175F (7.12 secondes), le 6787P (7.86 secondes), le 8592+ (8.68 secondes) et le 9965 (9.61 secondes). Le temps de démarrage à froid dépend davantage du stockage, et les liaisons entre disques diffèrent : Gen5 x4 sur Vera et le 6787P, x2 sur les deux systèmes EPYC et Gen4 sur le 8592+.
Vera a également chargé le jeu de données de 15 Go le plus rapidement, en 6.4 secondes, contre 7.3 secondes pour le 9965 et entre 10.2 et 16.4 secondes pour les autres processeurs. Le Xeon 6978P, avec un temps de 9.75 secondes à chaud et de 25.47 secondes à froid, a affiché des performances nettement inférieures à celles des autres Xeon pour des raisons que nous n'avons pas identifiées ; nous l'avons donc exclu du classement.
L'activation du multithreading spatial a ralenti Vera à 2.31 secondes à chaud et à 6.09 secondes à froid, soit une pénalité de 10 % par rapport au temps de calcul à chaud. Le partage des ressources de chaque cœur entre deux threads a engendré un coût supérieur aux gains pour les analyses de ClickHouse.
Valkey
Valkey exécute les commandes sur un seul thread principal, les threads d'E/S n'intervenant que jusqu'à un certain point. Par conséquent, les déploiements évoluent en ajoutant des shards, car l'ajout de cœurs à une instance n'apporte que peu d'amélioration. Nous analysons donc Valkey de deux manières : les performances d'un shard unique sur un nombre de cœurs identique, et les performances de chaque shard lorsqu'un socket est saturé. Dans les deux tests, les clients s'exécutent sur l'autre socket de la même machine, sans intervention de la carte réseau.
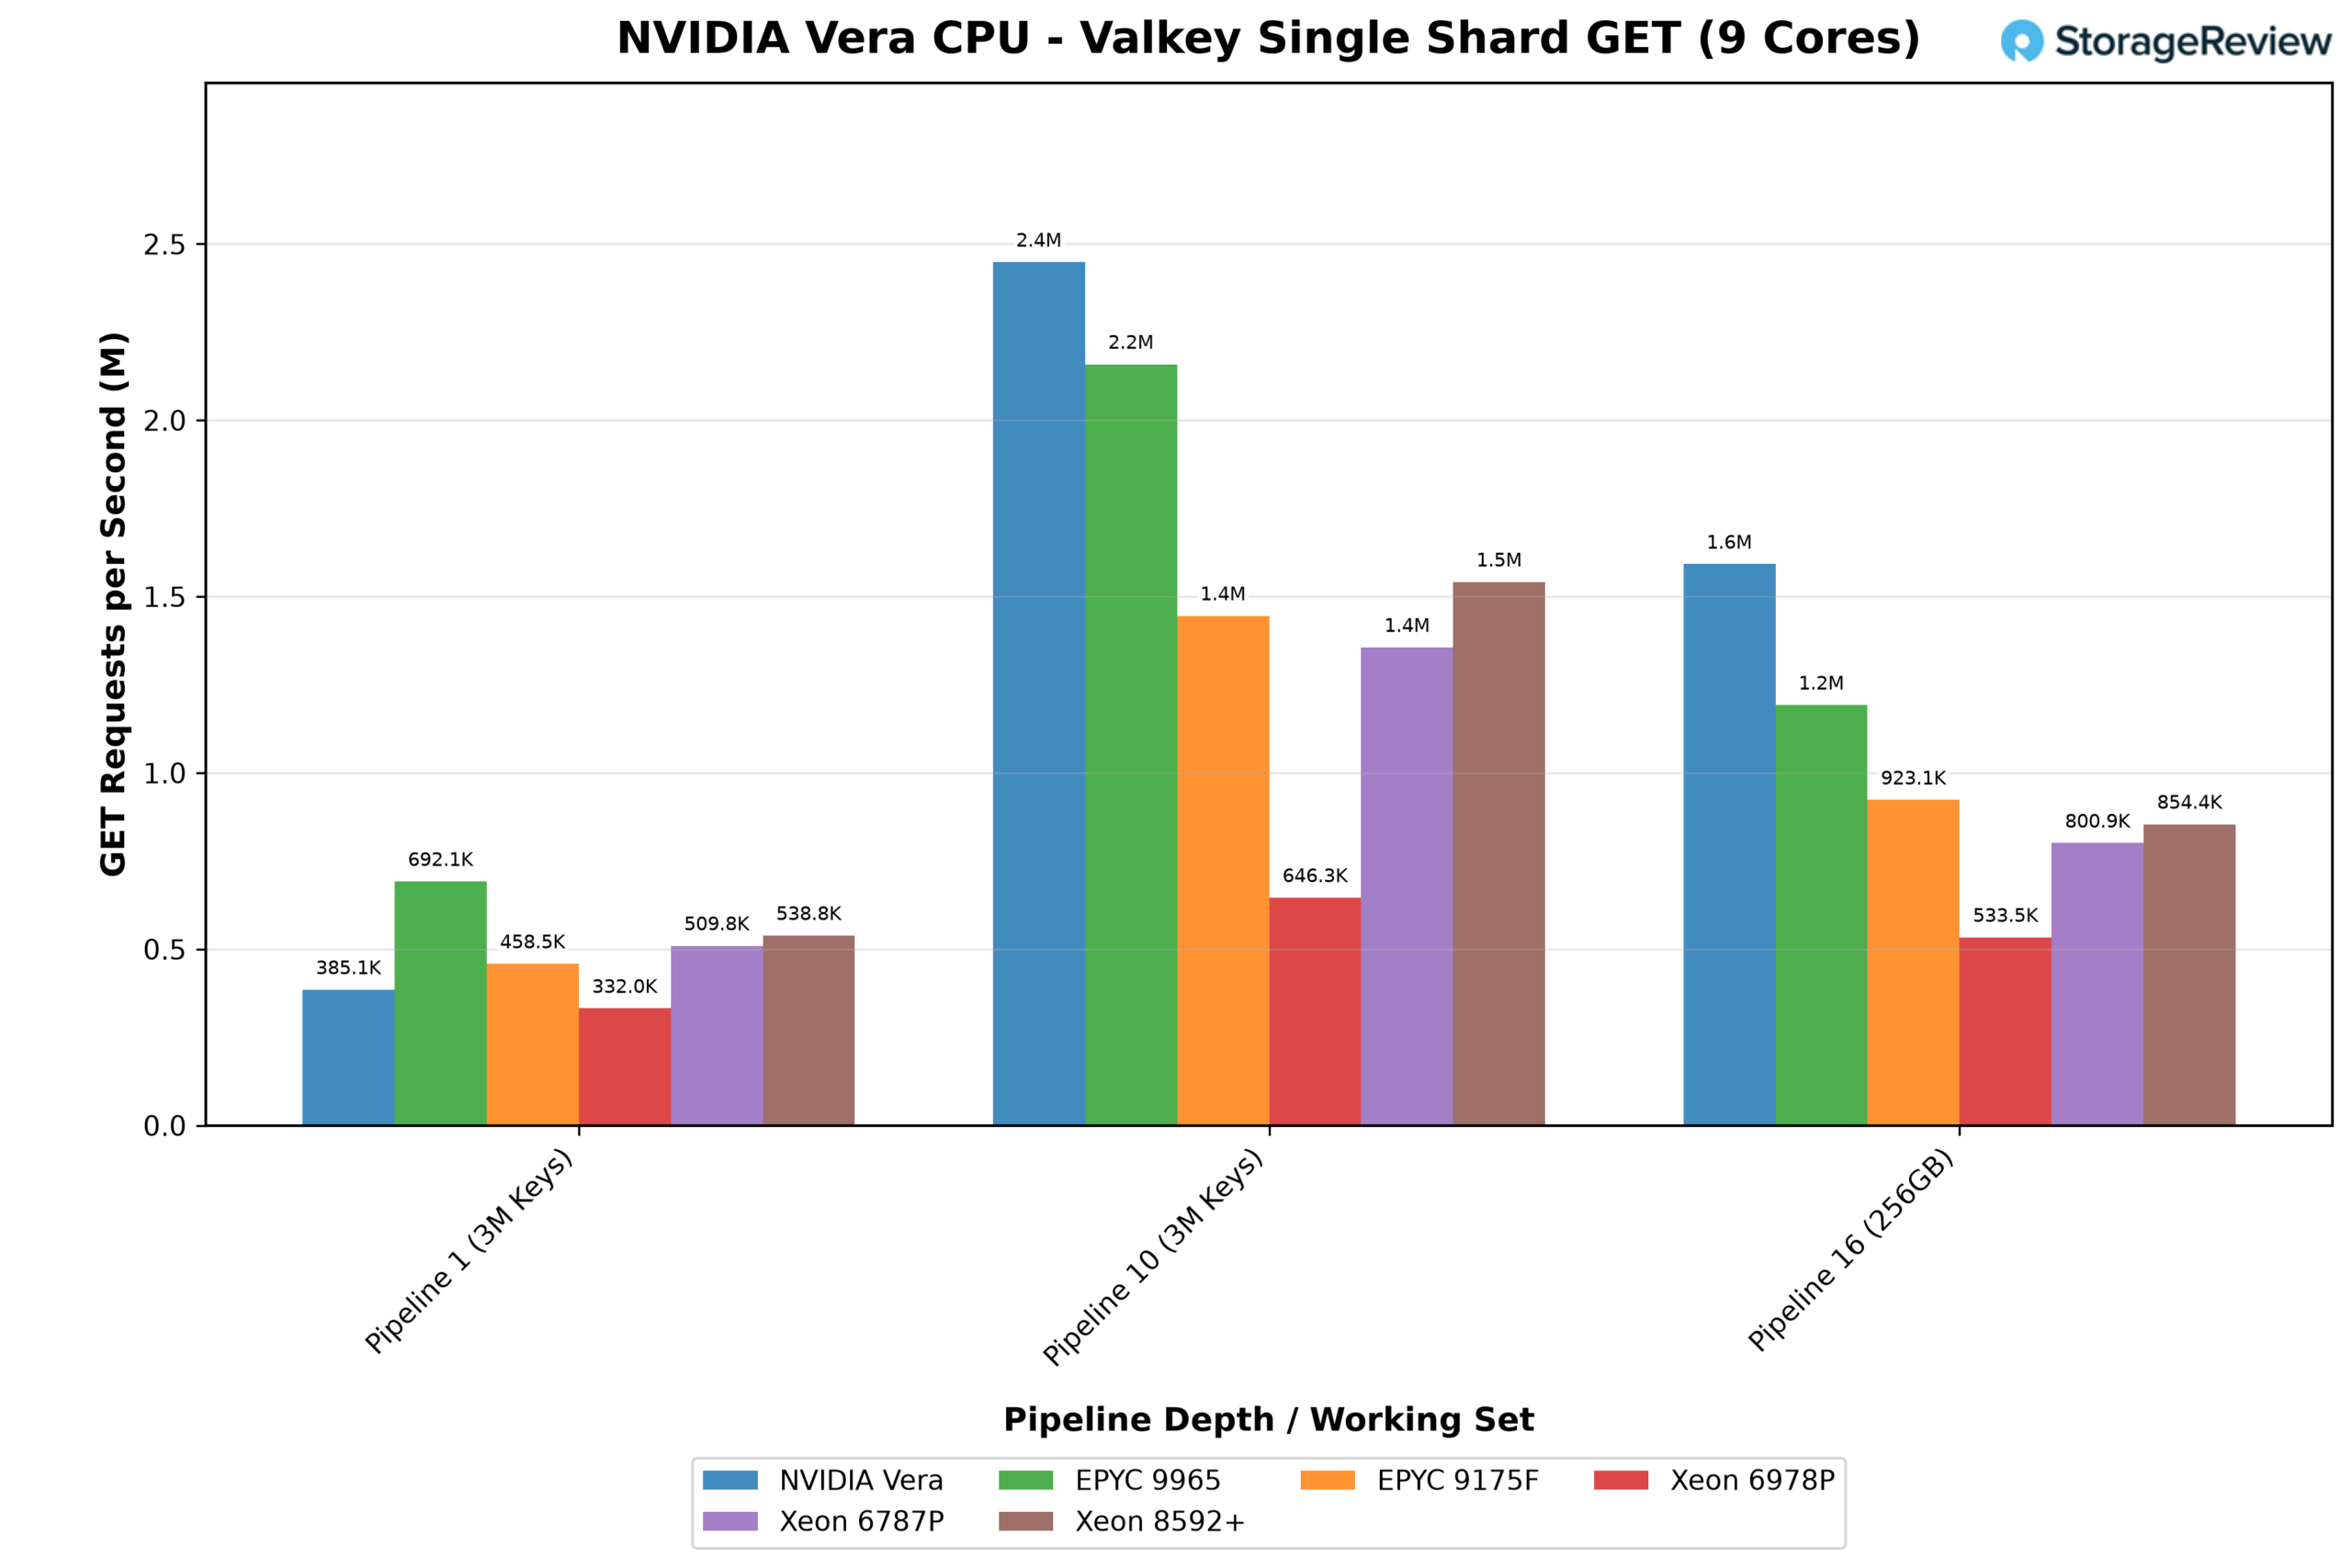
Le test mono-shard attribue neuf cœurs physiques à un serveur Valkey sur chaque plateforme. Il traite un ensemble de données de 3 millions de clés, les requêtes étant envoyées une par une, puis par lots de 10, et enfin un ensemble de données de 256 Go, trop volumineux pour être mis en cache, par lots de 16. Chaque requête envoyée individuellement doit effectuer un aller-retour complet avant que la suivante ne soit transmise ; c’est là que Vera présente ses faiblesses. Son shard a traité 385 000 requêtes GET par seconde, devançant seulement le Xeon 6978P, tandis que l’EPYC 9965 affichait le meilleur score avec 692 000 requêtes. La latence p99 de Vera était également plus élevée, à 1.76 ms contre 1.08 ms pour le 9965.
Le traitement par lots élimine la majeure partie du coût aller-retour, et Vera prend la tête. Avec des lots de 10, son shard a traité 2.45 millions de requêtes GET par seconde, soit 13 % de plus que le 9965 et largement devant tous les Xeon. L'ensemble de données de 256 Go a encore creusé l'écart. Avec la quasi-totalité des requêtes dirigées vers la mémoire, Vera a traité 1.59 million de requêtes GET par seconde, soit 34 % de plus que le 9965, tandis que les autres processeurs testés se situaient entre 0.53 million et 0.92 million. Les résultats des requêtes SET ont suivi la même tendance dans les deux tests.
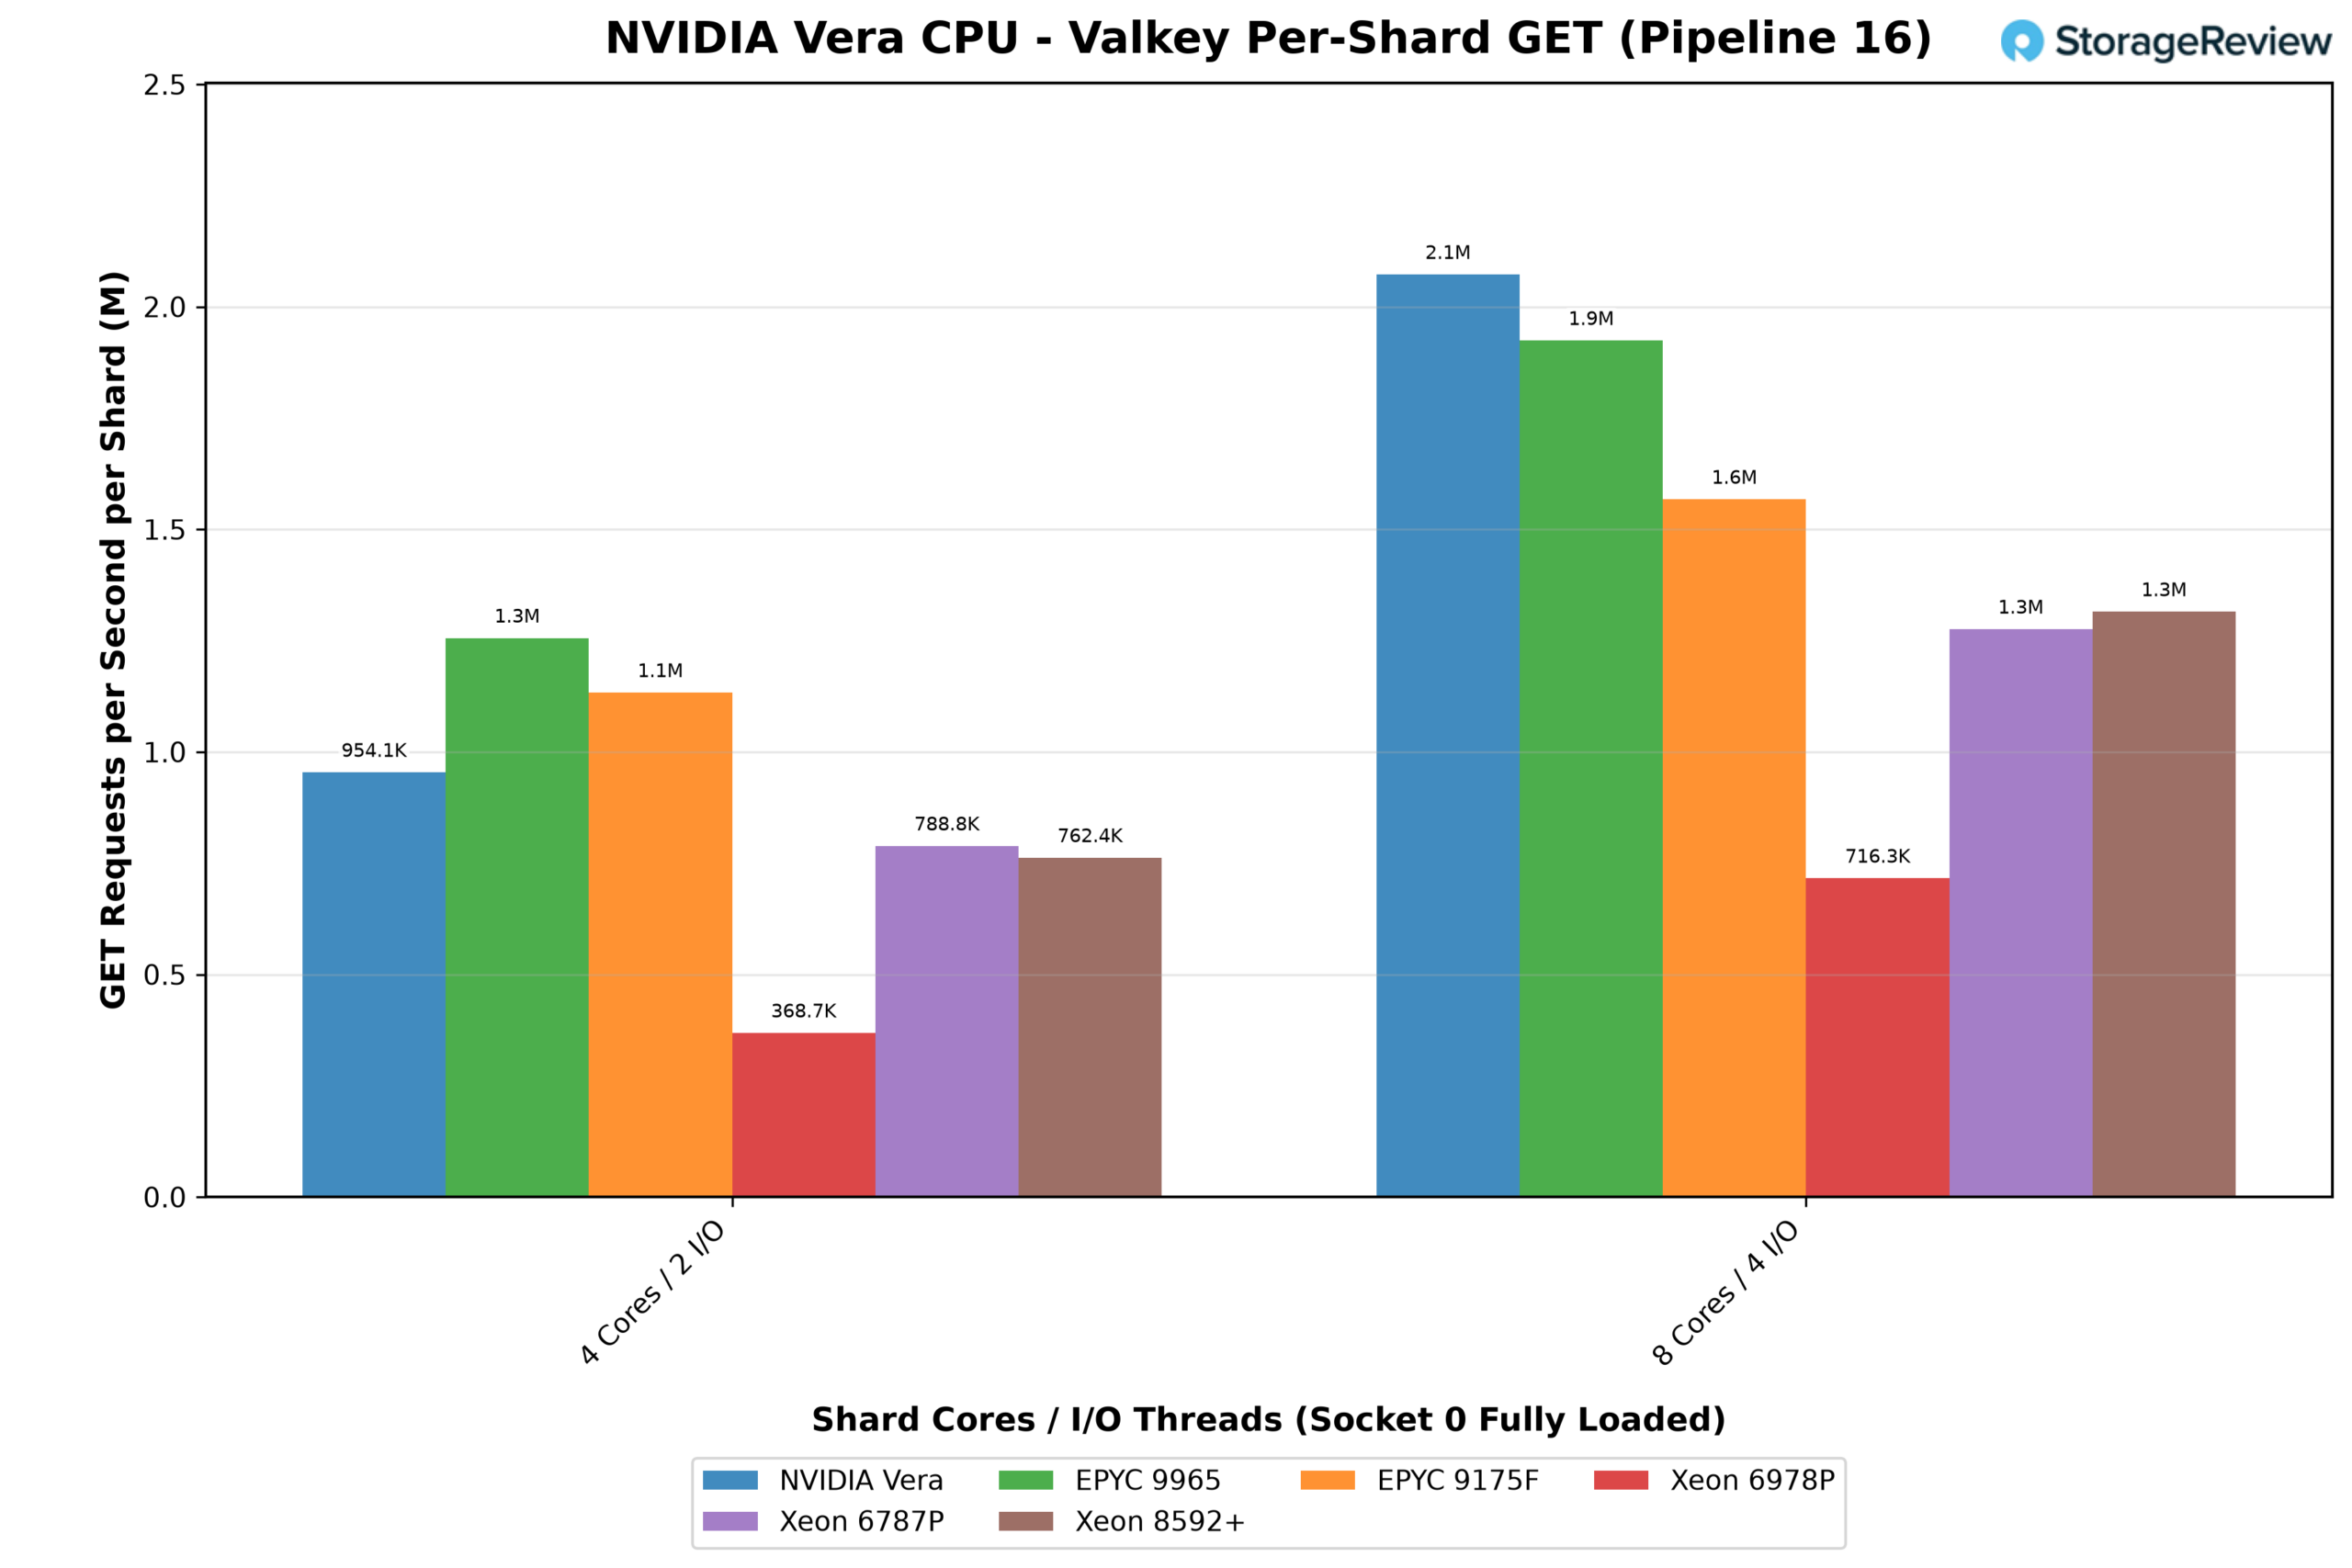
En mode socket, le socket 0 est composé de groupes identiques de quatre ou huit cœurs, tous traitant le trafic simultanément, ce qui se rapproche du fonctionnement d'un hôte Valkey dédié. Avec des groupes de 8 cœurs et des lots de 16, chaque groupe Vera a traité 2.07 millions de requêtes GET par seconde, dépassant les 1.92 million du 9965 et atteignant environ 1.6 fois les performances des Xeon 6787P et 8592+, bien que sa latence p99 ait atteint 2.2 ms contre environ 0.5 ms pour le 9965.
Avec des partitions de plus petite taille (4 cœurs), AMD a pris l'avantage : le 9965 a atteint 1.26 million de requêtes GET par partition contre 0.95 million pour Vera, même si Vera restait en tête parmi les Xeon. Avec des requêtes envoyées une par une, les partitions du 9965 étaient 1.5 à 1.7 fois plus rapides que celles de Vera, quelle que soit leur taille, et les 6787P et 8592+ ont également pris l'avantage sur les partitions à 8 cœurs.
La densité détermine le nombre total de sockets : un socket Vera héberge 11 shards à huit cœurs et a traité 22.8 millions de requêtes GET par seconde, tandis que les 192 cœurs du 9965 hébergent 48 shards à quatre cœurs et en ont traité 60.3 millions. Vera offre les shards les plus rapides de notre comparatif dès lors que chaque shard possède huit cœurs ou plus et que les requêtes sont regroupées, mais le 9965 peut héberger plus du double de shards dans un socket.
Débit mono-thread
Valkey et ClickBench exploitaient autant le système de mémoire que les cœurs. Cette section s'intéresse aux cœurs eux-mêmes et aux deux objectifs d'Olympus décrits précédemment : exécuter rapidement les tâches individuelles et maintenir cette vitesse même lorsque le socket est fortement sollicité. 7-Zip, OpenSSL et Python s'exécutent chacun dans un seul thread dédié à un cœur, illustrant les performances d'un cœur Olympus. 7-Zip et OpenSSL sont ensuite exécutés à nouveau sur tous les threads du système, démontrant ainsi la vitesse par cœur préservée lorsque tous les cœurs se partagent les mêmes caches et la même mémoire.
7-Zip
La compression LZMA de 7-Zip est un code entier à forte composante de branchement avec un accès mémoire imprévisible, le type de travail pour lequel l'interface frontale 10 bits et le préchargeur de graphes d'Olympus sont conçus.
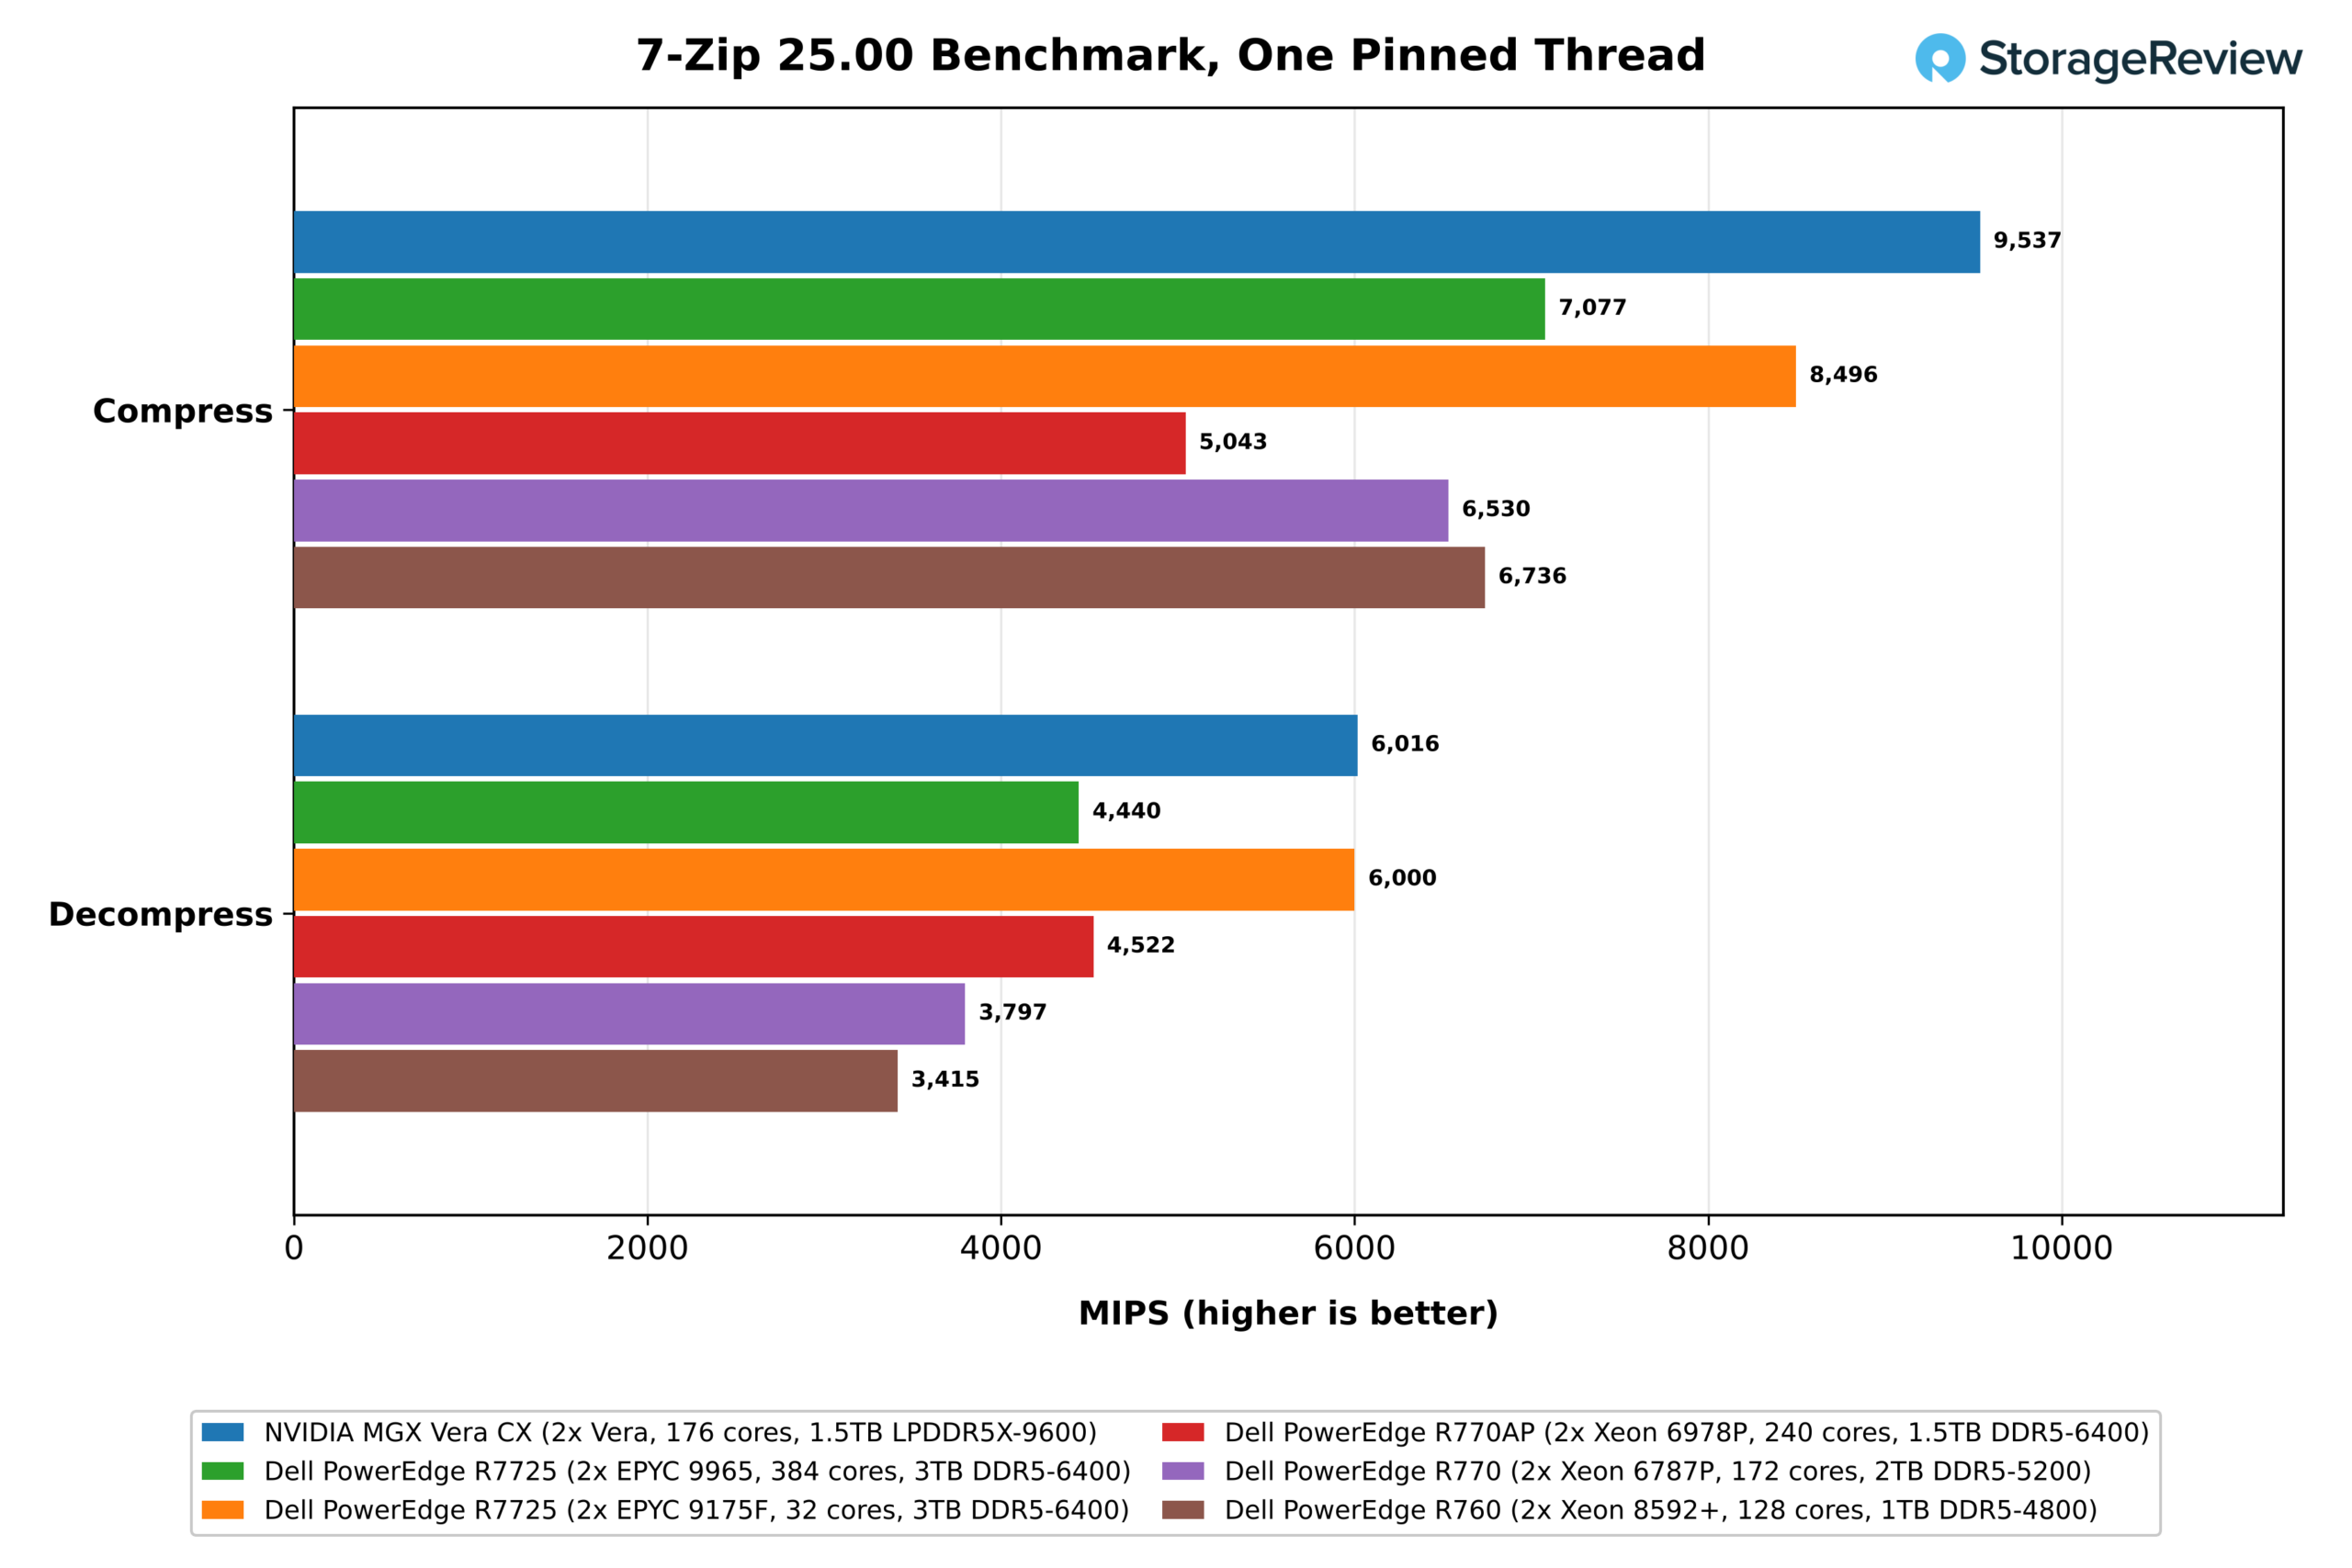
Sur un seul cœur, Olympus s'est avéré le plus rapide en compression parmi notre sélection. Il a atteint 9 537 MIPS, soit 12 % de plus que l'EPYC 9175F à 5.0 GHz, le cœur x86 le plus rapide de ce test, et largement supérieur à l'EPYC 9965 et à tous les Xeon. En décompression, les deux processeurs étaient à égalité : 6 016 MIPS pour Vera et 6 000 pour le 9175F, aucun autre système n'atteignant un écart inférieur à 20 %.
L'analyse de chaque thread permet de voir quelle part de cette avance subsiste lorsque l'ensemble du système est sollicité.
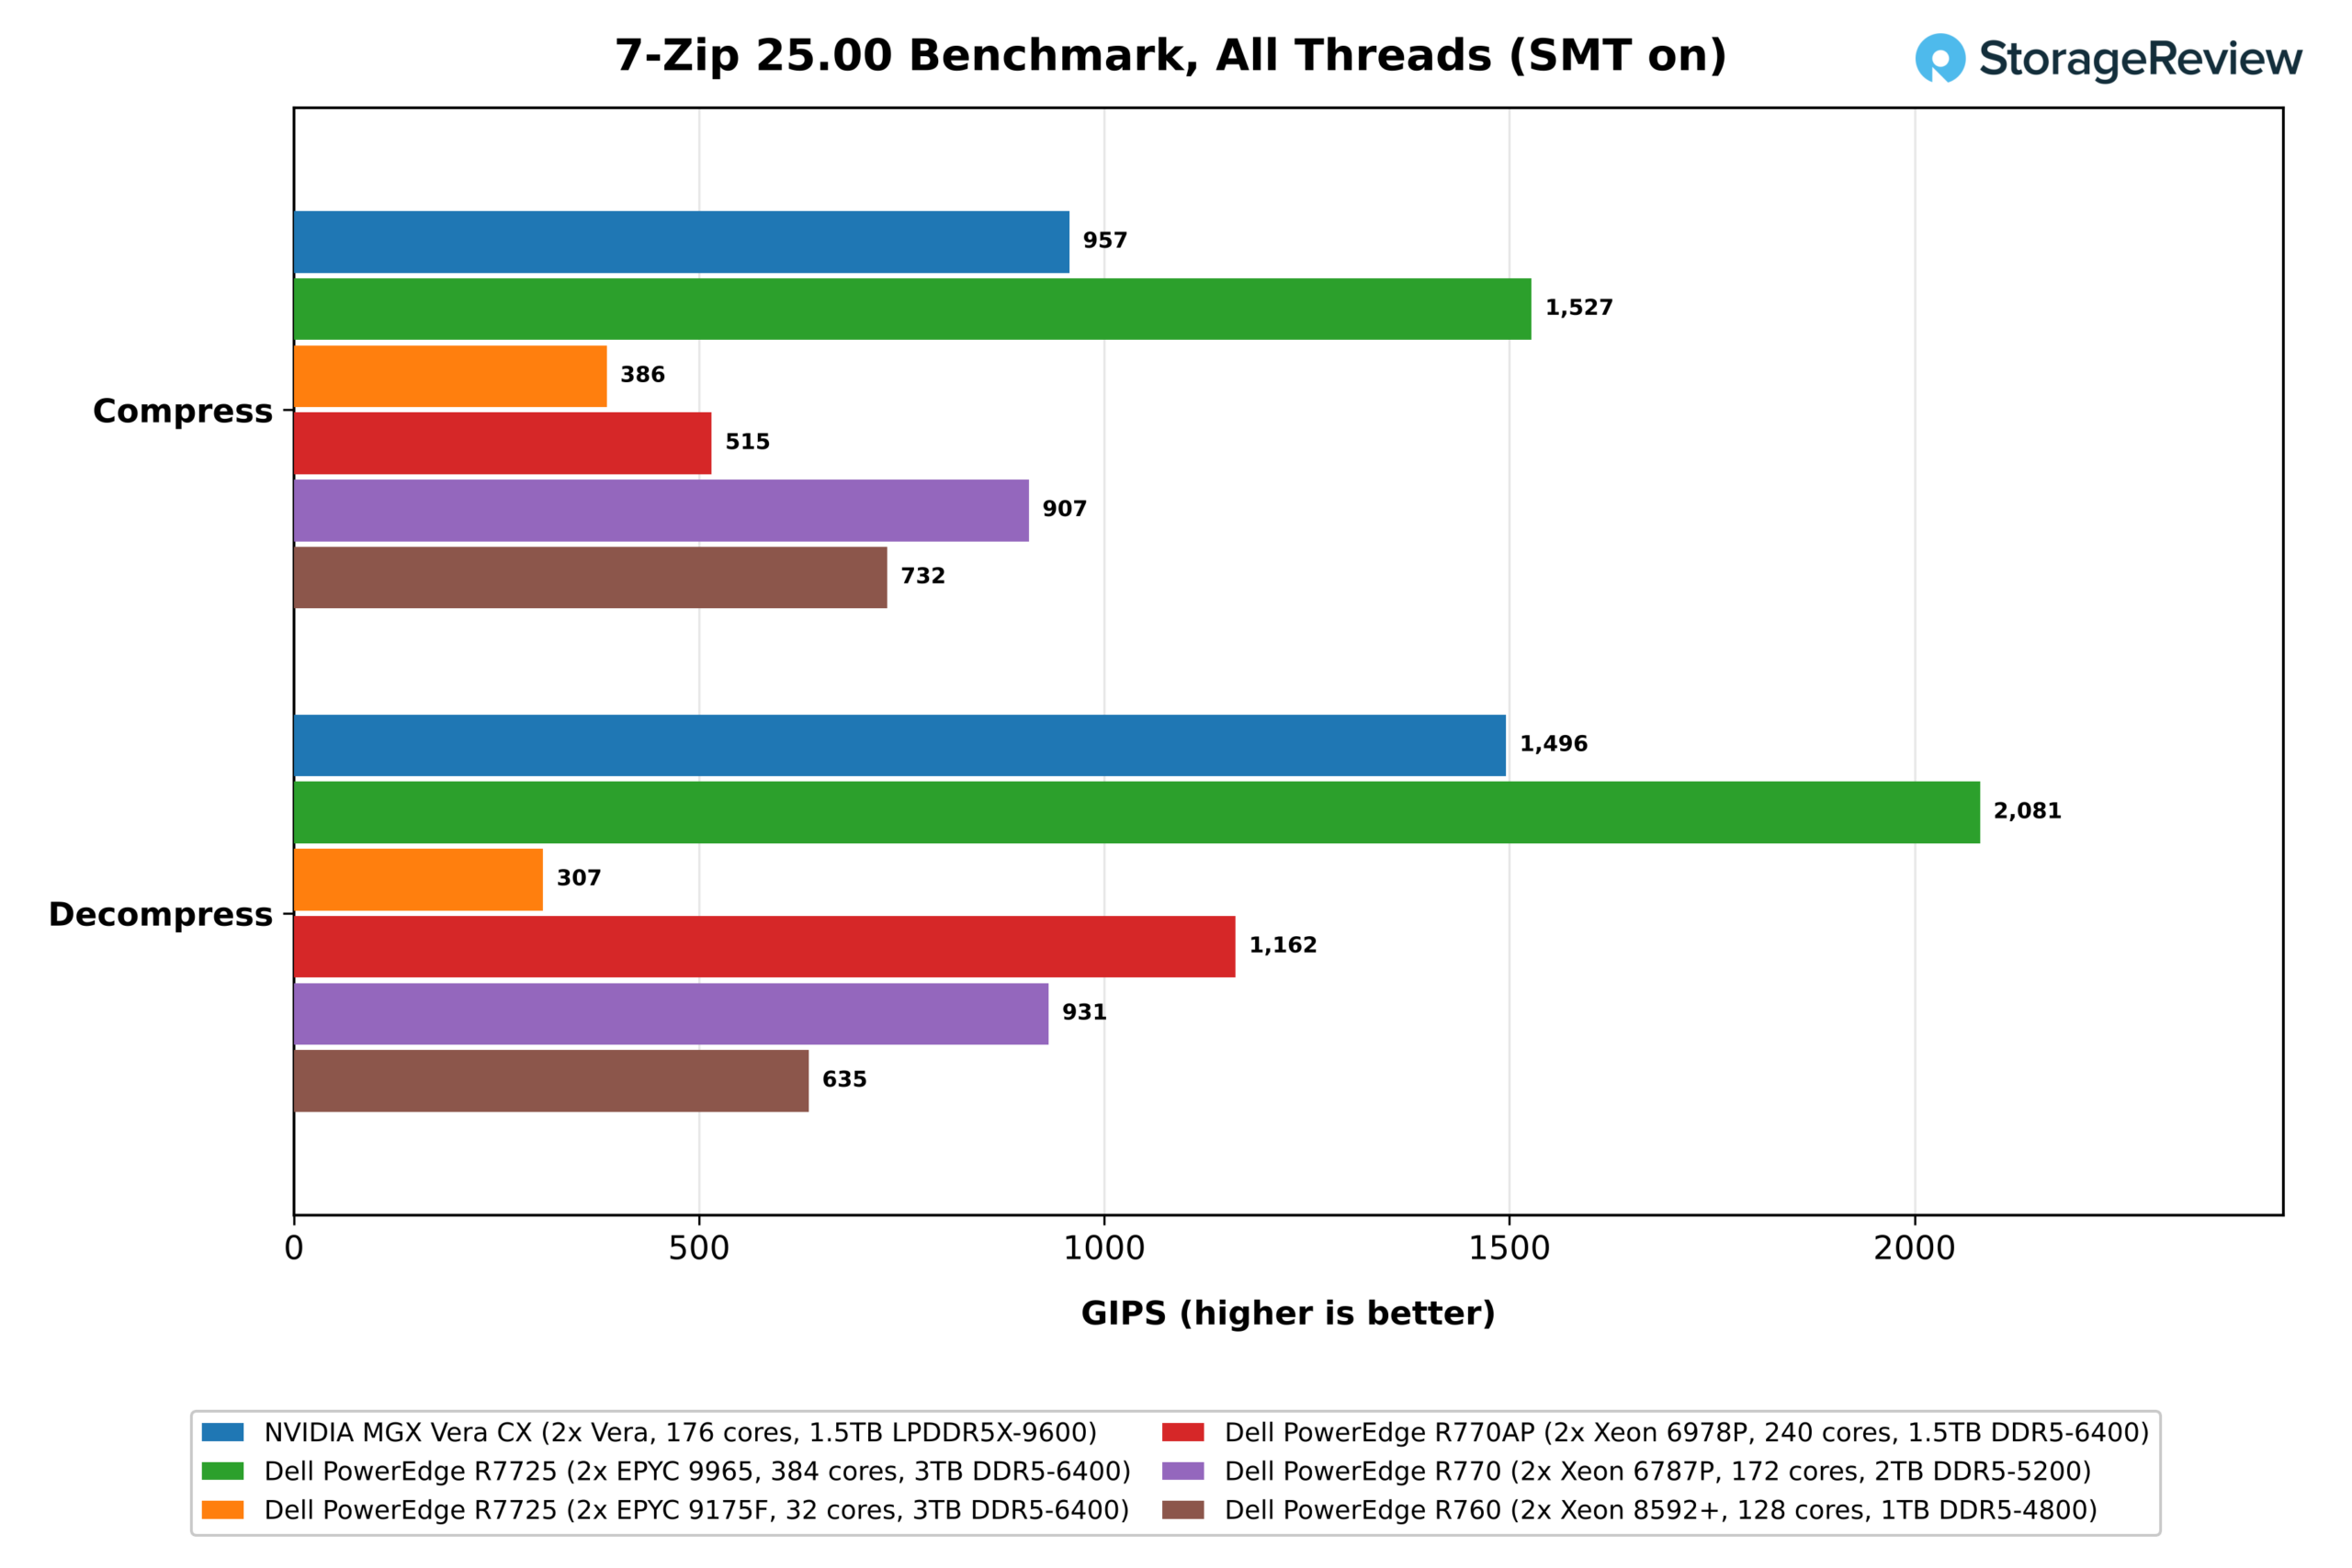
Avec tous ses threads actifs, l'EPYC 9965 et ses 768 threads se sont hissés en tête avec 1 527 GIPS en compression et 2 081 GIPS en décompression. Le Vera et ses 352 threads arrivent en deuxième position avec 957 GIPS en compression et 1 496 GIPS en décompression, devançant tous les Xeon. Le 6787P est le plus proche avec 907 GIPS en compression et 931 GIPS en décompression. Mesuré par cœur physique, le Vera se défend bien. Ses 5.4 GIPS de compression par cœur égalent ceux du 6787P et du 8592+ et surpassent les 4.0 GIPS du 9965. Ses 8.5 GIPS de décompression par cœur sont 57 % supérieurs à ceux du 9965 et surpassent tous les Xeon. Seul le 9175F à 32 cœurs, avec un nombre de cœurs bien inférieur partageant les caches et la mémoire de chaque socket, a fait mieux par cœur dans les deux cas.
OpenSSL
C’est lors du test AES-256-GCM d’OpenSSL que Vera accuse le plus de retard. Seuls deux des six cœurs SVE2 128 bits d’Olympus peuvent exécuter des instructions de chiffrement, tandis que les composants x86 peuvent exécuter l’AES sur des registres 512 bits avec VAES.
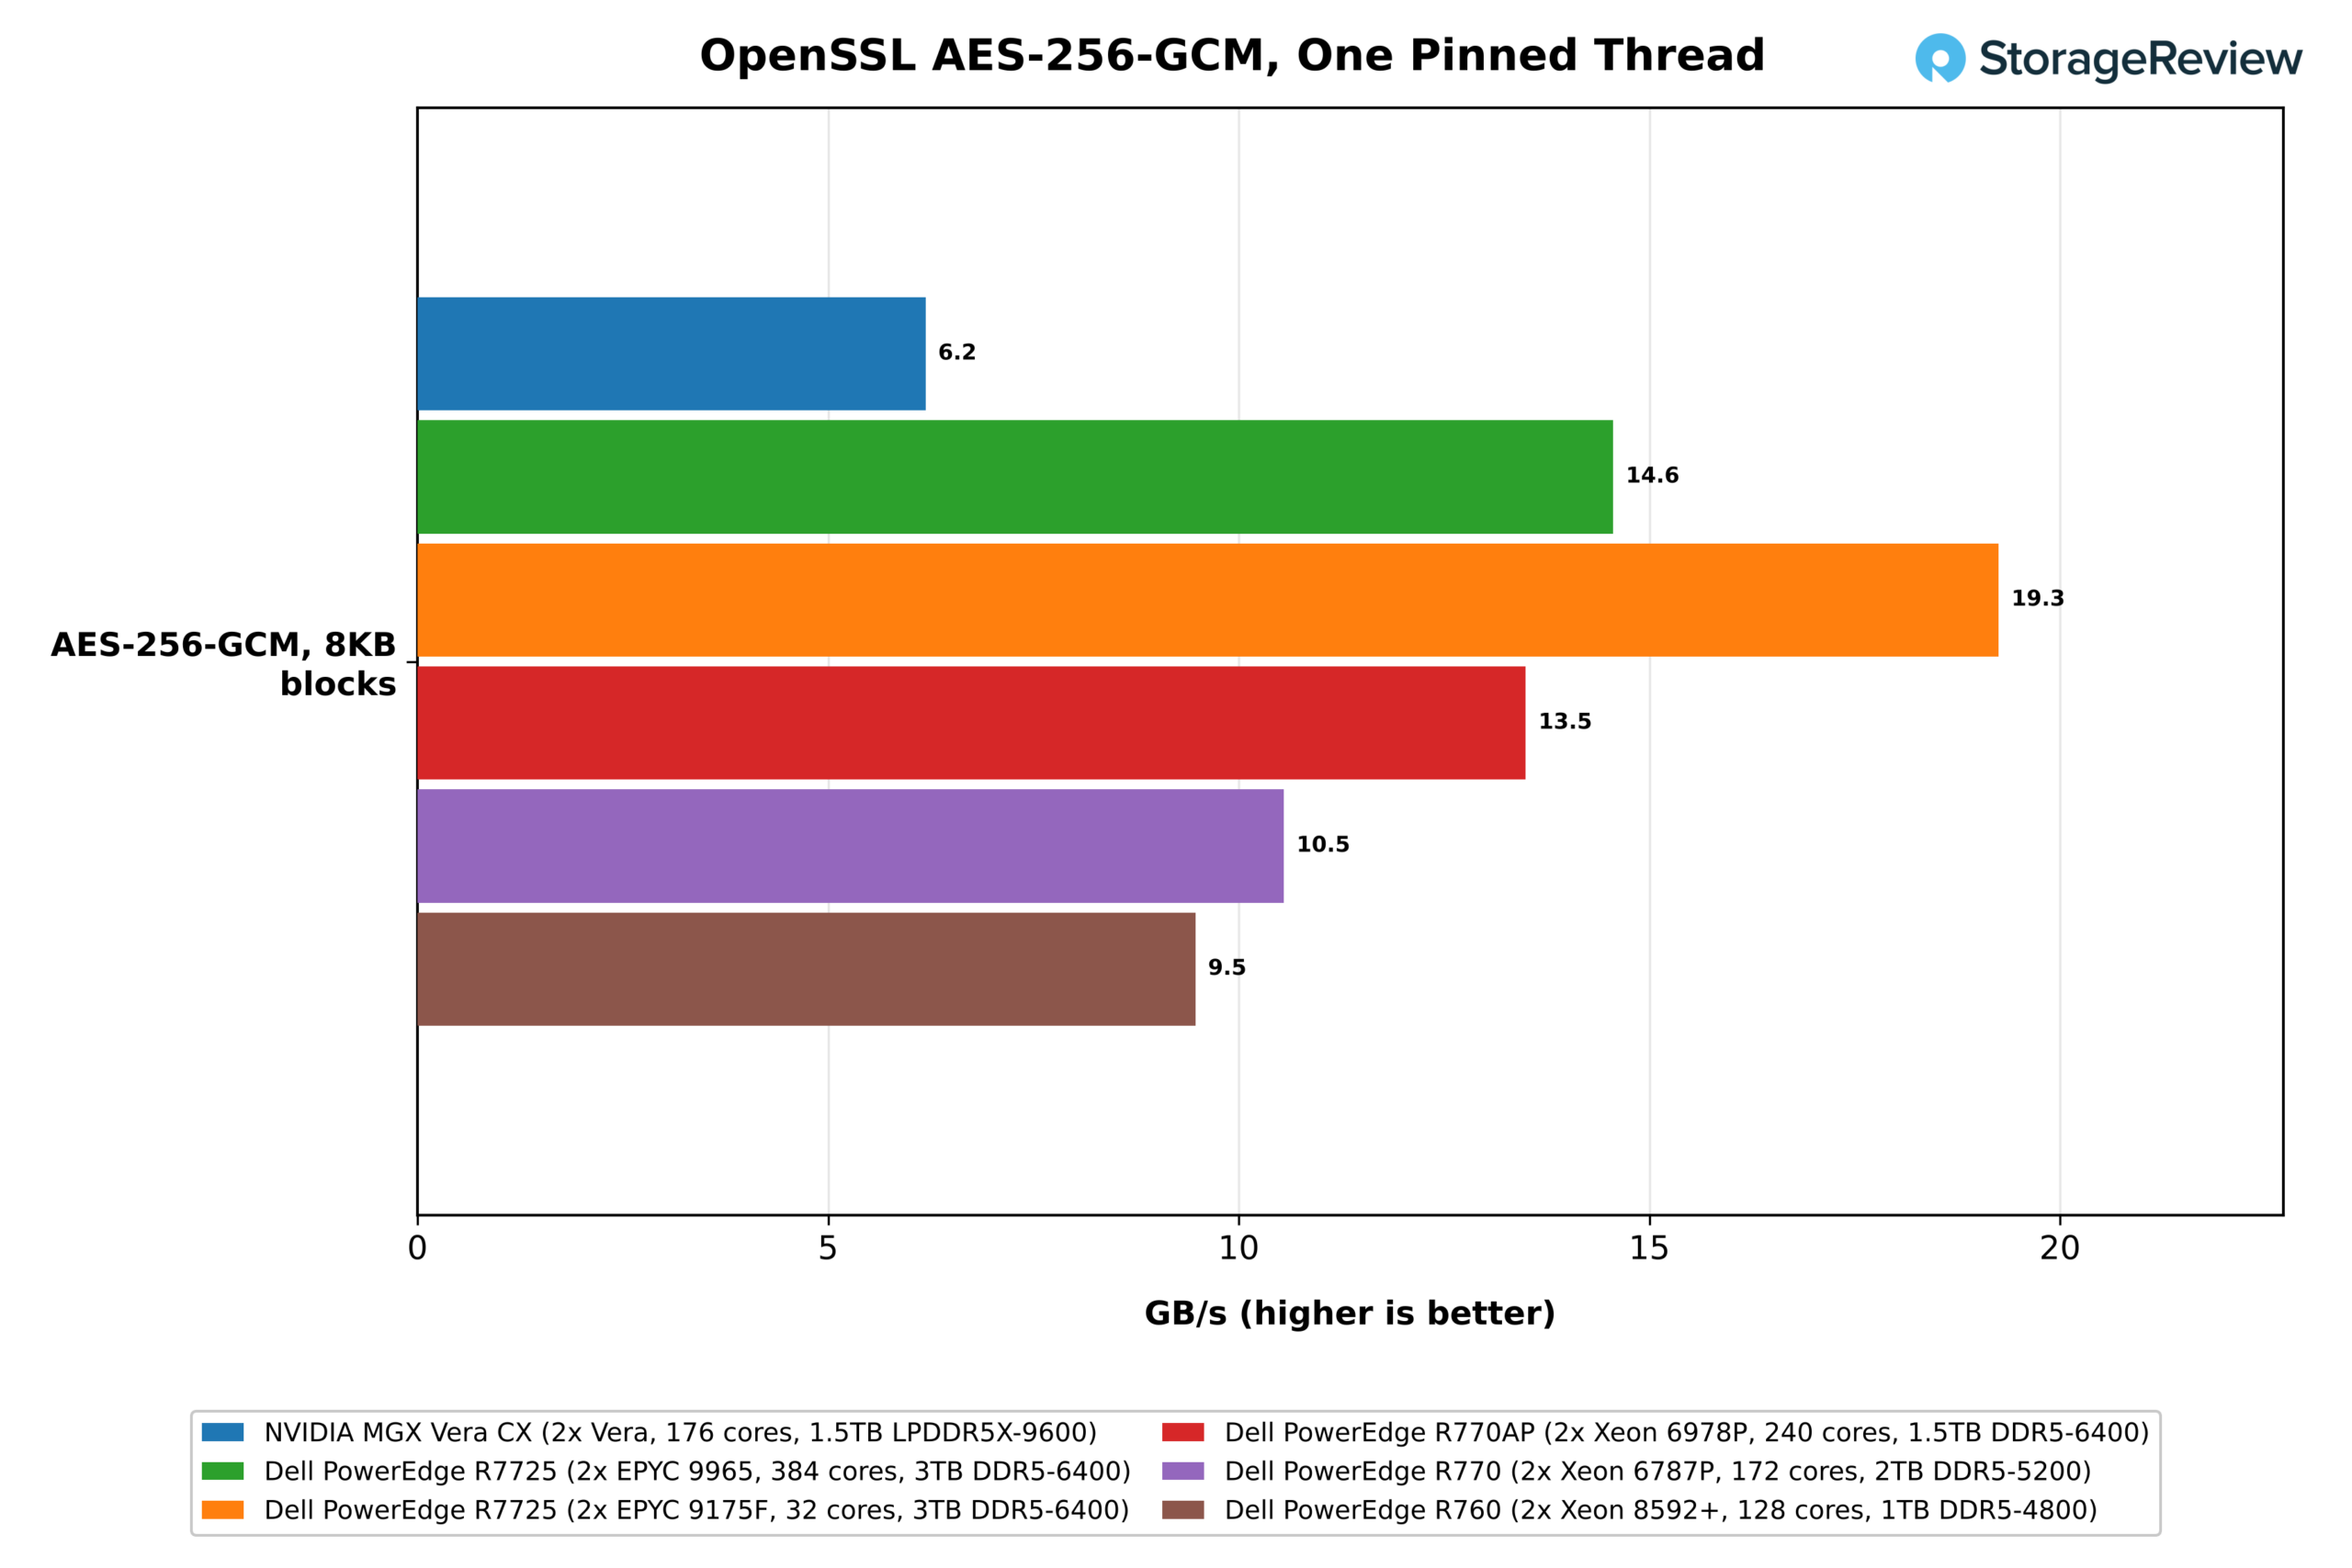
L'écart est le plus flagrant sur un seul thread. Un cœur Olympus a atteint une vitesse de chiffrement de 6.2 Go/s, soit environ un tiers des 19.3 Go/s de l'EPYC 9175F, et bien en deçà des performances de l'EPYC 9965 (14.6 Go/s) et du Xeon 6978P (13.5 Go/s).
Dans tous les domaines, les systèmes x86 se classent par nombre de cœurs, ce qui montre où se situe Vera en raison de ce déficit par cœur.
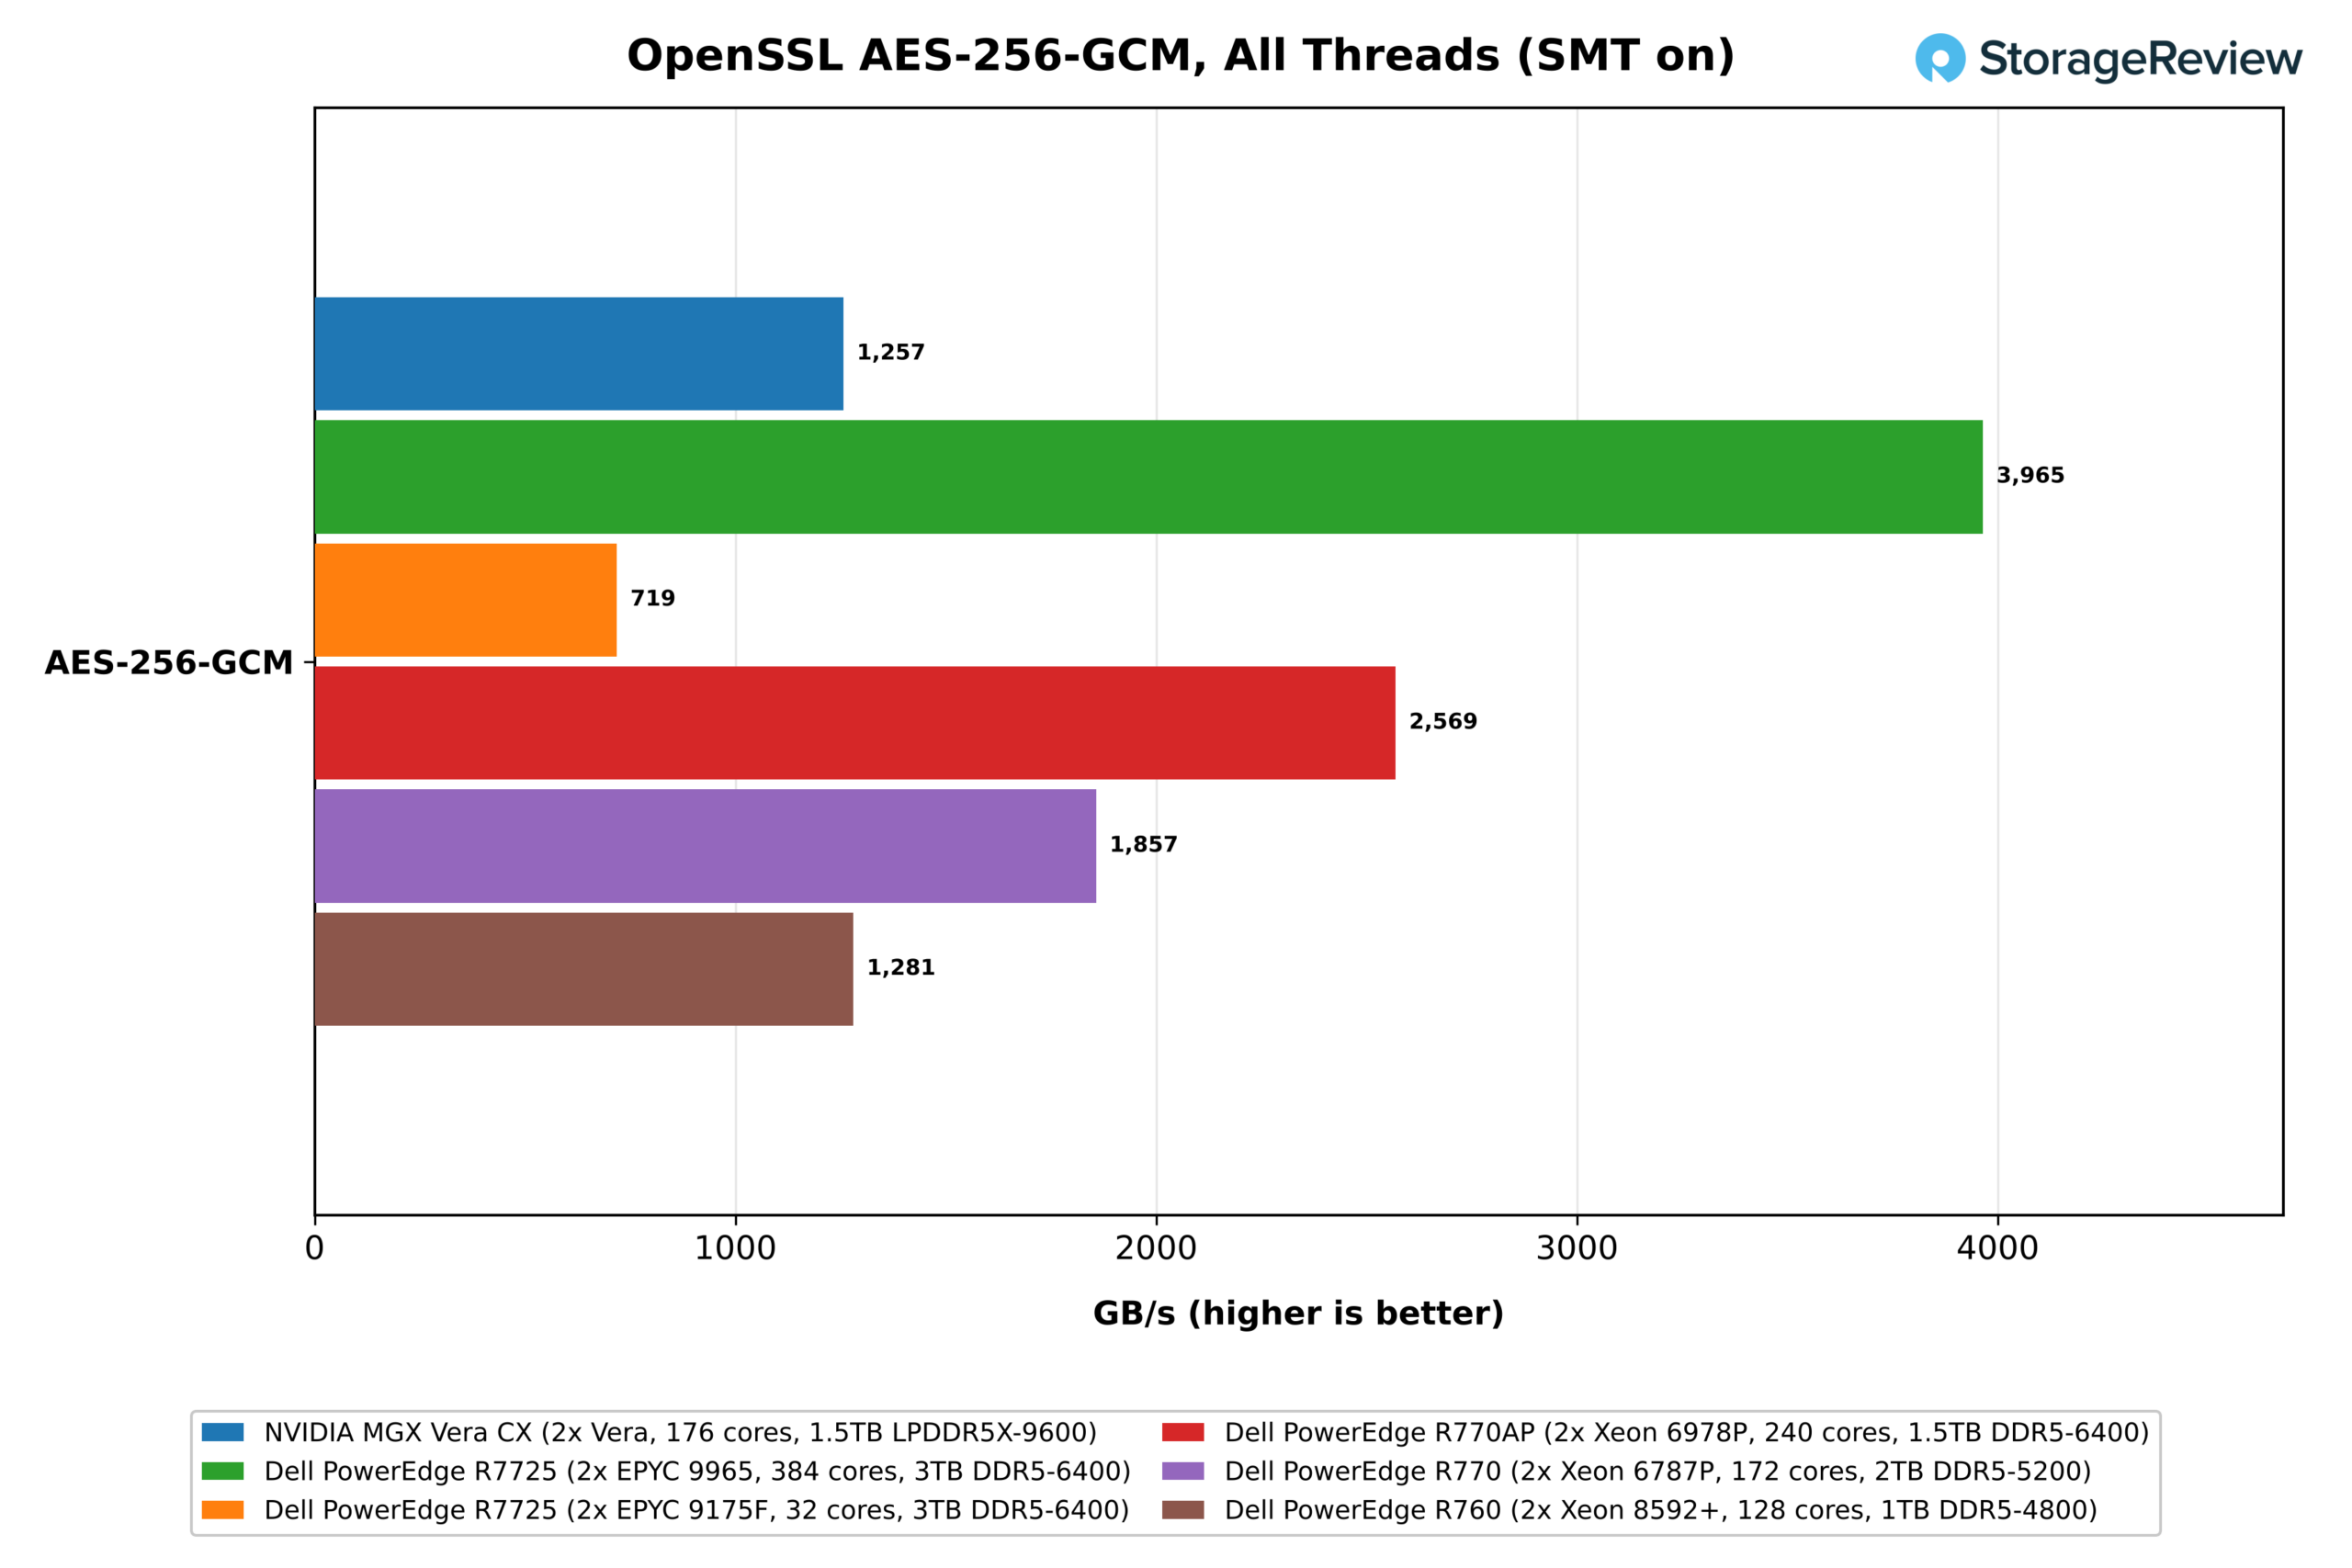
Avec ses 352 cœurs actifs, Vera a atteint 1.26 To/s, égalant ainsi le Xeon 8592+ à 128 cœurs (1.28 To/s) et devançant uniquement l'EPYC 9175F à 32 cœurs. L'EPYC 9965 a dominé avec 3.96 To/s, soit environ trois fois le résultat de Vera, suivi du Xeon 6978P à 2.57 To/s et du 6787P à 1.86 To/s.
Python
Python est essentiel aux environnements d'exécution isolés (sandboxes) que NVIDIA cible avec Vera, et pyperformance nous fournit trois tests monothread fixes : go, une recherche dans un arbre de jeu riche en objets ; regex_compile, qui compile les expressions régulières ; et nbody, une simulation physique à virgule flottante. Une différence logicielle est à noter : Vera utilisait Python 3.14.4 sous Ubuntu 26.04, tandis que les systèmes x86 utilisaient la version 3.12.3 sous Ubuntu 24.04. Cette dernière version apporte des gains de vitesse au niveau de l'interpréteur.
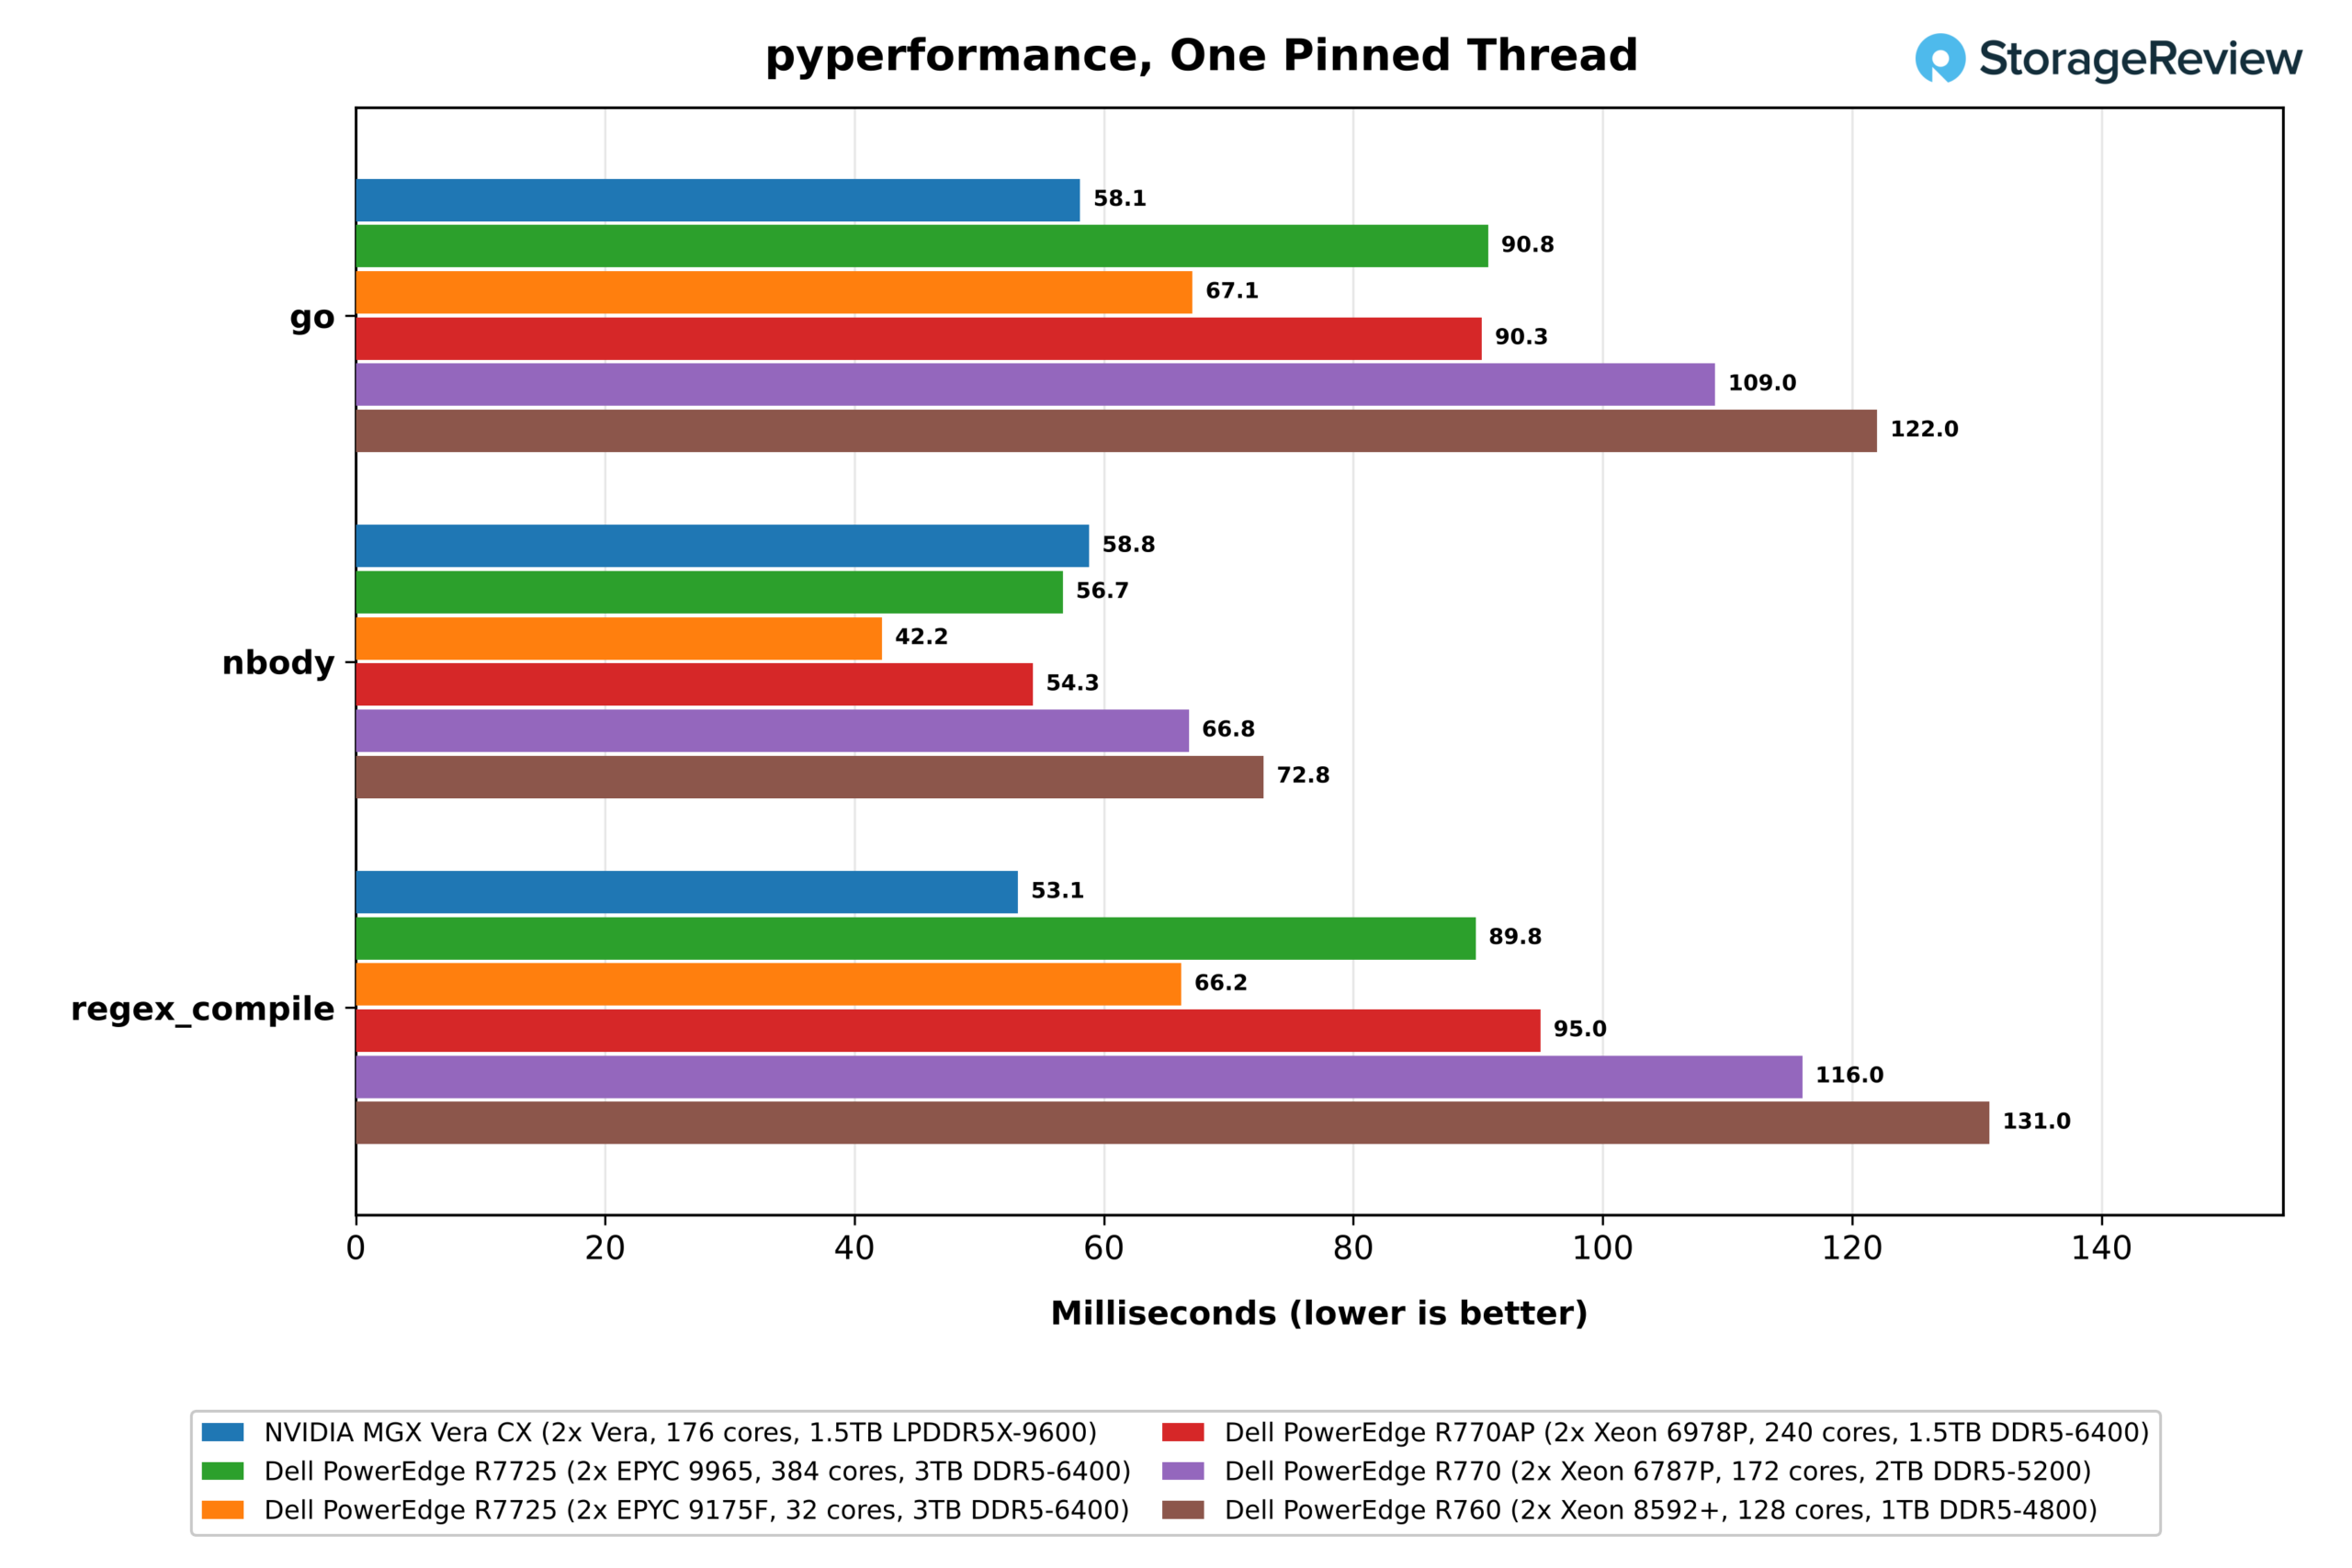
Vera a remporté les deux tests basés sur du code complexe et riche en objets. Le test « go » s'est terminé en 58.1 ms, soit 15 % plus rapide que l'EPYC 9175F, le cœur x86 le plus rapide de ce test, et 1.6 à 2.1 fois plus rapide que les autres processeurs testés. Le test « regex_compile » a affiché une marge plus importante, avec un temps d'exécution de 53.1 ms, soit 25 % plus rapide que le 9175F et 1.7 fois plus rapide que l'EPYC 9965. Comme Vera disposait également de la version la plus récente de Python, ces deux écarts représentent des limites supérieures.
nbody a opté pour une approche différente, car sa boucle d'initialisation en virgule flottante courte et son petit ensemble de travail favorisent les fréquences d'horloge élevées. Le 9175F à 5.0 GHz a ainsi remporté la victoire avec un temps de réponse de 42.2 ms, soit 39 % plus rapide que les 58.8 ms de Vera. Les Xeon 6978P et EPYC 9965 ont également devancé Vera, avec des temps de réponse respectifs de 54.3 ms et 56.7 ms, malgré la version plus récente de Python utilisée par Vera.
Latence du serveur Web, de la JVM et du planificateur
La dernière série de tests d'infrastructure couvre les logiciels qui entourent une application : la pile web, la machine virtuelle Java, le planificateur Linux et la chaîne d'outils de compilation. Ces résultats dépendent autant du nombre de threads exécutés par chaque système que de la fréquence de chaque cœur ; ils sont donc moins révélateurs des caractéristiques d'Olympus lui-même que les sections précédentes, mais ils illustrent le comportement d'un serveur Vera avec les logiciels serveur courants.
Nginx
NGINX traite les requêtes HTTPS vers le générateur de charge wrk exécuté sur la même machine, de sorte que le client et le serveur se disputent les mêmes cœurs, et le résultat reflète davantage la pile TLS et HTTP que le nombre brut de cœurs.
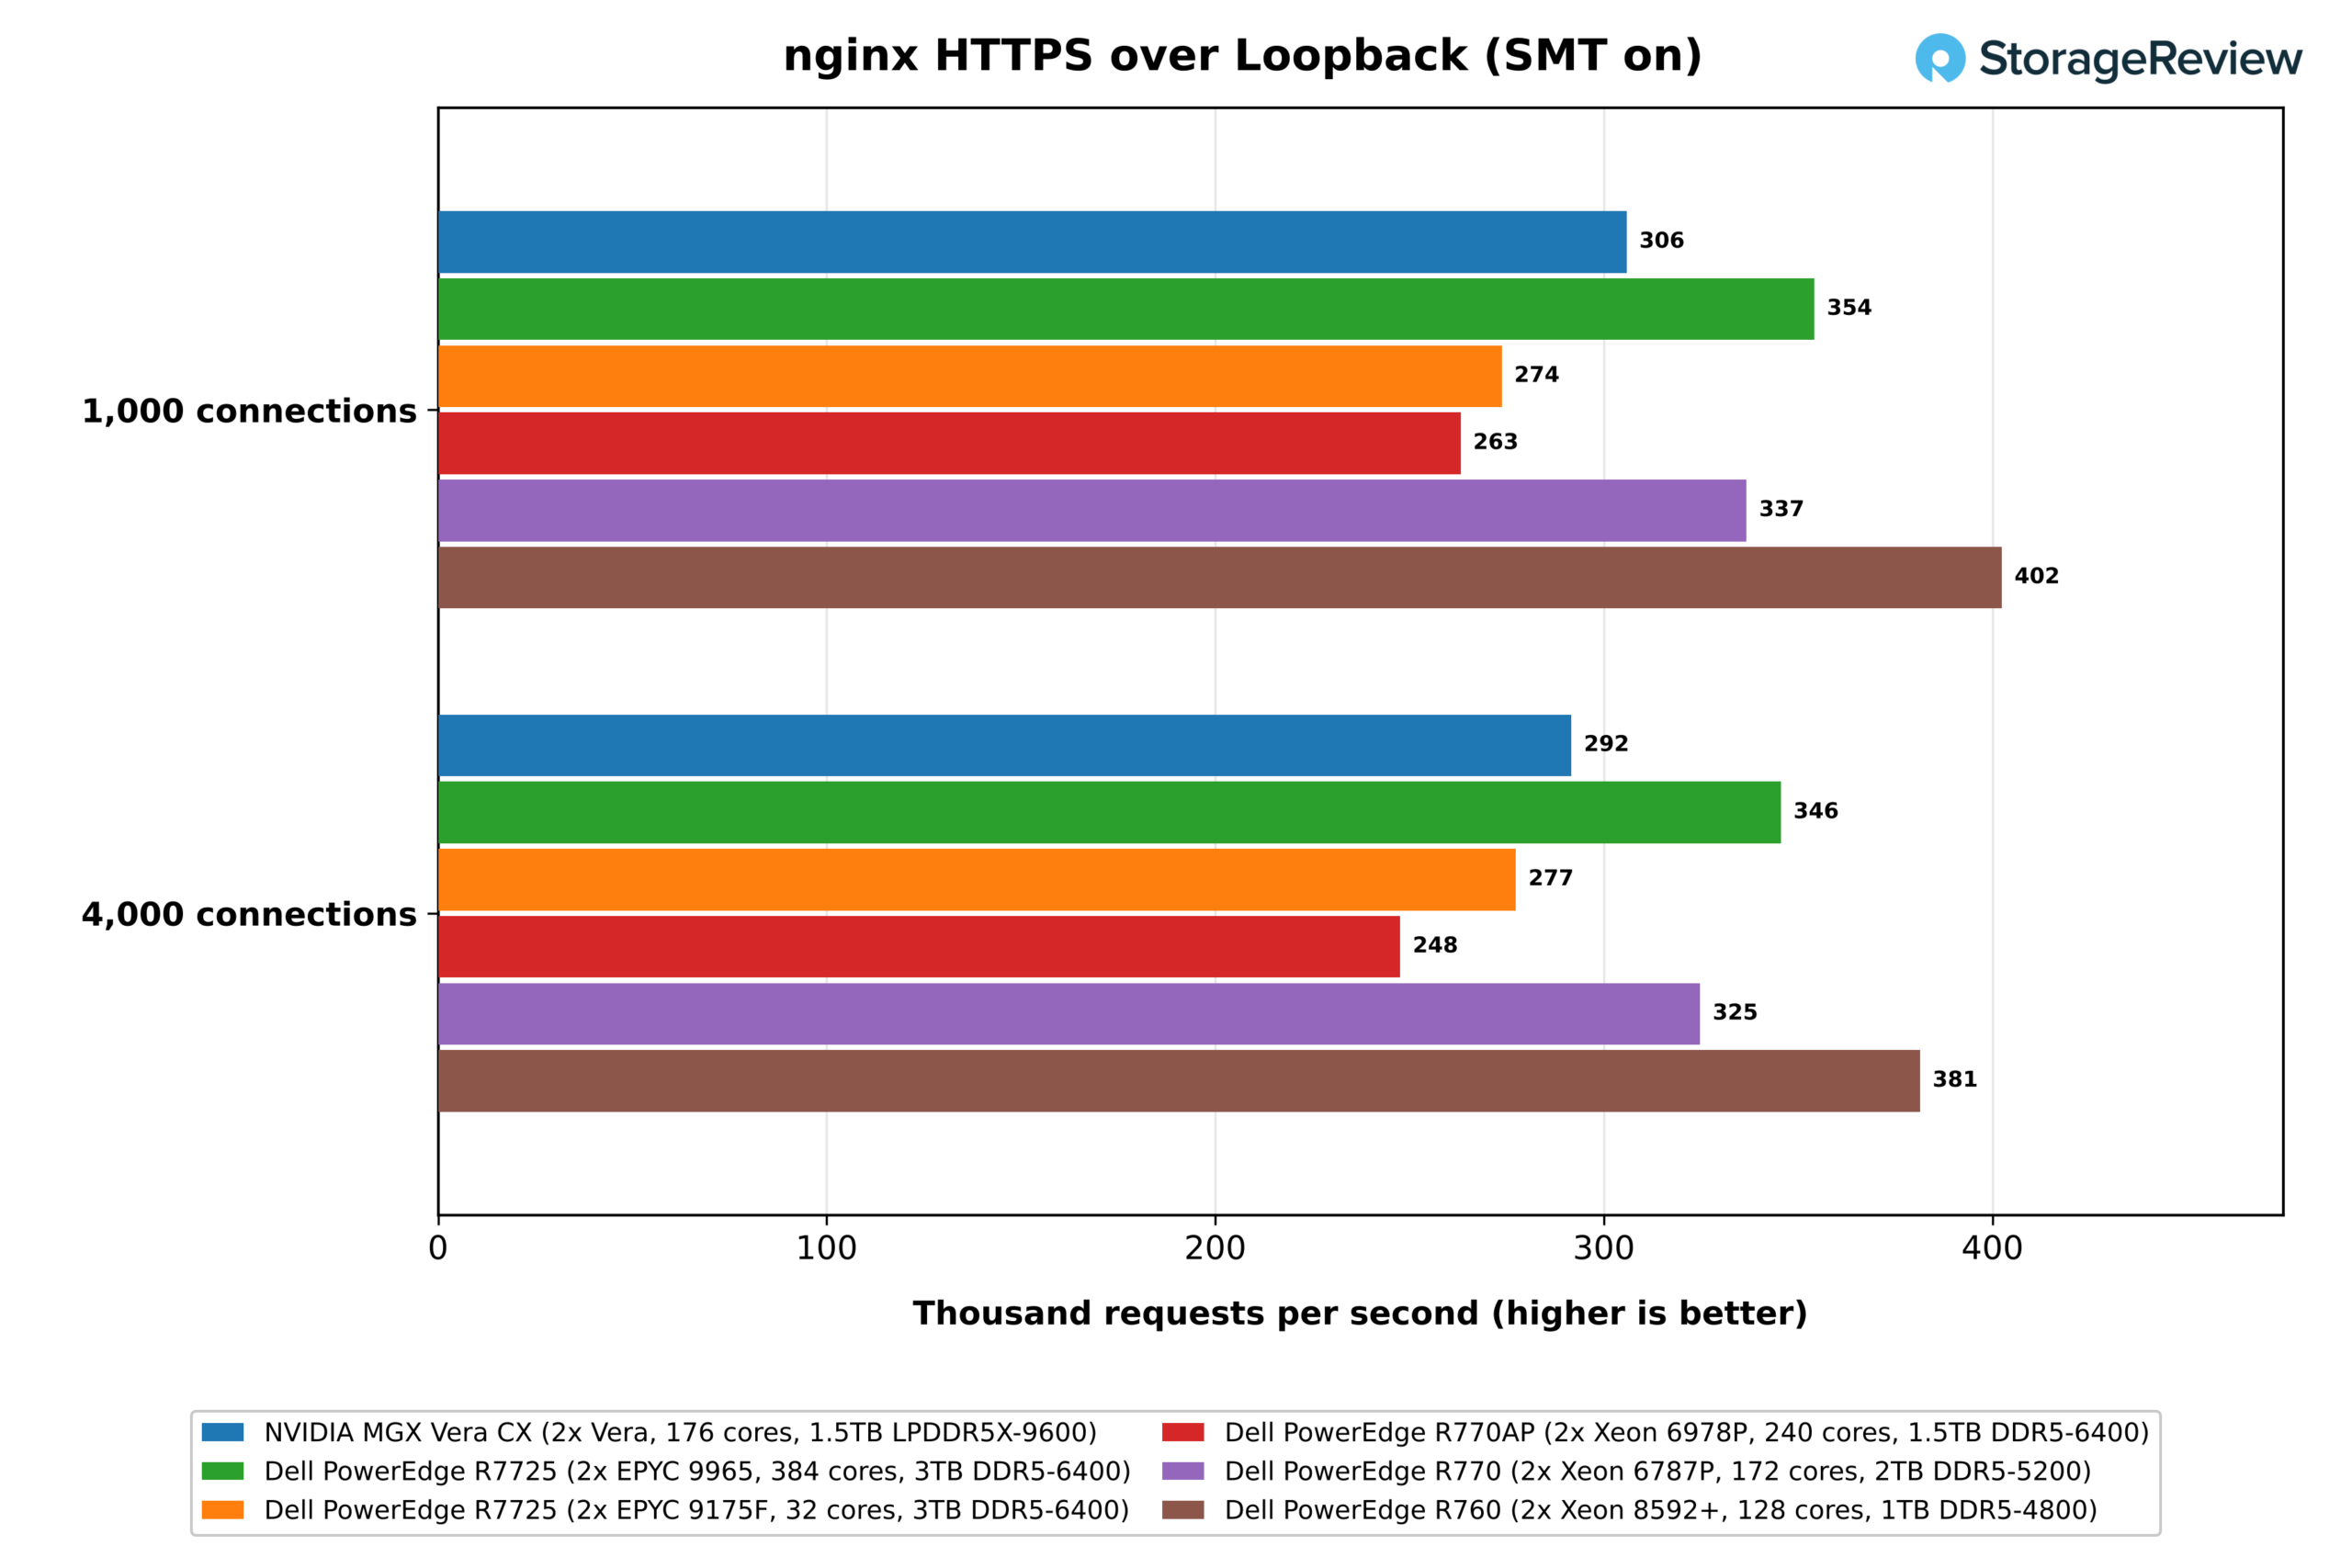
Avec le SMT activé, Vera a traité 306 000 requêtes par seconde à 1 000 connexions et 292 000 à 4 000, se situant ainsi dans la moyenne des performances observées, allant de 263 000 sur le Xeon 6978P à 402 000 sur le Xeon 8592+. L'EPYC 9965 a atteint 354 000 requêtes par seconde et le Xeon 6787P 337 000. La désactivation du SMT a permis à Vera d'atteindre 330 000 requêtes par seconde. La pile réseau de Vera est tout à fait comparable à celle des systèmes x86.
Renaissance
Renaissance exécute des charges de travail Java sur OpenJDK 11. Son test HTTP Finagle exploite une pile réseau Scala, et son test Akka un framework de concurrence basé sur le modèle d'acteurs. Les deux tests répartissent la charge sur tous les cœurs logiques accessibles par la JVM ; nous les avons donc exécutés avec et sans SMT.
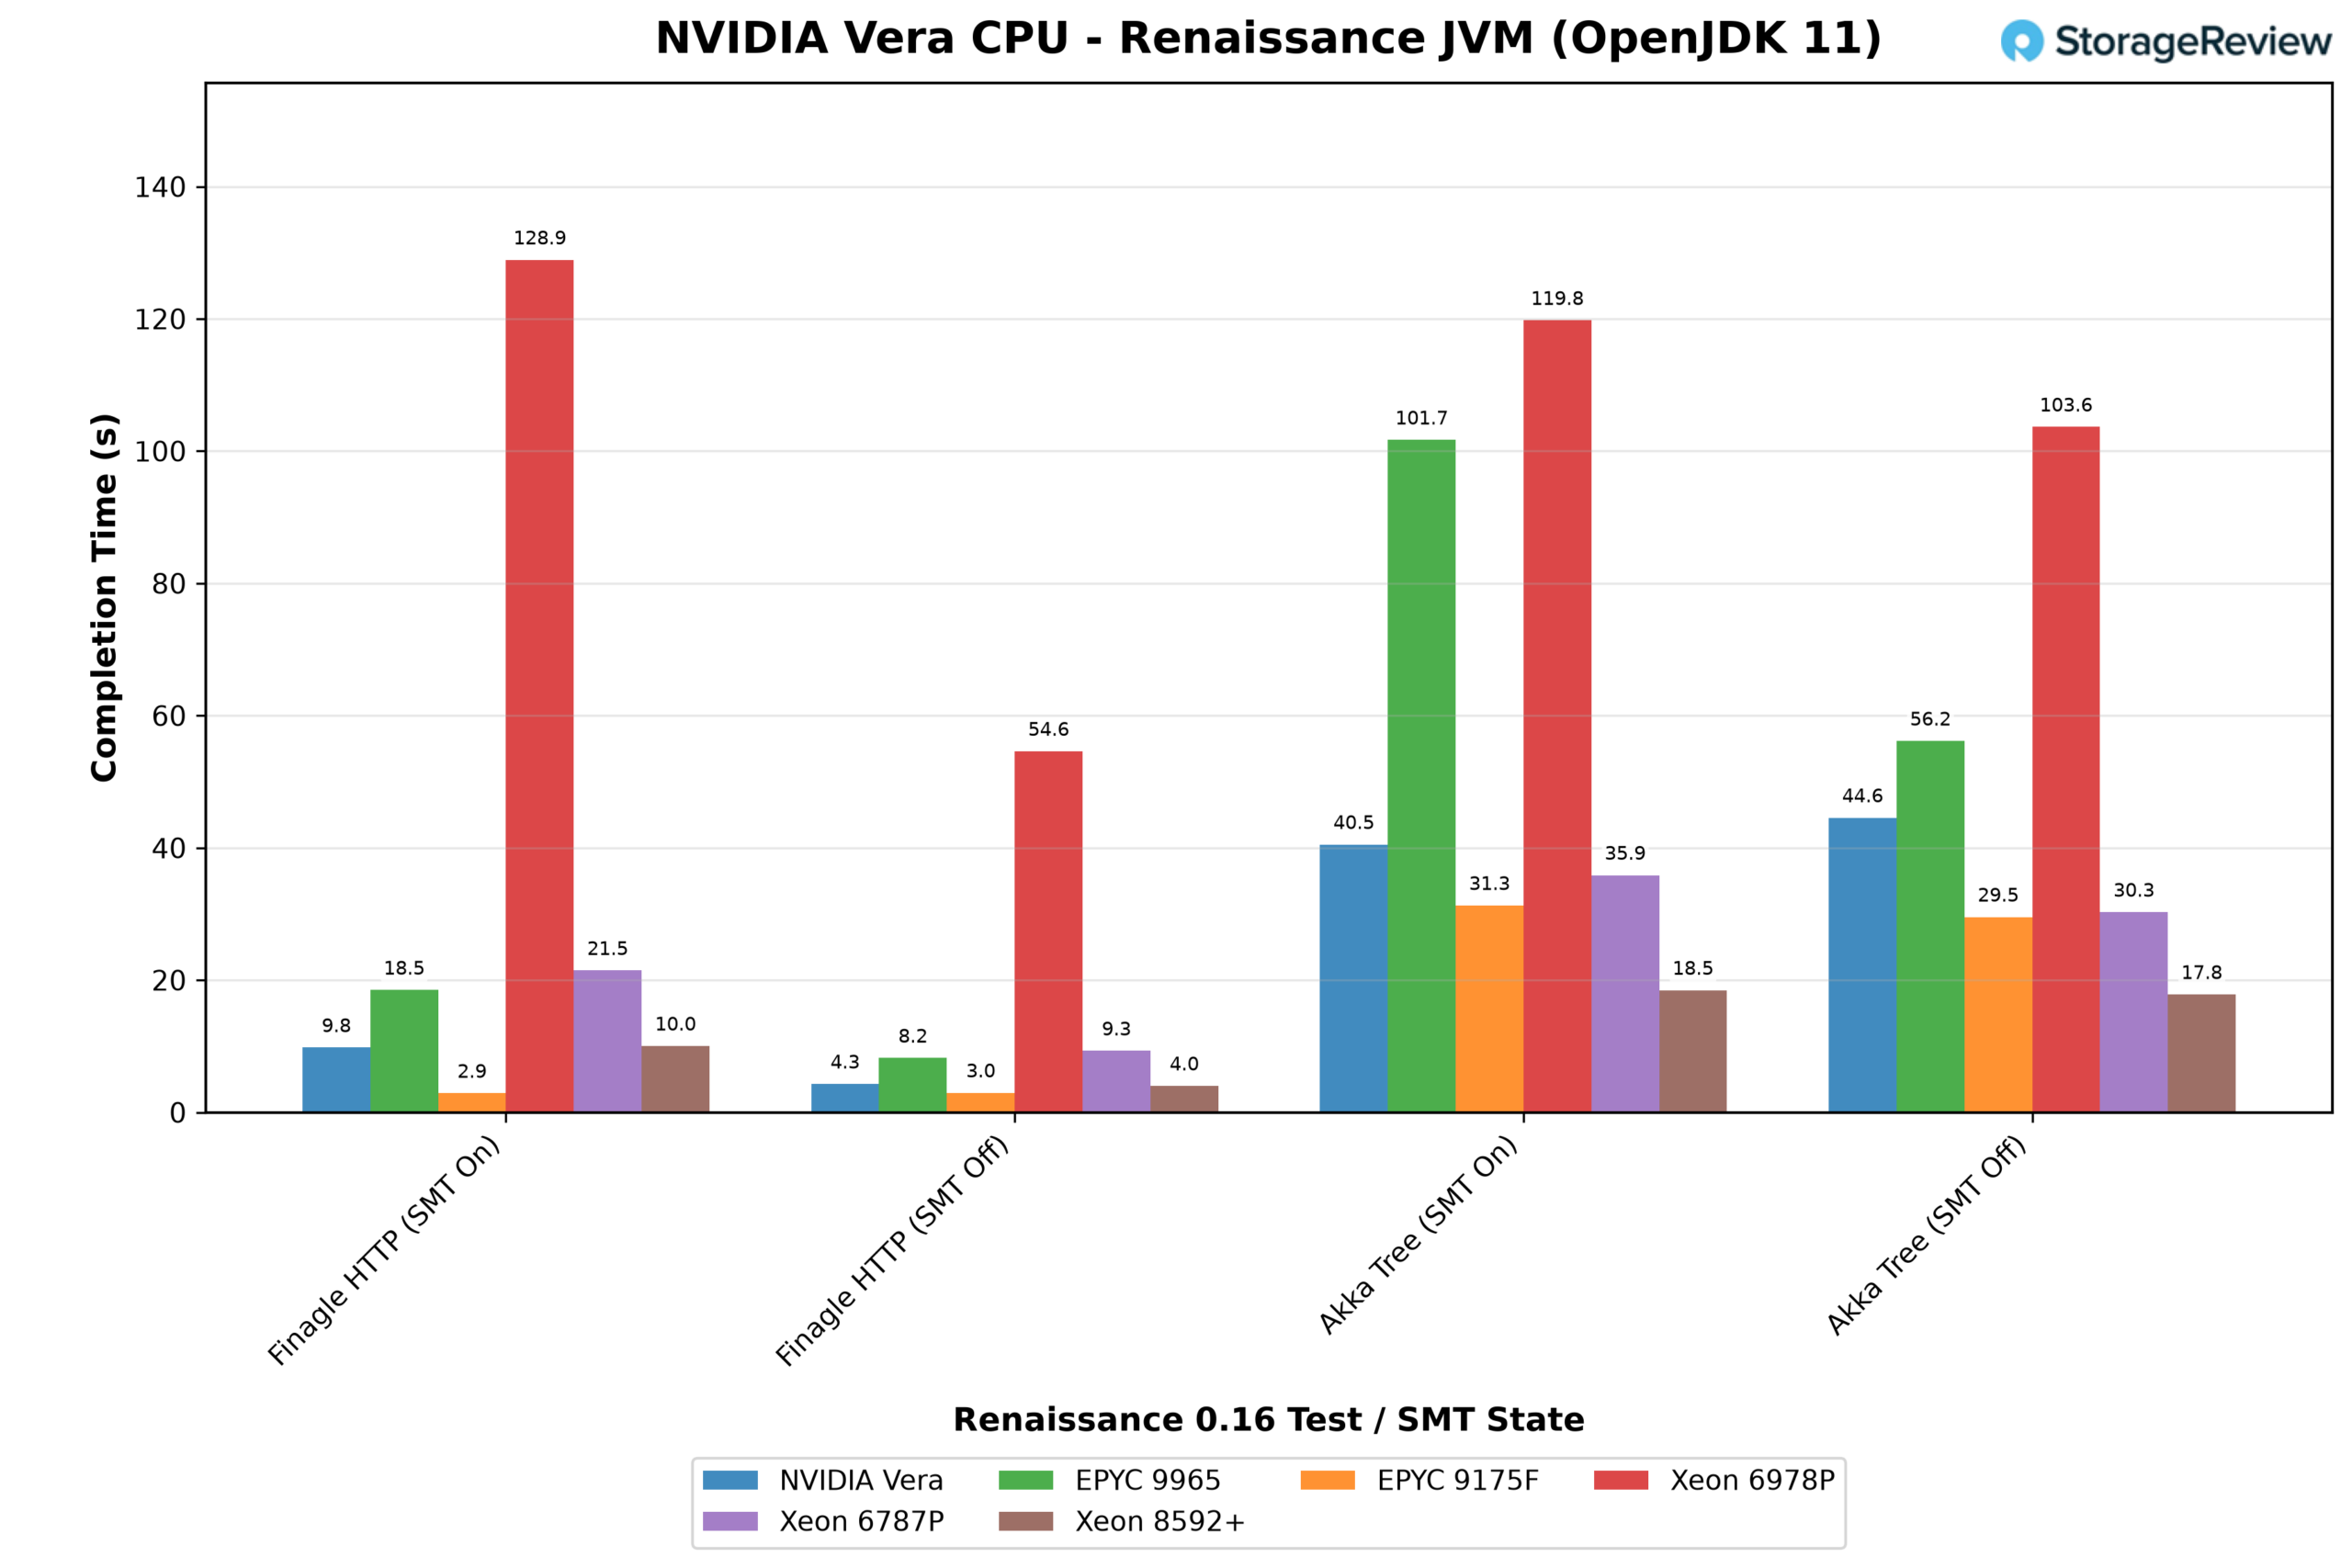
Finagle est plus rapide avec moins de threads. La désactivation de SMT, qui divise par deux le nombre de threads, a permis de réduire le temps d'exécution de Vera de 9.8 à 4.3 secondes, et les systèmes x86 plus puissants ont bénéficié d'une amélioration similaire, de 2.3 à 2.5 fois supérieure. Le processeur EPYC 9175F à 32 cœurs, avec peu de threads au départ, restait le plus rapide, avec un temps d'exécution d'environ 3 secondes.
Akka a privilégié le Xeon 8592+, qui a terminé l'exécution en environ 18 secondes, SMT activé ou non. Vera a quant à lui mis 40.5 secondes avec SMT activé, tandis que les deux systèmes les plus puissants, l'EPYC 9965 et le Xeon 6978P, ont été les plus lents, avec respectivement 101.7 et 119.8 secondes. Le troisième test Renaissance, un algorithme génétique, s'est exécuté en 1.6 à 2.6 secondes avec SMT activé sur tous les systèmes, à l'exception du 6978P, Vera affichant un temps de 2.6 secondes.
banc
schbench mesure la rapidité avec laquelle le planificateur Linux réveille les threads de travail, exécutant environ un travailleur par processeur logique avec 4 threads de messages et environ huit par processeur avec 32. Étant donné que le nombre de travailleurs augmente avec le système, les serveurs plus importants effectuent plus de travail, ces résultats décrivent donc la latence sous pleine charge sur chaque machine et ne constituent pas une comparaison directe.
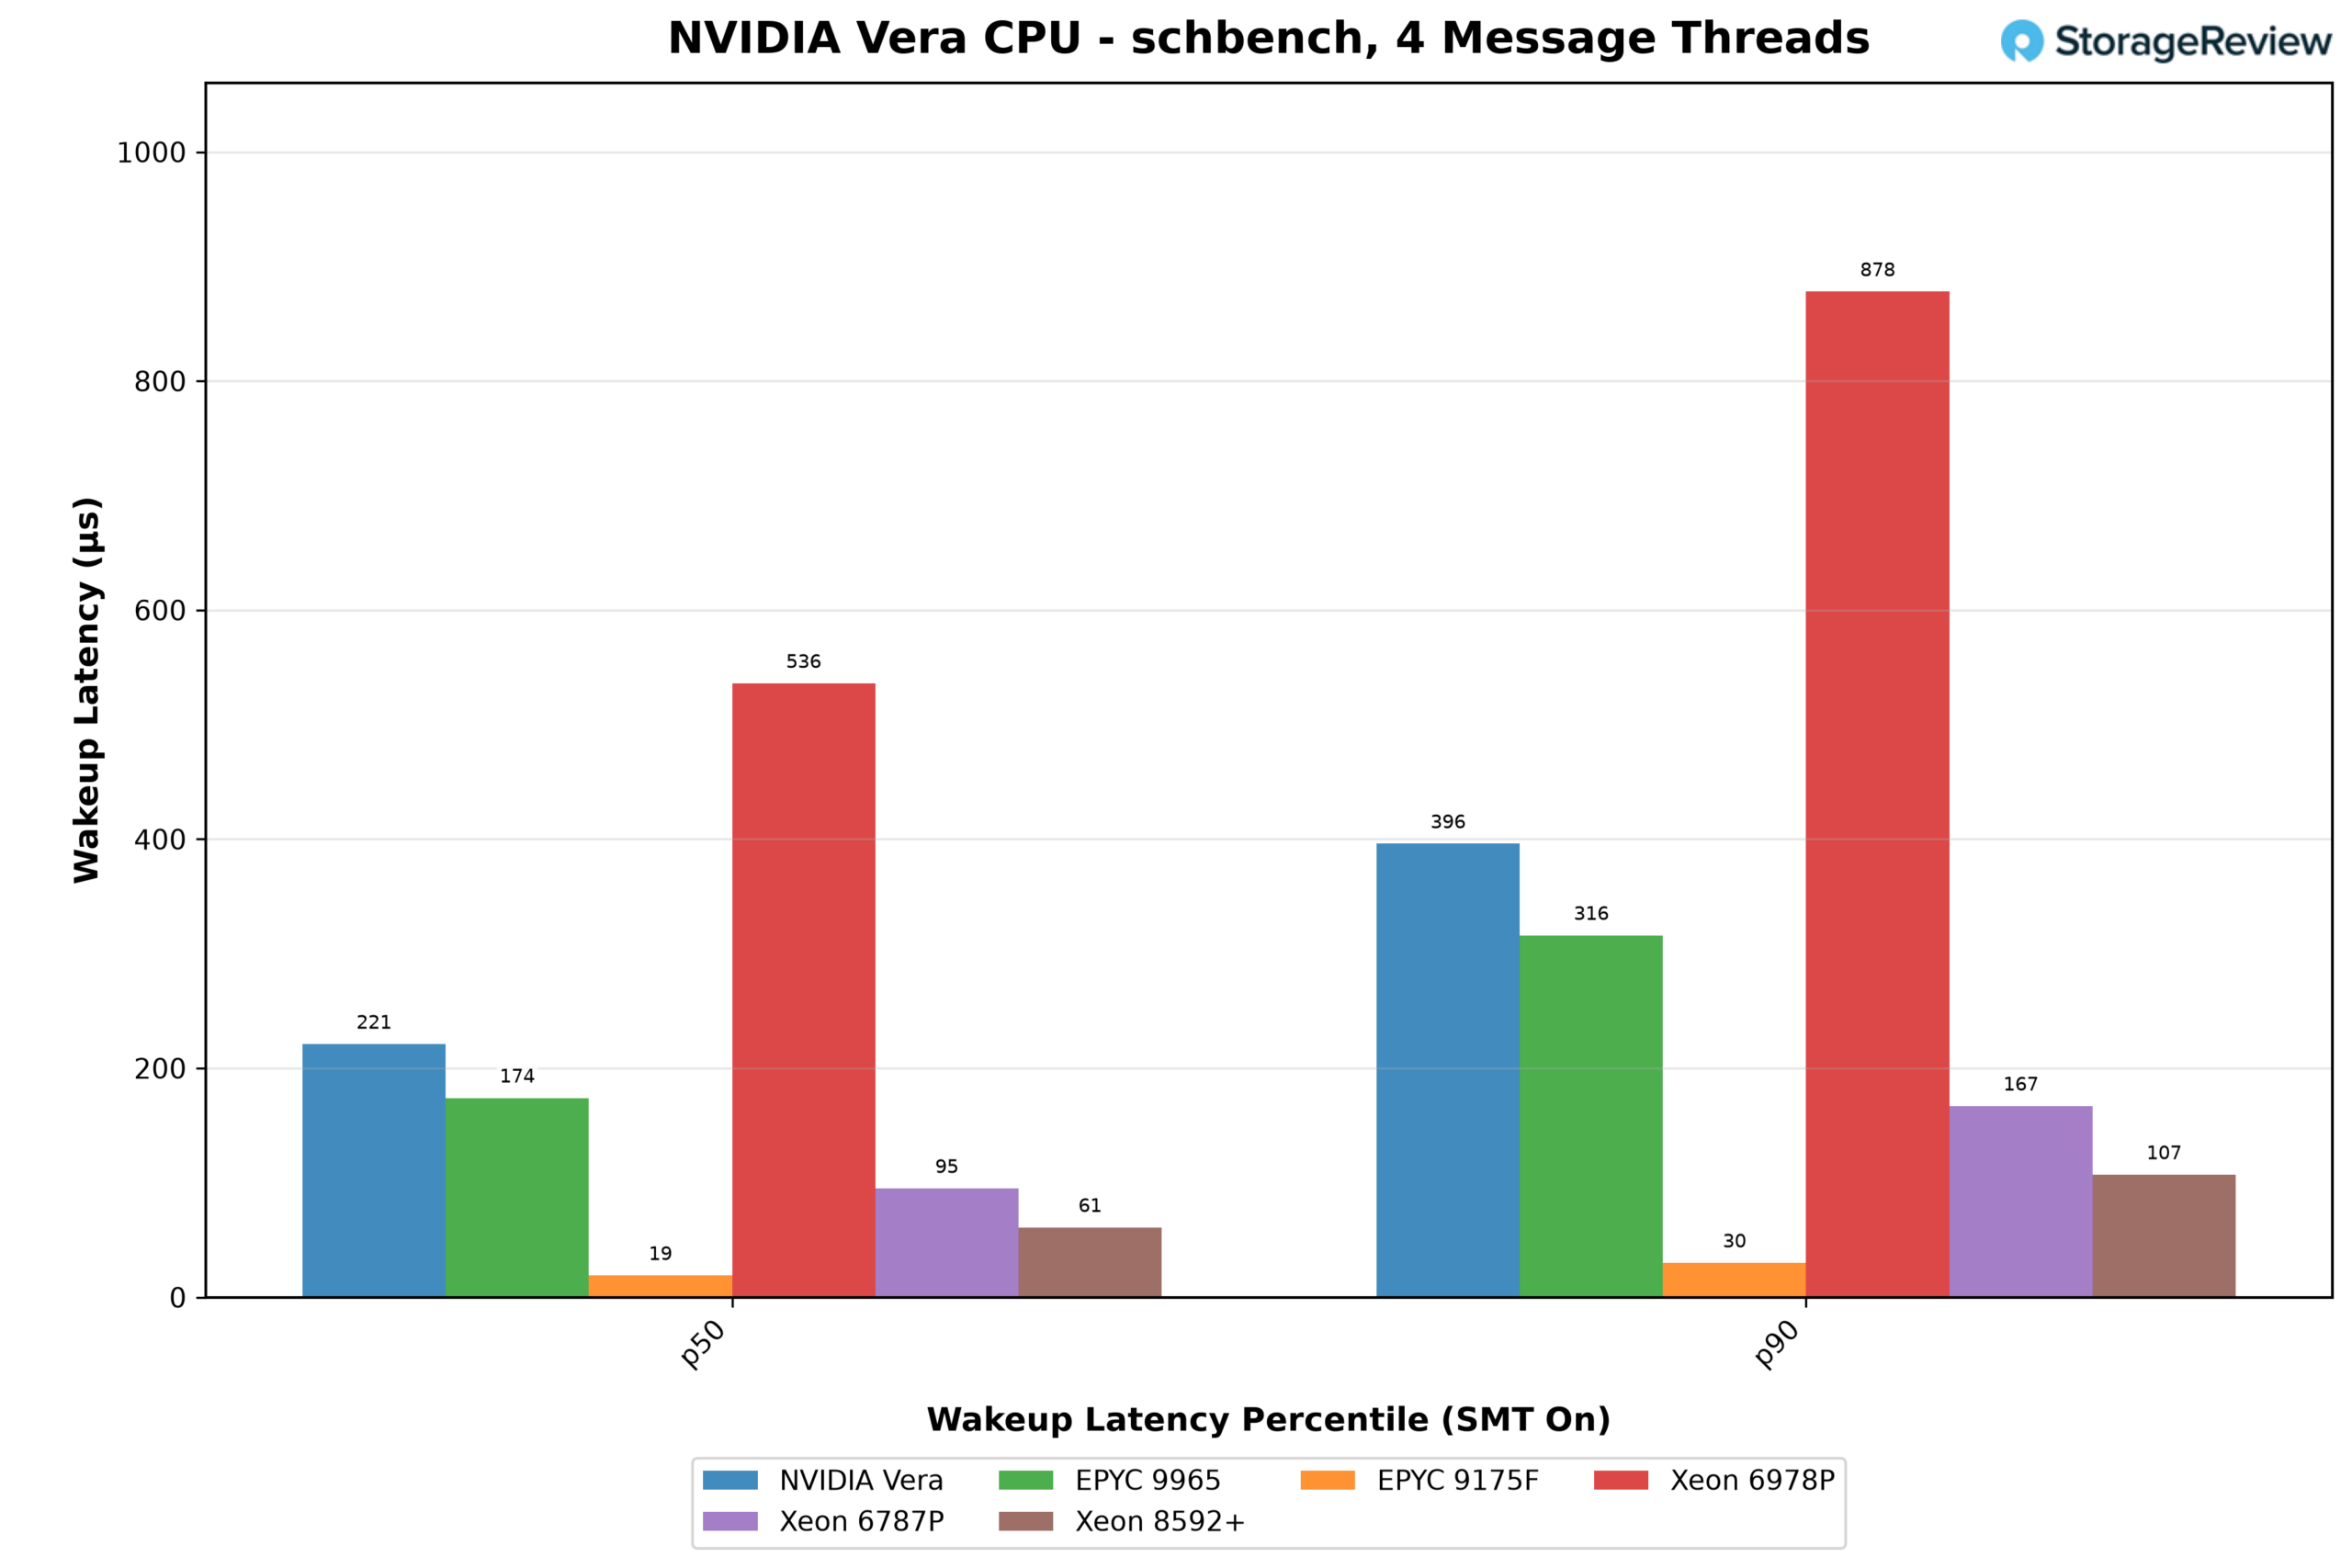
Avec 4 threads de messagerie, la latence de réveil médiane de Vera était de 221 µs et son p90 de 396 µs, supérieures à celles de tous les systèmes à l'exception du Xeon 6978P (536 µs et 878 µs respectivement). Les machines les plus petites ont réveillé leurs threads le plus rapidement : l'EPYC 9175F à 32 cœurs à 19 µs et le Xeon 8592+ à 128 cœurs à 61 µs.
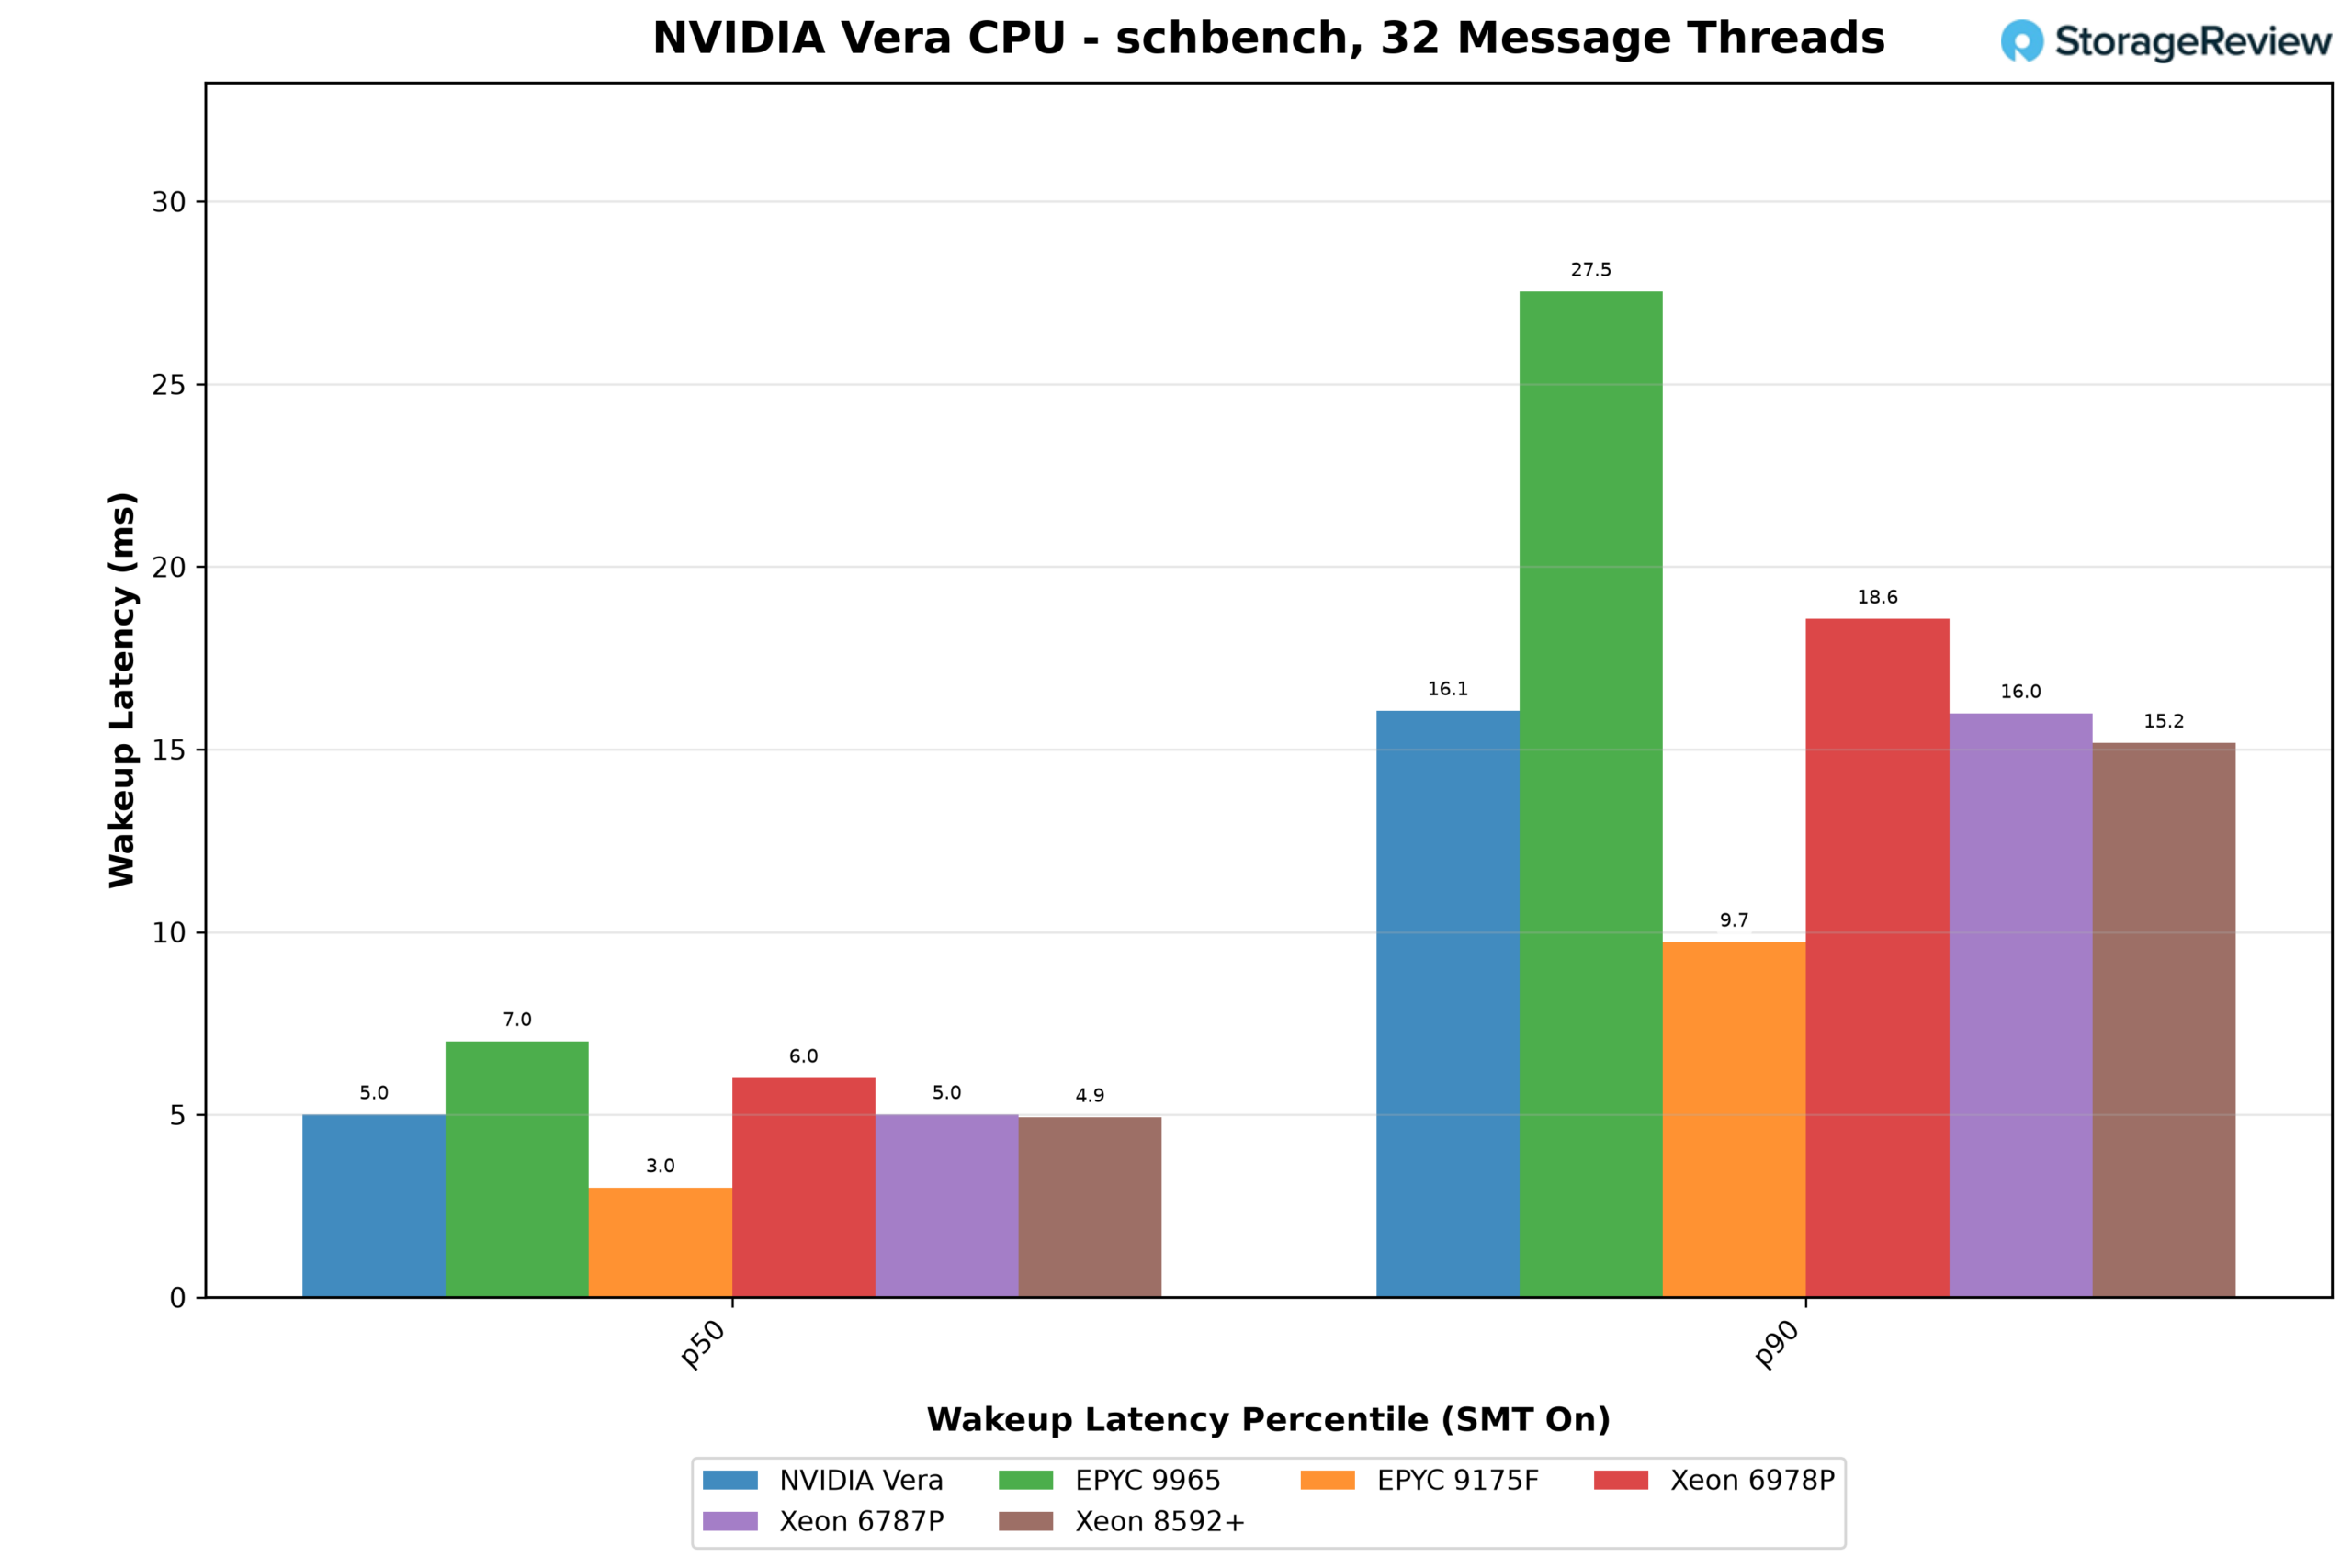
Avec 32 discussions ouvertes, Vera s'est retrouvée en milieu de classement. Son temps de réponse médian de 5.0 ms et son p90 de 16.1 ms étaient comparables à ceux des Xeon 6787P et 8592+, et supérieurs à ceux des Xeon 6978P et EPYC 9965, qui atteignaient 27.5 ms au p90. Seul le 9175F était nettement plus rapide, avec 3.0 ms et 9.7 ms.
Compilation du noyau Linux
Le résultat de la compilation du noyau Linux avec allmodconfig est le seul de cette section que nous ne classons pas. Vera compile l'arborescence du noyau arm64, qui inclut un ensemble différent de modules et de pilotes par rapport à l'arborescence x86-64 utilisée par les autres systèmes ; nous n'avons donc pas tenté de compilation croisée.
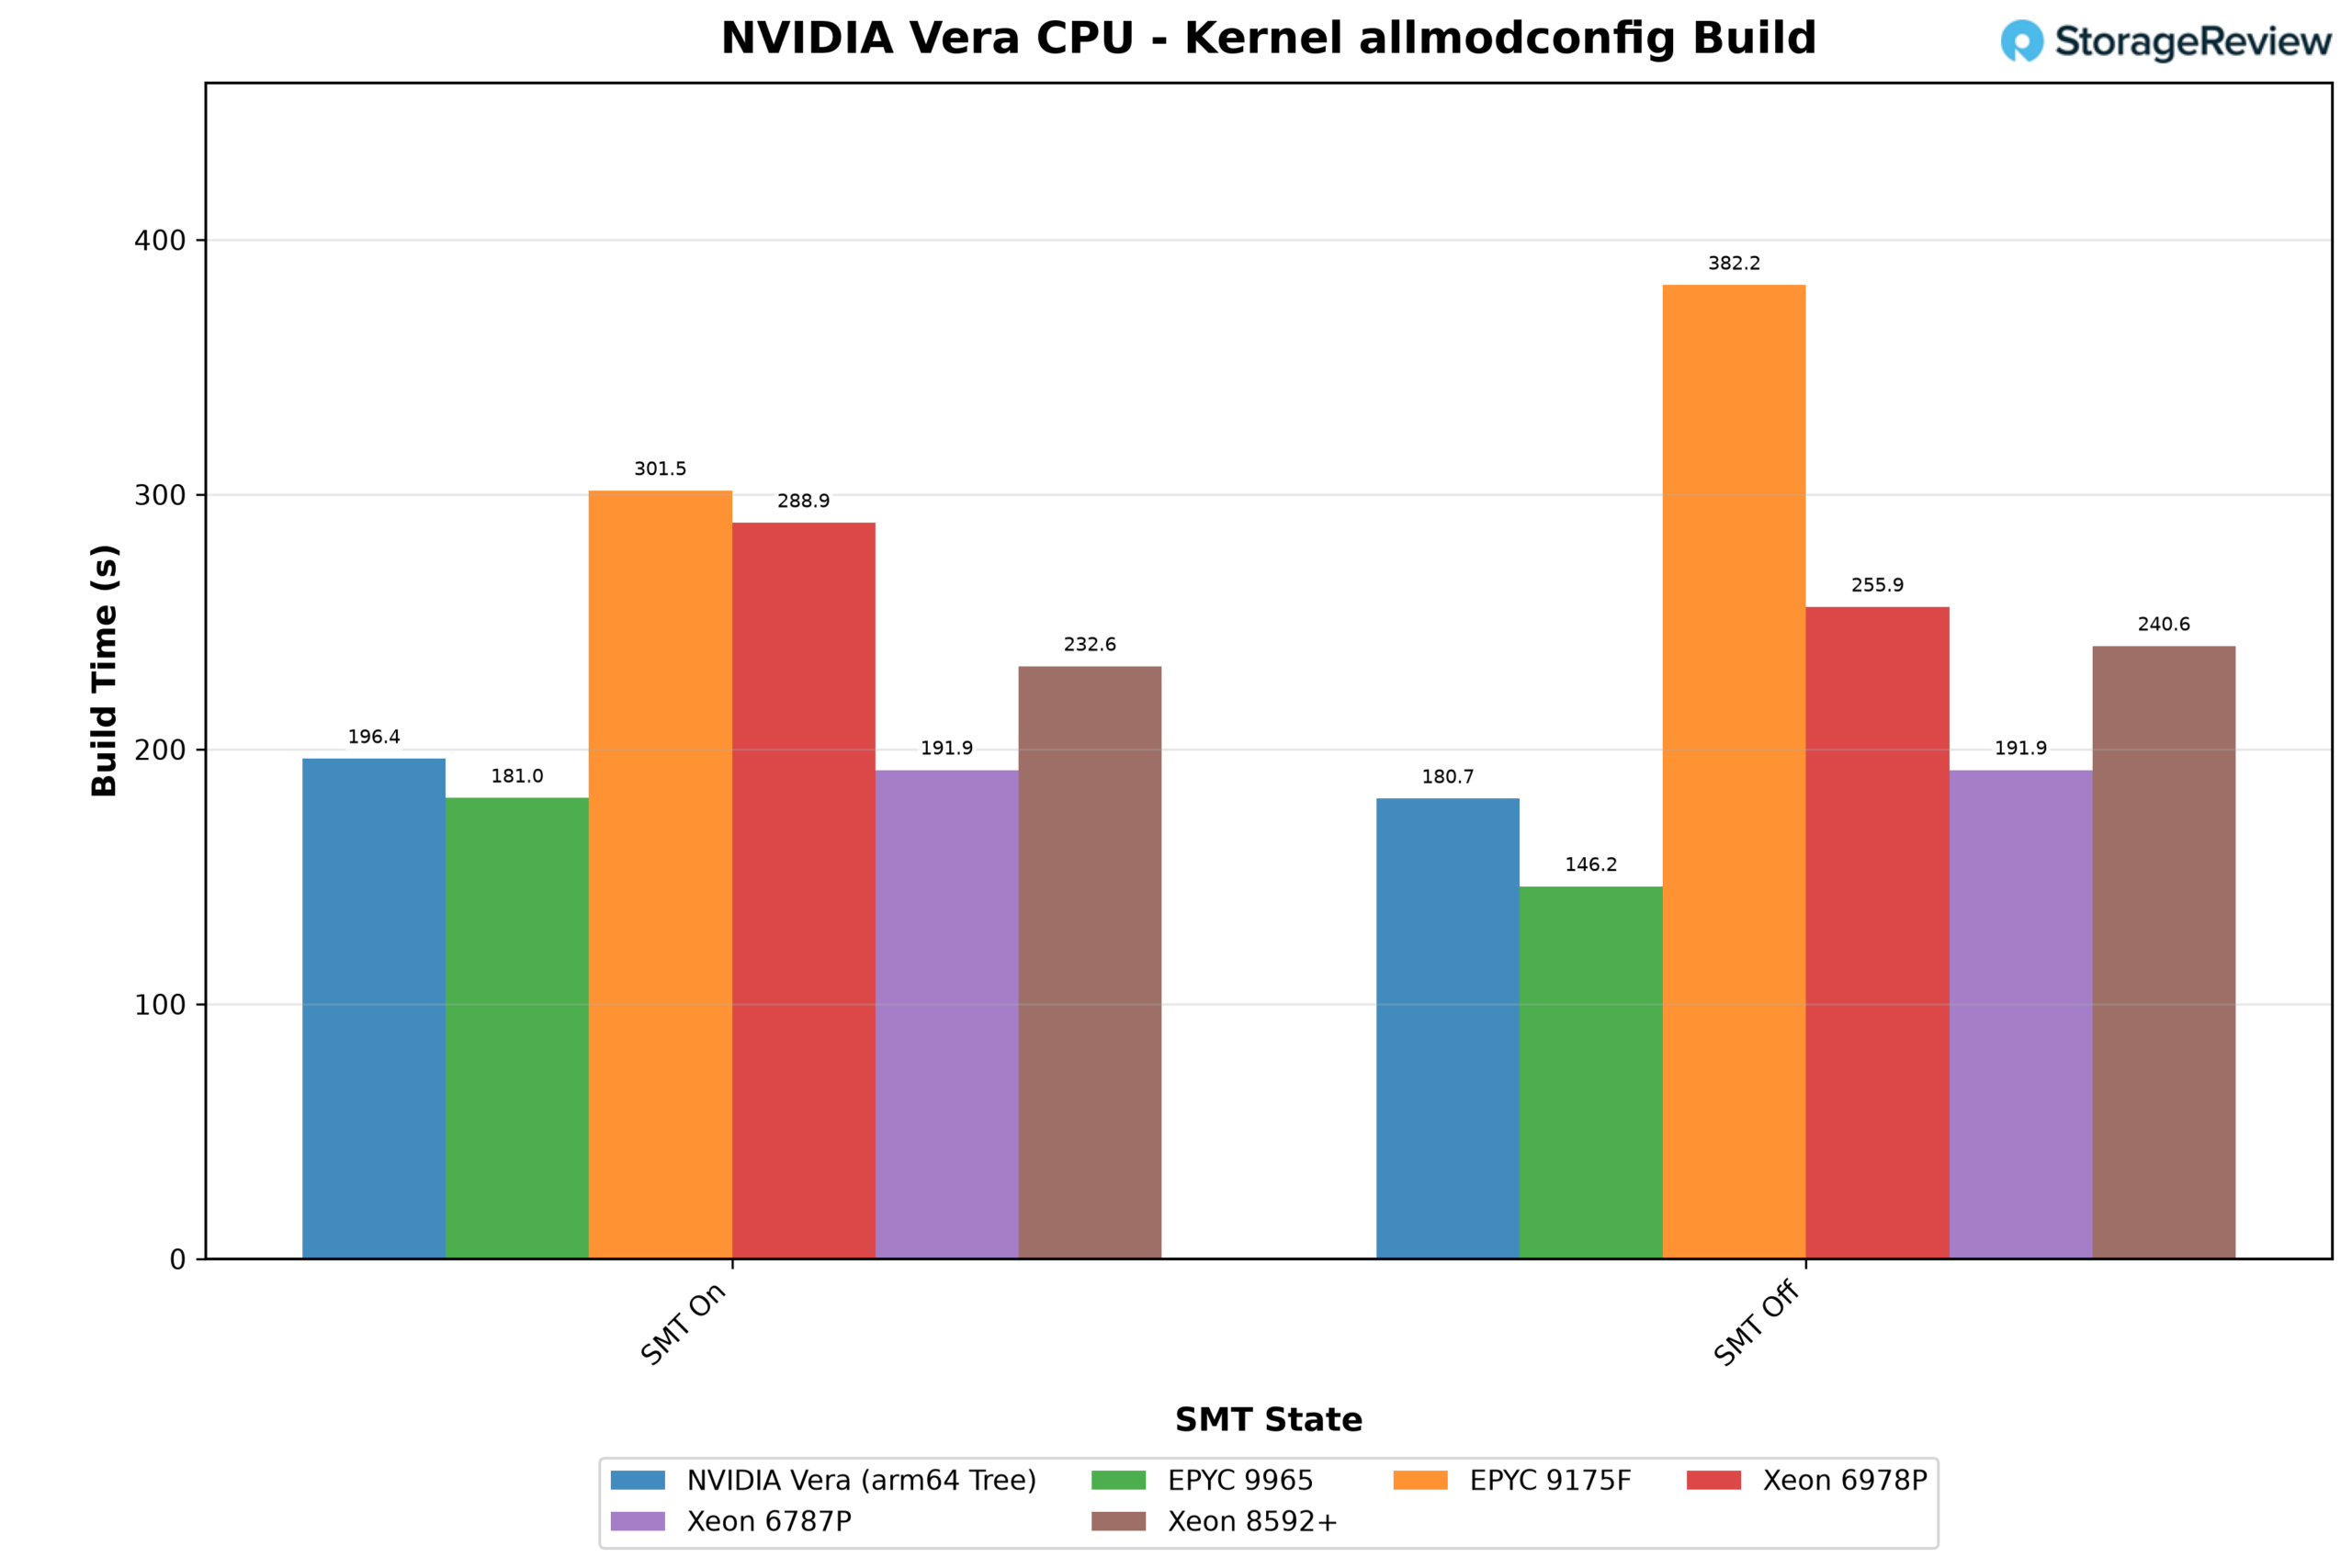
Vera a construit son arbre en 180.7 secondes avec SMT désactivé et en 196.4 secondes avec SMT activé ; les threads supplémentaires ont donc ralenti la compilation. Sur les systèmes x86, pour la construction d'un arbre natif, les temps variaient de 146.2 secondes sur l'EPYC 9965 (SMT désactivé) à 382.2 secondes sur l'EPYC 9175F à 32 cœurs.
Extension HammerDB
Pour les tests de base de données, nous avons fait appel à Steve Shaw, créateur et mainteneur de HammerDB. Shaw a exécuté la charge de travail TPROC-C de HammerDB, un benchmark OLTP dérivé de TPC-C mais non comparable aux résultats publiés de TPC, sur le serveur Vera, le Dell PowerEdge R7725 avec EPYC 9965 et le PowerEdge R770 avec Xeon 6787P. Il a testé cinq moteurs open source sur chacun d'eux : MariaDB 12.3.3 et 13.0.2, MySQL 26.7.0, VillageSQL 0.0.7 et PostgreSQL 18.6. La taille de la base de données était proportionnelle au nombre de cœurs, à raison de 16 entrepôts par cœur physique, soit 1 408 pour un seul socket Vera.
Chaque moteur a fonctionné sur un socket et sur deux, les processeurs du second socket étant désactivés pour les tests sur un seul socket. Tous les systèmes ont obtenu de meilleurs résultats sur un seul socket, ce qui est typique des performances des bases de données. Sur l'ensemble des 15 paires de systèmes, l'ajout du second socket a réduit le débit maximal de 23 % à 47 %, et de 29 % à 45 % sur Vera. Shaw a constaté depuis longtemps que les bases de données open source atteignent un plafond de mise à l'échelle avant d'être à court de cœurs. Au-delà de ce point, maintenir la cohérence des caches sur deux sockets coûte plus cher que les cœurs supplémentaires n'apportent de gain. Nous nous concentrons donc sur les résultats obtenus sur un seul socket, présentés dans le graphique ci-dessous.
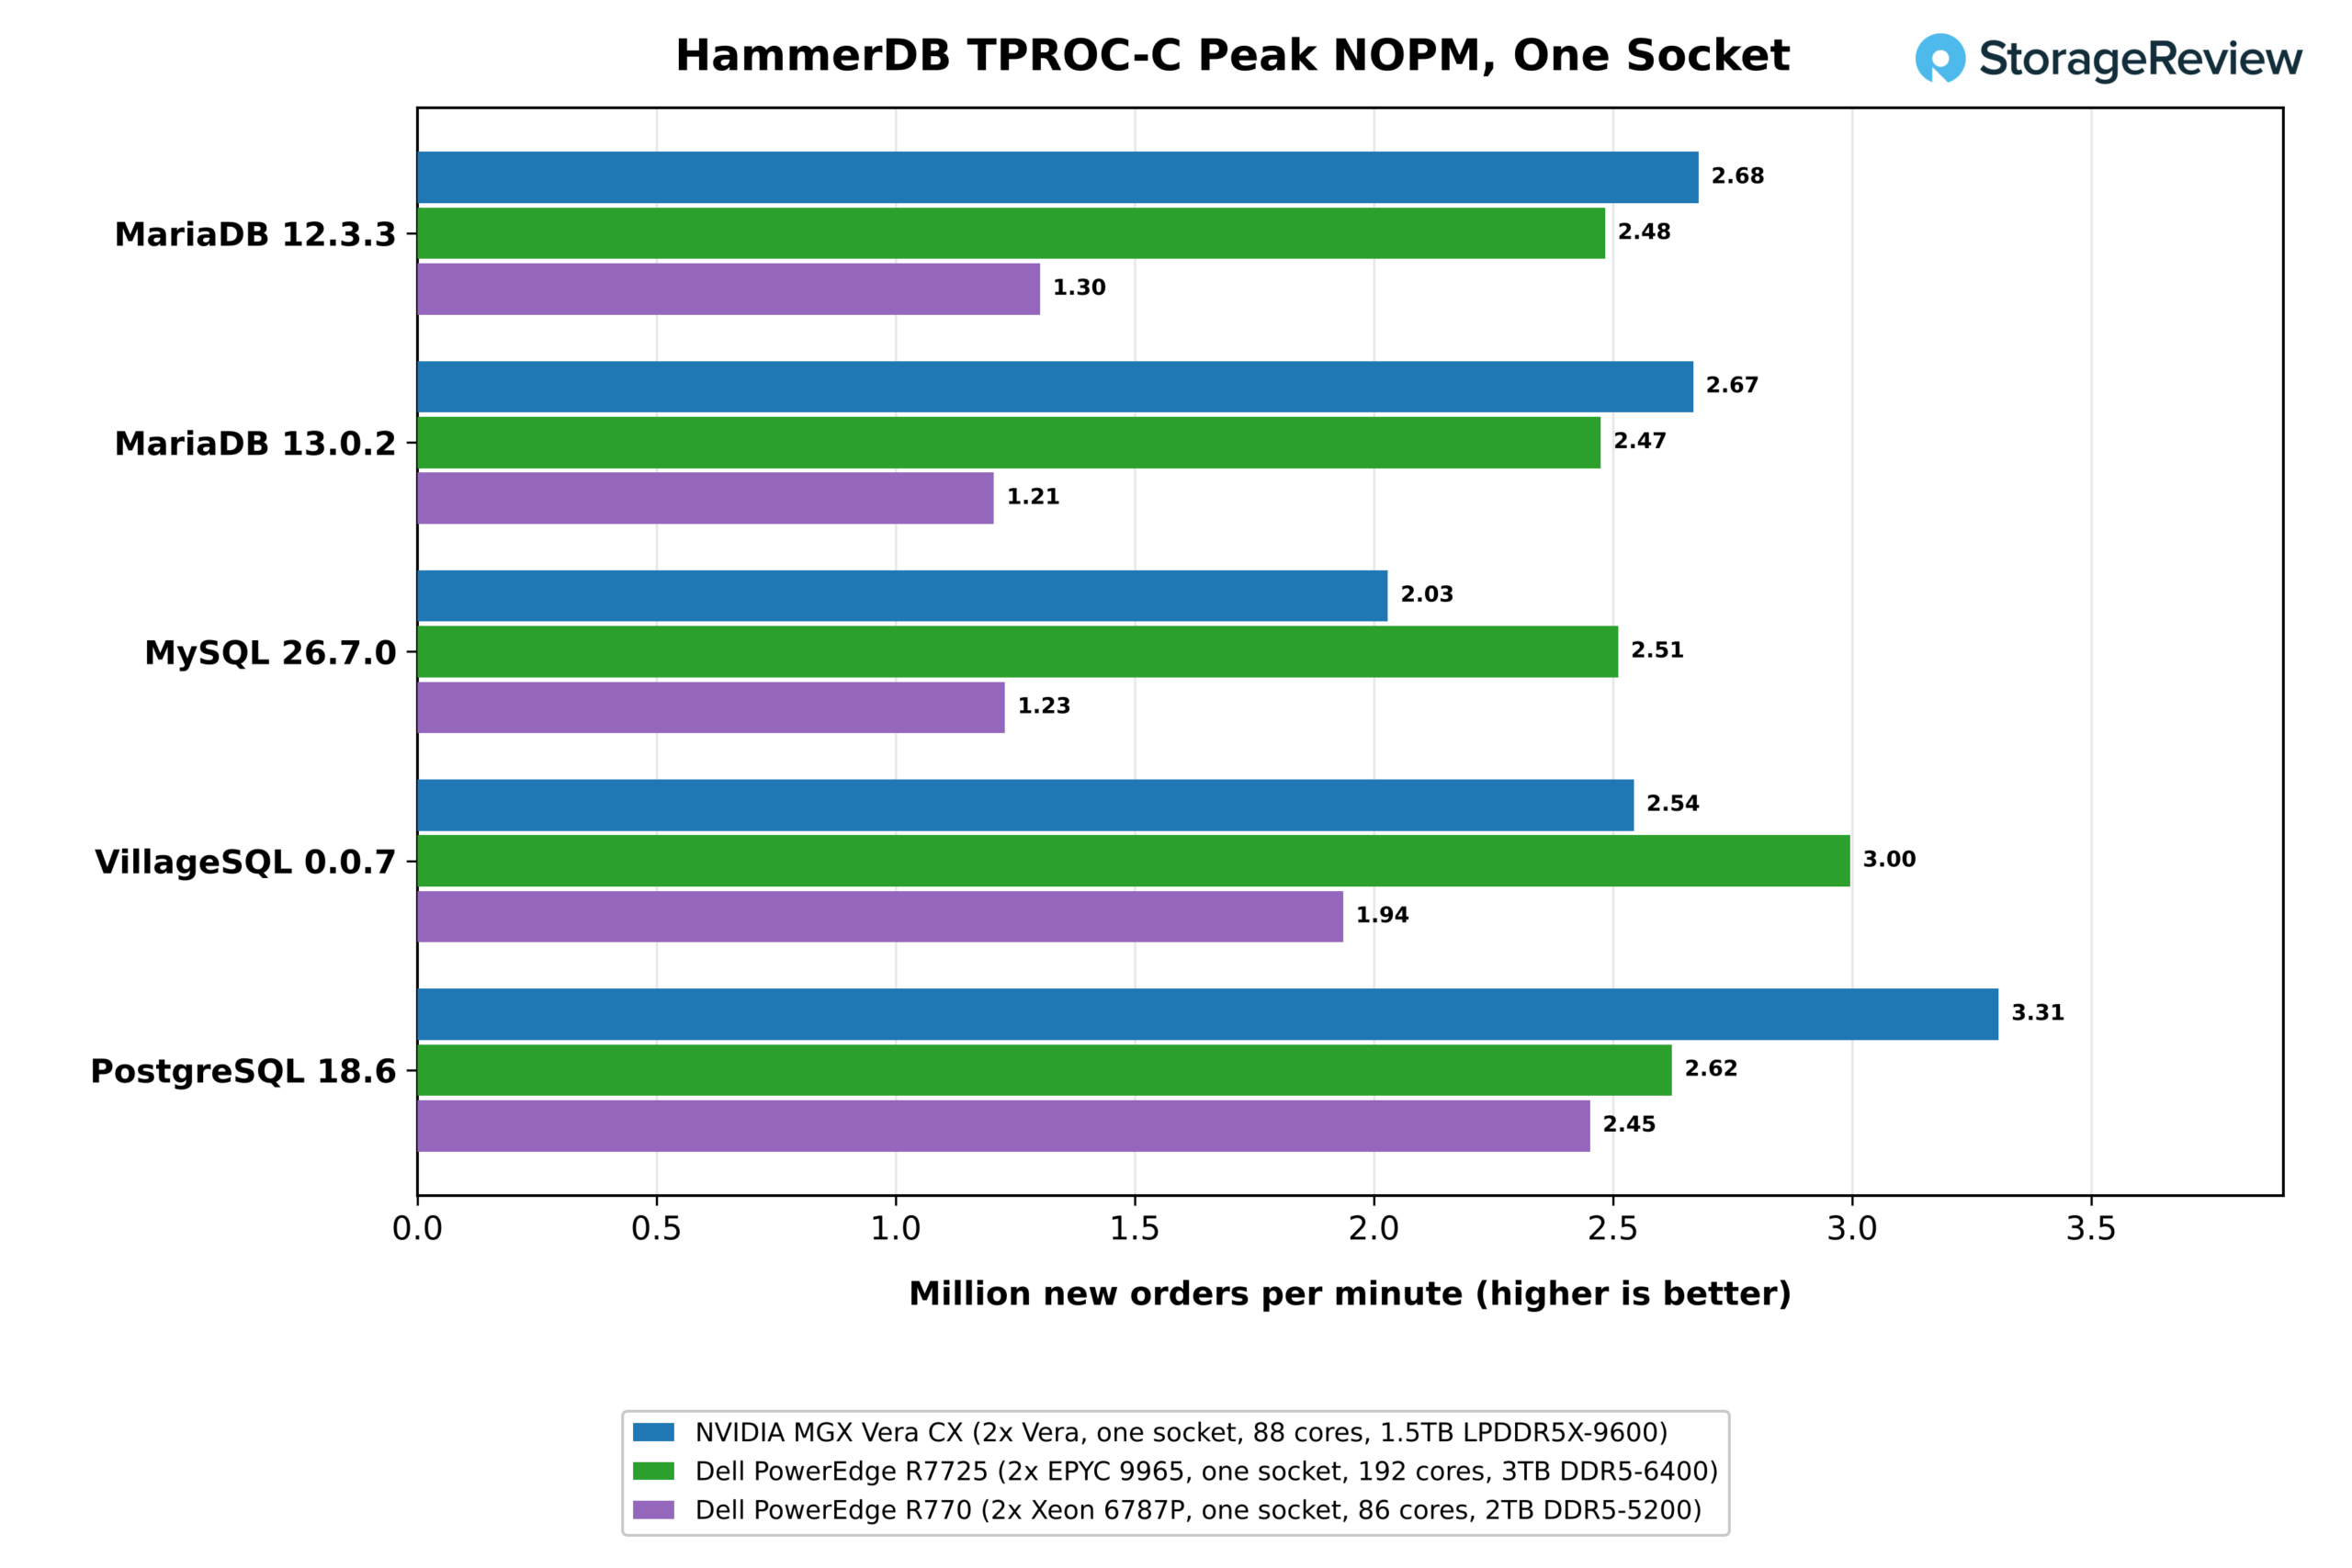
Sur un socket donné, le processeur Vera à 88 cœurs a dominé trois des cinq moteurs de calcul. C'est avec PostgreSQL 18.6 que Vera a enregistré sa plus large avance, atteignant 3.31 millions de nouvelles requêtes par minute (NOPM) avec 128 utilisateurs virtuels, contre 2.62 millions sur le socket EPYC 9965 à 192 cœurs et 2.45 millions sur le Xeon 6787P à 86 cœurs. Les deux versions de MariaDB ont également été plus performantes avec Vera, à 2.68 millions et 2.67 millions de NOPM, contre 2.48 millions et 2.47 millions sur EPYC. AMD a maintenu MySQL 26.7.0 à 2.51 millions de NOPM contre 2.03 millions pour Vera, et VillageSQL à 3.00 millions contre 2.54 millions. Le Xeon a accusé un retard de 1.21 million de NOPM sur les cinq moteurs, contre 2.45 millions pour Vera, et ses résultats avec MariaDB représentaient moins de la moitié de ceux de Vera.
Cette répartition des performances s'explique probablement par la capacité de chaque moteur à gérer la charge. Le modèle « processus par connexion » de PostgreSQL et InnoDB de MariaDB répartissent tous deux la charge de travail sur de nombreux cœurs avec un trafic mémoire partagé important, ce qui explique la bande passante locale supérieure à 1 To/s que chaque socket Vera a maintenue lors du test STREAM. MySQL et VillageSQL rencontrent plus rapidement des conflits de verrouillage internes ; leurs résultats dépendent donc davantage de la vitesse à laquelle chaque cœur libère une section critique, et c'est là que le 9965 prend l'avantage. Après la session d'octobre, Shaw a jugé Arm comme la plateforme la plus rapide, affirmant qu'Arm « s'est incontestablement imposé comme un serveur de base de données compétitif », tout en ajoutant qu'un EPYC monocœur à 96 cœurs qu'il avait testé précédemment pourrait le devancer.
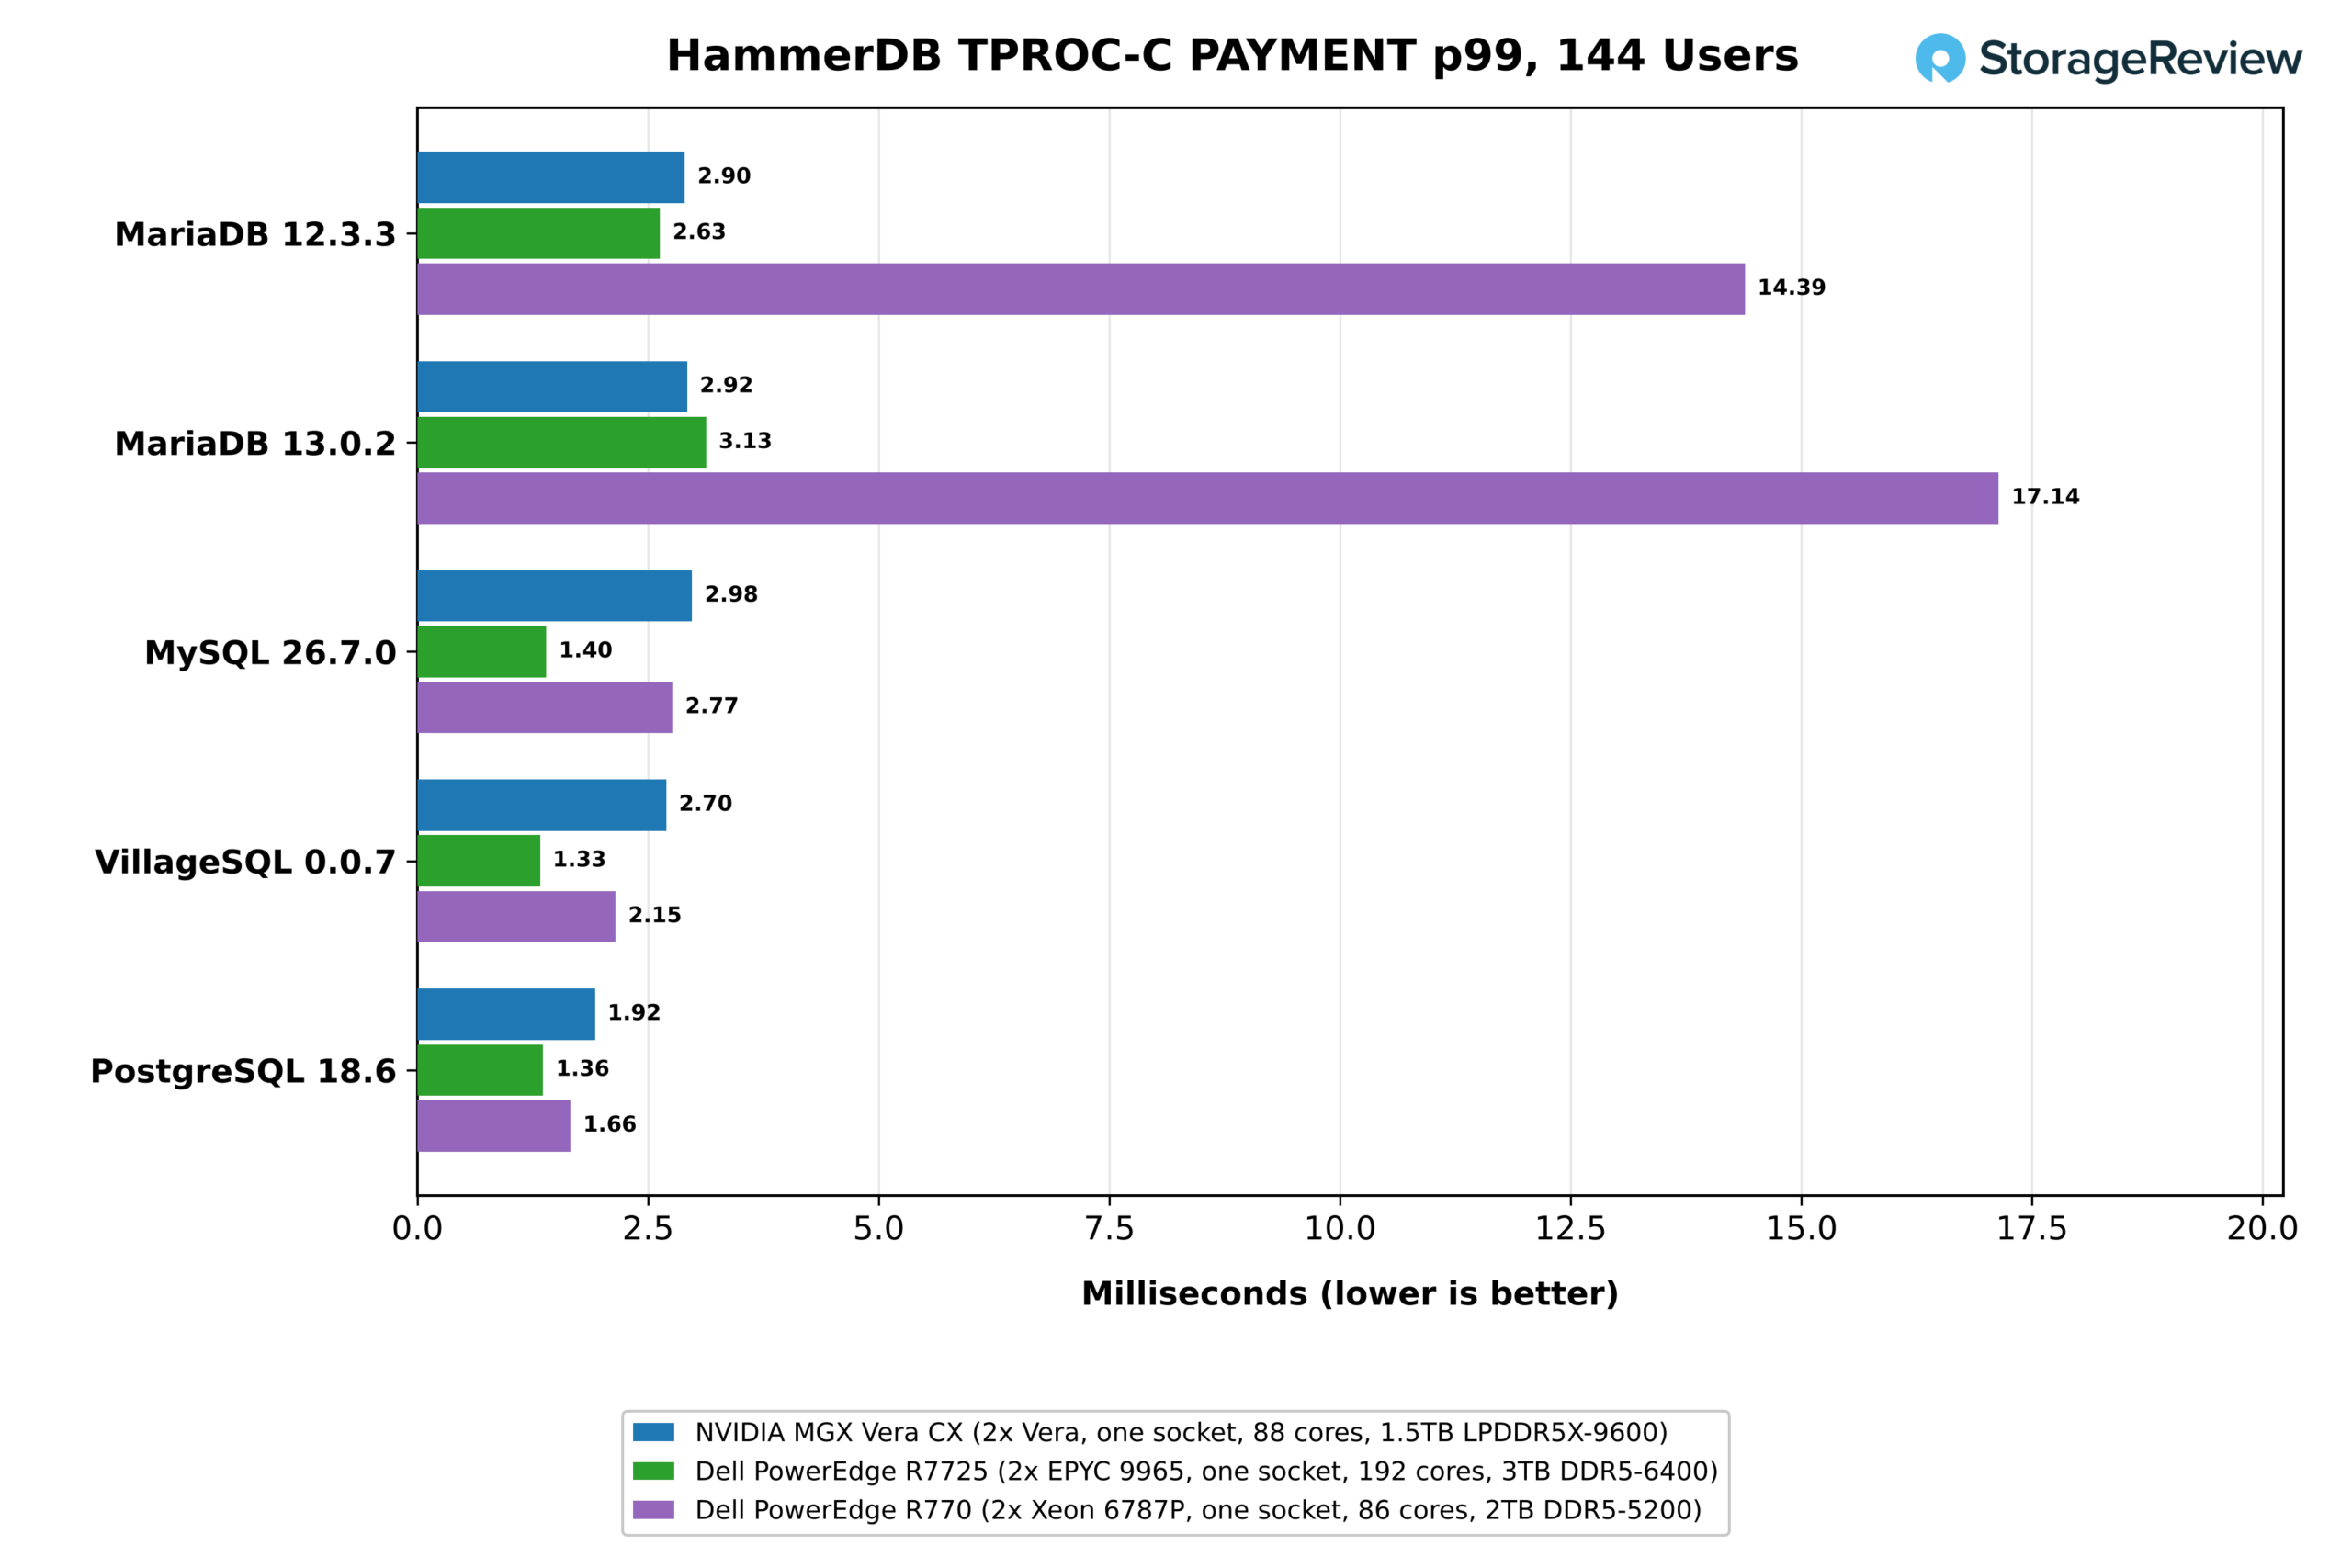
La latence de fin de requête à une charge équivalente de 144 utilisateurs virtuels présente la même répartition. La latence de paiement p99 de Vera variait de 1.92 ms sur PostgreSQL à 2.98 ms sur MySQL. L'EPYC 9965 a affiché des latences comprises entre 1.33 ms et 1.40 ms sur MySQL, VillageSQL et PostgreSQL, soit de 29 % à 53 % inférieures à celles de Vera, mais sa latence de 3.13 ms sur MariaDB 13.0.2 était supérieure aux 2.92 ms de Vera. Les latences de fin de requête du Xeon 6787P sur MariaDB, à 14.4 ms et 17.1 ms, étaient plusieurs fois supérieures à celles de Vera, ce qui correspond à son débit nettement inférieur à charge égale. Le transfert de verrous au sein des moteurs est probablement à l'origine des latences de fin de requête plus élevées de Vera, ce qui corrobore les résultats de Valkey, où l'envoi de requêtes une par une favorisait également AMD.
Les tests de novembre ont permis de vérifier l'intuition de Shaw. Il a exécuté la même charge de travail sur un socket du nouveau processeur AMD EPYC 9996 à 256 cœurs et sur un EPYC 9686F à 96 cœurs, en comparant le socket de Vera. Le 9996 et Vera ont affiché des performances similaires : Vera a conservé la priorité sur PostgreSQL et MariaDB, tandis que l'EPYC a dominé en termes de latence de queue. Le processeur à 96 cœurs a légèrement surpassé Vera sur PostgreSQL. Les résultats complets sont disponibles dans notre test de l'AMD EPYC Venice.
« J'ai été véritablement impressionné par les performances des bases de données open source sur NVIDIA Vera. C'est formidable de voir Arm rivaliser au sommet des performances de bases de données et proposer une alternative convaincante sur le marché des entreprises », a déclaré Steve Shaw, créateur et mainteneur de HammerDB, après la levée de fonds.
Conclusion
Vera n'est pas le processeur le plus rapide dans toutes les catégories, car AMD propose un modèle dédié pour chaque segment de marché. L'EPYC 9175F, optimisé en fréquence, est conçu pour la vitesse par cœur et reste performant pour les charges de travail qui tirent profit d'une fréquence élevée, comme le traitement nbody de Python, le calcul AES mono-thread ou les requêtes Valkey individuelles. L'EPYC 9965, quant à lui, est conçu pour le débit et excelle dans les tâches dont les performances augmentent avec le nombre de cœurs, notamment GROMACS, le traitement 7-Zip et AES multi-thread, ainsi que le nombre de fragments Valkey pouvant être traités sur un socket.
La particularité de Vera réside dans ses performances intermédiaires, notamment sa capacité à rivaliser avec les processeurs spécialisés sur leurs domaines de prédilection. Sur un seul cœur, elle a égalé, voire surpassé, le 9175F pour les calculs sur les entiers et deux des trois tests Python, avec une compression 12 % plus rapide sous 7-Zip et des performances d'exécution de go et regex_compile respectivement 15 % et 25 % plus rapides, tout en restant en retrait pour les calculs en virgule flottante et la cryptographie.
Sur l'ensemble du système, il a atteint 63 % à 72 % des performances multithread du 9965 sous 7-Zip et a terminé le test OpenFOAM de taille moyenne à seulement 12 % de celui-ci. Il a ensuite pris l'ascendant une fois la mémoire prise en compte, sur les tests de grande taille et sur ClickBench. C'est cette capacité à se maintenir aussi près du leader en termes de performances par cœur sur un thread et du leader en termes de débit sur l'ensemble du système qui fait de Vera un processeur polyvalent si performant. Pour les acheteurs qui recherchent une plateforme unique pour le milieu de gamme sans faire de compromis significatifs sur les performances extrêmes, c'est une solution extrêmement intéressante.
Vera offre une bande passante mémoire bien supérieure à celle de tous les systèmes x86 que nous avons testés. Deux sockets Vera ont maintenu 2 073 Go/s sur STREAM Triad, soit 2.3 fois le meilleur serveur DDR5 de ce test. Grâce à NVLink-C2C, cette bande passante reste accessible entre les sockets : les cœurs Vera lisent la mémoire de l’autre socket à 677 Go/s, une vitesse supérieure à celle de n’importe quel socket x86 lisant la mémoire locale.
Les charges de travail gourmandes en mémoire ont ensuite montré des performances remarquables : le maillage OpenFOAM de grande taille s'est résolu 1.44 fois plus rapidement que sur l'EPYC 9965, le test ClickBench à chaud s'est terminé en 2.09 secondes contre 2.70, l'ensemble de travail Valkey de 256 Go s'est exécuté 34 % plus rapidement, et sur un seul socket, Vera a surpassé HammerDB sur PostgreSQL et les deux versions de MariaDB. Le coût de la liaison se traduit par une latence : une lecture distante prend environ 2.1 fois plus de temps qu'une lecture locale, contre 1.75 fois sur l'EPYC 9175F. Par conséquent, le placement prenant en compte la NUMA et les pages énormes restent importants sur Vera.
Les faiblesses sont étonnamment minimes et directement liées à la conception. Six pipelines SVE2 128 bits ne correspondent pas aux unités AVX-512 512 bits sur le code conçu pour elles ; ainsi, une version à 16 cœurs de Vera a exécuté le test GROMACS benchMEM à la moitié des performances du 9175F et aux deux tiers de celles du 9965. Avec seulement deux de ces pipelines dédiés au chiffrement, un seul cœur Olympus a chiffré du AES-256-GCM à environ un tiers des performances du 9175F.
Le succès de Vera dépendra en grande partie des partenaires OEM. Dell a commencé à livrer son PowerEdge R8822 en octobre, tandis que le rack CPU Vera M9882 est attendu pour le premier trimestre 2027. HPE propose le ProLiant Compute DL394 Gen12 cet automne. Supermicro dispose d'un rack Vera à 256 processeurs, avec des systèmes Vera 1U et 2U refroidis par air dans sa gamme. ASUS, ASRock Rack, QCT, GIGABYTE, MSI, Compal, Foxconn, Pegatron, Wistron et Lenovo ont tous présenté des prototypes Vera. Oracle Cloud propose des instances Vera , et CoreWeave, Nebius, Lambda et d'autres suivront.
Vera est le premier processeur serveur Arm que nous avons testé qui rivalise avec les fleurons x86 pour les tâches générales, et le premier processeur, tous constructeurs confondus, à proposer une bande passante mémoire de 2 To/s dans un boîtier biprocesseur refroidi par air. Pour le milieu de gamme, il représente aujourd'hui une option crédible, et NVIDIA fait son entrée sur le marché des processeurs avec un sous-système mémoire unique en son genre. Pour le calcul haute performance vectoriel (HPC) et les services de cryptographie, les spécialistes x86 conservent leur avance. Nous soumettrons les systèmes OEM à la même série de tests dès leur arrivée au laboratoire, en commençant par le rôle de bac à sable pour lequel NVIDIA a conçu ce processeur.
Depuis ce test, le processeur AMD EPYC Venice est arrivé dans notre laboratoire, et nos tests de l'AMD EPYC Venice SP7 et du Dell PowerEdge R9825 ont soumis l'EPYC 9996 à 256 cœurs à la même suite de tests contre Vera, avec Vera sur son dernier firmware.
Classement : NVIDIA Vera détient la première place du classement des meilleurs serveurs Arm.


 Amazon