

Ollama 0.40.11 offre aux utilisateurs Windows une application de messagerie instantanée et un environnement d'exécution local pour d'autres logiciels. Ollama a également évolué au-delà de son interface en ligne de commande d'origine, en ajoutant un sélecteur de modèles avec fonction de recherche, la possibilité de joindre des images et des liens vers des outils de programmation. Certains contrôles nécessaires aux tests restent accessibles via PowerShell et les fichiers de configuration des modèles.
Nous avons installé Ollama sur notre serveur HP Z4 Rack G5, équipé de Windows 11 Pro pour stations de travail, de 128 Go de RAM et d'une carte graphique NVIDIA RTX 5000 Ada Generation. À l'aide de nos fichiers GGUF Jan V3.5 4B et Jan V2 VL High, nous avons testé la vitesse de génération, le chat, le traitement d'images, la recherche en ligne et l'API locale. Ollama a exécuté nos modèles locaux avec succès, bien que l'importation des fichiers GGUF et la collecte des données de performance nous aient contraints à interrompre le chat. Il s'agit de la troisième application de notre série sur les modèles LLM locaux, après Jan et Open WebUI , et les résultats alimentent notre page « Meilleurs outils LLM locaux » .
Système de test
| Composant | Configuration |
|---|---|
| Système d'exploitation | Windows 11 Pro pour les stations de travail |
| Processeur | Intel Xeon w5-2465X, 16 cœurs |
| Mémoire | 128GB |
| GPU | NVIDIA RTX 5000 Génération Ada |
| VRAM | 32 Go (32 760 Mio signalés) |
| NVIDIA pilote | 597.06 |
| Compatibilité CUDA | 13.2 (signalé par nvidia-smi) |
| Ollama | 0.40.11 |
| Exécution de l'inférence | Exécuteur Ollama llama.cpp (numéro de build non enregistré) |
Installation d'Ollama et prise en main
L'installation d'Ollama sur notre poste de travail Windows a été un soulagement après les difficultés rencontrées avec d'autres applications de cette série. Nous avons téléchargé le programme d'installation standard de Windows, lancé l'application, et n'avons eu besoin ni d'installer un environnement d'exécution d'inférence séparé, ni de rechercher des packages CUDA. Une vérification rapide via PowerShell a confirmé qu'Ollama 0.40.11 était en cours d'exécution et que son service local répondait déjà à l'adresse http://127.0.0.1:11434.
L'écran d'accueil d'Ollama présente ses fonctionnalités d'IA locale et ses connexions aux outils de codage avant d'ouvrir l'interface principale.
Une fois l'écran de bienvenue passé, Ollama s'est ouvert sur une interface de chat familière, avec les conversations récentes, les applications et les paramètres dans la barre latérale gauche. Le champ de message regroupe le bouton de pièce jointe, la recherche Web et le sélecteur de modèle. Nous pouvions commencer à discuter avec nos modèles locaux importés sans créer de compte, mais Ollama nous a demandé de nous connecter lorsque nous avons tenté d'activer la recherche Web lors de nos tests.
Navigation et ajout de modèles
Ollama propose une sélection de modèles assez simple, avec un menu déroulant affichant les modèles installés et ceux disponibles au téléchargement. Nous avons pu voir nos modèles Jan importés et Qwen3-VL, ainsi que plusieurs options basées sur le cloud, identifiées par une petite icône de nuage. Un champ de recherche permet également de trouver d'autres modèles, mais nous aurions apprécié davantage d'informations, comme la taille des modèles, la quantification et la configuration matérielle requise. Jan fournit ces détails via son hub de modèles, tandis qu'Ollama les dissimule pour la plupart dans l'interface de chat principale.
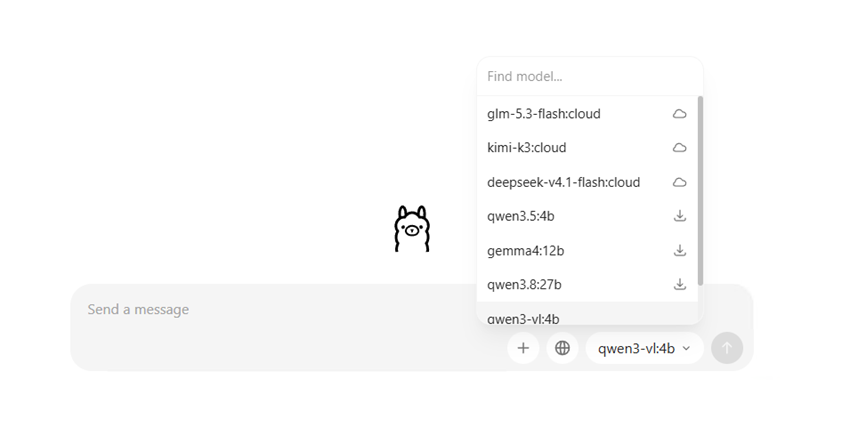
Le sélecteur de modèles rassemble les modèles téléchargeables et les modèles cloud avec les modèles locaux installés.
L'intégration de nos deux modèles de référence dans Ollama a nécessité davantage de travail car nous souhaitions utiliser les mêmes fichiers GGUF que lors de nos précédents tests, afin de garantir une comparabilité optimale des performances. Bien qu'Ollama permette de télécharger les modèles directement via son interface de bureau, nous n'avons trouvé aucune option pour importer les fichiers GGUF déjà stockés sur le poste de travail. Nous avons donc dû utiliser PowerShell, en créant un fichier Modelfile pour chaque modèle, pointant vers son fichier GGUF existant et incluant les paramètres d'échantillonnage utilisés lors de nos tests précédents. Nous avons ensuite utilisé… ollama create commande pour les ajouter à la bibliothèque de modèles d'Ollama.
Les deux importations ont fonctionné sans problème, Jan V3.5 apparaissant comme jan-v35-sr et Jan V2 VL Haut comme jan-v2-srNous avons également téléchargé Qwen3-VL 4B directement via Ollama pour un test d'analyse d'image séparé.
Après avoir importé les modèles, nous avons vérifié comment Ollama les identifiait et si leurs paramètres avaient été correctement conservés. Jan V2 VL High a été reconnu comme un modèle Qwen3-VL à 8.2 milliards de paramètres utilisant la quantification Q4_K_M, ce qui correspondait à notre fichier d'origine. Jan V3.5 faisait exception, car le fichier GGUF que nous avons importé était nommé Jan-v3.5-4B-Q4_K_XL.ggufOllama a cependant indiqué que sa quantification était Q4_K_M. Nous avons laissé le fichier original inchangé ; la raison probable est que Q4_K_XL est la quantification dynamique d'Unsloth, principalement construite à partir de couches Q4_K_M, et que les métadonnées du fichier enregistrent ce type de base.
Paramètres du modèle et utilisation du GPU
La page Paramètres d'Ollama propose l'accès au cloud, les mises à jour automatiques, l'accès réseau, un chemin d'accès au stockage des modèles et un curseur de longueur de contexte, initialement réglé sur 32 000. Nos tests de performance ont explicitement demandé 8 192 jetons via l'API ; les résultats de référence ci-dessous utilisent donc ce contexte, et non le contexte par défaut pour ordinateur.
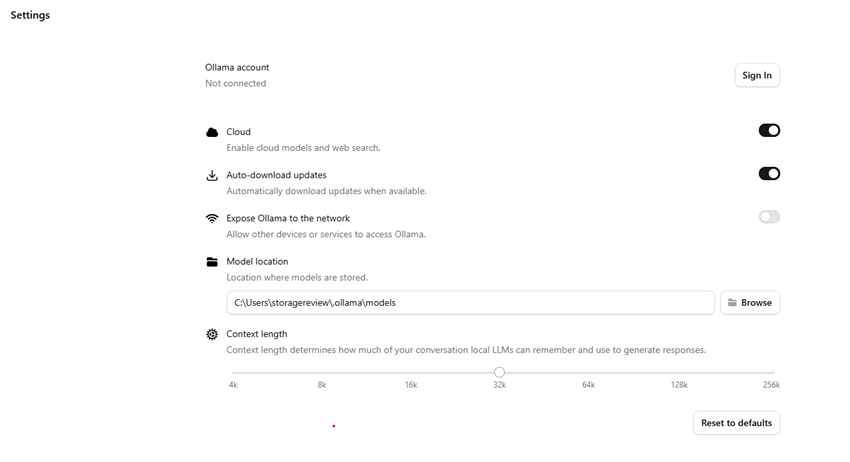
La page Paramètres propose des options pour le cloud, la mise à jour, le réseau, le stockage des modèles et la longueur du contexte. La valeur initiale du contexte affichée ici était de 32 Ko.
Comme Ollama ne propose pas le même niveau de configuration de modèle via son interface de bureau que Jan, nous avons effectué la plupart des ajustements via les fichiers de modèle et les requêtes API. Afin de garantir la comparabilité de nos résultats, nous avons utilisé les mêmes paramètres que lors de nos tests précédents : température 0.8, Top K 40, Top P 0.95, Min P 0.05 et une pénalité de répétition de 1.0. Nous avons également demandé une taille de lot de 2 048, sans toutefois pouvoir vérifier indépendamment si Ollama l’avait bien appliquée lors de la génération.
La configuration GPU était également différente, car il n'existait pas de paramètre de bureau équivalent aux 100 couches GPU utilisées en janvier. Ollama gérait automatiquement le déchargement GPU, et une vérification rapide à l'aide de ollama ps Il a été confirmé que les deux modèles importés fonctionnaient entièrement sur la RTX 5000 Ada.
Nous avons vérifié ce rapport en le comparant aux mesures de NVIDIA. La version 3.5 de janvier a augmenté l'allocation de VRAM de plusieurs gigaoctets après le chargement, et une mesure en temps réel a atteint 93 % d'utilisation du GPU pendant la génération. La version 2 de janvier a également signalé une utilisation maximale du GPU et affichait 96 % d'utilisation lors de notre test. Sur cette station de travail, nous n'avons pas eu besoin de recourir à une variante CUDA ou à une configuration de couche GPU supplémentaire pour obtenir une génération accélérée.
Performances de la production locale
Pour les tests de génération, nous avons repris la même consigne que dans notre tutoriel pratique de janvier : « Expliquez le RAID 5 et le RAID 6 à une personne qui assemble son premier NAS. Présentez les principaux avantages et inconvénients de chaque configuration, en environ 400 mots. » Nous avons désactivé la recherche Web, défini le contexte à 8 192 jetons et inclus uniquement ce message utilisateur dans chaque requête API. Nous avons écarté une réponse d’échauffement par modèle, puis collecté trois résultats.
Les deux modèles ont exécuté les trois tests sans erreur, et l'utilisation du GPU est restée élevée tout au long de l'expérience. Ollama n'a nécessité aucune configuration CUDA supplémentaire ni aucun ajustement manuel de la couche GPU pour que les deux modèles fonctionnent avec une accélération GPU complète, contrairement à Open WebUI où nous avons ajouté manuellement les DLL d'exécution CUDA.
| Modèle | Quantification | Jetons de sortie | Vitesse de décodage | Mémoire GPU |
|---|---|---|---|---|
| Jan V3.5 4B | Fichier Q4_K_XL* | 529 | 145.48 tok/s | 5,082 MiB |
| Jan V2 VL High | Q4_K_M | 1,696 | 92.87 tok/s | 7,124 MiB |
Remarque : Le nombre de jetons de sortie, les vitesses de décodage et les valeurs de mémoire GPU correspondent aux médianes de trois mesures, après l’exclusion d’une mesure d’échauffement. La mémoire GPU représente la médiane de l’utilisation maximale de la mémoire GPU enregistrée lors de chaque mesure.
*Le nom de fichier Jan V3.5 GGUF identifie Q4_K_XL, tandis que les informations du modèle d'Ollama indiquent Q4_K_M ; voir les notes d'importation ci-dessus.
Jan V3.5 a enregistré respectivement 145.48, 145.73 et 145.44 jetons/seconde lors de ses exécutions, tandis que Jan V2 a enregistré 92.87, 92.22 et 92.97 jetons/seconde. Les résultats des deux ensembles sont restés proches d'une exécution à l'autre, et les pics de mémoire GPU mesurés sont restés inchangés au sein de chaque ensemble. Jan V2 a produit un nombre considérablement plus élevé de jetons de sortie, incluant apparemment l'activité de raisonnement ; ces totaux ne permettent donc pas une comparaison directe de la longueur des réponses affichées.
Sur le même poste de travail et avec les mêmes fichiers de modèle, ce sont les résultats les plus rapides obtenus à ce jour dans cette série. Jan V3.5 a décodé 18 % plus rapidement que Jan lui-même (123 jetons/s) et 26 % plus rapidement qu'Open WebUI Desktop (115.32), tandis que Jan V2 était 13 % plus rapide que Jan (82) et 24 % plus rapide qu'Open WebUI (75.06). Chaque application exécute sa propre version de llama.cpp et gère le déchargement GPU de manière indépendante ; la comparaison porte donc sur l'ensemble du package fourni par chaque application, et non sur le modèle seul.
Nous n'avons pas publié les médianes de traitement rapide car les requêtes répétées ont produit des temps d'exécution très courts, susceptibles d'avoir été influencés par la mise en cache. De plus, les paramètres d'exécution ne peuvent être identiques en tous points : Jan a exposé directement les couches GPU, tandis qu'Ollama a géré le déchargement automatiquement.
Utilisation d'Ollama pour le chat local
Une fois les modèles installés, nous avons sélectionné Jan V3.5 ou Jan V2 dans le menu déroulant et saisi l'invite RAID. Les réponses s'affichaient sous forme de titres et de listes, tandis que les conversations récentes restaient dans la barre latérale. Ollama n'affichait ni le taux de génération ni le nombre de jetons sous les réponses ; nous avons donc récupéré ces données via son API.
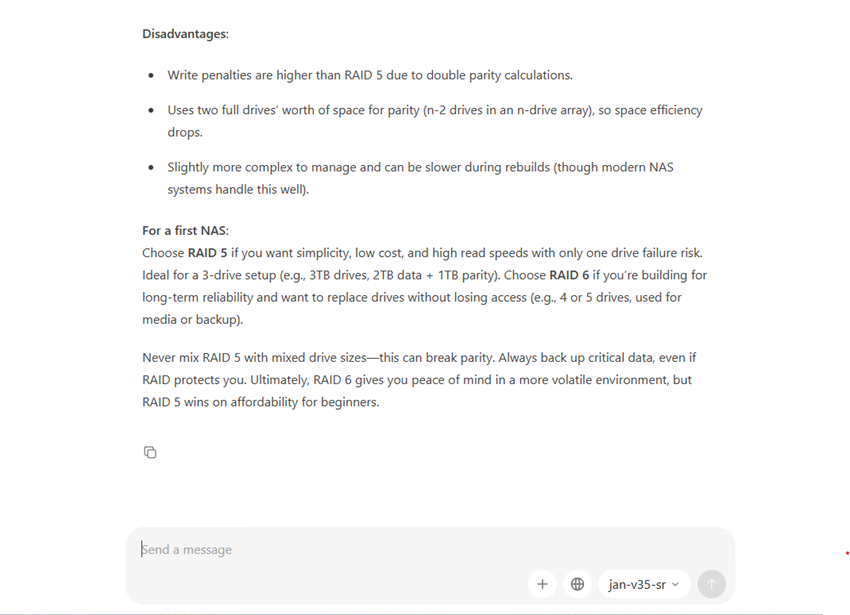
Jan V3.5 répond à la question RAID 5 versus RAID 6 dans le chat de bureau d'Ollama, sans affichage du taux de jetons sous la réponse.
Gérer les conversations dans Ollama était assez simple : un clic droit sur une conversation permettait de la renommer ou de la supprimer, et une option « Partager » était disponible dans le menu « Plus d’outils ». On pouvait également modifier les messages déjà envoyés, même si les options pour les réponses du modèle étaient plus limitées. Le seul bouton disponible était « Copier », qui restait visible sous chaque réponse, même sans survoler la souris. Dans la version testée, il était impossible de régénérer une réponse ou de consulter ses statistiques de génération depuis la fenêtre de chat.
Ollama propose également une section Applications avec des assistants de programmation, notamment Codex CLI, Claude Code, OpenCode et Cline. Curieux de voir comment ces intégrations fonctionnaient, nous avons cliqué sur Codex CLI pour observer la procédure d'installation. Ollama n'a pas ouvert d'écran de configuration ; il a simplement copié une commande de lancement dans le presse-papiers et nous a invités à la coller dans un terminal. Nous n'avons pas finalisé l'installation ni exécuté Codex, mais cela nous a permis de mieux comprendre comment Ollama connecte les modèles locaux aux applications externes.
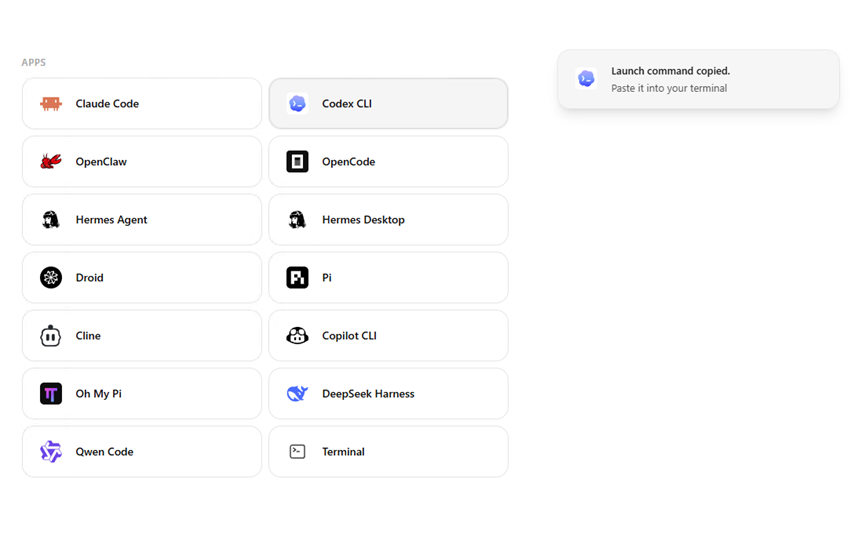
La sélection de Codex CLI sur la page Applications a copié une commande de lancement pour le terminal ; nous n'avons pas exécuté l'intégration elle-même.
Recherche Internet
Ollama a placé un bouton représentant un globe terrestre à côté du contrôle des pièces jointes dans la messagerie instantanée, mais en le sélectionnant, un message indiquait que la recherche Web nécessitait un compte Ollama. Après avoir créé un compte gratuit et activé la fonctionnalité, nous avons utilisé notre question de test existante demandant quelle était la dernière version stable d'Open WebUI au 15 octobre 2026, avec une citation de la source.
Lors du test de la fonctionnalité de recherche Web d'Ollama, nous avons rencontré un autre problème : l'application tentait de récupérer des résultats, mais renvoyait un message d'erreur « API de recherche (statut 402) ». Le code HTTP 402 indique que le service de recherche nécessite un abonnement payant, bien qu'Ollama ne l'ait pas mentionné. Le modèle suggérait que le problème pouvait être lié à la tarification du compte ou aux limites d'utilisation, mais nous n'avons pas pu en déterminer la cause exacte. Nos modèles locaux fonctionnant normalement, nous avons décidé de ne pas consacrer plus de temps au dépannage du service de recherche. Il était néanmoins décevant de ne pas avoir pu réaliser le même test de recherche Web que celui effectué avec les autres applications de cette série.
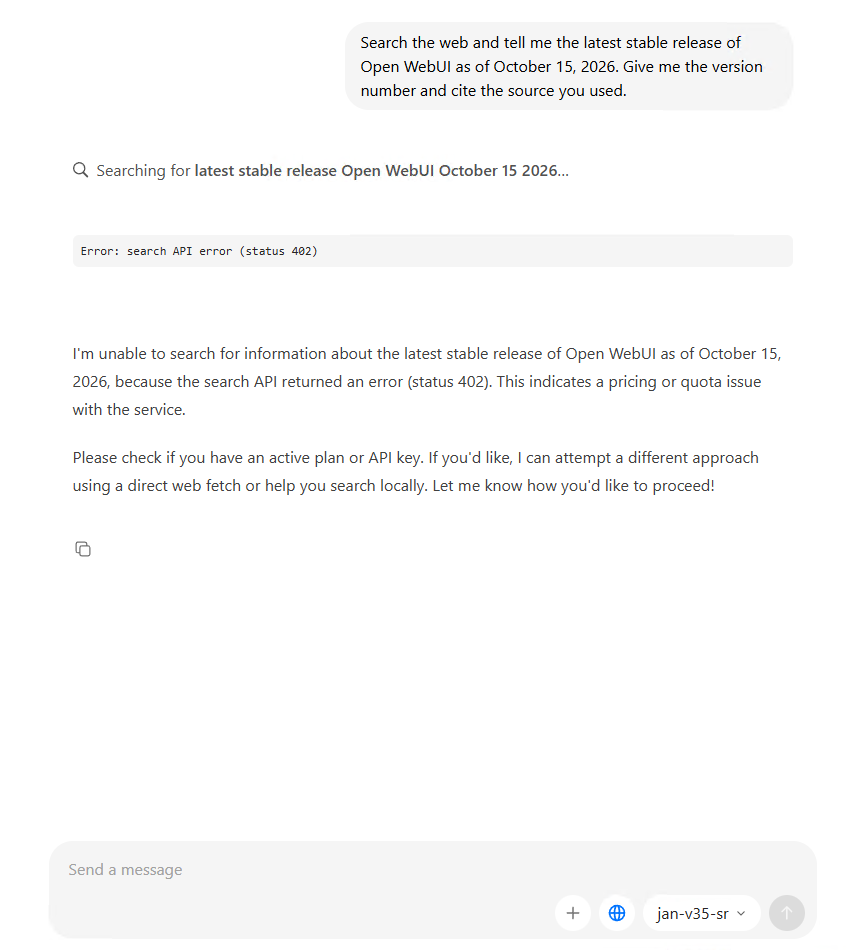
Ollama a tenté d'effectuer une requête sur notre version en ligne, mais a renvoyé une erreur HTTP 402 de l'API de recherche.
Entrée multimodale
Notre premier test d'image a utilisé le même modèle de langage Jan V2 VL High GGUF qui fonctionnait avec un projecteur de vision externe en janvier. Ollama a accepté le fichier de modèle de langage, mais notre procédure d'importation n'a pas associé le fichier mmproj correspondant. Lorsque nous avons tenté de joindre la capture d'écran NVIDIA à une conversation Jan V2, l'application de bureau a affiché le message « Ce modèle ne prend pas en charge les images » avant même que nous puissions envoyer l'invite.
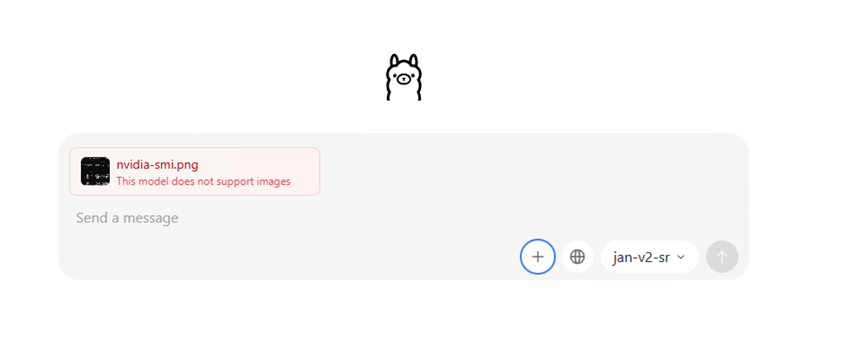
Notre modèle Jan V2 VL High importé a rejeté la capture d'écran NVIDIA, indiquant qu'il ne prenait pas en charge les images dans cette configuration.
Nous avons ensuite testé Qwen3-VL 4B, téléchargé via Ollama, en utilisant la même invite demandant le modèle de GPU, la version du pilote, la VRAM, l'utilisation, la température et la consommation. Ce modèle a accepté la capture d'écran et a affiché les six valeurs correctes : RTX 5000 Ada Generation, pilote 597.06, 32 760 Mio, 0 % d'utilisation, 39 °C et 40 W. Son fonctionnement n'a pas été sans faille, puisqu'il a brièvement affiché une valeur d'utilisation erronée de 8 % avant de la corriger dans le récapitulatif final.
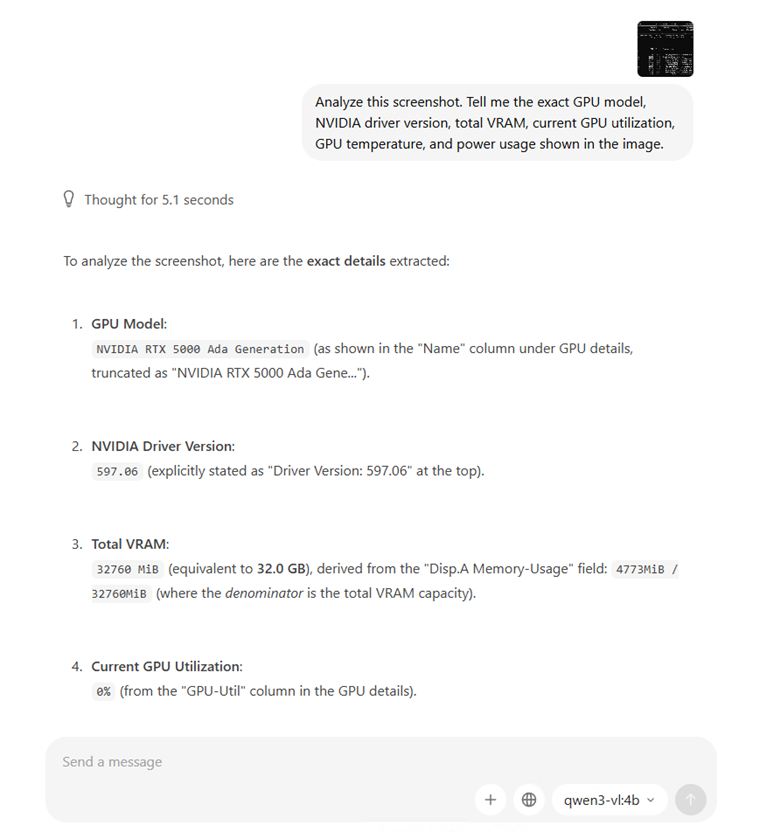
Le logiciel Qwen3-VL 4B d'Ollama a traité la capture d'écran NVIDIA jointe et a identifié les détails matériels ; son résumé final a donné les six relevés correctement.
Dans Ollama, il était impossible de coller directement une image depuis l'outil Capture d'écran Windows dans la fenêtre de discussion, contrairement aux autres applications. Il fallait d'abord enregistrer la capture d'écran, puis la télécharger à l'aide du bouton « + » situé à côté du champ de message. Cette opération a fonctionné sans problème et le modèle Qwen3-VL d'Ollama a analysé l'image avec succès. En revanche, notre modèle Jan V2 importé n'a pas pu accepter la même pièce jointe, ce qui nous a empêchés de reproduire le test multimodal initial.
Serveur API local
L'API locale d'Ollama était disponible dès le démarrage de son service Windows, sans qu'il soit nécessaire de lancer un serveur distinct depuis l'interface de bureau. Une requête à http://127.0.0.1:11434/v1/models nous avons renvoyé nos modèles Jan V3.5 et Qwen3-VL installés, et une demande à /v1/chat/completions L'utilisation de Jan V3.5 a généré une explication d'une phrase du RAID 6.
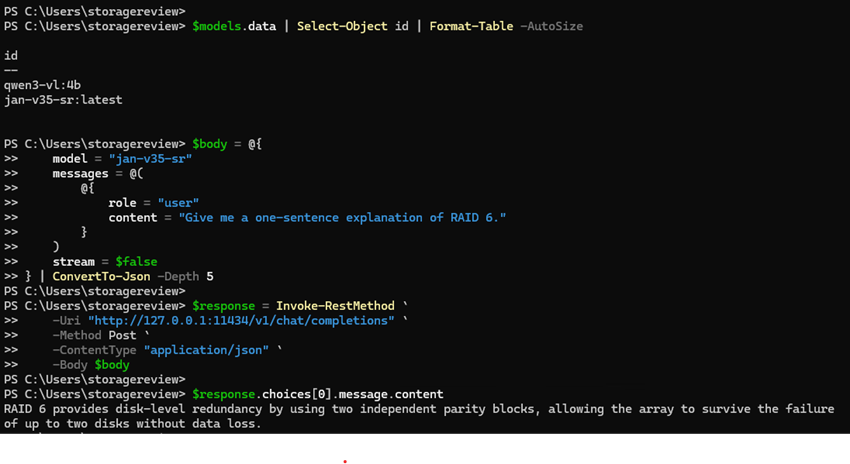
L'API locale compatible avec OpenAI a renvoyé la liste des modèles installés d'Ollama et une réponse de chat RAID 6 via PowerShell.
La réponse utilisait une formulation légèrement imprécise concernant la parité RAID 6, ce qui était dû à un problème de sortie du modèle et non à une défaillance de l'API. Le point de terminaison fonctionnel nous a permis d'interroger directement les modèles locaux depuis PowerShell sans utiliser la messagerie instantanée.
Qu'est ce qui ne s'est pas bien passé
Le problème le plus frustrant que nous avons rencontré a été de faire fonctionner notre modèle Jan V2 VL High importé avec des images. L'importation du fichier GGUF et l'exécution des invites textuelles avec l'accélération GPU complète ne posaient aucun problème, mais la situation s'est compliquée lorsque nous avons tenté de joindre notre capture d'écran NVIDIA. Ollama nous a indiqué que le modèle ne prenait pas en charge les images car notre importation n'incluait pas le projecteur de vision séparé requis par Jan V2. Nous avons néanmoins pu réaliser le test d'analyse d'image à l'aide du téléchargement Qwen3-VL d'Ollama, qui a fonctionné sans problème. Cela a démontré qu'Ollama pouvait traiter des images, mais que faire de même avec notre modèle Jan V2 existant n'était pas aussi simple que d'importer son fichier GGUF.
Pour utiliser la fonction de recherche Web, nous avons dû créer un compte Ollama avant de pouvoir l'activer. Après nous être connectés et avoir soumis notre question de test, le service a renvoyé une erreur HTTP 402 sans aucun résultat. Nous n'avons pas pu déterminer la cause de l'erreur et il n'y avait pas vraiment d'intérêt à modifier les paramètres du compte ou à essayer différents forfaits sans savoir si cela résoudrait le problème.
Nous avons également constaté la fréquence à laquelle nous devions recourir à PowerShell pour des tâches telles que l'importation de nos modèles existants, l'ajustement de leurs paramètres et la collecte de mesures de performance. L'application de bureau était facile à utiliser au quotidien, mais elle n'offrait pas le même niveau de contrôle que l'interface de Jan. Mis à part ces points, Ollama s'est avéré très fiable lors des tests : les deux modèles ont été importés avec succès, les six tests de performance ont été menés à bien et l'API locale a fonctionné comme prévu.
Conclusion
Nos tests avec Ollama 0.40.11 se sont globalement bien déroulés, notamment l'exécution des modèles locaux sur la RTX 5000 Ada. Nos deux GGUF importés ont fonctionné avec une accélération GPU complète sans configuration CUDA supplémentaire, et leurs performances ont surpassé celles de la série. Jan V3.5 a atteint une médiane de 145.48 jetons/seconde et Jan V2 VL High 92.87 jetons/seconde, soit les meilleurs résultats de cette série, avec une amélioration de 13 à 18 % par rapport à Jan sur la même station de travail. Une fois la configuration terminée, la navigation entre l'interface de chat et l'API locale s'est faite sans problème, et tous les tests de performance ont été exécutés avec succès.
Bien que nous ayons apprécié la simplicité d'Ollama pour les conversations quotidiennes, nous aurions préféré un contrôle plus poussé des modèles individuels dans l'application de bureau. L'utilisation de PowerShell et la création de fichiers de modèle pour importer nos GGUF existants ont ajouté quelques étapes supplémentaires, surtout comparé à Jan, où la plupart de ces paramètres sont accessibles directement dans l'interface. Cela ne gênera pas forcément les utilisateurs habitués à gérer des modèles locaux, mais les nouveaux venus souhaitant tout gérer via une interface graphique pourraient trouver Ollama limité. Nous avons également rencontré quelques problèmes avec la recherche Web et notre modèle de vision importé, bien qu'aucun n'ait affecté la génération de texte classique.
Ce qui nous a le plus plu avec Ollama, c'est sa capacité à diffuser facilement des modèles locaux vers d'autres applications sans nécessiter la configuration d'un serveur dédié. La messagerie instantanée est intuitive, et l'API locale ainsi que la compatibilité avec des outils de programmation externes offrent bien plus que la simple interaction avec les modèles locaux. Nous souhaiterions toutefois une meilleure gestion des modèles dans l'interface de bureau, mais Ollama a parfaitement fonctionné sur notre poste de travail et nous a permis d'exécuter nos deux modèles de test avec l'accélération GPU de manière fiable.
Classement : Ollama détient la meilleure performance globale en matière de temps d’exécution LLM local sur notre page des meilleurs outils LLM locaux , où ces résultats figurent désormais aux côtés de nos chiffres de janvier et d’Open WebUI.


 Amazon