

La décision la plus importante que de nombreuses entreprises prendront en matière d'infrastructure d'IA l'année prochaine ne concernera pas un investissement dans les GPU, mais la mise à niveau de leur base de données. Oracle AI Database 26ai est la version à support long terme vers laquelle Oracle oriente sa base installée 19c. La version 26ai intègre la recherche vectorielle au sein du même moteur que celui qui gère les transactions. Lorsque l'index vectoriel réside dans la base de données, la matrice de blocs et l'infrastructure SAN sous-jacente deviennent une infrastructure d'IA, prenant en charge le trafic de récupération en plus des transactions qu'elles traitent déjà.
La base de données a changé sous l'effet de l'IA
Oracle a conçu 26ai autour de cette idée : un type de données VECTOR natif, des fonctions de recherche vectorielle SQL, l’exécution de modèles directement dans la base de données via ONNX et SELECT AI pour les requêtes en langage naturel, le tout dans une version LTS qui, selon l’entreprise, intègre plus de 300 nouvelles fonctionnalités. Concrètement, un administrateur de base de données peut générer des représentations vectorielles, les stocker à côté des lignes qu’elles décrivent et effectuer une recherche de similarité au sein de la même transaction qu’une recherche de commande. Il n’y a pas de stockage vectoriel distinct à gérer, pas de pipeline de synchronisation à maintenir et aucune copie supplémentaire de données réglementées stockée hors de la piste d’audit.
IBM cite IDC à propos de cette tendance : « Les bases de données vectorielles intégrées constituent la plateforme de choix pour le stockage et l’interrogation des représentations vectorielles, car les organisations privilégient les environnements unifiés et gouvernés pour l’IA agentielle. » Les clients d’IBM et de Broadcom souhaitent étendre la base de données à laquelle ils font déjà confiance avant d’en déployer une nouvelle en parallèle.
Oracle n'est pas le seul à s'orienter dans cette direction. Le classement de popularité de DB-Engines d'octobre 2026 place les quatre principaux moteurs relationnels et multimodèles : Oracle, MySQL, Microsoft SQL Server et PostgreSQL. Tous quatre ont intégré la recherche vectorielle, nativement ou via des extensions telles que pgvector. IBM a choisi de commencer ses travaux de validation avec Oracle principalement en raison de sa position dominante sur le marché, bien que l'argument relatif au stockage présenté ici s'applique également aux autres.

Les arguments en faveur du stockage bloc sur site restent inchangés malgré l'arrivée de l'IA : les données essentielles au déploiement d'une IA, telles que les dossiers patients, les demandes de remboursement, les commandes et les transactions, ne peuvent être déplacées. Les copier sur une plateforme d'IA dédiée implique de payer le stockage deux fois, d'accepter que la copie dérive du cluster de production et de perdre les contrôles de gouvernance qui garantissaient la légalité de l'original. Conserver la récupération des données au sein de la base de données permet d'éviter ces trois problèmes. Le système qui assure une recherche de ligne en moins d'une milliseconde sert désormais simultanément à une analyse de similarité vectorielle pour un clinicien et à un flux de sauvegarde.
IBM Storage et l'équipe Fibre Channel (FC) de Broadcom ont entrepris de valider ce cas de charge de travail mixte et ont construit un environnement autour d'Oracle AI Database 26ai sur IBM FlashSystem avec la structure SAN Brocade Gen 8 de Broadcom et des cartes SecureHBA Emulex 64G . Ils ont ensuite examiné les questions que se posait une équipe d'infrastructure : quel est l'impact sur la latence transactionnelle lorsqu'une charge de travail vectorielle démarre à proximité ? Quel est l'effet de la vitesse de la structure sur le débit de recherche vectorielle ? Quelle est la capacité consommée par les intégrations ? Quelle est l'efficacité de la détection des ransomwares lorsqu'ils ciblent un volume de sauvegarde RMAN ? Et quelles sont les exigences pour ajouter un hôte au SAN sans ticket de zonage ?
Les données résident déjà sur le stockage par blocs, et maintenant l'IA s'y intéresse.
Rien de tout cela n'indique que les charges de travail d'IA en général doivent être stockées sur un stockage par blocs. Les entreprises conserveront des tableaux de fichiers et d'objets pour leurs données non structurées : documents, images, vidéos, ensembles d'entraînement et points de contrôle de modèles qui n'ont jamais été stockés dans une base de données et ne le seront probablement jamais. Dans la démonstration relative au secteur de la santé présentée ci-après, IBM conserve les images radiographiques brutes dans un stockage objet, tandis que seules les représentations vectorielles et les métadonnées des cas sont stockées dans Oracle. Ce qui change, c'est la charge sur le système de stockage, qui gère désormais simultanément plusieurs charges de travail présentant des profils d'E/S très différents.
La couche relationnelle est la plus connue : des millions d’E/S aléatoires de 4 à 16 Ko par seconde, des recherches et des validations de lignes qui doivent s’effectuer en quelques microsecondes, une forte concurrence d’écriture due aux opérations de restauration, d’annulation et de point de contrôle, et une latence de queue prévisible car une application utilisateur est en attente. RMAN, l’utilitaire de sauvegarde d’Oracle, est son opposé : un flux séquentiel qui nécessite une marge de manœuvre pour s’achever dans son intervalle de temps sans perturber la charge de travail en cours. Ces deux types de stockage sont bien maîtrisés et les baies IBM sont optimisées pour eux.
La couche vectorielle est plus difficile à caractériser car les grandes tables d'embeddings vectoriels peuvent donner l'impression que la recherche vectorielle est une tâche gourmande en bande passante : une analyse séquentielle de grande envergure. La caractérisation du chemin vectoriel d'Oracle 26ai par IBM est plus proche de celle d'un système OLTP. Chaque passage dans l'index correspond à une lecture aléatoire d'environ 4 Ko ; le chemin de requête est limité par les IOPS et sensible à la latence, et les lectures sont prédominantes car les écritures sont effectuées dans une phase d'ingestion et de construction d'index distincte.
La bande passante est cruciale lors des pics d'activité, comme la création d'un index ou le ré-encastrement d'un corpus, et ces pics sont généralement importants. Cette répartition est au cœur du problème des E/S mixtes : sur le chemin des requêtes, la charge de travail vectorielle entre en concurrence avec les transactions pour les mêmes files d'attente, ce qui rend l'isolation indispensable à la qualité de service. Et c'est durant ces phases de pics d'activité que la bande passante du réseau devient la limite, comme le montrent les résultats comparatifs 32 Gb/s et 64 Gb/s présentés plus loin.
L'architecture validée
IBM et Broadcom ont mis en place un environnement unique pour cette validation au sein du laboratoire d'IA de Broadcom dans le Colorado. Le stockage est assuré par une baie IBM FlashSystem série 9000 exécutant IBM Storage Virtualize 9.1.3 et équipée de 24 modules FlashCore. Cette baie dispose de ports Fibre Channel 64G connectés à deux commutateurs SAN Brocade Gen 8 G820. Le serveur de base de données est un système biprocesseur Intel Xeon 6767P doté de deux cartes SecureHBA Emulex LPe38102 64G à deux ports. Il exécute Oracle AI Database 26ai sur ASM, sans GPU dans le chemin de stockage. IBM Storage Insights assure la surveillance de la baie.

Nous avons exécuté les tests de performances (infrastructure et capacité), la comparaison de la recherche vectorielle 32G/64G et les mesures d'empreinte mémoire à l'aide de VectorDBBench sur le jeu de données BioASQ 1M, exclusivement sur ce serveur. Cette même configuration prend également en charge la charge de travail applicative. Un serveur Supermicro 821GE-TNHR, équipé de deux processeurs Xeon Platinum 8470 et de huit GPU NVIDIA H100 de 80 Go, héberge l'application de santé et son modèle de langage. La pile logicielle comprend l'intégration ONNX d'Oracle, Ollama Serving Llama 3 et NVIDIA cuVS. Un commutateur Broadcom Tomahawk 5 et des cartes réseau Thor 2 400GbE connectent les deux serveurs. Les démonstrations de qualité de service (QoS) des E/S, de multi-tenant, de détection de ransomware et d'application de santé ont été exécutées dans cet environnement.

Selon IBM, la gamme FlashSystem ( 5300 et 5600, 7300 et 7600, et 9500 et 9600) utilise le même logiciel Storage Virtualize. Les fonctionnalités présentées ici, notamment la limitation des E/S, le zonage automatique, la détection des ransomwares, la haute disponibilité basée sur des politiques et la migration des partitions de stockage, fonctionnent de la même manière avec Oracle AI Database 26ai sur n'importe laquelle de ces baies, au même niveau de code. Les performances et la densité varient selon le modèle et la génération du module FlashCore ; par conséquent, chaque chiffre mentionné dans cet article se rapporte au système sur lequel il a été mesuré.
Garantir des performances optimales pour les charges de travail OLTP et vectorielles grâce à la QoS d'E/S
La première question à laquelle IBM et Broadcom ont cherché à répondre est celle que se pose tout administrateur de base de données lorsqu'une charge de travail vectorielle est proposée pour la baie de production : qu'advient-il des transactions principales ? IBM a réalisé deux démonstrations sur la baie FlashSystem série 9000 en utilisant la limitation des E/S au niveau du volume, mécanisme sous-jacent à ce qu'IBM appelle la qualité de service des E/S (QoS). La base de données était répartie sur 30 volumes : 15 pour les espaces de tables OLTP (ORCL16 à ORCL30) sous Swingbench Order Entry avec 192 utilisateurs, et 15 pour les tables vectorielles (ORCL31 à ORCL45) sous un générateur synthétique à 200 threads exécutant des requêtes de similarité top-k 500, Storage Insights affichant des graphiques pour chaque groupe de volumes.
Lorsque le système OLTP fonctionnait seul, chaque volume affichait un débit stable de 20 500 opérations/s. Au démarrage du générateur vectoriel, le débit des volumes vectoriels a grimpé à environ 73 000 opérations/s chacun en une minute, tandis que celui des volumes OLTP chutait à environ 13 000 opérations/s, soit une baisse de 37 % sans modification du côté transactionnel. Le chemin de recherche vectorielle effectue des lectures aléatoires de 4 Ko avec la même taille de bloc que les transactions ; il sollicite donc les mêmes files d’attente et exploite les données disponibles sur la baie.

Une limite de 45 000 IOPS sur chaque volume vectoriel, une ligne de mkthrottle Dans l'interface de ligne de commande, les volumes vectoriels ont été poussés à leur limite, ce qui a ramené le débit OLTP à environ 17 000 opérations/s. La suppression de la limite a inversé la situation, et une fois l'exécution vectorielle terminée, le débit OLTP est revenu à 20 500 opérations/s. Le tableau de bord affichait la même chose : 1.28 million d'IOPS non limitées et environ 950 000 en dessous de la limite, ce qui, à quelques pourcents près, correspond au débit par volume multiplié par 30 volumes.

La seconde démonstration correspond à la configuration qu'IBM prévoit de déployer en production : les limites sont d'abord fixées à 45 000 IOPS par volume vectoriel et à 20 000 par volume OLTP, puis les deux charges de travail sont lancées simultanément. Les volumes vectoriels ont fonctionné à leur capacité maximale, les volumes OLTP se sont stabilisés à environ 12 200 opérations/s et sont restés constants pendant toute la durée de l'exécution. La baie a maintenu 870 000 IOPS (800 000 en lecture, 70 000 en écriture) avec un temps de réponse de 377 microsecondes et un débit de 6.9 Go/s, pour une utilisation du processeur de 25 %. La limite OLTP est restée supérieure à la demande de la charge de travail et n'a jamais été atteinte ; elle sert à éviter qu'une surcharge de l'un des volumes n'affecte l'autre.
Swingbench a maintenu ses 192 utilisateurs à environ 1.19 million de transactions par minute (soit approximativement 19 500 TPS) pendant toute la durée du test. Le générateur étant configuré pour saturer ses volumes, sa latence par requête ne constitue pas un indicateur de performance applicatif. Sur les 30 minutes de test, 35 672 requêtes ont été exécutées à une vitesse de 19.8 par seconde, avec une latence médiane d'environ 10 secondes et un p99 de 14.3 secondes, contre un délai d'expiration applicatif de 15 secondes. 99 requêtes (0.28 %) ont atteint ce délai d'expiration, sans que cela n'ait d'incidence sur les transactions.


La limitation FlashSystem impose un plafond de volume au niveau de la baie, indépendamment de l'hôte ou du chemin d'accès, avec une limite de bande passante optionnelle en plus de la limite d'IOPS. Elle plafonne le volume du voisin sans réserver de ressources. Ce plafond est un calcul de dimensionnement : 15 volumes vectoriels à 45 000 IOPS offrent une marge de 675 000 IOPS, ce qui a permis aux volumes OLTP de cette baie de disposer des ressources nécessaires. Une autre baie ou une autre configuration modifierait ces valeurs. Définissez le plafond vectoriel de manière à ce que les transactions maintiennent leur latence ; la charge de travail vectorielle bénéficiera alors de toutes les ressources excédentaires.
Détection de ransomware sur des volumes Oracle en production
L'étude Sophos de 2024, menée auprès de 2 974 organisations victimes de ransomware, a révélé que 94 % d'entre elles ont constaté que les attaquants ciblaient leurs sauvegardes, que la tentative réussissait dans 57 % des cas et que les coûts de récupération étaient en moyenne huit fois plus élevés en cas de succès. IBM a conçu son test selon le même principe, en ciblant d'abord les sauvegardes, puis la production, et en menant l'attaque sur le système de sauvegarde RMAN tout en épargnant les volumes de la base de données. RMAN a écrit ses ensembles de sauvegarde sur des volumes FlashSystem, un simulateur de ransomware a été exécuté sur ces volumes, et la baie de stockage a été laissée à elle-même, sans qu'aucun agent hôte ne soit impliqué.
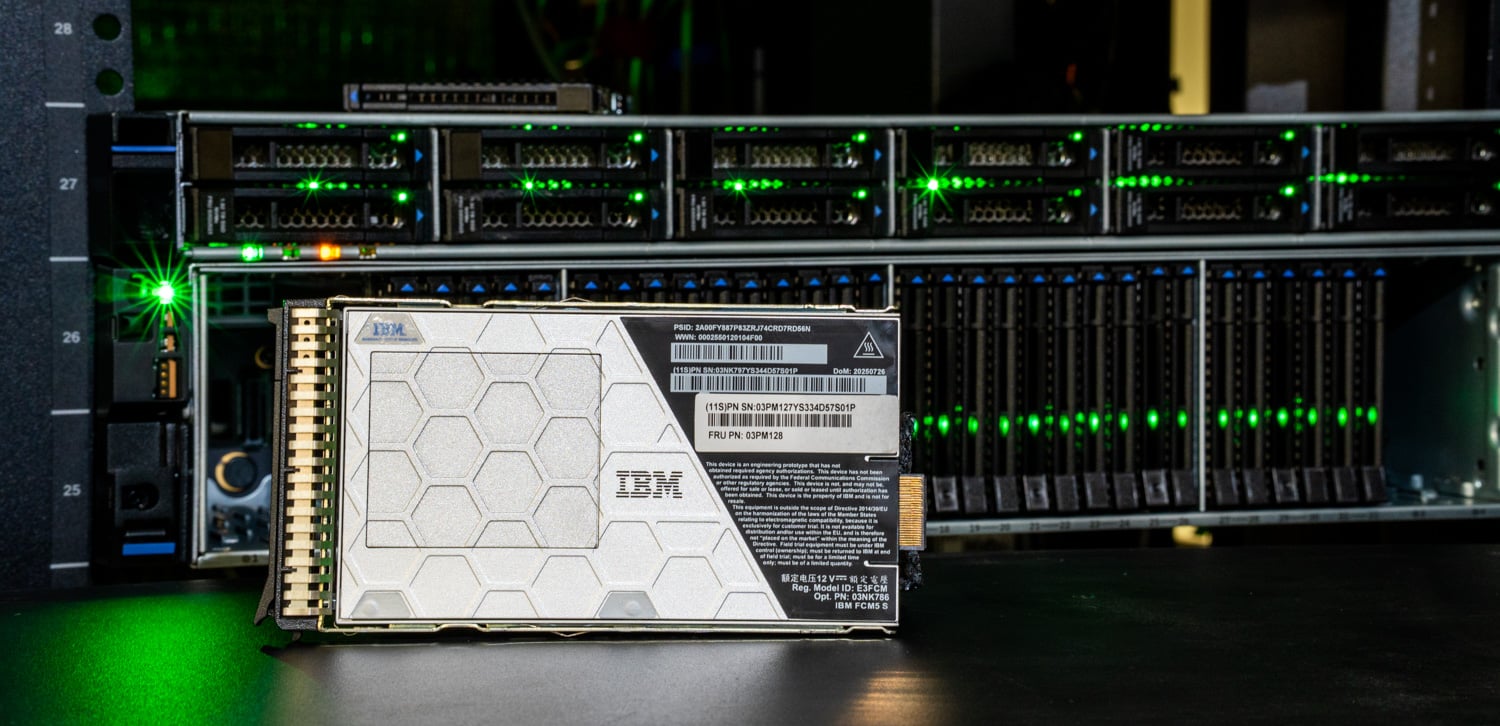
La détection s'effectue au sein même des disques : les modules FlashCore FCM4 et FCM5 calculent l'entropie et la compressibilité à chaque écriture, ainsi que la taille des blocs, l'adresse et les schémas de réécriture. Toutes les deux secondes, ils transmettent un résumé par volume à un moteur d'inférence intégré à Storage Virtualize (version 8.6.3 ou ultérieure avec le firmware FCM 4.1 ou ultérieur). Le modèle génère des alertes dans l'interface graphique de FlashSystem et IBM Storage Insights Pro, les transmet à Storage Defender ou à un SIEM, et peut être mis à jour indépendamment. Ainsi, un modèle réentraîné est distribué sous forme de petite mise à jour de sécurité, sans nécessiter de mise à niveau du firmware.
L'analyse s'exécutant sur le module, elle reste opérationnelle même si c'est l'hôte qui est compromis. Les données chiffrées présentent une entropie élevée et la compression cesse, ce qui se reflète dans les statistiques, que l'attaquant modifie les extensions de fichiers, chiffre un bloc sur deux seulement ou ralentisse le débit pour se dissimuler à un agent de sécurité.
Lors de la validation, RMAN a écrit la sauvegarde sur 16 canaux parallèles, chaque ensemble de sauvegarde étant limité à 150 Go. La base de données était répartie sur 15 disques de 200 Go par groupe de disques ASM pour les données OLTP et vectorielles. IBM a lancé l'attaque contre cette cible de sauvegarde et l'alerte a été transmise à Storage Insights en moins de 60 secondes, soit dans le délai de détection annoncé par IBM pour cette fonctionnalité. Storage Insights a signalé les 31 volumes du groupe, car une alerte concernant un seul volume entraîne la détection de l'ensemble du groupe comme une menace.
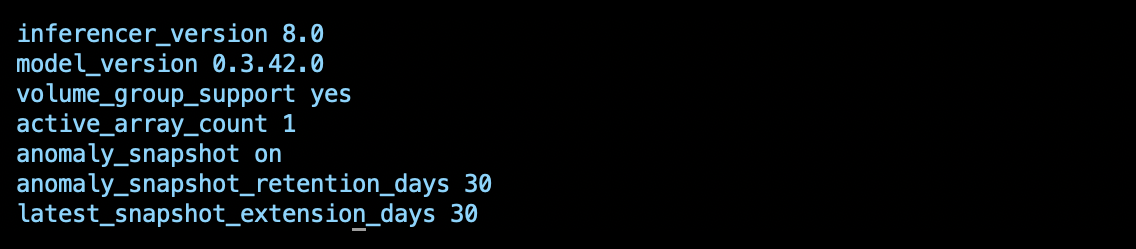
La réponse est une copie protégée, et la baie l'a gérée sans opérateur : le FlashSystem a pris un instantané immuable du groupe de volumes concerné dès que la menace a été détectée et a simultanément prolongé la durée de conservation du dernier instantané valide connu. lsanomalydetection La sortie du système révèle la configuration sous-jacente : moteur d'inférence 8.0 avec modèle 0.3.42.0, anomaly_snapshot activé, durée de conservation de 30 jours pour le nouveau snapshot et ajout de 30 jours au dernier snapshot valide. Storage Virtualize marque également le snapshot suspect afin d'empêcher toute restauration à partir de celui-ci, créant ainsi un point de restauration sain antérieur au chiffrement.
Le réseau Fibre Channel intègre également une couche de sécurité. Broadcom utilise la cryptographie post-quantique dans Brocade Gen 8, les cartes Emulex SecureHBA chiffrent les données en transit entre l'hôte et le réseau, et la nouvelle norme FC-SP-3 de la FCIA définit le niveau de sécurité minimal pour l'informatique quantique dans son ensemble.
Extension du SAN sans tickets de zonage : zonage automatique IBM FlashSystem utilisant le zonage piloté par cible Broadcom
L'ajout d'un hôte à un SAN Fibre Channel nécessite généralement un ticket et l'intervention de deux équipes : l'administrateur serveur récupère les WWPN des HBA, l'administrateur SAN crée manuellement les zones sur les deux réseaux, et l'administrateur stockage associe l'hôte aux ports cibles appropriés. Une simple erreur de saisie de WWPN peut priver un nouveau nœud Oracle RAC de ses chemins d'accès. L'AutoZoning délègue cette tâche à la baie de stockage : FlashSystem communique directement avec le réseau, identifie les WWPN de l'initiateur, sélectionne les ports cibles et crée automatiquement les zones, sans intervention humaine sur le commutateur.

Cette fonctionnalité repose sur le zonage piloté par cible (TDZ) de Brocade et a été intégrée au logiciel FlashSystem 9.1.2. Elle nécessite des commutateurs Brocade exécutant Fabric OS 9.1.1 ou une version ultérieure, avec le TDZ activé par l'administrateur du réseau sur les ports connectés aux ports cibles FlashSystem. Cette activation est la seule étape qui incombe à l'équipe SAN, et le zonage automatique n'intervient sur aucun port tant qu'elle n'est pas effectuée. Ensuite, FlashSystem crée des zones homologues, permettant aux initiateurs hôtes d'accéder au port cible mais pas de communiquer entre eux, sous un nom IBM_SV_ prévisible qui les identifie comme gérés par la baie.
La configuration commence dans la vue des ports Fibre Channel, qui affiche désormais le commutateur auquel chaque port est connecté, sa compatibilité AutoZone et la symétrie de sa connectivité (c'est-à-dire si le même ID de port sur chaque nœud est connecté au même réseau). Une vue topologique représente ces informations par un code couleur ; seuls les ports actifs, compatibles AutoZone et symétriques prenant en charge l'AutoZone apparaissent en vert. Les ports asymétriques sont exclus, même s'ils sont compatibles, car l'interface graphique signale qu'ils peuvent compromettre la redondance et la tolérance aux pannes.

La création d'un hôte commence par une liste d'hôtes non configurés, alimentée par FDMI, qui transmet au réseau le nom d'hôte, le système d'exploitation et les ports de chaque HBA. Dans la démonstration d'IBM, la boîte de dialogue « Ajouter un hôte » s'est ouverte avec le nom du serveur, le système d'exploitation et les deux ports HBA d'un hôte dont aucune zone n'était encore configurée. L'administrateur a sélectionné un ensemble de ports compatible AutoZone, définissant les ports cibles accessibles par l'hôte, puis a cliqué sur « Ajouter ». FlashSystem a associé ses ports cibles aux initiateurs de l'hôte, a déployé les zones sur les deux commutateurs et l'hôte est devenu accessible avec quatre chemins d'accès répartis sur deux réseaux.

Pour Oracle, IBM positionne AutoZoning comme solution idéale pour l'ajout de nœuds RAC et le remplacement des HBA. Cette fonctionnalité détecte les modifications de connectivité des hôtes ou du stockage et adapte les définitions de zone en conséquence ; ainsi, le remplacement d'un HBA ne nécessite pas de rezonage manuel. Cette même automatisation s'applique lorsque les hôtes ont besoin d'accéder à une seconde baie pour la migration de partitions de stockage ou la haute disponibilité basée sur des politiques (PBHA). L'équipe SAN conserve le contrôle des ports cibles participants, car aucune action n'est effectuée sur un port tant que la TDZ n'est pas activée. Par conséquent, l'ajout d'un hôte ne dépend plus d'une modification de zonage.
Enveloppe opérationnelle : PBHA, migration de grille, multi-location et placement
La haute disponibilité basée sur des politiques (PBHA) réplique de manière synchrone une partition de stockage entre deux baies FlashSystem distantes, avec un accès hôte actif-actif sur les deux sites. IBM indique que cette fonctionnalité est conçue pour un RPO nul et pour une reprise après incident de stockage qu'un déploiement Oracle correctement clusterisé peut gérer sans perte de données. Lorsque le site défaillant est de nouveau opérationnel, les données sont resynchronisées et la charge de travail reprend sans interruption de service.
La fonctionnalité FlashSystem Grid fédère jusqu'à 32 baies FlashSystem sous une interface de gestion unique. La migration des partitions de stockage permet de déplacer une partition, ainsi que ses volumes, groupes de volumes et hôtes, d'une baie à une autre sans interruption de service. Pour Oracle, IBM recommande le renouvellement du matériel, la vidange du système avant une mise à jour du firmware et le déplacement d'une partition vectorielle vers un système de plus grande capacité à mesure que le nombre de partitions embarquées augmente. La migration s'effectue partition par partition via Fibre Channel ou Ethernet haut débit. Les hôtes peuvent se connecter via Fibre Channel, iSCSI ou NVMe/TCP. Une partition déjà configurée pour PBHA n'est pas éligible à la migration.
L'outil de planification de l'infrastructure Storage Insights gère la planification pour une même grille. En fonction de la capacité, du taux de croissance, du profil d'E/S et de la latence cible d'une charge de travail, il évalue chaque système de la grille, classe le plus adapté avant tout provisionnement et peut également recommander une migration en cas de déséquilibre de CPU ou d'IOPS. La migration et le placement utilisent tous deux Storage Insights Pro, chaque système de la grille étant enregistré auprès du même tenant Storage Insights.

Le multitenant permet à une équipe d'administrateurs de bases de données (DBA) et à une équipe d'IA de partager la même baie de stockage sans en partager l'administration. Dans la démonstration d'IBM, un administrateur a créé deux locataires sur la même baie (Tenant_Scale et Tenant_oracle_ai) et a attribué à chacun un système, un groupe d'utilisateurs avec un rôle spécifique et un utilisateur principal. Il a ensuite créé une partition de stockage pour chaque locataire, avec un groupe de volumes, des volumes et des mappages d'hôtes distincts. L'interface graphique propose de configurer la réplication dès la création d'une nouvelle partition. Connecté en tant qu'utilisateur Tenant_Scale, l'interface graphique n'affichait que la partition et les ressources de ce locataire, sans aucune information concernant Tenant_oracle_ai. La même vérification effectuée depuis Tenant_oracle_ai a renvoyé le même résultat.
Le dividende du tissu : Fibre Channel 32G vs. 64G sous recherche vectorielle
La seule variable modifiée intentionnellement par IBM et Broadcom lors de ces tests était l'infrastructure réseau. La même baie de serveurs, le même hôte et les mêmes cartes SecureHBA Emulex LPe38102 ont exécuté VectorDBBench sur le jeu de données BioASQ 1M (un million de vecteurs de 1 024 dimensions issus du corpus de questions-réponses biomédicales) à deux reprises : une fois avec les deux ports HBA à 32 Gbit/s et une fois à 64 Gbit/s, via les mêmes commutateurs Brocade G820. Tous les autres éléments, des 16 volumes ASM à la SGA de 4 Go, sont restés inchangés. La différence entre les deux exécutions réside donc uniquement dans la génération du Fibre Channel.

La phase de recherche de ce test de performance consiste en une analyse en lecture seule : l’index IVF_FLAT d’Oracle achemine chaque requête vers un cluster de partitions et les lit intégralement. Avec des vecteurs FLOAT32 de 1 024 dimensions, cela représente une charge de travail importante en termes de bande passante. Sur deux ports 32 Gbit/s, les lectures côté hôte se sont stabilisées à 6.3 Go/s, soit le débit maximal de la paire, et la courbe de recherche s’est aplatie à 43.7 requêtes par seconde avec 20 threads. Sur deux ports 64 Gbit/s, le même hôte a atteint 12.5 Go/s en lecture et a continué à progresser jusqu’à 85.0 requêtes par seconde avec 80 threads, soit un débit supérieur de 95 % pour le même stockage.

La latence révèle l'autre aspect du problème avec le 64G : avec un seul thread, les deux architectures présentent un écart inférieur à 8 % (0.107 seconde contre 0.099 seconde), car une requête unique ne sature jamais l'une ou l'autre des voies. À partir de cinq threads, cependant, le 32G génère des files d'attente : la latence moyenne double celle du 64G à chaque étape, et avec 80 threads, le p99 atteint 4.08 secondes contre 1.14. Une architecture FC saturée ne tombe pas en panne ; elle met chaque requête en file d'attente, et cette attente se traduit par une latence résiduelle.

La phase de chargement a également évolué ; l’ingestion du million de vecteurs a pris 94.1 secondes sur 32 Gbit/s et 84.5 secondes sur 64 Gbit/s, et la création de l’index IVF_FLAT a pris 139.6 secondes contre 108.4 secondes, soit 28.8 % de plus sur l’infrastructure moins performante, pour un temps de chargement total de 233.7 secondes contre 193.0 secondes. Les taux de rappel et de NDCG étaient similaires à 0.1 % près entre les deux tests (83.81 % et 84.42 % sur 32 Gbit/s, 83.95 % et 84.56 % sur 64 Gbit/s), ce qui indique que l’infrastructure a influencé la rapidité d’obtention des réponses. Pour une base de données fonctionnant sur 32 Gbit/s depuis son déploiement, la mise à niveau du contrôleur HBA et du commutateur représente une opportunité évidente d’améliorer les performances.
Planification de la croissance des capacités vectorielles
La recherche vectorielle modifie le calcul de la capacité avant d'affecter les performances. Un vecteur est une copie numérique de largeur fixe d'un bloc de données source. Pour du texte, cette copie est généralement plus grande que le bloc qu'elle décrit : un passage de 1 000 octets devient un vecteur FLOAT32 de dimension 1 024 et de 4 096 octets avant que la base de données n'ajoute une ligne pour le stocker. L'équipe nomme ce phénomène « amplification du stockage vectoriel » et l'a mesuré sur le même jeu de données BioASQ 1M que celui utilisé pour la comparaison des performances.
Le texte source contenant le million de vecteurs pèse 0.90 Go. Dans Oracle 26ai, il est devenu une table de vecteurs de 7.67 Go, incluant environ 0.3 Go de surcharge liée aux lignes. L'index IVF_FLAT a ajouté 8.57 Go supplémentaires, car il conserve une seconde copie clusterisée de chaque vecteur, ainsi qu'environ 4 Mo de centroïdes. L'empreinte mémoire persistante sur le SAN est de 16.24 Go, soit 18 fois le texte source, sans compter l'espace opérationnel nécessaire à Oracle : 15 à 23 Go de mémoire temporaire (TEMP) pendant la création de l'index, et 4 à 8 Go de mémoire d'annulation (UNDO) et environ 15 Go de mémoire de restauration (REDO) pendant l'ingestion.

Le facteur multiplicateur est proportionnel au modèle d'intégration : Broadcom extrapole à partir de la même méthode, ce qui donne un facteur 4.8 fois supérieur à la source pour un modèle Cohere v3 de 768 dimensions (également mesuré), 9.6 fois supérieur pour un modèle MiniLM de 384 dimensions et 32.5 fois supérieur pour un modèle Mistral de 4 096 dimensions. La taille des segments est aussi importante que leur largeur, car un vecteur large sur un long passage amplifie moins que le même vecteur sur un court passage, et les index quantifiés réduisent la part de l'index.
Rien de tout cela n'est spécifique à FlashSystem ou à Oracle. L'amplification a lieu au sein de la base de données avant même que la baie ne traite un seul octet. Chaque index vectoriel, sur chaque plateforme, contient une copie des vecteurs ; il doit donc être intégré au budget de capacité dès l'approbation d'un projet vectoriel, au même titre que les GPU. La baie détermine la capacité d'accueil de cette croissance : le module FlashCore de cinquième génération d'IBM atteint 105.6 To par module, soit 3.3 Po bruts dans un boîtier 2U pour les plus grands modèles FlashSystem (11.8 Po effectifs selon IBM). Ainsi, une couche vectorielle peut évoluer sur place pendant des années avant qu'une partition ne doive être déplacée.
Le modèle de dimensionnement d'IBM pour l'application de santé décrite ci-après fonctionne différemment pour les images : 100 Go de radiographies occupent environ 2 Go dans la base de données, car seuls les vecteurs et les métadonnées des cas y sont stockés. Le texte, en revanche, représente un volume de données important : 100 Go de texte clinique segmenté occupent entre 860 Go et 1.2 To, principalement pour l'index HNSW. Le dimensionnement est basé sur le nombre de segments et la largeur du modèle ; le corpus source est un indicateur peu fiable. De plus, les vecteurs se compressent moins que les lignes (de 1.2 à 2 fois contre 2 à 4 fois pour les données relationnelles, d'après l'expérience d'IBM). Par conséquent, la réduction de données du module FlashCore ne compense qu'une faible partie de la croissance, et chaque réintégration nécessite à nouveau l'espace temporaire.
La règle pratique d'IBM est de mesurer avant de s'engager. Chargez 1 à 5 % du corpus réel avec le modèle d'embedding et les paramètres de segmentation de production, mesurez le nombre réel d'octets par vecteur, puis effectuez une mise à l'échelle linéaire et répétez l'exercice chaque fois que le modèle, le nombre de dimensions ou la politique de segmentation change.
Inférence IA de bout en bout : l’application aux soins de santé
IBM a développé l'application de validation RAD-AI, un assistant en radiologie et gastro-entérologie. Cette application, conçue à l'échelle d'une production, présente un pipeline d'inférence complet, appliqué aux mêmes données que celles utilisées pour les sections précédemment mesurées. Un clinicien saisit l'âge, le sexe et le motif de consultation du patient, télécharge une radiographie thoracique ou une image endoscopique, et reçoit un rapport structuré, établi à partir des cas antérieurs les plus similaires archivés.
L'archive contient 112 120 radiographies thoraciques issues du jeu de données NIH ChestX-ray14 et plus de 10 000 images d'endoscopie digestive provenant d'HyperKvasir, incluant les vecteurs par image de 367 vidéos d'endoscopie complètes, pour plus de 172 000 cas pré-intégrés. Chaque image est convertie en un vecteur de dimension 768 par un modèle CLIP ViT-L/14 exécuté dans la base de données Oracle AI Database 26ai via son environnement d'exécution ONNX. L'intégration est ainsi réalisée dans la même transaction que la ligne qui la contient. Les images brutes sont stockées dans un stockage objet ; les vecteurs et les métadonnées des cas sont stockés dans Oracle.

Lors de l'exécution d'une requête, Oracle effectue une recherche approximative du plus proche voisin par distance cosinus dans l'archive et renvoie les cas les plus proches, ainsi que leurs résultats, diagnostics et issues initiaux. Cet ensemble récupéré constitue le contexte de Llama 3, exécuté par Ollama sur l'un des GPU H100 du serveur Supermicro, qui génère le rapport : une priorité clinique, un résumé des résultats, un diagnostic différentiel hiérarchisé et des actions recommandées, les cas correspondants étant listés en dessous. L'endoscopie suit le même processus et ajoute une note clinique ; pour la vidéo, le pipeline intègre les images une par une afin de suivre une lésion le long du tube digestif.
L'application exécute deux charges de travail sur les mêmes volumes FlashSystem. La charge de travail transactionnelle gère les connexions, le stockage des rapports, la journalisation des audits et les sessions ; la charge de travail vectorielle effectue des lectures aléatoires à haut débit sur les tables d'intégration et les métadonnées des cas, conformément au profil du générateur de la démonstration de qualité de service d'E/S. Le déploiement IBM configure les limitations de volume décrites précédemment afin qu'une tâche de réintégration par lots ne ralentisse pas un clinicien accédant à un cas. La détection des ransomwares et la migration des partitions présentées ci-dessus s'appliquent à ces volumes sans modification.

L'étape la plus gourmande en ressources consiste à constituer l'archive. IBM l'a mesurée en intégrant à deux reprises l'ensemble complet de 112 120 radiographies thoraciques, avec le même modèle et la même cible VECTOR(768, FLOAT32). Avec le modèle ONNX exécuté dans la base de données sur les processeurs hôtes, le pipeline a maintenu un débit de 3.41 images par seconde (0.272 seconde par intégration), et l'ensemble complet a nécessité 9.1 heures. En déplaçant le modèle vers le conteneur Oracle Private AI Services sur le second serveur, le débit est passé à 8.55 images par seconde (0.097 seconde par image), et la même ingestion s'est achevée en 3.6 heures.

Le prétraitement (environ 0.019 seconde par image) et l'insertion dans Oracle (moins d'une milliseconde) étaient identiques lors des deux exécutions. Le gain de 2.5x provient donc entièrement du lieu d'exécution du modèle. Le service d'intégration de Private AI Services s'exécute sur un environnement d'exécution ONNX pour processeur ; les GPU H100 de ce serveur n'ont donc pas participé à ce test. Le gain provient du déplacement du modèle hors du serveur de base de données. La part du GPU dans le pipeline correspond à la création de l'index, qui sera abordée ci-après.
IBM a mesuré ces chiffres dans son laboratoire du Colorado ; nous n’avons ni exécuté ni audité le test. Concrètement, l’intégration initiale d’une archive, ainsi que chaque réintégration après une modification du modèle, correspond à un traitement par lots mesurant plusieurs heures, tandis que la récupération qui suit est une opération nécessitant l’utilisation du processeur et du stockage, mesurée en millisecondes.
Le même conteneur gère également la construction de l'index. Oracle 26ai peut envoyer une requête HNSW au service d'index vectoriel du conteneur, qui utilise NVIDIA cuVS sur le GPU pour construire le graphe de voisinage avant de renvoyer l'index finalisé à la base de données. Les recherches s'exécutent ensuite sans solliciter le GPU. Lors des tests effectués par IBM, la construction HNSW de base (32 voisins, efConstruction 200) a pris 8.47 secondes dans la base de données et 2.26 secondes avec le déchargement, soit une réduction de 3.7 fois. Ce test a été réalisé sur une petite table de démonstration, confirmant ainsi le bon fonctionnement de cette méthode sur cette configuration ; il reste à effectuer des mesures à l'échelle clinique.
L'application illustre la division du travail au cœur de cet article. Le serveur GPU héberge le modèle de langage et, lors des opérations de création ou de reconstruction d'archives, les services d'intégration et d'indexation. La base de données stocke les vecteurs avec les enregistrements qu'ils décrivent, tandis que le système de traitement et l'infrastructure gèrent les lectures et les transactions. Aucune étape du processus de récupération n'utilise d'API externe, et les données des patients ne quittent jamais le centre de données.
IBM a choisi le secteur de la santé pour valider le concept, et rien dans le modèle n'est spécifique à ce secteur. Remplacez les archives de radiographies par des historiques de sinistres, des dossiers de maintenance ou un catalogue de produits, et les trois mêmes éléments restent inchangés : les vecteurs sont stockés à côté des enregistrements qu'ils décrivent, la génération est effectuée sur le serveur GPU, et la récupération et les transactions se font sur une seule matrice. Tout secteur effectuant des inférences sur des données déjà en sa possession adopte la même architecture.
Que ce passe t-il après
La validation se poursuit sur le même matériel : la phase 2 déplace le cache KV du moteur d’inférence de la mémoire GPU vers FlashSystem via le même réseau Fibre Channel, permettant ainsi à un modèle à contexte long de conserver une plus grande partie de son ensemble de travail accessible ; le prochain article de cette série traite de ces travaux. IBM développe également un pipeline d’actualisation prenant en compte le contenu, avec IBM Storage Scale AFM et Kafka alimentant la vectorisation ONNX intégrée à la base de données avec les nouveaux documents dès leur arrivée, afin que l’index vectoriel suive ses sources sans réintégration par lots. IBM prévoit également d’étendre cette validation de stockage aux autres bases de données multimodèles ayant intégré la recherche vectorielle.
La phase 2 active également la couche de sécurité pour les nouvelles données. Lorsque le cache KV migre vers FlashSystem, le contexte de travail d'un modèle de soins (historique patient inclus) emprunte les mêmes liaisons Fibre Channel que l'index vectoriel et les enregistrements transactionnels. Les Emulex SecureHBA chiffrent les données en transit entre l'hôte et le réseau, tandis que le chiffrement post-quantique Brocade Gen 8 assure le chiffrement côté commutateur. Chaque phase ajoute une charge de travail au réseau sans créer de chemin de transmission en clair.
Classement : Le profil d'IBM sur notre page des meilleures baies de stockage inclut désormais le stockage par blocs FlashSystem ainsi que Storage Scale.
Ce rapport est sponsorisé par Broadcom. Tous les points de vue et opinions exprimés dans ce rapport sont basés sur notre vision impartiale du ou des produits concernés.



 Amazon