

Open WebUI regroupe le chat, la gestion des modèles, les fichiers, la recherche web, l'appel d'outils, la prise en charge des images, les fonctionnalités de connaissances et l'accès à l'API au sein d'une interface d'IA locale. Pour ce test pratique, nous nous sommes concentrés sur la version Windows et avons utilisé le même matériel et les mêmes fichiers de modèles que lors de nos tests précédents (janvier 2017) avec la version 0.8.6, afin de comparer les deux applications dans des conditions similaires.
Voici le deuxième élément de notre classement des meilleurs outils LLM locaux , où nous ajoutons des résultats de performance reproductibles obtenus avec le même matériel de test au fur et à mesure que nous passons en revue les plateformes de la liste.
Open WebUI est une plateforme d'IA open source et auto-hébergée, conçue pour offrir aux modèles d'IA locaux et distants une interface web similaire aux services de messagerie instantanée IA commerciaux. Elle peut se connecter à différents moteurs d'inférence et services compatibles avec OpenAI, tandis que l'application de bureau que nous avons testée permet d'exécuter des modèles GGUF localement grâce à son environnement llama.cpp intégré. Ceci lui confère un potentiel bien plus large qu'une simple application de messagerie instantanée locale, notamment une fois les outils, les préréglages de modèles, la recherche web, l'accès aux fichiers et l'API activés.
Pour nos tests, nous avons réutilisé la station de travail HP Z4 Rack G5 , le GPU NVIDIA RTX 5000 Ada Generation et deux modèles GGUF de janvier, comme lors de notre test de la version 0.8.6 de janvier. Nous avons conservé le contexte de 8 192 jetons, la taille de lot de 2 048, les 100 couches GPU et les mêmes valeurs d'échantillonnage pour les analyses de texte. Nous avons également exploré les préréglages de modèles, la saisie multimodale, la recherche web DDGS, la récupération d'URL et l'API locale d'Open WebUI.
La mise en place d'Open WebUI a pris beaucoup plus de temps que prévu, la majeure partie de ce temps étant consacrée à la configuration locale de llama.cpp et de CUDA avant même d'aborder les tests de modèles classiques. Nous avons finalement réussi à tout faire fonctionner, mais nous avons rencontré en cours de route un problème avec le téléchargement du runtime par défaut, des fichiers CUDA manquants, des allocations de contexte extrêmement importantes et quelques soucis avec le système d'outils intégré.
Système de test
Nous avons conservé la configuration système inchangée par rapport à nos tests de janvier afin que les résultats du modèle soient plus faciles à comparer entre les applications, tout en enregistrant les versions de bureau, serveur, Python et llama.cpp utilisées pour cette exécution d'Open WebUI.
| Composant | Configuration |
| Système d'exploitation | Windows 11 Pro pour les stations de travail |
| Processeur | Intel Xeon w5-2465X, 16 cœurs |
| Mémoire | 128GB |
| GPU | NVIDIA RTX 5000 Génération Ada |
| VRAM | 32 760 Mio (31.99 Go) |
| NVIDIA pilote | 597.06 |
| Compatibilité CUDA | 13.2 signalé par nvidia-smi |
| Ouvrir l'interface Web (bureau/serveur) | v0.0.20 / v0.12.2 |
| Python / llama.cpp | 3.12.13 / b11612, CUDA 12.4 |
Installation d'Open WebUI Desktop
L'installateur Windows commence par un écran de configuration de l'environnement où il est possible d'installer llama.cpp localement, d'activer Open Terminal et de modifier le répertoire d'installation dans les options avancées. Nous avons désactivé Open Terminal, activé llama.cpp, conservé le dossier par défaut dans le profil utilisateur Windows et poursuivi l'installation locale.
Une fois les paquets et l'environnement Python installés, Open WebUI nous a demandé de choisir une connexion, puis a ouvert l'interface locale de type navigateur. Lors d'une installation récente, Open WebUI s'est affiché comme connexion disponible, suivi de l'écran « Créer un compte administrateur » qui crée le premier compte administrateur local avant l'ouverture de la fenêtre de discussion principale.
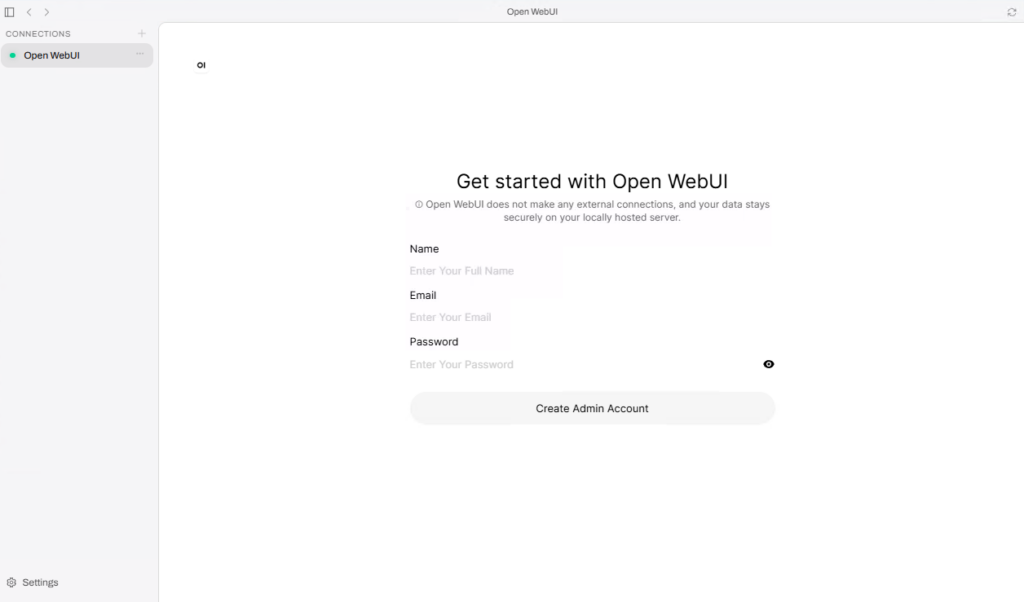
Une nouvelle installation locale d'Open WebUI demande le premier compte administrateur avant d'ouvrir l'interface de chat principale.
Un détail qui peut prêter à confusion au premier abord est que l'interface de bureau Open WebUI et le serveur local Open WebUI utilisent des numéros de version différents. Notre configuration finale utilisait l'interface de bureau v0.0.20 et le serveur Open WebUI v0.12.2, ce dernier s'exécutant dans l'environnement Python 3.12.13 intégré, sous le profil itinérant de l'utilisateur Windows.
Ajout de modèles et configuration de llama.cpp
L'application de bureau sépare les fichiers de modèles de l'environnement d'exécution de l'inférence ; ainsi, la page « Modèles » gère les GGUF locaux tandis que l'environnement d'exécution de l'inférence contrôle le fichier llama.cpp. Nous avons copié les mêmes fichiers Jan V3.5 4B Q4_K_XL et Jan V2 VL High Q4_K_M utilisés lors de nos tests précédents, ainsi que le fichier de projection multimodale V2, et les deux modèles sont apparus dans le sélecteur une fois l'environnement d'exécution activé.
Le premier problème d'exécution est apparu dès notre tentative d'installation de llama.cpp. En laissant le champ Version sur « latest » avec CUDA 12.4 sélectionné, l'installation a échoué presque immédiatement. L'examen du journal du bureau a révélé qu'Open WebUI avait résolu « latest » en llama.cpp v0.6.0 et tentait de télécharger une archive CUDA Windows indisponible pour cette version. Nous avons donc sélectionné la version b11612 et réessayé.
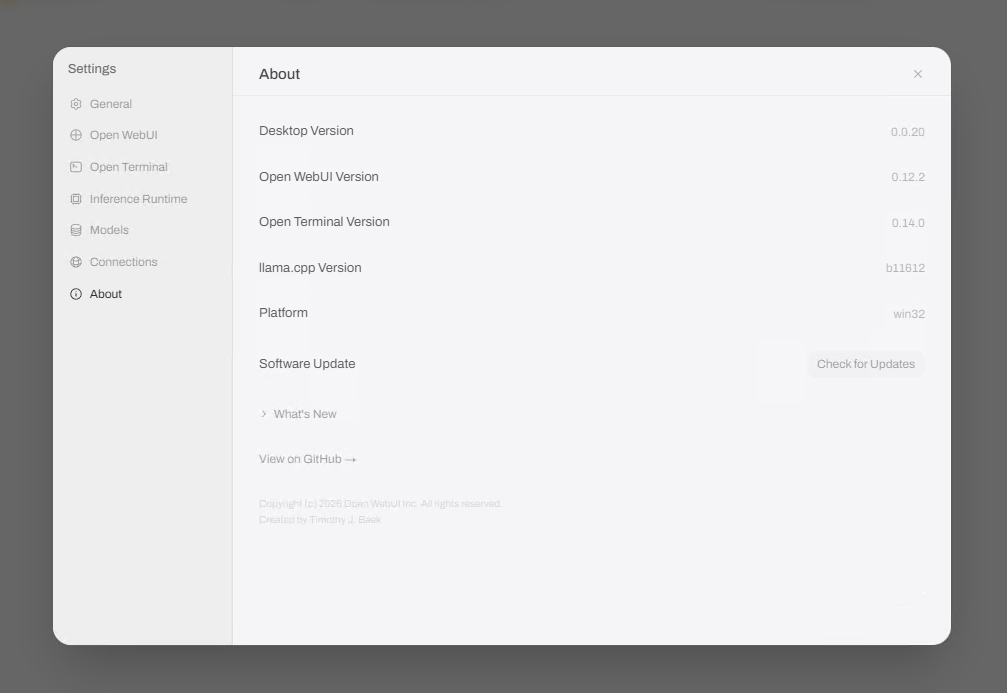
La page À propos répertorie les versions distinctes de Desktop, Open WebUI, Open Terminal et llama.cpp utilisées lors des tests.
Cela nous a permis de résoudre le premier problème, mais llama.cpp ne démarrait toujours pas car le package DLL d'exécution CUDA séparé n'avait pas été téléchargé avec l'archive principale. Nous avons ajouté manuellement cudart64_12.dll, cublas64_12.dll et cublasLt64_12.dll du package officiel CUDA 12.4 au répertoire b11612. Après cela, le serveur llama a démarré normalement sur le port 18881 et les modèles sont apparus dans l'interface de chat.
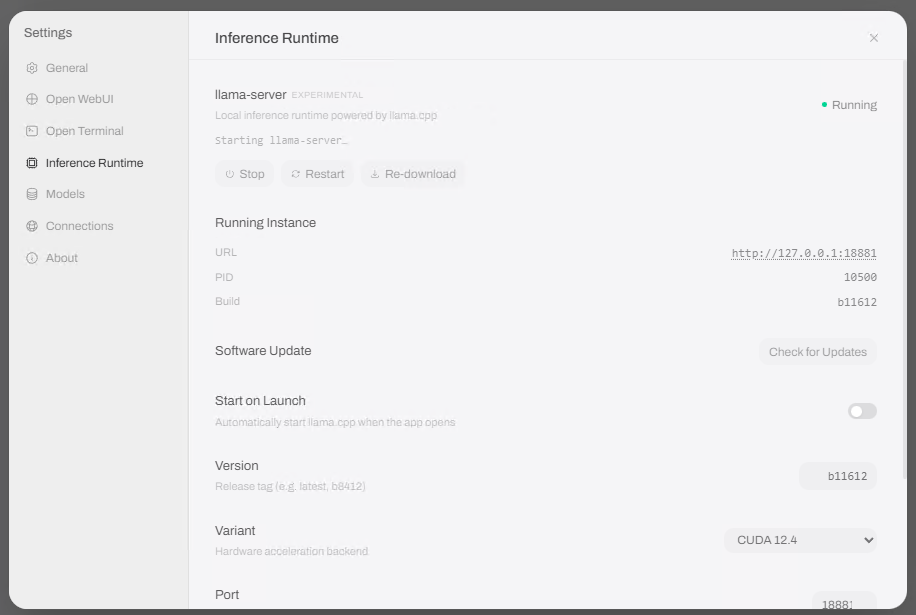
Après avoir épinglé la version b11612 et ajouté les DLL d'exécution CUDA requises, llama.cpp s'est exécuté localement sur le port 18881.
Paramètres du modèle et utilisation du GPU
Open WebUI répartit ses paramètres de modèle entre l'application de bureau et l'interface web principale ; il faut donc un certain temps pour s'y habituer. L'application de bureau gère les fichiers GGUF et l'environnement d'exécution llama.cpp, tandis que l'interface web principale ajoute des paramètres par conversation, des préréglages de modèle d'espace de travail, des fonctionnalités, des outils intégrés, des options de recherche web et l'administration du serveur.
Pour nos tests de texte, llama.cpp utilisait un contexte de 8 192 jetons, une taille de lot de 2 048 et 100 couches GPU. La mise en cache des invites était désactivée via l'option `--no-cache-prompt`, ce qui permettait d'obtenir une mesure de préremplissage réelle même en cas d'utilisation répétée de la même invite de test. Le journal d'exécution a également confirmé qu'Open WebUI transmettait la valeur GPU configurée à chaque processus du modèle via l'option `--n-gpu-layers 100`.
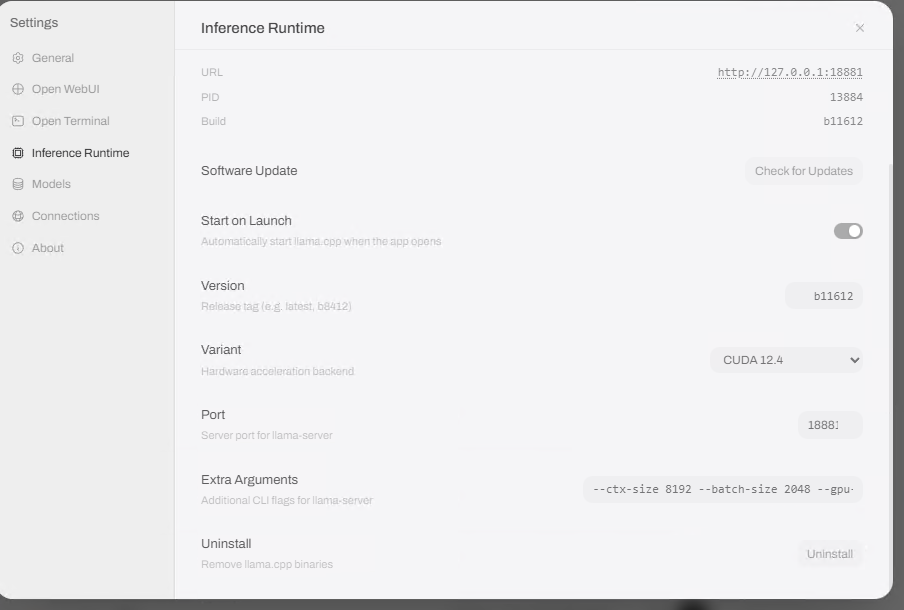
Nos tests ont utilisé un contexte de 8 192 jetons, une taille de lot de 2 048, 100 couches GPU et la mise en cache des invites a été désactivée.
Les paramètres par défaut du chat Open WebUI ne correspondaient pas aux valeurs de janvier dans tous les champs ; nous avons donc modifié les paramètres concernés avant chaque série de mesures. La température est restée à 0.8 et le Top K à 40, tandis que le Top P est passé de 0.9 à 0.95, le Min P de 0 à 0.05, la pénalité de fréquence de 1.1 à 0, la pénalité de présence est restée à 0, le nombre de répétitions (N) est resté à 64 et la pénalité de répétition a été fixée à 1.0.
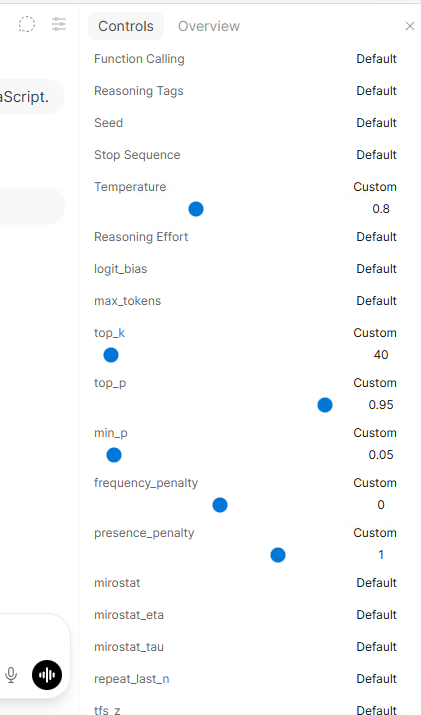
Nous avons fait correspondre les valeurs d'échantillonnage de janvier dans Open WebUI avant chaque exécution de texte mesurée.
Nous avons finalement créé des préréglages d'espace de travail dédiés pour les deux modèles de référence et désactivé leurs outils intégrés. Cette mesure s'est avérée nécessaire après avoir constaté qu'une session de modèle Open WebUI standard pouvait joindre un grand nombre d'instructions d'outils avant même l'envoi de notre invite, ajoutant ainsi suffisamment de contexte pour faire dépasser à la requête V2 notre limite de 8 192 jetons.
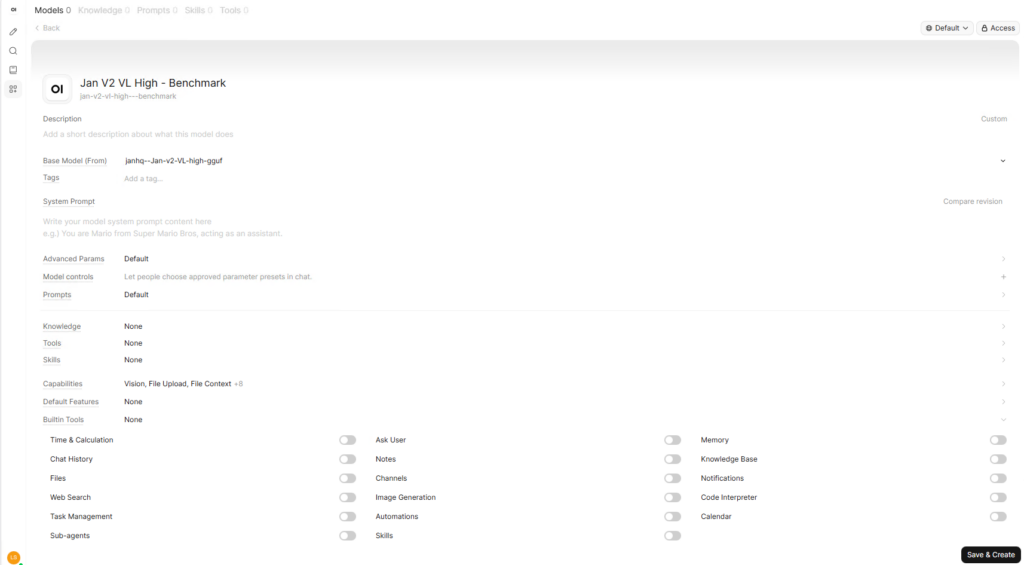
Un préréglage d'espace de travail dédié nous a permis de désactiver les outils intégrés tout en conservant le GGUF sous-jacent inchangé.
Performances de la production locale
L'invite de test de référence est restée identique à celle de l'exécution de janvier :
« Expliquez le RAID 5 et le RAID 6 à une personne qui construit son premier NAS. Incluez les principaux avantages et inconvénients de chacun, en environ 400 mots. »
La recherche Web a été désactivée, la première réponse après le chargement de chaque modèle a été écartée comme échauffement, et nous avons ensuite enregistré trois sessions de chat fraîches par modèle.
| Modèle | Quantification | Décodage médian | Production médiane | Durée totale médiane |
| Jan V3.5 4B | Q4_K_XL | 115.32 tok/s | Jetons 520 | 4.78 s |
| Jan V2 VL High | Q4_K_M | 75.06 tok/s | Jetons 1,612 | 21.81 s |
Le test Jan V3.5 4B a atteint un taux de décodage médian de 115.32 jetons/seconde, une production médiane de 520 jetons et un temps de génération total médian de 4.78 secondes. Le test Jan V2 VL High a atteint 75.06 jetons/seconde, a produit une production médiane de 1 612 jetons et a nécessité un temps médian de 21.81 secondes, la durée de traitement beaucoup plus longue expliquant en grande partie la différence.
Comparativement à nos résultats de janvier (version 0.8.6) sur le même poste de travail, Open WebUI était environ 6.2 % plus lent avec la version 3.5 4B et environ 8.5 % plus lent avec la version 2 VL High. La version de janvier atteignait respectivement 123 et 82 jetons/seconde, bien que les applications utilisent des versions différentes de llama.cpp. Cette comparaison reflète donc les performances globales des configurations logicielles testées et non celles de llama.cpp seul.
Préréglages de chat local et d'espace de travail
Une fois la configuration d'exécution terminée, l'expérience de chat s'est avérée bien plus simple, et les préréglages d'espace de travail sont rapidement devenus l'une des fonctionnalités les plus utilisées. Chaque préréglage peut pointer vers le même GGUF tout en proposant ses propres fonctionnalités, outils intégrés, invite système, options de connaissances et paramètres avancés. Ainsi, nous pouvions conserver des configurations distinctes pour les tests de performance et la recherche Web sans dupliquer le modèle lui-même.
Le système de préréglages nous a également permis de résoudre l'un des problèmes les plus étranges rencontrés lors de la configuration du test de performance. Lorsque nous utilisions Jan V2 VL High comme modèle brut, Open WebUI tentait automatiquement d'appeler la fonction query_knowledge_files pendant le test RAID, dépassant ainsi notre limite de contexte de 8 192 jetons. La création d'un préréglage de test de performance avec les outils intégrés désactivés a réduit l'invite de génération à 41 jetons et a empêché cet appel d'outil supplémentaire d'interférer avec le test.
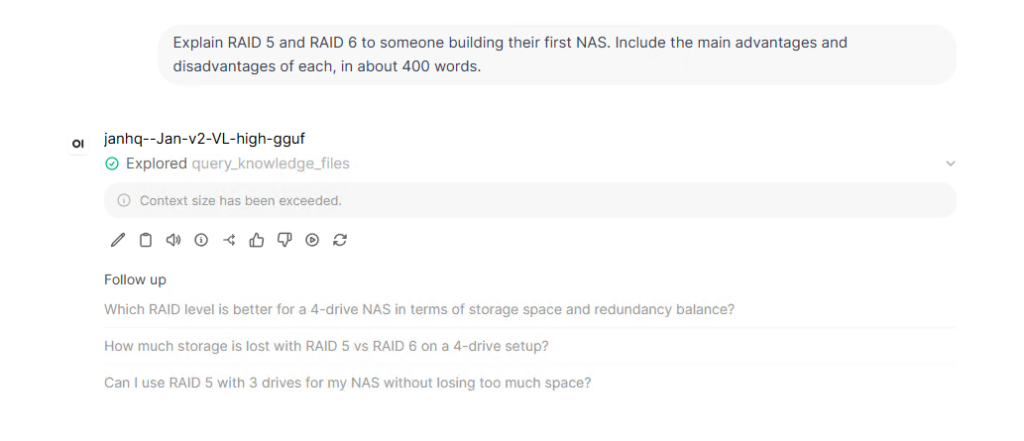
Le modèle V2 brut a dépassé le contexte de 8 192 jetons après l’ajout par Open WebUI d’un appel d’outil de fichier de connaissances intégré.
Pour une utilisation courante, le même système de préréglages peut être utilisé dans l'autre sens : un modèle local peut être doté de fonctionnalités de recherche web, d'accès aux fichiers ou autres, tandis qu'un autre modèle, minimaliste, se limite à la messagerie instantanée. Cette approche s'est avérée efficace lors de ce test, car elle a permis de séparer le modèle de référence du modèle de recherche web sans créer une nouvelle copie de GGUF.
Entrée multimodale
Jan V2 VL High a détecté automatiquement son fichier de projection multimodale. Nous avons donc réutilisé la capture d'écran nvidia-smi de notre test de Jan et demandé le modèle exact de GPU, le pilote, la VRAM totale, l'utilisation actuelle, la température du GPU et la consommation électrique affichées sur l'image. Le modèle a renvoyé correctement toutes les valeurs demandées.
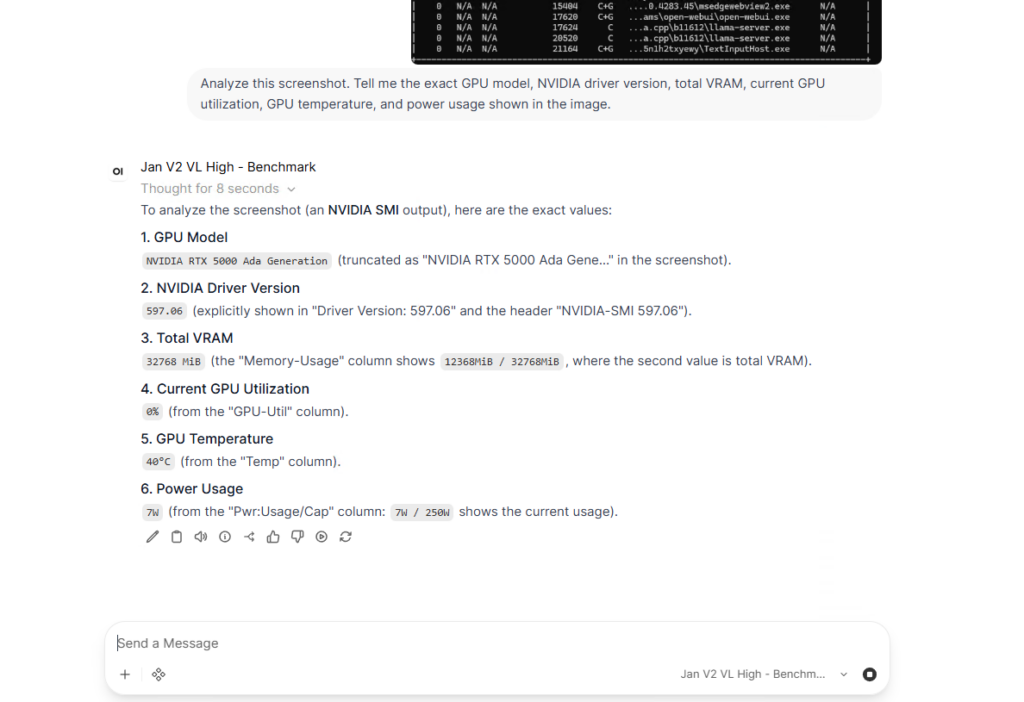
Jan V2 VL High a correctement identifié les valeurs demandées du GPU, du pilote, de la VRAM, de l'utilisation, de la température et de la puissance à partir de la capture d'écran nvidia-smi.
La réponse a identifié la carte graphique NVIDIA RTX 5000 de génération Ada, le pilote 597.06, 32 760 Mio de VRAM totale, une utilisation de 0 %, une température de 40 °C et une consommation de 7 W / 250 W. Ces valeurs correspondaient à la capture d’écran, ce qui a permis à Open WebUI de réussir notre test multimodal qualitatif.
Recherche Internet
La recherche Web dispose de sa propre section dans les paramètres d'administration, avec des options pour le fournisseur de recherche, le nombre de résultats, le chargement des URL, le comportement SSL et d'autres options de récupération. Nous avons choisi DDGS car il ne nécessitait pas de clé API supplémentaire et avons créé un préréglage Jan V3.5 4B distinct avec la recherche Web et l'accès aux outils intégrés requis activés.
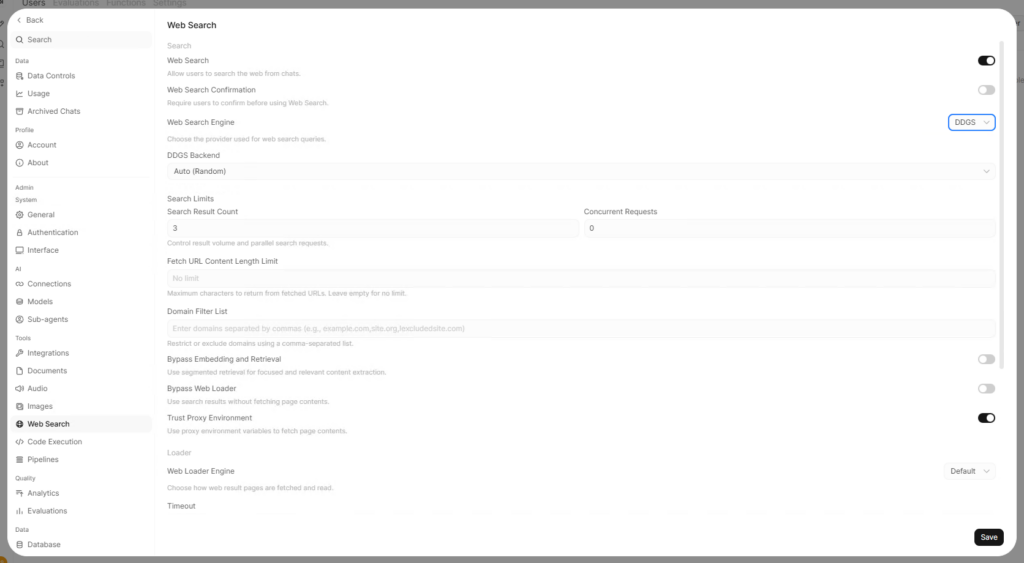
Nous avons activé la recherche Web et sélectionné DDGS comme fournisseur pour le test de recherche locale.
Notre premier essai a mis en évidence une des limites de l'association d'un petit modèle local à plusieurs étapes d'exécution. La version 3.5 a bien appelé `search_web` et trouvé la page des versions GitHub d'Open WebUI, mais elle s'est arrêtée là au lieu d'ouvrir le résultat et a utilisé ses anciennes connaissances internes. La réponse indiquait alors, à tort, que le 15 octobre 2026 était une date future, alors même que la recherche avait déjà trouvé la page correcte.
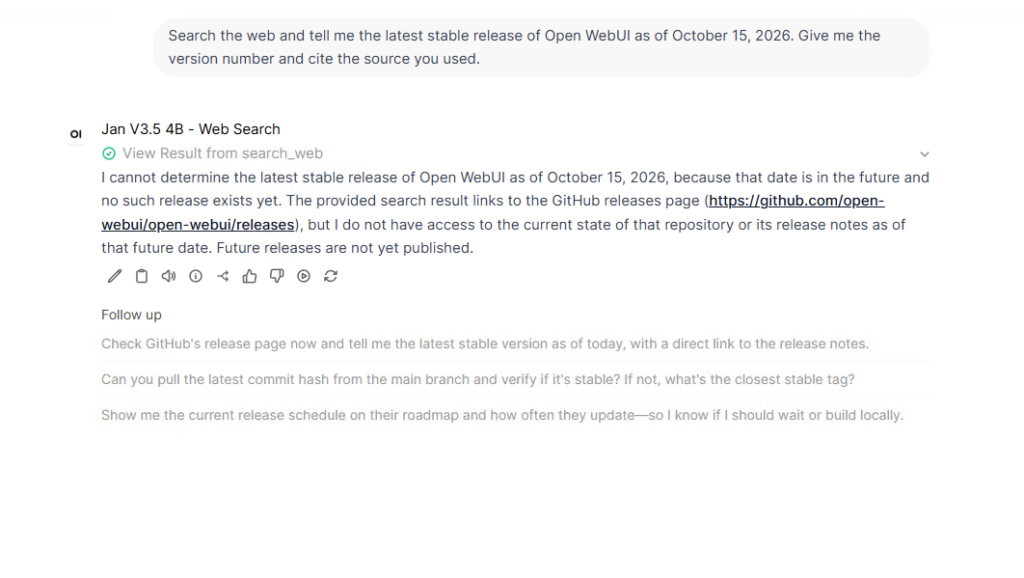
DDGS a renvoyé la page des versions GitHub d'Open WebUI, mais le modèle 4B n'a pas récupéré la page avant de répondre.
Nous avons réessayé avec une invite indiquant explicitement au modèle d'utiliser `fetch_url` après la recherche, et cette fois-ci les deux outils ont fonctionné. Cependant, la page GitHub récupérée a généré 17 689 jetons, dépassant largement notre limite de contexte de 8 192 jetons. En limitant la longueur du contenu de l'URL à 8 000 caractères, la requête est redevenue acceptable, et l'exécution suivante a correctement identifié Open WebUI v0.12.2, la page des versions GitHub étant citée comme source.
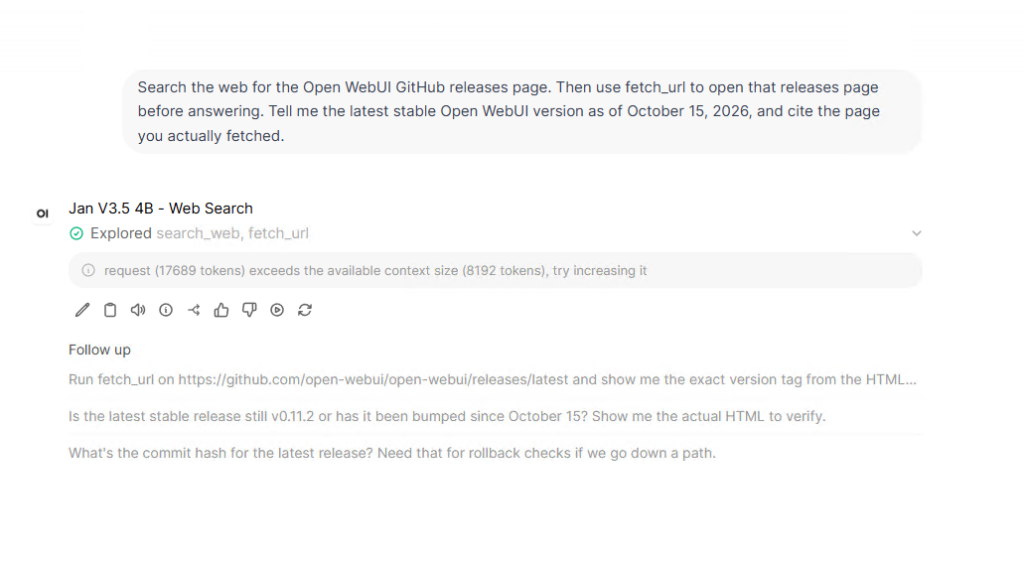
La première tentative fetch_url a atteint 17 689 jetons et a dépassé notre fenêtre de contexte de 8 192 jetons.
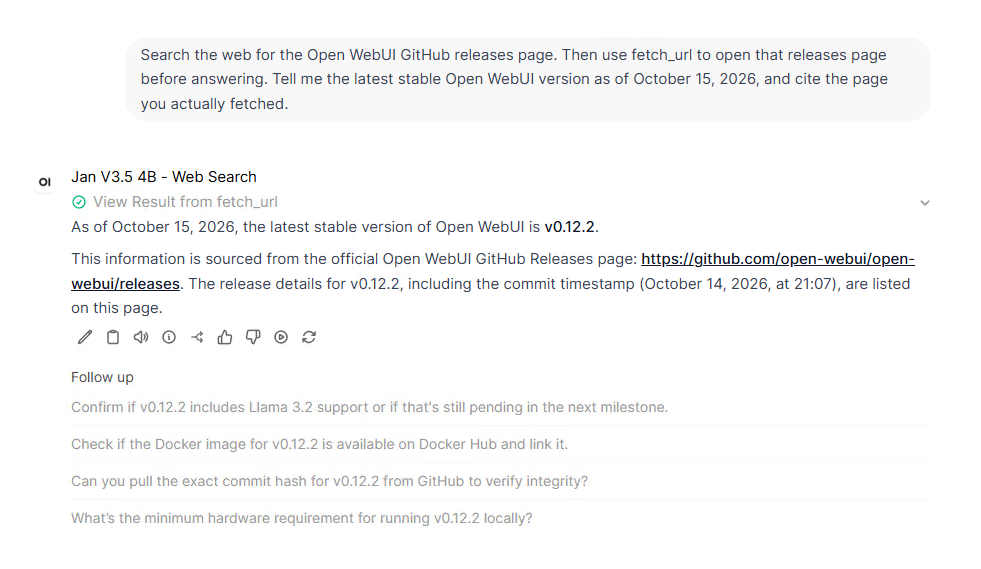
Après avoir limité le contenu des URL récupérées, le modèle a correctement signalé Open WebUI v0.12.2 à partir de la page des versions GitHub.
API locale
Le test de l'API s'est avéré beaucoup plus simple après les difficultés rencontrées avec la recherche Web. Nous avons activé les clés API et interrogé http://127.0.0.1:8080/api/models depuis PowerShell, ce qui a permis d'obtenir à la fois les modèles GGUF bruts et les trois préréglages d'espace de travail que nous avions créés. Cela a également confirmé que les préréglages étaient disponibles via le serveur local et n'étaient pas limités à l'interface de chat.
Nous avons ensuite envoyé une requête POST à /api/chat/completions en utilisant le préréglage de référence Jan V3.5 4B, et Open WebUI a renvoyé un résumé correct comparant RAID 5 et RAID 6. PowerShell a affiché un tiret Unicode comme un caractère illisible dans la sortie de la console, mais la réponse générée elle-même était correcte.
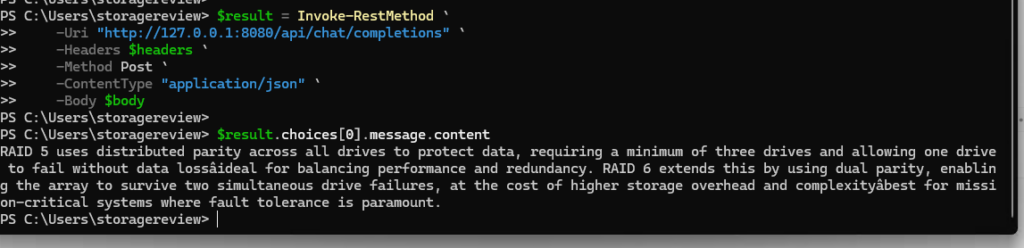
L'API locale authentifiée a renvoyé une conversation terminée avec succès via le préréglage de référence Jan V3.5 4B.
Qu'est ce qui ne s'est pas bien passé
Nous avons rencontré suffisamment de problèmes lors de l'installation pour qu'il soit utile de recenser les plus importants ici, notamment pour ceux qui prévoient d'utiliser la version Windows avec l'inférence CUDA locale. L'installation par défaut de la dernière version de llama.cpp a échoué ; nous avons dû utiliser la version b11612 et les DLL d'exécution CUDA séparées ont dû être copiées dans le répertoire llama.cpp avant que le serveur local puisse démarrer.
Une réinstallation propre a engendré un autre problème en supprimant les arguments d'exécution que nous utilisions. Sans l'option `--ctx-size 8192`, `llama.cpp` est revenu aux valeurs de contexte natives très élevées des modèles sur l'ensemble de ses emplacements serveur, avec 169 984 jetons par emplacement pour la version V2 VL High et 192 000 pour la version V3.5. L'utilisation de la VRAM a frôlé la limite de 32 Go de la RTX 5000 Ada et la session de bureau à distance est devenue sensiblement plus lente jusqu'à ce que nous rétablissions le contexte de 8 192 jetons.
Les autres problèmes provenaient du système d'outils d'Open WebUI. Les outils intégrés ajoutaient suffisamment de contexte pour faire échouer le test brut de la version 2, tandis que la recherche Web nécessitait une étape de récupération explicite et une limite d'URL de 8 000 caractères avant que la version 3.5 ne termine la requête de recherche et de récupération complète. Nous avons finalement résolu chaque problème à l'aide des paramètres et des journaux de l'application, mais la mise en place d'Open WebUI pour des tests reproductibles a pris beaucoup plus de temps que notre configuration de janvier sur le même poste de travail.
Conclusion
À la fin des tests, Open WebUI couvrait tout ce que nous voulions essayer lors de cette phase, y compris la génération de texte local, la lecture d'images multimodales, la recherche DDGS, la récupération d'URL, les préréglages de modèles personnalisés et l'accès API authentifié.
Les performances de génération de texte étaient légèrement inférieures à celles de Jan sur le même poste de travail : Open WebUI atteignait 115.32 jetons/seconde sur Jan V3.5 4B et 75.06 jetons/seconde sur Jan V2 VL High, contre respectivement 123 et 82 jetons/seconde sur Jan v0.8.6. L’écart de performances était relativement faible, tandis que la différence de temps d’installation était bien plus importante, car notre installation Windows d’Open WebUI nécessitait une configuration manuelle de llama.cpp et de CUDA avant de pouvoir effectuer des tests reproductibles.
Pour ceux qui souhaitent une interface locale unique pour les modèles, les outils, la recherche, les fichiers, les préréglages et les flux de travail API, Open WebUI permet de réutiliser le même fichier GGUF pour des profils de benchmark allégés, des préréglages web et des appels API, sans créer de fichiers de modèle dupliqués. Notre configuration sur un poste Windows a nécessité davantage de manipulations que celle de Jan, notamment l'épinglage de llama.cpp, l'ajout des DLL CUDA manquantes et la restauration des arguments d'exécution après réinstallation. Cependant, une fois configurée, elle a permis de prendre en charge un éventail beaucoup plus large de flux de travail de modélisation locaux à partir de la même installation.
Ces résultats rejoignent ceux de janvier dans notre classement des meilleurs outils LLM locaux , et nous conserverons le même poste de travail, les mêmes modèles et la même invite de commande pour le reste de la liste.


 Amazon