

NVIDIA와 마이크로소프트는 오늘 RTX Spark 윈도우 노트북 사전 주문을 시작했으며, 10월 16일부터 판매될 예정입니다. 소형 데스크톱은 11월에 출시될 예정이며, NVIDIA는 4분기에 출시할 DGX Station for Windows의 미리보기도 공개했습니다. 이러한 발표는 샌프란시스코에서 열린 마이크로소프트의 윈도우 AI 및 서피스 이벤트에서 이루어졌으며, 젠슨 황 CEO가 사티아 나델라 CEO와 함께 무대에 올랐습니다. 또한 마이크로소프트는 에이전트 격리 계층인 Microsoft Execution Containers를 윈도우 11에서 정식 출시한다고 발표했습니다.
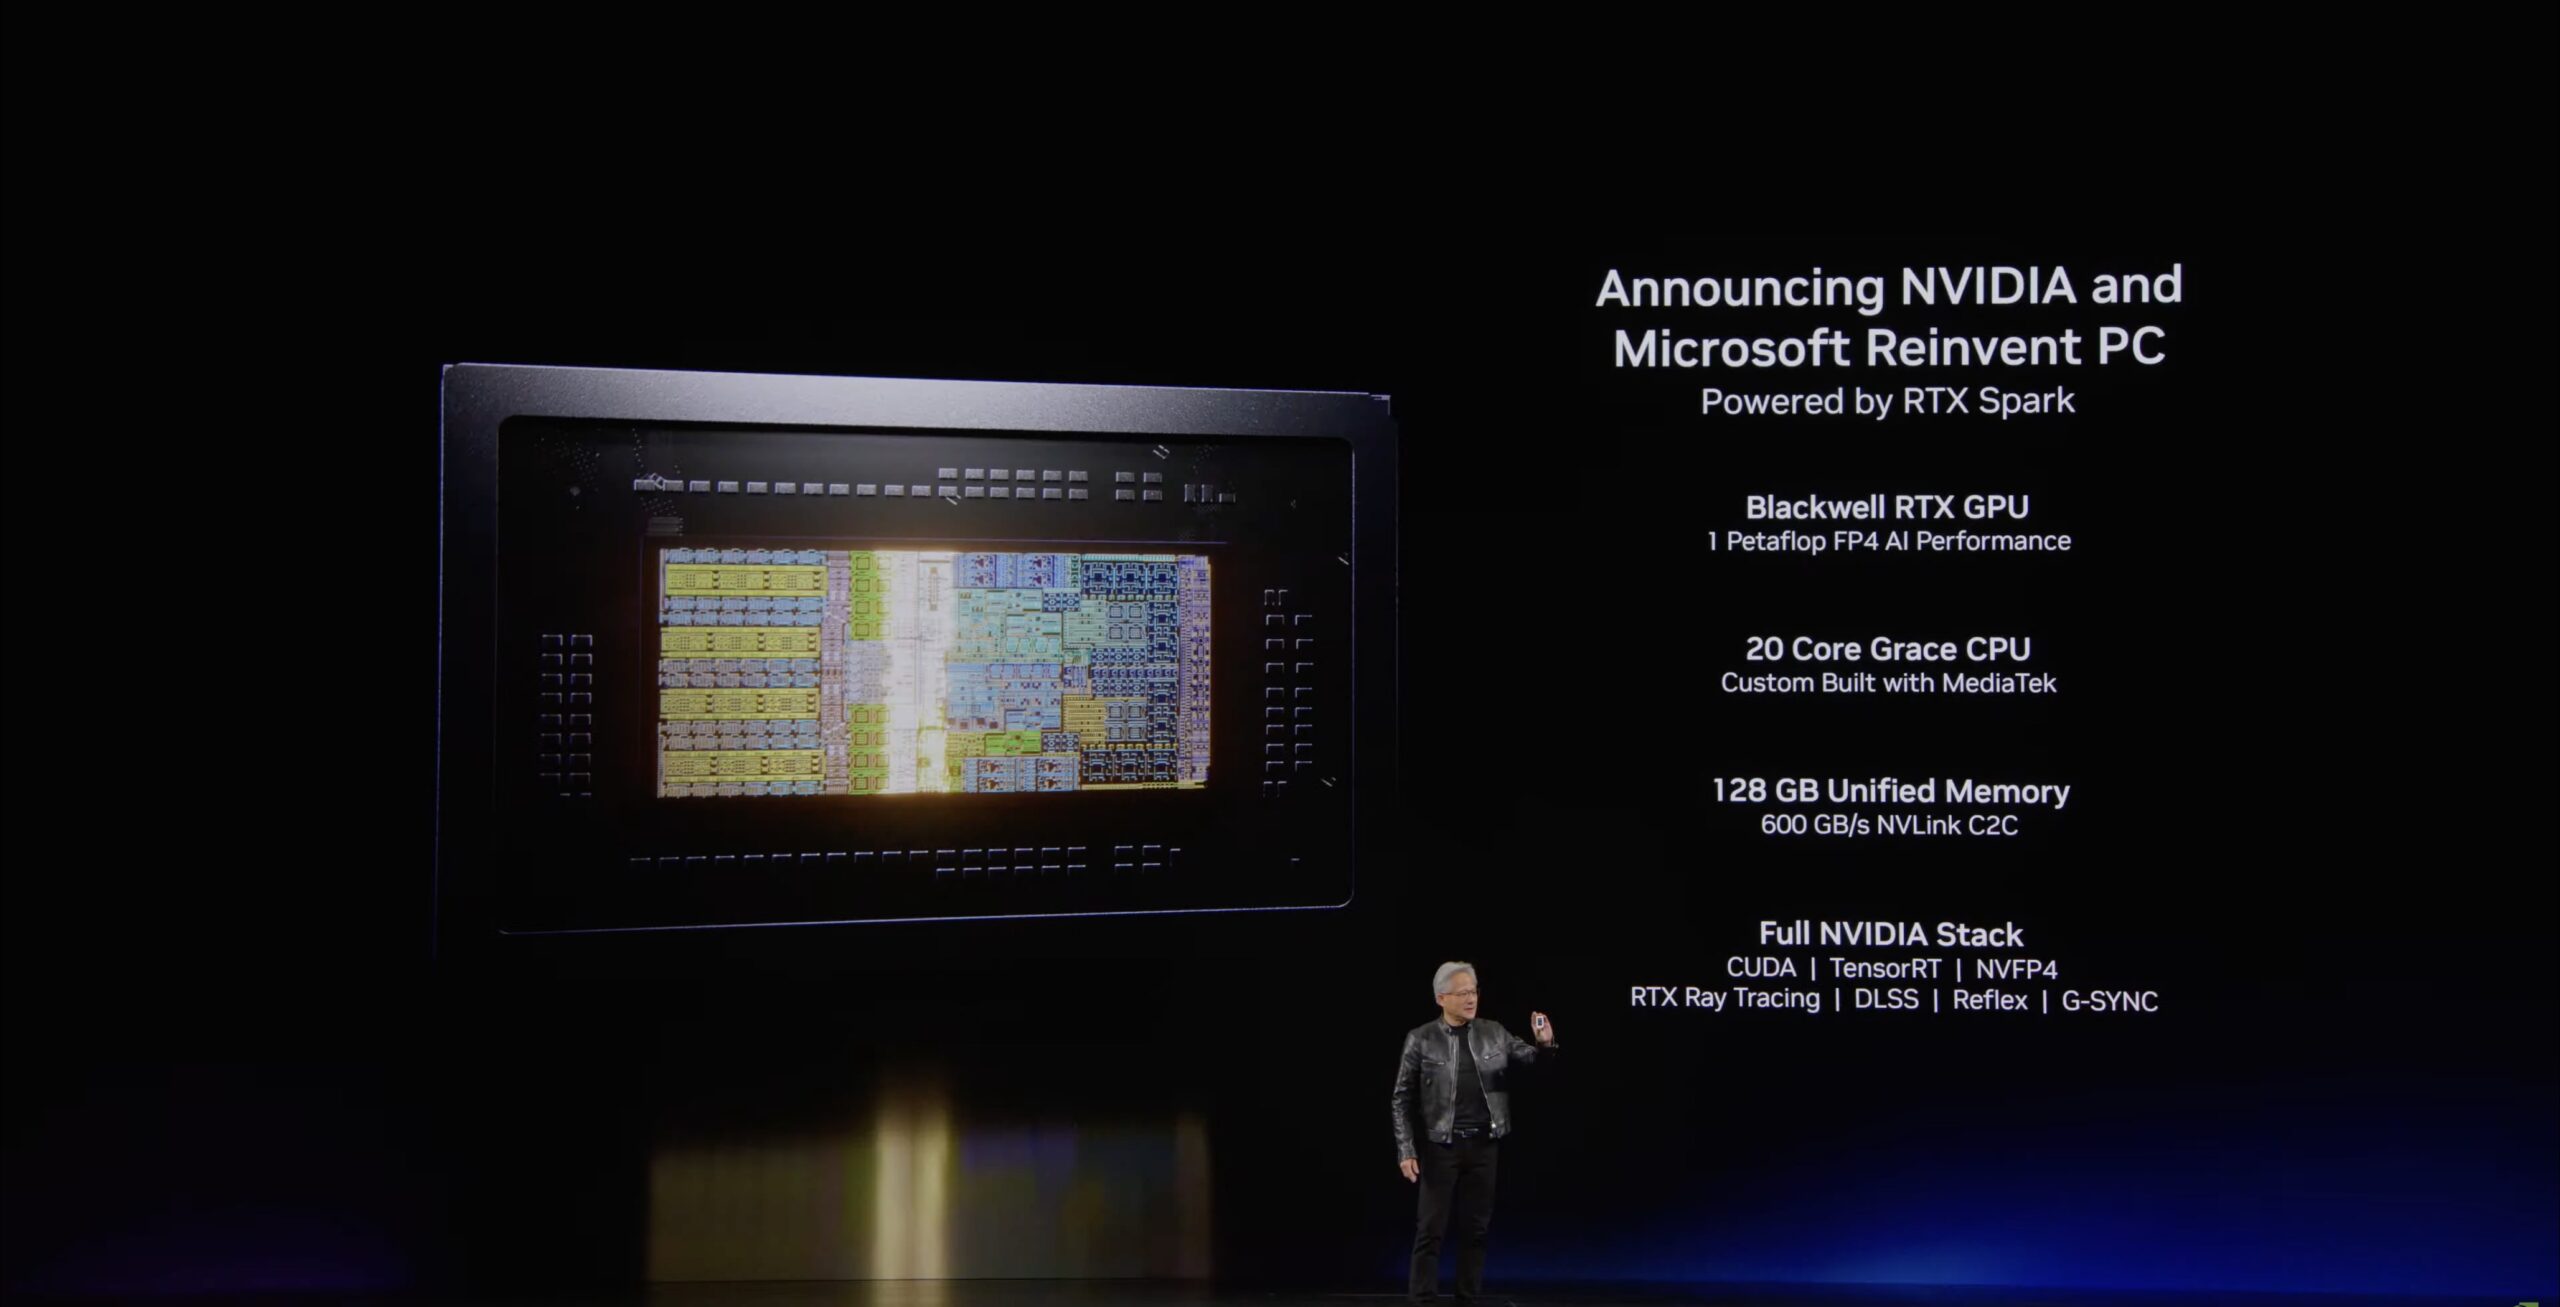
저희는 앞서 델 XPS 16 크리에이터 에디션 리뷰에서 이 시스템 중 첫 번째 제품을 다뤘고, 6월 컴퓨텍스 에서 해당 플랫폼을 공개했습니다 . 이번 글에서는 컴퓨텍스 행사 기간 동안 두 회사가 공개했지만 알려지지 않았던 내용들을 살펴보겠습니다. 여기에는 N1X 슈퍼칩의 전력 소비량, 윈도우가 통합 메모리 풀을 분할하는 방식, 노트북에서 1,370억 개의 파라미터를 가진 코딩 모델의 처리량 측정 결과, 샌드박스 에이전트 실행 환경, 그리고 윈도우 DGX 스테이션의 전체 사양표가 포함됩니다.
RTX Spark N1X: 두 개의 칩, 세 가지 전력 범위
NVIDIA의 RTX Spark 사양표는 이제 노트북과 데스크톱을 구분하고 있으며, 이러한 구분은 단순히 수치만으로 판단할 수 없는 더 많은 정보를 제공합니다. 노트북용 N1X는 두 가지 변형 모델이 있습니다. 하나는 6,144코어 Blackwell RTX GPU와 20코어 Grace CPU, 최대 128GB의 통합 LPDDR5X 메모리를 탑재한 모델이고, 다른 하나는 5,120코어 GPU와 18코어 CPU, 최대 64GB 메모리를 탑재한 모델입니다. 두 모델 모두 TDP는 45~80W입니다. 데스크톱용은 6,144코어, 20코어, 최대 128GB 메모리를 탑재한 모델만 제공되며, NVIDIA는 이 모델의 TDP를 140W로 명시하고 있습니다.
140W라는 수치는 NVIDIA가 DGX Spark에 공개한 GB10의 TDP와 동일하며, CPU와 GPU를 모두 포함한 수치입니다. 이는 NVIDIA가 지난 6월 두 칩이 서로 다른 플랫폼에 맞춰 최적화된 동일한 시스템이라고 밝힌 내용과 일치합니다. 또한, 노트북용 N1X는 데스크톱 버전 대비 32%~57%의 전력으로 작동하며, 모든 제품은 "최대 1페타플롭"의 FP4 성능을 제공한다고 명시되어 있습니다. 마이크로소프트 서피스의 각주에서는 이 수치를 희소성을 이용한 이론적인 FP4 성능으로 설명하고 있습니다.
| 스펙 | RTX Spark N1X (노트북) | RTX Spark N1X (노트북) | RTX Spark N1X (데스크탑) | GB10 (DGX 스파크) |
|---|---|---|---|---|
| GPU | 6,144코어 블랙웰 RTX | 5,120코어 블랙웰 RTX | 6,144코어 블랙웰 RTX | 블랙웰, 5세대 텐서 코어, 4세대 RT 코어 |
| CPU | 20코어 그레이스 | 18코어 그레이스 | 20코어 그레이스 | 20개의 Arm 코어(Cortex-X925 10개, Cortex-A725 10개) |
| TDP | 45 ~ 80W | 45 ~ 80W | 140W | 140W (240W 전원 공급 장치) |
| 통합 메모리 | 최대 128GB LPDDR5X | 최대 64GB LPDDR5X | 최대 128GB LPDDR5X | 64GB 또는 128GB LPDDR5X, 273GB/s |
| 미디어 엔진 | 9세대 NVENC 1개, 6세대 NVDEC 1개 | 9세대 NVENC 1개, 6세대 NVDEC 1개 | 9세대 NVENC 1개, 6세대 NVDEC 1개 | 1x NVENC, 1x NVDEC |
| 디스플레이 및 입출력 | PCIe Gen5, HDMI 2.1b, DisplayPort 2.1b | PCIe Gen5, HDMI 2.1b, DisplayPort 2.1b | PCIe Gen5, HDMI 2.1b, DisplayPort 2.1b | HDMI 2.1a, ConnectX-7 200Gb/s, 10GbE |
| 운영체제 | 윈도우 11 | 윈도우 11 | 윈도우 11 | 엔비디아 DGX OS |
NVIDIA는 N1X의 FP4 집적 응답 계수를 공개하지 않습니다. GB300의 경우 두 수치를 모두 공개하는데, 집적 응답 계수는 일반 응답 계수의 75%에 해당합니다. OEM의 열 설계가 DGX Spark 제품군과는 달리 이 두 노트북을 차별화할 것으로 예상되며, 제조사별 튜닝이 적용되기 전 노트북 TDP 범위 내에서 35W의 차이가 발생하는 것은 이를 뒷받침하는 첫 번째 확실한 증거입니다.
마이크로소프트는 데스크톱 시장에 새로운 변수를 추가했습니다. 자사의 Surface RTX Spark 개발자 박스 페이지에 따르면, 1,000개의 통풍구가 있는 알루미늄 섀시 내부의 열 설계 전력은 100W로, NVIDIA 데스크톱 N1X의 TDP보다 40W 낮습니다. 두 회사가 측정하는 기준이 다를 수 있습니다. 한쪽은 칩 성능을, 다른 쪽은 섀시 설계를 비교하는 것일 수 있지만, 11월에 소형 데스크톱을 비교하는 구매자라면 각 제조사의 제품 지속 전력 소비량을 확인해야 합니다.
메모리 속도 또한 GB10과의 플랫폼 차이점 중 하나입니다. Dell의 XPS 사양표에는 LPDDR5X 메모리가 9,400 MT/s의 속도를 제공한다고 명시되어 있는데, 이는 GB10과 같은 256비트 인터페이스에서 300.8GB/s에 해당합니다. 이는 NVIDIA가 6월에 발표한 300GB/s와 동일하며, DGX Spark의 273GB/s보다 약 10% 높은 수치입니다. CPU와 GPU는 NVLink-C2C를 통해 600GB/s의 속도로 연결됩니다. 나머지 사양은 세 제품 모두에 공통적입니다. 5세대 Tensor Core, 4세대 RT 코어, DLSS 5, Frame Warp를 지원하는 Reflex 2, 그리고 DSC를 지원하는 최대 4K 480Hz 또는 8K 120Hz의 HDMI 2.1b가 포함됩니다.
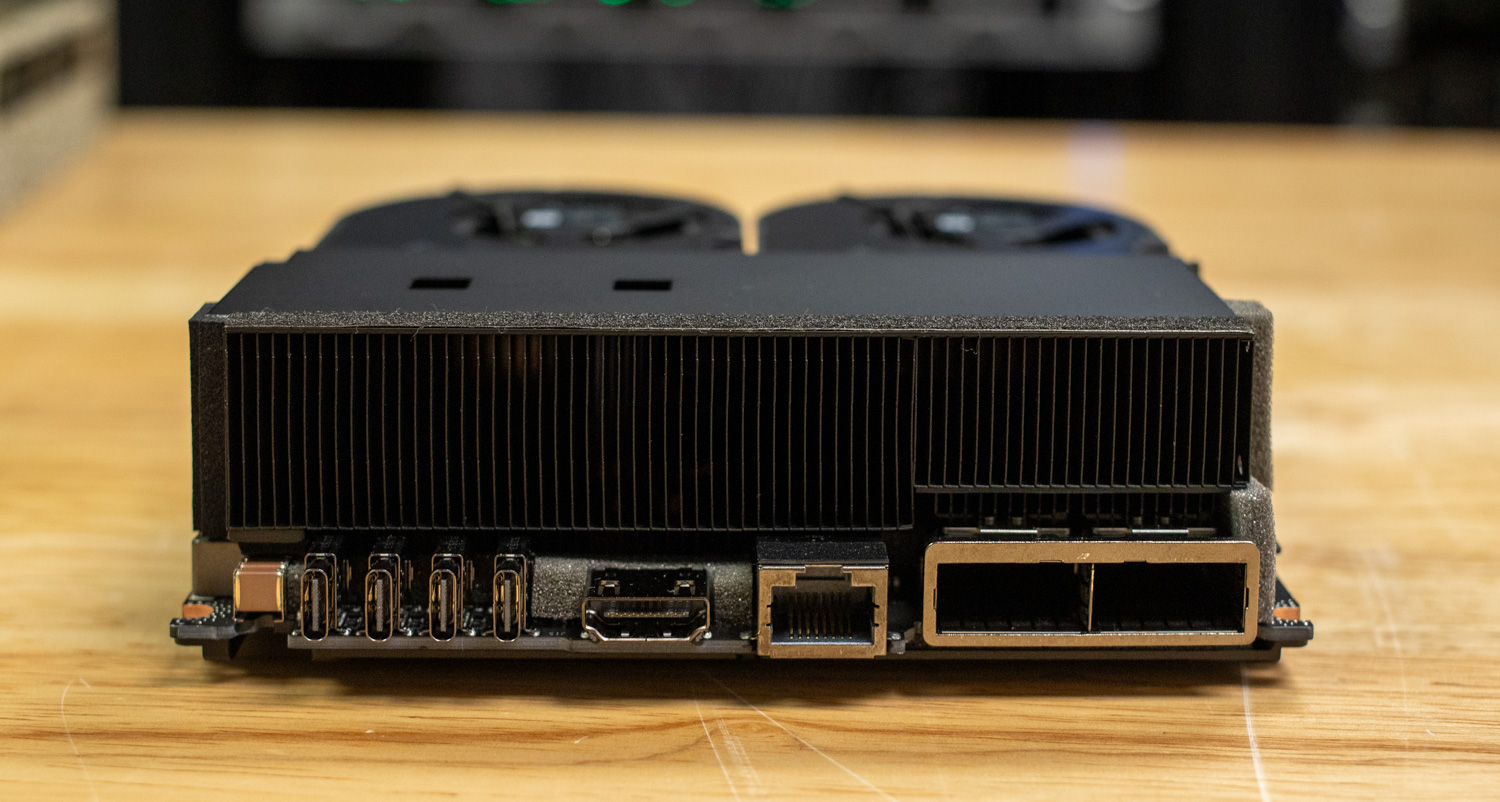
NVIDIA의 마켓플레이스에는 17가지 노트북 구성이 사전 주문 가능하며, 이 목록은 제목 아래에 숨겨진 다양한 사양을 보여줍니다. 우리가 살펴본 15가지 구성 중 7가지는 5,120코어 칩을 사용하고, 메모리는 24GB, 32GB, 48GB, 128GB이며, 저장 장치는 PCIe Gen4 및 Gen5 드라이브로 구성되어 있습니다.
윈도우는 128GB의 통합 메모리를 어떻게 분할할까요?
메모리는 CPU와 GPU 간에 동적으로 공유되며, GPU가 접근할 수 있는 최대 용량은 구성에 따라 다릅니다. 마이크로소프트와 깃허브의 엔지니어링 게시물에 있는 작업 관리자 스크린샷은 6,144코어 N1X가 탑재된 서피스 랩탑 울트라에서 이러한 상황이 어떻게 나타나는지 보여줍니다. Windows는 전용 GPU 메모리 74.9GB, 공유 GPU 메모리 35.5GB, 총 GPU 메모리 110GB, 시스템 메모리 51.5GB를 보고합니다.
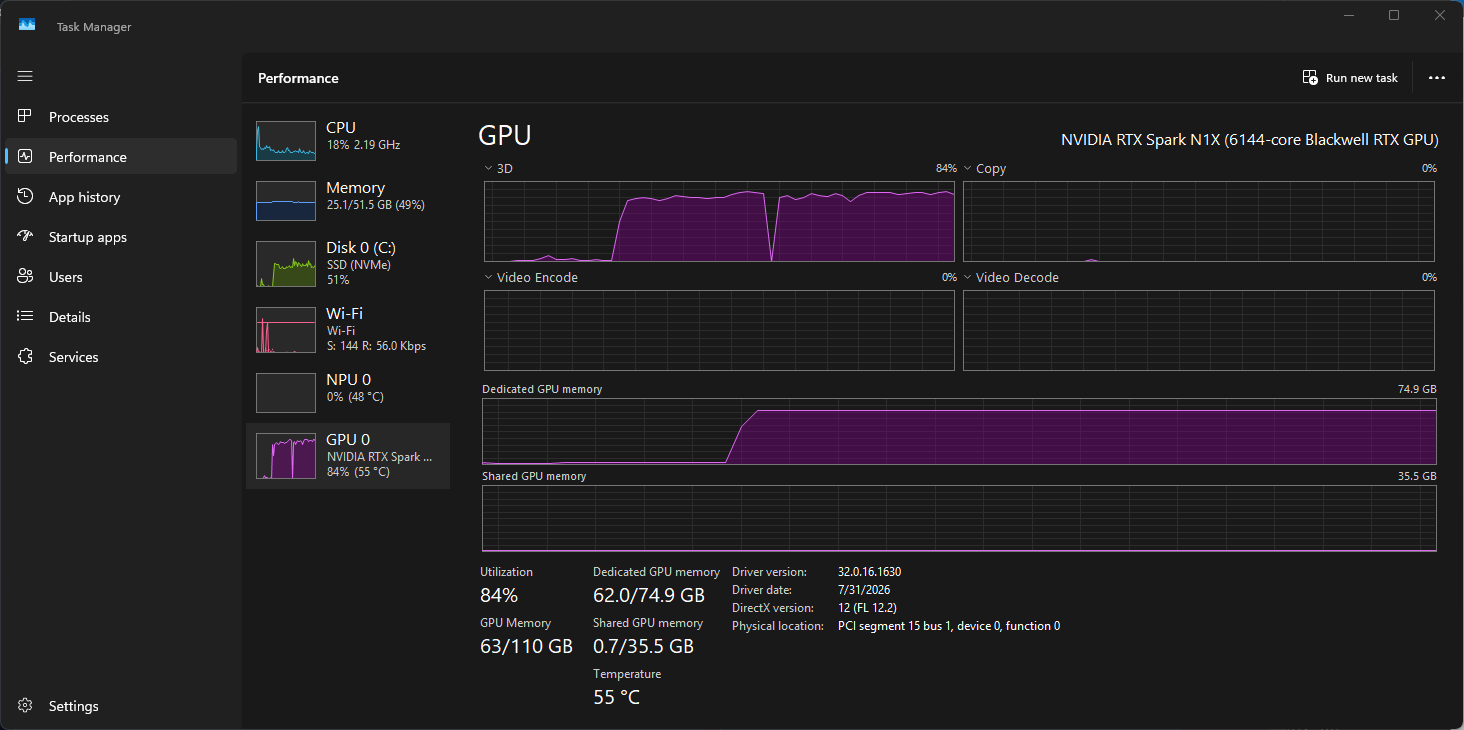
전용 메모리와 시스템 메모리를 합하면 126.4GB이므로 Windows는 통합 메모리 풀을 외장 그래픽 카드처럼 표시합니다. 즉, GPU가 시스템 메모리에서 일정 한도까지 빌려 쓸 수 있는 고정된 전용 할당량으로 표시하는 것입니다. 해당 시스템에서 GPU의 최대 메모리 사용량은 110GB, 즉 설치된 128GB의 86%이며, 가중치, 키-값 캐시 및 런타임 오버헤드 모두 이 한도 내에 맞춰야 합니다. 동일한 스크린샷에는 7월 31일자 드라이버 32.0.16.1630이 표시되어 있으며, NPU가 GPU와 별도의 장치로 나열되어 있습니다.
해당 게시글은 모델 가중치가 메모리 예산의 일부일 뿐이며, 운영 체제, 애플리케이션, 추론 런타임, 그리고 에이전트의 컨텍스트 확장에 따른 어텐션 상태를 저장하는 KV 캐시 모두 동일한 메모리 풀을 사용한다고 명시하고 있습니다. 사전 주문 목록의 상당 부분을 차지하는 24GB 및 32GB 구성의 경우, 4비트에서 27B급 모델 정도만 처리할 수 있으며 그 이상은 어렵습니다. 출시 자료에 언급된 대형 모델 관련 내용은 모두 128GB SKU를 기준으로 합니다.
호환 항목: 파라미터 개수 및 가중치당 비트 수
같은 칩에 대해 제시된 파라미터 상한값이 다소 불일치하는 것으로 보입니다. NVIDIA 제품 페이지에서는 120만 토큰 컨텍스트를 사용하는 모델이 최대 1억 개의 파라미터를 지원한다고 명시하고 있으며, 블로그에서는 Qwen 3.8 Flash Next를 125억 개의 파라미터를 지원하는 예시로 들고 있습니다. Microsoft는 120억 개를 초과하는 모델을 언급하며, RTX Spark에 탑재될 모델로 MAI Code 1.1 Flash(137억 개)와 DeepSeek V4 Flash(284억 개)를 예로 들고 있고, Dell은 200억 개를 제시하고 있습니다. 이러한 차이는 각 가중치가 사용하는 비트 수의 차이에서 비롯됩니다.
| 모델 | 파라미터 | 정밀성 | 발자국 | 출처 |
|---|---|---|---|---|
| MAI 코드 1.1 플래시 | 총 137억 명, 그중 6.8억 명이 활동 중(다양한 전문가 포함) | 혼합 정밀도, 가중치당 약 3.3비트 | 53GB 가중치; 256K 컨텍스트에서 최대 75.5GB | 마이크로소프트, 깃허브 |
| NVIDIA Nemotron (출시 예정) | 70억 이상 | 2-bit | 20GB 조금 넘는 용량 | Microsoft |
| DeepSeek V4 플래시 | 284B | 명시되지 않음 | 명시되지 않음 | Microsoft |
| Qwen 3.8 플래시 넥스트 | 125B | 명시되지 않음 | 명시되지 않음 | NVIDIA |
| 퀀3.5 27B | 27B | Q4_K_M | 명시되지 않음 | 마이크로소프트 벤치마크 각주 |
Microsoft가 제공한 MAI Code 1.1 플래시 메모리 관련 수치가 가장 완벽합니다. BF16의 클라우드 모델은 274GB이지만, 온디바이스 빌드는 53GB로, Microsoft는 이를 80% 감소라고 부릅니다. 이는 혼합 정밀도 양자화를 사용했을 때 가중치당 약 3.3비트를 기준으로 한 수치입니다. Nemotron의 수치도 마찬가지입니다. 70억 개의 가중치에 2비트를 사용하면 오버헤드를 제외하고 17.5GB가 필요합니다. DeepSeek V4 플래시 메모리는 284억 개의 파라미터를 처리할 경우 컨텍스트 로드 전 110GB GPU 용량 제한 내에서 처리하려면 가중치당 약 3.1~3.3비트 또는 그 이하의 비트가 필요합니다.
3비트 성능 주장에 주목할 만한 이유는 바로 품질 데이터 때문입니다. 마이크로소프트는 양자화된 온디바이스 모델이 SWE-Bench에서 70.8%의 성능을 보였다고 보고했는데, 이는 BF16 클라우드 버전의 72.6%와 비교했을 때 검증된 결과입니다. 또한 Terminal-Bench 2.1에서는 66.29%를 기록했는데, 이는 기존 모델의 62.9%와 비교됩니다. 두 번째 결과에서 양자화된 모델이 앞서긴 하지만, 89개 작업으로 구성된 테스트 세트에서 이는 3개 작업 차이에 불과하며, 큰 차이는 아닌 것으로 판단됩니다. 비교 대상인 Unsloth의 GPT-OSS-120B GGUF는 동일한 두 테스트에서 각각 32.0%와 23.6%를 기록했습니다.
이 처리량은 CUDA 백엔드와 Microsoft가 DFlash2 슬라이딩 윈도우 투기적 디코딩이라고 부르는 기술을 사용하는 Windows Arm64 빌드의 llama.cpp를 실행하는 Surface Laptop Ultra에서 합성 코드 생성 워크로드로 테스트한 결과입니다. Microsoft의 차트에는 데이터 레이블이 없으므로, 이는 저희의 추정치입니다. 2K 프롬프트에서 초당 약 63개 토큰, 8K에서 61개, 32K에서 57개, 64K에서 52개, 120K에서 55개, 256K에서 39개 토큰이 처리됩니다. 256K 컨텍스트에서의 최대 메모리 사용량은 75.5GB이며, 이는 작업 관리자 캡처에서 전용 GPU 수치와 정확히 일치합니다.

에이전트 작업에서 중요한 지표는 프롬프트 처리 속도입니다. 마이크로소프트는 64K 컨텍스트에서 초당 923.5개의 토큰, 128K 컨텍스트에서 초당 769.8개의 토큰을 처리합니다. 64K 프롬프트는 처리하는 데 약 71초가 걸리고, 128K 프롬프트는 첫 번째 출력 토큰이 나타나기까지 약 170초가 걸립니다. 블로그 게시물에서는 모델을 항상 로드해 둔다고 해서 응답 시간이 일정하게 유지되는 것은 아니며, Copilot은 작업을 라우팅할 때 캐시 상태를 고려한다는 점을 지적합니다. 따라서 리뷰용 하드웨어에서 먼저 측정할 수치는 사전 채움(prefill)입니다.
맥북 비교 및 참고 사항
마이크로소프트의 비교 결과에 따르면 RTX Spark PC는 M5 Pro 프로세서와 64GB RAM을 탑재한 16인치 MacBook Pro와 비교했을 때, 첫 번째 토큰 응답 시간은 최대 2.1배, 이미지 생성 속도는 최대 4.3배, 비디오 생성 속도는 최대 6.2배 빠른 것으로 나타났습니다. 첫 번째 토큰 응답 시간은 마이크로소프트가 의뢰한 llama.cpp 테스트에서 Qwen3.5 27B 컴파일러(Q4_K_M)와 8,192개의 토큰으로 구성된 고정 프롬프트를 사용한 결과입니다. 나머지 두 가지 결과는 NVIDIA가 ComfyUI에서 FLUX.2 Klein 4B 컴파일러(4단계, 1024 x 1024 해상도)와 LTX 2.3 22B 컴파일러(121프레임, 8단계, 1280 x 720 해상도)를 사용하여 수행한 테스트 결과입니다.
각주에는 몇 가지 제한 사항이 있는데, 우선 하드웨어부터 살펴보겠습니다. 모든 테스트는 9월에 64GB RAM을 탑재한 RTX Spark 사전 생산 시스템에서 실행되었으며, Apple 시스템은 M5 Pro이고 비교 대상에 M5 Max는 포함되지 않았습니다. ComfyUI 테스트는 모두 NVFP4 정밀도의 모델을 사용했으며, 각주에는 Mac의 소프트웨어 구성에 대한 설명이 없습니다. 언어 모델 결과는 하나의 프롬프트 길이에 대한 프리필 측정값이며, 두 회사 모두 초당 디코딩 토큰 수 비교 결과를 공개하지 않았는데, 이는 대부분의 현지 LLM 사용자들이 인용하는 수치입니다.
게임과 관련하여 NVIDIA는 RTX Spark가 DLSS 5, Reflex 및 G-SYNC를 지원하여 AAA급 게임을 1440p 해상도에서 초당 100프레임 이상으로 구동할 수 있다고 밝혔지만, 구체적인 게임 제목이나 설정은 공개하지 않았습니다. Microsoft는 DirectX 레이 트레이싱, 가변 레이트 셰이딩, DirectStorage 및 Advanced Shader Delivery를 지원하는 Gears of War: E-Day를 선보였는데, Microsoft는 Advanced Shader Delivery를 통해 최초 실행 시 셰이더 컴파일 시간을 몇 분에서 몇 초로 단축했다고 설명했습니다. 또한, Call of Duty를 2027년에 RTX Spark로 출시할 예정이라고 밝혔습니다. Prism 및 부정행위 방지 기능에 대한 자세한 내용은 Dell 관련 기사 에서 확인할 수 있습니다.
Microsoft 실행 컨테이너: 에이전트 샌드박스 작동 방식
MXC는 이번 발표에서 가장 광범위한 영향을 미칠 것으로 예상되는 부분으로, 모든 Windows 11 PC에 적용되며 오픈 소스 라이브러리 및 macOS와 Linux용 백엔드를 포함하는 다국어 SDK로 제공됩니다. 개발자는 JSON 정책을 통해 워크로드에 필요한 사항(수정 가능한 파일, 읽기 전용 파일, 인바운드 및 아웃바운드 네트워크 액세스, 데스크톱 접근 허용 여부 등)을 정의합니다. MXC는 이러한 정책을 격리 백엔드에 매핑하고 런타임에 적용하며, 정책은 워크로드 외부에 존재하므로 생성된 코드가 스스로에게 더 많은 액세스 권한을 부여할 수 없습니다.
| MXC 백엔드 | 플랫폼 | 기구 | 사용 목적 |
|---|---|---|---|
| 프로세스 컨테이너 | 윈도우 11, 맥OS, 리눅스 | Windows에서는 AppContainer, macOS에서는 Seatbelt, Linux에서는 Bubblewrap | 모델 생성 코드 및 도구 실행을 위한 저지연 격리 |
| 세션 컨테이너 | 윈도우 11 전용 | 별도의 Windows 계정과 세션을 사용하여 데스크톱, 클립보드, 사용자 인터페이스 및 입력 영역을 확보하십시오. | 데스크톱이 필요한 장기 실행 에이전트 및 자동화 |
| WSL 컨테이너(WSLc) | 윈도우 11 전용 | WSL을 통한 Linux 실행 환경 | 리눅스 우선 에이전트 툴체인 |
| 마이크로VM | Windows 11 및 Linux(실험적) | 하드웨어로 강제되는 가상화 경계 | 위험도가 높은 워크로드와 신뢰할 수 없는 코드 |
정책 작성 주기에는 세 가지 운영 모드가 있습니다. 적용 모드는 정책 범위를 벗어나는 모든 작업을 차단하고, 학습 모드는 해당 작업을 차단하고 JSON 활동 보고서에 기록합니다. 허용 모드는 작업을 허용하고 차단되었을 작업을 기록하므로, 팀에서 실제 작업 환경에서 에이전트를 실행하고 이를 바탕으로 최소 권한 정책을 수립할 수 있습니다. 활동 보고서는 Windows의 프로세스 컨테이너에서만 사용할 수 있습니다. 조직은 관리 도구를 통해 개발자 정책에 자체 제약 조건을 추가할 수 있으며, Microsoft는 MXC 프로세스 컨테이너에 대한 Intune 관리 기능이 곧 제공될 예정이라고 밝혔습니다.
일반적으로 사용 가능한 기능에 대해 명확히 할 필요가 있는데, 10월 7일에 출시된 것은 컨테이너 기능입니다. Microsoft Entra가 에이전트의 활동을 로그인한 사용자의 활동과 구분하는 에이전트 ID 기능은 곧 출시될 예정이며, Agent 365 제어 기능을 로컬 에이전트로 확장하는 기능도 마찬가지입니다. 이러한 기능이 출시될 때까지 MXC 컨테이너는 에이전트가 접근할 수 있는 영역을 제한하지만, 보안 도구는 여전히 사용자의 ID로 에이전트 활동을 인식합니다. 또한 Microsoft가 설명하는 플릿 수준의 거버넌스는 아직 구현되지 않았으며, Microsoft는 자체 각주에서 대규모 거버넌스를 위해서는 추가 서비스가 필요할 수 있다고 언급했습니다.
GitHub의 자체 통합 설명은 경계가 어디에 있는지 보여줍니다. Copilot은 Windows에서 프로세스 컨테이너의 기본 계층을 사용하며, 셸 명령과 로컬 모델 컨텍스트 프로토콜(MCP) 서버 및 언어 서버는 기본적으로 그 안에서 실행됩니다. Copilot의 내장 파일 도구는 에이전트 하네스에서 실행되며, 여기서 요청은 정책에 따라 검사되지만 운영 체제에 의해 격리되지는 않습니다. 또한 원격 MCP 서버는 로컬 샌드박스 외부에 완전히 위치합니다. 로컬 추론은 이러한 구조를 변경하지 않는데, 셸 명령은 어떤 모델이 요청했든 동일한 액세스 권한을 상속받기 때문입니다.
현재 MXC를 지원하는 에이전트에는 GitHub Copilot, OpenAI Codex, OpenClaw, Replit, LM Studio 및 Unsloth AI가 있으며, Claude Code, Perplexity, Manus 및 Hermes Agent는 향후 지원 예정으로 예정되어 있습니다. NVIDIA는 OpenShell을 MXC에 통합했는데, Microsoft에 따르면 이를 통해 파일 및 추론 서비스에 대한 에이전트 액세스 정책 제어, 고급 네트워크 제어, 자격 증명 관리 및 기업용 OCSF 감사 기능이 추가됩니다.
황 CEO는 이번 발표의 핵심을 컨테이너 계층에 두며 "윈도우와 DirectX가 애플리케이션 개발 방식을 혁신했듯이, MXC는 에이전트 개발 및 배포 방식을 혁신할 것"이라고 강조했습니다. 하지만 저희는 좀 더 좁은 시각으로 바라봅니다. 정책 모델 자체는 훌륭하고, 크로스 플랫폼 SDK 덕분에 도입 비용은 낮아졌지만, 지금까지 자세히 설명된 통합 방식은 가장 가벼운 백엔드를 사용하고 있으며, 에이전트의 격리 수준은 개발자가 선택한 백엔드에 따라 좌우됩니다.
하이브리드 라우팅: HydraFusion, Windows ML 및 llama.cpp
로컬 모델은 GitHub Copilot을 통해 개발자에게 제공됩니다. GitHub가 올해 초 각 작업을 적절한 클라우드 모델로 라우팅하기 위해 출시한 HydraFusion은 디바이스의 모델까지 확장될 예정이며, 10월 말 Copilot 앱, Copilot CLI 및 Visual Studio Code에서 실험적 미리 보기 버전이 제공될 예정입니다. 개발자는 모델 배치를 자동으로 설정하거나 Windows ML 공급자를 통해 제공되는 MAI Code 1.1 Flash 또는 OpenAI 호환 로컬 엔드포인트에 있는 모든 모델 중에서 명시적으로 로컬 모델을 선택할 수 있습니다.
마이크로소프트는 또한 위의 MAI 코드 번호가 생성된 런타임인 Windows ML에 llama.cpp 지원을 추가했으며, 이를 통해 오픈 모델 생태계가 플랫폼에 진출할 수 있는 지원 경로를 제공합니다. 저희의 ' 최고의 로컬 LLM 도구' 페이지에서는 이를 기반으로 구축된 런타임과 프런트엔드를 추적하고 있습니다. 하지만 마이크로소프트 자체의 주장은 다소 보수적입니다. 개발자 박스 페이지에서는 지능형 라우팅을 통해 Copilot 워크로드의 최대 20%를 로컬 모델로 오프로드할 수 있다고 명시하고 있는데, 이는 로컬 추론을 클라우드가 여전히 대부분의 작업을 수행하는 상황에서 제한된 예산을 효율적으로 활용하는 방법으로 설명하는 것입니다.
시스템, 가격 및 날짜
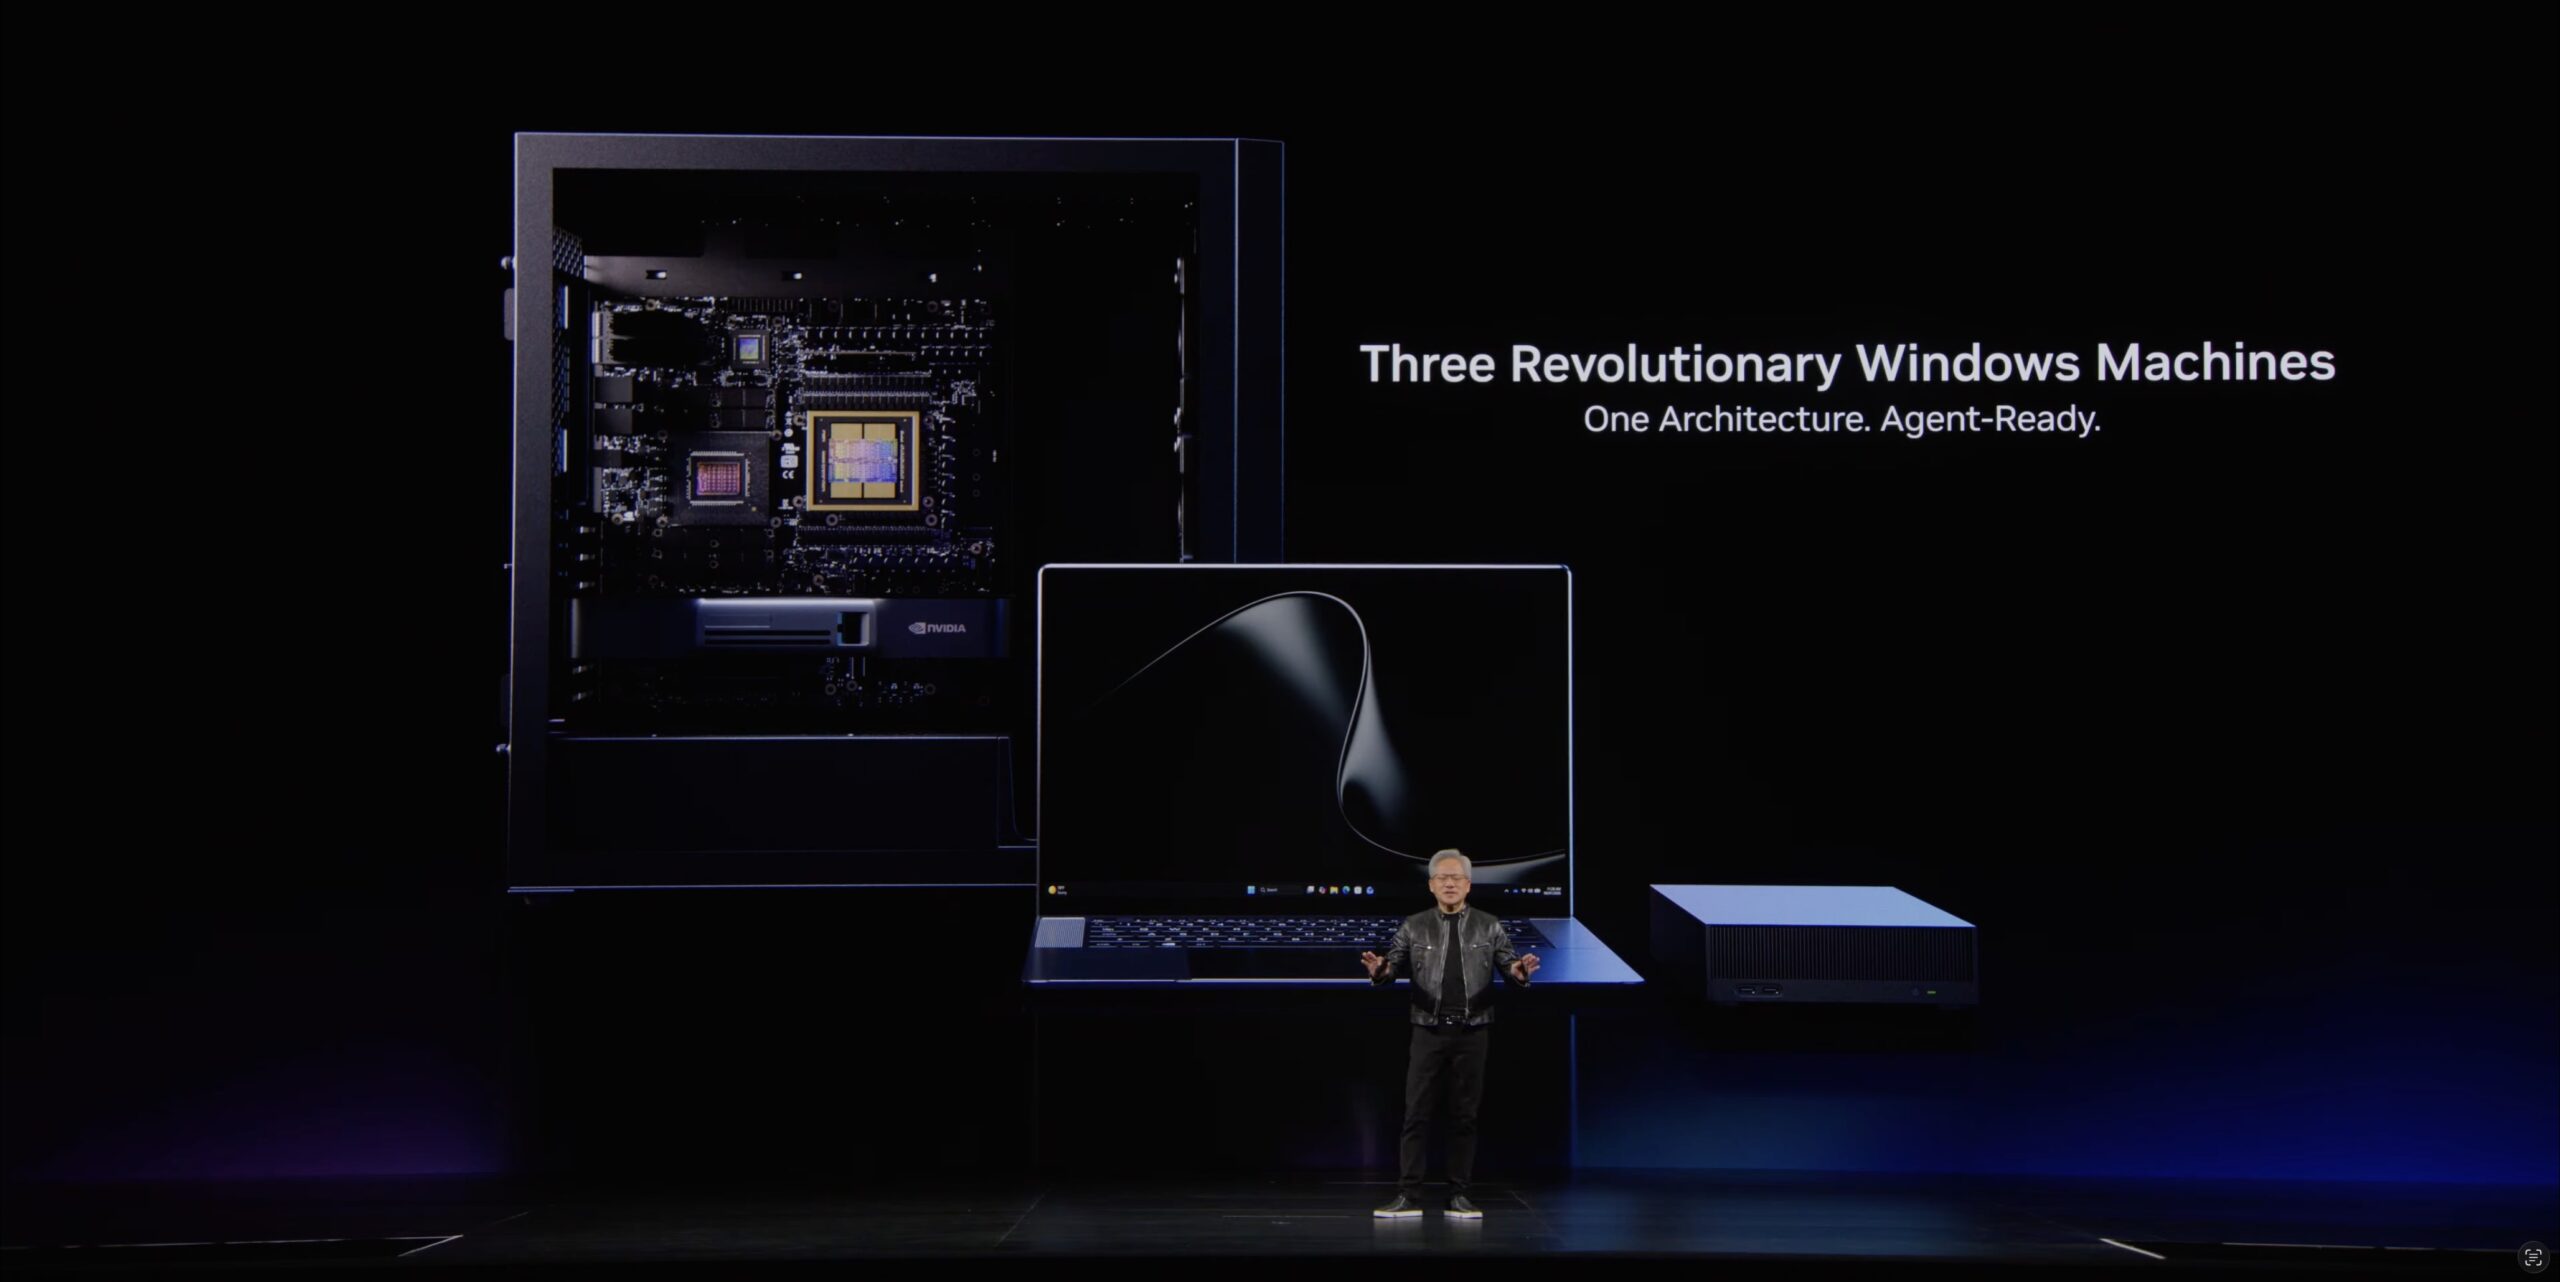
ASUS ProArt P16 및 P14, Dell XPS 16 Creator Edition , HP OmniBook Ultra 16, Lenovo Yoga 9n 2-in-1, MSI Prestige N16 Flip AI+, 그리고 Microsoft Surface Laptop Ultra 등 6개 OEM 업체가 10월 16일 출시 예정인 노트북 사전 주문을 받고 있습니다. NVIDIA 마켓플레이스에는 HP OmniBook X 14도 등록되어 있습니다. MSI 제품은 16인치 UHD+ 탠덤 OLED 디스플레이와 99.9Wh 배터리를 탑재했습니다. NVIDIA는 또한 Acer와 Gigabyte를 RTX Spark 시스템을 출시하는 업체로 언급했습니다.
Surface Laptop Ultra는 2,599달러부터 시작하며, 이는 지금까지 본 RTX Spark 탑재 제품 중 가장 저렴한 가격입니다. 마이크로소프트는 이 제품의 두께를 18mm 미만, 무게를 4.5파운드(약 2kg)로 발표했습니다. 기존 Surface Laptop보다 2.5배 향상된 열 용량, 3270 x 2180 해상도의 15인치 120Hz 터치스크린(10% 창 기준 최대 2,000니트의 HDR 밝기), 탈부착 가능한 저장 장치, 그리고 비디오와 데이터를 동시에 전송할 수 있는 마그네틱 USB-C 충전 포트를 갖추고 있습니다. 일부 구성에는 140W 전원 공급 장치가 포함됩니다. NVIDIA 마켓플레이스에서 가장 낮은 구성은 5,120코어 칩과 24GB RAM, 그리고 512GB Gen4 SSD를 탑재했습니다.
Surface RTX Spark Dev Box는 가격이 5,999달러(128GB 모델 기준)인 최초의 소형 데스크톱으로, 미국에서는 Microsoft.com에서만 판매되며 11월에 출시될 예정입니다. Visual Studio Code, Git, GitHub Copilot, WSL, Python, Node가 사전 설치되어 있습니다. 이는 4,999달러인 64GB DGX Spark 보다 1,000달러 더 비싸지만 메모리 용량은 두 배입니다. Microsoft는 USB-C 포트 2개, USB-A 포트 1개, HDMI 포트 1개, 이더넷 포트 1개, 헤드폰 잭 1개를 제공한다고 명시했지만, DGX Spark 클러스터링을 가능하게 하는 ConnectX-7 포트에 대한 언급은 없습니다. 이는 지난 6월 우리가 제기했던 데스크톱 네트워킹 문제에 대한 해답 중 하나였습니다.
DGX Station for Windows: 4분기 출시, 전체 사양표 포함
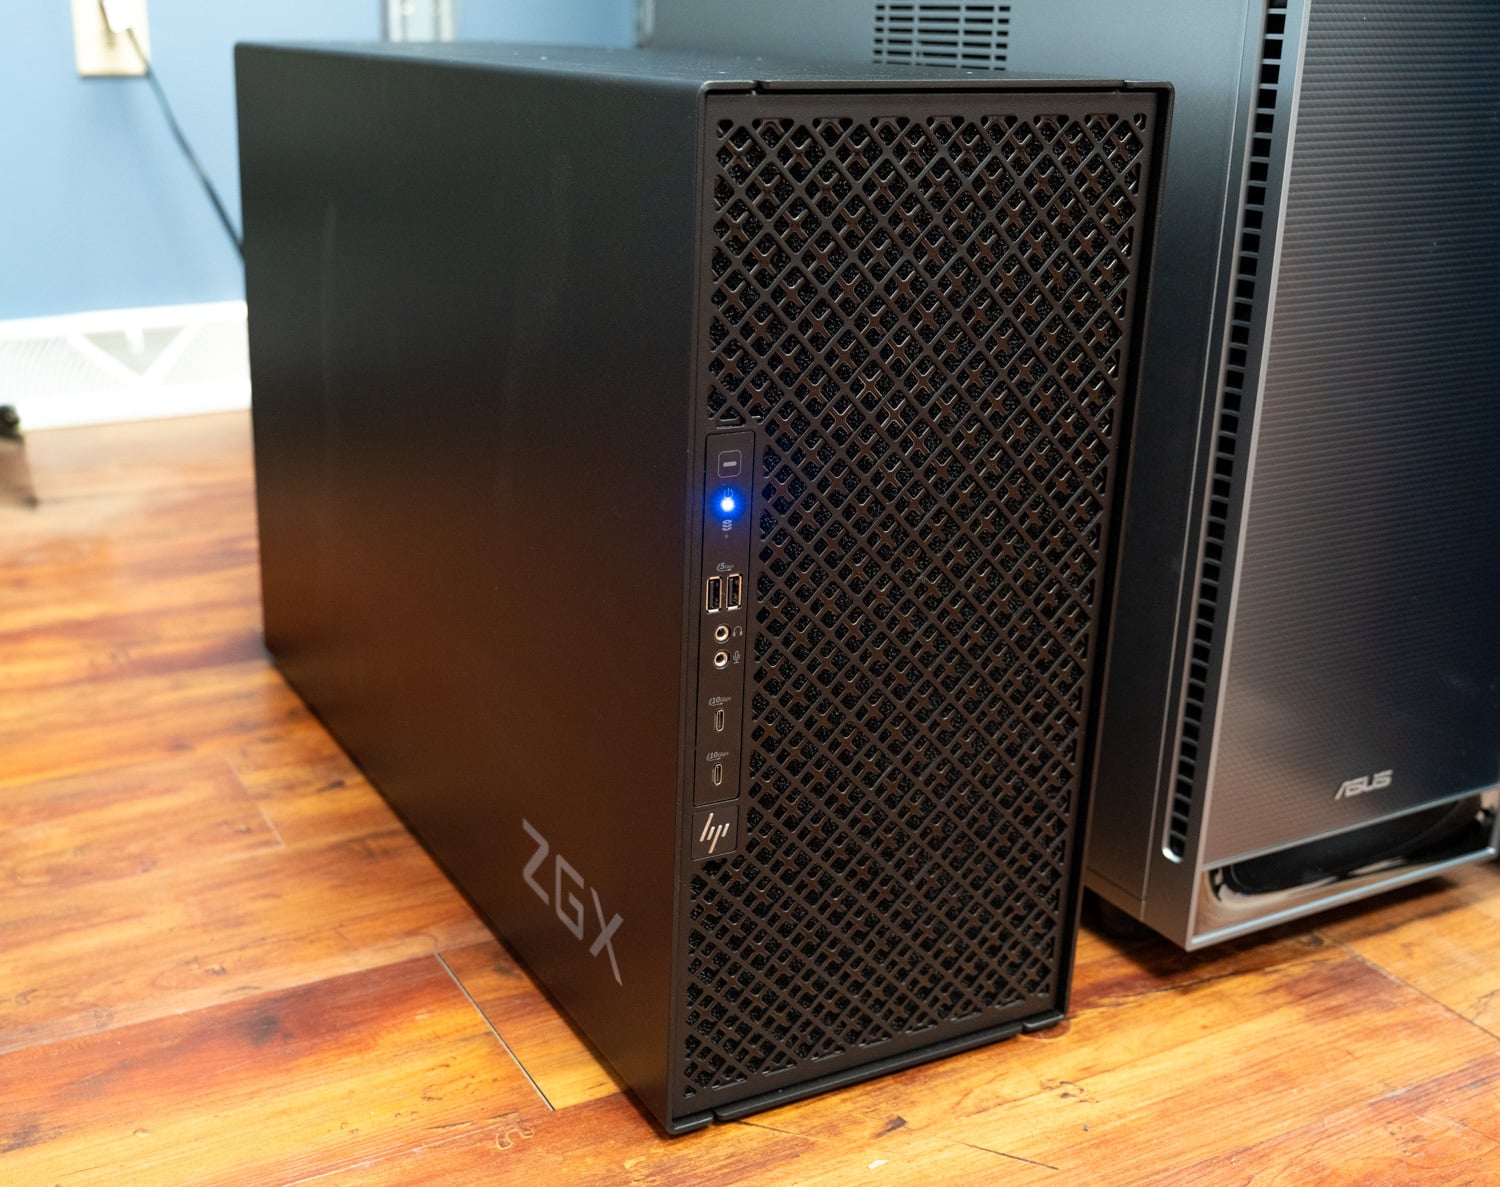
NVIDIA의 DGX Station for Windows 페이지에는 "4분기 출시 예정"이라고 표시되어 있으며, Microsoft는 Dell Pro Precision(GB300 탑재)과 HP ZGX Fury AI Station을 먼저 언급하며 올해 말 출시 예정이라고 밝혔습니다. NVIDIA의 파트너 목록에는 ASUS, Gigabyte, MSI, Supermicro가 추가되었습니다. 하드웨어는 GB300 Grace Blackwell Ultra Desktop Superchip으로, 이전에 Ubuntu에서 MSI XpertStation WS300 , ASUS ExpertCenter Pro ET900N G3 , 그리고 두 대의 데스크탑으로 구성된 클러스터 에서 테스트한 바 있습니다.
| 스펙 | NVIDIA DGX Station for Windows |
|---|---|
| GPU | NVIDIA Blackwell Ultra 1개, 252GB HBM3e (7.1TB/s) |
| CPU | 그레이스(Grace) 1개, 네오버스 V2 코어 72개, 496GB LPDDR5X 메모리 (396GB/s) |
| 일관된 기억 | 최대 748GB; NVLink-C2C, 900GB/s 속도 |
| FP4 텐서 코어 | 희소성 적용 시 20 PFLOPS, 희소성 미적용 시 15 PFLOPS |
| FP8 및 FP6 텐서 코어 | 10PFLOPS |
| FP16 및 BF16 텐서 코어 | 5PFLOPS |
| TF32 텐서 코어 | 2.5PFLOPS |
| FP32 / FP64 | 80 테라플롭스 / 1.3 테라플롭스 |
| 네트워킹 | ConnectX-8 SuperNIC, 최대 800Gb/s: 포트당 400Gb/s 속도의 QSFP112 2개 10GbE RJ-45 포트 1개, 1GbE RJ-45 포트(BMC) 1개 |
| 스토리지 | 4개의 M.2 PCIe Gen5 슬롯 |
| PCIe 슬롯 | PCIe Gen5 x16 1개; PCIe Gen5 x16 2개 (전기적 x8) |
| 지원되는 RTX PRO GPU | RTX PRO 6000 워크스테이션 에디션, RTX PRO 6000 블랙웰 맥스-Q 워크스테이션 에디션, RTX PRO 4000 블랙웰 SFF 에디션, RTX PRO 2000 블랙웰 (시스템에 따라 지원 여부가 다를 수 있습니다) |
| 디코더 | 7 NVDEC, 7 nvJPEG |
| 시스템 전원 | 1,600W; 20A 회로 필요 |
| 운영체제 | Microsoft Windows; WSL을 통한 Linux 툴체인 |
마이크로소프트는 Windows DGX Station의 두 가지 용도를 설명합니다. 하나는 엔지니어링 및 연구 작업을 위한 개인용 AI 슈퍼컴퓨터로, Llama 4 Maverick, Kimi K2.6, DeepSeek V4 Pro와 같은 모델을 실행하며, 각주에 따르면 하드웨어는 최대 1조 개의 매개변수를 가진 모델을 지원합니다. 다른 하나는 Windows 토큰 팩토리라고 부르는 공유 시스템으로, 팀에서 클라우드 토큰 사용량을 줄이기 위해 32개 이상의 에이전트를 동시에 실행할 수 있도록 지원합니다. 마이크로소프트는 IT 부서에서 자사의 Windows 시스템 전반에 사용하는 동일한 도구를 사용하여 이러한 시스템을 관리할 수 있다고 밝혔습니다.
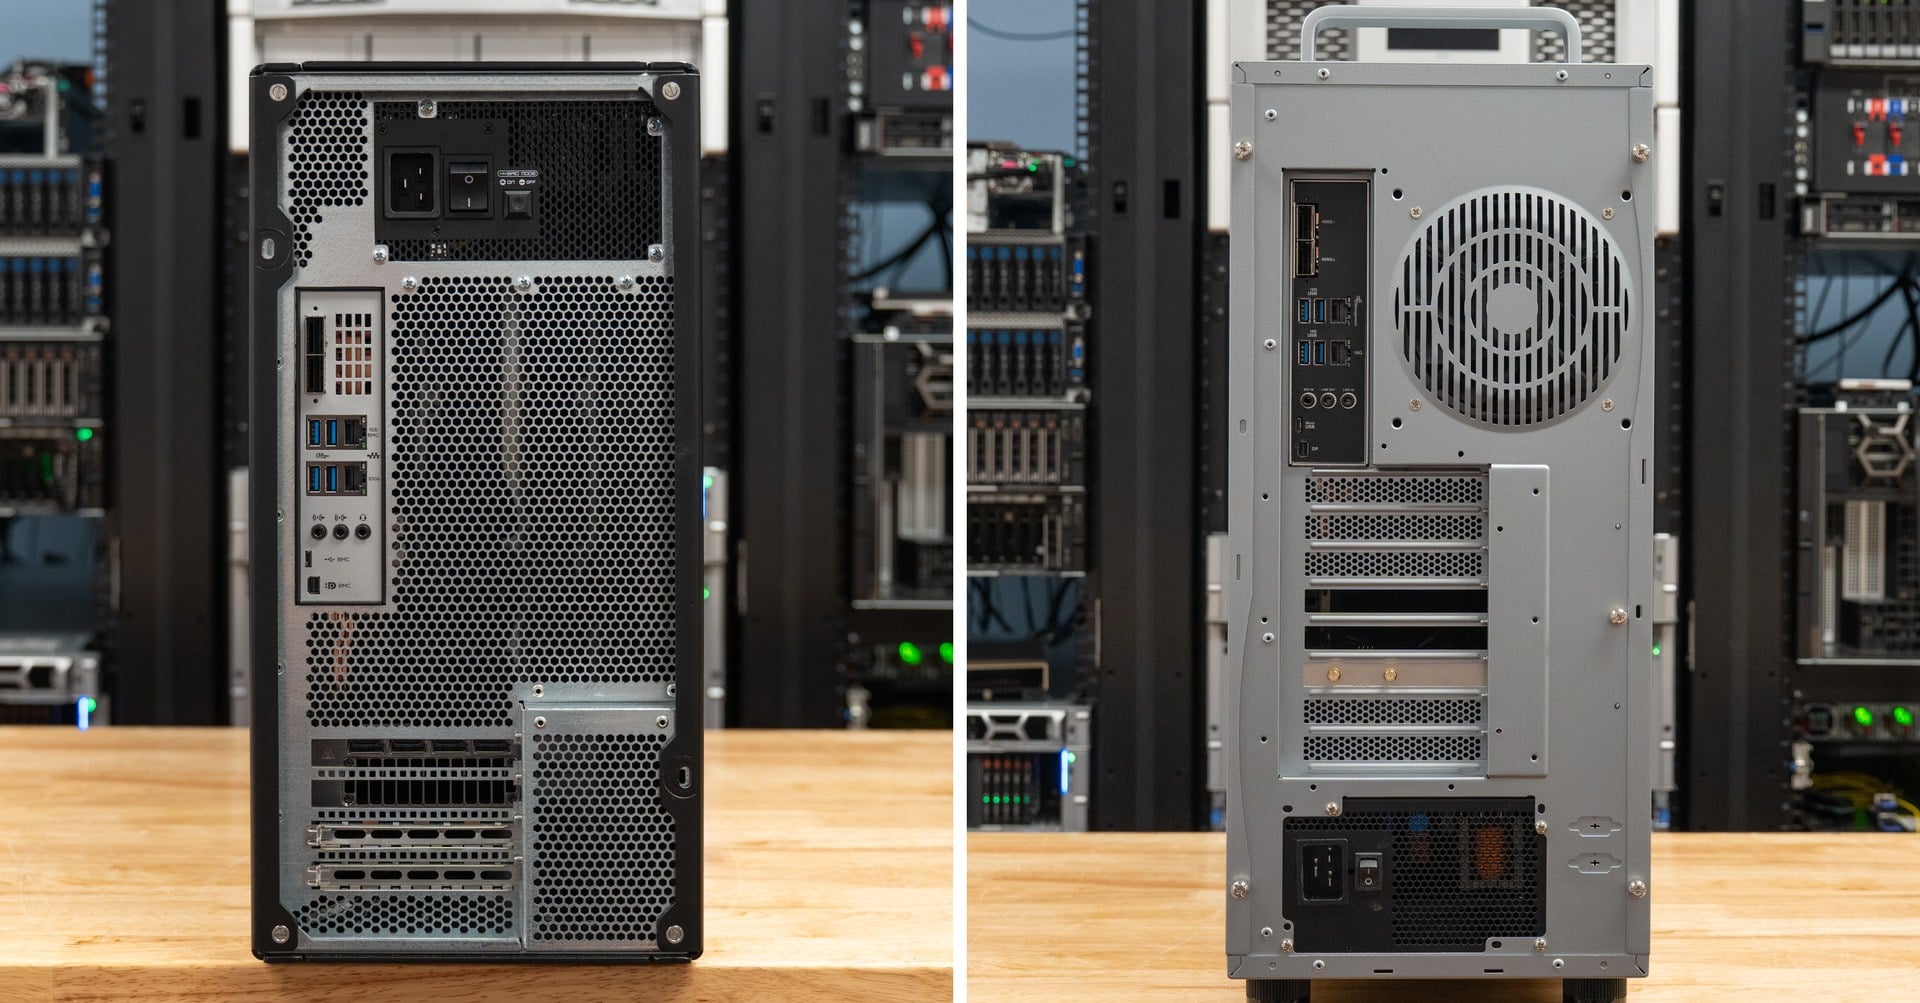
옵션 사양인 RTX PRO 카드는 리눅스에서보다 윈도우에서 훨씬 더 중요합니다. 컴퓨텍스에서 언급했듯이 GB300에 탑재된 블랙웰 울트라 GPU에는 RT 코어가 없으므로 윈도우 기반 설계 및 엔지니어링 애플리케이션에서 레이 트레이싱 시각화는 추가 카드에서 실행되고, 슈퍼칩은 AI를 처리합니다. NVIDIA는 RTX PRO 2000부터 6000까지 4가지 RTX PRO 블랙웰 카드를 지원하며, 시스템에 따라 지원 여부가 다를 수 있다고 안내하고 있습니다.
6월부터 제기되었던 의문점은 여전히 해결되지 않았습니다. 저희 GB300 테스트는 모두 Ubuntu, vLLM, NVIDIA 컨테이너 스택 환경에서 진행되었으며, 양사 모두 해당 하드웨어에서 Windows 네이티브로 실행되는 서버 스택과 WSL에서 실행되는 서버 스택, 그리고 400Gb/s 포트 두 개를 사용하는 72코어 Grace 호스트에서 WSL의 처리량 비용이 얼마인지에 대해 밝히지 않았습니다. Windows 환경의 제품이 연구실에 도착하면 가장 먼저 이러한 사항들을 테스트할 예정입니다.
총합은 얼마일까요?
이번 발표 자료는 컴퓨텍스에서 제기되었던 여러 의문점에 대한 해답을 제시합니다. 노트북은 45~80W, 데스크톱은 140W의 전력을 소비하며, 128GB 옵션은 두 칩 중 더 큰 용량의 칩을 사용합니다. 윈도우는 GPU에서 접근 가능한 메모리 용량을 설치된 총 메모리 용량보다 낮게 제한하고 있으며, 마이크로소프트의 첫 번째 소형 데스크톱에는 고속 네트워킹 기능이 포함되어 있지 않습니다. 마이크로소프트의 윈도우 및 디바이스 담당 부사장인 파반 다불루리가 "기존 데스크톱에서는 실행할 수 없는 모델도 이 노트북에서는 실행할 수 있다"고 말한 것은 128GB 구성에 적용되며, 초당 약 60개의 토큰을 처리하는 마이크로소프트의 137B 코딩 모델은 이를 입증하는 사례입니다.
아직 알려지지 않은 정보는 특정 섀시에 따라 달라지는 모든 것들입니다. 장시간 에이전트 세션 동안의 지속적인 전력 소비, Apple의 M5 Max 및 AMD의 Strix Halo 시스템과의 디코딩 처리량 비교, 추론 시 배터리 수명, 그리고 대부분의 128GB 노트북 가격 정보 등이 여기에 포함됩니다. 또한 지난달 펌웨어 업데이트를 통해 Windows 부팅 인증서를 획득한 GB10 기반 DGX Spark에 Windows가 언제 탑재될지도 알 수 없습니다. 리뷰용 제품은 저희가 선정한 '로컬 AI용 최고의 노트북' 및 '로컬 AI용 최고의 데스크톱' 순위표 와 동일한 테스트를 거칠 예정입니다.



 아마존