

NVIDIA နှင့် Microsoft တို့သည် RTX Spark Windows လက်ပ်တော့များအတွက် ယနေ့တွင် ကြိုတင်မှာယူမှုများကို ဖွင့်လှစ်ခဲ့ပြီး အောက်တိုဘာ ၁၆ ရက်တွင် ရရှိနိုင်မည်ဟု သတ်မှတ်ထားပြီး နိုဝင်ဘာလတွင် compact desktop များနှင့် NVIDIA သည် စတုတ္ထသုံးလပတ်တွင် ဖြန့်ချိမည့် DGX Station for Windows ၏ preview ကို မိတ်ဆက်ပေးခဲ့သည်။ ကြေငြာချက်များသည် ဆန်ဖရန်စစ္စကိုတွင် ကျင်းပသော Microsoft ၏ Windows AI နှင့် Surface ပွဲတွင် ထွက်ပေါ်လာခဲ့ပြီး Jensen Huang သည် Satya Nadella နှင့်အတူ စင်မြင့်ပေါ်တွင် ပါဝင်ခဲ့ပြီး Microsoft သည် ၎င်း၏ agent containment layer၊ Microsoft Execution Containers ကို Windows 11 တွင် ယေဘုယျအားဖြင့် ရရှိနိုင်ကြောင်း ကြေငြာခဲ့သည်။
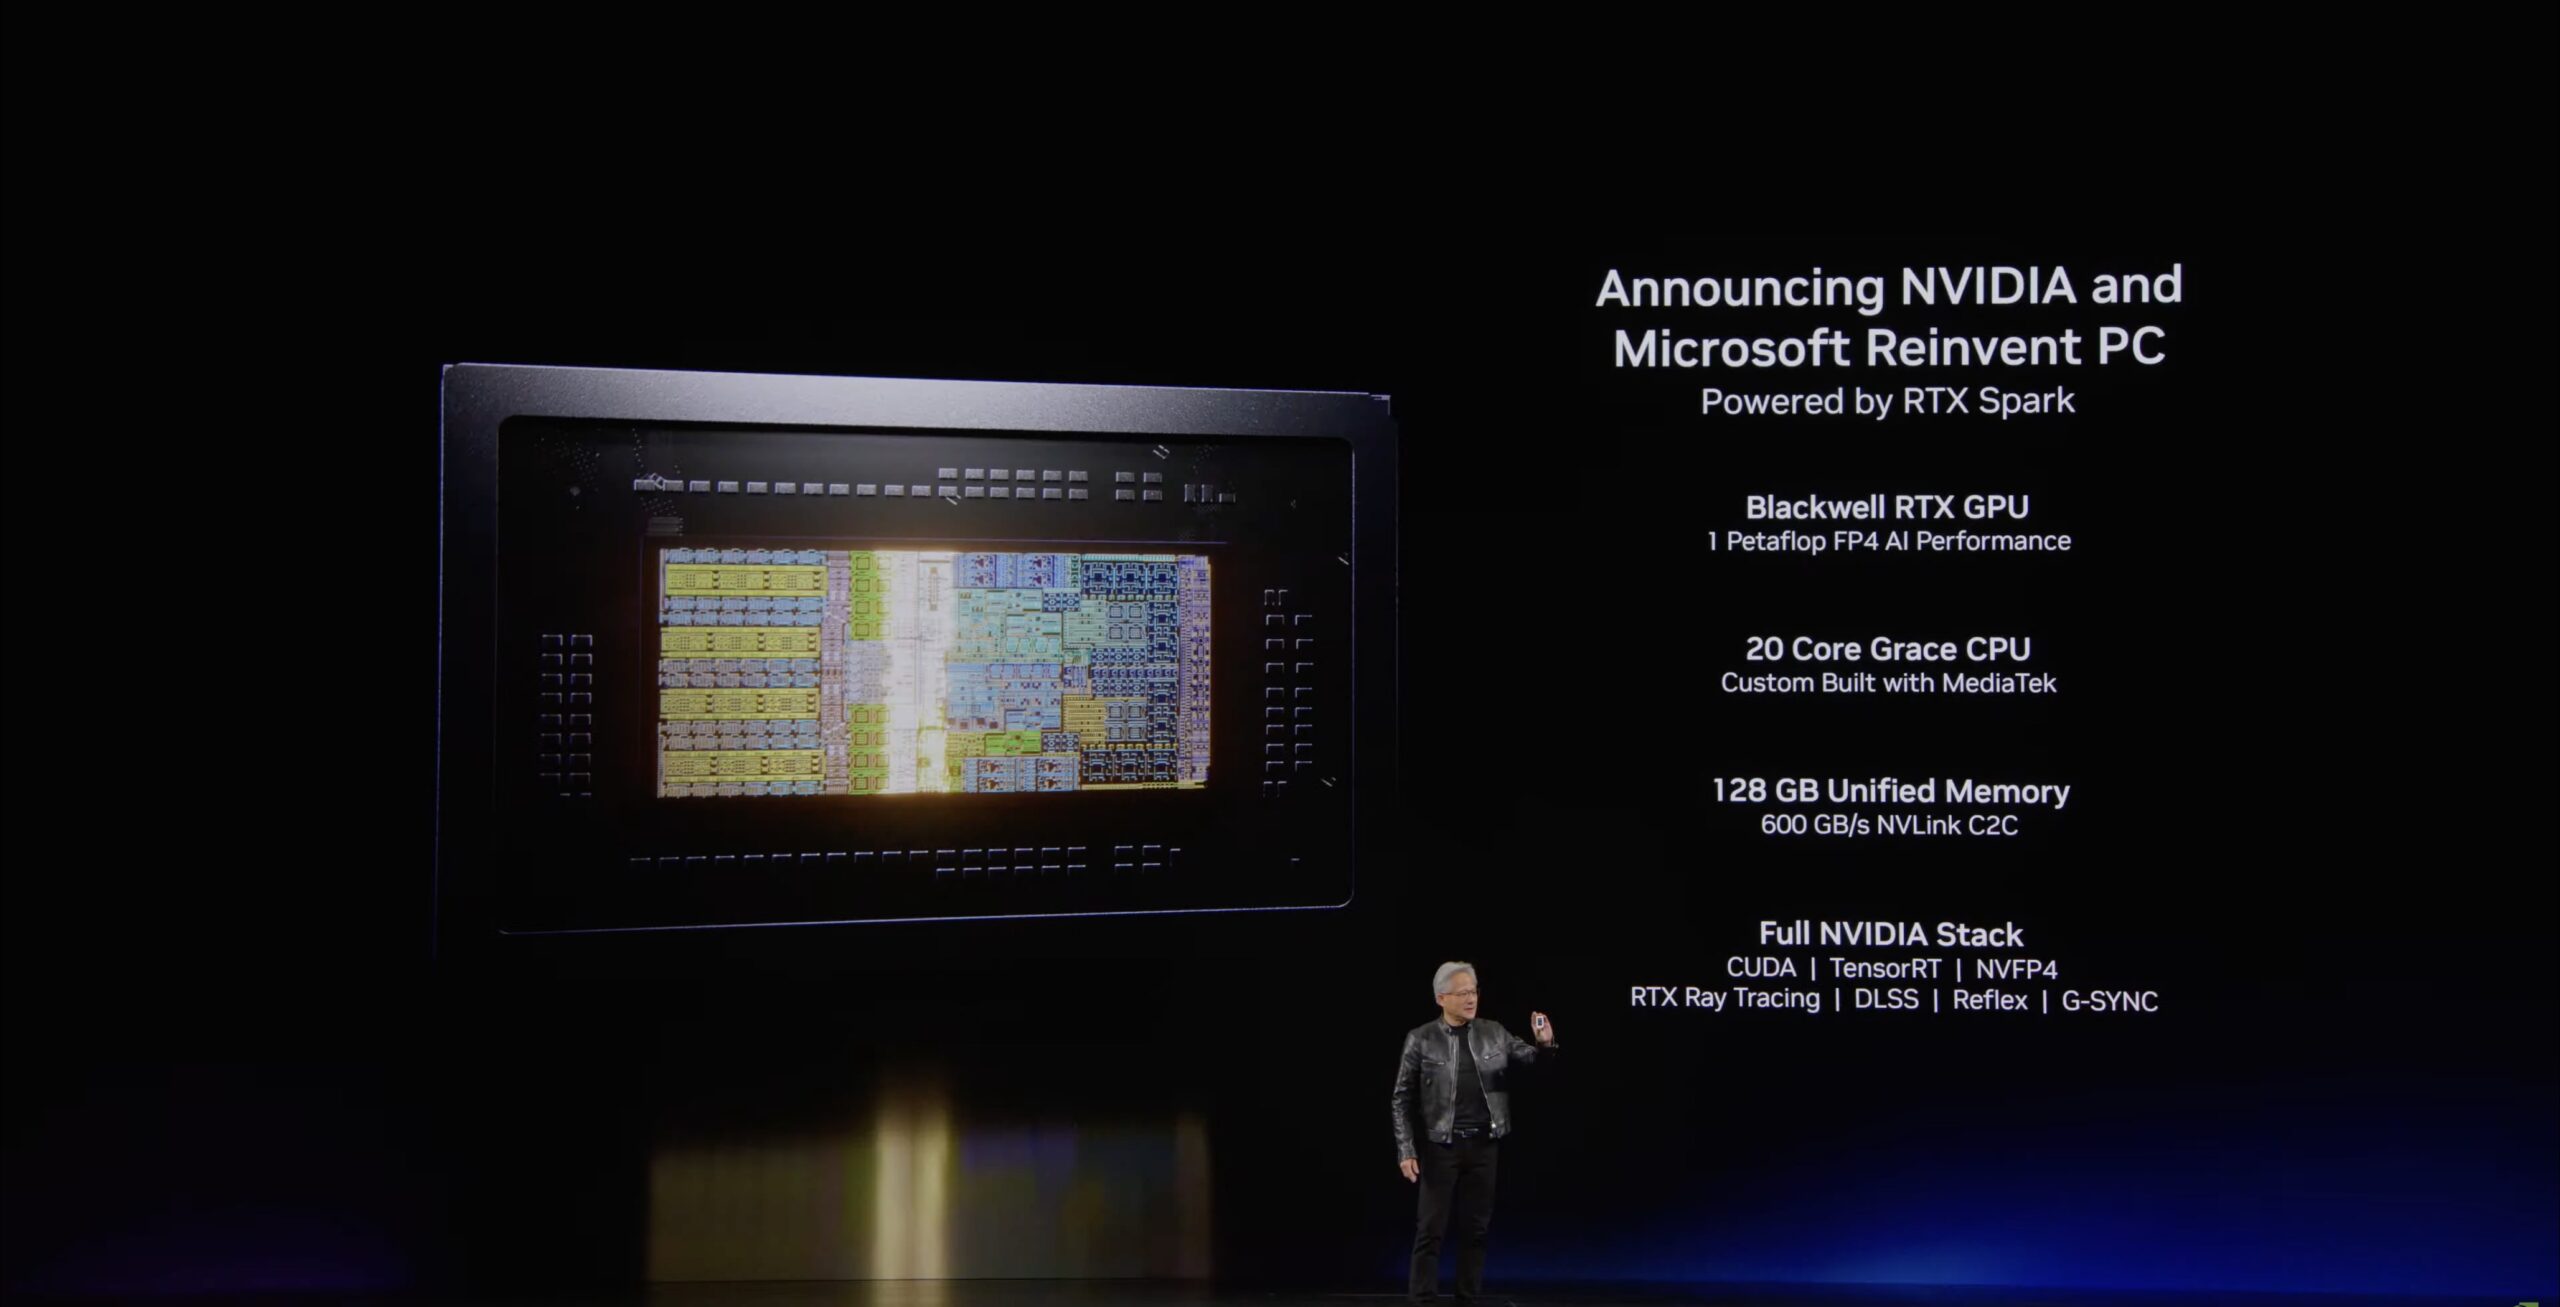
ကျွန်ုပ်တို့သည် ဤစနစ်များထဲမှ ပထမဆုံးစနစ်အကြောင်းကို ကျွန်ုပ်တို့၏ Dell XPS 16 Creator Edition ဆောင်းပါးနှင့် ဇွန်လတွင် Computex တွင် ကျင်းပခဲ့သော platform အကြောင်းကို ယနေ့အစောပိုင်းတွင် ဆွေးနွေးခဲ့ပါသည် ။ ဤဆောင်းပါးသည် ယခင်က မသိရှိခဲ့သော N1X superchip အတွက် power envelopes၊ Windows သည် unified memory pool ကို မည်သို့ခွဲဝေပေးသည်၊ laptop တွင် 137-billion-parameter coding model အတွက် တိုင်းတာထားသော throughput၊ sandbox agent များ၏ mechanics များ လည်ပတ်မည်နှင့် Windows DGX Station အတွက် အပြည့်အစုံ specification table အကြောင်းဖြစ်သည်။
RTX Spark N1X: ချစ်ပ်နှစ်ခု၊ ပါဝါအိတ်သုံးခု
NVIDIA ရဲ့ RTX Spark သတ်မှတ်ချက်ဇယားက အခုဆိုရင် လက်တော့ပ်တွေနဲ့ ဒက်စ်တော့ပ်တွေကို ခွဲခြားထားပြီး ခွဲခြားမှုက ခေါင်းစဉ်နံပါတ်တွေထက် ပိုပြီး သတင်းအချက်အလက်တွေ ပိုများပါတယ်။ လက်တော့ပ်တွေမှာ N1X ဗားရှင်းနှစ်မျိုး ရရှိနိုင်ပါတယ်- 20-core Grace CPU နဲ့ 128GB အထိ unified LPDDR5X ပါတဲ့ 6,144-core Blackwell RTX GPU နဲ့ 5,120-core 18-core CPU ပါတဲ့ 64GB GPU တို့ဖြစ်ပြီး နှစ်မျိုးစလုံးမှာ 45 မှ 80W TDP ပါရှိပါတယ်။ ဒက်စ်တော့ပ်တွေမှာ 6,144-core၊ 20-core အပိုင်းနဲ့ 128GB အထိသာ ရရှိပြီး NVIDIA က 140W မှာ စာရင်းပြုစုထားပါတယ်။
အဲဒီ 140W ကိန်းဂဏန်းဟာ DGX Spark မှာ GB10 အတွက် NVIDIA ကထုတ်ပြန်တဲ့ TDP နဲ့ အတူတူပါပဲ၊ CPU နဲ့ GPU တွေကို အတူတကွ လွှမ်းခြုံထားပါတယ်။ ဒါဟာ ဇွန်လတုန်းက NVIDIA က ချစ်ပ်နှစ်ခုဟာ မတူညီတဲ့ ပလက်ဖောင်းတွေအတွက် ချိန်ညှိထားတဲ့ စနစ်တစ်ခုတည်းဖြစ်တယ်ဆိုတဲ့ ပြောကြားချက်နဲ့ ကိုက်ညီပါတယ်။ ဒါ့အပြင် N1X လက်တော့ပ်ဟာ ဒက်စ်တော့ပ်အစိတ်အပိုင်းက အဆင့်သတ်မှတ်ထားတဲ့ ပါဝါရဲ့ 32% မှ 57% အထိ လည်ပတ်ပြီး မိသားစုထဲက စနစ်တိုင်းကို FP4 ရဲ့ “1 petaflop အထိ” တူညီတဲ့နှုန်းနဲ့ ရောင်းချတယ်လို့လည်း ဆိုလိုပါတယ်။ Microsoft ရဲ့ Surface အောက်ခြေမှတ်စုတွေမှာ အဲဒီကိန်းဂဏန်းကို sparsity ကို အသုံးပြုပြီး သီအိုရီ FP4 စွမ်းဆောင်ရည်အဖြစ် ဖော်ပြထားပါတယ်။
| specification | RTX Spark N1X (လက်တော့ပ်) | RTX Spark N1X (လက်တော့ပ်) | RTX Spark N1X (ဒက်စ်တော့) | GB10 (DGX Spark) |
|---|---|---|---|---|
| GPU ကို | ၆,၁၄၄-core Blackwell RTX | ၆,၁၄၄-core Blackwell RTX | ၆,၁၄၄-core Blackwell RTX | Blackwell၊ ပဉ္စမမျိုးဆက် Tensor Cores၊ စတုတ္ထမျိုးဆက် RT Cores |
| စီပီယူ | ၂၀-core Grace | ၂၀-core Grace | ၂၀-core Grace | ၂၀ Arm core (၁၀ Cortex-X925၊ ၁၀ Cortex-A725) |
| TDP | 45W မှ 80 | 45W မှ 80 | 140W | ၁၄၀ ဝပ် (၂၄၀ ဝပ် ပါဝါထောက်ပံ့မှု) |
| ပေါင်းစည်းမှတ်ဉာဏ် | LGBT LPDDR128X 5GB အထိရှိသည် | LGBT LPDDR64X 5GB အထိရှိသည် | LGBT LPDDR128X 5GB အထိရှိသည် | 64GB သို့မဟုတ် 128GB LPDDR5X၊ 273GB/s |
| မီဒီယာအင်ဂျင်များ | ၉ မျိုးဆက် NVENC ၁ ခု၊ ၆ မျိုးဆက် NVDEC ၁ ခု | ၉ မျိုးဆက် NVENC ၁ ခု၊ ၆ မျိုးဆက် NVDEC ၁ ခု | ၉ မျိုးဆက် NVENC ၁ ခု၊ ၆ မျိုးဆက် NVDEC ၁ ခု | ၁ x NVENC၊ ၁ x NVDEC |
| မျက်နှာပြင်နှင့် I/O | PCIe Gen5၊ HDMI 2.1b၊ DisplayPort 2.1b | PCIe Gen5၊ HDMI 2.1b၊ DisplayPort 2.1b | PCIe Gen5၊ HDMI 2.1b၊ DisplayPort 2.1b | HDMI 2.1a၊ ConnectX-7 200Gb/s၊ 10GbE |
| operating system | Windows ကို 11 | Windows ကို 11 | Windows ကို 11 | NVIDIA DGX OS |
NVIDIA က N1X အတွက် သိပ်သည်းတဲ့ FP4 ကိန်းဂဏန်းကို မထုတ်ပြန်ပါဘူး။ GB300 မှာ နှစ်ခုစလုံးကို ထုတ်ဝေတဲ့အခါ သိပ်သည်းတဲ့ ကိန်းဂဏန်းက ရှားပါးတဲ့ ကိန်းဂဏန်းရဲ့ 75% ရှိပါတယ်။ OEM thermal design က ဒီ laptop တွေကို DGX Spark unit တွေကို ဘယ်တုန်းကမှ မခွဲခြားခဲ့တဲ့ နည်းလမ်းနဲ့ ခွဲခြားပေးမယ်လို့ မျှော်လင့်ပါတယ်။ ပြီးတော့ vendor tuning မလုပ်ခင်မှာ laptop TDP range အတွင်းမှာ 35W spread ရှိနေတာက ပထမဆုံး ခိုင်မာတဲ့ သက်သေပါပဲ။
Microsoft ဟာ desktop ဘက်မှာ အားနည်းချက်တစ်ခု ထပ်ထည့်ထားပါတယ်။ သူ့ရဲ့ Surface RTX Spark Dev Box စာမျက်နှာမှာ လေဝင်ပေါက် ၁၀၀၀ ပါတဲ့ အလူမီနီယမ်ကိုယ်ထည်အတွင်း 100W အပူအဖုံးကို ကိုးကားထားပြီး desktop N1X အတွက် TDP NVIDIA စာရင်းအောက်မှာ 40W ရှိပါတယ်။ ကုမ္ပဏီနှစ်ခုဟာ မတူညီတဲ့အရာတွေကို တိုင်းတာနေကြပါတယ်၊ တစ်ခုက case မှာ chip အဆင့်သတ်မှတ်ချက်နဲ့ နောက်တစ်ခုက chassis ဒီဇိုင်းအချက်တို့ပဲ ဖြစ်ပါတယ်။ ဒါပေမယ့် နိုဝင်ဘာလမှာ compact desktop တွေကို နှိုင်းယှဉ်ဝယ်ယူသူတစ်ယောက်အနေနဲ့ ရောင်းချသူတိုင်းကို သူတို့ရဲ့ box မှာ ဘယ်လောက်ထိ ခံနိုင်ရည်ရှိတဲ့ ပါဝါရှိလဲဆိုတာ မေးမြန်းသင့်ပါတယ်။
GB10 နဲ့ ပလက်ဖောင်းကွာခြားချက်ကတော့ မန်မိုရီအမြန်နှုန်းပါ။ Dell ရဲ့ XPS spec sheet မှာ LPDDR5X ကို 9,400 MT/s မှာဖော်ပြထားပြီး GB10 လို 256-bit interface မှာဆိုရင် 300.8GB/s အထိအလုပ်လုပ်ပြီး ဇွန်လမှာ NVIDIA က ကိုးကားထားတဲ့ 300GB/s နဲ့ တူညီပြီး DGX Spark ရဲ့ 273GB/s ထက် ၁၀% လောက်ပိုများပါတယ်။ CPU နဲ့ GPU ထက်ဝက်ဟာ NVLink-C2C ကနေတစ်ဆင့် 600GB/s မှာ ချိတ်ဆက်ထားပါတယ်။ ဇယားရဲ့ကျန်အပိုင်းတွေကတော့ အပိုင်းသုံးပိုင်းစလုံးနဲ့ တူညီပါတယ်- ပဉ္စမမျိုးဆက် Tensor Cores၊ စတုတ္ထမျိုးဆက် RT cores၊ DLSS 5၊ Frame Warp ပါတဲ့ Reflex 2 နဲ့ DSC ပါတဲ့ HDMI 2.1b တို့ဟာ 4K 480Hz ဒါမှမဟုတ် 8K 120Hz အထိရှိပါတယ်။
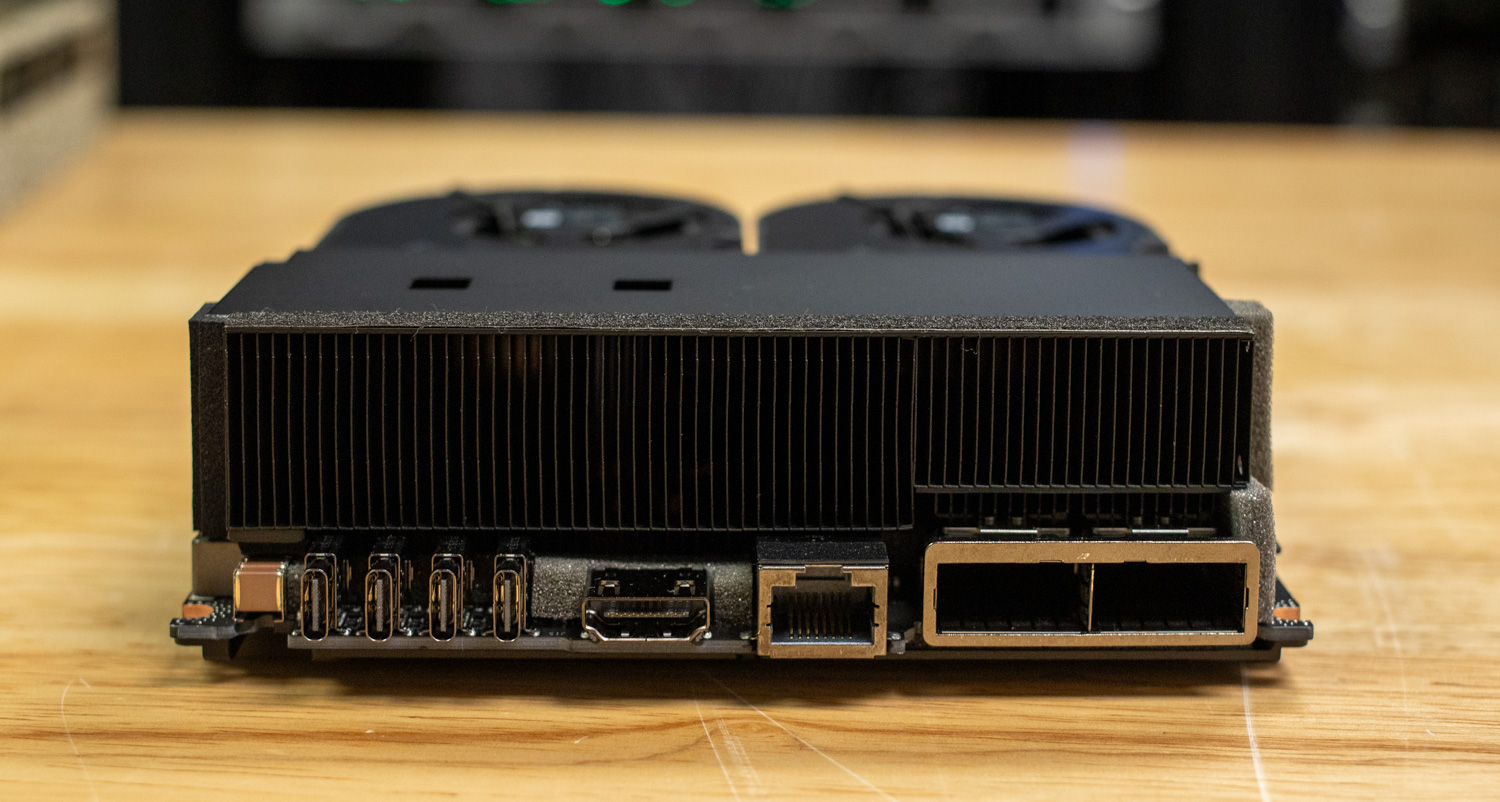
NVIDIA ရဲ့ marketplace မှာ pre-order မှာယူနိုင်တဲ့ laptop configuration ၁၇ မျိုးစာရင်းကို ဖော်ပြထားပြီး ခေါင်းစဉ်အောက်မှာ ဘယ်လောက်ပါဝင်လဲဆိုတာကိုလည်း ပြသထားပါတယ်။ ကျွန်တော်တို့ဖတ်ဖူးတဲ့ ၁၅ မျိုးထဲက ခုနစ်မျိုးက 5,120-core chip ကို အသုံးပြုထားပြီး memory က 24GB, 32GB, 48GB နဲ့ 128GB ရှိပြီး storage ကို PCIe Gen4 နဲ့ Gen5 drives တွေကြားမှာ ခွဲထားပါတယ်။
Windows က 128GB Unified Memory ကို ဘယ်လိုခွဲဝေပေးသလဲ
မှတ်ဉာဏ်ကို CPU နှင့် GPU အကြား တက်ကြွစွာ မျှဝေထားပြီး GPU မှ အများဆုံး စီမံခန့်ခွဲနိုင်သည့် ပမာဏသည် configuration ပေါ်တွင် မူတည်ပါသည်။ Microsoft နှင့် GitHub ၏ အင်ဂျင်နီယာပို့စ်တွင် Task Manager ဖန်သားပြင်ဓာတ်ပုံတွင် 6,144-core N1X ပါသည့် Surface Laptop Ultra တွင် ၎င်းမည်သို့ရှိမည်ကို ပြသထားသည်။ Windows တွင် သီးသန့် GPU မှတ်ဉာဏ် 74.9GB၊ မျှဝေ GPU မှတ်ဉာဏ် 35.5GB၊ စုစုပေါင်း GPU မှတ်ဉာဏ် 110GB နှင့် စနစ်မှတ်ဉာဏ် 51.5GB ရှိကြောင်း ဖော်ပြထားသည်။
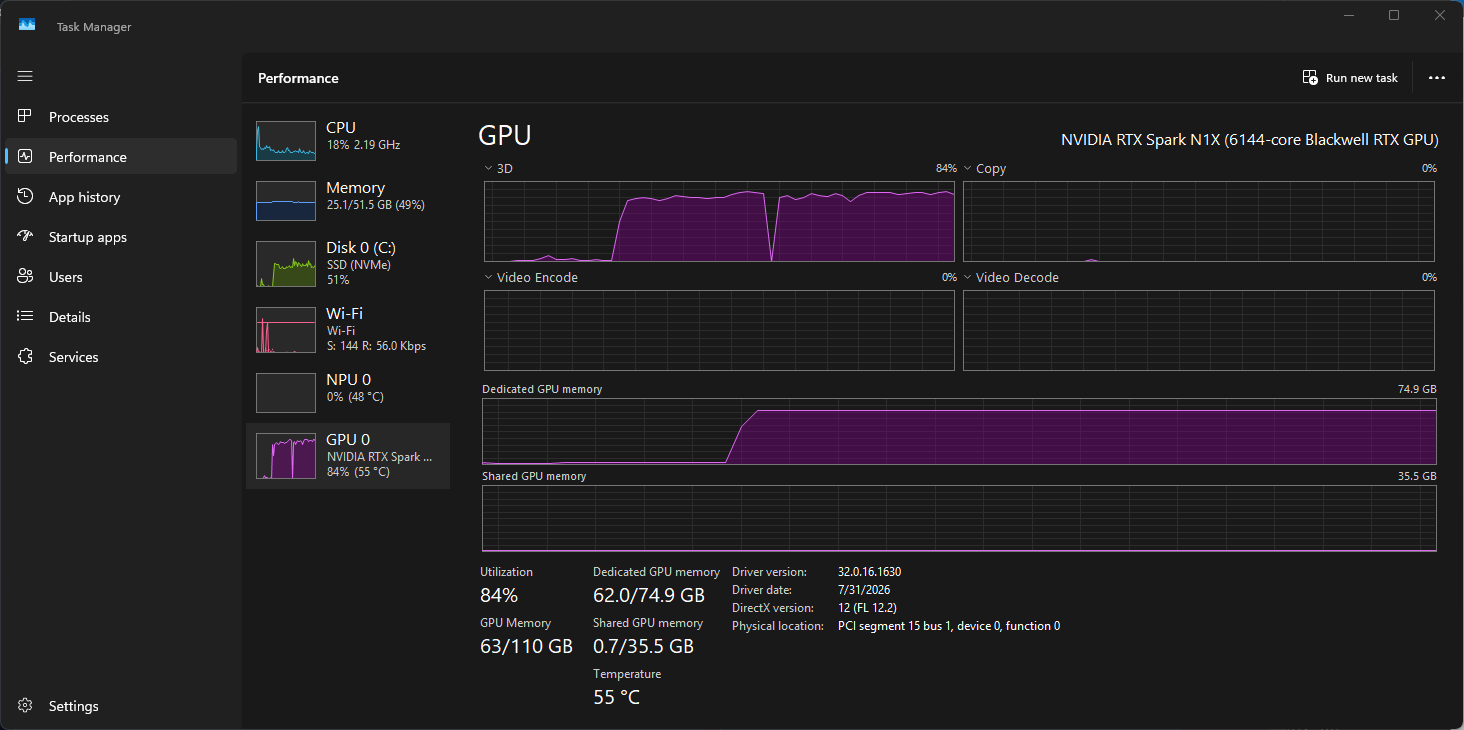
dedicated နဲ့ system ကိန်းဂဏန်းတွေရဲ့ စုစုပေါင်းပမာဏက 126.4GB ဖြစ်တာကြောင့် Windows က discrete card တစ်ခုမှာ တင်ပြထားတဲ့အတိုင်း unified pool ကို တင်ပြနေတာပါ- fixed dedicated allocation ဖြစ်ပြီး GPU က system memory ကနေ အကန့်အသတ်အထိ ငှားယူနိုင်ပါတယ်။ အဲဒီ unit မှာ GPU ရဲ့ အမြင့်ဆုံးပမာဏက 110GB ဒါမှမဟုတ် install လုပ်ထားတဲ့ 128GB ရဲ့ 86% ဖြစ်ပြီး weights, key-value cache နဲ့ runtime overhead တွေအားလုံးကို ၎င်းအောက်မှာ ထည့်သွင်းရပါမယ်။ အဲဒီ screenshot မှာပဲ ဇူလိုင်လ ၃၁ ရက်နေ့ ရက်စွဲနဲ့ driver 32.0.16.1630 နဲ့ GPU ကနေ သီးခြား device အဖြစ် စာရင်းပြုစုထားတဲ့ NPU တစ်ခုကို ပြသထားပါတယ်။
မော်ဒယ်အလေးချိန်များသည် မှတ်ဉာဏ်ဘတ်ဂျက်၏ အစိတ်အပိုင်းတစ်ခုသာဖြစ်ကြောင်း ပို့စ်တွင် ရှင်းလင်းစွာဖော်ပြထားသည်။ လည်ပတ်မှုစနစ်၊ အပလီကေးရှင်းများ၊ inference runtime နှင့် အေးဂျင့်၏ ကြီးထွားလာသောအခြေအနေအတွက် အာရုံစိုက်မှုအခြေအနေကို ထိန်းသိမ်းထားပေးသည့် KV cache အားလုံးသည် တူညီသော pool မှ ရယူသည်။ ကြိုတင်မှာယူမှုစာရင်း၏ အများစုကို ဖွဲ့စည်းထားသော 24GB နှင့် 32GB configuration များအတွက်၊ ၎င်းသည် 4-bit တွင် 27B-class မော်ဒယ်များအတွက် နေရာချန်ထားပြီး ထို့ထက်များစွာမပိုပါ။ မိတ်ဆက်ပစ္စည်းတွင်ပါရှိသော မော်ဒယ်ကြီးများ၏ ပြောဆိုချက်အားလုံးသည် 128GB SKU ကို ယူဆထားသည်။
ကိုက်ညီသည်- ကန့်သတ်ချက်အရေအတွက်နှင့် အလေးချိန်အလိုက် bits
တူညီတဲ့ချစ်ပ်အတွက် ကိုးကားထားတဲ့ parameter ceilings တွေက အနည်းငယ်လွဲချော်နေပါတယ်။ NVIDIA ရဲ့ ထုတ်ကုန်စာမျက်နှာမှာ token context ၁ သန်းနဲ့ parameter ၁၂၀ ဘီလီယံအထိရှိတဲ့ မော်ဒယ်တွေလို့ ဖော်ပြထားပြီး ၎င်းရဲ့ဘလော့ဂ်မှာ Qwen 3.8 Flash Next ကို 125B ဥပမာအဖြစ် ကိုးကားထားပါတယ်။ Microsoft က ၁၂၀ ဘီလီယံထက်ကျော်လွန်တဲ့ မော်ဒယ်တွေလို့ ပြောပြီးနောက် MAI Code 1.1 Flash ကို ၁၃၇ ဘီလီယံနဲ့ DeepSeek V4 Flash ကို ၂၈၄ ဘီလီယံလို့ RTX Spark မှာ ထွက်လာမယ့် မော်ဒယ်တွေအဖြစ် ဖော်ပြထားပြီး Dell က ၂၀၀ ဘီလီယံလို့ ကိုးကားထားပါတယ်။ ကွဲပြားမှုက အလေးချိန်တစ်ခုစီမှာ bit ဘယ်နှစ်ခုရလဲဆိုတဲ့အပေါ်မှာ မူတည်ပါတယ်။
| ပုံစံ | parameters | စေ့စပ်သေချာခြင်း | ခွေရာ | အရင်းအမြစ် |
|---|---|---|---|---|
| MAI ကုဒ် ၁.၁ ဖလက်ရှ် | စုစုပေါင်း ၁၃၇B၊ တက်ကြွသူ ၆.၈B (ကျွမ်းကျင်သူများ ရောနှော) | ရောနှောတိကျမှု၊ အလေးချိန်တစ်ခုလျှင် bit ၃.၃ ခန့် | အလေးချိန် 53GB; 256K အခြေအနေတွင် အမြင့်ဆုံး 75.5GB | Microsoft၊ GitHub |
| NVIDIA Nemotron (လာတော့မယ့်) | ၇၀ ဘီလီယံကျော် | 2-bit မှာ | 20GB ကျော်ပဲရှိတယ် | Microsoft က |
| DeepSeek V4 ဖလက်ရှ် | 284B | မဖော်ပြထားဘူး | မဖော်ပြထားဘူး | Microsoft က |
| Qwen 3.8 Flash Next | 125B | မဖော်ပြထားဘူး | မဖော်ပြထားဘူး | NVIDIA |
| Qwen3.5 27B | 27B | Q4_K_M | မဖော်ပြထားဘူး | မိုက်ခရိုဆော့ဖ် စံနှုန်း အောက်ခြေမှတ်စု |
Microsoft ရဲ့ MAI Code 1.1 Flash အတွက် ကိန်းဂဏန်းတွေက အပြည့်စုံဆုံးပါ။ BF16 မှာရှိတဲ့ cloud model က 274GB ဖြစ်ပြီး on-device build က 53GB ဖြစ်ပြီး Microsoft က 80% လျှော့ချမှုလို့ ခေါ်ပါတယ်။ mixed-precision quantization နဲ့ weight တစ်ခုကို bits ၃.၃ ခန့်နဲ့ပါ။ Nemotron ကိန်းဂဏန်းကလည်း အဲဒီအတိုင်းပဲ စစ်ဆေးပါတယ်။ ဘာလို့လဲဆိုတော့ weight ၇၀ ဘီလီယံမှာ bits ၂ ခုက overhead မတိုင်ခင်မှာ ၁၇.၅GB ရှိလို့ပါ။ 284 billion parameters ရှိတဲ့ DeepSeek V4 Flash ဟာ context တစ်ခုကို load မလုပ်ခင် weight တစ်ခုချင်းစီမှာ bits ၃.၁ မှ ၃.၃ ခန့် ဒါမှမဟုတ် အဲဒီထက်နည်းဖို့ လိုအပ်ပါတယ်။
အရည်အသွေးဒေတာက 3-bit ပြောဆိုချက်ကို အာရုံစိုက်ထိုက်စေပါတယ်။ Microsoft က SWE-Bench မှာ quantized on-device model ကို 70.8% ရရှိခဲ့ပြီး BF16 cloud version အတွက် 72.6% နဲ့ နှိုင်းယှဉ်ရင် အတည်ပြုပြီး Terminal-Bench 2.1 မှာ 66.29% နဲ့ နှိုင်းယှဉ်ရင် 62.9% ရရှိခဲ့တယ်လို့ ဖော်ပြခဲ့ပါတယ်။ ဒုတိယရလဒ်ကတော့ quantized model က သာလွန်နေပြီး 89-task set မှာ task သုံးခုကွာခြားချက်ဖြစ်ပြီး noise အဖြစ် ဖတ်ရှုနိုင်ပါတယ်။ နှိုင်းယှဉ်ချက်ဖြစ်တဲ့ Unsloth ရဲ့ GPT-OSS-120B GGUF က တူညီတဲ့ စမ်းသပ်မှုနှစ်ခုမှာ 32.0% နဲ့ 23.6% ရရှိခဲ့ပါတယ်။
Throughput ကို llama.cpp ၏ Windows Arm64 build ပေါ်ရှိ Surface Laptop Ultra မှ CUDA backend နှင့် Microsoft မှ DFlash2 sliding-window speculative decoding ဟုခေါ်သော synthetic code-generation workload ဖြင့် စမ်းသပ်ထားခြင်းမှ ရရှိသည်။ Microsoft ၏ဇယားတွင် data label များ မပါဝင်သောကြောင့် ကျွန်ုပ်တို့၏ခန့်မှန်းချက်များမှာ အောက်ပါအတိုင်းဖြစ်သည်- 2K prompt တွင် တစ်စက္ကန့်လျှင် token ၆၃ ခန့်၊ 8K တွင် ၆၁ ခု၊ 32K တွင် ၅၇ ခု၊ 64K တွင် ၅၂ ခု၊ 120K တွင် ၅၅ ခု နှင့် 256K တွင် ၃၉ ခု။ 256K context တွင် အမြင့်ဆုံး memory မှာ 75.5GB ဖြစ်ပြီး Task Manager capture တွင် dedicated GPU ကိန်းဂဏန်းသို့ ရောက်ရှိသည်။

Agent အလုပ်အတွက် Prompt processing က အဓိက နံပါတ်ပါ။ Microsoft က 64K context မှာ တစ်စက္ကန့်ကို token ၉၂၃.၅ ခုနဲ့ 128K မှာ တစ်စက္ကန့်ကို token ၉၆၉.၈ ခု ပေးပါတယ်။ အအေးခံထားတဲ့ 64K prompt က process လုပ်ဖို့ ၇၁ စက္ကန့်လောက် ကြာပြီး အအေးခံထားတဲ့ 128K prompt က ပထမဆုံး output token ပေါ်လာဖို့ ၁၇၀ စက္ကန့်လောက် ကြာပါတယ်။ မော်ဒယ်တစ်ခုကို load လုပ်ထားရုံနဲ့ response time တည်ငြိမ်မယ်လို့ အာမမခံနိုင်ဘူး၊ Copilot က အလုပ်လုပ်တဲ့အခါ cache state ကို ချိန်ဆပေးတယ်ဆိုတဲ့ ဆက်စပ်အချက်ကို blog post မှာ ဖော်ပြထားပါတယ်။ ဒါကြောင့် prefill က review hardware မှာ အရင်ဆုံး တိုင်းတာမယ့် ကိန်းဂဏန်းပါ။
MacBook နှိုင်းယှဉ်ချက်နှင့် ၎င်း၏ အောက်ခြေမှတ်စုများ
Microsoft ရဲ့ နှိုင်းယှဉ်ချက်မှာ RTX Spark PC တွေကို M5 Pro နဲ့ 64GB ပါတဲ့ ၁၆ လက်မ MacBook Pro နဲ့ ယှဉ်နိုင်ပါတယ်- ပထမဆုံး token ရဖို့ ၂.၁ ဆ ပိုမြန်၊ image generation ၄.၃ ဆ ပိုမြန် နဲ့ video generation ၆.၂ ဆ ပိုမြန်ပါတယ်။ ပထမတစ်ခုက Microsoft က llama.cpp မှာ Qwen3.5 27B ကို Q4_K_M မှာ စမ်းသပ်ပြီး fixed 8,192-token prompt နဲ့ စမ်းသပ်ထားတာပါ။ ကျန်နှစ်ခုကတော့ NVIDIA ရဲ့ ComfyUI မှာ စမ်းသပ်ထားတာဖြစ်ပြီး FLUX.2 Klein 4B ကို အဆင့်လေးဆင့်နဲ့ 1024 x 1024 နဲ့ LTX 2.3 22B ကို frame ၁၂၁၊ အဆင့်ရှစ်ဆင့်နဲ့ 1280 x 720 နဲ့ စမ်းသပ်ထားပါတယ်။
အောက်ခြေမှတ်စုများတွင် ဟာ့ဒ်ဝဲမှစတင်၍ အရည်အချင်းပြည့်မီမှုများစွာပါရှိသည်- စမ်းသပ်မှုအားလုံးကို စက်တင်ဘာလတွင် 64GB ပါသော ကြိုတင်ထုတ်လုပ်မှု RTX Spark စနစ်များတွင် ပြုလုပ်ခဲ့ပြီး Apple စနစ်မှာ M5 Pro ဖြစ်ပြီး နှိုင်းယှဉ်ချက်တွင် M5 Max မပါဝင်ပါ။ ComfyUI စမ်းသပ်မှုနှစ်ခုစလုံးသည် မော်ဒယ်များကို NVFP4 တိကျမှုဖြင့် အသုံးပြုခဲ့ပြီး အောက်ခြေမှတ်စုများတွင် Mac ၏ ဆော့ဖ်ဝဲဖွဲ့စည်းပုံကို မဖော်ပြထားပါ။ ဘာသာစကား-မော်ဒယ်ရလဒ်သည် prompt အရှည်တစ်ခုတည်းတွင် ကြိုတင်ဖြည့်သွင်းတိုင်းတာမှုတစ်ခုဖြစ်သည်။ ကုမ္ပဏီနှစ်ခုလုံးသည် တစ်စက္ကန့်လျှင် တိုကင်များကို နှိုင်းယှဉ်ခြင်းကို မထုတ်ဝေခဲ့ပါ၊ ၎င်းသည် ဒေသခံ LLM အသုံးပြုသူအများစုကိုးကားသည့် အရေအတွက်ဖြစ်သည်။
ဂိမ်းကစားခြင်းနဲ့ ပတ်သက်လာရင် NVIDIA က RTX Spark ဟာ DLSS 5၊ Reflex နဲ့ G-SYNC တို့နဲ့ AAA ဂိမ်းတွေကို 1440p အထက် တစ်စက္ကန့်ကို 100 frames နှုန်းနဲ့ run နိုင်တယ်လို့ ပြောပါတယ်။ ဒါပေမယ့် ဂိမ်းနာမည်တွေ၊ setting တွေကိုတော့ နာမည်မပေးပါဘူး။ Microsoft ရဲ့ ပံ့ပိုးကူညီမှုကတော့ Gears of War: E-Day ပါဝင်ပြီး Microsoft က ပထမဆုံး shader compilation ကို မိနစ်ကနေ စက္ကန့်အထိ လျှော့ချပေးတယ်လို့ ဆိုပါတယ်။ ဒါ့အပြင် Call of Duty ကို ၂၀၂၇ ခုနှစ်မှာ RTX Spark မှာ ဖြန့်ချိမယ်လို့လည်း ကတိပြုထားပါတယ်။ Prism နဲ့ anti-cheat အသေးစိတ်အချက်အလက်တွေကို Dell ရဲ့ လွှမ်းခြုံ မှုမှာ ဖော်ပြထားပါတယ် ။
Microsoft Execution Containers: Agent Sandbox ဘယ်လိုအလုပ်လုပ်လဲ
MXC ဟာ Windows 11 PC တိုင်းမှာ အကျုံးဝင်ပြီး macOS နဲ့ Linux အတွက် backend တွေပါတဲ့ open-source library နဲ့ multi-language SDK အနေနဲ့ တင်ပို့တာကြောင့် အကျယ်ပြန့်ဆုံး ပျံ့နှံ့နိုင်တဲ့ ကြေငြာချက်ရဲ့ အစိတ်အပိုင်းတစ်ခု ဖြစ်ပါတယ်။ developer တစ်ယောက်က JSON policy မှာ workload တစ်ခု ဘာတွေလိုအပ်လဲဆိုတာကို ကြေငြာပါတယ်- သူပြုပြင်နိုင်တဲ့ ဖိုင်တွေ၊ သူဖတ်နိုင်တဲ့ ဖိုင်တွေပဲ၊ inbound နဲ့ outbound network access နဲ့ desktop ကို ထိလို့ရမရ စတာတွေပါ။ MXC က အဲဒီ policy ကို isolation backend မှာ map လုပ်ပြီး runtime မှာ enforce လုပ်ပါတယ်၊ ပြီးတော့ policy က workload ရဲ့ အပြင်ဘက်မှာ ရှိနေတာကြောင့် generated code က သူ့ကိုယ်သူ access ပိုပေးလို့မရပါဘူး။
| MXC နောက်ခံ | ပလက်ဖောင်း | စက်ကိရိယာ | အသုံးပြုရန်ရည်ရွယ်လျက် |
|---|---|---|---|
| လုပ်ငန်းစဉ်ကွန်တိန်နာ | Windows 11၊ macOS၊ Linux | Windows မှာ AppContainer၊ macOS မှာ Seatbelt၊ Linux မှာ Bubblewrap | မော်ဒယ်မှထုတ်လုပ်သော ကုဒ်နှင့် ကိရိယာလုပ်ဆောင်ခြင်းအတွက် နှောင့်နှေးမှုနည်းသော ထိန်းချုပ်မှု |
| အစည်းအဝေး ကွန်တိန်နာ | Windows 11 သာ | Windows အကောင့်နှင့် session ကို ၎င်း၏ကိုယ်ပိုင် desktop၊ clipboard၊ UI နှင့် input ဖြင့် သီးခြားခွဲထားပါ | ဒက်စ်တော့တစ်ခု လိုအပ်သော ရေရှည်လည်ပတ်နေသော အေးဂျင့်များနှင့် အလိုအလျောက်စနစ်များ |
| WSL ကွန်တိန်နာ (WSLc) | Windows 11 သာ | WSL မှတစ်ဆင့် Linux အကောင်အထည်ဖော်မှုပတ်ဝန်းကျင် | Linux-ပထမဆုံး agent toolchains များ |
| မိုက်ခရိုဗွီအမ် | Windows 11 နှင့် Linux (စမ်းသပ်ဆဲ) | ဟာ့ဒ်ဝဲဖြင့် အားဖြည့်ထားသော virtualized နယ်နိမိတ် | အန္တရာယ်များသော workloads များနှင့် မယုံကြည်ရသော code များ |
မူဝါဒရေးသားခြင်းစက်ဝန်းကို လည်ပတ်မှုပုံစံသုံးမျိုးဖြင့် လွှမ်းခြုံထားသည်- အကောင်အထည်ဖော်မှုသည် မူဝါဒပြင်ပရှိ မည်သည့်အရာကိုမဆို ပိတ်ဆို့ပြီး Learning သည် ၎င်းကို ပိတ်ဆို့ပြီး JSON လုပ်ဆောင်ချက်အစီရင်ခံစာတွင် မှတ်တမ်းတင်သည်။ Permissive သည် လုပ်ဆောင်ချက်ကို ခွင့်ပြုပြီး ငြင်းပယ်ခံရမည့်အရာကို မှတ်တမ်းတင်သောကြောင့် အဖွဲ့တစ်ဖွဲ့သည် စစ်မှန်သောအလုပ်မှတစ်ဆင့် agent တစ်ခုကို လုပ်ဆောင်နိုင်ပြီး အထောက်အထားမှ အနည်းဆုံးအခွင့်ထူးမူဝါဒကို တည်ဆောက်နိုင်သည်။ လုပ်ဆောင်ချက်အစီရင်ခံစာကို Windows ရှိ process containers များအတွက်သာ ရရှိနိုင်သည်။ အဖွဲ့အစည်းများသည် စီမံခန့်ခွဲမှုကိရိယာများမှတစ်ဆင့် developer ၏မူဝါဒပေါ်တွင် ၎င်းတို့၏ကိုယ်ပိုင်ကန့်သတ်ချက်များကို ထည့်သွင်းနိုင်ပြီး Microsoft က MXC process containers များ၏ Intune စီမံခန့်ခွဲမှုသည် မကြာမီလာမည်ဟုဆိုသည်။
ယေဘုယျအားဖြင့် ဘာတွေရရှိနိုင်လဲဆိုတာကို ရှင်းရှင်းလင်းလင်းသိထားသင့်ပြီး ထိန်းချုပ်မှုဆိုတာ အောက်တိုဘာ ၇ ရက်နေ့မှာ တင်ပို့ခဲ့တာပါ။ Microsoft Entra က အေးဂျင့်ရဲ့လုပ်ဆောင်ချက်တွေနဲ့ ဝင်ရောက်ထားတဲ့အသုံးပြုသူရဲ့လုပ်ဆောင်ချက်တွေကို ခွဲခြားသတ်မှတ်ပေးတဲ့ အေးဂျင့်အထောက်အထားကို မကြာမီလာမယ်လို့ဖော်ပြထားသလို အေးဂျင့် 365 ထိန်းချုပ်မှုတွေကို ဒေသခံအေးဂျင့်တွေဆီ တိုးချဲ့ပေးသွားမှာပါ။ အဲဒီထိန်းချုပ်မှုတွေ မရောက်မချင်း MXC ကွန်တိန်နာက အေးဂျင့်တစ်ယောက် ရောက်ရှိနိုင်တာကို ကန့်သတ်ထားပေမယ့် လုံခြုံရေးကိရိယာတွေက အသုံးပြုသူရဲ့အထောက်အထားအောက်မှာ သူ့ရဲ့လုပ်ဆောင်ချက်ကို မြင်တွေ့နေရဆဲဖြစ်ပြီး Microsoft ဖော်ပြထားတဲ့ fleet-level အုပ်ချုပ်မှုစနစ်ကလည်း မရှိသေးပါဘူး။ သူ့ရဲ့ကိုယ်ပိုင်အောက်ခြေမှတ်ချက်မှာ အတိုင်းအတာတစ်ခုအထိ အုပ်ချုပ်မှုစနစ်က အပိုဝန်ဆောင်မှုတွေ လိုအပ်နိုင်တယ်လို့ ထပ်လောင်းဖော်ပြထားပါတယ်။
GitHub ရဲ့ integration အကြောင်းဖော်ပြချက်မှာ boundary ရဲ့တည်နေရာကိုပြသထားပါတယ်။ Copilot က Windows မှာ process container ရဲ့ base tier ကိုသုံးပြီး shell command တွေ၊ local Model Context Protocol server တွေနဲ့ default အနေနဲ့ language server တွေက အဲဒီထဲမှာ run ပါတယ်။ Copilot ရဲ့ built-in file tool တွေက agent harness မှာ run ပါတယ်။ အဲဒီမှာ request တွေကို policy နဲ့စစ်ဆေးပေမယ့် operating system ကခွဲထုတ်မထားပါဘူး။ remote MCP server တွေက local sandbox ရဲ့အပြင်ဘက်မှာလုံးဝရှိနေပါတယ်။ shell command က model တစ်ခုခုတောင်းဆိုတဲ့ access ကိုပဲအမွေဆက်ခံတဲ့အတွက် local inference က ဒီအရာတွေကိုဘာမှမပြောင်းလဲပါဘူး။
ယနေ့ခေတ် MXC ကို ပံ့ပိုးပေးသော အေးဂျင့်များတွင် GitHub Copilot၊ OpenAI Codex၊ OpenClaw၊ Replit၊ LM Studio နှင့် Unsloth AI တို့ပါဝင်ပြီး Claude Code၊ Perplexity၊ Manus နှင့် Hermes Agent တို့သည် လာမည့်စာရင်းတွင် ပါဝင်မည်ဖြစ်သည်။ NVIDIA သည် OpenShell ကို MXC ထဲသို့ ပေါင်းစပ်ထားပြီး Microsoft က ဖိုင်များနှင့် inference ဝန်ဆောင်မှုများကို အေးဂျင့်ဝင်ရောက်ခွင့်အတွက် မူဝါဒထိန်းချုပ်မှုများ၊ အဆင့်မြင့်ကွန်ရက်ထိန်းချုပ်မှုများ၊ အထောက်အထားစီမံခန့်ခွဲမှုနှင့် လုပ်ငန်းများအတွက် OCSF စာရင်းစစ်ဆေးခြင်းတို့ကို ထည့်သွင်းပေးသည်ဟု ပြောကြားခဲ့သည်။
Huang က ကြေငြာချက်ရဲ့ အလေးချိန်ကို container layer မှာ ထည့်ပြောခဲ့ပါတယ်- “Windows နဲ့ DirectX တို့က application တွေ တည်ဆောက်ပုံကို တော်လှန်ပြောင်းလဲခဲ့သလိုပဲ MXC ကလည်း agent တွေ တည်ဆောက်ပြီး ဖြန့်ကျက်ပုံကို တော်လှန်ပြောင်းလဲတော့မှာပါ။” ကျွန်တော်တို့ရဲ့ အမြင်က ပိုကျဉ်းမြောင်းပါတယ်- မူဝါဒပုံစံက ခိုင်မာပြီး cross-platform SDK က ၎င်းကို လက်ခံကျင့်သုံးခြင်းရဲ့ ကုန်ကျစရိတ်ကို လျှော့ချပေးပေမယ့် အသေးစိတ်ဖော်ပြထားတဲ့ integration တစ်ခုက အပေါ့ပါးဆုံး backend ကို အသုံးပြုပြီး agent တစ်ခု ရရှိတဲ့ isolation က ၎င်းရဲ့ developer ရွေးချယ်ထားတဲ့ backend လောက်သာ အားကောင်းပါတယ်။
Hybrid Routing: HydraFusion၊ Windows ML နှင့် llama.cpp
ဒေသတွင်း မော်ဒယ်များသည် GitHub Copilot မှတစ်ဆင့် developer များထံ ရောက်ရှိသည်။ လုပ်ငန်းတစ်ခုစီကို မှန်ကန်သော cloud မော်ဒယ်သို့ လမ်းကြောင်းပြောင်းရန် ယခုနှစ်အစောပိုင်းတွင် GitHub မှ စတင်ခဲ့သော HydraFusion ကို အောက်တိုဘာလနှောင်းပိုင်းတွင် Copilot အက်ပ်၊ Copilot CLI နှင့် Visual Studio Code တို့တွင် စမ်းသပ်မှု preview ဖြင့် စက်ပစ္စည်းပေါ်ရှိ မော်ဒယ်များအထိ တိုးချဲ့ထားသည်။ developer များသည် Auto တွင် နေရာချထားမှုကို ထားခဲ့နိုင်သည် သို့မဟုတ် Windows ML provider မှတစ်ဆင့် MAI Code 1.1 Flash သို့မဟုတ် OpenAI နှင့် တွဲဖက်အသုံးပြုနိုင်သော ဒေသတွင်း endpoint နောက်ကွယ်ရှိ မည်သည့်မော်ဒယ်ကိုမဆို ရွေးချယ်နိုင်သည်။
Microsoft သည် အထက်ဖော်ပြပါ MAI Code နံပါတ်များ ထုတ်လုပ်သည့် runtime ဖြစ်သော Windows ML တွင် llama.cpp ပံ့ပိုးမှုကို ထည့်သွင်းထားပြီး ၎င်းသည် open-model ဂေဟစနစ်ကို platform ပေါ်သို့ ပံ့ပိုးပေးသည့် လမ်းကြောင်းတစ်ခု ပေးသည်။ ကျွန်ုပ်တို့၏ Best Local LLM Tools စာမျက်နှာသည် ၎င်းပေါ်တွင် တည်ဆောက်ထားသော runtime များနှင့် front end များကို ခြေရာခံသည်။ သို့သော် Microsoft ၏ ကိုယ်ပိုင်ပြောဆိုချက်၏ အရွယ်အစားမှာ အသင့်အတင့်သာဖြစ်သည်။ ၎င်း၏ Dev Box စာမျက်နှာတွင် intelligent routing သည် Copilot workloads ၏ 20% အထိကို local model များသို့ offload လုပ်နိုင်ကြောင်း ဖော်ပြထားပြီး ၎င်းသည် local inference ကို token budget ကို တိုးချဲ့ရန် နည်းလမ်းတစ်ခုအဖြစ် ဘောင်ခတ်ထားပြီး cloud သည် အလုပ်အများစုကို လုပ်ဆောင်နေဆဲဖြစ်သည်။
စနစ်များ၊ ဈေးနှုန်းများနှင့် ရက်စွဲများ
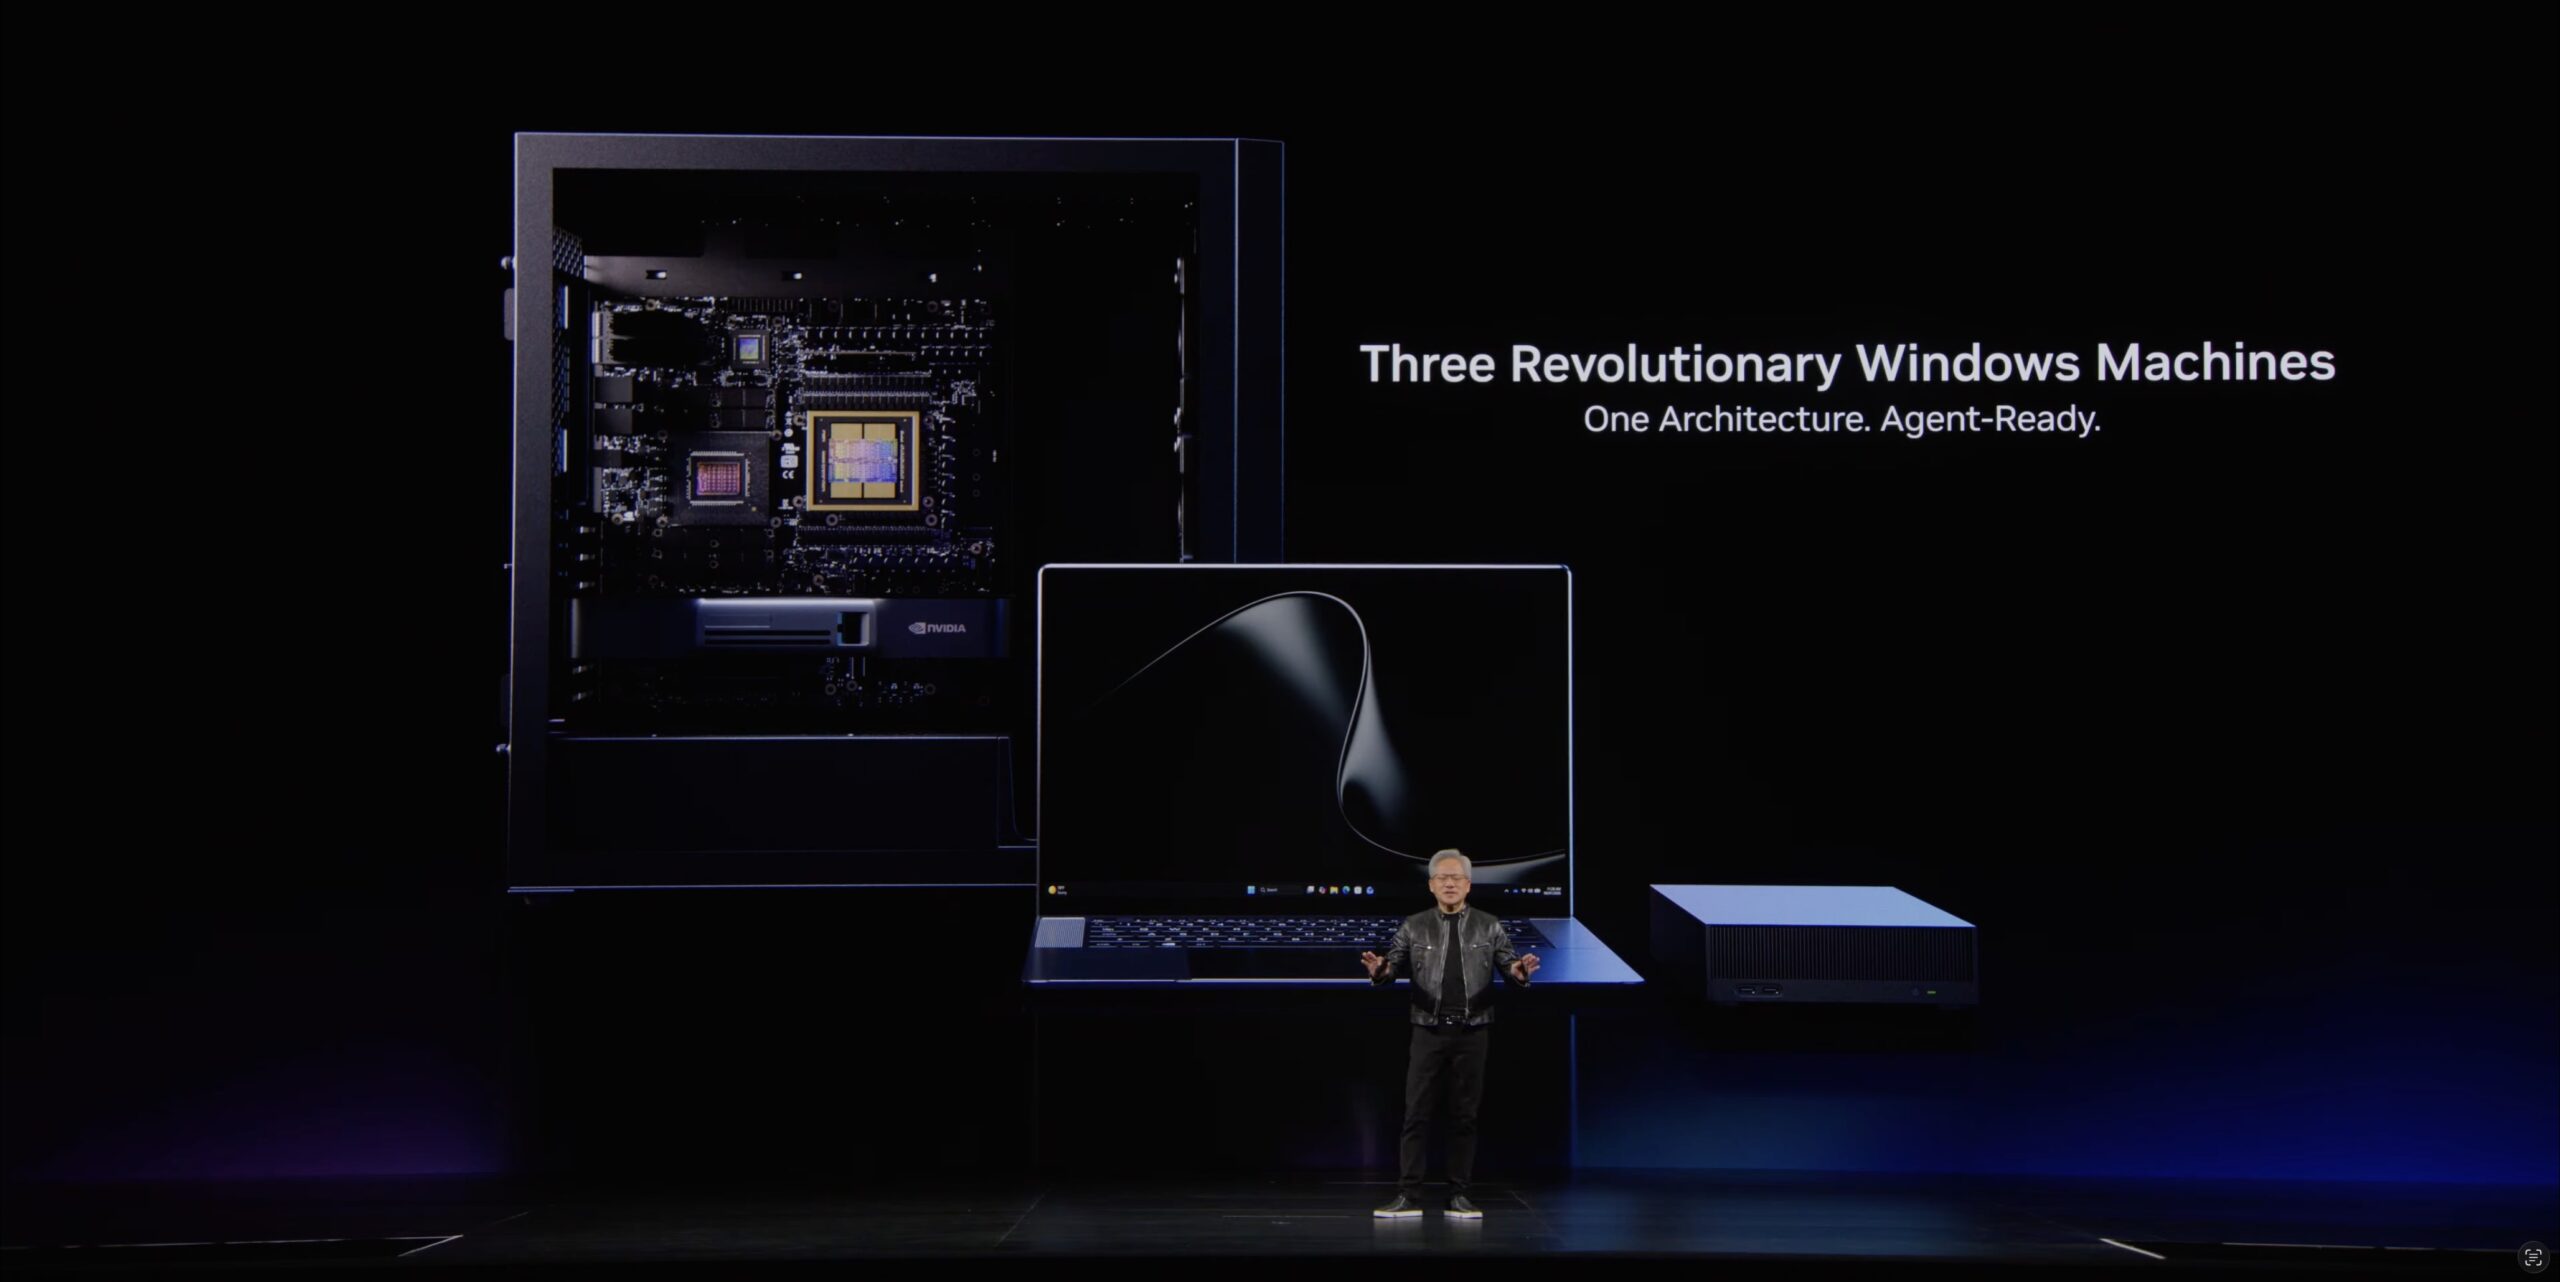
အောက်တိုဘာလ ၁၆ ရက်နေ့အတွက် OEM ခြောက်ခုက လက်တော့ပ်တွေကို ကြိုတင်မှာယူနိုင်ပါပြီ- ASUS ProArt P16 နှင့် P14၊ Dell XPS 16 Creator Edition ၊ HP OmniBook Ultra 16၊ Lenovo Yoga 9n 2-in-1၊ MSI Prestige N16 Flip AI+ နှင့် Microsoft ၏ Surface Laptop Ultra တို့ဖြစ်သည်။ NVIDIA ၏ marketplace တွင် HP OmniBook X 14 ကိုလည်း စာရင်းပြုစုထားသည်။ MSI ၏ စက်တွင် ၁၆ လက်မ UHD+ tandem OLED နှင့် 99.9Wh ဘက်ထရီ ပါရှိသည်။ NVIDIA သည် RTX Spark စနစ်များကို တင်ပို့ရောင်းချသူများထဲတွင် Acer နှင့် Gigabyte တို့ကိုလည်း ထည့်သွင်းထားသည်။
Surface Laptop Ultra ဟာ ဒေါ်လာ ၂,၅၉၉ ကနေစတင်ပြီး Microsoft က ၁၈ မီလီမီတာနဲ့ ၄.၅ ပေါင်အောက် အလေးချိန်ရှိတဲ့ ကိုယ်ထည်နဲ့ ထုတ်လုပ်ထားပြီး ကျွန်တော်တို့တွေ့ဖူးသမျှထဲမှာ အနိမ့်ဆုံး RTX Spark ဈေးနှုန်းဖြစ်ပါတယ်။ Microsoft က လက်ရှိ Surface Laptop တွေထက် ၂.၅ ဆ အပူချိန်စွမ်းရည်ပိုများတယ်လို့ ဆိုထားပြီး၊ 10% window မှာ တိုင်းတာထားတဲ့ အမြင့်ဆုံး HDR brightness 2,000 nits နဲ့ 3270 x 2180 ရှိတဲ့ ၁၅ လက်မ 120Hz touchscreen၊ user-removable storage နဲ့ ဗီဒီယိုနဲ့ data တွေကို သယ်ဆောင်ပေးနိုင်တဲ့ magnetic USB-C charging port တို့ ပါဝင်ပါတယ်။ 140W power supply ကို ရွေးချယ်ထားတဲ့ configuration တွေနဲ့ တွဲဖက်ပေးထားပါတယ်။ NVIDIA ရဲ့ marketplace မှာ အနိမ့်ဆုံး configuration ကတော့ 5,120-core chip နဲ့ 24GB နဲ့ 512GB Gen4 SSD တို့နဲ့ တွဲဖက်ထားပါတယ်။
Surface RTX Spark Dev Box ဟာ ပထမဆုံး compact desktop ဖြစ်ပြီး 128GB နဲ့ $5,999 ကျသင့်မှာဖြစ်ပြီး အမေရိကန်မှာ Microsoft.com မှာသာ ရောင်းချပြီး နိုဝင်ဘာလမှာ ပို့ဆောင်ပေးမှာ ဖြစ်ပါတယ်။ Visual Studio Code, Git, GitHub Copilot, WSL, Python နဲ့ Node တို့ကို ကြိုတင်ထည့်သွင်းပေးထားပါတယ်။ အဲဒါက memory နှစ်ဆပါတဲ့ $4,999 64GB DGX Spark ထက် $1,000 ပိုများပါတယ် ။ Microsoft က USB-C port နှစ်ခု၊ USB-A, HDMI, Ethernet နဲ့ headphone jack တစ်ခုတို့ကို စာရင်းပြုစုထားပြီး DGX Sparks တွေကို cluster လုပ်နိုင်တဲ့ ConnectX-7 port တွေအကြောင်းတော့ ဖော်ပြထားခြင်း မရှိပါဘူး။ ဇွန်လတုန်းက ကျွန်တော်တို့ မေးခဲ့တဲ့ desktop networking မေးခွန်းရဲ့ အဖြေတစ်ခုလည်း ဖြစ်ပါတယ်။
Windows အတွက် DGX Station: စတုတ္ထသုံးလပတ်၊ အပြည့်အစုံသတ်မှတ်ချက်ဇယားနှင့်အတူ
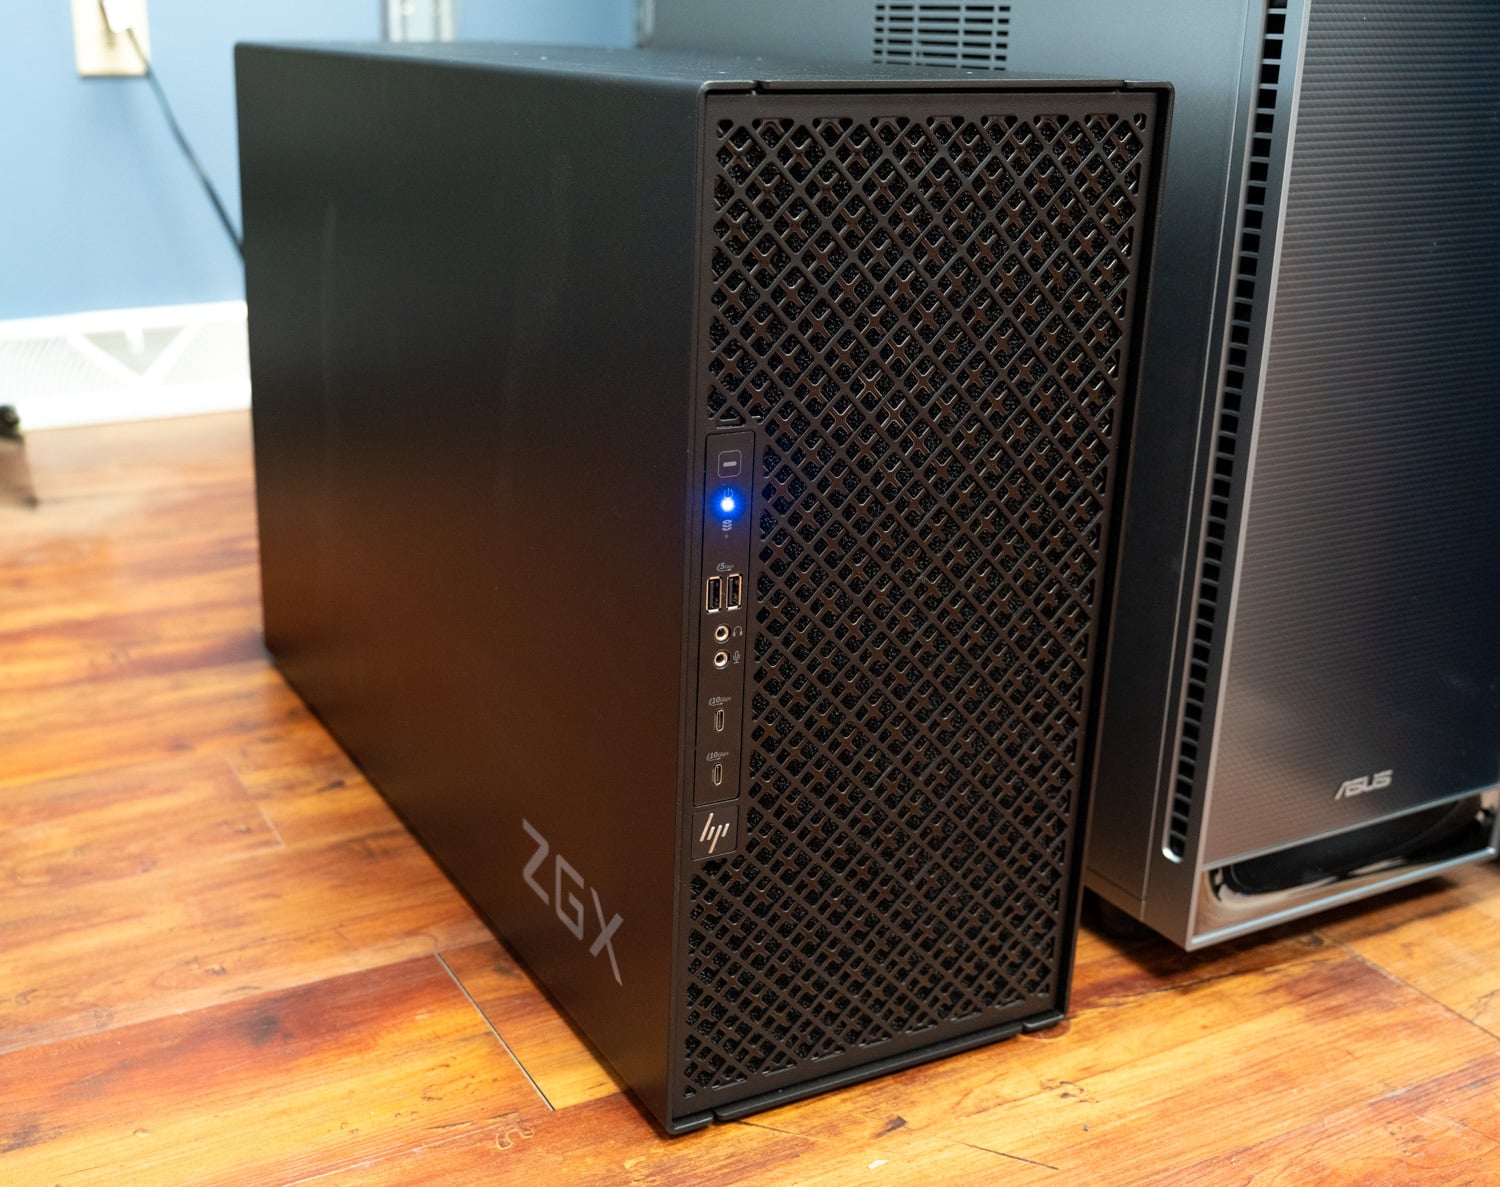
NVIDIA ရဲ့ DGX Station for Windows စာမျက်နှာမှာ “လာမည် စတုတ္ထသုံးလပတ်” လို့ ရေးထားပြီး Microsoft က ဒီနှစ်နှောင်းပိုင်းမှာ ဒီစနစ်တွေ ရောက်ရှိလာမယ်လို့ ပြောကြားထားပြီး Dell Pro Precision with GB300 နဲ့ HP ZGX Fury AI Station ကို ပထမဆုံး အမည်ပေးထားတယ်လို့ ဆိုပါတယ်။ NVIDIA ရဲ့ မိတ်ဖက်စာရင်းမှာ ASUS၊ Gigabyte၊ MSI နဲ့ Supermicro တို့ ပါဝင်ပါတယ်။ Hardware ကတော့ MSI XpertStation WS300 ၊ ASUS ExpertCenter Pro ET900N G3 နဲ့ two-tower cluster တို့ ဖြစ်ပါတယ် ။
| specification | Windows အတွက် NVIDIA DGX ဘူတာရုံ |
|---|---|
| GPU ကို | ၁ x NVIDIA Blackwell Ultra၊ 7.1TB/s ဖြင့် 252GB HBM3e |
| စီပီယူ | ၁x Grace၊ ၇၂ Neoverse V2 cores၊ 496GB LPDDR5X (396GB/s) |
| ညီညွတ်သော မှတ်ဉာဏ် | 748GB အထိ; NVLink-C2C တွင် 900GB/s |
| FP4 Tensor Core | ရှားပါးမှုရှိသော PFLOPS ၂၀၊ မပါဘဲ PFLOPS ၁၅ |
| FP8 နှင့် FP6 Tensor Core | ၁၁.၁၅ PFLOPS |
| FP16 နှင့် BF16 Tensor Core | ၁၁.၁၅ PFLOPS |
| TF32 တန်ဆာ အူတိုင် | ၁၁.၁၅ PFLOPS |
| FP32 / FP64 | ၈၀ TFLOPS / ၁.၃ TFLOPS |
| Network | ConnectX-8 SuperNIC၊ 800Gb/s အထိ- port တစ်ခုလျှင် 400Gb/s ဖြင့် 2x QSFP112 ၁ x 10GbE RJ-45၊ ၁ x 1GbE RJ-45 (BMC) |
| သိုလှောင်ခြင်း | M.2 PCIe Gen5 slot ၄ ခု |
| PCIe အပေါက်များ | PCIe Gen5 x16 ၁ ခု၊ PCIe Gen5 x16 ၂ ခု (x8 လျှပ်စစ်) |
| ပံ့ပိုးပေးထားသော RTX PRO GPU များ | RTX PRO 6000 Workstation Edition၊ RTX PRO 6000 Blackwell Max-Q Workstation Edition၊ RTX PRO 4000 Blackwell SFF Edition၊ RTX PRO 2000 Blackwell (ပံ့ပိုးမှုစနစ်အလိုက် ကွဲပြားနိုင်သည်) |
| ဒီကုဒ်ဒါတွေ | ၇ NVDEC၊ ၇ nvJPEG |
| စနစ်ပါဝါ | 1,600W; 20A ဆားကစ် လိုအပ်သည် |
| operating system | Microsoft Windows; WSL မှတစ်ဆင့် Linux toolchains |
Microsoft က Windows DGX Station အတွက် အသုံးပြုမှုနှစ်ခုကို ဖော်ပြထားပါတယ်။ တစ်ခုက အင်ဂျင်နီယာနဲ့ သုတေသနလုပ်ငန်းအတွက် ကိုယ်ပိုင် AI စူပါကွန်ပျူတာဖြစ်ပြီး Llama 4 Maverick၊ Kimi K2.6 နဲ့ DeepSeek V4 Pro အဖြစ် စာရင်းပြုစုထားတဲ့ မော်ဒယ်တွေကို အသုံးပြုပါတယ်။ ဟာ့ဒ်ဝဲပေါ်မှာတော့ သူ့ရဲ့ အောက်ခြေမှတ်ချက်မှာ မော်ဒယ်တွေကို 1 trillion parameters အထိ ပံ့ပိုးပေးတယ်လို့ ဖော်ပြထားပါတယ်။ နောက်တစ်ခုကတော့ Windows token factory လို့ခေါ်တဲ့ shared system တစ်ခုဖြစ်ပြီး cloud token သုံးစွဲမှုကို လျှော့ချဖို့အတွက် အဖွဲ့တစ်ဖွဲ့အတွက် တစ်ပြိုင်နက်တည်း agent ၃၂ ခု ဒါမှမဟုတ် ၃၂ ခုထက်ပိုပြီး ပံ့ပိုးပေးပါတယ်။ Microsoft က IT ဟာ ဒီစနစ်တွေကို သူ့ရဲ့ Windows fleet တစ်လျှောက်မှာ အသုံးပြုတဲ့ tools တွေနဲ့ စီမံခန့်ခွဲနိုင်တယ်လို့ ပြောပါတယ်။
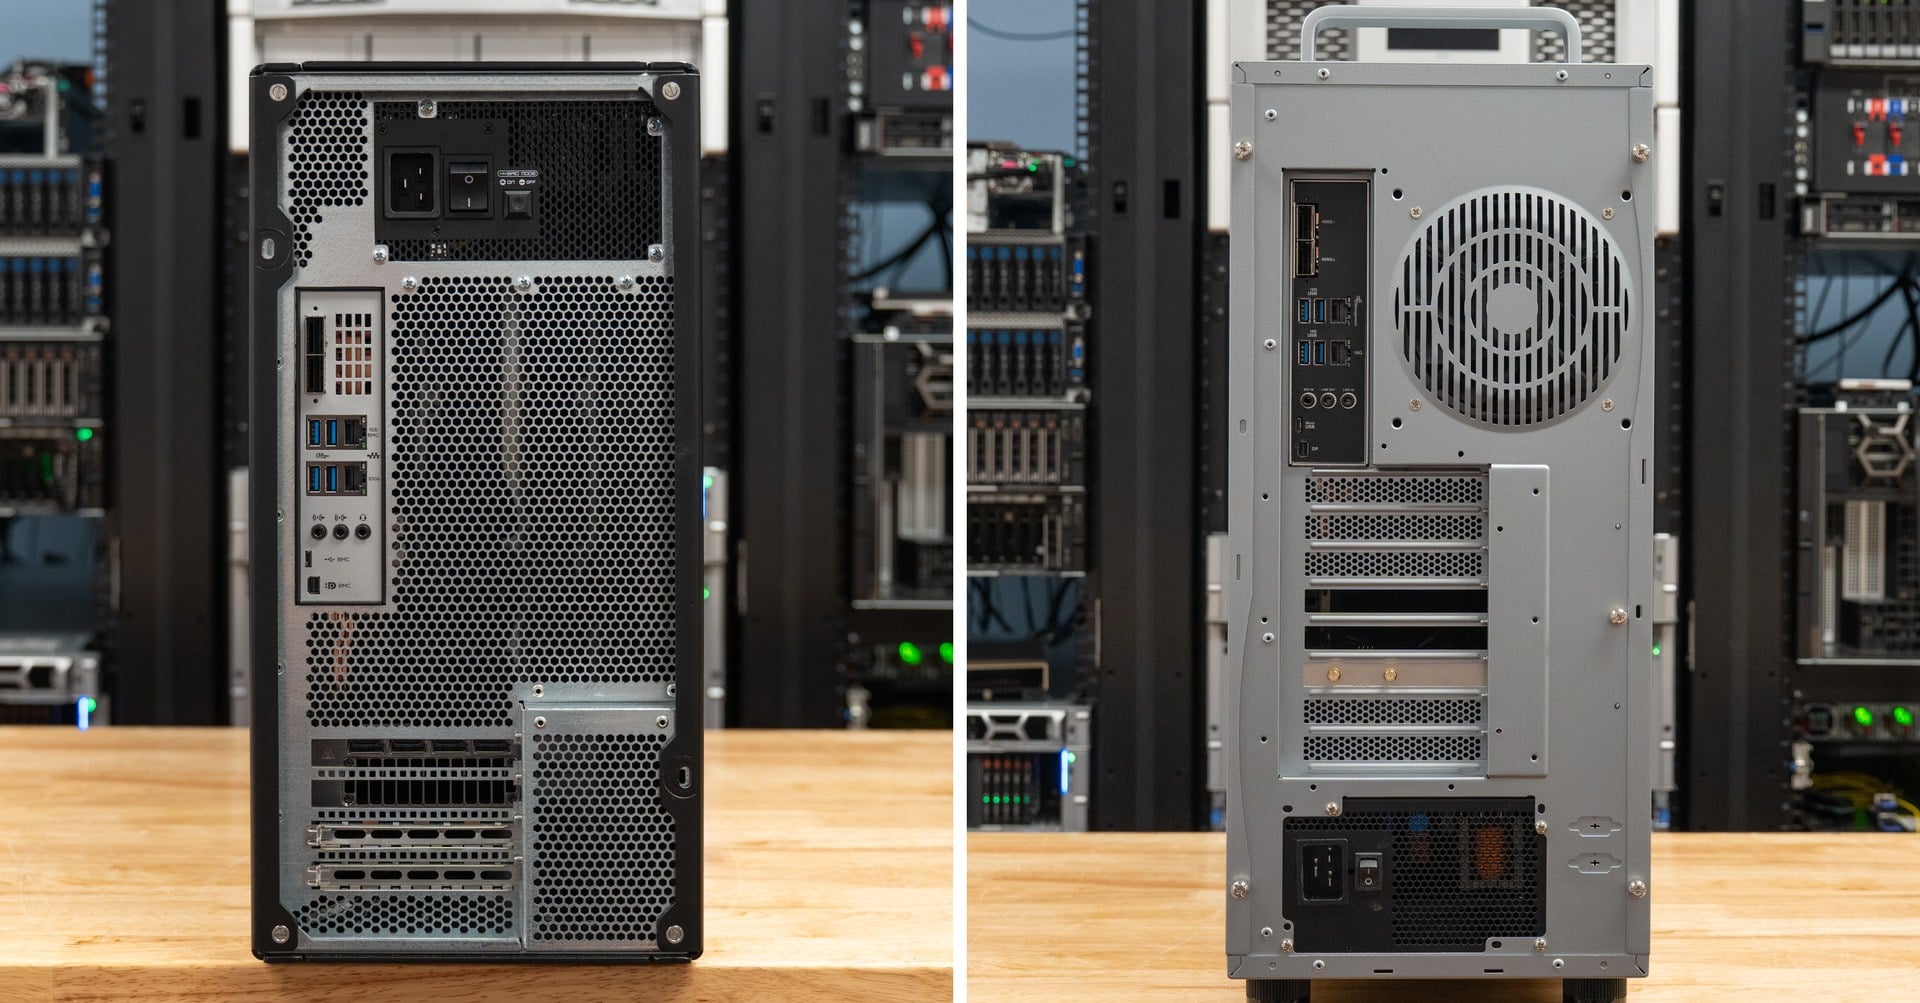
ရွေးချယ်နိုင်သော RTX PRO ကတ်သည် Linux ထက် Windows တွင် ပိုမိုအရေးကြီးပါသည်။ Computex တွင် ကျွန်ုပ်တို့ သတိပြုမိသည့်အတိုင်း GB300 ရှိ Blackwell Ultra GPU တွင် RT cores မပါဝင်သောကြောင့် Windows ဒီဇိုင်းနှင့် အင်ဂျင်နီယာအပလီကေးရှင်းများတွင် ray-traced visualization သည် add-in ကတ်ပေါ်တွင် အလုပ်လုပ်ပြီး superchip သည် AI ကို ကိုင်တွယ်သည်။ NVIDIA သည် RTX PRO 2000 မှ 6000 အထိ ပံ့ပိုးပေးသော RTX PRO Blackwell ကတ်လေးခုကို စာရင်းပြုစုထားပြီး ပံ့ပိုးမှုသည် စနစ်အလိုက် ကွဲပြားနိုင်သည်ဟု အကြံပြုထားသည်။
ဇွန်လကတည်းက ပွင့်နေတဲ့မေးခွန်းကတော့ အခုထိ ပွင့်နေဆဲပါ။ ကျွန်တော်တို့ရဲ့ GB300 လုပ်ဆောင်ချက်အားလုံးဟာ vLLM နဲ့ NVIDIA container stack ပါတဲ့ Ubuntu မှာ လုပ်ဆောင်ခဲ့တာဖြစ်ပြီး ဘယ် serving stack တွေက ဒီ hardware မှာ Windows မှာ natively run ပြီး ဘယ် serving stack တွေက WSL အောက်မှာ run လဲဆိုတာ ဒါမှမဟုတ် 400Gb/s port နှစ်ခုပါတဲ့ 72-core Grace host မှာ throughput မှာ WSL ဘယ်လောက်ကုန်ကျလဲဆိုတာကို ဘယ် company ကမှ မပြောခဲ့ပါဘူး။ Windows unit တစ်ခု lab ကိုရောက်တဲ့အခါ ဒါတွေက ကျွန်တော်တို့ ပထမဆုံးစမ်းသပ်မယ့်အရာတွေပါ။
ဘာတွေထပ်ပေါင်းထည့်လဲ
Computex မှာ ကျွန်တော်တို့ ချန်ထားခဲ့တဲ့ မေးခွန်းအတော်များများကို မိတ်ဆက်တဲ့ ပစ္စည်းက ဖြေဆိုပေးပါတယ်။ လက်တော့ပ်တွေမှာ ချစ်ပ်ကို ၄၅ မှ ၈၀ ဝပ်နဲ့ ဒက်စ်တော့တွေမှာ ၁၄၀ ဝပ်နဲ့ အသုံးပြုပါတယ်။ 128GB ရွေးချယ်မှုကတော့ ချစ်ပ်နှစ်ခုထဲက ပိုကြီးတဲ့ မော်ဒယ်နဲ့ ချိတ်ဆက်ထားပါတယ်။ Windows မှာ GPU-addressable memory ကို ထည့်သွင်းထားတဲ့ စုစုပေါင်းပမာဏထက် လျှော့ချထားပါတယ်။ ပြီးတော့ Microsoft ရဲ့ ပထမဆုံး compact desktop မှာ မြန်နှုန်းမြင့် networking မပါဝင်ပါဘူး။ Microsoft ရဲ့ Windows and Devices ဆိုင်ရာ အမှုဆောင်ဒုတိယဥက္ကဋ္ဌ Pavan Davuluri ရဲ့ စကားက “ရိုးရာစက်မှာ မကိုက်ညီတဲ့ မော်ဒယ်တွေကို ဒီလက်တော့ပ်မှာ အသုံးပြုနိုင်ပါတယ်” ဆိုတဲ့ စကားပါပဲ။ Microsoft ရဲ့ 137B coding မော်ဒယ်ကို တစ်စက္ကန့်ကို တိုကင် ၆၀ လောက်နဲ့ အသုံးပြုနိုင်တာက ဒီသရုပ်ပြမှုတစ်ခုပါပဲ။
ပျောက်ဆုံးနေဆဲကတော့ သတ်မှတ်ထားတဲ့ ကိုယ်ထည်တစ်ခုပေါ်မှာ မူတည်တဲ့ အရာအားလုံးပါပဲ- ရှည်လျားတဲ့ agent session တစ်ခုအောက်မှာ ကြာရှည်ခံတဲ့ ပါဝါ၊ Apple ရဲ့ M5 Max နဲ့ AMD ရဲ့ Strix Halo စနစ်တွေကို decode throughput လုပ်ခြင်း၊ တွက်ချက်မှုအောက်မှာ ဘက်ထရီသက်တမ်းနဲ့ 128GB လက်တော့ပ်အများစုရဲ့ ဈေးနှုန်းတွေပါ။ Windows ဟာ ပြီးခဲ့တဲ့လက firmware မှာ Windows boot certificate ရရှိခဲ့တဲ့ GB10-based DGX Spark ကို ဘယ်အချိန်မှာ ရောက်ရှိမလဲဆိုတာကိုလည်း ကျွန်တော်တို့ မသိသေးပါဘူး။ သုံးသပ်ချက်ယူနစ်တွေဟာ ကျွန်တော်တို့ရဲ့ ဒေသတွင်း AI အတွက် အကောင်းဆုံးလက်တော့ပ် တွေနဲ့ ဒေသတွင်း AI ဦးဆောင်ဘုတ်တွေအတွက် အကောင်းဆုံးဒက်စ်တော့ပ်တွေရဲ့ နောက်ကွယ်က တူညီတဲ့ suite ကို ဖြတ်သန်းသွားမှာဖြစ်ပါတယ် ။



 အမေဇုံ