

MSI XpertStation WS300 ကို NVIDIA ရဲ့ အသစ်ဆုံး DGX Station ဗိသုကာလက်ရာပေါ်မှာ တည်ဆောက်ထားပြီး၊ စွမ်းဆောင်ရည်အမြင့်ဆုံး မျိုးဆက်ဖြစ်ပြီး၊ သင့်စားပွဲဘေးမှာ GB300 Grace Blackwell Ultra node အပြည့်အစုံ ထားရှိပေးထားပါတယ်။ အဓိက နံပါတ်ကတော့ FP4 compute ရဲ့ 20 petaFLOPS ဖြစ်ပြီး၊ 900GB/s NVLink-C2C link ပေါ်က 72-core Grace CPU နဲ့ ချိတ်ဆက်ထားတဲ့ Blackwell Ultra GPU တစ်ခုတည်းကနေ ပေးပို့ပါတယ်။ processor နှစ်ခုစလုံးဟာ ပေါင်းစပ်ထားတဲ့ 748GB memory pool တစ်ခုတည်းကနေ ရယူပါတယ်။ HBM3e 252GB နဲ့ LPDDR5X 496GB တို့နဲ့ တွဲဖက်ထားရှိပြီး local memory မှာ trillion-parameter model တစ်ခုကို ထိန်းသိမ်းထားဖို့ လုံလောက်ပါတယ်။
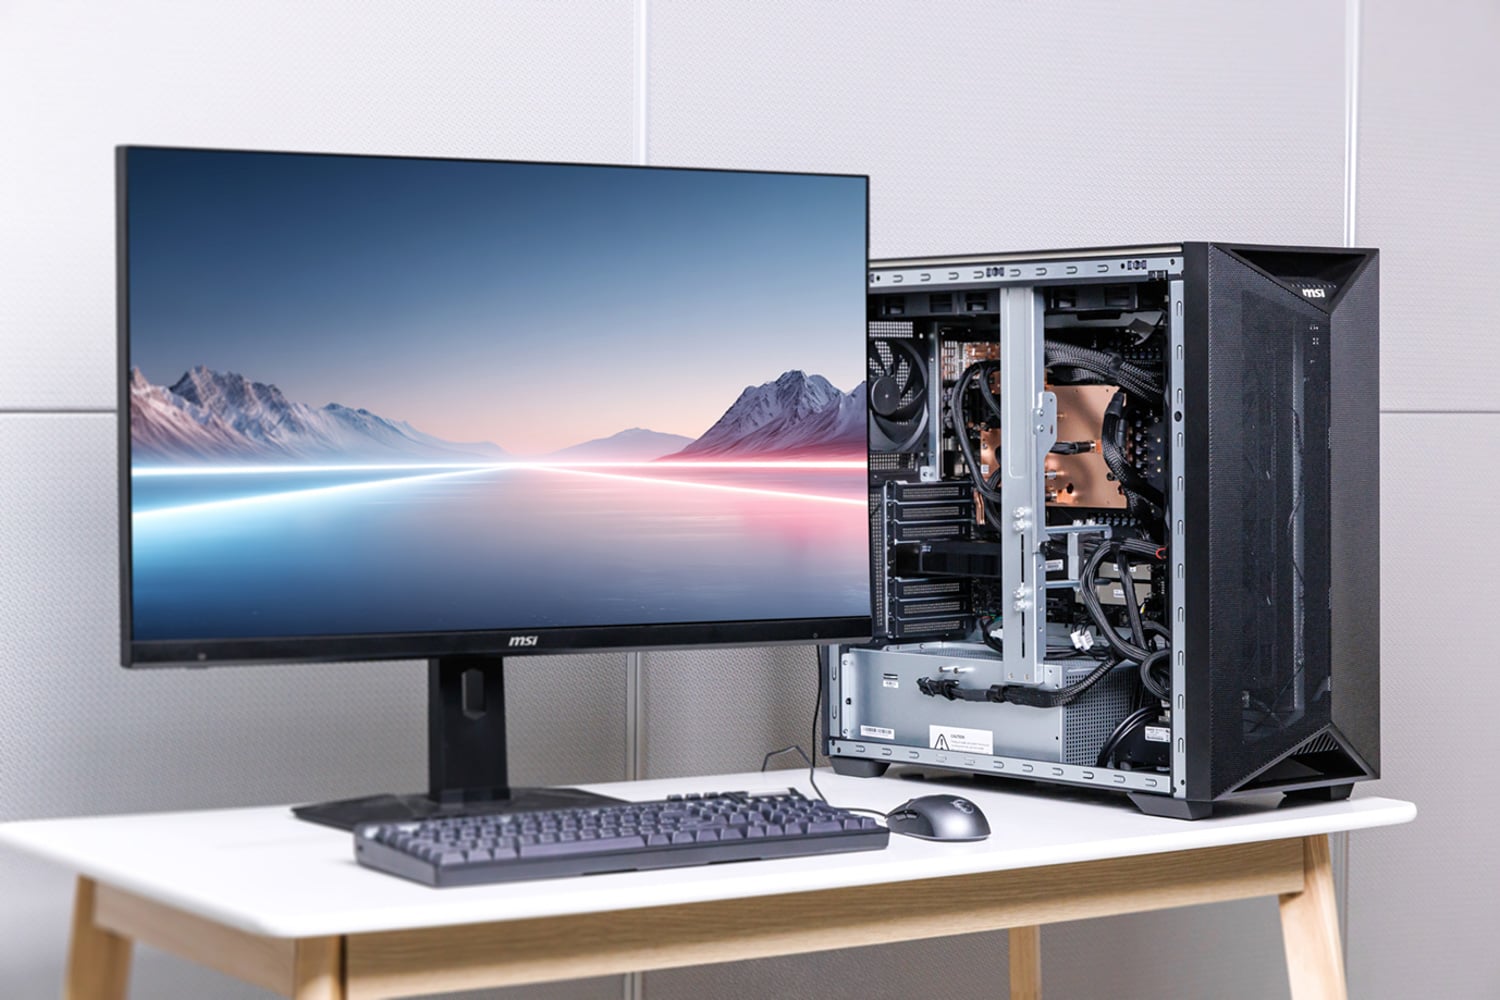
DGX Station သည် ၎င်း၏ ConnectX-8 SuperNIC ကို အသုံးပြု၍ ယူနစ်များစွာကို clustering လုပ်ခြင်းကို ပံ့ပိုးပေးပြီး ၎င်းသည် 800Gb/s fabric အတွက် 400GbE port နှစ်ခုကို ဖော်ထုတ်ပေးသည်။ ရလဒ်အနေဖြင့် server hall တွင်မဟုတ်ဘဲ အိမ် သို့မဟုတ် ရုံးခန်းတွင် လည်ပတ်နိုင်သော datacenter အဆင့်စက်တစ်ခုဖြစ်သည်။
NVIDIA DGX ဘူတာရုံ နည်းပညာဆိုင်ရာ သတ်မှတ်ချက်များ
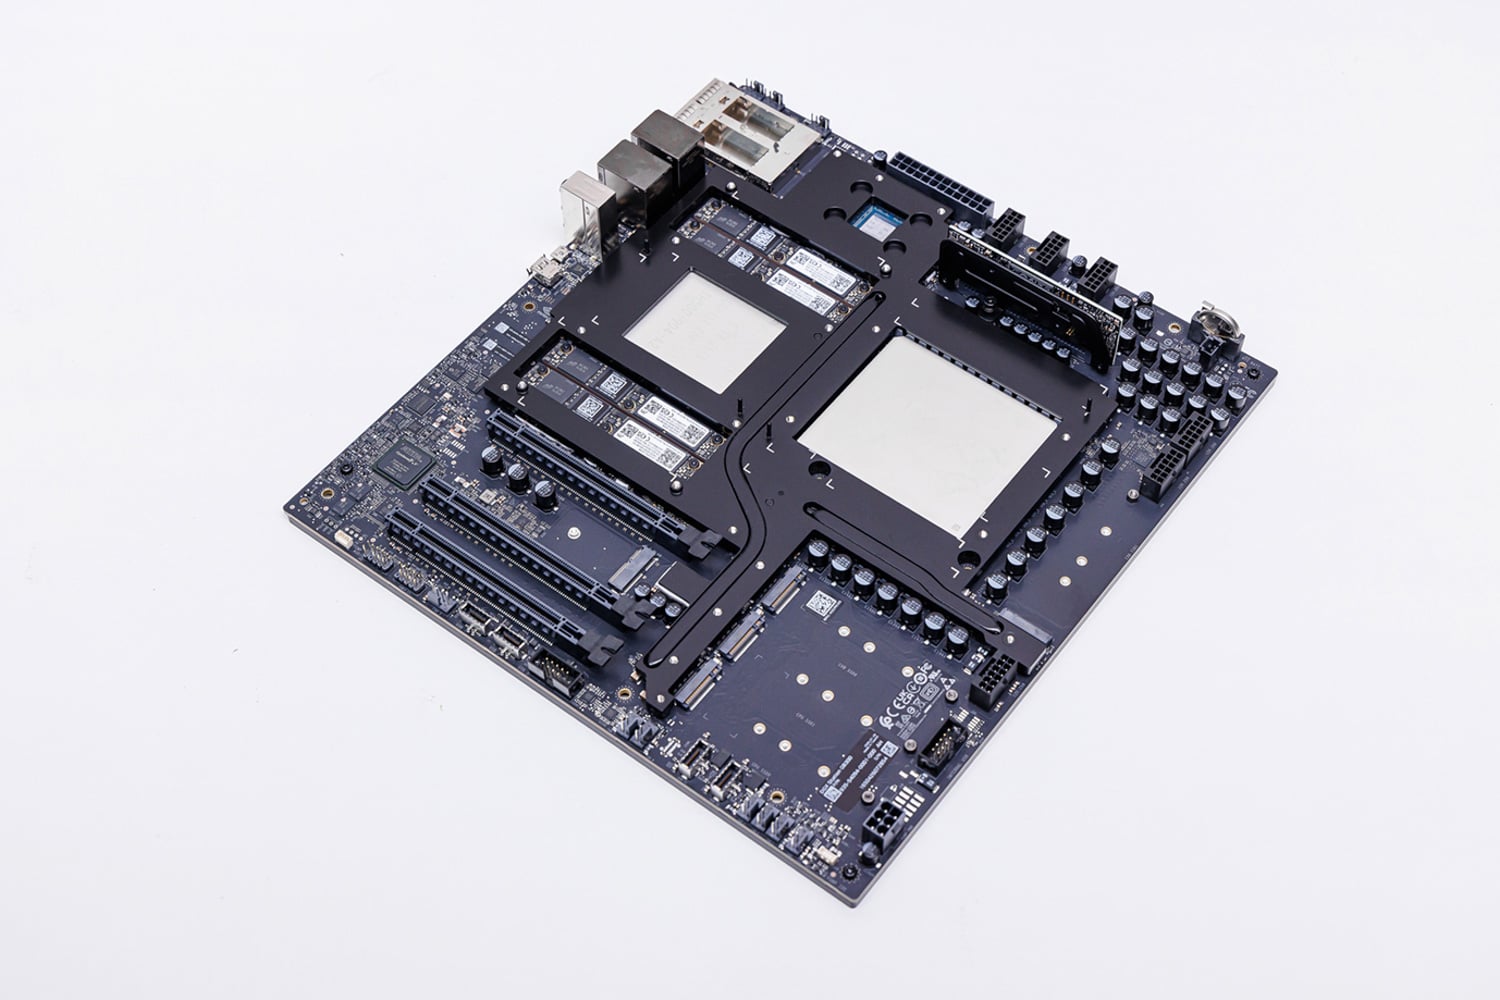
XpertStation WS300 သည် MSI ၏ NVIDIA ၏ GB300 DGX Station platform ကို အကောင်အထည်ဖော်ခြင်းဖြစ်သည်။ NVIDIA သည် Grace Blackwell Ultra baseboard နှင့် software environment ကို ထောက်ပံ့ပေးပြီး MSI သည် platform ကို deskside system တစ်ခုလုံးအဖြစ်သို့ ပြောင်းလဲပေးသည့် chassis၊ liquid cooling၊ power delivery၊ storage layout၊ external I/O နှင့် service model တို့ကို ထောက်ပံ့ပေးသည်။ Grace CPU၊ Blackwell Ultra GPU၊ NVLink-C2C interconnect နှင့် ConnectX-8 networking တို့ကို fixed လုပ်ထားသောကြောင့် OEM ၏ စစ်မှန်သော ခြားနားချက်မှာ ပတ်ဝန်းကျင် system သည် ထို hardware ကို မည်မျှထိရောက်စွာ ထောက်ပံ့ပေးသည်၊ စီမံခန့်ခွဲသည်၊ နှင့် ဖော်ထုတ်သည်ဆိုသည့်အချက်ဖြစ်သည်။ MSI သည် ဤ system ကို စမ်းသပ်ရန်အတွက် 2TB Micron 4600 Gen5 M.2 SSD လေးလုံးဖြင့် configure လုပ်ထားသည်။ SSD နှစ်ခုကို boot storage အတွက် RAID1 တွင် configure လုပ်ထားပြီး ကျန်နှစ်ခုမှာ scratch space သို့မဟုတ် အခြားအသုံးပြုမှုများအတွက် discrete SSD များဖြစ်သည်။
| specification | အသေးစိတ် |
|---|---|
| ဗိသုကာအတတ်ပညာ | |
| စီပီယူ | NVIDIA Grace၊ 72-core Arm Neoverse V2 |
| GPU ကို | NVIDIA Blackwell Ultra (B300) |
| Tensor core | 5th မျိုးဆက်ကျောင်းသားများ |
| CPU-GPU အပြန်အလှန်ချိတ်ဆက်မှု | NVLink-C2C၊ 900 GB/s နှစ်လမ်းသွား |
| မှတ်ဉာဏ် | |
| ညီညွတ်သော မှတ်ဉာဏ် | 748 GB အထိ |
| GPU မှတ်ဉာဏ် | 252GB HBM3e အထိ |
| GPU Memory Bandwidth | ၁ TB / s |
| CPU ကိုမှတ်ဉာဏ် | 496 GB LPDDR5X (4 x SOCAMM) အထိ |
| CPU မှတ်ဉာဏ် Bandwidth | 396 GB ကို / s နဲ့ |
| သိုလှောင်ခြင်း | |
| Boot Drives များ | 2 x M.2 2280 PCIe 5.0 x4 NVMe (CPU-attached)၊ RAID 1 တွင် 2 x 2TB Micron 4600 Gen5 ဖြင့် ထည့်သွင်းထားသည် |
| ချဲ့ထွင်မှု ဒရိုက်များ | 2 x M.2 2280 PCIe 5.0 x4 NVMe (ConnectX-8-attached)၊ 2 x 2TB Micron 4600 Gen5 ဖြင့် စမ်းသပ်ရန်အတွက် ထည့်သွင်းထားသည်။ |
| Network | |
| NIC | NVIDIA ConnectX-8 SuperNIC၊ 2 x 400G QSFP112 (စုစုပေါင်း 800 Gb/s) |
| Ethernet | ၁ x 10GBase-T RJ45 (Marvell AQC113) |
| စီမံခန့်ခွဲမှုဆိပ်ကမ်း | ၁ x 1000Base-T RJ45 (သီးသန့် out-of-band) |
| ကြိုးမဲ့ | M.2 2230 Key-E အပေါက်၊ PCIe 2.0 x1 (Wi-Fi 6E / Wi-Fi 7၊ Bluetooth) |
| ချဲ့ထွင်မှု | |
| PCIe slot | PCIe 5.0 x16 FHFL double-wide ၁ ခု၊ PCIe 5.0 x16 FHFL single-wide (x8 signal) ၂ ခု |
| ပံ့ပိုးပေးထားသော Add-in GPU များ | NVIDIA RTX PRO 2000 Blackwell၊ RTX PRO 4000 Blackwell SFF၊ RTX PRO 6000 Blackwell Workstation / Max-Q |
| ရှေ့/အပေါ် I/O | |
| ယူအက်စ်ဘီ | USB 3.2 Gen 2 Type-A ၂ ခု၊ USB 3.2 Gen 2 Type-C (5V/3A) ၂ ခု |
| audio | ဂျက် ၂ ခု (လိုင်းအထွက် / မိုက်ခရိုဖုန်း) |
| နောက်ဘက် အဝင်/အထွက် | |
| ယူအက်စ်ဘီ | USB 10Gbps Type-A ၄ ခု၊ Micro-USB COM (serial console) ၁ ခု |
| မျက်နှာပြင် | ၁ x Mini DisplayPort (BMC ဗီဒီယို၊ အများဆုံး 1024 x 768၊ DP++ မပါဝင်ပါ) |
| audio | ဂျက် ၃ ခု (လိုင်းဝင်/လိုင်းထွက်/မိုက်ခရိုဖုန်း) |
| စီမံခန့်ခွဲမှုနှင့် လုံခြုံရေး | |
| BMC | AMI MegaRAC firmware၊ IPMI 2.0 နှင့် Redfish၊ eMMC local storage ပါဝင်သော ASPEED AST2600 |
| လုံခွုံရေး | TPM 2.0၊ ကိုယ်ထည်ကျူးကျော်ဝင်ရောက်မှု၊ Microchip CEC1736 ဟာ့ဒ်ဝဲယုံကြည်မှုအမြစ် (ERoT) |
| အအေး | |
| အရည်အအေးခံခြင်း | 1400W CPU + GPU အတွက် အဆင့်သတ်မှတ်ထားသော အရည်အအေးပေးမော်ဂျူး၊ GPU၊ CPU၊ မှတ်ဉာဏ်နှင့် ConnectX-8 တွင် ပိတ်ဆို့ထားသည် |
| ရေတိုင်ကီများ / ပန်ကာများ | ၃၆၀ မီလီမီတာ ရေဒီယေတာ ၂ ခု၊ ၁၂၀၂၅ စနစ်ပန်ကာ ၁ ခု |
| စွမ်းအား | |
| Power ကထောက်ပံ့ရေး | ၁ x 1600W ATX၊ 80 PLUS Platinum (150 x 86 x 210 မီလီမီတာ) |
| AC input ကို | 100-114Vac, 15A, 47-63Hz (အများဆုံး 1300W အထွက်)၊ 115-240Vac, 15-8A, 47-63Hz (အများဆုံး 1600W အထွက်) |
| form ကို Factor | |
| ရှုထောင့် | ၅၂၇.၉ x ၂၄၇.၈ x ၅၆၇.၇ မီလီမီတာ (၂၀.၇၈ x ၉.၇၆ x ၂၂.၃၅ လက်မ)၊ အနံ x အမြင့် x အနက် |
ဒီဇိုင်းနှင့်တည်ဆောက်ပါ
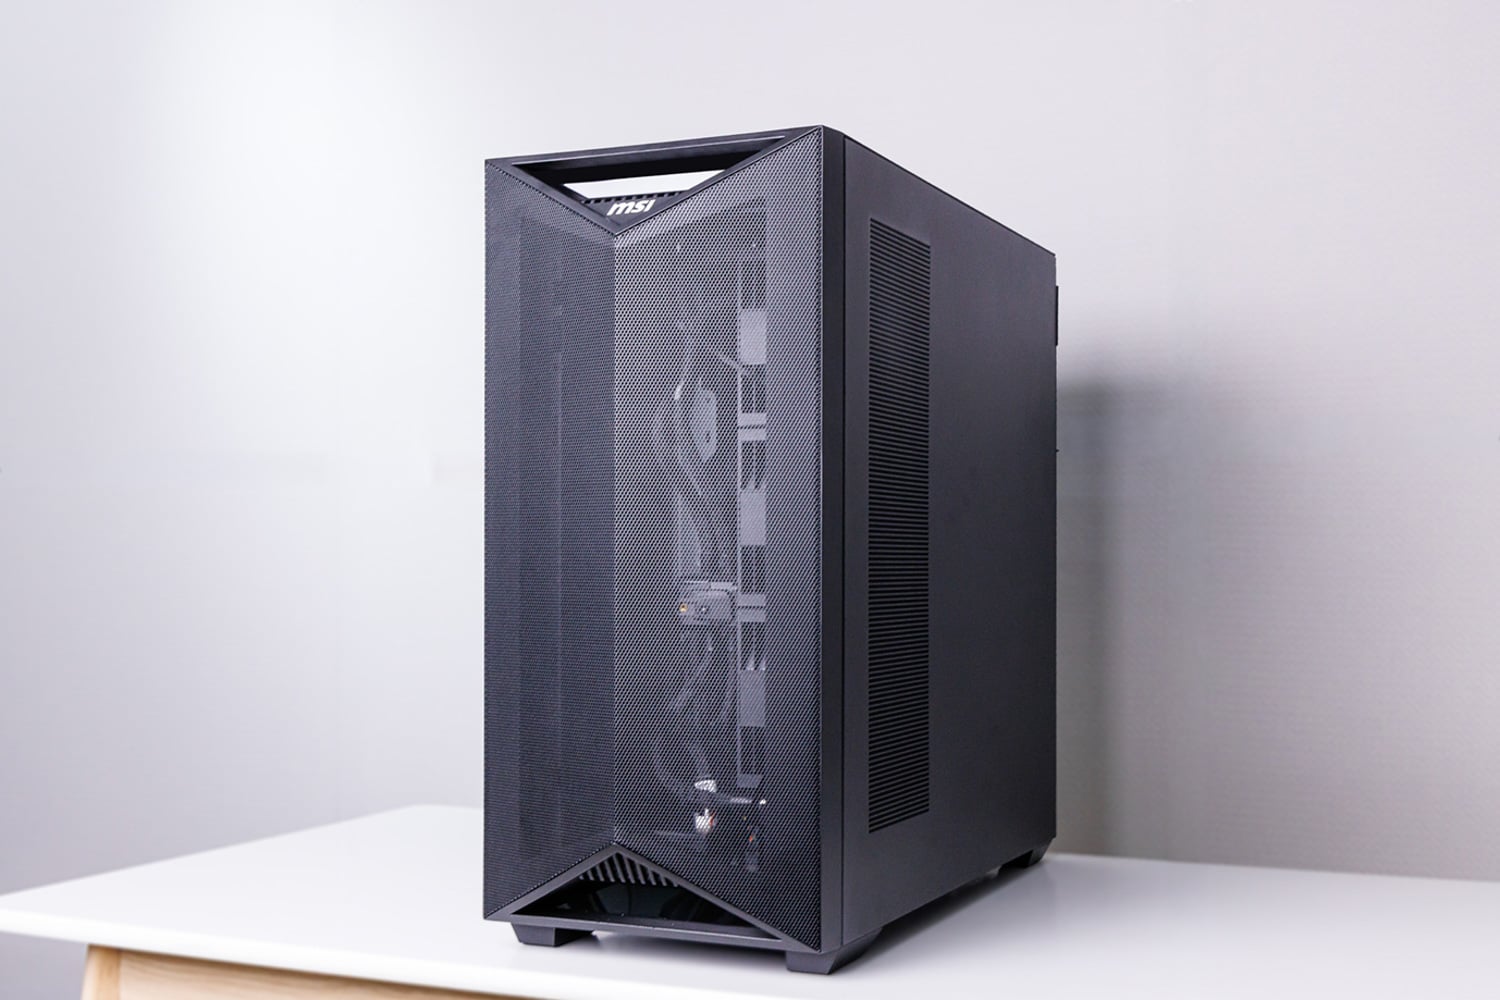
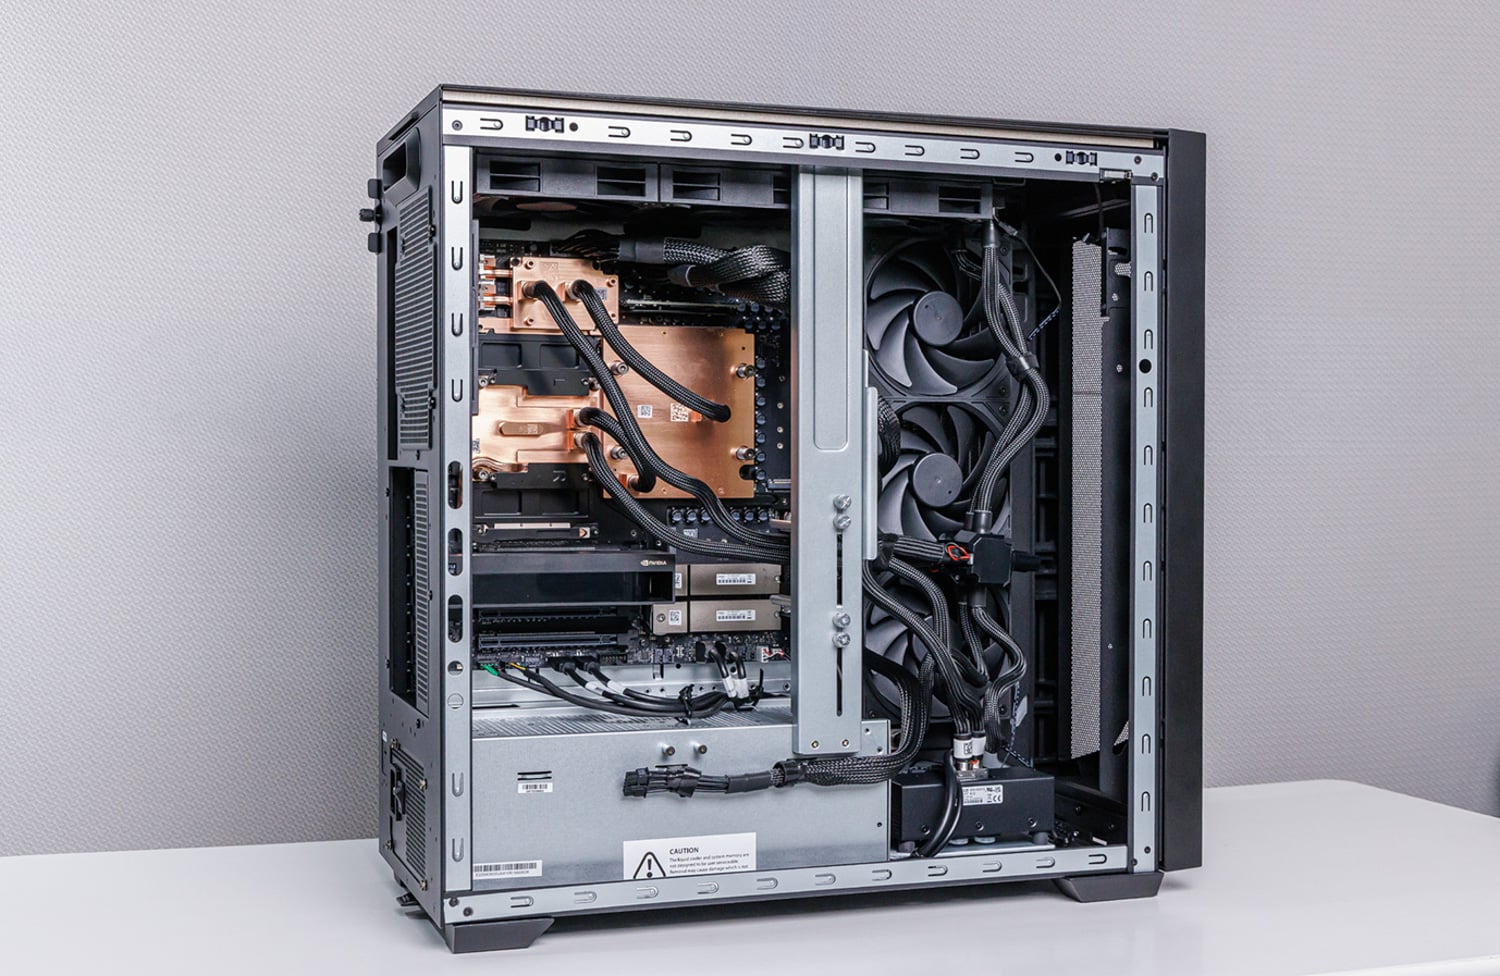
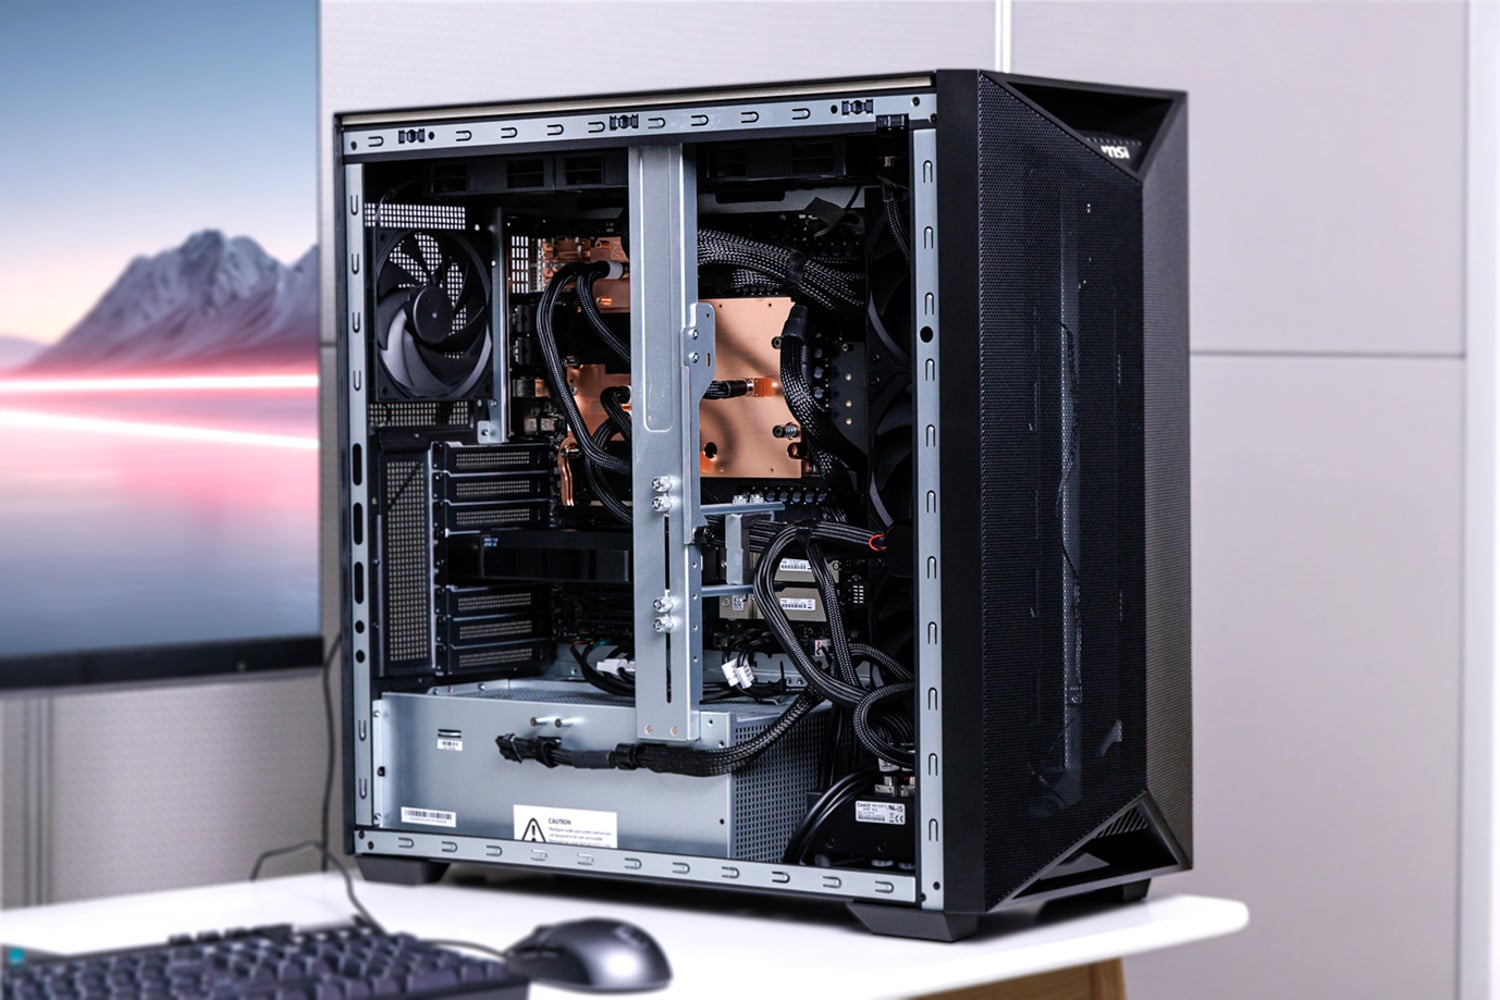
ပထမတစ်ချက်ကြည့်လိုက်ရင် XpertStation ဟာ ချောမွေ့တဲ့ ပရော်ဖက်ရှင်နယ်ဒီဇိုင်းနဲ့ စံသတ်မှတ်ထားတဲ့ ခေတ်မီ workstation တစ်ခုလိုပါပဲ။ ဘေးဘက် panel ကို ဖြုတ်လိုက်ရင် ဆင်တူမှုက အဲဒီမှာတင် ပြီးဆုံးသွားပါပြီ။
GB300 Grace Blackwell Ultra Desktop စူပါချစ်ပ်
WS300 ရဲ့ အဓိကအချက်ကတော့ Blackwell Ultra ဗိသုကာပုံစံနဲ့ တည်ဆောက်ထားတဲ့ NVIDIA ရဲ့ B300 GPU ပါပဲ။
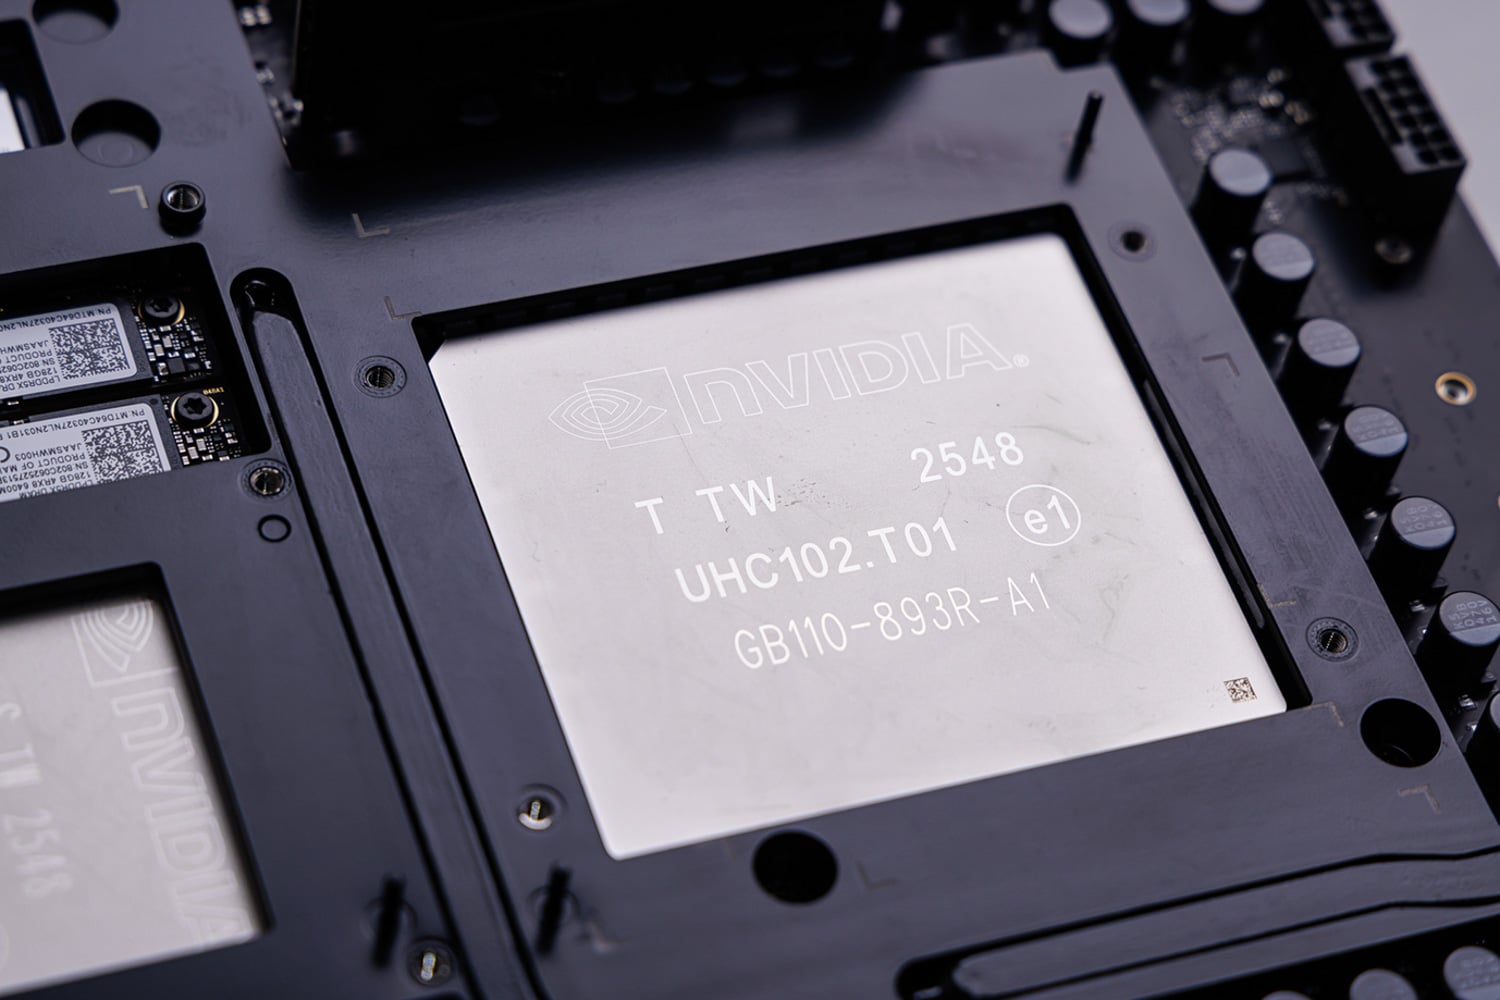
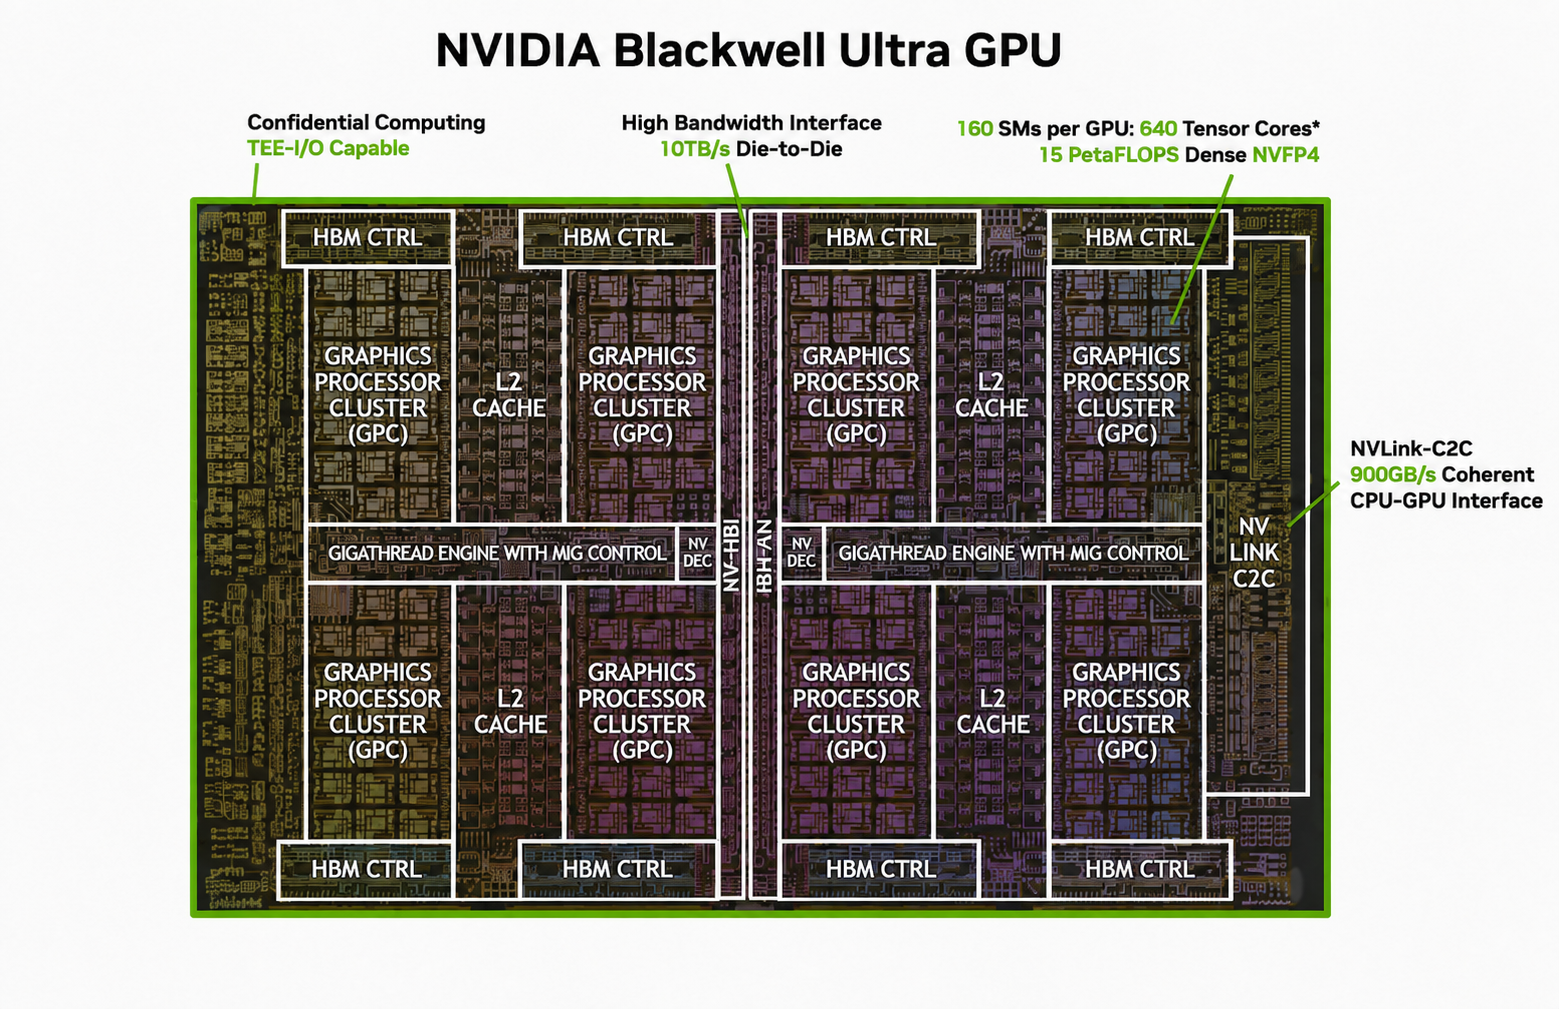
ရင်းမြစ်- NVIDIA၊ StorageReview မှ မှတ်ချက်ပြုထားသည်
B300 သည် ယနေ့ခေတ်တွင် ရရှိနိုင်သော အဆင့်မြင့်ဆုံး GPU များထဲမှ တစ်ခုဖြစ်ပြီး၊ TSMC ၏ 4NP လုပ်ငန်းစဉ်ပေါ်တွင် တည်ဆောက်ထားသော dual-reticle ဒီဇိုင်းပါရှိသည်။ die နှစ်ခုကို NVIDIA ၏ 10TB/s NV-HBI die-to-die interface ဖြင့် ပေါင်းစပ်ထားသောကြောင့် GPU ကို CUDA accelerator တစ်ခုတည်းအဖြစ် လုပ်ဆောင်နိုင်စေပါသည်။ DGX Station တွင် အသုံးပြုထားသော B300 သည် 208-billion-transistor Blackwell Ultra ဒီဇိုင်းကို အခြေခံထားပြီး SM ၁၆၀ အထိနှင့် ပဉ္စမမျိုးဆက် Tensor Core ၆၄၀ အထိ ပါဝင်သည်။ ၎င်းတွင် 7.1TB/s memory bandwidth ရှိသော 252GB HBM3e လည်း ပါရှိသည်။ data center အစိတ်အပိုင်းတစ်ခုအနေဖြင့်၊ B300 တွင် ပုံမှန် display output နှင့် NVENC hardware encoders များ မရှိပါ။ သို့သော် ၎င်းတွင် NVDEC engine ခုနစ်ခုနှင့် nvJPEG decoders ခုနစ်ခု ပါဝင်သည်။ GPU သည် MIG ကိုလည်း ပံ့ပိုးပေးသောကြောင့် သီးခြား instance ခုနစ်ခုအထိ ပိုင်းခြားနိုင်သည်။ compute ကိုကြည့်လျှင် B300 သည် အောက်ပါတို့ကို ပေးဆောင်သည်-
| စေ့စပ်သေချာခြင်း | အထွတ်အထိပ်စွမ်းဆောင်ရည် |
|---|---|
| B300 တွက်ချက်မှုစွမ်းဆောင်ရည် | |
| NVFP4 Tensor Core | PFLOPS ၂၀ ပါးလွှာ / PFLOPS ၁၅ သိပ်သည်း |
| FP8 / FP6 Tensor Core | ၁၁.၁၅ PFLOPS |
| INT8 Tensor Core | 330 ထိပ် |
| FP16 / BF16 Tensor Core | ၁၁.၁၅ PFLOPS |
| TF32 တန်ဆာ အူတိုင် | ၁၁.၁၅ PFLOPS |
| FP32 | 80 TFLOPS |
| FP64 / FP64 Tensor Core | 1.3 TFLOPS |
| အမြင့်ဆုံးနှုန်းထားများသည် GPU မြှင့်တင်မှုနာရီပေါ်တွင် အခြေခံသည်။ အခြားနည်းဖြင့် မှတ်ချက်မရှိပါက Tensor Core သတ်မှတ်ချက်များသည် sparsity ကို အသုံးပြုသည်။ | |
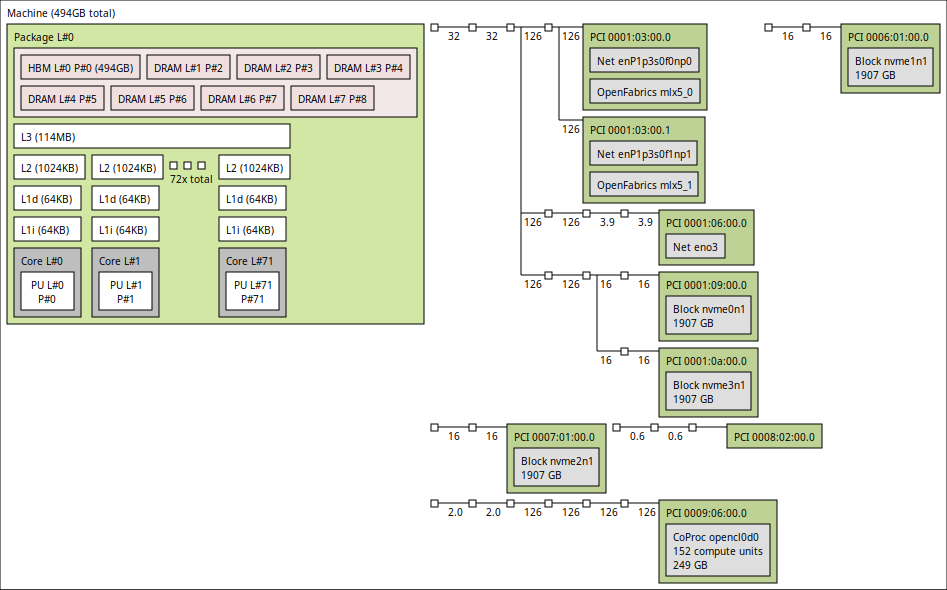
B300 နဲ့ တွဲဖက်အသုံးပြုထားတဲ့ NVIDIA ရဲ့ ပထမဆုံး data-center CPU ဖြစ်တဲ့ Grace ပါ။ Arm Neoverse V2 cores ၇၂ ခုကို အသုံးပြုထားပေမယ့် ပတ်ဝန်းကျင် processor ကတော့ NVIDIA ရဲ့ ကိုယ်ပိုင်ဒီဇိုင်းဖြစ်ပြီး cache hierarchy၊ memory controllers၊ system I/O၊ Scalable Coherency Fabric နဲ့ NVLink-C2C interface တွေ ပါဝင်ပါတယ်။ Grace မှာ cores ၇၂ ခုနဲ့ hardware thread ၇၂ ခုကို ဖော်ထုတ်ထားပြီး core တစ်ခုစီမှာ cryptography extensions တွေနဲ့ Armv9 ကို 128-bit SVE2 vector units လေးခုကို အကောင်အထည်ဖော်ထားပါတယ်။ core မှာ clock တစ်ခုလျှင် instructions ရှစ်ခုအထိ dispatching လုပ်နိုင်တဲ့ six-way instruction decoder တစ်ခု၊ scalar ALU ခြောက်ခု၊ L1 instruction နဲ့ data cache တစ်ခုစီမှာ 64KB နဲ့ private L2 1MB ပါဝင်ပါတယ်။ die တစ်လျှောက်မှာ CPU ဟာ L3 cache 114MB ကို မျှဝေအသုံးပြုထားပါတယ်။
core များနှင့် L3 cache slice များကို NVIDIA ၏ Scalable Coherency Fabric မှတစ်ဆင့် ချိတ်ဆက်ထားပြီး ၎င်းသည် bisection bandwidth 3.2TB/s ရှိသော mesh interconnect တစ်ခုဖြစ်သည်။ fabric သည် CPU core များကို memory၊ system I/O နှင့် NVLink-C2C interface တို့နှင့်လည်း ချိတ်ဆက်ပေးသောကြောင့် Grace သည် B300 ကို fed လုပ်ရန် လိုအပ်သော data-movement bandwidth ကို ပေးစွမ်းသည်။ WS300 တွင် Grace သည် accelerator နှင့်ပတ်သက်သော CPU-side လုပ်ဆောင်ချက်များကို ကိုင်တွယ်သည်- GPU kernel launches၊ data loading၊ preprocessing၊ tokenization နှင့် model orchestration။ အောက်ဖော်ပြပါ topology view သည် 72-core Grace CPU တစ်ခုနှင့် ၎င်းပတ်လည်တွင် ချိတ်ဆက်ထားသော platform device များပါရှိသော single-socket ဒီဇိုင်းကို ရှင်းရှင်းလင်းလင်း မြင်တွေ့နိုင်သည်။
Grace ကို 496GB LPDDR5X မှတ်ဉာဏ်နှင့် တွဲဖက်ထားပြီး bandwidth 396GB/s ပေးစွမ်းပါသည်။ မှတ်ဉာဏ်ကို baseboard နှင့် တိုက်ရိုက်ဂဟေဆက်မည့်အစား DGX Station သည် SOCAMM မော်ဂျူးလေးခုကို အသုံးပြုသည်။ SOCAMM သို့မဟုတ် System-on-Chip Advanced Memory Module သည် LPDDR5X ကို ကျစ်လျစ်ပြီး ဖြုတ်တပ်နိုင်သောပုံစံဖြင့် ထုပ်ပိုးထားသည်။ ၎င်းသည် ပလက်ဖောင်းအား LPDDR5X ၏ bandwidth နှင့် ပါဝါထိရောက်မှု အကျိုးကျေးဇူးများကို ထိန်းသိမ်းထားနိုင်စေပြီး မှတ်ဉာဏ်ကို ဝန်ဆောင်မှုပေးနိုင်စေပါသည်။ ချို့ယွင်းနေသော မော်ဂျူးကို baseboard တစ်ခုလုံးကို အစားထိုးစရာမလိုဘဲ အစားထိုးနိုင်သည်။
Grace နှင့် B300 ကို ချိတ်ဆက်ခြင်းသည် NVIDIA ၏ NVLink-C2C interface ဖြစ်ပြီး၊ ၎င်းသည် package-level interconnect တစ်ခုဖြစ်ပြီး bidirectional bandwidth 900GB/s ကို ပေးစွမ်းနိုင်ပြီး PCIe Gen5 x16 ချိတ်ဆက်မှုထက် ခုနစ်ဆခန့်ရှိသည်။ ပိုအရေးကြီးသော ကွာခြားချက်မှာ memory coherence ဖြစ်သည်။ သမားရိုးကျ workstation တွင် CPU နှင့် discrete GPU တို့သည် သီးခြား memory space များကို ထိန်းသိမ်းထားပြီး PCIe မှတစ်ဆင့် ၎င်းတို့အကြား data များကို ကူးယူသည်။ NVLink-C2C ဖြင့် Grace နှင့် B300 သည် coherent address space ကို မျှဝေပြီး processor တစ်ခုစီသည် တစ်ခုနှင့် ချိတ်ဆက်ထားသော memory ကို တိုက်ရိုက်ဝင်ရောက်ကြည့်ရှုနိုင်စေပါသည်။
ရလဒ်အနေနဲ့ 748GB coherent address space ဖြစ်ပြီး 748GB HBM block မဟုတ်ပါဘူး။ B300 မှာ 7.1TB/s ပို့ဆောင်ပေးတဲ့ HBM3e 252GB ရှိပြီး Grace ကတော့ 396GB/s မှာ LPDDR5X 496GB ကို ပံ့ပိုးပေးပါတယ်။ Grace memory မှာ သိမ်းဆည်းထားတဲ့ data တွေက C2C link ကို ဖြတ်ကျော်ရမှာဖြစ်လို့ HBM ဟာ မကြာခဏ ဝင်ရောက်ကြည့်ရှုတဲ့ model weight တွေ၊ tensors တွေနဲ့ buffers တွေအတွက် အကောင်းဆုံးနေရာအဖြစ် ရှိနေဦးမှာပါ။ Grace memory က large-capacity tier အနေနဲ့ လုပ်ဆောင်ပြီး B300 ရဲ့ 252GB local memory ထက် ကျော်လွန်တဲ့ workload တွေကို GPU အများအပြားမှာ ခွဲထုတ်မယ့်အစား system တစ်ခုတည်းမှာ ရှိနေခွင့်ပြုပါတယ်။ testing section မှာ အဲဒီ second memory tier ကို ဖြတ်ကျော်ခြင်းရဲ့ performance impact ကို နောက်ပိုင်းမှာ တိုင်းတာသွားပါမယ်။
စနစ် တိုပိုလိုဂျီ
GB300 package ကနေ ခွဲထွက်လာတဲ့ MSI ရဲ့ block diagram မှာ system ရဲ့ ကျန်တဲ့အပိုင်းတွေ Grace မှာ ဘယ်လိုချိတ်ဆက်ထားလဲဆိုတာ ပြသထားပါတယ်။ CPU ဟာ I/O topology ရဲ့ အလယ်ဗဟိုမှာ ရှိပြီး PCIe 5.0 x4 M.2 slot နှစ်ခုကို တိုက်ရိုက်ချိတ်ဆက်ထားပါတယ်။ MSI ဟာ operating system နဲ့ NVIDIA software stack အတွက် RAID 1 မှာ configure လုပ်ထားတဲ့ 2TB Micron 4600 SSD တစ်စုံကို ထည့်သွင်းထားပါတယ်။ full-length expansion slot သုံးခုကလည်း Grace ကနေ တိုက်ရိုက်ပါလာပြီး PCIe 5.0 x16 link တစ်ခုနဲ့ PCIe 5.0 x8 link နှစ်ခု ပါဝင်ပါတယ်။
MSI သည် ကြီးမားသော add-in GPU အတွက် ကိုယ်ထည်ကိုလည်း ပြင်ဆင်ထားပါသည်။ ကြိုတင်ဝါယာကြိုးတပ်ထားသော 12VHPWR ပါဝါကြိုးကို ကိုယ်ထည်၏ ရှေ့ဘက်တွင် အလွယ်တကူ ရောက်ရှိနိုင်သောကြောင့် စနစ်မှတစ်ဆင့် အခြားကြိုးတစ်ခု သွယ်တန်းရန် မလိုအပ်ပါ။ ကိုယ်ထည်ကို တောင့်တင်းစေသော ဒေါင်လိုက်သတ္တုကွင်းတွင် ရှည်လျားလေးလံသော RTX PRO ကတ်များကို ထောက်ပံ့ရန်အတွက် ကျိုးကျခြင်းမှ ကာကွယ်ပေးသော ကွင်းတစ်ခုလည်း ပါဝင်သည်။
Grace ဘက်ခြမ်းရှိ USB controller သည် စနစ်၏ အဓိက ရှေ့နှင့်နောက် USB port များနှင့်အတူ audio codec ကို ကိုင်တွယ်သည်။ Grace သည် ASPEED AST2600 BMC နှင့်လည်း ချိတ်ဆက်ထားပြီး ၎င်းတွင် သီးသန့် 1GbE management port၊ 1024 x 768 အထိ ကန့်သတ်ထားသော Mini DisplayPort output နှင့် Micro-USB serial console တို့ ပါဝင်သည်။ Mini DisplayPort သည် စနစ်၏ အဓိက display output အဖြစ် မဟုတ်ဘဲ ကနဦး setup နှင့် troubleshooting အတွက် ရည်ရွယ်ပါသည်။ WS300 ကို သမားရိုးကျ desktop အဖြစ် အသုံးပြုရန် စီစဉ်ထားသူတိုင်းသည် optional RTX PRO add-in card များထဲမှ တစ်ခုကို လိုအပ်ဦးမည်ဖြစ်သည်။
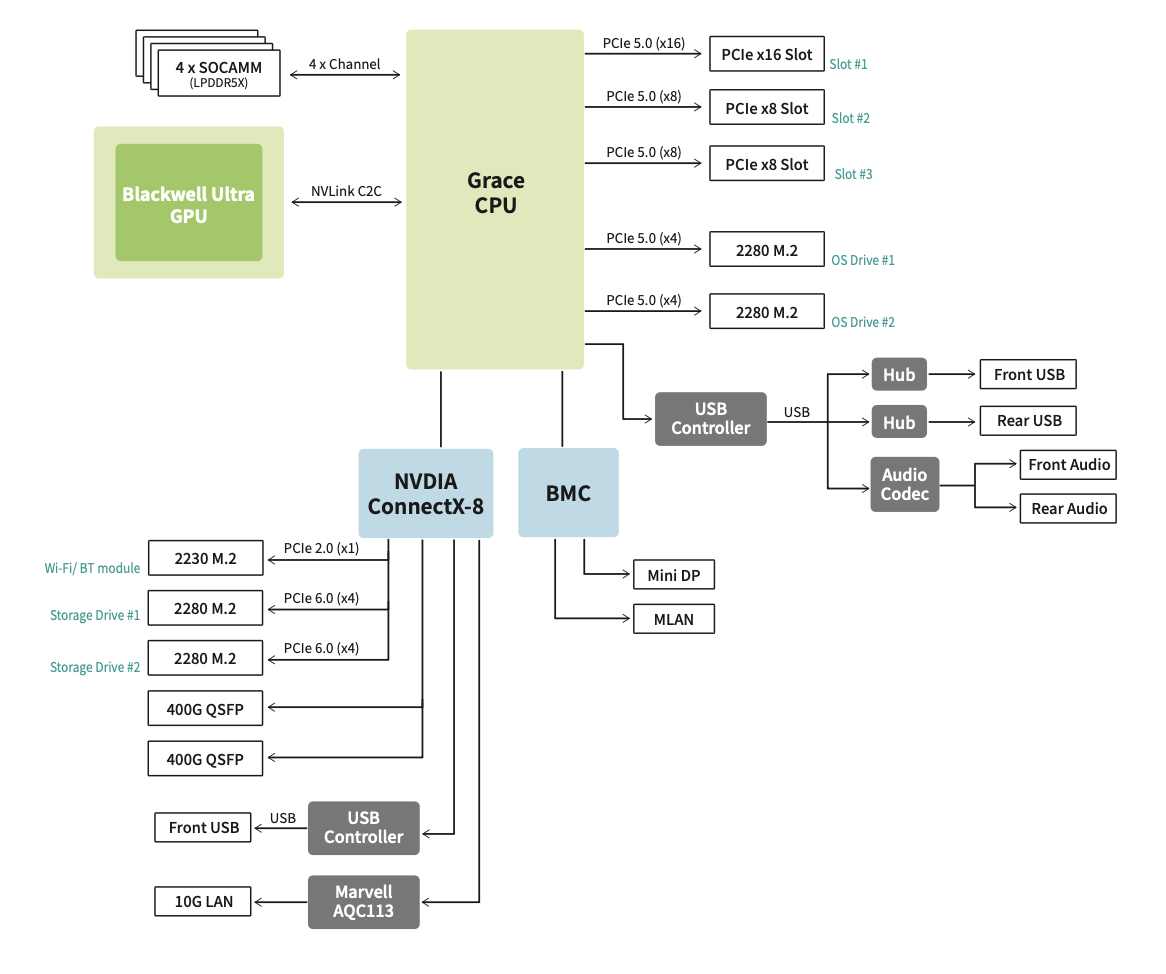
နောက်ထပ် အဓိက ဌာနခွဲတစ်ခုကတော့ NVIDIA ရဲ့ ConnectX-8 SuperNIC ပါ။ ၎င်းရဲ့ အထင်ရှားဆုံး အင်္ဂါရပ်ကတော့ နောက်ဘက် panel မှာရှိတဲ့ 400GbE QSFP112 port တစ်စုံဖြစ်ပြီး စုစုပေါင်း network bandwidth 800Gb/s အထိ ပံ့ပိုးပေးပါတယ်။ ConnectX-8 မှာ 48 lanes ပါဝင်တဲ့ integrated PCIe switch တစ်ခုလည်း ပါဝင်ပါတယ်။ ၎င်းရဲ့ upstream link ဟာ PCIe Gen6 ကို လုပ်ဆောင်နိုင်ပေမယ့် ၎င်းရဲ့ downstream port တွေဟာ စက်ပစ္စည်းတွေနဲ့ ချိတ်ဆက်ဖို့အတွက် PCIe 5.0 မှာ လည်ပတ်တာကြောင့် MSI အနေနဲ့ ၎င်းကို ရိုးရိုး network adapter တစ်ခုအဖြစ် အသုံးမပြုဘဲ secondary I/O hub အဖြစ် အသုံးပြုနိုင်ပါတယ်။
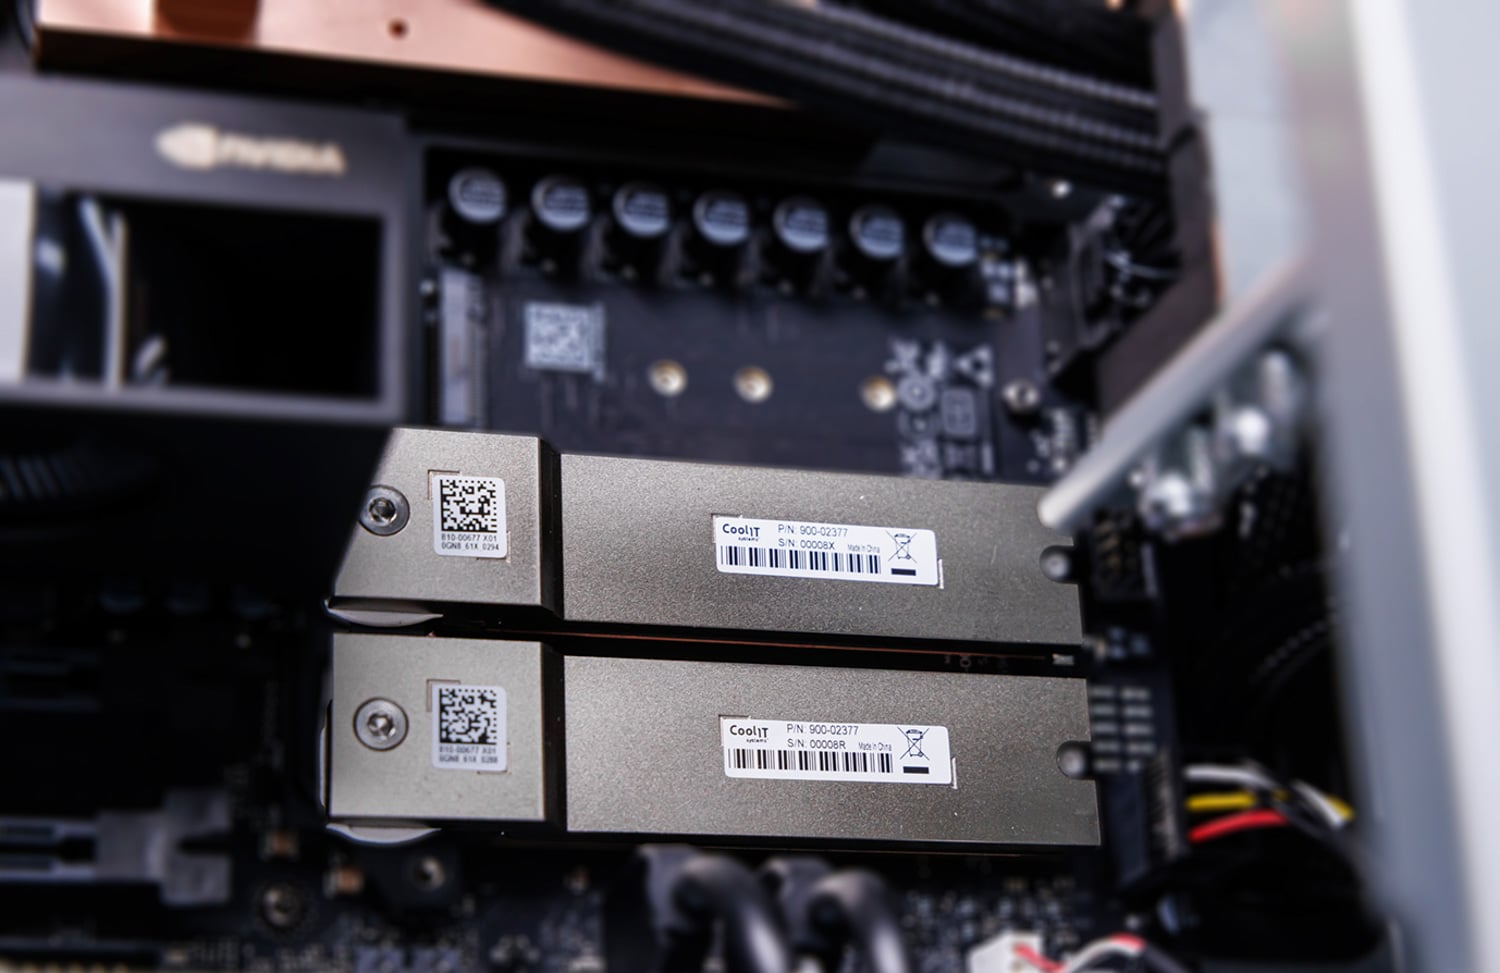
ConnectX-8 မှ PCIe 5.0 x4 လင့်ခ်နှစ်ခုသည် ကျန်ရှိသော M.2 2280 slot များသို့ ထောက်ပံ့ပေးပြီး MSI သည် တိုးချဲ့ရန်အတွက် ဖွင့်လှစ်ထားသည်။ ထိုဌာနခွဲသည် PCIe 2.0 x1 မှတစ်ဆင့် M.2 2230 Wi-Fi နှင့် Bluetooth slot၊ 10GBase-T port အတွက် Marvell AQC113 controller နှင့် ရှေ့ဘက် USB လမ်းကြောင်းအပိုတစ်ခုကို ဝန်ဆောင်မှုပေးသည့် ဒုတိယ USB controller ကိုလည်း ချိတ်ဆက်ပေးသည်။
ပါဝါနှင့်အအေး
WS300 ကို ပါဝါပေးရာတွင် C19 input ပါရှိသော 1,600W 80 PLUS Platinum ATX power supply တစ်ခုတည်းသာ ပါဝင်သည်။ မြောက်အမေရိက တပ်ဆင်မှုများအတွက် DGX Station သည် စနစ်အား ၎င်း၏ အပြည့်အဝ ပါဝါအဖုံးကို ပံ့ပိုးပေးရန်အတွက် သီးသန့် 20A circuit တစ်ခု လိုအပ်ပါသည်။
1,600W အဆင့်သတ်မှတ်ချက်သည် စနစ်တစ်ခုလုံးအတွက် အမြင့်ဆုံးဖြစ်သည်။ Grace၊ B300၊ သိုလှောင်မှု၊ ပန့်များ၊ ပန်ကာများနှင့် အခြားရွေးချယ်နိုင်သော RTX PRO ကတ်များအားလုံးသည် တူညီသောထောက်ပံ့မှုမှ ရယူကြသည်။ ပါဝါမြင့်ဂရပ်ဖစ်ကတ်တစ်ခုထည့်သွင်းခြင်းသည် WS300 ၏စွမ်းရည်များကို တိုးချဲ့ပေးသော်လည်း ကွဲပြားသောပါဝါအစုအဝေးမှ မရယူပါ။ B300 နှင့် RTX ကတ်နှစ်ခုစလုံးသည် ဝန်ပိနေချိန်တွင် ၎င်းတို့သည် ရှိပြီးသားအရာကို မျှဝေရပြီး ၎င်းသည် B300 GPU ၏စွမ်းဆောင်ရည်ကို လျော့ကျစေနိုင်သည်။
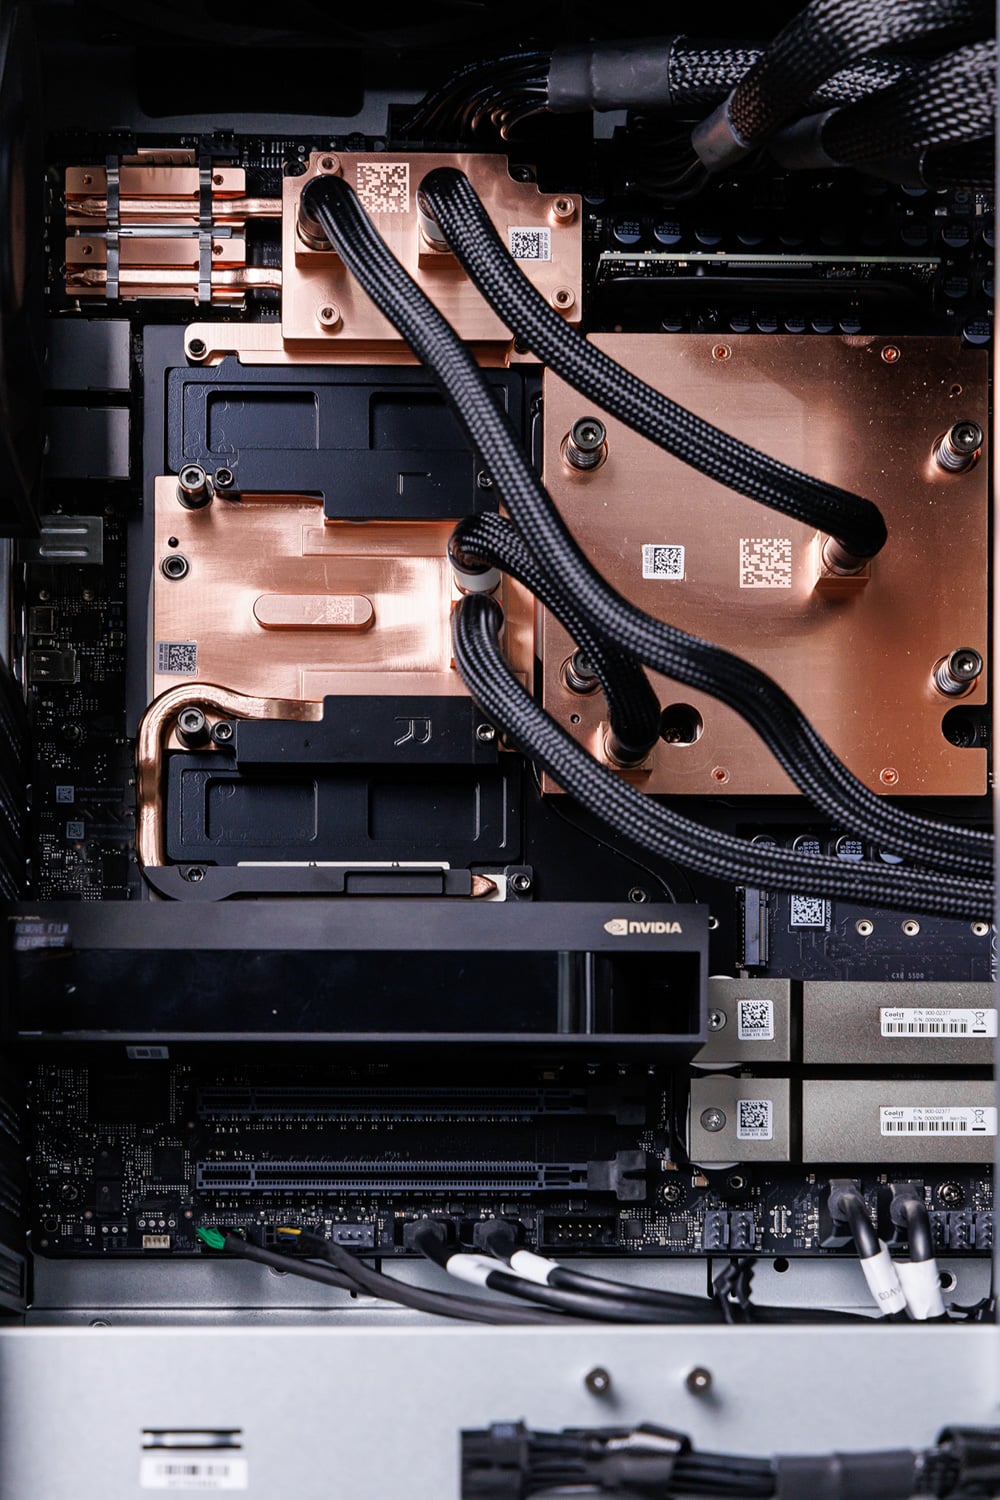
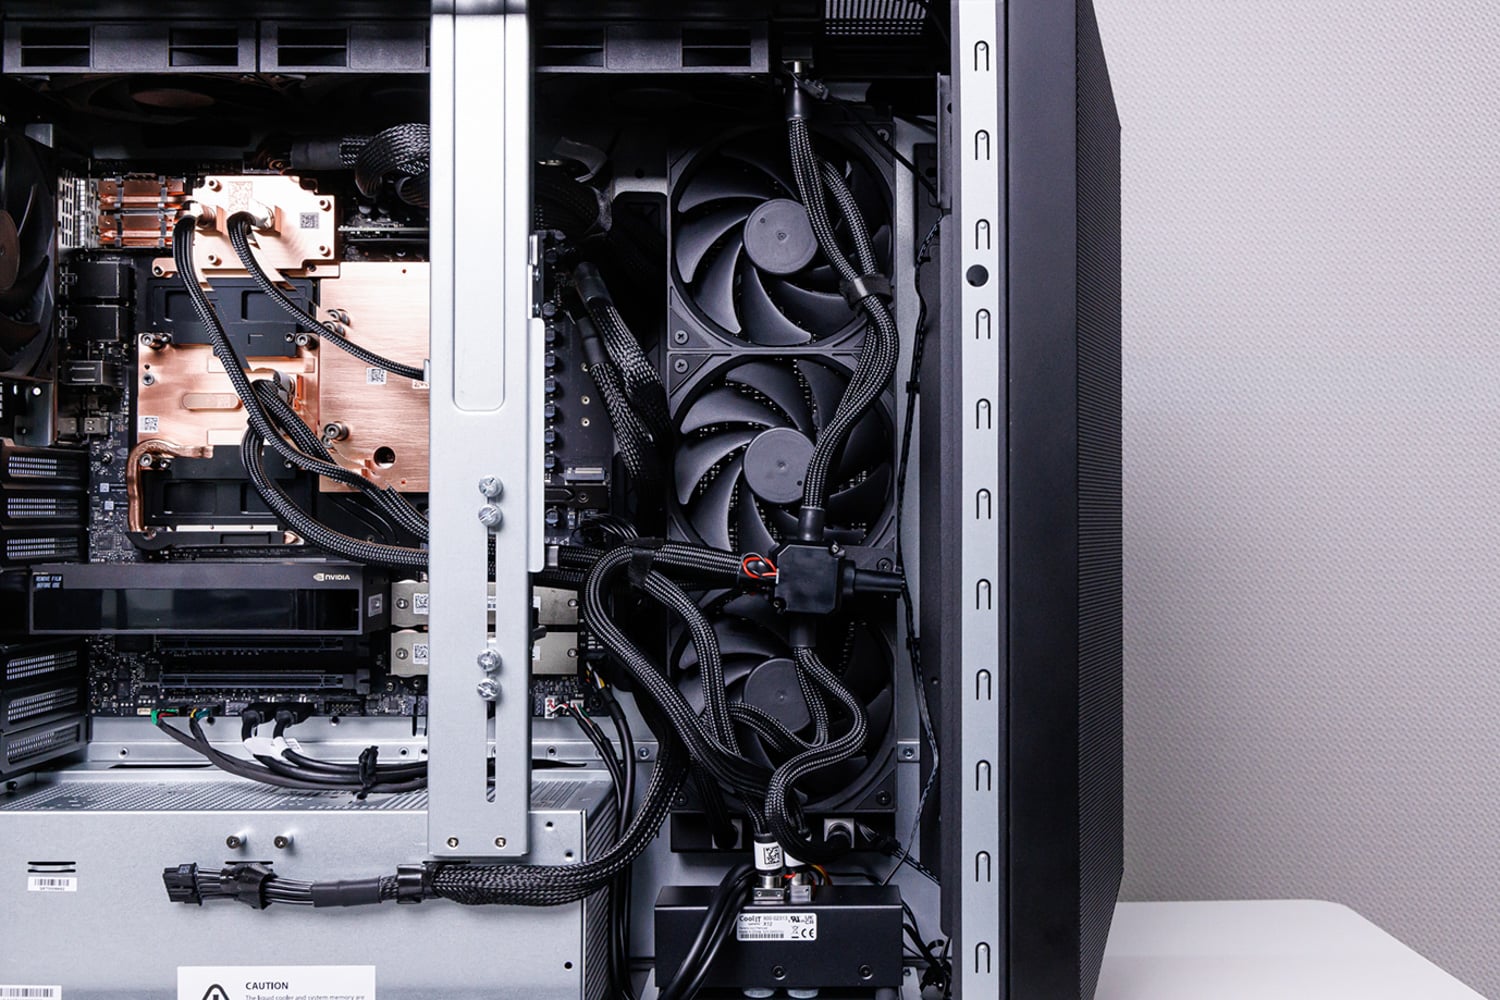
MSI သည် B300၊ Grace CPU၊ SOCAMM မှတ်ဉာဏ်နှင့် optical cages များအပါအဝင် ConnectX-8 ကို လွှမ်းခြုံထားသော custom liquid loop ဖြင့် ရလဒ်အနေဖြင့် thermal load ကို ကိုင်တွယ်သည်။ အပူကို 360mm radiators နှစ်ခုမှတစ်ဆင့် ပေးပို့ပြီး သီးခြား 120mm ပန်ကာတစ်ခုသည် chassis ၏ ကျန်အပိုင်းများမှတစ်ဆင့် လေကို ရွေ့လျားစေသည်။ MSI သည် CPU နှင့် GPU တစ်လျှောက်တွင် cooling assembly ကို 1,400W အထိ အဆင့်သတ်မှတ်သည်။ ကျွန်ုပ်တို့၏ စမ်းသပ်မှုအတွင်း B300 အပူချိန်သည် 71C တွင် အမြင့်ဆုံးရောက်ရှိခဲ့ပြီး GPU မှ 1292W power အသုံးပြုချိန်တွင် CPU သည် 65C ထက် ဘယ်သောအခါမှ ပိုမပူခဲ့ပါ။
ပါဝါနှေးကွေးခြင်း
NVIDIA သည် vsloshd ဝန်ဆောင်မှုမှတစ်ဆင့် မျှဝေထားသော ဘတ်ဂျက်ကို စီမံခန့်ခွဲသည်။ ၎င်း၏ မူရင်း dynamic မုဒ်တွင်၊ ဝန်ဆောင်မှုသည် GB300 မော်ဂျူးနှင့် ရွေးချယ်နိုင်သော RTX PRO ကတ်၏ အချိန်နှင့်တပြေးညီ ပါဝါသုံးစွဲမှုကို စောင့်ကြည့်ပြီး ကိရိယာတစ်ခုစီကို ပုံသေကန့်သတ်ချက်တွင် မထားဘဲ ၎င်းတို့အကြား ရရှိနိုင်သော headroom ကို ရွှေ့ပြောင်းပေးသည်။ လက်ရှိမူဝါဒအရ RTX ကတ်သည် ဦးစားပေးခံရသောကြောင့် ပါဝါပိုမိုလိုအပ်သည့်အခါ စနစ်သည် RTX ကန့်သတ်ချက်ကို မြှင့်တင်ခြင်းမပြုမီ GB300 ပါဝါကန့်သတ်ချက်ကို ဦးစွာလျှော့ချသည်။ RTX ကတ်မတပ်ဆင်ထားပါက မူဝါဒဘတ်ဂျက်အပြည့်အစုံကို GB300 မော်ဂျူးအတွက် ရရှိနိုင်ပါသည်။
ဆိုလိုသည်မှာ optional RTX PRO 6000 သည် B300 ထက် စွမ်းဆောင်ရည်ပိုမြင့်ရုံသာမကပါ။ GPU နှစ်ခုလုံး အလုပ်များနေချိန်တွင် RTX ကတ်သို့ သတ်မှတ်ပေးထားသော ပါဝါသည် GB300 ဘတ်ဂျက်မှ တိုက်ရိုက်ထွက်ပြီး B300 clocks နှင့် performance ကို လျော့ကျစေနိုင်သည်။
စနစ်က ပါဝါပေးပို့မှု ယိုယွင်းနေတာကို တွေ့ရှိတဲ့အခါတွေအတွက် ဒီပလက်ဖောင်းမှာ hardware power brake လည်း ပါဝင်ပါတယ်။ ပါဝါချိတ်ဆက်ကိရိယာတွေ လျော့ရဲနေတာကြောင့် WS300 ဟာ ပိတ်သွားမယ့်အစား ပါဝါကန့်သတ်ချက်ကို လျှော့ချလိုက်တာ ဒါမှမဟုတ် ချိတ်ဆက်မှု ပျက်ယွင်းသွားတာကြောင့် ပါဝါအပြည့်အဝ ဆက်လက်သုံးစွဲနေတာကို ကျွန်ုပ်တို့ လက်တွေ့လုပ်ဆောင်နေစဉ်မှာ ဒါကို မြင်တွေ့ခဲ့ရပါတယ်။ ချိတ်ဆက်မှုပြဿနာကို ဖြေရှင်းပြီးတဲ့အထိ စက်ဟာ ပါဝါလျှော့ချထားတဲ့ အခြေအနေမှာ အွန်လိုင်းမှာ ရှိနေခဲ့ပါတယ်။
connectivity
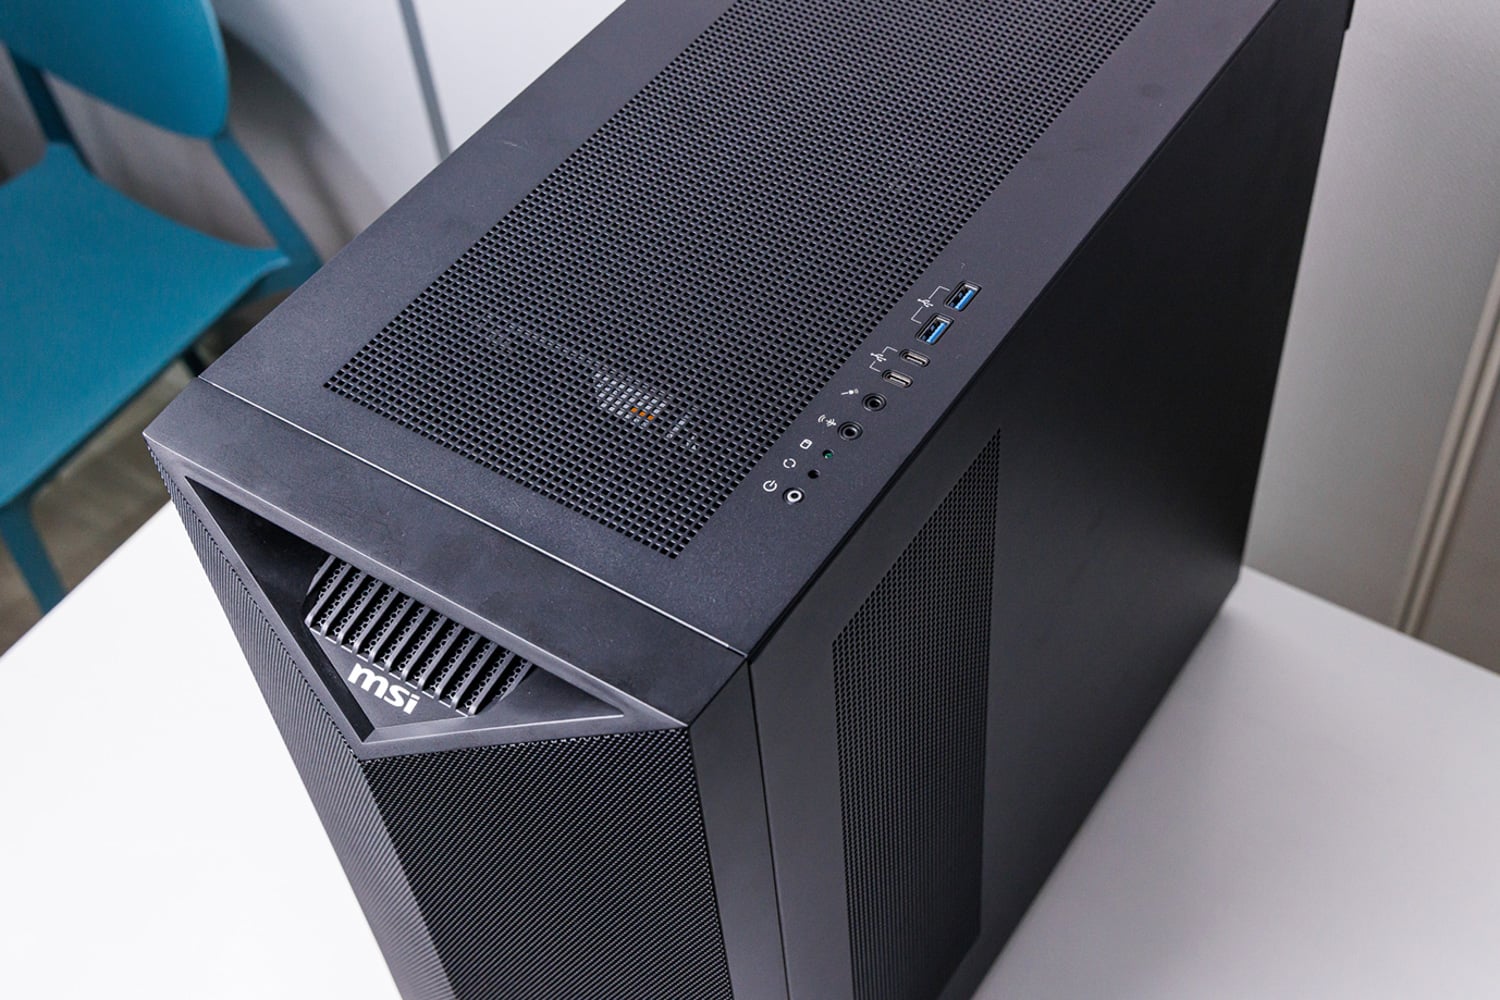
ကိုယ်ထည်ကနေ ဆက်မသွားခင် ရှေ့နဲ့နောက် I/O တွေကို အမြန်ကြည့်သင့်ပါတယ်။ ရှေ့ IO မှာ USB 3.2 Gen 2 Type-A port နှစ်ခု၊ USB 3.2 Gen 2 Type-C port နှစ်ခု၊ သီးခြား line-out နဲ့ microphone jack တွေ၊ power နဲ့ reset control တွေ ပါဝင်ပါတယ်။
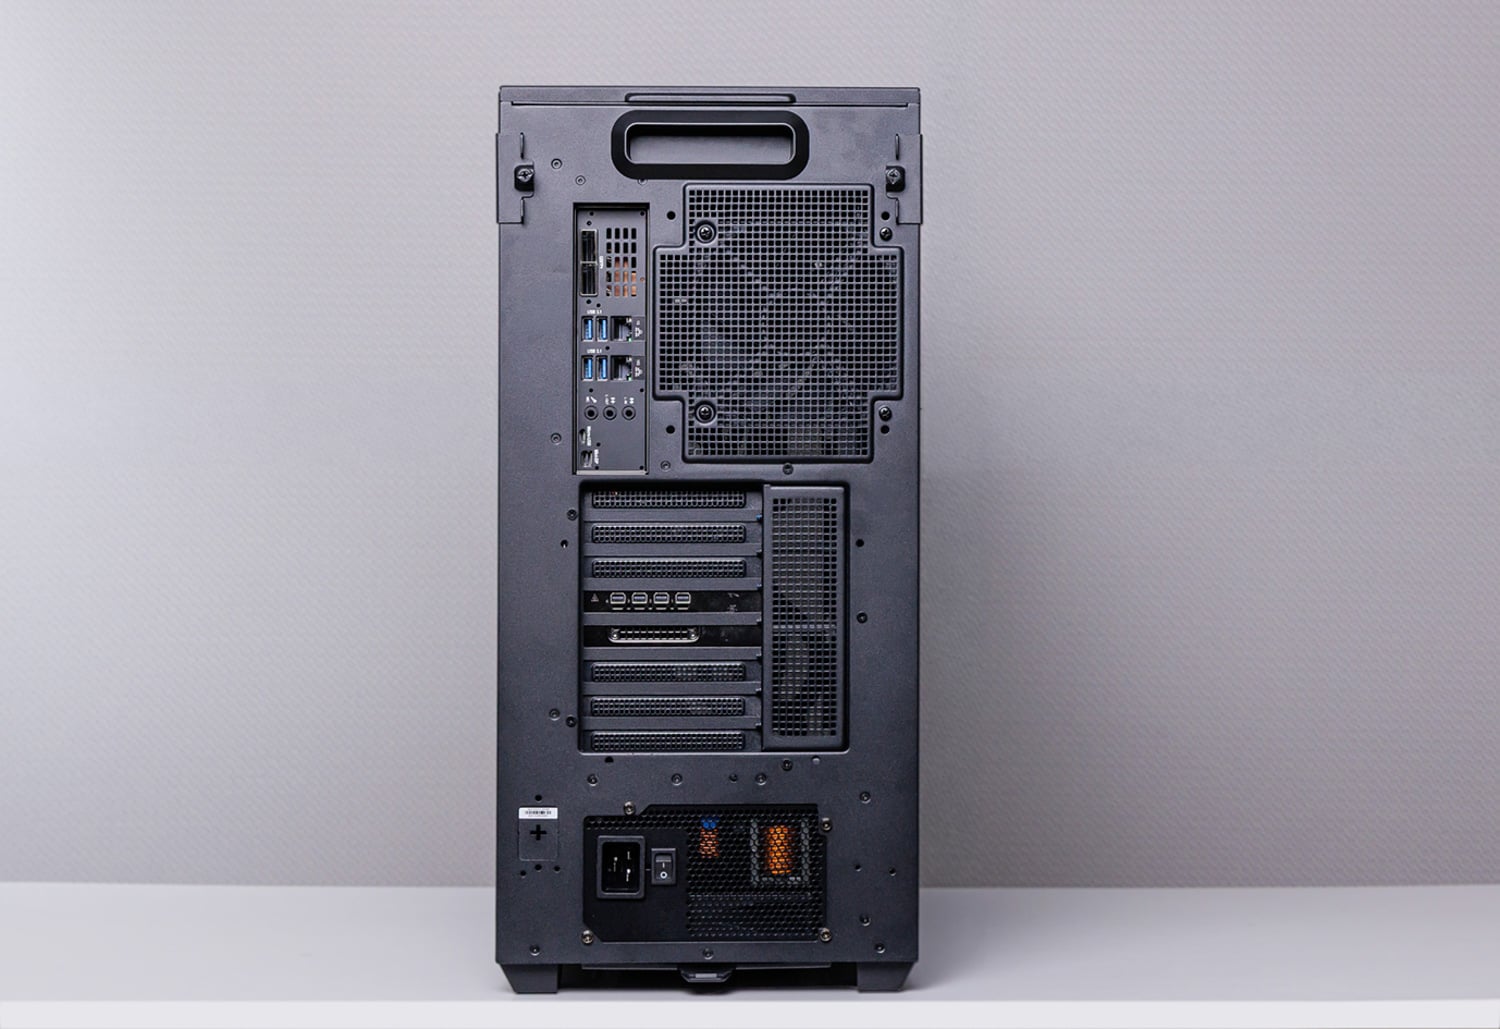
နောက်ဘက် panel ကို workstation ချိတ်ဆက်မှုနှင့် အောက်ဘက်ရှိ server hardware အကြား ပိုင်းခြားထားသည်။ ConnectX-8 သည် 400GbE QSFP112 port နှစ်ခု ပံ့ပိုးပေးထားပြီး သီးခြား 10GBase-T port တစ်ခုက ပုံမှန် host networking ကို ကိုင်တွယ်ပြီး သီးသန့် 1GbE port တစ်ခုသည် BMC နှင့် ချိတ်ဆက်ထားသည်။ 10Gbps USB Type-A port လေးခုနှင့် audio jack သုံးခုသည် local peripherals များကို ဖုံးအုပ်ထားသည်။ BMC တွင် Micro-USB serial console တစ်ခုနှင့် Mini DisplayPort တစ်ခုကိုလည်း ဖော်ထုတ်ထားသည်။ C19 power inlet သည် chassis ၏အောက်ခြေတွင် ရှိပြီး Wi-Fi 6E သို့မဟုတ် Bluetooth ပါသော Wi-Fi 7 ကို internal M.2 2230 Key-E slot မှတစ်ဆင့် ထည့်သွင်းနိုင်သည်။
စားပွဲပေါ်ရှိ ဒေတာစင်တာ အလုပ်ဝန်ထုပ်များ
ဒီအချိန်အထိ အရာအားလုံးက DGX Station ဆိုတာဘာလဲဆိုတာကို ဖော်ပြခဲ့ပြီးပါပြီ။ ဝယ်သူတွေအတွက် ပိုအသုံးဝင်တဲ့မေးခွန်းကတော့ XpertStation က အဖွဲ့တစ်ဖွဲ့ကို ဘာတွေလုပ်ဆောင်နိုင်စေလဲဆိုတာပါပဲ။ WS300 ကို ရိုးရိုးရှင်းရှင်း high-capacity inference system တစ်ခုအဖြစ် သဘောထားတဲ့အခါ development platform တစ်ခုအနေနဲ့ သဘောထားတဲ့အခါ သူ့ရဲ့တန်ဖိုးက ပိုရှင်းလင်းလာပါတယ်။ ၎င်းရဲ့ B300 GPU၊ Grace CPU၊ MIG support၊ optional RTX PRO graphics နဲ့ datacenter software stack တွေက shared cluster hardware ပေါ်မှာ မူတည်တဲ့ workflow အများအပြားကို local node တစ်ခုတည်းပေါ်မှာ ယူဆောင်လာပါတယ်။
MIG ကို ဖွံ့ဖြိုးတိုးတက်ရေးကိရိယာတစ်ခုအဖြစ်
GPU တစ်ခုတည်းမှာ တစ်ပြိုင်နက်တည်း အလုပ်များစွာကို လုပ်ဆောင်နေပြီး တစ်ခုနဲ့တစ်ခု သီးခြားစီဖြစ်နေတယ်ဆိုတာကို မြင်ယောင်ကြည့်ပါ။ Multi-Instance GPU (MIG) က အဲဒီလိုပဲ လုပ်ဆောင်ပါတယ်။ B300 ရဲ့ hardware ကို အရွယ်အစားတူ slices ခုနစ်ခုအထိ ဒါမှမဟုတ် instance တွေအဖြစ် နေရာအလိုက် ပိုင်းခြားထားပါတယ်။ instance တစ်ခုချင်းစီမှာ SMs၊ HBM၊ cache နဲ့ memory bandwidth တွေရဲ့ ကိုယ်ပိုင် fixed share ကို ရရှိပြီး ကိုယ်ပိုင် device identity ကို သယ်ဆောင်ထားကာ CUDA မှာတော့ သီးခြား GPU တစ်ခုအနေနဲ့ ပေါ်လာပါတယ်။
ဒါကြောင့် multi-GPU workloads တွေကို တီထွင်၊ စမ်းသပ်၊ အတည်ပြု၊ scripts တွေကို လေ့ကျင့်ပေး၊ Dynamo၊ LLM-D စတဲ့ tools တွေအတွက် တီထွင်နိုင်ပါတယ်။
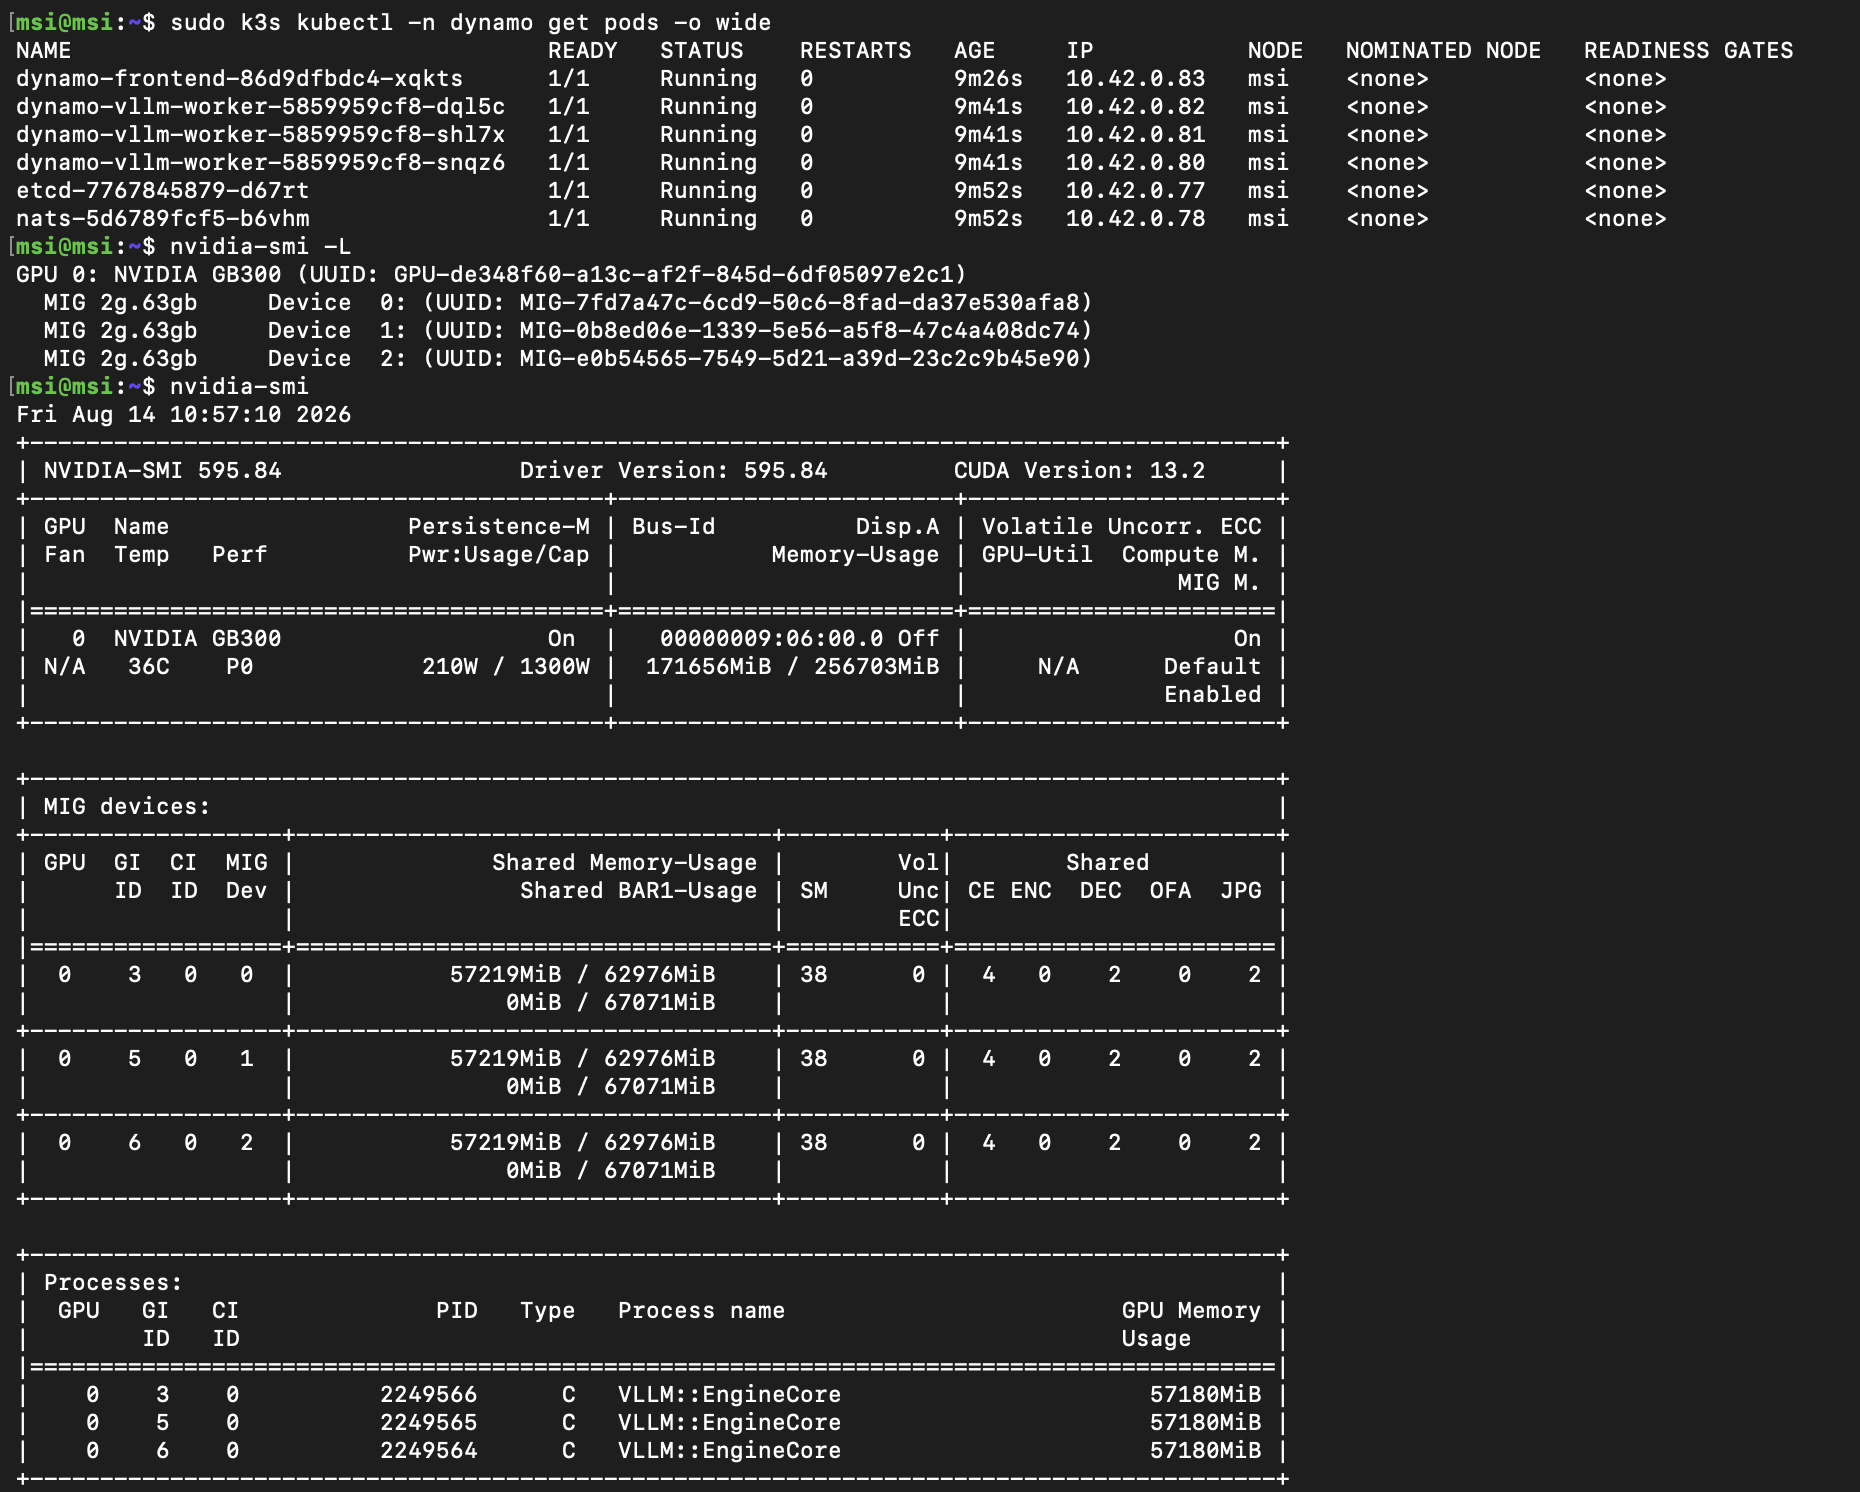
ကျွန်ုပ်တို့ရဲ့ စမ်းသပ်မှုအတွက်၊ B300 ကို MIG instance 3 ခုနဲ့ configure လုပ်ပြီး NVIDIA Dynamo components တွေကို သီးခြား CUDA-visible devices တွေမှာ ယူဆောင်လာဖို့ အသုံးပြုခဲ့ပါတယ်။ ဒါက ကျွန်ုပ်တို့ရဲ့ benchmark tooling ဘယ်လောက်တည်ဆောက်ထားလဲဆိုတာကို ထင်ဟပ်စေပါတယ်- ရည်ရွယ်ထားတဲ့အတိုင်း အတိအကျလုပ်ဆောင်ကြောင်း အတည်ပြုခြင်းဆိုတာ တကယ့် hardware တွေနဲ့ ထပ်ခါထပ်ခါ လုပ်ဆောင်ခြင်းပါပဲ။ local B300 ရှိခြင်းအားဖြင့် shared server မှာ အချိန်ဇယားဆွဲစရာမလိုဘဲ၊ အခန်းထဲက rack ရဲ့ ပါဝါဆွဲအား၊ အပူနဲ့ ဆူညံသံတွေမပါဘဲ ကျွန်ုပ်တို့ ပြန်လည်ပြင်ဆင်နိုင်ပြီး အဲဒီလို ထပ်ခါတလဲလဲလုပ်ဆောင်ရတဲ့ အလုပ်တွေကနေ overhead တွေကို အံ့သြစရာကောင်းလောက်အောင် ဖယ်ရှားပေးပါတယ်။
Isaac GR00T နှင့် ရုပ်ပိုင်းဆိုင်ရာ AI ကွင်းဆက်
DGX Station နှင့် အထူးသင့်လျော်သော နောက်ထပ် workflow တစ်ခုမှာ physical AI ဖြစ်သည်။
ကျွန်ုပ်တို့သည် ဤ workflow အမျိုးအစားကို ယခင်က စမ်းသပ် ဖူး သော်လည်း GPU အမျိုးအစား အမျိုးမျိုးတပ်ဆင်ထားသော စနစ်များစွာ လိုအပ်ပါသည်။ DGX Station သည် ယခင်က သီးခြားအဆင့်များကို စားပွဲဘေးရှိ စက်တစ်ခုတည်းတွင် စုစည်းပေးပါသည်။
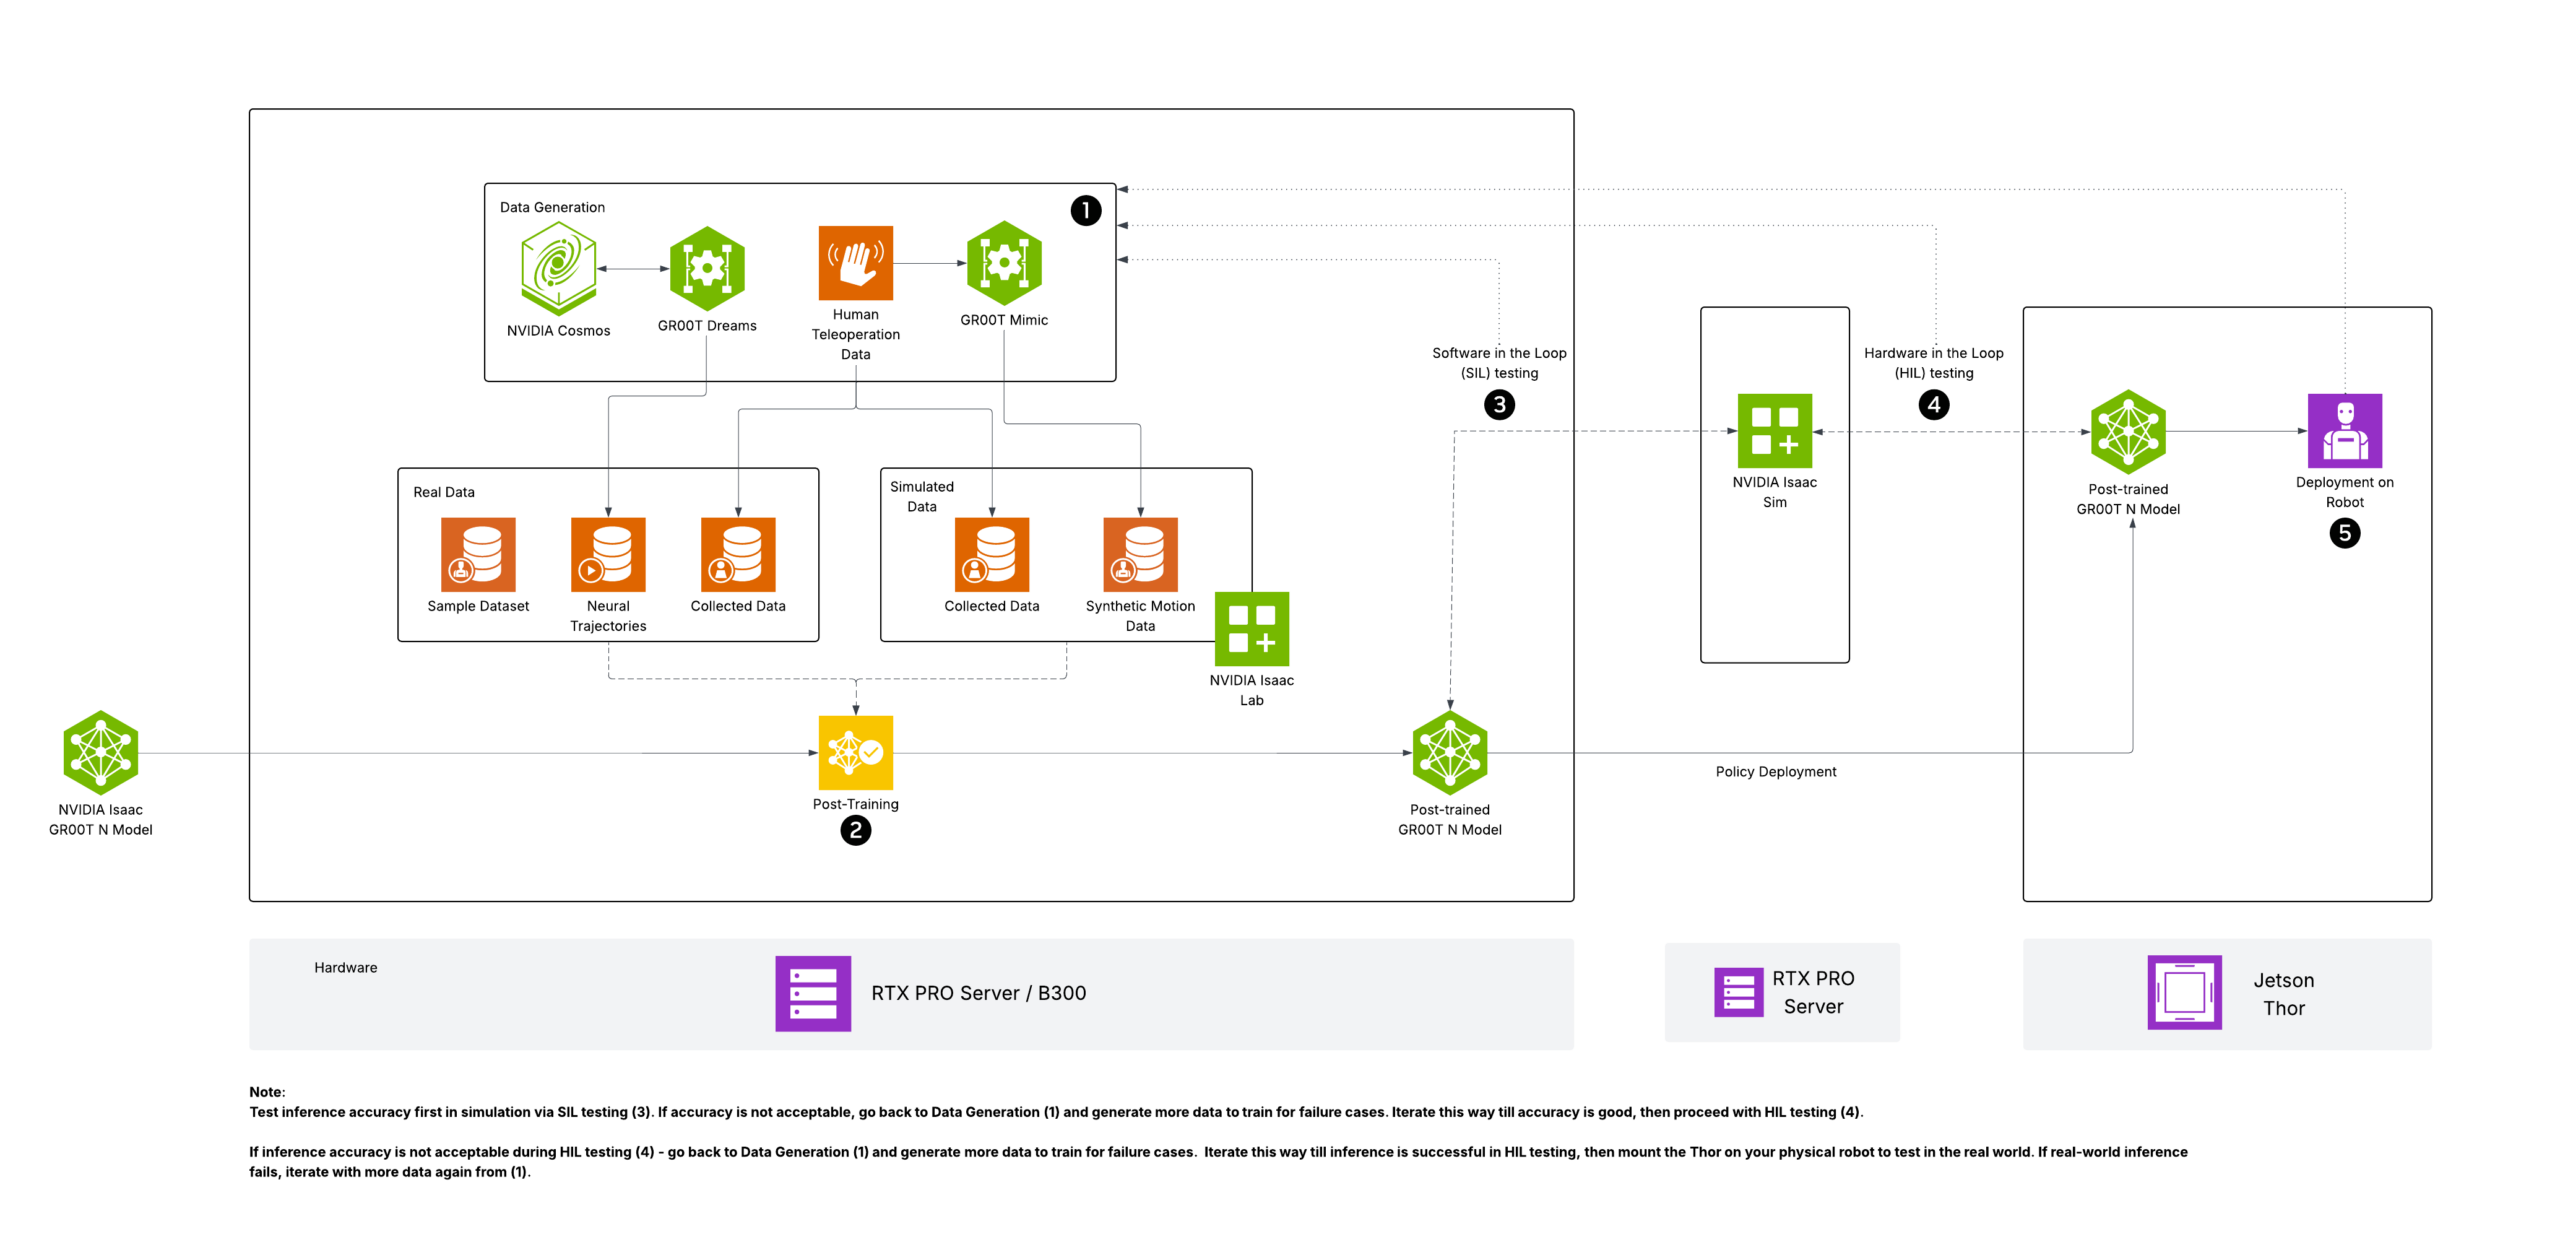
လုပ်ငန်းစဉ်သည် အဝေးမှလည်ပတ်မှုဖြင့် စတင်သည်- အော်ပရေတာတစ်ဦးသည် စက်ရုပ်အား လုပ်ငန်းတစ်ခုမှတစ်ဆင့် လမ်းညွှန်ပေးပြီး လက်တွေ့ကမ္ဘာ သရုပ်ပြမှုအနည်းငယ်ကို ဖမ်းယူသည်။ ထို့နောက် ထိုဥပမာများသည် Isaac GR00T လုပ်ငန်းစဉ်ထဲသို့ ဝင်ရောက်သည်။ ရွေးချယ်နိုင်သော RTX PRO GPU သည် Isaac Sim ၏ ဂရပ်ဖစ်နှင့် ray-tracing လိုအပ်ချက်များကို ကိုင်တွယ်ပေးပြီး Isaac Lab နှင့် GR00T-Mimic တို့သည် မူရင်းသရုပ်ပြမှုများကို ရုပ်ပိုင်းဆိုင်ရာအရ ဖြစ်နိုင်ခြေရှိသော ပေါင်းစပ်လမ်းကြောင်းများအဖြစ် တိုးချဲ့သည်။ နောက်ဆုံးတွင် B300 သည် အစစ်အမှန်နှင့် ပေါင်းစပ်ထားသော dataset ကို အသုံးပြု၍ GR00T မော်ဒယ်ကို အသေးစိတ်ချိန်ညှိပေးသည်။
အရင်းအမြစ်: NVIDIA
အသေးစိတ်ချိန်ညှိပြီးနောက်၊ ရရှိလာသောမူဝါဒကို လက်တွေ့ကမ္ဘာအကဲဖြတ်ရန်အတွက် စက်ရုပ်သို့ ဖြန့်ကျက်ခြင်းမပြုမီ simulation တွင် အတည်ပြုနိုင်သည်။ ၎င်းသည် တင်းကျပ်သော ဖွံ့ဖြိုးတိုးတက်မှုကွင်းဆက်တစ်ခုကို ဖန်တီးပေးသည်- တကယ့်သရုပ်ပြမှုကို ရယူခြင်း၊ simulation တွင် ပြန်လည်ထုတ်လုပ်ခြင်းနှင့် ပြောင်းလဲခြင်း၊ မော်ဒယ်ကို ပြန်လည်လေ့ကျင့်ခြင်းနှင့် ဟာ့ဒ်ဝဲပေါ်တွင် အပ်ဒိတ်လုပ်ထားသောမူဝါဒကို စမ်းသပ်ခြင်း။ စက်ရုပ်များ၊ အော်ပရေတာများ သို့မဟုတ် အချက်အလက်စုဆောင်းသည့်ဝင်းဒိုးများကို ဝင်ရောက်ခွင့်အကန့်အသတ်ရှိသော အဖွဲ့များအတွက် simulation၊ ပေါင်းစပ်ဒေတာထုတ်လုပ်ခြင်းနှင့် မော်ဒယ်လေ့ကျင့်ခြင်းတို့ကို တစ်ခုတည်းသော desk-side စနစ်တွင် ပေါင်းစပ်ခြင်းသည် ထပ်ခါတလဲလဲလုပ်ဆောင်ခြင်းတစ်ခုစီ၏ ပွတ်တိုက်မှုကို သိသိသာသာလျှော့ချနိုင်သည်။
Blackwell Ultra kernel ဖွံ့ဖြိုးတိုးတက်ရေး
သို့သော် DGX Station အတွက် အကောင်းဆုံးအသုံးပြုမှုအခြေအနေမှာ kernel optimization ဖြစ်သည်။ အဖွဲ့တစ်ဖွဲ့သည် Blackwell Ultra အတွက် CUDA သို့မဟုတ် Triton kernels များကို ရေးသားနေချိန်တွင် target architecture ပေါ်တွင် run ခြင်းအတွက် အစားထိုးစရာမရှိပါ။ WS300 သည် developer ဘေးတွင် B300 နှင့် 252GB HBM3e ကို ထားရှိသောကြောင့် workloads အစစ်အမှန်များကို profile လုပ်ခြင်း၊ memory behavior ကို စစ်ဆေးခြင်း၊ Tensor Core paths များကို ချိန်ညှိခြင်း၊ fuse operations များနှင့် eight-GPU server သို့မဟုတ် rack-scale system တွင် အချိန်ကြိုတင်စာရင်းသွင်းခြင်းမရှိဘဲ iterate လုပ်နိုင်သည်။
ပိုကြီးတဲ့စနစ်တွေက အရေးပါနေဆဲပါပဲ၊ ဒါပေမယ့် သူတို့ကို လိုအပ်တဲ့အလုပ်တွေအတွက် သီးသန့်ထားနိုင်ပါတယ်- NVLink scaling၊ NCCL collectives၊ communication kernels၊ multi-GPU inference နဲ့ final throughput validation။ WS300 က single-GPU kernel အလုပ်ကို ဒေသတွင်းမှာ ကိုင်တွယ်ပြီး စျေးကြီးတဲ့ shared system တွေကို scaled-up testing အတွက် ရရှိနိုင်အောင် ထိန်းထားပေးပါတယ်။ Blackwell Ultra optimization ကို အာရုံစိုက်တဲ့အဖွဲ့အတွက် ဒါက ဈေးကွက်က ပေးစွမ်းသလောက် တိုက်ရိုက် development machine တစ်ခုပါ။
DGX Station ကို ပထမဆုံး Blackwell Ultra စနစ်များနှင့်အတူ ပို့ဆောင်ခဲ့ပါက၊ ကနဦးထောက်ပံ့မှုသည် AI ဓာတ်ခွဲခန်းများ၊ compiler အဖွဲ့များ၊ inference-engine developer များနှင့် B300 အတွက် software ကို ချိန်ညှိရန် အပြိုင်အဆိုင်ကြိုးစားနေသော အခြားအဖွဲ့များထဲသို့ ချက်ချင်းပျောက်ကွယ်သွားလိမ့်မည်ဟု ကျွန်ုပ်တို့သံသယရှိသည်။ ယခုအချိန်တွင်ပင်၊ target GPU သို့ တိုက်ရိုက်ဝင်ရောက်ခွင့်သည် အဖွဲ့အစည်းတစ်ခုဝယ်ယူရန် အရှင်းလင်းဆုံးအကြောင်းပြချက်ဖြစ်နိုင်သည်။
performance
စမ်းသပ်ချက်မှတ်စု- MSI-hosted system တွင် အဝေးမှ စမ်းသပ်ခြင်းကို ပြုလုပ်ခဲ့ပြီး StorageReview သည် အကဲဖြတ်ဝင်းဒိုးတစ်လျှောက်လုံး software environment အပြည့်အစုံကို ထိန်းချုပ်ခဲ့သည်။ RTX PRO GPU သို့မဟုတ် အခြား PCIe add-in ကတ်များ မထည့်သွင်းဘဲ စနစ်ကို စမ်းသပ်ခဲ့သည်။ ၎င်းက GB300 Superchip ကို စမ်းသပ်နေစဉ်အတွင်း စနစ်၏ ရရှိနိုင်သော accelerator power budget အပြည့်အဝဖြင့် ထားရှိခဲ့သည်။
အများဆုံးရရှိနိုင်သော Matmul FLOPS (MAMF)
ပထမဦးစွာ၊ B300 ၏ တွက်ချက်မှုကို အကြောင်းအရာနှင့် ဆက်စပ်စေရန်အတွက်၊ ကျွန်ုပ်တို့သည် Blackwell-generation စနစ်သုံးခုတွင် MAMF ကို လုပ်ဆောင်ခဲ့သည်။ MAMF (Maximum Achievable Matmul FLOPS) သည် matrix multiplication လုပ်ဆောင်ချက်များအတွင်း machine learning accelerators များတွင် ရရှိနိုင်သော တစ်စက္ကန့်လျှင် လက်တွေ့ကျသော peak floating-point လုပ်ဆောင်ချက်များကို တိုင်းတာရန် ဒီဇိုင်းထုတ်ထားသော လက်တွေ့ကျသော စွမ်းဆောင်ရည် မက်ထရစ်တစ်ခုဖြစ်ပြီး hardware သတ်မှတ်ချက်များတွင် မကြာခဏ ကြော်ငြာထားသော သီအိုရီ peak FLOPS ထက် ပိုမိုတိကျသော benchmark ကို ပေးဆောင်သည်။
ဤစမ်းသပ်မှုအတွက်၊ ကျွန်ုပ်တို့သည် BF16၊ FP8 နှင့် NVFP4 ရှိ စနစ် ၃ ခုစလုံးကို လှည့်ပတ်စစ်ဆေးပြီး တိကျမှုအလိုက် အကောင်းဆုံးတည်တံ့သော (သိပ်သည်းဆ) ရလဒ်ကို တင်ပြပါသည်။
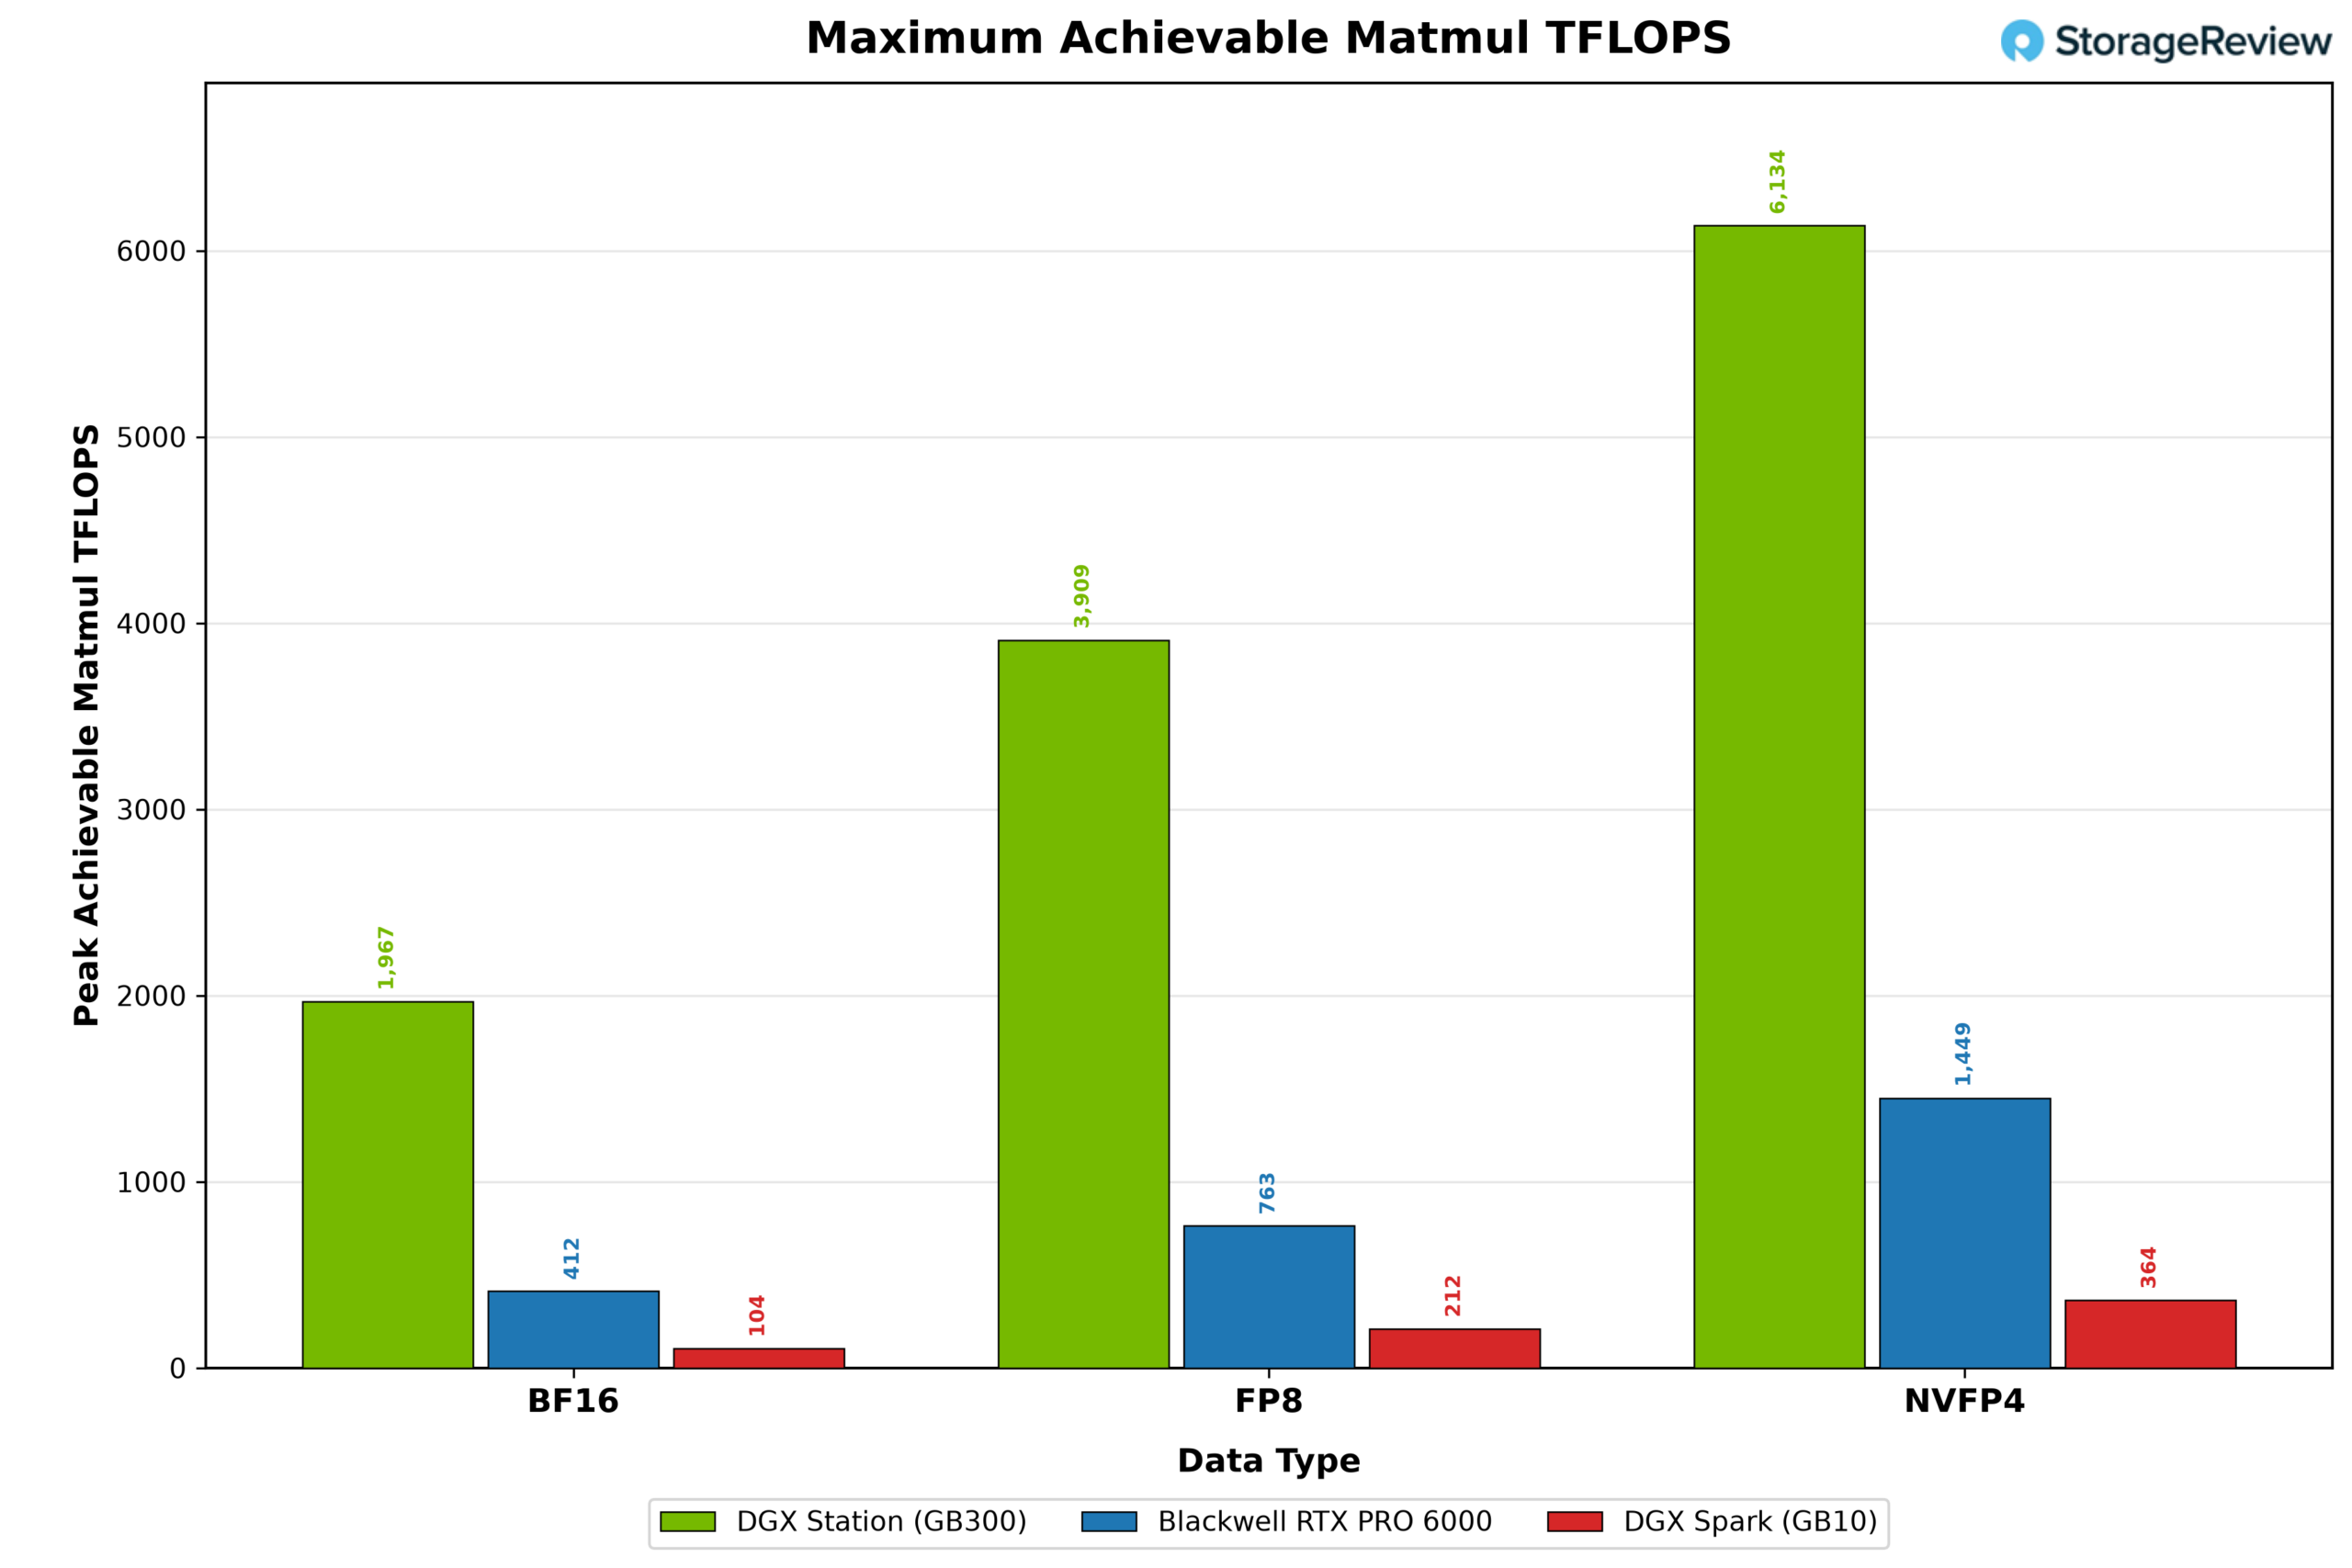
GB300 ဟာ တိကျမှုတိုင်းမှာ ဦးဆောင်နေပါတယ်။ BF16 မှာ RTX PRO 6000 မှာ 412 TFLOPS နဲ့ DGX Spark မှာ 104 TFLOPS ရရှိထားပြီး 1,967 TFLOPS ရရှိထား ပါတယ်။ FP8 ကလည်း အဲဒီပုံစံအတိုင်းပါပဲ- 3,909, 763 နဲ့ 211။ NVFP4 က GB300 ကို 6,134 TFLOPS အထိ ရောက်ရှိစေပြီး RTX PRO 6000 က 1,449 နဲ့ Spark က 364 TFLOPS ရရှိထားပါတယ်။ တိကျမှု အချိုးအစား သုံးခုစလုံးမှာ သိသိသာသာ တည်ငြိမ်ပါတယ်- GB300 ဟာ RTX PRO 6000 ထက် 4 ဆ မှ 5 ဆ အားသာချက်ရှိပြီး Spark ထက် 17 ဆ မှ 19 ဆ အားသာချက်ရှိပြီး RTX PRO 6000 ကတော့ Spark ထက် 4 ဆ ခန့် အားသာချက် ရှိပါတယ်။
NV bandwidth
Accelerator သည် ၎င်း၏ execution unit များကို data များဖြင့် ထောက်ပံ့ပေးထားနိုင်မှသာ raw compute throughput သည် အသုံးဝင်ပါသည်။ ၎င်းသည် AI inference အတွက် အထူးအရေးကြီးပါသည်၊ အဘယ်ကြောင့်ဆိုသော် decode phase အတွင်း token generation သည် ရရှိနိုင်သော FLOPS များထက် memory bandwidth ကြောင့် မကြာခဏ ကန့်သတ်ခံရလေ့ရှိသောကြောင့်ဖြစ်သည်။
GB300 Superchip မှာ အဲဒီအဆင့်ဆင့်ဟာ B300 ရဲ့ local HBM3e၊ Grace ရဲ့ LPDDR5X memory နဲ့ သူတို့ကို ချိတ်ဆက်ပေးတဲ့ NVLink-C2C interconnect တွေကို လွှမ်းခြုံထားပါတယ်။ NVIDIA ရဲ့ NVBandwidth utility ဟာ အဲဒီ components တွေတစ်လျှောက်မှာ copy path အမျိုးမျိုးကို လုပ်ဆောင်ပြီး GPU အတွင်းမှာ ရရှိနိုင်တဲ့ bandwidth နဲ့ GPU နဲ့ CPU memory domain တွေကြား data ရွှေ့ပြောင်းခြင်းရဲ့ ကုန်ကျစရိတ် နှစ်မျိုးလုံးကို ပြသပေးပါတယ်။
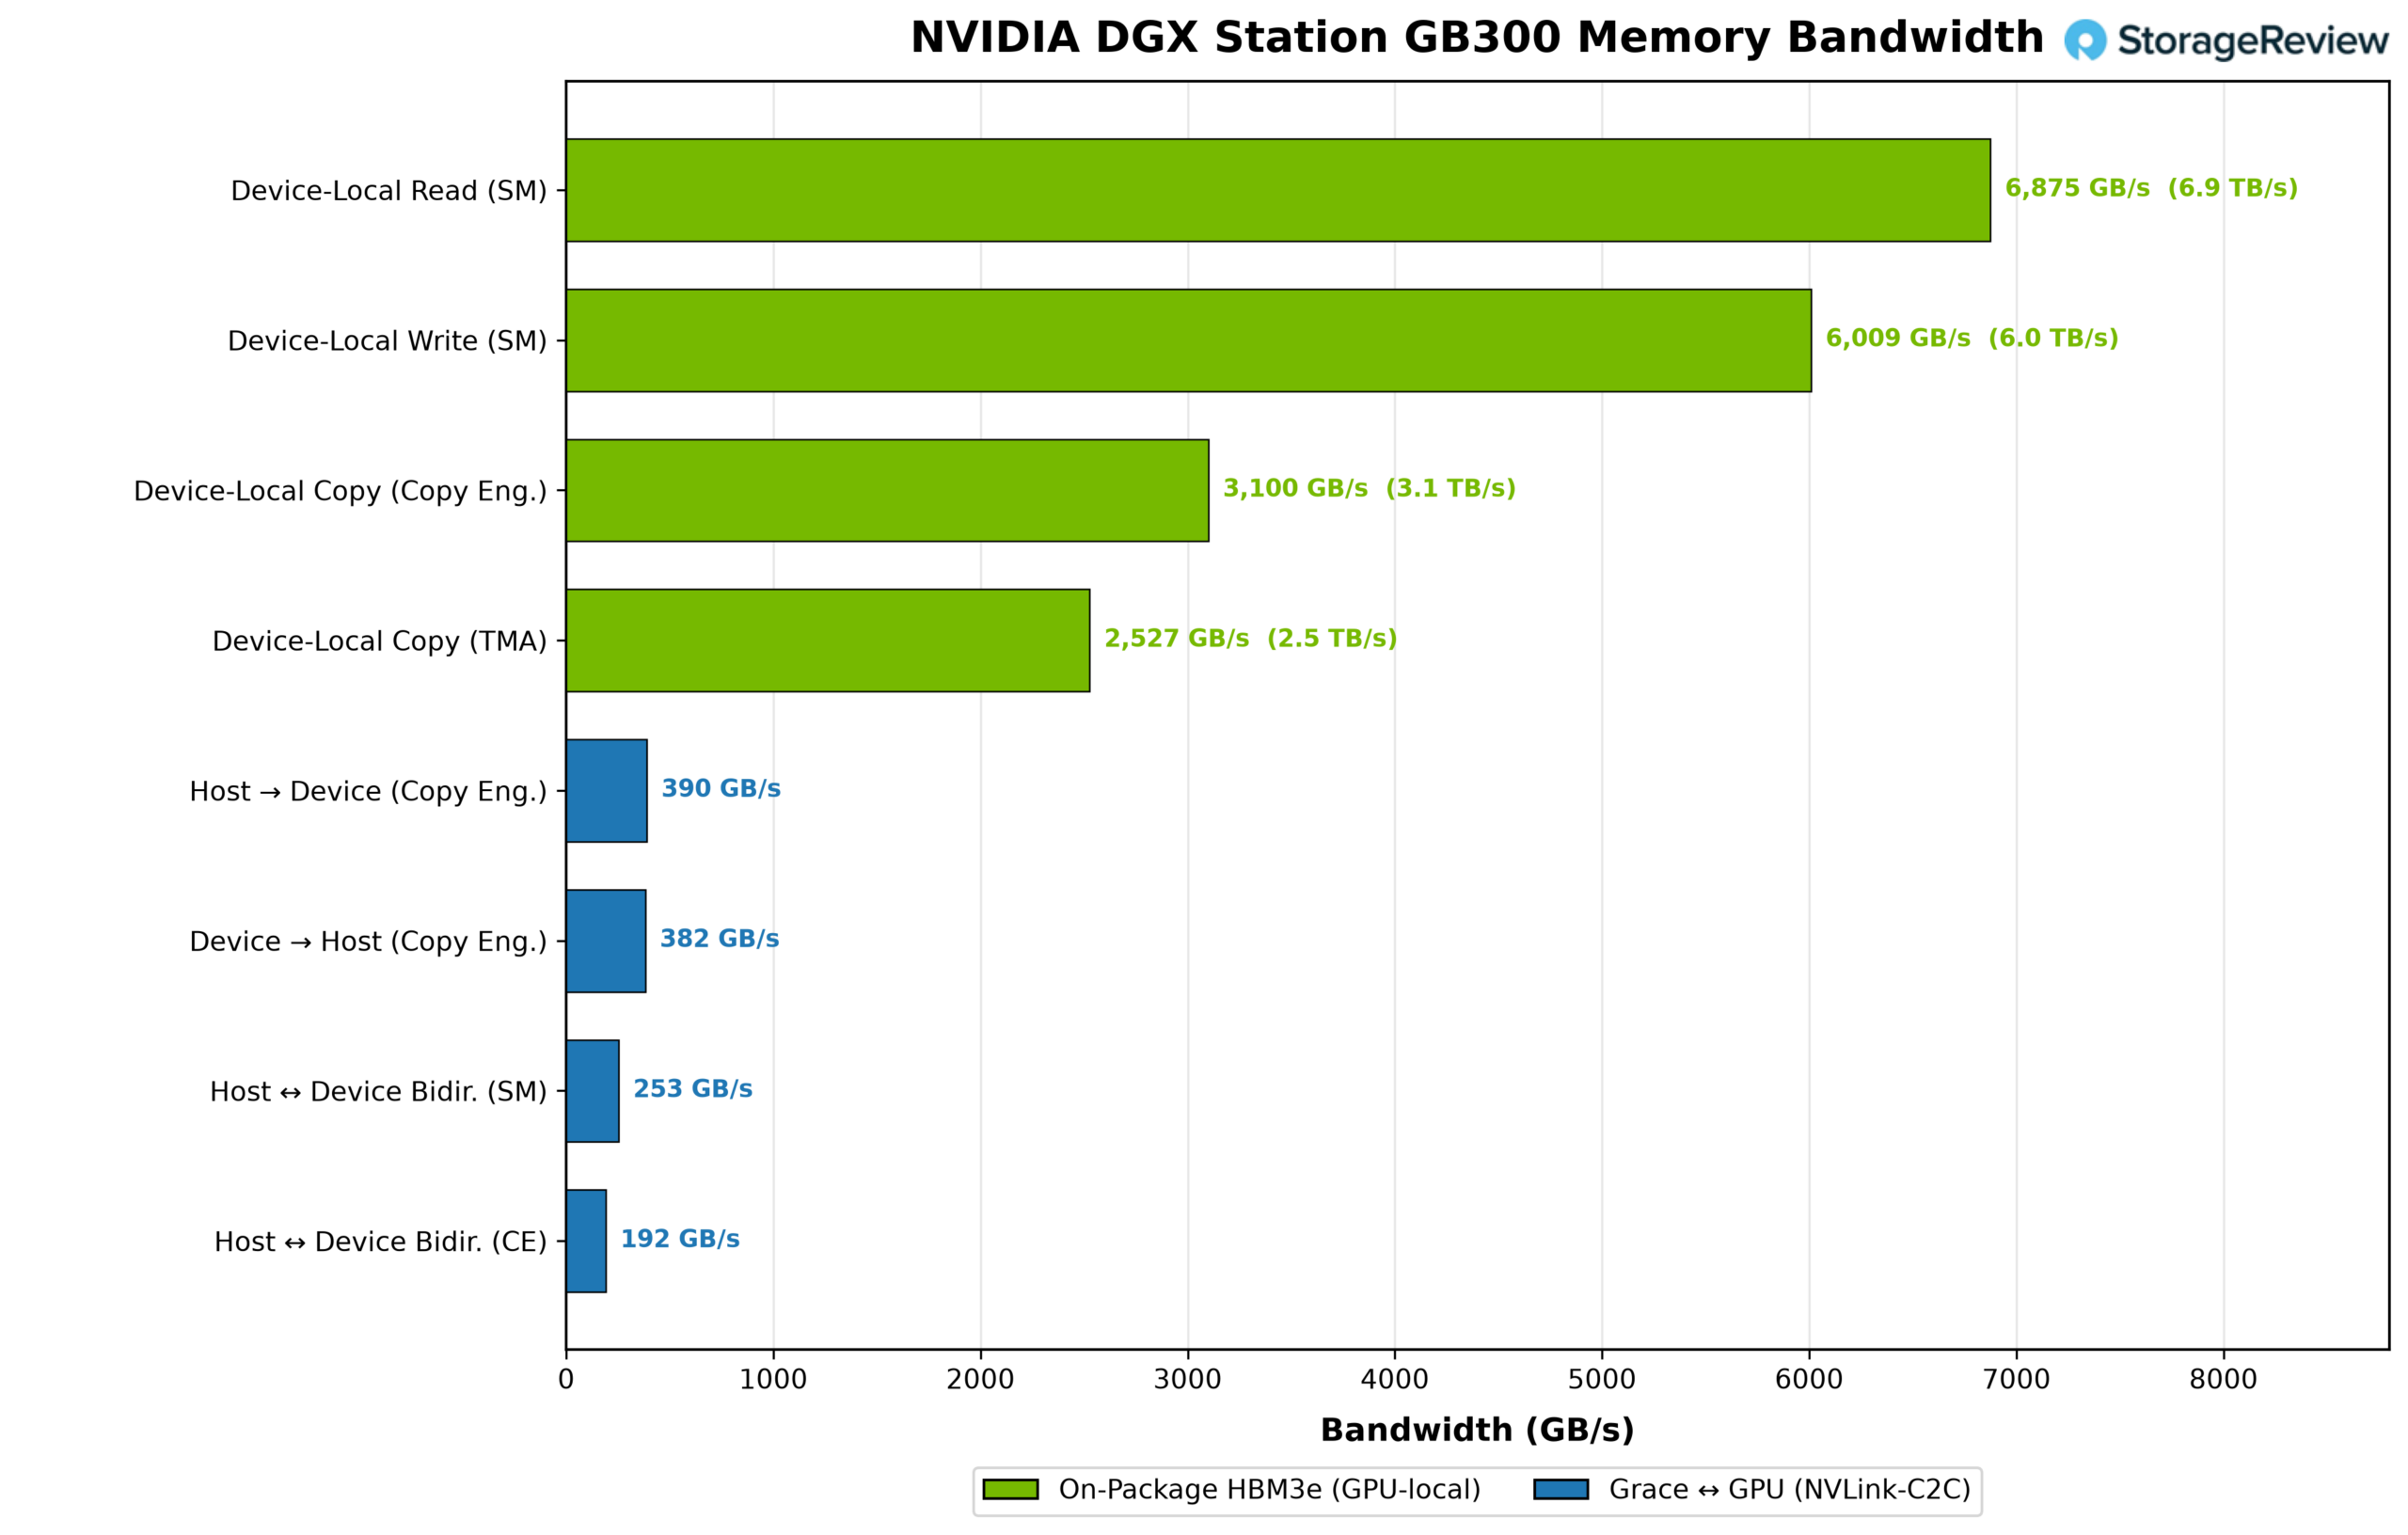
ပထမစမ်းသပ်မှုလေးခုသည် B300 ၏ 252GB HBM3e အတွင်းရှိ ဒေတာရွေ့လျားမှုကို တိုင်းတာသည်။ Device-local reads သည် 6,875 GB/s သို့မဟုတ် ခန့်မှန်းခြေအားဖြင့် 6.9 TB/s အထိရောက်ရှိပြီး ရလဒ်ကို GPU ၏ အဆင့်သတ်မှတ်ထားသော 7.1 TB/s မှတ်ဉာဏ် bandwidth ၏ ရာခိုင်နှုန်းအနည်းငယ်အတွင်း ထားရှိပေးသည်။ Device-local writes သည် 6,009 GB/s အထိရောက်ရှိသည်။
HBM-to-HBM မိတ္တူကူးယူခြင်းလုပ်ဆောင်ချက်များသည် နိမ့်ကျပါသည်- တစ်ကြိမ်မှာ ရင်းမြစ်ကိုဖတ်ရန်ဖြစ်ပြီး နောက်တစ်ကြိမ်မှာ ဦးတည်ရာကိုရေးသားရန်ဖြစ်သည်။ သီးသန့်မိတ္တူအင်ဂျင်များသည် 3,100 GB/s အထိရောက်ရှိပြီး Tensor Memory Accelerator သည် 2,527 GB/s အထိမှတ်တမ်းတင်သည်။
ကျန်ရှိနေသော စမ်းသပ်မှုများသည် NVLink-C2C ကိုဖြတ်ကျော်ပြီး Grace ၏ 496GB LPDDR5X မှတ်ဉာဏ်ကို ဝင်ရောက်ကြည့်ရှုသည်။ Grace မှတ်ဉာဏ်မှ B300 HBM သို့ လွှဲပြောင်းမှုများသည် 390 GB/s အထိရောက်ရှိပြီး ဆန့်ကျင်ဘက် ဦးတည်ချက်သို့ လွှဲပြောင်းမှုများသည် 382 GB/s အထိ ရောက်ရှိသည်။ NVLink-C2C သည် CPU နှင့် GPU အကြား ဆက်စပ်သော bandwidth 900 GB/s အထိ ပေးစွမ်းသော်လည်း၊ တိုင်းတာထားသော လွှဲပြောင်းမှုများကို Grace ၏ 396 GB/s LPDDR5X မှတ်ဉာဏ် bandwidth ဖြင့် ကန့်သတ်ထားသည်။ နှစ်လမ်းသွား လွှဲပြောင်းမှုများသည် ထိုကန့်သတ်ချက်ကို ပိုမိုဖော်ထုတ်သည်။ SM-based မိတ္တူများကို အသုံးပြု၍ တစ်ပြိုင်နက်တည်း လမ်းကြောင်းသည် 253 GB/s နှင့် မိတ္တူအင်ဂျင်များမှတစ်ဆင့် 192 GB/s အထိ ရောက်ရှိသည်။
အခြ
အဆင့်နိမ့်စမ်းသပ်မှုများကို လွှမ်းခြုံထားပြီး LLM ကောက်ချက်သို့ ကျွန်ုပ်တို့ ဆက်လက်သွားပါမည်။ ဤနေရာတွင်၊ အာရုံစိုက်မှုသည် အမြင့်ဆုံးနံပါတ်များမှ တစ်စက္ကန့်လျှင် တိုကင်များ၊ ပထမဆုံးတိုကင်သို့ အချိန်နှင့် ဝန်အောက်တွင် latency သို့ ပြောင်းလဲသွားပြီး WS300 သည် serving system တစ်ခုအနေဖြင့် မည်သို့ပြုမူသည်ကို ပိုမိုကောင်းမွန်စွာ မြင်တွေ့နိုင်စေပါသည်။
GB300 Superchip ရဲ့ အဓိပ္ပာယ်ဖွင့်ဆိုနိုင်စွမ်းနဲ့ စလိုက်ရအောင်- B300 ရဲ့ 252GB HBM3e စွမ်းရည်ကန့်သတ်ချက်ရဲ့ တစ်ဖက်တစ်ချက်စီမှာ မော်ဒယ်တွေကို ဝန်ဆောင်မှုပေးခြင်း။ ဒီနေရာမှာ သူ့ရဲ့ 748GB coherent memory pool က အရေးအကြီးဆုံးပါ။ စစ်ဆေးရေးဂိတ်ငါးခုဟာ HBM မှာ အဆင်ပြေပြေ ကိုက်ညီတဲ့ မော်ဒယ်နှစ်ခုကနေ runtime နဲ့ KV cache အတွက် နေရာအနည်းငယ်သာ ချန်ထားတဲ့ မော်ဒယ်တစ်ခုအထိ တိုးတက်လာပြီး နောက်ဆုံးမှာတော့ သူတို့ရဲ့ အလေးချိန်ရဲ့ အစိတ်အပိုင်းအတော်များများကို Grace memory ဆီ လွှဲပြောင်းပေးရမယ့် မော်ဒယ်နှစ်ခုအထိ တိုးတက်လာခဲ့ပါတယ်။
မှတ်ချက်- ဖော်ပြခဲ့သည့်နေရာတွင်၊ decode throughput မြင့်မားစေရန်အတွက် speculative decodeing ဖြင့် မော်ဒယ်များကို လုပ်ဆောင်ခဲ့ပြီး၊ forced acceptance token ပမာဏကို speculative decode token ပမာဏအဖြစ် သတ်မှတ်ထားသည်။ ထို့ကြောင့် ရလဒ်များသည် အကောင်းဆုံးစွမ်းဆောင်ရည်ကို ပြသသည်။ လက်တွေ့ကမ္ဘာတွင် serving တွင်၊ throughput သည် ပြောင်းလဲလွယ်ပြီး speculative-decode tokens များ၏ အရည်အသွေးပေါ်တွင် မူတည်သည်။
HBM နှင့် လုံးဝကိုက်ညီသော မော်ဒယ်များ
DeepSeek v4 Flash (၀၇၃၁)
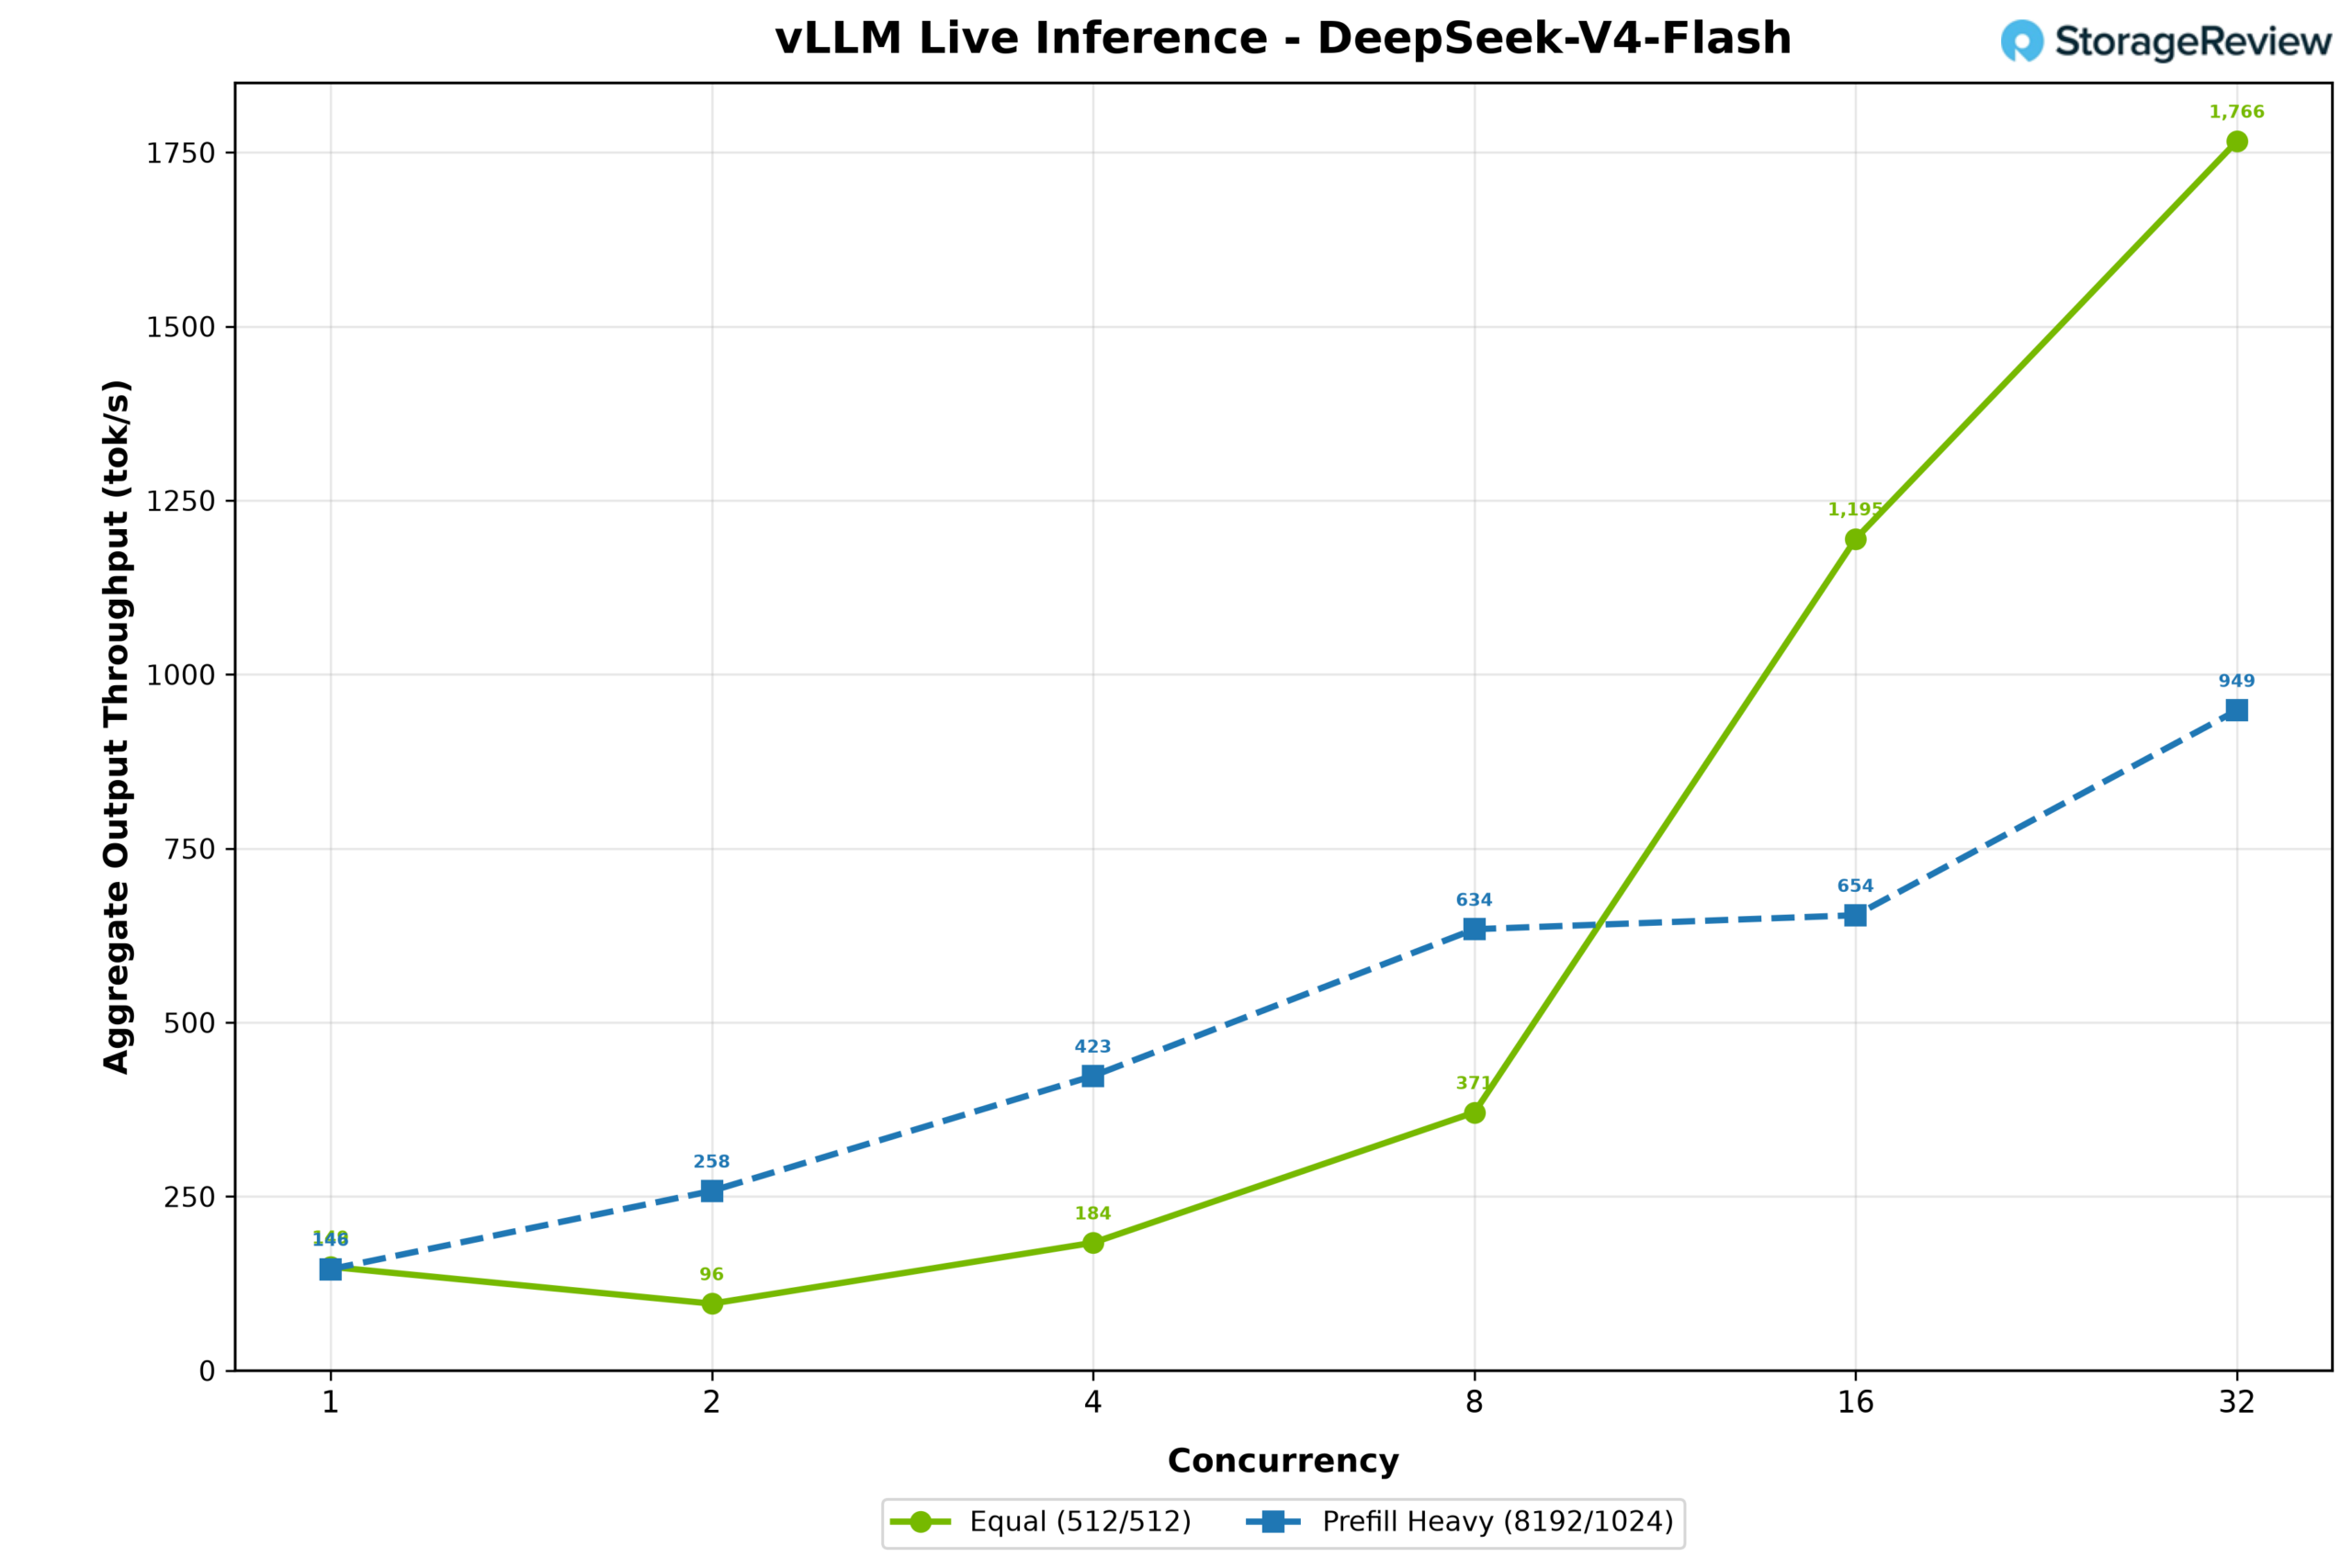
ပထမဆုံးအနေနဲ့ အလွန်ရေပန်းစားတဲ့ DeepSeek v4 Flash (0731) ဖြစ်ပြီး native FP8 checkpoint အနေနဲ့ memory 14+6GB ကို အသုံးပြုပါတယ်။ ဒီ model ဟာ အလွန်ထိရောက်ပြီး run ရတာလွယ်ကူတယ်လို့ လူသိများပြီး DGX Station မှာ ကျွန်တော်တို့ ကြုံတွေ့ခဲ့ရတာက အဲဒါပါပဲ။ 512/512 workload မှာ၊ output throughput ဟာ concurrency 1 မှာ တစ်စက္ကန့်ကို 149 tokens ကနေ စတင်ခဲ့ပြီး concurrency 32 မှာ 1,766 အထိ အလျင်အမြန် မြင့်တက်လာခဲ့ပါတယ်။ prefill-heavy workload ဟာ တစ်စက္ကန့်ကို 146 tokens ကနေ 949 tokens အထိ မြင့်တက်လာခဲ့ပါတယ်။
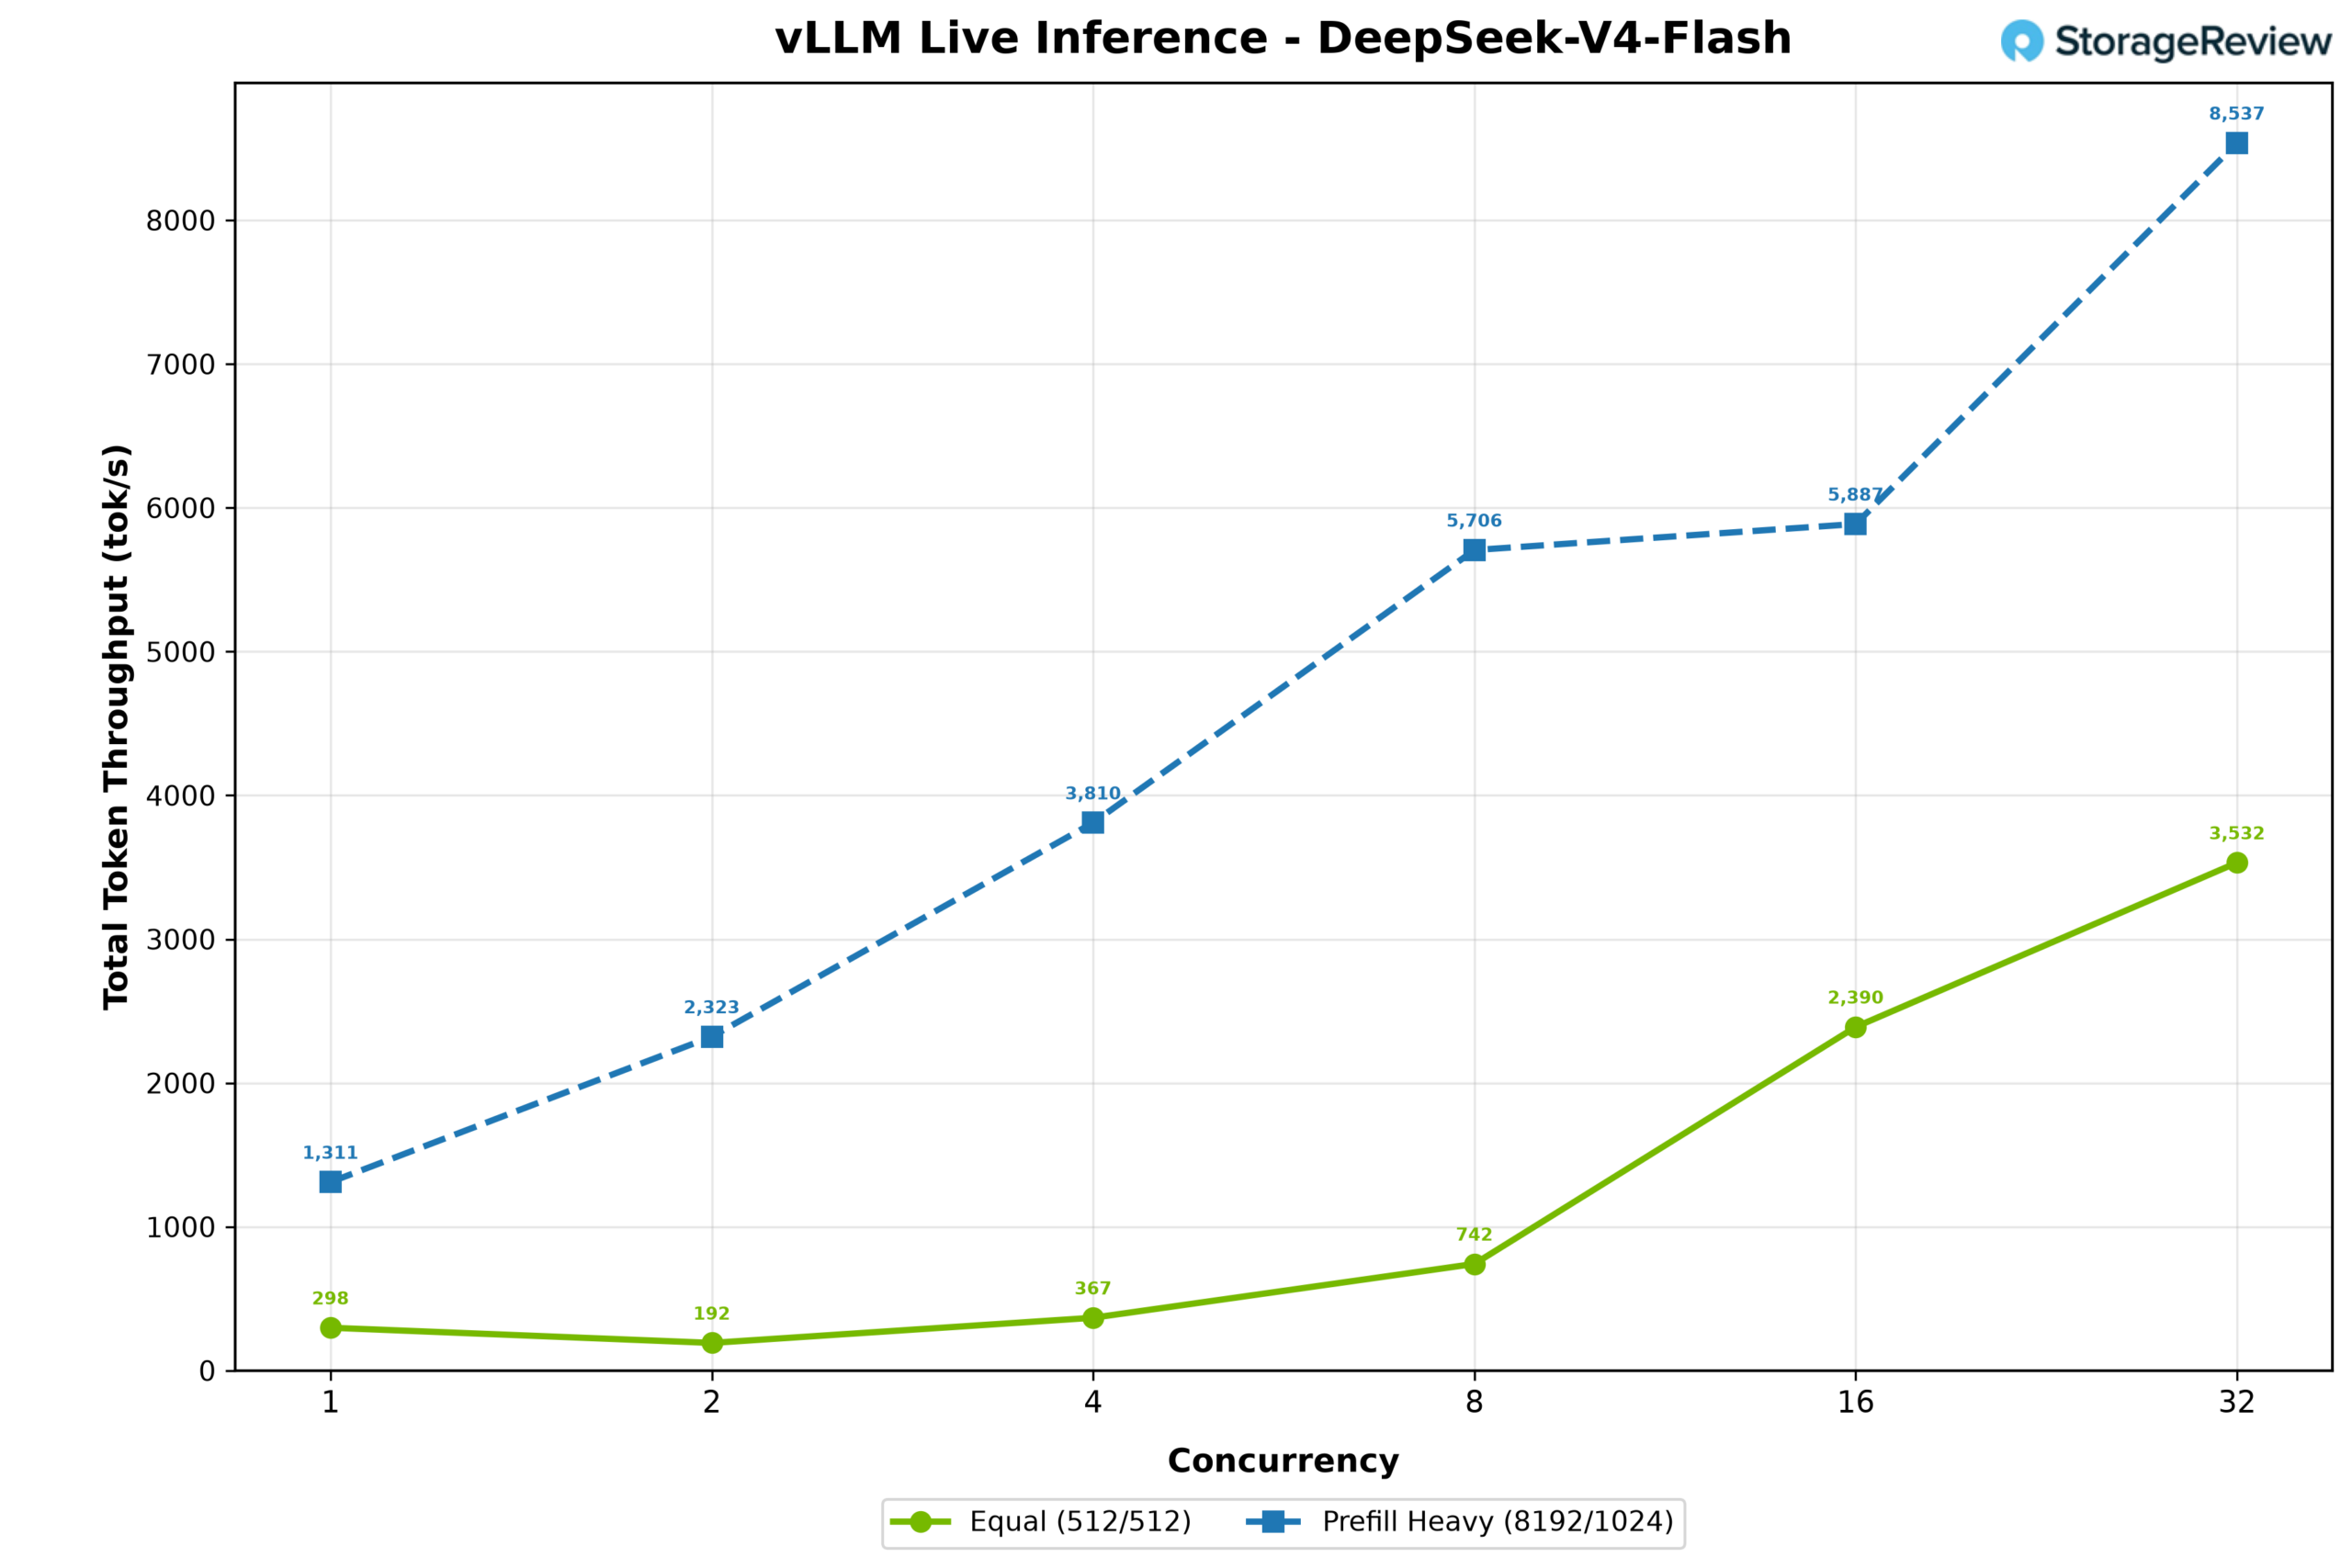
စုစုပေါင်း token throughput ကို lockstep ဖြင့် ချိန်ညှိထားပြီး 512/512 workload သည် တစ်စက္ကန့်လျှင် 298 မှ 3,532 tokens အထိ မြင့်တက်လာပြီး prefill-heavy workload သည် 1,311 မှ 8,537 အထိ မြင့်တက်လာပါသည်။
မီနီမက်စ် M2.7 (NVFP4)
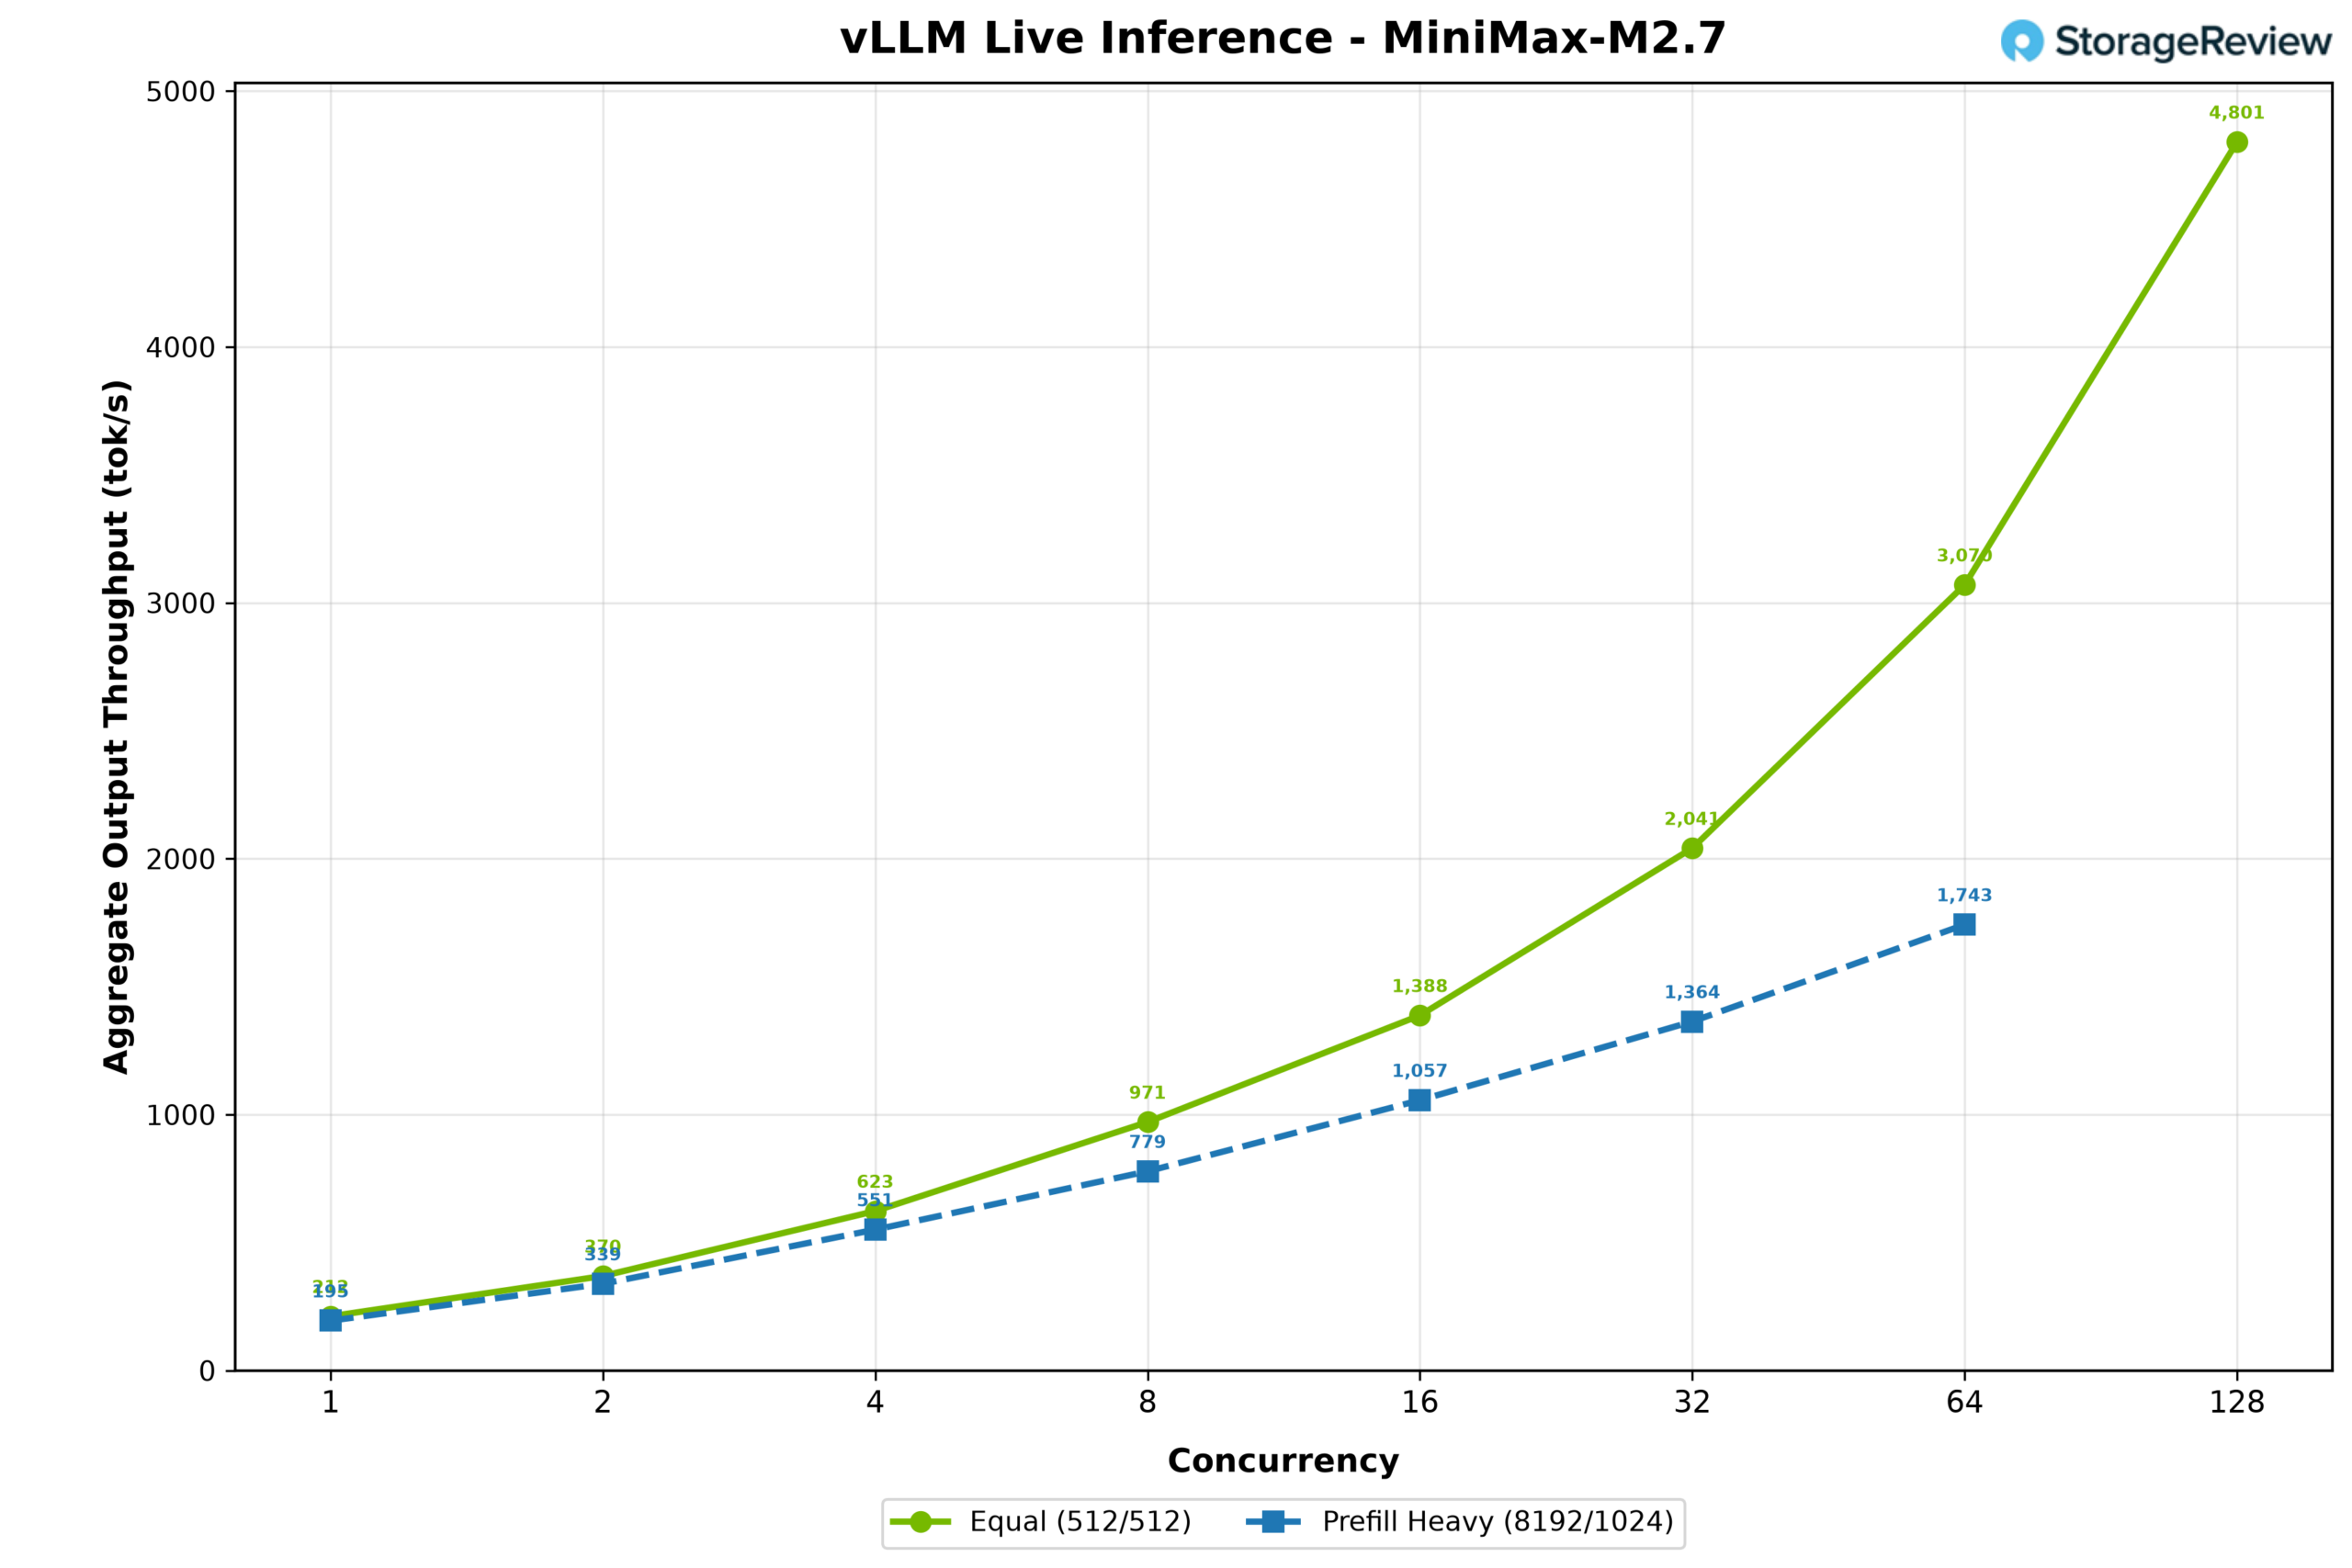
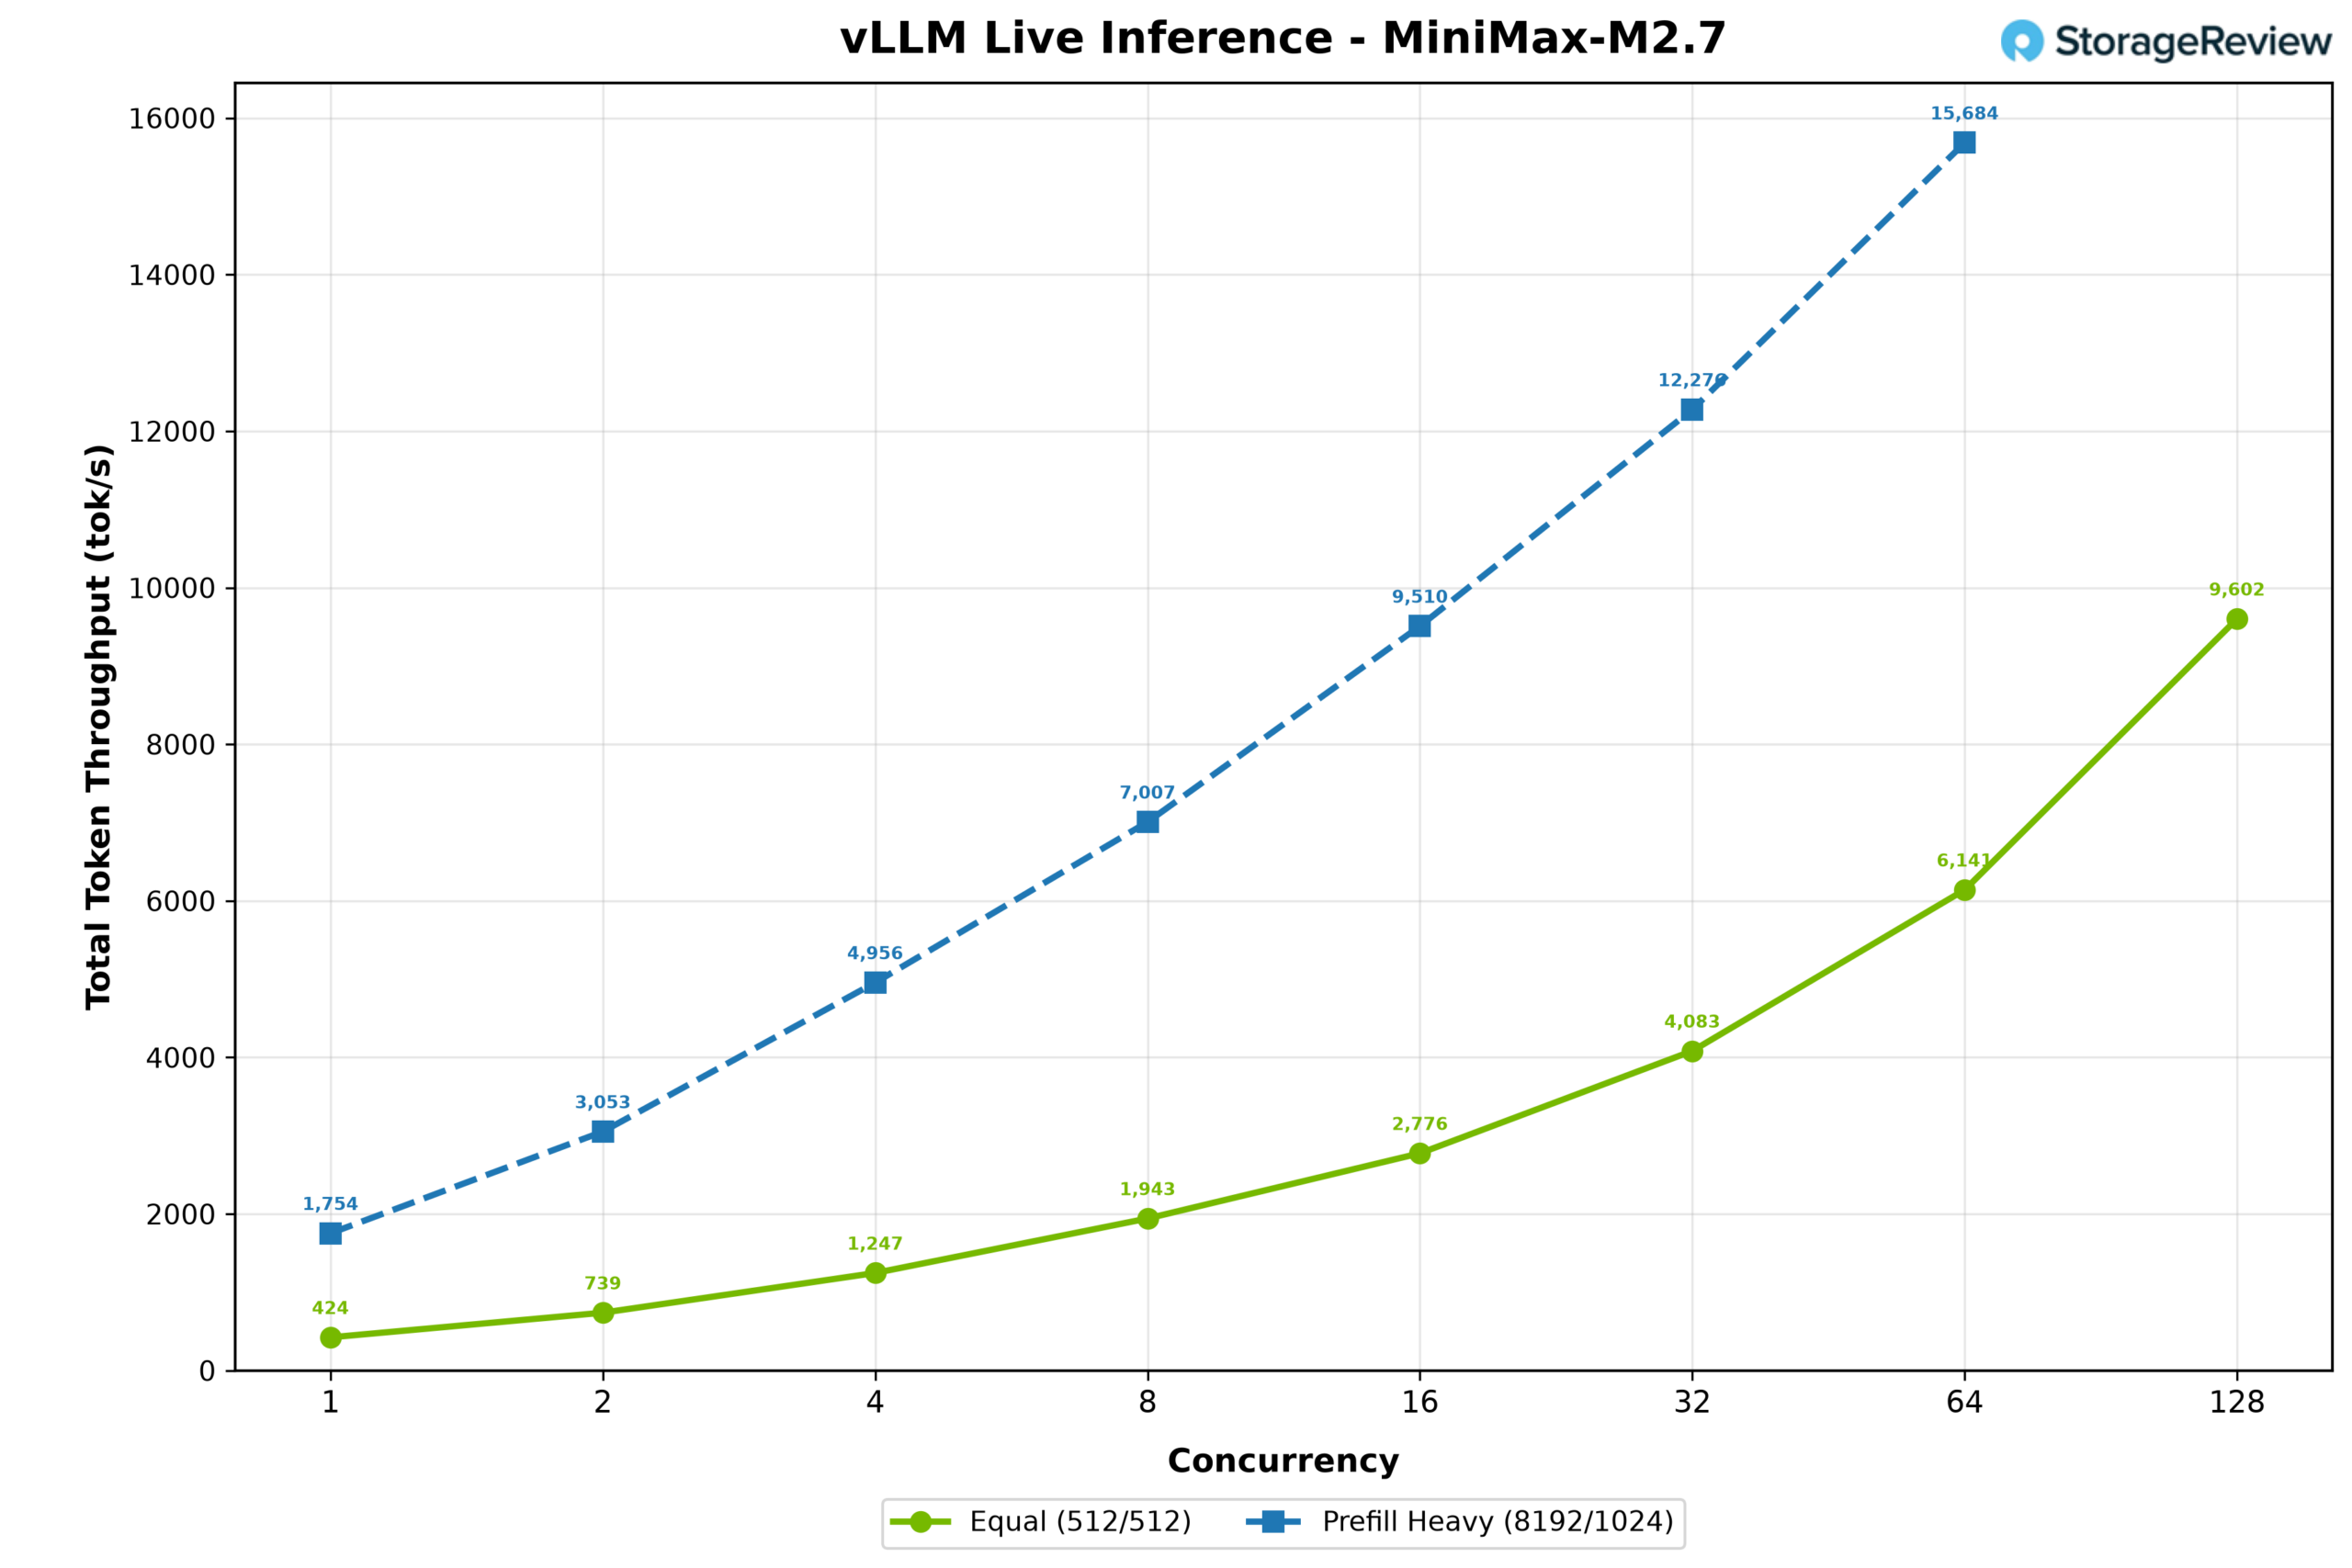
နောက်တစ်ခုကတော့ ကျွန်တော်တို့အကြိုက်ဆုံး မော်ဒယ်တစ်ခုဖြစ်တဲ့ MiniMax M2.7 ဖြစ်ပြီး NVIDIA ရဲ့ NVFP4 quant ကို အသုံးပြုပြီး VRAM 125GB နေရာမှာ စမ်းသပ်ထားပါတယ်။ 512/512 workload မှာ၊ concurrency 1 မှာ output throughput ဟာ တစ်စက္ကန့်ကို 193 tokens ကနေ စတင်ခဲ့ပြီး concurrency 128 မှာ တစ်စက္ကန့်ကို 4,801 tokens အထိ မြန်မြန်ဆန်ဆန် တိုးလာခဲ့ပါတယ်။ prefill-heavy workload ဟာ concurrency 1 မှာ တစ်စက္ကန့်ကို 195 tokens ကနေ concurrency 64 မှာ တစ်စက္ကန့်ကို 1,743 tokens အထိ တိုးလာခဲ့ပါတယ်။ Token throughput စုစုပေါင်းဟာ ဆန့်ကျင်ဘက် လမ်းကြောင်းကို ပြသခဲ့ပြီး prefill-heavy workload ဟာ တစ်စက္ကန့်ကို 1,754 ကနေ တစ်စက္ကန့်ကို 15,684 tokens အထိ မြင့်တက်လာခဲ့ပြီး၊ 512/512 workload ကတော့ တစ်စက္ကန့်ကို 424 ကနေ တစ်စက္ကန့်ကို 9,602 tokens အထိ မြင့်တက်လာခဲ့ပါတယ်။
စုစုပေါင်း token throughput သည် ဆန့်ကျင်ဘက်လမ်းကြောင်းကို ပြသခဲ့ပြီး၊ prefill-heavy workload သည် concurrency 64 တွင် တစ်စက္ကန့်လျှင် 1,754 မှ 15,684 အထိ မြင့်တက်လာခဲ့ပြီး၊ 512/512 workload သည် concurrency 128 တွင် တစ်စက္ကန့်လျှင် 424 မှ 9,602 အထိ တိုးလာခဲ့သည်။
HBM မှာ အံဝင်ခွင်ကျ မဖြစ်နိုင်တဲ့ မော်ဒယ်တွေ
မီနီမက်စ် M3 (NVFP4)
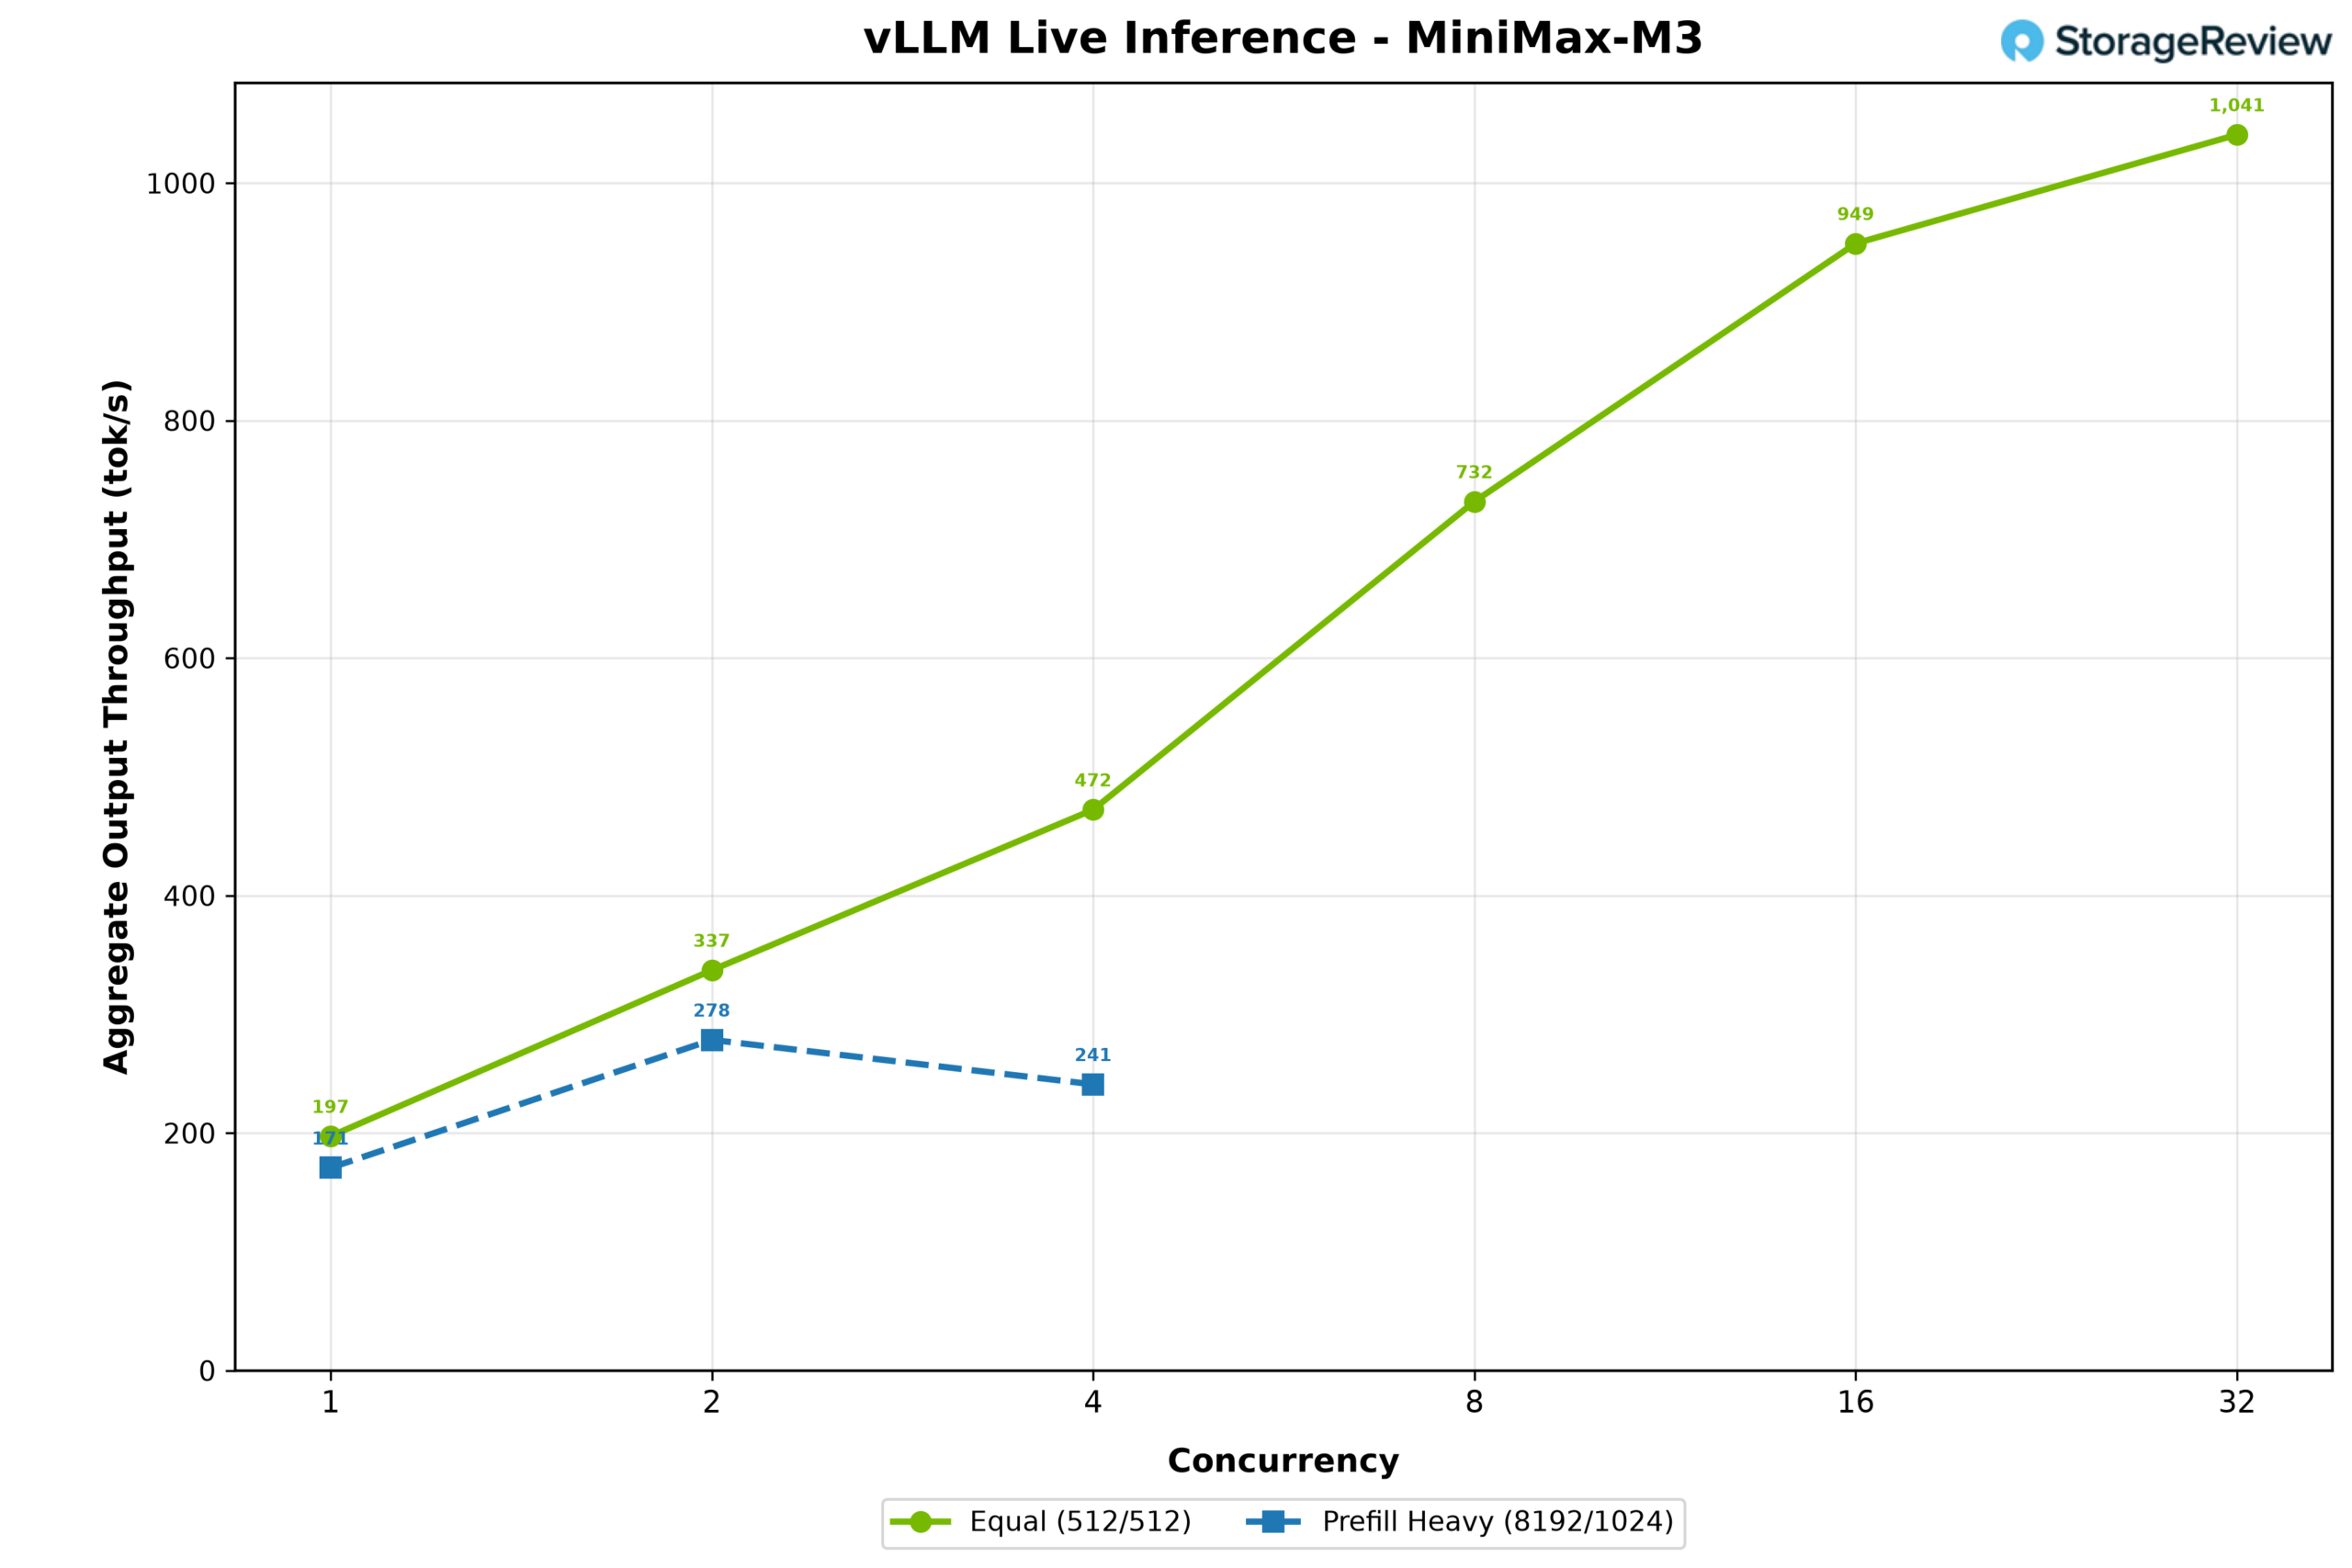
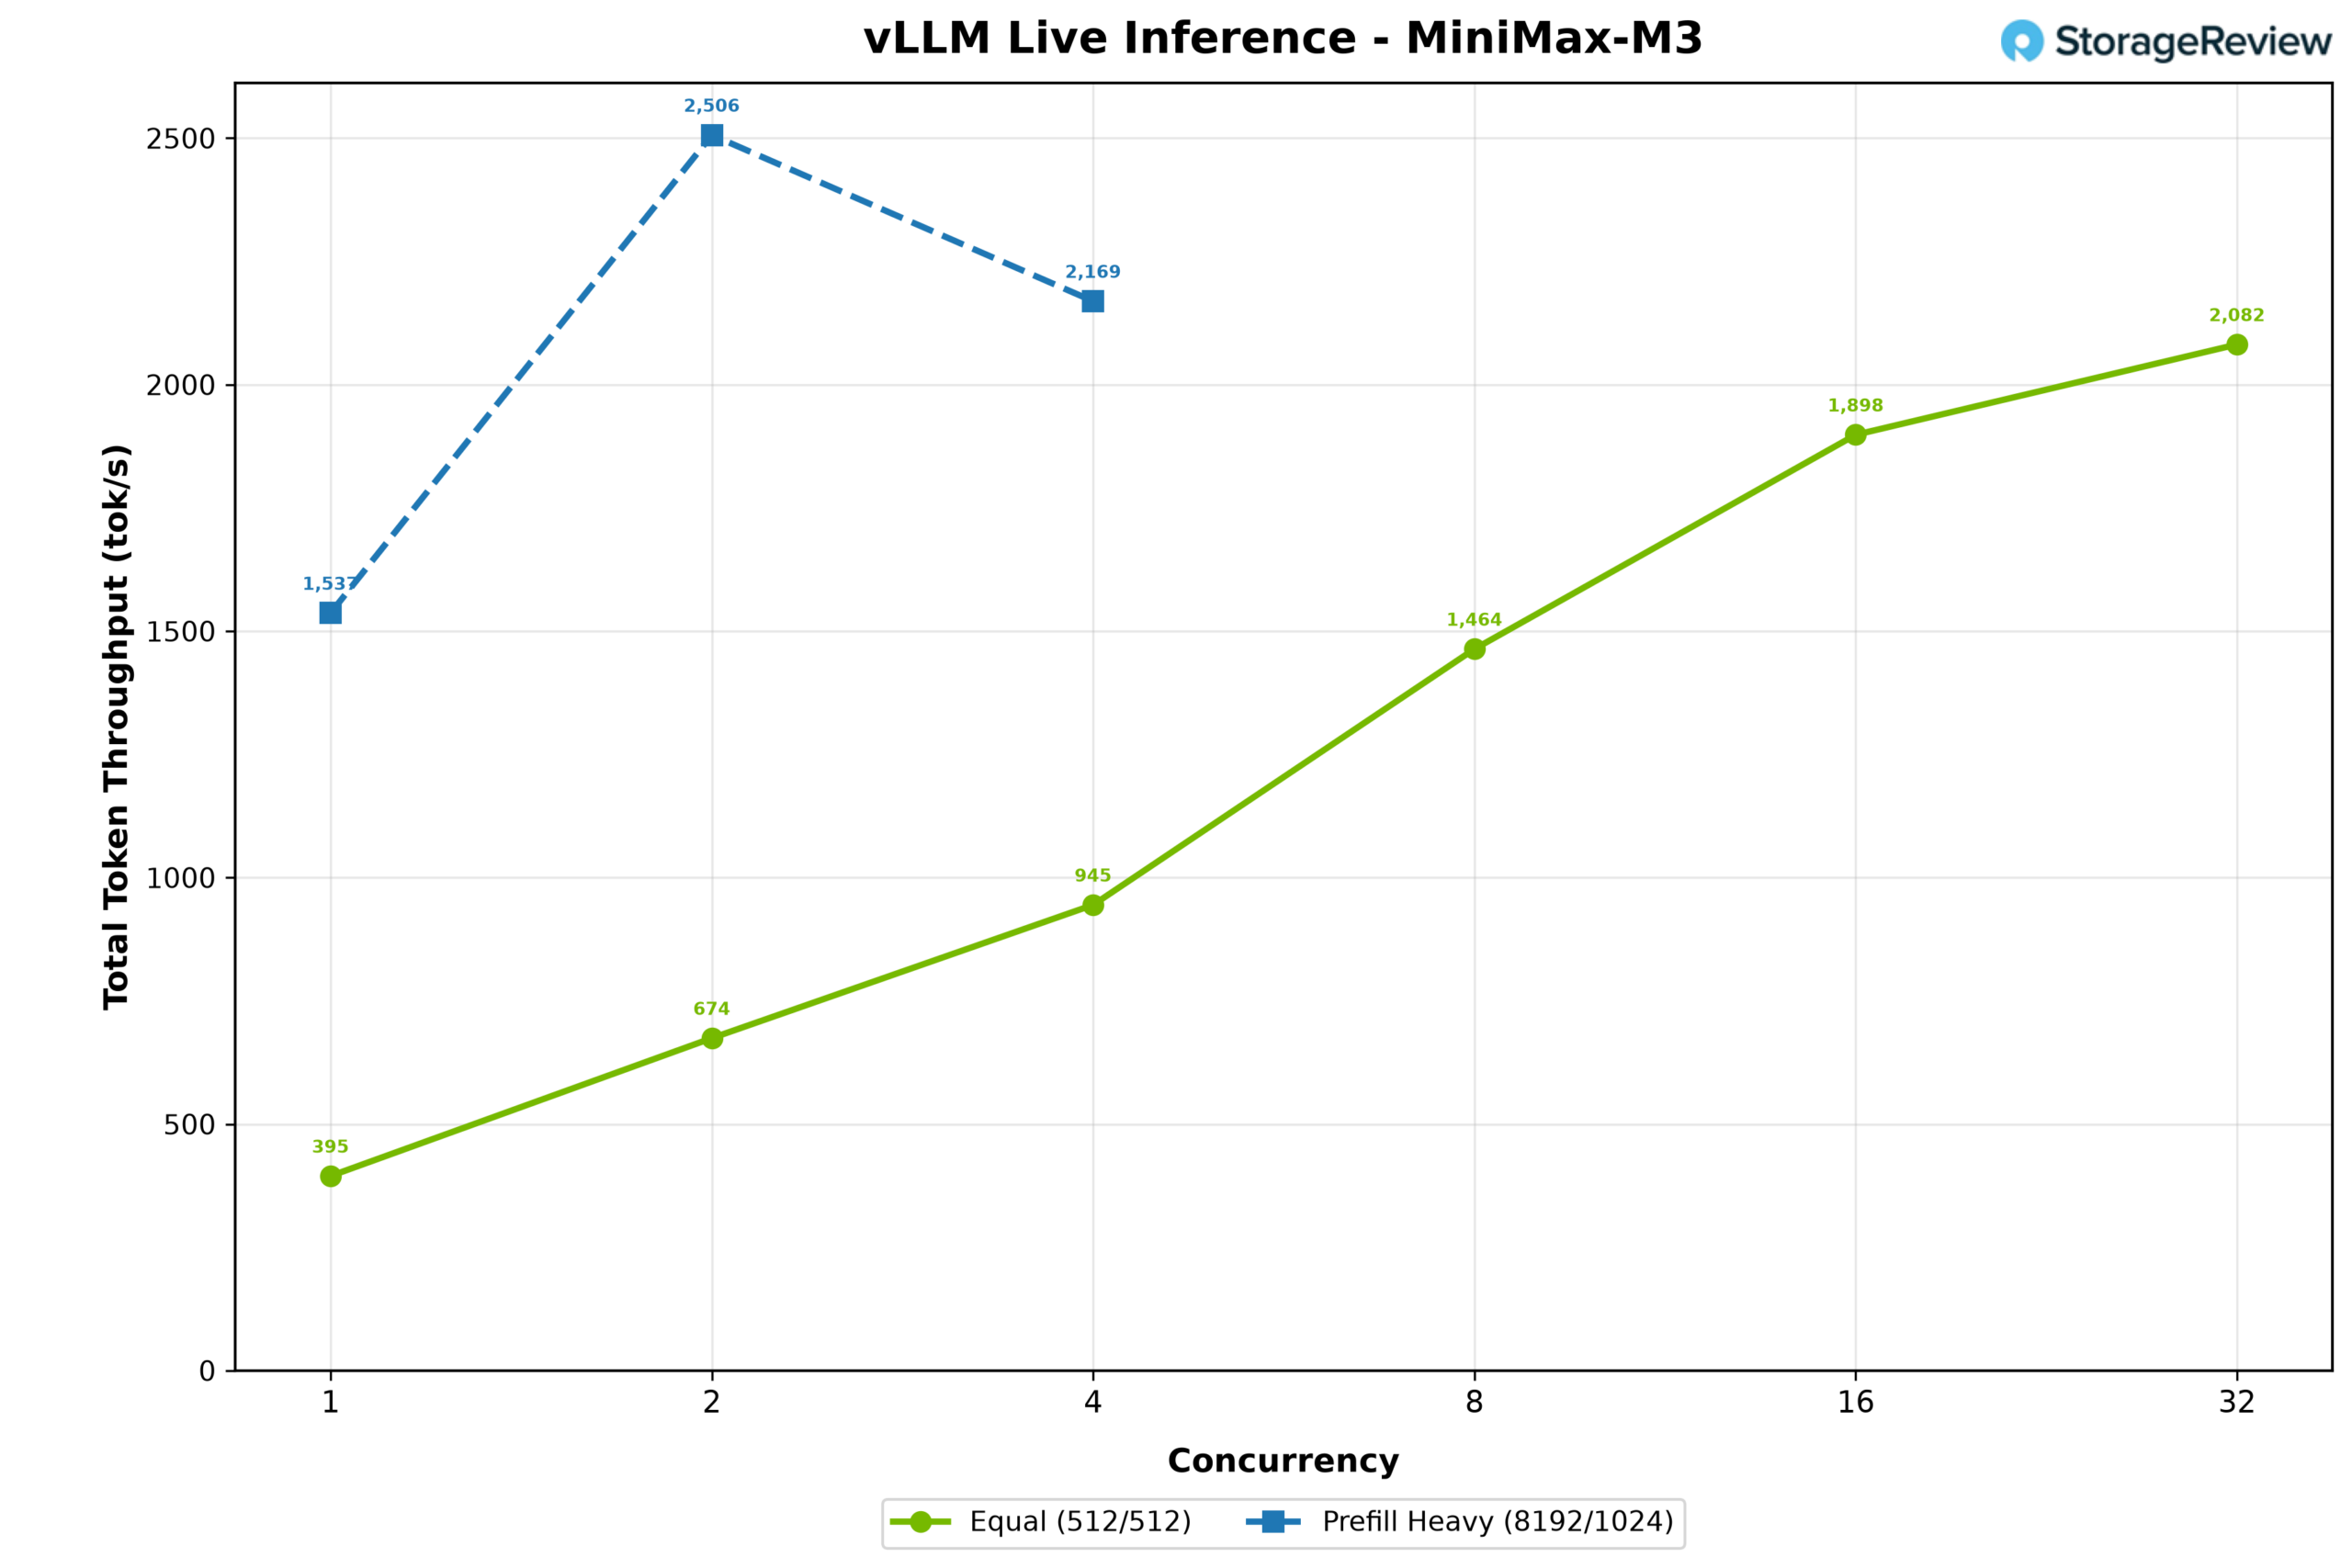
MiniMax M3 က လက်တွေ့မှာ ဘယ်လိုအံဝင်ခွင်ကျဖြစ်လဲဆိုတာကို ပြသထားပါတယ်။ သူ့ရဲ့ 233GB NVFP4 checkpoint ဟာ B300 ရဲ့ 252GB HBM ထက် သေးငယ်ပေမယ့် မော်ဒယ်မှာ runtime နဲ့ KV cache အတွက် နေရာလွတ်လိုအပ်နေပါသေးတယ်။ နောက်ဆုံးမှာ HBM 223GB ကို သိမ်းပိုက်ထားပြီး ကျွမ်းကျင်သူ ၂၁GB ကို Grace ကို လွှဲပြောင်းပေးခဲ့ပါတယ်။ EAGLE3-GQA speculative decoding ကို synthetic acceptance length 3 tokens နဲ့ အသုံးပြုခဲ့ပါတယ်။ 512/512 workload မှာ output throughput ဟာ concurrency 1 မှာ တစ်စက္ကန့်ကို 197 tokens ကနေ စတင်ခဲ့ပြီး concurrency 32 မှာ တစ်စက္ကန့်ကို 1,041 tokens အထိ တဖြည်းဖြည်း တိုးလာခဲ့ပါတယ်။ prefill-heavy workload ဟာ concurrency 1 မှာ တစ်စက္ကန့်ကို 171 tokens မှ concurrency 2 မှာ အမြင့်ဆုံး 278 အထိ မြင့်တက်လာခဲ့ပြီး concurrency 4 မှာ 241 အထိ ကျဆင်းသွားခဲ့ပါတယ်။
စုစုပေါင်း token throughput သည် အလားတူပုံစံအတိုင်း လိုက်ခဲ့ပြီး 512/512 workload သည် တစ်စက္ကန့်လျှင် 395 မှ 2,082 tokens အထိ မြင့်တက်လာခဲ့ပြီး prefill-heavy workload သည် concurrency 2 တွင် တစ်စက္ကန့်လျှင် 2,506 tokens အထိ အမြင့်ဆုံးရောက်ရှိခဲ့ပြီး concurrency 4 တွင် 2,169 သို့ ကျဆင်းသွားခဲ့သည်။
HBM မှာ မပါတဲ့ မော်ဒယ်တွေ
GLM-၅.၂ (NVFP၄)
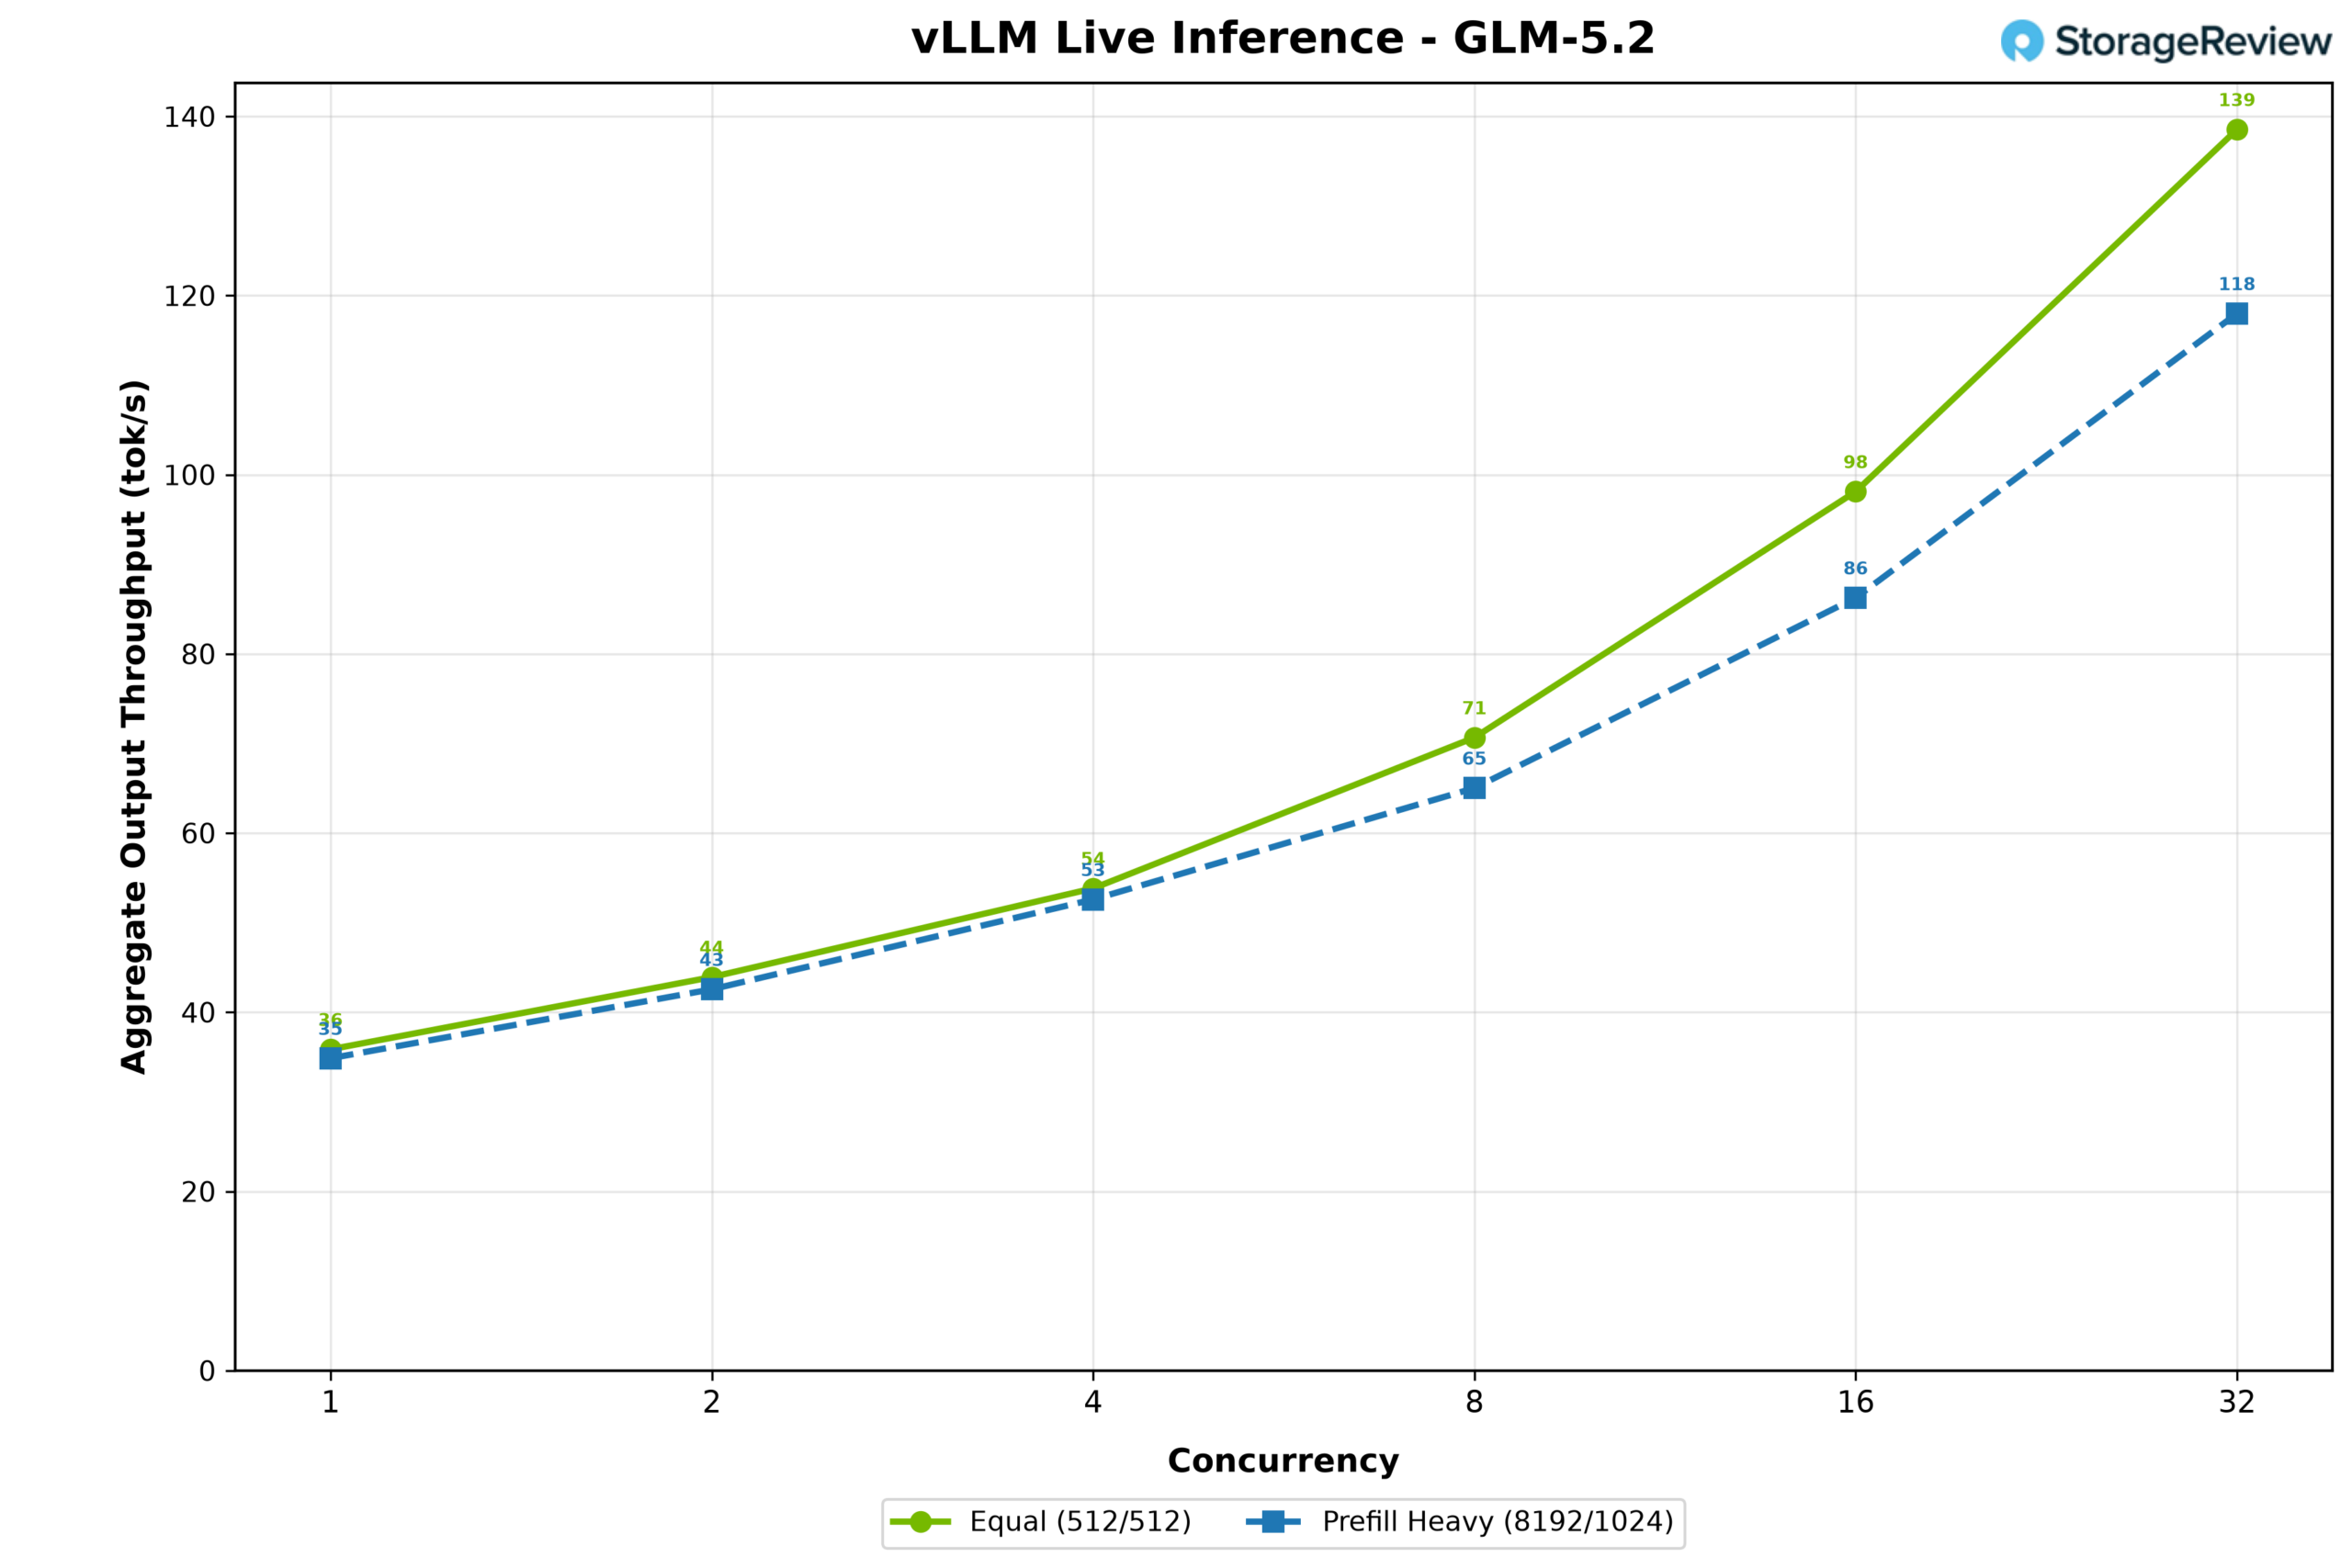
GLM-5.2 ကို NVIDIA ရဲ့ NVFP4 quant ကို အသုံးပြုပြီး စမ်းသပ်ခဲ့ပါတယ်။ သူ့ရဲ့ 433GB checkpoint မှာ HBM 218GB ကို အသုံးပြုခဲ့ပြီး expert weight 216GB ကို Grace memory ထဲကို offload လုပ်ခဲ့ပါတယ်။ MTP speculative decoding ကို token ၃ ခုရဲ့ synthetic acceptance length နဲ့ အသုံးပြုခဲ့ပါတယ်။ 512/512 workload မှာ output throughput ဟာ concurrency 1 မှာ တစ်စက္ကန့်ကို token ၃၆ ကနေ concurrency 32 မှာ ၁၃၉ အထိ မြင့်တက်လာခဲ့ပါတယ်။ 8,192/1,024 workload ဟာလည်း အနီးကပ်လိုက်လာပြီး တစ်စက္ကန့်ကို token ၃၅ ကနေ ၁၁၈ အထိ မြင့်တက်လာခဲ့ပါတယ်။ profile နှစ်ခုကြားက အလားတူရလဒ်တွေအရ generation ဟာ အဓိကအားဖြင့် offloaded experts တွေကို Grace memory နဲ့ GPU အကြား ရွှေ့ပြောင်းခြင်းအားဖြင့် အကန့်အသတ်ရှိနေကြောင်း ပြသနေပါတယ်။ နောက်ထပ် context အတွက် HBM မလုံလောက်တဲ့အတွက် sweep ဟာ concurrency 32 မှာ အဆုံးသတ်သွားခဲ့ပါတယ်။
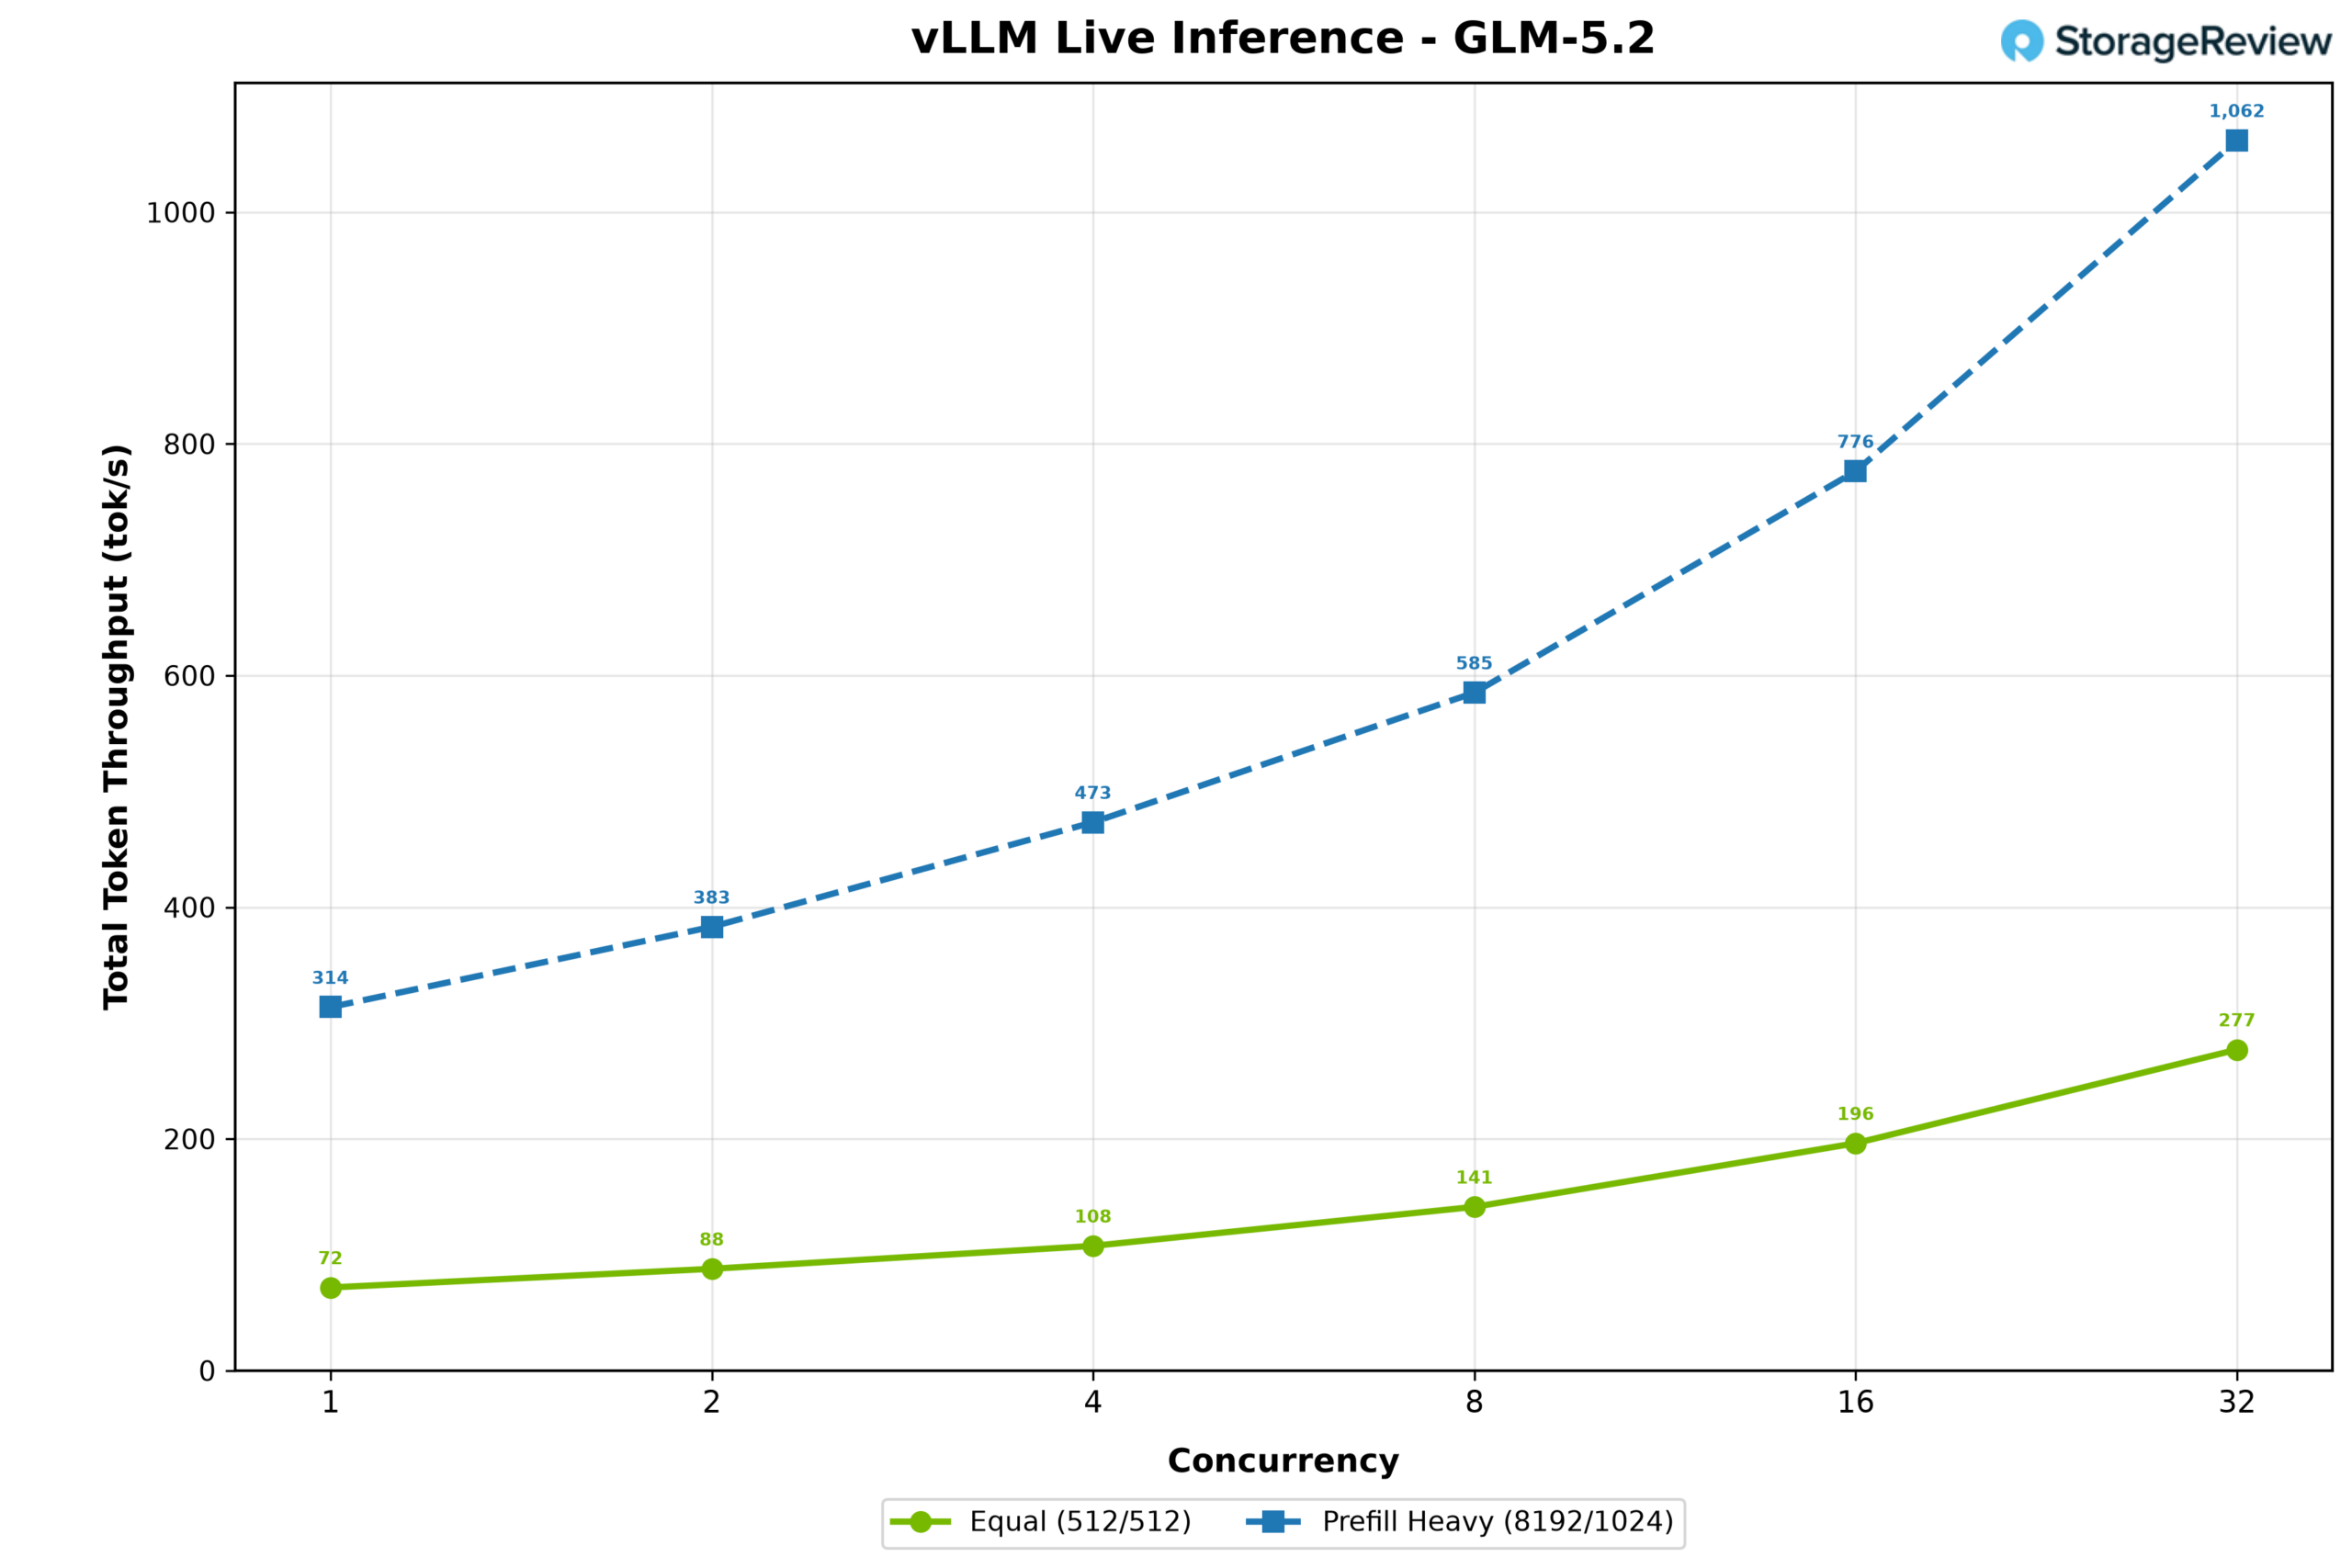
စုစုပေါင်း token throughput သည် တူညီသောပုံစံကို လိုက်နာခဲ့ပြီး 512/512 workload သည် တစ်စက္ကန့်လျှင် 72 မှ 277 tokens အထိ မြင့်တက်လာပြီး prefill-heavy workload သည် 314 မှ 1,062 အထိ မြင့်တက်လာခဲ့သည်။ ဤနေရာတွင် prefill tokens များသည် စုစုပေါင်းတွင် ရေတွက်သောကြောင့် ရှည်လျားသော prompts များသည် ပရိုဖိုင်နှစ်ခုကို နောက်ဆုံးတွင် ခွဲထုတ်လိုက်သည်။
နီမိုထရွန်-၃-အယ်လ်ထရာ ၅၅၀ဘီ (NVFP၄)
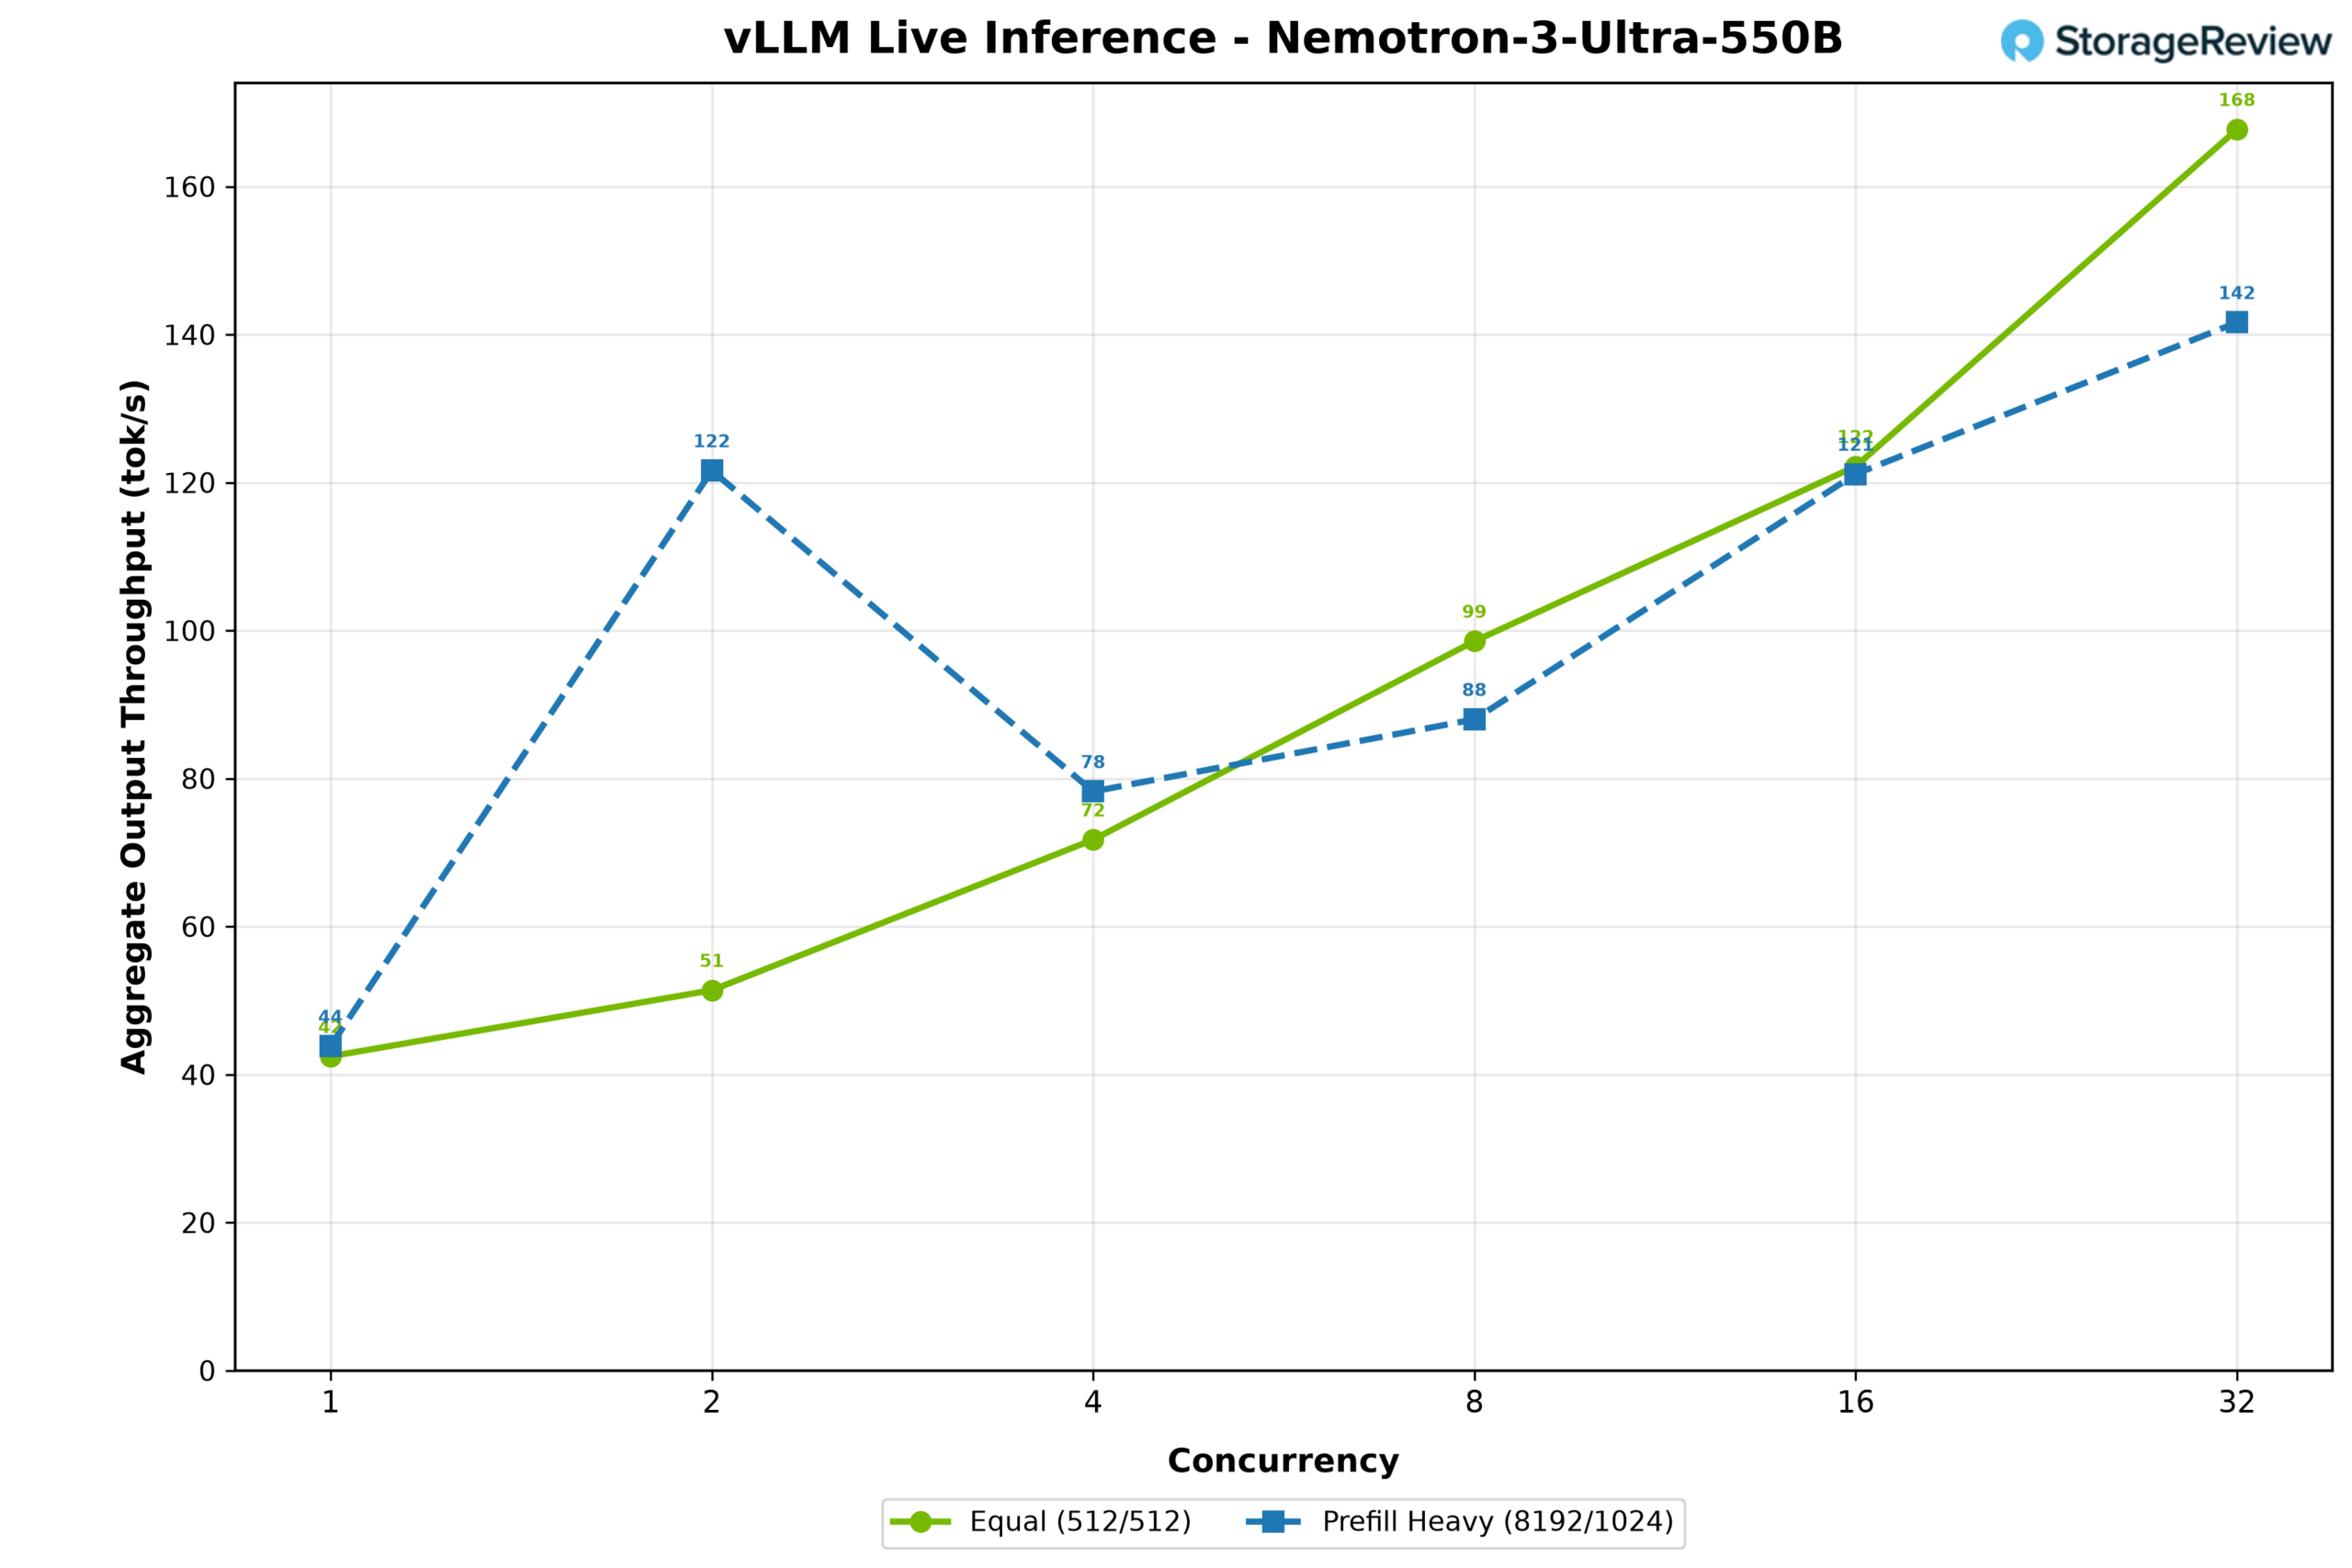
Nemotron-3-Ultra 550B သည် ကျွန်ုပ်တို့လုပ်ဆောင်ခဲ့သော အကြီးဆုံးမော်ဒယ်ဖြစ်ပြီး အပြည့်အဝ coherent pool ကို တိုက်ရိုက်အထိရောက်ဆုံး လုပ်ဆောင်ပေးသည့် မော်ဒယ်လည်းဖြစ်သည်။ ၎င်းသည် 307GB NVFP4 hybrid Transformer-Mamba မော်ဒယ်တစ်ခုဖြစ်ပြီး HBM တစ်ခုတည်းအတွက် အလွန်ကြီးမားလွန်းပြီး ၎င်း၏ weight 114GB ကို Grace memory သို့ offload လုပ်ထားသည်။ MTP speculative decoding ကို 5 tokens ၏ synthetic acceptance length ဖြင့် အသုံးပြုခဲ့သည်။ 512/512 workload ရှိ output throughput သည် concurrency 1 တွင် တစ်စက္ကန့်လျှင် 43 tokens မှစတင်ခဲ့ပြီး concurrency 32 တွင် 168 အထိ မြင့်တက်ခဲ့သည်။ prefill-heavy workload သည် ပို၍စိတ်ဝင်စားဖွယ်ကောင်းသော ဇာတ်လမ်းတစ်ပုဒ်ကို ပြောပြသည်- concurrency 1 တွင် တစ်စက္ကန့်လျှင် 44 tokens မှ concurrency 2 တွင် အမြင့်ဆုံး 122 အထိ မြင့်တက်လာခဲ့သော်လည်း concurrency 4 တွင် 78 သို့ ပြန်လည်ကျဆင်းသွားခဲ့သည်။ GLM-5.2 မှာလိုပဲ ပရိုဖိုင်နှစ်ခုဟာ တစ်ခုနဲ့တစ်ခု အနီးကပ် ခြေရာခံနေပြီး compute ထက် Grace နဲ့ GPU အကြား expert migration ကို ကန့်သတ်အချက်အဖြစ် ညွှန်ပြနေပါတယ်။ အကြောင်းရင်းတူကြောင့်ပဲ concurrency 32 မှာ sweep ပြီးဆုံးသွားခဲ့ပါတယ်။ နောက်ထပ် context အတွက် HBM မလုံလောက်ခဲ့ပါဘူး။
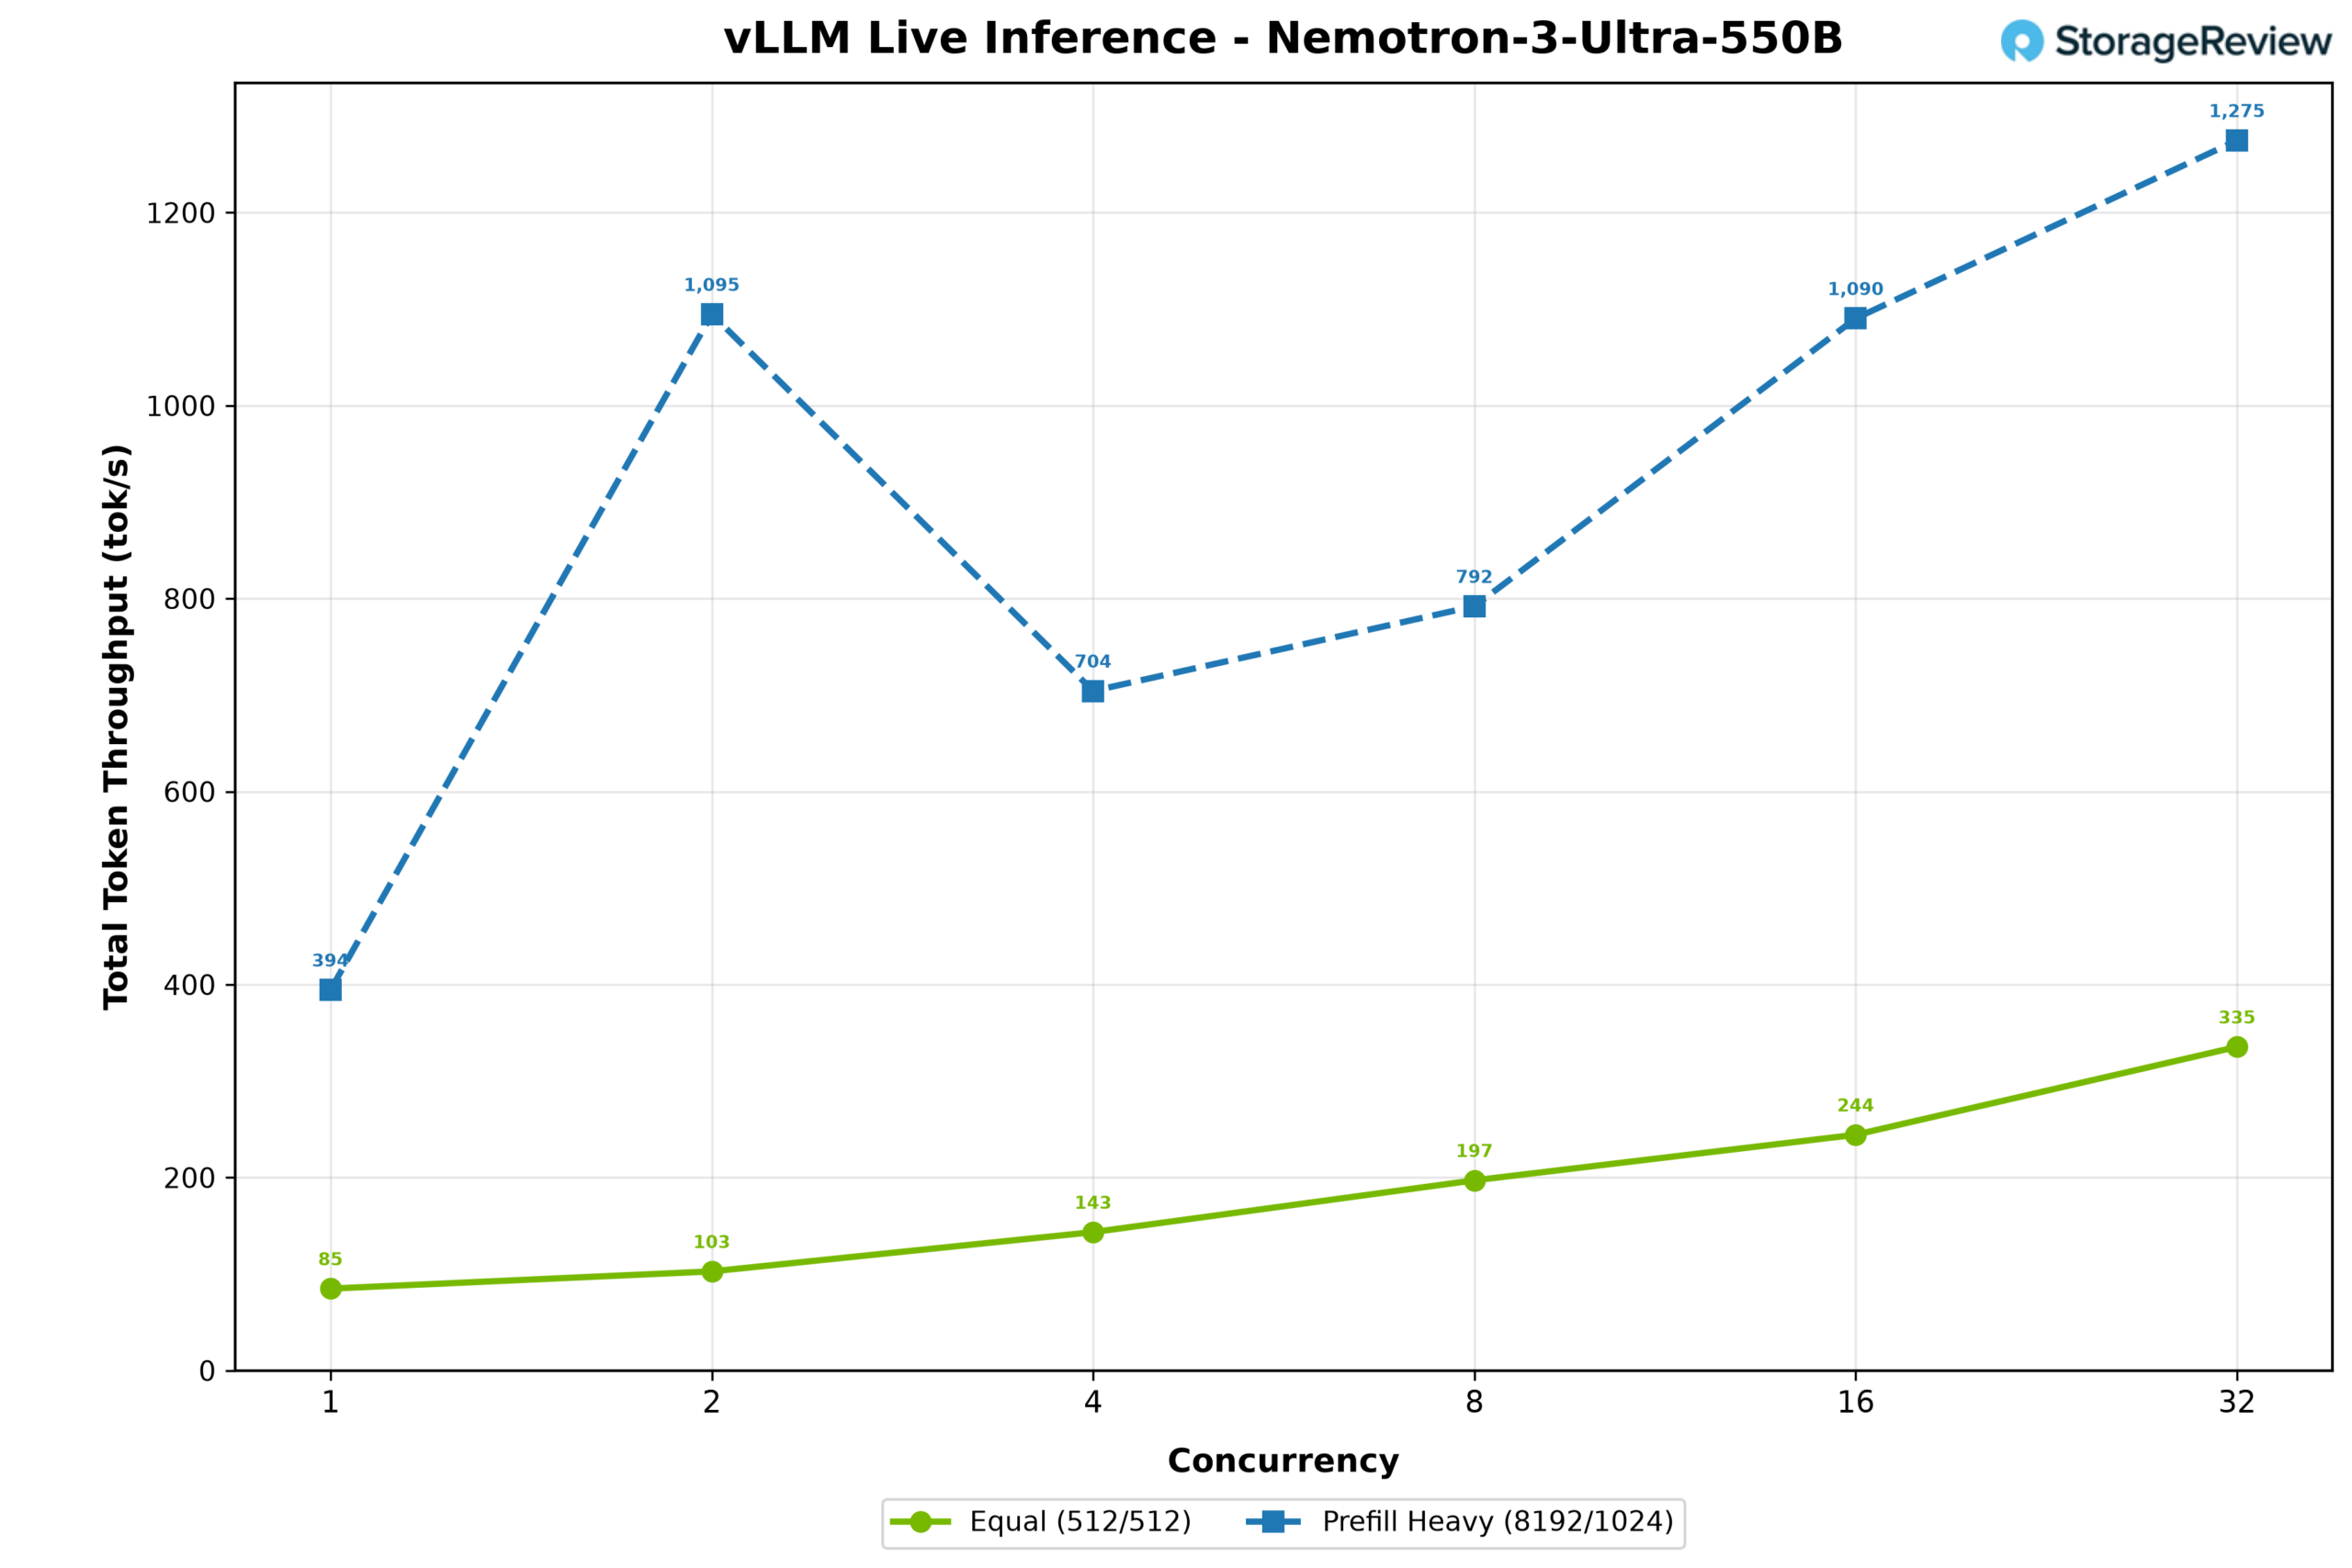
စုစုပေါင်း token throughput သည် နောက်မှလိုက်လာပြီး prefill-heavy workload သည် concurrency 2 တွင် တစ်စက္ကန့်လျှင် 2,506 tokens ဖြင့် အမြင့်ဆုံးရောက်ရှိခဲ့ပြီး concurrency 4 တွင် 2,169 သို့ ကျဆင်းသွားခဲ့ပြီး 512/512 workload သည် တစ်စက္ကန့်လျှင် 85 မှ 336 tokens အထိ တိုးမြှင့်ခဲ့သည်။
WS300 vs. Blackwell RTX PRO 6000 vs. DGX Spark
ကျွန်ုပ်တို့၏ ကောက်ချက်စမ်းသပ်မှု၏ ဤထက်ဝက်သည် WS300 ကို Blackwell ကို စားပွဲပေါ်တွင် သို့မဟုတ် စားပွဲအနီးတွင် ထားရှိရန် အခြားနည်းလမ်းနှစ်ခုနှင့် ယှဉ်ပြိုင်စေသည်- ကျွန်ုပ်တို့ အစောပိုင်းက သုံးသပ်ခဲ့သော Dell Pro Max Tower T2 တွင် တပ်ဆင်ထားသော Blackwell RTX PRO 6000၊ NVIDIA ၏ 600W workstation ကတ်နှင့် Acer Veriton GN100 မှ ဤနေရာတွင် ကိုယ်စားပြုထားသော GB10 အခြေခံ DGX Spark ။ စနစ်တစ်ခုစီသည် တူညီသော vLLM live inference workloads များကို အခြေအနေနှစ်ခုအောက်တွင် လုပ်ဆောင်ခဲ့သည်။ ၎င်းမှာ input ၅၁၂ ခုနှင့် output token ၅၁၂ ခုပါသော တူညီသော workload တစ်ခုနှင့် input ၈,၁၉၂ ခုနှင့် output token ၁,၀၂၄ ခုပါသော prefill heavy workload တစ်ခုတို့ကို ၁ မှ ၁၂၈ အထိ concurrency level များဖြင့် လုပ်ဆောင်ခဲ့သည်။ စနစ်သုံးခုစလုံးသည် တူညီသောဝန်ဆောင်မှုပေးနိုင်သည့် မော်ဒယ်တိုင်းအတွက် စုစုပေါင်း output နှင့် စုစုပေါင်း throughput ကို ကျွန်ုပ်တို့ဇယားဆွဲခဲ့သည်- ၎င်းတို့၏ native MXFP4 တွင် GPT-OSS-20B နှင့် GPT-OSS-120B၊ BF16၊ FP8 နှင့် NVFP4 တွင် Llama 3.1 8B နှင့် BF16 နှင့် FP8 တွင် Mistral Small 24B နှင့် Qwen3 Coder 30B တို့ဖြစ်သည်။
GPT-OSS-20B
GPT-OSS-20B သည် အစုံထဲတွင် အဖော်ရွေဆုံးစမ်းသပ်မှုဖြစ်ပြီး စနစ်သုံးခုလုံးတွင် အလွယ်တကူကိုက်ညီသော checkpoint တစ်ခုဖြစ်သည်။ တူညီသော workload ဖြင့် WS300 သည် တစ်ပြိုင်နက်တည်း stream ၁၂၈ ခုတွင် တစ်စက္ကန့်လျှင် output token ၂၂,၁၆၁ ခုအထိ ရှင်းလင်းစွာ ချိန်ညှိနိုင်ခဲ့ပြီး RTX PRO 6000 တွင် ၉,၀၀၀ ထက် ၂.၅ ဆခန့်နှင့် DGX Spark တွင် ၁၄၆၉ ထက် ၁၅ ဆခန့်ရှိသည်။ Single-stream ရလဒ်များသည် အသေးစားဇာတ်လမ်းကို ပြောပြသည်- Station တွင် တစ်စက္ကန့်လျှင် token ၅၃၀၊ ကတ်တွင် ၂၄၄ နှင့် Spark တွင် ၅၀။
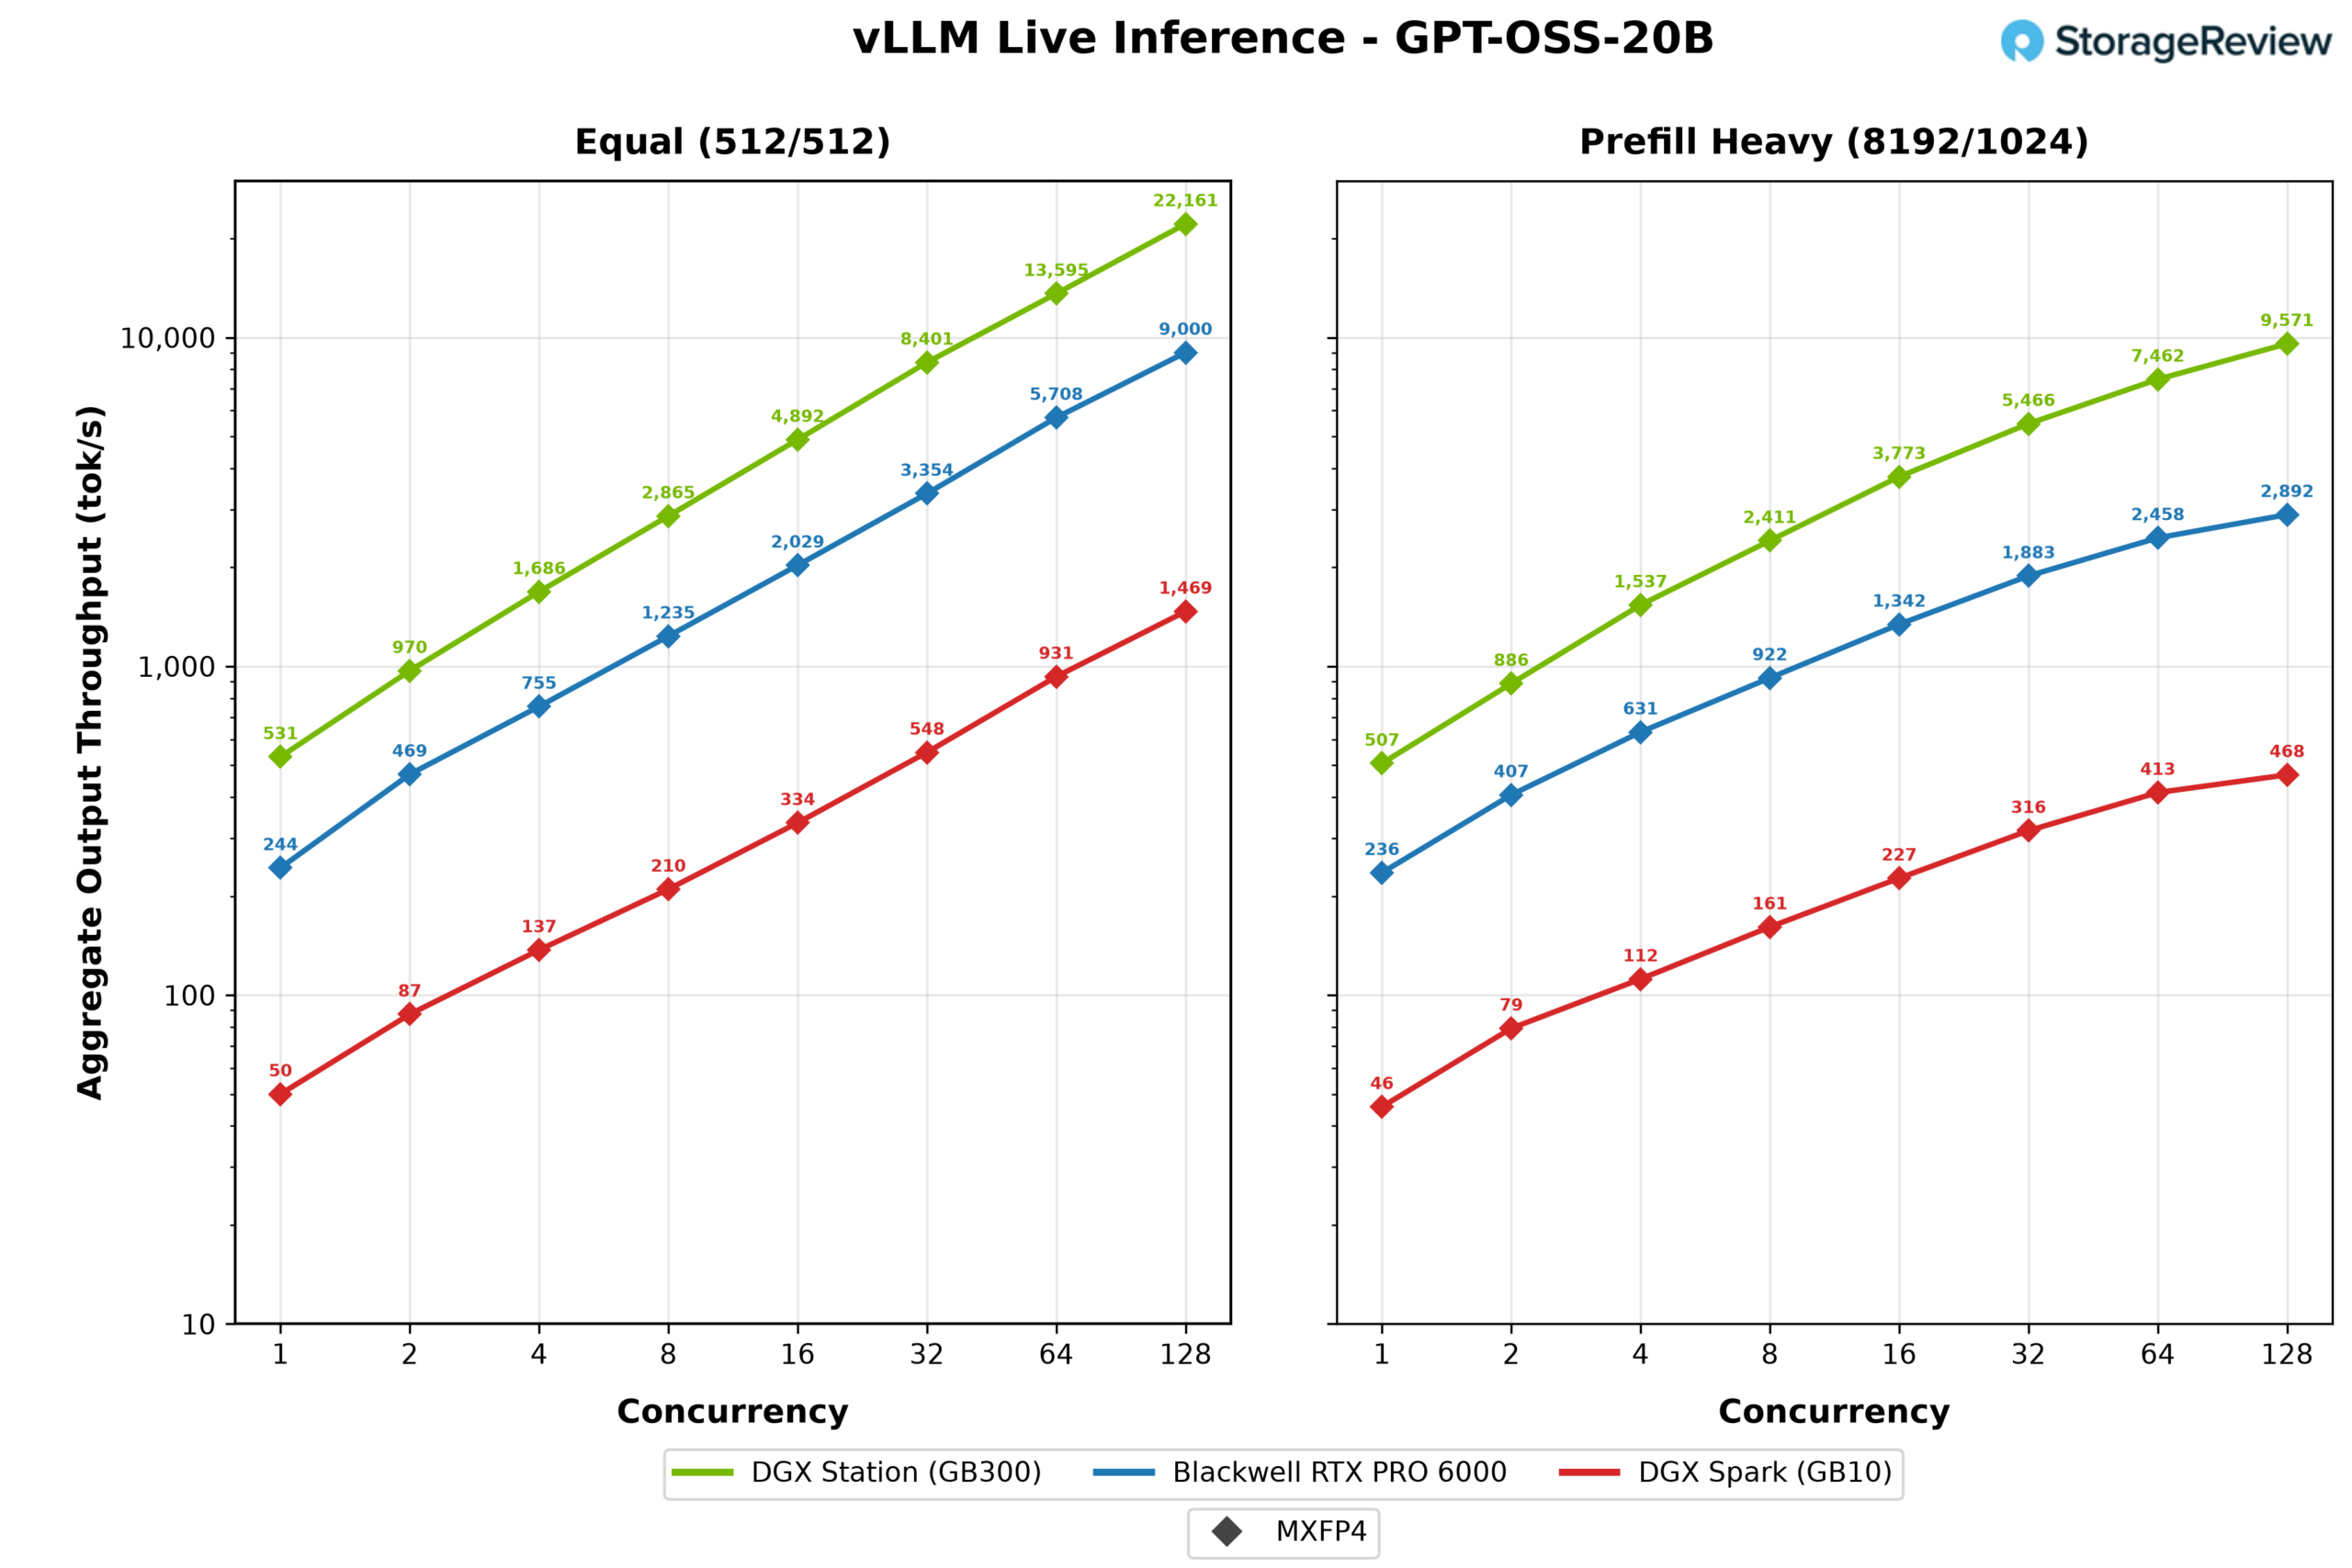
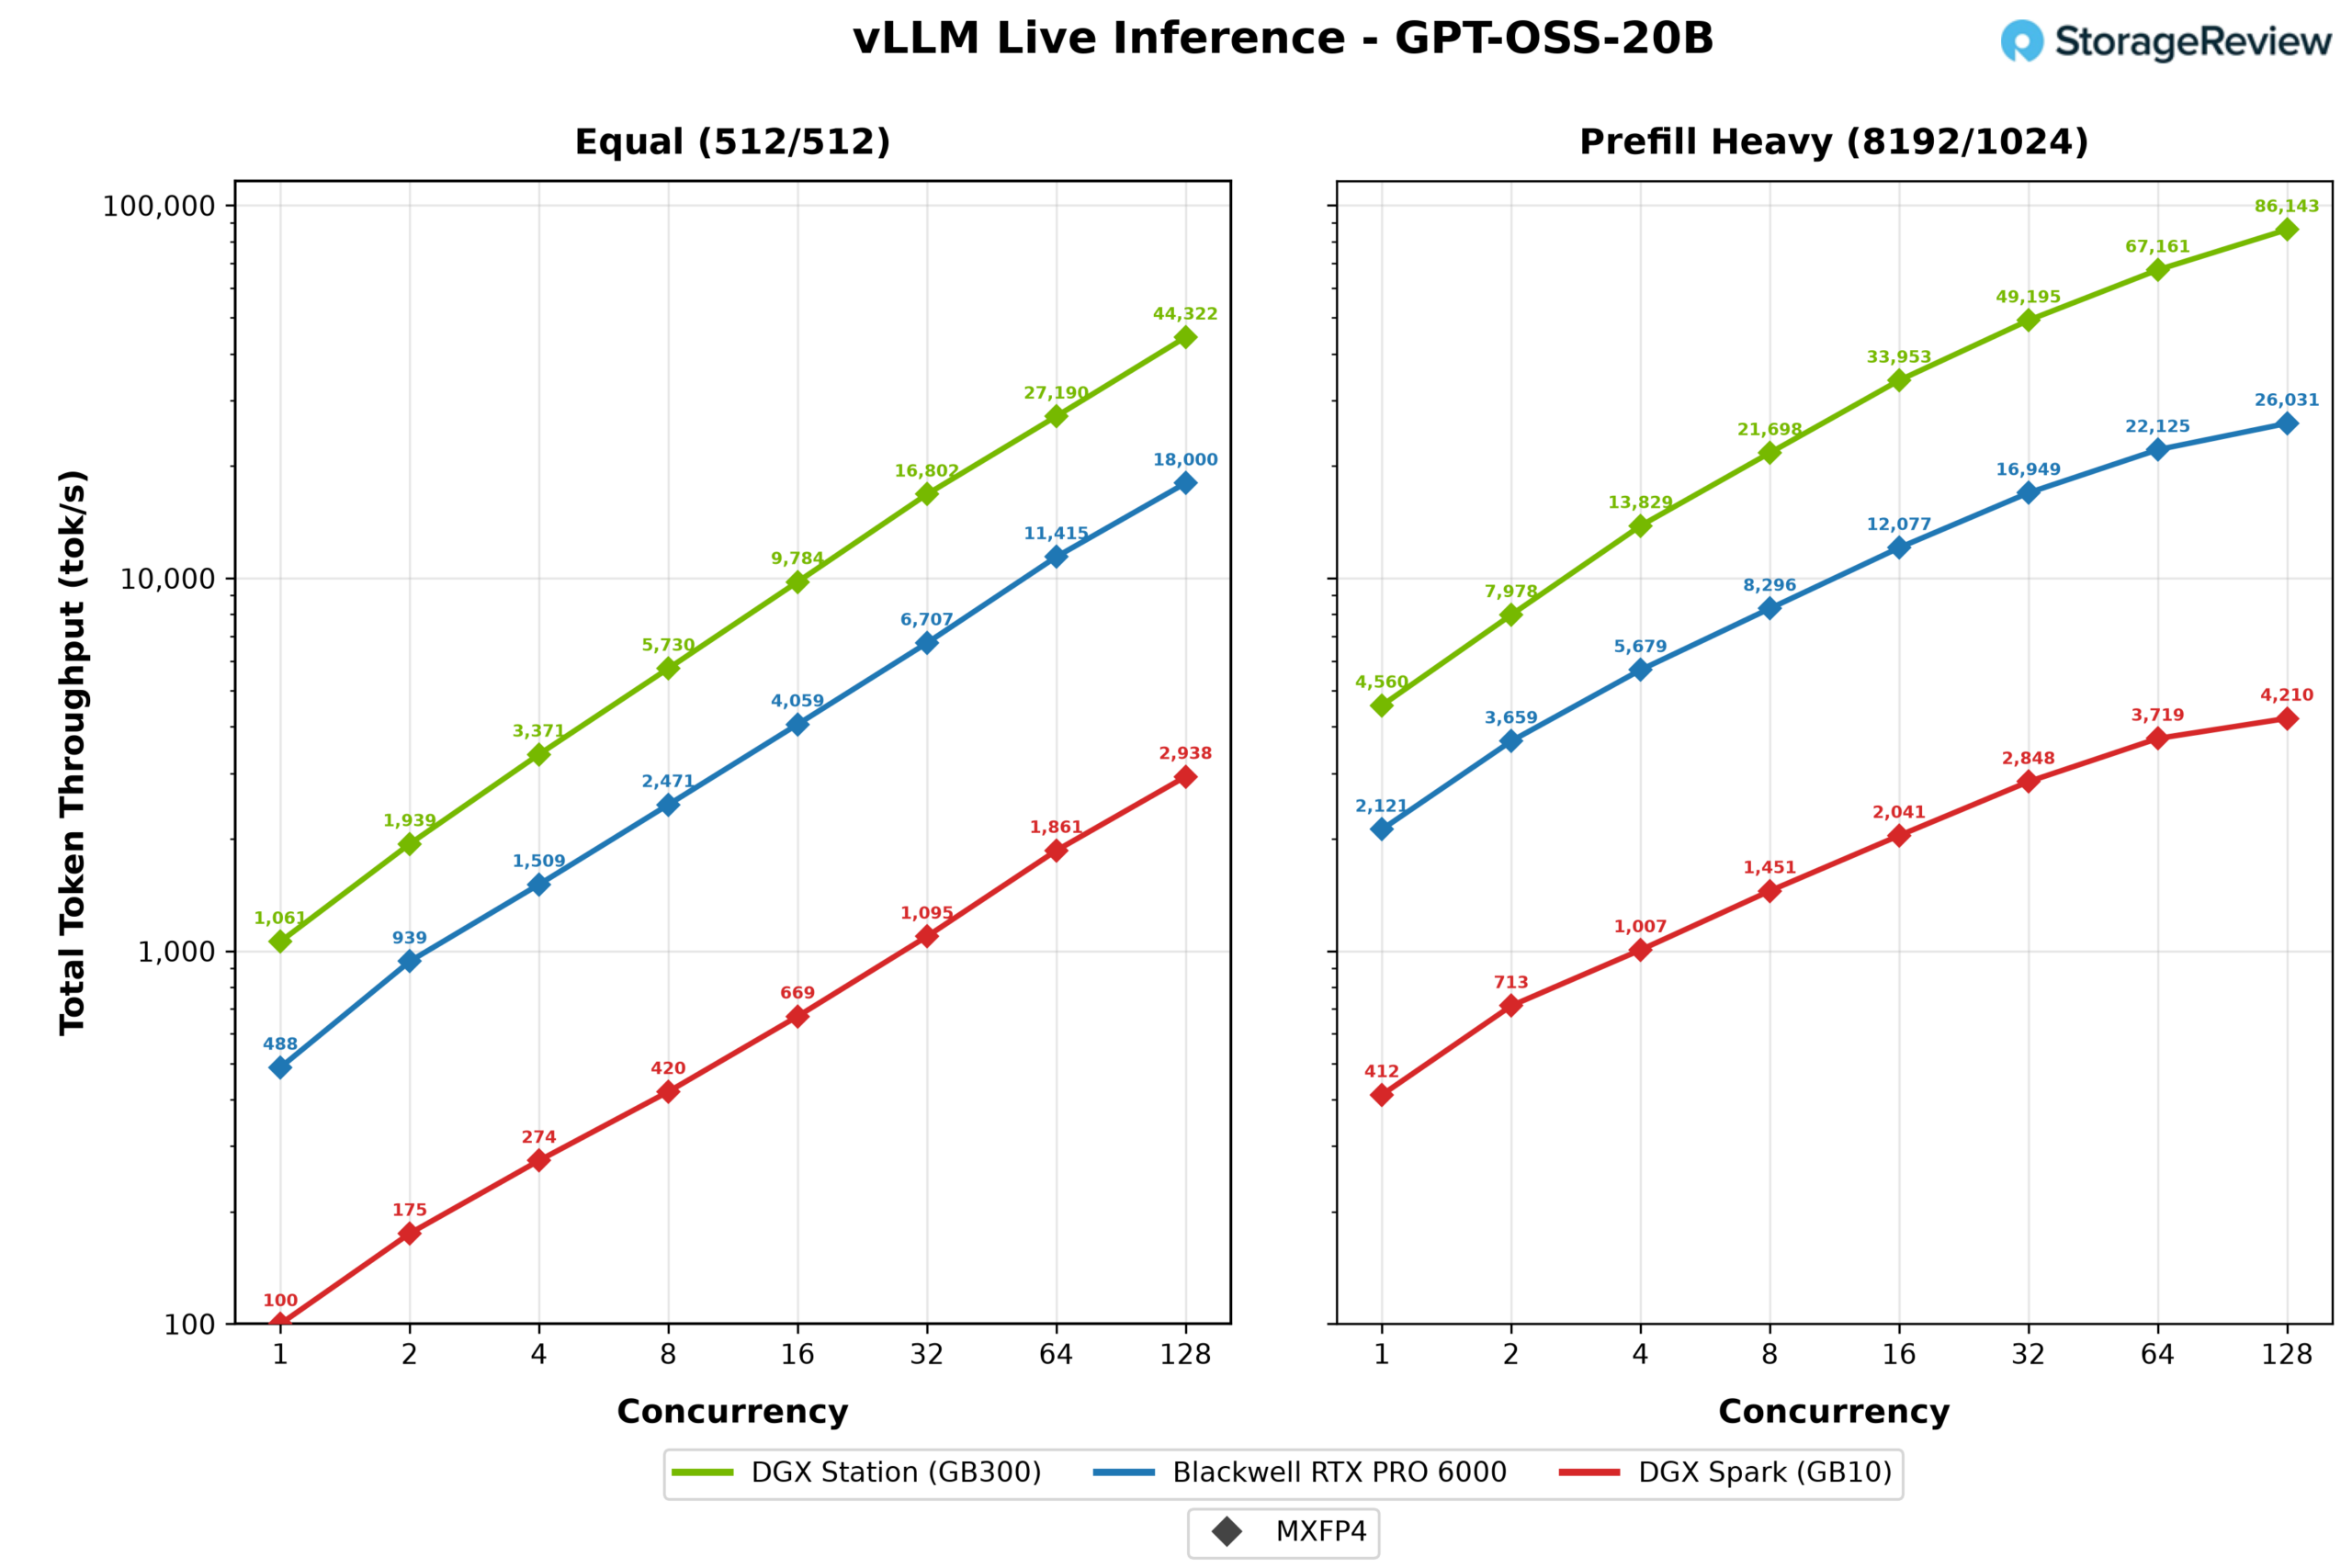
prefill များတဲ့ အခြေအနေက ဒီနယ်ပယ်ကို ပိုပြီး ခွဲခြားပေးပါတယ်။ token prompts ၈,၁၉၂ ခုကို တွန်းအားပေးခြင်းအားဖြင့် WS300 ဟာ အမြင့်ဆုံးအချိန်မှာ တစ်စက္ကန့်ကို output token ၉,၅၇၂ ခု ပေးပို့နေဆဲဖြစ်ပြီး prefill ကို ရေတွက်ပြီးတာနဲ့ တစ်စက္ကန့်ကို token စုစုပေါင်း ၈၆,၀၀၀ ကျော် ပေးပို့နိုင်ခဲ့ပါတယ်။ RTX PRO 6000 က ၂,၈၉၂ နဲ့ Spark က ၄၆၈ မှာ အမြင့်ဆုံး ရရှိခဲ့ပါတယ်။
GPT-OSS-120B
GPT-OSS-120B အထိ တက်လာရင်တော့ စနစ်သုံးခုစလုံးက မော်ဒယ်ကို load လုပ်နိုင်သေးပေမယ့် memory hierarchy က အရေးပါလာပါတယ်။ WS300 ဟာ တူညီတဲ့ workload အောက်မှာ တစ်စက္ကန့်ကို output token ၉,၂၉၄ အထိ ရောက်ရှိခဲ့ပြီး RTX PRO 6000 ထက် ၂.၇ ဆ ပိုများပြီး 500 မှာတော့ DGX Spark ထက် ၁၉ ဆ နီးပါး ပိုများပါတယ်။
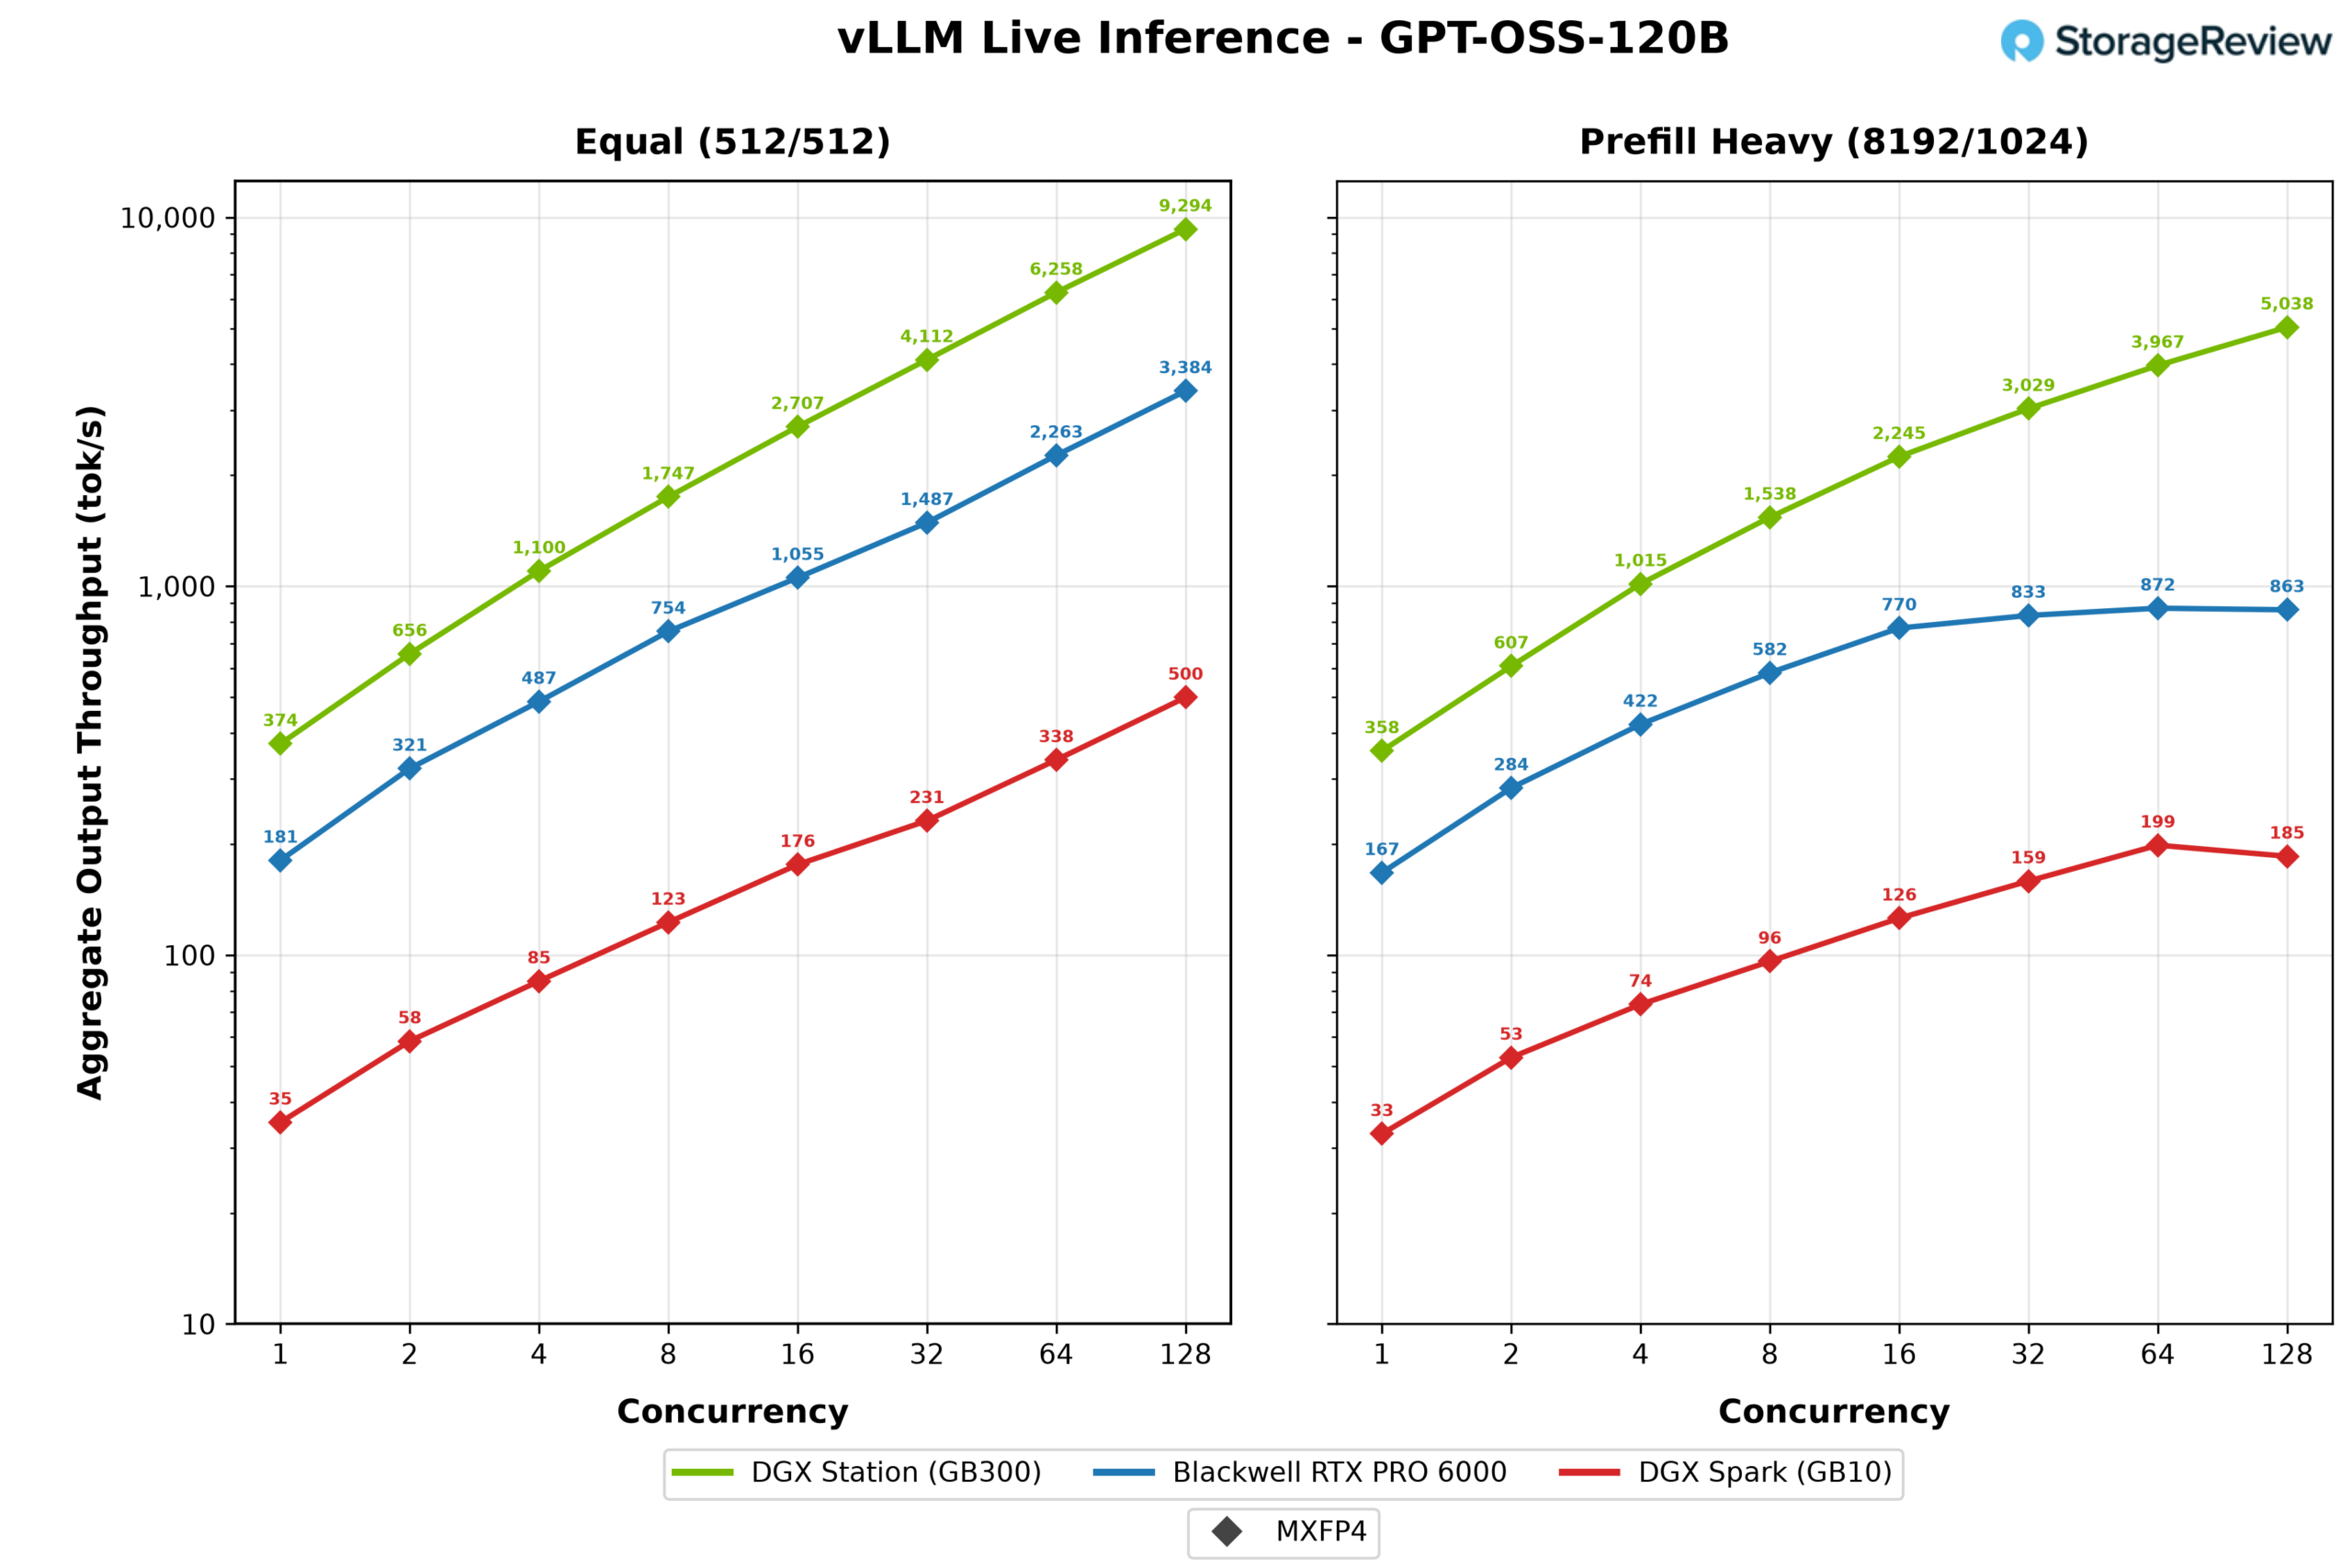
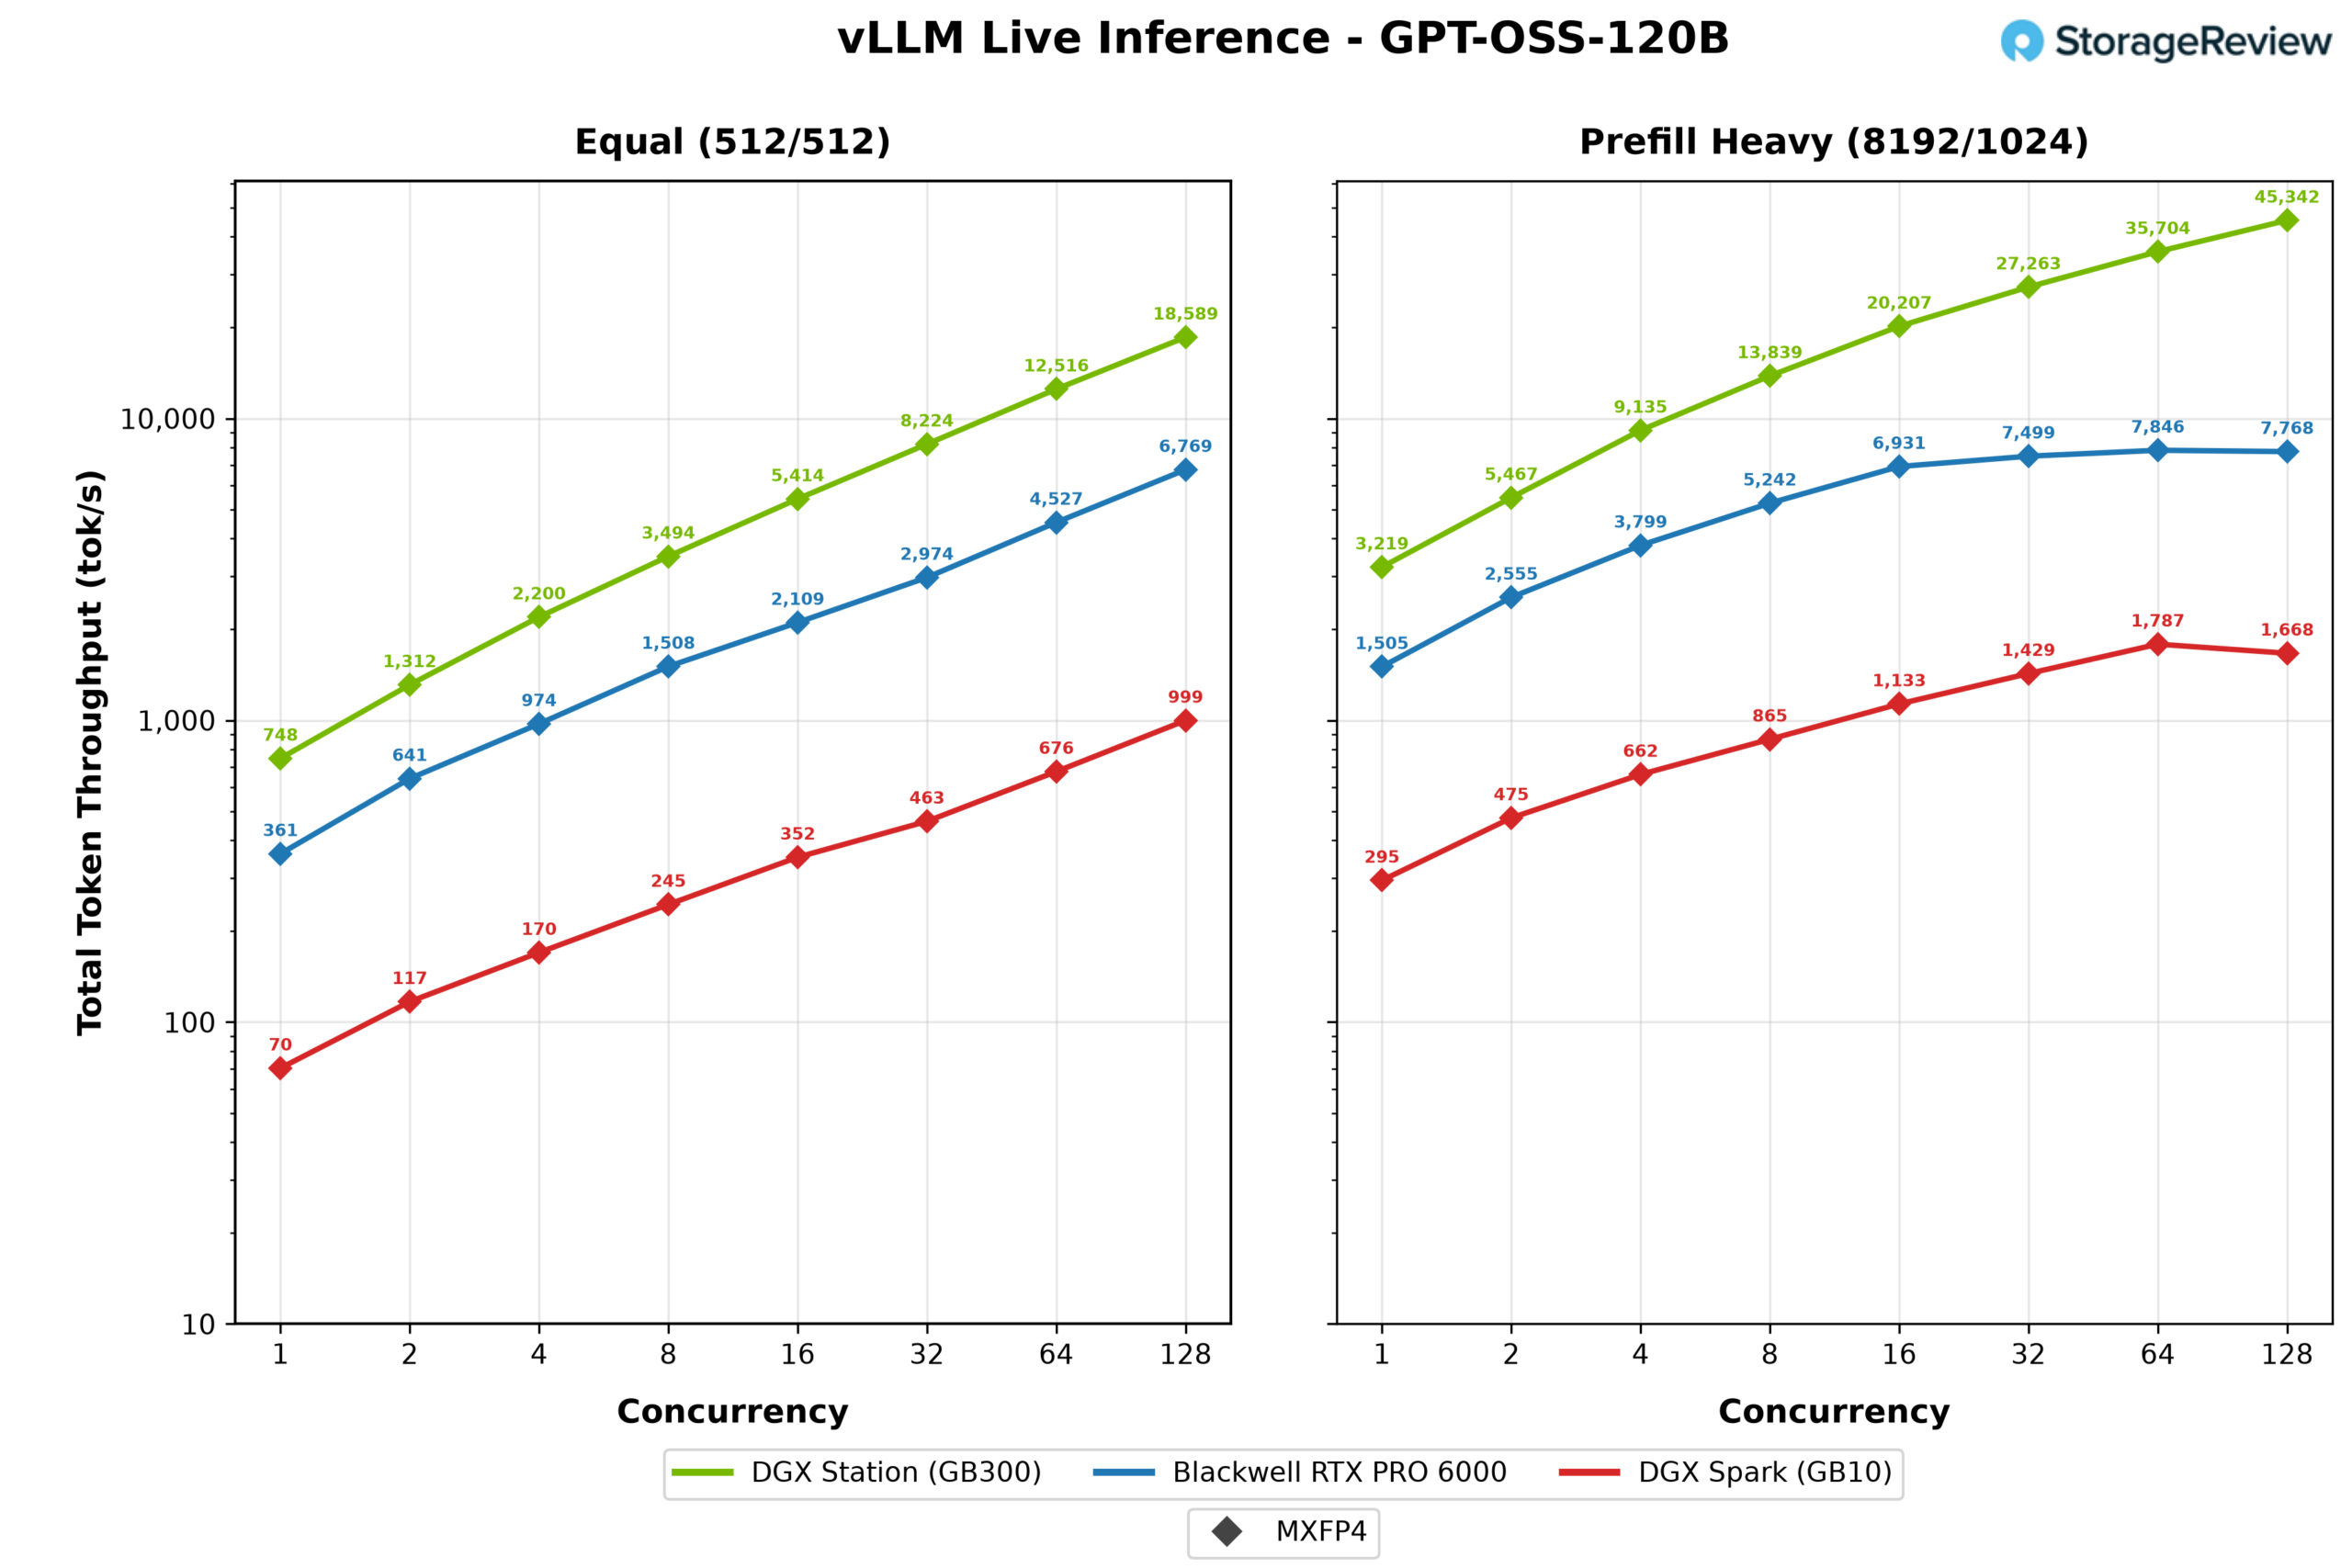
prefill heavy run ကတော့ စနစ်ငယ်လေးတွေရဲ့ အမြင့်ဆုံးအဆင့်ကို ရောက်ရှိသွားတဲ့အချိန်ပါပဲ။ RTX PRO 6000 က တစ်စက္ကန့်ကို output token ၈၇၂ ခုနဲ့ concurrent stream ၆၄ ခုနဲ့ ပြားချပ်နေပြီး Spark က ၁၉၉ ခုနဲ့ အဆုံးသတ်သွားပေမယ့် WS300 ကတော့ stream ၁၂၈ ခုနဲ့ မြင့်တက်နေဆဲဖြစ်ပြီး ၅၀၃၈ ခုနဲ့ အဆုံးသတ်သွားတာကြောင့် ကတ်ထက် ၆ ဆနီးပါး ကွာဟချက်ရှိပါတယ်။ ရှည်လျားတဲ့ prompts တွေက KV cache ကို ကြီးမားစေပြီး memory headroom နည်းတဲ့ စနစ်တွေက Station မတိုင်ခင် batch လုပ်ဖို့ နေရာလွတ်တွေ ကုန်ဆုံးသွားပါတယ်။
Llama 3.1 8B
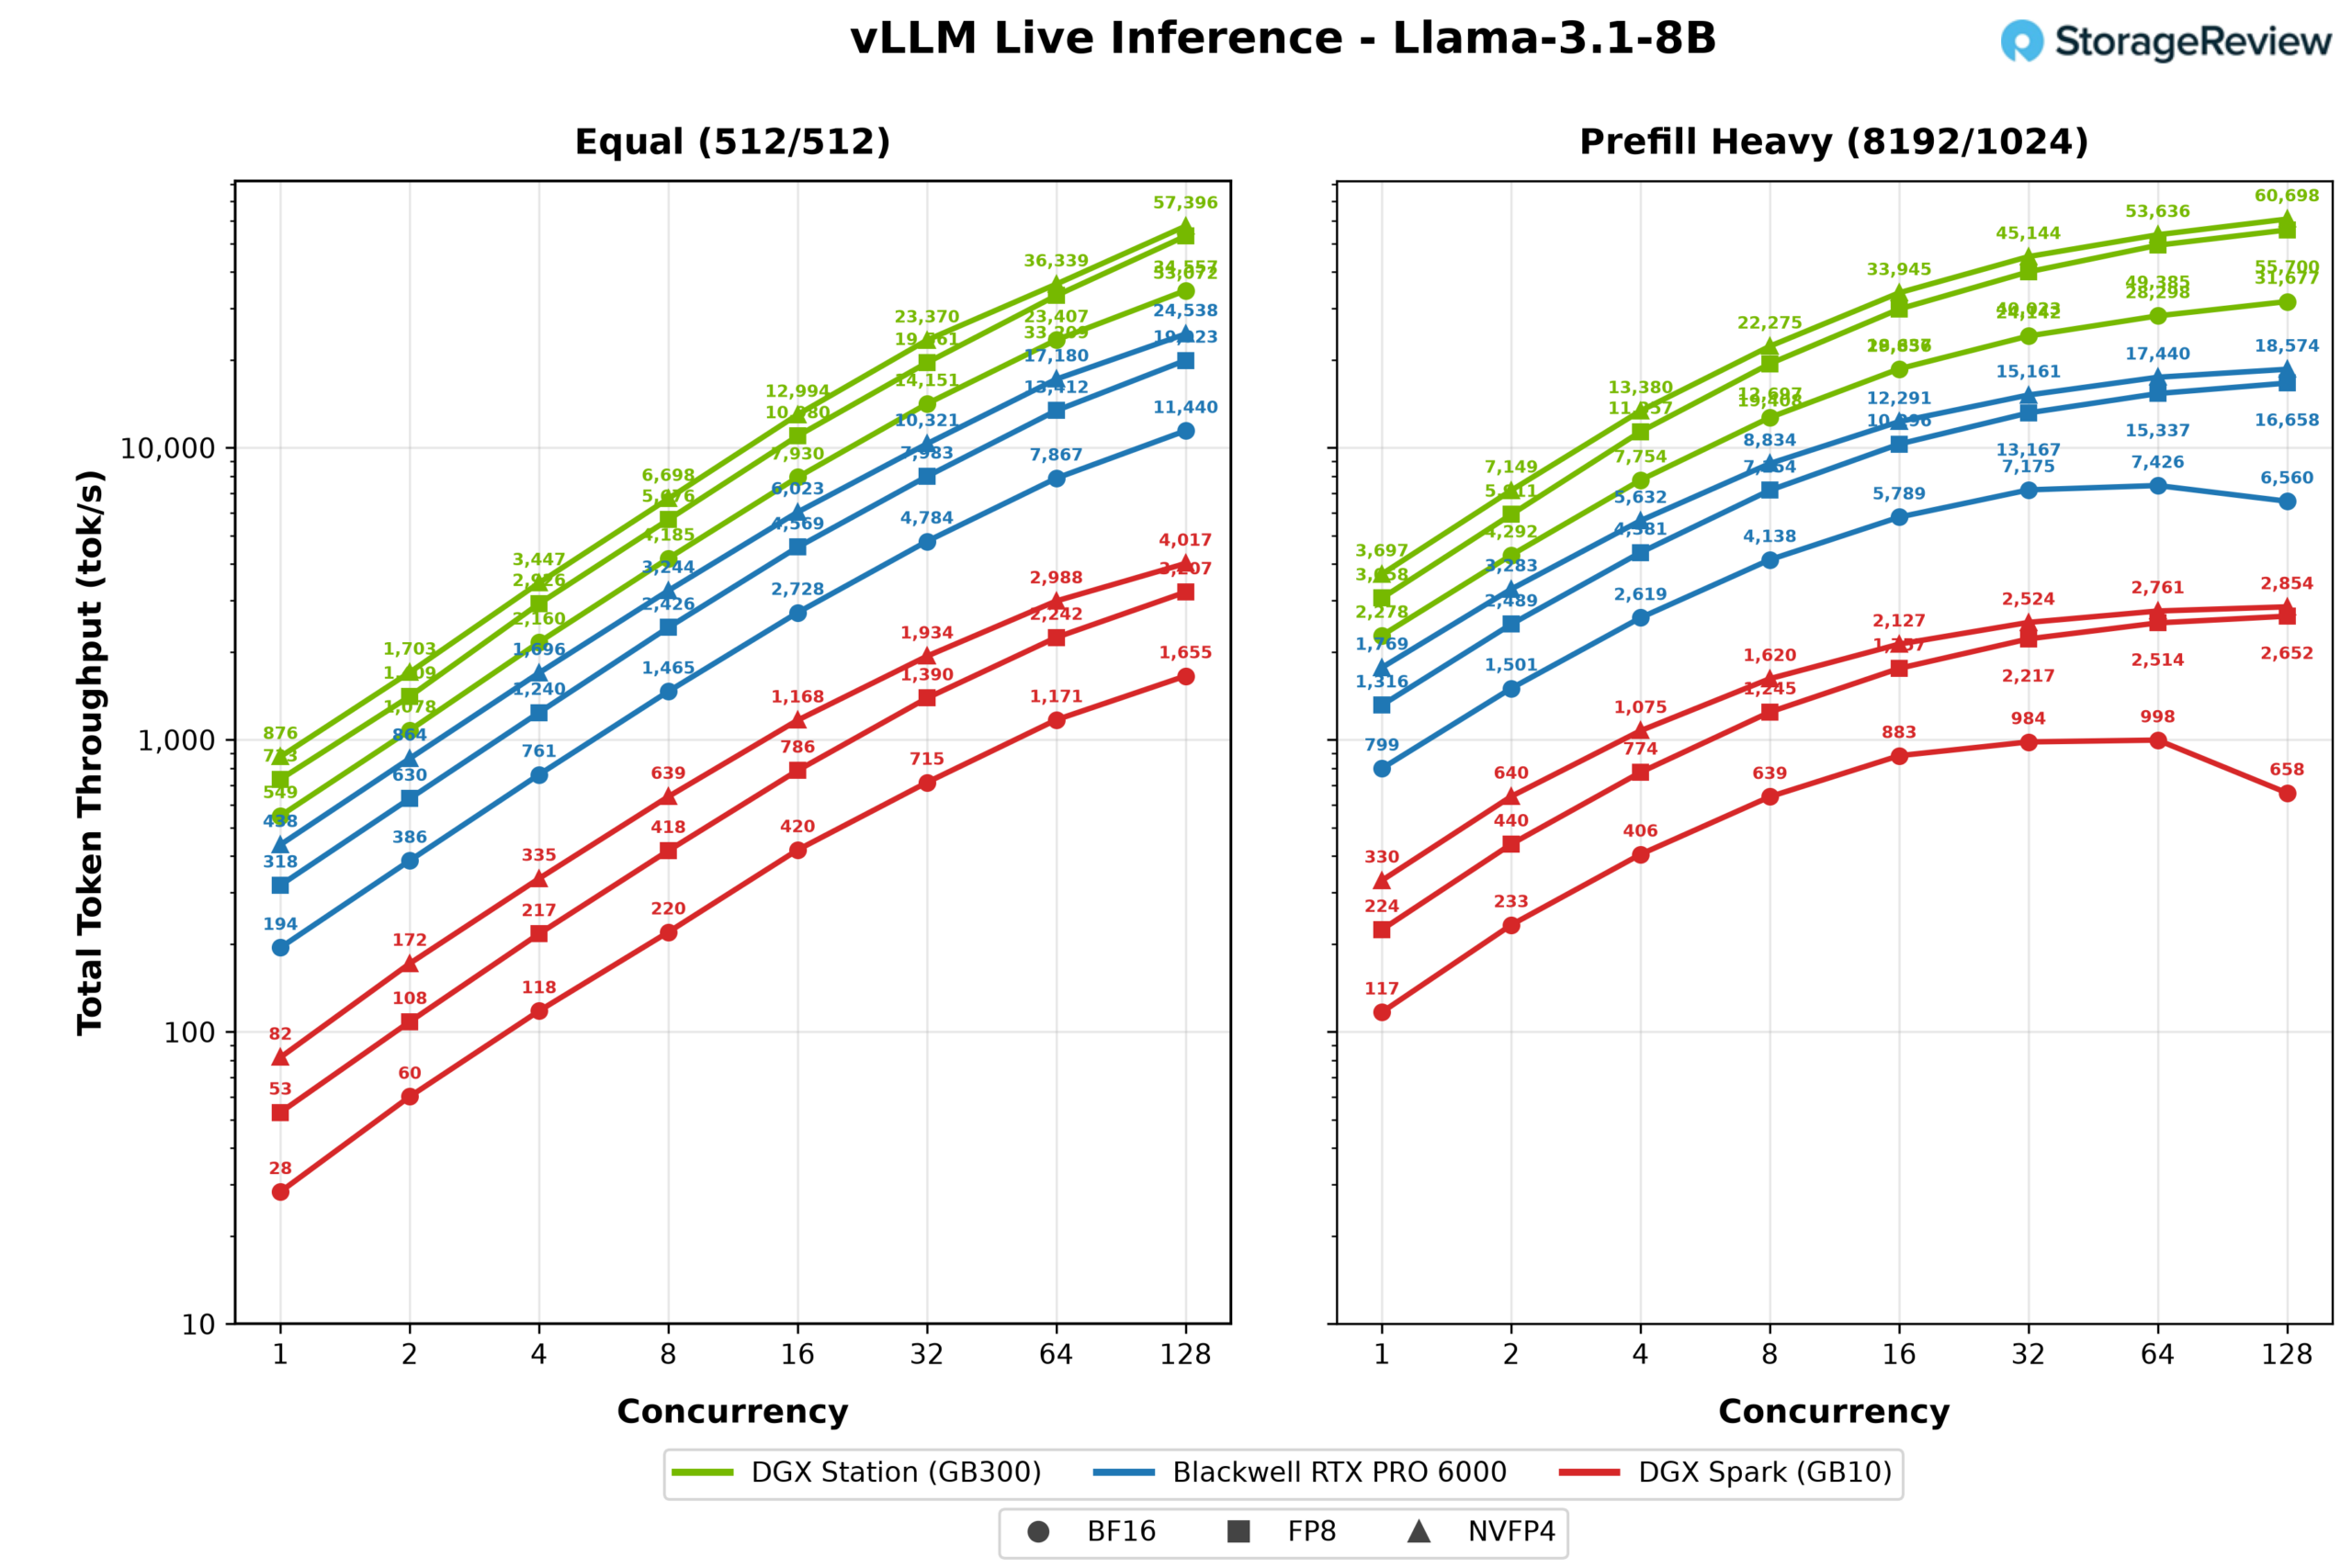
Llama 3.1 8B ဟာ စနစ်တိုင်းမှာ BF16၊ FP8 နဲ့ NVFP4 မှာ လည်ပတ်နိုင်လောက်အောင် သေးငယ်တာကြောင့် စက်တစ်ခုချင်းစီမှာ quantization က ဘာတွေကို ပေးစွမ်းနိုင်လဲဆိုတာကို အရှင်းလင်းဆုံး ကြည့်ရှုနိုင်ပါတယ်။ တူညီတဲ့ workload အောက်မှာ concurrent stream ၁၂၈ ခုမှာ WS300 ဟာ BF16 မှာ တစ်စက္ကန့်ကို output token ၁၇,၂၇၈ ခုကနေ NVFP4 မှာ ၂၈,၆၉၈ ခုအထိ တိုးတက်လာပြီး ၆၆ ရာခိုင်နှုန်း တိုးတက်လာခဲ့ပါတယ်။ RTX PRO 6000 ဟာ တူညီတဲ့ ရွေ့လျားမှုကနေ ၁၁၄ ရာခိုင်နှုန်း တိုးတက်လာခဲ့ပြီး ၅,၇၂၀ ကနေ ၁၂,၂၆၉ အထိ မြင့်တက်လာခဲ့ပြီး DGX Spark ကတော့ ၈၂၈ ကနေ ၂,၀၀၉ အထိ ၁၄၃ ရာခိုင်နှုန်း မြင့်တက်လာခဲ့ပါတယ်။ ဒီပုံစံကို မှတ်မိထားသင့်ပါတယ်- စက်က သေးငယ်လေ quantization က အကျိုးအမြတ်ပိုများလေပါပဲ။
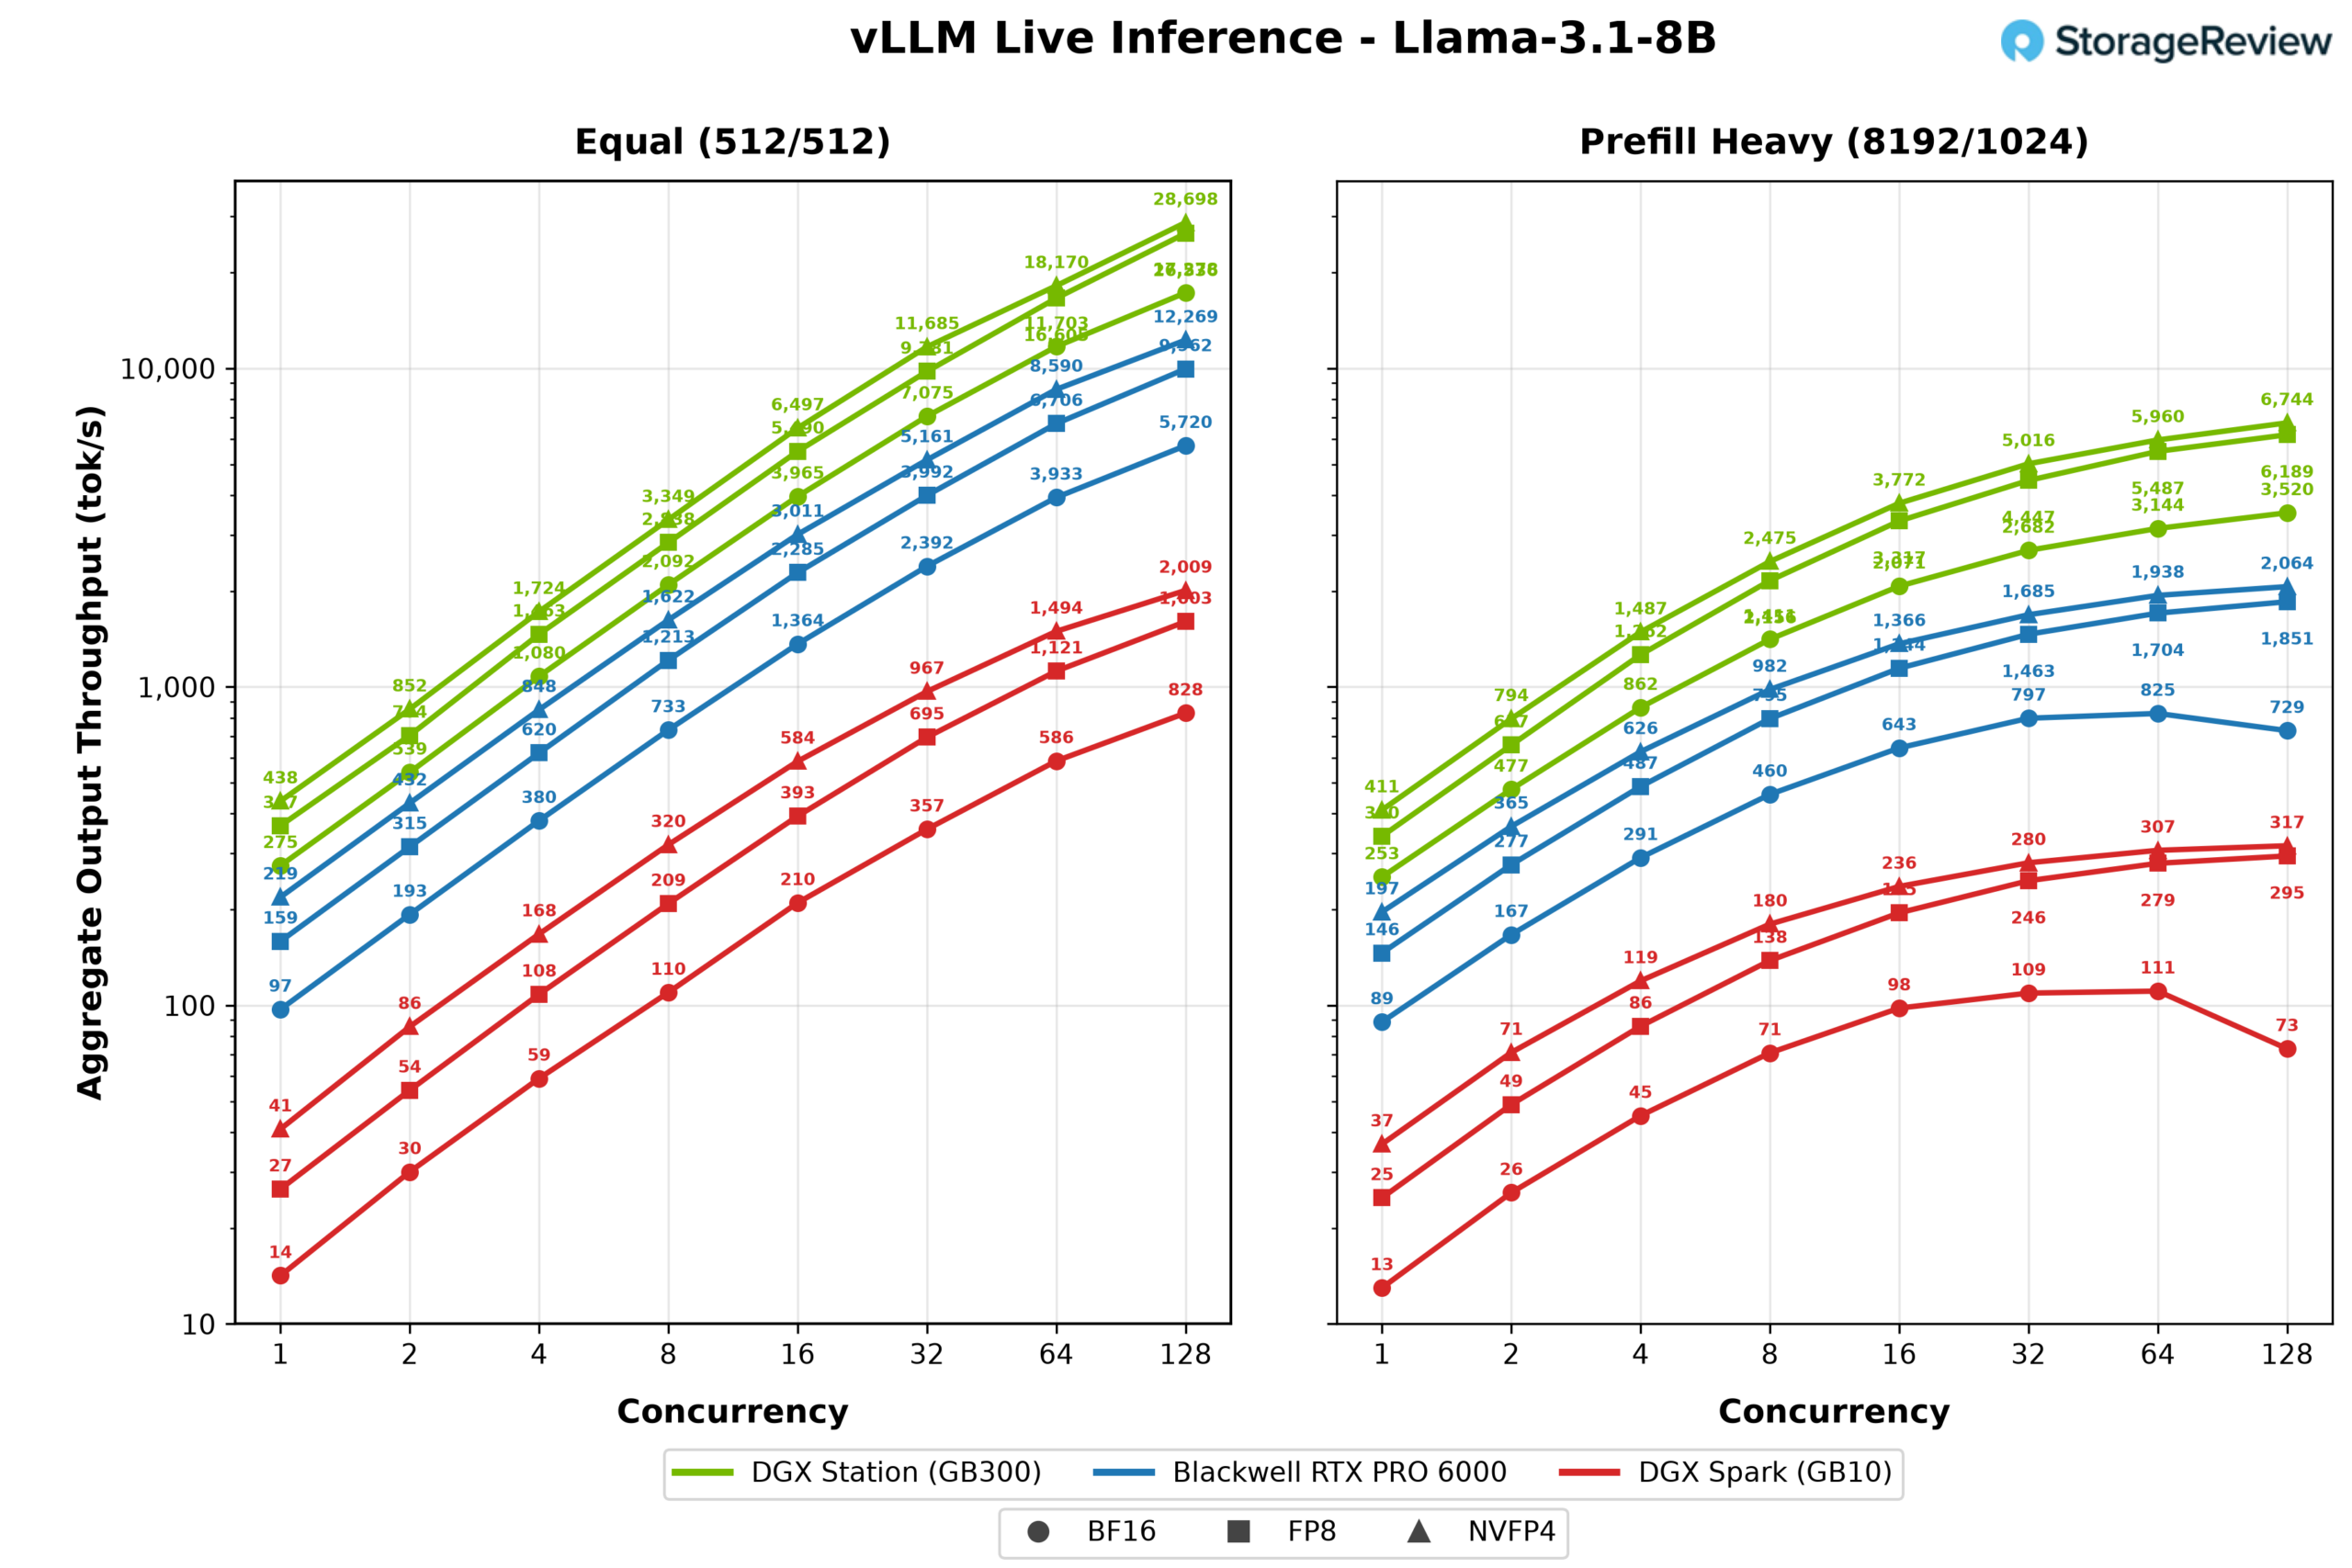
ကြိုတင်ဖြည့်သွင်းထားသော လေးလံသောရလဒ်များသည် လယ်ကွင်းတစ်ခုလုံးကို ဖိသိပ်ပေးပြီး WS300 ၏ NVFP4 လည်ပတ်မှုသည် တစ်စက္ကန့်လျှင် အထွက်တိုကင် ၆,၇၄၄ ခုဖြင့် အမြင့်ဆုံးရောက်ရှိခဲ့ပြီး ကတ်အတွက် ၂,၀၆၄ ခုနှင့် Spark အတွက် ၃၁၇ ခု ရှိသည်။
မစ်စထရယ် အသေးစား ၂၄ဘီ
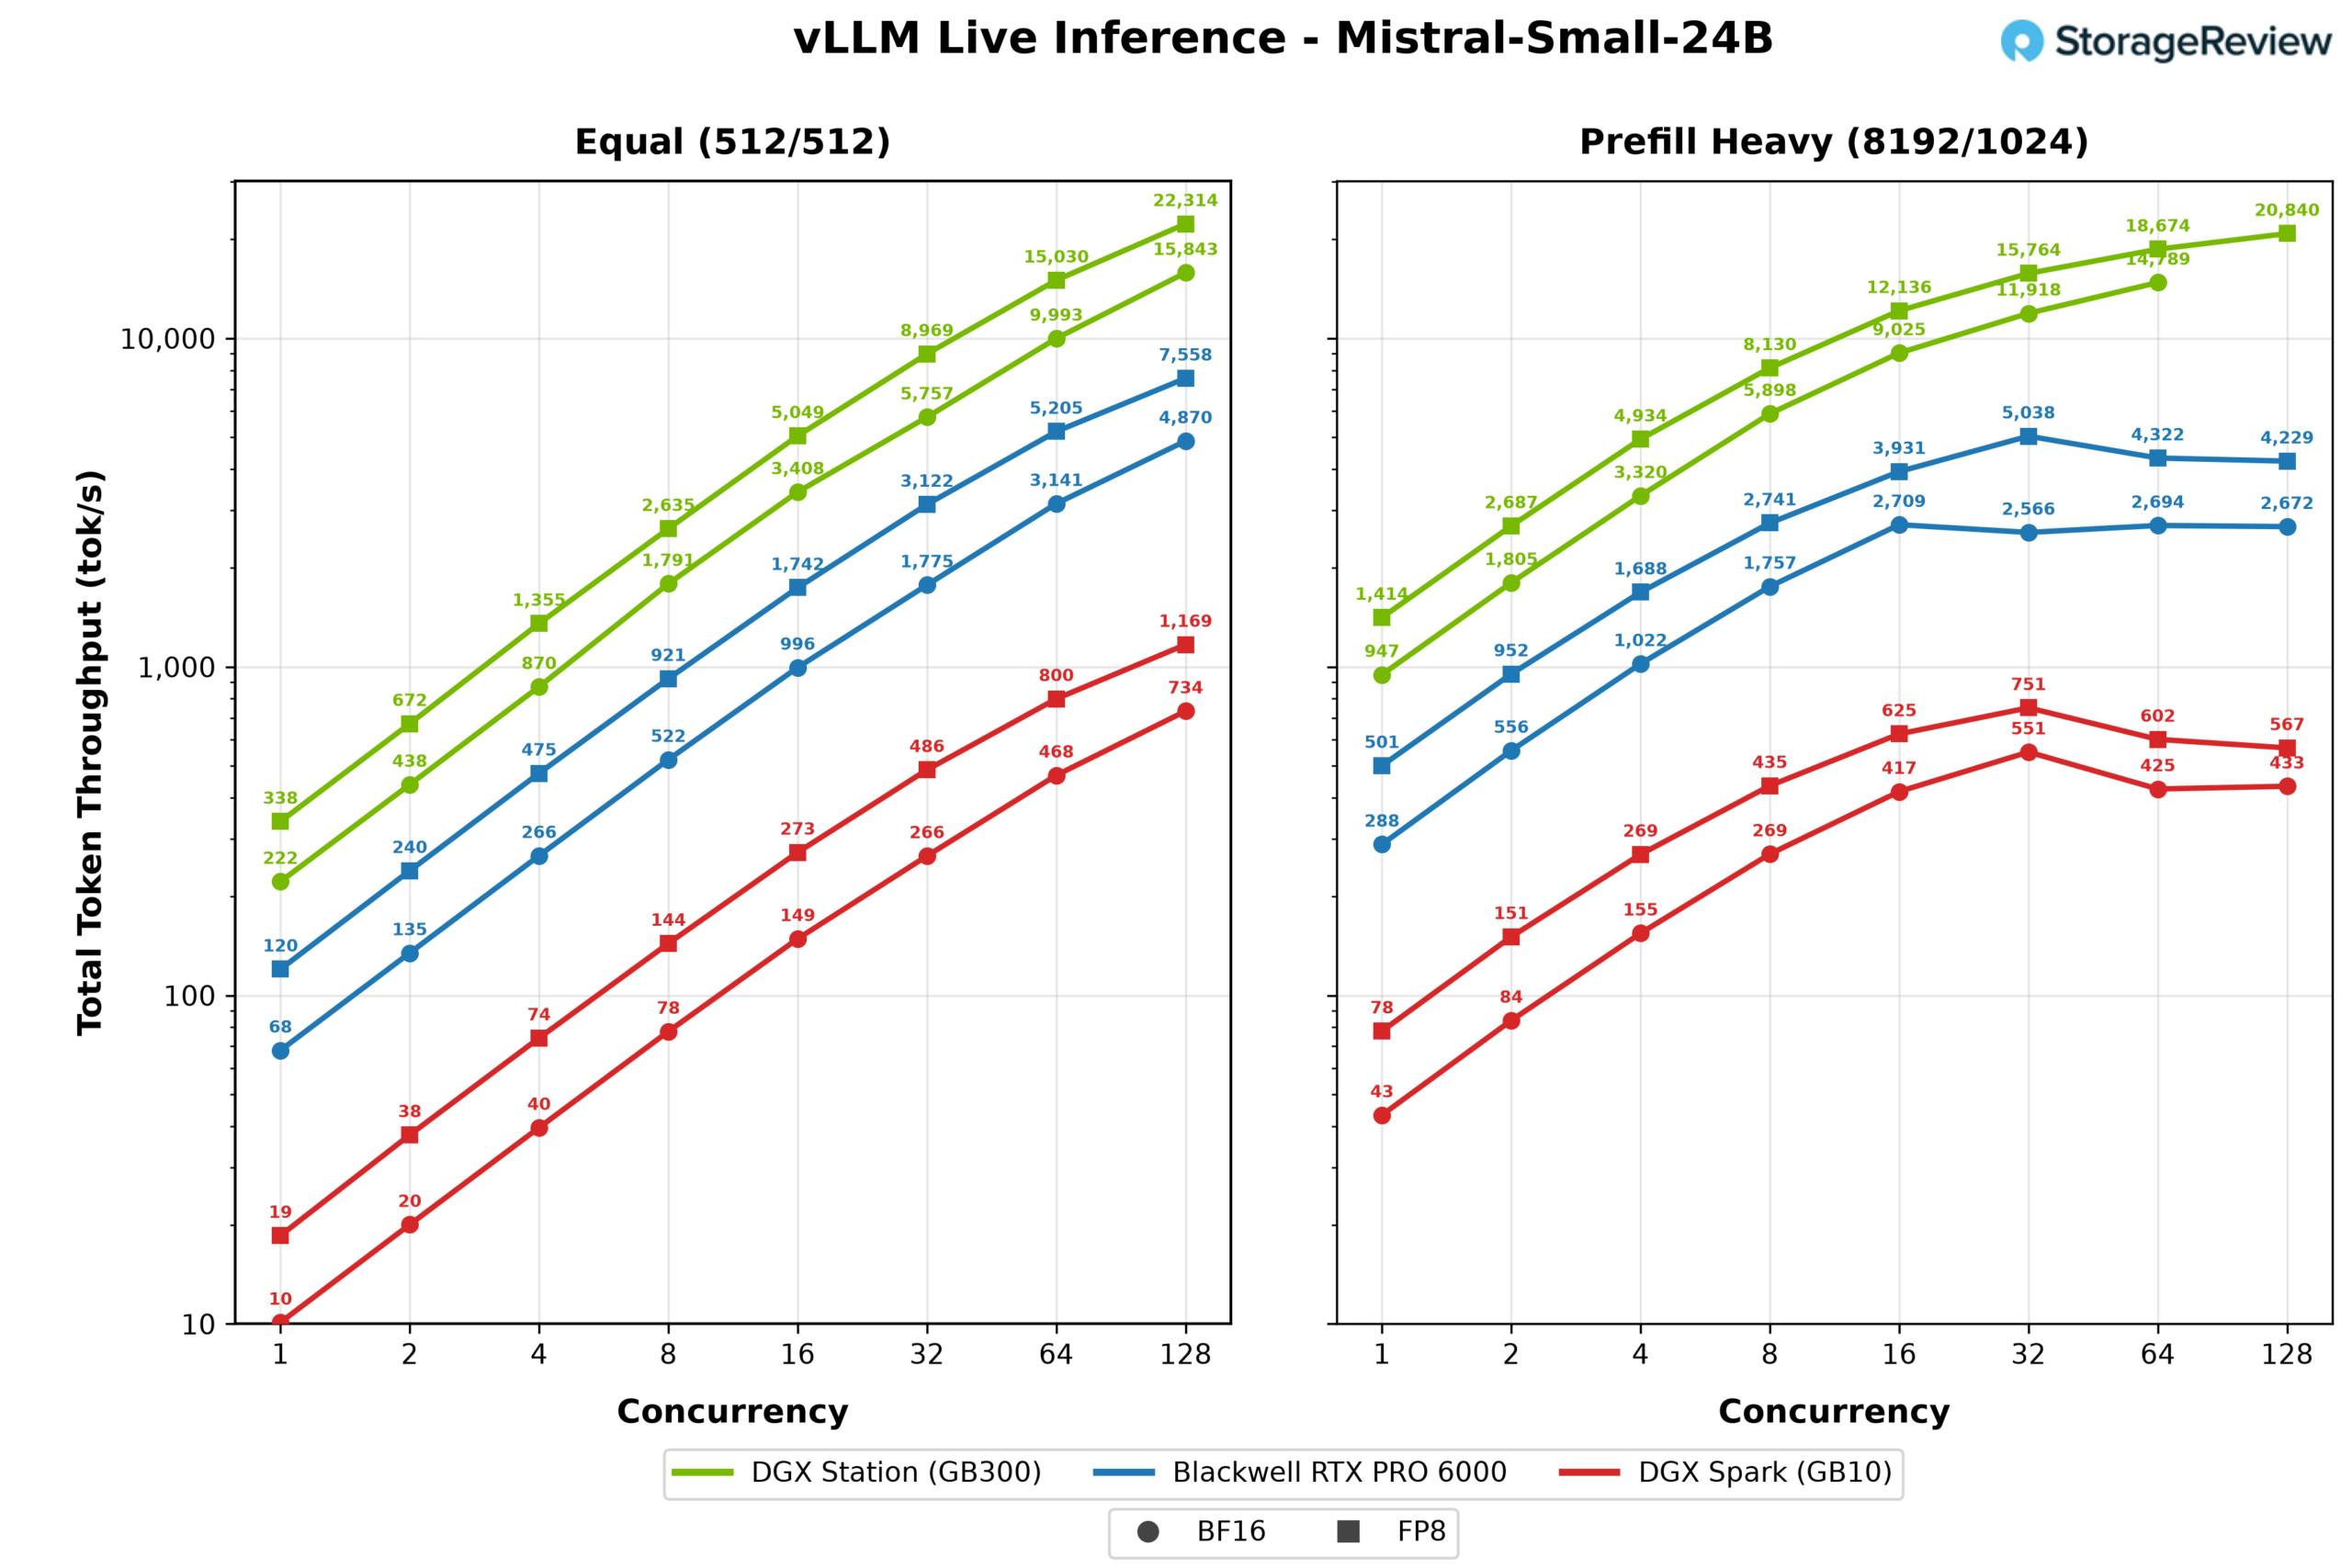
Mistral Small 24B သည် အစုံထဲတွင် အကျယ်ဆုံးကွာဟချက်များကို ထုတ်လုပ်ပေးခဲ့သည်။ တူညီသော workload အောက်တွင် FP8 တွင် WS300 သည် တစ်စက္ကန့်လျှင် output token ၁၁,၁၅၇ ခုဖြင့် အမြင့်ဆုံးရောက်ရှိခဲ့ပြီး RTX PRO 6000 ထက် သုံးဆဖြစ်သော ၃၇၇၉ ခုနှင့် DGX Spark ထက် ၁၉ ဆဖြစ်သော ၅၈၅ ခုဖြင့် အမြင့်ဆုံးရောက်ရှိခဲ့သည်။ Single stream ဖြစ်သော Station ၏ တစ်စက္ကန့်လျှင် တိုကင် ၁၆၉ ခုသည် Spark ၏ ၉ ခုထက် အပြန်အလှန်အကျိုးသက်ရောက်မှုရှိသော သက်တောင့်သက်သာရှိမှုနှင့် ပိုမိုနီးစပ်ပါသည်။
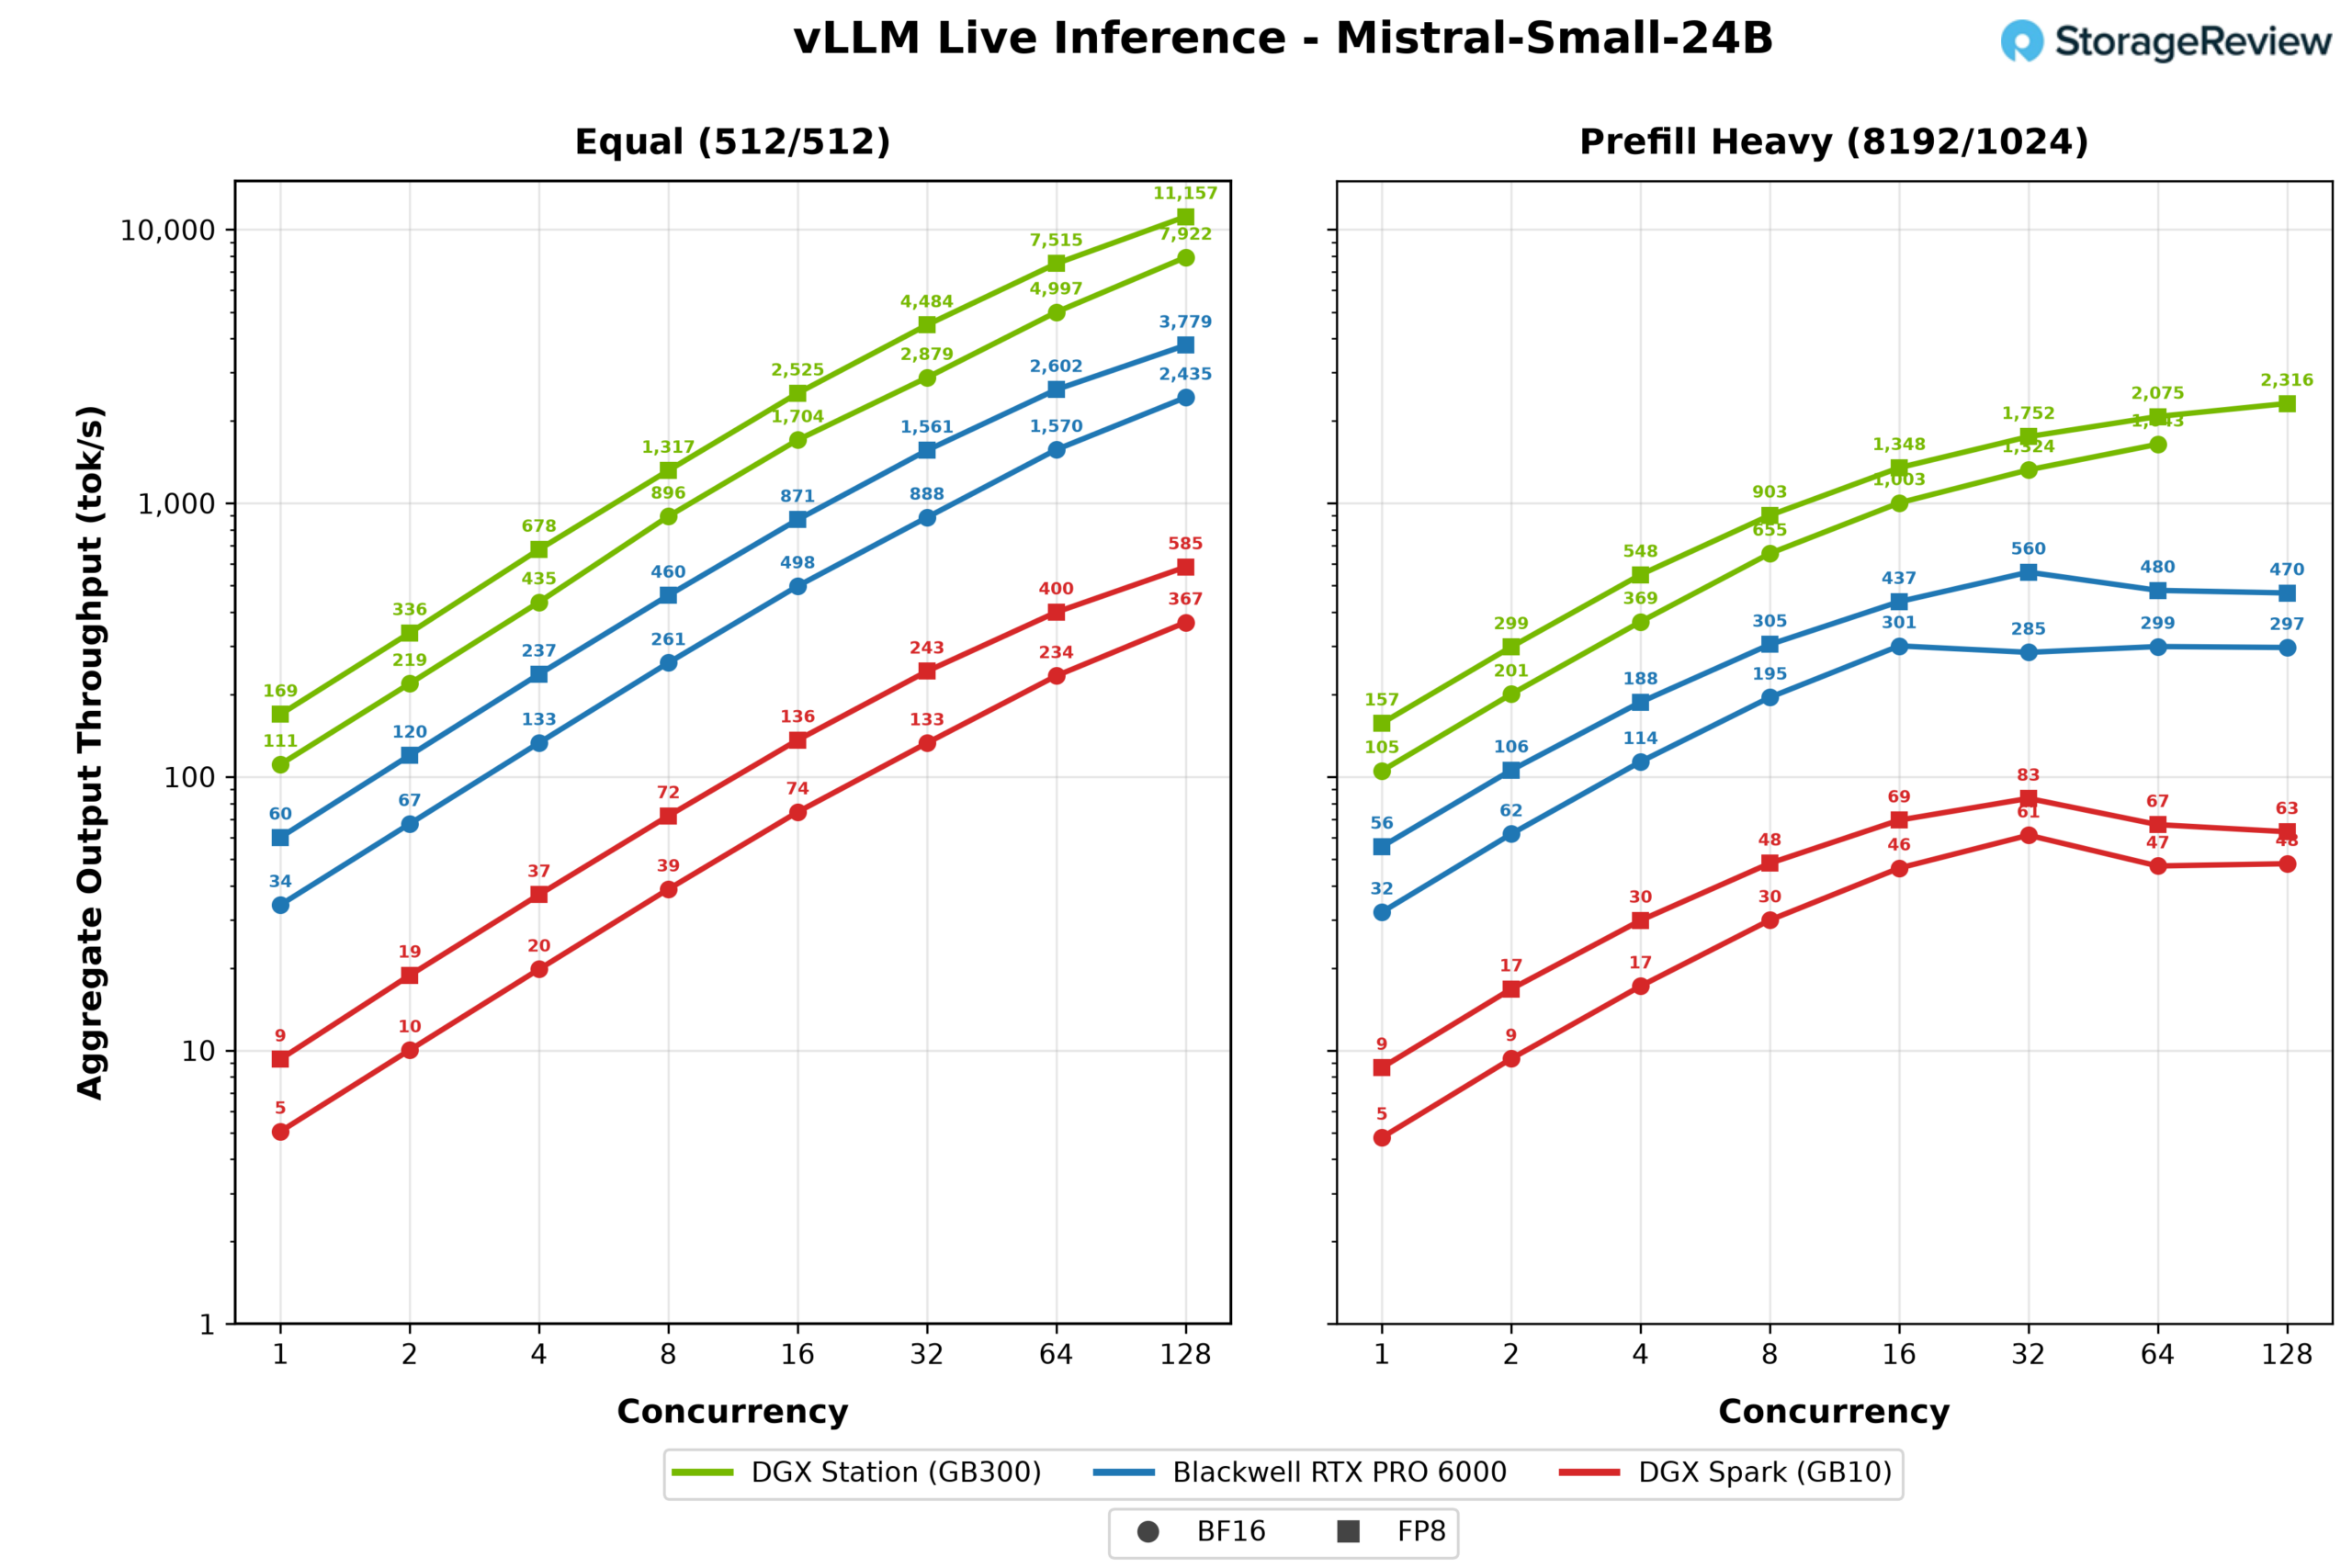
prefill heavy load အောက်မှာ RTX PRO 6000 ဟာ တစ်စက္ကန့်ကို concurrent stream ၃၂ ခုနဲ့ output token ၅၆၀ နဲ့ပဲ အမြင့်ဆုံးရောက်ခဲ့ပြီး ပြန်ကျသွားချိန်မှာ WS300 ကတော့ stream ၁၂၈ ခုမှာ ၂၃၁၆ အထိ ဆက်လက်မြင့်တက်ခဲ့ပါတယ်။
Qwen3 ကုဒ်ဒါ 30B
Qwen3 Coder 30B သည် ကျွမ်းကျင်သူများ ရောနှောထားသော မော်ဒယ်တစ်ခုဖြစ်ပြီး active parameter အရေအတွက် အနည်းငယ်သာ ပါဝင်ပြီး စနစ်ငယ်များက single stream gap ကို ပိတ်ပေးသည့် စမ်းသပ်မှုတစ်ခုဖြစ်သည်။ တူညီသော workload အောက်တွင် တစ်ပြိုင်နက်တည်း request တစ်ခုတွင် RTX PRO 6000 သည် WS300 ၏ 310 နှင့် တစ်စက္ကန့်လျှင် output token ၂၀၈ ခု ပေးပို့နိုင်ပြီး ဤနှိုင်းယှဉ်ချက်တွင် မည်သည့်ရလဒ်မဆို Station နှင့် အနီးစပ်ဆုံး ညီမျှပြီး Spark သည်ပင် အသုံးပြုနိုင်သော 55 ခုကို ရရှိခဲ့သည်။ Batching သည် ပုံမှန်အစီအစဉ်ကို ပြန်လည်ရရှိစေသည်- stream ၁၂၈ ခုတွင် FP8 တွင် Station ၏ တစ်စက္ကန့်လျှင် output token ၁၂,၄၂၅ ခုသည် ကတ်ထက် ၂.၄ ဆ ပိုများပြီး Spark ထက် ၁၆ ဆ နီးပါး ပိုများသည်။
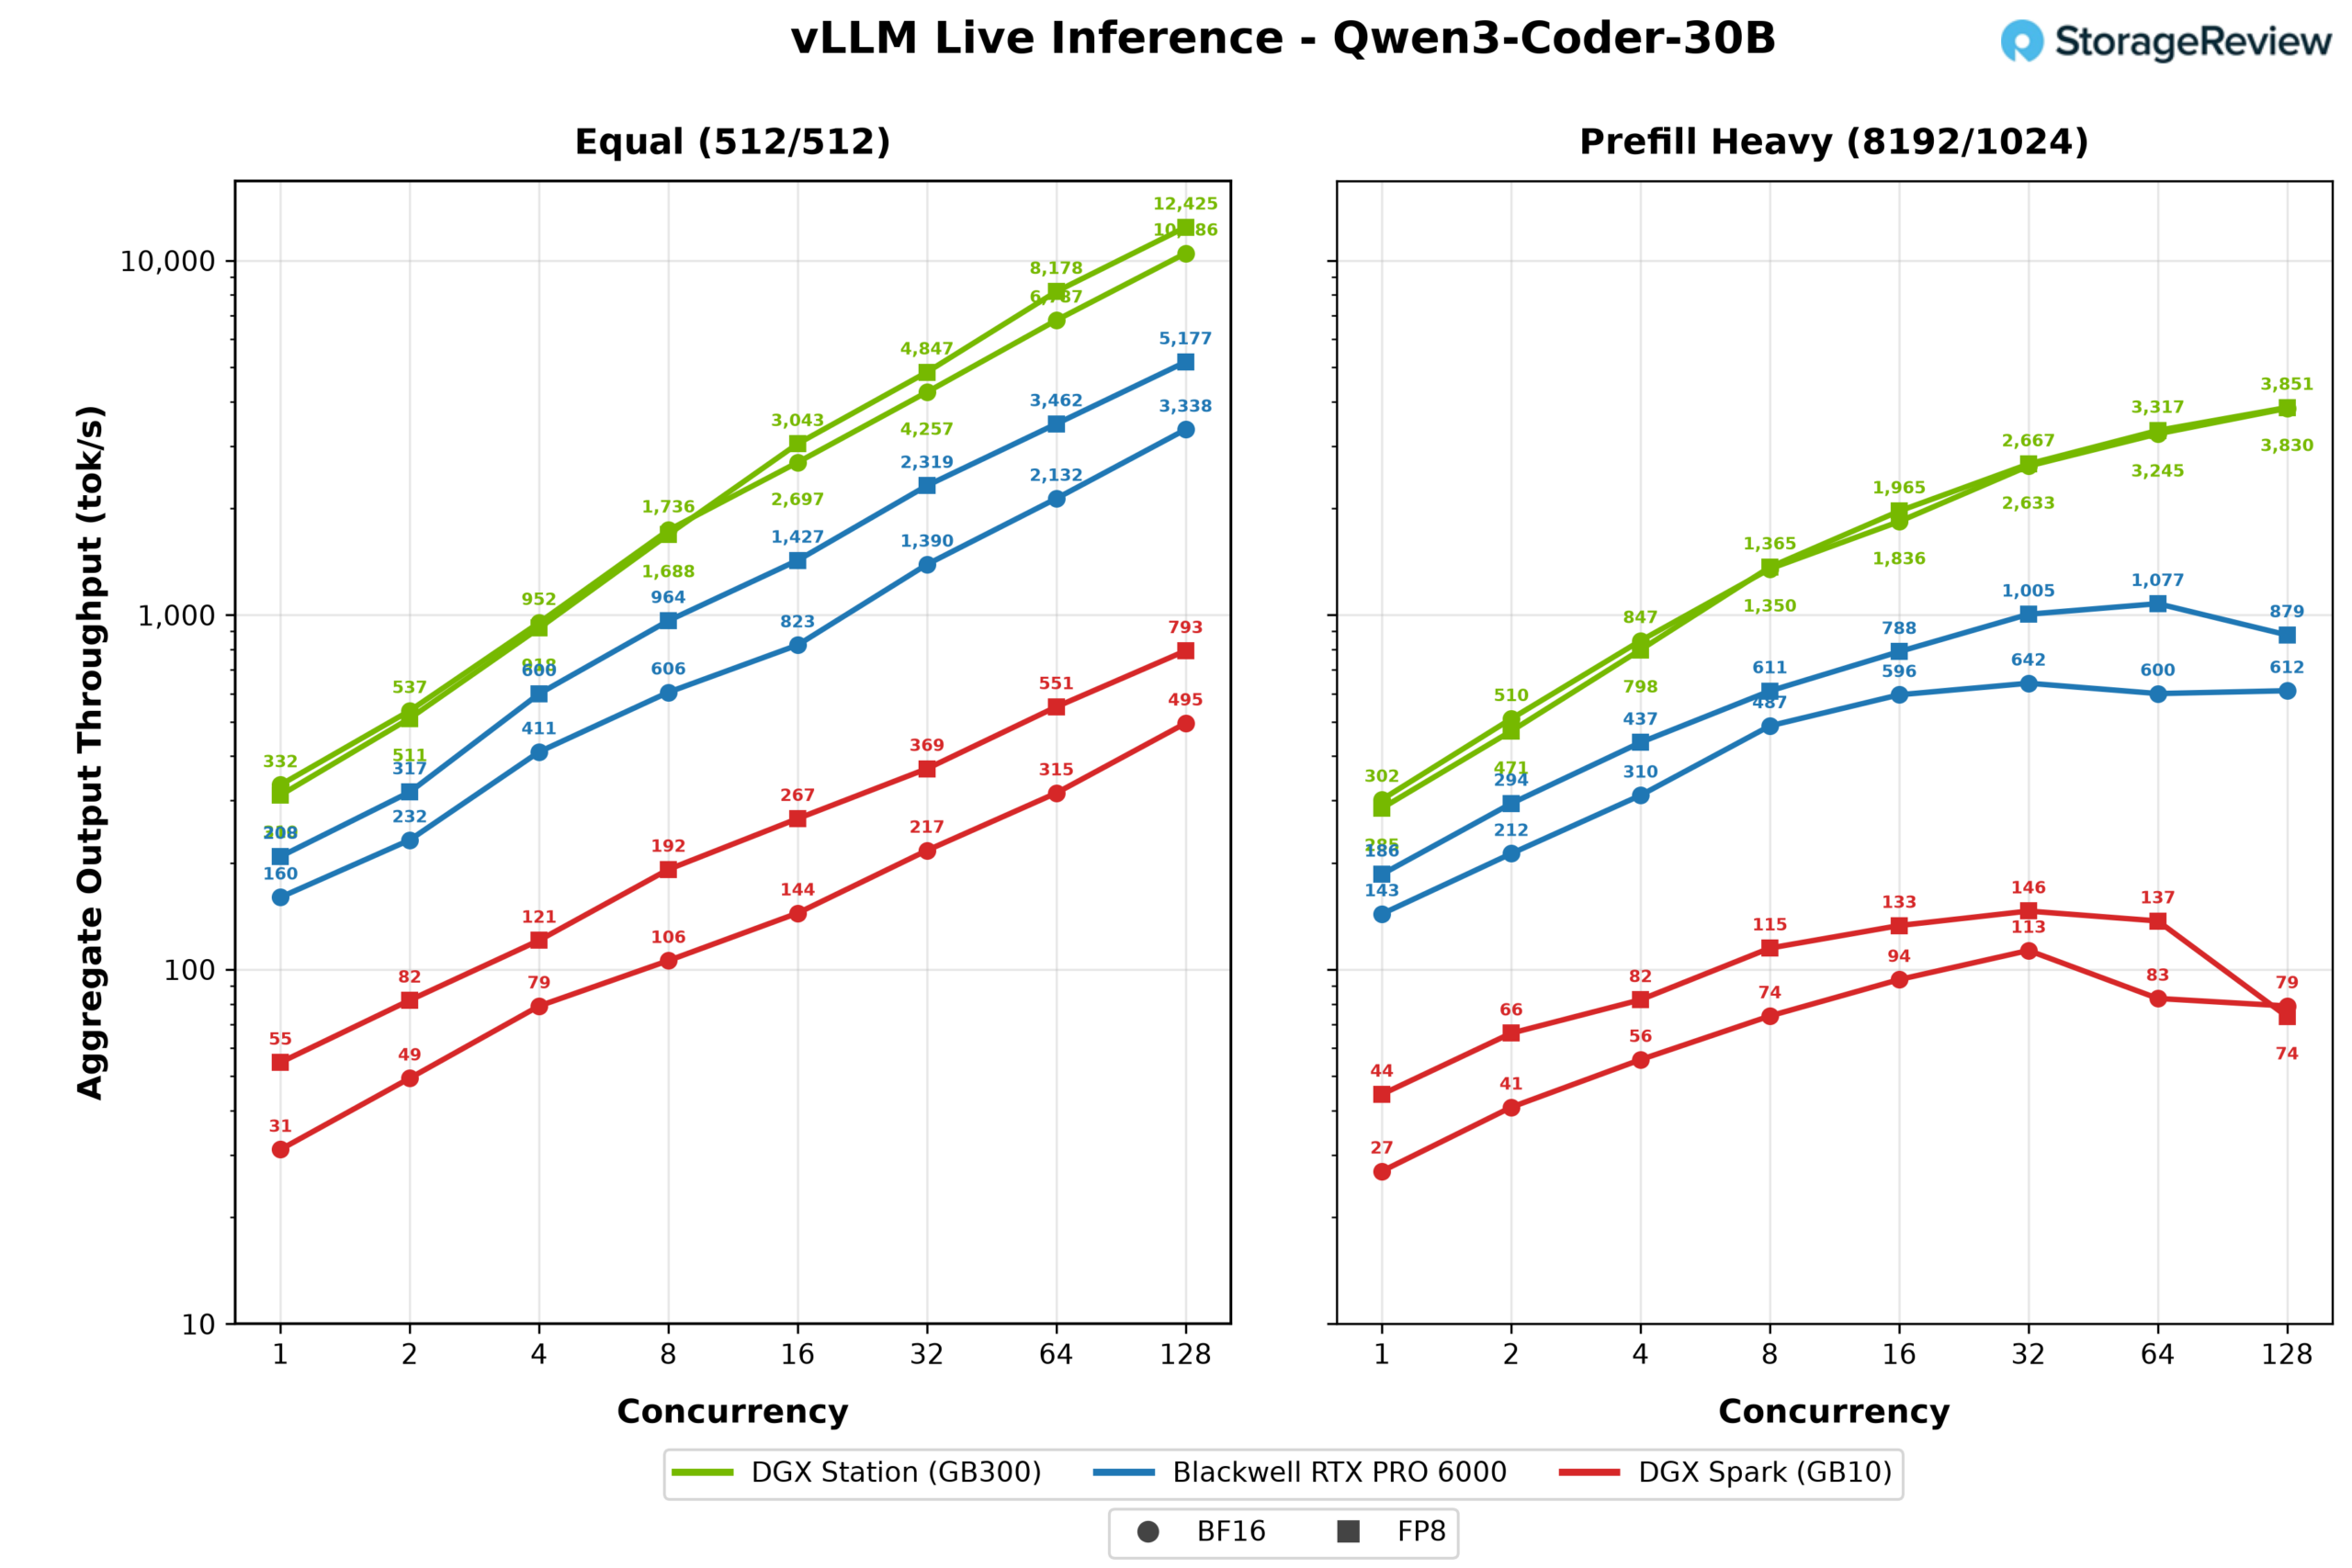
Prefill heavy သည် သတ်မှတ်ထားသောပုံစံကို လိုက်နာခဲ့ပြီး WS300 သည် တစ်စက္ကန့်လျှင် output tokens ၃,၈၅၁ ခု ရောက်ရှိခဲ့ပြီး ကတ်သည် ၁,၀၇၇ နှင့် Spark သည် ၁၄၆ တွင် အမြင့်ဆုံးရောက်ရှိခဲ့သည်။
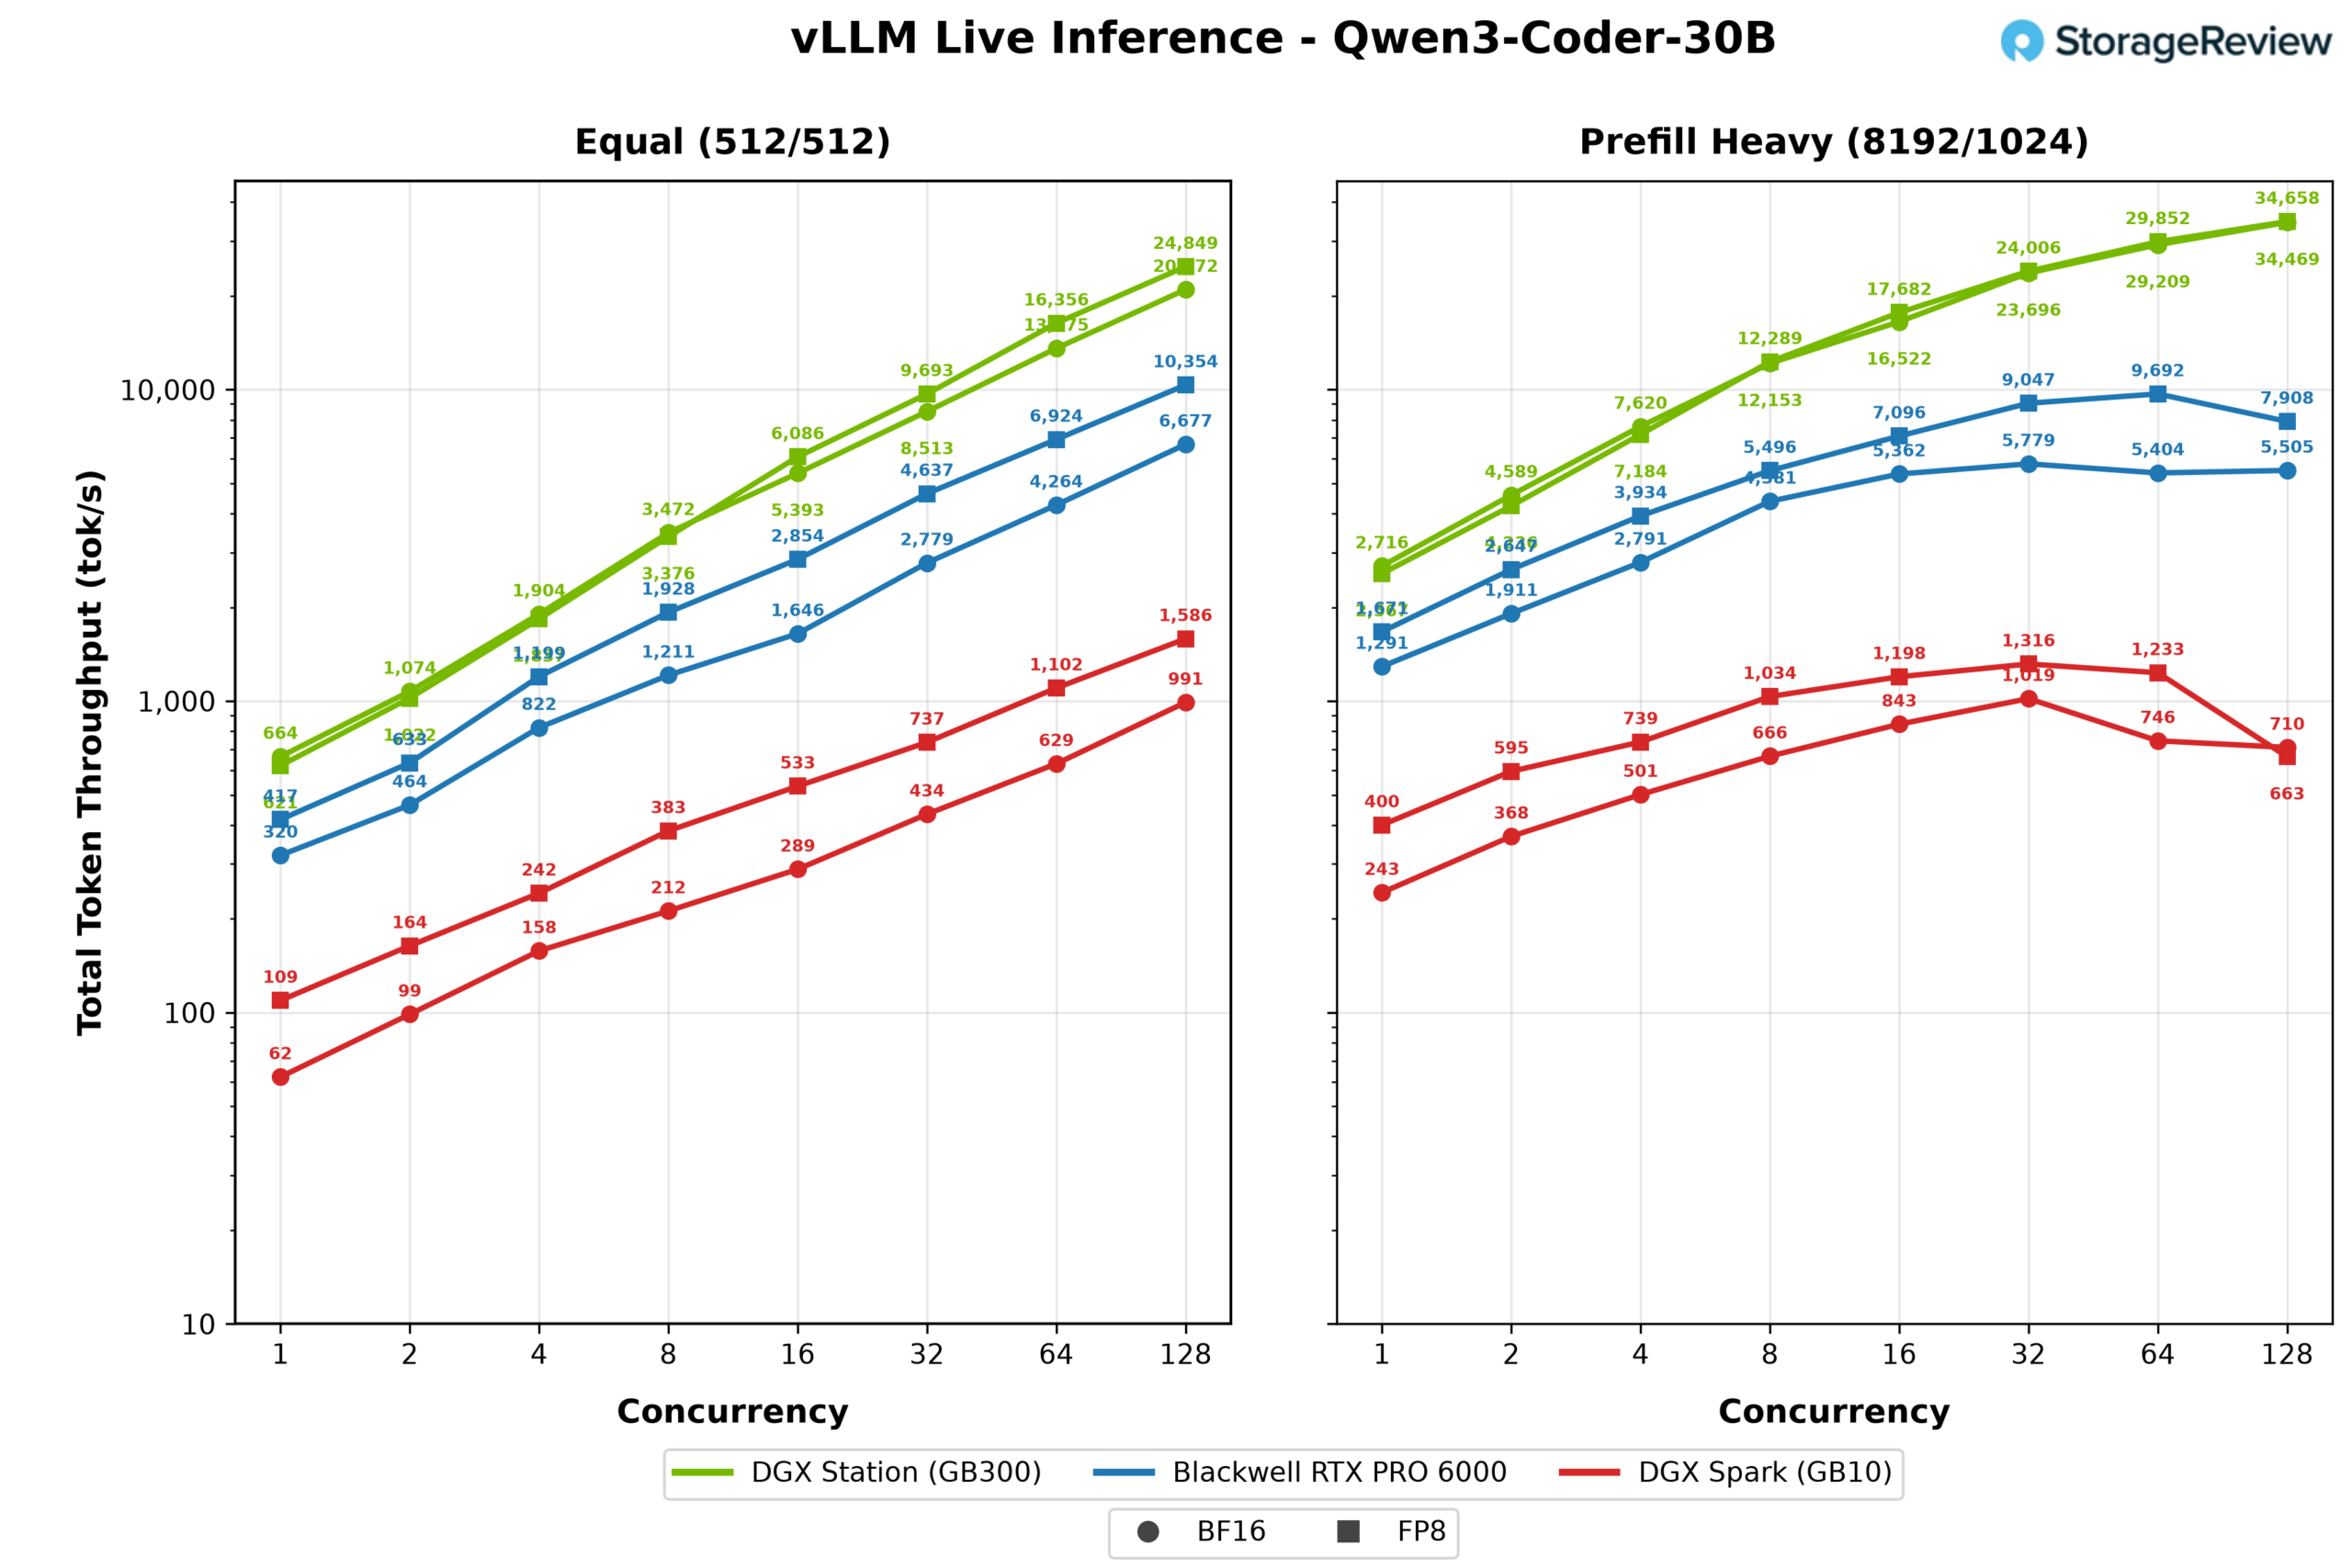
မျှဝေထားတဲ့ မော်ဒယ်ငါးခုမှာ WS300 ဟာ Blackwell RTX PRO 6000 ရဲ့ throughput ၂.၃ ဆကနေ ၃ ဆအထိ ရှိပြီး full concurrency မှာ DGX Spark ရဲ့ ၁၄ ဆကနေ ၁၉ ဆအထိ ရရှိခဲ့ပြီး long prompts တွေက KV cache ကို ဖိစီးစေတဲ့အခါ ကတ်ပေါ်မှာ margin က ၆ ဆအထိ ကျယ်ပြန့်သွားပါတယ်။ စက်သုံးလုံးစလုံးဟာ CUDA stack နဲ့ quantization paths တူညီတာကို run ပါတယ်။ Station က ဝယ်ယူတာက memory capacity နဲ့ bandwidth ပါ။ အဲဒါတွေက concurrency headroom နဲ့ long context tolerance အဖြစ် ဒီမှာပြသပါတယ်။ ဒီဇယားတွေက မပြသနိုင်တာကလည်း အရေးကြီးပါတယ်- အထက်က အပိုင်းတွေမှာ frontier scale model တွေထဲက ဘယ်ဟာမှ တခြား system နှစ်ခုမှာ load မလုပ်ပါဘူး။
GDSIO
ခေတ်သစ် AI workloads များသည် accelerator ကို အလုပ်များနေစေရန် storage မှ GPU memory သို့ data batches၊ model weights နှင့် checkpoints များကို လုံလောက်စွာ မြန်မြန်ဆန်ဆန် ရွှေ့ပြောင်းခြင်းအပေါ် မူတည်ပါသည်။ NVIDIA GPUDirect Storage သည် SSD မှ system memory ထဲသို့ data ကို ဦးစွာဖတ်ရှုပြီးနောက် GPU memory ထဲသို့ ကူးယူသည့် ရိုးရာ two-copy path ကို ဖယ်ရှားပေးပါသည်။
GB300 DGX Station သည် ၎င်းကို ရိုးရာ PCIe GPU server နှင့် ကွဲပြားစွာ အကောင်အထည်ဖော်သည်။ ကျွန်ုပ်တို့၏ စမ်းသပ်မှုအတွက် အသုံးပြုသော Micron 4600 ကို ConnectX-8 တွင် ပေါင်းစပ်ထားသော PCIe switch နှင့် ချိတ်ဆက်ထားသည်။ ConnectX-8 သည် Grace CPU သို့ upstream ချိတ်ဆက်ပြီး B300 GPU သည် NVLink-C2C မှတစ်ဆင့် Grace သို့ ချိတ်ဆက်သည်။ SSD နှင့် GPU သည် PCIe switch တစ်ခုတည်းအောက်တွင် မရှိပါ။ ယင်းအစား သိုလှောင်မှုအသွားအလာသည် ConnectX-8 switch မှတစ်ဆင့် ဖြတ်သန်းပြီး Grace PCIe root complex ထဲသို့ ဝင်ရောက်ကာ Grace coherency fabric ကို ဖြတ်သန်းကာ NVLink-C2C ကို ဖြတ်ကျော်ကာ B300 ၏ HBM3e သို့ ရောက်ရှိသည်။
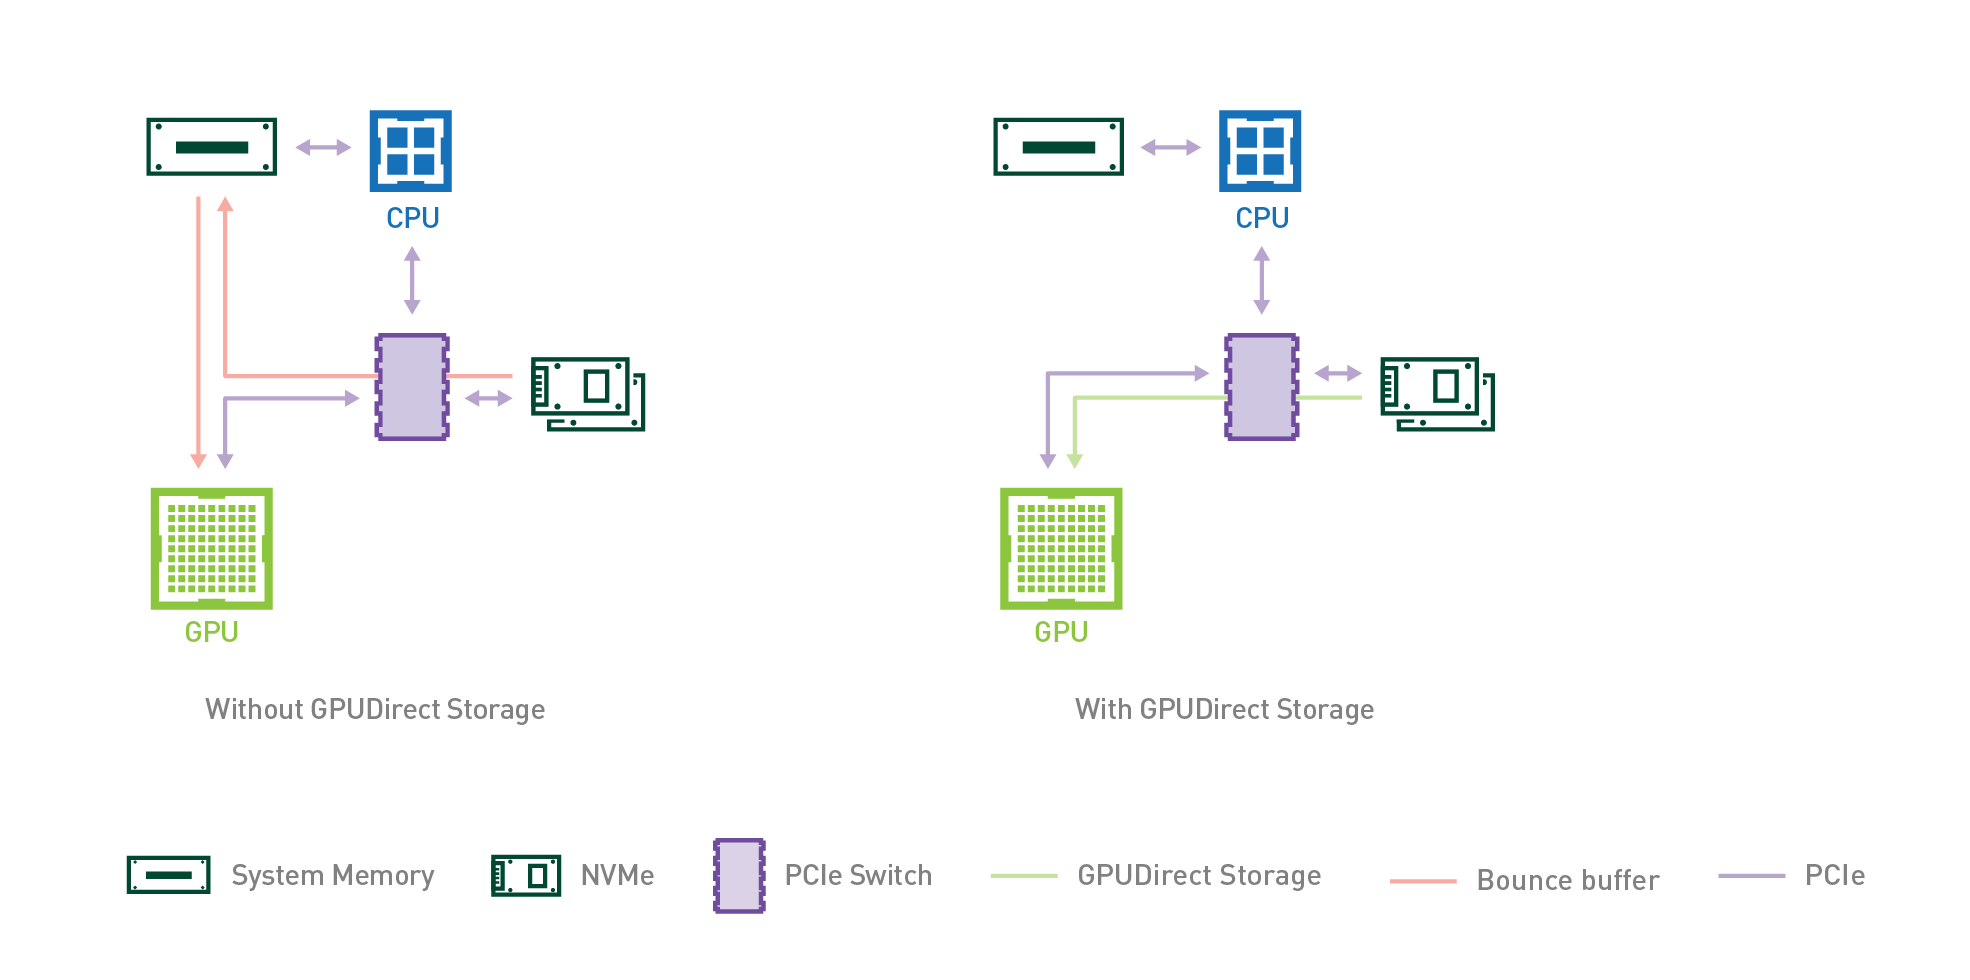
GPUDirect Storage ဖြင့် cuFile သည် B300 HBM3e တွင် ခွဲဝေထားသော buffer ကို storage I/O အတွက် source သို့မဟုတ် destination အဖြစ် register လုပ်သည်။ read လုပ်သည့်အခါ Micron 4600 ၏ controller သည် HBM3e တွင် data ထည့်ရန် DMA ကို အသုံးပြုသည်။ write လုပ်သည့်အခါ HBM3e မှ data ကို ပြန်လည်ရယူသည်။ လုပ်ဆောင်ချက်နှစ်ခုစလုံးသည် Grace ၏ LPDDR5X memory တွင် payload ကို staging မလုပ်ဘဲ အထက်တွင်ဖော်ပြထားသော Grace နှင့် NVLink-C2C path ကို လိုက်နာသည်။ Grace သည် command submission နှင့် address translation အပါအဝင် filesystem နှင့် NVMe control plane ကို စီမံခန့်ခွဲနေဆဲဖြစ်သော်လည်း data ကို copy မလုပ်ပါ။ ထို့ကြောင့် GPUDirect Storage သည် SSD နှင့် B300 memory အကြားတွင် traffic သည် Grace မှတစ်ဆင့် ဖြတ်သန်းသွားသော်လည်း system-memory staging step ကို ဖယ်ရှားသည်။ AI workloads အတွက်၊ sequential reads များသည် dataset streaming၊ model loading နှင့် checkpoint restores များနှင့် ကိုက်ညီပြီး sequential writes များသည် checkpoint saves များနှင့် storage သို့ ပြန်လည်လွှဲပြောင်းမှုများနှင့် ကိုက်ညီသည်။ GDSIO စွမ်းဆောင်ရည်ကို စမ်းသပ်ရန်အတွက်၊ ကျွန်ုပ်တို့သည် standalone secondary SSD တစ်ခုကို အသုံးပြု၍ storage စွမ်းဆောင်ရည်ကို တိုင်းတာခဲ့သည်။
GDSIO စမ်းသပ်ခြင်း ပုံစံ
- Boot Storage: RAID1 မှာ Micron 4600 2TB နှစ်ခု
- ဒုတိယသိုလှောင်မှု: 2 x Micron 4600 2TB
GDSIO Sequential Read စွမ်းဆောင်ရည်ကို ကြည့်မယ်ဆိုရင် ယူနစ်ဟာ thread အရေအတွက်နဲ့ block အရွယ်အစား နှစ်မျိုးလုံးမှာ တသမတ်တည်း ချိန်ညှိနိုင်ပါတယ်။ 16K မှာ thread 1 ခုမှာ 16MiB/s ကနေ thread 16 ခုမှာ 250MiB/s အထိ မြင့်တက်လာပြီး thread 128 ခုမှာ 2.0GiB/s အထိ ရောက်ရှိပါတယ်။ block အရွယ်အစားကြီးတွေက အများကြီး ပိုမြန်မြန် မြင့်တက်လာပြီး 256K ဟာ thread 64 ခုမှာ 11.8GiB/s အထိ ရောက်ရှိပြီး thread 128 ခုမှာ 12.9GiB/s အထိ အမြင့်ဆုံး ရောက်ရှိပါတယ်။ အားအကောင်းဆုံး ရလဒ်တွေက 512K နဲ့ 1M မှာ ပေါ်လာပြီး thread 13.1GiB/s အထိ အမြင့်ဆုံး ရောက်ရှိကာ 1M workload က thread 32 ခုမှာသာ ရောက်ရှိပြီး thread 128 ခုမှာ ထိန်းသိမ်းထားနိုင်ပါတယ်။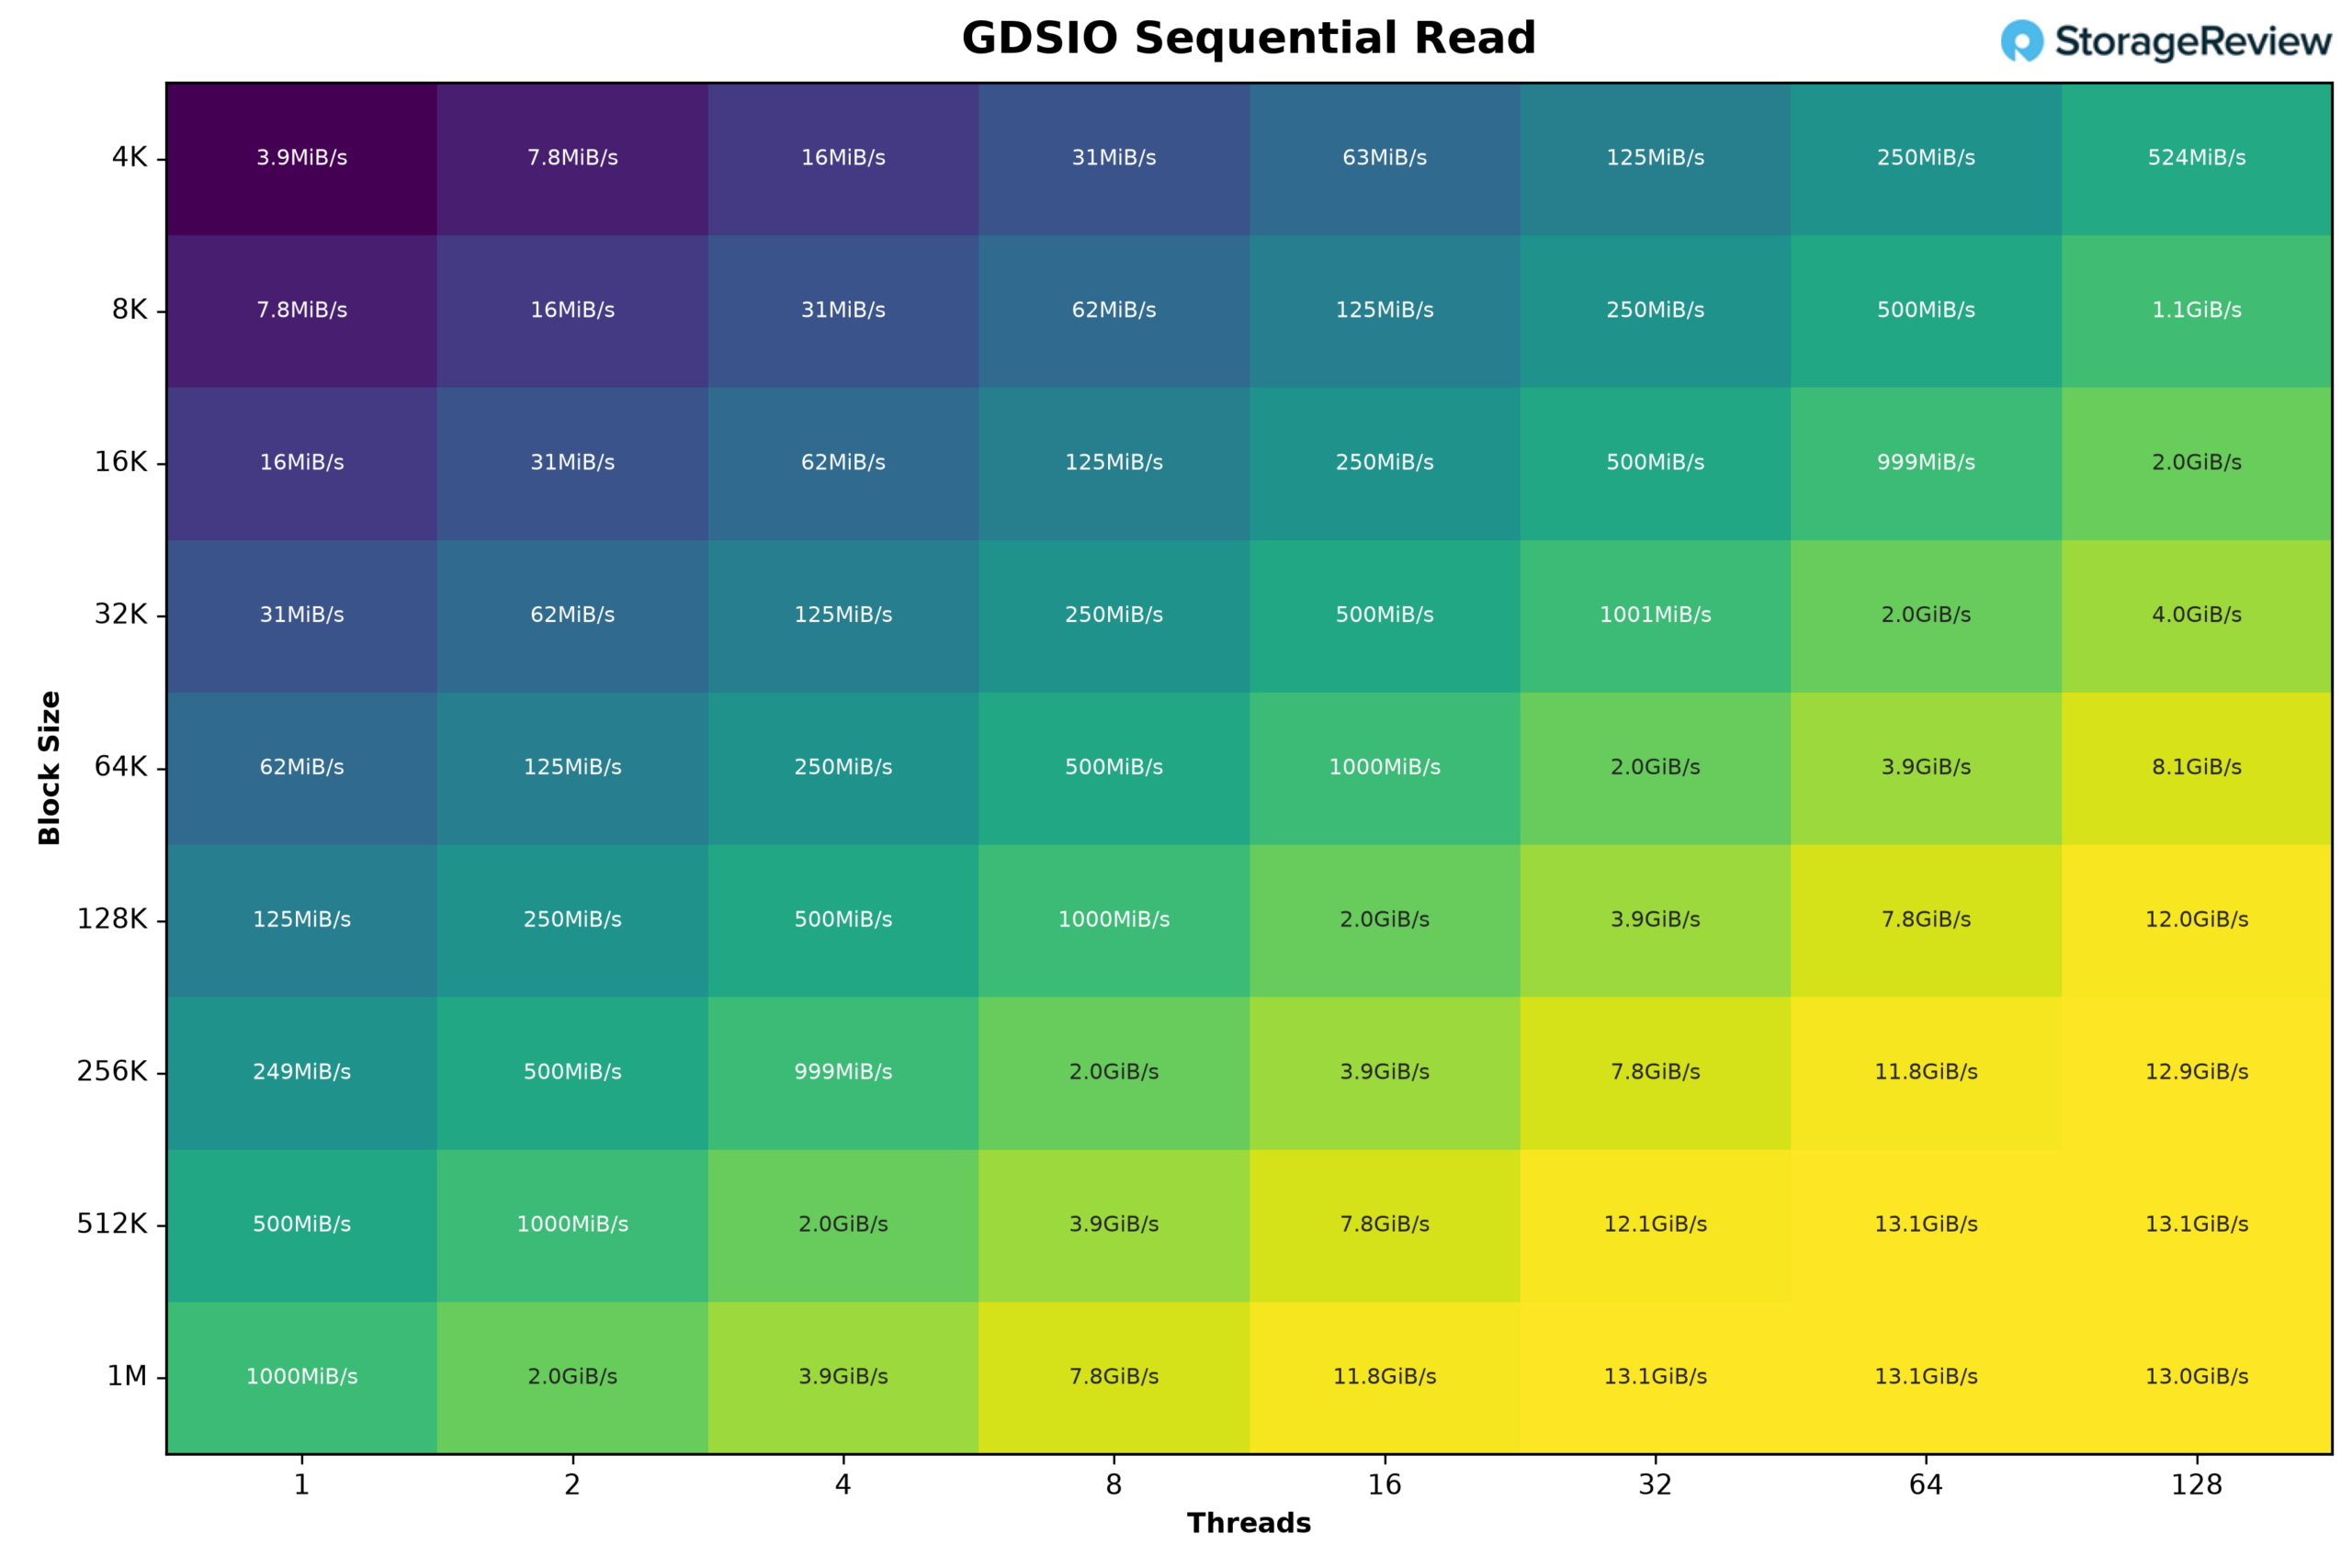
GDSIO Sequential Write စွမ်းဆောင်ရည်သို့ ရွေ့လျားသွားသောအခါ၊ ယူနစ်သည် thread အရေအတွက်နှင့် block အရွယ်အစား နှစ်မျိုးလုံးတွင် တသမတ်တည်း ချိန်ညှိပါသည်။ 16K တွင်၊ thread 1 ခုတွင် 16MiB/s မှ thread 16 ခုတွင် 250MiB/s အထိ တိုးလာပြီး thread 128 ခုတွင် 2.0GiB/s အထိ ရောက်ရှိပါသည်။ block အရွယ်အစားကြီးများသည် ပိုမိုမြန်ဆန်စွာ မြင့်တက်လာပြီး 256K သည် thread 32 ခုတွင် 7.5GiB/s နှင့် thread 64 ခုတွင် 12.0GiB/s အထိ ရောက်ရှိပါသည်။ အားအကောင်းဆုံးရလဒ်မှာ 1M workload မှ လာခြင်းဖြစ်ပြီး thread 16 ခုတွင် 12.0GiB/s အမြင့်ဆုံးသို့ ရောက်ရှိပြီး thread 128 ခုအထိ ထိုစွမ်းဆောင်ရည်ကို ထိန်းသိမ်းထားနိုင်မည်ဖြစ်သည်။ 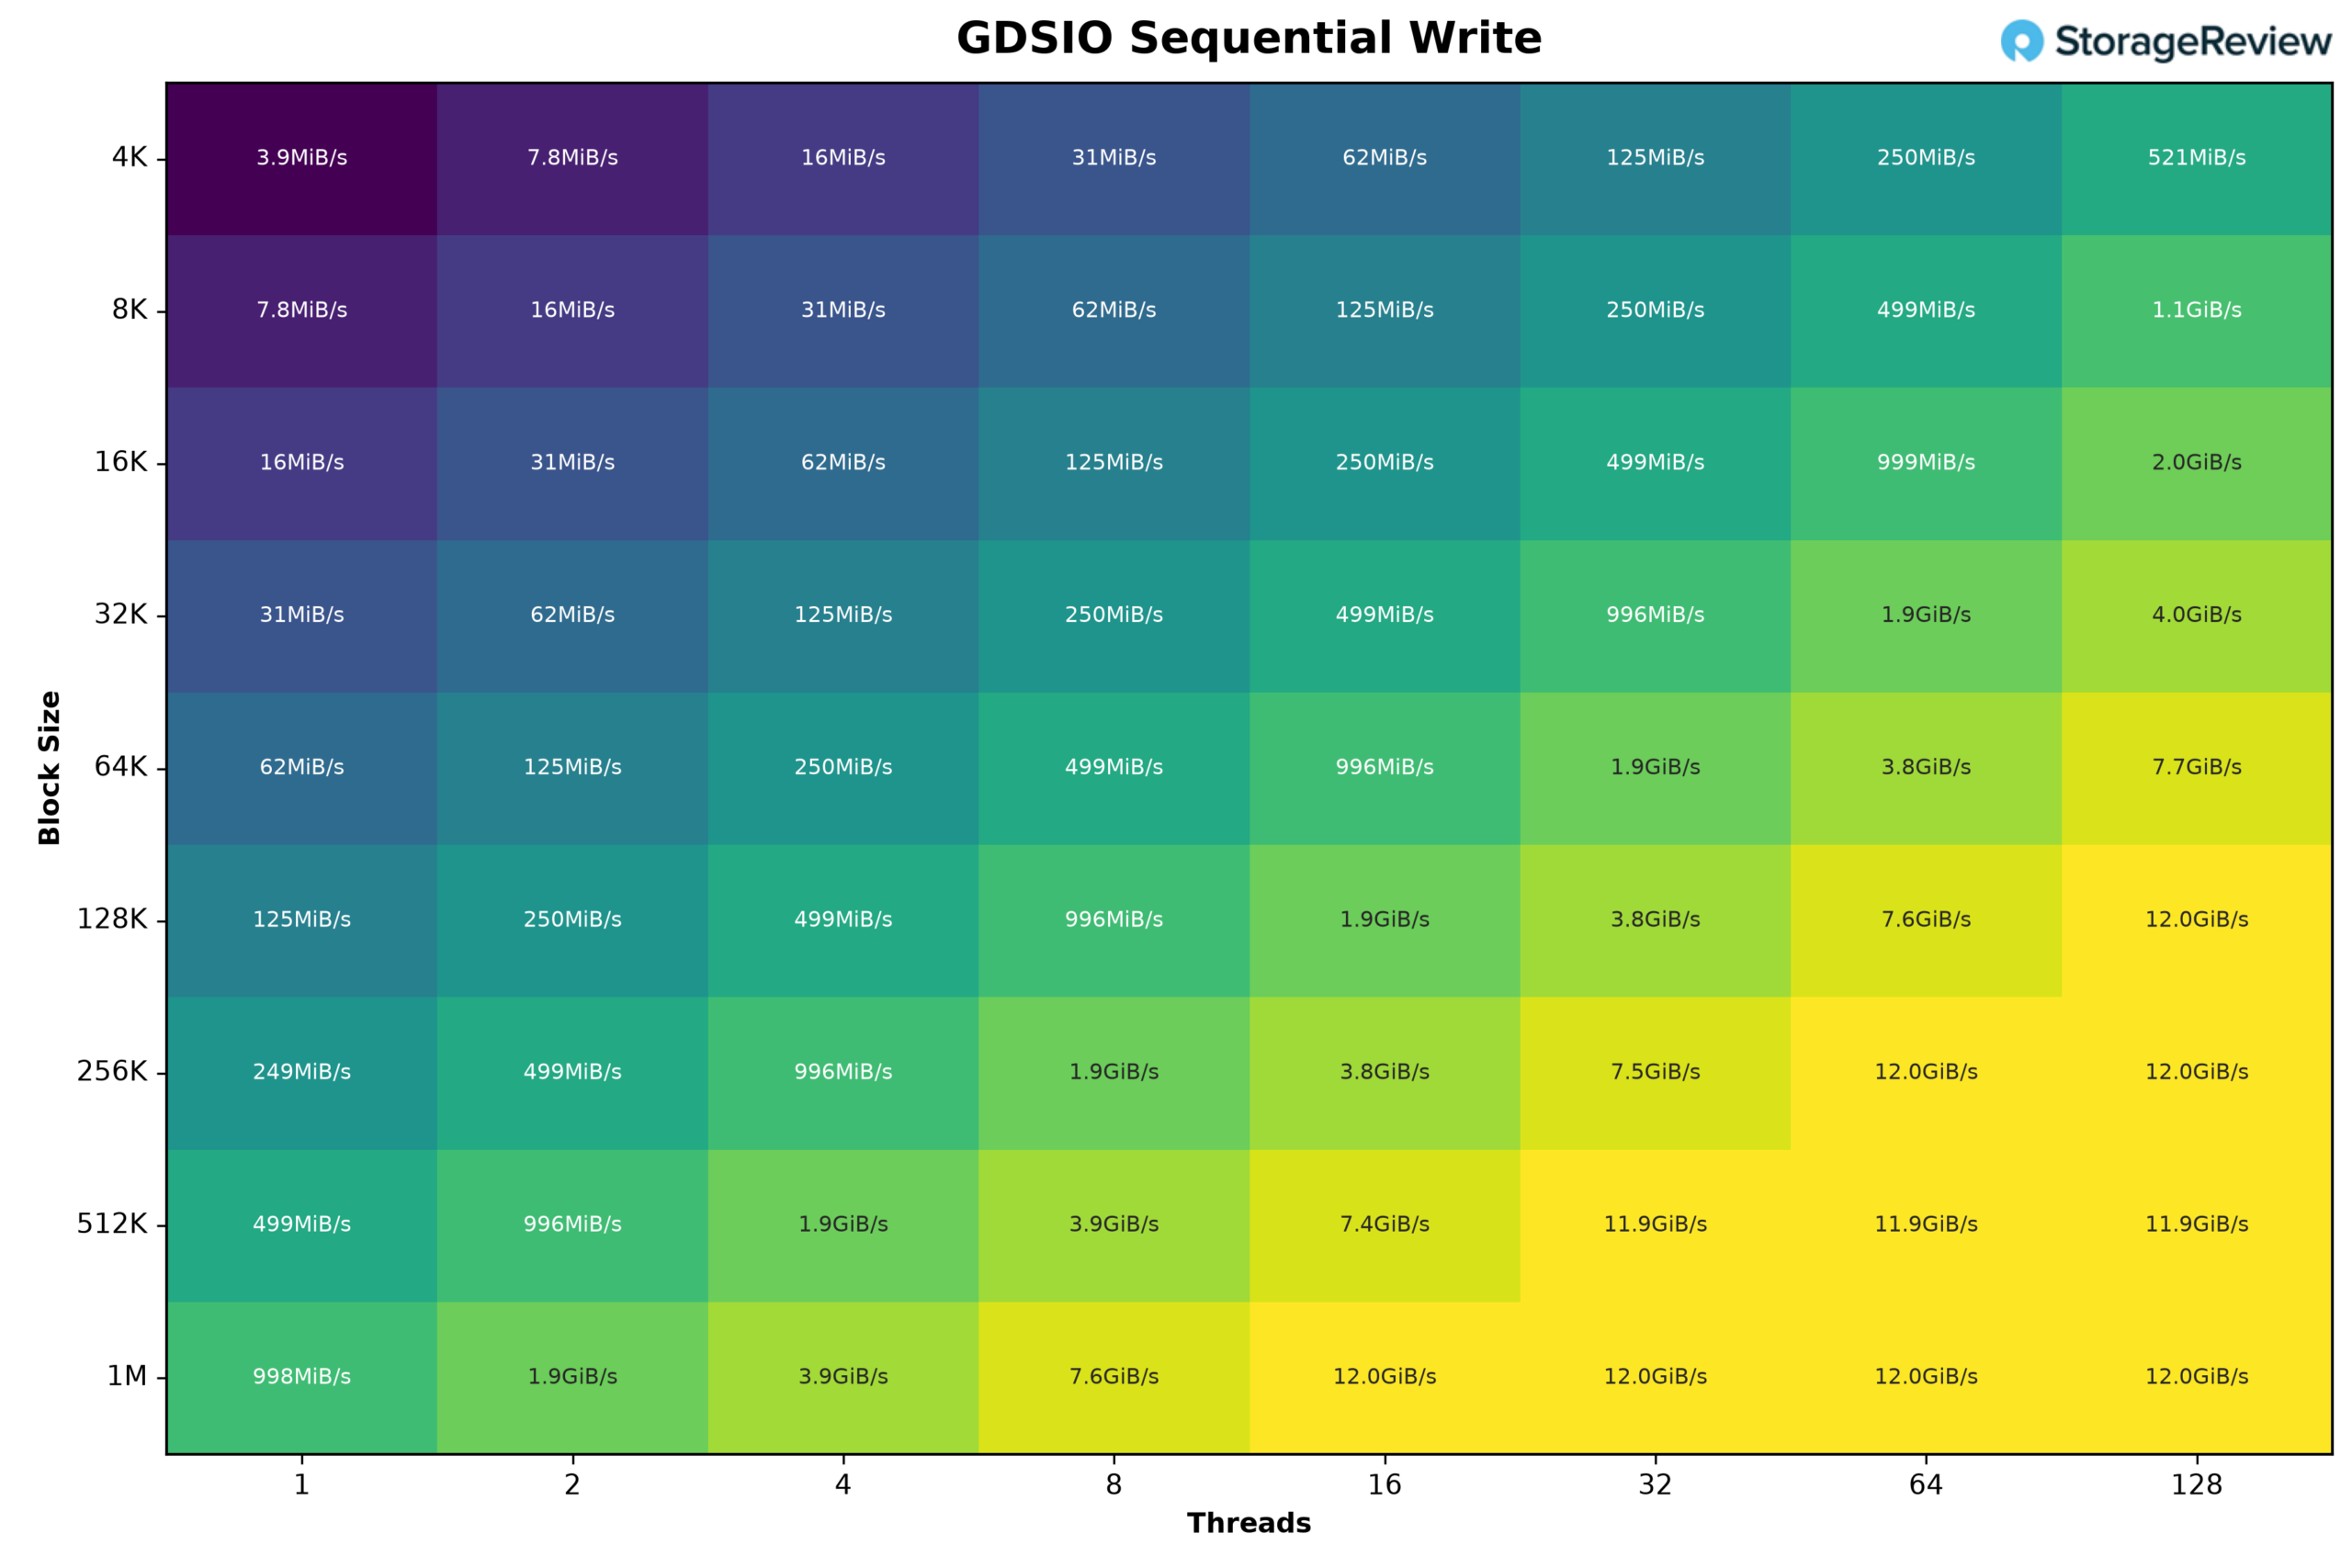
MSI XpertStation WS300 က ဘယ်သူတွေအတွက်လဲ။
WS300 သည် Blackwell Ultra သို့ တိုက်ရိုက်ဝင်ရောက်ခွင့် လိုအပ်သော်လည်း စမ်းသပ်မှုတိုင်းကို cluster reservation သို့မဟုတ် cloud request ဖြင့် စတင်လိုခြင်းမရှိသော အဖွဲ့အစည်းများအတွက်ဖြစ်သည်။ AI lab များ၊ inference-engine developer များ၊ framework နှင့် compiler အဖွဲ့များ၊ robotics အဖွဲ့များနှင့် enterprise AI အဖွဲ့များသည် အထက်ဖော်ပြပါ workflow များအတွက် local development node အဖြစ် အသုံးပြုနိုင်ပါသည်။ MIG သည် developer များအား multi-GPU setup အတွက် စမ်းသပ်ပြီး တီထွင်နိုင်စေပြီး BMC သည် စနစ်ကို အဝေးမှ စီမံခန့်ခွဲနိုင်စေပါသည်။
အလုပ်လုပ်ရန် အသင့်ရောက်ရှိနေသော စနစ်တစ်ခု လိုအပ်သော အတွေ့အကြုံရှိ AI developer များအတွက်လည်း ၎င်းသည် ကျိုးကြောင်းဆီလျော်ပါသည်။ တန်ဖိုးသည် B300 တစ်ခုတည်းမဟုတ်ပါ။ ၎င်းသည် ၎င်းပတ်လည်ရှိ ပြီးပြည့်စုံသော platform တစ်ခုဖြစ်သည်- HBM3e 252GB၊ Grace နှင့် LPDDR5X 496GB၊ ConnectX-8၊ mirrored boot storage၊ liquid cooling၊ remote management နှင့် MSI-backed support တို့ကို tower တစ်ခုတည်းတွင် ပေါင်းစပ်ထားသည်။ လက်တွေ့တွင် ကန့်သတ်ချက်များမှာ Arm host၊ သီးသန့် 20A circuit အတွက် လိုအပ်ချက်နှင့် RTX PRO ကတ်ကြီးတစ်ခု တပ်ဆင်သည့်အခါ shared 1,600W budget တို့ဖြစ်သည်။
WS300 မှ အများဆုံးရရှိခြင်းသည် ၎င်းနှင့်ပတ်သက်သည့် ဆော့ဖ်ဝဲလ်ပေါ်တွင်လည်း မူတည်ပါသည်။ NVIDIA သည် အဖွဲ့များအား စနစ်ကို အွန်လိုင်းသို့ ယူဆောင်လာပြီး ၎င်း၏ အရင်းအမြစ်များကို လျင်မြန်စွာ အလုပ်လုပ်စေရန် ကူညီပေးရန် ဒီဇိုင်းထုတ်ထားသော playbook များနှင့် deployment guides များ စုစည်းမှုကို ပံ့ပိုးပေးပါသည်။ workstation သို့ shared access ကို ရိုးရှင်းစေပြီး ထိုကဲ့သို့သော ဈေးကြီးသော အရင်းအမြစ်ကို အလဟဿ မဖြစ်စေရန်အတွက် အသုံးပြုမှုကို မြှင့်တင်ပေးနိုင်သည့် Brev အပါအဝင် အနာဂတ်လွှမ်းခြုံမှုတွင် ဤ tools အများအပြားကို ကျွန်ုပ်တို့ လေ့လာသွားပါမည်။
ဈေးနှုန်းနဲ့ပတ်သက်လို့ MSI က ထုတ်ပြန်ထားခြင်း မရှိသေးဘဲ ဒီအတန်းအစားထဲက စက်တွေမှာ စာရင်းဈေးနှုန်း ရှားရှားပါးပါးပဲ ရှိပါတယ်။ ဒါက add-to-cart ခလုတ် မဟုတ်ဘဲ အရောင်းအဖွဲ့နဲ့ အရင်းအနှီး ဆွေးနွေးမှုပါ။ ရိုးရိုးသားသား နှိုင်းယှဉ်ချက်က တခြား workstation တွေနဲ့ နှိုင်းယှဉ်တာ မဟုတ်ဘဲ AI အဖွဲ့တစ်ခုက ပေးဆောင်နေတဲ့ အရာတွေနဲ့ နှိုင်းယှဉ်တာပါ- reserved cluster time, cloud GPU commitments နဲ့ shared hardware မှာ စောင့်ဆိုင်းရတဲ့ အချိန်ဇယား ကုန်ကျစရိတ်တွေပါ။
ကောက်ချက်
MSI XpertStation WS300 ဟာ ကျွန်တော်တို့ သုံးသပ်ဖူးသမျှထဲမှာ စွမ်းဆောင်ရည်အမြင့်ဆုံး workstation ဖြစ်ပြီး ကျွမ်းကျင်သူတစ်ဦးတည်း ကြိုးစားနိုင်တာကို ပြောင်းလဲပေးနိုင်တဲ့ ရှားပါးထုတ်ကုန်လည်း ဖြစ်ပါတယ်။ ပုံမှန်အားဖြင့် cluster reservation နောက်ကွယ်မှာ ရှိနေလေ့ရှိတဲ့ Frontier-scale checkpoints တွေ၊ 433GB မှာ GLM-5.2 နဲ့ 550 billion parameters မှာ Nemotron-3-Ultra တို့ဟာ စားပွဲဘေးက box တစ်ခုမှာ သီးသန့်နဲ့ အမြဲတမ်း ရရှိနိုင်အောင် load လုပ်ပြီး ဝန်ဆောင်မှုပေးပါတယ်။ အဲဒါက ဒီစနစ်အပေါ် ကျွန်တော်တို့ရဲ့ စိတ်အားထက်သန်မှုရဲ့ အရင်းအမြစ်ပါပဲ။
DGX Station ဟာ developer တွေအတွက် ရည်ရွယ်ပါတယ်- Blackwell Ultra ကို ပစ်မှတ်ထားတဲ့ kernel developer တွေ၊ inference-engine နဲ့ framework teams တွေ၊ Isaac loop တစ်ခုလုံးကို လည်ပတ်နေတဲ့ robotics group တွေနဲ့ shared hardware နဲ့ပတ်သက်တဲ့ scheduling experiments တွေနဲ့ စိတ်ပျက်နေတဲ့ user တွေအတွက်ပါ။ အဲဒီ niche ကလွဲရင် ဒီ system တွေကို ဝယ်ယူဖို့ အငြင်းပွားမှုက အတော်လေး အကန့်အသတ်ရှိပါတယ်။ Arm host မှာ toolchain အချို့ကို ချန်လှပ်ထားမှာဖြစ်ပြီး 20A circuit က 120v circuits တွေမှာ installation requirement တစ်ခုဖြစ်ပြီး add-in card မပါဘဲ display output မရှိပါဘူး။ ပြီးတော့ RTX PRO 6000 workstation က ကုန်ကျစရိတ် အများကြီး သက်သာပြီး 96GB မှာ ဆန့်တဲ့ model တွေမှာ single-user work ကို လွှမ်းခြုံထားပါတယ်။
စီးပွားရေးအရလည်း သင့်တော်တဲ့ deployment size ကိုလည်း ထည့်သွင်းစဉ်းစားထားပါတယ်။ WS300 တစ်လုံးက cluster time ကို reserved လုပ်ထားတာထက် ကျိုးကြောင်းဆီလျော်အောင် လုပ်ဖို့ လွယ်ကူပြီး team တစ်ခုကို တစ်စုံတော့ ဖြစ်နိုင်ပါတယ်။ ထပ်ပြီး stacking လုပ်တာက တစ်ချိန်ချိန်မှာ အဓိပ္ပာယ်မရှိတော့ပါဘူး။ ဥပမာအားဖြင့် အဖွဲ့အစည်းတစ်ခုက GB300 tower လေးခု ဝယ်ယူတဲ့အခါမှာ GPU တစ်ခုစီမှာ memory ပိုများတဲ့၊ MIG partitioning ပိုသိပ်သည်းတဲ့ နဲ့ GPU တစ်ခုစီကြားမှာ NVLink ပါတဲ့ ရှစ်လမ်းသွား B300 server တစ်ခုအတွက် အဲဒီငွေပမာဏက လုံလောက်ပါတယ်။ အကောင်းဆုံးနေရာကတော့ desk ပေါ်မှာ တစ်ခု၊ lab မှာ နှစ်ခုလောက် ရှိတာက datacenter ရင်းနှီးမြှုပ်နှံမှုကို ဖြည့်စွက်ပေးပါတယ်။
NVIDIA က baseboard ကို ပံ့ပိုးပေးတာကြောင့် OEM တွေကြားက ခြားနားချက်က အကောင်အထည်ဖော်မှုပေါ်မှာ မူတည်ပြီး MSI ရဲ့ စွမ်းဆောင်ရည်က ခိုင်မာပါတယ်။ 1,400W liquid loop က B300၊ Grace၊ SOCAMM နဲ့ ConnectX-8 တို့ကို အအေးပေးတာကြောင့် platform က စမ်းသပ်မှုတစ်လျှောက်လုံး တည်ငြိမ်နေခဲ့ပါတယ်။ အဲဒီ ပိုနက်ရှိုင်းတဲ့ ရှုထောင့်ကို အခုထုတ်ဝေလိုက်ပါပြီ- ကျွန်ုပ်တို့ရဲ့ WS300 thermals deep dive က MSI ရဲ့ cold plate နဲ့ radiator data ကို 2.8 နာရီကြာ instrumented run နဲ့ တွဲပေးပြီး die ကို 60C မှာ ထိန်းထားပြီး full load မှာ 2.07GHz clock မှာ flat ဖြစ်နေပါတယ်။ 1,600W power budget ကို components တွေတစ်လျှောက် အလိုအလျောက် ဖြန့်ဝေပေးပြီး compromised connection နဲ့ hardware power brake ကို စမ်းသပ်တဲ့အခါ shutdown မလုပ်ဘဲ throttle လုပ်သွားပါတယ်။ pre-wired 12VHPWR lead နဲ့ anti-sag bracket က RTX PRO expansion path ကို ပံ့ပိုးပေးပါတယ်။ ကျွန်ုပ်တို့ဆီ ရောက်လာတဲ့ ပထမဆုံး GB300 DGX Station ကို စမ်းသပ်ပြီးတဲ့နောက် XpertStation WS300 က platform အတွက် မြင့်မားတဲ့ စံနှုန်းတစ်ခု သတ်မှတ်ပေးတယ်လို့ ပြောနိုင်ပါတယ်။
XpertStation WS300 သည် ကျွန်ုပ်တို့၏ Best Desktops for Local AI leaderboard တွင် Best GB300 System slot ကို ရရှိထားပြီး ၎င်းသည် ကျွန်ုပ်တို့၏ RAM၊ GPU နှင့် Storage for Agentic AI လမ်းညွှန်တွင် မှတ်ဉာဏ်ဆွေးနွေးမှုကို အခြေခံထားသည်။

ဦးဆောင်သူစာရင်း- MSI XpertStation WS300 သည် ကျွန်ုပ်တို့၏ Best Desktops for Local AI ဦးဆောင်သူစာရင်းတွင် အကောင်းဆုံး GB300 Deskside System ကို ရရှိထားသည်။


 အမေဇုံ