

ကျွန်တော်တို့ GB300 DGX Stations နှစ်ခုကို အခု ကြည့်ပြီးပါပြီ။ မကြာသေးခင်ကမှ ကျွန်တော်တို့ရဲ့ ဓာတ်ခွဲခန်းမှာ တစ်ပြိုင်နက်တည်း နှစ်ခုကို တပ်ဆင်နိုင်ခဲ့ပါတယ်။ ASUS ExpertCenter Pro ET900N G3 နဲ့ HP ZGX Fury AI Station တို့ပါ ။ တာဝါနှစ်ခုစလုံးကို ဘေးချင်းယှဉ်ပြီး ချိတ်ဆက်ပြီး ဒုတိယ GB300 က deskside AI workloads တွေကို ပိုပြီး ညှိနှိုင်းဆောင်ရွက်နိုင်ဖို့ တစ်ခုတည်းသော စက်ရဲ့ စွမ်းဆောင်ရည်ကို ဘယ်လို မြှင့်တင်ပေးနိုင်မလဲဆိုတာ ကြည့်ချင်ခဲ့ပါတယ်။
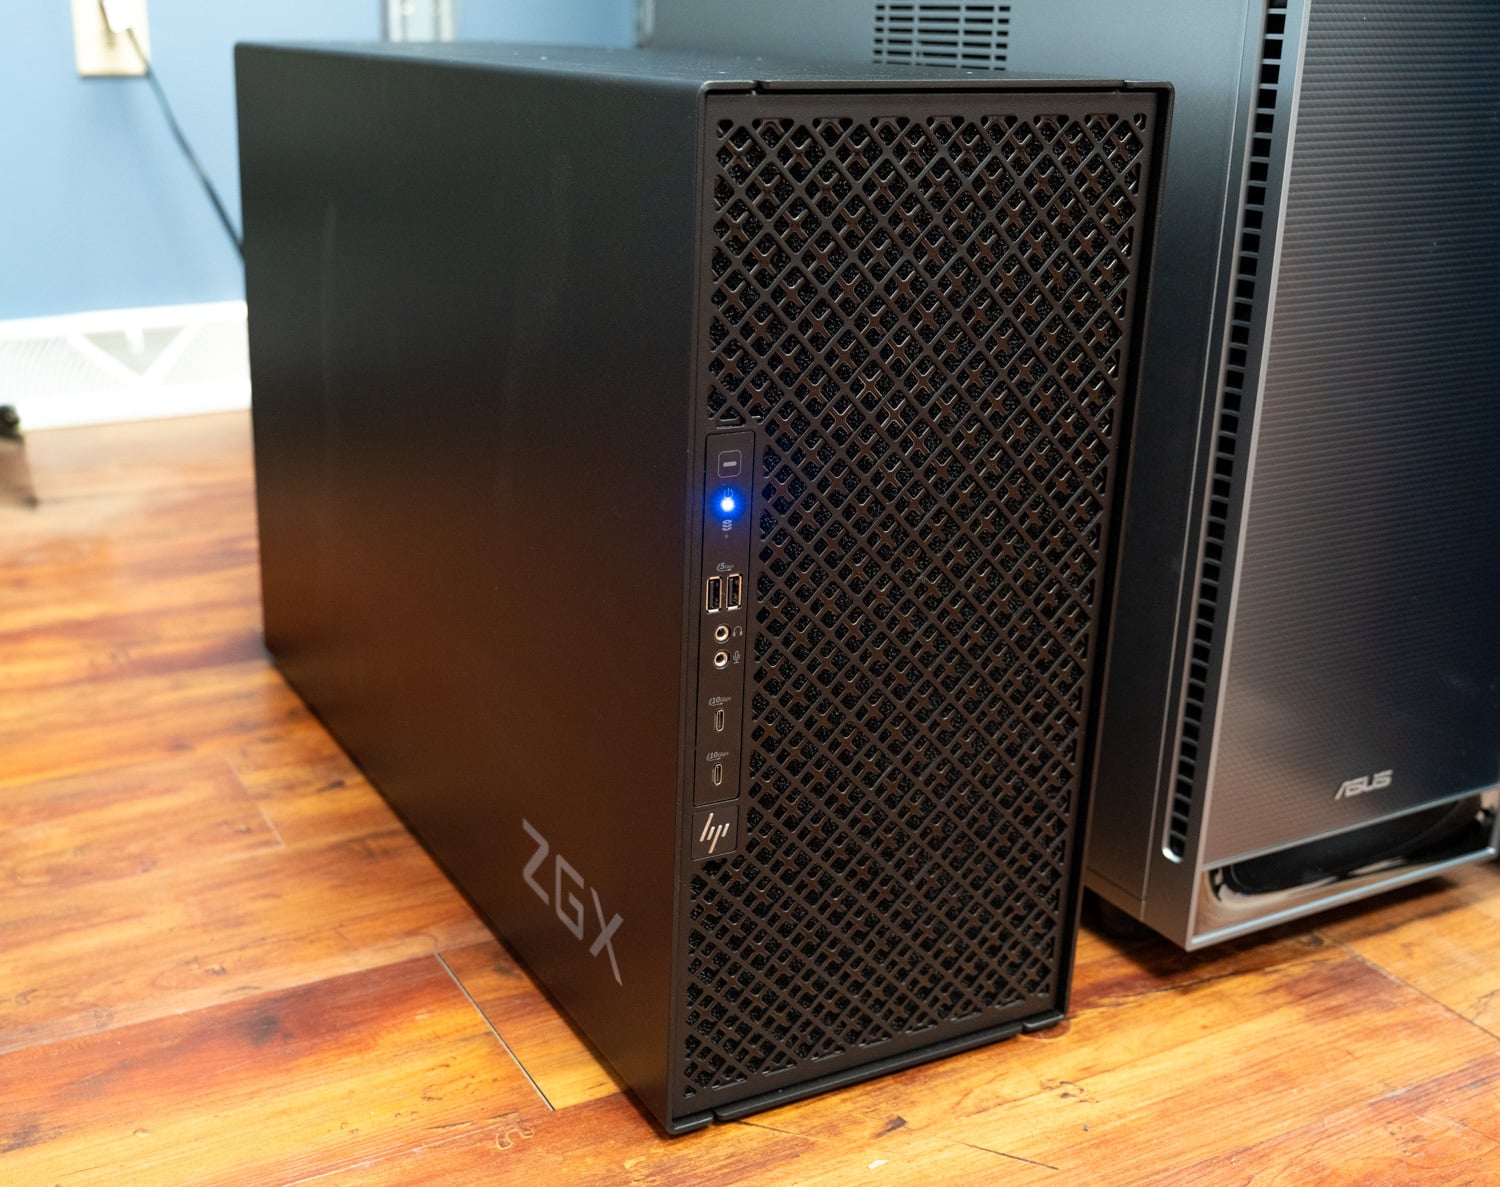
desktop setup တစ်ခုကို တစ်ခုချင်းစီ တိုးချဲ့တာဟာ အကြံဉာဏ်အသစ်မဟုတ်ပါဘူး။ NVIDIA က GB10 platform နဲ့ ဒါကို ရှင်းရှင်းလင်းလင်း မိတ်ဆက်ပေးခဲ့ပါတယ်။ DGX Spark ကို ထူးခြားစေတဲ့ အချက်တစ်ခုကတော့ စနစ်တစ်ခုနဲ့ စတင်ပြီး သင့်ရဲ့ workload တွေ တိုးလာတာနဲ့အမျှ ပိုမိုချိတ်ဆက်နိုင်စွမ်းပါပဲ။ GB300 ဟာ သိသိသာသာ စွမ်းဆောင်ရည်မြင့်မားစွာနဲ့ စတင်ပေမယ့် မော်ဒယ်ကြီးတွေကို အသုံးပြုတာ ဒါမှမဟုတ် အသုံးပြုသူတွေကို ပိုမိုဝန်ဆောင်မှုပေးတာက ကျွန်ုပ်တို့ စမ်းသပ်ဖူးသမျှ အမြန်ဆုံး desktop စက်တွေထဲက တစ်ခုကိုတောင် ထိခိုက်စေနိုင်ပါတယ်။ အဲဒါက ကျွန်ုပ်တို့ရဲ့ MSI review မှာ ပြောခဲ့တဲ့အချက်ပါ - သင့်ရဲ့ workload တွေက ဒီ Station တွေထဲက တစ်ခုကို မှန်ကန်တယ်ဆိုရင် နောက်ဆုံးမှာ အများအပြားကို ဘယ်လို မှန်ကန်အောင် လုပ်ဆောင်နိုင်မလဲဆိုတာ မြင်သာပါတယ်။
ဝယ်ယူသူအများစုအတွက် ကုန်ကျစရိတ်သည် ထိုတိုးချဲ့မှုသည် လက်တွေ့ကျလာမည့်အချိန်ကို ဆုံးဖြတ်ပေးလိမ့်မည်။ ဘူတာနှစ်ခု မည်မျှကောင်းမွန်စွာ အတူတကွ လုပ်ဆောင်သည်ကို ယခုနားလည်ခြင်းသည် ဘူတာတစ်ခုဖြင့် စတင်သူတစ်ဦးအား နောက်ပိုင်းတွင် တိုးချဲ့ခြင်းမှ မည်သည့်အကျိုးကျေးဇူးများ ရရှိနိုင်သည်ကို ပိုမိုရှင်းလင်းစွာ သိရှိနိုင်စေပါသည်။
Key ကို Takeaways
- ကြိုးနှစ်ချောင်း၊ လိုင်းနှုန်း၏ ၉၈%: ASUS ET900N G3 ရှိ ConnectX-8 port နှစ်ခုနှင့် HP ZGX Fury အကြားရှိ 400G DAC နှစ်ခုသည် NCCL သည် တစ်စုံသယ်ဆောင်နိုင်သော 100GB/s နှင့်နှိုင်းယှဉ်လျှင် broadcast၊ reduce နှင့် send/receive တွင် 98GB/s ရရှိခဲ့ပြီး၊ GPUDirect RDMA သည် rail တစ်ခုစီတွင် 392Gb/s ရရှိခဲ့ပြီး၊ 8-byte RDMA write သည် ပျမ်းမျှ 1.46 µs ရရှိခဲ့သည်။ NVIDIA ၏ playbook သည် setup ကို ကိုင်တွယ်ခဲ့သည်။
- GLM-5.2 သည် တစ်ပြိုင်နက်တည်း တူညီမှုတွင် ၁၁ ဆ တိုးလာသည်- 433GB NVFP4 checkpoint သည် stream ၃၂ ခုတွင် တစ်စက္ကန့်လျှင် output token ၁၃၉ ခုကို ဝန်ဆောင်မှုပေးသည့် Station တစ်ခုရှိ Grace memory ထဲသို့ expert weight ၂၁၅GB ခန့်ကို ယိုဖိတ်စေပြီး tensor parallel တွင် B300 နှစ်ခုတွင် ပိုင်းခြားထားသောကြောင့် stream ၃၂ ခုတွင် ၁၅၂၅ ခုနှင့် ၂၅၆ ခုတွင် ၃၁၄၁ ခုအထိ ရောက်ရှိခဲ့သည်။
- GLM-5.3 သည် တစ်စက္ကန့်လျှင် တိုကင် ၁၈၈ မှ ၅၀၁၈ အထိ တိုးလာသည်- အစုံထဲမှာ အကြီးမားဆုံး gain ဖြစ်တဲ့ 27x ဟာ 252GB HBM3e ကို ကျော်လွန်တဲ့ တခြားမော်ဒယ်ကနေ လာခဲ့တာဖြစ်ပြီး၊ ဒီမော်ဒယ်နှစ်ခုဟာ တူညီတဲ့ workload မှာ 256 streams မှာ မြင့်တက်နေဆဲဖြစ်ပြီး 8,192-token prompts တွေမှာ တစ်စက္ကန့်ကို output tokens 600 နီးပါးကို ထိန်းသိမ်းထားဆဲဖြစ်ပြီး single tower ထက် ငါးဆလောက်ရှိပါတယ်။
- MiniMax-M3 ရှည်လျားသော သတိပေးချက်များသည် ဘူတာတစ်ခုရှိ စီးကြောင်းရှစ်ခုတွင် ရပ်တန့်သွားသည်- KV cache ကုန်သွားသည်နှင့်အမျှ single tower သည် stream ရှစ်ခုတွင် တစ်စက္ကန့်လျှင် output token 103 သို့ ကျဆင်းသွားခဲ့သည်။ နှစ်ခုစလုံးသည် တစ်ချိန်တည်းတွင် 736၊ 7.1x ဖြင့် ဝန်ဆောင်မှုပေးခဲ့ပြီး stream 256 ခုတွင် 1,801 သို့ ဆက်လက်ရောက်ရှိခဲ့သည်။
- ကိုက်ညီသော မော်ဒယ်များသည် ဒုတိယမိတ္တူနှင့် prefill/decode ခွဲခြမ်းစိတ်ဖြာမှု ရရှိသည်- Station တစ်ခုကို prefill ထားပြီး နောက်တစ်ခုကို decode ထားချိန်တွင် GLM-5.3 Flash သည် stream ၃၂ ခု (၈၂၈ မှ ၂,၇၂၁) တွင် short-prompt throughput ကို သုံးဆတိုးစေပြီး long-prompt throughput ကို နှစ်ဆတိုးစေသည် (၁,၂၁၉ မှ ၂,၄၄၈)၊ DeepSeek V4.1 Flash သည် စမ်းသပ်ထားသော မော်ဒယ်များထဲတွင် အမြင့်ဆုံး output throughput ဖြစ်ပြီး stream ၂၅၆ ခုတွင် တစ်စက္ကန့်လျှင် တိုကင် ၅,၂၄၈ ရရှိခဲ့သည်။
DGX Station မှာ Networking လုပ်ခြင်း
cluster ထဲမဝင်ခင် MSI review မှာ ဖော်ပြခဲ့တဲ့ networking capabilities တွေကို ပြန်သုံးသပ်ကြည့်ရအောင်။ ConnectX-8 SuperNIC က network connection ကို ပံ့ပိုးပေးရုံသာမကပါဘူး။ ၎င်းရဲ့ integrated PCIe switch က Station ရဲ့ internal I/O ရဲ့ အစိတ်အပိုင်းတစ်ခုကိုလည်း ကိုင်တွယ်ပြီး Grace နဲ့ 2x PCIe Gen 6 x4 storage slot တွေနဲ့ ချိတ်ဆက်ပေးပါတယ်။
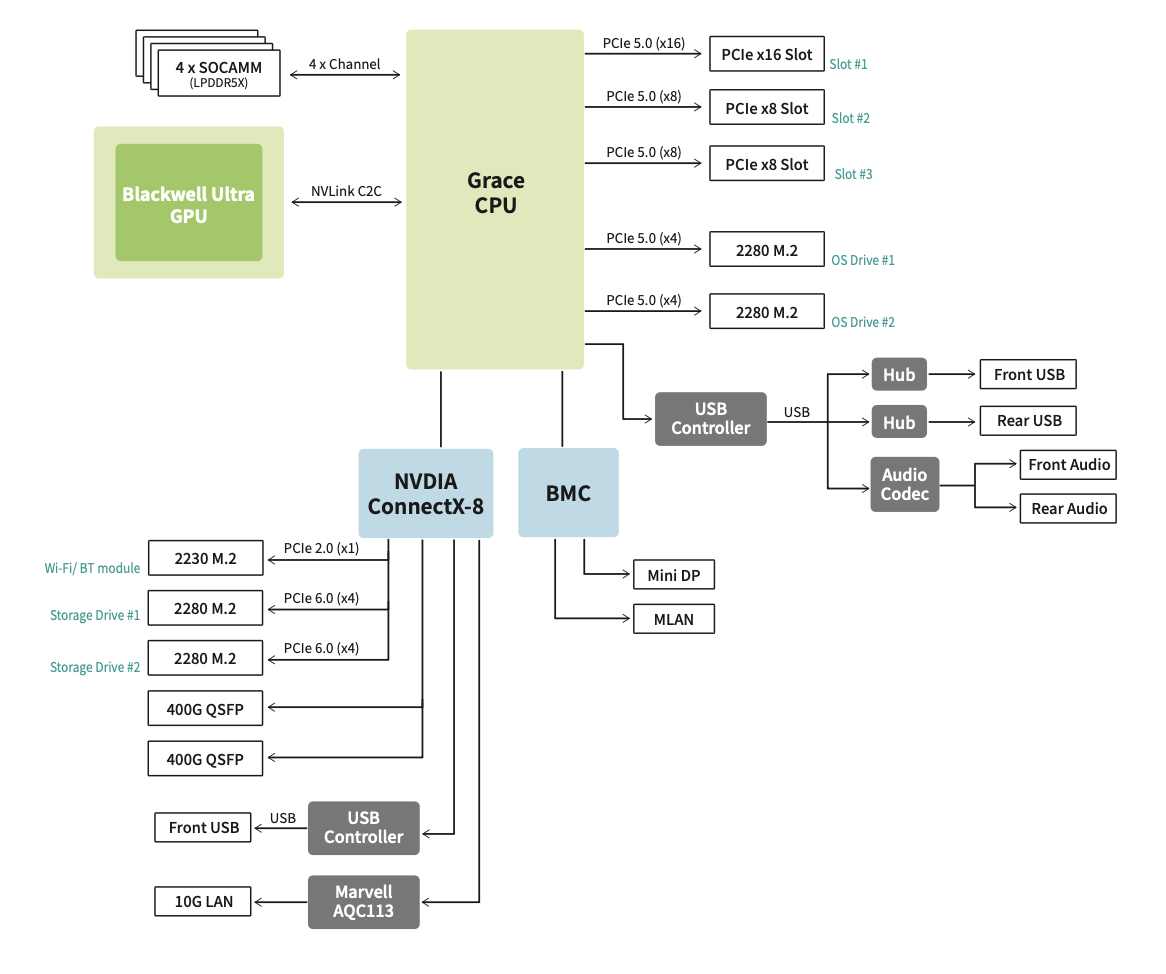
တကယ့်ကွန်ရက်ချိတ်ဆက်မှုအတွက်၊ စနစ်သည် 400Gb/s အဆင့်သတ်မှတ်ထားသော QSFP112 port နှစ်ခုကို ဖော်ထုတ်ပေးပြီး၊ Station များကို ချိတ်ဆက်ရန် သို့မဟုတ် ၎င်းတို့ကို ပိုကြီးသောကွန်ရက်သို့ ချိတ်ဆက်ရန်အတွက် စုစုပေါင်း bandwidth 800Gb/s ပေးပါသည်။
ကျွန်ုပ်တို့ရဲ့ မူရင်း DGX Spark သုံးသပ်ချက် မှာ ဖော်ပြခဲ့တဲ့ DGX Spark ရဲ့ အကောင်အထည်ဖော်မှုနဲ့ နှိုင်းယှဉ်ရင် Spark ရဲ့ 400Gb/s-class ConnectX-7 ဟာ GB10 ရဲ့ PCIe ချိတ်ဆက်မှု အပြည့်အဝ အသုံးပြုနိုင်တာထက် ပိုမိုစွမ်းဆောင်ရည်ရှိပါတယ်။ controller ဟာ သီးခြား PCIe 5.0 x4 link နှစ်ခုရဲ့ နောက်ကွယ်မှာ ရှိနေပြီး အသုံးဝင်တဲ့ aggregate network throughput ကို 200Gb/s လောက်အထိ ကန့်သတ်ထားပါတယ်။ ၎င်းရဲ့ physical port နှစ်ခုဟာ Linux မှာ logical Ethernet interface လေးခုအဖြစ်လည်း ပေါ်လာပါတယ်။ လိုအပ်တဲ့ bandwidth အပြည့်အဝရရှိဖို့ အဲဒီ interface တွေကို ချိတ်ဆက်ထားတဲ့ cage ကို ပြန် mapping လုပ်ခြင်း၊ ၎င်းနောက် ကွယ်က logical interface နှစ်ခုလုံးကို configure လုပ်ခြင်း နဲ့ RDMA traffic ဟာ PCIe path နှစ်ခုလုံးကို အသုံးပြုနိုင်ကြောင်း သေချာစေခြင်းတွေ ပါဝင်ပါတယ်။
Station က ကျွန်ုပ်တို့ကို ပိုမိုရိုးရှင်းတဲ့ အစီအစဉ်တစ်ခု ပေးစွမ်းပြီး 400Gb/s port နှစ်ခုစီက သီးခြား network rail အဖြစ် ဆောင်ရွက်ပေးနိုင်ပါတယ်။
Spark ရဲ့ အသုံးပြုနိုင်တဲ့ bandwidth ကို QSFP cages တစ်စုံကနေတစ်ဆင့် လေးဆတိုးပေးခြင်းအားဖြင့် အအေးပေးဝန်ကိုလည်း မြှင့်တင်ပေးပြီး ကျွန်ုပ်တို့ရဲ့ စမ်းသပ်မှုအတွင်းမှာ ယူနစ်တိုင်းက ဒါကို ကိုင်တွယ်ဖြေရှင်းပေးခဲ့ပါတယ်။ ConnectX-8 ကိုယ်တိုင်က အရည်နဲ့အအေးပေးထားပြီး ရောင်းချသူတချို့က MSI လို QSFP cages တွေဆီကို အဲဒီအအေးပေးစနစ်ကို တိုးချဲ့ပေးထားပြီး တခြားစနစ်တွေကတော့ ကျွန်ုပ်တို့ရဲ့ ASUS သုံးသပ်ချက်မှာ မြင်တွေ့ခဲ့ရတဲ့အတိုင်း cages တွေပေါ်မှာ heatsinks နဲ့ dedicated fan တွေကို အသုံးပြုကြပါတယ်။ အဲဒီအအေးပေးစနစ်ဟာ passive DACs တွေထက် အပူပိုထုတ်ပေးတဲ့ optical modules တွေအတွက် အထူးအသုံးဝင်ပါတယ်။ နည်းလမ်းနှစ်ခုစလုံးဟာ ကျွန်ုပ်တို့ရဲ့ စမ်းသပ်မှုမှာ ကောင်းမွန်စွာ အလုပ်ဖြစ်ခဲ့ပြီး networking မှာ အအေးပေးစနစ်ပြဿနာတွေနဲ့ ကြုံတွေ့ခဲ့ရတာ မရှိပါဘူး။
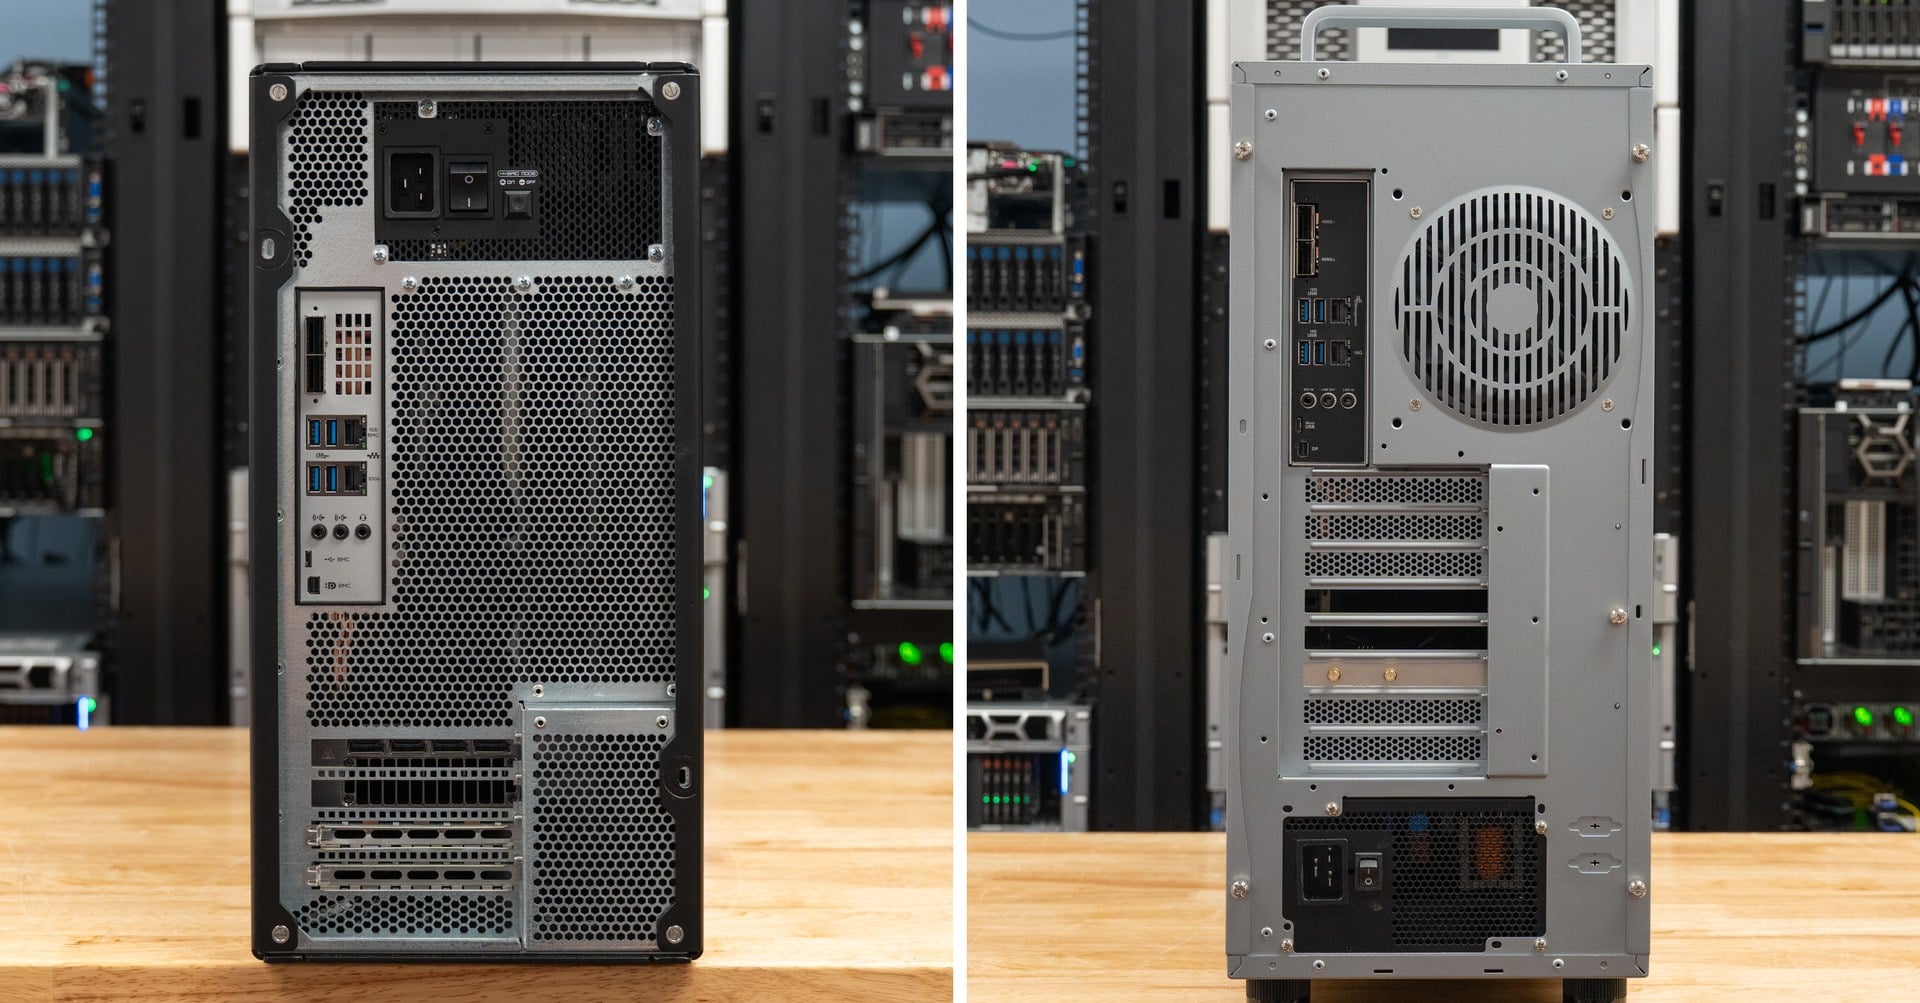
ဘူတာရုံနှစ်ခုကို ချိတ်ဆက်ခြင်း
DGX Stations နှစ်ခုကို clustering လုပ်တာက ရိုးရှင်းပါတယ်။ ASUS နဲ့ HP ကို သူတို့ရဲ့ QSFP112 ports တွေကြားမှာ 400G direct attach copper (DAC) cables နှစ်ခုကို အသုံးပြုပြီး တိုက်ရိုက်ချိတ်ဆက်ပေးခဲ့ပြီး သီးခြား 400Gb/s connection နှစ်ခုကို ရရှိခဲ့ပါတယ်။
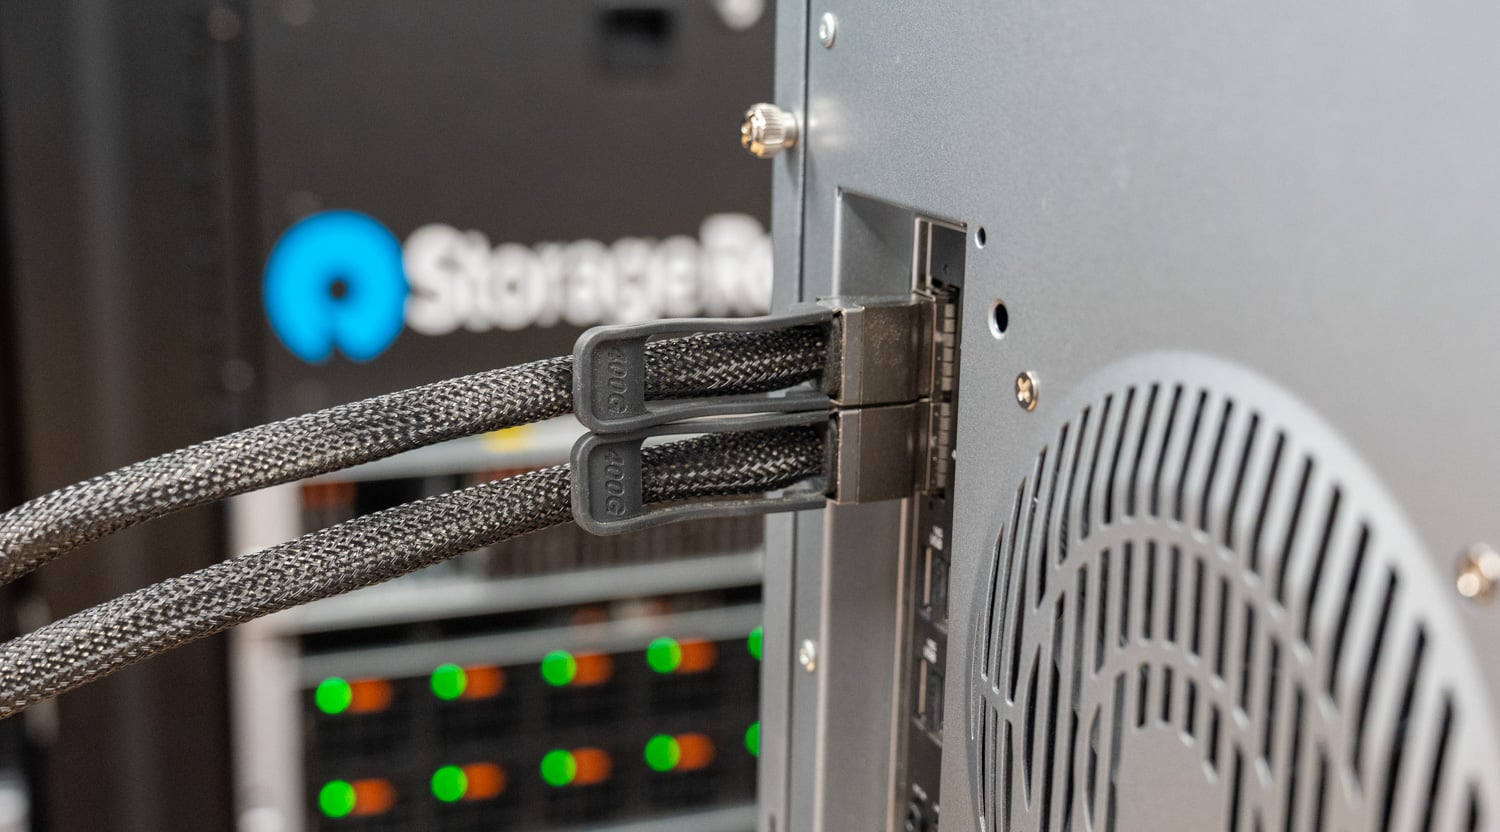
ဆော့ဖ်ဝဲလ်ဘက်မှာတော့ NVIDIA က စနစ်တွေကို clustering လုပ်နည်း အဆင့်ဆင့် လမ်းညွှန်ချက်တွေ ပေးထားပြီး ၊ ညွှန်ကြားချက်တွေကလည်း ရှင်းလင်းတာကြောင့် Claude Code ကို link ပေးပြီး setup ကို ကိုင်တွယ်ခိုင်းလိုက်ပါတယ်။ Station နှစ်ခုကြားက network ကို configure လုပ်၊ NCCL bandwidth tests တွေ လုပ်ဆောင်၊ ရလဒ်တွေရဲ့ report လည်း ပေးပါတယ်။
လမ်းညွှန်ချက်သည် တတိယစက်တစ်ခုမှ SSH မှတစ်ဆင့် Station နှစ်ခုလုံးကိုရောက်ရှိသည့် နံပါတ်တပ်ထားသော playbook တစ်ခုဖြစ်သည်။ port များကို QSFP0 မှ QSFP0 နှင့် QSFP1 မှ QSFP1 ကိုက်ညီသော rail များအဖြစ် cable တပ်ထားပြီး rail တစ်ခုစီသည် ၎င်း၏ကိုယ်ပိုင် point-to-point RoCEv2 link ဖြစ်လာသည်- script များသည် ConnectX-8 interface နှစ်ခုကို 9,000-byte MTU တွင် ယူဆောင်လာပြီး rail တစ်ခုစီကို ၎င်း၏ကိုယ်ပိုင် private /24 ပေးကာ RoCE နှင့် GPUDirect runtime setting များကို အသုံးပြုသည်။
ထို့နောက် validation pass သည် link နှစ်ခုစလုံးကို 400G တွင် လေ့ကျင့်ထားကြောင်း၊ jumbo ping များသည် rail တစ်ခုစီကို ဖြတ်ကျော်ကြောင်းနှင့် RDMA device နှစ်ခုဖြစ်သည့် mlx5_0 နှင့် mlx5_1 တို့သည် active ဖြစ်ကြောင်းနှင့် ib_write_bw သည် rail တစ်ခုစီတွင် run ခြင်းဖြင့် fabric သည် RDMA traffic ကို ping များသာမက ရွှေ့ကြောင်း သက်သေပြသည်။ ထို့နောက် NCCL ကို rail နှစ်ခုလုံးသို့ NCCL_IB_HCA=mlx5_0,mlx5_1 ဖြင့် ညွှန်ပြပြီး အခြား two-node run များကဲ့သို့ job launches ပြုလုပ်သည်။ အောက်ပါရလဒ်များသည် ထို sequence မှ ထွက်ပေါ်လာသည်။
ပထမဇယားသည် nccl-tests မှဖြစ်ပြီး၊ စုစည်းမှုများသည် ဖြန့်ဝေထားသော ကောက်ချက် သို့မဟုတ် လေ့ကျင့်ရေးအလုပ်ပြဿနာများဖြစ်ပြီး ရထားလမ်းနှစ်ခုလုံးကို အသုံးပြုထားသည့် B300 နှစ်ခုတွင် လည်ပတ်သည်။ Station တစ်ခုလျှင် GPU တစ်ခုဖြင့် စုစည်းမှုတိုင်းသည် 400G လင့်ခ်နှစ်ခုမှတစ်ဆင့် ဒေတာဖလှယ်သည့် GPU နှစ်ခုအပေါ် မူတည်သောကြောင့် bus bandwidth column သည် ကြိုးနှစ်ခုမှ ပေးဆောင်သော 100GB/s (800Gb/s) နှင့် တိုက်ရိုက်ဖတ်ရှုသည်။ Peak သည် မက်ဆေ့ချ်အရွယ်အစားများတွင် အကောင်းဆုံးရလဒ်ဖြစ်သည်။ 16 GiB column သည် bandwidth တည်ငြိမ်သွားသည့် အကြီးဆုံးမက်ဆေ့ချ်ဖြစ်သည်။
| စစ်ဆင်ရေး | အမြင့်ဆုံးအရွယ်အစား | အမြင့်ဆုံးဘတ်စ်ကား bandwidth | 16 GiB မှာ ဘတ်စ်ကား bandwidth |
|---|---|---|---|
| အားလုံးလျှော့ချ | ၂.၁ GiB | 92.242 GB ကို / s နဲ့ | 91.346 GB ကို / s နဲ့ |
| အားလုံးစုစည်းပြီး | ၂.၁ GiB | 87.893 GB ကို / s နဲ့ | 87.893 GB ကို / s နဲ့ |
| ပြန့်ကျဲမှုကို လျှော့ချပါ | ၂.၁ GiB | 93.930 GB ကို / s နဲ့ | 92.905 GB ကို / s နဲ့ |
| အသံလွှင်း | ၂.၁ GiB | 97.975 GB ကို / s နဲ့ | 97.975 GB ကို / s နဲ့ |
| Reduce | ၂.၁ GiB | 97.978 GB ကို / s နဲ့ | 97.978 GB ကို / s နဲ့ |
| အားလုံးမှ အားလုံးသို့ | ၂.၁ GiB | 80.522 GB ကို / s နဲ့ | 80.512 GB ကို / s နဲ့ |
| ပို့/လက်ခံ၊ တစ်လမ်းသွား | ၂.၁ GiB | 97.953 GB ကို / s နဲ့ | 97.953 GB ကို / s နဲ့ |
| ပို့/လက်ခံ၊ နှစ်လမ်းသွား | ၂.၁ GiB | ဦးတည်ချက်တစ်ခုလျှင် 83.748 GB/s | စုစုပေါင်း ၁၆၇.၄၉၆ GB/s |
Broadcast၊ reduce နှင့် one-way send/receive အားလုံးသည် 98GB/s အထိ ရောက်ရှိခဲ့ပြီး ကြိုးနှစ်ချောင်း သယ်ဆောင်နိုင်သည့်ပမာဏ၏ 98% ဖြစ်သည်။ တစ်ပြိုင်နက်တည်း နှစ်လမ်းစလုံးသို့ ဒေတာရွေ့လျားနေသော ပုံစံများသည် နိမ့်ကျသွားပြီး all-reduce အတွက် 92GB/s နှင့် all-to-all အတွက် 80GB/s ရှိသည်။ နှစ်လမ်းသွား send/receive ရလဒ်သည် ၎င်းတို့အတွက် ရည်ညွှန်းချက်ဖြစ်သည်- GPU နှစ်ခုလုံးသည် တစ်ချိန်တည်းတွင် ထုတ်လွှင့်နေချိန်တွင် လင့်ခ်တစ်လျှောက် ဦးတည်ချက်တစ်ခုစီသည် 84GB/s၊ စုစုပေါင်း 167GB/s တွင် တည်ငြိမ်သွားသည်။
ဒုတိယဇယားသည် NCCL အောက်ရှိ raw RDMA path သို့ ib_write_bw တစ်ကြိမ်လျှင် rail တစ်ခုတည်းကို အသုံးပြု၍ ရောက်ရှိသည်။ GPUDirect row များသည် B300 ၏ HBM တစ်ခုမှ အခြားတစ်ခုသို့ 1 MiB လွှဲပြောင်းမှုများကို ရေးသားပြီး NIC သည် GPU memory ကို တိုက်ရိုက်ဖတ်ရှုရေးသားသည်။ rail နှစ်ခုစလုံးသည် 392Gb/s ကိုရောက်ရှိပြီး line rate ၏ 98% ရှိသည်။ host-memory row များသည် လမ်းညွှန်၏ အခြေခံ smoke စမ်းသပ်မှုဖြစ်ပြီး NVIDIA ၏ playbook သည် 400G rail တွင် 220 မှ 230Gb/s အထိနှုန်းဖြင့် ရရှိသည်။ ကျွန်ုပ်တို့သည် 228Gb/s ကို တွေ့ရှိခဲ့သည်။ latency row သည် 8-byte write: ပျမ်းမျှအားဖြင့် 1.46 µs ဖြစ်သည်။
| စမ်းသပ် | bandwidth | လင့်ခ်အသုံးပြုမှု |
|---|---|---|
| GPUDirect RDMA၊ GPU မှတ်ဉာဏ်၊ ib_write_bw၊ 1 MiB လွှဲပြောင်းမှုများ | ||
| ရထားလမ်း ၉.၉ | 392.15 Gb / s ကို | 98.04% |
| ရထားလမ်း ၉.၉ | 392.15 Gb / s ကို | 98.04% |
| Host-memory RDMA၊ ရထားလမ်းနှစ်ခုလုံး | ||
| RDMA ရေးသားခြင်း၊ တစ်လမ်းသွား | 228.15 Gb / s ကို | |
| RDMA ဖတ်ရှုခြင်း၊ တစ်လမ်းသွား | 228.23 Gb / s ကို | |
| RDMA ပေးပို့ခြင်း၊ တစ်လမ်းသွား | 228.16 Gb / s ကို | |
| RDMA ရေးသားခြင်း၊ နှစ်လမ်းသွား | စုစုပေါင်း ၄၄၇.၁၀ Gb/s | |
| RDMA ရေးသားချိန် နှောင့်နှေးမှု၊ ၈ ဘိုက် | ပျမ်းမျှ ၁.၄၆ µs; ရထားလမ်းဖြင့် ၁.၆၃ နှင့် ၁.၆၆ µs ၉၉ ရာခိုင်နှုန်း | |
Cluster ကို ကျွန်ုပ်တို့ ဘယ်လိုစမ်းသပ်ခဲ့လဲ
စုံတွဲနဲ့ အချိန်အကန့်အသတ်ရှိတာကြောင့် ဒီနေ့ခေတ်မှာ အသုံးအများဆုံး AI workload ဖြစ်တဲ့ inference ကို အာရုံစိုက်ခဲ့ပါတယ်။ ဒီအလုပ်ကို cluster ပိုကြီးတွေဆီ တိုးချဲ့ဖို့ စီစဉ်ထားပါတယ်။ ဒီဆောင်းပါးအတွက်၊ ကျွန်တော်တို့က ပိုကြီးတဲ့ မော်ဒယ်တွေကို အာရုံစိုက်ပြီး tensor parallelism (TP) နဲ့ prefill/decode (PD) disaggregation ကို အသုံးပြုပြီး Single Station တစ်ခုကို Station နှစ်ခုနဲ့ နှိုင်းယှဉ်ခဲ့ပါတယ်။
Tensor parallelism သည် မော်ဒယ်အတွင်းရှိ weight tensors များနှင့် computations များကို GPU များစွာပေါ်တွင် ပိုင်းခြားပေးသည်။ ကျွန်ုပ်တို့၏ two-Station configuration သို့မဟုတ် TP2 တွင် B300 တစ်ခုစီသည် မော်ဒယ်၏ အစိတ်အပိုင်းတစ်ခုကို ကိုင်ဆောင်ထားပြီး နှစ်ခုစလုံးသည် request တစ်ခုစီတွင် အလုပ်လုပ်သည်။ ၎င်းသည် weight များကို ထည့်သွင်းရန် high-bandwidth memory (HBM) ပိုမိုရရှိစေသည့်အပြင် ၎င်းတို့ကို run ရန် compute ပိုမိုရရှိစေသည်။ ၎င်းသည် GPU များအား intermediate results များကို ဖလှယ်ရန်နှင့် inference တစ်လျှောက်လုံး NCCL မှတစ်ဆင့် synchronize လုပ်ရန်လည်း လိုအပ်သောကြောင့် communication overhead သည် မော်ဒယ်ကို run ခြင်း၏ ကုန်ကျစရိတ်၏ တစ်စိတ်တစ်ပိုင်းဖြစ်လာသည်။
Disaggregated inference သည် အလုပ်သမားများကို ခွဲထုတ်ရန် တောင်းဆိုမှု၏ prefill နှင့် decode အဆင့်များကို သတ်မှတ်ပေးသည်။ Prefill သည် input prompt ကို လုပ်ဆောင်ပြီး key/value (KV) cache ကို တည်ဆောက်သည်၊ ၎င်းမှာ model သည် generation အတွင်း ပြန်လည်အသုံးပြုသည့် attention state ဖြစ်သည်။ ထို့နောက် Decode သည် ထိုအခြေအနေကို အသုံးပြု၍ output token များကို တစ်ခုချင်းစီ generate လုပ်သည်။ အဆင့်နှစ်ဆင့်တွင် မတူညီသော processing လိုအပ်ချက်များရှိသည်- prefill သည် compute-weight များပြီး decode သည် memory bandwidth များသည်။ ပိုမိုကြီးမားသော setup များတွင်၊ ဤကဲ့သို့သော disaggregating inference သည် operator အား ဤအလုပ်သမားများကို demand အလိုက် လွတ်လပ်စွာ scale လုပ်ခွင့်ပြုသည်၊ ၎င်းသည် ကျွန်ုပ်တို့၏ KV cache offload စာတမ်းတွင် ပြသထားသည့်အတိုင်းဖြစ်သည်။
single-node setup မှာ၊ phases နှစ်ခုစလုံးမှာ worker တစ်ခုကို မျှဝေတဲ့အခါ၊ vLLM ဟာ incoming prompts တွေအတွက် prefill work ကို လုပ်ဆောင်နေတဲ့ request တွေရဲ့ decode work နဲ့ interleave လုပ်နိုင်ပါတယ်။ အဲဒီ prompt processing က output token တွေကြား အချိန်ကို တိုးစေနိုင်ပါတယ်။ ကျွန်ုပ်တို့ရဲ့ PD setup မှာ Station တစ်ခုက prefill ကို ကိုင်တွယ်ပြီး request ရဲ့ KV cache ကို တခြား Station ကို လွှဲပြောင်းပေးပြီး decode ကို ကိုင်တွယ်ပါတယ်။ worker တစ်ယောက်စီဟာ Grace memory မှာ ထည့်ထားသမျှ data တွေအပါအဝင် model ရဲ့ ကိုယ်ပိုင်မိတ္တူကို access လုပ်နိုင်ပါတယ်။ decode worker ဟာ token generation နဲ့အတူ prompt processing အသစ်ကို schedule လုပ်စရာမလိုတော့ဘဲ inference throughput ကို မြန်ဆန်စေပါတယ်။
ကျွန်ုပ်တို့ရဲ့ စမ်းသပ်မှုအတွက် မော်ဒယ်ရဲ့ မှတ်ဉာဏ်လိုအပ်ချက်တွေက ကျွန်ုပ်တို့ ဘယ်လိုချဉ်းကပ်မှုကို အသုံးပြုခဲ့လဲဆိုတာကို မောင်းနှင်ပေးခဲ့ပါတယ်။ တစ်ခုတည်းသော Station မှ မော်ဒယ်အလေးချိန်များစွာကို Grace မှတ်ဉာဏ်သို့ လျှော့ချရမည့် အကြီးဆုံးစစ်ဆေးရေးဂိတ်များအတွက် TP က ကျွန်ုပ်တို့ကို အကောင်းဆုံးစွမ်းဆောင်ရည်ကို ပေးစွမ်းခဲ့ပါတယ်။ GPU နှစ်ခုတွင် အလေးချိန်များကို ဖြန့်ကျက်ခြင်းဖြင့် မော်ဒယ်၏ အစိတ်အပိုင်းများစွာကို HBM တွင် ဆက်လက်တည်ရှိစေပြီး offload ပြစ်ဒဏ်ကို လျှော့ချပေးခဲ့ပါတယ်။ HBM တွင် လုံးဝပါဝင်သည် သို့မဟုတ် Grace သို့ offload ကန့်သတ်ထားသော Station တစ်ခုတည်းတွင် သင့်လျော်စွာ ကိုက်ညီသော မော်ဒယ်များအတွက်၊ ကျွန်ုပ်တို့ PD disaggregation ကို အသုံးပြုခဲ့ပါသည်။ ၎င်းတွင် Grace DRAM တွင် Engram lookup tables များထည့်သွင်းထားသော DeepSeek V4.1 Flash ပါဝင်သည်။
ကျွန်ုပ်တို့၏ ယခင်လွှမ်းခြုံမှုနှင့် နှိုင်းယှဉ်နိုင်မှုကို ထိန်းသိမ်းရန်အတွက်၊ fixed input sequence lengths (ISL) နှင့် output sequence lengths (OSL) ပါရှိသော ကျွန်ုပ်တို့၏ ရိုးရာနည်းလမ်းကို ဆက်လက်ထိန်းသိမ်းထားပါသည်။ ညီမျှသော workload သည် input tokens ၅၁၂ ခုနှင့် output tokens ၅၁၂ ခုကို အသုံးပြုပြီး prefill-heavy workload သည် input tokens ၈,၁၉၂ ခုနှင့် output tokens ၁၀၂၄ ခုကို အသုံးပြုပါသည်။ ထို sequence lengths များကို ပုံသေထားရှိစဉ်တွင် concurrent requests အရေအတွက်ကို ကျွန်ုပ်တို့ ပြောင်းလဲပါသည်။
ဇယားတစ်ခုစီရှိ single-Station baseline သည် ကျွန်ုပ်တို့၏သုံးသပ်ချက်မှ ASUS ET900N G3 ဖြစ်ပြီး stream ၃၂ ခုအထိ ပျံ့နှံ့သွားကာ station နှစ်ခုအထိ စီးဆင်းသွားကာ ၂၅၆ ခုအထိ ရောက်ရှိသွားသည်။ point တစ်ခုစီသည် single pass ဖြစ်သောကြောင့် concurrency level တစ်ခုတွင် ကျဆင်းမှုကို စုဆောင်းပြီးဟု အစီရင်ခံထားသည်။
ကောက်ချက်ချခြင်း ပုံစံ
| ပုံစံ | အစုအဝေးမုဒ် | Software များ | မှန်းဆချက်ဖြင့် ကုဒ်ဖြည်ခြင်း | ကျေးဇူးတော် မှတ်ဉာဏ် |
|---|---|---|---|---|
| DeepSeek V4.1 ဖလက်ရှ် (FP8) | ကြိုတင်ဖြည့်/ကုဒ်ဖြုတ် ခွဲခြမ်းစိတ်ဖြာခြင်း၊ ဘူတာတစ်ခုစီအတွက် အပြည့်အစုံမိတ္တူကူးခြင်း | vllm/vllm-openai:deepseekv41-flash-0909 | မော်ဒယ်ကိုယ်တိုင် ရေးဆွဲသူ၊ တိုကင် ၅ ခု ပြင်ဆင်ပြီး | FP8 Engram ဇယားနှစ်ခု (188.84GiB) ကို Grace မှတ်ဉာဏ်တွင် ထည့်သွင်းထားပြီး စခန်းတစ်ခုစီတွင် expert weights 131.97GB ကို offload လုပ်ထားသည်။ |
| GLM-၅.၂ NVFP၄ | တန်ဆာ ပါလက် (TP2) | NVIDIA vLLM 26.08 NGC ကွန်တိန်နာ (vLLM 0.27.1) | MTP၊ ပုံသေ ၃-တိုကင်မူကြမ်း | cluster မှာ ဘာမှ မရှိဘူး။ 215GB expert weights တွေကို Station တစ်ခုတည်းမှာ offload လုပ်ထားတယ်။ |
| GLM-5.3 ဖလက်ရှ် NVFP4 | ကြိုတင်ဖြည့်/ကုဒ်ဖြည်ခြင်း ခွဲခြမ်းစိတ်ဖြာခြင်း၊ ASUS ကြိုတင်ဖြည့်ခြင်း၊ HP ကုဒ်ဖြည်ခြင်း | vLLM ၀.၂၈.၁ RC၁ | MTP၊ ပုံသေ ၃-တိုကင်မူကြမ်း | အဘယ်သူမျှမ |
| GLM-၅.၂ NVFP၄ | တန်ဆာ ပါလက် (TP2) | NVIDIA vLLM 26.08 NGC ကွန်တိန်နာ (vLLM 0.27.1) | MTP၊ ပုံသေ ၃-တိုကင်မူကြမ်း | cluster မှာ ဘာမှ မရှိဘူး။ Station တစ်ခုတည်းမှာ expert weights ၂၁၅GB လောက် offload လုပ်ထားတယ်။ |
| MiniMax-M3 NVFP4 | တန်ဆာ ပါလက် (TP2) | NVIDIA vLLM 26.08 NGC ကွန်တိန်နာ (vLLM 0.27.1) | EAGLE3၊ ပြင်ဆင်ထားသော တိုကင် ၃ ခုပါ မူကြမ်း | အစုအဝေးတွင် မည်သူမျှ မရှိပါ။ တစ်ခုတည်းသော စခန်းတွင် ဖြန့်ကျက်ထားသော ကျွမ်းကျင်သူများ၏ အပိုင်းအစတစ်ခု |
ကောက်ချက်ချမှုစွမ်းဆောင်ရည်
DeepSeek V4.1 ဖလက်ရှ်
DeepSeek V4.1 Flash ကို ခွဲထားပြီး၊ တစ်ခုက Station ကို ကိုင်တွယ်ပြီး နောက်တစ်ခုက decode လုပ်ပါတယ်။ Station တစ်ခုစီမှာ မော်ဒယ်ရဲ့ မိတ္တူအပြည့်အစုံကို သိမ်းဆည်းထားပါတယ်။ စုစုပေါင်း FP8 Engram ဇယားနှစ်ခု၊ 188.84GiB ကို Grace မှတ်ဉာဏ်မှာ pin လုပ်ထားပြီး နောက်ထပ် 131.97GB expert weights ကို Grace မှာ offload လုပ်ထားပါတယ်။ ဒါကြောင့် စက်နှစ်ခုလုံးမှာ Grace မှတ်ဉာဏ်ကို အသုံးပြုထားတဲ့ set ထဲက တစ်ခုတည်းသော configuration ဖြစ်လာပါတယ်။ ASUS review မှာ single-Station line မပါဘဲ ဒီမှာရှိတဲ့ မော်ဒယ်တစ်ခုတည်းလည်း ဖြစ်ပါတယ်။ ဘာလို့လဲဆိုတော့ ASUS review က V4 Flash checkpoint ကို run ထားပြီး နှစ်ခုက တိုက်ရိုက်နှိုင်းယှဉ်လို့မရလို့ပါ။
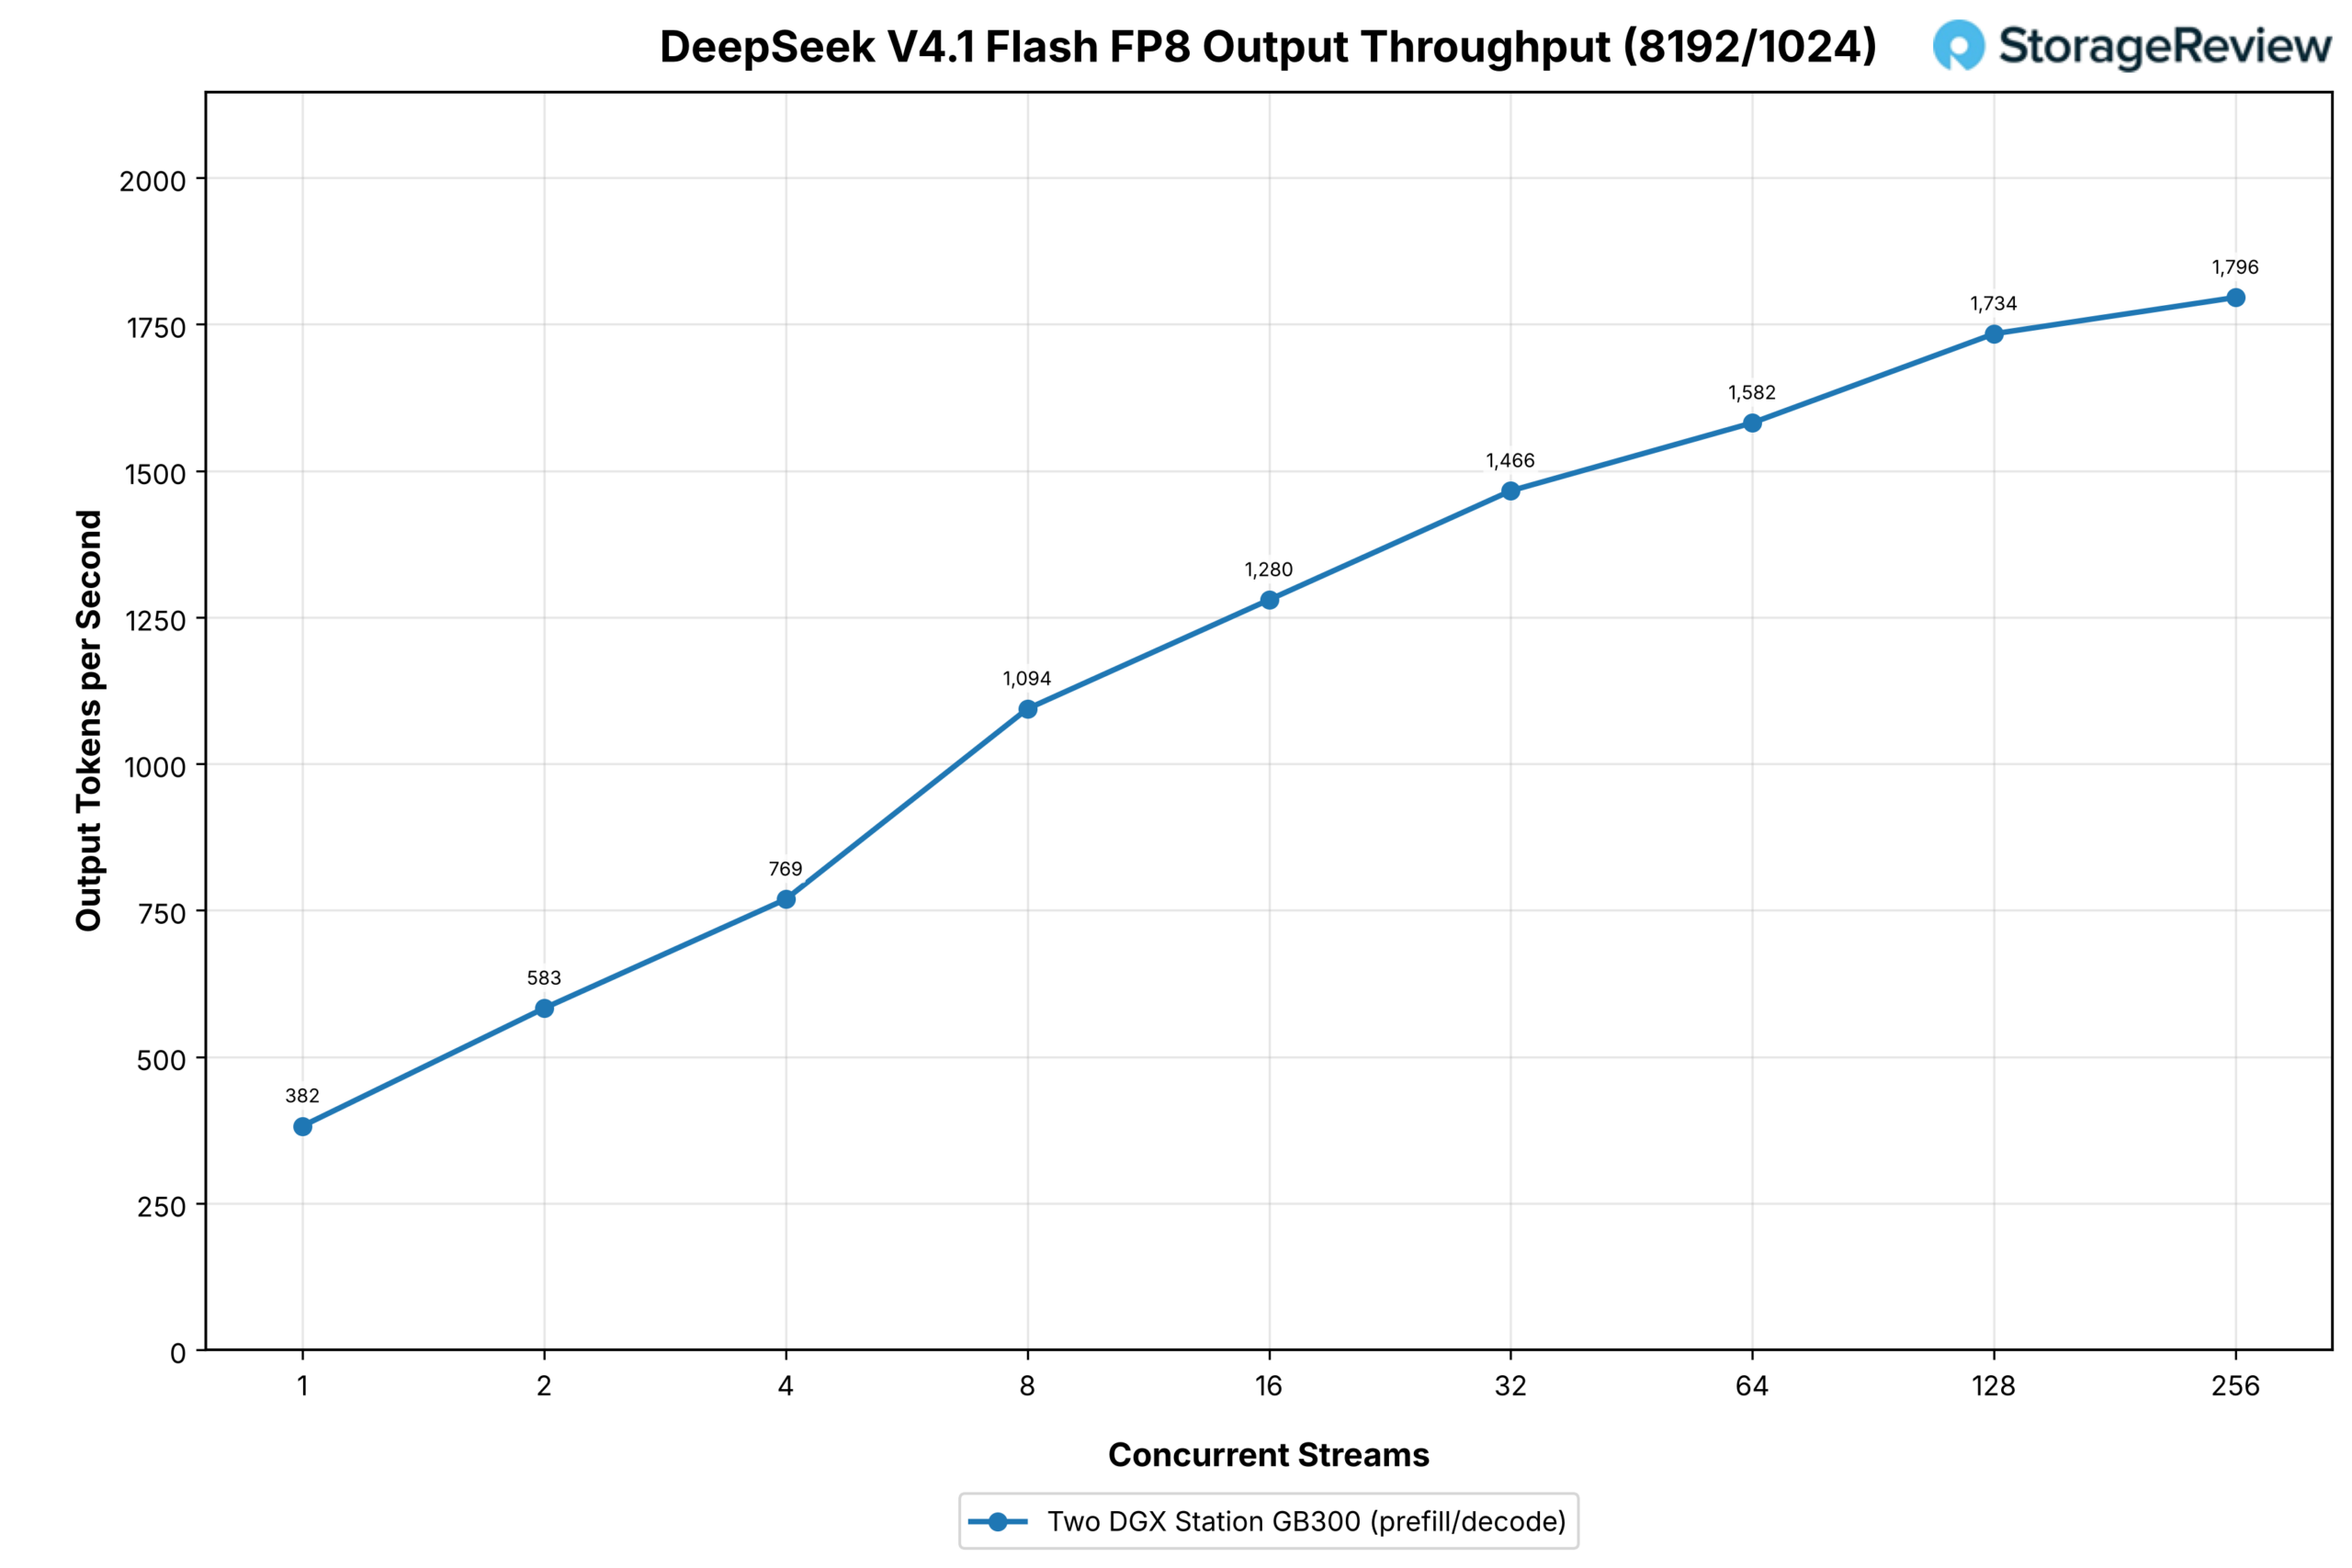
နှစ်ခု-Station cluster မှာ native FP8 မော်ဒယ်ဟာ stream တစ်ခုမှာ တစ်စက္ကန့်ကို output token ၄၄၁ ခုကနေ ၃၂ မှာ ၃၃၂၈ ခု၊ ၁၂၈ မှာ ၅၁၄၁ ခု နဲ့ ၂၅၆ မှာ ၅၂၄၈ ခုအထိ လည်ပတ်ခဲ့ပြီး ဒီ set ထဲက ဘယ်မော်ဒယ်ထက်မဆို အမြင့်ဆုံး output throughput ဖြစ်ပြီး curve က sweep ရဲ့ထိပ်မှာပဲ flattening ဖြစ်နေပါတယ်။ ကိုးကားချက်အနေနဲ့ ASUS Station တစ်ခုတည်းက V4 Flash ကို ကျွန်တော်တို့ရဲ့ review မှာ stream ၃၂ မှာ တစ်စက္ကန့်ကို output token ၁,၇၆၆ ခုနဲ့ လည်ပတ်ခဲ့ပါတယ်။
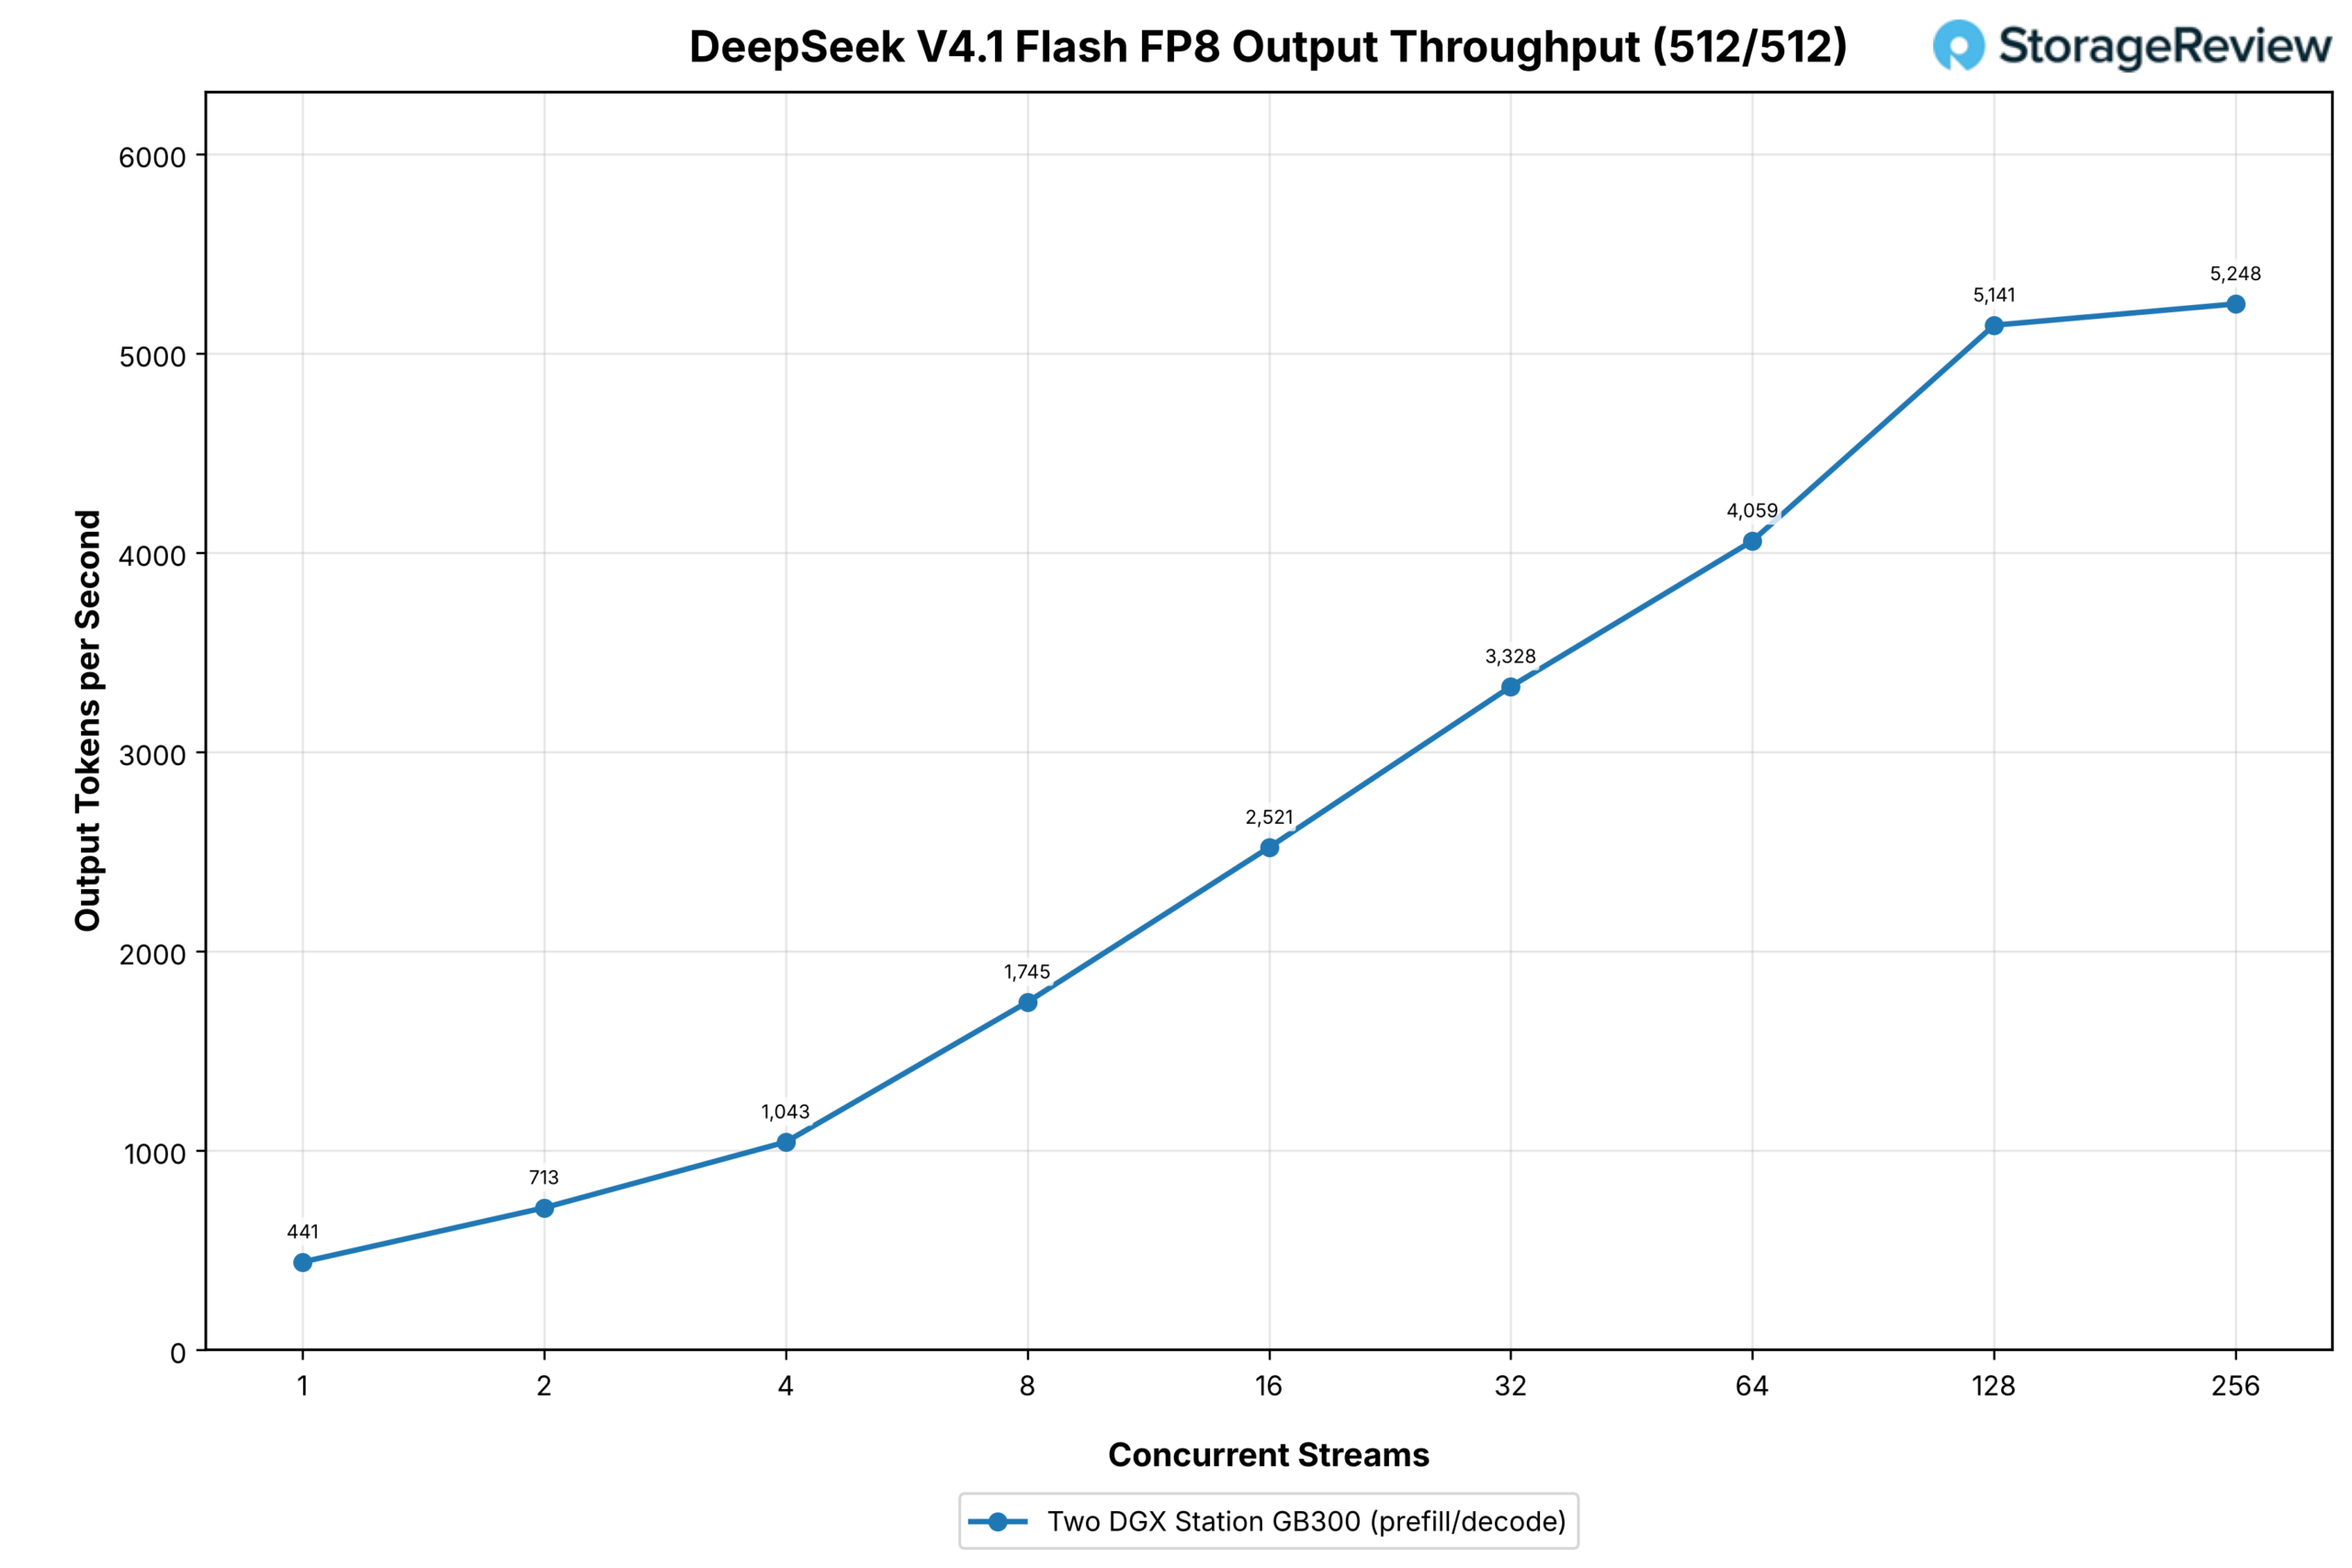
prefill-heavy profile တွင်၊ cluster သည် stream တစ်ခုတွင် တစ်စက္ကန့်လျှင် output tokens ၃၈၂ ခုမှ ၃၂ တွင် ၁,၄၆၆ ခုနှင့် ၂၅၆ တွင် ၁,၇၉၆ ခုအထိ လည်ပတ်ခဲ့ပြီး၊ request တစ်ခုစီတွင် input tokens ၈,၁၉၂ ခု ပါဝင်သောကြောင့်၊ sweep ၏ထိပ်တွင် စုစုပေါင်း throughput သည် တစ်စက္ကန့်လျှင် ၁၆,၁၆၃ ခုအထိ ရောက်ရှိခဲ့သည်။ Engram ဇယားများနှင့် expert weights ၁၃၁.၉၇GB တို့ကို Station တစ်ခုစီတွင် Grace memory တွင် ထည့်သွင်းထားခြင်းဖြင့်၊ curves များသည် မည်သို့ပင်ရှိစေကာမူ sweep တစ်လျှောက်လုံးတွင် ချောမွေ့နေခဲ့သည်။
GLM-5.3
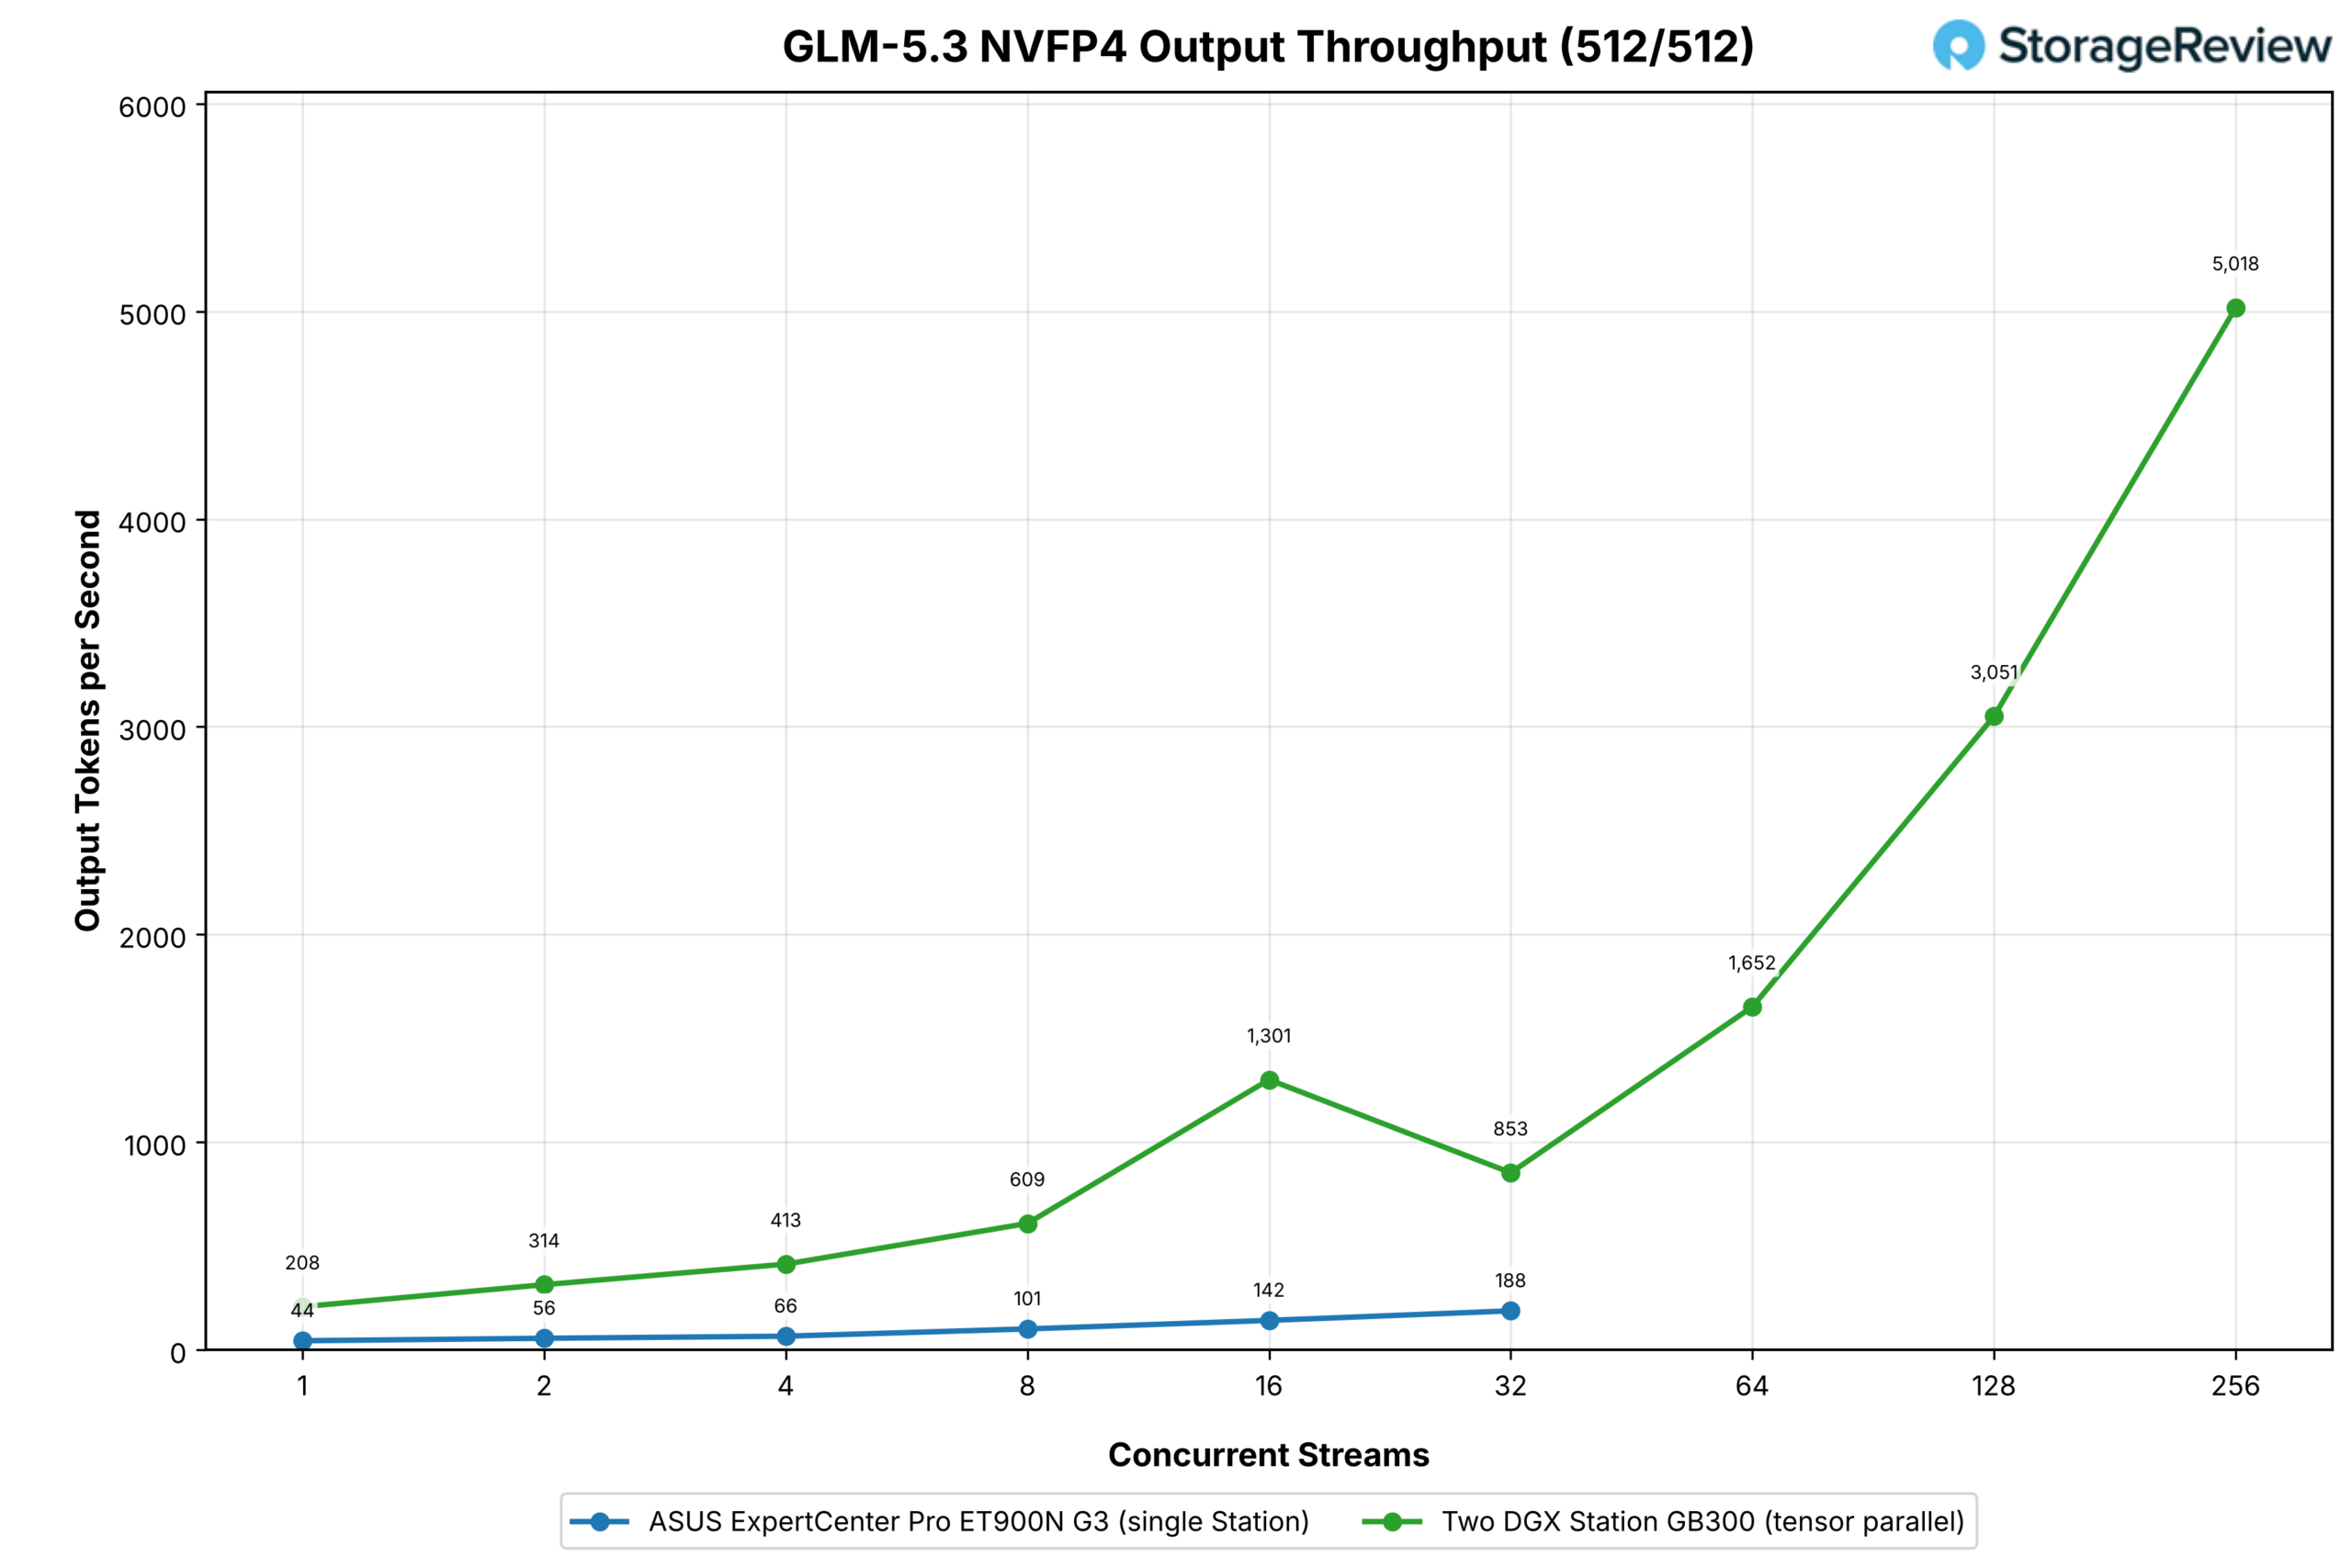
GLM-5.3 သည် TP2 တွင် Grace offload မရှိဘဲ လည်ပတ်ခဲ့သည်။ Station တစ်ခုတည်းတွင် expert weights 215GB ကို Grace memory သို့ offload လုပ်ပြီး၊ cluster ရလဒ်သည် GLM-5.2 သည် မညီမညာဖြစ်မသွားမီ sweep အများစုကို ဖြတ်သန်းသွားပါသည်။ Station တစ်ခုသည် တူညီသော workload တွင် stream တစ်ခုတွင် တစ်စက္ကန့်လျှင် output tokens ၄၄ ခုမှ ၁၈၈ ခုအထိ လည်ပတ်ခဲ့သည်။
နှစ်ခုပါသော Station cluster သည် stream တစ်ခုတွင် 208 မှ 16 တွင် 1,301 အထိ လည်ပတ်ခဲ့ပြီး၊ single tower တွင် 4.7x မှ 9.2x အကြားရှိခဲ့ပြီး 32 တွင် 853 သို့ ကျဆင်းသွားပြီးနောက် 64 တွင် 1,652၊ 128 တွင် 3,051 နှင့် 256 တွင် 5,018 သို့ ပြန်လည်တက်သွားခဲ့သည်။ 32-stream point သည် စုဆောင်းထားသော data တွင်ရှိသည်။ batching decision များနှင့် kernel selection နှစ်ခုစလုံးသည် concurrency မြင့်တက်လာသည်နှင့်အမျှ ပြောင်းလဲသွားပြီး tensor-parallel deployment သည် နောက်တစ်ဆင့်မတိုင်မီ ပြီးမြောက်ရမည့် layer တိုင်းတွင် collective တစ်ခုကို ပေါင်းထည့်ပေးသောကြောင့် curve သည် straight line မဟုတ်သော်လည်း 256 streams တွင် ceiling သည် Station တစ်ခု 32 တွင် ရောက်ရှိခဲ့သည်ထက် 27x ပိုများသည်။
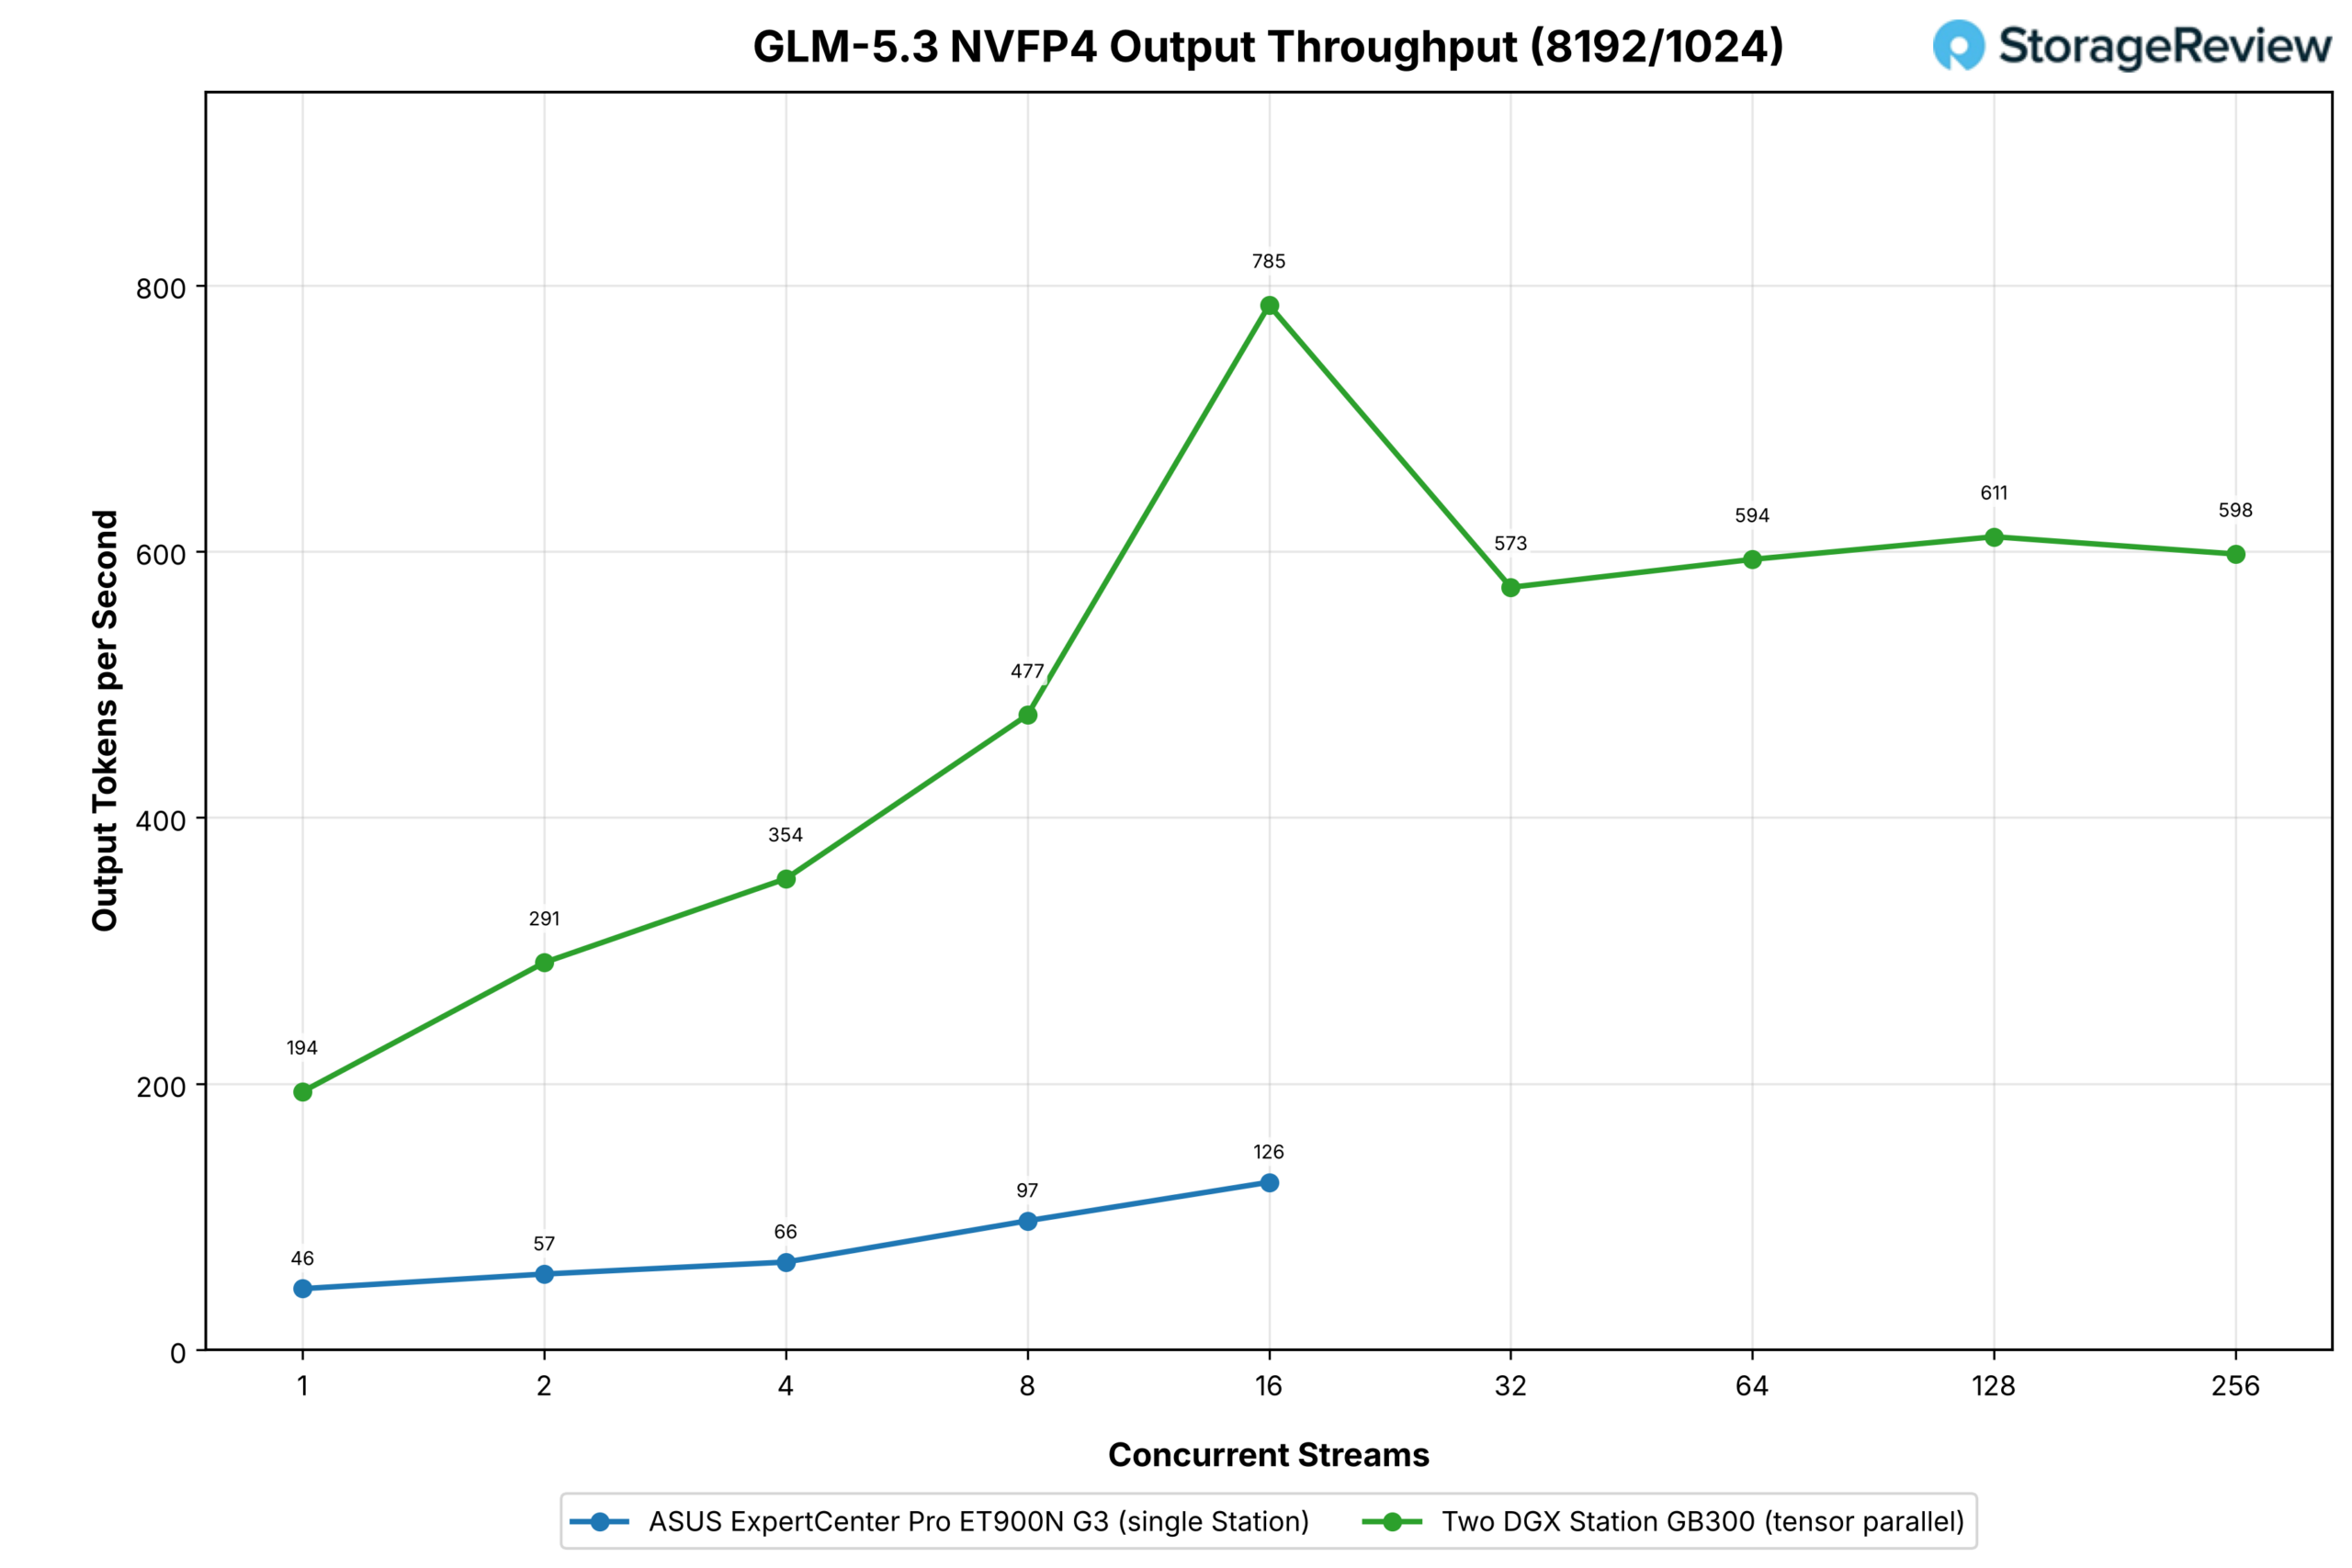
prefill-heavy profile မှာ single Station ဟာ ဒီဇိုင်းအရ stream ၁၆ ခုမှာ ရပ်တန့်သွားပါတယ်- offloaded model ဟာ အစောပိုင်းမှာ flatten ဖြစ်ပြီး concurrency ကို ဆက်လက်တွန်းအားပေးခြင်းကနေ သင်ယူစရာ အနည်းငယ်သာရှိပါတယ်။ stream တစ်ခုမှာ တစ်စက္ကန့်ကို output token ၄၆ ခုကနေ ၁၆ ခုမှာ ၁၂၆ ခုအထိ ရွေ့လျားသွားခဲ့ပါတယ်။ cluster ဟာ တူညီတဲ့ range မှာ ၁၉၄ ကနေ ၇၈၅ အထိ ရွေ့လျားခဲ့ပြီး အပေါ်ဆုံးမှာ ၆.၂x ရှိခဲ့ပြီး stream ၃၂ ခုကနေ ၂၅၆ ခုအထိ ၅၇၃ ကနေ ၆၁၁ ကြားမှာ တည်ငြိမ်နေခဲ့ပြီး တစ်စက္ကန့်ကို output token ၆၀၀ အနီးမှာ ကြာရှည်စွာ တည်ရှိနေခဲ့ပြီး single Station ရဲ့ အကောင်းဆုံးထက် ငါးဆလောက် မြင့်မားနေဆဲပါ။
GLM-5.3 ဖလက်ရှ်
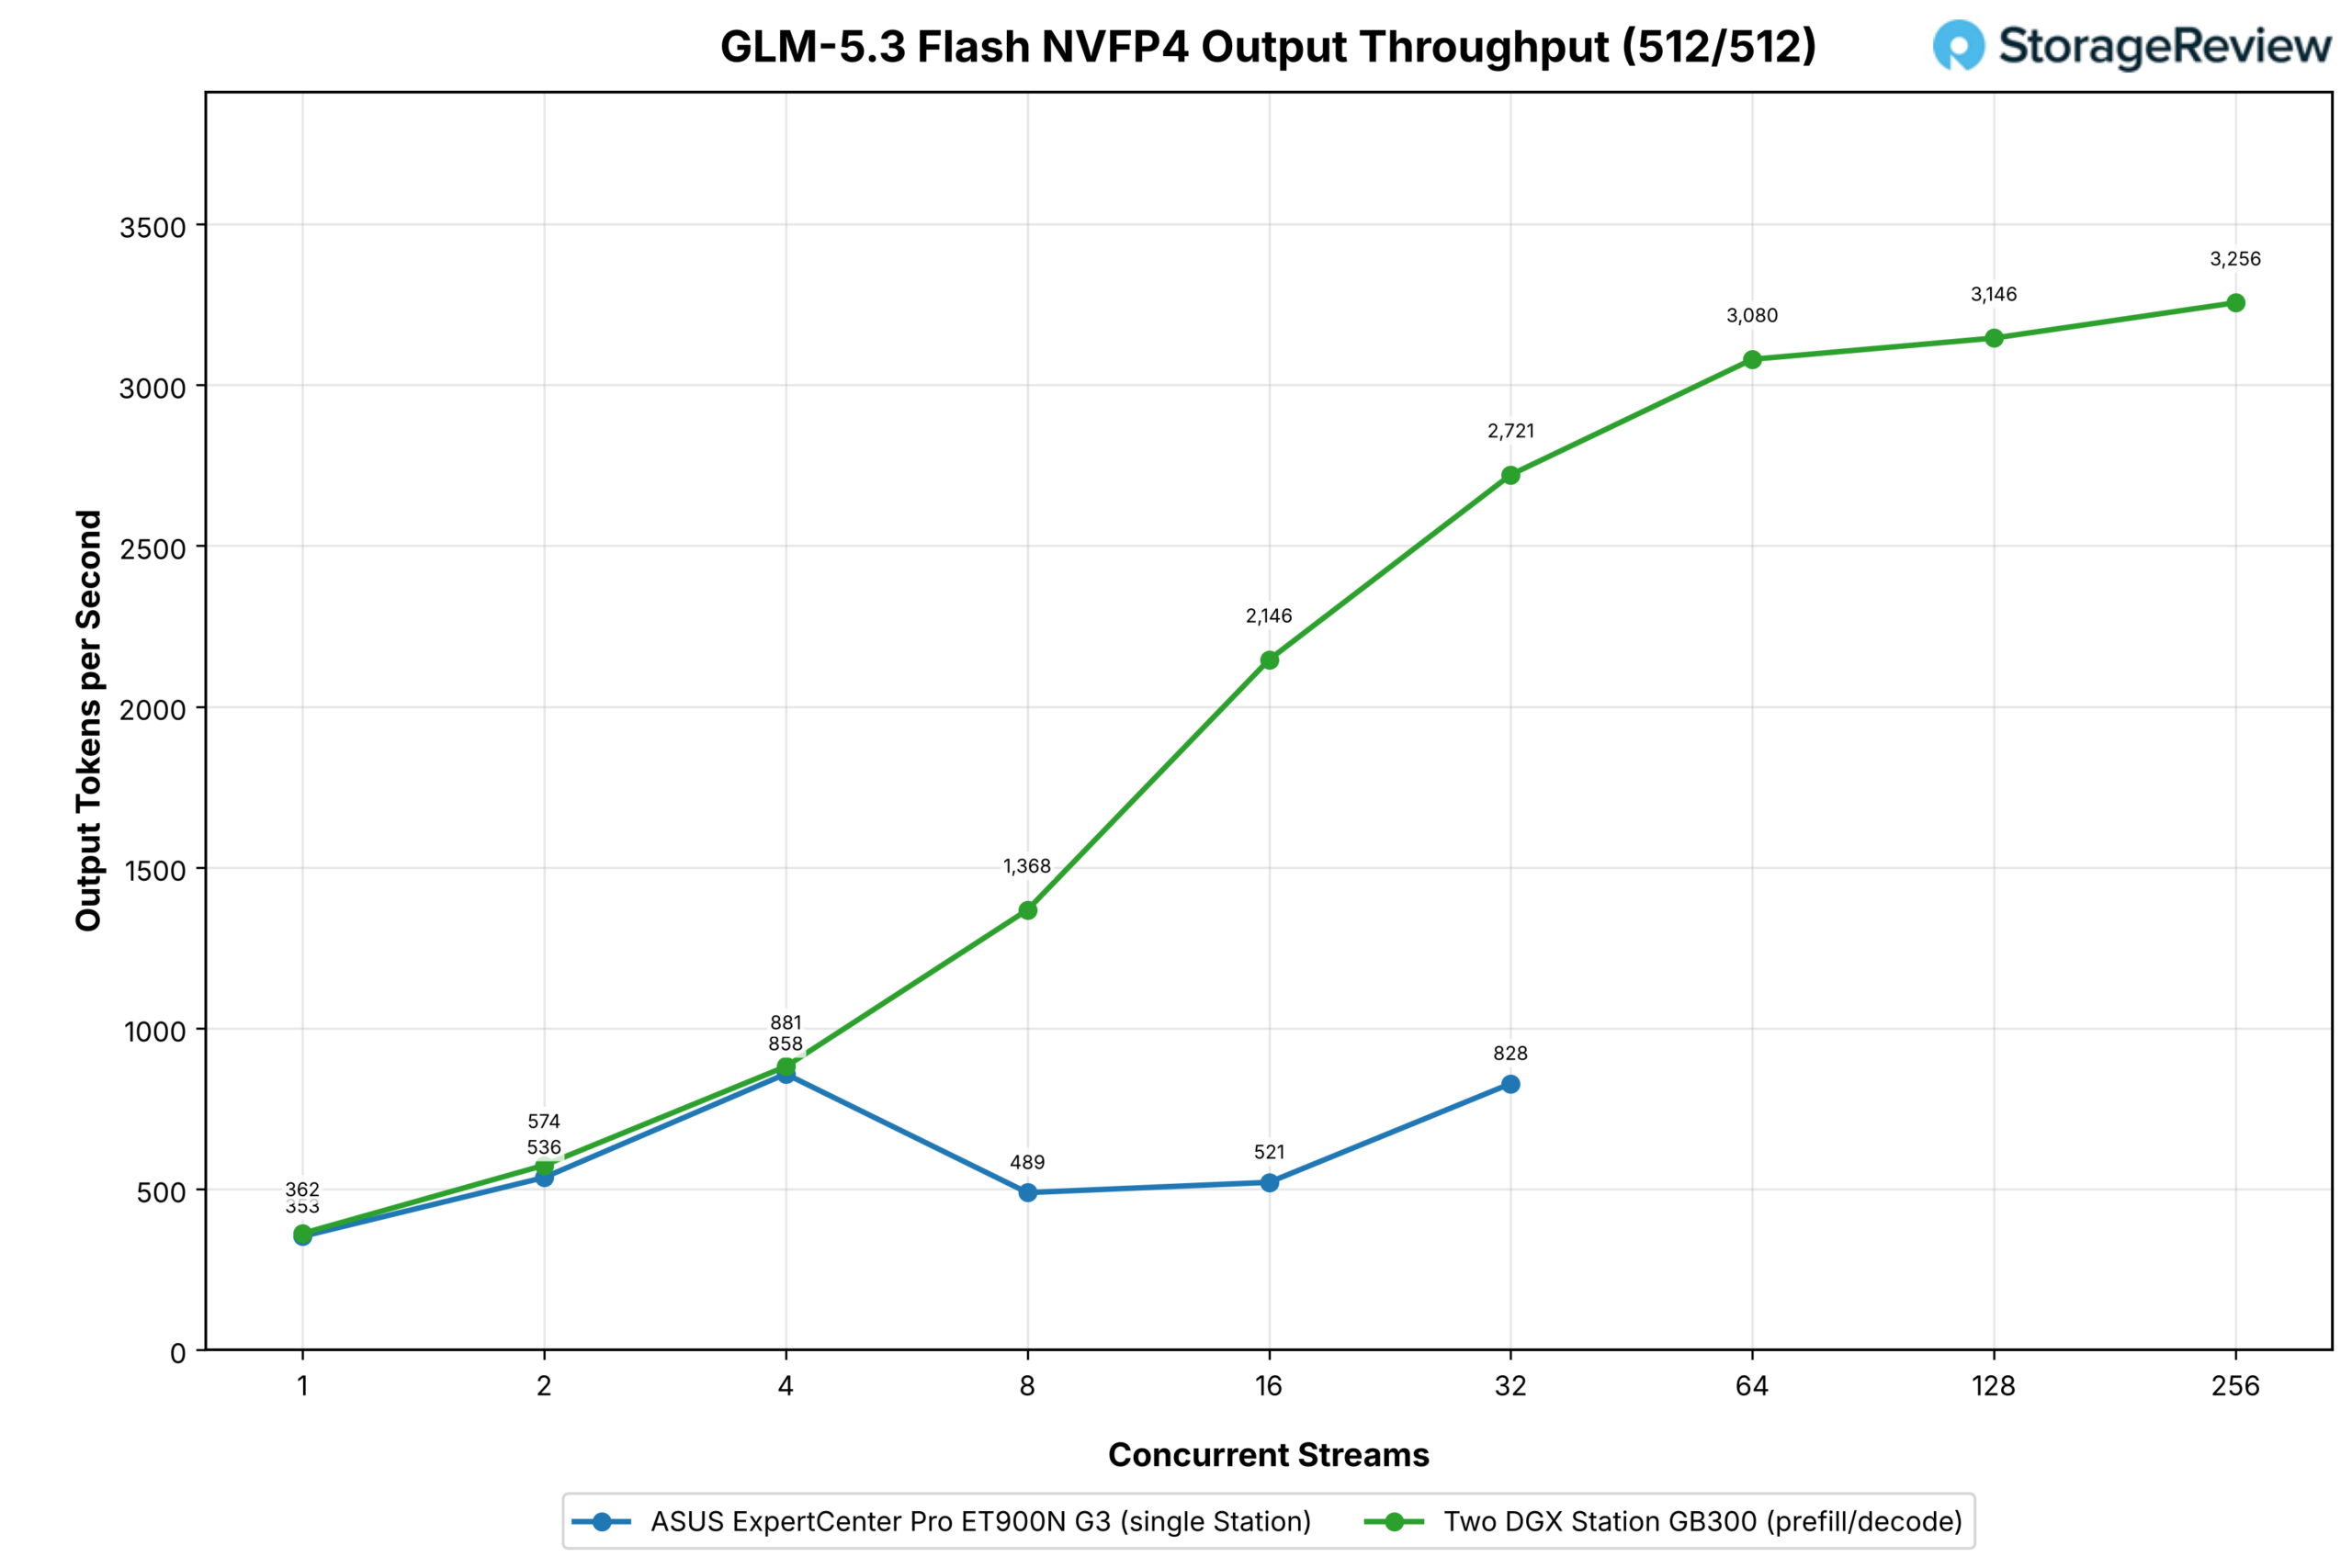
GLM-5.3 Flash ဟာ Station တစ်ခုစီအတွက် မိတ္တူအပြည့်အစုံ သိမ်းဆည်းထားနိုင်လောက်အောင် သေးငယ်တာကြောင့် ASUS handling prefill နဲ့ HP handling decode တို့နဲ့ ခွဲပြီး လုပ်ဆောင်ပါတယ်။ Flash မှာ active parameter အရေအတွက် နည်းတာကြောင့် Station တစ်ခုတည်းမှာ မြန်ဆန်စွာ လုပ်ဆောင်ပြီးသား ဖြစ်ပါတယ်- stream တစ်ခုမှာ တစ်စက္ကန့်ကို output token ၃၅၃ ခုနဲ့ equal workload မှာ ၃၂ ခုမှာ ၈၂၈ ခု၊ စုဆောင်းထားတဲ့ အလယ်မှာ မညီမညာ (stream လေးခုမှာ ၈၅၈ ခု၊ ရှစ်ခုမှာ ၄၈၉ ခု) ရှိပြီး ကျွန်ုပ်တို့က စုဆောင်းပြီးပြီလို့ အစီရင်ခံနေပါတယ်။
ခွဲထားသောအတွဲတွင်၊ တူညီသော workload သည် stream တစ်ခုတွင် တစ်စက္ကန့်လျှင် output tokens ၃၆၂ ခုမှ ၃၂ ခုတွင် ၂,၇၂၁ ခု၊ single tower တွင် ၃.၃ ဆ နှင့် stream ၂၅၆ ခုတွင် ၃,၂၅၆ ခုအထိ ရှိသည်။
stream တစ်ခုနဲ့ နှစ်ခုမှာ ဒီအတွဲဟာ တစ်ခုတည်းသော Station ကို တစ်ထပ်တည်း ကိုက်ညီစေပြီး decode Station က တစ်ခုတည်း အလုပ်လုပ်နေချိန်မှာ မျှော်လင့်ထားရမယ့်အရာပါ။ prefill Station အလုပ်များနေစေဖို့နဲ့ decode Station က prefill အတွက် ဘယ်တော့မှ ရပ်တန့်မနေစေဖို့အတွက် request တွေ လုံလောက်စွာ ရရှိတဲ့အခါ gain ရရှိပါတယ်။
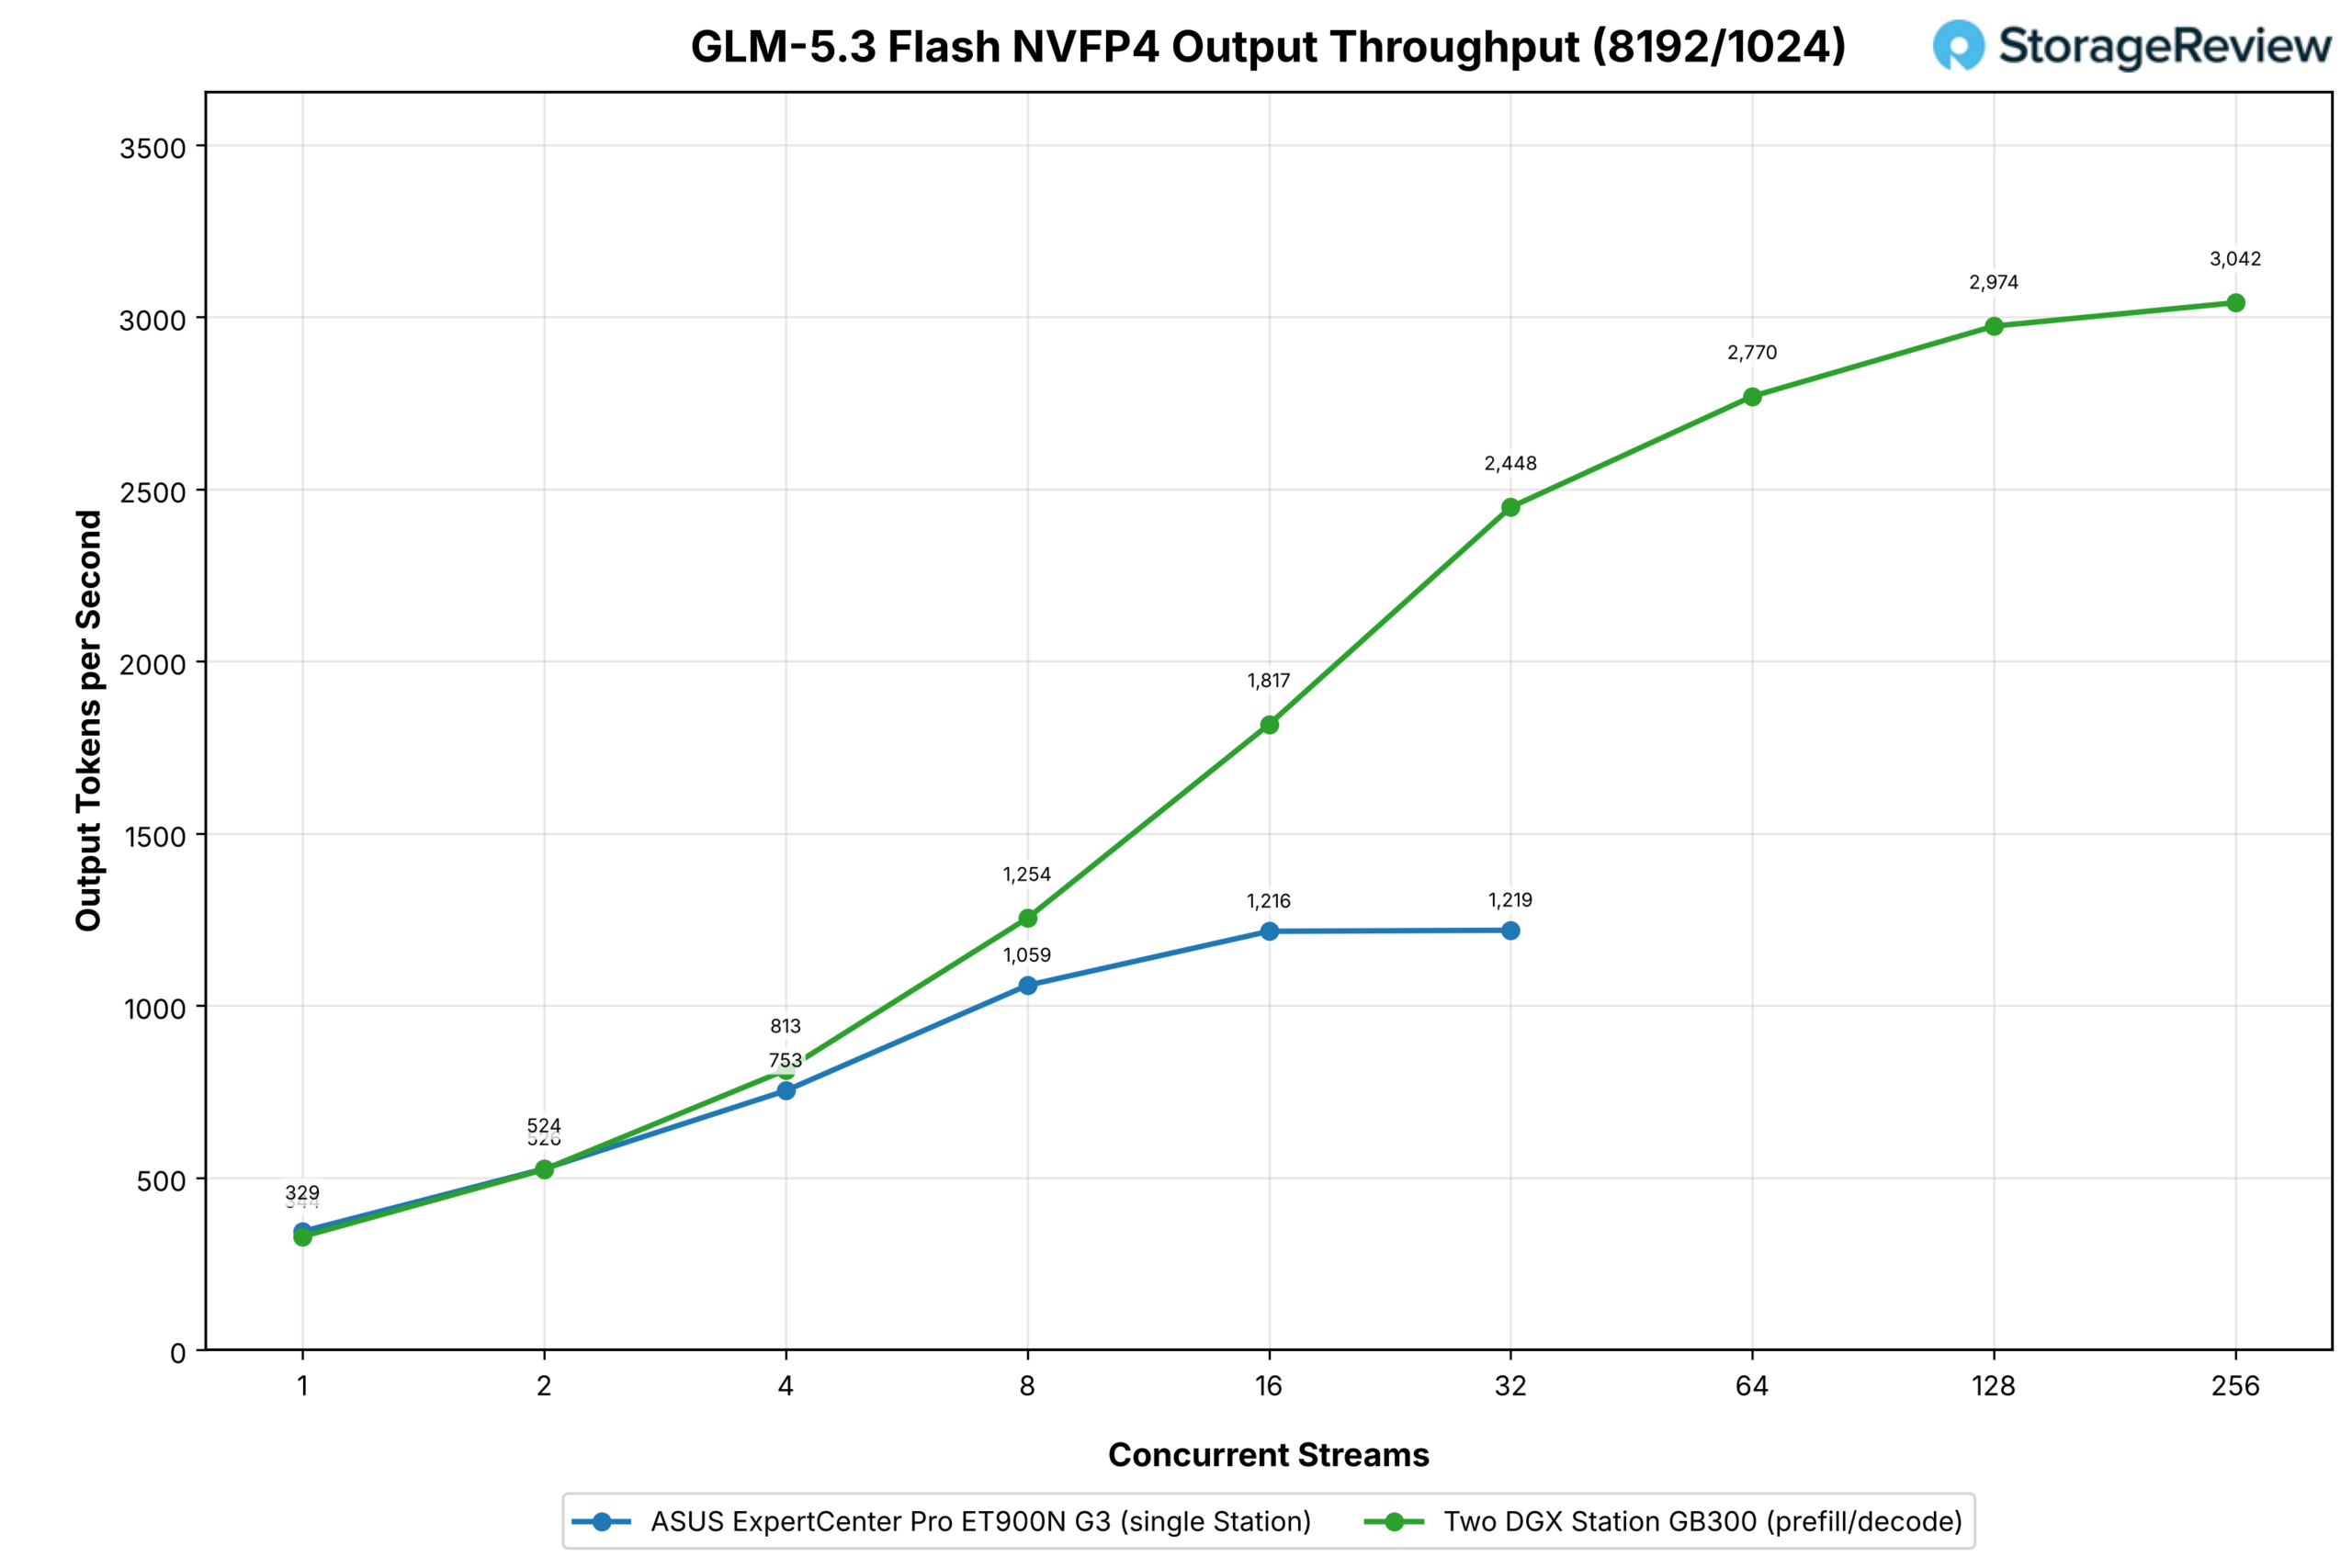
prefill-heavy profile မှာ single Station ဟာ stream တစ်ခုမှာ တစ်စက္ကန့်ကို output token ၃၄၄ ခုကနေ ၁၆ ခုမှာ ၁,၂၁၆ ခုအထိ မြင့်တက်ခဲ့ပြီး ၃၂ ခုမှာ ၁,၂၁၉ ခုအထိ ထိန်းထားနိုင်ခဲ့ပြီး ၁၆ ခုဆက်တိုက် stream တွေမှာတော့ တည်ငြိမ်နေခဲ့ပါတယ်။ prefill/decode pair ကတော့ stream တစ်ခုမှာ ၃၂၉ ခုကနေ ၃၂ ခုမှာ ၂,၄၄၈ ခုအထိ ဆက်လက်မြင့်တက်ခဲ့ပြီး leveled ဖြစ်ခဲ့တဲ့ single Station ရဲ့ နှစ်ဆနဲ့ ၂၅၆ ခုမှာ ၃၀၄၂ ခုအထိ မြင့်တက်ခဲ့ပါတယ်။ ဒီ split ကို တည်ဆောက်ထားတဲ့အတွက် ရှည်လျားတဲ့ prompts တွေရှိပါတယ်။ ဘာလို့လဲဆိုတော့ prefill Station က ၈,၁၉၂-token prompts တွေကို စုပ်ယူပြီး decode Station ရဲ့ KV cache နဲ့ compute က generation မှာပဲ ရှိနေလို့ပါ။
GLM-5.2
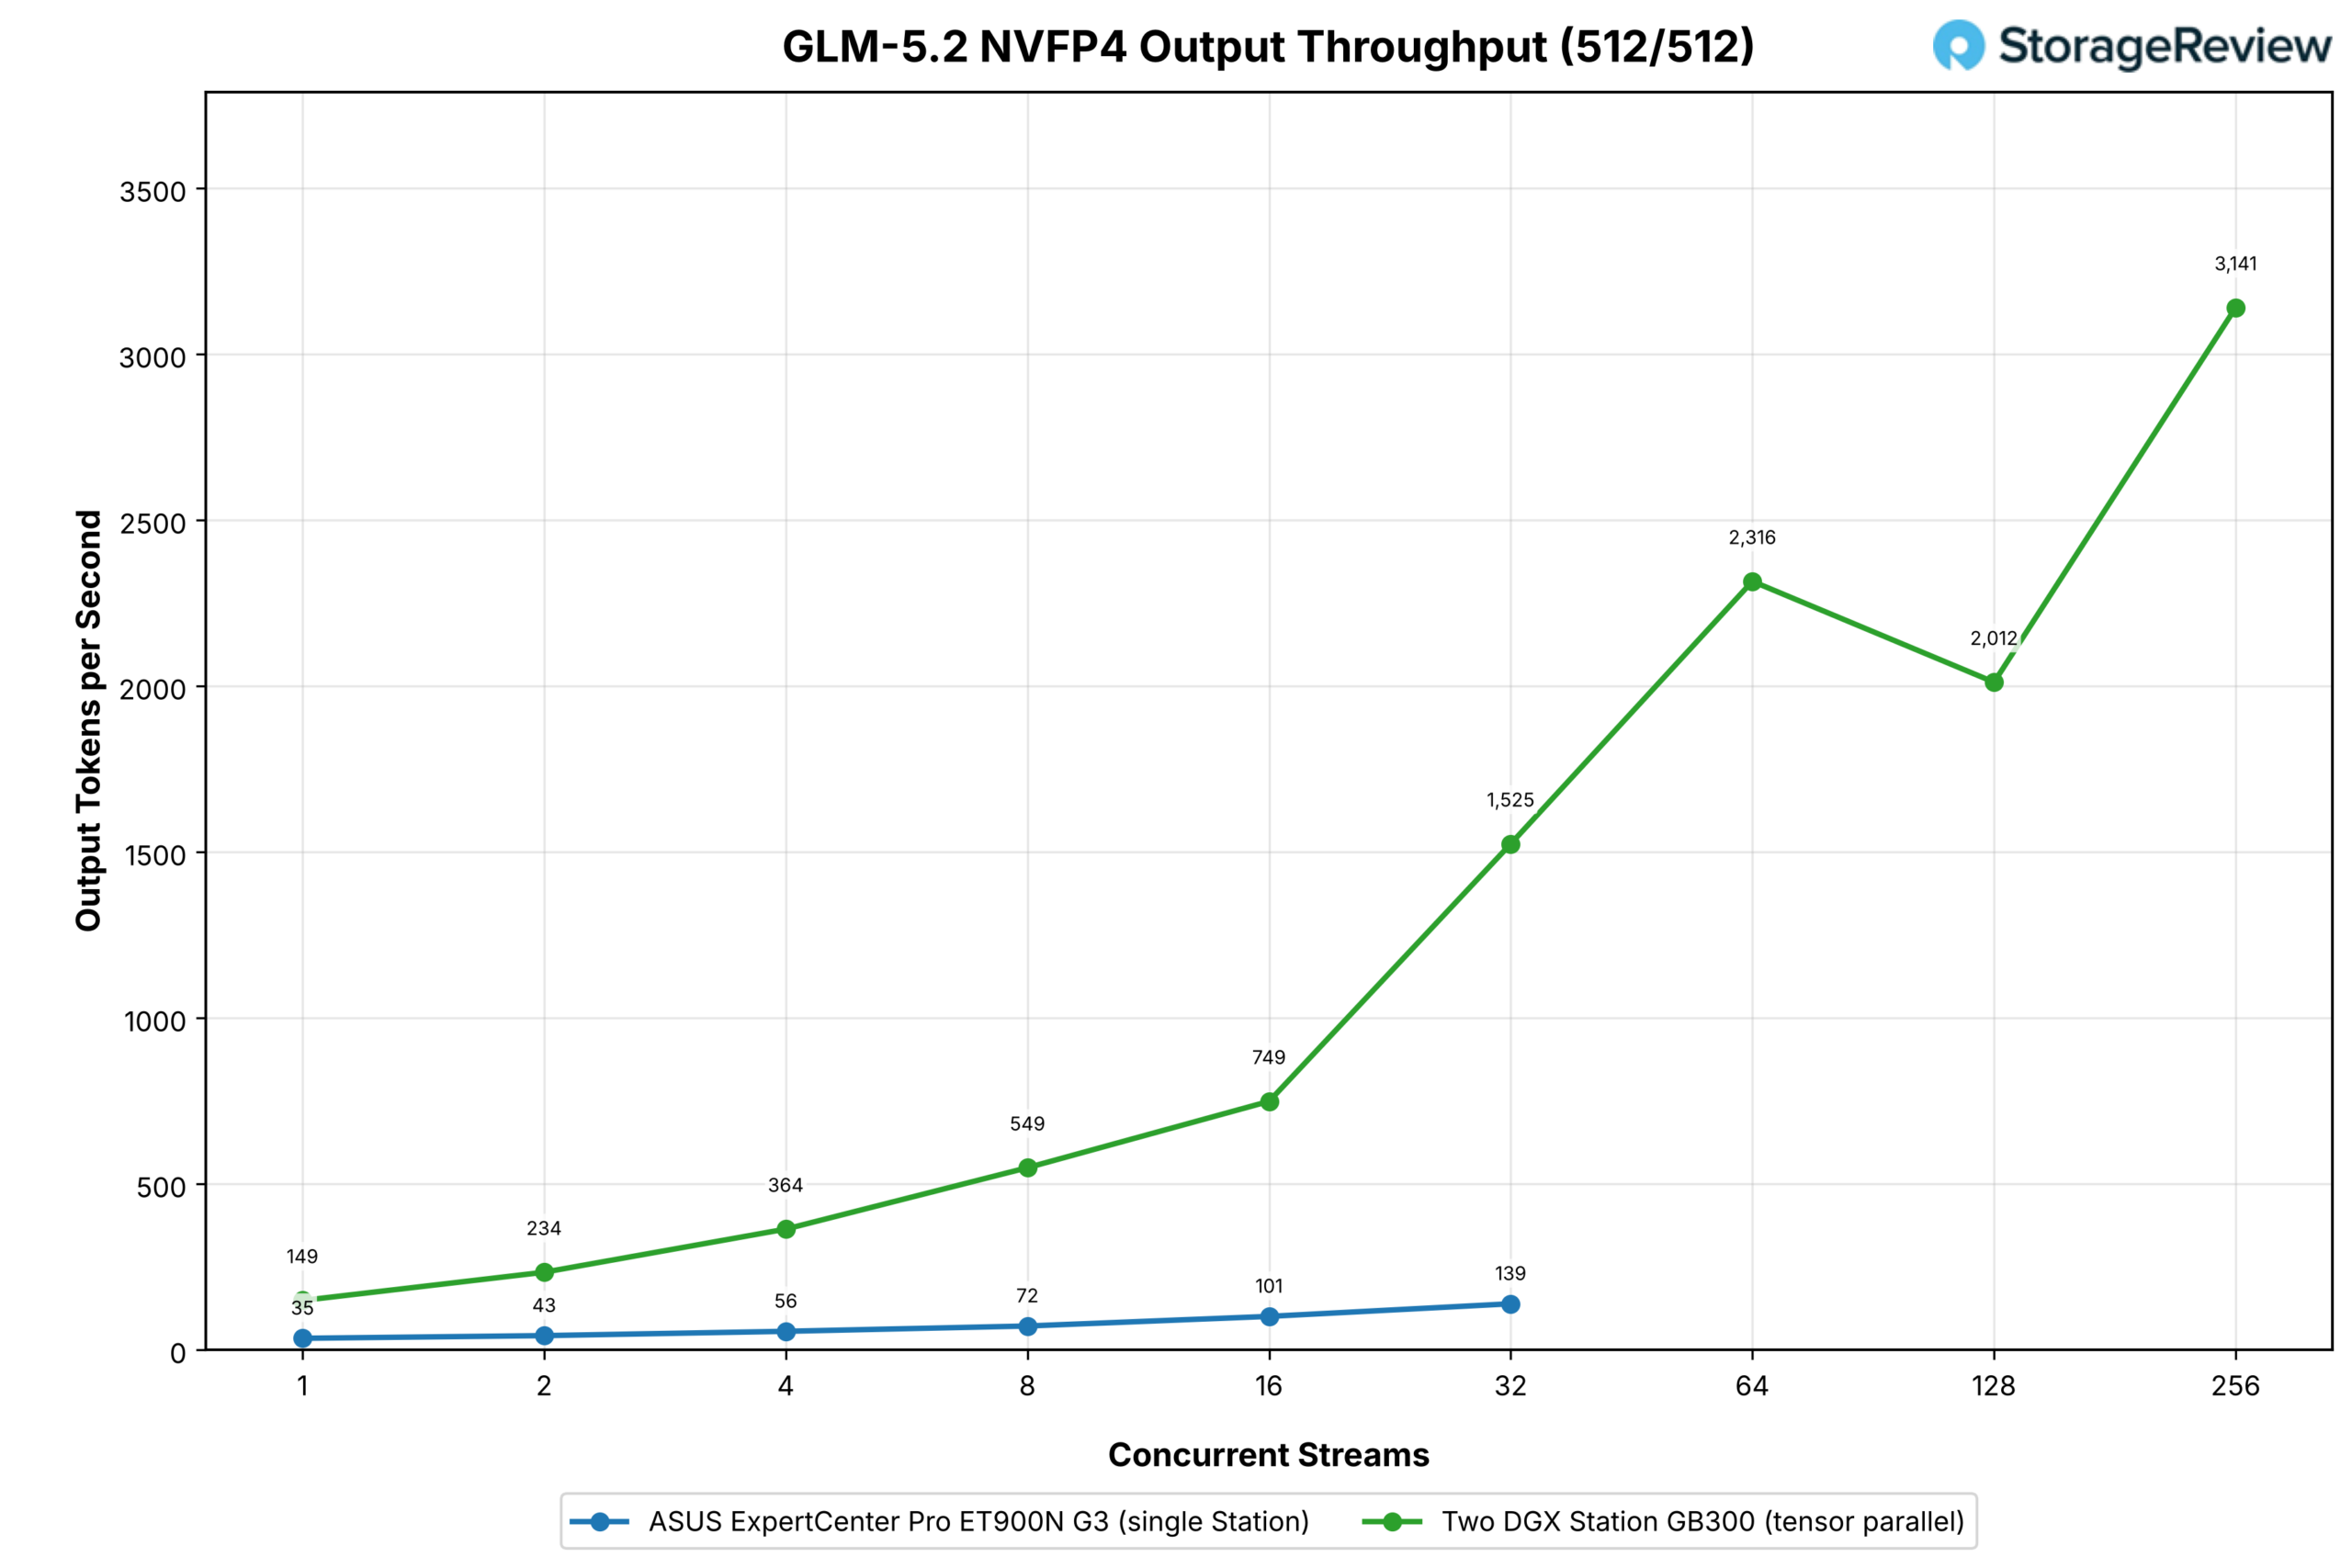
GLM-5.2 သည် cluster ပေါ်တွင် Grace offload မပါဘဲ TP2 တွင် run ခဲ့ပြီး ဒုတိယ Station အတွက် အားအကောင်းဆုံး case ဖြစ်စေသော model ဖြစ်သည်။ NVFP4 checkpoint သည် 433GB ခန့်ရှိသောကြောင့် GB300 တစ်ခုတွင် expert weights 215GB ခန့်သည် Grace memory တွင်ရှိပြီး ၎င်းတို့ကိုထိသော decode step တိုင်းသည် NVLink-C2C သို့ LPDDR5X သို့ 396GB/s ဖြင့်ဖြတ်သန်းသွားသည်။ Station နှစ်ခုတွင် ပိုင်းခြားထားသော B300 တစ်ခုစီတွင် HBM3e ရှိ model ၏ ထက်ဝက်ခန့်ကို သိမ်းဆည်းထားသည်။
တူညီသော workload တွင်၊ single ET900N G3 သည် stream တစ်ခုတွင် တစ်စက္ကန့်လျှင် output token ၃၅ ခုနှင့် 32 တွင် 139 ခု ပေးပို့ခဲ့သည်။ two-Station cluster သည် stream တစ်ခုတွင် တစ်စက္ကန့်လျှင် 149 tokens မှ စတင်ခဲ့ပြီး၊ single tower ထက် 4.3 ဆ ပိုများခဲ့ပြီး 32 တွင် 1,525 ခု၊ 11 ဆ ရှိလာကာ single Station ၏ အရေအတွက်ကို 64 တွင် 2,316 ခုနှင့် 256 တွင် 3,141 ခုအထိ ကျော်လွန်ခဲ့ပြီး 2,012 ခုအထိ ကျဆင်းသွားခဲ့သည်။ Station တစ်ခုသည် အသုံးပြုသူအနည်းငယ်အတွက် စကားပြောဆိုမှုအမြန်နှုန်းဖြင့် ဝန်ဆောင်မှုပေးသည့် မော်ဒယ်သည် Station နှစ်ခုသည် department တစ်ခုအတွက် ဝန်ဆောင်မှုပေးနိုင်သည့် မော်ဒယ်တစ်ခု ဖြစ်လာသည်။
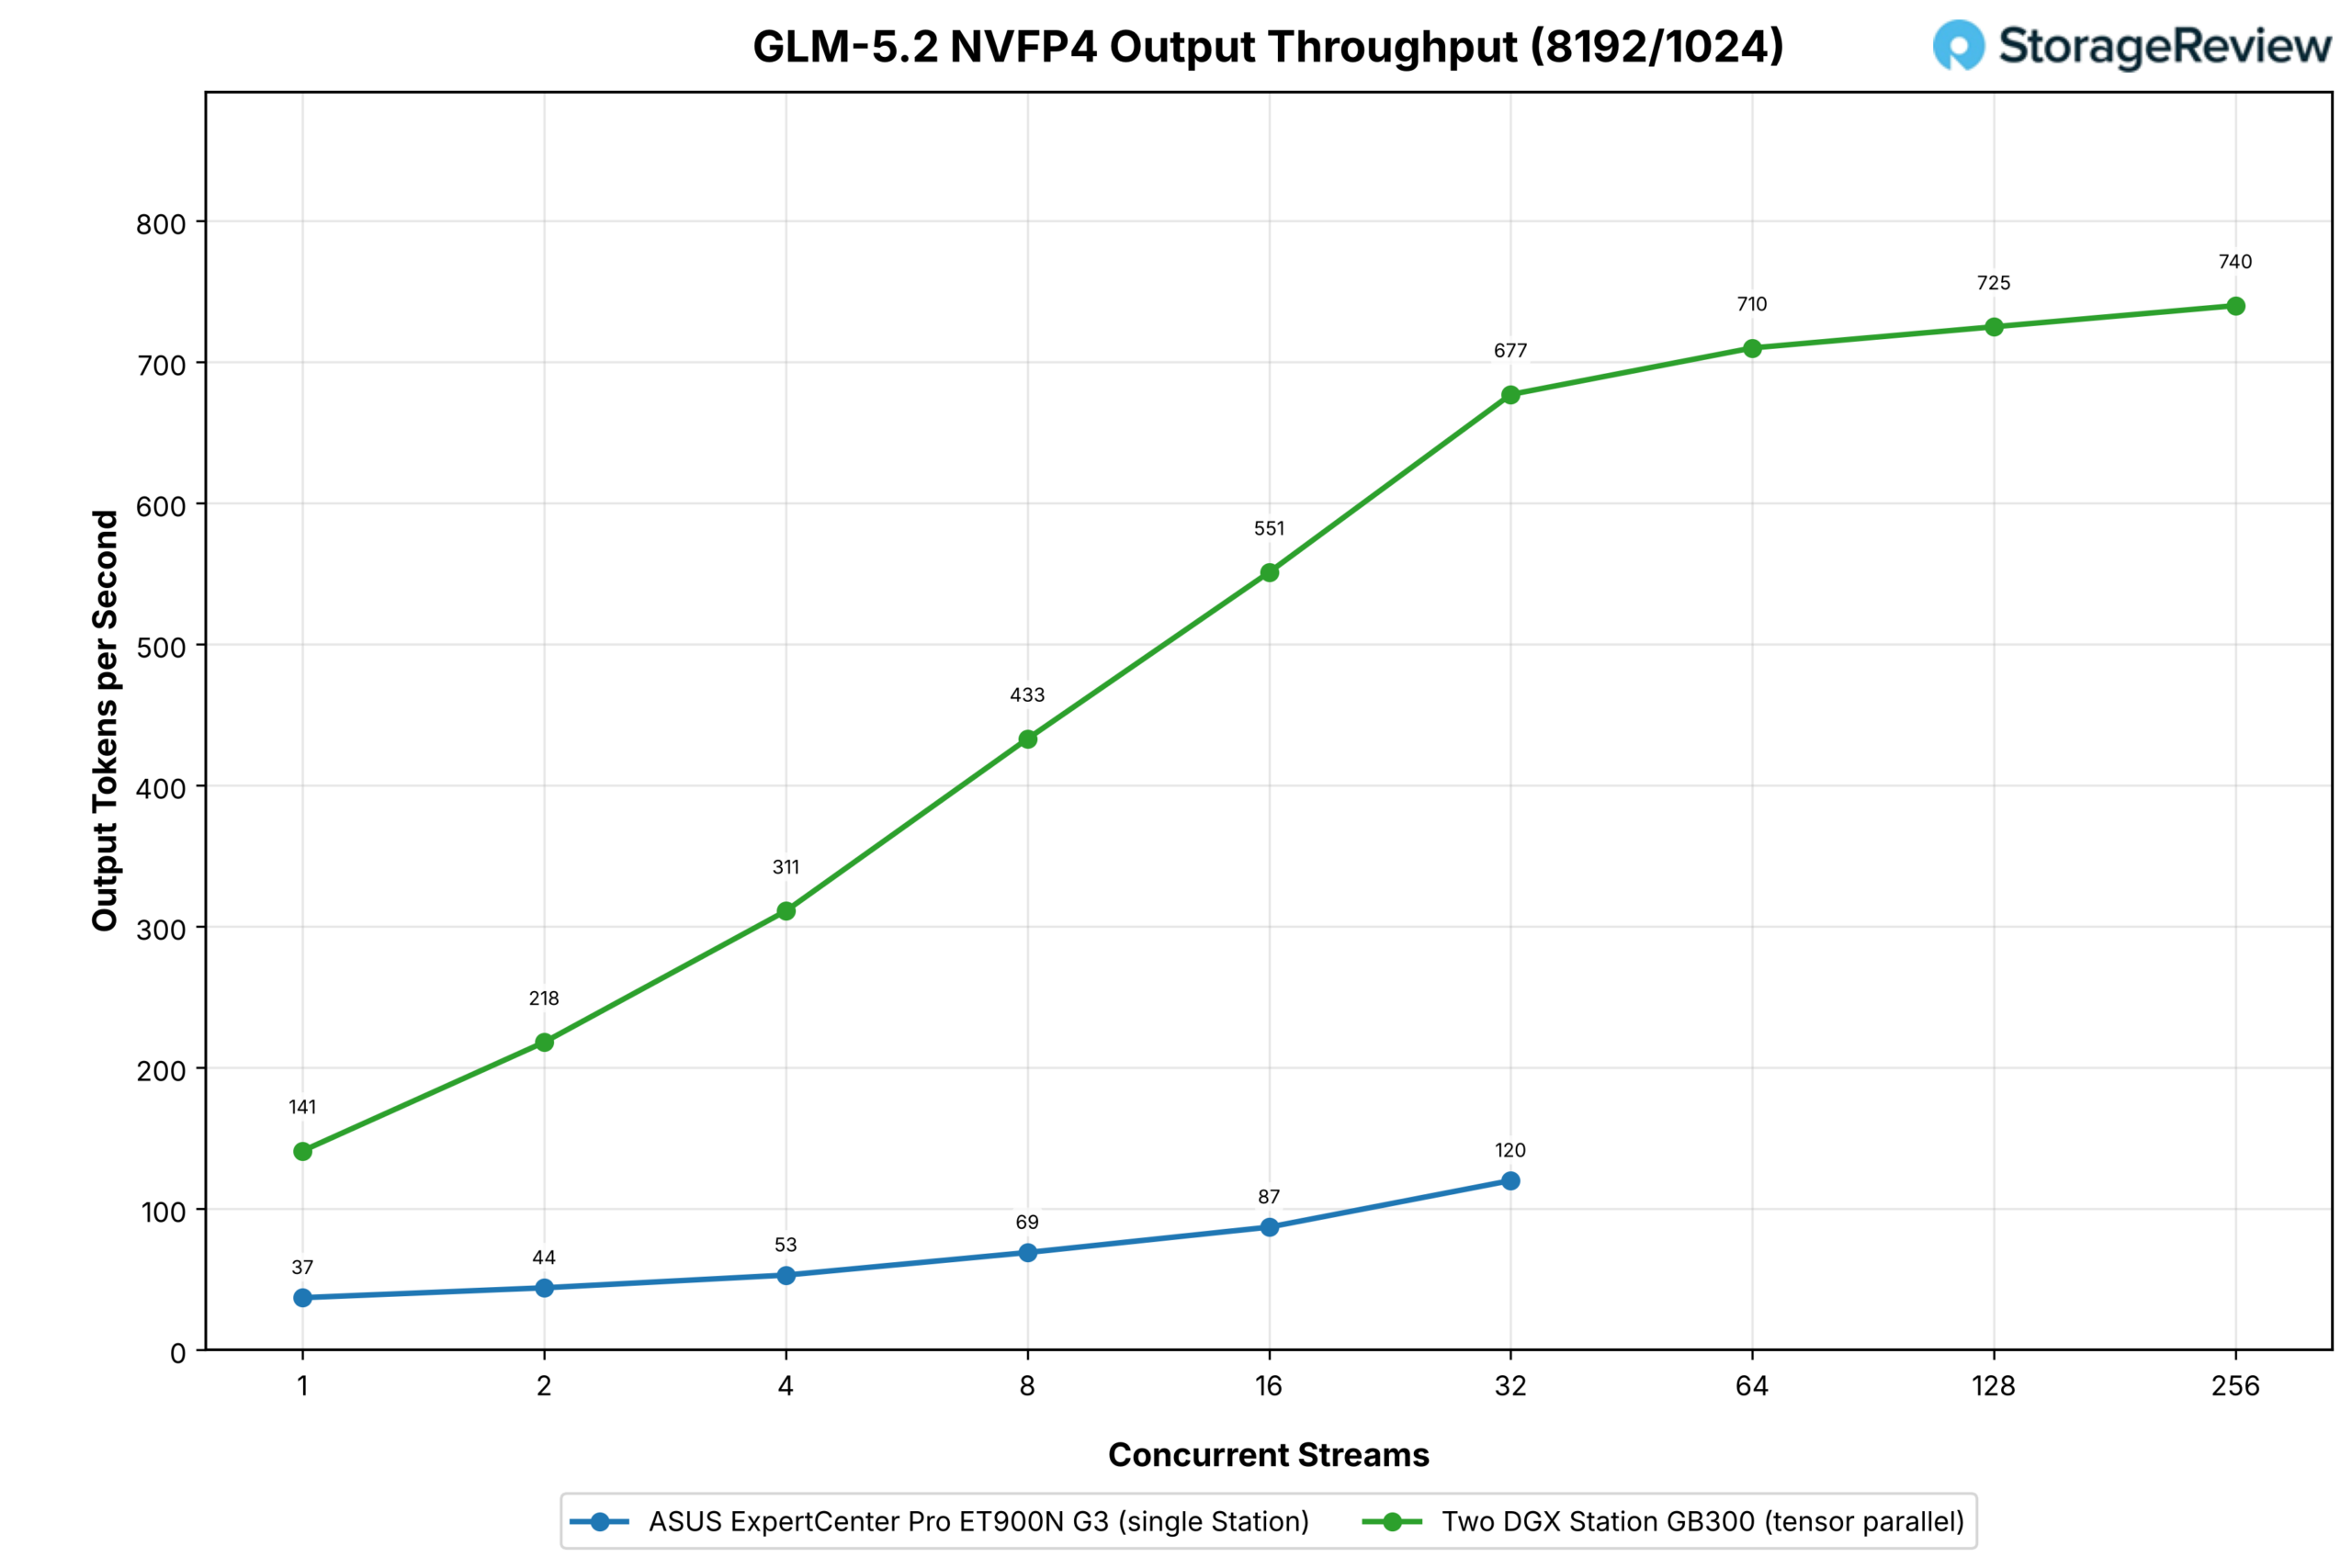
prefill-heavy profile သည် နိမ့်သောအမြင့်တွင်ပင် တူညီသောဇာတ်လမ်းကို ပြောပြသည်၊ stream တစ်ခုတွင် Station တစ်ခုသည် တစ်စက္ကန့်လျှင် output tokens ၃၇ ခုမှ ၃၂ ခုတွင် ၁၂၀ သို့ ရွေ့လျားပြီး cluster သည် တူညီသောအကွာအဝေးတွင် ၁၄၁ မှ ၆၇၇ သို့ ရွေ့လျားသည်၊ sweep ၏အောက်ခြေတွင် ၃.၈x နှင့် အပေါ်တွင် ၅.၆x၊ ထို့နောက် stream ၂၅၆ ခုမှတစ်ဆင့် ၇၁၀၊ ၇၂၅ နှင့် ၇၄၀ တွင် flattening လုပ်သည်။
ရှည်လျားသော prompts များသည် prefill တွင် အလုပ်ပိုမိုထည့်သည်၊ ထို့ကြောင့် configuration နှစ်ခုလုံးသည် compute-bound ဖြစ်သောကြောင့် ဒုတိယ Station ဖယ်ရှားလိုက်သော offload penalty သည် စုစုပေါင်း၏ ဝေစုထက် နည်းပါးသည်။ ဒုတိယ Station သည် LPDDR5X မှ 433GB မော်ဒယ်ကိုယူပြီး ၎င်းအားလုံးကို HBM တွင်ထည့်သောကြောင့် profile နှစ်ခုလုံးတွင် gain သည် 2x ကျော်သွားပြီး ဒုတိယ B300 ၏ compute ထက် ဤနေရာတွင် ပို၍အရေးကြီးသည်။
MiniMax-M3
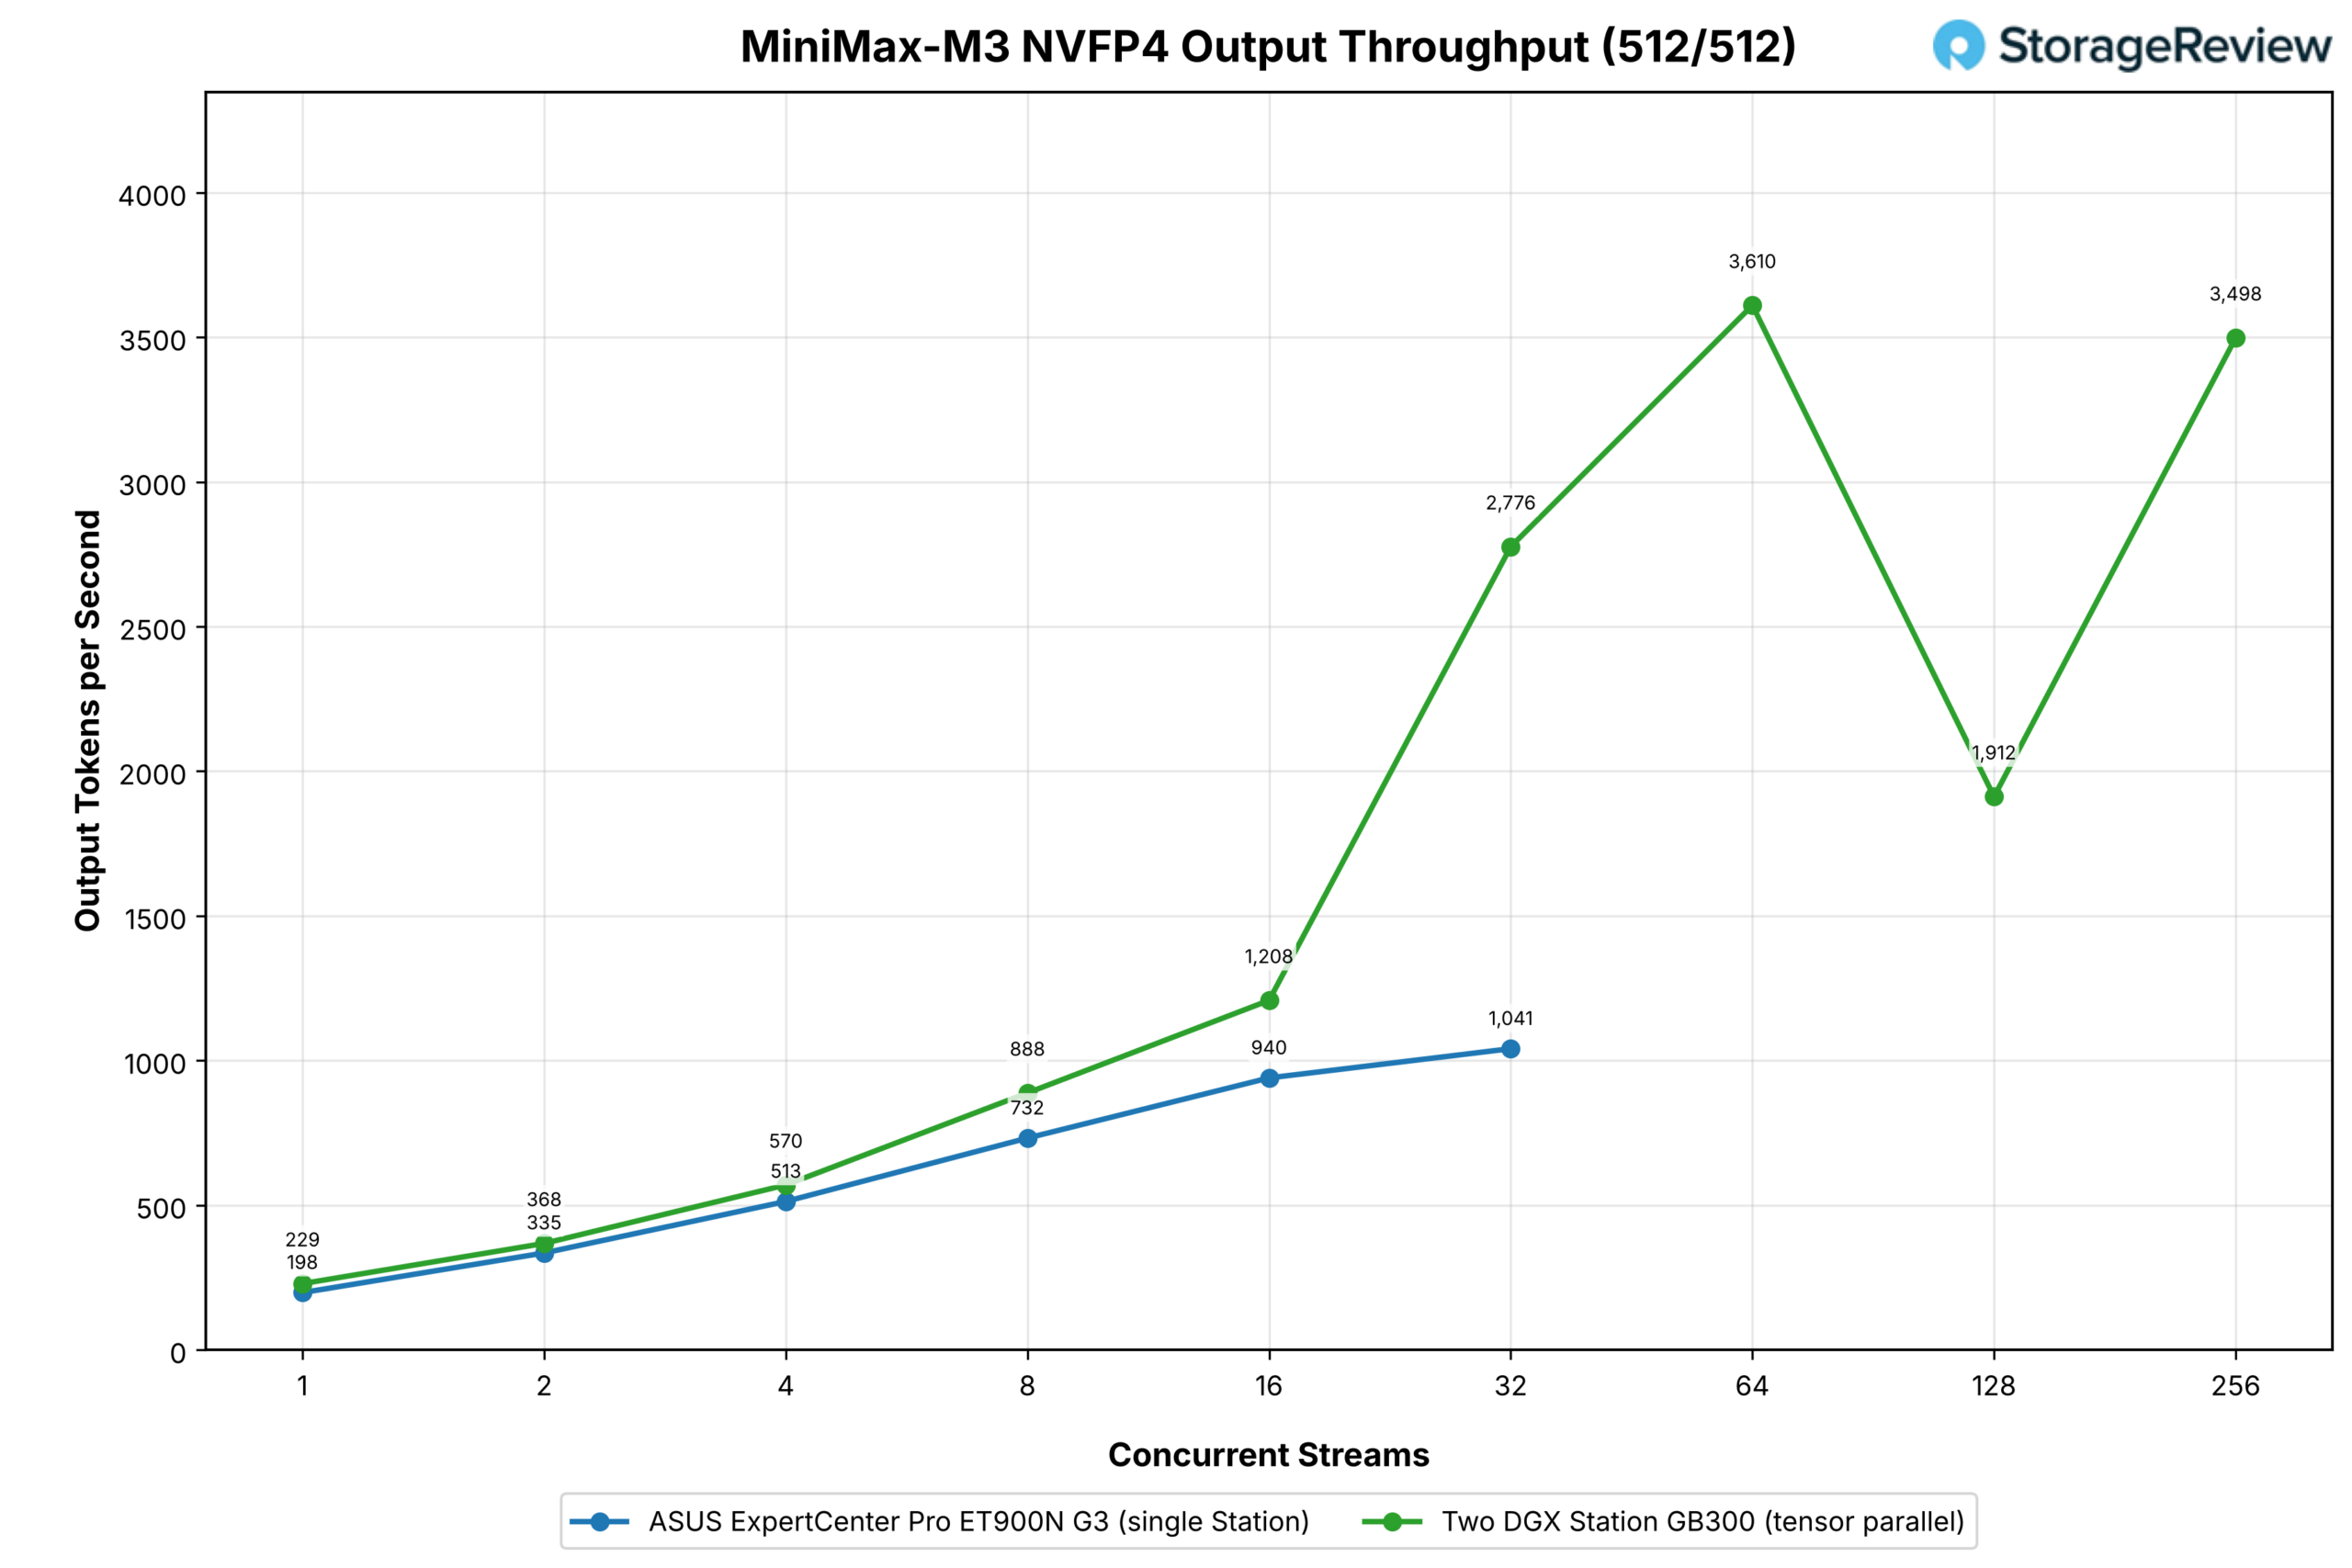
MiniMax-M3 ဟာ TP2 မှာ Grace offload မပါဘဲ run ခဲ့ပါတယ်။ Station တစ်ခုမှာတော့ HBM boundary မှာ Grace memory မှာရှိတဲ့ ကျွမ်းကျင်သူတွေရဲ့ အပိုင်းအစတစ်ခုနဲ့ တည့်တည့်ရှိနေပြီး ASUS review မှာ EAGLE3 နဲ့ တူညီတဲ့ workload မှာ stream ၃၂ ခုမှာ တစ်စက္ကန့်ကို output tokens ၁၀၄၁ ခု ရရှိခဲ့ပါတယ်။
cluster သည် single Station ကို stream ၁၆ ခု (၁,၂၀၈ vs ၉၄၀) မှတစ်ဆင့် အနီးကပ်ခြေရာခံပြီးနောက် ဆွဲထုတ်သွားသည်- ၃၂ တွင် ၂,၇၇၆၊ single tower တွင် ၂.၇x၊ ၆၄ တွင် ၃၆၁၀၊ ၁၂၈ တွင် ၁,၉၁၂ နှင့် ၂၅၆ တွင် ၃၄၉၈ သို့ ကျဆင်းသွားသည်။ Station နှစ်ခုသည် GLM-5.2 တွင်ထက် ဤနေရာတွင် လျော့နည်းစွာ ပေါင်းထည့်သည်၊ အဘယ်ကြောင့်ဆိုသော် Station တစ်ခုက ဤမော်ဒယ်၏ အများစုကို HBM တွင် သိမ်းဆည်းထားပြီးဖြစ်သောကြောင့် ဒုတိယ GPU ၏ ပံ့ပိုးကူညီမှုသည် KV cache headroom ဖြင့် plain compute scaling နှင့် ပိုမိုနီးစပ်သည်။
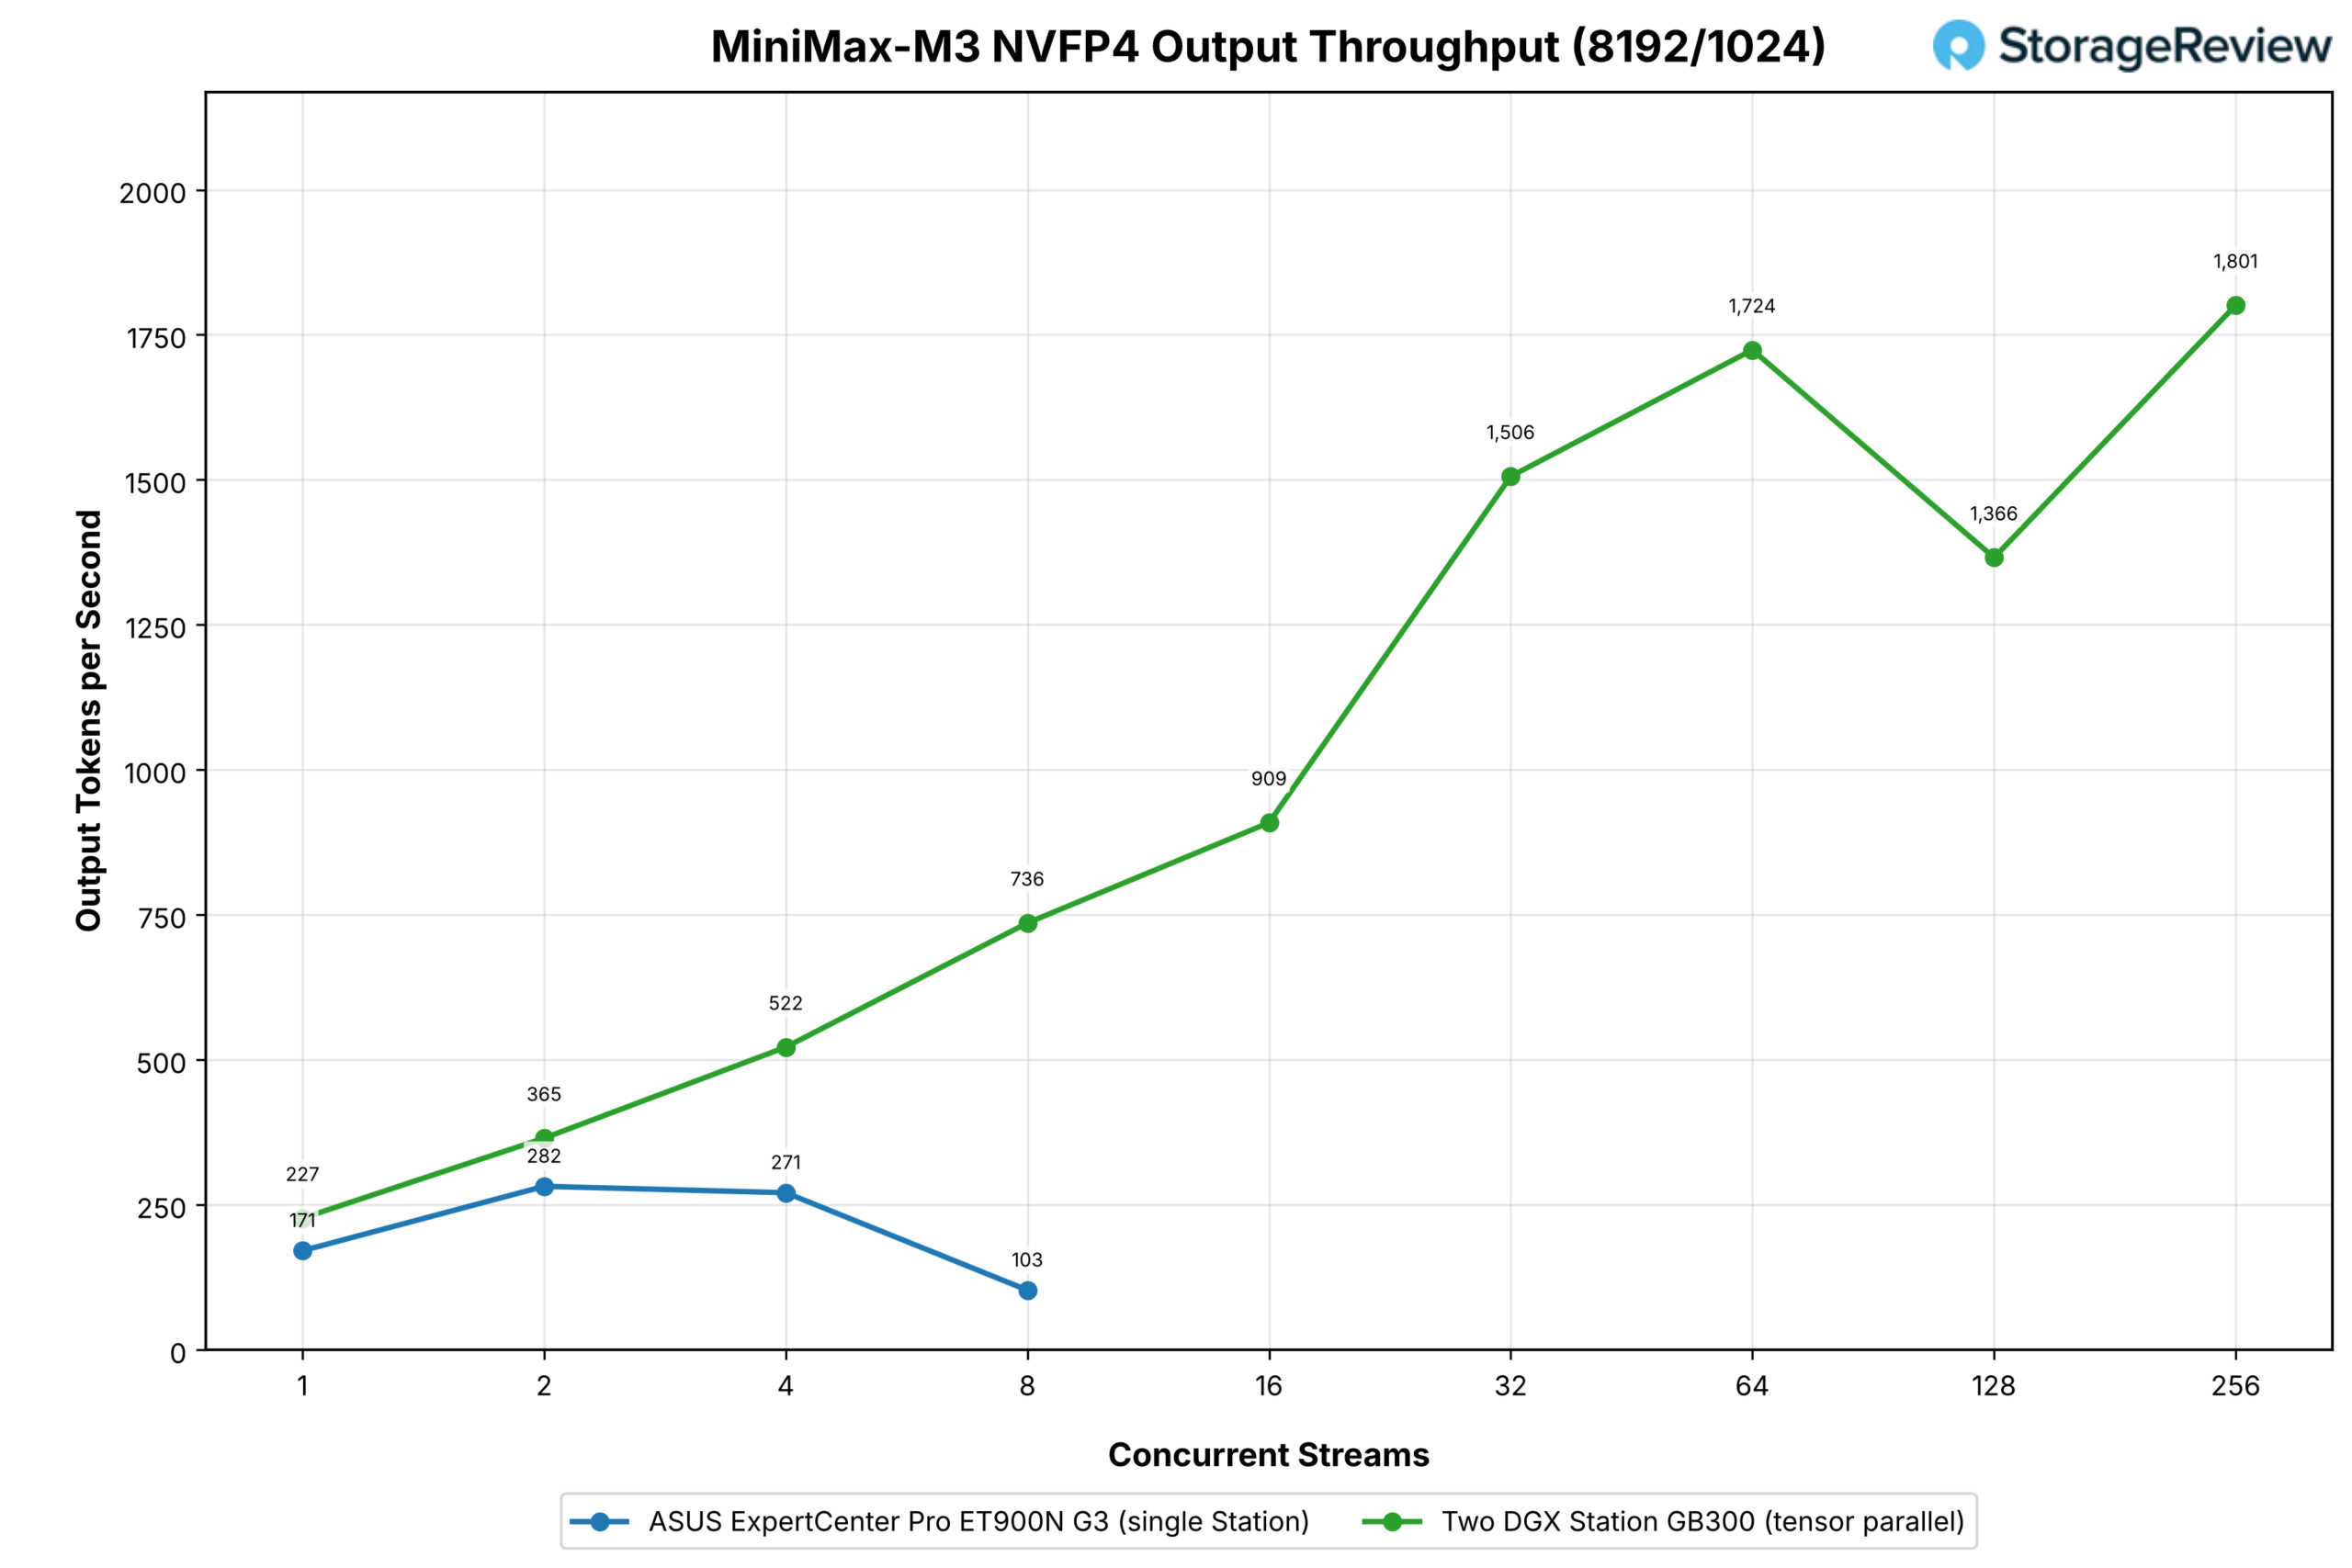
ကြိုတင်ဖြည့်သွင်းမှုများပြားသောပရိုဖိုင်သည် MiniMax-M3 သည် Station တစ်ခုတွင် နေရာကုန်သွားသည့်နေရာဖြစ်သည်- 8,192-token prompts များသည် ကျန်ရှိနေသော KV cache ကို လျင်မြန်စွာစားသုံးသောကြောင့် single tower သည် stream နှစ်ခုတွင် တစ်စက္ကန့်လျှင် output tokens 282 ဖြင့် အမြင့်ဆုံးရောက်ရှိခဲ့ပြီး လေးခုတွင် 271 ကို ထိန်းထားနိုင်ခဲ့ပြီး ရှစ်ခုတွင် 103 သို့ ကျဆင်းသွားခဲ့ပြီး တိုင်းတာရန် ဘာမှမကျန်တော့သောကြောင့် sweep ပြီးဆုံးသွားခဲ့သည်။
မော်ဒယ်ကို Station နှစ်ခုအဖြစ် ပိုင်းခြားထားတဲ့အခါ၊ တူညီတဲ့အမှတ်တွေက ၃၆၅၊ ၅၂၂ နဲ့ ၇၃၆ ဖြစ်ပြီး၊ configuration နှစ်ခုစလုံးမှာ cache အပိုရှိတဲ့ stream နှစ်ခုမှာ ၃၀% gain ရရှိပြီး stream ရှစ်ခုမှာ ၇.၁x ရရှိပြီး တစ်ခုကုန်သွားပါပြီ။ ထို့နောက် cluster သည် ၁၆ တွင် ၉၀၉၊ ၃၂ တွင် ၁၅၀၆၊ ၆၄ တွင် ၁၇၂၄၊ ၁၂၈ တွင် ၁၃၆၆ နဲ့ ၂၅၆ တွင် ၁၈၀၁ အထိ ဆက်လက်ရောက်ရှိခဲ့ပြီး၊ Station တစ်ခုတည်းက ဒီ profile မှာ လုံးဝမရောက်ရှိနိုင်တဲ့ အကွာအဝေးဖြစ်ပါတယ်။
ကောက်ချက်
GB300 DGX Stations နှစ်ခုကို ၎င်းတို့၏ကိုယ်ပိုင် ConnectX-8 ports များမှတစ်ဆင့် အတူတကွ ချိတ်ဆက်ထားခြင်းသည် NVIDIA ၏ စာရွက်စာတမ်းများတွင် ဖော်ပြထားသည့်အတိုင်း လုပ်ဆောင်ပေးသည်။ စနစ်ထည့်သွင်းခြင်းသည် လွယ်ကူပြီး ၎င်းသည် dual-system configuration အတွက် ကျွန်ုပ်တို့ မြင်တွေ့ခဲ့ရသည့် ပထမဆုံး throughput data ဖြစ်သည်။
ဒုတိယ Station သည် HBM3e 252GB ကျော်လွန်သော မော်ဒယ်များတွင် ၎င်း၏ စံချိန်ကို ရရှိသည်- GLM-5.2 သည် Station တစ်ခုတွင် stream ၃၂ ခုတွင် တစ်စက္ကန့်လျှင် output token ၁၃၉ ခုမှ နှစ်ခုတွင် ၁၅၂၅ ခုအထိ မြင့်တက်လာပြီး stream ၂၅၆ ခုတွင် ၃၁၄၁ ခုအထိ မြင့်တက်လာသည်၊ အဘယ်ကြောင့်ဆိုသော် 433GB မော်ဒယ်ကို LPDDR5X မှ ခွဲထုတ်လိုက်သောကြောင့်ဖြစ်သည်။ GLM-5.3 သည် single-Station ceiling ၁၈၈ ခုမှ stream ၂၅၆ ခုတွင် ၅၀၁၈ ခုအထိ ရောက်ရှိသည်။ ရှည်လျားသော prompts များတွင် MiniMax-M3 သည် stream ရှစ်ခုတွင် နှေးကွေးသော tower မှ 256 တွင် ဆက်လက်တက်နေဆဲဖြစ်သော စုံတွဲအထိ ရောက်ရှိသည်။
GLM-5.3 Flash နှင့် DeepSeek V4.1 Flash နှစ်ခုစလုံးတွင် Station တစ်ခုတည်းတွင် တပ်ဆင်နိုင်သော မော်ဒယ်များတွင် ဒုတိယ box ကိုအသုံးပြုရန် အကောင်းဆုံးနည်းလမ်းမှာ Station တစ်ခုစီကို မိတ္တူတစ်ခုလုံးပေးခြင်း၊ decode မှ prefill ကို ပိုင်းခြားခြင်းနှင့် decode worker ကို ရပ်တန့်ခြင်းမရှိဘဲ generate လုပ်ခွင့်ပေးခြင်းဖြစ်သည်။ GLM-5.3 Flash တွင် stream ၃၂ ခုတွင် long-prompt throughput ကို နှစ်ဆတိုးစေပြီး short-prompt throughput ကို သုံးဆတိုးစေခဲ့ပြီး DeepSeek V4.1 Flash သည် တစ်စက္ကန့်လျှင် 5,248 tokens ဖြင့် အမြင့်ဆုံး output throughput ကို ရရှိခဲ့သည်။
MSI XpertStation WS300 သုံးသပ်ချက် ပြီးကတည်းက ထုတ်ကုန်အပေါ် ကျွန်တော်တို့ရဲ့အမြင်က မပြောင်းလဲသေးပါဘူး ။ ဒါက သတ်မှတ်ထားတဲ့ ဈေးကွက်တစ်ခုအတွက် စိတ်ဝင်စားစရာကောင်းတဲ့ စက်တစ်လုံးဖြစ်ပြီး တစ်ခုအတွက် လိုအပ်ချက်တွေ့ရင် နောက်ထပ်တစ်ခုအတွက် လိုအပ်ချက်တွေ့နိုင်ပါတယ်။
၎င်းတို့ကို လည်ပတ်ရန် အကောင်းဆုံးနည်းလမ်းမှာ ပြောင်းလဲနိုင်သော အခြေခံအဆောက်အအုံဖြစ်သည်- အဖွဲ့တစ်ဖွဲ့သည် အလုပ်များကို အချိန်ဇယားဆွဲပြီး ပရောဂျက်များပြောင်းလဲသည်နှင့်အမျှ ပြန်လည်ပြုပြင်ပေးသည့် pool တစ်ခုဖြစ်ပြီး NVIDIA သည် ၎င်းကို အကောင်အထည်ဖော်ရန် အစိတ်အပိုင်းများကို ပိုင်ဆိုင်သည်။ ၎င်းသည် အချိန်ဇယားဆွဲရန် Run:ai၊ developer environments အတွက် Brev နှင့် compute marketplace အတွက် Lepton ကို ဝယ်ယူခဲ့ပြီး Stations rack တစ်ခုနှင့် တွဲဖက်အသုံးပြုသည့် သုံးခုစလုံးသည် သင်ဝင်ရောက်ခွင့်ရှိပါက ထုတ်ကုန်ကို ပိုမိုဆွဲဆောင်မှုရှိစေမည်ဖြစ်သည်။
two-box configuration က ကောင်းကောင်း scale လုပ်ထားပါတယ်။ ကျွန်တော်တို့တိုင်းတာခဲ့တဲ့ အကောင်းဆုံး gain က GLM-5.3 ဖြစ်ပြီး single Station တစ်ခုမှာ တစ်စက္ကန့်ကို output token ၁၈၈ ခုကနေ တစ်စုံမှာ ၅၀၁၈ ခု (27x gain) အထိ ရရှိခဲ့ပါတယ်။ matched concurrency မှာ GLM-5.2 က stream ၃၂ ခုမှာ ၁၁x ရရှိခဲ့ပါတယ်။ Station တစ်ခုတည်းက Grace memory ထဲကို weight တွေ spill လုပ်ရုံနဲ့ပဲ ပံ့ပိုးပေးနိုင်တဲ့ model တွေမှာပါ။ အဲဒါက 2x 400G ပေါ်မှာ GB300 ရလဒ်ဖြစ်ပြီး NVIDIA က နောက်မျိုးဆက် HBM နဲ့ NVLink-C2C နဲ့အတူ Vera Rubin Station ကို မိတ်ဆက်တဲ့အခါ ဘယ်လိုပုံစံဖြစ်မလဲဆိုတာ သိချင်စရာပါပဲ။
ဒီအံဝင်ခွင်ကျဖြစ်မှုကတော့ မပြောင်းလဲပါဘူး။ စားပွဲပေါ်က Station နှစ်ခု၊ rack ဒါမှမဟုတ် data center မပါဘဲ၊ GPU server နဲ့ ပါလာတဲ့ facilities တွေကို တရားမျှတအောင် လုပ်ဆောင်ခဲ့တဲ့ မော်ဒယ်တွေကို အခုအခါ အသုံးပြုလို့ရပါပြီ။ ဒါကြောင့် data center မှာ slot မရနိုင်တဲ့ ဒါမှမဟုတ် စောင့်ချင်တဲ့အဖွဲ့ဟာ သူတို့ဘေးမှာ frontier-class inference လမ်းကြောင်းတစ်ခု ရှိပါတယ်။ NVIDIA က အဲဒီအမျိုးအစားအတွက် စံနှုန်းကို သတ်မှတ်ထားပါတယ်၊ ဈေးနှုန်းကိုလည်း ချန်လှပ်ထားပါတယ်။ GB300 class ကို ကျွန်ုပ်တို့ရဲ့ Best Desktops for Local AI leaderboard မှာ အဆင့်သတ်မှတ်ထားပြီး ဒီ cluster data က အခုအချိန်မှာ ရွေးချယ်မှုကို ထောက်ခံပါတယ်။



 အမေဇုံ