

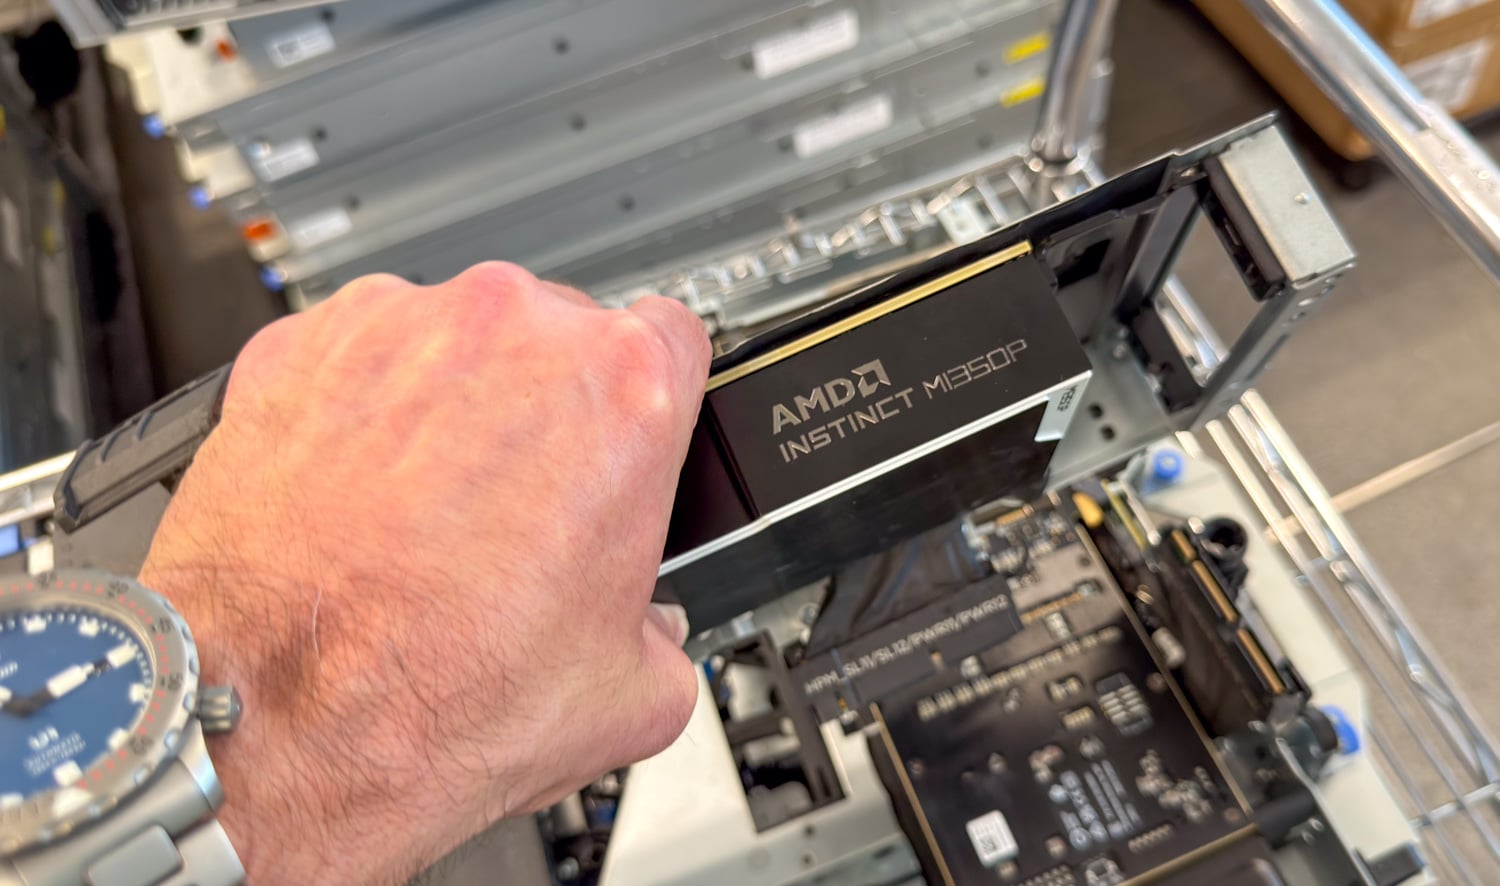
AMD Instinct MI350P သည် ၂၀၂၂ ခုနှစ်တွင် MI210 ထွက်ရှိပြီးနောက် လေးနှစ်အတွင်း AMD ၏ ပထမဆုံး PCIe Instinct GPU အသစ်ဖြစ်သည်။ ၎င်းသည် ကုမ္ပဏီ၏ CDNA 4 ဗိသုကာကို ရိုးရာ add-in ကတ်တစ်ခုသို့ ယူဆောင်လာပြီး MXFP4 စွမ်းဆောင်ရည် 4.6 PFLOPS အထိ၊ HBM3E 144GB နှင့် မန်မိုရီ bandwidth 4TB/s အထိ ရှိသည်။ ၎င်းအားလုံးသည် dual-slot၊ 600W လေအေးပေးကတ်တစ်ခုတွင် ကိုက်ညီပြီး ဖောက်သည်များအား ပိုကြီးသော 8 GPU OAM MI350/5X ပလက်ဖောင်းသို့ မပြောင်းရွှေ့ဘဲ Instinct GPU များကို ဖြန့်ကျက်ရန် အခြားနည်းလမ်းတစ်ခုကို ပေးစွမ်းသည်။
Key ကို Takeaways
- PCIe slot မှာ 144GB က ခေါင်းစဉ်ပါ။ MI350P မှာ လက်ရှိ PCIe accelerator တွေထဲမှာ မှတ်ဉာဏ်အများဆုံးပါဝင်ပြီး H200 NVL ထက် 3GB ပိုများပြီး RTX PRO 6000 Blackwell ထက် 48GB ပိုများကာ 4TB/s HBM3E ပါဝင်ကာ ဒီသုံးသပ်ချက်မှာပါတဲ့ မော်ဒယ်နဲ့ တိကျမှုပေါင်းစပ်မှု ဆယ်ခုထဲက ဆယ်ခုကို ကတ်တစ်ခုတည်းမှာ အသုံးပြုထားပါတယ်။
- တိုင်းတာထားသော တွက်ချက်မှုသည် NVIDIA ကတ်နှစ်ခုကြားတွင် ရှိသည်။ 450W တွင် MAMF သည် BF16 တွင် 580 TFLOPS၊ FP8 တွင် 1,120 နှင့် block-scaled FP4 တွင် 2,228 ရောက်ရှိခဲ့ပြီး၊ တိကျမှုတိုင်းတွင် 600W RTX PRO 6000 ထက် ၃၆ မှ ၃၈ ရာခိုင်နှုန်းအထိ မြင့်မားပြီး FP4 လမ်းကြောင်းမရှိသော BF16 နှင့် FP8 ရှိ H200 NVL ထက် နောက်ကျနေပါသည်။
- GPT-OSS သည် MI350P ၏ အားအကောင်းဆုံးရလဒ်ဖြစ်သည်။ AMDGPU 31.60၊ ROCm 10.1.0 နှင့် vLLM 0.32.0 တို့တွင် GPT-OSS-120B သည် chat workload ရှိ stream ၁၂၈ ခုတွင် တစ်စက္ကန့်လျှင် output tokens ၅,၀၅၇ ခုသို့ ရောက်ရှိခဲ့ပြီး RTX PRO 6000 ထက် ၆၅ ရာခိုင်နှုန်းနှင့် H200 NVL ထက် ၅၀ ရာခိုင်နှုန်း သာလွန်ခဲ့ပြီး curve သည် prompt shapes နှစ်ခုလုံးတွင် stream ၁၂၈ ခုမှတစ်ဆင့် ဆက်လက်တက်နေပါသည်။
- ချတ်အရွယ်အစား ညွှန်ကြားချက်များသည် MI350P ကို ဦးစားပေးသော်လည်း၊ ရှည်လျားသော ညွှန်ကြားချက်များသည် ရောထွေးနေပါသည်။ 512-token prompts တွေမှာ ဒီကတ်ဟာ FP8၊ BF16 နဲ့ GPT-OSS မော်ဒယ်တိုင်းရဲ့ stream ၁၂၈ ခုမှာ RTX PRO 6000 ထက် ၃၅ ရာခိုင်နှုန်းကနေ ၆၅ ရာခိုင်နှုန်းအထိ သာလွန်ပြီး FP4 နဲ့ NVFP4 matchup နှစ်ခုဟာ ၅ ရာခိုင်နှုန်းနဲ့ ၂၁ ရာခိုင်နှုန်းအတွင်းမှာ ရှိနေပါတယ်။ 8,192-token prompts တွေမှာ GPT-OSS နဲ့ Mistral Small တို့မှာ ဦးဆောင်နေပြီး Llama၊ Qwen FP8 နဲ့ MiniMax-M2.7 တို့မှာ curve အစောပိုင်းမှာ flat ဖြစ်သွားပါတယ်။
- ကတ်နှစ်ကတ်ရလဒ်များကို ROCm 7.2.3 တွင် ဖော်ပြပေးပါသည်။ DeepSeek-V4-Flash၊ MiniMax-M3၊ GLM-5.2 နှင့် GLM-5.3 Flash တို့ကို ထို stack ပေါ်ရှိ run များမှ အစီရင်ခံတင်ပြပါသည်၊ အဘယ်ကြောင့်ဆိုသော် ROCm 10.1 သည် CPU expert offload အသုံးပြုထားသော မော်ဒယ်များတွင် pass ဖြစ်ပြီး DeepSeek တွင် NVIDIA run သည့် speculative decoder တွင် pass မလုပ်ထားသောကြောင့်ဖြစ်သည်။
- 600W ကတော့ အခုထိ အဖြေရှာမရတဲ့ မေးခွန်းပါပဲ။ Dell က PowerEdge XE7745 မှာ 600W ရှိတဲ့ MI350P ရှစ်ခုကို မှတ်တမ်းတင်ထားပြီး အပြည့်အဝပါဝါနဲ့ နောက်ဆက်တွဲလုပ်ဆောင်ဖို့ စီစဉ်ထားပါတယ်။
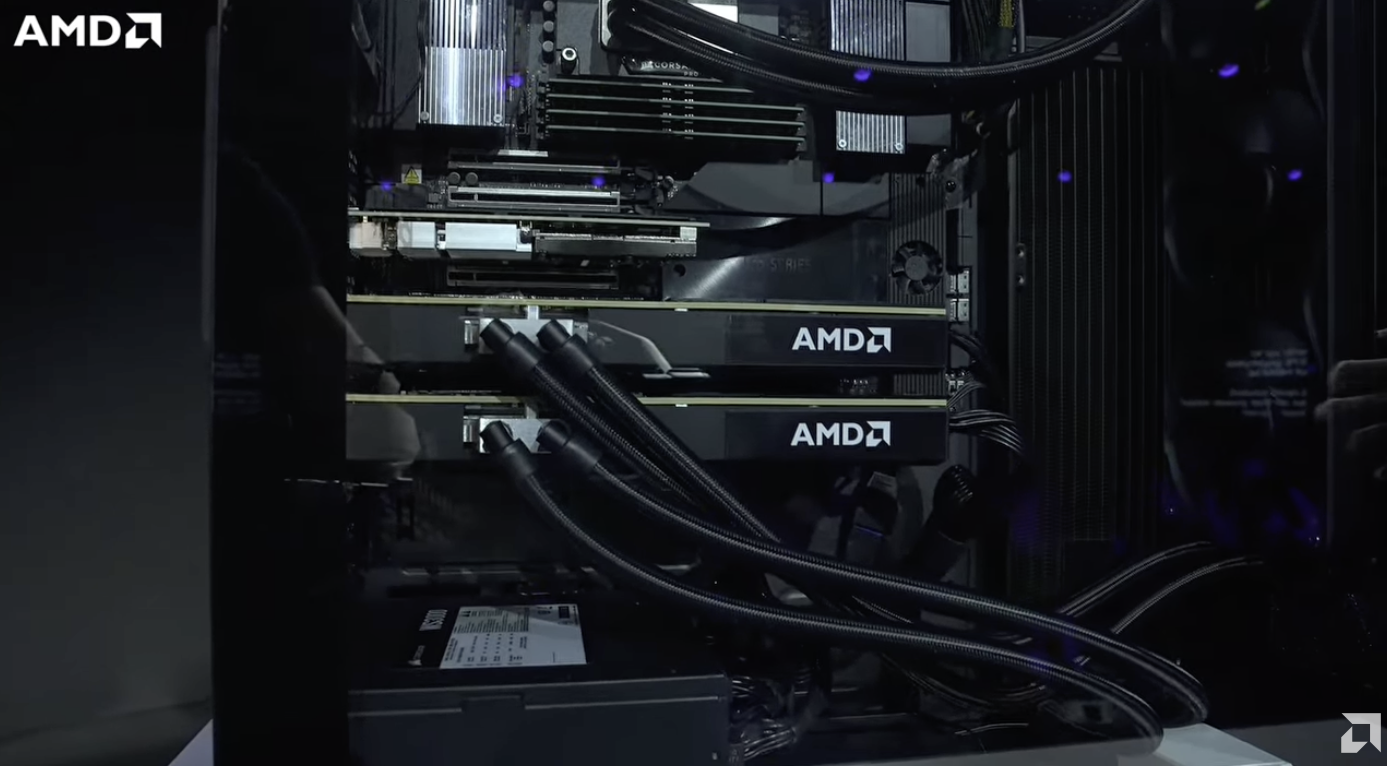
AMD သည် IFA 2026 တွင် ၎င်း၏ Threadripper Halo Station prototype တွင် MI350P ကို ပြသခဲ့ပြီး ထို accelerator များကို အရည်ဖြင့် အအေးပေးထားသည်။ workstation concept သည် MI350P လေးခုအထိ 96-core Threadripper PRO processor နှင့်အတူ ပံ့ပိုးပေးပြီး စက်တစ်ခုတည်းတွင် စုစုပေါင်း HBM3E စွမ်းရည် 576GB ကို ပေးစွမ်းသည်။ အောက်တိုဘာလတွင် အပ်ဒိတ်လုပ်ထားသော AMD ၏ ထုတ်ကုန်စာမျက်နှာတွင် ယခုအခါ စနစ်ကို ၂၀၂၇ ခုနှစ်တွင် မိတ်ဆက်မည်ဟု ဖော်ပြထားသည်။ ၎င်းက MI350P ကို ကြည့်ရှုရန် နည်းလမ်းနှစ်ခုကို ပေးသည်- server များအတွက် PCIe accelerator အဖြစ်နှင့် GB300 DGX Station ကဲ့သို့သော စက်များနှင့် ယှဉ်ပြိုင်နိုင်သည့် ပိုကြီးသော deskside AI စနစ်အတွက် building block အဖြစ်။
ဒီပထမဆုံးကြည့်လိုက်တဲ့အခါ server view ကိုယူထားတာကြောင့် PCIe accelerator ကိုသတ်မှတ်တဲ့ဝယ်သူတစ်ယောက်အတွက်အရေးကြီးတဲ့နှိုင်းယှဉ်ချက်ကတော့ NVIDIA RTX PRO 6000 Blackwell ပါပဲ။ ဒီကတ်က power class နဲ့ slot တူညီပြီး H200 NVL ကတော့ memory bandwidth က workload တွေအတွက် စွမ်းဆောင်ရည်အမြင့်ဆုံး NVIDIA add-in ကတ်အဖြစ်ဇယားမှာပါဝင်ပါတယ်။ GB300 DGX Station တစ်ခုတည်းက desk side view မှာပါဝင်ပါတယ်။ ဈေးနှုန်းကွဲပြားတဲ့စက်အမျိုးအစားဖြစ်ပြီး full Blackwell Ultra GPU က PCIe ကတ်တွေထက်ဘယ်လောက်သာလွန်လဲဆိုတာပြသဖို့ရှိပါတယ်။
AMD Instinct MI350P သတ်မှတ်ချက်များ
AMD ရဲ့ ထုတ်ပြန်ထားတဲ့ ကိန်းဂဏန်းတွေအရ MI350P ရဲ့ အလေးချိန်ဟာ တိကျမှုနည်းတယ်လို့ ဖော်ပြထားပါတယ်။ MXFP4 နဲ့ MXFP6 မှာ PFLOPS ၄.၆၊ FP8 မှာ PFLOPS ၂.၃ နဲ့ FP16 ဒါမှမဟုတ် BF16 မှာ PFLOPS ၁.၁၅ တို့ဖြစ်ပြီး အားလုံးက သိပ်သည်းတဲ့ ကိန်းဂဏန်းတွေပါ။ မန်မိုရီစနစ်က ကတ်ရဲ့ ကျန်တဲ့တစ်ဝက်ပါ။ 4TB/s မှာ 4,096-bit interface ပေါ်မှာ 144GB HBM3E ပါဝင်ပြီး 128MB Infinity Cache ပါရှိပါတယ်။ အောက်က single-stream ရလဒ်တွေက အဲဒီအပေါ်မှာ မူတည်ပါတယ်။ Board power က 450W configurable mode နဲ့ 600W ရှိပါတယ်။ ကျွန်တော်တို့ရဲ့ review unit က 450W မှာ run ပါတယ်။
MI350P သည် ပိုကြီးပြီး ပါဝါမြင့်သော MI350/5X GPU များကဲ့သို့ CDNA 4 ဗိသုကာပုံစံကို အသုံးပြုသည်။ MI350P ကို MI350X ၏ ထက်ဝက်ဟု ယူဆနိုင်သည်။ အဘယ်ကြောင့်ဆိုသော် ပိုကြီးသော GPU ကို မည်သို့တည်ဆောက်ထားသည်ကို နားလည်ရန် အထောက်အကူဖြစ်စေသည်။
MI350X သည် TSMC ၏ CoWoS သို့မဟုတ် Chip-on-Wafer-on-Substrate ထုပ်ပိုးမှုပေါ်တွင် တည်ဆောက်ထားသော 3D-stacked chiplet ဒီဇိုင်းတစ်ခုဖြစ်ပြီး monolithic die တစ်ခုမျှ မပါရှိပါ။ accelerator complex die ရှစ်ခု သို့မဟုတ် XCD များသည် I/O die နှစ်ခု၏ အထက်တွင် ရှိနေပြီး I/O die တစ်ခုစီတွင် XCD လေးခု ရှိသည်။ AMD ၏ Infinity Fabric သည် chiplet များကို ချိတ်ဆက်ပေးပြီး HBM3E stack ရှစ်ခုသည် GPU ၏ memory ကို ပံ့ပိုးပေးသည်။ CoWoS သည် package-level integration ကို ဖော်ပြထားသည်။ compute-over-I/O အစီအစဉ်သည် ဒီဇိုင်း၏ vertical၊ 3D-stacked component ဖြစ်သည်။

MI350P မှာ အဲဒီအစီအစဉ်ရဲ့ တစ်ဝက်ကို ယူထားပါတယ်- XCD လေးခု၊ I/O die တစ်ခုနဲ့ HBM3E stack လေးခုပါ။ XCD တစ်ခုစီမှာ active compute unit ၃၂ ခုပါဝင်ပြီး MI350X ရဲ့ ၂၅၆ ခုနဲ့ နှိုင်းယှဉ်ရင် ကတ်မှာ CU ၁၂၈ ခု ပါဝင်ပါတယ်။ memory resource တွေကိုလည်း ထက်ဝက်လျှော့ချထားပါတယ်- HBM3E 144GB နဲ့ 288GB၊ bandwidth 4TB/s နဲ့ 8TB/s နဲ့ Infinity Cache 128MB နဲ့ 256MB တို့ ဖြစ်ပါတယ်။

| specification | AMD Instinct MI350P |
|---|---|
| ပလက်ဖောင်းခြုံငုံသုံးသပ်ချက် | |
| ဗိသုကာအတတ်ပညာ | CDNA ၄ |
| ယူနစ်တွက်ချက် | 128 |
| စီးကြောင်းပရိုဆက်ဆာများ | 8,192 |
| မက်ထရစ် ကော်ပိုရိတ်များ | 512 |
| ဖြစ်စဉ် | TSMC 3nm နှင့် 6nm |
| transistors | 73 ဘီလီယံအထိ |
| အမြင့်ဆုံးအင်ဂျင်နာရီ | 2,200MHz |
| မှတ်ဉာဏ် | |
| စွမ်းဆောင်ရည်မြှင့် | ၂၈၈GB HBM3E |
| interface | 4,096-bit မှာ |
| bandwidth | ၃.၆ TB/s |
| နောက်ဆုံးအဆင့် ကက်ရှ် | 128MB |
| ECC | ချစ်ပ်အပြည့် |
| အမြင့်ဆုံးစွမ်းဆောင်ရည် (AMD မှဖော်ပြထားသည်) | |
| MXFP4 | ၁၁.၁၅ PFLOPS |
| MXFP6 | ၁၁.၁၅ PFLOPS |
| MXFP8 | ၁၁.၁၅ PFLOPS |
| OCP FP8 | ၂.၃ PFLOPS; ၄.၆ ဖွဲ့စည်းတည်ဆောက်ပုံ sparsity ပါရှိသော PFLOPS |
| FP16 | ၁.၁၅ PFLOPS; ၂.၃ PFLOPS များ ရှားပါးမှု |
| BF16 | ၁.၁၅ PFLOPS; ၂.၃ PFLOPS များ ရှားပါးမှု |
| FP32 | 72 TFLOPS |
| FP64 | 36 TFLOPS |
| ပါဝါ၊ အအေးပေးစနစ်နှင့် ပုံစံအடையாள் | |
| ပုံမှန်ဘုတ်ပါဝါ | အများဆုံး ၆၀၀ ဝပ်; ၄၅၀ ဝပ် ပြင်ဆင်သတ်မှတ်နိုင်သည် |
| Power က Connector | ၁၂ဗို့-၂×၆ |
| အအေး | မလှုပ်မရှားနေသော |
| form ကို Factor | PCIe ထပ်ထည့်ကတ်၊ အမြင့်အပြည့်၊ နှစ်ထပ် slot |
| ဘုတ်အလျား | ၃၁.၅ လက်မ (10.5mm) |
| အိမ်ရှင် Interface | PCIe 5.0 x16 |
| အင်္ဂါရပ်များ | |
| SR-IOV | Yes |
| Infinity Cache ကို | Yes |
| RAS | Yes |
| စာမျက်နှာ အနားယူခြင်းနှင့် ရှောင်ရှားခြင်း | Yes |
600W ပမာဏက အများဆုံးဖြစ်ပြီး AMD က ကတ်ကို 450W အထိ လျှော့ချခွင့်ပြုထားပြီး အဲဒါက ကျွန်တော်တို့ရဲ့ 2U host မှာ လည်ပတ်ခဲ့တဲ့နေရာပါ။ H200 NVL က R770 မှာ 450W နဲ့ တူညီပေမယ့် RTX PRO 6000 က XE7740 မှာ 600W အပြည့်နဲ့ လည်ပတ်ခဲ့တာကြောင့် NVIDIA ကတ်မှာ 150W ပိုသုံးထားပါတယ်။ full-power ရလဒ်တွေက 600W passive ကတ်ကို အအေးပေးနိုင်တဲ့ chassis အတွက် စောင့်မျှော်နေပြီး Dell ရဲ့ XE7745 နည်းပညာလမ်းညွှန်မှာ 600W မှာ MI350P ရှစ်ခုကို ဖော်ပြထားပါတယ်။
နောက်ထပ်မှတ်ချက်တစ်ခုကတော့ 12V-2×6 connector တစ်ခုတည်းနဲ့ 10.5-inch, double-slot board တို့ကြောင့်ဖြစ်ပြီး ဒီကတ်ကို ယနေ့ခေတ် RTX PRO 6000 ဒါမှမဟုတ် H200 NVL တွေမှာ တပ်ဆင်ထားတဲ့ riser တွေထဲကို ထည့်သွင်းအသုံးပြုနိုင်ပါတယ်။

အောက်ဖော်ပြပါဇယားတွင် MI350P ကို ကျွန်ုပ်တို့၏ဇယားရှိ NVIDIA စနစ်သုံးခုနှင့်အတူ သတ်မှတ်ထားသည်- ၎င်း၏ slot၊ ၎င်း၏ power range နှင့် ၎င်း၏ PCIe 5.0 x16 host link ကို မျှဝေသည့် RTX PRO 6000 Blackwell Server Edition၊ ၎င်းနှင့်ကိုက်ညီသော memory bandwidth ပါရှိသော H200 NVL နှင့် NVLink-C2C မှတစ်ဆင့် Grace CPU နှင့်တွဲဖက်ထားသော Blackwell Ultra GPU တစ်ခုတည်းဖြစ်သည့် GB300 DGX Station တို့ဖြစ်သည်။
အရင်ဆုံးဖတ်ရမယ့် အတန်းတွေကတော့ မှတ်ဉာဏ်စွမ်းရည်ဖြစ်ပြီး MI350P ရဲ့ 144GB က PCIe ကတ်သုံးကတ်ထဲမှာ အကြီးဆုံးဖြစ်ပြီး H200 NVL ထက် 3GB ပိုများပြီး RTX PRO 6000 ထက် 48GB ပိုများပါတယ်။ မှတ်ဉာဏ် bandwidth ကတော့ နှစ်ခုကြားမှာရှိပြီး 4TB/s ကတော့ ရှိနေပါတယ်။ ပြီးတော့ AMD က သိပ်သည်းတဲ့ကိန်းဂဏန်းကို ကိုးကားပြီး NVIDIA က ရှားပါးတယ်လို့ ကိုးကားထားတဲ့ FP4 လိုင်းဖြစ်ပါတယ်။
| specification | AMD Instinct MI350P | NVIDIA RTX PRO 6000 Blackwell Server Edition | NVIDIA H200 NVL PCIe | NVIDIA GB300 DGX ဘူတာရုံ |
|---|---|---|---|---|
| GPU တည်ဆောက်ပုံ | CDNA ၄ | ဘလက်ဝဲလ် | Hopper | Blackwell Ultra |
| Form ကိုအချက် | PCIe အရှိန်မြှင့်စက် | PCIe အရှိန်မြှင့်စက် | PCIe အရှိန်မြှင့်စက် | Blackwell Ultra GPU တစ်ခုနှင့် 72-core Grace CPU တို့ တွဲဖက်ထားသည် |
| GPU မမ်မိုရီ | ၂၈၈GB HBM3E | ၄၈GB GDDR7 ECC | ၂၈၈GB HBM3E | ၂၈၈GB HBM3E |
| GPU မှတ်ဉာဏ် bandwidth | ၃.၆ TB/s | ၃.၆ TB/s | ၃.၆ TB/s | ၃.၆ TB/s |
| FP4 | ၄.၆ PFLOPS MXFP4 (သိပ်သည်း) | ၂၀ PFLOPS NVFP4 (ရှားပါး) | မူရင်း FP4 မရှိပါ | ၂၀ PFLOPS NVFP4 (ရှားပါး) |
| FP8 | ၁.၁၅ PFLOPS (သိပ်သည်း) | ၅ PFLOPS (ရှားပါး) | ၅ PFLOPS (ရှားပါး) | ၅ PFLOPS (ရှားပါး) |
| BF16 | ၁.၁၅ PFLOPS (သိပ်သည်း) | ၅ PFLOPS (ရှားပါး) | ၅ PFLOPS (ရှားပါး) | ၅ PFLOPS (ရှားပါး) |
| FP32 | ၇၂ TFLOPS (သိပ်သည်း) | 120 TFLOPS (ရှားပါး) | 60 TFLOPS (ရှားပါး) | 80 TFLOPS (ရှားပါး) |
| ဟို့စ်ချိတ်ဆက်မှု | PCIe 5.0 x16 | PCIe 5.0 x16 | PCIe 5.0 x16 | Grace နှင့် GPU အကြား NVLink-C2C၊ 900GB/s (BiDi) |
| Multi-GPU ချိတ်ဆက်မှု | PCIe-အခြေခံ | PCIe-အခြေခံ | နှစ်လမ်း သို့မဟုတ် လေးလမ်း NVLink၊ GPU တစ်ခုလျှင် 900GB/s အထိ (BiDi) | ဘူတာရုံများအကြား ConnectX-8 ကွန်ရက်ချိတ်ဆက်မှု 800Gb/s |
| စွမ်းအား | ၄၅၀ မှ ၆၀၀ ဝပ်အထိ ချိန်ညှိနိုင်သည် | ၄၅၀ မှ ၆၀၀ ဝပ်အထိ ချိန်ညှိနိုင်သည် | ၄၅၀ မှ ၆၀၀ ဝပ်အထိ ချိန်ညှိနိုင်သည် | ပါဝါနှေးကွေးခြင်းပါရှိသော 1200W GPU အထိ |
RTX PRO 6000 နဲ့ ယှဉ်ရင် MI350P ရဲ့ memory subsystem က အနီးစပ်ဆုံး ကွာခြားချက်ပါ။ GPU memory ၅၀ ရာခိုင်နှုန်း ပိုများပြီး memory bandwidth ၂.၅ ဆ လောက် ရှိပါတယ်။ 96GB အတွင်း အဆင်ပြေပြေ မဆန့်တဲ့ မော်ဒယ်အတွက်၊ အပို capacity က GPU တစ်ခုတည်းမှာ အလုပ်လုပ်မလား၊ ဒါမှမဟုတ် GPU အများအပြားမှာ ဖြန့်ဝေဖို့ လိုအပ်မလားဆိုတာကို ဆုံးဖြတ်ပေးနိုင်ပါတယ်။
သို့သော် RTX PRO 6000 သည် AI စွမ်းရည်များနှင့်အတူ ဂရပ်ဖစ်၊ ray tracing နှင့် ဗီဒီယိုအတွက် hardware များပါဝင်သည့် ပိုမိုကျယ်ပြန့်သော workload အမျိုးမျိုးကို ဆောင်ရွက်ပေးပါသည်။ ရွေးချယ်မှုသည် အမြင့်ဆုံးတွက်ချက်မှုကိန်းဂဏန်းနှစ်ခုထက်ပို၍ အရေးကြီးပြီး ၎င်းသည် စနစ်က အခြားဘာလုပ်ရန် လိုအပ်သည်ပေါ်တွင်လည်း မူတည်ပါသည်။
H200 NVL သည် MI350P အတွက် မှတ်ဉာဏ်မြင့်မားသော PCIe accelerators များကြားတွင် ပိုမိုတိုက်ရိုက်နှိုင်းယှဉ်ခြင်းဖြစ်သည်။ Blackwell datacenter GPU ကြီးများသည် အတန်းအစားကွဲပြားသည်။ မှတ်ဉာဏ်စွမ်းရည်သည် 144GB တွင် H200 ၏ 141GB နှင့် နီးပါးတူညီပြီး နှစ်ခုစလုံးသည် HBM3E ကို အသုံးပြုထားပြီး H200 သည် 4.8TB/s တွင် မှတ်ဉာဏ် bandwidth 20 ရာခိုင်နှုန်းပိုမိုပေးဆောင်သည်။ နှစ်ခုစလုံးသည် အရွယ်အစားလည်းကွဲပြားသည်- PCIe ကတ်သုံးကတ်စလုံးသည် PCIe မှတစ်ဆင့် host သို့ချိတ်ဆက်သော်လည်း H200 NVL တွင် NVLink bridges များမှတစ်ဆင့် GPU လေးခုအထိချိတ်ဆက်သည့် dedicated GPU-to-GPU ချိတ်ဆက်မှုကို ထည့်သွင်းထားသည်။
ပိုကြီးတဲ့ MI350X နဲ့ MI355X တွေကို Blackwell နဲ့ ယှဉ်ပြိုင်ဖို့ တည်ဆောက်ခဲ့ပေမယ့် MI350P ကတော့ အဲဒီ hardware configuration ကို ထက်ဝက်လျှော့ချထားပါတယ်။ ဒါကြောင့် memory attributes နဲ့ overall positioning မှာ H200 NVL နဲ့ ပိုနီးစပ်သွားပါတယ်။ MI350P က သူ့ကိုယ်သူ ခွဲခြားနိုင်တဲ့ နေရာတစ်ခုကတော့ native MXFP4 နဲ့ MXFP6 support ပါပဲ။ ကောက်ချက်ချမှုက တိကျမှုနည်းလာတာနဲ့အမျှ ပိုအရေးကြီးပါတယ်။
AMD သည် HBM stack များ လျှော့ချမှုကို ပိုမိုမြန်ဆန်သော HBM3E ဖြင့် မချေဖျက်နိုင်သောကြောင့် MI350P သည် bandwidth 4TB/s ရှိပြီး ဤ metric တွင် H200 NVL ထက် နောက်ကျကျန်နေခဲ့သည်။ ၎င်းသည် ရရှိနိုင်သော compute မည်သို့ပင်ရှိစေကာမူ memory-bandwidth-bound workloads များတွင် စွမ်းဆောင်ရည်ကို ကန့်သတ်နိုင်သည်၊ အဘယ်ကြောင့်ဆိုသော် memory bandwidth နှင့် long-prompt inference တို့သည် review တွင် နောက်ပိုင်းတွင် ထွက်ပေါ်လာသောကြောင့်ဖြစ်သည်။
DGX Station နှိုင်းယှဉ်ချက်ကတော့ ပြောင်းပြန်ပါပဲ။ GB300 Station မှာ HBM stack တစ်ခုကို disable လုပ်ထားတဲ့ full B300 GPU ပါဝင်ပြီး datacenter power budget မှာ datacenter-class chip တစ်ခုပါရှိပါတယ်။ MI350P ကတော့ PCIe add-in card ရဲ့ 600W envelope ထဲမှာ တပ်ဆင်ထားတဲ့ datacenter-class chip ရဲ့ တစ်ဝက်ပါ။ AMD အနေနဲ့ single GPU နဲ့ ကိုက်ညီဖို့ MI350P နှစ်ခု ဒါမှမဟုတ် လေးခု လိုအပ်ပါတယ်။ စာရွက်ပေါ်မှာတော့ နှစ်ခုပဲ ရှိပါတယ်။ 288GB နဲ့ 8TB/s ရှိတဲ့ Station ရဲ့ 252GB နဲ့ 7.1TB/s ရှိတဲ့ resource တွေနဲ့ ယှဉ်ရင်ပေါ့။ ဒါပေမယ့် အဲဒီ resource တွေက card နှစ်ခုပေါ်မှာ ရှိနေပြီး workload က PCIe peer-to-peer ကနေတစ်ဆင့် data တွေကို ဖလှယ်နိုင်တဲ့အတွက် second card က ဘယ်လောက်ထည့်သွင်းရမလဲဆိုတာ ကန့်သတ်ထားပါတယ်။
performance
စမ်းသပ်ပလက်ဖောင်း
MI350P သုံးသပ်ချက်ယူနစ်သည် AMD EPYC 9555 ပရိုဆက်ဆာနှစ်ခု (တစ်ခုလျှင် 64 cores)၊ DIMM ၂၄ ခုတွင် DDR5-6400 1.5TB နှင့် 2U server အတွက် ကန့်သတ်ချက်မှာ 450W ရှိသည့် MI350P ကတ်နှစ်ခုပါရှိသော Dell PowerEdge R7725 ဖြစ်သည်။ RTX PRO 6000 Blackwell Server Edition ကတ်များ (600W) ကို ကျွန်ုပ်တို့၏ လေးကတ် inference build ပါရှိသော Dell PowerEdge XE7740 တွင် အသုံးပြုထားပြီး၊ ကျွန်ုပ်တို့၏ သုံးသပ်ချက်မှ Dell PowerEdge R770 တွင် H200 NVL (450W) တစ်ခုတည်းကို အသုံးပြုထားပြီး ၊ GB300 ကိန်းဂဏန်းများသည် စက်တင်ဘာလတွင် ကျွန်ုပ်တို့ သုံးသပ်ခဲ့သော ASUS ExpertCenter Pro ET900N G3 DGX Station မှ လာပါသည်။

အောက်ဖော်ပြပါ iDRAC စာရင်းတွင် ကတ်နှစ်ခု မည်သို့တပ်ဆင်ထားသည်ကို ပြသထားသည်။ ၎င်းတို့သည် PCIe slots 2 နှင့် 7 တွင် ရှိနေပြီး Gen5 x16 နှစ်ခုစလုံးသည် ကျန်းမာကြောင်း သတင်းပို့ထားပြီး device key များဖြစ်သည့် 0-139-0 နှင့် 1-199-0 တို့သည် EPYC socket တစ်ခုစီ၏နောက်ကွယ်တွင် ကတ်တစ်ခုအနေဖြင့် ကျွန်ုပ်တို့အား ဖတ်ရှုနိုင်သောကြောင့် MI350P နှစ်ခုကြားရှိ tensor-parallel traffic သည် root complex များအကြား ၎င်း၏လမ်းကြောင်းတွင် socket link ကို ဖြတ်ကျော်သွားသည်။ ၎င်းသည် 2U server တွင် ကတ်နှစ်ခု ဖြန့်ကျက်မှုတစ်ခုသည် default အနေဖြင့် ရရှိသော layout ဖြစ်ပြီး ကတ်နှစ်ခုရလဒ်များကို နောက်ပိုင်းတွင် မှတ်သားထားသင့်သည်။

မှတ်ဉာဏ်မြင်ကွင်းက host ရဲ့ ကျန်အပိုင်းကို ပြသထားပါတယ်- 64GB DDR5-6400 DIMM ၂၄ ခု၊ dual rank၊ အမြင့်ဆုံး 6TB ရှိတဲ့ server မှာ 1,536GB အတွက်၊ အားလုံး multi-bit ECC ပါရှိပါတယ်။ GLM-5.2 run အတွက် headroom က အရေးကြီးပါတယ်။ MXFP4 checkpoint က ကတ်နှစ်ခုရဲ့ 288GB မှာ မဆန့်ပါဘူး။ vLLM က expert weight ရဲ့ အစိတ်အပိုင်းတစ်ခုကို host memory ကို offload လုပ်ပါတယ်။

အများဆုံးရရှိနိုင်သော Matmul FLOPS (MAMF)
MI350P ရဲ့ တွက်ချက်မှုကို ဆက်စပ်နားလည်စေဖို့အတွက်၊ စနစ်လေးခုလုံးမှာ MAMF ကို လုပ်ဆောင်ခဲ့ပါတယ်။ MAMF (Maximum Achievable Matmul FLOPS) ဆိုတာ matrix multiplication လုပ်နေစဉ်အတွင်း accelerator တစ်ခု တစ်စက္ကန့်ကို ရောက်ရှိတဲ့ လက်တွေ့ကျတဲ့ peak floating-point လုပ်ဆောင်ချက်တွေကို တိုင်းတာဖို့ ဒီဇိုင်းထုတ်ထားတဲ့ လက်တွေ့ကျတဲ့ စွမ်းဆောင်ရည် မက်ထရစ်တစ်ခုဖြစ်ပြီး spec sheet မှာရှိတဲ့ theoretical peak FLOPS ထက် ပိုအသုံးဝင်တဲ့ benchmark တစ်ခုဖြစ်ပါတယ်။ BF16၊ FP8 နဲ့ block-scaled FP4 မှာရှိတဲ့ စနစ်တစ်ခုချင်းစီကို ကျွန်ုပ်တို့ ခွဲခြမ်းစိတ်ဖြာပြီး တိကျမှုအလိုက် အကောင်းဆုံး ထိန်းသိမ်းထားတဲ့ dense ရလဒ်ကို အစီရင်ခံပါတယ်။ hatched bar တွေက PCIe ကတ်တစ်ခုစီရဲ့ ရလဒ်ကို large-model serving run တွေမှာ အသုံးပြုတဲ့ ကတ်အရေအတွက်နဲ့ မြှောက်ပြီး တိုင်းတာမှုမရှိဘဲ တွက်ချက်ပါတယ်။

450W မှာ MI350P တစ်ခုဟာ BF16 မှာ 580 TFLOPS၊ FP8 မှာ 1,120 နဲ့ FP4 မှာ 2,228 အထိ ရောက်ရှိပါတယ်။ RTX PRO 6000 Blackwell ကတော့ 419၊ 820 နဲ့ 1,634 တို့မှာ အသီးသီး အသီးသီး အသီးသီး ရရှိတာကြောင့် MI350P ဟာ NVIDIA ကတ်ထက် တိကျမှုတိုင်းမှာ ၃၆ မှ ၃၈ ရာခိုင်နှုန်းအထိ ဦးဆောင်နေပြီး 150W အောက် ပြေးနေပြီး BF16 မှာ အကျယ်ဆုံး ကွာဟချက်က ၃၈.၄ ရာခိုင်နှုန်း ရှိပါတယ်။
BF16 မှာ H200 NVL ရဲ့ 652 TFLOPS နဲ့ FP8 မှာ 1,205 TFLOPS တွေက MI350P နှစ်ခုလုံးထက် သာလွန်နေပြီး FP4 လမ်းကြောင်းလည်း မရှိပါဘူး။ GB300 DGX Station က PCIe ကတ်သုံးခုလုံးရဲ့ အထက်မှာ 1,924, 3,802 နဲ့ 6,024 ရှိပြီး BF16 မှာ MI350P နဲ့ FP4 မှာ 2.7x လောက် ပိုများပါတယ်။ MI350P နှစ်ခုက စာရွက်ပေါ်မှာ 1,160 နဲ့ 4,456 နီးပါးရှိပြီး Station ရဲ့ GPU တစ်ခုတည်းနဲ့ ယှဉ်ရင် နည်းနေပါသေးတယ်။ ဒီသုံးသပ်ချက်မှာ NVIDIA MAMF ကိန်းဂဏန်းတွေက ကတ်တစ်ခုစီမှာ နောက်ဆုံးထွက်ရှိထားတဲ့ လုပ်ဆောင်ချက်တွေကနေ ဆင်းသက်လာတာဖြစ်ပြီး ကျွန်တော်တို့ရဲ့ အစောပိုင်းစမ်းသပ်မှုရလဒ်တွေကို အစားထိုးထားတာပါ။
GPU Memory Bandwidth
Accelerator သည် ၎င်း၏ execution unit များကို data များဖြင့် ထောက်ပံ့ပေးထားနိုင်မှသာ raw compute throughput သည် အသုံးဝင်ပါသည်။ ၎င်းသည် inference အတွက် အရေးကြီးဆုံးဖြစ်ပြီး၊ decode phase အတွင်း token generation ကို ရရှိနိုင်သော FLOPS များထက် memory bandwidth ဖြင့် ပိုမိုကန့်သတ်ထားသည်။ bandwidth test သည် GPU memory ကို compute kernel များနှင့် copy engine မှတစ်ဆင့် ဖတ်ရှုခြင်း၊ ရေးသားခြင်းနှင့် ကူးယူခြင်းတို့ကို ပြုလုပ်ပြီး GPU တစ်ခုစီအတွင်း ရရှိနိုင်သော bandwidth ကို ၎င်း၏ rated figure နှင့် နှိုင်းယှဉ်ပြသသည်။

MI350P တစ်လုံးသည် ၎င်း၏ HBM3E ကို 3,291GB/s ဖြင့် ဖတ်ရှုပြီး 3,204GB/s ဖြင့် ရေးသားပြီး 4TB/s အဆင့်သတ်မှတ်ချက်၏ ၈၀ ရာခိုင်နှုန်းခန့်ရှိပြီး မိတ္တူများကို 1,276 မှ 1,283GB/s အထိ ကူးယူနိုင်သည်။ မိတ္တူတစ်စောင်သည် bandwidth ကို နှစ်ကြိမ်အသုံးပြုသည်၊ တစ်ကြိမ်မှာ source ကိုဖတ်ရှုရန်နှင့် နောက်တစ်ကြိမ်မှာ destination ကိုရေးသားရန်ဖြစ်သည်။ RTX PRO 6000 ၏ GDDR7 သည် ဖတ်ရှုမှုတွင် 1,540GB/s နှင့် ရေးသားမှုတွင် 1,483GB/s ကို စီမံခန့်ခွဲသောကြောင့် MI350P သည် ကတ်တစ်ခုလျှင် အသုံးပြုနိုင်သော bandwidth ၏ ၂.၁ ဆခန့် သယ်ဆောင်သည်။
H200 NVL ရဲ့ 4,472GB/s read နဲ့ 4,156GB/s write ကိန်းဂဏန်းတွေဟာ MI350P ထက် ၃၆ ရာခိုင်နှုန်းနဲ့ ၃၀ ရာခိုင်နှုန်း သာလွန်နေပြီး 4TB/s နဲ့ ယှဉ်ရင် 4.8TB/s အဆင့်သတ်မှတ်ချက်နဲ့ ကိုက်ညီပါတယ်။ GB300 DGX Station က 6,869GB/s အထိ ရောက်ရှိပါတယ်။ MI350P နှစ်ခုဟာ Station အနီးမှာ read တွေမှာ 6,529GB/s အထိ ရောက်ရှိပေမယ့် အဲဒီ bandwidth ဟာ PCIe slot နှစ်ခုမှာ ရှိပြီး နှစ်ခုစလုံးကို လွှမ်းခြုံထားတဲ့ မော်ဒယ်က PCIe မှတစ်ဆင့် exchange တိုင်းအတွက် ပေးချေပါတယ်။
အခြ
အဆင့်နိမ့်စမ်းသပ်မှုများကို လွှမ်းခြုံထားပြီး၊ LLM ကောက်ချက်သို့ ကျွန်ုပ်တို့ ဆက်လက်သွားပါမည်။ ကျွန်ုပ်တို့၏ vLLM အွန်လိုင်းဝန်ဆောင်မှုစမ်းသပ်မှုသည် OpenAI နှင့် သဟဇာတဖြစ်သော endpoint တစ်ခုကို ပုံသေ concurrent stream အရေအတွက်ဖြင့် မောင်းနှင်ပြီး run တစ်လျှောက် တစ်စက္ကန့်လျှင် output token များကို မှတ်တမ်းတင်သည်။ ကျွန်ုပ်တို့သည် ပုံစံနှစ်မျိုးကို အစီရင်ခံပါသည်- chat-size ဖြစ်ပြီး decode-weight ဖြစ်သော in နှင့် out token 512 ခုနှင့် RAG နှင့် document-size ဖြစ်ပြီး prefill ပေါ်တွင် မူတည်သော in နှင့် out token 8,192 ခု။ Concurrency သည် stream တစ်ခုမှ အပေါ်သို့ နှစ်ဆတိုးလာပြီး ဇယားတစ်ခုစီသည် ၎င်းတွင်ပါဝင်သော card တစ်ခုစီ ပြီးမြောက်သည့် အမြင့်ဆုံး concurrency တွင် ရပ်တန့်သည်။ အမှတ်တိုင်းသည် stream တစ်ခုလျှင် request နှစ်ခုဖြစ်သောကြောင့် single-stream ကိန်းဂဏန်းများသည် request နှစ်ခုပေါ်တွင် အခြေခံထားပြီး concurrency point မြင့်မားခြင်းထက် run-to-run variance ပိုမိုသယ်ဆောင်သည်။
မော်ဒယ်တစ်ခုစီကို အနည်းဆုံးကတ်များဖြင့် လည်ပတ်သည်- GPT-OSS-120B နှင့် MiniMax-M2.7 မှတစ်ဆင့် အရာအားလုံးအတွက် MI350P တစ်ခုနှင့် DeepSeek-V4-Flash၊ MiniMax-M3၊ GLM-5.2 နှင့် GLM-5.3 Flash အတွက် နှစ်ခု။ RTX PRO 6000 လည်ပတ်မှုသည် MiniMax-M2.7 တွင် RTX ကတ်နှစ်ခုကို MI350P တစ်ခုနှင့် ယှဉ်ပြီး MiniMax-M3 နှင့် GLM-5.2 တွင် လေးခုကို ယှဉ်ပြီး နှစ်ခုကို ယှဉ်သည့် စည်းမျဉ်းတူကို လိုက်နာသည်။ တိကျမှုနည်းသော တည်ဆောက်မှုများသည် ရောင်းချသူအလိုက် ကွဲပြားသည်- AMD များသည် MXFP4 မှ Quark အထိ၊ NVIDIA များသည် NVFP4 ဖြစ်ပြီး FP4 တွဲဖက်မှုများကို ထိုနည်းအတိုင်း အညွှန်းတပ်ထားသည်။ GPT-OSS သည် MXFP4 အဖြစ် တင်ပို့ပြီး ကတ်တိုင်းတွင် အလေးချိန်တူညီစွာ လည်ပတ်သည်။ H200 NVFP4 တည်ဆောက်မှုများ မပါဝင်ပါ။
| ပုံစံ | MI350P | RTX PRO 6000 ဘလက်ဝဲလ် | H200 NVL | GB300 DGX ဘူတာရုံ |
|---|---|---|---|---|
| GLM-5.3 ဖလက်ရှ် | ကတ် ၂ ခု၊ MXFP4 | မပြေးပါ | မပြေးပါ | NVFP4 |
| GLM-5.2 | ကတ် ၂ ခု၊ MXFP4 (host memory သို့ offload လုပ်ခြင်း) | ကတ် ၂ ခု၊ NVFP4 | မပြေးပါ | NVFP4 (Grace မှတ်ဉာဏ်တွင် ကျွမ်းကျင်သူ ၂၁၅GB ခန့်) |
| MiniMax-M3 | ကတ် ၂ ခု၊ MXFP4 | ကတ် ၂ ခု၊ NVFP4 | မပြေးပါ | NVFP4 (Grace မှတ်ဉာဏ်ထဲက ကျွမ်းကျင်သူတွေရဲ့ အပိုင်းအစတစ်ခု) |
| DeepSeek-V4-Flash | ကတ် ၂ ခု၊ FP8 | ကတ် ၂ ခု၊ FP8 | မပြေးပါ | FP8 |
| MiniMax-M2.7 | ကတ် ၁ ခု၊ MXFP4 | ကတ် ၂ ခု၊ NVFP4 | မပြေးပါ | NVFP4 |
| GPT-OSS-120B | ကတ် ၁ ခု၊ MXFP4 | ကတ် ၁ ခု၊ MXFP4 | ကတ် ၁ ခု၊ MXFP4 | MXFP4 |
| GPT-OSS-20B | ကတ် ၁ ခု၊ MXFP4 | ကတ် ၁ ခု၊ MXFP4 | ကတ် ၁ ခု၊ MXFP4 | MXFP4 |
| Qwen3-Coder-30B-A3B | ကတ် ၁ ကတ်၊ FP8 နှင့် BF16 | ကတ် ၁ ကတ်၊ FP8 နှင့် BF16 | ကတ် ၁ ကတ်၊ FP8 နှင့် BF16 | FP8 နှင့် BF16 |
| မစ်စထရယ် အသေးစား ၃.၁ ၂၄ဘီ | ကတ် ၁ ကတ်၊ FP8 နှင့် BF16 | ကတ် ၁ ကတ်၊ FP8 နှင့် BF16 | ကတ် ၁ ကတ်၊ FP8 နှင့် BF16 | FP8 နှင့် BF16 |
| Llama 3.1 8B | ကတ် ၁ ခု၊ MXFP4၊ FP8 နှင့် BF16 | ကတ် ၁ ခု၊ NVFP4၊ FP8 နှင့် BF16 | ကတ် ၁ ကတ်၊ FP8 နှင့် BF16 | NVFP4၊ FP8 နှင့် BF16 |
MI350P ကော်လံကို ဖတ်ကြည့်ရင် ကတ်အရေအတွက်က 144GB မှာ ပထမဆုံးရမယ့်အရာပါ။ မော်ဒယ်ဆယ်ခုထဲက ခြောက်ခုက MI350P တစ်ခုတည်းမှာ လည်ပတ်နေပြီး RTX PRO 6000 ရဲ့ 96GB က MiniMax-M2.7 အတွက် ဒုတိယကတ်တစ်ခု လိုအပ်ပြီး MI350P နှစ်ခုဖြစ်တဲ့ MiniMax-M3 နဲ့ GLM-5.2 မှာ ရှိနေမယ့် MXFP4 checkpoints နှစ်ခုက RTX PRO 6000 လေးခု လိုအပ်ပါတယ်။ GLM-5.2 က 288GB ကိုတောင် ကျော်လွန်တဲ့ မော်ဒယ်ဖြစ်ပြီး vLLM က သူ့ရဲ့ expert weight တွေရဲ့ အစိတ်အပိုင်းတစ်ခုကို R7725 ရဲ့ host memory ကို offload လုပ်ပါတယ်။ GB300 ကတော့ Grace memory မှာ expert 215GB လောက်နဲ့ အတူတူပါပဲ။
single-card မော်ဒယ်များအတွက် MI350P ကိန်းဂဏန်းများကို အောက်တိုဘာ ၂၇ ရက်တွင် AMDGPU 31.60၊ ROCm 10.1.0 နှင့် vLLM 0.32.0 တို့တွင် လုပ်ဆောင်ခဲ့သည်။ Dell ၏ အတည်ပြုထားသော ပေါင်းစပ်မှုမှာ vLLM 0.27 နှင့် ROCm 10.0 နှင့် AMDGPU 31.5 ဖြစ်ပြီး အောက်တိုဘာ ၅ ရက်တွင် ROCm 10.1 ထုတ်ဝေမှုသို့ ကျွန်ုပ်တို့ နောက်တစ်ဆင့်တက်လှမ်းခဲ့သည်။ NVIDIA ကတ်များသည် CUDA 13.4.1 တွင် vLLM 26.08 container ကို တစ်လျှောက်လုံး လုပ်ဆောင်ခဲ့သည်။ ဇယားတွင် လုပ်ဆောင်မှုတစ်ခုစီ၏နောက်ကွယ်ရှိ build ကို ဖော်ပြထားသည်။
| ပုံစံ | vLLM ရုပ်ပုံ |
|---|---|
| AMD Instinct MI350P | |
| DeepSeek-V4-Flash-0731 | vllm/vllm-openai-rocm@sha256:a78d3e91404e7875aa650a61dea580a9e26d72553bee9ae5b93dbdef7107594d (ROCm 7.2.3) |
| GLM-၅.၂ MXFP၄ | vllm/vllm-openai-rocm:v0.27.1 (ROCm 7.2.3) |
| GLM-5.3 ဖလက်ရှ် MXFP4 | vllm/vllm-openai-rocm@sha256:a78d3e91404e7875aa650a61dea580a9e26d72553bee9ae5b93dbdef7107594d (ROCm 7.2.3) |
| GPT-OSS-120B MXFP4 | ROCm 10.1.0၊ AMDGPU 31.60 (အောက်တိုဘာ ၂၇) တွင် vLLM 0.32.0 ကို ရရှိနိုင်ပါသည်။ |
| GPT-OSS-20B MXFP4 | ROCm 10.1.0၊ AMDGPU 31.60 (အောက်တိုဘာ ၂၇) တွင် vLLM 0.32.0 ကို ရရှိနိုင်ပါသည်။ |
| လာမာ ၃.၁ ၈ဘီ BF၁၆ | ROCm 10.1.0၊ AMDGPU 31.60 (အောက်တိုဘာ ၂၇) တွင် vLLM 0.32.0 ကို ရရှိနိုင်ပါသည်။ |
| လာမာ ၃.၁ ၈ဘီ FP၈ | ROCm 10.1.0၊ AMDGPU 31.60 (အောက်တိုဘာ ၂၇) တွင် vLLM 0.32.0 ကို ရရှိနိုင်ပါသည်။ |
| လာမာ ၃.၁ ၈ဘီ MXFP၄ | ROCm 10.1.0၊ AMDGPU 31.60 (အောက်တိုဘာ ၂၇) တွင် vLLM 0.32.0 ကို ရရှိနိုင်ပါသည်။ |
| MiniMax-M2.7 MXFP4 | ROCm 10.1.0၊ AMDGPU 31.60 (အောက်တိုဘာ ၂၇) တွင် vLLM 0.32.0 ကို ရရှိနိုင်ပါသည်။ |
| MiniMax-M3 MXFP4 | vllm/vllm-openai-rocm:nightly-2a02f6efe319c885e3ccbcecde402e0028f9ec1e (ROCm 7.2.3) |
| မစ်စထရယ် အသေးစား ၃.၁ ၂၄ဘီ BF၁၆ | ROCm 10.1.0၊ AMDGPU 31.60 (အောက်တိုဘာ ၂၇) တွင် vLLM 0.32.0 ကို ရရှိနိုင်ပါသည်။ |
| မစ်စထရယ် အသေးစား ၃.၁ ၂၄ဘီ FP၈ | ROCm 10.1.0၊ AMDGPU 31.60 (အောက်တိုဘာ ၂၇) တွင် vLLM 0.32.0 ကို ရရှိနိုင်ပါသည်။ |
| Qwen3-Coder-30B BF16 | ROCm 10.1.0၊ AMDGPU 31.60 (အောက်တိုဘာ ၂၇) တွင် vLLM 0.32.0 ကို ရရှိနိုင်ပါသည်။ |
| Qwen3-Coder-30B FP8 | ROCm 10.1.0၊ AMDGPU 31.60 (အောက်တိုဘာ ၂၇) တွင် vLLM 0.32.0 ကို ရရှိနိုင်ပါသည်။ |
| NVIDIA RTX PRO 6000 Blackwell Server Edition (CUDA 13.4.1.012) | |
| DeepSeek-V4-Flash-0731 | nvcr.io/nvidia/vllm:26.08-py3 |
| GLM-၅.၂ NVFP၄ | nvcr.io/nvidia/vllm:26.08-py3 |
| GPT-OSS-120B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| GPT-OSS-20B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| လာမာ ၃.၁ ၈ဘီ BF၁၆ | nvcr.io/nvidia/vllm:26.08-py3 |
| လာမာ ၃.၁ ၈ဘီ FP၈ | nvcr.io/nvidia/vllm:26.08-py3 |
| လာမာ ၃.၁ ၈ဘီ NVFP၄ | nvcr.io/nvidia/vllm:26.08-py3 |
| MiniMax-M2.7 NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| MiniMax-M3 NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| မစ်စထရယ် အသေးစား ၃.၁ ၂၄ဘီ BF၁၆ | nvcr.io/nvidia/vllm:26.08-py3 |
| မစ်စထရယ် အသေးစား ၃.၁ ၂၄ဘီ FP၈ | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| NVIDIA H200 NVL (CUDA 13.4.1.012) | |
| GPT-OSS-120B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| GPT-OSS-20B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| လာမာ ၃.၁ ၈ဘီ BF၁၆ | nvcr.io/nvidia/vllm:26.08-py3 |
| လာမာ ၃.၁ ၈ဘီ FP၈ | nvcr.io/nvidia/vllm:26.08-py3 |
| မစ်စထရယ် အသေးစား ၃.၁ ၂၄ဘီ BF၁၆ | nvcr.io/nvidia/vllm:26.08-py3 |
| မစ်စထရယ် အသေးစား ၃.၁ ၂၄ဘီ FP၈ | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
ကတ်နှစ်ခုပါ မော်ဒယ်လေးခုဖြစ်သည့် DeepSeek-V4-Flash၊ MiniMax-M3၊ GLM-5.2 နှင့် GLM-5.3 Flash တို့ကို ROCm 7.2.3 တွင် run ခြင်းမှ အစီရင်ခံထားပါသည်။ ကျွန်ုပ်တို့၏ ROCm 10.1 သည် CPU expert offload တစ်လျှောက်လုံး အသုံးပြုခဲ့သော မော်ဒယ်များတွင် pass ရရှိခဲ့ပြီး DeepSeek-V4-Flash တွင် NVIDIA run မလုပ်ခဲ့သော speculative decoder တစ်ခုဖြစ်သောကြောင့် ၎င်းတို့ကို ကွဲပြားသော စမ်းသပ်မှုတစ်ခု ဖြစ်စေသောကြောင့် လက်ရှိ stack တွင် clean pass ရရှိရန်အတွက် ထိန်းသိမ်းထားမည်ဖြစ်ပြီး ဇယားများတွင် MI350P အတန်းတိုင်းကို ၎င်း၏ stack ဖြင့် label လုပ်ထားသည်။
AMD ၏ ဤမော်ဒယ်များအတွက် ဦးစားပေးလမ်းကြောင်းမှာ ၎င်း၏ AIM ကွန်တိန်နာများဖြစ်သည်။ အောက်တိုဘာလ ၉ ရက်နေ့တွင် ထုတ်ပြန်ခဲ့သော Enterprise AI Suite 2.5 ထုတ်ဝေမှုကို ROCm 10 တွင် အတည်ပြုပြီးဖြစ်ပြီး GPT-OSS-120B၊ Llama 3.3 70B နှင့် Gemma 3 27B အတွက် AIM များ ပါရှိသော်လည်း AMD ၏ accelerator ဇယားတွင် Wan2.2 အတွက်သာ အကောင်းဆုံးဖြစ်အောင်ပြုလုပ်ထားသော MI350P ပရိုဖိုင်ကို ဖော်ပြထားသည်။ ထို့ကြောင့် Stock vLLM သည် MI350P ဝယ်ယူသူတစ်ဦး ယနေ့တိုင် လျှောက်လှမ်းနေသော လမ်းကြောင်းဖြစ်ပြီး ကျွန်ုပ်တို့ တိုင်းတာခဲ့သည့်အတိုင်း ဖြစ်သည်။
ကောက်ချက်ရလဒ်များကို တစ်ချက်ကြည့်လိုက်ရုံဖြင့်
အောက်တွင် ဇယား ၂၈ ခုပါရှိသောကြောင့် ဇယားနှစ်ခုဖြင့် အတိုချုပ်ဖော်ပြထားပါသည်- မော်ဒယ်တစ်ခုစီအတွက် တစ်ပြိုင်နက်တည်း အမြင့်ဆုံးရရှိမှုတွင် တစ်စက္ကန့်လျှင် အထွက်တိုကင်များ၊ ကတ်တိုင်းပြီးစီးပြီး၊ chat-size 512-in, 512-out workload ကို ဦးစွာအသုံးပြုပါသည်။ MI350P ကိန်းဂဏန်းများသည် 450W တွင် ကတ်တစ်ခုဖြစ်ပြီး row တွင် အခြားနည်းဖြင့်ဖော်ပြထားခြင်းမရှိပါက၊ row တစ်ခုစီသည် stack အတွက် column တစ်ခုဖြင့် လာပါသည်။ GB300 DGX Station သည် B300 တစ်ခုတည်းဖြစ်သည်။
| ပုံစံ | ကတ်များ (MI350P / RTX PRO 6000) | MI350P အစုအဝေး | streams | MI350P | RTX PRO 6000 | H200 NVL | GB300 DGX ဘူတာရုံ |
|---|---|---|---|---|---|---|---|
| GLM-5.3 Flash (MXFP4 vs NVFP4) | ၂ / မရှိပါ | ROCm ၇.၂ | 32 | 1,462 | မပြေးပါ | မပြေးပါ | 828 |
| GLM-၅.၂ (MXFP4 နှင့် NVFP4) | 2 / 4 | ROCm ၇.၂ | 32 | 59 | 40 | မပြေးပါ | 139 |
| MiniMax-M3 (MXFP4 နှင့် NVFP4) | 2 / 4 | ROCm ၇.၂ | 32 | 1,509 | 759 | မပြေးပါ | 1,041 |
| DeepSeek-V4-Flash | 2 / 2 | ROCm ၇.၂ | 32 | 1,081 | 829 | မပြေးပါ | 1,766 |
| MiniMax-M2.7 (MXFP4 နှင့် NVFP4) | 1 / 2 | ROCm ၇.၂ | 128 | 1,524 | 1,932 | မပြေးပါ | 4,793 |
| GPT-OSS-120B MXFP4 | 1 / 1 | ROCm ၇.၂ | 128 | 5,057 | 3,064 | 3,376 | 9,280 |
| GPT-OSS-20B MXFP4 | 1 / 1 | ROCm ၇.၂ | 128 | 10,726 | 7,937 | 6,022 | 22,041 |
| Qwen3-Coder-30B FP8 | 1 / 1 | ROCm ၇.၂ | 128 | 6,451 | 3,995 | 7,459 | 12,439 |
| Qwen3-Coder-30B BF16 | 1 / 1 | ROCm ၇.၂ | 128 | 4,696 | 2,881 | 5,240 | 10,000 |
| မစ်စထရယ် အသေးစား ၂၄ဘီ FP၈ | 1 / 1 | ROCm ၇.၂ | 128 | 4,458 | 3,242 | 4,624 | 11,075 |
| မစ်စထရယ် အသေးစား ၂၄ဘီ BF၁၆ | 1 / 1 | ROCm ၇.၂ | 128 | 3,065 | 2,026 | 3,373 | 7,861 |
| လာမာ ၃.၁ ၈ဘီ (MXFP4 vs NVFP4) | 1 / 1 | ROCm ၇.၂ | 128 | 8,383 | 8,869 | မပြေးပါ | 28,400 |
| လာမာ ၃.၁ ၈ဘီ FP၈ | 1 / 1 | ROCm ၇.၂ | 128 | 11,045 | 8,073 | 11,054 | 25,602 |
| လာမာ ၃.၁ ၈ဘီ BF၁၆ | 1 / 1 | ROCm ၇.၂ | 128 | 6,819 | 4,740 | 8,069 | 17,074 |
ချက်ဇယားမှာ ရလဒ်နှစ်ခု ထင်ရှားပါတယ်။ MI350P ဟာ FP8၊ BF16 နဲ့ GPT-OSS မော်ဒယ်တိုင်းမှာ RTX PRO 6000 ထက် 35% မှ 65% အထိ သာလွန်ပြီး stream ၁၂၈ ခုမှာ NVIDIA ရဲ့ NVFP4 build တွေက Llama နဲ့ MiniMax-M2.7 curves ရဲ့ အပေါ်ဆုံးမှာပဲ နောက်ကျကျန်နေပြီး Llama 3.1 8B နဲ့ Mistral Small 24B မှာ single stream မှာ NVIDIA card ထက် နှစ်ဆလောက် သာလွန်ပါတယ်။ HBM3E 4TB/s က အလုပ်လုပ်ပါတယ်။
bandwidth ၂၀ ရာခိုင်နှုန်းပိုများသော H200 NVL သည် dense FP8 နှင့် BF16 မော်ဒယ်များတွင် 128 streams တွင် ၄ ရာခိုင်နှုန်းမှ ၁၈ ရာခိုင်နှုန်းအထိ ရှေ့ရောက်နေပြီး Llama 3.1 8B FP8 တွင် တူညီနေသည်။ GPT-OSS မော်ဒယ်နှစ်ခုတွင် အစီအစဉ်ပြောင်းပြန်ဖြစ်ပြီး MI350P သည် ၅၀ ရာခိုင်နှုန်းနှင့် ၇၈ ရာခိုင်နှုန်း ရှေ့ရောက်နေပါသည်။
ဒုတိယဇယားတွင် 8,192-token prompts များတွင် လေ့ကျင့်ခန်းကို ပြန်လည်ပြုလုပ်ထားပြီး၊ prefill သည် run ကို လွှမ်းမိုးထားပြီး compute နှင့် memory bandwidth အကြား ချိန်ခွင်လျှာသည် NVIDIA ကတ်များဆီသို့ ရွေ့လျားသွားသည်။
| ပုံစံ | ကတ်များ (MI350P / RTX PRO 6000) | MI350P အစုအဝေး | streams | MI350P | RTX PRO 6000 | H200 NVL | GB300 DGX ဘူတာရုံ |
|---|---|---|---|---|---|---|---|
| GLM-5.3 Flash (MXFP4 vs NVFP4) | ၂ / မရှိပါ | ROCm ၇.၂ | 32 | 760 | မပြေးပါ | မပြေးပါ | 1,219 |
| GLM-၅.၂ (MXFP4 နှင့် NVFP4) | 2 / 4 | ROCm ၇.၂ | 16 | 6 | 9 | မပြေးပါ | 87 |
| MiniMax-M3 (MXFP4 နှင့် NVFP4) | 2 / 4 | ROCm ၇.၂ | 8 | 524 | 444 | မပြေးပါ | 103 |
| DeepSeek-V4-Flash | 2 / 2 | ROCm ၇.၂ | 32 | 621 | 345 | မပြေးပါ | 954 |
| MiniMax-M2.7 (MXFP4 နှင့် NVFP4) | 1 / 2 | ROCm ၇.၂ | 64 | 331 | 501 | မပြေးပါ | 1,744 |
| GPT-OSS-120B MXFP4 | 1 / 1 | ROCm ၇.၂ | 128 | 2,101 | 1,169 | 1,825 | 5,023 |
| GPT-OSS-20B MXFP4 | 1 / 1 | ROCm ၇.၂ | 128 | 3,603 | 2,482 | 3,419 | 9,555 |
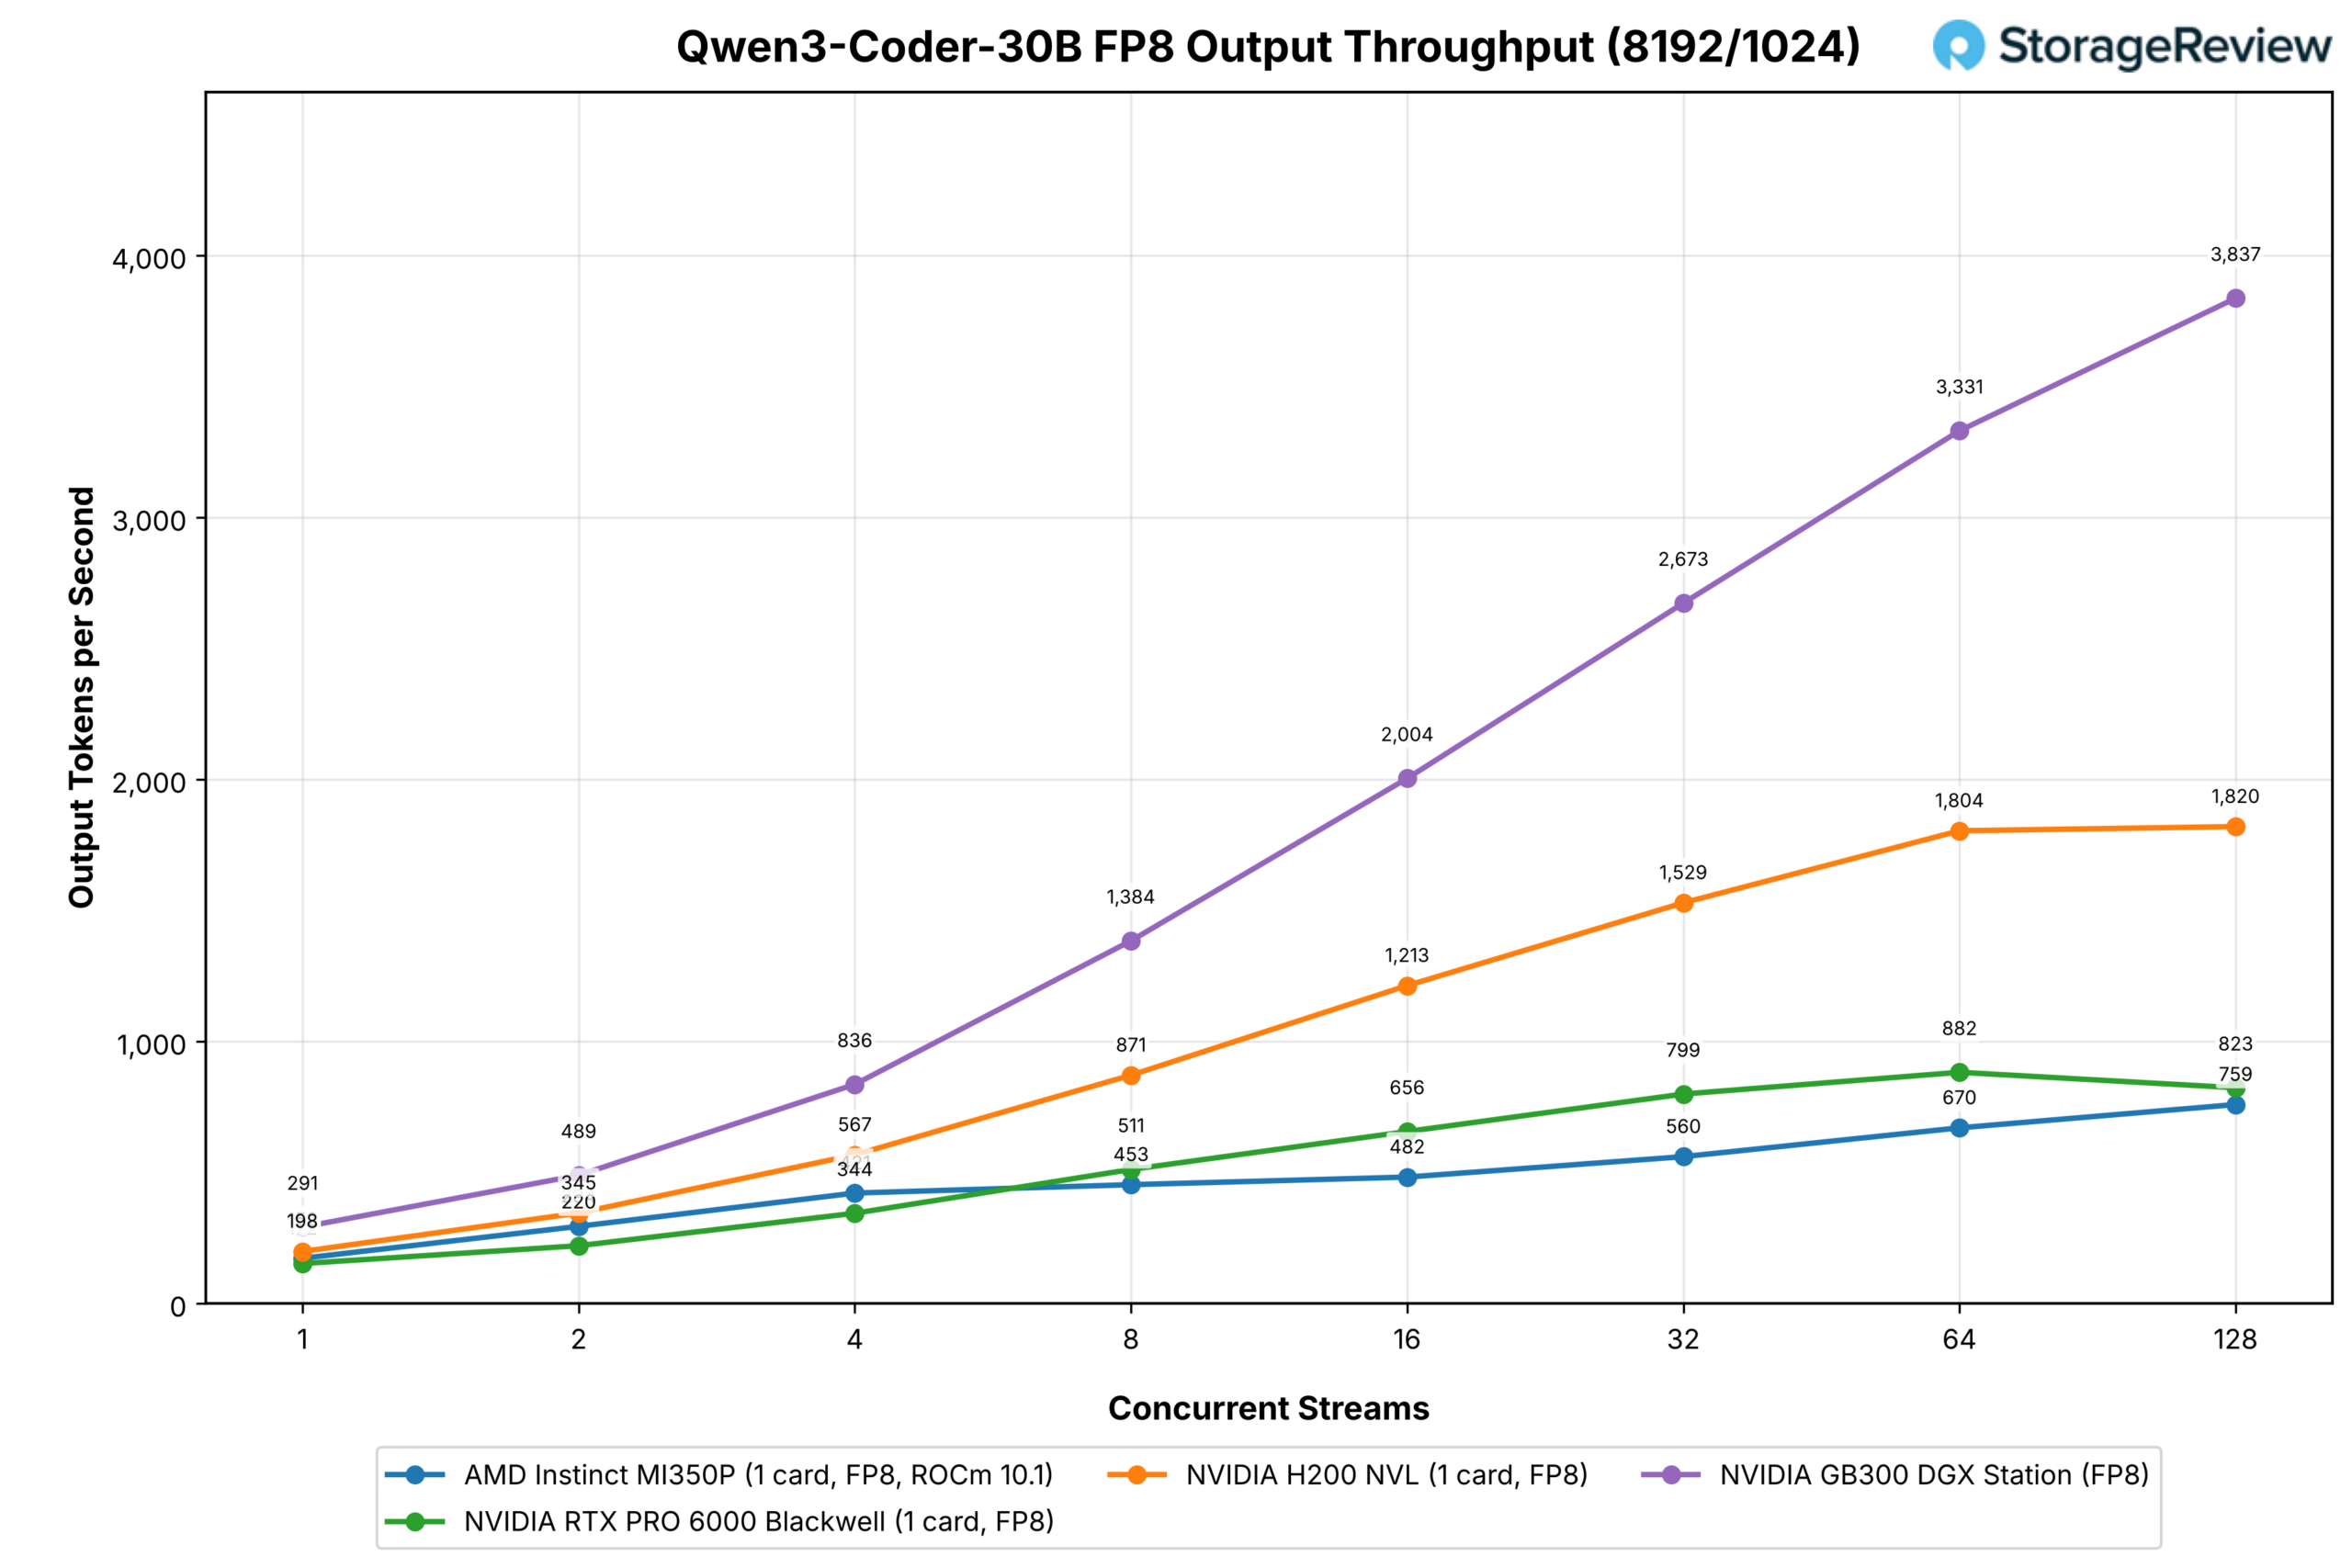
| Qwen3-Coder-30B FP8 | 1 / 1 | ROCm ၇.၂ | 128 | 759 | 823 | 1,820 | 3,837 |
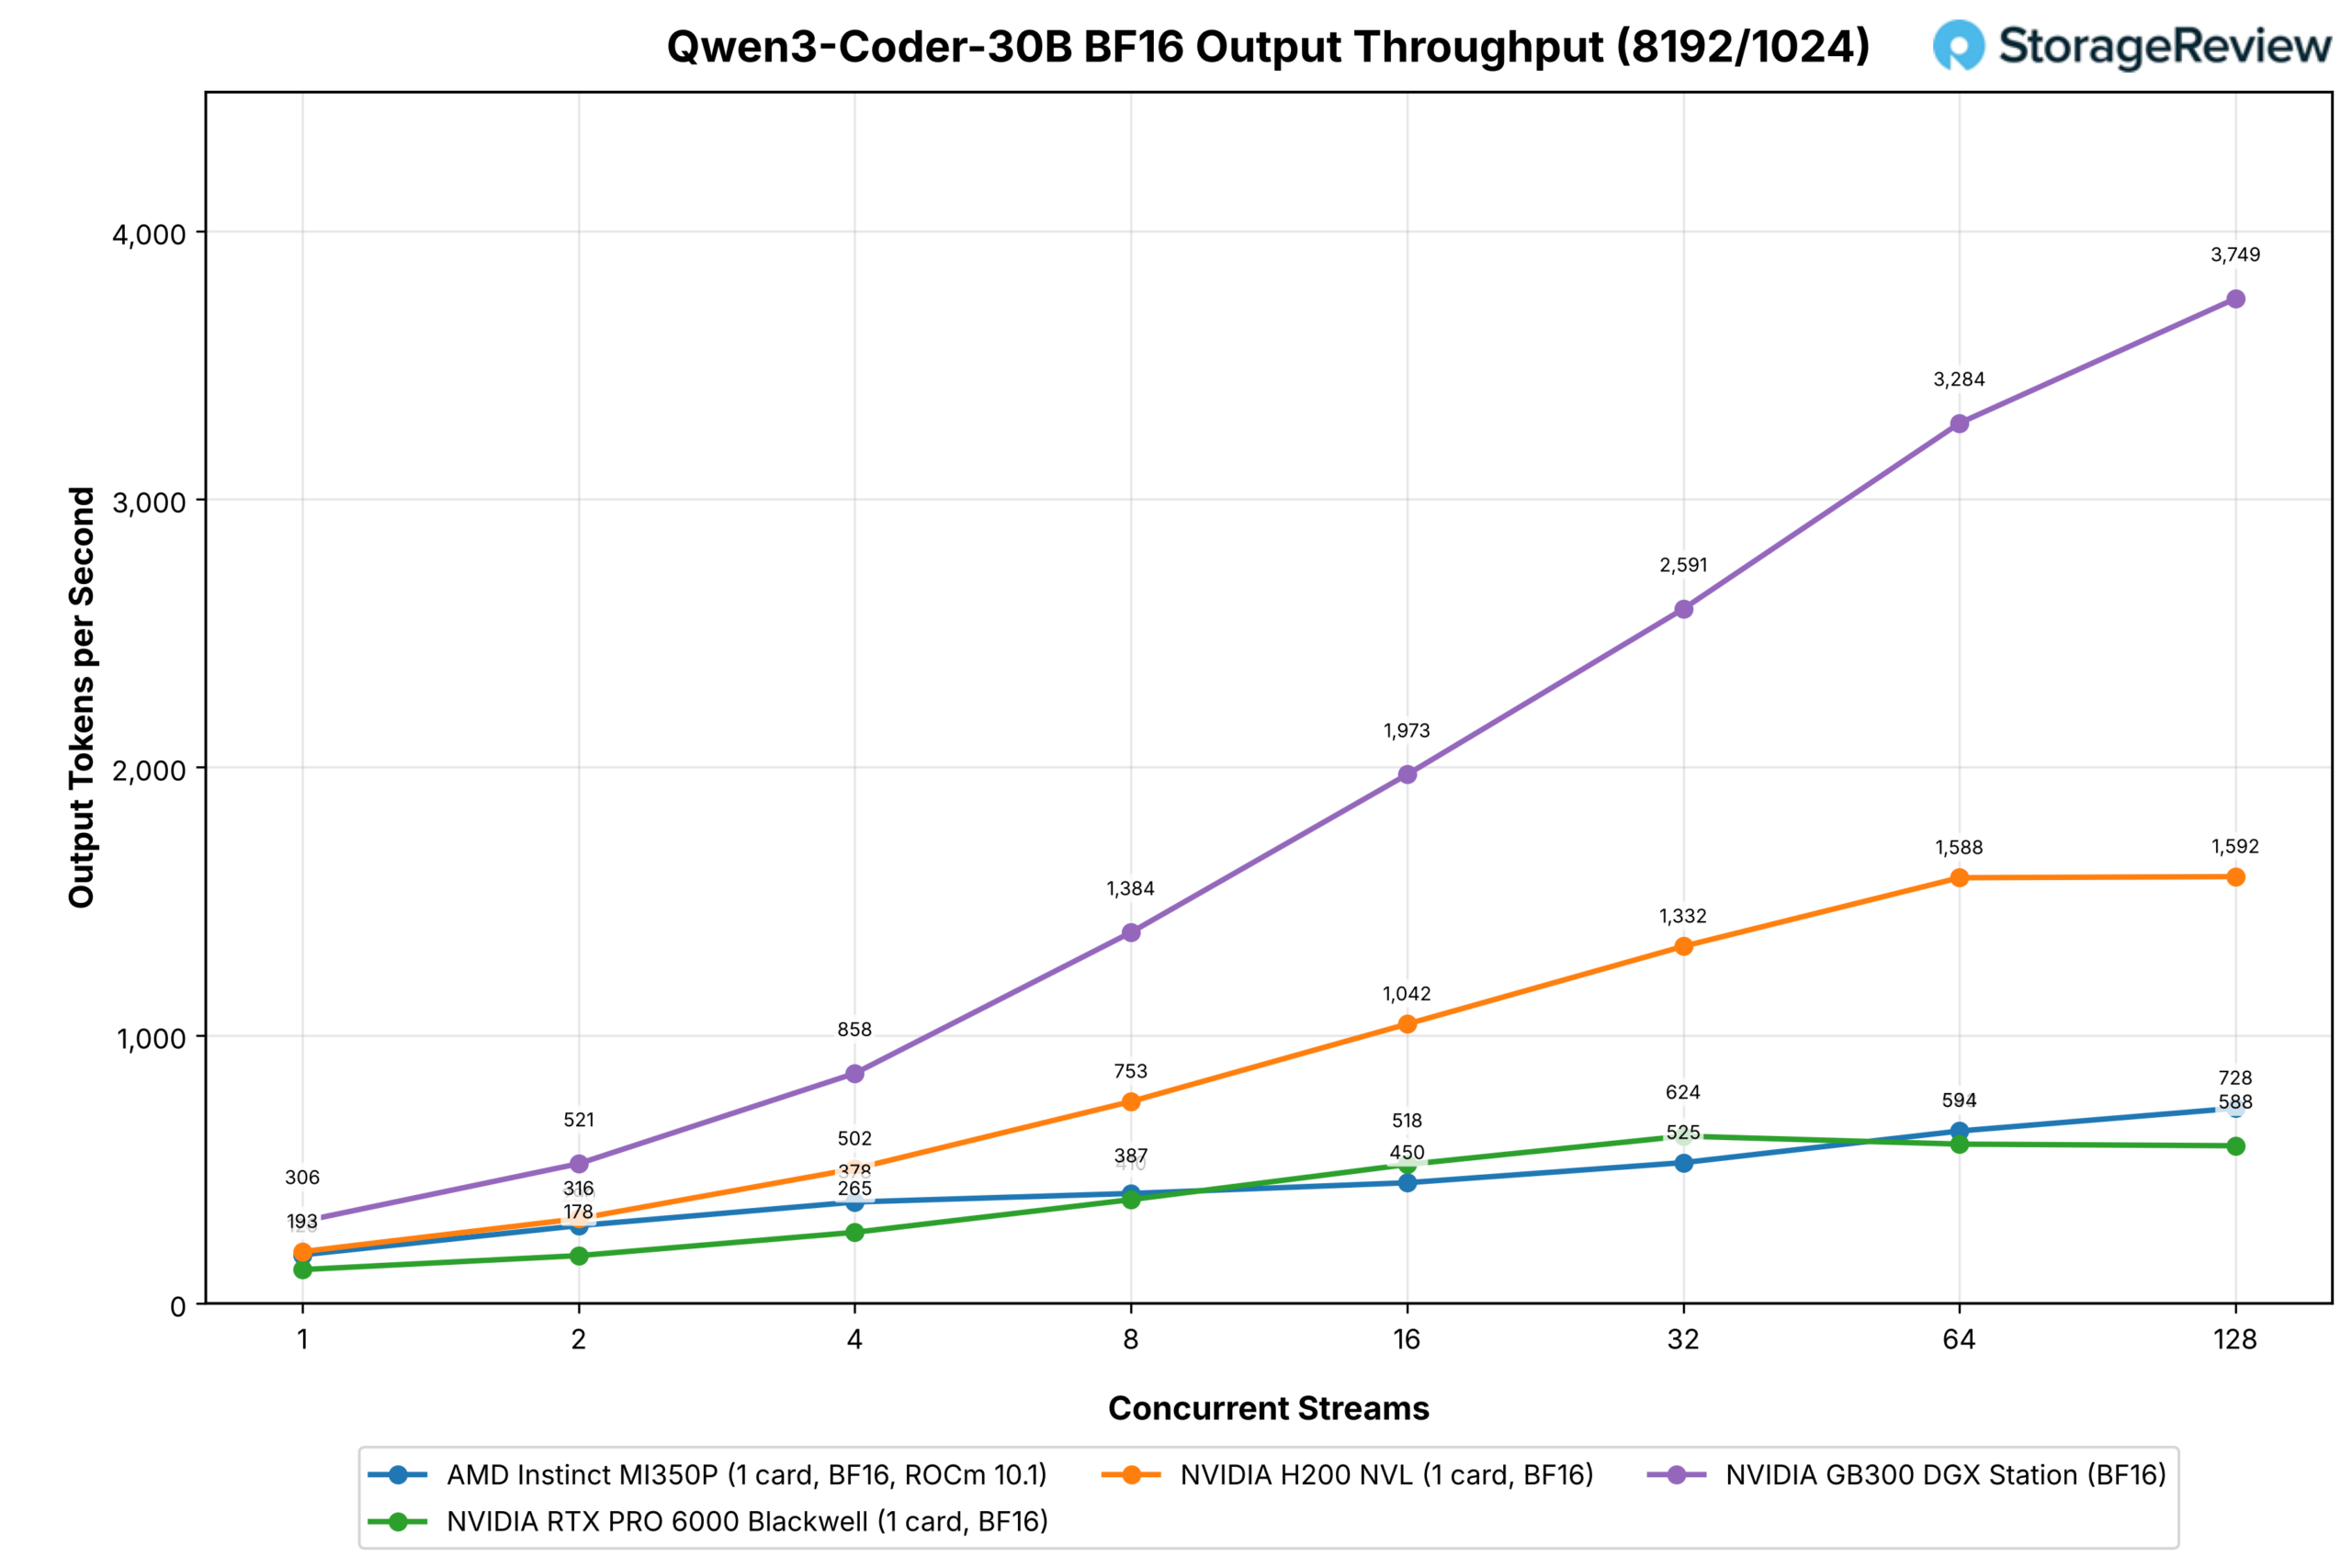
| Qwen3-Coder-30B BF16 | 1 / 1 | ROCm ၇.၂ | 128 | 728 | 588 | 1,592 | 3,749 |
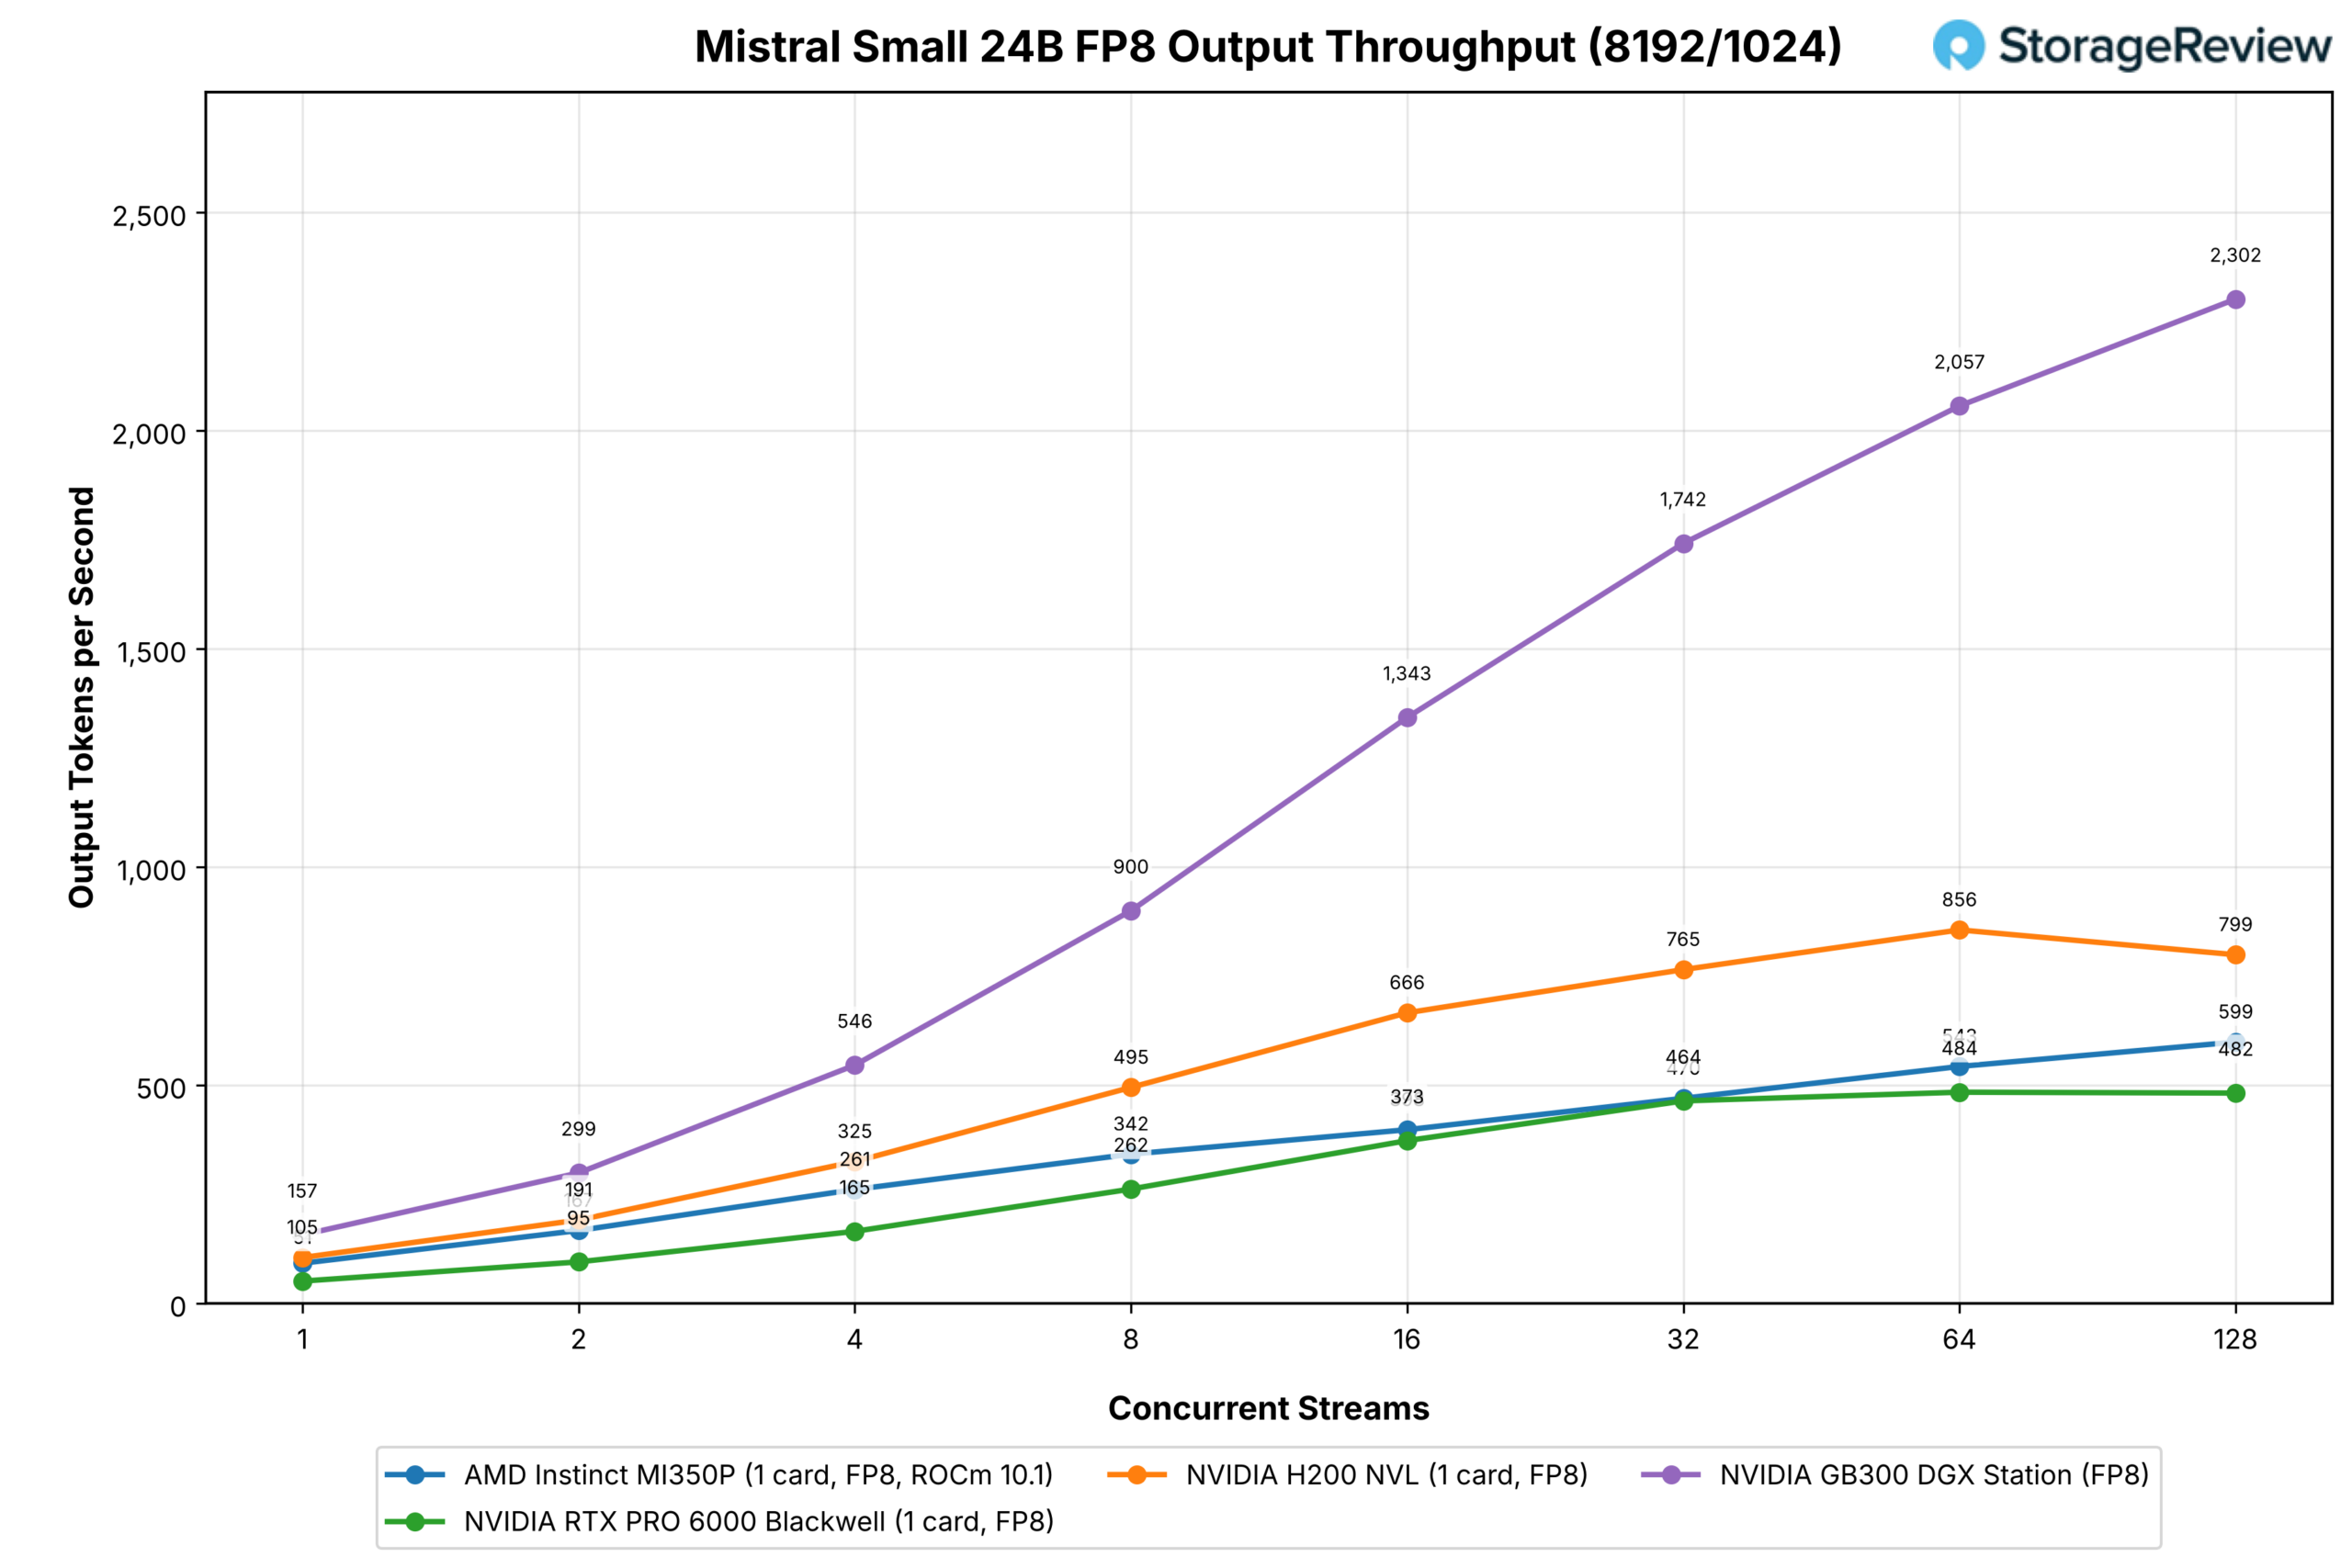
| မစ်စထရယ် အသေးစား ၂၄ဘီ FP၈ | 1 / 1 | ROCm ၇.၂ | 128 | 599 | 482 | 799 | 2,302 |
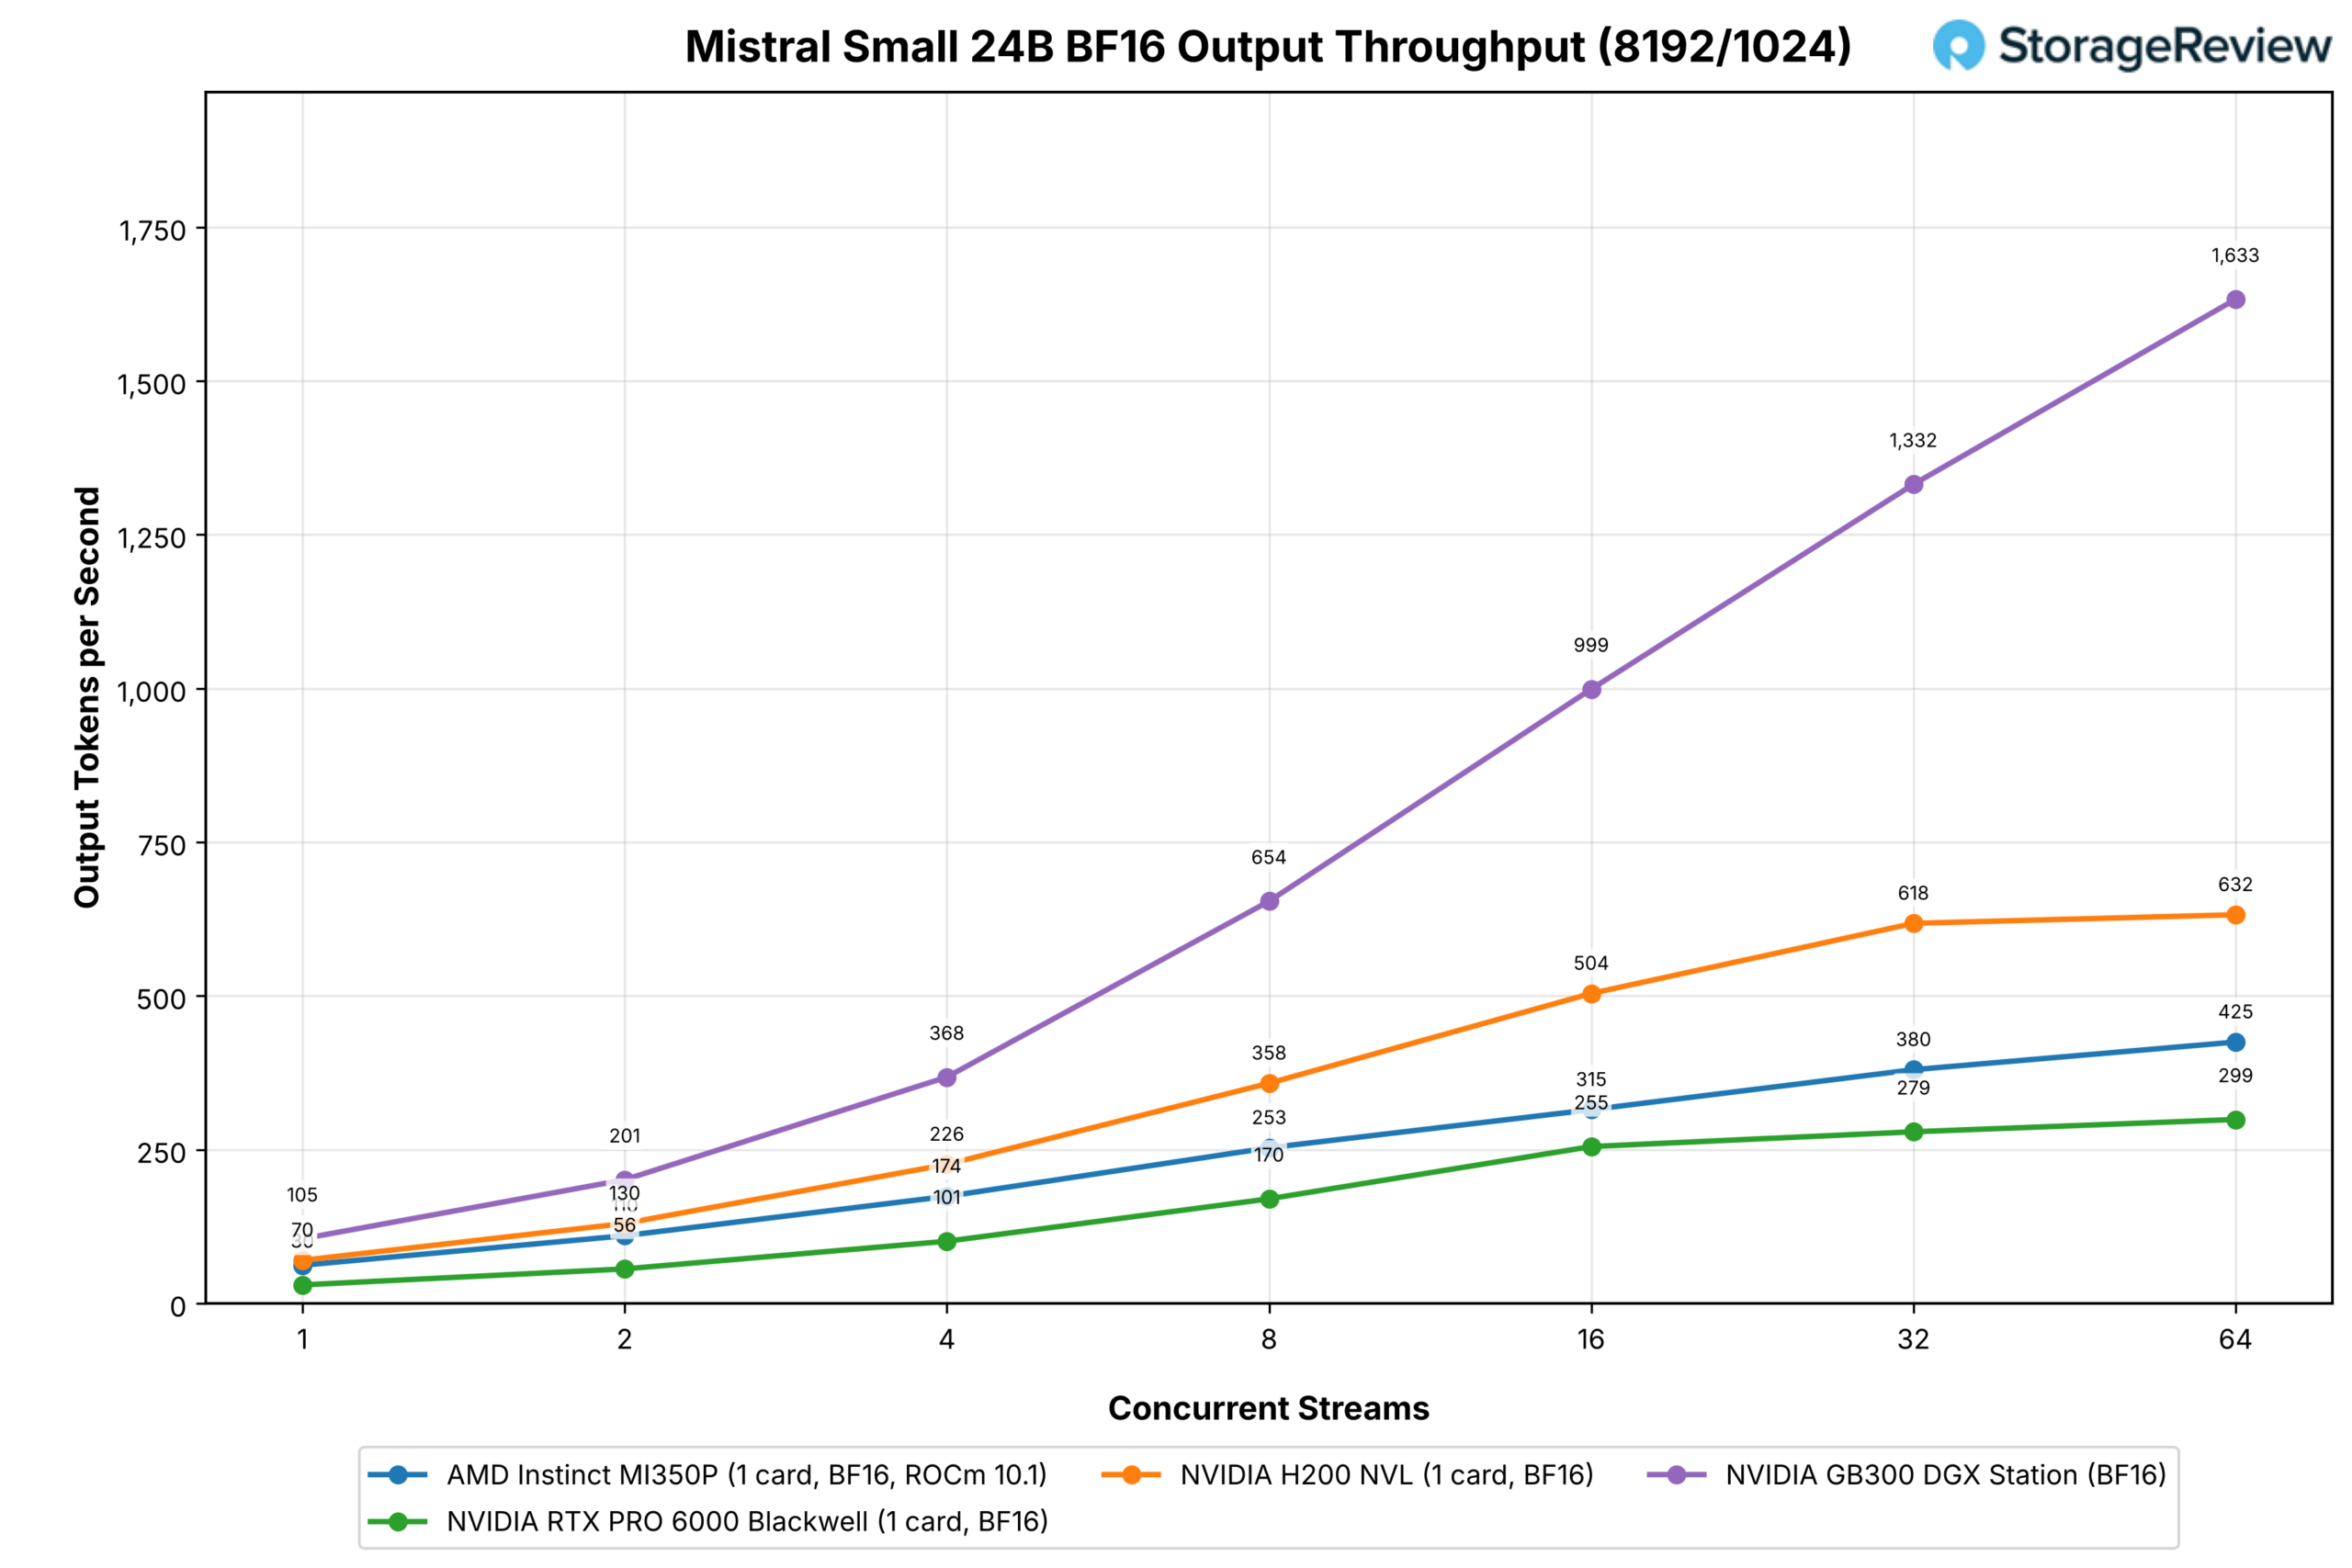
| မစ်စထရယ် အသေးစား ၂၄ဘီ BF၁၆ | 1 / 1 | ROCm ၇.၂ | 64 | 425 | 299 | 632 | 1,633 |
| လာမာ ၃.၁ ၈ဘီ (MXFP4 vs NVFP4) | 1 / 1 | ROCm ၇.၂ | 128 | 964 | 1,644 | မပြေးပါ | 6,737 |
| လာမာ ၃.၁ ၈ဘီ FP၈ | 1 / 1 | ROCm ၇.၂ | 128 | 1,211 | 1,481 | 2,045 | 6,164 |
| လာမာ ၃.၁ ၈ဘီ BF၁၆ | 1 / 1 | ROCm ၇.၂ | 128 | 686 | 716 | 1,358 | 3,498 |
prefill များတဲ့ prompts တွေမှာ အခြေအနေက ရောထွေးနေပါတယ်။ MI350P ဟာ GPT-OSS မော်ဒယ်နှစ်ခုလုံးမှာ stream count တိုင်းမှာရော Mistral Small မှာပါ RTX PRO 6000 ထက် ဦးဆောင်နေပြီး Qwen3-Coder ကို stream ၁၂၈ ခုမှာ ပိုင်းခြားထားပါတယ် (BF16 မှာ ၂၄ ရာခိုင်နှုန်း သာလွန်ပြီး FP8 မှာ ၈ ရာခိုင်နှုန်း နောက်ကျနေပါတယ်)၊ ပြီးတော့ Llama နဲ့ MiniMax-M2.7 မှာ stream ၁၆ ခုနဲ့ NVIDIA ကတ်ထက် သာလွန်နေပါတယ်။ H200 နဲ့ ယှဉ်ရင် 120B မော်ဒယ်မှာ GPT-OSS ကို ၁၅ ရာခိုင်နှုန်းနဲ့ 20B မှာ stream ၁၂၈ ခုနဲ့ trails တွေမှာ ၅ ရာခိုင်နှုန်းနဲ့ ဦးဆောင်နေပါတယ်။
MI350P နှစ်ခုနှင့် RTX PRO 6000 လေးခုကို ရင်ဆိုင်ရသည့် အကြီးဆုံး မော်ဒယ်များတွင် NVIDIA set သည် GLM-5.2 သည် chat workload တွင် 384GB GDDR7 နှင့် HBM3E 288GB ဖြင့် stream ၁၆ ခုမှတစ်ဆင့် ဦးဆောင်နေပြီး MiniMax-M3 တွင် configuration သုံးခုစလုံးသည် stream ရှစ်ခုမှတစ်ဆင့် 10 ရာခိုင်နှုန်းအတွင်းတွင် ရှိနေကာ RTX quad သည် 16 ဖြင့် ဦးဆောင်နေသည်။ GB300 တစ်ခုတည်းသည် ၎င်း၏ 252GB တွင် ဆန့်နိုင်သော မည်သည့်အရာတွင်မဆို PCIe configuration တိုင်းကို ကျယ်ပြန့်သော အကွာအဝေးဖြင့် ကျော်လွှားနိုင်သည်။
GLM-5.3 ဖလက်ရှ်
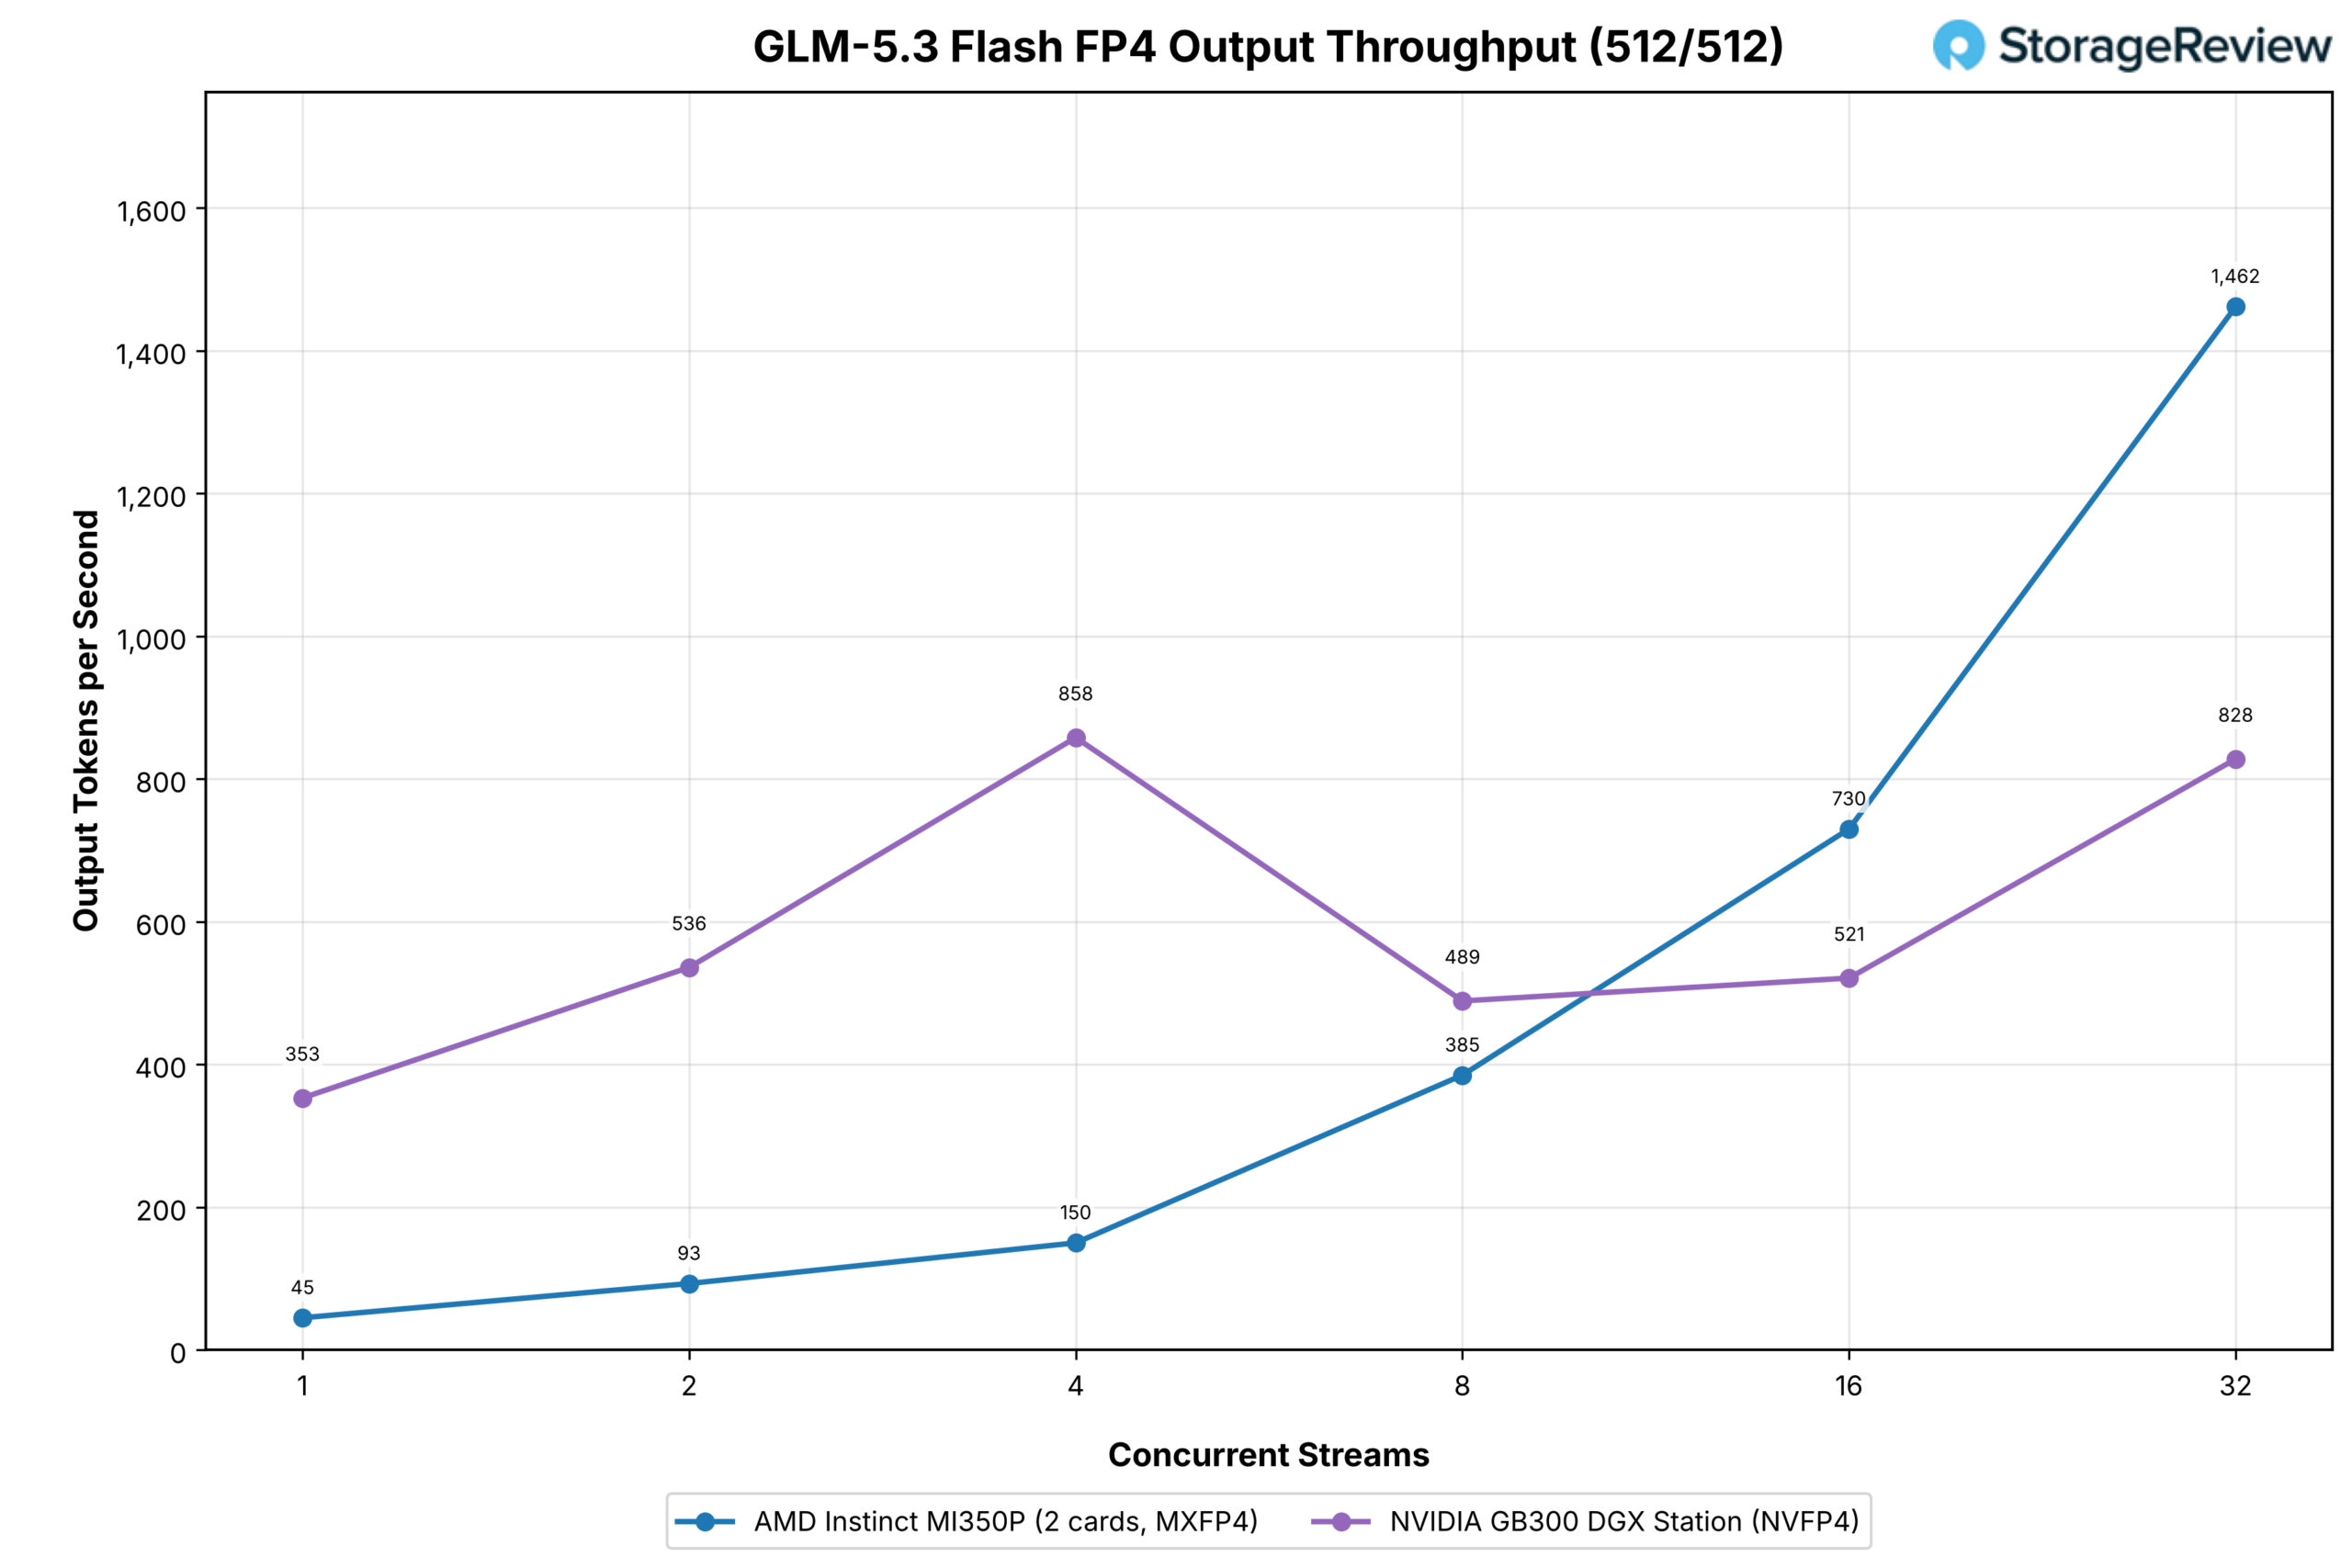
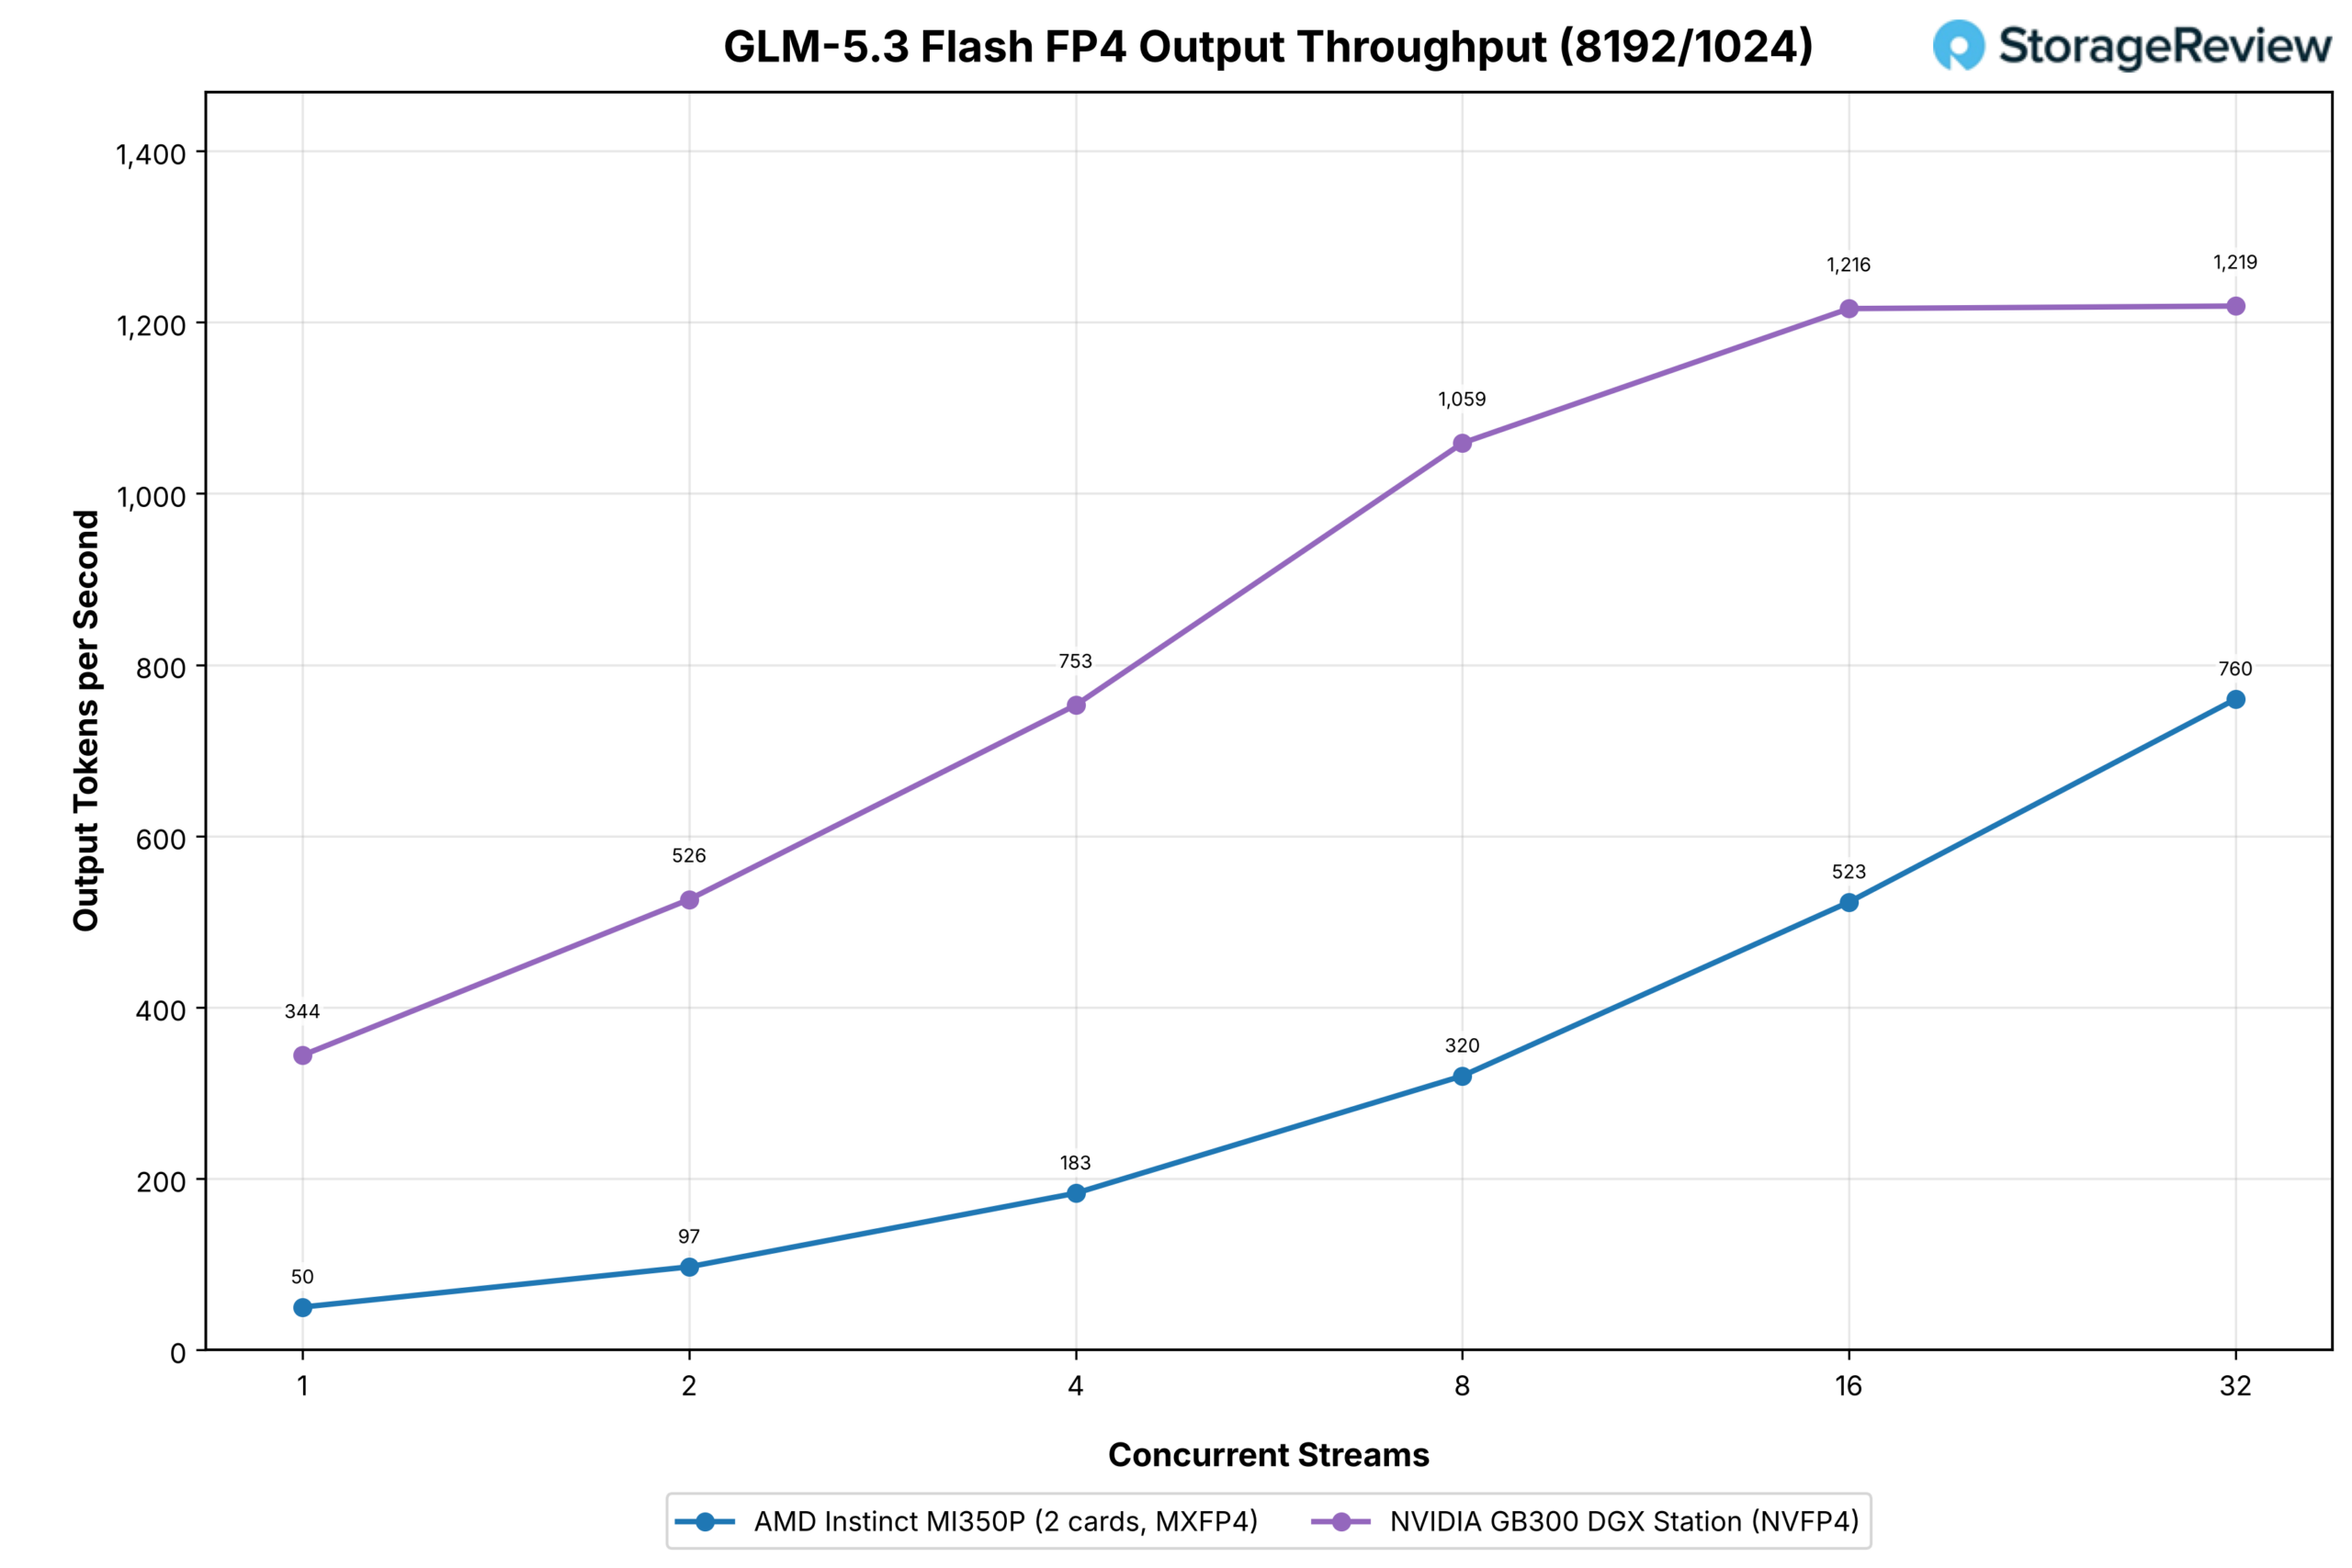
GLM-5.3 Flash ကို RTX PRO 6000 မှာ မလုပ်ဆောင်နိုင်တာကြောင့် MI350P ကတ်နှစ်ခုကို stream ၃၂ ခုကနေတစ်ဆင့် GB300 Station တစ်ခုတည်းနဲ့ နှိုင်းယှဉ်ကြည့်ရမှာပါ။ chat workload မှာ MI350P ကတ်တစ်စုံဟာ stream တစ်ခုစီမှာ တစ်စက္ကန့်ကို output token ၃၅၃ ခုနဲ့ ၄၅ ခု နောက်ကျပြီး Station ကို stream ရှစ်ခုနဲ့ ဖြတ်ကျော်ကာ stream ၃၂ ခုမှာ ၁၄၆၂ ခု ရရှိပြီး Station မှာတော့ ၈၂၈ ခု ရရှိပါတယ်။ prefill များတဲ့ workload မှာတော့ Station က stream ၃၂ ခုမှာ ၇၆၀ နဲ့ ဦးဆောင်နေပြီး prefill ကတ်နှစ်ခုရဲ့ prefill ဟာ ကတ်နှစ်ခုကြား PCIe ကို ဖြတ်ကျော်ရပြီး B300 က HBM တစ်ခုတည်းနဲ့ အားလုံးကို လုပ်ဆောင်ပါတယ်။
GLM-5.2
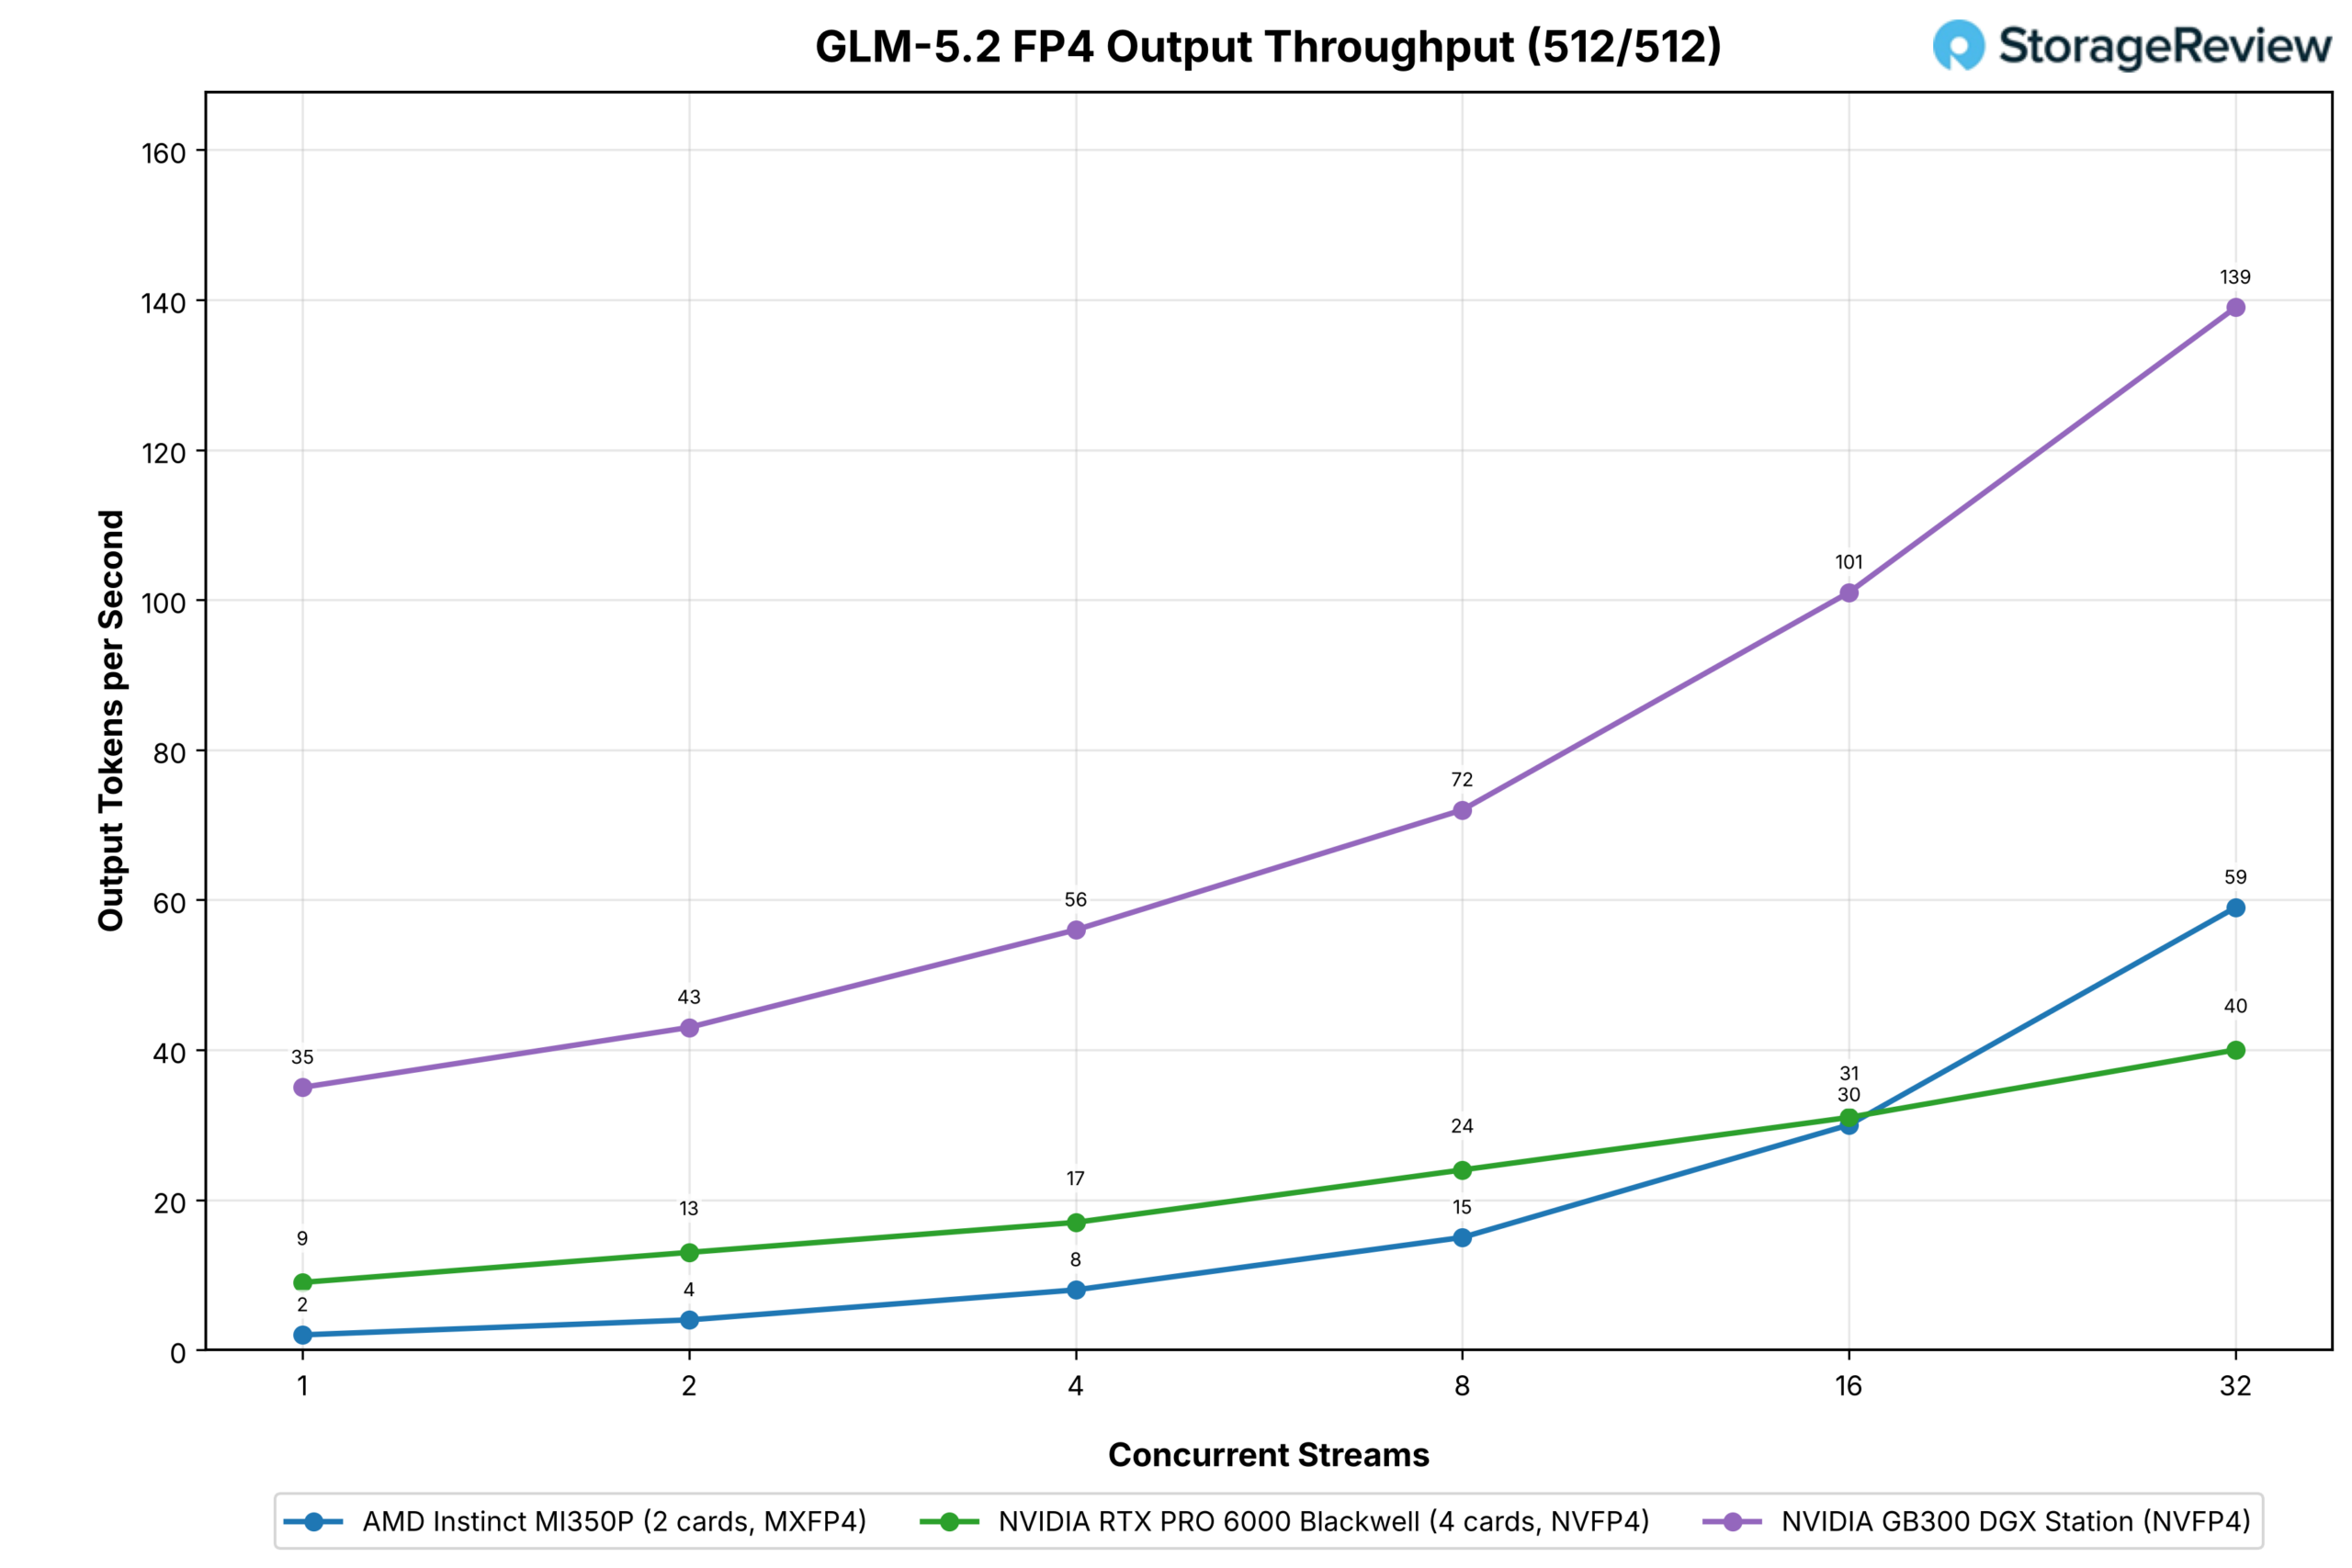
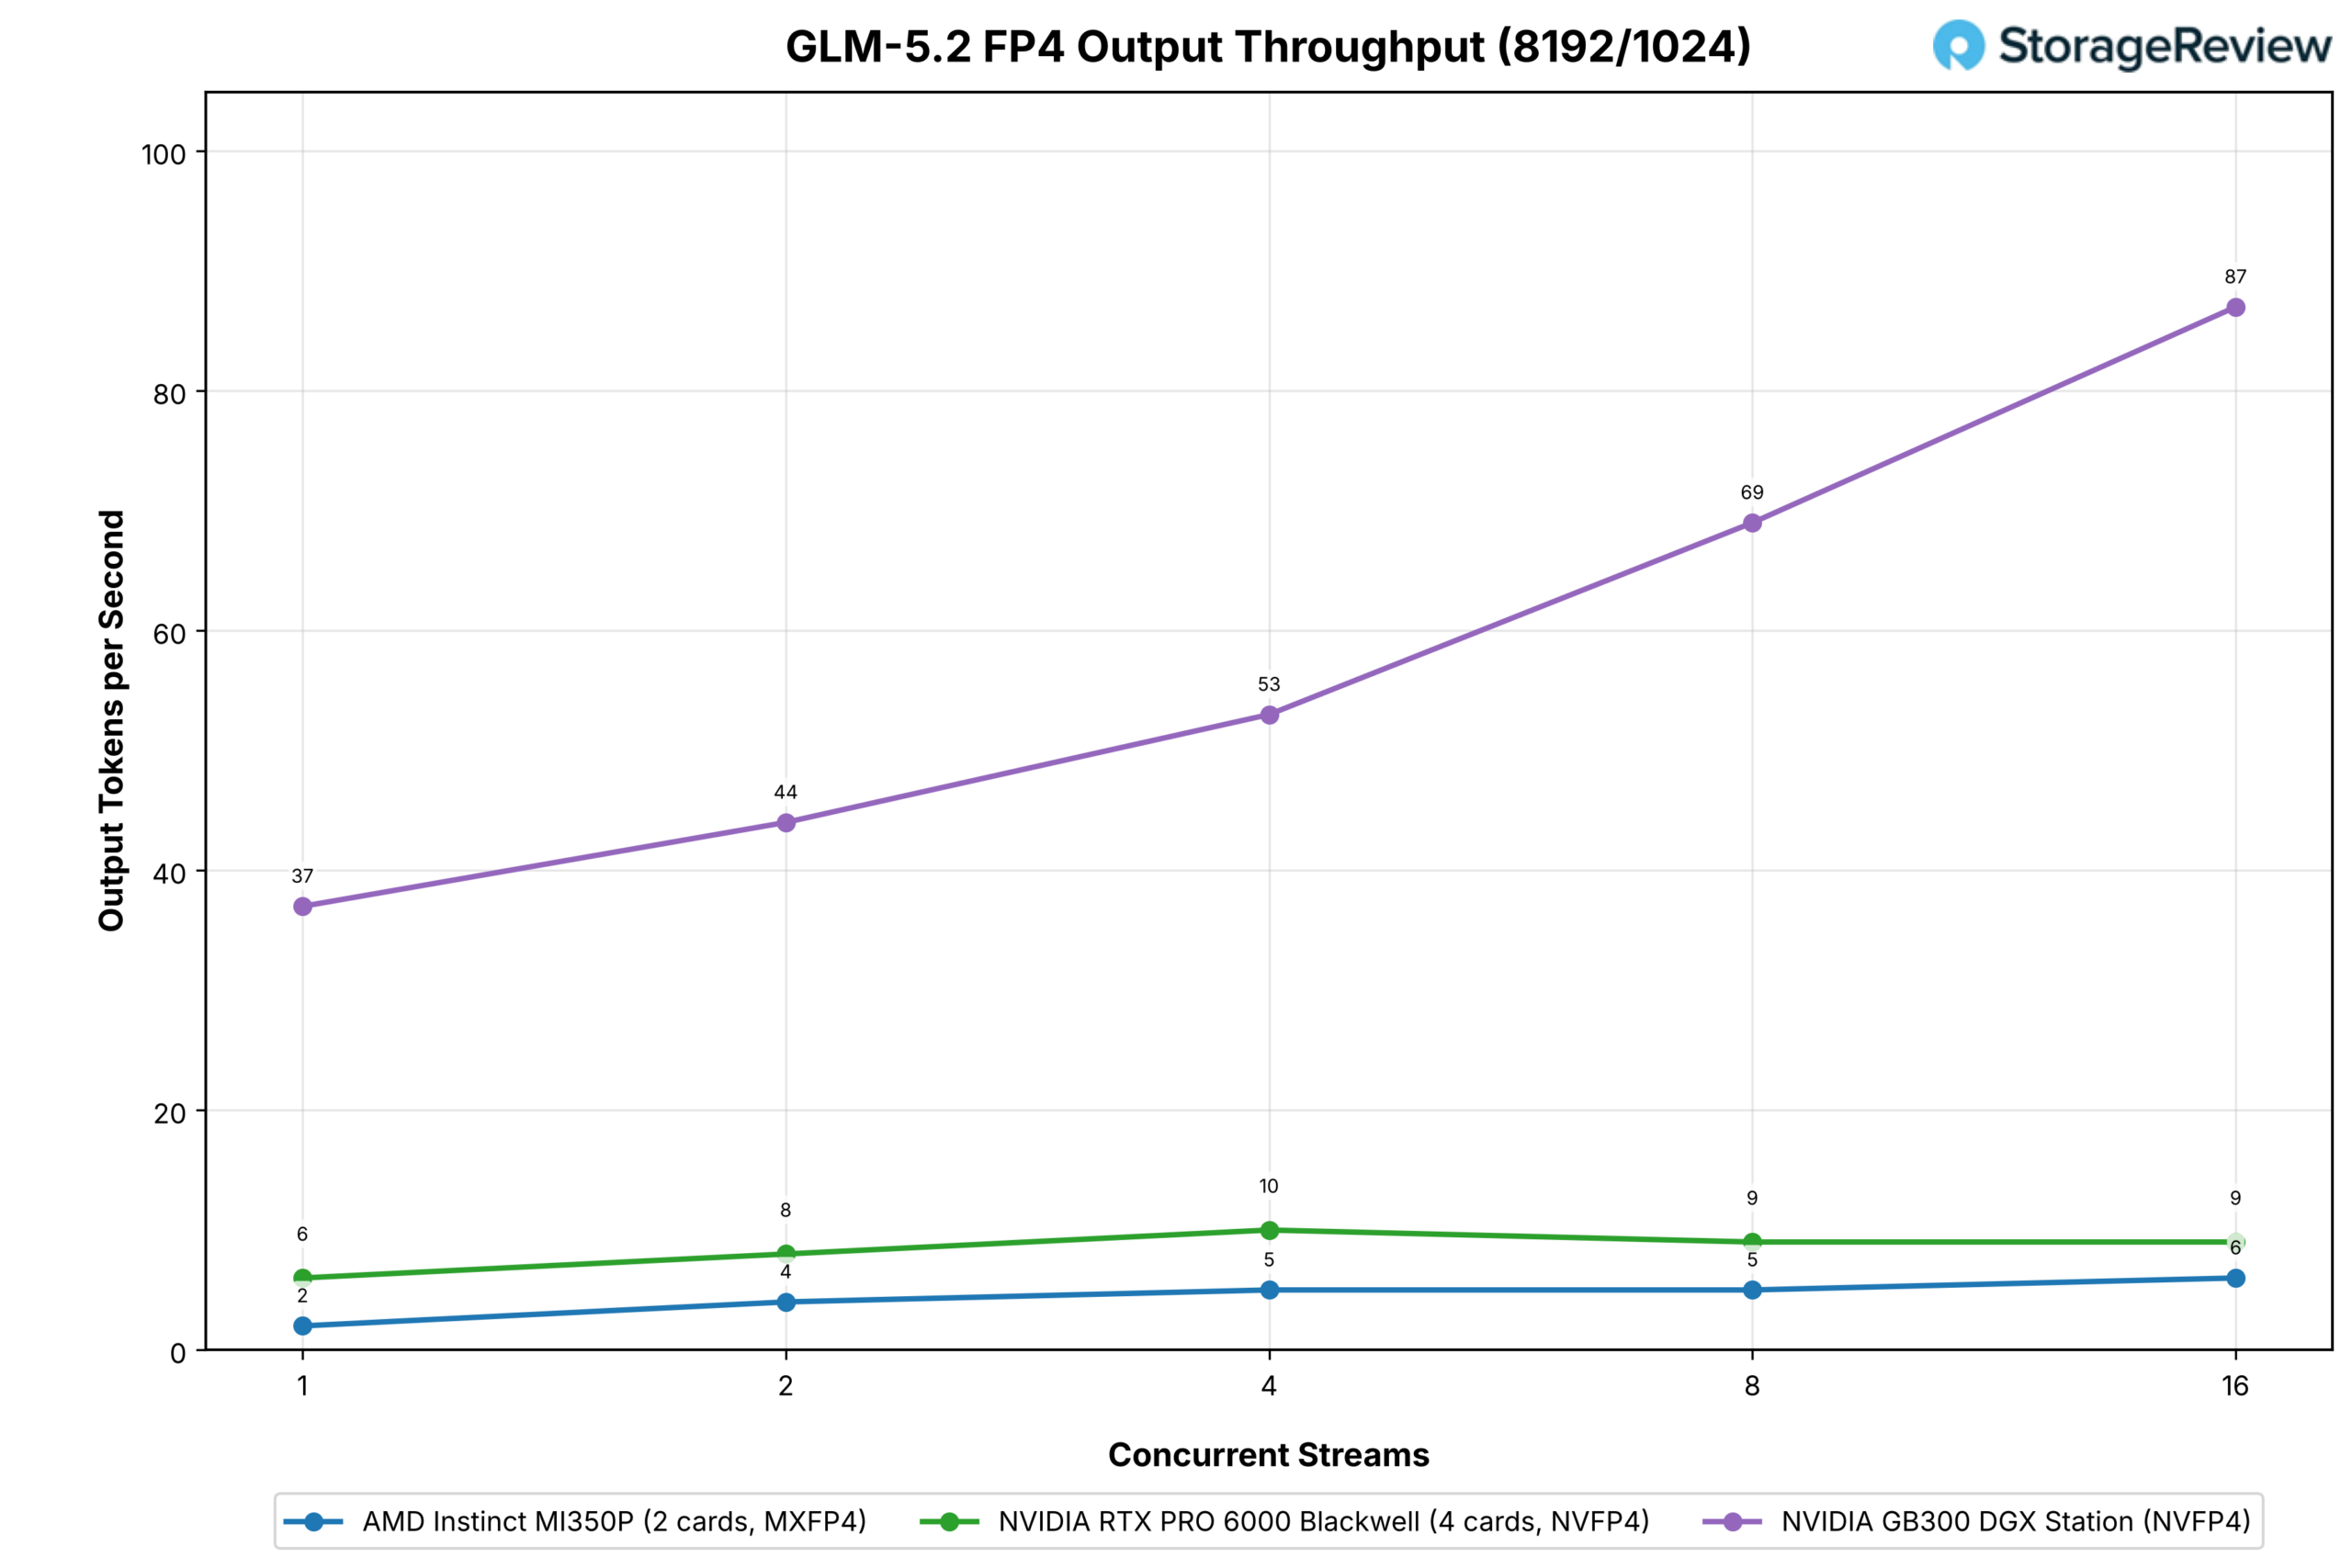
GLM-5.2 ကတော့ ဒီအစုံထဲက မှတ်ဉာဏ်ဇာတ်လမ်းပါ။ MXFP4 checkpoint က MI350P ကတ်နှစ်ခုရဲ့ 288GB ကို host memory ထဲကို ကျော်လွန်သွားတာကြောင့် single-stream throughput က တစ်စက္ကန့်ကို output token ၂ ခုဖြစ်ပြီး NVFP4 build မှာ 384GB GDDR7 ပါဝင်တဲ့ RTX PRO 6000 ကတ်လေးကတ်အတွက် 9 ခုနဲ့ Station အတွက် 35 ခုဖြစ်ပြီး expert weights 215GB လောက်ကို Grace memory ကို offload လုပ်ပါတယ်။ RTX quad က chat workload မှာ stream ၁၆ ခုကို ဦးဆောင်နေပါတယ်။ ၃၂ မှာ MI350P ကတ်က ၄၀ နဲ့ ၅၉ ခုအထိ ရောက်ရှိပြီး Station က ၁၃၉ ခုအထိ ရောက်ရှိပါတယ်။ prefill-heavy prompts တွေမှာ PCIe configuration ဘယ် stream မှ single digit ၁၆ ခုကို မကျော်လွန်ဘဲ Station အတွက် ၈၇ ခုသာ ရှိပါတယ်။
MiniMax-M3
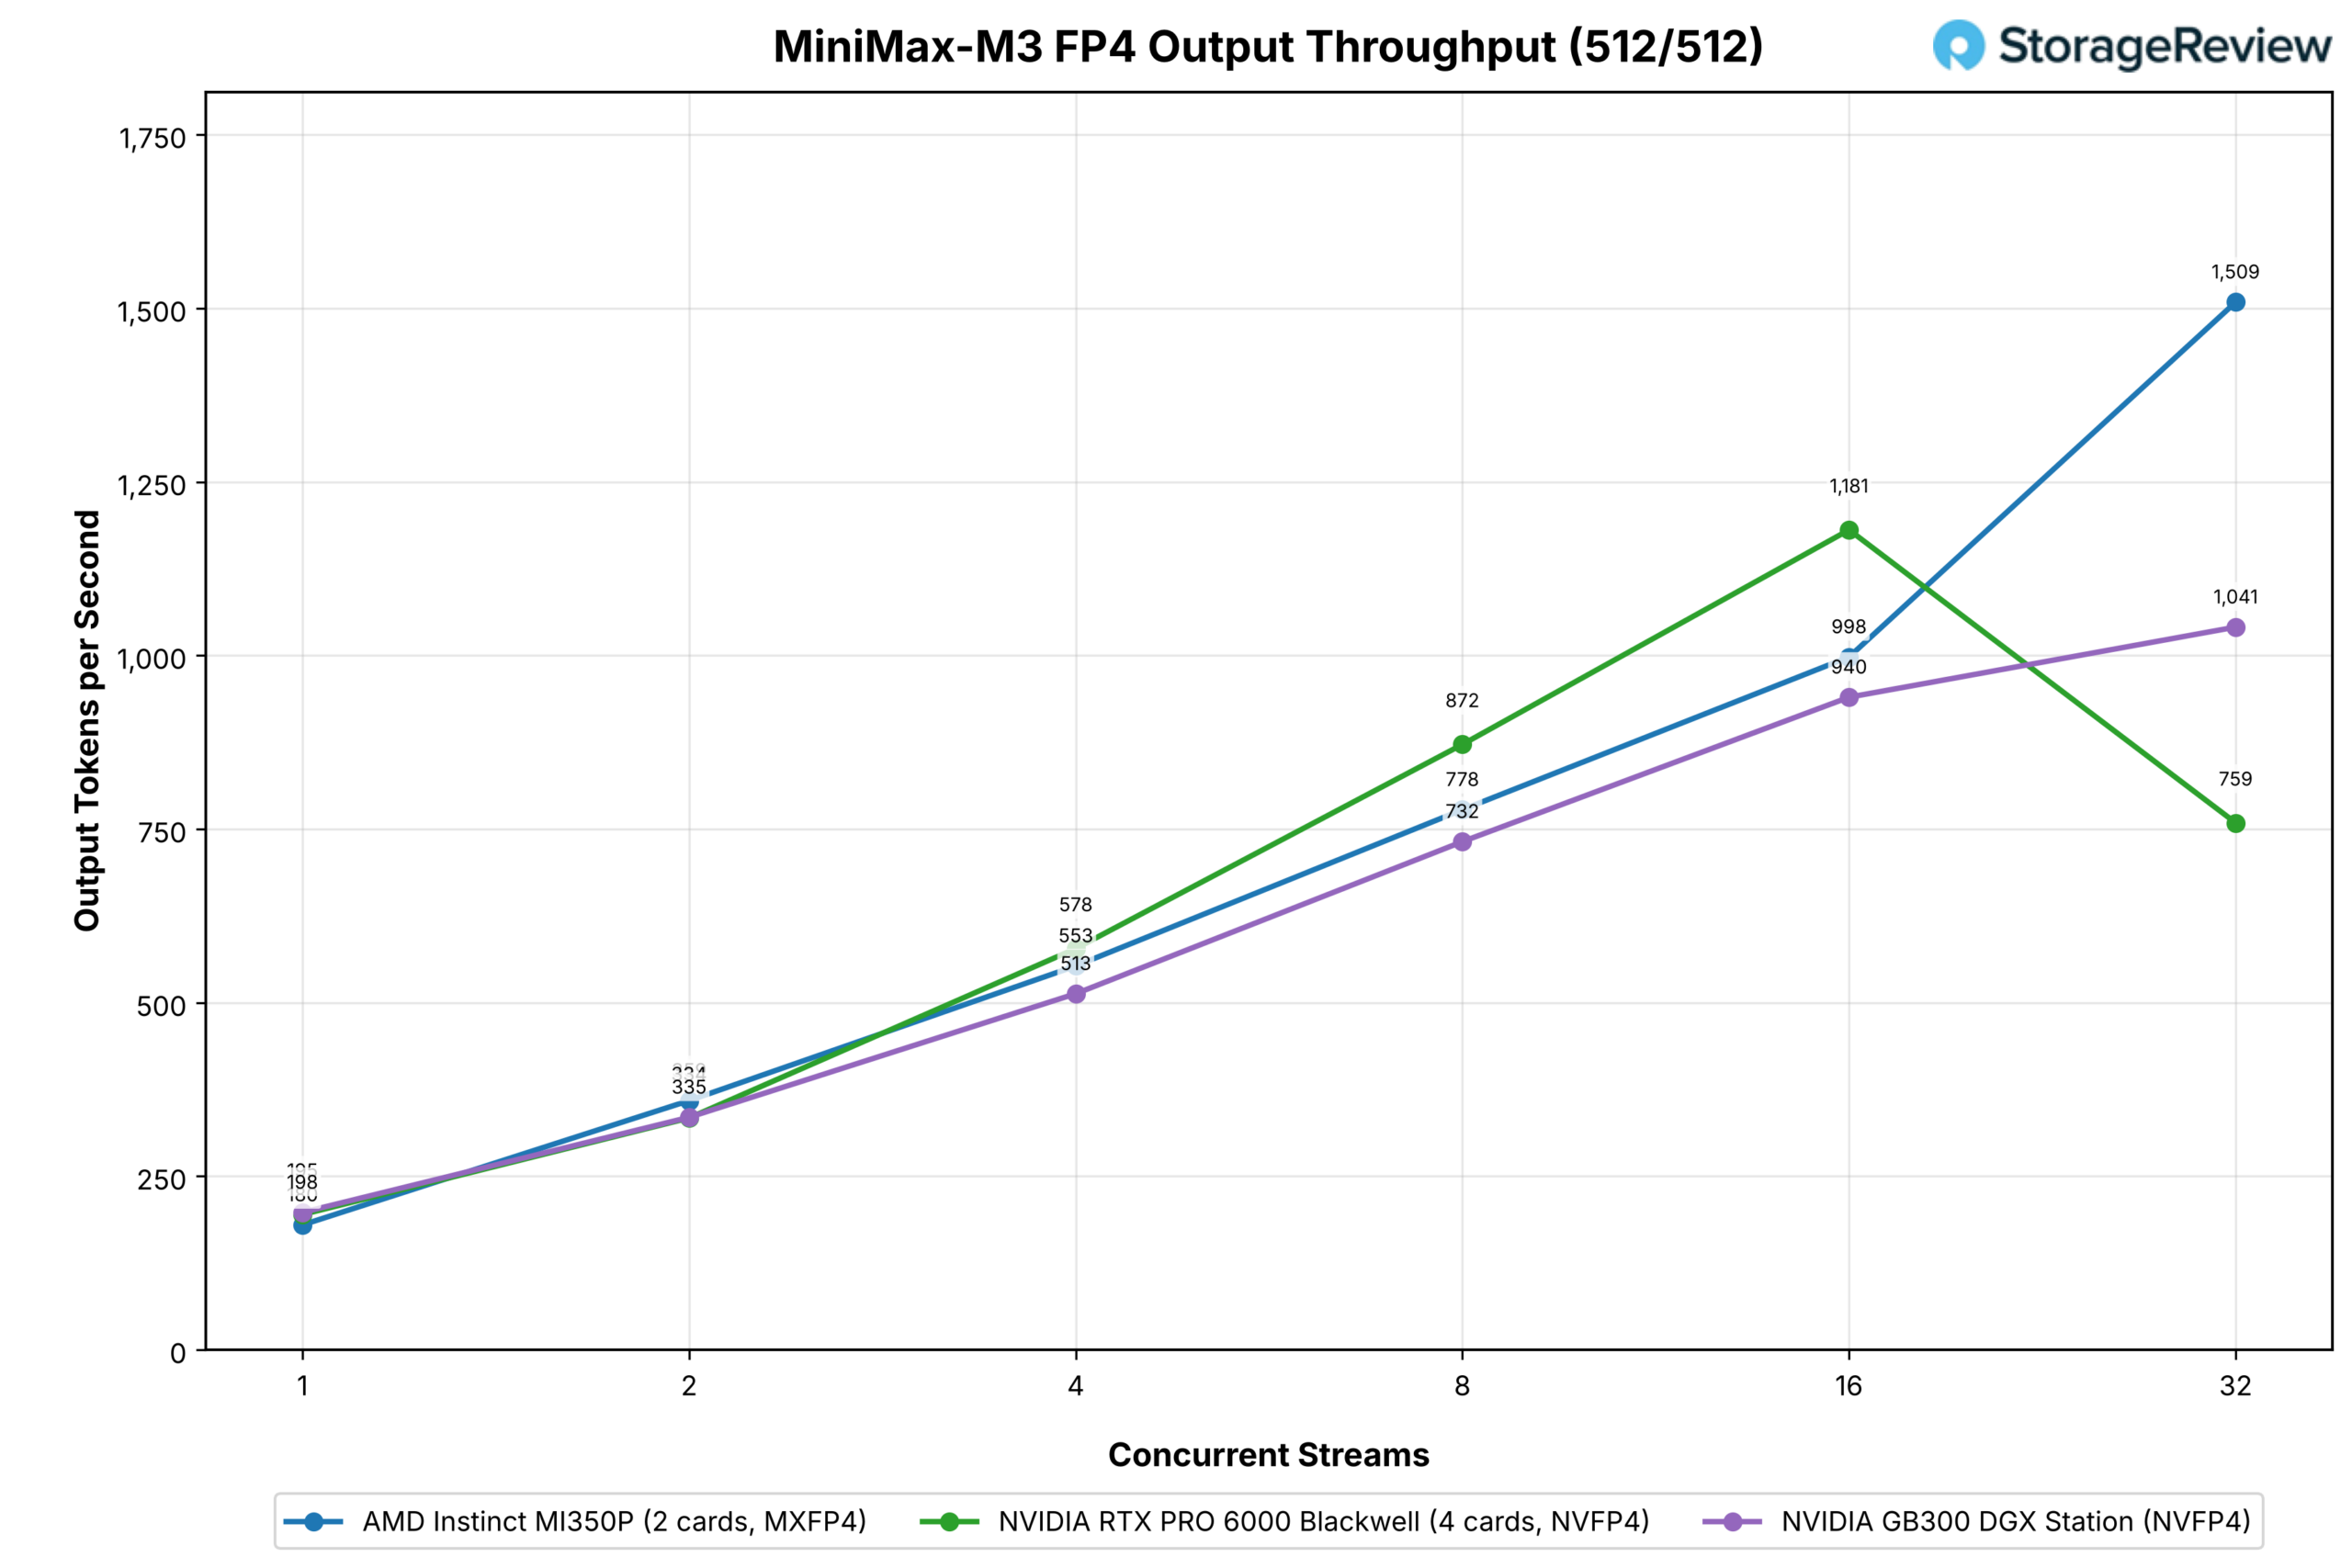
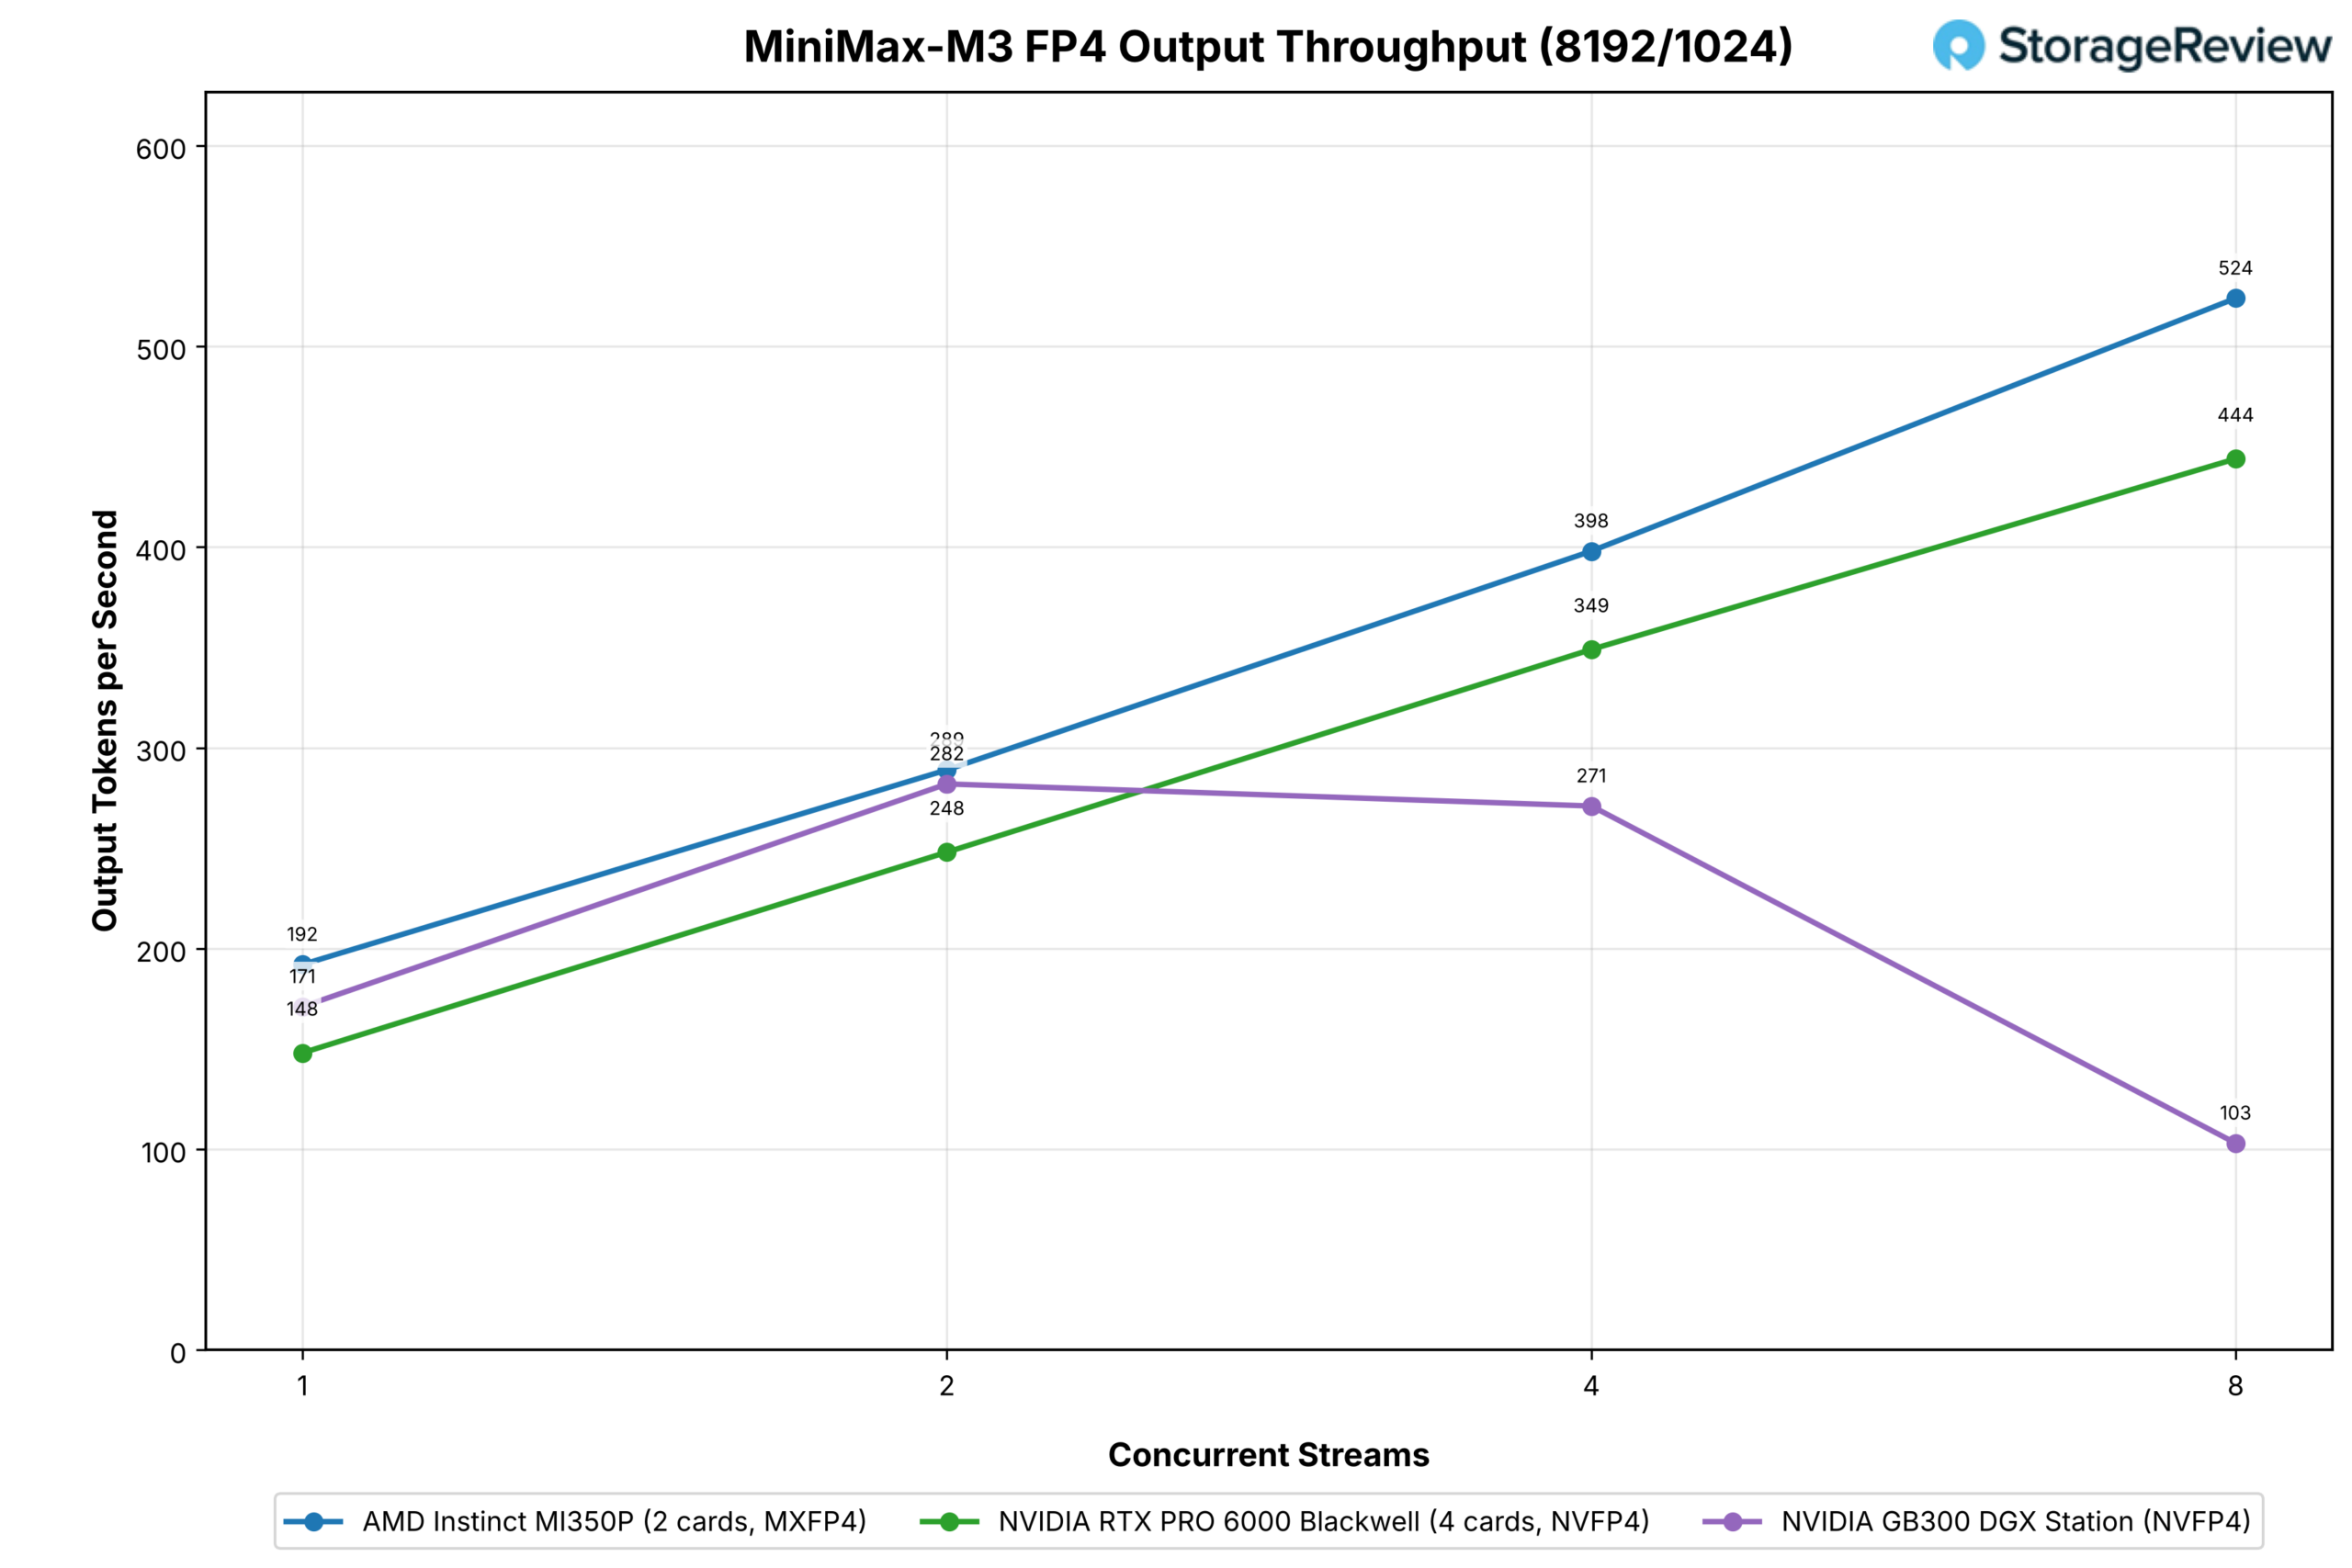
MI350P နှစ်ခုသည် MiniMax-M3 ၏ MXFP4 build ကို 288GB တွင် ထိန်းထားနိုင်ပြီး NVIDIA ဘက်တွင် RTX PRO 6000 ကတ်လေးခု လိုအပ်ပါသည်။ configuration သုံးခုသည် chat workload ပေါ်ရှိ stream ရှစ်ခုမှတစ်ဆင့် တစ်ခုနှင့်တစ်ခု ၁၀ ရာခိုင်နှုန်းအတွင်း လည်ပတ်ပါသည်။ RTX quad သည် ၁၆ တွင် ဦးဆောင်နေသည် (တစ်စုံအတွက် ၁,၁၈၁ နှင့် ၉၉၈ နှင့် Station အတွက် ၉၄၀)၊ ၃၂ တွင် MI350P စုံတွဲသည် ၁၅၀၉ နှင့် quad အတွက် ၇၅၉ နှင့် Station အတွက် ၁,၀၄၁ ရှိသည်။
ကြိုတင်ဖြည့်သွင်းမှုများသော ညွှန်ကြားချက်များတွင် MI350P အတွဲသည် ရှစ်စီးတွင် အမှတ်တိုင်းတွင် ဦးဆောင်နေပြီး quad အတွက် ၅၂၄ နှင့် ၄၄၄ ရရှိကာ ဤမော်ဒယ်၏ ကျွမ်းကျင်သူများ၏ အစိတ်အပိုင်းတစ်ခုကို Grace မှတ်ဉာဏ်တွင် ထိန်းသိမ်းထားသည့် Station မှာ ၁၀၃ သို့ ကျဆင်းသွားသည်။
DeepSeek-V4-Flash
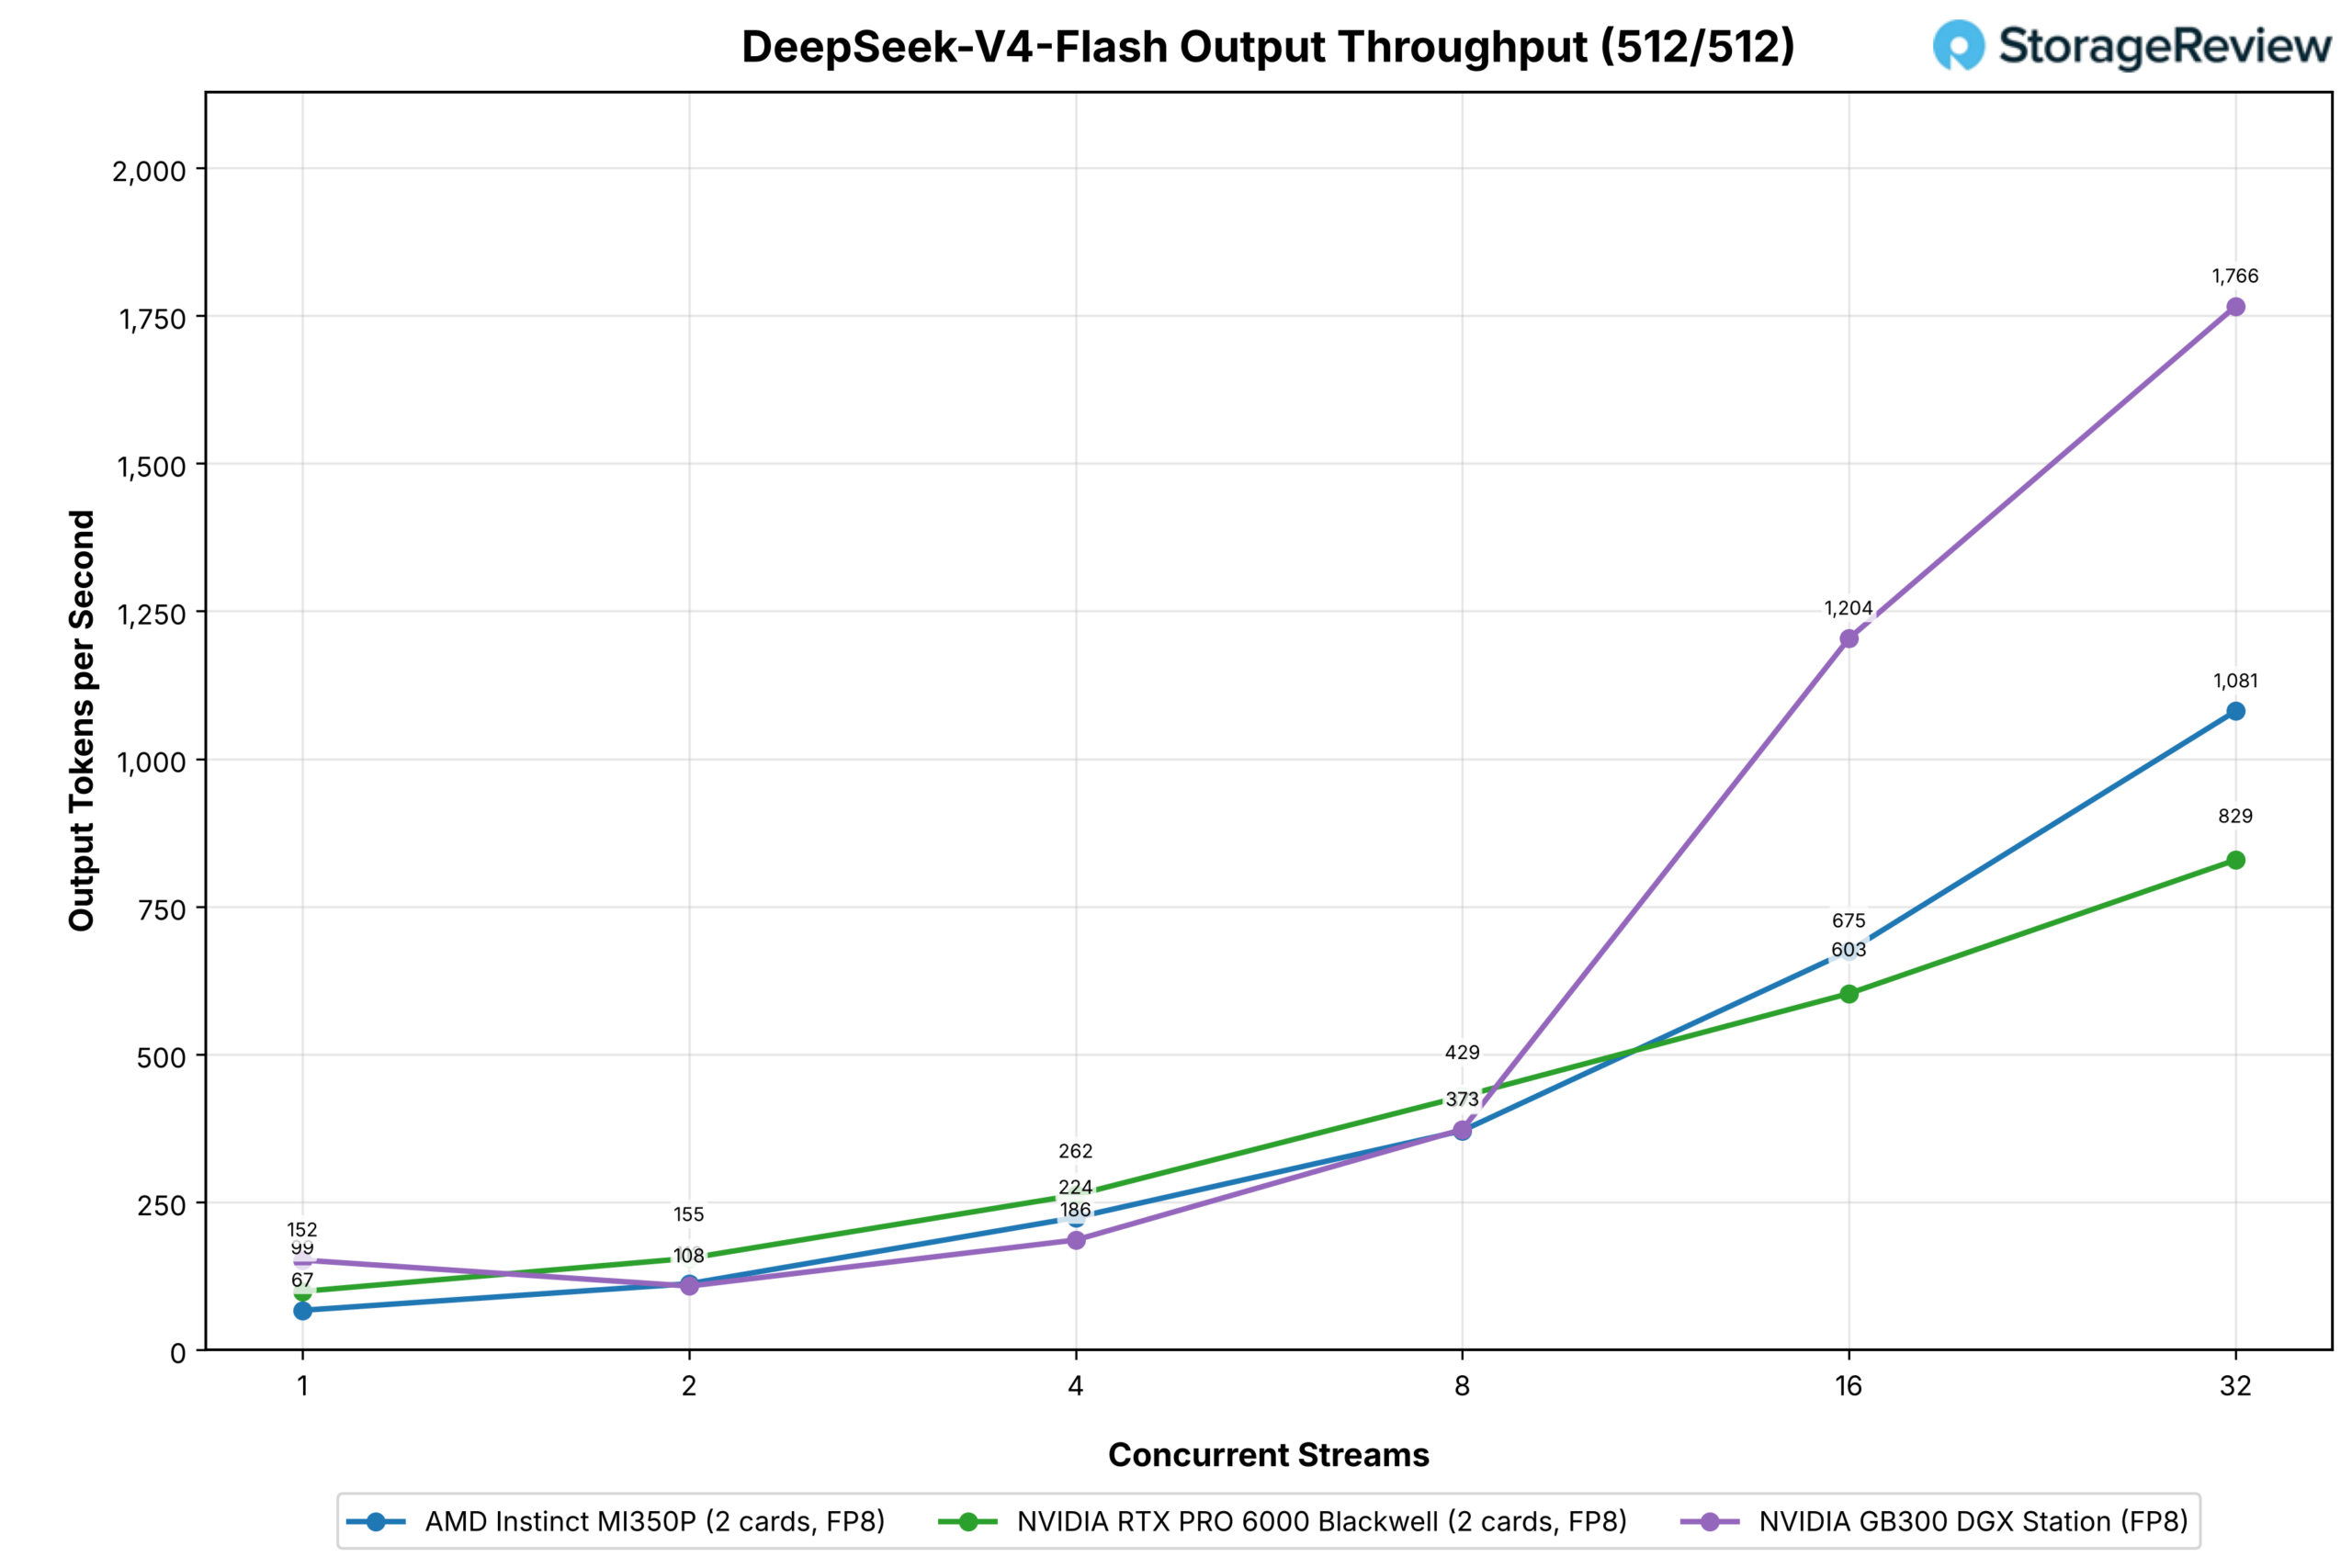
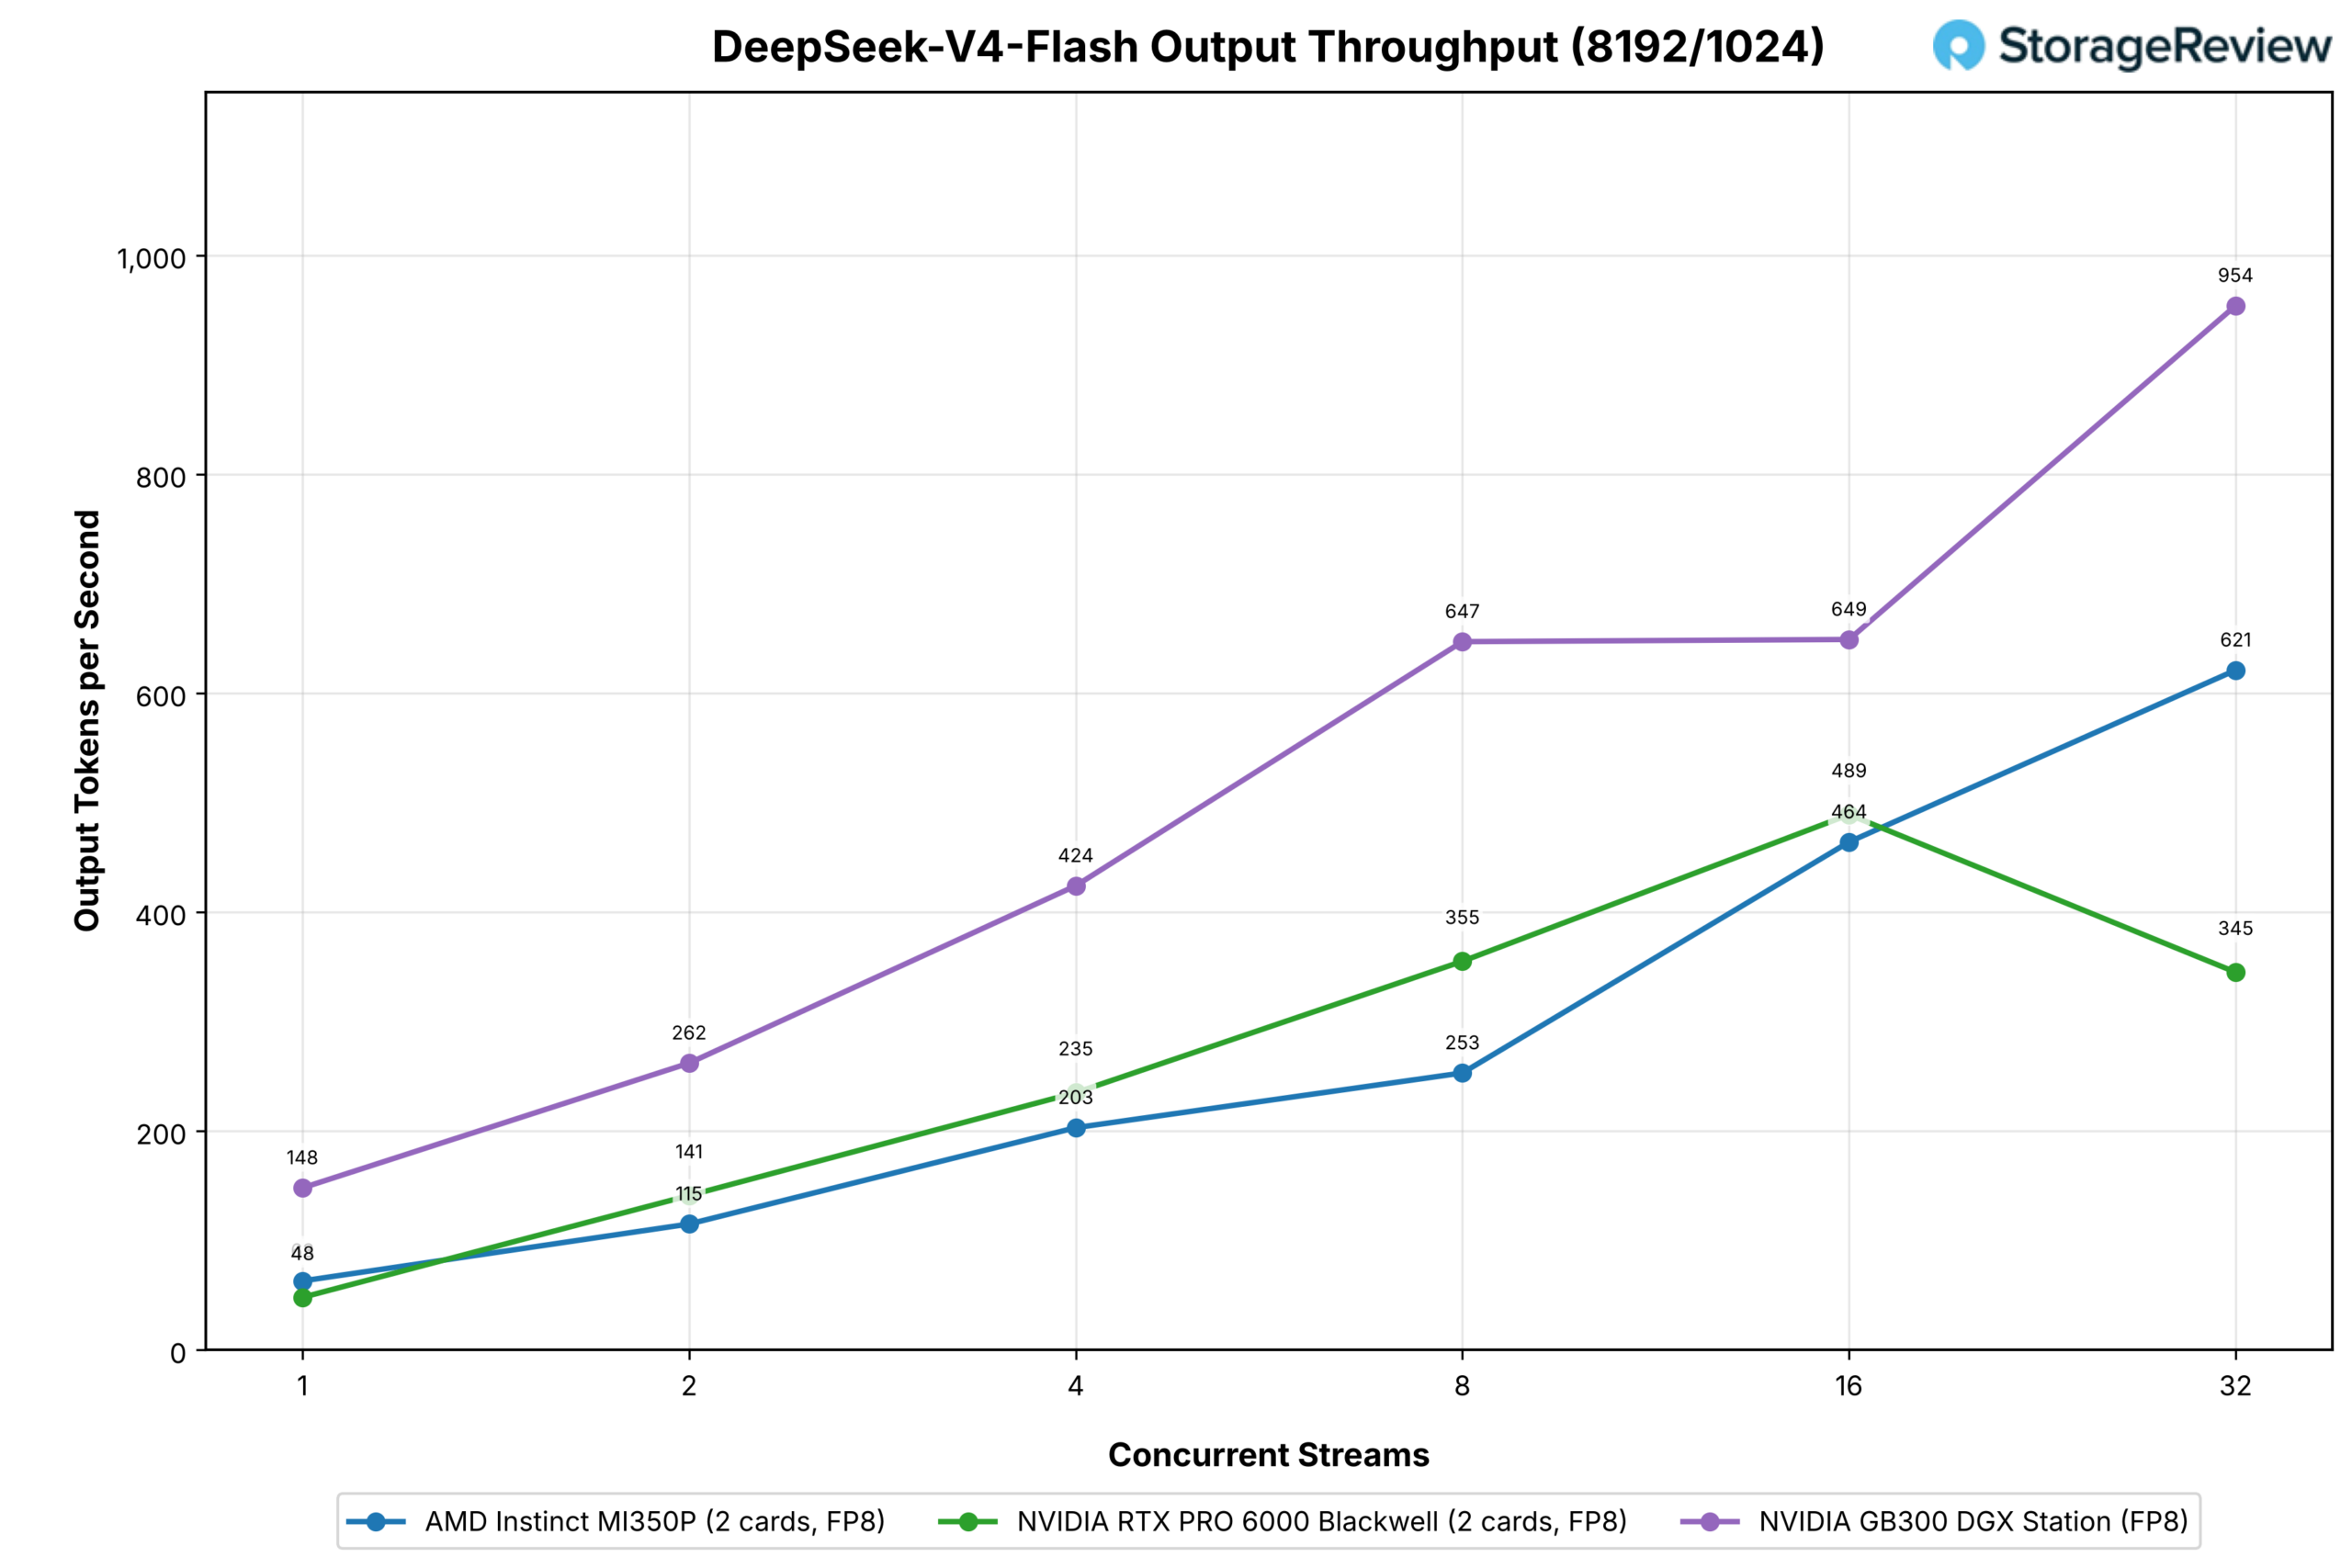
တစ်ဖက်စီတွင် ကတ်နှစ်ခုစီနှင့် native FP8 checkpoint ပါရှိသောကြောင့် RTX PRO 6000 အတွဲသည် chat workload တွင် stream ရှစ်ခုကို ဦးဆောင်နေပြီး MI350P အတွဲသည် ၁၆ ခုမှ လွှဲပြောင်းရယူကာ stream ၃၂ ခုတွင် ၈၂၉ ခုနှင့် 1,081 ခုဖြင့် အဆုံးသတ်ထားသည်။ Single Station သည် တူညီသောအမှတ်တွင် 1,766 ခုသို့ ရောက်ရှိသည်။ prefill-heavy run သည် တူညီသောပုံစံကို လိုက်နာပြီး MI350P အတွဲသည် stream ၃၂ ခုတွင် ၃၄၅ ခုနှင့် Station အတွက် ၉၅၄ ခုဖြင့် ရပ်တည်သည်။
MiniMax-M2.7
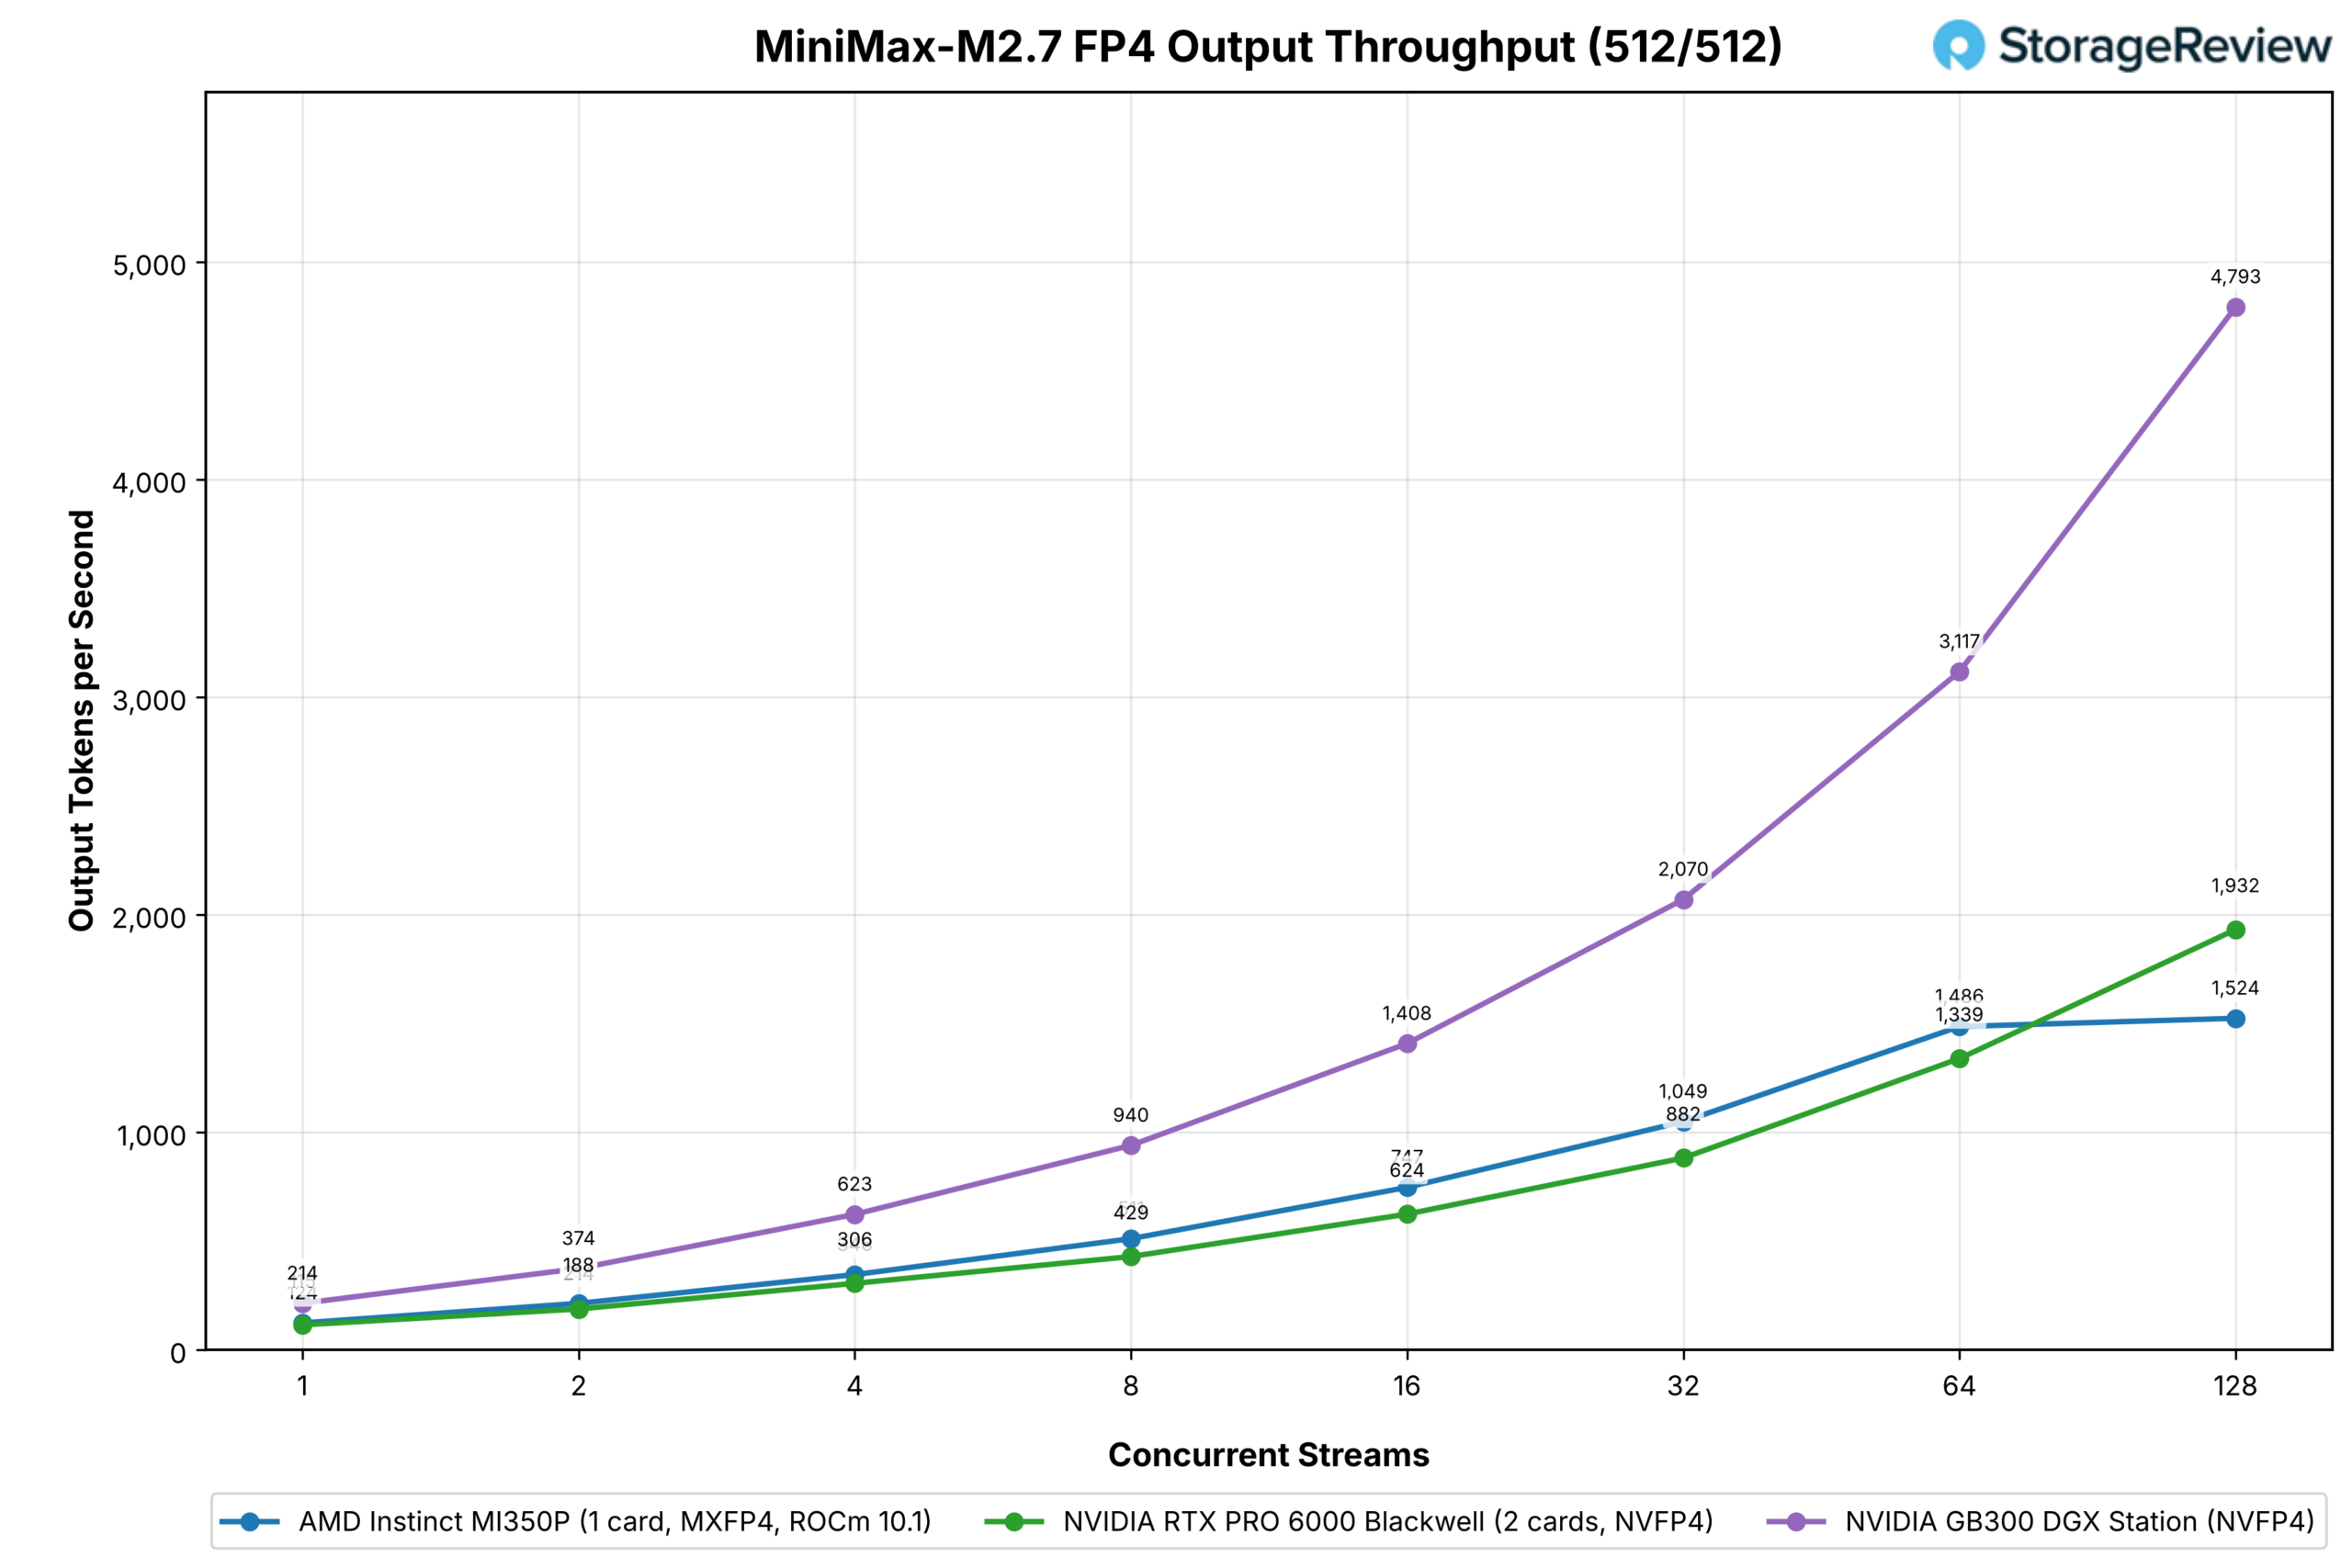
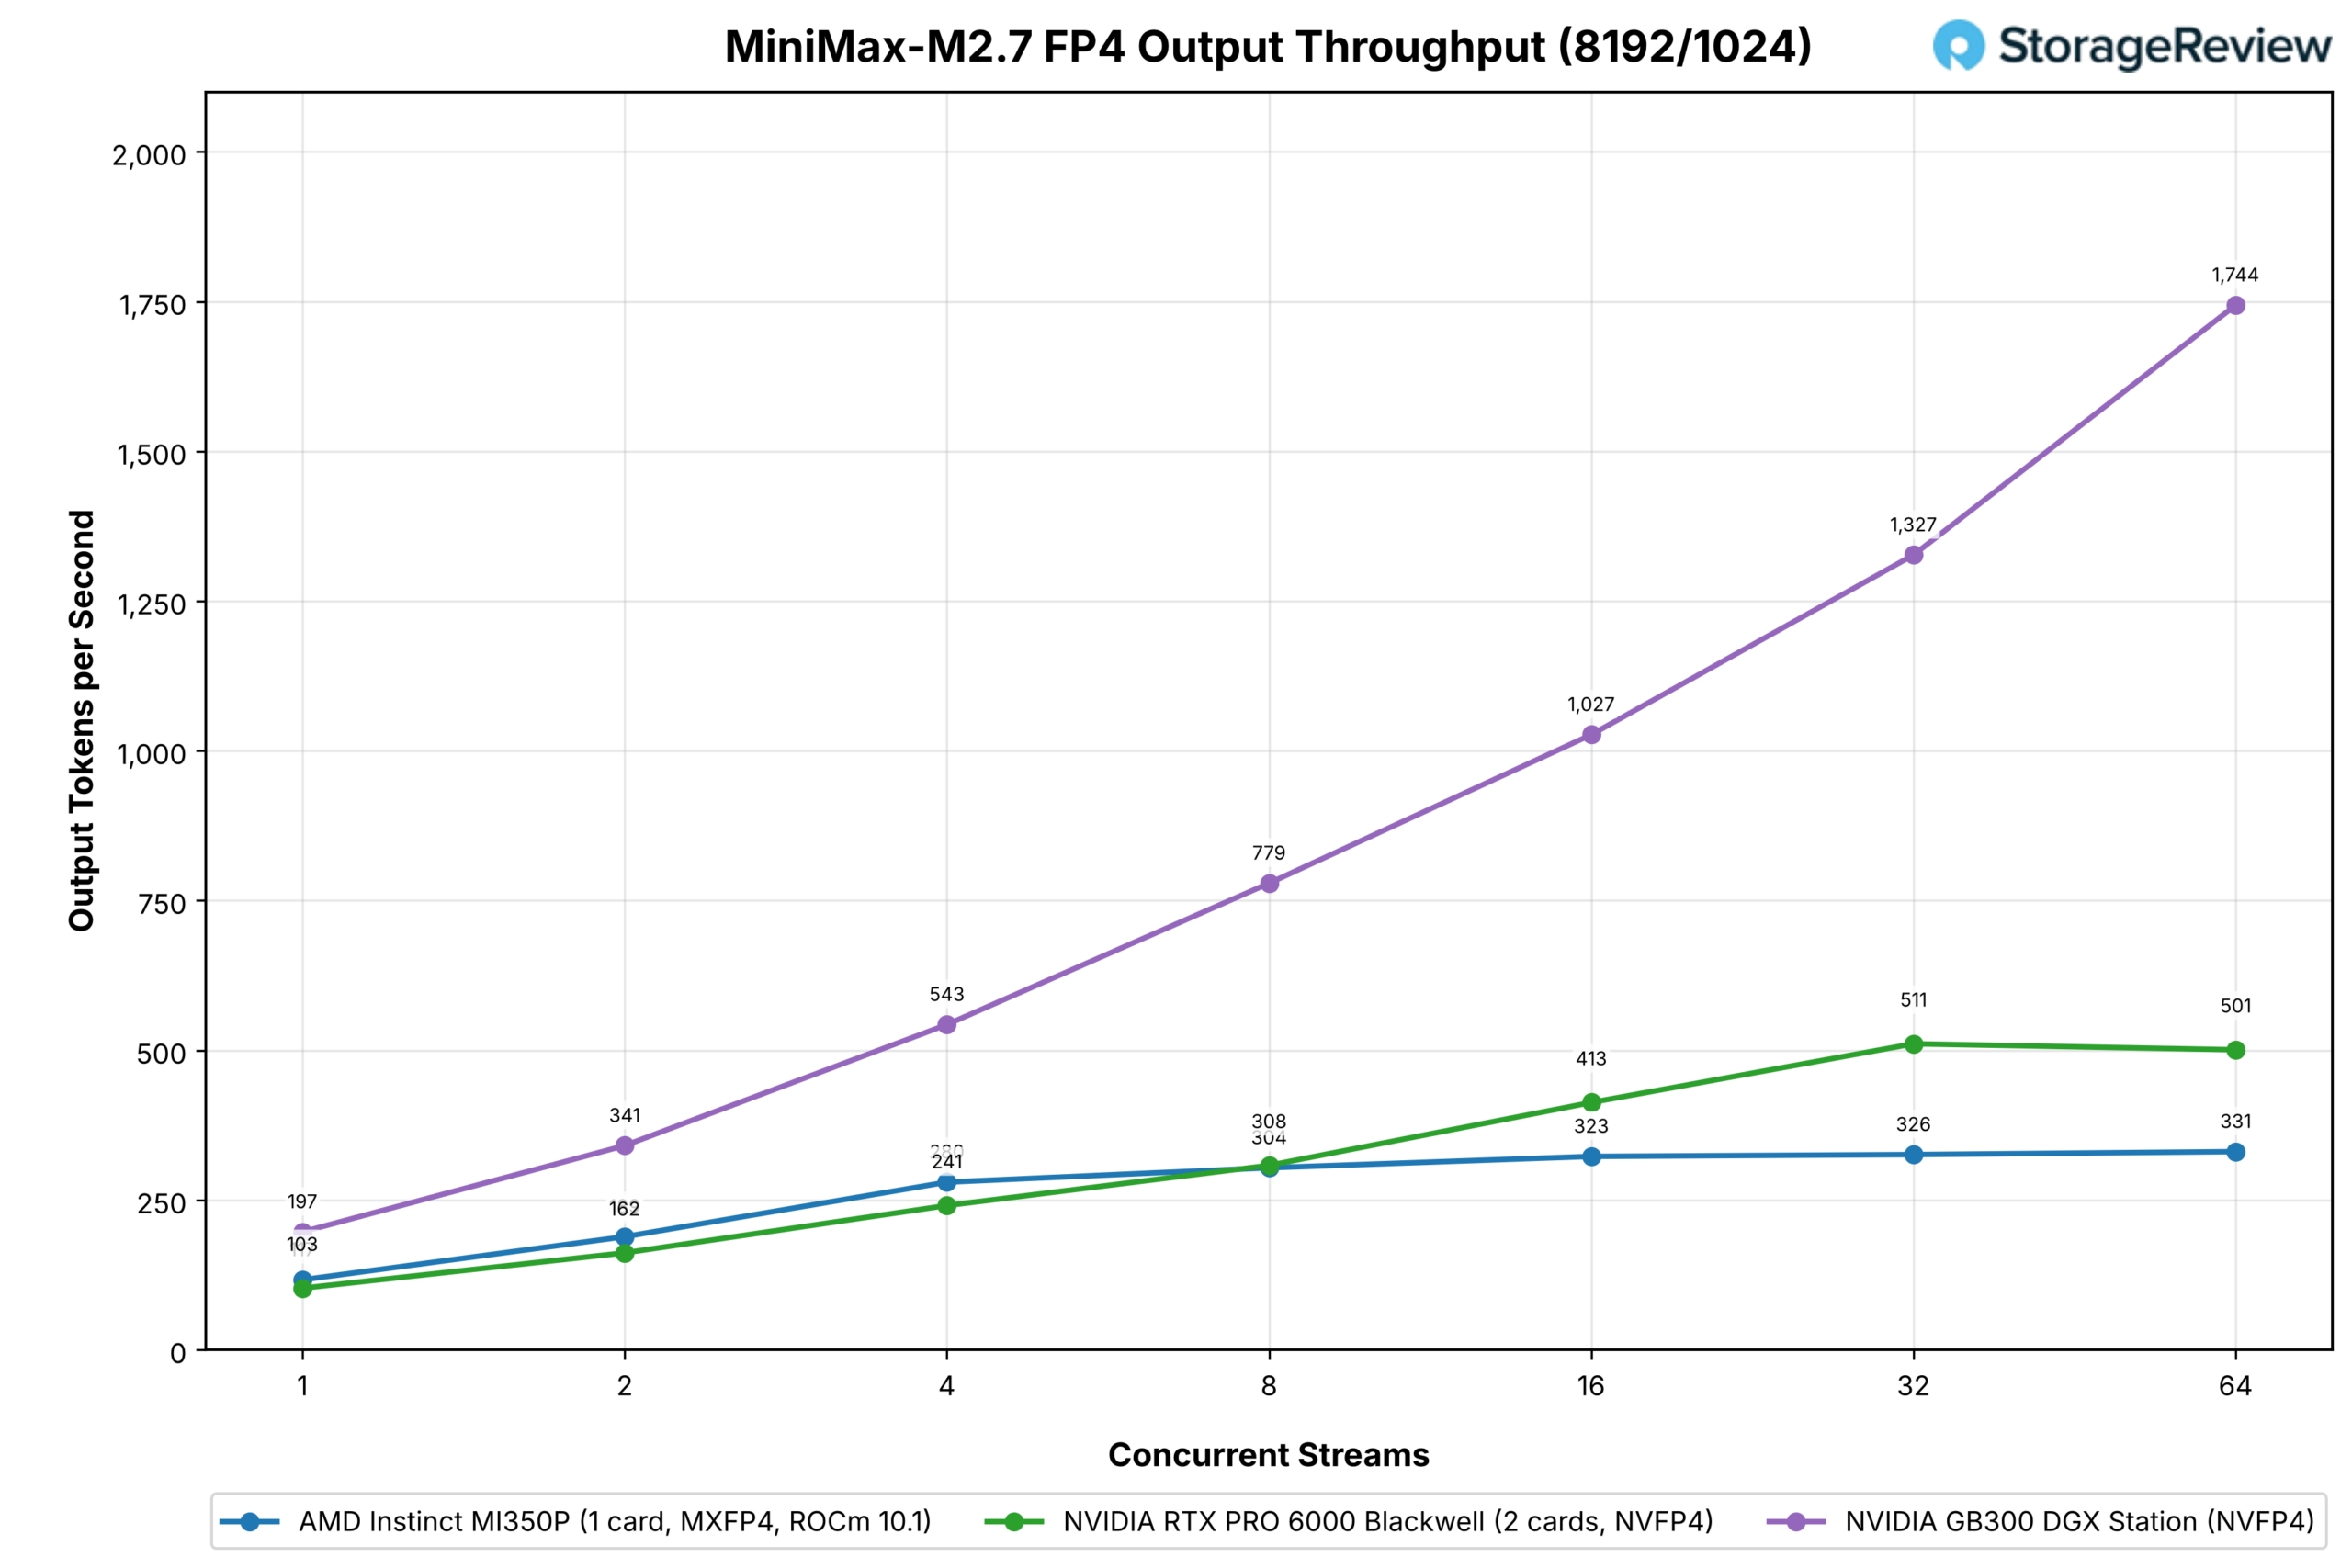
MI350P တစ်ခုက MiniMax-M2.7 ရဲ့ MXFP4 build ကို NVFP4 မှာရှိတဲ့ RTX PRO 6000 ကတ်နှစ်ခုနဲ့ ယှဉ်ပြိုင်နိုင်ပါတယ်။ MI350P တစ်ခုတည်းက ဒီနှစ်ခုကို stream တစ်ခု (124 vs 115) မှာ ဦးဆောင်နေပြီး stream ၆၄ ခုမှာ 1,486 vs 1,339 မှာ ၈ ရာခိုင်နှုန်းကနေ ၂၀ ရာခိုင်နှုန်းအထိ ဦးဆောင်နေကာ 1,524 vs 1,557 မှာ ၂၅၆ နဲ့ 1,557 မှာ ပြားချပ်နေပြီး RTX တစ်စုံကတော့ 1,932 နဲ့ 2,842 အထိ ဆက်လက်ရပ်တည်နေပါတယ်။ Station ကတော့ 4,793 အထိ ရောက်ရှိသွားပါတယ်။
ကြိုတင်ဖြည့်သွင်းမှုများပြားသော workload တွင် MI350P သည် stream ရှစ်ခုမှ တစ်စက္ကန့်လျှင် output token ၃၀၄ မှ ၃၃၁ အထိ ထိန်းသိမ်းထားနိုင်ပြီး RTX pair အတွက် ၅၀၁ နှင့် Station အတွက် ၁၇၄၄ ရှိသည်။
GPT-OSS-120B
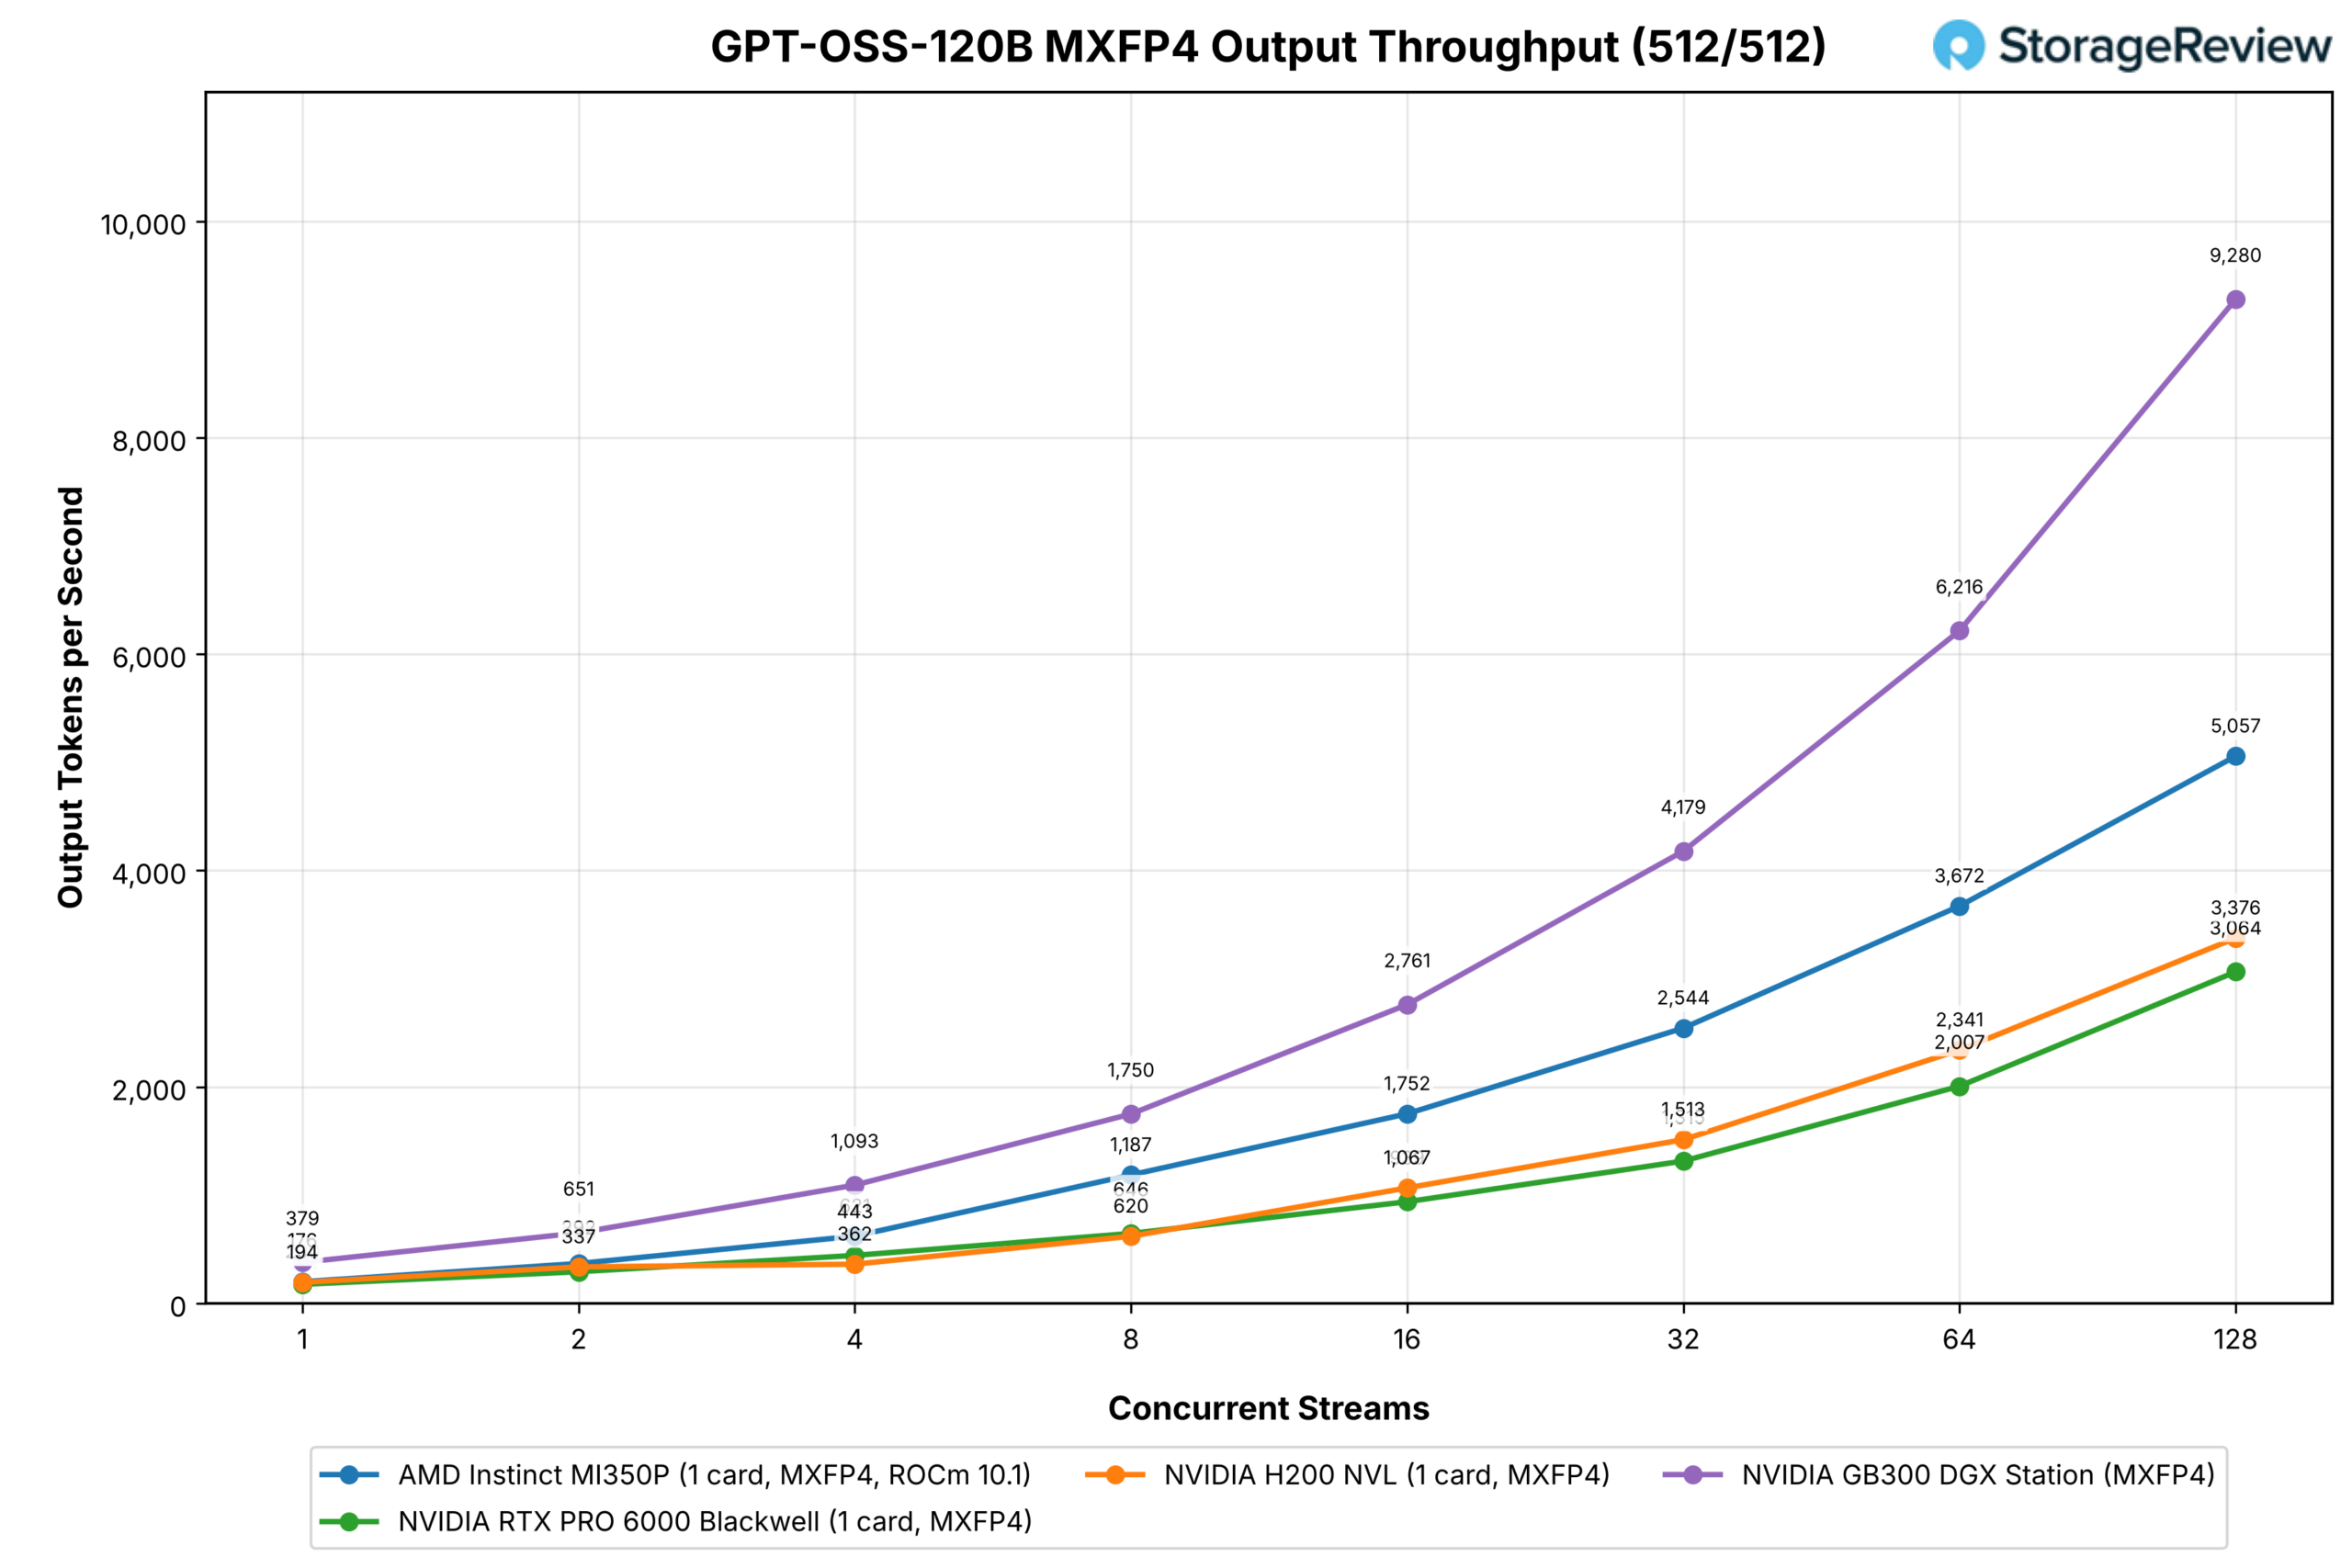
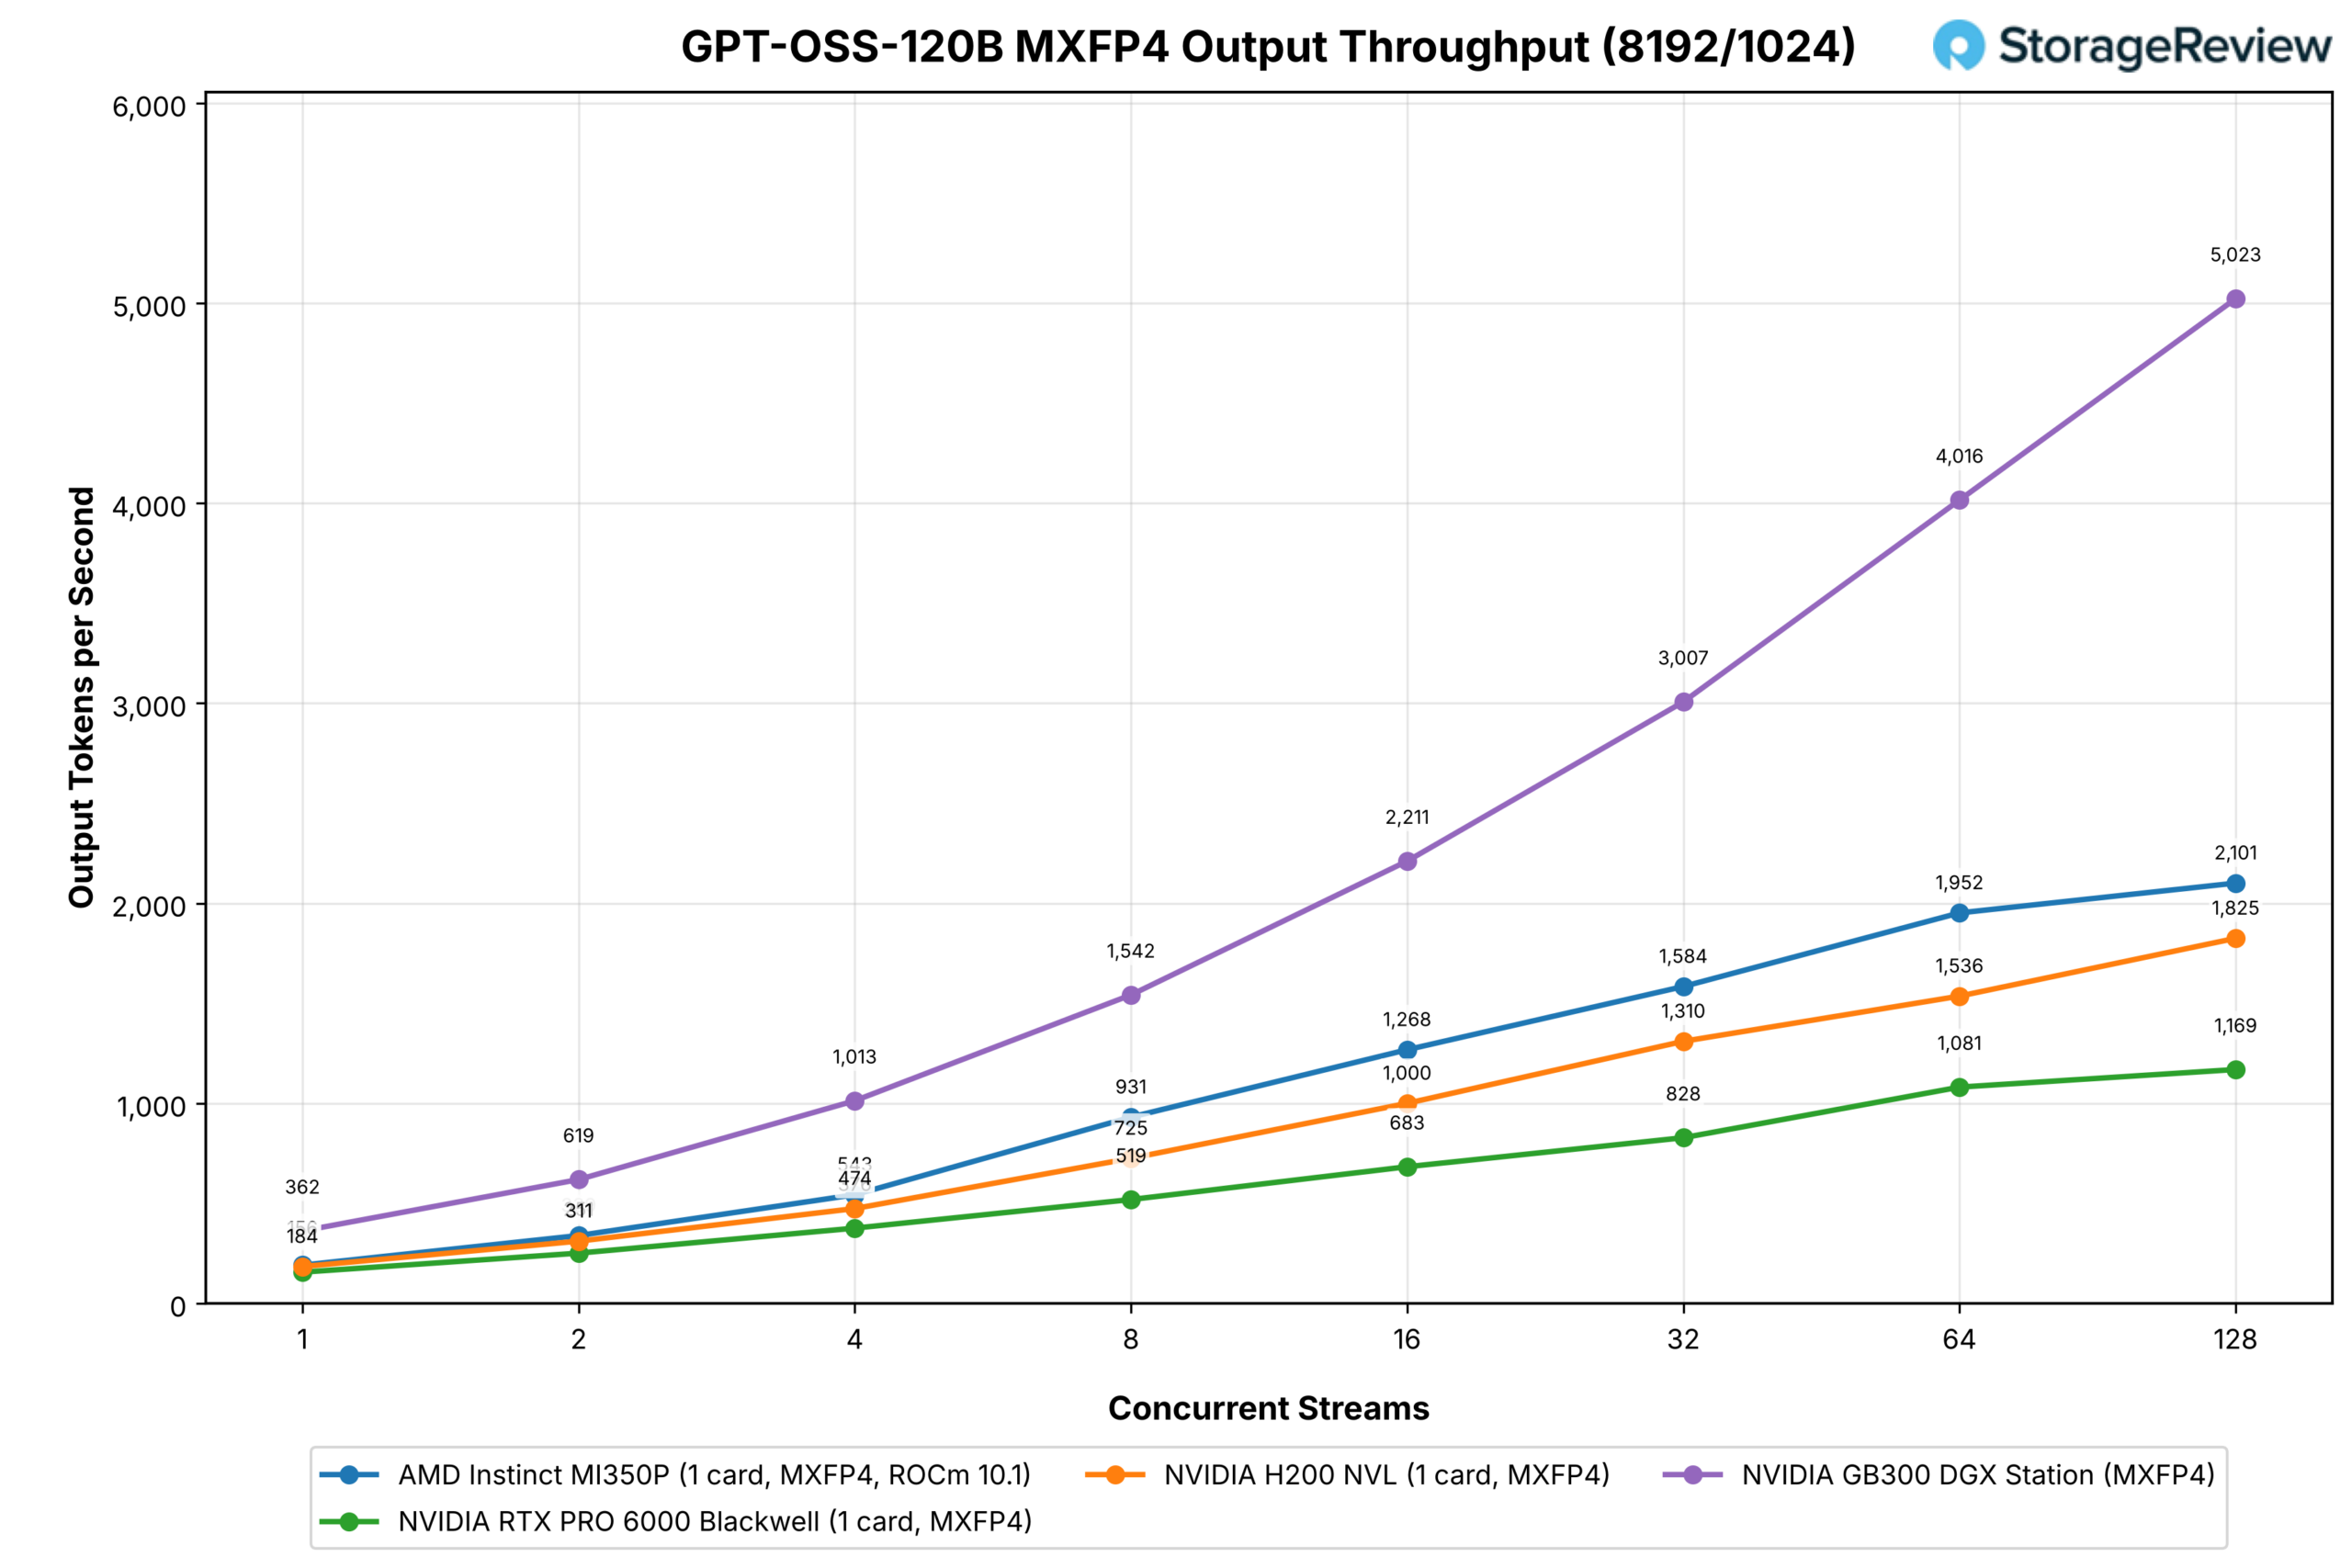
GPT-OSS သည် MXFP4 အဖြစ် တင်ပို့သောကြောင့် ကတ်တိုင်းတွင် အလေးချိန်တူညီသည်။ MI350P တစ်လုံးသည် workload နှစ်ခုလုံးတွင် stream count တိုင်းတွင် RTX PRO 6000 တစ်ခုကို ဦးဆောင်နေပြီး stream လေးခုမှ ၄၀ မှ ၉၃ ရာခိုင်နှုန်းအထိ ဦးဆောင်နေပြီး chat workload တွင် တစ်စက္ကန့်လျှင် output tokens ၅,၀၅၇ ခုနှင့် stream ၁၂၈ ခုတွင် prefill-heavy prompts တွင် တစ်စက္ကန့်လျှင် ၂,၁၀၁ ခု ရရှိပြီး RTX PRO 6000 အတွက် ၃,၀၆၄ နှင့် ၁,၁၆၉ ခုနှင့် H200 NVL အတွက် ၃,၃၇၆ နှင့် ၁,၈၂၅ ခု ရရှိထားသည်။ Station သည် ၉,၂၈၀ နှင့် ၅၀၂၃ ခုအထိ ရောက်ရှိသည်။
AMD နှင့် Dell တို့၏ စက်တင်ဘာလ ၁၆ ရက်နေ့တွင် တင်ပြခဲ့သော MLPerf Inference v6.1 သည် တူညီသော မော်ဒယ်အတွက် အမြင့်ဆုံးပမာဏကို ထားရှိသည်- PowerEdge XE7745 ရှိ MI350P ရှစ်ခုသည် အော့ဖ်လိုင်းတွင် တစ်စက္ကန့်လျှင် တိုကင် ၄၈,၉၇၁ ထုတ်လုပ်ပြီး GPT-OSS-120B ရှိ server scenario တွင် ၄၀,၈၆၈ ထုတ်လုပ်ပြီး ၎င်းသည် tuned submission stack တွင် GPU တစ်ခုလျှင် ၆,၁၂၁ နှင့် ၅,၁၀၈ ဖြစ်သည်။ ထို harness နှင့် ကျွန်ုပ်တို့၏ harness များသည် တူညီသော harness မဟုတ်သော်လည်း stock vLLM တွင် 128 streams တွင် ကျွန်ုပ်တို့ တိုင်းတာခဲ့သော 5,057 သည် ထိုအပိုင်းအခြား၏ အောက်ဆုံးတွင် ရှိသည်။
GPT-OSS-20B
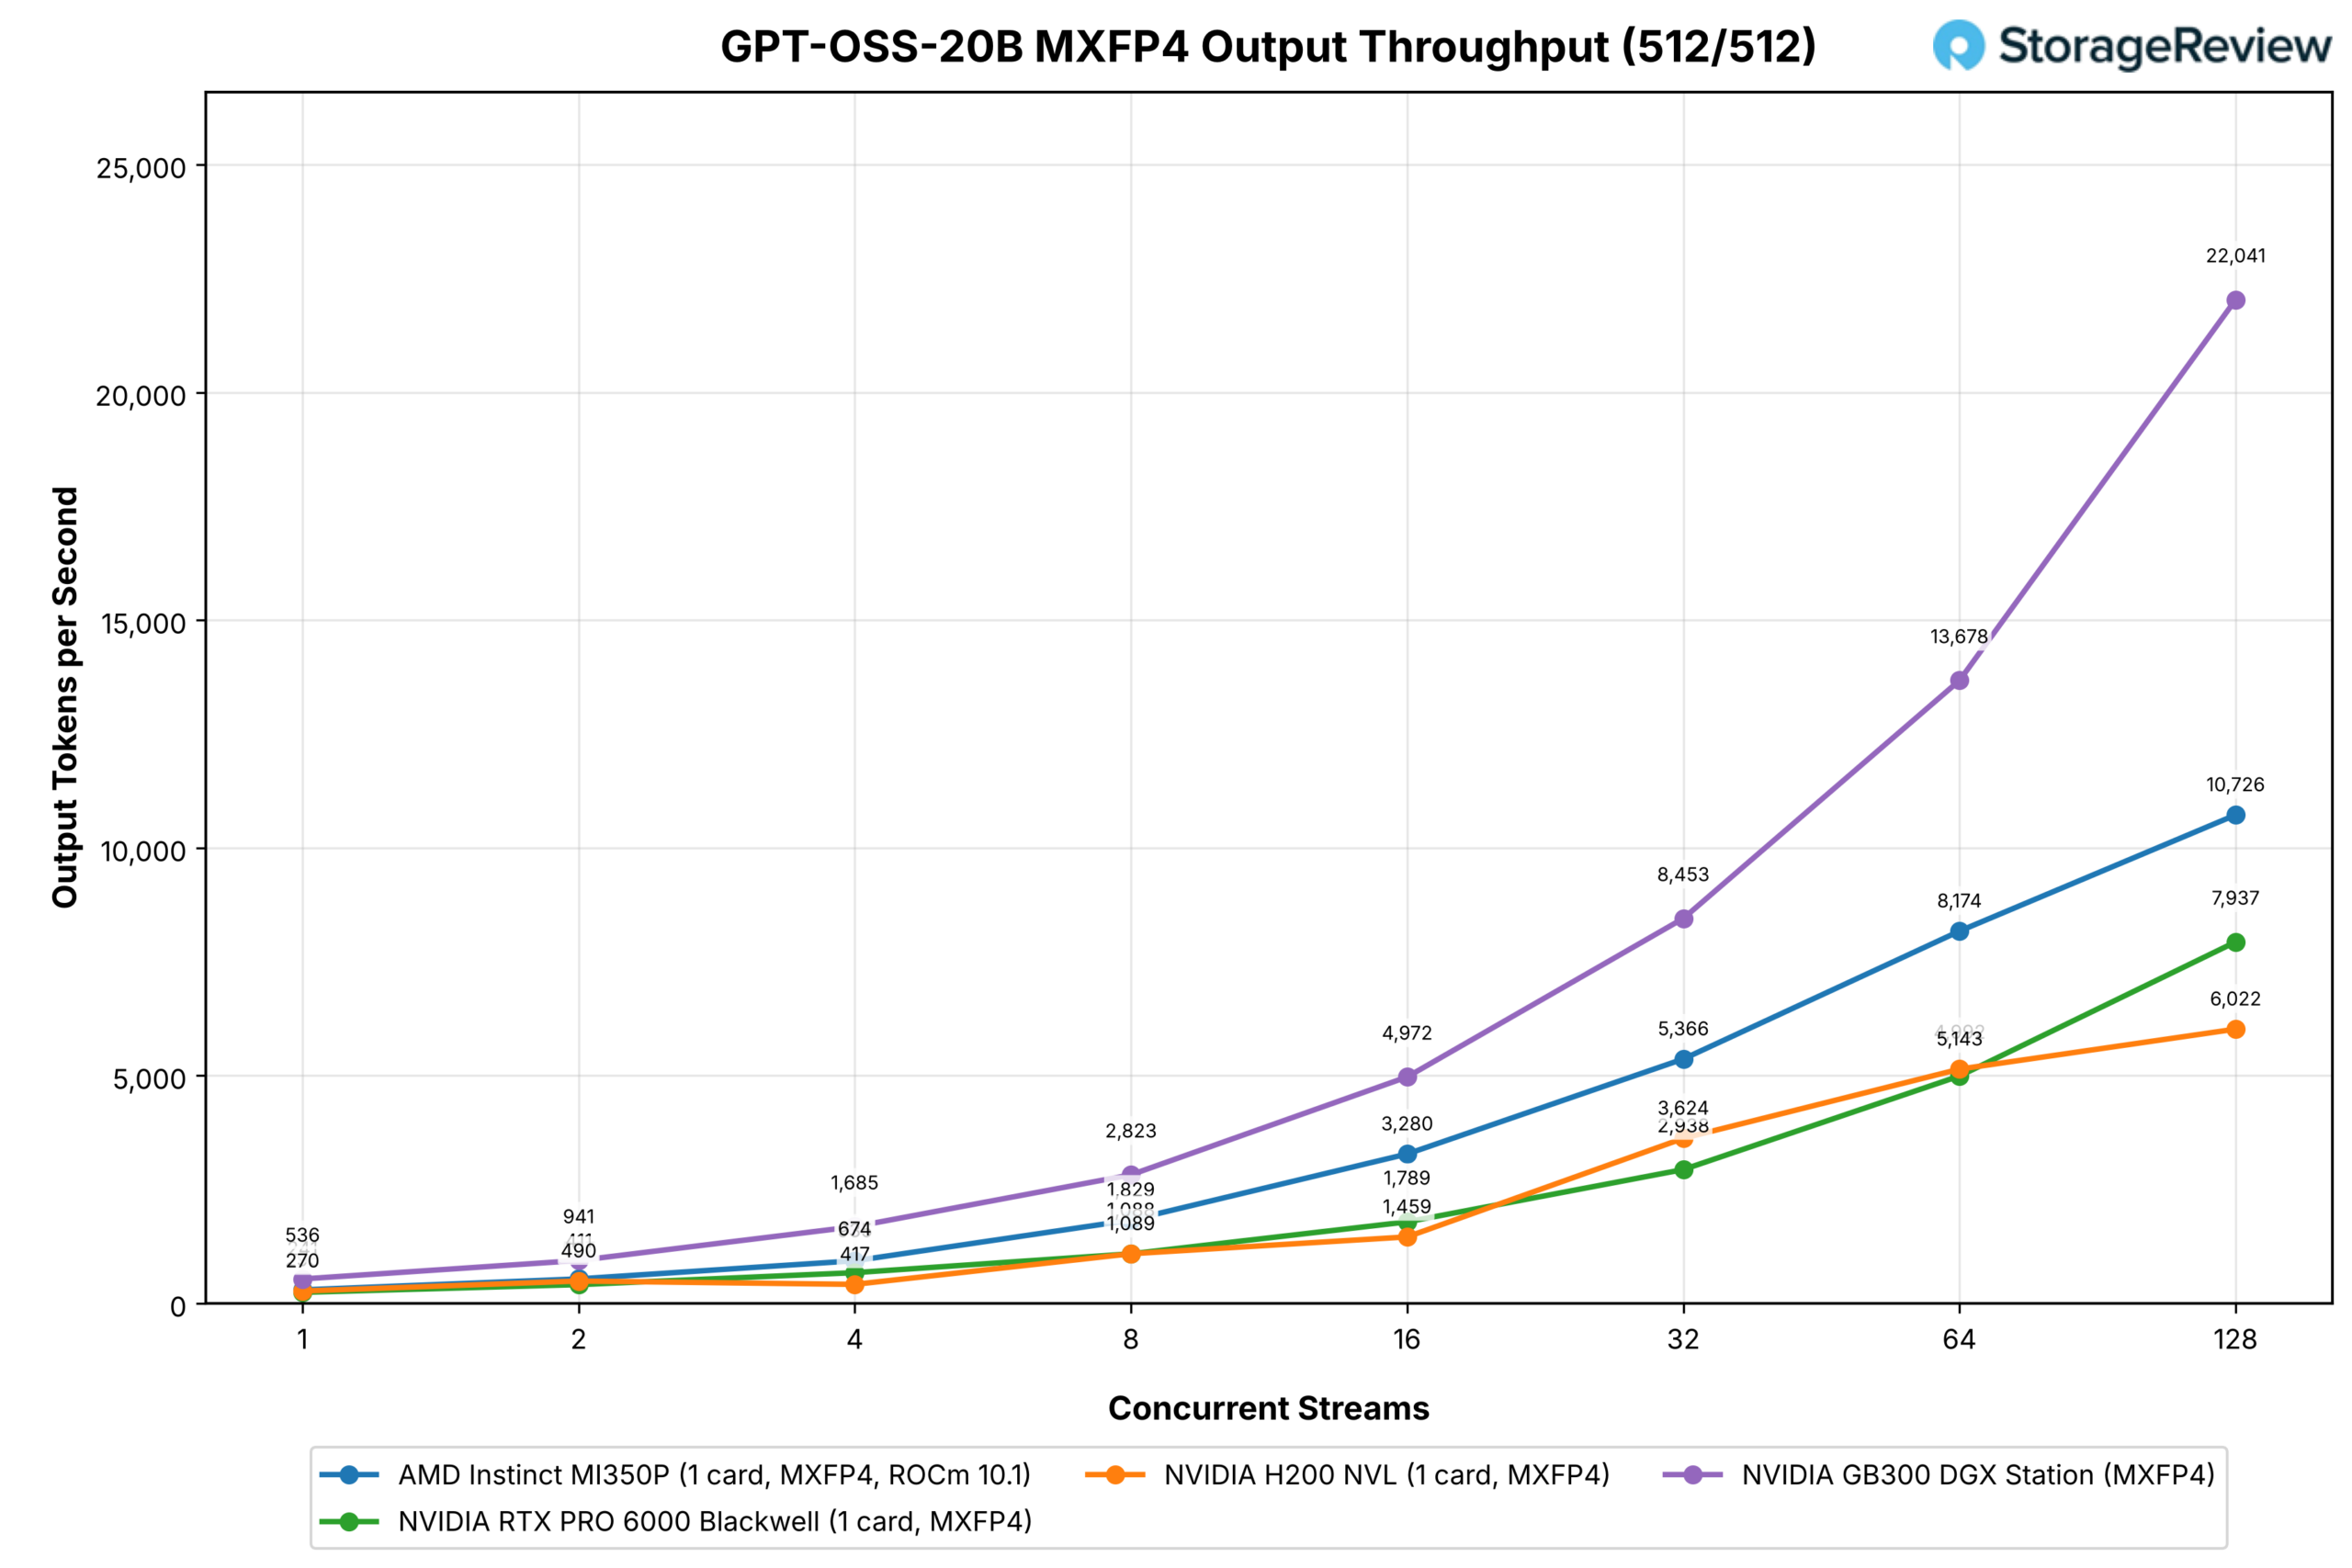
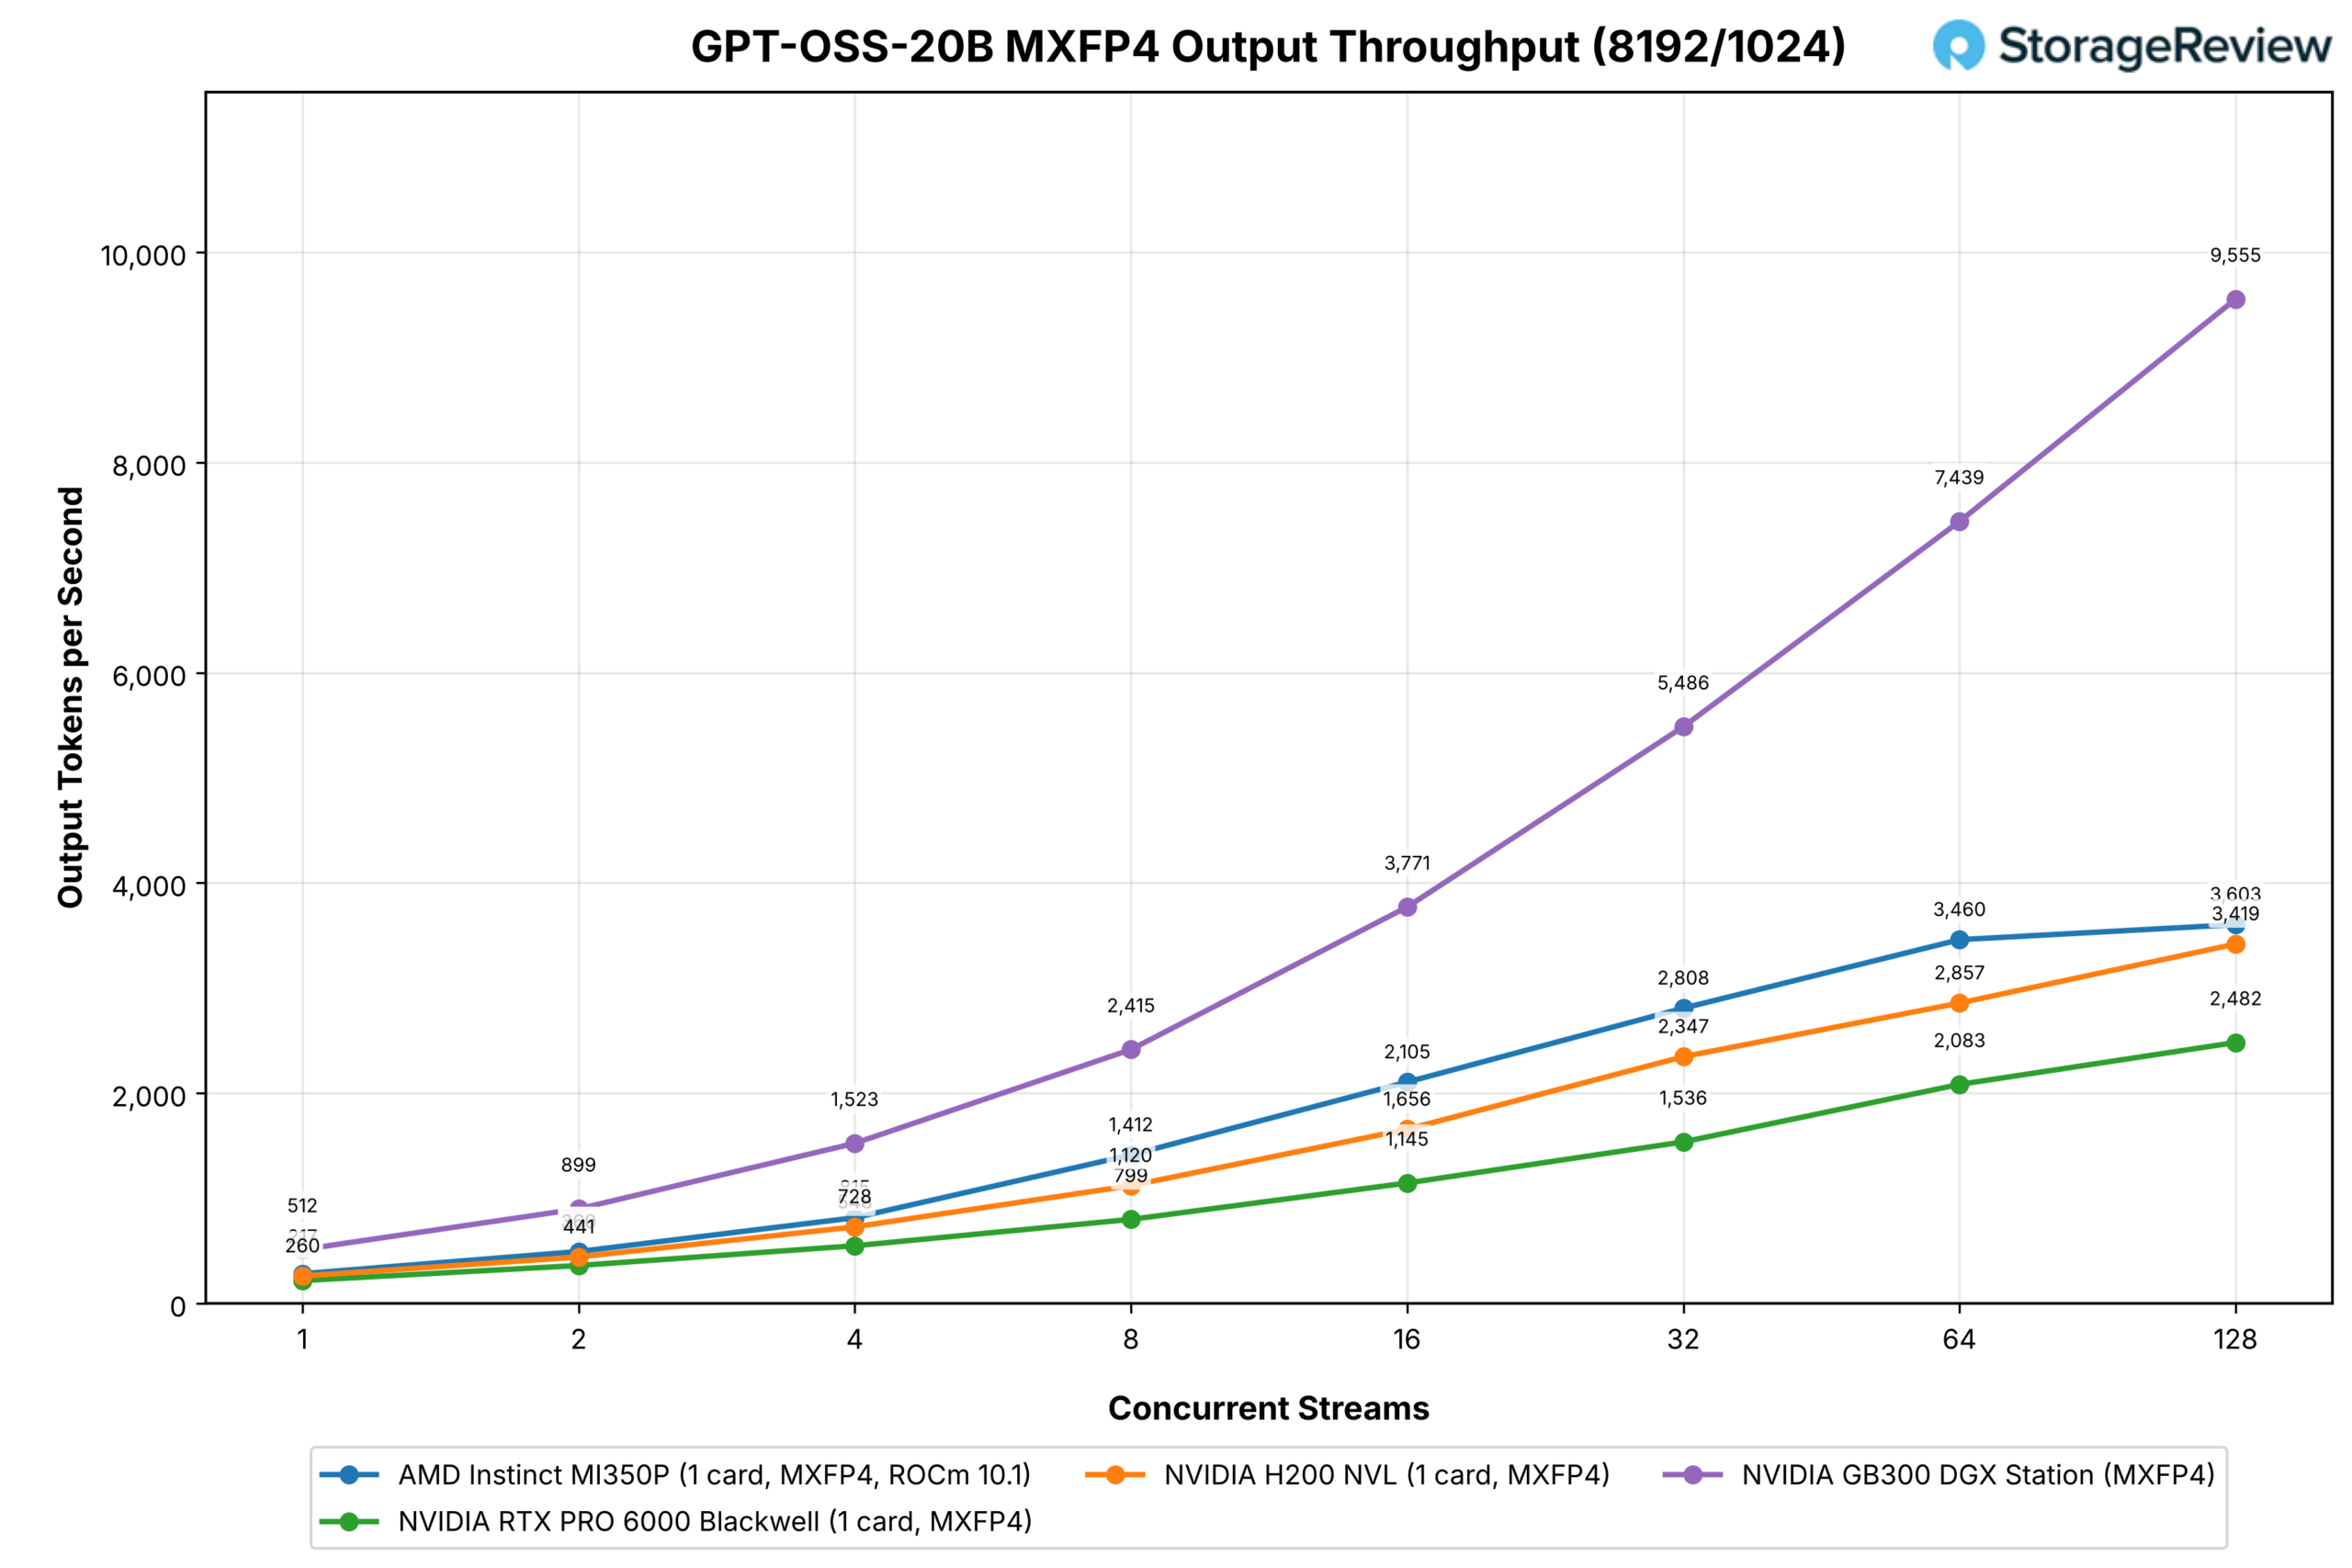
ပိုသေးငယ်တဲ့ OpenAI မော်ဒယ်ကလည်း အဲဒီမျဉ်းကွေးကို လိုက်နာပါတယ်။ MI350P က RTX PRO 6000 ထက် အမှတ်တိုင်းမှာ ဦးဆောင်နေပြီး stream ၆၄ ခုမှာ ၄၉၉၂ နဲ့ ယှဉ်ရင် ၈၁၇၄ နဲ့ chat workload ၁၂၈ ခုမှာ ၁၀၇၂၆ နဲ့ ယှဉ်ရင် ၇၉၃၇ နဲ့ ယှဉ်ရင် ၁၂၈ ခုမှာ ၁၀၇၂၆ နဲ့ prefill-heavy prompts ၂၀၀၀ နဲ့ ယှဉ်ရင် ၃၄၆၀ နဲ့ prefill-heavy prompts ၂၀၀၀ နဲ့ ယှဉ်ရင် ၂၀၀၀ နဲ့ ယှဉ်ရင် ၂၀၀၀ နဲ့ ယှဉ်ရင် ၃၆၀၃ နဲ့ ယှဉ်ရင် ၂၀၀၀ နဲ့ ယှဉ်ရင် ၂၀၀၀ နဲ့ ယှဉ်ရင် ၂၀၀၀ နဲ့ ယှဉ်ရင် ၂၀၀၀ နဲ့ ယှဉ်ရင် ၁၆၄၀၆ နဲ့ ညီမျှပါတယ်။ H200 NVL က stream ၁၂၈ ခုမှာ ၆၀၂၂ နဲ့ ၃၄၁၉ နဲ့ ပုံစံနှစ်မျိုးလုံးမှာ MI350P ထက် နောက်က လိုက်နေပြီး Station က ၂၂၀၄၁ နဲ့ ၉၅၅၅ မှာ ရှိပါတယ်။
Qwen3-Coder-30B-A3B
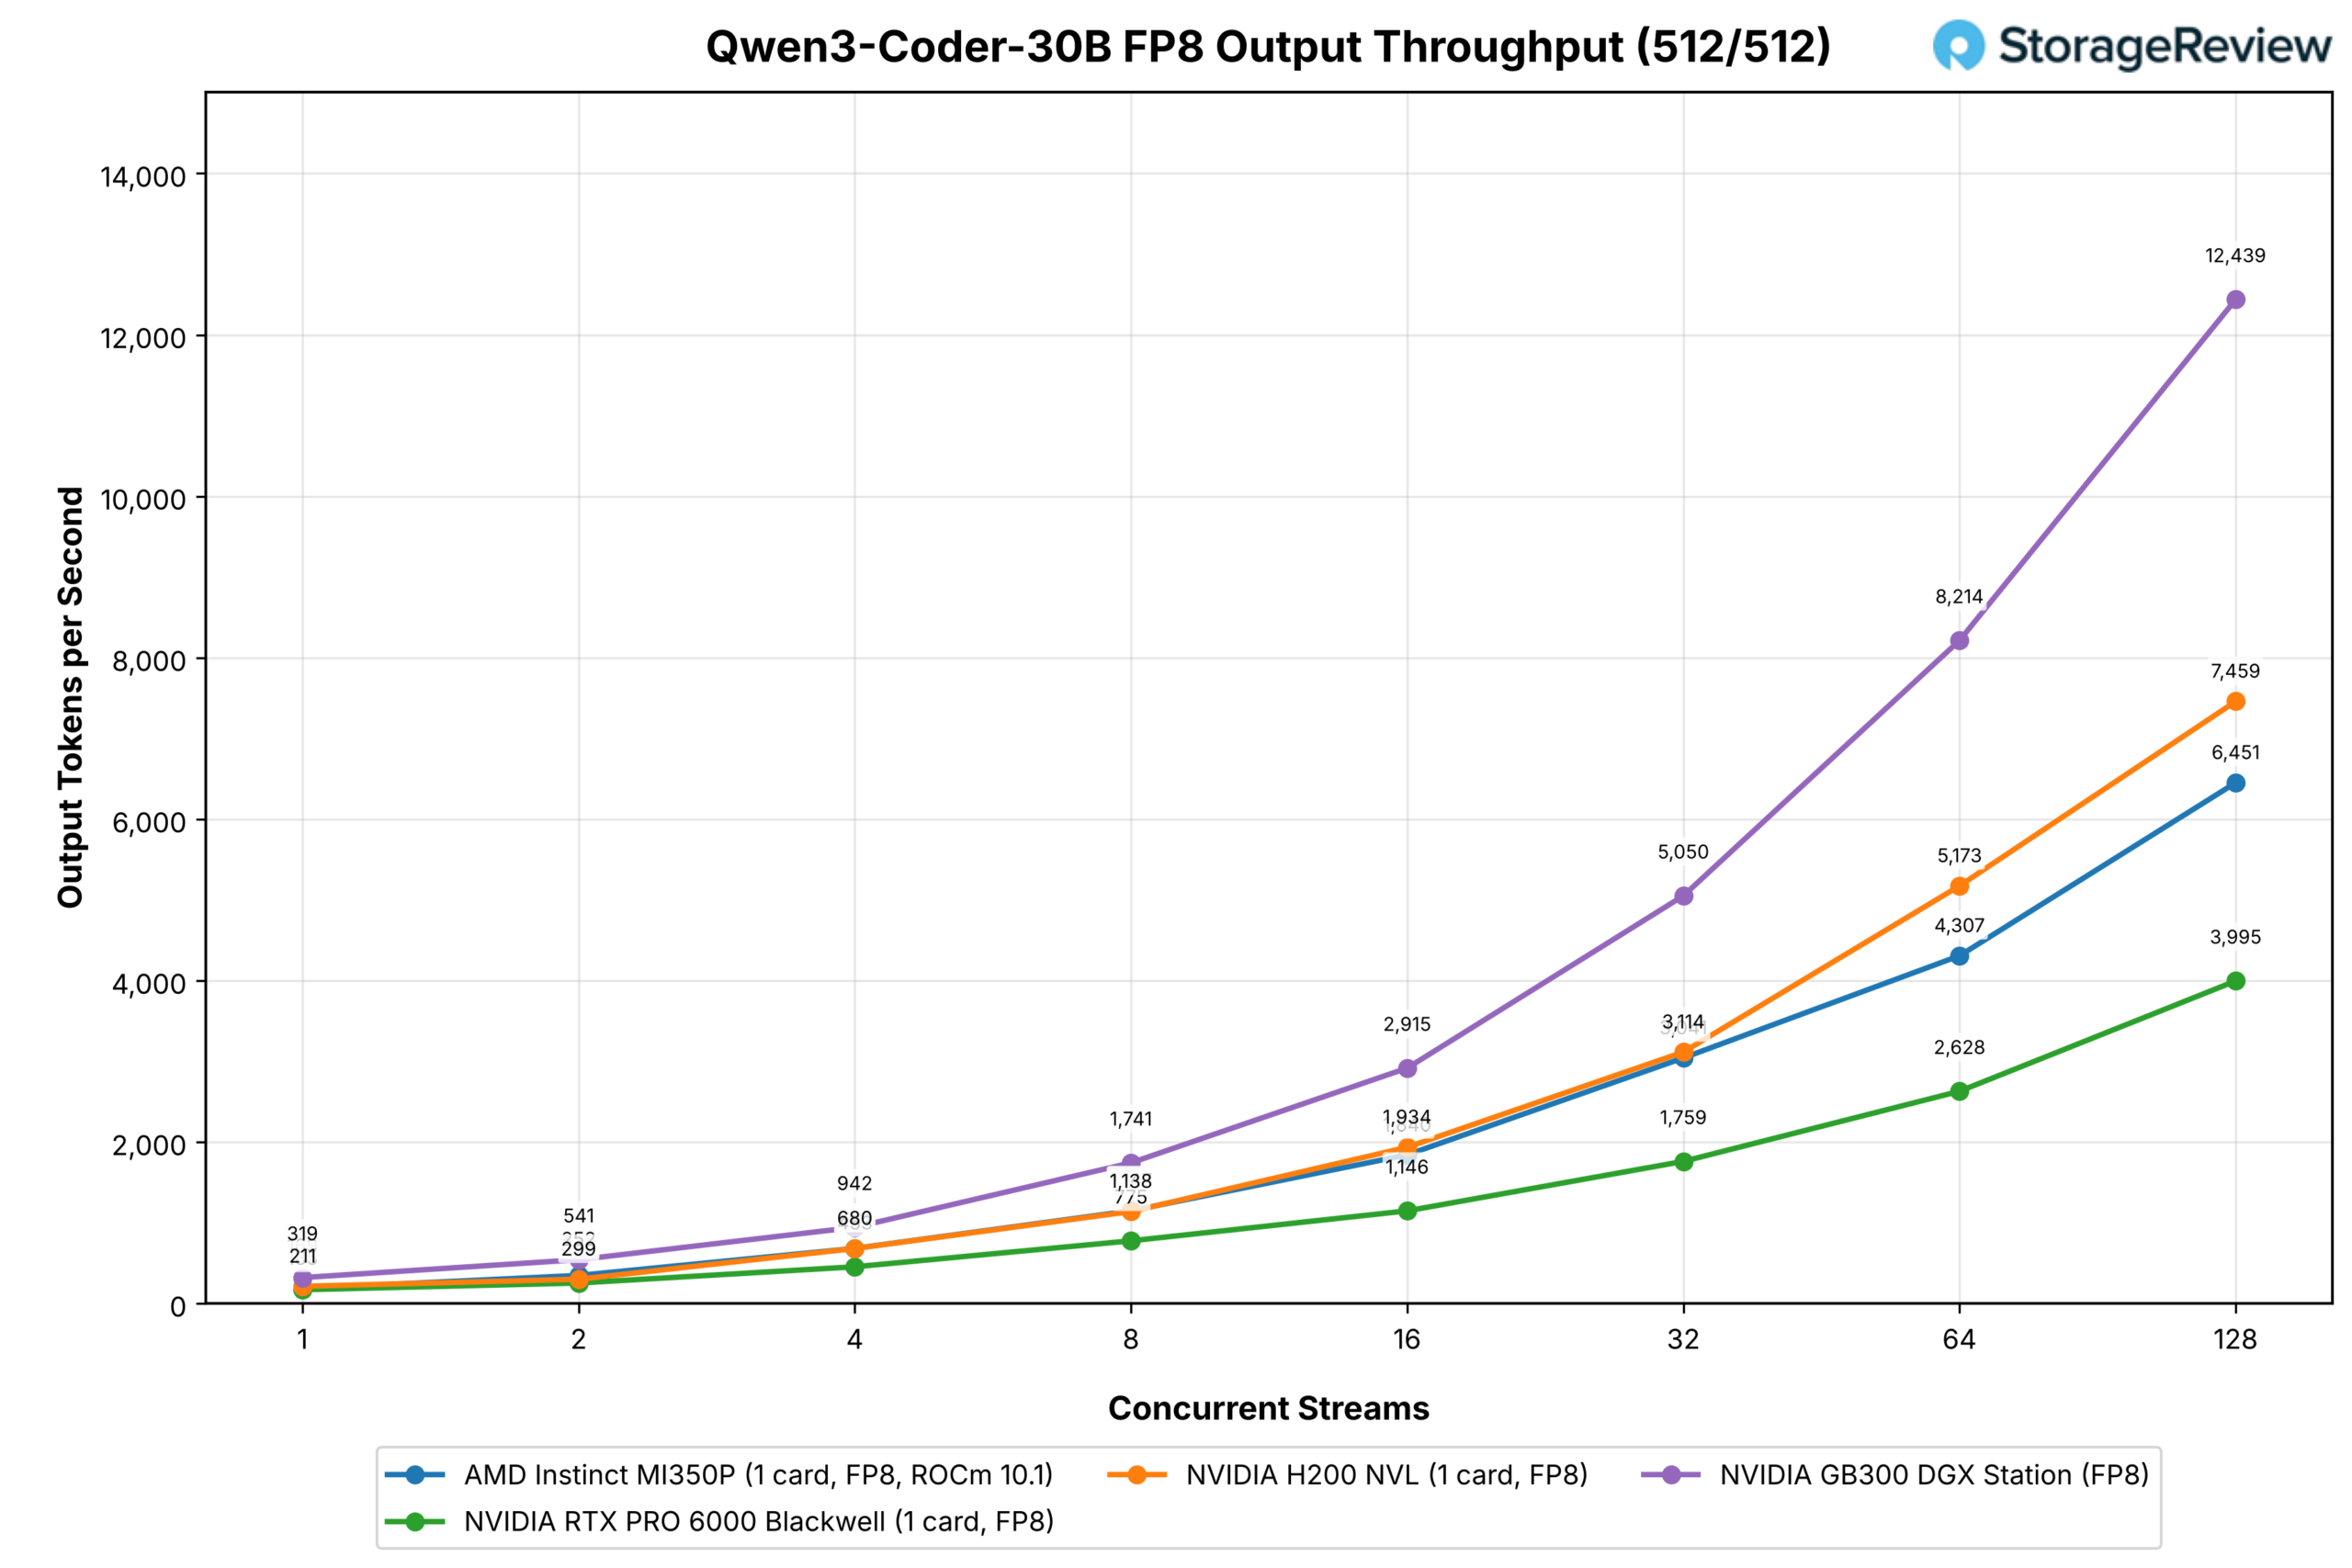
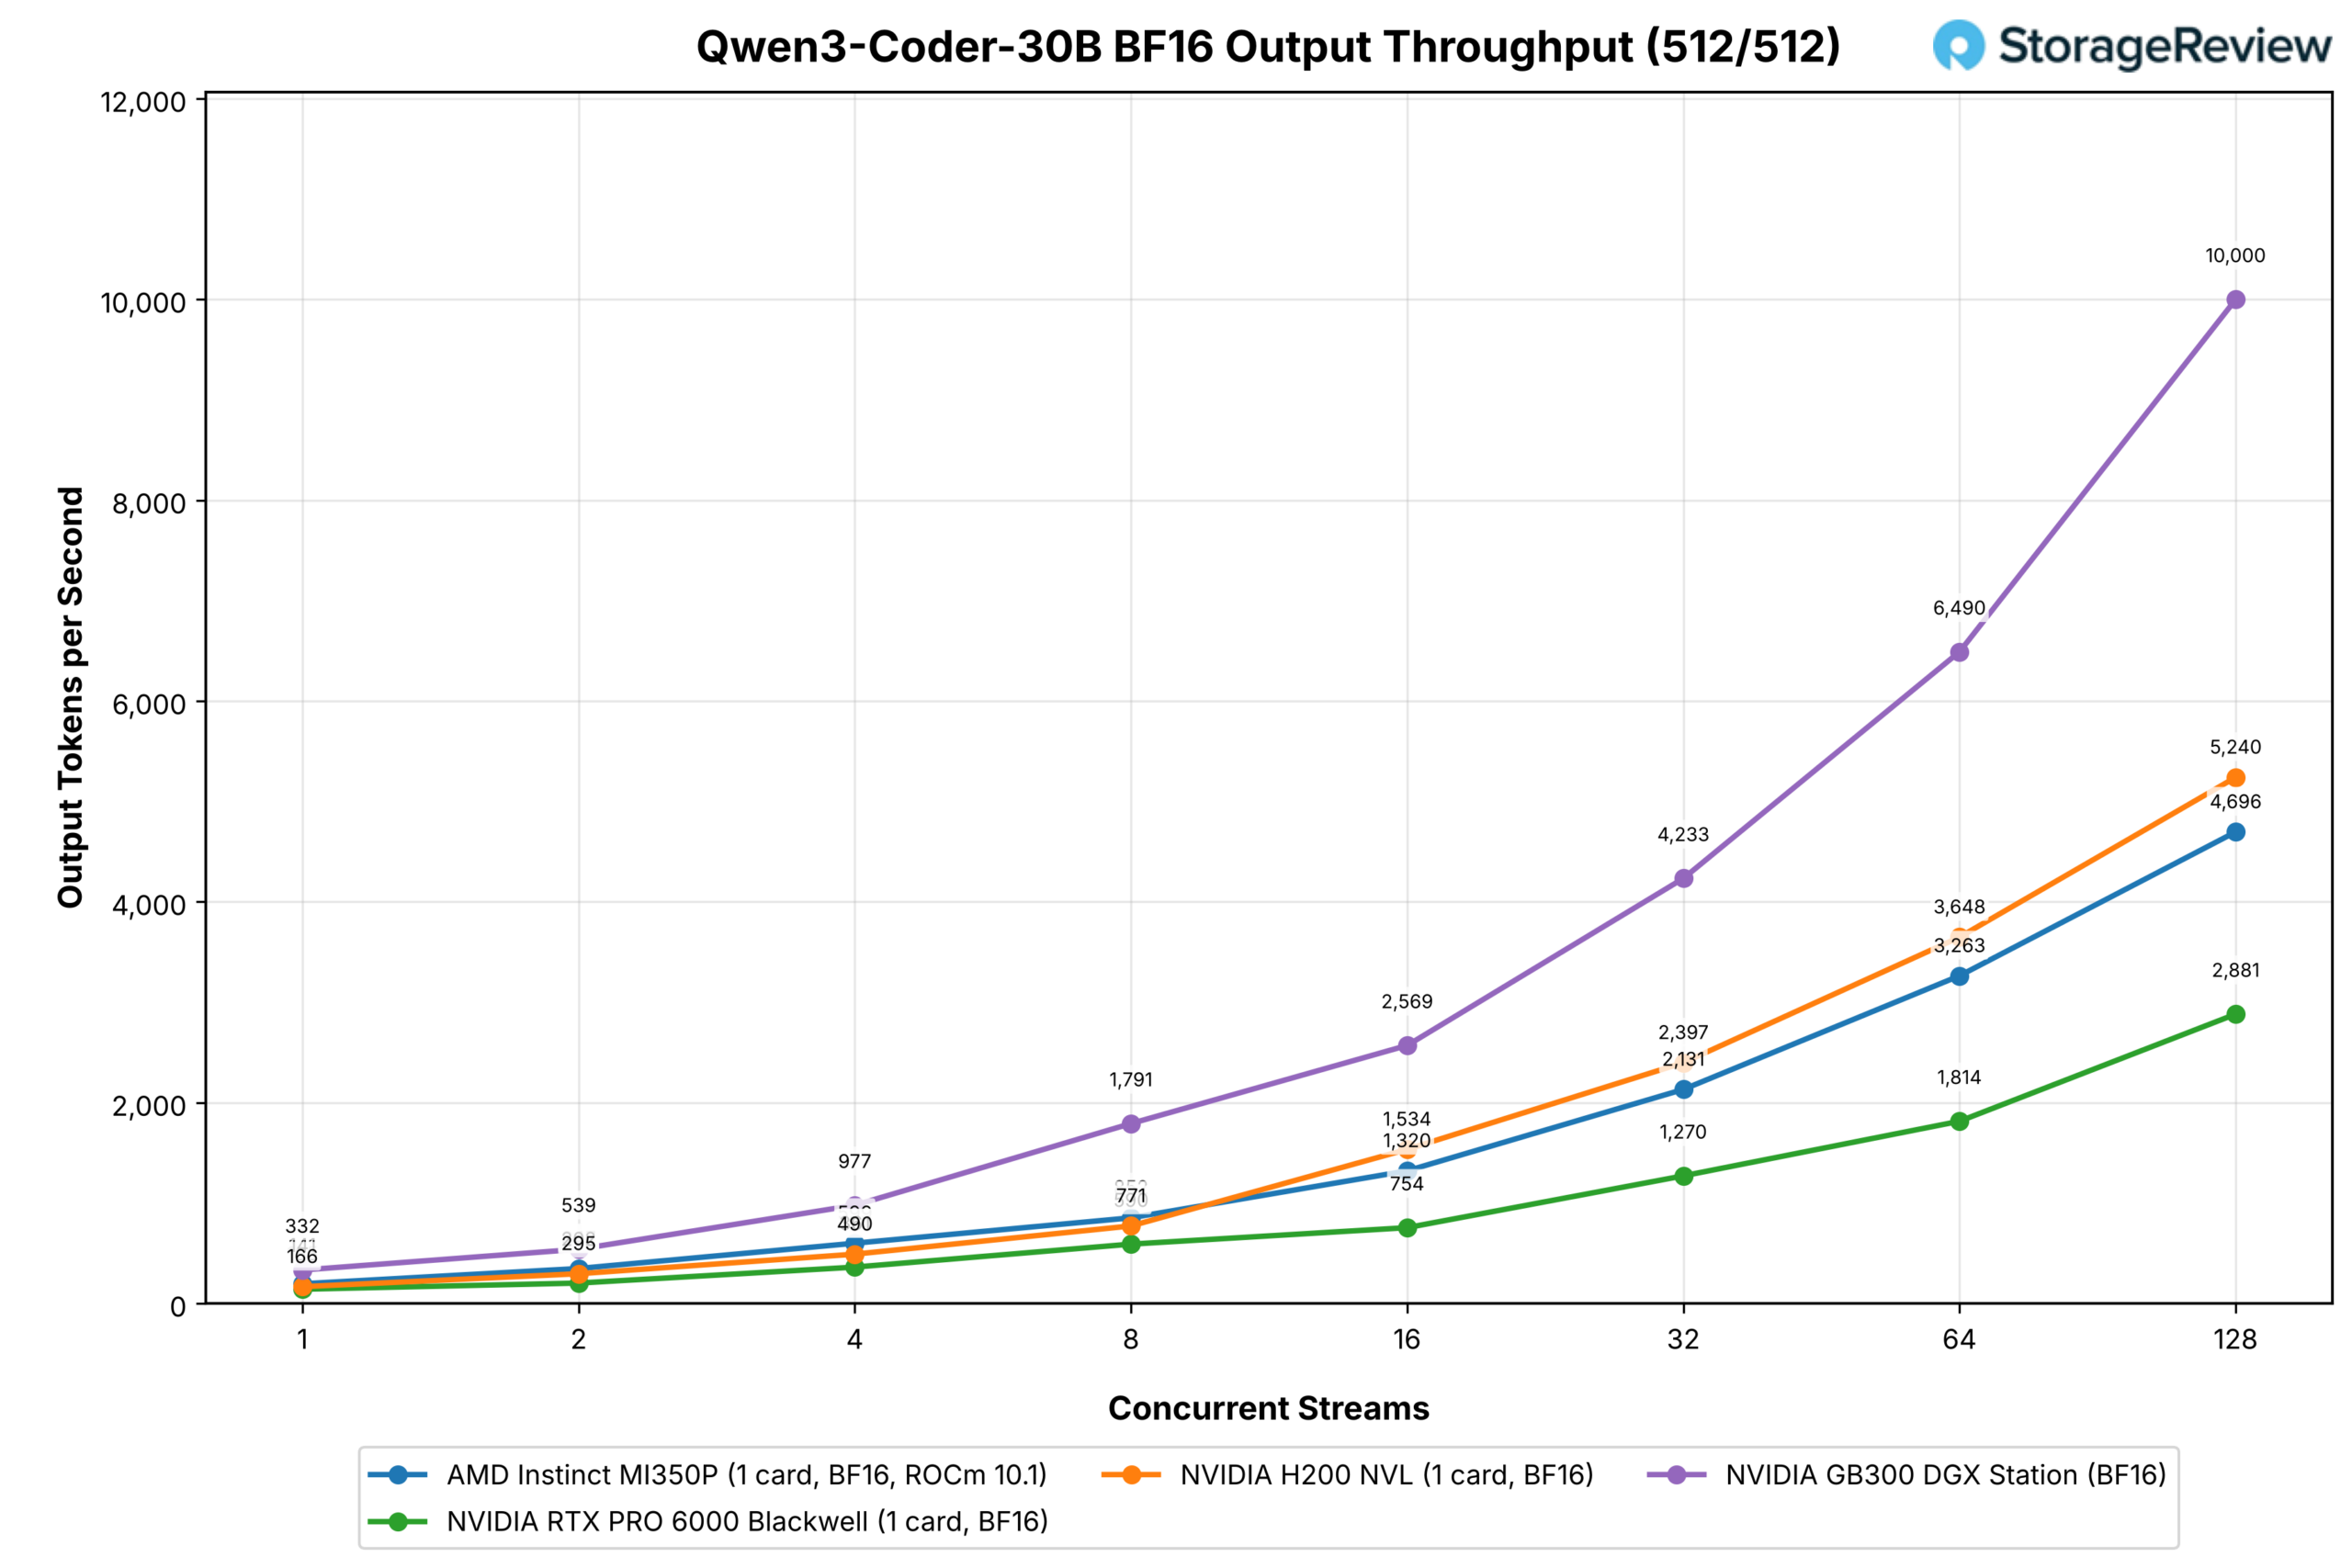
3B active parameters များပါရှိသော 30B MoE သည် MI350P ကို chat workload တွင် concurrency တိုင်းတွင် RTX PRO 6000 ထက် အသာရစေပြီး FP8 တွင် 6,451 ဖြင့် 3,995 ဖြင့် 128 streams တွင် 3,995 ဖြင့် အဆုံးသတ်ကာ BF16 တွင် 4,696 ဖြင့် 2,881 ဖြင့် အဆုံးသတ်ကာ H200 သည် 7,459 နှင့် 5,240 ဖြင့် အဆုံးသတ်သည်။
prefill များသော prompts များတွင် FP8 run သည် stream လေးခုမှတစ်ဆင့်သာ ဦးဆောင်ပြီး RTX PRO 6000 သည် ရှစ်ခုမှ ၁၂၈ အထိ နောက်ကျကျန်နေပြီး ၇၅၉ ခုနှင့်အထက်တွင် ၈၂၃ ခုရှိပြီး H200 သည် ၁၈၂၀ ရှိသည်။ BF16 run သည် stream ၁၂၈ ခုတွင် ၇၂၈ ခုသို့ မြင့်တက်ပြီး ၅၈၈ ခုနှင့် ၁၅၉၂ ခုတို့ထက် ပိုများသည်။
မစ်စထရယ် အသေးစား ၃.၁ ၂၄ဘီ
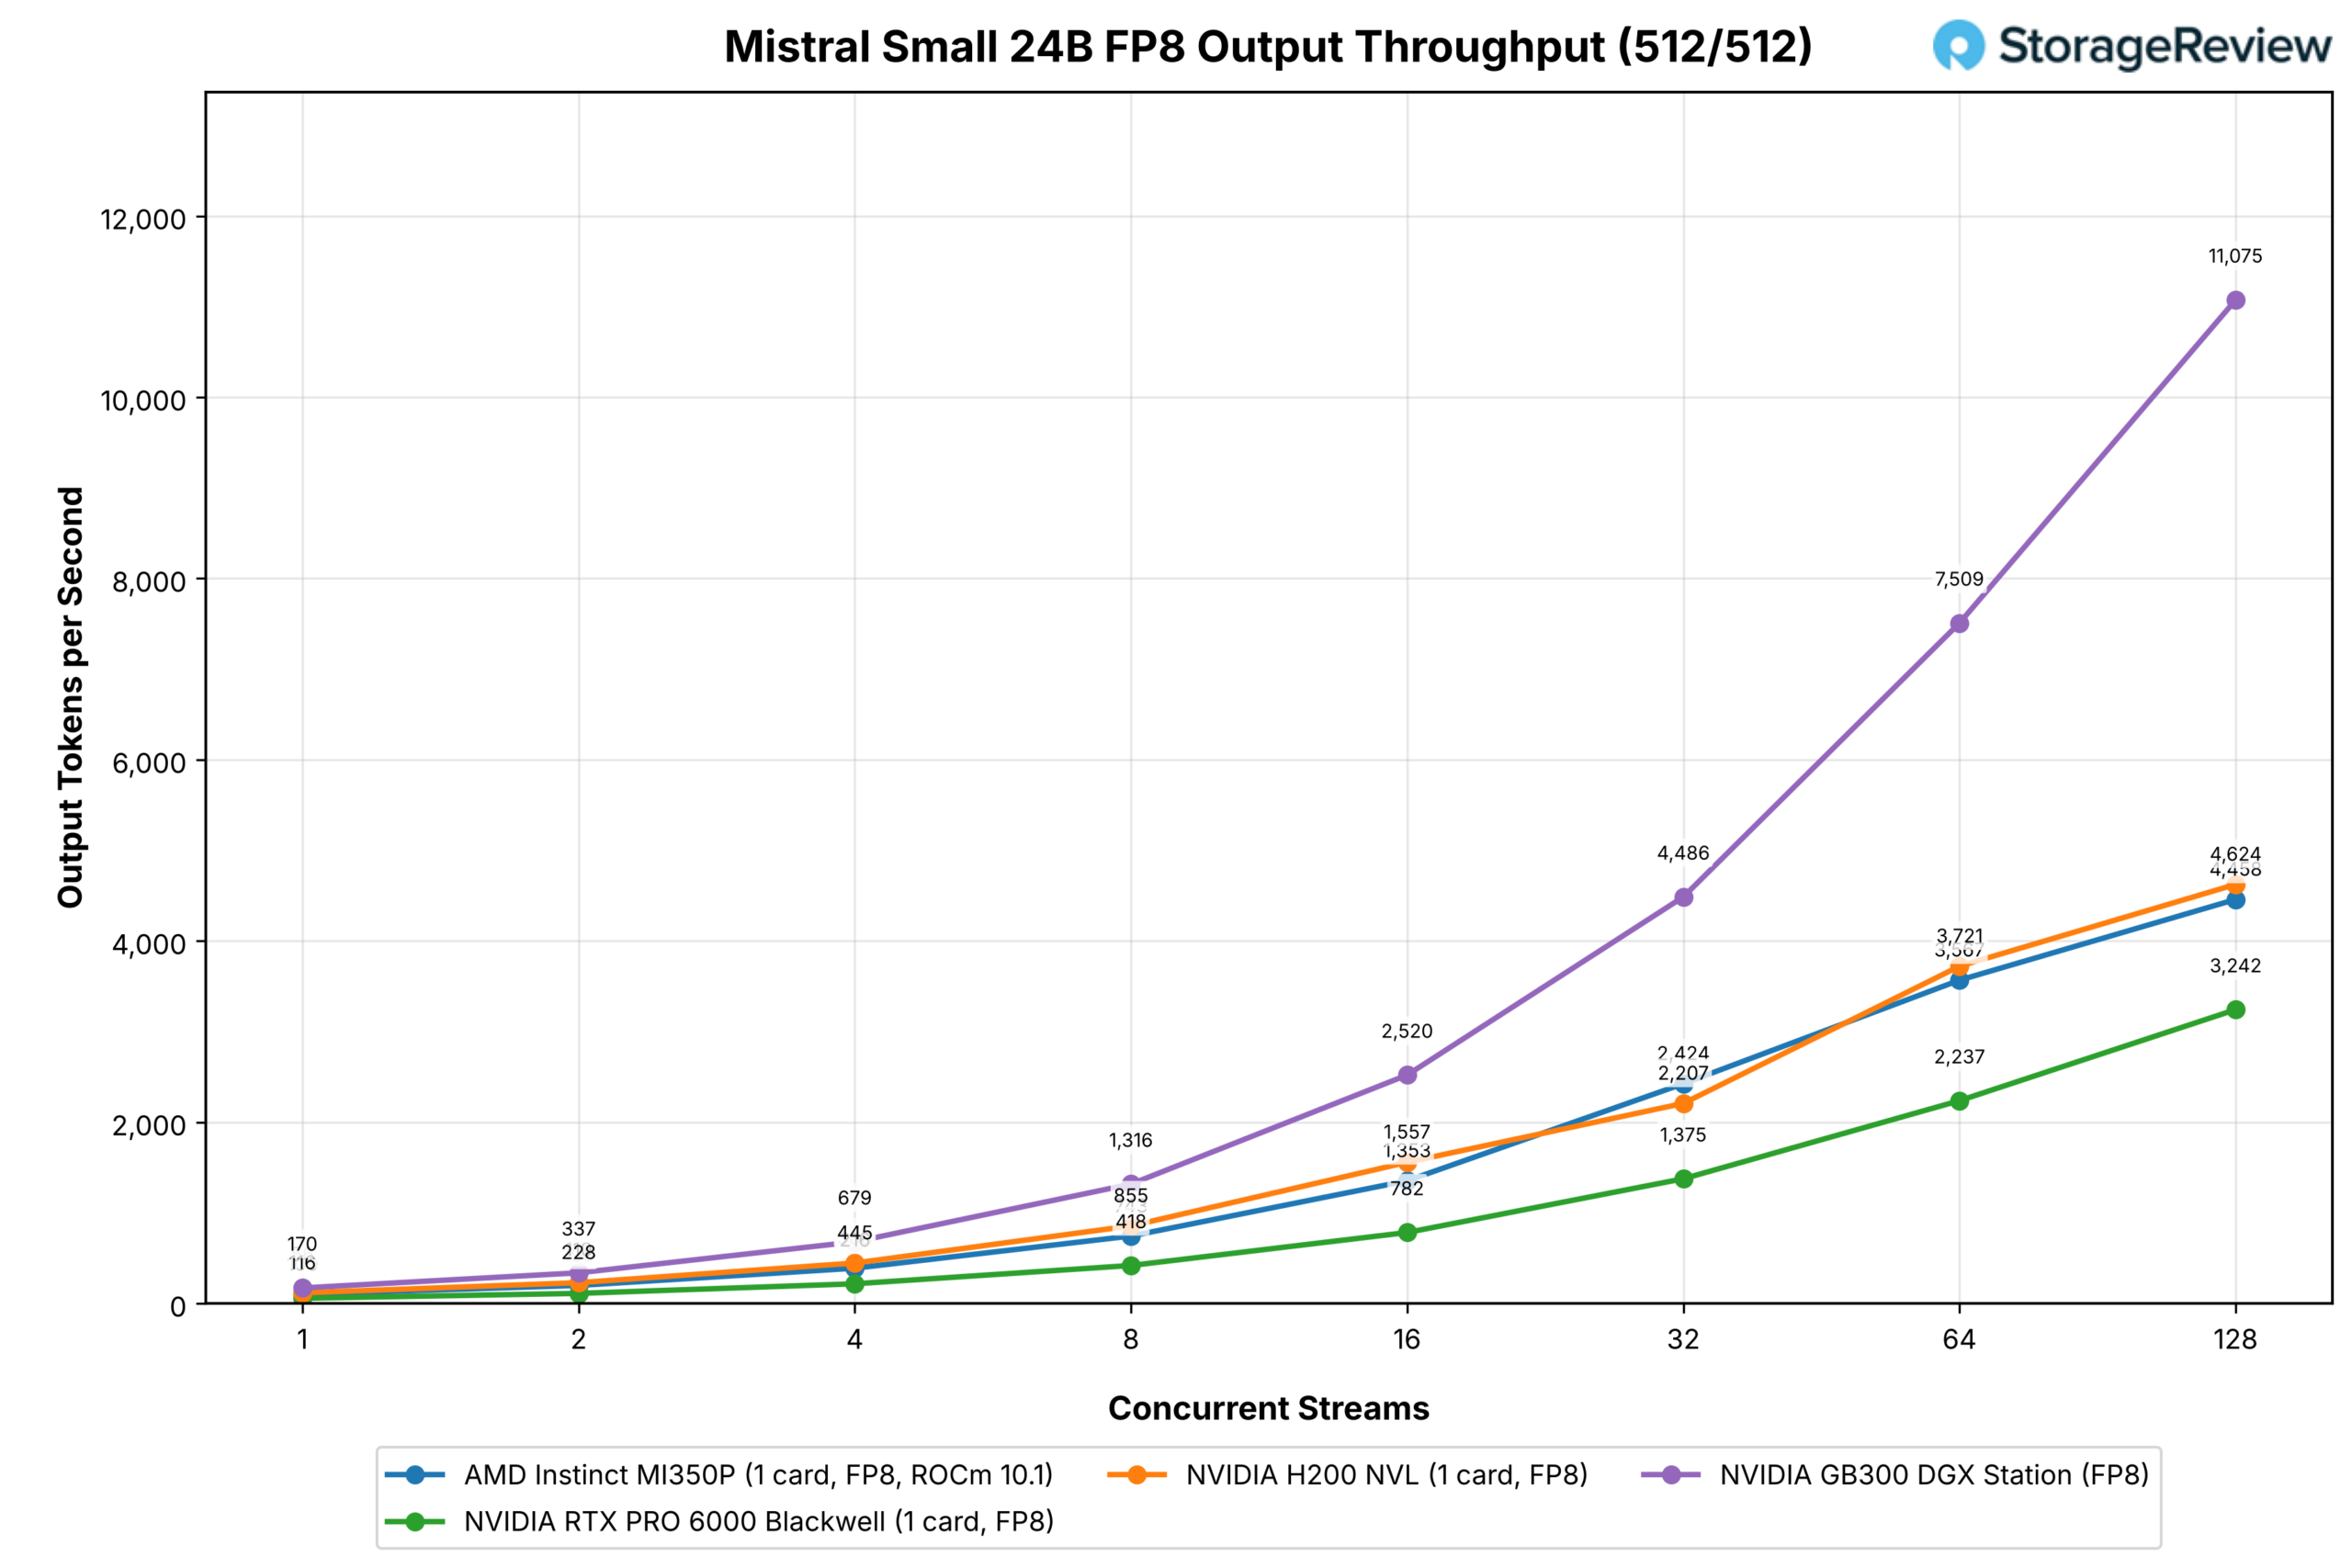
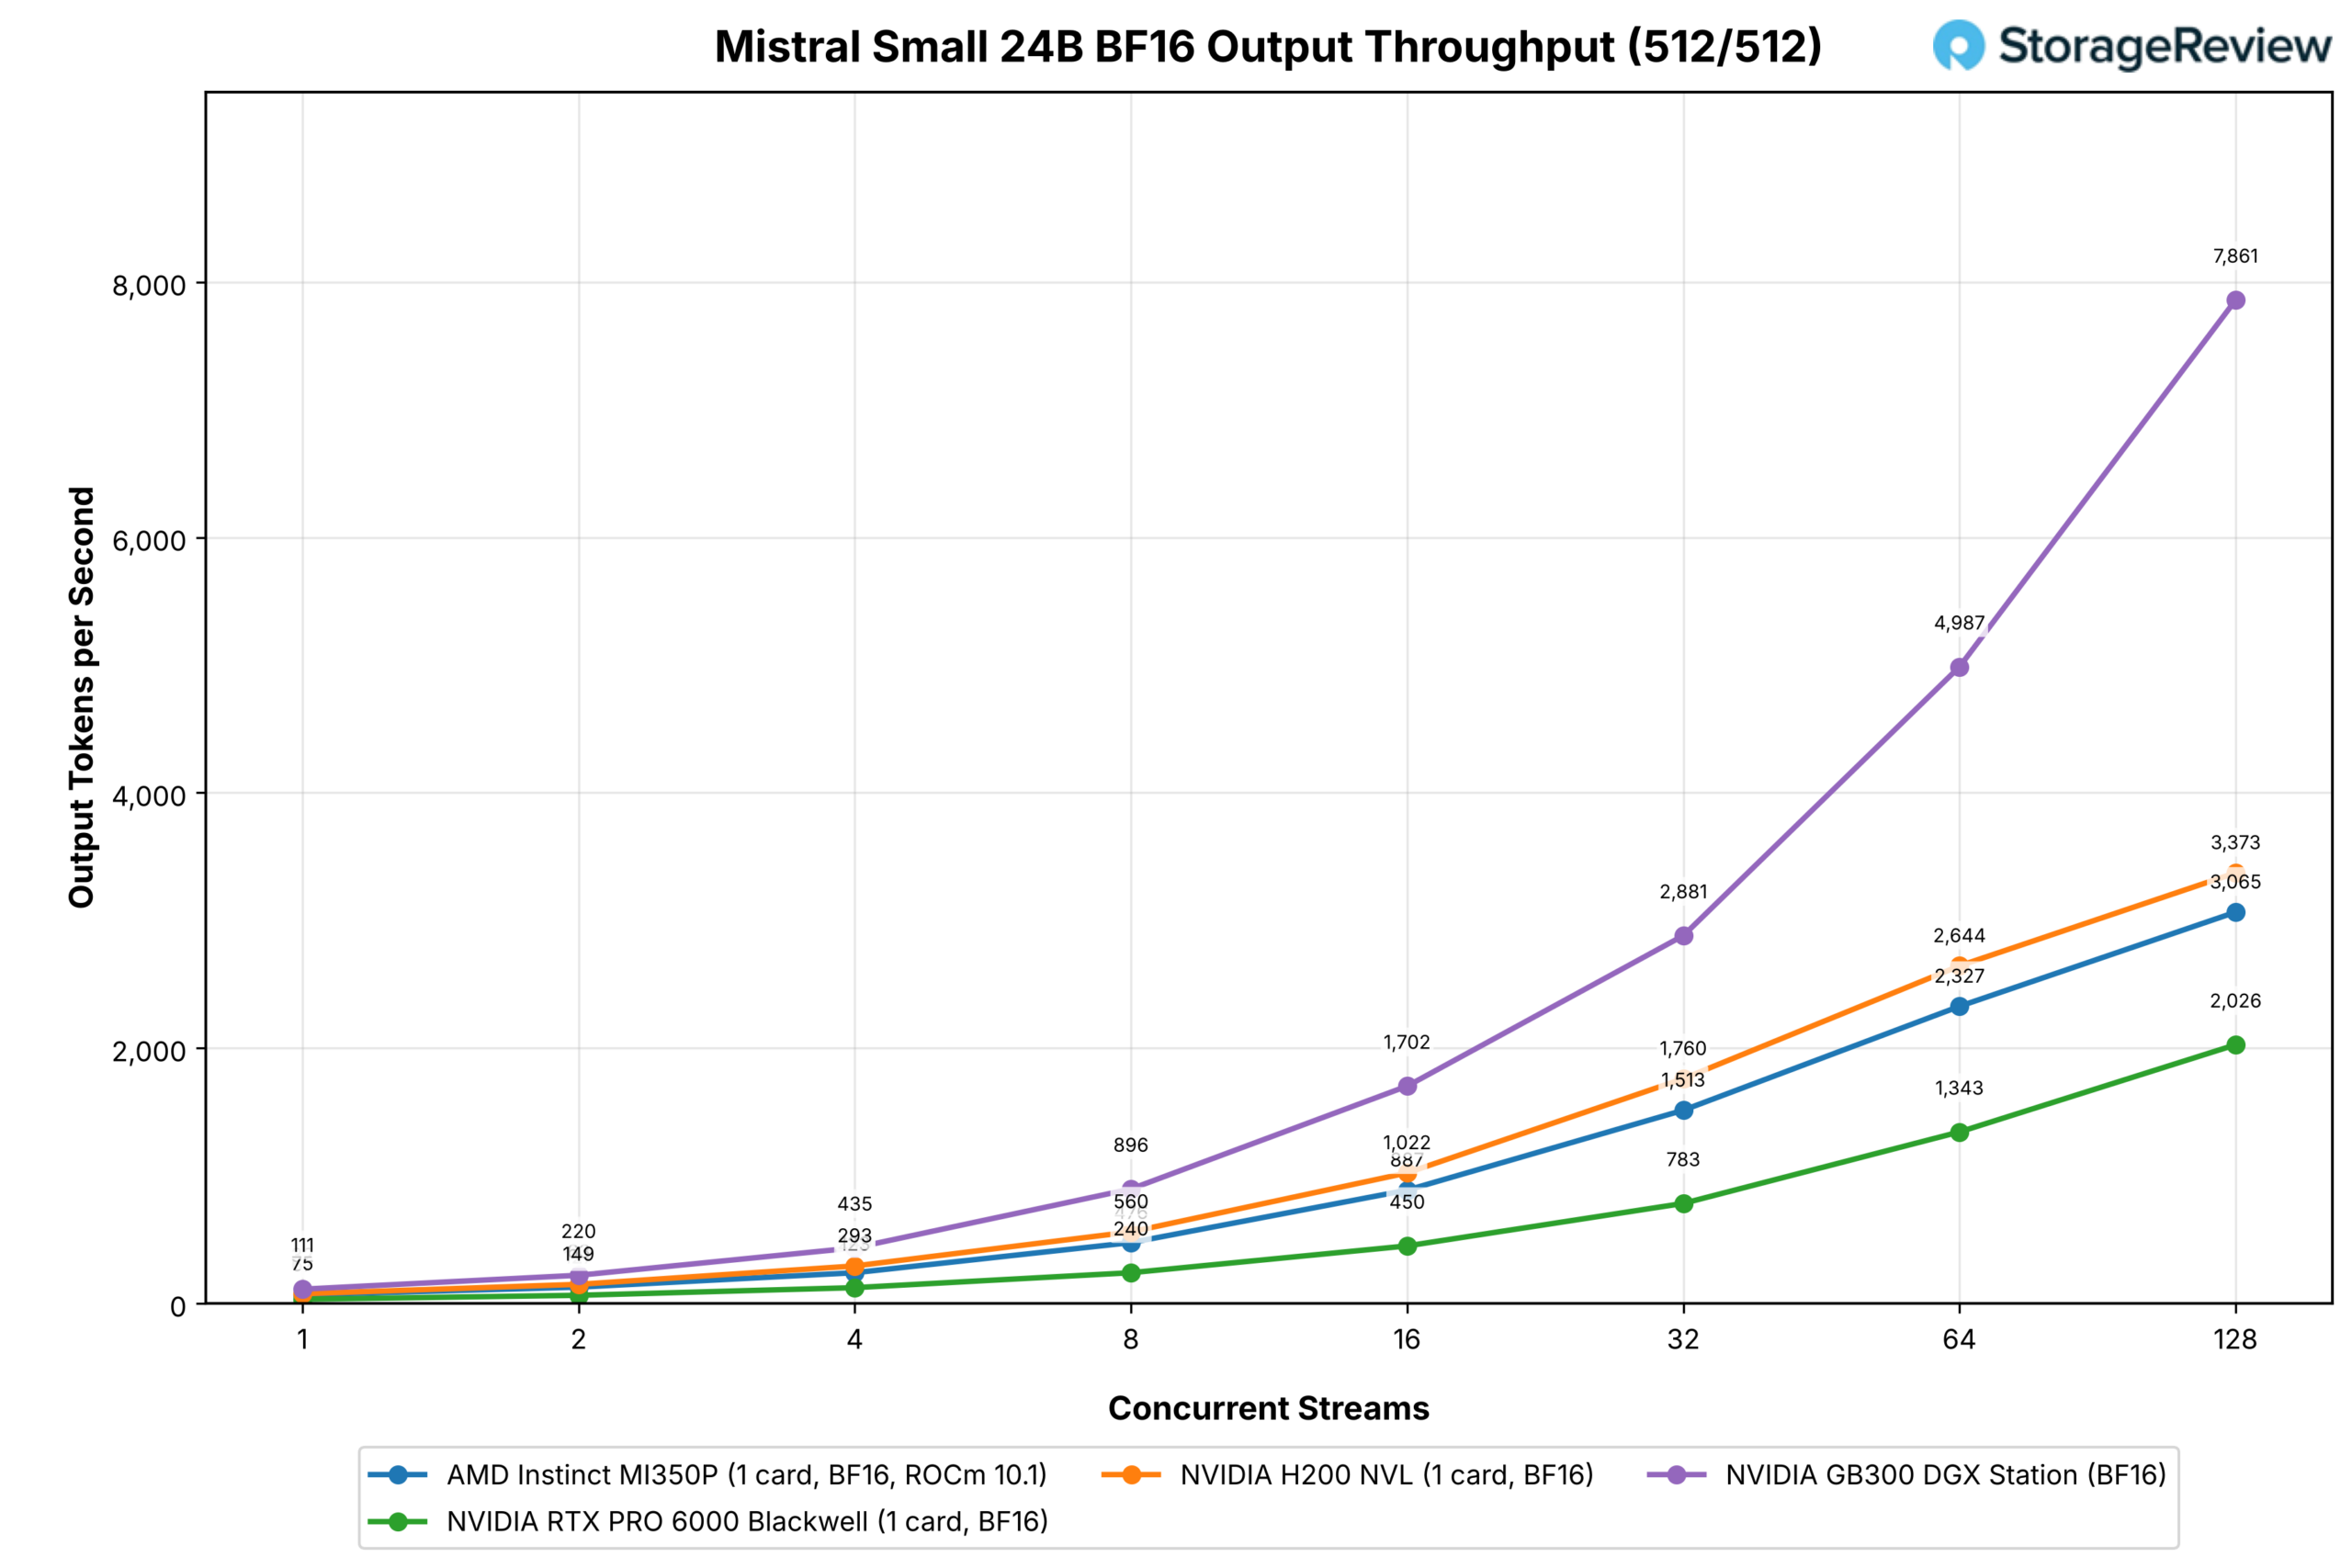
Mistral Small သည် MI350P ၏ RTX PRO 6000 နှင့် နှိုင်းယှဉ်လျှင် အားအကောင်းဆုံး dense ရလဒ်ဖြစ်သည်- chat workload တွင် 128 streams တွင် FP8 တွင် 4,458 နှင့် 3,242 နှင့် 3,065 နှင့် 2,026 ရှိပြီး BF16 တွင် 3,065 နှင့် 2,026 ရှိပြီး stream တစ်ခုတွင် MI350P သည် NVIDIA ကတ်ထက် နှစ်ဆခန့်ပိုများသည် (FP8 တွင် 100 နှင့် 56၊ BF16 တွင် 67 နှင့် 32)။
၎င်းသည် MI350P သည် prefill-heavy prompts များတွင် ဦးဆောင်နေပြီး၊ 128 streams တွင် FP8 တွင် 482 နှင့် 599 ရှိပြီး 64 streams တွင် BF16 တွင် 425 နှင့် 299 ရှိပြီး H200 သည် တူညီသောအမှတ်များတွင် 799 နှင့် 632 သို့ ရောက်ရှိသော်လည်း H200 သည် တူညီသောအမှတ်များတွင် 799 နှင့် 632 သို့ ရောက်ရှိသည်။
Llama 3.1 8B
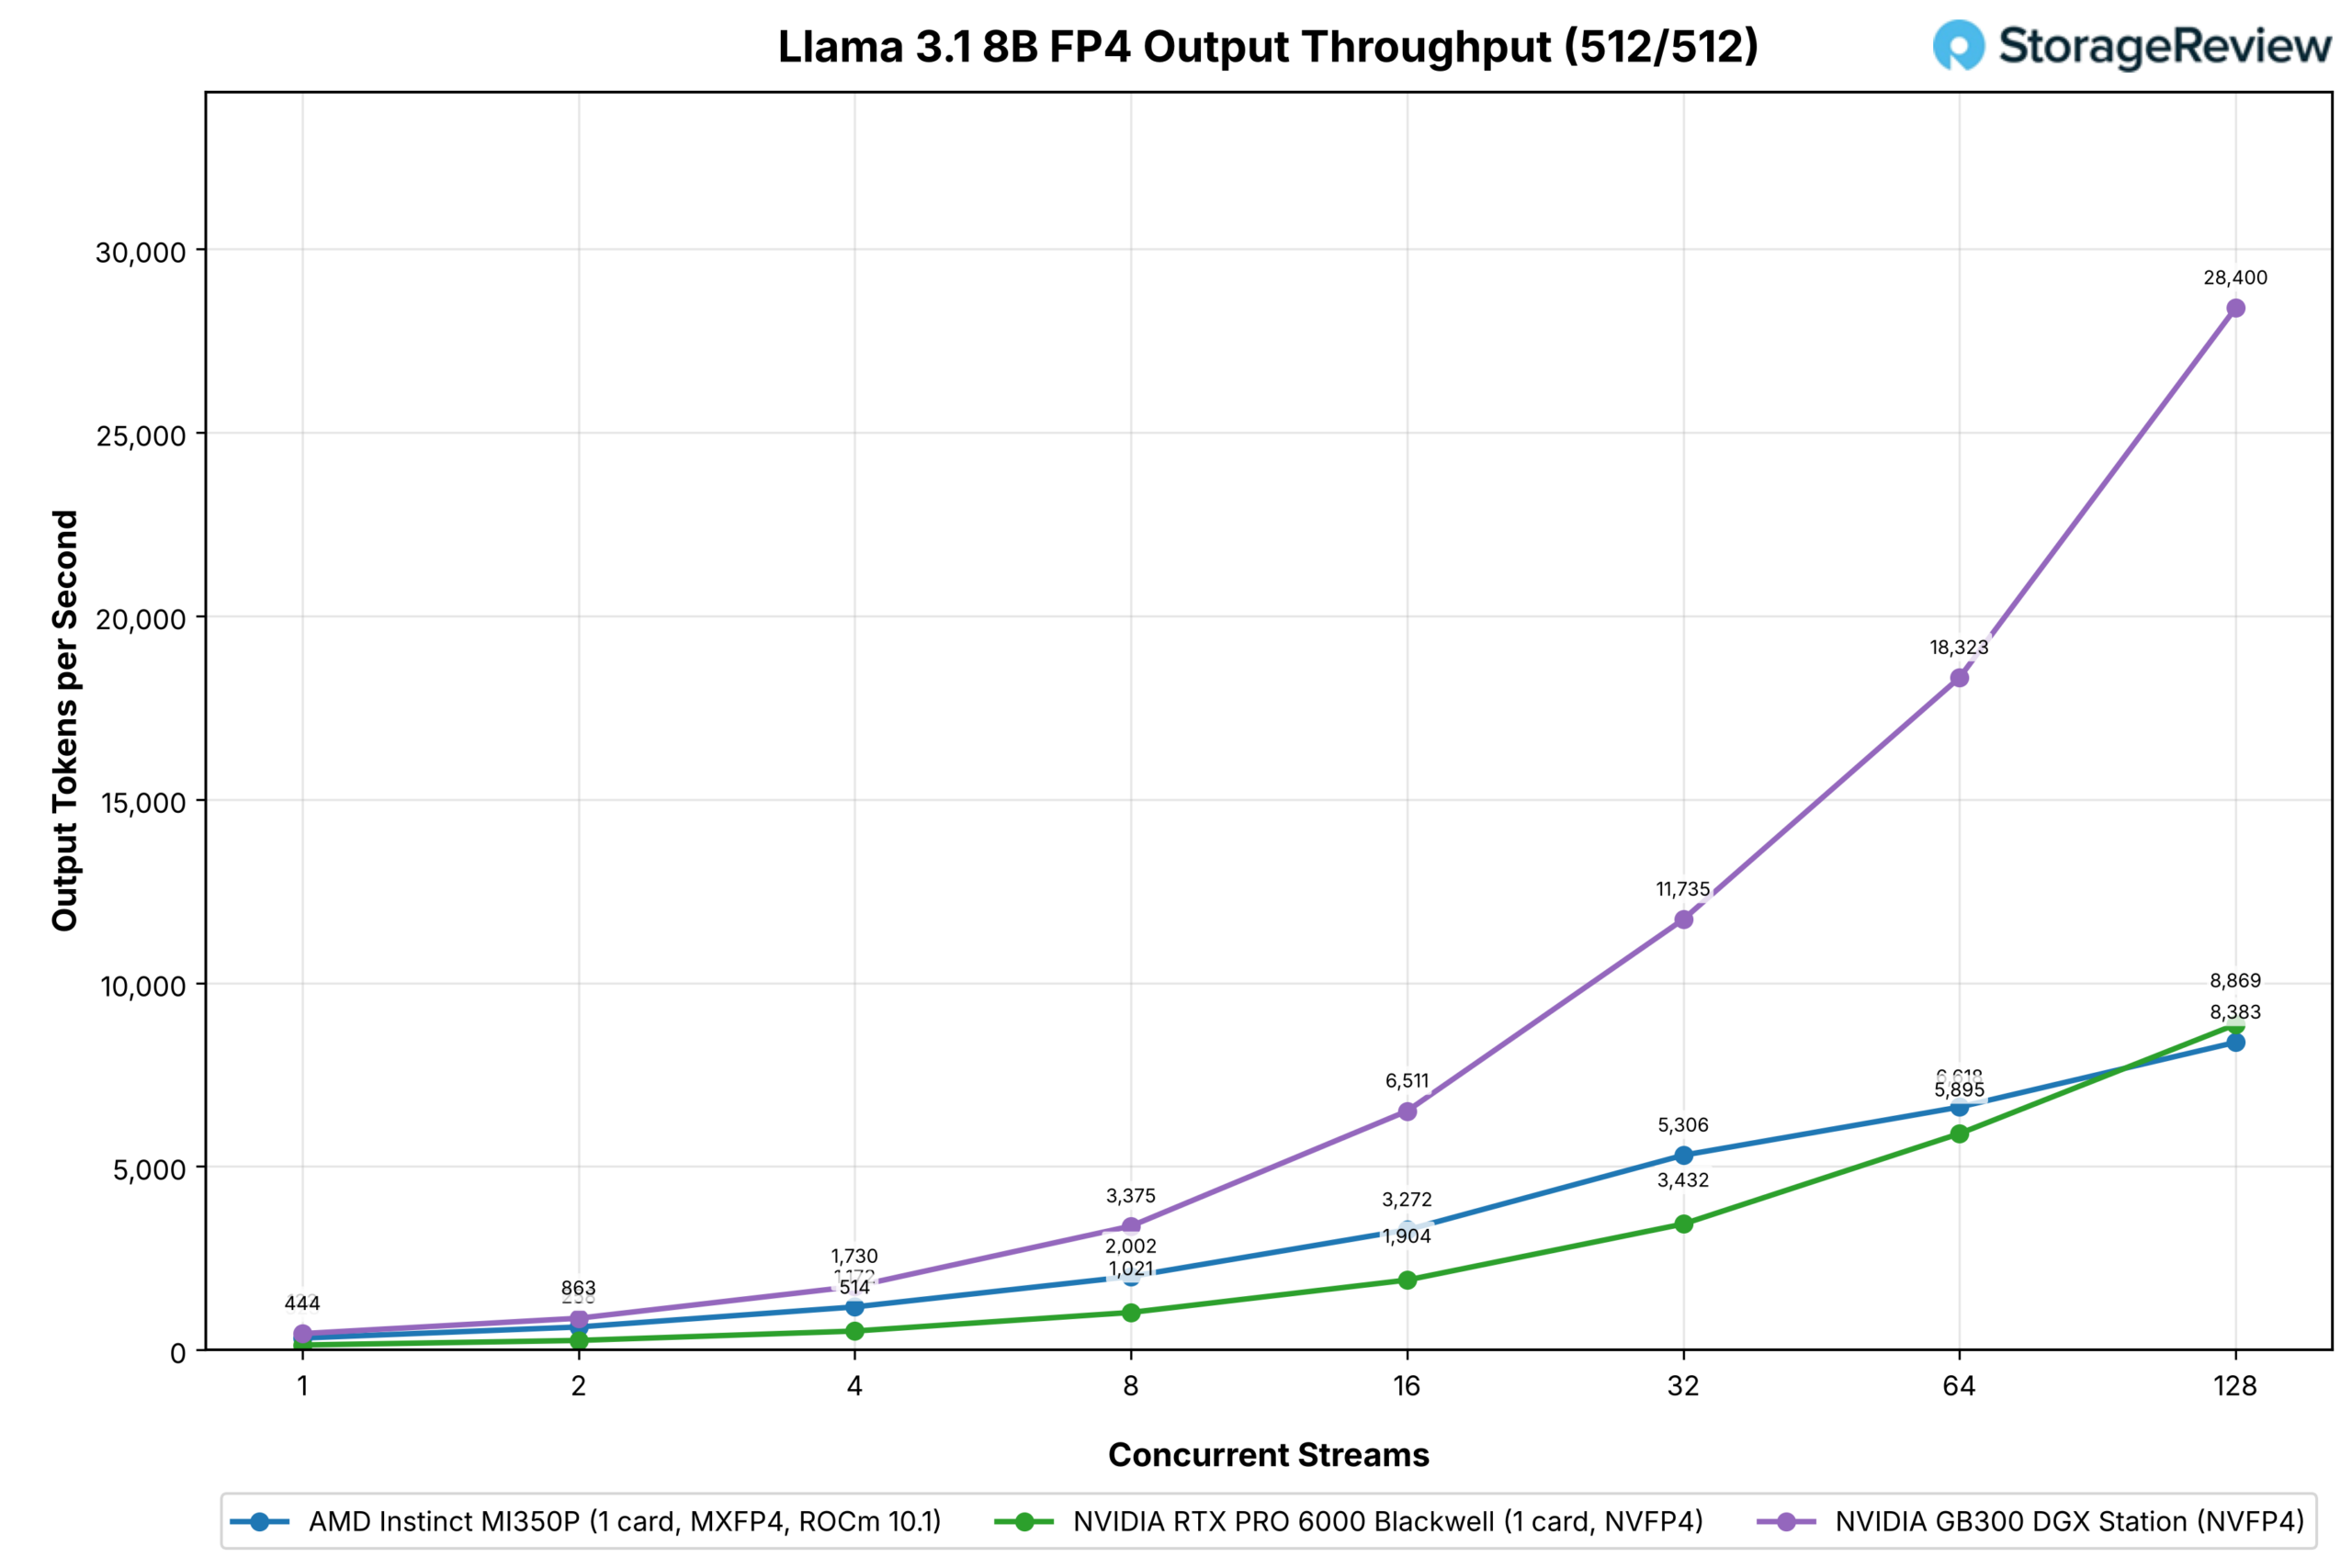
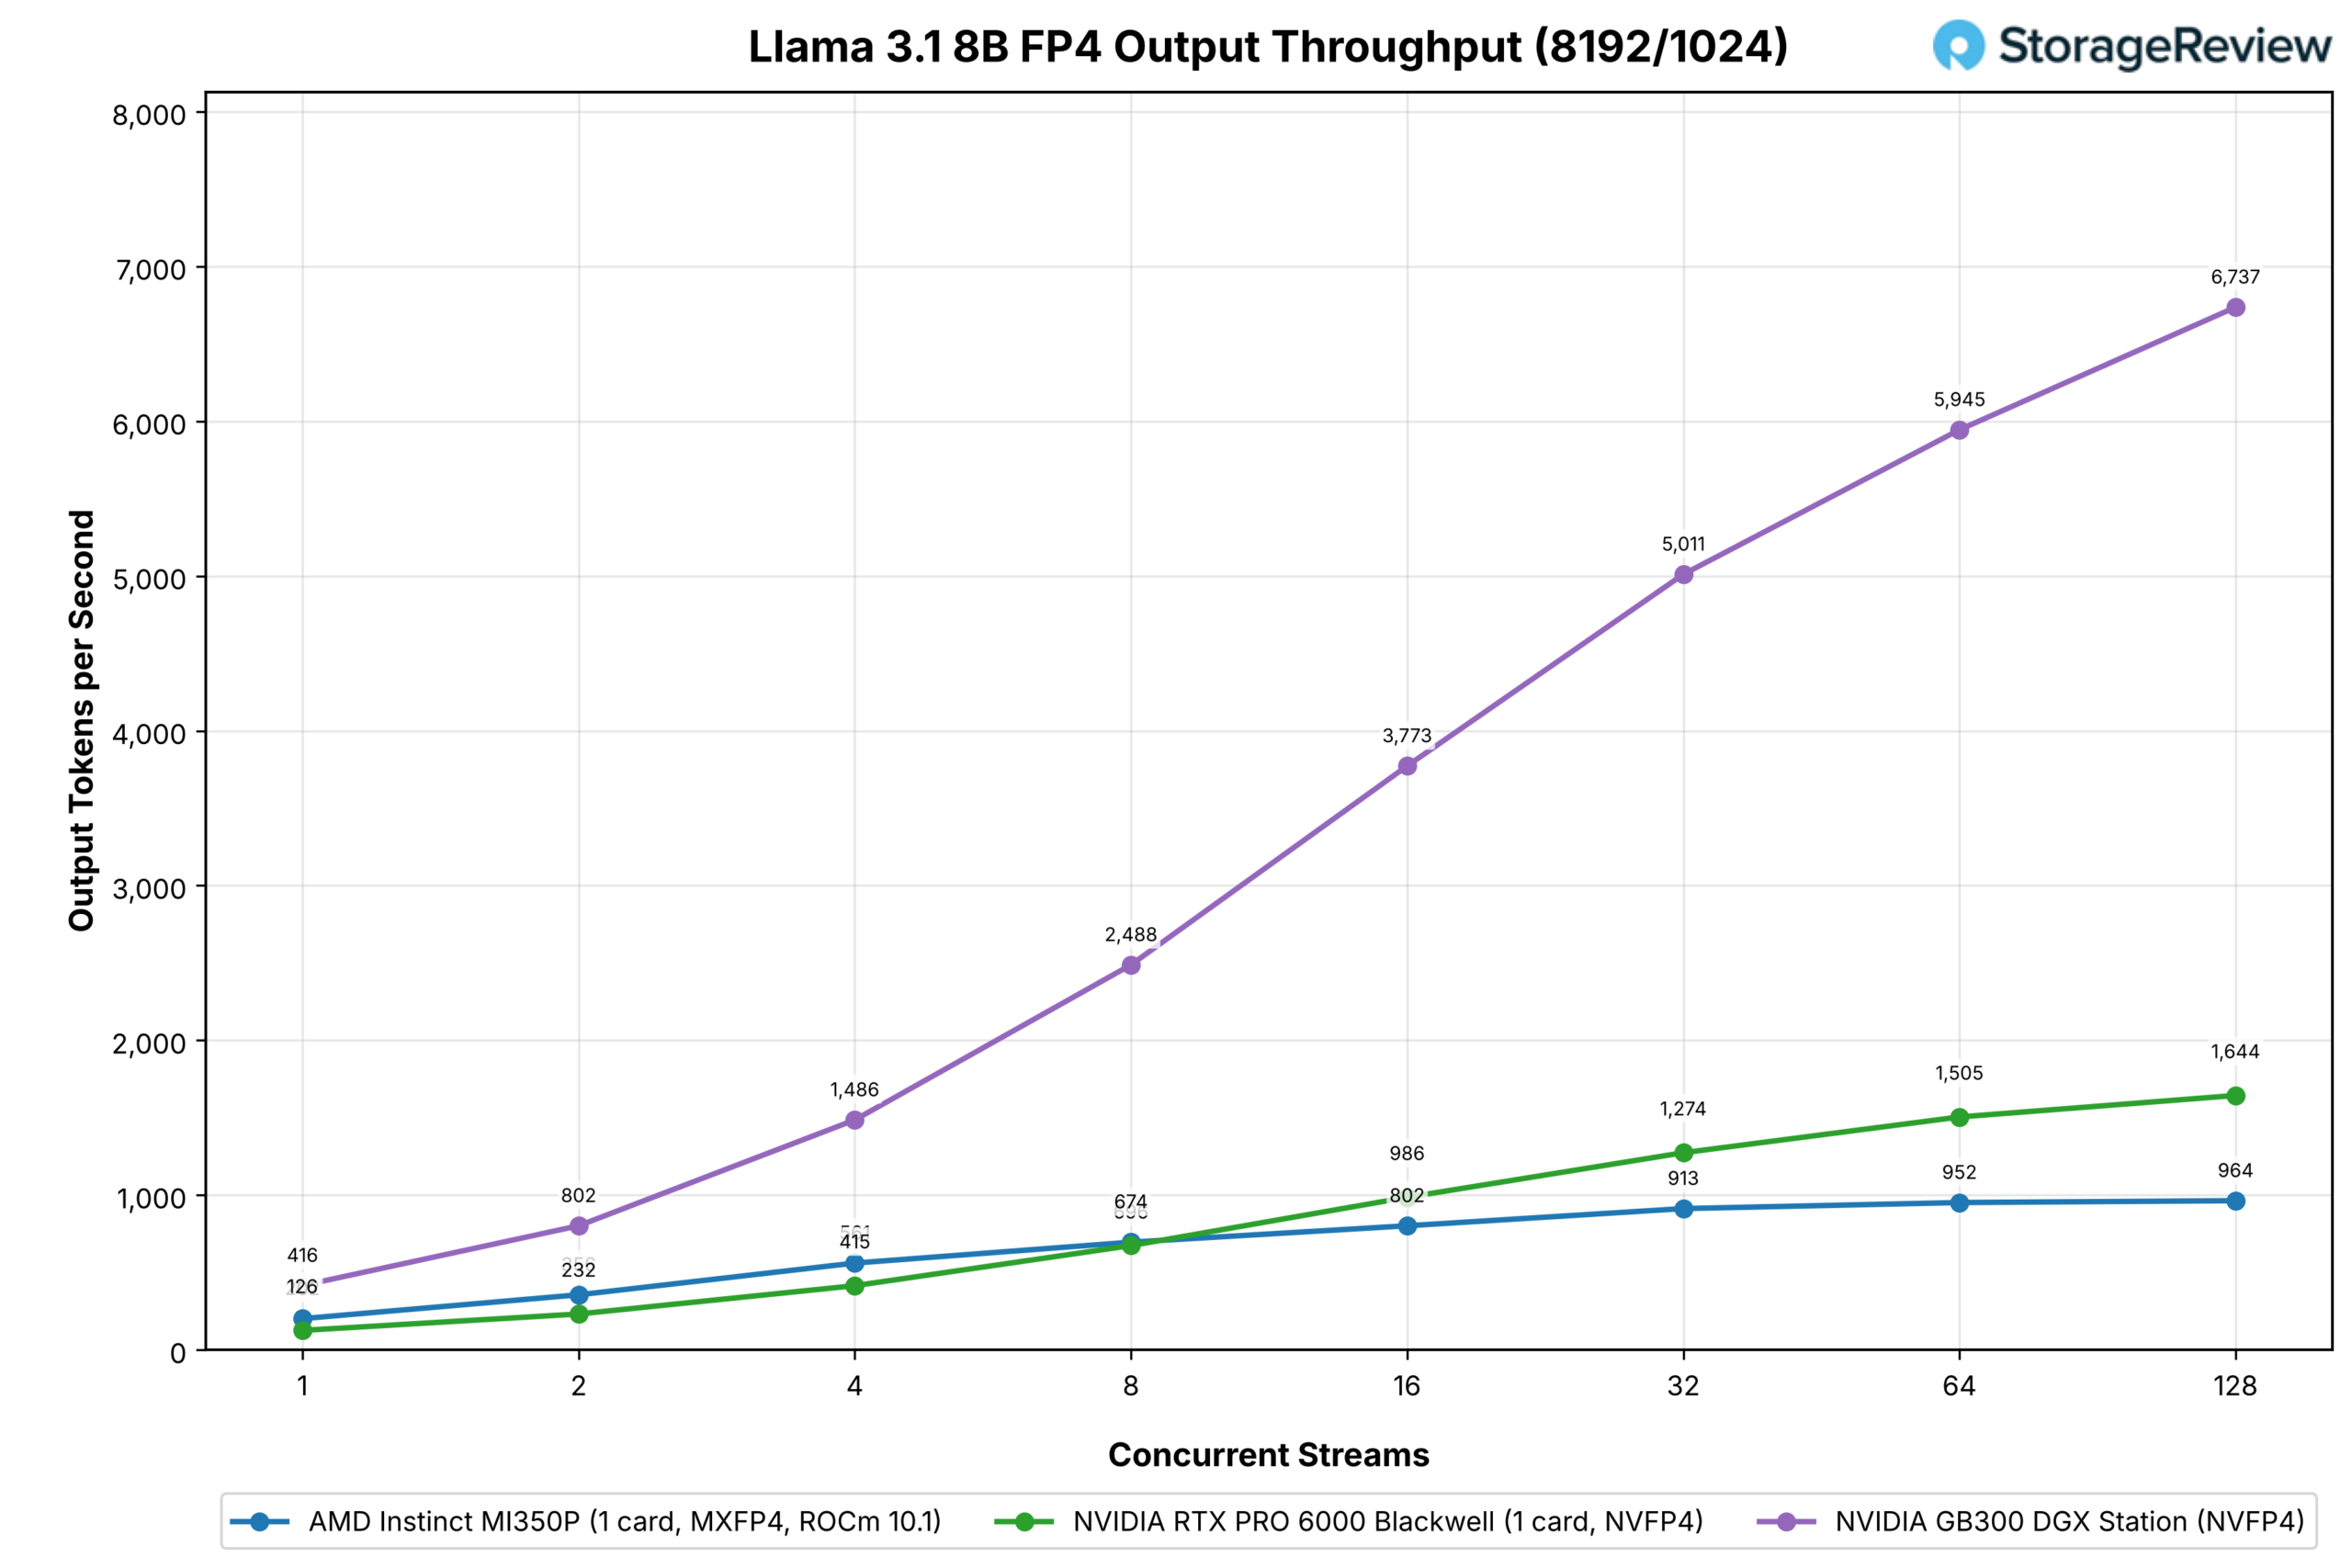
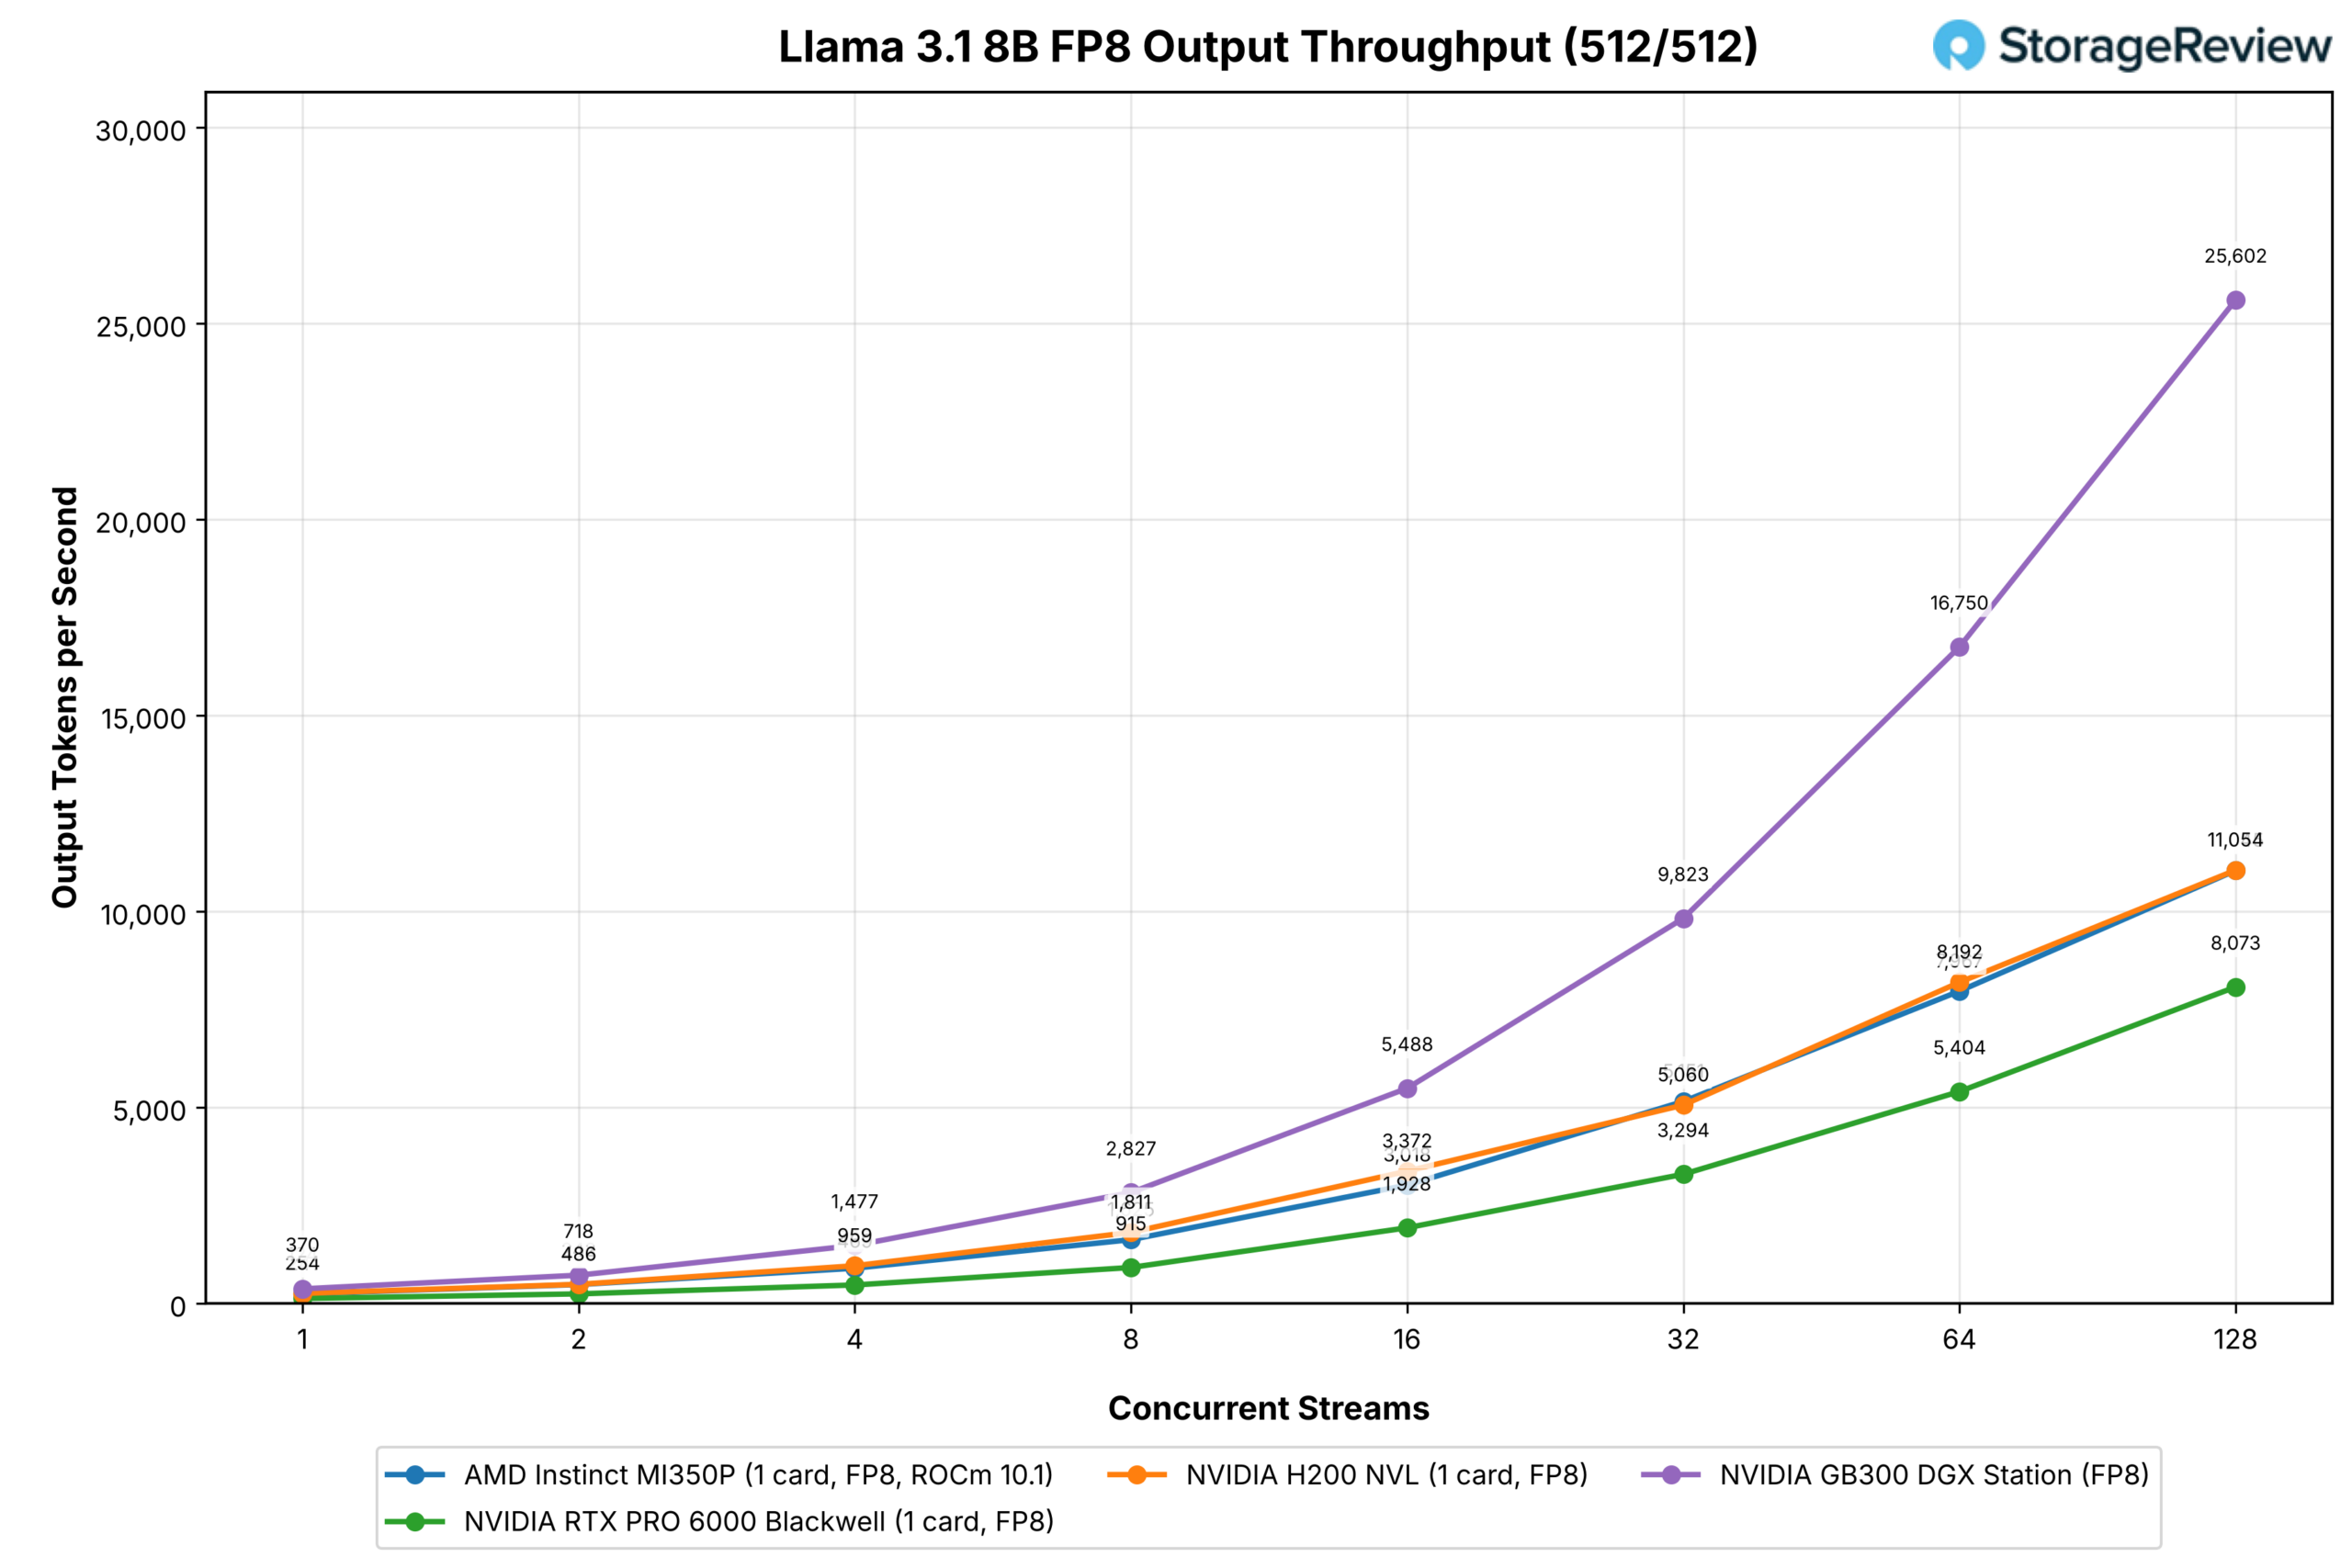
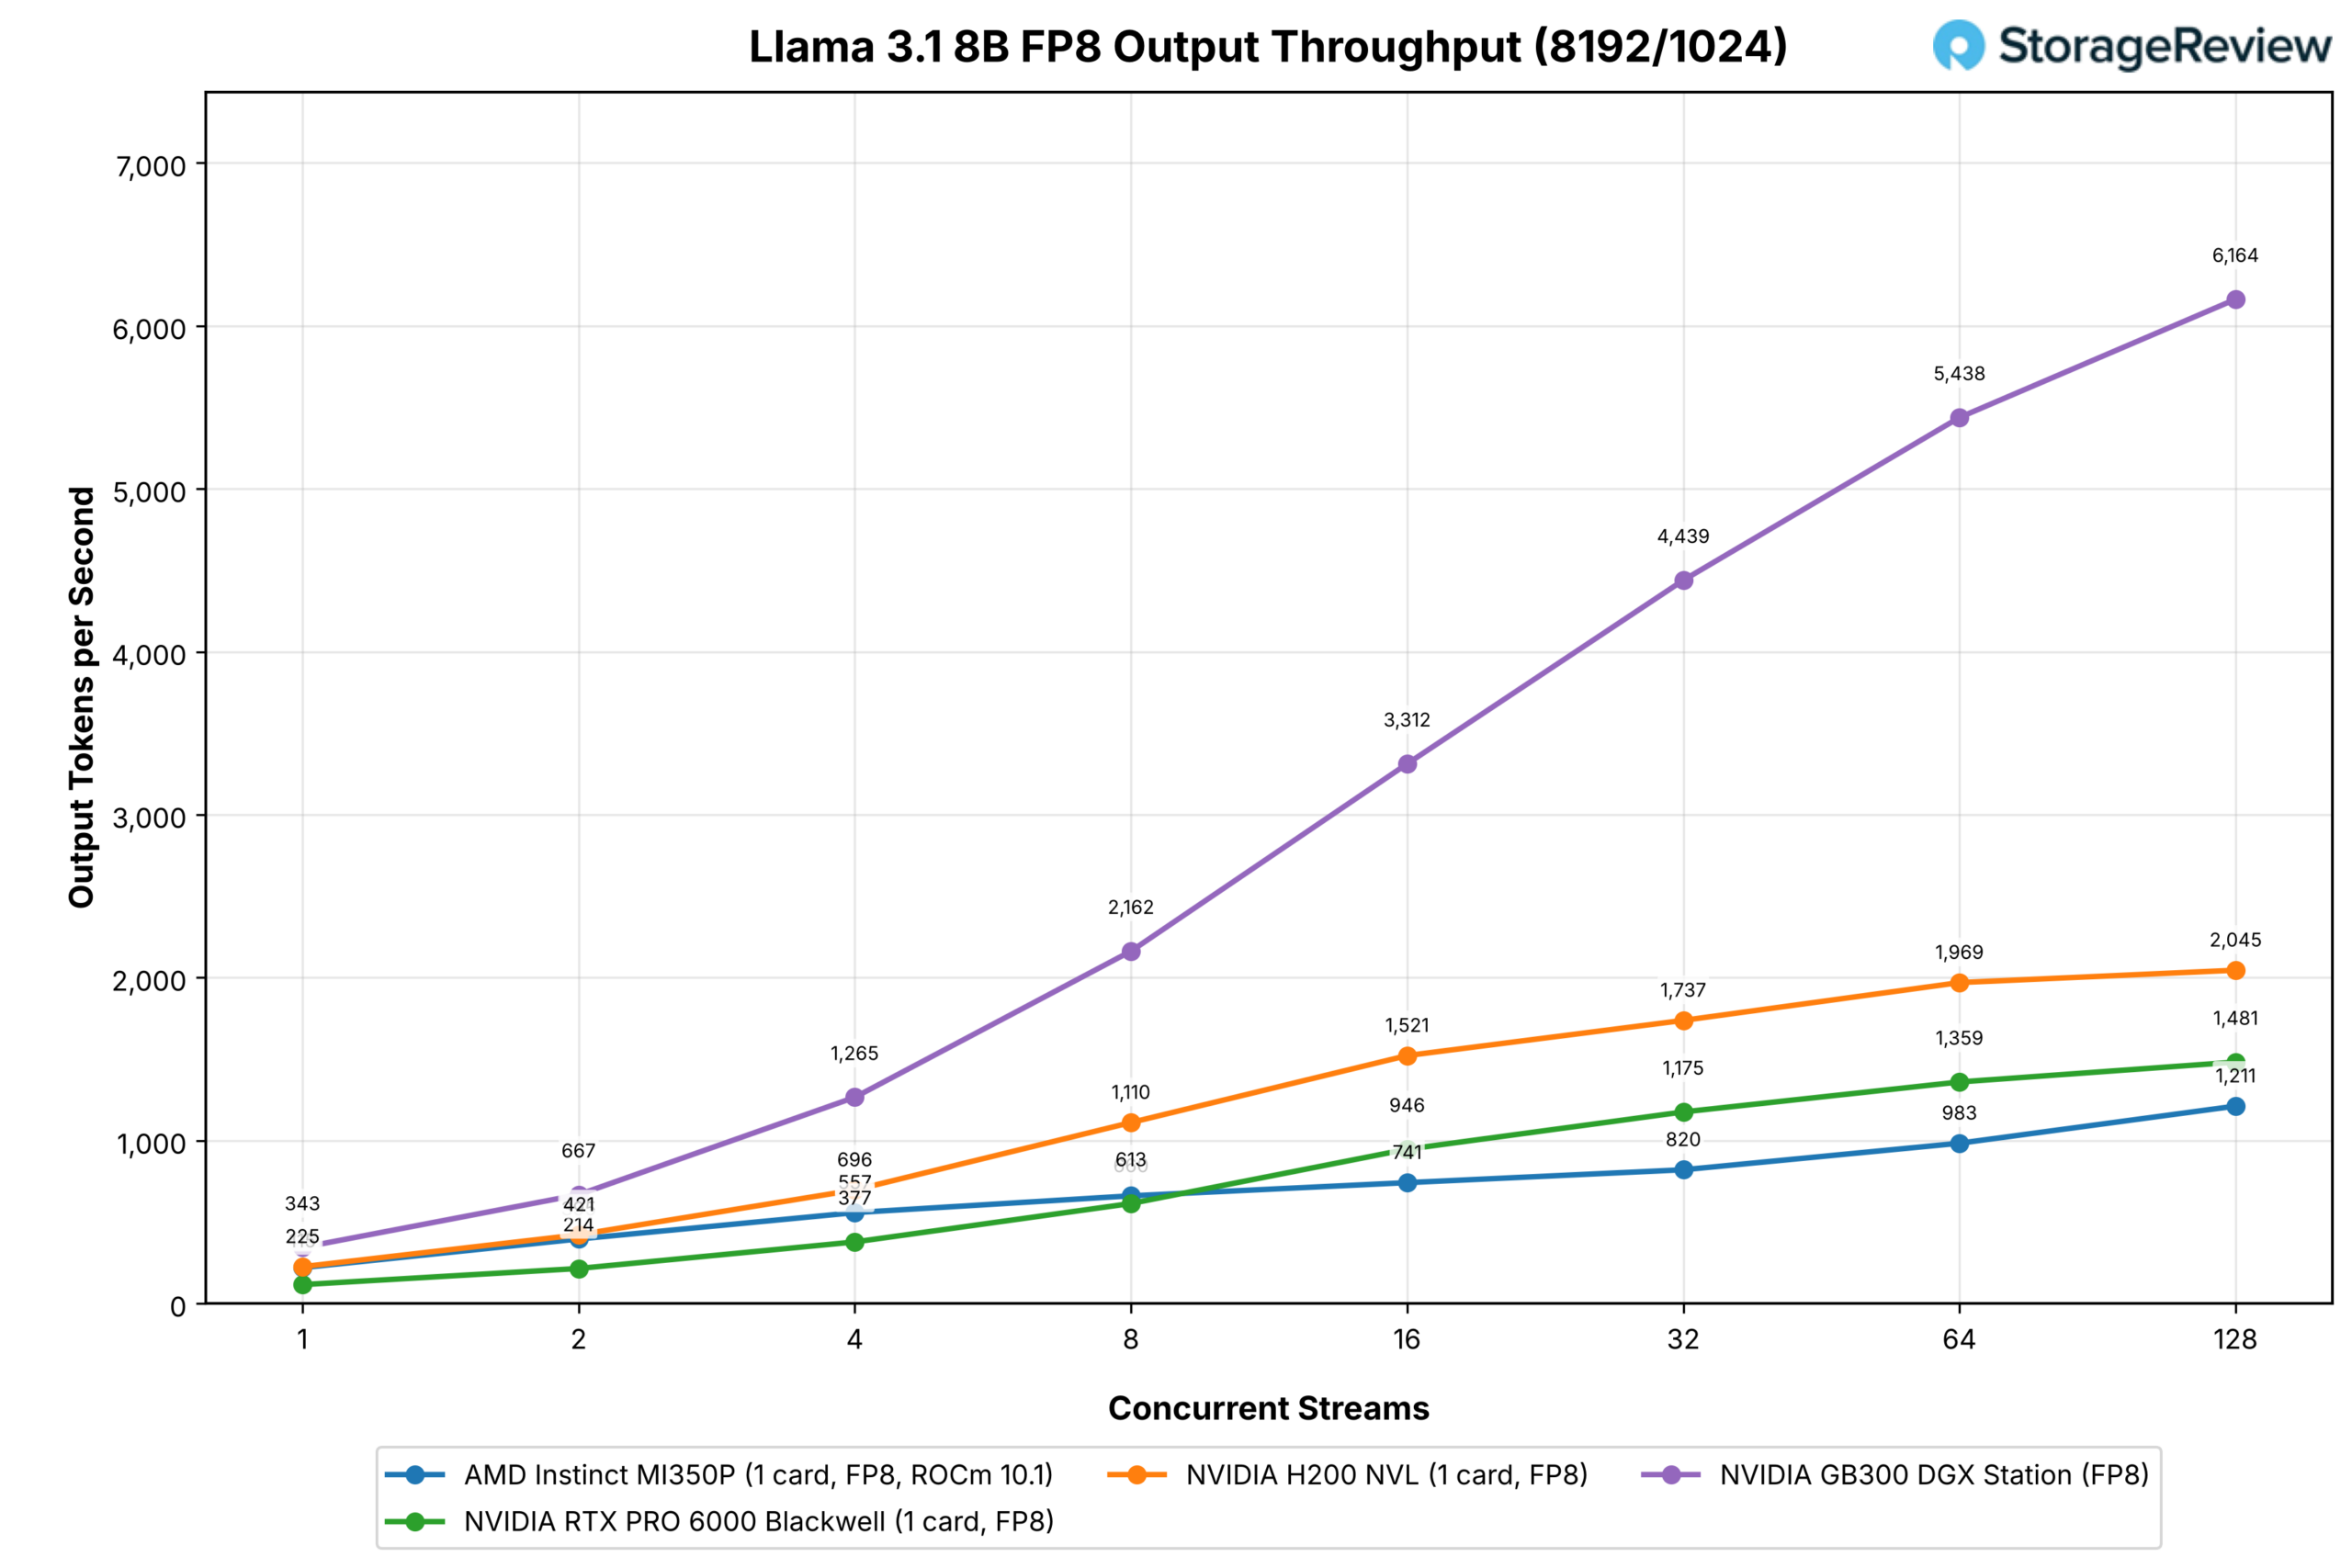
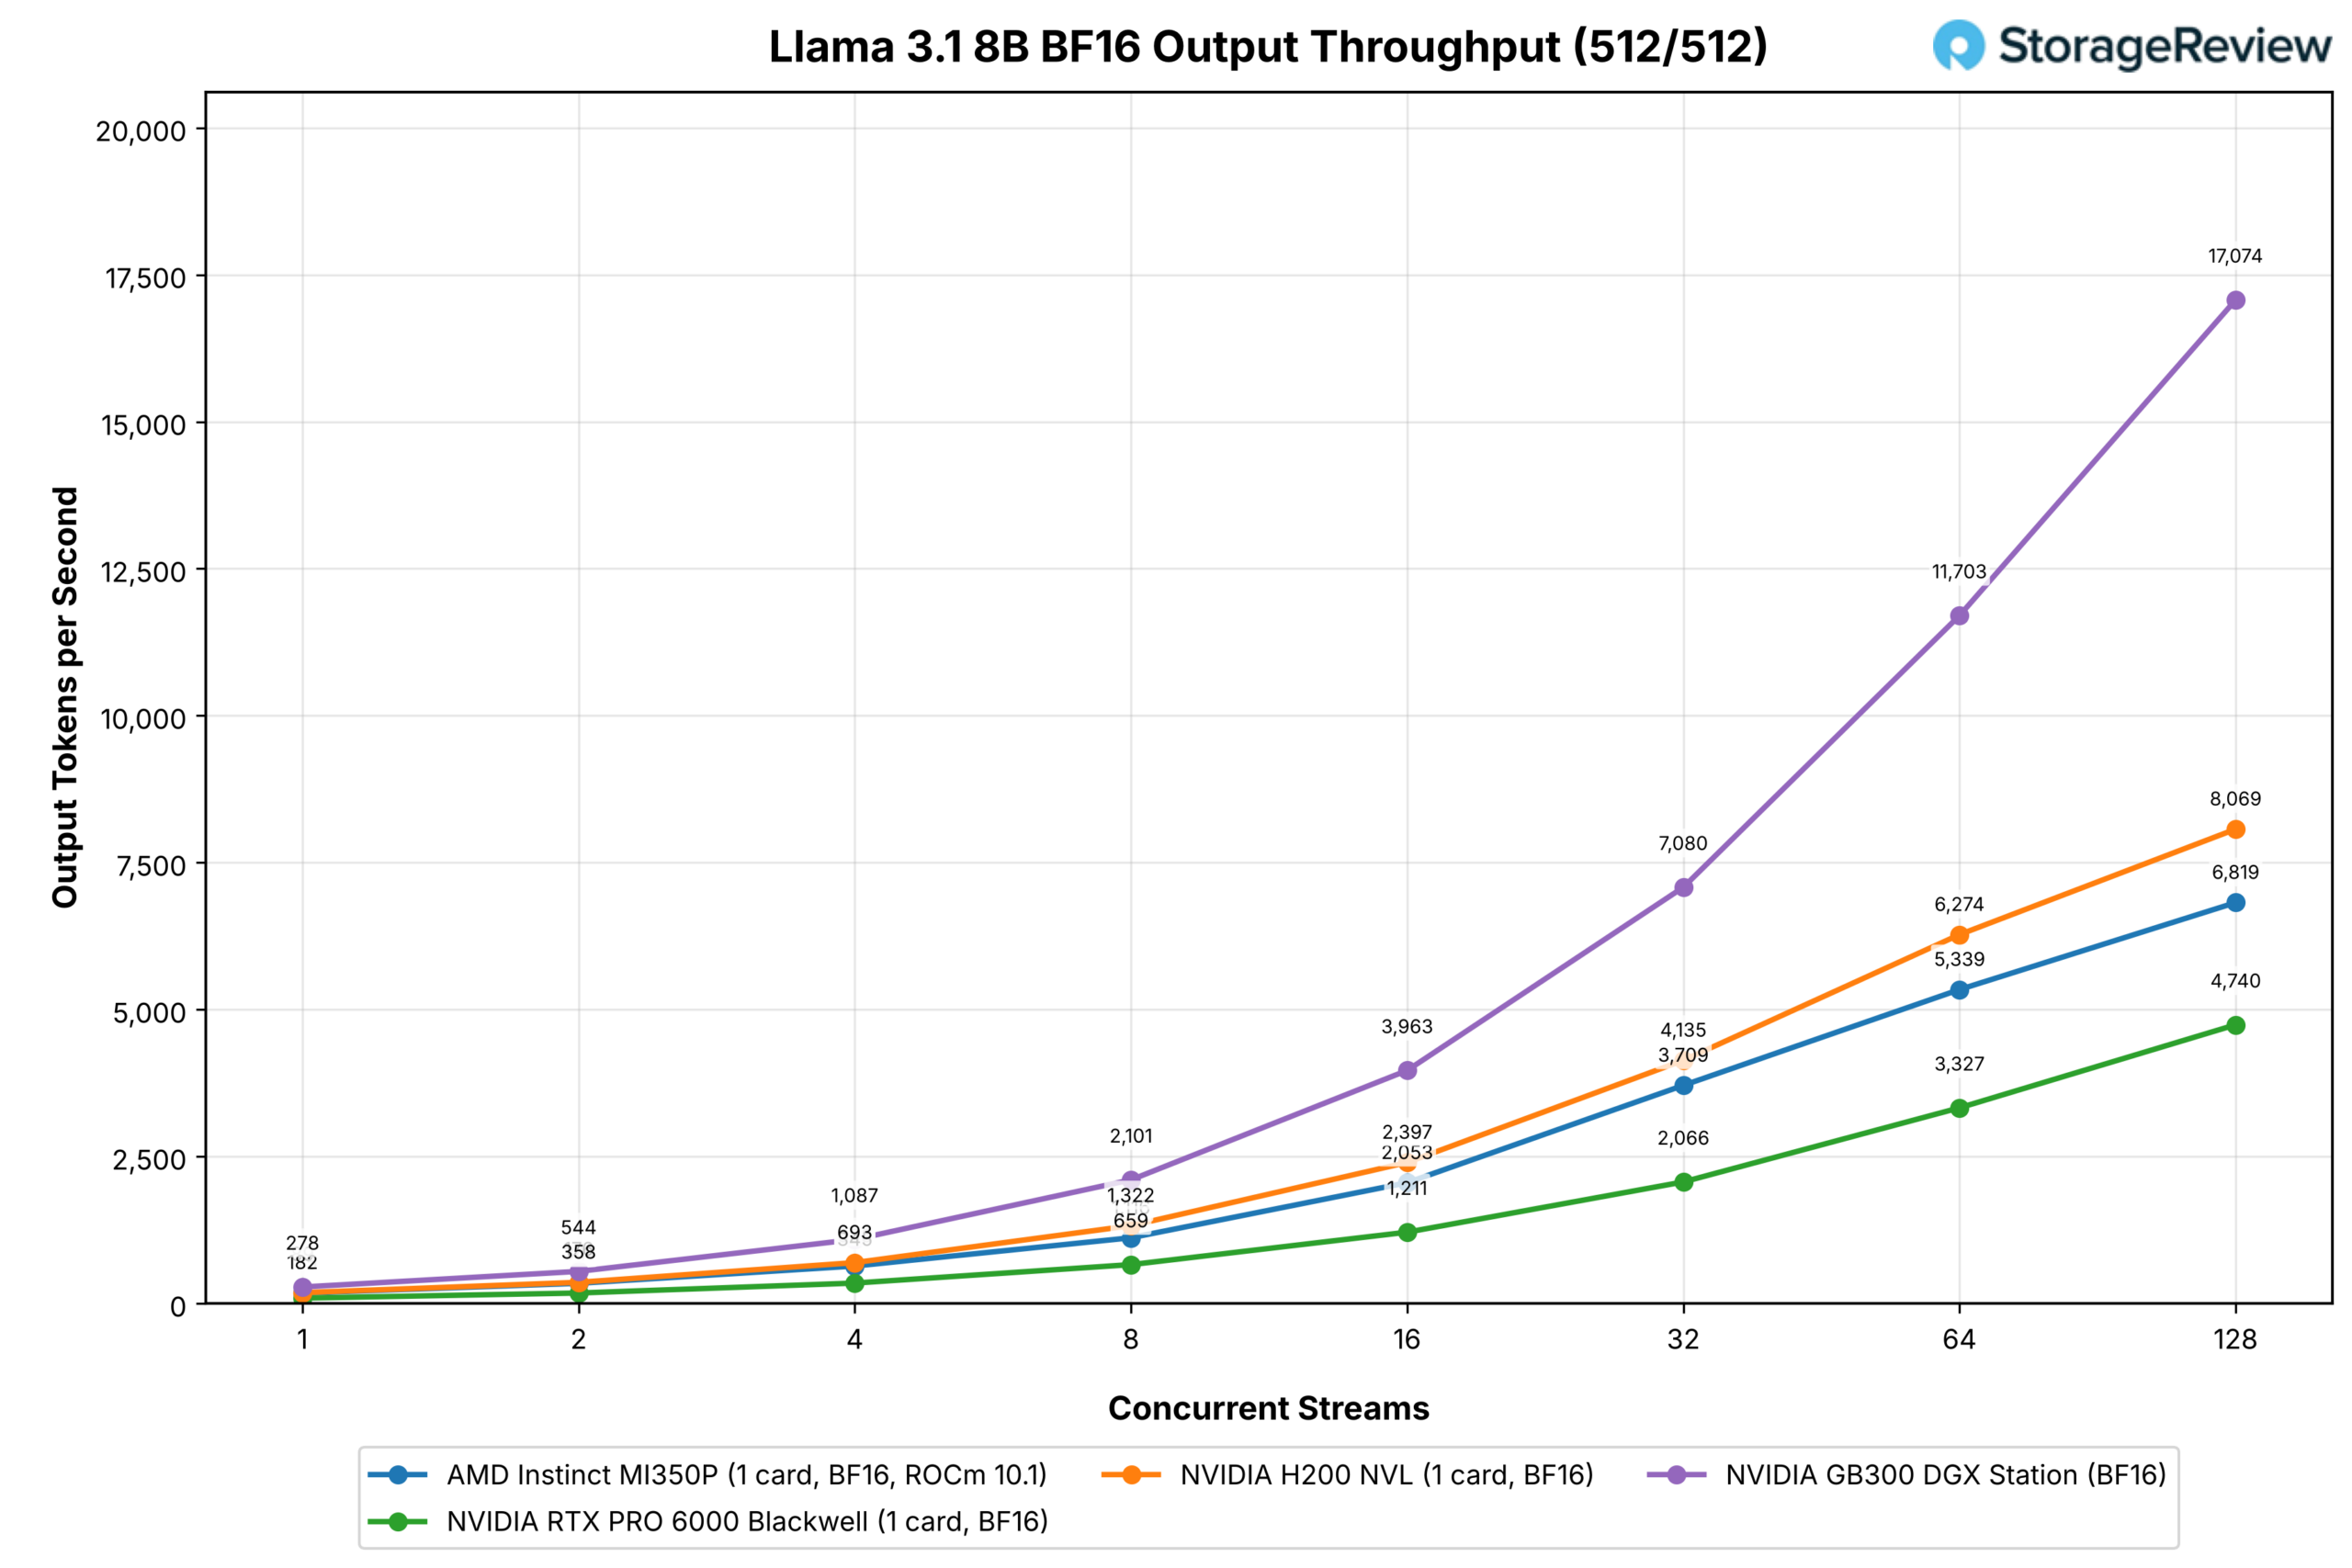
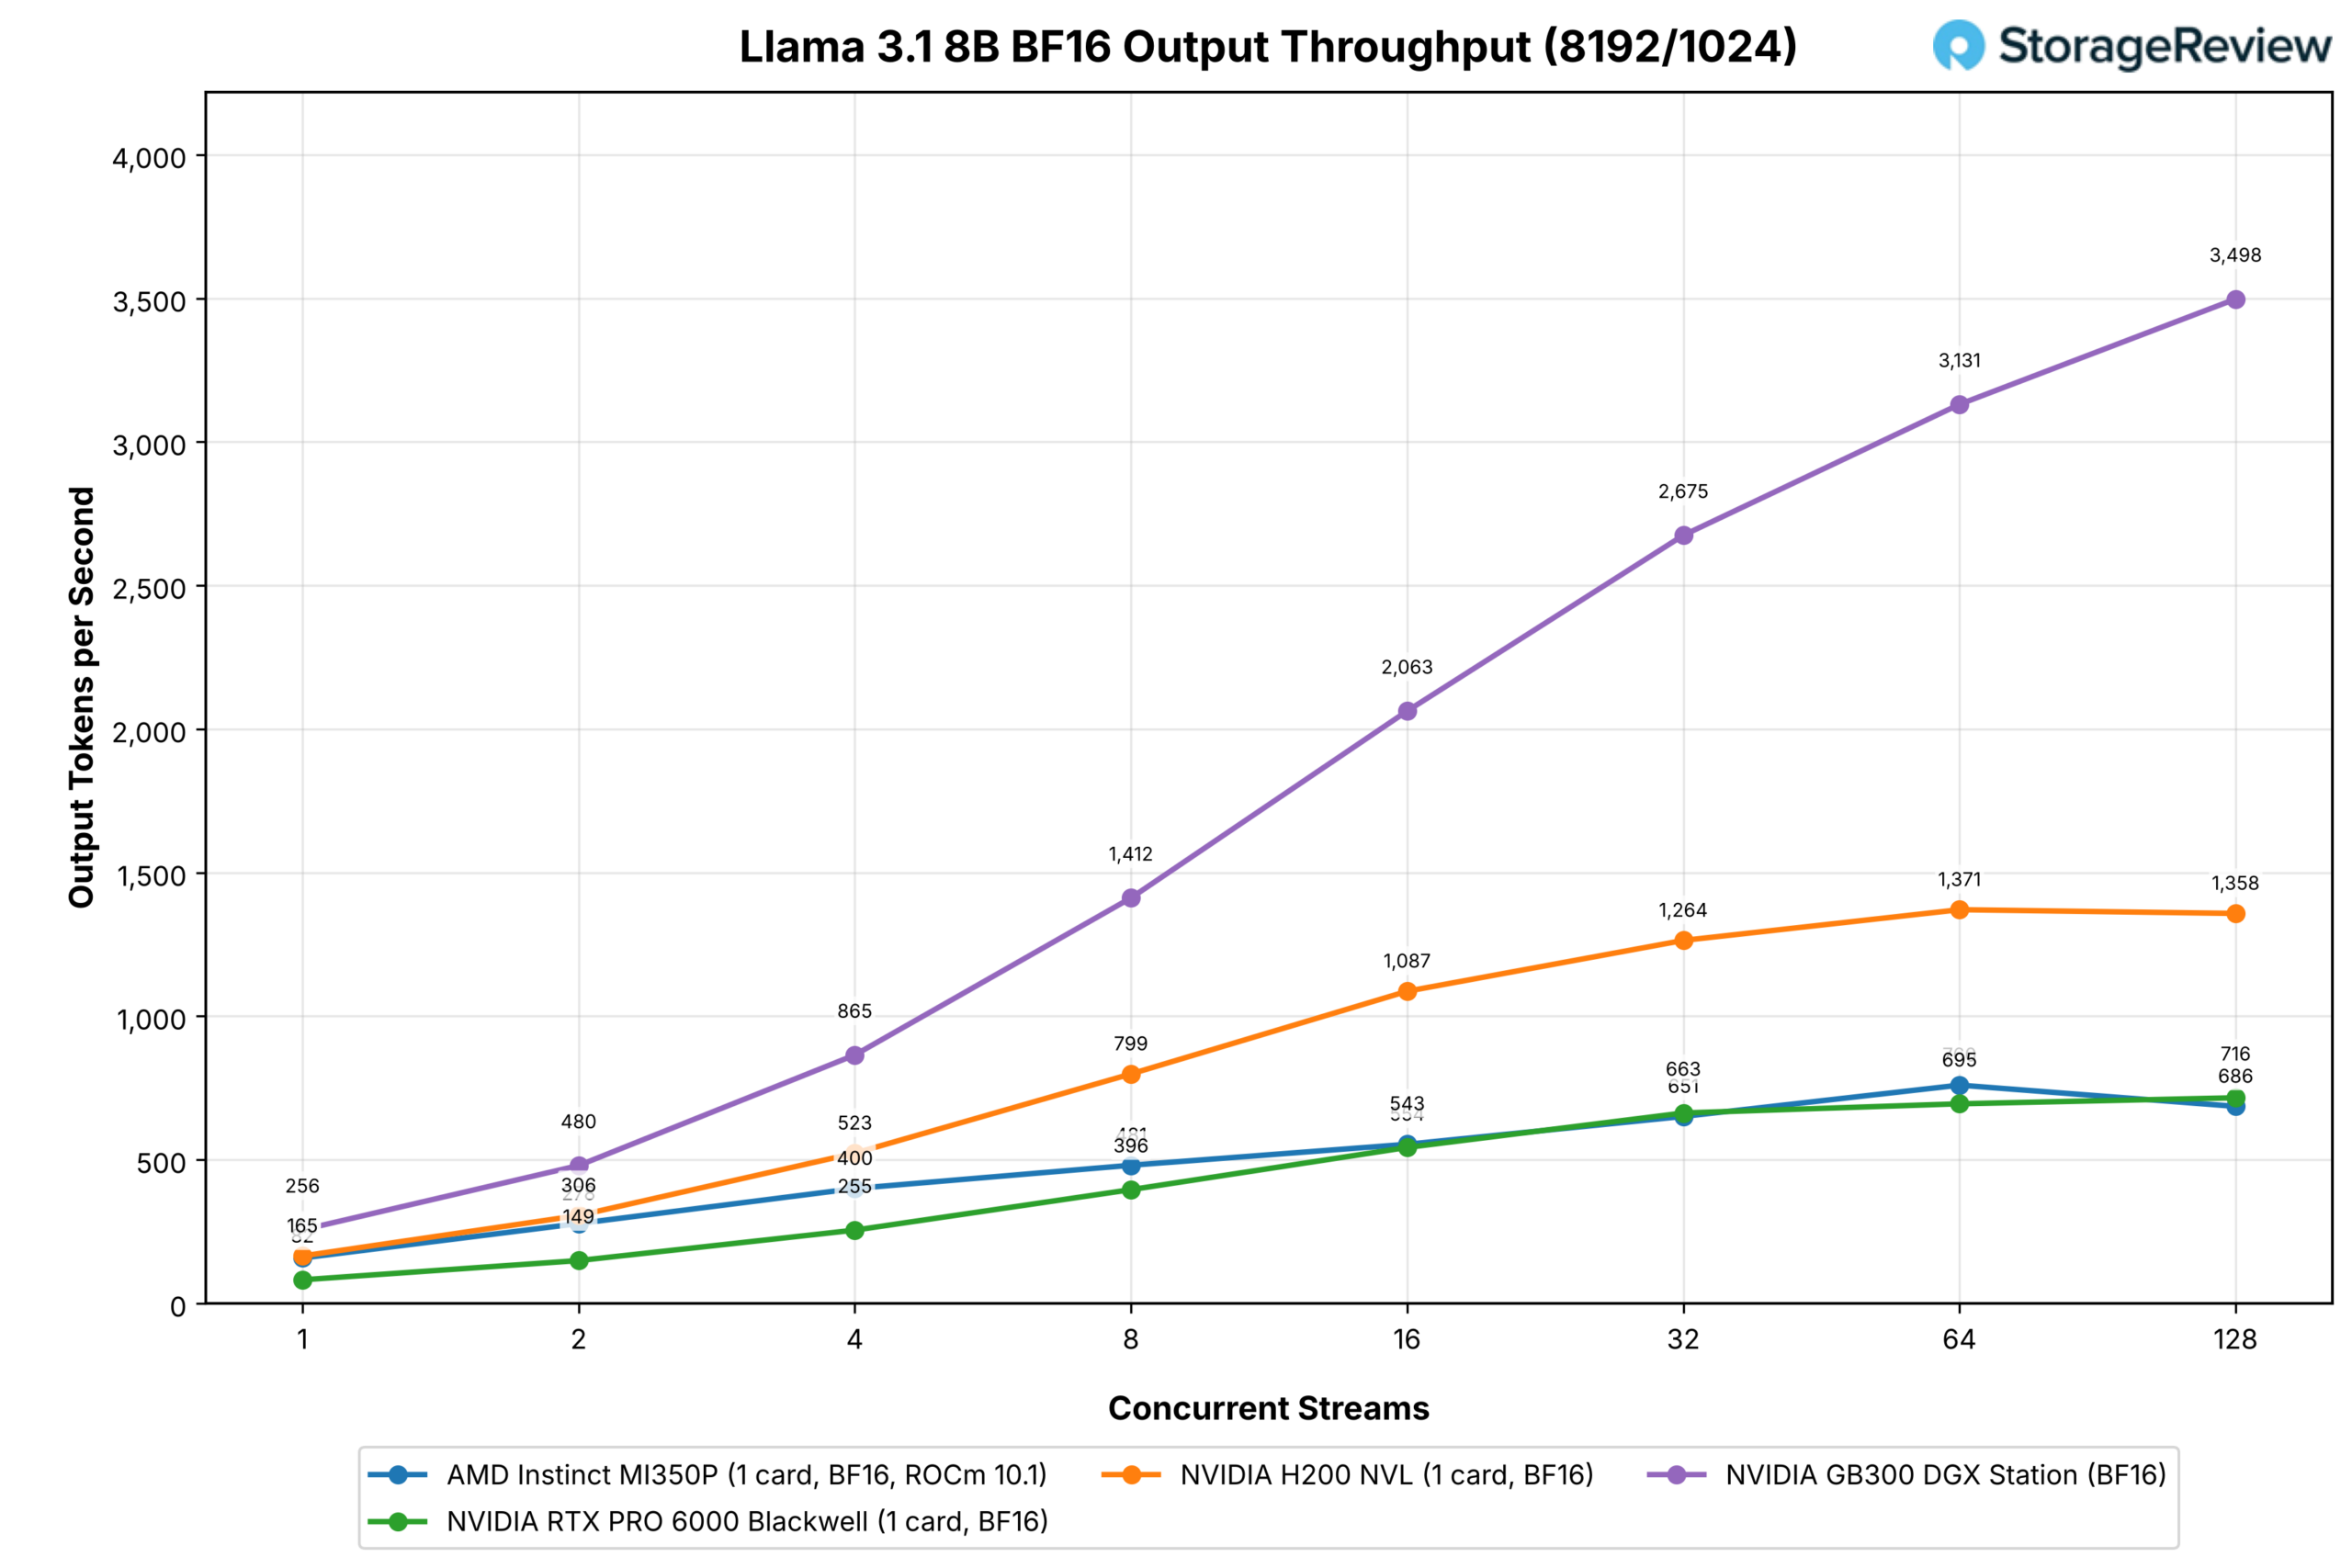
Llama 3.1 8B ဟာ ကျွန်ုပ်တို့ရဲ့ GPU အဟောင်းလွှမ်းခြုံမှုနဲ့ ဆက်လက်လည်ပတ်နိုင်ဖို့အတွက် ရောက်ရှိလာပါပြီ။ chat workload မှာ stream ၁၂၈ ခုမှာ MI350P ဟာ FP8 မှာ တစ်စက္ကန့်ကို output token ၁၁,၀၄၅ ခု ပေးစွမ်းနိုင်ပြီး RTX PRO 6000 အတွက် ၈၀၇၃ ခုနဲ့ H200 အတွက် ၁၁,၀၅၄ ခု ရရှိကာ Hopper card နဲ့ တူညီပြီး BF16 မှာ ၆,၈၁၉ ခု ရရှိကာ ၄,၇၄၀ နဲ့ ၈၀၆၉ ခု ရရှိပါတယ်။ AMD ရဲ့ MXFP4 build ဟာ stream ၁၂၈ ခုမှာ ၈,၃၈၃ ခု ရရှိပြီး RTX PRO 6000 (8,869) မှာ NVIDIA ရဲ့ NVFP4 build ထက် ၅ ရာခိုင်နှုန်း လျော့နည်းပါတယ်။ stream count နိမ့်တိုင်းမှာ ၁၂ ရာခိုင်နှုန်းကနေ ၁၄၃ ရာခိုင်နှုန်းအထိ ဦးဆောင်နေပါတယ်။ stream တစ်ခုတည်းမှာ MXFP4 run ဟာ ၁၃၃ ခုမှာ ၃၂၃ ခု ရရှိပါတယ်။
prefill များတဲ့ run တွေက ရလဒ်ကို ပြောင်းပြန်လှန်ပစ်လိုက်တယ်- MI350P FP8 ဟာ stream ၁၆ ခုနဲ့ ပြားချပ်သွားပြီး RTX PRO 6000 အတွက် 1,481 နဲ့ H200 အတွက် 2,045 ရရှိခဲ့ပေမယ့် 1,211 မှာ ပြီးဆုံးသွားခဲ့ပါတယ်၊ MI350P ဟာ stream တစ်ခုမှာတော့ RTX PRO 6000 ထက် 90 ရာခိုင်နှုန်း စောပြီး စတင်ခဲ့ပြီး MXFP4 build ကတော့ stream ၁၂၈ ခုမှာ NVFP4 ကို 41 ရာခိုင်နှုန်း နောက်ကျကျန်နေခဲ့ပါတယ်။
ကောက်ချက်
MI350P ဟာ လေးနှစ်အတွင်း စံ server ထဲကို ထည့်သွင်းလာတဲ့ ပထမဆုံး Instinct ကတ်ဖြစ်ပြီး 2U box မှာ 450W မှာ PCIe accelerator အနေနဲ့ အသုံးပြုနိုင်ပါသေးတယ်။ 4TB/s မှာ HBM3E 144GB၊ FP8 1,120 TFLOPS နဲ့ MAMF မှာ block-scaled FP4 2,228 ရှိပြီး RTX PRO 6000 Blackwell မှာတော့ 820 နဲ့ 1,634 ရှိပြီး NVIDIA ကတ်ရဲ့ အသုံးပြုနိုင်တဲ့ memory bandwidth ထက် ၂.၁ ဆ ပိုများပါတယ်။

RTX PRO 6000 နဲ့ ယှဉ်ရင် MI350P ဟာ FP8၊ BF16 နဲ့ GPT-OSS မော်ဒယ်တိုင်းမှာ chat-size prompts တွေမှာ ပိုမြန်ပြီး stream 128 ခုမှာ 35 ရာခိုင်နှုန်းကနေ 65 ရာခိုင်နှုန်းအထိ မြန်ဆန်ပါတယ်။ HBM3E ရဲ့ bandwidth နဲ့ capacity ဟာ 96GB GDDR7 ကတ်ထက် သာလွန်ပြီး GPT-OSS မော်ဒယ်နှစ်မျိုးလုံးမှာ prompt ပုံစံနှစ်မျိုးလုံးမှာ stream count တိုင်းမှာ ဦးဆောင်နေပါတယ်။
H200 NVL ဟာ သိပ်သည်းတဲ့ FP8 နဲ့ BF16 စမ်းသပ်မှုတွေမှာ chat prompts မှာ stream ၁၂၈ ခုမှာ ၄ ရာခိုင်နှုန်းကနေ ၁၈ ရာခိုင်နှုန်းအထိနဲ့ long prompts တွေမှာ ပိုသာပြီး bandwidth ၂၀ ရာခိုင်နှုန်းပိုများပြီး FP4 path မပါဝင်ပါဘူး။ GPT-OSS မှာ MI350P ဟာ Hopper card ထက် ၅၀ ရာခိုင်နှုန်းနဲ့ ၇၈ ရာခိုင်နှုန်းပိုသာပါတယ်။ ပိုကြီးတဲ့ မော်ဒယ်တွေကတော့ RTX PRO 6000 လေးလုံးက GLM-5.2 မှာ MI350P အတွဲကို ၁၆ stream တွေမှာ ဦးဆောင်နေတာကြောင့် တည်ငြိမ်မှုနည်းပါတယ်။ 384GB နဲ့ 288GB ရှိပြီး bandwidth နဲ့ compute ပိုများပါတယ်။
MiniMax-M3 က ပိုနီးစပ်ပါတယ်- chat prompts မှာ stream ရှစ်ခုကတစ်ဆင့် configuration သုံးခုက ၁၀ ရာခိုင်နှုန်းအတွင်းရှိနေပြီး RTX quad က ၁၆ ရာခိုင်နှုန်းနဲ့ ဦးဆောင်နေပြီး MI350P အတွဲက stream ရှစ်ခုကတစ်ဆင့် long prompts တွေမှာ ဦးဆောင်နေပါတယ်။ ကတ်တစ်ခုစီအတွက် MI350P ရဲ့ တိုင်းတာထားတဲ့ FP4 rate က RTX PRO 6000 ထက် ၃၆ ရာခိုင်နှုန်းပိုများတာကြောင့် အားသာချက်က ကတ်အရေအတွက်ပါ။ အဲဒီကတ်နှစ်ခုရလဒ်တွေကို ROCm 7.2.3 stack မှာဖော်ပြထားပြီး 600W စမ်းသပ်မှုနဲ့အတူ ROCm 10.1 မှာ ထပ်မံလုပ်ဆောင်သွားမှာဖြစ်ပါတယ်။
MI350P အပေါ် တိကျတဲ့ ထင်မြင်ချက်တစ်ခု ပေးနိုင်ဖို့က PowerEdge XE7745 မှာ 600W အပြည့်အဝ စမ်းသပ်ဖို့ စီစဉ်ထားပါတယ်။ Dell က အဲဒီ chassis မှာ 600W မှာ MI350P ရှစ်ခုကို ထောက်ပံ့ပေးပါတယ်။ AMD ရဲ့ အပို 150W အတွက် ခန့်မှန်းချက်က စွမ်းဆောင်ရည် ၁၀ ရာခိုင်နှုန်းလောက် ပိုများတယ်လို့ ကြားရပါတယ်။
AMD ဟာ အတော်လေး တိုးတက်အောင်မြင်ခဲ့ပြီး MI350/5X လိုင်းက ဒီဗိသုကာရဲ့ စွမ်းဆောင်ရည်ကို ပြသနေပါတယ်။ ကျွန်တော်တို့ရဲ့ ဓာတ်ခွဲခန်းမှာ MI300X box ကို ဖွံ့ဖြိုးတိုးတက်ရေးအတွက် လည်ပတ်ခဲ့ပြီး software stack ရဲ့ မြန်နှုန်းက software suite ရဲ့ ဘယ်လောက်ထိ stock vLLM မှာ error မရှိဘဲ လည်ပတ်နိုင်လဲဆိုတာကို ပြသခဲ့ပါတယ်။
ဒီ setup မှာ ကျွန်တော်တို့မြင်တွေ့ခဲ့ရတာတွေအရ MI350P ဟာ NVIDIA GPU တွေအတွက် အစားထိုးရွေးချယ်စရာတစ်ခုကို ရှာဖွေနေတဲ့ ဝယ်ယူသူတွေအတွက်ဖြစ်ပြီး၊ ပို့ဆောင်ချိန်၊ ဈေးနှုန်းကြောင့်ဖြစ်စေ၊ ထုတ်လုပ်သူတစ်ဦးတည်းကို မှီခိုအားထားမှုကို ရှောင်ရှားဖို့အတွက်ဖြစ်စေ ဖြစ်ပါတယ်။ PowerEdge လိုင်းမှာ Dell ရဲ့ ပံ့ပိုးမှုက ဆီလီကွန်ကွဲပြားမှု mainstream server တွေကို လိုအပ်ချက်နဲ့ ကိုက်ညီစေပါတယ်။
တရားမျှတစွာပြောရရင် ကျွန်တော်တို့ရဲ့အလုပ်က မပြီးသေးပါဘူး။ ဝယ်သူအများစုက ဒီကတ်တွေကို 2U server တွေမှာ ထည့်လို့ရပေမယ့် 600W ကတ်တွေအတွက် ဒီဇိုင်းထုတ်ထားတဲ့ ပိုကြီးတဲ့ chassis ထဲကို ထည့်လိုက်တဲ့အခါ စွမ်းဆောင်ရည်ပိုရှိပါတယ်။ ဘယ်လိုပဲ ဖြန့်ကျက်ထားပါစေ၊ AMD က add-in card server ဈေးကွက်ထဲ ပြန်ဝင်လာတာကို ပထမဆုံးအကြိမ် မြင်တွေ့ရတာ အကောင်းဆုံးပါပဲ။ software stack တွေ ဆက်လက်ရင့်ကျက်လာတာနဲ့အမျှ MI350P နဲ့ နောက်ထွက်လာမယ့် ကတ်တွေမှာ အနာဂတ်အလားအလာကောင်းတွေ ရှိပါတယ်။ ဒီနေ့ခေတ်မှာ 96GB ကနေ 144GB band ရှိတဲ့ မော်ဒယ်တွေကို ဝယ်ယူသူတစ်ယောက်အတွက် MI350P ဟာ GPU တစ်ခုတည်းမှာပဲ ထားရှိတဲ့ PCIe ကတ်နှစ်ခုထဲက တစ်ခုဖြစ်ပြီး 141GB ကျော်တဲ့ တစ်ခုတည်းသော ကတ်လည်း ဖြစ်ပါတယ်။
ဦးဆောင်သူစာရင်း- AMD Instinct MI350P သည် ကျွန်ုပ်တို့၏ အကောင်းဆုံး Enterprise GPU များ ဦးဆောင်သူစာရင်းတွင် Also Tested အောက်တွင် ပေါ်လာပြီး ၎င်း၏ ကတ်နှစ်ခုပါ ရလဒ်များကို Scale-Out Configurations အောက်တွင် တွေ့မြင်နိုင်သည်။



 အမေဇုံ