

နောက်နှစ်မှာ လုပ်ငန်းအများအပြား ပြုလုပ်မယ့် အကြီးမားဆုံး AI အခြေခံအဆောက်အအုံ ဆုံးဖြတ်ချက်က GPU ရင်းနှီးမြှုပ်နှံမှု မဟုတ်ဘဲ ဒေတာဘေ့စ် အဆင့်မြှင့်တင်မှု ဖြစ်ပါလိမ့်မယ်။ Oracle AI Database 26ai ဟာ Oracle က သူ့ရဲ့ 19c installed base ကို ဦးတည်မောင်းနှင်နေတဲ့ ရေရှည်ပံ့ပိုးမှု ဖြန့်ချိမှု ဖြစ်ပါတယ်။ 26ai ဟာ vector search ကို transaction တွေကို သိမ်းဆည်းထားတဲ့ engine တစ်ခုတည်းမှာ ထည့်သွင်းပါတယ်။ vector index ဟာ database ထဲမှာ ရှိနေတဲ့အခါ block array နဲ့ ၎င်းနောက်ကွယ်က SAN fabric ဟာ AI အခြေခံအဆောက်အအုံ ဖြစ်လာပြီး ၎င်းတို့ ဝန်ဆောင်မှုပေးနေတဲ့ transaction တွေနဲ့အတူ retrieval traffic ကို သယ်ဆောင်ပေးပါတယ်။
Key ကို Takeaways
- OLTP နှင့် vector search သည် array တစ်ခုကို မျှဝေအသုံးပြုသည်- vector volume တစ်ခုစီတွင် IOPS ၄၅,၀၀၀ ဖြင့် FlashSystem သည် ၂၅ ရာခိုင်နှုန်း CPU တွင် IOPS ၈၇၀,၀၀၀ နှင့် 6.9GB/s ကို ၃၇၇ မိုက်ခရိုစက္ကန့်တွင် ထိန်းသိမ်းထားနိုင်ခဲ့ပြီး Swingbench သည် လည်ပတ်မှုတစ်လျှောက်လုံးတွင် TPS ၁၉,၅၀၀ ခန့်ကို တသမတ်တည်းထိန်းသိမ်းထားနိုင်ခဲ့သည်။ ကန့်သတ်ချက်မရှိပါက vector workload သည် OLTP မှ ၃၇ ရာခိုင်နှုန်းကို လျှော့ချပေးခဲ့သည်။
- 64G Fibre Channel သည် vector search throughput ကို နှစ်ဆနီးပါးတိုးစေသည်- တူညီသော host၊ array နှင့် Emulex LPe38102 SecureHBA များသည် 64G တွင် တစ်စက္ကန့်လျှင် query ၈၅.၀ ခု ပေးပို့ခဲ့ပြီး 32G တွင် ၄၃.၇ ခု ပေးပို့ခဲ့ပြီး ၉၅ ရာခိုင်နှုန်း ပိုများကာ thread ၈၀ တွင် p99 latency သည် ၄.၀၈ စက္ကန့်မှ ၁.၁၄ သို့ ကျဆင်းသွားခဲ့ပြီး IVF_FLAT index build သည် ၂၈.၈ ရာခိုင်နှုန်း ပိုစော၍ ပြီးဆုံးခဲ့သည်။
- RMAN backup target ကို ရည်ရွယ်တဲ့ Ransomware ကို စက္ကန့် ၆၀ အတွင်း ဖမ်းမိခဲ့ပါတယ်။ FlashSystem သည် အုပ်စုရှိ volume ၃၁ ခုလုံးကို flag လုပ်ခဲ့ပြီး၊ မပြောင်းလဲနိုင်သော Safeguarded Copy snapshot ကို ၎င်းကိုယ်တိုင်ယူခဲ့ပြီး၊ လမ်းကြောင်းတွင် host agent မပါဘဲ နောက်ဆုံးသိရှိထားသော ကောင်းမွန်သော copy တွင် တိုးချဲ့ထိန်းသိမ်းထားခဲ့သည်။
- Vector စွမ်းရည်သည် ပထမနေ့ဘတ်ဂျက်အချက်ဖြစ်သည်။ 1,024-dimension embedding တစ်သန်းသည် SAN တွင် source text 0.90GB ကို 16.24GB အဖြစ်သို့ ပြောင်းလဲပေးခဲ့ပြီး ၎င်းသည် source ထက် ၁၈ ဆ ပိုများပြီး index build အတွင်း TEMP 15 မှ 23GB အထိ လိုအပ်ပြီး embedding model ပေါ်မူတည်၍ 4.8x မှ 32.5x အထိရှိသော multiplier တစ်ခု လိုအပ်ပါသည်။
- ဒုတိယနေ့ လုပ်ဆောင်ချက်များသည် array ပေါ်တွင် ရှိနေပါသည်- Brocade target-driven zoning ဖြင့် AutoZoning သည် zoning ticket မပါဘဲ host တစ်ခုကို ထည့်သွင်းပေးပြီး၊ storage partitions များသည် DBA နှင့် AI အဖွဲ့များအား system တစ်ခုတည်းတွင် သီးခြား tenant များ ပေးစွမ်းပြီး Emulex SecureHBA များသည် post-quantum cryptography ဖြင့် Brocade Gen 8 fabric တစ်လျှောက်တွင် host-to-array traffic ကို encrypt လုပ်ပါသည်။
AI အောက်မှာ ဒေတာဘေ့စ် ပြောင်းလဲသွားပါပြီ
Oracle သည် ထိုအတွေးအခေါ်ကို အခြေခံ၍ 26ai ကို တည်ဆောက်ခဲ့သည်- native VECTOR data type၊ SQL vector search function များ၊ ONNX မှတစ်ဆင့် in-database model execution နှင့် natural language queries များအတွက် SELECT AI တို့ဖြစ်ပြီး၊ ကုမ္ပဏီသည် LTS release တွင် feature အသစ် ၃၀၀ ကျော်ကို စာရင်းပြုစုထားသည်။ လက်တွေ့တွင် DBA သည် embedding များကို generate လုပ်နိုင်ပြီး ၎င်းတို့ဖော်ပြသော row များဘေးတွင် သိမ်းဆည်းနိုင်ပြီး order lookup နှင့် တူညီသော transaction scope အတွင်း similarity search ကို လုပ်ဆောင်နိုင်သည်။ run ရန် သီးခြား vector store မရှိ၊ ထိန်းသိမ်းရန် synchronization pipeline မရှိ၊ audit trail ပြင်ပတွင် နေထိုင်သော regulated data ၏ ဒုတိယမိတ္တူ မရှိပါ။
IBM က IDC ကို ကိုးကားပြီး “အဖွဲ့အစည်းများသည် အေးဂျင့် AI အတွက် ပေါင်းစည်းထားသော၊ အုပ်ချုပ်သောပတ်ဝန်းကျင်များကို နှစ်သက်ကြသောကြောင့် ပေါင်းစပ်ထားသော vector database များသည် vector embedding များကို သိမ်းဆည်းခြင်းနှင့် မေးမြန်းခြင်းအတွက် ရွေးချယ်မှု၏ ရှင်းလင်းသောပလက်ဖောင်းဖြစ်သည်။” IBM နှင့် Broadcom ၏ဖောက်သည်များသည် ၎င်းတို့ယုံကြည်ရသော database အသစ်တစ်ခုမတည်ဆောက်မီ ၎င်းနှင့်အတူ တိုးချဲ့လိုကြသည်။
Oracle တစ်ခုတည်းသာ ဤလမ်းကြောင်းတွင် ရှိနေသည်မဟုတ်ပါ။ DB-Engines ၏ ၂၀၂၆ ခုနှစ် အောက်တိုဘာလ လူကြိုက်များမှုအဆင့်သတ်မှတ်ချက်တွင် ထိပ်တန်း relational နှင့် multi-model engine လေးခုဖြစ်သည့် Oracle၊ MySQL၊ Microsoft SQL Server နှင့် PostgreSQL တို့ကို စာရင်းပြုစုထားပြီး လေးခုစလုံးတွင် natively သို့မဟုတ် pgvector ကဲ့သို့သော extension များမှတစ်ဆင့် vector type များ သို့မဟုတ် vector search ကို ထည့်သွင်းထားသည်။ IBM သည် ၎င်း၏စျေးကွက်ဦးဆောင်မှုကြောင့် Oracle ဖြင့် ၎င်း၏ validation အလုပ်ကို စတင်ရန် ရွေးချယ်ခဲ့သော်လည်း ဤဆောင်းပါးရှိ storage argument သည် အခြားအရာများနှင့်လည်း သက်ဆိုင်ပါသည်။

AI နဲ့အတူ block storage ကို on-prem မှာထားဖို့ ငြင်းခုံမှုတွေက မပြောင်းလဲပါဘူး။ လူနာမှတ်တမ်းတွေ၊ တောင်းဆိုချက်တွေ၊ အော်ဒါတွေနဲ့ အရောင်းအဝယ်တွေလိုမျိုး AI ဖြန့်ကျက်မှုကို အသုံးဝင်စေတဲ့ ဒေတာတွေဟာ ထွက်သွားလို့မရပါဘူး။ သီးသန့် AI platform တစ်ခုဆီ ကူးယူခြင်းဆိုတာ သိုလှောင်မှုအတွက် နှစ်ကြိမ်ပေးချေခြင်း၊ မိတ္တူဟာ ထုတ်လုပ်မှု cluster ကနေ ရွေ့သွားတယ်ဆိုတာကို လက်ခံခြင်းနဲ့ မူရင်းကို တရားဝင်ကာကွယ်နိုင်တဲ့ အုပ်ချုပ်မှုထိန်းချုပ်မှုတွေ ဆုံးရှုံးခြင်းတို့ကို ဆိုလိုပါတယ်။ database ထဲမှာ ပြန်လည်ရယူခြင်းကို ထားရှိခြင်းက ဒီသုံးခုလုံးကို ရှောင်ရှားနိုင်ပါတယ်။ sub-millisecond row lookup ကို ဝန်ဆောင်မှုပေးတဲ့ array ဟာ အခုဆိုရင် ဆရာဝန်အတွက် vector similarity scan နဲ့ backup stream တို့ကို တစ်ပြိုင်နက်တည်း ဝန်ဆောင်မှုပေးပါတယ်။
IBM Storage နှင့် Broadcom ၏ Fibre Channel (FC) အဖွဲ့သည် ထိုရောနှောထားသော workload case ကို အတည်ပြုရန် စတင်ခဲ့ပြီး Broadcom ၏ Brocade Gen 8 SAN fabric နှင့် Emulex 64G SecureHBA များ ဖြင့် IBM FlashSystem ပေါ်ရှိ Oracle AI Database 26ai ပတ်လည်ရှိ environment တစ်ခုကို တည်ဆောက်ခဲ့သည် ။ ထို့နောက် ၎င်းတို့သည် infrastructure team တစ်ခုမှ မေးမြန်းနေသော မေးခွန်းများကို ဖြေရှင်းခဲ့ကြသည်- vector workload တစ်ခုဘေးတွင် စတင်သောအခါ transactional latency အပေါ် သက်ရောက်မှုကား အဘယ်နည်း၊ vector search throughput အပေါ် fabric speed ၏ အကျိုးသက်ရောက်မှု၊ embedding များမှ သုံးစွဲသော capacity၊ RMAN backup volume ကို ပစ်မှတ်ထားသည့်အခါ ransomware detection ၏ ထိရောက်မှုနှင့် zoning ticket မပါဘဲ SAN သို့ host တစ်ခုထည့်သွင်းရန် လိုအပ်ချက်များကား အဘယ်နည်း။
ဒေတာများသည် Block Storage တွင် ရှိနှင့်ပြီးဖြစ်ပြီး ယခုအခါ AI သည် ၎င်းကို လုပ်ဆောင်လာပါပြီ
ဒီအရာတွေထဲက တစ်ခုမှ AI workloads တွေဟာ block storage မှာ ပါဝင်တယ်လို့ မပြောပါဘူး။ Enterprise တွေဟာ unstructured estate အတွက် file နဲ့ object array တွေကို သိမ်းဆည်းထားမှာဖြစ်ပါတယ်- database မှာ ဘယ်တုန်းကမှ မရှိခဲ့ဖူးသလို ဘယ်တော့မှလည်း ရှိမှာမဟုတ်တဲ့ document တွေ၊ image တွေ၊ video တွေ၊ training set တွေနဲ့ model checkpoint တွေပါ။ နောက်ဆက်တွဲ ကျန်းမာရေးစောင့်ရှောက်မှု သရုပ်ပြမှုမှာ IBM ဟာ raw X-ray image တွေကို object storage မှာ သိမ်းဆည်းထားပြီး Oracle မှာ embedding တွေနဲ့ case metadata တွေကိုပဲ သိမ်းဆည်းထားပါတယ်။ ပြောင်းလဲသွားတာကတော့ array ရဲ့ ဝန်ထုပ်ဝန်ပိုးဖြစ်ပြီး အခုဆိုရင် တစ်ချိန်တည်းမှာ I/O profile အမျိုးမျိုးနဲ့ workloads အများအပြားကို သယ်ဆောင်ထားပါတယ်။
relational tier ကတော့ အရင်းနှီးဆုံးပါပဲ- တစ်စက္ကန့်ကို random 4KB မှ 16KB အထိ I/O သန်းပေါင်းများစွာ၊ microseconds အတွင်း ဆင်းသက်ရမယ့် row lookup တွေနဲ့ commit တွေ၊ redo, undo နဲ့ checkpoint traffic တွေကနေ heavy write concurrency နဲ့ user-facing application က စောင့်နေလို့ ခန့်မှန်းလို့ရတဲ့ tail latency တို့ပါပဲ။ Oracle ရဲ့ backup utility ဖြစ်တဲ့ RMAN ကတော့ ပြောင်းပြန်ပါပဲ- ပထမဆုံး workload ကို မနှောင့်ယှက်ဘဲ window ထဲမှာ အပြီးသတ်ဖို့ headroom လိုအပ်တဲ့ sequential stream တစ်ခုပါ။ နှစ်ခုစလုံးကို ကောင်းကောင်းနားလည်ထားပြီး IBM ရဲ့ array တွေကိုလည်း သူတို့အတွက် ချိန်ညှိပေးထားပါတယ်။
vector embedding တွေရဲ့ ဇယားကြီးတွေက vector search ကို bandwidth-intensive workload တစ်ခုလို ထင်ရစေနိုင်တာကြောင့် vector tier ကို ဖော်ပြဖို့ ပိုခက်ပါတယ်- sequential scan ကြီးတစ်ခုလိုပါပဲ။ IBM ရဲ့ Oracle 26ai vector path ရဲ့ ဖော်ပြချက်က OLTP နဲ့ ပိုနီးစပ်ပါတယ်။ index ကနေ hop တစ်ခုစီဟာ 4KB လောက် random read တစ်ခုပါ။ query path က IOPS-bound ဖြစ်ပြီး latency-sensitive ဖြစ်ပြီး write တွေက သီးခြား ingest နဲ့ index-build phase မှာ ရှိနေလို့ read တွေက အဓိကကျပါတယ်။
Bandwidth ဟာ burst တွေမှာ အရေးပါပါတယ်၊ index တစ်ခုကို တည်ဆောက်တဲ့အခါ ဒါမှမဟုတ် corpus တစ်ခုကို ပြန်လည် embed လုပ်တဲ့အခါ၊ အဲဒီ burst တွေက အတော်လေး ကြီးမားလေ့ရှိပါတယ်။ အဲဒီ split ဟာ ရောနှောထားတဲ့ I/O ပြဿနာရဲ့ အဓိကအချက်ပါ- query path မှာ vector workload ဟာ တူညီတဲ့ queue တွေအတွက် transaction တွေနဲ့ ယှဉ်ပြိုင်တာကြောင့် isolation ဟာ quality-of-service စိုးရိမ်စရာ ဖြစ်စေပါတယ်။ ပြီးတော့ bursty phases တွေဟာ fabric bandwidth ရဲ့ အမြင့်ဆုံးအဆင့် ဖြစ်လာတဲ့နေရာတွေဖြစ်ပြီး 32G နဲ့ 64G ရလဒ်တွေက ဒီအပိုင်းရဲ့ နောက်ပိုင်းမှာ ပြသထားတဲ့အတိုင်းပါပဲ။
အတည်ပြုထားသော ဗိသုကာ
IBM နှင့် Broadcom တို့သည် Broadcom ၏ Colorado AI ဓာတ်ခွဲခန်းတွင် ဤအတည်ပြုချက်အတွက် ပတ်ဝန်းကျင်တစ်ခုကို တည်ဆောက်ခဲ့ကြသည်။ သိုလှောင်မှုသည် IBM Storage Virtualize 9.1.3 ကို 24 FlashCore Modules များဖြင့် လုပ်ဆောင်သော IBM FlashSystem 9000 series array တစ်ခုဖြစ်ပြီး Brocade Gen 8 G820 SAN switches တစ်စုံသို့ 64G Fibre Channel ports များကို ပေးဆောင်သည်။ database host သည် 2-port Emulex LPe38102 64G SecureHBAs နှစ်ခုပါသော dual-socket Intel Xeon 6767P server တစ်ခုဖြစ်ပြီး storage path တွင် GPU မပါဘဲ ASM ပေါ်တွင် Oracle AI Database 26ai ကို လုပ်ဆောင်သည်။ IBM Storage Insights သည် array ကို စောင့်ကြည့်သည်။

ကျွန်ုပ်တို့သည် fabric နှင့် capacity ရလဒ်များ၊ 32G နှင့် 64G vector search နှိုင်းယှဉ်ချက်နှင့် VectorDBBench ကို အသုံးပြု၍ ထို host ပေါ်ရှိ BioASQ 1M dataset နှင့် နှိုင်းယှဉ်၍ footprint တိုင်းတာမှုများကို လုပ်ဆောင်ခဲ့ပါသည်။ တူညီသော configuration သည် application workload ကိုလည်း ပံ့ပိုးပေးပါသည်။ Xeon Platinum 8470 processors နှစ်ခုနှင့် NVIDIA H100 80GB GPU ရှစ်ခုပါသည့် Supermicro 821GE-TNHR သည် healthcare application နှင့် ၎င်း၏ language model ကို host လုပ်ပါသည်။ software stack တွင် Oracle ၏ in-database ONNX embedding၊ Ollama serving Llama 3 နှင့် NVIDIA cuVS တို့ ပါဝင်သည်။ Broadcom Tomahawk 5 switch နှင့် Thor 2 400GbE NICs များသည် server နှစ်ခုကို ချိတ်ဆက်ပေးသည်။ I/O QoS၊ multi-tenancy၊ ransomware detection နှင့် healthcare demonstrations များကို ဤပတ်ဝန်းကျင်တွင် လုပ်ဆောင်ခဲ့သည်။

IBM ၏ အဆိုအရ FlashSystem မိသားစု ( 5300 နှင့် 5600၊ 7300 နှင့် 7600၊ 9500 နှင့် 9600) သည် တူညီသော Storage Virtualize software ကို အသုံးပြုပြီး I/O throttling၊ AutoZoning၊ ransomware detection၊ Policy-Based HA နှင့် storage partition migration အပါအဝင် ဤနေရာတွင် သရုပ်ပြထားသော လုပ်ဆောင်ချက်များသည် တူညီသော code level ရှိ မည်သည့် array တွင်မဆို Oracle AI Database 26ai နှင့် အလားတူနည်းလမ်းဖြင့် လုပ်ဆောင်ပါသည်။ စွမ်းဆောင်ရည်နှင့် သိပ်သည်းဆသည် မော်ဒယ်နှင့် FlashCore Module ထုတ်လုပ်မှုအလိုက် ကွဲပြားသောကြောင့် ဤအပိုင်းရှိ ကိန်းဂဏန်းတိုင်းသည် ၎င်းတိုင်းတာခဲ့သော စနစ်နှင့် သက်ဆိုင်ပါသည်။
I/O QoS ဖြင့် အကောင်းဆုံး OLTP နှင့် Vector Workload စွမ်းဆောင်ရည်ကို သေချာစေခြင်း
IBM နှင့် Broadcom တို့ဖြေဆိုရန် ပထမဆုံးသတ်မှတ်ထားသော မေးခွန်းမှာ production array အတွက် vector workload တစ်ခုကို အဆိုပြုသည့်အခါ DBA တိုင်းမေးလေ့ရှိသော မေးခွန်းဖြစ်သည်- core transaction တွေ ဘာဖြစ်သွားမလဲ။ IBM သည် FlashSystem 9000 series array တွင် volume-level I/O throttles များကို အသုံးပြု၍ demonstration နှစ်ခုအဖြစ် လုပ်ဆောင်ခဲ့ပြီး IBM သည် I/O QoS ဟုခေါ်သော ယန္တရားဖြစ်သည်။ database ကို volume ၃၀ တွင် ချပြခဲ့သည်- Swingbench Order Entry အောက်တွင် OLTP tablespaces (ORCL16 မှ ORCL30) အတွက် ၁၅ ခုနှင့် vector table များ (ORCL31 မှ ORCL45) အတွက် ၁၅ ခုကို user ၁၉၂ ဦးဖြင့် top-k 500 similarity queries များကို လုပ်ဆောင်နေသော 200-thread synthetic generator အောက်တွင် top-k 500 similarity queries များကို လုပ်ဆောင်နေပြီး Storage Insights သည် volume group တစ်ခုစီကို charting လုပ်သည်။
OLTP တစ်ခုတည်းလည်ပတ်နေချိန်တွင် OLTP volume တစ်ခုစီသည် ops/s 20,500 ရှိသည်။ vector generator စတင်သောအခါ vector volume များသည် တစ်မိနစ်အတွင်း ops/s တစ်ခုချင်းစီကို 73,000 ခန့်အထိ မြင့်တက်ခဲ့ပြီး OLTP volume များသည် 13,000 ခန့်အထိ ကျဆင်းခဲ့ပြီး transactional ဘက်တွင် ဘာမှမပြောင်းလဲဘဲ ၃၇ ရာခိုင်နှုန်း ကျဆင်းခဲ့သည်။ vector search path သည် transactions များနှင့် block size တူညီသော 4KB random reads ဖြစ်သောကြောင့် တူညီသော queues များကို ထိမှန်ပြီး array ပေးသည့်အရာကို ယူသည်။

vector volume တစ်ခုစီတွင် IOPS ၄၅၀၀၀ ကန့်သတ်ချက်ရှိပြီး၊ တစ်ကြောင်း mkthrottle CLI မှာ vector volumes တွေကို limit အထိ ဆွဲထုတ်ပြီး OLTP ကို 17,000 ops/s လောက်အထိ ပြန်မြှင့်ပေးခဲ့ပါတယ်။ cap ကို ဖယ်ရှားလိုက်တဲ့အခါ ပြောင်းပြန်ဖြစ်သွားပြီး vector run ပြီးဆုံးသွားတဲ့အခါ OLTP က 20,500 ကို ပြန်ရောက်သွားခဲ့ပါတယ်။ dashboard က စုစုပေါင်း IOPS ၁.၂၈ သန်းကို unthrottle လုပ်ထားပြီး cap အောက်မှာ ၉၅၀,၀၀၀ လောက် ရှိနေပြီး ရာခိုင်နှုန်းအနည်းငယ်အတွင်းမှာပဲ volume တစ်ခုချင်းစီရဲ့ rate နဲ့ မြှောက်ထားတဲ့ ပမာဏ ဖြစ်ပါတယ်။

ဒုတိယ demo ကတော့ IBM က production မှာ deploy လုပ်မယ်လို့ မျှော်လင့်ထားတဲ့ configuration ပါ- caps တွေကို အရင်သတ်မှတ်ပြီး၊ vector volume တစ်ခုကို IOPS ၄၅,၀၀၀ နဲ့ OLTP volume တစ်ခုကို ၂၀,၀၀၀ ထားပြီးနောက် workload နှစ်ခုလုံးကို အတူတကွ launch လုပ်ပါတယ်။ vector volumes တွေက သူတို့ရဲ့ ceiling မှာ run နေပြီး၊ OLTP volumes တွေက ops/s ၁၂,၂၀၀ လောက်မှာ တည်ငြိမ်ပြီး run တစ်လျှောက်လုံး တသမတ်တည်းရှိနေခဲ့ပြီး၊ array က IOPS ၈၇၀,၀၀၀ (read ၈၀၀,၀၀၀၊ write ၇၀,၀၀၀) ကို ၃၇၇ microseconds နဲ့ ၂၅% CPU မှာ ၆.၉GB/s နဲ့ ထိန်းထားနိုင်ခဲ့ပါတယ်။ OLTP cap က workload ရဲ့ demand အထက်မှာ ရှိနေပြီး ဘယ်တော့မှ engaged မလုပ်ပါဘူး။ တစ်ဖက်နဲ့တစ်ဖက် runaway တွေက တစ်ဖက်ကို ငတ်မွတ်အောင် မလုပ်နိုင်ပါဘူး။
Swingbench သည် ၎င်း၏အသုံးပြုသူ ၁၉၂ ဦးကို တစ်မိနစ်လျှင် ငွေပေးငွေယူ ၁.၁၉ သန်းခန့် (ခန့်မှန်းခြေအားဖြင့် TPS ၁၉,၅၀၀) ဖြင့် ထိန်းသိမ်းထားနိုင်ခဲ့သည်။ generator ကို ၎င်း၏ volume များ ပြည့်နှက်နေစေရန် ချိန်ညှိထားသောကြောင့် ၎င်း၏ query တစ်ခုချင်းစီ၏ latency သည် application benchmark မဟုတ်ပါ။ မိနစ် ၃၀ အတွင်း ၎င်းသည် တစ်စက္ကန့်လျှင် ၁၉.၈ ဖြင့် query ၃၅,၆၇၂ ခုကို ပြီးမြောက်ခဲ့ပြီး ပျမ်းမျှ latency ၁၀ စက္ကန့်ခန့်နှင့် ၁၅ စက္ကန့် application timeout နှင့် နှိုင်းယှဉ်ပါက p99 သည် ၁၄.၃ စက္ကန့်ဖြစ်သည်။ query ၉၉ ခု (၀.၂၈ ရာခိုင်နှုန်း) သည် ထို timeout သို့ ရောက်ရှိခဲ့ပြီး ငွေပေးငွေယူများသည် ၎င်းကို သတိမထားမိခဲ့ပါ။


FlashSystem throttle ဆိုတာ host ဒါမှမဟုတ် path မခွဲခြားဘဲ array မှာ enforce လုပ်ထားတဲ့ volume ceiling တစ်ခုဖြစ်ပြီး IOPS limit နဲ့အတူ optional bandwidth limit လည်းပါဝင်ပါတယ်။ neighbor ကို cap လုပ်ပြီး ဘာမှ reserve မလုပ်ပါဘူး။ cap ဆိုတာ sizing exercise တစ်ခုပါ။ IOPS ၄၅,၀၀၀ မှာ vector volume ၁၅ ခုဟာ vector headroom ၆၇၅,၀၀၀ IOPS ရှိပြီး ဒီ array ရဲ့ OLTP volume တွေကို သူတို့လိုအပ်တဲ့အရာအဖြစ်ထားခဲ့ပါတယ်။ မတူညီတဲ့ array ဒါမှမဟုတ် mix က နံပါတ်တချို့ကို ရွှေ့ပေးပါတယ်။ transaction တွေက သူတို့ရဲ့ latency ကိုထိန်းထားပြီး vector workload က အရာအားလုံးကို ၎င်းအထက်မှာထားတဲ့နေရာမှာ vector cap ကိုသတ်မှတ်ပါ။
Live Oracle Volumes များတွင် Ransomware ထောက်လှမ်းခြင်း
Sophos ရဲ့ ၂၀၂၄ ခုနှစ် ransomware တိုက်ခိုက်မှုခံရတဲ့ အဖွဲ့အစည်း ၂၉၇၄ ခုကို စစ်တမ်းကောက်ယူမှုအရ တိုက်ခိုက်သူတွေဟာ သူတို့ရဲ့ backup တွေကို လိုက်လံရှာဖွေတာကို ၉၄ ရာခိုင်နှုန်းက မြင်တွေ့ခဲ့ရပြီး၊ အဲဒီကြိုးပမ်းမှုဟာ ၅၇ ရာခိုင်နှုန်း အောင်မြင်ခဲ့ပြီး၊ ပြန်လည်ရယူရေးကုန်ကျစရိတ် ပျမ်းမျှဟာ ရှစ်ဆ ပိုများခဲ့တယ်လို့ တွေ့ရှိခဲ့ပါတယ်။ IBM ဟာ စမ်းသပ်မှုကို တူညီတဲ့ အခြေခံမူပေါ်မှာ တည်ဆောက်ခဲ့ပြီး backup တွေကို အရင်လုပ်ပြီး production ကိုတော့ ဒုတိယအနေနဲ့ တည်ဆောက်ခဲ့ပြီး database volume တွေကိုပဲ ထားခဲ့ပြီး RMAN backup target ကို တိုက်ခိုက်မှုကို ပစ်မှတ်ထားခဲ့ပါတယ်။ RMAN ဟာ သူ့ရဲ့ backup set တွေကို FlashSystem volume တွေထဲကို ရေးသားခဲ့ပြီး ransomware simulator တစ်ခုကို သူတို့ကို တိုက်ခိုက်ခဲ့ပြီး array ကို host agent မပါဘဲ path မှာ ထားခဲ့ပါတယ်။
drive များအတွင်း ထောက်လှမ်းခြင်း ဖြစ်ပေါ်သည်- FCM4 နှင့် FCM5 FlashCore Modules များသည် block size၊ address နှင့် rewrite pattern များနှင့်အတူ ၎င်း land လုပ်တိုင်း entropy နှင့် compressibility ကို တွက်ချက်ပေးပြီး နှစ်စက္ကန့်တိုင်းတွင် per-volume summary ကို Storage Virtualize (8.6.3 သို့မဟုတ် နောက်ပိုင်းထွက် FCM firmware 4.1 သို့မဟုတ် နောက်ပိုင်းထွက်) အတွင်းရှိ inference engine သို့ ပေးပို့သည်။ မော်ဒယ်သည် FlashSystem GUI နှင့် IBM Storage Insights Pro တွင် alerts များ ထုတ်ပေးပြီး Storage Defender သို့မဟုတ် SIEM သို့ forward လုပ်ကာ ၎င်းကိုယ်တိုင် patch လုပ်နိုင်သည်။ ထို့ကြောင့် ပြန်လည်လေ့ကျင့်ထားသော မော်ဒယ်သည် firmware upgrade မလုပ်ဘဲ သေးငယ်သော security update အဖြစ် ပေးပို့သည်။
ခွဲခြမ်းစိတ်ဖြာမှုသည် module ပေါ်တွင် လုပ်ဆောင်သောကြောင့် host သည် အန္တရာယ်ကျရောက်နေသည့်တိုင် ဆက်လက်အလုပ်လုပ်နေပါသည်။ ကုဒ်ဝှက်ထားသော output သည် entropy မြင့်မားပြီး compression ရပ်တန့်သွားပြီး ၎င်းသည် attacker သည် file extension များကို ပြောင်းလဲသည်ဖြစ်စေ၊ အခြား block တိုင်းကို encrypt လုပ်သည်ဖြစ်စေ၊ endpoint agent မှ ပုန်းအောင်းရန်နှုန်းကို နှေးကွေးစေသည်ဖြစ်စေ စာရင်းအင်းများတွင် ပေါ်လာပါသည်။
အတည်ပြုချက်ကာလအတွင်း RMAN သည် backup ကို parallel channel ၁၆ ခုမှတစ်ဆင့် ရေးသားခဲ့ပြီး backup set တစ်ခုစီကို 150GB အထိ ကန့်သတ်ထားခဲ့ပြီး database သည် OLTP နှင့် vector data အတွက် ASM disk group တစ်ခုလျှင် 15 x 200GB disk များပေါ်တွင် သိမ်းဆည်းထားသည်။ IBM သည် ထို backup target ကို တိုက်ခိုက်မှုကို လုပ်ဆောင်ခဲ့ပြီး သတိပေးချက်သည် စက္ကန့် ၆၀ အတွင်း Storage Insights သို့ ရောက်ရှိခဲ့ပြီး ၎င်းသည် IBM မှ ရှာဖွေတွေ့ရှိမှု window အတွင်းတွင် ရှိနေသည်။ volume တစ်ခုပေါ်ရှိ သတိပေးချက်တစ်ခုသည် group တစ်ခုလုံးကို ခြိမ်းခြောက်မှုတစ်ခုအဖြစ် အမှတ်အသားပြုထားသောကြောင့် Storage Insights သည် volume group ရှိ volume ၃၁ ခုလုံးကို flag လုပ်ခဲ့သည်။
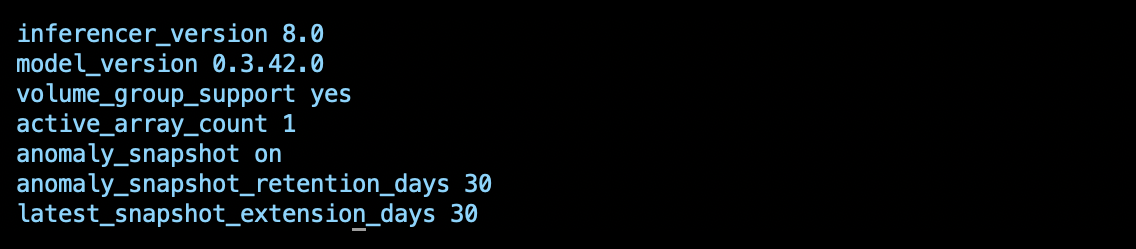
တုံ့ပြန်မှုမှာ Safeguarded Copy ဖြစ်ပြီး array သည် operator မပါဘဲ ၎င်းကို ကိုင်တွယ်ခဲ့သည်- FlashSystem သည် ခြိမ်းခြောက်မှု ပေါ်ပေါက်လာသည်နှင့် ထိခိုက်ခံရသော volume group ၏ မပြောင်းလဲနိုင်သော snapshot ကို ရိုက်ယူခဲ့ပြီး တစ်ချိန်တည်းတွင် နောက်ဆုံးသိရှိထားသော ကောင်းမွန်သော snapshot ၏ ထိန်းသိမ်းမှုကို တိုးချဲ့ခဲ့သည်။ lsanomalydetection array မှ output သည် ၎င်း၏နောက်ကွယ်ရှိ configuration ကိုပြသသည်- model 0.3.42.0 ပါသည့် inference engine 8.0၊ anomaly_snapshot ကိုဖွင့်ထားသည်၊ snapshot အသစ်တွင် ၃၀ ရက်ထိန်းသိမ်းထားခြင်းနှင့် နောက်ဆုံးကောင်းမွန်သော snapshot သို့ ၃၀ ရက်ထပ်ထည့်ထားသည်။ Storage Virtualize သည် သံသယဖြစ်ဖွယ် snapshot ကိုလည်းမှတ်သားထားသောကြောင့် မည်သူမျှ ၎င်းမှ restore မလုပ်ဘဲ encryption မစတင်မီက သန့်ရှင်းသော restore point ကိုချန်ထားခဲ့သည်။
ဒီ fabric မှာ လုံခြုံရေးအလွှာတစ်ခုလည်း ပါဝင်ပါတယ်။ Broadcom က post-quantum cryptography ကို Brocade Gen 8 platform တွေထဲကို တည်ဆောက်ပေးပြီး၊ Emulex SecureHBA တွေက အဲဒီ fabric တစ်လျှောက်မှာ host မှ storage array အထိ flight မှာ data တွေကို encrypt လုပ်ပါတယ်၊ ပြီးတော့ FCIA ရဲ့ FC-SP-3 standard အသစ်က Fibre Channel တစ်ခုလုံးအတွက် quantum-ready security baseline ကို သတ်မှတ်ပေးပါတယ်။
ဇုန်ခွဲခြားခြင်းမရှိဘဲ SAN ကြီးထွားမှုလက်မှတ်များ- Broadcom Target-Driven Zoning ကို အသုံးပြု၍ IBM FlashSystem AutoZoning
Fibre Channel SAN မှာ host တစ်ခုထည့်ဖို့အတွက် ticket တစ်ခုနဲ့ team နှစ်ခုလိုအပ်ပါတယ်- server admin က HBA WWPN တွေကို စုဆောင်းပြီး၊ SAN admin က fabric နှစ်ခုလုံးမှာ zone တွေကို လက်နဲ့တည်ဆောက်ပြီး၊ storage admin က host ကို မှန်ကန်တဲ့ target port တွေဆီ map လုပ်ပါတယ်။ WWPN မှားရိုက်ထည့်မိရင် Oracle RAC node အသစ်တစ်ခုကို path တွေမပါဘဲထားခဲ့ပါတယ်။ AutoZoning က အလုပ်လုပ်တဲ့ array ကို ရွှေ့ပါတယ်- FlashSystem က fabric နဲ့ တိုက်ရိုက်ဆက်သွယ်ပြီး၊ initiator WWPN တွေကို ခွဲခြားသတ်မှတ်ပြီး၊ target port တွေကို ရွေးချယ်ပြီး၊ switch ထဲကို ဘယ်သူမှ login မလုပ်ဘဲ zone တွေကို ဖန်တီးပါတယ်။

ဒီ feature ကို Brocade Target Driven Zoning (TDZ) မှာ တည်ဆောက်ထားပြီး FlashSystem software 9.1.2 မှာ ပါဝင်လာပါတယ်။ ၎င်းအတွက် Fabric OS 9.1.1 သို့မဟုတ် နောက်ပိုင်းဗားရှင်းကို အသုံးပြုနေတဲ့ Brocade switch တွေ လိုအပ်ပြီး FlashSystem target port တွေကို မျက်နှာမူထားတဲ့ switch port တွေမှာ fabric administrator က TDZ ကို enable လုပ်ရပါမယ်။ အဲဒီ enablement ဟာ SAN team မှာ ရှိနေတဲ့ တစ်ခုတည်းသော ခြေလှမ်းဖြစ်ပြီး AutoZoning က port တစ်ခု မပြီးမချင်း လုပ်ဆောင်ချက် မရှိပါဘူး။ အဲဒီကနေစပြီး FlashSystem က peer zone တွေကို တည်ဆောက်ပြီး host initiator တွေဟာ target port ကို ရောက်ရှိနိုင်ပေမယ့် အချင်းချင်းကိုတော့ array-managed အဖြစ် အမှတ်အသားပြုတဲ့ IBM_SV_ name အောက်မှာ မရောက်အောင် ခွင့်ပြုပါတယ်။
Fibre Channel port view မှာ setup စတင်ပါတယ်။ အခုဆိုရင် port တစ်ခုစီ ချိတ်ဆက်ထားတဲ့ switch၊ port က AutoZone လုပ်နိုင်လား၊ ချိတ်ဆက်မှုက symmetric ဖြစ်တာလားဆိုတာကို ပြသပါတယ်။ ဆိုလိုတာက node တိုင်းမှာရှိတဲ့ port ID တူညီတာက fabric တစ်ခုတည်းမှာ ဆင်းသက်ပါတယ်။ topology view က အရောင်နဲ့ map လုပ်ထားပြီး active ဖြစ်နေတဲ့၊ AutoZone လုပ်နိုင်ပြီး symmetric ဖြစ်တဲ့ အစိမ်းရောင် port တွေပဲ AutoZoning ကို support လုပ်ပါတယ်။ GUI က redundancy နဲ့ failover ကို ထိခိုက်စေနိုင်တယ်လို့ သတိပေးထားတာကြောင့် Asymmetric port တွေက တခြားနည်းနဲ့ အလုပ်လုပ်ရင်တောင် ပျက်နေတတ်ပါတယ်။

Host ဖန်တီးခြင်းသည် Unconfigured hosts list မှစတင်ပြီး FDMI မှတစ်ဆင့်ဖြည့်ပြီး HBA တစ်ခုစီ၏ host name၊ operating system နှင့် port များကို fabric သို့တင်ပြသည်။ IBM ၏ walkthrough တွင် Add Host dialog သည် server name၊ operating system နှင့် zone များမရှိသေးသော host ၏ HBA port နှစ်ခုလုံးဖြင့် ပွင့်လာသည်။ admin သည် host ရောက်ရှိနိုင်သော target port များကို သတ်မှတ်ပေးသည့် AutoZone-enabled port set ကို ရွေးချယ်ပြီး Add ကို နှိပ်လိုက်သည်။ FlashSystem သည် ၎င်း၏ target port များကို host initiator များနှင့် တွဲချိတ်ပြီး zone များကို switch နှစ်ခုလုံးသို့ push လုပ်ကာ host သည် fabric နှစ်ခုတွင် path လေးခုဖြင့် online ဖြစ်သွားပါသည်။

Oracle အတွက်၊ IBM သည် RAC node များထည့်သွင်းခြင်းနှင့် HBA များကို အစားထိုးခြင်းအတွက် AutoZoning ကို နေရာချထားသည်၊ အဘယ်ကြောင့်ဆိုသော် ဤအင်္ဂါရပ်သည် host သို့မဟုတ် storage ချိတ်ဆက်မှုတွင် ပြောင်းလဲမှုများကို ခြေရာခံပြီး zone definitions များကို ကိုက်ညီစေရန် လိုက်လျောညီထွေဖြစ်အောင် ပြုလုပ်ပေးသောကြောင့်ဖြစ်သည်၊ ထို့ကြောင့် swapping လုပ်ထားသော HBA သည် manual rezone မလိုအပ်ပါ။ host များသည် storage partition migration သို့မဟုတ် Policy-Based HA (PBHA) အတွက် ဒုတိယ array သို့ path များ လိုအပ်သည့်အခါတွင်လည်း အလားတူ automation သည် အကျုံးဝင်ပါသည်။ TDZ ကို enable မလုပ်မချင်း port တွင် ဘာမှမဖြစ်ပျက်သောကြောင့် SAN အဖွဲ့သည် မည်သည့် target port များပါဝင်သည်ကို ထိန်းချုပ်နေဆဲဖြစ်သည်။ ထို့ကြောင့် host တစ်ခုထည့်သွင်းခြင်းသည် zoning ပြောင်းလဲမှုတစ်ခုကို စောင့်စရာမလိုတော့ပါ။
လုပ်ငန်းလည်ပတ်မှုဆိုင်ရာ စာအိတ်- PBHA၊ Grid Migration၊ Multi-Tenancy နှင့် Placement
Policy-Based HA (PBHA) သည် FlashSystem array နှစ်ခုကြားရှိ storage partition ကို metro distance မှ synchronously replicate လုပ်ကာ site နှစ်ခုလုံးတွင် active-active host access ဖြင့် လုပ်ဆောင်ပေးသည်။ IBM က ဤ feature ကို zero RPO အတွက်နှင့် Oracle deployment သည် data lost မရှိဘဲ ဖြတ်သန်းနိုင်သော storage failover အတွက် ဒီဇိုင်းထုတ်ထားကြောင်း ပြောကြားခဲ့သည်။ failed site ပြန်ရောက်သောအခါ data သည် resynchronize လုပ်ပြီး workload သည် outage မရှိဘဲ ပြန်လည်ရွေ့လျားသည်။
FlashSystem Grid လုပ်ဆောင်ချက်သည် စီမံခန့်ခွဲမှုမြင်ကွင်းတစ်ခုအောက်တွင် FlashSystem array ၃၂ ခုအထိ ပေါင်းစပ်ပေးပြီး storage partition migration သည် ၎င်း၏ volume များ၊ volume group များနှင့် host များပါရှိသော partition တစ်ခုကို application downtime မရှိဘဲ array တစ်ခုမှ နောက်တစ်ခုသို့ ရွှေ့ပေးသည်။ Oracle အတွက် IBM သည် hardware refresh လုပ်ခြင်း၊ firmware update မတိုင်မီ system တစ်ခုကို drain လုပ်ခြင်းနှင့် embedding set ကြီးထွားလာသည်နှင့်အမျှ vector partition တစ်ခုကို capacity ပိုများသော system သို့ ရွှေ့ခြင်းတို့ကို ထောက်ပြသည်။ system သည် Fibre Channel သို့မဟုတ် high-speed Ethernet မှတစ်ဆင့် partition တစ်ခုကို တစ်ကြိမ်လျှင် migrate လုပ်သည်။ host များသည် Fibre Channel၊ iSCSI သို့မဟုတ် NVMe/TCP မှတစ်ဆင့် ချိတ်ဆက်နိုင်ပြီး PBHA အတွက် configure လုပ်ပြီးသား partition သည် migration အတွက် အရည်အချင်းမပြည့်မီပါ။
Storage Insights နေရာချထားမှု အကြံပေးပုဂ္ဂိုလ်သည် တူညီသော grid အတွက် စီစဉ်ခြင်းကို ကိုင်တွယ်သည်။ workload ၏ စွမ်းရည်၊ ကြီးထွားမှုနှုန်း၊ I/O ပရိုဖိုင်နှင့် latency target တို့ကို ထည့်သွင်းစဉ်းစားလျှင် grid ရှိ စနစ်တိုင်းကို အမှတ်ပေးသည်၊ မည်သည့်အရာကိုမျှ ပံ့ပိုးပေးခြင်းမပြုမီ အကောင်းဆုံးကိုက်ညီမှုကို အဆင့်သတ်မှတ်သည်၊ ထို့အပြင် CPU သို့မဟုတ် IOPS မညီမျှမှုကို တွေ့ရှိသည့်အခါ migration ကို အကြံပြုနိုင်သည်။ migration နှင့် placement နှစ်ခုစလုံးသည် grid စနစ်တိုင်းကို Storage Insights tenant တစ်ခုတည်းတွင် မှတ်ပုံတင်ထားသော Storage Insights Pro ကိုအသုံးပြုသည်။

Multi-tenancy က DBA အဖွဲ့နဲ့ AI အဖွဲ့ကို administration မျှဝေစရာမလိုဘဲ grid ကို မျှဝေခွင့်ပြုပါတယ်။ IBM ရဲ့ walkthrough မှာ administrator တစ်ယောက်ဟာ array တစ်ခုတည်းမှာ tenant နှစ်ခု (Tenant_Scale နဲ့ Tenant_oracle_ai) ကို ဖန်တီးပြီး တစ်ခုစီကို system တစ်ခု၊ tenant role ရှိတဲ့ user group တစ်ခုနဲ့ first user တစ်ခုစီ ပေးခဲ့ပါတယ်။ ပြီးတော့ သူတို့ဟာ သီးခြား volume group၊ volume တွေနဲ့ host mapping တွေပါတဲ့ storage partition တစ်ခုကို တည်ဆောက်ခဲ့ပါတယ်။ GUI က partition အသစ်တစ်ခုရှိတာနဲ့ replication ကို configure လုပ်နိုင်ပါတယ်။ Tenant_Scale user အနေနဲ့ login ဝင်တဲ့အခါ GUI က Tenant_oracle_ai နဲ့ မသက်ဆိုင်တဲ့ tenant ရဲ့ partition နဲ့ resource တွေကိုပဲ ပြသပြီး Tenant_oracle_ai နဲ့ မသက်ဆိုင်ပါဘူး။ Tenant_oracle_ai ဘက်ကလည်း အလားတူစစ်ဆေးမှုက ရလဒ်တူကို ပြန်ပေးခဲ့ပါတယ်။
အထည်အလိပ် အကျိုးအမြတ်- Vector Search အောက်ရှိ 32G နှင့် 64G Fibre Channel
ဒီစမ်းသပ်မှုမှာ IBM နဲ့ Broadcom တို့က ရည်ရွယ်ချက်ရှိရှိ ပြောင်းလဲလိုက်တဲ့ variable တစ်ခုတည်းက fabric ပါ။ တူညီတဲ့ array၊ host နဲ့ Emulex LPe38102 SecureHBA တွေက VectorDBBench ကို BioASQ 1M dataset (ဇီဝဆေးပညာမေးခွန်းအဖြေ corpus မှ 1,024-dimension vector တစ်သန်း) နဲ့ နှစ်ကြိမ် run ခဲ့ပါတယ်- တစ်ကြိမ်က HBA port နှစ်ခုကို 32G မှာနဲ့ တစ်ကြိမ်က 64G မှာ Brocade G820 switches တွေကနေတစ်ဆင့် run ခဲ့ပါတယ်။ 16 ASM volumes ကနေ 4GB SGA အထိ ကျန်တာအားလုံးက တူညီနေခဲ့တာကြောင့် run နှစ်ခုကြားက ကွာခြားချက်က Fibre Channel ထုတ်လုပ်မှုပဲဖြစ်ပြီး တခြားဘာမှမရှိပါဘူး။

ဒီ benchmark ရဲ့ search phase က read-only scan ပါ- Oracle ရဲ့ IVF_FLAT index က query တစ်ခုစီကို partitions cluster တစ်ခုဆီ route လုပ်ပြီး အပြည့်အစုံဖတ်ပါတယ်၊ 1,024-dimension FLOAT32 vectors တွေနဲ့ဆိုရင် bandwidth workload တစ်ခုပါ။ 32G port နှစ်ခုမှာ host-side reads က 6.3GB/s မှာ leveled ဖြစ်သွားပြီး search curve က thread ၂၀ နဲ့ တစ်စက္ကန့်ကို query ၄၃.၇ ခုနဲ့ ပြားချပ်သွားပါတယ်။ 64G port နှစ်ခုမှာ တူညီတဲ့ host က 12.5GB/s မှာ read လုပ်ပြီး thread ၈၀ မှာ 85.0 QPS အထိ scale လုပ်ထားပြီး တူညီတဲ့ storage ကနေ throughput ၉၅% ပိုများပါတယ်။

Latency က 64G ဇာတ်လမ်းရဲ့ တခြားအပိုင်းကို ပြောပြပါတယ်- thread တစ်ခုမှာ fabric နှစ်ခုဟာ တစ်ခုနဲ့တစ်ခု 8% အတွင်းမှာပဲ ရှိနေပြီး 0.099 နဲ့ နှိုင်းယှဉ်ရင် 0.107 စက္ကန့်ပဲ ရှိပါတယ်။ ဘာလို့လဲဆိုတော့ query တစ်ခုတည်းက pipe နှစ်ခုလုံးကို ဘယ်တော့မှ မဖြည့်ပေးလို့ပါ။ ဒါပေမယ့် thread ငါးခုကစပြီး 32G မှာ queue တွေကို run ပါတယ်- ပျမ်းမျှ latency ဟာ 64G ကိန်းဂဏန်းကို အဆင့်တိုင်းမှာ နှစ်ဆတိုးစေပြီး thread ၈၀ မှာ p99 က 1.14 နဲ့ နှိုင်းယှဉ်ရင် 4.08 စက္ကန့်ပဲ ရှိပါတယ်။ saturated FC fabric က fail မဖြစ်ပါဘူး။ query တိုင်းကို queue လုပ်ပါတယ်၊ အဲဒီ wait က tail latency အဖြစ် ပေါ်လာပါတယ်။

load phase လည်း ရွေ့လျားသွားခဲ့ပါတယ်။ vector သန်းပေါင်းများစွာကို စားသုံးခြင်းဟာ 32G မှာ 94.1 စက္ကန့်နဲ့ 64G မှာ 84.5 စက္ကန့်ကြာမြင့်ခဲ့ပြီး IVF_FLAT index build ဟာ 108.4 နဲ့ ယှဉ်ရင် 139.6 စက္ကန့်ကြာမြင့်ခဲ့ပြီး၊ နှေးကွေးတဲ့ fabric မှာ 28.8% ပိုကြာခဲ့ပြီး၊ စုစုပေါင်း load 193.0 နဲ့ ယှဉ်ရင် 233.7 စက္ကန့်ကြာမြင့်ခဲ့ပါတယ်။ Recall နဲ့ NDCG တို့ဟာ run နှစ်ခုမှာ 0.1% အတွင်းမှာပဲ ရှိခဲ့ကြပါတယ် (32G မှာ 83.81% နဲ့ 84.42%၊ 64G မှာ 83.95% နဲ့ 84.56%)၊ ဒါကြောင့် fabric က အဖြေတွေ ဘယ်လောက်မြန်မြန်ရောက်လာလဲဆိုတာကို ပြောင်းလဲစေခဲ့ပါတယ်။ ဖြန့်ကျက်ပြီးကတည်းက 32G မှာရှိနေတဲ့ database အတွက် HBA နဲ့ switch upgrade ဟာ ပိုမိုကောင်းမွန်တဲ့ performance ကို ပေးစွမ်းနိုင်ဖို့ ထင်ရှားတဲ့ အခွင့်အရေးတစ်ခုပဲ ဖြစ်ပါတယ်။
Vector စွမ်းရည်တိုးတက်မှုအတွက် စီစဉ်ခြင်း
Vector search သည် စွမ်းဆောင်ရည်မပြောင်းလဲမီ capacity math ကိုပြောင်းလဲစေသည်။ embedding ဆိုသည်မှာ source data ၏ chunk တစ်ခု၏ fixed-width numeric copy တစ်ခုဖြစ်ပြီး ထို copy သည် ၎င်းဖော်ပြသော chunk ထက် များသောအားဖြင့် ပိုကြီးသည်- database သည် ၎င်းကိုသိမ်းဆည်းရန် row တစ်ခုမထည့်မီ 1,000-byte passage တစ်ခုသည် 4,096 bytes ၏ 1,024-dimension FLOAT32 vector ဖြစ်လာသည်။ အဖွဲ့သည် ဤ vector storage amplification ဟုခေါ်ပြီး fabric comparison တွင်အသုံးပြုသည့် BioASQ 1M dataset တွင် တိုင်းတာခဲ့သည်။
vector သန်းပေါင်းများစွာရဲ့နောက်ကွယ်က source text က 0.90GB ရှိပါတယ်။ Oracle 26ai မှာ 7.67GB vector table ဖြစ်လာပြီး row overhead 0.3GB ခန့်ပါဝင်ကာ IVF_FLAT index က vector တိုင်းရဲ့ ဒုတိယ clustered copy နဲ့ centroid 4MB ခန့်ကို သိမ်းဆည်းထားတာကြောင့် အပေါ်မှာ 8.57GB ထပ်ထည့်ထားပါတယ်။ SAN မှာ persistent footprint က source text ရဲ့ ၁၈ ဆ ပိုများပါတယ်။ Oracle က ၎င်းပတ်ဝန်းကျင်မှာ လိုအပ်တဲ့ operational space မတိုင်ခင်မှာ 16.24GB ရှိပါတယ်။ index တည်ဆောက်နေချိန်မှာ TEMP 15 မှ 23GB၊ UNDO 4 မှ 8GB နဲ့ ingest လုပ်နေချိန်မှာ REDO 15GB ခန့် လိုအပ်ပါတယ်။

multiplier သည် embedding model နှင့်အတူ scale လုပ်သည်- Broadcom သည် တူညီသောနည်းလမ်းမှ ခန့်မှန်းပြီး 768-dimension Cohere v3 model (လည်းတိုင်းတာထားသည်) ကို source ၏ 4.8x တွင်၊ 384-dimension MiniLM ကို 9.6x တွင် နှင့် 4,096-dimension Mistral model ကို 32.5x တွင် ထားရှိသည်။ Chunk အရွယ်အစားသည် width ကဲ့သို့ပင် အရေးကြီးသည်၊ အဘယ်ကြောင့်ဆိုသော် ရှည်လျားသော passage ပေါ်ရှိ wide vector သည် short passage ပေါ်ရှိ တူညီသော vector ထက် နည်းပါးစွာ amplify လုပ်သောကြောင့်ဖြစ်ပြီး၊ quantized index များသည် index share ကို ကျုံ့စေသောကြောင့်ဖြစ်သည်။
ဒါတွေထဲက တစ်ခုမှ FlashSystem ဒါမှမဟုတ် Oracle အတွက် သီးသန့်မဟုတ်ပါဘူး။ array က byte တစ်ခုကို မမြင်ခင် database အတွင်းမှာ amplification ဖြစ်ပေါ်ပြီး platform တိုင်းမှာရှိတဲ့ vector index တိုင်းမှာ vector ရဲ့ copy တစ်ခုစီ ပါရှိတာကြောင့် vector project တစ်ခုကို GPU တွေနဲ့အတူ အတည်ပြုတဲ့နေ့မှာ capacity budget မှာ ပါဝင်ပါတယ်။ array က ဆုံးဖြတ်တာက အဲဒီတိုးတက်မှုရဲ့ ပမာဏကို ဘယ်လောက်ထိန်းထားနိုင်မလဲဆိုတာပါပဲ။ IBM ရဲ့ ပဉ္စမမျိုးဆက် FlashCore Module ဟာ module တစ်ခုလျှင် 105.6TB အထိ လည်ပတ်ပြီး အကြီးဆုံး FlashSystem မော်ဒယ်တွေမှာ 2U enclosure မှာ 3.3PB raw ကို ပေးစွမ်းပြီး IBM ရဲ့ ကိန်းဂဏန်းအရ 11.8PB ထိရောက်မှုရှိတာကြောင့် vector tier ဟာ partition တစ်ခု မရွှေ့ခင် နှစ်ပေါင်းများစွာ ကြီးထွားနိုင်ပါတယ်။
IBM ရဲ့ ကျန်းမာရေးစောင့်ရှောက်မှုအပလီကေးရှင်းအတွက် အရွယ်အစားပုံစံက ရုပ်ပုံတွေအတွက် တခြားနည်းလမ်းနဲ့ လုပ်ဆောင်ပါတယ်- X-ray 100GB ဟာ database ထဲမှာ 2GB လောက် ရှိပါတယ်၊ ဘာလို့လဲဆိုတော့ embedding တွေနဲ့ case metadata တွေပဲ အဲဒီမှာ ရှိနေလို့ပါ။ Text က ဈေးကြီးတဲ့ case ပါ- chunked clinical text 100GB က 860GB ကနေ 1.2TB အထိ ရောက်သွားပြီး၊ အများစုက HNSW index ပါ။ sizing input က chunk count နဲ့ model width ပါ။ source corpus က လမ်းညွှန်ချက် မကောင်းပါဘူး။ Embedding တွေက row တွေထက် နည်းပါတယ်၊ 1.2x ကနေ 2x နဲ့ relational data အတွက် 2x ကနေ 4x ပဲ ချုံ့ပါတယ်၊ IBM ရဲ့ အတွေ့အကြုံအရ၊ relational data အတွက် 2x ကနေ 4x ပဲ ချုံ့ပါတယ်၊ ဒါကြောင့် FlashCore Module data reduction က growth ကို နည်းနည်းပဲ ပြန်ရပြီး re-embed တိုင်းက TEMP space ကို ပြန်လိုအပ်ပါတယ်။
IBM ရဲ့ လက်တွေ့ကျတဲ့ စည်းမျဉ်းကတော့ commit မလုပ်ခင် တိုင်းတာဖို့ပါ။ real corpus ရဲ့ ၁ ရာခိုင်နှုန်းကနေ ၅ ရာခိုင်နှုန်းအထိကို production embedding model နဲ့ chunking setting တွေနဲ့ load လုပ်ပြီး vector တစ်ခုချင်းစီရဲ့ တကယ့် bytes ကို တိုင်းတာပါ၊ ပြီးရင် linearly scale လုပ်ပြီး model၊ dimension count ဒါမှမဟုတ် chunking policy ပြောင်းလဲတိုင်း ဒီလေ့ကျင့်ခန်းကို ပြန်လုပ်ပါ။
အဆုံးမှအဆုံး AI ကောက်ချက်ချခြင်း- ကျန်းမာရေးစောင့်ရှောက်မှုအပလီကေးရှင်း
IBM သည် ဤအတည်ပြုချက်အတွက် အပလီကေးရှင်းကို RAD-AI ဟုခေါ်သော ရေဒီယိုဓာတ်မှန်ရိုက်ခြင်းနှင့် အစာအိမ်နှင့်အူလမ်းကြောင်းဆိုင်ရာ အကူအဖြစ် တည်ဆောက်ခဲ့သည်။ ၎င်းသည် ထုတ်လုပ်မှုပုံစံလိုအပ်ချက်များပါရှိသော နမူနာအပလီကေးရှင်းတစ်ခုဖြစ်ပြီး ဤစာတမ်းတွင် ယခင်အပိုင်းများကို တိုင်းတာခဲ့သည့် တူညီသော array နှင့် fabric ပေါ်တွင် ပြီးပြည့်စုံသော inference pipeline ကို ပြသထားသည်။ ဆရာဝန်တစ်ဦးသည် လူနာ၏ အသက်၊ ကျားမ နှင့် တင်ပြနေသော တိုင်ကြားချက်ကို ရိုက်ထည့်ပြီး ရင်ဘတ် X-ray သို့မဟုတ် endoscopy ပုံကို အပ်လုဒ်လုပ်ကာ မော်ကွန်းတိုက်တွင် အလားတူယခင်ဖြစ်ရပ်များမှ တည်ဆောက်ထားသော ဖွဲ့စည်းတည်ဆောက်ထားသော အစီရင်ခံစာကို လက်ခံရရှိသည်။
မော်ကွန်းတိုက်တွင် NIH ChestX-ray14 dataset မှ ရင်ဘတ် X-ray ၁၁၂,၁၂၀ နှင့် HyperKvasir မှ GI endoscopy ပုံ ၁၀,၀၀၀ ကျော်ကို သိမ်းဆည်းထားပြီး၊ ၎င်းတွင် pre-embedded cases ၁၇၂,၀၀၀ ကျော်အတွက် full endoscopy ဗီဒီယို ၃၆၇ ခုမှ per-frame vector များ ပါဝင်သည်။ ပုံတစ်ပုံစီသည် Oracle AI Database 26ai အတွင်း ၎င်း၏ ONNX runtime မှတစ်ဆင့် လည်ပတ်နေသော CLIP ViT-L/14 မော်ဒယ်မှ ၇၆၈-dimensional vector တစ်ခု ဖြစ်လာသောကြောင့် embedding သည် ၎င်းကို သိမ်းဆည်းထားသော row နှင့် တူညီသော transaction တွင် ရောက်ရှိသည်။ raw images များသည် object storage တွင် ရှိနေမည်ဖြစ်ပြီး vector များနှင့် case metadata များသည် Oracle တွင် ရှိနေသည်။

မေးမြန်းချိန်တွင် Oracle သည် archive တစ်လျှောက် cosine အကွာအဝေးဖြင့် အနီးဆုံးအိမ်နီးချင်းရှာဖွေမှုကို လုပ်ဆောင်ပြီး ၎င်းတို့၏ မူလတွေ့ရှိချက်များ၊ ရောဂါရှာဖွေမှုများနှင့် ရလဒ်များနှင့်အတူ အနီးစပ်ဆုံး case များကို ပြန်ပေးသည်။ ထိုရယူထားသော set သည် Supermicro server ရှိ H100 GPU တစ်ခုတွင် Ollama မှ ဝန်ဆောင်မှုပေးသော Llama 3 အတွက် context ဖြစ်ပြီး အစီရင်ခံစာကို ရေးသားသည်- clinical priority၊ findings summary၊ ranked differential diagnosis နှင့် recommended actions များကို ၎င်းအောက်တွင် ကိုက်ညီသော case များဖြင့် ဖော်ပြထားသည်။ Endoscopy သည် တူညီသောလမ်းကြောင်းကို လိုက်နာပြီး clinical note ကို ထည့်သွင်းသည်။ video အတွက် pipeline သည် GI tract တစ်လျှောက်တွင် lesion တစ်ခုကို ခြေရာခံနိုင်စေရန် frame-by-frame ကို embed လုပ်သည်။
အပလီကေးရှင်းသည် တူညီသော FlashSystem volume များနှင့် workload နှစ်ခုကို လုပ်ဆောင်သည်။ transactional workload တွင် logins၊ report storage၊ audit logging နှင့် session များ ပါဝင်သည်။ vector workload သည် embedding table များနှင့် case metadata များတွင် high fan-out random read များကို လုပ်ဆောင်ပြီး I/O QoS demonstration ရှိ generator profile နှင့် ကိုက်ညီစေသည်။ IBM ၏ deployment သည် အစောပိုင်းကဖော်ပြခဲ့သော volume throttles များကို သတ်မှတ်ပေးသောကြောင့် batch re-embedding job သည် case တစ်ခုထဲသို့ ဝင်ရောက်လာသော clinician ကို နှေးကွေးစေမည်မဟုတ်ပါ။ အထက်တွင်ပြထားသည့် ransomware detection နှင့် partition migration သည် ဤ volume များအတွက် မပြောင်းလဲဘဲ သက်ရောက်မှုရှိသည်။

အရင်းအမြစ်များစွာအသုံးပြုရသည့် အဆင့်မှာ archive တည်ဆောက်ခြင်းဖြစ်ပြီး IBM သည် တူညီသော မော်ဒယ်နှင့် တူညီသော VECTOR(768, FLOAT32) target ဖြင့် ရုပ်ပုံ ၁၁၂,၁၂၀ ပါ ရင်ဘတ် X-ray set အပြည့်အစုံကို နှစ်ကြိမ်ထည့်သွင်းခြင်းဖြင့် တိုင်းတာခဲ့သည်။ ONNX မော်ဒယ်ကို host CPU များပေါ်ရှိ database အတွင်းတွင် လည်ပတ်နေချိန်တွင် pipeline သည် တစ်ကြိမ်ထည့်သွင်းမှုလျှင် ၀.၂၇၂ စက္ကန့်ဖြင့် တစ်စက္ကန့်လျှင် ရုပ်ပုံ ၃.၄၁ ပုံ ရရှိခဲ့ပြီး အစုံအပြည့်အစုံသည် ၉.၁ နာရီကြာမြင့်ခဲ့သည်။ မော်ဒယ်ကို ဒုတိယ server ရှိ Oracle ၏ Private AI Services container သို့ ရွှေ့ပြောင်းခြင်းဖြင့် throughput ကို တစ်စက္ကန့်လျှင် ရုပ်ပုံ ၈.၅၅ ပုံ (ပုံတစ်ပုံလျှင် ၀.၀၉၇ စက္ကန့်) အထိ မြှင့်တင်ပေးခဲ့ပြီး တူညီသော ingest ကို ၃.၆ နာရီအတွင်း ပြီးစီးခဲ့သည်။

Preprocessing (ပုံတစ်ပုံလျှင် ၀.၀၁၉ စက္ကန့်ခန့်) နှင့် Oracle insert (မီလီစက္ကန့်အောက်) တို့သည် နှစ်ခုလုံးတွင် အတူတူပင်ဖြစ်သောကြောင့် 2.5x gain သည် မော်ဒယ်က execute လုပ်သည့်နေရာမှ အပြည့်အဝလာပါသည်။ Private AI Services embedding service သည် CPU ONNX runtime တွင် run သောကြောင့် ထို server ရှိ H100s များသည် ဤစမ်းသပ်မှုတွင် မပါဝင်ခဲ့ပါ။ gain သည် မော်ဒယ်ကို database host မှ ဖယ်ရှားခြင်းမှ ရရှိခဲ့ပြီး pipeline ၏ GPU ၏ဝေစုမှာ နောက်တွင် ဆွေးနွေးမည့် index build ဖြစ်သည်။
IBM သည် ဤကိန်းဂဏန်းများကို Colorado ဓာတ်ခွဲခန်းတွင် တိုင်းတာခဲ့ပြီး၊ ကျွန်ုပ်တို့သည် စမ်းသပ်မှုကို လုပ်ဆောင်ခြင်း သို့မဟုတ် စာရင်းစစ်ခြင်း မပြုခဲ့ပါ။ လက်တွေ့ကျသောအချက်မှာ မော်ကွန်းတိုက်၏ ပထမဆုံး embed လုပ်ခြင်းနှင့် မော်ဒယ်ပြောင်းလဲပြီးနောက် ပြန်လည် embed လုပ်ခြင်းတိုင်းကို နာရီအလိုက် batch job ဖြင့် တိုင်းတာပြီး နောက်ဆက်တွဲ retrieval လုပ်ခြင်းကို မီလီစက္ကန့်ဖြင့် တိုင်းတာသည်။
အဲဒီ container မှာပဲ index တည်ဆောက်မှုကိုလည်း ကိုင်တွယ်ပါတယ်။ Oracle 26ai ဟာ HNSW build ကို container ရဲ့ Vector Index Service ကို ပို့နိုင်ပါတယ်။ အဲဒီဝန်ဆောင်မှုက GPU မှာ NVIDIA cuVS ကိုသုံးပြီး neighbor graph ကို တည်ဆောက်ပါတယ်။ ပြီးရင် GPU မပါဝင်ဘဲ ရှာဖွေမှုတွေ လုပ်ဆောင်ပါတယ်။ IBM ရဲ့ မှတ်တမ်းတင်မှုမှာ baseline HNSW build (32 neighbors, efConstruction 200) ဟာ database မှာ 8.47 စက္ကန့်နဲ့ offload နဲ့ 2.26 စက္ကန့် ကြာမြင့်ပြီး 3.7x လျှော့ချမှု ရှိခဲ့ပါတယ်။ အဲဒီ run မှာ demonstration table သေးသေးလေးတစ်ခုကို အသုံးပြုထားတာကြောင့် path က ဒီ configuration မှာ အလုပ်လုပ်တယ်ဆိုတာ အတည်ပြုပါတယ်။ clinical-scale number ကို တိုင်းတာဖို့ လိုအပ်နေပါသေးတယ်။
ဤစာတမ်း၏ အဓိကအချက်အချာတွင် အလုပ်ခွဲဝေမှုကို အပလီကေးရှင်းက သရုပ်ပြထားသည်။ GPU server သည် ဘာသာစကားမော်ဒယ်ကို လက်ခံဆောင်ရွက်ပေးပြီး archive builds သို့မဟုတ် rebuilds များအတွင်း embedding နှင့် indexing services များကို ဆောင်ရွက်ပေးပါသည်။ database သည် ၎င်းတို့ဖော်ပြသည့် မှတ်တမ်းများနှင့်အတူ vectors များကို သိမ်းဆည်းပြီး array နှင့် fabric သည် retrieval reads နှင့် transactions များကို ကိုင်တွယ်ပါသည်။ retrieval path ရှိ မည်သည့်အဆင့်မျှ external API ကို အသုံးမပြုပါ။ လူနာဒေတာသည် data center မှ ဘယ်သောအခါမှ မထွက်ခွာပါ။
IBM သည် ကျန်းမာရေးစောင့်ရှောက်မှုကို ဒေါင်လိုက်အဖြစ် ရွေးချယ်ခဲ့ပြီး ပုံစံတွင် မည်သည့်အရာမှ ၎င်းနှင့် သီးသန့်မပါဝင်ပါ။ X-ray မော်ကွန်းတိုက်ကို တောင်းဆိုမှုမှတ်တမ်းများ၊ ပြုပြင်ထိန်းသိမ်းမှုမှတ်တမ်းများ သို့မဟုတ် ထုတ်ကုန်ကတ်တလောက်အတွက် လဲလှယ်ပြီး တူညီသော အပိုင်းသုံးပိုင်းကို သယ်ဆောင်သွားသည်- ၎င်းတို့ဖော်ပြသည့် မှတ်တမ်းများဘေးတွင် သိမ်းဆည်းထားသော vector များ၊ GPU server တွင် generation နှင့် array တစ်ခုတွင် retrieval နှင့် transaction များ။ ၎င်းတွင်ရှိနှင့်ပြီးသော data ကို ကောက်ချက်ချသည့် မည်သည့်စက်မှုလုပ်ငန်းမဆို တူညီသော architecture ပေါ်တွင် ဆင်းသက်သည်။
နောင်လာမည့်အရာ
အတည်ပြုခြင်းကို တူညီသော hardware တွင် ဆက်လက်လုပ်ဆောင်သည်- အဆင့် ၂ သည် inference engine ၏ KV cache ကို GPU memory မှ တူညီသော Fibre Channel fabric ပေါ်ရှိ FlashSystem သို့ ရွှေ့ပေးသောကြောင့် long-context model သည် ၎င်း၏အလုပ်လုပ်ပုံများကို ပိုမိုရရှိနိုင်စေပါသည်။ ဤစီးရီး၏ နောက်စာတမ်းတွင် ထိုအလုပ်ကို ဖော်ပြထားသည်။ IBM သည် content-aware refresh pipeline တစ်ခုကိုလည်း တည်ဆောက်နေပြီး IBM Storage Scale AFM နှင့် Kafka တို့သည် စာရွက်စာတမ်းအသစ်များကို in-database ONNX vectorization ထဲသို့ ပေးပို့သောကြောင့် vector index သည် ၎င်း၏ရင်းမြစ်များကို batch re-embed မလုပ်ဘဲ ခြေရာခံသည်။ IBM သည် vector search ကို ထည့်သွင်းထားသော အခြား multi-model database များသို့ တူညီသော storage validation ကို တိုးချဲ့ရန်လည်း စီစဉ်ထားသည်။
အဆင့် ၂ မှာ လုံခြုံရေးအလွှာကို အချက်အလက်အသစ်တွေမှာ အလုပ်လုပ်စေပါတယ်။ KV cache ဟာ FlashSystem ပေါ် ရောက်သွားတဲ့အခါ ကျန်းမာရေးစောင့်ရှောက်မှုပုံစံရဲ့ အလုပ်လုပ်ပုံ (လူနာမှတ်တမ်းအပါအဝင်) ဟာ vector index နဲ့ transactional record တွေလိုပဲ Fibre Channel link တွေကို ဖြတ်ကျော်သွားပါတယ်။ Emulex SecureHBA တွေက Brocade Gen 8 fabric က encrypted traffic ကို transparently သယ်ဆောင်ပေးပြီး inter-switch link (ISL) နဲ့ long-distance traffic အတွက် post-quantum cryptography ကိုလည်း ပေးစွမ်းပါတယ်။ အဆင့်တစ်ခုစီက data တွေ clearly သွားလာနိုင်တဲ့ path မထည့်ဘဲ fabric မှာ workload တစ်ခု ထပ်ထည့်ပေးပါတယ်။
Leaderboard: ကျွန်ုပ်တို့၏ Best Storage Arrays စာမျက်နှာ ရှိ IBM ၏ပရိုဖိုင်တွင် Storage Scale နှင့်အတူ FlashSystem block storage ကိုယခုဖော်ပြထားသည်။
ဤအစီရင်ခံစာကို Broadcom မှ ကမကထပြုပါသည်။ ဤအစီရင်ခံစာတွင် ဖော်ပြထားသော အမြင်များနှင့် ထင်မြင်ယူဆချက်အားလုံးသည် ထည့်သွင်းစဉ်းစားနေသော ထုတ်ကုန်(များ)အပေါ် ကျွန်ုပ်တို့၏ ဘက်မလိုက်သော အမြင်ပေါ်တွင် အခြေခံထားပါသည်။



 အမေဇုံ