

Ollama 0.40.11 သည် Windows အသုံးပြုသူများအား desktop chat application နှင့် အခြား software အတွက် local model runtime ကို ပေးသည်။ Ollama သည် ၎င်း၏ မူရင်း command-line interface ထက် ကျော်လွန်၍ ရှာဖွေနိုင်သော model selector၊ image attachment များနှင့် coding tools များသို့ link များကို ထည့်သွင်းထားသည်။ စမ်းသပ်ရန်အတွက် လိုအပ်သော control အချို့သည် PowerShell နှင့် model configuration files များတွင် ရှိနေဆဲဖြစ်သည်။
ကျွန်ုပ်တို့သည် Ollama ကို ကျွန်ုပ်တို့၏ HP Z4 Rack G5 တွင် Windows 11 Pro for Workstations ကိုအသုံးပြုထားပြီး 128GB RAM နှင့် NVIDIA RTX 5000 Ada Generation GPU ပါရှိသည်။ ကျွန်ုပ်တို့၏ရှိပြီးသား Jan V3.5 4B နှင့် Jan V2 VL High GGUF များကိုအသုံးပြု၍ generation speed၊ chat၊ image များ၊ online search နှင့် local API တို့ကို စမ်းသပ်ခဲ့သည်။ Ollama သည် ကျွန်ုပ်တို့၏ local model များကို ကောင်းစွာလည်ပတ်နိုင်ခဲ့သော်လည်း GGUF များကို import လုပ်ခြင်းနှင့် performance data များစုဆောင်းခြင်းသည် desktop chat မှ ကျွန်ုပ်တို့ကို ထုတ်ပယ်ခဲ့သည်။ ၎င်းသည် Jan နှင့် Open WebUI ပြီးနောက် ကျွန်ုပ်တို့၏ local LLM series တွင် တတိယမြောက် application ဖြစ်ပြီး ရလဒ်များကို ကျွန်ုပ်တို့၏ Best Local LLM Tools စာမျက်နှာတွင် ဖော်ပြထားပါသည်။
စမ်းသပ်ခြင်းစနစ်
| component | configuration |
|---|---|
| ကွန်ပျူတာစက်လည်ပတ်ရေးစနစ်ပရိုဂရမ် | Workstations အတွက် Windows 11 Pro |
| စီပီယူ | Intel Xeon w5-2465X၊ 16 cores |
| မှတ်ဉာဏ် | 128GB |
| GPU ကို | NVIDIA RTX 5000 Ada မျိုးဆက် |
| VRAM အ | ၃၂GB (၃၂,၇၆၀ MiB အစီရင်ခံထားသည်) |
| NVIDIA ဒရိုက်ဗာ | 597.06 |
| CUDA လိုက်ဖက်ညီမှု | ၁၃.၂ (nvidia-smi မှ အစီရင်ခံထားသည်) |
| အိုလာမာ | 0.40.11 |
| ကောက်ချက်ချချိန် | Ollama llama.cpp runner (တည်ဆောက်နံပါတ်ကို မှတ်တမ်းတင်မထားပါ) |
Ollama ကို ထည့်သွင်းခြင်းနှင့် စတင်အသုံးပြုခြင်း
ကျွန်ုပ်တို့၏ Windows workstation တွင် Ollama ကို ထည့်သွင်းခြင်းသည် ဤစီးရီးရှိ အခြား application များတွင် ကြုံတွေ့ရသော setup ခေါင်းခဲမှုအချို့နှင့် နှိုင်းယှဉ်ပါက ကြိုဆိုဖွယ်ကောင်းသော ပြောင်းလဲမှုတစ်ခုဖြစ်သည်။ ကျွန်ုပ်တို့သည် standard Windows installer ကို ဒေါင်းလုဒ်လုပ်ပြီး application ကို စတင်ခဲ့ပြီး သီးခြား inference runtime ကို ထည့်သွင်းရန် သို့မဟုတ် CUDA package များကို ခြေရာခံရန် မလိုအပ်ပါ။ PowerShell ကို အမြန်စစ်ဆေးကြည့်ခြင်းဖြင့် Ollama 0.40.11 သည် လည်ပတ်နေပြီး ၎င်း၏ local service သည် http://127.0.0.1:11434 တွင် တုံ့ပြန်နေပြီဖြစ်ကြောင်း အတည်ပြုခဲ့သည်။
Ollama ရဲ့ ကြိုဆိုမျက်နှာပြင်က အဓိက interface ကို မဖွင့်ခင်မှာ ဒေသတွင်း AI လုပ်ဆောင်ချက်တွေနဲ့ coding tool တွေနဲ့ ချိတ်ဆက်မှုတွေကို မိတ်ဆက်ပေးပါတယ်။
ကြိုဆိုရေးစခရင်ကို ကျော်သွားပြီးနောက်၊ အိုလာမာသည် ဘယ်ဘက်ဘေးဘားရှိ မကြာသေးမီက စကားပြောဆိုမှုများ၊ အက်ပ်များနှင့် ဆက်တင်များပါရှိသော ရင်းနှီးသော ချတ်အင်တာဖေ့စ်ကို ဖွင့်လိုက်သည်။ မက်ဆေ့ချ်အကွက်တွင် ပူးတွဲပါခလုတ်၊ ဝဘ်ရှာဖွေမှုနှင့် မော်ဒယ်ရွေးချယ်ကိရိယာတို့ကို အတူတကွထားရှိသည်။ အကောင့်တစ်ခုမဖန်တီးဘဲ ကျွန်ုပ်တို့၏ တင်သွင်းလာသော ဒေသတွင်းမော်ဒယ်များနှင့် ချတ်လုပ်နိုင်ပါသည်။ သို့သော် စမ်းသပ်နေစဉ်အတွင်း ဝဘ်ရှာဖွေမှုကို ဖွင့်ရန် အိုလာမာက ကျွန်ုပ်တို့အား အကောင့်ဝင်ရန် တောင်းဆိုခဲ့သည်။
မော်ဒယ်များကို ကြည့်ရှုခြင်းနှင့် ထည့်သွင်းခြင်း
Ollama က မော်ဒယ်ရွေးချယ်မှုကို ရိုးရှင်းအောင်ထားပေးပြီး ထည့်သွင်းထားတဲ့ မော်ဒယ်တွေနဲ့ ဒေါင်းလုဒ်လုပ်နိုင်တဲ့ တခြားမော်ဒယ်တွေကို ပြသတဲ့ dropdown တစ်ခုပါရှိပါတယ်။ ကျွန်ုပ်တို့တင်သွင်းထားတဲ့ Jan မော်ဒယ်တွေနဲ့ Qwen3-VL မော်ဒယ်တွေကို cloud-based option အများအပြားနဲ့အတူ မြင်တွေ့နိုင်ပြီး cloud icon ငယ်လေးတစ်ခုနဲ့ ခွဲခြားသိရှိနိုင်ပါတယ်။ တခြားမော်ဒယ်တွေကို ရှာဖွေဖို့အတွက် search field တစ်ခုလည်း ရှိပါတယ်၊ ဒါပေမယ့် မော်ဒယ်အရွယ်အစား၊ ပမာဏနဲ့ hardware လိုအပ်ချက်တွေလိုမျိုး နောက်ထပ်အချက်အလက်တွေကို ဒီမှာ မြင်တွေ့ချင်ပါတယ်။ Jan ကတော့ သူ့ရဲ့ model hub ကနေတစ်ဆင့် အဲဒီအသေးစိတ်အချက်အလက်တွေကို ပေးစွမ်းပြီး Ollama ကတော့ အဲဒီအချက်အလက်အများစုကို main chat interface မှာ မသိမ်းဆည်းထားပါဘူး။
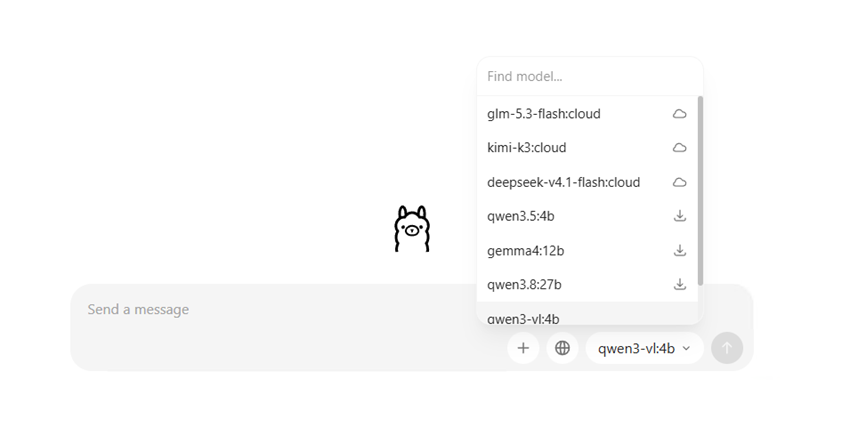
မော်ဒယ်ရွေးချယ်မှုသည် ဒေါင်းလုဒ်လုပ်နိုင်သော မော်ဒယ်များနှင့် cloud မော်ဒယ်များကို ထည့်သွင်းထားသော ဒေသတွင်း မော်ဒယ်များနှင့်အတူ ယူဆောင်လာပါသည်။
စွမ်းဆောင်ရည်စမ်းသပ်မှုတွေကို တတ်နိုင်သမျှ နှိုင်းယှဉ်နိုင်အောင် ထိန်းသိမ်းထားဖို့၊ ကျွန်တော်တို့ရဲ့ benchmark မော်ဒယ်နှစ်ခုကို Ollama ထဲ ထည့်သွင်းဖို့က အလုပ်ပိုလုပ်ရပါတယ်။ ဘာလို့လဲဆိုတော့ ကျွန်တော်တို့ရဲ့ ယခင်သုံးသပ်ချက်တွေက GGUF ဖိုင်တွေကို တစ်ထပ်တည်း အသုံးပြုချင်လို့ပါ။ Ollama က မော်ဒယ်တွေကို desktop interface ကနေ တိုက်ရိုက် download လုပ်ခွင့်ပေးပေမယ့် workstation မှာ သိမ်းထားပြီးသား GGUF ဖိုင်တွေကို import လုပ်ဖို့ option ကို ရှာမတွေ့ခဲ့ပါဘူး။ PowerShell ကို အသုံးပြုပြီး မော်ဒယ်တစ်ခုချင်းစီအတွက် ရှိပြီးသား GGUF ကို ညွှန်ပြပြီး ကျွန်တော်တို့ရဲ့ အစောပိုင်းစမ်းသပ်မှုတွေမှာ အသုံးပြုခဲ့တဲ့ sampling parameters တွေပါဝင်တဲ့ Modelfile တစ်ခု ဖန်တီးခဲ့ရပါတယ်။ ပြီးတော့ ကျွန်တော်တို့ အသုံးပြုခဲ့ပါတယ်။ ollama create ၎င်းတို့ကို Ollama ၏ မော်ဒယ်စာကြည့်တိုက်ထဲသို့ ထည့်သွင်းရန် command။
Jan V3.5 ပေါ်လာပြီး တင်သွင်းမှုနှစ်ခုစလုံးသည် ပြဿနာမရှိဘဲ အလုပ်လုပ်ခဲ့သည် jan-v35-sr နှင့် Jan V2 VL မြင့်မားသော jan-v2-srသီးခြား ရုပ်ပုံခွဲခြမ်းစိတ်ဖြာမှု စမ်းသပ်မှုအတွက် Ollama မှတစ်ဆင့် Qwen3-VL 4B ကိုလည်း တိုက်ရိုက် ဒေါင်းလုဒ်လုပ်ထားပါသည်။
မော်ဒယ်များကို တင်သွင်းပြီးနောက်၊ Ollama က ၎င်းတို့ကို မည်သို့ဖော်ထုတ်ခဲ့သည်နှင့် ၎င်းတို့၏ဆက်တင်များသည် ကောင်းမွန်စွာ ဆက်လက်တည်ရှိနေခြင်း ရှိ၊ မရှိကို ကျွန်ုပ်တို့ စစ်ဆေးခဲ့ပါသည်။ Jan V2 VL High ကို Q4_K_M quantization ကို အသုံးပြု၍ 8.2-billion-parameter Qwen3-VL မော်ဒယ်အဖြစ် အသိအမှတ်ပြုခဲ့ပြီး ၎င်းသည် ကျွန်ုပ်တို့၏ မူရင်းဖိုင်နှင့် ကိုက်ညီပါသည်။ Jan V3.5 သည် ခြွင်းချက်ဖြစ်သည်၊ အဘယ်ကြောင့်ဆိုသော် ကျွန်ုပ်တို့ တင်သွင်းခဲ့သော GGUF ကို အမည်ပေးထားသောကြောင့်ဖြစ်သည်။ Jan-v3.5-4B-Q4_K_XL.gguf, ဒါပေမယ့် Ollama က သူ့ရဲ့ quantization ကို Q4_K_M အဖြစ် တင်ပြခဲ့ပါတယ်။ မူရင်းဖိုင်ကို မပြောင်းလဲဘဲ ထားခဲ့ပါတယ်။ ဖြစ်နိုင်ခြေရှိတဲ့ အကြောင်းရင်းကတော့ Q4_K_XL ဟာ Unsloth ရဲ့ dynamic quantization ဖြစ်ပြီး အများစုကတော့ Q4_K_M layer တွေကနေ တည်ဆောက်ထားတာဖြစ်ပြီး ဖိုင်ရဲ့ metadata က အဲဒီ base type ကို မှတ်တမ်းတင်ထားပါတယ်။
မော်ဒယ်ဆက်တင်များနှင့် GPU အသုံးပြုမှု
Ollama ရဲ့ Settings စာမျက်နှာမှာ cloud access၊ automatic updates၊ network access၊ model-storage path နဲ့ context-length slider တို့ ပါဝင်ပါတယ်။ ကျွန်တော်တို့ ပထမဆုံး စစ်ဆေးတုန်းက 32K ပြသခဲ့ပါတယ်။ ကျွန်တော်တို့ရဲ့ performance test တွေက API ကနေတစ်ဆင့် token ၈,၁၉၂ ခုကို ရှင်းရှင်းလင်းလင်း တောင်းဆိုခဲ့တာကြောင့် အောက်က benchmark ရလဒ်တွေက desktop default မဟုတ်ဘဲ အဲဒီ context ကို အသုံးပြုထားပါတယ်။
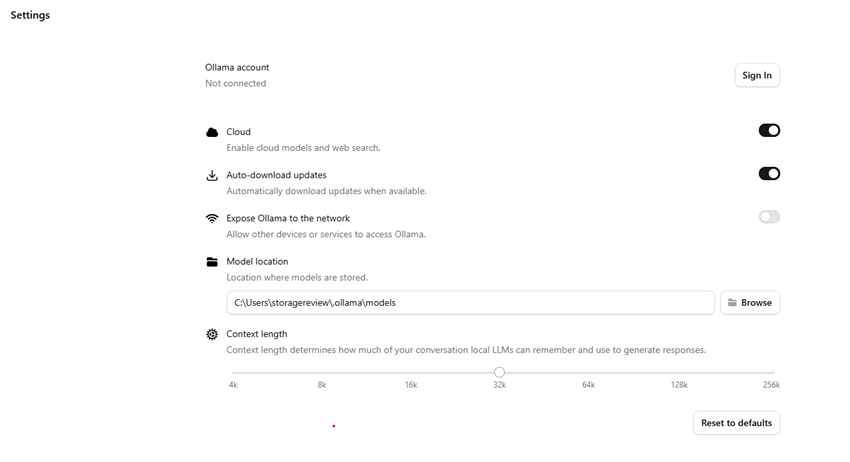
Settings စာမျက်နှာတွင် cloud၊ update၊ network၊ model-storage နှင့် context-length ရွေးချယ်စရာများကို ပေးဆောင်သည်။ ဤနေရာတွင်ပြသထားသော ကနဦး context setting သည် 32K ဖြစ်သည်။
Ollama သည် Jan ကဲ့သို့ desktop interface မှတစ်ဆင့် မော်ဒယ်ဖွဲ့စည်းမှုအဆင့်ကို မပေးဆောင်သောကြောင့်၊ ကျွန်ုပ်တို့သည် Modelfiles နှင့် API requests များမှတစ်ဆင့် အများစုကို ချိန်ညှိမှုများ ပြုလုပ်ခဲ့ပါသည်။ ကျွန်ုပ်တို့၏ benchmarks များကို နှိုင်းယှဉ်နိုင်စေရန်အတွက်၊ ကျွန်ုပ်တို့၏ ယခင်စမ်းသပ်မှုများကဲ့သို့ setting များကို အသုံးပြုခဲ့သည်- အပူချိန် 0.8၊ Top K 40၊ Top P 0.95၊ Min P 0.05 နှင့် ထပ်ခါတလဲလဲပြစ်ဒဏ် 1.0။ ကျွန်ုပ်တို့သည် batch size 2,048 ကိုလည်း တောင်းဆိုခဲ့သော်လည်း၊ Ollama သည် ၎င်းကို ထုတ်လုပ်မှုအတွင်း အသုံးပြုခဲ့ခြင်း ရှိ၊ မရှိကို သီးခြားစီ အတည်မပြုနိုင်ပါ။
GPU configuration ကလည်း ကွဲပြားပါတယ်၊ ဘာလို့လဲဆိုတော့ ဇန်နဝါရီလမှာ ကျွန်တော်တို့အသုံးပြုခဲ့တဲ့ GPU layer ၁၀၀ နဲ့ ညီမျှတဲ့ desktop setting မရှိလို့ပါ။ Ollama က GPU offloading ကို အလိုအလျောက် ကိုင်တွယ်ခဲ့ပြီး အမြန်စစ်ဆေးဖို့... ollama ps တင်သွင်းလာသော မော်ဒယ်နှစ်ခုစလုံးသည် RTX 5000 Ada တွင်သာ အပြည့်အဝလည်ပတ်နေကြောင်း အတည်ပြုခဲ့သည်။
ကျွန်ုပ်တို့သည် ထိုအစီရင်ခံစာကို NVIDIA ၏ကိုယ်ပိုင်ဖတ်ရှုမှုများနှင့် တိုက်ဆိုင်စစ်ဆေးခဲ့ပါသည်။ Jan V3.5 သည် loading လုပ်ပြီးနောက် VRAM allocation ကို gigabytes အများအပြားတိုးမြှင့်ခဲ့ပြီး၊ ထုတ်လုပ်မှုကာလအတွင်း live reading သည် 93 ရာခိုင်နှုန်း GPU utilization သို့ရောက်ရှိခဲ့သည်။ Jan V2 သည် GPU residency အပြည့်အစုံကိုလည်း အစီရင်ခံခဲ့ပြီး ကျွန်ုပ်တို့၏ diagnostic run တွင် 96 ရာခိုင်နှုန်း utilization ကိုပြသခဲ့သည်။ အနည်းဆုံးတော့ ဤ workstation တွင်၊ အရှိန်မြှင့်ထုတ်လုပ်မှုရရှိရန် သီးခြား CUDA variant သို့မဟုတ် GPU-layer setup မှတစ်ဆင့် အလုပ်လုပ်ရန်မလိုအပ်ပါ။
ဒေသခံမျိုးဆက်စွမ်းဆောင်ရည်
မျိုးဆက်စမ်းသပ်ခြင်းအတွက်၊ ကျွန်ုပ်တို့သည် ဇန်နဝါရီလတွင်ထုတ်ဝေခဲ့သော လက်စွဲစာအုပ်မှ တူညီသော prompt ကို အသုံးပြုခဲ့သည် - “RAID 5 နှင့် RAID 6 တို့ကို ၎င်းတို့၏ပထမဆုံး NAS တည်ဆောက်သူတစ်ဦးအား ရှင်းပြပါ။ တစ်ခုချင်းစီ၏ အဓိကအားသာချက်များနှင့် အားနည်းချက်များကို စကားလုံး ၄၀၀ ခန့်ဖြင့် ထည့်သွင်းပါ။” ကျွန်ုပ်တို့သည် Web Search ကို ပိတ်ပြီး context ကို 8,192 tokens အဖြစ် သတ်မှတ်ကာ API request တစ်ခုစီတွင် ထို user message တစ်ခုတည်းကိုသာ ထည့်သွင်းခဲ့သည်။ ကျွန်ုပ်တို့သည် model တစ်ခုလျှင် warm-up response တစ်ခုကို စွန့်ပစ်ပြီးနောက် တိုင်းတာထားသော run သုံးခုကို စုဆောင်းခဲ့သည်။
မော်ဒယ်နှစ်ခုစလုံးသည် တိုင်းတာထားသော လုပ်ဆောင်မှုသုံးခုစလုံးကို ထုတ်လုပ်မှုချို့ယွင်းမှုမရှိဘဲ ပြီးမြောက်ခဲ့ပြီး GPU အသုံးပြုမှုသည် စမ်းသပ်မှုတစ်လျှောက်လုံး မြင့်မားနေခဲ့သည်။ Ollama သည် မော်ဒယ်နှစ်ခုစလုံးကို GPU အရှိန်မြှင့်တင်မှုအပြည့်အဝဖြင့် လည်ပတ်စေရန်အတွက် နောက်ထပ် CUDA ပြင်ဆင်မှု သို့မဟုတ် ကိုယ်တိုင် GPU-layer ချိန်ညှိမှုများ မလိုအပ်ပါ၊ Open WebUI တွင်မူ CUDA runtime DLL များကို ကိုယ်တိုင်ထည့်သွင်းခဲ့ခြင်းမရှိပါ။
| ပုံစံ | အရေအတွက် | အထွက်တိုကင်များ | ကုဒ်ဖြုတ်မြန်နှုန်း | GPU မှတ်ဉာဏ် |
|---|---|---|---|---|
| ဇန်နဝါရီ V3.5 4B | Q4_K_XL ဖိုင်* | 529 | ၈.၇၁၂ tok/s | ၆.၁ MiB |
| ဇန်နဝါရီ V2 VL မြင့်မားသော | Q4_K_M | 1,696 | ၈.၇၁၂ tok/s | ၆.၁ MiB |
မှတ်ချက်- Output-token အရေအတွက်၊ decode speed များနှင့် GPU memory ကိန်းဂဏန်းများသည် စွန့်ပစ်ထားသော warm-up run တစ်ကြိမ်ပြီးနောက် တိုင်းတာထားသော run သုံးခု၏ ပျမ်းမျှတန်ဖိုးများဖြစ်သည်။ GPU memory သည် တိုင်းတာထားသော run တစ်ခုစီအတွင်း မှတ်တမ်းတင်ထားသော GPU-wide memory အသုံးပြုမှု၏ ပျမ်းမျှတန်ဖိုးဖြစ်သည်။
*Jan V3.5 GGUF ဖိုင်အမည်သည် Q4_K_XL ကို ဖော်ထုတ်ပြီး Ollama ၏ မော်ဒယ်အချက်အလက်သည် Q4_K_M ကို အစီရင်ခံသည်။ အထက်ပါ တင်သွင်းမှုမှတ်စုများကို ကြည့်ပါ။
Jan V3.5 သည် ၎င်း၏တိုင်းတာထားသော လုပ်ဆောင်ချက်များတွင် 145.48၊ 145.73 နှင့် 145.44 tokens/sec မှတ်တမ်းတင်ခဲ့ပြီး Jan V2 သည် 92.87၊ 92.22 နှင့် 92.97 tokens/sec မှတ်တမ်းတင်ခဲ့သည်။ အစုံနှစ်ခုစလုံးသည် လည်ပတ်မှုတစ်ခုနှင့်တစ်ခု နီးကပ်စွာရှိနေခဲ့ပြီး တိုင်းတာထားသော GPU မှတ်ဉာဏ်ထိပ်များသည် အစုံတစ်ခုစီတွင် မပြောင်းလဲခဲ့ပါ။ Jan V2 သည် ကျိုးကြောင်းဆင်ခြင်ခြင်းလုပ်ဆောင်ချက်အပါအဝင် သိသိသာသာပိုမိုအစီရင်ခံထားသော output tokens များကို ထုတ်လုပ်ခဲ့ပုံရသောကြောင့် ထိုစုစုပေါင်းများသည် မြင်နိုင်သောအဖြေအရှည်ကို တိုက်ရိုက်နှိုင်းယှဉ်ခြင်းမဟုတ်ပါ။
တူညီတဲ့ workstation နဲ့ model files တွေမှာ ဒါတွေက ဒီ series မှာ အမြန်ဆုံးရလဒ်တွေပါ။ Jan V3.5 က Jan ထက် ၁၈ ရာခိုင်နှုန်း ပိုမြန်ပြီး (123 tokens/sec) နဲ့ Open WebUI Desktop (115.32) ထက် ၂၆ ရာခိုင်နှုန်း ပိုမြန်တဲ့ decode လုပ်ခဲ့ပြီး Jan V2 က Jan (82) ထက် ၁၃ ရာခိုင်နှုန်း ပိုမြန်ပြီး Open WebUI (75.06) ထက် ၂၄ ရာခိုင်နှုန်း ပိုမြန်ပါတယ်။ application တစ်ခုစီက သူ့ရဲ့ကိုယ်ပိုင် llama.cpp build ကို လုပ်ဆောင်ပြီး GPU offload ကို သူ့ကိုယ်ပိုင်နည်းလမ်းနဲ့ စီမံခန့်ခွဲတာကြောင့် နှိုင်းယှဉ်ချက်က model တစ်ခုတည်းကို မဟုတ်ဘဲ တစ်ခုချင်းစီ ပို့ဆောင်ပေးတဲ့ package အပြည့်အစုံကို ထင်ဟပ်စေပါတယ်။
ထပ်ခါတလဲလဲ တောင်းဆိုမှုများသည် caching ကြောင့် သက်ရောက်မှုရှိနိုင်သည့် အလွန်တိုတောင်းသော အချိန်များကို ဖြစ်ပေါ်စေသောကြောင့် prompt-processing medians များကို ကျွန်ုပ်တို့ မထုတ်ဝေခဲ့ပါ။ runtime setting များသည်လည်း မည်သည့်ရှုထောင့်မှမဆို တူညီနိုင်မည်မဟုတ်ပါ- Jan သည် GPU layer များကို တိုက်ရိုက်ဖော်ထုတ်ခဲ့ပြီး Ollama သည် offload ကို အလိုအလျောက် စီမံခန့်ခွဲခဲ့သည်။
ဒေသတွင်းစကားပြောခန်းအတွက် Ollama အသုံးပြုခြင်း
မော်ဒယ်များကို ထည့်သွင်းပြီးသည်နှင့်၊ ကျွန်ုပ်တို့သည် dropdown မှ Jan V3.5 သို့မဟုတ် Jan V2 ကို ရွေးချယ်ပြီး RAID prompt သို့ ဝင်ရောက်ခဲ့သည်။ အဖြေများသည် ခေါင်းစဉ်များနှင့် စာရင်းများပါရှိပြီး မကြာသေးမီက စကားပြောဆိုမှုများသည် sidebar တွင် ရှိနေခဲ့သည်။ Ollama သည် တုံ့ပြန်မှုများအောက်တွင် generation rate သို့မဟုတ် token count ကို မပြသသောကြောင့်၊ ကျွန်ုပ်တို့သည် ထိုကိန်းဂဏန်းများကို ၎င်း၏ API မှတစ်ဆင့် စုဆောင်းခဲ့သည်။
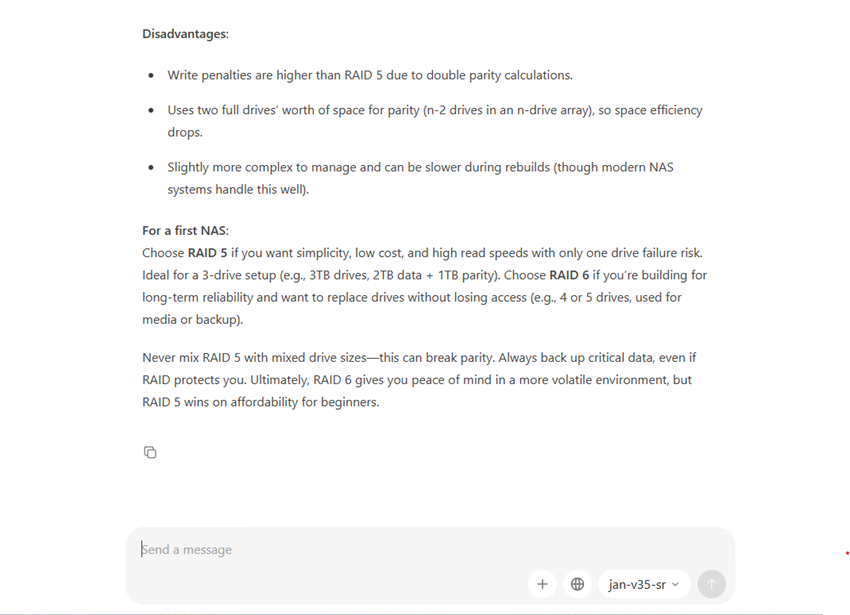
Jan V3.5 သည် Ollama ၏ desktop chat ရှိ RAID 5 နှင့် RAID 6 prompt ကို ဖြေကြားပေးပြီး response အောက်တွင် token-rate မပြသပါ။
Ollama မှာ စကားပြောဆိုမှုတွေကို စီမံခန့်ခွဲရတာ အတော်လေးလွယ်ကူပါတယ်၊ ဘာလို့လဲဆိုတော့ အစောပိုင်းက စကားပြောဆိုမှုကို right click နှိပ်လိုက်ရင် ၎င်းကို အမည်ပြောင်းဖို့ ဒါမှမဟုတ် ဖျက်ပစ်ဖို့ ရွေးချယ်စရာတွေ ပေါ်လာပြီး More tools အောက်မှာ Share option ပါရှိလို့ပါ။ မော်ဒယ်ရဲ့ တုံ့ပြန်မှုတွေအတွက် ရွေးချယ်စရာတွေ သိပ်မများပေမယ့် ကျွန်တော်တို့ ပို့ပြီးသား prompts တွေကိုလည်း ပြန်သွားပြီး တည်းဖြတ်နိုင်ပါတယ်။ ကျွန်တော်တို့တွေ့ရှိခဲ့တဲ့ တစ်ခုတည်းသော ခလုတ်က Copy ခလုတ်ဖြစ်ပြီး အဖြေတစ်ခုပေါ်မှာ mouse မတင်ထားရင်တောင်မှ အဖြေတစ်ခုစီအောက်မှာ မြင်နေရမှာပါ။ အနည်းဆုံးတော့ ကျွန်တော်တို့ စမ်းသပ်ထားတဲ့ ဗားရှင်းမှာတော့ chat window ကနေ response တစ်ခုကို ပြန်လည်ထုတ်လုပ်ဖို့ ဒါမှမဟုတ် ၎င်းရဲ့ generation statistics တွေကို ကြည့်ရှုဖို့ နည်းလမ်းကို ကျွန်တော်တို့ ရှာမတွေ့ခဲ့ပါဘူး။
Ollama မှာ Codex CLI၊ Claude Code၊ OpenCode နဲ့ Cline အပါအဝင် coding assistant တွေပါဝင်တဲ့ Apps အပိုင်းလည်း ရှိပါတယ်။ ဒီပေါင်းစပ်မှုတွေ ဘယ်လိုအလုပ်လုပ်လဲဆိုတာ ကြည့်ချင်လို့ Codex CLI ကို နှိပ်ပြီး ဘယ်လို setup တွေ ပါဝင်လဲဆိုတာ ကြည့်ခဲ့ပါတယ်။ Ollama က configuration screen ကို မဖွင့်ခဲ့ပါဘူး။ launch command ကို clipboard ပေါ် ကူးယူပြီး terminal ထဲ paste လုပ်ဖို့ ပြောခဲ့ပါတယ်။ ကျွန်တော်တို့ full installation ကို မပြီးမြောက်ခဲ့သလို Codex ကို run လည်း မလုပ်ခဲ့ပါဘူး။ ဒါပေမယ့် Ollama က local model တွေကို external application တွေနဲ့ ဘယ်လိုချိတ်ဆက်ပေးလဲဆိုတာကို ပိုကောင်းတဲ့ အကြံဥာဏ်တစ်ခု ပေးခဲ့ပါတယ်။
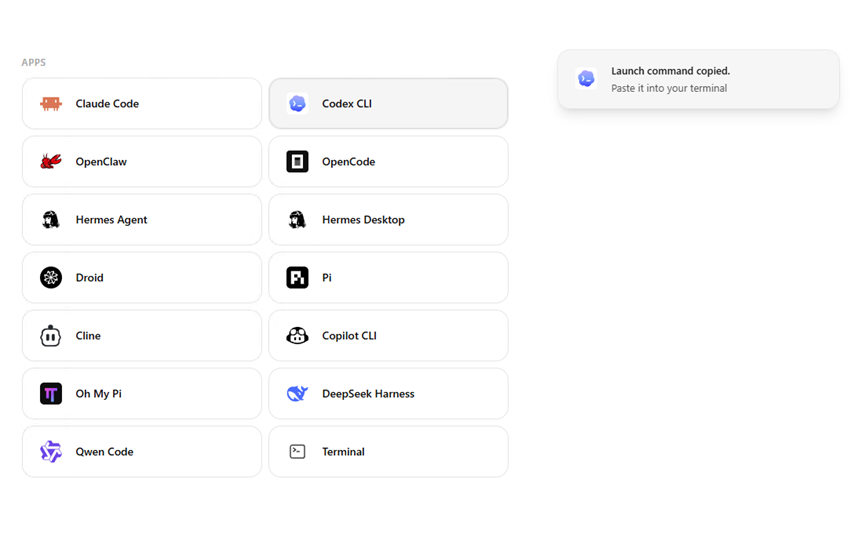
Apps စာမျက်နှာတွင် Codex CLI ကို ရွေးချယ်ခြင်းဖြင့် terminal အတွက် launch command ကို ကူးယူခဲ့ပါသည်။ ကျွန်ုပ်တို့သည် integration ကို ၎င်းကိုယ်တိုင် မလုပ်ဆောင်ခဲ့ပါ။
Web ကိုရှာရန်
Ollama က Chat မှာ attachment control ဘေးမှာ globe button တစ်ခုထားပေမယ့် ရွေးချယ်လိုက်တဲ့အခါ Web Search က Ollama account လိုအပ်တယ်ဆိုတဲ့ မက်ဆေ့ချ်တစ်ခု ပေါ်လာပါတယ်။ အခမဲ့အကောင့်တစ်ခုအတွက် sign up လုပ်ပြီး ဒီ feature ကို enable လုပ်ပြီးတဲ့နောက်မှာ ၂၀၂၆ ခုနှစ် အောက်တိုဘာလ ၁၅ ရက်နေ့အထိ နောက်ဆုံးပေါ် stable Open WebUI release အတွက် source citation နဲ့အတူ မေးမြန်းထားတဲ့ ကျွန်တော်တို့ရဲ့ လက်ရှိစမ်းသပ်မေးခွန်းကို အသုံးပြုခဲ့ပါတယ်။
Ollama ရဲ့ Web Search feature ကို စမ်းသပ်တဲ့အခါ နောက်ထပ်ပြဿနာတစ်ခုနဲ့ ကြုံတွေ့ခဲ့ရပါတယ်။ application က ရလဒ်တွေကို ရယူဖို့ ကြိုးစားပေမယ့် “search API error (status 402)” မက်ဆေ့ချ်ကိုပဲ ပြန်ပေးခဲ့ပါတယ်။ HTTP 402 က Payment Required code ဖြစ်ပြီး search service က paid plan လိုအပ်တယ်လို့ ညွှန်ပြပေမယ့် Ollama က မပြောခဲ့ပါဘူး။ model က ပြဿနာက account pricing ဒါမှမဟုတ် usage limits နဲ့ ဆက်စပ်နေနိုင်တယ်လို့ အကြံပြုထားပေမယ့် အကြောင်းရင်းအတိအကျကိုတော့ ကျွန်တော်တို့ မဆုံးဖြတ်နိုင်ခဲ့ပါဘူး။ ကျွန်တော်တို့ရဲ့ ဒေသတွင်း model တွေက ပုံမှန်အလုပ်လုပ်နေတဲ့အတွက် search service ကို ပြဿနာရှာဖွေရာမှာ အချိန်ပိုမဖြုန်းဖို့ ဆုံးဖြတ်ခဲ့ပါတယ်။ ဒီ series ထဲက တခြား application တွေနဲ့ ကျွန်တော်တို့ ကြိုးစားခဲ့တဲ့ Web Search test ကို မပြီးမြောက်နိုင်တာက စိတ်ပျက်စရာပါပဲ။
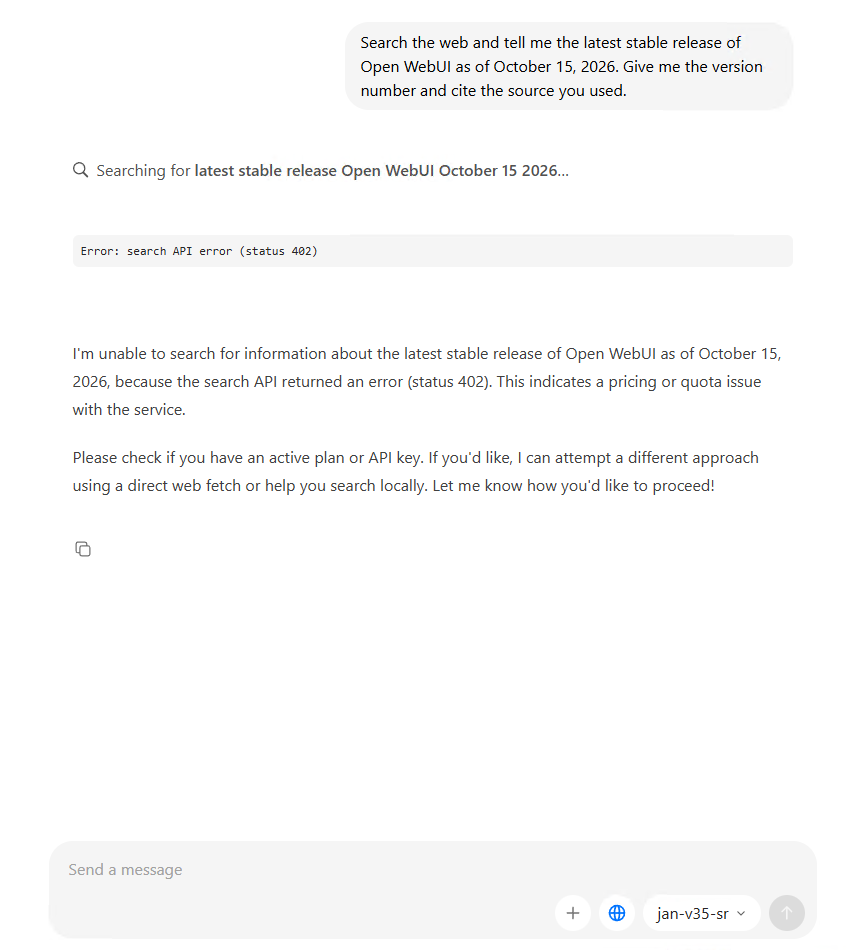
Ollama က ကျွန်ုပ်တို့ရဲ့ အွန်လိုင်းဗားရှင်းရှာဖွေမှုကို ကြိုးစားခဲ့ပေမယ့် ရှာဖွေရေး API ကနေ HTTP 402 အမှားတစ်ခုကို ပြန်ပေးခဲ့ပါတယ်။
ဘက်စုံသုံး ထည့်သွင်းမှု
ကျွန်ုပ်တို့ရဲ့ ပထမဆုံး image test မှာ ဇန်နဝါရီလတုန်းက သီးခြား vision projector နဲ့ အလုပ်လုပ်ခဲ့တဲ့ Jan V2 VL High GGUF ကို အသုံးပြုခဲ့ပါတယ်။ Ollama က language-model file ကို လက်ခံခဲ့ပေမယ့် ကျွန်ုပ်တို့ရဲ့ import procedure က ပူးတွဲပါ mmproj file ကို associate မလုပ်ခဲ့ပါဘူး။ NVIDIA screenshot ကို Jan V2 conversation နဲ့ attach လုပ်တဲ့အခါ၊ prompt မပို့ခင် desktop application က “This model does not support images” လို့ ပြပါတယ်။
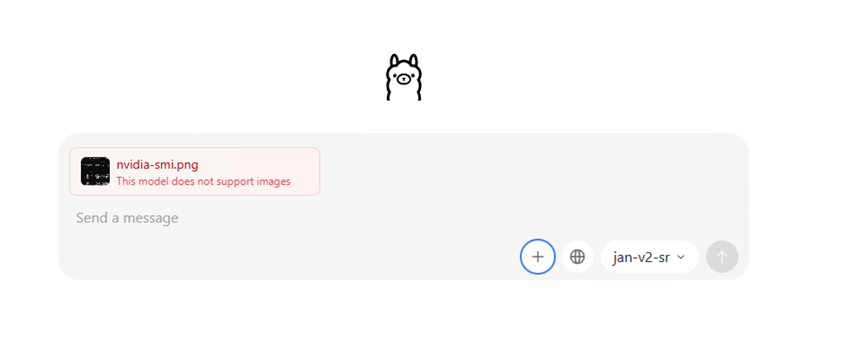
ကျွန်ုပ်တို့တင်သွင်းထားသော Jan V2 VL High မော်ဒယ်သည် ဤဖွဲ့စည်းပုံတွင် ရုပ်ပုံများကို မပံ့ပိုးကြောင်း သတင်းပို့ပြီး NVIDIA ဖန်သားပြင်ဓာတ်ပုံကို ငြင်းပယ်ခဲ့သည်။
ထို့နောက် Ollama မှတစ်ဆင့် ဒေါင်းလုဒ်လုပ်ထားသော Qwen3-VL 4B ကို GPU မော်ဒယ်၊ ဒရိုက်ဘာဗားရှင်း၊ VRAM၊ အသုံးပြုမှု၊ အပူချိန်နှင့် ပါဝါတို့ကို မေးမြန်းသည့် prompt တစ်ခုတည်းကို အသုံးပြု၍ စမ်းကြည့်ခဲ့သည်။ ထိုမော်ဒယ်သည် ဖန်သားပြင်ဓာတ်ပုံကို လက်ခံပြီး RTX 5000 Ada Generation၊ ဒရိုက်ဘာ 597.06၊ 32,760 MiB၊ 0 ရာခိုင်နှုန်း အသုံးပြုမှု၊ 39C နှင့် 40W ဟူသော တန်ဖိုးခြောက်ခုဖြင့် မှန်ကန်သောရလဒ်ကို ရရှိခဲ့သည်။ ၎င်း၏တုံ့ပြန်မှုသည် ပြီးပြည့်စုံခြင်းမရှိပါ၊ အဘယ်ကြောင့်ဆိုသော် နောက်ဆုံးအကျဉ်းချုပ်တွင် ထိုတန်ဖိုးကို ပြင်ဆင်ခြင်းမပြုမီ အသုံးပြုမှု ၈ ရာခိုင်နှုန်းကို မှားယွင်းစွာ ဖတ်ရှုခြင်းကို ခေတ္တပေးခဲ့သောကြောင့်ဖြစ်သည်။
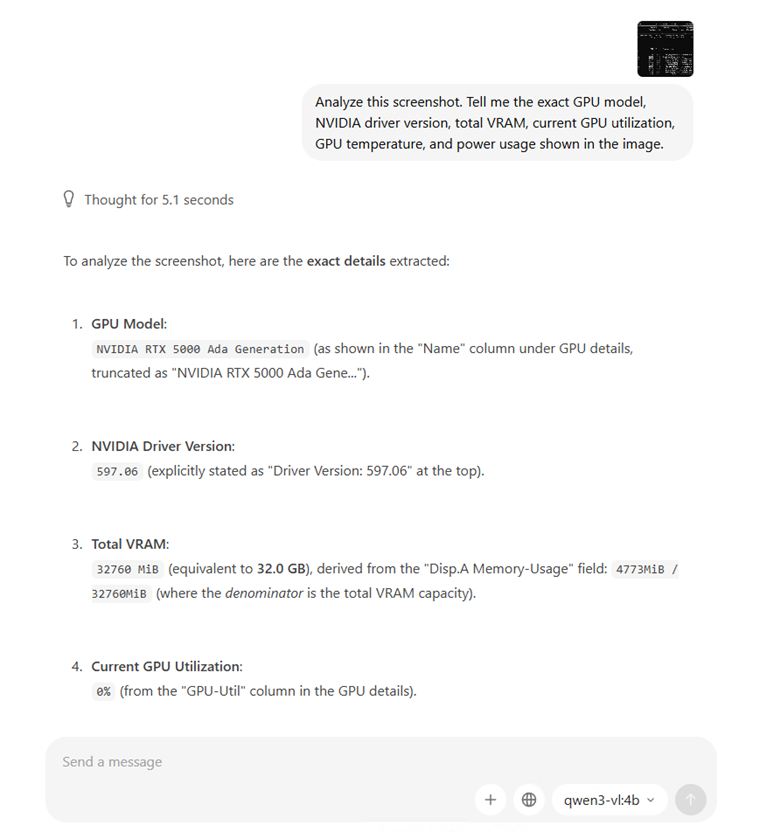
Ollama ရဲ့ Qwen3-VL 4B က ပူးတွဲပါ NVIDIA ဖန်သားပြင်ဓာတ်ပုံကို စီမံဆောင်ရွက်ပြီး ဟာ့ဒ်ဝဲအသေးစိတ်အချက်အလက်တွေကို ဖော်ထုတ်ခဲ့ပါတယ်။ ၎င်းရဲ့ နောက်ဆုံးအကျဉ်းချုပ်က ဖတ်ရှုမှုခြောက်ခုစလုံးကို မှန်ကန်စွာ ပေးခဲ့ပါတယ်။
Ollama မှာ တခြား application တွေလို Windows Snipping Tool ကနေ ပုံတစ်ပုံကို chat window ထဲ တိုက်ရိုက် paste လုပ်လို့မရပါဘူး။ အဲဒီအစား screenshot ကို အရင် save လုပ်ပြီး message field ဘေးက + button ကိုသုံးပြီး upload လုပ်ရပါတယ်။ အဲဒါက ပြဿနာမရှိဘဲ အလုပ်လုပ်ခဲ့ပြီး Ollama ရဲ့ Qwen3-VL model က ပုံကို အောင်မြင်စွာ analyze လုပ်နိုင်ခဲ့ပါတယ်။ ကျွန်ုပ်တို့တင်သွင်းလာတဲ့ Jan V2 model က attachment တစ်ခုတည်းကို လက်မခံနိုင်တာကြောင့် မူရင်း multimodal test ကို ပြန်လုပ်နိုင်စွမ်းကို ကန့်သတ်ထားပါတယ်။
ဒေသတွင်း API ဆာဗာ
Ollama ရဲ့ local API ကို desktop interface ကနေ သီးခြား server တစ်ခု စတင်စရာမလိုဘဲ Windows service စတင်တာနဲ့ အသုံးပြုနိုင်ပါပြီ။ တောင်းဆိုချက်တစ်ခု http://127.0.0.1:11434/v1/models ကျွန်ုပ်တို့တပ်ဆင်ထားသော Jan V3.5 နှင့် Qwen3-VL မော်ဒယ်များကို ပြန်ပို့ပြီး တောင်းဆိုချက်တစ်ခု /v1/chat/completions Jan V3.5 ကိုအသုံးပြု၍ RAID 6 ၏ တစ်ကြောင်းတည်းသောရှင်းလင်းချက်ကို ထုတ်ပေးခဲ့သည်။
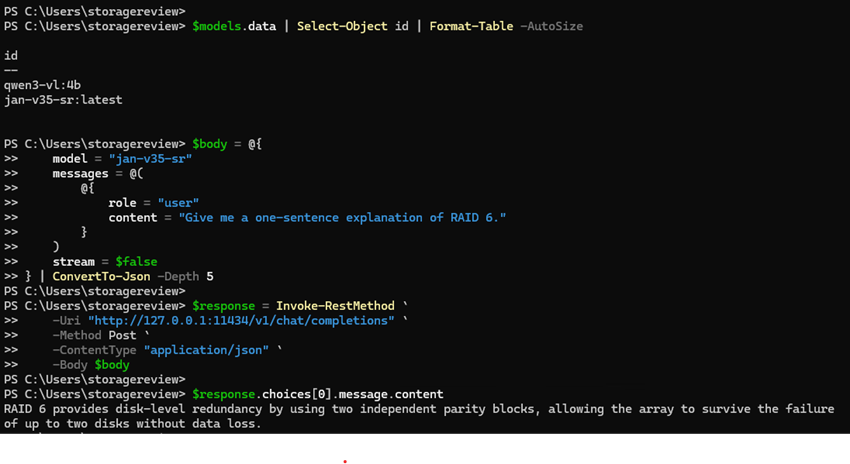
OpenAI နှင့် တွဲဖက်အသုံးပြုနိုင်သော local API သည် Ollama ၏ install လုပ်ထားသော model list နှင့် PowerShell မှတစ်ဆင့် RAID 6 chat response ကို ပြန်ပေးပါသည်။
တုံ့ပြန်မှုတွင် အနည်းငယ် မတိကျသော RAID 6 parity wording ကို အသုံးပြုထားပြီး ၎င်းသည် API ပျက်ကွက်မှုမဟုတ်ဘဲ model-output ပြဿနာတစ်ခုဖြစ်သည်။ အလုပ်လုပ်နေသော endpoint သည် desktop chat မသုံးဘဲ PowerShell မှ local model များကို တိုက်ရိုက် query လုပ်ခွင့်ပြုသည်။
ဘာမှားသှား
ကျွန်တော်တို့ ကြုံတွေ့ခဲ့ရတဲ့ အခက်ခဲဆုံးပြဿနာကတော့ ကျွန်တော်တို့ရဲ့ တင်သွင်းလာတဲ့ Jan V2 VL High မော်ဒယ်ကို ရုပ်ပုံတွေနဲ့ အလုပ်လုပ်အောင် လုပ်ရတာပါပဲ။ GGUF ကို တင်သွင်းတာ ဒါမှမဟုတ် GPU အရှိန်မြှင့်စနစ်အပြည့်နဲ့ စာသားတောင်းဆိုချက်တွေကို လုပ်ဆောင်ရာမှာ ဘာပြဿနာမှ မရှိခဲ့ပေမယ့် NVIDIA screenshot ကို ပူးတွဲကြည့်တဲ့အခါ အခြေအနေတွေ ပြောင်းလဲသွားခဲ့ပါတယ်။ Jan V2 လိုအပ်တဲ့ သီးခြား vision projector မပါဝင်တဲ့အတွက် မော်ဒယ်က ရုပ်ပုံတွေကို မပံ့ပိုးဘူးလို့ Ollama က ပြောပါတယ်။ Ollama ရဲ့ Qwen3-VL download ကို အသုံးပြုပြီး image-analysis စမ်းသပ်မှုကို ပြီးမြောက်အောင် လုပ်ဆောင်နိုင်ခဲ့ပေမယ့် ပြဿနာမရှိဘဲ အလုပ်လုပ်ခဲ့ပါတယ်။ ဒါက Ollama က ရုပ်ပုံတွေကို လုပ်ဆောင်နိုင်တယ်ဆိုတာ ပြသနေပေမယ့် ကျွန်တော်တို့ရဲ့ ရှိပြီးသား Jan V2 မော်ဒယ်ကို အဲဒီလိုလုပ်ဖို့က GGUF ဖိုင်ကို တင်သွင်းသလောက် မလွယ်ကူပါဘူး။
Web Search လုပ်ဆောင်ချက်ကို အသုံးပြုဖို့အတွက် Ollama အကောင့်တစ်ခု ဖန်တီးပြီးမှ ဖွင့်ရပါမယ်။ ကျွန်တော်တို့ရဲ့ စမ်းသပ်မေးခွန်းကို အကောင့်ဝင်ပြီး တင်သွင်းလိုက်တဲ့အခါ ဝန်ဆောင်မှုက HTTP 402 အမှားကို ပြန်ပြပြီး ရှာဖွေမှုရလဒ်တွေ မရှိပါဘူး။ အမှားဘာကြောင့်ဖြစ်တယ်ဆိုတာ ကျွန်တော်တို့ မဆုံးဖြတ်နိုင်ခဲ့ပါဘူး။ ဒါ့အပြင် အဲဒါက အထောက်အကူဖြစ်မဖြစ် မသိဘဲ အကောင့်ဆက်တင်များကို ပြောင်းလဲနေဖို့ ဒါမှမဟုတ် တခြားအစီအစဉ်တွေကို စမ်းကြည့်ဖို့ အကြောင်းပြချက်လည်း သိပ်မရှိပါဘူး။
ကျွန်ုပ်တို့၏ရှိပြီးသားမော်ဒယ်များကိုတင်သွင်းခြင်း၊ ၎င်းတို့၏ဆက်တင်များကိုချိန်ညှိခြင်းနှင့်စွမ်းဆောင်ရည်တိုင်းတာမှုများစုဆောင်းခြင်းကဲ့သို့သောအလုပ်များအတွက် PowerShell သို့မည်မျှမကြာခဏပြန်လာရသည်ကိုလည်းကျွန်ုပ်တို့သတိပြုမိပါသည်။ desktop application သည်နေ့စဉ်စကားပြောဆိုရန်အတွက်အသုံးပြုရလွယ်ကူသော်လည်း Jan ၏ interface မှတစ်ဆင့်ကျွန်ုပ်တို့ရရှိခဲ့သောထိန်းချုပ်မှုအဆင့်ကိုမပေးဆောင်နိုင်ပါ။ ဤပြဿနာများအပြင် Ollama သည်စမ်းသပ်မှုအတွင်းကျွန်ုပ်တို့အားအခက်အခဲအနည်းငယ်သာပေးခဲ့သည်။ မော်ဒယ်နှစ်ခုစလုံးကိုအောင်မြင်စွာတင်သွင်းခဲ့ပြီးတိုင်းတာထားသော benchmark run ခြောက်ခုစလုံးပြီးစီးခဲ့ပြီး local API သည်မျှော်လင့်ထားသည့်အတိုင်းအလုပ်လုပ်ခဲ့သည်။
ကောက်ချက်
Ollama 0.40.11 နဲ့ ကျွန်တော်တို့ရဲ့ စမ်းသပ်မှုကို ယေဘုယျအားဖြင့် ကောင်းမွန်စွာ လုပ်ဆောင်နိုင်ခဲ့ပြီး အထူးသဖြင့် RTX 5000 Ada မှာ ဒေသတွင်း မော်ဒယ်တွေကို အသုံးပြုနိုင်အောင် လုပ်ဆောင်နိုင်ခဲ့ပါတယ်။ ကျွန်တော်တို့ရဲ့ တင်သွင်းလာတဲ့ GGUF နှစ်ခုစလုံးဟာ နောက်ထပ် CUDA setup မလိုအပ်ဘဲ GPU အရှိန်မြှင့်တင်မှု အပြည့်အဝနဲ့ အလုပ်လုပ်ခဲ့ပြီး စွမ်းဆောင်ရည်က စီးရီးကို ဦးဆောင်ခဲ့ပါတယ်။ Jan V3.5 ဟာ ပျမ်းမျှ 145.48 tokens/sec ရရှိခဲ့ပြီး Jan V2 VL High ဟာ 92.87 tokens/sec ရရှိခဲ့ပြီး ဒီစီးရီးမှာ အမြန်ဆုံးရလဒ်တွေဖြစ်ပြီး တူညီတဲ့ workstation မှာ Jan ထက် ၁၃ ရာခိုင်နှုန်းကနေ ၁၈ ရာခိုင်နှုန်းအထိ ပိုများခဲ့ပါတယ်။ အရာအားလုံးကို configure လုပ်ပြီးတာနဲ့ desktop chat interface နဲ့ local API ကြားမှာ ပြောင်းရွှေ့ရာမှာ ဘာပြဿနာမှ မရှိခဲ့ဘဲ တိုင်းတာထားတဲ့ benchmark run တွေအားလုံးကိုလည်း ပြဿနာမရှိဘဲ ပြီးမြောက်ခဲ့ပါတယ်။
နေ့စဉ်စကားပြောဆိုမှုအတွက် Ollama ရဲ့ ရိုးရှင်းမှုကို ကျွန်တော်တို့ သဘောကျပေမယ့် desktop application မှာ မော်ဒယ်တစ်ခုချင်းစီကို ပိုပြီးထိန်းချုပ်နိုင်စေချင်ပါတယ်။ PowerShell ကိုသုံးပြီး ကျွန်တော်တို့ရဲ့ ရှိပြီးသား GGUF တွေကို import လုပ်ဖို့အတွက် Modelfiles တွေ ဖန်တီးရတာက အပိုအဆင့်တွေ ထပ်ထည့်ပေးပါတယ်၊ အထူးသဖြင့် Jan နဲ့ နှိုင်းယှဉ်ရင် အဲဒီ setting အများစုကို interface မှာ တိုက်ရိုက်ရနိုင်ပါတယ်။ ဒါက local model တွေကို run တာနဲ့ ရင်းနှီးပြီးသားသူတစ်ယောက်အတွက် စိတ်အနှောင့်အယှက်ဖြစ်စေမှာ မဟုတ်ပေမယ့် graphical interface ကနေတစ်ဆင့် အရာအားလုံးကို စီမံခန့်ခွဲချင်တဲ့ အသစ်ဝင်လာသူတွေအတွက် Ollama ရဲ့ ကန့်သတ်ချက်တွေကို တွေ့ရှိနိုင်ပါတယ်။ Web Search နဲ့ ကျွန်တော်တို့ရဲ့ import လုပ်ထားတဲ့ vision model မှာလည်း ပြဿနာအနည်းငယ် ကြုံတွေ့ခဲ့ရပေမယ့် ဘယ်ဟာမှ normal text generation ကို မထိခိုက်ခဲ့ပါဘူး။
Ollama မှာ ကျွန်တော်တို့ အကြိုက်ဆုံးကတော့ သီးခြား server တစ်ခု configure လုပ်စရာမလိုဘဲ ဒေသတွင်းမော်ဒယ်တွေကို တခြား application တွေဆီ အလွယ်တကူ ပေးပို့နိုင်ခြင်းပါပဲ။ desktop chat က စတင်အသုံးပြုရတာလွယ်ကူပြီး ဒေသတွင်း API နဲ့ external coding tools တွေအတွက် support ကြောင့် user တွေအနေနဲ့ ဒေသတွင်းမော်ဒယ်တွေနဲ့ chat လုပ်ရုံထက် အများကြီးပိုလုပ်ဆောင်နိုင်ပါတယ်။ desktop interface မှာ ပိုကောင်းတဲ့ model-management control တွေကို မြင်ချင်သေးပေမယ့် Ollama က ကျွန်တော်တို့ရဲ့ workstation မှာ ကောင်းမွန်စွာ လုပ်ဆောင်နိုင်ခဲ့ပြီး ကျွန်တော်တို့ရဲ့ test model နှစ်ခုလုံးကို GPU acceleration နဲ့ run နိုင်အောင် ယုံကြည်စိတ်ချရတဲ့ နည်းလမ်းတစ်ခု ပေးစွမ်းနိုင်ခဲ့ပါတယ်။

ဦးဆောင်သူစာရင်း- ကျွန်ုပ်တို့၏ အကောင်းဆုံးဒေသခံ LLM Tools စာမျက်နှာတွင် Ollama သည် အကောင်းဆုံး ಒಟ್ಟಾರೆ ဒေသတွင်း LLM Runtime ကို ရရှိထားပြီး ယခုရလဒ်များသည် ကျွန်ုပ်တို့၏ Jan နှင့် Open WebUI နံပါတ်များနှင့်အတူ ရှိနေပါသည်။


 အမေဇုံ