

NVIDIA DGX Spark ကို ကျွန်တော်တို့ ပြန်လည်သုံးသပ်တဲ့အခါ storage က platform ရဲ့ အရှင်းလင်းဆုံး ဒီဇိုင်းချို့ယွင်းချက်ဖြစ်ပြီး တခြားဘာမှမဖြစ်ခင် form-factor ပြဿနာတစ်ခုပါ။ Spark ရဲ့ internal slot တွေမှာ packaging က အနိုင်ရပြီး capacity ဆုံးရှုံးတဲ့ 2230 နဲ့ 2242 class တိုတို M.2 drives တွေကို အသုံးပြုထားပါတယ်။ client SSD ဈေးကွက်ရဲ့ high-capacity end ကတော့ full-size 2280 drives တွေဖြစ်ပြီး 8TB မော်ဒယ်တွေကို ဒီနေ့မှာ တင်ပို့ရောင်းချနေပြီး Spark မှာ ထားစရာနေရာမရှိပါဘူး။ ဒါကြောင့် AI အလုပ်တွေအတွက် တည်ဆောက်ထားတဲ့ စက်တစ်လုံးဟာ ပါးလွှာပေါ့ပါးတဲ့ laptop အတွက် ပိုသင့်တော်တဲ့ storage ceiling နဲ့ အတွင်းပိုင်းလမ်းကြောင်း မရှိပါဘူး။ Luisuantech GP Spark က အဲဒီပြဿနာအတွက် အဖြေတစ်ခုပါပဲ။ full-size M.2 drives တွေအတွက် 0.58-liter, four-bay box တစ်ခုဖြစ်ပြီး Spark ရဲ့ 100GbE port နဲ့ ချိတ်ဆက်ထားပြီး drivers ဒါမှမဟုတ် formatting မပါဘဲ native NVMe devices တွေအဖြစ် ပေါ်လာပြီး GPU Direct Storage traffic ကို line rate နဲ့ နီးစပ်အောင် ဝန်ဆောင်မှုပေးပါတယ်။
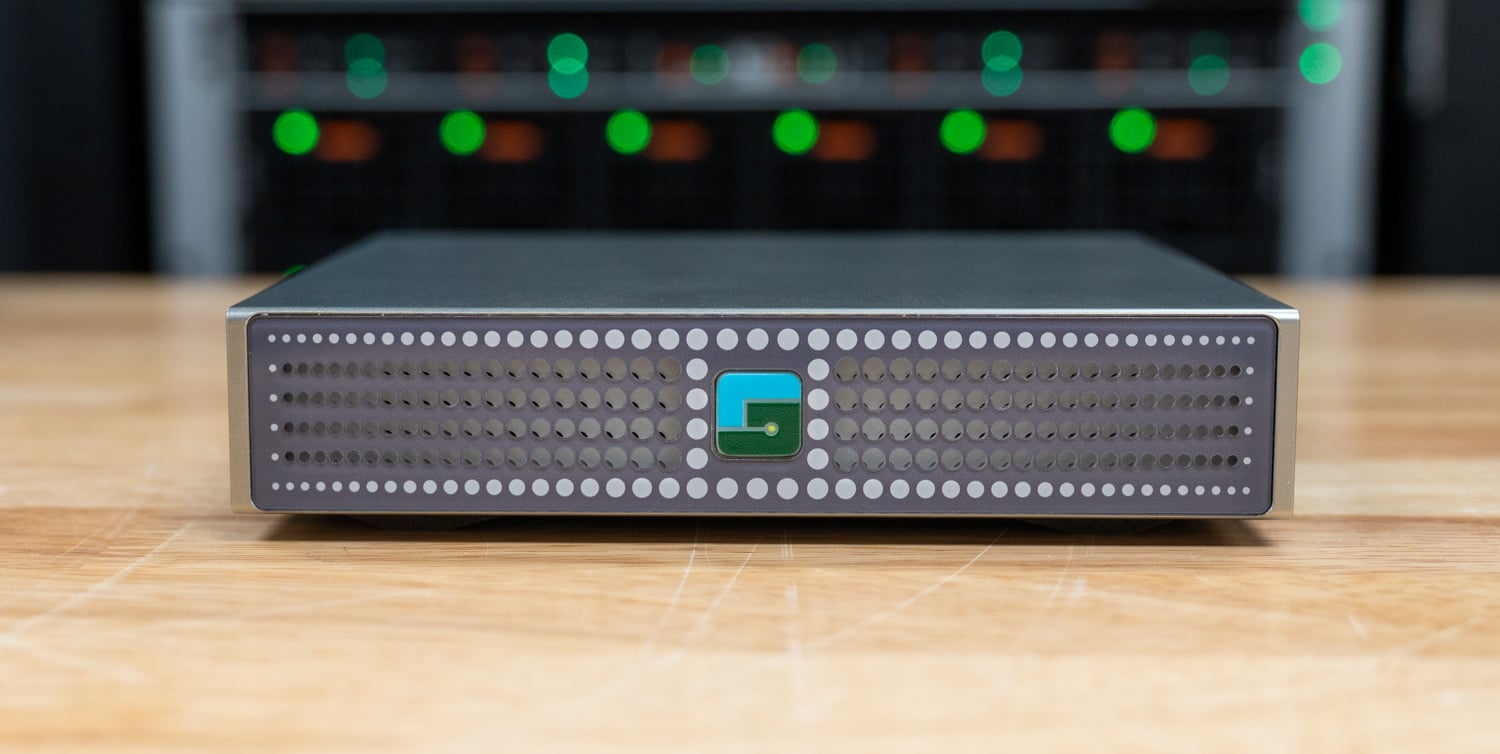
အဓိကအချက်ကတော့ client-drive စီးပွားရေးနဲ့ ရိုးရှင်းပါတယ်။ GP Spark ရဲ့ bay လေးခုမှာ သာမန် M.2 2280 ဒါမှမဟုတ် 22110 NVMe SSD တွေကို အသုံးပြုထားပြီး Spark ရဲ့ form factor တွေက lock out ဖြစ်ပြီး dedicated chip ပေါ်က hardware offload engine ကနေတစ်ဆင့် NVMe-oF RDMA ကနေတစ်ဆင့် တင်ဆက်ပေးပါတယ်။ Luisuantech ရဲ့ spec sheet က ဒီနေ့ခေတ်မှာ 4TB အထိ drive တွေကို validate လုပ်ပါတယ်၊ enclosure တစ်ခုစီမှာ 16TB ရှိပါတယ်၊ ဒါပေမယ့် ဒါတွေက 8TB client drive တွေ တင်ပို့ပြီးသား slot တွေပါပဲ၊ ဒါကြောင့် လက်တွေ့ကျတဲ့ ceiling က mechanical ထက် validation မေးခွန်းတစ်ခုသာ ဖြစ်ပါတယ်။ ဒီမှာ enterprise array မရှိပါဘူး၊ licensing မရှိပါဘူး၊ storage OS ကိုလည်း လေ့လာစရာမလိုပါဘူး။ GP Spark နဲ့ DGX Spark ကြားမှာ DAC ဒါမှမဟုတ် AOC cable ကို တပ်ဆင်ပြီး Spark ရဲ့ Ubuntu base မှာ modprobe nvme-rdma ကို run လိုက်ရင် drive တွေက GDS access အတွက် အသင့်ဖြစ်နေတဲ့ /dev/nvme device တွေအဖြစ် ပေါ်လာပါလိမ့်မယ်။
ဒီဇိုင်းနှင့်တည်ဆောက်ပါ
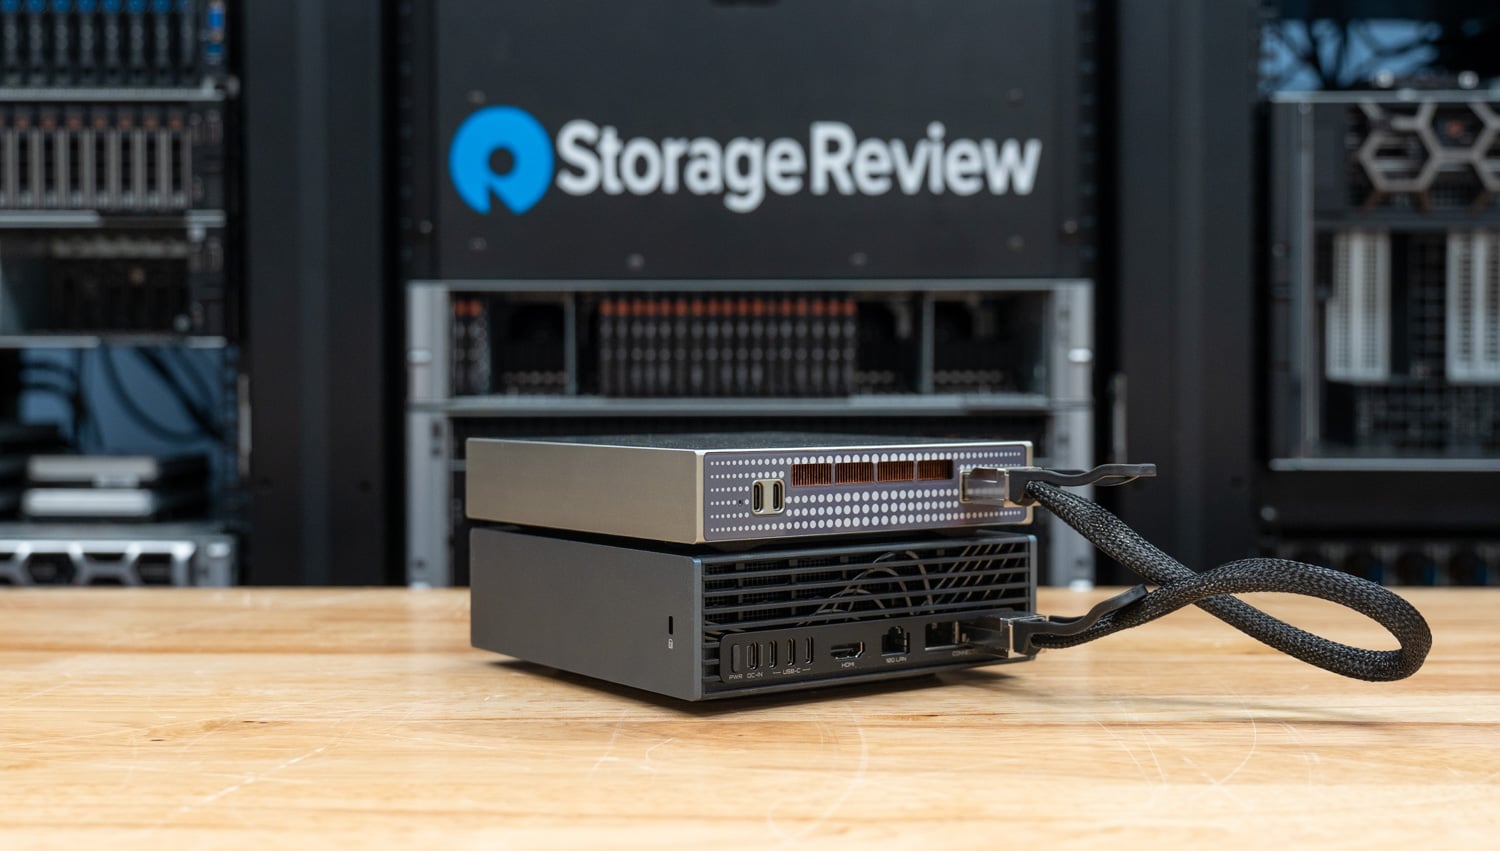
GP Spark ဟာ 150mm x 150mm x 26mm အရွယ်အစားရှိတဲ့ ဘူးခွံတစ်ခုဖြစ်ပြီး Spark ထက် အရွယ်အစားသေးငယ်ပြီး အပေါက်ဖောက်ထားတဲ့ သတ္တုကိုယ်ထည်နဲ့ ထုပ်ပိုးထားပါတယ်။ status light အနေနဲ့လည်း အသုံးပြုနိုင်တဲ့ power button တစ်ခုတည်းပါဝင်ပါတယ်။ အစိမ်းရောင်က ပုံမှန်ဖြစ်ပြီး အနီရောင်ကတော့ fault အနေနဲ့ အသုံးပြုနိုင်ပါတယ်။ ပါဝါကို USB-C PD ကနေတစ်ဆင့် 20V/5.4A external adapter ကနေတစ်ဆင့် ရရှိပါတယ်။ drive တွေအပါအဝင် unit တစ်ခုလုံးကို 100W အောက် rating ပေးထားပါတယ်။ နောက်ဘက် panel မှာ connector သုံးခုပါဝင်ပါတယ်။ USB-C power input၊ USB-C factory debug port နဲ့ copper DAC ဒါမှမဟုတ် optical module တွေကို လက်ခံတဲ့ QSFP28 100GbE data port တို့ပါဝင်ပါတယ်။ အတွင်းပိုင်းမှာ dedicated data processor နဲ့ coprocessor က NVMe-oF offload ကို ကိုင်တွယ်ပေးပြီး M.2 bay လေးခုက အပေါ်အဖုံးအောက်မှာ ရှိပါတယ်။
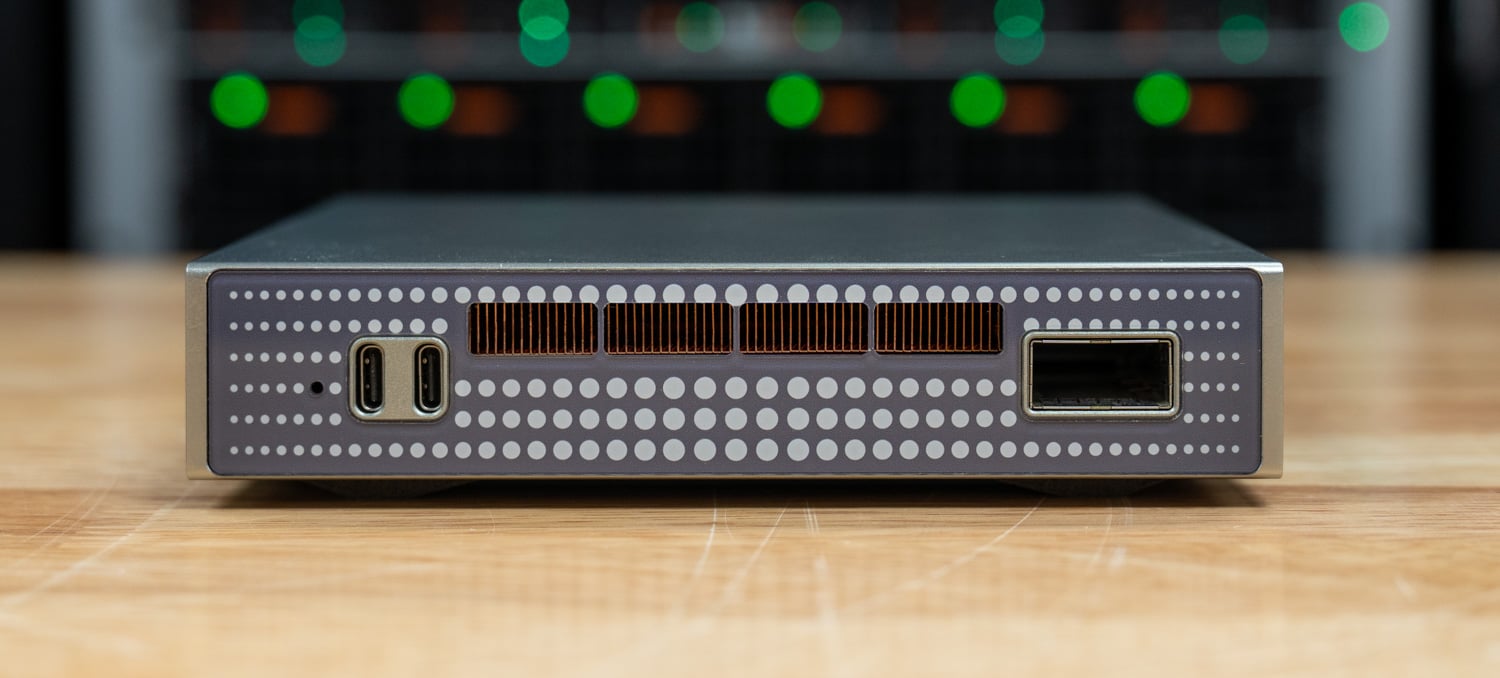
နောက်ဘက် panel က လုပ်ငန်းသုံးပါပဲ- ဘယ်ဘက်ခြမ်းမှာ USB-C power နဲ့ debug port တွေ၊ ညာဘက်ခြမ်းမှာ QSFP28 cage တွေနဲ့ ကြားက vents တွေကနေ မြင်ရတဲ့ copper fin stack တန်းတစ်ခုပါ။ အအေးပေးစနစ်က passive ပါပဲ။
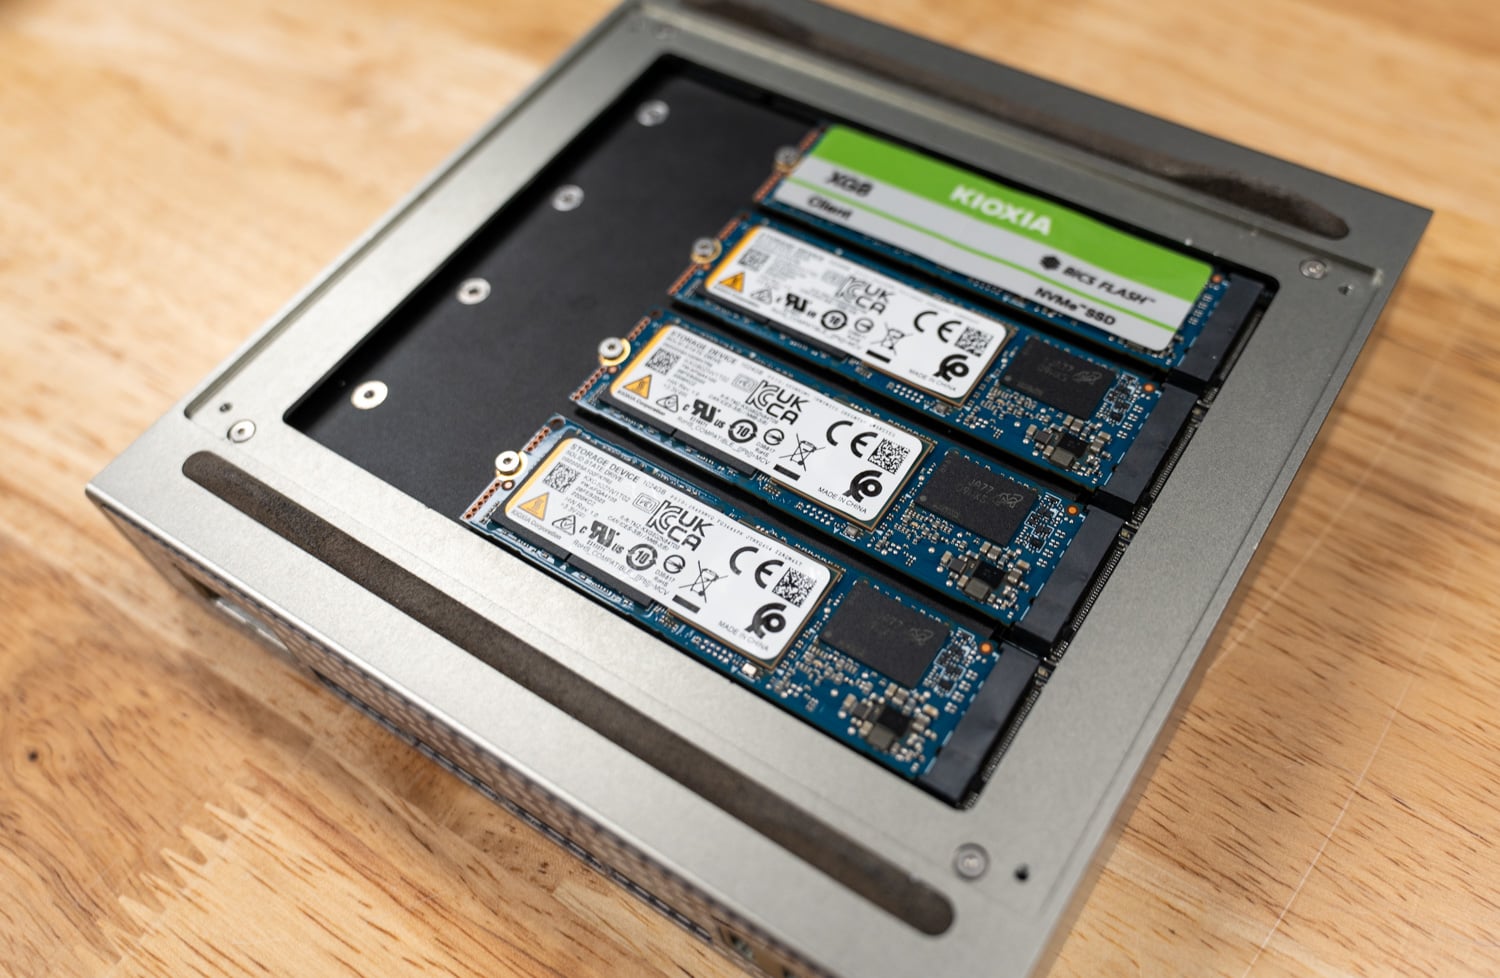
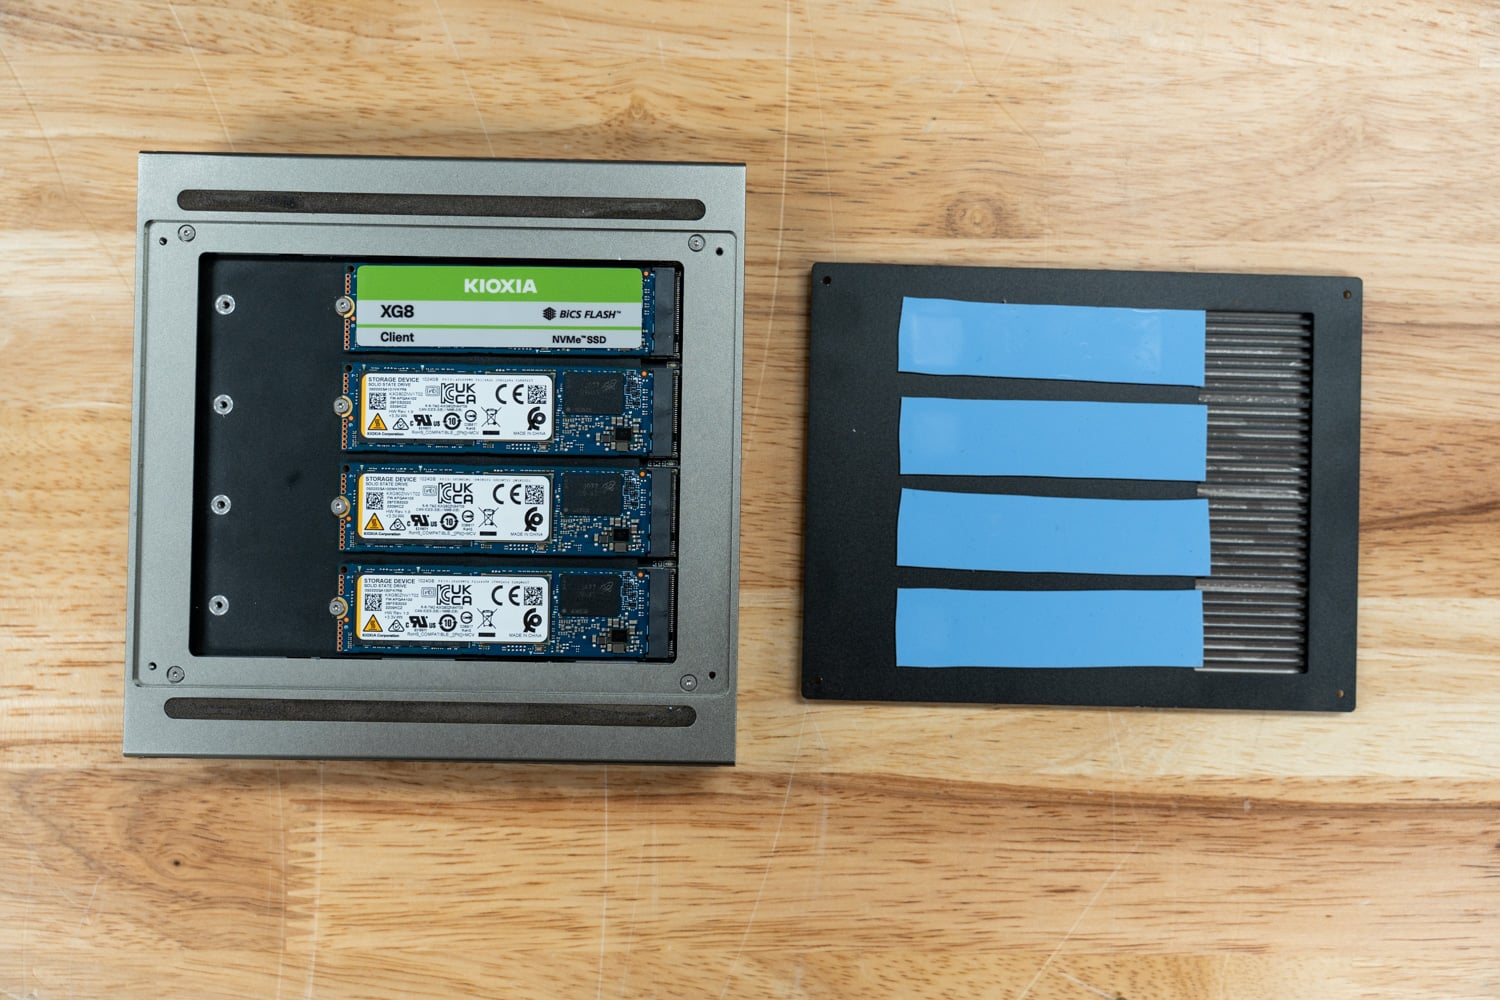
အပေါ်အဖုံးကို ဖွင့်လိုက်တဲ့အခါ M.2 bay လေးခုဟာ တန်းစီပြီး ဒီမှာ ကျွန်တော်တို့ရဲ့ KIOXIA XG8 စမ်းသပ် drive တွေနဲ့ ပြည့်နှက်နေပါတယ်။ အဖုံးကိုယ်တိုင်က drive cooler ပါ- အောက်က အပြာရောင် thermal pad တွေက SSD တစ်ခုစီကို chassis ရဲ့ အပေါ်ဆုံးကို ဖွဲ့စည်းထားတဲ့ finned heatsink နဲ့ ချိတ်ဆက်ပေးထားပြီး enterprise duty cycle တွေကို ကြာရှည်မခံတဲ့ client drive တွေအတွက် သန့်ရှင်းတဲ့ passive solution တစ်ခုပါ။
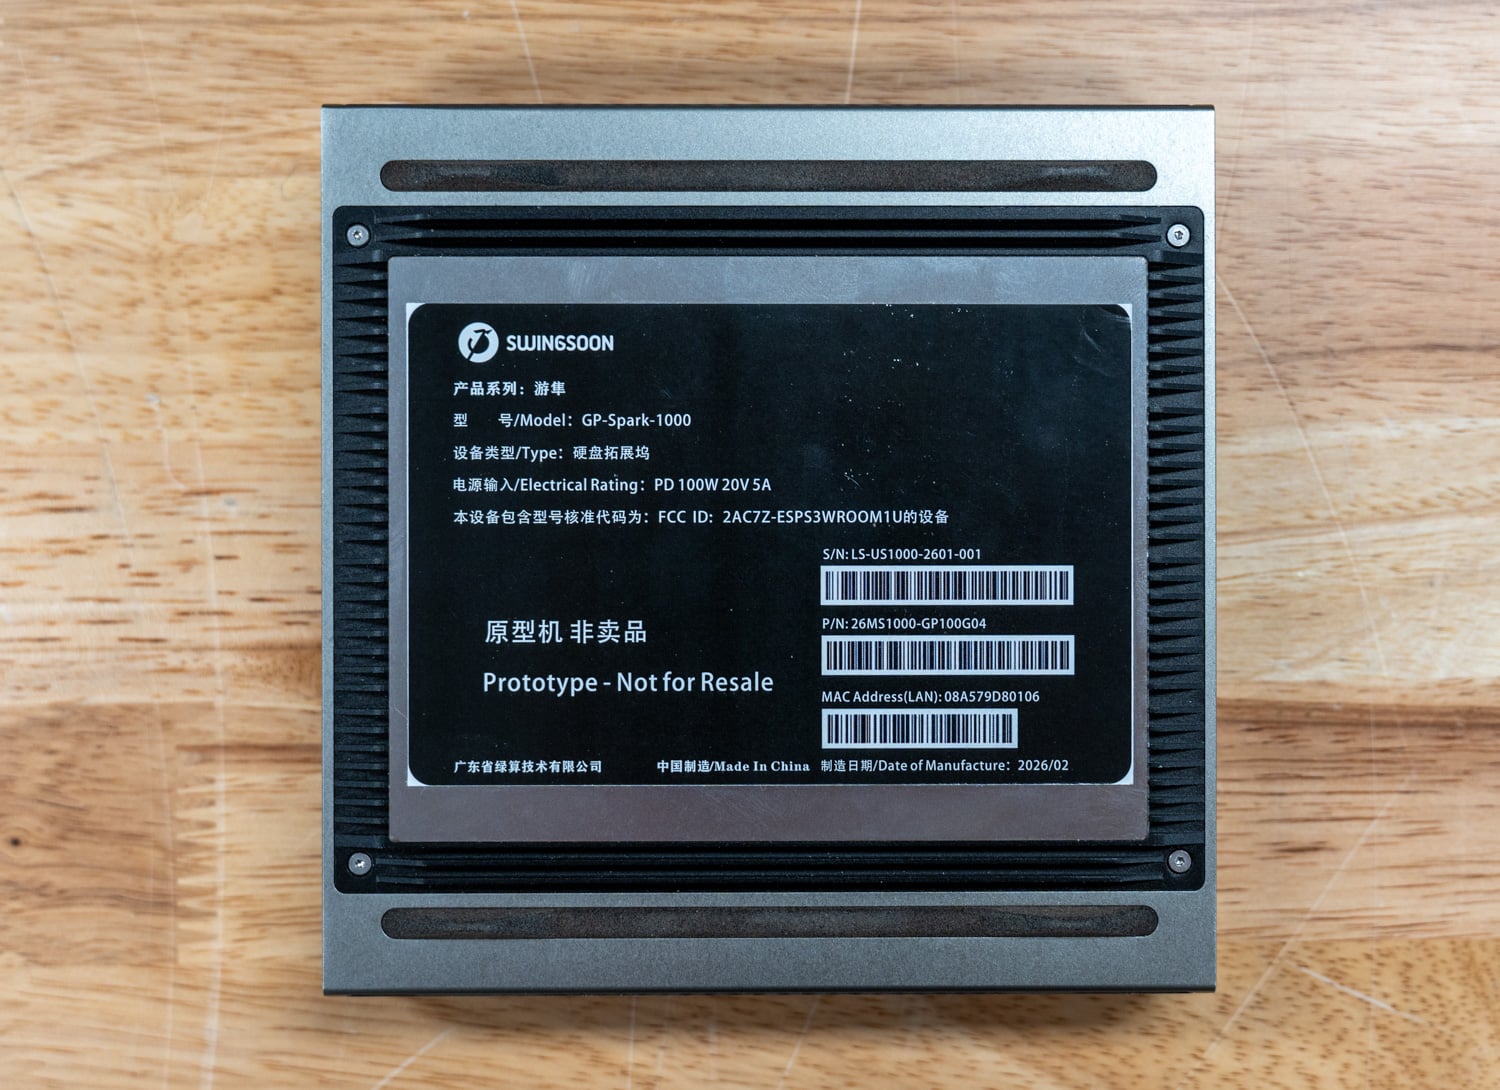
ကိန်းဂဏန်းများမတိုင်မီ ထုတ်ဖော်ချက်တစ်ခု- ကျွန်ုပ်တို့၏ယူနစ်သည် ပုံစံငယ်တစ်ခုဖြစ်သည်။ အောက်ခြေတံဆိပ်တွင် GP-Spark-1000 ဟုရေးထားပြီး Prototype ကို အမှတ်အသားပြုထားပြီး ပြန်လည်ရောင်းချရန်မဟုတ်ပါ၊ Swingsoon အမှတ်တံဆိပ် Luisuantech မှ ဟာ့ဒ်ဝဲတွင် အသုံးပြုသည့် Swingsoon အမှတ်တံဆိပ်အောက်တွင် ၂၀၂၆ ခုနှစ် ဖေဖော်ဝါရီလတွင် တည်ဆောက်မည့်ရက်စွဲပါရှိသည်။ ထုတ်လုပ်မှုယူနစ်များသည် တပ်ဆင်မှုနှင့် အပြီးသတ်ကွဲပြားနိုင်သော်လည်း ကျွန်ုပ်တို့စမ်းသပ်ထားသော ပလက်ဖောင်းအပြုအမူသည် Luisuantech မှ ယနေ့သုံးသပ်သူများထံ ပေးပို့နေသည့်အရာဖြစ်သည်။ ဘူးထဲမှထုတ်သည့်အတွေ့အကြုံနှင့်ပတ်သက်သည့် နောက်ထပ်မှတ်စုနှစ်ခု။ ကျွန်ုပ်တို့၏ယူနစ်သည် ပုံနှိပ်ထားသောလက်စွဲစာအုပ်နှစ်အုပ်ဖြင့် ထုပ်ပိုးထားပြီး ကနဦးတပ်ဆင်မှုသည် Wi-Fi onboarding မှတစ်ဆင့် လမ်းကြောင်းပြောင်းသွားပုံရသည်။ ဤဘူးသည် ပရိသတ်အတွက် ပိတ်ဆို့ခြင်းတစ်ခုမျှမဟုတ်သော်လည်း အနောက်တိုင်းတွင် ဖြန့်ချိရန်အတွက် အင်္ဂလိပ်စာရွက်စာတမ်းများ လိုအပ်မည်ဖြစ်သည်။
စနစ်ထည့်သွင်းမှုနှင့် ဗိသုကာ
RAID controller နဲ့ storage abstraction onboard မပါပါဘူး။ GP Spark က JBOF ဖြစ်တဲ့အတွက် install လုပ်ထားတဲ့ SSD တစ်ခုစီကို သူ့ရဲ့ကိုယ်ပိုင် NVMe-oF namespace အဖြစ် ဖော်ထုတ်ပေးပါတယ်။ ကျွန်တော်တို့ရဲ့ configuration မှာ drive လေးခုက host မှာ /dev/nvme device လေးခုအဖြစ် ပေါ်လာပါတယ်။ Redundancy ဒါမှမဟုတ် striping က host ရဲ့အလုပ်ပါ။ vendor spec sheet မှာ 10GB/s နဲ့ 2.7M IOPS မှာ 100GbE port တစ်ခုတည်းကို ဖော်ပြထားပါတယ်။ product report မှာ 2x100GbE configuration တွေနဲ့ 24GB/s အထိ သီးခြားစီ ရည်ညွှန်းထားပြီး Luisuantech က aggregate read plus write လို့ အတည်ပြုထားတဲ့ ကိန်းဂဏန်းပါ။ ကျွန်တော်တို့ရဲ့ unit နဲ့ testing မှာ single-port configuration ကို အသုံးပြုထားပါတယ်။
Luisuantech GP Spark သတ်မှတ်ချက်များ
| specification | Luisuantech GP Spark |
|---|---|
| ပလက်ဖောင်းခြုံငုံသုံးသပ်ချက် | |
| ဒရိုက်ဘေးများ | ၄ x M.2 NVMe (၂၂၈၀ / ၂၂၁၁၀) ရောနှောစွမ်းရည်များကို ပံ့ပိုးပေးထားပြီး၊ drive တစ်ခုလျှင် 4TB အထိ |
| Network | QSFP28 100GbE (DAC သို့မဟုတ် optical) RDMA လိုအပ်သည် |
| protocol များ | NVMe-oF RDMA GPU တိုက်ရိုက်သိုလှောင်မှု (GDS) |
| စွမ်းဆောင်ရည် (ရောင်းချသူ-ဖော်ပြထားသည်) | |
| throughput | 100GbE port တစ်ခုလျှင် 10GB/s စုစုပေါင်း ဖတ်ရှုခြင်းနှင့် ရေးခြင်း 24GB/s အထိ |
| IOPS | 2.7M |
| ဝင်ရောက်ခွင့် နှောင့်နှေးမှု | ၂၀ မိုက်ခရိုစက္ကန့်အောက် |
| တန်ခိုးနှင့်ရုပ် | |
| စွမ်းအား | စုစုပေါင်း 100W အောက် 20V/5.4A USB-C PD ပြင်ပ အဒက်တာ |
| ရှုထောင့် | 150mm x 150mm x 26mm (0.58L) |
| Operating အပူချိန် | 0 မှ 40C |
| လိုက်ဖက်တဲ့ | NVIDIA DGX Spark DGX ဘူတာ RDMA-capable NIC များပါရှိသော Workstation များနှင့် server များ |
performance
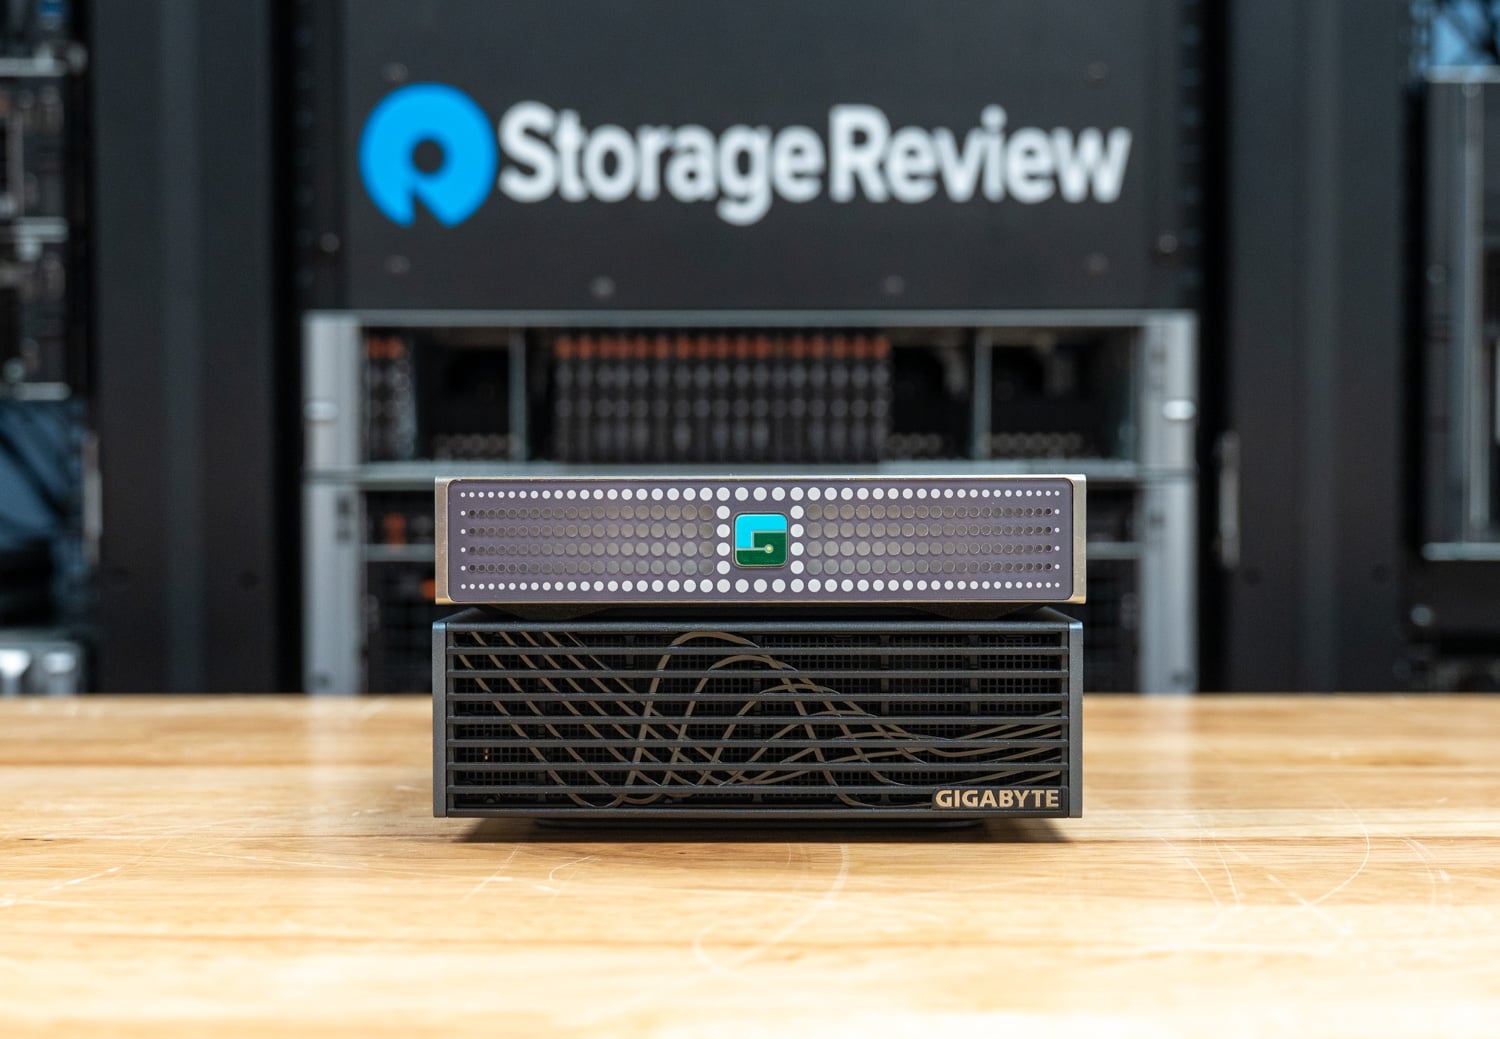
ကျွန်ုပ်တို့၏ စမ်းသပ်ဖွဲ့စည်းပုံသည် GP Spark ကို GIGABYTE DGX Spark နှင့် တိုက်ရိုက် 100GbE ချိတ်ဆက်မှုမှတစ်ဆင့် တွဲဖက်ထားပြီး၊ 1TB KIOXIA XG8 client NVMe SSD လေးလုံးသည် bay များတွင် ပြည့်နှက်နေသည်။ သင်ရွေးချယ်သော drive များသည် တိုင်းတာထားသော စွမ်းဆောင်ရည်တွင် အရေးပါသော အခန်းကဏ္ဍမှ ပါဝင်မည်ကို သတိပြုရန် အရေးကြီးပါသည်။ ကျွန်ုပ်တို့သည် client Gen5 SSD များကို အသုံးချခဲ့သည်။ အချို့မော်ဒယ်များ၊ အထူးသဖြင့် enterprise SSD များသည် ပိုမိုမြင့်မားသော ရေရှည်ရေးသားစွမ်းဆောင်ရည်ကို ပေးစွမ်းနိုင်သည်။ ကျွန်ုပ်တို့သည် 4K နှင့် 64K random နှင့် 1M sequential workloads များတွင် FIO sweeps များကို လုပ်ဆောင်ခဲ့ပြီး၊ read and write၊ iodepth နှင့် numjobs များကို step လုပ်ကာ အပြည့်အစုံကို map လုပ်ခဲ့သည်။ ရလဒ်များသည် Luisuantech ၏ MTU လမ်းညွှန်ချက်ကို အသုံးပြုပြီးနောက် နောက်ဆုံးပြန်လည်စမ်းသပ်မှုကို ထင်ဟပ်စေပြီး ကျွန်ုပ်တို့၏ ကနဦးလုပ်ဆောင်မှုများထက် transfer အပြုအမူကို တိုးတက်စေခဲ့သည်။
4K ကျပန်းစွမ်းဆောင်ရည်
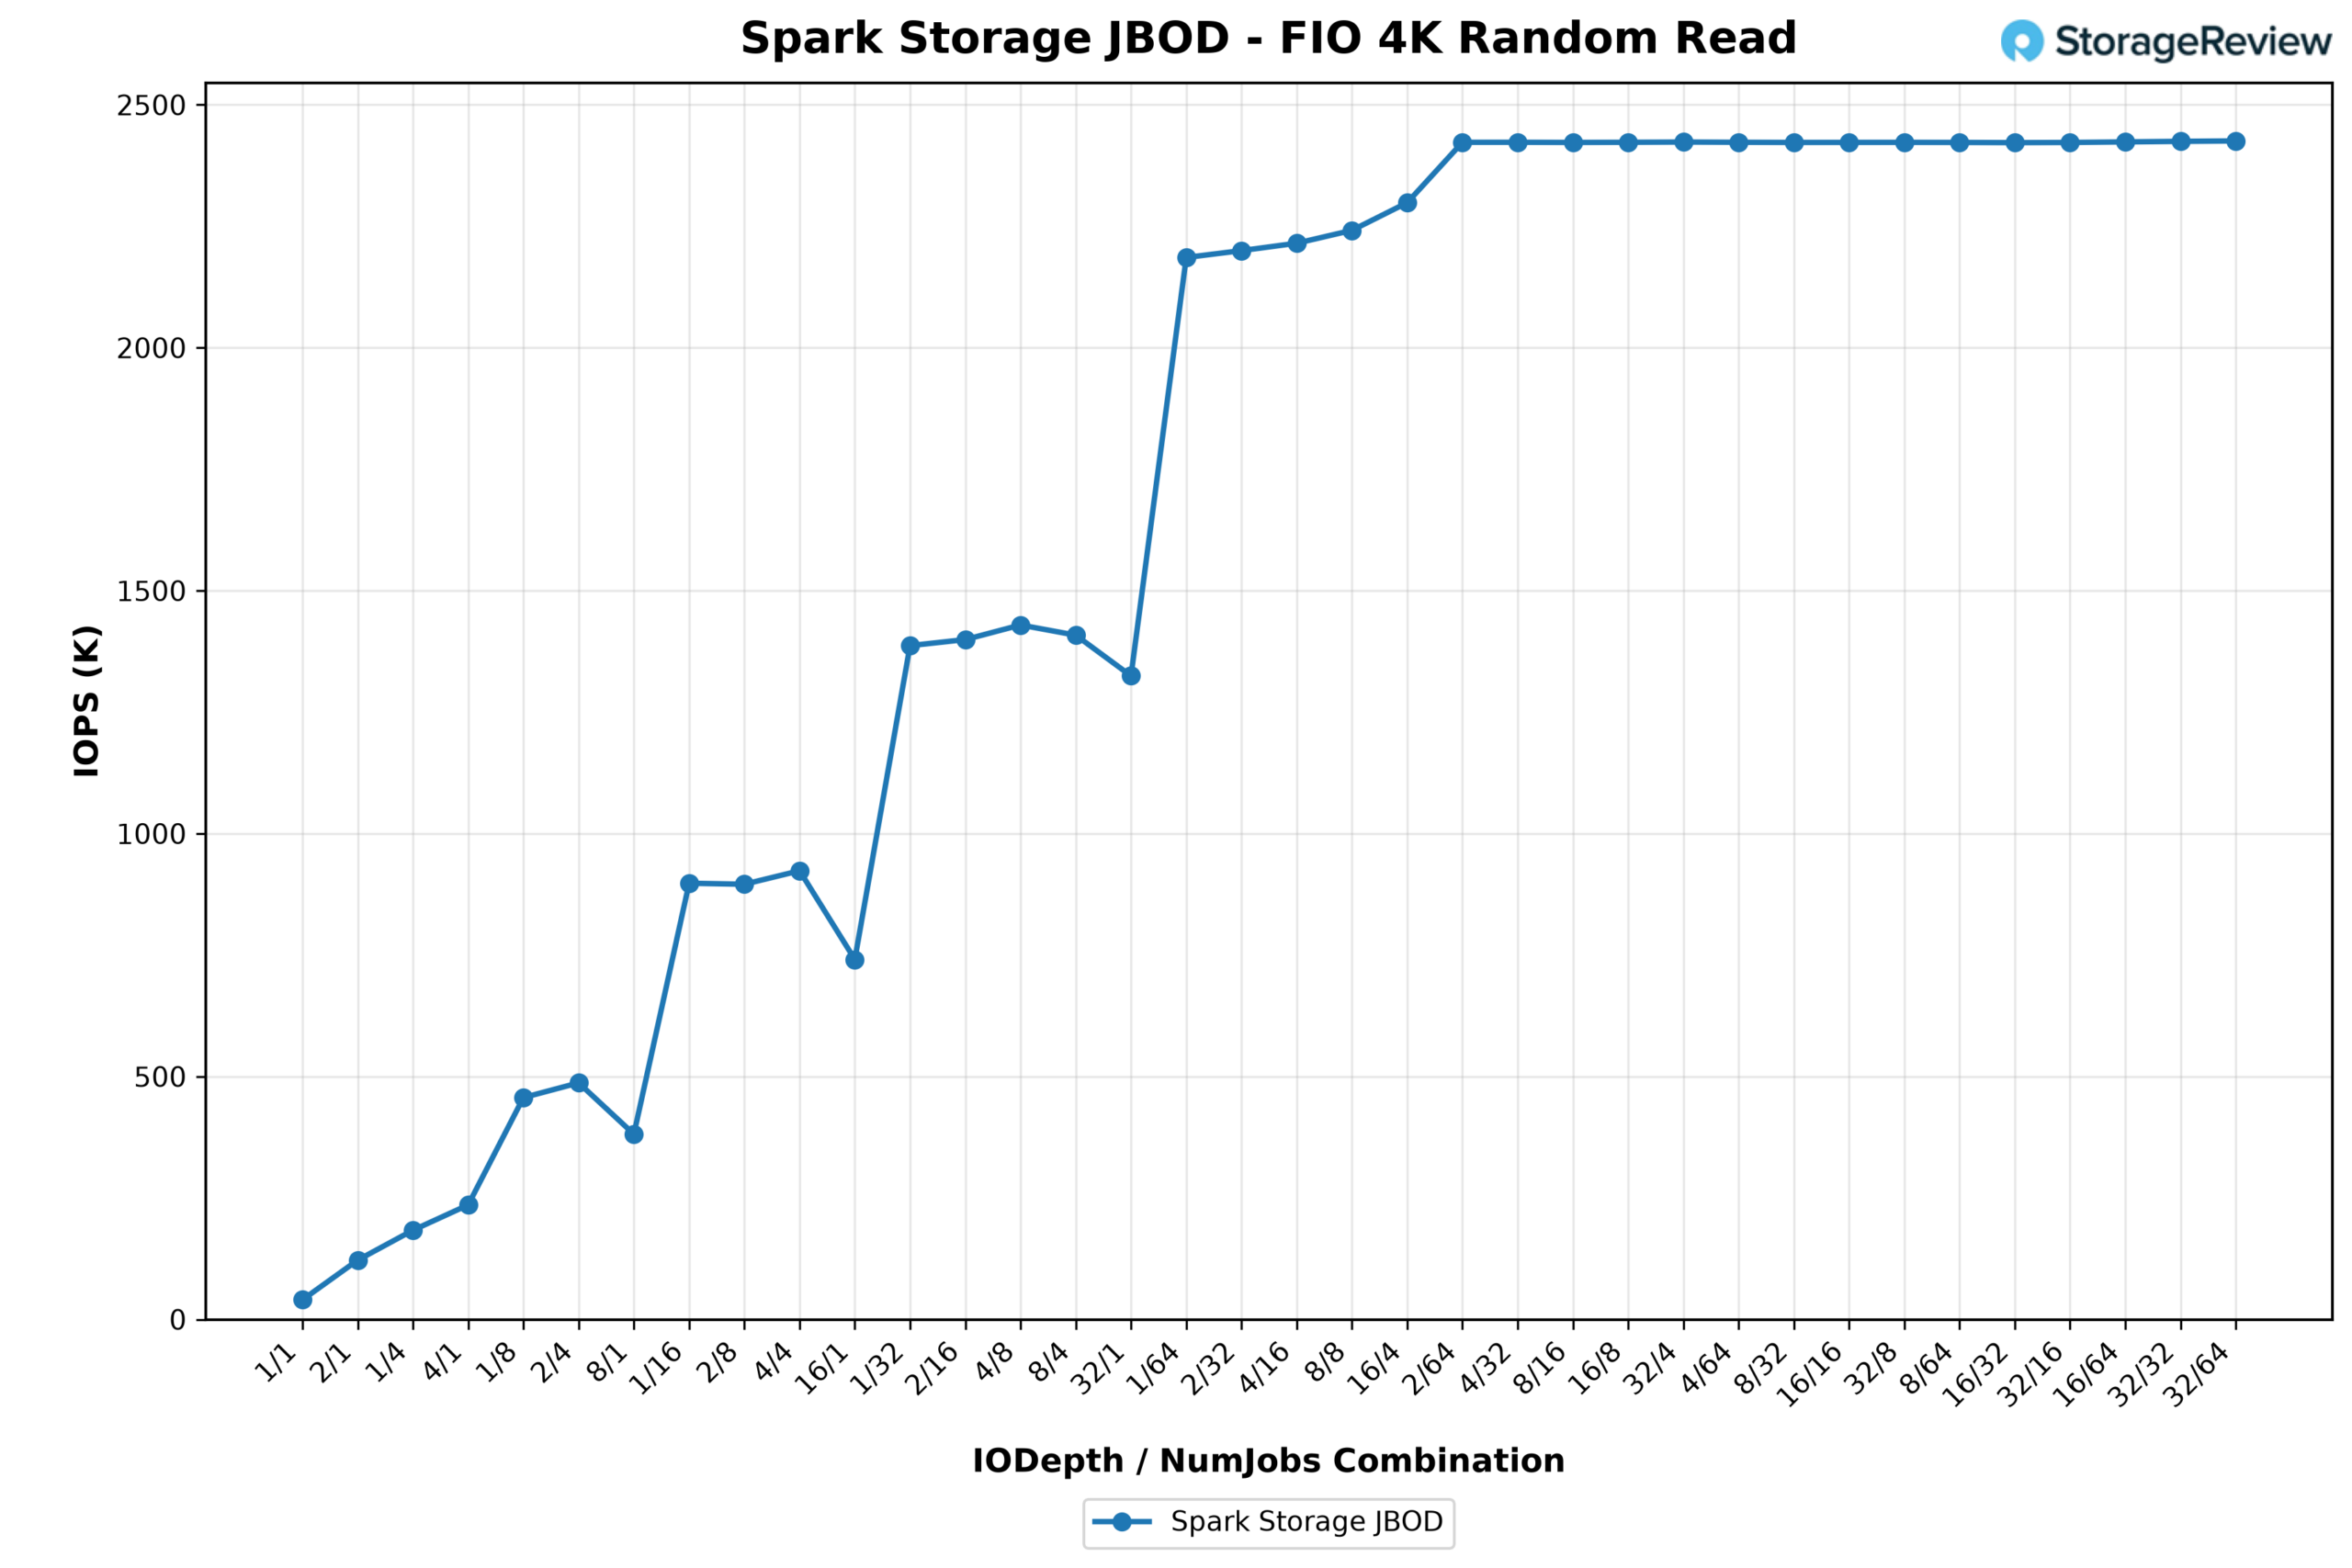
Small-block reads များသည် offload engine ၏တန်ဖိုးကိုပြသသည့်နေရာများဖြစ်သည်။ 4K random reads များကို queue depth ဖြင့် 2.43 million IOPS အထိ 9,475 MiB/s ဖြင့် အမြင့်ဆုံးသို့ ချိန်ညှိထားပြီး vendor ၏ 2.7M claim နှင့် နီးကပ်စွာရှိပြီး 100GbE link ကို 4K transfers များဖြင့် ထိရောက်စွာပြည့်နှက်စေသည်။ desk-side AI system ကို feeding လုပ်သည့် passively powered four-bay box အတွက် ၎င်းသည် ထူးခြားသောကိန်းဂဏန်းတစ်ခုဖြစ်သည်။
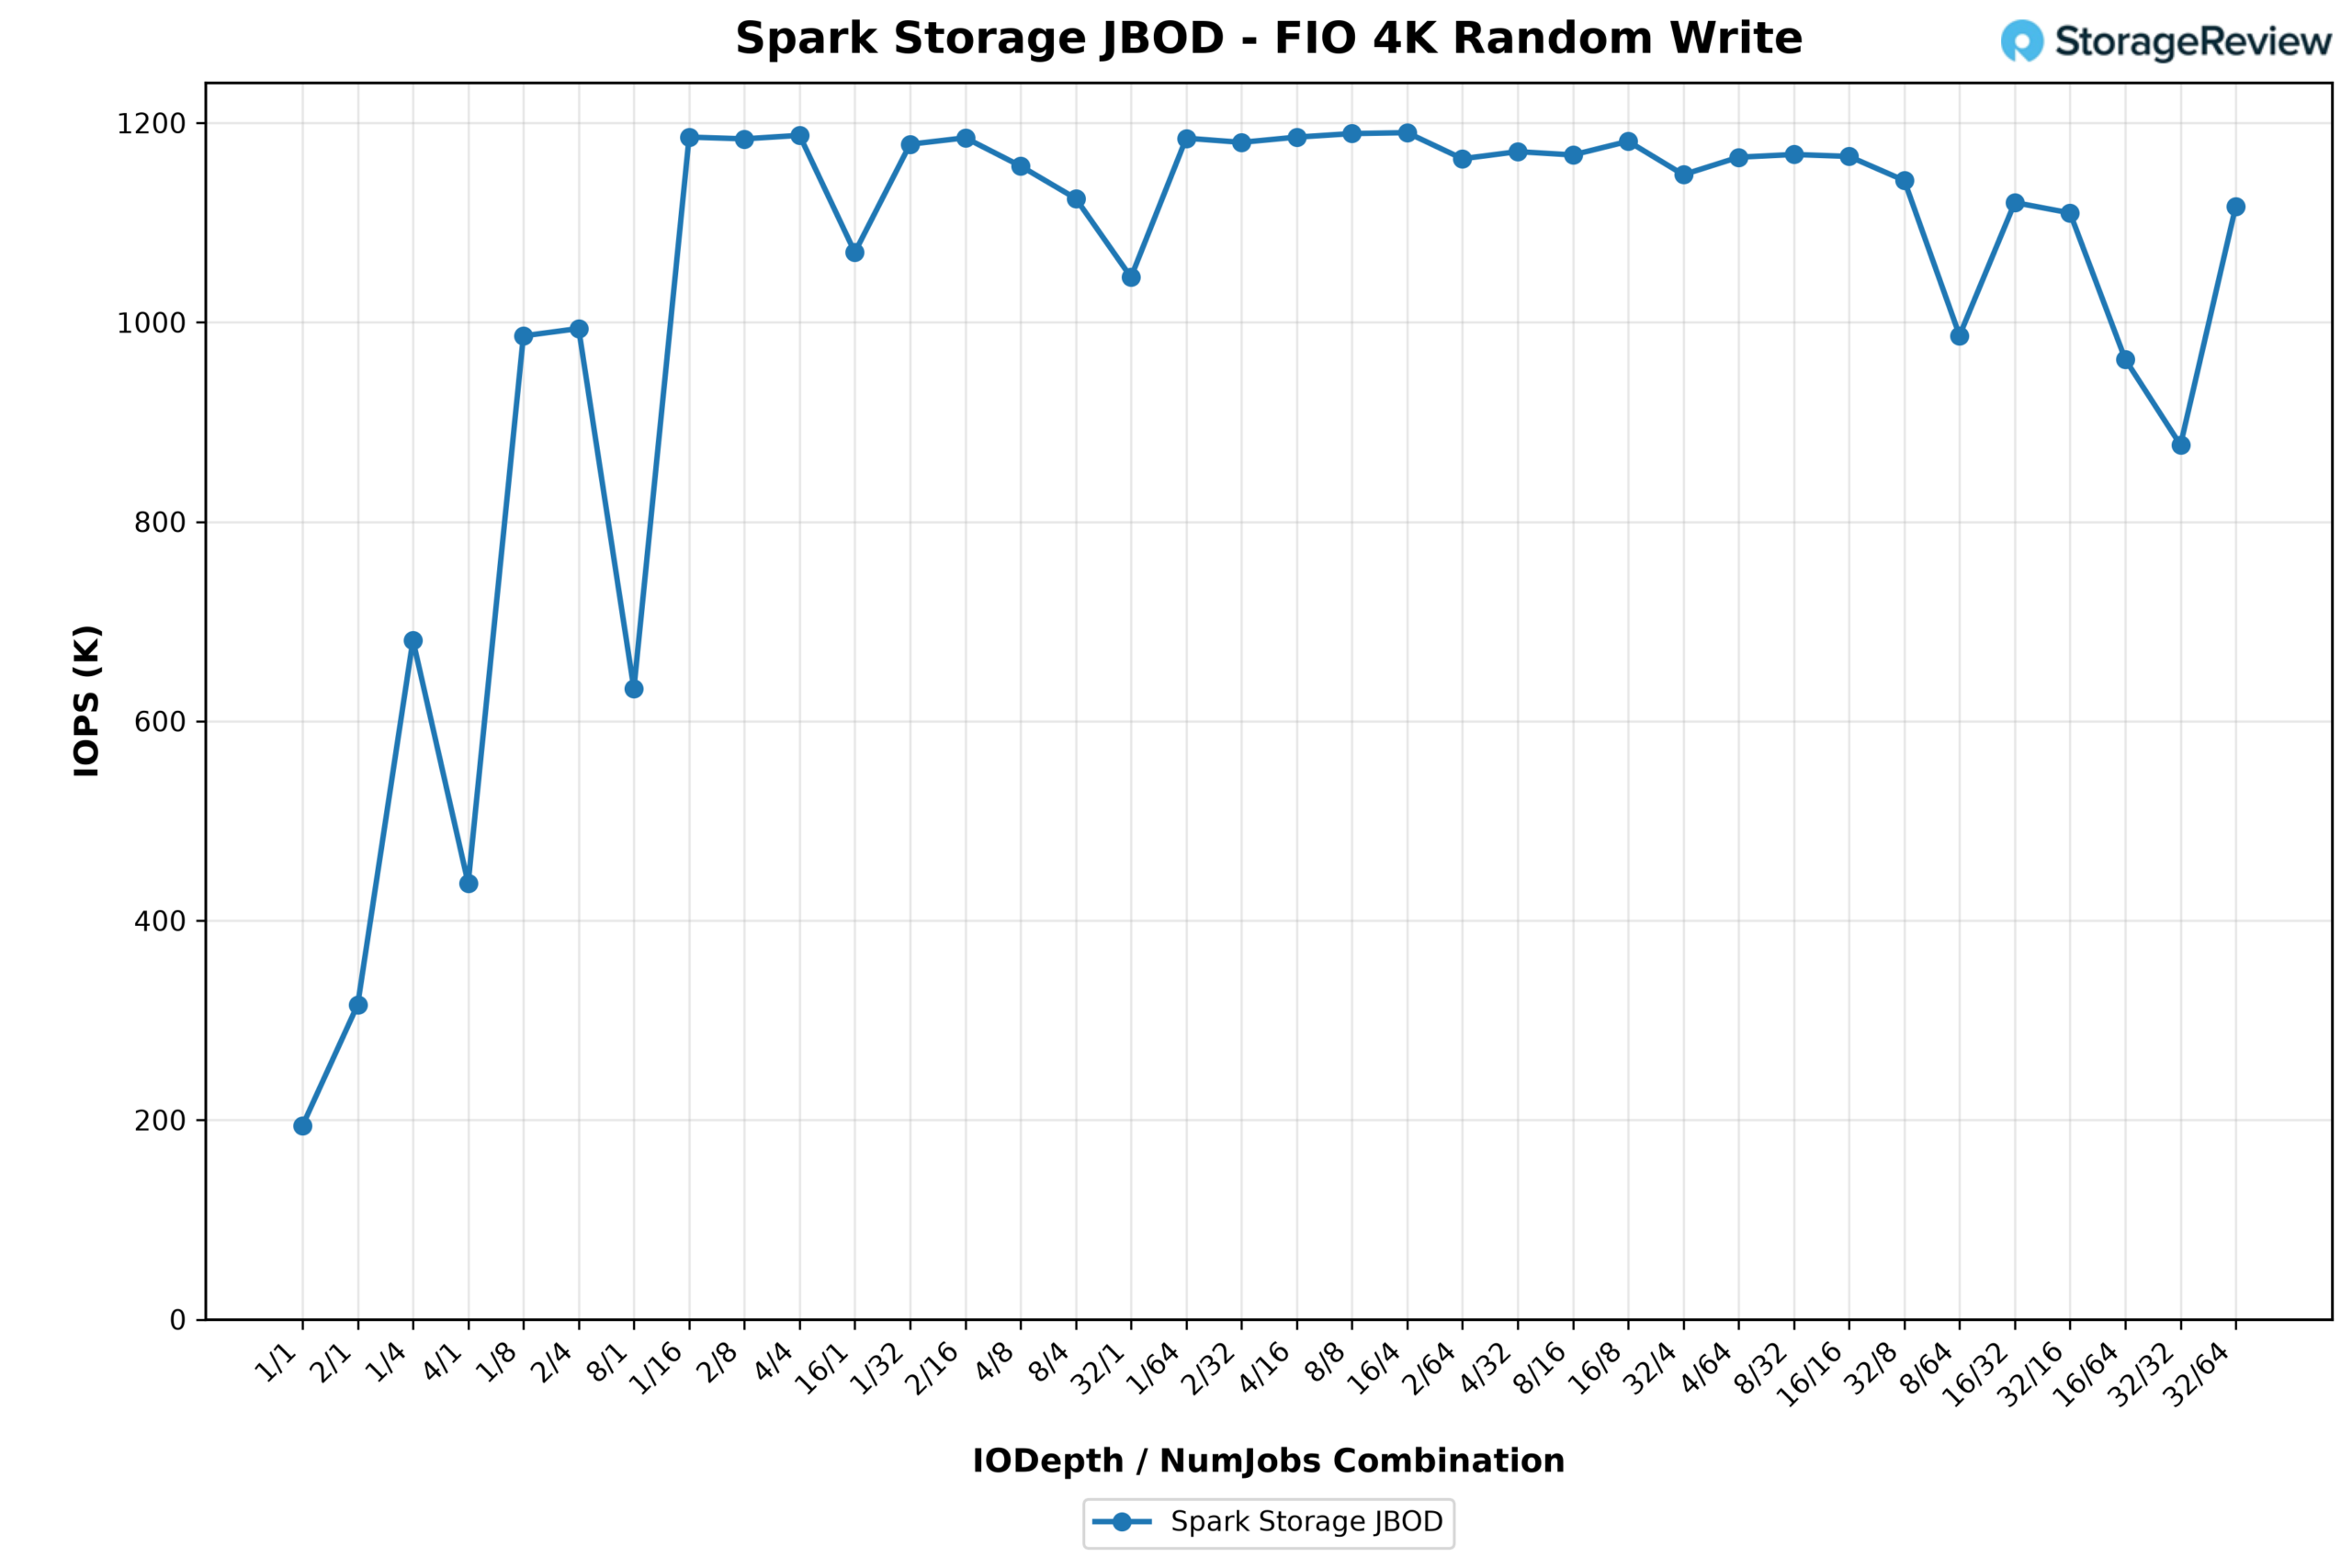
ရေးသားမှုများသည် အမြင့်၏ထက်ဝက်ခန့်တွင် တူညီသောပုံသဏ္ဍာန်ကို လိုက်နာပြီး IOPS ၁.၁၉ သန်းအထိ အမြင့်ဆုံးရောက်ရှိသည်။ ဖတ်ရှုမှုနှင့် ရေးသားမှု အမြင့်ဆုံးအတိုင်းအတာကြား ကွာဟချက်သည် ကျွန်ုပ်တို့လုပ်ဆောင်ခဲ့သော workload တိုင်းတွင် တသမတ်တည်းရှိသည်။ စွမ်းဆောင်ရည်သည် အခြေခံ drive များနှင့် တိုက်ရိုက်ဆက်စပ်နေသောကြောင့် ဤနေရာရှိ ရလဒ်များသည် configuration ပေါ် မူတည်၍ ကွဲပြားလိမ့်မည်။
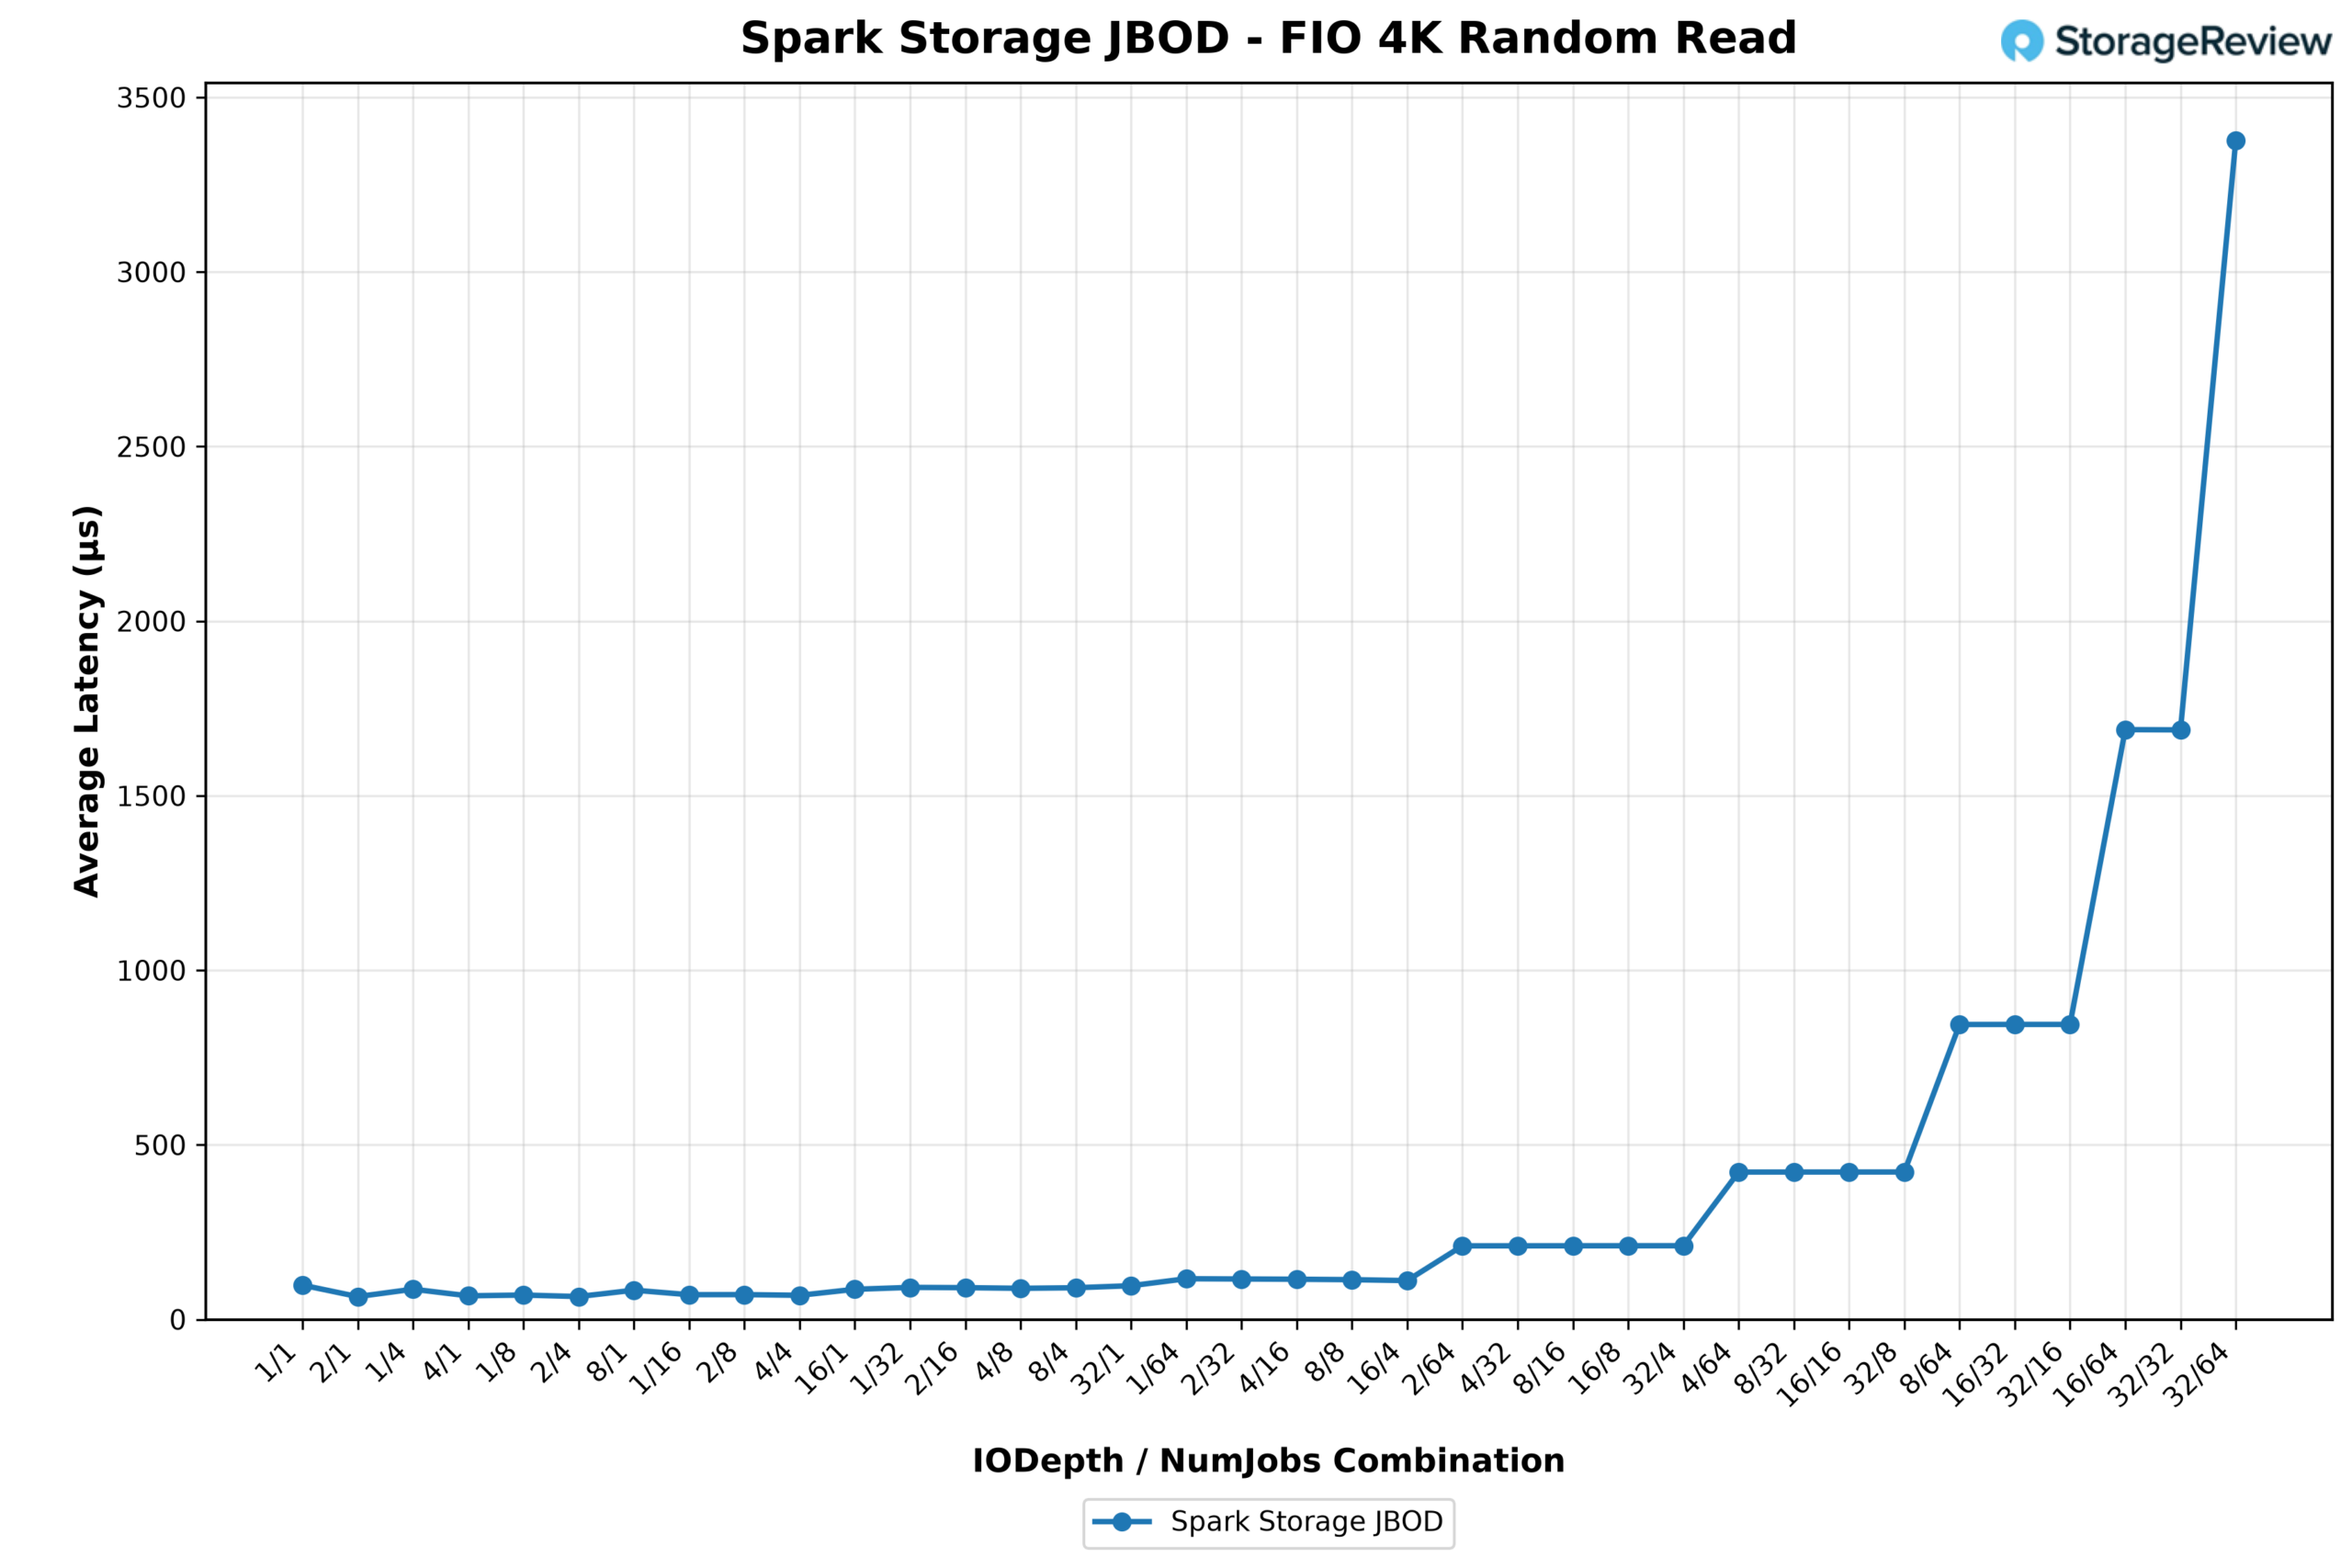
ဖတ်ရှုချိန် နှေးကွေးမှုသည် queue အနက်နိမ့်ချိန်တွင် ပျမ်းမျှအားဖြင့် 65.3 microseconds တွင် အနိမ့်ဆုံးသို့ ရောက်ရှိသည်။ ၎င်းသည် ရောင်းချသူ၏ 20-microsecond အောက် ပြောဆိုချက်ထက် မြင့်မားသော်လည်း ရလဒ်များသည် drive ရွေးချယ်မှုနှင့် network configuration ပေါ် မူတည်၍ ကွဲပြားလိမ့်မည်။ network round trip သည်လည်း ထိုအရေအတွက်ဖြင့် အလုပ်လုပ်နေသည်။ link ပြည့်သွားသည်အထိ နှေးကွေးမှုသည် တသမတ်တည်းရှိပြီး ခန့်မှန်းနိုင်သည်။
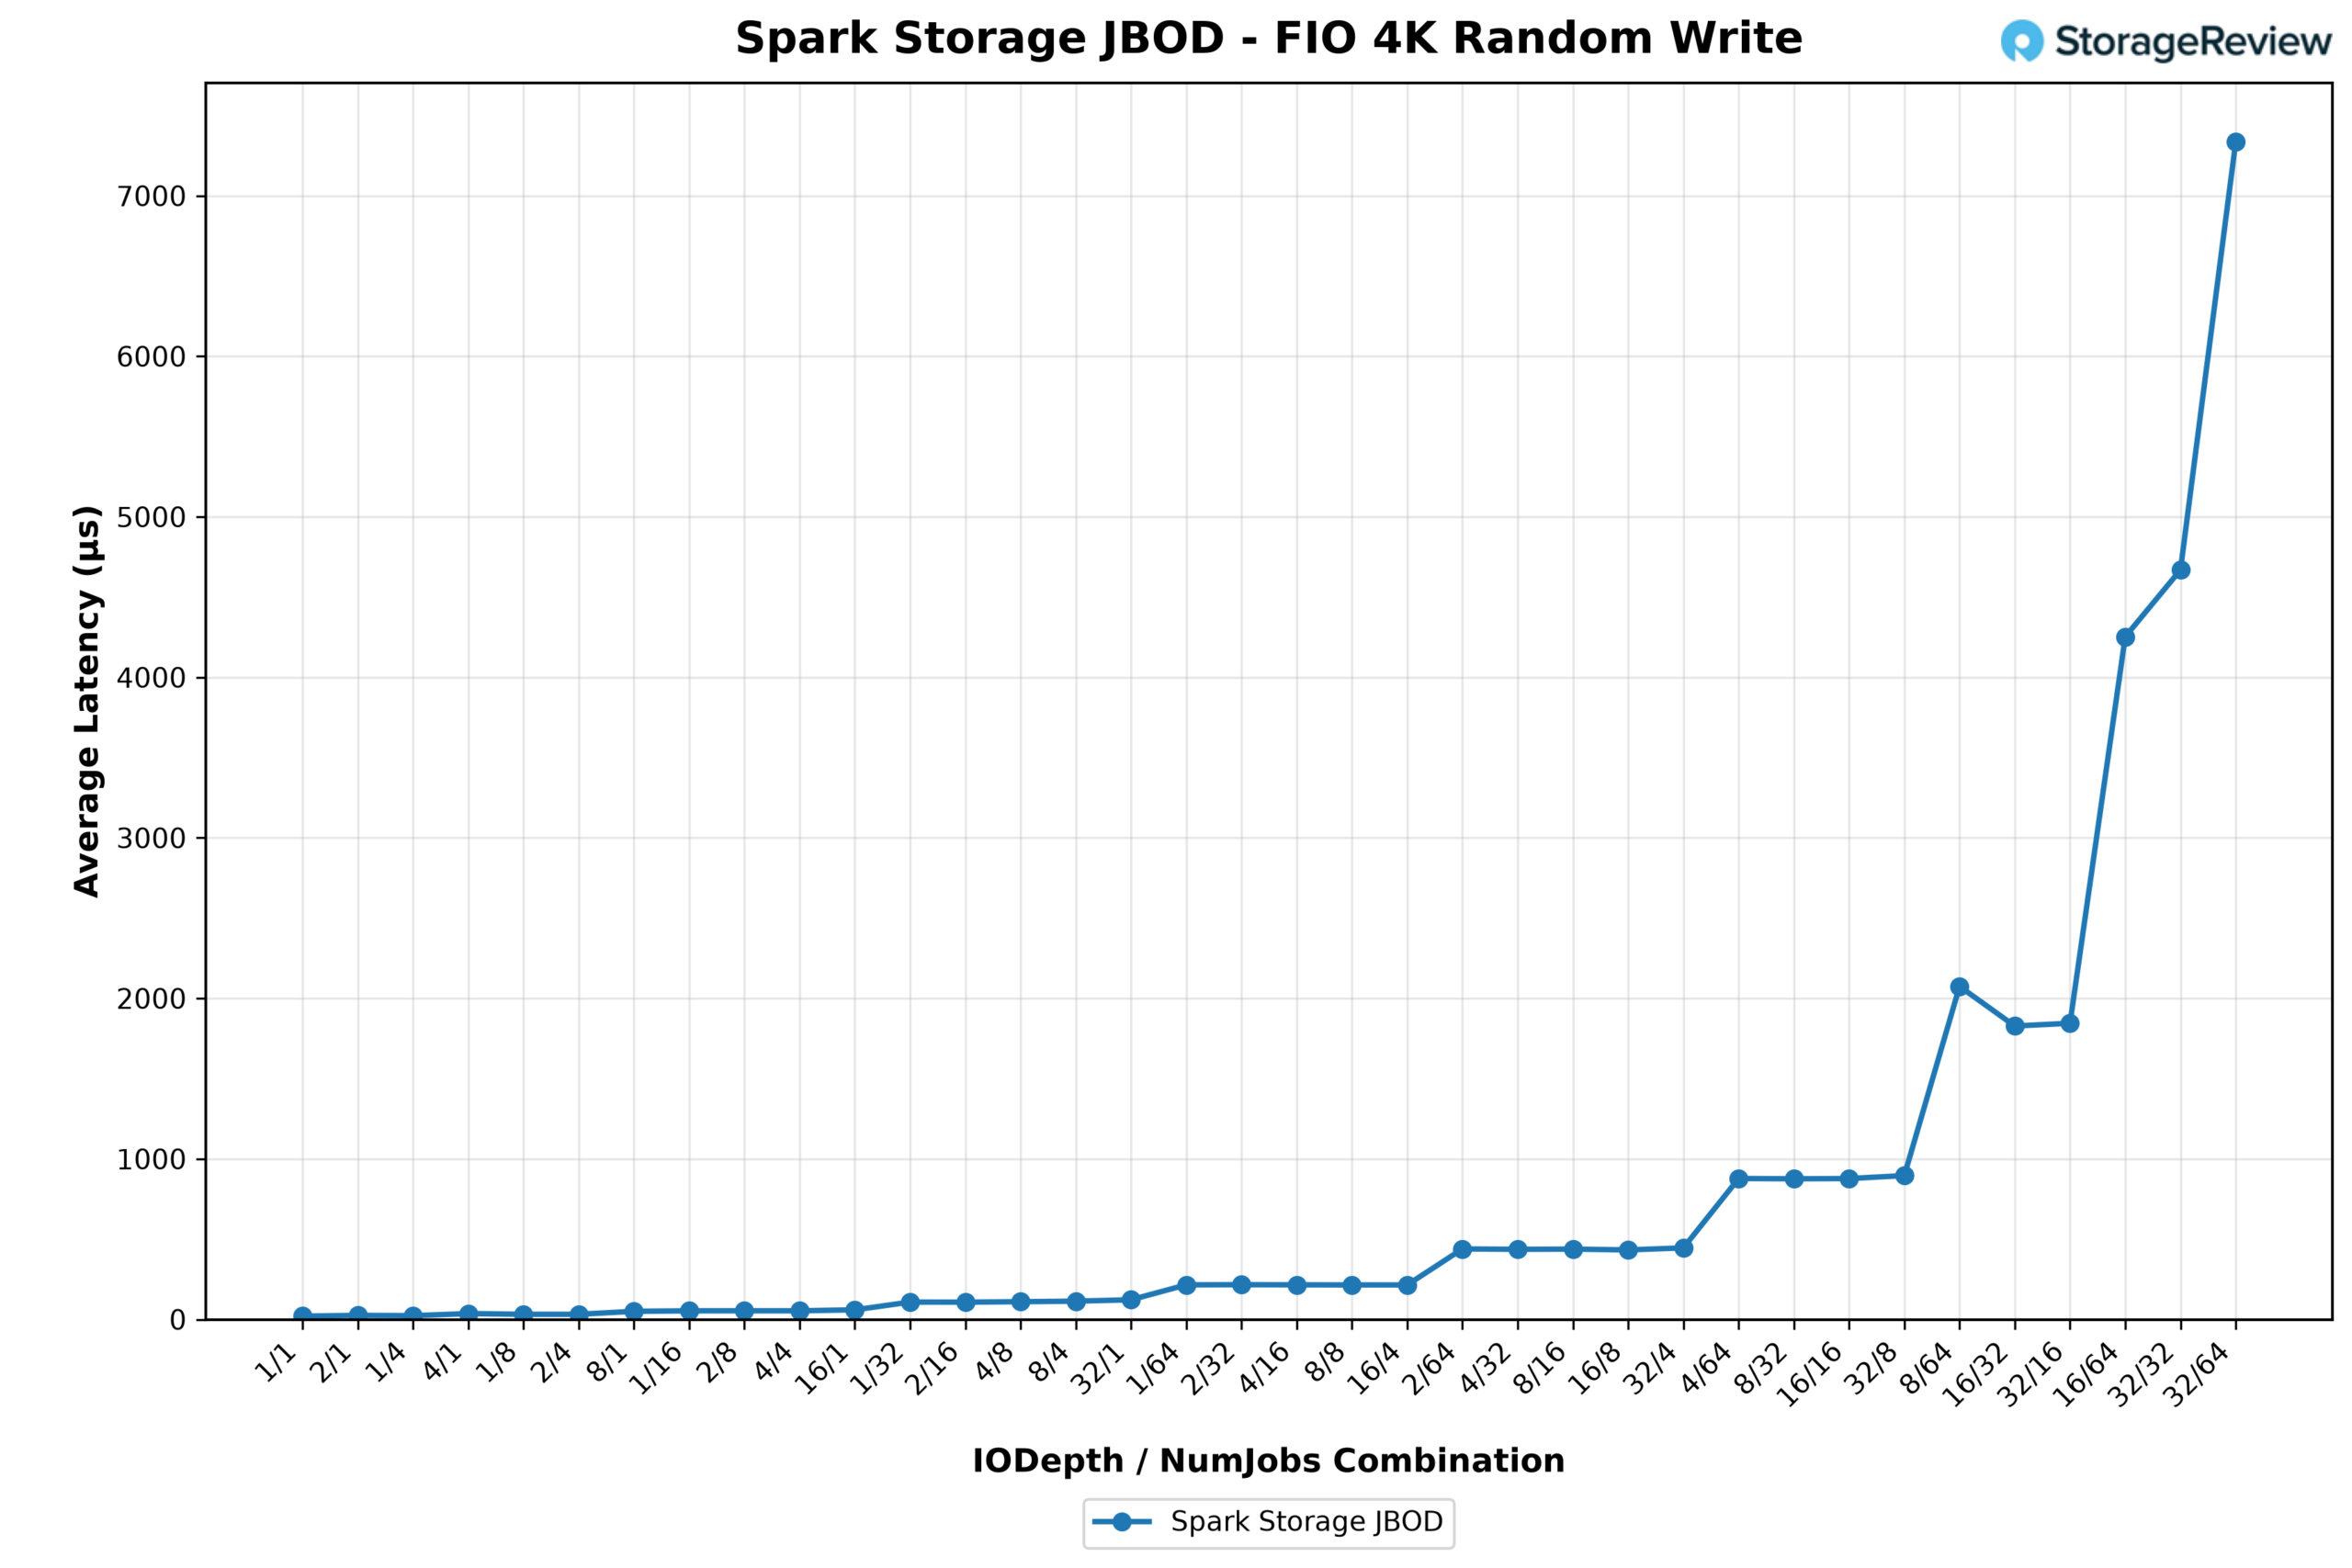
ရေးသားရန် နှောင့်နှေးမှုမှာ spec sheet တွင် ဖော်ပြထားသည့် တစ်ခုတည်းသောနေရာဖြစ်သည်- အနည်းဆုံးအနက်တွင် ပျမ်းမျှ ၂၀.၄ မိုက်ခရိုစက္ကန့်၊ ရောင်းချသူ၏ ၂၀ မိုက်ခရိုစက္ကန့်အောက် ကိန်းဂဏန်းတွင်ပင်ရှိပြီး application မှ fabric ကို မမြင်နိုင်လောက်အောင် နိမ့်သည်။
64K ကျပန်းစွမ်းဆောင်ရည်
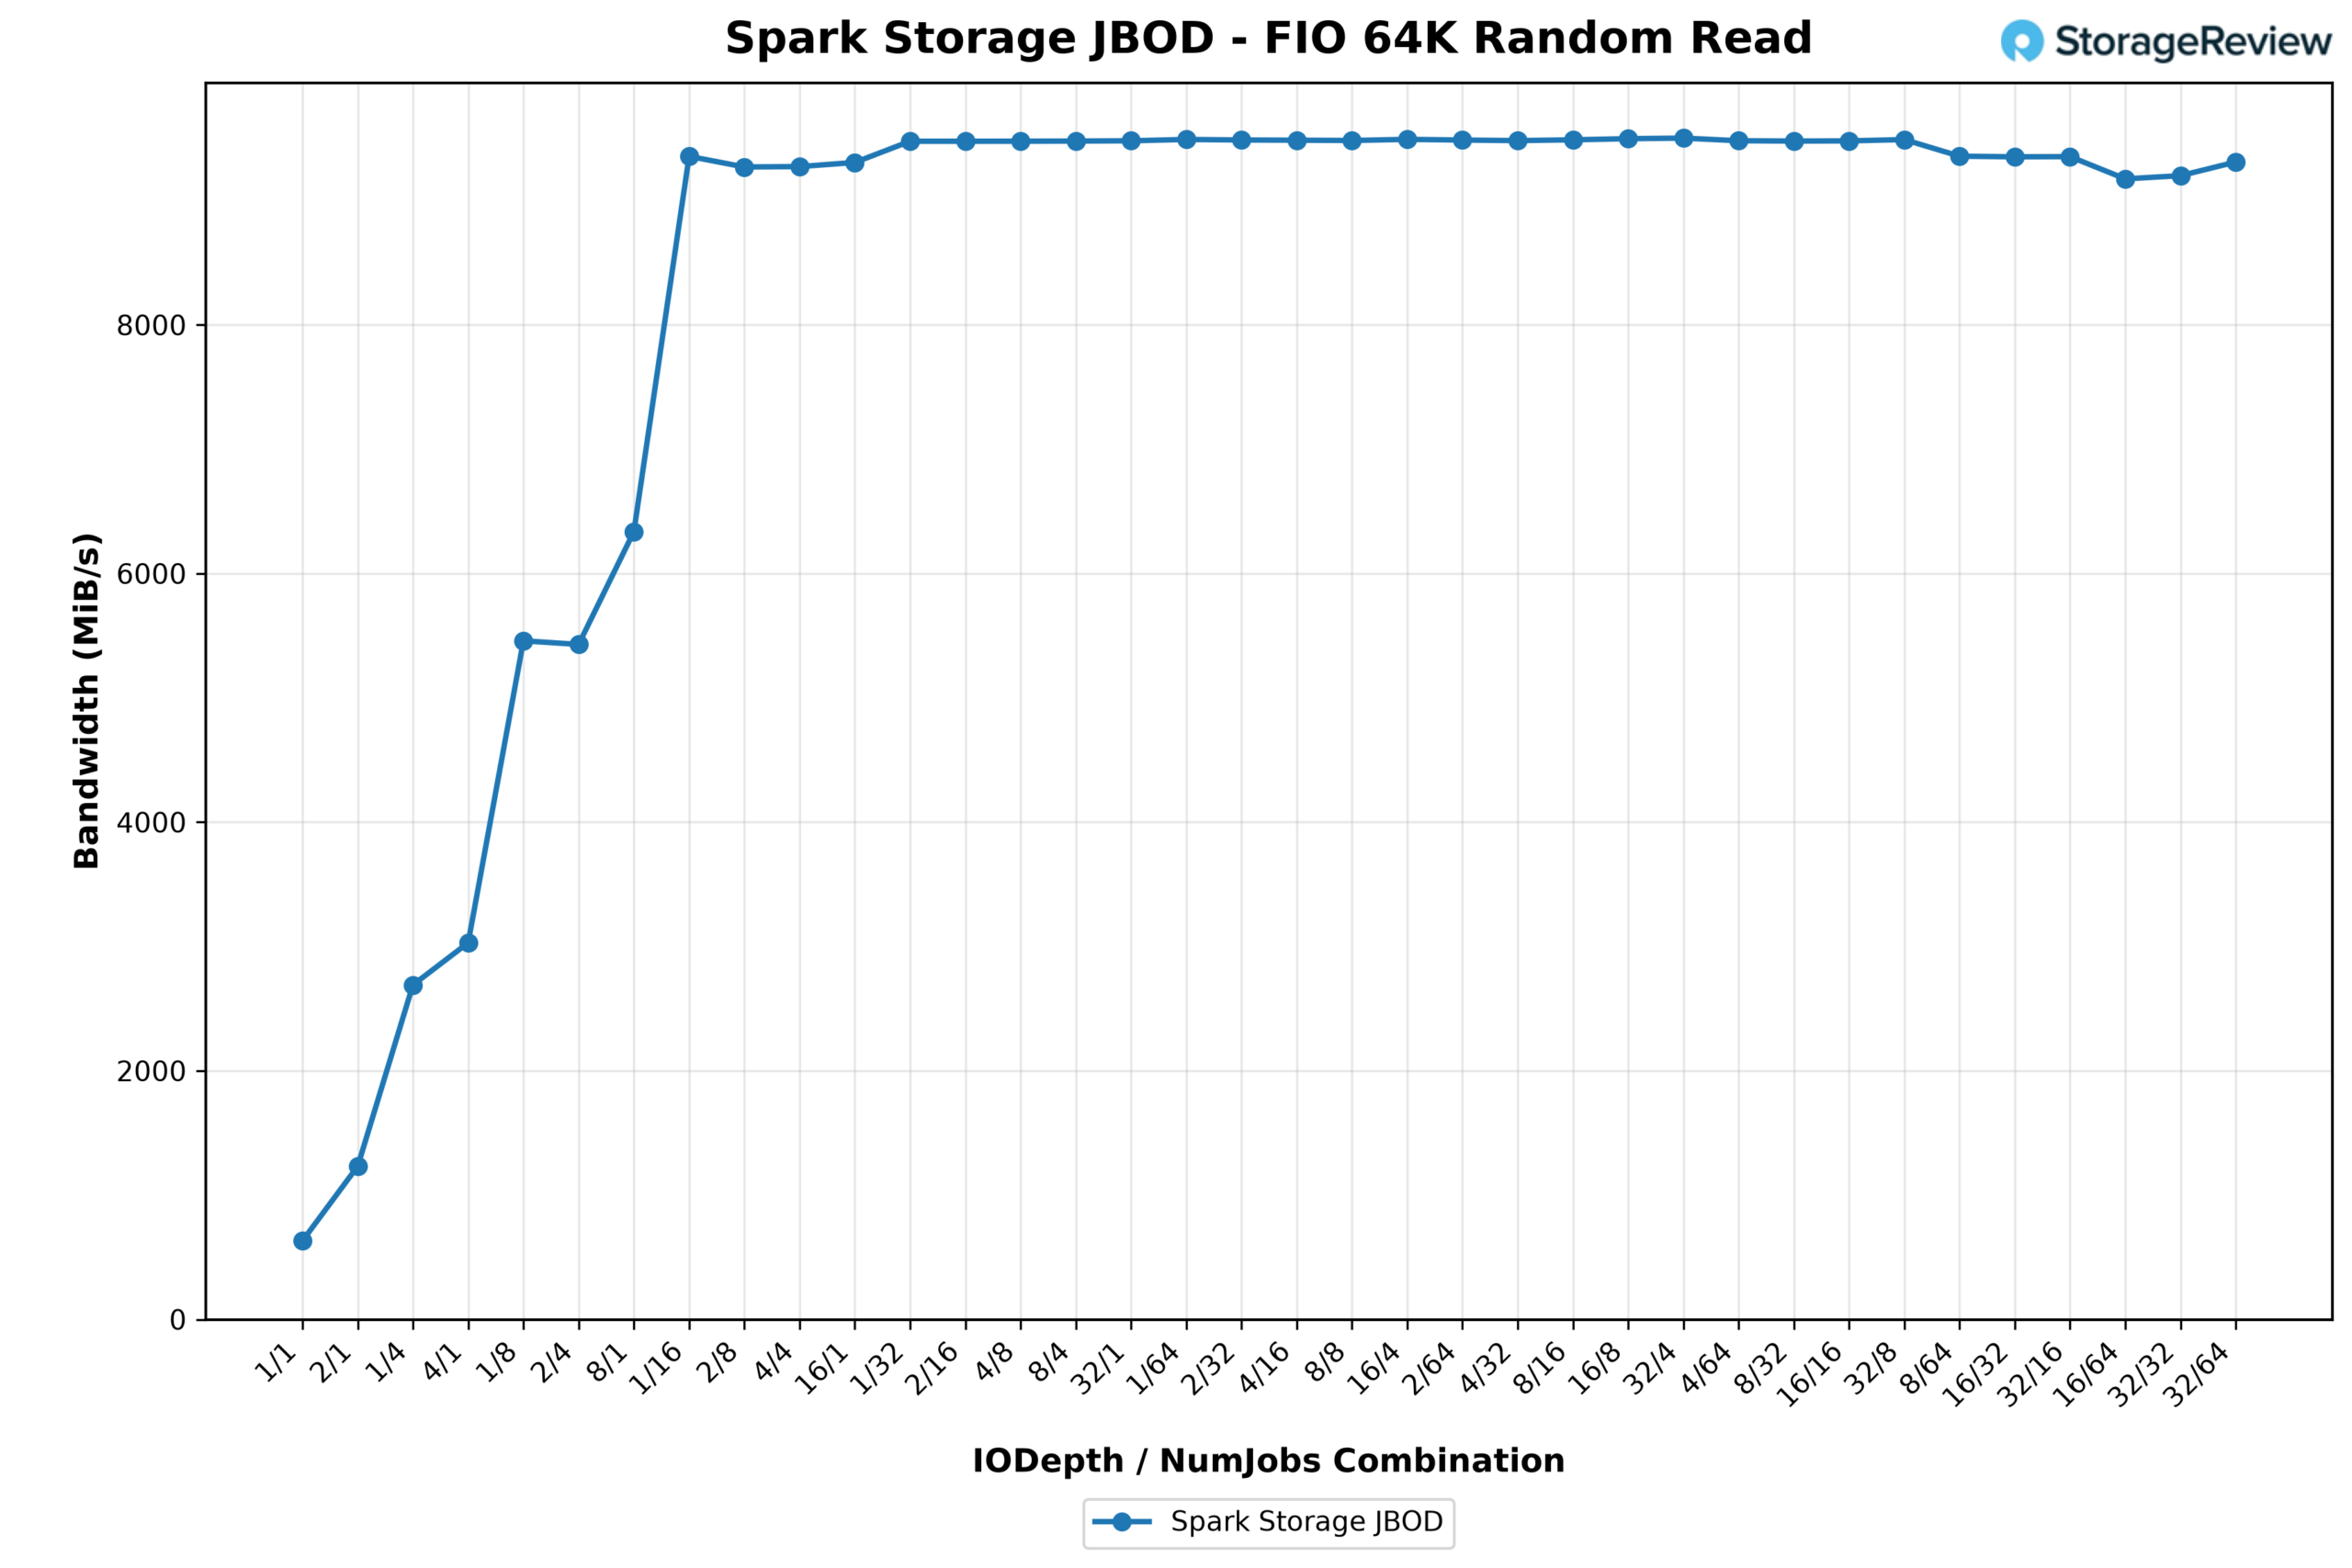
64K မှာဆိုရင် ဇာတ်လမ်းက bandwidth အကြောင်းသက်သက်ပါ။ အမြင့်ဆုံးအဆင့်မှာ random reads က 9,503 MiB/s ရှိပြီး 4K နဲ့ 1M ceilings တွေနဲ့ စာရင်းအင်းအရ တူညီပါတယ်။ workload က block size ဘယ်လိုပဲယူဆောင်လာပါစေ GP Spark က တူညီတဲ့အဖြေကို ပေးစွမ်းပါတယ်- သူ့ရဲ့ 100GbE port ရဲ့ full line rate ပါ။
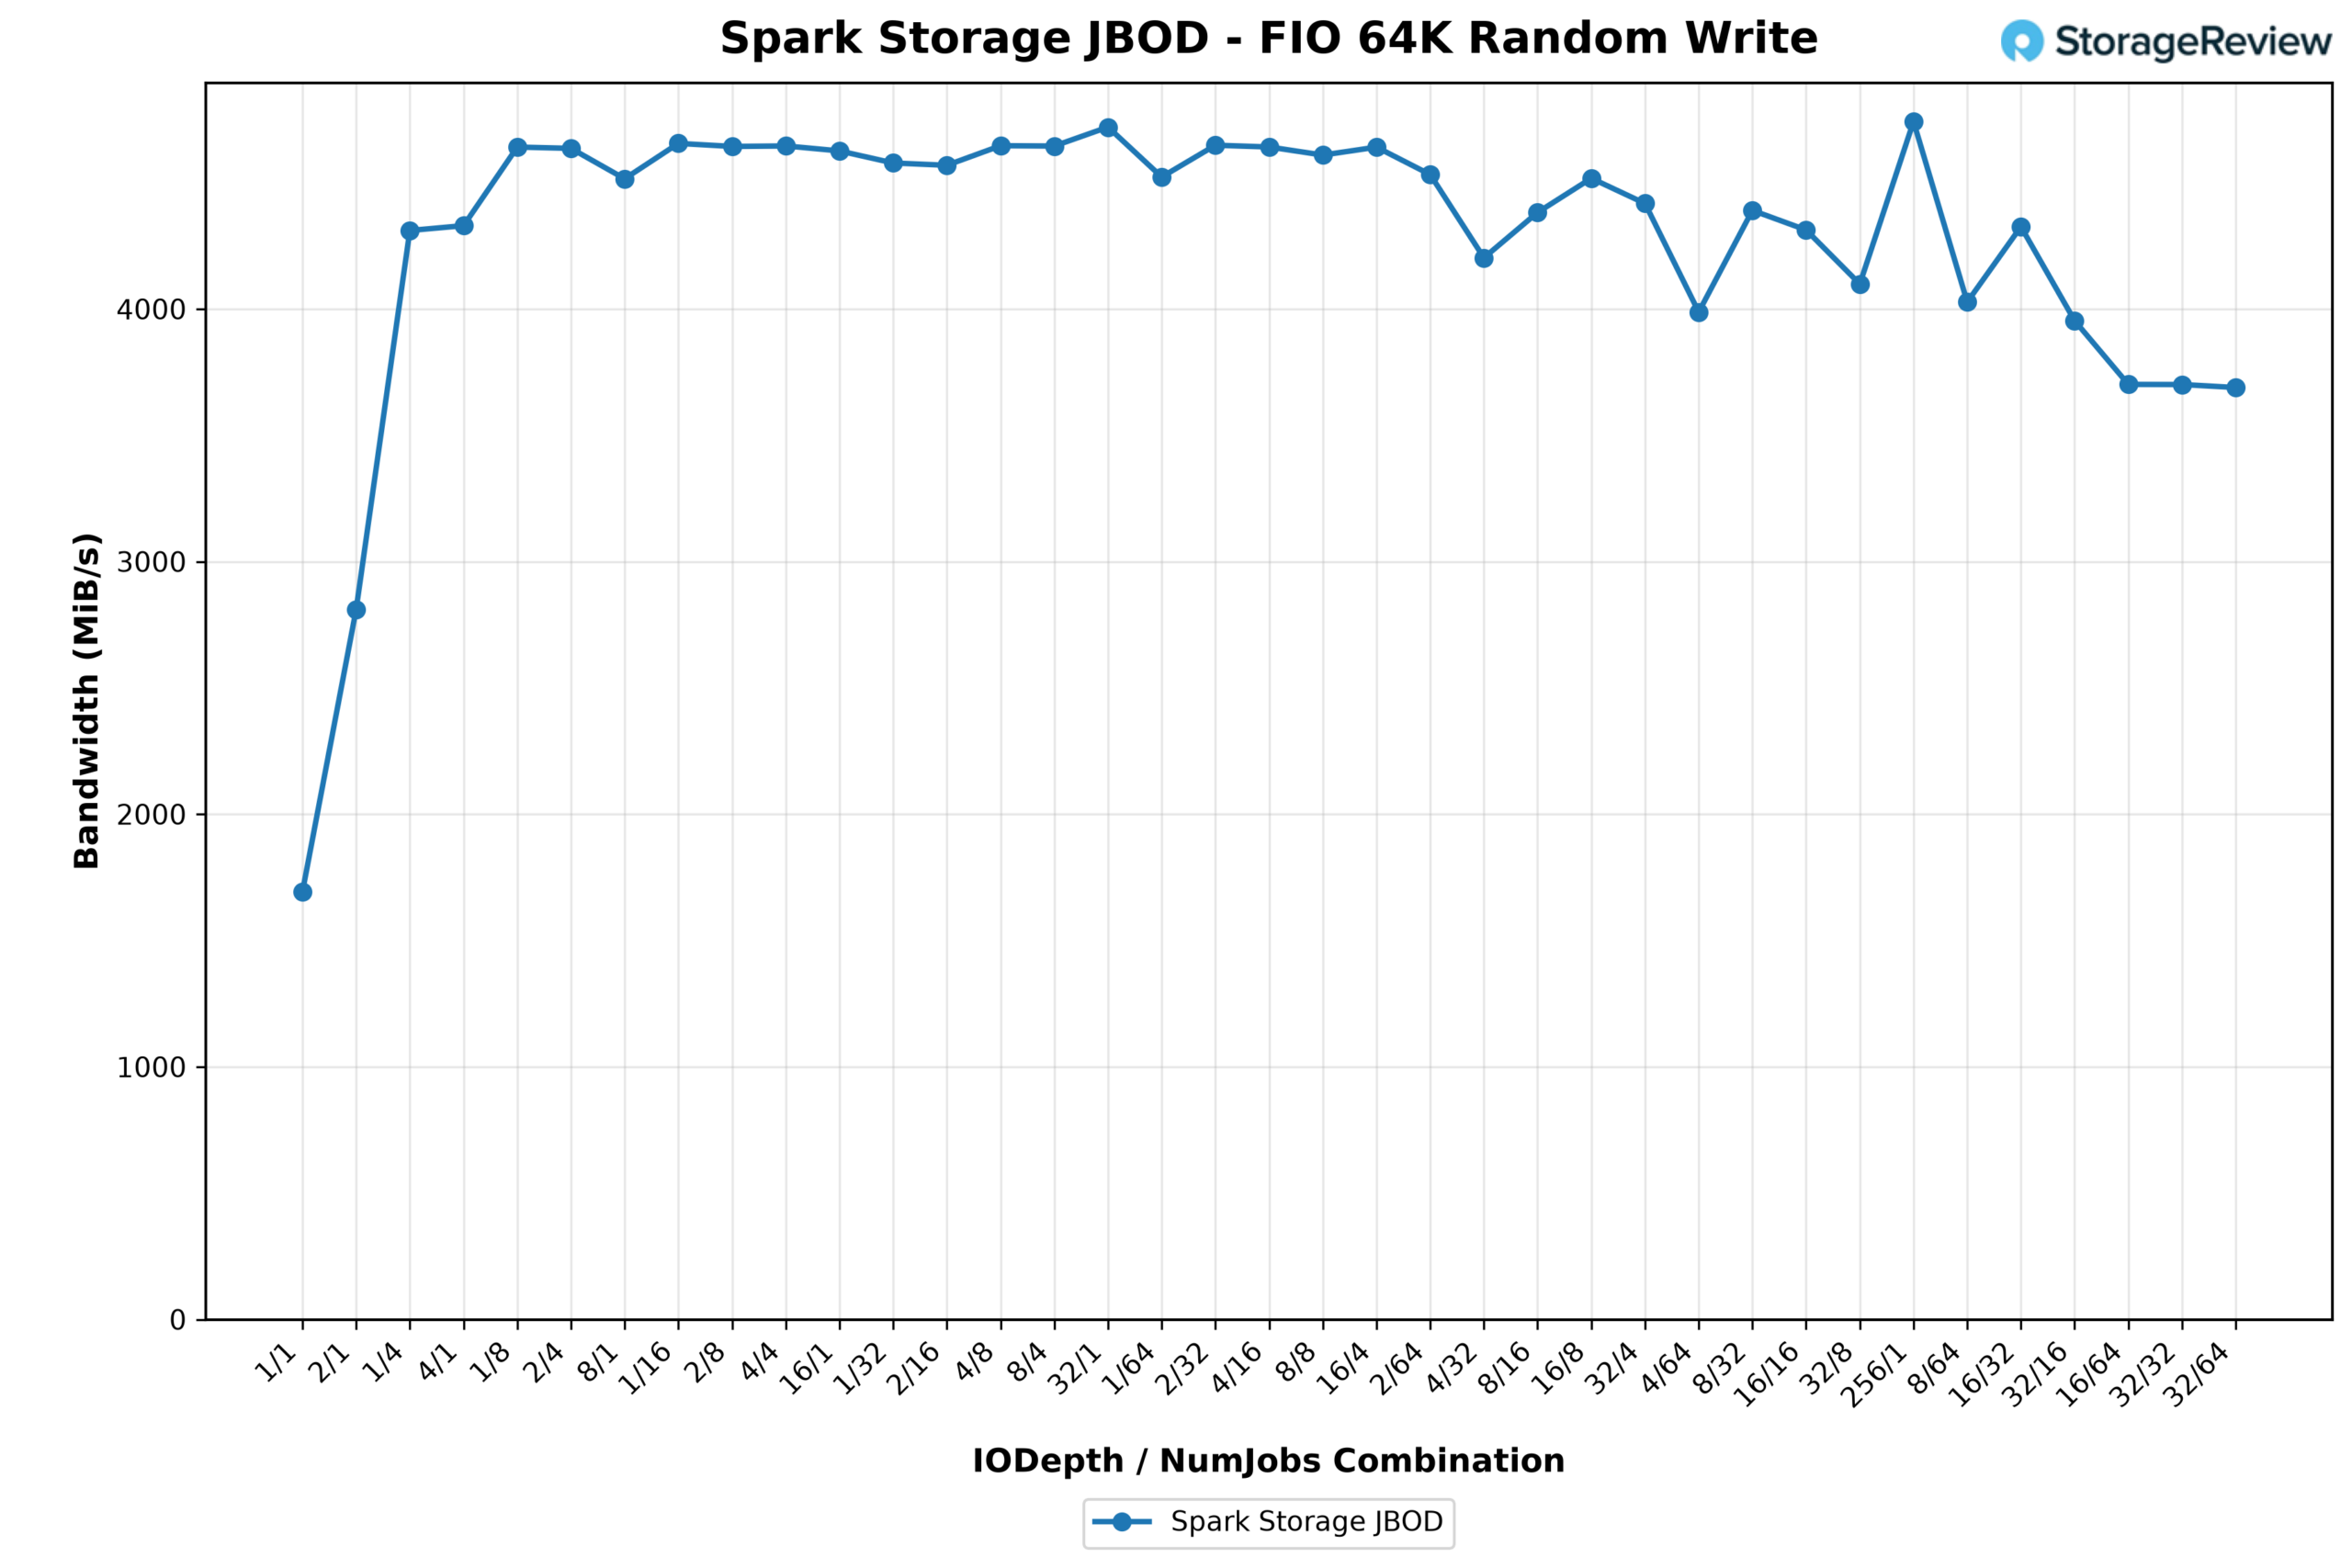
64K ကျပန်းရေးသားမှုမှာ 4,742 MiB/s တွင် တည်ငြိမ်ပြီး အခြား block အရွယ်အစားတိုင်းတွင် ကျွန်ုပ်တို့ တိုင်းတာခဲ့သော အမြင့်ဆုံးပမာဏနှင့် အတူတူပင်ဖြစ်သည်။
၁ သန်း အဆက်မပြတ် စွမ်းဆောင်ရည်
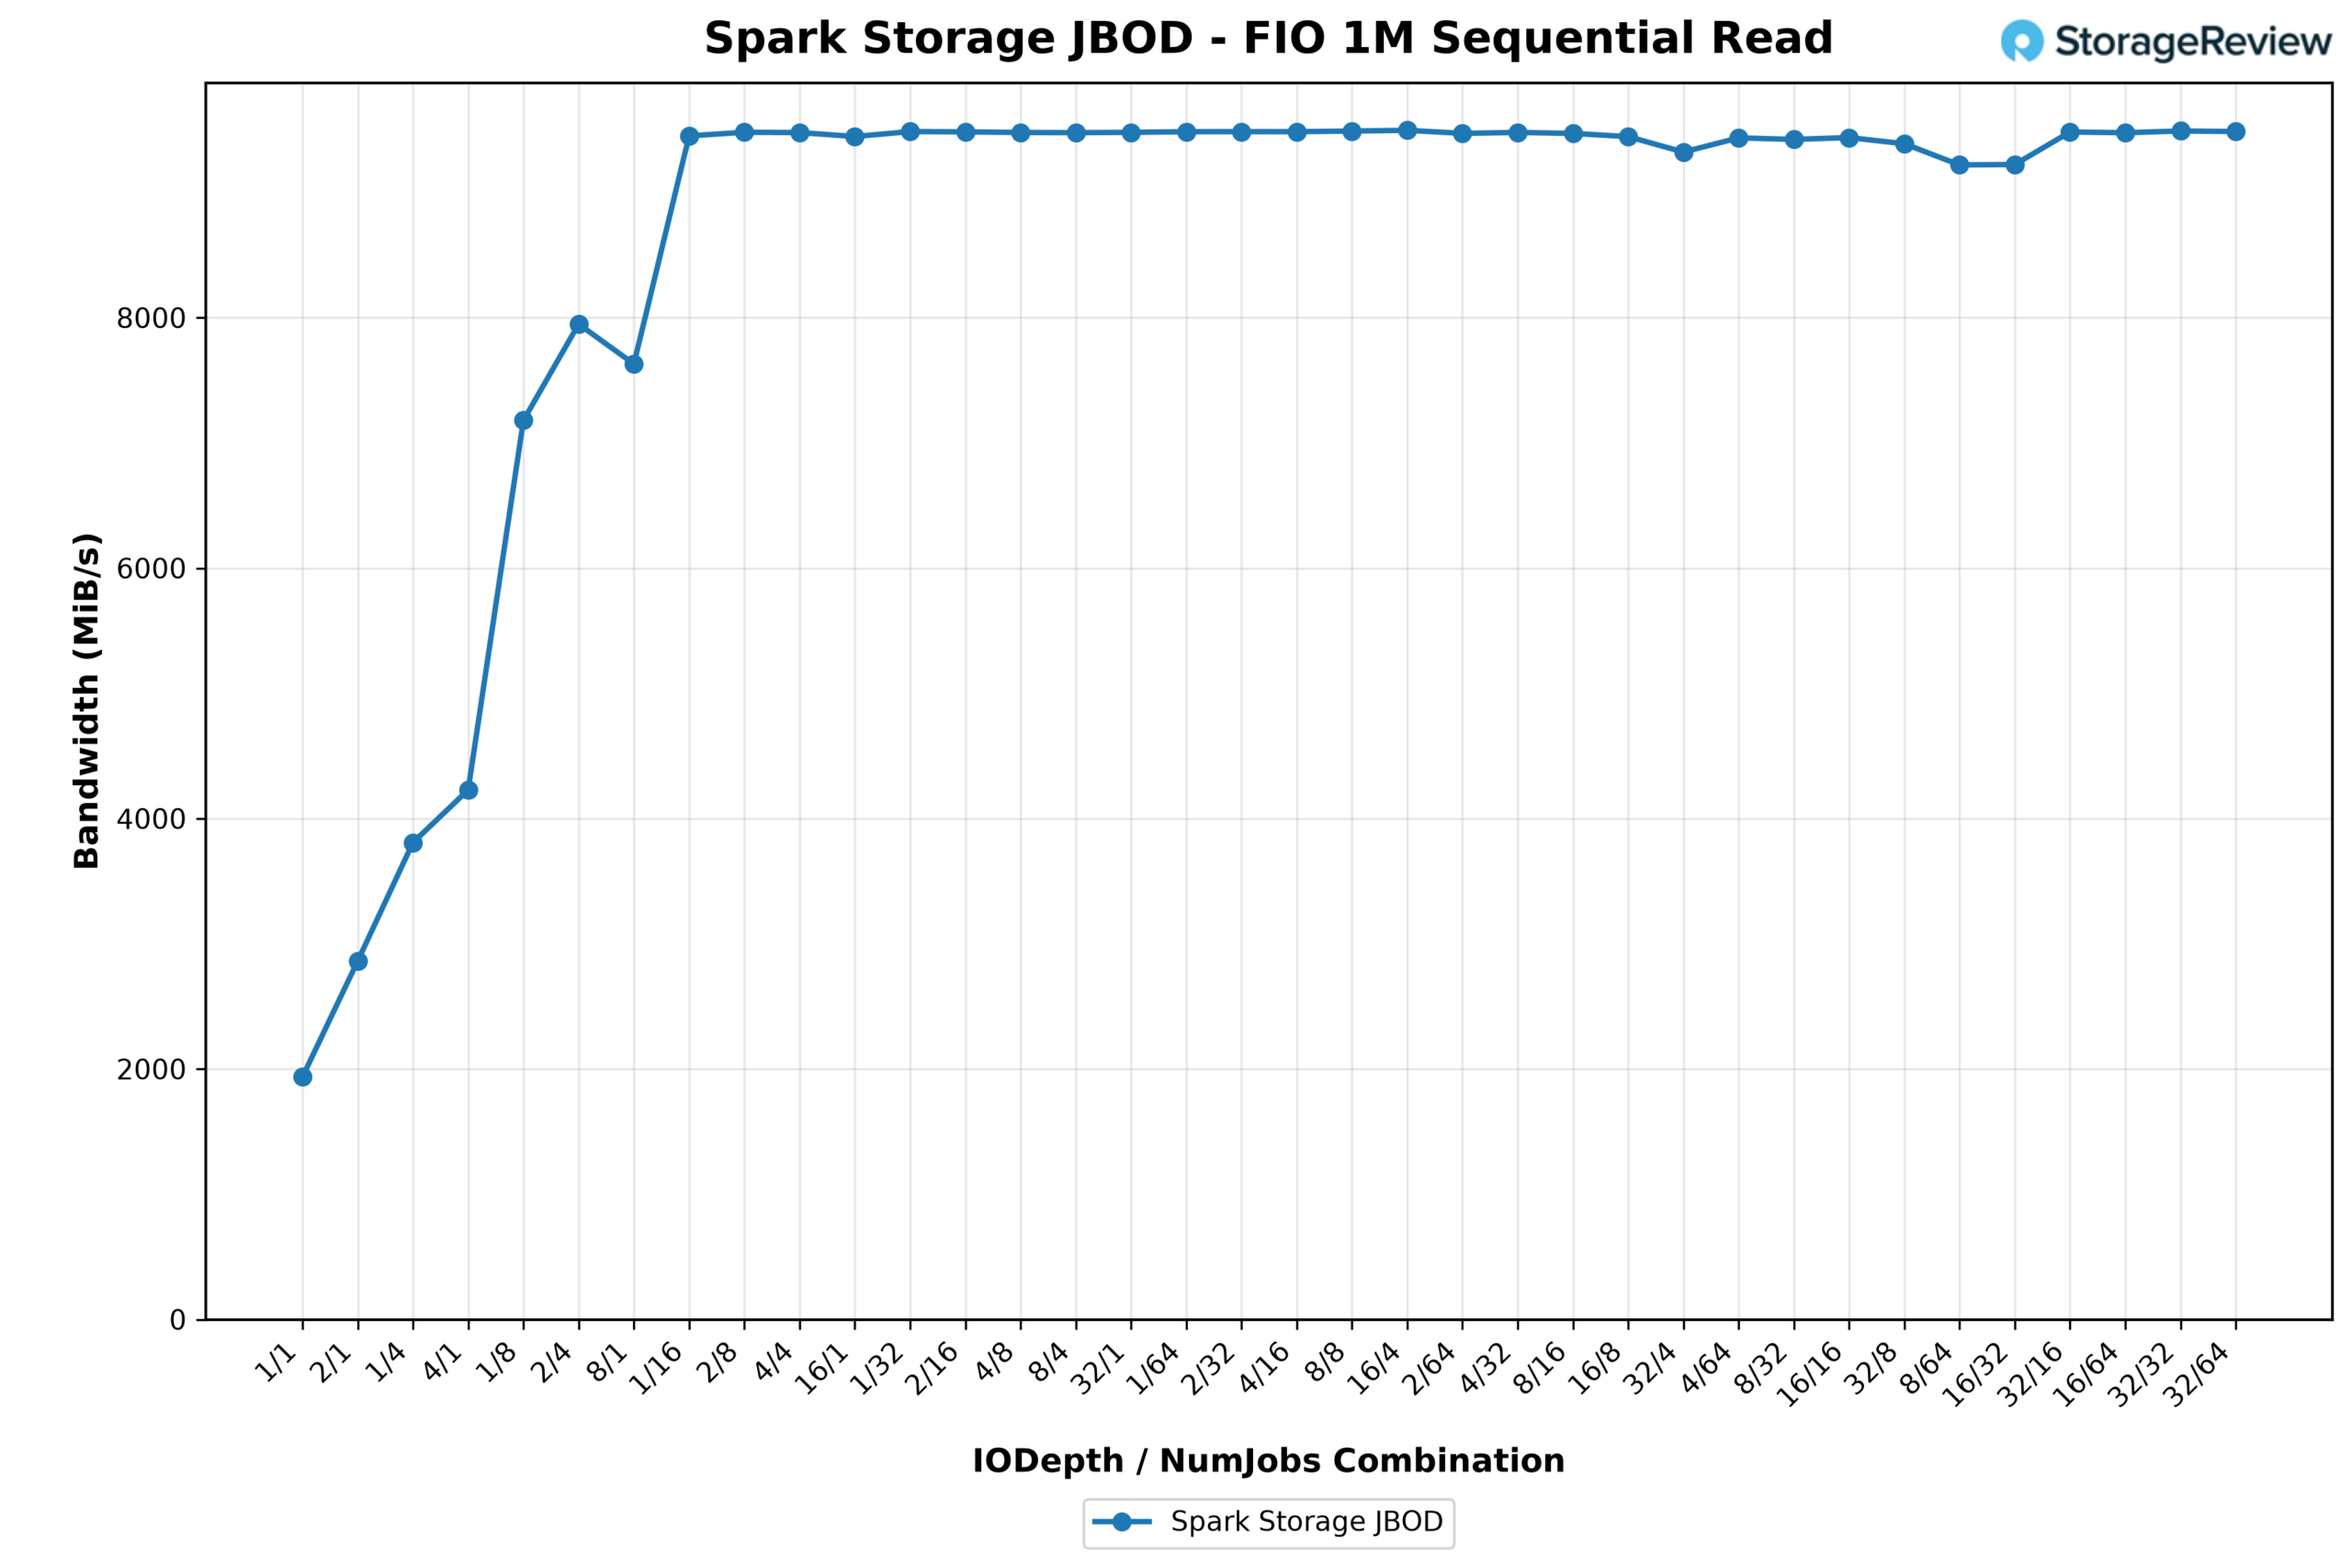
မော်ဒယ်တင်ခြင်းနှင့် dataset streaming ၏ပရိုဖိုင်ဖြစ်သော Large-block sequential reads များသည် 9,496 MiB/s အထိရောက်ရှိပြီး အသင့်အတင့် queue depths မှစတင်၍ ထိုနေရာတွင်ရှိနေပါသည်။ ဤသည် GP Spark တွင်ရှိပြီး wire ဖြင့်လည်ပတ်သည်။
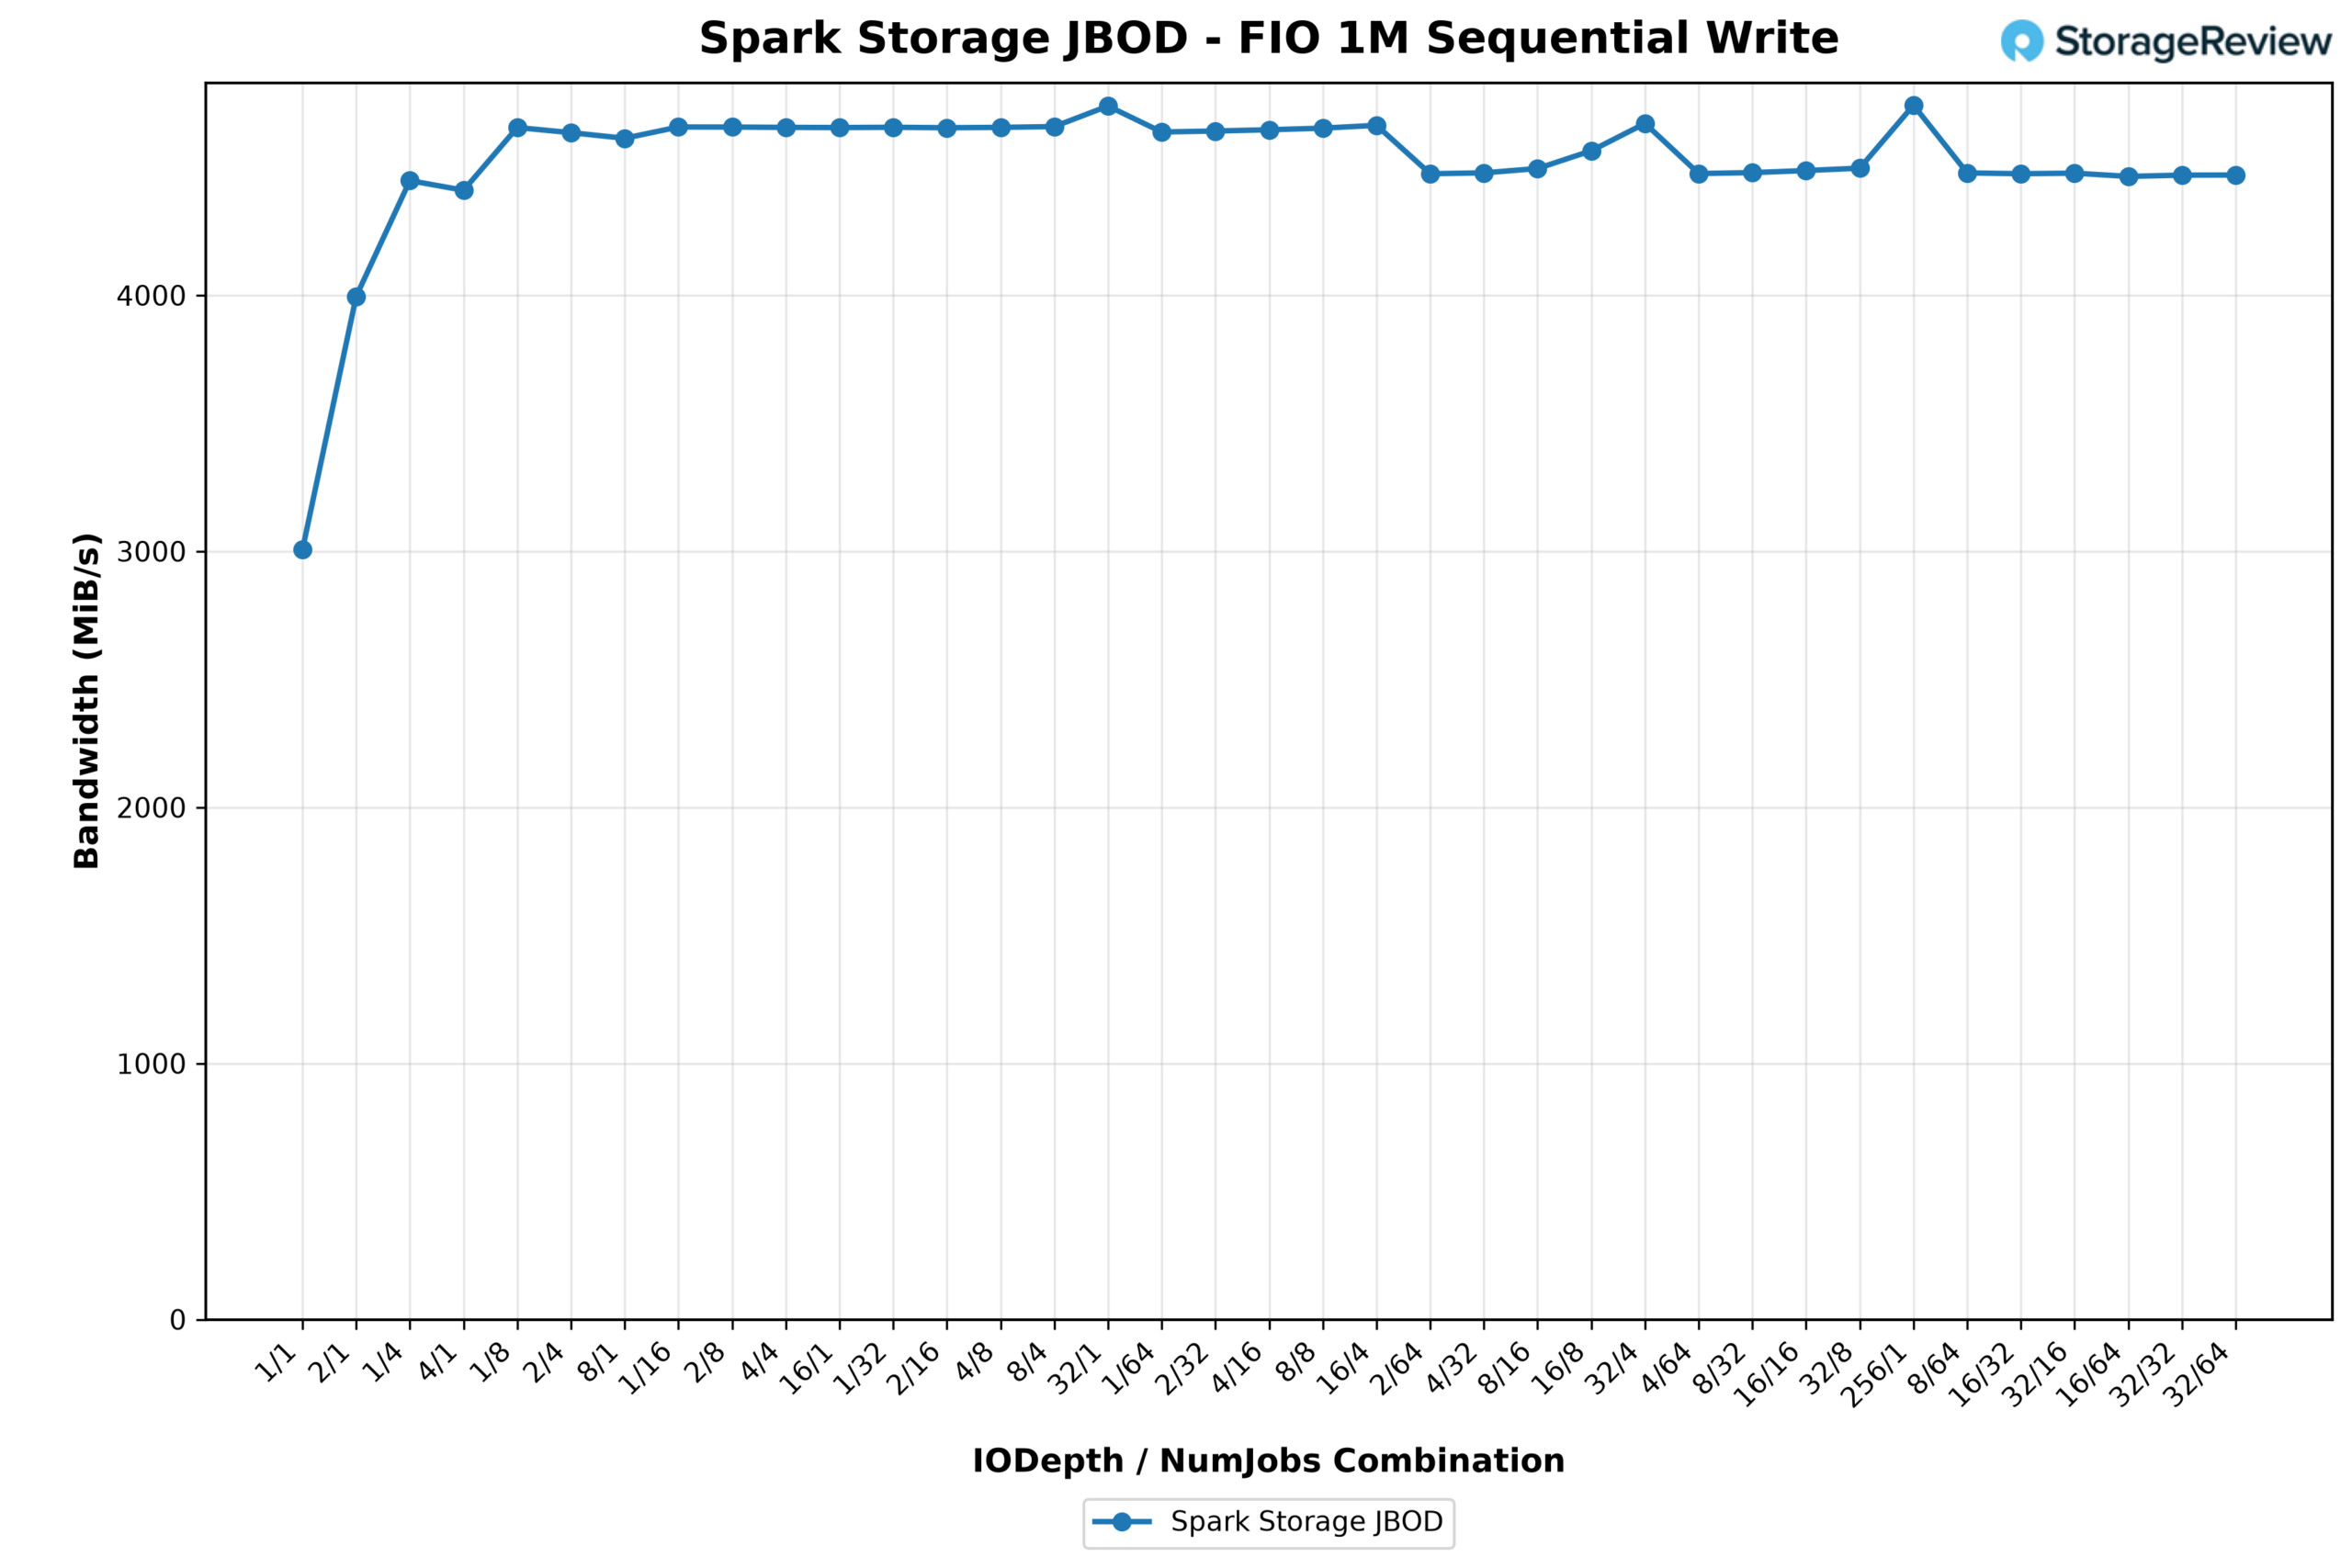
Sequential writes က 4,742 MiB/s ရှိပြီး read throughput ရဲ့ ထက်ဝက်လောက်ရှိပါတယ်။ ကျွန်တော်တို့စမ်းသပ်ထားတဲ့ block size တိုင်းမှာ အဲဒီ ceiling က အတူတူပါပဲ။ စမ်းသပ်နေစဉ်အတွင်း Luisuantech ကို asymmetry ကို flag လုပ်ခဲ့ပြီး MTU ပြောင်းလဲမှုတွေအပါအဝင် ကုမ္ပဏီနဲ့ tuning တစ်ကြိမ်လုပ်ခဲ့ပါတယ်။ ဒီမှာရှိတဲ့ ကိန်းဂဏန်းတွေက platform က သူ့ရဲ့လက်ရှိ single-port configuration မှာ အကောင်းဆုံးပေးစွမ်းနိုင်တာကို ကိုယ်စားပြုပြီး Luisuantech က write path အတွက် သူ့ရဲ့ specifications တွေနဲ့ ကိုက်ညီကြောင်း အတည်ပြုခဲ့ပါတယ်။ read-dominated workloads တွေအတွက် ဒီ box က target လုပ်ထားတဲ့ model loading, dataset streaming နဲ့ RAG retrieval တွေအတွက် footnote ပါ။ heavy ingest အတွက် size expectations ကို လိုက်လျောညီထွေဖြစ်အောင် လုပ်ပါတယ်။
ကောက်ချက်
GP Spark က တစ်ခုပဲလုပ်တယ်။ သန့်ရှင်းသပ်ရပ်တယ်။ ပလက်ဖောင်းအတွက် တကယ်လိုအပ်တဲ့ DGX Spark တစ်ခု ဒါမှမဟုတ် တစ်ခုထက်ပိုတဲ့ storage ကို ပေးတယ်။ ကြိုးတပ်ပြီး kernel module ကို load လုပ်လိုက်ရင် driver install မလုပ်ဘဲ၊ storage OS ဒါမှမဟုတ် enterprise invoice မလိုဘဲ GDS-accessible flash ရဲ့ 10GB/s နီးပါး ပေါ်လာလိမ့်မယ်။ client M.2 drives တွေနဲ့ ဖြည့်တာက အဓိကအချက်ပဲ။ box က 2280 ဒါမှမဟုတ် 22110 SSD တွေကို လက်ခံတဲ့အခါ capacity က အတော်လေး ဈေးသက်သာပြီး offload engine က drives တွေ မမြင်ရတဲ့ protocol work ကို ကိုင်တွယ်တယ်။
ကျွန်ုပ်တို့အမြင်ကတော့ ဒါက တိုးတက်မှုတစ်ခုထက် သပ်ရပ်ပြီး ကောင်းမွန်စွာ လုပ်ဆောင်ထားတဲ့ add-on တစ်ခုလို့ ထင်ပါတယ်။ ဖတ်ရှုမှုနှုန်းက single link ရဲ့ line rate မှာ ရပ်တန့်သွားပြီး ရေးသားမှုနှုန်းက အဲဒီရဲ့ ထက်ဝက်လောက်မှာ ရပ်တန့်သွားပါတယ်။ ဈေးနှုန်းကတော့ မေးခွန်းထုတ်စရာပါ။ GP Spark ကို အမေရိကန် ဒါမှမဟုတ် တရုတ်နိုင်ငံမှာ လက်လီရောင်းချမှုမှာ မစာရင်းသွင်းရသေးသလို၊ ကျွန်ုပ်တို့ရဲ့ စမ်းသပ်ယူနစ်က prototype တစ်ခုဖြစ်ပြီး Luisuantech က ဈေးနှုန်းကို မထုတ်ပြန်သေးပါဘူး။ တန်ဖိုးအငြင်းပွားမှုက client-drive ဒီဇိုင်းက ခွင့်ပြုသင့်သလို enterprise NVMe-oF ရွေးချယ်စရာတွေထက် သိသိသာသာ နိမ့်ကျနေတဲ့ box ပေါ်မှာ မူတည်ပါတယ်။ internal storage wall ကို ထိခိုက်စေတဲ့ Spark ပိုင်ရှင်တွေအတွက်၊ ကျွန်ုပ်တို့ရဲ့ မူရင်းသုံးသပ်ချက်က သူတို့ထဲက အများစုဟာ ဒီလိုလုပ်လိမ့်မယ်လို့ အကြံပြုထားတာကြောင့်၊ ဒါက ကြီးမားတဲ့ enterprise storage estate ကနေ storage ကို ခွဲထုတ်စရာမလိုဘဲ အဲဒီပြဿနာကို ဖြေရှင်းဖို့ လွယ်ကူတဲ့ နည်းလမ်းတစ်ခုပါပဲ။



 အမေဇုံ