

Firma VAST Data ogłosiła, że DeepL wdraża system operacyjny VAST AI jako podstawę danych dla środowisk badawczych obsługujących tłumaczenia pisemne i głosowe w czasie rzeczywistym. Zgodnie z obecnymi planami wdrożenia, DeepL spodziewa się około trzykrotnie większej pojemności pamięci masowej niż dotychczas wykorzystywany sprzęt NVMe, a do migracji danych z dotychczasowego środowiska wykorzysta technologię SyncEngine firmy VAST. Platforma DeepL obsługuje ponad 200 000 zespołów biznesowych, a firma twierdzi, że to szkolenia głosowe w czasie rzeczywistym napędzają nowe zapotrzebowanie na dane.
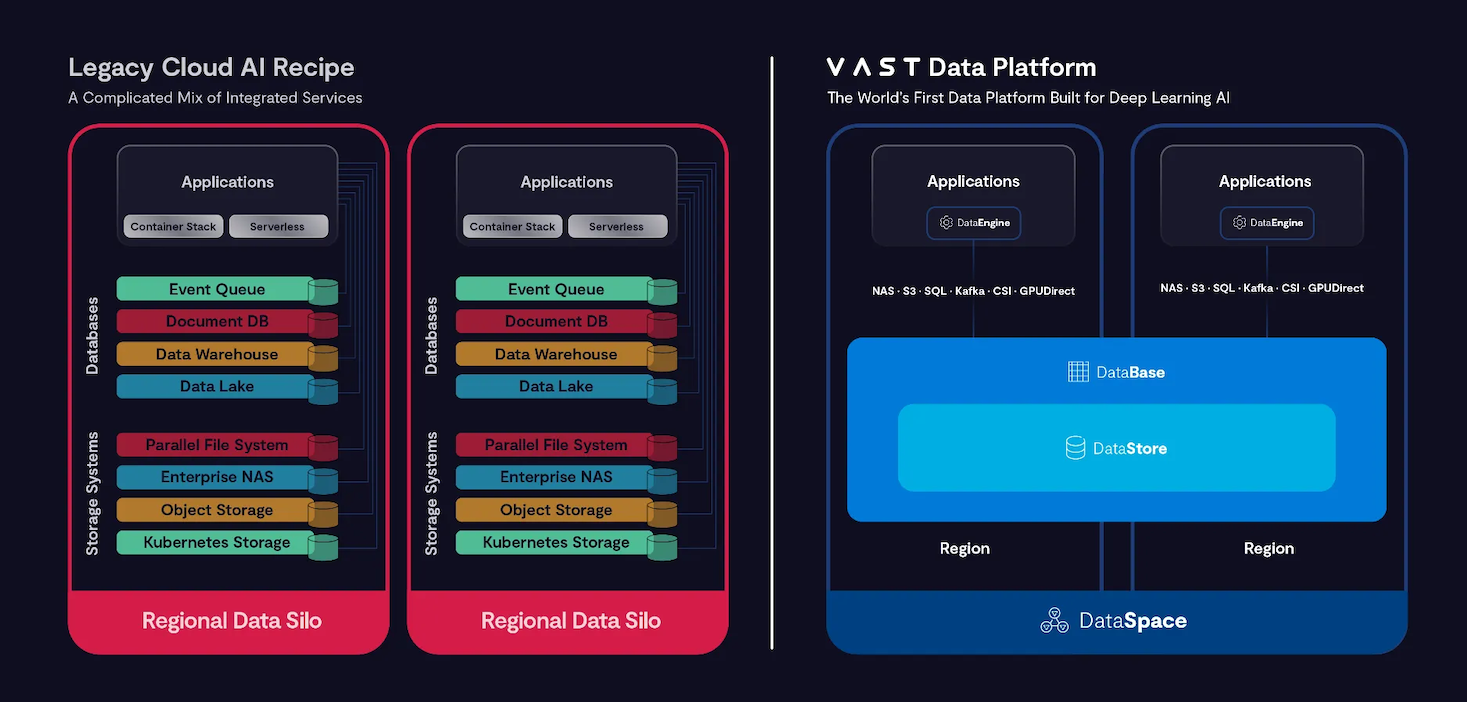
Konsolidacja NVMe ma na celu 3-krotne zwiększenie użytecznej pojemności
Trzykrotna wartość obejmuje istniejącą infrastrukturę NVMe firmy DeepL, a DeepL opisuje zysk jako możliwość skalowania rozwoju modelu bez jednoczesnego zwiększenia fizycznego sprzętu. Żadna z firm nie rozdziela zysku między redukcję danych, kodowanie erasure i konsolidację oddzielnych pul na jednej platformie, a VAST nie powiązał tej wartości z programem Amplify , który uruchomił w styczniu, deklarując nawet sześciokrotne zwiększenie efektywnej pojemności istniejących dysków SSD. Modele dysków, surowe pojemności i harmonogram wdrożenia nie zostały ujawnione.
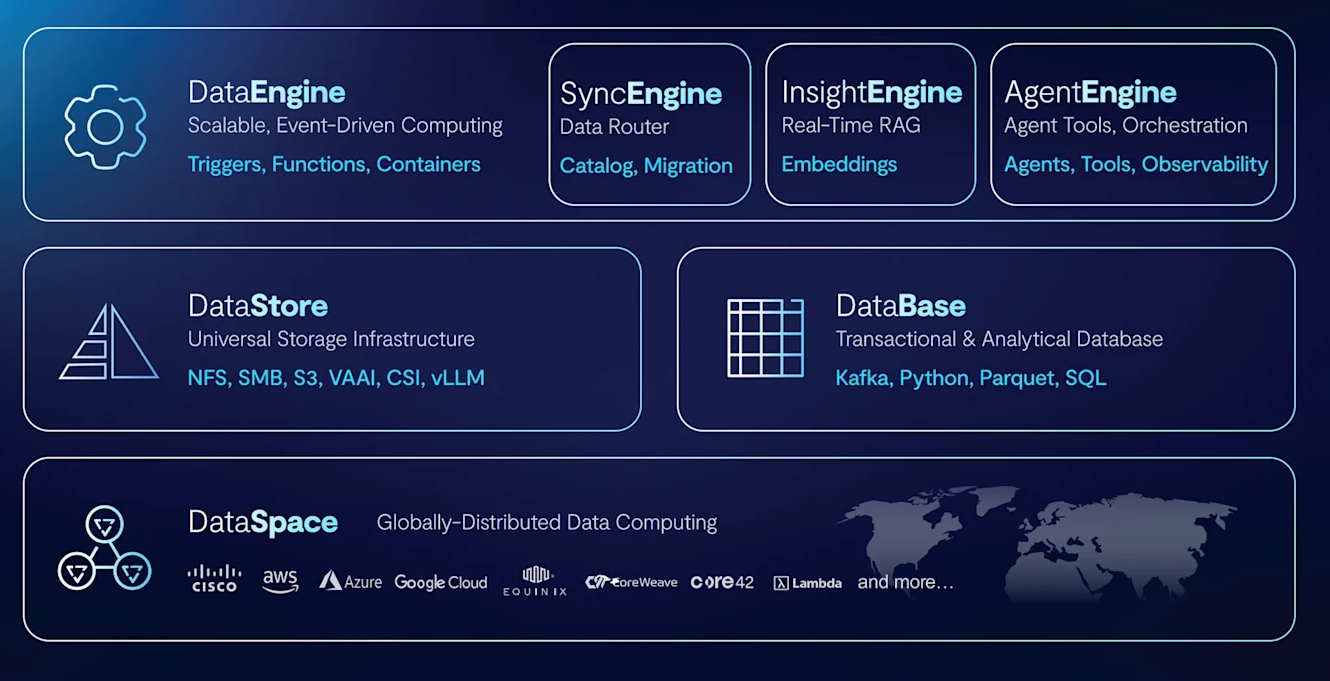
SyncEngine, komponent systemu operacyjnego AI, który kataloguje i migruje dane, przenosi dane DeepL z obecnego środowiska na platformę VAST. Stamtąd platforma obsługuje przechowywanie plików i obiektów z jednego systemu, co, jak twierdzi DeepL, upraszcza strukturę danych w zespołach badawczych i zapewnia elastyczność w miarę zmian obciążeń związanych z modelami.
„VAST zapewnia nam niezbędną wydajność i niezawodność, a jednocześnie pozwala nam znacznie efektywniej wykorzystać infrastrukturę, którą już dysponujemy” – powiedział Stefan Andresen, główny naukowiec w DeepL. „Co równie ważne, otwiera nam drogę do łatwiejszego dostępu do danych w naszych własnych centrach danych, a z czasem także w środowiskach chmurowych, ograniczając ręczne przenoszenie danych, które może utrudniać badania”.
DeepL Voice, wprowadzony w listopadzie 2024 roku do prowadzenia wielojęzycznych rozmów na żywo, to obciążenie, które zwiększa wymagania. Ostatnie aktualizacje pozwalają zachować charakterystykę głosu mówcy w różnych językach, a DeepL twierdzi, że trenowanie tych możliwości stawia większe wymagania w zakresie dostępu do danych i wydajności infrastruktury niż w przypadku tekstu, a priorytetem jest sprawne przemieszczanie się między środowiskami szkoleniowymi a produkcyjnymi.
Hybrydowe zarządzanie danymi obejmuje lokalnie i w chmurze
Wdrożenie rozpocznie się w centrach danych DeepL, a plany zakładają rozszerzenie VAST na środowiska chmurowe z czasem, aby badacze uzyskali taki sam dostęp do zestawów danych, niezależnie od lokalizacji klastra szkoleniowego, i nie musieli ręcznie kopiować danych między lokalizacjami. Żadna z firm nie podała, z których usług VAST będzie korzystać w fazie chmurowej ani kiedy się ona rozpocznie.
„W miarę jak sztuczna inteligencja wkracza do produkcji, niezawodność infrastruktury staje się równie ważna, co jej wydajność” – powiedział Jeff Denworth, współzałożyciel VAST Data. „Język pisany, komunikacja głosowa w czasie rzeczywistym i nowa generacja rozwiązań AI stawiają dane w różnym stopniu, ale badacze nie powinni musieć przeprojektowywać infrastruktury bazowej za każdym razem, gdy zmienia się model lub produkt”.
VAST pozycjonuje system operacyjny AI jako wspólną bazę danych dla tworzenia modeli, ich trenowania i wnioskowania, konsolidując usługi plików i obiektów ze spójnym dostępem w całej rozproszonej infrastrukturze. DeepL jest kontynuacją serii zapowiedzi VAST z tej jesieni, w tym DataEnclave do uruchamiania modeli na regulowanych danych w ramach poufnych obliczeń NVIDIA oraz integracji z CrowdStrike , która została uruchomiona we wrześniu.


 Amazon