

Firma Intel przedstawiła plany dotyczące wysokowydajnych obliczeń dla platformy SC26, w centrum których znalazła się platforma Diamond Rapids, oparta na architekturze serwerowej Xeon nowej generacji. Intel twierdzi, że platforma będzie skalowalna do 256 rdzeni o wysokiej wydajności, przepustowości pamięci do 1.6 TB/s i do 1.28 GB pamięci podręcznej ostatniego poziomu. Zarys koncepcji przedstawił Jeff McVeigh, wiceprezes i dyrektor generalny ds. strategicznych programów centrów danych, i obejmuje on również procesory graficzne Intel GPU serii D, oprogramowanie HPC, fotonikę krzemową oraz rozwój technologii kwantowych. Intel nie podał daty premiery platformy Diamond Rapids.
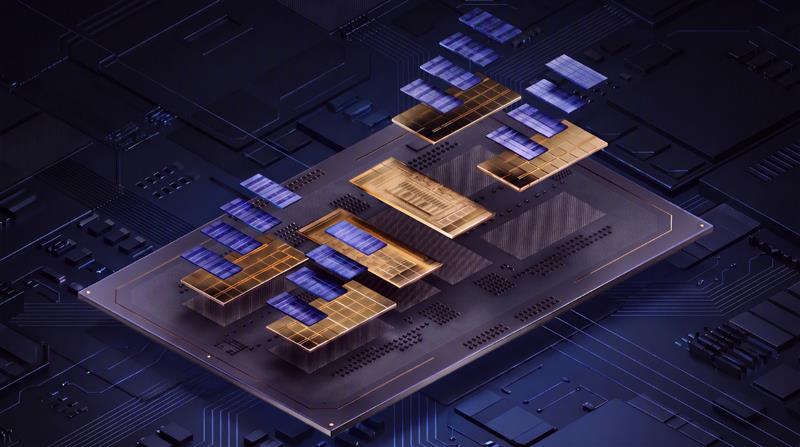
Architektura procesora Diamond Rapids
Intel opisuje technologię Diamond Rapids , którą szczegółowo opisał w Hot Chips, jako konstrukcję 18A-P, łączącą wyższą gęstość obliczeniową z większą przepustowością pamięci, większą pamięcią podręczną i ulepszoną akceleracją procesora. Rozszerzenia Intel Advanced Performance Extensions (APX) mają na celu zwiększenie wydajności na wątek, a to, co Intel nazywa zunifikowaną strukturą pamięci, zapewnia wydajność 1.6 TB/s. Intel nie ujawnił, ile kanałów pamięci ani jaka prędkość pamięci stoi za tą wartością, ani czy dotyczy ona pojedynczego gniazda.
Architektura obsługuje również technologię Intel AVX 10.2 i ulepszone rozszerzenia Intel Advanced Matrix Extensions (Intel AMX). Intel określa procesor Xeon nowej generacji jako jedyny serwerowy procesor x86 z wbudowanymi obliczeniami macierzowymi do zadań HPC i AI. Dla porównania, najlepsze testowane przez nas procesory AMD EPYC Venice mają 256 rdzeni Zen 6c na gniazdo.
McVeigh przedstawił plan działania w oparciu o systemy mieszane, w których procesory koordynują przepływy pracy i obsługują biblioteki komunikacji równoległej, podczas gdy akceleratory przejmują zadania związane ze sztuczną inteligencją, pisząc, że przyszłość HPC jest „otwarta, heterogeniczna i zrównoważona”.
Oprogramowanie Intel GPU serii D i HPC
Karta Intel GPU serii D łączy akcelerację AI z obliczeniami o podwójnej precyzji (FP64) w chłodzonej powietrzem karcie PCIe, z obsługą typów danych od FP4 i MXFP4 do FP64. Karta Intel GPU D270 posiada 160 GB pamięci LPDDR5X o przepustowości 1.5 TB/s, a konfiguracje zaprojektowane przez partnerów skalują się do 480 GB. Argument Intela za ośrodkami badawczymi koncentruje się na pojemności pamięci, ponieważ przechowywanie większych zbiorów danych roboczych na karcie zmniejsza partycjonowanie i transfery między hostem a akceleratorem, które spowalniają procesy naukowe. Intel rekomenduje również tę kartę dla stale działających agentów AI, którzy generują kod i uruchamiają zadania obliczeniowe.
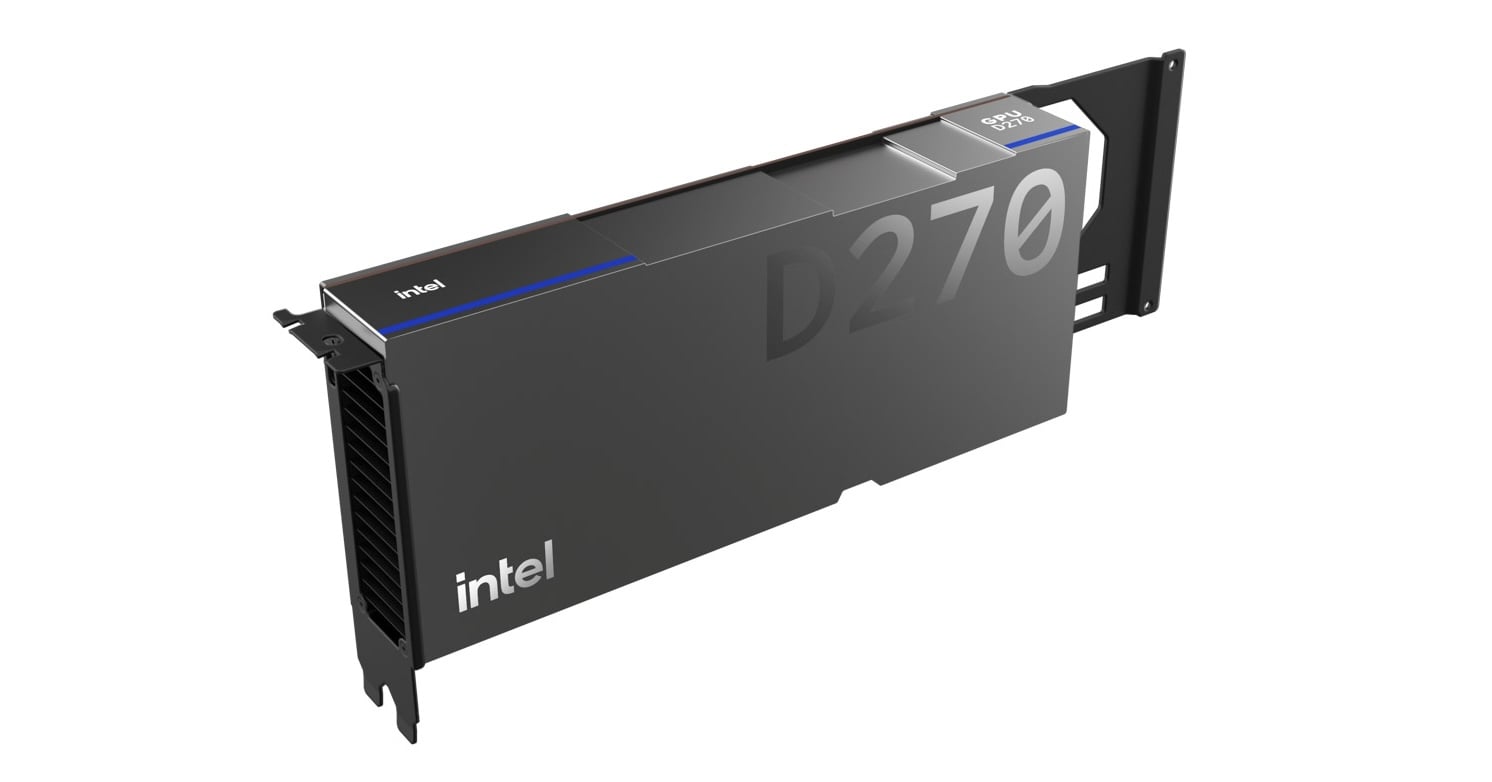
Firma Intel przeprowadza na swoim stoisku SC26 dwie demonstracje na żywo karty graficznej GPU D270, karty z serii D, wcześniej o nazwie kodowej Crescent Island. Pierwsza to mini-aplikacja do obrazowania sejsmicznego firmy Veridien, przeniesiona z HIP i CUDA do SYCL w niecały miesiąc. Intel twierdzi, że 90% jego jąder działało poprawnie bez optymalizacji specyficznej dla Intela. Druga dzieli potok wnioskowania między karty D270, które obsługują prefill, a jednostki SambaNova SN50, które obsługują dekodowanie, pod nadzorem procesorów Xeon 6 i Xeon 6+.
Intel opublikował również porównania z kartą NVIDIA RTX PRO 6000 Blackwell Server Edition. W obciążeniach finansowych FP64, deklaruje ona do 5.9x wyższą przepustowość w europejskim teście Monte Carlo, 5.6x w europejskim teście Black-Scholesa, 4.6x w teście dwumianowym i 1.92x w amerykańskim teście Black-Scholesa, przy poborze mocy przez kartę D270 wynoszącym 350 W i kartę NVIDIA 600 W. Dla porównania, Intel deklaruje do 29% niższe opóźnienie w przypadku Drex v2.0 i 1.12x wyższą przepustowość tokenów wyjściowych w Qwen3-30B-A3B w FP8.
Są to wyniki dostawców dla układów przedprodukcyjnych, których nie testowaliśmy ani nie weryfikowaliśmy. Konfiguracja testu finansowego firmy Intel wymienia osiem kart NVIDIA w porównaniu z jedną kartą D270 i nie podaje, czy wyniki są znormalizowane dla każdej karty. Wnioskowanie NVIDIA przeprowadzono na maszynie wirtualnej AWS.
W obszarze oprogramowania, Intel zapowiada dalsze inwestycje w Intel MPI, Fortran, optymalizację kompilatorów i oneAPI, aby istniejące równoległe bazy kodu działały sprawnie na systemach z mieszanymi procesorami CPU i GPU. Firma pracuje również nad integracją z frameworkami sztucznej inteligencji, środowiskami wnioskowania i środowiskami wdrożeniowymi. Deklarowanym celem jest zapewnienie, aby standardowe modele i narzędzia działały na nowym sprzęcie, takim jak seria D, od pierwszego dnia wdrożenia.
Łączność optyczna i rozwój kwantowy
Intel zwrócił również uwagę na swoje prace nad fotoniką krzemową, która wykorzystuje światło do przesyłania danych na większe odległości, zużywając, jak twierdzi firma, ułamek energii zużywanej przez łącza miedziane. Intel nie dołączył do tego stwierdzenia żadnych danych liczbowych ani harmonogramu rozwoju produktu.
W kontekście technologii kwantowej Intel ponownie przedstawił argumenty przemawiające za planowanym przejęciem Classiq , które miałoby połączyć platformę Classiq do zautomatyzowanej syntezy algorytmów kwantowych z technologią spin-kubitów krzemowych i produkcją chipów Intela. Intel zapowiedział, że spodziewa się sfinalizowania transakcji w pierwszej połowie 2027 roku, po uzyskaniu zgody organów regulacyjnych.


 Amazon