

Firma NVIDIA ogłosiła dwa istotne posunięcia ukierunkowane na obliczenia o wysokiej wydajności i sztuczną inteligencję: przejęcie SchedMD, firmy stojącej za menedżerem obciążeń Slurm, oraz premierę rodziny Nemotron 3, obejmującej otwarte modele, dane i narzędzia do wieloagentowej sztucznej inteligencji. Wszystkie te działania wzmacniają pozycję firmy NVIDIA w obszarze HPC, generatywnej sztucznej inteligencji i infrastruktury AI dla przedsiębiorstw, jednocześnie kładąc nacisk na otwarte, niezależne od dostawców oprogramowanie.
Slurm i SchedMD: Wzmocnienie otwartego, niezależnego od dostawców harmonogramowania HPC
SchedMD jest głównym twórcą Slurm, jednego z najpopularniejszych menedżerów obciążeń open source dla klastrów HPC i AI. Slurm służy do kolejkowania, planowania i alokacji zasobów obliczeniowych w klastrach dużej skali, które obsługują ściśle powiązane, równoległe obciążenia. Wraz ze wzrostem rozmiarów klastrów i złożoności modeli, efektywne planowanie staje się kluczowe dla utrzymania wykorzystania i przepustowości.
Slurm ma znaczący udział w HPC. Jest używany w ponad połowie systemów z listy TOP500 (10 i 100 najlepszych), ze względu na swoją skalowalność, wysoką przepustowość i obsługę złożonego zarządzania regułami. W przypadku obciążeń AI, Slurm stał się kluczowym komponentem infrastruktury wykorzystywanej przez twórców modeli bazowych i konstruktorów AI do koordynowania trenowania i wnioskowania modeli na dużą skalę w systemach akcelerowanych przez GPU.
Po przejęciu NVIDIA planuje kontynuować rozwój i dystrybucję Slurm jako oprogramowania open source, niezależnego od dostawcy. Firma deklaruje, że Slurm pozostanie dostępny dla szerszej społeczności HPC i AI oraz będzie nadal wspierać heterogeniczne środowiska na szerokiej gamie platform sprzętowych i programowych. NVIDIA współpracuje z SchedMD od ponad dekady, a to formalne przejęcie ma na celu przyspieszenie realizacji tego planu, a nie stanowi strategicznego zwrotu.
Kierownictwo SchedMD postrzega tę umowę jako potwierdzenie centralnej roli Slurm w dziedzinie HPC i sztucznej inteligencji (AI). Firma zauważyła, że doświadczenie firmy NVIDIA w dziedzinie akcelerowanych obliczeń powinno pomóc Slurm w spełnieniu przyszłych wymagań w zakresie sztucznej inteligencji i superkomputerów, przy jednoczesnym zachowaniu modelu open source i zaangażowania społeczności.
Wpływ na klienta i wsparcie platformy
W przypadku obecnych klientów SchedMD, NVIDIA zamierza utrzymać ciągłość wsparcia, szkoleń i rozwoju Slurm. Obecne wdrożenia Slurm obejmują dostawców usług chmurowych, producentów, firmy zajmujące się sztuczną inteligencją oraz organizacje badawcze z takich sektorów jak autonomiczne pojazdy, opieka zdrowotna i nauki przyrodnicze, energetyka, usługi finansowe, administracja publiczna oraz przemysł wytwórczy.
NVIDIA spodziewa się również przyspieszenia dostępu SchedMD do nowych systemów i architektur. Dla klientów standaryzujących się na platformie akcelerowanych obliczeń NVIDIA powinno to przełożyć się na szybszą obsługę nowych generacji procesorów GPU i konfiguracji systemowych. Jednocześnie NVIDIA podkreśla, że Slurm będzie nadal obsługiwać szeroki wachlarz środowisk heterogenicznych, umożliwiając klastrom różnych dostawców wdrażanie nowych możliwości Slurm bez konieczności ograniczania się do jednego stosu sprzętowego.
Wspólne wysiłki firm NVIDIA i SchedMD stanowią część szerszej inicjatywy mającej na celu wzmocnienie ekosystemu oprogramowania typu open source w dziedzinie obliczeń o wysokiej wydajności (HPC) i sztucznej inteligencji (AI), co umożliwi innowacje w różnych branżach i na różną skalę.
Nemotron 3: Otwarte modele MoE dla wieloagentowej, agentowej sztucznej inteligencji
Jednocześnie NVIDIA wprowadziła rodzinę Nemotron 3 – otwarty ekosystem modeli, zestawów danych i bibliotek do tworzenia transparentnych i wydajnych systemów AI opartych na agentach. Wraz z przechodzeniem organizacji od chatbotów jednomodelowych do bardziej złożonych architektur wieloagentowych, napotykają one wyzwania, takie jak narzut komunikacyjny między agentami, dryf kontekstu w długich procesach pracy oraz rosnące koszty wnioskowania. Rośnie również zapotrzebowanie na transparentność, aby umożliwić zrozumienie i zaufanie do systemów AI wbudowanych w krytyczne procesy biznesowe.
Nemotron 3 spełnia te wymagania dzięki hybrydowej architekturze opartej na utajonej mieszance ekspertów (MoE), zaprojektowanej z myślą o skalowalnych obciążeniach wieloagentowych. Modele te mają wspierać współpracę agentów, specjalistyczne umiejętności i efektywne kierowanie zadaniami, przy jednoczesnym zachowaniu przewidywalnych profili wydajności i kosztów.
Jensen Huang, założyciel i prezes firmy NVIDIA, podkreślił, że otwarta innowacja jest niezbędna dla rozwoju sztucznej inteligencji. Podkreślił, że Nemotron przekształca najnowocześniejszą sztuczną inteligencję w dostępną platformę, zwiększając przejrzystość i wydajność, wspierając rozwój systemów agentowych na dużą skalę.
Krajowe i regionalne inicjatywy AI w Europie, Korei Południowej i innych regionach już rozważają Nemotron jako fundament otwartego, lokalnie kontrolowanego rozwoju AI. Wcześni użytkownicy, tacy jak Accenture, Cadence, CrowdStrike, Cursor, Deloitte, Palantir, Perplexity i inni, włączają modele Nemotron do procesów obejmujących produkcję, cyberbezpieczeństwo, inżynierię oprogramowania, media i komunikację.
Gama modeli: Nano, Super i Ultra
Nemotron 3 składa się z trzech głównych poziomów modelu MoE, z których każdy jest przeznaczony do obsługi różnych klas obciążeń:
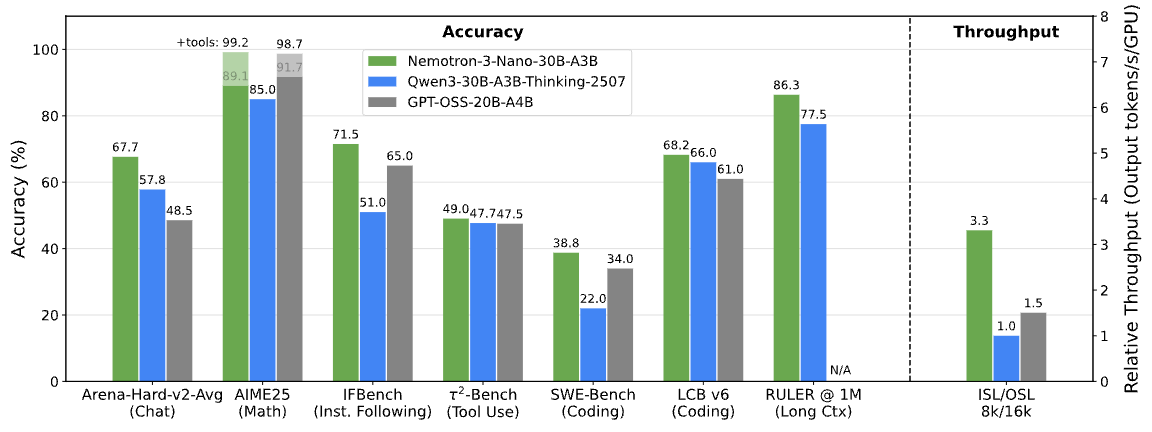
- Nano jest małym modelem o około 30 miliardach parametrów, który aktywuje do 3 miliardów parametrów na token dla efektywne wnioskowanie. To jest odpowiedni do zadań like debugowanie, podsumowanie, AI rurociągii wyszukiwanie informacji, gdzie wymagane są niskie opóźnienia i koszt jest kluczowa. Jego hybrydowa konstrukcja MoE zapewnia nawet czterokrotnie większą przepustowość tokenów niż Nemotron 2 Nano i zmniejsza koszty wnioskowania nawet o 60 procent, co przekłada się na niższe całkowite koszty wnioskowaniaZ oknem kontekstowym o pojemności 1 miliona tokenów Nemotron 3 Nano utrzymaćs więcej stanów w całym kraju długie przepływy pracy, zwiększanie dokładności i łączenie odległego kontekstu. Niezależne testy porównawcze oceniają go wśród najbardziej otwartych i wydajnych modeli w swojej branży klasaZ Top dokładność wśród pars.
- Super to model wnioskowania o wyższej dokładności, obejmujący około 100 miliardów parametrów i do 10 miliardów aktywnych parametrów na token. Został zaprojektowany z myślą o aplikacjach wieloagentowych, w których wielu agentów współpracuje ze sobą, aby osiągnąć złożone cele przy niskich opóźnieniach. Super sprawdza się w scenariuszach, w których głębokość wnioskowania, wykorzystanie narzędzi i koordynacja między agentami muszą być skalowalne bez ponoszenia kosztów porównywalnych z największymi modelami.
- Ultra to model najwyższej klasy, który działa jak rozbudowany silnik wnioskowania, obsługujący około 500 miliardów parametrów i do 50 miliardów aktywnych parametrów na token. Jest przeznaczony do najbardziej wymagających procesów AI, w tym dogłębnych badań, planowania strategicznego i złożonych systemów wspomagania decyzji, które wymagają wysokiej jakości wnioskowania w bardzo długich kontekstach.
Nemotron 3 Super i Ultra są trenowane z wykorzystaniem 4-bitowego formatu NVFP4 firmy NVIDIA w architekturze Blackwell. Ten format treningowy znacznie zmniejsza zapotrzebowanie na pamięć i poprawia przepustowość, zachowując jednocześnie dokładność porównywalną z formatami o wyższej precyzji. Dla przedsiębiorstw i dostawców usług może to umożliwić trenowanie większych modeli w istniejącej infrastrukturze lub zmniejszyć zapotrzebowanie na sprzęt wymagane dla danej skali.
Dzięki tej wielopoziomowej rodzinie programiści mogą dopasowywać rozmiar i możliwości modelu do konkretnych obciążeń i celów kosztowych, skalując się od kilkudziesięciu do kilkuset agentów, zachowując jednocześnie szybsze i dokładniejsze długoterminowe wnioskowanie w złożonych, wieloetapowych przepływach pracy.
Trasowanie, ekonomia tokenów i strategie modeli hybrydowych
Wraz z rozwojem systemów wieloagentowych, wiele organizacji wdraża strategie modeli hybrydowych. Modele zastrzeżone Frontier są wykorzystywane do najbardziej złożonych zadań wnioskowania, podczas gdy wydajne, konfigurowalne modele otwarte obsługują obciążenia rutynowe lub specyficzne dla danej domeny. Nemotron 3 został zaprojektowany specjalnie z myślą o tego typu architekturze opartej na routingu.
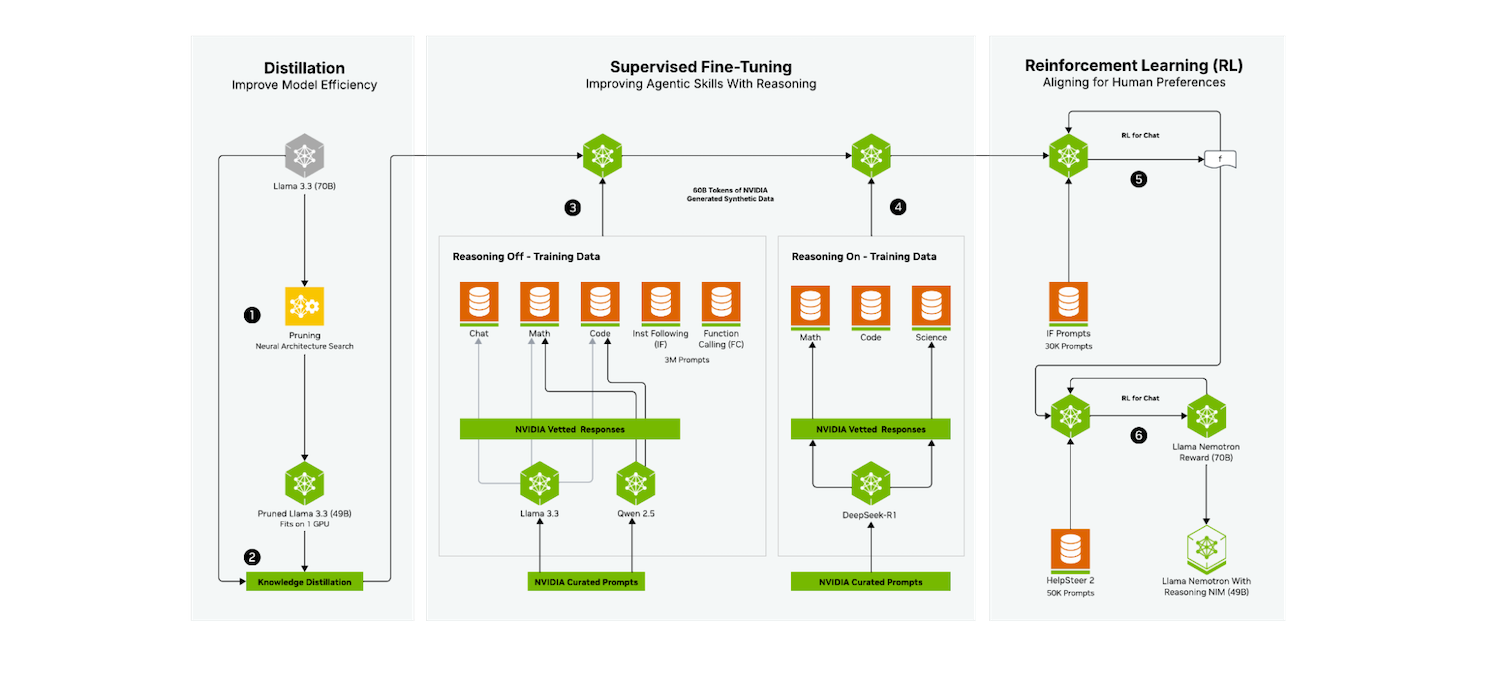
W typowej konfiguracji router agentowy analizuje zadania w czasie rzeczywistym. Wysyła je do precyzyjnie dostrojonego modelu Nemotron, takiego jak Nemotron 3 Ultra, lub do modelu zastrzeżonego, gdy zapewnia on unikalną wartość. Takie podejście pomaga zoptymalizować ekonomię tokenów poprzez rezerwację kosztownej przepustowości granicznej dla najbardziej wymagających przypadków i wykorzystanie Nemotrona do obsługi obciążeń o wysokiej przepustowości i wysokiej wydajności.
Partnerzy tworzący platformy asystentów AI i agentów informują, że taka strategia routingu pozwala im zapewnić większą responsywność i lepszą kontrolę kosztów, zachowując jednocześnie elastyczność w zakresie integracji różnych dostawców modeli i strategii szkoleniowych w czasie.
Otwarte dane, biblioteki i narzędzia bezpieczeństwa
Oprócz samych modeli firma NVIDIA udostępnia obszerny zestaw otwartych zasobów wspomagających tworzenie niestandardowych agentów:
Zestawy danych szkoleniowych i RL
NVIDIA udostępnia 3 biliony tokenów zestawów danych Nemotron do uczenia przed, po i przez wzmacnianie. Zestawy te zawierają szeroki wachlarz przykładów obejmujących wnioskowanie, kodowanie i wieloetapowe przepływy pracy, które można wykorzystać do trenowania lub dostrajania agentów specyficznych dla danej domeny. Zestaw danych Nemotron Agentic Safety Dataset oferuje rzeczywiste dane telemetryczne, które zespoły mogą wykorzystać do oceny i poprawy bezpieczeństwa złożonych, autonomicznych systemów.
Siłownia NeMo i NeMo RL
Aby uprościć uczenie się przez wzmacnianie i proces posttreningowy, NVIDIA udostępniła biblioteki open source NeMo Gym i NeMo RL. Zapewniają one środowiska treningowe i podstawy posttreningowe zgodne z modelami Nemotron, które można również rozszerzać lub adaptować do innych architektur. Dołączony NeMo Evaluator umożliwia ocenę bezpieczeństwa i wydajności modelu w szeregu testów porównawczych i przypadków użycia.
Wszystkie te narzędzia i zestawy danych są dostępne na GitHubie i Hugging Face, co umożliwia zespołom integrację ich z istniejącymi procesami MLOps i procesami szkoleniowymi. Firmy z ekosystemu, takie jak Prime Intellect i Unsloth, już integrują środowiska treningowe NeMo Gym ze swoimi platformami, aby uprościć uczenie się przez wzmacnianie dla użytkowników korporacyjnych.
Modele Nemotron 3 są również zgodne z popularnymi platformami wnioskowania i wdrażania, w tym LM Studio, llama.cpp, SGLang i vLLM, które ułatwiają przeprowadzanie lokalnych eksperymentów i wdrażanie w różnych środowiskach.
Dostępność:
Nemotron 3 Nano jest już dostępny w wielu kanałach dystrybucji opisanych poniżej.
Huby modeli i dostawcy inferencji: Model Nemotron 3 Nano jest dostępny w Hugging Face oraz za pośrednictwem dostawców inferencji, takich jak Baseten, DeepInfra, Fireworks, FriendliAI, OpenRouter i Together AI. Usługi te zapewniają zespołom szybką ścieżkę do oceny modelu i integracji go z istniejącymi aplikacjami.
Platformy korporacyjne: Modele Nemotron są integrowane z korporacyjnymi platformami sztucznej inteligencji i danych, takimi jak Couchbase, DataRobot, H2O.ai, JFrog, Lambda i UiPath. Dzięki temu klienci mogą osadzać funkcje Nemotron bezpośrednio w swoich stosach danych, orkiestracji i automatyzacji.
Chmura publiczna i mikrousługi NIM: Użytkownicy chmury publicznej będą mogli korzystać z rozwiązania Nemotron 3 Nano w chmurze AWS za pośrednictwem Amazon Bedrock, umożliwiającego wnioskowanie bezserwerowe, a także z rozwiązań Google Cloud, CoreWeave, Crusoe, Microsoft Foundry, Nebius, Nscale i Yotta.
Rozwiązanie Nemotron 3 Nano oferowane jest również jako mikrousługa NVIDIA NIM, umożliwiająca bezpieczne i skalowalne wdrożenie w infrastrukturze akcelerowanej przez NVIDIA. Dzięki temu przedsiębiorstwa mają większą kontrolę nad prywatnością, lokalizacją danych i wydajnością.
Oczekuje się, że Nemotron 3 Super i Ultra będą dostępne w pierwszej połowie 2026 r., co da organizacjom czas na standaryzację warstwy Nano w przypadku wczesnych przypadków użycia agentów i zaplanowanie przyszłych migracji do większych modeli w miarę wzrostu wymagań.


 Amazon