

NVIDIA ogłosiła na targach SC26 nowy procesor graficzny do obliczeń naukowych. Rubin HPC jest częścią platformy Vera Rubin, która oferuje ponad 50 000 rdzeni CUDA na jednym procesorze graficznym, a NVIDIA spodziewa się, że będzie on dostępny w 2028 roku. Pozostałe elementy oferty SC26 firmy obejmują 192-procesorowy procesor Vera do symulacji, którego premiera planowana jest na początek 2027 roku, pakiet Nemotron for Science o otwartym modelu, nowe biblioteki CUDA-X, platformę do wspólnego projektowania kwantowego z IBM i Fermilab oraz wdrożenie przez Lambdę przełączników optycznych w pakietach.
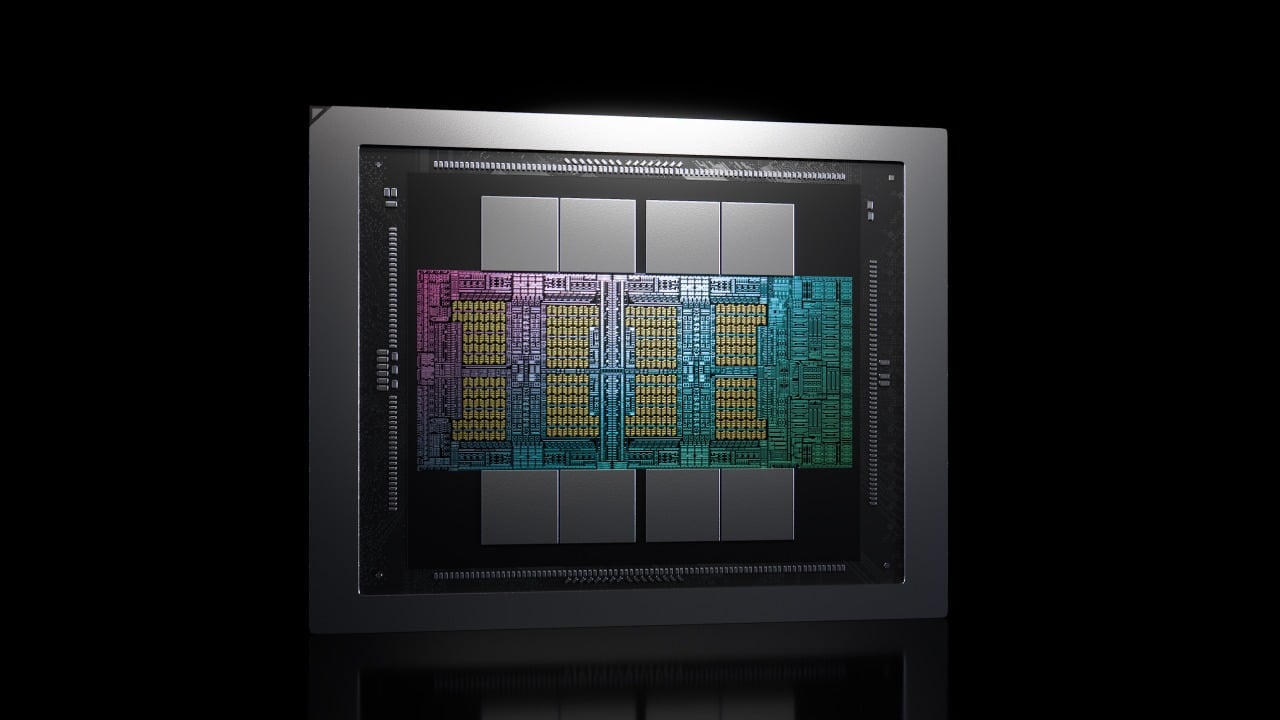
Procesor graficzny Rubin HPC
NVIDIA opisuje Rubin HPC jako procesor GPU do symulacji i przetwarzania danych w nauce, inżynierii i analityce, stworzony z myślą o skalowaniu przepływu danych wraz z mocą obliczeniową. Oprócz liczby rdzeni, którą NVIDIA uznaje za rekordową, firma wymienia również funkcję akceleracji danych rozproszonych, która zapewnia zasilanie tych rdzeni danymi i łączy między procesorami graficznymi (GPU) za pośrednictwem NVLink siódmej generacji. Docelowe obciążenia obejmują operacje na macierzach rozproszonych, obliczenia szablonowe, sortowanie i redukcje, wzorce modeli klimatycznych, symulacje inżynierskie, analizę genomiczną oraz ryzyko finansowe.

Na scenie SC26 firma NVIDIA poinformowała, że Rubin HPC potraja wydajność symulacji i analityki oraz obsługuje każdy poziom precyzji od FP64 do FP4. Firma nie podała wartości bazowej dla 3-krotności i nie opublikowała pojemności pamięci, przepustowości FP64, mocy ani konfiguracji systemu. Ian Buck, wiceprezes ds. obliczeń hiperskalowych i wysokowydajnych w firmie NVIDIA, powiązał tę kwestię z badaniami nad agentami, mówiąc, że „szybsza symulacja oznacza szybsze odkrycia” dla agentów pracujących nad problemami naukowymi i inżynieryjnymi. Intel prezentuje na targach swój procesor graficzny D270 z obsługą FP64, przeznaczony do tych samych obciążeń symulacyjnych.
Stojaki procesorów Vera do komputerów HPC
Platforma procesorów Vera dla systemów HPC to chłodzona cieczą obudowa NVIDIA MGX, mieszcząca 192 procesory Vera połączone za pomocą Quantum-X800 InfiniBand, oferująca około 300 TB pamięci RAM, 1 PB pamięci masowej i łączną szczytową przepustowość pamięci ponad 200 TB/s. Każda tacka 1U mieści osiem procesorów wraz z pamięcią masową NVMe i systemem zarządzania, a obudowa wykorzystuje obudowę, system dystrybucji zasilania i chłodzenie systemów NVL72. Każdy procesor ma 88 rdzeni Olympus, 176 wątków i pamięć SOCAMM2 LPDDR5X o przepustowości do 1.2 TB/s.

To inna konfiguracja niż 256-procesorowe szafy Vera, które Dell i Supermicro zapowiedziały dla środowisk testowych agentów na targach GTC Berlin. Dodano również InfiniBand i obliczenia sieciowe SHARP, aby zapewnić ściśle sprzężone symulacje. NVIDIA twierdzi, że Dell Technologies, HPE, Lenovo i Supermicro będą oferować szafy HPC od początku 2027 roku. Niemieckie Centrum Obliczeń Klimatycznych DKRZ wybrało procesory Vera do swojego superkomputera HLRE-5, który został zbudowany przez Bull i obejmuje również systemy GB200 oraz Quantum-2 InfiniBand. Jego premiera spodziewana jest na początku 2028 roku.
NVIDIA deklaruje dwukrotnie większą efektywność energetyczną niż procesory x86 w procesorach Vera. W testach Vera zapewniła 1.9-krotnie większą wydajność i 2.4-krotnie większą wydajność na wat niż systemy x86 w obudowie OpenFOAM MotorBike Large, a w modelu Weather Research and Forecasting prognozuje 1.6-krotnie większą wydajność i 2-krotnie większą sprawność. Są to wyniki od dostawców, których nie analizowaliśmy ani nie audytowaliśmy, a NVIDIA nie podała nazw procesorów x86. W naszej recenzji procesorów Vera , dwugniazdowy system Vera ukończył test dużej siatki OpenFOAM 1.44-krotnie szybciej niż system z 384-rdzeniowym procesorem EPYC 9965 i 1.20-krotnie szybciej niż system z 240-rdzeniowym procesorem Xeon 6978P.
Jeśli chodzi o oprogramowanie, NVIDIA HPC SDK 26.11 jest już dostępny z kompilatorami i bibliotekami dostosowanymi do Vera, a kompilator Fortran nowej generacji, opracowany we współpracy z centrami HPC i laboratoriami krajowymi, znajduje się w fazie publicznej wersji beta. Firma NVIDIA twierdzi, że kompilator ten uruchamia istniejące programy Fortran szybciej na swoich platformach, bez konieczności przepisywania kodu.
Nemotron dla nauki i biblioteki CUDA-X
Nemotron for Science oferuje otwarty model Nemotron 3.5 Super VL z ewaluacjami naukowymi, przepisami po treningu oraz LitmusBench v0.2, otwartym zbiorem danych zawierającym prawie 50 000 pytań z zakresu rozumowania chemicznego. Model i zbiór danych są już dostępne w Hugging Face, a NVIDIA twierdzi, że model został zoptymalizowany do lokalnego działania na 128-gigabajtowej pamięci DGX Spark. Argonne National Laboratory integruje go ze swoim wieloagentowym systemem StructBioReasoner do terapii opartych na białkach, a RIKEN udostępnił go na swojej superkomputerowej platformie RIKYU AI.
Wśród klientów, którzy przeszkolili model po jego przeszkoleniu, Lila Sciences niemal podwoiła dokładność syntezy kropek kwantowych do 61%, co według NVIDIA przewyższa 54% w przypadku GPT-6 Astra, przy 10-20-krotnie niższym koszcie wnioskowania. Terray Therapeutics odzyskał około 76% reakcji z adnotacjami w teście RxnScribe do odczytu diagramów reakcji chemicznych. Agent Królewskiego Instytutu Technologicznego KTH naprawił 81% uszkodzonych układów dynamiki molekularnej GROMACS w ciągu jednej nocy na jednym urządzeniu DGX Spark.
Wśród dodatków CUDA-X, zestaw narzędzi cuPhoton koreluje obserwacje z Teleskopu Horyzontu Zdarzeń w osiem minut, podczas gdy wcześniej analiza zajmowała ponad miesiąc. cuPotential przyspiesza istniejące oprogramowanie do symulacji molekularnych nawet trzykrotnie, a Daviator, zestaw wsadowych jąder GPU dla pakietu symulacji ab initio Vienna, wykonuje obliczenia mechaniki kwantowej do 22 razy szybciej, przy kosztach niższych nawet o 75%. NVIDIA nie podała wartości bazowych dla cuPotential i Daviatora.
cuSpa i biblioteka HMMER z akceleracją GPU są teraz dostępne jako oprogramowanie open source. cuSpa zapewniło 900-krotny wzrost szybkości obliczeń wielokątów komórek w porównaniu z procesorami CPU w Centrum Onkologicznym Memorial Sloan Kettering, a biblioteka HMMER przeprowadzała wyszukiwania benchmarkowe do 84 razy szybciej niż standardowa biblioteka HMMER w Basecamp Research. Biblioteka Rapids-SingleCell, opracowana we współpracy ze scverse, jest teraz dostępna w jednym kontenerze przeznaczonym dla agentów, a firma 10x Genomics zintegrowała ją ze swoją platformą Sentira.
Współprojektowanie kwantowe z IBM i Fermilab
W dziedzinie komputerów kwantowych, NVIDIA i IBM kolokują systemy NVIDIA DGX B200 z komputerami kwantowymi IBM, w tym systemami z procesorem IBM Quantum Nighthawk, aby wspierać modułową platformę do współprojektowania komputerów kwantowych opracowaną we współpracy z Fermilab. Naukowcy wykorzystają ją do oceny kodów korekcji błędów, algorytmów dekodujących oraz zastosowań kwantowo-klasycznych w fizyce wysokich energii i fizyce jądrowej. IBM nawiązało podobne porozumienie z AMD i Oak Ridge National Laboratory , łącząc Nighthawk z klastrem Instinct MI355X. NVIDIA nie podała liczby systemów, ich lokalizacji ani harmonogramu.
Oddzielnie, NVIDIA wydała TCBP-JOBS, algorytm dekodowania w bibliotece CUDA-Q QEC 0.9.0, który, jak twierdzi, dekoduje do 13 000 razy szybciej niż wiodące istniejące algorytmy i skraca czas obliczeń w nowych projektach komputerów kwantowych z 12 tygodni do 45 minut. Platforma CUDA-Q zyskuje również serwer dekoderów, rozszerzony zestaw prymitywów odpornych na błędy, bibliotekę algorytmów CUDA-Q z komponentami aplikacji wielokrotnego użytku oraz CUDA-Q Pulse do kształtowania impulsów sterujących, które napędzają kubity.
Firma NVIDIA twierdzi, że liczba wdrożeń procesorów kwantowych w centrach superkomputerowych wzrosła prawie siedmiokrotnie w ciągu pięciu lat, a prawie 30 centrów wdraża obecnie ponad 50 procesorów. Slurm 26.11, którego premiera odbędzie się w listopadzie, dodaje interfejs kwantowy, który pozwala konstruktorowi procesorów QPU opisać sprzęt raz, w jednym pliku, i ponownie wykorzystać tę integrację w każdym centrum. Obsługuje on interfejsy kwantowe-HPC QRMI i QDMI, a IBM przyczynia się do tego poprzez swój interfejs Quantum Resource Management Interface, dzięki czemu centra mogą planować wdrożenie procesorów kwantowych wraz z procesorami CPU i GPU. System ten wdrażają firmy Alice & Bob, IBM, IQM, Pasqal, Quantuum i MQSC, a pod koniec 2025 roku NVIDIA przejęła firmę SchedMD, twórcę Slurm.
NVIDIA wskazała również na prace IBM i RIKEN w dziedzinie chemii kwantowo-klasycznej, finalistów Nagrody Gordona Bella ACM 2026, które obliczyły energie wiązania dla kompleksów białko-ligand o długości do 12 635 atomów. To ponad 40-krotnie więcej niż poprzedni test kwantowo-klasyczny dla 303 atomów. Analiza klasyczna została przeprowadzona na superkomputerze ROQUO firmy RIKEN, zbudowanym na systemach NVIDIA GB200 i Quantum-X800 InfiniBand.
Wśród projektów ekosystemowych na platformie, Altera i Oxford Quantum Circuits zbudowały kontroler kwantowy oparty na FPGA , który łączy sterowanie i odczyt kubitów z procesorami graficznymi (GPU) za pośrednictwem NVQLink, a Quantum Motion zintegrowało swoją platformę chemiczną QUICHE z CUDA-Q. QunaSys wykorzystało cuQuantum i 1,024 procesory graficzne NVIDIA Hopper-generation na platformie ABCI-Q do symulacji ponad 300 milionów operacji kwantowych, osiągając dokładność chemiczną dla modelu czterech atomów wodoru. Naukowcy z NVIDIA wykorzystali superkomputer JUPITER do symulacji 104 kubitów w warunkach realistycznego szumu.
Lambda wdraża współpakowaną optykę
Lambda wykorzystuje przełączniki NVIDIA Photonics Co-Packaged Optics (CPO) do łączenia szaf GB300 NVL72 w ramach wdrożenia obejmującego ponad 10 000 procesorów graficznych. Każdy przełącznik ma 144 porty o przepustowości 800 Gb/s i 18 zewnętrznych źródeł światła, które technicy mogą wymienić w terenie, podczas gdy awaria lasera w podłączanym module optycznym oznacza konieczność wymiany całego modułu. Testy przytoczone przez firmę NVIDIA wykazały, że opóźnienia sieciowe są o około 4% niższe w przypadku szaf rack i do około 10% niższe w przypadku modułów pod, przy takiej samej przepustowości jak w przypadku podłączanego modułu optycznego.

Średnia temperatura optyki w tym wdrożeniu wyniosła 36°C, w porównaniu z 51°C w przypadku konwencjonalnej optyki wtykowej. NVIDIA ocenia swoje przełączniki fotoniczne na nawet 5-krotnie wyższą efektywność energetyczną, nawet 15-krotnie wyższą niezawodność i 4-krotnie mniejszą liczbę laserów niż w przypadku konstrukcji wtykowych. NVIDIA wykorzystała również targi do uczczenia 20-lecia technologii CUDA, która, jak twierdzi, ma obecnie ponad 11 milionów programistów i ponad 1,000 bibliotek CUDA-X.


 Amazon