

Firma WEKA ogłosiła integrację swojej platformy NeuralMesh z architekturą referencyjną NVIDIA STX, co czyni z Augmented Memory Grid kluczowy komponent infrastruktury AI nowej generacji. To połączone rozwiązanie eliminuje jedno z głównych ograniczeń w środowiskach wnioskowania na dużą skalę: ograniczenia pamięci, które wpływają na wydajność, koszty i skalowalność.
Działająca w oparciu o technologię NeuralMesh, technologia Augmented Memory Grid firmy WEKA rozszerza pamięć GPU poprzez eksternalizację i utrwalanie pamięci podręcznej typu klucz-wartość. Wdrożenia NVIDIA STX obsługują wysokoprzepustową pamięć kontekstową dla zadań AI opartych na agentach, umożliwiając wnioskowanie w oparciu o długi kontekst w sesjach, narzędziach i przepływach pracy. Firma twierdzi, że konfiguracje wykorzystujące systemy NVIDIA Vera Rubin NVL72 , jednostki DPU BlueField-4 i sieć Ethernet Spectrum-X mogą zwiększyć przepustowość tokenów pamięci kontekstowej od 4 do 10 razy. Oczekuje się również, że platforma zapewni przepustowość odczytu na poziomie co najmniej 320 GB/s i zapisu na poziomie 150 GB/s, co oznacza ponad dwukrotny wzrost wydajności w porównaniu z konwencjonalnymi systemami pamięci masowej AI.

Infrastruktura pamięci staje się wąskim gardłem wnioskowania
WEKA koncentruje się na integracji wokół rosnącego ograniczenia we wdrożeniach AI: bariery pamięci. W nowoczesnych procesach wnioskowania, ograniczona pamięć o wysokiej przepustowości na procesorach GPU prowadzi do częstego usuwania pamięci podręcznej KV, co skutkuje koniecznością ponownego obliczania i spadkiem wydajności. Wraz ze wzrostem współbieżności, te problemy się nasilają, zwiększając koszty infrastruktury i zmniejszając przewidywalność systemu.
Firma opowiada się za współdzieloną infrastrukturą pamięci podręcznej KV jako rozwiązaniem. Dzięki utrzymywaniu stałego kontekstu dla użytkowników i sesji, współdzielona pamięć podręczna eliminuje redundantne obliczenia i stabilizuje przepustowość tokenów. NVIDIA STX zapewnia architekturę referencyjną do implementacji tego modelu, a WEKA dostarcza warstwę rozszerzenia pamięci masowej i pamięci.
Architektura sieci neuronowych i siatki pamięci rozszerzonej
NeuralMesh to rozproszona platforma pamięci masowej firmy WEKA, zaprojektowana do działania w całym stosie NVIDIA STX. System zapewnia wysokowydajne usługi danych dostosowane do obciążeń AI, a Augmented Memory Grid pełni funkcję dedykowanej warstwy rozszerzenia pamięci, która grupuje pamięć podręczną KV poza pamięcią GPU.
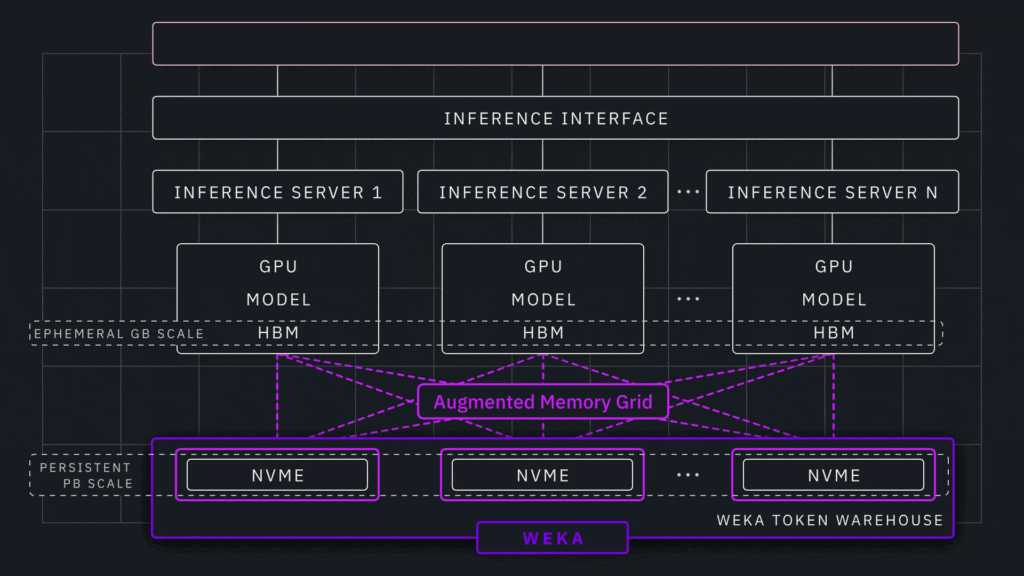
To podejście pozwala środowiskom wnioskowania na utrzymywanie sesji długiego kontekstu bez wyczerpywania zasobów GPU. Dzięki zachowaniu stanu pamięci podręcznej i umożliwieniu ponownego wykorzystania w różnych obciążeniach, platforma dąży do utrzymania wysokiego poziomu wykorzystania i spójnej wydajności w miarę skalowania wdrożeń.
WEKA informuje, że technologia Augmented Memory Grid, po raz pierwszy zaprezentowana na targach GTC 2025, a obecnie powszechnie dostępna, została przetestowana na platformach procesorów NVIDIA Grace z procesorami DPU BlueField. Architektura ta zapewnia wymierną poprawę wydajności wnioskowania, w tym znacznie krótszy czas do pierwszego tokena, wyższą przepustowość tokenów na GPU oraz stabilną wydajność przy rosnącej współbieżności. Odciążenie ścieżki danych pamięci masowej na BlueField-4 dodatkowo zmniejsza obciążenie procesora i minimalizuje wąskie gardła wejścia/wyjścia.
Wzrost wydajności i efektywności
W środowiskach dostosowanych do produkcji platforma została zaprojektowana z myślą o zwiększeniu responsywności i wydajności infrastruktury. WEKA wskazuje, że Augmented Memory Grid może skrócić czas do wygenerowania pierwszego tokena nawet od 4 do 20 razy, jednocześnie zwiększając wydajność tokenów na GPU nawet o 6.5 raza. Korzyści te wynikają z wyższych wskaźników trafień w pamięci podręcznej KV i mniejszej liczby ponownych obliczeń, co pozwala systemom utrzymać wydajność wraz ze wzrostem liczby okien kontekstowych i użytkowników.
Firmus, dostawca infrastruktury AI, jest wymieniany jako jeden z pierwszych użytkowników technologii NeuralMesh z infrastrukturą zgodną z NVIDIA. Firma informuje o zwiększonej przepustowości tokenów i zmniejszonych opóźnieniach w dużej skali, przypisując te korzyści bardziej efektywnemu wykorzystaniu istniejących zasobów GPU, a nie rozbudowie sprzętu.
Implikacje dla projektowania infrastruktury AI
Integracja podkreśla zmianę w architekturze systemów AI, w której projektowanie pamięci i pamięci masowej w coraz większym stopniu decyduje o ogólnej wydajności i opłacalności. Wraz ze wzrostem obciążeń agentowych AI i wydłużaniem się okien kontekstowych, podejścia oparte wyłącznie na pamięci DRAM stają się mniej opłacalne ze względu na rosnące obciążenie rekomputacyjne i niewykorzystane procesory graficzne.
WEKA pozycjonuje trwałą, współdzieloną pamięć podręczną KV jako fundamentalną funkcję dla fabryk AI. Organizacje, które wdrożą ten model, mogą utrzymać wyższe wykorzystanie GPU, zmniejszyć zużycie energii na zadanie wnioskowania i osiągnąć bardziej przewidywalne charakterystyki skalowania. Z drugiej strony, środowiska, które nadal polegają wyłącznie na lokalnej pamięci GPU, prawdopodobnie będą musiały zmierzyć się ze wzrostem kosztów operacyjnych i malejącymi zyskami w miarę skalowania obciążeń.
Dostępność:
Siatka pamięci rozszerzonej firmy WEKA jest ogólnie dostępna jako część platformy NeuralMesh.


 Amazon