

Firma WhiteFiber udostępniła komercyjnie rozwiązanie WhiteFiber Continuum, przekształcając dwulokalizacyjny superklaster GPU, który po raz pierwszy został opisany w lipcu jako Projekt Redwood , w produkt, który przedsiębiorstwa mogą wdrażać. WhiteFiber nazywa Continuum swoim najwydajniejszym rozwiązaniem sieciowym dla wielu centrów danych i pierwszą komercyjnie dostępną architekturą rozproszonego superklastera GPU. Łączy ono geograficznie oddzielone centra danych w jeden logiczny superklaster GPU, co, jak twierdzi WhiteFiber, eliminuje ograniczenia przepustowości i przepustowości, które mogłyby wpływać na sposób i miejsce wdrażania infrastruktury AI.
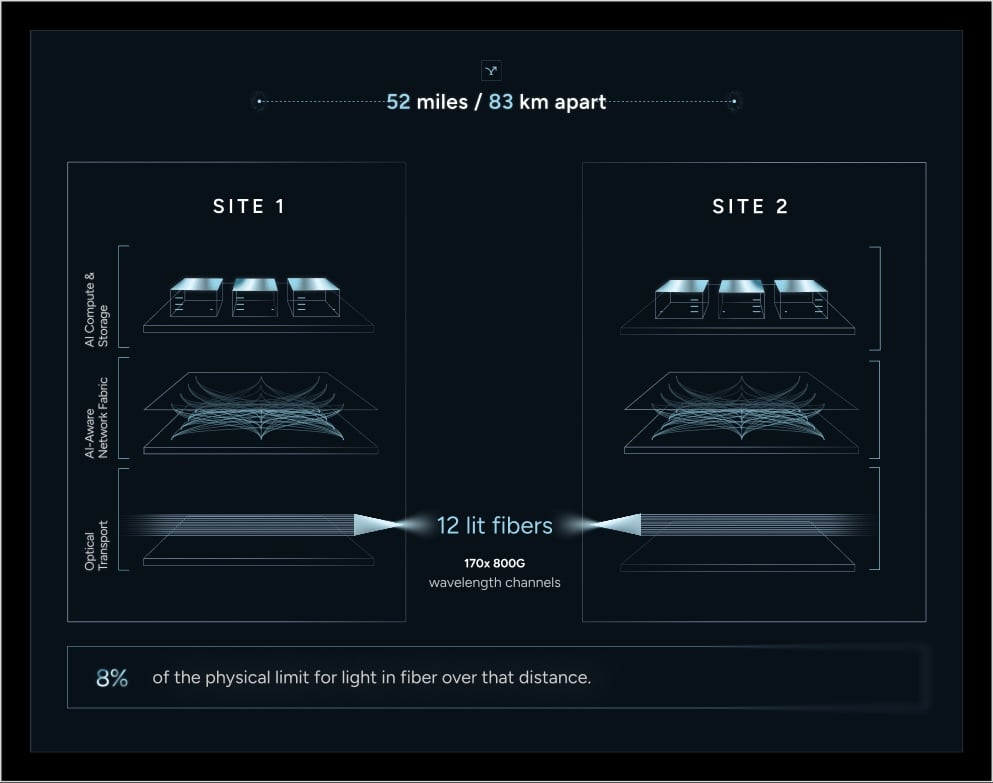
Continuum działa w dwóch certyfikowanych przez HITRUST obiektach QTS, oddalonych od siebie o 83 kilometry, połączonych ponad 12 ciemnymi włóknami światłowodowymi Zayo. Sieć obsługuje technologia DriveNets AI Fabric, a sieć NeuralMesh firmy WEKA zapewnia infrastrukturę pamięci masowej i przechowywania danych w całym klastrze. WhiteFiber ocenia architekturę na łączną przepustowość 136 Tb/s, co na stronie produktu jest przedstawione jako 170 kanałów długości fali 800G, z gwarantowanym opóźnieniem w obie strony wynoszącym 0.9 milisekundy, co według firmy mieści się w 8% fizycznego limitu dla światła we włóknie na tym dystansie. Lipcowe wyniki prac badawczo-rozwojowych wykazały 111.2 Tb/s w części widma światłowodowego; WhiteFiber twierdzi, że projekt osiąga 136 Tb/s po uruchomieniu dodatkowych fal, a testy pełnego widma światłowodowego w celu potwierdzenia gwarantowanych specyfikacji komercyjnych są w toku. Firma złożyła wnioski patentowe dotyczące wdrożenia bazowego.
„WhiteFiber Continuum to infrastrukturalna odpowiedź na problem, z którym branża zmaga się od lat: odległość geograficzna stanowi ograniczenie możliwości klastra” – powiedział Sam Tabar, dyrektor generalny WhiteFiber. „Dziś udostępniamy ją komercyjnie przedsiębiorstwom, które potrzebują obliczeń opartych na sztucznej inteligencji, aby działały na dużą skalę, spełniały wymogi zgodności i nie psuły się, gdy w jednej lokalizacji wystąpi problem”.
Struktura sztucznej inteligencji DriveNets na łączu o długości 83 km
DriveNets dostarcza infrastrukturę AI Fabric opartą na sieci Ethernet, łączącą obie lokalizacje, taką samą rolę, jaką odegrała w lipcowych pracach badawczo-rozwojowych. „Technologia AI Fabric firmy DriveNets oparta na sieci Ethernet zapewnia najwyższą wydajność nawet w najbardziej wymagających środowiskach o wysokiej przepustowości i niskich opóźnieniach, zapewniając skalowalność w obrębie superklastrów, wydajne przesyłanie danych, maksymalizację wykorzystania GPU i optymalizację efektywności energetycznej” – powiedział Yossi Kikozashvili, wiceprezes ds. produktów i GTM w dziale infrastruktury AI w DriveNets. Strona produktu firmy WhiteFiber informuje, że obie lokalizacje obsługują jednocześnie ruch na żywo, a przez łącze między lokalizacjami przechodzą tylko gradienty modelu. Dzięki temu pojedyncze zadanie może być realizowane w całym klastrze lub podzielone na niezależne obciążenia, które będą rozłożone na kolejne lokalizacje w miarę zmian zapotrzebowania.
WEKA NeuralMesh jako współdzielona warstwa danych
WEKA zapewnia warstwę pamięci masowej i operacyjnej za pomocą NeuralMesh , co zapewnia Continuum pojedynczą bazę pamięci masowej i operacyjnej obejmującą oba obiekty. Liran Zvibel, współzałożyciel i dyrektor generalny WEKA, powiedział: „Superklaster jest tak zunifikowany, jak jego dane”, dodając: „NeuralMesh firmy WEKA zapewnia Continuum pojedynczą, wysokowydajną bazę pamięci masowej i operacyjnej w różnych lokalizacjach, dzięki czemu procesory graficzne oddalone od siebie o wiele kilometrów działają tak, jakby dane były lokalne”.
Agregacja mocy i kontrola granic danych regulacyjnych
Continuum pozwala instytucjom telekomunikacyjnym i miejskim dysponującym zapasem mocy i przepustowości światłowodowej współtworzyć jeden logiczny superklaster GPU, który WhiteFiber przedstawia jako sposób na przekształcenie osieroconych zasobów telekomunikacyjnych i miejskich w zasoby dla wnioskowania i zadań agentów na ostatniej mili. Przedsiębiorstwa mogą korzystać z tej samej architektury do grupowania procesorów GPU w różnych lokalizacjach i pokonywać limity mocy i przestrzeni pojedynczego kampusu, dodając nadmiarową przepustowość do szkolenia i wnioskowania bez konieczności tworzenia oddzielnego wdrożenia typu greenfield. W przypadku branż regulowanych, WhiteFiber twierdzi, że Continuum utrzymuje wrażliwe obciążenia w ich pierwotnej jurysdykcji, podczas gdy przełączanie awaryjne i zbiorcze przetwarzanie danych odbywają się w różnych lokalizacjach. Ponieważ żadna z lokalizacji nie jest pojedynczym punktem awarii, system został zaprojektowany tak, aby szkolenia były kontynuowane w przypadku awarii jednej z lokalizacji.
Firma WhiteFiber twierdzi, że z czasem do tego samego klastra logicznego będzie można dołączyć kolejne witryny, korzystając z tego samego podejścia sieciowego. 14 października firma zorganizuje techniczny przegląd architektury z udziałem firm DriveNets i WEKA.


 Amazon