

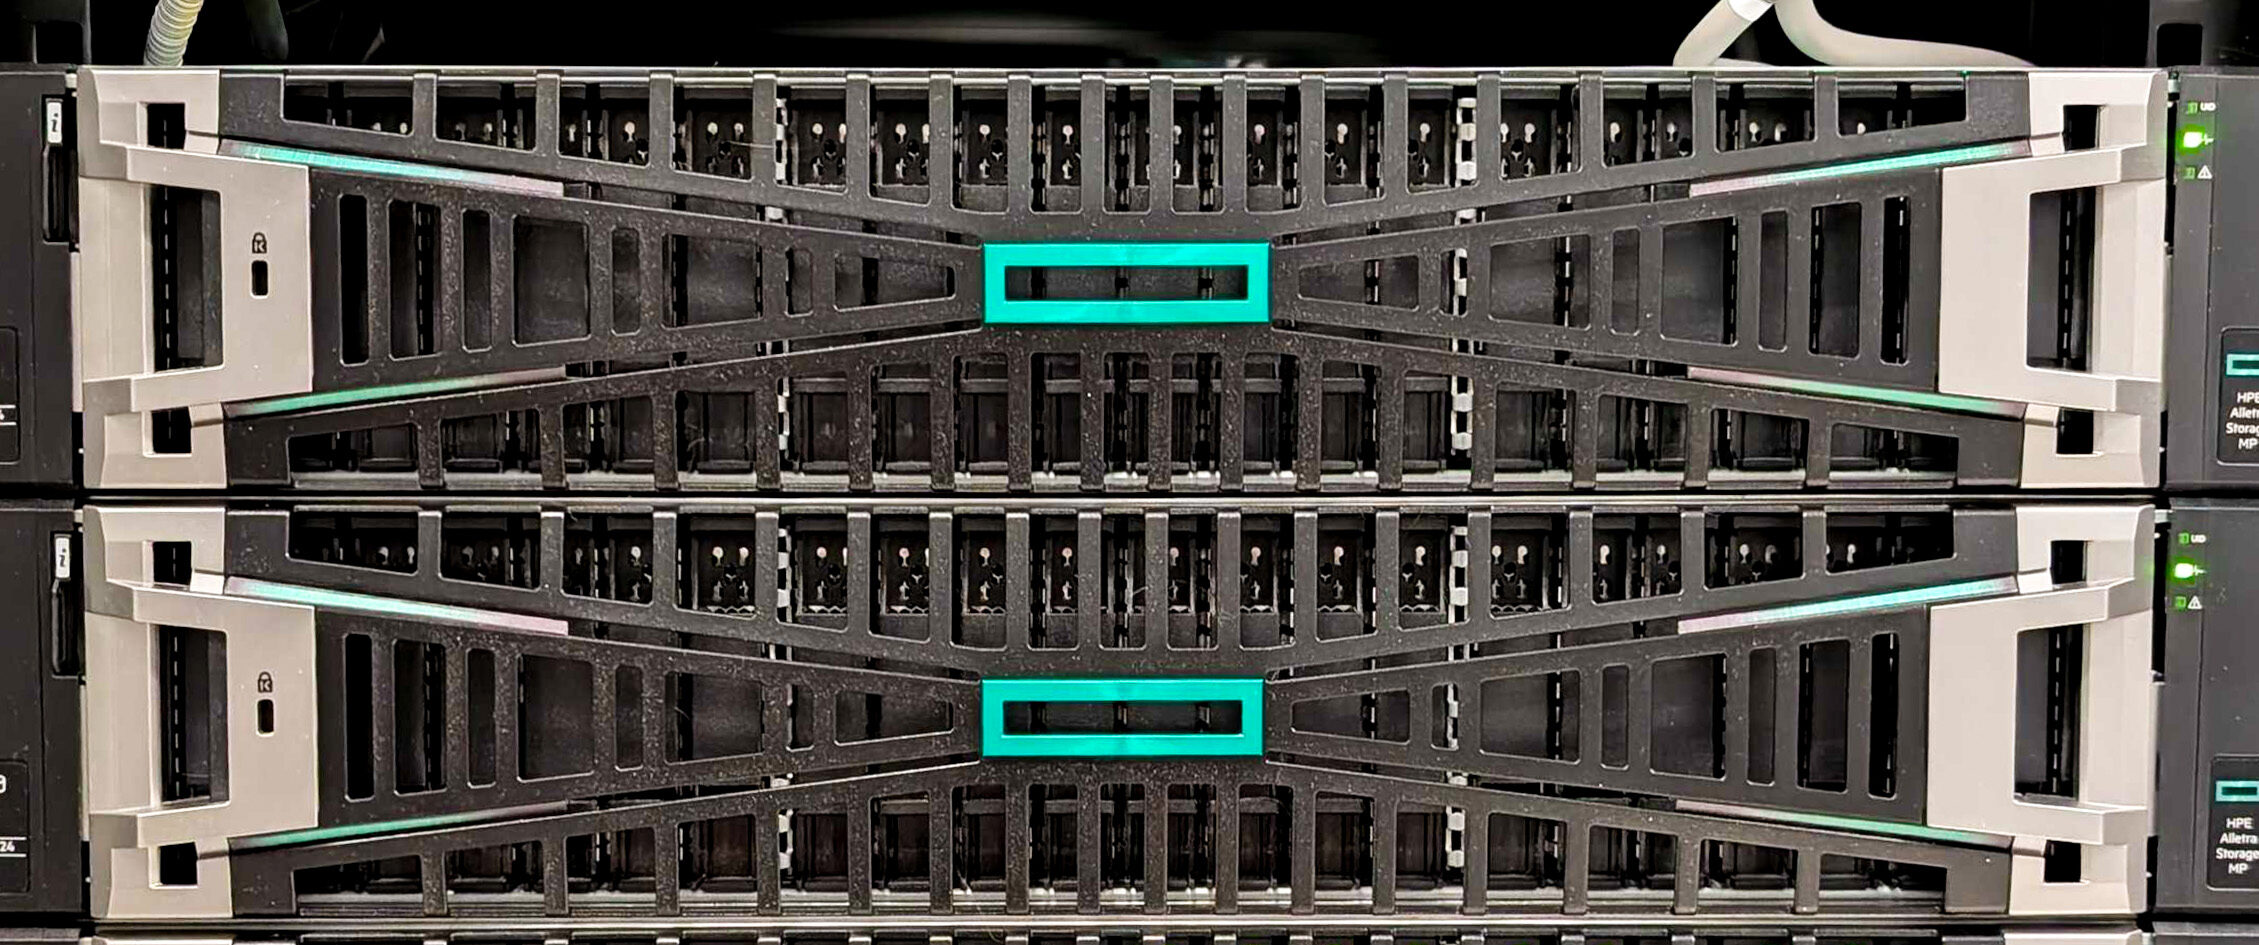
Brian gościł Patricka Osborne'a, starszego wiceprezesa ds. przyspieszenia technologii chmury hybrydowej w HPE, w podcaście na żywo na LinkedIn 26 października. Tematem było to, czy korporacyjna pamięć masowa jest gotowa na sztuczną inteligencję. Odpowiedź wiązała się z decyzją dotyczącą architektury Alletra Storage MP, którą HPE podjęło pięć lat temu, drugim życiem pamięci blokowej w oparciu o Oracle AI Database 26ai i wyszukiwanie wektorowe, matematyką mocy i gęstości stojącą za dyskami SSD o pojemności 245 TB oraz rekordowym rokiem dla taśm LTO, Morpheus VM Essentials jako środowiska uruchomieniowego w systemach chmury prywatnej HPE oraz cyberodpornością wbudowaną w macierz.
Większość z tego obszaru omówiliśmy w laboratorium: architekturę cyberodporności B10000 i jej laboratorium ransomware , X10000 z węzłem Data Protection Accelerator Node oraz weekend wyścigowy z Mercedes F1 i HPE na torze COTA w tygodniu poprzedzającym to nagranie.
Patrick spędził ponad 16 lat w Hewlett Packard Enterprise, zajmując się pamięcią masową, infrastrukturą chmurową i dużymi zbiorami danych. Kierował działem Big Data, Analytics i platform skalowalnych, a następnie jednostką biznesową ds. pamięci masowej, zanim objął stanowisko w dziale infrastruktury danych w chmurze, obejmującym linię Alletra Storage MP. Ostatnio był gościem podcastu w odcinku 119 , nagranym podczas HPE GreenLake Day for Storage w Houston w 2023 roku.
Pamięć masowa HPE regularnie gości w naszym laboratorium: testowaliśmy B10000 zaraz po jego premierze, mierzyliśmy przepustowość tworzenia kopii zapasowych i przywracania danych przez węzeł Data Protection Accelerator Node w Raleigh, pracowaliśmy nad architekturą cyberodporności NIST CSF 2.0 z brytyjskim laboratorium HPE ds. oprogramowania ransomware, a także omawialiśmy wersję 4 X10000 i jej migrację do 16 węzłów i natywnego NFS. W zeszłym roku zaprezentowaliśmy również pakiet SimpliVity i VM Essentials.
Odcinek trwa około 58 minut. Liczby, które utkwiły nam w pamięci: Alletra Storage MP ma już pięć lub sześć lat i skaluje się od systemów podstawowych do dziesiątek petabajtów w jednej architekturze; pytanie „czy moje dane są gotowe na sztuczną inteligencję” od 18 miesięcy prowadzi rozmowy z klientami HPE; VM Essentials wypuszczał comiesięczne wersje w pierwszym roku, podczas gdy aktualizacje konsoli GreenLake pojawiają się w ciągu kilku tygodni; taśmy LTO miały w zeszłym roku większą pojemność niż kiedykolwiek wcześniej; a Mercedes F1 pracuje przy torze wyścigowym z zespołem IT liczącym około 18 osób. Jeśli nie masz czasu, aby wysłuchać całości, podzieliliśmy to na segmenty, abyś mógł wybrać to, co jest dla Ciebie najważniejsze.
[00:00] Przechowywanie znów jest interesujące
Dwóch weteranów branży magazynowej otwarcie mówi o tym, dlaczego kategoria ta z towarów stała się głównym tematem.
- Patrick opisuje okres komodyfikacji pamięci masowej i zarządzania danymi, który skłonił klientów do korzystania z doświadczeń zarządczych, wzorców wdrażania w centrach danych, systemach hybrydowych i brzegowych oraz modeli ekonomicznych GreenLake.
- Jak twierdzi, przez ostatnie 18 miesięcy każda rozmowa zaczynała się od pytania, czy dane i infrastruktura klienta nadają się do obsługi zadań związanych ze sztuczną inteligencją. Jest to kwestia, która ma szeroki zakres oddziaływania na bezpieczeństwo, wydajność i ekosystem aplikacji.
- Koncepcja Briana jest taka, że rewolucja w zakresie danych jest większa niż sztuczna inteligencja, a odnowione zainteresowanie przechowywaniem danych jest ogromne.
[02:36] Dlaczego HPE zdecydowało się na Alletra Storage MP
Brian prosi Patricka o ponowne rozważenie decyzji o połączeniu niestandardowych platform pamięci masowej w jedną architekturę.
- Rozwiązanie Alletra Storage MP zadebiutowało pięć lub sześć lat temu i jak twierdzi HPE, jest to pierwsza w branży rozproszona architektura pamięci masowej z oddzielnymi węzłami obliczeniowymi i danych, dzięki czemu klienci mogą niezależnie skalować pojemność, wydajność, koszty i odporność.
- W projekcie wykorzystano standardowe komponenty x86, infrastrukturę sieciową o niskim opóźnieniu oraz gamę nośników, od wydajnego TLC po QLC o dużej pojemności, przy czym różnice występują na poziomie oprogramowania; wcześniejsze architektury opierały się na pamięci podtrzymywanej bateryjnie, mostkach krzyżowych i niestandardowym krzemie.
- Dwa warianty obejmują dane ustrukturyzowane i nieustrukturyzowane w ramach jednego paradygmatu zarządzania, od systemów wejściowych po dziesiątki petabajtów pamięci masowej o znaczeniu krytycznym, a Patrick podaje wzrost liczby jednostek i jakość platformy jako miarę sukcesu.
[08:02] Renesans sztucznej inteligencji w Block Storage
Przechowywanie sztucznej inteligencji zwykle oznacza pliki i obiekty, ale Brian dostrzega zapotrzebowanie wokół bloku Fibre Channel na bazy danych transakcyjnych umożliwiające wyszukiwanie wektorowe.
- Patrick opisuje sztuczną inteligencję jako zbiór usług o różnych wzorcach wejścia/wyjścia: blokowy dla baz danych wektorowych i półustrukturyzowanych, plikowy dla nieustrukturyzowanych danych zdegradowanych przez NFS i SMB oraz obiekt S3 dla zupełnie nowych danych z nowoczesnych aplikacji. Wnioskując, jest to najszybciej rosnące zastosowanie.
- Jedną z platform dla usług blokowych, plikowych i obiektowych, a także usług danych (tagowanie metadanych, odporność, tworzenie kopii zapasowych, odzyskiwanie po awarii) jest magnes dla użytkowników. Brian dodaje, że sterowanie zakłóconym sąsiedztwem i QoS mają znaczenie ponownie, gdy obciążenie wektorowe Oracle 26ai znajdzie się obok środowiska produkcyjnego.
- Niedobór procesorów GPU skłania klientów do korzystania z rozwiązań wielodostępnych i ograniczania czasu potrzebnego na ich wykorzystanie, a HPE współpracuje z rozwiązaniami firmy NVIDIA w zakresie integracji na poziomie pamięci masowej, takimi jak pamięć podręczna KV i S3 przez RDMA, dzięki czemu część przepływu danych jest realizowana w warstwie pamięci masowej.
[12:57] Układanie warstw w celu wnioskowania i rozwiewanie tajemnic
Brian pyta, o czym klienci planujący wdrożenie wnioskowania korporacyjnego powinni pomyśleć poza współdzieloną warstwą pamięci podręcznej KV.
- Patrick twierdzi, że model i środowisko wykonawcze ustabilizowały się w ciągu 12–18 miesięcy, a prywatna chmura HPE ma na celu umożliwienie pierwszego użycia tokena w ciągu kilku dni lub godzin.
- Wprowadzenie na rynek HPE Discover w czerwcu to krok w kierunku stworzenia pionowego stosu rozwiązań dla przedsiębiorstw, obejmującego agentów MCP, inteligencję danych i obsługę istniejących typów danych. Dzięki temu klient nie jest integratorem technologii i nie musi jej usuwać ani zastępować.
- Oba artykuły opisują doświadczenia HPE z Mercedes F1 na targach COTA: rozproszone lokalizacje, duże ilości danych przenoszone z powrotem do centralnej fabryki oraz organizację przypominającą tę, którą charakteryzuje każde przedsiębiorstwo posiadające oddziały.
[18:06] Od sieci autonomicznych do centrum danych AI autonomicznych
Partnerstwa sportowe, Juniper i dlaczego dyskusja na temat magazynowania staje się coraz szersza.
- Oprócz Mercedesa Patrick wskazuje na Ryder Cup oraz partnerstwa z NFL, NBA, EPL i La Liga jako przykłady wykorzystania analiz w czasie rzeczywistym, w których każdy z nich dostosowuje proces w celu uzyskania przewagi.
- Klienci, którzy wybrali Juniper jako podstawę swojej sieci, otrzymują pakiet HPE CloudOps zintegrowany z Mist, który Patrick pozycjonuje jako autonomiczne centrum danych oparte na sztucznej inteligencji, w którym sieć stanowi jeden z jego elementów.
- Mówi, że w kwestiach ekonomicznych tokenomika i dopasowywanie modeli działają tylko wtedy, gdy możliwa jest obserwacja każdej warstwy stosu, co w ciągu ostatniego roku stanowiło wyzwanie nawet w HPE.
[21:53] Moc, gęstość i rekordowy rok dla taśmy
Brian zastanawia się, jak wygląda obciążenie pamięci masowej w obliczu rosnącego zapotrzebowania na moc procesorów graficznych i procesorów.
- Przejście z dysków na dyski hybrydowe, a następnie all-flash poprawiło zasilanie i chłodzenie, a gęstość dysków SSD i nowe formaty, takie jak linijki, zwiększają liczbę terabajtów na jednostkę rack, podczas gdy rack może pomieścić tylko ograniczoną ilość energii. Obecnie w grę wchodzą systemy w pełni chłodzone cieczą.
- Patrick zauważa, że w ubiegłym roku branża sprzedała więcej taśm LTO niż w jakimkolwiek innym roku, a Brian argumentuje, że biblioteki LTO-10 mogą pełnić funkcję lokalnego archiwum, którego przechowywanie jest praktycznie bezpłatne, a starsze dane stają się ponownie cenne dla nowszych narzędzi analitycznych.
- Brian śledzi pojemność dysków SSD od długiego okresu czasu, od 2 do 4 TB, poprzez 15, 30, 61 i 122 TB do 245 TB, z obsługą dzielonych platform E1.S, E3.S i E3.L, dzięki czemu nikt nie może trzymać kilku skrzynek dysków na półce.
[28:23] Plany, sprzęt AGD i niekupowanie największego pudełka
W jaki sposób HPE tworzy pakiety dla przedsiębiorstw, które nie mają zaawansowanych umiejętności w zakresie infrastruktury AI.
- Alletra Storage MP stanowi podstawę danych dla rozwiązania HPE Private Cloud AI, które klienci mogą zbudować na podstawie projektu NVIDIA lub kupić jako urządzenie z modułami NIM, projektami i modelami podstawowymi gotowymi do uruchomienia, a następnie skalować procesory graficzne i pamięć masową w miarę potrzeb.
- Brian podkreśla, że właściwym rozwiązaniem często nie jest największy system: odpowiednim rozwiązaniem może okazać się serwer z kilkoma kartami RTX PRO 6000 lub 4500, a najtrudniejszą częścią jest dopasowanie ogłoszenia o nowej platformie do rzeczywistych wyników biznesowych.
[30:42] Pytanie od publiczności: Podstawy i pamięć masowa Morpheus VM
Pierwsze pytanie dotyczyło tego, w jakim stopniu VM Essentials wpłynie na sprzęt i architekturę pamięci masowej HPE.
- Rozwiązanie VM Essentials wprowadzono na rynek wirtualizacji około dwa lata temu, a Patrick twierdzi, że liczba pobrań sterowników CSI dla Alletra Storage MP gwałtownie wzrosła, ponieważ klienci korzystają jednocześnie z serwerów fizycznych, maszyn wirtualnych i kontenerów.
- Prace integracyjne obejmują zarówno poufne przetwarzanie, jak i wtyczki do przechowywania danych przeznaczone do tworzenia migawek i replikacji, a także definiowaną programowo sieć. VM Essentials jest obecnie środowiskiem wykonawczym w ramach rozwiązań HPE Private Cloud 1000, 3000 i Private Cloud AI, zarządzanym za pośrednictwem pakietu CloudOps.
- HPE utrzymuje szeroką listę kompatybilności sprzętu i integruje się z Veeam, Commvault, Cohesity, Rubrik i innymi, oferując jednocześnie lepsze wrażenia „razem” w przypadku pamięci masowej HPE.
- Brian wspomina pracę laboratoryjną nad SimpliVity i VM Essentials: rozwiązanie to jest zaskakująco proste do wdrożenia, z ochroną danych wbudowaną w proces tworzenia maszyn wirtualnych i sprawdza się w małych i średnich przedsiębiorstwach (SLED), małych i średnich firmach (SMB) oraz oddziałach firmy.
[37:40] Izolacja wielodostępna i rytm wydań
Drugie pytanie od publiczności dotyczyło wycieku metadanych pomiędzy dzierżawcami i szybkości dostaw HPE.
- Patrick podejmuje kwestię izolacji wielu dzierżawców jako temat swojego bloga; architektura wielodzierżawców HPE izoluje środowiska niezależnie od protokołu, a jego zespół jest winien post zadającemu pytanie ze szczegółami.
- Aktualizacje konsoli GreenLake są dostarczane w ciągu kilku tygodni, podczas gdy oprogramowanie układowe macierzy pozostaje na swoim miejscu, odchodząc od starego zwyczaju aktualizacji co 12–18 miesięcy; VM Essentials na początku dostarczał comiesięczne wersje, a wraz z dojrzewaniem oprogramowania tempo spadało, a rada doradcza klientów zauważyła, jak daleko zaszło w ciągu 18 miesięcy.
[42:09] Ochrona danych: DPAN, Zerto i laboratorium ransomware
Brian odnosi się do prac laboratoryjnych w Raleigh nad węzłem Data Protection Accelerator Node i pyta, na jakim etapie jest bezpieczeństwo w HPE.
- Patrick mówi, że bezpieczeństwo jest tematem na szczeblu zarządu, który zyskuje na znaczeniu, ponieważ atakujący wykorzystują sztuczną inteligencję do grupowania i skalowania luk w zabezpieczeniach, a HPE jest członkiem projektu Glasswing wraz ze swoimi partnerami technologicznymi.
- Przejęcie firmy Zerto wprowadziło podejście oparte na celach odzyskiwania punktów do warstwy pamięci masowej, a macierz teraz generuje alerty, wykonuje migawki i poddaje kwarantannie kopie, w tym oryginalną kopię poza siedzibą firmy, bez konieczności angażowania zespołu ludzi do jej zbudowania i uruchomienia.
- HPE prowadzi rozmowy z klientami, poruszając trzy tematy: możliwości sztucznej inteligencji, resetowanie maszyn wirtualnych oraz bezpieczeństwo i zgodność; Brian wskazuje na laboratorium w Wielkiej Brytanii, w którym HPE naraża swoje systemy na ataki ransomware.
- Na podstawie testów DPAN Brian zauważył, że wąskim gardłem w procesie przywracania danych były dyski SSD wewnątrz serwerów docelowych, a nie struktura, co przemawia za ograniczeniem wyboru komponentów do poziomu dysku, gdy na szali leży cel czasu odzyskiwania.
[48:22] Odporność od pierwszego dnia i specjalista ds. IT
Poziomy usług platynowych określone w momencie świadczenia usług i to, co pokazał mały zespół w Mercedes F1.
- W przypadku Morpheus Enterprise wydajność, odporność i cyberbezpieczeństwo są powiązane z usługą od momentu wdrożenia, bez względu na to, czy jest to usługa fizyczna, wirtualna czy kontenerowa, i towarzyszą jej przez cały okres użytkowania.
- Brian mówi, że zespół Mercedesa pracujący przy torze wyścigowym, składający się z około 18 osób, korzysta z tych samych narzędzi, dzięki czemu inżynierowie poświęcają swój czas na pracę nad samochodem, a nie na administrację – jest to kompromis, który jest koniecznością w każdej firmie.
- Patrick rzadko spotyka się z klientami dysponującymi dedykowanymi zespołami ds. tworzenia kopii zapasowych, przechowywania danych i obliczeń; każdy ma własne obciążenie i poziom usług, a osoba zajmująca się kompleksową obsługą potrzebuje widoczności i łatwości zarządzania w całym stosie.
[52:30] Co dalej z pamięcią masową dla przedsiębiorstw
Brian pyta, jakie tematy klienci powinni rozważyć w ciągu najbliższych sześciu do dwunastu miesięcy.
- Patrick dostrzega, że klienci przemyślają na nowo architekturę pamięci masowych pod kątem połączenia wirtualizacji, wymogów cyberodporności i procesów opartych na sztucznej inteligencji, przy jednoczesnym ścisłym zarządzaniu udostępnianiem danych i przejściu na systemy zorientowane pionowo, w których jeden dostawca dostarcza cały stos.
- Oczekuje on, że w warstwie pamięci masowej osadzonych zostanie więcej usług danych opartych na sztucznej inteligencji, w tym magazyny wartości kluczowych, zapytania o metadane oraz nowe standardy bezpieczeństwa, a docelowo także procesory graficzne i modele działające w samej warstwie pamięci masowej.
- Brian dodaje, że urządzenia klasy DPU pojawią się zarówno po stronie obliczeniowej, jak i pamięci masowej w celu odciążenia, a oba te elementy zbliżają się do pięciu lat istnienia platformy, która nie napotkała obciążenia, którego nie byłaby w stanie obsłużyć.
Możesz przeczytać nasz artykuł na temat cyberodporności B10000 , recenzję węzła akceleratora ochrony danych X10000 , recenzję SimpliVity i VM Essentials oraz fragment z weekendu wyścigowego Mercedes F1, aby zapoznać się z pracą omówioną w odcinku.


 Amazon