

Można powiedzieć, że układ scalony AMD pojawił się pierwszy: mini komputery i laptopy Strix Halo były dostarczane ze 128 GB zunifikowanej pamięci na długo przed pojawieniem się NVIDIA. Jednak kategoria komputerów stacjonarnych z lokalną sztuczną inteligencją została skutecznie stworzona przez NVIDIA, gdy umieściła superukład Grace Blackwell w litrowym pudełku i nazwała go DGX Spark . Pomysł był prosty: maszyna klasy deweloperskiej z wystarczającą ilością zunifikowanej pamięci, aby pomieścić wydajne modele, stojące na biurku, a nie mierzone w chmurze. AMD Ryzen AI Halo to odpowiedź AMD na tę maszynę. AMD ogłosiło ją wraz z serią Ryzen AI Max PRO 400 w maju 2026 r.; zamówienia w przedsprzedaży rozpoczęły się w czerwcu wyłącznie za pośrednictwem Micro Center , a w sklepach będzie dostępna od 10 lipca. Ryzen AI Halo ma podobną konstrukcję, 128 GB zunifikowanej pamięci, cenę 3,999 USD i krótką listę decyzji, które czynią go znacząco inną propozycją niż Spark.
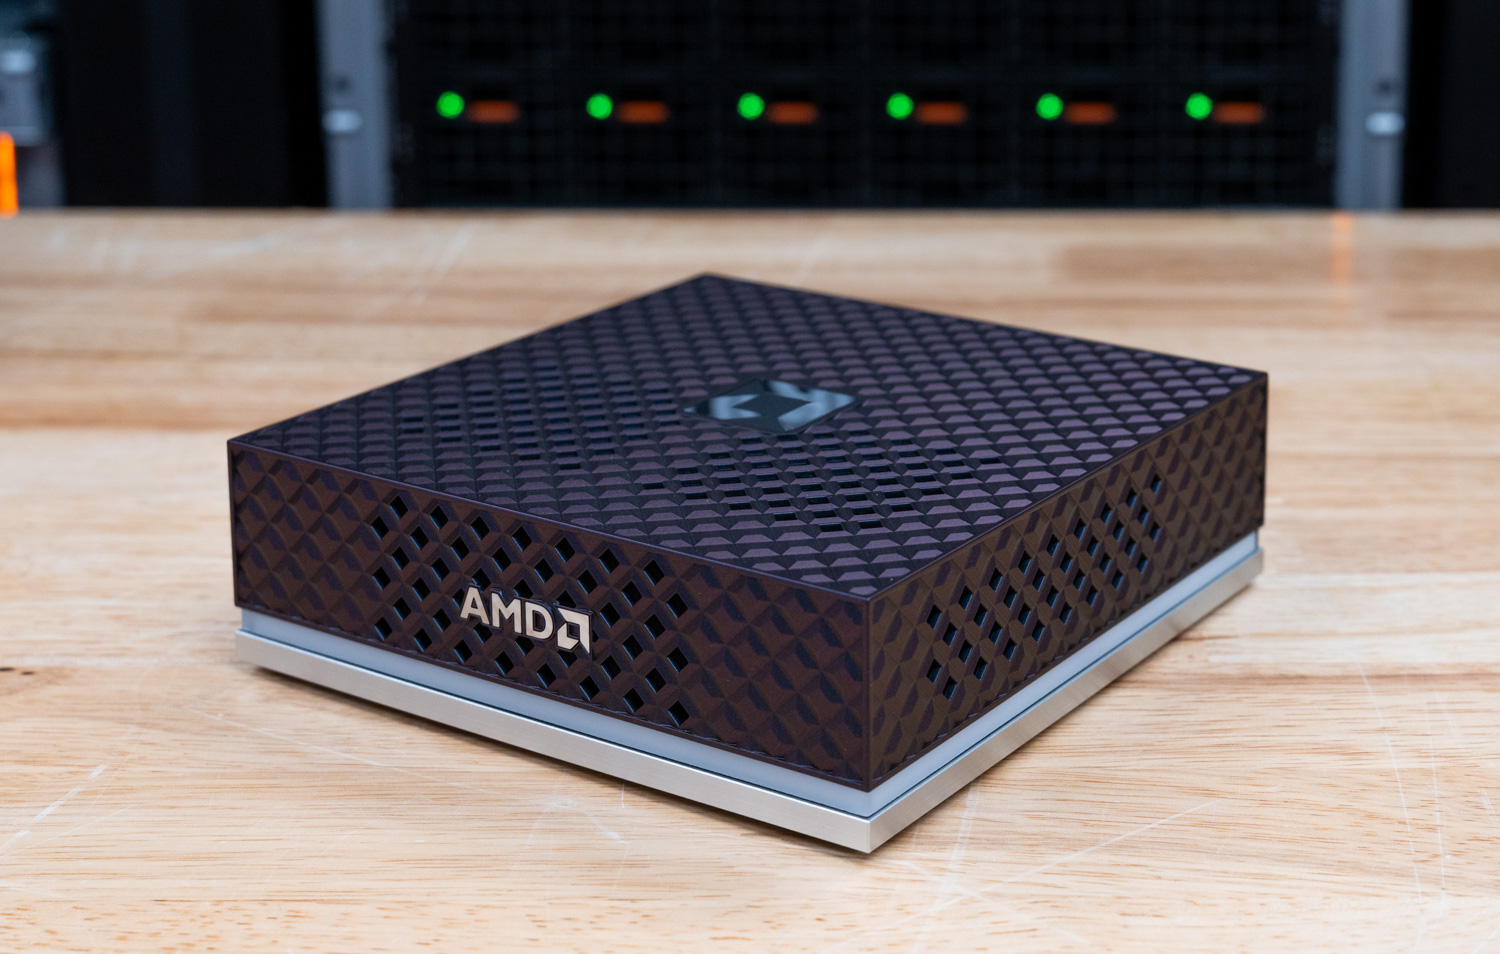
AMD reklamuje Halo jako swoją pierwszą platformę deweloperską AI, dającą deweloperom szybką, bezproblemową ścieżkę do lokalnego tworzenia i uruchamiania AI. Pod maską znajduje się Ryzen AI Max+ 395, 16-rdzeniowy, 32-wątkowy element „Zen 5” ze zintegrowaną grafiką Radeon 8060S (40 jednostek obliczeniowych RDNA 3.5) i XDNA 2 NPU o mocy 50 TOPS, wszystko w ramach platformy, którą AMD sprzedaje z łączną przepustowością AI do 126 TOPS. 128 GB pamięci LPDDR5x działa z prędkością 8000 MT/s, dostarczając przepustowość 256 GB/s, a cała platforma pobiera energię z pojedynczego wejścia USB-C o mocy 120 W. AMD twierdzi, że pula pamięci jest wystarczająca do obsługi modeli z pamięcią urządzenia do 200 miliardów parametrów. Jest to kompletna mini-stacja robocza x86, co jest źródłem najważniejszej różnicy.
Różnica tkwi w systemie Windows. Spark działa na systemie operacyjnym DGX firmy NVIDIA opartym na Linuksie i niczym innym; Halo uruchamia system Windows 11 lub obraz deweloperski Linuxa od AMD na tym samym sprzęcie. Natywna obsługa systemu Windows była najczęściej zgłaszaną prośbą od osób zainteresowanych Sparkiem i zmienia to postrzeganie tego urządzenia. Pozycjonowanie AMD wskazuje na to samo: Windows i Linux kontra Spark tylko z Linuksem ( przynajmniej na dziś ).
Trzy kolejne decyzje oddzielają Halo od Sparka, a każda z nich odnosi się do skargi, którą słyszeliśmy na temat obecnego modelu. Halo wykorzystuje standardowy dysk SSD M.2 2280 zamiast mniej popularnego dysku 2242, który pasuje do Sparka, co otwiera znacznie większą pulę opcji na rynku wtórnym, w tym pojemności 8 TB, dla każdego, kto chce wymienić dysk. Dostarczany jest ze zmienną pamięcią graficzną (Variable Graphics Memory) wstępnie ustawioną na maksymalną alokację w obu systemach operacyjnych, więc duże modele ładują się bez ręcznego dostrajania. Obudowa jest również otoczona podświetlanym pierścieniem stanu, niewielką korektą w stosunku do ciemnych, bezświetlnych jednostek Spark, które otrzymywali niektórzy nabywcy, w zależności od producenta OEM. Koszt podejścia AMD widać z tyłu obudowy, gdzie nie ma szybkiej struktury, tylko 10GbE, co ogranicza możliwości klastrowania wielowęzłowego. To są kompromisy, które definiują obciążenia, do których ta maszyna jest przeznaczona, zanim uruchomione zostaną jakiekolwiek testy porównawcze.
W kwestii ceny, niuanse mają znaczenie. Cena Halo z dyskiem SSD 2 TB wynosi 3,999 dolarów, co plasuje go dokładnie na poziomie standardowej ceny podstawowego systemu klasy Spark. Porównanie zależy od tego, o jakim Sparku mowa. Własny system DGX Spark firmy NVIDIA z większym dyskiem kosztuje obecnie bliżej 4,700 dolarów, co jest związane z niedoborem pamięci LPDDR5X i NAND. Podstawowe systemy Grace Blackwell od ASUS-a i innych producentów nadal kosztują około 4,000 dolarów i są dziś dostępne na Amazon (link afiliacyjny). W porównaniu z bazą kategorii, Halo plasuje się na równi, a jego atut opiera się na powyższych decyzjach, a nie na słabszej pozycji w stawce.
Przeprowadziliśmy test Halo za pomocą lokalnego pakietu AI firmy StorageReview na systemach Windows i Linux, a wyniki przedstawiono obok analizy projektu i oprogramowania w niniejszej recenzji.
Na wynos
- Alternatywa dla dwóch systemów operacyjnych x86: Ryzen AI Halo to jedyny komputer w kategorii Spark, który uruchamia system Windows 11 lub Linux na pełnej platformie x86. Cena wynosi 3,999 USD z dyskiem SSD o pojemności 2 TB, podczas gdy cena modelu DGX Spark Founders Edition wynosi 4,699 USD.
- Pamięć do przechowywania dużych modeli: 128 GB zunifikowanej pamięci LPDDR5x-8000 o przepustowości 256 GB/s obsługuje modele do 200 miliardów parametrów lokalnie, a zmienna pamięć graficzna jest wstępnie dostrojona tak, aby duże modele można było ładować bez konieczności ręcznej konfiguracji.
- Najmocniejszy Ryzen AI Max+ 395, jaki testowaliśmy: Halo wyprzedziło HP Z2 Mini G1a i ZBook Ultra G1a w niemal każdym obciążeniu systemu Windows, w tym 37 316 w teście wielordzeniowym Cinebench R23, 184.2 GIPS w 7-Zip oraz wiodące wyniki w generowaniu tekstu przez Procyon AI (Phi 1,192) i generowaniu obrazu (SD 1.5 FP16 937).
- Wygrywa CPU, traci wnioskowanie w starciu ze Sparkiem: W systemie Linux Halo zdecydowanie pokonało DGX Spark pod względem wykorzystania procesora — kompresowało o 11% szybciej i dekompresowało o 38% szybciej w 7-Zip, a także kończyło kompilację LLVM o 14% szybciej. Jednak w większości scenariuszy obsługi vLLM przy wyższej współbieżności wynik był gorszy od dwu- do czterokrotnie, osiągając nawet 8.8-krotnie w przypadku zadań z użyciem pre-fill GPT OSS 120B.
- Duża pojemność pamięci masowej, skromna sieć: Standardowa zatoka M.2 2280 umożliwia rozbudowę systemu do 8 TB, choć platforma konstrukcyjnie negocjuje dołączoną kartę Gen5 Micron 4600 do Gen4, a pojedynczy port 10GbE bez szybkiej struktury wyklucza klastrowanie wielowęzłowe, które umożliwia moduł ConnectX-7 200G Spark.
SPECYFIKACJA
| Specyfikacja | System AMD Ryzen AI Halo |
|---|---|
| Procesor | |
| CPU | Procesor AMD Ryzen™ AI Max+ 395 16 rdzeni / 32 wątki (architektura Zen 5) |
| GPU | Zintegrowana karta graficzna AMD Radeon™ 8060S 40 jednostek obliczeniowych (architektura RDNA™ 3.5) |
| NPU | Procesor NPU AMD XDNA™ 2 |
| Pamięć | |
| Typ pamięci | LPDDR5x |
| Pojemność pamięci | 128GB |
| Szybkość pamięci | 8000 MT / s |
| Przepustowość pamięci | 256GB / s |
| Dyski | |
| Dyski | Dysk SSD M.2 NVMe o pojemności 2 TB (SED) |
| Sieci i łączność | |
| Ethernet | 1 × 10 GbE |
| Wi-Fi | Wi-Fi 7 |
| Bluetooth | Bluetooth 5.4 |
| I / O | |
| USB | 3 × USB-C, 1 × USB-C (wejście zasilania) |
| Wyświetl wyjście | 1xHDMI 2.1b |
| Konfiguracja | |
| TDP | 120W |
| System operacyjny | Linux lub Windows 11 |
| Wymiary | 150 × 150 × 45.4 mm (5.9 × 5.9 × 1.79 cala) |
| Waga | Mniej niż 1.2 kg (2.65 funta) |
Budowa i projekt AMD Ryzen AI Halo
System AMD Ryzen AI Halo charakteryzuje się kompaktową obudową, przypominającą „NVIDIA Spark”, o wymiarach zaledwie 150 × 150 × 45.4 mm i wadze poniżej 1.2 kg (2.65 funta). Aluminiowa obudowa charakteryzuje się wyrazistym, geometrycznym wzorem wentylacji u góry i z przodu, nadając systemowi charakterystyczny wygląd i maksymalizując przepływ powietrza do układu chłodzenia. Pomimo niewielkich rozmiarów, platforma została zaprojektowana jako pełnoprawna stacja robocza AI, zdolna do obsługi aplikacji stacji roboczych, lokalnego wnioskowania LLM oraz zadań programistycznych AI.
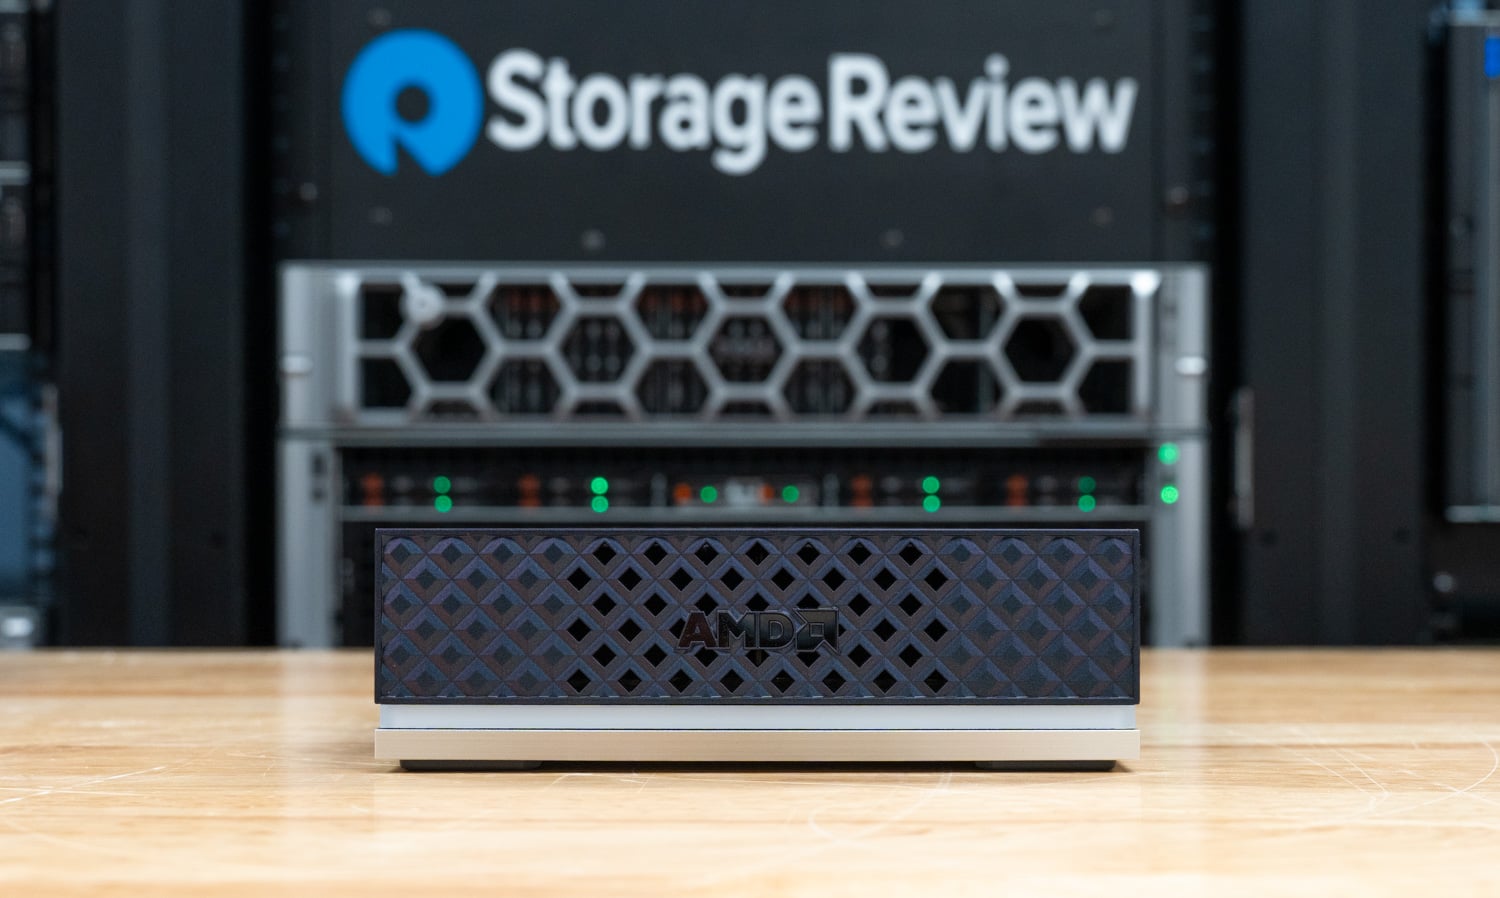
Przód
Przód systemu jest celowo czysty, składając się niemal w całości z dużej, siatkowej kratki wentylacyjnej, która rozciąga się na całą szerokość obudowy. Zamiast umieszczać porty z przodu, AMD przeznaczyło ten obszar na przepływ powietrza, umożliwiając dopływ chłodnego powietrza do systemu przez duży, wzorzysty wlot, jednocześnie zachowując porządek w przedniej części. Srebrny akcent u dołu obudowy tworzy subtelny kontrast wizualny z matowo-czarną obudową.
Tylne wejście/wyjście
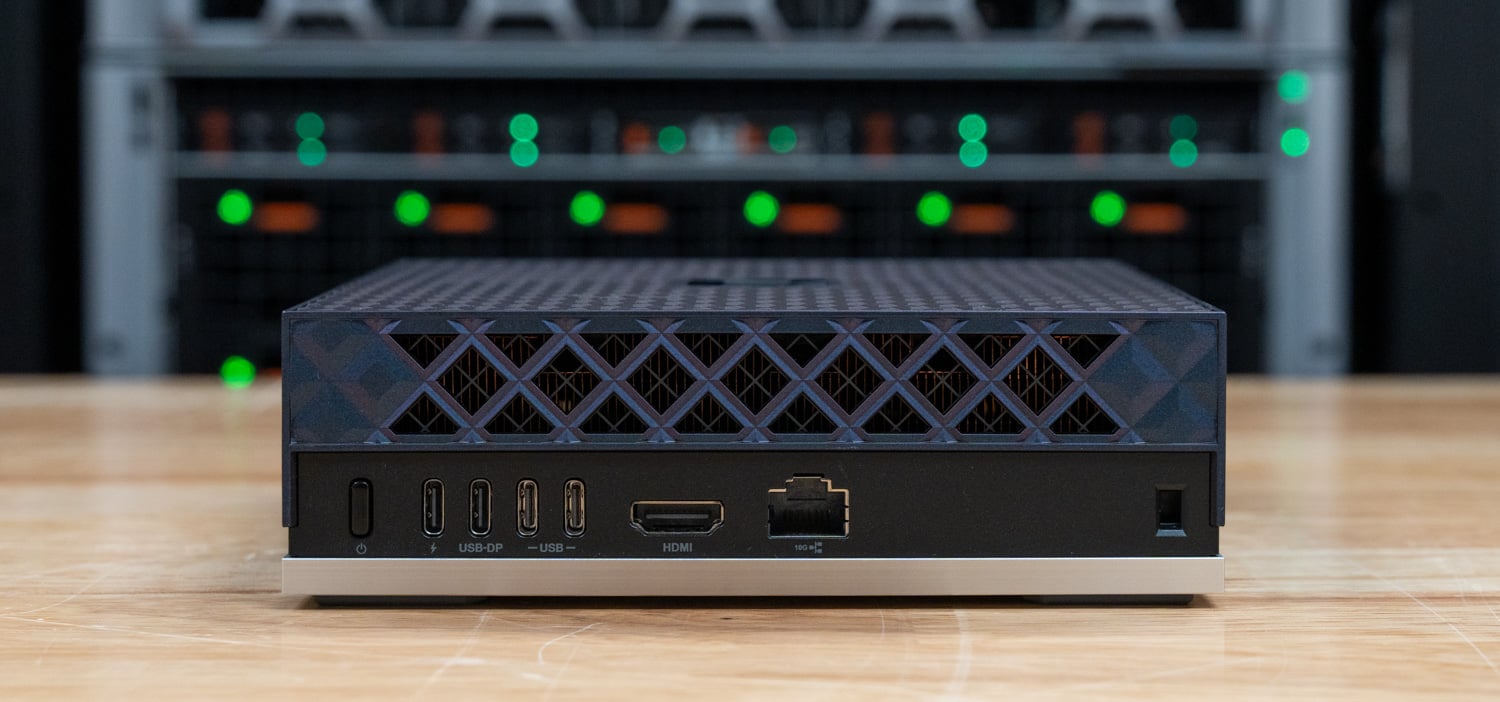
Wszystkie złącza zewnętrzne znajdują się z tyłu systemu. Patrząc od lewej do prawej, na tylnym panelu znajdują się następujące elementy:
- Wejście zasilania USB-C
- Port USB-C z trybem DisplayPort Alt
- Dwa dodatkowe porty USB-C
- Wyjście HDMI 2.1b
- 10GbE RJ45 Ethernet
- Gniazdo blokady bezpieczeństwa Kensington
System oferuje trzy porty danych USB-C oraz dedykowane złącze zasilania USB-C, umożliwiając jednoczesne podłączenie wielu szybkich urządzeń peryferyjnych i wyświetlaczy. Złącze HDMI 2.1b zapewnia natywne wyjście wideo, a zintegrowany interfejs Ethernet 10GbE sprawia, że platforma doskonale nadaje się do szybkiej łączności NAS, przesyłania zestawów danych AI oraz lokalnych środowisk programistycznych.
Projektowanie wewnętrzne
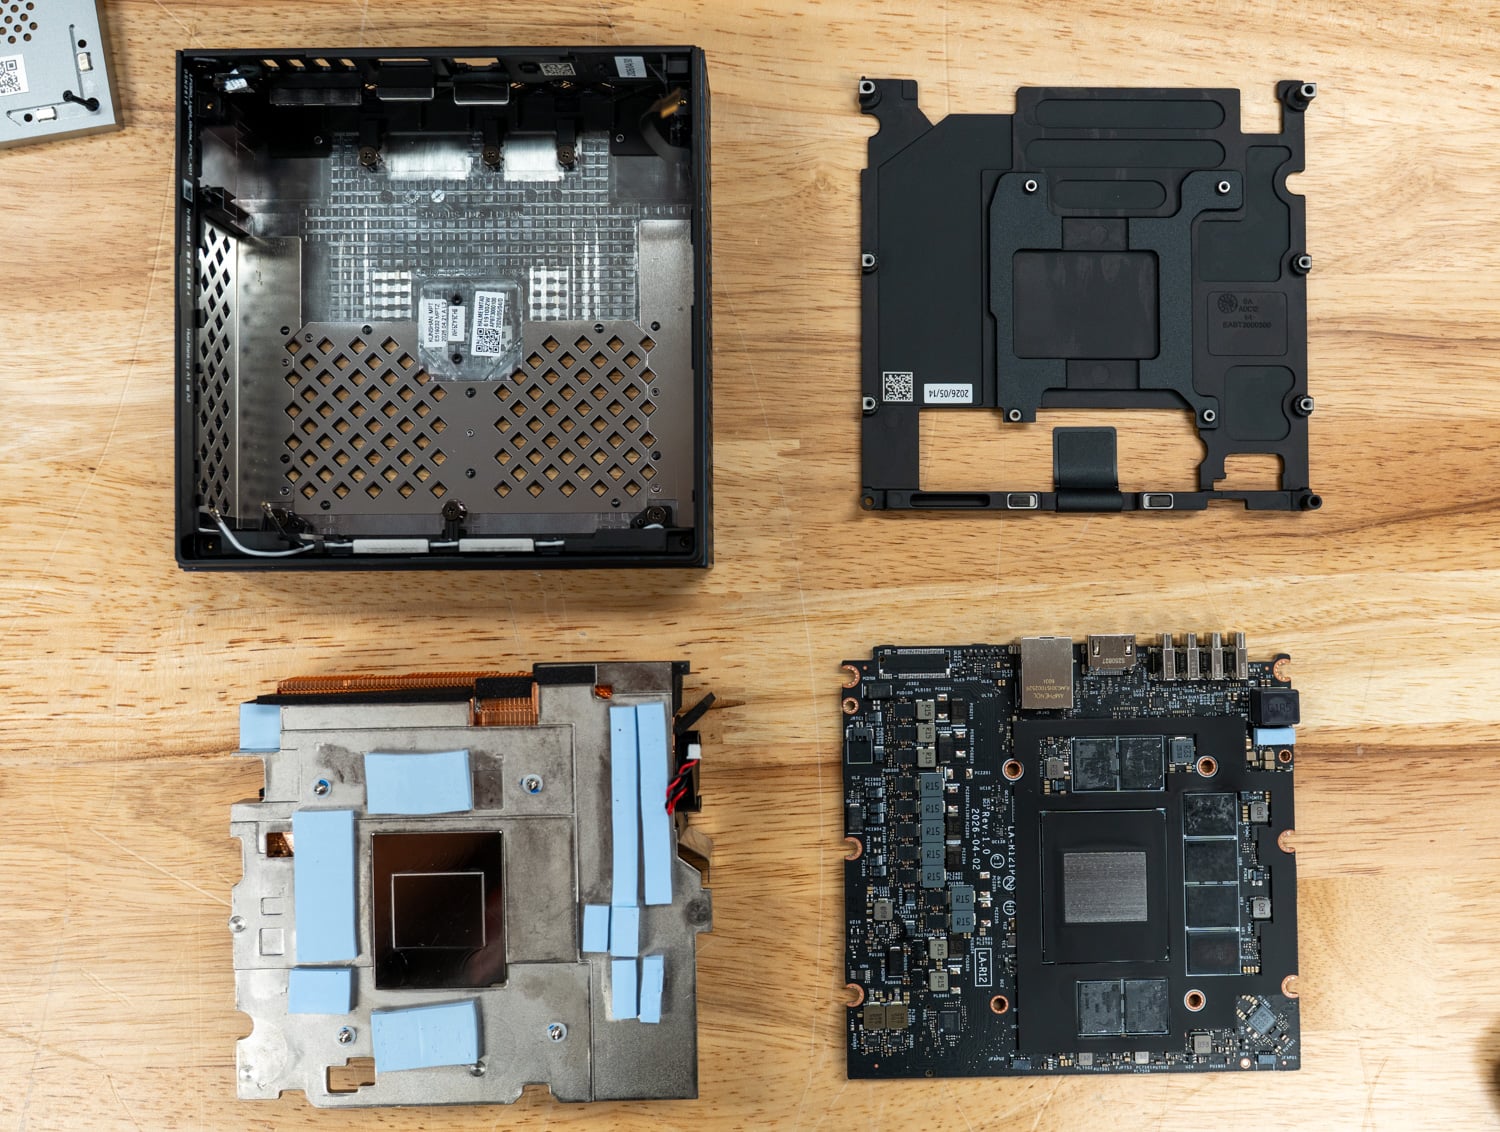
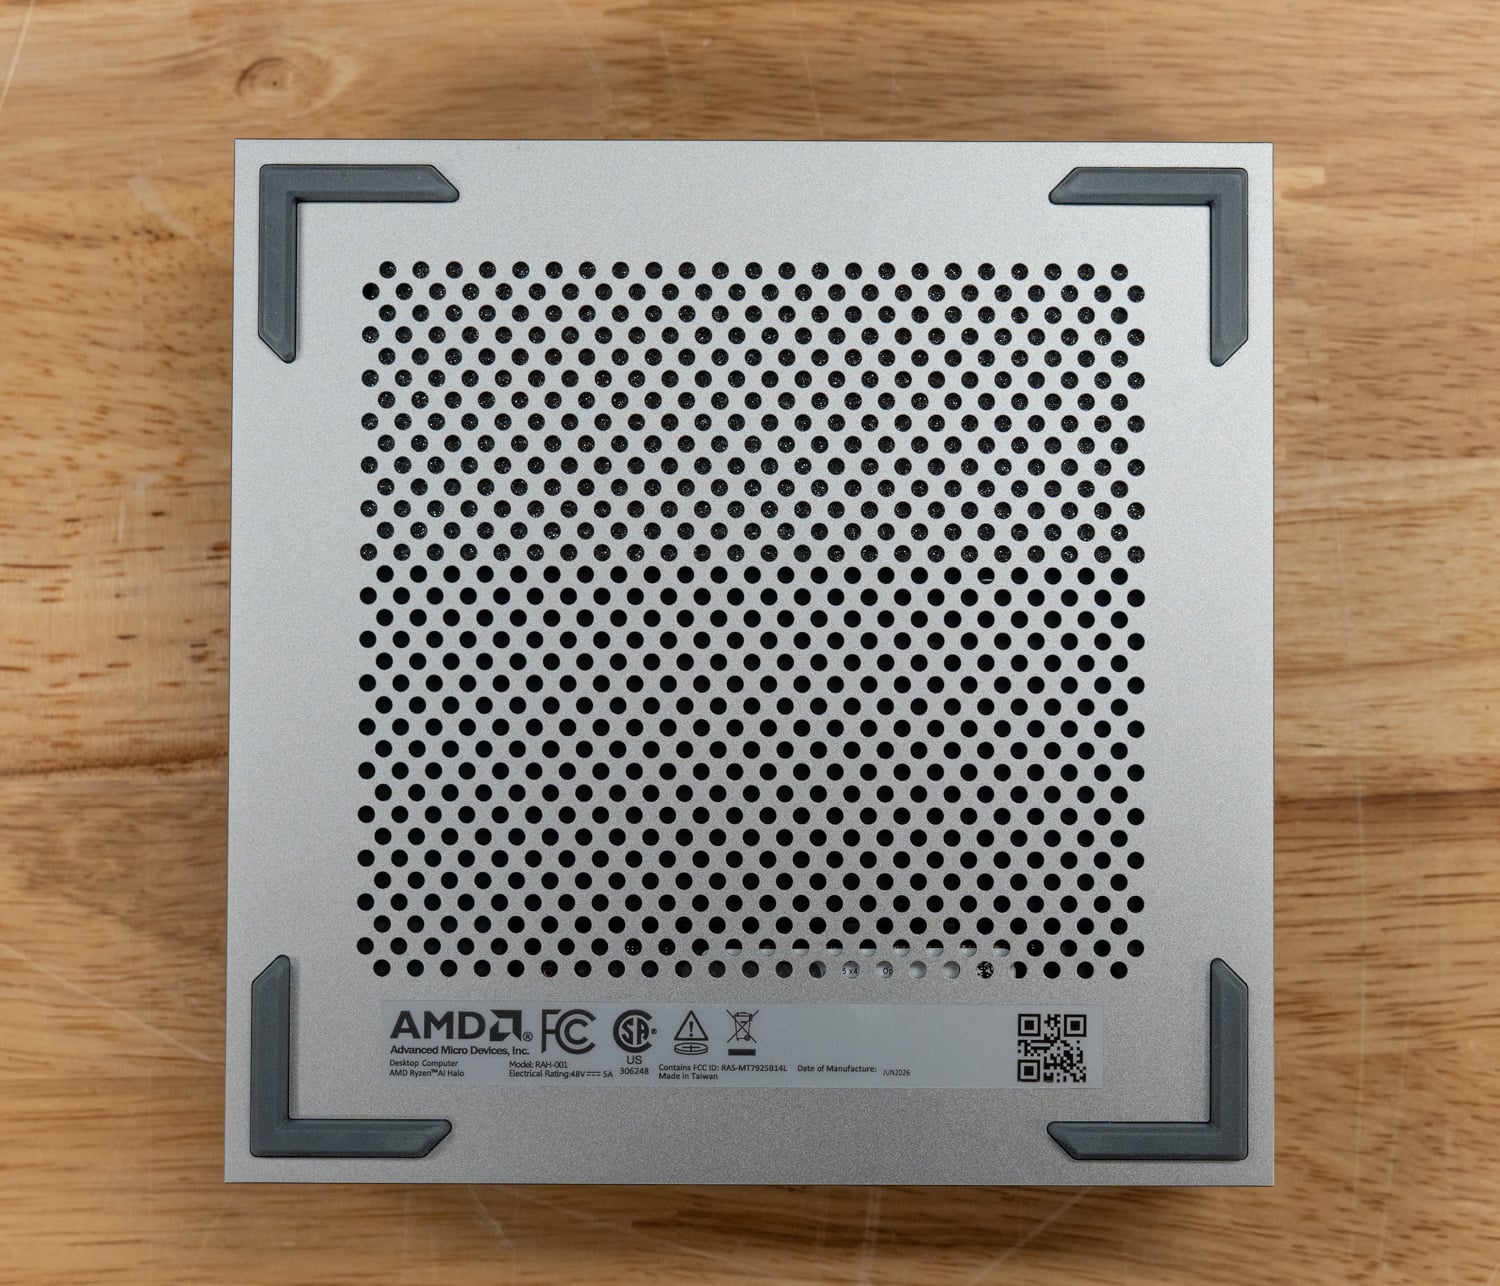
Spód karty Ryzen AI Halo wyposażono w duży, perforowany otwór wentylacyjny, który zasysa powietrze, chłodząc podzespoły zamontowane w dolnej części płyty, a cztery gumowe nóżki w rogach zapewniają stabilność urządzenia na biurku lub półce.
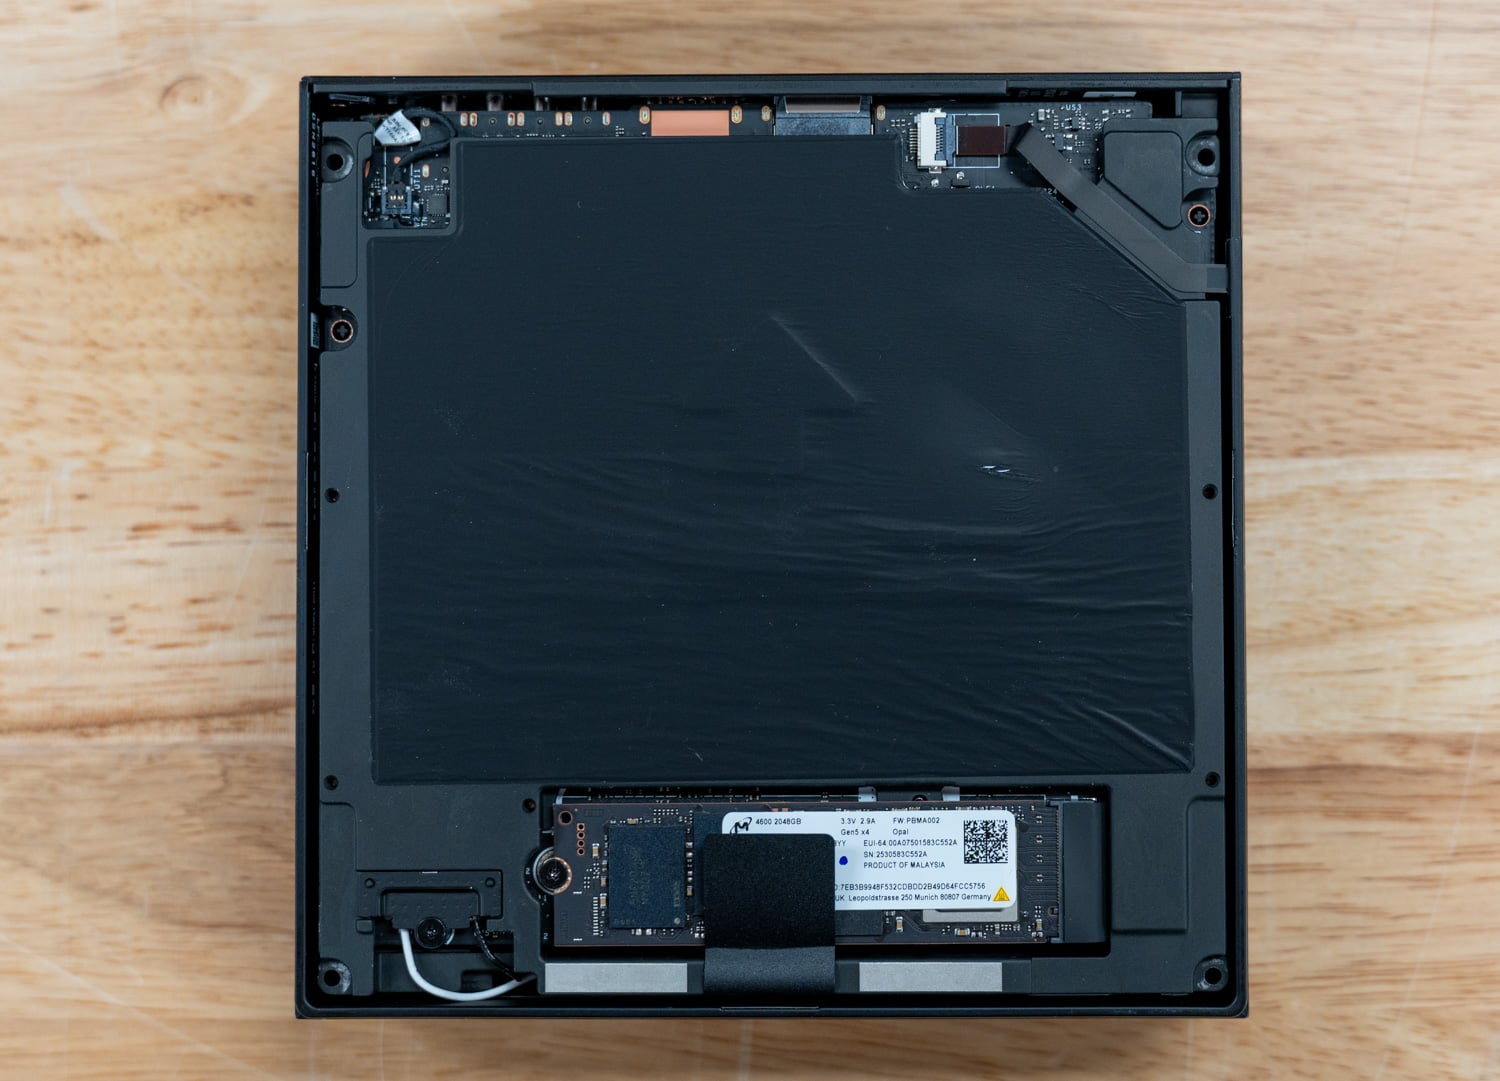
Po odkręceniu czterech śrub mocujących dolny panel odsłania się zatoka dysku SSD M.2 i kilka dolnych podzespołów płyty głównej, w tym złącze karty Wi-Fi. W naszym egzemplarzu testowym to gniazdo mieści dysk SSD Micron 4600 2TB Gen5 x4, a czarna folia klejąca chroni resztę płyty głównej przed odsłoniętym spodem.
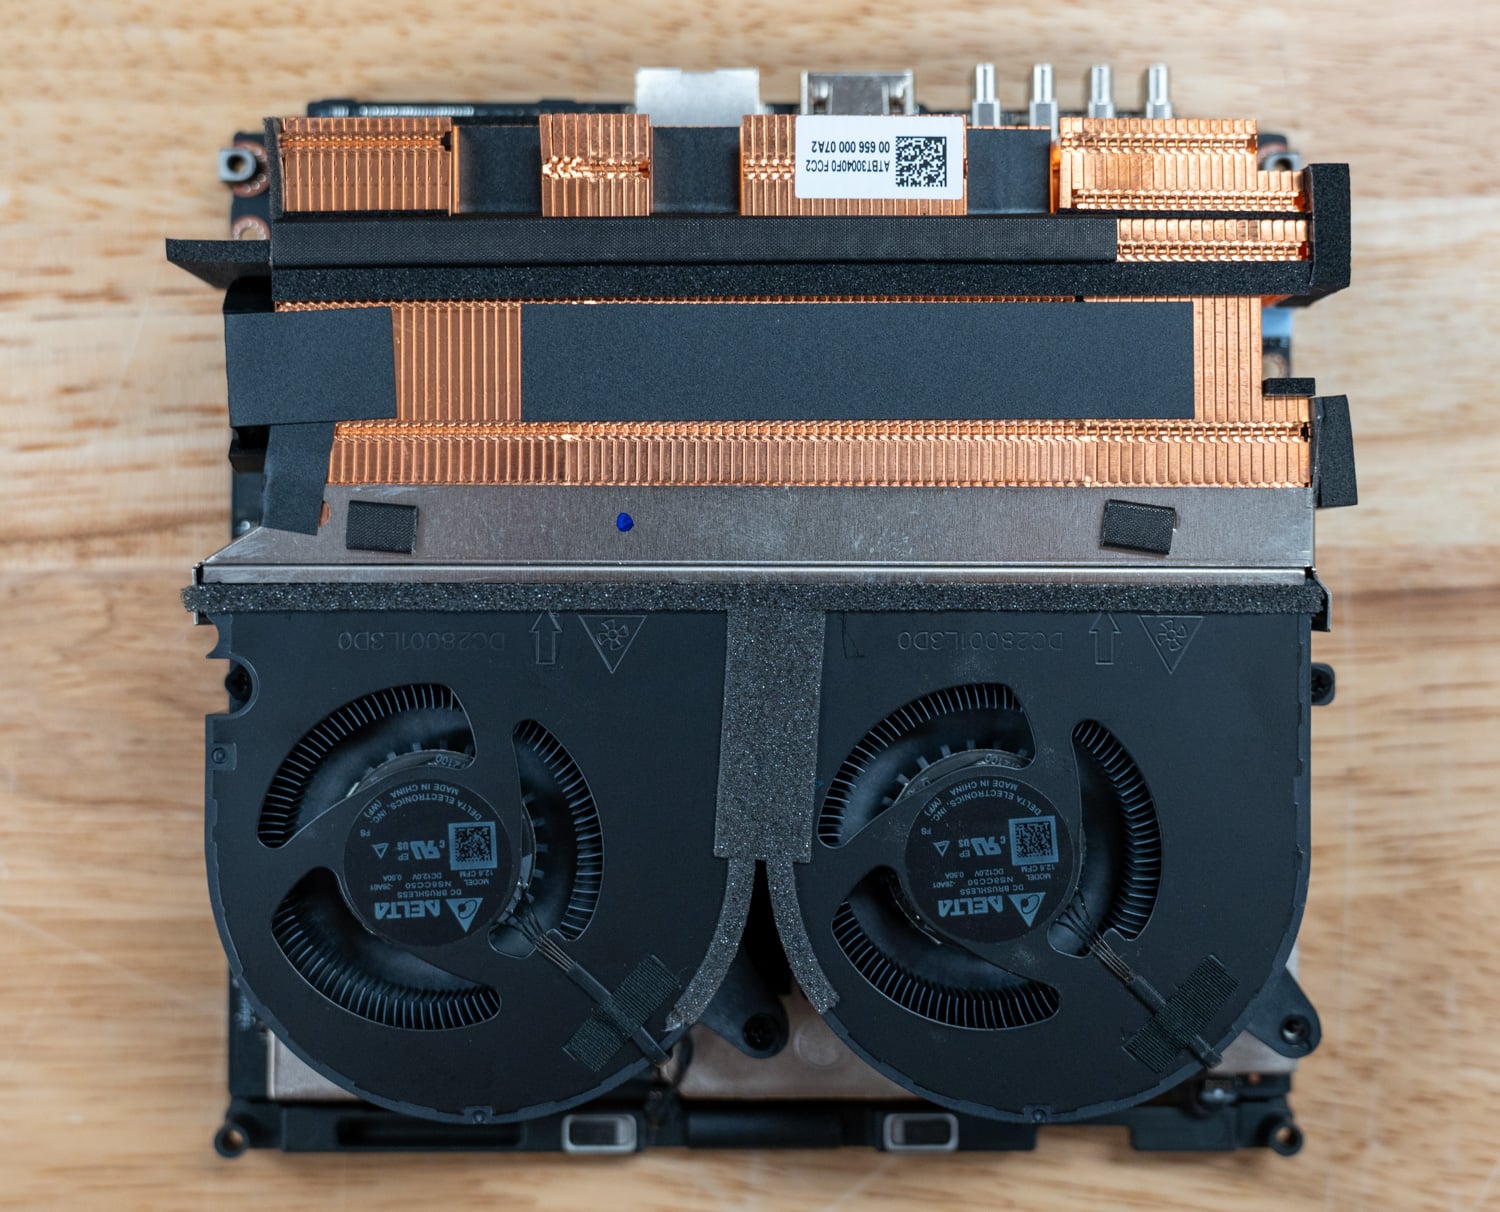
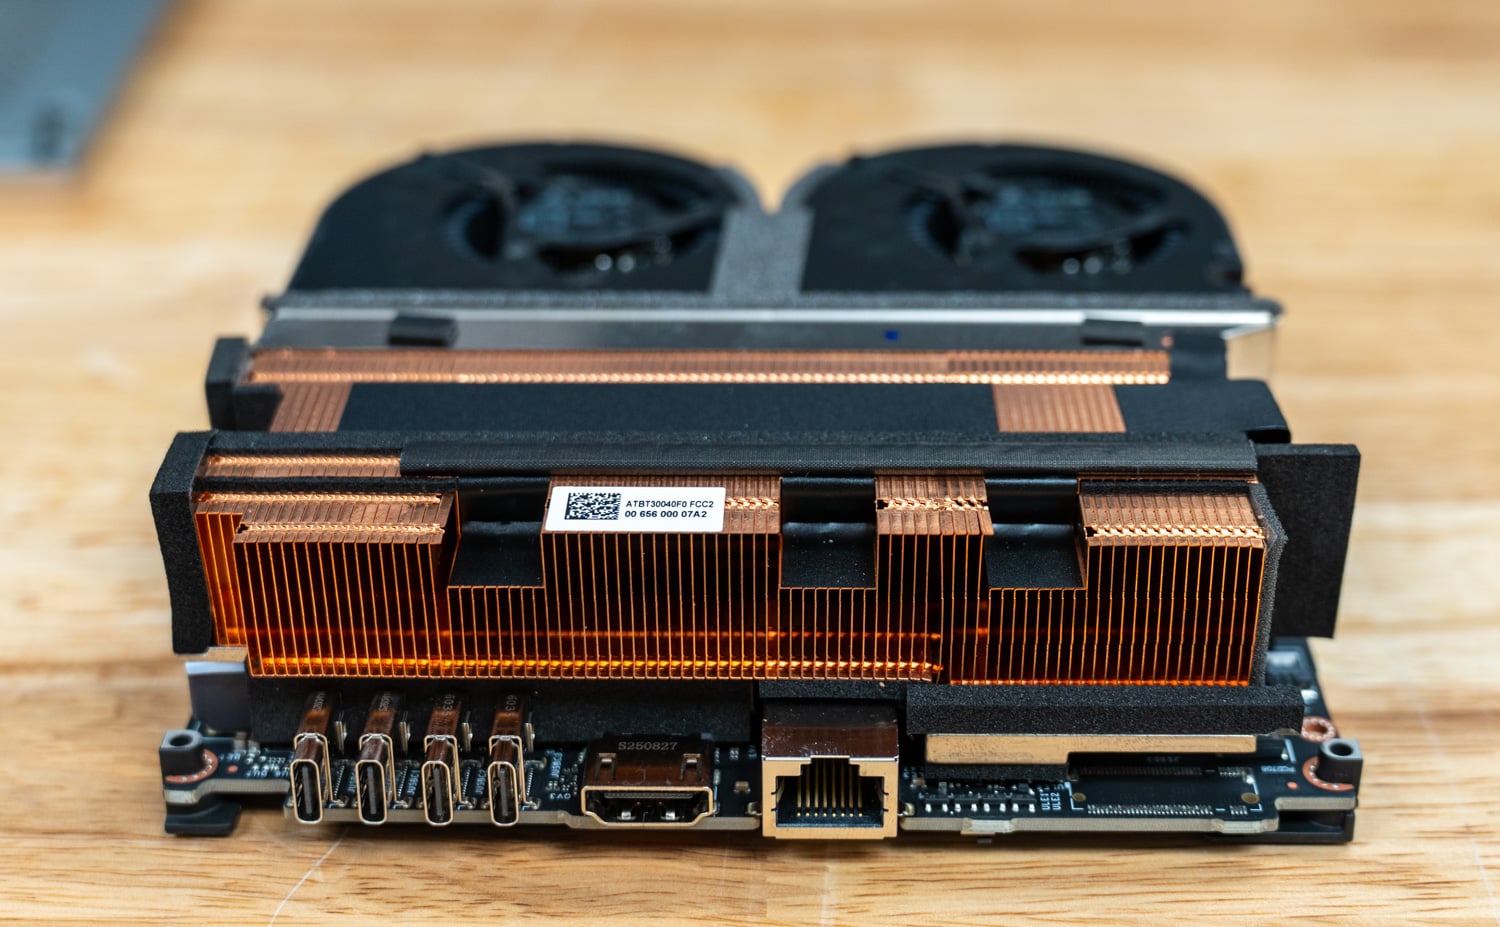
W kwestii chłodzenia firma AMD zastosowała podobne rozwiązanie jak w przypadku karty DGX Spark firmy NVIDIA, wykorzystując dwa wentylatory, które tłoczą powietrze przez żebrowany radiator i wydmuchują je przez tylną część obudowy.
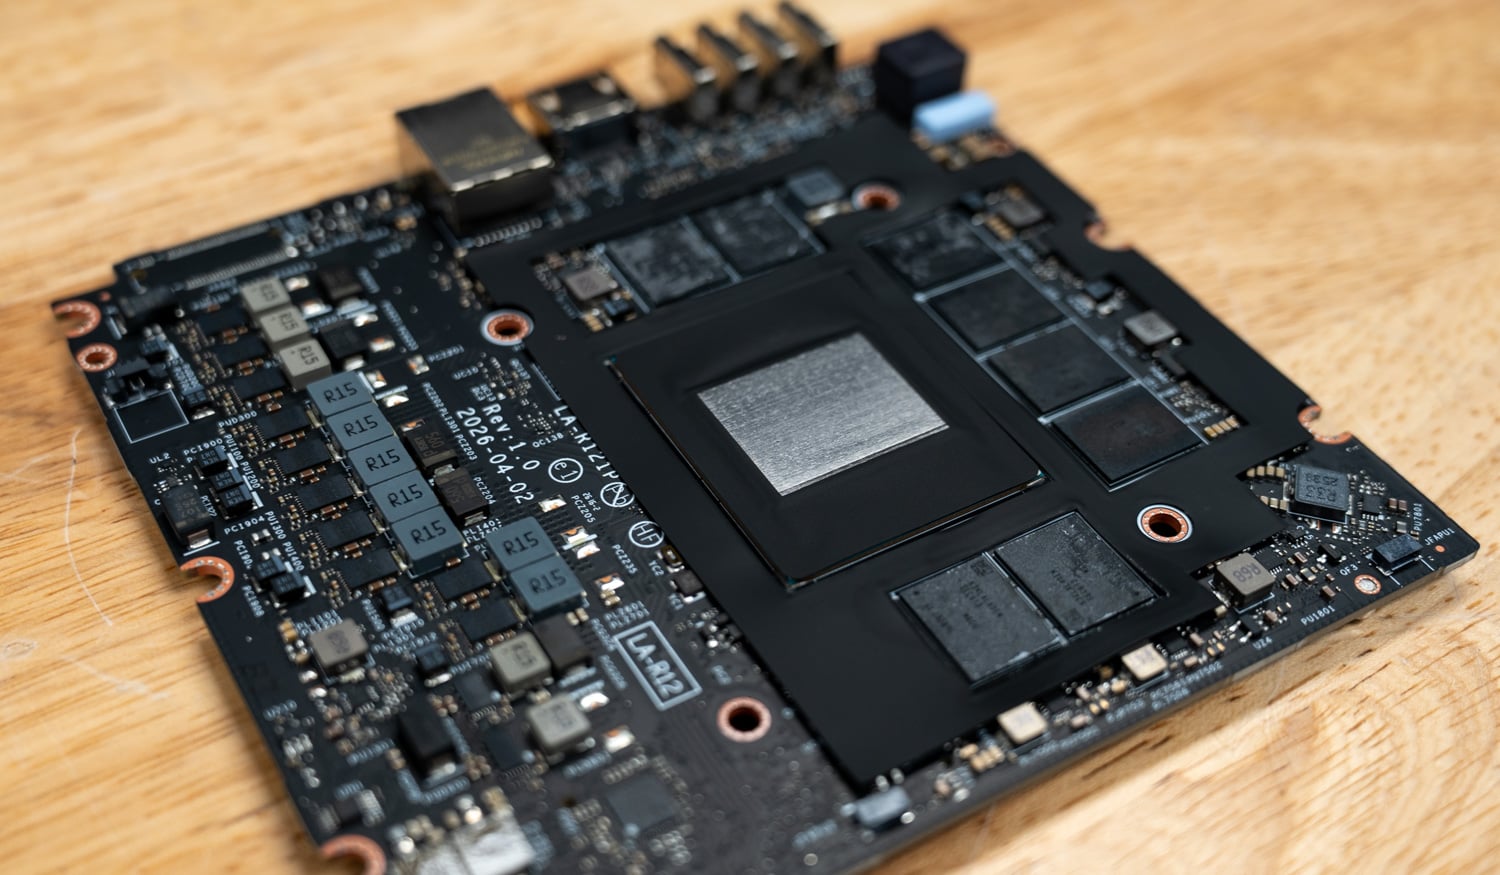
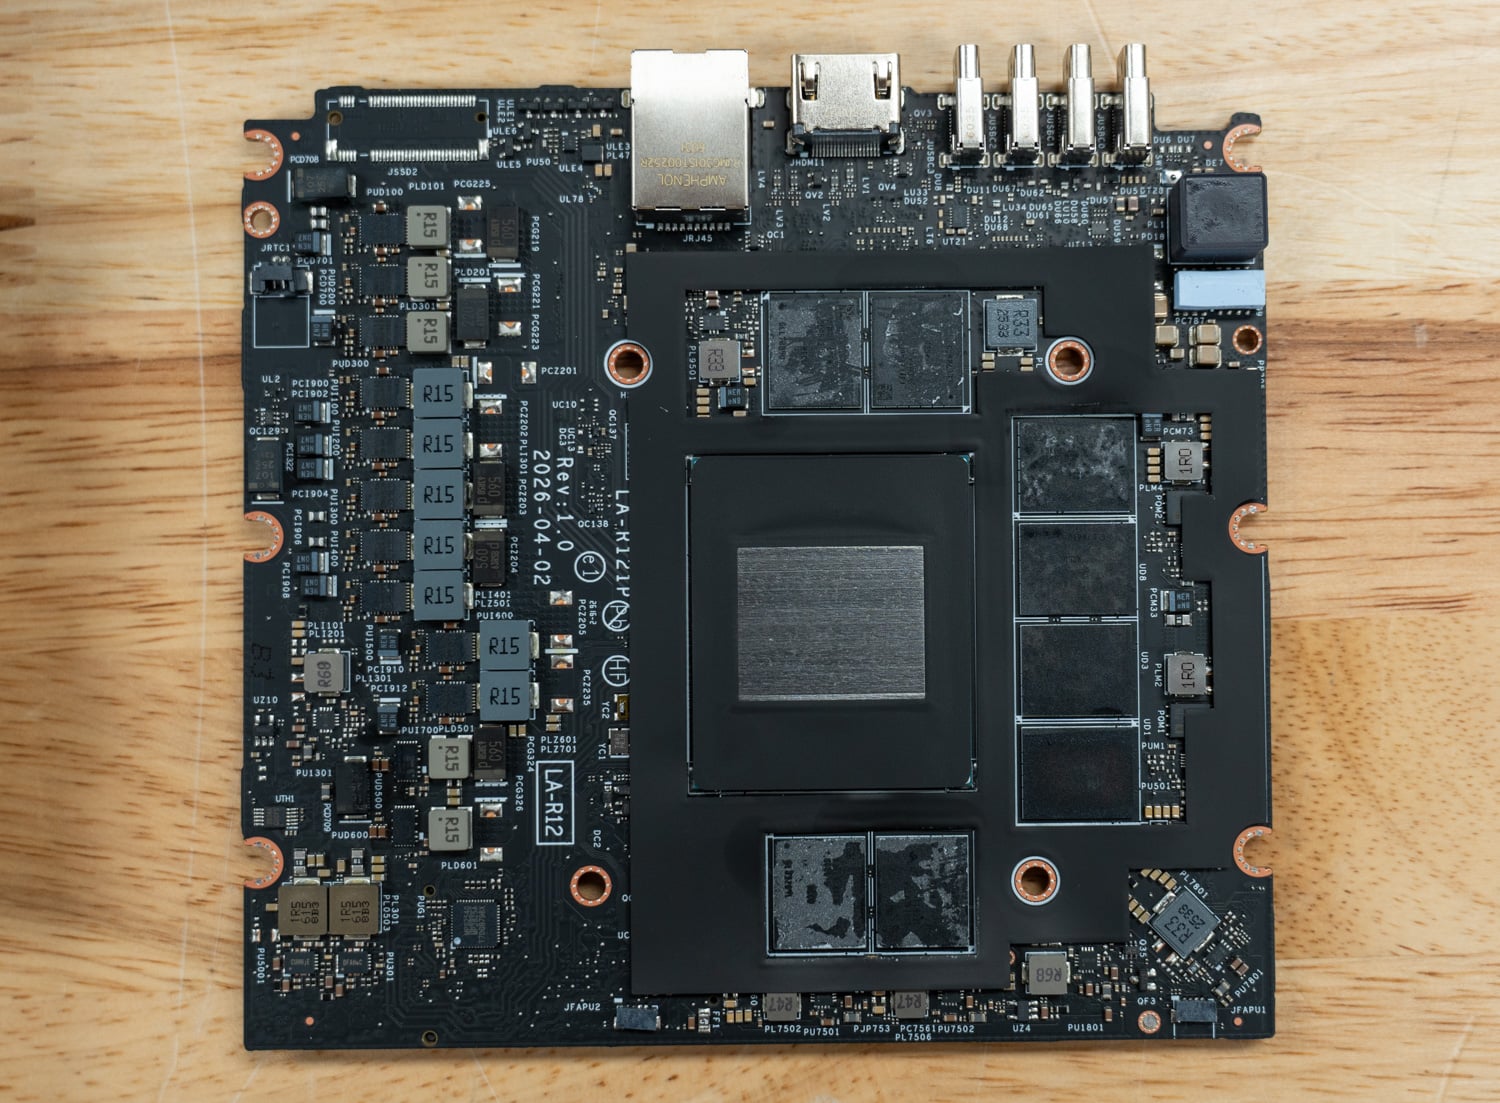
Po odsunięciu układu chłodzenia, ukazuje się płyta główna, odsłaniając centralnie umieszczoną strukturę APU, otoczoną z obu stron modułami pamięci oraz obwodami VRM biegnącymi wzdłuż lewej krawędzi. Srebrny kwadrat widoczny na strukturze nie jest wykonany z ciekłego metalu ani pasty; to pozostałość po stałej podkładce termicznej lub powłoce AMD nałożonej na styku struktury z radiatorem, co wyjaśnia jej jednolity, suchy wygląd, w przeciwieństwie do mokrego, rozmazanego wyglądu pasty lub ciekłego metalu, który zazwyczaj pozostawia.
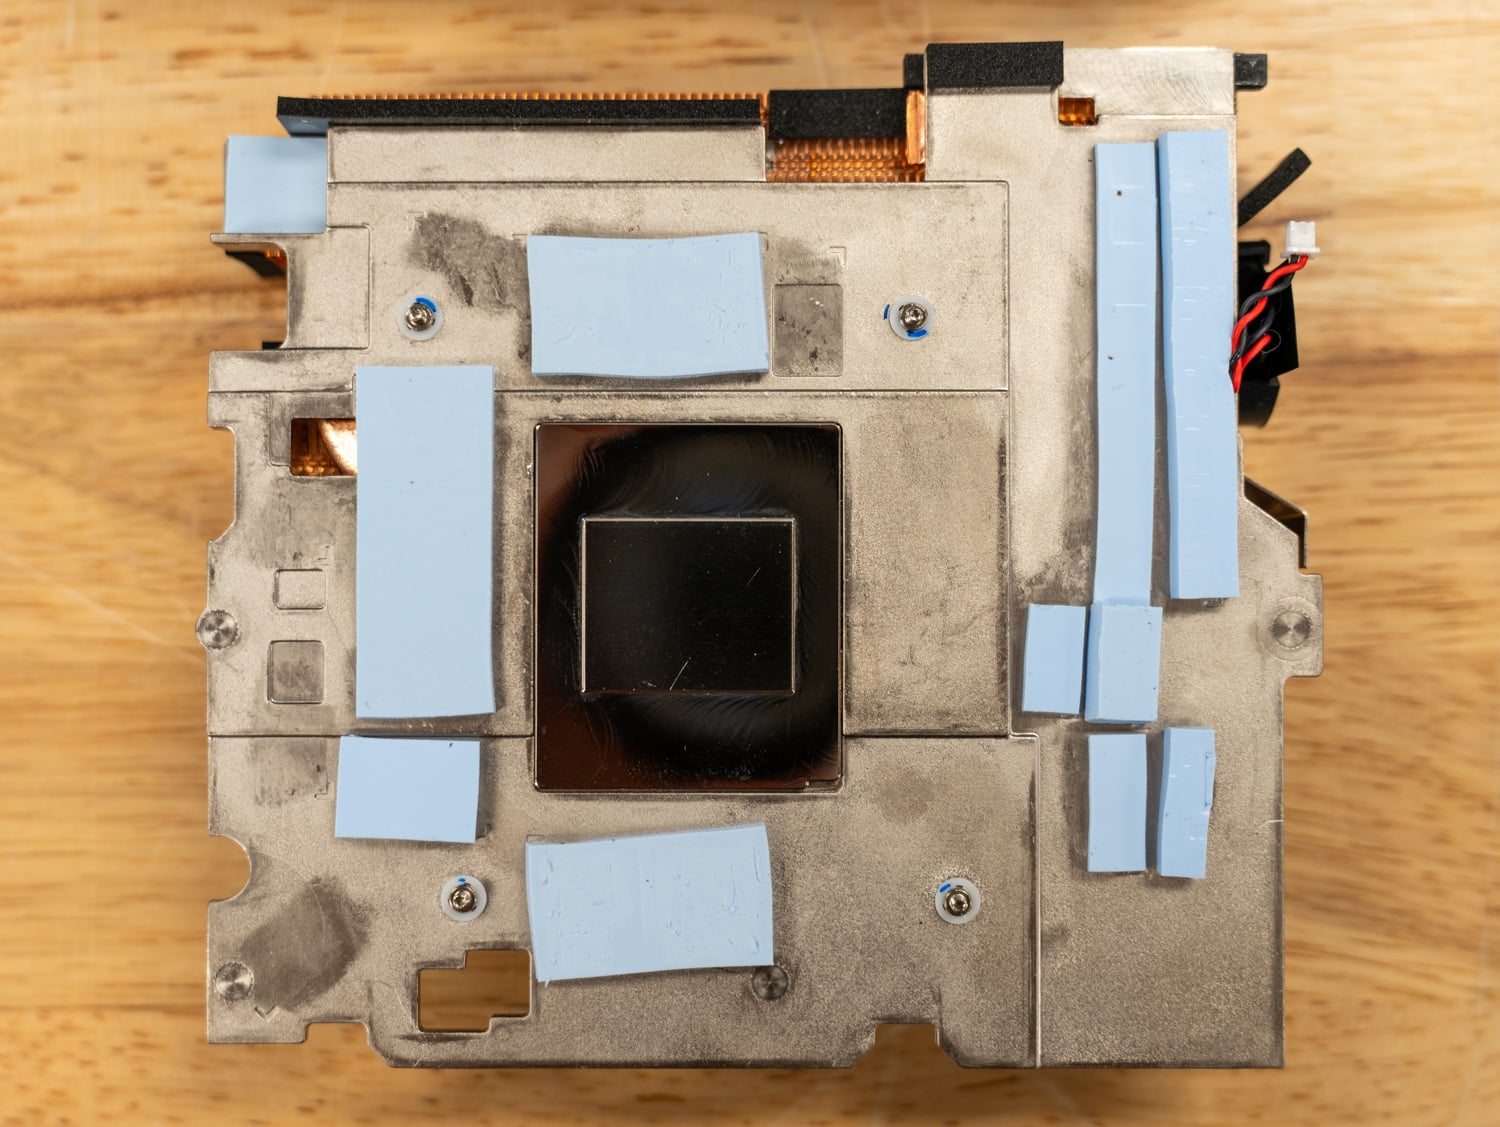
Po odwróceniu radiatora widać spód jego płyty chłodzącej, gdzie wypolerowana na lustro sekcja styka się bezpośrednio z rdzeniem. Jednocześnie otaczające ją strefy pamięci i zasilania są pokryte fabrycznie nałożonymi podkładkami termicznymi o różnej grubości.
Testy wydajności AMD Ryzen AI Halo
Przeprowadziliśmy testy platformy AMD Ryzen AI Halo w systemach Windows i Linux, aby ocenić jej wydajność w aplikacjach na stacje robocze i obciążeniach zorientowanych na sztuczną inteligencję. W testach w systemie Windows system AMD Ryzen AI Halo porównano z dwoma komercyjnie dostępnymi systemami z procesorem Ryzen AI Max+ PRO 395: HP Z2 Mini G1a, kompaktową stacjonarną stacją roboczą, oraz HP ZBook Ultra G1a 14-calowym, mobilną stacją roboczą. Ponieważ wszystkie trzy systemy korzystają z tej samej architektury procesora i zintegrowanej karty graficznej Radeon 8060S, porównania te podkreślają wydajność platformy Halo w różnych obudowach termicznych i konstrukcjach.
W testach systemu Linux skupiliśmy się na rozwoju sztucznej inteligencji i obciążeniach pamięci masowej, porównując system Ryzen AI Halo z platformą NVIDIA DGX Spark. Testy te koncentrowały się na benchmarkingu pamięci masowej FIO i wydajności wnioskowania vLLM, porównując platformę deweloperską AMD opartą na platformie Ryzen AI Halo ze specjalnie opracowanym systemem rozwoju sztucznej inteligencji firmy NVIDIA do wnioskowania w lokalnym modelu dużego języka.
Testowane jednostki
UL Procyon: Wizja komputerowa AI
Test Procyon AI Computer Vision Benchmark zapewnia szczegółowy wgląd w wydajność silników wnioskowania AI na profesjonalnym poziomie. Dzięki wykorzystaniu silników wielu dostawców, zapewnia on wyniki wydajności, które dokładnie odzwierciedlają możliwości urządzenia. Test ten ocenia najnowocześniejsze modele sieci neuronowych, porównując ich wydajność akceleracji AI na różnych typach sprzętu – w tym procesorach CPU, GPU i NPU – umożliwiając użytkownikom ocenę względnej wydajności w szerokim zakresie obciążeń i warunków.
Aby odzwierciedlić rzeczywiste obciążenia AI, benchmark wykorzystuje sześć zróżnicowanych modeli sieci neuronowych, z których każdy wybrano ze względu na jego przydatność dla współczesnych zadań z zakresu wizji komputerowej. MobileNet V3 to kompaktowy model skoncentrowany na urządzeniach mobilnych, przeznaczony do identyfikacji obiektów na obrazach, podczas gdy Inception V4 wykonuje to samo zadanie, wykorzystując bardziej złożoną architekturę.
YOLO V3 (You Only Look Once) specjalizuje się w detekcji obiektów w czasie rzeczywistym poprzez szacowanie prawdopodobieństwa ich wystąpienia. DeepLab V3, oparty na MobileNet V2, koncentruje się na semantycznej segmentacji obrazu i klastrowaniu pikseli. Real-ESRGAN, najbardziej wymagający obliczeniowo test, skaluje obrazy z rozdzielczości 250×250 do 1,000×1,000. Wreszcie, ResNet 50 to solidny model klasyfikacyjny, który umożliwia efektywniejsze trenowanie głębokich sieci neuronowych.
Platforma Ryzen AI Halo zapewniła niezmiennie wysoką wydajność wnioskowania AI w przypadku obciążeń procesora i karty graficznej. W testach procesora uzyskała wynik ogólny 216 punktów, nieznacznie ustępując HP Z2 Mini (227) i zdecydowanie przewyższając HP ZBook Ultra (186). Wnioskowanie GPU było jeszcze bardziej imponujące, a system Halo uzyskał najwyższy wynik ogólny – 553, wyprzedzając ZBook Ultra (528) i Z2 Mini (528). Odnotowała również najszybszą inferencję MobileNet V3 – 0.38 ms – i ukończyła wymagające obciążenie REAL-ESRGAN w 185.08 ms, w porównaniu z 211.76 ms w Z2 Mini i 200.40 ms w ZBook Ultra.
| UL Procyon: Wnioskowanie w zakresie wizji komputerowej AI (im niżej, tym lepiej) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) | HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Czasy procesora | |||
| Ogólny wynik AI Computer Vision (im wyższy, tym lepiej) | 216 | 227 | 186 |
| Sieć komórkowa V3 | 0.73 ms | 0.75 ms | 1.09 ms |
| ResNet 50 | 6.02 ms | 5.99 ms | 6.84 ms |
| Incepcja V4 | 17.18 ms | 17.12 ms | 19.80 ms |
| DeepLab V3 | 29.21 ms | 21.20 ms | 28.27 ms |
| YOLO V3 | 35.60 ms | 36.58 ms | 41.64 ms |
| REAL-ESRGAN | 1,931.13 ms | 1,892.10 ms | 2,138.97 ms |
| Czasy GPU | |||
| Ogólny wynik AI Computer Vision (im wyższy, tym lepiej) | 553 | 528 | 583 |
| Sieć komórkowa V3 | 0.38 ms | 0.42 ms | 0.46 ms |
| ResNet 50 | 4.04 ms | 3.85 ms | 3.27 ms |
| Incepcja V4 | 13.26 ms | 15.15 ms | 11.62 ms |
| DeepLab V3 | 12.72 ms | 10.98 ms | 10.72 ms |
| YOLO V3 | 11.17 ms | 12.64 ms | 10.57 ms |
| REAL-ESRGAN | 185.08 ms | 211.76 ms | 200.40 ms |
UL Procyon: generowanie tekstu AI
Benchmark Procyon AI Text Generation usprawnia testowanie wydajności AI LLM, oferując zwięzłą i spójną metodę oceny. Umożliwia wielokrotne testowanie wielu modeli LLM, minimalizując jednocześnie złożoność dużych rozmiarów modeli i zmiennych czynników. Opracowany we współpracy z liderami w dziedzinie sprzętu AI, optymalizuje wykorzystanie lokalnych akceleratorów AI, zapewniając bardziej niezawodne i wydajne oceny wydajności. Poniższe wyniki uzyskano za pomocą TensorRT.
Platforma referencyjna Ryzen AI Halo okazała się najlepsza wśród testowanych modeli językowych w teście Procyon AI Text Generation. Osiągnęła najwyższy ogólny wynik Phi na poziomie 1,192, w porównaniu z 965 dla HP Z2 Mini i 922 dla HP ZBook Ultra. Mistral podążył za podobnym trendem z wynikiem 998, wyprzedzając 850 i 829, a Llama3 uzyskała 847, przewyższając konkurencyjne systemy odpowiednio z wynikiem 766 i 756. Platforma Halo skróciła również czas generowania pierwszego tokena w każdym modelu, generując pierwszy token Phi w zaledwie 0.996 sekundy, czyli prawie o połowę mniej niż systemy HP. Chociaż przepustowość generowania tokenów czasami sprzyjała Z2 Mini, znacznie niższe opóźnienie uruchamiania platformy Halo zapewniło najlepsze ogólne wyniki w testach porównawczych.
| UL Procyon: generowanie tekstu AI | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Wynik ogólny Phi | 1,192 | 965 | 922 |
| Czas wyjścia Phi do pierwszego tokena | 0.996 sekund | 1.898 sekund | 1.956 sekund |
| Tokeny wyjściowe Phi na sekundę | 55.271 tokenów/sek. | 68.967 tokenów/sek. | 64.986 tokenów/sek. |
| Całkowity czas trwania Phi | 56.237 sekund | 52.666 sekund | 55.501 sekund |
| Wynik ogólny Mistral | 998 | 850 | 829 |
| Czas wyjścia Mistral do pierwszego tokena | 1.603 sekund | 2.734 sekund | 2.783 sekund |
| Żetony wyjściowe Mistral na sekundę | 35.027 tokenów/sek. | 43.358 tokenów/sek. | 41.992 tokenów/sek. |
| Całkowity czas trwania Mistrala | 88.582 sekund | 81.716 sekund | 84.065 sekund |
| Ocena ogólna Llama3 | 847 | 766 | 756 |
| Czas wyjścia Llama3 do pierwszego tokena | 1.963 sekund | 2.545 sekund | 2.578 sekund |
| Tokeny wyjściowe Llama3 na sekundę | 34.630 tokenów/sek. | 36.752 tokenów/sek. | 36.243 tokenów/sek. |
| Całkowity czas trwania Llama3 | 92.026 sekund | 91.987 sekund | 93.200 sekund |
| Ocena ogólna Llama2 | N / A | 936 | 929 |
| Czas wyjścia Llama2 do pierwszego tokena | N/A sekund | 3.813 sekund | 3.860 sekund |
| Tokeny wyjściowe Llama2 na sekundę | N/A tokenów/ów | 24.685 tokenów/sek. | 24.619 tokenów/sek. |
| Całkowity czas trwania Llama2 | N/A sekund | 136.077 sekund | 136.720 sekund |
UL Procyon: Generowanie obrazu AI
Test Procyon AI Image Generation Benchmark oferuje spójny i dokładny sposób pomiaru wydajności wnioskowania AI na różnych urządzeniach, od energooszczędnych NPU po zaawansowane procesory graficzne (GPU). Obejmuje on trzy testy: Stable Diffusion XL (FP16) dla zaawansowanych procesorów graficznych, Stable Diffusion 1.5 (FP16) dla procesorów graficznych o umiarkowanej mocy oraz Stable Diffusion 1.5 (INT8) dla urządzeń o niskim poborze mocy. Test wykorzystuje optymalny silnik wnioskowania dla każdego systemu, zapewniając uczciwe i porównywalne wyniki.
Generowanie obrazu okazało się jednym z najsilniejszych obciążeń procesora Ryzen AI Halo. W teście Stable Diffusion 1.5 FP16 platforma Halo uzyskała wynik ogólny 937 punktów, w porównaniu z 725 punktami dla Z2 Mini i 648 punktami dla ZBook Ultra, jednocześnie skracając czas generowania obrazu do 106.7 sekundy, w porównaniu z odpowiednio 137.8 i 154.2 sekundy. Równie wyraźną przewagę wykazała wersja Stable Diffusion XL, z czasem 878.5 sekundy dla systemu Halo, czyli o około 174 sekundy szybciej niż w przypadku Z2 Mini i o ponad 450 sekund szybciej niż w przypadku ZBook Ultra. Platforma ukończyła również test Stable Diffusion 1.5 INT8 z wynikiem ogólnym 9,158 punktów, co stanowi wynik niedostępny dla żadnego z systemów porównawczych HP.
| UL Procyon: generowanie obrazu AI | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Stabilna dyfuzja 1.5 (FP16) – wynik ogólny | 937 | 725 | 648 |
| Stabilna dyfuzja 1.5 (FP16) – czas całkowity | 106.7 sekund | 137.815 sekund | 154.203 sekund |
| Stabilna dyfuzja 1.5 (FP16) – prędkość generowania obrazu | 6.670 s/obraz | 8.613 s/obraz | 9.638 s/obraz |
| Stabilna dyfuzja 1.5 (INT8) – wynik ogólny | 9,158 | N / A | N / A |
| Stabilna dyfuzja 1.5 (INT8) – czas całkowity | 27.298 sekund | N / A | N / A |
| Stabilna dyfuzja 1.5 (INT8) – prędkość generowania obrazu | 3.412 s/obraz | N / A | N / A |
| Stabilna dyfuzja XL (FP16) – ocena ogólna | 682 | 570 | 451 |
| Stabilna dyfuzja XL (FP16) – czas całkowity | 878.493 sekund | 1,052.468 sekund | 1,329.592 sekund |
| Stabilna dyfuzja XL (FP16) – prędkość generowania obrazu | 54.906 s/obraz | 65.779 s/obraz | 83.100 s/obraz |
Stacja robocza SPEC 4
Benchmark SPECworkstation 4.0 to kompleksowe narzędzie do oceny wszystkich kluczowych aspektów wydajności stacji roboczych. Zapewnia on rzeczywisty pomiar wydajności procesora, karty graficznej, akceleratora i dysku, dostarczając specjalistom dane niezbędne do podejmowania świadomych decyzji dotyczących inwestycji w sprzęt. Benchmark zawiera dedykowany zestaw testów skoncentrowanych na obciążeniach AI i ML, takich jak zadania z zakresu analizy danych oraz testy wnioskowania oparte na środowisku uruchomieniowym ONNX, odzwierciedlając rosnące znaczenie AI/ML w środowiskach stacji roboczych. Obejmuje siedem branż i cztery podsystemy sprzętowe, zapewniając szczegółowy i trafny pomiar wydajności dzisiejszych stacji roboczych.
Test SPECworkstation 4 podkreślił zbalansowane możliwości platformy Ryzen AI Halo w zakresie stacji roboczych. Platforma uzyskała najwyższe wyniki w kategoriach Usługi finansowe (2.92), Media i rozrywka (2.97), Projektowanie produktu (2.22) oraz Produktywność i rozwój (1.27), przewyższając w tych kategoriach zarówno HP Z2 Mini, jak i HP ZBook Ultra. Z2 Mini nieznacznie wyprzedził w kategoriach Energia (2.50 vs. 2.35) oraz Nauki przyrodnicze (2.60 vs. 2.33). Ogólnie rzecz biorąc, platforma referencyjna Halo wykazała wysoką wydajność w profesjonalnych obciążeniach testowych i pozostała konkurencyjna w każdej testowanej kategorii.
| SPECworkstation 4.0.0 (im wyższy, tym lepiej) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S)
|
HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Wartość energetyczna | 2.35 | 2.50 | 2.20 |
| Usługi finansowe | 2.92 | 2.35 | 1.60 |
| Life Sciences | 2.33 | 2.60 | 2.20 |
| Media i rozrywka | 2.97 | 2.22 | 1.90 |
| Product Design | 2.22 | 2.00 | 1.74 |
| Produktywność i rozwój | 1.27 | 1.00 | 1.03 |
Luxmark
Luxmark to test wydajności GPU, który wykorzystuje LuxRender, open-source'owy moduł renderujący z wykorzystaniem ray tracingu, do oceny wydajności systemu w przypadku bardzo szczegółowych scen 3D. Ten test jest przydatny do oceny możliwości renderowania graficznego serwerów i stacji roboczych, szczególnie w aplikacjach do efektów wizualnych i wizualizacji architektonicznej, gdzie precyzyjna symulacja oświetlenia ma kluczowe znaczenie.
Wyniki Luxmarka wykazały minimalną różnicę między trzema platformami Ryzen AI Max+ 395. System referencyjny Halo uzyskał najwyższy wynik w teście Food – 4,158, wyprzedzając Z2 Mini (3,943) i ZBook Ultra (3,915). W teście Hallbench uzyskał wynik 8,014, nieznacznie poniżej 8,477 punktów Z2 Mini, ale powyżej 7,833 punktów ZBook Ultra. Ogólnie rzecz biorąc, wyniki sugerują, że systemy zbudowane z kartą Radeon 8060S zapewniają bardzo podobną wydajność śledzenia promieni, niezależnie od formatu.
| Luxmark (Im wyżej, tym lepiej) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Ławka Hallbench | 8,014 | 8,477 | 7,833 |
| Jedzenie | 4,158 | 3,943 | 3,915 |
Kompresja 7-Zip
Test kompresji 7-Zip ocenia wydajność procesora podczas kompresji i dekompresji, mierząc wydajność w GIPS (gigainstrukcjach na sekundę) i obciążenie procesora. Wyższy GIPS i efektywniejsze wykorzystanie procesora wskazują na lepszą wydajność.
Platforma Ryzen AI Halo prowadziła we wszystkich głównych kategoriach w teście 7-Zip. Osiągnęła współczynnik kompresji 176.7 GIPS, w porównaniu do 139.3 GIPS w HP Z2 Mini i 139.6 GIPS w ZBook Ultra. Wydajność dekompresji pozostała równie wysoka, na poziomie 191.6 GIPS, przewyższając 164.0 GIPS w Z2 Mini i 174.0 GIPS w ZBook Ultra. Łącznie platforma Halo uzyskała najwyższy ogólny wynik 184.2 GIPS, przewyższając konkurencyjne systemy o około 20% i wykazując doskonałą przepustowość całkowitą w zadaniach tworzenia i ekstrakcji archiwów.
| Test kompresji 7-Zip (im wyższy, tym lepiej) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) | |||
|---|---|---|---|---|---|---|
| Ściskanie | ||||||
| Aktualne użycie procesora | 2,741% | 2,734% | 2,868% | |||
| Aktualna ocena/zastosowanie | 6.370 GIPS | 5.136 GIPS | 4.883 GIPS | |||
| Prądu | 174.589 GIPS | 140.405 GIPS | 140.061 GIPS | |||
| Wynikowe użycie procesora | 2,751% | 2,718% | 2,855% | |||
| Wynikowa ocena/wykorzystanie | 6.424 GIPS | 5.126 GIPS | 4.890 GIPS | |||
| Wynikowa ocena | 176.742 GIPS | 139.298 GIPS | 139.617 GIPS | |||
| Dekompresja | ||||||
| Aktualne użycie procesora | 2,568% | 2,343% | 2,904% | |||
| Aktualna ocena/zastosowanie | 7.670 GIPS | 6.805 GIPS | 6.029 GIPS | |||
| Prądu | 196.986 GIPS | 159.451 GIPS | 175.104 GIPS | |||
| Wynikowe użycie procesora | 2,469% | 2,414% | 2,887% | |||
| Wynikowa ocena/wykorzystanie | 7.766 GIPS | 6.793 GIPS | 6.028 GIPS | |||
| Wynikowa ocena | 191.645 GIPS | 163.969 GIPS | 174.046 GIPS | |||
| Ocena całkowita | ||||||
| Całkowite użycie procesora | 2,610% | 2,566% | 2,871% | |||
| Całkowita ocena/wykorzystanie | 7.095 GIPS | 5.959 GIPS | 5.459 GIPS | |||
| Ocena całkowita | 184.194 GIPS | 151.634 GIPS | 156.832 GIPS | |||
Test porównawczy Blendera
Blender to aplikacja do modelowania 3D o otwartym kodzie źródłowym. Ten test porównawczy został przeprowadzony za pomocą narzędzia Blender Benchmark. Wynik jest mierzony w próbkach na minutę, a wyższe wartości oznaczają lepszą wydajność.
Renderowanie CPU to kolejny obszar, w którym Ryzen AI Halo osiągnął mistrzostwo. W kategorii Monster osiągnął 244.7 próbek na minutę, wyprzedzając HP Z2 Mini (224.3) i HP ZBook Ultra (189.3). Junkshop uplasował się na drugim miejscu ze 159.4 próbek na minutę, w porównaniu ze 149.5 i 129.4, a Classroom uzyskał 131.6 próbek na minutę, przewyższając Z2 Mini (116.3) o około 13% i ZBook Ultra (94.1) o prawie 40%. Wyniki te dowodzą, że Ryzen AI Max+ 395 zapewnia doskonałą wydajność renderowania wielowątkowego pomimo kompaktowych rozmiarów stacji roboczej.
| Test procesora Blendera (liczba próbek na minutę, im wyższa liczba, tym lepiej) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Potwór | 244.7 próbek/m | 224.3 próbek/m | 189.29 próbek/m |
| Sklep ze złomem | 159.4 próbek/m | 149.5 próbek/m | 129.42 próbek/m |
| Sala szkoleniowa | 131.6 próbek/m | 116.3 próbek/m | 94.14 próbek/m |
Wyniki renderowania GPU były znacznie zbliżone w obu systemach. Platforma referencyjna Halo renderowała scenę Monster z prędkością 704.2 próbek na minutę, plasując się za Z2 Mini (745.6), ale wyprzedzając ZBook Ultra (661.5). Junkshop plasował się praktycznie na równi między platformą Halo (366.6) a Z2 Mini (366.5). Jednocześnie system Halo uzyskał najwyższy wynik w Classroom, wynoszący 361.5 próbek na minutę, nieznacznie przewyższając Z2 Mini (359.0) i ZBook Ultra (333.3). Wyniki wskazują, że Radeon 8060S zapewnia niezwykle spójną wydajność renderowania GPU we wszystkich implementacjach.
| Blender Benchmark GPU (liczba próbek na minutę, im wyższa, tym lepiej) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Potwór | 704.2 próbek/m | 745.55 próbek/m | 661.50 próbek/m |
| Sklep ze złomem | 366.6 próbek/m | 366.54 próbek/m | 341.92 próbek/m |
| Sala szkoleniowa | 361.51 próbek/m | 359.01 próbek/m | 333.26 próbek/m |
y-cruncher
y-cruncher to wielowątkowy, skalowalny program, który potrafi obliczać Pi i inne stałe matematyczne z dokładnością do bilionów cyfr. Od momentu premiery w 2009 roku, stał się popularnym narzędziem do benchmarkingu i testów obciążeniowych dla overclockerów i entuzjastów sprzętu.
Wyniki y-crunchera różnią się pod względem rozmiaru obliczeń. W przypadku obliczeń na 1 miliardzie i 2.5 miliarda cyfr, wszystkie trzy systemy ukończyły obliczenia z różnicą kilku dziesiątych sekundy, a systemy HP wyprzedziły je nieznacznie. Wraz ze wzrostem obciążenia, Halo wyprzedził system, wykonując obliczenia na 5 miliardach cyfr w 71.948 sekundy, w porównaniu z 75.021 sekundy dla Z2 Mini i 78.19 sekundy dla ZBook Ultra. Przy 10 miliardach cyfr, Halo ukończył obliczenia w 151.409 sekundy, czyli o około 6% szybciej niż Z2 Mini i 12% szybciej niż ZBook Ultra, co sugeruje, że obudowa komputera stacjonarnego lepiej radzi sobie z dużym obciążeniem wielowątkowym w miarę wydłużania się czasu obliczeń.
| Y-Cruncher (całkowity czas obliczeń) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| 1 Billion | 13.193 sekund | 12.965 sekund | 12.93 sekund |
| 2.5 Billion | 34.578 sekund | 34.533 sekund | 34.91 sekund |
| 5 Billion | 71.948 sekund | 75.021 sekund | 78.19 sekund |
| 10 Billion | 151.409 sekund | 160.252 sekund | 171.72 sekund |
Geekbench 6
Geekbench 6 to wieloplatformowy test porównawczy mierzący ogólną wydajność systemu.
Geekbench 6 potwierdził zrównoważony profil wydajności platformy Halo. Osiągnęła ona najwyższy wynik w teście jednordzeniowym – 2,986, wyprzedzając HP Z2 Mini (2,862) i ZBook Ultra (2,825). Wydajność wielordzeniowa również przewodziła w porównaniu z wynikiem 18 068. Radeon 8060S uzyskał najwyższy wynik w teście OpenCL GPU – 92 883, nieznacznie przewyższając Z2 Mini (91 591) i zdecydowanie przewyższając ZBook Ultra (85 337). Stała przewaga w testach CPU i GPU ilustruje wszechstronną wydajność platformy Ryzen AI Max+ 395.
| Geekbench 6 (im wyższy wynik, tym lepiej) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Procesor jednordzeniowy | 2,986 | 2,862 | 2,825 |
| Procesor wielordzeniowy | 18,068 | 17,210 | 17,562 |
| GPU OpenCL | 92,883 | 91,591 | 85,337 |
Cinebench R23
Cinebench R23 to powszechnie uznany test porównawczy do oceny wydajności procesora w obciążeniach renderowania 3D. Oparty na silniku Cinema 4D, mierzy, jak dobrze procesor radzi sobie z zadaniami jedno- i wielowątkowymi, oferując wgląd w ogólną responsywność i możliwości przetwarzania równoległego.
Test Cinebench R23 pokazał bardzo wyrównaną rywalizację między dwoma stacjonarnymi implementacjami Ryzen AI Max+ 395. Platforma referencyjna Halo uzyskała wynik wielordzeniowy na poziomie 37 316, wyprzedzając HP Z2 Mini z wynikiem 37 156, podczas gdy oba modele z łatwością przebiły HP ZBook Ultra z wynikiem 29 112. Wydajność pojedynczego rdzenia utrzymała się na podobnym poziomie, z wynikiem platformy Halo na poziomie 2,047, w porównaniu do 2,020 punktów w Z2 Mini i 1,984 punktów w ZBook Ultra. Chociaż przewaga nad Z2 Mini była niewielka, system Halo konsekwentnie plasował się na szczycie benchmarku.
| Cinebench R23 (im wyższa wartość, tym lepiej) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Multi-Core | 37,316 | 37,156 | 29,112 |
| Pojedynczy rdzeń | 2,047 | 2,020 | 1,984 |
Cinebench 2024
Cinebench 2024 bazuje na fundamentach R23, wprowadzając testy renderowania oparte na GPU, jednocześnie koncentrując się na wydajności CPU. W tym segmencie analizujemy wyłącznie wyniki CPU, które oferują zaktualizowany wgląd w to, jak dobrze każdy system radzi sobie z nowoczesnymi zadaniami renderowania 3D.
Nowszy benchmark Cinebench 2024 odzwierciedlał wyniki z R23. Ryzen AI Halo uzyskał najwyższy wynik w teście wielordzeniowym – 1,916 punktów, nieznacznie wyprzedzając HP Z2 Mini (1,906 punktów) i utrzymując znaczną przewagę nad HP ZBook Ultra (1,579 punktów). Wydajność pojedynczego rdzenia również okazała się korzystniejsza dla platformy Halo, uzyskując 116 punktów w porównaniu ze 112 punktami dla Z2 Mini i 111 dla ZBook Ultra. Chociaż różnice między systemami stacjonarnymi pozostały niewielkie, wyniki potwierdzają zdolność Ryzen AI Max+ 395 do konsekwentnego zapewniania najwyższej klasy wydajności renderowania procesora.
| Cinebench 2024 (im wyższy wynik, tym lepiej) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Multi-Core | 1,916 | 1,906 | 1,579 |
| Pojedynczy rdzeń | 116 | 112 | 111 |
Testy porównawcze Phoronix
Phoronix Test Suite to zautomatyzowana platforma testowa typu open source, która obsługuje ponad 450 profili testowych i ponad 100 pakietów testowych za pośrednictwem OpenBenchmarking.org. Obsługuje ona wszystko, od instalowania zależności, przez uruchamianie testów, po zbieranie wyników, co czyni ją idealną do porównywania wydajności, walidacji sprzętu i ciągłej integracji. Przyjrzymy się wydajności w testach Stream, 7-Zip i LLVM.
Analizując zestaw testów porównawczych Phoronix, zaobserwowaliśmy dość równy podział między platformą AMD Ryzen AI Halo a NVIDIA DGX Spark. System Ryzen AI Halo konsekwentnie przewodził obciążeniom skoncentrowanym na procesorze, przewyższając DGX Spark o 11% w kompresji 7-Zip, o 38% w dekompresji 7-Zip i kończąc test kompilacji LLVM o 14% szybciej. Z drugiej strony, DGX Spark wykazał się większą stałą przepustowością pamięci, wyprzedzając testy STREAM Scale, Triad i Add odpowiednio o 17%, 13% i 15%. Halo zachowało 18% przewagę w teście STREAM Copy, co pokazuje, że chociaż oba systemy są bardzo wydajne, platforma Ryzen AI Halo faworyzuje wydajność obliczeniową ogólnego przeznaczenia, podczas gdy DGX Spark wykazuje wyższą przepustowość w obciążeniach skoncentrowanych na przepustowości pamięci.
| Testowanie | AMD Ryzen AI Halo | NVIDIA® DGX Spark® | Zwycięzca |
|---|---|---|---|
| Kompresja 7-Zip (MIPS) | 186,921 | 169,052 | Aureola (+11%) |
| Dekompresja 7-Zip (MIPS) | 146,109 | 106,084 | Aureola (+38%) |
| Kopiowanie strumieniowe (MB/s) | 145,363 | 123,730 | Aureola (+18%) |
| Skala STREAM (MB/s) | 110,611 | 128,970 | Iskra (+17%) |
| STREAM Triad (MB/s) | 107,105 | 121,433 | Iskra (+13%) |
| STREAM Dodaj (MB/s) | 107,022 | 122,815 | Iskra (+15%) |
| Kompilacja LLVM (Make, Seconds) | 431.8 | 504.3 | Halo (14% szybszy) |
Wskaźnik wydajności FIO
Do pomiaru wydajności pamięci masowej w oparciu o typowe wskaźniki branżowe, używamy narzędzia fio. Nasz tradycyjny test dysków SSD zakłada, że każdy dysk jest traktowany jako dysk dodatkowy z dwoma pełnymi zapełnieniami; w tym przypadku testowaliśmy każdy dysk w systemie, poprzez system plików. Wcześniej testowaliśmy systemy NVIDIA z GDSIO, ale AMD nie oferuje porównywalnego testu pamięci masowej bezpośrednio na GPU, więc uruchomienie narzędzia fio na poziomie systemu plików na obu platformach stawia je na równych warunkach, co ma większe znaczenie niż testowanie dysków oddzielnie.
Zarówno NVIDIA DGX Spark (Founders Edition), jak i AMD Ryzen AI Halo są dostarczane z dyskiem PCIe Gen5, więc teoretycznie obie platformy mają identyczne limity przepustowości. W praktyce jednak dysk Halo działa w tym systemie z prędkością łącza PCIe Gen4, co ogranicza dostępną przepustowość znacznie poniżej możliwości samego dysku. To ograniczenie prędkości łącza warto mieć na uwadze w tej sekcji, ponieważ stanowi ono znaczną część różnicy w przepustowości między obiema platformami.
W tej sekcji skupiamy się na następujących wskaźnikach FIO:
- 128K sekwencyjny
- 64K Losowo
- 16K sekwencyjny
- 16K Losowo
- 4K Losowo
128K Sekwencyjny odczyt
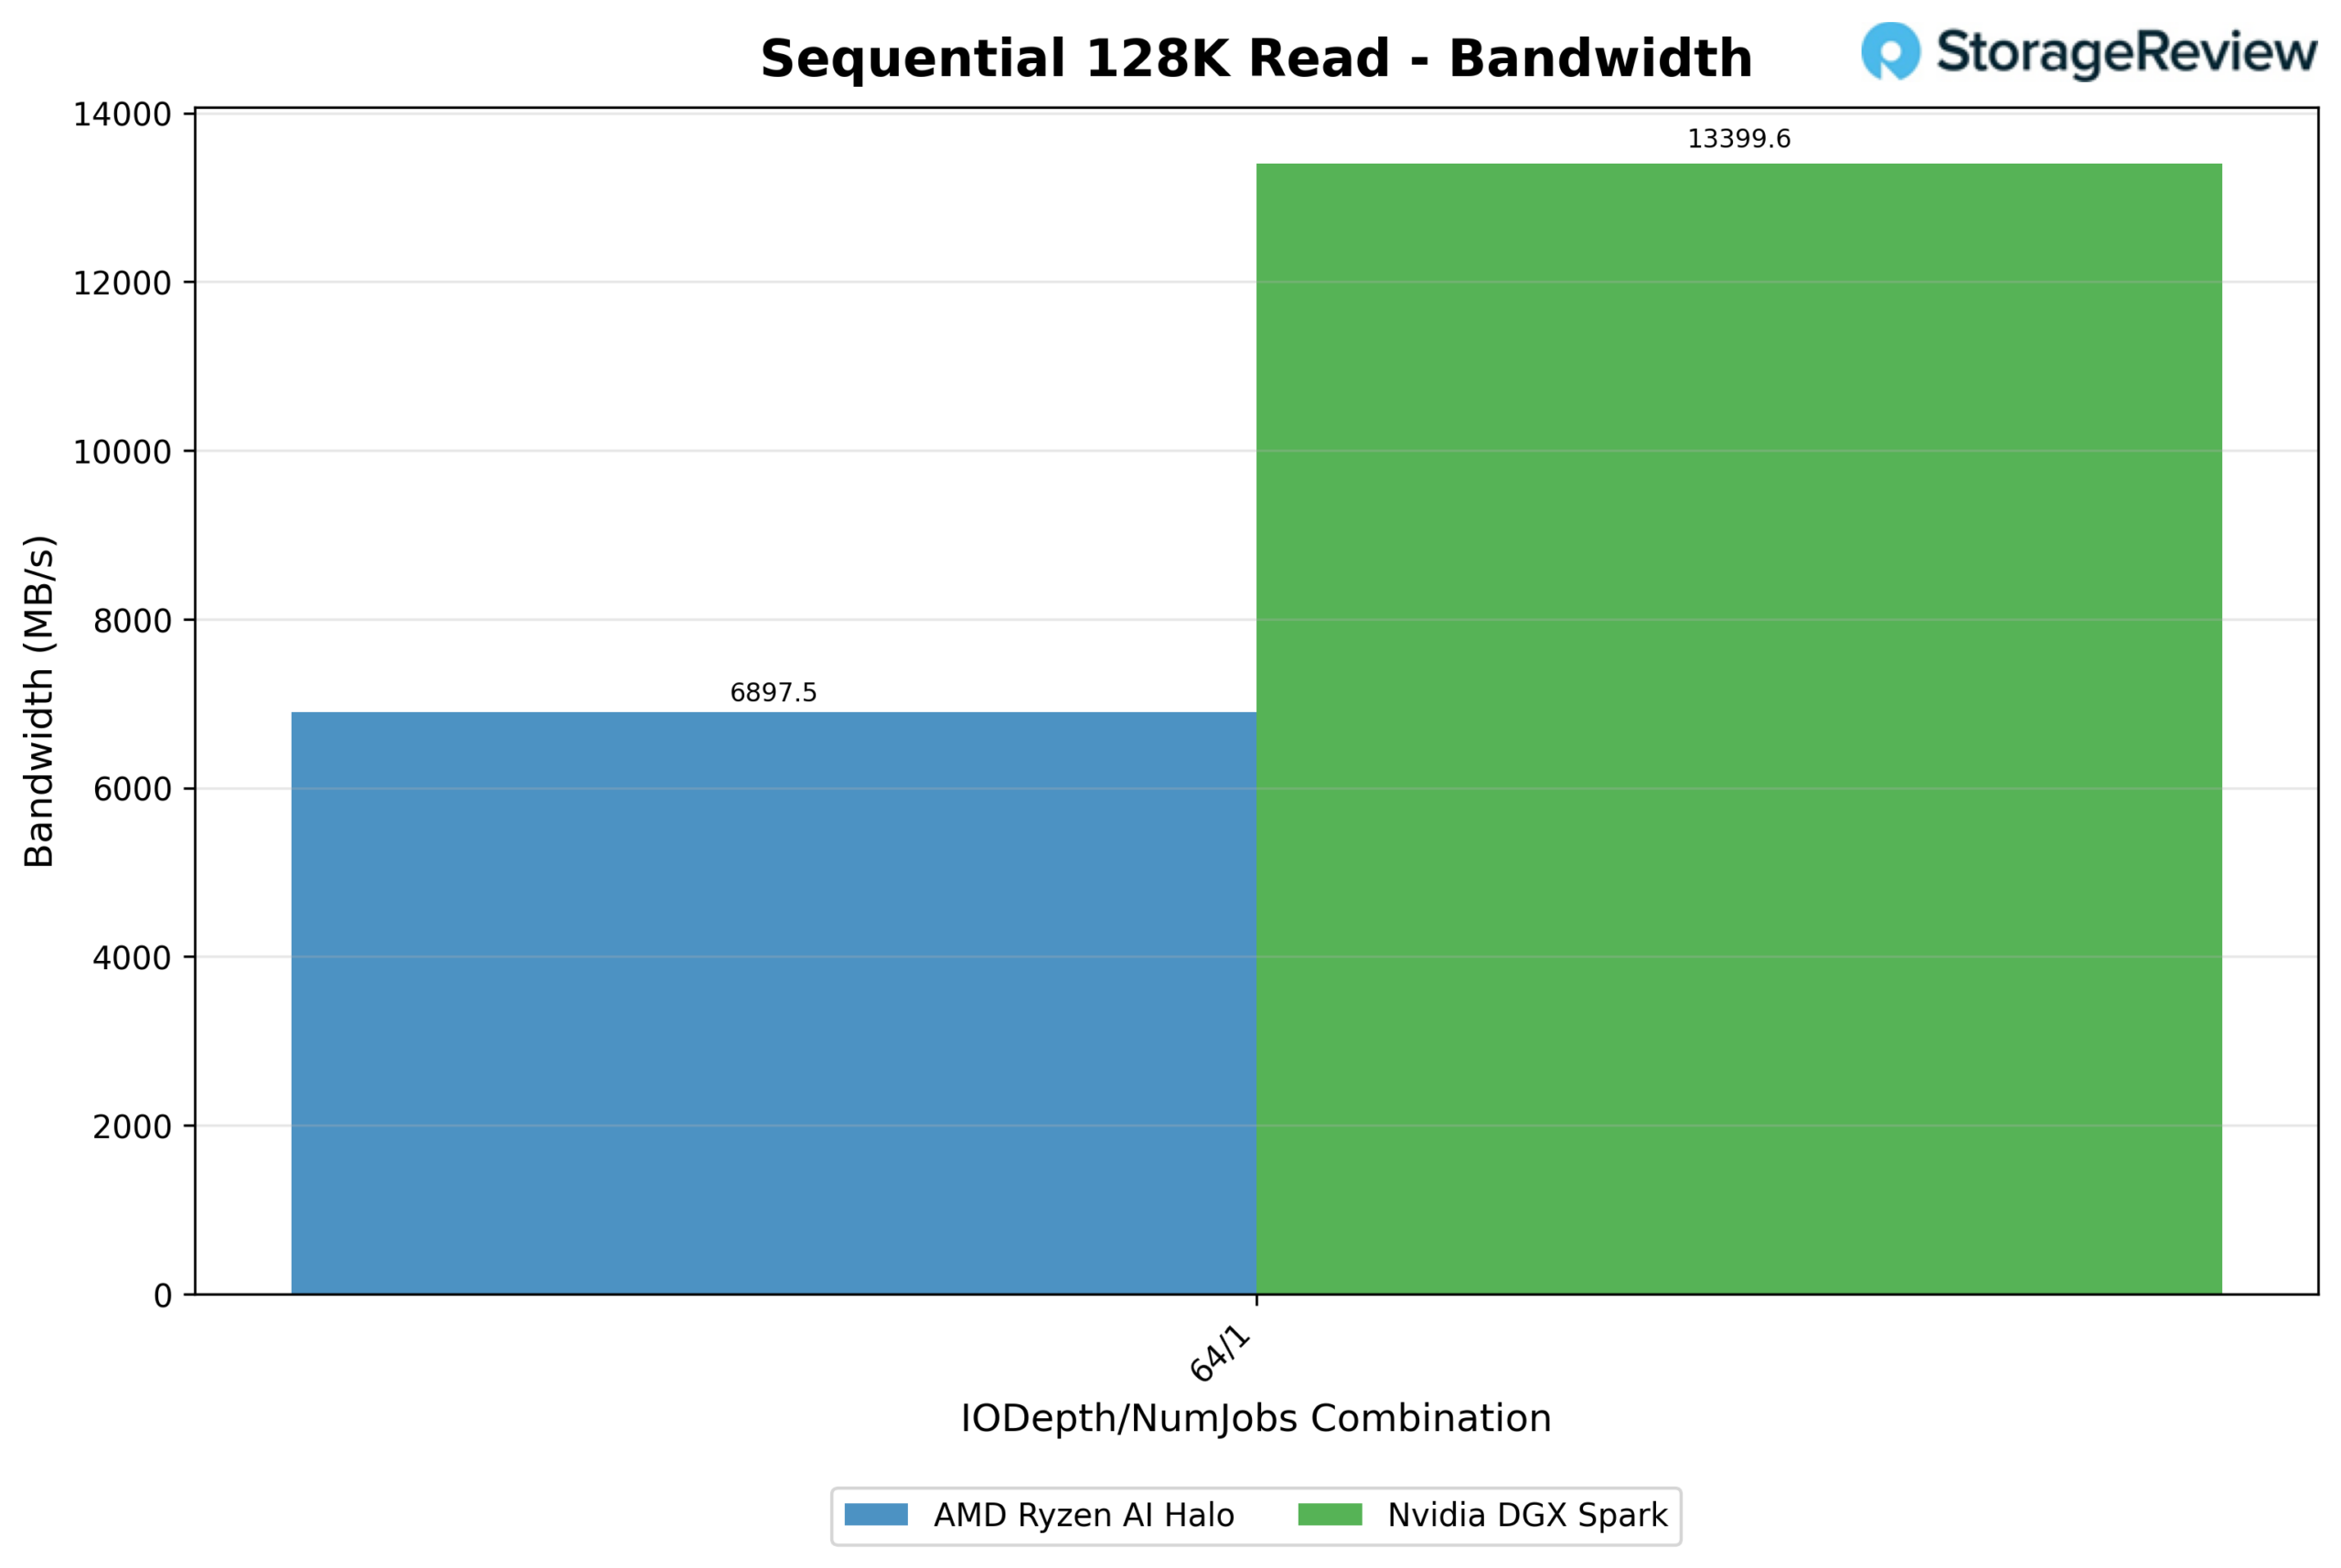
Przy jednowątkowym, głębokim odczycie sekwencyjnym 128 KB (64/1), NVIDIA DGX Spark uzyskała 13 399,6 MB/s, prawie dwukrotnie więcej niż 6,897.5 MB/s AMD Ryzen AI Halo. Opóźnienie wykazywało ten sam wzorzec: średnie opóźnienie Sparka na tej głębokości wyniosło 0.597 ms, podczas gdy Halo pozostawało w tyle, osiągając 1.159 ms, prawie dwukrotnie wolniej na żądanie, pomimo przesyłania połowy danych. Jest to najwyraźniejsza różnica w całym przebiegu, sugerująca, że stos pamięci masowej Sparka został zaprojektowany z myślą o wyższej, stałej przepustowości sekwencyjnej przy tym rozmiarze bloku.
128K Sekwencyjny zapis
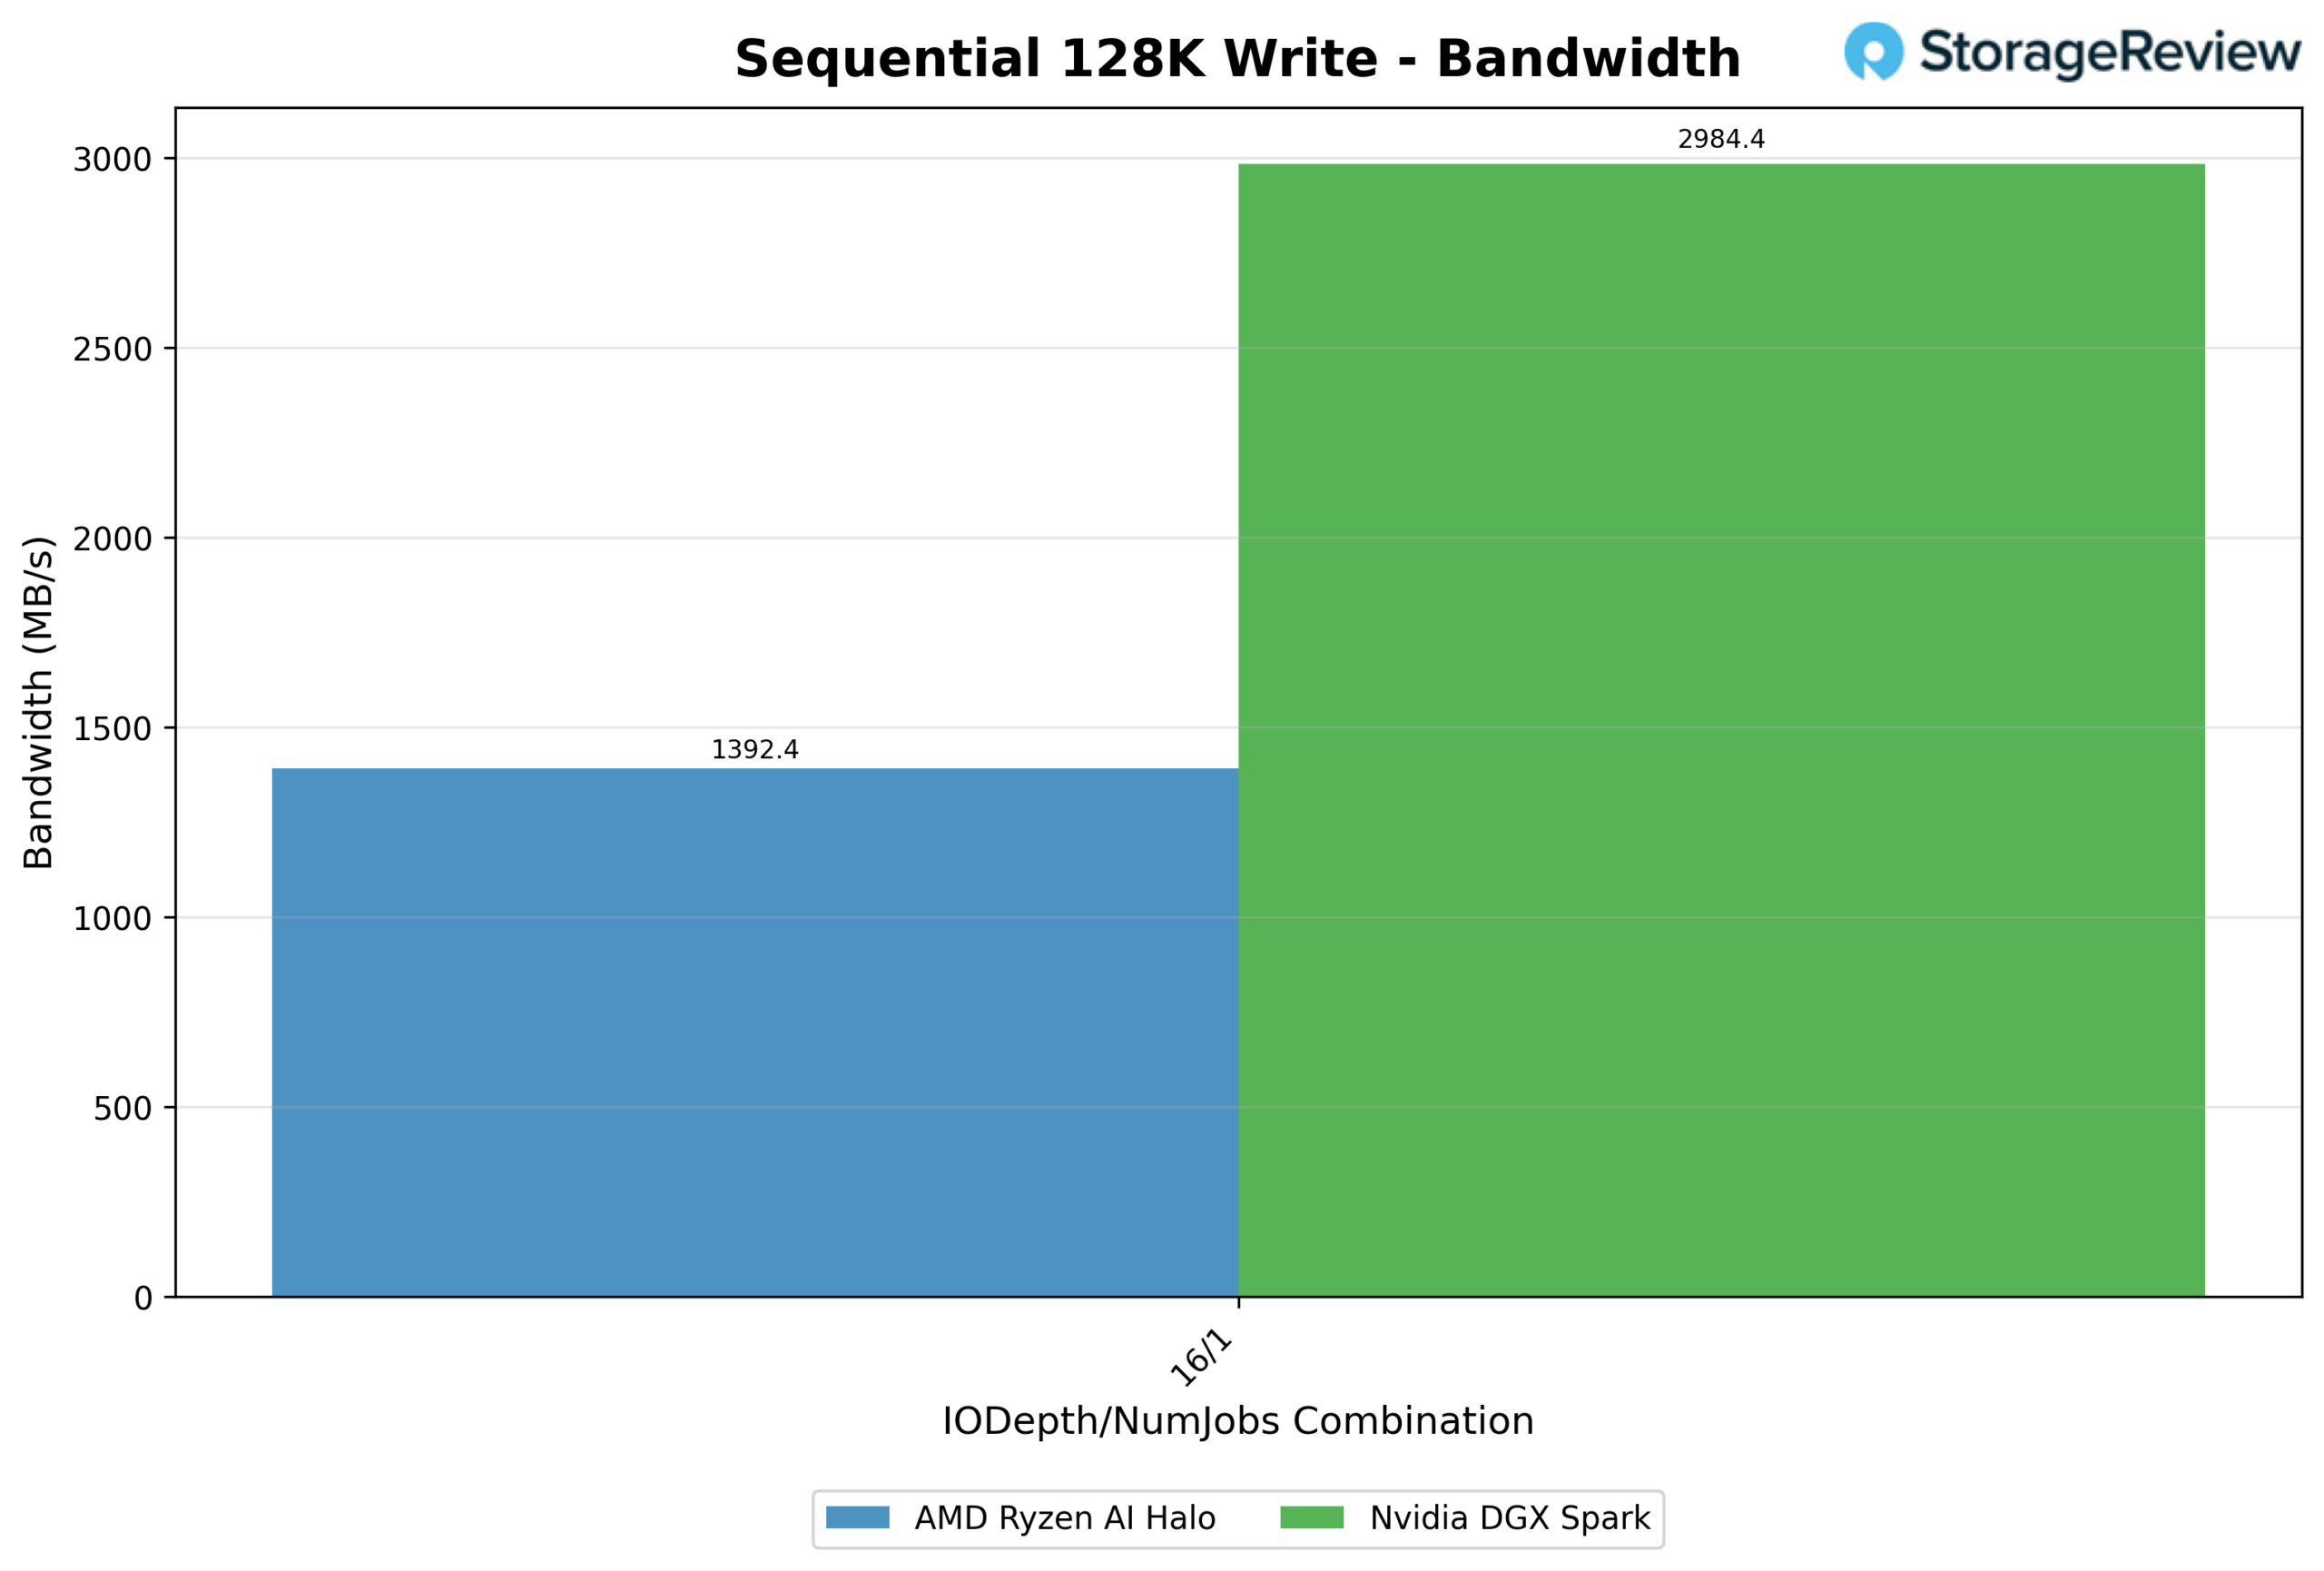
Podobnie przedstawia się sytuacja po stronie zapisu. Przy IODepth 16/1, Spark osiągnął 2,984.4 MB/s, w porównaniu z 1,392.4 MB/s w Halo, co daje 114% przewagi dla NVIDIA. Opóźnienie ponownie okazało się korzystne dla Sparka, wynosząc 0.67 ms w porównaniu z 1.436 ms w Halo. W połączeniu z wynikami odczytu, sekwencyjny odczyt 128 KB jest zdecydowanie najsilniejszym wynikiem Sparka w porównaniu z Halo.
Odczyt losowy 64K
To właśnie tutaj ujawnia się przewaga Halo w zakresie opóźnień przy niskiej głębokości kolejki. Przy ustawieniu 1/1, Halo odpowiedziało w zaledwie 0.051 ms, w porównaniu z 0.275 ms w przypadku Spark, co oznacza ponad 5-krotnie krótszy czas oczekiwania na pojedyncze oczekujące żądanie. Ta różnica utrzymuje się w przypadku niskich i średnich głębokości kolejek, przy czym Halo śledził opóźnienia znacznie poniżej 0.2 ms, podczas gdy Spark przez większość czasu utrzymywał się w zakresie 0.2–0.45 ms.
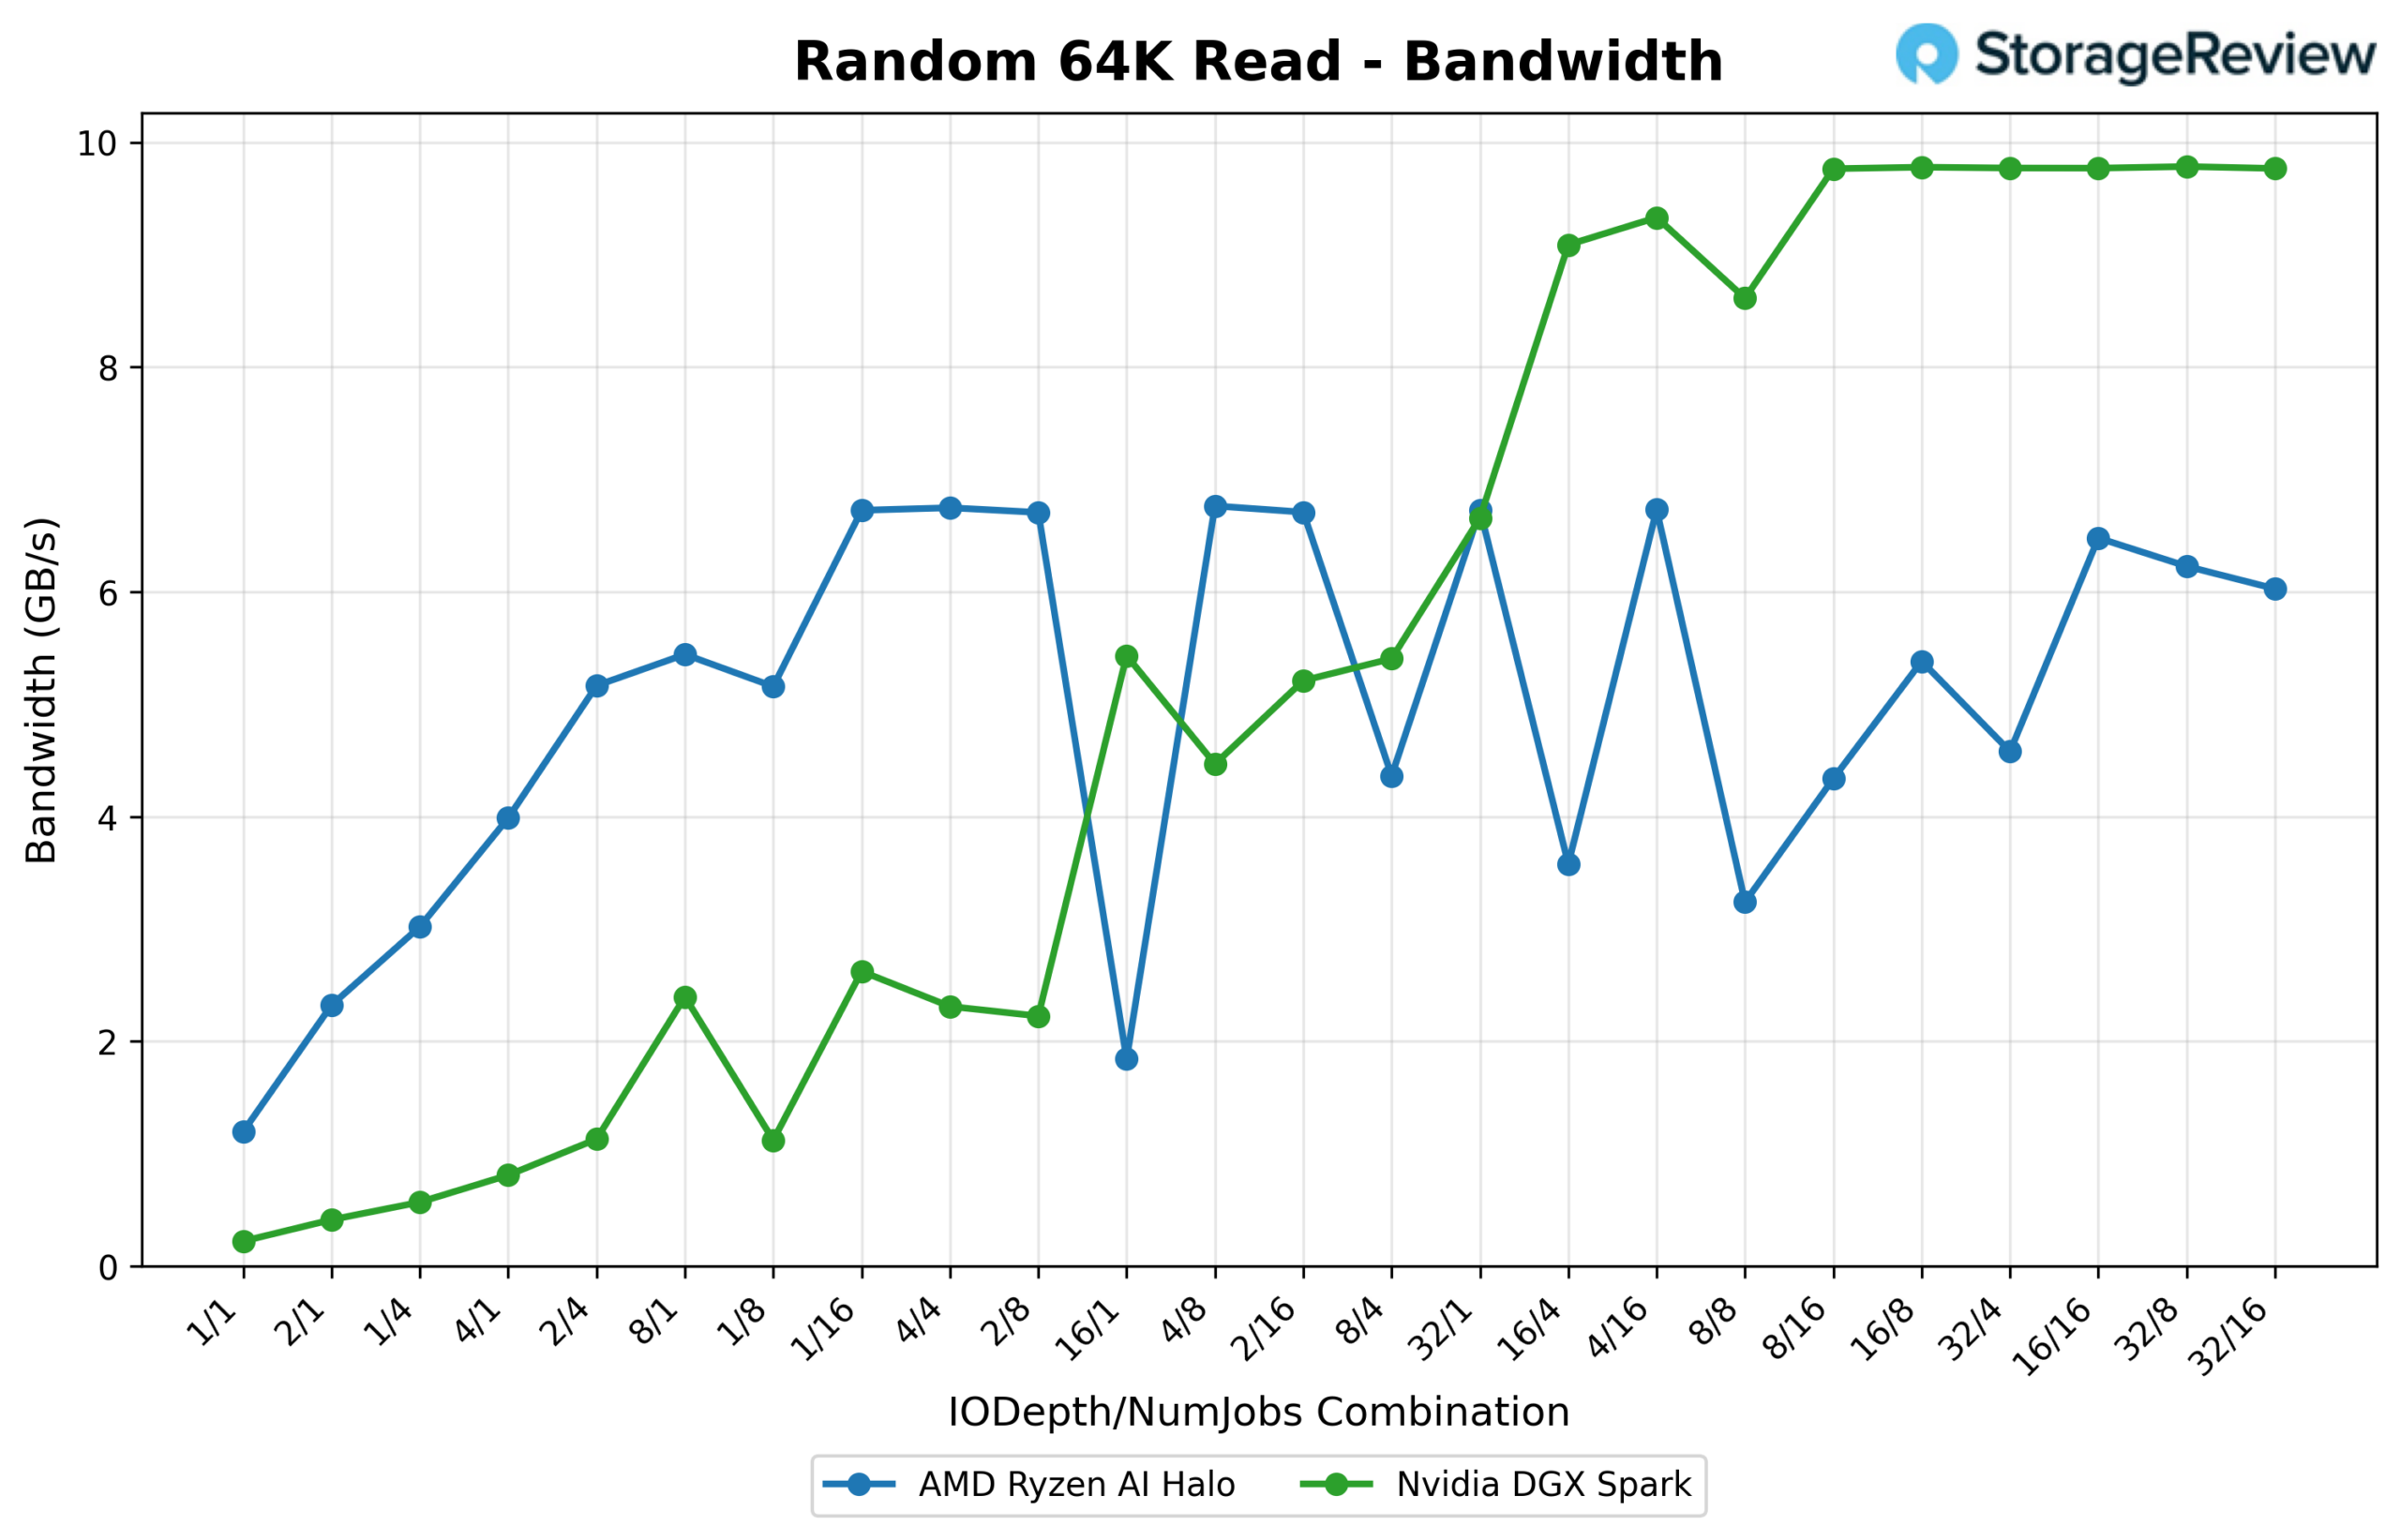
Sytuacja zmienia się jednak w zależności od skali. Gdy głębokość kolejki i liczba wątków przekraczają około 16/4, przepustowość Sparka odrywa się od niej i osiąga plateau około 9.8 GB/s od 8/16, osiągając szczyt na poziomie 10 019,1 MB/s (160.3 tys. IOPS) przy 32/8. Halo nigdy nie osiąga tego pułapu: oscyluje w zakresie 6.0–6.9 GB/s, osiągając szczyt na poziomie 6,926.5 MB/s (110.8 tys. IOPS) przy 4/8. Jego krzywa przepustowości jest zauważalnie bardziej nieregularna, oscylując między około 2 a 6.8 GB/s w zależności od kombinacji głębokości/wątku, zamiast płynnie rosnąć.
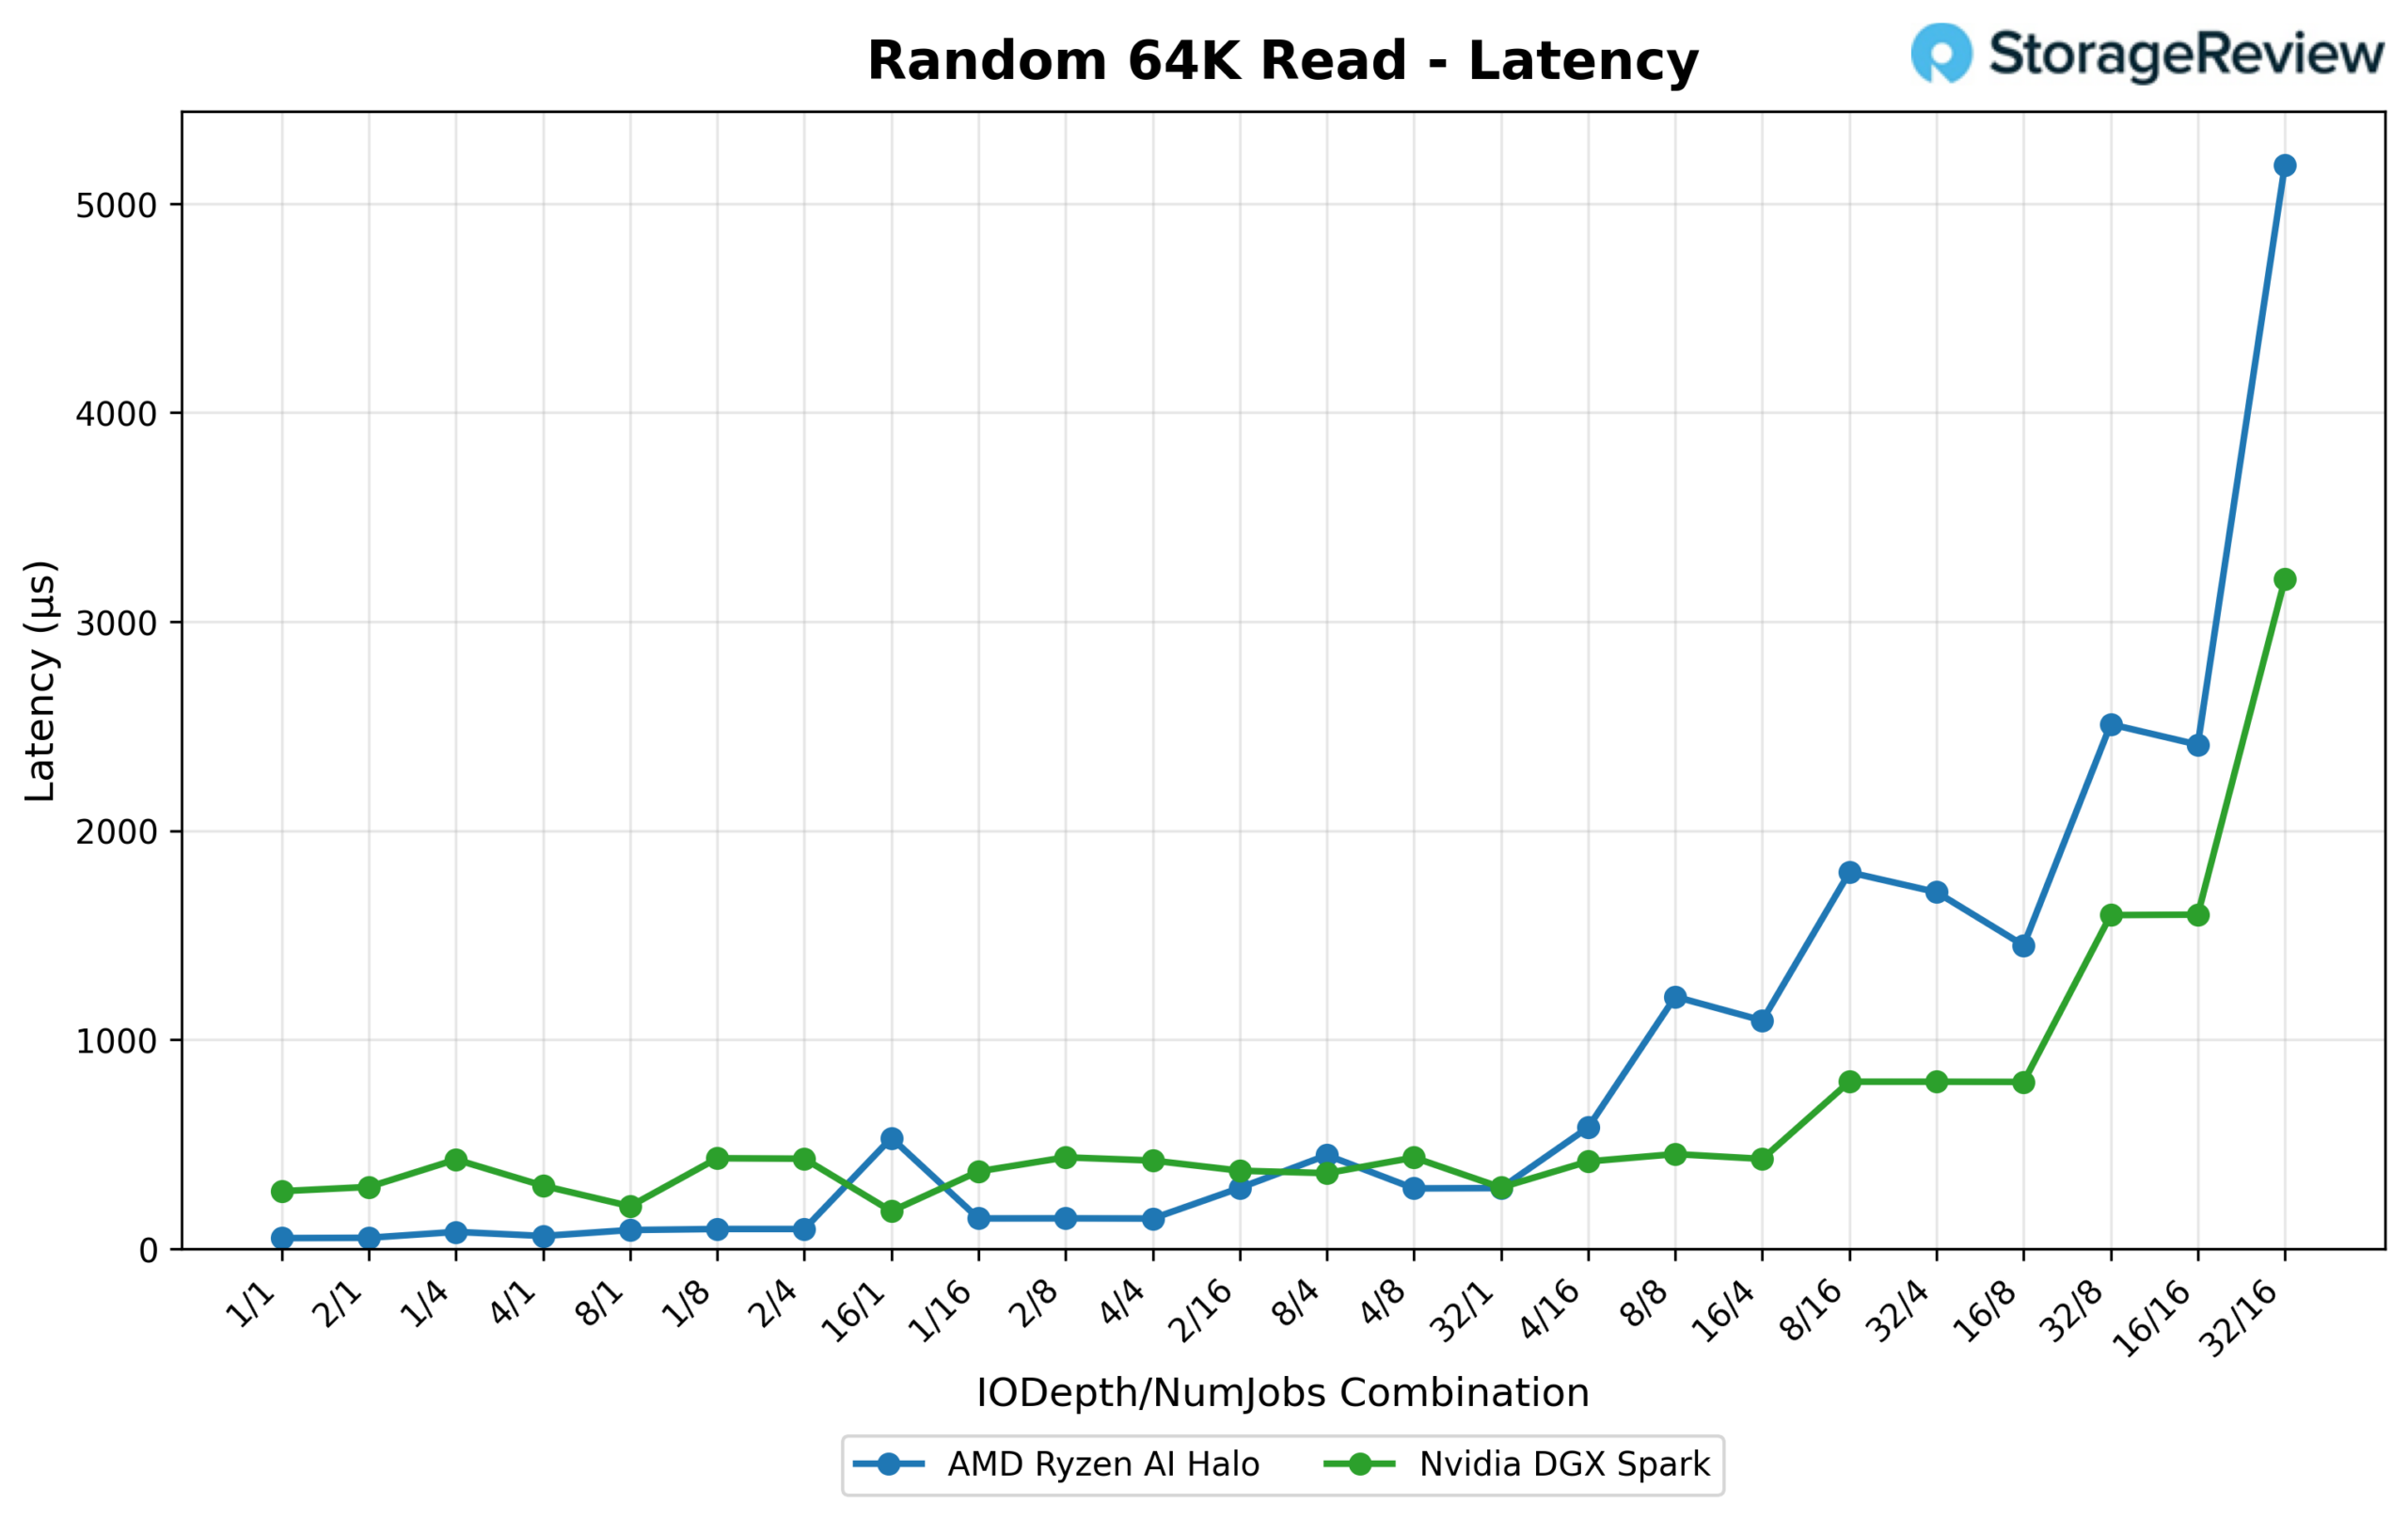
Opóźnienie przy pełnym nasyceniu również działa na korzyść Sparka: przy 32/16 średnie opóźnienie Halo wzrasta do 5.185 ms, w porównaniu z 3.204 ms w przypadku Sparka, co oznacza, że Halo płaci za niską szybkość reakcji przy dużej głębokości kolejki gorszym zachowaniem ogona, gdy kolejka jest w pełni załadowana.
Losowy zapis 64K
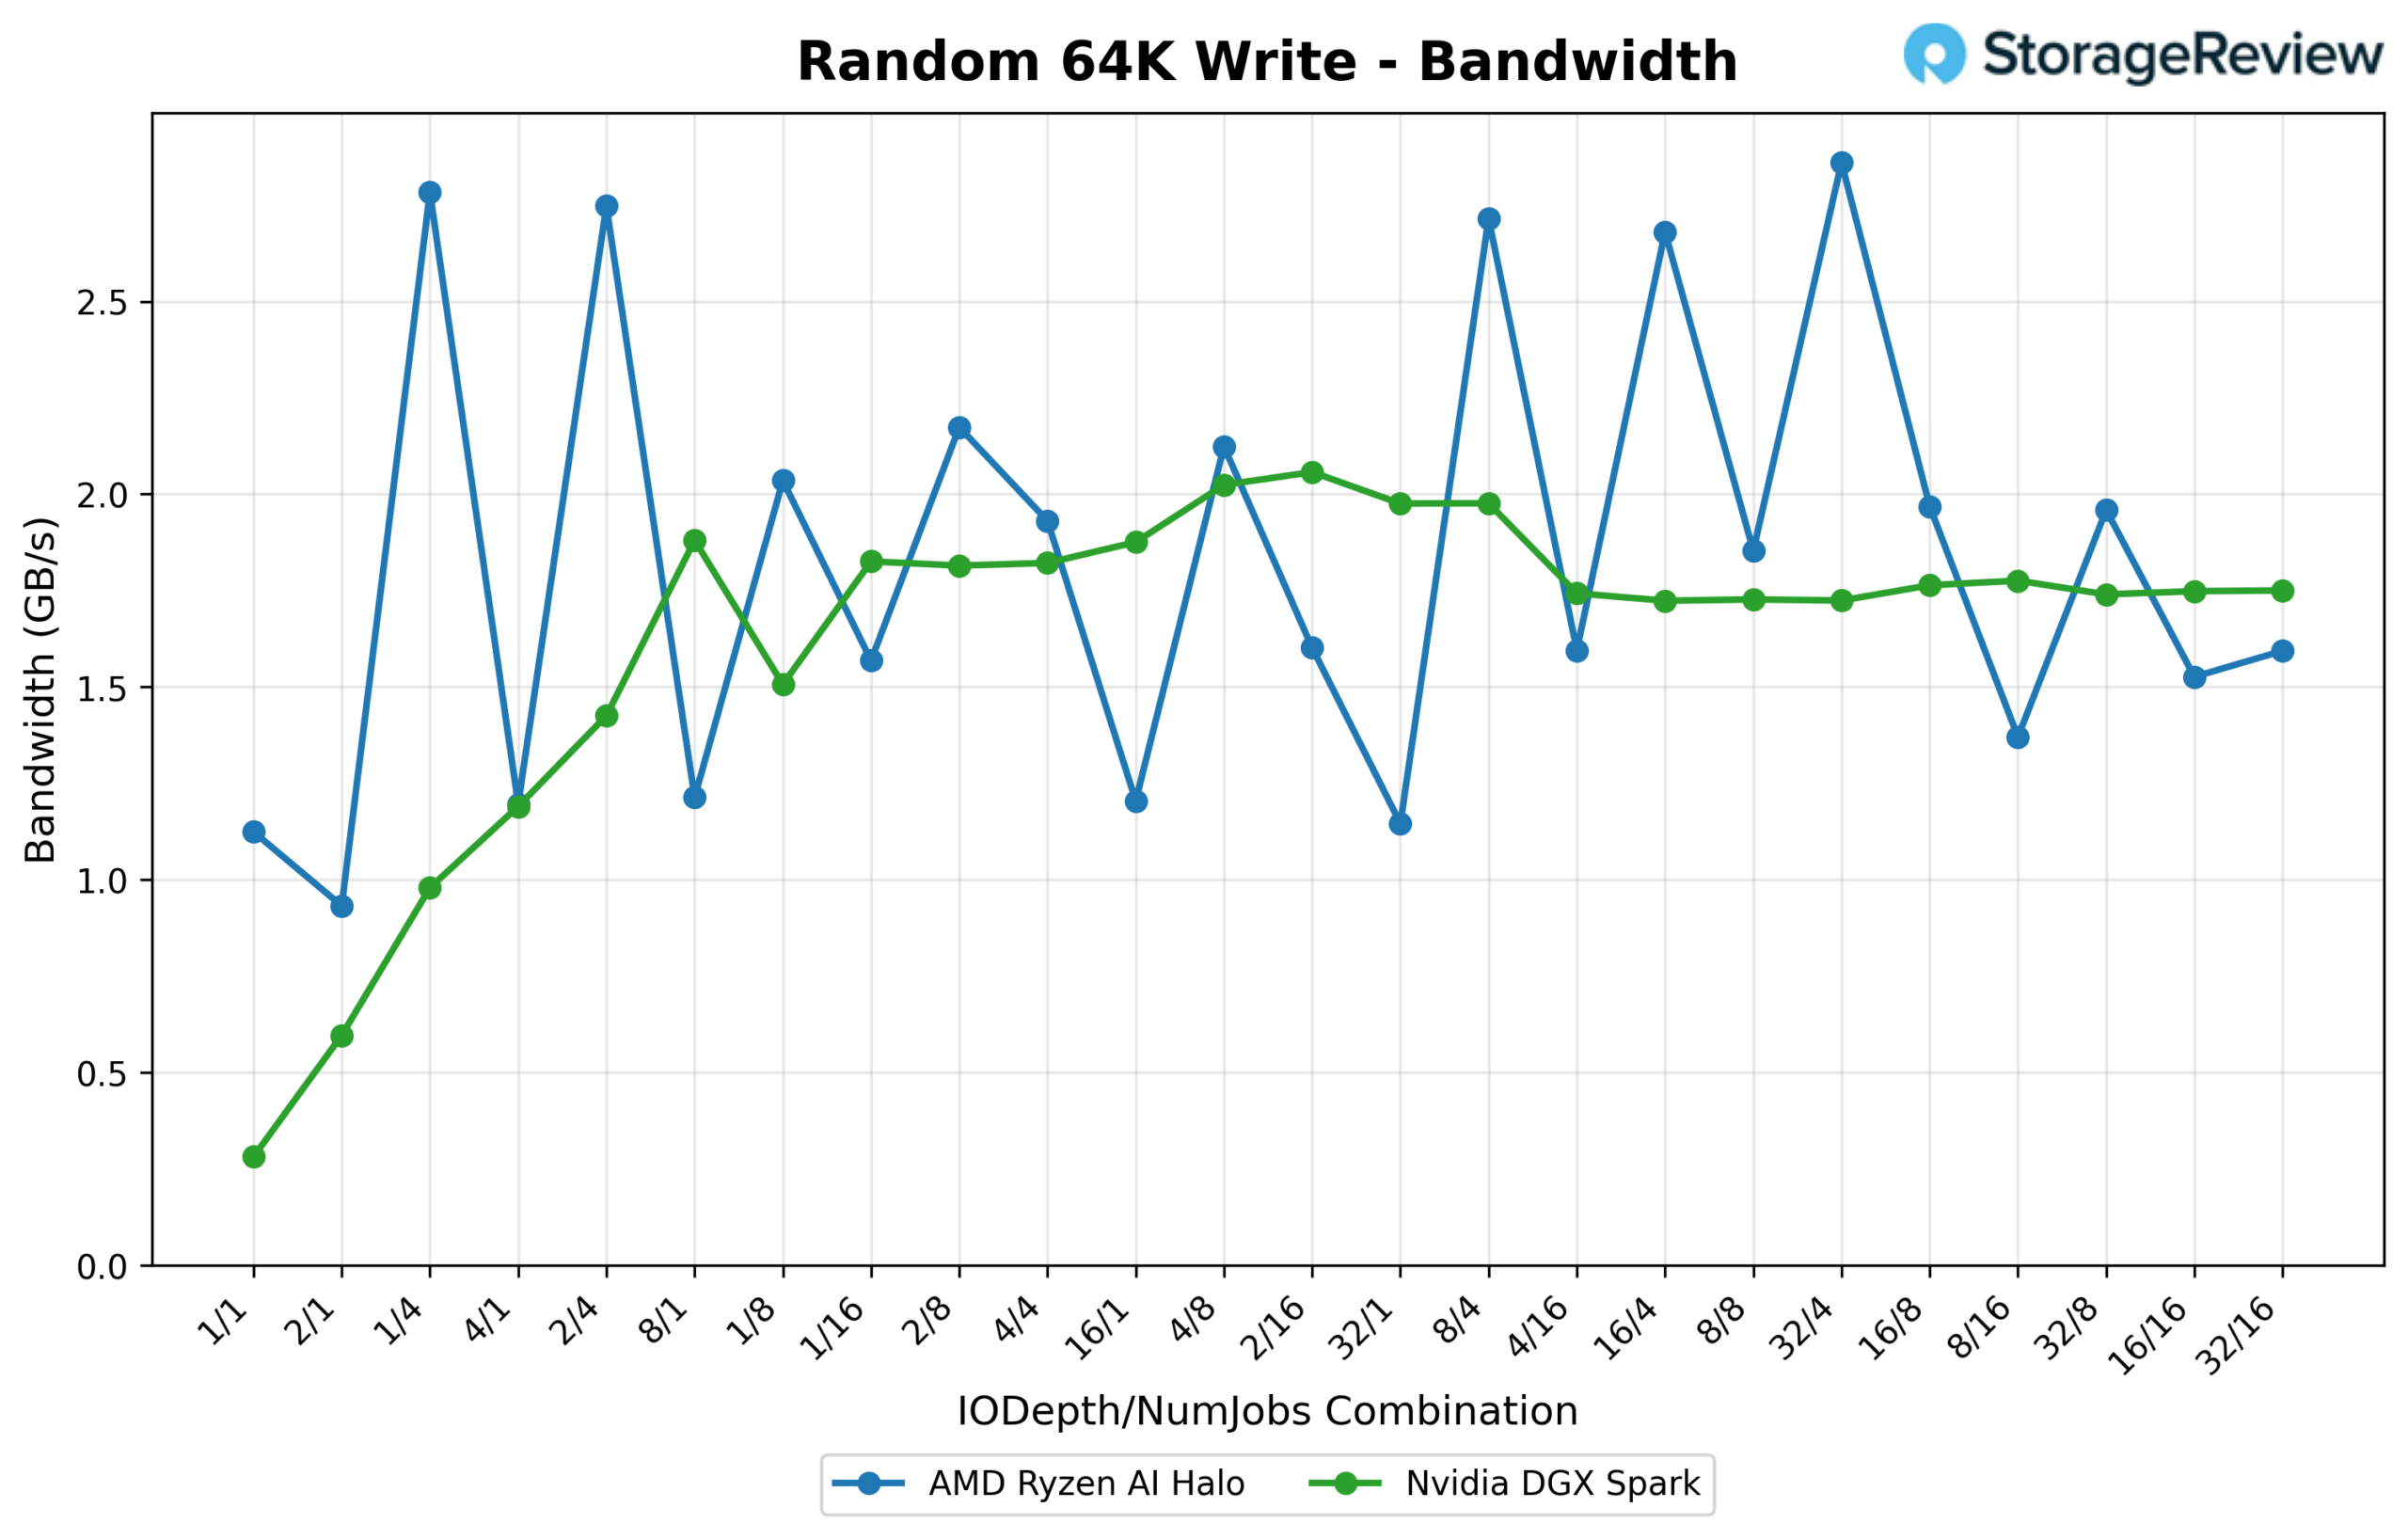
Przepustowość losowego zapisu 64 KB jest bliższa przepustowości odczytu na obu platformach, choć kształty krzywych są bardzo różne. Przepustowość Halo jest bardziej dynamiczna: wielokrotnie przekracza 2.5 GB/s (osiągając szczyt 2,929.1 MB/s / 46.9 tys. IOPS przy 32/4), po czym spada do zakresu 1.1–1.5 GB/s w sąsiednich kombinacjach. Spark jest stosunkowo stabilny, utrzymując się w paśmie 1.7–2.0 GB/s przez większość czasu i osiągając szczyt 2,106.6 MB/s (33.7 tys. IOPS) przy 2/16.
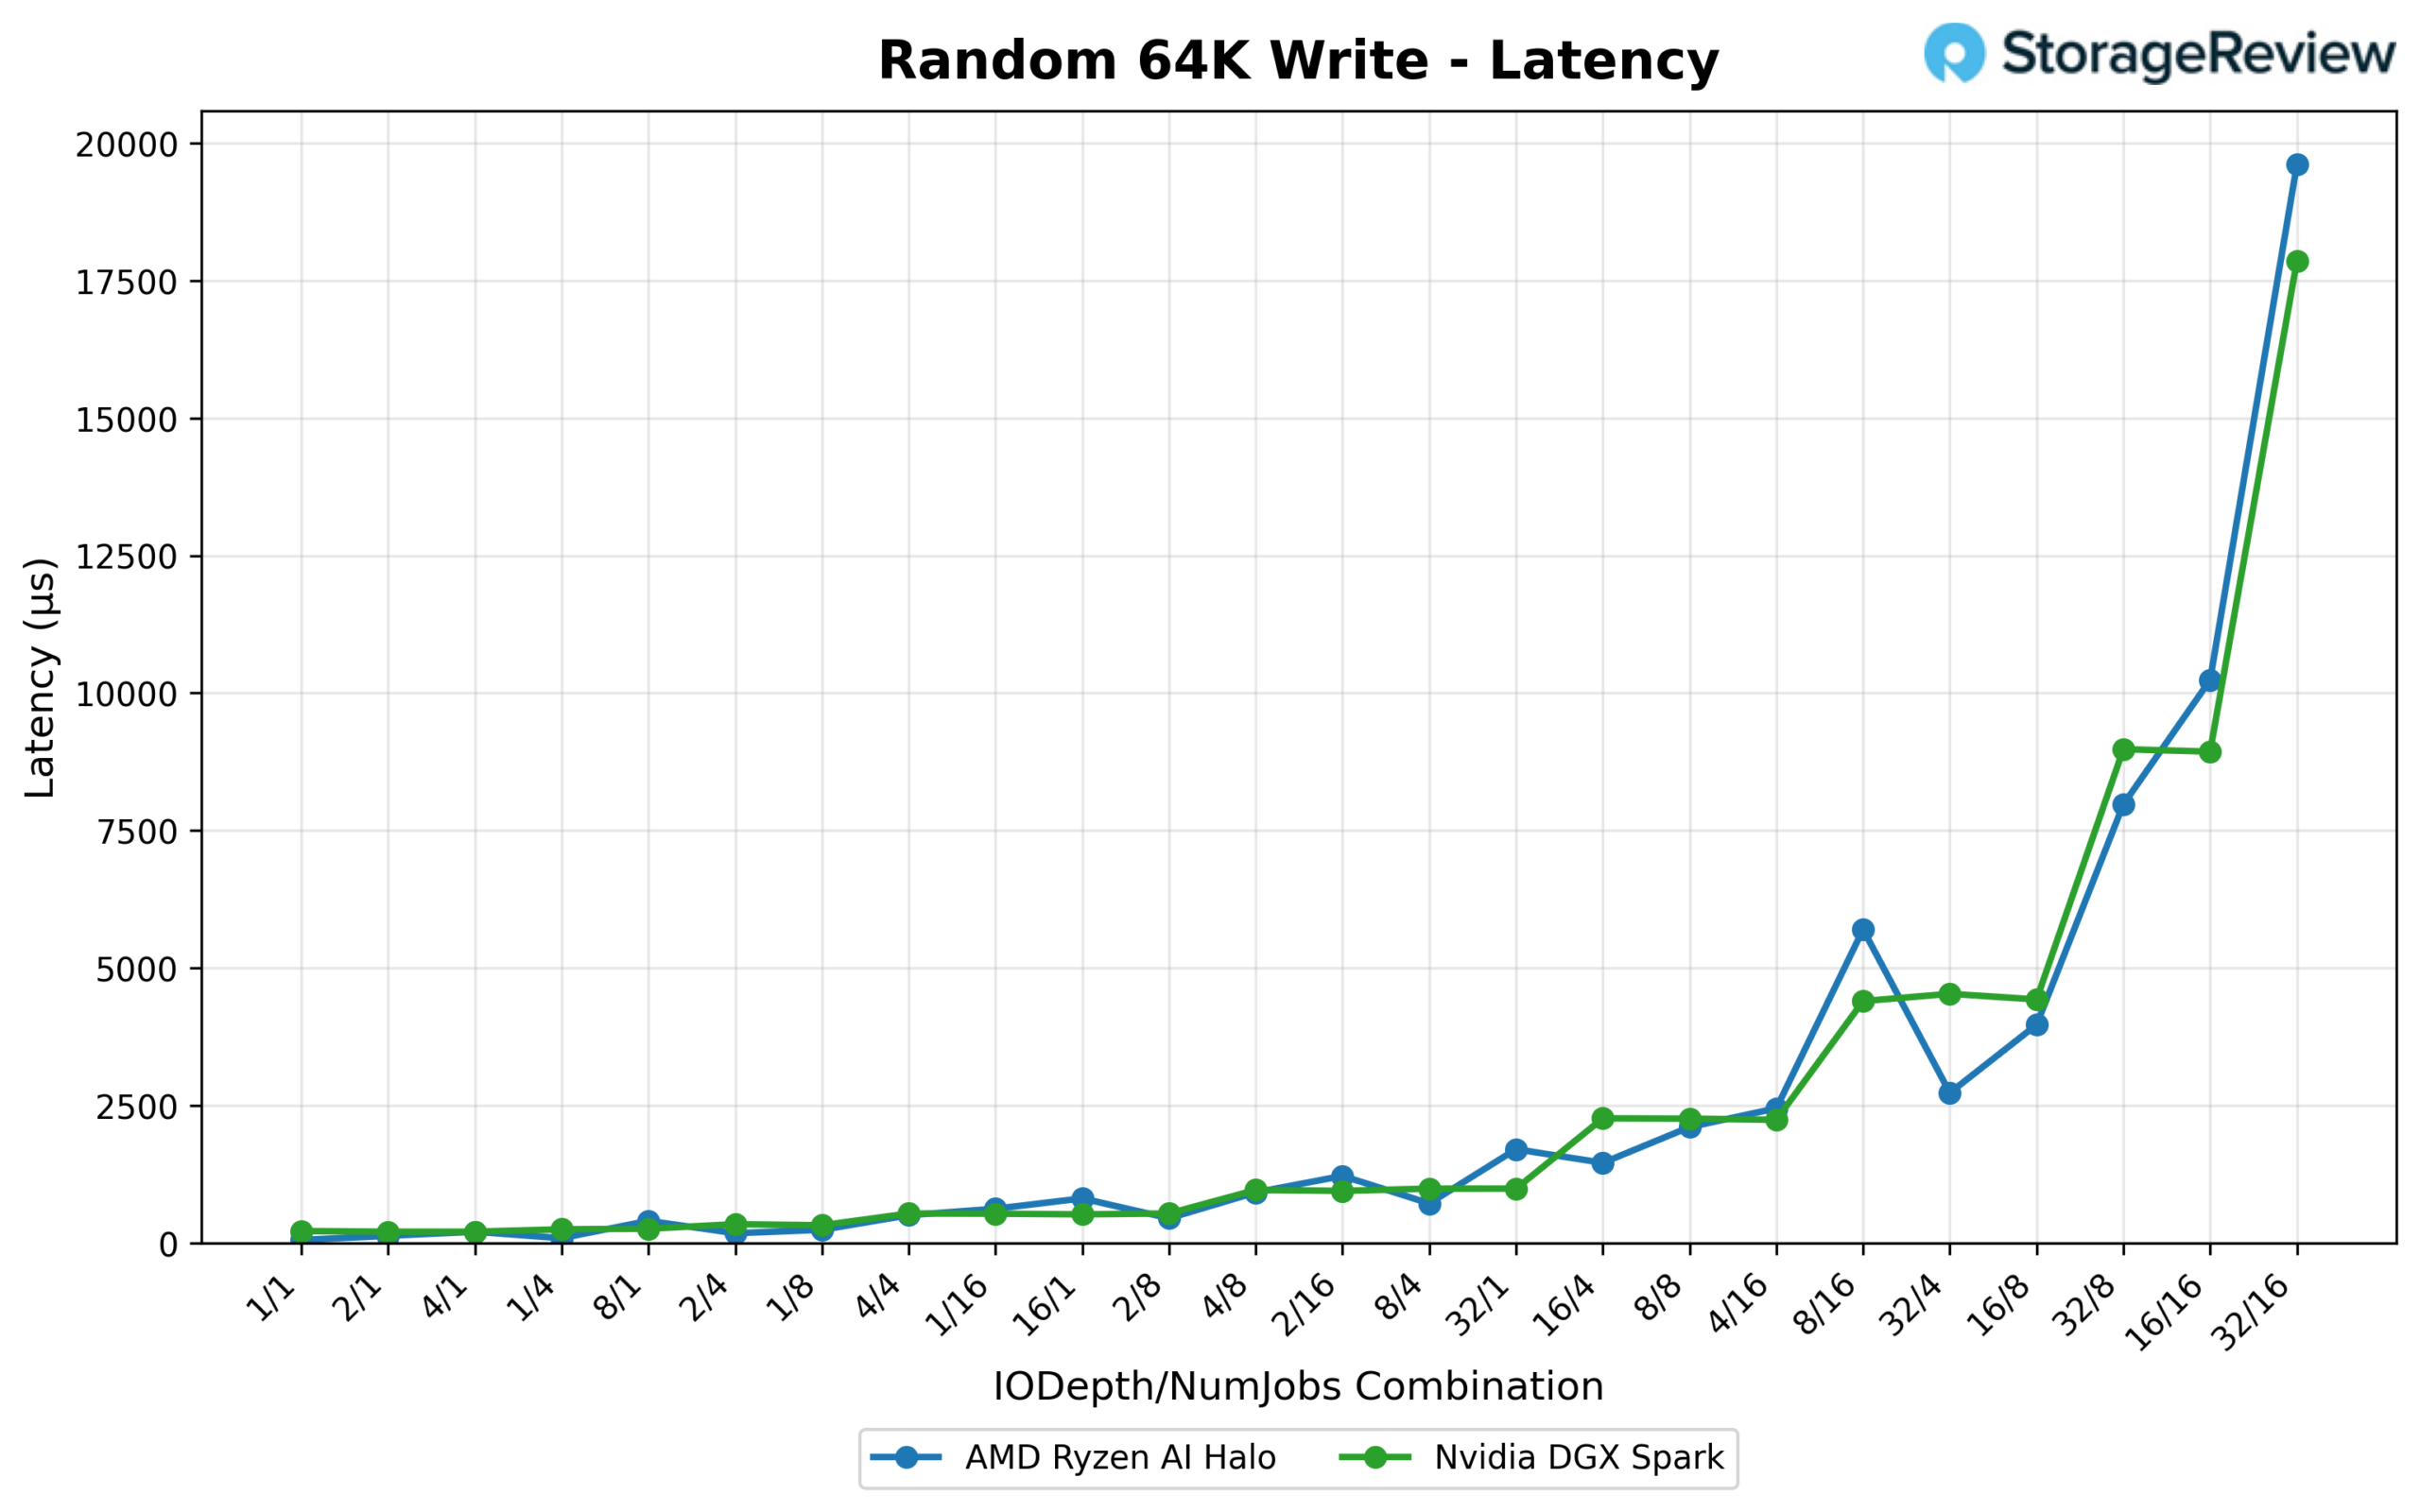
Opóźnienie odzwierciedla wzorzec odczytu 64 KB: Halo jest znacznie szybszy przy niskiej głębokości kolejki (0.054 ms przy 1/1 w porównaniu z 0.217 ms dla Spark), a oba dyski gwałtownie tracą wydajność, gdy głębokość kolejki i liczba wątków rosną do dwucyfrowych wartości. Przy pełnym nasyceniu (32/16) opóźnienie Halo sięga 19.611 ms, w porównaniu z 17.857 ms dla Spark. Oba dyski są w tym momencie wyraźnie obciążone dużym wzmocnieniem zapisu, a Halo ponownie wypada nieco gorzej na samym szczycie krzywej.
16K Sekwencyjny odczyt
Przepustowość utrzymuje się na wysokim poziomie przez większość czasu, przy czym oba dyski osiągają prędkość rzędu 1–8 GB/s, w zależności od kombinacji głębokości/wątku. Spark wyprzedza wyższy szczyt, osiągając 8,069.3 MB/s (516.4 tys. IOPS) przy 32/1, podczas gdy Halo osiąga szczyt na poziomie 6,715.8 MB/s (429.8 tys. IOPS) przy 8/4.
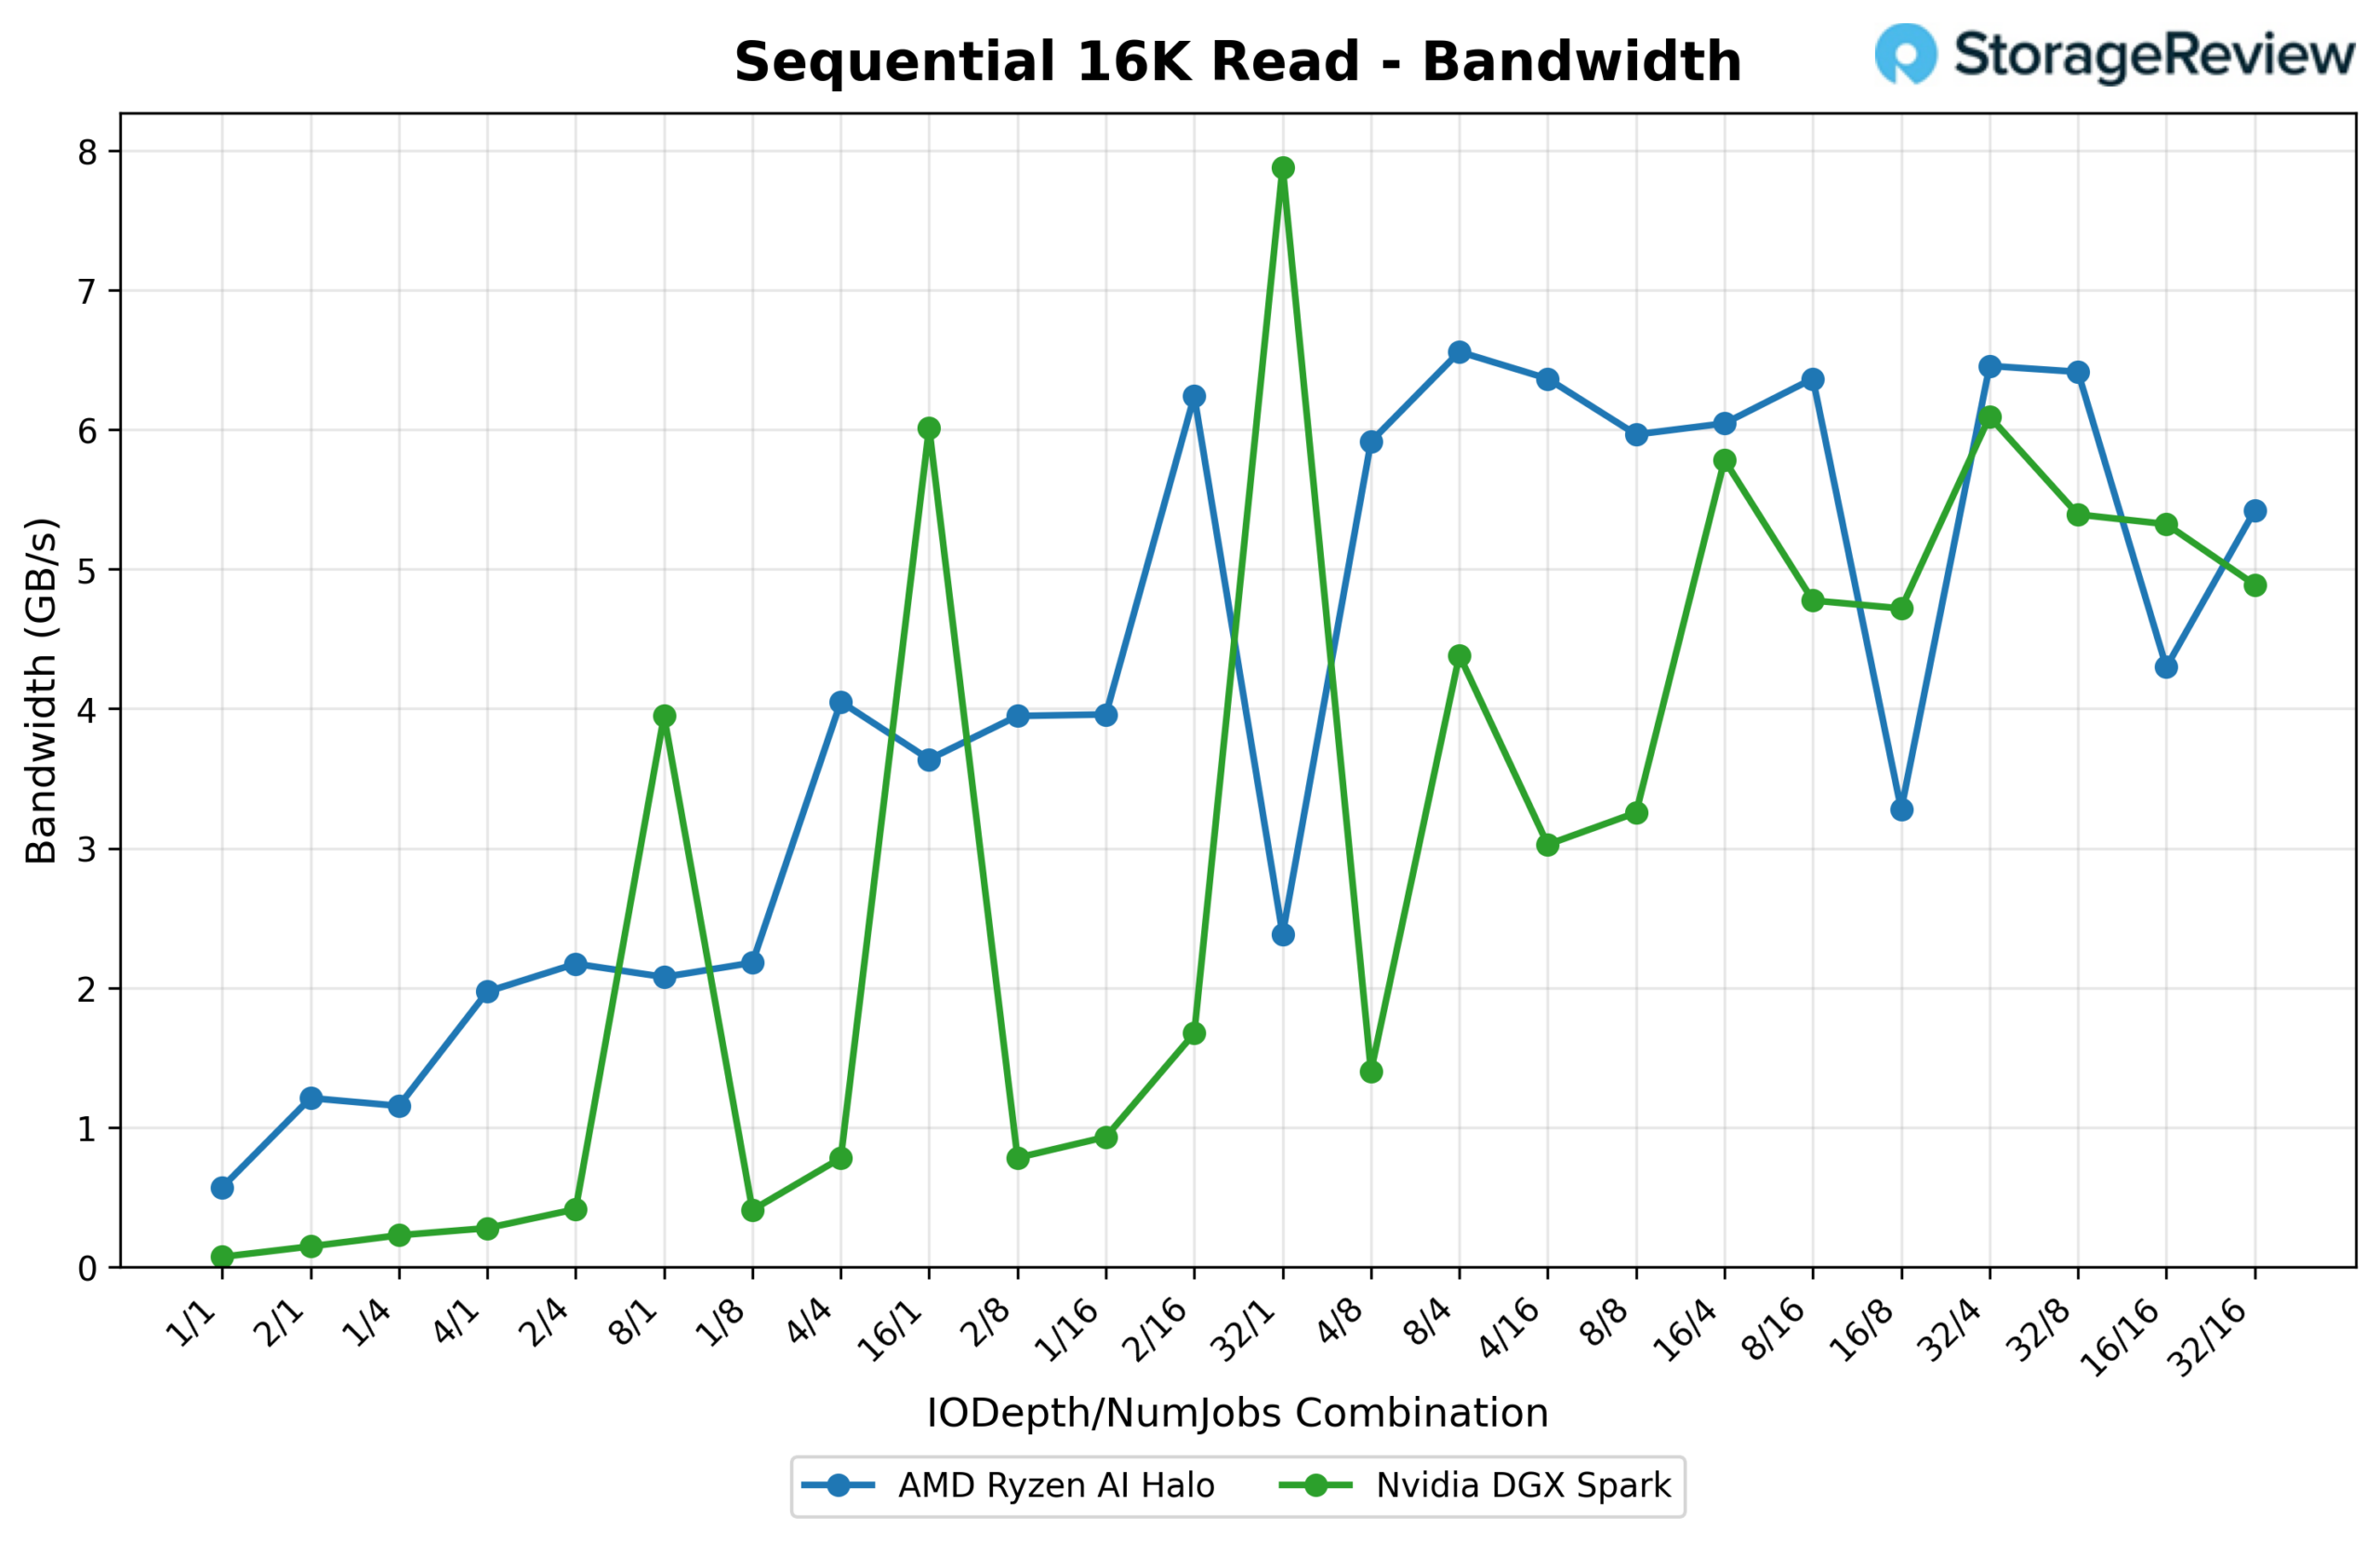
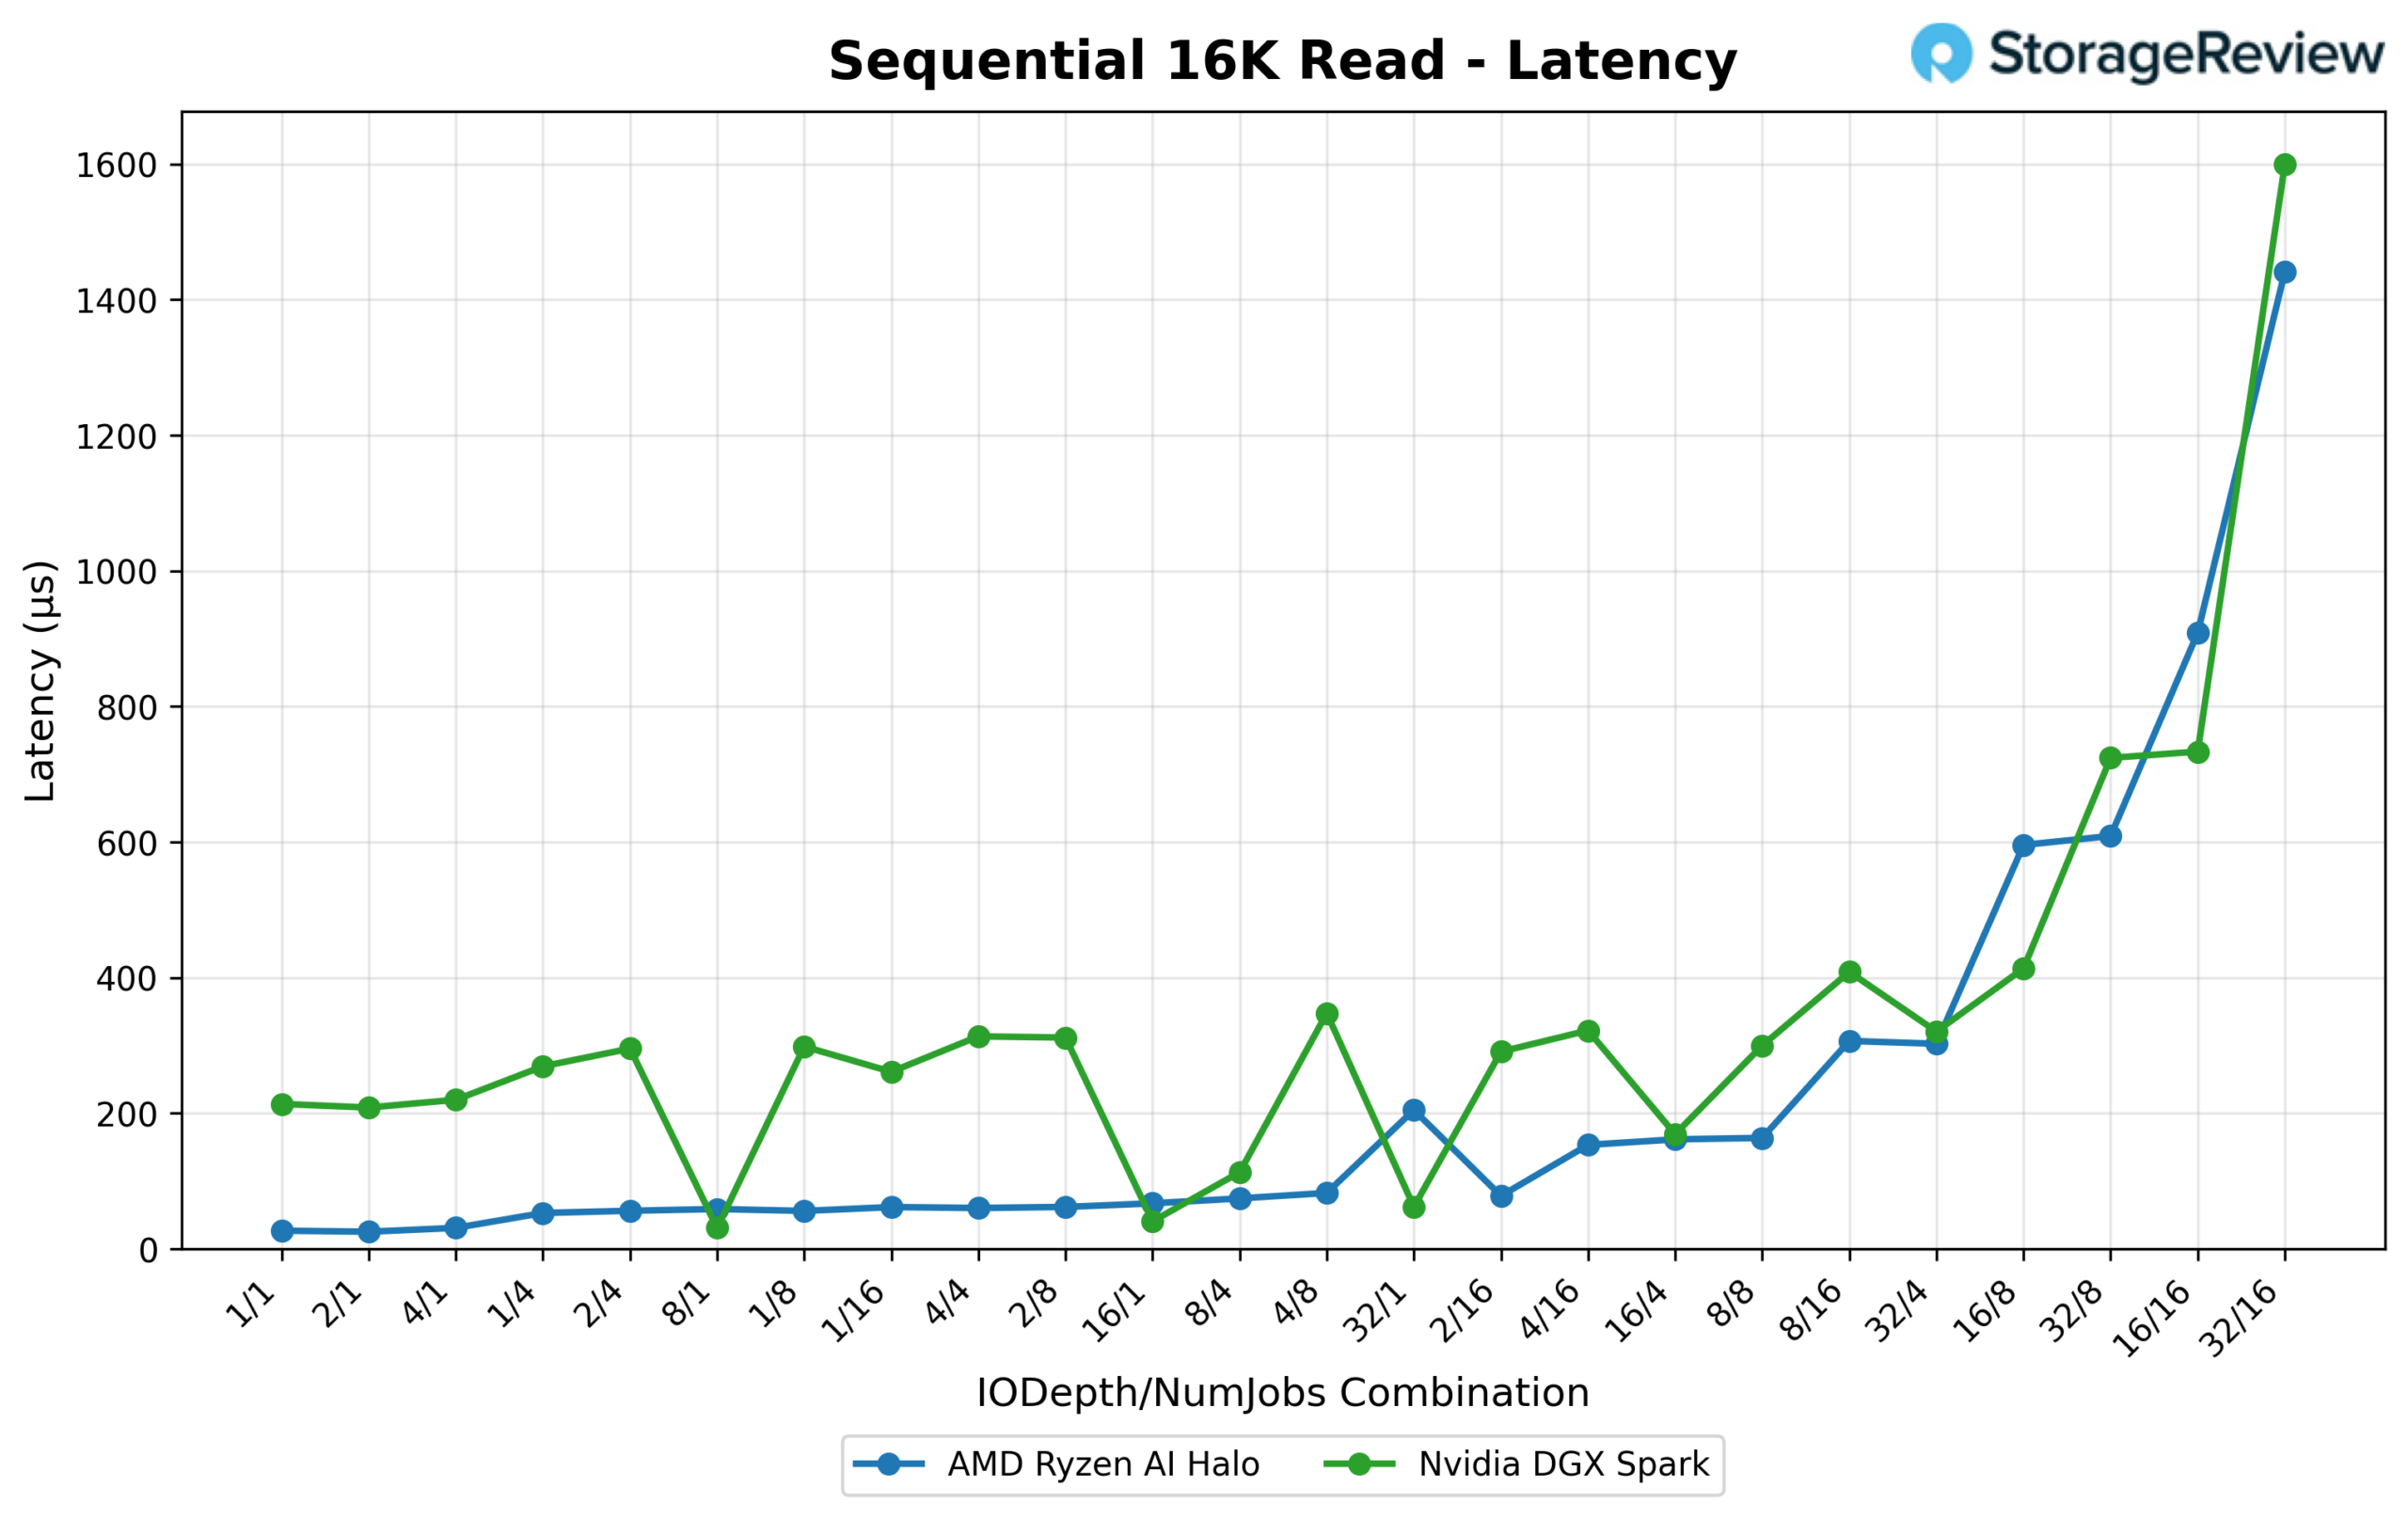
Opóźnienie ponownie sprzyja Halo wszędzie, z wyjątkiem samego szczytu kolejki. Przy ustawieniu 1/1, Halo odpowiada w 0.027 ms, w porównaniu z 0.214 ms w przypadku Sparka, a Halo utrzymuje niższe opóźnienie przez większość czasu trwania sekwencji. Różnica zmniejsza się tylko przy najgłębszych kombinacjach. Przy ustawieniu 32/16, średnie opóźnienie Halo wynoszące 1.441 ms plasuje się tuż poniżej 1.599 ms w przypadku Sparka, co czyni go jednym z niewielu punktów, w których krzywa opóźnienia Halo nie przewyższa krzywej Sparka w momencie nasycenia.
16K Sekwencyjny zapis
Przepustowość jest tutaj również zbliżona: Spark osiąga szczyt na poziomie 2,141.6 MB/s (137.1 tys. IOPS) przy 16/1, a Halo niewiele od niego odstaje, osiągając 1,970.9 MB/s (126.1 tys. IOPS) przy 1/8.
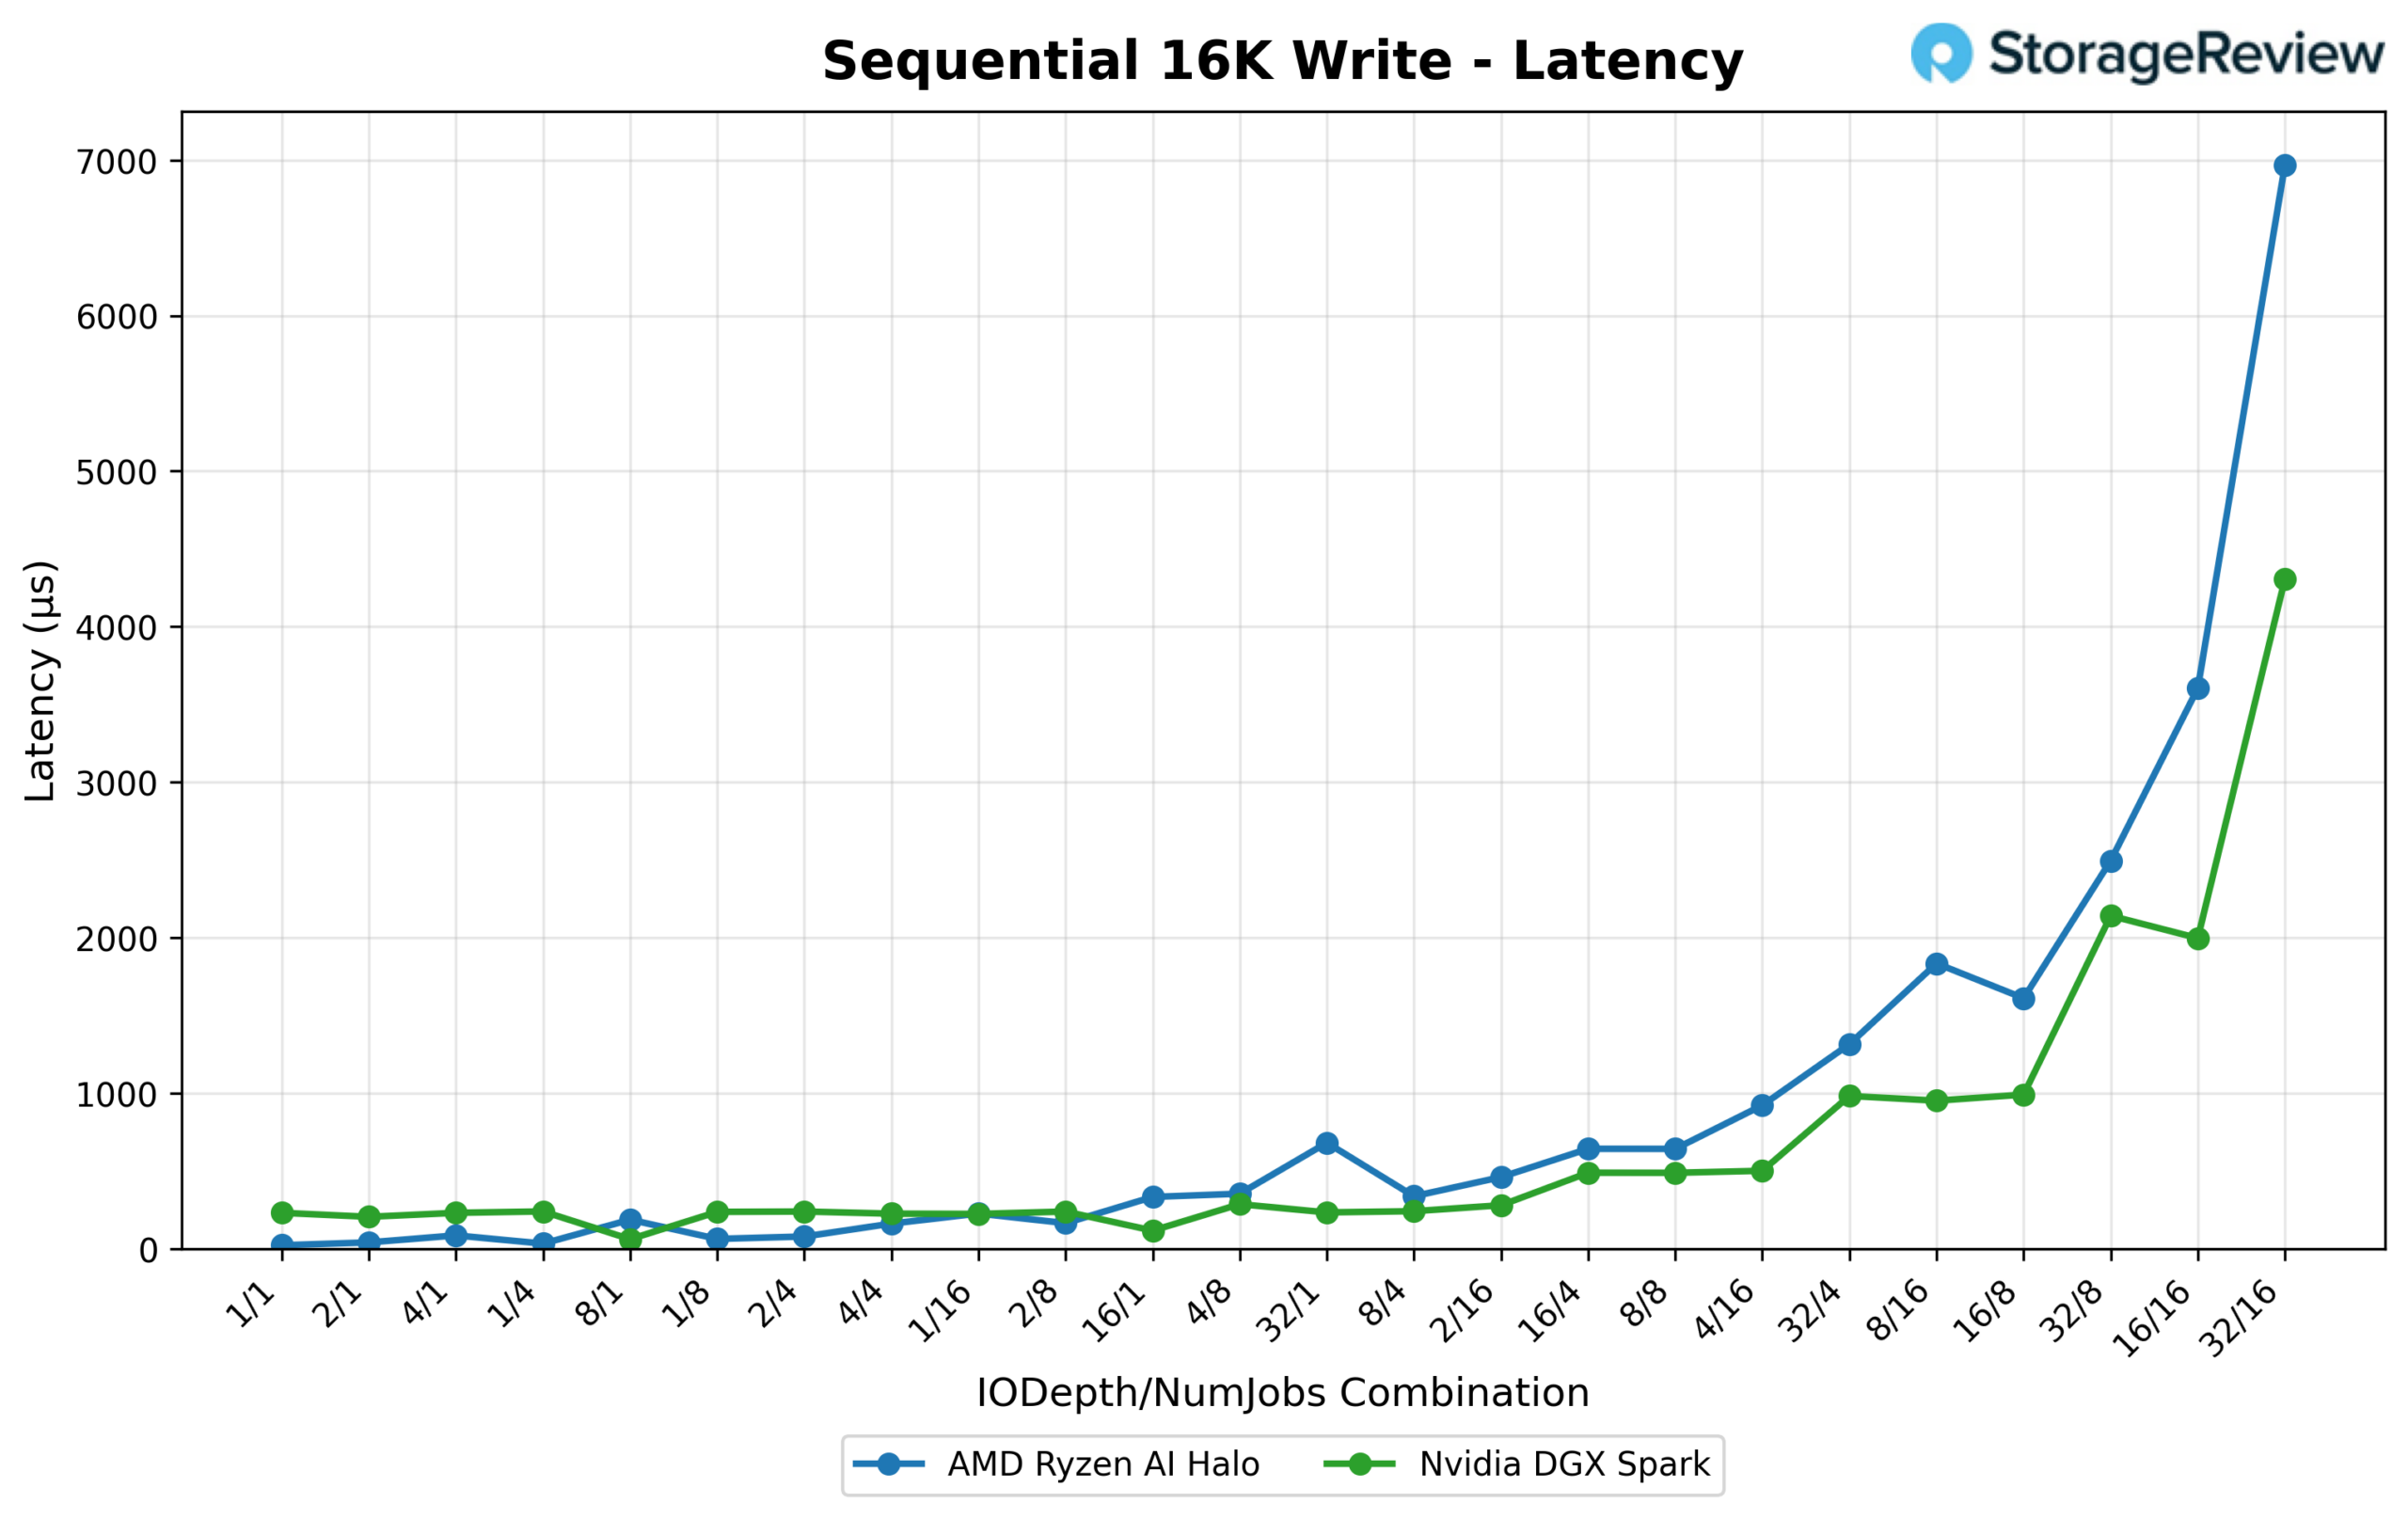
Opóźnienie to punkt, w którym te dwa urządzenia wyraźnie się rozchodzą. Halo zaczyna z dużą przewagą przy niskiej głębokości kolejki (0.022 ms przy 1/1 w porównaniu z 0.231 ms w Sparku), ale jego krzywa opóźnień gwałtownie rośnie wraz z zapełnianiem się kolejki. Do 32/16 średnie opóźnienie Halo wzrosło do 6.967 ms, znacznie przekraczając 4.306 ms w tym samym momencie dla Sparka. Krzywa Halo jest również znacznie mniej przewidywalna, z ostrymi skokami w kilku kombinacjach średniego zakresu, podczas gdy Spark pozostaje stosunkowo płaski.
Odczyt losowy 16K
To jeden z lepszych wyników Halo. W rzeczywistości osiąga on wyższą przepustowość szczytową, wynoszącą 6,609.4 MB/s (423.0 tys. IOPS) przy 32/16, w porównaniu z 6,082.6 MB/s (389.3 tys. IOPS) Sparka przy tej samej kombinacji.
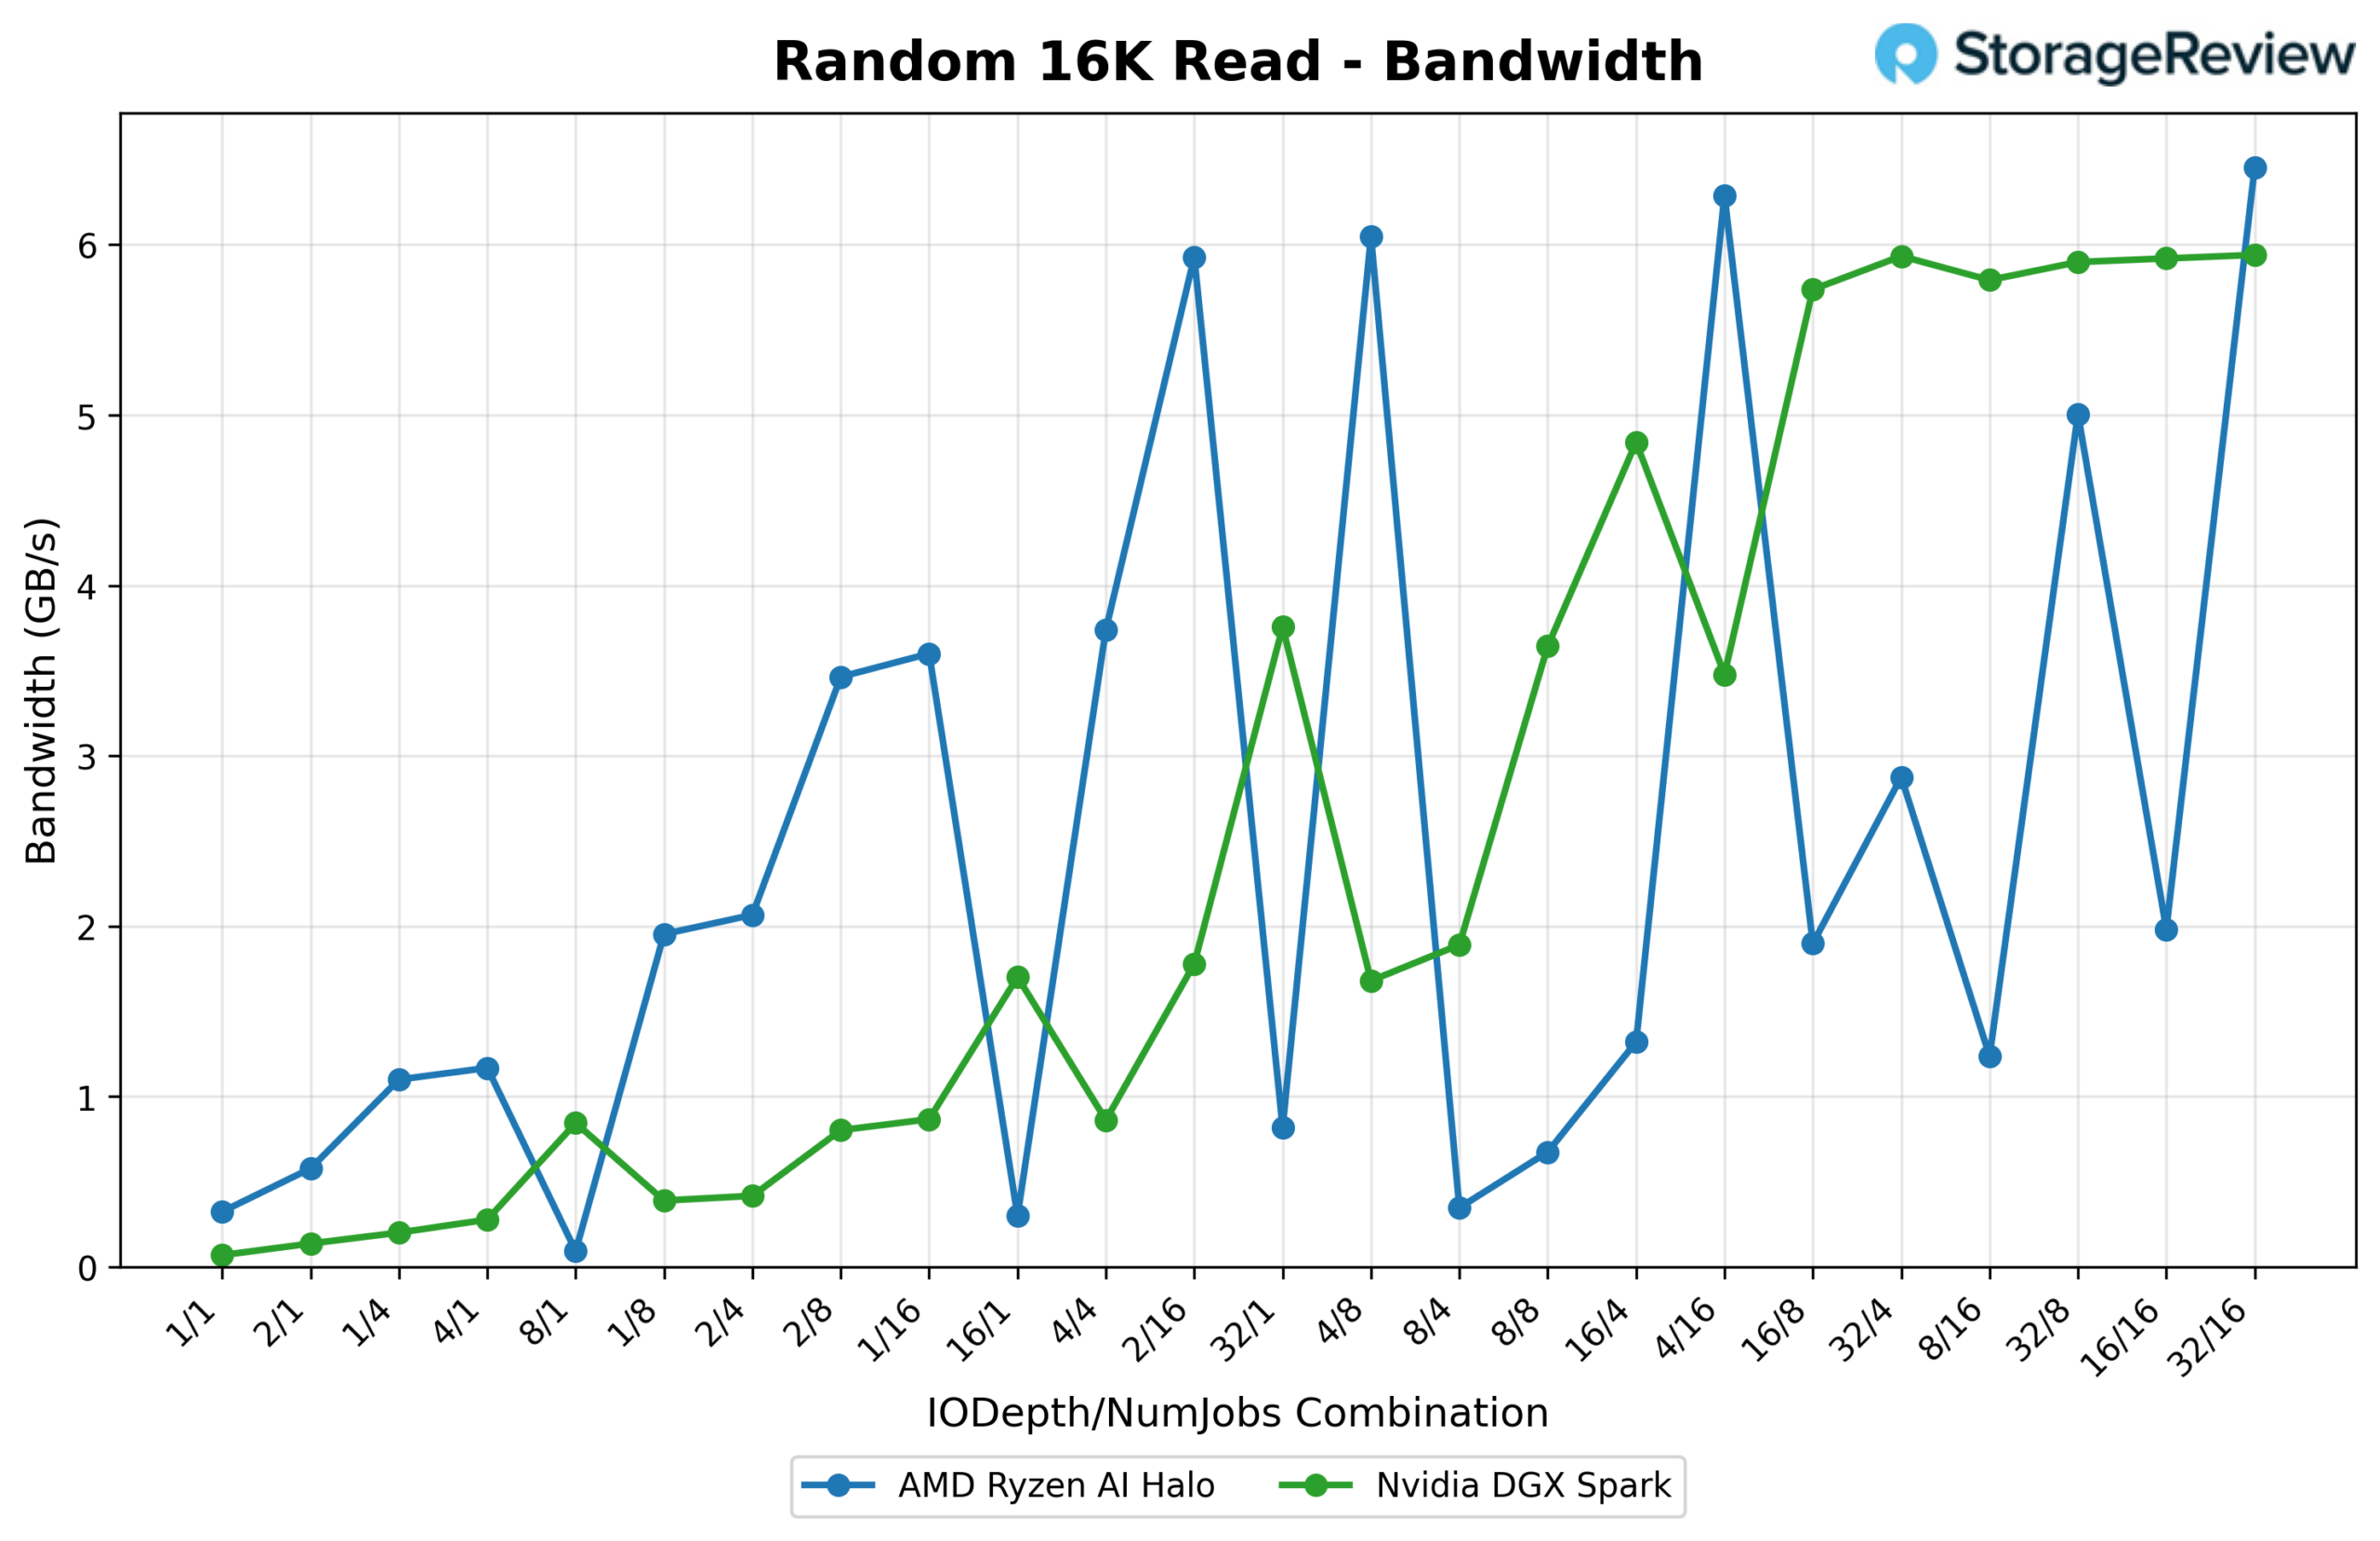
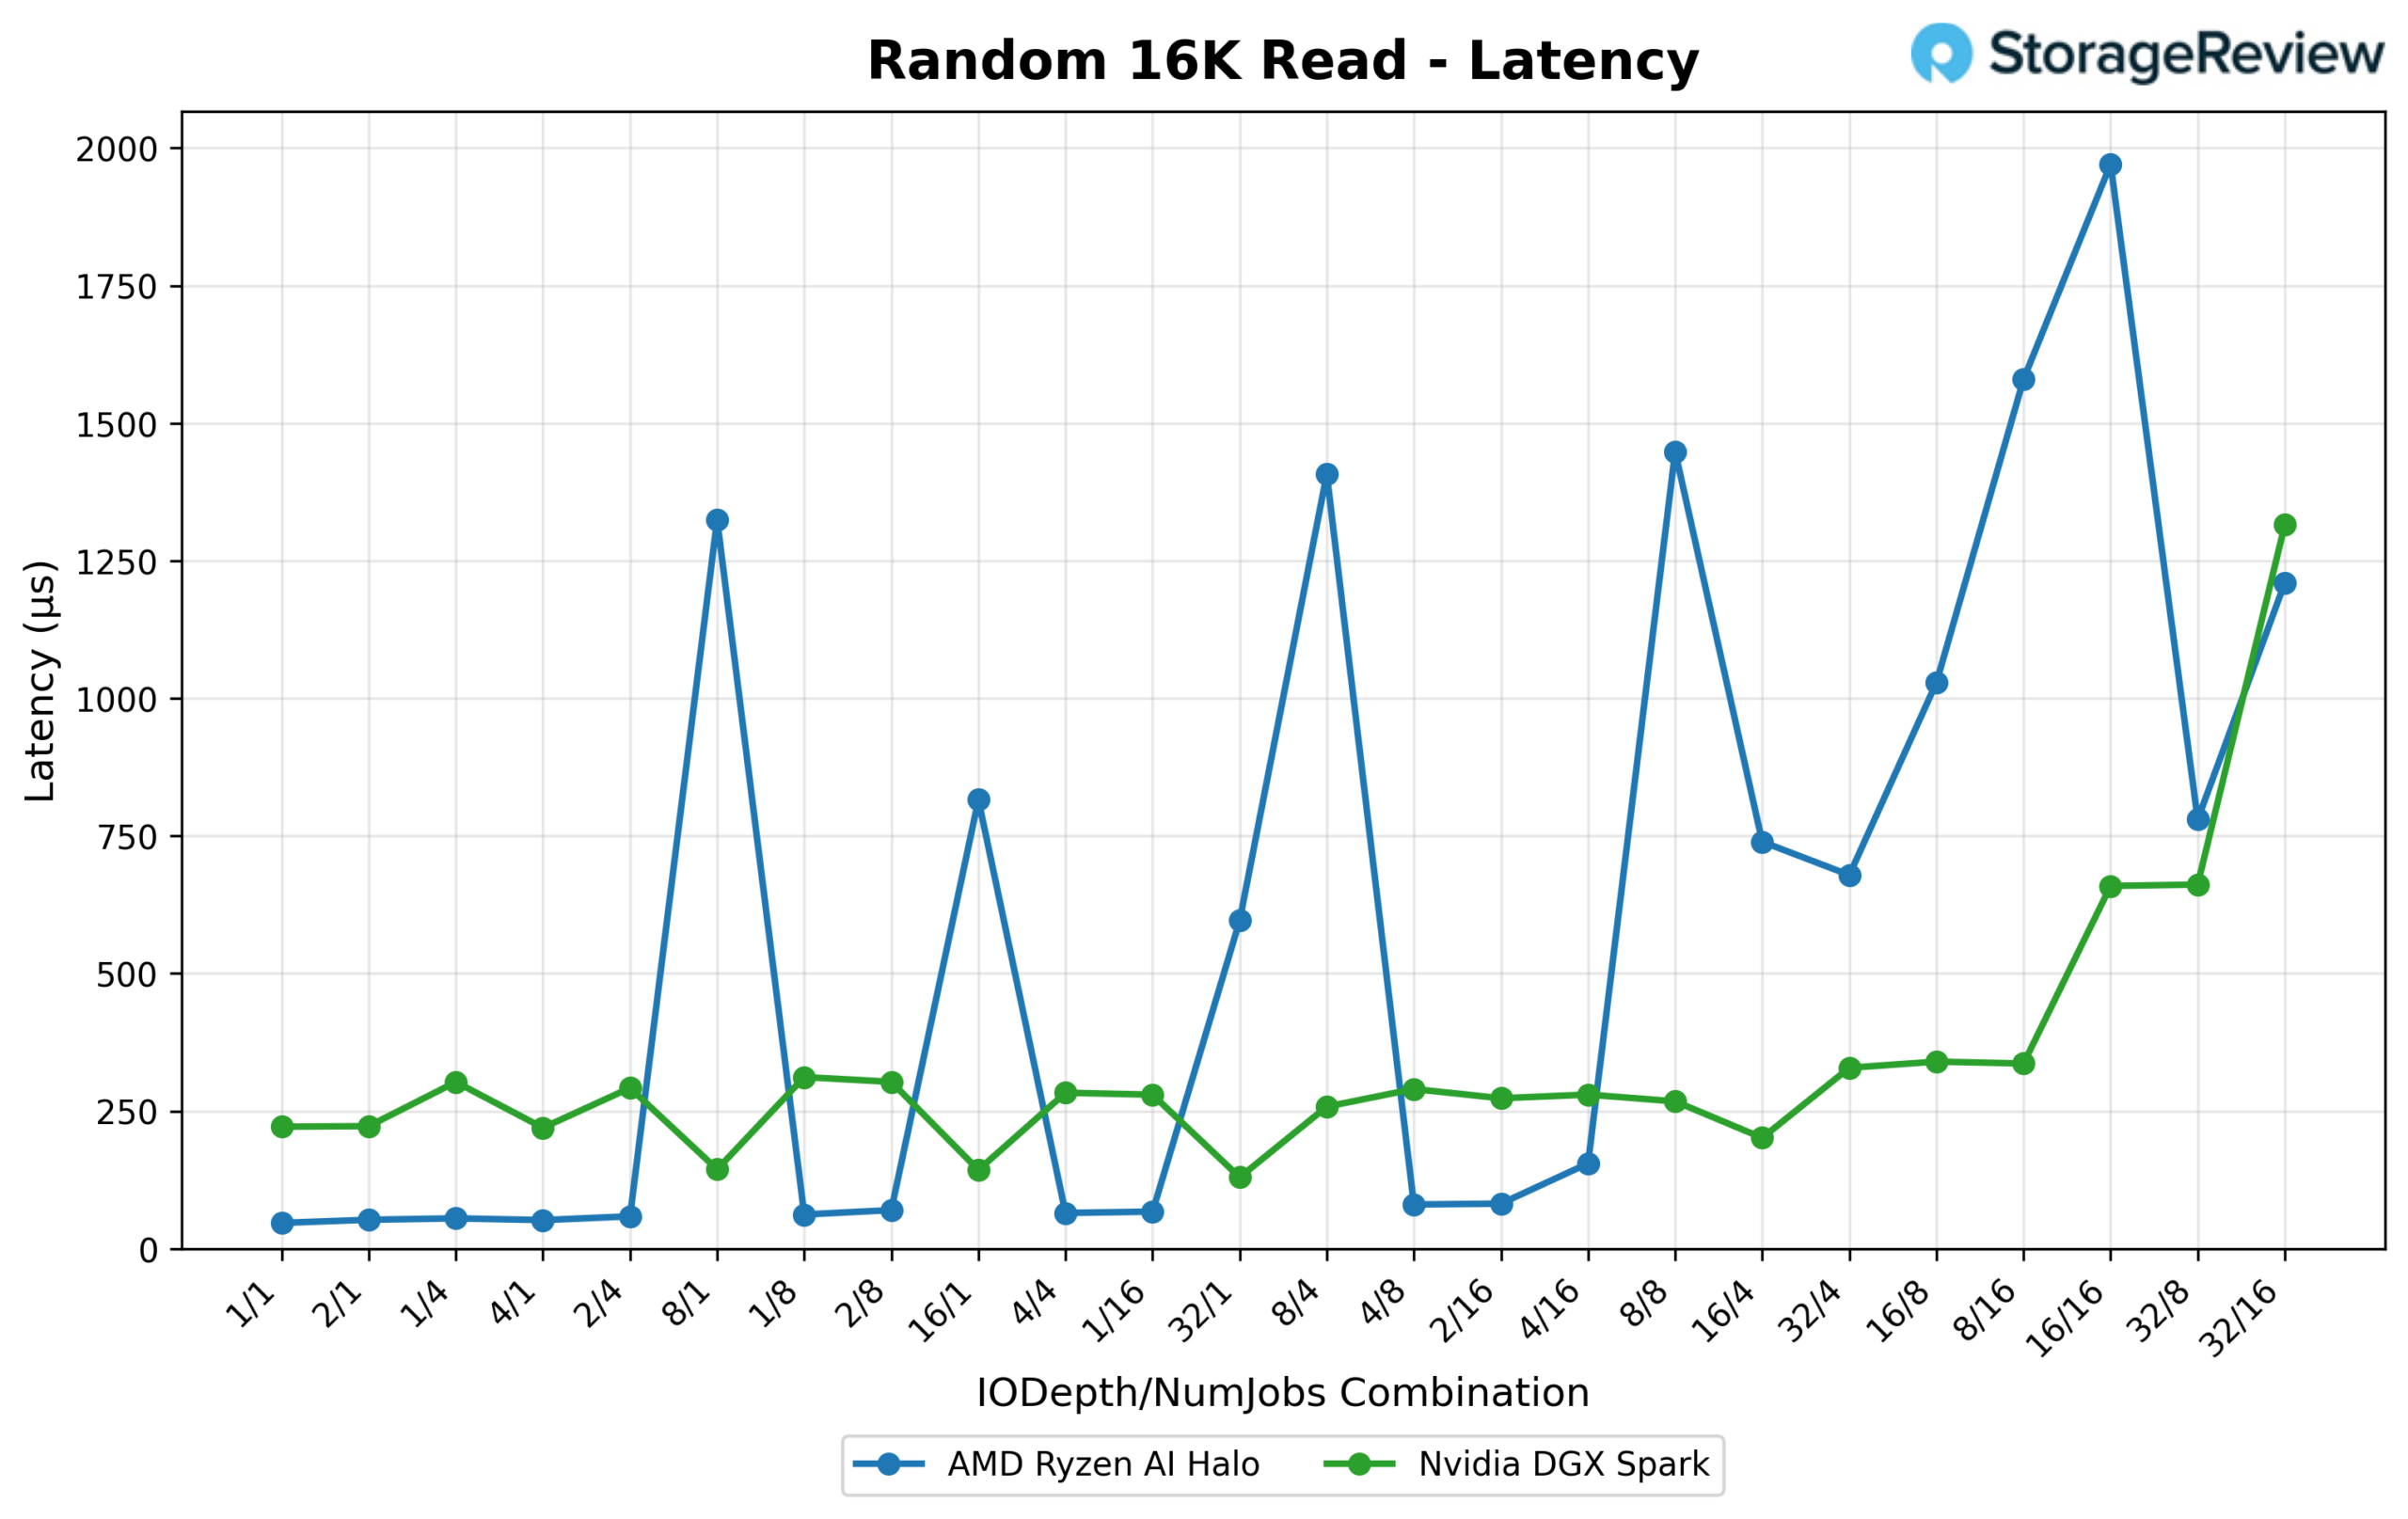
Opóźnienie ponownie początkowo zdecydowanie przemawia na korzyść Halo (0.047 ms przy 1/1 w porównaniu z 0.222 ms dla Spark). Mimo to, krzywa opóźnień Halo jest znacznie bardziej zmienna w całym zakresie, z ostrymi skokami przy 8/1, 16/1, 8/4 i 8/8, które znacznie przewyższają stosunkowo płynną (choć wyższą) krzywą Sparka. Na samym szczycie kolejki szczytowe opóźnienie Halo wynoszące 1.971 ms (przy 16/16) przewyższa szczytowe opóźnienie Sparka wynoszące 1.315 ms (przy 32/16), więc Halo oferuje spójność kosztem szybkości i niskiej głębokości kolejki.
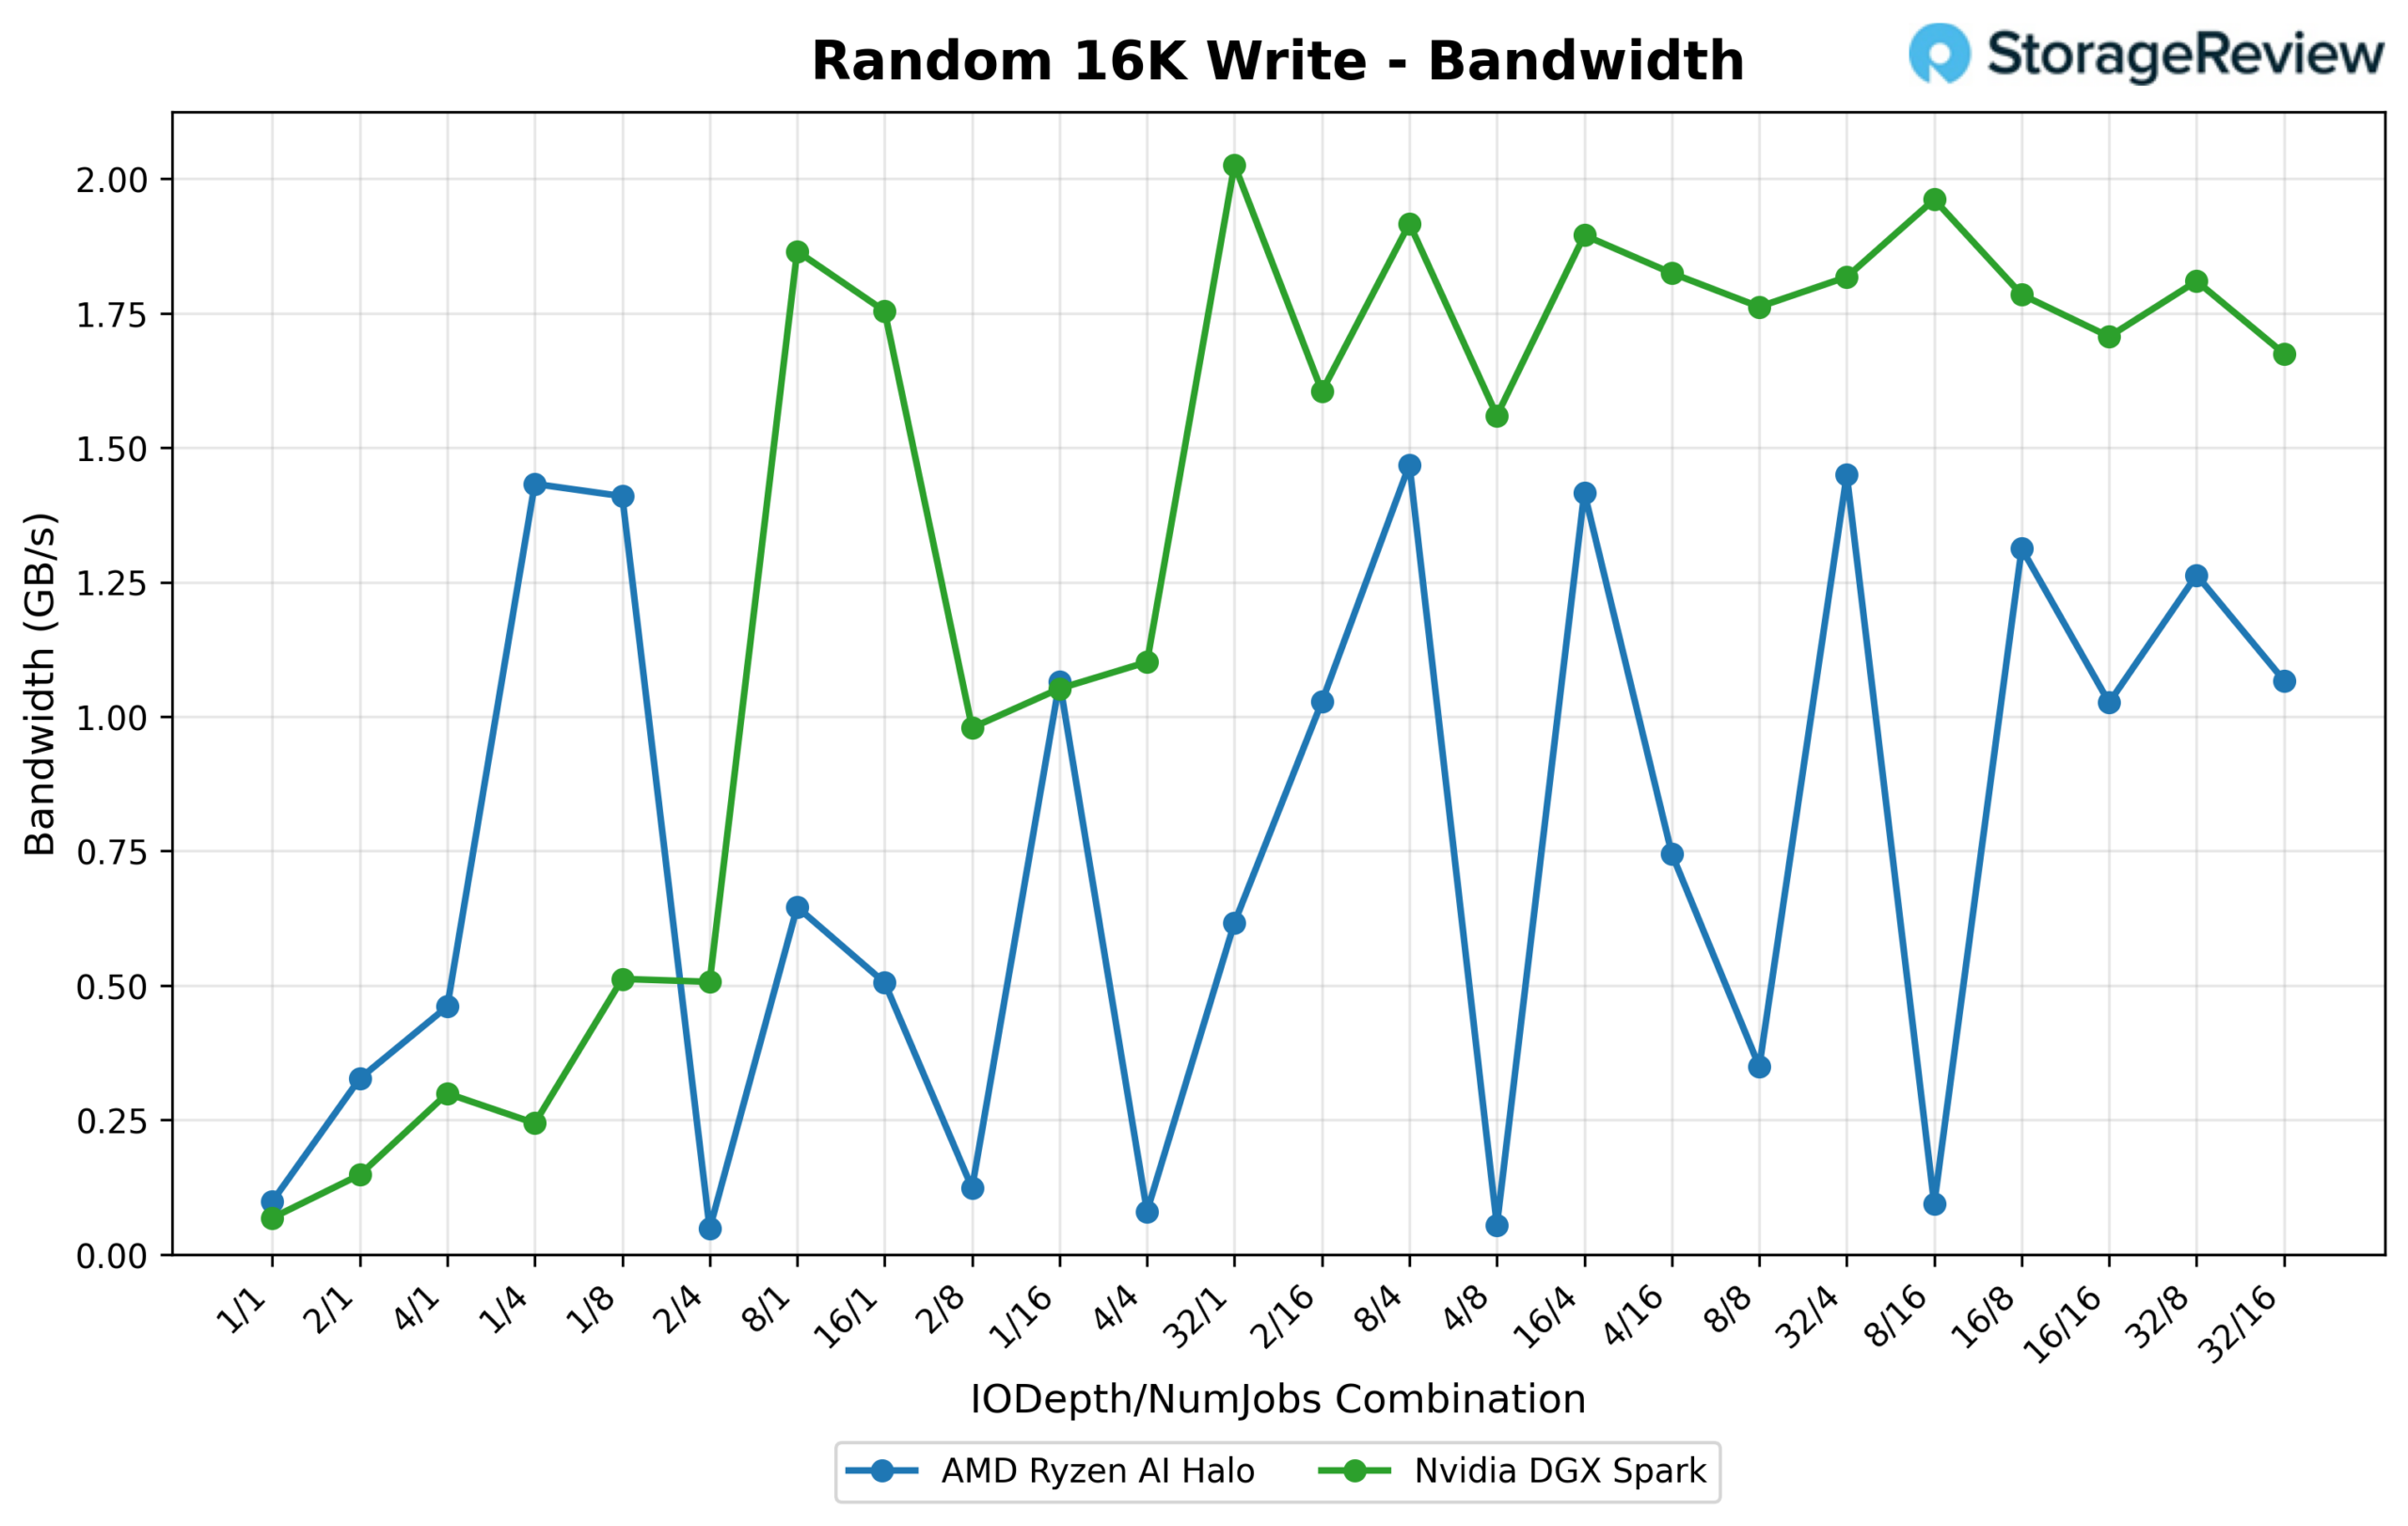
Losowy zapis 16K
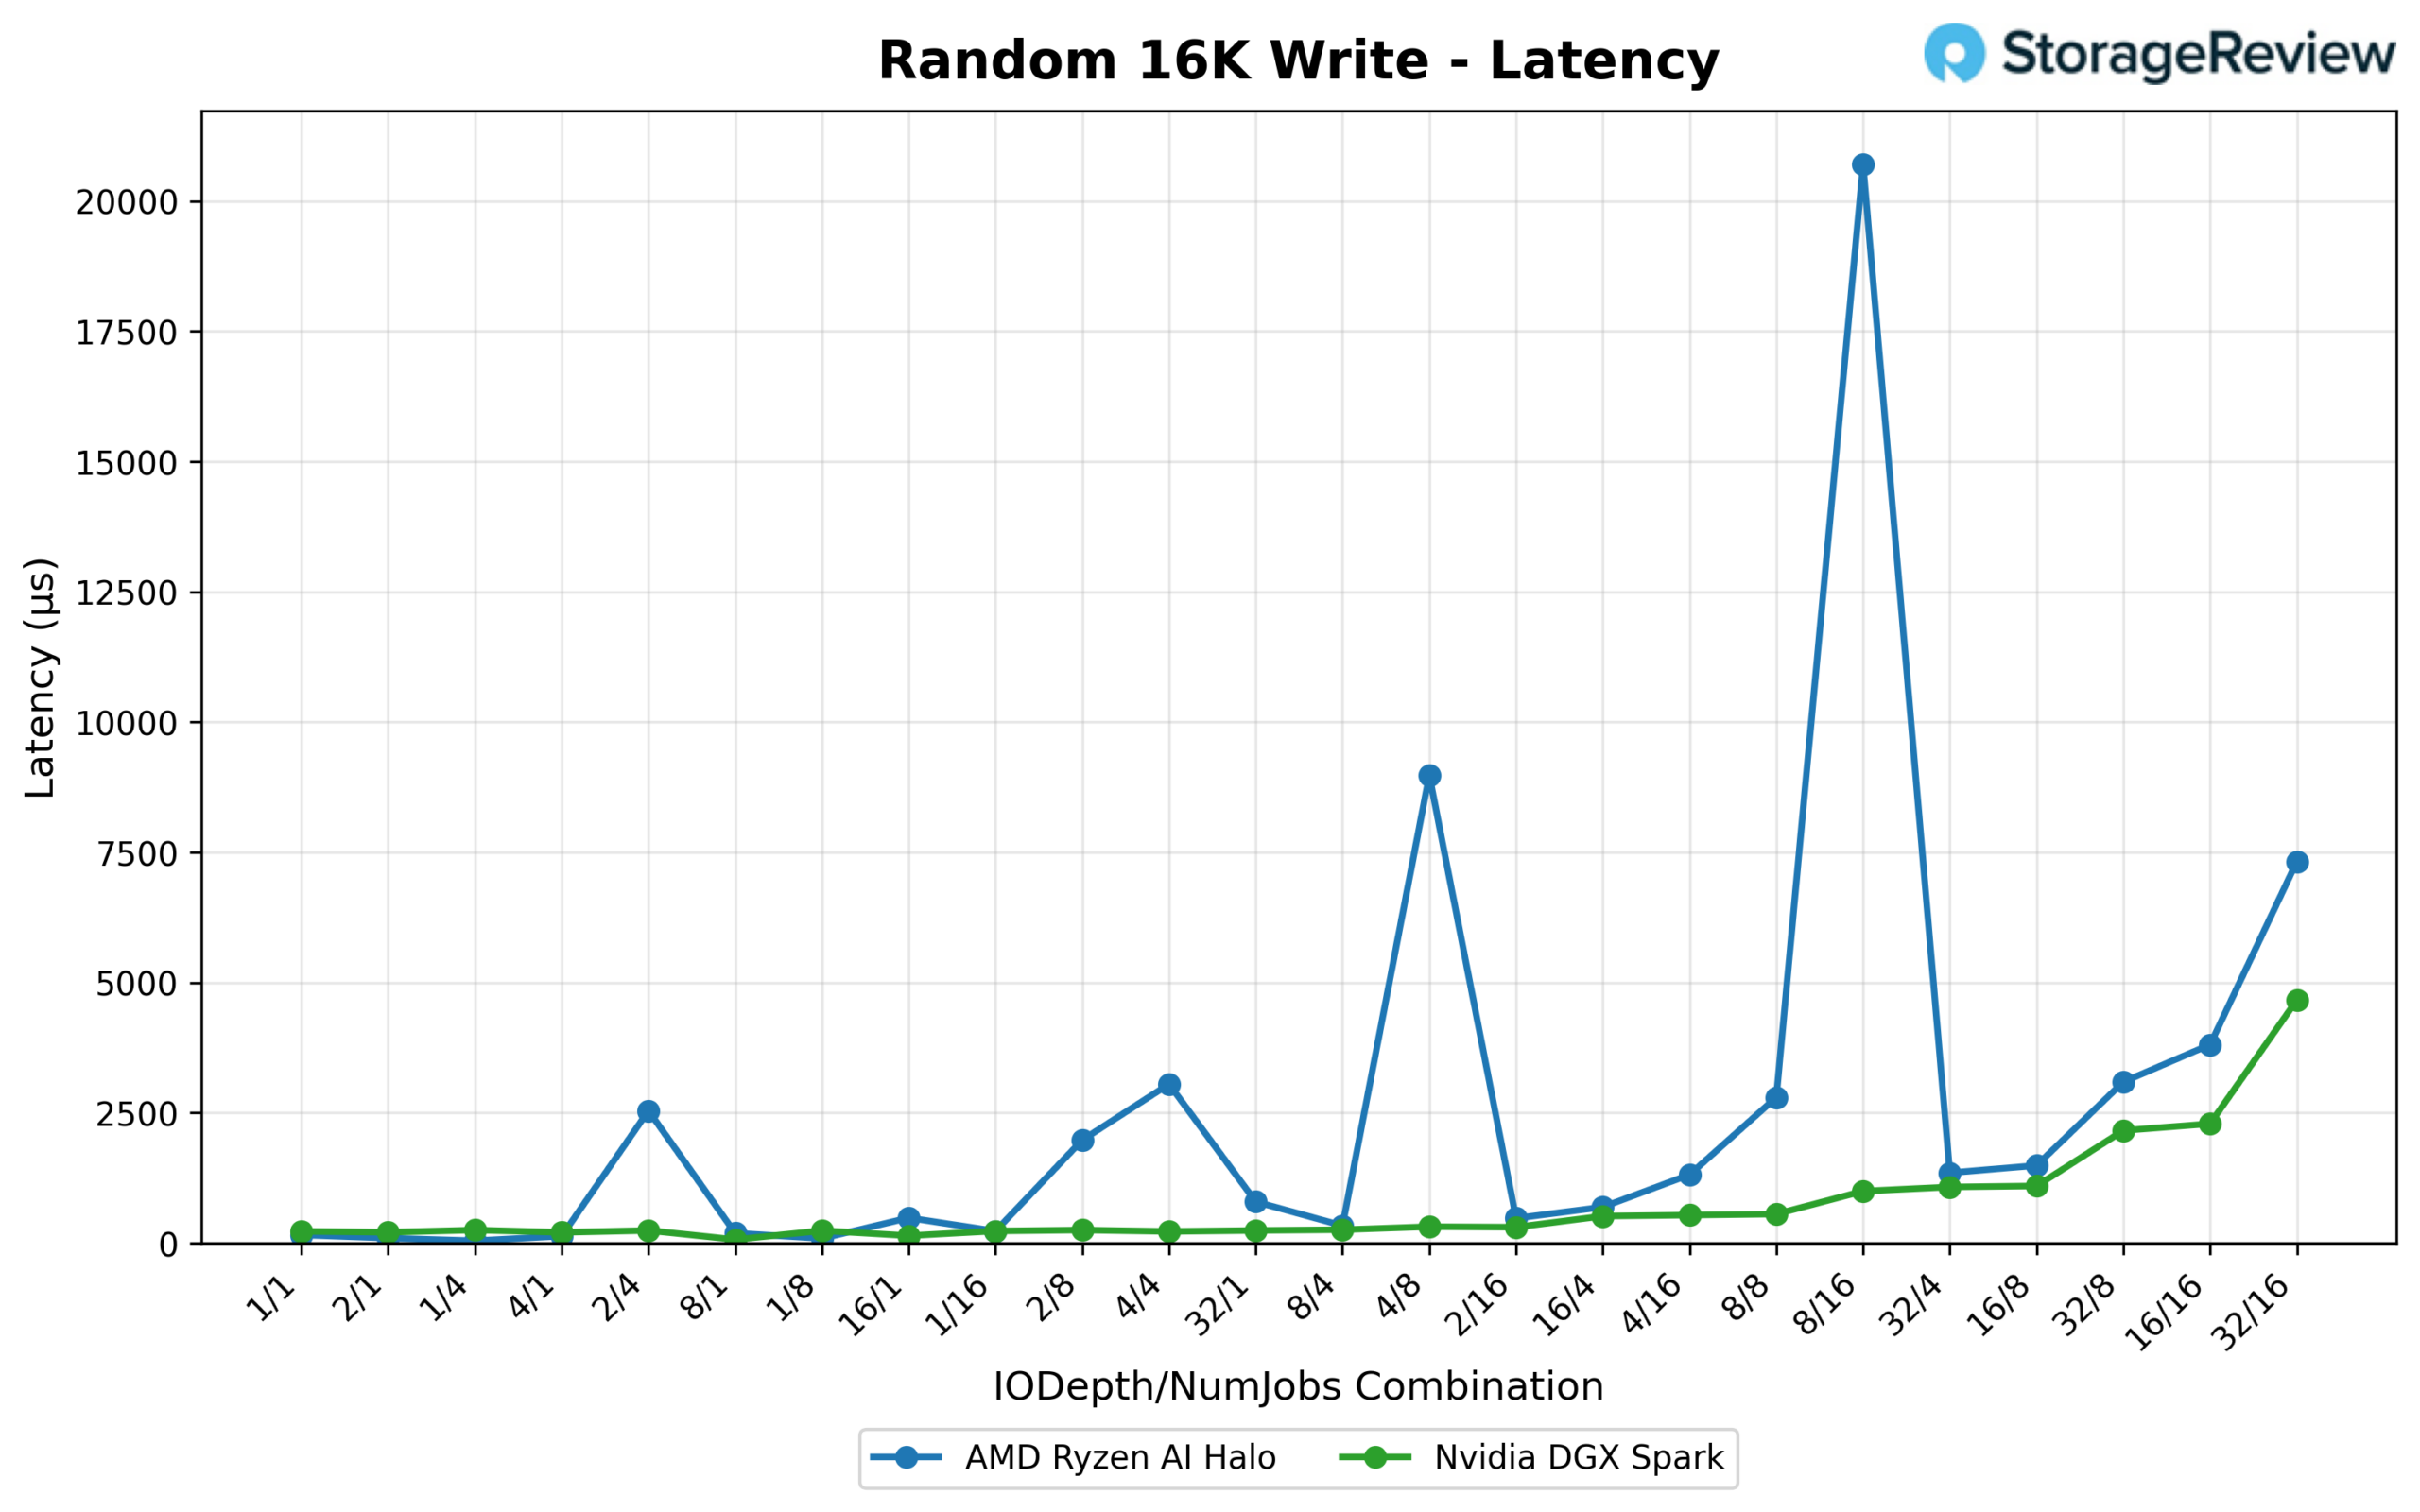
Przepustowość w tym przypadku sprzyja Sparkowi, który osiąga 2,074.1 MB/s (132.7 tys. IOPS) przy 32/1, w porównaniu z 1,503.5 MB/s (96.2 tys. IOPS) Halo przy 8/4. Krzywa przepustowości Sparka jest również znacznie bardziej spójna, utrzymując się w zakresie 1.6–2.0 GB/s przez większość okresu po początkowym wzroście. Dla porównania, Halo waha się gwałtownie między około 0.1 a 1.5 GB/s między jedną kombinacją a drugą.
Opóźnienie to cecha, która wyróżnia ten test: Halo zaczyna od niższego poziomu 1/1 (0.154 ms vs. 0.224 ms), ale przy 8/16 jego średnie opóźnienie gwałtownie wzrasta do ekstremalnego poziomu 20.698 ms, prawie 4.5 razy wyższego niż najgorszy przypadek Sparka, wynoszący 4.664 ms, w dowolnym miejscu w teście. Pomijając ten pojedynczy skok, opóźnienie Halo jest w porządku, ale stanowi znaczący wyjątek, który warto oznaczyć dla każdego obciążenia, które mogłoby trafić na tę konkretną kombinację głębokości/wątku.
Odczyt losowy 4K
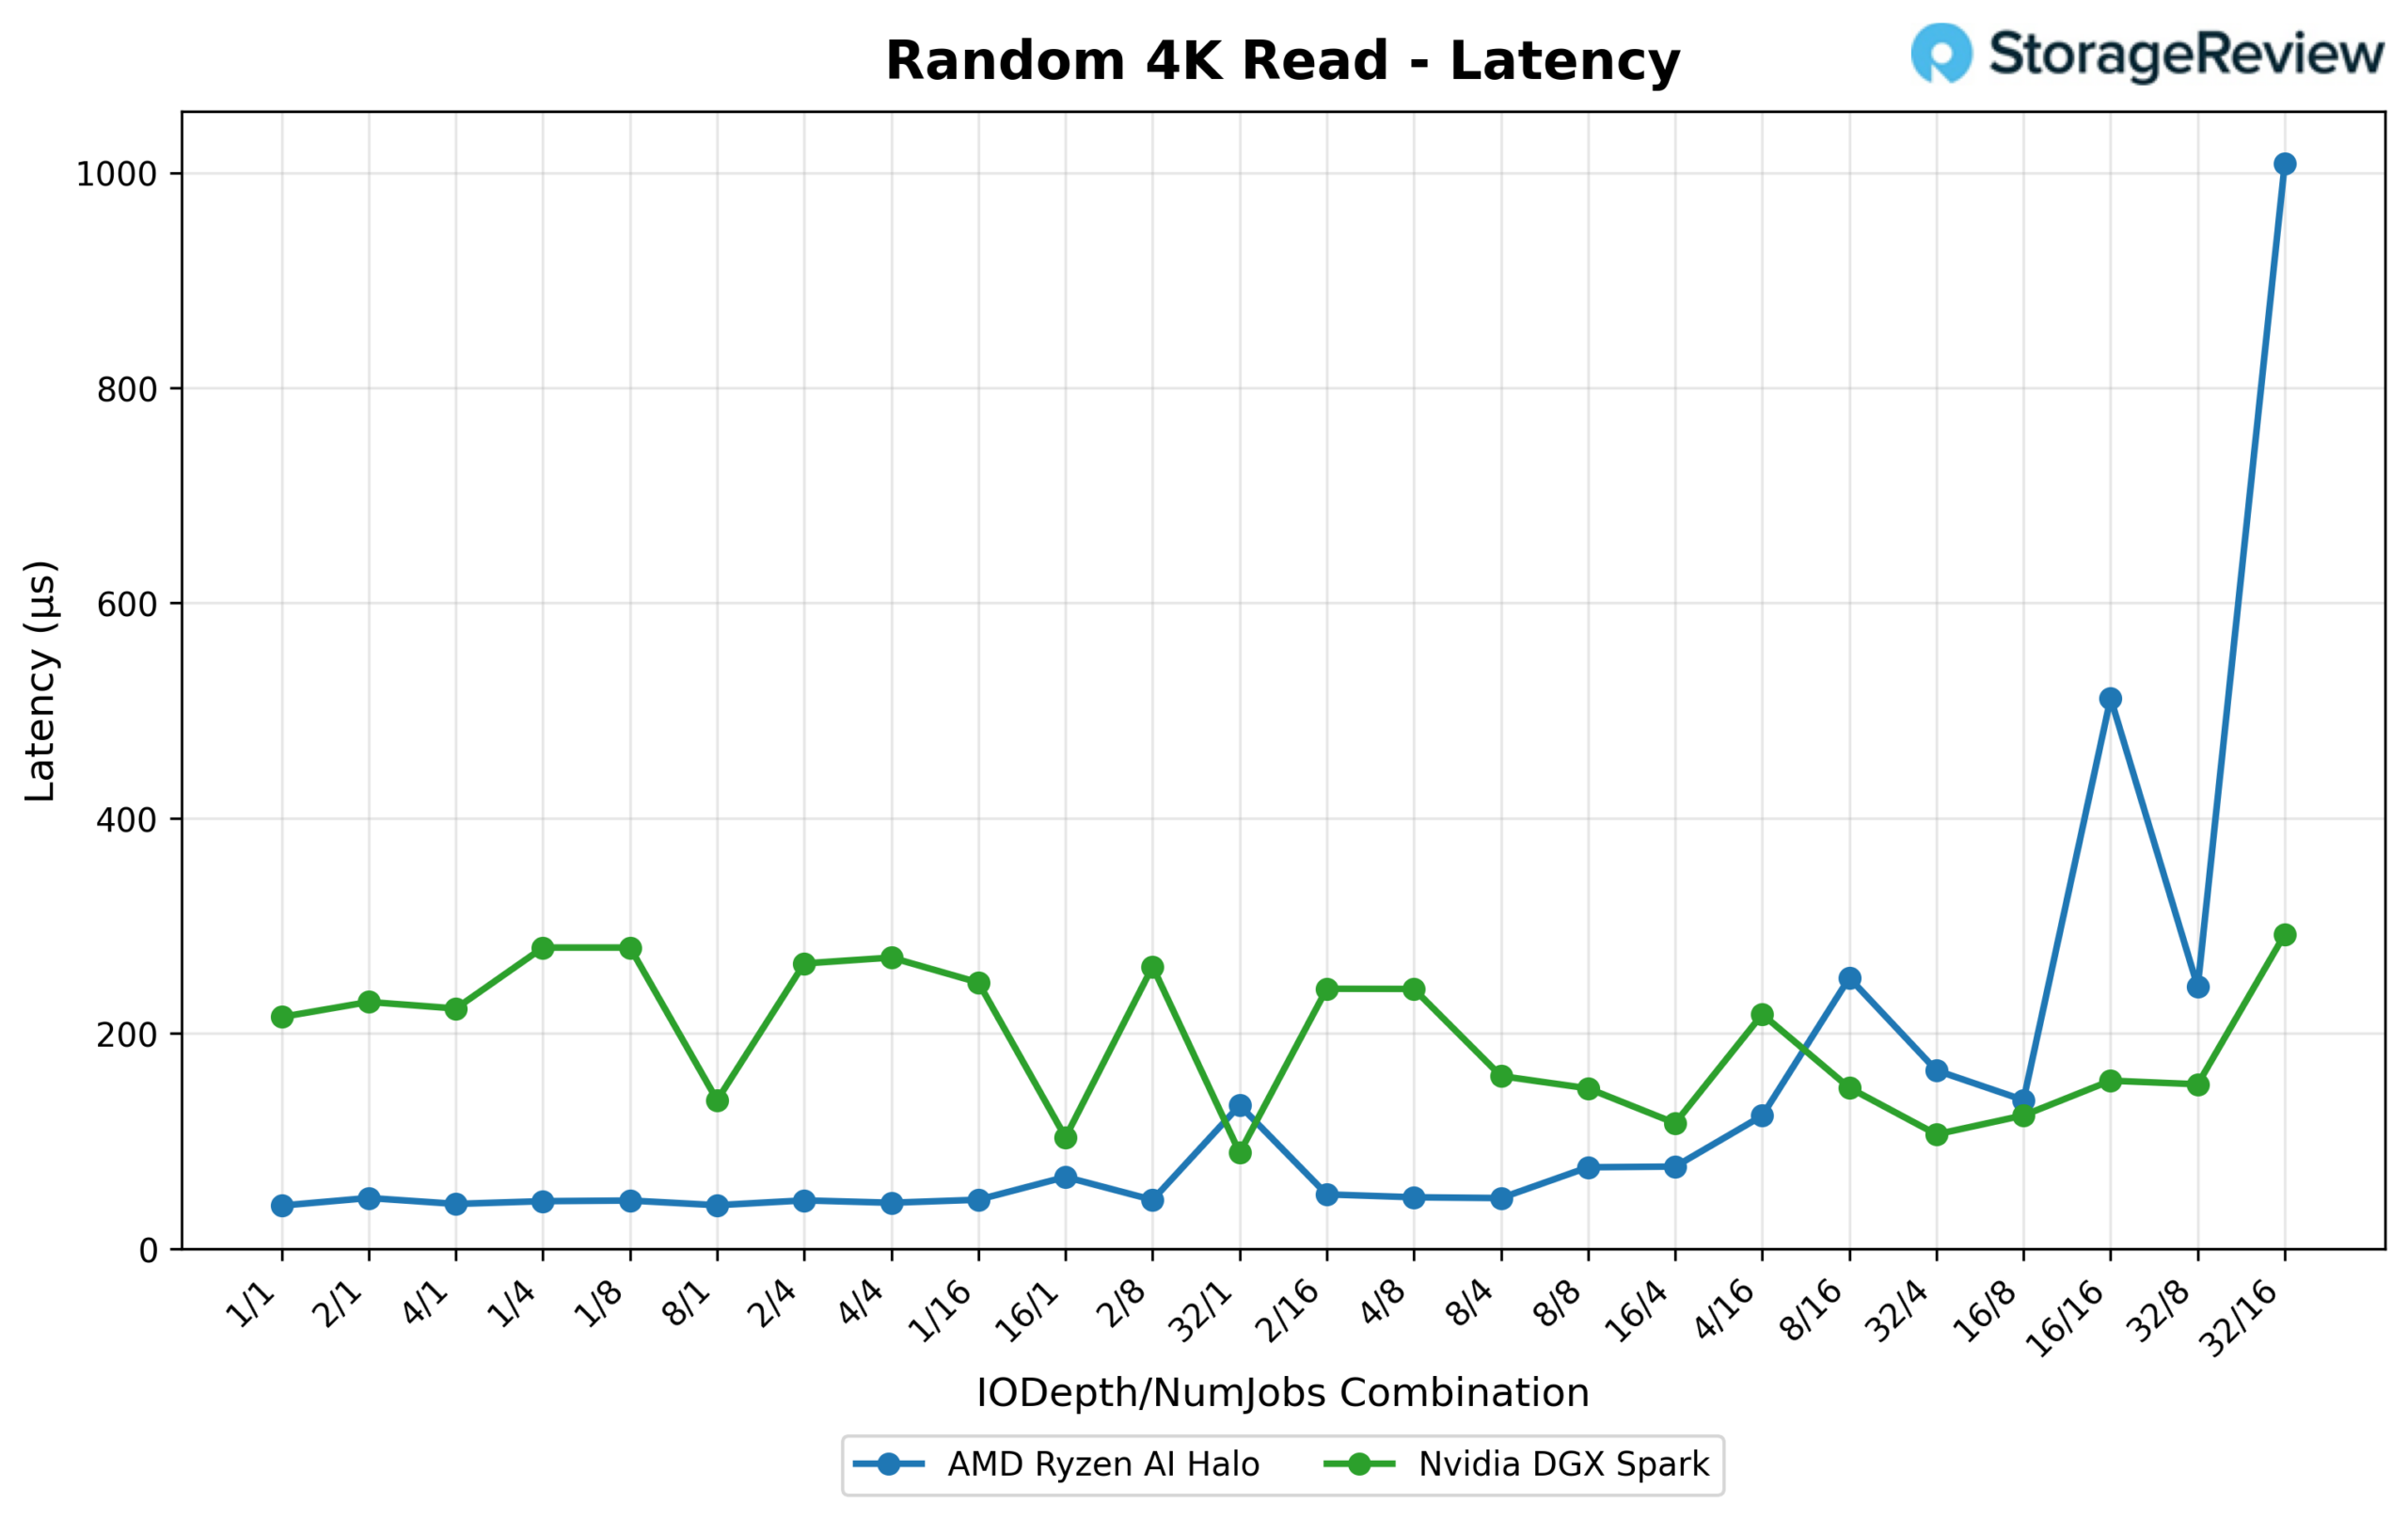
Przy niskiej głębokości kolejki, Halo reaguje znacznie szybciej (0.04 ms przy 1/1 w porównaniu z 0.215 ms w Sparku) i utrzymuje przewagę w zakresie opóźnień w większości niskiego i średniego zakresu częstotliwości próbkowania. Spark jednak zdecydowanie wyprzedza pod względem przepustowości w dużej skali: jego szczytowe IOPS osiąga 1,750.7 K (6,838.8 MB/s) przy 32/16, znacznie przewyższając szczytowe wartości Halo wynoszące 1,050.4 K IOPS (4,103.2 MB/s) przy 32/8.
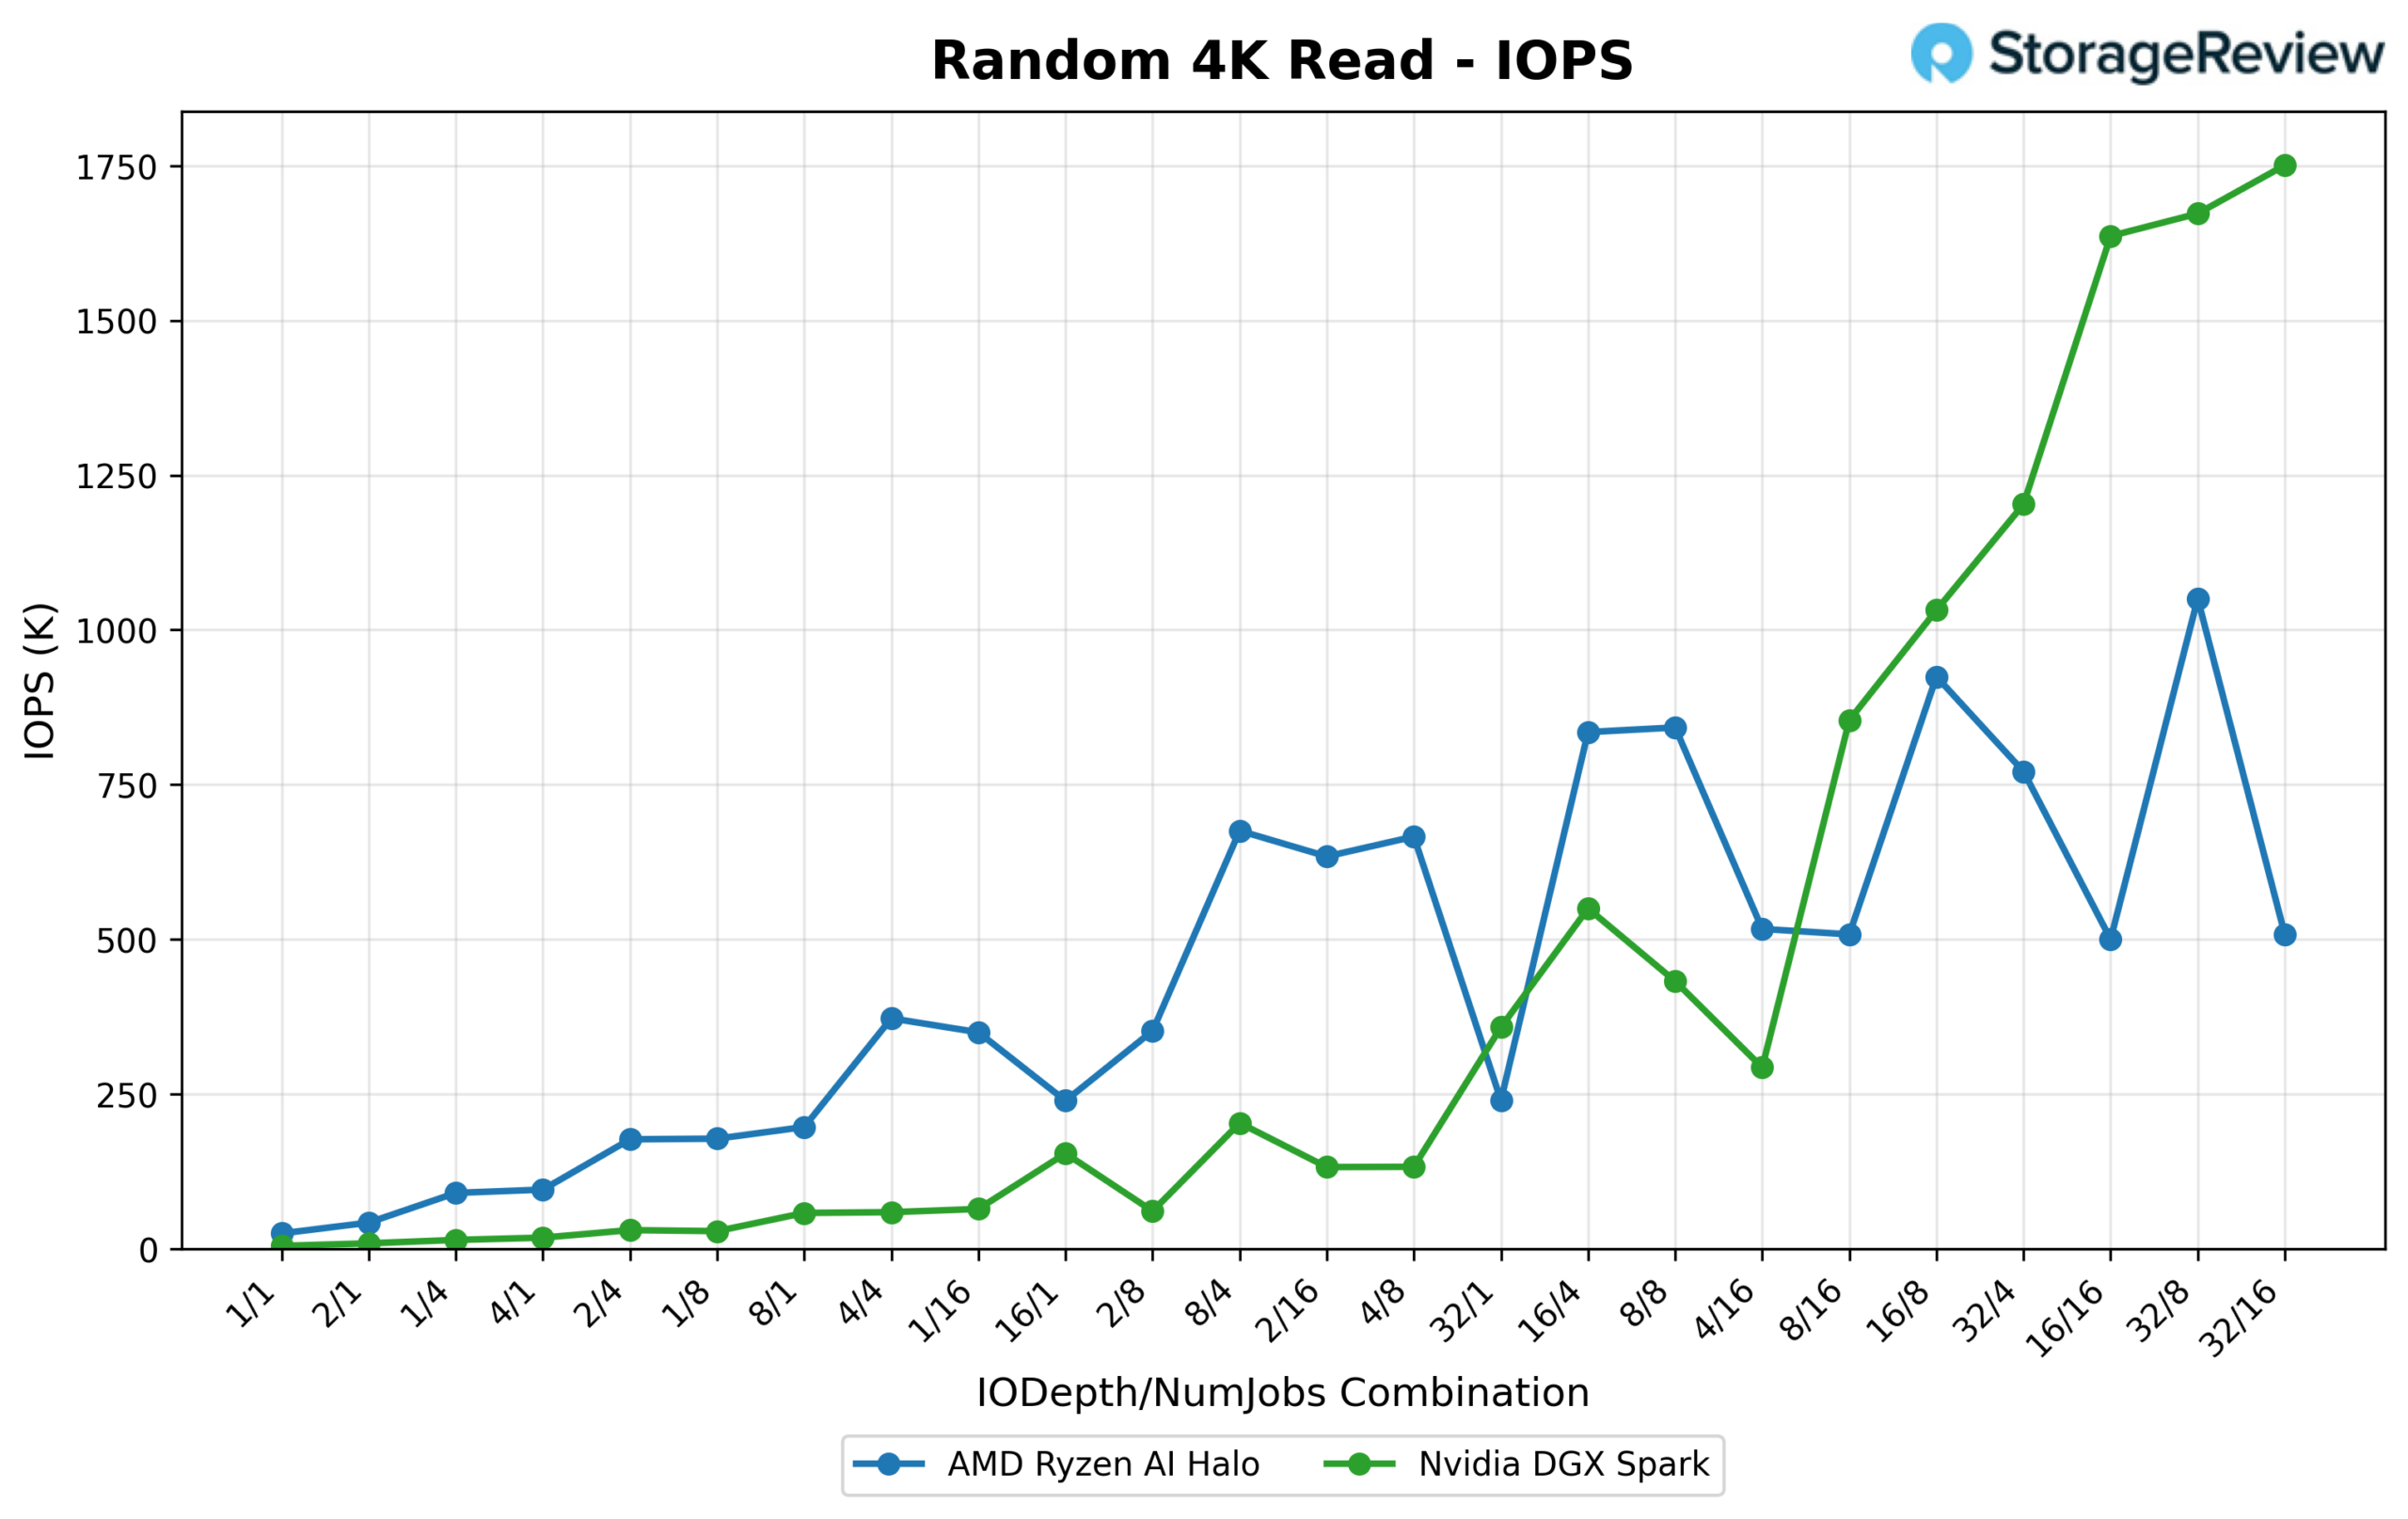
Co ciekawe, obraz opóźnienia odwraca się przy dużej głębokości kolejki. Krzywa opóźnienia Sparka pozostaje stosunkowo niska, nawet gdy głębokość i liczba wątków rosną, osiągając szczyt na poziomie zaledwie 0.292 ms. Z kolei w przypadku Halo, opóźnienie gwałtownie wzrasta przy 16/16 (0.513 ms) i ponownie przy 32/16 (1.009 ms), przekraczając swoją ustaloną linię bazową ponad 3-krotnie. Oznacza to, że jego doskonała responsywność przy małej głębokości kolejki nie przekłada się na pełne nasycenie.
Losowy zapis 4K
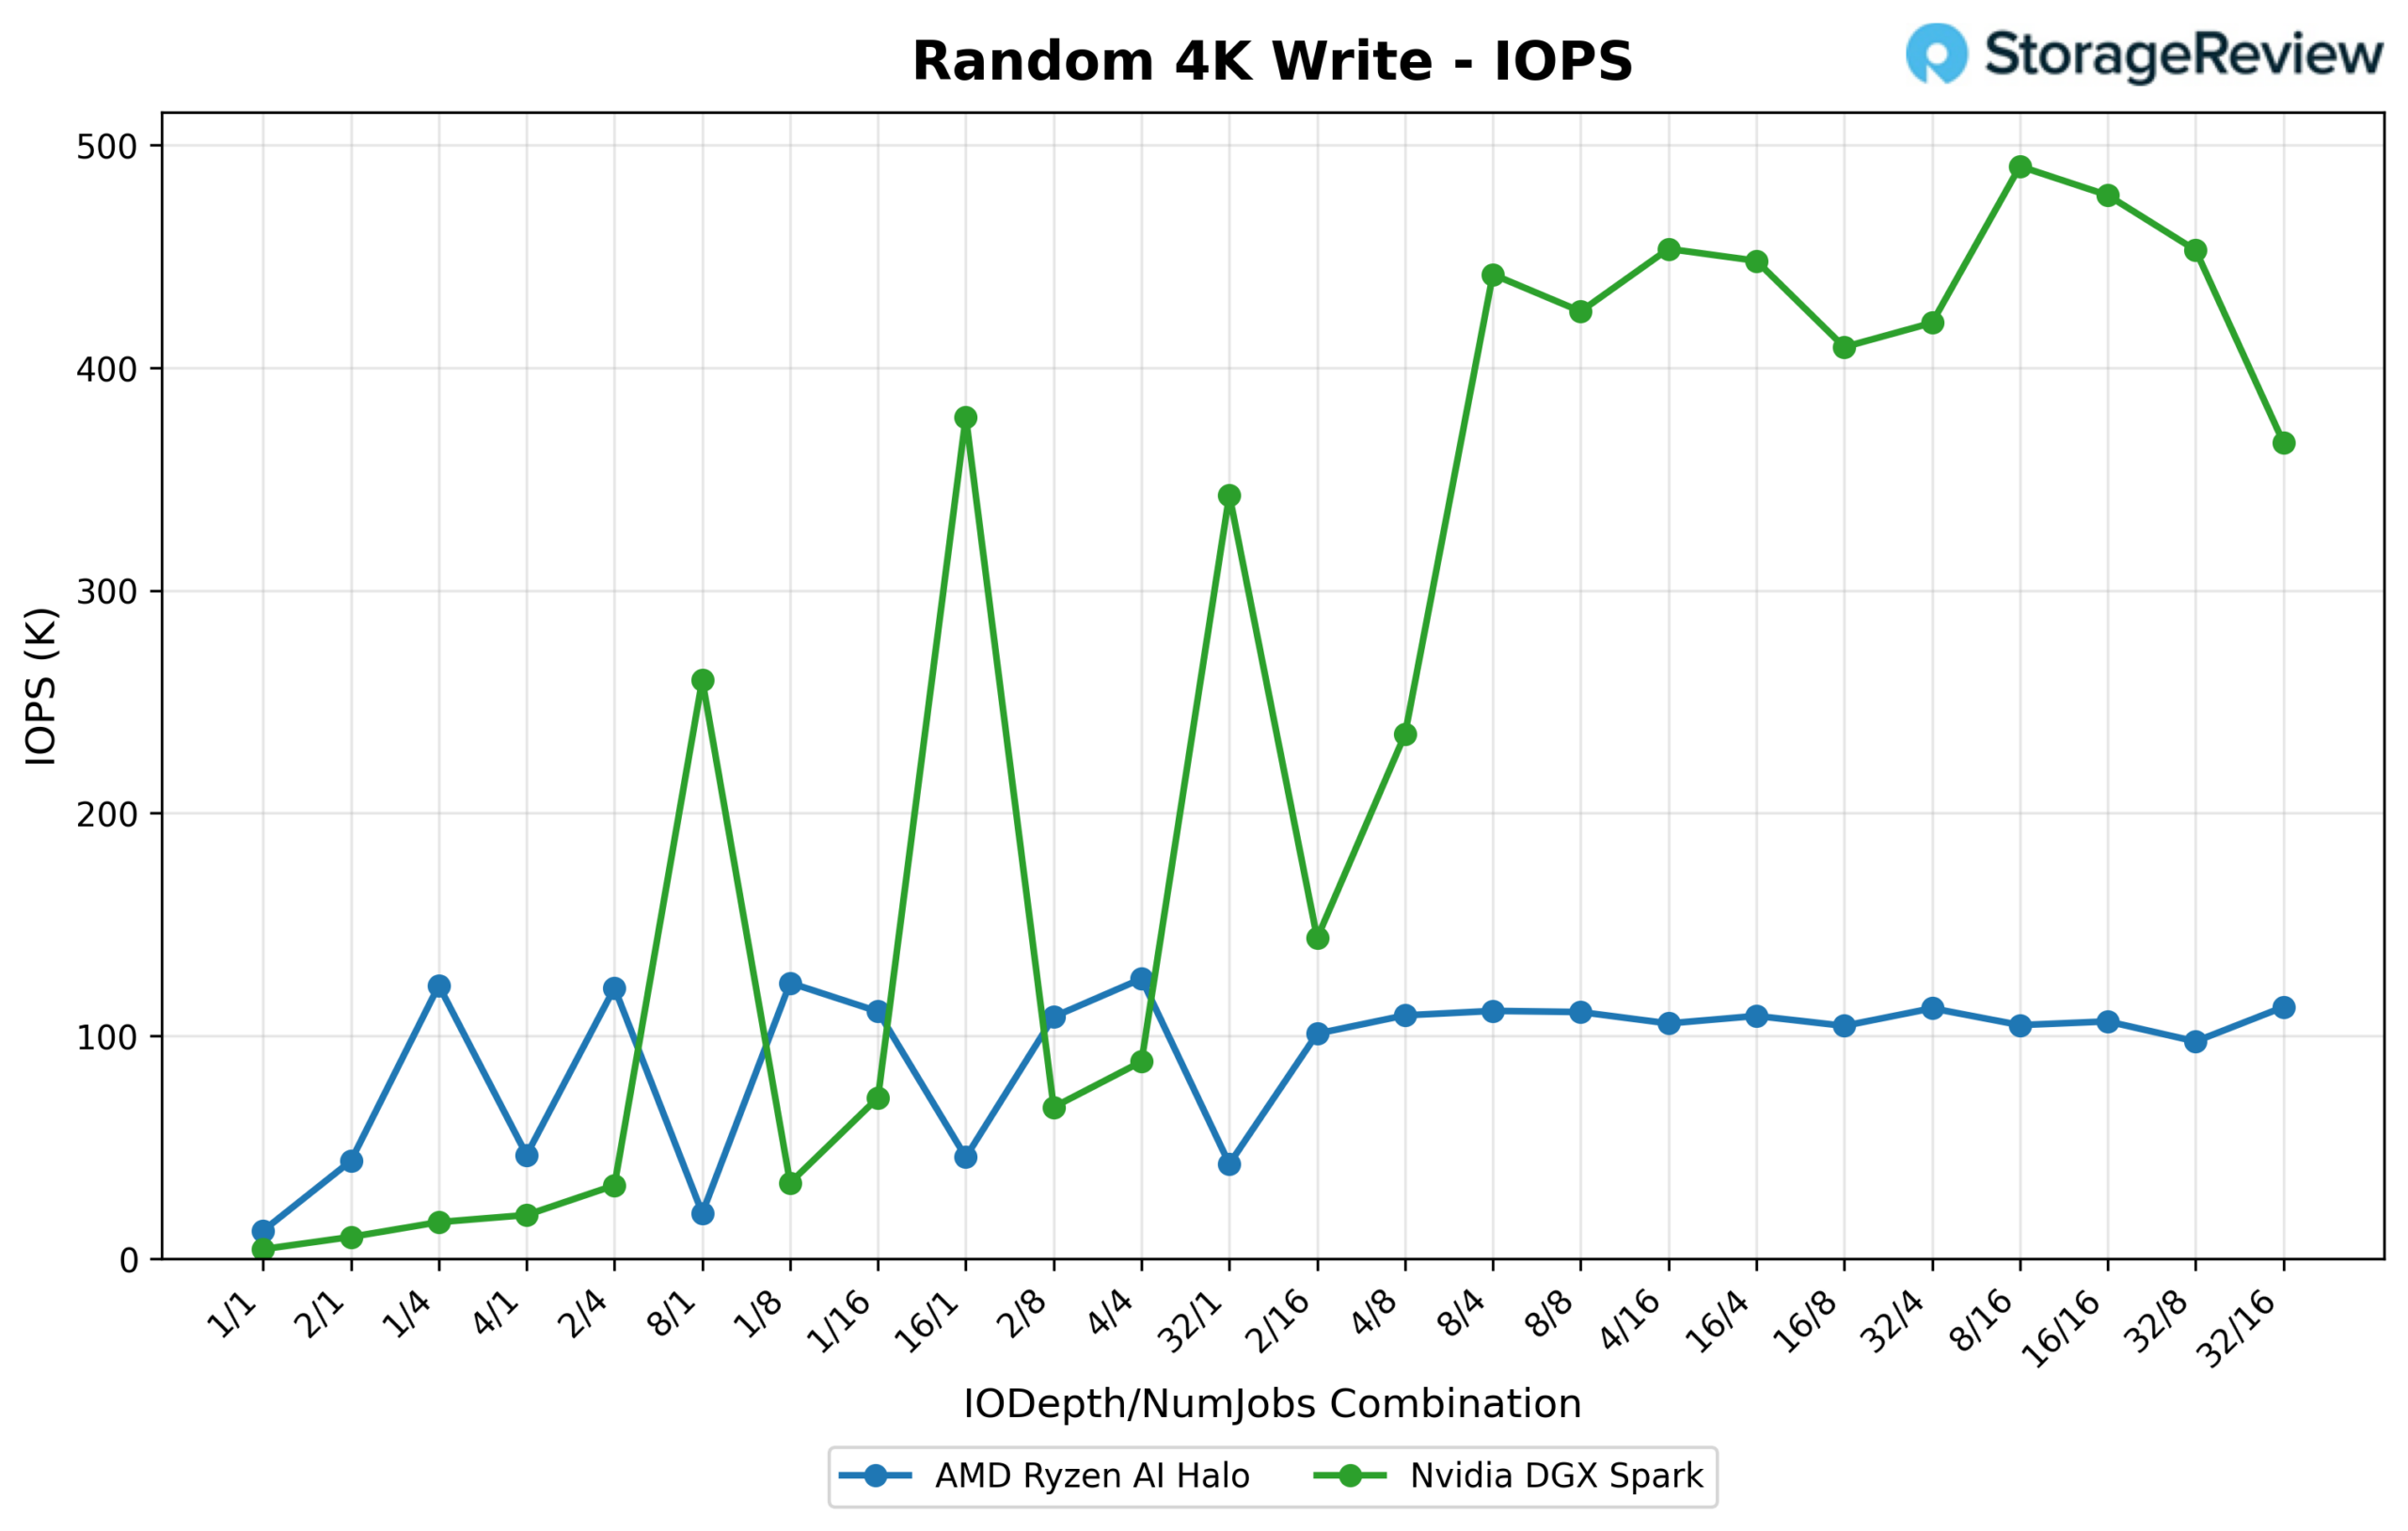
To największa różnica w IOPS w tym cyklu. Wydajność losowego zapisu 4K Sparka gwałtownie rośnie wraz ze wzrostem głębokości kolejki i liczby wątków, osiągając 490.4 tys. IOPS (1,915.6 MB/s) przy 8/16. Tymczasem Halo osiąga plateau znacznie wcześniej i na znacznie niższym poziomie, osiągając szczyt na poziomie 125.6 tys. IOPS (490.7 MB/s) przy 4/4 i nigdy nie przekraczając około 110–115 tys. IOPS przez resztę cyklu. Spark działa tutaj z prawie czterokrotnie większą wydajnością niż Halo.
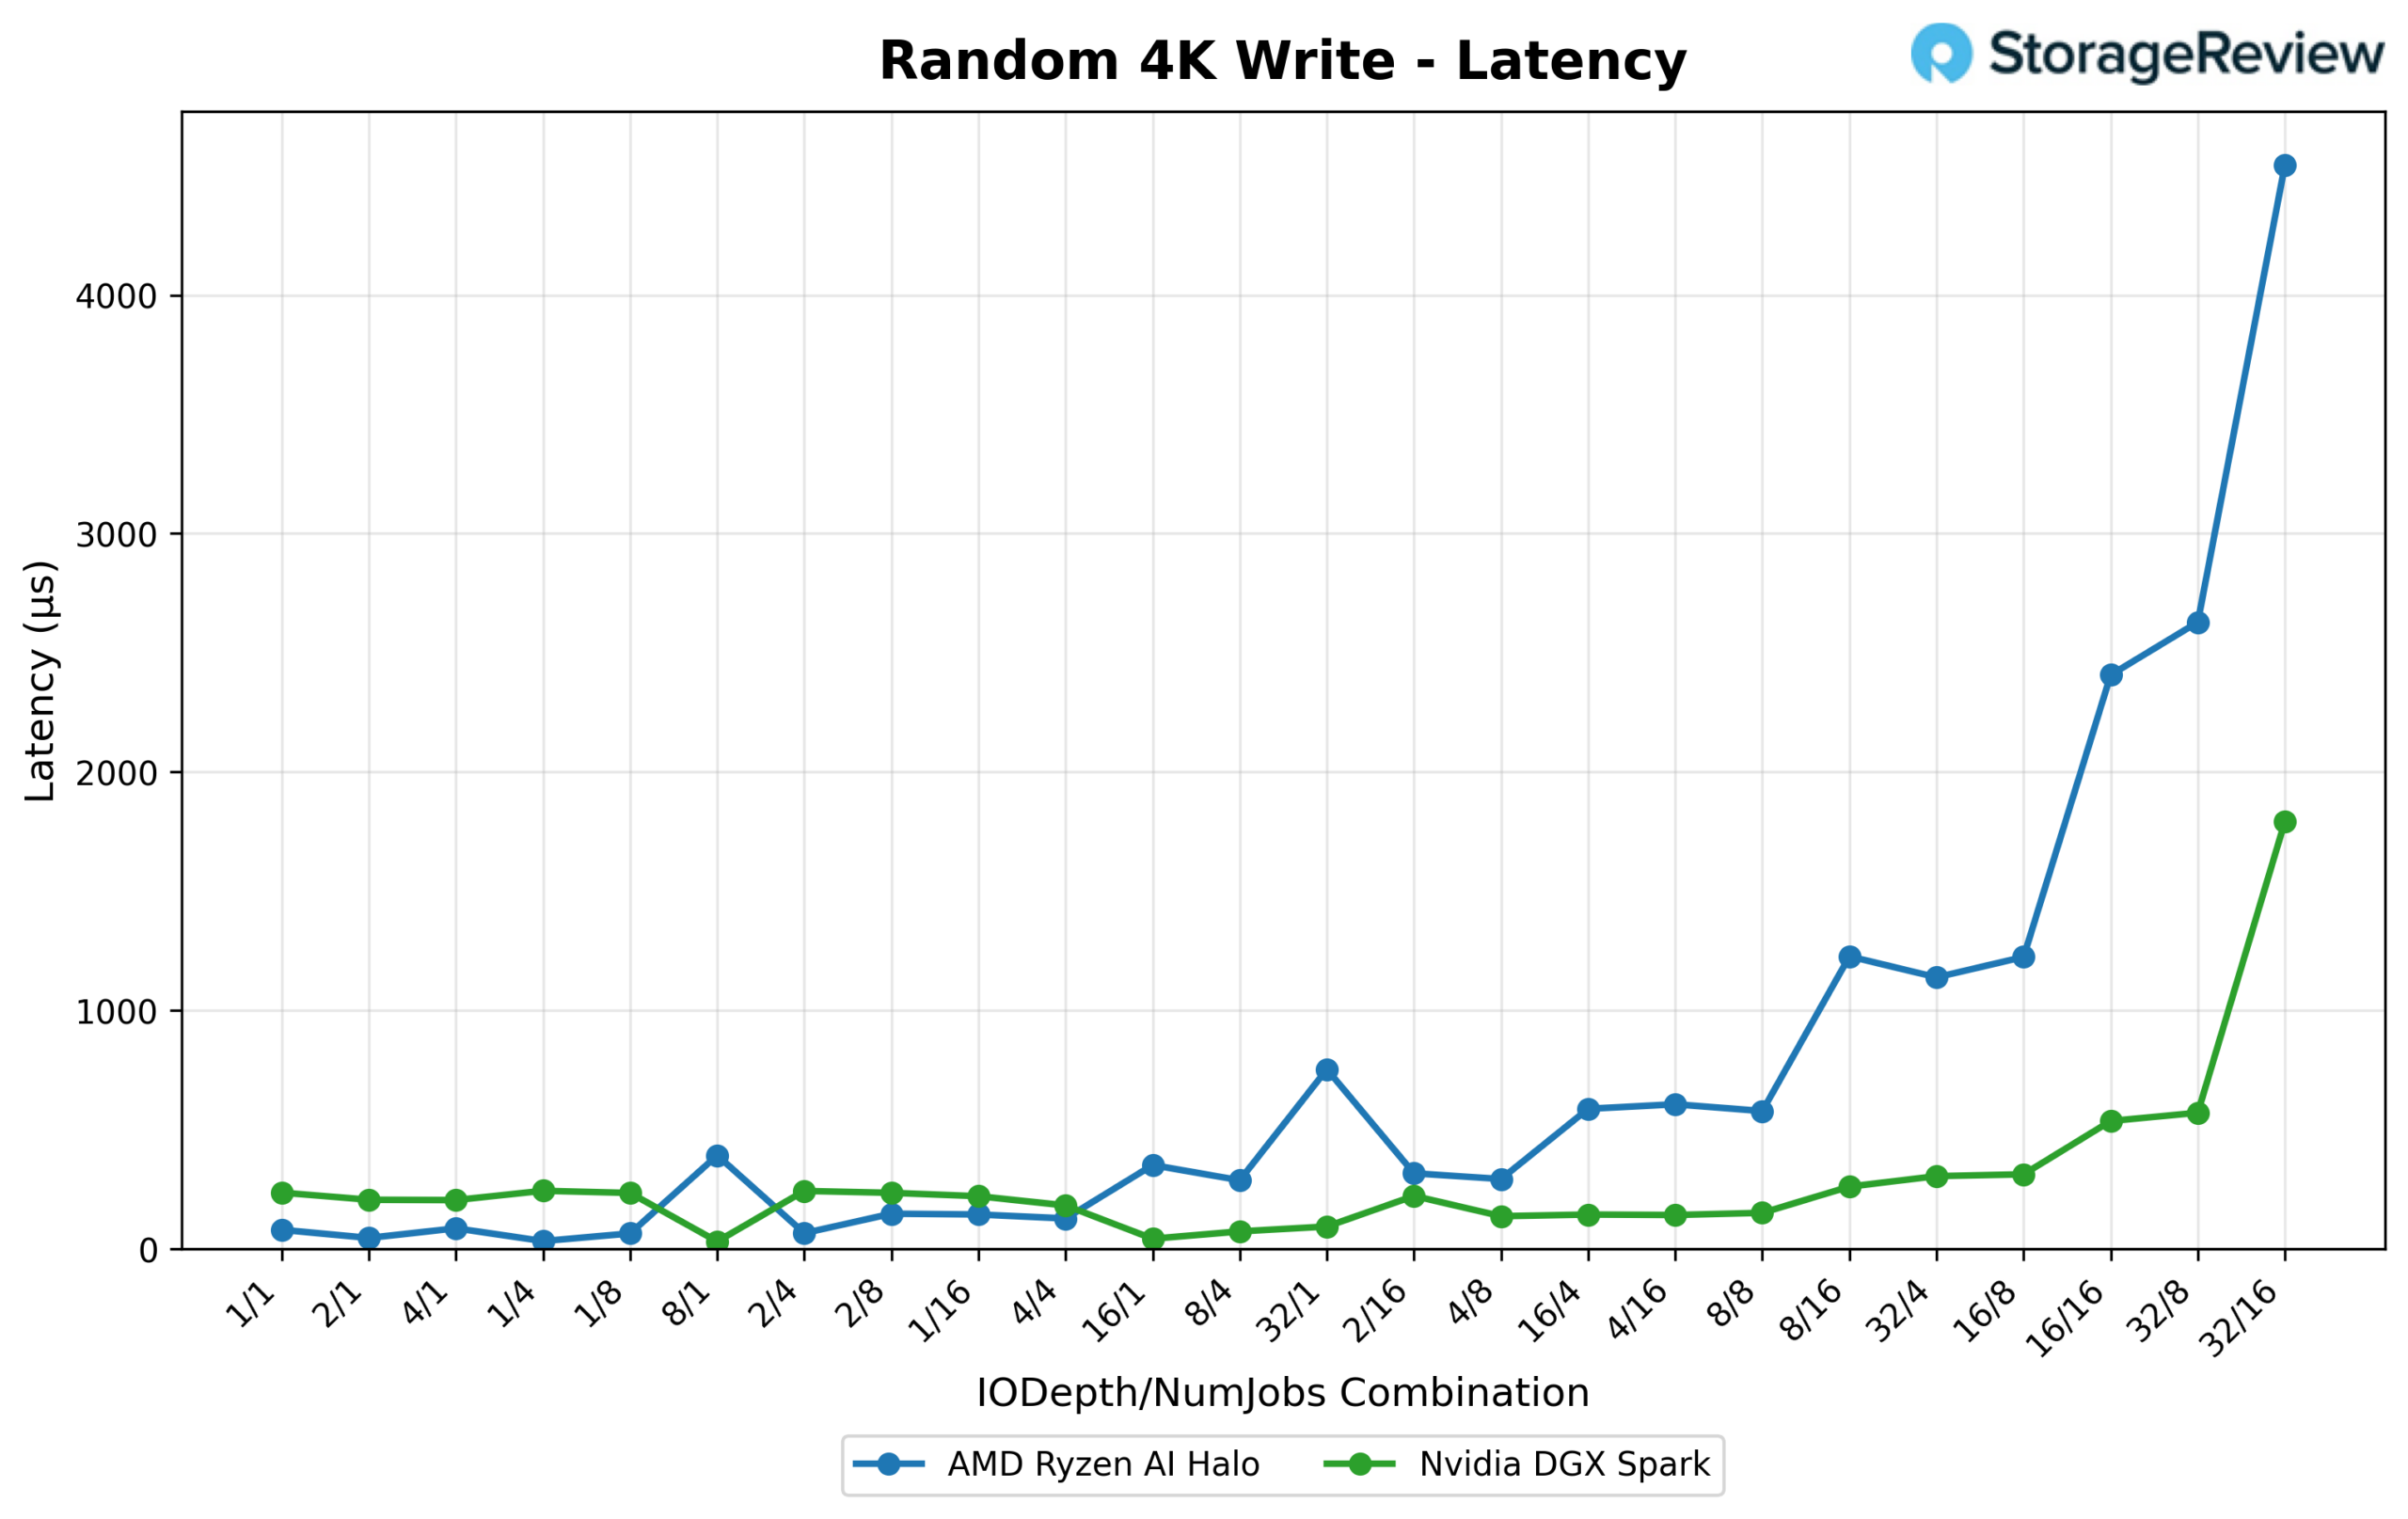
Opóźnienie ponownie zaczyna działać na korzyść Halo przy niskiej głębokości kolejki (0.079 ms w porównaniu z 0.235 ms przy 1/1). Do 32/16 średnie opóźnienie Halo wzrosło do 4.546 ms, podczas gdy Spark pozostaje względnie kontrolowany na poziomie 1.792 ms. W połączeniu z różnicą w IOPS, jest to test, w którym przewaga Sparka jest najbardziej widoczna i najbardziej spójna w całym zakresie głębokości/wątku.
vLLM Online Serving – wydajność wnioskowania LLM
vLLM to jeden z najpopularniejszych wysokoprzepustowych silników wnioskowania i obsługi dla systemów LLM. Test porównawczy obsługi online vLLM ocenia rzeczywistą wydajność obsługi tego silnika wnioskowania przy współbieżnych żądaniach. Symuluje obciążenia produkcyjne poprzez wysyłanie żądań do działającego serwera vLLM, z konfigurowalnymi parametrami, takimi jak częstotliwość żądań, długość wejścia i wyjścia oraz liczba współbieżnych klientów. Test mierzy kluczowe wskaźniki, takie jak przepustowość (liczba tokenów na sekundę), czas do pierwszego tokena i czas na token wyjściowy (TPOT), pomagając użytkownikom zrozumieć, jak vLLM działa w różnych warunkach obciążenia.
Przetestowaliśmy wydajność wnioskowania w ramach kompleksowego zestawu modeli obejmujących różne architektury, skale parametrów i strategie kwantyzacji, aby ocenić przepustowość w różnych profilach współbieżności.
GPT OSS 120B
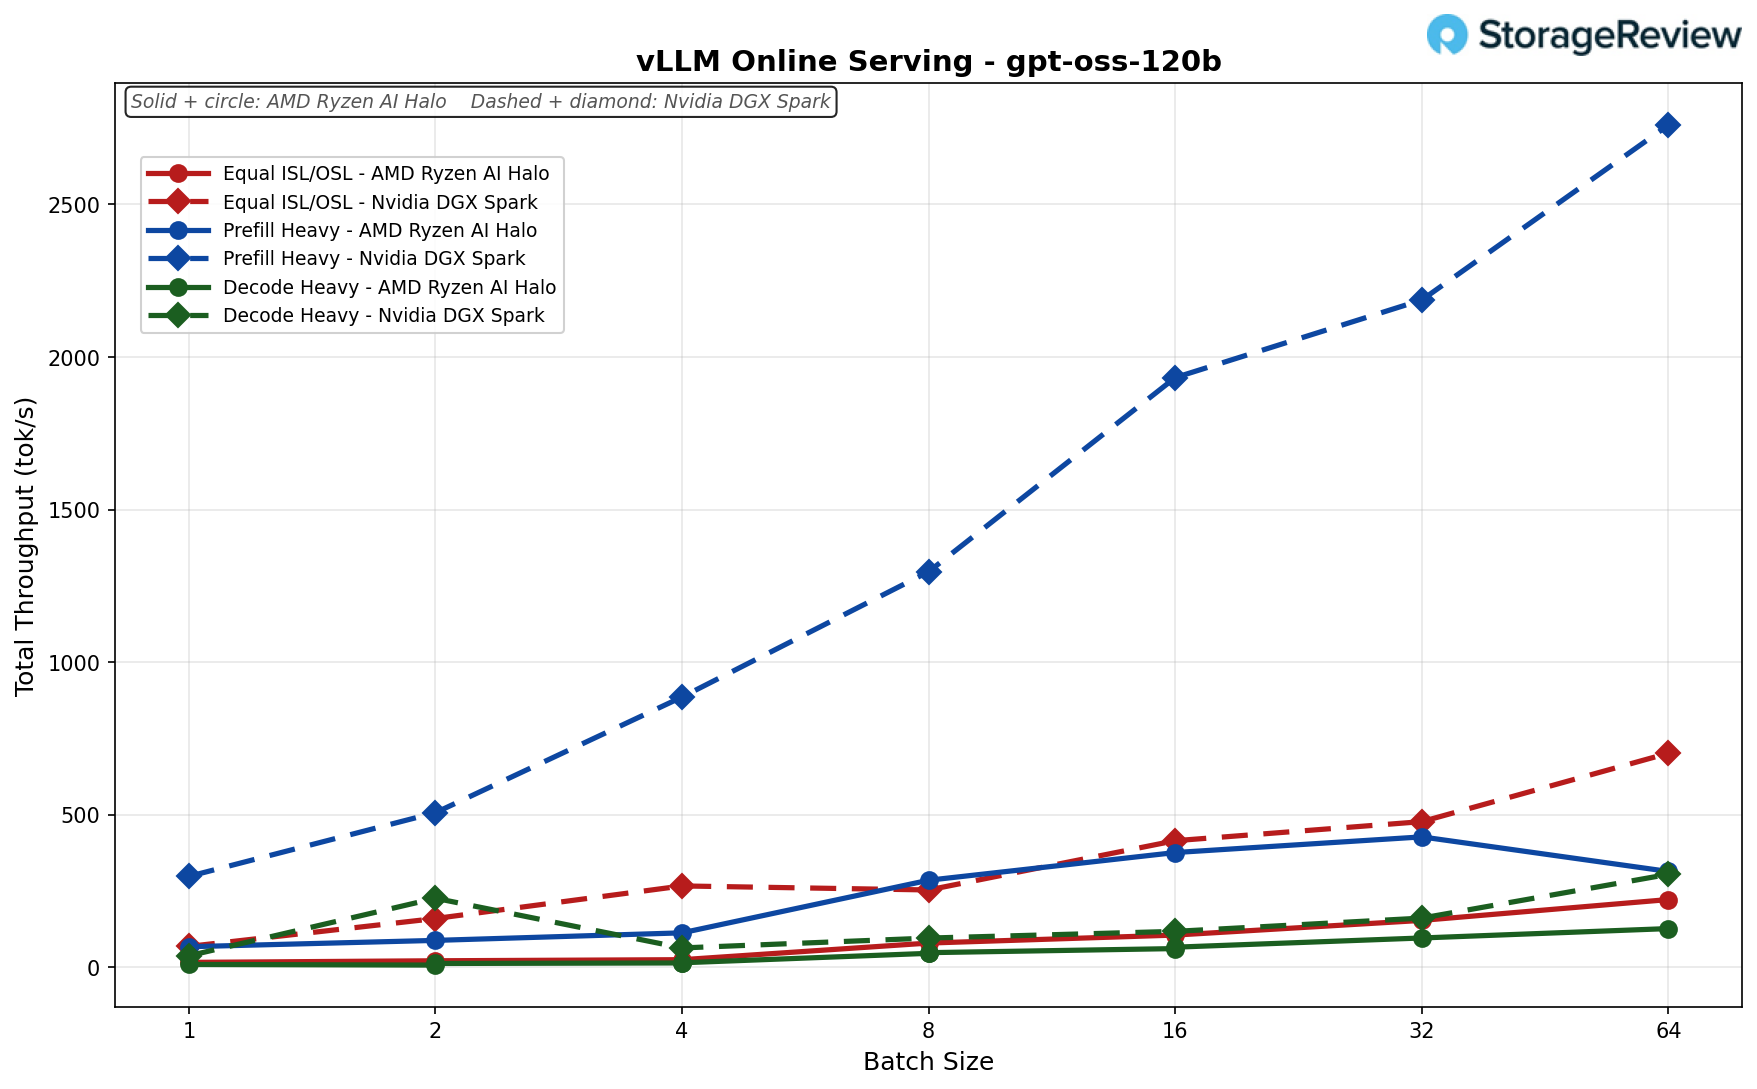
Równy ISL/OSL (256/256): Halo osiągnęło 222 tok/s przy rozmiarze partii 64, podczas gdy Spark osiągnął 701 (około 3.2x mniej).
Prefill Heavy (8k/1k): Przepustowość Halo osiągnęła szczyt w partii 32 (427 tok/s), a następnie spadła do 314 w partii 64, podczas gdy Spark wzrósł do 2,760 (około 8.8x) — była to największa różnica w zestawie.
Decode Heavy (1k/8k): Halo osiągnęło 127 tok/s, w porównaniu z 305 tok/s Sparka przy rozmiarze partii 64 (około 2.4x).
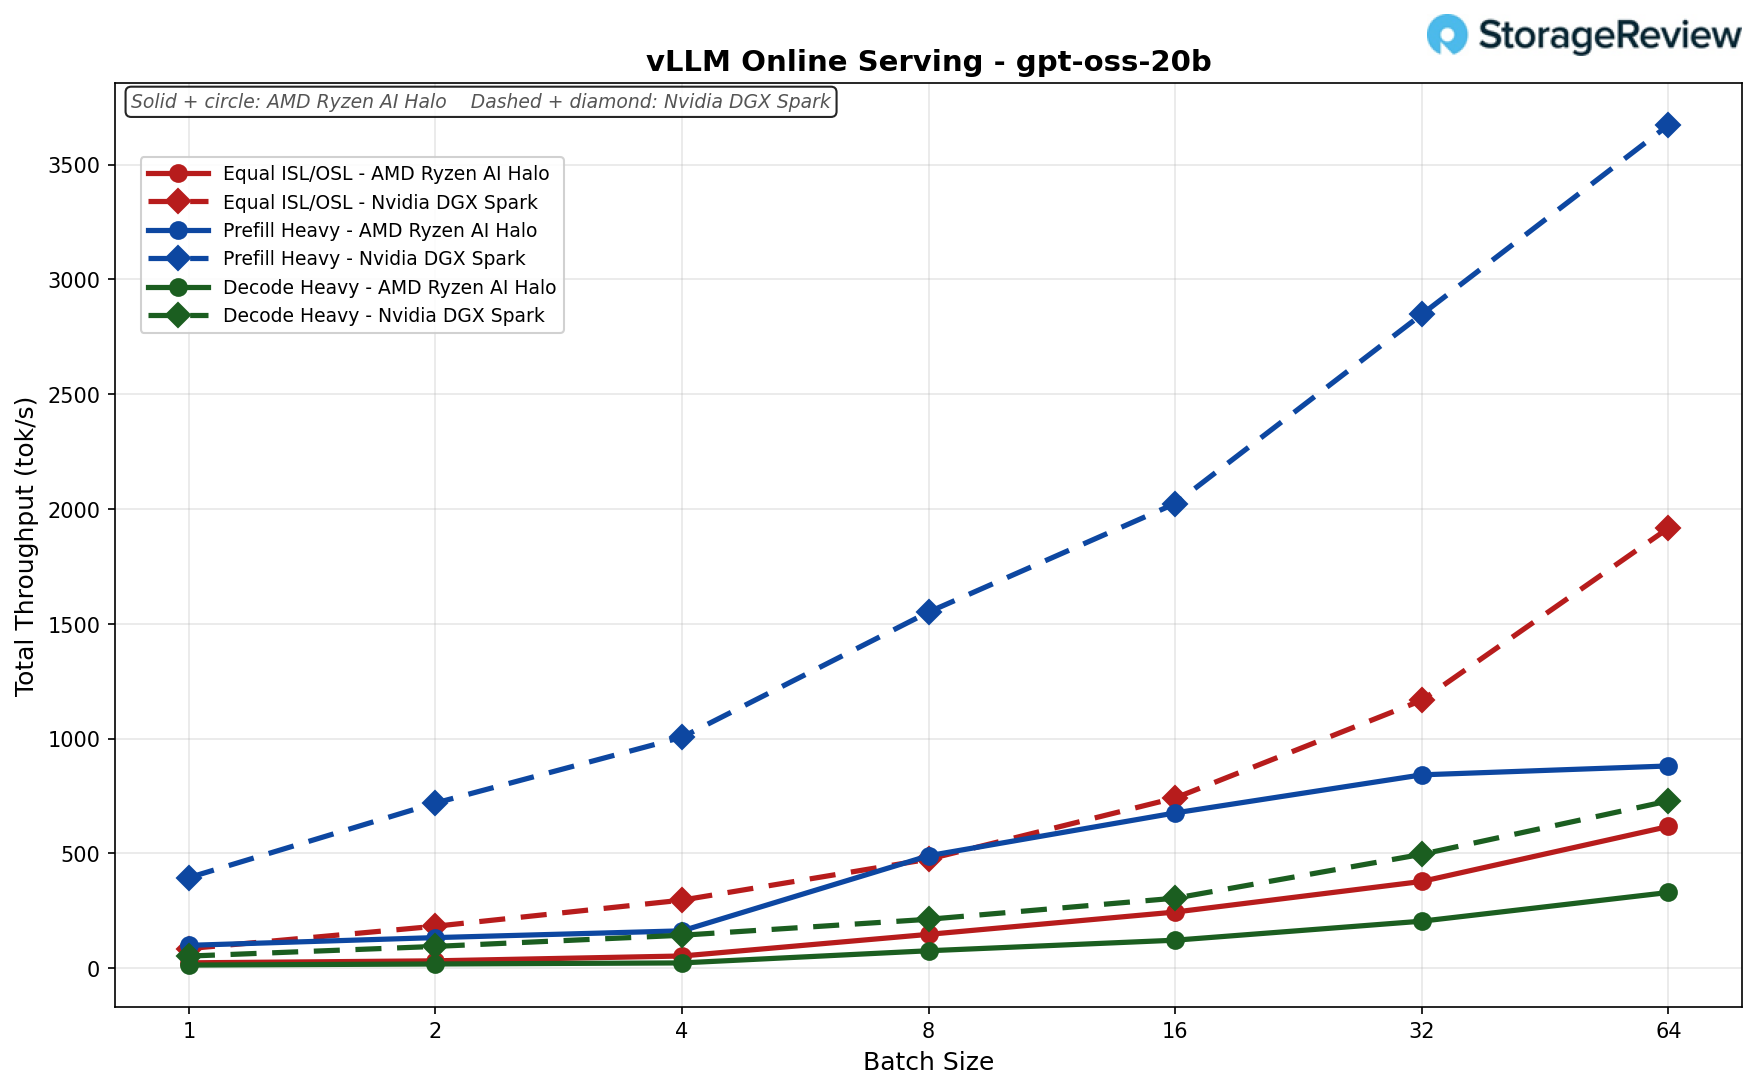
GPT OSS 20B
Równy ISL/OSL (256/256): Spark prowadził w każdej partii, skalując się do 1,917 w porównaniu do 617 tok/s w partii 64 (Spark około 3.1x do przodu).
Prefill Heavy (8 tys./1 tys.): największa przewaga Spark, wzrastająca do 3,672 w porównaniu do 881 tok/s przy rozmiarze partii 64 (Spark ma około 4.2-krotną przewagę).
Decode Heavy (1k/8k): Spark ma przewagę przez cały czas, osiągając 728 w porównaniu do 330 tok/s w partii 64 (Spark ma przewagę około 2.2x).
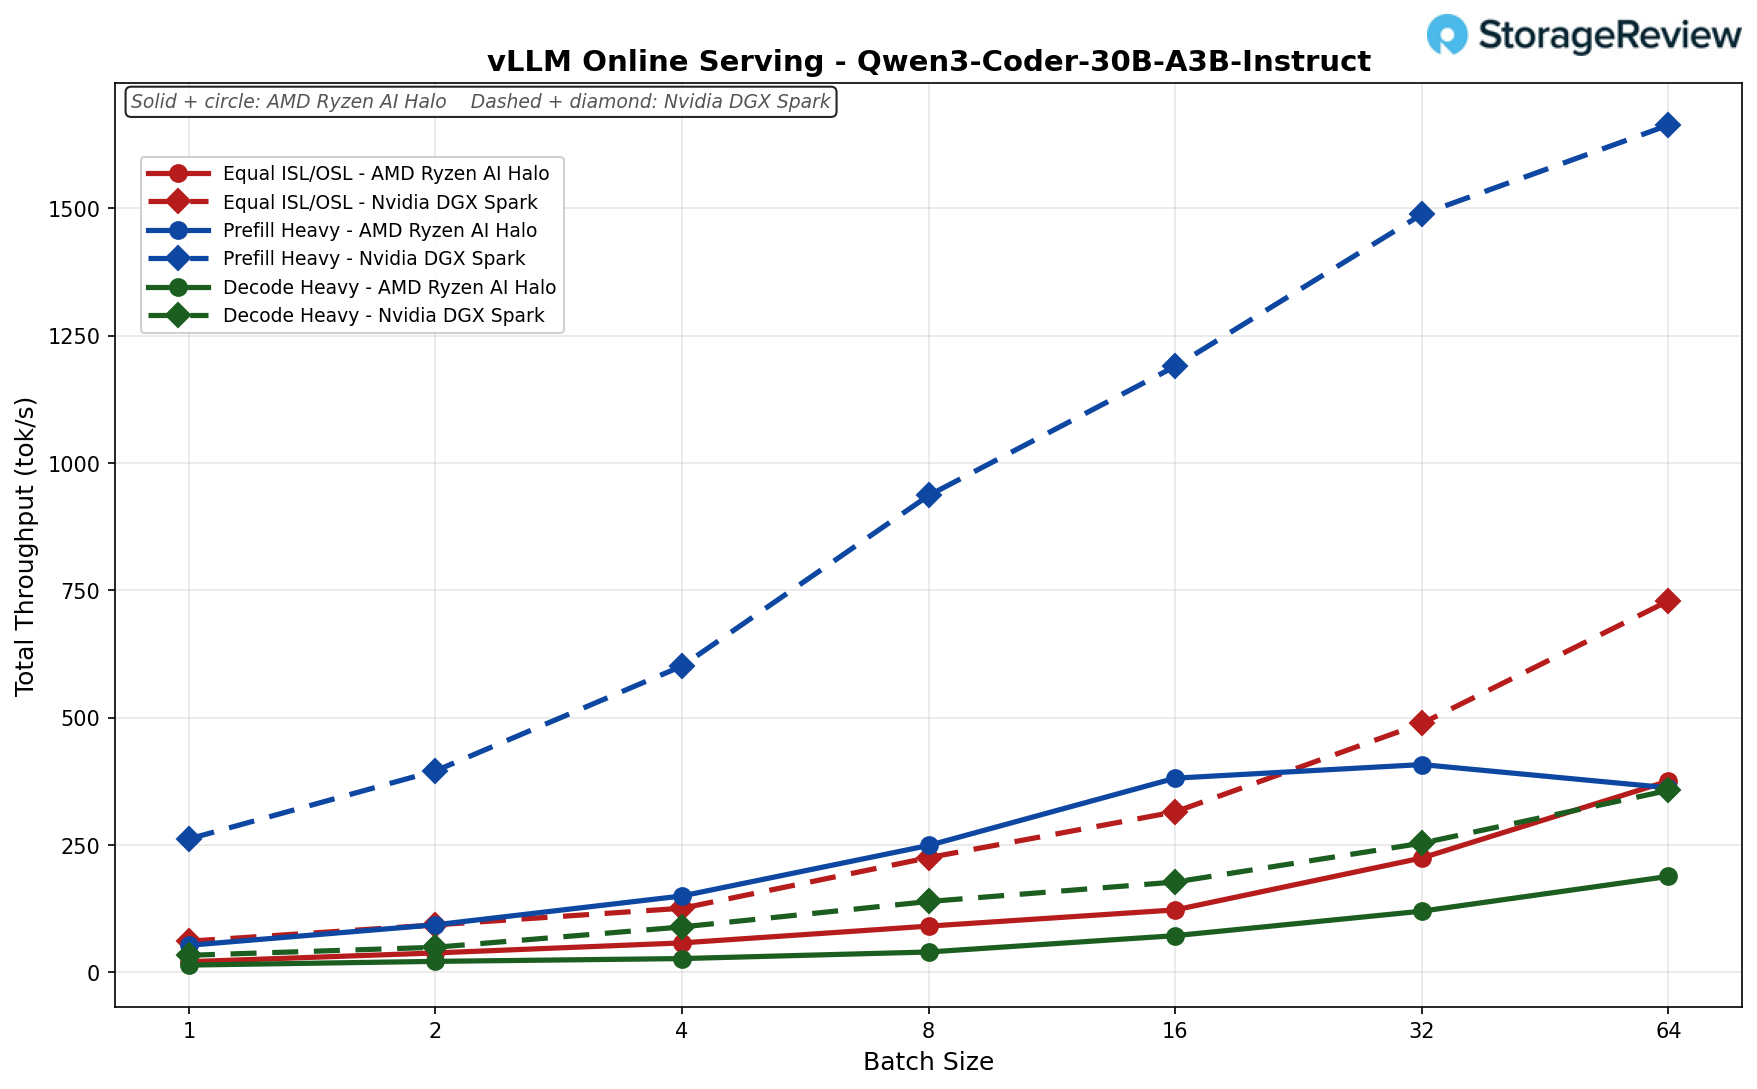
Instrukcja Qwen3 Coder 30B A3B
Równe ISL/OSL (256/256): Halo osiągnęło 376 tok/s przy rozmiarze partii 64, co stanowi mniej więcej połowę 729 wyników Spark (około 1.9x) — jeden z lepszych wyników Equal ISL/OSL.
Prefill Heavy (8k/1k): Halo osiągnęło szczyt w partii 32 (408 tok/s), a następnie spadło do 362 w partii 64, pozostając w tyle za Sparkiem z wynikiem 1,663 (około 4.6x).
Decode Heavy (1k/8k): Halo osiągnęło 188 tok/s, w porównaniu z 357 tok/s dla Spark przy rozmiarze partii 64 (około 1.9x).
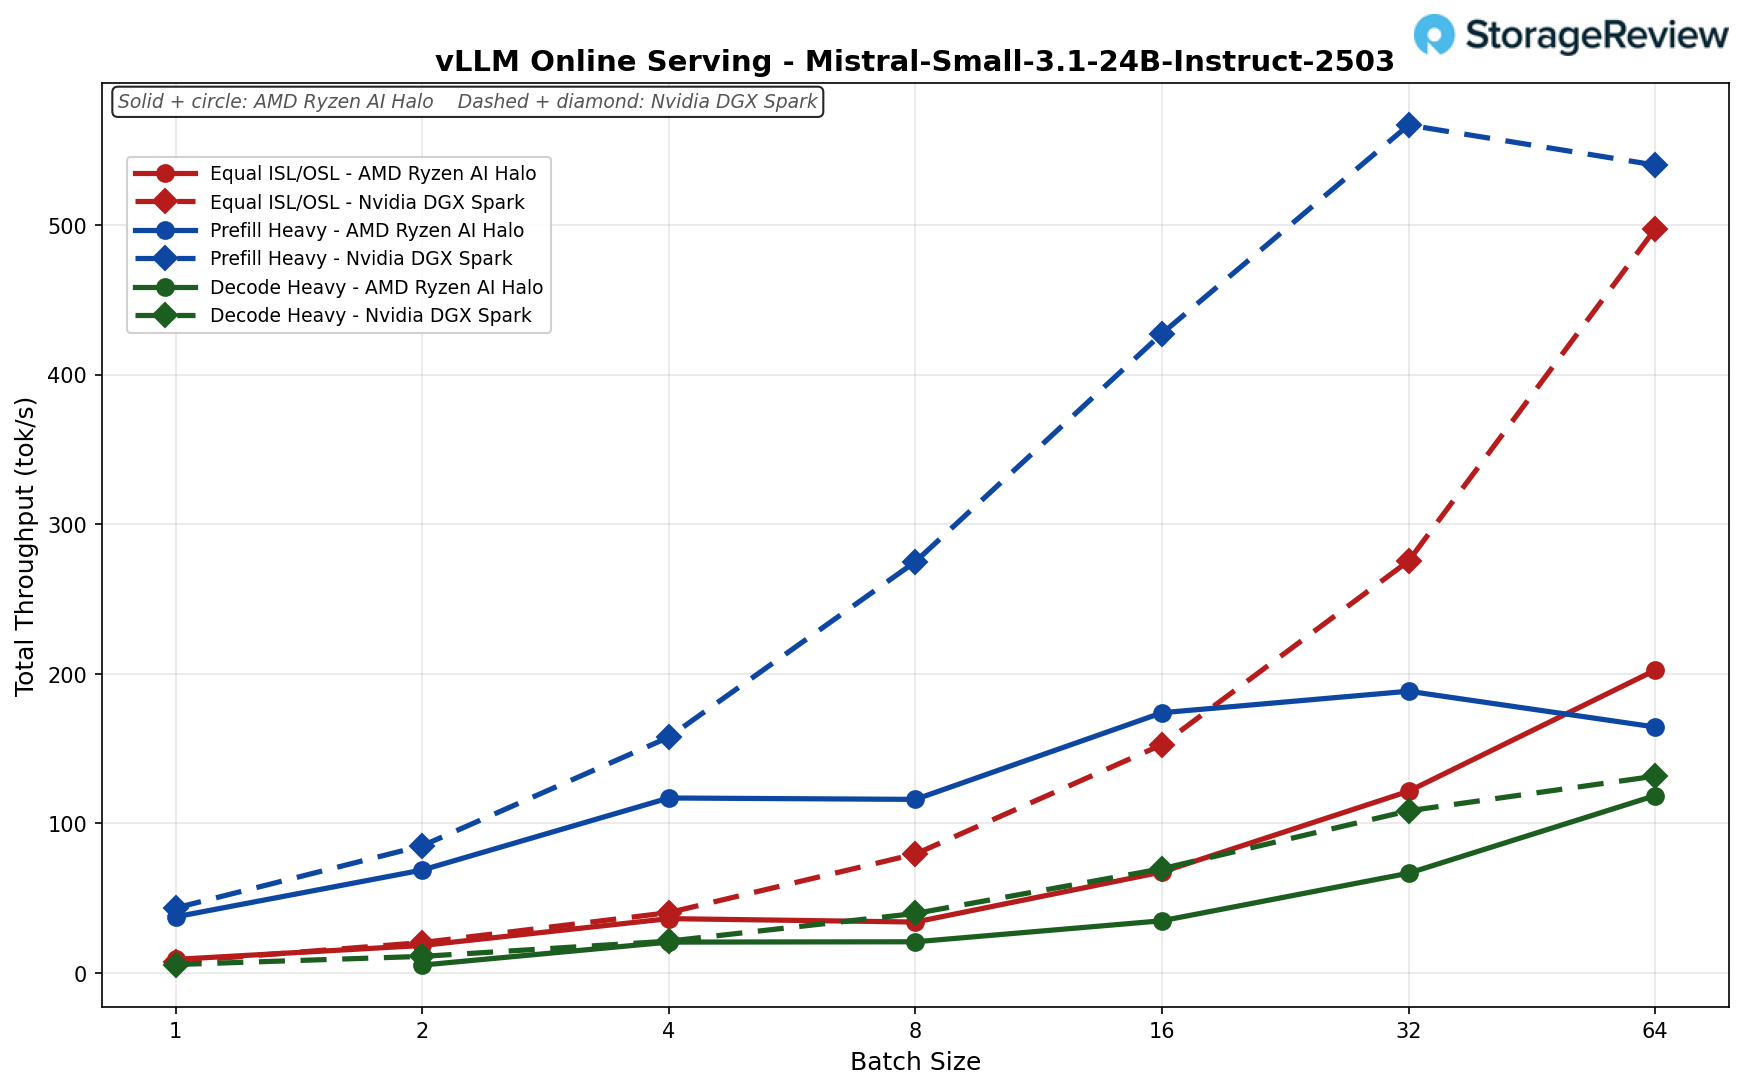
Mistral Small 3.1 24B Instrukcja
Równy wynik ISL/OSL (256/256): Halo faktycznie prowadziło w partii 1 (9 vs. 8 tok/s), a następnie ustabilizowało się na poziomie 202 tok/s w partii 64, podczas gdy Spark osiągnął wynik 498 (około 2.5x gorzej).
Prefill Heavy (8k/1k): Halo osiągnęło szczyt w partii 32 (188 tok/s), a następnie nieznacznie spadło do 164 w partii 64, pozostając w tyle za Sparkiem z wynikiem 540 (około 3.3x).
Decode Heavy (1 tys./8 tys.): Prawie remis, Halo osiągnął 119 tok/s, a Spark 132 w partii 64 (różnica w granicach 11%).
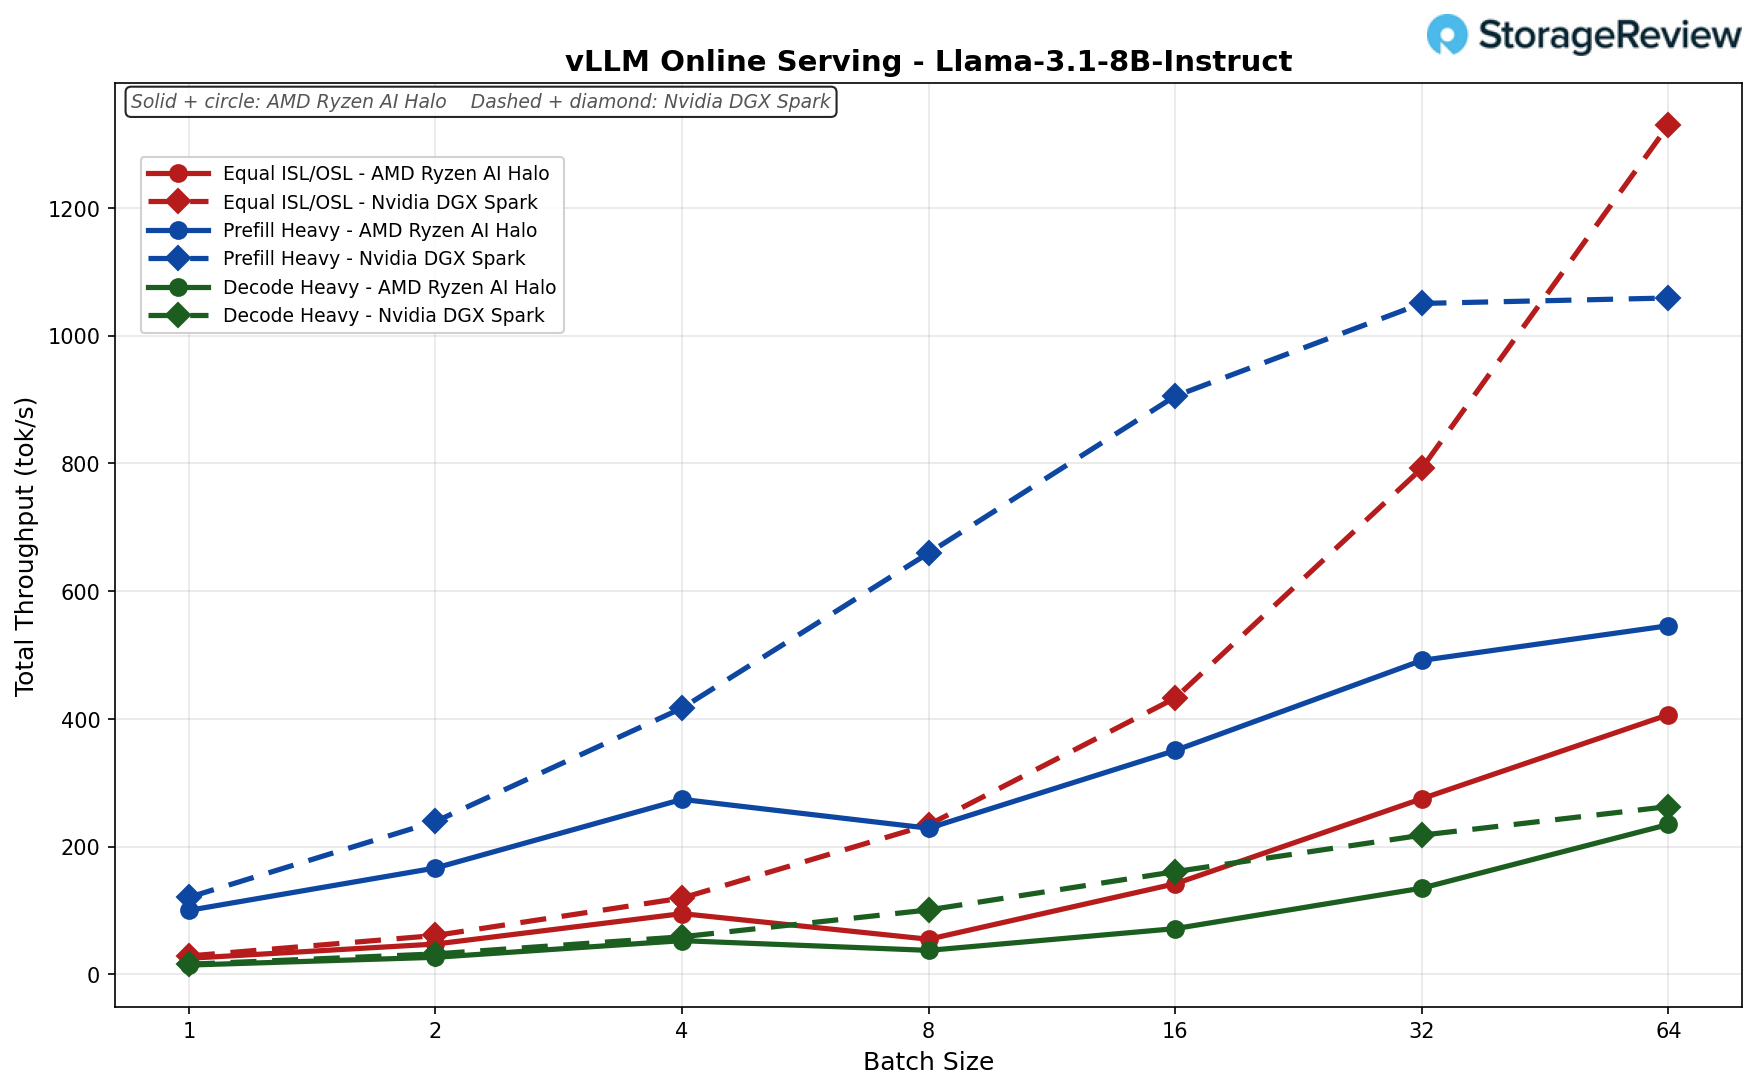
Lama 3.1 8B Instruktaż
Równy ISL/OSL (256/256): Halo skalowało się czysto od 25 tok/s w partii 1 do 407 tok/s w partii 64, podążając blisko Sparka w partii 4, po czym Spark wyprzedził go do 1,330 (Halo pozostawało w tyle o około 3.3x w szczytowym momencie).
Prefill Heavy (8k/1k): Halo osiągnęło 546 tok/s przy rozmiarze partii 64, utrzymując mniej więcej połowę 1,059 tok/s Sparka.
Decode Heavy (1k/8k): Najbardziej konkurencyjny scenariusz Halo, osiągający 235 tok/s w porównaniu z 263 tok/s w przypadku Spark przy rozmiarze partii wynoszącym 64 (z odchyleniem o około 12%).
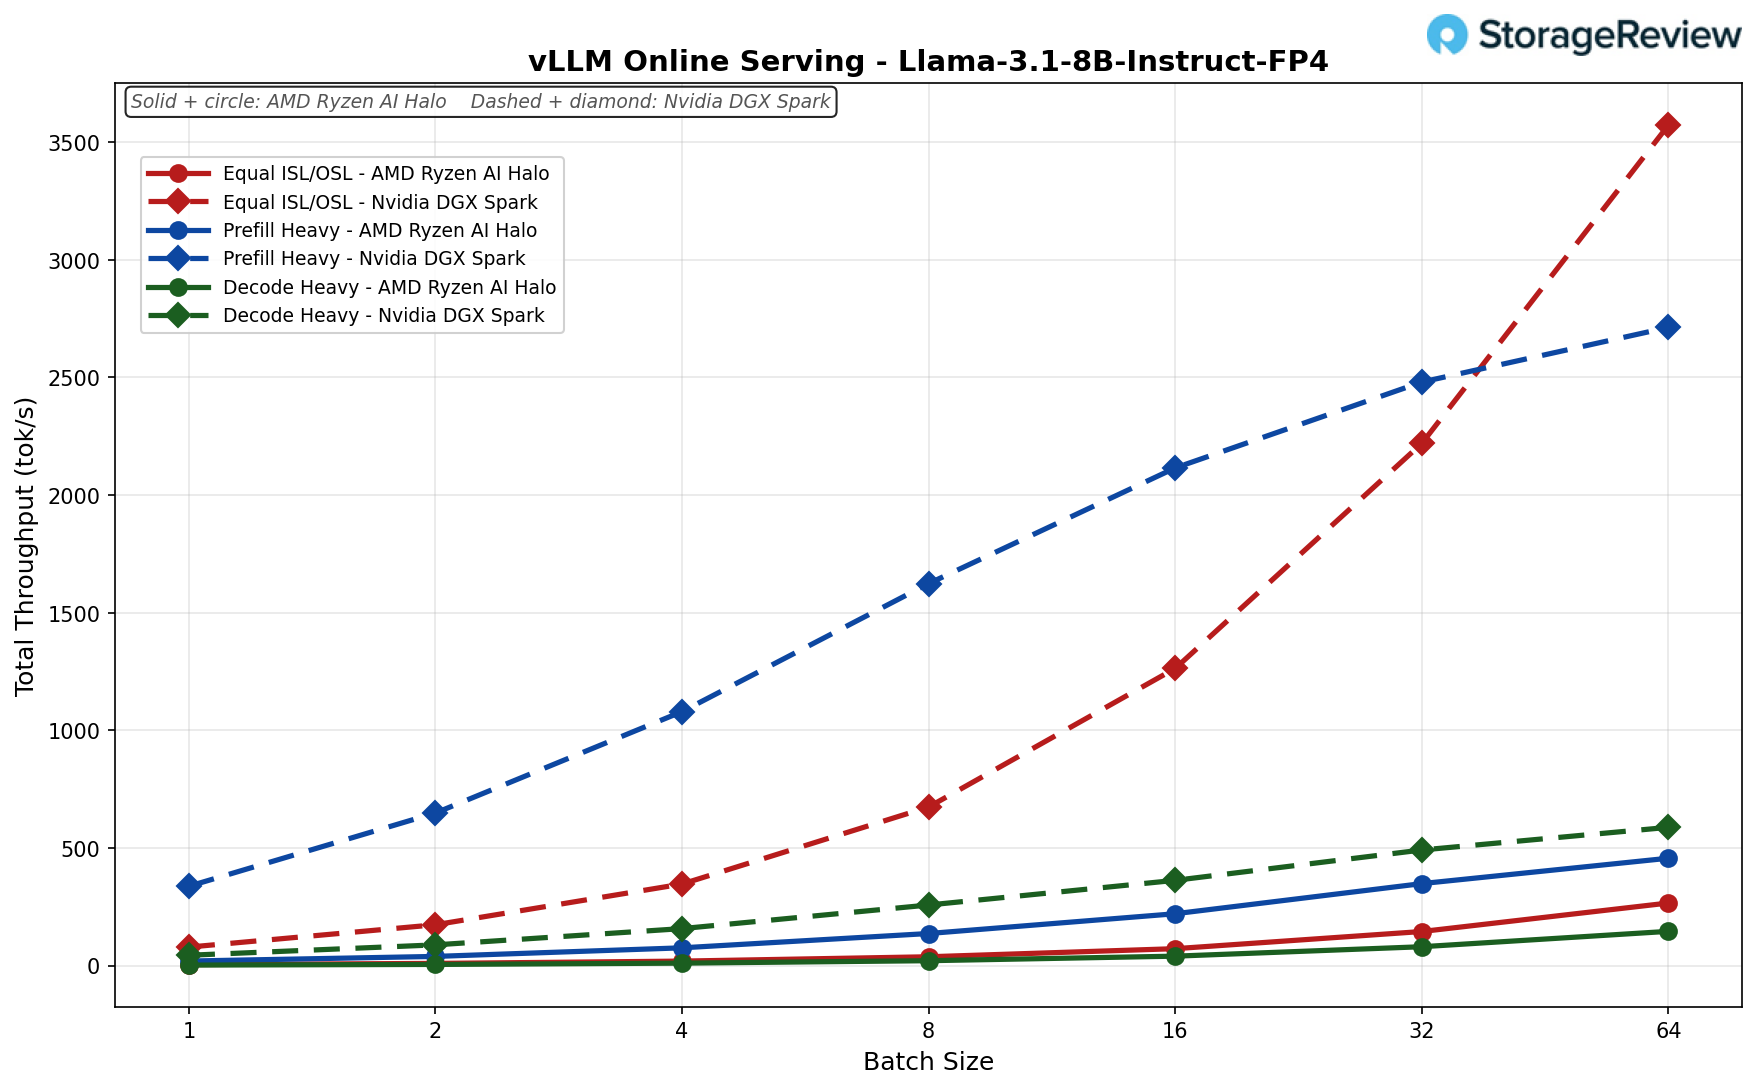
Llama 3.1 8B Instrukcja FP4
Równy ISL/OSL (256/256): Halo osiągnął szczyt na poziomie 267 tok/s przy rozmiarze partii 64, znacznie poniżej Sparka z wynikiem 3,573 — FP4 wykazuje największą różnicę (około 13.4x).
Prefill Heavy (8k/1k): Halo osiągnęło 457 tok/s przy rozmiarze partii 64, w porównaniu z 2,713 dla Spark (około 5.9x).
Decode Heavy (1k/8k): Halo osiągnęło 146 tok/s, w porównaniu z 588 tok/s Sparka przy rozmiarze partii wynoszącym 64 (około 4x).
Wniosek
AMD Ryzen AI Halo wkracza w kategorię, którą NVIDIA skutecznie stworzyła dzięki DGX Spark, i nie próbuje pokonać Sparka w jego własnej grze. W naszych testach vLLM, Spark miał dwu- do czterokrotną przewagę w przepustowości w większości scenariuszy przy wyższej współbieżności, zwiększając ją do 8.8-krotnie w przypadku zadań z prefillem GPT OSS 120B i zawężając do około 10% jedynie w dwóch przebiegach wymagających dekodowania, a jego podsystem pamięci masowej wygrał niemal każdy test FIO przy nasyceniu. Halo oferuje natomiast te same 128 GB zunifikowanej pamięci i limit 200 miliardów parametrów w podobnej obudowie, w cenie 3,999 USD w porównaniu z 4,699 USD za Spark Founders Edition (choć niektórzy producenci OEM oferują je poniżej 4,000 USD), w pełnej maszynie x86, która uruchamia system Windows 11 lub Linux, a nie sam system DGX.
Odłóżmy Sparka na bok, a Halo to najmocniejsza implementacja Ryzen AI Max+ 395, jaką testowaliśmy. Uzyskał najwyższe noty w porównaniu z HP Z2 Mini G1a i ZBook Ultra G1a w niemal każdym uruchomionym przez nas obciążeniu systemu Windows: 37 316 w wielordzeniowym Cinebench R23, 184.2 GIPS w 7-Zip w porównaniu ze 151.6 i 156.8 dla HP, najwyższe wyniki generowania tekstu i obrazu przez Procyon AI oraz najszybsze czasy y-cruncher na poziomie 5 i 10 miliardów cyfr. Na Linuksie, w porównaniu ze Sparkiem, wygrał testy Phoronix obciążające procesor, kompresując o 11% szybciej w 7-Zip i kończąc kompilację LLVM o 14% szybciej. To pierwsza kompaktowa stacja robocza, w której rola programisty AI jest nałożona na nią, a nie ją zastępuje.
Deweloperzy, którzy potrzebują maksymalnej liczby lokalnych tokenów na sekundę lub planują klastrowanie węzłów w szybkiej sieci szkieletowej, nadal powinni kupić Sparka; limity 10 GbE i vLLM Halo są bardzo bliskie. Dla deweloperów tworzących komputery pod ROCm, zespołów, które potrzebują systemu Windows, lub każdego, kto potrzebuje jednego komputera do obsługi profesjonalnych obciążeń i pracy z modelami lokalnymi, Halo jest lepszym wyborem. Standardowa zatoka M.2 2280 i wstępnie dostrojona pamięć graficzna Variable Graphics Memory eliminują dwa najczęstsze problemy zgłaszane przez posiadaczy komputerów Spark. AMD zapowiedziało również, że platforma otrzyma układy scalone Ryzen AI Max PRO serii 400 z maksymalnie 192 GB pamięci zunifikowanej w trzecim kwartale, więc nabywcy poszukujący większych modeli mają jasną ścieżkę rozwoju bez konieczności zmiany platformy.
Strona produktu – AMD Ryzen AI Halo
Tabela wyników: AMD Ryzen AI Halo zajmuje pierwsze miejsce w rankingu najlepszych komputerów stacjonarnych dla lokalnej sztucznej inteligencji jako najlepsza alternatywa dla procesorów x86.



 Amazon