

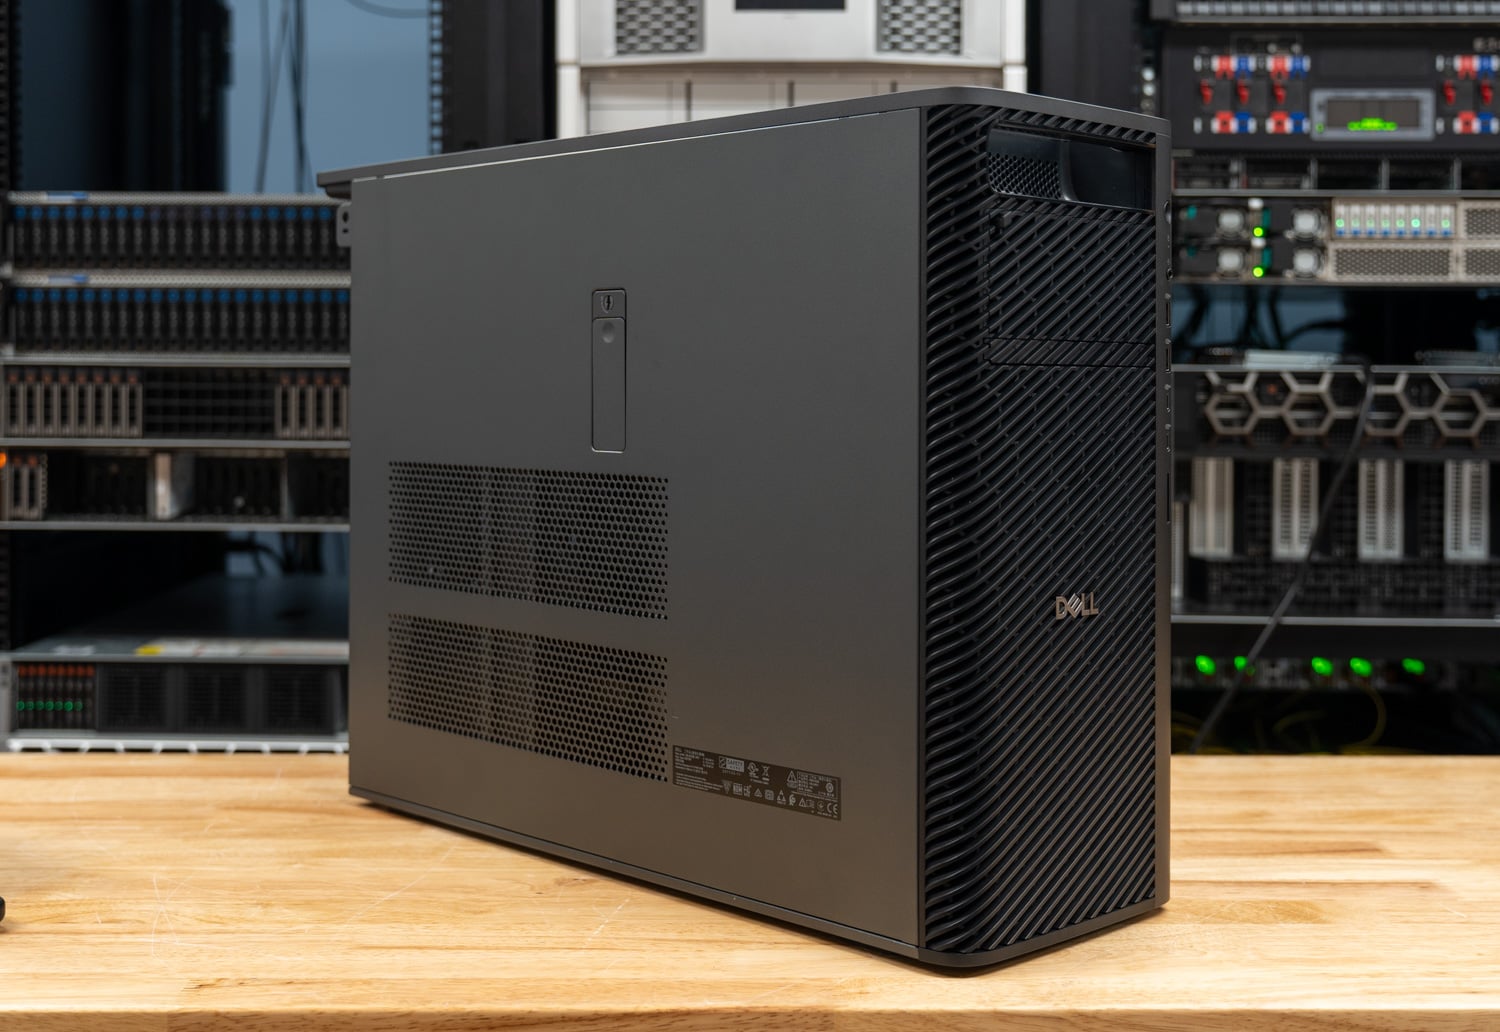
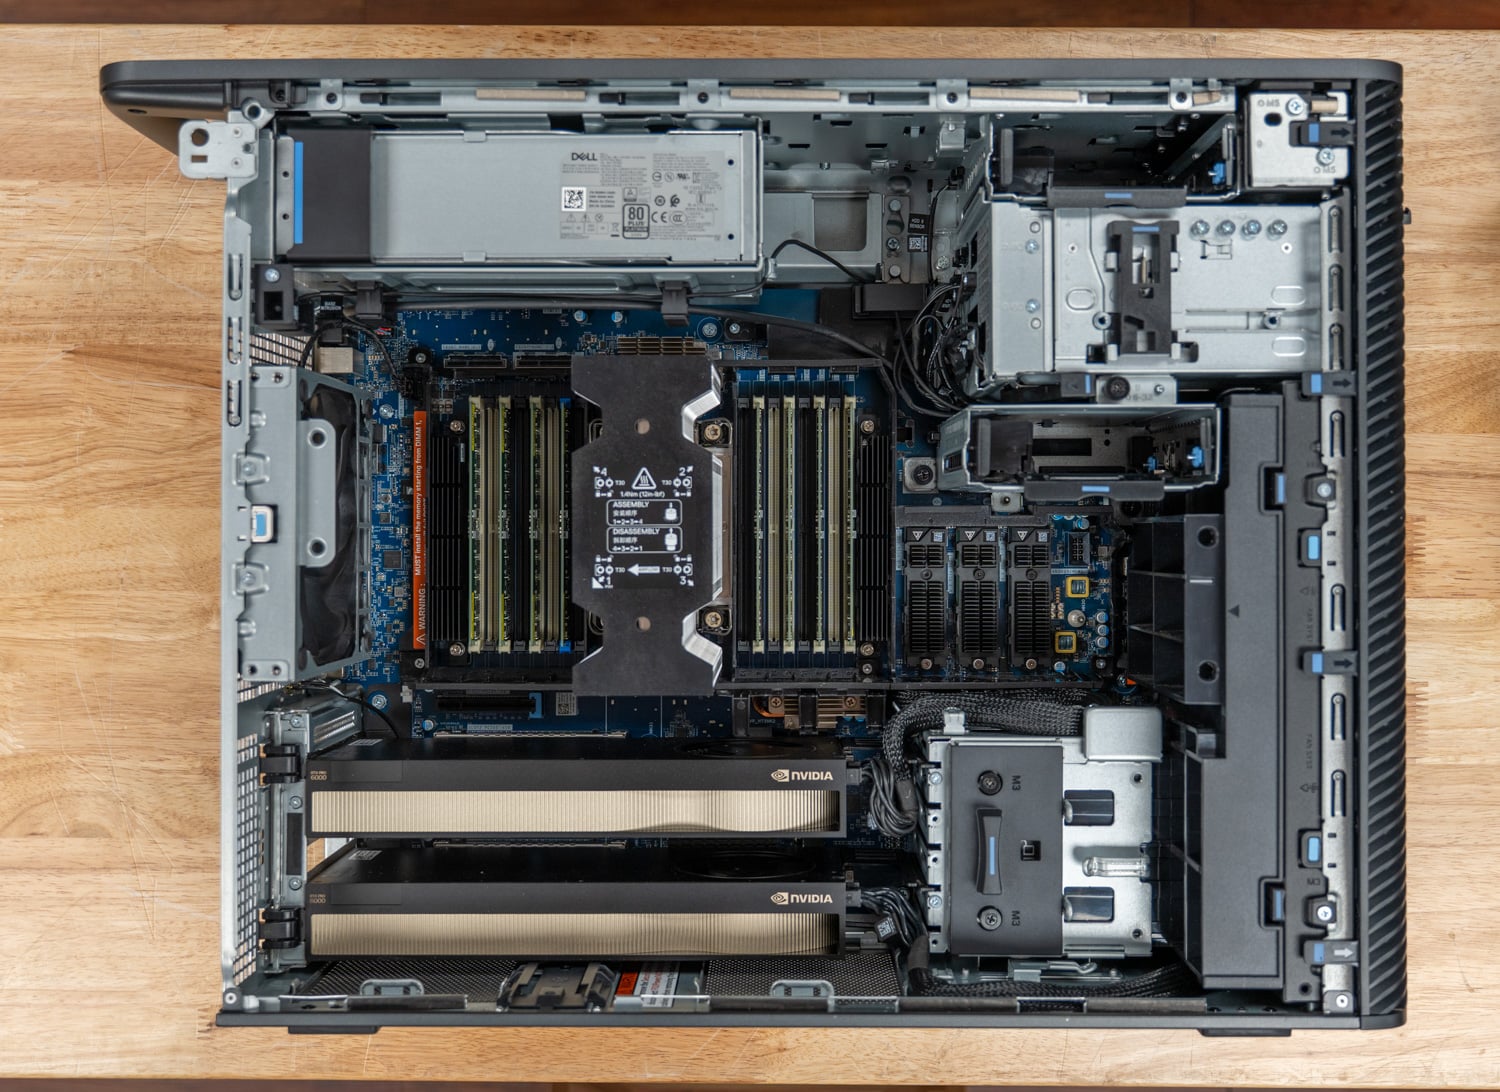
Dell Pro Precision 9 T4 to jednoprocesorowy komputer typu tower z najwyższej półki linii Dell Pro Precision. Nasz egzemplarz testowy został skonfigurowany pod kątem lokalnej sztucznej inteligencji w skali, której nie oferuje większość stacji roboczych. Wyposażony jest w 86-rdzeniowy procesor Intel Xeon 698X z 256 GB pamięci DDR5-6400 ECC, dwie karty NVIDIA RTX PRO 6000 Blackwell Max-Q o mocy 300 W każda, każda o pojemności 96 GB GDDR7, dwa dyski SSD Gen5 o pojemności 2 TB oraz dwuportowy adapter 25 GbE zasilany zasilaczem 2400 W. W podobnej konfiguracji na stronie Dell.com, jego cena wynosi około 66 600 dolarów.
Na wynos
- Dwa procesory graficzne sprawiają, że model, który nie mieści się na jednej karcie, staje się użyteczny. MiniMax M2.7 o pojemności 129.3 GB wygenerował 83.7 tokenów na sekundę dla jednego użytkownika po podzieleniu ich na dwie karty RTX PRO 6000, co stanowi 2.8-krotność 30.3 tokenów na sekundę w przypadku jednej karty i reszty modelu w pamięci systemowej.
- Drugi procesor graficzny zwiększył serwowanie od 1.85 do 2.02 razy, a osadzanie o 1.92 razy. Szczytowa wydajność llama.cpp wzrosła z 582.5 do 1,176.1 tokenów na sekundę na Ministral 3 3B i z 424.8 do 787.9 na gpt-oss 120B z jednym serwerem na GPU, a osadzanie miliona fragmentów Wikipedii skróciło się z 890 do 464 sekund.
- Drugi procesor graficzny skrócił epokę LoRA o 37 procent. Jedna epoka LoRA na Ministral 3 8B trwała 31.5 minuty na jednym GPU i 19.7 minuty na dwóch, kończąc się stratami na poziomie 1.169 i 1.167.
- Pod względem przepustowości pamięci Xeon T4 jest na prowadzeniu. STREAM Triad osiągnął 328 GB/s, czyli o 53 procent więcej niż Threadripper PRO 9995WX w procesorze Precision 7875, a T4 ukończył rozwiązanie problemu OpenFOAM drive w 293 sekundy w porównaniu do 556, a obliczenia 10-miliardowego y-crunchera zajęły 53.9 sekundy w porównaniu do 83.7.
- Precision 7875 jest liderem pod względem wykorzystania potencjału rdzeni procesora. 96-rdzeniowy Threadripper uzyskał o 37 procent lepszą wydajność w 7-Zip i o 30 procent lepszą w Blender Monster, a kompilację LLVM ukończył w 43.7 sekundy w porównaniu do 58.4.
Gdzie znajduje się Pro Precision 9 T4
Dell pozycjonuje T4 jako swoją flagową, jednoprocesorową stację roboczą typu tower dla organizacji wymagających maksymalnej gęstości obliczeniowej i możliwości rozbudowy, z rozwojem sztucznej inteligencji, symulacjami inżynierskimi i obliczeniami naukowymi na czele listy zadań. Model ten plasuje się powyżej modelu Dell Pro Precision 9 T2 , który wykorzystuje tę samą platformę stacji roboczej Granite Rapids-WS Xeon 6 w mniejszej obudowie z jednym procesorem GPU. Model T4 oferuje ośmiokanałowe procesory z najwyższej półki, do 86 rdzeni, oraz miejsce na maksymalnie cztery karty graficzne, w zależności od modelu.
Opcje procesorów na stronie Dell.com zaczynają się od 12-rdzeniowego Xeona 634, poprzez 64-rdzeniowy Xeon 696X, aż po 86-rdzeniowy Xeon 698X w naszym urządzeniu, które oferuje 336 MB pamięci podręcznej, taktowanie bazowe 2.0 GHz, maksymalne 4.8 GHz i moc 350 W. Pamięć sięga do 4 TB pamięci DDR5 RDIMM w 16 gniazdach, a nasze urządzenie wypełnia osiem z nich modułami 32 GB o przepustowości 6400 MT/s. Karta graficzna zaczyna się od pojedynczej karty RTX A400, a liczba kart zależy od modelu: konfigurator Della zawiera cztery karty RTX A1000, trzy karty RTX PRO 4000 Blackwell, dwie karty RTX PRO 6000 Max-Q o mocy 300 W lub jedną kartę RTX PRO 6000 o mocy 600 W.
Podstawowa konfiguracja jest oferowana na Dell.com w cenie 5,925 dolarów. Nasza konfiguracja to wydatek rzędu 8,300 dolarów za procesor Xeon 698X, 15 000 dolarów za 256 GB pamięci RAM i 30 820 dolarów za parę kart RTX PRO 6000 Max-Q, przed doliczeniem pamięci masowej, sieci i 36-miesięcznego pakietu ProSupport, który Dell automatycznie dodaje do konfiguracji na tym poziomie.
Budowa i projektowanie
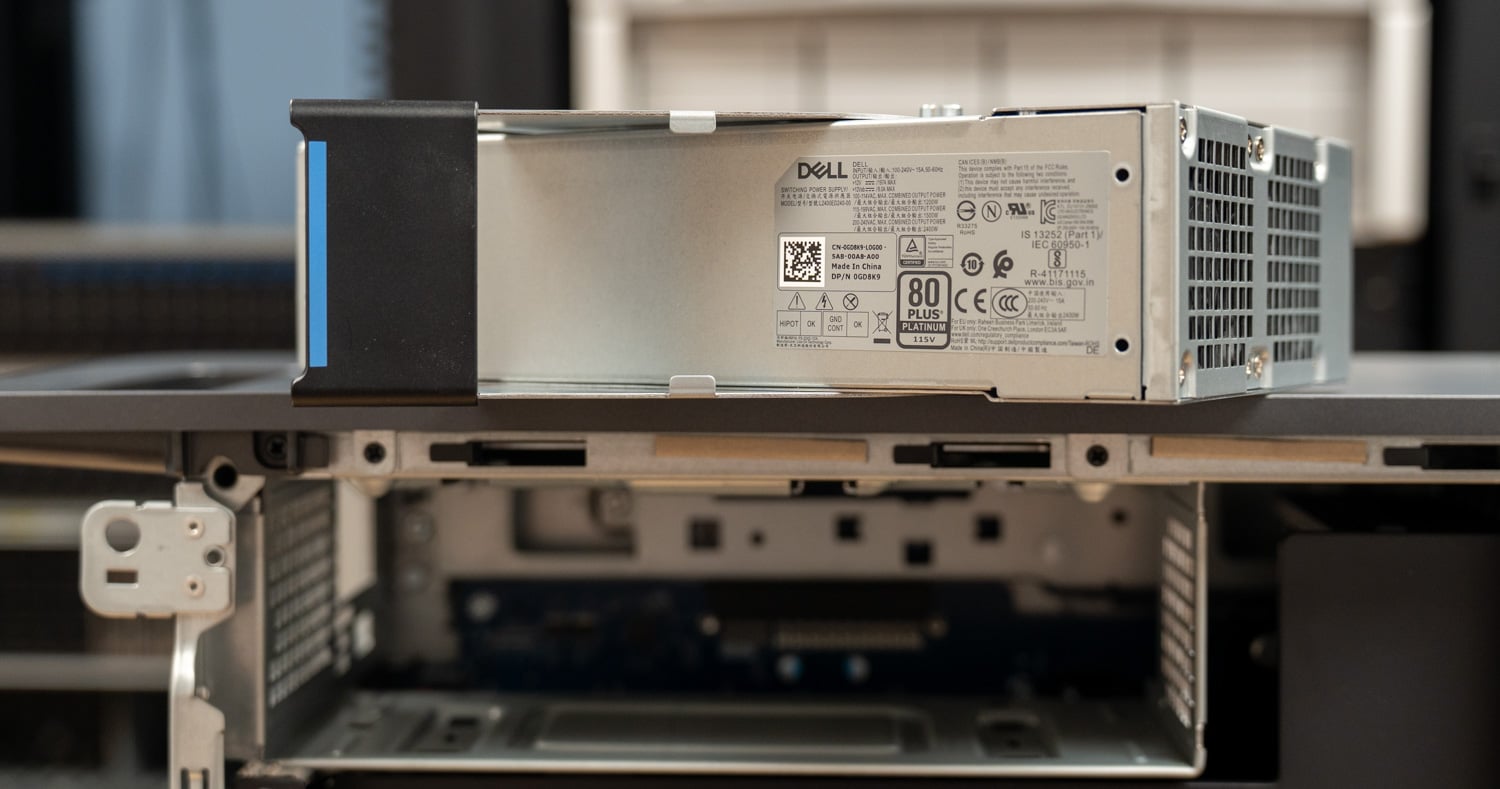
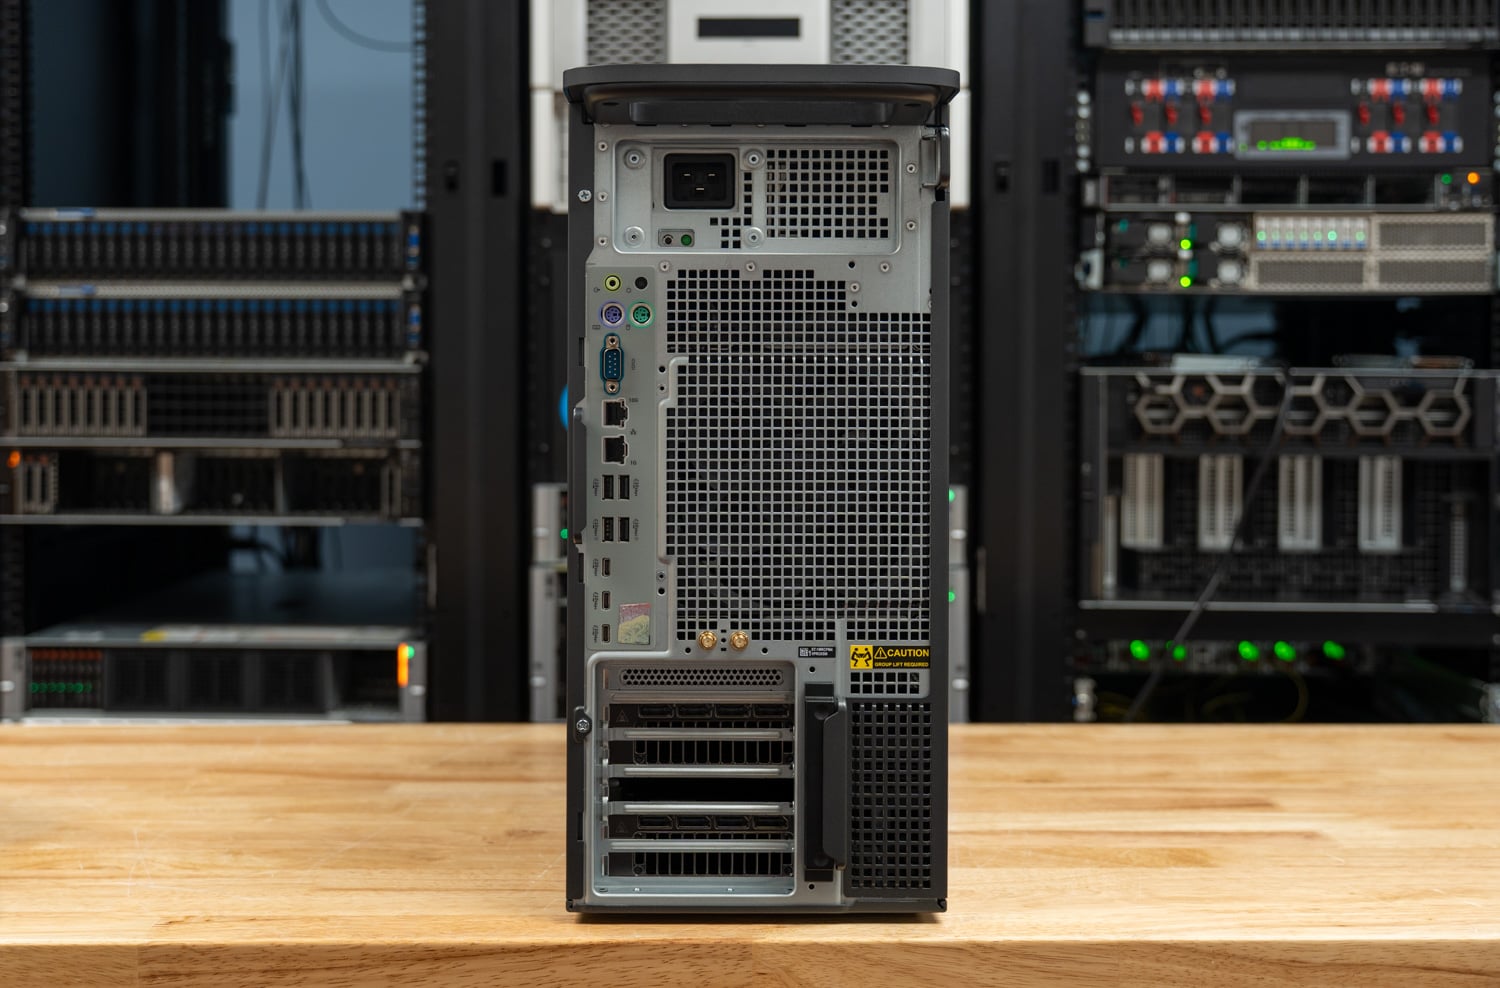
T4 to obudowa typu full-tower o wysokości 449.8 mm, szerokości 203.7 mm i głębokości 617.5 mm. Według specyfikacji Della minimalna waga wynosi 24.1 kg, a maksymalna 33.6 kg, w zależności od konfiguracji. Nasz model korzysta z zasilacza Platinum o mocy 2400 W, który konfigurator Della wybiera do konfiguracji z dwiema kartami RTX PRO 6000, a zasilacz 1500 W jest domyślnie instalowany w lżejszych konfiguracjach.
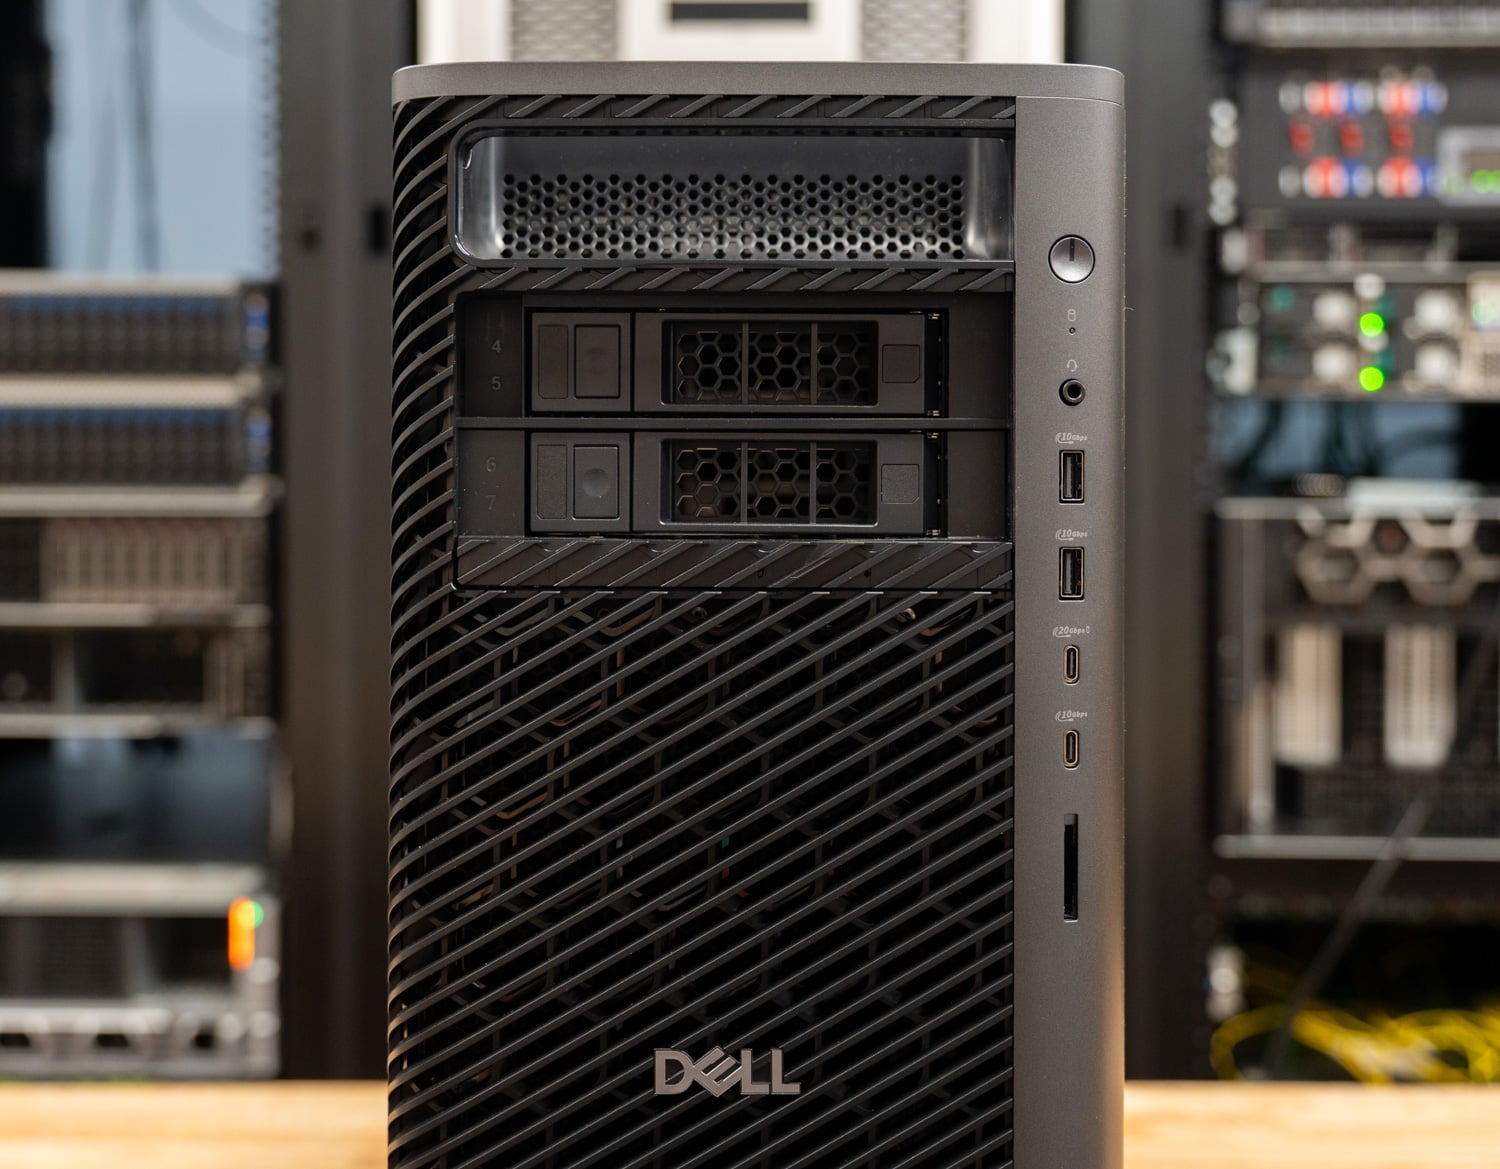
Łatwość serwisowania to mocna strona T4, począwszy od beznarzędziowego dostępu przez zatrzask na panelu bocznym, po zasilacz o mocy 2400 W wysuwany ręcznie z górnej tylnej części obudowy. Wszystkie pozostałe elementy, w tym karty graficzne i dyski SSD, można wyjąć za pomocą śrubokręta krzyżakowego, a niebieskie punkty dotykowe firmy Dell oznaczają elementy wyjmowane ręcznie. Laboratorium stwierdziło, że platforma jest łatwa do naprawy w terenie, co ma znaczenie w przypadku stacji roboczej w tej cenie.
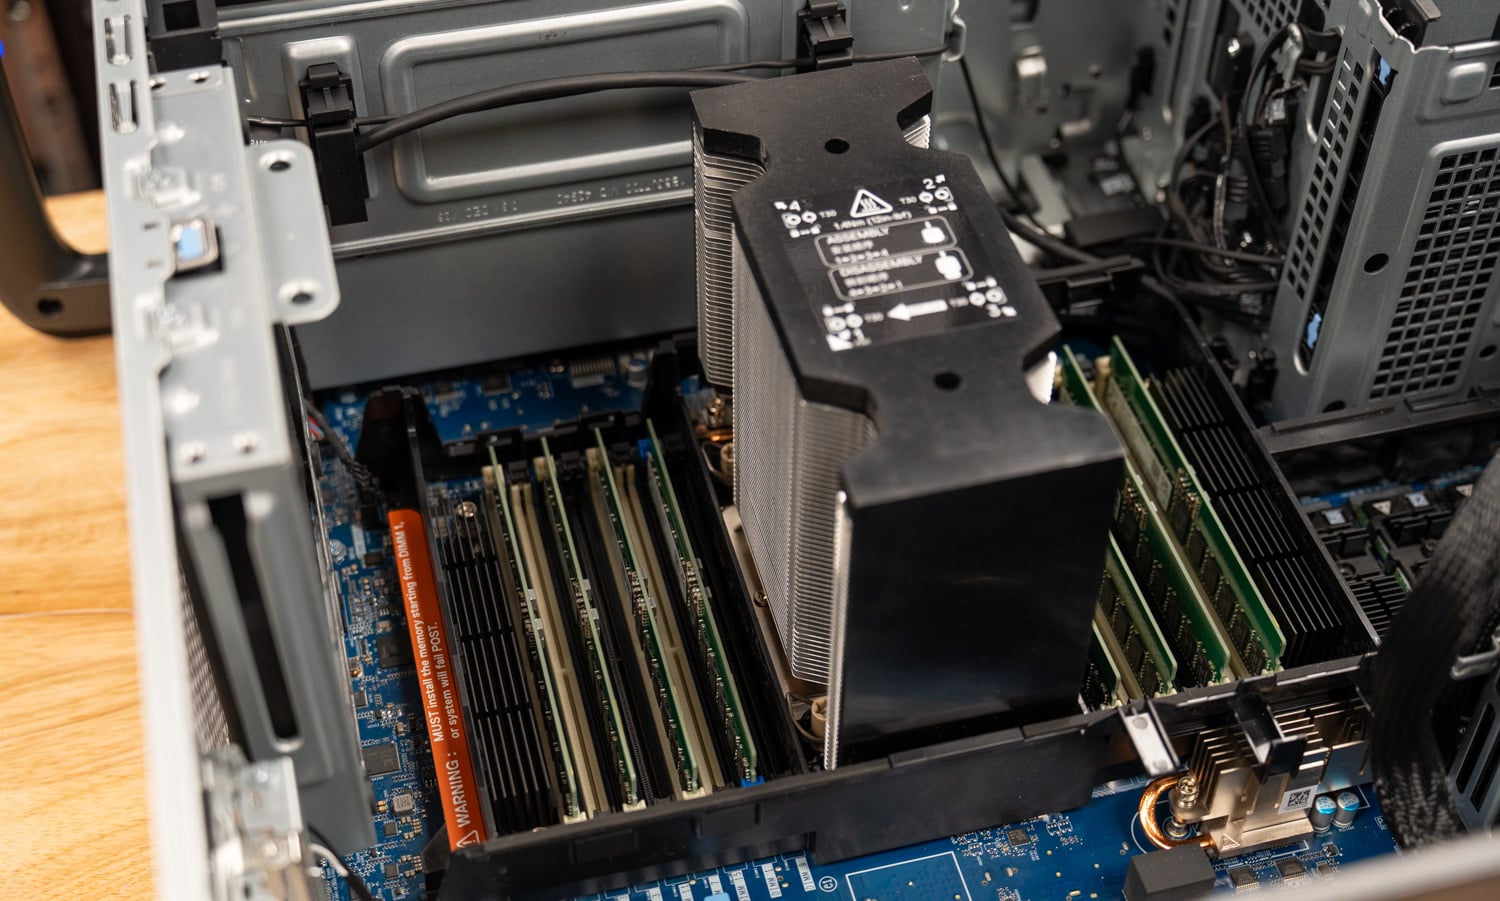
Chłodzenie jest najlepszym rozwiązaniem, jakie widzieliśmy w firmie Dell w tej klasie obudów typu tower. Powietrze przepływa od przodu do tyłu, a duże, dopasowane osłony kierują je w dół i w poprzek procesora i pamięci, jednocześnie oddzielając ten kanał od obszaru PCIe. Dzięki temu dwie karty graficzne o mocy 300 W pobierają powietrze z oddzielnego strumienia i nie chłoną ciepła z Xeona o mocy 350 W. Po zamontowaniu osłon, dwa wentylatory znajdują się między strefą procesora a wnęką na kartę, a obudowa ma te same niebieskie punkty styku i można ją wyjąć, aby uzyskać dostęp do pamięci.
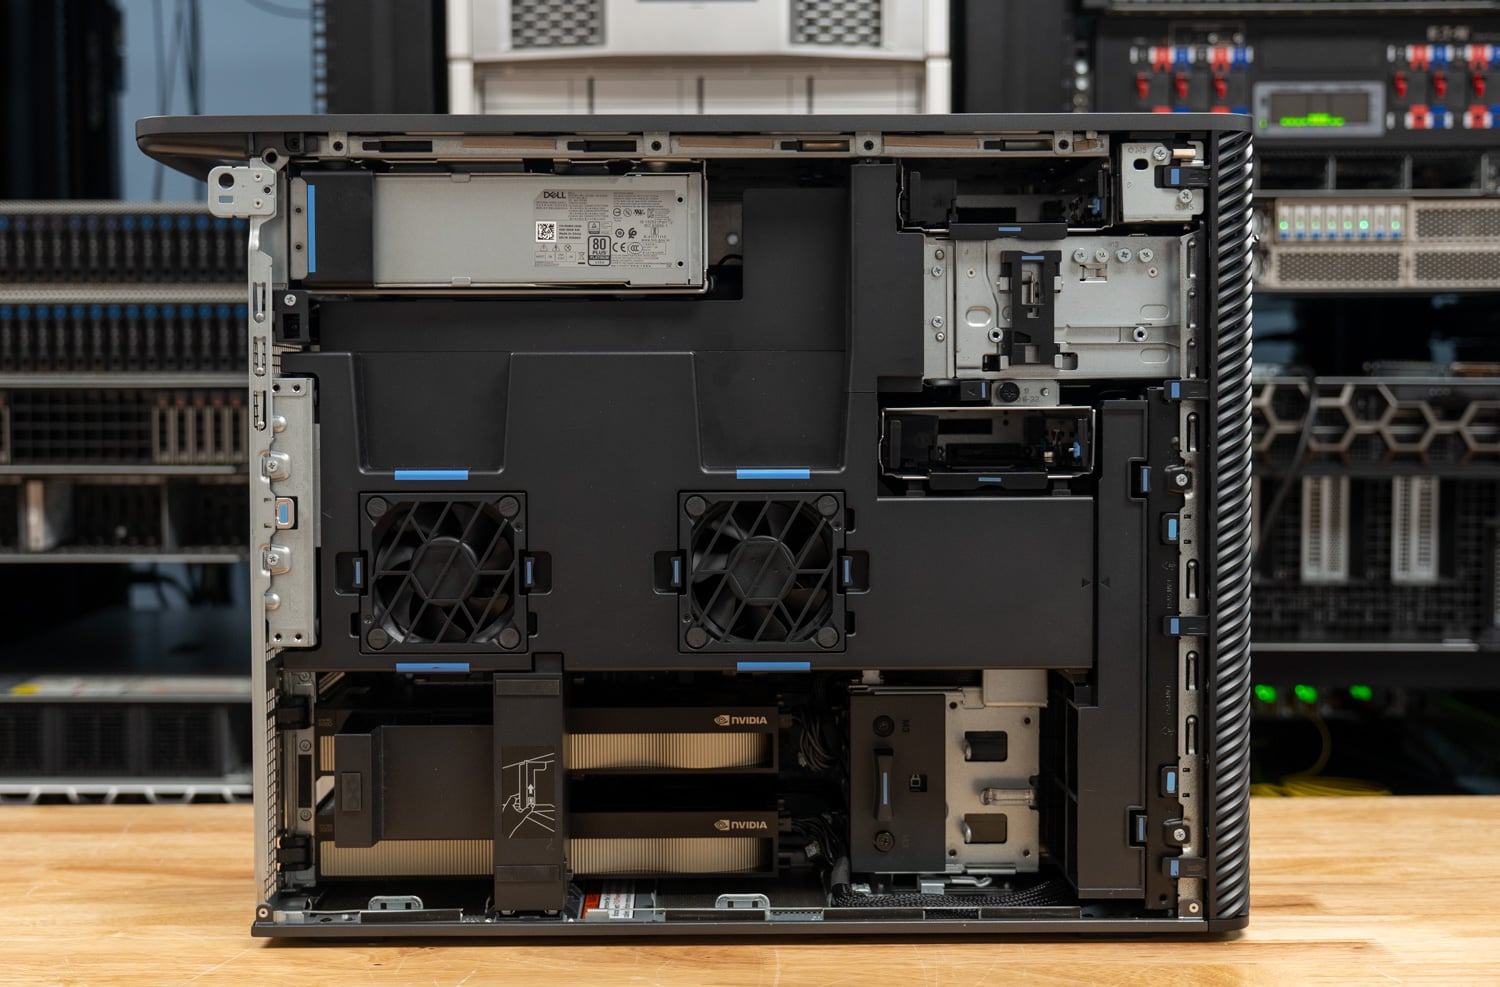
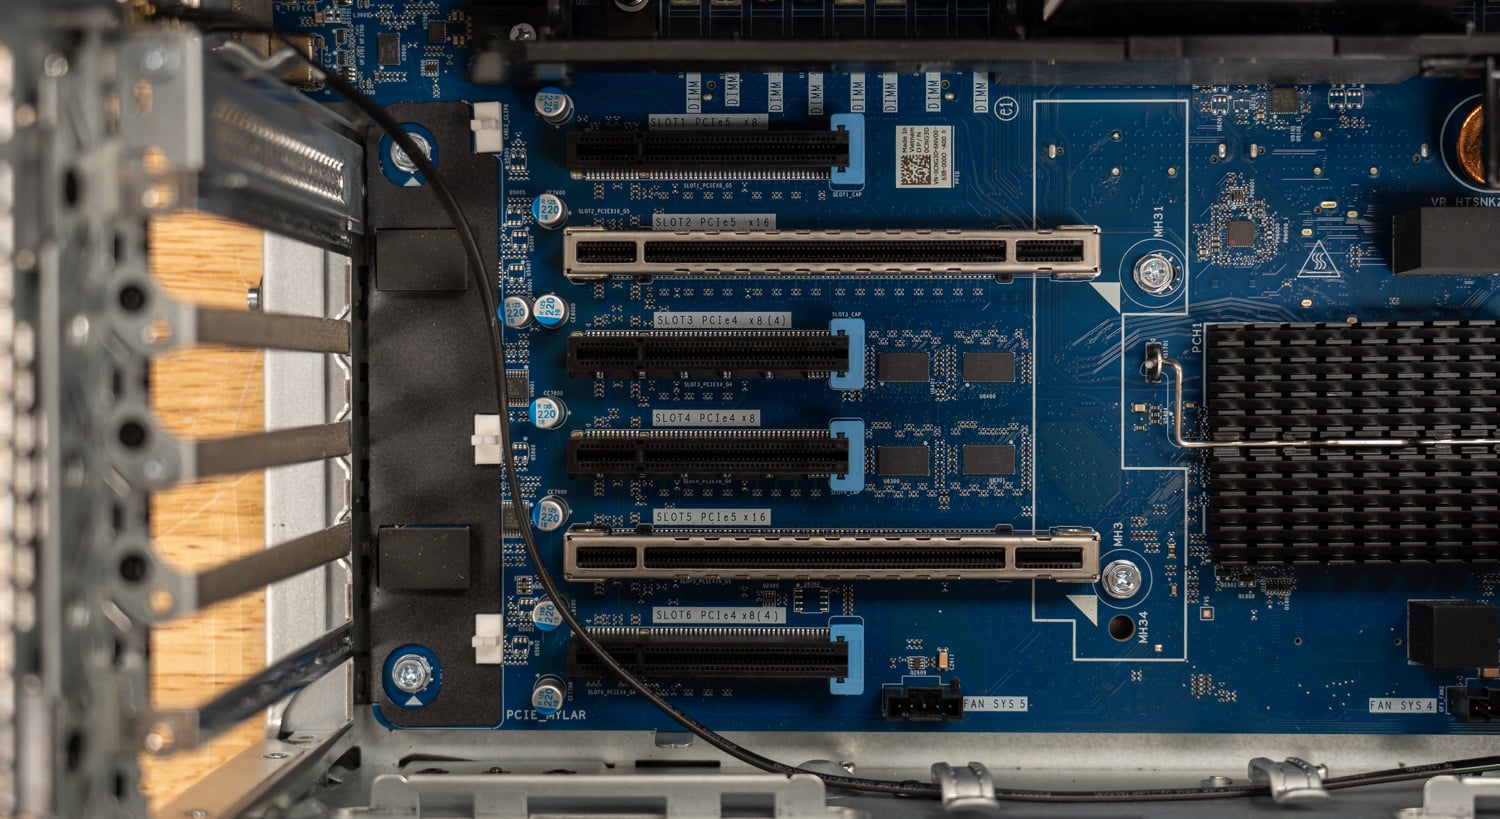
Rozszerzenia można uzyskać za pomocą sześciu gniazd PCIe o pełnej wysokości: dwóch gniazd Gen5 x16, które mieszczą karty graficzne, jednego Gen5 x8, jednego Gen4 x8 oraz dwóch gniazd Gen4 ze złączami x8 i okablowaniem x4. Pamięć masowa obejmuje trzy wewnętrzne gniazda M.2 Gen5 i jedno gniazdo Gen4, dwie wewnętrzne wnęki SATA 3.5 cala oraz przednią wnękę FlexBay, która pomieści do czterech dysków NVMe lub dwa dyski 3.5 cala, z opcjonalnym napędem optycznym typu slim. Nasze urządzenie uruchamia się z wewnętrznego dysku Gen5 o pojemności 2 TB i mieści kolejny dysk Gen5 o pojemności 2 TB w wewnętrznym gnieździe M.2.
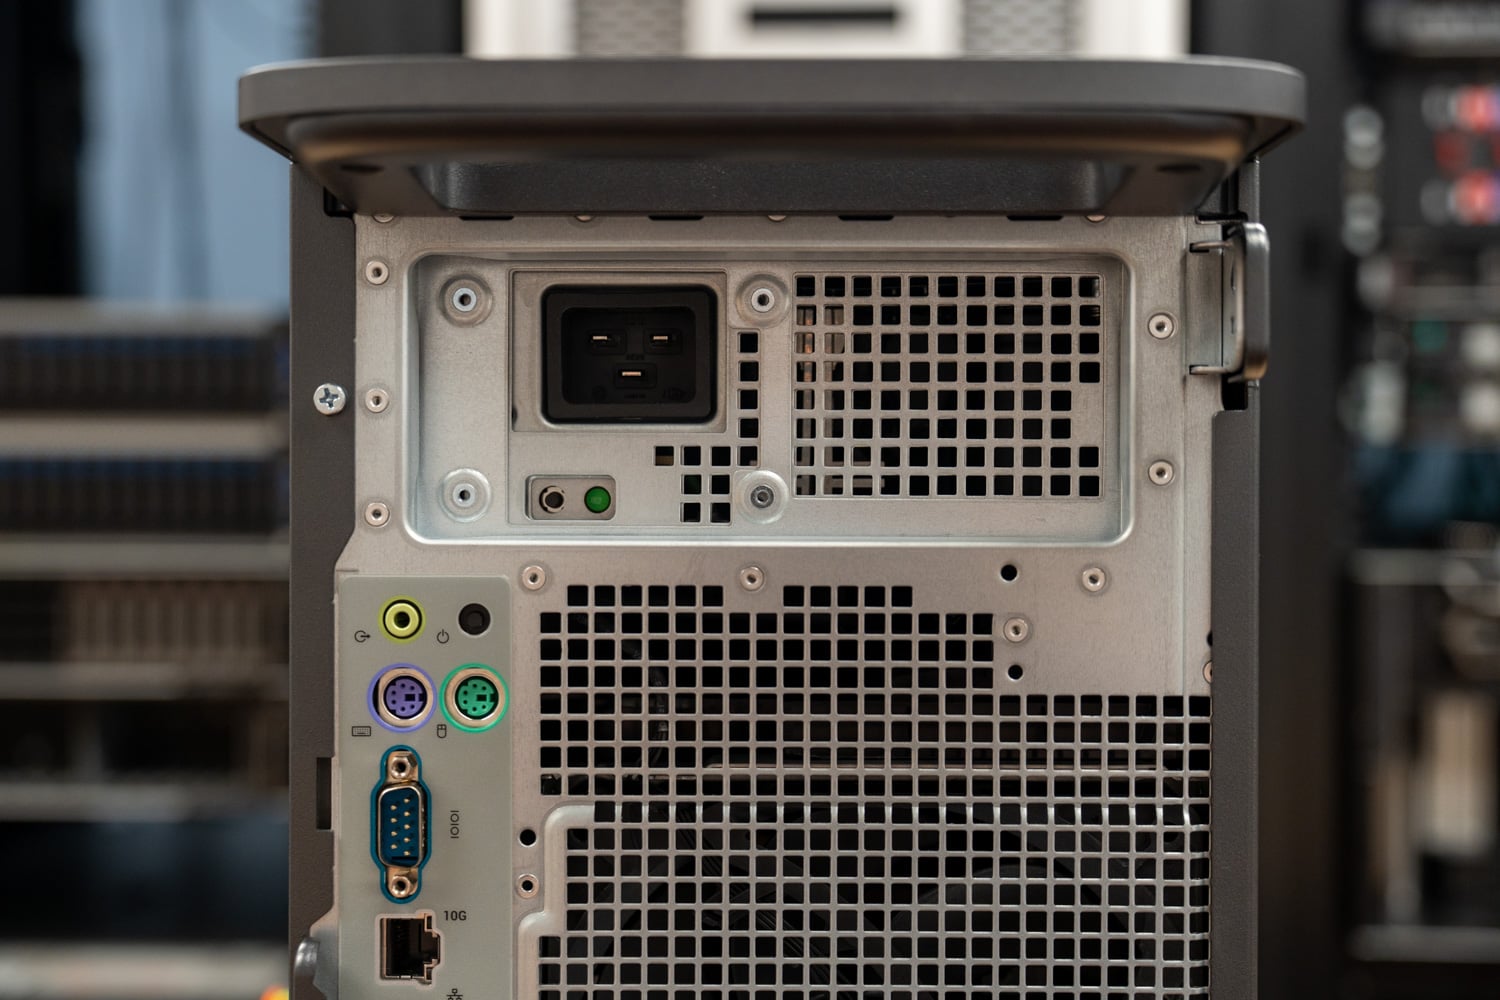
Na przednim panelu znajduje się gniazdo słuchawkowe, dwa porty USB-A 10 Gb/s, port USB-C 20 Gb/s z funkcją PowerShare, port USB-C 10 Gb/s oraz opcjonalne gniazdo na kartę SD. Z tyłu znajdują się porty RJ-45 10 Gb/s i 1 Gb/s, cztery porty USB-A 10 Gb/s, dwa porty USB-C 10 Gb/s, port USB-C 20 Gb/s, port szeregowy, dwa porty PS/2 oraz wyjście liniowe. Urządzenie jest wyposażone w dwuportowy adapter Intel E810-XXV 25 Gb/s SFP28, kartę sieciową MediaTek Wi-Fi 7 MT7925 z Bluetooth 5.4, czytnik kart pamięci oraz podwójną kartę rozszerzeń USB-C firmy Dell.
Systemy bezpieczeństwa i zarządzania obejmują moduł TPM 2.0, Dell SafeBIOS, wykrywanie włamań do obudowy, obsługę samoszyfrujących dysków, bezpieczne wymazywanie danych z BIOS-u oraz technologię Intel vPro Enterprise. Firma Dell podaje, że w kluczowych komponentach T4 do 85% plastiku pochodzi z recyklingu, uchwyty z 90% aluminium z recyklingu, a obudowa z 11% stali z recyklingu. Konfiguracja ta spełnia wymagania normy ENERGY STAR.
Specyfikacja Dell Pro Precision 9 T4
| Specyfikacja | Dell Pro Precision 9 T4 (testowany) |
|---|---|
| Platforma | |
| Model | Dell Pro Precision 9 T4 (PW9T4260) |
| Procesor | Intel Xeon 698X, 86 rdzeni, 172 wątki, pamięć podręczna 336 MB, taktowanie bazowe 2.0 GHz, do 4.8 GHz, 350 W |
| Opcje procesora | Xeon 634 (12 rdzeni) do Xeon 698X (86 rdzeni) |
| Pamięć | 256 GB (8x 32 GB) DDR5-6400 RDIMM ECC 16 gniazd, do 4TB |
| Grafika | 2x NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition, 96 GB GDDR7 każda, 300 W każda |
| System operacyjny | Windows 11 Pro dla stacji roboczych (testowany na Ubuntu 26.04.1 LTS) |
| Dyski | |
| Zgodnie z konfiguracją | 2 dyski twarde 2TB M.2 2280 Gen5 x4 TLC SED (oba w wewnętrznych gniazdach M.2) |
| Gniazda wewnętrzne | 3x M.2 2230/2280 Gen5 NVMe 1x M.2 2230/2280 Gen4 NVMe 2x 3.5-calowe SATA |
| FlexBay | Do 4 dysków NVMe plus opcjonalny napęd ODD o smukłej konstrukcji lub 2 dyski SATA 3.5 cala |
| Rozbudowa i łączność | |
| Sloty PCIe | 2x Gen5 x16 1x Gen5 x8 1x Gen4 x8 2x Gen4 x8 (x4 elektryczne) |
| Sieci | Intel E810-XXV dwuportowy 25GbE SFP28 (dodatek) Wbudowane 10GbE i 1GbE RJ-45 MediaTek Wi-Fi 7 MT7925, Bluetooth 5.4 |
| Porty czołowe | 1x USB-C 20 Gb/s z funkcją PowerShare 1x USB-C 10 Gb/s 2x USB-A 10 Gb/s Gniazdo słuchawek Opcjonalne gniazdo na kartę SD |
| Tylne porty | 1x USB-C 20 Gb/s 2x USB-C 10 Gb/s 4x USB-A 10 Gb/s Szeregowy, 2x PS/2, wyjście liniowe |
| Moc i Fizyczność | |
| Zasilacz laboratoryjny | 2400 W Platinum (opcja 1500 W) |
| Wymiary | 449.8 x 203.7 x 617.5mm (17.70 x 8.01 x 24.31in) |
| Waga | od 24.1 kg do 33.6 kg (od 53.1 do 74.1 funta) w zależności od konfiguracji |
| Gwarancja | ProSupport z serwisem na miejscu po diagnozie zdalnej, 36 miesięcy |
| Cena | Podstawa 5,925 XNUMX dolarów Około 66 600 USD w konfiguracji (Dell.com) |
Konfiguracja i metodologia testów
Testujemy stacje robocze klasy high-end w systemie Linux. Na wszystkich czterech systemach w tej recenzji działało Ubuntu 26.04.1 LTS z jądrem 7.0.0-43, sterownikiem NVIDIA 595.99.02, CUDA 13, llama.cpp build b11716 oraz Ollama 0.40.3, w profilu wydajnościowym Linuksa. Wyniki pochodzą z trzech narzędzi: sr-client do lokalnych obciążeń AI i klienta, sr-harness do kompilacji, kompresji, szyfrowania, obsługi stron internetowych i y-cruncher oraz sr-suite r5.28 do GROMACS, OpenFOAM, ClickHouse, Valkey i przepustowości pamięci. Każdy wynik to mediana z powtarzanych przebiegów.
Wszystkie cztery systemy działały z trybem termicznym BIOS-u ustawionym na Ultra Performance, a w przypadku T4 zastosowano BIOS 1.2.0. W przypadku T4 zastosowano SR-Harness w wersji 3.3, w przypadku Precision 7875 w wersji 3.5, a w przypadku obu T2 w wersji 3.6, przy zachowaniu tej samej serii testów dla tych wersji.
Każdy system porównawczy to obudowa Dell Tower z kartą graficzną RTX PRO 6000 Blackwell. Dell Precision 7875 łączy 96-rdzeniowy procesor Threadripper PRO 9995WX z tymi samymi dwiema kartami RTX PRO 6000 Max-Q i 512 GB pamięci DDR5-5600, co czyni go najbardziej zbliżonym. Dell Pro Precision 9 T2 działa z 24-rdzeniowym procesorem Xeon 658X z jedną kartą Max-Q, a Dell Pro Max Tower T2 z 24-rdzeniowym procesorem Core Ultra 9 285K z kartą RTX PRO 6000 o mocy 600 W, co pokazuje, ile mocy generuje wyższy limit mocy na kartę graficzną.
| Konfiguracja | CPU | Pamięć | GPU | Test Drive | Tryb termiczny BIOS-u |
|---|---|---|---|---|---|
| Dell Pro Precision 9 T4 | Xeon 698X, 86 rdzenie | 256 GB DDR5-6400 (8 kanały) | 2x RTX PRO 6000 Max-Q (300 W) | 2TB SK hynix PCB01 Gen5 | Ultra wydajność |
| Dell Precision 7875 | Threadripper PRO 9995WX, 96 rdzeni | 512 GB DDR5-5600 (8 kanały) | 2x RTX PRO 6000 Max-Q (300 W) | 2TB Samsung Gen4 | Ultra wydajność |
| Dell Pro Precision 9 T2 | Xeon 658X, 24 rdzenie | 128 GB DDR5-6400 (4 kanały) | 1x RTX PRO 6000 Max-Q (300 W) | Dyski Samsung PM9E1 Gen5, 2TB w układzie pasmowym | Ultra wydajność |
| Dell Pro Max Tower T2 | Core Ultra 9 285K, 24 rdzenie | 128 GB DDR5-4400 (2 kanały) | 1x RTX PRO 6000 (600 W) | 2TB Samsung PM9F1 Gen4 | Ultra wydajność |
Lokalna wydajność sztucznej inteligencji
Każdy z naszych systemów zawiera co najmniej jedną kartę graficzną RTX PRO 6000 Blackwell z 96 GB pamięci GDDR7, więc wyniki testów pojedynczego GPU mierzą kartę, jej limit mocy i szybkość, z jaką platforma ją zasila. To właśnie dwie karty T4 wyróżniają ten model, a nasze testy z dwoma GPU uruchamiają każdy model na trzy sposoby: dwa niezależne serwery, po jednym na każdy GPU, dla przepustowości; jeden model podzielony warstwowo na obie karty; oraz, w przypadku MiniMax M2.7, jedną kartę z resztą modelu w pamięci systemowej.
LLM obsługujący jeden procesor GPU
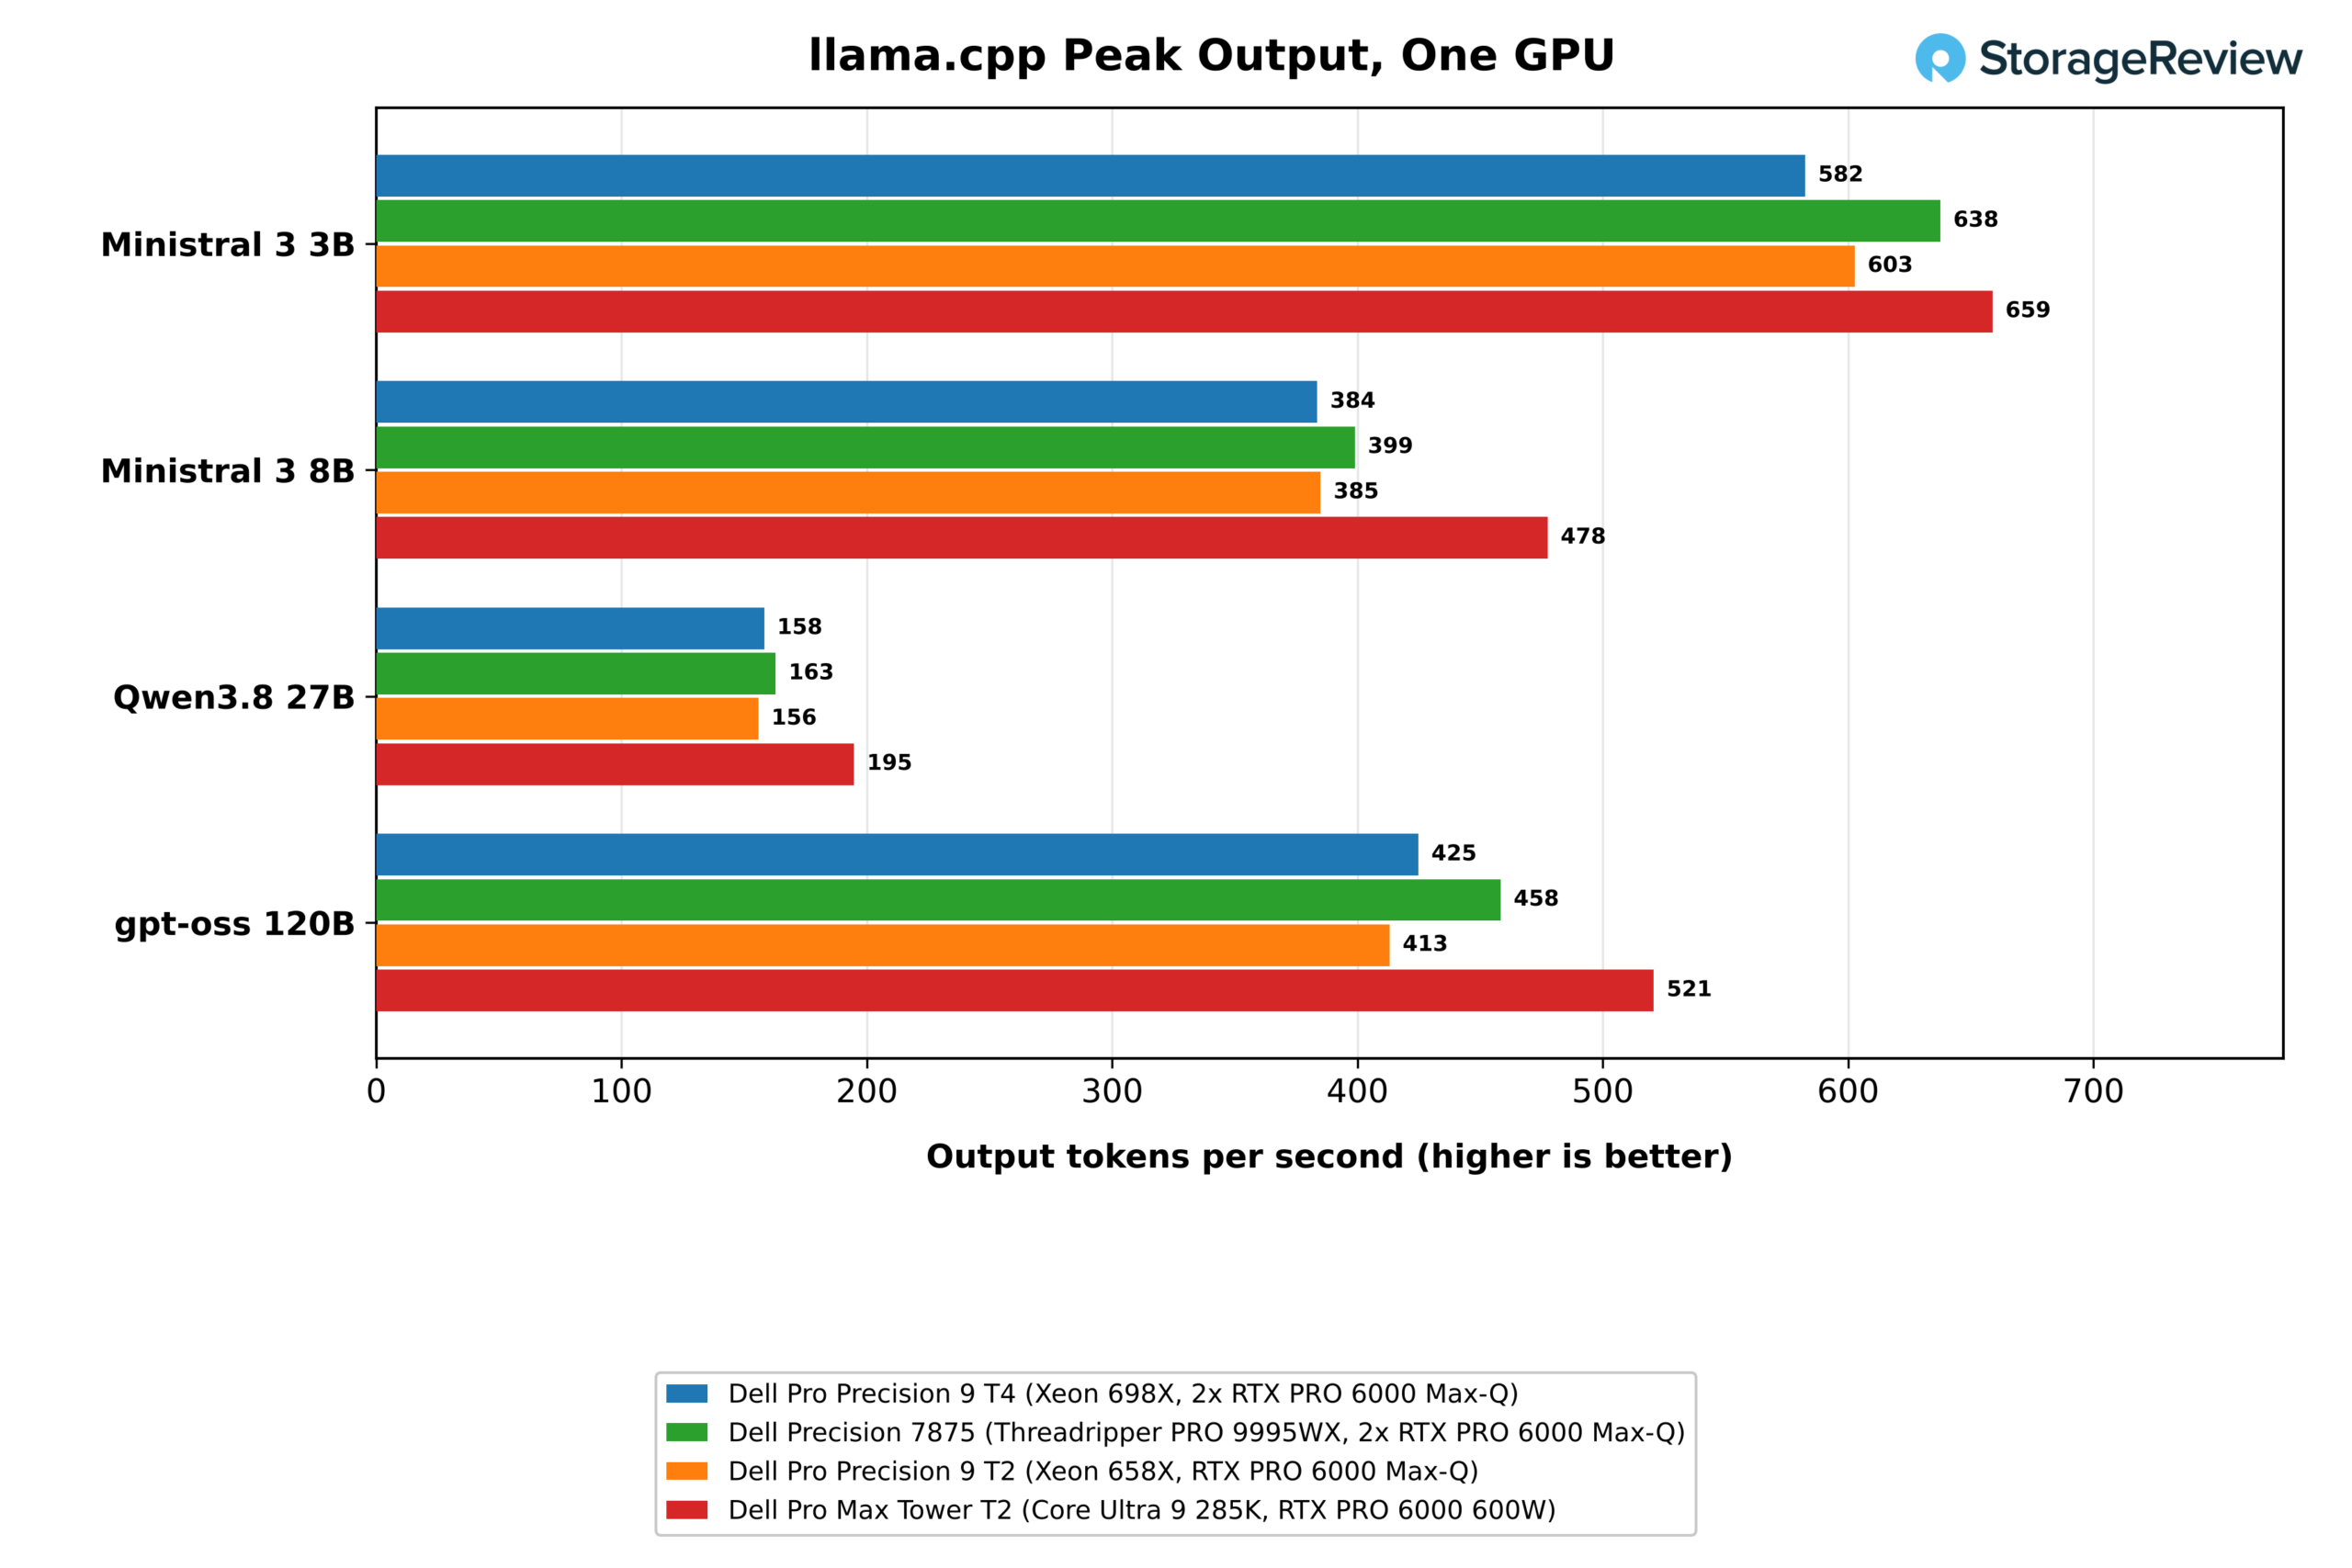
| Serwer llama.cpp, jeden GPU (liczba tokenów wyjściowych/s, im więcej tym lepiej) | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Tower T2 |
|---|---|---|---|---|
| Ministral 3 3B, jedno żądanie | 240.5 | 252.6 | 243.8 | 261.6 |
| Ministral 3 3B, szczyt | 582.5 | 637.6 | 602.6 | 658.8 |
| Ministral 3 8B, jedno żądanie | 166.8 | 171.1 | 167.3 | 194.5 |
| Ministral 3 8B, szczyt | 383.6 | 398.9 | 384.9 | 477.5 |
| Qwen3.8 27B, jedno żądanie | 54.9 | 55.4 | 53.8 | 64.5 |
| Qwen3.8 27B, szczyt | 158.1 | 162.8 | 155.8 | 194.7 |
| gpt-oss 120B, jedno żądanie | 166.9 | 171.2 | 164.5 | 193.0 |
| gpt-oss 120B, szczyt | 424.8 | 458.4 | 413.1 | 520.7 |
| gpt-oss 120B, jedno żądanie, czas do pierwszego tokena (ms, im niższy tym lepszy) | 1,189 | 1,181 | 1,213 | 844 |
Na jednym GPU, T4 osiąga limit 300 W. Generuje 166.9 tokenów na sekundę dla jednego użytkownika na gpt-oss 120B i osiąga szczytową wartość 424.8 przy 64 równoczesnych żądaniach, co mieści się w granicach od 1 do 9 procent wartości identycznej karty Max-Q Precision 7875 we wszystkich czterech modelach i jest na równi z Pro Precision 9 T2. Karta 600 W w obudowie Pro Max Tower T2 jest od 13 do 25 procent szybsza w szczytowej wydajności w każdym modelu, osiągając 520.7 tokenów na sekundę na gpt-oss 120B.
Dwa procesory graficzne: repliki i modele podzielone
| Serwer llama.cpp, dwa procesory GPU (liczba tokenów wyjściowych/s, im więcej, tym lepiej) | Dell Pro Precision 9 T4 | Dell Precision 7875 |
|---|---|---|
| Ministral 3 3B, szczyt, jeden serwer na GPU | 1,176.1 | 1,260.2 |
| Ministral 3 8B, szczyt, jeden serwer na GPU | 765.7 | 796.4 |
| Qwen3.8 27B, szczyt, jeden serwer na GPU | 310.8 | 323.2 |
| gpt-oss 120B, szczyt, jeden serwer na GPU | 787.9 | 905.8 |
| gpt-oss 120B, jedno żądanie, podzielone według warstwy | 170.6 | 182.4 |
| gpt-oss 120B, szczyt, podział według warstwy | 539.2 | 619.4 |
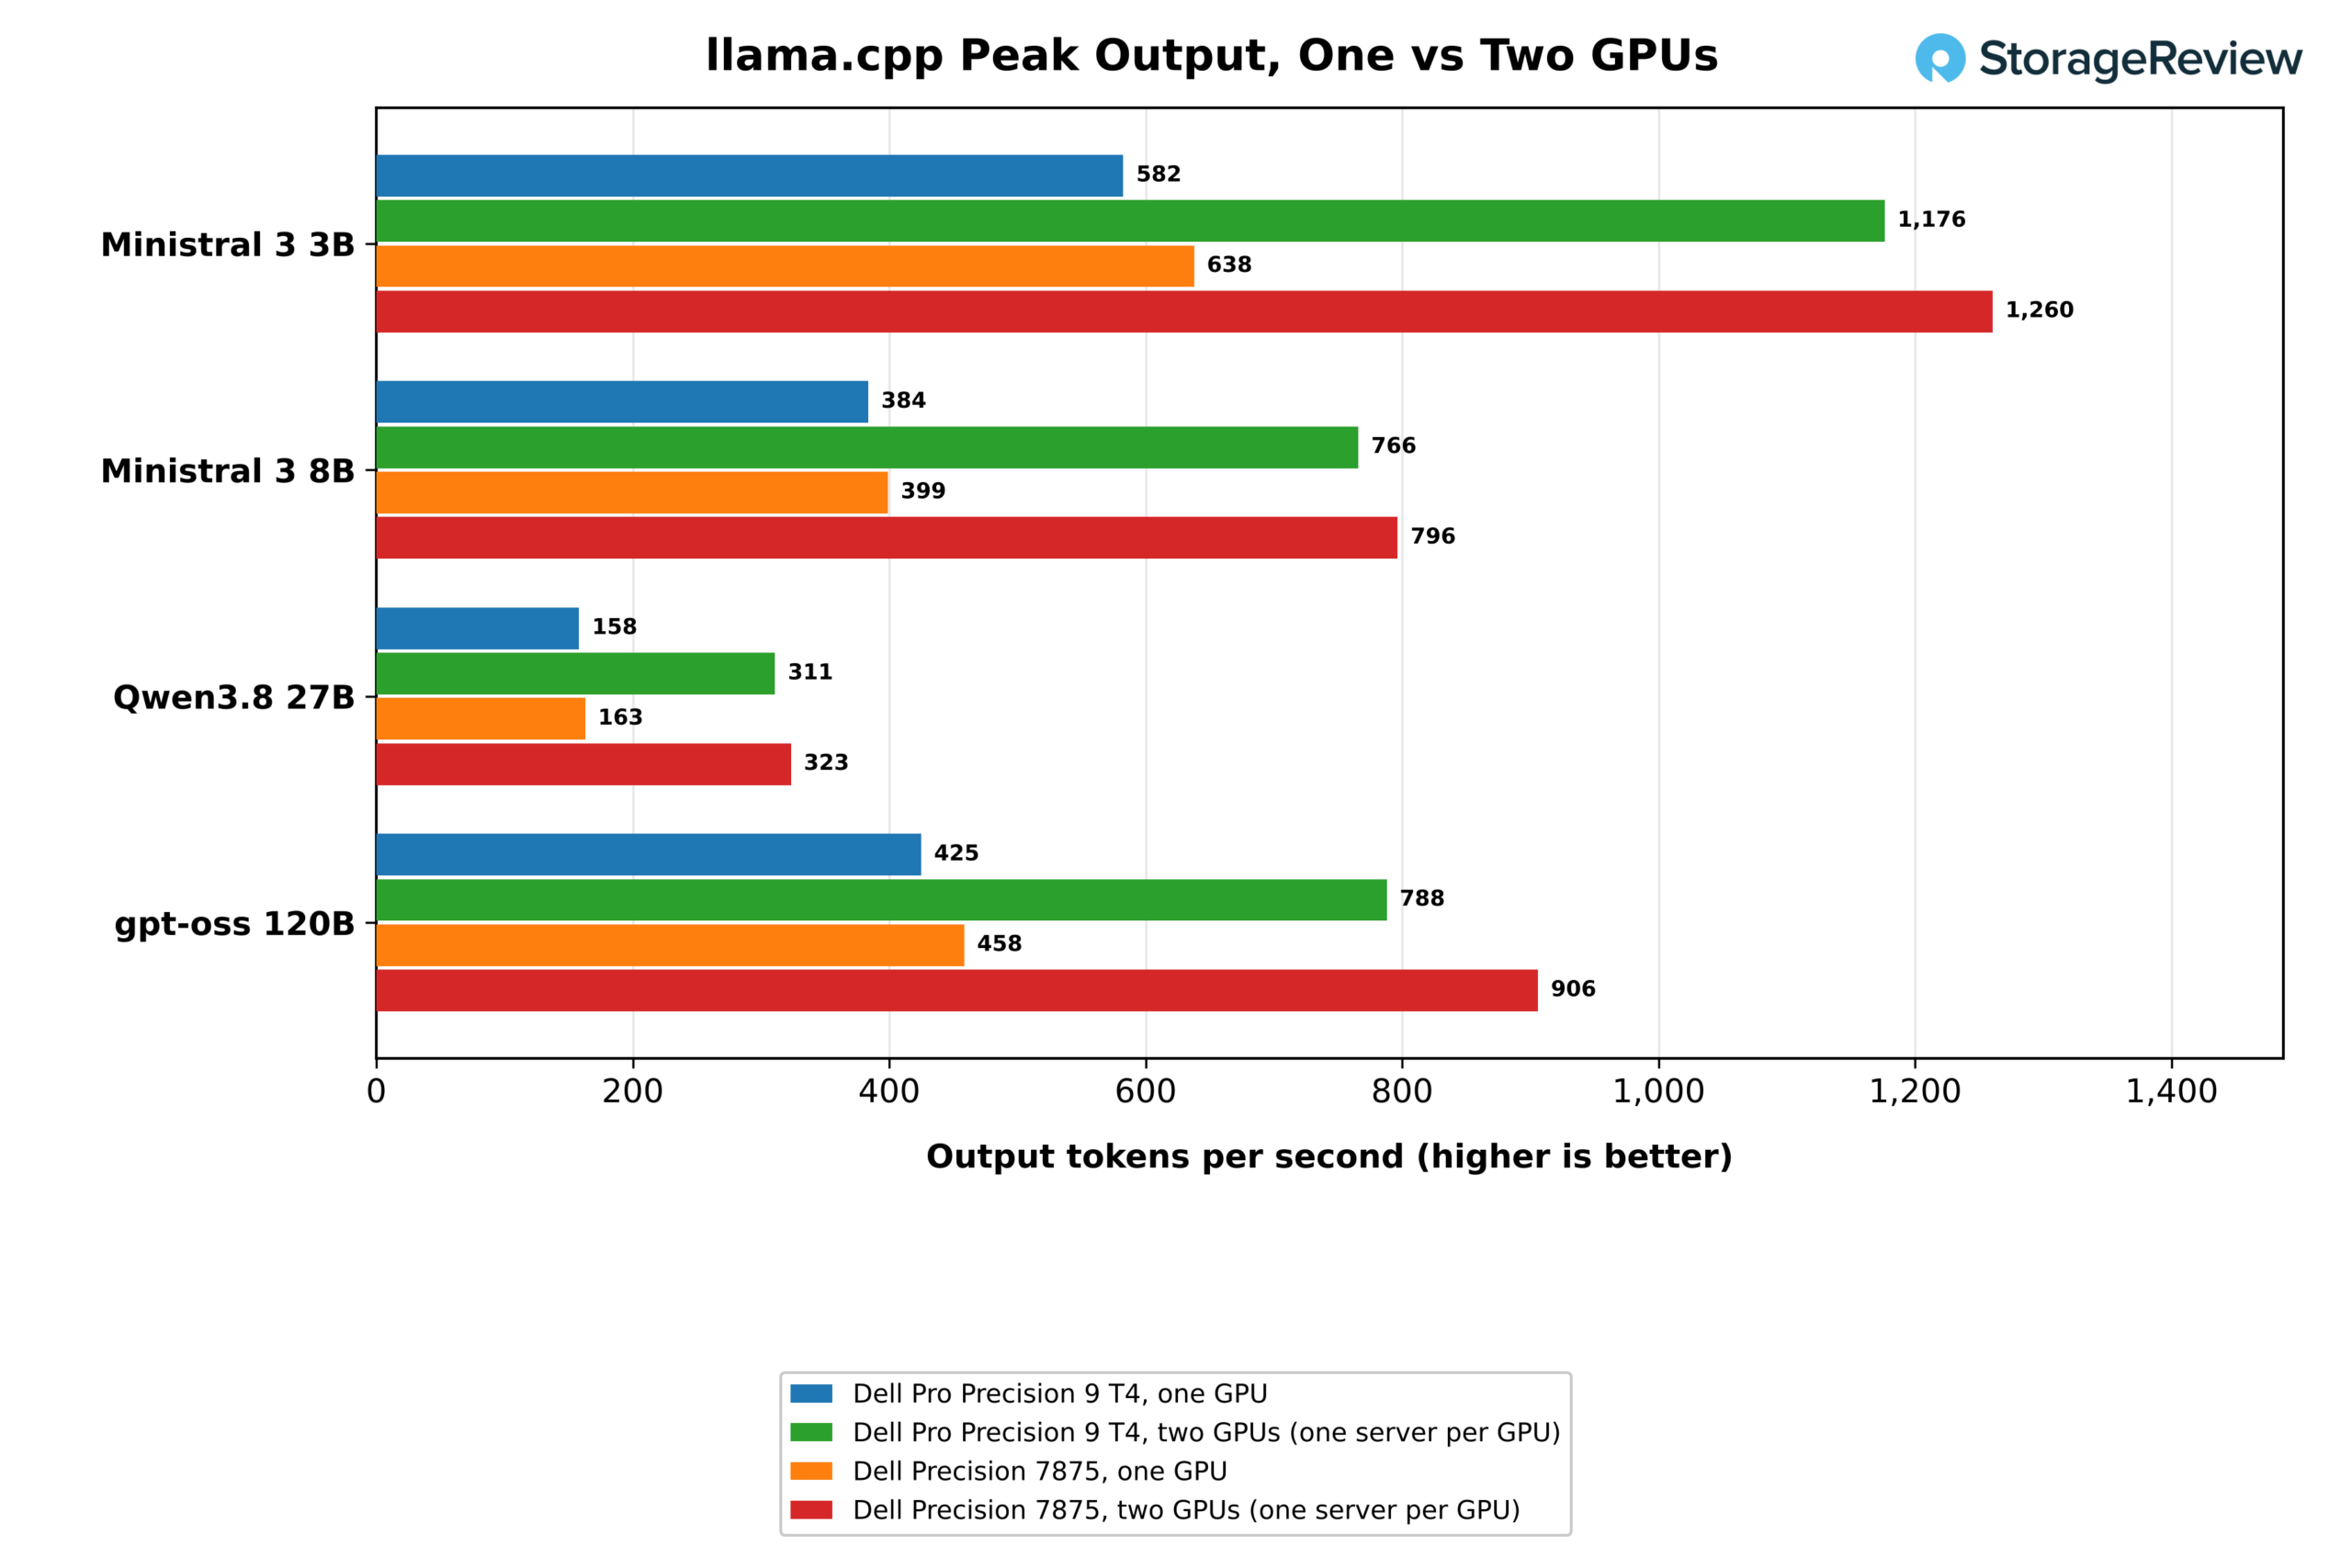
Uruchomienie jednego serwera na GPU zwiększyło szczytową wydajność T4 od 1.85 do 2.02 razy we wszystkich czterech modelach. Maksymalna wydajność wzrosła z 582.5 do 1,176.1 tokenów na sekundę w modelu Ministral 3 3B, z 383.6 do 765.7 w modelu 8B oraz ze 158.1 do 310.8 w modelu Qwen3.8 27B, skalując się od 1.97 do 2.02 razy. Gpt-oss 120B skalował się 1.85 razy do 787.9 tokenów na sekundę w modelu T4 i 1.98 razy do 905.8 w modelu Precision 7875, który osiągnął szczyt na poziomie 128 równoczesnych żądań, podczas gdy w modelu T4 szczyt wyniósł 64.
Podzielenie gpt-oss 120B warstwami na obie karty to wolniejszy sposób wykorzystania drugiego GPU, gdy model mieści się już na jednym. Obsługiwał on jednego użytkownika z prędkością 170.6 tokenów na sekundę, co stanowiło 3% różnicy w porównaniu z jedną kartą, a szczytowy wynik wyniósł 539.2, czyli o 27% więcej niż jeden GPU i znacznie mniej niż 787.9 tokenów, które zapewniały dwie repliki. Układ rozdzielony sprawdza się w modelach, które nie mieszczą się na jednej karcie, i właśnie tam wkracza MiniMax M2.7.
| Serwer llama.cpp, gpt-oss 120B, monity 8,192 tokenów, wyjścia 1,024 tokenów | T4, jeden procesor graficzny | T4, dwa procesory GPU, jeden serwer na każdy procesor GPU | T4, dwa procesory GPU, podzielone warstwami | Precision 7875, dwa procesory GPU, jeden serwer na każdy procesor GPU |
|---|---|---|---|---|
| 1 współbieżne: całkowita przepustowość (tokeny/s) | 1,502 | 1,504 | 1,536 | 1,530 |
| 1 współbieżne: czas do pierwszego tokena, mediana (ms, im niższy tym lepiej) | 1,189 | 1,180 | 719 | 1,189 |
| 8 współbieżne: całkowita przepustowość (tokeny/s) | 2,760 | 4,820 | 3,300 | 4,949 |
| 8 współbieżne: dane wyjściowe na użytkownika (tokeny/s) | 38.3 | 66.9 | 45.8 | 68.7 |
| 8 współbieżne: czas do pierwszego tokena, mediana (ms, im niższy tym lepiej) | 2,654 | 2,523 | 1,622 | 2,472 |
| 64 współbieżne: całkowita przepustowość (tokeny/s) | 3,823 | 7,091 | 4,853 | 7,557 |
| 64 współbieżne: dane wyjściowe na użytkownika (tokeny/s) | 6.6 | 12.3 | 8.4 | 13.1 |
| 64 współbieżne: czas do pierwszego tokena, mediana (ms, im niższy tym lepiej) | 3,874 | 3,226 | 2,852 | 2,867 |
Pełny wykres dla gpt-oss 120B pokazuje, jak druga karta zmienia krzywą, z całkowitą przepustowością liczącą tokeny monitu i wyjścia razem. Jeden GPU wzrósł z 1,502 tokenów na sekundę dla pojedynczego żądania do 2,760 przy ośmiu i 3,823 przy 64, gdzie każdy użytkownik otrzymywał 6.6 tokenów wyjściowych na sekundę. Przy jednym serwerze na GPU, osiem żądań było realizowanych z częstotliwością 4,820, a 64 żądania osiągnęły 7,091, 1.85 razy więcej niż jedna karta, przy 12.3 tokenach na sekundę na użytkownika. Podział modelu osiągnął niższy szczyt na poziomie 4,853, ale zwrócił pierwszy token pojedynczego użytkownika w 719 ms w porównaniu z 1,189 ms.

MiniMax M2.7: Model za duży na jedną kartę
| MiniMax M2.7 Q4_K_M, 129.3 GB (im większa, tym lepiej, chyba że zaznaczono inaczej) | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Tower T2 |
|---|---|---|---|---|
| Jeden procesor GPU plus pamięć RAM systemu, jedno żądanie (tokeny/s) | 30.3 | 32.8 | 22.6 | 15.8 |
| Jeden procesor GPU plus pamięć RAM systemu, szczytowa (tokeny/s) | 35.5 | 39.1 | 27.7 | 18.0 |
| Jeden procesor GPU plus pamięć RAM systemu, czas do pierwszego tokena (ms, im niższy tym lepiej) | 16,224 | 16,143 | 16,216 | 18,522 |
| Dwa procesory GPU podzielone warstwami, jedno żądanie (tokeny/s) | 83.7 | 85.0 | Pojedynczy GPU | Pojedynczy GPU |
| Dwa procesory GPU podzielone według warstwy, szczyt (tokeny/s) | 127.3 | 129.5 | Pojedynczy GPU | Pojedynczy GPU |
| Dwa procesory graficzne podzielone warstwami, czas do pierwszego tokena (ms, im niższy tym lepiej) | 3,138 | 3,162 | Pojedynczy GPU | Pojedynczy GPU |
| Zimne obciążenie, jeden procesor graficzny i pamięć RAM (im mniej tym lepiej) | 40.5 | 65.8 | 37.6 | 81.1 |
| Zimne obciążenie, rozdzielenie dwóch procesorów graficznych (im mniejszy tym lepiej) | 27.6 | 50.7 | Pojedynczy GPU | Pojedynczy GPU |
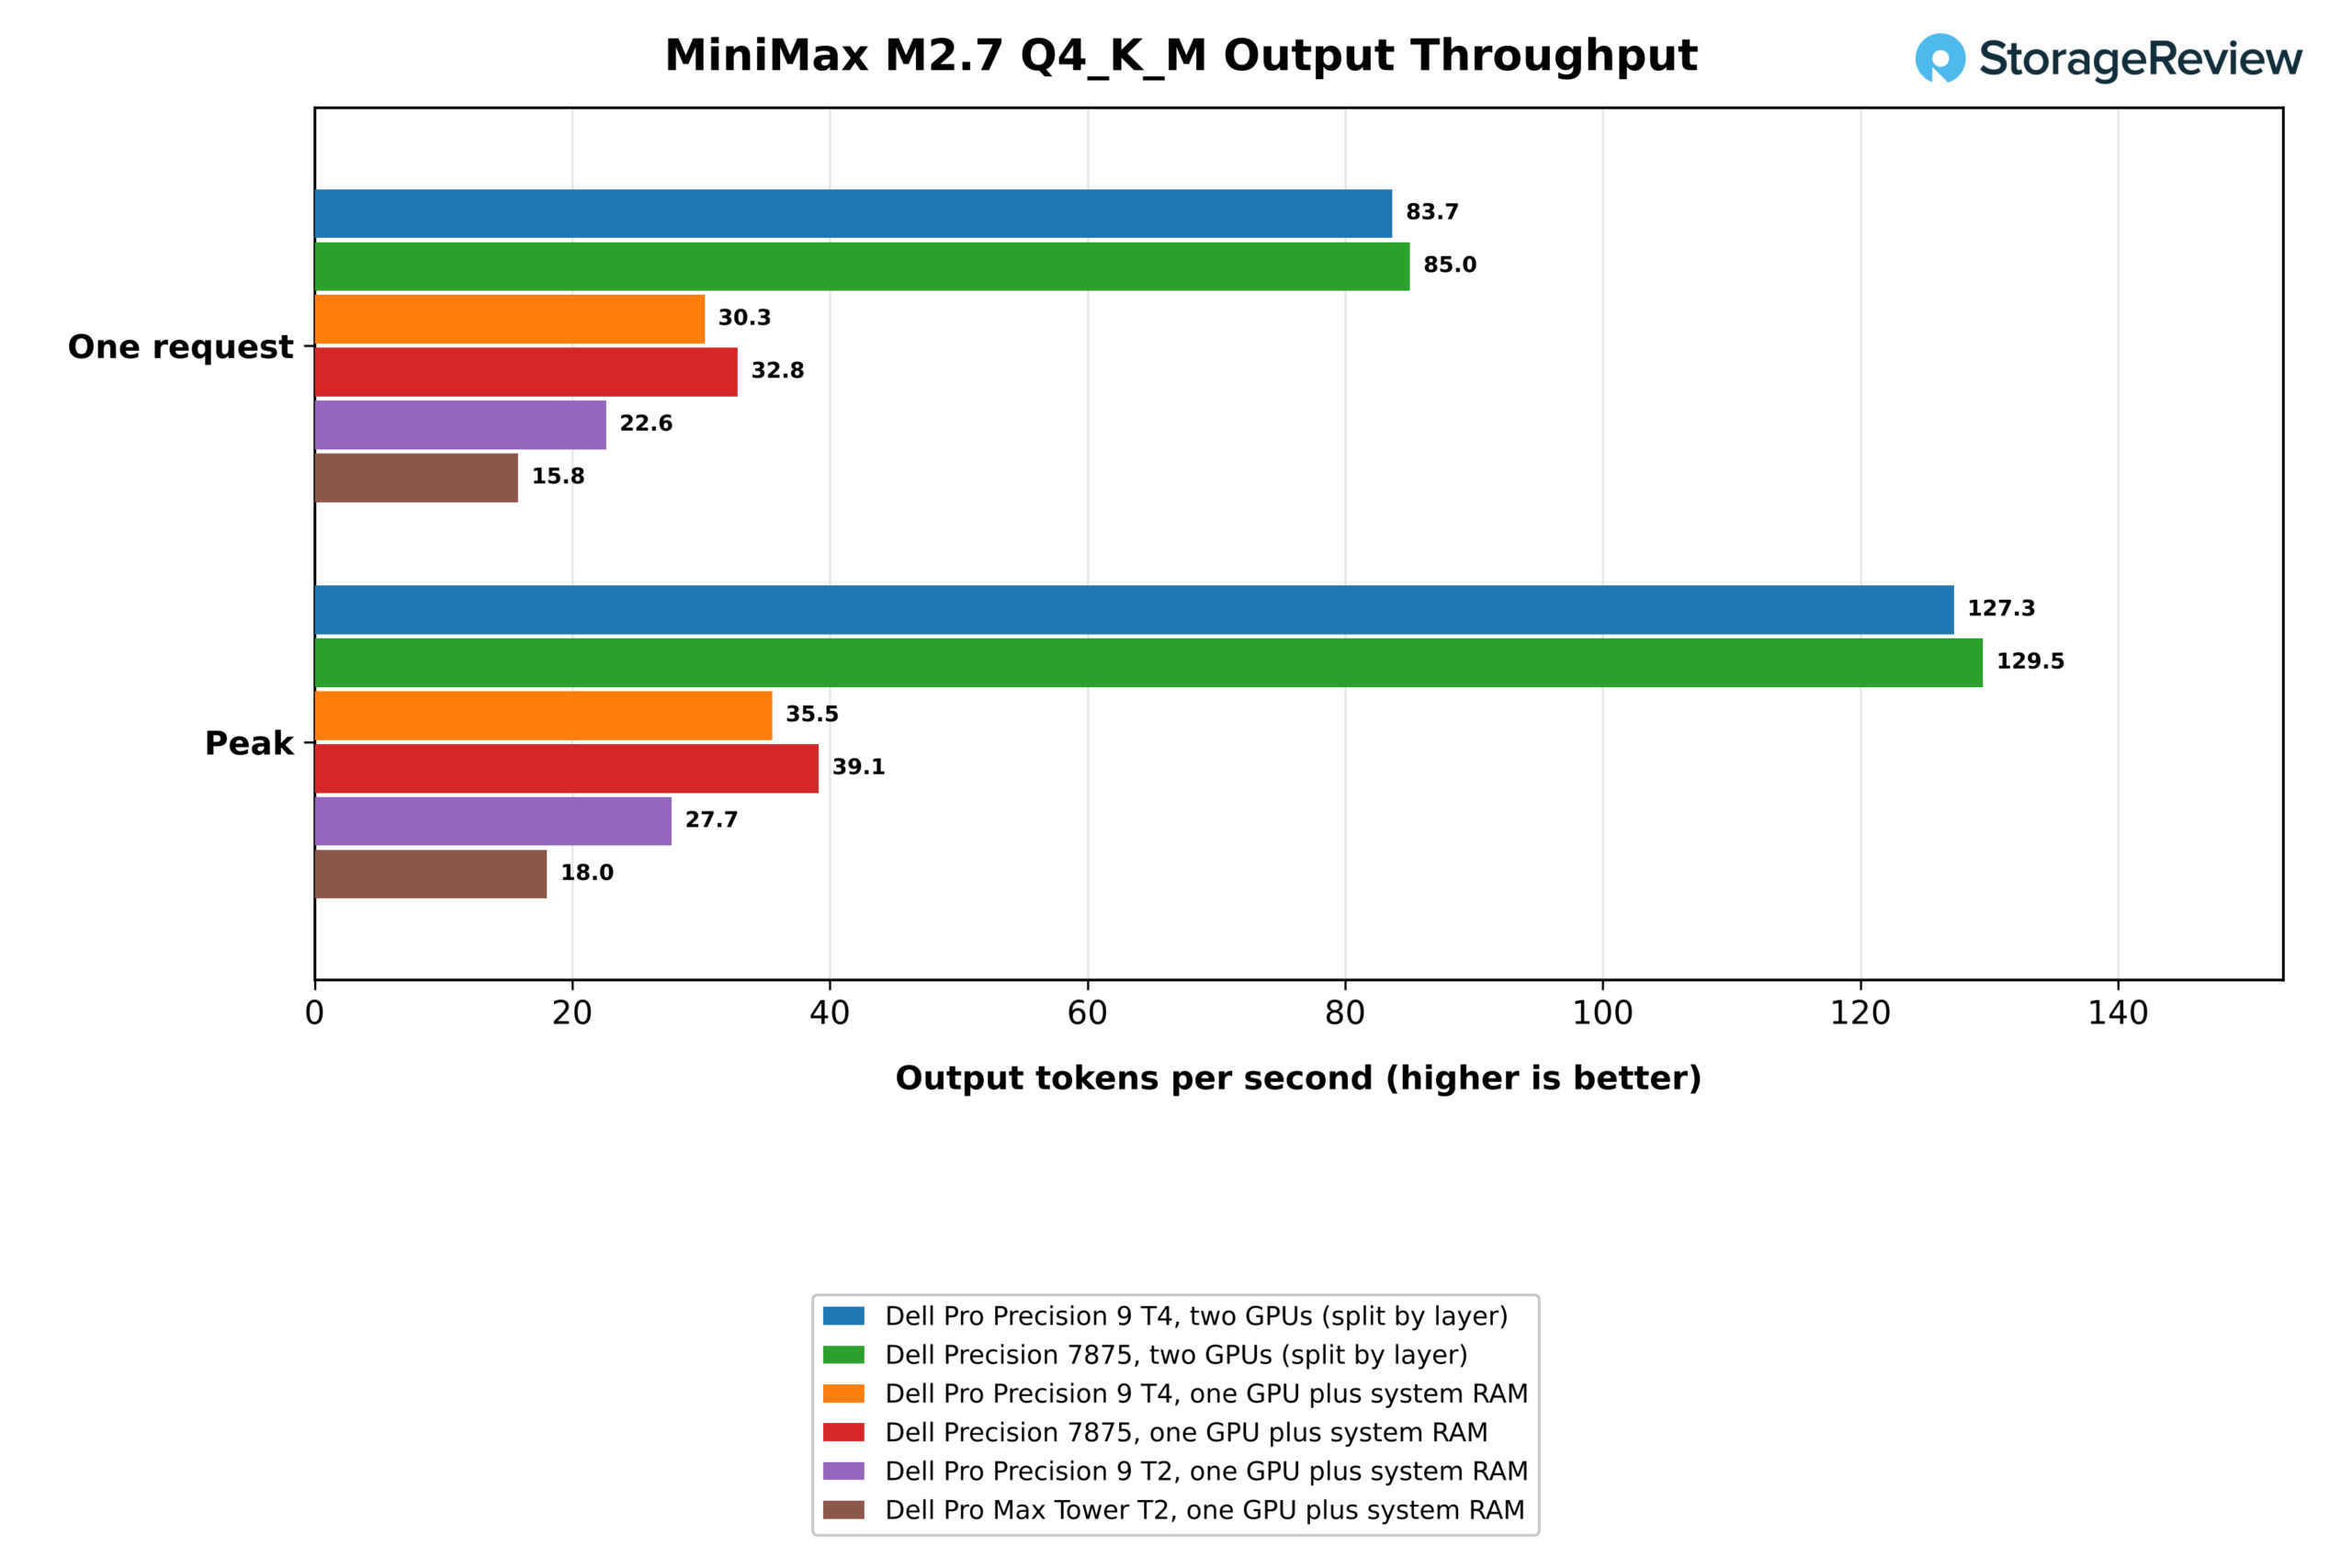
MiniMax M2.7 to model o 230 miliardach parametrów, zbudowany z mieszanki ekspertów, a nasza 4-bitowa kwantyzacja zajmuje 129.3 GB, czyli więcej niż 96 GB w jednym RTX PRO 6000. Na jednej karcie, z resztą w pamięci systemowej, T4 generował 30.3 tokena na sekundę dla jednego użytkownika i potrzebował 16.2 sekundy na zwrócenie pierwszego tokena. Rozkładając to na obie karty, generował 83.7 tokena na sekundę, czyli 2.8 razy szybciej, zwrócił pierwszy token w 3.1 sekundy i osiągnął szczytową wartość 127.3 tokena na sekundę w porównaniu do 35.5.
Wyniki z jednym GPU pokazują, jak ważna jest platforma hosta, gdy model rozszerzy pamięć systemową. Osiem kanałów DDR5-6400 w T4 daje mu 34-procentową przewagę nad czterokanałowym Pro Precision 9 T2 z wynikiem 22.6 tokenów na sekundę i 1.9-krotną przewagę nad dwukanałowym Pro Max Tower T2 z wynikiem 15.8, mimo że karta Pro Max Tower T2 o mocy 600 W jest szybsza w każdym modelu, który się zmieści. Precision 7875 wyprzedził T4 z wynikiem 32.8 tokenów na sekundę przy o 35% mniejszej przepustowości pamięci, więc sama przepustowość nie decyduje o tym wyniku. Podajemy przewagę 7875 na podstawie pomiarów i nie wyodrębniliśmy jej przyczyny.
Ładowanie modelu
| Obciążenie modelu Ollama 0.40.3 i llama.cpp (im niższa wartość, tym lepiej) | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Tower T2 |
|---|---|---|---|---|
| gpt-oss:20b (12.8 GB), zimny | 5.79 | 7.61 | 5.57 | 7.95 |
| gpt-oss:20b, ciepły | 3.45 | 2.50 | 3.47 | 3.05 |
| gpt-oss:120b (60.9 GB), zimny | 15.16 | 25.80 | 15.16 | 28.18 |
| gpt-oss:120b, ciepły | 7.49 | 5.01 | 7.87 | 6.81 |
| gpt-oss:120b, zimny, jedna kopia na każdym GPU | 26.47 | 35.55 | Pojedynczy GPU | Pojedynczy GPU |
| MiniMax M2.7 (129.3 GB), zimny, jeden procesor graficzny i pamięć RAM | 40.5 | 65.8 | 37.6 | 81.1 |
| MiniMax M2.7, ciepły, jeden GPU i RAM | 28.6 | 15.2 | 36.7 | 80.5 |
W przypadku ładowania na zimno preferowane są dyski Gen5. T4 ładuje gpt-oss:120b z dysku SSD SK hynix Gen5 w 15.2 sekundy, co dorównuje wynikom Pro Precision 9 T2 i znacznie przewyższa wyniki 25.8 i 28.2 sekundy w przypadku modeli Precision 7875 i Pro Max Tower T2 wyposażonych w Gen4. Ładowanie na ciepło z pamięci podręcznej stronicowania jest odwrotne – 7875 osiąga 5.0 sekundy w porównaniu z 7.5 sekundy w modelu T4, a jednoczesne załadowanie kopii na każdy z procesorów graficznych zajęło 26.5 sekundy w modelu T4.
Generacja wzbogacona o wyszukiwanie na dużą skalę
| RAG ponad 1 002 067 fragmentów Wikipedii | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Tower T2 |
|---|---|---|---|---|
| Osadzanie, jeden GPU (przejścia/s) | 1,126 | 1,196 | 1,141 | 1,388 |
| Czas osadzenia ściany, jeden procesor GPU (im niższy tym lepiej) | 890 | 838 | 878 | 722 |
| Osadzanie, dwa GPU (przejścia/s) | 2,162 | 2,371 | Pojedynczy GPU | Pojedynczy GPU |
| Osadzanie czasu ściennego, dwa procesory GPU (im niższy tym lepszy) | 464 | 423 | Pojedynczy GPU | Pojedynczy GPU |
| Budowa indeksu HNSW (s, im niższy tym lepiej) | 27.3 | 34.8 | 46.3 | 118.6 |
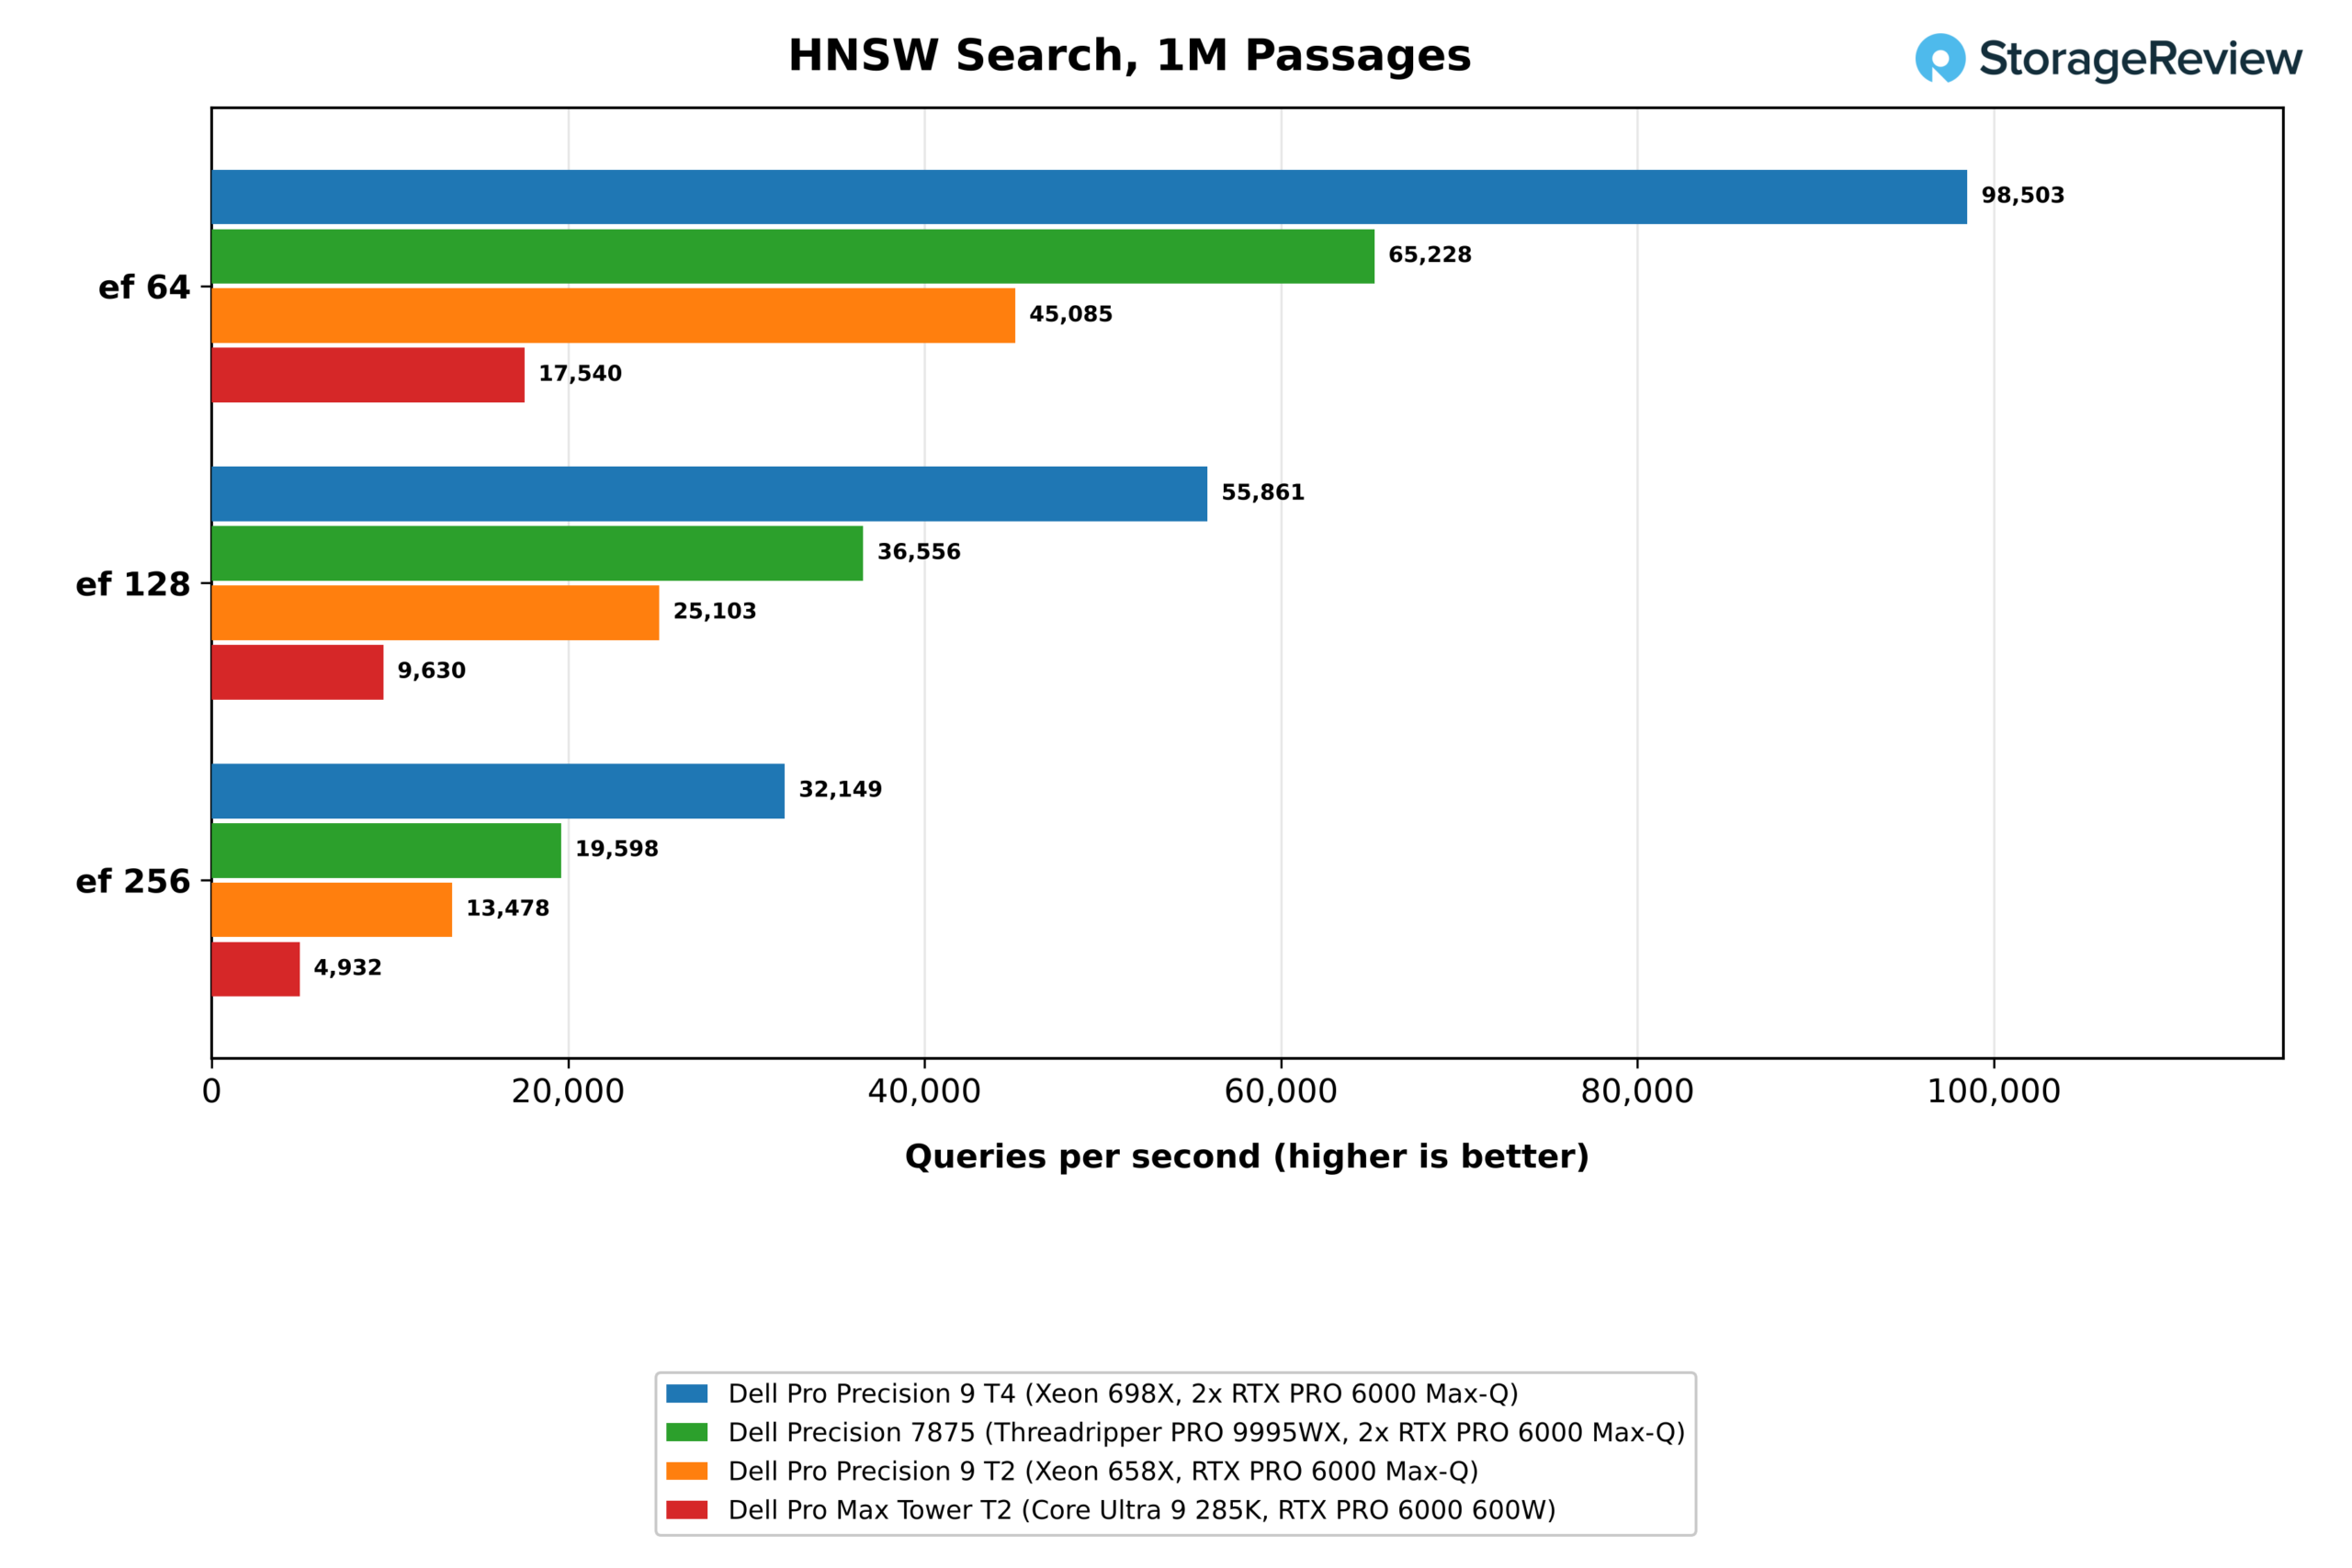
| Wyszukiwanie HNSW, ef 64 (zapytań/s) | 98,503 | 65,228 | 45,085 | 17,540 |
| Wyszukiwanie HNSW, ef 256 (zapytań/s) | 32,149 | 19,598 | 13,478 | 4,932 |
| Recall@5 vs dokładne wyszukiwanie, ef 256 (%) | 97.59 | 97.67 | 97.26 | 97.70 |
| Pytanie do odpowiedzi p50 (s, im niżej tym lepiej) | 0.123 | 0.082 | 0.117 | 0.095 |
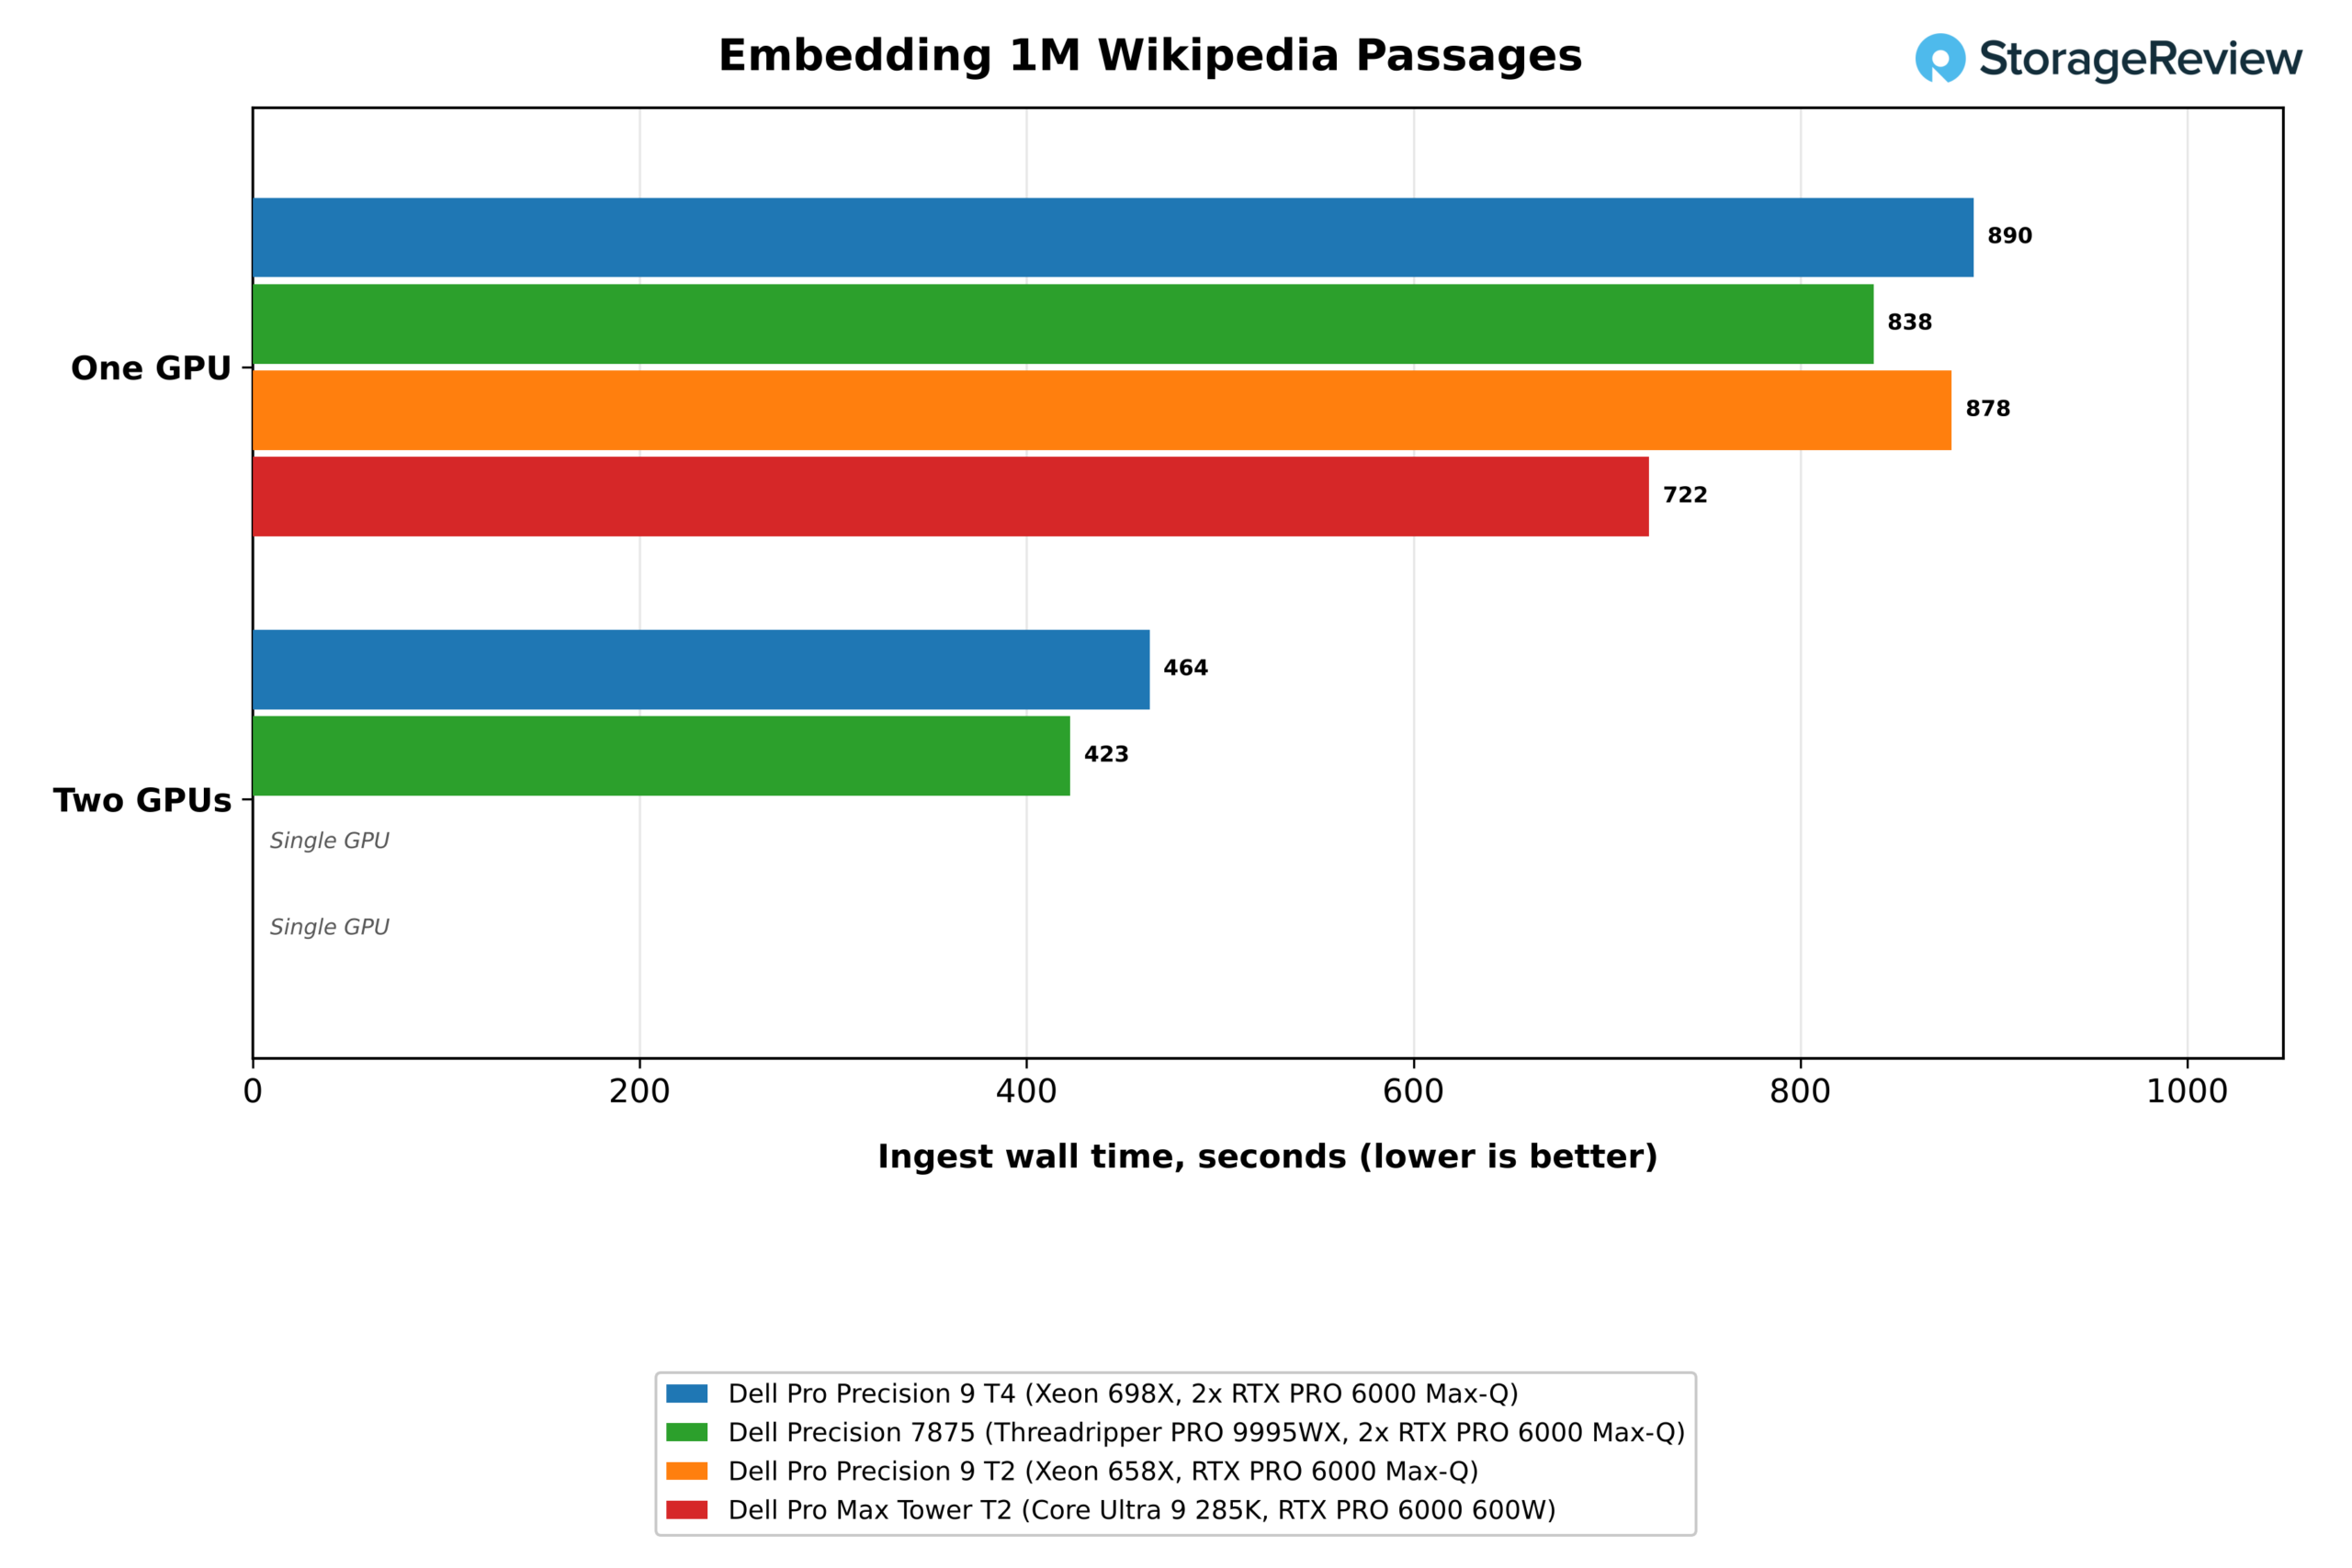
Test RAG-at-scale ukrywa pytania SQuAD wśród miliona fragmentów Wikipedii, osadza je za pomocą nomic-embed-text, buduje indeks HNSW i odpowiada za pomocą Phi-4-mini. Osadzanie zajęło 890 sekund na jednym GPU T4 i 464 sekundy na dwóch, co oznacza przyspieszenie 1.92x, a Precision 7875 ukończył zadanie w 423 sekundy na dwóch kartach. Karta 600 W w obudowie Pro Max Tower T2 jest najszybszą kartą graficzną z jednym GPU – 722 sekundy.
Budowa indeksu i wyszukiwanie wektorowe są wykonywane przez procesor, a pod tym względem T4 jest liderem. Zbudował indeks HNSW w 27.3 sekundy, w porównaniu z 34.8 sekundy w modelu Precision 7875 i 118.6 sekundy w modelu Pro Max Tower T2, a przeszukiwał z szybkością 98 503 zapytań na sekundę przy EF 64, 1.51 razy szybciej niż w modelu 7875 i 5.6 razy szybciej niż w systemie Core Ultra. Przy EF 256, przetworzył 32 149 zapytań na sekundę, osiągając 97.6% wskaźnika odtworzenia w porównaniu z wyszukiwaniem dokładnym, a odpowiedzi pojawiły się w medianie 0.12 sekundy.
Strojenie
| Ministral 3 8B LoRA, BF16, jedna epoka Dolly 15k | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Tower T2 |
|---|---|---|---|---|
| Czas szkolenia epoki, jeden procesor GPU (minuty, im mniej, tym lepiej) | 31.5 | 27.2 | 30.6 | 22.3 |
| Przepustowość, jeden GPU (tokeny/s) | 1,584 | 1,834 | 1,631 | 2,236 |
| Strata wytrzymywana przed i po szkoleniu, jeden procesor GPU | 1.534 do 1.169 | 1.534 do 1.172 | 1.534 do 1.167 | 1.534 do 1.167 |
| Czas szkolenia epoki, dwa procesory GPU (minuty, im mniej, tym lepiej) | 19.7 | 18.1 | Pojedynczy GPU | Pojedynczy GPU |
| Przepustowość, dwa procesory GPU (tokeny/s) | 2,528 | 2,754 | Pojedynczy GPU | Pojedynczy GPU |
| Przyspieszenie z drugiego GPU | 1.60x | 1.50x | Pojedynczy GPU | Pojedynczy GPU |
| Strata wytrzymywana po szkoleniu, dwa procesory graficzne | 1.167 | 1.168 | Pojedynczy GPU | Pojedynczy GPU |
Test LoRA dla jednej epoki dostraja Ministral 3 8B w BF16 na Dolly 15k w 1,849 krokach i punktuje 200 zatrzymanych przykładów co 100 kroków. Każdy system rozpoczął się ze stratą 1.534 i zakończył między 1.167 a 1.172, więc wynik, który je dzieli, to czas trwania epoki. Jeden układ GPU T4 zakończył test w 31.5 minuty z prędkością 1,584 tokenów na sekundę, co stanowi wynik o 3% gorszy od Pro Precision 9 T2 na tej samej karcie Max-Q. Precision 7875 potrzebował 27.2 minuty, a karta 600 W w obudowie Pro Max Tower T2 – 22.3.
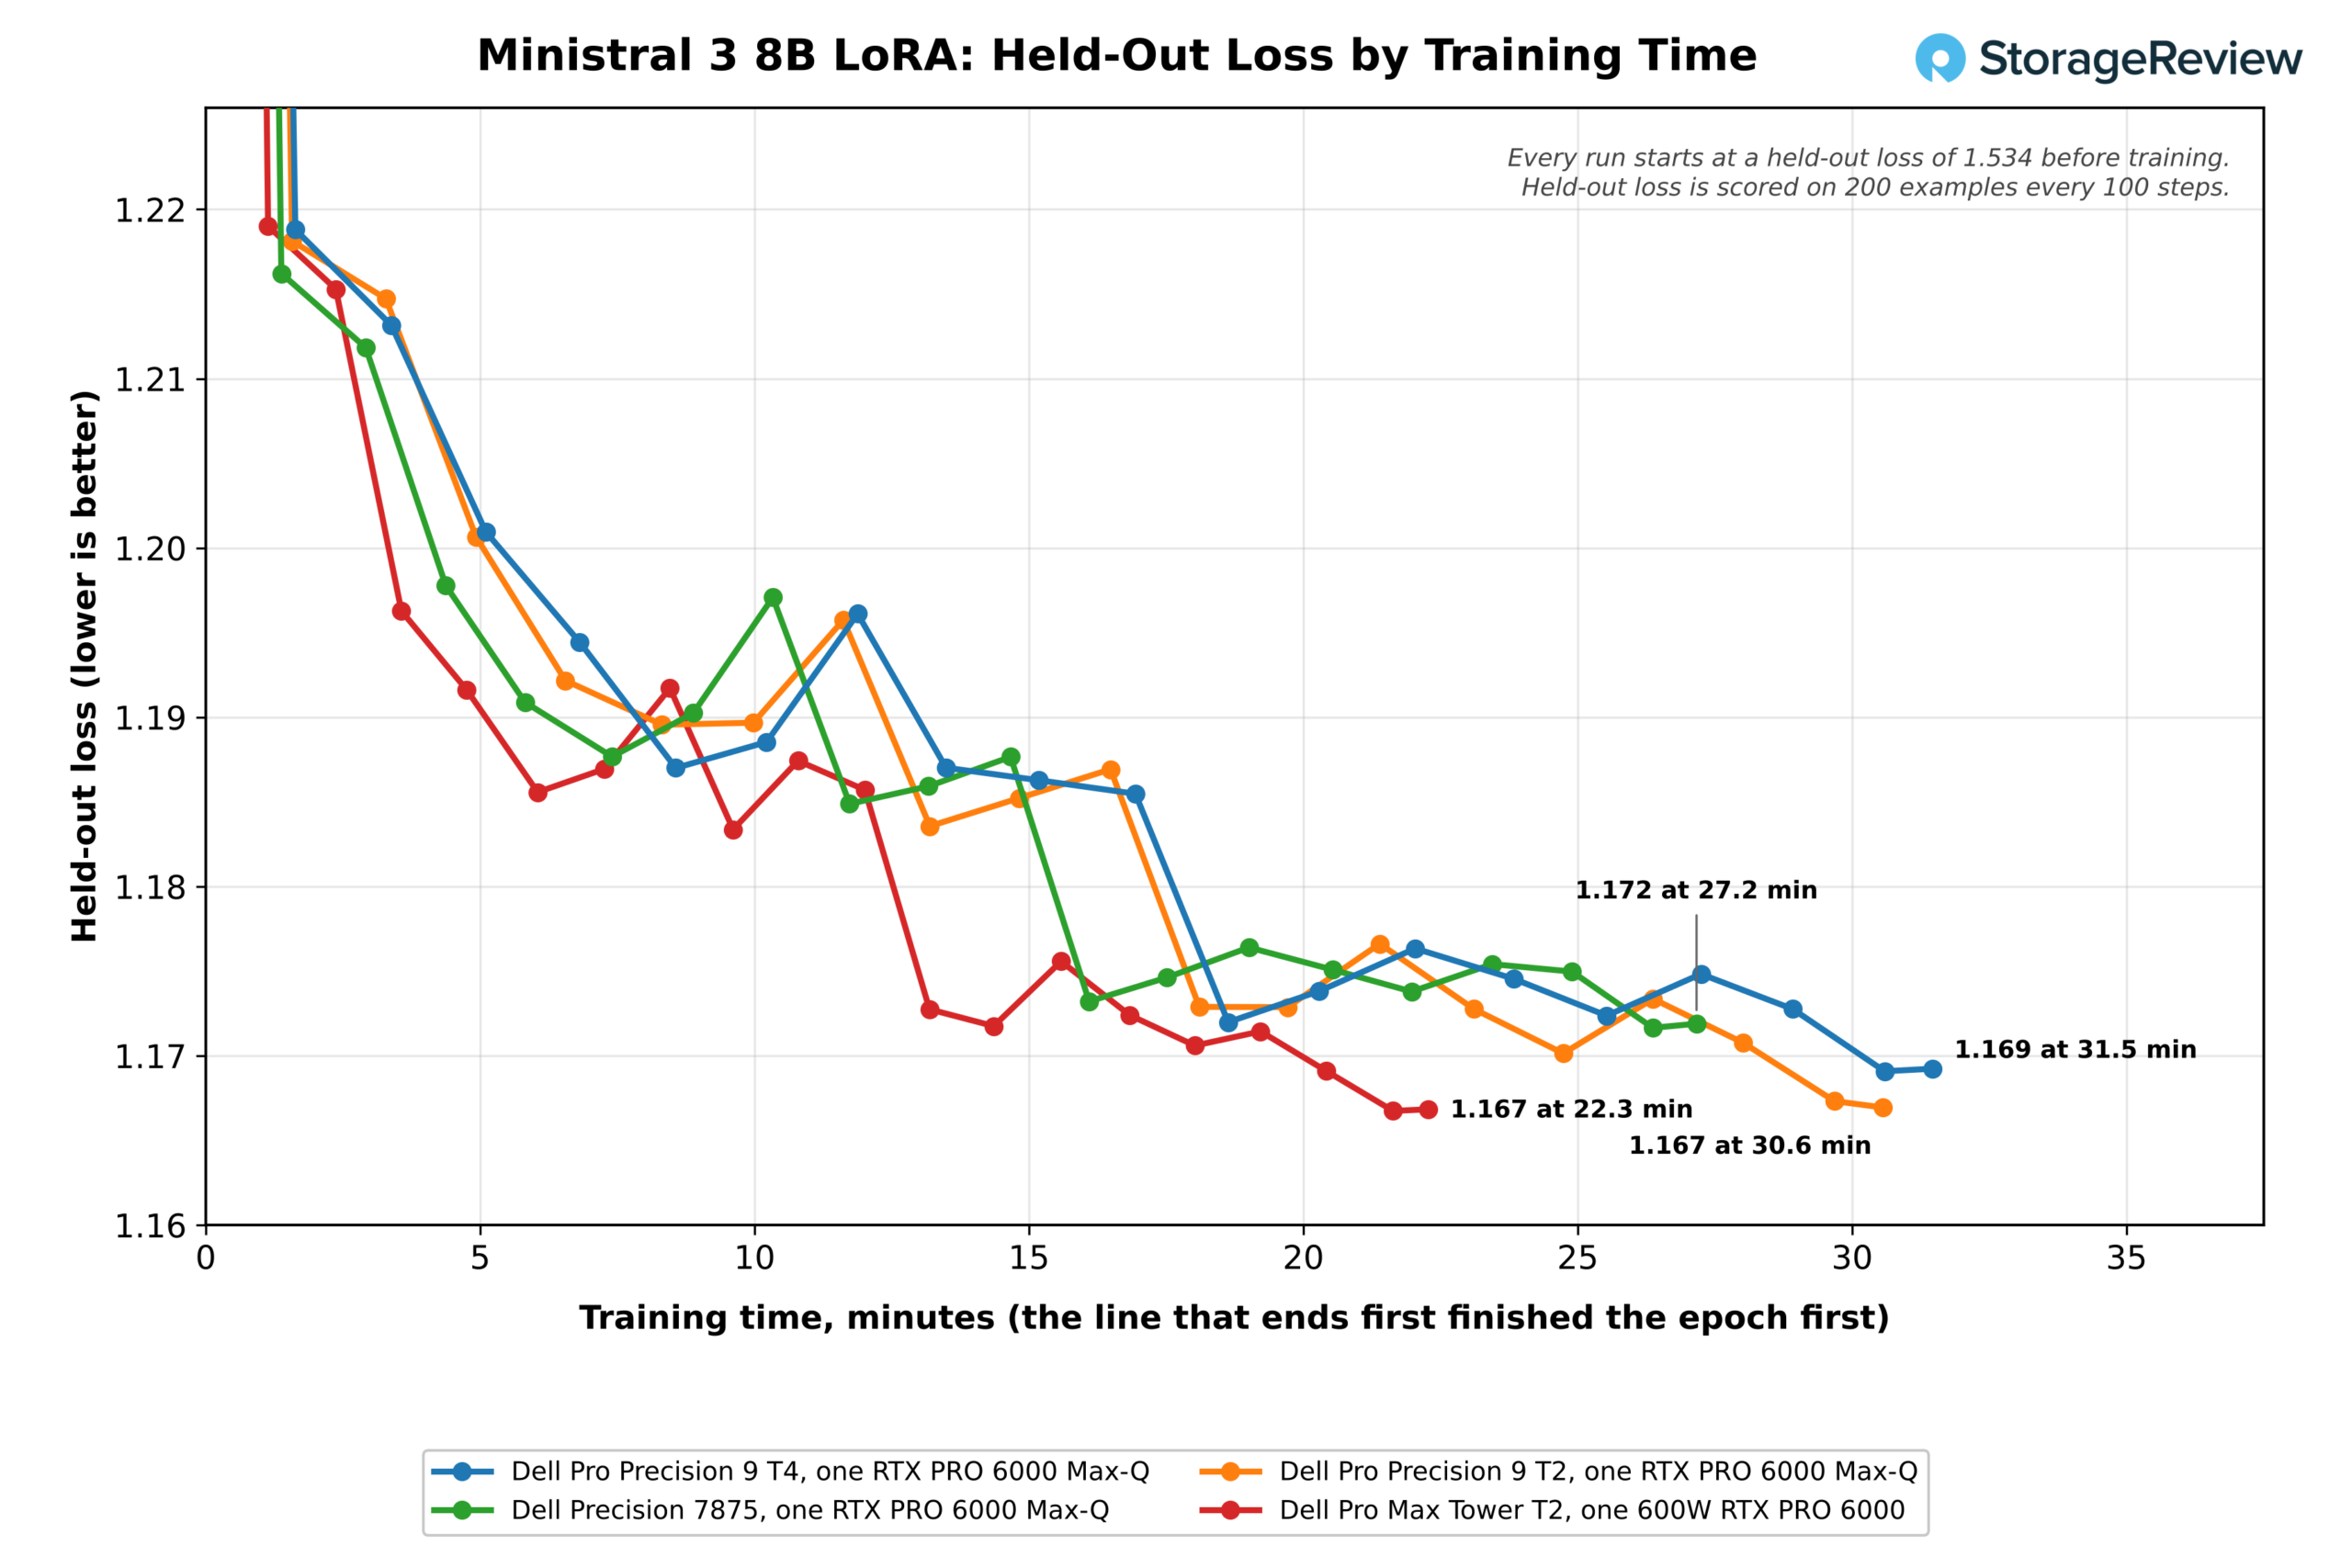
Strata w T4 spadła z 1.534 do 1.219 w pierwszych 100 krokach, 1.6 minuty po rozpoczęciu treningu, a następnie spadła do 1.169 przez resztę epoki. Dodanie drugiego GPU skróciło epokę T4 do 19.7 minuty przy 2,528 tokenach na sekundę, co stanowiło przyspieszenie 1.60x i zakończyło ją przed 22.3 minutami pojedynczej karty 600 W. Precision 7875 ukończył epokę z dwoma GPU w 18.1 minuty, co oznacza przyspieszenie 1.50x, a przebiegi z dwoma GPU zakończyły się stratami w wysokości 1.167 i 1.168.
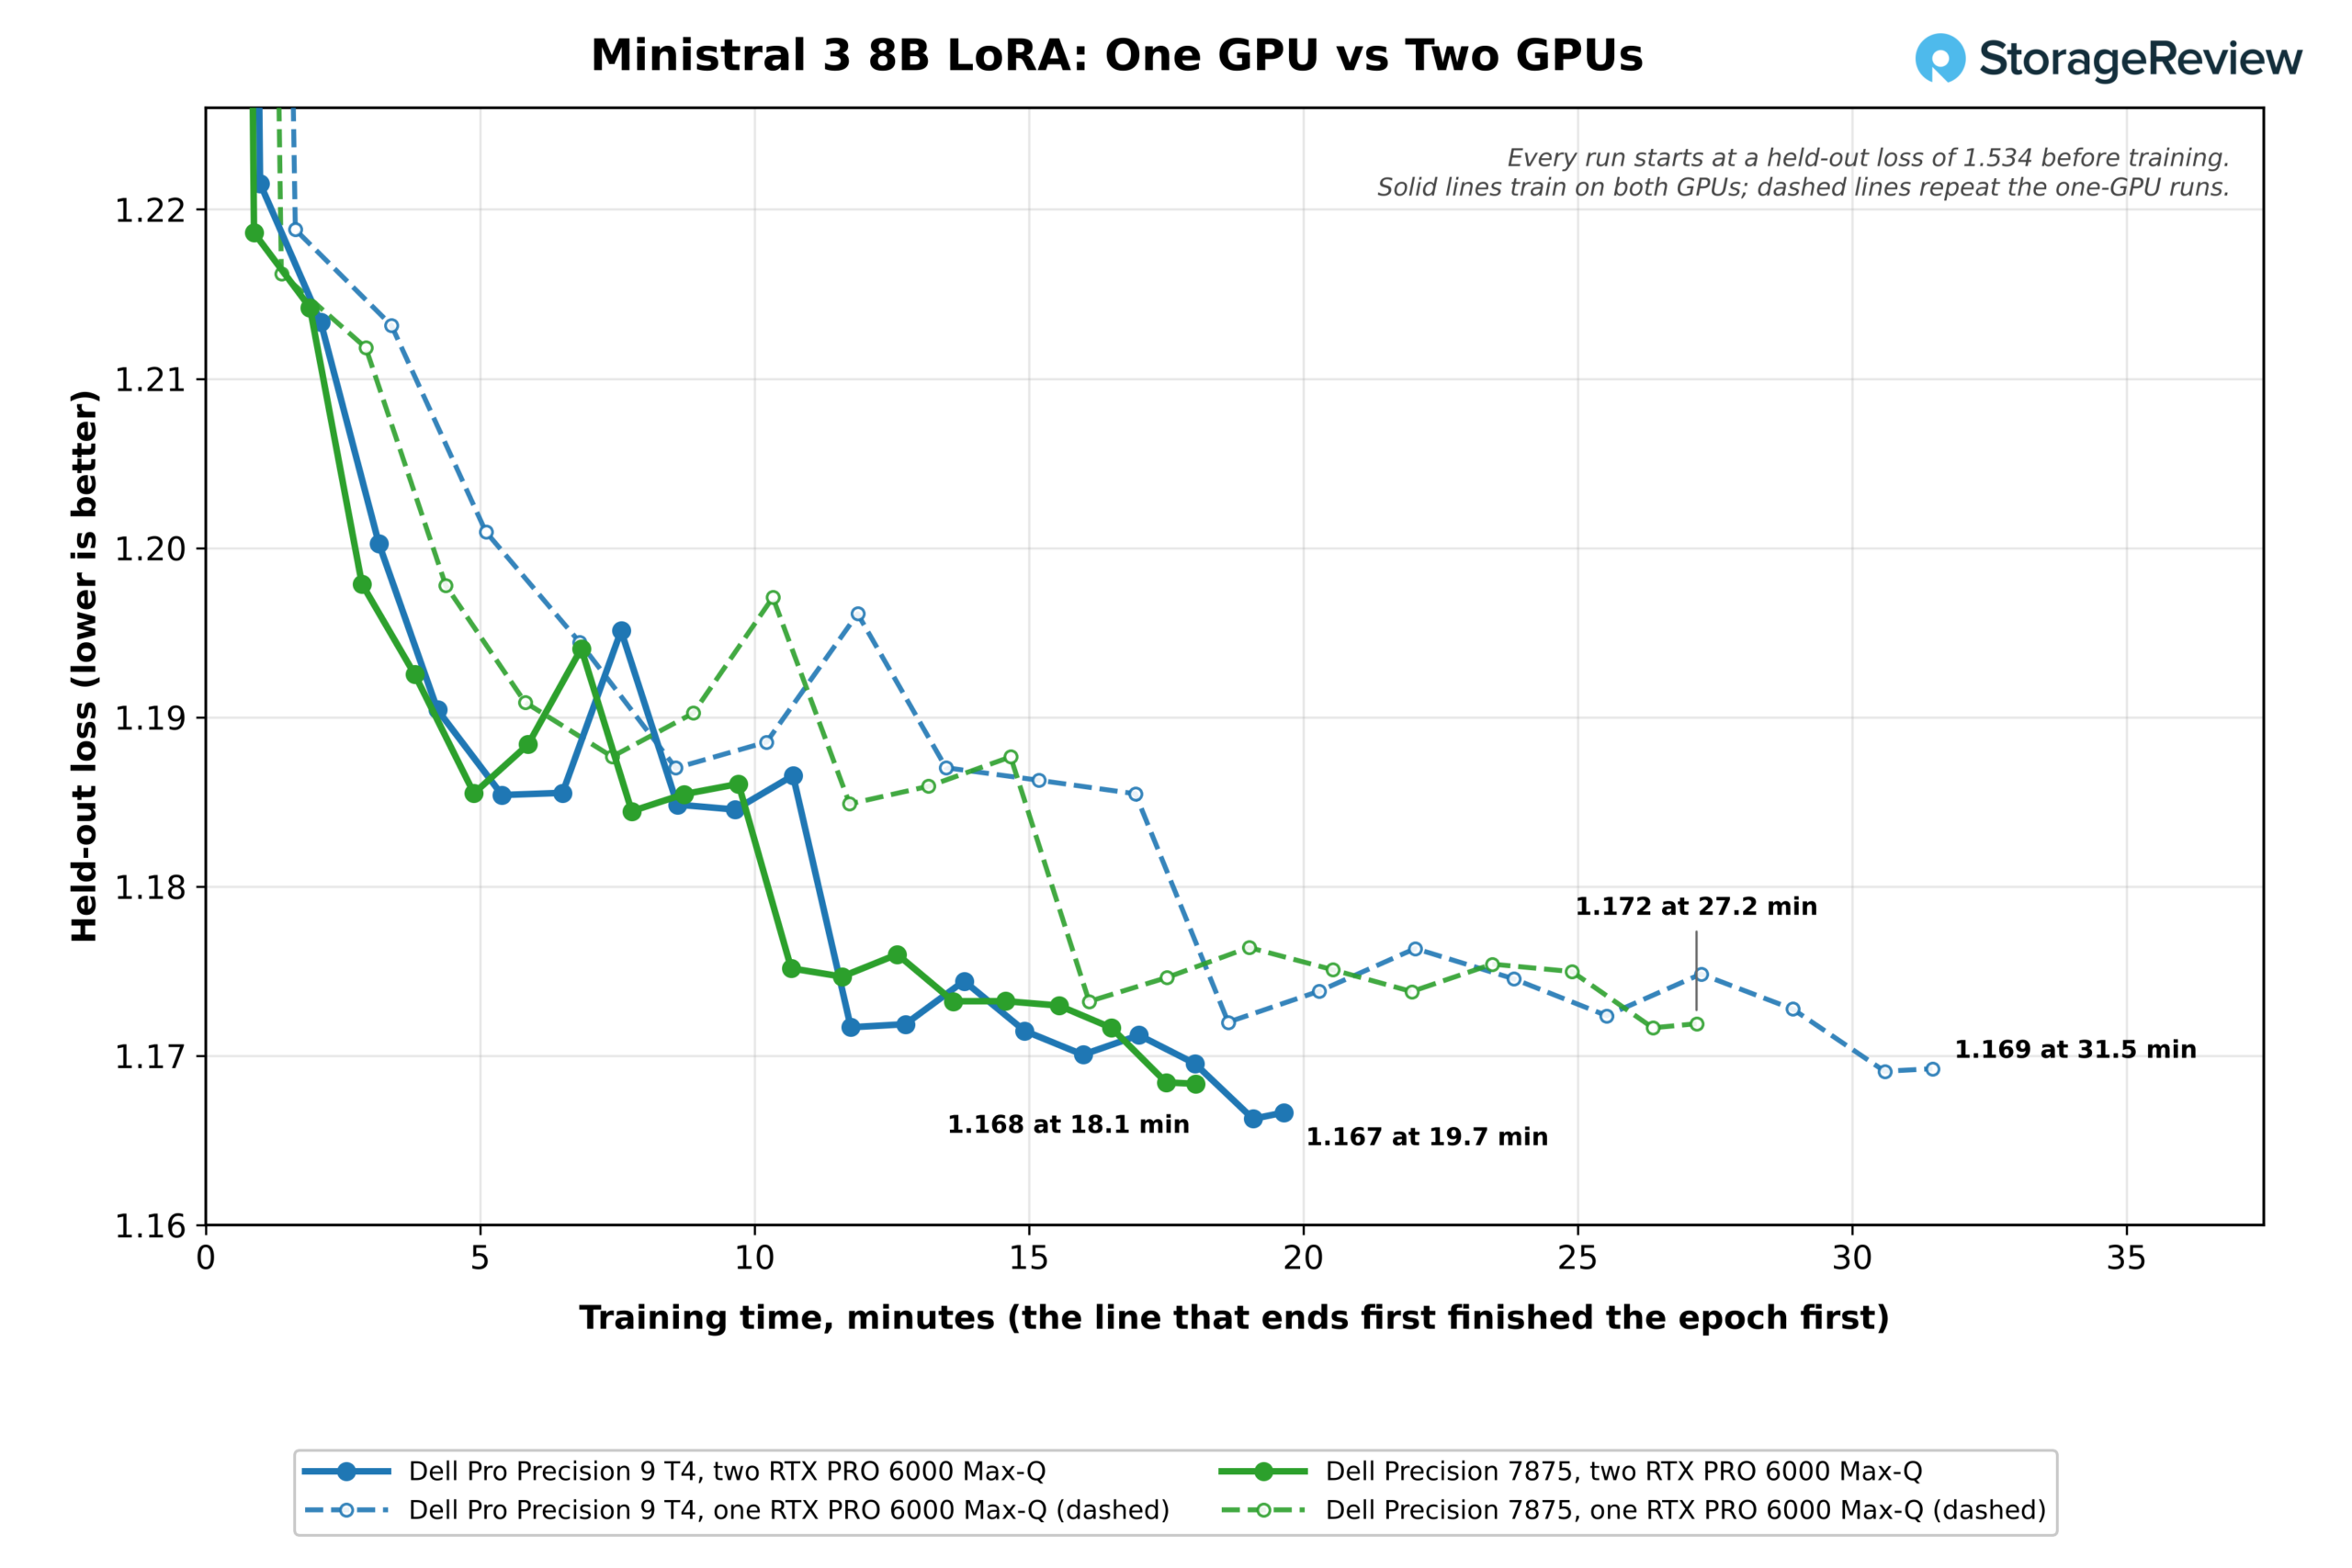
Obie karty przetwarzają dane równolegle, z dwoma przykładami na GPU i gradientami kumulowanymi do tej samej globalnej partii ośmiu, w czterech przebiegach na jednym GPU i dwóch przebiegach na parze. Dzięki temu przebieg na dwóch GPU zawiera te same przykłady na każdym kroku i generuje taką samą stratę. Z dwoma krótkimi przykładami na GPU w każdym przebiegu, druga karta ma niewiele pracy do przetworzenia, a wymiana gradientów zajmuje większą część każdego kroku. Epoka osiągnęła szczyt na poziomie 19.5 GB pamięci GPU na jednej karcie i 19.7 GB na karcie na dwóch kartach, co stanowi ułamek 96 GB na każdej karcie RTX PRO 6000.
Agent kodujący, RAG na małą skalę i generowanie obrazu
| Agent kodujący, RAG i generowanie obrazu (im wyższa wartość, tym lepiej, chyba że zaznaczono inaczej) | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Tower T2 |
|---|---|---|---|---|
| Agent kodujący, gpt-oss:20b 64K, pomyślne uruchomienia (z 3) | 3 | 2* | 2* | 2* |
| Agent kodujący, gpt-oss:120b 128K, pomyślne uruchomienia (z 3) | 3 | 3 | 3 | 3 |
| Agent kodujący, gpt-oss:120b, szybkość generacji (tokeny/s) | 161.5 | 167.9 | 166.7 | 183.2 |
| RAG, 20 963 pasaże, spożycie (pasaży/s) | 304.6 | 433.8 | 392.1 | 371.6 |
| Generowanie odpowiedzi RAG, Phi-4-mini (tokeny/s) | 372.5 | 410.0 | 402.8 | 415.8 |
| FLUX.2 klein 4B BF16, 1024×1024 (obrazów/min) | 40.96 | 43.03 | 41.32 | 54.25 |
| Z-Image Turbo 6B BF16 (obrazów/min) | 17.29 | 17.67 | 17.27 | 23.83 |
| Qwen-Image 20B BF16 (obrazów/min) | 2.43 | 2.45 | 2.39 | 3.20 |
*Oznaczone przez pakiet: jeden z trzech agentów uruchomionych w tym systemie nie przeszedł wszystkich 11 testów.
T4 przeszedł wszystkie testy agenta kodującego na każdym poziomie modelu, w tym wszystkie trzy testy gpt-oss:20b w kontekście 64 KB, podczas gdy pozostałe trzy systemy przeszły dwa z trzech testów, generując 161.5 tokena na sekundę w kontekście gpt-oss:120b. Generowanie obrazu odbywa się na jednym GPU, więc 40.96 obrazów na minutę T4 w środowisku FLUX.2 klein w BF16 plasuje się na poziomie 54.25 w innych systemach Max-Q, za kartą 600 W.
Wydajność procesora
Wyniki CPU zestawiają 86 rdzeni Xeon T4 z 96 rdzeniami Threadrippera w Precision 7875, przy czym dwa 24-rdzeniowe T2 stanowią punkty odniesienia. Threadripper ma dziesięć rdzeni więcej i oferuje 192 wątki w porównaniu do 172 wątków w Xeon. T4 prowadzi, gdzie o wyniku decyduje przepustowość pamięci, a 7875 prowadzi, gdzie decyduje liczba rdzeni i taktowanie.
Kompresja, renderowanie i kompilacja
| Testowanie | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Tower T2 |
|---|---|---|---|---|
| 7-Zip, wszystkie wątki (GIPS) | 619.8 | 850.0 | 285.1 | 172.7 |
| 7-Zip, jeden wątek (GIPS) | 8.85 | 10.58 | 9.27 | 11.04 |
| Blender 4.5 Monster (próbki/min) | 961.8 | 1,253.8 | 400.7 | 303.0 |
| Blender 4.5 Junkshop (próbki/min) | 641.9 | 849.7 | 266.9 | 191.9 |
| Blender 4.5 Classroom (próbki/min) | 442.8 | 612.2 | 187.2 | 147.1 |
| Hamulec ręczny x265 (fps) | 31.4 | 41.7 | 41.5 | 40.0 |
| Hamulec ręczny SVT-AV1 (fps) | 159.4 | 255.8 | 198.5 | 122.6 |
| Kompilacja LLVM 21 (s, im niższa tym lepsza) | 58.4 | 43.7 | 106.4 | 155.9 |
| Jądro Linux allmodconfig (s, im mniej tym lepiej) | 312 | 264 | 537 | 843 |
| OpenSSL AES-256-GCM, wszystkie wątki (GB/s) | 882.6 | 1,139.1 | 371.2 | 137.0 |
| nginx, 1,000 połączeń (żądań/s) | 414,468 | 467,128 | 323,567 | 153,732 |
Procesor T4 uzyskał 619.8 GIPS w 7-Zip i 961.8 próbek na minutę w Blender Monster, czyli 2.2 i 2.4 razy więcej niż 24-rdzeniowy procesor Pro Precision 9 T2. Procesor Precision 7875 uzyskał o 37% lepszy wynik w 7-Zip i o 30% lepszy w Blenderze, a kompilację LLVM ukończył w 43.7 sekundy w porównaniu z 58.4 sekundami, a kompilację allmodconfig jądra Linux w 264 sekundy w porównaniu z 312 sekundami. Słabym punktem procesora T4 jest prędkość na rdzeń, z najniższym wynikiem GIPS w tej grupie w teście jednowątkowym 7-Zip, wynoszącym 8.85 GIPS.
Kodowanie x265 w HandBrake'u jest wartością odstającą w tej tabeli, a przyczyną jest raczej enkoder niż procesor. Pozostałe trzy systemy uzyskały wyniki między 40.0 a 41.7 kl./s z 24 lub 96 rdzeniami, więc x265 przy tym ustawieniu nie skaluje się wraz z liczbą rdzeni, a 31.4 kl./s w T4 jest zgodne z niższą prędkością na rdzeń w wątkach, z których korzysta x265. Podczas kodowania T4 osiągał średnio około 1 GHz na 172 wątkach przy temperaturze od 51°C do 64°C, co pokazuje, że większość procesora jest w stanie spoczynku. SVT-AV1 skalował się lepiej, osiągając 159.4 kl./s na T4 w porównaniu z 255.8 kl./s na 7875.


Przepustowość pamięci, symulacja i matematyka
| Testowanie | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Tower T2 |
|---|---|---|---|---|
| STREAM Triad (MB/s) | 328,329 | 215,177 | 141,832 | 45,102 |
| OpenFOAM 13 sterownik, ogniwa 3M, rozwiązanie (s, im niższy tym lepszy) | 293 | 556 | 826 | Nie skończyłem |
| GROMACS benchPEP, wszystkie rdzenie (ns/dzień) | 1.243 | 1.034 | Nie uruchomiono | Nie uruchomiono |
| GROMACS benchMEM, 16 rdzeni (ns/dzień) | 68.09 | 84.94 | 78.03 | 54.26 |
| OpenBLAS DGEMM, wszystkie rdzenie (GFLOPS) | 3,664 | 4,745 | 2,319 | 1,063 |
| OpenBLAS LU rozwiązuje N=20000 (GFLOPS) | 1,660 | 1,172 | 1,616 | 858 |
| y-cruncher Pi, 1B cyfr (s, im mniej, tym lepiej) | 4.01 | 7.45 | 8.51 | 24.61 |
| y-cruncher Pi, 10B cyfr (s, im mniej, tym lepiej) | 53.9 | 83.7 | 119.2 | 347.9 |
| y-cruncher Pi, 25B cyfr (s, im mniej, tym lepiej) | 155.6 | 259.6 | Nie uruchomiono | Nie uruchomiono |
Osiem kanałów DDR5-6400 zapewnia T4 328 GB/s w STREAM Triad, o 53 procent więcej niż DDR5-5600 w Precision 7875 i 2.3 razy więcej niż czterokanałowy Pro Precision 9 T2. Poniżej przedstawiono wyniki pracy w zakresie przepustowości: T4 rozwiązał problem z 3-milionową obudową OpenFOAM w 293 sekundy, w porównaniu z 556 sekundami w modelu 7875 i 826 sekundami w Pro Precision 9 T2, podczas gdy Pro Max Tower T2 nie zmieścił się w 150-minutowym limicie pamięci. T4 również rozwiązał problem z obudową z 22.6 milionami komórek w 6,851 sekund.

GROMACS benchPEP, duży symulator dynamiki molekularnej z rdzeniami, działał z szybkością 1.243 ns/dzień na procesorze T4 w porównaniu z 1.034 ns/dzień na procesorze 7875, a obliczenia LU osiągnęły 1,660 GFLOPS w porównaniu z 1,172. y-cruncher obliczył 10 miliardów cyfr liczby Pi w 53.9 sekundy w porównaniu z 83.7 ns/dzień na procesorze 7875 i 25 miliardów w 155.6 sekundy w porównaniu z 259.6. Gęste obliczenia, które pozostają w pamięci podręcznej, sprzyjają Threadripperowi, który wyprzedził OpenBLAS DGEMM z wynikiem 4,745 GFLOPS w porównaniu z 3,664 ns/dzień.


Bazy danych i usługi
| Testowanie | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Tower T2 |
|---|---|---|---|---|
| Test ClickBench, 43 zapytania (im mniej, tym lepiej) | 3.21 | 2.88 | 4.80 | 10.44 |
| Test ClickBench na zimno, 43 zapytania (im mniej tym lepiej) | 6.45 | 7.09 | 6.92 | 14.22 |
| Pamięć podręczna Valkey, SET (żądania/s) | 666,714 | 1,138,696 | 914,832 | 1,719,108 |
| Pamięć podręczna Valkey, GET (żądania/s) | 865,353 | 1,279,429 | 991,576 | 1,648,278 |
| Sztokfisz, wszystkie wątki (Mnps) | 68.21 | 168.27 | 45.44 | 37.42 |
| PyPerformance go (ms, im niższy tym lepiej) | 74.3 | 66.0 | 72.1 | 56.7 |
ClickHouse uruchomił 43 zapytania ClickBench w 3.21 sekundy na gorąco i 6.45 sekundy na zimno na T4, 0.33 sekundy za 7875 w gorącym przebiegu i 0.64 sekundy przed 7875 w zimnym przebiegu. Valkey preferuje szybkie rdzenie nad wieloma rdzeniami, a 666 714 żądań SET na sekundę w T4 jest gorszy od wszystkich trzech systemów porównawczych, przy czym Core Ultra 9 285K w obudowie Pro Max Tower T2 prowadzi z wynikiem 1.72 miliona. Ten wzorzec jest zgodny z wynikami T4 dla jednego wątku i warto go rozważyć w przypadku usług ograniczonych opóźnieniem.
Przy wszystkich 172 załadowanych wątkach i średniej temperaturze procesora 87°C, T4 przeszukał 68.21 miliona węzłów na sekundę w Stockfish, 1.5 raza więcej niż 48-wątkowy Pro Precision 9 T2 i znacznie mniej niż połowa 168.27 węzłów na 192 wątkach procesora 7875. Test zakończył się również przekroczeniem limitu czasu podczas pierwszego pełnego uruchomienia T4, zanim niezależny retest przyniósł tę wartość. Przedstawiamy wynik jako zmierzony i nie wyodrębniliśmy przyczyny słabego skalowania.
Wydajność pamięci masowej
| fio, 25GiB śladu (im większy tym lepszy) | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Tower T2 |
|---|---|---|---|---|
| Odczyt sekwencyjny 128K (MB/s) | 14,152 | 7,089 | 20,914 * | 7,234 |
| Zapis sekwencyjny 128 KB (MB/s) | 10,078 | 5,265 | 12,564 | 6,772 |
| Losowy odczyt 4K, szczyt (IOPS) | 2,306,346 | 993,569 | 3,214,066 | 1,538,387 |
| Losowy zapis 4K, szczyt (IOPS) | 1,830,776 | 787,388 | 2,353,766 | 1,326,030 |
*Oznaczone przez pakiet ze względu na rozbieżności między przebiegami po ponownym uruchomieniu.
Dysk rozruchowy SK Hynix Gen5 o pojemności 2 TB w obudowie T4 osiągnął prędkość odczytu 14 152 MB/s i zapisu 10 078 MB/s, czyli około dwukrotnie więcej niż odczyt sekwencyjny dysków Gen4 w obudowach Precision 7875 i Pro Max Tower T2. Osiągnął on szczytową wartość 2.31 miliona losowych operacji odczytu i zapisu na sekundę (IOPS) oraz 1.83 miliona losowych operacji zapisu na sekundę (IOPS). Sekwencyjny odczyt z obudowy Pro Precision 9 T2, wynoszący 20 914 MB/s, przekracza prędkość jednego łącza Gen5 x4, co odpowiada objętości testowej tego systemu – macierzy pasmowej dysków Samsung PM9E1 Gen5. Testowaliśmy sam dysk rozruchowy obudowy T4, a drugi dysk o pojemności 2 TB nie był częścią tego testu.

Termiczne i zegary pod obciążeniem
| Dell Pro Precision 9 T4 | Maksymalna moc procesora (C) | Średnia wydajność procesora (C) | Średnie taktowanie procesora (MHz) |
|---|---|---|---|
| 7-Zip | 93 | 80.6 | 1,967 |
| mikser | 91 | 85.7 | 2,587 |
| GROMACS | 96 | 81.3 | 1,313 |
| Kompilacja LLVM | 83 | 74.5 | 2,127 |
| OtwórzBLAS | 80 | 62.9 | 1,325 |
| Obsługa LLM | 84 | 65.0 | 924 |
| Strojenie | 71 | 61.2 | 854 |
| RAG na dużą skalę | 74 | 64.4 | 987 |
| Dyski | 64 | 55.4 | 942 |
W trybie Ultra Performance (Ultra Performance) BIOS-u, Xeon 698X osiągnął temperaturę szczytową 93°C w 7-Zip i 96°C w GROMACS, a wartości taktowania w tabeli są średnimi dla wszystkich 172 logicznych procesorów. Blender i Stockfish obciążały każdy wątek i utrzymywały taktowanie na poziomie 2.5–2.6 GHz, powyżej bazowego taktowania układu 2.0 GHz. GROMACS i OpenBLAS obciążały 64 i 86 rdzeni fizycznych, pozostawiając pozostałe wątki bezczynne w okolicach 0.8 GHz, dlatego ich średnie wartości wynoszą około 1.3 GHz. Praca z wykorzystaniem GPU utrzymywała niższą temperaturę procesora, średnio od 61°C do 65°C podczas testów LLM, dostrajania i RAG, ponieważ te testy obciążają karty.

Wniosek
Dell Pro Precision 9 T4 został stworzony do lokalnej pracy z AI, a druga karta RTX PRO 6000 jest tego najlepszym przykładem. Dwie karty Max-Q zwiększyły szczytową przepustowość serwowania od 1.85 do 2.02 razy w czterech modelach i 1.92 razy w trybie osadzania, skróciły epokę LoRA na Ministral 3 8B z 31.5 do 19.7 minuty i zwiększyły wydajność MiniMax M2.7, modelu zbyt dużego dla jednej karty, z 30.3 do 83.7 tokenów na sekundę dla pojedynczego użytkownika. Na gpt-oss 120B, jeden serwer na GPU osiągnął łączną przepustowość 7,091 tokenów na sekundę przy 64 żądaniach, a podział modelu na obie karty zwrócił pierwszy token pojedynczego użytkownika w 719 ms w porównaniu z 1,189 ms.

Osiem kanałów pamięci DDR5-6400 dało procesorowi Xeon 698X o 53% większą przepustowość pamięci niż Threadripper PRO 9995WX. Dzięki tej przepustowości procesor T4 uzyskał szybsze wyniki wyszukiwania w OpenFOAM, GROMACS benchPEP, y-cruncher i HNSW niż Precision 7875, a pamięć masowa Gen5 procesora T4 ładowała duże modele szybciej. Na pochwałę zasługuje również obudowa, z najlepszym układem chłodzenia, jaki widzieliśmy w tej klasie produktów firmy Dell, oraz beznarzędziowym dostępem do zasilacza.
Procesor 7875 utrzymuje przewagę w zakresie renderowania, kompresji i kompilacji na poziomie rdzenia o 18–38%, a w SVT-AV1 aż o 60%. Prędkość na rdzeń procesora Xeon była niższa od wszystkich systemów w tej grupie, co było widoczne w przypadku Valkey i innych usług o małej liczbie wątków. Dostrajanie na pojedynczym GPU było również wolniejsze w przypadku T4, gdzie epoka LoRA trwała 31.5 minuty w porównaniu z 27.2 minuty w przypadku 7875 i 22.3 minuty w przypadku karty 600 W w obudowie Pro Max Tower T2. Każdy system zakończył test z wynikiem poniżej 0.005 sekundy straty.
W cenie około 66 600 dolarów (w konfiguracji na Dell.com), karta T4 jest idealna dla zespołów, które chcą obsługiwać, osadzać i dostrajać modele lokalnie, w tym modele wymagające ponad 96 GB pamięci GPU, a także symulować i analizować dane z wykorzystaniem pamięci na tej samej maszynie. Klienci, którzy pracują głównie nad renderowaniem i kompilacją, uznają platformę Threadripper za szybszą, a klienci potrzebujący jednego GPU mogą kupić tę samą kartę w mniejszym modelu Pro Precision 9 T2.

Tabela wyników: Dell Pro Precision 9 T4 został zwycięzcą konkursu Best Xeon Tower for Local AI w naszym rankingu Best Desktops for Local AI.


 Amazon