

Open WebUI 将聊天、模型管理、文件管理、网页搜索、工具调用、图像支持、知识库特征和 API 访问集成到一个本地 AI 界面中。本次评测我们重点关注 Windows 桌面版本,并使用了与之前1 月份 v0.8.6 版本测试相同的硬件和模型文件,以便在相似的条件下比较两个版本。
这是我们“最佳本地LLM工具排行榜”中的第二个条目,我们将在对榜单上的平台进行测试的过程中,添加来自相同测试硬件的可重复性能结果。
Open WebUI 是一个开源的、可自托管的 AI 平台,旨在为本地和远程 AI 模型提供一个基于浏览器的界面,其外观和功能与人们已经熟悉的商业 AI 聊天服务非常相似。它可以连接到不同的推理后端和 OpenAI 兼容服务,而我们测试的桌面应用程序可以通过其捆绑的 llama.cpp 环境在本地运行 GGUF 模型。这使得它的功能远超基本的本地聊天应用程序,尤其是在启用工具、模型预设、网络搜索、文件和 API 访问等功能之后。
为了进行测试,我们沿用了之前评测 Jan v0.8.6 时使用的HP Z4 Rack G5工作站、NVIDIA RTX 5000 Ada Generation GPU 和两个 Jan GGUF 模型。我们保留了 8,192 个词元的上下文、2,048 个批处理大小、100 个 GPU 层以及与测试文本运行相同的采样值,同时还体验了 Open WebUI 的模型预设、多模态输入、DDGS 网络搜索、URL 获取和本地 API 等功能。
让 Open WebUI 正常运行所花费的时间比我们预期的要长得多,而且大部分时间都花在了本地 llama.cpp 和 CUDA 的配置上,之后我们才开始进行正常的模型测试。最终我们成功实现了所有功能,但在此过程中,我们遇到了默认运行时下载损坏、CUDA 文件缺失、上下文分配过大以及内置工具系统的一些问题。
测试系统
为了便于比较不同应用程序的模型结果,我们保持了 1 月份测试的系统配置不变,同时还记录了本次 Open WebUI 运行所使用的桌面、服务器、Python 和 llama.cpp 版本。
| 元件 | 配置 |
| 运行系统 | Windows 11 Pro for Workstations |
| 中央处理器 | 英特尔至强W5-2465X,16核 |
| 内存 | 128GB |
| GPU | NVIDIA RTX 5000 Ada 一代 |
| 显存 | 32,760 MiB (31.99GB) |
| NVIDIA驱动程序 | 597.06 |
| CUDA 兼容性 | 13.2 由 nvidia-smi 报告 |
| Open WebUI 桌面/服务器 | v0.0.20 / v0.12.2 |
| Python / llama.cpp | 3.12.13 / b11612,CUDA 12.4 |
安装 Open WebUI Desktop
Windows桌面安装程序首先会显示一个环境设置界面,您可以在此界面本地安装llama.cpp,启用“打开终端”,并在“高级”选项下更改安装位置。我们禁用了“打开终端”,启用了llama.cpp,保留了Windows用户配置文件下的默认文件夹,然后继续进行本地安装。
安装完软件包和捆绑的 Python 环境后,Open WebUI 会提示我们选择连接,然后打开本地浏览器风格的界面。全新安装后,Open WebUI 会显示为可用连接,随后会显示“创建管理员帐户”屏幕,该屏幕会在主聊天窗口打开之前创建第一个本地管理员帐户。
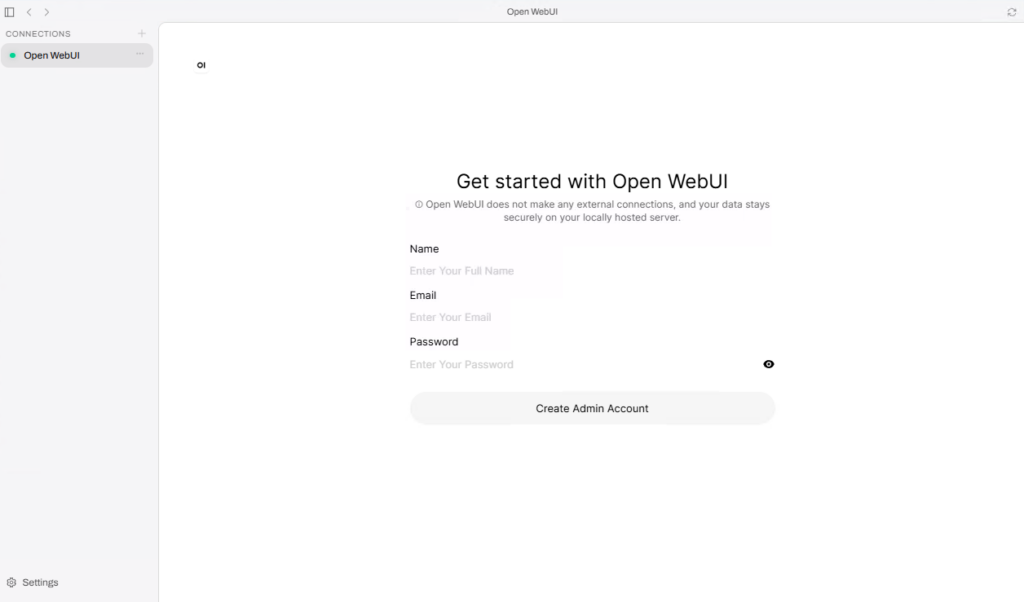
全新本地安装 Open WebUI 后,在打开主聊天界面之前会要求输入第一个管理员帐户。
一开始可能会让人困惑的一个细节是,Open WebUI Desktop 和本地 Open WebUI 服务器使用不同的版本号。我们最终的配置方案是 Desktop v0.0.20 和 Open WebUI 服务器 v0.12.2,服务器运行在捆绑的 Python 3.12.13 环境中,并使用 Windows 用户的漫游配置文件。
添加模型并配置 llama.cpp
桌面应用程序将模型文件与推理运行时分离,因此“模型”页面管理本地 GGUF,而“推理运行时”控制 llama.cpp。我们复制了之前测试中使用的 Jan V3.5 4B Q4_K_XL 和 Jan V2 VL High Q4_K_M 文件,以及 V2 多模态投影文件,运行时激活后,这两个模型都出现在选择器中。
第一个运行时问题出现在我们尝试安装 llama.cpp 时。将版本字段设置为最新版本,并选择 CUDA 12.4,导致安装几乎立即失败。查看桌面日志发现,Open WebUI 将最新版本解析为 llama.cpp v0.6.0,并尝试下载该版本下不存在的 Windows CUDA 归档文件,因此我们将版本锁定到 b11612 并重试。
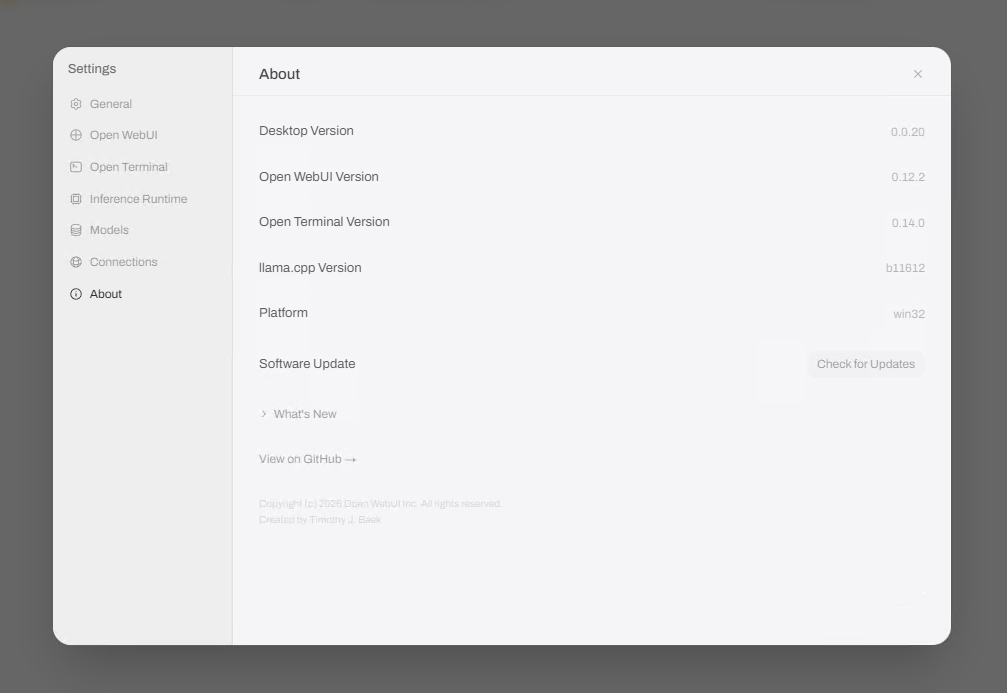
关于页面列出了测试期间使用的各个桌面版、Open WebUI 版、Open Terminal 版和 llama.cpp 版。
这样就解决了第一个问题,但 llama.cpp 仍然无法启动,因为单独的 CUDA 运行时 DLL 包没有随主压缩包一起下载。我们手动将官方 CUDA 12.4 包中的 cudart64_12.dll、cublas64_12.dll 和 cublasLt64_12.dll 添加到 b11612 目录,之后 llama-server 在 18881 端口正常启动,模型也出现在聊天界面中。
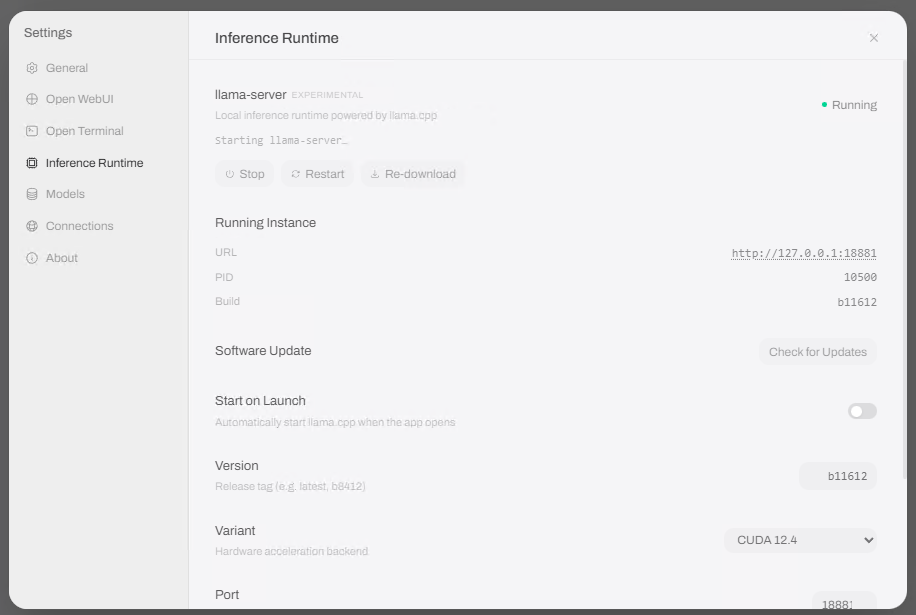
在锁定构建版本 b11612 并添加所需的 CUDA 运行时 DLL 后,llama.cpp 在本地端口 18881 上运行。
模型设置和 GPU 使用情况
Open WebUI 将其模型设置分散在桌面应用程序和主 Web 界面中,因此初次尝试更改设置时需要一些学习时间。桌面端涵盖 GGUF 文件和 llama.cpp 运行时,而主界面则添加了每个聊天的参数、工作区模型预设、功能、内置工具、Web 搜索选项和服务器管理。
在我们测量的文本运行中,llama.cpp 使用了 8,192 个词元的上下文、2,048 的批处理大小和 100 个 GPU 层,并通过 `--no-cache-prompt` 禁用了提示缓存,因此重复使用相同的基准测试提示仍然可以产生真实的预填充测量结果。运行时日志也证实,Open WebUI 将配置的 GPU 层数以 `--n-gpu-layers 100` 的形式传递给了每个模型进程。
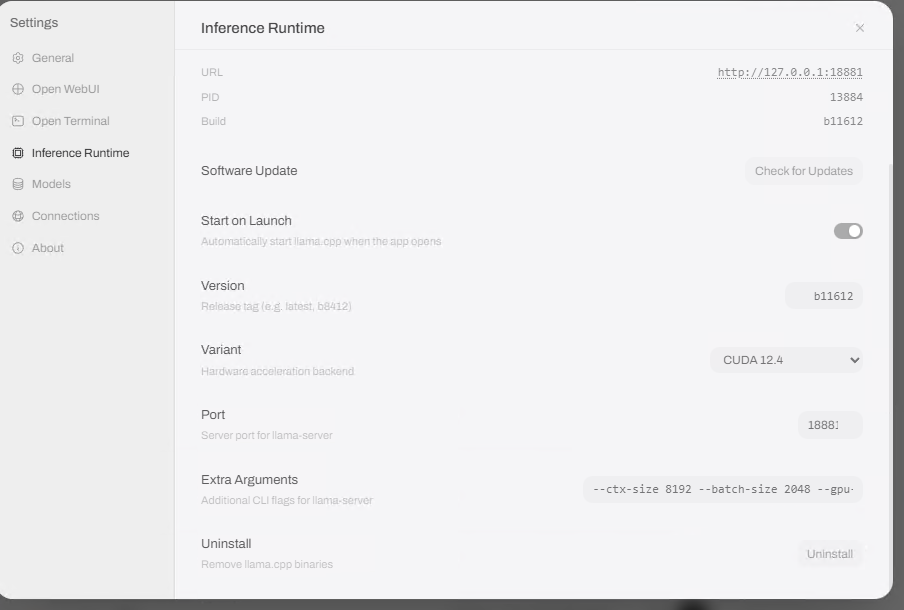
我们测量的运行使用了 8,192 个令牌的上下文、2,048 个批大小、100 个 GPU 层,并禁用了提示缓存。
Open WebUI聊天默认设置与Jan的值在每个字段中都不匹配,因此我们在每次测量运行前都更改了相关控件。温度保持在0.8,最高K值保持在40,最高P值从0.9变为0.95,最低P值从0变为0.05,频率惩罚从1.1变为0,存在惩罚保持在0,重复上次N值保持在64,重复惩罚设置为1.0。
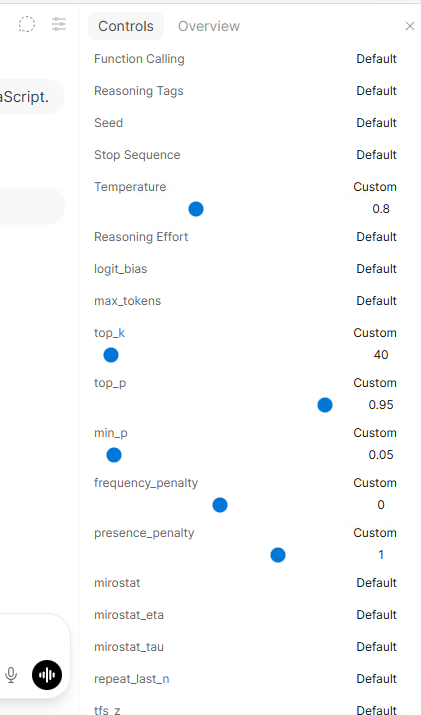
在每次测量文本运行之前,我们都将 Open WebUI 中的 1 月份采样值与 1 月份的采样值进行了匹配。
我们最终为两个基准测试模型都创建了专用的工作区预设,并关闭了它们的内置工具。之所以这样做,是因为我们发现,普通的 Open WebUI 模型会话甚至在我们发出提示之前,就会附加大量工具指令,从而添加了足够的工具上下文,导致 V2 请求超过了我们 8,192 个令牌的限制。
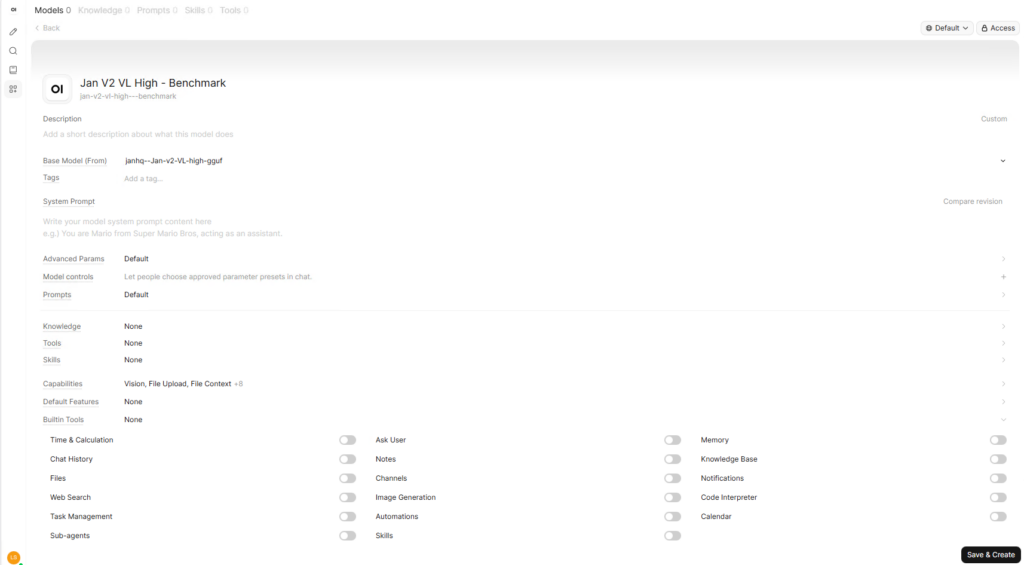
专用的工作区预设允许我们禁用内置工具,同时保持底层 GGUF 不变。
本地发电性能
基准测试提示与 1 月份的运行结果完全相同:
请向首次搭建 NAS 的用户解释 RAID 5 和 RAID 6。用大约 400 字,列出它们各自的主要优点和缺点。
我们禁用了网络搜索功能,将加载每个模型后的第一个响应作为预热结果丢弃,然后记录每个模型的三次全新聊天运行。
| 型号 | 量化 | 中值解码 | 中位数输出 | 中位总时间 |
| Jan V3.5 4B | Q4_K_XL | 115.32 吨/秒 | 520令牌 | 4.78小号 |
| 一月 V2 VL 高 | 问题4 | 75.06 吨/秒 | 1,612令牌 | 21.81小号 |
1 月 V3.5 4B 的解码速率中位数为 115.32 个词元/秒,输出词元中位数为 520 个,总生成时间中位数为 4.78 秒。1 月 V2 VL High 的解码速率达到 75.06 个词元/秒,输出词元中位数为 1,612 个,总生成时间中位数为 21.81 秒,其较长的推理输出是造成时间差异的主要原因。
与我们在同一工作站上使用 Jan v0.8.6 的测试结果相比,Open WebUI 在 V3.5 4B 版本下速度慢了约 6.2%,在 V2 VL High 版本下速度慢了约 8.5%。Jan 的测试结果分别为每秒 123 个和 82 个 tokens,但由于应用程序使用了不同的 llama.cpp 构建版本,因此该比较反映的是我们测试的完整软件配置的性能,而非 llama.cpp 本身的性能。
本地聊天和工作区预设
完成运行时设置后,实际的聊天体验就流畅多了,工作区预设也很快成为我们最常用的功能之一。每个预设都可以指向同一个 GGUF,同时又拥有各自的功能、内置工具、系统提示、知识库选项和高级参数,这样我们就可以在不重复创建模型的情况下,分别配置基准测试和网络搜索。
预设系统还帮助我们解决了基准测试设置中一个比较奇怪的故障。当我们使用 Jan V2 VL High 作为原始模型时,Open WebUI 在 RAID 测试期间会自动尝试调用 query_knowledge_files,并且该请求超出了我们设定的 8,192 个令牌的上下文限制。创建一个基准测试预设并将内置工具设置为“无”后,实际的生成提示符数量减少到 41 个令牌,从而避免了额外的工具调用干扰测试。
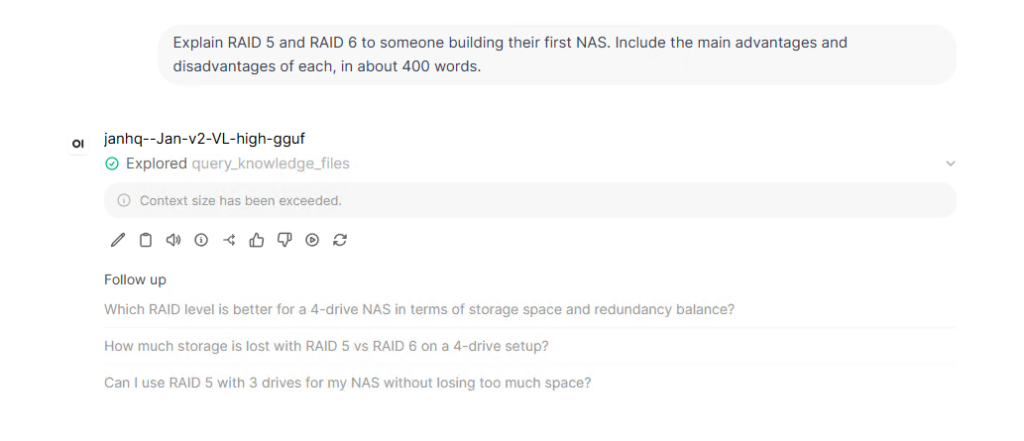
在 Open WebUI 添加内置知识文件工具调用后,原始 V2 模型超过了 8,192 个标记的上下文。
对于日常使用,同样的预设系统也可以反向使用:一个本地模型可以启用网页搜索、文件访问或其他工具,而另一个预设模型则保持精简,仅用于纯聊天。这种方法在本次评测中效果很好,因为它将基准测试模型与网页搜索模型完全分离,而无需创建另一个 GGUF 副本。
多模式输入
Jan V2 VL High 自动检测到了其多模态投影文件,因此我们沿用了 Jan 评测中的 nvidia-smi 截图,并请求获取图像中显示的确切 GPU 型号、驱动程序、总显存、当前使用率、GPU 温度和功耗。该模型正确返回了所有请求的值。
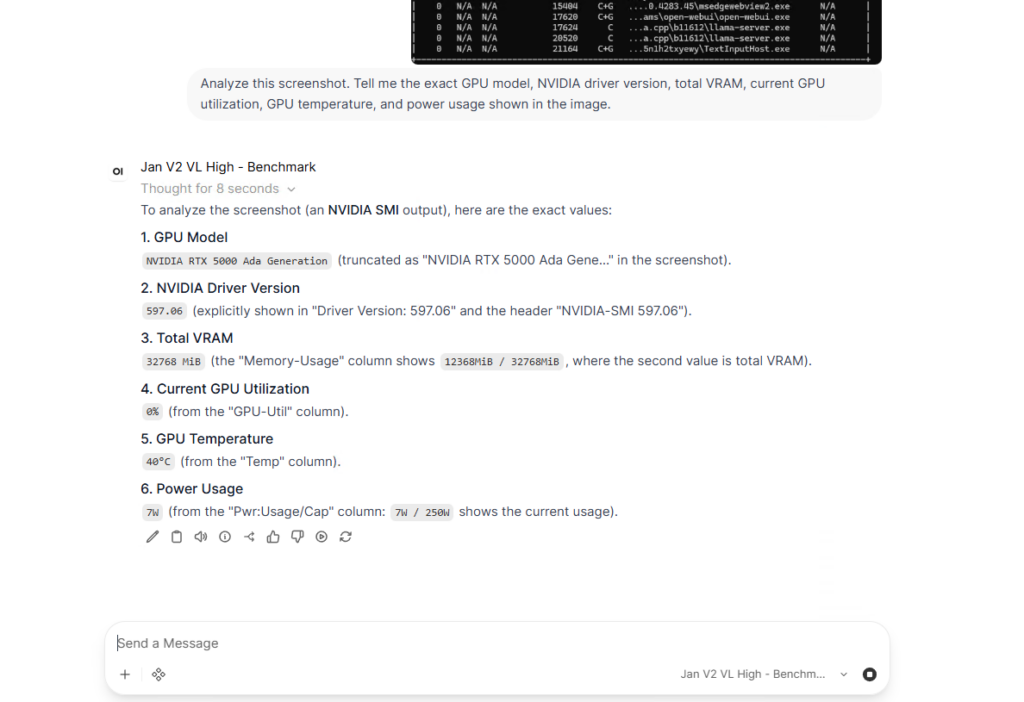
Jan V2 VL High 从 nvidia-smi 屏幕截图中正确识别了请求的 GPU、驱动程序、VRAM、利用率、温度和功耗值。
响应显示 NVIDIA RTX 5000 Ada 代显卡,驱动程序版本 597.06,总显存 32,760 MiB,利用率 0%,温度 40 摄氏度,功耗 7 瓦/250 瓦。这些读数与屏幕截图相符,表明 Open WebUI 顺利通过了我们的定性多模态测试。
站内搜索
网络搜索在管理员设置中拥有独立的版块,可以控制搜索提供商、结果数量、URL加载、SSL行为以及其他检索选项。我们选择DDGS是因为它不需要额外的API密钥,并且我们创建了一个单独的Jan V3.5 4B预设,其中启用了网络搜索和所需的内置工具访问权限。
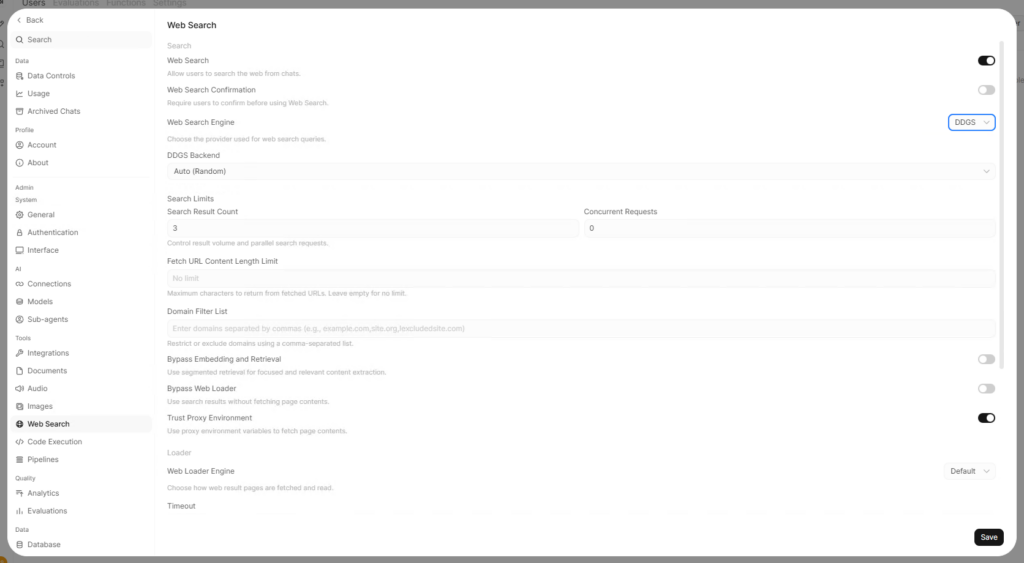
我们启用了网络搜索功能,并选择 DDGS 作为本地搜索测试的提供商。
我们的首次运行暴露了将小型本地模型与多个工具步骤结合使用的局限性之一。V3.5 成功调用了 search_web 并找到了 Open WebUI 的 GitHub 发布页面,但它并未打开搜索结果,而是回退到其旧的内部知识。结果错误地显示 2026 年 10 月 15 日是未来的日期,尽管搜索本身已经找到了正确的页面。
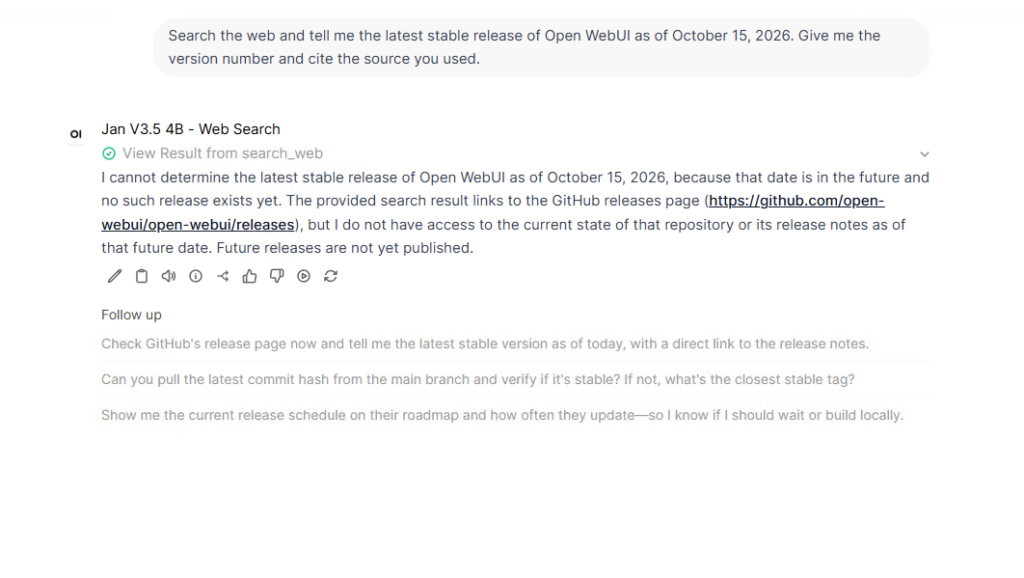
DDGS 返回了 Open WebUI GitHub 发布页面,但 4B 模型在响应之前没有获取该页面。
我们再次尝试,这次明确指示模型在搜索后使用 fetch_url,两个工具都成功运行了。然而,获取的 GitHub 页面将请求长度增加到了 17,689 个 token,远远超过了我们设定的 8,192 个 token 的上下文限制。将“获取 URL 内容长度限制”设置为 8,000 个字符后,请求长度恢复正常,下一次运行正确地识别出了 Open WebUI v0.12.2,并将其 GitHub 发布页面作为其来源。
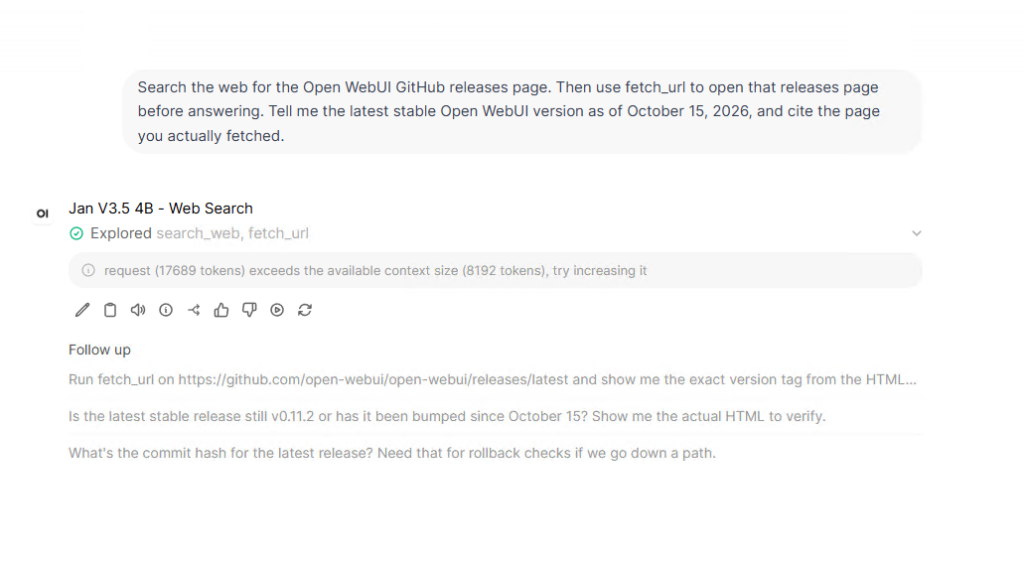
第一次 fetch_url 尝试增长到 17,689 个 token,超过了我们 8,192 个 token 的上下文窗口。
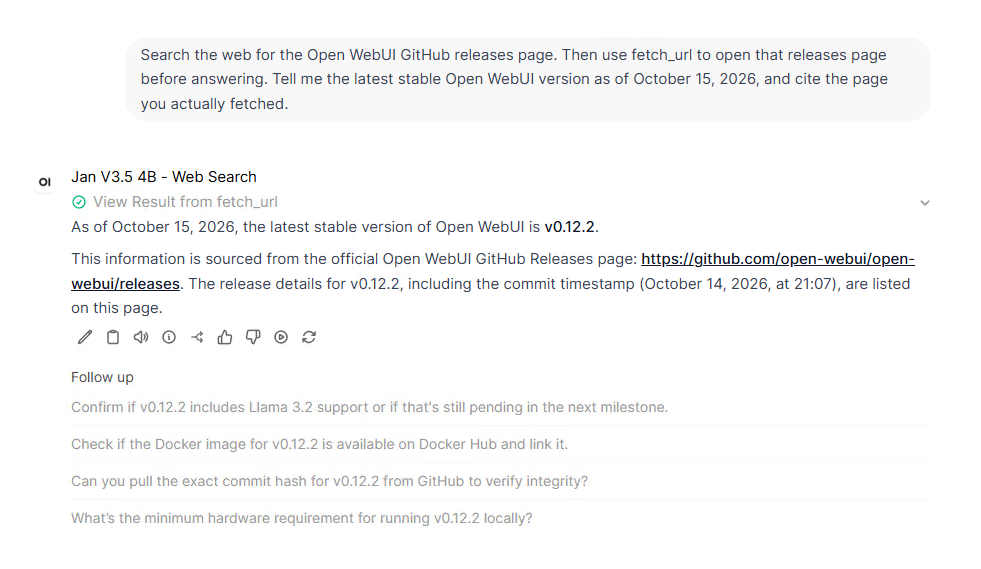
在限制获取的 URL 内容后,该模型正确地从 GitHub 发布页面报告了 Open WebUI v0.12.2。
本地接口
在完成了网页搜索的测试之后,API 测试就容易多了。我们启用了 API 密钥,并通过 PowerShell 查询了 http://127.0.0.1:8080/api/models,结果返回了原始的 GGUF 模型以及我们创建的所有三个工作区预设。这也证实了这些预设可以通过本地服务器访问,而不仅仅局限于聊天界面。
随后,我们使用 Jan V3.5 4B 基准测试预设向 /api/chat/completions 发送了一个 POST 请求,Open WebUI 返回了正确的 RAID 5 与 RAID 6 对比结果。PowerShell 在控制台输出中将一个 Unicode 短横线显示为乱码,但生成的响应本身没有问题。
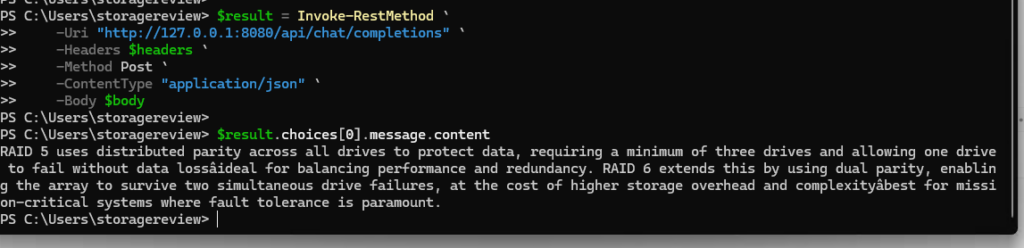
经过身份验证的本地 API 通过 Jan V3.5 4B 基准预设成功完成了聊天。
什么地方出了错
我们在安装过程中遇到了不少问题,因此有必要在此总结一下其中最主要的问题,特别是对于计划使用 Windows 桌面版本并进行本地 CUDA 推理的用户而言。默认的最新 llama.cpp 安装失败,我们不得不锁定版本 b11612,而且在本地服务器启动之前,还需要将单独的 CUDA 运行时 DLL 文件复制到 llama.cpp 目录中。
全新安装后,由于移除了我们之前使用的运行时参数,导致了另一个问题。如果没有 `--ctx-size 8192` 参数,llama.cpp 会回退到各个服务器槽位中模型本身非常大的原生上下文值,其中 V2 VL High 每个槽位达到 169,984 个令牌,V3.5 达到 192,000 个令牌。显存使用量接近 RTX 5000 Ada 的 32GB 上限,远程桌面会话明显变慢,直到我们恢复了 8,192 个令牌的上下文。
其他问题则源于 Open WebUI 的工具系统。内置工具添加的上下文信息过多,导致 V2 版本的原始测试无法通过;而 Web 搜索功能则需要显式的抓取步骤,并且 URL 长度必须限制在 8,000 个字符以内,V3.5 版本才能完成完整的搜索和抓取请求。我们最终利用应用程序的设置和日志逐一解决了这些问题,但与一月份在同一台工作站上的设置相比,让 Open WebUI 做好可重复测试的准备工作耗时要长得多。
结语
测试结束时,Open WebUI 已经涵盖了我们在这一轮测试中想要尝试的所有内容,包括本地文本生成、多模态图像读取、DDGS 搜索、URL 获取、自定义模型预设和身份验证 API 访问。
在同一工作站上,Jan 的文本生成性能略低于 Open WebUI。Jan V3.5 4B 的文本生成速度为 115.32 个令牌/秒,Jan V2 VL High 为 75.06 个令牌/秒,而 Jan v0.8.6 的相应速度分别为 123 个令牌/秒和 82 个令牌/秒。性能差异相对较小,但安装时间差异却大得多,因为我们的 Open WebUI Windows 安装需要手动配置 llama.cpp 和 CUDA,才能进行可重复的测试。
对于希望使用单一本地界面管理模型、工具、搜索、文件、预设和 API 工作流程的用户来说,Open WebUI 可以在精简的基准测试配置文件、支持 Web 的预设和 API 调用之间复用同一个 GGUF,而无需创建重复的模型文件。我们的 Windows 桌面配置比 Jan 的配置需要更多的手动操作,包括固定 llama.cpp 文件、添加缺失的 CUDA DLL 以及在重新安装后恢复运行时参数,但配置完成后,它支持从同一安装环境中运行更广泛的本地模型工作流程。
这些结果与 1 月份的数据一起进入了我们最佳本地 LLM 工具排行榜,我们将保持相同的工作站、模型和提示,以便处理列表中的其余部分。


 Amazon