

NVIDIA 和 Cisco 今日宣布了超高密度小型可插拔光模块 (USFP) 的计划,这是一种专为 AI 架构中 400Gb/s 单通道以太网而设计的光模块格式。首批计划推出的收发器在与 OSFP 模块尺寸相近的封装内集成了 16 条全双工通道,每个模块的传输速率可达 6.4Tb/s。该连接器设计可扩展至 32 条通道和 12.8Tb/s 的传输速率。NVIDIA 和 Cisco 表示,USFP 的带宽和前面板密度是 200Gb/s 单通道可插拔光模块的 4 倍,而能效约为后者的 1.3 倍。
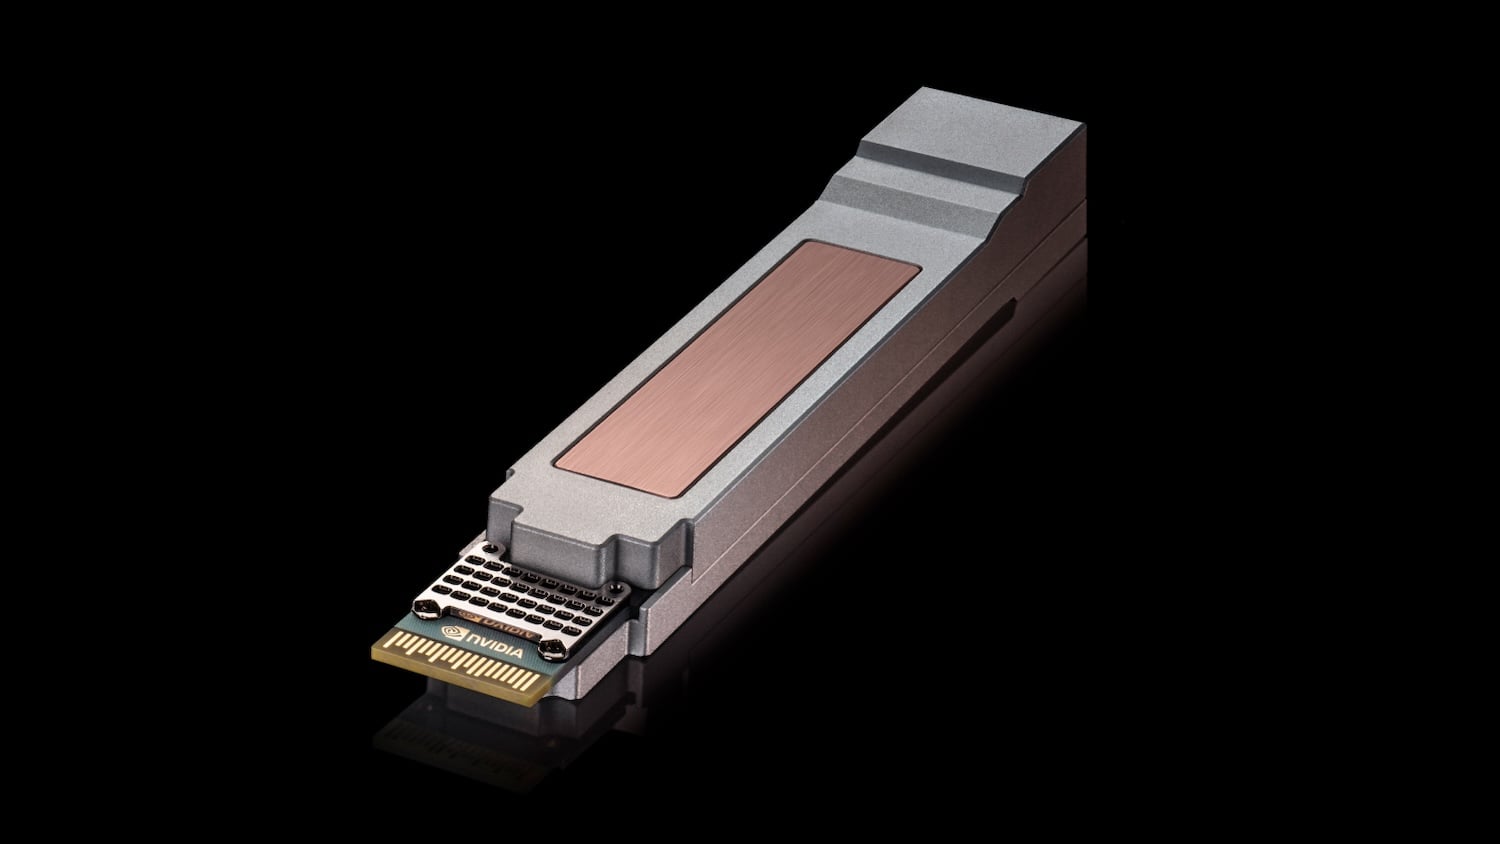
USFP计划目前没有样品发放时间表或上市日期,NVIDIA和思科计划通过社区主导的多方合作协议,将该设计转化为开放的行业规范。这是NVIDIA在OCP全球峰会上众多贡献的一部分,其他贡献还包括Vera Rubin机架设计、DSX AI工厂软件、设施和电网规范、800VDC电源以及与Meta和Google合作的以太网项目。
USFP 增加通道数量和前面板带宽密度
USFP模块的通道数和单通道速率均是现有模块的两倍,NVIDIA和思科表示,这使得交换机无需增加网络层即可连接更多1.6Tb/s的终端。这些模块适用于交换机和超级网卡。两家公司认为前面板密度是AI架构扩展的限制因素:一旦交换机的端口用完,下一步就需要增加一个包含更多光模块的交换机层,这会增加延迟、功耗和成本。USFP模块保持了可插拔的设计,因此模块可以现场更换和维护。
英伟达高级副总裁吉拉德·沙伊纳表示:“构建全球最大的人工智能工厂,首先要重新思考最细微的连接。”思科高级副总裁兼光系统与光器件总经理比尔·加特纳则指出,要将可插拔光模块的单通道传输速度提升至400Gb/s,仅仅对现有模块设计进行简单的扩展是不够的。
新型连接器支持 400Gb/s 信号传输
该连接器采用二维触点阵列设计,并具有两步插入顺序,高速触点仅在模块就位后才接合。NVIDIA 和 Cisco 表示,这种设计可减少触点磨损、提高信号完整性并使插入力更可预测。该连接器设计用于每通道 400Gb/s 的传输速率,并且据两家公司称,在每通道 200Gb/s 的传输速率下也能提升性能。
USFP模块无需收发器内部的专用冷却电路即可耗散高达100W的功率,两家公司表示,这简化了交换机设计并提高了可靠性。每种USFP配置都支持可简化信号处理的光学设计,从而降低延迟和功耗,并且该格式兼容多种光学技术和传输距离等级。NVIDIA和思科正与TE Connectivity和Amphenol合作开发笼式结构、连接器和模块,预计未来将有更多合作伙伴加入,进一步拓展NVIDIA Spectrum-X和思科Silicon One以太网之间的互操作性工作。
MGX 1.2 扩展了 Vera Rubin 机架基础设施
NVIDIA 通过其开放的 MGX 架构,将其Vera Rubin机架和计算托架设计贡献给了 OCP,作为 OCP 开放数据中心计划中第三代 MGX 参考设计的一部分,同时贡献的还有 MQD 和 MQDB 开放式液冷设计。MGX 1.2 规范新增了机架级盲插式液冷、可互操作的机架级互连基础设施以及液冷式 5,000A 母线,原生支持 19 英寸设备和高达 250kW 的机架部署。
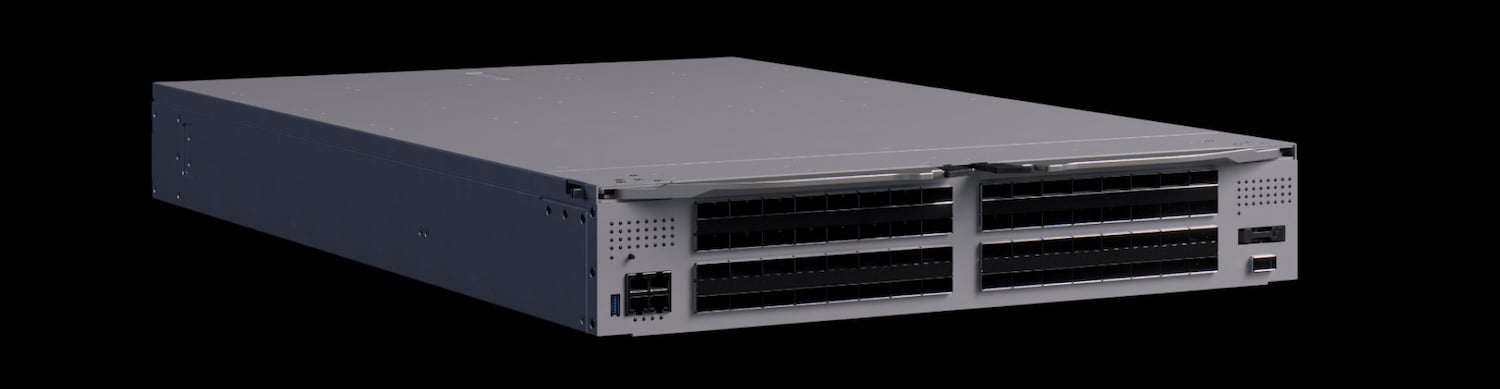
可配置的 I/O 插槽、无风扇液冷计算托架以及标准化的电源和散热接口完善了该规范。NVIDIA 表示,通用接口可缩短合作伙伴的组装、测试和服务时间。另一项Vera CPU机架设计规范将 MGX 的功能扩展到加速计算之外。NVIDIA 将 Vera Rubin NVL72 定位为大规模训练和推理平台,并将 Vera CPU 机架定位为代理工作负载所需的工具调用、编排和沙盒执行平台。
DSX OS 新增网络、机架和集群管理组件
NVIDIA 扩展了其DSX AI 工厂平台的开源操作系统 DSX OS,新增了四个开源组件。NVIDIA Config Manager 可自动完成 AI 架构的交换机配置、验证和维护。NVIDIA Cluster Readiness Engine 可在训练开始前使用工作负载模拟对 GPU 集群进行压力测试,NVIDIA 表示,这可以发现那些会导致作业失败的硬件问题。

NVIDIA 机架管理服务将机架视为运行单元,并在该层级进行硬件抽象和固件管理。NVIDIA 基础架构控制器集群 API 提供程序负责裸机部署和租户入驻,NVIDIA 声称它可以在数小时内将原始硬件转化为可用于生产环境的集群。这些组件源于 NVIDIA 运营 DGX Cloud 的经验,旨在帮助云提供商和软件合作伙伴将 AI 工厂运营融入多租户平台。
开放规范涵盖设施设计和电网恢复
NVIDIA、AMD、Google 和 Meta 联合发布了开放数据中心规范 v0.7,这是一份共享的设施蓝图,涵盖了电源架构、冷却和物理布局,设备制造商、托管服务提供商和运营商可以据此进行设计。Google、Meta、Microsoft 和 NVIDIA 还发布了 OCP 电网弹性规范,该规范定义了大型 AI 设施应如何应对公用设施中断:保持连接、自动响应并在两秒内恢复到接近满负荷运行。NVIDIA 表示,这两项规范均与其 DSX 参考设计相符。
Visionbay 公布了 K-1 计划,这是一个 AI 工厂平台,它将 NVIDIA 的800VDC参考架构与 Vertiv 的电源和散热设备相结合,用于未来的 Vera Rubin 部署。K-1 将交流到直流的转换转移到集群级电源中心,并将 800VDC 电源分配到更靠近计算单元的位置,并分阶段采用 800VDC、液冷和模块化扩展。Visionbay 尚未公布部署日期。
Meta 采用 Spectrum-6 和多平面网络
Meta 将在其 Vera Rubin AI 工厂中采用 NVIDIA Spectrum-6 102.4Tb/s 以太网。NVIDIA 表示,Spectrum-6 的交换容量和单通道带宽是 Spectrum-4 的两倍,单通道运行速度高达 200G,并实现了作业间的性能隔离。Meta 基于 Spectrum-6 的 N-IceCube 交换机将安装在其 IcePack 100T 液冷机架中,并运行 Meta 的开放式交换机软件 FBOSS。FBOSS 使用 OCP 交换机抽象接口,实现对硬件的独立于厂商的控制。
Spectrum-X Multiplane 将 Spectrum-6 交换机与 ConnectX-9 SuperNIC 结合使用,并通过硬件将 GPU 流量分散到多达八个独立的网络平面上。NVIDIA 表示,该设计可扩展至 100,000 万个以上的 GPU,且所需交换机层级更少;当某个组件发生故障时,流量会转移到剩余的平面,从而以较低的带宽继续运行任务。Meta 和 NVIDIA 表示,他们已在本地和云端验证了该方案的弹性提升,但未公布具体数据。
Google Falcon Transport 瞄准未来 NVIDIA 网络硬件
NVIDIA 和 Google 宣布,未来的 NVIDIA ConnectX-10 SuperNIC 和 BlueField DPU 将支持 Falcon Transport 协议。Falcon 通过多路径负载均衡、可编程拥塞控制、基于硬件的丢包恢复以及基于连接的安全机制,在以太网上提供可靠的数据传输。NVIDIA 利用硬件加速和 DOCA 软件实现了 Falcon,因此 NVIDIA 和 Google 的网卡可以使用通用的传输协议,而应用程序则保留标准的 RDMA 接口。两家公司表示,随着以太网架构的扩展,这将提高 AI 和存储流量的带宽利用率和性能可预测性。
思科推出 Silicon One G300 系统,并新增 51.2T 机架顶部组件
思科利用 OCP 的同一公告更新了其芯片产品线。102.4Tb/s 的 Silicon One G300 芯片现已开始提供样品,首批基于 G300 的系统已交付给客户。此外,思科还推出了 G302,这是一款 51.2Tb/s 的交换机 ASIC,配备 200G SerDes,专为机架顶部系统设计,采用 1.6T 光模块和芯片级液冷技术,预计将于 2026 年底前交付。思科还表示,其 51.2Tb/s 的 P200 深缓冲路由芯片目前已在超大规模数据中心投入生产:微软已将 P200 系统投入生产,阿里云也已在其 eCORE 骨干网上部署了基于 P200 芯片的自主研发的 Quantum Cat 路由器,并运行 SONiC 协议。
思科其余产品均已投入使用。思科 8001 是一款基于 Silicon One A100 的管理交换机,提供 10G 和 1G 版本,可将 SONiC 引入带外网络,使运营商能够从网络架构到机架运行一套 API 和自动化流程。经思科验证的 SONiC 已集成到 Nexus One 架构中,并且计划于 2027 年年中推出 Live Protect 选项,该选项可在永久修复程序发布之前,在运行时修补已披露的漏洞。思科是 ESUN 成员,并表示正在制定用于纵向扩展网络的 1.0 版本规范。


 Amazon