

CoreWeave 利用其在旧金山举办的 Fully Connected 2026 大会,将 NVIDIA Vera Rubin NVL72 投入生产环境,Cognition 成为首个在其上运行实际工作负载的客户。Cognition 的工程师报告称,在 SWE-2 推理任务中,NVL72 的 GPU 总令牌吞吐量在匹配交互性下最高可达 GB200 基准的 4.8 倍;在强化学习任务中,其 GPU 输出令牌吞吐量最高可达 GB200 基准的 3.8 倍。这两项测试均由 Cognition 在 CoreWeave Cloud 上进行,运行于生产级智能体工作负载,但未披露模型规模、上下文长度或批处理设置等具体信息。
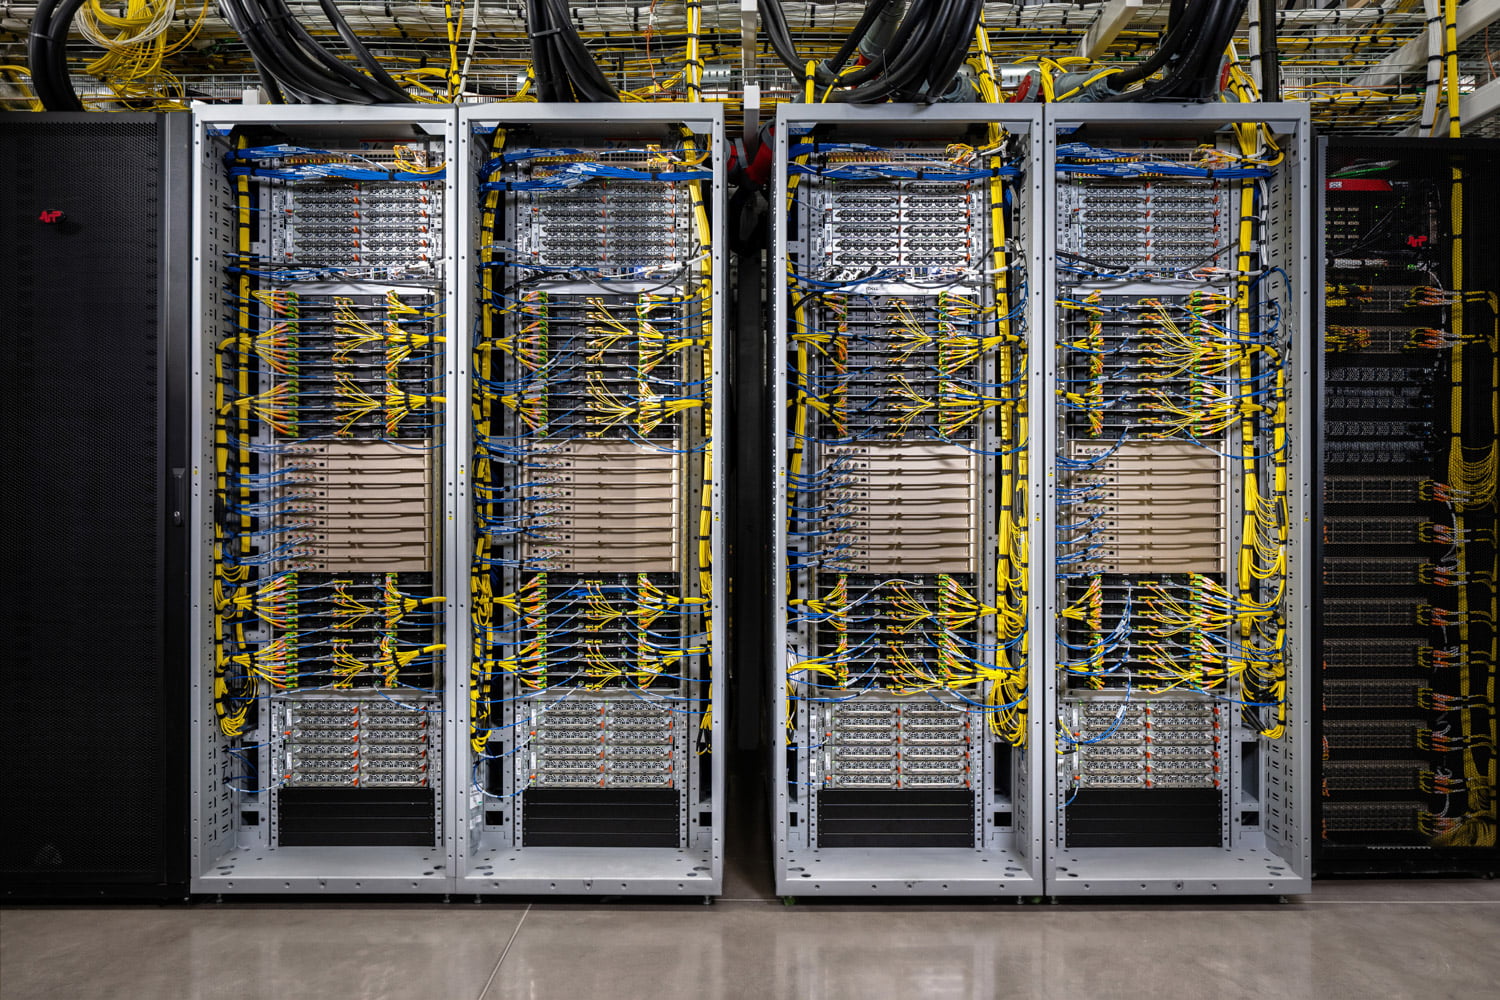
Vera Rubin NVL72 进入 CoreWeave 生产阶段
Cognition 在 CoreWeave 上运行 Devin 的训练、强化学习和生产推理。CoreWeave 表示,他们在 9 月初搭建了 Vera Rubin NVL72 集群,并在机架交付后几天内就让 Cognition 的工作负载投入运行。CoreWeave 称 Cognition 的运行是首个由客户执行的 Vera Rubin 推理基准测试。Cognition 认为,SWE-2 的结果意味着每个 GPU 可以支持更多并发的 Devin 会话,从而加快研究速度。
CoreWeave 的新闻稿称 Vera Rubin NVL72 现已推出;但其博客文章中关于 Cognition 部署的内容指出,该资源目前供应有限,因此预计分配将受到限制。客户使用与 CoreWeave GB200 NVL72 和 GB300 NVL72 集群相同的软件和操作模式来运行它:CoreWeave Kubernetes Service、SUNK、Mission Control、Sandboxes 和 Serverless Inference。
我们在九月份的多机架部署报告中介绍了机架本身,包括戴尔制造的NVL72机架(每个GPU配备两个ConnectX-9 SuperNIC网卡),以及CoreWeave在机架投入生产前进行的阶段性验证。而此次的新进展是,我们迎来了一位付费客户。
NVIDIA Vera CPU 针对代理沙箱密度
CoreWeave还将把NVIDIA Vera CPU添加到其产品组合中,作为独立的计算层,用于智能体工作:沙箱执行、强化学习环境、工具调用、代码执行以及围绕GPU训练和推理任务的数据处理。目前尚未公布具体日期,仅表示“即将推出”。
CoreWeave 上的 Vera 节点配备两颗 88 核 Vera CPU、1.5TB 内存、15.36TB 本地 NVMe 固态硬盘以及一颗 800Gbps 的 BlueField-4 DPU。一个完整的机架可容纳 128 颗 CPU 和 11,264 个核心,配备 BlueField-4 DPU 和 Spectrum-X 以太网交换机,CoreWeave 表示可支持超过 11,000 个并发隔离环境。CoreWeave 在其测试中报告称,Vera 上的代理沙箱启动速度比其未指明的 x86 CPU 快 3 倍以上。Vera 将以与 GPU 集群相同的平台和消费模式(包括竞价容量)在裸机上运行。
CoreWeave Forge 连接开发和生产
在本次展会上发布的 CoreWeave Forge 将 Weights & Biases Models、OpenPipe 的训练后处理工作以及开源的 marimo notebook 项目整合到一个用于模型和智能体的开发层中。它涵盖了实验跟踪、评估、智能体追踪、检查点、沙盒执行、训练后处理和推理部署等功能。CoreWeave 表示,该平台可跨模型、框架和其他云平台开放。MasterClass 和 Canva 等公司已经开始基于该平台进行开发。
Forge 提供免费版、专业版和企业版,专业版起价为每月 60 美元,并提供 30 天免费试用。目前已正式推出的功能包括:ARIA、沙箱、权重与偏差模型、无服务器 SFT、无服务器 RL、注册表、笔记本,以及无服务器和专用推理。预览版功能包括:Agent Lens、模型蒸馏和 RL Rollouts,后者允许在训练循环持续运行的同时,将检查点加载到实时部署中。
CoreWeave 的新闻稿称,Agent Lens 检测到的关键故障数量提高了 20%,修复成本仅为十分之一(以一款未具名的通用前沿 LLM 为基准);但该公司自己的博客文章中却将成本估算值定为一半,因此该数据仅供参考。新闻稿还声称,无服务器强化学习的训练速度比自托管方案快 1.4 倍,成本降低 40%。然而,新闻稿并未提供工作负载、模型、硬件和方法论等信息。
合作伙伴网络和临床推理部署
CoreWeave 合作伙伴网络今日正式上线,该网络汇集了 CoreWeave 声称已在生产负载下测试并根据客户需求认证的集成方案,涵盖基础设施、数据服务、独立软件供应商 (ISV)、安全以及模型和推理等领域。已公布的合作伙伴包括 CrowdStrike、VAST Data、Reflection、ClickHouse、LanceDB、Inferact、RadixArk、IBM 和 Red Hat。Exa、Parallel Web Systems 和 You.com 则通过一项共享搜索集成加入,该集成适用于托管在 CoreWeave 上的代理,并将在公告发布后的几周内推出。CoreWeave 的卖点在于,客户在将工作负载迁移到云端时,可以保留其现有的服务层、可观测性、运行手册和安全工具。
Ennoble Care是一家为遍布15个州的约50,000万名患者提供居家初级护理、姑息治疗和临终关怀服务的机构,该公司选择CoreWeave Cloud进行临床AI推理。该部署运行在预留的NVIDIA RTX PRO 6000 Blackwell Server Edition节点上,并通过CoreWeave Kubernetes Service (CKS) 实现,采用硬件强制隔离和零信任控制来保护临床数据,并提供直接的工程支持。CoreWeave声称CKS的容器启动速度比通用云方案快8到10倍,但并未透露具体平台、工作负载或测试配置。


 Amazon