

在几代硬件发展历程中,内存和网络设备供应商都曾关注过高性能计算集群中不同的瓶颈。内存制造商专注于提升封装内存带宽,而网络架构供应商则致力于提升机箱间和机架间的吞吐量。如今,这两种视角都聚焦于同一个瓶颈:限制分布式计算节点和内存池之间数据传输的带宽壁垒。
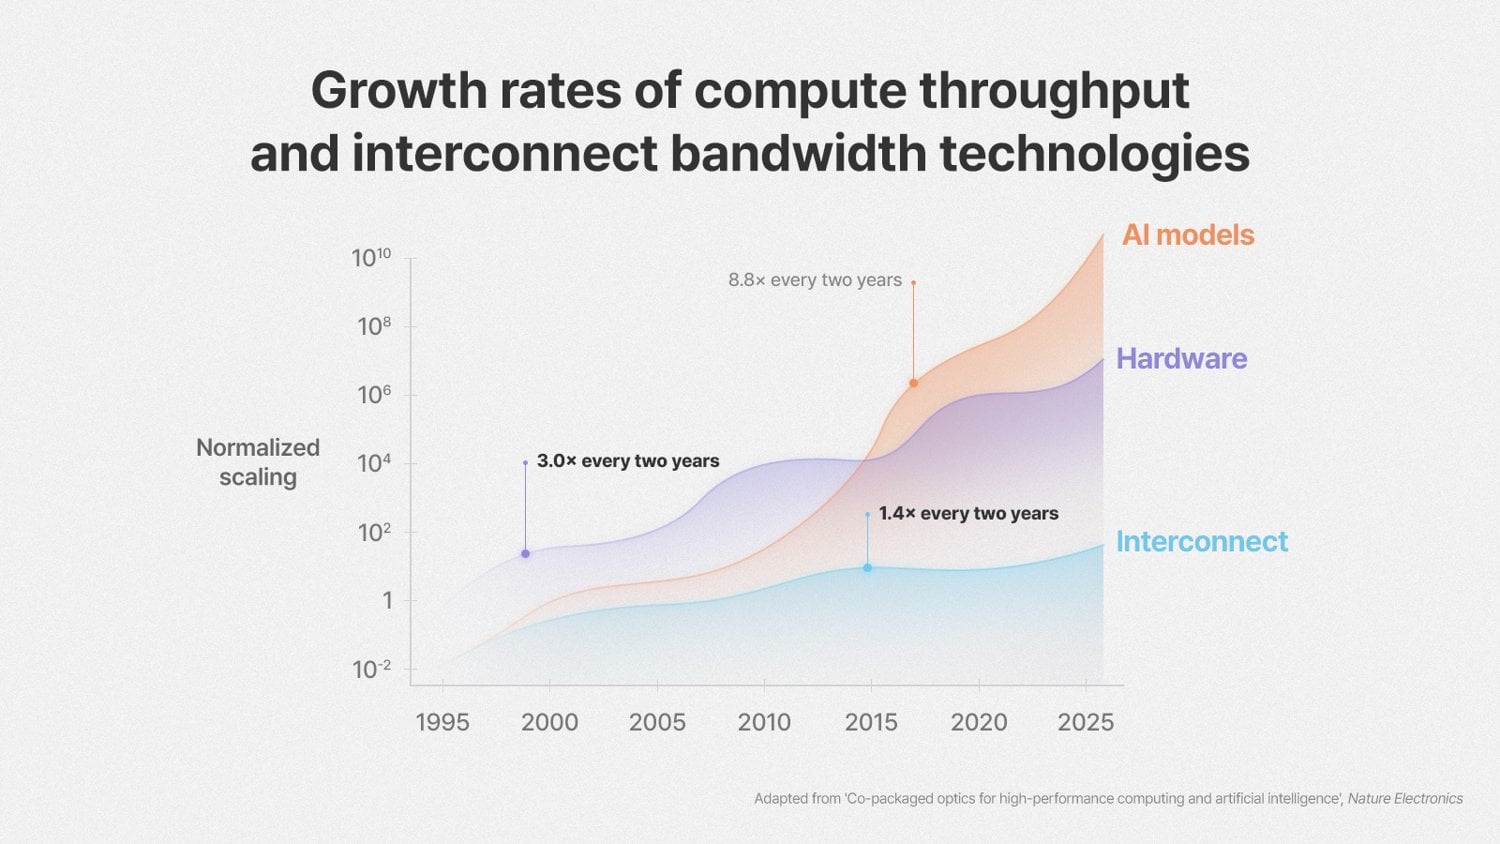
虽然高带宽内存(HBM) 有效地解决了单个 AI 加速器封装级带宽的限制,但现代超大规模训练和推理工作负载如今已扩展到分布在机架和节点上的数万个处理器。在这些分布式拓扑结构中,计算吞吐量历来每两年增长约 3 倍,而互连带宽同期仅增长约 1.4 倍。由此产生的不平衡使得主要的扩展瓶颈集中在物理互连层。
该评估源自8月20日发表于《自然·电子学》的一篇题为《用于高性能计算和人工智能的共封装光学器件》的观点论文,该论文由SK海力士与弗吉尼亚大学、伊利诺伊大学厄巴纳-香槟分校、麻省理工学院、南洋理工大学和延世大学的研究人员共同撰写。SK海力士人工智能基础设施团队负责人洪承勋和弗吉尼亚大学教授李奎相为通讯作者。
| 阶段 | 成果 |
|---|---|
| AI集群扩展瓶颈转移 | |
| HBM 封装内 | 解决了芯片/封装内存瓶颈问题 |
| 铜迹线 | 芯片外物理衰减/功率墙 |
| CPO整合 | 将光学织物直接汇聚到基板上 |
为了解决这一限制,SK海力士与弗吉尼亚大学、伊利诺伊大学香槟分校、南洋理工大学、麻省理工学院和延世大学的研究人员合作,在《自然·电子学》杂志上发表了一篇题为“用于高性能计算和人工智能的共封装光学器件”的研究论文。该论文详细阐述了共封装光学器件(CPO)和光计算互连(OCI)如何与存储器和封装架构协同发展,以支持未来集群的扩展。
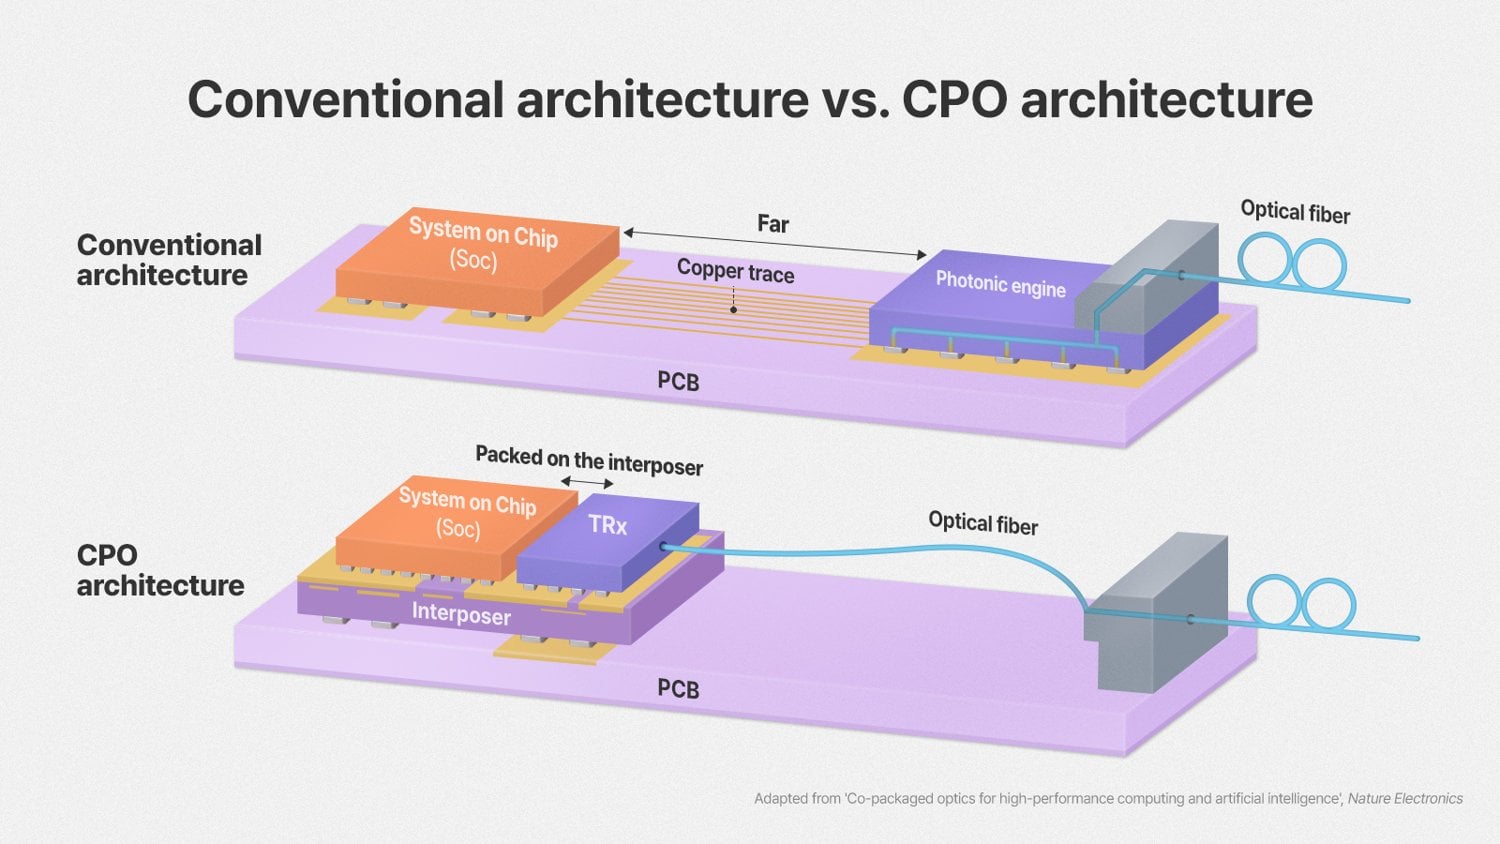
铜互连的物理极限
在短距离传输中,依赖铜线和直连铜缆的标准电气互连仍然实用。然而,随着数据速率的提高,电信号传输会面临严重的信号衰减、插入损耗和功耗增加的问题。在较长的电路板走线和背板上管理高速信号需要复杂的均衡和重定时电路,这会增加延迟并消耗大量功率。
共封装光学器件如何改变路径
CPO 通过将光收发器直接安装在与主机处理器或加速器相同的封装基板上,克服了这些物理限制。将高速电信号直接转换为计算硅附近的光子通道,最大限度地缩短了电气走线长度,从而降低了寄生电容和信号衰减。这种架构能够在电路板、机架和扩展舱之间实现低损耗、高带宽的光传输,同时保持更高的带宽密度和更强的抗电磁干扰能力。
| 米制 | 目标规格 |
|---|---|
| CPO节点的目标规格 | |
| 节点带宽密度 | 每个节点 > 100 Tb/s |
| 能源效率 | < 1 pJ/比特 |
| 芯片间互连延迟 | <10 ns |
| 整合路径 | 2.5D 中介层到 3D 异质结构 |
该路线图描绘了架构演进的蓝图,从标准的二维多芯片模块和2.5D硅中介层集成,逐步迈向三维异构堆叠。最终的架构里程碑是将光链路直接延伸到存储器子系统本身。
通过使用光子中介层将内存堆栈与计算引擎直接连接,系统可以绕过传统的板级布线限制。这种方法能够实现解耦式、低延迟的共享内存池,多个计算引擎可以通过光背板访问共享容量,而无需像传统网络结构那样承受串行化和解串行化带来的性能损耗。
商业部署面临的工程挑战
将CPO从先进封装演示过渡到生产数据中心硬件面临诸多尚未解决的工程难题。将低功耗硅光子器件与高功率主机逻辑集成,需要精密的隔热措施以及先进的微流控或直接封装冷却设计。
此外,业界必须开发标准化的低延迟相干协议,以便在无需专有软件开销的情况下协调光耦合内存事务。可靠的商业化需要端到端的硬件协同设计,涵盖DRAM芯片拓扑结构、定制内存控制器、光子引擎和异构基板封装。对于SK海力士而言,光耦合技术路线图与其传统路线图并行推进;该公司在2026年FMS大会上详细介绍了16层HBM4和晶圆键合的375层NAND闪存。


 Amazon