

StorageReview 实验室团队展示了令人惊叹的计算能力,将圆周率计算到令人难以置信的 202,112,290,000,000 位,创造了连续的世界纪录。这一非凡成就打破了该团队之前保持的 105 万亿位纪录。它展示了现代高性能计算和精心设计的商用硬件平台无与伦比的能力。
前所未有的计算壮举
StorageReview 实验室团队利用一套高度先进的设备完成了这项壮举。他们使用 Intel Xeon 8592+ CPU 和Solidigm P5336 61.44TB NVMe SSD,进行了长达 85 天的近乎不间断的计算,在 28 块 Solidigm SSD 上消耗了近 1.5 PB 的空间。这项突破性的项目展示了计算能力和效率方面的显著提升。
StorageReview 实验室团队的系统架构师 Jordan Ranous 表示:“这项新纪录凸显了当今高性能计算基础设施的非凡潜力。通过实现这一里程碑,我们不仅在计算数学方面树立了新的标杆,还为各个科学和工程学科的未来创新铺平了道路。”
2024年3月,StorageReview实验室团队创造了一项世界纪录,将圆周率π计算到了小数点后105万亿位。该团队利用一台拥有256个核心的双处理器AMD EPYC系统和近1PB的Solidigm QLC固态硬盘,克服了包括内存和存储限制在内的重大技术挑战。这一里程碑式的成就不仅展现了现代硬件的强大性能,也为优化高性能计算系统提供了宝贵的经验。
StorageReview 实验室总监 Kevin O'Brien 表示:“Solidigm 硬盘和戴尔 PowerEdge R760 服务器不仅完美配合,而且这次新纪录几乎无需人工干预,这与我们上次挑战纪录的种种险阻相比,无疑是一个令人欣喜的改变。” 他继续说道:“经历了上次挑战 105 万亿位数的种种考验后,我很高兴我们选择了这个平台来创造新的纪录。” 如需了解更多关于上次挑战 105 万亿位数及其挑战的详情,请点击此处阅读全文。
计算机科学和数学课
当我们第一次开始寻找测试大容量 SSD 的有趣方法时,显而易见的答案就在我们的 CPU 和系统评测中:y-cruncher。当利用交换空间进行大量计算时,空间要求在数字上大约为 4.7:1,因此 100 万亿位数字需要大约 470TiB 的空间。无需深入研究数学和计算机科学,y-cruncher(Chudnovsky 算法)基于从模函数和椭圆曲线理论中得出的快速收敛级数。该算法的核心依赖于以下无限级数:

关于 100T 和 105T 计算,我们收到的第一个问题是:“好吧,没什么大不了的。为什么这需要这么长时间并且需要这么多内存?”这个问题是有关开源和 Alex Yee 编程能力的其他恼人问题之一。让我们退一步从系统层面来看这个问题。
计算 Pi 的大量位数(例如 100 万亿)需要大量空间,因为涉及大量算术运算。挑战主要在于乘以大数字,这本身就需要大量内存。例如,用于乘以 N 位数字的最佳算法需要大约 4N 字节的内存,其中大部分用作暂存空间。在计算过程中必须多次访问此内存,从而将该过程变成磁盘 I/O 密集型任务,而不是 CPU 密集型任务。
广泛用于计算 Pi 的多个数字的 Chudnovsky 公式需要进行大量的算术运算。这些乘法、除法和平方运算通常简化为大量乘法。从历史上看,超级计算机使用 AGM 算法,尽管速度较慢,但更容易实现,并且受益于众多机器的强大计算能力。然而,现代技术进步已将瓶颈从计算能力转移到内存访问速度。
处理器算术逻辑单元 (ALU) 和浮点单元 (FPU) 处理这些大乘法数字的方式与在纸上手动乘法类似,将它们分解为更小、更易于管理的运算。以前,圆周率计算受计算限制,但如今的计算能力超越了内存访问速度,使得存储和可靠性成为创下圆周率记录的关键因素。例如,我们的 128 核 Intel 机器和 256 核 AMD Bergamo 之间的性能差异很小;重点是磁盘 I/O 效率。
Solidigm SSD 在这些计算中发挥着至关重要的作用,这并不是因为它们的固有速度,而是因为其出色的存储密度。消费级 NVMe 驱动器可以在小体积内存储高达 4TB 的数据,而企业级 SSD 将这些芯片堆叠起来以获得更大的容量。尽管 QLC NAND 可能比其他类型的闪存慢,但这些密集 SSD 中的并行性可提供更高的聚合带宽,使其成为大规模 Pi 计算的理想选择。
Solidigm QLC NVMe SSD,实现疯狂
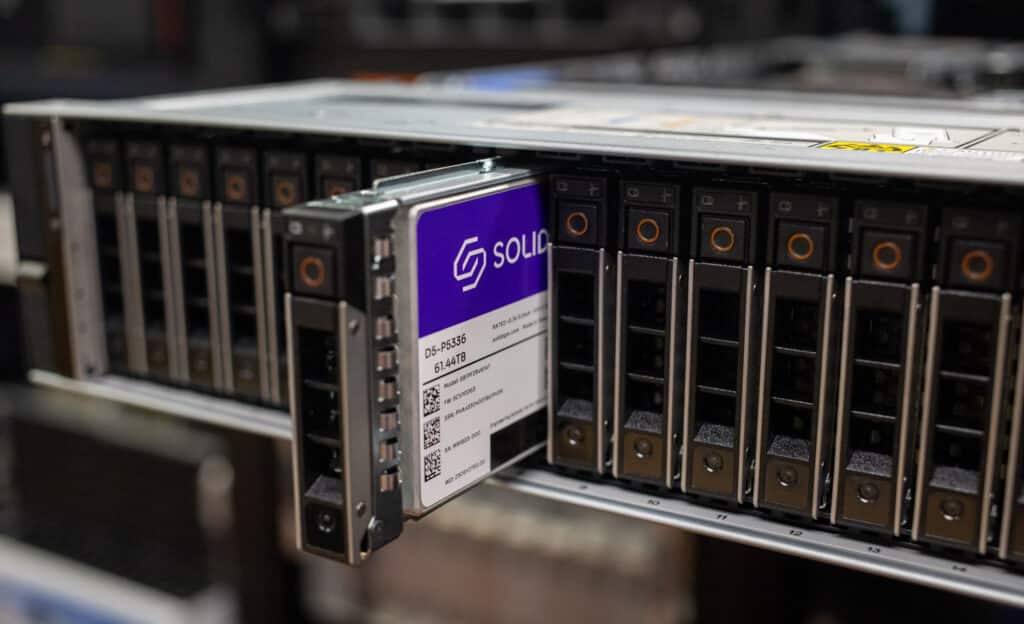
好了,如果你还没睡醒,还能跟上我的思路,那么你只需要知道,当计算的数字太大而无法全部放入内存时,计算机必须使用软件算法进行多精度运算。这些算法会将大数分解成易于处理的小块,并使用特殊技术进行除法运算。Solidigm P5336 61.44TB NVMe SSD 正是为此而生的。y-cruncher 会将这些易于处理的小块数据先累积到系统内存中,然后再交换到暂存盘空间。
请记住,我们需要大约 4.7:1 的交换,因为上面那个可怕的公式的每个部分都必须由很多很多位来表示。
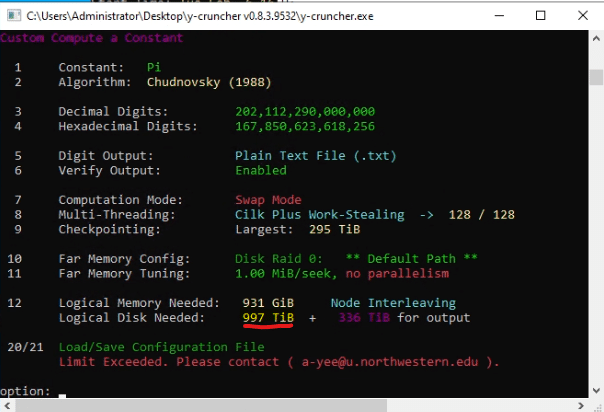
y-cruncher 有一个内置估算器,用于估算所需的驱动器空间量(仍然标记为磁盘*咳嗽*),我们发现它在本次和过去的运行中都是完全准确的。
虽然你可以用一些硬盘或对象存储设备来解决这个问题,但正如我们在第一轮测试中所发现的,原始容量只是一个非常复杂等式中的一小部分。随着人工智能的蓬勃发展,如何在靠近计算设备的地方获得足够大容量且速度足够快的存储设备,一直是StorageReview近期关注的重点。交换空间的性能是这项计算中最大的瓶颈。直连式NVMe是目前性能最高的存储方案,虽然某些方案可能拥有最快的单设备吞吐量,但我们使用的大型、高密度QLC阵列整体而言完全能够胜任这项任务。
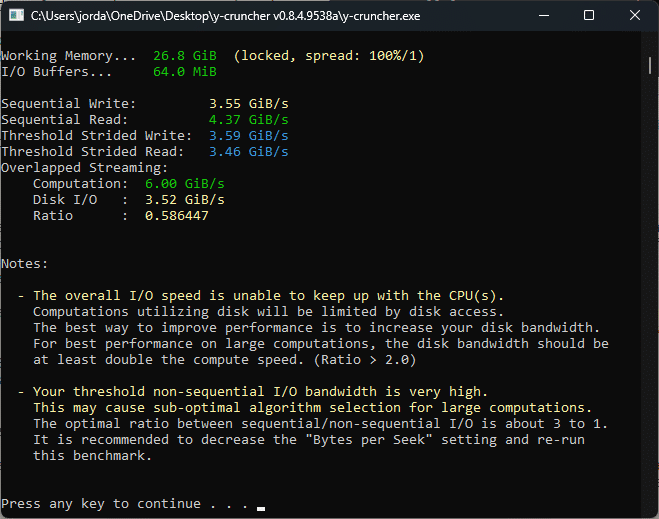
消费者驱动器和 CPU 性能。不是记录系统
y-cruncher 内置了一个基准测试工具,可以让你调整所有设置,找到磁盘阵列的最佳性能配置。这一点至关重要。上面的截图显示,该基准测试工具会针对这套消费级系统提供反馈,包括 CPU 的处理速度和 SSD 的性能指标。
Alex 提供了一些详尽的文档,但总而言之,经过数周的测试,我们发现让 y-cruncher 直接与硬盘交互是最佳方案。我们测试了网络目标、SAS RAID 卡后面的硬盘、NVMe RAID 卡以及 iSCSI 目标。将硬件控制权交给 y-cruncher 后,性能有了显著提升。iSCSI 似乎也还可以接受,但我们只测试了输出文件,因为输出文件可以使用“直接 I/O”进行交互。交换模式 RAID 代码的设计应该相当完善,从我们的测试以及与开发人员的交流中,我们可以推断它在底层与硬盘协同工作。
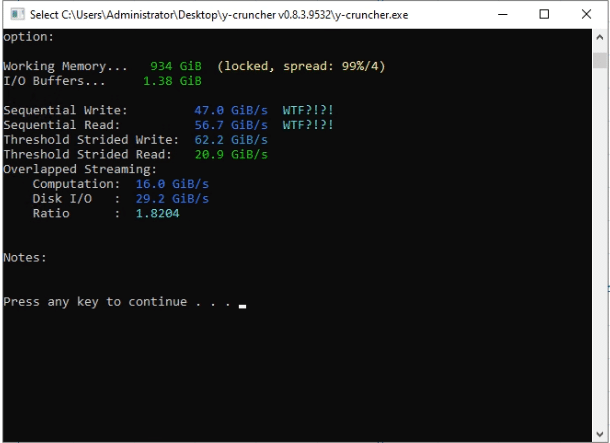
61.44TB Solidigm 硬盘开始成为解决该领域诸多难题的最佳解决方案。在我们的系统上运行基准测试,我们发现硬盘的读取和写入性能均符合规格。我们特意选择了英特尔 CPU,以便尽可能接近最佳的 2:1 硬盘与计算比率。这是最佳比率,因此您不会在 CPU 上浪费时间等待硬盘执行。随着硬盘技术的发展,我们可以通过选择核心数更高的 CPU 进行更广泛、更快速的运行。
“定制” Dell PowerEdge R760 服务器
俗话说,第三次会成功。这不是我们第一次用 Pi 打破记录;我们从前两次迭代中吸取了教训,以构建最好的 Pi 平台。我们的第一个版本利用了一台 2U 服务器,该服务器有 16 个 NVMe 托架和三个内部 SSD 托架。使用 30.72TB Solidigm P5316 SSD,我们包含了 y-cruncher 的交换存储,但我们必须利用基于 HDD 的存储服务器来存储输出文件。这不是最理想的,特别是在写出阶段结束时。我们的第二个平台使用相同的服务器,连接了一个外部 NVMe JBOF,这为我们提供了额外的 NVMe 托架——但代价是敏感的布线和不平衡的性能。这两个平台的缺点是需要在整个 y-cruncher 运行过程中依赖外部硬件,代价是增加功率和增加故障点。
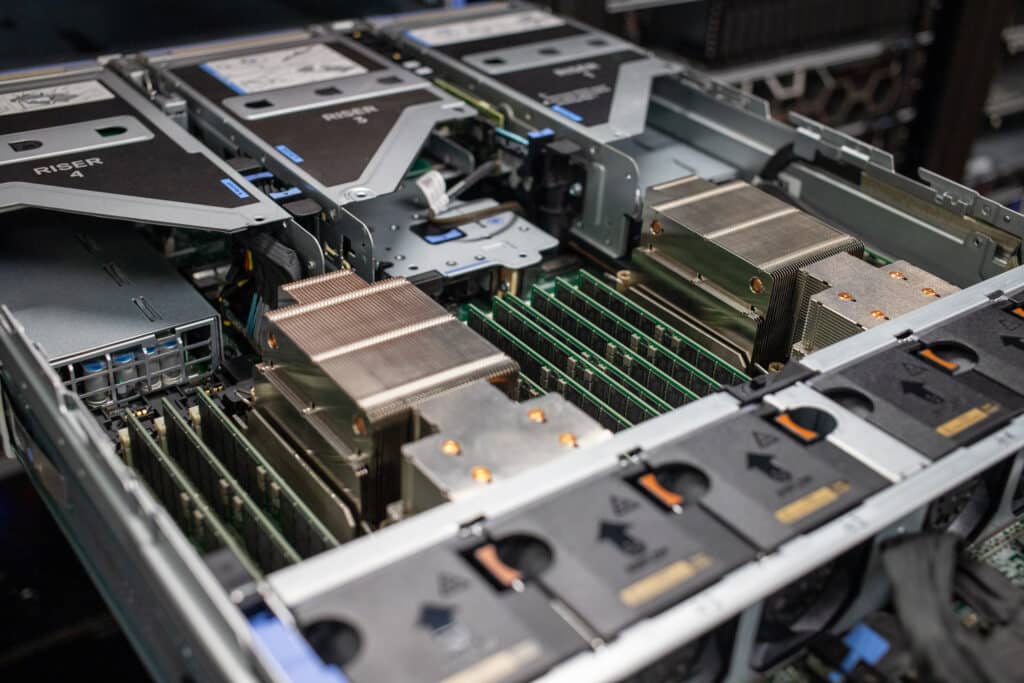
这次运行中,我们希望利用一台全直接 NVMe 单服务器,并在一个金属板屋顶下为我们的 y-cruncher 交换存储和输出存储留出足够的空间。使用带有 760 托架 NVMe Direct Drives 背板的 Dell PowerEdge R24。该平台利用内部 PCIe 交换机让所有 NVMe 驱动器同时与服务器通信,无需任何额外的硬件或 RAID 设备。然后,我们在实验室环境中将多个 R760 拼凑成 PCIe 转接卡配置,在后部为额外的 U.2 安装 NVMe SSD 提供四个 PCIe 插槽。额外的好处是从另一台 R760 上取下更大的散热器,为我们提供了尽可能多的涡轮增压空间。直接液冷进入我们的实验室晚了一个月,无法在这次运行中实施。
“StorageReview 实验室团队使用第五代英特尔® 至强® 处理器将圆周率 π 计算到超过 202 万亿位,这充分展现了这些 CPU 的强大性能和卓越能效。凭借第五代至强® 处理器更高的核心数量和更先进的性能特性,这一里程碑式的成就为计算数学树立了新的标杆,并将继续为各种科学和工程工作负载的创新铺平道路。”英特尔®第五代至强® 处理器产品总经理 Suzi Jewett表示。
虽然从技术上讲,您可以订购与本次运行中使用的配置完全相同的戴尔配置,但这不是他们随手可得的东西,需要拼凑起来。(也许迈克尔会运行限量版“Pi”R760,采用这种精确的配置、定制油漆和 SR 徽标。)
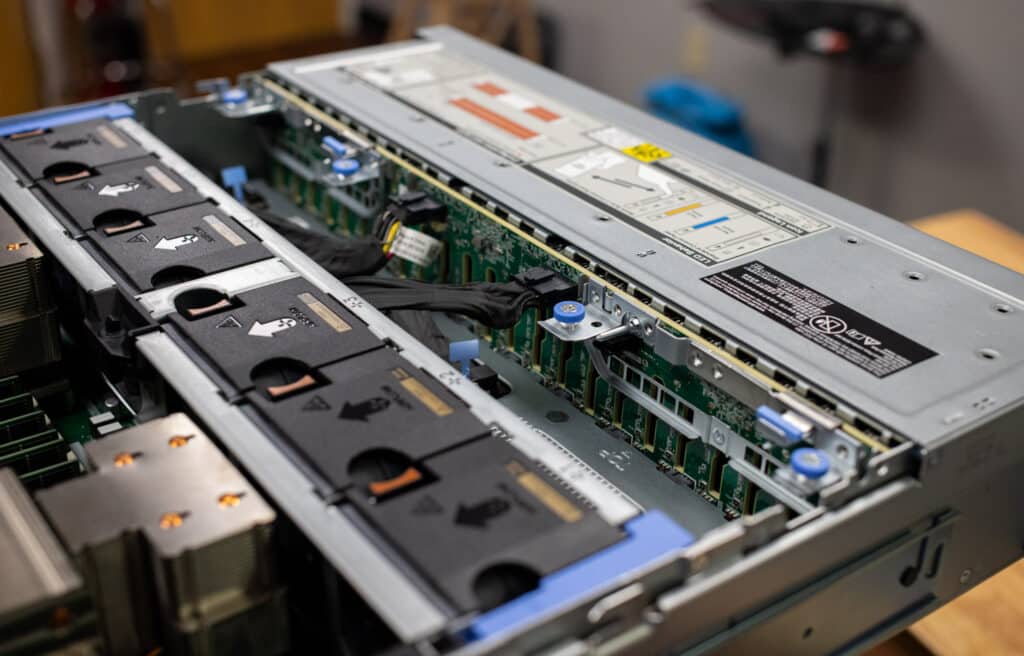
电源大小对于这次运行也至关重要。虽然大多数人会立即认为 CPU 消耗了大部分电力,但在一个屋檐下放置 28 个 NVMe SSD 对电力的影响相当大。我们的构建利用了 2400W PSU,结果发现它几乎不起作用。我们遇到了几次接近临界水平的电力消耗时刻,如果系统断开一个电源连接,我们就会供电不足。这在早期就出现了;当 CPU 负载达到峰值时,功耗飙升,系统增加了所有 SSD 的 I/O 活动。如果我们不得不再次这样做,2800W 型号将是首选。
性能规格
技术亮点
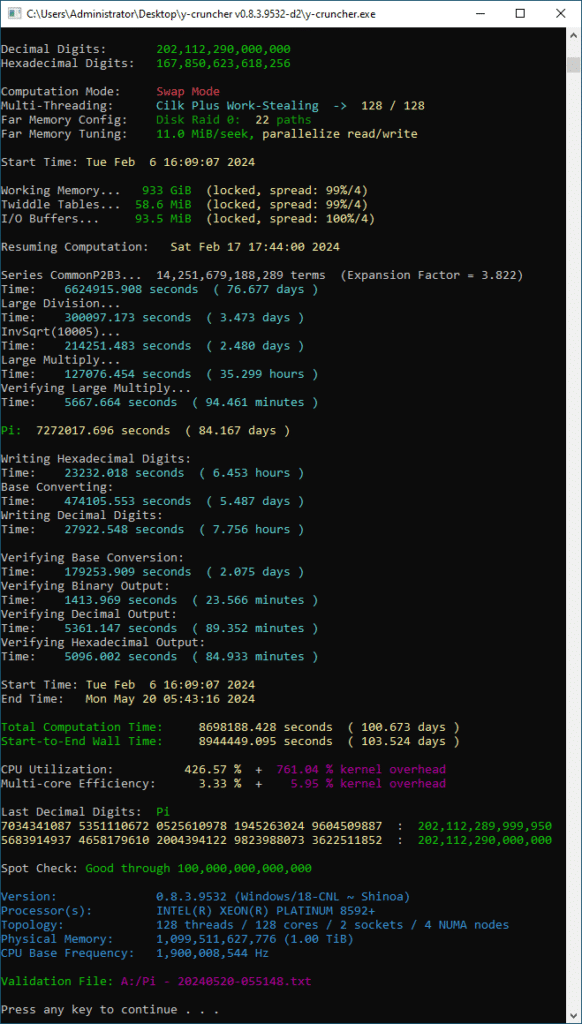
- 已计算总位数:202,112,290,000,000
- 二手硬件:Dell PowerEdge R760,配备 2 个 Intel Xeon 8592+ CPU、1TB DDR5 DRAM、28 个 Solidigm 61.44TB P5336
- 软件和算法:y-cruncher v0.8.3.9532-d2,Chudnovsky
- 数据存储:每个驱动器写入 3.76 PB,交换阵列的 82.7 个磁盘共计 22 PB
- 计算时长:100.673天
y-cruncher 遥测
- 逻辑最大检查点:305,175,690,291,376 (278 TiB)
- 逻辑峰值磁盘使用:1,053,227,481,637,440 ( 958 TiB)
- 读取的逻辑磁盘字节数:102,614,191,450,271,272 (91.1 PiB)
- 写入的逻辑磁盘字节数:88,784,496,475,376,328 (78.9 PiB)
- 开始日期:6 年 16 月 09 日星期二 07:2024:XNUMX
- 结束日期:20 年 05 月 43 日星期一 16:2024:XNUMX
- Pi:7,272,017.696 秒,84.167 天
- 总计算时间:8,698,188.428 秒,100.673 天
- 从开始到结束的挂钟时间:8,944,449.095 秒,103.524 天
圆周率 (Pi) 的最大已知数字是 2,位于第 202,112,290,000,000 位(二百零二万亿一百一十二亿二亿九千万)。
更广泛的含义
虽然计算出如此多的 π 位数似乎是一项抽象的挑战,但该项目开发的实际应用和技术具有深远的影响。这些进步可以增强各种计算任务,从密码学到物理学和工程学中的复杂模拟。
最近的 202 万亿位圆周率计算凸显了存储密度和总拥有成本 (TCO) 的显著进步。我们的设备在单个 1.720U 机箱内实现了惊人的 2 PB NVMe SSD 存储。这一密度代表了数据存储能力的飞跃,尤其是考虑到在满负荷 CPU 和驱动器负载下,总功耗峰值仅为 2.4kW。
这种能源效率与传统的 HPC 记录运行形成了鲜明对比,后者消耗的电量明显更多,而且会产生过多的热量。如果您需要扩展低容量共享存储(相对于高密度本地存储),那么当您考虑横向扩展存储系统的额外节点时,功耗会成倍增加。热量管理至关重要,尤其是对于较小的数据中心和服务器机柜而言。冷却传统的 HPC 记录系统并非易事,需要数据中心冷却器消耗的电量比单独运行的设备更多。通过最大限度地降低功耗和热量输出,我们的设置为小型企业提供了更可持续、更易于管理的解决方案。作为额外福利,我们的大部分运行都是采用新鲜空气冷却进行的。
为了更好地理解这一点,想象一下那些使用网络共享存储和未优化平台的人所面临的挑战。这些设置需要一台或多台数据中心冷却器来控制温度。在这些环境中,节省的每一瓦都意味着更少的冷却需求和更低的运营成本,这使得我们的高密度、低功耗方法成为理想的选择。运行精益高效的平台以实现创纪录运行的另一个关键好处是使用电池备份硬件保护整个设置。如前所述,您需要为计算服务器、交换机、存储服务器、冷却器和水泵提供电池备份,以使其在一年中的大部分时间里保持正常运行。
总体而言,这一破纪录的成就展示了当前 HPC 技术的潜力,并强调了能源效率和热管理在现代计算环境中的重要性。
确保准确性:Bailey–Borwein–Plouffe 公式
将圆周率计算到 202 万亿位是一项艰巨的任务,但确保这些数字的准确性也同样重要。这就是贝利-博文-普洛夫 (BBP) 公式发挥作用的地方。
BBP 公式允许我们以十六进制(基数为 16)格式验证 π 的二进制数字,而无需计算所有前面的数字。这对于交叉检查我们大量计算的各个部分特别有用。
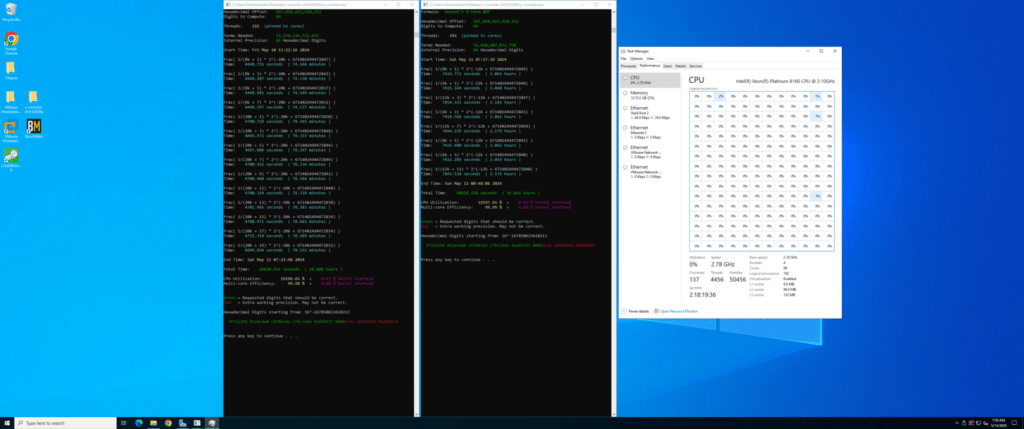
两个验证计算。
这是一个简单的解释:
- 十六进制输出:在主计算过程中,我们首先生成 pi 的十六进制数字。BBP 公式可以直接计算 16 进制中 pi 的任意单个数字。您可以使用 GPUPI 等其他程序执行此操作,但 y-cruncher 也有一个内置函数。如果您更喜欢开源方法, 这些公式是众所周知的。
- 交叉验证:我们可以通过使用 BBP 公式独立计算 pi 的十六进制数字的特定位置,将这些结果与我们的主要计算进行比较。如果它们匹配,则强烈表明我们的整个序列是正确的。我们进行了六次交叉检查;以下是其中两次。
例如,如果我们的主要计算在各个点产生的十六进制数字与从 BBP 公式获得的数字相同,我们可以自信地断言我们的数字是准确的。这种方法不仅仅是理论上的;它已实际应用于所有重要的 pi 计算,确保结果的稳健性和可靠性。
R=正式运行结果,V=验证结果
- R: f3f7e2296 822ac6a8c9 7843dacfbc 1eeb4a5893 37088*
- V: *3f7e2296 822ac6a8c9 7843dacfbc 1eeb4a5893 370888
细心的读者会注意到,截图和上述对比中的验证结果略有偏移(*)。虽然并非必要,因为十六进制最终也会受到影响,但我们还是抽查了一些其他位置(例如第 100 万亿位和第 105 万亿位),以确保运行结果一致。理论上,可以使用类似的方法计算圆周率的任何十进制数字,但尚不清楚这种方法能否精确到超过 100 亿位,或者计算效率是否更高,毕竟直接使用 Chudnovsky 公式计算所有数字是不够的。(如果 Eric Weisstein 看到这篇文章,请联系我;我很乐意尝试一下。)
通过整合这一数学交叉检查过程,我们可以确保破纪录的 202 万亿位圆周率计算的完整性,从而证明我们的计算精度和对科学准确性的承诺。
前方的路
StorageReview 实验室团队成功将圆周率计算到 202 万亿位以上,证明了高性能计算和存储技术的显著进步。这一创纪录的壮举利用了我们的 Dell PowerEdge R8592 和 Solidigm 760TB QLC NVMe SSD 中的 Intel Xeon 61.44+ CPU,凸显了现代硬件以前所未有的效率处理复杂且资源密集型任务的能力。该项目的成功不仅展示了 StorageReview 团队的实力,还凸显了当今 HPC 基础设施突破计算数学和其他科学学科界限的潜力。
“这项新的圆周率世界纪录令人振奋,因为其计算量与我们今天看到的许多人工智能工作负载一样密集。Solidigm 数据中心存储事业部副总裁Greg Matson表示:“Solidigm D5-P5336 61.44TB SSD 再次证明,超高容量、PCIe 4 满载读取性能和高 PB 级写入能力的强大组合,能够承受并释放当今一些最苛刻应用的全部潜力。我们很高兴有机会与戴尔科技集团的合作伙伴以及 StorageReview 的专家们一起,再次创造计算圆周率的纪录。”
这项努力还为优化存储密度和能源效率提供了宝贵的见解,为更可持续、更易于管理的计算解决方案铺平了道路。随着我们继续探索 HPC 的可能性,从这个项目中吸取的经验教训无疑将推动未来的创新,使从密码学到工程的各个领域受益。StorageReview 实验室团队的成就是计算历史上的一个里程碑,表明我们可以通过硬件和专业知识的正确组合达到科学发现和技术进步的新高度。
致谢
StorageReview Lab 团队感谢 Solidigm、戴尔科技、英特尔和 y-cruncher Alex Yee 对该项目坚定不移的支持和贡献。


 Amazon